

في دليل حماية تطبيقات الويب وضعنا حداً لمعدل الطلبات على صفحة الدخول في Nginx وTraefik وCaddy وHAProxy، فكتبنا سطرين ورأينا الرمز 429 يظهر بعد الطلب السادس. وهذا يكفي لحماية صفحة الدخول، ولكن عندما تبني واجهة برمجية API يستخدمها عملاؤك، أو تشغل عدة نسخ من التطبيق خلف موزع الحمل، تظهر أسئلة لا يجيب عنها ذلك السطر: ماذا يعني «خمسة طلبات في الدقيقة» بالضبط، وهل يسمح لعميل أن يرسل عشرة طلبات في نصف ثانية إذا جاءت على حد الدقيقة؟ وكيف تعرف النسخة الثالثة من التطبيق كم طلباً أرسل هذا العميل إلى النسختين الأخريين؟ وماذا يجب أن يقول الرد للعميل حتى يعرف متى يعيد المحاولة؟
وفي هذا المقال نجيب عن هذه الأسئلة من داخل الخوارزمية، فنكتب الخوارزميات الخمس المشهورة بأنفسنا كسكربتات Lua في Valkey، ونرسل لها نفس الطلبات، ونرى الفرق بالأرقام.
 دليلحماية تطبيقات الويب بطبقات أمان في ال Reverse Proxyكلمة المرور وحدها لا تحمي تطبيقاً مكشوفاً على الإنترنت، لذلك نضع أمامه طبقات حماية في ال Reverse Proxy نفسه.
 دليلأمن ال API بالأمثلة مع OWASP API Security Top 10أشهر عشرة مخاطر في واجهات API كما ترتبها OWASP، ولكل خطر مثال لكود ضعيف وكيف تصلحه وتختبره.
 دليلكيف تصمم API لا تضطر إلى كسره بعد سنةمبادئ تصميم API يتطور دون أن يكسر التطبيقات التي تعتمد عليه، وكيف تختار الشكل المناسب لنظامك.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تحد معدل الطلبات أصلاً، وما الذي تحميه بالضبط.
- النافذة الثابتة Fixed Window ومشكلة الحد بين نافذتين، ثم السجل المنزلق Sliding Log والعداد المنزلق Sliding Window Counter.
- الدلو والتوكنات Token Bucket والدلو المثقوب Leaky Bucket، والفرق بين رفض الطلب وتأخيره.
- الحد على عدة سيرفرات: لماذا يفشل «اقرأ ثم زد»، وكيف يحل سكربت Lua واحد المشكلة.
- الرد الصحيح: الرمز 429 والترويسة Retry-After كما في المواصفات، وترويسات RateLimit التي ما زالت مسودة.
- أين تضع الحد: ال CDN أم البوابة Gateway أم التطبيق، وبأي مفتاح.
- تجربة عملية تقارن الخوارزميات الخمس على نفس الطلبات، وتكسر العداد بالسباق، ثم تشغل واجهة صغيرة ترد بالرمز 429 الصحيح.
لماذا تحد معدل الطلبات؟
تحديد معدل الطلبات Rate Limiting هو أن تقرر عدد الطلبات المسموح بها لكل عميل في مدة معينة، وما زاد عنها ترفضه أو تؤخره، والمثال الذي تعرفه هو صراف البنك الذي يسمح لك بسحب مبلغ محدد في اليوم، ليس لأنه لا يثق بك، وإنما لأنه يحمي الصندوق من أن يفرغه شخص واحد. وفي الأنظمة يحمي الحد ثلاثة أشياء مختلفة، ومن المهم أن تعرف أيها تحمي لأن كل واحد منها يحتاج حداً مختلفاً:
- الأمان: تخمين كلمات المرور، وتجربة أرقام البطاقات، وجمع البيانات Scraping، وهذا ما شرحناه في دليل الحماية، وفي البند API4 في قائمة OWASP لأمن الواجهات.
- العدالة بين العملاء: عميل واحد يرسل حلقة لا تنتهي بسبب خطأ في كوده يجب ألا يبطئ الخدمة على الجميع، وهذا هو الاستخدام الأول عند Stripe كما سيأتي.
- التكلفة: كل رسالة SMS وكل استدعاء لنموذج لغوي وكل تصدير لتقرير كبير يكلف مالاً أو وقتاً، فتضع له حصة لكل مستخدم أو لكل باقة.
ولاحظ أن الحد لا يغني عن السعة، فإذا كان حدك ألف طلب في الثانية لكل عميل وعندك ألف عميل، فقد وعدت بمليون طلب في الثانية، والحد هنا يحمي من عميل واحد يتجاوز حصته، أما حماية النظام كله من ضغط يفوق طاقته فلها أدوات أخرى مثل رفض الطلبات الأقل أهمية Load Shedding، وقد وصفت Stripe في مقالها Scaling your API with rate limiters سنة 2017 أربعة أنواع تستخدمها: حد لعدد الطلبات في الثانية لكل مستخدم، وحد لعدد الطلبات المتزامنة، ونوعين لرفض الطلبات غير المهمة عندما يضيق النظام بها حتى تبقى سعة للطلبات المهمة مثل إنشاء عملية دفع.
العد في نوافذ زمنية Windows
أبسط طريقة لتنفيذ «10 طلبات في كل 10 ثوان» هي النافذة الثابتة Fixed Window: تقسم الوقت إلى نوافذ من 10 ثوان تبدأ من الصفر، ولكل عميل عداد في كل نافذة، فتزيده بالأمر INCR مع كل طلب، وإذا تجاوز 10 رفضت. وهي سهلة جداً، مفتاح واحد لكل عميل يختفي وحده بعد انتهاء النافذة، ولكن فيها مشكلة تظهر في الصورة التالية، والطلبات فيها هي نفس طلبات التجربة العملية:
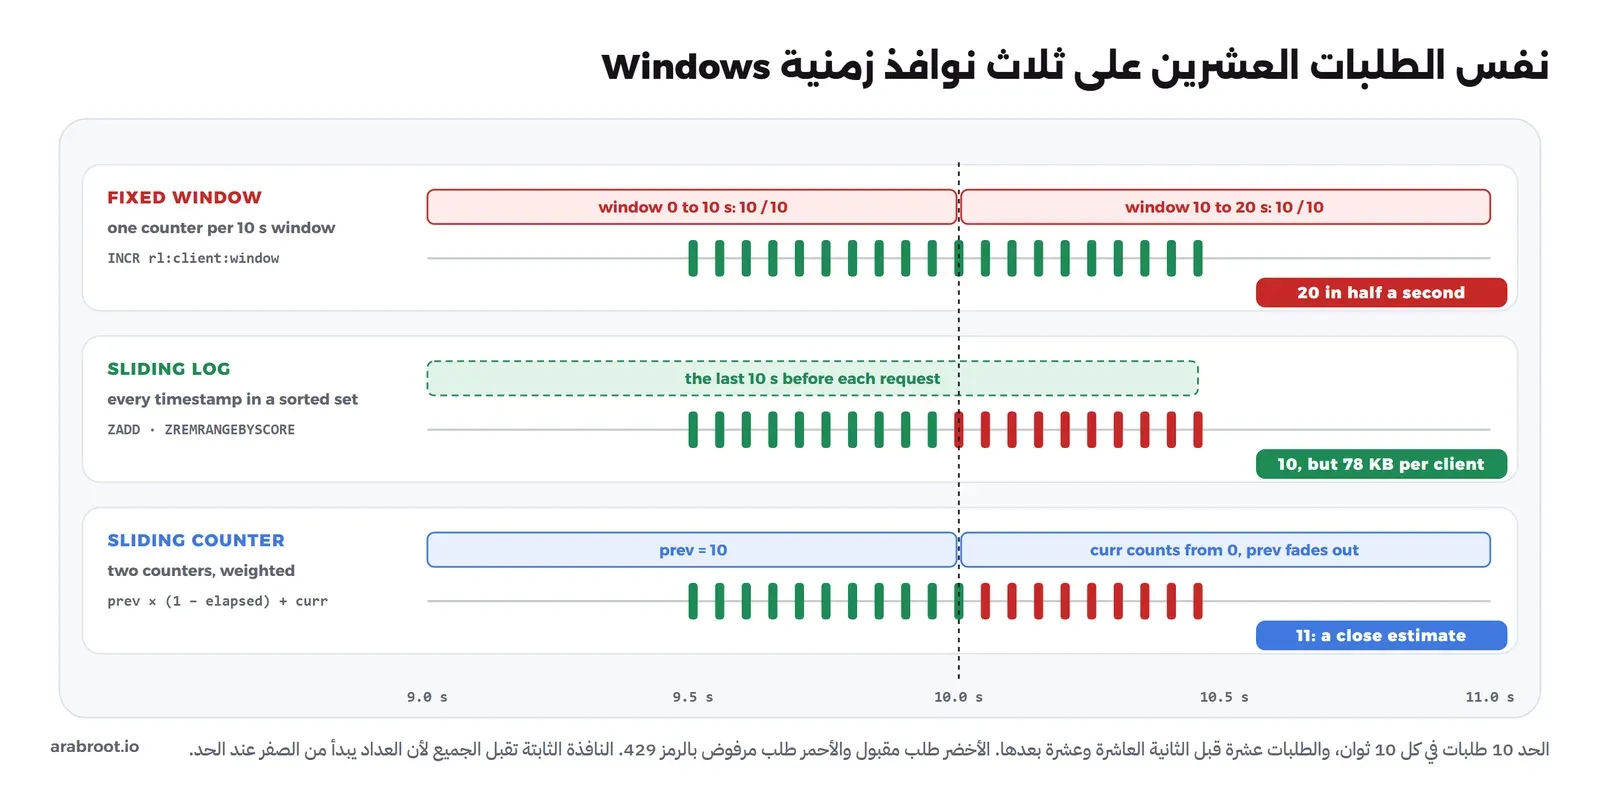
العميل أرسل عشرة طلبات قبل الثانية العاشرة بنصف ثانية، وعشرة بعدها مباشرة، فالنافذة الأولى رأت عشرة والثانية رأت عشرة، وكلاهما ضمن الحد، ولكن الحقيقة أن عشرين طلباً مرت في نصف ثانية، أي ضعف الحد. وهذه ليست حالة نظرية، فأي برنامج يعرف أن الحد يتجدد في بداية كل دقيقة يستطيع أن يرسل دفعتين متتاليتين على الحد.
والحل الأول هو السجل المنزلق Sliding Log: تحفظ وقت كل طلب في مجموعة مرتبة Sorted Set، وعند كل طلب جديد تحذف الأوقات الأقدم من 10 ثوان بالأمر ZREMRANGEBYSCORE، ثم تعد ما بقي، فتكون النافذة دائماً «آخر 10 ثوان قبل هذا الطلب» بالضبط. وهو دقيق تماماً، ولكنه يحفظ كل طلب، ففي التجربة احتاج 78,624 بايت لعميل واحد بحد 1000 طلب في الساعة، بينما احتاجت العدادات 56 بايت، فإذا كان عندك مئة ألف عميل فالفرق بين 5 ميجابايت و7.8 جيجابايت.
والحل الوسط هو العداد المنزلق Sliding Window Counter: تحفظ عداد النافذة الحالية وعداد النافذة السابقة فقط، وتقدر عدد الطلبات في آخر 10 ثوان بأن تأخذ من النافذة السابقة جزءاً يتناسب مع ما بقي منها داخل المدة. فإذا مضت 25% من النافذة الحالية، فالتقدير هو 75% من عداد السابقة زائد عداد الحالية. وهذه هي الطريقة التي شرحتها Cloudflare في مقالها How we built rate limiting capable of scaling to millions of domains سنة 2017، وذكرت أن تحليلاً على 400 مليون طلب من 270 ألف مصدر وجد أن 0.003% فقط من الطلبات قبلت أو رفضت خطأ. وفي تجربتنا قبل 11 طلباً بدل 10، والسبب أن الطلب الأول بعد الحد جاء بعد أن مضى جزء صغير من النافذة الجديدة، فأصبح التقدير 9.95 وهو أقل من 10.
الدلو والتوكنات Token Bucket والدلو المثقوب Leaky Bucket
النوافذ تعد الطلبات، أما الدلاء فتفكر في المعدل بطريقة أخرى، والصورة التالية تبين الاثنين:
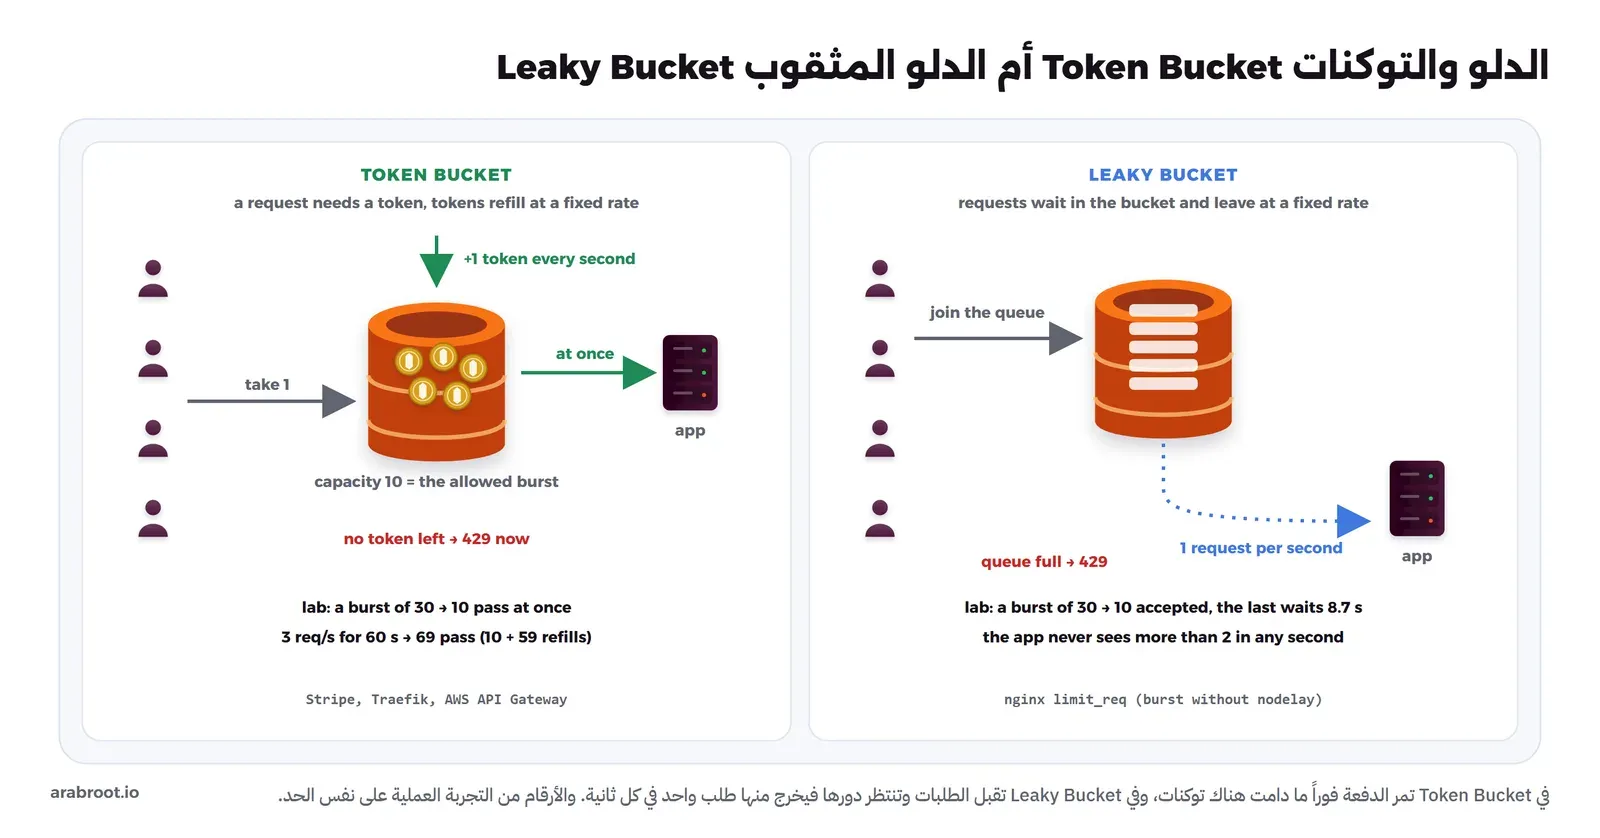
- Token Bucket: لكل عميل دلو يتسع لعشرة توكنات، ويضاف إليه توكن كل ثانية حتى يمتلئ، وكل طلب يأخذ توكناً، فإذا لم يجد رفض. والسعة هي حجم الدفعة المسموح بها Burst، والمعدل هو المتوسط على المدى الطويل، فالعميل الهادئ يستطيع أن يرسل عشرة طلبات دفعة واحدة، ثم طلباً كل ثانية. ولا تحتاج أن تزيد التوكنات بمؤقت، وإنما تحفظ عدد التوكنات ووقت آخر طلب، وعند كل طلب تحسب كم توكناً كان يجب أن يضاف منذ ذلك الوقت. وهذه الخوارزمية هي التي تستخدمها Stripe كما في مقالها، وAWS API Gateway، ووحدة RateLimit في Traefik.
- Leaky Bucket: الطلبات تدخل الدلو وتخرج من ثقب في أسفله بمعدل ثابت، فالدلو هنا طابور، والطلب المقبول لا ينفذ فوراً وإنما ينتظر دوره، وإذا امتلأ الدلو رفض الطلب الجديد. وهذه هي الطريقة التي يصف بها توثيق وحدة limit_req في Nginx نفسها، ولذلك تجد في الإعداد هناك الخيار
nodelayالذي استخدمناه في دليل الحماية، فهو يقول ل Nginx أن يمرر الدفعة المسموح بها فوراً بدل أن يؤخرها، فيصبح سلوكه أقرب إلى Token Bucket.
وقد يتساءل البعض: أيهما أفضل؟ والإجابة تعتمد على من يحتاج الحماية. فإذا كان الذي خلف الحد خدمة تتحمل دفعات قصيرة، مثل واجهتك البرمجية، فاختر Token Bucket، لأن العميل الحقيقي يرسل طلباته على دفعات، كتطبيق جوال يفتح صفحة فيطلب خمسة أشياء معاً، ولا معنى لتأخيره. أما إذا كان الذي خلف الحد خدمة لا تتحمل إلا معدلاً ثابتاً، مثل مزود رسائل SMS يسمح لك بعشر رسائل في الثانية، فالدلو المثقوب يحول دفعتك إلى تدفق يقبله المزود. وفي التجربة قبل الدلو المثقوب عشرة طلبات من دفعة الثلاثين مثل Token Bucket تماماً، ولكن آخرها انتظر 8.7 ثانية، ولم يصل إلى التطبيق أكثر من طلبين في أي ثانية.
الحد على عدة سيرفرات
عندما يعمل تطبيقك بنسخة واحدة يكفي عداد في ذاكرته، أما إذا كان عندك ثلاث نسخ خلف موزع الحمل، وكل نسخة تعد وحدها، فكل عميل يحصل على ثلاثة أضعاف حصته، لأن موزع الحمل يوزع طلباته على النسخ الثلاث. لذلك يجب أن يكون العداد في مكان مشترك، وValkey هو المكان الطبيعي لأنه سريع ويدعم مدة الصلاحية على كل مفتاح.
والحل البسيط الذي يكتبه أغلب المطورين هو أن يقرأ العداد بالأمر GET، فإذا كان أقل من الحد زاده بالأمر INCR. وهذا الكود يعمل تماماً عندما تختبره وحدك، ولكن عندما يصل خمسون طلباً في نفس اللحظة يقرأ كل منها أن العداد صفر قبل أن يزيده أي طلب، فيمر الخمسون، وهذه هي حالة السباق Race Condition نفسها التي رأيناها في نظام حجز التذاكر، وفي التجربة مر 50 طلباً من 50 والحد 10.
والحل الصحيح أن يحدث القرار كله داخل Valkey في خطوة واحدة، وذلك بسكربت Lua تنفذه بالأمر EVAL، ويذكر توثيق السكربتات في Valkey أن السكربت ينفذ بشكل ذري Atomic، أي لا ينفذ أي أمر آخر أثناء تنفيذه، فالقراءة والمقارنة والزيادة تحدث كأنها أمر واحد. وفي التجربة مر 10 طلبات بالضبط من 50 بنفس الحد.
وهناك ثلاث ملاحظات عند تشغيل الحد على Valkey في الإنتاج:
- كل طلب على واجهتك يضيف ذهاباً وعودة إلى Valkey عبر الشبكة، وهذا عادة أقل من ملي ثانية داخل نفس الشبكة، ولكنها تجعل Valkey جزءاً من طريق كل طلب، فقرر مسبقاً ماذا تفعل إذا توقف: هل تسمح بكل الطلبات Fail Open أم ترفضها Fail Closed؟ والأنسب لأغلب الواجهات أن تسمح، مع حد بسيط في ذاكرة كل نسخة، لأن توقف Valkey يجب ألا يوقف خدمتك كلها، أما حد صفحة الدخول فالأنسب أن يرفض.
- في عنقود Valkey Cluster يجب أن تكون كل المفاتيح التي يلمسها السكربت على نفس الجزء Slot، لذلك إذا استخدم السكربت مفتاحين، كما في العداد المنزلق، ضع الجزء المشترك من الاسم بين قوسين معقوفين مثل
rl:{client42}:1700، فيحسب الهاش من الجزء الذي بين القوسين فقط. - الوقت في السكربت: إذا أخذ كل سيرفر الوقت من ساعته وأرسله للسكربت، فاختلاف الساعات بين السيرفرات يغير الحسابات قليلاً، وفي التجربة نرسل الوقت كمعامل لسبب آخر، وهو أن نعيد نفس الطلبات بالضبط على كل خوارزمية، أما في الإنتاج فتستطيع أن تأخذ الوقت داخل السكربت بالأمر
TIME.
الرد الصحيح: 429 وRetry-After
الرمز الصحيح للطلب المرفوض بسبب الحد هو 429 Too Many Requests، وقد عرفه القسم الرابع من RFC 6585 سنة 2012، ويقول إن الرد ينبغي أن يشرح السبب، ويجوز أن يحمل الترويسة Retry-After التي تقول كم ينتظر العميل قبل أن يعيد المحاولة، ويذكر أيضاً أن هذا الرد يجب ألا يحفظه أي Cache. أما Retry-After نفسها فيعرفها القسم 10.2.3 من RFC 9110، وقيمتها إما عدد ثوان مثل Retry-After: 2، أو تاريخ ووقت بصيغة HTTP، والثواني أسهل لأنها لا تتأثر باختلاف الساعات.
ولا ترد بالرمز 503 كما يفعل Nginx افتراضياً، والسبب أن 503 تعني أن الخدمة متعطلة، فتفهمها أدوات المراقبة وموزعات الحمل على أنها عطل، أما 429 فتقول للعميل إن المشكلة في سرعته هو. ولا ترد بالرمز 403، لأن العميل سوف يظن أن الصلاحية مرفوضة نهائياً ولن يعيد المحاولة.
وكثير من الواجهات ترسل مع كل رد، وليس مع الرفض فقط، ترويسات تخبر العميل بحصته قبل أن يصل إلى الحد، مثل GitHub التي ترسل كما في توثيق حدود واجهتها الترويسات x-ratelimit-limit وx-ratelimit-remaining وx-ratelimit-reset، وتطلب من العميل ألا يعيد المحاولة قبل المدة في retry-after إذا وجدها. ولأن كل جهة اختارت أسماء مختلفة، تعمل مجموعة HTTPAPI في IETF على مسودة ترويسات RateLimit، ووصلت إلى الإصدار 11 وما زالت مسودة Internet-Draft ولم تصبح RFC، وفيها ترويستان: RateLimit-Policy التي تصف الحصة، مثل "default";q=100;w=60 أي 100 طلب في 60 ثانية، وRateLimit التي تصف ما بقي، مثل "default";r=50;t=30 أي بقي 50 طلباً وتتجدد الحصة بعد 30 ثانية. وإذا استخدمتها فاعلم أن صيغتها قد تتغير قبل أن تصبح معياراً، أما 429 وRetry-After فمعيار ثابت.
وعلى طرف العميل، إذا كتبت كوداً يستدعي واجهة غيرك، فاحترم Retry-After إذا وجدتها، وإذا لم تجدها فأعد المحاولة بتأخير متزايد مع عشوائية كما شرحنا في مقال الأنظمة الموزعة، ولا تعد المحاولة فوراً، لأن ألف عميل يعيدون المحاولة في نفس اللحظة سوف يصطدمون بالحد مرة أخرى معاً.
أين تضع الحد، وبأي مفتاح؟
لا يوجد مكان واحد صحيح، فكل طبقة تعرف شيئاً لا تعرفه الأخرى، والصورة التالية تبين ذلك:
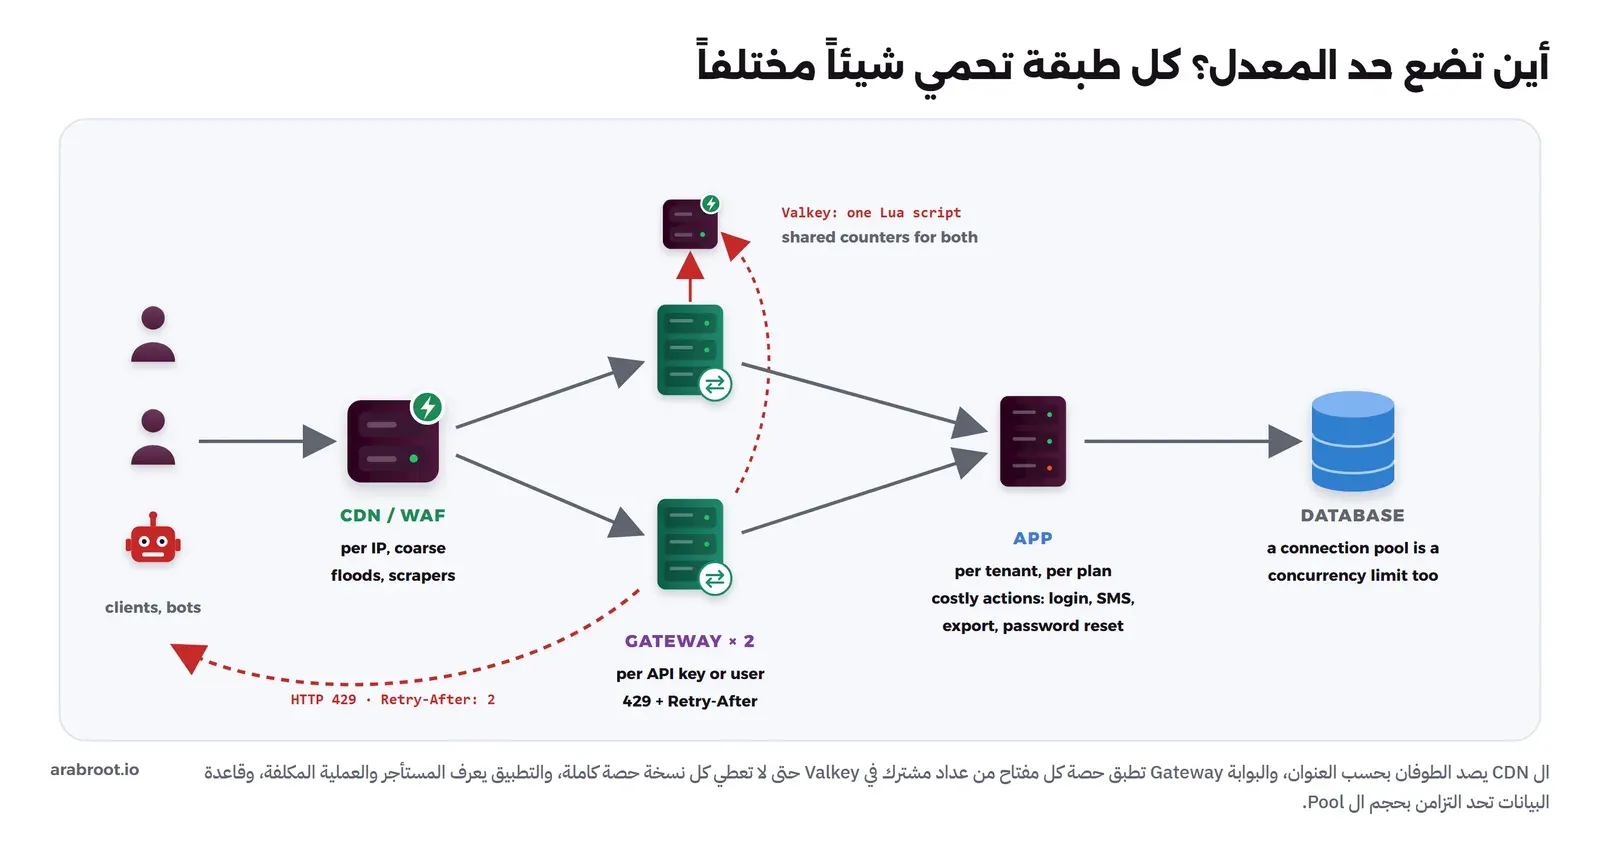
- ال CDN وجدار الحماية WAF: يعرفان عنوان IP فقط، فحدهما خشن ومناسب لصد الطوفان والبوتات قبل أن تصل إلى سيرفرك.
- البوابة Gateway أو ال Reverse Proxy: تعرف مفتاح ال API أو التوكن، فتطبق حصة كل عميل، وهذا هو المكان الطبيعي لأغلب الحدود، لأن الطلب المرفوض لا يصل إلى تطبيقك أبداً.
- التطبيق: يعرف ما لا تعرفه البوابة، مثل المستأجر Tenant وباقته، وأن هذا الطلب يرسل رسالة SMS أو يصدر تقريراً، فالحدود المرتبطة بالعمل مكانها هنا، مثل «ثلاث رسائل تحقق في الساعة لكل رقم جوال».
- قاعدة البيانات: مجموعة الاتصالات Connection Pool هي حد للتزامن في الحقيقة، فإذا امتلأت انتظرت الطلبات، ولذلك يجب أن تكون الحدود قبلها أضيق منها.
أما المفتاح فاختر أدق ما تعرفه: المستخدم أو مفتاح ال API إن وجد، وإلا فعنوان IP. وانتبه إلى أن عنوان IP مشترك أحياناً بين آلاف المستخدمين، مثل شبكة شركة كاملة خلف NAT أو مستخدمي شبكات الجوال، فحد منخفض على العنوان قد يحظر شركة كاملة. وتأكد أن تطبيقك يرى عنوان الزائر الحقيقي وليس عنوان ال Reverse Proxy، كما شرحنا في دليل تطبيقك خلف Reverse Proxy، وإلا فكل زوارك عميل واحد في نظر الحد.
تجربة عملية: خمس خوارزميات على نفس الطلبات
في هذه التجربة نشغل Valkey في Container، ونكتب الخوارزميات الخمس كسكربتات Lua في ملف Python واحد، ثم نرسل لها نفس الطلبات ونطبع كم طلباً قبلت كل منها، ثم نكسر العداد بطلبات متزامنة، ثم نشغل واجهة صغيرة خلف Token Bucket ونرسل لها طلبات بالأمر curl. والحد في المقارنة 10 طلبات في كل 10 ثوان، أي طلب في الثانية مع دفعة حتى 10.
المتطلبات: جهاز عليه Docker Engine وDocker Compose، والواجهة الصغيرة تنشر المنفذ 18089 على 127.0.0.1 فقط.
ملفات التجربة
أنشئ مجلداً فيه ثلاثة ملفات، الأول compose.yaml:
name: lab-ratelimit
services:
  cache:
    image: valkey/valkey:9.1.2-alpine
    container_name: lab-ratelimit-valkey
    command: ["valkey-server", "--save", "", "--appendonly", "no"]
    healthcheck:
      test: ["CMD", "valkey-cli", "ping"]
      interval: 2s
      retries: 30
  api:
    build: .
    image: lab-ratelimit-app:1
    container_name: lab-ratelimit-api
    command: ["serve"]
    environment:
      VALKEY_URL: valkey://cache:6379/0
    ports:
      - "127.0.0.1:18089:8080"
    depends_on:
      cache:
        condition: service_healthy
  app:
    image: lab-ratelimit-app:1
    container_name: lab-ratelimit-app
    environment:
      VALKEY_URL: valkey://cache:6379/0
    depends_on:
      cache:
        condition: service_healthy
    profiles: ["run"]
والثاني Dockerfile:
FROM python:3.13.16-slim
RUN pip install --no-cache-dir "valkey==6.1.1"
WORKDIR /app
COPY ratelimit.py .
ENTRYPOINT ["python", "-u", "ratelimit.py"]
والثالث ratelimit.py، وفيه السكربتات الخمسة والمقارنة والواجهة:
# Five rate limiting algorithms as Lua scripts in Valkey, compared on the same traffic.
#   python ratelimit.py compare | memory | race | serve
# The scripts take the time as an argument (ARGV[1], in ms), so the same traffic can be replayed exactly.
import asyncio, math, os, sys, time

import valkey

r = valkey.Valkey.from_url(os.environ["VALKEY_URL"], decode_responses=True)

FIXED_WINDOW = r.register_script("""
local now, window, limit = tonumber(ARGV[1]), tonumber(ARGV[2]), tonumber(ARGV[3])
local key = KEYS[1] .. ':' .. math.floor(now / window)
local count = redis.call('INCR', key)
if count == 1 then redis.call('PEXPIRE', key, window * 2) end
if count <= limit then return {1, 0} end
return {0, window - (now % window)}                       -- wait until the next window starts
""")

SLIDING_LOG = r.register_script("""
local now, window, limit, id = tonumber(ARGV[1]), tonumber(ARGV[2]), tonumber(ARGV[3]), ARGV[4]
redis.call('ZREMRANGEBYSCORE', KEYS[1], 0, now - window)   -- forget requests older than the window
if redis.call('ZCARD', KEYS[1]) < limit then
  redis.call('ZADD', KEYS[1], now, id)
  redis.call('PEXPIRE', KEYS[1], window)
  return {1, 0}
end
local oldest = redis.call('ZRANGE', KEYS[1], 0, 0, 'WITHSCORES')
return {0, tonumber(oldest[2]) + window - now}            -- wait until the oldest request leaves the window
""")

SLIDING_COUNTER = r.register_script("""
local now, window, limit = tonumber(ARGV[1]), tonumber(ARGV[2]), tonumber(ARGV[3])
local idx = math.floor(now / window)
local curr_key, prev_key = KEYS[1] .. ':' .. idx, KEYS[1] .. ':' .. (idx - 1)
local curr = tonumber(redis.call('GET', curr_key) or '0')
local prev = tonumber(redis.call('GET', prev_key) or '0')
local elapsed = (now % window) / window
local estimate = prev * (1 - elapsed) + curr               -- the previous window counts less as time passes
if estimate < limit then
  redis.call('INCR', curr_key)
  redis.call('PEXPIRE', curr_key, window * 2)
  return {1, 0}
end
return {0, math.ceil(window / limit)}
""")

TOKEN_BUCKET = r.register_script("""
local now, rate, capacity = tonumber(ARGV[1]), tonumber(ARGV[2]), tonumber(ARGV[3])   -- rate = tokens per ms
local b = redis.call('HMGET', KEYS[1], 'tokens', 'ts')
local tokens, ts = tonumber(b[1]) or capacity, tonumber(b[2]) or now
tokens = math.min(capacity, tokens + (now - ts) * rate)    -- refill for the time that passed
local allowed, wait = 0, 0
if tokens >= 1 then tokens = tokens - 1; allowed = 1 else wait = math.ceil((1 - tokens) / rate) end
redis.call('HSET', KEYS[1], 'tokens', tokens, 'ts', now)
redis.call('PEXPIRE', KEYS[1], math.ceil(capacity / rate))
return {allowed, wait}
""")

LEAKY_QUEUE = r.register_script("""
local now, rate, capacity = tonumber(ARGV[1]), tonumber(ARGV[2]), tonumber(ARGV[3])   -- rate = requests per ms
local b = redis.call('HMGET', KEYS[1], 'level', 'ts')
local level, ts = tonumber(b[1]) or 0, tonumber(b[2]) or now
level = math.max(0, level - (now - ts) * rate)             -- the bucket leaks at a fixed rate
if level + 1 > capacity then return {0, math.ceil((level + 1 - capacity) / rate)} end
local delay = math.ceil(level / rate)                      -- accepted, but served in its turn: the output is smooth
redis.call('HSET', KEYS[1], 'level', level + 1, 'ts', now)
redis.call('PEXPIRE', KEYS[1], math.ceil(capacity / rate) + 1000)
return {1, delay}
""")

LIMIT, WINDOW = 10, 10_000           # 10 requests per 10 seconds = 1 request per second, bursts up to 10
RATE = LIMIT / WINDOW

def make(name, client):
    key = f"rl:{name}:{client}"
    seq = iter(range(10**9))
    return {
        "fixed window":    lambda now: FIXED_WINDOW(keys=[key], args=[now, WINDOW, LIMIT]),
        "sliding log":     lambda now: SLIDING_LOG(keys=[key], args=[now, WINDOW, LIMIT, f"{now}-{next(seq)}"]),
        "sliding counter": lambda now: SLIDING_COUNTER(keys=[key], args=[now, WINDOW, LIMIT]),
        "token bucket":    lambda now: TOKEN_BUCKET(keys=[key], args=[now, RATE, LIMIT]),
        "leaky bucket":    lambda now: LEAKY_QUEUE(keys=[key], args=[now, RATE, LIMIT]),
    }[name]

ALGOS = ["fixed window", "sliding log", "sliding counter", "token bucket", "leaky bucket"]
BASE = 1_000_000_000_000             # a round start time (ms) so window edges fall on round numbers

def traffic(name):
    if name == "edge":               # 10 requests just before a window edge and 10 just after it
        return [BASE + 9_500 + 50 * i for i in range(10)] + [BASE + 10_000 + 50 * i for i in range(10)]
    if name == "steady":             # 3 requests per second for 60 seconds, three times the allowed rate
        return [BASE + 333 * i for i in range(180)]
    if name == "after-idle":         # a quiet client sends 30 requests in one second
        return [BASE + 60_000 + 33 * i for i in range(30)]

def compare():
    print(f"limit: {LIMIT} requests per {WINDOW // 1000} s (bucket capacity {LIMIT}, refill 1 per second)\n")
    print(f"{'traffic':<34}" + "".join(f"{a:>17}" for a in ALGOS))
    waits = {}
    for t, label in [("edge", "edge: 10 before + 10 after 10.0 s"), ("steady", "steady: 3 req/s for 60 s"), ("after-idle", "burst: 30 requests in 1 s")]:
        row = []
        for a in ALGOS:
            client = f"{t}"; r.delete(*(r.keys(f"rl:{a}:{client}*") or ["x"]))
            fn = make(a, client)
            res = [fn(now) for now in traffic(t)]
            allowed = sum(x[0] for x in res)
            if a == "leaky bucket":
                waits[label] = max(x[1] for x in res if x[0]) / 1000
            row.append(f"{allowed}/{len(res)}")
        print(f"{label:<34}" + "".join(f"{c:>17}" for c in row))
    print()
    for label, w in waits.items():
        print(f"leaky bucket, {label}: longest wait for its turn {w:.1f} s")
    # the worst 1-second span inside the edge traffic
    print()
    for a in ALGOS:
        client = "edge-span"; r.delete(*(r.keys(f"rl:{a}:{client}*") or ["x"]))
        fn = make(a, client)
        res = [(now, fn(now)) for now in traffic("edge")]
        # the leaky bucket accepts a request now but serves it later (now + wait); the others serve at once
        ok = [now + (x[1] if a == "leaky bucket" else 0) for now, x in res if x[0]]
        worst = max(sum(1 for x in ok if s <= x < s + 1000) for s in ok)
        print(f"{a:<16} most requests reaching the app in any 1 s: {worst}")

def memory():
    # 1000 requests per hour from one client: how much memory does each method keep?
    global LIMIT, WINDOW, RATE
    LIMIT, WINDOW = 1000, 3_600_000; RATE = LIMIT / WINDOW
    print("one client, limit 1000 per hour, after 1000 requests:")
    for a in ALGOS:
        client = "mem"; r.delete(*(r.keys(f"rl:{a}:{client}*") or ["x"]))
        fn = make(a, client)
        now = int(time.time() * 1000)
        for i in range(1000):
            fn(now + i * 100)
        keys = r.keys(f"rl:{a}:{client}*")
        print(f"  {a:<16} keys: {len(keys)}   bytes: {sum(r.memory_usage(k) for k in keys)}")

async def race():
    # 50 requests at once from the same client, limit 10 per minute, two implementations
    import valkey.asyncio as av
    ar = av.Valkey.from_url(os.environ["VALKEY_URL"], decode_responses=True, max_connections=60)
    await asyncio.gather(*(ar.ping() for _ in range(50)))
    async def check_then_incr(key):
        count = int(await ar.get(key) or 0)          # read ...
        if count >= 10:
            return False
        await ar.incr(key)                           # ... then write: another request may sit between the two lines
        await ar.expire(key, 60)
        return True
    async def atomic(key):
        res = await ar.eval(FIXED_WINDOW.script, 1, key, int(time.time() * 1000), 60_000, 10)
        return res[0] == 1
    for name, fn in [("GET, compare, then INCR from the app", check_then_incr), ("one Lua script inside Valkey", atomic)]:
        key = f"rl:race:{name[:3]}"; await ar.delete(*(await ar.keys(key + "*") or ["x"]))
        res = await asyncio.gather(*(fn(key) for _ in range(50)))
        print(f"{name:<40} allowed {sum(res)} of 50 (limit 10)")
    await ar.aclose()

def serve():
    # a small API behind a token bucket: 5 requests, then 1 more every 2 seconds per client IP
    from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
    CAP, PER_MS = 5, 1 / 2000
    class H(BaseHTTPRequestHandler):
        def do_GET(self):
            ok, wait_ms = TOKEN_BUCKET(keys=[f"rl:api:{self.client_address[0]}"], args=[int(time.time() * 1000), PER_MS, CAP])
            tokens = float(r.hget(f"rl:api:{self.client_address[0]}", "tokens"))
            if ok:
                self.send_response(200); body = b'{"products": []}\n'
            else:
                self.send_response(429); body = b'{"error": "too many requests"}\n'
                self.send_header("Retry-After", str(math.ceil(wait_ms / 1000)))
            self.send_header("RateLimit-Policy", f'"api";q={CAP};w={int(CAP / PER_MS / 1000)}')
            self.send_header("RateLimit", f'"api";r={int(tokens)};t={math.ceil((CAP - tokens) / PER_MS / 1000)}')
            self.send_header("Content-Type", "application/json"); self.send_header("Content-Length", str(len(body)))
            self.end_headers(); self.wfile.write(body)
        def log_message(self, *a): pass
    print("listening on :8080"); ThreadingHTTPServer(("0.0.0.0", 8080), H).serve_forever()

mode = sys.argv[1] if len(sys.argv) > 1 else "compare"
if mode == "compare": compare()
elif mode == "memory": memory()
elif mode == "race": asyncio.run(race())
elif mode == "serve": serve()
في الكود أعلاه لاحظ التالي:
- كل سكربت يأخذ الوقت بالملي ثانية في
ARGV[1]، ويرجع قائمة من رقمين: هل قبل الطلب، وكم ملي ثانية ينتظر العميل، وهذا الرقم الثاني هو الذي نحوله إلىRetry-After. - كل سكربت يضع مدة صلاحية على مفاتيحه بالأمر
PEXPIRE، فالعميل الذي توقف عن الطلب لا يترك مفاتيح في الذاكرة للأبد. - في
LEAKY_QUEUEالرقم الثاني للطلب المقبول ليس صفراً، وإنما هو الوقت الذي ينتظره الطلب حتى يأتي دوره. - الدالة
raceتطلق 50 طلباً معاً، مرة بقراءة ثم زيادة من التطبيق، ومرة بسكربت النافذة الثابتة نفسه.
الآن نشغل Valkey والواجهة:
docker compose up -d --build --waitالمقارنة على نفس الطلبات
docker compose run --rm -q app compareوالمخرج سوف يكون كما يلي:
limit: 10 requests per 10 s (bucket capacity 10, refill 1 per second)

traffic                                fixed window      sliding log  sliding counter     token bucket     leaky bucket
edge: 10 before + 10 after 10.0 s             20/20            10/20            11/20            10/20            10/20
steady: 3 req/s for 60 s                     60/180           60/180           60/180           69/180           69/180
burst: 30 requests in 1 s                     10/30            10/30            10/30            10/30            10/30

leaky bucket, edge: 10 before + 10 after 10.0 s: longest wait for its turn 8.6 s
leaky bucket, steady: 3 req/s for 60 s: longest wait for its turn 8.7 s
leaky bucket, burst: 30 requests in 1 s: longest wait for its turn 8.7 s

fixed window     most requests reaching the app in any 1 s: 20
sliding log      most requests reaching the app in any 1 s: 10
sliding counter  most requests reaching the app in any 1 s: 11
token bucket     most requests reaching the app in any 1 s: 10
leaky bucket     most requests reaching the app in any 1 s: 2
في المخرج أعلاه لاحظ التالي:
- الصف الأول هو مشكلة الحد بين نافذتين: النافذة الثابتة قبلت الطلبات العشرين كلها، والبقية قبلت عشرة أو أحد عشر.
- في الحمل المستمر بثلاثة أضعاف الحد قبلت النوافذ 60 طلباً في 60 ثانية، والدلاء 69، أي الدفعة الأولى 10 ثم توكن كل ثانية لمدة 59 ثانية، فكلاهما صحيح ولكن الدلاء تعطي العميل الهادئ دفعته في البداية.
- الدلو المثقوب قبل نفس العدد مثل Token Bucket، ولكنه لم يمرر إلى التطبيق أكثر من طلبين في أي ثانية، وثمن ذلك أن آخر طلب مقبول انتظر 8.7 ثانية، فإذا كان العميل ينتظر الرد في متصفح فهذا الانتظار أسوأ من الرفض.
كم تكلف كل خوارزمية من الذاكرة؟
docker compose run --rm -q app memoryوالمخرج سوف يكون كما يلي:
one client, limit 1000 per hour, after 1000 requests:
  fixed window     keys: 1   bytes: 56
  sliding log      keys: 1   bytes: 78624
  sliding counter  keys: 1   bytes: 56
  token bucket     keys: 1   bytes: 104
  leaky bucket     keys: 1   bytes: 96
الأرقام من الأمر MEMORY USAGE لكل مفتاح، والسجل المنزلق يحتاج نحو 1400 ضعف ما تحتاجه البقية، لأنه يحفظ ألف وقت، ولذلك لا يستخدم إلا لحدود صغيرة مثل خمس محاولات دخول في الدقيقة، حيث الدقة مهمة والسجل صغير.
نكسر العداد: اقرأ ثم زد
docker compose run --rm -q app raceوالمخرج سوف يكون كما يلي:
GET, compare, then INCR from the app     allowed 50 of 50 (limit 10)
one Lua script inside Valkey             allowed 10 of 50 (limit 10)
كل الطلبات الخمسين قرأت العداد صفراً قبل أن يزيده أي منها، فلم يوقف الحد شيئاً، وأعدنا التشغيل مرة ثانية فكانت النتيجة نفسها. أما السكربت فقبل عشرة بالضبط، لأن Valkey نفذ الخمسين سكربتاً واحداً بعد الآخر.
الواجهة ترد بالرمز 429
الواجهة الصغيرة تسمح بخمسة طلبات دفعة واحدة، ثم طلب كل ثانيتين لكل عنوان، ونرسل لها سبعة طلبات متتالية ثم نعرض الرد كاملاً:
for i in 1 2 3 4 5 6 7; do curl -s -o /dev/null -w "%{http_code} " http://127.0.0.1:18089/products; done; echo
curl -si http://127.0.0.1:18089/products
sleep 4
curl -si http://127.0.0.1:18089/products | head -1
والمخرج سوف يكون كما يلي:
200 200 200 200 200 429 429
HTTP/1.0 429 Too Many Requests
Server: BaseHTTP/0.6 Python/3.13.16
Date: Sat, 10 Oct 2026 05:12:34 GMT
Retry-After: 2
RateLimit-Policy: "api";q=5;w=10
RateLimit: "api";r=0;t=10
Content-Type: application/json
Content-Length: 31

{"error": "too many requests"}
HTTP/1.0 200 OK
في المخرج أعلاه لاحظ التالي:
- الطلبات الخمسة الأولى استهلكت الدلو، فرفض السادس والسابع.
Retry-After: 2هي المدة حتى يضاف توكن واحد، فالعميل الذي ينتظرها سوف ينجح طلبه، وهذا ما حدث بعد أربع ثوان.- ترويستا
RateLimit-PolicyوRateLimitبصيغة المسودة، وتقولان إن الحصة 5 طلبات في 10 ثوان، وإن ما بقي صفر، وإن الدلو يمتلئ بعد 10 ثوان.
حذف التجربة
docker compose --profile run down -v
docker image rm lab-ratelimit-app:1
أي خوارزمية تختار؟
| الخوارزمية | نقاط القوة | نقاط الضعف | تناسب |
|---|---|---|---|
| Fixed Window | مفتاح واحد وأمر واحد، والأسهل في الفهم | ضعف الحد على حد النافذتين | الحصص اليومية والشهرية |
| Sliding Log | دقيق تماماً | يحفظ كل طلب، فالذاكرة تكبر مع الحد | حدود صغيرة وحساسة مثل محاولات الدخول |
| Sliding Window Counter | قريب جداً من الدقة بعدادين فقط | تقدير وليس عداً | حدود الواجهات العامة |
| Token Bucket | يسمح بالدفعة ويحفظ المتوسط، ورقمان لكل عميل | يحتاج اختيار رقمين بدل رقم واحد | أغلب الواجهات البرمجية |
| Leaky Bucket | تدفق ثابت إلى ما خلفه | الطلب المقبول قد ينتظر طويلاً | حماية مزود بمعدل ثابت مثل SMS |
أخطاء شائعة
- عداد في ذاكرة كل نسخة من التطبيق خلف موزع الحمل، فيحصل العميل على حصته مضروبة في عدد النسخ.
- قراءة العداد ثم زيادته في أمرين من التطبيق بدل سكربت واحد أو أمر ذري.
- الرد بالرمز 503 أو 403 بدل 429، أو 429 دون
Retry-After، فيعيد العميل المحاولة فوراً. - الحد بعنوان IP على واجهة يستخدمها موظفو شركة كاملة من عنوان واحد، أو قبل أن يرى التطبيق العنوان الحقيقي.
- نسيان مدة الصلاحية على مفاتيح الحد، فتملأ عناوين البوتات ذاكرة Valkey.
- عدم تحديد ماذا يحدث إذا توقف Valkey، فيتوقف كل شيء معه.
- حد واحد لكل المسارات، فصفحة الدخول وتصدير التقارير وقراءة المنتجات لها نفس الحصة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- حد المعدل يحمي من عميل واحد يتجاوز حصته، لأمان أو لعدالة أو لتكلفة، وكل سبب يحتاج حداً ومفتاحاً مختلفين.
- النافذة الثابتة سمحت في التجربة بعشرين طلباً في نصف ثانية بحد عشرة، والعداد المنزلق يحل ذلك بعدادين فقط كما تفعل Cloudflare.
- Token Bucket هو الاختيار الأنسب لأغلب الواجهات، والدلو المثقوب لما خلفه معدل ثابت.
- على عدة سيرفرات يجب أن يكون العداد مشتركاً والقرار ذرياً، فقراءة ثم زيادة سمحت بخمسين طلباً بحد عشرة، وسكربت Lua سمح بعشرة.
- الرد الصحيح 429 مع
Retry-Afterكما في RFC 6585 وRFC 9110، وترويسات RateLimit ما زالت مسودة.
وفي هذا القسم مقالات قريبة: التخزين المؤقت الذي يخفف الحمل قبل أن يصل إلى الحد، وجعل العمليات آمنة عند تكرارها حتى تكون إعادة المحاولة بعد 429 آمنة:
 دليلالتخزين المؤقت Caching بالتفصيل: الاستراتيجيات والإبطالكيف تختار نمط التخزين المؤقت المناسب، ومتى تبطل القيمة، وكيف تمنع انهيار قاعدة البيانات عندما ينتهي مفتاح مشهور.
 دليلIdempotency: كيف تجعل العملية آمنة عند تكرارهالماذا تصل الرسالة نفسها أكثر من مرة، وكيف تكتب مستهلكاً يطبقها مرة واحدة فقط مهما تكررت.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع Valkey 9.1.2 وPython 3.13.16 وvalkey-py 6.1.1.


