

عندما يكون تطبيقك برنامجاً واحداً على سيرفر واحد فلا يوجد سؤال عن العناوين، فالكود يستدعي الدالة مباشرة، وقاعدة البيانات عنوانها ثابت في ملف الإعدادات. ولكن عندما تقسم النظام إلى خدمات Services، وتشغل من كل خدمة أكثر من نسخة Instance في Containers تولد وتموت، وتضيف نسخاً عند الضغط وتحذفها بعده، يظهر سؤال بسيط في شكله وصعب في حله: خدمة الطلبات orders تريد أن تتصل بخدمة الدفع، فما هو عنوانها الآن؟ وأي نسخها سليمة في هذه اللحظة؟ وإذا غيرنا مهلة الاتصال بالبنك فكيف تصل القيمة الجديدة إلى عشرين نسخة دون أن نعيد تشغيلها؟
وهذان السؤالان هما موضوع هذا المقال: اكتشاف الخدمات Service Discovery، والإعدادات الموزعة Distributed Configuration، وقد ذكرنا الأداتين المشهورتين لهما etcd وConsul في الأنظمة الموزعة للمبتدئين عند الكلام عن الإجماع Consensus وخوارزمية Raft، وشغلنا هناك عنقود etcd وأوقفنا القائد وكسرنا الأغلبية من جهة السيرفرات، فلن نكرر ذلك هنا، وإنما سوف ننظر من جهة تطبيقك: كيف يسجل نفسه، وكيف يجد غيره، وكيف يستلم الإعدادات، وماذا يرى عندما يتعطل العنقود تحته.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلمصطلحات Kubernetes مشروحة بالترتيب، من Pod إلى Ingressشرح مصطلحات Kubernetes بالترتيب الذي يبني بعضها على بعض، مع رسم لكل مفهوم وملفات YAML حقيقية.
 دليلHAProxy: توزيع الحمل Load Balancing أمام خدماتكعندما يعمل تطبيقك على أكثر من سيرفر، يوزع HAProxy الطلبات بينها ويستبعد المعطل منها تلقائياً مع شهادات HTTPS.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي ملف إعدادات فيه العناوين، ولا حتى سجل DNS ثابت.
- سجل الخدمات Service Registry وفحص الصحة Health Check، ومن يسجل النسخة: النسخة نفسها أم طرف ثالث.
- الاكتشاف من جهة الكلاينت Client-side Discovery والاكتشاف من جهة السيرفر Server-side Discovery، ونقاط القوة والضعف في كل منهما.
- الاكتشاف عبر ال DNS بسجلات SRV، وأين يقابلك هذا في Kubernetes.
- الإعدادات الموزعة في مخزن مفاتيح Key-Value ومراقبة التغيير Watch بدل السؤال المتكرر Polling.
- لماذا يحتاج السجل إلى إجماع، وماذا يعني ذلك لتطبيقك عندما تضيع الأغلبية.
- Consul أم etcd، وتغيير ترخيص Consul إلى BUSL سنة 2023.
- تجربة عملية: عنقود etcd من ثلاثة سيرفرات، ومراقبة مفتاح إعدادات، وتسجيل بمهلة Lease يختفي عندما تموت النسخة، ثم إيقاف سيرفر ثم فقدان الأغلبية، ثم Consul يجيب عن سؤال DNS ويخرج النسخة المعطلة.
لماذا لا يكفي ملف إعدادات فيه العناوين؟
الحل البسيط الذي يبدأ به كل فريق هو أن يكتب عناوين الخدمات في ملف الإعدادات أو في متغيرات البيئة: PAYMENTS_URL=http://10.0.1.11:8080، وهذا الحل يعمل تماماً ما دام كل شيء ثابتاً، ولكنه يتعطل في ثلاث حالات تحدث كل أسبوع في أي نظام حي:
- إعادة النشر Redeploy: ال Container الجديد يأخذ عنواناً جديداً في أغلب البيئات، فإذا لم يتحدث الملف عند كل خدمة تتصل به فسوف تتصل بعنوان فارغ.
- التوسع التلقائي Autoscaling: أضفت خمس نسخ من خدمة الدفع وقت الذروة، ولكن الخدمات التي تتصل بها لا تعرف عنها شيئاً، فتبقى ترسل إلى النسختين القديمتين وحدهما.
- النسخة المعطلة: نسخة توقفت أو علقت، وعنوانها ما زال في الملف، فيذهب إليها جزء من الطلبات ويفشل حتى يتدخل شخص ويعدل الملف ويعيد التشغيل.
والخطوة التالية التي يفكر فيها الناس هي سجل DNS عادي: اسم payments.internal يشير إلى عناوين النسخ، وهذا أفضل لأن الكود يحمل اسماً وليس عنواناً، ولكن سجل DNS الذي تحدثه يدوياً لا يعرف أن نسخة ماتت، ولا يعرف المنفذ Port، والإجابة تحفظ في ذاكرة الكلاينت المؤقتة Cache حسب ال TTL، كما شرحنا في شرح DNS وسجلاته. والذي نحتاجه في الحقيقة شيء يعرف في كل لحظة من حي ومن ميت، ويتحدث وحده دون أن يتدخل أحد، وهذا هو سجل الخدمات.
سجل الخدمات Service Registry: دفتر عناوين يتحدث وحده
سجل الخدمات قاعدة بيانات صغيرة فيها لكل خدمة قائمة نسخها الحية مع عناوينها ومنافذها، ويعرفه نمط Service Registry بأنه قاعدة بيانات للخدمات ونسخها ومواقعها، تسجل فيها النسخة عند التشغيل وتحذف عند الإيقاف. والصورة التالية تبين الدورة الكاملة في أربع خطوات:
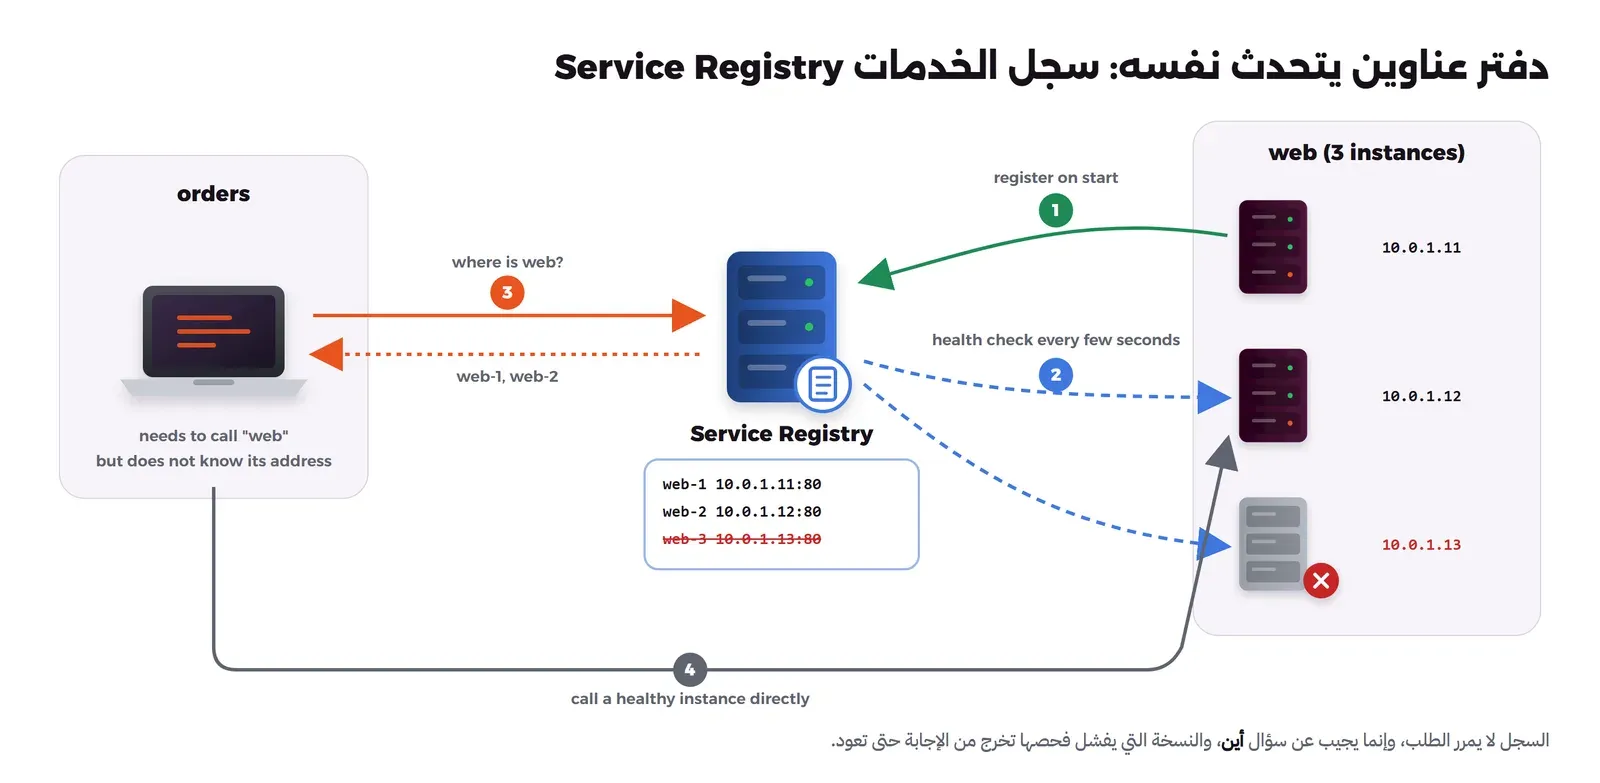
في الصورة أعلاه لاحظ التالي:
- النسخة تسجل نفسها عند التشغيل (الخطوة 1)، والسجل يسأل كل نسخة دورياً هل ما زالت سليمة (الخطوة 2)، وهذا هو فحص الصحة Health Check الذي شرحنا فكرته ونبض القلب Heartbeat في الأنظمة الموزعة للمبتدئين.
- النسخة الثالثة فشل فحصها فشطبت من القائمة، ولكنها لم تحذف من السجل، فإذا عادت للعمل نجح الفحص وعادت إلى الإجابة دون أن يسجلها أحد من جديد.
- خدمة
ordersتسأل السجل (الخطوة 3) ثم تتصل بالنسخة مباشرة (الخطوة 4)، فالسجل ليس في طريق الطلب، وإذا تعطل لدقيقة تستطيع الخدمات أن تكمل بآخر قائمة عرفتها.
من يسجل النسخة؟
هناك طريقتان، ولكل منهما مكانها:
- التسجيل الذاتي Self-registration: النسخة نفسها تكتب عنوانها في السجل عند التشغيل، وتجدد تسجيلها دورياً، وتحذفه عند الإيقاف. وهذا بسيط ولكنه يربط كل خدمة بمكتبة السجل، ويجب أن تكتبه في كل لغة تستخدمها.
- التسجيل عبر طرف ثالث 3rd Party Registration: شيء خارج الخدمة يراقب ما يعمل ويسجله، مثل وكيل Consul الذي يقرأ ملف تعريف الخدمة، أو Kubernetes الذي يعرف كل Pod يعمل ويحدث قائمة عناوين ال Service بنفسه. وهنا الخدمة لا تعرف بوجود السجل أصلاً، وهذه هي الطريقة الأنسب عندما تكون منصة التشغيل قادرة عليها.
وفي الحالتين يبقى السؤال المهم: متى يخرج السجل نسخة ماتت فجأة دون أن تحذف نفسها؟ والإجابة أن هناك آليتين: إما أن يسألها السجل دورياً ويخرجها إذا فشل الفحص، كما يفعل Consul مع فحص HTTP، وإما أن يكون تسجيلها نفسه بمهلة Lease أو TTL، فإذا لم تجددها النسخة خلال المهلة حذفها السجل وحده، وهذا ما يفعله etcd، وسوف نرى الاثنين في التجربة العملية.
من يختار النسخة: الكلاينت نفسه أم موزع الحمل أمامه؟
بعد أن يعرف النظام قائمة النسخ السليمة يبقى سؤال: من يقرأ القائمة ويختار نسخة لكل طلب؟ والصورة التالية تبين الطريقتين:
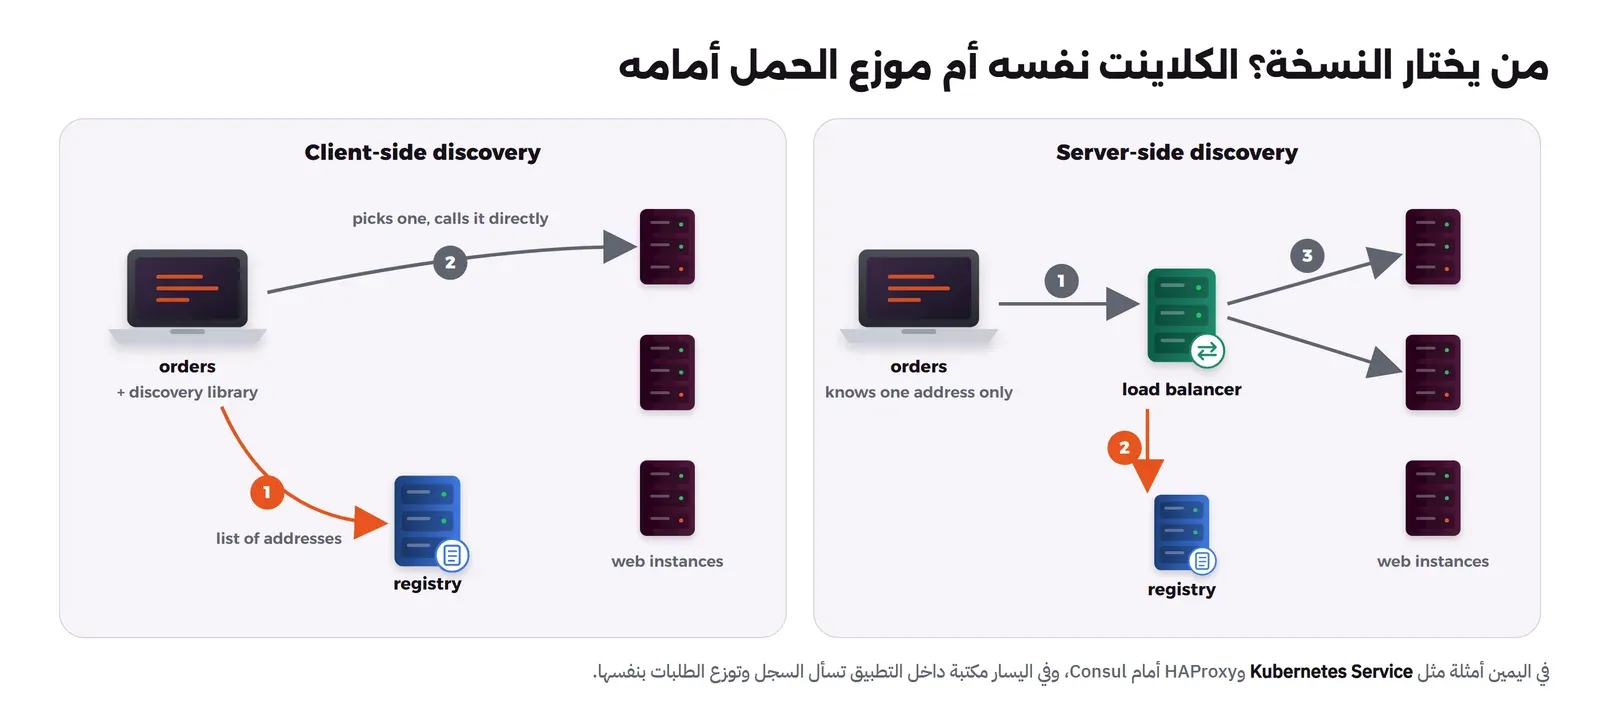
الاكتشاف من جهة الكلاينت Client-side Discovery: التطبيق نفسه يسأل السجل ويختار نسخة ويتصل بها، والمثال الذي يذكره microservices.io هو Eureka من Netflix مع مكتبة Ribbon التي توزع الطلبات داخل التطبيق.
- نقاط القوة: لا توجد قفزة إضافية في الشبكة، والتطبيق يستطيع أن يختار بذكاء، مثل النسخة الأقرب أو الأقل ضغطاً.
- نقاط الضعف: منطق الاكتشاف وتوزيع الحمل مكرر في كل خدمة وبكل لغة، وأي خطأ فيه أو أي تحديث له يعني تحديث كل الخدمات.
الاكتشاف من جهة السيرفر Server-side Discovery: التطبيق يرسل إلى عنوان واحد ثابت، وخلفه موزع حمل Load Balancer أو Proxy يعرف القائمة من السجل ويوزع عليها، ويذكر microservices.io موزع الحمل في AWS مثالاً، ويذكر أن Kubernetes يشغل Proxy على كل عقدة يقوم بهذا الدور.
- نقاط القوة: التطبيق لا يعرف شيئاً عن السجل، فأي لغة تعمل، والتغيير في مكان واحد.
- نقاط الضعف: قفزة إضافية في كل طلب، وموزع الحمل نفسه يجب أن يكون متوفراً دائماً، وإلا صار نقطة فشل واحدة Single Point of Failure كما شرحنا في مفاهيم التوفر العالي.
وقد يتساءل البعض: أيهما أختار؟ والإجابة أن أغلب الفرق اليوم لا تختار بنفسها، لأن منصة التشغيل تقرر عنها: إذا كنت على Kubernetes فأنت تستخدم الاكتشاف من جهة السيرفر كل يوم دون أن تسميه، فال Service عنوان ثابت أمام Pods تتغير، وقد شرحناه في مصطلحات Kubernetes. وإذا كنت على سيرفرات عادية أو Docker Compose على أكثر من سيرفر، فالطريقة الأبسط غالباً هي موزع حمل مثل HAProxy يقرأ القائمة من السجل، أما المكتبة داخل التطبيق فاتركها للحالات التي تحتاج فيها فعلاً اختياراً ذكياً لا يقدمه موزع الحمل.
الاكتشاف عبر ال DNS: اسم الخدمة يكفي
هناك طريق ثالث يجمع بساطة الاثنين: أن يجيب السجل نفسه عن أسئلة DNS، فالتطبيق يسأل عن اسم مثل web.service.consul بأي مكتبة DNS موجودة في كل لغة، والسجل يجيب بعناوين النسخ السليمة فقط. وهذا ما يفعله Consul DNS، والصورة التالية تبين الطريق:
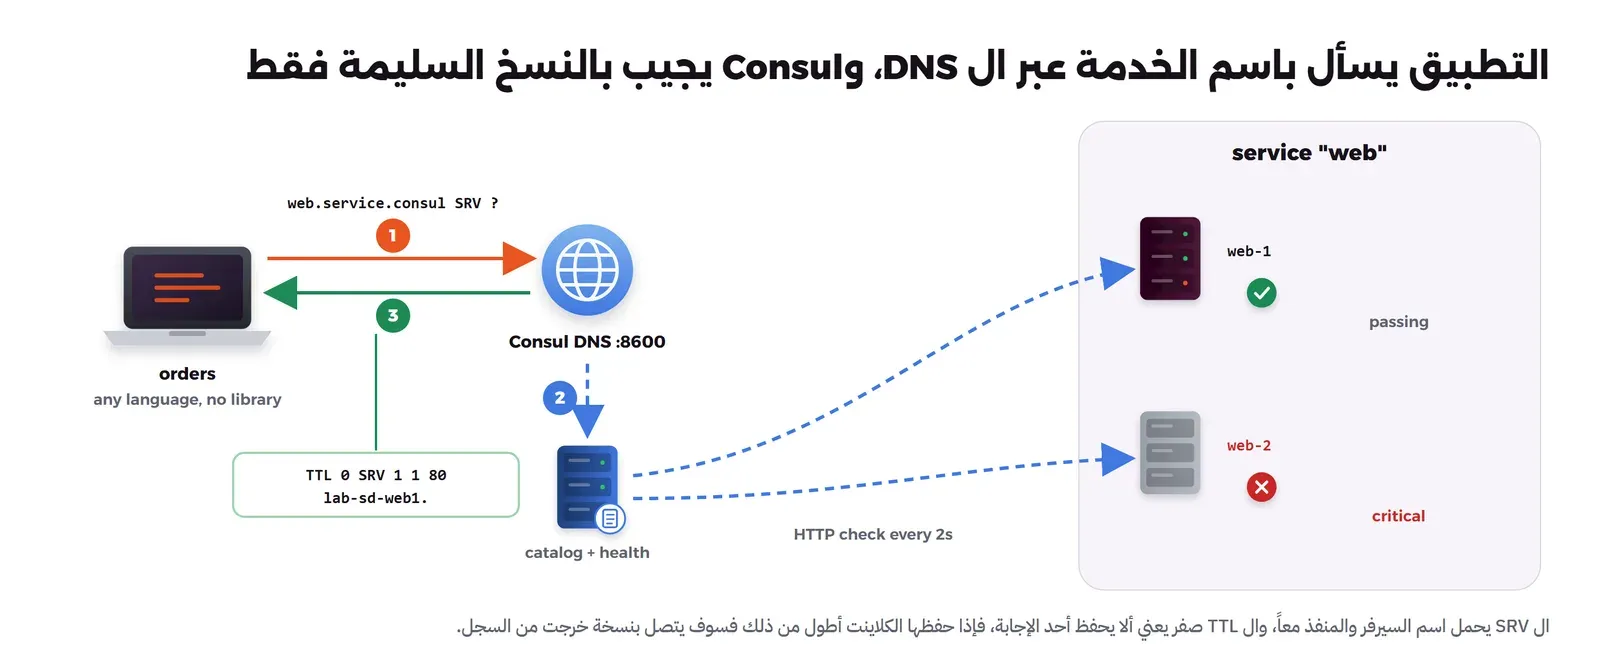
في الصورة أعلاه لاحظ التالي:
- سجل SRV يحمل المنفذ مع الاسم، فلا تحتاج أن تثبت المنفذ في الكود، وهذا ما ينقص سجل A العادي.
- ال TTL في الإجابة صفر، وهذا ما رأيناه فعلاً في التجربة، أي أن Consul يطلب ألا تحفظ الإجابة، والسبب أن القائمة تتغير مع كل فحص.
- المشكلة هنا من جهة الكلاينت وليس من جهة Consul: بعض المكتبات وبيئات التشغيل تحفظ إجابة DNS لمدة أطول من ال TTL، أو تحل الاسم مرة واحدة عند تشغيل البرنامج وتنسى السؤال بعدها، فتبقى تتصل بنسخة خرجت من السجل منذ دقائق، لذلك تأكد من سلوك المكتبة التي تستخدمها قبل أن تعتمد على DNS.
وهذا الطريق نفسه موجود في Kubernetes، فكل Service يأخذ اسماً في DNS العنقود على الشكل my-svc.my-namespace.svc.cluster-domain.example كما في توثيق DNS في Kubernetes، ويجيب عنه خادم DNS العنقود مثل CoreDNS، والمنفذ المسمى Named Port في ال Service يحصل على سجل SRV أيضاً. وكذلك يستطيع HAProxy أن يبني قائمة سيرفراته من سجلات SRV عبر قسم resolvers مع server-template كما في توثيق إعداد HAProxy، فيجمع ميزة موزع الحمل مع قائمة تتحدث وحدها.
الإعدادات الموزعة: مخزن مفاتيح ومراقبة التغيير
السؤال الثاني في هذا المقال يشبه الأول: لديك عشرون نسخة من خدمة الدفع، وتريد أن تغير مهلة الاتصال بالبنك من ألفي ملي ثانية إلى ألف وخمسمئة، أو أن تطفئ ميزة جديدة Feature Flag ظهر فيها خطأ. والحل البسيط هو تعديل متغير البيئة وإعادة نشر كل النسخ، وهذا يعمل، ولكنه بطيء ويعيد تشغيل كل شيء من أجل رقم واحد، وفي لحظة خطأ في الإنتاج تريد أن تطفئ الميزة في ثوان وليس في عشر دقائق.
والحل الأفضل أن تضع الإعدادات التي تتغير أثناء التشغيل في مخزن مفاتيح وقيم Key-Value موزع مثل etcd أو KV في Consul، ويقرأ كل تطبيق قيمه عند التشغيل، ثم يراقبها، والمراقبة هنا لها طريقتان:
- السؤال المتكرر Polling: كل نسخة تسأل كل عشر ثوان «هل تغير شيء؟»، وهذا بسيط ولكنه إما بطيء في الاستجابة وإما ثقيل على المخزن إذا قصرت الفترة وكثرت النسخ.
- المراقبة Watch: النسخة تفتح اتصالاً واحداً وتقول «أخبرني عندما يتغير أي مفتاح تحت
/config/shop/»، والمخزن يرسل التغيير فور حدوثه. وفي etcd هذا هو Watch API، وفي Consul هو الاستعلام المعلق Blocking Query الذي يصفه التوثيق بأنه Long Polling، أي طلب ينتظر عند السيرفر حتى يحدث تغيير أو تنتهي مهلته.
وفي etcd ميزة مهمة هنا: كل تغيير في المخزن يرفع رقم مراجعة Revision واحداً للعنقود كله، وكل مفتاح يحفظ رقم المراجعة التي غيرته، لذلك تستطيع النسخة التي انقطعت لدقيقة أن تعود وتقول «أرسل لي كل ما تغير بعد المراجعة 7»، فلا يضيع عليها تغيير حدث وهي غائبة، بشرط ألا يكون etcd قد حذف ذلك التاريخ بالضغط Compaction، لأن التوثيق يذكر أن المراقبة ممكنة من آخر مراجعة مضغوطة فقط.
ولكن لا تضع كل شيء في هذا المخزن، والسبب أنه مصمم لبيانات صغيرة يحتاج كل النظام أن يتفق عليها، فيذكر توثيق etcd في حدود النظام أن أكبر طلب افتراضياً 1.5 MiB، وأن حد التخزين الافتراضي 2 GiB، وأن 8 GiB هو الحد الأقصى المقترح. لذلك ضع فيه العناوين والإعدادات ومفاتيح الميزات والأقفال، أما الملفات وبيانات المستخدمين فمكانها قاعدة البيانات. وكذلك الأسرار مثل كلمات المرور ومفاتيح ال API لا توضع كنص عادي في مخزن يقرؤه كل من له صلاحية على المفاتيح.
لماذا يحتاج السجل إلى إجماع، وماذا يكلفك ذلك؟
السجل والإعدادات بيانات يعتمد عليها كل النظام، فلا يصح أن تعطي نسخة من السجل قائمة ونسخة أخرى قائمة مختلفة، ولا أن يغير شخص مهلة البنك فتراها نصف الخدمات فقط، لذلك تبنى هذه المخازن فوق الإجماع Consensus: كل كتابة لا تعتبر ناجحة حتى توافق عليها أغلبية السيرفرات، وهذا ما تفعله Raft في etcd وفي سيرفرات Consul. وقد شرحنا Raft خطوة بخطوة في الأنظمة الموزعة للمبتدئين، وشرحنا هناك لماذا ثلاثة أو خمسة وليس أربعة، وهو ما يكرره سؤال etcd الشائع عن العدد الفردي للأعضاء.
والذي يهمك من جهة التطبيق هو الثمن: هذه المخازن تختار الاتساق Consistency على التوفر عند انقطاع الشبكة، فإذا ضاعت الأغلبية توقفت الكتابة. وفي etcd تكون القراءة افتراضياً قراءة خطية Linearizable، أي ترجع أحدث قيمة كتبت، وهذا يحتاج قائداً وأغلبية، ويسمح لك بالقراءة المتسلسلة Serializable التي يصفها توثيق ضمانات ال API بأنها قد ترجع قيمة قديمة ولكنها لا تحتاج الإجماع. وسوف نرى في التجربة ماذا يعني هذا بالضبط: كتابة تفشل، وقراءة عادية تفشل، وقراءة متسلسلة تنجح بقيمة قديمة، ومراقبة وتجديد تسجيل يتوقفان.
Consul أم etcd؟
الأداتان تحلان المشكلة نفسها من زاويتين مختلفتين: etcd مخزن مفاتيح صغير ومتين، يعطيك المكونات الأساسية مثل المفاتيح والمراقبة والمهلة Lease والمعاملات، وأنت تبني فوقها السجل والإعدادات، وأشهر من يستخدمه Kubernetes نفسه، الذي يصفه في مكونات Kubernetes بأنه المخزن لكل بيانات ال API Server. أما Consul فمنتج كامل للاكتشاف: وكيل Agent على كل سيرفر، وكتالوج للخدمات، وفحوص صحة جاهزة، وواجهة DNS، ومخزن KV، وشبكة خدمات Service Mesh، وسيرفراته فقط هي التي تتفق عبر Raft كما في معمارية Consul، أما الوكلاء فيرسلون طلباتهم إلى السيرفرات.
| المعيار | etcd | Consul |
|---|---|---|
| ما هو؟ | مخزن مفاتيح موزع، والاكتشاف تبنيه أنت فوقه | منصة اكتشاف كاملة مع KV وفحوص وDNS |
| كيف تسجل النسخة؟ | مفتاح مربوط بمهلة Lease تجددها النسخة | ملف تعريف أو API عند الوكيل، وفحص يقرر الحالة |
| كيف يجدها الكلاينت؟ | قراءة المفاتيح ومراقبتها عبر gRPC | DNS أو HTTP API |
| فحص الصحة | غير موجود، غياب التجديد هو الإشارة | HTTP وTCP وأوامر وTTL، والحالة passing أو warning أو critical |
| الإجماع | Raft بين أعضاء العنقود | Raft بين السيرفرات، والوكلاء لا يشاركون فيه |
| الترخيص | Apache-2.0 | BUSL 1.1 منذ الإصدار 1.17.0 |
| الجهة | مشروع متخرج في CNCF | HashiCorp، وهي اليوم جزء من IBM |
الترخيص: نقطة يجب أن تعرفها قبل أن تختار
في 10 أغسطس 2023 أعلنت HashiCorp نقل الإصدارات القادمة من منتجاتها، ومنها Consul، من ترخيص MPL 2.0 مفتوح المصدر إلى Business Source License 1.1، واختصاراً BUSL أو BSL، وقد شرحنا القصة كاملة بالتواريخ في Terraform أم OpenTofu. وملف LICENSE في مستودع Consul اليوم ينص على أن الترخيص يشمل Consul 1.17.0 وما بعده، وأن المرخص هو IBM، بعد أن أكملت IBM شراء HashiCorp في 27 فبراير 2025. والنص يسمح بالاستخدام في الإنتاج، ويمنع أن تقدم Consul لطرف ثالث كمنتج مستضاف أو مدمج ينافس نسخ IBM المدفوعة، لذلك إذا كنت تستخدمه داخل شركتك فالأمر غالباً لا يمسك، أما إذا كنت تبني منتجاً تبيعه ويضم Consul فاقرأ النص مع مستشار قانوني، وتذكر أن BUSL ليس ترخيصاً مفتوح المصدر بتعريف OSI.
أما etcd فترخيصه Apache-2.0، وهو مشروع في مؤسسة CNCF أعلنت تخرجه في 24 نوفمبر 2020، فلا تملكه شركة واحدة تستطيع أن تغير ترخيصه.
كيف تختار؟
- إذا كنت على Kubernetes فالاكتشاف موجود عندك أصلاً عبر ال Service وDNS العنقود، والإعدادات عبر ConfigMap، فلا تضف Consul أو etcd ثانياً إلا لسبب واضح. ولا تستخدم etcd الخاص بالعنقود لبيانات تطبيقك، والسبب أن أي ضغط عليه يبطئ ال API Server الذي يدير العنقود كله.
- إذا كانت خدماتك على سيرفرات عادية أو أكثر من بيئة، وتريد فحوص صحة وDNS جاهزة دون أن تكتب كوداً، فConsul يعطيك ذلك من اليوم الأول، بشرط أن يناسبك ترخيصه.
- إذا كنت تحتاج مخزناً صغيراً متيناً للإعدادات والأقفال والقيادة Leader Election، أو تبني أداة تحتاج إجماعاً، أو تريد ترخيصاً مفتوحاً بالكامل، فetcd هو الأنسب، وهو ما تختاره أدوات مثل Patroni كما ذكرنا في عناقيد قواعد البيانات.
تجربة عملية: الإعدادات والتسجيل وفقدان الأغلبية
سوف نشغل على جهاز واحد عنقود etcd من ثلاثة سيرفرات، ووكيل Consul واحداً في وضع التطوير، ونسختين من خدمة web هما Nginx فقط، و Container صغيراً للكلاينت فيه etcdctl وdig وcurl، ثم نجرب كل ما شرحناه، وكل المخرجات أدناه حقيقية من تشغيلنا.
ملفات التجربة
ملف compose.yaml، ولاحظ أن كل المنافذ مربوطة على 127.0.0.1 فقط:
# Service discovery lab: 3-node etcd + one Consul agent in dev mode + two small web services + a client box
#   docker compose -p lab-sd up -d
x-etcd: &etcd
  image: gcr.io/etcd-development/etcd:v3.7.2
  networks: [lab-sd]

services:
  etcd1:
    <<: *etcd
    container_name: lab-sd-etcd1
    ports: ["127.0.0.1:24791:2379"]
    command: >
      etcd --name etcd1 --data-dir /etcd-data
      --listen-client-urls http://0.0.0.0:2379 --advertise-client-urls http://etcd1:2379
      --listen-peer-urls http://0.0.0.0:2380 --initial-advertise-peer-urls http://etcd1:2380
      --initial-cluster etcd1=http://etcd1:2380,etcd2=http://etcd2:2380,etcd3=http://etcd3:2380
      --initial-cluster-token lab-sd --initial-cluster-state new
  etcd2:
    <<: *etcd
    container_name: lab-sd-etcd2
    ports: ["127.0.0.1:24792:2379"]
    command: >
      etcd --name etcd2 --data-dir /etcd-data
      --listen-client-urls http://0.0.0.0:2379 --advertise-client-urls http://etcd2:2379
      --listen-peer-urls http://0.0.0.0:2380 --initial-advertise-peer-urls http://etcd2:2380
      --initial-cluster etcd1=http://etcd1:2380,etcd2=http://etcd2:2380,etcd3=http://etcd3:2380
      --initial-cluster-token lab-sd --initial-cluster-state new
  etcd3:
    <<: *etcd
    container_name: lab-sd-etcd3
    ports: ["127.0.0.1:24793:2379"]
    command: >
      etcd --name etcd3 --data-dir /etcd-data
      --listen-client-urls http://0.0.0.0:2379 --advertise-client-urls http://etcd3:2379
      --listen-peer-urls http://0.0.0.0:2380 --initial-advertise-peer-urls http://etcd3:2380
      --initial-cluster etcd1=http://etcd1:2380,etcd2=http://etcd2:2380,etcd3=http://etcd3:2380
      --initial-cluster-token lab-sd --initial-cluster-state new

  consul:
    image: hashicorp/consul:2.0.4
    container_name: lab-sd-consul
    networks: [lab-sd]
    ports: ["127.0.0.1:24500:8500"]
    volumes: ["./consul.d:/lab-config:ro"]
    command: agent -dev -client 0.0.0.0 -config-dir /lab-config

  client:
    build: { context: ., dockerfile: Dockerfile.client }
    image: lab-sd-client:1
    container_name: lab-sd-client
    networks: [lab-sd]

  web1:
    image: nginx:1.29.8-alpine
    container_name: lab-sd-web1
    networks: [lab-sd]
  web2:
    image: nginx:1.29.8-alpine
    container_name: lab-sd-web2
    networks: [lab-sd]

networks:
  lab-sd:
    name: lab-sd
ملف Dockerfile.client للكلاينت:
# A small client box: etcdctl from the same etcd release, plus dig and curl for the Consul part
FROM alpine:3.24.2
RUN apk add --no-cache bind-tools curl jq
COPY --from=gcr.io/etcd-development/etcd:v3.7.2 /usr/local/bin/etcdctl /usr/local/bin/etcdctl
COPY --chmod=755 register.sh /usr/local/bin/register
ENV ETCDCTL_ENDPOINTS=etcd1:2379,etcd2:2379,etcd3:2379
CMD ["sleep", "infinity"]
ملف register.sh الذي يسجل نسخة بمهلة Lease ثم يجددها، وهو تسجيل ذاتي Self-registration في أبسط صوره:
#!/bin/sh
# register.sh NAME ADDRESS: put /services/web/NAME under a 10-second lease, then keep the lease alive.
# If this process dies, nobody renews the lease and etcd deletes the key by itself.
set -e
LEASE=$(etcdctl lease grant 10 | cut -d' ' -f2)
etcdctl put --lease="$LEASE" "/services/web/$1" "$2" >/dev/null
echo "$(date +%T) registered $1 -> $2 with lease $LEASE"
exec etcdctl lease keep-alive "$LEASE" >/dev/null
وملف consul.d/web.hcl الذي يعرف لConsul النسختين مع فحص HTTP كل ثانيتين، وهذا تسجيل عبر طرف ثالث، لأن Nginx نفسه لا يعرف بوجود Consul:
# Two instances of the same service "web", each with an HTTP health check every 2 seconds
services = [
  {
    id      = "web-1"
    name    = "web"
    address = "lab-sd-web1"
    port    = 80
    check = { id = "web-1-http", http = "http://lab-sd-web1:80/", interval = "2s", timeout = "1s" }
  },
  {
    id      = "web-2"
    name    = "web"
    address = "lab-sd-web2"
    port    = 80
    check = { id = "web-2-http", http = "http://lab-sd-web2:80/", interval = "2s", timeout = "1s" }
  }
]
في الإعداد أعلاه لاحظ التالي:
- ملفات الإعداد لConsul تركب في
/lab-configوليس في/consul/config، والسبب أن سكربت التشغيل في ال Docker Image الرسمية لConsul ينفذchownعلى المجلد الثاني، فإذا ركبته للقراءة فقط يتوقف ال Container فوراً برسالةchown: /consul/config: Read-only file system، وهذا ما حدث معنا في أول تشغيل. - الخيار
-devيشغل Consul كما يصفه توثيق الأمر agent بكل خيارات الحفظ مطفأة وفي الذاكرة فقط، فلا يصلح للإنتاج إطلاقاً، ويكفي هنا لنرى الفحوص وDNS. - متغير
ETCDCTL_ENDPOINTSفيه السيرفرات الثلاثة، فيتصل الكلاينت بأي سيرفر سليم منها.
تشغيل العنقود
docker compose -p lab-sd up -d --build
docker exec lab-sd-client etcdctl member list -w table
والمخرج سوف يكون كما يلي:
┌──────────────────┬─────────┬───────┬───────────────────┬───────────────────┬────────────┐
│        ID        │ STATUS  │ NAME  │    PEER ADDRS     │   CLIENT ADDRS    │ IS LEARNER │
├──────────────────┼─────────┼───────┼───────────────────┼───────────────────┼────────────┤
│ 6506527bdb06188e │ started │ etcd1 │ http://etcd1:2380 │ http://etcd1:2379 │      false │
│ a0c560962eb34af5 │ started │ etcd3 │ http://etcd3:2380 │ http://etcd3:2379 │      false │
│ cbde59998a1e0ad1 │ started │ etcd2 │ http://etcd2:2380 │ http://etcd2:2379 │      false │
└──────────────────┴─────────┴───────┴───────────────────┴───────────────────┴────────────┘
وفي تشغيلنا كان القائد هو etcd3، وتعرفه من عمود IS LEADER في الأمر etcdctl endpoint status -w table.
export MSYS_NO_PATHCONV=1 قبلها، والسبب أن Git Bash يحول أي معامل يبدأ بشرطة مائلة مثل /config/shop/ إلى مسار Windows، وقد كتب معنا في أول محاولة مفتاحاً اسمه C:/Program Files/Git/config/shop/... بدل المفتاح الذي أردناه.الخطوة 1: مفتاح إعدادات ونسخة تراقبه
نشغل مراقباً في الخلفية على كل المفاتيح تحت /config/shop/، وهو يمثل نسخة من خدمة الدفع، ثم نكتب ثلاث قيم ونقرأ ما وصله:
X="docker exec lab-sd-client"
$X sh -c 'etcdctl watch --prefix /config/shop/ > /tmp/watch.log 2>&1 &'
$X etcdctl put /config/shop/payment_timeout_ms 2000
$X etcdctl put /config/shop/feature_new_checkout off
$X etcdctl put /config/shop/payment_timeout_ms 1500
$X etcdctl get /config/shop/ --prefix
$X sh -c 'etcdctl get /config/shop/payment_timeout_ms -w json | jq -c "{rev: .header.revision, create: .kvs[0].create_revision, mod: .kvs[0].mod_revision, version: .kvs[0].version}"'
$X cat /tmp/watch.log
والمخرج سوف يكون كما يلي:
OK
OK
OK
/config/shop/feature_new_checkout
off
/config/shop/payment_timeout_ms
1500
{"rev":8,"create":6,"mod":8,"version":2}
PUT
/config/shop/payment_timeout_ms
2000
PUT
/config/shop/feature_new_checkout
off
PUT
/config/shop/payment_timeout_ms
1500
في المخرج أعلاه لاحظ التالي:
- المراقب استلم التغييرات الثلاثة بالترتيب دون أن يسأل عنها، وهذا ما تفعله النسخة الحقيقية: تستلم القيمة الجديدة وتطبقها دون إعادة تشغيل.
- العنقود كله عند المراجعة 8، والمفتاح أنشئ في المراجعة 6 وآخر تعديل له في المراجعة 8، و
versionيعني أنه عدل مرتين منذ إنشائه. ولا تستغرب أن الأرقام لم تبدأ من 1، فالمراجعات قبلها كانت للمفتاح الخطأ الذي كتبه Git Bash ثم حذفناه، وكل حذف أو كتابة يرفع المراجعة.
والآن نفرض أن نسخة كانت متوقفة أثناء هذه التغييرات، وآخر مراجعة رأتها هي 6، فتعود وتطلب كل ما تغير من المراجعة 7:
$X sh -c 'timeout 2 etcdctl watch --rev 7 --prefix /config/shop/ -w fields' | grep -E '"(Type|Key|Value|ModRevision|Revision)"'والمخرج سوف يكون كما يلي:
"Revision" : 8
"Type" : PUT
"Key" : "/config/shop/feature_new_checkout"
"ModRevision" : 7
"Value" : "off"
"Type" : PUT
"Key" : "/config/shop/payment_timeout_ms"
"ModRevision" : 8
"Value" : "1500"
فاستلمت التغييرين اللذين فاتاها بالترتيب، وهذا هو الفرق بين المراقبة في etcd وبين إشعار يضيع إذا لم تكن موجوداً لحظة إرساله، لذلك احفظ في تطبيقك آخر مراجعة طبقتها، واستأنف منها عند كل إعادة اتصال.
الخطوة 2: تسجيل بمهلة Lease، ونسخة تموت فجأة
الآن نجعل الكلاينت يمثل موزع حمل يراقب /services/، ونسجل النسختين بالسكربت register، ثم ننتظر لنتأكد أن التجديد يبقي التسجيل حياً، ثم نقتل عملية التجديد للنسخة الأولى فقط كأن السيرفر انطفأ دون أن تحذف النسخة نفسها:
$X sh -c 'etcdctl watch --prefix /services/ | while read l; do echo "$(date +%T) $l"; done > /tmp/svc.log 2>&1 &'
$X sh -c 'register web-1 lab-sd-web1:80 > /tmp/reg1.log 2>&1 &'
$X sh -c 'register web-2 lab-sd-web2:80 > /tmp/reg2.log 2>&1 &'
$X cat /tmp/reg1.log /tmp/reg2.log
$X etcdctl get /services/web/ --prefix
$X sh -c 'for l in $(etcdctl lease list | tail -n +2); do etcdctl lease timetolive $l --keys; done'
sleep 15; $X etcdctl get /services/web/ --prefix --keys-only
$X sh -c 'pkill -f "keep-alive $(grep -o "lease [0-9a-f]*" /tmp/reg1.log | cut -d" " -f2)"; echo "$(date +%T) web-1 keep-alive killed"'
sleep 14; $X etcdctl get /services/web/ --prefix
$X cat /tmp/svc.log
والمخرج سوف يكون كما يلي:
05:05:23 registered web-1 -> lab-sd-web1:80 with lease 0ad1a1245c024406
05:05:24 registered web-2 -> lab-sd-web2:80 with lease 188ea1245bf5e306
/services/web/web-1
lab-sd-web1:80
/services/web/web-2
lab-sd-web2:80
lease 0ad1a1245c024406 granted with TTL(10s), remaining(9s), attached keys([/services/web/web-1])
lease 188ea1245bf5e306 granted with TTL(10s), remaining(9s), attached keys([/services/web/web-2])
/services/web/web-1

/services/web/web-2

05:05:44 web-1 keep-alive killed
/services/web/web-2
lab-sd-web2:80
05:05:23 PUT
05:05:23 /services/web/web-1
05:05:23 lab-sd-web1:80
05:05:24 PUT
05:05:24 /services/web/web-2
05:05:24 lab-sd-web2:80
05:05:51 DELETE
05:05:51 /services/web/web-1
05:05:51
والصورة التالية تبين ما حدث على خط زمني بالأوقات نفسها:
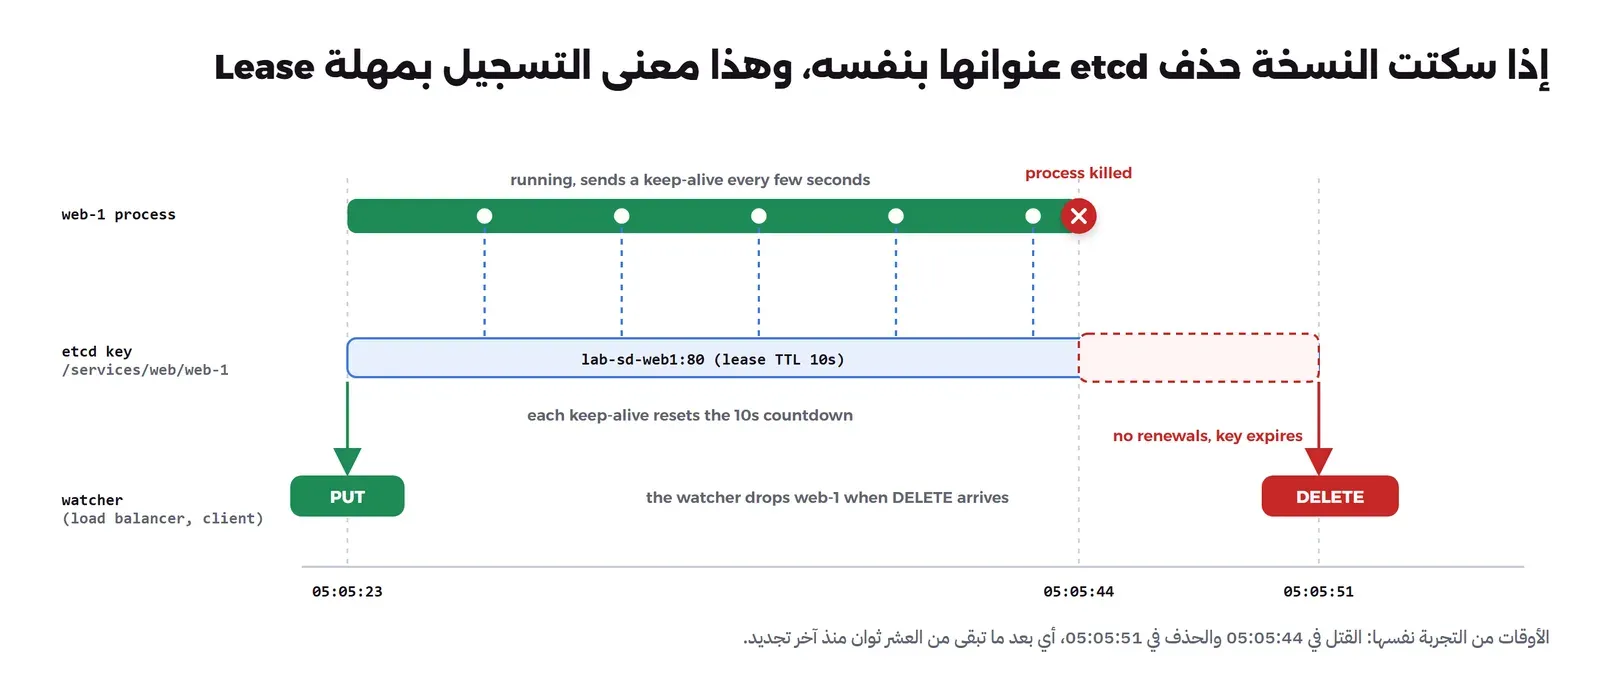
في المخرج أعلاه لاحظ التالي:
- بعد 15 ثانية من التسجيل كان المفتاحان موجودين رغم أن المهلة 10 ثوان، والسبب أن
lease keep-aliveيجدد المهلة باستمرار، فكما يقول توثيق Lease API: المهلة تنتهي إذا لم يستلم العنقود تجديداً خلال ال TTL، وعند انتهائها تحذف كل المفاتيح المربوطة بها. - لم يحذف أحد المفتاح
web-1بأمر، وإنما حذفه etcd وحده بعد سبع ثوان من موت عملية التجديد، ووصل الحذف إلى المراقب فوراً على شكلDELETE، فموزع الحمل الذي يراقب يخرج النسخة من قائمته في اللحظة نفسها. - المدة بين الموت والحذف هي ما تبقى من المهلة، وهي هنا بين صفر وعشر ثوان، وخلالها قد يرسل موزع الحمل طلبات إلى نسخة ميتة. والمهلة القصيرة تكشف الموت أسرع ولكنها تحذف نسخاً سليمة عند أي بطء عابر في الشبكة أو توقف قصير للبرنامج، لذلك اختر المهلة بحسب ما يتحمله نظامك، واجمعها مع إعادة المحاولة والمهلات عند الكلاينت كما في كيف تمنع خدمة بطيئة من إسقاط نظامك كله.
الخطوة 3: نوقف القائد
نعيد تسجيل web-1، ونفتح مراقباً جديداً على الإعدادات، ثم نوقف etcd3 وهو القائد، ونتأكد من الكتابة والمراقبة والتسجيل:
$X sh -c 'register web-1 lab-sd-web1:80 > /tmp/reg1.log 2>&1 &'
$X sh -c 'etcdctl watch --prefix /config/shop/ | while read l; do echo "$(date +%T) $l"; done > /tmp/watch2.log 2>&1 &'
docker stop lab-sd-etcd3
$X etcdctl endpoint health
$X etcdctl put /config/shop/payment_timeout_ms 1200
$X cat /tmp/watch2.log
sleep 12; $X etcdctl get /services/web/ --prefix --keys-only
والمخرج سوف يكون كما يلي، بعد حذف سطور التحذير الطويلة التي يكتبها الكلاينت وهو يحاول الاتصال ب etcd3:
etcd3:2379 is unhealthy: failed to commit proposal: context deadline exceeded
Error: unhealthy cluster
etcd2:2379 is healthy: successfully committed proposal: took = 15.296907ms
etcd1:2379 is healthy: successfully committed proposal: took = 15.548722ms
OK
05:06:34 PUT
05:06:34 /config/shop/payment_timeout_ms
05:06:34 1200
/services/web/web-1

/services/web/web-2
وفي endpoint status بعد الإيقاف ظهر etcd1 قائداً جديداً في الدورة Term رقم 3 بعد أن كانت 2. فالعنقود فقد سيرفراً واحداً من ثلاثة وما زالت الأغلبية موجودة، والكتابة نجحت، والمراقب استلم التغيير، والتسجيلان بقيا لأن التجديد استمر عبر السيرفرين الباقيين، أي أن تطبيقك لم يلاحظ شيئاً تقريباً، وهذا هو الهدف من العنقود الثلاثي.
الخطوة 4: كسر الأغلبية، وما يراه تطبيقك
نوقف etcd2 أيضاً، فيبقى سيرفر واحد من ثلاثة، ونوجه الكلاينت إليه وحده:
docker stop lab-sd-etcd2
X1="docker exec -e ETCDCTL_ENDPOINTS=etcd1:2379 lab-sd-client"
time $X1 etcdctl put /config/shop/payment_timeout_ms 900
time $X1 etcdctl get /config/shop/payment_timeout_ms
$X1 etcdctl get /config/shop/payment_timeout_ms --consistency=s
$X1 etcdctl get /services/web/ --prefix --keys-only --consistency=s
$X1 ps
والمخرج سوف يكون كما يلي:
Error: context deadline exceeded

real	0m5.371s
user	0m0.151s
sys	0m0.092s
Error: context deadline exceeded

real	0m5.447s
user	0m0.106s
sys	0m0.200s
/config/shop/payment_timeout_ms
1200
/services/web/web-1

/services/web/web-2

PID   USER     TIME  COMMAND
    1 root      0:00 sleep infinity
   29 root      0:00 [etcdctl]
   30 root      0:00 [sh]
   45 root      0:00 [etcdctl]
   81 root      0:00 [etcdctl]
  225 root      0:00 [etcdctl]
  262 root      0:00 [etcdctl]
  263 root      0:00 [sh]
  473 root      0:00 ps
والصورة التالية تجمع ما رآه التطبيق في المراحل الثلاث:
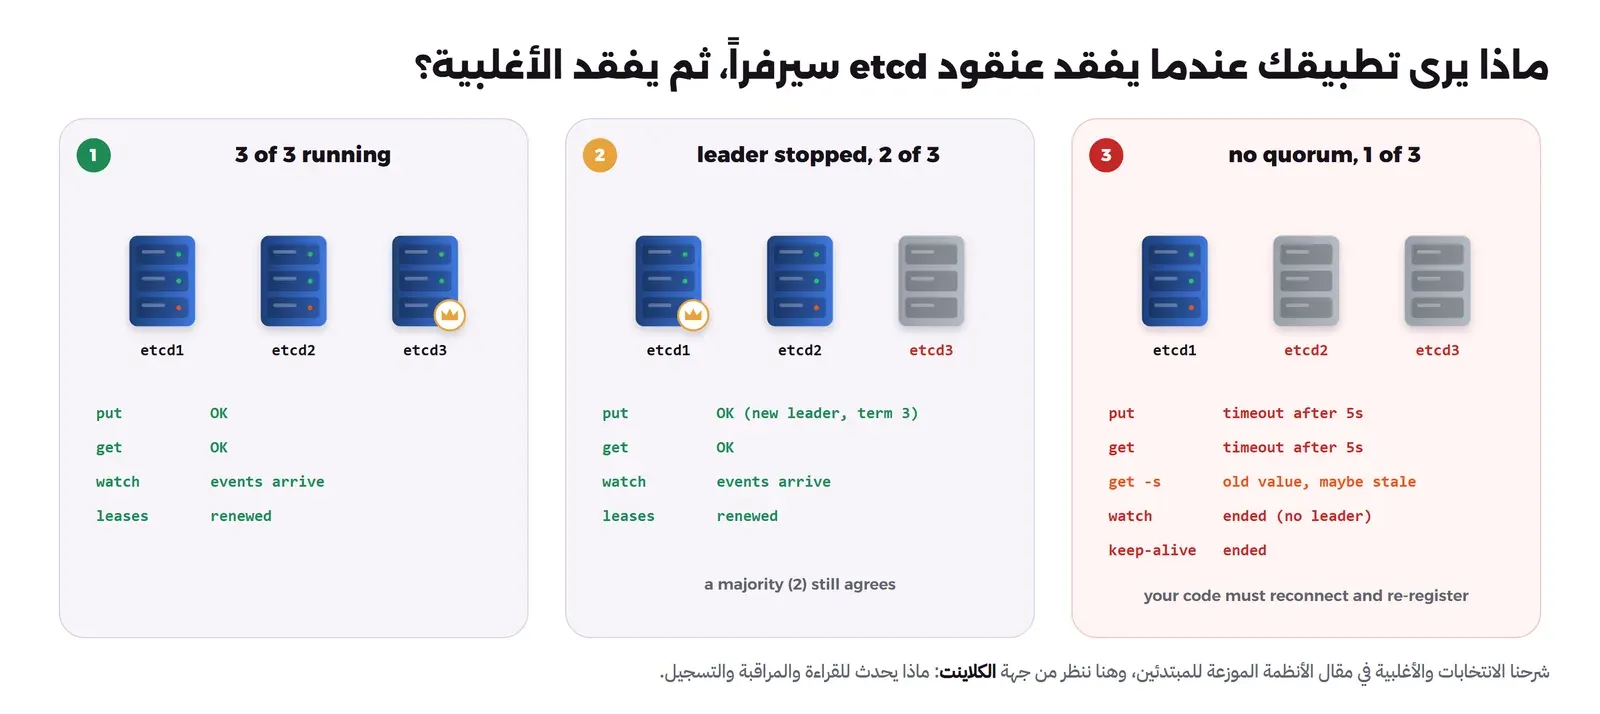
في المخرج أعلاه لاحظ التالي:
- الكتابة لم تفشل فوراً، وإنما انتظرت خمس ثوان حتى انتهت مهلتها، وهذا مهم في تطبيقك: إذا كانت الكتابة إلى السجل في طريق الطلب فكل طلب سوف ينتظر هذه الثواني، لذلك ضع لها مهلة قصيرة ولا تجعل الطلب يعتمد عليها.
- القراءة العادية فشلت هي أيضاً، والسبب أنها خطية Linearizable تحتاج تأكيد الأغلبية أنها أحدث قيمة، أما القراءة المتسلسلة
--consistency=sفنجحت من البيانات المحلية للسيرفر الباقي، ورجعت 1200، وهي هنا صحيحة لأن كتابة 900 فشلت، ولكنها في حالات أخرى قد تكون قديمة دون أن تعرف. - القائمة
/services/web/ما زالت فيها النسختان بالقراءة المتسلسلة، ولكن ليس لأن التسجيل يتجدد، بل لأن انتهاء المهلة نفسه قرار يحتاج قائداً. - أهم ما في المخرج هو قائمة العمليات: كل عمليات
etcdctlفي الخلفية، أي المراقبان وعمليتا التجديد، أصبحت[etcdctl]أي انتهت. والسبب في كود etcd نفسه: الأمرwatchيفتح المراقبة معWithRequireLeaderكما في watch_command.go، فإذا لم يجد السيرفر قائداً ألغى المراقبة، وتعليق الدالةKeepAliveفي lease.go يذكر أن حلقة التجديد تتوقف عند خطأ مثلetcdserver: no leaderوتغلق القناة.
والنتيجة العملية التي يجب أن تبني عليها كودك: المراقبة والتجديد ليسا اتصالاً يبقى للأبد، فعندما ينتهي أي منهما يجب على التطبيق أن يعيد المحاولة بتأخير متزايد، وأن يستأنف المراقبة من آخر مراجعة رآها، وأن يسجل نفسه من جديد بمهلة جديدة، وإلا بقيت النسخة تعمل وهي غير موجودة في السجل بعد عودة العنقود.
الخطوة 5: عودة العنقود
docker start lab-sd-etcd2
$X sh -c 'ETCDCTL_ENDPOINTS=etcd1:2379,etcd2:2379; for l in $(etcdctl lease list | tail -n +2); do etcdctl lease timetolive $l --keys; done'
sleep 12; $X sh -c 'ETCDCTL_ENDPOINTS=etcd1:2379,etcd2:2379 etcdctl get /services/web/ --prefix --keys-only'
docker start lab-sd-etcd3
$X etcdctl endpoint health
$X etcdctl get /config/shop/ --prefix
والمخرج سوف يكون كما يلي:
lease 0ad1a1245c02440a granted with TTL(10s), remaining(7s), attached keys([/services/web/web-1])
lease 188ea1245bf5e306 granted with TTL(10s), remaining(7s), attached keys([/services/web/web-2])
etcd1:2379 is healthy: successfully committed proposal: took = 8.301917ms
etcd3:2379 is healthy: successfully committed proposal: took = 8.403623ms
etcd2:2379 is healthy: successfully committed proposal: took = 8.761146ms
/config/shop/feature_new_checkout
off
/config/shop/payment_timeout_ms
1200
عندما عاد القائد بدأ عد المهلتين من جديد، ولأن عمليتي التجديد انتهتا في الخطوة السابقة فلم يجددهما أحد، وبعد اثنتي عشرة ثانية كانت قائمة /services/web/ فارغة تماماً، رغم أن خادمي Nginx يعملان طوال الوقت. وهذا بالضبط ما شرحناه: إذا لم يكن في كود التسجيل حلقة تعيد التسجيل بعد الانقطاع، فإن عودة العنقود تمسح كل خدماتك من السجل. وقيمة الإعداد بقيت 1200، أي أن الكتابة التي فشلت أثناء الانقطاع لم تحفظ جزئياً.
الخطوة 6: Consul يجيب عبر ال DNS ويخرج النسخة المعطلة
الآن نسأل وكيل Consul عن الخدمة web عبر ال DNS على المنفذ 8600، وعبر ال HTTP API للفحوص، ثم نوقف web2 ونسأل مرة أخرى:
$X dig +noall +answer @lab-sd-consul -p 8600 web.service.consul SRV
$X sh -c 'curl -s "http://lab-sd-consul:8500/v1/health/service/web?passing" | jq -r ".[] | \"\(.Service.ID) \(.Service.Address):\(.Service.Port) \(.Checks[] | select(.CheckID != \"serfHealth\") | .Status)\""'
docker stop lab-sd-web2; sleep 6
$X dig +noall +answer @lab-sd-consul -p 8600 web.service.consul SRV
$X sh -c 'curl -s "http://lab-sd-consul:8500/v1/health/checks/web" | jq -r ".[] | \"\(.ServiceID) \(.Status)\""'
docker start lab-sd-web2; sleep 5
$X dig +noall +answer @lab-sd-consul -p 8600 web.service.consul SRV
والمخرج سوف يكون كما يلي:
web.service.consul.	0	IN	SRV	1 1 80 lab-sd-web1.
web.service.consul.	0	IN	SRV	1 1 80 lab-sd-web2.
web-1 lab-sd-web1:80 passing
web-2 lab-sd-web2:80 passing
web.service.consul.	0	IN	SRV	1 1 80 lab-sd-web1.
web-1 passing
web-2 critical
web.service.consul.	0	IN	SRV	1 1 80 lab-sd-web2.
web.service.consul.	0	IN	SRV	1 1 80 lab-sd-web1.
في المخرج أعلاه لاحظ التالي:
- كل سطر SRV فيه الأولوية Priority ثم الوزن Weight ثم المنفذ 80 ثم اسم السيرفر، والرقم 0 بعد الاسم هو ال TTL، أي لا تحفظ الإجابة.
- بعد إيقاف
web2بست ثوان صار فحصهاcriticalبرسالةconnection refused، واختفت من إجابة DNS دون أن نغير أي ملف، وعادت بعد تشغيلها خلال خمس ثوان، وهذا هو التسجيل عبر طرف ثالث مع فحص الصحة كما في توثيق الفحوص في Consul. - الفرق مع etcd واضح هنا: في etcd كان علينا أن نكتب سكربت التسجيل والتجديد بأنفسنا، وكان غياب التجديد هو الفحص الوحيد، أما Consul فيعطيك الفحص والكتالوج وال DNS جاهزة، وهذا هو الفرق الذي يجب أن تزنه مع الترخيص.
حذف التجربة
docker compose -p lab-sd down -v
docker image rm lab-sd-client:1
أخطاء شائعة
- عناوين الخدمات ثابتة في ملفات الإعداد أو متغيرات البيئة في نظام فيه توسع تلقائي وإعادة نشر.
- تسجيل ذاتي يكتب العنوان مرة واحدة عند التشغيل، دون مهلة ولا تجديد ولا حذف عند الإيقاف، فيبقى السجل مليئاً بنسخ ميتة.
- كود تسجيل أو مراقبة لا يعيد المحاولة بعد الانقطاع، فتختفي الخدمات من السجل أو تتوقف عن استلام الإعدادات بعد أول عطل في العنقود، كما رأينا في الخطوة الخامسة.
- مراقبة لا تحفظ آخر مراجعة، فتضيع التغييرات التي حدثت أثناء الانقطاع.
- فحص صحة يختبر أن العملية حية فقط، أو فحص يسقط كل النسخ معاً بسبب خدمة مشتركة متعطلة.
- الاعتماد على DNS مع مكتبة تحفظ الإجابة أطول من ال TTL أو تحل الاسم مرة واحدة عند التشغيل.
- عنقود من سيرفرين أو أربعة، فيضيع التحمل الذي تتوقعه، أو عنقود ثلاثي كل سيرفراته على جهاز واحد أو في غرفة واحدة.
- تخزين الملفات والبيانات الكبيرة أو الأسرار كنص عادي في etcd أو KV في Consul.
- استخدام etcd الخاص بعنقود Kubernetes لبيانات تطبيقك.
- تشغيل Consul بالخيار
-devخارج التجارب.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- في نظام تتغير نسخه باستمرار لا تكفي العناوين الثابتة، وتحتاج سجلاً يعرف في كل لحظة النسخ الحية، ويتحدث وحده.
- النسخة تدخل السجل بتسجيل ذاتي أو عبر طرف ثالث، وتخرج منه إما بفحص صحة يفشل وإما بمهلة Lease لا تتجدد.
- الاكتشاف من جهة الكلاينت يوفر قفزة ويكرر المنطق في كل خدمة، ومن جهة السيرفر يبسط التطبيق ويضيف موزع حمل يجب أن يكون متوفراً، وKubernetes يعطيك الثاني جاهزاً.
- الاكتشاف عبر DNS وسجلات SRV يعمل من أي لغة، بشرط أن يحترم الكلاينت ال TTL.
- الإعدادات التي تتغير أثناء التشغيل مكانها مخزن KV مع مراقبة تستأنف من آخر مراجعة، وليس إعادة نشر كل النسخ.
- السجل مبني على الإجماع، فعند ضياع الأغلبية تتوقف الكتابة والقراءة الخطية وتنتهي المراقبة والتجديد، وكودك يجب أن يعيد الاتصال ويعيد التسجيل.
- etcd مخزن صغير متين بترخيص Apache-2.0 تبني عليه، وConsul منصة اكتشاف كاملة بترخيص BUSL 1.1 منذ الإصدار 1.17.0.
وفي مقالات هذا القسم نكمل ما يحدث بين الخدمات بعد أن تجد بعضها، من المهلات وإعادة المحاولة إلى تتبع الطلب عبر عدة خدمات:
 دليلكيف تمنع خدمة بطيئة من إسقاط نظامك كله؟لماذا تسقط خدمة بطيئة واحدة تطبيقك السليم، وكيف تحميه بالمهلة وإعادة المحاولة المحدودة وقاطع الدائرة ورفض الزائد.
 دليلالتتبع الموزع Distributed Tracing مع OpenTelemetryكيف ترى طلباً واحداً يمر بعدة خدمات في شجرة زمنية واحدة، فتعرف أين أبطأ وأين فشل دون أن تخمن من السجلات.
 دليلMonolith أم Microservices؟ قرار صادق للفرق الصغيرة والكبيرةمتى يكفيك برنامج واحد مقسم إلى وحدات، ومتى تستحق الخدمات المصغرة ثمنها، مع حالات موثقة وتجربة تقيس الفرق.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع etcd 3.7.2 وConsul 2.0.4 وNginx 1.29.8.