

عندما تقرأ أول مرة عن Kubernetes تقابل في الصفحة الأولى عشرين كلمة جديدة: Pod وNode وDeployment وReplicaSet وService وIngress وNamespace، وكل شرح يفترض أنك تعرف الكلمات الأخرى، فتدور في دائرة. وفي هل تحتاج Kubernetes فعلاً؟ ناقشنا متى يستحق Kubernetes تكلفته، أما هذا المقال فيشرح المصطلحات نفسها بالترتيب الذي يبني بعضها على بعض، ولكل مفهوم رسم يوضحه قبل الكلام، ومعه ملف YAML حقيقي ومقارنة بما تعرفه من Docker Compose.
وهذا المقال من مرحلة Kubernetes وGitOps في خريطة الطريق، والمقالات العملية مثل تثبيت K3s وHelm والتخزين مع Longhorn مذكورة هناك، وسوف نتناول في هذا المقال ما يلي:
- العنقود Cluster والعقد Nodes وأجزاء التحكم Control Plane، وماذا يحدث عندما تنفذ
kubectl apply. - ال Pod وال ReplicaSet وال Deployment، وال Labels وال Selectors التي تربطها ببعض.
- ال Service بأنواعه، وIngress أم Gateway API لدخول الطلبات من الإنترنت.
- ConfigMap وSecret وNamespace.
- التخزين الدائم PersistentVolume وPersistentVolumeClaim، ثم StatefulSet وDaemonSet وJob وCronJob.
- الأوامر المباشرة Imperative أم ملفات YAML مع
kubectl apply، وجدول يلخص كل المصطلحات.
كيف ولدنا ملفات YAML في هذا المقال
لم نشغل عنقوداً حقيقياً في هذا المقال، والسبب أن المساحة على جهاز التجربة لم تسمح بتنزيل Docker Images جديدة ل K3s أو kind، لذلك اعتمدنا على مصدرين: الأول أداة kubectl نفسها، فأغلب أوامر الإنشاء فيها تقبل الخيار --dry-run=client -o yaml فتطبع ملف YAML الذي كانت سوف ترسله دون أن تتصل بأي سيرفر، وهذه طريقة مفيدة لك أيضاً لتبدأ ملفاتك منها، والثاني ملفات كتبناها بأيدينا على أمثلة توثيق Kubernetes وتحققنا أنها YAML صحيح بمكتبة PyYAML. والنسخة التي استخدمناها:
kubectl version --clientوالمخرج سوف يكون كما يلي:
Client Version: v1.36.1
Kustomize Version: v5.8.1
العنقود Cluster والعقد Nodes
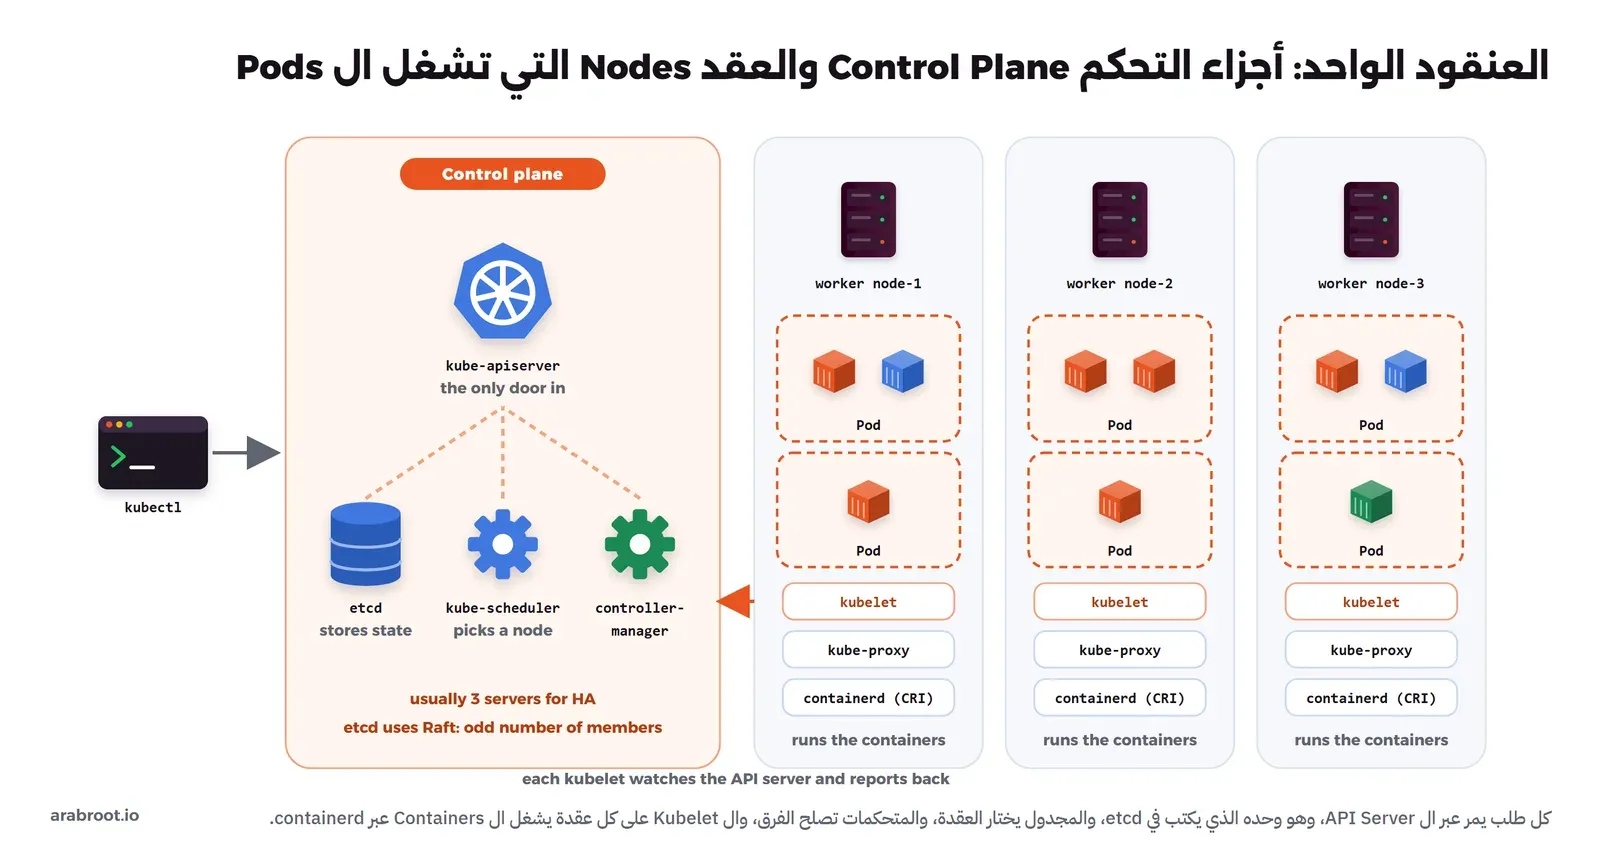
العنقود Cluster هو مجموعة سيرفرات يديرها Kubernetes كأنها جهاز واحد كبير، وكل سيرفر فيها يسمى عقدة Node، سواء كان سيرفراً حقيقياً أو VPS أو جهازاً افتراضياً. والعقد نوعان: عقد التحكم التي تشغل أجزاء التحكم Control Plane وتقرر ما يحدث، والعقد العاملة Worker Nodes التي تشغل تطبيقاتك، وفي العناقيد الصغيرة مثل K3s على سيرفر واحد يقوم السيرفر نفسه بالدورين. والصورة التالية تبين الأجزاء كلها:
ما الذي يعمل على كل عقدة؟
بحسب صفحة مكونات Kubernetes يعمل على كل عقدة ثلاثة أشياء:
- ال Kubelet: الوكيل الذي يتأكد أن ال Pods المطلوبة على هذه العقدة تعمل بال Containers التي فيها، فهو يسأل ال API Server عما يجب أن يعمل هنا، ويشغله، ويرسل الحالة.
- kube-proxy: يضبط قواعد الشبكة على العقدة حتى يصل الطلب الموجه إلى Service إلى أحد ال Pods خلفه، ويصفه التوثيق بأنه اختياري لأن بعض إضافات الشبكة تقوم بعمله بنفسها.
- بيئة تشغيل ال Containers Container Runtime: البرنامج الذي يشغل ال Containers فعلاً، مثل containerd أو CRI-O، ويتحدث معه ال Kubelet عبر واجهة CRI. ولاحظ أن Kubernetes لم يعد يتحدث مع Docker Engine مباشرة منذ أزيل ال dockershim في النسخة 1.24 كما في أسئلة dockershim الشائعة، لكن أي Docker Image تبنيها ب Docker تعمل عليه لأنها بالصيغة القياسية نفسها.
أجزاء التحكم Control Plane
أجزاء التحكم هي العقل الذي يحفظ ما طلبته ويحاول أن يجعل العنقود يطابقه، وهي أربعة أجزاء أساسية بحسب الصفحة نفسها:
- ال API Server واسمه kube-apiserver: الباب الوحيد إلى العنقود، فكل أمر من kubectl وكل متحكم وكل Kubelet يتحدث معه وحده، وهو الذي يتحقق من الطلب وصلاحيته ثم يحفظه، ولذلك فسجل التدقيق الذي شرحناه في سجل تدقيق Kubernetes API يكتبه هو.
- etcd: قاعدة بيانات مفتاح وقيمة Key-Value يحفظ فيها ال API Server حالة العنقود كلها، وتعمل بالإجماع عبر خوارزمية Raft التي شرحناها خطوة خطوة في الأنظمة الموزعة، وتراها تعمل في تجربة عنقود etcd من ثلاثة سيرفرات، ولذلك يكون عدد أعضائها فردياً، وإذا فقدت etcd ونسختها الاحتياطية فقدت العنقود.
- المجدول kube-scheduler: يبحث عن كل Pod لم تحدد له عقدة ويختار له عقدة مناسبة بحسب الموارد التي يطلبها والقيود التي تكتبها.
- مدير المتحكمات kube-controller-manager: يشغل المتحكمات Controllers، وكل متحكم حلقة تراقب نوعاً من الكائنات وتصلح الفرق بين الحالة المطلوبة والحالة الحالية، فمتحكم ال Deployment ينشئ ReplicaSets، ومتحكم ال ReplicaSet ينشئ Pods، ومتحكم العقد يلاحظ العقدة التي توقفت.
ويوجد جزء خامس اختياري هو cloud-controller-manager، وهو الذي يربط العنقود بمزود السحابة، فينشئ مثلاً موزع حمل حقيقياً عندما تطلب Service من نوع LoadBalancer. والصورة التالية تبين كيف تعمل هذه الأجزاء معاً عندما ترسل ملفاً:
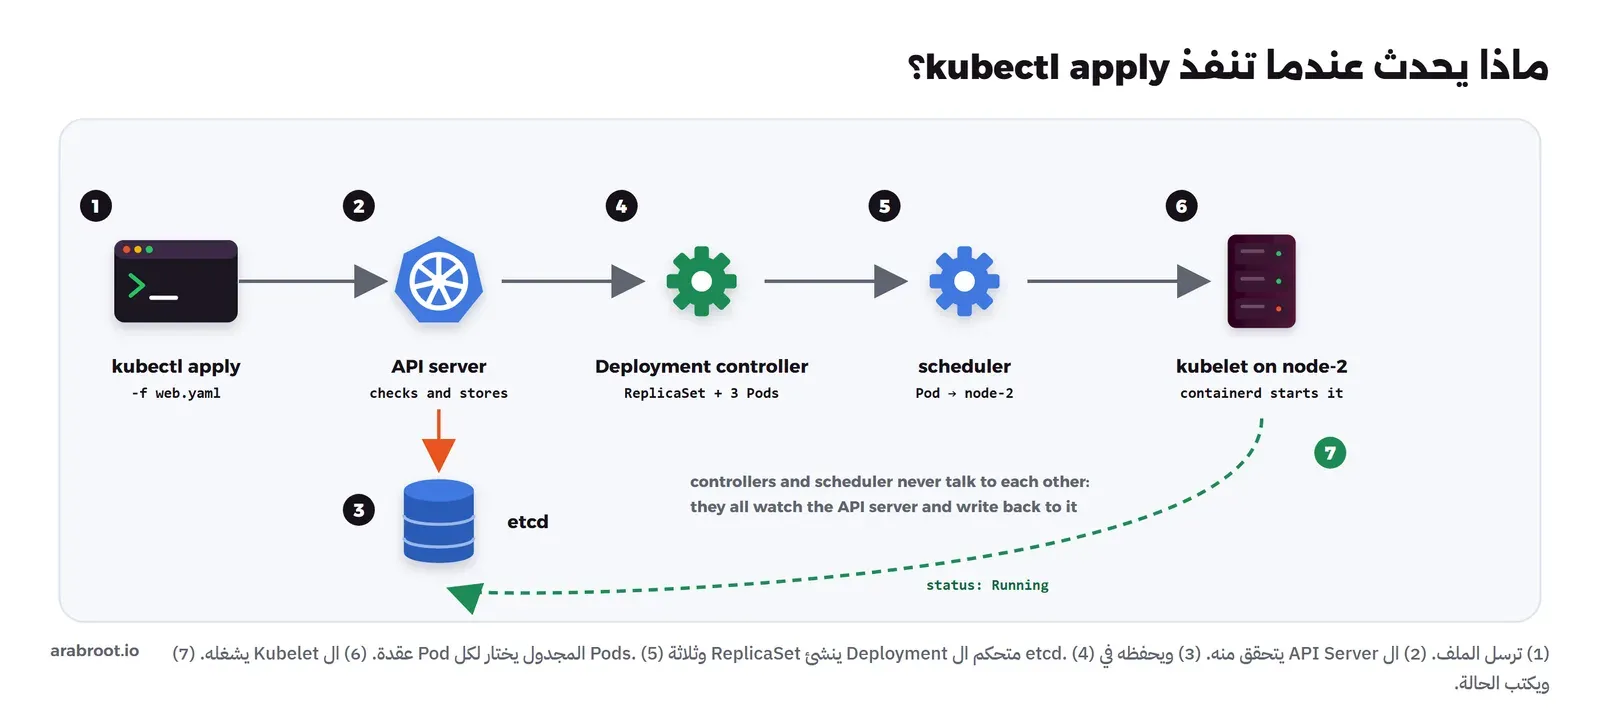
في الصورة أعلاه لاحظ التالي:
- kubectl لا يشغل شيئاً بنفسه، فهو يرسل ما تريده إلى ال API Server ثم ينتهي عمله، ولذلك ينجح الأمر قبل أن يعمل التطبيق فعلاً، وتحتاج
kubectl get podsأوkubectl rollout statusلتعرف النتيجة. - إذا توقفت أجزاء التحكم كلها تبقى ال Containers التي تعمل الآن تعمل، لأن ال Kubelet على كل عقدة يشغلها، لكن لا يوجد من يصلح أو يجدول أو يقبل ملفاً جديداً حتى تعود.
ال Pod: أصغر شيء تشغله
ال Pod هو أصغر وحدة تنشئها وتديرها في Kubernetes، وهو بحسب توثيق ال Pods مجموعة من Container واحد أو أكثر يشتركون في التخزين والشبكة ومعهم مواصفات تشغيلهم. وأغلب ال Pods فيها Container واحد، وأحياناً تضيف بجانبه Container مساعداً Sidecar يرسل السجلات أو يجدد شهادة، والصورة التالية تبين ما يشترك فيه:
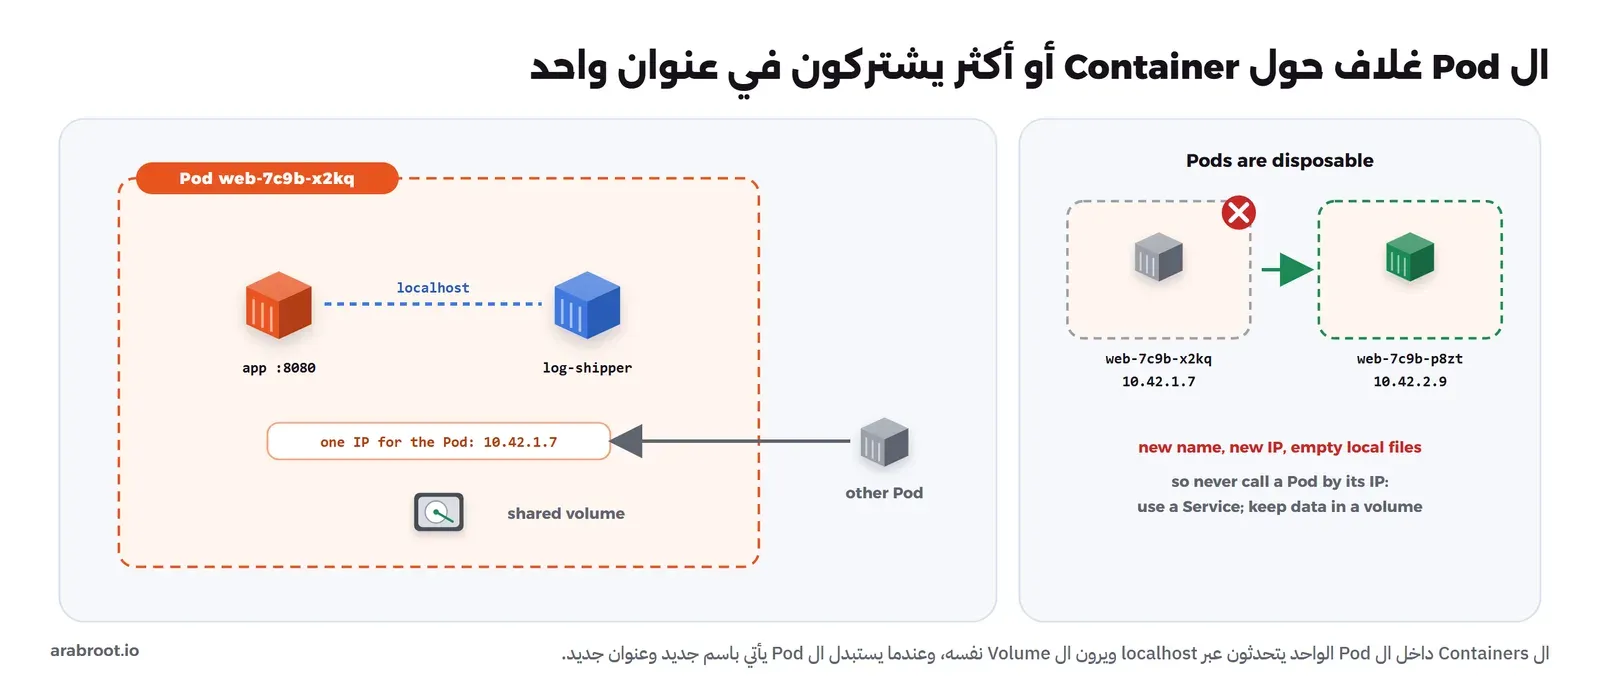
والملف التالي ينشئ Pod فيه Container واحد:
apiVersion: v1
kind: Pod
metadata:
  name: web
  labels:
    app: web
spec:
  containers:
  - name: app
    image: nginx:1.31-alpine
    ports:
    - containerPort: 80
في الإعداد أعلاه لاحظ التالي:
- كل كائن في Kubernetes له أربعة أجزاء:
apiVersionوkindلنوعه، وmetadataلاسمه وال Labels، وspecلما تريده منه، ويضيف Kubernetes جزءاً خامساً هوstatusيكتب فيه الحالة الحالية. - لا تنشئ Pods بهذا الشكل في الإنتاج Production، والسبب أن هذا ال Pod إذا حذف أو توقفت عقدته لا يعيده أحد، فهو يشبه
docker runدون--restart، والذي يعيده هو ال Deployment في القسم التالي. - عنوان ال Pod يتغير عند كل استبدال، فلا تكتب عنوانه في أي إعداد، واستخدم Service كما سيأتي.
ال ReplicaSet وال Deployment
ال ReplicaSet كائن وظيفته واحدة: أن يبقى عدد محدد من ال Pods المتطابقة يعمل دائماً، فإذا طلبت ثلاثة وحذف أحدها أنشأ بديلاً. وال Deployment فوقه، فهو يملك ReplicaSet لكل نسخة من إعداد التطبيق، وعندما تغير ال Docker Image ينشئ ReplicaSet جديداً ويكبره تدريجياً ويصغر القديم، كما في توثيق ال Deployment. والصورة التالية تبين التحديث من 1.4.1 إلى 1.4.2:
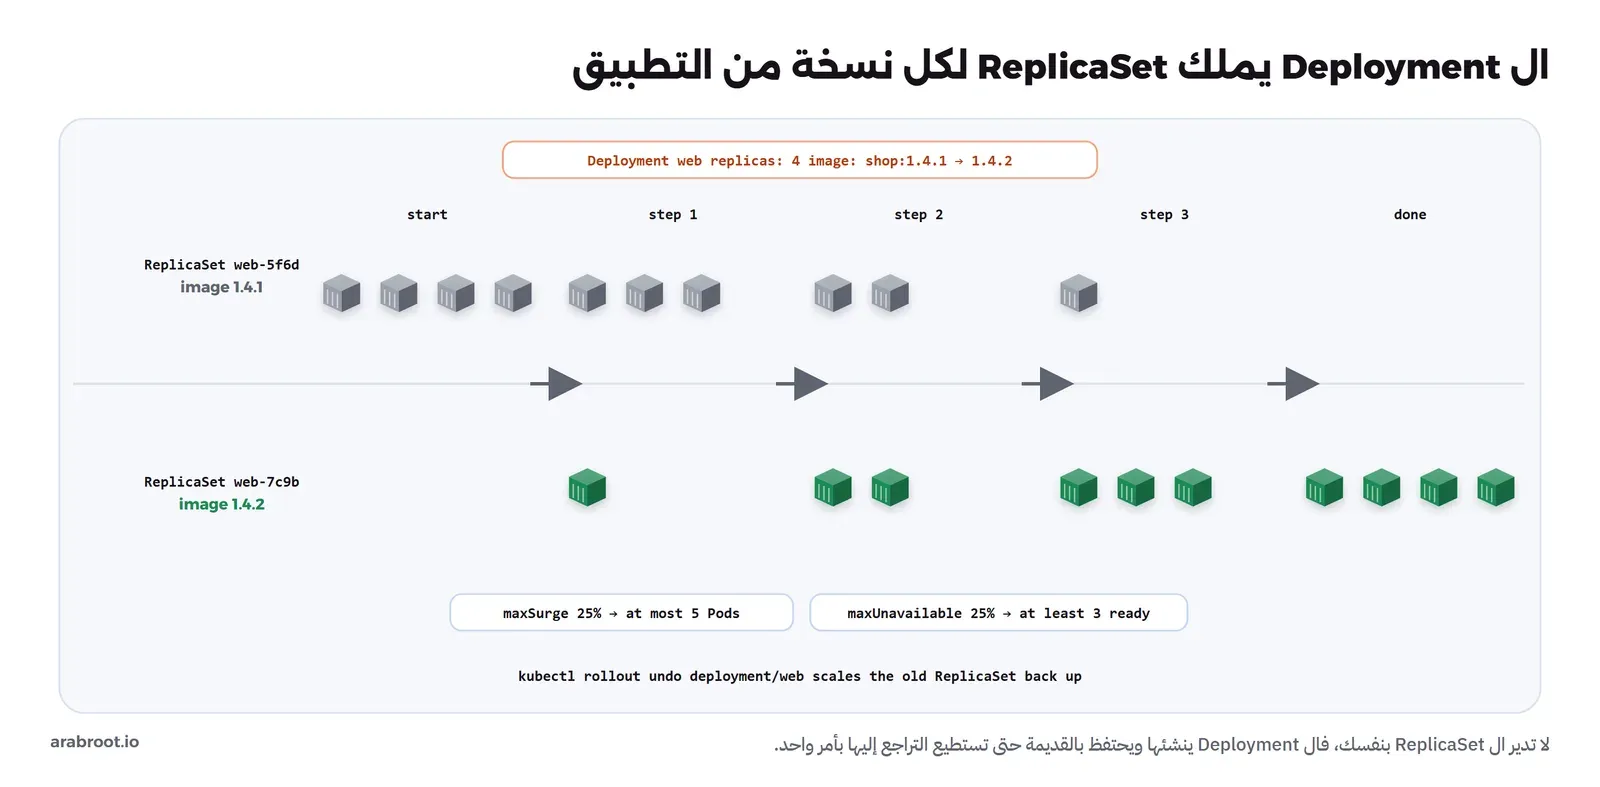
والأمر التالي يولد ملف Deployment بثلاث نسخ دون أن يتصل بأي عنقود:
kubectl create deployment web --image=nginx:1.31-alpine --replicas=3 --port=80 --dry-run=client -o yamlوالمخرج سوف يكون كما يلي:
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: web
  name: web
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  strategy: {}
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
      - image: nginx:1.31-alpine
        name: nginx
        ports:
        - containerPort: 80
        resources: {}
status: {}
في المخرج أعلاه لاحظ التالي:
- الجزء
templateهو قالب ال Pod نفسه الذي رأيته في القسم السابق، وال Deployment ينشئ منه ثلاث نسخ. - الجزء
selector.matchLabelsيقول إن ال Pods التي يملكها هذا ال Deployment هي التي تحملapp: web، ولذلك يجب أن يطابق ال Labels في القالب، وهذا ما نشرحه في القسم التالي. strategy: {}فارغة، فيستخدم Kubernetes الاستراتيجية الافتراضية RollingUpdate بقيمmaxSurgeوmaxUnavailableتساوي 25%، وresources: {}فارغة أيضاً، وفي الإنتاج أضف طلبات الموارد Requests وحدودها Limits حتى يعرف المجدول أين يضع ال Pod.- لا تعدل ال ReplicaSet الذي يملكه Deployment بيدك، فالتوثيق ينص على ذلك صراحة، والسبب أن ال Deployment سوف يعيده إلى ما في ملفه.
ال Labels وال Selectors
ال Labels أزواج من مفتاح وقيمة تلصقها على أي كائن، مثل app: web وenv: prod، وال Selector شرط يختار الكائنات التي تحمل Labels معينة، كما في توثيق ال Labels. وهذه هي الطريقة التي يجد بها كل جزء في Kubernetes ما يخصه، فال Deployment لا يعرف ال Pods بأسمائها، وال Service لا يعرف عناوينها، وإنما يبحث كل منهما عن ال Labels، والصورة التالية تبين ذلك:
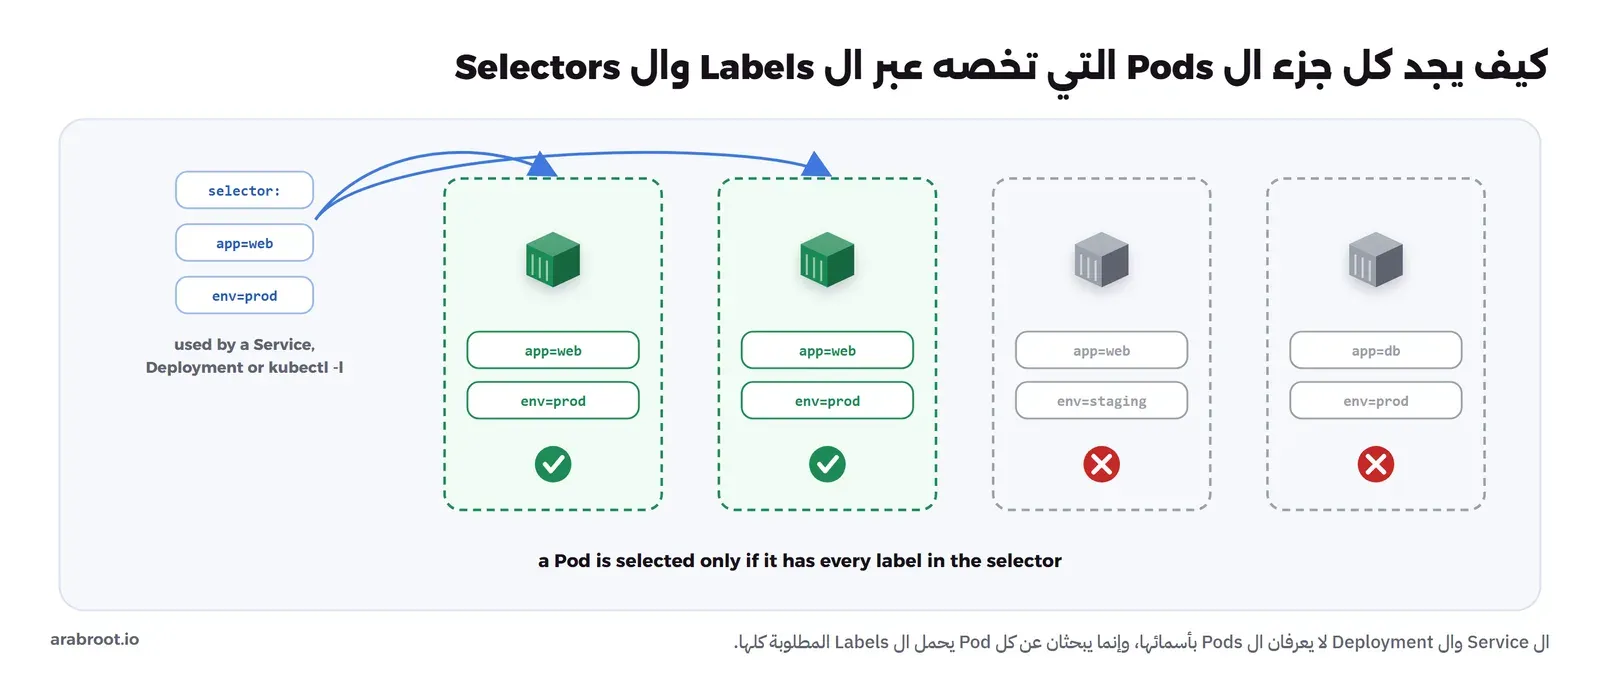
وتستخدمها أنت أيضاً من سطر الأوامر، فالأمر kubectl get pods -l app=web,env=prod يعرض ال Pods التي تحمل الاثنين معاً. ولاحظ أن خطأ صغيراً في ال Labels، مثل app: web في ال Service وapp: Web في ال Pods، يجعل ال Service لا يجد أحداً فيرد بخطأ دون أن يظهر أي شيء غريب في ال Pods نفسها، وهذا من أكثر الأخطاء شيوعاً عند البداية.
ال Service وأنواعه
ال Service يعطي مجموعة Pods يختارها ب Selector اسماً ثابتاً وعنواناً ثابتاً، ويوزع الطلبات على الجاهزة منها، وله في DNS داخل العنقود اسم بالشكل web.shop.svc.cluster.local كما في توثيق DNS. وهذا يشبه اسم الخدمة في Compose الذي شرحناه في شبكات Docker، والفرق أن ال Pods قد تكون على عقد مختلفة. وأنواعه الأربعة في توثيق ال Service تحدد من أين يأتي الطلب، والصورة التالية تبينها:
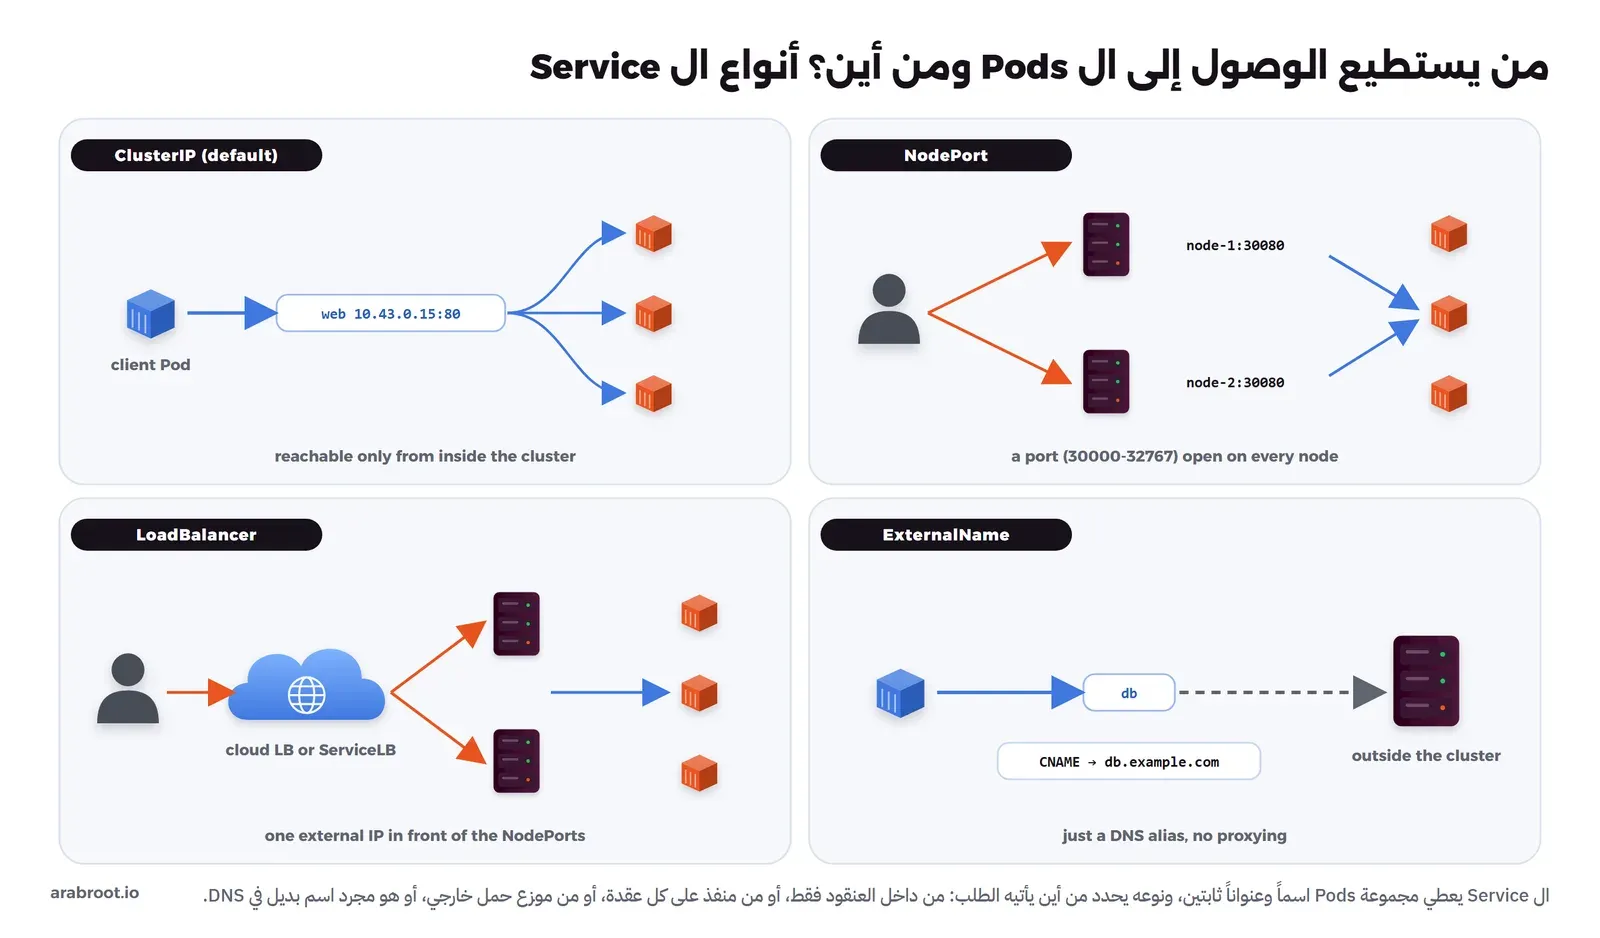
- ClusterIP: النوع الافتراضي، عنوان داخلي لا يصل إليه أحد من خارج العنقود، وهو المناسب لقاعدة البيانات وللخدمات الداخلية، ويشبه خدمة في Compose لم تنشر منفذها.
- NodePort: يفتح منفذاً من النطاق الافتراضي 30000 إلى 32767 على كل عقدة، ويشبه
ports:في Compose، ولا ينصح به للإنترنت مباشرة لأنه يفتح المنفذ على كل العقد. - LoadBalancer: يطلب من مزود السحابة موزع حمل بعنوان خارجي أمام ال NodePorts، وفي K3s يقوم بهذا ServiceLB على السيرفر نفسه.
- ExternalName: لا يوجه أي حركة، وإنما يعيد اسماً بديلاً CNAME لخدمة خارج العنقود.
ويوجد شكل خاص اسمه Headless Service تكتب فيه clusterIP: None، فلا يأخذ عنواناً واحداً، وإنما يعيد DNS عناوين ال Pods نفسها، وهو الذي يحتاجه ال StatefulSet كما سيأتي. والأمر التالي يولد Service من نوع NodePort:
kubectl create service nodeport web --tcp=80:80 --node-port=30080 --dry-run=client -o yamlوالمخرج سوف يكون كما يلي:
apiVersion: v1
kind: Service
metadata:
  labels:
    app: web
  name: web
spec:
  ports:
  - name: 80-80
    nodePort: 30080
    port: 80
    protocol: TCP
    targetPort: 80
  selector:
    app: web
  type: NodePort
status:
  loadBalancer: {}
في المخرج أعلاه لاحظ التالي:
selector: app: webهو الذي يربط ال Service بال Pods التي أنشأها ال Deployment في القسم السابق، فلا يوجد أي ذكر لأسماء ال Pods.portهو منفذ ال Service نفسه، وtargetPortمنفذ ال Container، وnodePortالمنفذ المفتوح على كل عقدة، وثلاثتها قد تكون مختلفة.
Ingress أم Gateway API؟
ال Service من نوع LoadBalancer يعطي كل خدمة عنواناً خارجياً، وهذا مكلف وغير عملي مع عشر خدمات تحت نطاق واحد، ولذلك يوجد مستوى أعلى يعمل كال Reverse Proxy الذي تعرفه: يستقبل كل الطلبات على المنفذين 80 و443 ويوجهها بحسب النطاق والمسار إلى ال Service المناسب. وفي Kubernetes طريقتان لذلك، والصورة التالية تضعهما بجانب بعضهما:
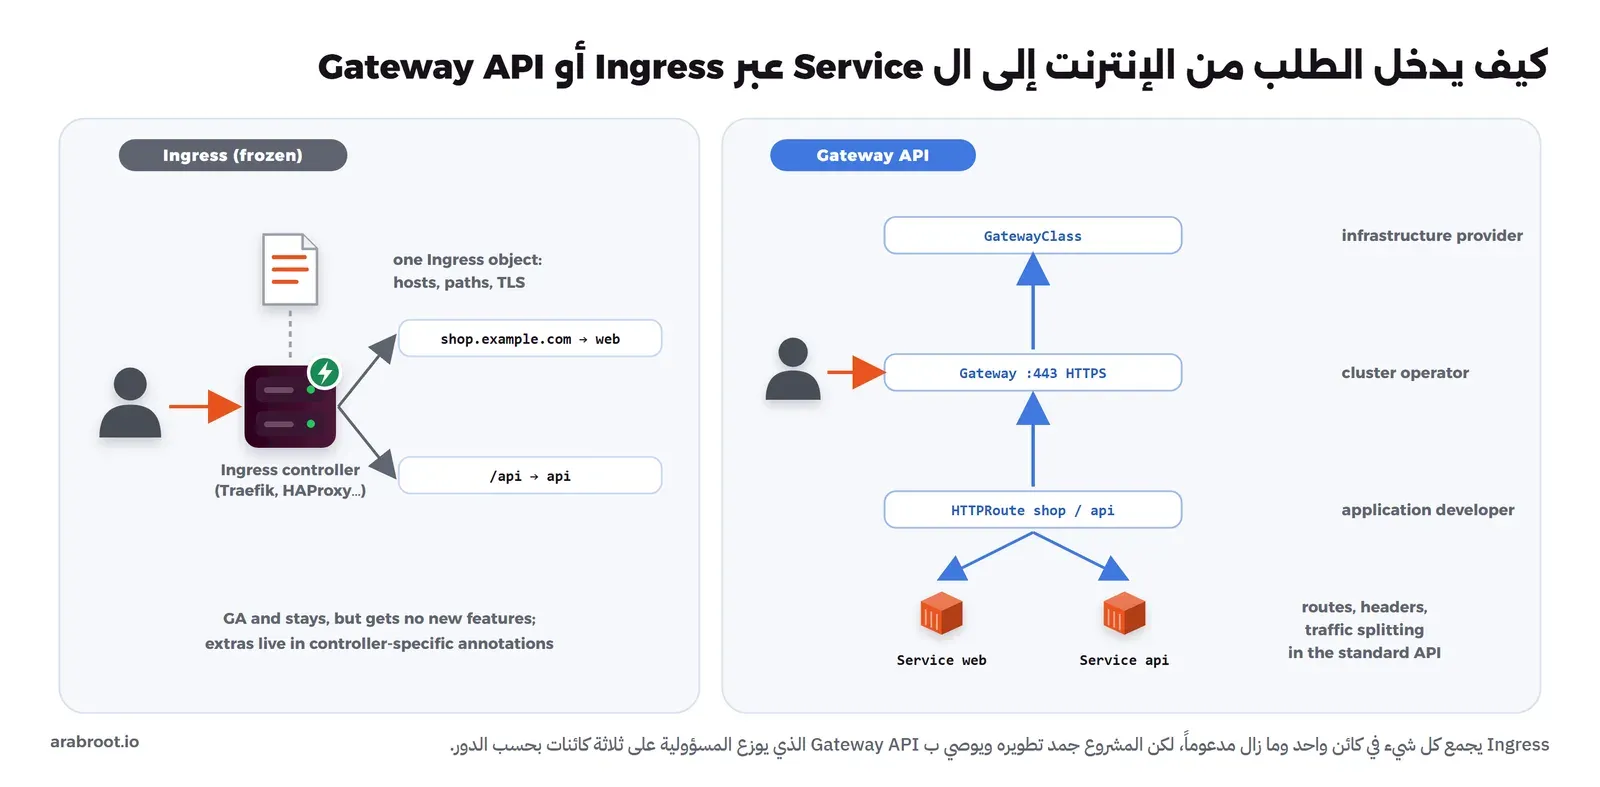
الطريقة الأولى Ingress، وهي كائن واحد تكتب فيه النطاقات والمسارات والشهادات، ويقرؤه متحكم Ingress Controller تثبته أنت مثل Traefik الذي يأتي مع K3s. وتقول صفحة Ingress في التوثيق إن واجهتها مجمدة ولن تتغير، وإن المشروع يوصي ب Gateway API بدلاً منها، مع بقائها مدعومة دون نية لحذفها. وأشهر متحكم لها Ingress NGINX توقف تطويره بعد مارس 2026، فإذا بدأت اليوم فلا تختره. والأمر التالي يولد Ingress:
kubectl create ingress web --class=traefik --rule="app.example.com/*=web:80" --dry-run=client -o yamlوالمخرج سوف يكون كما يلي:
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: web
spec:
  ingressClassName: traefik
  rules:
  - host: app.example.com
    http:
      paths:
      - backend:
          service:
            name: web
            port:
              number: 80
        path: /
        pathType: Prefix
status:
  loadBalancer: {}
والطريقة الثانية Gateway API، وهي بحسب صفحة Gateway API إضافة تثبت كتعريفات CRD، وفيها أربعة أنواع مستقرة: GatewayClass وGateway وHTTPRoute وGRPCRoute، وفكرتها أن المسؤولية موزعة على ثلاثة أدوار: مزود البنية يعرف GatewayClass، ومشغل العنقود ينشئ Gateway بالمنافذ والشهادات، ومطور التطبيق يكتب HTTPRoute لتطبيقه في Namespace الخاص به، وآخر إصدار من مشروع Gateway API عند كتابة المقال هو v1.6.3. والملف التالي يكتب الدخول نفسه بطريقة Gateway API:
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: public
  namespace: infra
spec:
  gatewayClassName: traefik
  listeners:
  - name: https
    protocol: HTTPS
    port: 443
    hostname: "*.example.com"
    tls:
      certificateRefs:
      - name: wildcard-example-com
    allowedRoutes:
      namespaces:
        from: All
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: web
  namespace: shop
spec:
  parentRefs:
  - name: public
    namespace: infra
  hostnames:
  - shop.example.com
  rules:
  - matches:
    - path:
        type: PathPrefix
        value: /
    backendRefs:
    - name: web
      port: 80
في الإعداد أعلاه لاحظ التالي:
- ال Gateway في Namespace اسمه
infraيملكه مشغل العنقود، وفيه الشهادة، وال HTTPRoute في Namespace التطبيقshop، فيستطيع المطور أن يغير مساراته دون أن يلمس الشهادة. allowedRoutes.namespaces.from: Allيسمح لل Routes من كل ال Namespaces بأن ترتبط بهذا ال Gateway، وفي عنقود مشترك بين فرق قيده ب Selector.- اسم
gatewayClassNameيحدده المتحكم الذي ثبته، فراجع توثيقه قبل أن تنسخ هذا الملف.
ConfigMap وSecret
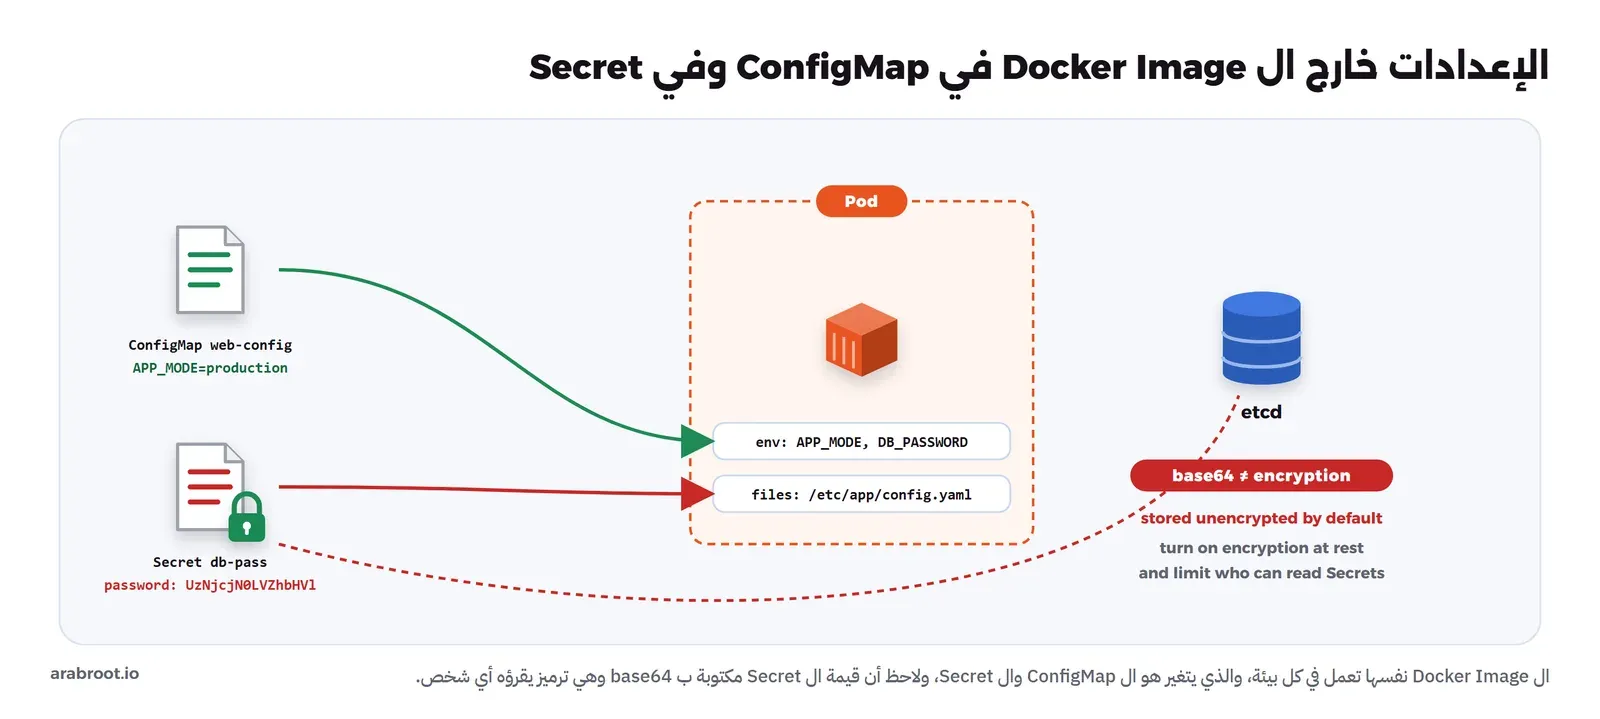
في البيئات ومعاينة الميزات ذكرنا أن الكود لا يختلف بين البيئات والإعداد هو الذي يختلف، وفي Kubernetes يوضع هذا الإعداد في كائنين: ConfigMap للقيم العادية، وهو بحسب توثيق ال ConfigMap كائن يحفظ بيانات غير سرية بشكل مفتاح وقيمة ولا يتجاوز حجمه 1 ميغابايت، وSecret للباسوردات والمفاتيح. والاثنان يصلان إلى ال Pod كمتغيرات بيئة Environment Variables أو كملفات داخل ال Container، والصورة التالية تبين ذلك:
والأمران التاليان يولدان ConfigMap وSecret:
kubectl create configmap web-config --from-literal=APP_MODE=production --from-literal=LOG_LEVEL=info --dry-run=client -o yaml
kubectl create secret generic db-pass --from-literal=password=S3cr3t-Value --dry-run=client -o yaml
والمخرج سوف يكون كما يلي:
apiVersion: v1
data:
  APP_MODE: production
  LOG_LEVEL: info
kind: ConfigMap
metadata:
  name: web-config
---
apiVersion: v1
data:
  password: UzNjcjN0LVZhbHVl
kind: Secret
metadata:
  name: db-pass
لاحظ أن قيمة الباسورد في ال Secret ليست مشفرة، وإنما مكتوبة بترميز base64، والأمر التالي يعيدها كما هي:
echo 'UzNjcjN0LVZhbHVl' | base64 -dوالمخرج سوف يكون كما يلي:
S3cr3t-Valueال Namespace
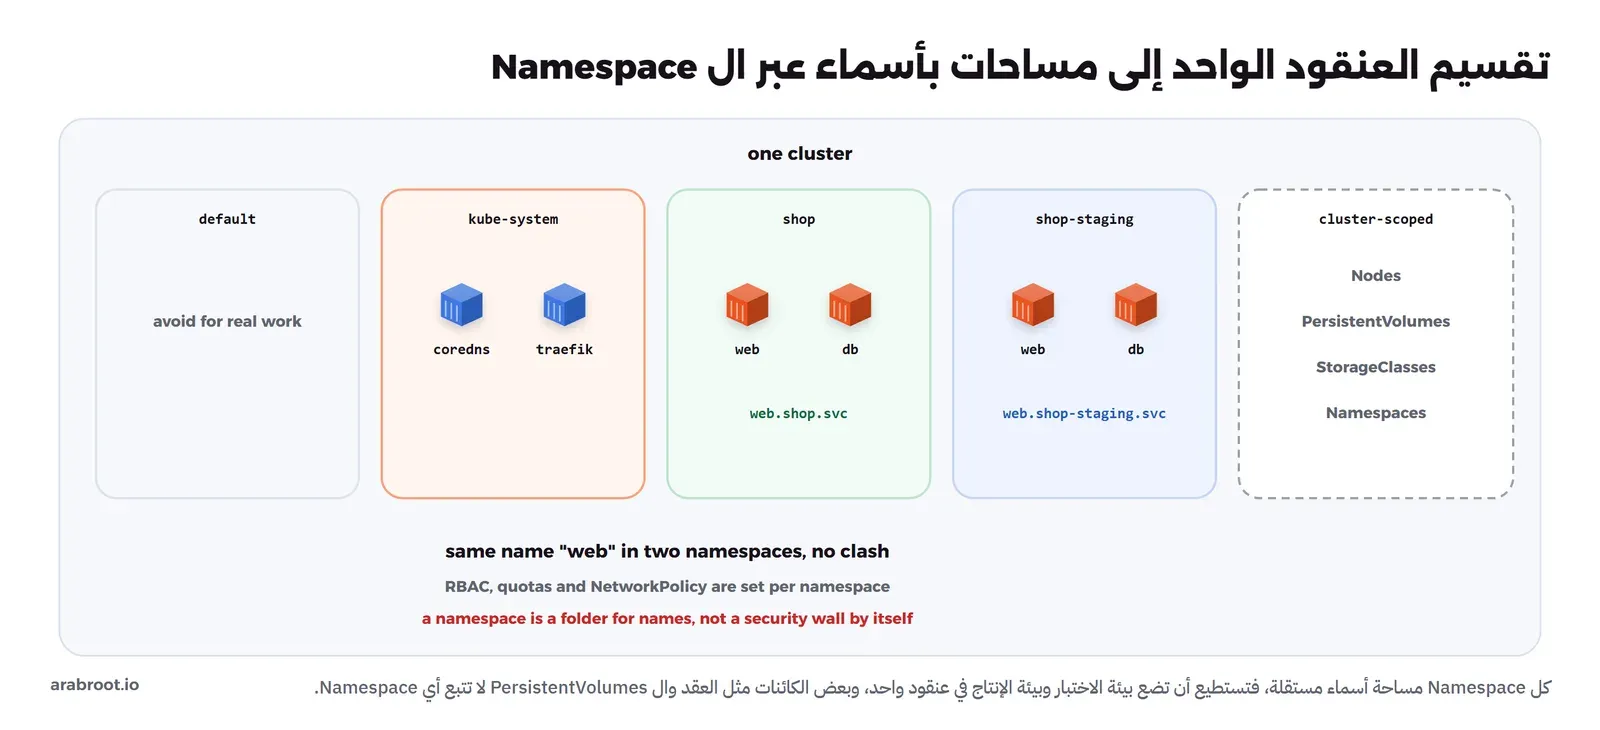
ال Namespace مساحة أسماء داخل العنقود، فتستطيع أن تنشئ Deployment اسمه web في shop وآخر بالاسم نفسه في shop-staging دون تعارض، وتضبط الصلاحيات وحدود الموارد لكل واحدة على حدة. ويبدأ كل عنقود بأربع مساحات بحسب توثيق ال Namespaces: default التي يوصي التوثيق بألا تستخدمها في عنقود الإنتاج، وkube-system لكائنات النظام، وkube-public المقروءة للجميع، وkube-node-lease التي تحفظ نبض العقد حتى يعرف العنقود أن عقدة توقفت. والصورة التالية تبين التقسيم:
والأمر التالي يولد Namespace:
kubectl create namespace shop --dry-run=client -o yamlوالمخرج سوف يكون كما يلي:
apiVersion: v1
kind: Namespace
metadata:
  name: shop
spec: {}
status: {}
وقد يتساءل البعض: هل يكفي أن أضع كل فريق في Namespace لأعزله عن الآخرين؟ والإجابة لا، فال Pods في مساحات مختلفة تستطيع أن تتصل ببعضها بشكل افتراضي، والعزل الحقيقي يحتاج صلاحيات RBAC لكل مساحة وسياسات شبكة NetworkPolicy تمنع الاتصال، وهذا موضوع مقال قادم في المرحلة.
التخزين الدائم PersistentVolume وPersistentVolumeClaim
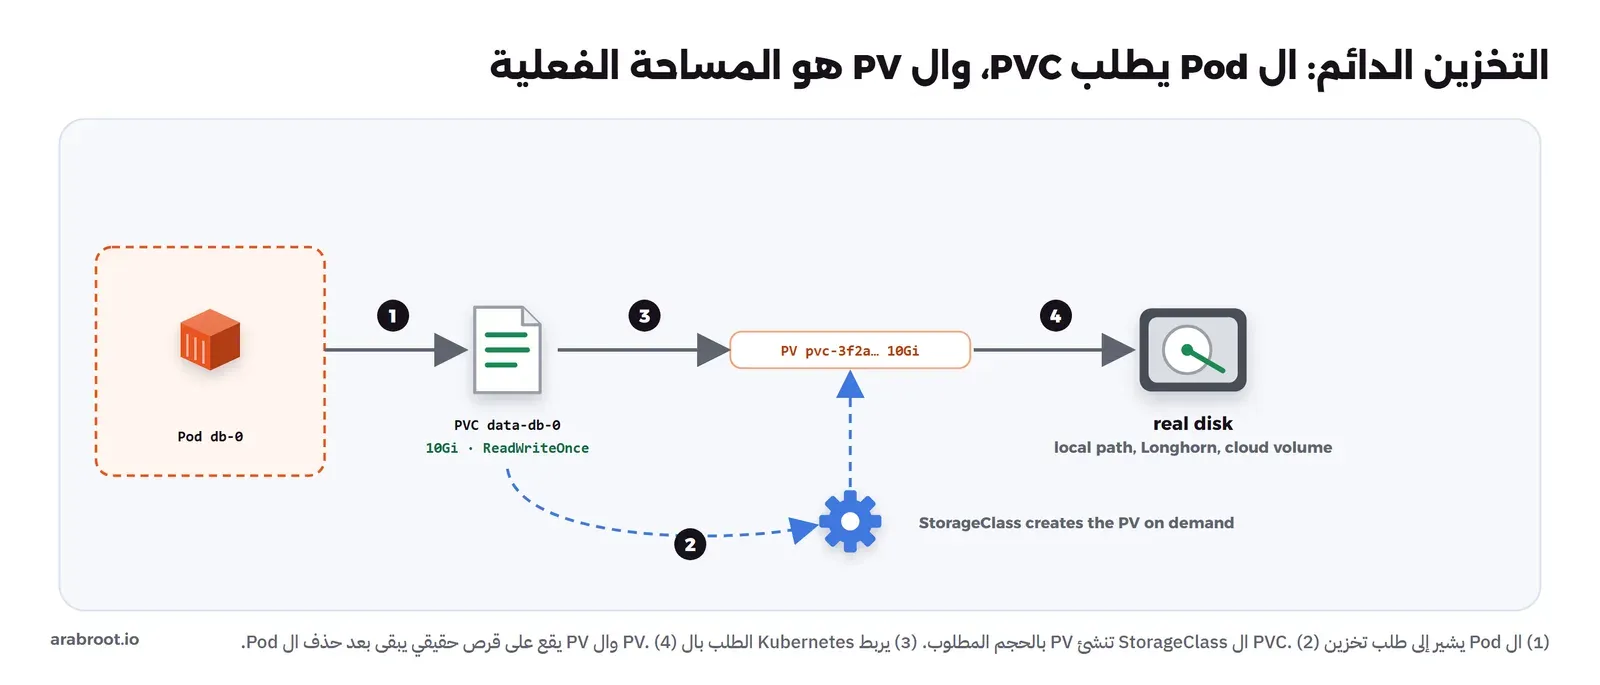
الملفات داخل ال Container تختفي عندما يستبدل ال Pod، وفي Compose تحل هذا ب Volume على قرص السيرفر، أما في Kubernetes فال Pod قد يبدأ على عقدة أخرى، ولذلك فصل Kubernetes التخزين إلى كائنين بحسب توثيق التخزين الدائم: ال PersistentVolume واختصاراً PV، وهو مساحة تخزين حقيقية في العنقود، وال PersistentVolumeClaim واختصاراً PVC، وهو طلب يكتبه التطبيق «أريد 10 غيغابايت يكتب فيها جهاز واحد». وبينهما StorageClass تنشئ PV تلقائياً عندما يأتي طلب لا يوجد ما يطابقه، والصورة التالية تبين الخطوات:
والملف التالي يطلب 10 غيغابايت من ال StorageClass التي يأتي بها K3s:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: uploads
  namespace: shop
spec:
  accessModes:
  - ReadWriteOnce
  storageClassName: local-path
  resources:
    requests:
      storage: 10Gi
في الإعداد أعلاه لاحظ التالي:
- طريقة الوصول
ReadWriteOnceتعني أن عقدة واحدة تكتب فيه، وهناكReadOnlyManyللقراءة من عدة عقد، وReadWriteManyللكتابة من عدة عقد، وReadWriteOncePodل Pod واحد فقط، وليست كل أنواع التخزين تدعم كل الطرق، فالقرص Block Storage يدعم غالباً RWO فقط كما شرحنا في أنواع التخزين. local-pathفي K3s يضع البيانات على قرص العقدة نفسها، فإذا توقفت العقدة لا تنتقل البيانات معها، ولهذا تحتاج في عنقود حقيقي تخزيناً موزعاً مثل Longhorn، وهو مقال قادم في المرحلة.- عند حذف ال PVC تقرر سياسة الاسترجاع Reclaim Policy مصير البيانات:
Deleteيحذف القرص، وRetainيبقيه لتستعيده بيدك، فتأكد من القيمة قبل أن تحذف أي PVC لقاعدة بيانات.
StatefulSet: لقواعد البيانات وما يشبهها
ال Pods التي ينشئها Deployment متطابقة وقابلة للتبديل، أسماؤها عشوائية ويشترك كلها في قالب واحد، وهذا مناسب لتطبيق ويب لا يحفظ شيئاً محلياً، أما قاعدة البيانات أو عنقود etcd أو Kafka فكل نسخة فيها لها هوية: هذه هي الرئيسية وتلك نسخة منها، ولكل واحدة بياناتها. ولذلك يوجد StatefulSet، وهو بحسب توثيق ال StatefulSet يعطي كل Pod اسماً ثابتاً في الشبكة، وتخزيناً دائماً خاصاً به، وتشغيلاً وتحديثاً بالترتيب، والصورة التالية تقارنه بال Deployment:
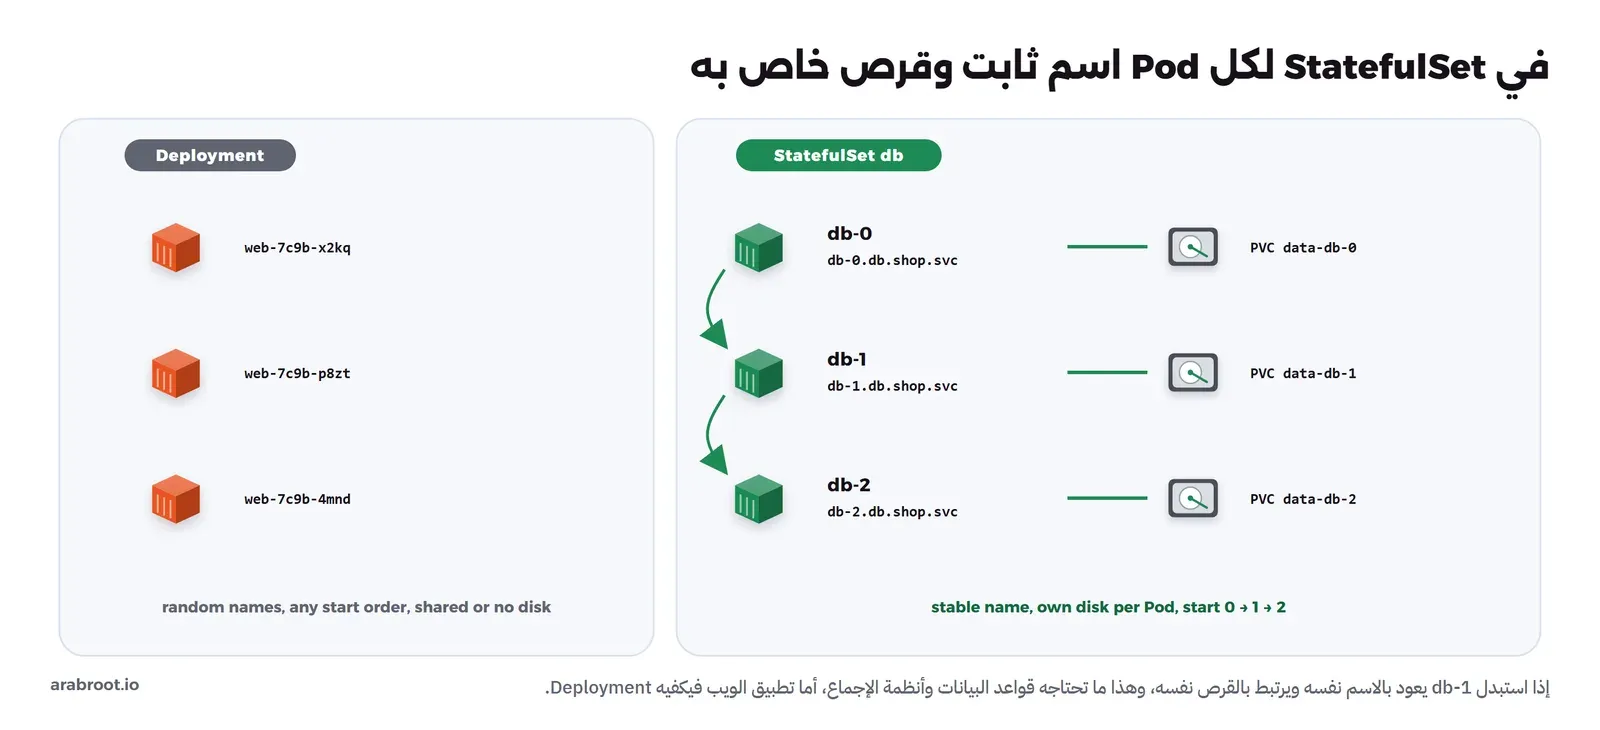
والجزء المهم في ملف ال StatefulSet هو volumeClaimTemplates، الذي ينشئ PVC لكل Pod بالاسم data-db-0 ثم data-db-1 وهكذا، ومعه serviceName الذي يشير إلى Headless Service يعطي كل Pod اسمه في DNS:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: db
spec:
  serviceName: db
  replicas: 1
  selector:
    matchLabels:
      app: db
  template:
    metadata:
      labels:
        app: db
    spec:
      containers:
      - name: postgres
        image: postgres:18
        env:
        - name: POSTGRES_PASSWORD
          valueFrom:
            secretKeyRef:
              name: db-pass
              key: password
        ports:
        - containerPort: 5432
        volumeMounts:
        - name: data
          mountPath: /var/lib/postgresql
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes: ["ReadWriteOnce"]
      resources:
        requests:
          storage: 10Gi
ولاحظ أن StatefulSet بثلاث نسخ من PostgreSQL لا يعطيك عنقود قاعدة بيانات، فهو يشغل ثلاث قواعد مستقلة بأسماء ثابتة، أما النسخ المتماثل والانتقال عند العطل فتحتاج لهما أداة مثل Patroni أو مشغلاً Operator مثل CloudNativePG، وقد شرحنا ما يحتاجه العنقود الحقيقي في عناقيد قواعد البيانات.
DaemonSet وJob وCronJob
بقيت ثلاثة أنواع من الأحمال Workloads تقابلها كثيراً، والصورة التالية تبينها:
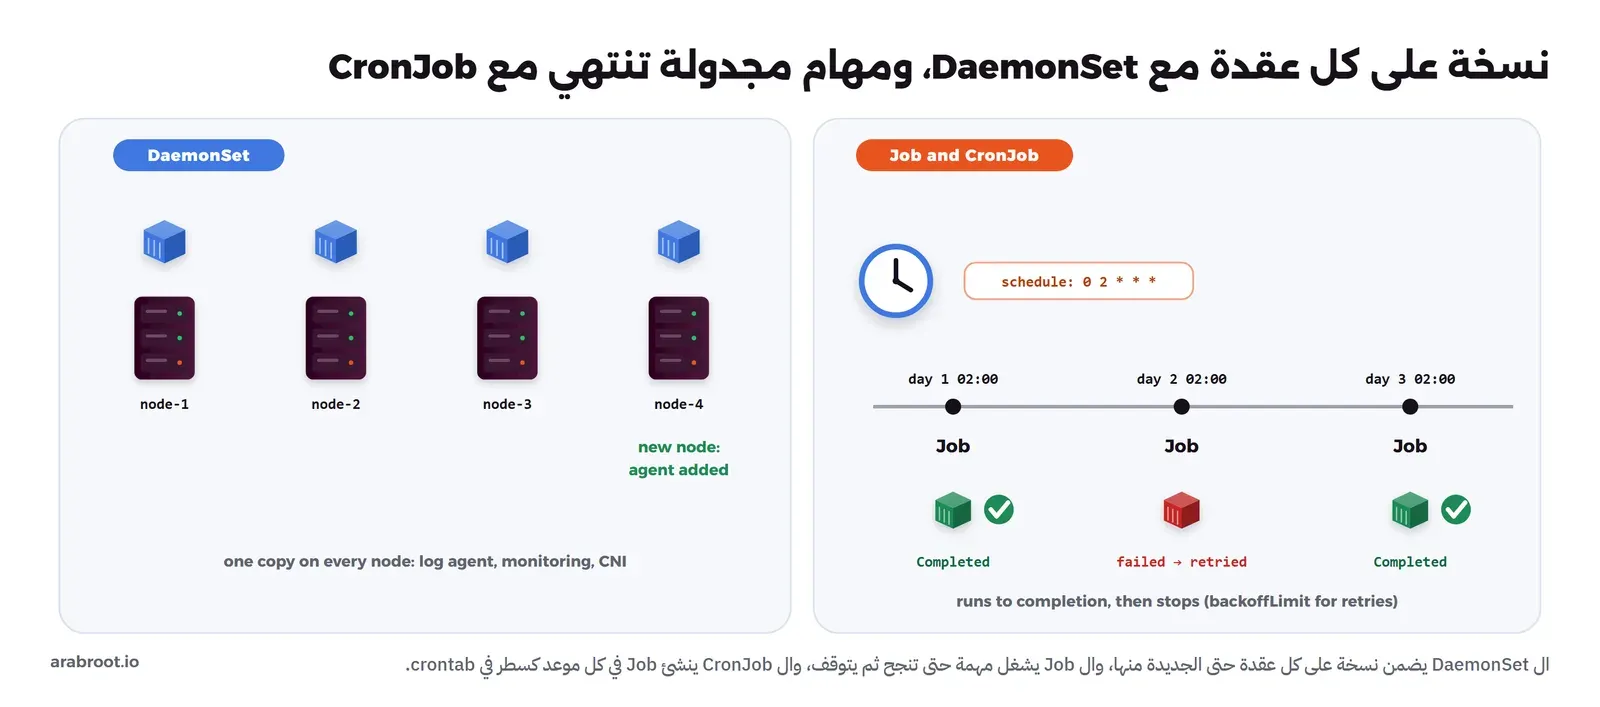
- DaemonSet: يضمن نسخة من ال Pod على كل عقدة أو على مجموعة منها، وعندما تضاف عقدة جديدة يضاف إليها ال Pod تلقائياً، كما في توثيق ال DaemonSet، ويستخدم لوكلاء جمع السجلات والمراقبة والشبكة.
- Job: ينشئ Pod أو أكثر ويعيد المحاولة حتى ينجح عدد محدد منها ثم يتوقف، كما في توثيق ال Job، ويناسب ترحيل قاعدة البيانات Migration قبل الإصدار أو معالجة دفعة من الملفات.
- CronJob: ينشئ Job في كل موعد من جدول بصيغة crontab، كما في توثيق ال CronJob، الذي ينبه إلى أن الموعد تقريبي، فقد ينشأ Job مرتين أو لا ينشأ في حالات نادرة، ولذلك اكتب المهمة بحيث لا يضرها التكرار.
والملف التالي DaemonSet لوكيل سجلات يقرأ مجلد /var/log من كل عقدة:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: log-agent
  namespace: kube-system
spec:
  selector:
    matchLabels:
      app: log-agent
  template:
    metadata:
      labels:
        app: log-agent
    spec:
      containers:
      - name: agent
        image: fluent/fluent-bit:5.1
        volumeMounts:
        - name: varlog
          mountPath: /var/log
          readOnly: true
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
والأمر التالي يولد CronJob ينسخ قاعدة البيانات كل ليلة في الثانية:
kubectl create cronjob db-backup --image=postgres:18 --schedule="0 2 * * *" --dry-run=client -o yaml -- sh -c 'pg_dump -h db -U app app > /backup/app.sql'والمخرج سوف يكون كما يلي:
apiVersion: batch/v1
kind: CronJob
metadata:
  name: db-backup
spec:
  jobTemplate:
    metadata:
      name: db-backup
    spec:
      template:
        metadata: {}
        spec:
          containers:
          - command:
            - sh
            - -c
            - pg_dump -h db -U app app > /backup/app.sql
            image: postgres:18
            name: db-backup
            resources: {}
          restartPolicy: OnFailure
  schedule: 0 2 * * *
status: {}
في المخرج أعلاه لاحظ التالي:
- CronJob يحوي قالب Job، وال Job يحوي قالب Pod، فهي ثلاث طبقات، وكل طبقة لها متحكم خاص بها.
restartPolicy: OnFailureيعني أن ال Container الذي يفشل يعاد في ال Pod نفسه، ولا يقبل ال Job القيمةAlwaysلأن المهمة يجب أن تنتهي.- هذا الملف بداية فقط، فالمسار
/backupغير مربوط بأي Volume، وكلمة المرور غير موجودة، فأضف PVC أو ارفع النسخة إلى تخزين كائنات، وأضف Secret، ثم اختبر الاستعادة.
الأوامر المباشرة أم ملفات YAML مع kubectl apply؟
في كل الأقسام السابقة استخدمنا أوامر kubectl create لنولد الملفات فقط، وهذا مقصود، فالتوثيق في إدارة الكائنات يذكر ثلاث طرق: الأوامر المباشرة Imperative Commands على الكائنات الحية، وهي مناسبة للتجربة لكنها لا تترك سجلاً يراجع، والأوامر على ملفات مثل kubectl create -f، والطريقة التصريحية Declarative بملفات في مجلد تطبقها ب kubectl apply وتراجع الفرق قبلها ب kubectl diff، وهي الموصى بها للإنتاج، والصورة التالية تبين الفرق:
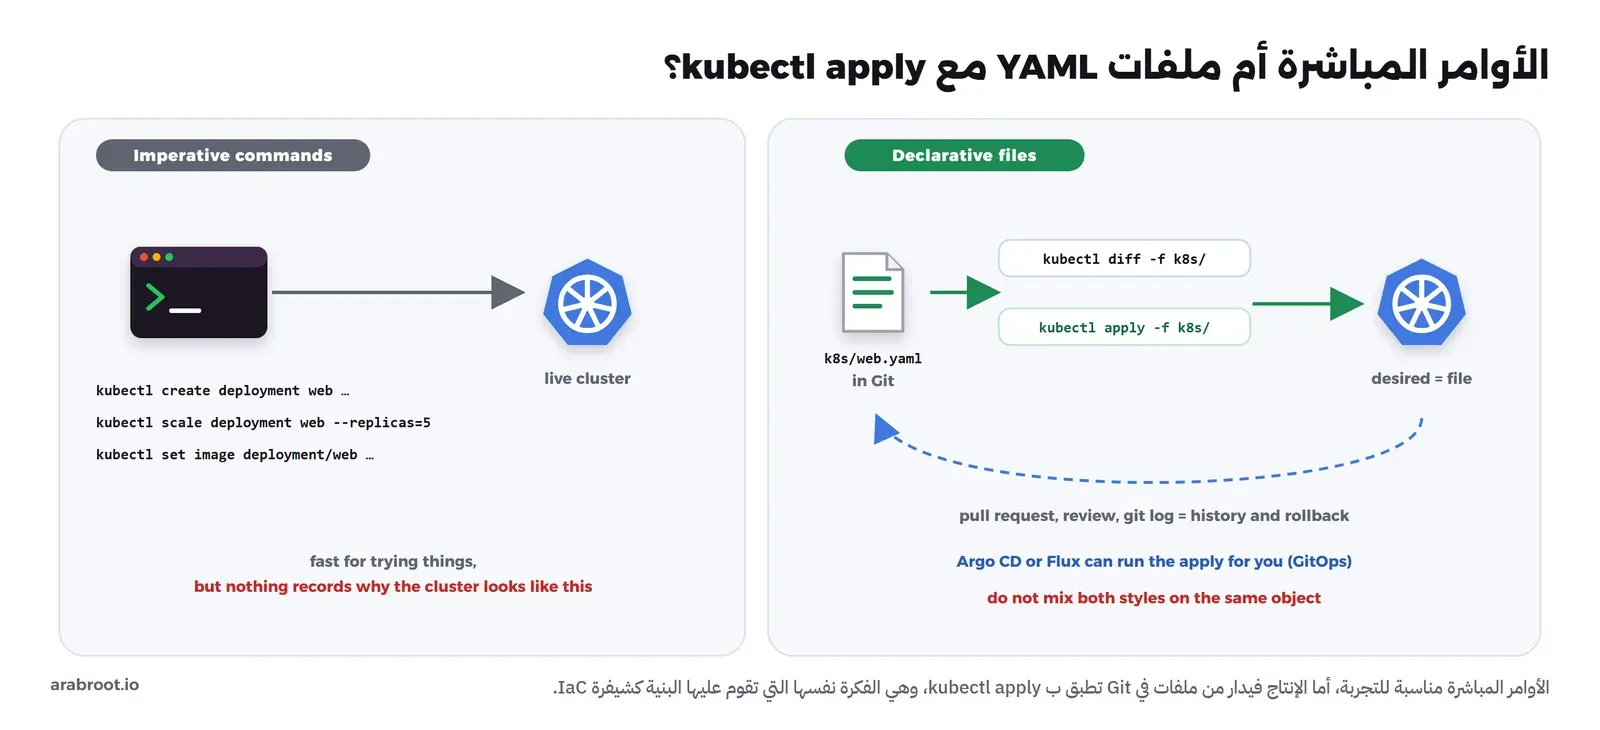
وهي الفكرة نفسها التي شرحناها في البنية كشيفرة IaC للمبتدئين: الحالة المطلوبة مكتوبة في ملفات، والأداة تقارنها بالواقع وتصلح الفرق، وعندما يتولى أداة مثل Argo CD تطبيق ما في المستودع تلقائياً يسمى ذلك GitOps، كما في GitOps ببساطة. ولاحظ تحذير التوثيق بأن الكائن الواحد يجب أن يدار بطريقة واحدة فقط، فإذا غيرت عدد النسخ بالأمر kubectl scale ثم طبقت الملف عاد العدد إلى ما في الملف، وهذا صحيح لأن الملف هو المرجع.
ماذا يحدث إذا نفذت apply دون عنقود؟
لنكسر الأمر عمداً لنفهم ما يفعله، فالملف الذي ولدناه للتو ما زال على جهازنا، ولا يوجد أي عنقود في إعداد kubectl:
kubectl apply -f web-deploy.yamlوالمخرج سوف يكون كما يلي:
error: error validating "web-deploy.yaml": error validating data: failed to download openapi: Get "http://localhost:8080/openapi/v2?timeout=32s": dial tcp [::1]:8080: connectex: No connection could be made because the target machine actively refused it.; if you choose to ignore these errors, turn validation off with --validate=falseثم نجرب الخيار الذي يقترحه الخطأ مع --dry-run=client، لعل kubectl يكتفي بالملف:
kubectl apply --validate=false --dry-run=client -f web-deploy.yamlوالمخرج سوف يكون كما يلي:
E1007 07:55:58.748956   26520 memcache.go:265] "Unhandled Error" err="couldn't get current server API group list: Get \"http://localhost:8080/api?timeout=32s\": dial tcp [::1]:8080: connectex: No connection could be made because the target machine actively refused it."
error: unable to recognize "web-deploy.yaml": Get "http://localhost:8080/api?timeout=32s": dial tcp [::1]:8080: connectex: No connection could be made because the target machine actively refused it.
في المخرج أعلاه لاحظ التالي:
- عندما لا يجد kubectl ملف إعداد
~/.kube/configيحاول الاتصال بالعنوانlocalhost:8080، فإذا رأيت هذا العنوان في خطأ فالمشكلة أن kubectl لا يعرف أي عنقود، وليست في الملف. - الخطأ الأول يأتي من التحقق Validation، فkubectl ينزل وصف الواجهات OpenAPI من ال API Server ليتحقق من الحقول قبل الإرسال.
- والخطأ الثاني أوضح: حتى مع
--dry-run=clientيحتاج kubectl أن يسأل ال API Server عن الأنواع التي يعرفها ليفهم أنapps/v1 Deploymentنوع موجود، فكل شيء في Kubernetes يمر عبر ال API Server كما رأيت في الصورة الثانية، أماkubectl create … --dry-run=clientفينجح لأنه يعرف أنواعه مسبقاً.
كل المصطلحات في جدول واحد
| المصطلح | ماذا يفعل | أقرب شيء في Docker Compose |
|---|---|---|
| Cluster | مجموعة سيرفرات يديرها Kubernetes كجهاز واحد | لا يوجد، فCompose على سيرفر واحد |
| Node | سيرفر في العنقود، للتحكم أو للعمل | السيرفر الذي عليه Docker Engine |
| Control Plane | API Server وetcd والمجدول والمتحكمات | Docker Engine نفسه |
| Kubelet | يشغل ال Pods على العقدة ويرسل حالتها | Docker Engine على السيرفر |
| Pod | Container أو أكثر بعنوان واحد | Container واحد |
| ReplicaSet | يبقي عدداً محدداً من ال Pods | deploy.replicas |
| Deployment | يملك ال ReplicaSets ويحدث ويتراجع | خدمة في services: |
| Label وSelector | يربط الكائنات ببعضها | اسم الخدمة |
| Service | اسم وعنوان ثابتان أمام ال Pods | اسم الخدمة في الشبكة، وports: للنوع NodePort |
| Ingress وGateway API | توجيه الطلبات من الإنترنت بحسب النطاق والمسار | ال Reverse Proxy مثل Traefik أو Caddy |
| ConfigMap | إعدادات غير سرية | environment: وconfigs: |
| Secret | باسوردات ومفاتيح، بترميز base64 | secrets: |
| Namespace | مساحة أسماء داخل العنقود | اسم المشروع -p |
| PV وPVC وStorageClass | تخزين دائم يطلبه التطبيق وينشأ تلقائياً | volumes: |
| StatefulSet | Pods بأسماء ثابتة وقرص لكل منها | خدمة قاعدة بيانات مع Volume خاص بها |
| DaemonSet | نسخة على كل عقدة | لا يوجد، وmode: global في Swarm |
| Job وCronJob | مهمة تنتهي، مرة أو في كل موعد | docker compose run مع cron على السيرفر |
| kubectl apply | يطبق الحالة المكتوبة في الملفات | docker compose up -d |
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- العنقود سيرفرات بعضها للتحكم وبعضها للعمل، وكل شيء يمر عبر ال API Server الذي يحفظ الحالة في etcd، والمجدول يختار العقدة، والمتحكمات تصلح الفرق، وال Kubelet ينفذ على كل عقدة.
- ال Pod أصغر وحدة وعنوانه يتغير، فلا تنشئه وحده، وإنما عبر Deployment يملك ReplicaSet لكل نسخة ويحدث ويتراجع.
- ال Labels وال Selectors هي الرابط بين كل شيء، وخطأ حرف واحد فيها يجعل ال Service لا يجد ال Pods.
- ال Service يعطي اسماً ثابتاً، ونوعه يحدد من أين يأتي الطلب، وIngress مجمدة والمشروع يوصي ب Gateway API.
- ConfigMap للإعدادات وSecret للأسرار، وال Secret مكتوب ب base64 ومحفوظ دون تشفير افتراضياً، فلا تضعه في Git كما هو.
- PVC يطلب التخزين وPV هو التخزين، وStatefulSet يعطي كل Pod اسماً وقرصاً ثابتين، وDaemonSet نسخة على كل عقدة، وJob وCronJob للمهام التي تنتهي.
- أدر الإنتاج بملفات في Git تطبقها ب
kubectl apply، واستخدم الأوامر المباشرة للتجربة فقط، ولا تخلط الطريقتين على الكائن نفسه.
 دليلهل تحتاج Kubernetes فعلاً؟ متى يكفي Docker Composeما الذي يحله Kubernetes وما الذي يكلفك، ومتى يكفيك Docker Compose على سيرفر واحد أو بضعة سيرفرات.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلمن الفرع إلى الإنتاج: البيئات وGitOps للفرقكيف يختبر فريقك كل ميزة وحدها ويعرضها على العميل دون أن تصل ميزة غير جاهزة إلى الإنتاج.
 دليلمصطلحات البنية كشيفرة IaC التي تحتاجها قبل أي أداةما معنى أن تكتب بنيتك في ملفات داخل Git، ولماذا يفشل السكربت العادي عند تشغيله مرة ثانية، وما الذي تحفظه الأداة في ملف الحالة.
 دليلأنواع التخزين وواجهة S3: أين تضع بيانات تطبيقك؟أين تضع قاعدة البيانات وملفات المستخدمين والنسخ الاحتياطية، ولماذا يناسب كلاً منها نوع مختلف من التخزين.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتوليد ملفات Deployment وService وIngress وConfigMap وSecret وNamespace وCronJob ب kubectl v1.36.1 مع
--dry-run=clientدون عنقود، وكتابة ملفات Pod وPVC وStatefulSet وDaemonSet وGateway وHTTPRoute على أمثلة توثيق Kubernetes 1.37 والتحقق منها بمكتبة PyYAML.


