


تفتح لوحة المراقبة Dashboard صباحاً فتجد أن متوسط زمن الاستجابة Average Latency لصفحة المنتج 18 ميلي ثانية، وهو رقم ممتاز لا يستدعي أي قلق، ثم تصلك في الوقت نفسه رسالة من الدعم الفني بأن عدداً من العملاء يشتكون من أن الصفحة «تعلق» أحياناً ربع ثانية قبل أن تظهر. فمن تصدق: الرقم الذي على الشاشة أم العملاء؟ والإجابة أن الاثنين صادقان، فالمتوسط حسب بشكل صحيح، ولكنه رقم واحد يلخص آلاف الطلبات، وقد أخفى في هذا التلخيص بالضبط الطلبات التي يشتكي منها العملاء. وهذا المقال عن الأدوات التي تكشف ما أخفاه المتوسط: الوسيط Median والمئين Percentile مثل p95 وp99، والمدرج التكراري Histogram، ولماذا لا يجوز أن تحسب متوسط p99 لعدة سيرفرات، وكيف يمكن لأداة اختبار الضغط Load Testing نفسها أن تخفي عنك التوقف.
وهذا المقال من مرحلة الرياضيات التي يحتاجها المبرمج فعلاً، والفكرة فيها أن نتعلم الرياضيات من المشكلة التقنية التي تحلها، لذلك لن تجد هنا معادلات كتب الإحصاء، وإنما أرقاماً حقيقية قسناها من سيرفر صغير شغلناه تحت الضغط Load، وكل رقم في المقال خرج من هذه التجربة. وإذا كنت قد قرأت مقال مفاهيم المراقبة Observability فقد مر عليك سؤال «لماذا p95 وليس المتوسط؟» باختصار، وهنا سوف ننزل إلى التفاصيل. وسوف نناقش في هذا المقال ما يلي:
- لماذا يخدعك المتوسط، وما الفرق بينه وبين الوسيط، وأين يقع كل منهما في أشكال التوزيع المختلفة.
- لماذا لا يشبه زمن الاستجابة منحنى الجرس، ومن أين يأتي الذيل الطويل Long Tail، ولماذا لا يفيدك الانحراف المعياري Standard Deviation هنا.
- المئين Percentile: تعريفه بالترتيب، وطرق حسابه المختلفة، وكم طلباً تحتاج حتى يكون p99 رقماً له معنى.
- تجربة عملية بسيرفر HTTP صغير في Python تحت الضغط، ومشكلة حقيقية ظهرت في أول تشغيل جعلت الوسيط 50 ميلي ثانية بدل 7.
- المدرج التكراري Histogram وفئاته Buckets، وما يقدره Prometheus من الفئات مقارنة بالقيمة الحقيقية.
- لماذا لا يجوز حساب متوسط المئين، وما الذي يجمع بشكل صحيح.
- كيف تخفي أداة اختبار الضغط التوقف عن نفسها Coordinated Omission، وماذا يحدث للمئين عندما يقترب السيرفر من طاقته.
- الأخطاء الشائعة، وجدول يحدد أي رقم تستخدم لأي سؤال، وقائمة تحقق للوحات المراقبة.
لماذا يخدعك المتوسط Mean؟
المتوسط الحسابي Mean هو مجموع القيم مقسوماً على عددها، وهو أول ما تعلمناه في المدرسة، وأول ما تعرضه أغلب الأدوات، والسبب أنه سهل الحساب جداً: يكفي أن تحفظ عدادين فقط، مجموع الأزمنة وعدد الطلبات، ثم تقسم الأول على الثاني في أي وقت. ولكن هذه السهولة لها ثمن، فالمتوسط يتأثر بكل قيمة بحسب حجمها، وبالتالي طلب واحد استغرق 30 ثانية بسبب Timeout يرفع متوسط ألف طلب سريع بمقدار 30 ميلي ثانية كاملة، فيبدو كأن كل الطلبات أبطأ قليلاً، مع أن الحقيقة أن 999 طلباً لم يتغير فيها شيء وطلباً واحداً كان كارثياً.
أما الوسيط Median فهو القيمة التي في المنتصف بعد ترتيب الطلبات من الأسرع إلى الأبطأ، أي أن نصف الطلبات أسرع منه ونصفها أبطأ، وهو لا يهتم بحجم القيم البعيدة وإنما بترتيبها فقط، فالطلب الذي استغرق 30 ثانية لا يحرك الوسيط إلا بمقدار خانة واحدة في الترتيب. لذلك يقال إن الوسيط «مقاوم» للقيم المتطرفة Outliers، وإن المتوسط حساس لها.
ولنأخذ مثالاً من التجربة العملية التي سوف نشرحها بالتفصيل بعد قليل: سيرفران يخدمان صفحة المنتج، وأرسلنا إليهما 24,000 طلب خلال دقيقة، فكان المتوسط 18.0 ميلي ثانية، والوسيط 10.7، وأبطأ طلب 294.1. فلو سألت «كم ينتظر العميل عادة؟» فالجواب الأقرب هو الوسيط وليس المتوسط، ولو سألت «هل يوجد عملاء ينتظرون كثيراً؟» فلا المتوسط ولا الوسيط يجيبان، لأن كليهما لا يقول شيئاً عن أبطأ 1% من الطلبات، وهؤلاء هم من يكتبون للدعم الفني. وقد وصف كتاب Google عن هندسة الموثوقية هذه المشكلة في فصل مراقبة الأنظمة الموزعة، حيث ذكر أن خدمة متوسط زمن استجابتها 100 ميلي ثانية قد يأخذ 1% من طلباتها 5 ثوان بسهولة، وأن الفكرة القائلة إن أغلب الطلبات قريبة من المتوسط هي «تفكير متفائل» ما لم تقس التوزيع نفسه.
وقد يتساءل البعض: إذا كان الوسيط أفضل، فلماذا لا نكتفي به؟ والإجابة أن الوسيط يصف العميل العادي، ولكنه أعمى عن النصف البطيء كله، فلو أصبح أبطأ 40% من الطلبات أبطأ عشر مرات لما تحرك الوسيط أبداً. لذلك لا يوجد رقم واحد يكفي، وإنما مجموعة أرقام لكل منها سؤال، وهذا ما سوف نبنيه خطوة خطوة.
شكل التوزيع Distribution: لماذا لا يشبه زمن الاستجابة Latency منحنى الجرس Bell Curve؟
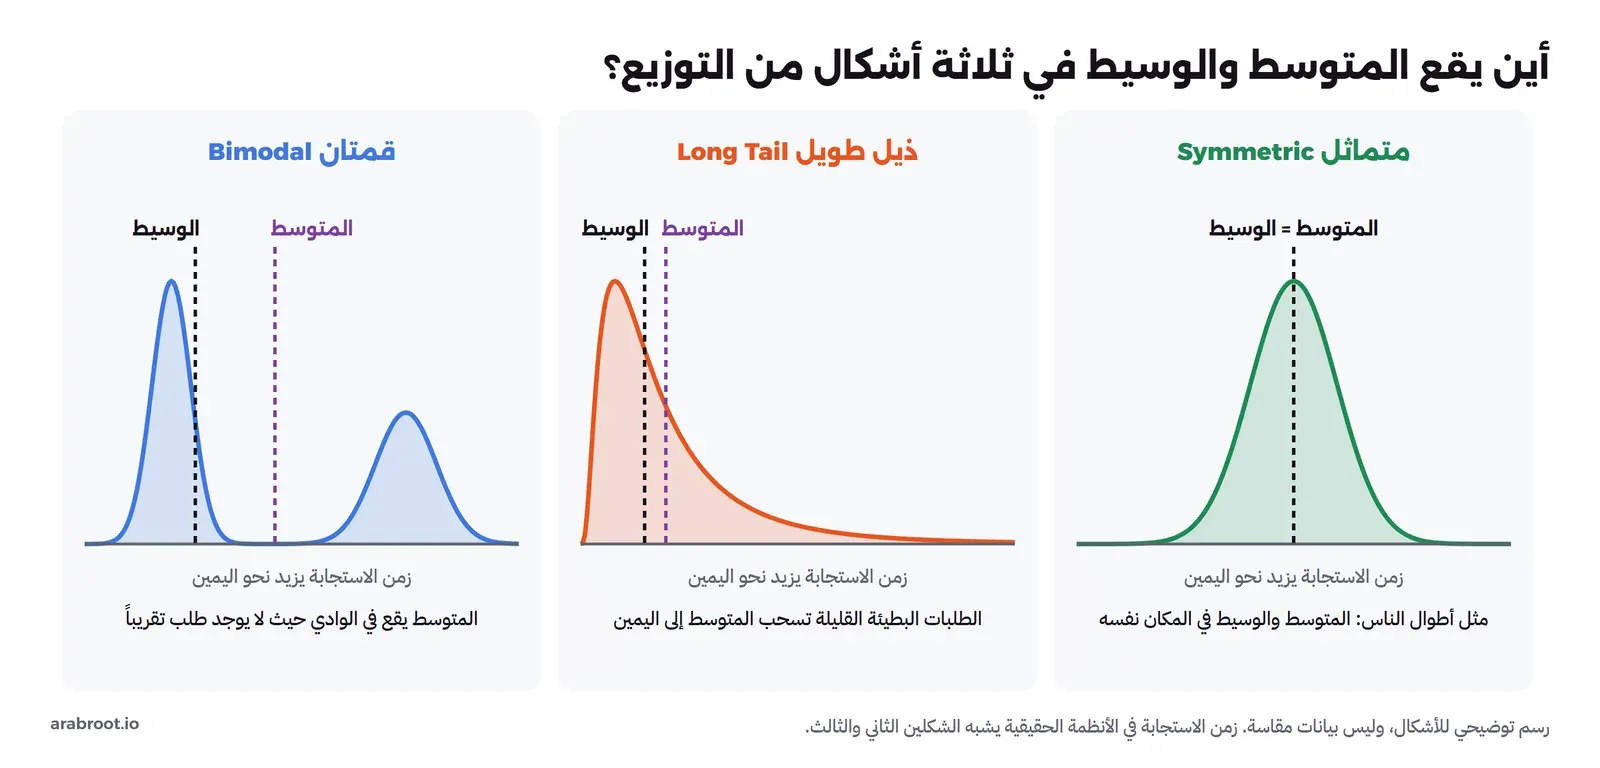
التوزيع Distribution هو الطريقة التي تنتشر بها القيم: أين تتجمع، وإلى أي مدى تبتعد. وأغلب ما تعلمناه في الإحصاء المدرسي مبني على التوزيع الطبيعي Normal Distribution، وهو منحنى الجرس المتماثل الذي يقع المتوسط والوسيط فيه في المكان نفسه، مثل أطوال الناس أو أخطاء القياس الصغيرة. ولكن زمن الاستجابة لا يشبه الجرس إطلاقاً، والصورة التالية تبين ثلاثة أشكال للتوزيع وأين يقع المتوسط والوسيط في كل منها:
ولزمن الاستجابة ذيل طويل نحو اليمين لأسباب يعرفها كل من شغل نظاماً في بيئة الإنتاج Production:
- له حد أدنى وليس له حد أعلى: لا يمكن أن يكون الطلب أسرع من زمن الشبكة وأقل عمل يقوم به السيرفر، ولكن يمكن أن يكون أبطأ بأي مقدار، فالتوزيع ملتصق بالحد الأدنى من اليسار ومفتوح من اليمين.
- الانتظار في الطابور Queueing: عندما تصل عدة طلبات في اللحظة نفسها وعدد العمال Workers أو اتصالات قاعدة البيانات محدود، ينتظر بعضها دوره، ومدة الانتظار تكبر بسرعة كلما اقترب السيرفر من طاقته، كما سوف نرى في التجربة.
- إصابة ال Cache أو عدمها: الطلب الذي يجد بياناته في ال Cache ينتهي في ميلي ثانية أو اثنتين، والذي لا يجدها يذهب إلى قاعدة البيانات فيأخذ عشرات الميلي ثانية، وهذا يصنع قمتين منفصلتين بدل قمة واحدة.
- التوقفات الدورية: تنظيف الذاكرة Garbage Collection، ومهمة مجدولة تقفل جدولاً، ونسخة احتياطية تشغل القرص، وكل منها يوقف جزءاً من الطلبات لفترة قصيرة ثم يختفي.
- إعادة المحاولة Retry والمهلة Timeout: الطلب الذي فقدت حزمة منه في الشبكة يعاد إرساله بعد مهلة، فيظهر بزمن أكبر بكثير من بقية الطلبات.
والتوزيع ذو القمتين Bimodal هو أخطر الأشكال على المتوسط، فإذا كانت 90% من الطلبات تنتهي في 5 ميلي ثانية و10% في 45، فالمتوسط نحو 9 ميلي ثانية، وهو رقم لم يأخذه أي طلب تقريباً. ومع ذلك تجد من يكتب في تقرير الأداء أن «الطلب يأخذ 9 ميلي ثانية»، وهذا وصف لطلب غير موجود.
ولماذا لا يكفي الانحراف المعياري Standard Deviation؟
الانحراف المعياري Standard Deviation يقيس متوسط بعد القيم عن المتوسط، وفي التوزيع الطبيعي له قاعدة مشهورة: نحو 95% من القيم تقع بين المتوسط ناقص انحرافين معياريين والمتوسط زائد انحرافين. والمشكلة أن هذه القاعدة صحيحة للجرس فقط، فإذا طبقتها على زمن الاستجابة حصلت على نتائج لا معنى لها. ففي التجربة كان متوسط السيرفر A يساوي 23.2 ميلي ثانية والانحراف المعياري 38.5، فالمتوسط ناقص انحراف واحد رقم سالب، أي أن القاعدة تتوقع طلبات تنتهي قبل أن تبدأ، والمتوسط زائد انحرافين 100.2 ميلي ثانية، بينما p99 الحقيقي للسيرفر نفسه 222.9، أي أكثر من الضعف. لذلك لا تقم ببناء تنبيه على «المتوسط زائد انحرافين» لزمن الاستجابة، والسبب أن هذا الحد يفترض شكلاً للتوزيع لا تملكه بياناتك.
المئين Percentile: ترتيب وليس متوسطاً
المئين Percentile، ويسمى أيضاً الكمية Quantile عندما يكتب كنسبة بين 0 و1، هو القيمة التي تقع تحتها نسبة معينة من الطلبات بعد ترتيبها. فالمئين 99، واختصاراً p99، هو الزمن الذي تنتهي قبله 99% من الطلبات، والوسيط ليس إلا p50. والطريقة الأبسط لحسابه، وتسمى أقرب رتبة Nearest Rank، كما يلي:
- رتب الطلبات من الأسرع إلى الأبطأ.
- اضرب النسبة في عدد الطلبات، وقرب الناتج إلى الأعلى، فيكون هذا رقم الترتيب: لمئة طلب يكون p99 هو الطلب رقم 99، ولعشرة آلاف طلب هو الطلب رقم 9,900.
- القيمة في هذا الترتيب هي المئين.
والصورة التالية تبين ذلك على 100 طلب حقيقي من التجربة وصلت إلى السيرفر A خلال ثانية واحدة، وفي هذه الثانية تحديداً اشتغلت مهمة تقرير في الخلفية وأوقفت الطلبات ربع ثانية:
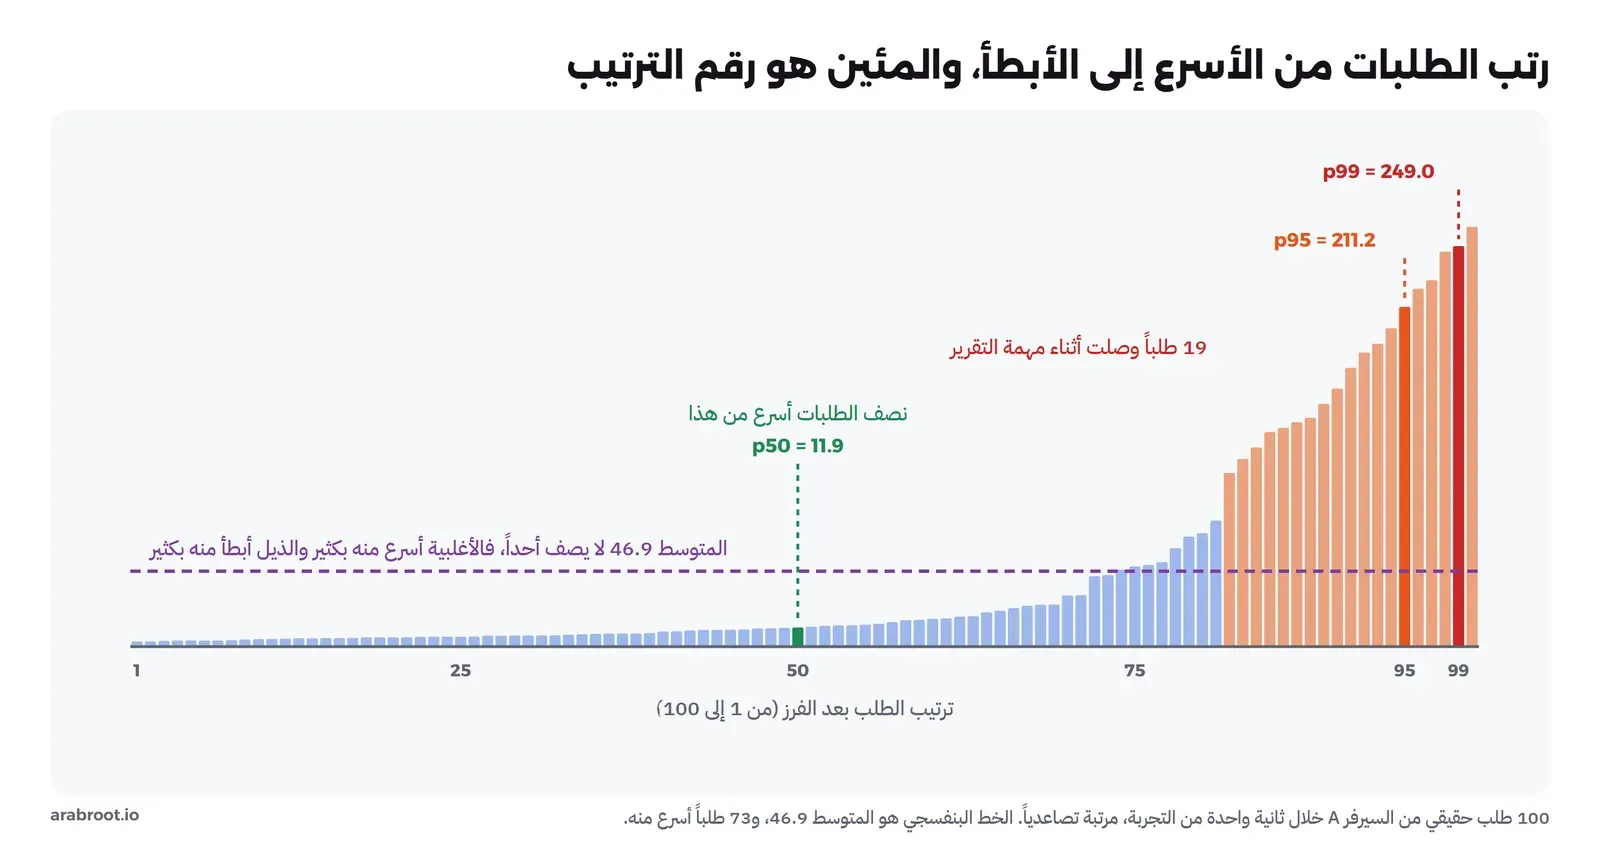
لاحظ في الصورة أن المتوسط 46.9 ميلي ثانية، وأن 73 طلباً من المئة أسرع منه بكثير، وأن الطلبات الأبطأ منه أبطأ بكثير أيضاً، فهو رقم يقع بين المجموعتين ولا يصف أياً منهما. أما الوسيط 11.9 فيصف العميل العادي بدقة، و p95 هو 211.2، أي أن 5 طلبات من كل مئة في هذه الثانية انتظرت أكثر من 200 ميلي ثانية، وهذه هي المعلومة التي كان المتوسط يخفيها.
والأرقام المعتادة في لوحات المراقبة لكل منها معنى:
| الرقم | معناه | متى تستخدمه |
|---|---|---|
| p50 (الوسيط) | نصف الطلبات أسرع منه | تجربة العميل العادي، ومقارنة إصدارين في الحالة الطبيعية |
| p90 و p95 | طلب واحد من كل 10 أو 20 أبطأ منه | أهداف الخدمة SLO للواجهات التي يراها المستخدم |
| p99 | طلب واحد من كل 100 أبطأ منه | الذيل الذي يراه العميل عدة مرات في اليوم، والخدمات الداخلية التي يستدعيها غيرها كثيراً |
| p99.9 | طلب واحد من كل 1000 أبطأ منه | الخدمات ذات الحجم الكبير، حيث يعني 0.1% آلاف الطلبات في الساعة |
| الأقصى Max | أبطأ طلب في الفترة | كشف التوقفات والمهل Timeouts، وليس لوصف التجربة العامة |
لماذا تعطي الأدوات أرقاماً مختلفة للمئين Percentile نفسه؟
أقرب رتبة ليست الطريقة الوحيدة، فعندما يقع المئين بين طلبين في الترتيب، تأخذ بعض الأدوات أحدهما، وتأخذ أخرى قيمة بينهما بالتوزيع الخطي Linear Interpolation، وبعضها يفترض أن البيانات عينة من مجتمع أكبر قد تكون فيه قيم أبعد. ففي Python مثلاً تحسب الدالة statistics.quantiles المئين بطريقتين، الافتراضية exclusive وهي تفترض أن البيانات عينة، وinclusive وهي تعامل البيانات كأنها المجتمع كله. والفرق بينها صغير عندما تكون الطلبات كثيرة، ففي تشغيل التجربة الثاني، عند حساب المئين من عمود زمن الخدمة service_ms لـ 24,000 طلب، كانت النتائج كما يلي:
nearest rank 121.2 | statistics.quantiles exclusive 121.8 | inclusive 121.3أي فرق أقل من ميلي ثانية واحدة. ولكن مع عدد قليل من الطلبات يصبح الفرق كبيراً، لأن المسافة بين الطلب رقم 99 والطلب رقم 100 قد تكون عشرات الميلي ثانية. والقاعدة العملية من هذا: عندما تقارن رقمين من أداتين مختلفتين، مثل أداة اختبار الضغط ولوحة Grafana، فتأكد أنهما يحسبان المئين بالطريقة نفسها وعلى الفترة نفسها، أو قارن الشكل العام ولا تقارن الكسور العشرية.
كم طلباً تحتاج حتى يكون p99 رقماً له معنى؟
هذه نقطة يتجاوزها كثيرون: p99 لمئة طلب هو ثاني أبطأ طلب فيها، أي أنه رقم يعتمد على طلبين فقط، وبالتالي يتغير كثيراً من فترة إلى أخرى حتى لو لم يتغير شيء في النظام. وقد حسبنا في التجربة p99 لعشر مجموعات، كل منها 100 طلب متتال من السيرفر A، في دقيقة واحدة لم يتغير فيها الكود ولا الضغط:
134 54 59 57 249 89 65 50 50 240الرقم نفسه تراوح بين 50 و249 ميلي ثانية، والسبب ليس في السيرفر وإنما في الحساب، فالمجموعة التي وقعت فيها مهمة التقرير ظهر فيها p99 كبيراً، والتي لم تقع فيها ظهر صغيراً. ولكي يكون المئين مستقراً تحتاج إلى أن يكون عدد الطلبات خلفه كافياً، والقاعدة التقريبية أن يكون في الذيل نفسه عشرات الطلبات على الأقل، أي بضعة آلاف طلب لحساب p99 وعشرات الآلاف لحساب p99.9. وهذا يعني عملياً أن p99.9 في نافذة دقيقة واحدة لخدمة تستقبل عشرة طلبات في الثانية رقم لا يعتمد عليه، فإما أن توسع النافذة الزمنية، وإما أن تكتفي بمئين أقل.
وماذا عن الأقصى Max؟
أبطأ طلب في الفترة رقم مفيد جداً لسؤال واحد: هل حدث توقف أو Timeout؟ فإذا كان الأقصى يساوي بالضبط 30 ثانية أو 60 ثانية تكراراً، فالأرجح أن هناك مهلة في مكان ما تقطع الطلب، وهذا تشخيص سريع. ولكن الأقصى رقم صاخب جداً، فهو طلب واحد، ويتغير مع كل نافذة زمنية، ولا يصلح أن يكون هدفاً للخدمة ولا أساساً لتنبيه، لذلك اعرضه بجانب المئين في اللوحة، ولا تعتمد عليه وحده.
تجربة عملية Lab: سيرفر صغير تحت الضغط Load
الكلام عن الذيل الطويل يبقى نظرياً حتى ترى الأرقام بنفسك، لذلك سوف نبني سيرفراً صغيراً يشبه في سلوكه خدمة حقيقية، ونرسل إليه آلاف الطلبات، ونحسب كل الأرقام السابقة من القياسات. والتجربة كلها بالمكتبة القياسية في Python، فلا تحتاج إلى تثبيت أي شيء غير Docker، وكل الملفات في مجلد lab داخل حزمة المقال.
السيرفر: ثلاثة مصادر للبطء
السيرفر التالي يخدم صفحة منتج، وقد وضعنا فيه ثلاثة مصادر للبطء تجدها في أغلب الأنظمة الحقيقية: عدد محدود من اتصالات قاعدة البيانات Connection Pool فتنتظر الطلبات دورها عند الضغط، وطلب من كل عشرة لا يجد بياناته في ال Cache فيأخذ استعلاماً مدته 40 ميلي ثانية، ومهمة تقرير في الخلفية تقفل الجدول ربع ثانية كل أربع ثوان. احفظ الملف التالي باسم server.py:
# A small "product page" API with the usual sources of tail latency, standard library only.
#   python server.py <port> <report|quiet> [--nagle]
# - a pool of 4 "database connections" (a semaphore): under load, requests wait in line for one
# - 1 request in 10 misses the cache and runs a 40 ms "query"; the rest take about 2 ms
# - with "report": every 4 seconds a background report job holds the table lock for 250 ms,
#   and every request that needs the table waits until it finishes
import random, sys, threading, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

PORT, MODE = int(sys.argv[1]), sys.argv[2]
NAGLE_OFF = "--nagle" not in sys.argv          # pass --nagle to see the first run's 40 ms delay again
pool = threading.Semaphore(4)
table_lock = threading.Lock()


def report_job():
    while True:
        time.sleep(4)
        with table_lock:
            time.sleep(0.25)


class Handler(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"          # keep the connection open between requests
    disable_nagle_algorithm = NAGLE_OFF     # TCP_NODELAY: send the body without waiting for an ACK

    def do_GET(self):
        with pool:                          # wait for a free connection
            with table_lock:                # wait here while the report job holds the lock
                pass
            time.sleep(0.040 if random.random() < 0.10 else 0.002)
        body = b'{"ok":true}'
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def log_message(self, *args):           # no access log on the console
        pass


if MODE == "report":
    threading.Thread(target=report_job, daemon=True).start()
ThreadingHTTPServer.daemon_threads = True
print(f"listening on {PORT} ({MODE})", flush=True)
ThreadingHTTPServer(("127.0.0.1", PORT), Handler).serve_forever()
في الكود أعلاه لاحظ التالي:
threading.Semaphore(4)يمثل أربعة اتصالات بقاعدة البيانات، فإذا كانت الأربعة مشغولة ينتظر الطلب الخامس، وهذا هو الطابور Queue الذي يصنع جزءاً كبيراً من الذيل.with table_lock: passلا يقوم بأي عمل، وإنما ينتظر فقط إذا كانت مهمة التقرير تمسك القفل، وهذا يشبه استعلاماً عادياً ينتظر قفلاً على جدول أخذه تقرير ثقيل.time.sleep(0.040 if random.random() < 0.10 else 0.002)يمثل إصابة ال Cache في 90% من الطلبات وعدم إصابته في 10%.- السيرفر نفسه يعمل بنسختين:
reportفيها مهمة التقرير، وquietبدونها، وسوف نسميهما A و B. - السطر
disable_nagle_algorithmلم يكن موجوداً في النسخة الأولى، وسوف نرى بعد قليل لماذا أضفناه.
أداة توليد الضغط Load Generator: حلقة مغلقة Closed Loop وحلقة مفتوحة Open Loop
الملف الثاني يرسل الطلبات ويسجل زمن كل طلب في ملف CSV، وله طريقتان سوف نحتاج إلى الفرق بينهما في قسم لاحق: الحلقة المغلقة Closed Loop، حيث يرسل كل عميل طلباً وينتظر الرد ثم يرسل التالي، والحلقة المفتوحة Open Loop، حيث تخرج الطلبات في مواعيد ثابتة سواء كان السيرفر سريعاً أم بطيئاً، ويحسب زمن كل طلب من الموعد الذي كان يجب أن يخرج فيه. احفظه باسم load.py:
# Sends load to the two servers and writes one line per request to a CSV file.
#   python load.py closed <seconds> A=<clients>,B=<clients> <out.csv>
#       closed loop: each client sends a request, waits for the answer, then sends the next one
#   python load.py open <seconds> A=<requests per second>,B=<requests per second> <out.csv>
#       open loop: requests leave on a fixed schedule whether the server is slow or not,
#       and latency is measured from the moment the request SHOULD have been sent
import csv, http.client, sys, threading, time

MODE, SECONDS, OUT = sys.argv[1], float(sys.argv[2]), sys.argv[4]
LOAD = {k: int(v) for k, v in (x.split("=") for x in sys.argv[3].split(","))}
SERVERS = {"A": 19300, "B": 19301}
rows, rows_lock = [], threading.Lock()
t0 = time.perf_counter() + 0.5


def get(conn):
    conn.request("GET", "/product?id=42")
    r = conn.getresponse()
    r.read()
    return r.status


def closed_client(name, port):
    conn = http.client.HTTPConnection("127.0.0.1", port)
    while time.perf_counter() < t0:
        time.sleep(0.001)
    while (start := time.perf_counter()) < t0 + SECONDS:
        get(conn)
        end = time.perf_counter()
        with rows_lock:
            rows.append((name, round(start - t0, 4), round((end - start) * 1000, 3), round((end - start) * 1000, 3)))


def open_worker(name, port, schedule, next_i):
    conn = http.client.HTTPConnection("127.0.0.1", port)
    while True:
        with next_i[1]:
            i = next_i[0]
            next_i[0] += 1
        if i >= len(schedule):
            return
        planned = schedule[i]
        while (now := time.perf_counter()) < planned:
            time.sleep(min(0.001, planned - now))
        sent = time.perf_counter()
        get(conn)
        end = time.perf_counter()
        with rows_lock:   # latency from the planned time, and the service time the server alone gave
            rows.append((name, round(planned - t0, 4), round((end - planned) * 1000, 3), round((end - sent) * 1000, 3)))


threads = []
for name, port in SERVERS.items():
    N = LOAD[name]
    if MODE == "closed":
        threads += [threading.Thread(target=closed_client, args=(name, port)) for _ in range(N)]
    else:
        schedule = [t0 + i / N for i in range(int(SECONDS * N))]
        counter = [0, threading.Lock()]
        threads += [threading.Thread(target=open_worker, args=(name, port, schedule, counter)) for _ in range(32)]
for t in threads:
    t.start()
for t in threads:
    t.join()

with open(OUT, "w", newline="") as f:
    w = csv.writer(f)
    w.writerow(["server", "start_s", "latency_ms", "service_ms"])
    w.writerows(sorted(rows, key=lambda r: r[1]))
print(f"{MODE}: {len(rows)} requests in {SECONDS:.0f} s -> {OUT}")
لاحظ أن الأداة تقيس الزمن بالدالة time.perf_counter وليس بساعة النظام time.time، والسبب أن ساعة النظام قد تقفز للأمام أو للخلف عندما تصححها خدمة NTP، فتظهر طلبات بزمن سالب أو زمن كبير وهمي، أما perf_counter فساعة رتيبة Monotonic لا تعود للخلف أبداً، وهي المناسبة لقياس المدد. ولاحظ أيضاً أن الحلقة المفتوحة تسجل عمودين: latency_ms من الموعد المخطط، وservice_ms من لحظة الإرسال الفعلية.
الحساب: كل الأرقام من ملف واحد
الملف الثالث يقرأ ملف CSV ويطبع ما تعرضه لوحة المراقبة عادة، ثم ما تخفيه: المدرج التكراري، والمئين بأكثر من طريقة، ومتوسط المئين مقابل المئين الحقيقي، وتقدير Prometheus من الفئات، ونسبة الطلبات تحت حد معين. احفظه باسم stats.py:
# Reads the CSV from load.py and prints the numbers a dashboard would show, and the ones it hides.
#   python stats.py <file.csv> [column]      column: latency_ms (default) or service_ms
import csv, math, statistics, sys
from collections import defaultdict

FILE = sys.argv[1]
COL = sys.argv[2] if len(sys.argv) > 2 else "latency_ms"
data = defaultdict(list)          # server -> latencies
per_sec = defaultdict(list)       # (server, second) -> latencies
for r in csv.DictReader(open(FILE)):
    v = float(r[COL])
    data[r["server"]].append(v)
    per_sec[(r["server"], int(float(r["start_s"])))].append(v)
data["A+B"] = data["A"] + data["B"]


def pct(values, p):
    """Nearest rank: the smallest value that has at least p% of the values at or below it."""
    s = sorted(values)
    return s[max(1, math.ceil(p / 100 * len(s))) - 1]


print(f"== {FILE} ({COL})")
print(f"{'':6}{'count':>7}{'mean':>9}{'stdev':>9}{'p50':>9}{'p90':>9}{'p95':>9}{'p99':>9}{'p99.9':>9}{'max':>9}")
for name in ("A", "B", "A+B"):
    v = data[name]
    print(f"{name:6}{len(v):>7}{statistics.fmean(v):>9.1f}{statistics.stdev(v):>9.1f}"
          + "".join(f"{pct(v, p):>9.1f}" for p in (50, 90, 95, 99, 99.9)) + f"{max(v):>9.1f}")

print("\n-- histogram of A+B, buckets double in size (ms)")
v, lo = data["A+B"], 1.0
while lo < max(v):
    n = sum(lo <= x < lo * 2 for x in v) + (sum(x < lo for x in v) if lo == 1.0 else 0)
    print(f"{('<' if lo == 1.0 else '')+format(lo, 'g'):>6} .. {lo * 2:<6g}{n:>7}  {'#' * math.ceil(60 * n / len(v)) if n else ''}")
    lo *= 2

print("\n-- p99 from different methods, A+B")
v = data["A+B"]
q = {m: statistics.quantiles(v, n=100, method=m)[98] for m in ("exclusive", "inclusive")}
print(f"nearest rank {pct(v, 99):.1f} | statistics.quantiles exclusive {q['exclusive']:.1f} | inclusive {q['inclusive']:.1f}")

print("\n-- averaging percentiles")
pa, pb, pab = pct(data["A"], 99), pct(data["B"], 99), pct(data["A+B"], 99)
print(f"p99 A = {pa:.1f}  p99 B = {pb:.1f}  average of the two = {(pa + pb) / 2:.1f}  real p99 of all requests = {pab:.1f}")
secs = [pct(x, 99) for (s, _), x in per_sec.items() if s == "A"]
print(f"server A: average of {len(secs)} per-second p99 values = {statistics.fmean(secs):.1f}  "
      f"max of them = {max(secs):.1f}  real p99 over the whole run = {pa:.1f}")

print("\n-- what a Prometheus histogram with the default buckets would estimate (A+B)")
bounds = [5, 10, 25, 50, 100, 250, 500, 1000, 2500, 5000, 10000]   # ms, the default buckets in seconds x 1000
cum = [sum(x <= b for x in v) for b in bounds]
for p in (50, 95, 99):
    rank = p / 100 * len(v)
    i = next(k for k, c in enumerate(cum) if c >= rank)
    lo_b, lo_c = (bounds[i - 1], cum[i - 1]) if i else (0, 0)
    est = lo_b + (bounds[i] - lo_b) * (rank - lo_c) / (cum[i] - lo_c)
    print(f"p{p}: bucket ({lo_b}, {bounds[i]}] -> estimate {est:.1f}  exact {pct(v, p):.1f}")

print("\n-- share of requests under 100 ms (this one CAN be combined)")
for name in ("A", "B"):
    print(f"{name}: {sum(x < 100 for x in data[name])} of {len(data[name])} = {100 * sum(x < 100 for x in data[name]) / len(data[name]):.2f}%")
ok = sum(x < 100 for x in data["A+B"])
print(f"A+B: {ok} of {len(data['A+B'])} = {100 * ok / len(data['A+B']):.2f}%  (the counts add up, the percentiles do not)")

print("\n-- p99 from only 100 requests, ten different windows of server A")
a = data["A"]
step = len(a) // 10
print(" ".join(f"{pct(a[i * step:i * step + 100], 99):.0f}" for i in range(10)))
والدالة pct هي طريقة أقرب رتبة التي شرحناها، بسطرين فقط: ترتيب القيم ثم أخذ القيمة في الترتيب المحسوب. وتشغيل التجربة كاملة بأمر واحد، حيث يشغل الملف run.sh السيرفرين ثم ثلاث جولات ضغط مدة كل منها دقيقة:
#!/bin/sh
# The whole lab, inside python:3.13.17-slim (standard library only, nothing to install):
#   docker run --rm --name scm-stat-lab -v "$PWD:/lab" -w /lab python:3.13.17-slim sh run.sh
# Add --nagle after "report" and "quiet" to see the 40 ms delay of the first run.
python server.py 19300 report &
python server.py 19301 quiet &
sleep 1
# 1) closed loop, 8 clients per server
python load.py closed 60 A=8,B=8 closed.csv
python stats.py closed.csv
# 2) open loop, 100 req/s to A and 300 req/s to B
python load.py open 60 A=100,B=300 open.csv
python stats.py open.csv
python stats.py open.csv service_ms
# 3) what happens if B gets 550 req/s instead of 300?
python load.py open 60 A=100,B=550 busy.csv
python stats.py busy.csv
python stats.py busy.csv service_ms
cd lab
docker run --rm --name scm-stat-lab -v "$PWD:/lab" -w /lab python:3.13.17-slim sh run.shوالخيار --rm يحذف ال Container بعد انتهائه، فلا يبقى على جهازك إلا ملفات CSV في المجلد، ويمكنك حذفها بعد قراءة النتائج.
المشكلة التي ظهرت في أول تشغيل: 50 ميلي ثانية سببها Nagle مع Delayed ACK
في النسخة الأولى من السيرفر لم يكن السطر disable_nagle_algorithm موجوداً، وكانت نتيجة الحلقة المغلقة بثمانية عملاء لكل سيرفر كما يلي:
closed: 16428 requests in 60 s -> closed.csv
== closed.csv (latency_ms)
        count     mean    stdev      p50      p90      p95      p99    p99.9      max
A        7997     60.0     30.8     50.3     89.5     90.4    270.4    320.4    539.6
B        8431     56.9     17.5     50.3     80.0     90.0    100.1    324.6    550.6
A+B     16428     58.5     24.9     50.3     88.5     90.2    105.9    320.4    550.6
والرقم الذي يجب أن يوقفك هنا هو الوسيط: 50.3 ميلي ثانية للسيرفرين، مع أن 90% من الطلبات لا تعمل إلا 2 ميلي ثانية، فالوسيط كان يجب أن يكون قريباً من ذلك. ولاحظ أيضاً أن السيرفر B الذي ليس فيه مهمة تقرير وصل أبطأ طلب فيه إلى 550.6 ميلي ثانية. وعندما فحصنا توزيع طلبات B وجدنا أن 5,538 طلباً من 8,431 تجمعت حول 50 ميلي ثانية بالضبط، وهذا لا يمكن أن يكون صدفة: هناك تأخير ثابت قيمته نحو 40 ميلي ثانية يضاف إلى كل طلب تقريباً.
والسبب تفاعل معروف بين آليتين في TCP. الأولى خوارزمية Nagle، وقد وصفت في RFC 896، وهي تمنع المرسل من إرسال حزمة صغيرة جديدة ما دامت حزمة سابقة لم يصل تأكيد استلامها ACK، والهدف تقليل الحزم الصغيرة في الشبكة. والثانية التأكيد المتأخر Delayed ACK، وقد سمح به RFC 1122، حيث ينتظر المستقبل قليلاً قبل إرسال ال ACK على أمل أن يرسله مع بيانات أخرى. والمشكلة أن BaseHTTPRequestHandler في Python يكتب ال Headers في عملية كتابة، ثم ال Body في عملية كتابة ثانية، لأن قيمة wbufsize فيه صفر كما في كود socketserver، فيرسل السيرفر ال Headers، ثم يمنعه Nagle من إرسال ال Body حتى يصل ال ACK، والكلاينت يؤخر ال ACK لأنه ينتظر بقية الرد، فيبقى الطرفان ينتظران حتى ينتهي مؤقت التأكيد المتأخر عند الكلاينت.
والحل أحد أمرين: أن تكتب الرد كاملاً في عملية كتابة واحدة، أو أن توقف Nagle على هذا الاتصال بالخيار TCP_NODELAY، وهو ما يفعله السطر disable_nagle_algorithm = True في StreamRequestHandler، والتفاصيل في صفحة tcp(7). وبعد إضافة السطر أعدنا التشغيل نفسه:
closed: 72209 requests in 60 s -> closed.csv
== closed.csv (latency_ms)
        count     mean    stdev      p50      p90      p95      p99    p99.9      max
A       34843     13.8     18.9      7.3     42.6     45.4     57.4    257.7    299.3
B       37366     12.8     13.0      7.2     41.3     45.0     53.6     73.5    104.0
A+B     72209     13.3     16.1      7.2     42.2     45.2     55.4    254.0    299.3
نزل الوسيط من 50.3 إلى 7.2 ميلي ثانية، وزاد عدد الطلبات في الدقيقة نفسها من 16,428 إلى 72,209، أي أكثر من أربعة أضعاف، بسطر واحد. والدرس الإحصائي هنا أهم من الدرس الشبكي: الذي كشف المشكلة هو الوسيط، لأنه قال إن الطلب العادي يأخذ 50 ميلي ثانية، وهذا يتعارض مع ما نعرفه عن الكود، أما المتوسط 58.5 فكان سيبدو رقماً معقولاً لسيرفر Python لا يثير الشك. لذلك اعرف دائماً الرقم المتوقع للطلب العادي من الكود نفسه، وقارن به الوسيط، فإذا اختلفا كثيراً فهناك شيء لا تعرفه بين الكود والشبكة.
قراءة نتيجة الحلقة المفتوحة Open Loop سطراً سطراً
الجولة الثانية ترسل 100 طلب في الثانية إلى السيرفر A و300 طلب في الثانية إلى السيرفر B، في مواعيد ثابتة، لمدة دقيقة، وهذه هي الجولة التي سوف نعتمد عليها في بقية المقال لأنها تقيس ما يراه المستخدمون فعلاً كما سوف نشرح. والمخرج سوف يكون كما يلي:
open: 24000 requests in 60 s -> open.csv
== open.csv (latency_ms)
        count     mean    stdev      p50      p90      p95      p99    p99.9      max
A        6000     23.2     38.5     10.5     48.7     88.4    222.9    262.0    294.1
B       18000     16.3     15.3     10.7     43.5     49.9     67.6    119.8    164.6
A+B     24000     18.0     23.6     10.7     44.9     51.9    124.7    245.6    294.1

-- histogram of A+B, buckets double in size (ms)
    <1 .. 2           0
     2 .. 4        1066  ###
     4 .. 8        6493  #################
     8 .. 16       9575  ########################
    16 .. 32       3465  #########
    32 .. 64       2802  ########
    64 .. 128       372  #
   128 .. 256       219  #
   256 .. 512         8  #

-- p99 from different methods, A+B
nearest rank 124.7 | statistics.quantiles exclusive 124.7 | inclusive 124.7

-- averaging percentiles
p99 A = 222.9  p99 B = 67.6  average of the two = 145.2  real p99 of all requests = 124.7
server A: average of 60 per-second p99 values = 105.8  max of them = 283.9  real p99 over the whole run = 222.9

-- what a Prometheus histogram with the default buckets would estimate (A+B)
p50: bucket (10, 25] -> estimate 11.6  exact 10.7
p95: bucket (50, 100] -> estimate 60.7  exact 51.9
p99: bucket (100, 250] -> estimate 141.0  exact 124.7

-- share of requests under 100 ms (this one CAN be combined)
A: 5721 of 6000 = 95.35%
B: 17954 of 18000 = 99.74%
A+B: 23675 of 24000 = 98.65%  (the counts add up, the percentiles do not)

-- p99 from only 100 requests, ten different windows of server A
134 54 59 57 249 89 65 50 50 240
في المخرج أعلاه لاحظ التالي:
- سطر العنوان: 24,000 طلب، منها 6,000 للسيرفر A و18,000 للسيرفر B، وهذا يطابق 100 و300 طلب في الثانية لمدة 60 ثانية.
- الوسيط متقارب في السيرفرين: 10.5 و10.7 ميلي ثانية، فالطلب العادي لا يشعر بأي فرق بينهما، ومن ينظر إلى p50 وحده يظن أن السيرفرين متطابقان.
- p99 مختلف تماماً: 222.9 للسيرفر A مقابل 67.6 للسيرفر B، والفرق كله من مهمة التقرير، فهي لا تمس إلا نحو 6% من وقت السيرفر A، ولكنها تملك ذيله بالكامل.
- المتوسط لا يفرق كثيراً: 23.2 مقابل 16.3، فرق صغير لا يوحي بأن عميلاً من كل مئة على السيرفر A ينتظر أكثر من 200 ميلي ثانية.
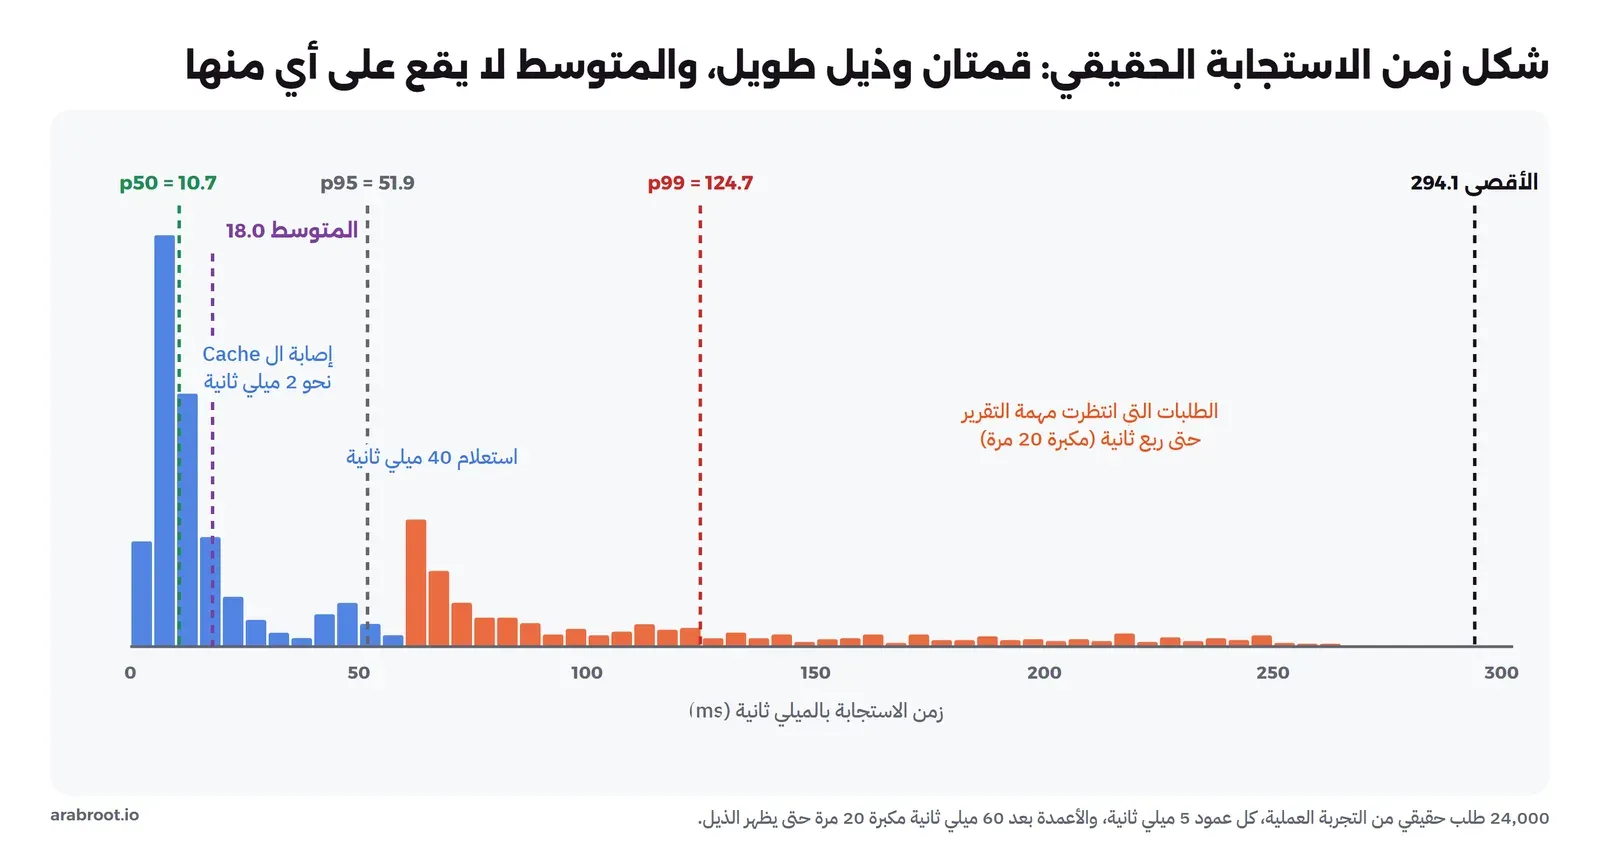
- المدرج التكراري: الفئات تتضاعف 2 ثم 4 ثم 8، وفيه قمة بين 8 و16 ميلي ثانية للطلبات التي أصابت ال Cache، وتجمع آخر بين 32 و64 للاستعلامات، ثم 599 طلباً فوق 64 ميلي ثانية، وهذا هو الذيل.
- طرق المئين: الطرق الثلاث أعطت 124.7 لأن الطلبات كثيرة، وهذا ما ذكرناه سابقاً.
- بقية الأقسام: متوسط المئين، وتقدير Prometheus، والنسبة تحت 100 ميلي ثانية، ولكل منها قسم بعد قليل.
والمدرج نفسه بفئات 5 ميلي ثانية يظهر في الصورة التالية، مع موقع المتوسط والمئين عليه:
ولكي ترى من أين جاء الذيل بالضبط، رسمنا كل طلب من طلبات السيرفر A في أول 12 ثانية كنقطة، فالمحور الأفقي وقت إرسال الطلب والعمودي زمنه:
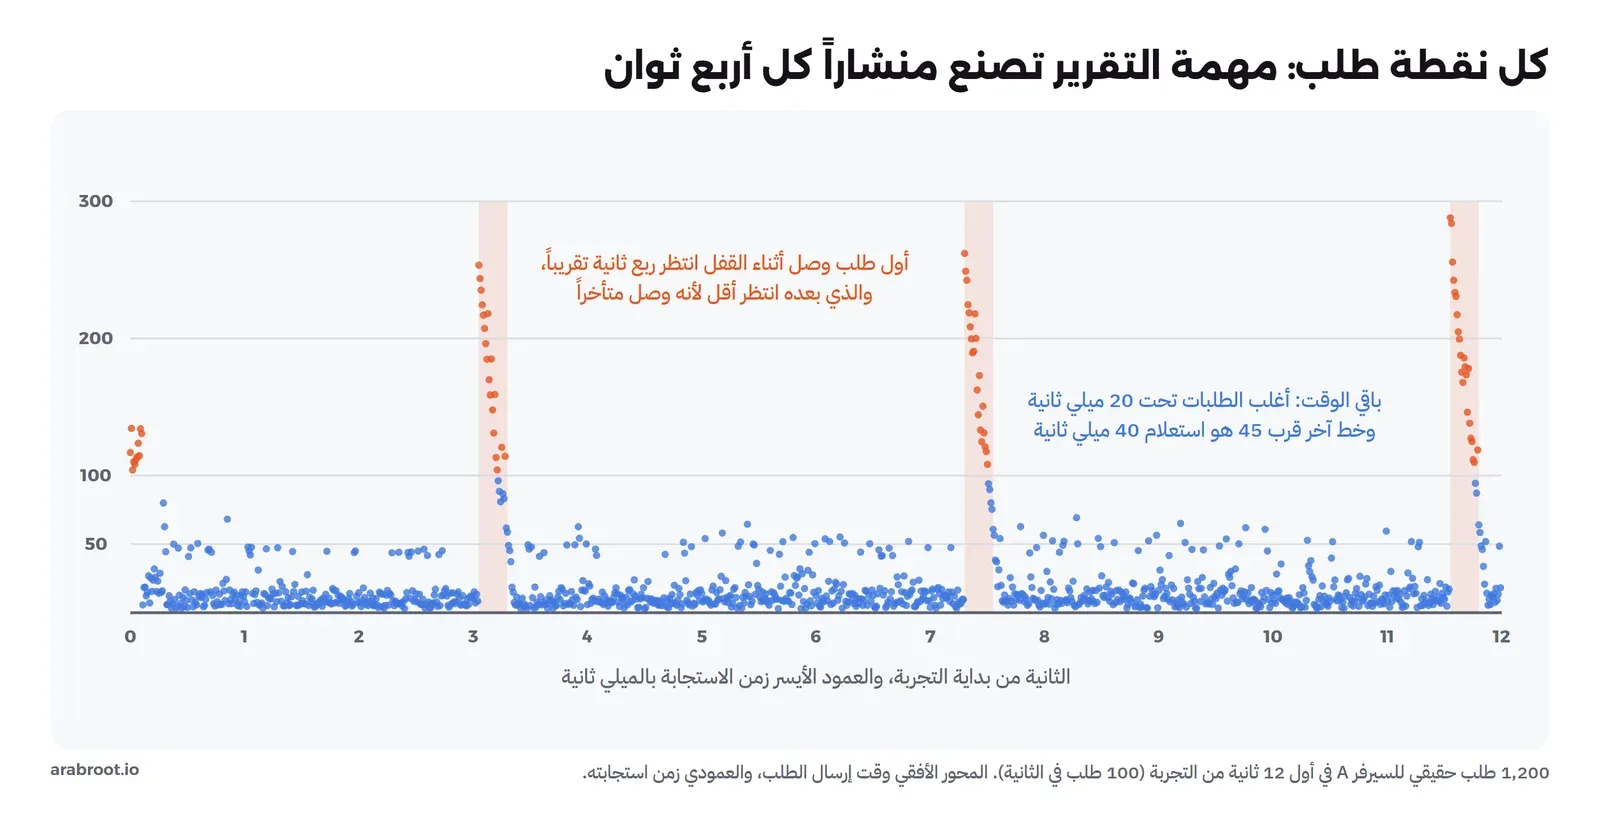
وفي هذا الرسم ثلاث ملاحظات. الأولى أن مهمة التقرير تصنع شكل المنشار: أول طلب وصل بعد أن أمسكت المهمة القفل انتظر ربع ثانية تقريباً، والذي وصل بعده بعشرة ميلي ثانية انتظر أقل بعشرة ميلي ثانية، وهكذا حتى يتحرر القفل. والثانية أن هذا الحدث يأخذ ربع ثانية من كل أربع ثوان، ومع ذلك صنع p99 كاملاً، وهذا هو المعنى العملي للذيل: حدث نادر في الزمن، ولكنه يصيب عدداً ثابتاً من المستخدمين في كل مرة. والثالثة أن أول 0.1 ثانية من التجربة فيها طلبات بين 100 و134 ميلي ثانية، وهذه فترة البدء Warm-up حيث تفتح الاتصالات وتبدأ عشرات ال Threads في وقت واحد، وهي سبب من أسباب أن تستبعد أول ثوان من أي اختبار أداء قبل أن تحسب الأرقام.
المدرج التكراري Histogram: الصورة الكاملة بدل رقم واحد
المئين أفضل من المتوسط، ولكنه في النهاية رقم واحد أيضاً، والصورة الكاملة هي المدرج التكراري Histogram: تقسم المحور الزمني إلى فئات Buckets، وتعد كم طلباً وقع في كل فئة. وفي المدرج السابق ظهر بوضوح ما لا يظهره أي رقم: أن هناك قمتين وليس قمة واحدة، وأن الذيل ليس طلبات عشوائية متفرقة وإنما مجموعة لها سبب.
وللمدرج ميزة أخرى أهم في المراقبة، وهي أنه رخيص: لا تحتاج إلى حفظ زمن كل طلب، وإنما عداد لكل فئة يزيد بواحد، فمهما كان عدد الطلبات تبقى الذاكرة ثابتة. وهذا ما تفعله أدوات المراقبة، فالنوع Histogram في Prometheus يحفظ عداداً تراكمياً لكل حد من حدود الفئات، ثم يقدر المئين عند الاستعلام.
كيف تختار حدود الفئات Buckets؟
الفئات المتساوية، مثل كل 10 ميلي ثانية، تصلح لمجال صغير فقط، فإذا كانت الطلبات بين 1 ميلي ثانية و10 ثوان احتجت إلى ألف فئة، أغلبها فارغ. لذلك تستخدم الأدوات فئات أسية Exponential تتضاعف أو تزيد بنسبة ثابتة، كما فعلنا في stats.py، فتكون دقيقة في الأزمنة الصغيرة وأقل دقة في الكبيرة، وهذا مناسب لأن خطأ ميلي ثانية في طلب مدته 2 ميلي ثانية مهم، وخطأ ميلي ثانية في طلب مدته ثانيتان لا يهم أحداً. وقد ذكر كتاب Google في فصل المراقبة نفسه أن توزيع حدود الفئات بشكل أسي، بمضاعف قريب من 3 مثل 10 و30 و100 و300 ميلي ثانية، طريقة سهلة لرؤية توزيع الطلبات.
وعندما يقدر Prometheus المئين من الفئات، فهو يعرف فقط عدد الطلبات في كل فئة، ولا يعرف أين وقعت داخلها، فيفترض أنها موزعة بالتساوي ويحسب القيمة بالتوزيع الخطي. وقد شرحنا هذه الآلية بمثال في مقال مفاهيم المراقبة، والآن نقارن التقدير بالقيمة الحقيقية على بيانات التجربة، باستخدام الفئات الافتراضية لعملاء Prometheus، وهي بالثواني 0.005 و0.01 و0.025 و0.05 و0.1 و0.25 و0.5 و1 و2.5 و5 و10:
p50: bucket (10, 25] -> estimate 11.6  exact 10.7
p95: bucket (50, 100] -> estimate 60.7  exact 51.9
p99: bucket (100, 250] -> estimate 141.0  exact 124.7
التقدير أعلى من الحقيقة في الثلاثة، وأكبر خطأ في p99 حيث بلغ 16.3 ميلي ثانية، والسبب أن الفئة التي وقع فيها p99 واسعة جداً، من 100 إلى 250 ميلي ثانية، وأغلب الطلبات داخلها قريبة من بدايتها وليست موزعة بالتساوي كما يفترض الحساب. وهذا ما يؤكده توثيق Prometheus عن ال Histograms، حيث يذكر أن خطأ المئين محدود بعرض الفئة التي يقع فيها. والقاعدة العملية من ذلك: ضع حدود الفئات حول الأرقام التي تتخذ عليها قراراً، فإذا كان هدف الخدمة 300 ميلي ثانية فيجب أن يكون 0.3 حداً من حدود الفئات، فيكون سؤال «كم طلباً تجاوز 300 ميلي ثانية؟» دقيقاً تماماً حتى لو كان المئين المعروض تقريبياً.
وقد ظهرت حلول تخفف هذه المشكلة، منها ال Native Histograms في Prometheus وال Exponential Histogram في نموذج بيانات OpenTelemetry، وكلاهما يختار حدود الفئات تلقائياً بنسبة ثابتة بدل أن تحددها بيدك، ومنها مكتبة HdrHistogram التي تحفظ المدرج بدقة نسبية ثابتة تختارها، مثل رقمين أو ثلاثة أرقام معنوية، على مجال واسع جداً.
المدرج عبر الزمن: ال Heatmap
المدرج يصف فترة واحدة، فإذا أردت أن ترى كيف يتغير التوزيع عبر الزمن فالحل هو ال Heatmap: كل عمود فيها مدرج لدقيقة واحدة، وكل خلية لونها بحسب عدد الطلبات في تلك الفئة في تلك الدقيقة. وفي Grafana نوع لوحة جاهز لذلك يقرأ فئات Prometheus مباشرة. وفائدتها أنها تظهر ما يخفيه خط p99 أيضاً، مثل ظهور قمة ثانية جديدة بعد إصدار معين، أو ذيل يظهر في ساعة محددة من كل يوم بسبب مهمة مجدولة، وهو ما رأيناه في رسم المنشار السابق.
لماذا لا يجوز حساب متوسط المئين Percentile؟
هذا أشهر خطأ في لوحات المراقبة، وشكله المعتاد كما يلي: كل سيرفر يحسب p99 لنفسه ويرسله، ثم تأخذ اللوحة متوسط هذه الأرقام وتعرضه على أنه «p99 الخدمة». والمشكلة أن المئين ترتيب، والترتيب لا يجمع، فلكي تعرف الطلب رقم 99 من كل مئة في الخدمة كلها يجب أن ترتب طلبات كل السيرفرات معاً، ومتوسط ترتيبين منفصلين لا يعطيك ذلك. ومن التجربة كانت الأرقام كما يلي:
p99 A = 222.9 p99 B = 67.6 average of the two = 145.2 real p99 of all requests = 124.7متوسط الرقمين 145.2، والحقيقة 124.7، أي خطأ 20.5 ميلي ثانية في هذه الحالة. والسبب أن المتوسط أعطى السيرفر A وزناً مساوياً للسيرفر B، مع أن A لم يخدم إلا ربع الطلبات. وقد يكون الخطأ في الاتجاه الآخر أيضاً، فلو كان السيرفر البطيء هو الذي يخدم أغلب الطلبات لكان المتوسط أقل من الحقيقة، وبالتالي لا يمكنك أن تعرف حتى اتجاه الخطأ من الرقم نفسه. والصورة التالية تبين ذلك، وتبين في الجهة الأخرى الرقم الذي يجمع بشكل صحيح:
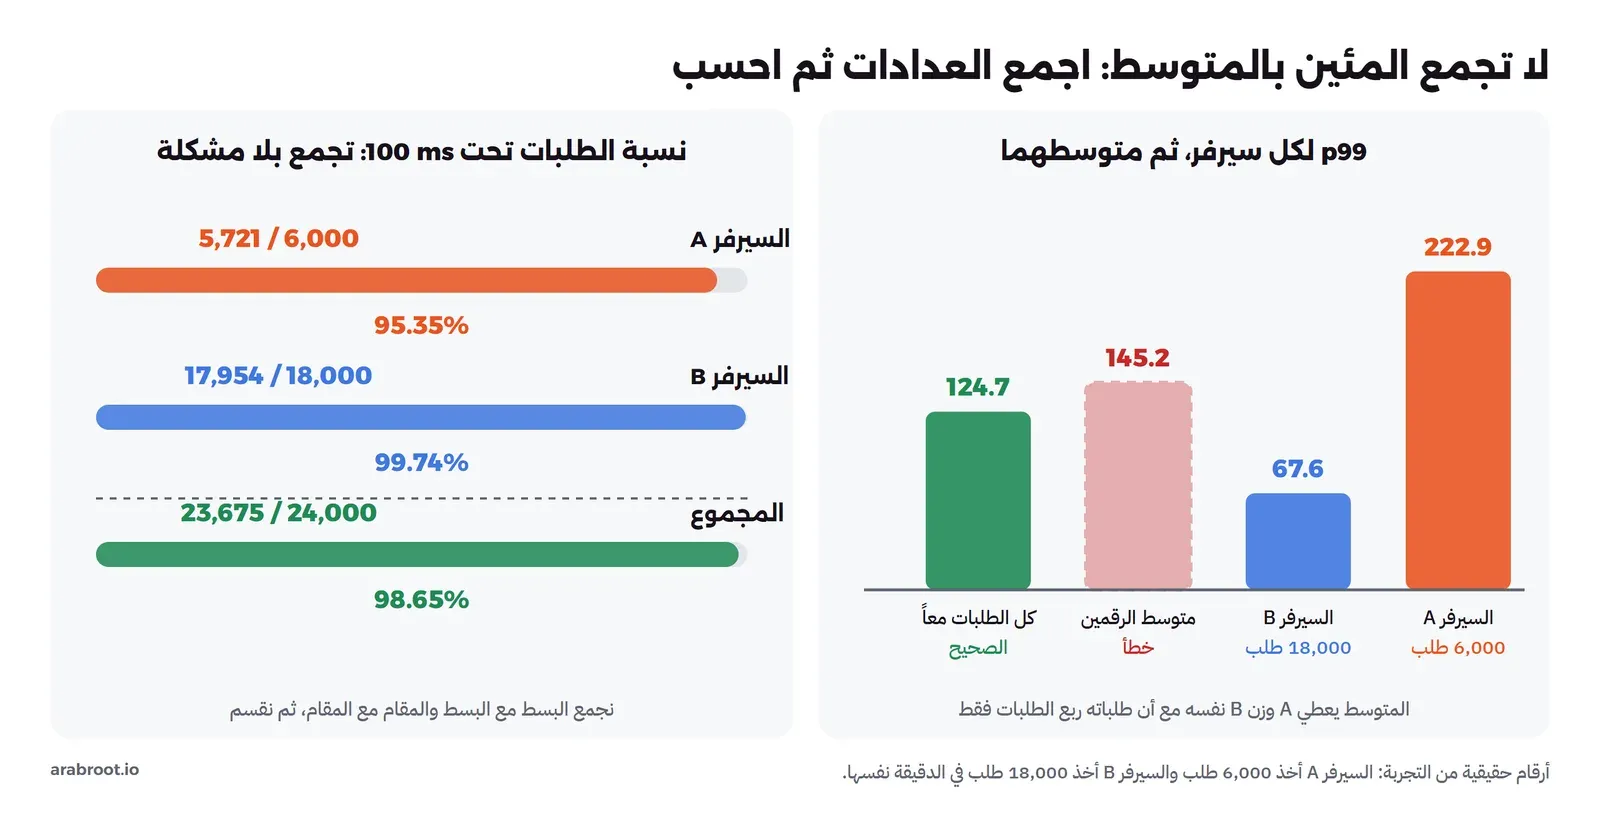
والخطأ نفسه يحدث عبر الزمن، وهو أخفى من الأول. فلوحات المراقبة كثيراً ما تحسب p99 لكل دقيقة، ثم عندما تختار عرض يوم كامل تأخذ متوسط هذه الأرقام. وفي التجربة حسبنا p99 لكل ثانية من الستين ثانية للسيرفر A:
server A: average of 60 per-second p99 values = 105.8 max of them = 283.9 real p99 over the whole run = 222.9متوسط المئين لكل ثانية 105.8، والمئين الحقيقي للدقيقة 222.9، أي أن المتوسط أظهر أقل من نصف الحقيقة. والسبب أن مهمة التقرير تقع في ثانية واحدة من كل أربع ثوان تقريباً، فالثواني الهادئة الكثيرة تسحب المتوسط إلى الأسفل، مع أن الطلبات التي انتظرت في الثواني المزدحمة حقيقية ولم تختف.
ما الذي يجمع Aggregate بشكل صحيح؟
القاعدة البسيطة: اجمع العدادات، ثم احسب. والعدادات تجمع لأنها أعداد طلبات، ومجموع طلبات سيرفرين هو عدد طلبات الخدمة، وبالتالي:
- اجمع فئات المدرج ثم قدر المئين: إذا كانت كل السيرفرات تستخدم الحدود نفسها للفئات، فمجموع الفئة نفسها من كل السيرفرات هو فئة الخدمة، ثم تحسب المئين من المجموع. وفي Prometheus يكون ذلك بالدالة
histogram_quantileبعد جمع الفئات على الحدle، كما في المثال التالي. - أو احسب نسبة الطلبات تحت الحد: عدد الطلبات تحت 100 ميلي ثانية مقسوماً على كل الطلبات، فهذه نسبة يجمع بسطها مع بسطها ومقامها مع مقامها، كما في التجربة: 5,721 زائد 17,954 يساوي 23,675، و6,000 زائد 18,000 يساوي 24,000، والنسبة 98.65% صحيحة تماماً للخدمة كلها.
- لا تجمع المئين المحسوب مسبقاً: ومنه النوع Summary في Prometheus، فهو يحسب المئين داخل التطبيق ويرسل الرقم الجاهز، ويذكر التوثيق صراحة أن هذا الرقم لا يمكن تجميعه بين النسخ.
# p99 of the whole service over 5 minutes: sum the buckets of all instances first
histogram_quantile(0.99, sum by (le) (rate(http_request_duration_seconds_bucket[5m])))

# share of requests under 300 ms, also correct across instances
sum(rate(http_request_duration_seconds_bucket{le="0.3"}[5m]))
  / sum(rate(http_request_duration_seconds_count[5m]))
في الاستعلام الأول لاحظ أن sum by (le) يأتي داخل histogram_quantile، أي أن الجمع يحدث على الفئات قبل حساب المئين، ولو عكست الترتيب فحسبت المئين لكل نسخة ثم أخذت المتوسط بالدالة avg لوقعت في الخطأ نفسه الذي رأيناه في التجربة. والاستعلام الثاني هو الشكل الذي تبنى عليه أهداف الخدمة SLO عادة، وقد شرحنا الأهداف وميزانية الأخطاء في مقال مفاهيم المراقبة، والسبب في أن الهدف يكتب عادة «99% من الطلبات تحت 300 ميلي ثانية» وليس «p99 أقل من 300» هو هذا بالضبط: الصيغة الأولى نسبة تجمع عبر السيرفرات وعبر الزمن، فيمكن حسابها لشهر كامل من عدادات كل دقيقة.
أداة توليد الضغط نفسها قد تخفي عنك التوقف: التجاهل المنسق Coordinated Omission
قارن الآن رقمين للسيرفر نفسه A من الجولتين: في الحلقة المغلقة بثمانية عملاء كان p99 يساوي 57.4 ميلي ثانية، وفي الحلقة المفتوحة كان 222.9. والسيرفر هو هو، والكود هو هو، ومهمة التقرير هي نفسها كل أربع ثوان، فمن أين جاء هذا الفرق الكبير؟
والإجابة في طريقة إرسال الطلبات. ففي الحلقة المغلقة لا يرسل العميل طلباً جديداً حتى يصله الرد، فعندما تمسك مهمة التقرير القفل ربع ثانية، يرسل كل عميل من الثمانية طلباً واحداً ثم يقف منتظراً، فلا يسجل إلا ثمانية طلبات بطيئة في كل توقف، بينما يسجل في الوقت الطبيعي مئات الطلبات السريعة في الثانية. والنتيجة أن الطلبات البطيئة أصبحت نادرة جداً في البيانات، فظهرت في p99.9 بقيمة 257.7 ولم تظهر في p99. أما المستخدمون الحقيقيون فلا ينسقون مع السيرفر بهذا الشكل، فهم يصلون في مواعيدهم سواء كان السيرفر متوقفاً أم لا، وكل من وصل أثناء التوقف ينتظر. وهذه الظاهرة لها اسم هو Coordinated Omission، أي أن أداة القياس «تتفق» مع السيرفر على عدم قياس الفترة السيئة، وقد اشتهر الاسم مع أداة wrk2 التي بنيت لتصحيحه بإرسال الطلبات بمعدل ثابت وحساب الزمن من الموعد المخطط. والصورة التالية تبين الفرق:
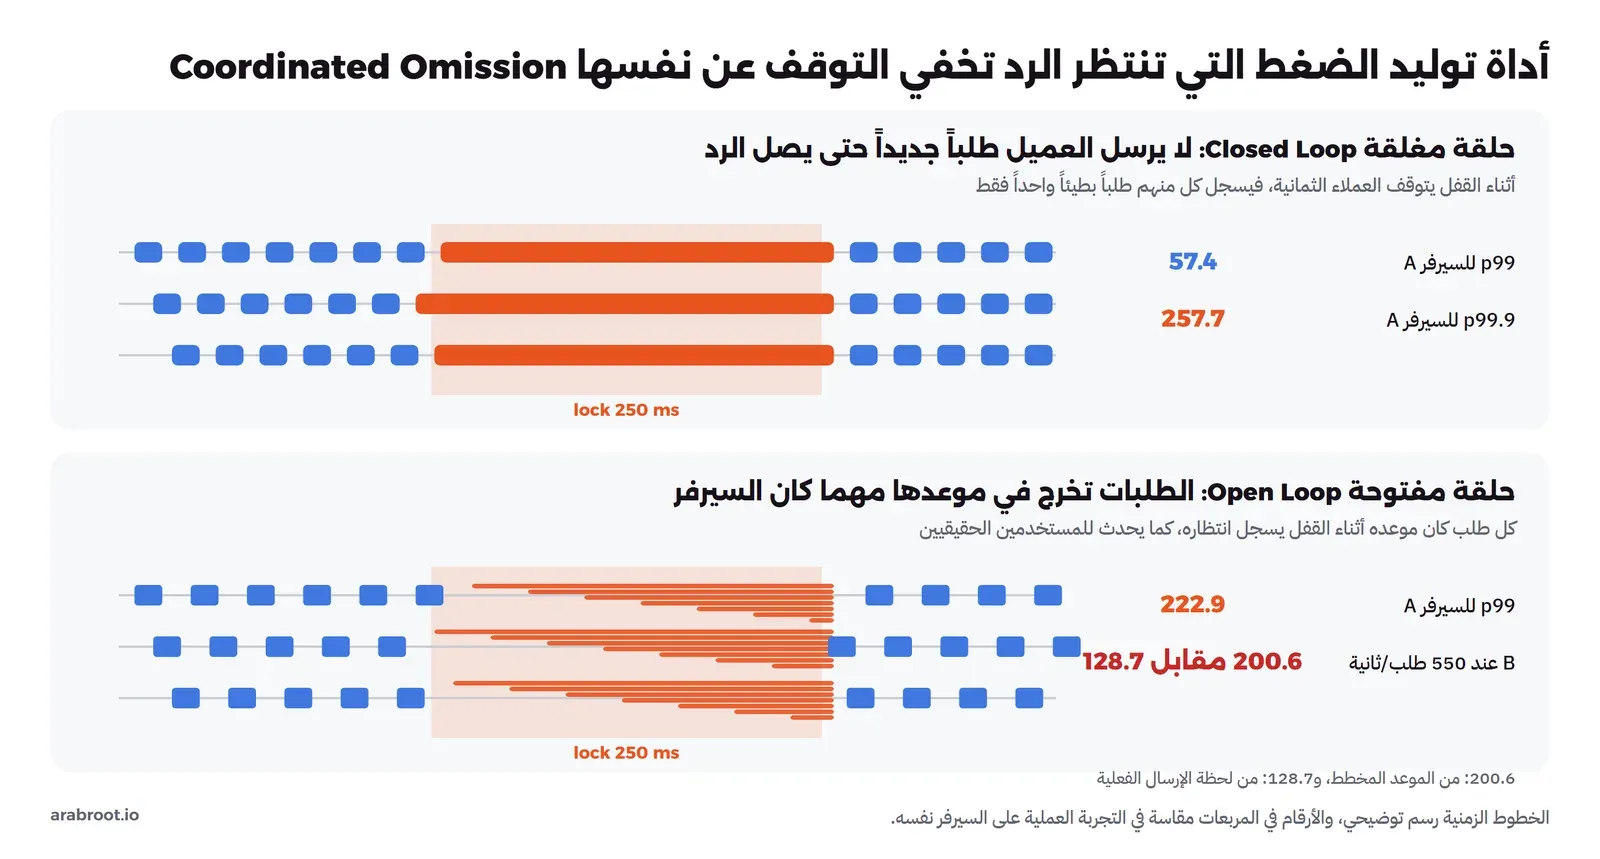
وهذا لا يعني أن الحلقة المغلقة خاطئة دائماً، فهي مناسبة عندما يكون سلوك المستخدم الحقيقي نفسه مغلقاً، مثل برنامج يعالج طابوراً من المهام واحدة بعد الأخرى. ولكن لخدمة ويب يصل إليها مستخدمون مستقلون فالحلقة المفتوحة هي الأقرب للواقع، ولذلك تفرق أدوات اختبار الضغط بين النموذجين، كما في توثيق k6 عن النموذج المفتوح والمغلق، حيث تستخدم ال Executors من نوع Arrival Rate النموذج المفتوح. وقد شرحنا أنواع اختبارات الضغط وأدواتها في مقال اختبار الضغط، والمهم هنا أن تعرف أي النموذجين تستخدم أداتك قبل أن تثق في p99 الذي تطبعه.
ماذا يحدث إذا اقترب السيرفر من طاقته Capacity؟
في الجولة الثالثة تركنا السيرفر A كما هو عند 100 طلب في الثانية، ورفعنا الضغط على السيرفر B من 300 إلى 550 طلباً في الثانية، أي أقل من ضعف الضغط السابق. ولكي تعرف أين يقع هذا الرقم من طاقة السيرفر، احسبها من الكود: أربعة اتصالات، ومتوسط عمل الطلب 0.9 في 2 زائد 0.1 في 40، أي 5.8 ميلي ثانية، فالسيرفر يخدم نظرياً نحو 690 طلباً في الثانية قبل أن يمتلئ، والضغط الجديد نحو 80% منها. والمخرج سوف يكون كما يلي:
open: 39000 requests in 60 s -> busy.csv
== busy.csv (latency_ms)
        count     mean    stdev      p50      p90      p95      p99    p99.9      max
A        6000     23.8     39.8      9.9     51.0     91.7    227.9    274.5    319.2
B       33000     60.0     48.4     47.7    131.6    161.0    200.6    248.1    333.5
A+B     39000     54.4     48.9     40.7    125.7    158.3    202.6    255.5    333.5
== busy.csv (service_ms)
        count     mean    stdev      p50      p90      p95      p99    p99.9      max
A        6000     20.4     39.5      6.4     46.2     89.8    224.2    268.1    311.3
B       33000     37.5     29.2     33.3     76.0     91.6    128.7    185.8    260.7
A+B     39000     34.9     31.6     28.4     74.1     91.6    141.4    238.1    311.3
والجدول التالي يضع أرقام B في الجولتين بجانب بعضها:
| السيرفر B | 300 طلب/ثانية | 550 طلب/ثانية | التغير |
|---|---|---|---|
| المتوسط | 16.3 | 60.0 | 3.7 أضعاف |
| p50 | 10.7 | 47.7 | 4.5 أضعاف |
| p99 | 67.6 | 200.6 | 3 أضعاف |
p99 من لحظة الإرسال service_ms | 60.0 | 128.7 | ضعفان |
زاد الضغط 1.8 مرة، فزاد الوسيط 4.5 مرات، والسبب هو الطابور: عندما يكون السيرفر مشغولاً 40% من الوقت نادراً ما يجد الطلب الاتصالات الأربعة مشغولة، وعندما يكون مشغولاً 80% من الوقت يجدها مشغولة كثيراً، فينتظر، وانتظاره يجعل الذي بعده ينتظر أكثر. وهذه هي العلاقة المعروفة في نظرية الطوابير Queueing Theory، أن زمن الانتظار لا يكبر بشكل خطي مع الضغط، وإنما ببطء في البداية ثم بسرعة كبيرة كلما اقترب الاستخدام Utilization من 100%. وهذا سبب عملي لترك هامش في الطاقة، فالسيرفر الذي يعمل على 80% ليس «أكثر كفاءة» من الذي يعمل على 40%، وإنما أبطأ بكثير لكل مستخدم.
ولاحظ السطر الأخير في الجدول: عند 550 طلباً في الثانية أصبح الفرق بين p99 من الموعد المخطط 200.6 و p99 من لحظة الإرسال 128.7 أكثر من 70 ميلي ثانية، والسبب أن ال Workers الاثنين والثلاثين في أداة توليد الضغط أصبحوا مشغولين في أوقات الذروة، فتأخر خروج بعض الطلبات عن موعدها. ولو حسبنا الزمن من لحظة الإرسال فقط لأخفينا هذا التأخير، وهذه صورة أخرى من Coordinated Omission، تظهر حتى في الحلقة المفتوحة إذا لم تحسب الزمن من الموعد المخطط.
وعندما أعدنا التجربة كاملة بالملف run.sh على الجهاز نفسه في وقت لاحق، أعطت الجولة الثالثة للسيرفر B وسيطاً 18.5 بدل 47.7، و p99 بقيمة 138.5 بدل 200.6، أي أن الشكل بقي كما هو، فالوسيط ارتفع أكثر من الضغط والذيل اتسع، ولكن الأرقام نفسها تغيرت كثيراً. والسبب أن السيرفر قرب طاقته حساس جداً لأي تغير صغير في المعالج المتاح له، والتجربة تعمل في Docker على جهاز تطوير تشغل فيه برامج أخرى، فبضع نقاط مئوية من المعالج تكفي لتغيير طول الطابور. وهذه نتيجة بحد ذاتها: كلما اقترب السيرفر من طاقته أصبحت أرقامه أقل ثباتاً بين التشغيلات، فلا تحكم على سيرفر يعمل على 80% من تشغيل واحد.
والسيرفر A لم يتغير تقريباً، فالوسيط 9.9 بدل 10.5 و p99 بقيمة 227.9 بدل 222.9، وهذا متوقع لأن الضغط عليه لم يتغير، ولأن السيرفرين عمليتان منفصلتان. وهذا الثبات نفسه معلومة مفيدة: الفروقات الصغيرة بين الجولات، مثل 5 ميلي ثانية في p99، هي الضجيج الطبيعي للقياس وليست تغيراً في السيرفر.
لماذا يهمك p99 أكثر مما تظن؟
قد يبدو 1% رقماً صغيراً لا يستحق كل هذا الاهتمام، ولكن هناك سببين يجعلانه أهم مما يبدو. الأول أن المستخدم لا يرسل طلباً واحداً، فصفحة واحدة في تطبيق حديث قد ترسل عشرات الطلبات إلى ال API، ومستخدم يتصفح عشر صفحات في الجلسة يرسل مئات الطلبات، وبالتالي احتمال أن يصادف طلباً من أبطأ 1% في جلسته كبير جداً، أي أن p99 ليس تجربة «عميل نادر» وإنما تجربة أغلب العملاء في بعض اللحظات.
والثاني هو التوزيع على الخدمات Fan-out، فعندما يحتاج طلب واحد من المستخدم إلى انتظار ردود عدة خدمات داخلية، فإنه ينتظر أبطأها، وكلما زاد عدد الخدمات زاد احتمال أن تكون إحداها في ذيلها. وقد عبر كتاب Google عن ذلك في فصل المراقبة الذي ذكرناه، حيث قال إن p99 لخدمة خلفية واحدة قد يصبح بسهولة الوسيط لزمن الواجهة الأمامية. وحساب هذا الاحتمال بالأرقام، ولماذا يصل إلى نحو 63% مع مئة خدمة، موجود في مقال الاحتمالات للمبرمجين في هذه المرحلة نفسها، والمهم هنا النتيجة العملية: الخدمة الداخلية التي يستدعيها غيرها كثيراً يجب أن تراقب ب p99 أو p99.9، وليس ب p95.
هل التحسين حقيقي؟ مقارنة قبل وبعد Before and After
من أكثر الأسئلة تكراراً بعد أي تعديل للأداء: «هل أصبح أسرع؟». والخطأ المعتاد أن تشغل الاختبار مرة قبل التعديل ومرة بعده، وتقارن المتوسط، وتعلن النتيجة. ورأينا في التجربة أن السيرفر A دون أي تغيير أعطى p99 بقيمة 222.9 في جولة و227.9 في جولة أخرى، وأن وسيط السيرفر B عند 550 طلباً في الثانية كان 47.7 في تشغيل و18.5 في تشغيل لاحق، وأن p99 لمئة طلب تراوح بين 50 و249 في الدقيقة نفسها، وبالتالي فرق 5% بين تشغيلين قد يكون ضجيجاً كاملاً. وفيما يلي ما يجعل المقارنة صادقة:
- الضغط نفسه بالنموذج نفسه: عدد الطلبات في الثانية نفسه، والحلقة نفسها مفتوحة أو مغلقة، وإلا قارنت طابوراً قصيراً بطابور طويل كما رأينا عند 300 و550 طلباً.
- استبعد فترة البدء: الثواني الأولى فيها فتح الاتصالات وتسخين ال Cache وترجمة الكود في اللغات التي تستخدم JIT، فلا تدخلها في الحساب.
- كرر التشغيل: ثلاث مرات على الأقل لكل حالة، وانظر هل المدى بين التشغيلات في حالة واحدة أصغر من الفرق بين الحالتين، فإذا كان المدى أكبر من الفرق فلا يمكنك أن تقول شيئاً بعد.
- قارن المدرج وليس رقماً واحداً: التعديل قد يحسن الوسيط ويسوء الذيل، مثل Cache جديد يسرع الإصابات ويضيف قفلاً عند التحديث، وهذا لا يظهر إلا إذا وضعت المدرجين بجانب بعضهما.
- فكر في عدد الطلبات خلف المئين: p99.9 من دقيقة بعشرة آلاف طلب رقم يعتمد على عشرة طلبات فقط، فلا تبن عليه قراراً.
أخطاء شائعة
- لوحة فيها المتوسط وحده: المتوسط يخفي الذيل ويخفي القمتين، فإذا كان في لوحتك رقم واحد لزمن الاستجابة فاجعله مدرجاً أو مجموعة مئين، p50 و p95 و p99، والأقصى بجانبها.
- متوسط p99 بين السيرفرات أو عبر الزمن: أعطانا في التجربة 145.2 بدل 124.7 بين سيرفرين، و105.8 بدل 222.9 عبر الثواني، فاجمع الفئات أو العدادات ثم احسب.
- استخدام النوع Summary لخدمة لها عدة نسخ: المئين المحسوب داخل كل نسخة لا يجمع، فاستخدم Histogram بالحدود نفسها في كل النسخ.
- فئات لا تحتوي حد الهدف: إذا كان الهدف 300 ميلي ثانية والفئات 250 ثم 500، فكل قرار «فوق الهدف أم تحته» تقدير، فأضف الحد 0.3 إلى الفئات.
- p99.9 على عدد قليل من الطلبات: رقم يعتمد على طلب أو اثنين يتغير مع كل نافذة زمنية، فوسع النافذة أو اكتف بمئين أقل.
- اختبار ضغط بحلقة مغلقة لخدمة يصلها مستخدمون مستقلون: يخفي التوقفات كما رأينا في 57.4 مقابل 222.9، فاستخدم معدلاً ثابتاً واحسب الزمن من الموعد المخطط.
- قاعدة «المتوسط زائد انحرافين» لزمن الاستجابة: تفترض منحنى الجرس، وأعطت في التجربة 100.2 بينما p99 الحقيقي 222.9.
- قياس الزمن بساعة النظام:
time.timeوما يشبهها قد تقفز مع NTP، فاستخدم ساعة رتيبة مثلtime.perf_counterفي Python. - تجاهل الوسيط عندما يبدو المتوسط معقولاً: الوسيط هو الذي كشف مشكلة Nagle في التجربة، لأنه قال إن الطلب العادي 50 ميلي ثانية والكود لا يعمل إلا 2.
أي رقم تستخدم لأي سؤال؟ جدول القرار Decision Table
| السؤال | الرقم المناسب | لماذا |
|---|---|---|
| كم ينتظر العميل عادة؟ | p50 (الوسيط) | لا يتأثر بالقيم البعيدة، ويكشف التأخير الثابت مثل Nagle |
| هل يوجد عملاء ينتظرون كثيراً؟ | p95 و p99 | يصفان الذيل الذي يكتب منه العملاء للدعم الفني |
| هل حدث توقف أو Timeout؟ | الأقصى Max | طلب واحد يكفي لكشفه، مع أنه لا يصلح هدفاً |
| هل التزمنا بهدف الخدمة SLO؟ | نسبة الطلبات تحت الحد | تجمع عبر السيرفرات وعبر الزمن بشكل صحيح |
| ما شكل الأداء؟ قمتان؟ ذيل؟ | المدرج Histogram أو ال Heatmap | يظهر ما لا يظهره أي رقم واحد |
| كم سيرفراً أحتاج؟ كم تكلف الطلبات؟ | المتوسط مع عدد الطلبات | المتوسط مضروباً في العدد هو مجموع وقت العمل، وهذا سؤال سعة وليس سؤال تجربة مستخدم |
| p99 للخدمة كلها من عدة نسخ | histogram_quantile على مجموع الفئات | الجمع قبل الحساب، وليس متوسط المئين |
ولاحظ الصف قبل الأخير: المتوسط ليس رقماً سيئاً في كل الحالات، وإنما رقم لسؤال آخر، فإذا كنت تخطط للسعة Capacity فمجموع وقت العمل هو ما يحدد عدد السيرفرات، والمتوسط مضروباً في عدد الطلبات يعطيك هذا المجموع بالضبط، وهو ما لا يعطيك إياه الوسيط ولا المئين.
قائمة تحقق Checklist للوحة زمن الاستجابة Latency
- تعرض اللوحة p50 و p95 و p99 على الأقل، والأقصى بجانبها، أو Heatmap للمدرج.
- المئين للخدمة كلها يحسب من مجموع فئات كل النسخ، وليس من متوسط المئين لكل نسخة.
- حدود الفئات تتضمن كل رقم تتخذ عليه قراراً، مثل هدف الخدمة وحد التنبيه.
- هدف الخدمة مكتوب كنسبة طلبات تحت حد، مثل 99% تحت 300 ميلي ثانية.
- النافذة الزمنية فيها طلبات كافية للمئين المعروض، أي آلاف الطلبات ل p99.
- عند عرض فترة طويلة لا تأخذ اللوحة متوسط المئين لكل دقيقة.
- أداة اختبار الضغط ترسل بمعدل ثابت وتحسب الزمن من الموعد المخطط.
- الوسيط قريب مما تتوقعه من الكود للطلب العادي، وإلا فابحث عن تأخير ثابت في الطريق.
- مقارنات قبل وبعد تكرر ثلاث مرات على الأقل وتستبعد فترة البدء.
تدريب عملي
- شغل السيرفرين بالخيار
--nagleثم بدونه، واحسب الوسيط في الحالتين، ثم عدلdo_GETلترسل ال Headers وال Body في عملية كتابة واحدة مع إبقاء Nagle مفعلاً، وتأكد أن الوسيط ينزل أيضاً. - غير مدة مهمة التقرير في
server.pyمن 0.25 إلى 0.05 ثانية، وانظر ماذا يحدث ل p99 و p99.9 للسيرفر A في الحلقة المفتوحة، ثم فسر النتيجة بعدد الطلبات التي تصل أثناء القفل. - أضف إلى
stats.pyحساب p99 من فئات تتضاعف كل مرة، مثل 1 و2 و4 حتى 512 ميلي ثانية، وقارن خطأه بخطأ الفئات الافتراضية لعملاء Prometheus.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المتوسط يتأثر بحجم القيم البعيدة ويقع في المكان الخطأ في الذيل الطويل وفي التوزيع ذي القمتين، فلا تجعله الرقم الوحيد لزمن الاستجابة.
- زمن الاستجابة له حد أدنى وذيل مفتوح بسبب الطابور وال Cache والتوقفات الدورية، لذلك لا تنطبق عليه قواعد منحنى الجرس ولا قاعدة «المتوسط زائد انحرافين».
- المئين رقم ترتيب: p99 هو الطلب رقم 99 من كل مئة بعد الفرز، ويحتاج إلى طلبات كافية خلفه، فقد تراوح p99 لمئة طلب بين 50 و249 في الدقيقة نفسها.
- الوسيط هو الذي كشف تأخير Nagle في التجربة، فقارنه دائماً بما تتوقعه من الكود.
- لا تحسب متوسط المئين بين السيرفرات ولا عبر الزمن، واجمع فئات المدرج أو عدد الطلبات تحت الحد ثم احسب.
- أداة توليد الضغط التي تنتظر الرد قبل الطلب التالي تخفي التوقفات، فقد أعطت 57.4 للسيرفر الذي يراه المستخدمون عند 222.9.
- زمن الانتظار يكبر بسرعة كلما اقترب السيرفر من طاقته، فزيادة الضغط 1.8 مرة رفعت الوسيط 4.5 مرات.
وفي مرحلة الرياضيات التي يحتاجها المبرمج فعلاً يأتي بعد هذا المقال مقال الاحتمالات للمبرمجين عن تصادم المعرفات والهاش وتوفر الأنظمة، ثم مقال الرياضيات خلف التشفير في RSA. وهذه مقالات منشورة يعتمد عليها هذا المقال أو يكملها:
 دليلمفاهيم المراقبة Observability: من الإشارة إلى التنبيهما الذي تجيب عنه المقاييس والسجلات والتتبع، وكيف تبني تنبيهاً على ما يشعر به المستخدم وعلى ميزانية الأخطاء بدل كل رقم.
 دليلاختبار الضغط Load Testing للمبتدئينلماذا يعمل تطبيقك مع خمسة مستخدمين وينهار مع خمسمئة، وكيف تكتشف ذلك وتصلحه قبل يوم الإطلاق.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلFloating Point من الداخل: كيف يخزن الحاسب الكسوركيف يحفظ معيار IEEE 754 الكسور في البتات، ولماذا تكبر الفجوة بين الأرقام وتضيع خانات المعرفات، ومتى تحتاج النوع العشري.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة في Container على x86-64 مع Python 3.13.17 (python:3.13.17-slim) وDocker Engine 29.8.0.


