


نعود إلى الفريق الذي بدأنا معه السلسلة: بعد أن امتلأ قرص سيرفر الملفات فجراً بنى الفريق لوحة Grafana فيها المعالج والذاكرة والقرص لكل سيرفر، وأضاف تنبيهاً يتوقع امتلاء القرص قبل حدوثه، وشعر الجميع أن المراقبة أصبحت جيدة. ثم جاء أول عرض تسويقي كبير، وأرسلت الشركة رسالة لكل العملاء في الساعة التاسعة مساءً، وبعد عشر دقائق امتلأت قناة الدعم برسائل تقول إن صفحة الدفع «تدور» ولا تنتهي. وفتح الفريق اللوحة فوجدها خضراء بالكامل: المعالج في سيرفر التطبيق عند 5%، والذاكرة مستقرة، والقرص بعيد عن الامتلاء، ولا يوجد خطأ واحد في السجلات. وبقي الفريق نصف ساعة يبحث في المكان الخطأ، لأن اللوحة تقيس السيرفر، والذي امتلأ لم يكن السيرفر وإنما شيء داخل الخدمة نفسها.
وهذا هو موضوع المقال الثاني في السلسلة: في مقاييس السيرفرات مع Prometheus ولوحات Grafana قسنا الأجهزة، والآن نقيس الخدمة كما يراها المستخدم، بالإشارات الذهبية الأربع Four Golden Signals: زمن الاستجابة Latency، وحجم الحركة Traffic، والأخطاء Errors، والتشبع Saturation. وقد عرفنا هذه الإشارات مع طريقتي RED وUSE باختصار في مفاهيم المراقبة Observability، وهنا ننزل إلى التفاصيل التي لا تظهر إلا عندما تضيف القياس إلى كود حقيقي وتضغط عليه حتى ينهار. والمواضيع في السلسلة:
- مقاييس السيرفرات مع Prometheus ولوحات Grafana.
- ماذا تقيس في خدمتك؟ الإشارات الذهبية Golden Signals (الموضوع الحالي).
- فحص التوفر Uptime Checks مع Blackbox Exporter أو Uptime Kuma.
- التنبيهات Alerting: ماذا تنبه عليه، وكيف تتجنب تعب التنبيهات Alert Fatigue.
- بوابة مراقبة واحدة Monitoring Portal تجمع Grafana مع Wazuh.
وسوف نناقش في هذا المقال ما يلي:
- من أين جاءت الإشارات الأربع، ولماذا تكفي أربع لأغلب الخدمات.
- خدمة دفع صغيرة نضيف إليها القياس Instrumentation بمكتبة Prometheus الرسمية لـ Python، ومولد ضغط Load Generator يقيس من جهة العميل.
- حجم الحركة: لماذا قالت المقاييس 50 طلباً في الثانية ونحن نرسل 55.
- زمن الاستجابة: كيف أعطانا المدرج التكراري Histogram رقماً أكبر من الحقيقي بـ 85%، وكيف أصلحناه.
- الأخطاء: الخطأ الذي يرجع برمز 200 ولا تراه أي لوحة.
- التشبع: مجمع اتصالات Pool امتلأ، فانتظر الطلب ست ثوان، والمعالج عند 5%، دون خطأ واحد.
- اللوحة الكاملة، والانتقال من العرض في RED إلى السبب في USE، وماذا تقيس في الخدمات التي لا تستقبل طلبات HTTP، ثم الأخطاء الشائعة وقائمة تحقق.
لماذا أربع إشارات Signals فقط؟
أي مكتبة قياس تعطيك عشرات الأرقام دون أن تطلب، وأي إطار عمل يضيف عشرات أخرى، والسؤال الذي يواجهه كل فريق ليس «كيف أجمع الأرقام؟» وإنما «أي رقم يقول لي إن المستخدم يعاني؟». والإجابة الأشهر جاءت من فصل مراقبة الأنظمة الموزعة في كتاب Google SRE الذي نشر عام 2016، حيث يقول إنك إذا كنت لا تستطيع أن تقيس إلا أربعة أرقام في نظامك الذي يتعامل مع المستخدم فركز على هذه الأربعة، ويضيف أنك إذا قست الأربعة ونبهت أحداً عندما تسوء إحداها، أو في حالة التشبع عندما تقترب من السوء، فإن خدمتك مغطاة بالمراقبة بشكل مقبول على الأقل.
وقبل ذلك بسنة وضع Tom Wilkie طريقة RED للخدمات، وهي المعدل Rate والأخطاء Errors والمدة Duration، كما يذكر مقال Grafana عنها، وهي الإشارات الثلاث الأولى نفسها بأسماء مختلفة. أما الرابعة، أي التشبع، فهي من عالم الموارد، وأشهر طريقة لها هي طريقة USE لـ Brendan Gregg: لكل مورد افحص الاستخدام Utilization والتشبع Saturation والأخطاء Errors. والفكرة التي تجمع الثلاث: الإشارات الثلاث الأولى تقول ماذا يرى المستخدم، والتشبع يقول كم بقي قبل أن يبدأ المستخدم في الرؤية، ولذلك هو الإشارة الوحيدة التي تنبهك قبل أن تحدث المشكلة.
وقد يتساءل البعض: لماذا لا نكتفي بمقاييس السيرفر التي بنيناها في المقال السابق؟ والإجابة في قصة الفريق نفسها: المعالج والذاكرة والقرص موارد عامة يشترك فيها كل شيء على السيرفر، ولكن الخدمة لها موارد خاصة بها لا يراها نظام التشغيل، مثل عدد اتصالات قاعدة البيانات المسموحة، وعدد العمليات Workers في الخادم، وحجم الطابور Queue الداخلي، وحدود الطلبات عند مزود خارجي. فإذا امتلأ أحدها فالسيرفر مرتاح تماماً والمستخدم ينتظر، وهذا بالضبط ما سوف نراه بالأرقام بعد قليل.
الخدمة التي نقيسها: صفحة الدفع checkout
نبني نسخة صغيرة من خدمة الدفع التي تعطلت في القصة. كل طلب على المسار /checkout يحتاج اتصالاً من مجمع اتصالات قاعدة البيانات Connection Pool، والمجمع فيه أربعة اتصالات فقط، وكل استعلام يأخذ في المتوسط 80 مللي ثانية، وقد يتراوح بين 40 و120، ثم يرجع الاتصال إلى المجمع. فإذا جاء طلب والاتصالات الأربعة مشغولة فإنه ينتظر حتى يتحرر أحدها. وهذا التصميم ليس مصطنعاً، فأغلب أطر العمل تفتح مجمعاً بحجم ثابت صغير بشكل افتراضي، وكثير من الفرق لا تعرف كم حجمه حتى يمتلئ. والصورة التالية تبين مسار الطلب، والمقياس الذي يقيس كل إشارة:
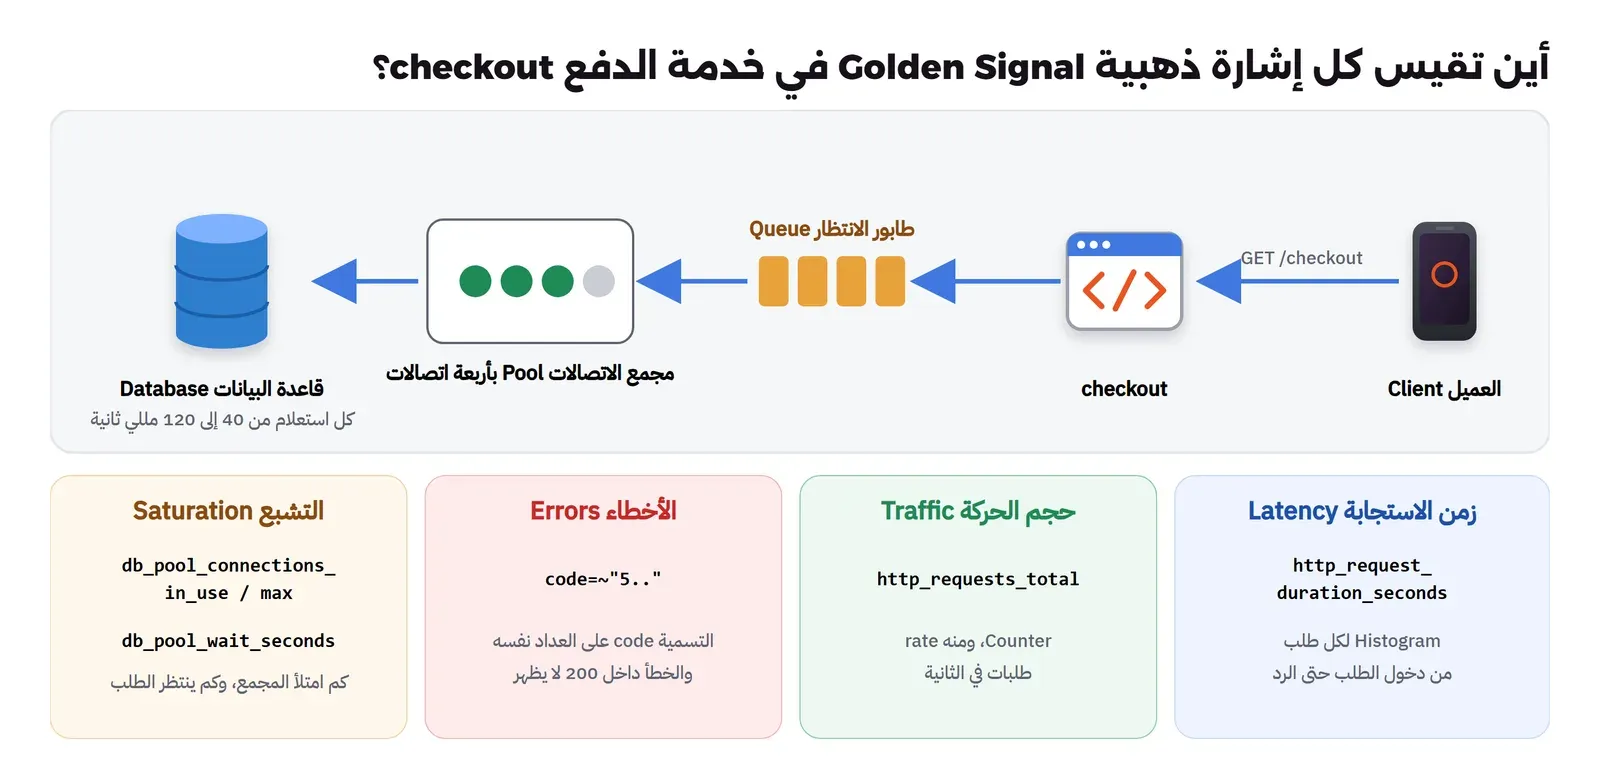
وطاقة هذه الخدمة يمكن حسابها قبل أي تجربة: أربعة اتصالات، وكل اتصال يخدم طلباً كل 0.08 ثانية، أي 12.5 طلباً في الثانية، فالطاقة القصوى 4 ÷ 0.08 = 50 طلباً في الثانية، وكل ما يزيد عن ذلك سوف يتراكم في الطابور. وهذا الحساب البسيط مفيد جداً في الواقع، فهو يعطيك رقماً تقارن به ما تراه في المقاييس.
إضافة القياس Instrumentation إلى الكود
نستخدم المكتبة الرسمية prometheus_client لـ Python، بالإصدار 0.23.1، مع خادم HTTP من المكتبة القياسية حتى يبقى كل شيء واضحاً دون إطار عمل. والملف app.py كاملاً:
# checkout: a small HTTP service with the four golden signals instrumented by prometheus_client.
# Every /checkout request needs one of POOL_SIZE database connections; the "query" takes DB_MS milliseconds.
import os, random, threading, time
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
from urllib.parse import urlparse, parse_qs
from prometheus_client import Counter, Gauge, Histogram, generate_latest, CONTENT_TYPE_LATEST

POOL_SIZE = int(os.environ.get("POOL_SIZE", "4"))
DB_MS = float(os.environ.get("DB_MS", "80"))
# latency buckets in seconds; the default is prometheus_client's (.005 ... 10)
BUCKETS = tuple(float(b) for b in os.environ["BUCKETS"].split(",")) if os.environ.get("BUCKETS") else Histogram.DEFAULT_BUCKETS
state = {"fail_rate": 0.0, "soft_fail": False}

REQUESTS = Counter("http_requests_total", "HTTP requests by route and status code", ["route", "code"])
DURATION = Histogram("http_request_duration_seconds", "Time to answer one request", ["route"], buckets=BUCKETS)
IN_FLIGHT = Gauge("http_requests_in_flight", "Requests being handled right now")
POOL_IN_USE = Gauge("db_pool_connections_in_use", "Database connections taken from the pool")
POOL_MAX = Gauge("db_pool_connections_max", "Size of the database connection pool")
POOL_WAIT = Histogram("db_pool_wait_seconds", "Time a request waited for a free connection",
                      buckets=(.001, .005, .01, .025, .05, .1, .25, .5, 1, 2.5, 5, 10))
POOL_MAX.set(POOL_SIZE)
pool = threading.BoundedSemaphore(POOL_SIZE)


def checkout():
    t0 = time.perf_counter()
    with pool:                                   # waits here when all connections are busy
        POOL_WAIT.observe(time.perf_counter() - t0)
        POOL_IN_USE.inc()
        try:
            time.sleep(random.uniform(0.5, 1.5) * DB_MS / 1000)
        finally:
            POOL_IN_USE.dec()
    if random.random() < state["fail_rate"]:
        return (200, b'{"ok": false, "error": "payment provider timeout"}') if state["soft_fail"] else (503, b'{"error": "payment provider timeout"}')
    return 200, b'{"ok": true}'


class Handler(BaseHTTPRequestHandler):
    def log_message(self, *a):
        pass

    def reply(self, code, body, ctype="application/json"):
        self.send_response(code)
        self.send_header("Content-Type", ctype)
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def do_GET(self):
        url = urlparse(self.path)
        if url.path == "/metrics":
            return self.reply(200, generate_latest(), CONTENT_TYPE_LATEST)
        if url.path == "/admin/fail":                # lab switch: /admin/fail?rate=0.05&soft=1
            q = parse_qs(url.query)
            state["fail_rate"] = float(q.get("rate", ["0"])[0])
            state["soft_fail"] = q.get("soft", ["0"])[0] == "1"
            return self.reply(200, str(state).encode(), "text/plain")
        route = "/checkout" if url.path == "/checkout" else "other"
        IN_FLIGHT.inc()
        start = time.perf_counter()
        try:
            code, body = checkout() if route == "/checkout" else (404, b'{"error": "not found"}')
        except Exception:
            code, body = 500, b'{"error": "internal"}'
        finally:
            IN_FLIGHT.dec()
        DURATION.labels(route).observe(time.perf_counter() - start)
        REQUESTS.labels(route, str(code)).inc()
        self.reply(code, body)


if __name__ == "__main__":
    ThreadingHTTPServer.daemon_threads = True
    ThreadingHTTPServer(("0.0.0.0", 8000), Handler).serve_forever()
في الكود أعلاه لاحظ التالي:
- عداد واحد
http_requests_totalبتسميتينrouteوcode، وليس عداداً للنجاح وآخر للفشل، لأن دليل القياس ينصح بأن تكون المقاييس التي تريد جمعها أو قسمتها مقياساً واحداً بتسميات، وبهذا الشكل حجم الحركة هو مجموع العداد، ونسبة الأخطاء هي جزء منه مقسوماً عليه. - التسمية
routeتأخذ قيمة من قائمة ثابتة،/checkoutأوother، ولا تأخذ المسار كما جاء من العميل، لأن أي شخص يستطيع أن يرسل ملايين المسارات المختلفة فيصنع ملايين السلاسل، وهذه مشكلة كثرة القيم Cardinality التي شرحناها في المقال السابق. - المدة تقاس من لحظة دخول الطلب إلى المعالج حتى الرد، وتشمل وقت انتظار المجمع، وهذا هو ما يشعر به المستخدم. أما
db_pool_wait_secondsفيقيس الانتظار وحده، وهو مقياس التشبع. http_requests_in_flightمقياس لحظي يزيد عند دخول الطلب وينقص عند خروجه، وهو الرقم الذي يقترحه الدليل نفسه لأنظمة الخدمة المباشرة Online-serving Systems بجانب العدد والأخطاء والمدة.- المسار
/admin/failمفتاح للمختبر فقط، نشغل به أخطاء مزود الدفع بنسبة نحددها، مرة برمز 503 ومرة برمز 200 مع رسالة خطأ في الجسم.
مولد ضغط مفتوح Open-loop Load Generator
هناك طريقتان لتوليد الضغط على خدمة: الحلقة المغلقة Closed Loop، أي عدد ثابت من المستخدمين الافتراضيين، كل واحد يرسل طلباً وينتظر الرد ثم يرسل التالي، والحلقة المفتوحة Open Loop، أي إرسال عدد ثابت من الطلبات في الثانية بغض النظر عن سرعة الرد. والفرق مهم جداً في قياس التشبع: في الحلقة المغلقة إذا أبطأت الخدمة فإن المولد نفسه يبطئ، لأن كل مستخدم افتراضي ينتظر، فيقل الضغط تلقائياً ولا ترى الطابور يكبر أبداً. أما المستخدمون الحقيقيون في يوم العرض التسويقي فلا ينتظرون بعضهم، فكل واحد يفتح الصفحة عندما يقرأ الرسالة، ولذلك كتبنا مولداً مفتوحاً، ويقيس أيضاً المدة من جهة العميل، لأن الدليل يقول إن أنظمة الخدمة المباشرة يجب أن تراقب من جهة العميل ومن جهة الخادم، وإذا اختلف ما يراه الطرفان فهذه معلومة مفيدة جداً في التشخيص. والملف load.py:
# Open-loop load: sends requests at a fixed rate whatever the service does, and measures latency on the client side.
#   python load.py <url> <rps>:<seconds> [<rps>:<seconds> ...]
import sys, threading, time, urllib.request, urllib.error, statistics, json

url, phases = sys.argv[1], [tuple(map(float, p.split(":"))) for p in sys.argv[2:]]


def one(results):
    t0 = time.perf_counter()
    try:
        with urllib.request.urlopen(url, timeout=30) as r:
            body = r.read(); code = r.status
    except urllib.error.HTTPError as e:
        code, body = e.code, b""
    except Exception:
        code, body = 0, b""
    results.append((time.perf_counter() - t0, code, b'"ok": false' in body))


for rps, seconds in phases:
    results, threads = [], []
    start = time.perf_counter(); n = int(rps * seconds)
    print(time.strftime("%H:%M:%S", time.gmtime()), f"phase {rps:g} rps for {seconds:g} s", flush=True)
    for i in range(n):
        delay = start + i / rps - time.perf_counter()
        if delay > 0:
            time.sleep(delay)
        t = threading.Thread(target=one, args=(results,), daemon=True); t.start(); threads.append(t)
    for t in threads:
        t.join()
    lat = sorted(r[0] for r in results)
    q = lambda p: lat[min(len(lat) - 1, int(p * len(lat)))]
    codes = {}
    for _, c, _ in results:
        codes[c] = codes.get(c, 0) + 1
    soft = sum(1 for r in results if r[2])
    print(json.dumps({"rps": rps, "requests": len(lat), "mean_ms": round(statistics.mean(lat) * 1000, 1),
                      "p50_ms": round(q(.5) * 1000, 1), "p95_ms": round(q(.95) * 1000, 1), "p99_ms": round(q(.99) * 1000, 1),
                      "max_ms": round(lat[-1] * 1000, 1), "codes": codes, "ok_false_in_200": soft}), flush=True)
ثم نبني Image واحدة للخدمة والمولد، ونشغل الخدمة وPrometheus 3.15.1 وGrafana 13.3.0 على شبكة واحدة، وفترة السحب هنا 5 ثوان حتى تكون في كل مرحلة من مراحل التجربة عينات كافية:
cat > Dockerfile <<'EOF'
FROM python:3.13-slim
RUN pip install --no-cache-dir prometheus-client==0.23.1
COPY app.py load.py /srv/
WORKDIR /srv
CMD ["python", "app.py"]
EOF
docker build -t mon-gs-app:1 .
docker network create mon-net
docker run -d --name mon-gs-app --network mon-net -e POOL_SIZE=4 -e DB_MS=80 mon-gs-app:1
docker run -d --name mon-gs-prom --network mon-net -p 127.0.0.1:19090:9090 \
  -v "$PWD/prometheus.yml:/etc/prometheus/prometheus.yml:ro" -v "$PWD/rules.yml:/etc/prometheus/rules.yml:ro" \
  prom/prometheus:v3.15.1 --config.file=/etc/prometheus/prometheus.yml --storage.tsdb.retention.time=1d
والتجربة الأولى ثلاث مراحل بلا أخطاء: 20 طلباً في الثانية لمدة ثلاث دقائق، ثم 40، ثم 55 لمدة دقيقتين، أي 40% و80% و110% من الطاقة التي حسبناها:
docker run -d --name mon-gs-load --network mon-net mon-gs-app:1 \
  python load.py http://mon-gs-app:8000/checkout 20:180 40:180 55:120
docker logs -f mon-gs-load
والمخرج سوف يكون كما يلي:
22:57:59 phase 20 rps for 180 s
{"rps": 20.0, "requests": 3600, "mean_ms": 87.0, "p50_ms": 84.1, "p95_ms": 121.3, "p99_ms": 234.3, "max_ms": 522.7, "codes": {"200": 3600}, "ok_false_in_200": 0}
23:00:59 phase 40 rps for 180 s
{"rps": 40.0, "requests": 7200, "mean_ms": 84.4, "p50_ms": 84.8, "p95_ms": 120.6, "p99_ms": 132.3, "max_ms": 192.1, "codes": {"200": 7200}, "ok_false_in_200": 0}
23:04:00 phase 55 rps for 120 s
{"rps": 55.0, "requests": 6600, "mean_ms": 6021.0, "p50_ms": 6033.1, "p95_ms": 11461.1, "p99_ms": 12078.8, "max_ms": 22745.7, "codes": {"200": 6600}, "ok_false_in_200": 0}
وهذا المخرج وحده يحكي قصة يوم العرض: في المرحلتين الأوليين الوسيط p50 حول 84 مللي ثانية، أي زمن الاستعلام نفسه تقريباً، ومضاعفة الضغط من 20 إلى 40 لم تغير شيئاً يشعر به المستخدم. ثم زدنا الضغط 15 طلباً فقط فوق الأربعين، فقفز الوسيط من 85 مللي ثانية إلى 6 ثوان، والطلب الأبطأ انتظر 22.7 ثانية، وكل الطلبات الستة آلاف وستمئة رجعت برمز 200، أي لا يوجد خطأ واحد. ولاحظ أيضاً أن p99 في المرحلة الأولى كان 234 مللي ثانية، أعلى من المرحلة الثانية، والسبب أن جهاز المختبر كان يشغل مهام أخرى في تلك الدقائق، وبعض الطلبات تأخرت في المعالج نفسه، وهذا يحدث في السيرفرات المشتركة أيضاً، ولذلك لا تحكم على خدمة من دقيقة واحدة. والآن نرى ما قاله Prometheus عن كل إشارة في المراحل نفسها.
حجم الحركة Traffic: لماذا رأينا 50 ونحن نرسل 55؟
يعرف كتاب SRE حجم الحركة بأنه مقياس لحجم الطلب على النظام بوحدة تناسبه: لخدمة ويب عدد طلبات HTTP في الثانية، ولخدمة بث صوتي عدد الجلسات المتزامنة أو حجم الشبكة، ولقاعدة مفتاح وقيمة عدد عمليات القراءة والكتابة في الثانية. وفي خدمتنا نحسبه بقاعدة تسجيل من العداد:
      - record: service:http_requests:rate1m
        expr: sum by (service) (rate(http_requests_total{route="/checkout"}[1m]))
وسألنا Prometheus عن القيمة في منتصف كل مرحلة. والسكربت at.py في ملفات المختبر يرسل استعلاماً لحظياً في وقت محدد بتوقيت UTC:
python at.py 23:00:30 'service:http_requests:rate1m'
python at.py 23:03:30 'service:http_requests:rate1m'
python at.py 23:05:30 'service:http_requests:rate1m'
23:00:30 service=checkout 20.00181834712247
23:03:30 service=checkout 40.02182016546959
23:05:30 service=checkout 50.07545866138154في المرحلتين الأوليين الرقم مطابق لما نرسله، أما في الثالثة فالمقياس يقول 50 والمولد يرسل 55. والسبب في الكود: العداد يزيد بعد أن ينتهي الطلب وليس عند وصوله، والخدمة لا تستطيع أن تنهي أكثر من 50 طلباً في الثانية، فهذا هو الرقم الذي يراه العداد، والخمسة الباقية في كل ثانية تتراكم في الطابور دون أن يعدها أحد. أي أن المقياس يقيس ما خدمته الخدمة Throughput، وليس ما طلبه المستخدمون Demand، والفرق بينهما هو بالضبط الشيء الذي تريد أن تعرفه في يوم العرض.
وهناك ثلاثة دروس عملية من هذه النتيجة:
- إذا رأيت حجم الحركة يستقر عند رقم ثابت تماماً في وقت يفترض أن يزيد فيه، فقد يكون هذا سقف الطاقة وليس سقف الطلب، فانظر مباشرة إلى التشبع.
- إذا أردت أن تعرف الطلب الحقيقي فقسه من مكان قبل الخدمة، مثل الـ Reverse Proxy أو الـ Load Balancer، أو أضف عداداً يزيد عند دخول الطلب وليس عند خروجه.
- انخفاض حجم الحركة فجأة إشارة لا تقل أهمية عن ارتفاعه: إذا كانت الخدمة تستقبل عادة 20 طلباً في الثانية في هذا الوقت ثم أصبحت صفراً، فإما أن الناس توقفوا عن الشراء فجأة، وهذا نادر، وإما أن شيئاً قبل الخدمة توقف، مثل شهادة TLS منتهية أو سجل DNS خاطئ، والخدمة نفسها لن تشكو من شيء لأنها لا ترى أي طلب.
زمن الاستجابة Latency: دقة المدرج التكراري Histogram
شرحنا في مقال المفاهيم لماذا نقيس زمن الاستجابة بالنسب المئوية Percentiles وليس بالمتوسط، وهنا نرى كيف يحسبها Prometheus وأين يخطئ. فالمكتبة لا تحفظ مدة كل طلب، وإنما تحفظ عداداً لكل فئة Bucket: كم طلباً انتهى في أقل من 5 مللي ثانية، وفي أقل من 10، وفي أقل من 25، وهكذا، وكل فئة تشمل ما قبلها، ولذلك اسم التسمية le أي «أقل من أو يساوي». والفئات الافتراضية في المكتبة كما ظهرت في صفحة /metrics هي:
http_request_duration_seconds_bucket{le="0.005",route="/checkout"} 0.0
http_request_duration_seconds_bucket{le="0.01",route="/checkout"} 0.0
http_request_duration_seconds_bucket{le="0.025",route="/checkout"} 0.0
http_request_duration_seconds_bucket{le="0.05",route="/checkout"} 0.0
http_request_duration_seconds_bucket{le="0.075",route="/checkout"} 0.0
http_request_duration_seconds_bucket{le="0.1",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="0.25",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="0.5",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="0.75",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="1.0",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="2.5",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="5.0",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="7.5",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="10.0",route="/checkout"} 1.0
http_request_duration_seconds_bucket{le="+Inf",route="/checkout"} 1.0
http_request_duration_seconds_count{route="/checkout"} 1.0
http_request_duration_seconds_sum{route="/checkout"} 0.08310103099938715
هذا بعد طلب واحد أخذ 83 مللي ثانية، فظهر في كل الفئات من 0.1 وما بعدها. والدالة histogram_quantile تحسب منها النسبة المئوية: تبحث عن الفئة التي يقع فيها الطلب رقم 99 من كل مئة، ثم تفترض أن الطلبات موزعة بالتساوي داخل هذه الفئة، فتقدر موقعه بالتناسب بين حديها. والقاعدة في ملفنا:
      - record: service:http_request_duration_seconds:p99_1m
        expr: histogram_quantile(0.99, sum by (service, le) (rate(http_request_duration_seconds_bucket{route="/checkout"}[1m])))
ولاحظ sum by (service, le): يجب أن تبقى التسمية le بعد الجمع، لأن الدالة تحتاج الفئات، فإذا جمعت السلاسل دون le فلن يبقى مدرج تكراري أصلاً. وهذه ميزة Histogram على Summary التي ذكرناها في المقال السابق: تستطيع أن تجمع الفئات من عشرة سيرفرات ثم تحسب النسبة المئوية للكل.
مشكلة واجهتنا: النسبة المئوية Percentile أكبر من الحقيقي بـ 85%
عندما قارنا ما قاله Prometheus بما قاسه المولد من جهة العميل في مرحلة الأربعين طلباً وجدنا فرقاً كبيراً. وحتى تكون المقارنة عادلة حسبنا النسب على المرحلة كلها، أي ثلاث دقائق، بالدالة increase:
python at.py 23:03:59 'histogram_quantile(0.5, sum by (le) (increase(http_request_duration_seconds_bucket[3m])))'
python at.py 23:03:59 'histogram_quantile(0.95, sum by (le) (increase(http_request_duration_seconds_bucket[3m])))'
python at.py 23:03:59 'histogram_quantile(0.99, sum by (le) (increase(http_request_duration_seconds_bucket[3m])))'
python at.py 23:03:59 'sum(increase(http_request_duration_seconds_sum[3m])) / sum(increase(http_request_duration_seconds_count[3m]))'
23:03:59 0.08207979436745641
23:03:59 0.22226707252514555
23:03:59 0.2444534145050291
23:03:59 0.08177039860200938| المقياس | من جهة العميل load.py | من Prometheus بالفئات الافتراضية | الفرق |
|---|---|---|---|
| المتوسط Mean | 84.4 ms | 81.8 ms (من sum ÷ count) | قريب جداً |
| الوسيط p50 | 84.8 ms | 82.1 ms | قريب جداً |
| p95 | 120.6 ms | 222.3 ms | أكبر بـ 84% |
| p99 | 132.3 ms | 244.5 ms | أكبر بـ 85% |
المتوسط والوسيط صحيحان، ولكن p95 وp99 أكبر من الحقيقة بنحو الضعف تقريباً. والسبب أن كل الطلبات بين 100 و120 مللي ثانية سقطت في فئة واحدة واسعة، من 0.1 إلى 0.25، والدالة لا تعرف أين داخل الفئة تقع هذه الطلبات، فتفترض أنها موزعة بالتساوي على 150 مللي ثانية كاملة، فتضع p95 وp99 قرب الحد الأعلى للفئة. ويشرح دليل المدرجات التكرارية هذا الخطأ في قسم أخطاء تقدير النسب المئوية، ويبين أن دقة النتيجة تعتمد على عرض الفئة التي تقع فيها النسبة المطلوبة. والصورة التالية تبين ما حدث:
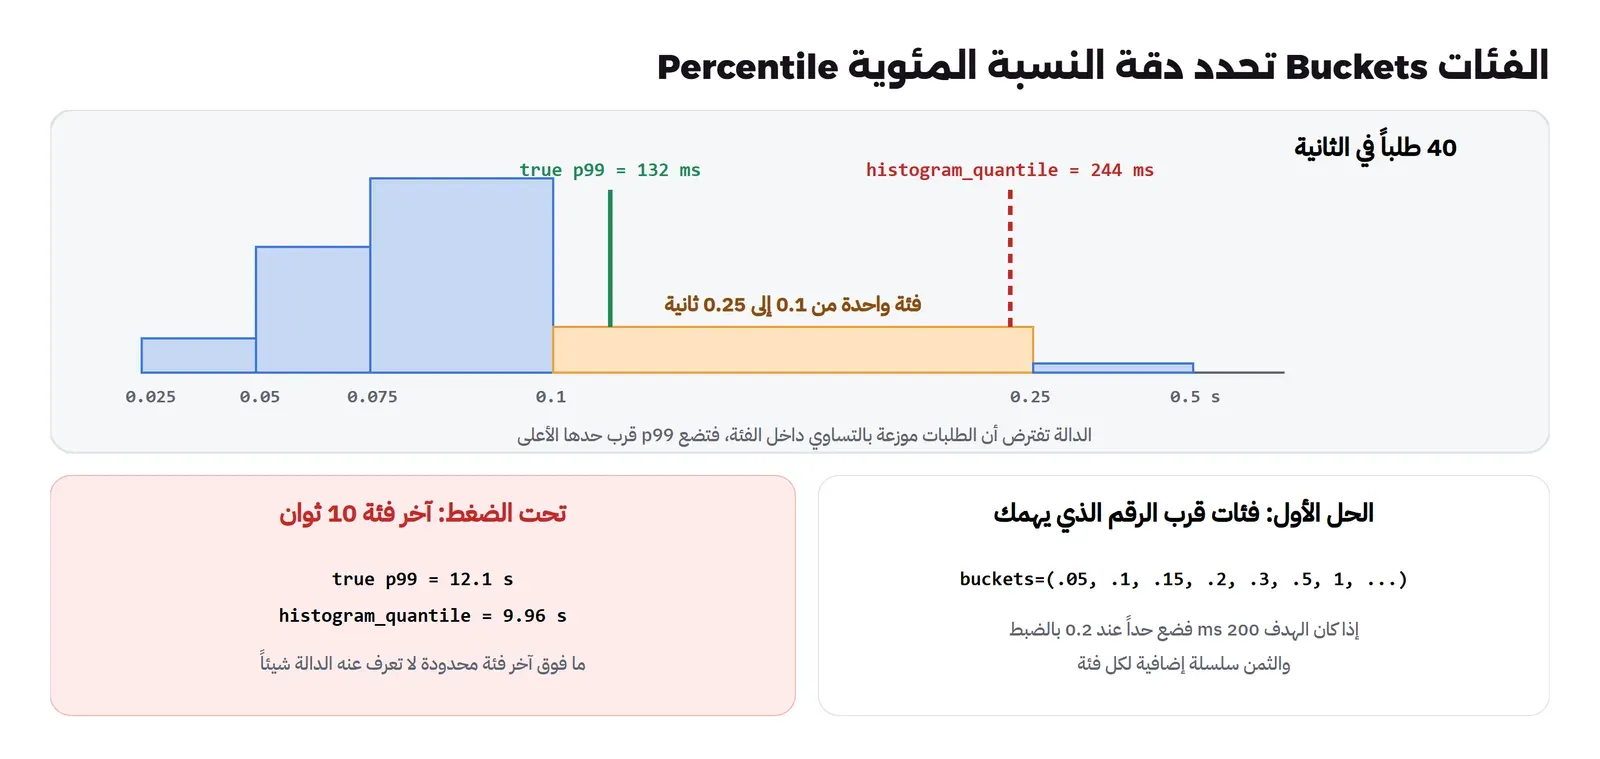
وهذا الخطأ ليس مسألة أرقام فقط، فلو كان هدف الخدمة أن ينتهي 95% من الطلبات في أقل من 200 مللي ثانية، والتنبيه مكتوب على p95، لأطلق التنبيه طوال المرحلة الثانية والخدمة في الحقيقة تحقق هدفها بفارق كبير، فيتعلم الفريق أن هذا التنبيه كاذب ويتجاهله. وفي مرحلة الضغط الزائد حدث العكس: قاس العميل p99 بـ 12.1 ثانية، وقال Prometheus 9.96 ثانية، لأن آخر فئة محدودة في القائمة الافتراضية هي 10 ثوان، وما فوقها يدخل في +Inf الذي لا يعرف عنه شيء، فالدالة لا تستطيع أبداً أن تقول رقماً أكبر من 10.
ماذا يحدث إذا وضعنا الفئات Buckets حول الرقم الذي يهمنا؟
الحل الأول الذي يقترحه الدليل هو أن تختار حدود الفئات بحسب خدمتك، وخاصة أن تضع حداً عند الرقم الذي تلتزم به، فإذا كان الهدف 200 مللي ثانية فيجب أن يكون 0.2 حداً لفئة، لأن السؤال «كم طلباً انتهى في أقل من 200 مللي ثانية؟» يصبح عندها قراءة مباشرة لعداد وليس تقديراً. فأعدنا تشغيل الخدمة بفئات أكثر بين 100 و300 مللي ثانية، من خلال متغير البيئة BUCKETS في الكود أعلاه، ثم أعدنا مرحلة الأربعين طلباً:
docker rm -f mon-gs-app
docker run -d --name mon-gs-app --network mon-net -e POOL_SIZE=4 -e DB_MS=80 \
  -e BUCKETS=.025,.05,.075,.1,.125,.15,.2,.3,.5,1,2.5,5,10,20 mon-gs-app:2
docker run -d --name mon-gs-load --network mon-net mon-gs-app:2 python load.py http://mon-gs-app:8000/checkout 40:180
python at.py 23:37:30 'histogram_quantile(0.95, sum by (le) (increase(http_request_duration_seconds_bucket[3m])))'
python at.py 23:37:30 'histogram_quantile(0.99, sum by (le) (increase(http_request_duration_seconds_bucket[3m])))'
{"rps": 40.0, "requests": 7200, "mean_ms": 92.9, "p50_ms": 86.1, "p95_ms": 137.5, "p99_ms": 333.6, "max_ms": 1312.6, "codes": {"200": 7200}, "ok_false_in_200": 0}
23:37:30 0.12728211009174306
23:37:30 0.29846969696969694والنتيجة: p95 من Prometheus أصبح 127 مللي ثانية والعميل قاس 137.5، وp99 أصبح 298 والعميل قاس 334، أي أن الخطأ نزل من 85% إلى قرابة 10%، وأصبح في الاتجاه الآخر قليلاً. ولاحظ أن هذه المرة كانت فيها لحظة تأخر من جهاز المختبر، فأطول طلب أخذ 1.3 ثانية وارتفع p99 الحقيقي إلى 334 مللي ثانية، وحتى هذا الارتفاع قاسه المدرج بشكل معقول، لأن الفئتين 0.2 و0.3 و0.5 أصبحت قريبة منه. وهذا هو الثمن والفائدة: أضفنا خمس فئات، أي خمس سلاسل لكل مسار ولكل سيرفر، وأصبحت النسبة المئوية حول الرقم المهم قابلة للاعتماد. وإذا كانت لديك خدمات كثيرة بأزمنة مختلفة جداً، فيذكر الدليل نفسه المدرجات التكرارية الأصلية Native Histograms التي تختار فئاتها تلقائياً بدقة عالية، وهي خيار يستحق القراءة عندما يكبر النظام.
زمن الأخطاء Error Latency
هناك ملاحظة أخرى في كتاب SRE لا ينتبه لها كثيرون: يجب أن تفرق بين زمن الطلبات الناجحة وزمن الطلبات الفاشلة، فالخطأ 500 الذي يحدث لأن الاتصال بقاعدة البيانات انقطع قد يرجع بسرعة كبيرة، فإذا خلطته مع الناجحة فسوف ينخفض زمن الاستجابة في اللوحة في الوقت الذي تسوء فيه الخدمة. ويضيف الكتاب أن الخطأ البطيء أسوأ من الخطأ السريع. وفي خدمتنا لم نضع التسمية code على المدرج التكراري، فعندما سألنا عن p99 لكل رمز في مرحلة الأخطاء جاءت النتيجة سلسلة واحدة لا تفرق بين 200 و503:
23:13:30 0.2443298969072165وهذا قرار يجب أن تتخذه بوعي: إضافة code إلى المدرج تضرب عدد سلاسله في عدد الرموز التي تظهر، والحل الوسط الشائع أن تضيف تسمية بقيمتين فقط، مثل outcome="success" وoutcome="error"، بدلاً من الرمز الكامل.
الأخطاء Errors: الخطأ الذي يرجع 200
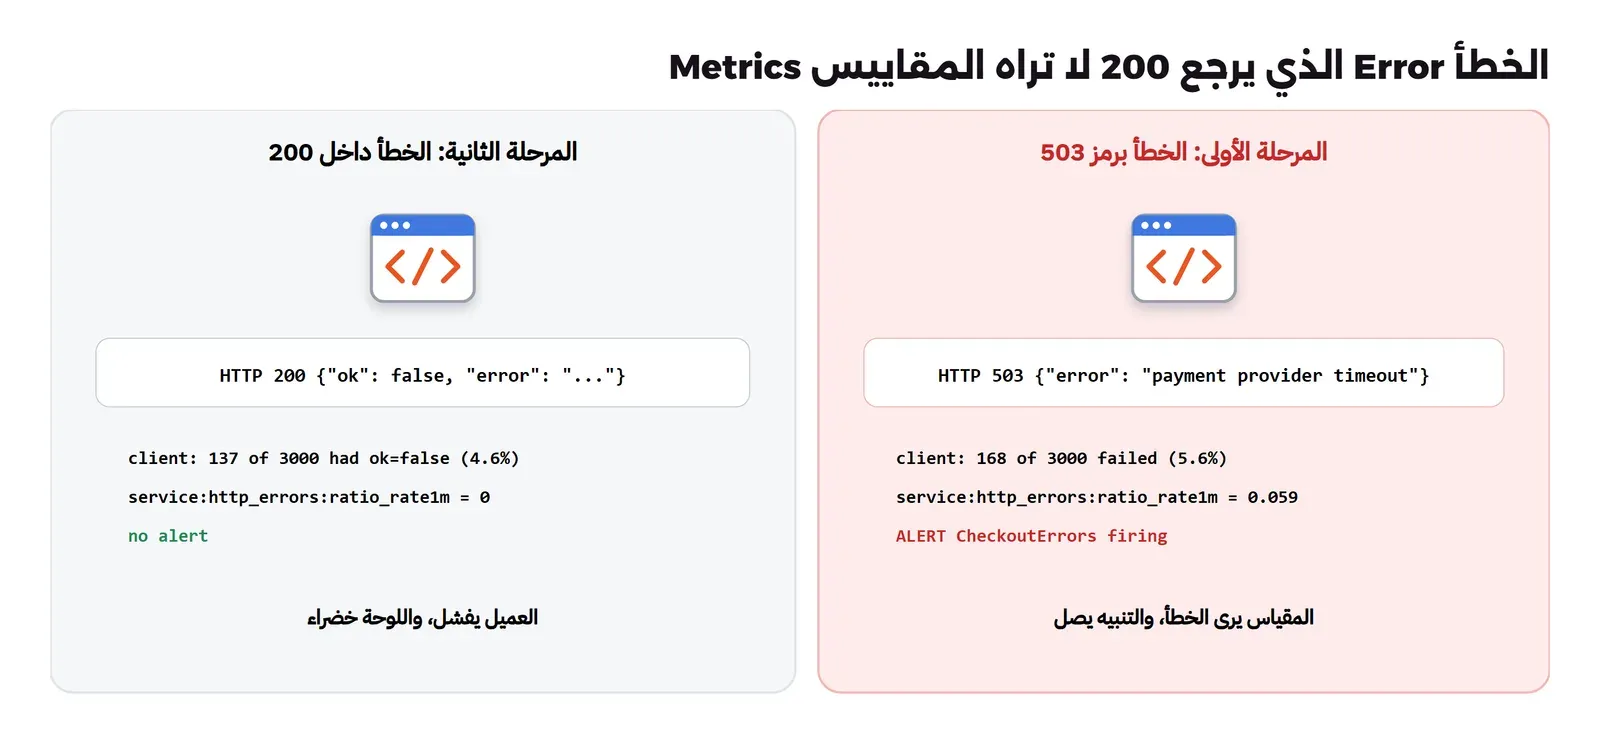
يعرف كتاب SRE الأخطاء بأنها معدل الطلبات التي تفشل، ويذكر ثلاثة أنواع: الفشل الصريح، مثل رمز 500، والفشل الضمني، مثل رد برمز 200 ولكن بمحتوى خاطئ، والفشل بحسب السياسة، مثل أن تقول «أي طلب يتجاوز ثانية واحدة هو خطأ لأننا التزمنا بذلك». والنوع الثاني هو الأخطر، لأن كل الأدوات التي تقرأ رموز HTTP لا تراه. وفي المختبر شغلنا أخطاء مزود الدفع بنسبة 5% مرتين: مرة ترجع الخدمة 503، ومرة ترجع 200 مع {"ok": false} في الجسم:
curl -s 'mon-gs-app:8000/admin/fail?rate=0.05'
python load.py http://mon-gs-app:8000/checkout 20:150
curl -s 'mon-gs-app:8000/admin/fail?rate=0.05&soft=1'
python load.py http://mon-gs-app:8000/checkout 20:150
{'fail_rate': 0.05, 'soft_fail': False}
{"rps": 20.0, "requests": 3000, "mean_ms": 82.5, "p50_ms": 81.9, "p95_ms": 119.6, "p99_ms": 122.7, "max_ms": 171.2, "codes": {"200": 2832, "503": 168}, "ok_false_in_200": 0}
{'fail_rate': 0.05, 'soft_fail': True}
{"rps": 20.0, "requests": 3000, "mean_ms": 83.7, "p50_ms": 83.6, "p95_ms": 118.9, "p99_ms": 122.3, "max_ms": 356.0, "codes": {"200": 3000}, "ok_false_in_200": 137}ثم سألنا Prometheus عن نسبة الأخطاء وعن التنبيهات في منتصف كل مرحلة:
python at.py 23:13:30 'service:http_errors:ratio_rate1m'
python at.py 23:13:30 'ALERTS{alertname="CheckoutErrors"}'
python at.py 23:24:30 'service:http_errors:ratio_rate1m'
python at.py 23:24:30 'sum by (code) (rate(http_requests_total{route="/checkout"}[1m]))'
23:13:30 service=checkout 0.05909090909090908
23:13:30 alertname=CheckoutErrors,alertstate=firing,service=checkout,severity=page 1
23:24:30 service=checkout 0
23:24:30 code=200 19.98327151065532
23:24:30 code=503 0في المرحلة الأولى فشل 168 طلباً من 3000، أي 5.6%، وقال Prometheus 5.9% في الدقيقة التي سألنا عنها، وأطلق التنبيه CheckoutErrors الذي يطلق إذا تجاوزت النسبة 2% لمدة دقيقة. وفي المرحلة الثانية فشل 137 طلباً من 3000 من وجهة نظر العميل، أي 4.6%، لأن الدفع لم يتم، ولكن نسبة الأخطاء في Prometheus صفر بالضبط، وكل الطلبات تظهر في العداد برمز 200، ولم يطلق أي تنبيه. والصورة التالية تضع المرحلتين بجانب بعضهما:
والحل ليس في Prometheus، وإنما في الكود: الخدمة هي الوحيدة التي تعرف أن الدفع فشل، فعليها أن تقول ذلك. وهناك طريقتان، والأفضل أن تجمع بينهما:
- رمز الحالة الصحيح: إذا فشل الطلب فارجع رمزاً يدل على ذلك، 502 أو 503 إذا كان السبب في مزود خارجي، و500 إذا كان في الكود، و4xx إذا كان الخطأ من العميل. وكثير من واجهات GraphQL وبعض الواجهات القديمة ترجع 200 دائماً مع حقل خطأ، فإذا كانت خدمتك كذلك فاعرف أن كل لوحات الأخطاء المبنية على رموز HTTP لا تعني شيئاً لها.
- عداد للنتيجة في منطق العمل: مثل
payments_total{result="ok"}وpayments_total{result="provider_timeout"}، وهذا العداد يقيس ما يهم العمل فعلاً، أي هل تم الدفع، ويبقى صحيحاً مهما كان الرمز الذي ترجعه الطبقات الأخرى. ويوصي دليل القياس بأن تعد الفشل والمحاولات الكلية بعدادين أو بتسمية حتى تحسب النسبة.
أما الأخطاء من نوع السياسة فهي الطريقة التي تربط زمن الاستجابة بالأخطاء: إذا التزمت بأن الدفع ينتهي في أقل من ثانيتين، فطلب أخذ 6 ثوان في مرحلة الضغط هو خطأ من وجهة نظر المستخدم حتى لو رجع 200. وهنا تأتي فائدة الفئات التي اخترناها: عداد الفئة le="2.5" يقول لك مباشرة كم طلباً التزم بالهدف، ونسبة الباقي هي نسبة أخطاء السياسة، وهذه هي الفكرة التي يبنى عليها مؤشر الخدمة SLI الذي شرحناه في مقال المفاهيم.
التشبع Saturation: الإشارة التي تنبهك قبل غيرها
يعرف كتاب SRE التشبع بأنه «كم الخدمة ممتلئة»، مع التركيز على المورد الأكثر تقييداً، ويذكر ملاحظتين مهمتين: أن كثيراً من الأنظمة يسوء أداؤها قبل أن تصل إلى 100% من الاستخدام، ولذلك تحتاج هدفاً للاستخدام أقل من الحد الكامل، وأن ارتفاع زمن الاستجابة غالباً مؤشر مبكر على التشبع. والسؤال الصعب في كل خدمة هو: ما المورد الأكثر تقييداً؟ وفي خدمتنا الإجابة معروفة لأننا صممناها، فهو مجمع الاتصالات، ولذلك قسنا ثلاثة أرقام: كم اتصالاً مستخدماً من المجمع، وكم ينتظر الطلب ليحصل على اتصال، وكم طلباً داخل الخدمة الآن. وهذه نتائج المراحل الثلاث كما سألنا عنها Prometheus:
for t in 23:00:30 23:03:30 23:05:30; do
  for q in 'service:db_pool:utilization' 'service:db_pool_wait_seconds:p95_1m' \
           'avg_over_time(http_requests_in_flight[1m])' 'rate(process_cpu_seconds_total[1m])'; do
    python at.py $t "$q"
  done
done
23:00:30 service=checkout 0.5416666666666666
23:00:30 service=checkout 0.0009812206572769953
23:00:30 service=checkout 2.3333333333333335
23:00:30 service=checkout 0.026184198563505783
23:03:30 service=checkout 0.8125
23:03:30 service=checkout 0.012362204724409426
23:03:30 service=checkout 3.25
23:03:30 service=checkout 0.02854804982271113
23:05:30 service=checkout 1
23:05:30 service=checkout 9.639814814814814
23:05:30 service=checkout 310.6666666666667
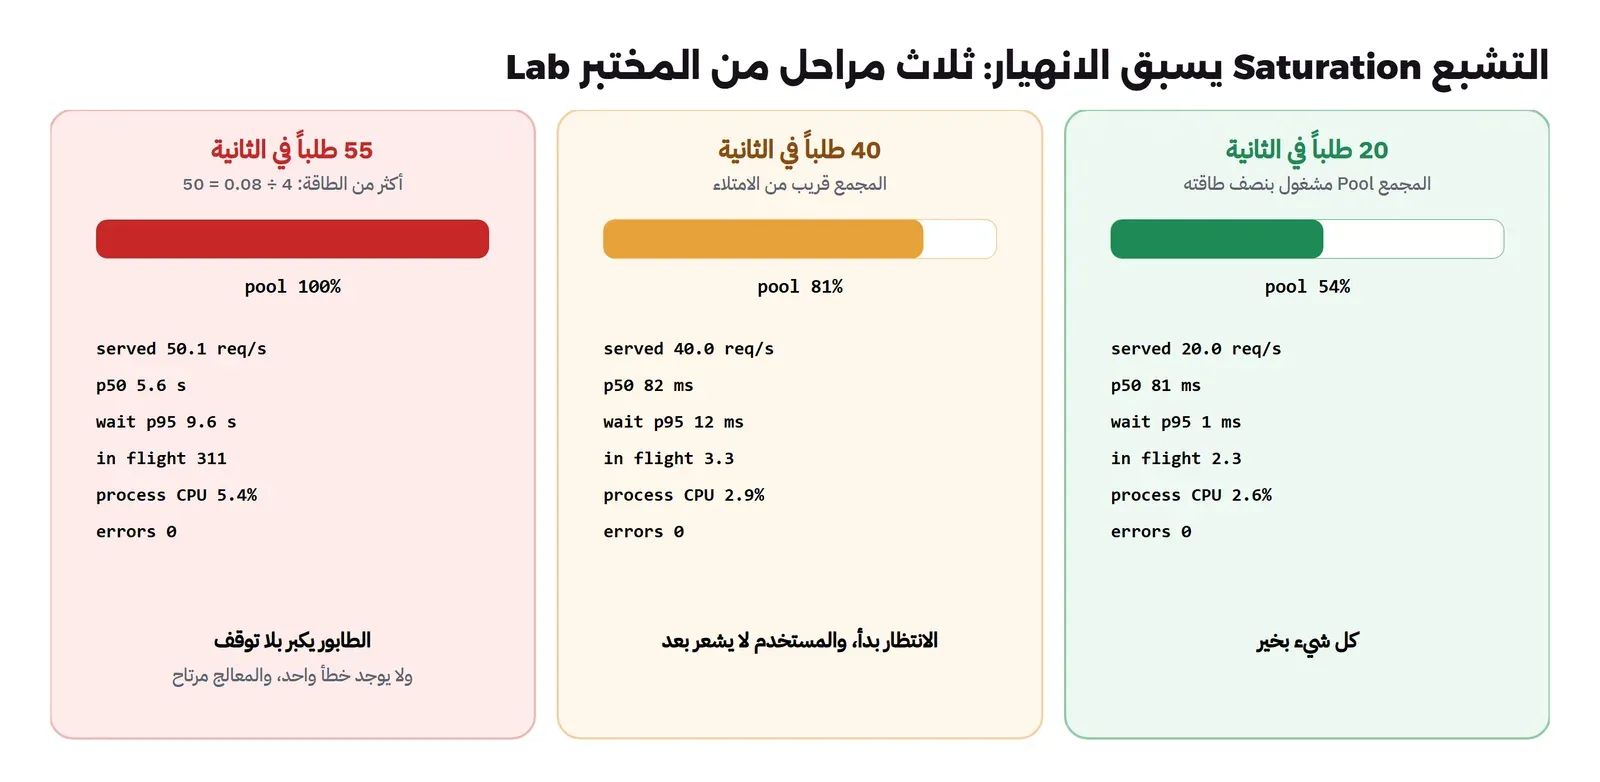
23:05:30 service=checkout 0.054002945615215354والصورة التالية تجمع الأرقام في مكان واحد مع ما قاسه العميل:
وطريقة قراءة هذه الأرقام كما يلي:
- عند 20 طلباً: المجمع مشغول 54% من الوقت، وهذا قريب من الحساب النظري، لأن 20 طلباً في 0.08 ثانية تعني 1.6 اتصال مشغول في المتوسط من أربعة، أي 40%، والفرق يأتي من أن الاستعلام يتراوح بين 40 و120 مللي ثانية ومن تأخر الجهاز. والانتظار مللي ثانية واحدة.
- عند 40 طلباً: المجمع 81% والانتظار p95 أصبح 12 مللي ثانية، أي أن الطلبات بدأت تصطف، ولكن 12 مللي ثانية لا يشعر بها أحد. وهنا اللحظة التي كان يجب أن يعرف فيها الفريق أن العرض التسويقي القادم سوف يتجاوز الطاقة، لأن 81% بعد هذا الحد أي زيادة صغيرة تصبح طابوراً.
- عند 55 طلباً: المجمع 100% طوال الوقت، والانتظار p95 تجاوز 9.6 ثانية، وفي الخدمة 311 طلباً ينتظر أغلبها، والمعالج يستخدم 5.4% من نواة واحدة فقط.
والرقم 311 ليس عشوائياً، فهو ما يقوله قانون Little من نظرية الطوابير Queueing Theory: عدد الطلبات داخل النظام يساوي معدل خروجها مضروباً في الوقت الذي يقضيه كل طلب، أي 50 طلباً في الثانية × 6 ثوان تقريباً = 300، وهذا قريب جداً مما قسناه. وهذا القانون يفيدك في الواقع بطريقتين: إذا عرفت اثنين من الثلاثة حسبت الثالث، وإذا رأيت عدد الطلبات داخل الخدمة يرتفع وحجم الحركة ثابت، فالوقت الذي يقضيه كل طلب يرتفع بالضرورة، حتى قبل أن تنظر إلى لوحة زمن الاستجابة.
ولاحظ أيضاً أن الانتقال من 81% إلى 110% لم يكن تدريجياً: زيادة 37% في الضغط ضاعفت زمن الانتظار نحو ثمانمئة مرة، من 12 مللي ثانية إلى 9.6 ثانية، لأن الخدمة عندما تتجاوز طاقتها لا تبطئ قليلاً وإنما تبدأ طابوراً يكبر كل ثانية بمقدار الفرق، أي خمسة طلبات في الثانية في حالتنا، وكلما بقي الضغط زاد الانتظار. ولذلك يقول الكتاب إنك تحتاج هدفاً للاستخدام أقل من 100%، ونقطة البداية المعقولة لمجمع مثل هذا هي التنبيه غير العاجل عند 80%، والتخطيط للزيادة قبل الوصول إليها في أوقات الذروة.
وتنبيه التشبع في ملفنا مبني على الانتظار وليس على نسبة الاستخدام:
      - alert: CheckoutSaturated
        expr: service:db_pool_wait_seconds:p95_1m > 0.1
        for: 1m
        labels: { severity: warning }
        annotations: { summary: "checkout waits {{ $value | humanizeDuration }} for a database connection (p95)" }
23:05:30 alertname=CheckoutSaturated,service=checkout,severity=warning 1793660644والرقم في آخر السطر هو وقت بداية التنبيه بصيغة Unix، أي 23:04:04، بعد أربع ثوان من بدء المرحلة الثالثة، ثم أطلق بعد دقيقة كما في for: 1m. والسبب في اختيار الانتظار أن نسبة الاستخدام 100% وحدها لا تعني بالضرورة مشكلة، فمجمع مشغول بالكامل دون طلب واحد ينتظر هو مجمع بحجم مناسب تماماً، أما الانتظار فهو اللحظة التي يبدأ فيها المستخدم يدفع ثمن الامتلاء. وفي الإنتاج سوف تجد في أغلب مكتبات الاتصال بقواعد البيانات مقاييس جاهزة للمجمع، وفي خوادم الويب مقاييس لعدد العمليات المشغولة، فابحث عنها قبل أن تكتبها بنفسك.
لوحة الخدمة Service Dashboard
جمعنا الإشارات الأربع في لوحة Grafana واحدة، كل إشارة في لوح، ومعها عدد الطلبات داخل الخدمة واستهلاك المعالج للمقارنة، والملف make_dashboard.py في ملفات المختبر يولدها كما فعلنا في المقال السابق. والصورة التالية للوحة على كامل فترة المختبر، من 22:57 إلى 23:26 بتوقيت UTC:
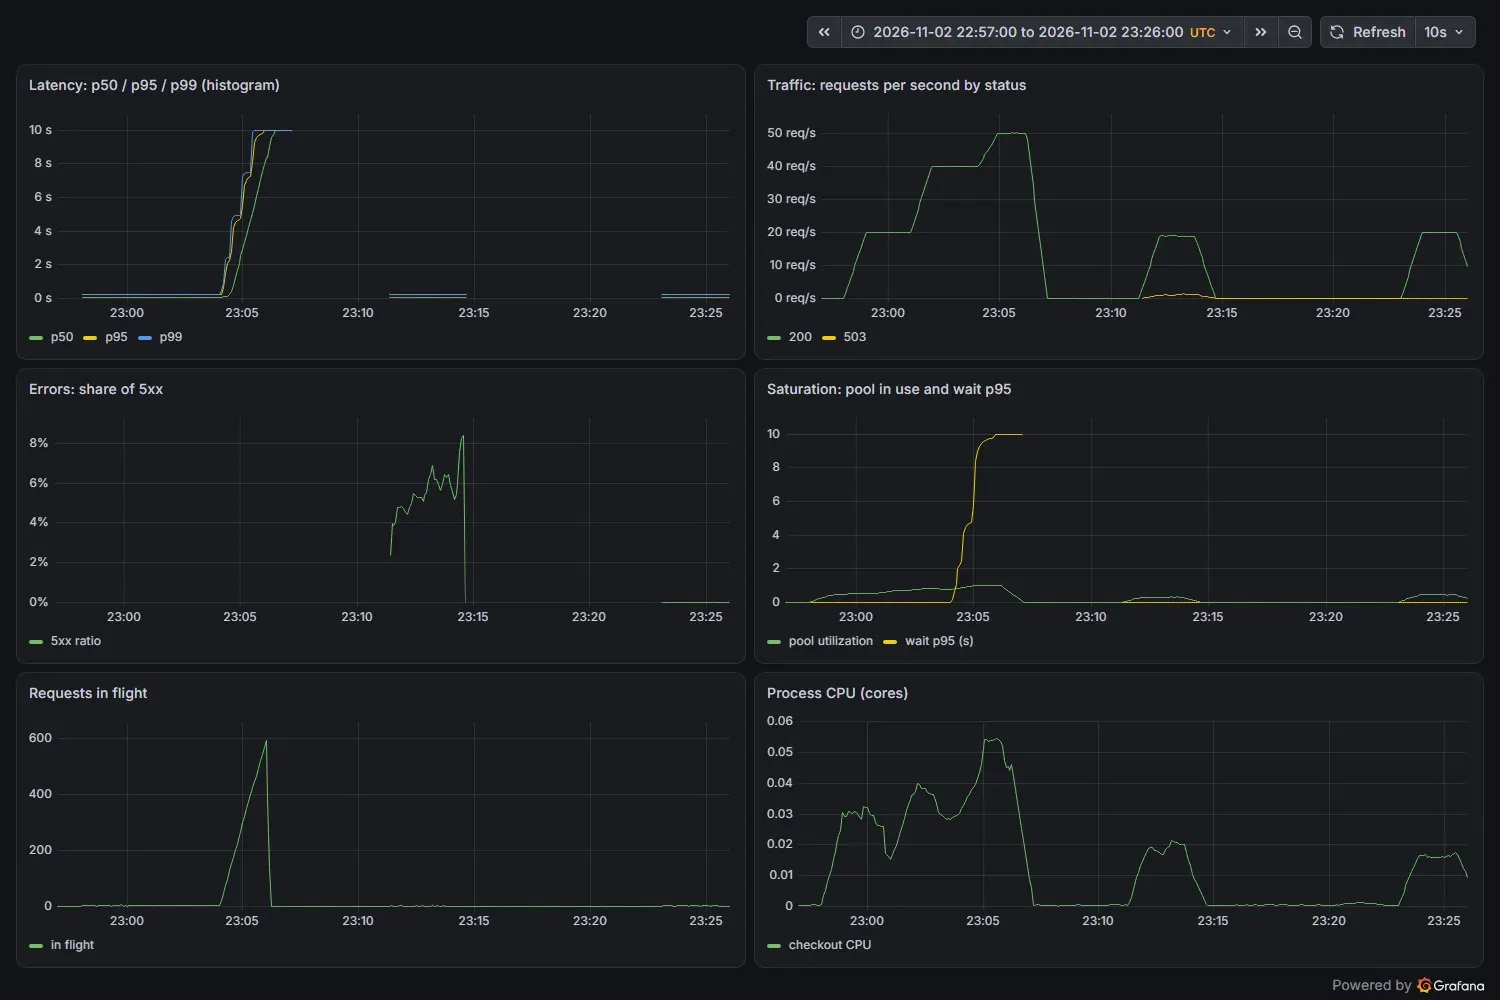
وفي هذه اللوحة عدة أشياء تستحق الانتباه:
- لوح زمن الاستجابة يرتفع ثم يستقر عند 10 ثوان بالضبط، وهذا ليس زمن الطلبات الحقيقي، وإنما سقف آخر فئة الذي شرحناه، فالخط المسطح في أعلى رسم النسب المئوية علامة على أن الفئات لا تغطي ما يحدث.
- لوح حجم الحركة يصل إلى 50 ويستقر عندها والمولد يرسل 55، وهذا سقف الطاقة كما ذكرنا.
- لوح الطلبات داخل الخدمة يصل إلى نحو 600 في نهاية المرحلة الثالثة ثم ينزل فجأة، لأن المولد توقف عن الإرسال فأفرغت الخدمة الطابور، وكل طلب في هذا الطابور كان مستخدماً ينتظر صفحة الدفع.
- لوح الأخطاء يظهر في المرحلة الأولى من الأخطاء بين 2% و8%، ثم يبقى صفراً في المرحلة الأخيرة التي فشل فيها 4.6% من الطلبات داخل 200.
- لوح المعالج لم يتجاوز 0.055 من نواة واحدة طوال التجربة، وهذه هي الصورة التي رآها الفريق في القصة: المعالج مرتاح والمستخدم يعاني.
وكان لدينا هنا مشكلة صغيرة في التشغيل: ظهرت اللوحة أول مرة بكل ألواحها فارغة مع علامة خطأ حمراء، والسبب أننا نسخنا ملف مصدر البيانات من مختبر المقال السابق، وفيه عنوان Prometheus القديم mon-prom، بينما اسم Prometheus في هذا المختبر mon-gs-prom. وهذا الخطأ شائع عندما تنقل إعداد Grafana بين بيئات، ولذلك اجعل العنوان في ملف مصدر البيانات متغيراً من متغيرات البيئة، فـ Grafana يدعم صيغة $VAR داخل ملفات Provisioning كما يذكر توثيقه، وافتح صفحة مصادر البيانات واضغط Test بعد كل نشر جديد.
من RED إلى USE: من العرض Symptom إلى السبب Cause
الإشارات الأربع تقول لك إن الخدمة تعاني، ولكنها لا تقول لك دائماً لماذا. وهنا تأتي العلاقة بين RED وUSE التي ذكرناها في مقال المفاهيم: لوحة RED، أي المعدل والأخطاء والمدة، هي ما تنبه عليه، لأنها ما يشعر به المستخدم، ثم تنتقل إلى USE لكل مورد خلف الخدمة لتعرف أيها امتلأ. والصورة التالية تبين هذا الانتقال بأرقام مرحلة الضغط الزائد:
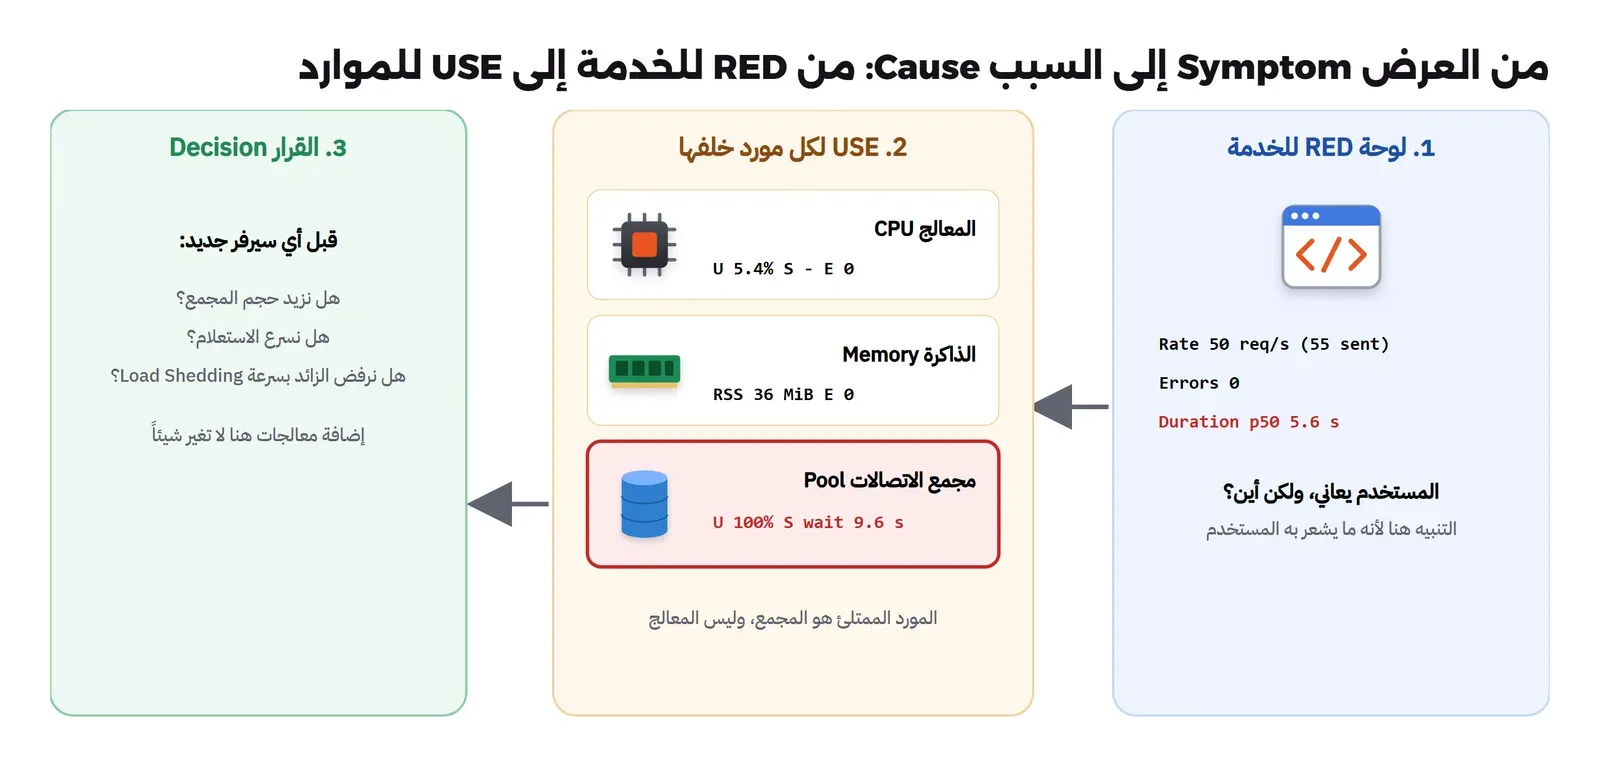
والقرار الذي يخرج به الفريق من هذا التحليل يختلف تماماً عما كان سوف يفعله دون قياس المجمع. فالرد الطبيعي على «الخدمة بطيئة في يوم العرض» هو طلب سيرفر أكبر، ولكن المعالج عند 5%، فسيرفر بضعف عدد الأنوية لن يغير شيئاً، لأن المجمع ما زال أربعة اتصالات. والخيارات الحقيقية ثلاثة، ولكل منها ثمن:
- زيادة حجم المجمع: أسهل حل، ولكن قاعدة البيانات نفسها لها حد لعدد الاتصالات، وكل اتصال يستهلك ذاكرة فيها، فإذا كان لديك عشرة سيرفرات تطبيق وزدت المجمع في كل منها إلى 50 فقد طلبت 500 اتصال من قاعدة بيانات قد لا تتحمل 200. وهنا تحتاج أن تراقب التشبع في قاعدة البيانات أيضاً، وهذا مثال على أن الحل في مكان ينقل المشكلة إلى مكان آخر.
- تسريع الاستعلام: إذا نزل الاستعلام من 80 إلى 40 مللي ثانية تضاعفت الطاقة إلى 100 طلب في الثانية دون أي تغيير في البنية، وهذا غالباً أرخص حل وأكثره استدامة، مثل فهرس Index ناقص أو استعلام يمكن أن يخزن مؤقتاً Cache.
- رفض الزائد بسرعة Load Shedding: بدل أن ينتظر الطلب 20 ثانية ثم يغلق المستخدم الصفحة، ترفض الخدمة الطلب فوراً برمز 503 إذا كان الطابور أطول من حد معين، فيرى بعض المستخدمين رسالة «حاول بعد دقيقة»، ويحصل الباقون على خدمة سريعة. وهذا الخيار يحول التشبع إلى أخطاء، وهو قرار عمل قبل أن يكون قراراً تقنياً.
ماذا تقيس في الخدمات التي لا تستقبل طلبات HTTP؟
الإشارات الأربع مكتوبة بلغة الطلبات، وليست كل خدمة تستقبل طلبات. ويقسم دليل القياس في Prometheus الأنظمة إلى ثلاثة أنواع: أنظمة الخدمة المباشرة Online-serving التي ينتظر فيها شخص أو نظام الرد، وأنظمة المعالجة غير المباشرة Offline Processing التي لا ينتظر فيها أحد وتعمل غالباً على دفعات، والمهام الدفعية Batch Jobs التي تعمل ثم تنتهي. والجدول التالي يترجم الإشارات الأربع لكل نوع بحسب ما يقترحه الدليل:
| نوع الخدمة | حجم الحركة | الأخطاء | زمن الاستجابة | التشبع |
|---|---|---|---|---|
| واجهة HTTP أو gRPC | الطلبات في الثانية | نسبة الطلبات الفاشلة، بما فيها الأخطاء داخل 200 | p50 وp95 وp99 من Histogram | الطلبات داخل الخدمة، والمجمعات، والعمليات المشغولة |
| عامل يقرأ من طابور Queue Worker | الرسائل المعالجة في الثانية | الرسائل الفاشلة والمعادة | عمر أقدم رسالة لم تعالج، ومدة المعالجة | طول الطابور، وهل يكبر أسرع مما يفرغ |
| مهمة دفعية مثل النسخ الاحتياطي | عدد السجلات أو البايتات | آخر تشغيل فشل | مدة التشغيل كاملاً | آخر وقت نجحت فيه، وهو أهم مقياس بحسب الدليل |
| قاعدة بيانات | الاستعلامات في الثانية | الاستعلامات الفاشلة والأقفال الميتة Deadlocks | زمن الاستعلامات البطيئة | الاتصالات المستخدمة من الحد الأقصى، والقرص |
والصف الثالث مهم بشكل خاص، فالدليل يقول إن المقياس الأساسي للمهمة الدفعية هو آخر وقت نجحت فيه، لأن المهمة التي لا تعمل أصلاً لا تنتج أخطاء ولا زمناً ولا أي رقم، فلا يطلق أي تنبيه على هذه الأرقام. وهذا بالضبط ما حدث في حادثة GitLab الشهيرة التي ذكرناها في مقال المفاهيم، حيث كانت النسخ الاحتياطية تفشل بصمت. وسوف نبني تنبيهاً على آخر نجاح للنسخ الاحتياطي في المقال القادم عن فحص التوفر، مع ما يسمى مفتاح الرجل الميت Dead Man's Switch.
خدمات لا تملك كودها: المصادر الجاهزة Exporters
كل ما سبق يفترض أنك تستطيع أن تعدل كود الخدمة، ولكن نصف ما يعمل على سيرفرات الفريق في قصتنا ليس من كتابته: الـ Reverse Proxy، وقاعدة البيانات، والذاكرة المؤقتة، وبرامج جاهزة مثل نظام البريد أو منصة التذاكر. وهنا تأتي المصادر الجاهزة Exporters، وفي قائمة المصادر في توثيق Prometheus مئات منها لقواعد البيانات وخوادم الويب والطوابير والأجهزة. والسؤال الذي تسأله لكل مصدر قبل أن تعتمد عليه: أي إشارة من الأربع يعطيني؟ لأن أغلبها يعطيك بعض الإشارات ولا يعطيك البقية.
فخذ مثلاً Nginx: الوحدة المدمجة فيه stub_status تعرض عدد الاتصالات النشطة، وعدد الاتصالات المقبولة والمعالجة، وعدد الطلبات الكلي، وكم اتصالاً يقرأ أو يكتب أو ينتظر الآن. ومن هذه الأرقام تحصل على حجم الحركة من عداد الطلبات، وعلى شيء من التشبع من الاتصالات النشطة والمنتظرة، ولكنك لا تحصل على زمن الاستجابة ولا على رموز الحالة، أي لا توجد أخطاء ولا مدة. فإذا كان Nginx هو باب خدماتك فإن المصدر المبني على stub_status وحده يتركك دون نصف الإشارات، وتحتاج أن تأخذ الباقي من سجلات الوصول Access Logs، أو من الخدمة نفسها خلفه. وفي المقابل يعرض Caddy مقاييس Prometheus بنفسه كما يذكر توثيق المقاييس فيه، ومنها عداد الطلبات caddy_http_requests_total ومدرج المدة caddy_http_request_duration_seconds والطلبات الجارية caddy_http_requests_in_flight، أي الإشارات الأربع تقريباً جاهزة على مستوى الباب.
وقواعد البيانات مثال آخر، فمصدر PostgreSQL المعروف postgres_exporter يعطيك عدد الاتصالات بحسب حالتها، والمعاملات Transactions الملتزمة والمتراجعة، وحجم قواعد البيانات، وهذه ممتازة للتشبع ولحجم الحركة، ولكن زمن الاستعلامات لا يأتي منه مباشرة كمدرج، ويحتاج إضافات في قاعدة البيانات نفسها مثل pg_stat_statements. والقاعدة العامة التي تخرج بها: عندما لا تملك الكود فقس الإشارات الأربع من أقرب نقطة تملكها، وغالباً تكون الـ Reverse Proxy أمام الخدمة، لأنها ترى كل طلب ورمزه ومدته، ثم أكمل التشبع من مصدر الخدمة نفسها. ولاحظ أن قياس الباب يرى ما يراه المستخدم بدقة أكبر من الخدمة نفسها، فهو يعد الطلب عند وصوله، وهذا يحل مشكلة الخمسين والخمسة والخمسين التي رأيناها في حجم الحركة.
ويجدر الإشارة هنا إلى أمر عملي: لا تضع كل مصدر تجده دون أن تسأل عن عدد السلاسل التي يضيفها، فبعض المصادر تعرض آلاف السلاسل لكل جدول أو لكل مفتاح، وقد يصبح مصدر واحد أكبر من كل مقاييس السيرفرات معاً، وقد رأينا في المقال السابق أن الحجم يأتي من عدد السلاسل، فابدأ بالمقاييس التي تجيب عن الإشارات الأربع، واستبعد الباقي بالخيار metric_relabel_configs حتى تحتاجه.
أخطاء شائعة Common Mistakes
- مقاييس السيرفر بدل مقاييس الخدمة: المعالج والذاكرة مهمة للتشخيص، ولكنها لا تقول إن المستخدم يعاني، كما رأينا عند 5% والانتظار 6 ثوان.
- الفئات الافتراضية دون مراجعة: أعطتنا p99 أكبر من الحقيقي بـ 85%، وسقفاً عند 10 ثوان لا يتجاوزه أي رقم. ضع حدوداً حول هدفك، وحداً أعلى من أسوأ ما تتوقع.
- حساب النسبة المئوية دون
le: مثلhistogram_quantile(0.99, sum(rate(..._bucket[5m])))، فالنتيجة فارغة أو خاطئة، لأن الدالة تحتاج الفئات. - متوسط النسب المئوية بين السيرفرات: متوسط p99 لخمسة سيرفرات ليس p99 للخدمة، اجمع الفئات أولاً ثم احسب.
- الأخطاء داخل 200: نسبة الأخطاء صفر والعميل يفشل في 4.6% من المحاولات.
- حجم الحركة من مكان بعد السقف: العداد في الخدمة رأى 50 والطلب 55، فقس الطلب قبل الخدمة إذا أردت أن تعرف الطلب الحقيقي.
- تنبيه على الاستخدام بدل الانتظار: مجمع عند 100% دون انتظار قد يكون بحجم مثالي، والانتظار هو العرض الحقيقي للتشبع.
- مولد ضغط بحلقة مغلقة: يبطئ مع الخدمة فلا ترى الطابور ولا الانهيار، وتخرج من اختبار الضغط بثقة في غير مكانها.
- تسمية بقيمة لا حدود لها: مثل المسار الكامل مع المعرفات، فيصبح كل طلب سلسلة جديدة، استخدم قالب المسار مثل
/orders/{id}.
قائمة تحقق Checklist لكل خدمة
| البند | كيف تتحقق منه |
|---|---|
| عداد للطلبات بتسمية للمسار والرمز | sum by (code) (rate(http_requests_total[5m])) يرجع الرموز الموجودة فقط، والمسارات من قائمة ثابتة |
| Histogram للمدة بفئات حول الهدف | حد للفئة عند رقم الهدف بالضبط، ومقارنة p95 من Prometheus بما يقيسه العميل أو الـ Reverse Proxy |
| زمن الأخطاء منفصل عن زمن النجاح | تسمية outcome بقيمتين على المدرج |
| الأخطاء في منطق العمل لها عداد | عداد للنتيجة، مثل الدفع الناجح والفاشل، وليس رموز HTTP فقط |
| المورد الأكثر تقييداً معروف ومقاس | مقياس لاستخدامه وللانتظار عليه، مثل المجمع أو العمليات أو الطابور |
| الطاقة محسوبة | حساب بسيط مثل 4 ÷ 0.08، ثم اختبار ضغط بحلقة مفتوحة يؤكده |
| تنبيه على الأعراض | نسبة الأخطاء وزمن الاستجابة، وتنبيه غير عاجل على الانتظار قبل الامتلاء |
| لوحة واحدة للخدمة | الإشارات الأربع في الصف الأول، وموارد USE تحتها |
تدريب عملي Practice
- أضف إلى
app.pyرفض الطلبات بسرعة إذا تجاوز عدد الطلبات داخل الخدمة 50، ثم أعد مرحلة 55 طلباً، وقارن زمن الاستجابة ونسبة الأخطاء بما رأيناه. - غير
POOL_SIZEإلى 8 دون أن تغير شيئاً آخر، واحسب الطاقة الجديدة قبل التجربة، ثم تحقق منها بالمولد.
حذف المختبر Cleanup
docker rm -f mon-gs-load mon-gs-app mon-gs-prom mon-gs-grafana
docker rmi mon-gs-app:1 mon-gs-app:2
docker network rm mon-net
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الإشارات الأربع تقيس الخدمة كما يراها المستخدم، والتشبع وحده ينبهك قبل أن يرى المستخدم شيئاً، ولذلك ابحث في كل خدمة عن المورد الأكثر تقييداً وقس الانتظار عليه.
- في مختبرنا امتلأ مجمع من أربعة اتصالات عند 50 طلباً في الثانية، فقفز الوسيط من 85 مللي ثانية إلى 6 ثوان، دون خطأ واحد، والمعالج عند 5%.
- حجم الحركة الذي تقيسه الخدمة هو ما خدمته وليس ما طلب منها، فإذا استقر عند سقف فانظر إلى التشبع.
- النسبة المئوية من Histogram تقدير داخل الفئة، والفئات الافتراضية أعطتنا p99 أكبر من الحقيقي بـ 85%، والفئات حول الهدف قللت الخطأ إلى قرابة 10%.
- الخطأ الذي يرجع 200 لا يراه أي مقياس مبني على رموز HTTP، فعد النتيجة في منطق العمل.
وفي المقال القادم من السلسلة بإذن الله ننتقل إلى السؤال الذي يسبق كل هذا: هل تصل طلبات المستخدمين إلى الخدمة أصلاً؟ مع فحص التوفر من الخارج، وانتهاء الشهادات، والمهام المجدولة التي تتوقف بصمت، ومن يراقب سيرفر المراقبة نفسه.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلمفاهيم المراقبة Observability: من الإشارة إلى التنبيهما الذي تجيب عنه المقاييس والسجلات والتتبع، وكيف تبني تنبيهاً على ما يشعر به المستخدم وعلى ميزانية الأخطاء بدل كل رقم.
 دليلالتتبع الموزع Distributed Tracing مع OpenTelemetryكيف ترى طلباً واحداً يمر بعدة خدمات في شجرة زمنية واحدة، فتعرف أين أبطأ وأين فشل دون أن تخمن من السجلات.
 دليلتتبع الأخطاء Error Tracking للمطورين مع GlitchTipماذا يضيف تتبع الأخطاء فوق السجلات، وكيف تشغل GlitchTip بديلاً خفيفاً لـ Sentry يستقبل أخطاء تطبيقك بالـ SDK نفسه.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Python 3.13 مع prometheus_client 0.23.1 وPrometheus 3.15.1 وGrafana 13.3.0 على Docker Engine 29.8.0.


