


بعد شهرين من المقالين السابقين أصبح لدى الفريق الذي نتابعه في هذه السلسلة لوحات للسيرفرات ولوحة للإشارات الذهبية لخدمة الدفع، وتنبيهات تتوقع امتلاء القرص وتلاحظ امتلاء مجمع الاتصالات. ثم جاء صباح يوم خميس، وفتح أحد الزملاء الموقع من هاتفه فظهرت له صفحة المتصفح الحمراء التي تقول إن الاتصال غير آمن. فقد انتهت شهادة TLS في منتصف الليل، لأن المهمة المجدولة التي تجددها توقفت منذ أسابيع بعد تحديث للسيرفر، ولم يلاحظ أحد. والمحير أن كل اللوحات كانت خضراء: الخدمة تعمل، والطلبات التي تصل إليها تنجح، ونسبة الأخطاء صفر، والسبب أن المستخدمين لم يصلوا إلى الخدمة أصلاً، فالمتصفح أوقفهم قبل الباب. ثم اكتشف الفريق في الأسبوع نفسه أن سيرفر المراقبة نفسه كان متوقفاً يومين كاملين بسبب صيانة عند مزود الاستضافة، ولم يرسل أي تنبيه، لأن الذي يرسل التنبيهات هو الذي توقف.
وهذا هو موضوع المقال الثالث في السلسلة: الفحص من الخارج، أي أن تسأل الخدمة كما يسألها المستخدم، وأن تتأكد أن المهام التي يفترض أن تعمل كل ليلة عملت فعلاً، وأن يكون هناك فحص واحد على الأقل خارج سيرفر المراقبة يخبرك إذا توقف. وقد بنينا في مقاييس السيرفرات مع Prometheus ولوحات Grafana نظام المقاييس، وفي الإشارات الذهبية Golden Signals قسنا الخدمة من داخلها، والآن نكمل الصورة من الخارج. والمواضيع في السلسلة:
- مقاييس السيرفرات مع Prometheus ولوحات Grafana.
- ماذا تقيس في خدمتك؟ الإشارات الذهبية Golden Signals.
- فحص التوفر Uptime Checks مع Blackbox Exporter أو Uptime Kuma (الموضوع الحالي).
- التنبيهات Alerting: ماذا تنبه عليه، وكيف تتجنب تعب التنبيهات Alert Fatigue.
- بوابة مراقبة واحدة Monitoring Portal تجمع Grafana مع Wazuh.
وسوف نناقش في هذا المقال ما يلي:
- الفرق بين الفحص من الخارج Black-box والقياس من الداخل White-box، ولماذا تحتاج الاثنين.
- Blackbox Exporter: كيف يعمل نمط الأهداف المتعددة Multi-target، ومختبر يفحص HTTP وTCP وICMP وشهادات TLS، ومشكلة واجهتنا في ملف الإعداد.
- أين يذهب وقت الفحص: مراحل الطلب من DNS إلى آخر بايت، بأرقام حقيقية.
- مراقبة انتهاء الشهادات، ولماذا وصلتنا ثلاثة تنبيهات لشهادة واحدة.
- Uptime Kuma: التثبيت والفحوص، ومشكلة الكلمة المفتاحية التي لم يجدها رغم أنها موجودة.
- Blackbox أم Uptime Kuma، ومن يراقب سيرفر المراقبة نفسه، مع تجربة إيقافه.
- مفتاح الرجل الميت Dead Man's Switch للمهام المجدولة والنسخ الاحتياطي، ثم الأخطاء الشائعة وقائمة تحقق.
الفحص من الخارج Black-box مع القياس من الداخل White-box
يفرق كتاب Google SRE في فصل مراقبة الأنظمة الموزعة بين نوعين من المراقبة: المراقبة من الداخل White-box، وهي المقاييس التي يعرضها النظام عن نفسه، مثل كل ما بنيناه في المقالين السابقين، والمراقبة من الخارج Black-box، ويعرفها بأنها اختبار السلوك الظاهر كما يراه المستخدم. والفرق بينهما ليس في الأداة وإنما في السؤال: الأولى تسأل «ماذا يحدث داخل الخدمة؟» والثانية تسأل «هل يحصل المستخدم على ما يريد؟». ويذكر الكتاب أن الفحص من الخارج يرى المشكلة التي تحدث الآن، ولا يرى المشكلة التي سوف تحدث، ولذلك هو مكمل للقياس من الداخل وليس بديلاً عنه.
وقصة الفريق تبين لماذا تحتاج الاثنين: الشهادة المنتهية مشكلة لا تراها الخدمة أبداً، لأن الطلب لا يصل إليها، وكذلك سجل DNS خاطئ بعد نقل النطاق، وجدار ناري Firewall أغلق المنفذ 443 بعد تحديث، ومزود إنترنت عنده مشكلة في طريق الوصول إلى السيرفر. وفي المقابل الفحص من الخارج لا يرى أن مجمع الاتصالات وصل إلى 81%، ولا أن القرص سوف يمتلئ بعد ثماني ساعات، فهو يقول لك فقط إن الصفحة فتحت أو لم تفتح، وكم أخذت. والقاعدة العملية: القياس من الداخل للتشخيص والتنبؤ، والفحص من الخارج للحقيقة النهائية التي يراها المستخدم، وأي خدمة مهمة تحتاج فحصاً واحداً على الأقل من الخارج.
وهناك أداتان منتشرتان لهذا العمل في عالم الاستضافة الذاتية، ولكل منهما فلسفة مختلفة: Blackbox Exporter من مشروع Prometheus نفسه، وهو برنامج صغير بلا واجهة يفحص الأهداف ويعرض النتيجة كمقاييس، فيصبح الفحص جزءاً من Prometheus ولوحات Grafana وتنبيهاته، وUptime Kuma، وهو تطبيق كامل بواجهة ويب وقاعدة بيانات خاصة به، تضيف فيه الفحوص بالنقر وترسل منه التنبيهات إلى عشرات الخدمات مباشرة، ورخصته MIT. وسوف نشغل الاثنين في المختبر، ثم نقارن بينهما بأرقام ما رأيناه.
كيف يعمل Blackbox Exporter؟ نمط الأهداف المتعددة Multi-target
في المقال الأول كان كل هدف في Prometheus برنامجاً يعرض أرقامه على /metrics. ولكن موقع العميل أو قاعدة Redis لا تعرض أرقام الفحص عن نفسها، وإنما نحتاج طرفاً ثالثاً يفحصها ثم يعرض النتيجة. وهذا ما يسميه توثيق Prometheus نمط المصدر متعدد الأهداف Multi-target Exporter: يطلب Prometheus من Blackbox الصفحة /probe مع اسم الهدف واسم الوحدة Module، فيقوم Blackbox بالفحص في اللحظة نفسها، ثم يرد بمقاييس تصف ما حدث، مثل probe_success وprobe_duration_seconds. والصورة التالية تبين ذلك:
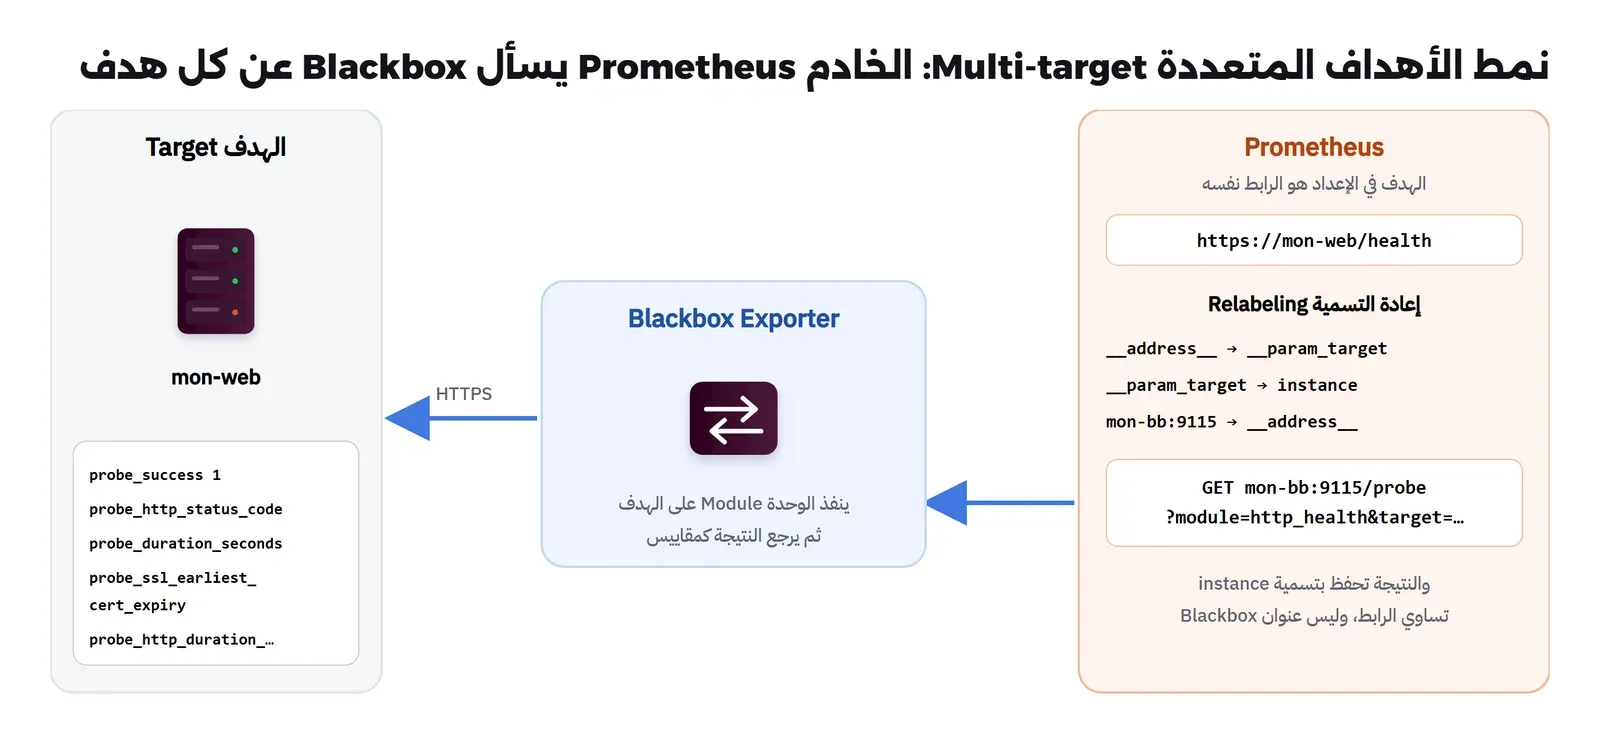
والوحدة Module هي وصف للفحص: البروتوكول، والمهلة، وما الذي يعتبر نجاحاً. فالوحدة http_2xx تقول «اطلب الصفحة واعتبر أي رمز 2xx نجاحاً»، ووحدة أخرى قد تقول «اطلب الصفحة، ويجب أن يحتوي الجسم على كلمة معينة». والفائدة من هذا الفصل أن ملف Blackbox يصف أنواع الفحص مرة واحدة، وملف Prometheus يقرر أي هدف يفحص بأي وحدة وكل كم ثانية، فإذا أضفت موقعاً جديداً أضفت سطراً واحداً في Prometheus دون أن تلمس Blackbox.
المختبر Lab: متجر وقاعدة Redis مع مهمة نسخ احتياطي
نبني نسخة صغيرة من بيئة الفريق: متجر على Nginx 1.31.6 يرد على HTTPS بشهادة موقعة ذاتياً Self-signed صلاحيتها عشرة أيام فقط حتى نرى تنبيه الانتهاء، وفيه صفحة صحة /health، وواجهة /api/orders ترجع 200 مع رسالة خطأ في الجسم كما رأينا في مقال الإشارات الذهبية. ومعه Redis، وBlackbox Exporter 0.29.1، وPrometheus 3.15.1، وnode_exporter 1.12.1 لمقاييس المهمة المجدولة، وUptime Kuma 2.5.9. ونبدأ بالشهادة:
docker run --rm -v "$PWD/certs:/c" python:3.13-slim openssl req -x509 -newkey rsa:2048 -nodes -days 10 \
  -subj "/CN=shop.lab" -addext "subjectAltName=DNS:shop.lab,DNS:mon-web" -keyout /c/shop.key -out /c/shop.crt
docker run --rm -v "$PWD/certs:/c" python:3.13-slim openssl x509 -in /c/shop.crt -noout -subject -enddate
subject=CN=shop.lab
notAfter=Nov 12 23:52:29 2026 GMTوالملف web/nginx.conf يصف المتجر:
# The "shop": HTTPS with a 10-day self-signed certificate, a health endpoint and an API that fails inside 200.
server {
    listen 80;
    location / { return 301 https://$host$request_uri; }
}
server {
    listen 443 ssl;
    ssl_certificate     /etc/nginx/certs/shop.crt;
    ssl_certificate_key /etc/nginx/certs/shop.key;
    default_type application/json;
    location = /health     { return 200 '{"status": "ok", "db": "ok"}'; }
    location = /api/orders { return 200 '{"ok": false, "error": "database unavailable"}'; }
    location /             { return 200 '<html><body>Shop</body></html>'; default_type text/html; }
}
والملف blackbox.yml فيه ست وحدات، كل واحدة لنوع من الفحص:
modules:
  # page answers with 2xx, following redirects, over IPv4
  http_2xx:
    prober: http
    timeout: 5s
    http:
      preferred_ip_protocol: ip4
  # the health endpoint must answer 2xx AND say the database is ok
  http_health:
    prober: http
    timeout: 5s
    http:
      preferred_ip_protocol: ip4
      tls_config: { insecure_skip_verify: true }   # lab only: self-signed certificate
      fail_if_body_not_matches_regexp: ['"db": "ok"']
  # same check for an API that answers 200 with an error inside
  http_api_ok:
    prober: http
    timeout: 5s
    http:
      preferred_ip_protocol: ip4
      tls_config: { insecure_skip_verify: true }
      fail_if_body_matches_regexp: ['"ok": false']
  # TLS only: is the certificate valid and when does it expire
  tls_cert:
    prober: tcp
    timeout: 5s
    tcp:
      preferred_ip_protocol: ip4
      tls: true
      tls_config: { insecure_skip_verify: true }
  # Redis answers PING with PONG
  tcp_redis:
    prober: tcp
    timeout: 5s
    tcp:
      preferred_ip_protocol: ip4
      query_response:
        - send: "PING"
        - expect: '^\+PONG'
  icmp:
    prober: icmp
    timeout: 5s
    icmp:
      preferred_ip_protocol: ip4
في الإعداد أعلاه لاحظ التالي:
preferred_ip_protocol: ip4في كل وحدة، لأن القيمة الافتراضية بحسب مرجع الإعدادات هيip6مع الرجوع إلى IPv4 إذا لم يتوفر، وفي شبكات كثيرة ليس فيها IPv6 حقيقي يضيف هذا تأخيراً أو فشلاً لا علاقة له بالخدمة.insecure_skip_verify: trueللمختبر فقط لأن الشهادة موقعة ذاتياً، ولا تضعه أبداً على فحص موقع حقيقي، لأنه يعني أن الفحص سوف ينجح حتى لو كانت الشهادة مزورة أو منتهية، وهو بالضبط ما تريد أن تعرفه.fail_if_body_not_matches_regexpيجعل الفحص يفشل إذا لم يجد النص المطلوب في الجسم، وfail_if_body_matches_regexpعكسه، وهذان الخياران هما ما يكشف الخطأ الذي يرجع 200.query_responseفي TCP يرسل نصاً وينتظر رداً يطابق تعبيراً نمطياً، فلا يكفي أن يقبل المنفذ الاتصال، وإنما يجب أن يرد Redis بكلمة PONG.
مشكلة واجهتنا: Blackbox لا يقرأ ملف الإعداد Config
في المحاولة الأولى كتبنا التعبير النمطي لـ Redis بين علامتي تنصيص مزدوجتين "^\+PONG"، فتوقفت كل الفحوص، وفي سجل Blackbox ظهرت هذه الرسالة:
level=ERROR source=main.go:103 msg="Error loading config" err="error parsing config file: yaml: line 40: found unknown escape character"والسبب أن YAML يعامل الشرطة المائلة العكسية داخل التنصيص المزدوج كبداية رمز خاص Escape، مثل \n، و\+ ليس رمزاً معروفاً فيرفض الملف كله. والحل أن تكتب التعبيرات النمطية بين علامتي تنصيص مفردتين '^\+PONG'، لأن YAML لا يفسر شيئاً داخلها. ولاحظ أيضاً ما حدث في Prometheus في تلك الدقيقة: كل أهداف Blackbox ظهرت down، لأن Blackbox يرفض العمل دون ملف صحيح، أي أن خطأً واحداً في ملف الإعداد أطفأ كل فحوص التوفر معاً، ولذلك افحص الملف قبل النشر، فـ Blackbox يقبل الخيار --config.check الذي يتحقق من الملف ويخرج دون تشغيل.
ربط Prometheus مع Blackbox
ملف prometheus.yml فيه وظيفة Job لكل وحدة، والأهداف هي الروابط والعناوين التي نريد فحصها، وإعادة التسمية Relabeling هي التي تحولها إلى طلبات لـ Blackbox كما في الصورة السابقة:
global:
  scrape_interval: 15s
  evaluation_interval: 15s
rule_files: [/etc/prometheus/rules.yml]
scrape_configs:
  # one job per Blackbox module; the target list is the thing to check, not the exporter
  - job_name: blackbox_http
    metrics_path: /probe
    params: { module: [http_2xx] }
    static_configs:
      - targets: ["https://prometheus.io/", "http://mon-web/"]
    relabel_configs: &bb
      - source_labels: [__address__]
        target_label: __param_target      # ?target=<the url> on the /probe request
      - source_labels: [__param_target]
        target_label: instance            # keep the url as the instance label
      - target_label: __address__
        replacement: mon-bb:9115          # but actually scrape the Blackbox Exporter
  - job_name: blackbox_health
    metrics_path: /probe
    params: { module: [http_health] }
    static_configs: [{ targets: ["https://mon-web/health"] }]
    relabel_configs: *bb
  - job_name: blackbox_api
    metrics_path: /probe
    params: { module: [http_api_ok] }
    static_configs: [{ targets: ["https://mon-web/api/orders"] }]
    relabel_configs: *bb
  - job_name: blackbox_tls
    metrics_path: /probe
    params: { module: [tls_cert] }
    static_configs: [{ targets: ["mon-web:443", "arabroot.io:443"] }]
    relabel_configs: *bb
  - job_name: blackbox_tcp
    metrics_path: /probe
    params: { module: [tcp_redis] }
    static_configs: [{ targets: ["mon-redis:6379"] }]
    relabel_configs: *bb
  - job_name: blackbox_icmp
    metrics_path: /probe
    params: { module: [icmp] }
    static_configs: [{ targets: ["mon-web", "1.1.1.1"] }]
    relabel_configs: *bb
  - job_name: blackbox_exporter          # the exporter's own health
    static_configs: [{ targets: ["mon-bb:9115"] }]
  - job_name: node
    static_configs: [{ targets: ["mon-up-node:9100"], labels: { server: files-1 } }]
والعلامتان &bb و*bb ميزة في YAML اسمها المرساة Anchor والإشارة Alias، تكتب بها قواعد إعادة التسمية مرة واحدة وتعيد استخدامها في كل وظيفة. ولاحظ أن Prometheus هنا يرى المقياس up لكل هدف، ولكنه يقول فقط هل رد Blackbox، وليس هل نجح الفحص، فإذا كان الموقع متوقفاً فإن up يبقى 1 وprobe_success يصبح 0، وهذا خطأ شائع عند من ينبه على up وحده مع Blackbox. ثم نشغل كل شيء على شبكة واحدة:
docker network create mon-net
docker run -d --name mon-web --network mon-net -v "$PWD/web/nginx.conf:/etc/nginx/conf.d/default.conf:ro" \
  -v "$PWD/certs:/etc/nginx/certs:ro" nginx:1.31.6-alpine
docker run -d --name mon-redis --network mon-net redis:8-alpine
docker run -d --name mon-bb --network mon-net -v "$PWD/blackbox.yml:/etc/blackbox_exporter/config.yml:ro" prom/blackbox-exporter:v0.29.1
docker run -d --name mon-up-prom --network mon-net -p 127.0.0.1:19090:9090 \
  -v "$PWD/prometheus.yml:/etc/prometheus/prometheus.yml:ro" -v "$PWD/rules.yml:/etc/prometheus/rules.yml:ro" \
  prom/prometheus:v3.15.1 --config.file=/etc/prometheus/prometheus.yml --storage.tsdb.retention.time=1d
فحص HTTP: رمز الحالة، التحويل Redirect، الجسم Body
بعد دقيقة سألنا Prometheus عن نتيجة كل فحص بالسكربت q.py الذي استخدمناه في المقال الأول:
python q.py 'probe_success'
python q.py 'probe_http_status_code'
python q.py 'probe_http_redirects'
probe_success{instance="https://mon-web/health",job="blackbox_health"} 1
probe_success{instance="mon-web:443",job="blackbox_tls"} 1
probe_success{instance="http://mon-web/",job="blackbox_http"} 0
probe_success{instance="arabroot.io:443",job="blackbox_tls"} 1
probe_success{instance="mon-redis:6379",job="blackbox_tcp"} 1
probe_success{instance="1.1.1.1",job="blackbox_icmp"} 1
probe_success{instance="mon-web",job="blackbox_icmp"} 1
probe_success{instance="https://mon-web/api/orders",job="blackbox_api"} 0
probe_http_status_code{instance="https://mon-web/health",job="blackbox_health"} 200
probe_http_status_code{instance="http://mon-web/",job="blackbox_http"} 0
probe_http_status_code{instance="https://mon-web/api/orders",job="blackbox_api"} 200
probe_http_redirects{instance="http://mon-web/",job="blackbox_http"} 1فحصان فشلا، ولكل منهما قصة:
http://mon-web/: رمز الحالة 0 والتحويلات 1، أي أن Blackbox طلب الصفحة على HTTP فحوله Nginx إلى HTTPS، ثم فشل الطلب الثاني قبل أن يصل إلى رمز حالة. وفي سجل Blackbox ظهر السبب:tls: failed to verify certificate: x509: certificate signed by unknown authority، لأن الوحدةhttp_2xxتتحقق من الشهادة، والشهادة موقعة ذاتياً. وهذا بالضبط ما سوف يراه المستخدم في المتصفح، فالفحص صادق، والدرس أن الفحص يتبع التحويل افتراضياً، فاختر الرابط الذي يكتبه المستخدم فعلاً، لأن خطأً في التحويل نفسه مشكلة حقيقية./api/orders: رمز الحالة 200، ومع ذلك فشل الفحص، لأن الجسم يحتوي على"ok": false. وهذا هو الخطأ الذي لم يره Prometheus في مقال الإشارات الذهبية لأنه يرجع 200، وها هو الفحص من الخارج يكشفه.
ولكي تعرف لماذا فشل فحص معين دون أن تبحث في السجلات، أضف debug=true إلى طلب /probe، فيرد Blackbox بسجل الفحص كاملاً قبل المقاييس:
curl -s 'http://mon-bb:9115/probe?module=http_api_ok&target=https://mon-web/api/orders&debug=true'level=ERROR source=http.go:59 msg="Body matched regular expression" module=http_api_ok target=https://mon-web/api/orders regexp="\"ok\": false"
level=ERROR source=handler.go:140 msg="Probe failed" module=http_api_ok target=https://mon-web/api/orders duration_seconds=0.022152616
probe_failed_due_to_regex 1
probe_success 0والمقياس probe_failed_due_to_regex مفيد في التنبيه نفسه، فرسالة «الصفحة ترد ولكن محتواها يقول إن قاعدة البيانات غير متاحة» تختلف تماماً عن «الصفحة لا ترد»، والأولى توجه من يستقبل التنبيه إلى قاعدة البيانات مباشرة.
أين يذهب وقت الفحص؟ مراحل الطلب Phases
المقياس probe_duration_seconds يعطيك الوقت الكلي، ولكن Blackbox يقسم وقت فحص HTTP إلى مراحل في المقياس probe_http_duration_seconds، وهذا التقسيم يختصر عليك كثيراً من التشخيص. وأفضل مثال هو موقع حقيقي على الإنترنت، فطلبنا https://prometheus.io/ مرتين متتاليتين:
curl -s 'http://mon-bb:9115/probe?module=http_2xx&target=https://prometheus.io/' | grep -E '^probe_http_duration_seconds|^probe_duration'probe_duration_seconds 0.614639207
probe_http_duration_seconds{phase="connect"} 0.1088023
probe_http_duration_seconds{phase="processing"} 0.143360355
probe_http_duration_seconds{phase="resolve"} 0.083997481
probe_http_duration_seconds{phase="tls"} 0.120327351
probe_http_duration_seconds{phase="transfer"} 0.152396044
probe_duration_seconds 0.538429241
probe_http_duration_seconds{phase="connect"} 0.112932135
probe_http_duration_seconds{phase="processing"} 0.155906992
probe_http_duration_seconds{phase="resolve"} 0.005008627
probe_http_duration_seconds{phase="tls"} 0.115339318
probe_http_duration_seconds{phase="transfer"} 0.148547925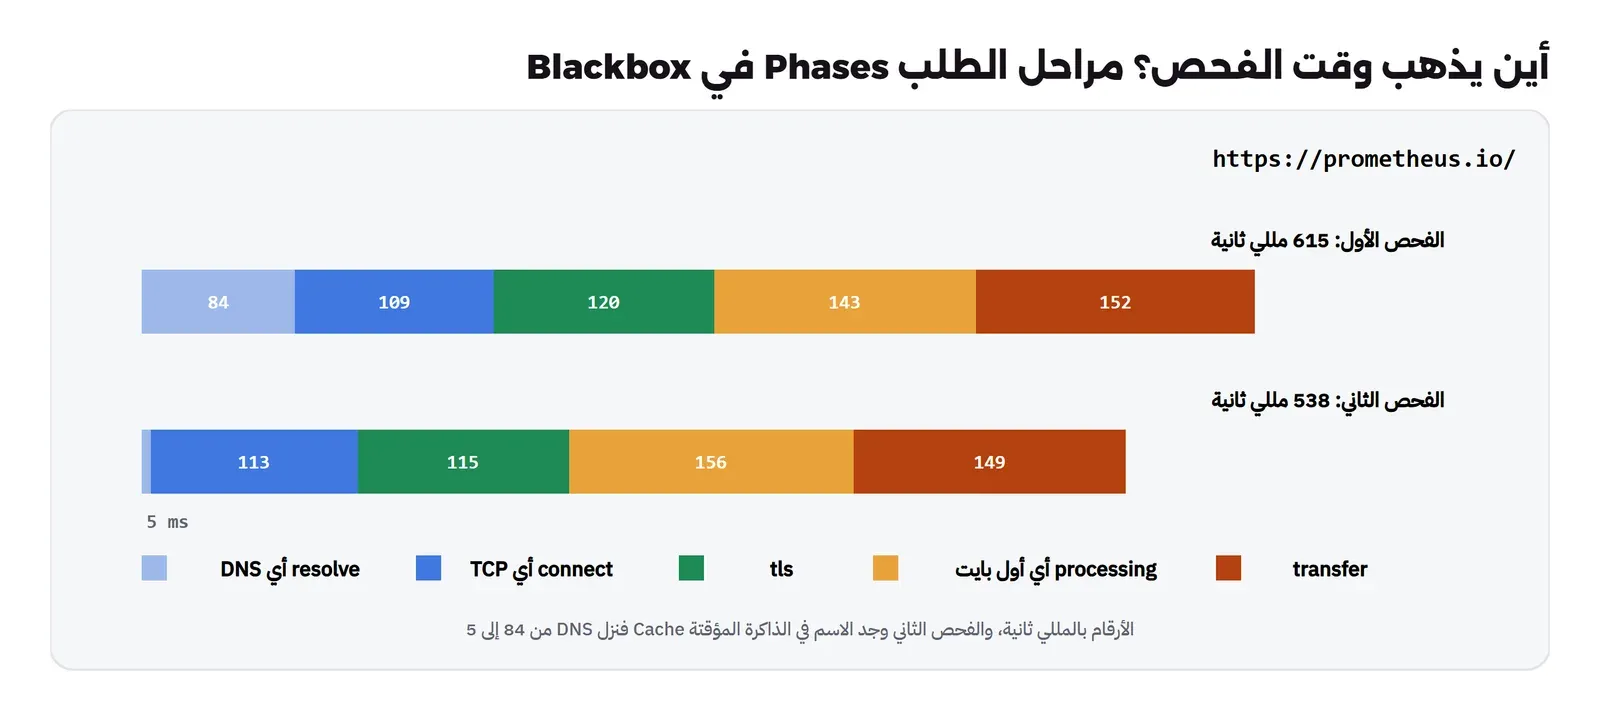
وكل مرحلة تشير إلى مكان مختلف إذا ارتفعت:
- resolve: وقت ترجمة الاسم بخادم DNS، وفي الفحص الأول 84 مللي ثانية، وفي الثاني 5 فقط، لأن الاسم أصبح في الذاكرة المؤقتة Cache. فإذا ارتفعت هذه المرحلة فجأة فالمشكلة في خادم DNS الذي يستخدمه سيرفر المراقبة، أو في مزود DNS للنطاق.
- connect: وقت فتح اتصال TCP، وهو تقريباً زمن الذهاب والعودة في الشبكة، ونحو 110 مللي ثانية هنا لأن الموقع بعيد جغرافياً عن جهاز المختبر. وارتفاعه يعني مشكلة شبكة بين الطرفين.
- tls: المصافحة Handshake، وتحتاج ذهاباً وعودة إضافياً في الشبكة على الأقل، فإذا ارتفعت وحدها فقد تكون المشكلة في ضغط التشفير على السيرفر أو في سلسلة شهادات طويلة.
- processing: من إرسال الطلب حتى أول بايت من الرد، وهذا وقت التطبيق نفسه، فإذا ارتفع وحده فالمشكلة داخل الخدمة، وهنا تنتقل إلى لوحة الإشارات الذهبية.
- transfer: نقل الجسم كاملاً، ويعتمد على حجم الصفحة وسرعة الشبكة.
وهذا التقسيم يجعل الفحص من الخارج أداة تشخيص وليس مجرد نعم أو لا، فإذا وصلك تنبيه أن الموقع بطيء من الخارج، والمرحلة المرتفعة هي processing، فاللوحة الداخلية سوف تؤكد المشكلة، أما إذا كانت connect فاللوحة الداخلية خضراء ولن تجد شيئاً فيها.
فحص TCP مع Redis، وفحص ICMP
فحص TCP البسيط يتأكد فقط أن المنفذ يقبل الاتصال، وهذا لا يعني أن البرنامج خلفه يعمل، فقد يقبل الاتصال ثم يعلق. ولذلك استخدمنا query_response لنرسل PING وننتظر +PONG، فنجح الفحص في 1.2 مللي ثانية:
probe_success{instance="mon-redis:6379",job="blackbox_tcp"}  1
probe_duration_seconds{instance="mon-redis:6379",job="blackbox_tcp"}  0.001222978
والطريقة نفسها تعمل مع أي بروتوكول نصي: SMTP يرد بسطر يبدأ بـ 220، وSSH يرد بسطر يبدأ بـ SSH-2.0، وتستطيع حتى أن تطلب STARTTLS في منتصف الحوار لتفحص شهادة خادم البريد، كما يبين مرجع الإعدادات.
أما ICMP، أي ping، فيحتاج صلاحيات خاصة، ويذكر توثيق Blackbox أنه يحتاج على Linux إما المستخدم root، أو الصلاحية CAP_NET_RAW، أو أن تكون مجموعة المستخدم ضمن الإعداد net.ipv4.ping_group_range. وفي المختبر عمل مباشرة، وكان زمن الذهاب والعودة إلى 1.1.1.1 نحو 38 مللي ثانية، وإلى المتجر داخل الشبكة 0.26 مللي ثانية:
probe_icmp_duration_seconds{instance="1.1.1.1",job="blackbox_icmp",phase="rtt"}  0.037956831
probe_icmp_duration_seconds{instance="mon-web",job="blackbox_icmp",phase="rtt"}  0.000262312
ولا تعتمد على ping وحده لأي خدمة، فهو يقول إن السيرفر يرد على الشبكة، وليس إن الموقع يعمل، وكثير من مزودي الاستضافة يغلقون ICMP في الجدار الناري افتراضياً، فيبدو السيرفر متوقفاً وهو يعمل. ومكانه المناسب هو الأجهزة التي لا تملك خدمة تفحصها، مثل الـ Router أو جهاز في فرع الشركة.
الشهادات TLS: متى تنتهي؟
نعود إلى قصة الشهادة المنتهية. كل فحص فيه TLS في Blackbox يعرض المقياس probe_ssl_earliest_cert_expiry، وهو بحسب كود Blackbox نفسه أقرب تاريخ انتهاء بين الشهادات التي يرسلها السيرفر في المصافحة، أي شهادة الموقع والشهادات الوسيطة Intermediate معاً، بصيغة ثواني Unix. فإذا طرحت منه الوقت الحالي وقسمت على 86400 حصلت على الأيام المتبقية:
(probe_ssl_earliest_cert_expiry - time()) / 86400{instance="https://mon-web/health",job="blackbox_health"} 9.997504004629121
{instance="mon-web:443",job="blackbox_tls"} 9.997504004629121
{instance="arabroot.io:443",job="blackbox_tls"} 52.271219282406896
{instance="https://mon-web/api/orders",job="blackbox_api"} 9.997504004629121شهادة المتجر بقي لها عشرة أيام كما أصدرناها، وشهادة موقع عرب رووت بقي لها 52 يوماً. ولاحظ أن الشهادات الوسيطة مهمة هنا أيضاً، فقد شرحنا في دليل الشهادات سلسلة الثقة، وقد يحدث أن تجدد شهادة الموقع وتبقى شهادة وسيطة قديمة في ملف السلسلة على السيرفر. وهناك حادثة معروفة لهذا النوع، فقد انتهت في 30 سبتمبر 2021 الشهادة الرئيسية القديمة DST Root CA X3 التي كانت توقع عليها Let's Encrypt بشكل متقاطع، ونشرت Let's Encrypt صفحة تشرح ما يتغير للأجهزة القديمة والواجهات البرمجية التي تتصل بها أجهزة لا تحدث قائمة الشهادات الرئيسية، وكثير من المشكلات في ذلك اليوم كانت عند الأنظمة التي تتصل بالواجهات وليس في المتصفحات.
وقاعدة التنبيه في rules.yml كانت في البداية كما يلي:
      - alert: CertificateExpiresSoon
        expr: (probe_ssl_earliest_cert_expiry - time()) / 86400 < 14
        labels: { severity: warning }
        annotations: { summary: "certificate of {{ $labels.instance }} expires in {{ $value | printf \"%.1f\" }} days" }
وهنا مشكلة ثانية واجهتنا: وصلت ثلاثة تنبيهات للشهادة نفسها:
CertificateExpiresSoon https://mon-web/health firing 2026-11-02T23:55:56 certificate of https://mon-web/health expires in 10.0 days
CertificateExpiresSoon mon-web:443 firing 2026-11-02T23:55:56 certificate of mon-web:443 expires in 10.0 days
CertificateExpiresSoon https://mon-web/api/orders firing 2026-11-02T23:55:56 certificate of https://mon-web/api/orders expires in 10.0 days
والسبب أن كل فحص HTTPS للسيرفر نفسه يعرض المقياس نفسه، فصفحة الصحة والواجهة وفحص TLS المخصص رأت الشهادة نفسها. وفي فريق عنده عشرون رابطاً لخمسة نطاقات سوف تصله عشرون رسالة لخمس شهادات، وهذا طريق مباشر إلى تعب التنبيهات. والحل أن تجعل فحص الشهادة وظيفة مستقلة بهدف واحد لكل نطاق، وتقيد التنبيه بها:
expr: (probe_ssl_earliest_cert_expiry{job="blackbox_tls"} - time()) / 86400 < 14وبعد إعادة تحميل الإعداد بقي تنبيه واحد للشهادة. أما اختيار 14 يوماً فله سبب: الشهادات الافتراضية في Let's Encrypt صلاحيتها 90 يوماً بحسب أسئلتها الشائعة، وأداة certbot منذ الإصدار 4.0.0 تعتبر الشهادة جاهزة للتجديد عندما يبقى أقل من ثلث مدتها كما يذكر دليل استخدامها، أي قبل 30 يوماً تقريباً لشهادة مدتها 90 يوماً، فإذا بقي لها 14 يوماً فالتجديد فشل أياماً متتالية، وهذا وقت كاف لكي يصلحه أحد في وقت العمل دون عجلة. وكما ذكرنا في قسم مدة الشهادات فإن المدة تقصر كل عام، وكلما قصرت أصبح التجديد الآلي ومراقبته أهم من أي وقت.
Uptime Kuma: الفحص بالواجهة
Uptime Kuma تطبيق مختلف تماماً في طريقة العمل: لا توجد ملفات إعداد، وإنما واجهة ويب تضيف منها الفحوص، وكل فحص له تاريخه ونسبة توفره ورسومه، وتنبيهاته تصل مباشرة إلى البريد أو Telegram أو Slack أو عشرات الخدمات الأخرى دون Alertmanager، وفيه صفحات حالة Status Pages عامة تعرضها لعملائك. وأنواع الفحص التي يذكرها مستودعه تشمل HTTP مع كلمة مفتاحية أو استعلام JSON، وTCP، وping، وDNS، وDocker، والفحص بالدفع Push. وقد استخدمنا الإصدار 2.5.9 بالوسم slim، وهو في Docker Hub نحو 185 MB مضغوطاً مقابل 617 MB للوسم الكامل:
docker run -d --name mon-kuma --network mon-net -p 127.0.0.1:13001:3001 -v mon-kuma-data:/app/data louislam/uptime-kuma:2.5.9-slimوعند أول فتح يسألك عن قاعدة البيانات، SQLite المدمجة أو MariaDB/MySQL خارجية، ثم ينشئ حساب المدير. ولأن Kuma لا يوثق واجهة برمجية REST لإنشاء الفحوص، وإنما تعمل واجهته عبر WebSocket، أضفنا الفحوص الثلاثة بسكربت يتحكم في متصفح Chrome دون واجهة، وهو kuma-setup.mjs في ملفات المختبر، وفي الاستخدام العادي تضيفها بالنقر:
- shop health: من نوع HTTP(s) Keyword على
https://mon-web/healthكل 20 ثانية، والكلمة المفتاحية"db": "ok"، مع تجاهل خطأ الشهادة الموقعة ذاتياً. - prometheus (monitoring server): من نوع HTTP(s) على
http://mon-up-prom:9090/-/healthyكل 20 ثانية، وهي صفحة الصحة التي يعرضها Prometheus عن نفسه. - nightly backup heartbeat: من نوع Push بمهلة 120 ثانية، وسوف نشرحه في قسم المهام المجدولة.
مشكلة واجهتنا: الكلمة المفتاحية Keyword موجودة لكن Kuma لا يجدها
بعد دقائق كان فحص المتجر أحمر بالكامل، بينما Blackbox يقول إن الصفحة نفسها سليمة ويجد فيها "db": "ok". ولأن رسالة الفشل في الواجهة مختصرة قرأنا آخر النتائج من قاعدة بيانات Kuma مباشرة:
docker exec -w /app mon-kuma node -e "const s=require('@louislam/sqlite3');const d=new s.Database('/app/data/kuma.db');
d.all('select monitor_id,status,msg,time from heartbeat order by id desc limit 2',(e,r)=>console.log(r))"
[
{ monitor_id: 2, status: 1, msg: '200 - OK', time: '2026-11-03 00:10:37.913' },
{ monitor_id: 1, status: 0, msg: '200 - OK, but keyword is not in [{"status":"ok","db":"ok"}]', time: '2026-11-03 00:10:29.870' }
]والرسالة تكشف السبب: الجسم الذي بحث فيه Kuma هو {"status":"ok","db":"ok"} بلا مسافات، بينما الذي يرسله Nginx فيه مسافة بعد كل نقطتين. أي أن Kuma عندما وجد أن الرد JSON حوله إلى كائن ثم أعاد كتابته نصاً قبل البحث، فاختفت المسافات، والكلمة المفتاحية التي كتبناها بمسافة لم تعد موجودة. وBlackbox يبحث في النص الخام كما وصل، ولذلك نجح. والحل في Kuma أن تكتب الكلمة كما تظهر بعد إعادة الكتابة "db":"ok"، أو الأفضل أن تستخدم نوع الفحص JSON Query الذي يقرأ الحقل بالاسم، وبعد التعديل أصبح الفحص أخضر:
{ monitor_id: 1, status: 1, msg: '200 - OK, keyword is found', time: '2026-11-03 00:11:39.297' }والدرس العام من هذه المشكلة: كل أداة فحص تفسر الرد بطريقتها، فلا تفترض أن الكلمة المفتاحية التي نجحت في أداة سوف تنجح في أخرى، وجرب كل فحص جديد مرة بشكل يفشل ومرة بشكل ينجح قبل أن تعتمد عليه.
Blackbox Exporter أم Uptime Kuma؟
بعد أن شغلنا الاثنين على الأهداف نفسها نستطيع أن نقارن بما رأيناه، والسؤال ليس أيهما أفضل، وإنما أيهما يناسب مكانه في نظامك:
| المعيار | Blackbox Exporter | Uptime Kuma |
|---|---|---|
| طريقة الإعداد | ملفات YAML في Git، ومراجعة كود لكل تغيير | واجهة ويب، والإعداد في قاعدة SQLite |
| النتيجة | مقاييس في Prometheus، مع لوحات Grafana والتنبيهات نفسها | تاريخ ونسبة توفر ورسوم داخل التطبيق |
| التنبيهات | عبر Alertmanager مع التجميع والتوجيه | مباشرة إلى أكثر من 90 خدمة بحسب مستودعه |
| تقسيم وقت HTTP | خمس مراحل من DNS إلى النقل | زمن الرد الكلي |
| فحص الجسم | تعبيرات نمطية على النص الخام | كلمة مفتاحية بعد تفسير JSON، أو استعلام JSON |
| المهام المجدولة | لا يوجد، وتحتاج textfile أو Pushgateway | فحص Push مدمج برابط لكل مهمة |
| صفحة حالة للعملاء | لا يوجد | مدمجة |
| الحجم في المختبر | Image بحجم 58 MB | Image بحجم 861 MB للوسم slim بعد فك الضغط |
ومن هذه المقارنة تخرج نقاط القوة والضعف لكل أداة:
- نقاط القوة في Blackbox: كل فحص جزء من نظام المقاييس نفسه، فترسم توفر الموقع بجانب زمن الاستجابة الداخلي في لوحة واحدة، وتنبه عليه بالقواعد والتوجيه نفسه، والإعداد في Git يراجع ويعاد بناؤه.
- نقاط الضعف في Blackbox: لا يعمل وحده، فيحتاج Prometheus لكي يكون له معنى، ولا يملك واجهة ولا صفحة حالة، ويحتاج حلاً منفصلاً للمهام المجدولة.
- نقاط القوة في Uptime Kuma: تشغيل في دقيقة، وواجهة يفهمها أي شخص في الفريق، وتنبيهات مباشرة، وفحص Push جاهز، وصفحة حالة للعملاء.
- نقاط الضعف في Uptime Kuma: الإعداد في قاعدة بيانات وليس في ملفات، فيصعب أن تراجعه أو تعيد بناءه، ولا توجد واجهة برمجية موثقة لإضافة الفحوص، وبياناته منفصلة عن بقية المقاييس.
والترتيب الذي يناسب فريقاً مثل فريق القصة هو أن يستخدم الاثنين، ولكن لكل منهما دور واضح: Blackbox داخل نظام المراقبة لكل الفحوص اليومية حتى تكون في Grafana مع بقية الأرقام، وهذا ما سوف نبني عليه في مقال البوابة الواحدة، وUptime Kuma خارج نظام المراقبة لعدد قليل من الفحوص المهمة جداً، وأولها فحص سيرفر المراقبة نفسه، وهذا هو القسم التالي.
من يراقب المراقب؟ Who Monitors the Monitor
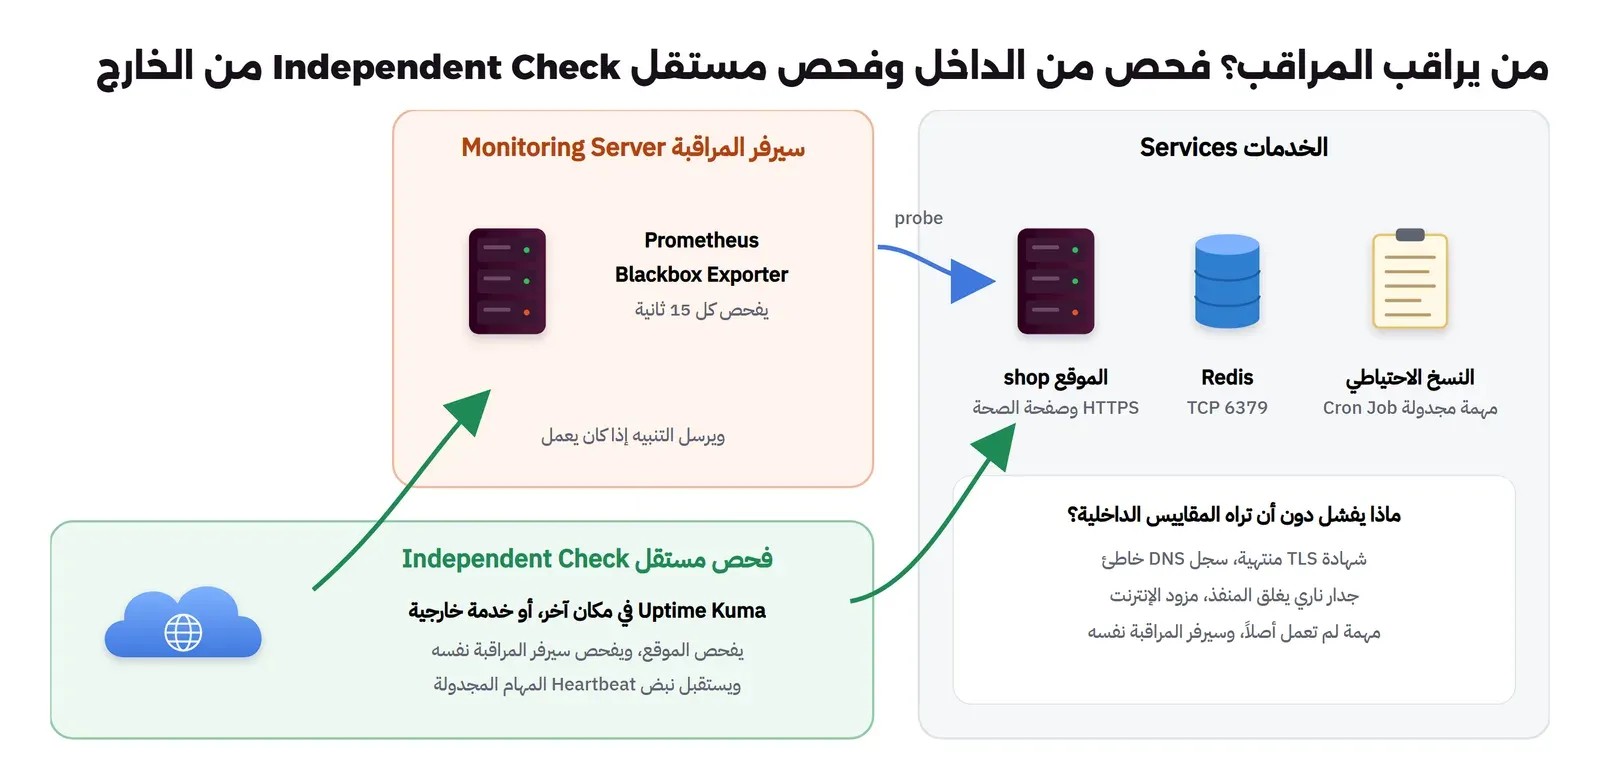
في قصة الفريق توقف سيرفر المراقبة يومين دون أن يعرف أحد، والسبب بسيط ومزعج: نظام التنبيه لا يستطيع أن ينبه على توقفه هو. فإذا توقف Prometheus فلن تقيم القواعد، وإذا توقف Alertmanager فلن ترسل الرسائل، وإذا انقطعت شبكة السيرفر فلن يصل شيء، والنتيجة في كل الحالات واحدة: صمت، والصمت يشبه تماماً حالة «كل شيء بخير». والحل أن يكون هناك فحص واحد على الأقل في مكان آخر: سيرفر آخر في مزود استضافة مختلف إن أمكن، أو خدمة فحص خارجية، يفحص سيرفر المراقبة نفسه، ويرسل تنبيهه بطريق لا يمر بسيرفر المراقبة. والصورة التالية تبين هذا الترتيب:
وفي المختبر جربنا ذلك فعلاً: أوقفنا Prometheus عند 00:12:12 بتوقيت UTC، ثم قرأنا ما سجله Kuma لفحص Prometheus:
docker stop mon-up-prom{ status: 0, msg: 'getaddrinfo ENOTFOUND mon-up-prom', time: '2026-11-03 00:12:53.041', retries: 2 }
{ status: 0, msg: 'connect EHOSTUNREACH 192.168.96.6:9090', time: '2026-11-03 00:12:17.908', retries: 1 }
{ status: 1, msg: '200 - OK', time: '2026-11-03 00:11:57.907', retries: 0 }بعد ست ثوان من الإيقاف سجل Kuma الفحص الفاشل الأول، وجعل الحالة Down مباشرة لأن عدد المحاولات الإضافية Retries في هذا الفحص صفر، ثم تغيرت الرسالة في المحاولة التالية من «لا يمكن الوصول إلى العنوان» إلى «الاسم غير موجود»، لأن Docker حذف اسم الـ Container من DNS الداخلي بعد توقفه. والصورة التالية من واجهة Kuma في تلك اللحظة، والأوقات فيها بتوقيت السعودية لأن المتصفح يعرض الوقت المحلي:
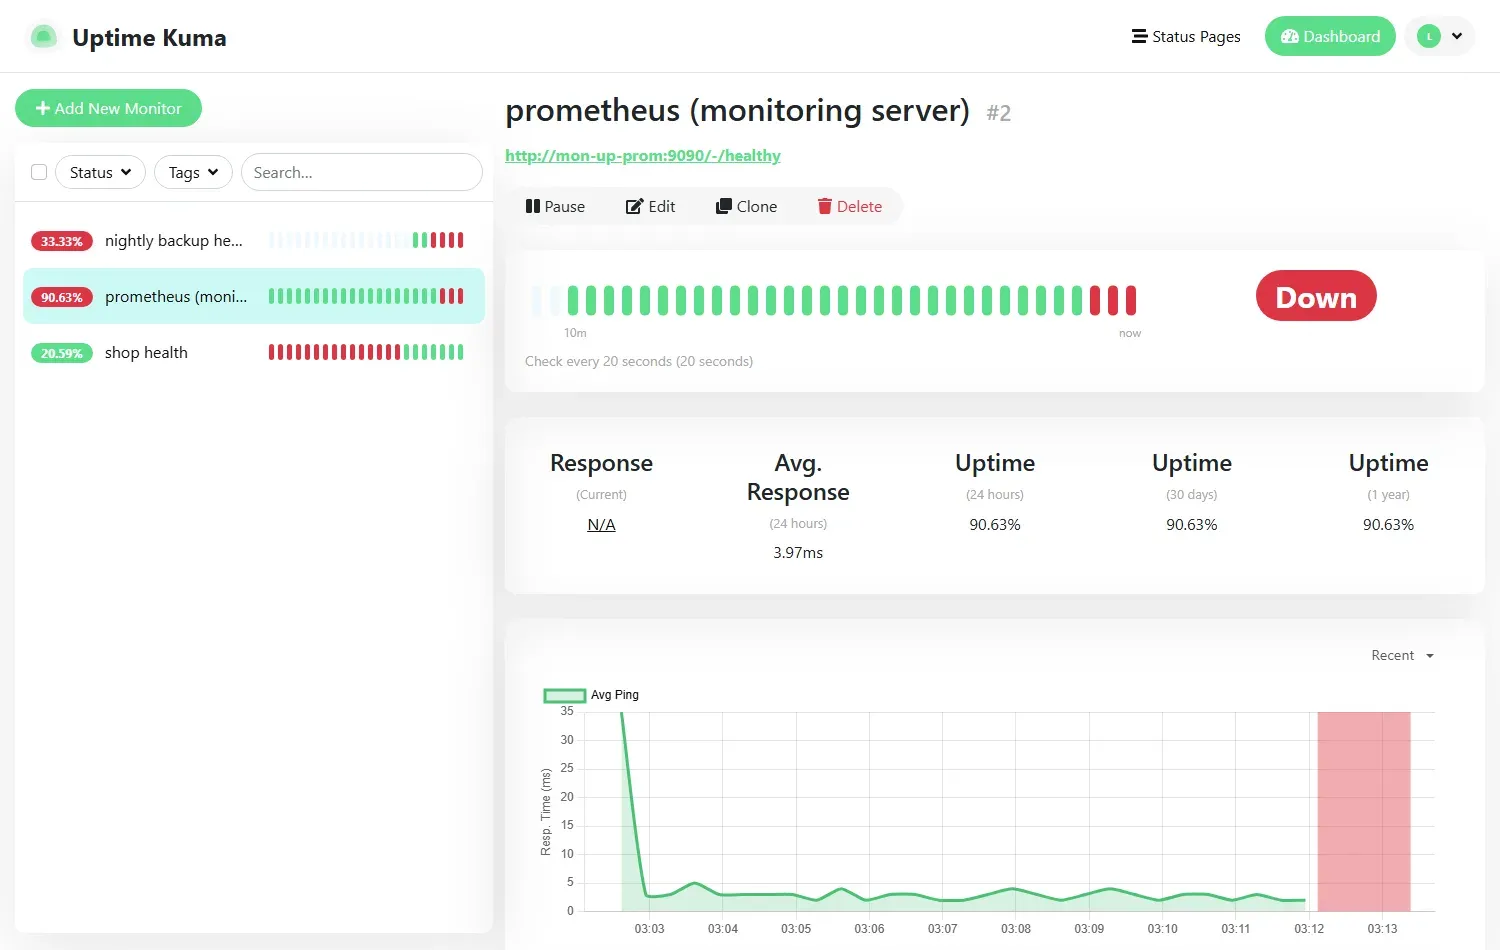
وفي هذه اللحظة لو كان Prometheus هو الوحيد الذي يراقب لما وصلت أي رسالة، ولبقيت كل اللوحات تعرض آخر ما رأته. وهناك طريقة ثانية تكمل هذه الطريقة ولا تغني عنها، وهي تنبيه دائم الإطلاق اسمه Watchdog: قاعدة في Prometheus شرطها صحيح دائماً، مثل vector(1)، فيطلق التنبيه طوال الوقت، ويرسله Alertmanager إلى خدمة خارجية تنتظره كل بضع دقائق، فإذا توقف وصوله عرفت الخدمة أن مسار التنبيه كله متعطل. ويشرح دليل تشغيل Watchdog في مشروع Prometheus Operator هذه الفكرة: تنبيه يهدف إلى التأكد أن مسار التنبيه كاملاً يعمل، ويجب أن يكون في حالة إطلاق دائماً. والفرق بين الطريقتين أن فحص Kuma لصفحة /-/healthy يقول إن Prometheus يرد، أما Watchdog فيقول إن Prometheus يقيم القواعد وAlertmanager يرسل والرسالة تصل، أي أنه يختبر المسار كله، وسوف نبنيه في مقال التنبيهات القادم.
المهام المجدولة Cron Jobs: مفتاح الرجل الميت Dead Man's Switch
أصعب ما يمكن مراقبته هو الشيء الذي يجب أن يحدث ولم يحدث. فالنسخ الاحتياطي الليلي الذي توقف لا يرسل خطأ، ولا يكتب سطراً في السجلات، ولا يغير أي مقياس، لأنه لم يعمل أصلاً. وقد ذكرنا في مقال المفاهيم حادثة GitLab عام 2017 حيث كانت النسخ الاحتياطية تفشل بصمت، وفي دليل النسخ الاحتياطي بقاعدة 3-2-1 شرحنا كيف تبني النسخ وتختبر الاستعادة، والآن نكمل الجزء الذي يخبرك أن النسخة لم تصنع. والفكرة اسمها مفتاح الرجل الميت Dead Man's Switch: لا تنبه عندما يصل الفشل، وإنما عندما يغيب النجاح، فكل مهمة ترسل إشارة عند نجاحها، والتنبيه يطلق إذا مر وقت أطول من المتوقع دون إشارة.
وهناك طريقتان، وجربنا الاثنتين على مهمة نسخ احتياطي تعمل كل 60 ثانية في المختبر بدل كل ليلة. والطريقة الأولى مع Prometheus: يقول دليل القياس إن المقياس الأساسي للمهمة الدفعية هو آخر وقت نجحت فيه، والطريقة المناسبة لمهمة على سيرفر هي مجمع الملفات النصية textfile في node_exporter، حيث تكتب المهمة ملفاً بصيغة Prometheus في مجلد يقرؤه node_exporter مع كل سحب. والسكربت backup.sh:
#!/bin/sh
# Fake nightly backup, run every 60 s in the lab. On success it writes the metrics for node_exporter's textfile collector.
# Touch /textfile/FAIL to make it fail.
OUT=/textfile/backup.prom
while true; do
  start=$(date +%s)
  if [ ! -e /textfile/FAIL ] && tar czf /tmp/backup.tgz /etc 2>/dev/null; then code=0; else code=1; fi
  end=$(date +%s)
  {
    echo "# HELP backup_last_exit_code Exit code of the last backup run."
    echo "# TYPE backup_last_exit_code gauge"
    echo "backup_last_exit_code $code"
    echo "# HELP backup_last_run_timestamp_seconds When the last backup run finished."
    echo "# TYPE backup_last_run_timestamp_seconds gauge"
    echo "backup_last_run_timestamp_seconds $end"
    if [ $code -eq 0 ]; then
      echo "# HELP backup_last_success_timestamp_seconds When the last successful backup finished."
      echo "# TYPE backup_last_success_timestamp_seconds gauge"
      echo "backup_last_success_timestamp_seconds $end"
      echo "backup_last_duration_seconds $((end - start))"
    else
      grep -E '^backup_last_(success_timestamp|duration)_seconds' $OUT 2>/dev/null   # keep the last good values
    fi
  } > $OUT.$$ && mv $OUT.$$ $OUT
  [ -n "$PUSH_URL" ] && [ $code -eq 0 ] && wget -q -O /dev/null "$PUSH_URL?status=up&msg=backup+ok" || true
  sleep 60
done
في السكربت أعلاه لاحظ التالي:
- الملف يكتب أولاً باسم مؤقت
$OUT.$$ثم ينقل بالأمرmv، وهذه هي الطريقة التي يوصي بها توثيق node_exporter، لأن النقل داخل نظام الملفات نفسه عملية ذرية Atomic، فلا يقرأ node_exporter ملفاً نصف مكتوب في منتصف السحب. - وقت آخر نجاح يكتب فقط عند النجاح، وعند الفشل نحتفظ بالقيمة القديمة، فيبقى المقياس يحمل آخر مرة نجحت فيها المهمة فعلاً، وهذا هو الرقم الذي ننبه عليه.
- عند النجاح فقط يرسل السكربت طلباً إلى رابط Push في Kuma، وهذه هي الطريقة الثانية التي نشرحها بعد قليل.
ثم شغلنا node_exporter مع المجلد، والمهمة نفسها في Container يكتب في المجلد نفسه:
docker run -d --name mon-up-node --network mon-net -v "$PWD/textfile:/textfile:ro" \
  prom/node-exporter:v1.12.1 --collector.textfile.directory=/textfile
docker run -d --name mon-backup --network mon-net -e PUSH_URL=http://mon-kuma:3001/api/push/fikQgnLGCiXJDPuobuAHNyJCz3ARYXs7 \
  -v "$PWD/textfile:/textfile" -v "$PWD/backup.sh:/backup.sh:ro" alpine:3.22 sh /backup.sh
cat textfile/backup.prom
# HELP backup_last_exit_code Exit code of the last backup run.
# TYPE backup_last_exit_code gauge
backup_last_exit_code 0
# HELP backup_last_run_timestamp_seconds When the last backup run finished.
# TYPE backup_last_run_timestamp_seconds gauge
backup_last_run_timestamp_seconds 1793664270
# HELP backup_last_success_timestamp_seconds When the last successful backup finished.
# TYPE backup_last_success_timestamp_seconds gauge
backup_last_success_timestamp_seconds 1793664270
backup_last_duration_seconds 0وقاعدتا التنبيه في rules.yml:
  - name: scheduled-jobs
    rules:
      # dead man's switch for the nightly backup: lab threshold 3 minutes, production about 26 hours
      - alert: BackupTooOld
        expr: time() - backup_last_success_timestamp_seconds > 180
        labels: { severity: warning }
        annotations: { summary: "last successful backup on {{ $labels.server }} was {{ $value | humanizeDuration }} ago" }
      - alert: BackupMetricMissing
        expr: absent(backup_last_success_timestamp_seconds)
        for: 5m
        labels: { severity: warning }
        annotations: { summary: "no backup metric at all: the job never ran or the textfile is gone" }
والقاعدة الأولى هي مفتاح الرجل الميت نفسه: الوقت منذ آخر نجاح أكبر من الحد. واختيار الحد قرار له طرفان: يقترح دليل التنبيه في Prometheus للمهام الدفعية أن يكون الحد كافياً لتشغيلين كاملين على الأقل، أي قرابة 48 ساعة لمهمة ليلية، حتى لا يوقظك تأخر ليلة واحدة، وفي المقابل إذا كانت خسارة نسخة ليلة واحدة غير مقبولة عندك فاجعله 26 ساعة تقريباً، أي يوم كامل مع هامش لتأخر المهمة أو طولها، ولا تجعله 24 ساعة بالضبط، وإلا أطلق التنبيه كل ليلة تأخرت فيها المهمة دقيقة. والحل الوسط الشائع تنبيه غير عاجل عند 26 ساعة، وعاجل عند 48. والقاعدة الثانية تغطي حالة يغفل عنها كثيرون: إذا لم يوجد المقياس أصلاً، لأن المهمة لم تعمل أبداً على سيرفر جديد أو لأن أحداً حذف الملف، فإن القاعدة الأولى لا ترجع أي نتيجة، والنتيجة الفارغة لا تطلق تنبيهاً كما رأينا في المقال الأول، فالدالة absent ترجع قيمة فقط عندما يغيب المقياس.
والطريقة الثانية مع Uptime Kuma أبسط: الفحص من نوع Push يعطيك رابطاً خاصاً لكل مهمة، والمهمة تطلبه عند كل نجاح، فإذا مرت المهلة دون طلب أصبح الفحص Down. وهذه الطريقة لا تحتاج node_exporter ولا Prometheus، ولذلك تناسب المهام على سيرفرات صغيرة أو خارج نظام المراقبة، كما تكمل الطريقة الأولى كفحص مستقل.
ماذا يحدث إذا توقف النسخ الاحتياطي Backup؟
بعد أن عملت المهمة بنجاح مرتين جعلناها تفشل عند 00:06:01 بإنشاء الملف FAIL، ثم راقبنا الطريقتين:
touch textfile/FAIL
python q.py 'time() - backup_last_success_timestamp_seconds'
{instance="mon-up-node:9100",job="node",server="files-1"} 131.46799993515015BackupTooOld mon-up-node:9100 firing 2026-11-03T00:08:42 last successful backup on files-1 was 3m 12s ago{ status: 1, msg: 'backup ok', time: '2026-11-03 00:04:30.239' }
{ status: 1, msg: 'backup ok', time: '2026-11-03 00:05:30.397' }
{ status: 0, msg: 'No heartbeat in the time window', time: '2026-11-03 00:07:32.397' }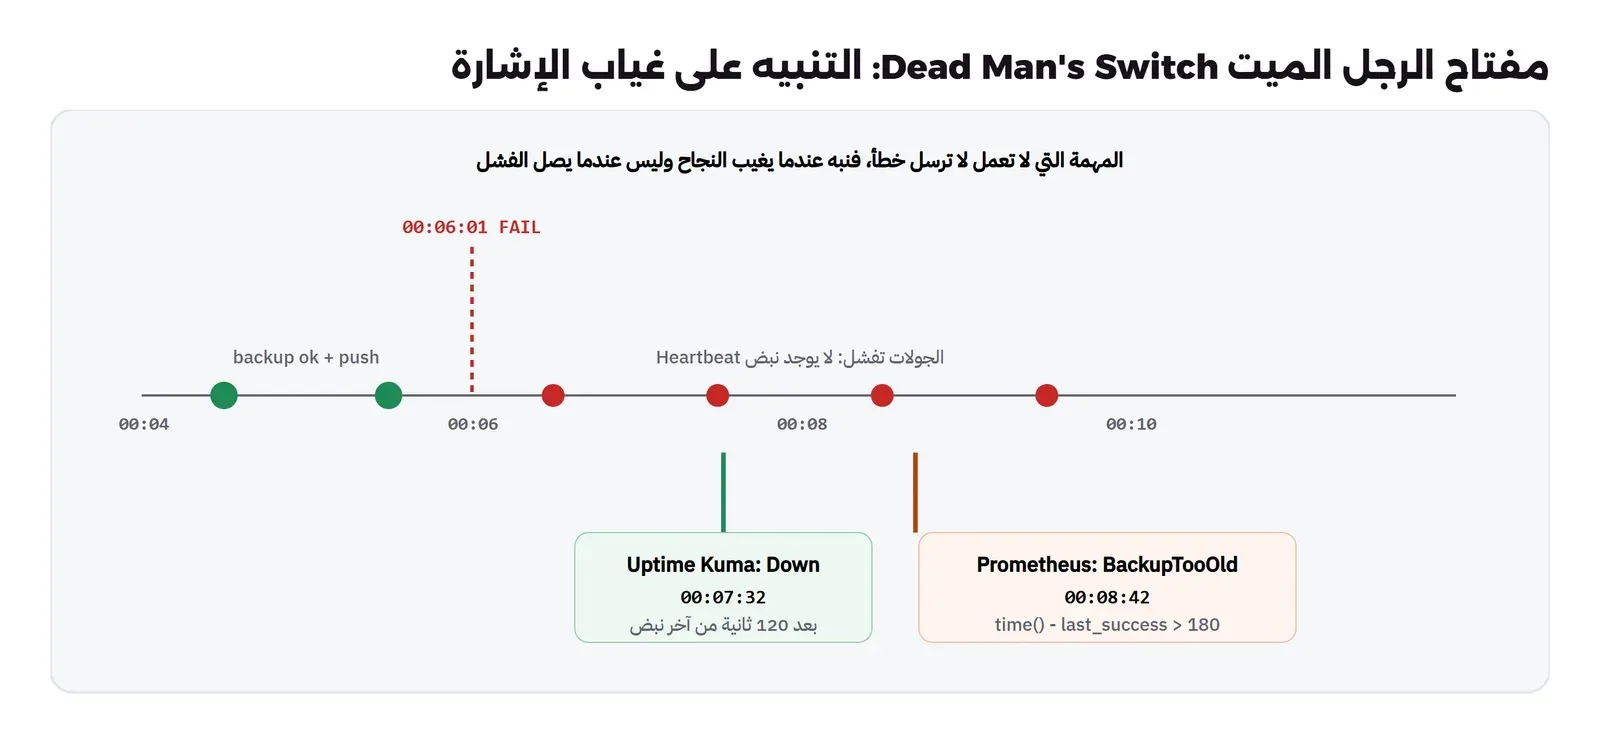
آخر نجاح كان عند 00:05:30، فأصبح Kuma في حالة Down عند 00:07:32، أي بعد 120 ثانية بالضبط من آخر نبض كما حددنا، وأطلق Prometheus التنبيه BackupTooOld عند 00:08:42 بعد أن تجاوز الوقت 180 ثانية وجاءت دورة التقييم التالية. ولاحظ أن الطريقتين لم تريا الفشل نفسه، أي لم تعرفا أن tar فشل، وإنما رأتا أن النجاح غاب، وهذا هو المطلوب، لأن المهمة التي يحذفها أحد من crontab بالخطأ، أو السيرفر الذي يتوقف قبل موعدها، أو القرص الممتلئ الذي يمنعها من البدء، كلها تنتج النتيجة نفسها: نجاح غائب. والصورة التالية من صفحة الفحص في Kuma بعد أن أصبح Down:
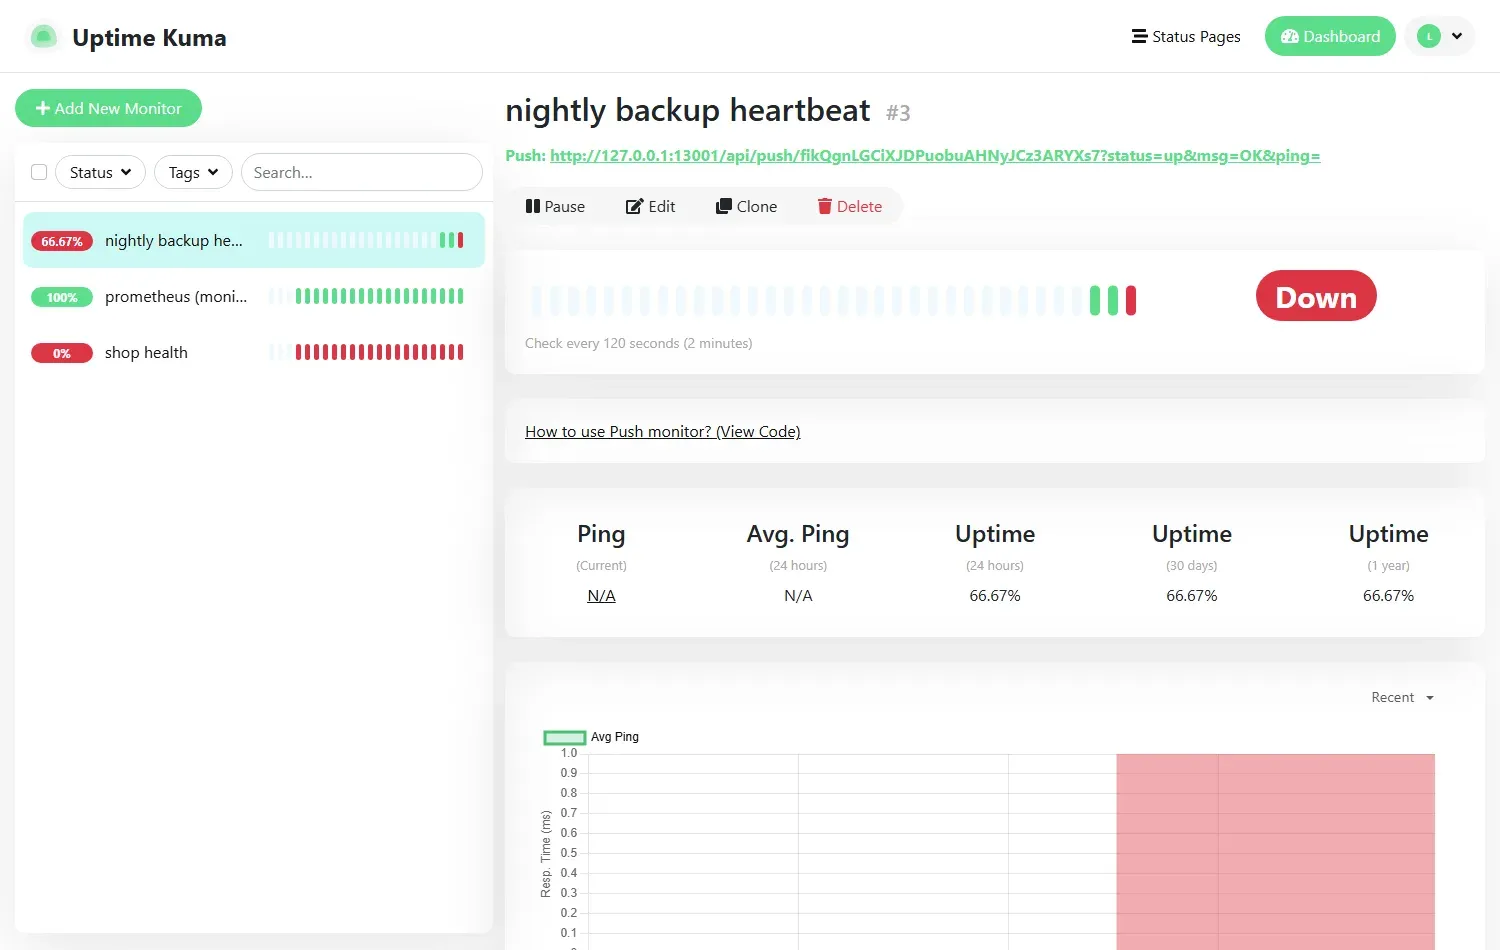
والملاحظة الأخيرة في هذه الصورة أن فحص المتجر في القائمة على اليسار ما زال 0%، لأنها أخذت قبل أن نصلح مشكلة الكلمة المفتاحية، وهذا تذكير بأن التنبيه الذي يبقى أحمر لأسباب لا علاقة لها بالخدمة يعلم الفريق أن يتجاهل اللون الأحمر.
كل كم ثانية تفحص؟ الفترة Interval مع المحاولات Retries
كل فحص من الخارج له رقمان يحددان سلوكه أكثر من أي إعداد آخر: الفترة بين كل فحصين، وكم فحصاً فاشلاً متتالياً تنتظر قبل أن تقول إن الخدمة متوقفة. وفي Blackbox الفترة هي scrape_interval في Prometheus، أي 15 ثانية في مختبرنا، والانتظار هو for في قاعدة التنبيه، وقد جعلناه دقيقة في ProbeFailed. وفي Kuma الفترة هي حقل Heartbeat Interval، أي 20 ثانية في فحوصنا، والانتظار هو حقل Retries، وكان صفراً، ولذلك أصبح فحص Prometheus في حالة Down من أول فشل بعد ست ثوان من الإيقاف.
والحساب هنا بسيط ومفيد: إذا كانت الفترة 20 ثانية والمحاولات صفراً فإن أي حزمة ضائعة واحدة في الشبكة، أو أي تأخر عابر أطول من المهلة، يعطيك تنبيهاً كاذباً، وعدد الفحوص في اليوم 86400 ÷ 20 = 4320 فحصاً، فإذا فشل واحد من كل ألف بسبب الشبكة وحدها فسوف تصلك أربعة تنبيهات كاذبة في اليوم لموقع سليم تماماً. وإذا جعلت المحاولات اثنتين فإن التنبيه يحتاج ثلاثة فشل متتالية، واحتمال أن تحدث ثلاثة أخطاء شبكة عابرة متتالية صغير جداً، والثمن أن الاكتشاف يتأخر من 20 ثانية إلى دقيقة تقريباً. وهذا هو التوازن الذي يجب أن تختاره بوعي لكل فحص: الموقع الذي يخسر فيه العميل طلباً في كل دقيقة توقف يستحق فترة قصيرة ومحاولة أو اثنتين، والأداة الداخلية التي يستخدمها خمسة موظفين تكفيها فترة دقيقة وثلاث محاولات.
وهناك أمر ثالث ينساه كثيرون: المهلة Timeout يجب أن تكون أقل من الفترة، وأقل من الوقت الذي يعتبره المستخدم فشلاً. فقد رأينا في سجل Kuma أن المهلة الافتراضية لفحص HTTP كانت 48 ثانية، فلو كان الموقع يرد بعد 40 ثانية لاعتبره Kuma ناجحاً، بينما المستخدم أغلق الصفحة بعد خمس ثوان. وفي Blackbox جعلنا المهلة timeout: 5s في كل وحدة، فالصفحة التي تأخذ أكثر من خمس ثوان هي صفحة متوقفة من وجهة نظر المستخدم، وهذا مثال على الخطأ بحسب السياسة الذي ذكرناه في مقال الإشارات الذهبية. ولاحظ أن Prometheus نفسه له حد: يجب أن تكون مهلة الوحدة أقل من scrape_timeout في Prometheus، وإلا ألغى Prometheus الطلب قبل أن ينتهي Blackbox من الفحص، فيظهر الهدف down دون أن تعرف نتيجة الفحص.
وأخيراً لا تبالغ في عدد الفحوص من الخارج: الفحص من الخارج يقول إن المستخدم لا يصل، ولا يقول لماذا، فخمسة فحوص للصفحات الأهم، مع صفحة صحة تلمس كل اعتمادية مهمة، أنفع من خمسين فحصاً لكل رابط في الموقع، لأن الخمسين سوف تطلق كلها معاً عندما يتوقف السيرفر، وتصلك خمسون رسالة عن مشكلة واحدة. وسوف نرى في مقال التنبيهات كيف يجمع Alertmanager هذه الرسائل، ولكن أفضل تجميع هو ألا تصنع التنبيهات المكررة من الأصل.
أخطاء شائعة Common Mistakes
- التنبيه على
upمع Blackbox:upيقول إن Blackbox رد، والفحص نفسه فيprobe_success. insecure_skip_verifyعلى مواقع حقيقية: ينجح الفحص والشهادة منتهية، أي أنك ألغيت الشيء الذي تريد أن تعرفه.- فحص الصفحة الرئيسية فقط: الصفحة الرئيسية قد تأتي من الذاكرة المؤقتة وتعمل والدفع متوقف، فافحص صفحة صحة تلمس قاعدة البيانات، أو واجهة مهمة، مع فحص الجسم.
- صفحة صحة تكذب:
/healthترجع 200 دائماً دون أن تفحص شيئاً، فلا تفيد إلا في معرفة أن العملية تعمل. - تنبيه لكل رابط على الشهادة نفسها: رأينا ثلاثة تنبيهات لشهادة واحدة، فاجعل فحص الشهادة وظيفة مستقلة بهدف لكل نطاق.
- التعبيرات النمطية بين تنصيص مزدوج في YAML: أوقفت كل فحوص Blackbox في المختبر.
- مراقبة المهام بالفشل وحده: المهمة التي لا تعمل لا تفشل، فنبه على غياب آخر نجاح، ومعه
absentلغياب المقياس. - حد مفتاح الرجل الميت بالضبط على موعد المهمة: 24 ساعة لمهمة يومية تطلق التنبيه كل ليلة تأخرت فيها دقيقة، والدليل يقترح وقت تشغيلين كاملين.
- الفحص المستقل على السيرفر نفسه: يتوقف مع سيرفر المراقبة ولا يخبرك بشيء.
- فحص من مكان واحد فقط: مشكلة شبكة عند مزود سيرفر المراقبة تجعل كل المواقع تبدو متوقفة، والعكس، فإذا كان لديك عملاء في أكثر من شبكة فافحص من أكثر من مكان.
قائمة تحقق Checklist لفحص التوفر
| البند | كيف تتحقق منه |
|---|---|
| كل موقع وواجهة مهمة لها فحص HTTP من الخارج | count by (job) (probe_success) يطابق قائمة الخدمات |
| الفحص يتحقق من الجسم وليس الرمز فقط | fail_if_body_not_matches_regexp أو JSON Query، وتجربة فاشلة متعمدة |
| صفحة الصحة تفحص الاعتماديات | إيقاف قاعدة البيانات يجعل الفحص يفشل |
| تنبيه واحد لكل شهادة قبل 14 يوماً | وظيفة blackbox_tls بهدف لكل نطاق، دون insecure_skip_verify |
| كل مهمة مجدولة لها مفتاح رجل ميت | آخر نجاح في textfile أو Push، وحد أطول من موعدها بهامش |
| غياب المقياس نفسه ينبه | قاعدة absent لكل مهمة مهمة |
| فحص مستقل لسيرفر المراقبة | إيقاف Prometheus يصل تنبيهه بطريق لا يمر بسيرفر المراقبة |
| مسار التنبيه كاملاً مختبر | تنبيه Watchdog دائم يصل إلى خدمة خارجية |
| ملف Blackbox مفحوص قبل النشر | blackbox_exporter --config.check في مسار CI |
تدريب عملي Practice
- أضف إلى
blackbox.ymlوحدة تفحص خادم بريدك على المنفذ 25 بطلب STARTTLS، واعرض الأيام المتبقية لشهادته. - احذف الملف
backup.promبالكامل بدل إنشاءFAIL، وتأكد أن القاعدةBackupMetricMissingتطلق بعد خمس دقائق، وأنBackupTooOldلا تطلق أبداً في هذه الحالة.
حذف المختبر Cleanup
docker rm -f mon-web mon-redis mon-bb mon-up-node mon-backup mon-up-prom mon-kuma
docker volume rm mon-kuma-data
docker rmi louislam/uptime-kuma:2.5.9-slim
rm -rf certs textfile
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- القياس من الداخل يقول ماذا يحدث في الخدمة، والفحص من الخارج يقول ماذا يرى المستخدم، والشهادة المنتهية والـ DNS الخاطئ لا يظهران إلا في الثاني.
- Blackbox Exporter يحول كل فحص إلى مقاييس في Prometheus، ومراحل HTTP الخمس تشير إلى مكان المشكلة، والتحقق من الجسم يكشف الخطأ الذي يرجع 200.
- نبه على الشهادة قبل 14 يوماً من وظيفة واحدة لكل نطاق، فقد رأينا ثلاثة تنبيهات لشهادة واحدة.
- Uptime Kuma مناسب للفحص المستقل وصفحات الحالة وفحص Push، ولكنه يفسر الرد قبل البحث فيه، فجرب كل فحص بحالة فاشلة.
- المهمة التي لا تعمل لا ترسل خطأ، فنبه على غياب آخر نجاح، وضع فحصاً واحداً على الأقل خارج سيرفر المراقبة يراقبه، فقد رأى Kuma توقف Prometheus بعد ست ثوان.
وفي المقال القادم من السلسلة بإذن الله نجمع كل هذه التنبيهات في مكان واحد مع Alertmanager: ماذا يستحق أن يوقظ أحداً، والتجميع والكتم، وما يرسل فوراً وما يجمع في رسالة يومية واحدة.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلالإشارات الذهبية Golden Signals: ماذا تقيس في خدمتك؟نضيف القياس إلى خدمة دفع حقيقية ونضغط عليها حتى تنهار، فنرى لماذا انتظر المستخدم ست ثوان والمعالج عند 5% دون خطأ واحد.
 دليلالشهادات الرقمية TLS للمبتدئين وصيغ ملفاتهاكيف يعرف المتصفح أنه يتحدث مع الموقع الحقيقي، وماذا يوجد داخل الشهادة، ولماذا تأتي ملفاتها بأكثر من صيغة.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Blackbox Exporter 0.29.1 وUptime Kuma 2.5.9 وPrometheus 3.15.1 وnode_exporter 1.12.1 وNginx 1.31.6 على Docker Engine 29.8.0.