


إذا شغلت يوماً تطبيق Spring Boot ورأيت شعار Spring يرتسم بالحروف في أول سطور السجل، أو ثبتت أداة على Linux فاستقبلتك بقرة تتكلم داخل فقاعة من الشرطات، أو فتحت أداة لعرض معلومات النظام فرسمت لك شعار توزيعتك بالرموز والألوان، فقد رأيت شكلاً من أقدم أشكال الفن في عالم الحاسب: الرسم بالحروف، أو كما يسميه أهله ASCII Art. وقد يبدو لك الأمر مجرد زينة يضعها المبرمجون في أدواتهم، ولكنه في الحقيقة قصة طويلة بدأت قبل الحاسب بمائة سنة تقريباً، في صفحات الصحف وعلى الآلات الكاتبة، ومرت بطابعات التلكس ولوحات الرسائل والمجموعات التي كانت توقع أعمالها بلوحات من الحروف، ثم وصلت إلى طرفيتك اليوم دون أن تختفي، رغم أن الشاشات أصبحت تعرض ملايين الألوان.
والسؤال الذي يجعل هذه القصة تستحق أن تروى ليس «كيف رسموا بالحروف؟» فقط، وإنما «لماذا ما زلنا نفعل ذلك؟»، والإجابة فيها درس هندسي حقيقي عن النص كصيغة تصل إلى كل مكان، وعن القيود التي تصنع حلولاً أذكى من الأدوات المتاحة. وفي هذا المقال سوف نروي القصة من البداية، ثم نفتح الصندوق: نكتب محولاً من الصورة إلى الحروف بأنفسنا ونقيس كثافة كل حرف، ونشغل FIGlet وTOIlet وcowsay داخل Container، ونجرب عليها العربية لنرى أين تتعثر ولماذا، لأن الحرف العربي يتصل ويتغير شكله ويكتب من اليمين، وكل هذا لا تعرفه الشبكة التي بني عليها هذا الفن. وكل مخرج في المقال حقيقي، من الكود الموجود في مجلد lab.
وسوف نناقش في هذا المقال ما يلي:
- قبل الحاسب: الحروف الكبيرة المصنوعة من حروف في إعلانات الصحف، ثم صور الآلة الكاتبة.
- الطابعات عن بعد Teletype وصور الراديو، ثم ASCII نفسه، والوجه المبتسم الذي ولد في لوحة رسائل جامعية.
- لوحات الرسائل BBS وفن ANSI وملفات NFO، ولماذا تظهر هذه الأعمال اليوم رموزاً غريبة إذا فتحتها بالترميز الخطأ.
- FIGlet وTOIlet وcowsay: الأدوات التي جعلت الحروف الكبيرة أمراً واحداً في الطرفية.
- كيف يعمل محول الصورة إلى حروف من الداخل، والتجربة العملية مع قياس حقيقي لكثافة الحروف وثلاثة أخطاء شائعة.
- العربية في فن الحروف: لماذا تفشل الأدوات معها، وما الذي يعمل فعلاً.
- أين تراه اليوم، والدروس من القصة، وقائمة قرار قبل أن تضع شعاراً بالحروف في أداتك.
قبل الحاسب: حروف تصنع حروفاً Typography
في السادس من يناير سنة 1875 نشرت صحيفة Brooklyn Daily Eagle الأمريكية إعلاناً تجارياً لمصنع في نيويورك، وأراد عامل الطباعة أن يكتب اسم صاحب المصنع بحروف كبيرة تلفت النظر، ولكن صندوق حروفه لم يكن فيه حروف بهذا الحجم. فماذا فعل؟ رص الحروف الصغيرة نفسها في شكل الحروف الكبيرة: كلمة SMITH'S مكتوبة بحرف S الصغير مكرراً في شكل S كبير، وحرف M الصغير في شكل M كبير، وهكذا. وهذه الصفحة محفوظة اليوم في Wikimedia Commons، وتراها في الصورة التالية، وإذا نظرت إليها ثم نظرت إلى مخرج الأمر figlet الذي سنشغله بعد قليل، فسوف ترى نفس الفكرة بعد قرن ونصف.
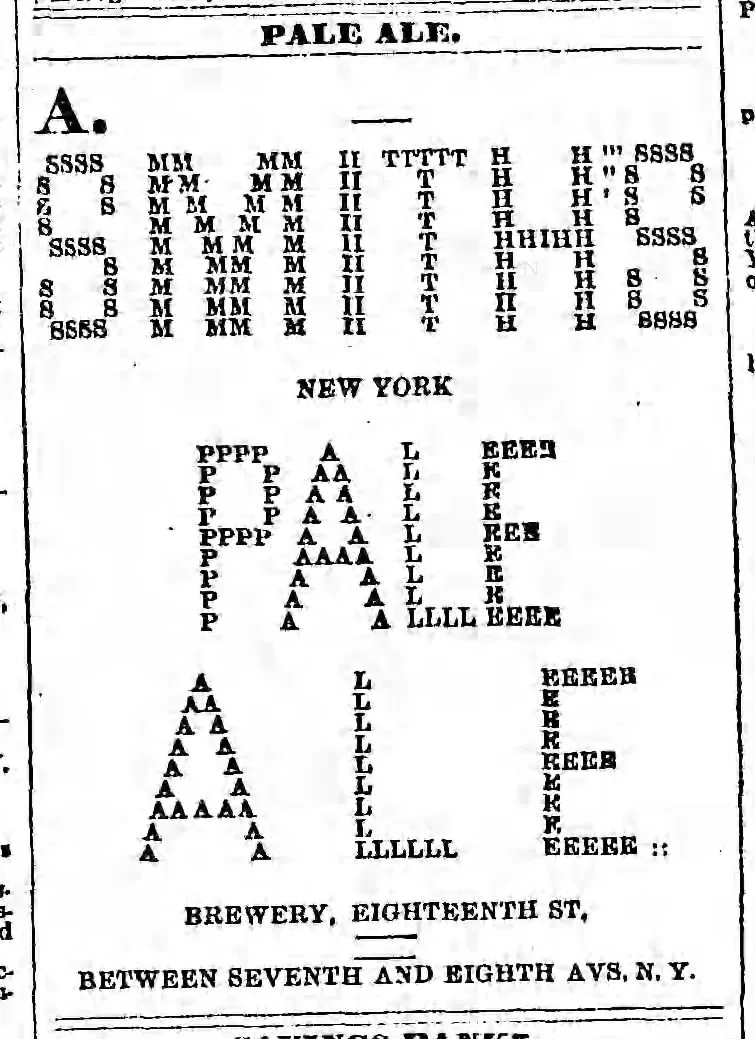

ولاحظ ما الذي حدث هنا، لأنه سيتكرر في كل فصل من القصة: كانت هناك أداة لها حدود واضحة، وهي صندوق حروف بحجم واحد، وكانت هناك حاجة تتجاوز هذه الحدود، وهي عنوان كبير، فخرج حل لا يحتاج أداة جديدة، وإنما يستخدم الأداة القديمة بطريقة لم تصمم لها. وهذا هو تعريف الهاك Hack بالمعنى الأصلي للكلمة، كما شرحنا في مقال كلمات ثقافة المبرمجين: حل ذكي من داخل القيود.
الآلة الكاتبة Typewriter Art
ومع انتشار الآلة الكاتبة في نهاية القرن التاسع عشر ظهر فن كامل حولها. والآلة الكاتبة أفقر من صندوق الطباعة، فكل الحروف بنفس العرض، ولا يوجد إلا لون واحد، ولكن فيها ميزة لم ينتبه لها صانعوها: تستطيع أن ترجع العربة وتضرب حرفاً فوق حرف. فإذا ضربت حرف O ثم ضربت فوقه X، حصلت على مربع أغمق من أي حرف وحده، وإذا ضربت النقطة والفاصلة في مكان واحد حصلت على درجة رمادية فاتحة. وبهذه الطريقة رسم الكتبة صوراً كاملة، وانتشرت في المجلات تعليمات خطوة خطوة لطباعة صورة: في السطر الأول اضرب عشر مسافات ثم ثلاث نقاط، وفي الثاني... وهكذا. وكانت هذه الصور تنتقل من مكتب إلى مكتب كما تنتقل النكتة اليوم.
والفكرة التقنية التي اكتشفها هؤلاء دون أن يسموها هي نفس الفكرة التي سنبرمجها في قسم التجربة: كل حرف له «كثافة» Density، أي نسبة الحبر التي يتركها على مساحته، ويمكن أن يعامل كبكسل رمادي. والنقطة فاتحة، وحرف M غامق، وحرف @ أغمق منه. وما فعلته الآلة الكاتبة بالضرب المتكرر هو أنها وسعت سلم الدرجات بحروف مركبة لا توجد في لوحة المفاتيح.
الطابعات عن بعد Teletype مع صور الراديو RTTY
في منتصف القرن العشرين أصبحت الطابعة عن بعد Teletype، أو التلكس كما عرفها الناس، وسيلة نقل الأخبار والبرقيات بين المدن والقارات: آلة كاتبة متصلة بخط هاتف أو براديو، تضغط حرفاً في طرف فيطبع في الطرف الآخر. وعندما ربطت هذه الآلات بالحاسبات أصبحت أول «شاشة» يعرفها المبرمجون، فالطرفية Terminal في الستينات كانت طابعة من هذا النوع، تكتب عليها الأمر ويطبع لك الحاسب الإجابة على ورق. وأشهرها Teletype Model 33، التي تراها في الصورة التالية، وما زالت أسماء بعض مفاهيمها معنا حتى اليوم: فالجهاز /dev/tty في Linux اختصار TeleTYpewriter، والحرفان CR وLF، أي إرجاع العربة وسطر جديد، هما حرفا تحكم كانت الطابعة تحتاجهما فعلاً لتحرك رأس الطباعة والورقة.
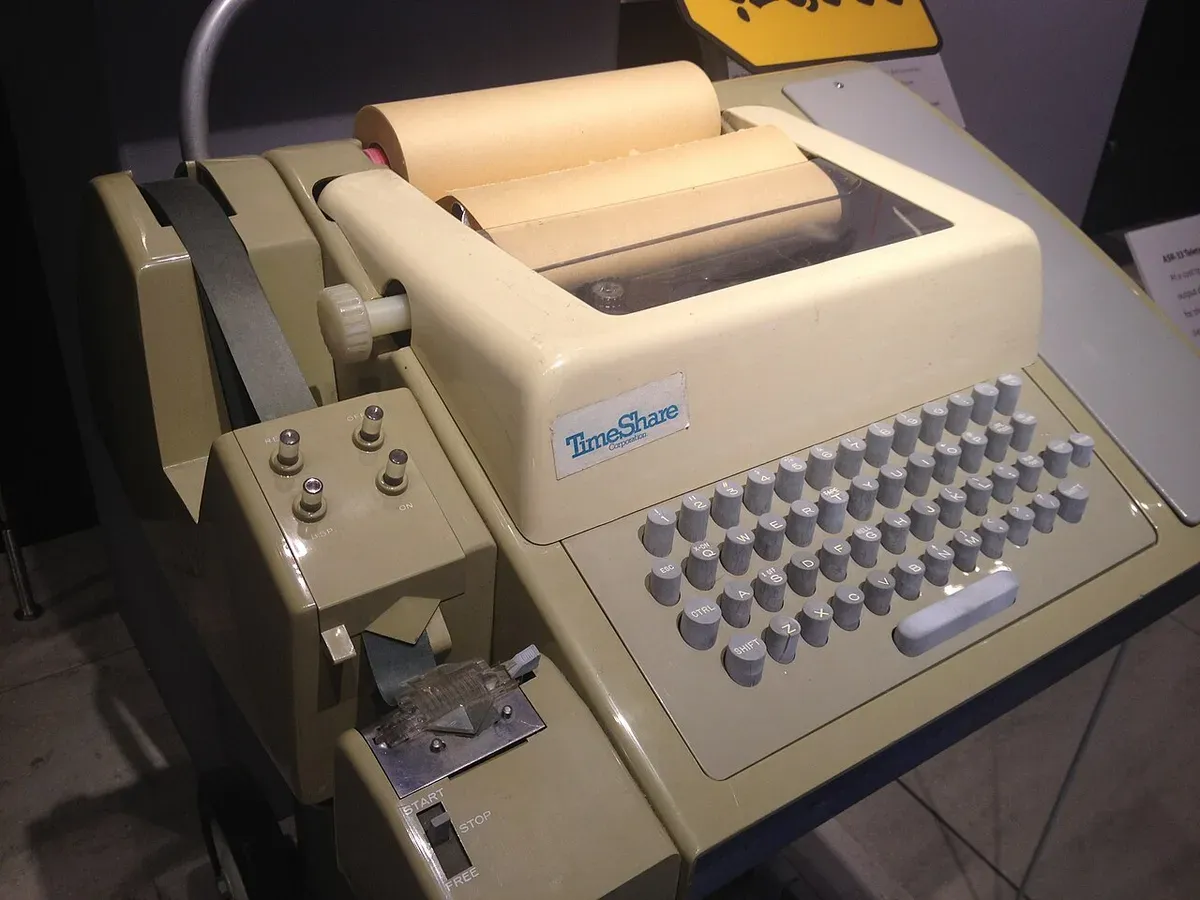

ومع هذه الآلات ظهرت صور الراديو. فهواة الراديو الذين يرسلون النصوص بالطابعات عبر موجات الراديو، وتسمى هذه الطريقة RTTY اختصاراً لـ Radio Teletype، بدأوا يتبادلون صوراً كاملة مطبوعة بالحروف، فلا توجد طريقة أخرى لإرسال صورة عبر خط لا يحمل إلا الحروف. وانتشرت هذه الصور في الستينات والسبعينات، وكانت تحفظ على أشرطة ورقية مثقبة يعاد إرسالها مرة بعد مرة. وفي نفس الفترة كان الباحثون في مختبرات الحاسب يجربون الطابعات السطرية Line Printers التي تطبع سطراً كاملاً في كل ضربة، ويطبعون عليها صوراً بالضرب المتكرر، كما فعلت الآلة الكاتبة قبلها، ولكن بسرعة لا يقدر عليها إنسان.
والدرس من هذا الفصل أن الصورة بالحروف لم تكن فناً للفن في البداية، وإنما كانت حلاً لمشكلة نقل: الخط الذي يحمل النص موجود في كل مكان، والخط الذي يحمل الصورة غير موجود. ولذلك فإن هذا الفن يعيش دائماً حيث يكون النص هو الصيغة الوحيدة المضمونة، وهذا ما سيفسر لك لماذا بقي في الطرفية حتى اليوم.
ASCII نفسه: 95 حرفاً قابلاً للطباعة
في سنة 1963 صدر المعيار الأمريكي لتبادل المعلومات ASCII، الذي شرحناه بتفصيل في مقال ترميز النصوص، وأعطى كل حرف إنجليزي ورقم وعلامة رقماً من 0 إلى 127. ومن هذه الأرقام 95 حرفاً قابلاً للطباعة، من المسافة رقم 32 إلى العلامة ~ رقم 126، والباقي حروف تحكم مثل CR وLF. وهذه الحروف الخمسة والتسعون هي اللوحة الكاملة التي رسم بها فنانو ASCII Art أعمالهم، ومنها جاء الاسم. فلا ألوان، ولا خطوط مائلة غير / و\، ولا منحنيات غير الأقواس، ومع ذلك خرجت منها وجوه وحيوانات وخرائط ومخططات كاملة.
والميزة التي جعلت ASCII لوحة فنية لا ترميزاً فقط هي أن الطرفيات والطابعات في ذلك الوقت كانت تعرض الحروف بعرض ثابت Monospace، أي أن كل حرف يأخذ نفس المساحة، فالحرف i يأخذ مساحة الحرف W. وهذا يجعل الشاشة شبكة Grid من الخلايا، كل خلية فيها حرف واحد، وبالتالي فإن الحرف في العمود العاشر من السطر الأول يقع فوق الحرف في العمود العاشر من السطر الثاني تماماً. وعلى هذه الشبكة يقوم الفن كله، فإذا اختفت، كما يحدث عندما تفتح لوحة ASCII في محرر يستخدم خطاً متغير العرض، تنهار الصورة. وتذكر هذه الملاحظة جيداً، لأنها سبب كل مشاكل العربية التي سنراها في آخر المقال.
ومن أوضح الأمثلة على أن هذه الشبكة أداة هندسية لا فنية فقط، أن مخططات البروتوكولات في معايير الإنترنت ما زالت ترسم بالحروف. فإذا فتحت المعيار RFC 791 الذي يصف بروتوكول IP، وجدت ترويسة الحزمة مرسومة بالرموز + و- و|، وكل عمود فيها يمثل بتاً واحداً، والسبب أن المعيار يجب أن يقرأ في أي جهاز وأي محرر نصوص بعد عشرات السنين، والنص الخالص هو الصيغة الوحيدة التي تضمن ذلك.
الوجه المبتسم Emoticon: سطر واحد غير طريقة الكتابة
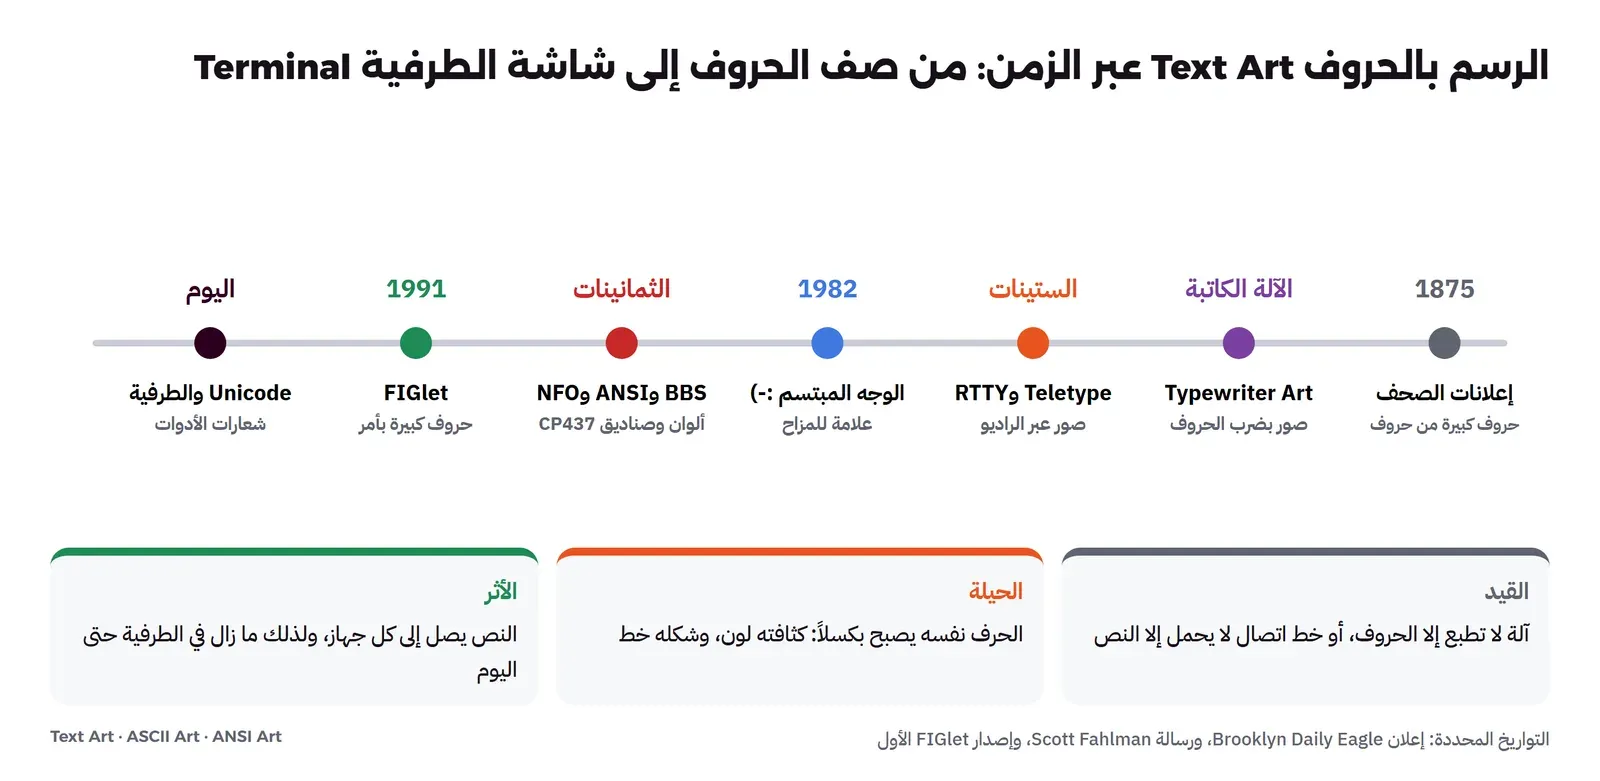
في بداية الثمانينات كان قسم علوم الحاسب في جامعة Carnegie Mellon يستخدم لوحات رسائل إلكترونية داخلية، يكتب فيها الأساتذة والطلاب والموظفون عن كل شيء، من إعلانات المحاضرات إلى مواقف السيارات. وكما يحدث في أي نقاش مكتوب حتى اليوم، كانت النكتة تفهم أحياناً على أنها كلام جاد، فيرد عليها أحدهم برد غاضب طويل، ويضيع النقاش الأصلي. وفي إحدى المرات فهمت نكتة على أنها تحذير حقيقي من خطر في المبنى. فاقترح بعضهم أن توضع علامة على الرسائل غير الجادة، وفي 19 سبتمبر 1982 كتب الباحث Scott Fahlman أن العلامة يمكن أن تكون :-)، وأن تقرأ بإمالة الرأس، واقترح معها :-( للرسائل الجادة، وهي التي أصبحت بعد ذلك علامة للضيق. ويروي Fahlman القصة بنفسه في صفحته في الجامعة، ويقول إنه اختار هذه الحروف لأنها تعمل في كل طرفيات ذلك الوقت.
وهذا المثال الصغير يحمل الفكرة كلها: ثلاثة حروف من ASCII، لا تحتاج أي برنامج أو صورة، حلت مشكلة اجتماعية حقيقية في التواصل المكتوب، وهي غياب نبرة الصوت وتعبير الوجه. وانتقلت العلامة من لوحة رسائل جامعية إلى البريد الإلكتروني ومجموعات الأخبار، ثم إلى الهواتف، حتى أصبحت لها حروفها الخاصة في Unicode، أي الرموز التعبيرية Emoji التي تستخدمها اليوم. ولاحظ المفارقة: الوجه الذي ولد لأنه لا يحتاج إلا ASCII، أصبح اليوم حرفاً لا يوجد في ASCII أصلاً.
لوحات الرسائل BBS: فن ANSI مع ملفات NFO
في الثمانينات وبداية التسعينات، قبل أن يصل الإنترنت إلى البيوت، كان الهواة يتصلون بحاسبات بعضهم مباشرة عبر خط الهاتف والمودم، ويدخلون إلى ما يسمى نظام لوحة الرسائل Bulletin Board System، واختصاراً BBS. وكل لوحة لها صاحب يشغلها من بيته غالباً، وفيها رسائل وملفات وألعاب، وأول ما تراه عند الاتصال شاشة ترحيب. وهنا أصبح الرسم بالحروف هوية: كل لوحة تريد شاشة ترحيب تميزها، ولا يوجد ما ترسم به إلا الحروف، لأن الخط بطيء والطرفية نصية.
وتطور الفن هنا خطوتين. الأولى الألوان: فالطرفيات كانت تفهم تسلسلات تحكم تبدأ بحرف الهروب Escape وتسمى تسلسلات ANSI، مثل ESC[31m لتجعل ما بعدها أحمر، وما زالت كل طرفية اليوم تفهمها، وهي التي تلون مخرج ls وgit عندك. والثانية رموز الرسم: فحاسب IBM الشخصي جاء بصفحة ترميز اسمها CP437، فيها إلى جانب ASCII رموز لا توجد فيه، مثل المربعات بدرجات الكثافة ░ ▒ ▓ █ وخطوط الصناديق ═ ║ ╔ ╗. وبهذه الرموز والألوان الستة عشر رسم الفنانون شاشات كاملة، وسمي هذا فن ANSI Art، وظهرت مجموعات فنية تتنافس في الأسلوب وتنشر أعمالها في حزم شهرية، ويحفظ كثيراً منها اليوم أرشيف artscene في textfiles.
وفي نفس البيئة ظهرت ملفات NFO، اختصاراً لـ Info، وهي ملفات نصية ترافق البرامج والإصدارات التي تتبادلها المجموعات، فيها اسم المجموعة بحروف ضخمة، وإطار مزخرف، ثم معلومات الإصدار. وكثير من هذه المجموعات كانت تنسخ البرامج المحمية وتوزعها، وهذا جانب من القصة لا يمكن تجميله، ولكن الأثر الفني بقي، فأسلوب الحروف الضخمة بالمربعات المظللة الذي تراه اليوم في شعارات بعض أدوات سطر الأوامر جاء من هذه الملفات مباشرة.
وهنا درس تقني ستقابله إذا فتحت أحد هذه الملفات اليوم: الملف مكتوب بترميز CP437، فإذا فتحته بمحرر يفترض UTF-8 أو Latin-1، فإن المربع █، وهو البايت DB في CP437، يظهر حرفاً آخر تماماً أو علامة استفهام، فتتحول اللوحة إلى رموز مشوهة Mojibake. والبايتات لم تتغير، وإنما تغير الجدول الذي يقرأ به البرنامج البايتات. وسوف ترى نفس المشكلة بالضبط مع العربية في FIGlet بعد قليل، ولكن في الاتجاه المعاكس.
الحروف الكبيرة بأمر واحد: FIGlet ثم TOIlet
في سنة 1991 ظهر برنامج صغير يفعل ما فعله عامل الطباعة في 1875: يأخذ كلمة، ويرسمها بحروف كبيرة مصنوعة من الحروف العادية. وكتبه Glenn Chappell وIan Chai، وسمي FIGlet اختصاراً لـ Frank, Ian and Glen's letters، وما زال موقعه الرسمي يعرض نماذج من خطوطه، وآخر إصدار منه 2.2.5 الصادر سنة 2012. وفكرته الهندسية بسيطة وذكية: الخط ليس صورة، وإنما ملف نصي بامتداد .flf فيه رسم كل حرف كمجموعة أسطر من الحروف، والبرنامج يضع رسوم الحروف بجانب بعضها، ثم يقرب بينها بعملية يسميها Smushing، أي أن يدمج الحرفين المتجاورين في عمود مشترك إذا كان أحدهما فارغاً في ذلك العمود، فتبدو الكلمة متماسكة لا حروفاً متباعدة. ولأن الخط ملف نصي، كتب الناس مئات الخطوط بأنفسهم بمحرر نصوص عادي.
وفي سنة 2006 كتب Sam Hocevar برنامج TOIlet، واسمه مزاح على اسم FIGlet، فهو اختصار The Other Implementation's letters كما يشرح موقع المشروع. ويقرأ خطوط FIGlet نفسها، ويضيف إليها دعم Unicode والألوان والمرشحات مثل الإطار والتدرج، ومبني على مكتبة libcaca التي كتبها نفس المطور لعرض الصور والفيديو بالحروف في الطرفية.
البقرة التي تتكلم cowsay
وكتب Tony Monroe برنامج cowsay بلغة Perl، وهو يأخذ نصاً ويضعه في فقاعة كلام فوق بقرة مرسومة بالحروف، وله خيارات لعيون البقرة ولسانها، ومجموعة من الحيوانات والشخصيات الأخرى في ملفات .cow. والبرنامج لا يفعل أي شيء مفيد بالمعنى الهندسي، ولكنه أصبح جزءاً من ثقافة Unix، لأن المستخدمين وجدوا أنه يجمع جيداً مع برنامج fortune الذي يطبع حكمة أو نكتة عشوائية، فأصبح الأمر fortune | cowsay يظهر في ملفات الدخول على كثير من السيرفرات، فيستقبلك السيرفر ببقرة تقول حكمة. وهذا هو نفس الروح التي شرحناها في مقال البيض المخفي Easter Eggs: المبرمجون يتركون في أدواتهم شيئاً من شخصيتهم.
من الصورة إلى الحروف: كيف يعمل المحول؟ Image to ASCII
الخطوة التي أكملت القصة كانت أن يرسم الحاسب الصورة بالحروف بنفسه بدل الفنان. ومكتبات مثل AAlib، ثم libcaca التي تصف نفسها في صفحة المشروع بأنها مكتبة رسم تخرج نصاً بدل البكسلات، جعلت مشغلات الفيديو قادرة على عرض الأفلام في طرفية نصية. والفكرة الأساسية في كل هذه الأدوات واحدة، وسوف نكتبها الآن بأنفسنا في عشرين سطراً لنفهمها، ثم نرى أين تخطئ.
وأول سؤال يجب أن نجيب عليه هو السؤال الذي أجابت عليه الكاتبات على الآلة الكاتبة بالتجربة: كم حبراً في كل حرف؟ لأن المحول سوف يضع لكل جزء من الصورة حرفاً كثافته قريبة من سطوع ذلك الجزء. ولذلك بدأنا التجربة بقياس حقيقي.
التجربة العملية Lab: كثافة كل حرف Character Density
بنينا Image خفيفة من debian:trixie-slim فيها Python ومكتبة الصور Pillow مع libraqm التي تشكل الحروف العربية، وFIGlet وTOIlet وcowsay وخطان، والملف في lab/Dockerfile. ثم كتبنا lab/density.py الذي يرسم كل حرف من الحروف الخمسة والتسعين بخط DejaVu Sans Mono في خلية خاصة به، ويعد البكسلات المضيئة فيها، والتشغيل:
cd lab
docker build -q -t spa-ascii:1 .
docker run --rm --name spa-ascii -v "$PWD:/w" spa-ascii:1 python3 density.py
والمخرج سوف يكون كما يلي:
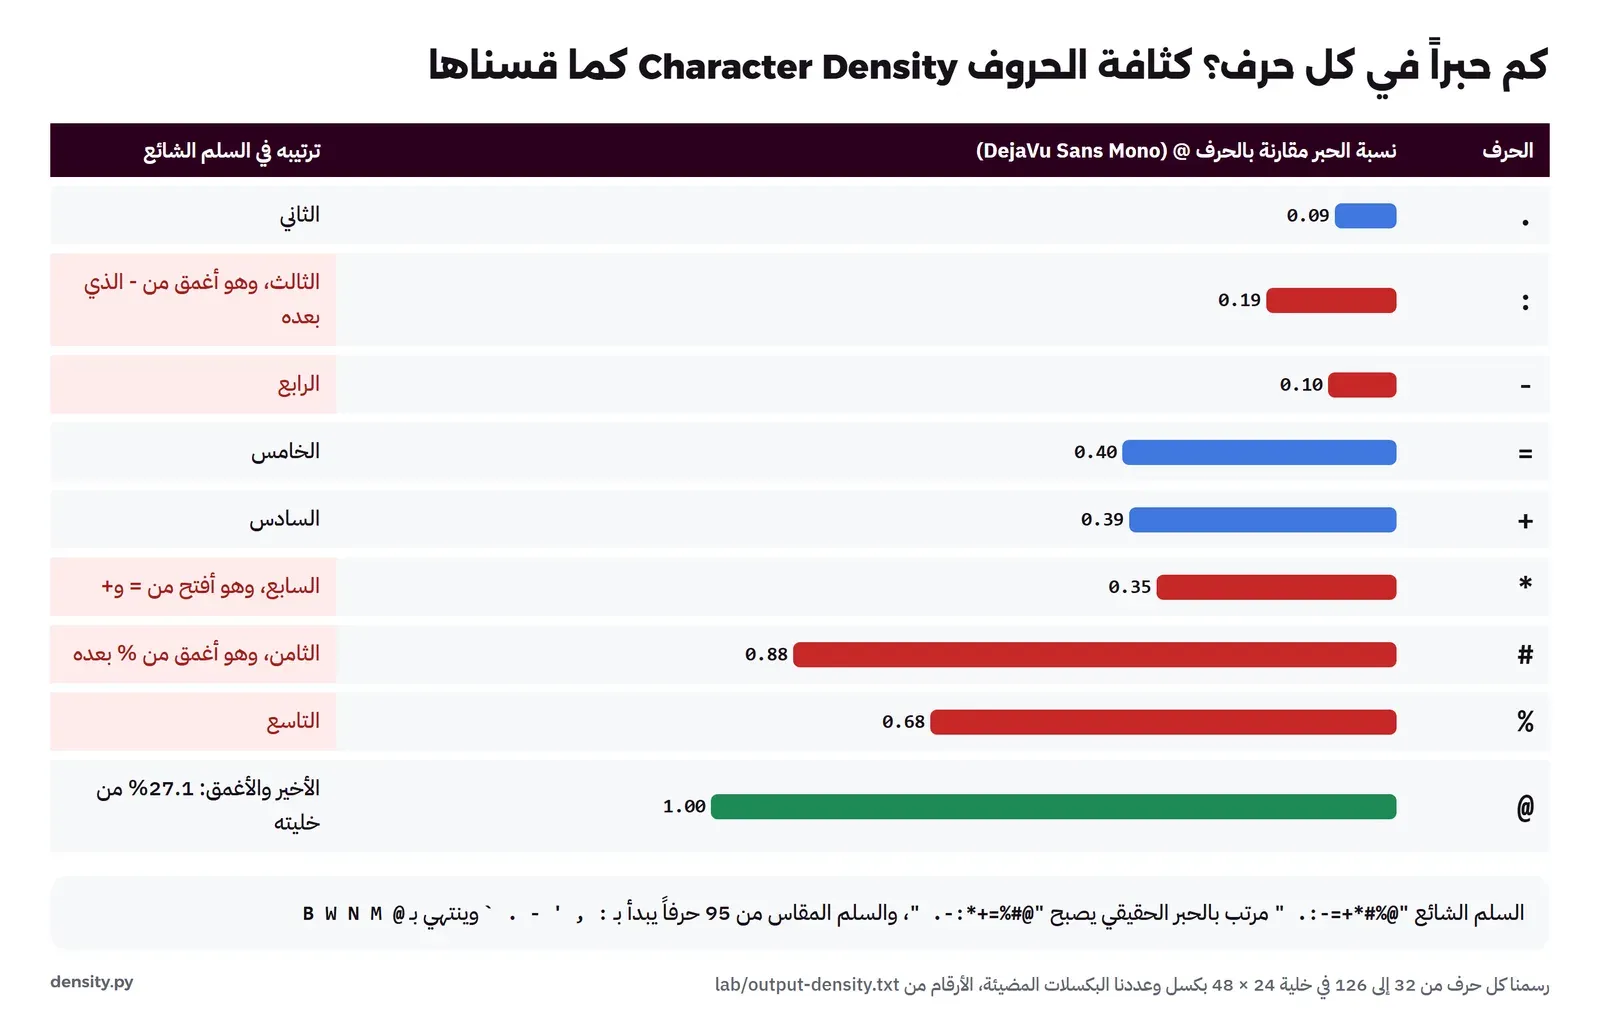
DejaVu Sans Mono 40px: cell 24 x 48 px, width/height = 0.500
darkest '@' covers 27.1% of its cell; lightest non-space '`' 2.1%
measured ramp, light to dark:
 `.-',:~_"^;!*r+\/=()|><?lcviL][7ztjfx1sTJ}Y{CunIyFo235eV%hkwZSa4XPGEAU$bdpqm96&KOH0Dg#R8QBWNM@
the common 10-character ramp, measured:
  ' ' 0.00  '.' 0.09  ':' 0.19  '-' 0.10  '=' 0.40  '+' 0.39  '*' 0.35  '#' 0.88  '%' 0.68  '@' 1.00
  sorted by real ink: ' .-:*+=%#@'  different order
في المخرج أعلاه لاحظ التالي:
- السطر الأول يقول إن خلية الحرف في هذا الخط عرضها نصف ارتفاعها بالضبط، 24 في 48 بكسلاً. وهذا الرقم سوف يكون أهم رقم في المحول، كما سترى في الخطأ الأول.
- أغمق حرف هو
@، ومع ذلك لا يغطي إلا 27.1% من خليته، أي أن أغمق «بكسل» نملكه رمادي لا أسود. ولهذا تبدو صور ASCII دائماً باهتة مقارنة بالأصل، ولهذا استخدمت الآلة الكاتبة الضرب المتكرر. - السطر الطويل هو السلم المقاس Ramp من الأفتح إلى الأغمق، ويبدأ بالعلامة
`والنقطة والشرطة، وينتهي بالحروف الكبيرة العريضة B وW وN وM ثم@. - والسطر الأخير هو المفاجأة: السلم المشهور
" .:-=+*#%@"الذي تجده في أغلب الأمثلة على الإنترنت ليس مرتباً بالحبر الحقيقي في هذا الخط. فالنقطتان:أغمق من الشرطة-التي بعدها، والنجمة*أفتح من=و+اللتين قبلها، والعلامة#أغمق من%التي بعدها. والترتيب الصحيح لنفس الحروف العشرة بالقياس هو" .-:*+=%#@".
والدرس من هذه النقطة الصغيرة أكبر منها: السلم المشهور صحيح تقريباً في خط ما، ثم نسخه الناس من مقال إلى مقال دون أن يقيسه أحد في الخط الذي يستخدمه. والكثافة صفة للخط لا للحرف، فنفس الحرف في Consolas له كثافة مختلفة عنه في DejaVu Sans Mono. فإذا كان الرسم مهماً لك، فقس السلم بالخط الذي سيعرض به، كما فعلنا في عشرين سطراً.
المحول Converter: أربع خطوات
بعد أن عرفنا السلم، أصبح المحول أربع خطوات، وهي في lab/ascii.py. والقلب كله في هذه الأسطر:
img = ImageOps.autocontrast(Image.open(a.image).convert("L"))      # grey, then stretch to the full 0-255 range
w, h = img.size
rows = round(h / w * a.width * (1 if a.no_aspect else a.cell))   # fewer rows than columns: cells are tall
small = img.resize((a.width, rows), Image.Resampling.BOX)          # each cell = the average of its pixel block
ramp = a.ramp[::-1] if a.invert else a.ramp
n = len(ramp) - 1
lines = []
for y in range(rows):
    lines.append("".join(ramp[n - round(small.getpixel((x, y)) / 255 * n)] for x in range(a.width)))
في الكود أعلاه لاحظ التالي:
- السطر الأول يحول الصورة إلى درجات رمادي، أي رقم واحد لكل بكسل من 0 للأسود إلى 255 للأبيض، ثم يمد المدى بـ
autocontrastحتى يصبح أغمق بكسل في الصورة صفراً وأفتحه 255. والسبب أن سلم الحروف قصير، عشر درجات فقط، فإذا كانت الصورة كلها بين 80 و180 فلن نستخدم إلا نصف السلم. - السطر الثالث يحسب عدد الأسطر، والضرب في
a.cell، وقيمته 0.5، هو ما قسناه قبل قليل: خلية الحرف طولها ضعف عرضها، فإذا أردنا 80 عموداً لصورة طولها مرة ونصف عرضها، فنحتاج 60 سطراً لا 120. - السطر الرابع يصغر الصورة إلى عمود لكل حرف وسطر لكل سطر، بمرشح
BOXالذي يأخذ متوسط كل مربع من البكسلات، لا بكسلاً واحداً منه. وهذا مهم، لأن أخذ بكسل واحد من كل مربع يجعل التفاصيل الصغيرة تظهر وتختفي عشوائياً. - الحلقة الأخيرة تحول كل سطوع إلى موقع في السلم: البكسل المضيء على ورقة بيضاء يأخذ أفتح حرف، أي المسافة، والمعتم يأخذ
@.
وجربناه على لوحة الموناليزا من Wikimedia Commons، وهي في الملك العام، بصورة صغيرة 500 في 745 بكسلاً، وأضفنا للبرنامج خياراً يرسم النص الناتج بخط حقيقي في ملف PNG حتى نراه كما يراه القارئ:
docker run --rm --name spa-ascii -v "$PWD:/w" spa-ascii:1 python3 ascii.py mona-lisa.jpg mona-80.txt --width 80 --png mona-80.pngmona-lisa.jpg 500x745 -> 80 columns x 60 rows, ramp ' .:-=+*#%@'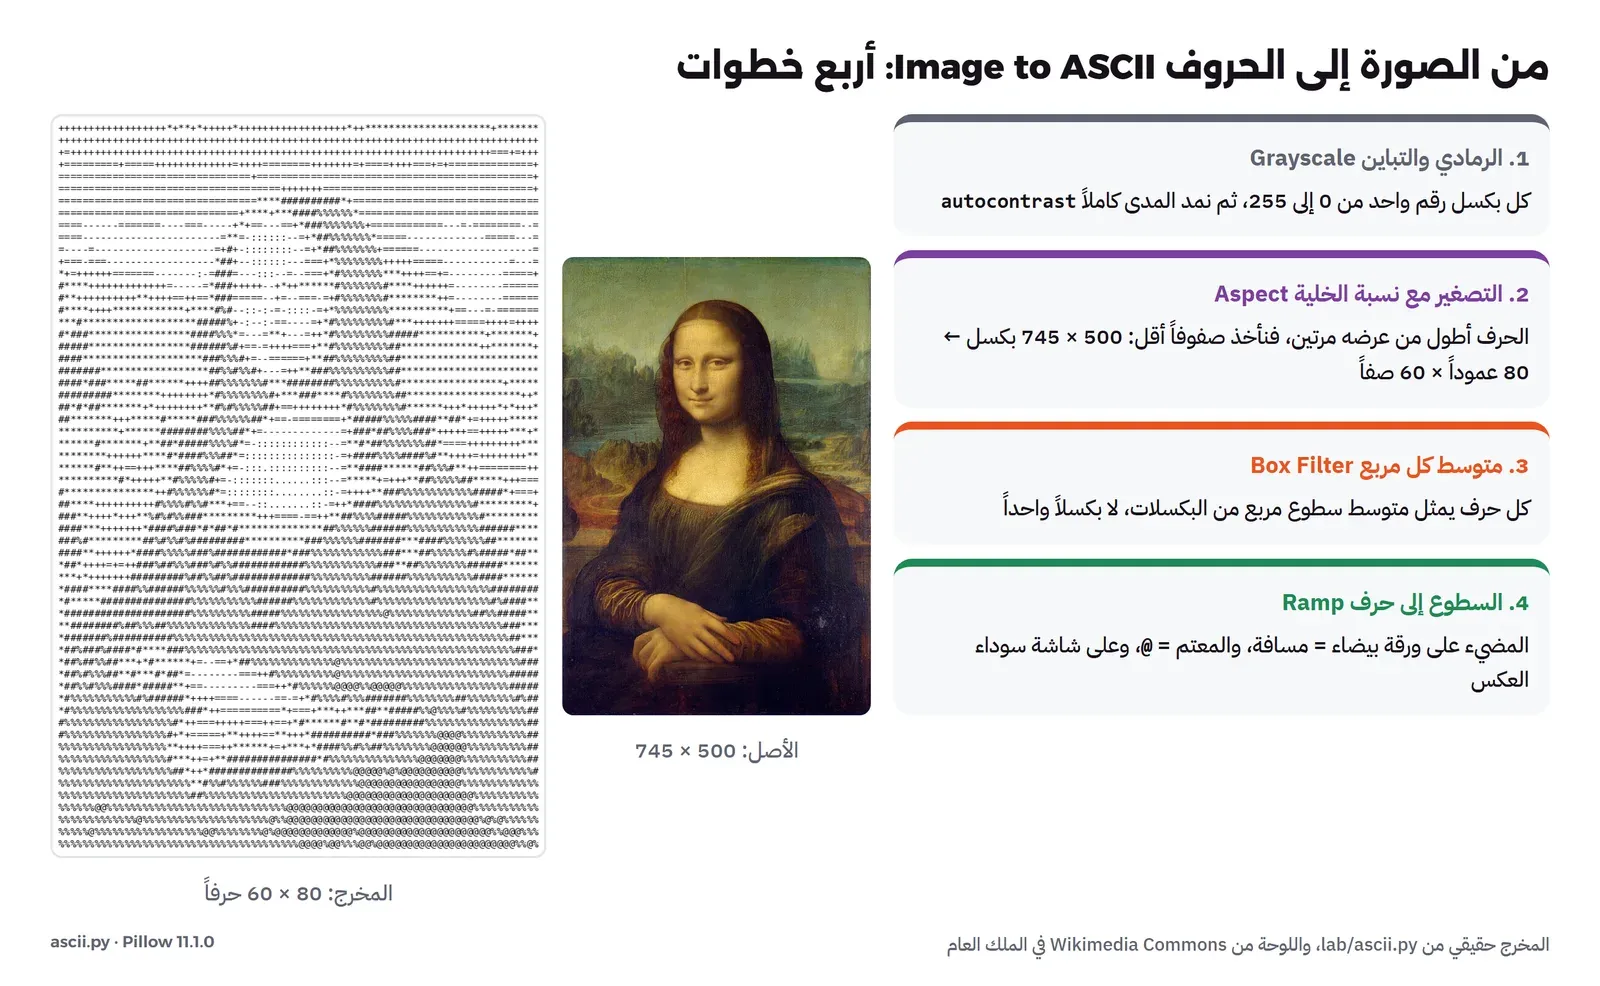
ثلاثة أخطاء حقيقية Common Mistakes
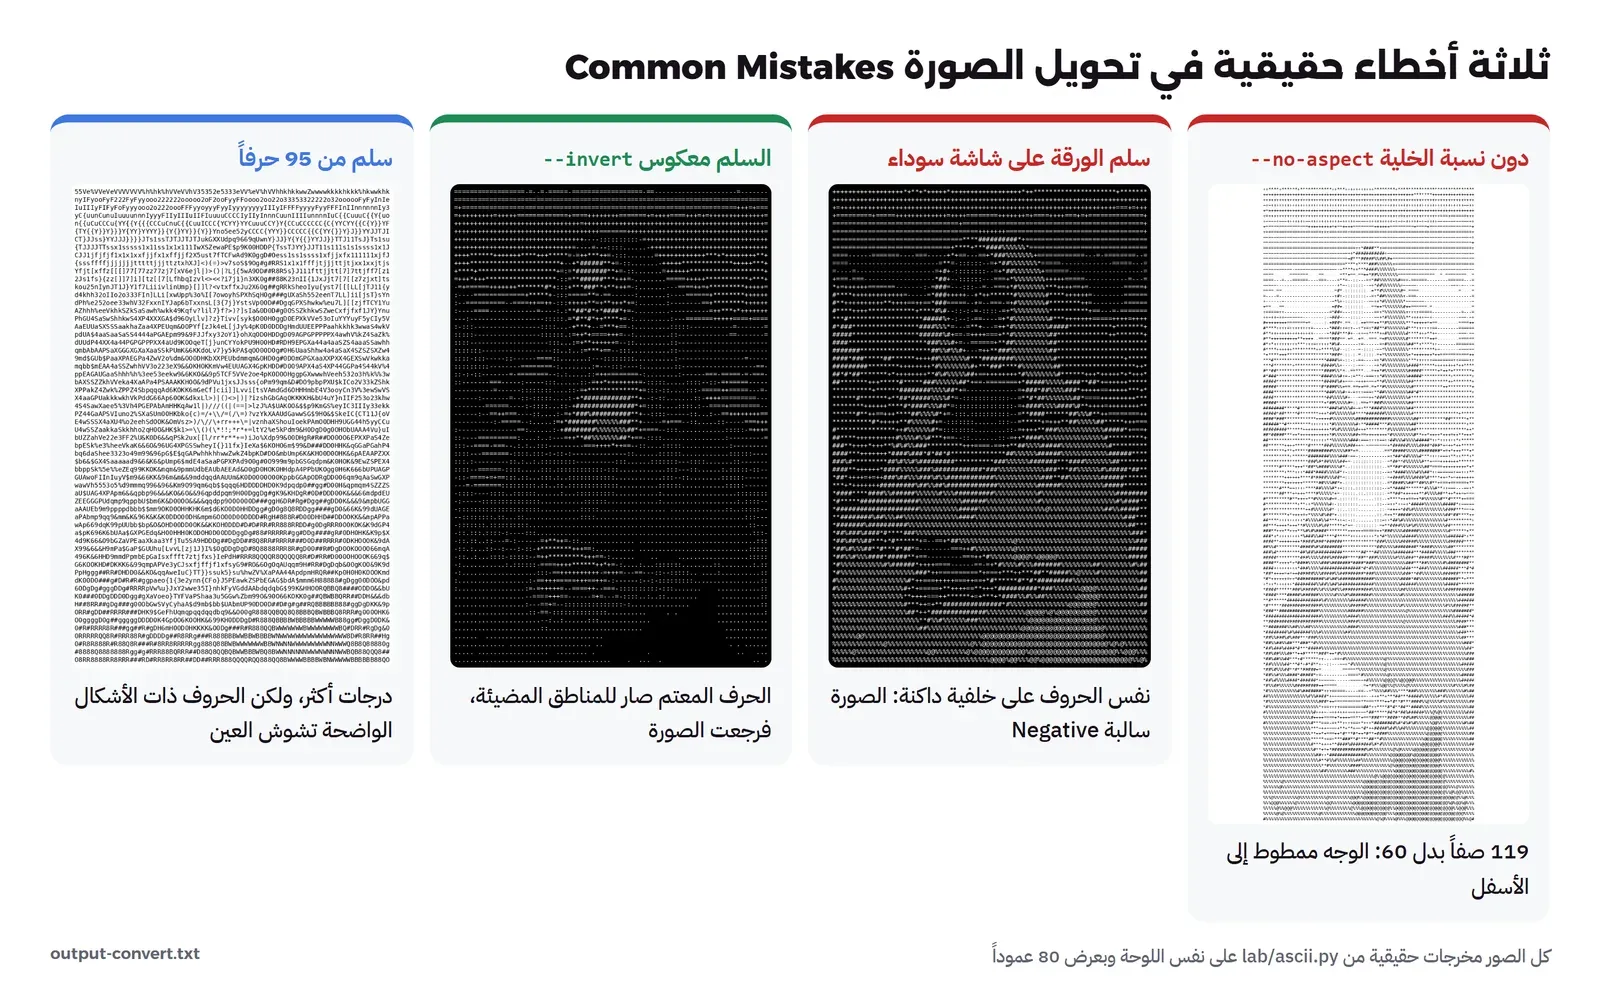
المحول يبدو بسيطاً، ولكن كل خطوة فيه لها خطأ شائع، وجربنا كل خطأ عمداً لنرى أثره، والصورة التالية تجمع المخرجات الحقيقية:
- نسيان نسبة الخلية: مع الخيار
--no-aspectأصبح عدد الأسطر 119 بدل 60، أي أن البرنامج عامل خلية الحرف كمربع، فخرج الوجه ممطوطاً إلى ضعف طوله. وهذا أشهر خطأ في كل محولات المبتدئين، وتراه في الصور التي تبدو «طويلة» على الإنترنت. - سلم الورقة على شاشة سوداء: السلم الافتراضي مصمم لحروف سوداء على ورقة بيضاء، فالمسافة تعني «فاتح». ولكن أغلب المطورين يعملون في طرفية سوداء بحروف فاتحة، وهناك المسافة تعني «داكن». فعرضنا نفس المخرج على خلفية سوداء، فخرجت الصورة سالبة Negative، الوجه داكن والخلفية مضيئة. والإصلاح هو الخيار
--invertالذي يعكس السلم. - سلم طويل جداً: جربنا السلم المقاس كاملاً، 95 درجة بدل 10، والنتيجة فيها درجات أكثر فعلاً، ولكن العين لا ترى الحروف كبكسلات رمادية فقط، وإنما تقرأ أشكالها، فالحروف مثل
Jو{و7تظهر كخطوط لا كظلال، وتشوش الصورة. ولذلك يستخدم أغلب الفنانين سلالم قصيرة من حروف «بلا شكل واضح».
وقد يتساءل البعض: لماذا لا يكتشف المحول لون الطرفية بنفسه؟ والإجابة أن البرنامج الذي يكتب إلى الطرفية لا يعرف لونها في الغالب، فبعض الطرفيات تجيب على سؤال خاص عن لون الخلفية وأغلبها لا يجيب، ولذلك تعطي الأدوات الجيدة المستخدم خياراً صريحاً، وتختار افتراضياً ما يناسب أغلب مستخدميها. وهذا قرار تصميم صغير يتكرر في كل أداة تكتب ألواناً في الطرفية.
التجربة الثانية Lab: ثلاث أدوات للحروف الكبيرة Banners
والسبب في أننا نجرب هذه الأدوات بالعربية تحديداً ليس الفضول، وإنما أن كثيراً من الفرق تضع شعاراً بالحروف في أدواتها الداخلية، أو تطبع رسالة ترحيب في ملف الدخول على السيرفر، ثم يأتي يوم يريد فيه أحدهم أن يكتب اسم الشركة أو رسالة بالعربية بنفس الطريقة. ومعرفة أين تتعثر كل أداة، ولماذا، توفر عليك ساعة من البحث، وتعلمك شيئاً عن الترميز والخطوط أعمق من الأداة نفسها.
الملف lab/run-tools.sh يشغل الأدوات الثلاث بالإنجليزية أولاً، ثم بالعربية، داخل نفس الـ Container:
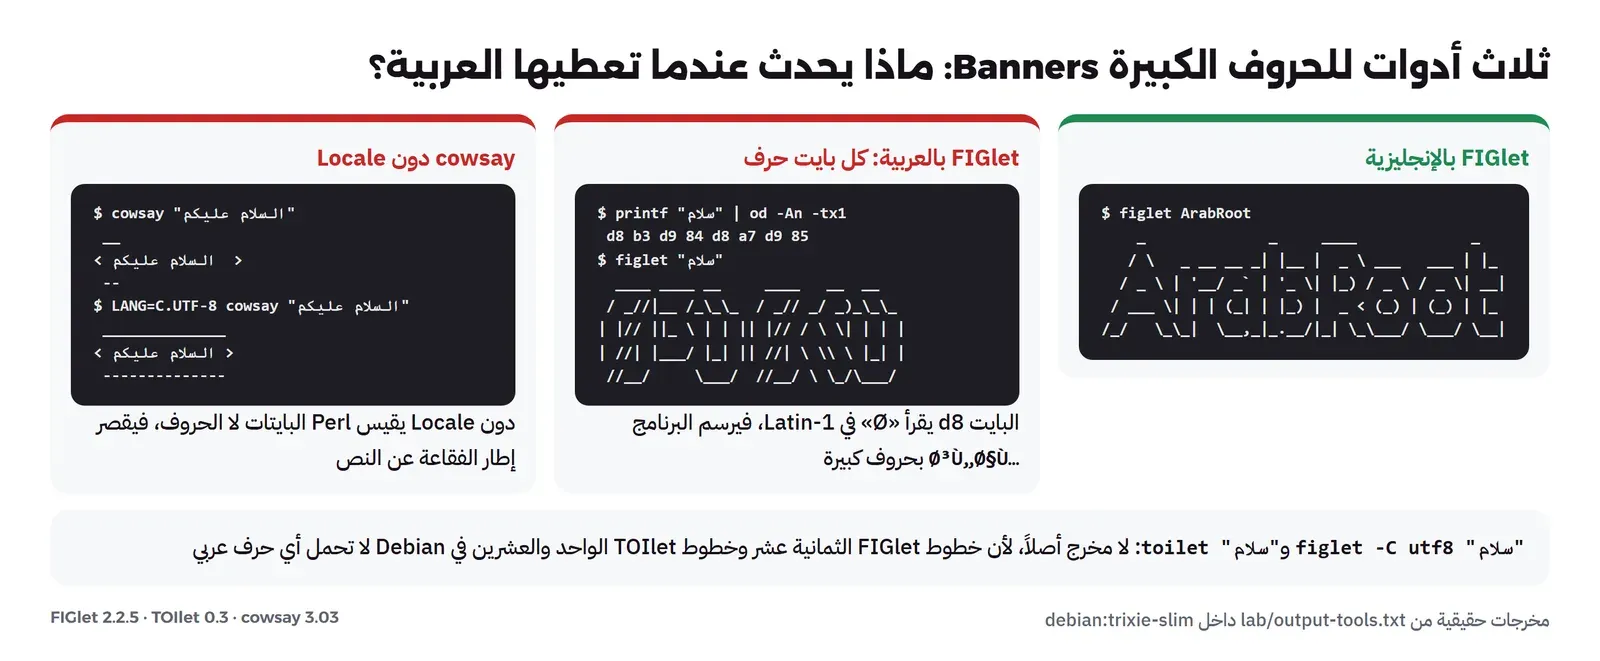
docker run --rm --name spa-ascii -v "$PWD:/w" spa-ascii:1 sh run-tools.sh > output-tools.txt 2>&1وهذا أول المخرج، الأمر figlet "ArabRoot" ثم figlet -f slant "ASCII":
    _              _     ____             _
   / \   _ __ __ _| |__ |  _ \ ___   ___ | |_
  / _ \ | '__/ _` | '_ \| |_) / _ \ / _ \| __|
 / ___ \| | | (_| | |_) |  _ < (_) | (_) | |_
/_/   \_\_|  \__,_|_.__/|_| \_\___/ \___/ \__|

    ___   _____ ______________
   /   | / ___// ____/  _/  _/
  / /| | \__ \/ /    / / / /
 / ___ |___/ / /____/ /_/ /
/_/  |_/____/\____/___/___/
ولاحظ في الكلمة الأولى كيف تتلاصق الحروف المتجاورة وتتشارك بعض الأعمدة، وهذا هو الدمج Smushing الذي شرحناه، فبدونه تكون الكلمة أعرض بعدة أعمدة وتبدو الحروف متفرقة. وفي الثانية خط slant المائل، وهو ملف نصي آخر من الخطوط الثمانية عشر التي تأتي مع الحزمة في Debian.
العربية في الأدوات: الرموز المشوهة Mojibake ثم الـ Locale
ثم أعطينا الأدوات كلمة «سلام». وقبلها طبعنا بايتات الكلمة نفسها، لأنها مفتاح فهم ما حدث:
--- the bytes of the Arabic word:
 d8 b3 d9 84 d8 a7 d9 85
--- figlet with Arabic input (default: one byte = one character):
  ____ ____ __     ____   __  __
 / _//|__ /_\_\_  / _// _/ _)_\_\_
| |// ||_ \ | | || |// / \ \| | | |
| //| |___/ |_| || //| \ \\ \ |_| |
 //__/     \___/  //__/ \ \_/\___/
                       (__/
--- figlet -C utf8 with Arabic input:
0000000
--- toilet with Arabic input:
0000000
في المخرج أعلاه لاحظ التالي:
- الكلمة أربعة حروف، ولكنها ثمانية بايتات في UTF-8، لأن كل حرف عربي يأخذ بايتين.
- FIGlet في وضعه الافتراضي يقرأ كل بايت كحرف مستقل من جدول Latin-1، فالبايت
d8يصبح الحرف «Ø»، وb3يصبح «³»، وهكذا. ثم يرسم هذه الحروف الغريبة بحروف كبيرة بكل ثقة:سلام. وهذه هي الرموز المشوهة Mojibake نفسها التي رأيناها مع ملفات NFO، ولكن في الاتجاه المعاكس: هناك قرئت بايتات CP437 بجدول آخر، وهنا قرئت بايتات UTF-8 بجدول Latin-1. - مع الخيار
-C utf8قرأ FIGlet الحروف صحيحة، ولم يطبع شيئاً أصلاً، لأن الخط لا يحتوي رسماً لأي حرف عربي، وكذلك TOIlet رغم دعمه لـ Unicode. فالمشكلة الأولى كانت في الترميز، والثانية في الخط، وإصلاح الأولى كشف الثانية.
ثم جربنا cowsay، وهنا ظهرت المشكلة التي ستقابلها في أي Container:
--- cowsay with Arabic input, no locale set (LANG=''):
 __
< السلام عليكم  >
 --
--- cowsay with LANG=C.UTF-8:
 ______________
< السلام عليكم >
 --------------
البرنامج مكتوب بلغة Perl، ويحسب طول النص ليرسم إطار الفقاعة بنفس الطول. ودون أي Locale في البيئة، وهذه حالة أغلب Images الخفيفة التي لا تضبط المتغير LANG، لم يتعامل البرنامج مع النص كحروف UTF-8، فخرج الإطار العلوي شرطتين فقط فوق نص أطول منه بكثير، مع مسافة زائدة في آخر السطر. وعندما ضبطنا LANG=C.UTF-8 أصبح الطول صحيحاً، 14 شرطة لنص من 12 حرفاً ومسافتين. والدرس عملي جداً: إذا كانت أداتك تتعامل مع نص غير إنجليزي داخل Container، فاضبط الـ Locale صراحة في الـ Image، لأن المشكلة لا تظهر على جهازك حيث الـ Locale مضبوط، وتظهر في خط CI أو على السيرفر.
العربية في فن الحروف: لماذا لا تصلح الشبكة؟ Arabic and the Grid
رأينا أن الأدوات لا تعرف العربية، ولكن السؤال الأعمق: هل يمكن أصلاً أن يرسم فن ASCII بالحروف العربية، أو أن تكتب العربية بحروف كبيرة على طريقة FIGlet؟ والإجابة تحتاج أن نرجع إلى أساس هذا الفن كله، أي الشبكة: كل حرف في خلية، وكل خلية بنفس العرض، والأعمدة من اليسار إلى اليمين. والعربية تخالف هذا الأساس في ثلاثة أشياء، شرحنا تفاصيلها في مقال التعريب i18n والنص ثنائي الاتجاه:
- التشكيل Shaping: الحرف العربي له أربعة أشكال بحسب موقعه، منفرد وأول ووسط وآخر، ويتصل بما حوله. فالحرف ليس صورة ثابتة في خلية، وإنما يتغير بحسب جيرانه، وبعض الحروف تندمج في رسم واحد مثل «لا».
- الاتجاه RTL: النص يكتب من اليمين، والشبكة ترقم الأعمدة من اليسار، والطرفية تحتاج خوارزمية الاتجاه الثنائي Bidi لتقرر أين يظهر كل حرف، وأغلب الطرفيات تطبقها جزئياً أو لا تطبقها.
- العرض: الحركات مثل الفتحة والشدة حروف في الذاكرة ولا تأخذ عموداً على الشاشة، والتطويل يأخذ عموداً ولا يحمل معنى، وخطوط العرض الثابت المشهورة قليلاً ما تحتوي الحروف العربية، فيعرضها البرنامج من خط آخر متغير العرض.
ولكي نرى ذلك بالأرقام، كتبنا lab/arabic_width.py الذي يعد لكل كلمة عدد نقاط الترميز Code Points بالدالة len()، وعدد الأعمدة الحقيقية بدالة صغيرة تتجاهل الحركات وتعطي الحروف العريضة عمودين، على طريقة معيار العرض في Unicode:
text       len() columns  code points
ASCII          5       5  U+0041 U+0053 U+0043 U+0049 U+0049
سلام           4       4  U+0633 U+0644 U+0627 U+0645
لا             2       2  U+0644 U+0627
السلام         6       6  U+0627 U+0644 U+0633 U+0644 U+0627 U+0645
مُحَمَّد       8       4  U+0645 U+064F U+062D U+064E U+0645 U+064E U+0651 U+062F
سلـــام        7       7  U+0633 U+0644 U+0640 U+0640 U+0640 U+0627 U+0645
🙂              1       2  U+1F642
ولاحظ أن عدد الأعمدة نفسه وعد لا تفي به الشاشة: «لا» نقطتا ترميز وعمودان بحسب الحساب، ولكنها ترسم كرسم واحد، و«محمد» المشكولة ثماني نقاط وأربعة أعمدة، والوجه المبتسم نقطة واحدة وعمودان. ثم رسم البرنامج صندوقاً حول كل كلمة مرتين، مرة بحشو المسافات بحسب len() كما يفعل أغلب الكود، ومرة بحسب الأعمدة، وفتحنا الملف في متصفح داخل وسم <pre> بخط عرض ثابت. والنتيجة الحقيقية في الصورة التالية: صندوق ASCII وحده استقام، وكل الصناديق العربية خرجت حوافها اليمنى في غير مكانها، بالطريقتين، لأن المتصفح لم يجد الحروف العربية في خط العرض الثابت، فرسمها بخط آخر عرض حروفه متغير، فلم يعد للعمود معنى أصلاً.
ماذا لو رسمنا العربية كصورة أولاً؟ What If
إذا كانت الشبكة لا تفهم العربية، فهناك طريق آخر: أن نترك محرك نصوص حقيقياً يرسم الكلمة العربية كصورة، بالتشكيل والاتجاه الصحيحين، ثم نحول الصورة إلى حروف بالمحول الذي كتبناه. وهذا ما يفعله lab/arabic_banner.py: يرسم «عرب رووت» بخط أميري Amiri في Pillow، ثم يحول البكسلات إلى # ومسافات. وجربناه مرتين، مرة بمحرك التخطيط Raqm الذي يشكل الحروف ويرتبها من اليمين، ومرة بالمحرك البسيط BASIC الذي لا يفعل ذلك:
for engine, name in [(ImageFont.Layout.RAQM, "raqm"), (ImageFont.Layout.BASIC, "basic")]:
    font = ImageFont.truetype("/usr/share/fonts/opentype/fonts-hosny-amiri/Amiri-Bold.ttf", 64, layout_engine=engine)
ومع Raqm خرجت الكلمتان متصلتين وفي الاتجاه الصحيح، وتحولت إلى لوحة حروف تقرأ فيها «عرب رووت» إذا ابتعدت عن الشاشة قليلاً. أما مع BASIC فخرج النص «ت وور ب رع»: كل حرف بشكله المنفرد، والترتيب كما خزن في الذاكرة من اليسار إلى اليمين، أي معكوساً. وهذا بالضبط ما تراه في أي برنامج يرسم العربية دون محرك تشكيل، ومنها كثير من الألعاب القديمة والطابعات وأنظمة نقاط البيع، وهو سبب أن مكتبات الصور تحتاج libraqm أو ما يقابلها لتكتب العربية.
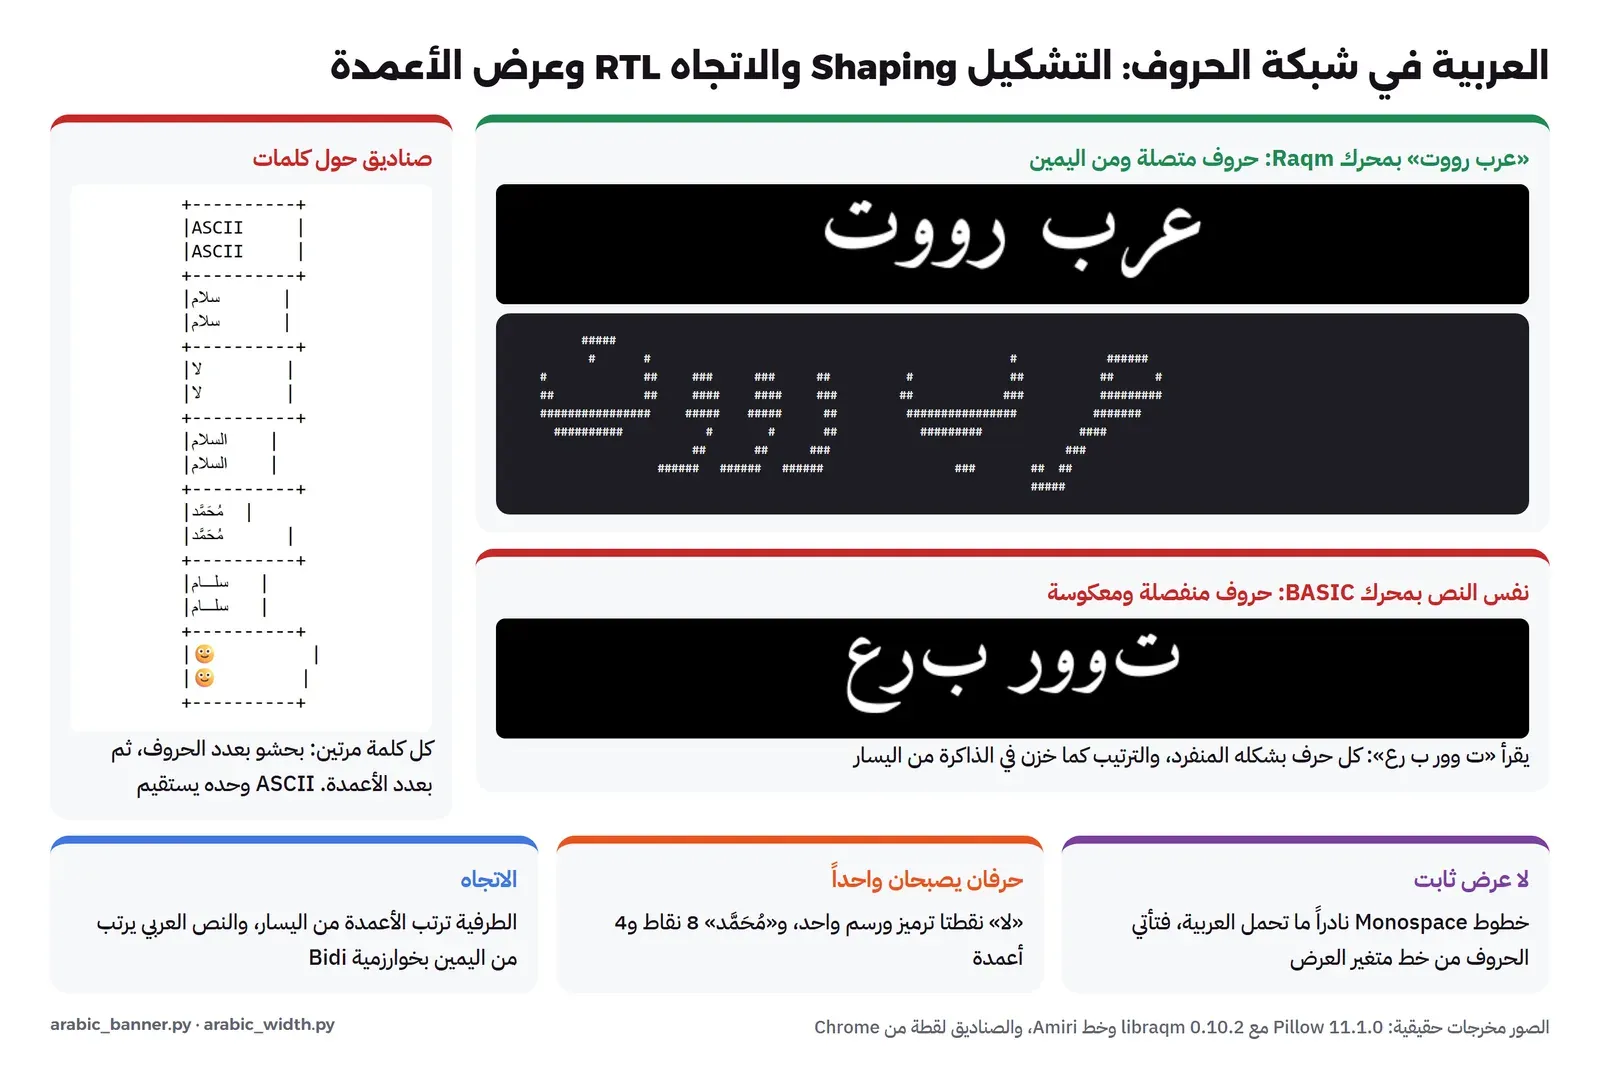
ولاحظ شيئاً جميلاً في هذا الفصل من القصة: العربية لم تكن يوماً فقيرة في فن «الكتابة التي تصبح صورة»، فالخط العربي فيه تقليد قديم لرسم الطيور والسفن والحيوانات بالكلمات نفسها، أي أن الحروف تشكل الصورة كما في ASCII Art، ولكن بالاتصال والانحناء بدل الشبكة. فالمشكلة ليست في العربية، وإنما في أن فن الحروف الحاسوبي بني على افتراض الشبكة المستطيلة، وهذا الافتراض يناسب الحروف اللاتينية المنفصلة ولا يناسب خطاً متصلاً. ولذلك فإن فن الحروف العربي في الحاسب يأتي غالباً من الطريق الذي جربناه: صورة يرسمها محرك يفهم العربية، ثم تحويل إلى رموز لا تحتاج اتجاهاً، مثل # والمربعات █.
أين تراه اليوم؟ ASCII Art Today
قد تظن أن هذا الفن انتهى مع شاشات الألوان، ولكنك تراه كل يوم إذا عملت في البرمجة:
- شعارات أدوات سطر الأوامر: كثير من الأدوات تطبع شعاراً بالحروف عند التشغيل، وSpring Boot مثلاً يطبع شعاره ويسمح لك بتغييره بوضع ملف
banner.txtكما في توثيق Spring Boot. - أدوات معلومات النظام: أدوات تطبع شعار التوزيعة بالحروف الملونة بجانب معلومات المعالج والذاكرة، وصارت لقطات الشاشة منها تقليداً بين مستخدمي Linux.
- المخططات في الكود والمعايير: ترويسات البروتوكولات في RFC، ومخططات صغيرة في تعليقات الكود تشرح بنية بيانات أو تدفقاً، لأنها تبقى صحيحة في أي محرر وفي مراجعة الكود.
- رسائل في أدوات المطور: مواقع كبيرة تطبع شعاراً بالحروف ورسالة توظيف في نافذة Console في المتصفح لمن يفتحها من المطورين.
- الألعاب النصية: ألعاب الأقبية Roguelike التي ترسم الخريطة والوحوش بالحروف، وما زالت تصدر منها ألعاب جديدة.
والسبب في كل هذه الأمثلة هو نفس سبب RTTY في الستينات: النص هو الصيغة الوحيدة التي تصل إلى كل مكان. فالسجل نص، والطرفية نص، وملف الكود نص، ورسالة البريد نص، ومراجعة الكود في Git نص، وأي صورة تحتاج شيئاً إضافياً لتظهر.
دروس من القصة Lessons
- القيد يصنع الحل: من صندوق الحروف في 1875 إلى خط الراديو إلى المودم البطيء، كل مرحلة جاءت من أداة محدودة استخدمت بطريقة لم تصمم لها. وعندما تواجه قيداً في عملك، فابحث أولاً عما تستطيع أن تفعله بالأداة الموجودة قبل أن تطلب أداة جديدة.
- النص صيغة لا تموت: المخطط في RFC 791 ما زال يقرأ بعد أكثر من أربعين سنة، وأغلب صيغ الصور في ذلك الوقت تحتاج اليوم برامج خاصة لتفتح. فإذا كان شيء يجب أن يعيش طويلاً، فاجعله نصاً إن استطعت.
- البايتات ليست حروفاً: ملفات NFO المشوهة، وFIGlet الذي رسم «Ø³Ù„ام»، وcowsay دون Locale، كلها نفس الخطأ: برنامج افترض جدولاً لقراءة البايتات غير الجدول الذي كتبت به.
- قس ولا تنسخ: السلم المشهور منسوخ من مقال إلى مقال وترتيبه خاطئ في الخط الذي قسناه. وكل «رقم معروف» في الهندسة يستحق قياساً سريعاً في بيئتك.
- الطرفة لها قيمة: cowsay لا يحل أي مشكلة، ومع ذلك بقي سنوات طويلة على السيرفرات، لأن الأدوات التي يحبها الناس تحمل شيئاً من شخصية من كتبها. ولا بأس أن تضع في أداتك الداخلية لمسة صغيرة، بشرط أن تبقى خارج طريق من يستخدمها في سكربت أو خط CI.
- افتراضات اللغة تختبئ في الأساس: الشبكة المستطيلة افتراض صغير لا يذكره أحد، وهو وحده يجعل العربية خارج هذا الفن. وعندما تصمم واجهة أو صيغة أو أداة، فاسأل: ما الذي افترضته عن اللغة دون أن أكتبه؟
قائمة قرار Checklist: قبل أن تضع شعاراً بالحروف في أداتك
- هل يظهر الشعار فقط عندما يكون المخرج طرفية تفاعلية؟ افحص ذلك بـ
isatty، ولا تطبعه عندما يمرر المخرج إلى برنامج آخر أو إلى ملف سجل يقرؤه نظام مراقبة. - هل يمكن إيقافه؟ أضف خياراً أو متغير بيئة لإيقاف الشعار، واحترم المتغير
NO_COLORللألوان كما يقترح موقع NO_COLOR. - هل عرضه أقل من 80 عموداً؟ هذا هو العرض الذي يمكن أن تفترضه في أي طرفية.
- هل الملف بترميز UTF-8 ويحتوي فقط حروفاً تعرضها خطوط العرض الثابت الشائعة؟ إذا استخدمت رموز المربعات فجربها في أكثر من طرفية.
- إذا كان في الأداة نص عربي، هل وضعته خارج الشعار، في سطر عادي تتولى الطرفية اتجاهه، بدل أن تحاول رسمه بالحروف؟
- إذا كانت الأداة تعمل في Container، هل ضبطت
LANG=C.UTF-8في الـ Image؟ - إذا كان الشعار في صفحة ويب، هل أخفيته عن قارئات الشاشة، لأنها ستقرأ الشرطات والخطوط حرفاً حرفاً؟
الخلاصة Summary
وصلنا لنهاية القصة، وأهم ما فيها:
- الرسم بالحروف بدأ قبل الحاسب، في إعلان صحيفة سنة 1875 وعلى الآلة الكاتبة، ثم عاش على الطابعات عن بعد وخطوط الراديو، لأن النص كان الشيء الوحيد الذي يصل.
- ASCII أعطى الفن لوحته من 95 حرفاً، والعرض الثابت أعطاه شبكته، ومنه ولد الوجه المبتسم
:-)في 1982، ثم فن ANSI وملفات NFO بألوانها ورموز CP437. - FIGlet سنة 1991 وTOIlet بعده جعلا الحروف الكبيرة أمراً واحداً بخطوط هي ملفات نصية، وcowsay أصبح جزءاً من ثقافة Unix.
- المحول من الصورة إلى الحروف أربع خطوات، وأهم رقم فيه نسبة الخلية 0.5، وقياسنا بين أن أغمق حرف يغطي 27.1% فقط من خليته، وأن السلم المشهور ليس مرتباً بالحبر الحقيقي.
- مع العربية رسم FIGlet رموزاً مشوهة لأنه يقرأ البايتات كحروف Latin-1، ثم لم يرسم شيئاً لأن خطوطه لا تحتوي العربية، وcowsay احتاج
LANG=C.UTF-8ليقيس النص صحيحاً. - العربية لا تناسب شبكة الأعمدة بسبب التشكيل والاتجاه والعرض المتغير، والطريق الذي يعمل هو رسمها بمحرك تشكيل مثل Raqm ثم تحويلها إلى رموز.
وهذا المقال من مرحلة قصص المطورين والشركات، وهذه مقالات منشورة ترتبط به:
 دليلGeek، Nerd، Hacker: من أين جاءت كلمات ثقافة المبرمجين؟قصة الكلمات التي يصف بها المبرمجون أنفسهم، من نادي القطارات في MIT وملف المصطلحات Jargon File إلى نشرات الأخبار، وكيف نستخدمها بالعربية دون أن نخلط بين الهاكر والمخترق.
 دليلالبيض المخفي Easter Eggs: من Atari إلى محاكي الطيران في Excelقصة الكود الذي أخفاه المبرمجون داخل البرامج، من توقيع Warren Robinett في Atari إلى ألعاب Office، ولماذا منعته Microsoft وما الذي يقوله عن المراجعة والأمان وثقافة الفريق.
 دليلترميز النصوص Text Encoding: من ASCII إلى UTF-8نتابع نصاً عربياً بايتاً بايتاً من الكتابة إلى قاعدة البيانات، ونرى لماذا يتحول إلى «Ø§Ù„» وكيف تمنع ذلك وتقارن النصوص وتقطعها بشكل صحيح.
 دليلالتعريب i18n للمطورين: لماذا ينقلب النص العربي في الواجهة؟لماذا ينقلب النص المختلط في الواجهة العربية وكيف تعزله، وكيف تنسق الأرقام والتواريخ وصيغ الجمع العربية بأدوات المتصفح نفسها.
 دليلصيغ الصور: كيف تختار الصيغة المناسبة لموقعككيف تحفظ كل صيغة صور البكسلات والألوان، ولماذا يصغر الملف نفسه إلى الثلث أو أقل عندما تختار الصيغة والمقاس المناسبين.
 دليلسطر الأوامر في Linux للمبتدئين: أول ما تحتاجه على السيرفركيف تتنقل بين الملفات على السيرفر، وتربط الأوامر ببعضها، وتتحكم في العمليات Processes دون أن تحذف شيئاً بالخطأ.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل محول الصورة إلى حروف وقياس كثافة الحروف بـ Pillow 11.1.0 وlibraqm 0.10.2، وتجربة FIGlet 2.2.5 وTOIlet 0.3 وcowsay 3.03 مع العربية داخل Docker على Debian 13.