


لنفرض أن فريقك يملك منصة لحجز الدورات التدريبية، بنيت من أول يوم بالإنجليزية، ثم قررت الإدارة إطلاق الواجهة العربية خلال شهر لأن أغلب العملاء يكتبون بالعربية. ترجم الفريق النصوص في ملف واحد، وقلب اتجاه الصفحة إلى dir="rtl"، وظن أن العمل انتهى، ثم بدأت التذاكر تصل من أول أسبوع: صفحة التعليقات تعرض «3 - user99 تعليقات» بدلاً من «user99 - 3 تعليقات»، ورقم الدعم الفني يظهر وعلامة + في آخره، وصفحة الملفات تكتب «ملفات 2» و«ملفات 11»، والعميل الذي كتب رقم جواله بالأرقام العربية ٠٥٠ يرفضه النموذج لأن الرقم «غير صحيح»، وموعد الدورة يظهر بالتاريخ الميلادي بينما يسأل بعض العملاء عن التاريخ الهجري، والبحث عن «احمد» لا يجد «أحمد»، وأخيراً وصل مرفق اسمه يبدو invoiceexe.pdf وهو في الحقيقة ملف تنفيذي. ولا توجد مشكلة واحدة من هذه سببها الترجمة، وإنما سببها أن الكود نفسه لم يكتب ليتعامل مع لغة أخرى، وهذا بالضبط الفرق بين الترجمة والتدويل.
وهذا المقال من مرحلة هندسة الواجهات وتطبيقات الويب Frontend، ويتعامل مع النص والأرقام والتواريخ فقط، أما تخطيط الصفحة نفسها للعربية بالخصائص المنطقية في CSS فله مقال مستقل في نفس المرحلة، وأما البايتات وUTF-8 فشرحنا الترميز في مقال الترميز Encoding ولن نعيده هنا. وسوف نناقش في هذا المقال ما يلي:
- الفرق بين التدويل i18n والتوطين l10n، وما هو الـ Locale، وكيف تقرأ وسماً مثل
ar-SA-u-ca-islamic-umalqura-nu-latn. - خوارزمية النص ثنائي الاتجاه BiDi في Unicode: أنواع الحروف والمستويات، ولماذا يقفز الرقم إلى طرف الجملة، ولماذا تنقلب
C++ورقم الجوال. - العزل Isolation بالعنصر
<bdi>والخاصيةdirوالحروف الخفية، والفرق بينه وبين التضمين القديم، ومتى تكفي العلامات LRM وRLM. - الحروف الخفية كأداة للخداع: أسماء الملفات المزيفة وهجوم Trojan Source.
- تنسيق الأرقام والعملة بالواجهة
Intl.NumberFormat، والتواريخ بالتقويم الميلادي وتقويم أم القرى، والتاريخ النسبي. - صيغ الجمع الست في العربية، وملفات الترجمة، ولماذا لا تبني الجملة بجمع النصوص.
- ترتيب الأسماء العربية والبحث فيها، وقراءة الأرقام التي يكتبها المستخدم بالأرقام العربية.
- تجربة عملية كاملة في Node.js وفي Chrome مع المخرجات الحقيقية، ثم الأخطاء الشائعة وقائمة تحقق.
ما الفرق بين التدويل i18n والتوطين l10n؟
التدويل Internationalization، واختصاراً i18n لأن بين الحرف الأول والأخير ثمانية عشر حرفاً، هو أن تكتب الكود بحيث لا يفترض لغة أو منطقة بعينها، فلا توجد جملة ثابتة داخل الكود، ولا يحفظ التاريخ كنص منسق، ولا يجمع الكود الجملة من قطع، ولا يفترض أن النص يكتب من اليسار. وهذا عمل تقوم به مرة واحدة في الكود، وغالباً يقوم به المطورون. أما التوطين Localization، واختصاراً l10n، فهو تجهيز المنتج لمنطقة ولغة محددة: ترجمة الجمل، واختيار صيغة الجمع المناسبة، والعملة، والتقويم، وشكل الأرقام، واتجاه الواجهة، ويتكرر هذا العمل لكل لغة تضيفها، وغالباً يشارك فيه المترجمون وفريق المنتج. والعلاقة بينهما بسيطة: التدويل يجعل التوطين ممكناً، فإذا لم يكن الكود مدولاً فكل لغة جديدة تعني تعديل الكود نفسه، وهذا ما حدث مع الفريق في القصة أعلاه، فقد قام بالتوطين (الترجمة) دون التدويل.
وبين الاثنين يوجد مفهوم ثالث يحمل كل القرارات، وهو الـ Locale، أي مجموعة التفضيلات التي تحدد كيف يرى المستخدم النص والأرقام والتواريخ. والـ Locale يكتب بوسم لغة Language Tag حسب المعيار BCP 47، وأبسط صورة له لغة فقط مثل ar، ثم لغة ومنطقة مثل ar-SA للعربية في السعودية وar-EG للعربية في مصر. ويمكن أن يحمل الوسم أيضاً امتداد Unicode، وهو الحرف u وبعده أزواج من المفاتيح والقيم كما في RFC 6067 والمعيار UTS #35، فالمفتاح ca يحدد التقويم Calendar، والمفتاح nu يحدد نظام الأرقام Numbering System، والقيم المسموحة لكل مفتاح موجودة في بيانات CLDR، مثل قائمة التقاويم التي فيها islamic-umalqura وقائمة أنظمة الأرقام التي فيها arab للأرقام العربية الهندية ٠١٢٣ وlatn للأرقام 0123. والصورة التالية تبين أجزاء الوسم الذي استخدمناه في التجربة وما يملكه كل من التدويل والتوطين:
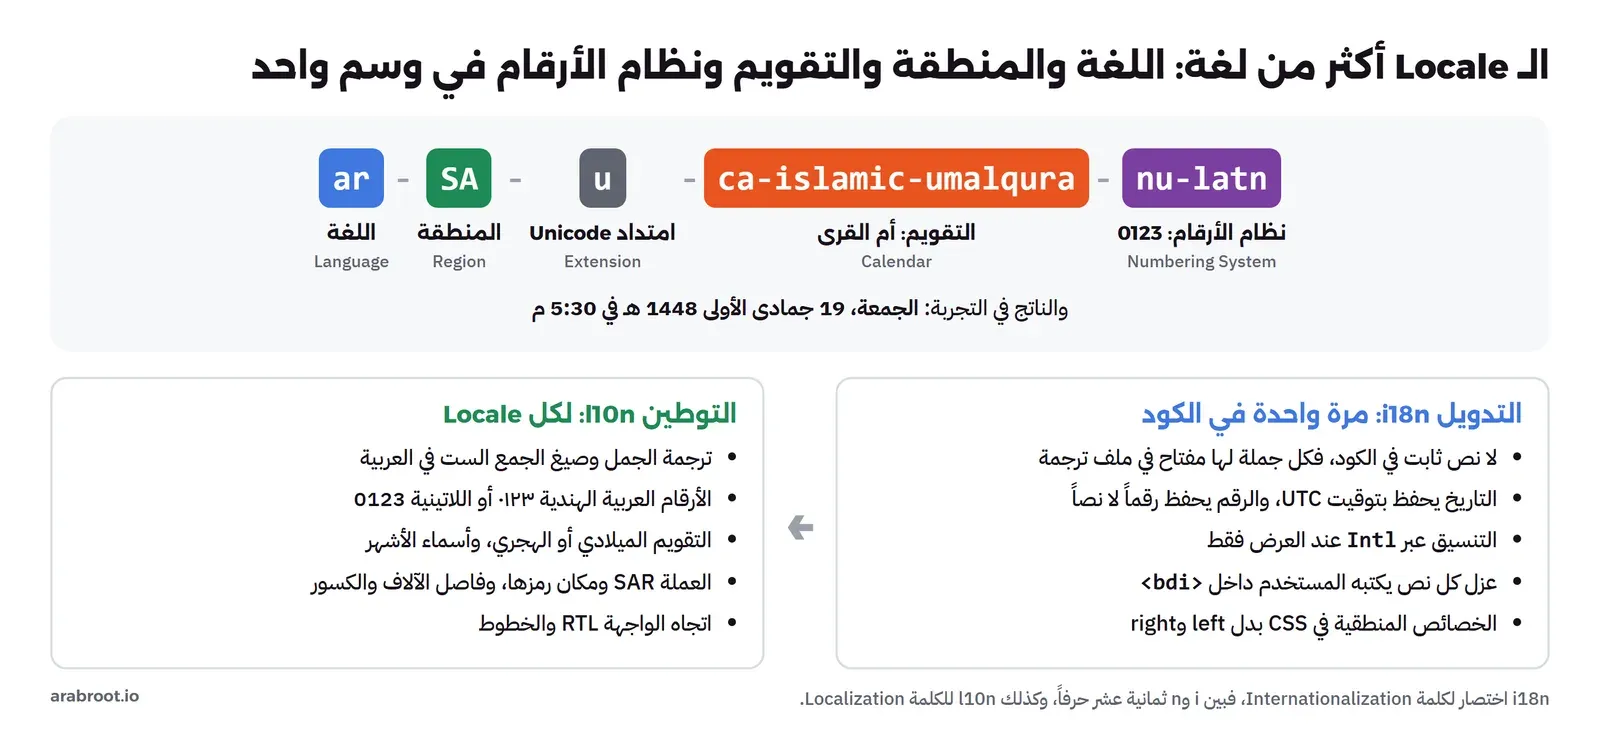
والشيء الذي يفاجئ كثيراً من المطورين هو أن اختيار الوسم وحده يغير النتيجة، فقد طلبنا في التجربة من Intl.Locale ومن الدوال الأخرى أن تخبرنا بما تختاره لكل وسم، فكانت النتيجة كما يلي:
== 1) locale tags
ar                           numberingSystem=latn calendar=gregory max=ar-Arab-EG
ar-SA                        numberingSystem=arab calendar=gregory max=ar-Arab-SA
ar-EG                        numberingSystem=arab calendar=gregory max=ar-Arab-EG
ar-MA                        numberingSystem=latn calendar=gregory max=ar-Arab-MA
ar-SA-u-nu-latn              numberingSystem=latn calendar=gregory max=ar-Arab-SA-u-nu-latn
ar-SA-u-ca-islamic-umalqura  numberingSystem=arab calendar=islamic-umalqura max=ar-Arab-SA-u-ca-islamic-umalqura
في المخرج أعلاه لاحظ التالي:
- الوسم
arوحده اختار الأرقام اللاتينيةlatn، والدالةmaximize()أكملته إلىar-Arab-EG، أي أن العربية بلا منطقة تعني في بيانات CLDR العربية المكتوبة بالحرف العربي في مصر، وهذا لا يناسب منتجاً يستهدف السعودية. - الوسم
ar-SAاختار الأرقام العربية الهنديةarabوالتقويم الميلاديgregory، بينما اختارar-MAالأرقام اللاتينية، وسوف نرى بعد قليل أن المغرب يستخدم أيضاً فواصل مختلفة. - عندما أضفنا
-u-nu-latnتغير نظام الأرقام فقط وبقي كل شيء آخر سعودياً، وعندما أضفنا-u-ca-islamic-umalquraتغير التقويم فقط، وهذه هي الفائدة الحقيقية من الامتداد: تعدل تفضيلاً واحداً دون أن تختار منطقة أخرى.
ومن أين يأتي الـ Locale في تطبيق ويب؟ المصدر الأول هو اختيار المستخدم نفسه إذا كان مسجلاً، فتحفظه في ملفه الشخصي أو في Cookie كما شرحنا في مقال الجلسات، والمصدر الثاني هو ترويسة Accept-Language التي يرسلها المتصفح مع كل طلب كما رأينا في مقال HTTP، وnavigator.languages في JavaScript. ولا تقم باستنتاج اللغة من عنوان IP، والسبب أن الموقع الجغرافي لا يحدد اللغة، فالمهندس الهندي الذي يعمل داخل المملكة يريد غالباً الواجهة الإنجليزية، والطالب السعودي في الخارج يريد العربية، وأسوأ تجربة هي أن يتغير اتجاه الواجهة كلما سافر المستخدم أو استخدم VPN. وتذكر أيضاً أن تضع الخاصية lang على عنصر html، لأن قارئ الشاشة يختار النطق منها كما ذكرنا في مقال سهولة الوصول، والمتصفح يختار منها الخط وقواعد تقسيم الكلمات.
لماذا ينقلب النص المختلط؟ خوارزمية BiDi
نعود إلى أول تذكرة في القصة، فالقالب في الكود كان بسيطاً: اسم المستخدم ثم شرطة ثم عدد التعليقات ثم كلمة «تعليقات»، والنص المحفوظ في الذاكرة صحيح تماماً، ومع ذلك ظهر على الشاشة بترتيب آخر. والسبب أن الشاشة لا تعرض الحروف بترتيب حفظها، وإنما بترتيب تحسبه خوارزمية النص ثنائي الاتجاه Unicode Bidirectional Algorithm، وهي موصوفة في الملحق UAX #9، وكل متصفح وكل نظام تشغيل يطبقها. والفكرة الأساسية أن هناك ترتيبين: الترتيب المنطقي Logical Order، وهو ترتيب الحروف في الذاكرة كما كتبت وكما تقرؤها، والترتيب المرئي Visual Order، وهو مكان كل حرف على الشاشة من اليسار إلى اليمين. والخوارزمية تأخذ الأول وتنتج الثاني على أربع مراحل تقريباً.
المرحلة الأولى: لكل حرف نوع
كل حرف في Unicode له خاصية اسمها Bidi_Class، والأنواع تنقسم إلى ثلاث مجموعات:
- الحروف القوية Strong: ولها اتجاه ثابت، فالحروف اللاتينية من النوع L، أي من اليسار إلى اليمين، والحروف العبرية من النوع R، والحروف العربية من النوع AL، وهو نوع يتصرف مثل R مع فرق في معاملة الأرقام كما سيأتي.
- الحروف الضعيفة Weak: ولها اتجاه ولكنها تتأثر بما حولها، وأهمها الأرقام الأوروبية 0 إلى 9 من النوع EN، والأرقام العربية الهندية ٠ إلى ٩ من النوع AN، وعلامات مثل + و- من النوع ES، والنقطة والفاصلة والنقطتان من النوع CS.
- الحروف المحايدة Neutral: وليس لها اتجاه أصلاً، مثل المسافة وعلامات الترقيم والأقواس وعلامة التعجب، وهي تأخذ اتجاهها من الحروف القوية على جانبيها.
المرحلة الثانية: اتجاه الفقرة Paragraph Direction
لكل فقرة اتجاه أساسي يسمى اتجاه الفقرة Paragraph Direction، وتحدده الخوارزمية في القاعدتين P2 وP3 من أول حرف قوي في الفقرة إذا لم يحدده أحد، أما في HTML فالخاصية dir على العنصر أو أحد آبائه هي التي تحدده، ولذلك كان سطر dir="rtl" الذي أضافه الفريق صحيحاً وضرورياً، ولكنه حل نصف المشكلة فقط. ومن اتجاه الفقرة تبدأ المستويات Embedding Levels، فالفقرة التي اتجاهها RTL تبدأ بالمستوى 1، والنص اللاتيني داخلها يرفع إلى المستوى 2، والقاعدة البسيطة أن المستوى الفردي يعرض من اليمين إلى اليسار والمستوى الزوجي من اليسار إلى اليمين.
المرحلة الثالثة: حل الحروف الضعيفة Weak والمحايدة Neutral
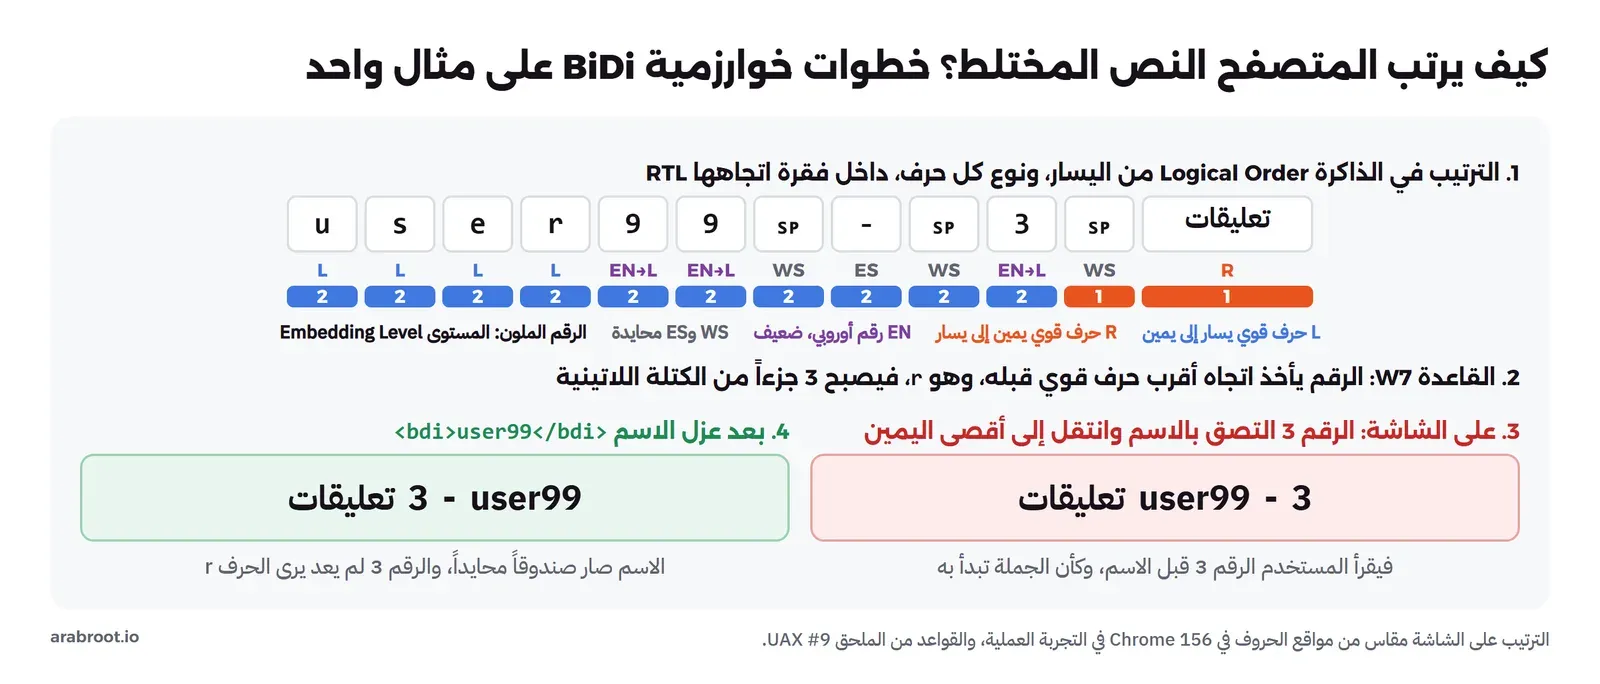
هنا يحدث كل ما يفاجئ المطورين. فالقاعدة W2 تقول إن الرقم الأوروبي EN الذي يسبقه حرف عربي AL يتحول إلى رقم عربي AN، والقاعدة W7 تقول إن الرقم الأوروبي الذي يكون أقرب حرف قوي قبله لاتينياً L يتحول إلى L، أي يصبح جزءاً من الكتلة اللاتينية. ثم تأتي القاعدتان N1 وN2 للحروف المحايدة، فالحرف المحايد الواقع بين حرفين قويين من نفس الاتجاه يأخذ اتجاههما، والواقع بين اتجاهين مختلفين يأخذ اتجاه الفقرة. والآن طبق هذا على النص user99 - 3 تعليقات في فقرة اتجاهها RTL:
- الحروف
userمن النوع L، فتأخذ المستوى 2. - الرقمان
99يسبقهما الحرفrوهو L، فيتحولان إلى L بالقاعدة W7. - الرقم
3أقرب حرف قوي قبله هو أيضاًr، لأن المسافة والشرطة ليست حروفاً قوية، فيتحول هو الآخر إلى L. - المسافة والشرطة والمسافة تقع بين L وL، فتأخذ اتجاه L، وبهذا أصبحت
user99 - 3كلها كتلة واحدة من اليسار إلى اليمين في المستوى 2. - المسافة الأخيرة تقع بين L وكلمة «تعليقات» العربية، فتأخذ اتجاه الفقرة RTL، والكلمة العربية في المستوى 1.
المرحلة الرابعة: إعادة الترتيب وعكس الأقواس Mirroring
في المرحلة الأخيرة تعكس الخوارزمية بالقاعدة L2 كل سلسلة متصلة من المستويات من الأعلى إلى الأدنى، فتعرض الكتلة user99 - 3 من اليسار إلى اليمين كما هي، ثم توضع كاملة في بداية السطر من جهة اليمين لأنها أول شيء في الفقرة، ثم تأتي كلمة «تعليقات» على يسارها. والنتيجة أن الرقم 3 أصبح في أقصى اليمين، فيقرأ المستخدم العربي الجملة من اليمين ويرى الرقم أولاً، ثم الاسم، ثم الكلمة. والصورة التالية تبين هذه الخطوات على نفس المثال، والترتيب الذي فيها مقاس من الشاشة في التجربة العملية وليس استنتاجاً:
وفي نفس المرحلة يحدث شيء آخر، وهو عكس الحروف المتقابلة Mirroring، فالحروف التي لها الخاصية Bidi_Mirrored، مثل الأقواس ( ) و[ ] وعلامتي < و>، ترسم بشكلها المعكوس إذا وقعت في مستوى فردي، والقائمة الكاملة في الملف BidiMirroring.txt. ولهذا تكتب في الكود العربي القوس المفتوح ( في بداية الجملة فيظهر على يمينها بالشكل الصحيح. ومنذ الإصدار 6.3 من Unicode أضيفت إلى الخوارزمية قاعدة أزواج الأقواس Paired Brackets، فأصبح القوسان المتقابلان يأخذان نفس الاتجاه، بعد أن كانت الأقواس حول نص لاتيني في جملة عربية تظهر أحياناً في أماكن غريبة. ولكن العكس نفسه يفاجئ في حالة واحدة، وهي العبارات الرياضية، فالنص 3 > 2 داخل جملة عربية يظهر على الشاشة كأنه 2 < 3 إذا قرأته من اليسار، وهو صحيح للقارئ العربي الذي يقرأ من اليمين، ولكنه يربك أي شخص يقرأ العبارة كمعادلة، ولذلك تعامل مع المعادلات والكود كنص لاتيني معزول كما سيأتي.
الحالات المشهورة: رقم الجوال واسم C++ والوقت والمسار
بنفس القواعد الأربع تستطيع أن تفسر كل التذاكر التي وصلت للفريق، وقد عرضنا كل حالة منها في Chrome وقسنا ترتيبها على الشاشة كما في التجربة العملية:
- رقم الجوال الدولي
+966 50 123 4567: كل مجموعة أرقام EN، والمسافات بينها محايدة، والجملة عربية، فتعرض كل مجموعة من اليسار إلى اليمين ولكن المجموعات نفسها ترتب من اليمين إلى اليسار، وعلامة + تتحول إلى محايد يأخذ اتجاه الجملة، فظهر الرقم على الشاشة بترتيب المجموعات المعكوس وعلامة + في آخره من جهة اليمين، أي4567 123 50 966+إذا قرأته من اليسار. - اسم اللغة
C++: الحرفCمن النوع L، وعلامتا + بعده محايدتان بين L وكلمة عربية، فتأخذان اتجاه الفقرة وتنتقلان إلى الجهة الأخرى من الحرف، فيظهر++C، وهي من أشهر الأخطاء في إعلانات الوظائف العربية. - الوقت
05:30 PM: الرقم يسبقه حرف عربي فيبقى رقماً، وPMكتلة لاتينية منفصلة، والمسافة بينهما تأخذ اتجاه الجملة، فتظهر الكتلتان بترتيب معكوسPM 05:30. - السعر
1,499.50 SAR: نفس القصة، فالرقم والعملة كتلتان، وظهر على الشاشةSAR 1,499.50. - مسار الملف
/home/sara/تقارير/2026.pdf: وهو أسوأها، لأن المسار فيه حروف عربية في وسطه، فتقطعت أجزاؤه وانتقلتpdf.2026إلى أول السطر.
وقد يتساءل البعض: إذا كانت الخوارزمية تنتج هذه الأخطاء، فلماذا لا تصلحها Unicode؟ والإجابة أن الخوارزمية لا تعرف المعنى، فهي لا تعرف أن user99 اسم مستخدم وأن 3 عدد تعليقات، ولا تعرف أن +966 50 123 4567 رقم واحد وليس أربعة أرقام في جملة عربية، والمعلومة الناقصة هنا عند المطور فقط، ووظيفة المطور أن يقول للمتصفح أين يبدأ النص المستقل وأين ينتهي، وهذا هو العزل.
العزل Isolation: كيف تخبر المتصفح أين يبدأ النص المستقل؟
العزل يعني أن تضع النص الذي يأتي من مصدر آخر، مثل اسم المستخدم أو رقم الجوال أو اسم الملف، داخل صندوق، والصندوق له صفتان: اتجاه ما بداخله يحسب وحده دون أن يتأثر بما حوله، وما حوله يرى الصندوق كله كأنه حرف محايد واحد. وفي HTML يوجد العنصر bdi، واسمه اختصار Bi-Directional Isolate، وهو يحدد اتجاه ما بداخله من أول حرف قوي فيه، وبهذا يصلح القالب في القصة بتعديل واحد:
<!-- قبل: الرقم يلتصق بالاسم اللاتيني -->
<p>${user} - ${count} تعليقات</p>

<!-- بعد: الاسم معزول، فلا يؤثر على الرقم ولا يتأثر بالجملة -->
<p><bdi>${user}</bdi> - ${count} تعليقات</p>
وعند عرض الصفحة في Chrome ظهر الاسم في أقصى اليمين، ثم الشرطة، ثم الرقم 3، ثم كلمة «تعليقات»، وهو الترتيب الذي أراده الفريق. ولاحظ أن العنصر <bdi> لم يحدد اتجاهاً معيناً، وإنما ترك المتصفح يكتشفه، وهذا مهم في أسماء المستخدمين لأن بعضهم يكتب اسمه بالعربية وبعضهم بالإنجليزية، فالاسم العربي عمر_2 في صفحة إنجليزية يحتاج نفس الحماية، وقد عرضناه في التجربة في صفحة اتجاهها LTR، فظهر بدون عزل بالشكل التالي:
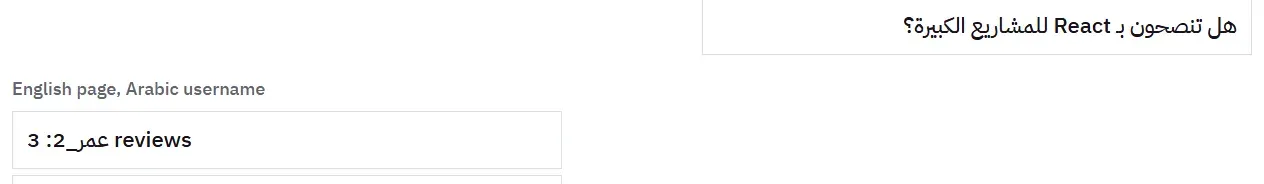
وفي السطر الأول من الصورة تحول الرقم 3 إلى رقم عربي AN لأنه جاء بعد حرف عربي بالقاعدة W2، فدخل هو والنقطتان في الكتلة العربية وانعكس ترتيبها، أما في السطر الثاني فالاسم معزول، فظهرت الجملة الإنجليزية كما كتبت.
أدوات العزل: عناصر HTML وخصائص CSS والحروف الخفية
هناك أربع طرق للعزل، وكلها تؤدي نفس العمل في الخوارزمية، والفرق في المكان الذي تستخدم فيه كل طريقة:
- العنصر
<bdi>: للنص الذي لا تعرف اتجاهه مسبقاً، مثل الأسماء والتعليقات وعناوين المنتجات التي يكتبها المستخدمون. - الخاصية dir على أي عنصر: مثل
<span dir="ltr">لرقم الجوال أو المسار أو الكود، لأنك تعرف أن اتجاهها LTR دائماً. وقد تأكدنا في التجربة أن Chrome يعطي أي عنصر عليهdirالقيمةunicode-bidi: isolateتلقائياً، ولذلك أصلح<span dir="ltr">المشكلة بينما لم يصلحها<span>بدون الخاصية. - الخاصية unicode-bidi في CSS: بالقيمة
isolateأوplaintext، وتستخدمها عندما لا تستطيع تعديل HTML، مثل محتوى يأتي من محرر نصوص. - حروف العزل الخفية في النص نفسه: وهي LRI بالرمز U+2066، وRLI بالرمز U+2067، وFSI بالرمز U+2068، وكلها تغلق بالحرف PDI بالرمز U+2069، وتستخدمها حيث لا يوجد HTML أصلاً: الإشعارات Push Notifications، والرسائل النصية SMS، وعنوان البريد Subject، والنص داخل ملف PDF أو صورة، وعنوان الصفحة
<title>الذي لا يقبل عناصر.
والحرف FSI، أي First Strong Isolate، هو المقابل النصي للعنصر <bdi>، لأنه يحدد الاتجاه من أول حرف قوي داخل الصندوق، ولذلك إذا كانت عندك دالة واحدة تبني نصوص الإشعارات من بيانات المستخدمين فاجعلها تحيط كل قيمة متغيرة بالحرفين FSI وPDI، وهذا ما فعلناه في القسم الثامن من التجربة. وتنصح W3C في مقال الحروف الخفية أم HTML باستخدام العناصر والخصائص في HTML كلما أمكن، والسبب أن الحروف الخفية لا تراها في الكود ولا في قاعدة البيانات، فيصعب اكتشافها عند تتبع خطأ، وقد تنقص أو تزيد عند قص النص فتبقى بداية صندوق بلا نهاية.
لماذا لا تكفي حروف التضمين Embedding القديمة؟
قبل الإصدار 6.3 كانت الأداة المتاحة هي التضمين Embedding بالحروف LRE وRLE وإغلاقهما بالحرف PDF، وما زالت تجدها في مكتبات قديمة وفي إجابات كثيرة على الإنترنت. والتضمين يرفع مستوى النص بداخله، ولكنه لا يعزله، فالحروف التي بعده تحسب حدودها من المستوى الأعلى، وبالتالي يبقى الرقم 3 بعد الاسم المضمن متأثراً باتجاهه. وقد جربنا ذلك في Chrome، فوضعنا الاسم بين LRE وPDF مرة، وبين LRI وPDI مرة، فبقي الخطأ كما هو مع التضمين، واختفى مع العزل. والصورة التالية تلخص الفرق، ومعه جدول الحروف الخفية وما يقابلها في HTML:
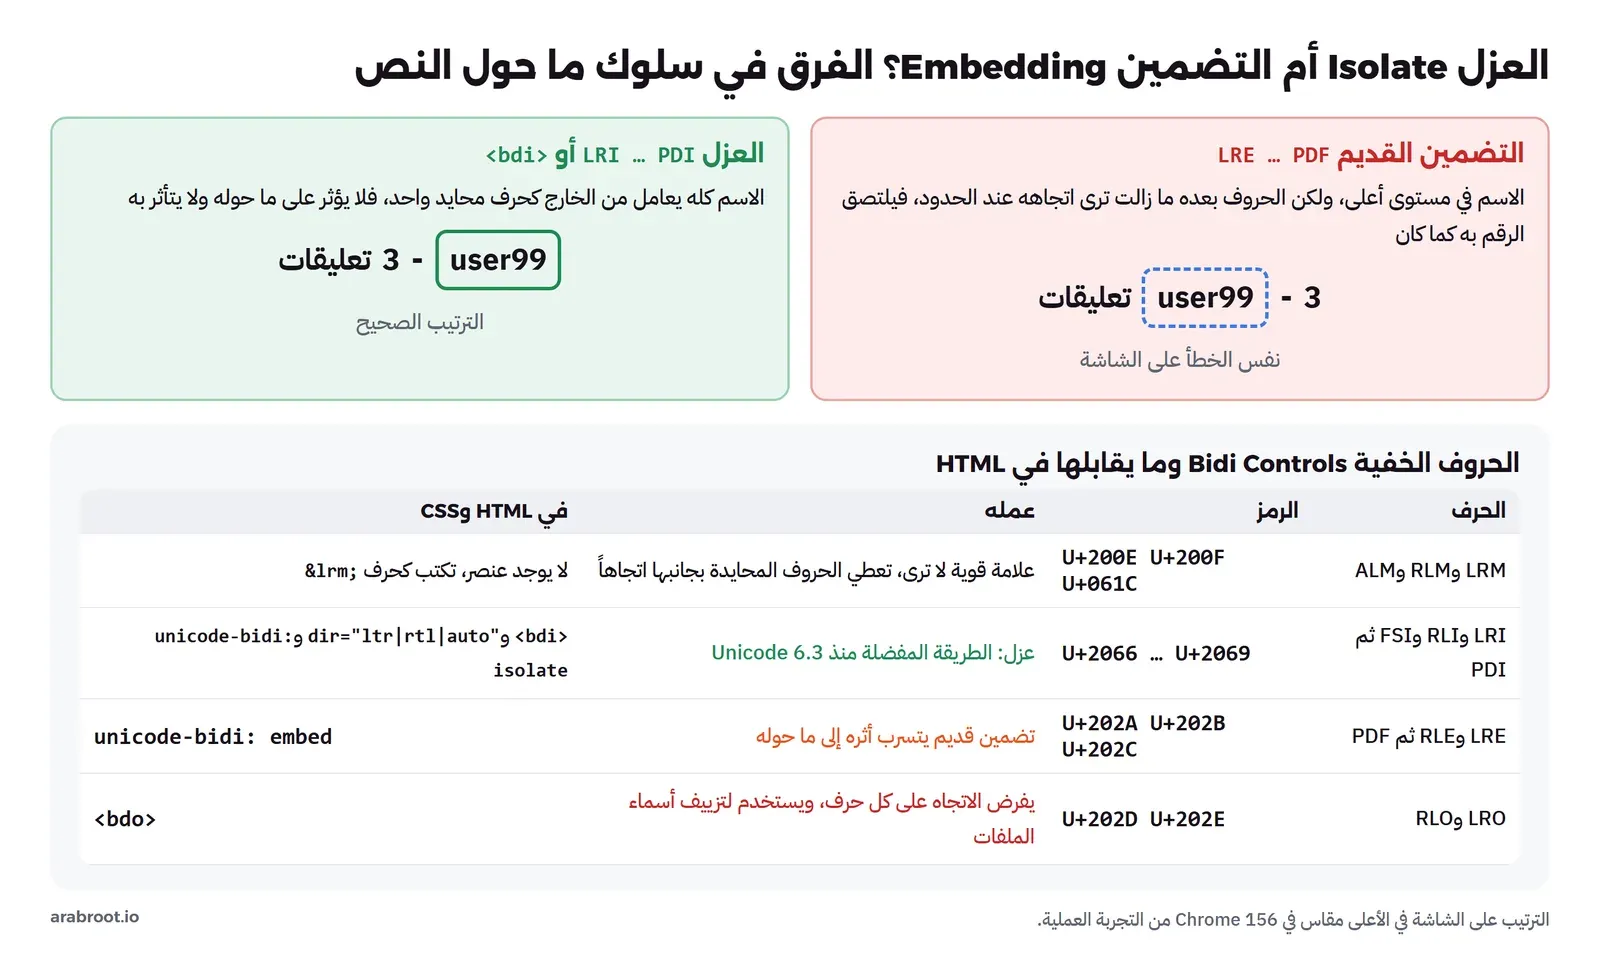
وتبقى العلامات LRM بالرمز U+200E وRLM بالرمز U+200F وALM بالرمز U+061C، وهي حروف قوية لا ترى، فهي لا تفتح صندوقاً وإنما تضع حرفاً قوياً في مكان معين، فتغير اتجاه الحروف المحايدة بجانبها. ومثالها المعروف علامة التعجب في آخر جملة عربية داخل صفحة إنجليزية، فإذا وضعت RLM بعدها أصبحت بين حرفين من نوع R فتأخذ اتجاههما. والعلامات مفيدة في الحالات الصغيرة، ولكن لا تقم ببناء حل كامل عليها، والسبب أن كل حالة جديدة تحتاج علامة في مكان جديد، بينما العزل يحل كل الحالات بقاعدة واحدة. وستجد هذه العلامات في مخرج Intl نفسه كما سيأتي في قسم الأرقام، فمكتبة ICU تضعها في السعر والنسبة المئوية والرقم السالب لتحمي ترتيبها.
مشكلة ظهرت في التجربة: المسار المعزول بقي مقلوباً
عندما عزلنا مسار الملف بالعنصر <bdi dir="ltr"> توقعنا أن ينتهي الأمر، ولكن القياس من الشاشة أظهر أن المسار ما زال يعرض بالشكل /home/sara/2026/تقارير.pdf، أي أن الرقم 2026 انتقل قبل اسم المجلد العربي. والسبب أن العزل حمى المسار من الجملة الخارجية، ولكن داخل الصندوق نفسه ما زالت الخوارزمية تعمل، فالرقم 2026 يسبقه اسم مجلد عربي، فتحول إلى AN بالقاعدة W2، وأصبح هو والمجلد العربي كتلة واحدة من اليمين إلى اليسار. والحل كان أن نعزل كل جزء من المسار وحده، فالمسار يتكون من أجزاء مستقلة تفصلها علامة /، تماماً كما أن الجملة تتكون من كلمات:
<bdi dir="ltr">/<bdi>home</bdi>/<bdi>sara</bdi>/<bdi>تقارير</bdi>/<bdi>2026.pdf</bdi></bdi>وبعد هذا التعديل ظهر المسار على الشاشة بترتيبه الصحيح. ونفس الدرس ينطبق على الروابط URL التي فيها مسارات عربية، وعلى عناوين البريد، وعلى أي نص له بنية داخلية: العزل الخارجي يحمي الجملة، والعزل الداخلي يحمي البنية. وفي الكود يمكنك أن تبني هذا بدالة صغيرة تقسم المسار على / وتعزل كل جزء، بدلاً من كتابته بيدك في كل قالب.
التعليقات التي يكتبها المستخدم والقيمة dir="auto"
في صفحة التعليقات مشكلة من نوع آخر، فالتعليق نفسه قد يكون عربياً أو إنجليزياً، ولا تعرف اتجاه الفقرة مسبقاً. والقيمة dir="auto" تجعل المتصفح يحدد اتجاه الفقرة من أول حرف قوي فيها، وهي مناسبة للتعليقات والرسائل وحقول الإدخال، ولكن انتبه إلى حالة شائعة في المجتمع التقني العربي، وهي التعليق العربي الذي يبدأ بكلمة إنجليزية:
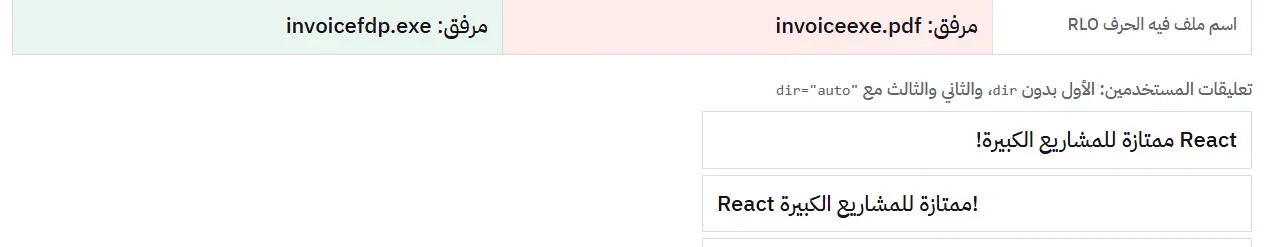
التعليق الثاني في الصورة يبدأ بكلمة React، فحسب Chrome اتجاه الفقرة LTR، فوضع React في أقصى اليسار وعلامة التعجب في أقصى اليمين، والقارئ العربي يرى الجملة مقطعة. وهذا ليس خطأ في المتصفح، فهذا ما تقوله القاعدة P2، ولكنه يعني أن dir="auto" تخمين وليس معرفة. ولهذا إذا كان التطبيق عربياً في الأساس، فالأفضل أن تضع في نموذج التعليق زراً يختار به المستخدم الاتجاه وتحفظه مع التعليق، أو أن تجعل الاتجاه الافتراضي للتعليقات RTL وتستخدم auto فقط في الأماكن التي يغلب عليها الإنجليزية.
الحروف الخفية كأداة للخداع
الحرف RLO، أي Right-to-Left Override بالرمز U+202E، يفرض اتجاه اليمين إلى اليسار على كل حرف بعده مهما كان نوعه، وهذا يعني أنه يستطيع أن يجعل النص يظهر عكس ما هو مخزن تماماً. واستغلال هذا في أسماء الملفات تقنية موثقة في قاعدة MITRE ATT&CK باسم Right-to-Left Override، فالملف المخزن باسم invoice ثم RLO ثم fdp.exe يظهر على الشاشة كأنه invoiceexe.pdf، وهذا ما رأيناه حرفياً في Chrome في التجربة، بينما الدالة endsWith('.exe') في الكود أعادت true، أي أن الكود يعرف الحقيقة والمستخدم يرى غيرها. ولاحظ أن <bdi> لم يحم المستخدم هنا، لأن الحرف الخفي داخل الصندوق نفسه، والحل الوحيد أن تحذف هذه الحروف من أسماء الملفات وأسماء المستخدمين عند الإدخال، أو ترفضها.
الأرقام والعملة: لا تقم بتنسيقها بيدك
التذكرة التالية في القصة كانت عن الأسعار، فقد كتب الفريق السعر بقالب ثابت price + ' ر.س'، فظهر الرقم بأرقام لاتينية وبدون فاصل الآلاف، وانتقلت العملة إلى طرف آخر في بعض الصفحات. والواجهة Intl.NumberFormat تحل كل هذا من بيانات CLDR، وقد طبعنا بها نفس الرقم بعدة وسوم فكانت النتيجة كما يلي:
== 2) numbers
en-US "1,234,567.891"
ar-SA "١٬٢٣٤٬٥٦٧٫٨٩١"
ar-EG "١٬٢٣٤٬٥٦٧٫٨٩١"
ar-MA "1.234.567,891"
ar-SA-u-nu-latn "1,234,567.891"
ar-AE "1,234,567.891"
currency ar-SA "١٬٤٩٩٫٥٠ ر.س."
currency ar-SA-u-nu-latn "1,499.50 ر.س."
currency en-SA "SAR 1,499.50"
percent ar-SA "١٥٪"
compact ar-SA "٢٫٥ مليون"
compact ar-SA long "٢٫٥ مليون"
negative ar-SA "-٤٢"
codepoints of ar-SA 15% "U+0661 U+0665 U+066A U+061C"في المخرج أعلاه لاحظ التالي:
- الوسم
ar-SAكتب الرقم بالأرقام العربية الهندية، وفاصل الآلاف فيه ليس الفاصلة العادية وإنما الحرف٬بالرمز U+066C، والفاصلة العشرية هي الحرف٫بالرمز U+066B كما يظهر في آخر سطر من القسم السابع في التجربة، وهذا مهم لأن أي كود يحاول قراءة هذا النص كرقم سوف يفشل. - الوسم
ar-MAاستخدم النقطة لفاصل الآلاف والفاصلة للكسور، أي عكس السعودية تماماً، ولو كتبت الفواصل بيدك لكان الرقم خاطئاً في واحدة من الدولتين. - الوسم
ar-AEكتب الرقم بالأرقام اللاتينية، فاختيار الأرقام في بيانات CLDR يختلف بين الدول العربية، ولذلك لا تفترض أن «العربية» تعني الأرقام العربية الهندية. - السعر بالعملة
SARظهر بالرمزر.س.بعد الرقم، وفي بدايته ونهايته حرف خفي هو RLM، وهو ما تحدثنا عنه في القسم السابق، فمكتبة ICU تحمي ترتيب السعر داخل الجمل. وفي الوسمen-SAظهرت العملةSARقبل الرقم، فمكان رمز العملة جزء من التوطين وليس من الترجمة. - النسبة المئوية استخدمت الحرف
٪بالرمز U+066A ثم الحرف الخفي ALM بالرمز U+061C كما يبين سطر الرموز، والرقم السالب بدأ أيضاً بالحرف ALM قبل علامة السالب، حتى لا تنتقل العلامة إلى الطرف الآخر من الرقم. - الصيغة المختصرة
compactكتبت «٢٫٥ مليون»، وهي مناسبة للوحات المؤشرات Dashboards والأرقام الكبيرة في الواجهة.
وهنا قرار منتج يجب أن يتخذه الفريق صراحة: الأرقام العربية الهندية أم اللاتينية؟ والتقنية تدعم الاثنين بنفس السهولة، فالامتداد -u-nu-latn أعطى نفس التنسيق السعودي بالأرقام اللاتينية. والمهم ألا يترك القرار للصدفة، فلا تختلط الأرقام في نفس الشاشة، ولا يظهر السعر بالأرقام العربية الهندية في صفحة المنتج وباللاتينية في الفاتورة. وأياً كان قرارك، فالرقم يحفظ في قاعدة البيانات رقماً، وليس نصاً منسقاً، والتنسيق يحدث عند العرض فقط، والسبب أن النص المنسق لا يمكن جمعه ولا ترتيبه ولا تحويله إلى Locale آخر، وأن الفاتورة التي ترسل بالبريد قد تحتاج أرقاماً غير التي في الواجهة.
التاريخ والتقويم الهجري: احفظ UTC ونسق عند العرض
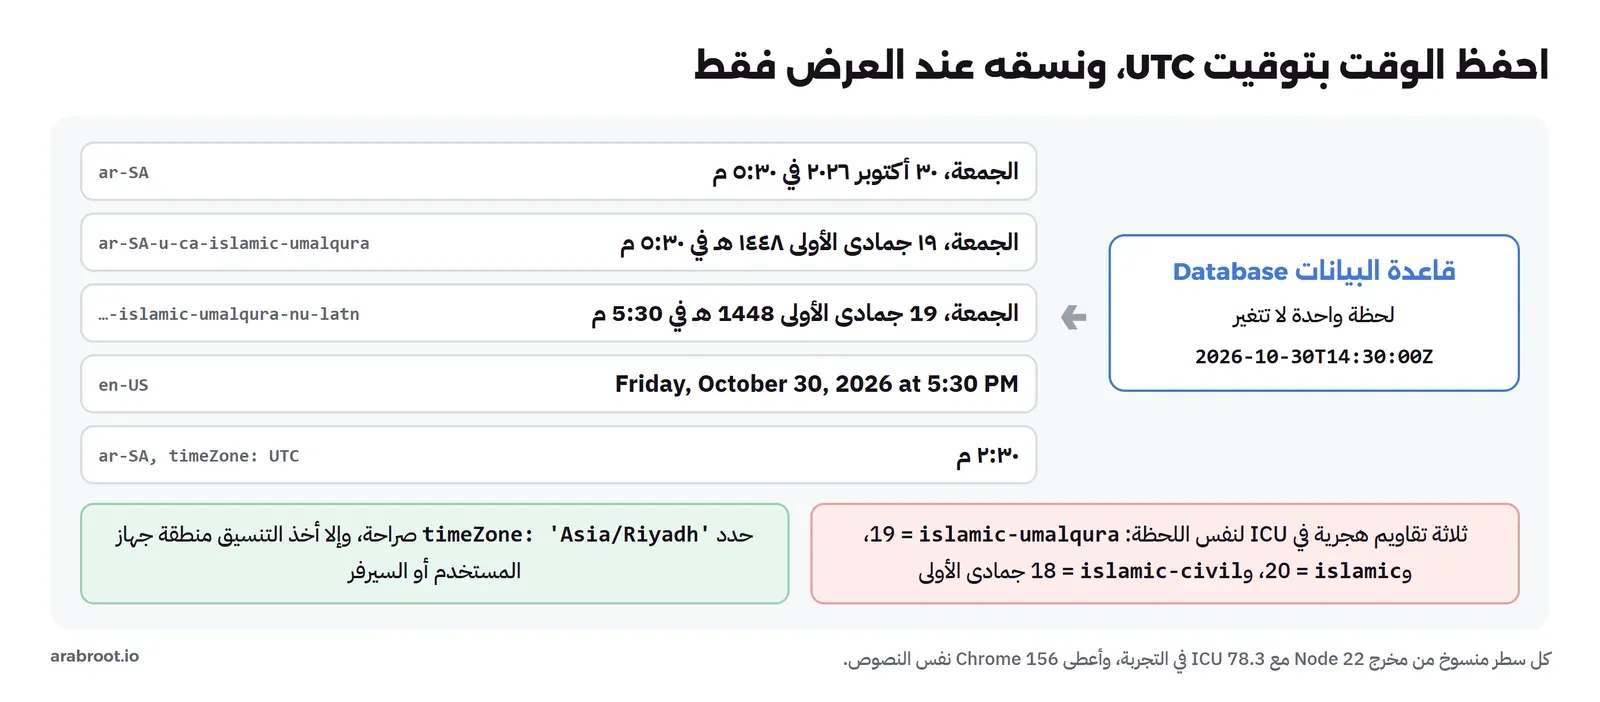
مواعيد الدورات في المنصة كانت تحفظ كنص منسق باللغة الإنجليزية، فلما جاءت الواجهة العربية اضطر الفريق إلى تحويل النص إلى تاريخ ثم تنسيقه من جديد، وظهرت أخطاء في المواعيد التي تقع قرب منتصف الليل. والقاعدة التي تمنع هذا كله هي أن تحفظ اللحظة نفسها بتوقيت UTC، أي 2026-10-30T14:30:00Z، ثم تنسقها عند العرض بالـ Locale والمنطقة الزمنية Time Zone الخاصة بالمستخدم، وهذا ما تقوم به الواجهة Intl.DateTimeFormat. وقد نسقنا في التجربة لحظة واحدة بعدة وسوم وتقاويم، فكانت النتيجة كما يلي:
== 3) dates
iso (stored)               "2026-10-30T14:30:00.000Z"
ar-SA                      "الجمعة، ٣٠ أكتوبر ٢٠٢٦ في ٥:٣٠ م"
ar-SA-u-ca-gregory         "الجمعة، ٣٠ أكتوبر ٢٠٢٦ في ٥:٣٠ م"
ar-SA-u-ca-islamic-umalqura "الجمعة، ١٩ جمادى الأولى ١٤٤٨ هـ في ٥:٣٠ م"
ar-SA-u-ca-islamic-umalqura-nu-latn "الجمعة، 19 جمادى الأولى 1448 هـ في 5:30 م"
ar-EG                      "الجمعة، ٣٠ أكتوبر ٢٠٢٦ في ٥:٣٠ م"
en-US                      "Friday, October 30, 2026 at 5:30 PM"
islamic (civil?)           "٢٠ جمادى الأولى ١٤٤٨ هـ"
islamic-civil              "١٨ جمادى الأولى ١٤٤٨ هـ"
umalqura parts             "month=5 day=19 year=1448 era=AH"
same instant UTC           "٢:٣٠ م"
hour12 ar-SA               "٥:٣٠ م"
في المخرج أعلاه لاحظ التالي:
- اللحظة المحفوظة هي الساعة 14:30 بتوقيت UTC، وقد ظهرت في كل الأسطر الساعة 5:30 مساءً لأننا حددنا
timeZone: 'Asia/Riyadh'، أما السطرsame instant UTCفطلب نفس اللحظة بتوقيت UTC فظهرت ٢:٣٠ م. ولو لم نحدد المنطقة الزمنية لأخذ التنسيق منطقة الجهاز الذي يعمل عليه الكود، وهي على السيرفر غالباً UTC، وفي متصفح المستخدم منطقة جهازه. - الوسم
ar-SAوحده أعطى التاريخ الميلادي، والوسم مع-u-ca-islamic-umalquraأعطى «١٩ جمادى الأولى ١٤٤٨ هـ» لنفس اللحظة، وأسماء الأيام والأشهر وكلمة «في» و«م» كلها من بيانات CLDR. - ظهر في بيانات ICU ثلاثة تقاويم هجرية، وأعطت لنفس اللحظة ثلاثة أيام مختلفة:
islamic-umalquraأعطى 19، وislamicأعطى 20، وislamic-civilأعطى 18.
وسبب الاختلاف في التقاويم الهجرية أنها ليست تقويماً واحداً، فوثائق IslamicCalendar في ICU تشرح أن التقويم المدني islamic-civil يستخدم دورة ثابتة من أشهر طولها 29 و30 يوماً، فيمكن حسابه مسبقاً، أما التقويم الديني وتقويم أم القرى الذي تستخدمه السعودية فيعتمدان على رؤية الهلال أو حسابه، ولذلك قد يختلفان عن التقويم المدني بعدة أيام. والنتيجة العملية أن المنتج الذي يستهدف المستخدم في السعودية يجب أن يحدد islamic-umalqura صراحة، وليس islamic، والسبب أن الفرق بينهما يوم كامل في مثالنا، وهو فرق كاف ليصل موعد الدورة في يوم غير الذي يتوقعه العميل. والصورة التالية تلخص الفكرة:
وفي هذا القسم شيئان آخران. الأول أن التقويم الافتراضي لكل Locale جزء من بيانات CLDR، وهذه البيانات تتغير بين الإصدارات، ولذلك لا تعتمد على أن ar-SA سوف يعطي التقويم الميلادي أو الهجري، وإنما حدد التقويم دائماً بالامتداد ca أو بالخيار calendar في الدالة. والثاني أن التقويم يؤثر على حدود اليوم والشهر في التقارير، فإذا كانت الإدارة تريد تقرير مبيعات «شهر رمضان» فالمطلوب أن تحسب بداية الشهر ونهايته بتقويم أم القرى وبتوقيت السعودية، ثم تحولهما إلى UTC وتستعلم بهما قاعدة البيانات، وليس العكس. وفي المستقبل سوف يسهل الكائن Temporal في JavaScript هذا النوع من الحسابات، لأنه يدعم التقاويم والمناطق الزمنية في الحساب نفسه وليس في التنسيق فقط، فراجع دعم المتصفحات له قبل الاعتماد عليه.
التاريخ النسبي والقوائم
جزء كبير من أي واجهة هو التاريخ النسبي مثل «قبل 3 ساعات» و«أمس»، والقوائم مثل «أحمد وسارة وليلى»، وكلاهما يبنيه المطورون عادة بجمع النصوص فيخطئ في العربية. والواجهة Intl.RelativeTimeFormat تعرف أن اليوم السابق «أمس» واليوم الذي قبله «أول أمس»، وأن الأسبوعين «أسبوعين» وليس «2 أسابيع»، وIntl.ListFormat تعرف أن «و» في العربية تلتصق بالكلمة التالية بدون مسافة، كما ترى في القسم السادس من التجربة. ولاحظ في نفس القسم أن «قبل 3 ساعات» ظهرت بالأرقام اللاتينية، والسبب أننا استخدمنا الوسم ar وحده، وقد رأينا في القسم الأول أنه يختار latn، فلو استخدمنا ar-SA لظهرت بالأرقام العربية الهندية، وهذا يعني أن خلط الوسوم بين أجزاء التطبيق ينتج شاشة فيها نوعان من الأرقام. فاجعل الـ Locale قيمة واحدة تمر لكل دوال التنسيق، ولا تكتب الوسم بيدك في كل مكان.
صيغ الجمع: لماذا ظهرت «ملفات 2»؟
الكود الذي كتب «ملفات 2» كان يشبه هذا السطر الذي تجده في أغلب المشاريع التي بدأت بالإنجليزية:
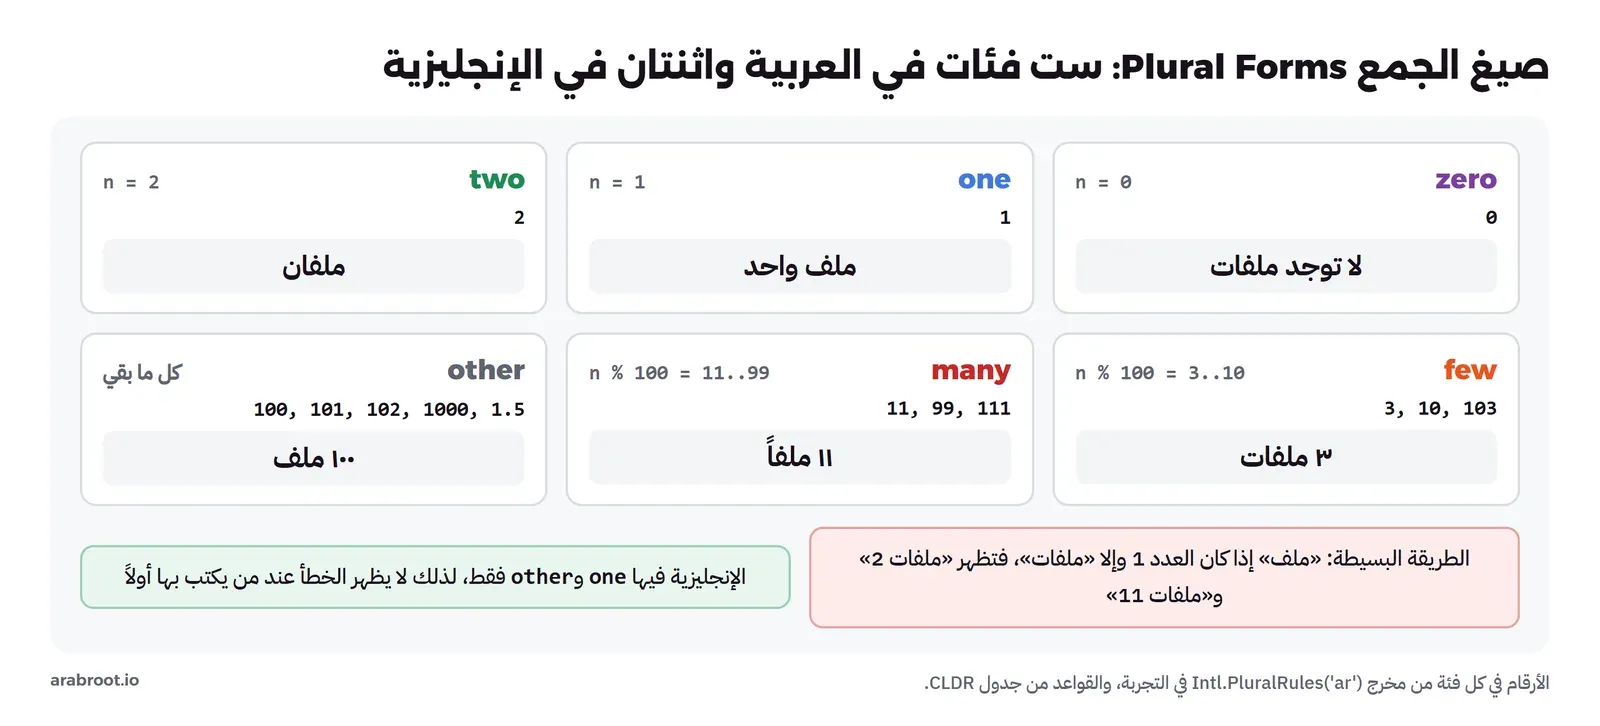
const label = (n === 1 ? 'ملف' : 'ملفات') + ' ' + n;وهذا السطر صحيح في الإنجليزية لأن فيها فئتين فقط للجمع، المفرد وكل ما عداه، ولكن العربية فيها ست فئات حسب جدول قواعد الجمع في CLDR: صفر zero، ومفرد one، ومثنى two، وقليل few للأعداد التي باقي قسمتها على 100 من 3 إلى 10، وكثير many للأعداد التي باقي قسمتها على 100 من 11 إلى 99، وفئة أخرى other لكل ما بقي مثل 100 و1000 والأعداد العشرية. والواجهة Intl.PluralRules لا تترجم شيئاً، وإنما تخبرك بالفئة التي ينتمي إليها العدد، ثم تختار أنت الجملة المناسبة لهذه الفئة من ملف الترجمة. وقد سألناها في التجربة عن مجموعة أعداد:
== 4) plural categories
ar categories              ["few","many","one","two","zero","other"]
en categories              ["one","other"]
0      zero
1      one
2      two
3      few
10     few
11     many
99     many
100    other
101    other
102    other
103    few
111    many
1000   other
1.5    other
لاحظ أن 103 عادت إلى الفئة few مثل 3، لأن القاعدة تنظر إلى باقي القسمة على 100، فالعربي يقول «103 ملفات» كما يقول «3 ملفات»، وأن 111 عادت إلى many مثل 11، وأن 100 و101 و102 في الفئة other، فنقول «100 ملف» و«101 ملف» و«102 ملف» عند كتابة الرقم بالأرقام، وأن العدد العشري 1.5 في other. والصورة التالية تجمع الفئات الست مع الجملة التي اخترناها لكل فئة:
ثم بنينا من هذه الفئات رسالة كاملة، والمهم في الكود أن الجملة كلها في ملف الترجمة، بما فيها مكان الرقم، وليس الكلمة فقط:
== 5) a message per category
0    لا توجد ملفات
1    ملف واحد
2    ملفان
3    ٣ ملفات
11   ١١ ملفاً
100  ١٠٠ ملف
102  ١٠٢ ملف
naive 11 -> ملفات 11 | naive 2 -> ملفات 2
والسطر الأخير يبين ما كانت تعرضه المنصة قبل الإصلاح. ولاحظ أن الفئة two لا تحتاج الرقم أصلاً، فالعربي يقول «ملفان» ولا يقول «2 ملفان»، وأن zero جملة مختلفة تماماً، وهذا ما لا يمكن الوصول إليه بإضافة لاحقة إلى كلمة.
ملفات الترجمة Message Catalogs والجمل المركبة
في التطبيقات الحقيقية لا تكتب الجمل في الكود كما فعلنا في التجربة، وإنما في ملفات ترجمة Message Catalogs، ملف لكل لغة، وكل جملة لها مفتاح ثابت. والصيغة الأكثر انتشاراً لوصف الجمل التي فيها جمع أو اختيار هي ICU MessageFormat، وتستخدمها مكتبات مثل FormatJS، وشكل الجملة السابقة فيها كما يلي:
{count, plural,
  zero {لا توجد ملفات}
  one {ملف واحد}
  two {ملفان}
  few {# ملفات}
  many {# ملفاً}
  other {# ملف}
}
والعلامة # هي مكان الرقم بعد تنسيقه حسب الـ Locale. أما مكتبة i18next فتستخدم طريقة مختلفة، فهي تضيف لاحقة الفئة إلى المفتاح، مثل files_zero وfiles_few، وتعتمد في اختيار الفئة على Intl.PluralRules نفسها كما تذكر وثائق الجمع فيها، ولذلك إذا كان التطبيق يعمل في بيئة لا تدعم Intl.PluralRules فالجمع العربي لن يعمل فيها. وهناك مقترح في TC39 لإضافة Intl.MessageFormat إلى JavaScript نفسها، وما زال في المرحلة الأولى Stage 1، فلا تعتمد عليه الآن.
وأياً كانت المكتبة، فهناك أخطاء في بناء الجمل يقع فيها الفريق مرة واحدة على الأقل:
- جمع الجملة من قطع: مثل
t('you_have') + n + t('files')، والسبب في أنه خطأ أن ترتيب الكلمات يختلف بين اللغات، والمترجم يرى قطعاً لا يعرف كيف تجتمع، فاكتب الجملة كاملة بمتغيراتها في مفتاح واحد. - إعادة استخدام كلمة في سياقين: كلمة Open في الإنجليزية قد تكون «افتح» على زر و«مفتوح» على حالة طلب، فاجعل لكل سياق مفتاحاً، واكتب للمترجم ملاحظة عن مكان ظهوره.
- تجاهل التذكير والتأنيث: الرسالة «قام X بالتعليق» تصبح «قامت» للمستخدمة، والصيغة
selectفي ICU MessageFormat تختار الجملة حسب قيمة متغير مثل الجنس، وإذا لم يكن الجنس معروفاً فاكتب الجملة بصيغة لا تحتاجه، مثل «تعليق جديد من X». - نسيان العزل داخل الجملة المترجمة: اسم المستخدم داخل جملة مترجمة يحتاج عزلاً مثل أي مكان آخر، فاجعل دالة التنسيق تعزل كل متغير نصي تلقائياً، بدلاً من الاعتماد على كل مطور في كل قالب.
ترتيب الأسماء العربية والبحث فيها
شكوى البحث في القصة كانت أن «احمد» لا يجد «أحمد»، وشكوى أخرى أن قائمة المدربين مرتبة بشكل غريب. والسبب في الثانية أن الدالة sort() بدون مقارن ترتب حسب رموز UTF-16، فتأتي الحروف اللاتينية الكبيرة قبل الصغيرة، ثم الحروف العربية حسب رموزها، فتأتي «آمنة» قبل «أحمد»، وتنفصل «أحمد» عن «احمد» فيقع بينهما «إبراهيم» و«ابراهيم». والواجهة Intl.Collator ترتب حسب خوارزمية الترتيب في UTS #10 وبيانات اللغة، ومخرجها في القسم السادس من التجربة يبين الفرق: الأسماء العربية أولاً لأن الـ Locale عربي، و«إبراهيم» بجانب «ابراهيم»، و«أحمد» بجانب «احمد»، ثم الأسماء الإنجليزية بدون تفريق بين الحرف الكبير والصغير.
أما البحث فيحتاج شيئاً إضافياً، وهو مستوى الحساسية Sensitivity، فالمقارن الافتراضي يعتبر «أحمد» و«احمد» مختلفين وإن رتبهما متجاورين، أما الخيار sensitivity: 'base' فيقارن الحروف الأساسية فقط، فأعاد true للمقارنة بينهما. وهذا يكفي للمقارنة داخل المتصفح في قائمة صغيرة، أما البحث في قاعدة البيانات فيحتاج توحيد النص Normalization عند الحفظ والبحث، مثل توحيد أشكال الهمزة وحذف التطويل، وهذا موضوع خاص بمحركات البحث يستحق مقالاً مستقلاً.
الأرقام التي يكتبها المستخدم
آخر تذكرة كانت عن العميل الذي كتب رقم جواله بالأرقام العربية الهندية، ولوحة المفاتيح العربية في بعض الأجهزة تكتب هذه الأرقام افتراضياً، فرفض النموذج الرقم. والسبب ظاهر في القسم السابع من التجربة:
== 7) parsing user digits
"٠٥٠١٢٣٤٥٦٧"     Number= NaN parseInt= NaN toAscii= "0501234567"
"۰۵۰۱۲۳۴۵۶۷"     Number= NaN parseInt= NaN toAscii= "0501234567"
"١٬٢٣٤٫٥"        Number= NaN parseInt= NaN toAscii= "1٬234٫5"
\d matches ٣ ?             false
\d with u flag ?           false
\p{Nd} matches ٣ ?         true
ar-SA separators           ["group=U+66C","decimal=U+66B"]
في المخرج أعلاه لاحظ التالي:
NumberوparseIntأعاداNaNللأرقام العربية الهندية وللأرقام الفارسية۰۵۰، وهي أرقام لها رموز أخرى من U+06F0 إلى U+06F9 يكتبها بعض المستخدمين إذا كانت لوحة مفاتيحهم فارسية أو أردية.- التعبير
\dفي JavaScript لا يطابق٣حتى مع العلامةu، لأنه يعني 0 إلى 9 فقط، ولذلك يفشل أي تحقق Validation بتعبير مثل/^05\d{8}$/، أما الفئة\p{Nd}في تعبيرات Unicode فتطابق كل الأرقام العشرية في كل الأنظمة. - الدالة
toAsciiحولت الرقم إلى0501234567فأصبح صالحاً، ولكنها في السطر الثالث حولت الأرقام فقط وتركت فاصل الآلاف٬والفاصلة العشرية٫كما هما، فالمبلغ «١٬٢٣٤٫٥» يحتاج أيضاً تحويل هذين الحرفين قبل قراءته، وقد طبعنا رمزيهما في السطر الأخير.
والقاعدة هنا أن تقبل الأرقام بأي نظام يكتبه المستخدم، ثم تحولها إلى الأرقام اللاتينية في أول نقطة تستقبلها، أي في المتصفح قبل التحقق، وفي السيرفر مرة أخرى قبل الحفظ، والسبب أن السيرفر لا يستطيع الاعتماد على تحقق المتصفح أصلاً، وأن الطلب قد يأتي من تطبيق جوال أو من API مباشرة. وفي حقول الأرقام استخدم inputmode="numeric" لتظهر لوحة الأرقام على الجوال، ولا تحاول منع المستخدم من كتابة الأرقام العربية، فهي ليست خطأ منه.
التجربة العملية Lab: في Node.js ثم في Chrome
التجربة من ثلاثة ملفات في المجلد lab بجانب المقال: الملف intl.mjs يطبع نتيجة كل دالة من دوال Intl ويعمل بدون تعديل في Node.js وفي المتصفح، والصفحة bidi.html فيها جدول بكل حالات النص المختلط قبل العزل وبعده، والملف visual.mjs يفتح الصفحة في Chrome ويقيس مكان كل حرف على الشاشة ليطبع الترتيب المرئي. ولا تحتاج التجربة إلى أي مكتبة، فكل ما فيها من الواجهات المدمجة في JavaScript.
الجزء الأول: Intl في Node.js
الملف intl.mjs كاملاً كما يلي:
// Intl lab for the i18n-l10n-arabic article. Runs in Node (node intl.mjs) and, pasted as a script, in Chrome.
// Every section prints real output from the ICU data the runtime ships with.
const out = [];
const log = (...a) => out.push(a.join(' '));
const show = (label, v) => log(label.padEnd(26), JSON.stringify(v));

if (typeof process !== 'undefined' && process.versions) {
  log('== 0) runtime');
  show('node', process.versions.node);
  show('icu', process.versions.icu);
  show('unicode', process.versions.unicode);
  show('cldr', process.versions.cldr);
  show('tz', process.versions.tz);
}

log('== 1) locale tags');
for (const tag of ['ar', 'ar-SA', 'ar-EG', 'ar-MA', 'ar-SA-u-nu-latn', 'ar-SA-u-ca-islamic-umalqura']) {
  const l = new Intl.Locale(tag);
  const r = new Intl.NumberFormat(tag).resolvedOptions();
  const d = new Intl.DateTimeFormat(tag).resolvedOptions();
  log(tag.padEnd(28), 'numberingSystem=' + r.numberingSystem, 'calendar=' + d.calendar, 'max=' + l.maximize().toString());
}

log('== 2) numbers');
const n = 1234567.891;
for (const tag of ['en-US', 'ar-SA', 'ar-EG', 'ar-MA', 'ar-SA-u-nu-latn', 'ar-AE']) show(tag, new Intl.NumberFormat(tag).format(n));
show('currency ar-SA', new Intl.NumberFormat('ar-SA', { style: 'currency', currency: 'SAR' }).format(1499.5));
show('currency ar-SA-u-nu-latn', new Intl.NumberFormat('ar-SA-u-nu-latn', { style: 'currency', currency: 'SAR' }).format(1499.5));
show('currency en-SA', new Intl.NumberFormat('en-SA', { style: 'currency', currency: 'SAR' }).format(1499.5));
show('percent ar-SA', new Intl.NumberFormat('ar-SA', { style: 'percent' }).format(0.15));
show('compact ar-SA', new Intl.NumberFormat('ar-SA', { notation: 'compact' }).format(2500000));
show('compact ar-SA long', new Intl.NumberFormat('ar-SA', { notation: 'compact', compactDisplay: 'long' }).format(2500000));
show('negative ar-SA', new Intl.NumberFormat('ar-SA').format(-42));
show('codepoints of ar-SA 15%', [...new Intl.NumberFormat('ar-SA', { style: 'percent' }).format(0.15)].map(c => 'U+' + c.codePointAt(0).toString(16).toUpperCase().padStart(4, '0')).join(' '));

log('== 3) dates');
const t = new Date(Date.UTC(2026, 9, 30, 14, 30, 0)); // 2026-10-30T14:30:00Z
show('iso (stored)', t.toISOString());
const full = { dateStyle: 'full', timeStyle: 'short', timeZone: 'Asia/Riyadh' };
for (const tag of ['ar-SA', 'ar-SA-u-ca-gregory', 'ar-SA-u-ca-islamic-umalqura', 'ar-SA-u-ca-islamic-umalqura-nu-latn', 'ar-EG', 'en-US']) show(tag, new Intl.DateTimeFormat(tag, full).format(t));
show('islamic (civil?)', new Intl.DateTimeFormat('ar-SA-u-ca-islamic', { dateStyle: 'long', timeZone: 'Asia/Riyadh' }).format(t));
show('islamic-civil', new Intl.DateTimeFormat('ar-SA-u-ca-islamic-civil', { dateStyle: 'long', timeZone: 'Asia/Riyadh' }).format(t));
show('umalqura parts', new Intl.DateTimeFormat('en-u-ca-islamic-umalqura', { year: 'numeric', month: 'numeric', day: 'numeric', timeZone: 'Asia/Riyadh' }).formatToParts(t).filter(p => p.type !== 'literal').map(p => p.type + '=' + p.value).join(' '));
show('same instant UTC', new Intl.DateTimeFormat('ar-SA', { timeStyle: 'short', timeZone: 'UTC' }).format(t));
show('hour12 ar-SA', new Intl.DateTimeFormat('ar-SA', { hour: 'numeric', minute: '2-digit', timeZone: 'Asia/Riyadh' }).format(t));

log('== 4) plural categories');
const pr = new Intl.PluralRules('ar');
show('ar categories', pr.resolvedOptions().pluralCategories);
show('en categories', new Intl.PluralRules('en').resolvedOptions().pluralCategories);
for (const k of [0, 1, 2, 3, 10, 11, 99, 100, 101, 102, 103, 111, 1000, 1.5]) log(String(k).padEnd(6), pr.select(k));

log('== 5) a message per category');
const files = { zero: 'لا توجد ملفات', one: 'ملف واحد', two: 'ملفان', few: '{n} ملفات', many: '{n} ملفاً', other: '{n} ملف' };
const nf = new Intl.NumberFormat('ar-SA');
const msg = (k) => files[pr.select(k)].replace('{n}', nf.format(k));
for (const k of [0, 1, 2, 3, 11, 100, 102]) log(String(k).padEnd(4), msg(k));
const naive = (k) => (k === 1 ? 'ملف' : 'ملفات') + ' ' + k;
log('naive 11 ->', naive(11), '| naive 2 ->', naive(2));

log('== 6) relative time, lists, sorting');
const rtf = new Intl.RelativeTimeFormat('ar', { numeric: 'auto' });
for (const [v, u] of [[-1, 'day'], [1, 'day'], [-2, 'day'], [-3, 'hour'], [-11, 'minute'], [2, 'week']]) show(`${v} ${u}`, rtf.format(v, u));
show('list and', new Intl.ListFormat('ar', { type: 'conjunction' }).format(['أحمد', 'Sara', 'ليلى']));
show('list or', new Intl.ListFormat('ar', { type: 'disjunction' }).format(['بطاقة', 'Apple Pay', 'تحويل']));
const names = ['يوسف', 'أحمد', 'إبراهيم', 'احمد', 'آمنة', 'ابراهيم', 'زياد', 'Zaid', 'adam', 'عمر'];
show('default sort()', [...names].sort());
show('Collator ar', [...names].sort(new Intl.Collator('ar').compare));
const base = new Intl.Collator('ar', { sensitivity: 'base' });
show('أحمد == احمد base', base.compare('أحمد', 'احمد') === 0);
show('أحمد == احمد default', new Intl.Collator('ar').compare('أحمد', 'احمد') === 0);

log('== 7) parsing user digits');
const toAscii = (s) => s.replace(/[٠-٩]/g, d => d.charCodeAt(0) - 0x0660).replace(/[۰-۹]/g, d => d.charCodeAt(0) - 0x06F0);
for (const s of ['٠٥٠١٢٣٤٥٦٧', '۰۵۰۱۲۳۴۵۶۷', '١٬٢٣٤٫٥']) log(JSON.stringify(s).padEnd(16), 'Number=', Number(s), 'parseInt=', parseInt(s, 10), 'toAscii=', JSON.stringify(toAscii(s)));
show('\\d matches ٣ ?', /\d/.test('٣'));
show('\\d with u flag ?', /\d/u.test('٣'));
show('\\p{Nd} matches ٣ ?', /\p{Nd}/u.test('٣'));
const parts = new Intl.NumberFormat('ar-SA').formatToParts(1234.5);
show('ar-SA separators', parts.filter(p => p.type === 'group' || p.type === 'decimal').map(p => p.type + '=U+' + p.value.codePointAt(0).toString(16).toUpperCase()));

log('== 8) bidi control characters in user input');
const BIDI_CONTROLS = /[\u061C\u200E\u200F\u202A-\u202E\u2066-\u2069]/g;
const upload = 'invoice\u202Efdp.exe';
show('name (controls shown)', upload.replace(BIDI_CONTROLS, c => '<U+' + c.codePointAt(0).toString(16).toUpperCase() + '>'));
show('length', upload.length);
show('endsWith(".exe")', upload.endsWith('.exe'));
show('controls found', (upload.match(BIDI_CONTROLS) || []).map(c => 'U+' + c.codePointAt(0).toString(16).toUpperCase()));
show('cleaned', upload.replace(BIDI_CONTROLS, ''));
const isolate = (s) => '\u2068' + s.replace(BIDI_CONTROLS, '') + '\u2069';
show('isolated for display', [...isolate('user99')].map(c => c.codePointAt(0) > 127 ? 'U+' + c.codePointAt(0).toString(16).toUpperCase() : c).join(' '));

if (typeof module === 'undefined' && typeof window !== 'undefined') window.__out = out.join('\n');
else console.log(out.join('\n'));
ونشغله في Container من Image رسمي صغير لـ Node.js 22، ثم يحذف Docker الـ Container تلقائياً بعد انتهائه بالخيار --rm:
docker run --rm --name sfe-i18n-node -v "$PWD:/lab" -w /lab node:22-alpine node intl.mjs > node-output.txtوالمخرج يبدأ بإصدارات البيئة، وهي أهم سطور التجربة لأن كل ما بعدها يعتمد عليها:
== 0) runtime
node                       "22.23.4"
icu                        "78.3"
unicode                    "17.0"
cldr                       "48.0"
tz                         "2026e"
كل نتائج Intl تأتي من مكتبة ICU المدمجة في Node.js، وإصدارها هنا 78.3، ومعها بيانات CLDR 48.0 وUnicode 17.0 وقاعدة المناطق الزمنية 2026e، وإذا شغلت نفس الملف على إصدار آخر من Node.js فقد تختلف بعض النصوص، مثل التقويم الافتراضي أو شكل رمز العملة، لأن بيانات CLDR تتغير. ولهذا اطبع process.versions.icu في أي تقرير خطأ يتعلق بالتنسيق، ولاحظ أن وثائق Node.js تذكر أن بعض طرق بناء Node.js تأتي ببيانات ICU مختصرة لا تحتوي إلا الإنجليزية، فإذا رأيت العربية تخرج بتنسيق إنجليزي في بيئة معينة فهذا أول ما تتحقق منه. وقد مررنا على بقية الأقسام في أماكنها من المقال، وبقي القسم الثامن عن الحروف الخفية في مدخلات المستخدم:
== 8) bidi control characters in user input
name (controls shown)      "invoice<U+202E>fdp.exe"
length                     15
endsWith(".exe")           true
controls found             ["U+202E"]
cleaned                    "invoicefdp.exe"
isolated for display       "U+2068 u s e r 9 9 U+2069"
طول الاسم 15 حرفاً مع أن المرئي منه 14، والحرف الزائد هو RLO كما يبين السطر controls found، والدالة endsWith('.exe') أكدت أن الملف تنفيذي، وبعد حذف الحروف الخفية ظهر الاسم الحقيقي invoicefdp.exe. والسطر الأخير يبين شكل اسم المستخدم بعد الدالة isolate، فهو محاط بالحرفين U+2068 وU+2069، أي FSI وPDI، وهذا هو الشكل الذي ترسله في نص إشعار أو رسالة SMS.
الجزء الثاني: نفس الكود في Chrome، ثم العرض على الشاشة
الملف chrome.mjs يشغل Chrome بدون واجهة Headless عبر بروتوكول DevTools، ويفتح الصفحة bidi.html، ثم ينفذ نفس الملف intl.mjs داخل الصفحة ويحفظ مخرجه، ثم يلتقط صور الجدول. وأول ما فعلناه هو مقارنة مخرج المتصفح بمخرج Node.js بعد حذف سطور الإصدارات:
node lab/chrome.mjs
tail -n +7 node-output.txt > node.txt
tail -n +2 chrome-output.txt > chrome.txt
diff node.txt chrome.txt
والمخرج سوف يكون كما يلي:
37c37
< ar categories              ["few","many","one","two","zero","other"]
---
> ar categories              ["zero","one","two","few","many","other"]
كل النصوص المنسقة متطابقة بين Node.js 22 وChrome 156، فالأرقام والتواريخ والتقاويم الهجرية الثلاثة والترتيب والجمع أعطت نفس الحروف، والفرق الوحيد هو ترتيب أسماء الفئات في resolvedOptions().pluralCategories، فقد أعادها Node.js بترتيب أبجدي تقريباً، وأعادها Chrome بالترتيب الطبيعي من zero إلى other. والسبب تعديل في المعيار ECMA-402 جعل هذا الترتيب محدداً في التعديل رقم 918، وقد طبقه محرك V8 الأحدث في Chrome، أما V8 في Node.js 22 فأقدم منه. والدرس العملي أن هذه القائمة تصلح لمعرفة الفئات المتاحة، ولكن لا تقم ببناء واجهة المترجم أو أعمدة ملف الترجمة على ترتيبها، والسبب أنه اختلف أمامك بين بيئتين في نفس اليوم.
بعد ذلك صورنا جدول الحالات في الصفحة، وفي كل سطر النص بدون عزل في العمود الأوسط، ونفس النص بعد العزل في العمود الأيسر، والخلفية الحمراء للخطأ والخضراء للإصلاح:
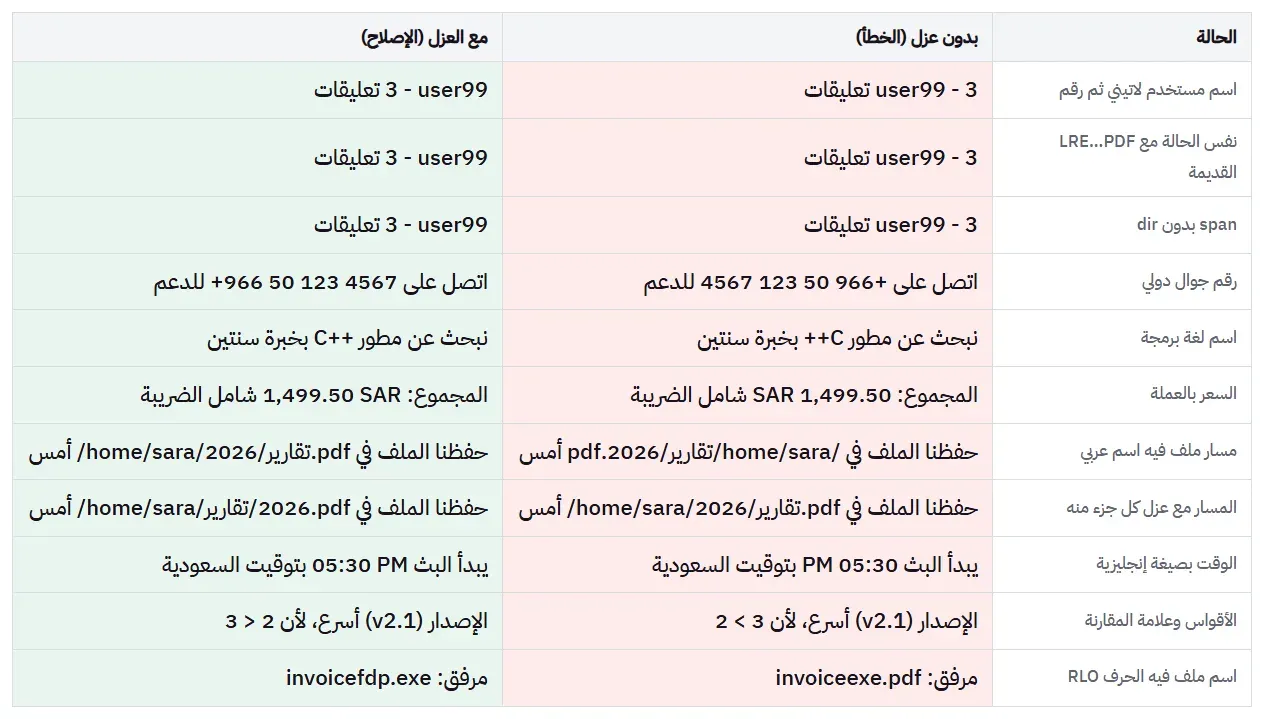
ولأن الصورة وحدها لا تكفي للتأكد من الترتيب، خاصة مع الأرقام والعلامات، كتبنا visual.mjs ليقيس موقع كل حرف على الشاشة بالدالة getBoundingClientRect على Range لكل حرف، ثم يرتب الحروف من اليسار إلى اليمين. ولأن الكلمات العربية لو طبعت كما هي داخل سطر المخرج لأعادت شاشتك ترتيبها من جديد، يطبع الملف كل كلمة عربية برمز مثل A1 ويكتب معناها في سطر الحالة. والأمر والمخرج كما يلي:
node lab/visual.mjscase 1 A1=تعليقات
bug: A1 user99 - 3
fix: A1 3 - user99
case 2 A1=تعليقات
bug: A1 <U+202A>user99<U+202C> - 3
fix: A1 3 - <U+2069>user99<U+2066>
case 3 A1=تعليقات
bug: A1 user99 - 3
fix: A1 3 - user99
case 4 A1=اتصل A2=على A3=للدعم
bug: A3 4567 123 50 966+ A2 A1
fix: A3 +966 50 123 4567 A2 A1
case 5 A1=نبحث A2=عن A3=مطور A4=بخبرة A5=سنتين
bug: A5 A4 ++C A3 A2 A1
fix: A5 A4 C++ A3 A2 A1
case 6 A1=المجموع A2=شامل A3=الضريبة
bug: A3 A2 SAR 1,499.50 :A1
fix: A3 A2 1,499.50 SAR :A1
case 7 A1=حفظنا A2=الملف A3=في A4=تقارير A5=أمس
bug: A5 pdf.2026/A4/home/sara/ A3 A2 A1
fix: A5 /home/sara/2026/A4.pdf A3 A2 A1
case 8 A1=حفظنا A2=الملف A3=في A4=تقارير A5=أمس
bug: A5 /home/sara/2026/A4.pdf A3 A2 A1
fix: A5 /home/sara/A4/2026.pdf A3 A2 A1
case 9 A1=يبدأ A2=البث A3=بتوقيت A4=السعودية
bug: A4 A3 PM 05:30 A2 A1
fix: A4 A3 05:30 PM A2 A1
case 10 A1=الإصدار A2=أسرع، A3=لأن
bug: 2 > 3 A3 A2 )v2.1( A1
fix: 3 > 2 A3 A2 )v2.1( A1
case 11 A1=مرفق
bug: invoiceexe.pdf<U+202E> :A1
fix: invoicefdp.exe :A1
box 1 (rtl): !A3 A2 A1 React A1=ممتازة A2=للمشاريع A3=الكبيرة
box 2 (ltr): React A3 A2 A1! A1=ممتازة A2=للمشاريع A3=الكبيرة
box 3 (rtl): A5 A4 React A3 A2 A1 A1=هل A2=تنصحون A3=بـ A4=للمشاريع A5=الكبيرة؟
box 4 (ltr): 3 :2_A1 reviews A1=عمر
box 5 (ltr): 2_A1: 3 reviews A1=عمراقرأ كل سطر من اليسار إلى اليمين كما يظهر على الشاشة، والقارئ العربي يقرؤه من اليمين، ثم لاحظ التالي:
- الحالة 1: بدون عزل ظهر
user99 - 3كتلة واحدة، فالرقم 3 هو أقرب شيء إلى يمين الشاشة، ومع العزل أصبح الاسم في أقصى اليمين وبعده الرقم ثم كلمة «تعليقات»A1. - الحالة 2: التضمين بالحروف U+202A وU+202C ترك الخطأ كما هو، والعزل بالحرفين U+2066 وU+2069 أصلحه. ولاحظ أن الحرفين ظهرا في المخرج بترتيب معكوس
<U+2069>user99<U+2066>، لأن الحروف الخفية نفسها تأخذ مكاناً في الترتيب المرئي. - الحالة 3:
<span>بدونdirلا يعزل شيئاً، و<span dir="ltr">يعزل لأن Chrome يعطيهunicode-bidi: isolate، وقد طبعchrome.mjsهذه القيمة منgetComputedStyleللعناصر الثلاثةbdiوspan[dir]وdiv[dir=auto]. - الحالات 4 إلى 6 و9: الجوال ظهر بمجموعات معكوسة و+ في آخره، و
C++أصبحت++C، والسعر والوقت انقلبت كتلتاهما، وكلها صلحت بالعزل. - الحالتان 7 و8: هذه المشكلة التي شرحناها في قسم المسار، فالعزل الخارجي في الحالة 7 لم يكف، وعزل كل جزء في الحالة 8 أعطى الترتيب الصحيح
/home/sara/A4/2026.pdf. - الحالة 10: القوسان ظهرا في المخرج بترتيب
)v2.1(لأن المخرج يطبع الحرف المخزن في كل موقع، والمتصفح رسم كل قوس بشكله المعكوس، فرأى المستخدم(v2.1)صحيحة، وهذا هو العكس Mirroring بعينه. وعلامة>كذلك رسمت معكوسة، فظهرت العبارة على الشاشة2 < 3، ومع العزل بالاتجاه LTR ظهرت3 > 2. - الحالة 11: الحرف RLO جعل
fdp.exeتظهرexe.pdf، والعزل لم يغير ذلك، والإصلاح الوحيد كان حذف الحرف. - الصناديق 1 إلى 5: التعليق الذي يبدأ بكلمة React مع
dir="auto"أخذ الاتجاهltrوانتقلت علامة التعجب إلى اليمين، والاسم العربي في الصفحة الإنجليزية تغير مكان الرقم 2 والنقطتين حوله بدون عزل، ورجع صحيحاً مع<bdi>.
ماذا يحدث إذا غيرنا الوسم Language Tag أو اتجاه الصندوق؟
بعد أن عملت التجربة قمنا بتغيير شيء واحد في كل مرة لنرى أثره، وكل النتائج التالية موجودة في المخرجات أعلاه:
- ماذا يحدث إذا استخدمنا
arبدلاً منar-SA؟ تتغير الأرقام إلى اللاتينية كما في القسم الأول، ولهذا ظهر التاريخ النسبي في القسم السادس بالأرقام اللاتينية بينما بقية الشاشة بالأرقام العربية الهندية. - ماذا يحدث إذا استخدمنا
islamicبدلاً منislamic-umalqura؟ يتقدم التاريخ يوماً كاملاً في مثالنا، من 19 إلى 20 جمادى الأولى، دون أي رسالة خطأ. - ماذا يحدث إذا وضعنا الاسم بين LRE وPDF بدلاً من LRI وPDI؟ يبقى الخطأ كما في الحالة 2، فالتضمين ليس عزلاً.
- ماذا يحدث إذا وضعنا
dir="auto"على تعليق عربي يبدأ بكلمة إنجليزية؟ تصبح الفقرة LTR كما في الصندوق 2. - ماذا يحدث إذا عزلنا المسار كله باتجاه LTR؟ تبقى أجزاؤه العربية مع الأرقام بعدها مقلوبة كما في الحالة 7، حتى نعزل كل جزء.
وإذا أردت أن تثبت هذه الحالات في مشروعك فاكتبها كاختبارات تلتقط صورة الصفحة بالـ Locale العربي، فأداة Playwright تسمح بتحديد locale وtimezoneId لكل اختبار كما في وثائق المحاكاة، وقد شرحنا بناء هذه الاختبارات في مقال اختبارات E2E مع Playwright، وأضف إليها اختباراً بتاريخ قريب من منتصف الليل بتوقيت السعودية واختباراً لكل فئة من فئات الجمع.
أخطاء شائعة
- اعتبار التعريب ترجمة فقط: الترجمة آخر خطوة، وقبلها يجب أن يكون الكود خالياً من الجمل الثابتة ومن التنسيق اليدوي ومن الجمل المركبة.
- إدخال اسم المستخدم في الجملة دون عزل: كل نص لا تتحكم فيه، من اسم أو عنوان أو رقم أو مسار، يدخل الصفحة داخل
<bdi>أو عنصر عليهdir. - استخدام
<span>بدونdirللعزل: العنصر بدون الخاصية لا يعزل شيئاً، كما رأينا في الحالة 3. - استخدام حروف التضمين القديمة LRE وRLE: استبدلها بحروف العزل LRI وRLI وFSI مع PDI.
- الثقة في
dir="auto"للنص العربي المختلط: أول حرف قوي يحكم الفقرة كلها، فاحفظ الاتجاه الذي اختاره المستخدم إن أمكن. - ترك الحروف الخفية في أسماء الملفات والمستخدمين: احذفها عند الإدخال، فهي أداة خداع وليست تنسيقاً.
- حفظ التاريخ أو الرقم كنص منسق: احفظ UTC والرقم الخام، ونسق عند العرض فقط.
- الاعتماد على التقويم الافتراضي أو استخدام
islamicبدلاً منislamic-umalqura: حدد التقويم صراحة، وحدد المنطقة الزمنية صراحة. - شرط المفرد والجمع: العربية فيها ست فئات، فاستخدم
Intl.PluralRulesوملف ترجمة فيه الفئات الست. - رفض الأرقام العربية في النماذج: حولها إلى اللاتينية قبل التحقق، ولا تنس الفاصلين U+066B وU+066C.
- الترتيب بالدالة
sort()بدون مقارن: استخدمIntl.Collatorبالـ Locale الصحيح. - اختلاف الوسم بين أجزاء التطبيق: اجعل الـ Locale قيمة واحدة تمر إلى كل دوال التنسيق.
قائمة تحقق Checklist قبل إطلاق الواجهة العربية
الجدول التالي يجمع المشكلات التي رأيناها مع الأداة المناسبة لكل منها، واستخدمه كقائمة مراجعة قبل الإطلاق:
| المشكلة | الأداة | أين تطبقها |
|---|---|---|
| اتجاه الصفحة واللغة | <html lang="ar" dir="rtl"> | القالب الرئيسي |
| اسم أو عنوان يكتبه المستخدم داخل جملة | <bdi> | كل قالب يعرض بيانات مستخدمين |
| رقم جوال، مسار، رابط، كود، معادلة | dir="ltr" على عنصر، وعزل كل جزء في المسارات | القوالب |
| فقرة اتجاهها غير معروف | dir="auto"، أو حفظ الاتجاه مع النص | التعليقات والرسائل وحقول الإدخال |
| نص بدون HTML | FSI ثم النص ثم PDI | الإشعارات والبريد وSMS |
| الحروف الخفية في المدخلات | حذف U+202A إلى U+202E وU+2066 إلى U+2069 | السيرفر عند الحفظ |
| الأرقام والعملة والنسب | Intl.NumberFormat مع قرار صريح nu | عند العرض |
| التاريخ والتقويم الهجري | UTC في القاعدة، وIntl.DateTimeFormat مع calendar وtimeZone | عند العرض |
| الجمع | Intl.PluralRules وملف ترجمة بالفئات الست | ملفات الترجمة |
| الترتيب والبحث | Intl.Collator مع sensitivity المناسبة | القوائم والفلاتر |
| الأرقام التي يكتبها المستخدم | تحويل إلى اللاتينية ثم التحقق | المتصفح والسيرفر |
| اختلاف البيئات | طباعة process.versions.icu واختبارات بلقطات شاشة | CI |
وإذا كنت تستعد لمقابلة عمل في الواجهات، فأسئلة الاتجاه والتعريب تظهر كثيراً، وقد جمعنا أمثلة منها في أسئلة مقابلة مطور Frontend.
تدريب عملي
- عدل الملف
intl.mjsليطبع السعر 1499.5 بالوسومar-SAوar-EGوar-AEمع العملة المحلية لكل دولة، وقارن مكان رمز العملة والأرقام في كل منها. - أضف إلى الصفحة
bidi.htmlسطراً لعنوان بريد إلكتروني اسمه عربي، مثلسارة@example.com، وجرب العزل الخارجي وحده ثم عزل كل جزء، كما فعلنا مع المسار. - اكتب دالة
formatCount(n, key)تقرأ الجمل الست من ملف JSON وتختار منها بـIntl.PluralRules، واختبرها على 0 و1 و2 و5 و11 و100 و103. - احسب بداية شهر رمضان 1448 ونهايته بتقويم أم القرى وبتوقيت السعودية، ثم حولهما إلى UTC، واكتب استعلام SQL يجلب الطلبات بينهما.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التدويل i18n عمل في الكود يتم مرة واحدة، والتوطين l10n عمل لكل لغة ومنطقة، والترجمة وحدها لا تجعل التطبيق عربياً.
- الـ Locale وسم BCP 47 يحمل اللغة والمنطقة والتقويم ونظام الأرقام، و
arوحده ليسar-SA. - الشاشة تعرض النص بترتيب تحسبه خوارزمية BiDi من أنواع الحروف، فالرقم يلتصق بأقرب حرف قوي قبله، والمحايد يأخذ اتجاه جيرانه، والأقواس تعكس.
- الحل هو العزل:
<bdi>للنص المجهول، وdir="ltr"للجوال والمسار والكود، وحروف FSI وPDI حيث لا يوجد HTML، والتضمين القديم لا يكفي، والنص الذي له بنية داخلية يحتاج عزل كل جزء. - الحروف الخفية تستخدم للخداع في أسماء الملفات والكود، فاحذفها من المدخلات.
- الأرقام والتواريخ تحفظ خاماً وتنسق عند العرض بالواجهة
Intl، مع تحديد التقويمislamic-umalquraوالمنطقة الزمنية صراحة. - العربية فيها ست فئات للجمع، فاكتب الجملة كاملة لكل فئة في ملف الترجمة، ولا تجمع الجمل من قطع.
- Node.js وChrome أعطيا نفس النصوص في تجربتنا، ولكن بيانات ICU وCLDR تتغير بين الإصدارات، فاطبع إصدارها واختبر الشاشات بالـ Locale العربي.
وفي مرحلة هندسة الواجهات وتطبيقات الويب تجد المقالات التي يكملها هذا المقال، ومنها تخطيط الصفحة للعربية بالخصائص المنطقية:
 دليلCSS للعربية واتجاه RTL: الخصائص المنطقية Logical Propertiesكيف تكتب ملف CSS واحداً يعمل بالعربية والإنجليزية، ولماذا تخطئ margin-left في الصفحة العربية، مع قياسات حقيقية من Chrome.
 دليلكيف يرسم المتصفح صفحتك؟ من HTML إلى البكسلاتماذا يفعل المتصفح بين وصول HTML وظهور الصفحة، ولماذا تتجمد صفحة فيها ألفا صف، وكيف تقيس كل مرحلة في Chrome وتصلحها.
 دليلحلقة الأحداث Event Loop: لماذا تتأخر النقرة في صفحتك؟كيف ترتب JavaScript المهام والوعود والرسم على خيط واحد، ولماذا تنتظر النقرة خلف مهمة طويلة، وكيف تقسم العمل لتبقى الصفحة سريعة.
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
 دليلسهولة الوصول Accessibility: موقع وتطبيق يستخدمه الجميعكيف تبني صفحات وتطبيقات يستخدمها الجميع بلوحة المفاتيح وقارئ الشاشة، من عناصر HTML الأصلية إلى النوافذ والنماذج العربية.
 دليلأسئلة مقابلة مطور Frontend من المبتدئ إلى الخبيربنك أسئلة لمقابلة مطور Frontend، لكل سؤال إجابة المبتدئ وإجابة الخبير وأسئلة متابعة، مع تمارين عملية شغلناها فعلاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة في Node.js 22.23.4 مع ICU 78.3 وCLDR 48.0 داخل Container من node:22-alpine، وفي Chrome 156 بدون واجهة.