


بعد ثلاثة مقالات أصبح لدى الفريق الذي نتابعه في هذه السلسلة قرابة أربعين قاعدة تنبيه: القرص، والذاكرة، والمعالج، وإعادة تشغيل الـ Containers، والإشارات الذهبية لخدمة الدفع، وفحوص التوفر من الخارج، والشهادات، والنسخ الاحتياطي. وكانت كل القواعد ترسل إلى قناة واحدة في تطبيق المحادثة، وبعد أسبوعين أصبحت القناة تستقبل مئات الرسائل في اليوم، أغلبها عن قرص وصل إلى 81% أو معالج ارتفع دقيقتين في وقت النسخ الاحتياطي، فكتم الجميع القناة. ثم توقفت قاعدة البيانات ليلة الجمعة، فأرسل النظام في الدقائق الخمس الأولى سبعاً وثلاثين رسالة، واحدة لكل خدمة لا تصل إلى قاعدة البيانات، ولم يقرأ أحد أياً منها حتى اتصل أول عميل في الصباح. والمشكلة هنا ليست في القياس، فكل رقم كان صحيحاً، وإنما في التنبيه: ماذا يستحق أن يقطع نوم أحد؟ وكيف تصل المشكلة الواحدة في رسالة واحدة؟ وأين تذهب الأشياء التي يجب أن تعرفها ولكنها تستطيع أن تنتظر حتى الصباح؟
وهذا هو موضوع المقال الرابع في السلسلة. وقد شرحنا في مفاهيم المراقبة Observability فكرة التنبيه على ما يشعر به المستخدم، وميزانية الأخطاء ومعدل الاستهلاك Burn Rate، وإرهاق التنبيهات، فلن نكرر ذلك، وإنما نبني الطبقة التي تنقل التنبيه من Prometheus إلى الإنسان المناسب، في الوقت المناسب، مرة واحدة، مع Alertmanager، ونجرب كل قرار في مختبر حقيقي بالثواني. والمواضيع في السلسلة:
- مقاييس السيرفرات مع Prometheus ولوحات Grafana.
- ماذا تقيس في خدمتك؟ الإشارات الذهبية Golden Signals.
- فحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟
- التنبيهات Alerting: ماذا تنبه عليه ومتى توقظ أحداً؟ (الموضوع الحالي).
- بوابة مراقبة واحدة Monitoring Portal تجمع Grafana مع Wazuh.
وسوف نناقش في هذا المقال ما يلي:
- ماذا تنبه عليه، وكم تنبيهاً عاجلاً يحتمل المناوب On-call في اليوم بحسب كتاب Google SRE.
- العتبات Thresholds والمدة
for، ومسار التنبيه من تغير الرقم إلى وصول الرسالة بالثواني. - مختبر فيه Prometheus وAlertmanager ومستقبل رسائل Webhook، ومشكلة واجهتنا في التسميات أرسلت «تم الحل» لمشكلة لم تحل.
- التجميع Grouping والتوجيه Routing بحسب الأهمية Severity، والكتم Inhibition، والإسكات Silences.
- العاجل فوراً والروتيني في ملخص يومي واحد، وما الذي لا يستطيعه Alertmanager في هذا.
- روابط دليل التشغيل Runbook في كل تنبيه، وتنبيه Watchdog، ثم الأخطاء الشائعة وقائمة تحقق.
ماذا تنبه عليه؟ What to Alert On
يلخص دليل التنبيه في توثيق Prometheus القاعدة في جملة واحدة: اجعل التنبيهات قليلة قدر الإمكان، ونبه على الأعراض المرتبطة بألم المستخدم بدل أن تحاول أن تلتقط كل طريقة يمكن أن يحدث بها هذا الألم. ثم يفصل لكل نوع من الأنظمة: في أنظمة الخدمة المباشرة نبه على زمن الاستجابة ونسبة الأخطاء في أعلى نقطة ممكنة من المسار، ونبه على زمن الاستجابة في نقطة واحدة فقط، فإذا كان مكون في الأسفل أبطأ مما يجب ولكن المستخدم لا يشعر بشيء فلا داعي لإيقاظ أحد. وفي المهام الدفعية نبه إذا لم تنجح المهمة منذ وقت كاف لتشغيلين كاملين على الأقل، وهذا ما بنيناه في مقال فحص التوفر.
ويذهب كتاب Google SRE أبعد من ذلك في فصل مراقبة الأنظمة الموزعة، حيث يضع فلسفة للتنبيه العاجل Page من وجهة نظر من يستقبله: كل مرة يرن فيها الهاتف يجب أن أتصرف بإحساس بالعجلة، ولا أستطيع أن أفعل ذلك إلا مرات قليلة في اليوم قبل أن أتعب، وكل تنبيه عاجل يجب أن يكون قابلاً للتنفيذ Actionable، وكل رد عليه يجب أن يحتاج تفكيراً، فإذا كان الرد آلياً ثابتاً فلا يجب أن يكون تنبيهاً عاجلاً، والتنبيه العاجل يجب أن يكون عن مشكلة جديدة لم ترها من قبل. وهذه الفلسفة تتحول بسهولة إلى أربعة أسئلة تسألها قبل أن تكتب أي قاعدة، كما في الصورة التالية:
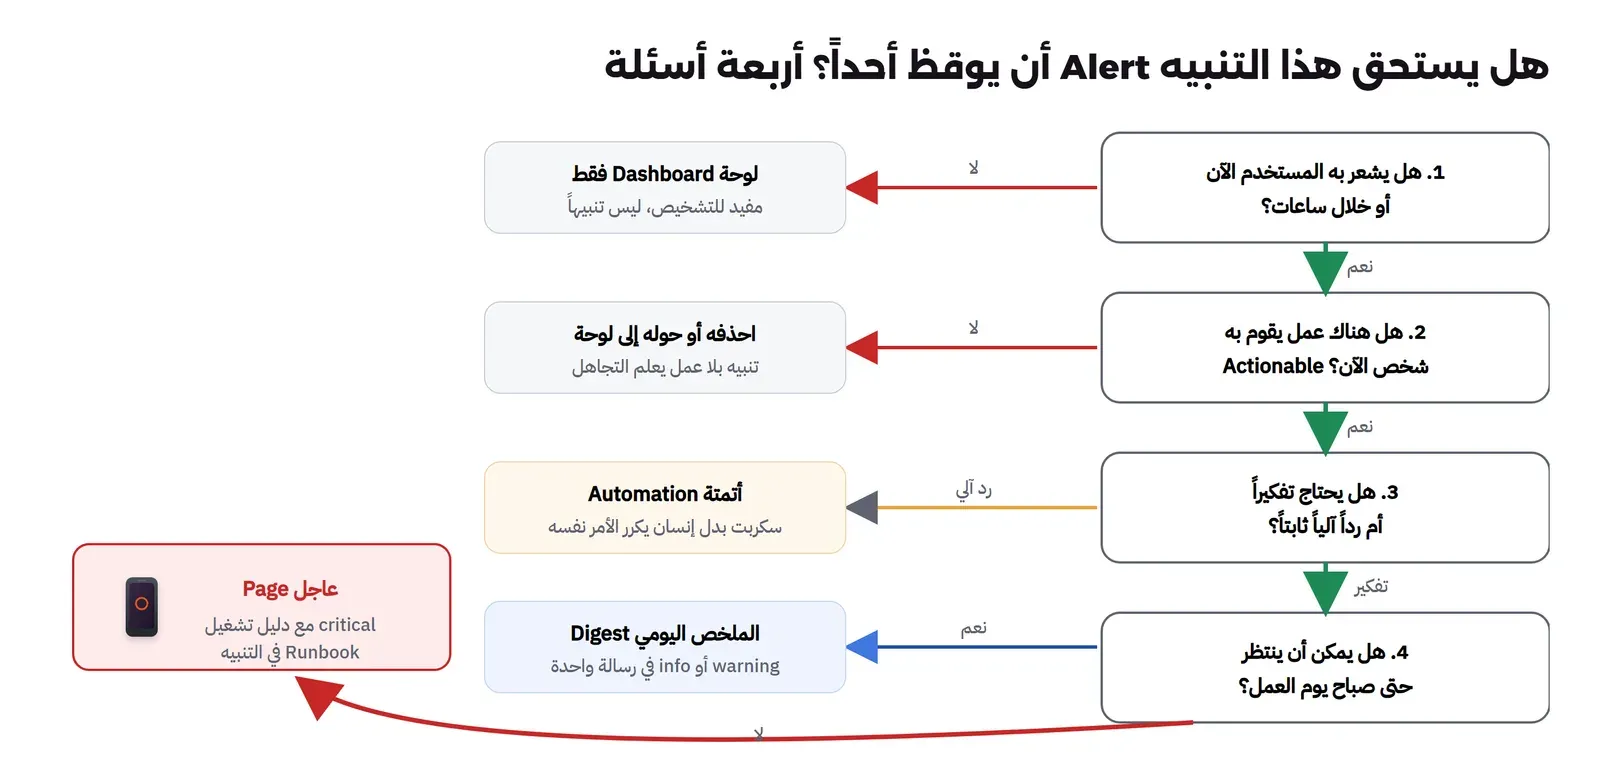
ولو طبق الفريق في القصة هذه الأسئلة على قواعده الأربعين لوجد أن أغلبها لا يصل إلى السؤال الرابع أصلاً: القرص عند 81% لا يشعر به المستخدم، والمعالج المرتفع دقيقتين في وقت النسخ الاحتياطي لا يحتاج عملاً، وإعادة تشغيل Container مرة واحدة يعالجها Docker نفسه. والذي يبقى للتنبيه العاجل عدد قليل: الموقع لا يصل إليه أحد من الخارج، ونسبة أخطاء الدفع فوق الحد، وزمن الاستجابة فوق الهدف لمدة تهدد ميزانية الأخطاء، والقرص الذي سوف يمتلئ خلال ساعات. وكل ما تبقى إما لوحة، أو تذكرة، أو سطر في الملخص اليومي.
وقد يتساءل البعض: إذا حذفنا تنبيهات الأسباب، مثل اتصال الخدمة بقاعدة البيانات، فكيف نعرف أن قاعدة البيانات هي السبب ليلة الجمعة؟ والإجابة أن السبب لا يختفي، وإنما ينتقل من الهاتف إلى اللوحة: التنبيه العاجل الواحد يقول «الدفع يفشل لنسبة 40% من العملاء»، والمناوب يفتح لوحة الخدمة من رابط دليل التشغيل، فيرى في ثوان أن كل الخدمات فقدت قاعدة البيانات في اللحظة نفسها. أي أن السبعة والثلاثين تنبيهاً في القصة كانت معلومات صحيحة في المكان الخطأ، ومكانها الصحيح رسم واحد في لوحة يفتحها من يحقق، وليس سبعاً وثلاثين رسالة يقرؤها من نام.
كم تنبيهاً يحتمل المناوب؟ On-call Load
هذا السؤال له رقم في فصل المناوبة في كتاب SRE: يذكر الفريق أن التعامل مع حادثة واحدة، من تحليل السبب إلى الإصلاح والمتابعة وكتابة تقرير ما بعد الحادثة، يأخذ في المتوسط ست ساعات، وبالتالي فالحد الأقصى حادثتان في كل مناوبة مدتها 12 ساعة، ويضيف أن توزيع التنبيهات العاجلة يجب أن يكون مسطحاً جداً عبر الزمن، وأن القيمة الوسيطة المتوقعة صفر في اليوم. أي أن المناوب في اليوم العادي لا يجب أن يرن هاتفه أبداً، فإذا كان مكون معين يسبب تنبيهاً كل يوم فهذه مشكلة تحتاج إصلاحاً، وليست مناوبة طبيعية. وقد كتبنا عن أثر المناوبة على الإنسان نفسه في ضغط المناوبة On-call والحوادث، والتنبيهات الكثيرة هي أول أسباب هذا الضغط.
العتبات Thresholds مع المدة for
كل قاعدة تنبيه في Prometheus لها جزءان يحددان متى تطلق: العتبة في الشرط نفسه، مثل نسبة الأخطاء أكبر من 5%، والمدة for، أي كم يجب أن يبقى الشرط صحيحاً قبل أن يصبح التنبيه في حالة الإطلاق. ويشرح توثيق قواعد التنبيه أن التنبيه بين أول مرة يصبح فيها الشرط صحيحاً وانتهاء المدة يكون في حالة الانتظار pending، ثم يصبح firing، وأن هناك خياراً مكملاً اسمه keep_firing_for يبقي التنبيه مطلقاً مدة محددة بعد أن يتوقف الشرط، لمنع التذبذب Flapping والحل الكاذب عند نقص البيانات.
واختيار العتبة لا يأتي من رقم مشهور، وإنما من سؤالين: ما الرقم الذي يبدأ عنده المستخدم في الشعور؟ وما الرقم الطبيعي لهذه الخدمة في أسوأ أوقاتها العادية؟ فإذا كانت نسبة أخطاء الدفع في أسوأ ساعة من الأسبوع الماضي 0.8%، والعميل يبدأ في الاتصال عندما يفشل واحد من كل عشرين، فعتبة 5% منطقية، أما عتبة 1% فسوف تطلق كل أسبوع دون سبب. ولذلك افتح لوحة الخدمة على شهر كامل قبل أن تكتب أي عتبة، وإذا كان لديك هدف خدمة SLO فاستخدم معدل الاستهلاك بنافذتين كما شرحنا في مقال المفاهيم، فهو أدق من أي عتبة ثابتة.
أما المدة for فهي ثمن تدفعه بالوقت لتشتري الهدوء: كل ثانية فيها تأخير في معرفة المشكلة الحقيقية، وكل ثانية تحذفها تزيد التنبيهات الكاذبة من الارتفاعات العابرة. وقد قسنا في المختبر مسار تنبيه واحد من البداية إلى النهاية، والصورة التالية تبينه:
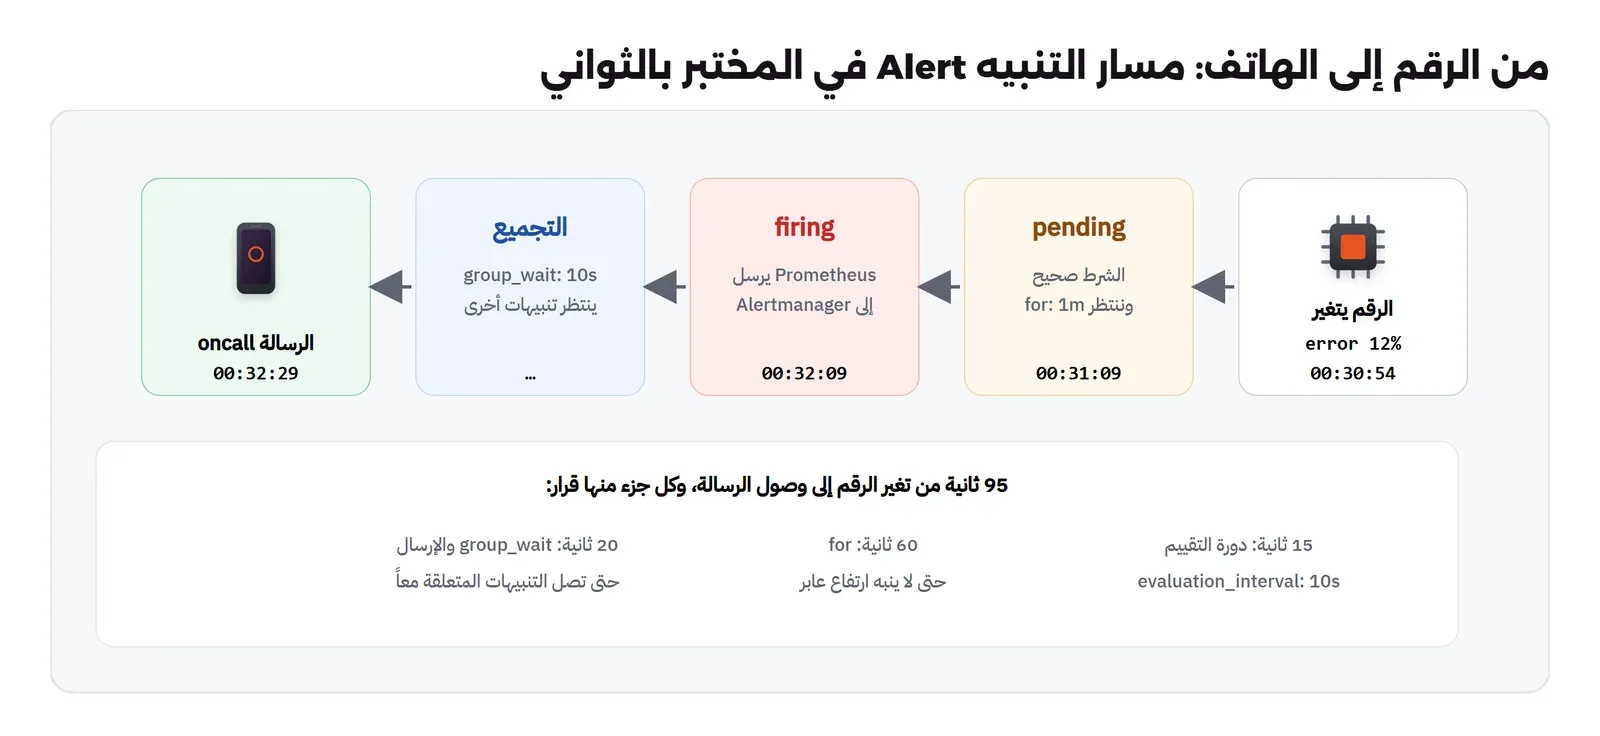
والقاعدة العملية في المدة: للأعراض العاجلة بين دقيقة وخمس دقائق، بحسب كم ثانية توقف يتحملها عملك، وللتنبؤات مثل امتلاء القرص مدة أطول، مثل 15 أو 30 دقيقة، لأن التنبؤ نفسه يتذبذب مع كل ملف كبير يكتب ثم يحذف، وللأسباب التي تذهب إلى الملخص اليومي لا تهم المدة كثيراً، لأنها لن تصل قبل موعد الملخص على أي حال.
التذبذب Flapping: تنبيه يطلق وينتهي كل دقيقتين
هناك نوع من التنبيهات يتعب الفريق أكثر من غيره: التنبيه الذي يطلق ثم ينتهي ثم يطلق مرة أخرى، لأن الرقم يتحرك حول العتبة نفسها. فإذا كانت نسبة الأخطاء تتراوح بين 4.8% و5.3% والعتبة 5%، فكل مرة تتجاوزها لدقيقة يطلق التنبيه، وكل مرة تنزل تحتها ترسل رسالة الحل، فيصل المناوب في الليلة الواحدة عشرون زوجاً من الرسائل عن مشكلة واحدة لم تتغير. وهناك ثلاث طرق لمنع ذلك، ولكل منها مكان. الأولى نافذة أطول في الاستعلام نفسه، مثل نسبة الأخطاء على عشر دقائق بدل دقيقة، فيصبح الرقم أهدأ بطبيعته. والثانية الخيار keep_firing_for الذي ذكرناه، فيبقى التنبيه مطلقاً عشر دقائق بعد أن ينزل الرقم، ولا ترسل رسالة الحل إلا إذا بقي تحت العتبة طوال هذه المدة. والثالثة عتبتان، واحدة للإطلاق وأخرى أقل منها للحل، وهذه تحتاج كتابة شرط يعتمد على حالة التنبيه نفسه من السلسلة ALERTS، وهي أعقد من أن تبدأ بها. والترتيب العملي أن تبدأ بالنافذة الأطول، ثم keep_firing_for إذا بقي التذبذب، ولاحظ أن الاثنين يؤخران رسالة الحل، أي أن المناوب سوف يعرف أن المشكلة انتهت بعد دقائق من انتهائها فعلاً، وهذا ثمن مقبول في أغلب الحالات مقابل ليلة هادئة.
المختبر Lab: Prometheus مع Alertmanager ثم مستقبل Webhook
نحتاج في هذا المختبر أن نتحكم في الأرقام بدقة، لنطلق تنبيهاً معيناً في لحظة معينة ونرى ما يحدث له، ولذلك بنينا مصدراً صغيراً للمقاييس بلغة Python يقرأ الأرقام من ملف JSON مع كل سحب، فنغير الواقع بتعديل الملف. ولدينا ثلاث نسخ منه: سيرفران app-1 وapp-2، وفحص من الخارج يقول هل يصل إلى كل سيرفر. والملف labexporter.py:
# Lab exporter: serves the numbers in /state/<name>.json as Prometheus gauges, so we can change "reality" by editing a file.
#   {"server": "app-1", "metrics": {"lab_http_error_ratio": 0.0, "lab_disk_hours_to_full": 300}}
import json, os
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
STATE = os.environ.get("STATE", "/state/state.json")

class H(BaseHTTPRequestHandler):
    def log_message(self, *a): pass
    def do_GET(self):
        s = json.load(open(STATE))
        lines = []
        for name, val in s["metrics"].items():
            if isinstance(val, dict):                      # {"labelvalue": number} for per-target series
                for target, v in val.items():
                    lines.append(f'{name}{{server="{s["server"]}",target="{target}"}} {v}')
            else:
                lines.append(f'{name}{{server="{s["server"]}"}} {val}')
        body = ("\n".join(lines) + "\n").encode()
        self.send_response(200); self.send_header("Content-Type", "text/plain; version=0.0.4"); self.end_headers(); self.wfile.write(body)

ThreadingHTTPServer(("0.0.0.0", 9000), H).serve_forever()
ومستقبل الرسائل webhook.py يطبع سطراً لكل رسالة يرسلها Alertmanager، كما يراها المناوب على هاتفه أو في قناة الفريق: الوقت، والمستقبل، والحالة، وتسميات المجموعة، وعدد التنبيهات فيها:
# Webhook receiver: prints one line per notification Alertmanager sends, as an on-call phone or a chat channel would see it.
import json, time
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler

class H(BaseHTTPRequestHandler):
    def log_message(self, *a): pass
    def do_POST(self):
        n = json.loads(self.rfile.read(int(self.headers["Content-Length"])))
        alerts = ", ".join(f'{a["labels"]["alertname"]}[{a["labels"].get("server", "-")}]={a["status"]}' for a in n["alerts"])
        print(time.strftime("%H:%M:%S", time.gmtime()), f'to={self.path.strip("/")} status={n["status"]} '
              f'group={n["groupLabels"]} n={len(n["alerts"])} :: {alerts}', flush=True)
        for a in n["alerts"][:1]:
            if a["annotations"].get("runbook_url"):
                print("         runbook:", a["annotations"]["runbook_url"], flush=True)
        self.send_response(200); self.end_headers()

ThreadingHTTPServer(("0.0.0.0", 9095), H).serve_forever()
وقواعد التنبيه في rules.yml ست قواعد، ثلاث عاجلة وثنتان روتينيتان وWatchdog:
groups:
  - name: lab-alerts
    rules:
      - alert: ServerDown
        expr: up{job="server"} == 0
        for: 30s
        labels: { severity: critical, team: ops }
        annotations:
          summary: "{{ $labels.server }} does not answer scrapes"
          runbook_url: "https://wiki.example.com/runbooks/server-down"
      - alert: SiteUnreachable
        expr: label_replace(lab_probe_success, "server", "$1", "target", "(.*)") == 0
        for: 30s
        labels: { severity: critical, team: ops }
        annotations:
          summary: "outside probe cannot reach {{ $labels.server }}"
          runbook_url: "https://wiki.example.com/runbooks/site-unreachable"
      - alert: CheckoutErrors
        expr: lab_http_error_ratio > 0.05
        for: 1m
        labels: { severity: critical, team: dev }
        annotations:
          summary: "{{ $value | humanizePercentage }} of checkout requests fail on {{ $labels.server }}"
          runbook_url: "https://wiki.example.com/runbooks/checkout-errors"
      - alert: DiskWillFillIn24h
        expr: lab_disk_hours_to_full < 24
        for: 1m
        labels: { severity: warning, team: ops }
        annotations:
          summary: "disk on {{ $labels.server }} full in {{ $value | printf \"%.0f\" }} hours"
          runbook_url: "https://wiki.example.com/runbooks/disk-filling"
      - alert: CertificateExpiresSoon
        expr: lab_cert_days_left < 14
        labels: { severity: warning, team: ops }
        annotations:
          summary: "certificate on {{ $labels.server }} expires in {{ $value }} days"
          runbook_url: "https://wiki.example.com/runbooks/certificate-renewal"
      - alert: Watchdog
        expr: vector(1)
        labels: { severity: none }
        annotations: { summary: "always firing: proves the whole alert path works" }
في القواعد أعلاه لاحظ التالي:
- كل قاعدة لها التسمية
severityبثلاث قيم فقط:criticalللعاجل، وwarningللروتيني، وnoneلـ Watchdog، وAlertmanager يوجه بحسبها كما سوف نرى. وكثرة المستويات، مثل خمسة أو ستة، لا تفيد، لأن القرار الحقيقي واحد: هل يوقظ أحداً الآن أم لا. - كل قاعدة لها
runbook_urlفي التعليقات Annotations، وهو رابط دليل التشغيل الذي يفتحه المناوب أولاً، وسوف نخصص له قسماً. - التسمية
teamتحدد من المسؤول، فأخطاء الدفع للمطورين، والسيرفر المتوقف للتشغيل، وتستطيع أن توجه بها إلى مستقبلين مختلفين. label_replaceفيSiteUnreachableتنقل اسم السيرفر من التسميةtargetإلىserver، لأن قاعدة الكتم تحتاج التسمية نفسها في التنبيهين.
وملف alertmanager.yml هو قلب المقال، ونعرضه كاملاً هنا ثم نشرح كل جزء منه في الأقسام التالية:
global:
  resolve_timeout: 5m

route:
  receiver: digest                 # anything not matched below
  group_by: [alertname, server]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers: [alertname="Watchdog"]
      receiver: watchdog
      group_wait: 0s
      group_interval: 1m
      repeat_interval: 1m          # the outside dead man's switch expects a ping every minute
    - matchers: [severity="critical"]
      receiver: oncall
      group_by: [server]           # one message per server, not one per alert
      group_wait: 10s
      group_interval: 1m
      repeat_interval: 1h
    - matchers: [severity=~"warning|info"]
      receiver: digest
      group_by: [severity]         # every routine alert in one message
      group_wait: 30s
      group_interval: 1m
      repeat_interval: 24h
      active_time_intervals: [daily-digest]

time_intervals:
  - name: daily-digest
    time_intervals:
      - times: [{ start_time: "00:38", end_time: "00:44" }]

inhibit_rules:
  # a server that is down explains everything else on it
  - source_matchers: [alertname=~"ServerDown|SiteUnreachable"]
    target_matchers: [severity=~"critical|warning", alertname!~"ServerDown|SiteUnreachable"]
    equal: [server]

receivers:
  - name: oncall
    webhook_configs: [{ url: "http://mon-al-hook:9095/oncall", send_resolved: true }]
  - name: digest
    webhook_configs: [{ url: "http://mon-al-hook:9095/digest", send_resolved: false }]
  - name: watchdog
    webhook_configs: [{ url: "http://mon-al-hook:9095/watchdog" }]
ونافذة الملخص في المختبر ست دقائق بعد بداية التجربة بقليل، من 00:38 إلى 00:44 بتوقيت UTC، حتى نرى سلوكها دون أن ننتظر يوماً كاملاً، وفي الإنتاج سوف تكون مثل التاسعة صباحاً بتوقيت السعودية. وقبل التشغيل نفحص الملفين بالأداتين المرفقتين في Images الرسمية:
docker run --rm -v "$PWD/alertmanager.yml:/a.yml:ro" --entrypoint amtool prom/alertmanager:v0.34.2 check-config /a.yml
docker run --rm -v "$PWD/rules.yml:/r.yml:ro" --entrypoint promtool prom/prometheus:v3.15.1 check rules /r.yml
Checking '/a.yml' SUCCESS
Found:
- global config
- route
- 1 inhibit rules
- 3 receivers
- 0 templates
Checking /r.yml
SUCCESS: 6 rules foundثم نشغل كل شيء، Alertmanager 0.34.2 وPrometheus 3.15.1 والمصادر الثلاثة والمستقبل:
docker network create mon-net
for n in 1 2; do
  docker run -d --name mon-al-app$n --network mon-net -e STATE=/state/app-$n.json \
    -v "$PWD/state:/state:ro" -v "$PWD/labexporter.py:/x.py:ro" python:3.13-slim python /x.py
done
docker run -d --name mon-al-probe --network mon-net -e STATE=/state/probe.json \
  -v "$PWD/state:/state:ro" -v "$PWD/labexporter.py:/x.py:ro" python:3.13-slim python /x.py
docker run -d --name mon-al-hook --network mon-net -v "$PWD/webhook.py:/w.py:ro" python:3.13-slim python /w.py
docker run -d --name mon-al-am --network mon-net -p 127.0.0.1:19093:9093 \
  -v "$PWD/alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro" prom/alertmanager:v0.34.2
docker run -d --name mon-al-prom --network mon-net -p 127.0.0.1:19090:9090 \
  -v "$PWD/prometheus.yml:/etc/prometheus/prometheus.yml:ro" -v "$PWD/rules.yml:/etc/prometheus/rules.yml:ro" \
  prom/prometheus:v3.15.1 --config.file=/etc/prometheus/prometheus.yml --storage.tsdb.retention.time=1d
docker logs -f mon-al-hook
وأول سطر وصل بعد ثوان من التشغيل هو Watchdog، وهذا مقصود:
00:30:15 to=watchdog status=firing group={'alertname': 'Watchdog'} n=1 :: Watchdog[-]=firingمشكلة واجهتنا: التسمية exported_server مع رسالة «تم الحل» الكاذبة
عند 00:30:54 غيرنا نسبة الأخطاء في app-2 إلى 12%، فوصلت الرسالة الأولى عند 00:32:29 كما في الصورة السابقة. ثم نظرنا إلى التنبيه في Alertmanager بالأداة amtool فوجدنا تسمية غريبة:
alertname="CheckoutErrors" exported_server="app-2" instance="mon-al-app2:9000" job="server" server="app-2" severity="critical" team="dev"والسبب في ملف Prometheus: أضفنا التسمية server إلى الهدف بإعادة التسمية حتى تحملها السلسلة up، والمصدر نفسه يرسل التسمية server على مقاييسه، وعندما تتعارض تسمية من الهدف مع تسمية من المقياس فإن Prometheus يحتفظ بتسمية الهدف ويعيد تسمية الأخرى إلى exported_server. والحل عندما يكون المصدر هو صاحب الحقيقة في التسمية هو الخيار honor_labels: true على الوظيفة، فيحتفظ Prometheus بتسمية المقياس كما هي. فأضفناه وأعدنا تحميل الإعداد عند 00:33:15، فوصلت هاتان الرسالتان:
00:34:29 to=oncall status=resolved group={'server': 'app-2'} n=1 :: CheckoutErrors[app-2]=resolved
00:34:49 to=oncall status=firing group={'server': 'app-2'} n=2 :: CheckoutErrors[app-2]=firing, CheckoutErrors[app-2]=resolved
وهذا درس أهم من التسمية نفسها: الأخطاء ما زالت 12%، ولم يحل أحد شيئاً، ومع ذلك وصلت رسالة «تم الحل» resolved إلى المناوب. والسبب أن Alertmanager يعرف كل تنبيه بمجموعة تسمياته كاملة، فعندما اختفت exported_server أصبح التنبيه القديم منتهياً، وظهر تنبيه جديد بتسميات مختلفة. أي أن أي تغيير في التسميات، في قاعدة أو في إعداد السحب، يرسل حلاً كاذباً لكل التنبيهات المطلقة التي تحملها، ثم يعيد إطلاقها. لذلك لا تغير التسميات في وقت فيه تنبيهات مطلقة إلا إذا كنت تعرف ذلك، وأخبر المناوب قبلها.
التجميع Grouping: مشكلة واحدة في رسالة واحدة
يشرح توثيق مفاهيم Alertmanager التجميع بمثال يشبه ليلة الجمعة في قصتنا: عشرات النسخ من خدمة تفقد الاتصال بقاعدة البيانات في وقت واحد، وكل نسخة تطلق تنبيهاً، والتجميع يجعلها رسالة واحدة تقول ما الذي تأثر. وفي الإعداد أربعة أرقام تحدد سلوك المجموعة، والتوثيق المرجعي في مرجع إعدادات Alertmanager يشرح كلاً منها:
group_by: التسميات التي تحدد المجموعة، فالتنبيهات التي لها القيم نفسها في هذه التسميات تصل في رسالة واحدة. وفي مسار العاجل جعلناها[server]، أي رسالة لكل سيرفر مهما كان عدد المشاكل فيه، وفي مسار الملخص[severity]، أي كل التنبيهات الروتينية في رسالة واحدة.group_wait: كم ينتظر Alertmanager بعد أول تنبيه في مجموعة جديدة قبل أن يرسلها، حتى تلحق بها التنبيهات المرتبطة التي تطلق بعد ثوان. ويذكر المرجع أن القيمة القصيرة تسرع الرسالة الأولى ولكنها قد ترسل رسالة ناقصة ثم رسالة أخرى بعدها، والطويلة تجمع أكثر وتؤخر. وجعلناها 10 ثوان للعاجل.group_interval: بعد الرسالة الأولى، كل كم يتحقق Alertmanager من تغير المجموعة، أي تنبيه جديد فيها أو تنبيه انتهى، فيرسل تحديثاً.repeat_interval: إذا لم يتغير شيء، بعد كم يعيد إرسال المجموعة نفسها للتذكير، ويذكر المرجع أنه يجب أن يكون مضاعفاً لـgroup_intervalلأنه يفحص عند كل دورة منه.
وفي المختبر رأينا التجميع يعمل في الرسالة التي وصلت عند 00:34:49، حيث حملت تنبيهين لسيرفر واحد في رسالة واحدة، وسوف نراه بشكل أوضح في الملخص اليومي.
التوجيه Routing بحسب الأهمية Severity
شجرة التوجيه Routing Tree في Alertmanager تبدأ من المسار الرئيسي route، وكل تنبيه يمر على المسارات الفرعية بالترتيب، وأول مسار تطابق شروطه التنبيه يأخذه، ولا يكمل إلى ما بعده إلا إذا وضعت continue: true. ويرث المسار الفرعي إعدادات الأب إذا لم يحدد غيرها، ما عدا أوقات الكتم والتفعيل التي يذكر المرجع أنها لا تورث. والصورة التالية تبين شجرة المختبر:
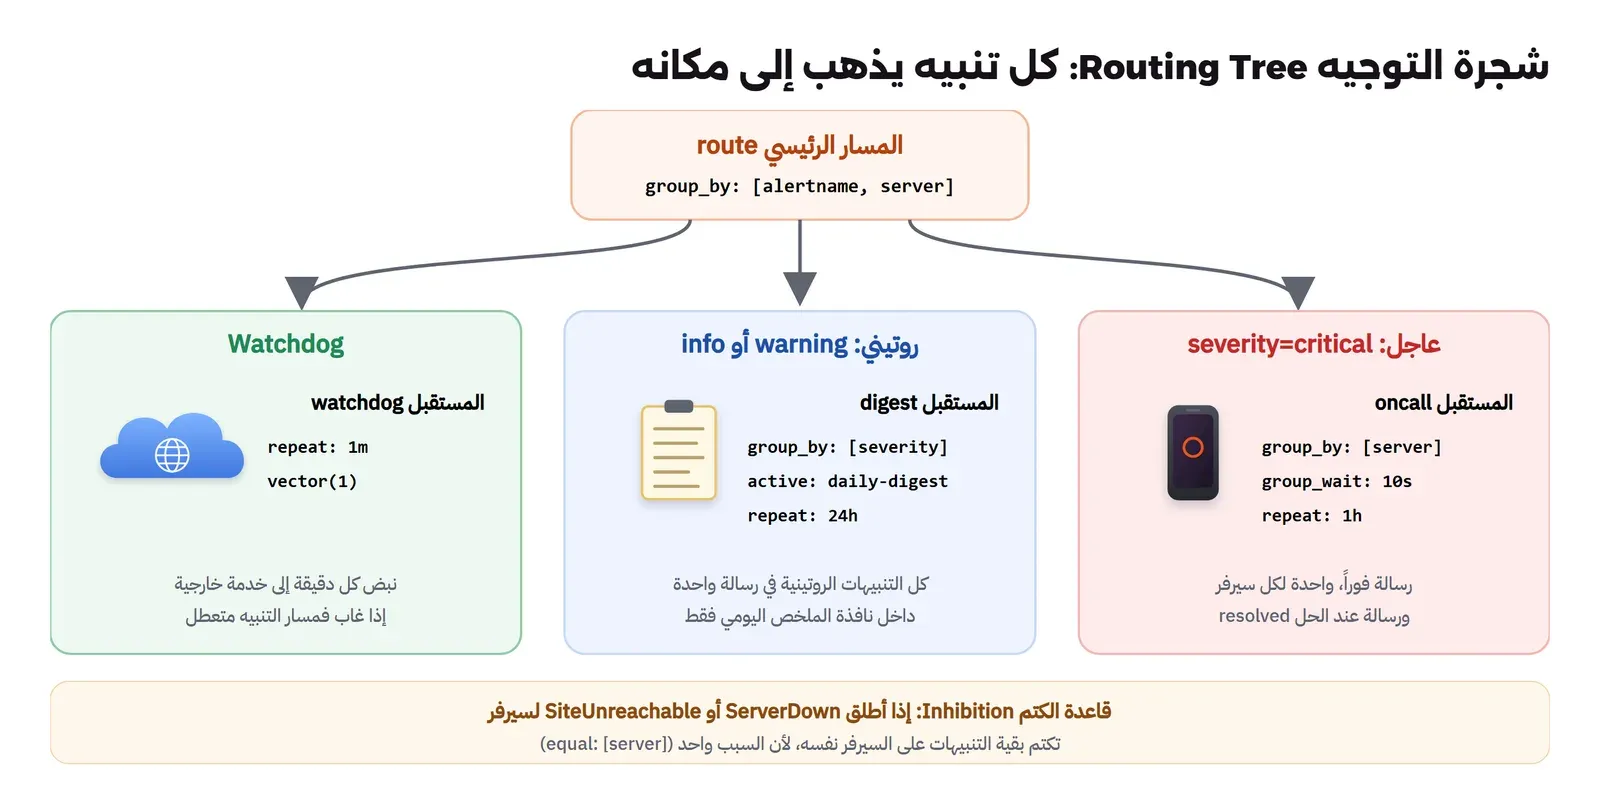
ولاحظ ترتيب المسارات: Watchdog أولاً لأن مستواه none ولا نريده أن يقع في أي مسار آخر، ثم العاجل، ثم الروتيني، والمستقبل الافتراضي في المسار الرئيسي هو الملخص، فإذا نسي أحد أن يضع severity على قاعدة جديدة فإنها تذهب إلى الملخص ولا توقظ أحداً. وهذا اختيار مقصود، فالبديل أن يكون الافتراضي هو المناوب، فتصبح كل قاعدة ناقصة تنبيهاً عاجلاً، والأفضل أن يكون العكس، وأن تراجع الملخص صباحاً فترى القاعدة التي تحتاج تصنيفاً.
وقبل أن تنشر أي تعديل على الشجرة اختبرها دون تشغيل Alertmanager، فالأداة amtool تقرأ الملف وتقول لك أين يذهب تنبيه بتسميات تحددها أنت، وهذا ما جربناه على أربع حالات، منها قاعدة جديدة نسي صاحبها أن يضع لها severity:
for a in "alertname=CheckoutErrors severity=critical server=app-1"          "alertname=DiskWillFillIn24h severity=warning server=app-2"          "alertname=NewRule server=app-1" "alertname=Watchdog severity=none"; do
  echo "== $a"
  docker run --rm -v "$PWD/alertmanager.yml:/a.yml:ro" --entrypoint amtool prom/alertmanager:v0.34.2     config routes test --config.file=/a.yml $a
done
docker run --rm -v "$PWD/alertmanager.yml:/a.yml:ro" --entrypoint amtool prom/alertmanager:v0.34.2 config routes --config.file=/a.yml
== alertname=CheckoutErrors severity=critical server=app-1
oncall
== alertname=DiskWillFillIn24h severity=warning server=app-2
digest
== alertname=NewRule server=app-1
digest
== alertname=Watchdog severity=none
watchdog
Routing tree:
.
└── default-route receiver: digest
├── {alertname="Watchdog"} receiver: watchdog
├── {severity="critical"} receiver: oncall
└── {severity=~"warning|info"} receiver: digestوالسطر الثالث هو ما أردنا أن نراه: القاعدة التي لا تحمل مستوى ذهبت إلى الملخص وليس إلى المناوب، أي أن الخطأ في التصنيف يصل صباحاً إلى من يستطيع إصلاحه بهدوء، ولا يوقظ أحداً. وضع هذه الاختبارات في مسار CI مع ملف القواعد، فإذا غير أحد ترتيب المسارات وأصبح تنبيه عاجل يذهب إلى الملخص فسوف يفشل الاختبار قبل أن تفشل الليلة.
الكتم Inhibition: السبب الواحد يخفي نتائجه
الكتم Inhibition بحسب التوثيق هو أن تمنع رسائل بعض التنبيهات إذا كانت تنبيهات أخرى مطلقة، والمثال الذي يضربه هو مجموعة سيرفرات لا يمكن الوصول إليها، فتكتم كل التنبيهات الأخرى عنها. وفي المختبر قاعدة واحدة: إذا أطلق ServerDown أو SiteUnreachable لسيرفر فتكتم بقية التنبيهات العاجلة والروتينية على السيرفر نفسه، والشرط equal: [server] هو ما يربط المصدر بالهدف، أي أن الكتم يحدث فقط إذا كانت قيمة server نفسها في التنبيهين. وجربنا ذلك عند 00:34:38: جعلنا الفحص من الخارج لا يصل إلى app-1، ونسبة أخطائه 20% في الوقت نفسه، وكان عليه قبلها تنبيه روتيني عن القرص:
00:35:29 to=oncall status=firing group={'server': 'app-1'} n=1 :: SiteUnreachable[app-1]=firing
         runbook: https://wiki.example.com/runbooks/site-unreachable
رسالة واحدة فقط عن app-1، مع أن CheckoutErrors أطلق بعدها بعشرين ثانية. ولكي نرى ما حدث للتنبيهات الأخرى سألنا Alertmanager:
docker exec mon-al-am amtool --alertmanager.url=http://localhost:9093 alert query --inhibited -o simple
curl -s 127.0.0.1:19093/api/v2/alerts | python3 -c "import sys,json;[print(a['labels']['alertname'],a['labels'].get('server'),a['status']['state'],a['status']['inhibitedBy']) for a in json.load(sys.stdin)]"
Alertname Starts At Summary State
DiskWillFillIn24h 2026-11-03 00:34:19 UTC disk on app-1 full in 10 hours suppressed
CheckoutErrors 2026-11-03 00:35:49 UTC 20% of checkout requests fail on app-1 suppressed
DiskWillFillIn24h app-1 suppressed ['ee5e75faa70226a4']
Watchdog None active []
CheckoutErrors app-1 suppressed ['ee5e75faa70226a4']
CheckoutErrors app-2 active []
CertificateExpiresSoon app-2 active []
SiteUnreachable app-1 active []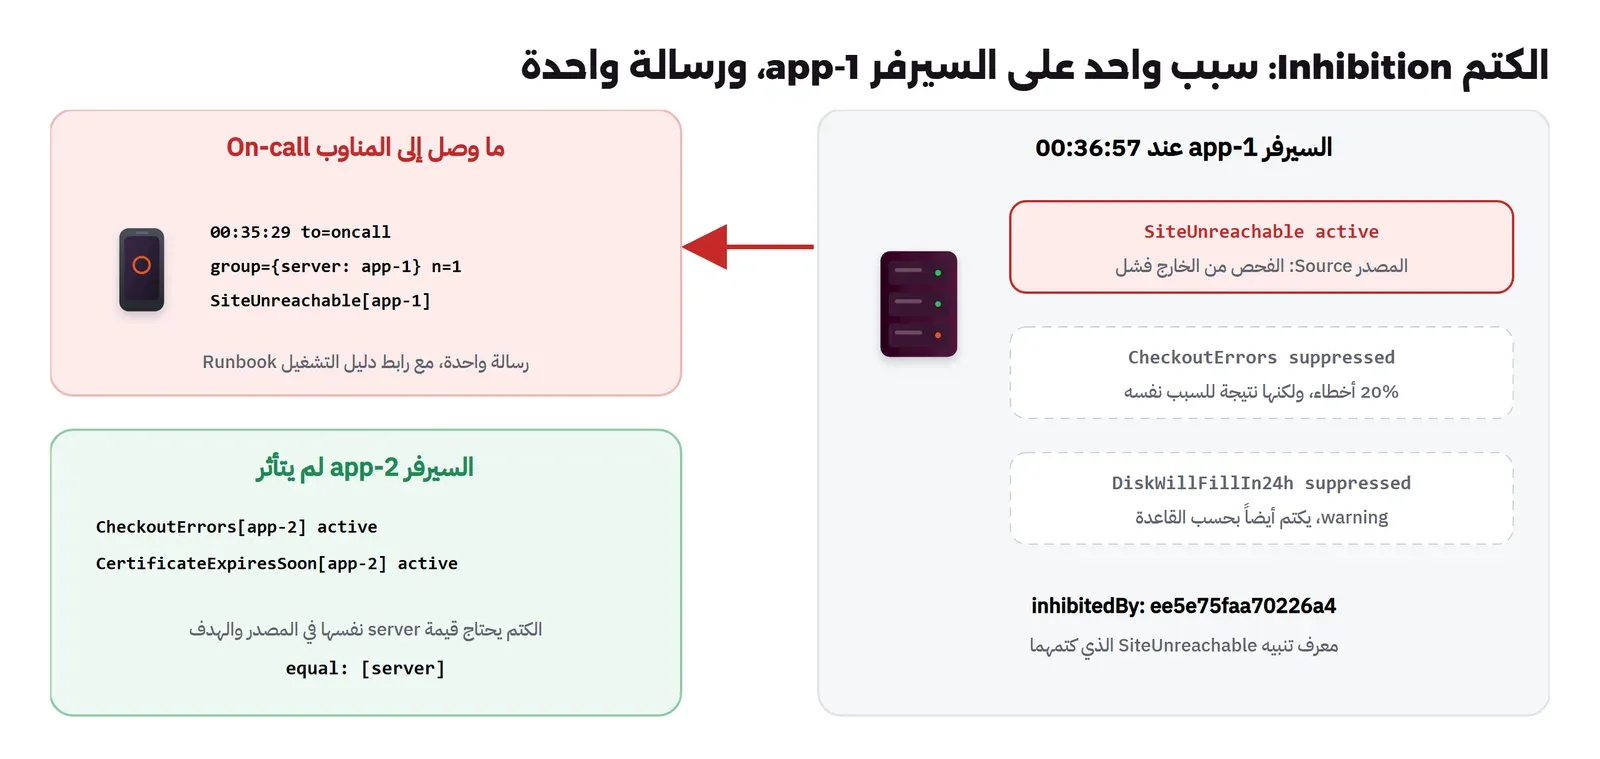
والتنبيهان المكتومان ما زالا موجودين في Alertmanager، وكل منهما يحمل في inhibitedBy معرف التنبيه الذي كتمه، فالمناوب الذي يفتح واجهة Alertmanager يراهما، ولكن هاتفه لم يرن لهما. ثم أعدنا الفحص من الخارج عند 00:39:05، فوصلت هذه الرسالة:
00:39:29 to=oncall status=firing group={'server': 'app-1'} n=2 :: SiteUnreachable[app-1]=resolved, CheckoutErrors[app-1]=firingوهذا هو السلوك الصحيح: عندما انتهى السبب انتهى الكتم، ووصل تنبيه الأخطاء لأنه ما زال صحيحاً، فالموقع يصل إليه الناس الآن ولكن 20% من الدفع يفشل، وهذه مشكلة مستقلة يجب أن يعرفها المناوب. ولاحظ أن الرسالتين جاءتا في رسالة واحدة لأنهما في المجموعة نفسها server: app-1.
وقد يتساءل البعض: لماذا لا نكتم كل شيء عندما يتوقف أي سيرفر؟ والإجابة أن الكتم الواسع يخفي مشاكل حقيقية في أماكن أخرى، ولذلك يجب أن يكون equal دقيقاً، وأن يكون المصدر سبباً حقيقياً لا يمكن أن يتعايش مع الهدف، مثل السيرفر المتوقف وأخطاء خدماته، أو موقع البيانات Datacenter المنقطع وكل ما فيه. وأخطر خطأ هنا قاعدة كتم بلا equal، فيكتم تنبيه واحد في أي مكان كل التنبيهات في كل مكان.
الإسكات Silences: صيانة مخطط لها
الكتم يعمل تلقائياً بقاعدة دائمة، أما الإسكات Silence فهو قرار مؤقت يتخذه إنسان: «أعرف أن هذه المشكلة موجودة، وأعمل عليها، أو هي صيانة مخطط لها، فلا ترسل عنها شيئاً حتى الساعة كذا». ويذكر التوثيق أن الإسكات يعتمد على مطابقة التسميات مثل شجرة التوجيه، وأنه يضاف من واجهة Alertmanager أو بالأداة amtool. وفي المختبر كان CheckoutErrors على app-2 مطلقاً بسبب مزود الدفع، فأسكتناه نصف ساعة:
docker exec mon-al-am amtool --alertmanager.url=http://localhost:9093 silence add alertname=CheckoutErrors server=app-2 \
  --duration=30m --author="ops-lab" --comment="payment provider maintenance window, ticket OPS-112"
docker exec mon-al-am amtool --alertmanager.url=http://localhost:9093 silence query
0f320e4b-7f80-4a63-9de9-a18b139d46ce
ID Matchers Ends At Created By Comment
0f320e4b-7f80-4a63-9de9-a18b139d46ce alertname="CheckoutErrors" server="app-2" 2026-11-03 01:07:10 UTC ops-lab payment provider maintenance window, ticket OPS-112وبعدها ظهر التنبيه في الواجهة البرمجية بحالة suppressed مع معرف الإسكات:
CheckoutErrors app-2 suppressed ['0f320e4b-7f80-4a63-9de9-a18b139d46ce'] []وللإسكات ثلاث قواعد عملية:
- مدة محددة دائماً: الإسكات بلا نهاية قريبة هو حذف للتنبيه دون أن يعرف أحد، فاجعله بطول الصيانة نفسها مع هامش صغير، وإذا انتهى والمشكلة باقية فسوف تعرف.
- تسميات دقيقة: أسكتنا
CheckoutErrorsعلىapp-2فقط، ولو أسكتناalertname=CheckoutErrorsوحده لاختفت أخطاءapp-1أيضاً، وهذا ما كان سوف يخفي الرسالة التي وصلت عند 00:39:29. - اسم وسبب ورقم تذكرة: الحقلان
--authorو--commentيجيبان لاحقاً عن سؤال «من أسكت هذا ولماذا؟»، وفي الفرق التي تتبادل المناوبة هذا السؤال يتكرر كل أسبوع.
العاجل فوراً، والروتيني في ملخص يومي Daily Digest
نعود إلى القناة التي كتمها الفريق في القصة. أغلب ما كان فيها حقيقي ومفيد، مثل شهادة سوف تنتهي بعد تسعة أيام، أو قرص سوف يمتلئ بعد يومين، أو نسخة احتياطية تأخرت، ولكنه لا يحتاج أن يصل لحظة حدوثه، والمكان المناسب له رسالة واحدة كل صباح يقرؤها شخص بهدوء ويفتح لها تذاكر. والسؤال: كيف تبني هذا الملخص في Alertmanager؟
الأداة التي يوفرها Alertmanager هي active_time_intervals على المسار، ويقول المرجع إن المسار يرسل الرسائل فقط عندما يكون نشطاً، ويعمل بشكل طبيعي في غير ذلك. فإذا جعلت مسار الروتيني نشطاً ربع ساعة كل صباح، مع group_by: [severity] حتى تكون كل التنبيهات الروتينية في مجموعة واحدة، فسوف تصل رسالة واحدة في أول النافذة بكل ما هو مطلق في تلك اللحظة. ولكن هل هذا ما يحدث فعلاً؟ هذا ما جربناه، وقد أطلقت التنبيهات الروتينية قبل النافذة: الشهادة على app-2 عند 00:31، والقرص على app-1 عند 00:34، ثم القرص على app-2 عند 00:38:49 داخل النافذة:
00:38:49 to=digest status=firing group={'severity': 'warning'} n=1 :: CertificateExpiresSoon[app-2]=firing
00:39:49 to=digest status=firing group={'severity': 'warning'} n=3 :: DiskWillFillIn24h[app-1]=firing, CertificateExpiresSoon[app-2]=firing, DiskWillFillIn24h[app-2]=firing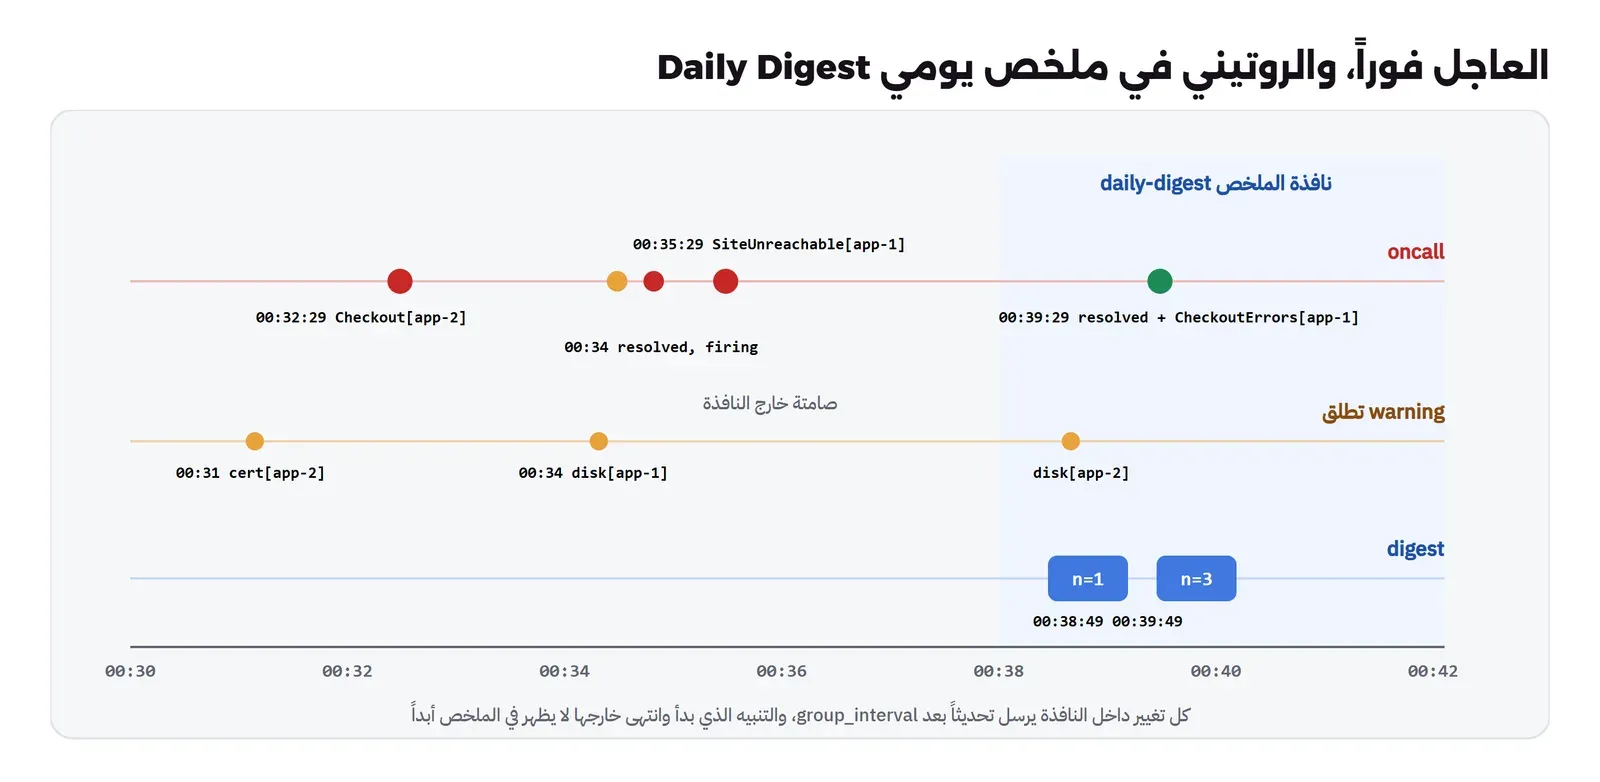
والنتيجة فيها ما نريده وما لا نريده، ويجب أن تعرف الاثنين قبل أن تعتمد على هذه الطريقة:
- ما نجح: لم تصل أي رسالة روتينية قبل 00:38، مع أن الشهادة أطلقت قبلها بسبع دقائق، وكل الرسائل الروتينية في النافذة جاءت مجمعة في مجموعة واحدة
severity: warning، وبعد 00:39:49 لم تتغير المجموعة فلم تصل أي رسالة أخرى حتى نهاية النافذة، لأنrepeat_interval24 ساعة. - ما لم يكن كما توقعنا: الرسالة الأولى حملت تنبيهاً واحداً فقط، مع أن قرص
app-1كان مطلقاً منذ 00:34، والسبب أنه كان في تلك اللحظة مكتوماً بتنبيهSiteUnreachable، فلما انتهى الكتم عند 00:39 دخل في التحديث التالي. وهذا يعني أن الملخص ليس رسالة واحدة بالضرورة، فكل تغيير في المجموعة داخل النافذة يرسل تحديثاً بعدgroup_interval. - ما لا تستطيعه هذه الطريقة: التنبيه الروتيني الذي يطلق في الليل وينتهي قبل الصباح لا يظهر في الملخص أبداً، لأن Alertmanager يرسل ما هو مطلق داخل النافذة فقط، وليس ما حدث خلال اليوم. فإذا كان مهماً أن تعرف أن القرص اقترب من الامتلاء ثلاث مرات أمس ثم نزل، فهذا ليس تنبيهاً، وإنما تقرير.
ثم جربنا الحالة الأخيرة: عند 00:44:31، أي بعد أن انتهت النافذة، جعلنا شهادة app-1 تنتهي بعد سبعة أيام، فأطلق التنبيه عند 00:44:39، وسألنا Alertmanager بعد ثلاث دقائق:
CertificateExpiresSoon app-1 active 2026-11-03T00:44:39التنبيه في حالة active داخل Alertmanager، ولكن لم تصل عنه أي رسالة حتى 00:48، ولن تصل حتى تبدأ نافذة الغد، وهذا بالضبط ما نريده لشهادة بقي لها أسبوع.
والخلاصة العملية لهذه التجربة: active_time_intervals مع group_by: [severity] تعطيك ملخصاً صباحياً جيداً لما هو قائم الآن، وهذا يكفي أغلب الفرق الصغيرة، فاجعل النافذة قصيرة، مثل ربع ساعة، وgroup_interval قريباً من طولها حتى لا تصل تحديثات كثيرة داخلها، وحدد المنطقة الزمنية بالحقل location مثل Asia/Riyadh، لأن المرجع يذكر أن الأوقات تفسر بتوقيت UTC إذا لم تحددها. وإذا احتجت تقريراً بكل ما حدث خلال اليوم، فاكتب مهمة مجدولة صغيرة تسأل Prometheus عن السلسلة ALERTS خلال آخر 24 ساعة، وهي سلسلة يكتبها Prometheus لكل تنبيه في حالة الانتظار أو الإطلاق، وترسل النتيجة رسالة واحدة. وكثير من منصات المناوبة التجارية والمفتوحة تقدم هذا الملخص جاهزاً، ولكن الفكرة واحدة.
روابط دليل التشغيل Runbook في كل تنبيه
كل قاعدة في مختبرنا تحمل runbook_url، والمستقبل يطبعه تحت كل رسالة كما رأيت:
00:32:29 to=oncall status=firing group={'server': 'app-2'} n=1 :: CheckoutErrors[app-2]=firing
         runbook: https://wiki.example.com/runbooks/checkout-errors
والسبب أن المناوب الذي يستيقظ في الثالثة فجراً لا يجب أن يتذكر أي شيء، وإنما يفتح الرابط ويتبع الخطوات. ويقول دليل التنبيه في Prometheus إن التنبيهات يجب أن تربط باللوحات المناسبة وتجعل معرفة المكون المسؤول سهلة، ودليل التشغيل هو الامتداد الطبيعي لذلك. وفي أدلة التشغيل في مشروع Prometheus Operator مثال جيد على الشكل، حيث كل دليل له أربعة أقسام: المعنى Meaning، والأثر Impact، والتشخيص Diagnosis، والعلاج Mitigation. ومثال لدليل تنبيه أخطاء الدفع في فريقنا:
# CheckoutErrors
Meaning:    more than 5% of checkout requests failed for 1 minute on one server.
Impact:     customers cannot pay; every minute is lost orders.
Diagnosis:  1. Open the "Checkout golden signals" dashboard for the server in the alert.
            2. Errors with normal latency: check the payment provider status page and our provider logs.
            3. Errors with high latency and the pool at 100%: see the "CheckoutSaturated" runbook.
            4. Errors right after a deploy: compare the error start time with the last deploy time.
Mitigation: roll back the last deploy, or switch to the backup payment provider (steps in section 5).
Owner:      team=dev, escalate to the payments lead after 30 minutes.
ولاحظ أن الدليل نفسه اختبار للتنبيه: إذا لم تستطع أن تكتب قسم العلاج، أي لا يوجد شيء يفعله المناوب، فالتنبيه غير قابل للتنفيذ، ومكانه لوحة أو ملخص وليس الهاتف. وإذا كان العلاج دائماً الأمر نفسه، مثل إعادة تشغيل خدمة، فالتنبيه مرشح للأتمتة كما في السؤال الثالث من الصورة الأولى.
تنبيه Watchdog: هل يعمل مسار التنبيه نفسه؟
ذكرنا في مقال فحص التوفر أن نظام التنبيه لا يستطيع أن ينبه على توقفه، وأن الحل الأول فحص مستقل من الخارج، والحل الثاني تنبيه Watchdog. وفي مختبرنا القاعدة Watchdog شرطها vector(1)، أي صحيح دائماً، ومسارها فيه repeat_interval: 1m، ووصلت رسالته بانتظام طوال التجربة، ولكن ليس كل دقيقة كما كتبنا:
docker logs mon-al-hook | grep watchdog | head -400:30:15 to=watchdog status=firing group={'alertname': 'Watchdog'} n=1 :: Watchdog[-]=firing
00:32:09 to=watchdog status=firing group={'alertname': 'Watchdog'} n=1 :: Watchdog[-]=firing
00:34:09 to=watchdog status=firing group={'alertname': 'Watchdog'} n=1 :: Watchdog[-]=firing
00:36:09 to=watchdog status=firing group={'alertname': 'Watchdog'} n=1 :: Watchdog[-]=firingالرسائل العشر جاءت كل دقيقتين بالضبط، من 00:32:09 إلى 00:48:09، والمرجع يذكر أن إعادة الإرسال تفحص عند كل دورة من group_interval، والتفسير الأرجح أنه عندما يكون الاثنان دقيقة واحدة فإن الدورة التي تأتي بعد دقيقة من الإرسال تجد أن المدة لم تكتمل بفارق أجزاء من الثانية، فتنتظر الدورة التالية. والدرس أن الإيقاع الحقيقي قد يكون ضعف ما كتبت، فاجعل مهلة الخدمة الخارجية التي تنتظر Watchdog عدة أضعاف هذا الإيقاع، مثل عشر دقائق، وإلا أطلقت تنبيهاً كاذباً بأن مسار التنبيه متوقف.
وفي الإنتاج يذهب هذا الإرسال إلى خدمة خارجية تعرف أنه يصل كل دقيقة، مثل فحص Push في Uptime Kuma على سيرفر آخر كما بنينا في المقال السابق، فإذا غاب أكثر من بضع دقائق فهي التي تنبهك بطريقها الخاص. والقيمة هنا أن Watchdog يختبر المسار كاملاً: Prometheus يقيم القواعد، ويرسل إلى Alertmanager، وAlertmanager يوجه ويرسل، والشبكة تخرج، والمستقبل يستقبل، فأي خطوة تتعطل تقطع النبض.
قياس تعب التنبيهات Alert Fatigue
شرحنا تعب التنبيهات وأسبابه في مقال المفاهيم، والإضافة هنا أنك تستطيع أن تقيسه، لأن Alertmanager نفسه يعرض مقاييس Prometheus عن كل ما يرسله، ومنها عدد الرسائل لكل مستقبل:
curl -s 127.0.0.1:19093/metrics | grep -E '^alertmanager_notifications_total|^alertmanager_alerts\{'alertmanager_alerts{state="active"} 6
alertmanager_alerts{state="suppressed"} 1
alertmanager_alerts{state="unprocessed"} 0
alertmanager_notifications_total{integration="webhook"} 17وعدد الرسائل 17 خلال ثماني عشرة دقيقة، منها عشر لـ Watchdog وخمس للمناوب واثنتان للملخص، وهذا يطابق ما طبعه المستقبل سطراً بسطر. ولاحظ أن المقياس مقسم بحسب نوع التكامل Integration، أي webhook أو email أو slack، وليس بحسب المستقبل، فإذا أردت أن تعرف كم رسالة وصلت إلى المناوب وحده فاجعل كل مستقبل مهم يستخدم تكاملاً مختلفاً، أو اعده عند المستقبل نفسه. والفكرة العملية أن تضع هذا الرقم في لوحة، وتنظر إليه في اجتماع أسبوعي قصير مع قائمة التنبيهات التي أطلقت: كل تنبيه عاجل لم يحتج عملاً يعدل أو يحذف أو ينقل إلى الملخص، وكل حادثة عرفتم بها من عميل قبل التنبيه تضيف قاعدة. وإذا كان عدد الرسائل العاجلة في الأسبوع أكبر من بضع رسائل، فقد تجاوزتم الحد الذي يذكره كتاب SRE، وهذا سبب كاف لإيقاف إضافة القواعد حتى تنظفوا الموجود.
أين تذهب الرسائل؟ المستقبلات Receivers
المستقبل في Alertmanager هو اسم يجمع طريقة أو أكثر للإرسال، مثل البريد وSlack وTelegram وWebhook وخدمات المناوبة، والمرجع يسرد عشرات التكاملات Integrations الجاهزة، وقد رأيتها كلها في مقاييس Alertmanager في القسم السابق. واختيار الطريقة لكل مستوى أهم من اختيار الأداة نفسها، والقاعدة التي تناسب فريقاً صغيراً:
- العاجل: طريقة تصل إلى شخص واحد محدد وتوقظه، مثل تطبيق مناوبة على الهاتف يرن بصوت، أو مكالمة، وليس قناة يقرؤها الجميع ولا يتحمل مسؤوليتها أحد. وإذا لم يرد المناوب خلال مدة محددة فيجب أن يصعد التنبيه Escalation إلى شخص ثان، وAlertmanager نفسه لا يقوم بالتصعيد ولا يعرف جدول المناوبة، وهذه وظيفة أداة المناوبة التي يرسل إليها.
- الروتيني: رسالة واحدة في قناة الفريق أو بريد صباحي، يقرؤها المسؤول عن الملخص في ذلك الأسبوع ويفتح التذاكر.
- Watchdog: خدمة خارجية فقط، ولا يجب أن يراه أي إنسان إلا عندما يغيب.
ولاحظ أمراً يغفل عنه كثيرون: البريد الذي يرسله Alertmanager يمر بخادم بريد، فإذا كان هذا الخادم على السيرفر نفسه، أو كانت رسائله ترفض عند المستقبل بسبب إعدادات توثيق البريد للنطاق، فإن التنبيه لا يصل، وقد رأينا في حادثة GitLab التي ذكرناها في مقال المفاهيم أن رسائل التنبيه عن فشل النسخ الاحتياطي رفضها الخادم المستقبل لأن DMARC لم يكن مفعلاً لها. لذلك أرسل رسالة اختبار من Alertmanager إلى كل مستقبل بعد أي تغيير، وتأكد بعينك أنها وصلت، ولا تكتفي بأن amtool check-config قال SUCCESS، لأنه يفحص صيغة الملف فقط.
تنبيهات الأمن Security Alerts: العاجل والروتيني أيضاً
كل ما سبق ينطبق على تنبيهات الأمن، وهي التي سوف نجمعها مع البقية في البوابة الواحدة في المقال القادم. فأداة مثل Wazuh التي شرحناها في دليل Wazuh تنتج مئات الأحداث في اليوم على سيرفرات قليلة، وأداة فحص الثغرات مثل Trivy التي شرحناها في دليل فحص الحاويات قد تجد عشرات الثغرات في Image واحدة، فإذا أرسلت كل ذلك فوراً إلى المناوب فقد أعدت قصة القناة المكتومة نفسها، ولكن هذه المرة مع الأمن. والتقسيم نفسه يعمل هنا:
- عاجل فوراً: ما يدل على هجوم يحدث الآن أو استغلال مؤكد، مثل تخمين كلمات مرور ناجح، أو ملف تنفيذي جديد في مجلد الموقع، أو ثغرة في خدمة مكشوفة للإنترنت موجودة في قائمة الثغرات المستغلة فعلاً KEV، كما شرحنا في ترتيب أولوية الثغرات.
- الملخص اليومي: الثغرات الجديدة الأخرى مرتبة بحسب الأولوية، وتحديثات الحزم المتاحة، ونتائج تقييم الإعدادات، فهذه تحتاج عملاً في الأيام القادمة وليس في الثالثة فجراً.
- لوحة فقط: الأحداث منخفضة المستوى التي يحتاجها من يحقق في حادثة، ولا يحتاجها أحد قبل ذلك.
والفرق الوحيد في الأمن أن الخطأ في الاتجاه الآخر أغلى: تنبيه أمني عاجل ضاع بين الضجيج قد يعني أياماً يبقى فيها المخترق داخل السيرفر، ولذلك راجع قواعد الأمن العاجلة بالأسئلة الأربعة نفسها، ولكن لا تنقل شيئاً منها إلى الملخص إلا بعد أن تتأكد أن أحداً يقرأ الملخص فعلاً كل صباح.
أخطاء شائعة Common Mistakes
- كل القواعد إلى قناة واحدة: العاجل والروتيني معاً، فيكتم الفريق القناة ويضيع العاجل، كما في القصة.
- التنبيه على الأسباب بدل الأعراض: المعالج 90% والقرص 81% يوقظان أحداً دون أن يتأثر مستخدم.
forصفر على كل شيء: كل ارتفاع عابر يصبح رسالة، ثم رسالة حل بعدها بثوان.group_byبكل التسميات: مثل[alertname, instance, job, server, ...]، فتصبح كل مجموعة تنبيهاً واحداً، ويضيع التجميع كله، ومثلهgroup_by: ['...']الذي يجمع بكل التسميات فيلغي التجميع عملياً.- المستقبل الافتراضي هو المناوب: كل قاعدة نسي أحد تصنيفها توقظ أحداً.
- قاعدة كتم بلا
equal: تنبيه واحد في أي مكان يكتم كل شيء في كل مكان. - إسكات بلا مدة أو بتسميات واسعة: يخفي مشاكل أخرى، ولا يعرف أحد لاحقاً من أسكت ولماذا.
- تغيير التسميات والتنبيهات مطلقة: رأينا رسالة «تم الحل» لمشكلة لم تحل بسبب تغيير تسمية.
- تنبيه بلا دليل تشغيل: المناوب يبدأ من الصفر في الثالثة فجراً.
- الاعتماد على الملخص الصباحي لما حدث في الليل: التنبيه الذي بدأ وانتهى قبل النافذة لا يظهر فيه أبداً.
- لا يوجد Watchdog: إذا توقف مسار التنبيه فلن يخبرك أحد، والصمت يشبه الهدوء.
قائمة تحقق Checklist للتنبيهات
| البند | كيف تتحقق منه |
|---|---|
| كل قاعدة عاجلة عرض يشعر به المستخدم | الأسئلة الأربعة في الصورة الأولى لكل قاعدة critical |
كل قاعدة لها severity وteam وrunbook_url | promtool check rules مع مراجعة كود، وسكربت يبحث عن القواعد الناقصة |
المدة for مختارة لكل قاعدة | دقيقة إلى خمس للأعراض، وأطول للتنبؤات |
| العاجل يصل فوراً ومجمعاً | تجربة: رسالة واحدة لكل سيرفر خلال ثوان من الإطلاق |
| الروتيني في ملخص واحد | مسار بـ active_time_intervals وlocation صحيح |
الكتم بـ equal دقيق | إيقاف سيرفر تجريبي يكتم تنبيهاته فقط |
| الإسكات بمدة وسبب | amtool silence query لا يظهر إسكاتاً بلا تعليق أو بمدة أيام |
| Watchdog يصل إلى خدمة خارجية | إيقاف Alertmanager يطلق تنبيهاً من الخدمة الخارجية |
| عدد الرسائل مراقب | alertmanager_notifications_total لكل مستقبل في لوحة، ومراجعة أسبوعية |
| ملف Alertmanager مفحوص | amtool check-config في مسار CI قبل النشر |
تدريب عملي Practice
- أضف إلى
alertmanager.ymlمساراً للتسميةteam="dev"يرسل إلى مستقبل خاص بالمطورين، وتأكد بالأمرamtool config routes test severity=critical team=devأين يذهب التنبيه قبل أن تنشر. - أوقف
mon-al-app1بالكامل بدل تغيير الفحص من الخارج، وراقب ماذا يحدث لتنبيهات القرص عليه، ولماذا لا تحتاج الكتم هنا أصلاً.
حذف المختبر Cleanup
docker rm -f mon-al-app1 mon-al-app2 mon-al-probe mon-al-hook mon-al-am mon-al-prom
docker network rm mon-net
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التنبيه العاجل للأعراض التي يشعر بها المستخدم وتحتاج عملاً وتفكيراً الآن، وكتاب SRE يضع الحد عند حادثتين في مناوبة 12 ساعة، والوسيط المتوقع صفر.
- من تغير الرقم إلى وصول الرسالة 95 ثانية في مختبرنا، منها 60 للمدة
for، وكل جزء قرار بين السرعة والهدوء. - التجميع يجعل المشكلة الواحدة رسالة واحدة، والكتم يخفي نتائج السبب الواحد بشرط
equalدقيق، والإسكات قرار مؤقت بمدة وسبب. - العاجل في مسار يرسل فوراً، والروتيني في مسار نشط ربع ساعة كل صباح، ولكن الملخص يرسل ما هو قائم داخل النافذة فقط.
- كل تنبيه له دليل تشغيل، وWatchdog يختبر المسار كله، وعدد الرسائل نفسه مقياس تراقبه وتراجعه.
وفي المقال الأخير من السلسلة بإذن الله نجمع كل ما بنيناه في بوابة واحدة: لوحة رئيسية في Grafana للسيرفرات والخدمات والسجلات والتنبيهات، مع Wazuh للأحداث الأمنية والثغرات، وميزانيات التخزين من اليوم الأول.
 دليلمفاهيم المراقبة Observability: من الإشارة إلى التنبيهما الذي تجيب عنه المقاييس والسجلات والتتبع، وكيف تبني تنبيهاً على ما يشعر به المستخدم وعلى ميزانية الأخطاء بدل كل رقم.
 دليلفحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟نفحص الموقع والشهادة وRedis من الخارج مع Blackbox Exporter وUptime Kuma، ونكشف النسخ الاحتياطي الذي توقف بصمت، ونتأكد أن أحداً يراقب سيرفر المراقبة نفسه.
 دليلضغط المناوبة On-call والحوادث: كيف تحمي نفسك وفريقكما الحدود التي يضعها كتاب Google SRE للمناوبة المستدامة، وكيف تقلل التنبيهات وتصمم الجدول وتطلب التعويض والراحة دون صدام.
 دليلاللوم بعد العطل Blame: حين يلومك الفريق على ما لم تسببهماذا تقول في الساعة الأولى بعد عطل نسب إليك، وكيف توثق الحقائق بخط زمني، ومتى تصعد اللوم المتكرر ومتى تغادر.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Alertmanager 0.34.2 وPrometheus 3.15.1 وPython 3.13 على Docker Engine 29.8.0.