

يتصل بك أحد الزملاء من فريق المبيعات ويقول إن العملاء يشتكون من بطء صفحة الدفع منذ نصف ساعة، فتفتح لوحة المراقبة Dashboard وتجد كل شيء باللون الأخضر: المعالج CPU في السيرفر عند 3%، والذاكرة مستقرة، والخدمة تعمل ولم تتوقف. والمشكلة هنا ليست غياب المراقبة، فالخدمة مراقبة، وإنما أن المراقبة تجيب عن أسئلة لا يسألها العميل: هل السيرفر يعمل؟ وكم يستهلك من المعالج؟ أما سؤال العميل فهو: هل يكتمل طلبي بسرعة؟ وهذا السؤال لم يضعه أحد في اللوحة ولا في التنبيهات.
وهذا المقال هو بداية مرحلة المراقبة Observability في خارطة الطريق، ونجمع فيه المفاهيم التي تبني عليها بقية المقالات: ما الفرق بين المراقبة التقليدية وال Observability، وما الذي يجيب عنه كل نوع من الإشارات، وماذا تقيس في السيرفر وفي الخدمة، وكيف تبني تنبيهاً يوقظك عندما يتأثر المستخدم فعلاً ولا يوقظك لأجل رقم لا يعني شيئاً. وسوف نتناول في هذا المقال:
- الفرق بين المراقبة Monitoring وال Observability.
- الإشارات الثلاث: المقاييس Metrics والتتبع Traces والسجلات Logs، والسؤال الذي يجيب عنه كل منها، مع مثال عملي على حادثة بطء حقيقية في خدمة صغيرة.
- لماذا نقيس زمن الاستجابة بالنسب المئوية Percentiles وليس بالمتوسط.
- ماذا تقيس: طريقة USE للموارد، وطريقة RED للخدمات، والإشارات الذهبية Golden Signals من كتاب Google SRE.
- التنبيه على ما يشعر به المستخدم بدل التنبيه على الأسباب، وأهداف الخدمة SLO وميزانية الأخطاء Error Budget ومعدل الاستهلاك Burn Rate.
- إرهاق التنبيهات Alert Fatigue، وخريطة الأدوات التي نشرحها في هذه المرحلة.
ما الفرق بين المراقبة Monitoring وال Observability؟
المراقبة Monitoring هي أن تحدد مسبقاً ما الذي يمكن أن يفشل، ثم تضع له رقماً ولوحة وتنبيهاً: امتلاء القرص، وتوقف الخدمة، وارتفاع المعالج. وهذا جيد ولا غنى عنه، ولكنه يغطي فقط الأعطال التي توقعتها، أي الأسئلة التي كتبتها قبل أن تحدث المشكلة. أما ال Observability فيعرفها توثيق OpenTelemetry بأنها القدرة على فهم النظام من الخارج بأن تسأله أسئلة دون أن تعرف تفاصيله الداخلية، ويضيف أن ذلك يعتمد على أن يرسل التطبيق إشاراته من مقاييس وتتبع وسجلات، حتى تجيب عن الأسئلة الجديدة دون أن تضيف كوداً جديداً وتنشره.
والفرق يظهر وقت الحادثة: في المثال الذي بدأنا به لم يكن أحد يتوقع أن تبطئ السلات الكبيرة وحدها، فلا توجد لوحة لذلك ولا تنبيه. فإذا كان كل ما عندك هو أرقام المعالج والذاكرة فسوف تبقى تخمن، وإذا كان التطبيق يرسل مدة كل طلب، وتفاصيل كل جزء منه، وسجلاً مربوطاً بمعرف الطلب، فسوف تسأل النظام «أي الطلبات بطيئة؟ وما المشترك بينها؟» وتصل إلى الجواب في دقائق. لذلك لا تنظر إلى الاثنين كبديلين: المراقبة هي الأسئلة المعروفة التي تنبهك، وال Observability هي ما يسمح لك بالإجابة عن السؤال الذي لم تتوقعه.
ثلاث إشارات Signals، ولكل منها سؤال
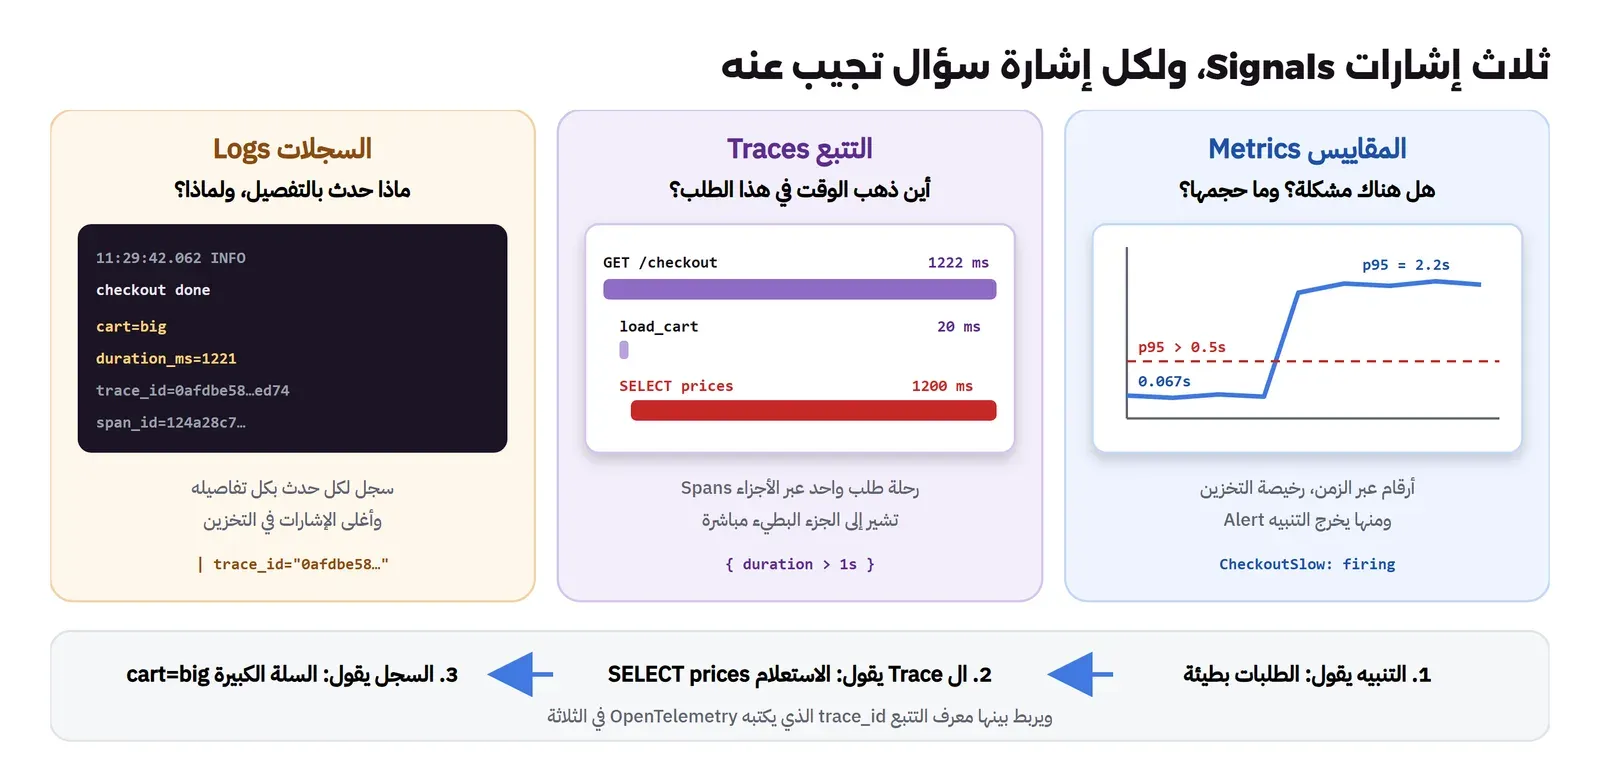
شرحنا في دليل السجلات الإشارات الثلاث باختصار، وهنا نركز على الشيء الأهم عند استخدامها: كل إشارة تجيب عن سؤال مختلف، ولها كلفة مختلفة، ولا تغني إحداها عن الأخرى. والصورة التالية تبين ذلك بأرقام المثال العملي الذي سوف نشرحه بعد قليل:
| الإشارة | السؤال الذي تجيب عنه | شكلها | الكلفة |
|---|---|---|---|
| المقاييس Metrics | هل هناك مشكلة؟ ومنذ متى؟ وما حجمها؟ | أرقام عبر الزمن: عدد الطلبات، ومدتها، ونسبة الأخطاء | الأرخص، وحجمها لا يزيد مع عدد الطلبات وإنما مع عدد السلاسل Series |
| التتبع Traces | أين ذهب الوقت في هذا الطلب؟ وأي خدمة فشلت؟ | شجرة أجزاء Spans لطلب واحد عبر الخدمات | متوسطة، ولذلك تؤخذ منها عينات Sampling في الأنظمة الكبيرة |
| السجلات Logs | ماذا حدث بالضبط؟ ولأي عميل؟ ولماذا؟ | سطر لكل حدث بكل تفاصيله | الأغلى، لأن حجمها يزيد مع كل طلب |
وهناك إشارتان تكملان الصورة: تتبع الأخطاء Error Tracking الذي يجمع الاستثناءات المتشابهة في مشكلة واحدة ويربطها بالإصدار، وله مقال خاص في هذه المرحلة مع GlitchTip، والتحليل المستمر Continuous Profiling الذي يبين أي دالة في الكود تستهلك المعالج والذاكرة، وتضعه OpenTelemetry في قائمة الإشارات التي ما زالت قيد التطوير باسم Profiles.
مثال عملي: صفحة الدفع بطيئة والمعالج مرتاح
لنأخذ مثالاً صغيراً يبين كيف تعمل الإشارات الثلاث معاً. لدينا خدمة دفع اسمها checkout مكتوبة بلغة Python، فيها نقطة واحدة /checkout تحمل السلة ثم تستعلم عن الأسعار، والسلات الكبيرة تصيب استعلاماً بدون فهرس Index فيأخذ 1.2 ثانية بدل 30 ميلي ثانية. والخدمة لا تحتوي على أي كود مراقبة خاص، فقط تعمل تحت opentelemetry-instrument الذي يضيف القياس التلقائي Zero-code Instrumentation لـ Flask، ويرسل الإشارات الثلاث إلى Container واحد هو grafana/otel-lgtm الذي يجمع OpenTelemetry Collector وPrometheus للمقاييس وTempo للتتبع وLoki للسجلات وGrafana للعرض، وهو مناسب للتجربة والتطوير وليس للإنتاج.
والكود التالي هو الخدمة app.py:
# checkout: one small endpoint that produces all three signals through OpenTelemetry.
import logging, time
from flask import Flask, request
from opentelemetry import trace, metrics

app = Flask(__name__)
log = logging.getLogger("checkout")
log.setLevel(logging.INFO)
tracer = trace.get_tracer("checkout")
orders = metrics.get_meter("checkout").create_counter("checkout_orders", description="orders placed")

@app.get("/checkout")
def checkout():
    cart = request.args.get("cart", "small")
    started = time.perf_counter()
    with tracer.start_as_current_span("load_cart") as span:
        span.set_attribute("cart.size", cart)
        time.sleep(0.02)
    with tracer.start_as_current_span("SELECT prices") as span:
        span.set_attribute("db.system.name", "postgresql")
        # big carts hit a price query without an index
        time.sleep(1.2 if cart == "big" else 0.03)
    if request.args.get("fail") == "1":
        log.error("payment provider refused the request", extra={"cart": cart, "error_code": "PSP_UNAVAILABLE"})
        return {"ok": False, "error": "PSP_UNAVAILABLE"}, 503
    orders.add(1, {"cart": cart})
    log.info("checkout done", extra={"cart": cart, "duration_ms": round((time.perf_counter() - started) * 1000)})
    return {"ok": True, "cart": cart}
وال Dockerfile يثبت Flask وحزم OpenTelemetry بإصدارات ثابتة:
FROM python:3.13.17-slim
RUN pip install --no-cache-dir flask==3.1.3 \
    opentelemetry-distro==0.66b1 opentelemetry-exporter-otlp-proto-http==1.45.1 \
    opentelemetry-instrumentation-flask==0.66b1 opentelemetry-instrumentation-logging==0.66b1 \
    opentelemetry-instrumentation-system-metrics==0.66b1
WORKDIR /app
COPY app.py load.py ./
CMD ["opentelemetry-instrument", "flask", "--app", "app", "run", "--host", "0.0.0.0", "--port", "8080"]
والملف compose.yaml يشغل الخدمة بجانب otel-lgtm، ويحدد عبر متغيرات البيئة اسم الخدمة وإصدارها وعنوان الإرسال:
name: obs1-intro
services:
  lgtm:
    image: grafana/otel-lgtm:0.37.0
    container_name: obs1-lgtm
    volumes:
      - ./prometheus.yaml:/otel-lgtm/prometheus.yaml:ro
      - ./alerts.yaml:/otel-lgtm/alerts.yaml:ro
    ports:
      - "127.0.0.1:33000:3000"   # Grafana
      - "127.0.0.1:33090:9090"   # Prometheus
      - "127.0.0.1:33200:3200"   # Tempo
      - "127.0.0.1:33100:3100"   # Loki
  app:
    build: .
    image: obs1-checkout:1
    container_name: obs1-app
    environment:
      OTEL_SERVICE_NAME: checkout
      OTEL_RESOURCE_ATTRIBUTES: service.version=1.4.0,deployment.environment.name=lab
      OTEL_EXPORTER_OTLP_ENDPOINT: http://lgtm:4318
      OTEL_EXPORTER_OTLP_PROTOCOL: http/protobuf
      OTEL_METRIC_EXPORT_INTERVAL: "5000"
      OTEL_LOGS_EXPORTER: otlp
      OTEL_PYTHON_LOGGING_AUTO_INSTRUMENTATION_ENABLED: "true"
      OTEL_SEMCONV_STABILITY_OPT_IN: http
    depends_on: [lgtm]
في الإعداد أعلاه لاحظ التالي:
OTEL_SEMCONV_STABILITY_OPT_IN: httpيجعل مقياس مدة الطلبات يظهر بالاسم الثابت في معيار OpenTelemetry، وهوhttp.server.request.durationبالثواني، ويصل إلى Prometheus باسمhttp_server_request_duration_seconds.OTEL_PYTHON_LOGGING_AUTO_INSTRUMENTATION_ENABLEDيرسل سجلات مكتبةloggingعبر OTLP، ويضيف إلى كل سطرtrace_idوspan_idللطلب الذي كتبه، وهذا ما سوف يربط السجل بال Trace.- المنافذ مربوطة بـ
127.0.0.1فقط، لأن Grafana في هذه ال Image تعمل بحساب مدير بدون كلمة مرور.
أما prometheus.yaml فهو ملف الإعداد الذي يأتي مع ال Image نفسها مختصراً، وأضفنا إليه سطرين: ملف القواعد rule_files، وتقييم القواعد كل 15 ثانية:
# The image's own prometheus.yaml (shortened) with two additions: rule_files and a faster rule evaluation.
global:
  scrape_native_histograms: true
  evaluation_interval: 15s
otlp:
  keep_identifying_resource_attributes: true
  promote_resource_attributes:
    - service.name
    - service.version
    - deployment.environment.name
rule_files:
  - /otel-lgtm/alerts.yaml
وفي ملف القواعد alerts.yaml وضعنا ثلاثة تنبيهات، وسوف نعود إلى كل منها في الأقسام التالية: CheckoutSlow على ما يشعر به العميل، وهو أن 95% من الطلبات تنتهي في أقل من نصف ثانية، وCheckoutHighCPU على سبب تقليدي هو المعالج، وCheckoutErrorBudgetBurn على ميزانية الأخطاء:
groups:
  - name: checkout
    rules:
      # Symptom: what the customer feels. p95 of checkout above half a second for one minute.
      - alert: CheckoutSlow
        expr: |
          histogram_quantile(0.95,
            sum by (le) (rate(http_server_request_duration_seconds_bucket{service_name="checkout", http_route="/checkout"}[1m]))
          ) > 0.5
        for: 1m
        labels:
          severity: page
        annotations:
          summary: "checkout p95 is {{ $value | humanizeDuration }}"

      # Cause: a classic resource alert. The app process uses more than 80% of one CPU core.
      - alert: CheckoutHighCPU
        expr: sum by (service_name) (rate(process_cpu_time_seconds_total{service_name="checkout"}[1m])) > 0.8
        for: 1m
        labels:
          severity: ticket

      # SLO: 99.9% of checkout requests succeed over 30 days (error budget 0.1%).
      # Fast burn from the SRE Workbook: burn rate above 14.4 on a long (1h) and a short (5m) window.
      - alert: CheckoutErrorBudgetBurn
        expr: |
          (
            sum(rate(http_server_request_duration_seconds_count{service_name="checkout", http_response_status_code=~"5.."}[1h]))
            / sum(rate(http_server_request_duration_seconds_count{service_name="checkout"}[1h]))
          ) / (1 - 0.999) > 14.4
          and
          (
            sum(rate(http_server_request_duration_seconds_count{service_name="checkout", http_response_status_code=~"5.."}[5m]))
            / sum(rate(http_server_request_duration_seconds_count{service_name="checkout"}[5m]))
          ) / (1 - 0.999) > 14.4
        labels:
          severity: page
        annotations:
          summary: "checkout is burning its error budget fast"
والملف load.py يرسل خمسة طلبات تقريباً في الثانية، ويمكن أن يجعل كل طلب رقم n سلة كبيرة:
# Sends steady traffic to /checkout, about 5 requests per second.
# usage: python load.py <seconds> <every nth request is a big cart, 0 = never> <every nth request fails, 0 = never>
import sys, time, urllib.request, urllib.error
seconds, big, fail = int(sys.argv[1]), int(sys.argv[2]), int(sys.argv[3])
end, i, errors = time.time() + seconds, 0, 0
while time.time() < end:
    i += 1
    cart = "big" if big and i % big == 0 else "small"
    flag = "&fail=1" if fail and i % fail == 0 else ""
    try:
        urllib.request.urlopen(f"http://127.0.0.1:8080/checkout?cart={cart}{flag}").read()
    except urllib.error.HTTPError:
        errors += 1
    time.sleep(0.2)
print(f"sent {i} requests, {errors} errors")
الحادثة: كل طلب رابع سلة كبيرة
نشغل ال Containers، ثم نرسل حركة عادية 40 ثانية، ثم نبدأ الحادثة لمدة ثلاث دقائق بأن تكون كل رابع طلب سلة كبيرة:
docker compose up -d --build
docker exec obs1-app python load.py 40 0 0
docker exec obs1-app python load.py 180 4 0
والمخرج سوف يكون كما يلي:
sent 151 requests, 0 errors
sent 324 requests, 0 errors
لاحظ أنه لا يوجد أي خطأ، فكل الطلبات نجحت، ولو كان تنبيهك الوحيد على الأخطاء أو على توقف الخدمة لما عرفت بشيء. أما حالة القواعد في Prometheus خلال الحادثة فكانت كما يلي، وقد بدأ الحمل في الساعة 08:29:07:
--- 08:29:38
CheckoutSlow pending 2026-10-22T08:29:20.408920948Z 2.1624999999999996e+00
CheckoutHighCPU inactive
--- 08:30:47
CheckoutSlow firing 2026-10-22T08:29:20.408920948Z 2.2e+00
CheckoutHighCPU inactive
--- 08:32:31
CheckoutSlow firing 2026-10-22T08:29:20.408920948Z 2.2e+00
CheckoutHighCPU inactive
التنبيه على ما يشعر به العميل دخل حالة الانتظار pending بعد 13 ثانية من بداية الحادثة، ثم أطلق firing بعد دقيقة كما طلبنا في for: 1m، أما تنبيه المعالج فلم يتحرك أبداً، والسبب يظهر عندما نسأل Prometheus عن استهلاك المعالج خلال الدقائق الثلاث:
sum by (service_name) (rate(process_cpu_time_seconds_total{service_name="checkout"}[3m]))
{"service_name":"checkout"} 0.025831412387494347
أي 2.6% من نواة واحدة، لأن الخدمة لا تعمل وإنما تنتظر الاستعلام البطيء، وهذا بالضبط مشهد البداية: العميل ينتظر والمعالج مرتاح.
من التنبيه إلى ال Trace
التنبيه يقول إن الطلبات بطيئة، ولا يقول لماذا، لذلك ننتقل إلى التتبع ونسأل Tempo بلغة TraceQL عن الطلبات التي أخذت أكثر من ثانية:
{ resource.service.name = "checkout" && duration > 1s }وعند فتح أول نتيجة نجد التالي:
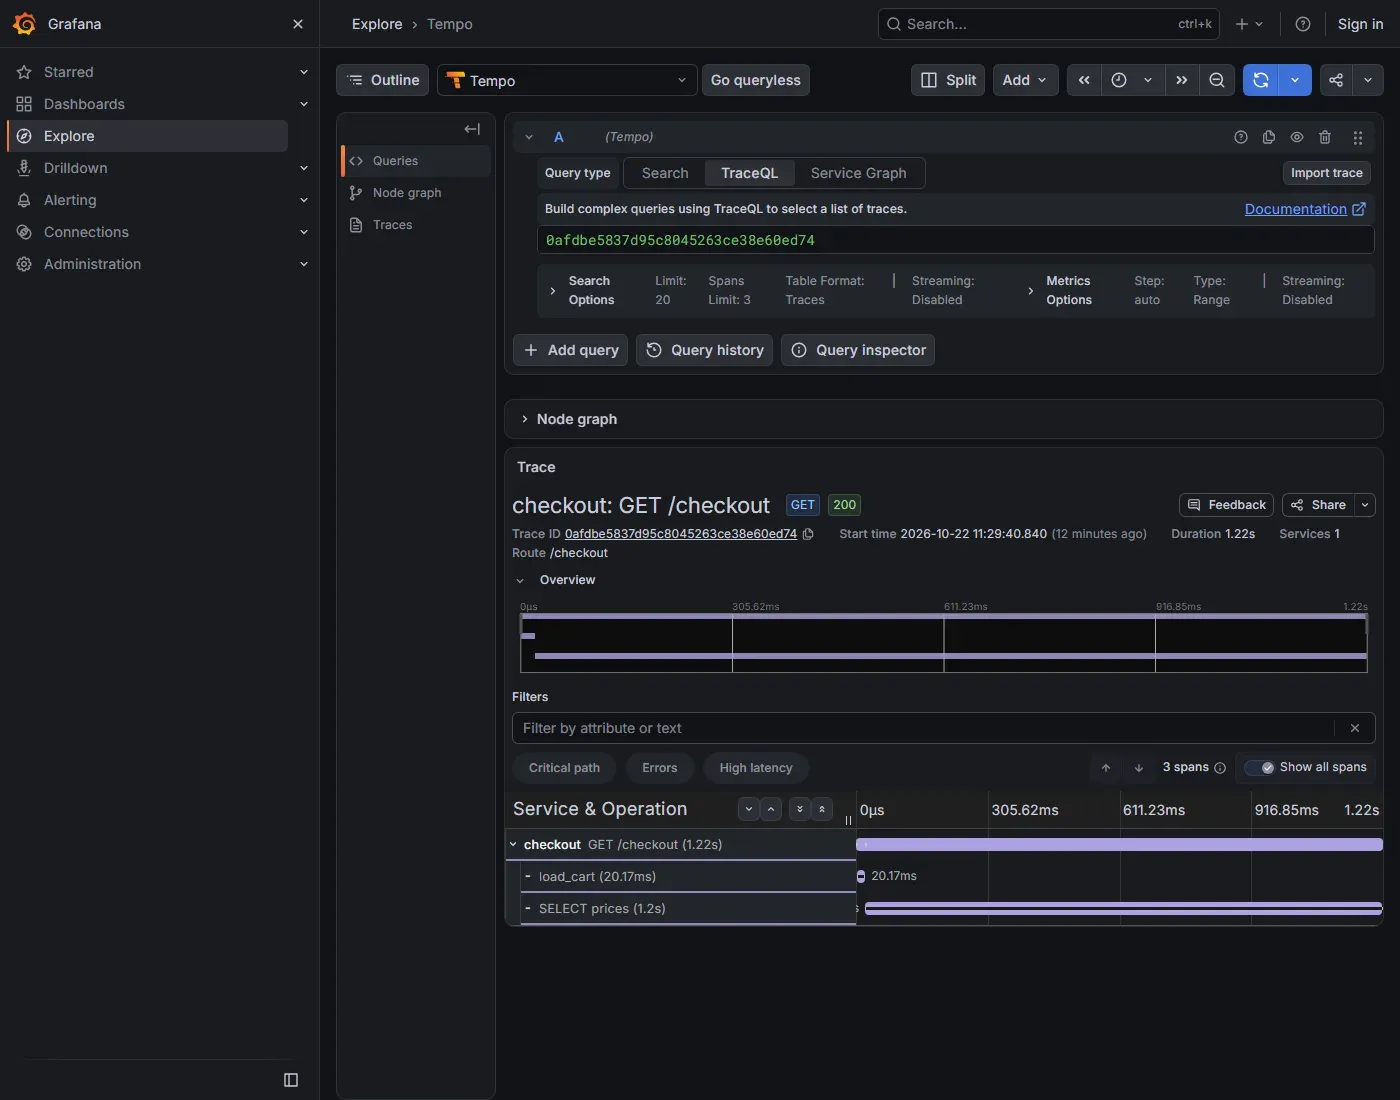
GET /checkout  span=124a28c704dabb0f parent=-   1222.5 ms  {'http.response.status_code': '200', 'http.route': '/checkout'}
load_cart      span=b546da231666f187 parent=124a28c704dabb0f     20.2 ms  {'cart.size': 'big'}
SELECT prices  span=99a733c345036076 parent=124a28c704dabb0f   1200.2 ms  {'db.system.name': 'postgresql'}
الطلب أخذ 1222 ميلي ثانية، منها 1200 في الاستعلام SELECT prices، وحجم السلة big. والصورة التالية تبين ال Trace نفسه في Grafana:
من ال Trace إلى السجل
وبمعرف التتبع نفسه نبحث في Loki عن السجلات التي كتبها هذا الطلب:
{service_name="checkout"} | trace_id="0afdbe5837d95c8045263ce38e60ed74"checkout done
{"cart":"big","duration_ms":"1221","severity_text":"INFO","service_name":"checkout","service_version":"1.4.0",
"span_id":"124a28c704dabb0f","trace_id":"0afdbe5837d95c8045263ce38e60ed74", …}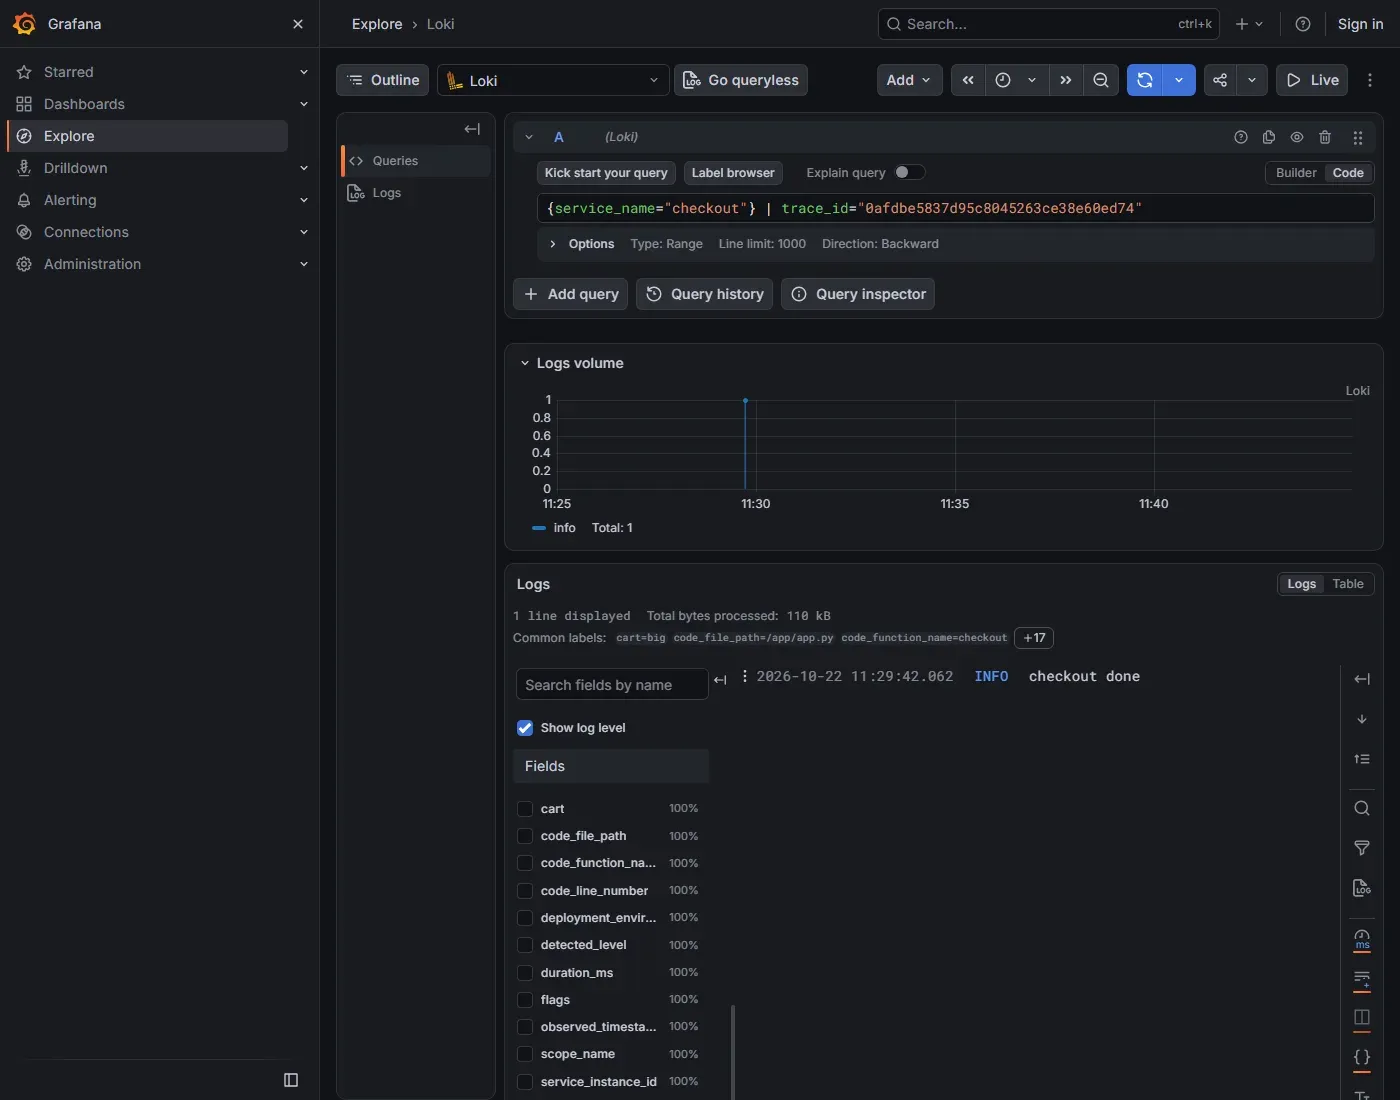
وبهذا الشكل نكون قد انتقلنا من «الطلبات بطيئة» إلى «الاستعلام عن الأسعار بطيء في السلات الكبيرة» في ثلاث خطوات، دون أن نفتح الكود أو نضيف سطراً واحداً، وهذا ما نقصده بال Observability. ولكن لاحظ أن كل خطوة اعتمدت على شيء أعده أحدهم مسبقاً: قياس مدة الطلبات، وتسمية الجزء SELECT prices، وإضافة cart.size إلى ال Span، ومعرف التتبع في السجل. وقد شرحنا تفاصيل التتبع في مقال التتبع الموزع مع OpenTelemetry، وكتابة السجلات التي تساعد وقت الحادثة في مقال السجلات التي تساعدك فعلاً.
لماذا p95 وليس المتوسط Average؟
لاحظ أن التنبيه استخدم النسبة المئوية 95 واختصاراً p95، أي المدة التي تنتهي قبلها 95% من الطلبات. والسبب أن المتوسط يخفي المشكلة التي تصيب جزءاً من العملاء: في المثال كان ربع الطلبات تأخذ 1.2 ثانية، وثلاثة أرباعها نحو 50 ميلي ثانية، فالمتوسط نحو ثلث ثانية، وهو رقم لا يصف أي عميل حقيقي، لا السريع ولا البطيء. أما p50 فهو ما يراه نصف العملاء، وp95 وp99 ما يراه أسوأ العملاء حظاً، وهؤلاء هم من يتصلون بالدعم الفني.
وفي المثال سألنا Prometheus عن النسبتين خلال دقائق الحادثة الثلاث، فكان الجواب كما يلي:
histogram_quantile(0.50, …[3m])  0.06677083333333333
histogram_quantile(0.95, …[3m])  2.2054878048780484
وقد يتساءل البعض: لماذا p95 هنا 2.2 ثانية والطلبات البطيئة كانت 1.22 ثانية؟ والإجابة أن Prometheus لا يحفظ مدة كل طلب، وإنما يحفظ عدد الطلبات في كل فئة Bucket من الفئات التي حددها ال SDK، والفئات الافتراضية التي وصلت من OpenTelemetry لهذا المقياس فيها 0.5 ثم 0.75 ثم 1 ثانية ثم 2.5 ثانية مباشرة، فكل ما يعرفه Prometheus أن نحو 40 طلباً كانت بين 1 و2.5 ثانية، فيقدر p95 بالتوزيع الخطي داخل الفئة. وهذا موضح في توثيق Prometheus عن ال Histograms، والقاعدة العملية منه: اجعل حدود الفئات قريبة من الأرقام التي تهمك، فإذا كان هدفك نصف ثانية فيجب أن تكون 0.5 حداً من حدود الفئات، كما هو في الفئات الافتراضية هنا، فيكون قرار «فوق نصف ثانية أم تحتها» دقيقاً حتى لو كان الرقم المعروض تقريبياً.
ماذا تقيس؟ USE وRED والإشارات الذهبية Golden Signals
أصعب سؤال عند بداية المراقبة ليس «كيف أجمع المقاييس؟» وإنما «أي المقاييس؟»، فأي سيرفر يعطيك مئات الأرقام، وأي مكتبة قياس تعطيك عشرات أخرى. وهناك ثلاث قوائم معروفة تختصر هذا القرار، والصورة التالية تبينها:
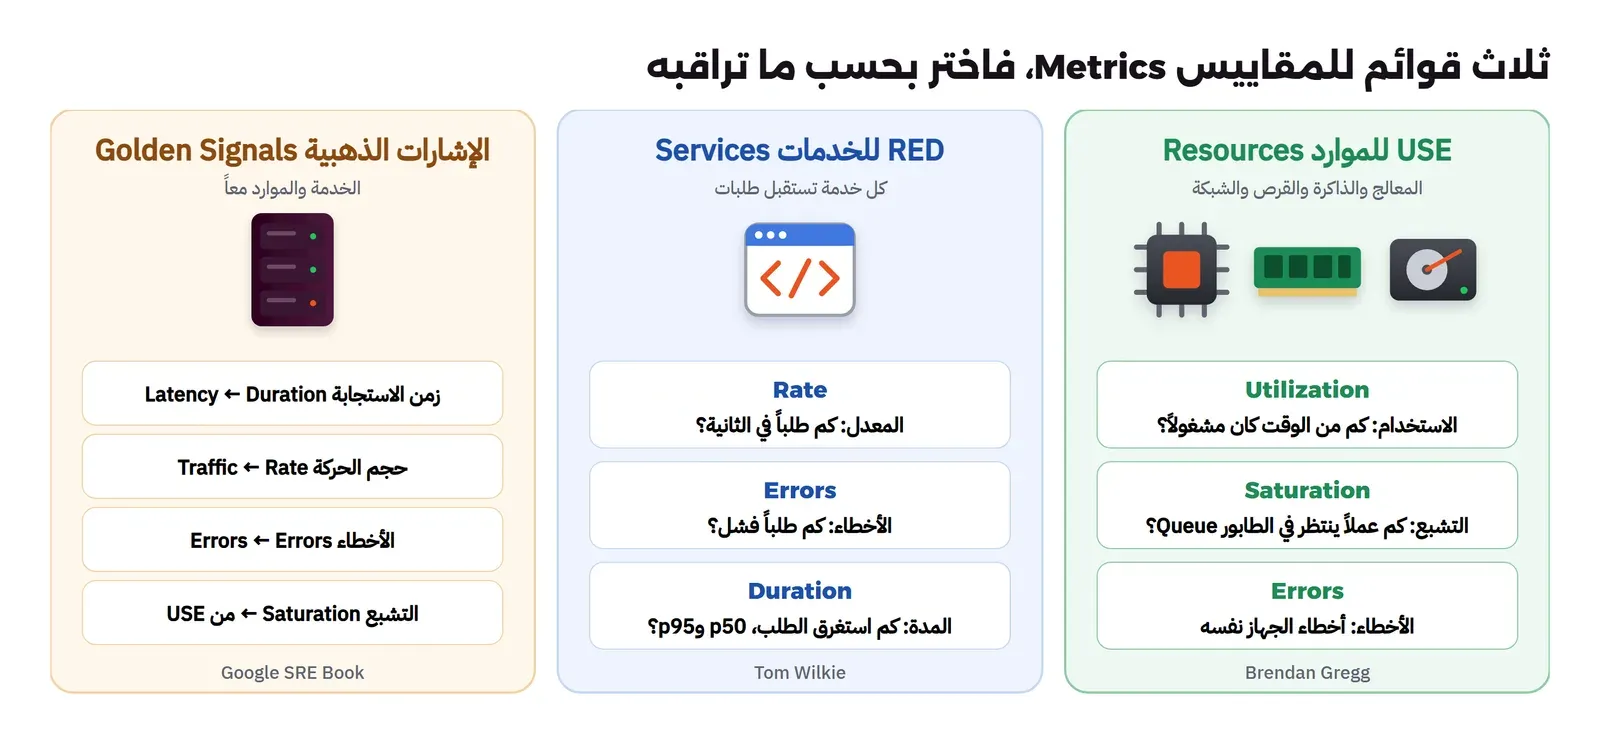
- طريقة USE للموارد: وضعها Brendan Gregg، وملخصها في صفحته: لكل مورد Resource، مثل المعالج والذاكرة والقرص والشبكة، افحص الاستخدام Utilization أي الوقت الذي كان فيه مشغولاً، والتشبع Saturation أي العمل الذي ينتظر لأنه لا يستطيع خدمته، والأخطاء Errors. وهي القائمة التي تستخدمها لتشخيص السيرفر نفسه.
- طريقة RED للخدمات: وضعها Tom Wilkie عام 2015 كما يذكر مقال Grafana عنها: لكل خدمة قس المعدل Rate أي عدد الطلبات في الثانية، والأخطاء Errors أي كم منها يفشل، والمدة Duration أي كم تستغرق. ويذكر المقال أن USE لا تناسب الخدمات وإنما الأجهزة، وأن الطريقتين نظرتان مختلفتان إلى النظام نفسه.
- الإشارات الذهبية الأربع Four Golden Signals: من فصل مراقبة الأنظمة الموزعة في كتاب Google SRE، وهي زمن الاستجابة Latency، وحجم الحركة Traffic، والأخطاء Errors، والتشبع Saturation أي «كم الخدمة ممتلئة». والثلاث الأولى هي RED نفسها بأسماء مختلفة، والرابعة تأتي من USE.
والتطبيق العملي في أغلب الفرق كما يلي: لكل خدمة لوحة RED في أعلاها، ولكل سيرفر أو قاعدة بيانات لوحة USE، فإذا أطلقت لوحة RED تنبيهاً انتقلت إلى USE لتعرف هل السبب في المورد أم في الكود. وفي مثالنا كانت لوحة RED تقول إن المدة ارتفعت، ولوحة USE تقول إن المعالج مرتاح، فالسبب ليس في المورد وإنما في الانتظار، وهذا ما أكده ال Trace.
نبه على ما يشعر به المستخدم Symptoms لا على الأسباب Causes
يقول كتاب Google SRE إن نظام المراقبة يجب أن يجيب عن سؤالين: ما الذي تعطل؟ ولماذا؟ والفكرة أن «ما الذي تعطل» هو العرض Symptom الذي يشعر به المستخدم، مثل البطء والأخطاء، و«لماذا» هو السبب Cause، مثل امتلاء القرص أو ارتفاع المعالج. والتنبيه الذي يوقظ أحداً من نومه يجب أن يكون على العرض، والسبب يبقى في اللوحات وفي التنبيهات غير العاجلة، وذلك لأن:
- العرض يغطي كل الأسباب، حتى التي لم تتوقعها: في مثالنا لم يكن أحد يعرف أن الفهرس ناقص، ومع ذلك أطلق
CheckoutSlowبعد دقيقة. - السبب قد يحدث دون أن يتأثر أحد: المعالج عند 90% في سيرفر يخدم الطلبات بسرعة ليس مشكلة، فإذا أيقظ أحداً فهو تنبيه بلا عمل.
- السبب قد يغيب والمستخدم يعاني: كما رأينا في المعالج عند 2.6% والطلبات تنتظر 1.2 ثانية.
ويضع الكتاب نفسه شروطاً للتنبيه العاجل Page، منها أن كل تنبيه يجب أن يكون قابلاً للتنفيذ Actionable، وأن يتطلب تفكيراً وليس رداً آلياً، فالتنبيه الذي يكون رده دائماً «انتظر حتى يختفي» يجب أن يحذف، والتنبيه الذي يكون رده دائماً الأمر نفسه يجب أن يتحول إلى أتمتة. ولذلك وضعنا في alerts.yaml التسمية severity: page على تنبيه العرض، وseverity: ticket على تنبيه السبب، فالأول يذهب إلى من عليه المناوبة On-call، والثاني يفتح تذكرة تعالج في وقت العمل.
أهداف الخدمة SLI وSLO وميزانية الأخطاء Error Budget
التنبيه على p95 فوق نصف ثانية خطوة جيدة، ولكن الرقم نفسه من أين جاء؟ ولماذا نصف ثانية وليس ثانية؟ وماذا لو كانت هناك أخطاء قليلة متفرقة، هل نوقظ أحداً لكل خطأ؟ هنا تأتي ثلاثة مصطلحات من ممارسات SRE:
- مؤشر الخدمة SLI: وتعرفه OpenTelemetry بأنه قياس لسلوك الخدمة من وجهة نظر المستخدم، مثل نسبة الطلبات الناجحة، أو نسبة الطلبات التي انتهت في أقل من نصف ثانية.
- هدف الخدمة SLO: القيمة التي تلتزم بها لهذا المؤشر خلال مدة محددة، مثل «99.9% من طلبات الدفع تنجح خلال 30 يوماً». ويفصل الكتاب في فصل أهداف الخدمة كيف تختارها، والقاعدة الأهم أن الهدف ليس 100%، لأن المستخدم لا يفرق بين 99.99% و100%، وكل تسعة إضافية تكلف أضعاف ما قبلها.
- ميزانية الأخطاء Error Budget: وهي الباقي من الهدف، فهدف 99.9% خلال 30 يوماً يعني أن 0.1% من الطلبات مسموح أن تفشل، وإذا كانت الأخطاء تعني توقفاً كاملاً فهي 43.2 دقيقة في الشهر، لأن 0.1% من 43200 دقيقة هي 43.2 دقيقة.
والميزانية تغير طريقة الحديث بين الفريق والإدارة: ما دامت الميزانية متبقية فالفريق ينشر الميزات ويجرب، وإذا نفدت يتوقف النشر ويتجه العمل إلى الاستقرار، وهذا موضح في فصل تطبيق أهداف الخدمة في SRE Workbook. أما في التنبيهات فالميزانية تجيب عن سؤالنا: لا نوقظ أحداً لكل خطأ، وإنما عندما تستهلك الأخطاء الميزانية بسرعة تهدد الهدف.
التنبيه بمعدل الاستهلاك Burn Rate
يعرف SRE Workbook معدل الاستهلاك بأنه السرعة التي تستهلك بها الخدمة ميزانية الأخطاء مقارنة بالهدف، ويضرب مثالاً: مع هدف 99.9% خلال 30 يوماً، نسبة أخطاء ثابتة 0.1% تستهلك الميزانية كلها في آخر يوم من الشهر بالضبط، وهذا معدل استهلاك 1. فإذا كانت نسبة الأخطاء 1.44% فالمعدل 14.4، وتنفد الميزانية في 50 ساعة، أي أن كل ساعة تستهلك 2% منها. والصورة التالية تبين ذلك:
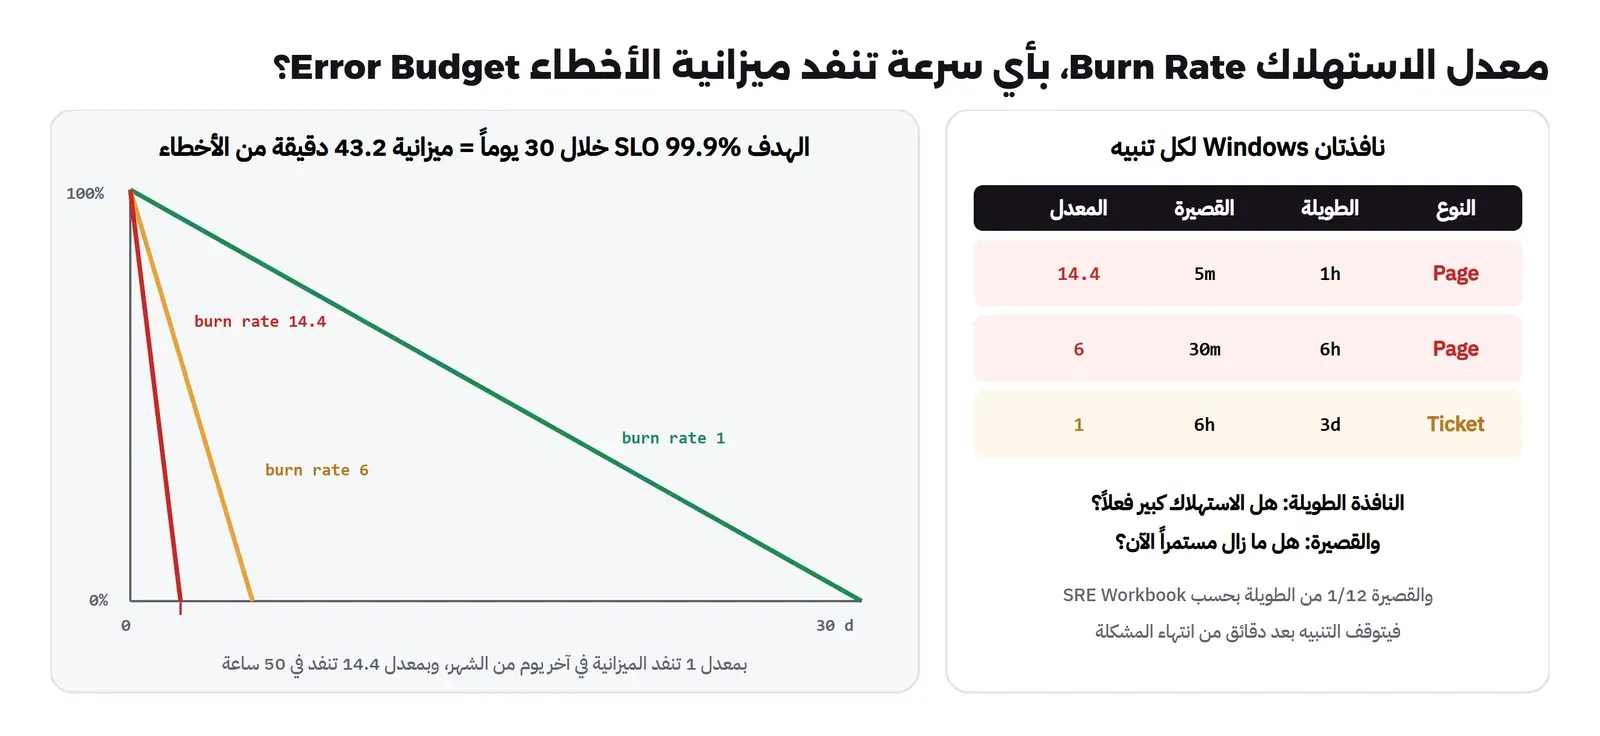
وقد يتساءل البعض: لماذا لا ننبه ببساطة إذا تجاوزت نسبة الأخطاء 0.1% في آخر خمس دقائق؟ والإجابة أن هذا هو الحل الأول الذي يناقشه الفصل نفسه، ويبين مشكلته: النافذة القصيرة وحدها تطلق تنبيهاً لكل ارتفاع عابر لا يهدد الهدف، حتى إنه يحسب أنك قد تستقبل 144 تنبيهاً في اليوم دون أن تعمل على أي منها وتبقى ضمن الهدف. والحل الثاني نافذة طويلة وحدها، مثل ساعة، وهذه تبقى تنبه بعد انتهاء المشكلة بوقت طويل، وتتأخر في اكتشاف المشكلة الكبيرة. والحل الذي يوصي به الفصل هو التنبيه بنافذتين ومعدلات متعددة Multiwindow, Multi-burn-rate، بهذه القيم لهدف 99.9%:
| النوع | النافذة الطويلة | النافذة القصيرة | معدل الاستهلاك | ما يستهلكه من الميزانية |
|---|---|---|---|---|
| Page | ساعة | 5 دقائق | 14.4 | 2% |
| Page | 6 ساعات | 30 دقيقة | 6 | 5% |
| Ticket | 3 أيام | 6 ساعات | 1 | 10% |
والنافذة الطويلة تتأكد أن الاستهلاك كبير فعلاً، والقصيرة تتأكد أنه ما زال مستمراً الآن، فيتوقف التنبيه بعد دقائق من انتهاء المشكلة، ويوصي الفصل بأن تكون القصيرة جزءاً من 12 من الطويلة. والقاعدة CheckoutErrorBudgetBurn في ملف alerts.yaml أعلاه هي السطر الأول من الجدول مكتوباً بلغة PromQL: نسبة الطلبات التي ردت بخطأ 5xx مقسومة على الميزانية (1 - 0.999)، على نافذة ساعة وعلى نافذة خمس دقائق، والتنبيه يطلق فقط إذا تجاوز الاثنان 14.4. ولاحظ أن خطأ 503 الذي يرجعه checkout عند fail=1 يدخل في هذه النسبة لأن المقياس يحمل http_response_status_code، أما الخطأ الذي يرجع 200 مع رسالة خطأ في الجسم فلن تراه هذه القاعدة أبداً، لذلك لا تقم بإرجاع الأخطاء برمز نجاح.
إرهاق التنبيهات Alert Fatigue
إرهاق التنبيهات هو ما يحدث عندما تصل التنبيهات بكثرة، وأغلبها لا يحتاج عملاً، فيتعلم الفريق أن يتجاهلها، ثم يأتي التنبيه الحقيقي فيتجاهله أيضاً. ولا يحدث ذلك فجأة، وإنما بالتدريج: تنبيه على المعالج هنا، وتنبيه على القرص 80% هناك، وتنبيه على كل خطأ في السجل، وبعد أشهر تجد قناة التنبيهات فيها مئات الرسائل في اليوم، ولا أحد يقرؤها. وهذه قواعد عملية لتجنبه:
- قلل التنبيهات العاجلة إلى ما يشعر به المستخدم: تنبيهات الأعراض وميزانية الأخطاء، وتنبيهات قليلة للأسباب التي سوف تصبح عرضاً قريباً لا محالة، مثل قرص سوف يمتلئ خلال ساعات.
- لكل تنبيه صاحب ودليل تشغيل Runbook: رابط في التنبيه نفسه يقول ماذا تفحص أولاً، فإذا لم تستطع أن تكتب هذا الدليل فالتنبيه غير قابل للتنفيذ.
- راجع التنبيهات دورياً: كل تنبيه أطلق ولم يحتج عملاً يعدل أو يحذف، وكل حادثة اكتشفها المستخدم قبلك تضيف تنبيهاً.
- اجمع التنبيهات المتشابهة: أداة مثل Alertmanager تجمع التنبيهات Grouping وتمنع تكرارها Inhibition، فإذا توقفت قاعدة البيانات لا تصلك خمسون رسالة من خمسين خدمة.
- اختبر طريق التنبيه نفسه: التنبيه الذي لا يصل أسوأ من عدمه، لأنك تظن أنك محمي.
خريطة أدوات هذه المرحلة
بعد المفاهيم تأتي الأدوات، والصورة التالية تبين أين تقع كل أداة نشرحها في هذه المرحلة، من مصدر الإشارة إلى العرض والتنبيه:
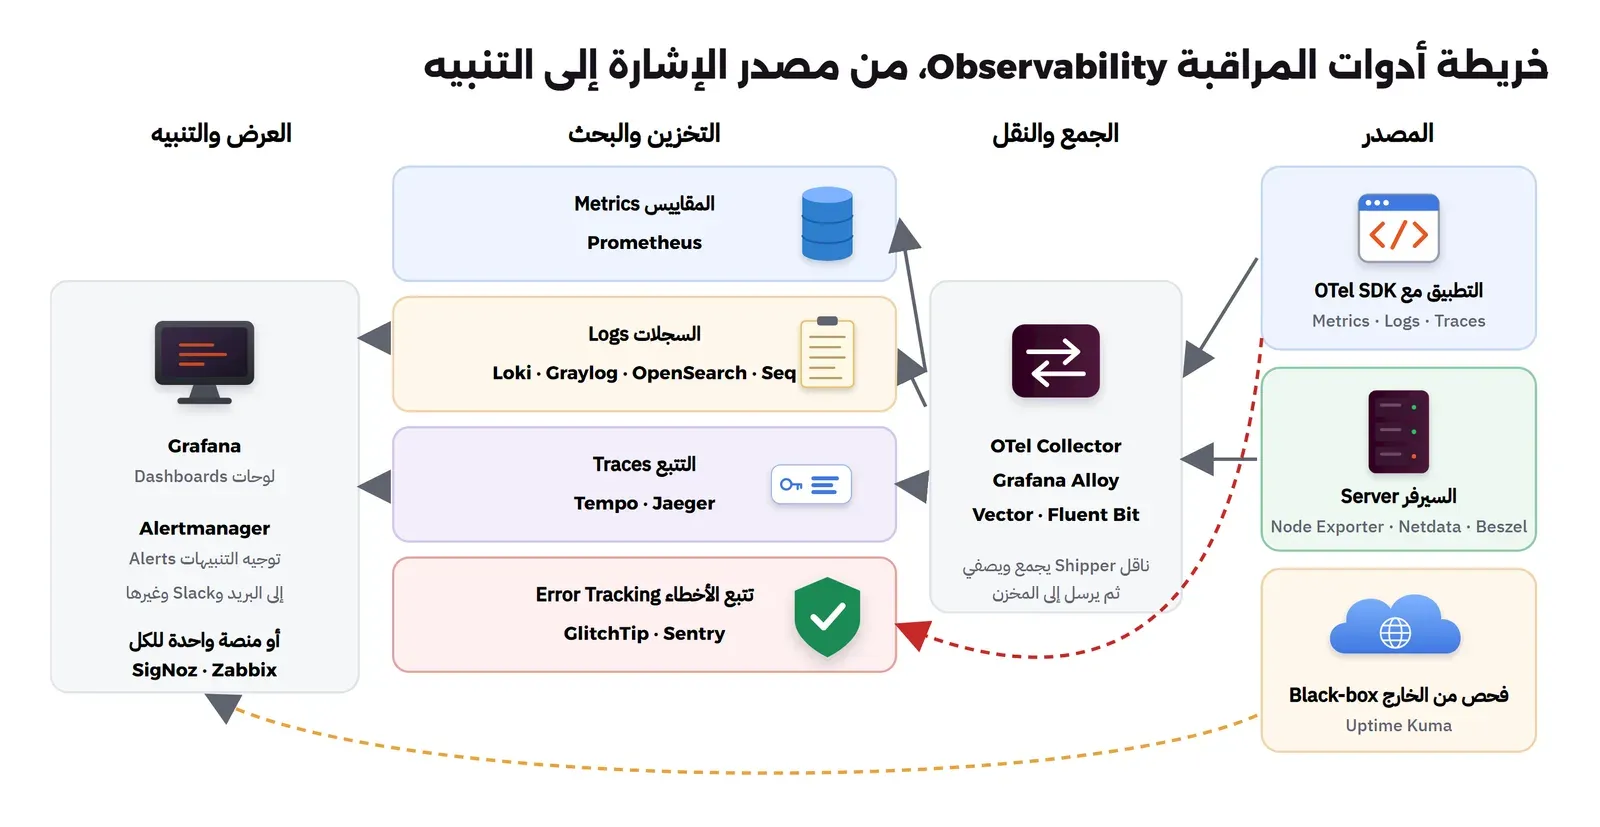
| الحاجة | الأدوات |
|---|---|
| هل الخدمة تعمل من وجهة نظر المستخدم؟ فحص من الخارج Black-box | Uptime Kuma |
| صحة سيرفر واحد بسرعة ودون إعداد كبير | Netdata وBeszel |
| مقاييس السيرفرات والخدمات والتنبيه عليها | Prometheus وNode Exporter وGrafana وAlertmanager |
| كتابة السجلات ونقلها وجمعها مركزياً | مكتبات السجلات، وVector وFluent Bit وGrafana Alloy، وLoki وGraylog وOpenSearch وSeq |
| تتبع الطلبات عبر الخدمات | OpenTelemetry مع Jaeger أو Tempo |
| الاستثناءات في الكود مجمعة ومربوطة بالإصدار | GlitchTip وSentry |
| من فعل ماذا ومتى | سجل التدقيق Audit Trail مع auditd وpgAudit |
| منصة واحدة بدل عدة أدوات | SigNoz، وZabbix لمراقبة البنية التحتية |
والمقالات المنشورة من هذه المرحلة حتى الآن:
 دليلالسجلات Logging للمطورين: ماذا تسجل وماذا لا تسجلكيف تكتب سجلات Logs تساعدك على فهم ما حدث في الإنتاج، وما الذي لا يدخل السجل أبداً، وكيف تجمعها في مكان واحد.
 دليلسجلات تساعدك فعلاً: من «حدث خطأ» إلى سبب المشكلةكيف تكتب سجلات تجيب عن أسئلة الحادثة، بتحقيق في عطل حقيقي بسجلات سيئة ثم بحدث واسع Wide Event لكل طلب، مع قياس الفرق.
 دليلمسار السجل Log Pipeline من التطبيق إلى البحث والتنبيهكيف ينتقل السجل من التطبيق إلى المخزن عبر الناقل Shipper، وكيف تخفي البيانات الشخصية وتوجه الأخطاء وتحمي السجلات إذا توقفت الوجهة.
 دليلAudit Trail: كيف تبني سجل تدقيق لا يقبل العبثكيف تصمم سجلاً يجيب عن سؤال من غير هذه الصلاحية ومتى، وتحميه من الحذف والتعديل بعد كتابته.
 دليلالتتبع الموزع Distributed Tracing مع OpenTelemetryكيف ترى طلباً واحداً يمر بعدة خدمات في شجرة زمنية واحدة، فتعرف أين أبطأ وأين فشل دون أن تخمن من السجلات.
 دليلتتبع الأخطاء Error Tracking للمطورين مع GlitchTipماذا يضيف تتبع الأخطاء فوق السجلات، وكيف تشغل GlitchTip بديلاً خفيفاً لـ Sentry يستقبل أخطاء تطبيقك بالـ SDK نفسه.
 دليلجمع السجلات Logs مركزياً مع Grafana Lokiكيف تشغل Grafana Loki مع Alloy وGrafana، وتختار التسميات Labels التي لا توقف الإدخال، ثم تبحث وتنبه وتحذف بلغة LogQL.
 دليلالسجلات المركزية Logs مع Graylog وOpenSearchكيف تثبت Graylog فوق OpenSearch، وتوجه الرسائل بال Streams وتخفي بياناتها بال Pipelines وتنبه منها، وما الذي لا يجده بحثه العربي.
 دليلسجلات منظمة Structured Logs تبحث فيها بالخصائص مع Seqكيف تشغل Seq وترسل إليه السجلات من .NET وأي لغة أخرى، وتبحث فيها بالخصائص، وتضبط الاحتفاظ والتنبيهات، مع ما يسمح به الترخيص المجاني.
 دليلOpenSearch: البديل المفتوح لـ Elasticsearch وقصة الترخيصلماذا ولد OpenSearch من Elasticsearch، وكيف تشغله على سيرفرك بصلاحيات دقيقة وتنبيهات حقيقية على سجلاتك.
 دليلأي أداة لسجلاتك المركزية؟ مقارنة بالأرقام على البيانات نفسهاأدخلنا 500 ألف حدث في Loki وGraylog وSeq وOpenSearch، وقارنا التخزين والذاكرة والبحث بالعربية والتكلفة ومن يناسبه كل منها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المراقبة Monitoring تجيب عن الأسئلة التي توقعتها، وال Observability تسمح لك بالإجابة عن السؤال الذي لم تتوقعه، بشرط أن يرسل التطبيق إشاراته مسبقاً.
- المقاييس تقول هل هناك مشكلة وما حجمها، والتتبع يقول أين ذهب الوقت، والسجل يقول ماذا حدث بالتفصيل، ومعرف التتبع trace_id يربط الثلاثة.
- قس زمن الاستجابة بالنسب المئوية p50 وp95 وp99 وليس بالمتوسط، واجعل حدود فئات ال Histogram قريبة من الرقم الذي تنبه عليه.
- استخدم RED لكل خدمة وUSE لكل مورد، فالأولى تقول إن المستخدم يعاني، والثانية تقول هل السبب في المورد.
- نبه بشكل عاجل على ما يشعر به المستخدم، وعلى ميزانية الأخطاء بنافذتين ومعدل استهلاك، واترك الأسباب للوحات والتذاكر، واختبر أن التنبيه يصل فعلاً.
وفي المقالات القادمة من هذه المرحلة بإذن الله سوف ننتقل إلى الأدوات نفسها: Uptime Kuma للفحص من الخارج، ثم Prometheus وGrafana وAlertmanager لبناء ما شرحناه هنا على سيرفراتك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ المثال العملي بخدمة Python 3.13.17 مع Flask 3.1.3 وOpenTelemetry Python 1.45.1 في Docker، مع grafana/otel-lgtm 0.37.0 الذي يضم Prometheus 3.15.0 وTempo 3.1.0 وLoki 3.7.8 وGrafana 13.2.3 وOpenTelemetry Collector 0.162.0.


