

عندما يقرر الفريق أن يجمع السجلات في مكان واحد، يبدأ النقاش غالباً من اسم أداة سمع به أحدهم: «نستخدم ELK مثل الجميع»، أو «Loki لأنه مجاني ويعمل مع Grafana». ثم بعد أشهر يكتشف الفريق أن القرص يمتلئ كل أسبوعين، أو أن البحث عن كلمة عربية لا يجد شيئاً، أو أن السيرفر يحتاج ذاكرة ضعف ما توقعه. والسبب أن هذه الأدوات تختلف في الفكرة التي بنيت عليها، أي في ما تفهرسه وقت وصول السطر، وهذا الاختلاف هو ما يحدد التكلفة والسرعة والبحث بالعربية.
وقد شرحنا في مسار السجل Log Pipeline كيف يصل السطر إلى المخزن، ثم ثبتنا كل مخزن في دليل مستقل: Grafana Loki وGraylog وSeq وOpenSearch ومجموعة ELK. وفي هذا المقال نقارنها بالأرقام، بعد أن أدخلنا في كل منها البيانات نفسها وسألناها الأسئلة نفسها:
 دليلجمع السجلات Logs مركزياً مع Grafana Lokiكيف تشغل Grafana Loki مع Alloy وGrafana، وتختار التسميات Labels التي لا توقف الإدخال، ثم تبحث وتنبه وتحذف بلغة LogQL.
 دليلالسجلات المركزية Logs مع Graylog وOpenSearchكيف تثبت Graylog فوق OpenSearch، وتوجه الرسائل بال Streams وتخفي بياناتها بال Pipelines وتنبه منها، وما الذي لا يجده بحثه العربي.
 دليلسجلات منظمة Structured Logs تبحث فيها بالخصائص مع Seqكيف تشغل Seq وترسل إليه السجلات من .NET وأي لغة أخرى، وتبحث فيها بالخصائص، وتضبط الاحتفاظ والتنبيهات، مع ما يسمح به الترخيص المجاني.
 دليلOpenSearch: البديل المفتوح لـ Elasticsearch وقصة الترخيصلماذا ولد OpenSearch من Elasticsearch، وكيف تشغله على سيرفرك بصلاحيات دقيقة وتنبيهات حقيقية على سجلاتك.
 دليلمجموعة ELK: Elasticsearch وLogstash وKibanaكيف تجمع سجلات سيرفراتك في Elasticsearch وتبحث فيها من Kibana بأمان، وما الذي تعنيه رخصته لك اليوم.
في هذا المقال سوف نتناول:
- ماذا تفهرس كل أداة وقت الإدخال، ولماذا يحدد ذلك كل شيء بعده.
- مختبر واحد: 500 ألف حدث في كل أداة، مع زمن الإدخال والتخزين والذاكرة وسرعة أربعة أسئلة.
- لغة الاستعلام في كل أداة للسؤال نفسه، والبحث بالنص العربي.
- التكلفة والترخيص والتوسع Scaling، ثم نقاط القوة ونقاط الضعف لكل أداة.
- من يختار ماذا، وأين يقع VictoriaLogs من كل ذلك.
الفكرة التي تفرق بينها: ماذا يفهرس كل منها؟
كل مخزن سجلات يجيب عن سؤال واحد بطريقته: هل أبني الفهرس Index وقت وصول السطر فأدفع الثمن تخزيناً وذاكرة، أم أؤجل العمل إلى وقت البحث فأدفع الثمن انتظاراً؟ والشكل التالي يبين إجابة كل أداة:
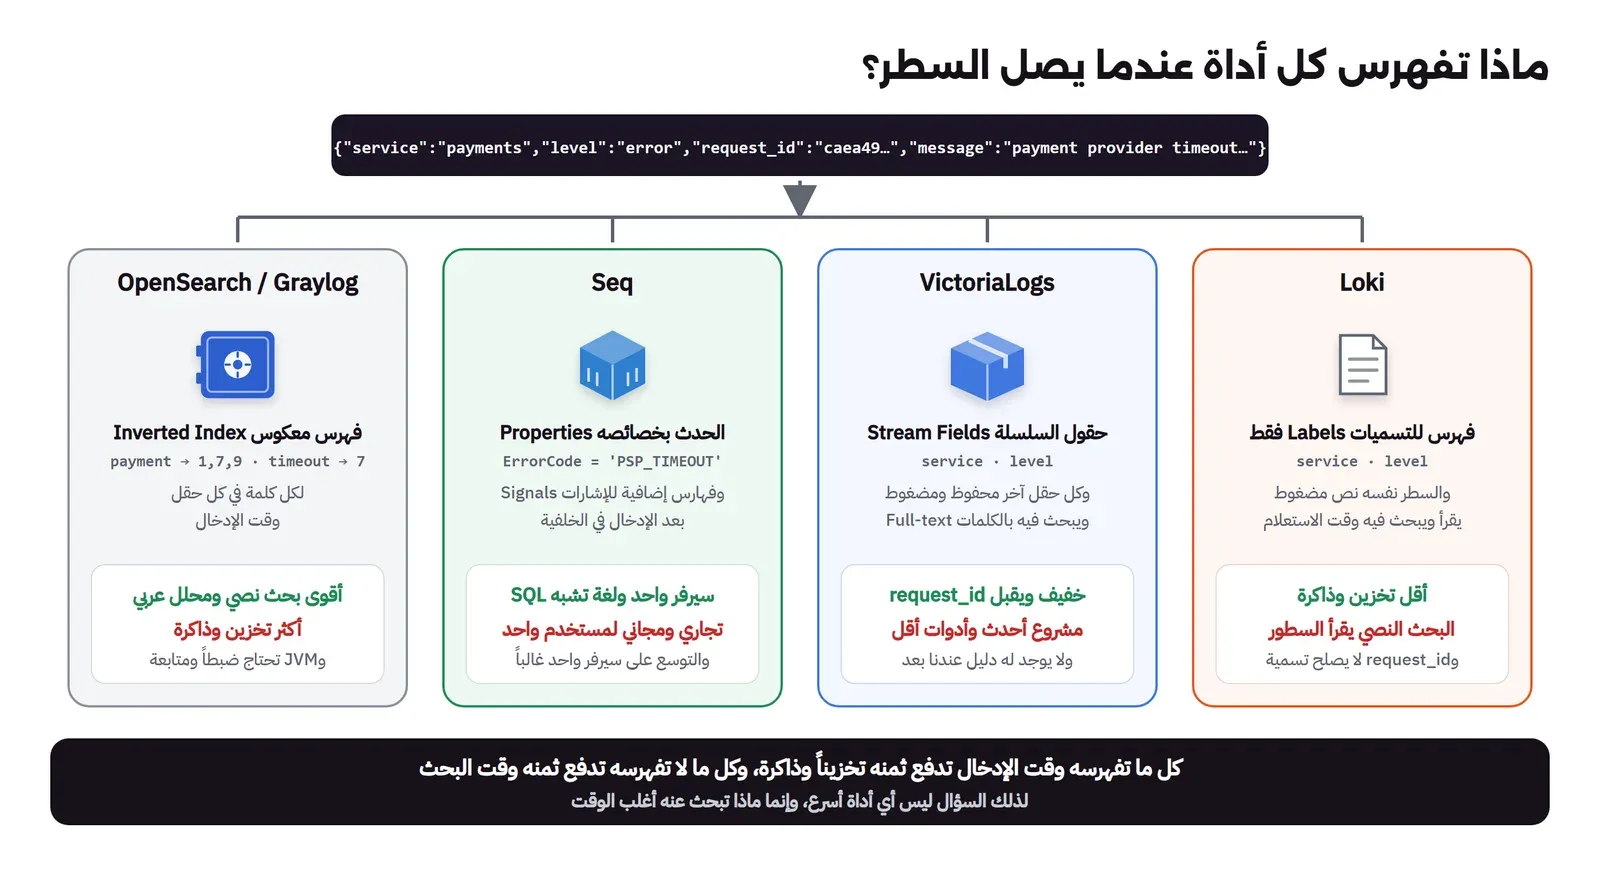
- Loki: يفهرس التسميات Labels فقط، ويخزن السطر نصاً مضغوطاً في أجزاء Chunks، وعند البحث عن كلمة يفك الضغط ويقرأ السطور. ولذلك يجب أن تبقى التسميات قليلة القيم، وقد رأينا في دليل Loki كيف رفض الإدخال عند 5000 سلسلة عندما أصبح معرف الطلب تسمية.
- OpenSearch وElasticsearch وGraylog: تبني فهرساً معكوساً Inverted Index لكل كلمة في كل حقل وقت الإدخال، فالبحث فوري ولكن الفهرس كبير، وGraylog نفسه يخزن الرسائل في OpenSearch.
- Seq: يحفظ الحدث بخصائصه Properties ويستعلم عنها بلغة تشبه SQL، ويبني فهارس للإشارات Signals في الخلفية بعد الإدخال.
- VictoriaLogs: يقسم البيانات إلى أجزاء يومية وكتل مضغوطة، ويقبل الحقول كثيرة القيم مثل
trace_idوuser_idكما تذكر صفحته الرئيسية، ويبحث في النص بالكلمات.
المختبر: البيانات نفسها في خمس أدوات
ولدنا بسكربت Python ملفاً فيه 500 ألف حدث JSON موزعة على 12 ساعة لثماني خدمات، بنسبة 3% أخطاء و7% تحذيرات، و5% منها فيها حقل message_ar بجملة عربية مثل «فشل الدفع بسبب انتهاء المهلة»، وحجم الملف 152 MB. ثم أرسلنا الملف نفسه إلى كل أداة بأداة Vector 0.60.0 بالصيغة التي تفهمها، وكل أداة وحدها على الجهاز ثم حذفناها قبل التالية:
| الأداة | الإصدار | طريق الإدخال من Vector |
|---|---|---|
| Loki | 3.7.9، وضع Monolithic على القرص المحلي | Loki sink بتسميتين service وlevel |
| VictoriaLogs | v1.53.0 | واجهة Elasticsearch bulk مع _stream_fields=service,level |
| Seq | 2026.1.17182 | HTTP بصيغة CLEF |
| OpenSearch | 3.9.0، عقدة واحدة وذاكرة Java بحجم 1 GB | Elasticsearch sink بفهرس واحد وتعيين تلقائي Dynamic Mapping |
| Graylog | 7.2.1 مع OpenSearch 3.7.0 وMongoDB 8.0، وذاكرة Java بحجم 1 GB لكل منهما | GELF عبر TCP |
ثم سألنا كل أداة أربعة أسئلة، ثلاث مرات لكل سؤال، وحسبنا الوقت من جهاز الاختبار حتى وصول الرد كاملاً:
- الإبرة Needle: حدث واحد بقيمة
request_idمعينة. - التجميع Aggregation: عدد الأخطاء لكل خدمة.
- البحث النصي: عدد الأحداث التي في رسالتها كلمة
timeout. - البحث العربي: عدد الأحداث التي في
message_arفيها عبارة «انتهاء المهلة».
والإجابات الصحيحة حسبناها من الملف نفسه بسكربت Python: 1882 خطأ لخدمة auth مثلاً، و3765 سطراً فيها timeout، و6271 حدثاً فيها العبارة العربية. والجهاز بثمانية معالجات وذاكرة 32 GB ويشاركه أعمال أخرى، لذلك قارن الأدوات ببعضها ولا تأخذ الأرقام المطلقة على أنها أداء سيرفرك.
النتائج بالأرقام
| القياس | Loki | VictoriaLogs | Seq | OpenSearch | Graylog |
|---|---|---|---|---|---|
| زمن الإدخال حتى يصبح الكل قابلاً للبحث | 17 ثانية | 12.5 ثانية | 25 ثانية | 31 ثانية | 80 ثانية |
| التخزين على القرص | 24 MB أجزاء مضغوطة، و159 MB سجل كتابة WAL | 15 MB | 135 MB ثم 69 MB بعد نصف ساعة | 287 MB | 555 MB في OpenSearch |
| الذاكرة بعد الإدخال والأسئلة | 270 MiB | 282 MiB | 1.2 GiB | 1.7 GiB | 3.5 GiB للثلاثة معاً |
الإبرة بـ request_id | 0.23 ثانية | أقل من 0.01 | 0.2 ثانية | 0.01 ثانية | 0.07 ثانية |
| الأخطاء لكل خدمة | 0.04 ثانية | أقل من 0.01 | 0.7 ثم 0.01 ثانية | 0.02 ثانية | 1.3 ثم 0.08 ثانية |
كلمة timeout (3765) | 0.26 ثانية | أقل من 0.01 | 0.2 ثم 0.01 ثانية | 0.02 ثانية | 0.07 ثانية |
| «انتهاء المهلة» (6271) | 6271 في 0.22 ثانية | 6271 في 0.01 ثانية | 6271 في 0.6 ثم 0.01 ثانية | 6271 في 0.02 ثانية | 0 نتيجة |
كل الأدوات أعطت الأعداد الصحيحة في الأسئلة الثلاثة الأولى، والفرق في الوقت والموارد. وفي الجدول أعلاه لاحظ التالي:
- التخزين: الفهرس المعكوس كلف OpenSearch قرابة ضعف حجم الملف الأصلي، وكلف Graylog أكثر من ذلك (555 MB) لأنه يضيف حقوله الخاصة لكل رسالة، بينما ضغطت Loki وVictoriaLogs الملف إلى 15 أو 24 MB. أما سجل الكتابة WAL في Loki فهو مؤقت يحمي ما لم يكتب بعد، ويبقى حجمه بحسب ما يصل في الساعات الأخيرة.
- الذاكرة: Graylog يحتاج ثلاثة مكونات (الخادم وOpenSearch وMongoDB)، فكان مجموعها 3.5 GiB بحد ذاكرة Java يساوي 1 GB لكل من الأولين، أي أكثر من عشرة أضعاف Loki أو VictoriaLogs. وSeq ارتفع إلى 1.2 GiB لأنه يستخدم الذاكرة لتسريع الاستعلامات المكررة، وهو ما يفسر نزول زمن السؤال الثاني من 0.7 إلى 0.01 ثانية.
- Loki والبحث في النص: سؤال التجميع بالتسميات أخذ 0.04 ثانية، أما البحث عن كلمة داخل السطور فأخذ ربع ثانية لأن Loki يقرأ السطور المضغوطة. والفرق هنا صغير لأن البيانات صغيرة، ولكنه يكبر مع حجم السجلات، لذلك ابدأ الاستعلام دائماً بتسميات تضيق السلاسل التي يقرؤها.
- Loki والبيانات القديمة: البيانات كانت بتاريخ الأمس، ووصلت كلها إلى Loki في 11 ثانية، ولكن جزءاً منها لم يظهر في البحث حتى أفرغنا ذاكرة ال Ingester إلى القرص بالطلب
POST /flush، لأن الاستعلام عن وقت أقدم من ثلاث ساعات يذهب إلى المخزن فقط. وفي الإنتاج تصل السجلات حية فلا تظهر المشكلة، ولكنها تظهر عندما تستورد سجلات قديمة، كما ذكر دليل Loki. - زمن الإدخال يتغير بحمل الجهاز: عندما أدخلنا البيانات نفسها في Seq في وقت سابق والجهاز مشغول بأعمال أخرى أخذت 276 ثانية بدل 25، لذلك قس على سيرفرك قبل أن تعتمد على هذه الأرقام.
السؤال نفسه بخمس لغات استعلام
لغة الاستعلام هي ما سوف يكتبه فريقك كل يوم، لذلك انظر إلى السؤال الثاني (عدد الأخطاء لكل خدمة) كما كتبناه في كل أداة:
| الأداة | اللغة | الاستعلام |
|---|---|---|
| Loki | LogQL | sum by (service) (count_over_time({level="error"}[13h])) |
| VictoriaLogs | LogsQL | level:error | stats by (service) count() n |
| Seq | SQL Queries | select count(*) from stream where @Level = 'error' group by service |
| OpenSearch | Query DSL | {"query":{"term":{"level.keyword":"error"}},"aggs":{"s":{"terms":{"field":"service.keyword"}}}} |
| Graylog | صيغة بحث Lucene ثم تجميع في الواجهة | level:error ثم تجميع بالحقل service في Aggregation |
وقد يتساءل البعض: أي لغة أسهل؟ والإجابة تعتمد على فريقك: من يعرف SQL يكتب استعلام Seq دون تعلم شيء، ومن يعرف PromQL من Prometheus يجد LogQL مألوفة، وفريق العمليات الذي لا يكتب كوداً يجد في Graylog وOpenSearch Dashboards البحث والتجميع بالنقر في الواجهة. أما Query DSL في OpenSearch فهي JSON طويل لا يكتبه أحد يدوياً كل يوم، ولذلك يستخدم الناس فوقه لغة DQL في الواجهة أو PPL أو SQL.
البحث بالنص العربي
وجدت أربع أدوات العبارة «انتهاء المهلة» بعددها الصحيح 6271، ولكن كل منها بطريقة مختلفة، وهذا يحدد ماذا تتوقع منها:
- Loki وSeq: يطابقان الحروف كما هي داخل النص (
|= "انتهاء المهلة"وlike '%انتهاء المهلة%')، فإذا كتب أحدهم «المهله» بالهاء أو «إنتهاء» بالهمزة لم يجد شيئاً، وقد جربنا ذلك في دليل Seq. - VictoriaLogs: يقسم النص إلى كلمات ويبحث بالعبارة
message_ar:"انتهاء المهلة"، ولكنه لا يطبع الحروف العربية Normalization ولا يعرف «ال». - OpenSearch: وجدها بالبحث بالعبارة
match_phraseعلى حقل نصي، وهو الوحيد بين الخمسة الذي فيه محلل عربي Arabic Analyzer يطبع الهمزات والتاء المربوطة ويزيل «ال» إذا عرفته في قالب الفهرس، وقد شرحناه في البحث في النصوص العربية. - Graylog: أرجع صفراً، والسبب أن Graylog يحفظ كل حقل نصي إضافي بالنوع
keyword، أي قيمة كاملة لا تقسم إلى كلمات، فلم يجد الحدث إلا عندما بحثنا بالجملة كاملة «فشل الدفع بسبب انتهاء المهلة» فأرجع 6271. وتفاصيل ذلك وحله في دليل Graylog.
والقاعدة العملية لكل الأدوات: لا تبن تنبيهاً أو لوحة على نص عربي حر، وإنما ضع في الحدث خاصية ثابتة بالإنجليزية مثل error_code=PSP_TIMEOUT، واترك النص العربي للقراءة.
التكلفة والترخيص
التكلفة في السجلات لها جزءان: سعر البرنامج إن وجد، وثمن السيرفر والقرص الذي يحتاجه، والجزء الثاني هو الأكبر غالباً عند الأدوات المفتوحة. والجدول التالي يجمعهما كما راجعناهما في أكتوبر 2026:
| الأداة | الرخصة | السعر | ما تدفعه فعلاً |
|---|---|---|---|
| Loki | AGPLv3 منذ 2021 | مجاني عند الاستضافة الذاتية | أقل قرص وذاكرة، ويمكن نقل التخزين إلى Object Storage رخيص |
| VictoriaLogs | Apache 2.0 | مجاني، وله نسخة Enterprise مدفوعة | الأقل في مختبرنا قرصاً |
| Seq | تجاري | مجاني لمستخدم واحد، وTeam بـ 1,090 دولاراً سنوياً لعشرة مستخدمين، كما في صفحة الأسعار | الترخيص للفريق، وسيرفر مخصص كما توصي متطلباته |
| OpenSearch | Apache 2.0 | مجاني | قرص وذاكرة أكثر، ووقت فريق لإدارة JVM والفهارس |
| Elasticsearch | AGPLv3 أو SSPL أو ELv2، كما في قصة رخصته | الرخصة الأساسية Basic مجانية | مثل OpenSearch، وبعض الخصائص في الخطط المدفوعة |
| Graylog Open | SSPL | مجاني بدون حد للإدخال، والإصدارات Enterprise وSecurity مدفوعة | الأكثر ذاكرة في مختبرنا، لأنه ثلاثة مكونات |
ولاحظ أن SSPL وELv2 ليستا رخصتين مفتوحتين بتعريف OSI، ولكنهما لا تؤثران عليك إذا شغلت الأداة لسجلات جهتك، وإنما إذا قدمتها خدمة مدارة لغيرك.
التوسع Scaling
- Loki: يعمل بالوضع Monolithic على سيرفر واحد، ثم يقسم إلى مكونات مستقلة ويخزن في Object Storage عندما يكبر الحجم، وهذا ما صمم له أصلاً.
- VictoriaLogs: له نسخة عقدة واحدة ونسخة Cluster برخصة Apache 2.0 نفسها.
- Seq: يعتمد على سيرفر واحد قوي في الغالب، والتجميع Clustering فقط في خطة Datacenter.
- OpenSearch وElasticsearch وGraylog: تتوسع بإضافة عقد Nodes وتوزيع الفهارس على Shards، وهي الأثبت في الأحجام الكبيرة جداً، ولكن كل عقدة JVM تحتاج ضبطاً ومتابعة.
نقاط القوة ونقاط الضعف لكل أداة
Grafana Loki
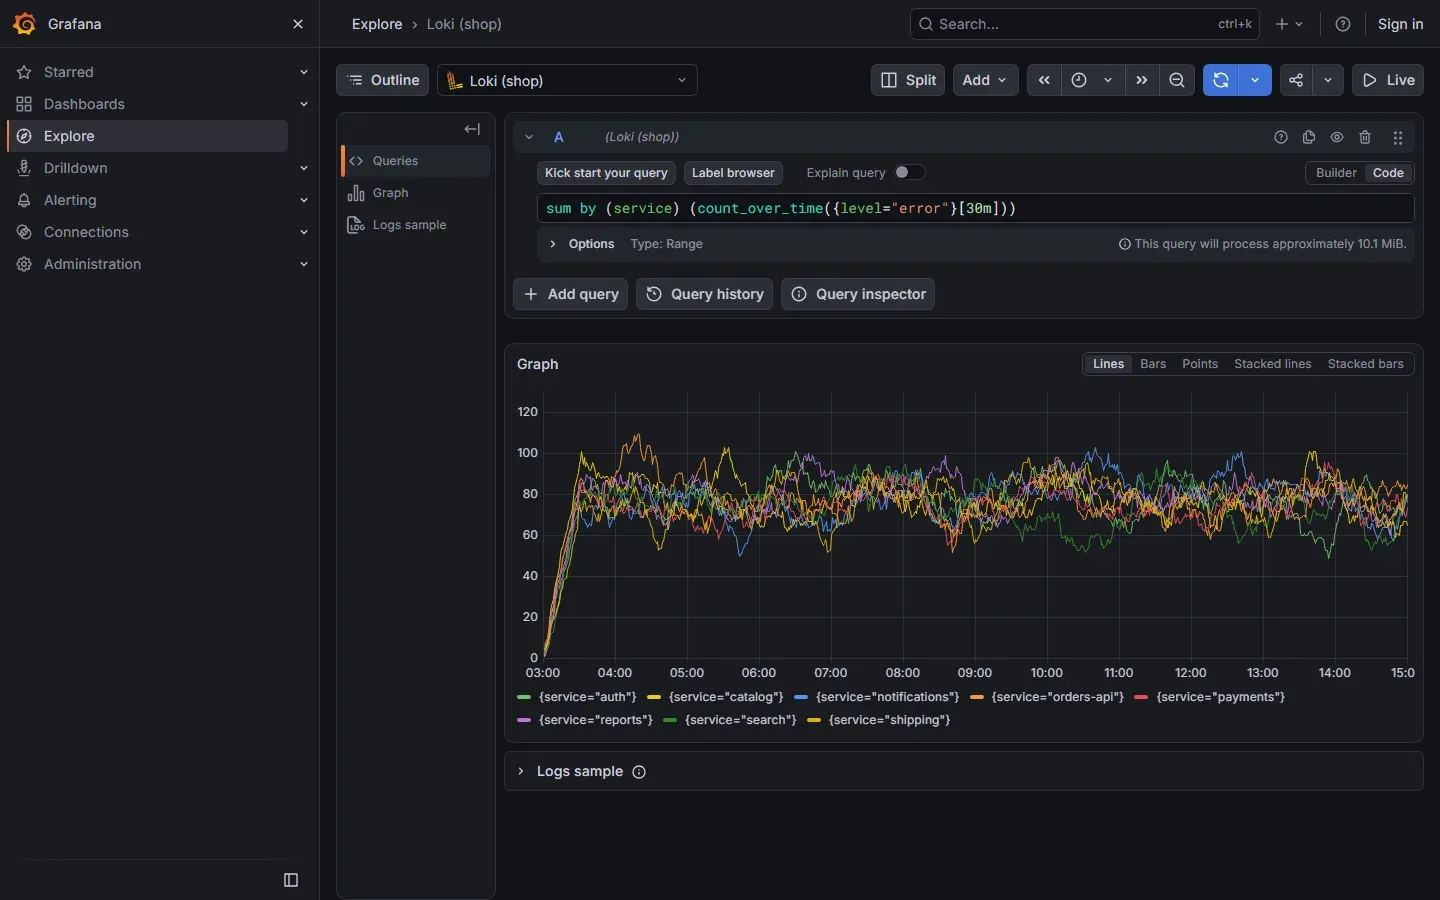
نقاط القوة:
- أقل ذاكرة وتخزين بين الأدوات المفتوحة الثلاث الأشهر، والتخزين يمكن نقله إلى Object Storage.
- يعمل مع Grafana في الواجهة نفسها مع المقاييس Metrics والتتبع Traces.
- التنبيه من السجلات بال Ruler بلغة LogQL، وتعدد المستأجرين Multi-tenancy مدمج.
نقاط الضعف:
- اختيار التسميات قرار يجب أن يكون صحيحاً من البداية، والقيم الكثيرة مثل معرف الطلب توقف الإدخال.
- البحث عن كلمة داخل السطور يقرأ البيانات، فيبطؤ مع الحجم إذا لم تضيقه بالتسميات.
- لا يوجد بحث عربي يفهم الكلمات، والمطابقة بالحروف كما هي.
Graylog
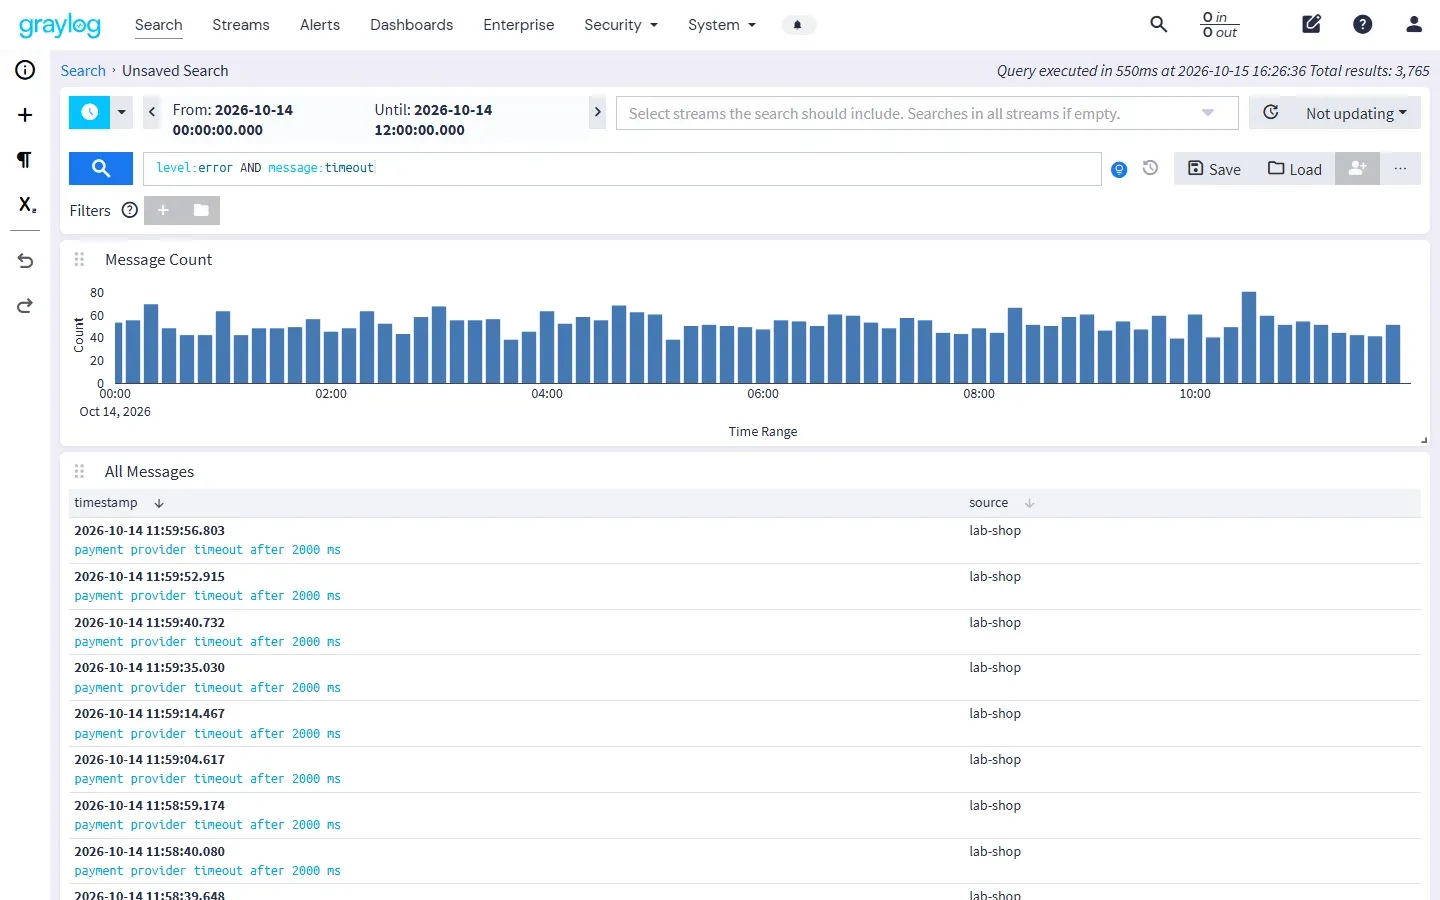
نقاط القوة:
- كل شيء من الواجهة: المدخلات Inputs والتوجيه Streams والتعديل Pipelines والتنبيهات والصلاحيات.
- مدخلات جاهزة لـ Syslog وGELF وغيرها، فيناسب السيرفرات وأجهزة الشبكة.
- بحث فوري في كل حقل لأنه فوق OpenSearch، وال Journal على القرص يحفظ الرسائل إذا توقف OpenSearch.
نقاط الضعف:
- الأكثر ذاكرة وتخزيناً في مختبرنا، لأنه ثلاثة مكونات وفهرس كامل.
- الحقول الإضافية تحفظ قيمة كاملة، فالبحث العربي داخلها لا يجد الكلمات بدون إعداد إضافي.
- رخصة SSPL، وإصدارات OpenSearch وMongoDB المسموحة يحددها جدول التوافق.
Seq
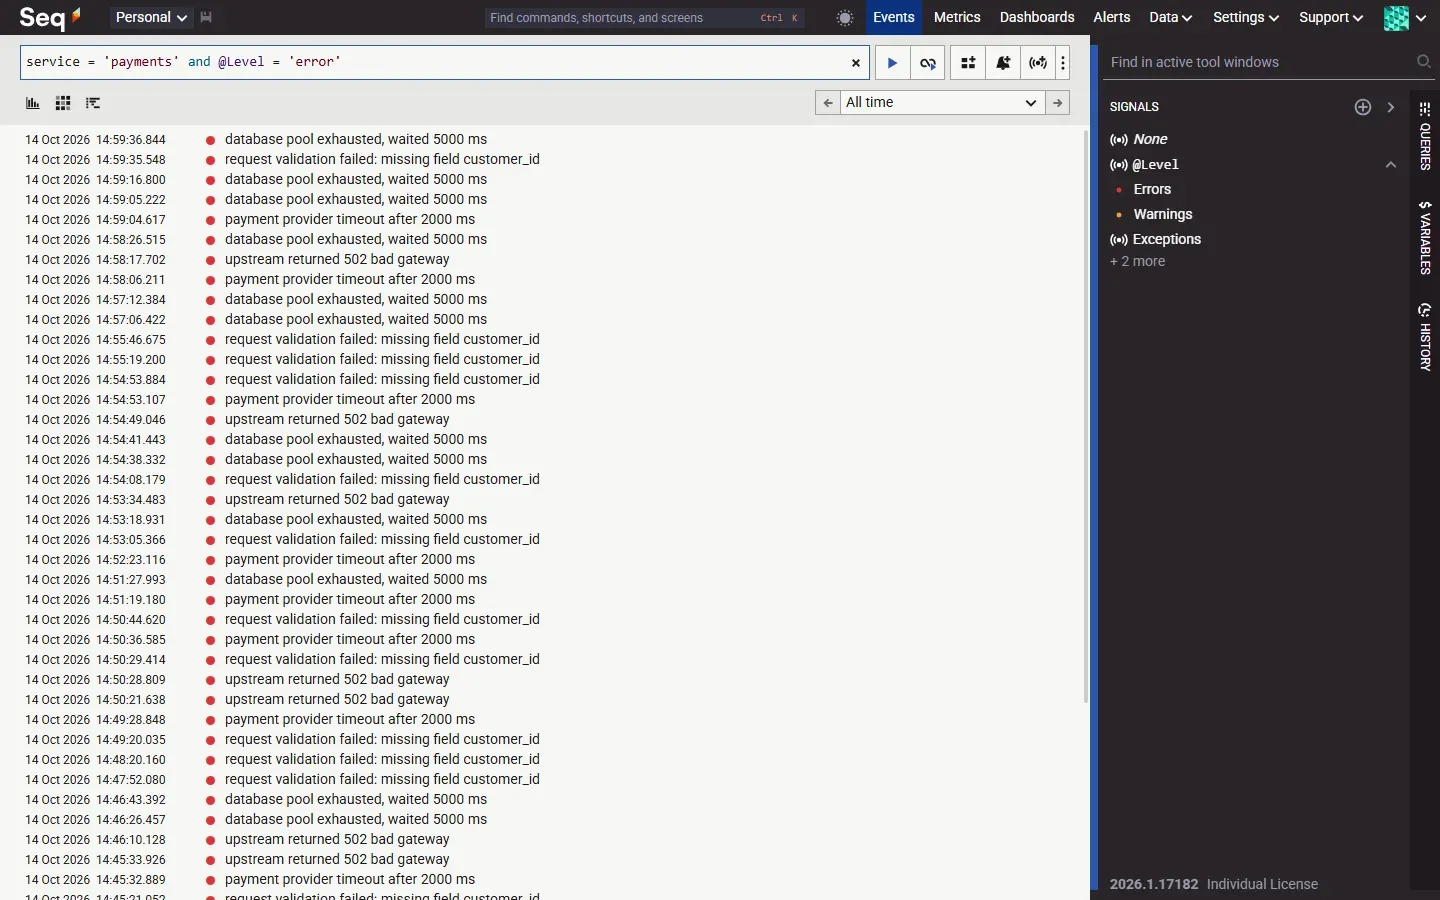
نقاط القوة:
- سيرفر واحد يعمل خلال دقائق، ولغة تشبه SQL يعرفها كل مطور.
- الأفضل تكاملاً مع .NET وSerilog، ويستقبل من أي لغة بصيغة CLEF أو OpenTelemetry.
- الإشارات Signals والتنبيهات والاحتفاظ لكل إشارة مدمجة في الواجهة.
نقاط الضعف:
- ليس مفتوح المصدر، والنسخة المجانية لمستخدم واحد فقط.
- التوسع على سيرفر واحد غالباً، ويستهلك ما يجده من ذاكرة.
- البحث العربي يطابق الحروف كما هي.
OpenSearch ومجموعة ELK
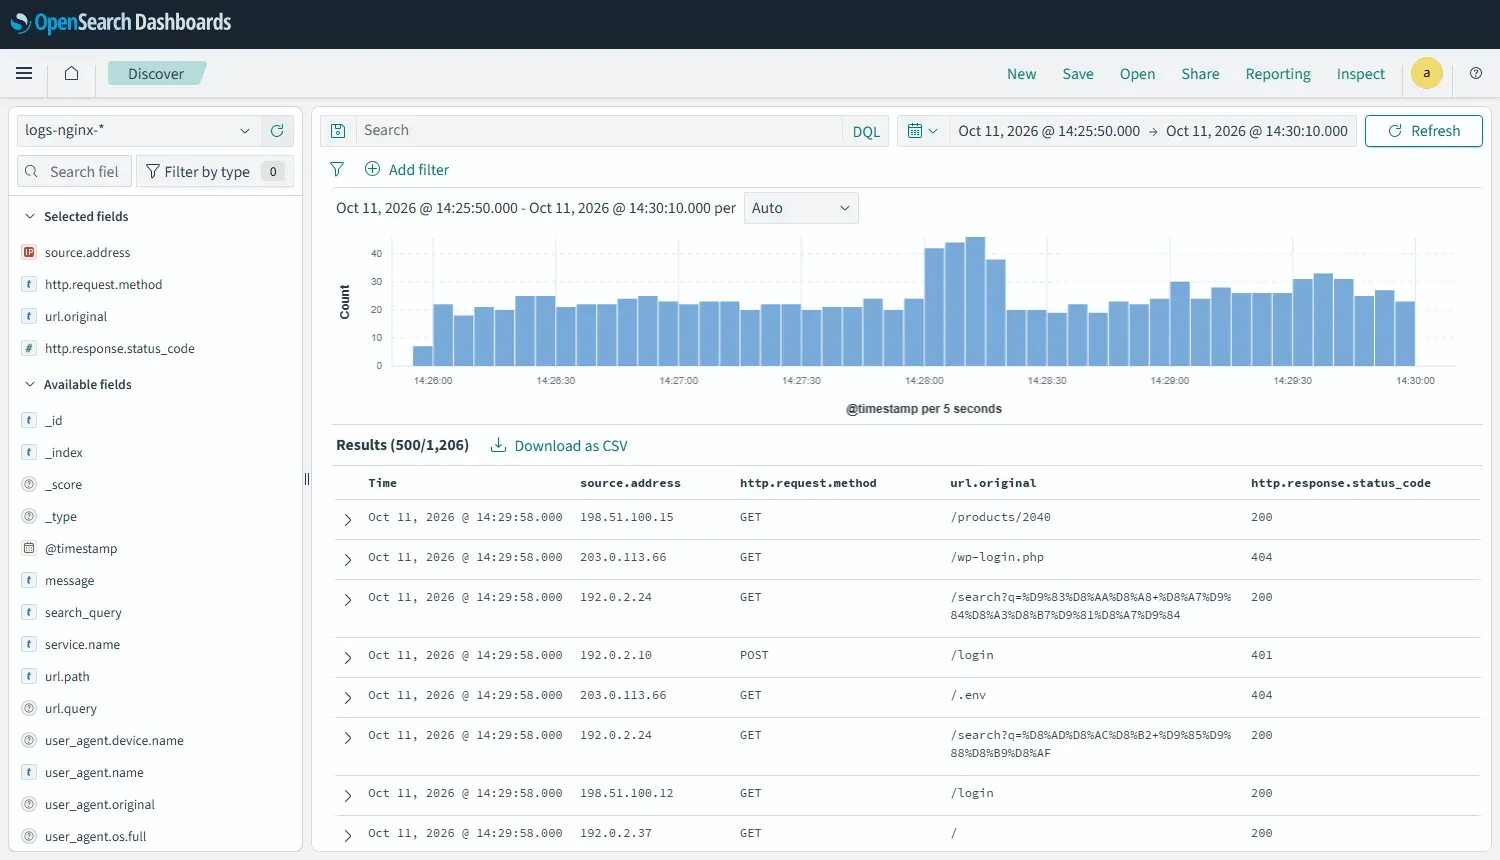
نقاط القوة:
- أسرع بحث نصي في مختبرنا، وأقوى أدوات البحث والتحليل، ومحلل عربي حقيقي.
- يتوسع إلى أحجام كبيرة جداً بالعقد وال Shards، ويستخدم أيضاً للأمن SIEM والبحث في التطبيقات.
- OpenSearch برخصة Apache 2.0، وElasticsearch عاد إلى خيار AGPLv3.
نقاط الضعف:
- الفهرس قرابة ضعف حجم البيانات في مختبرنا، والذاكرة أكثر من 1.5 GiB لعقدة واحدة صغيرة.
- تحتاج من يفهم JVM والفهارس وال Shards وسياسات دورة الحياة ILM أو ISM.
- Query DSL طويلة، والفريق يحتاج الواجهة أو لغة أبسط فوقها.
وماذا عن VictoriaLogs؟
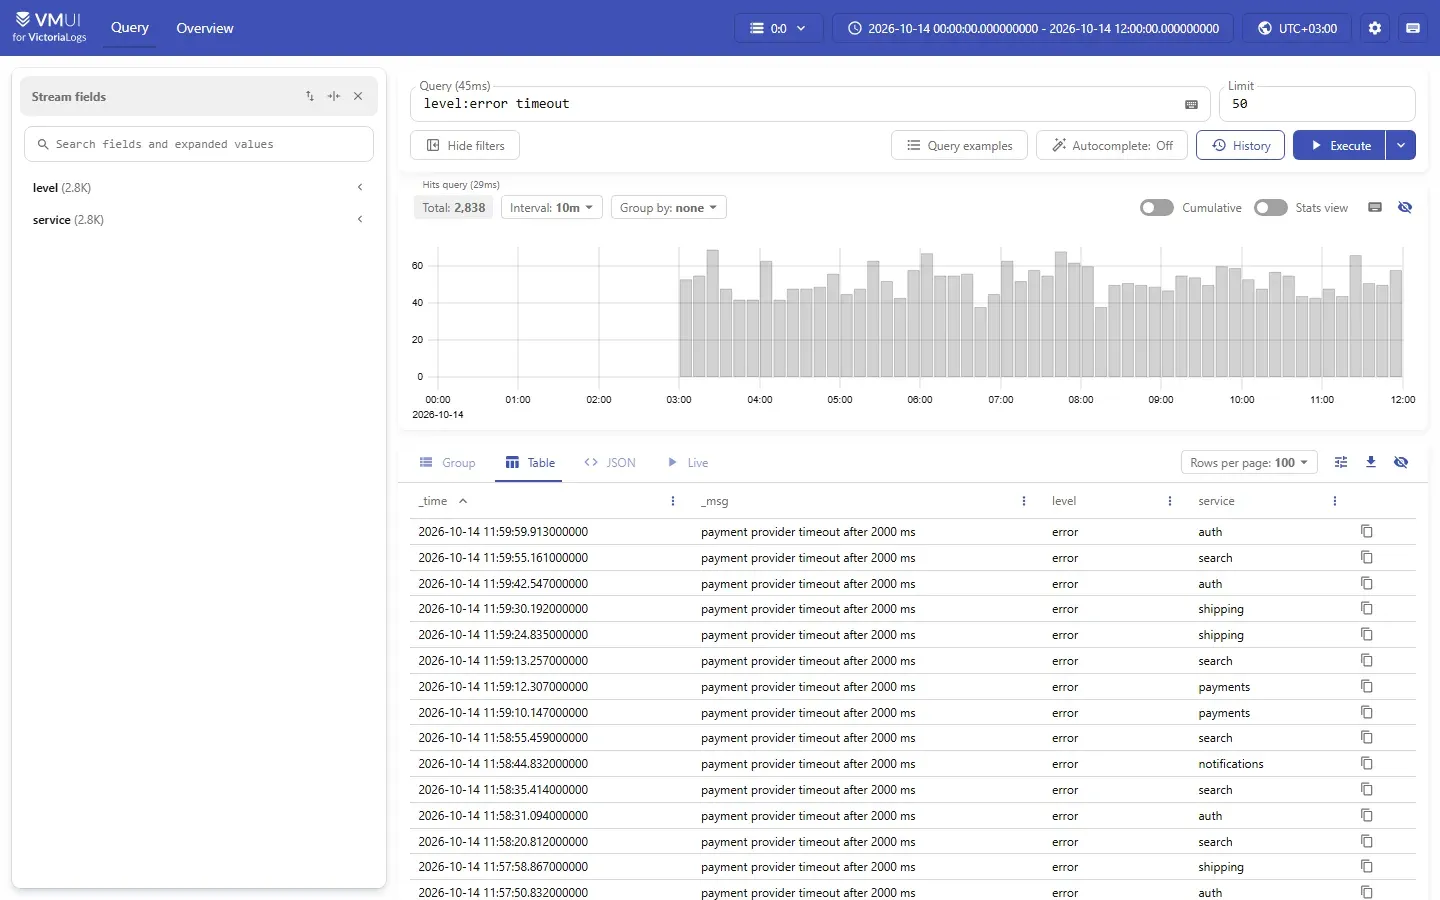
VictoriaLogs من الشركة نفسها التي تطور VictoriaMetrics، وكان في مختبرنا الأسرع إدخالاً والأقل تخزيناً، وأجاب الأسئلة الأربعة صحيحة في أقل من 0.01 ثانية تقريباً، ويقبل الحقول كثيرة القيم دون أن يوقف الإدخال كما يفعل Loki. وتذكر صفحته أنه يستخدم ذاكرة أقل حتى 30 مرة وقرصاً أقل حتى 15 مرة من Elasticsearch وLoki، وهذا ادعاء الشركة نفسها، وأرقامنا على 500 ألف حدث تتفق مع اتجاهه ولكنها لا تكفي لإثبات النسبة. ونقاط ضعفه أنه مشروع أحدث من الباقين، وأدواته ومجتمعه أصغر، ولم نكتب له دليل تثبيت بعد، لذلك نتركه خياراً يستحق التجربة في مختبرك قبل الإنتاج.
من يختار ماذا؟
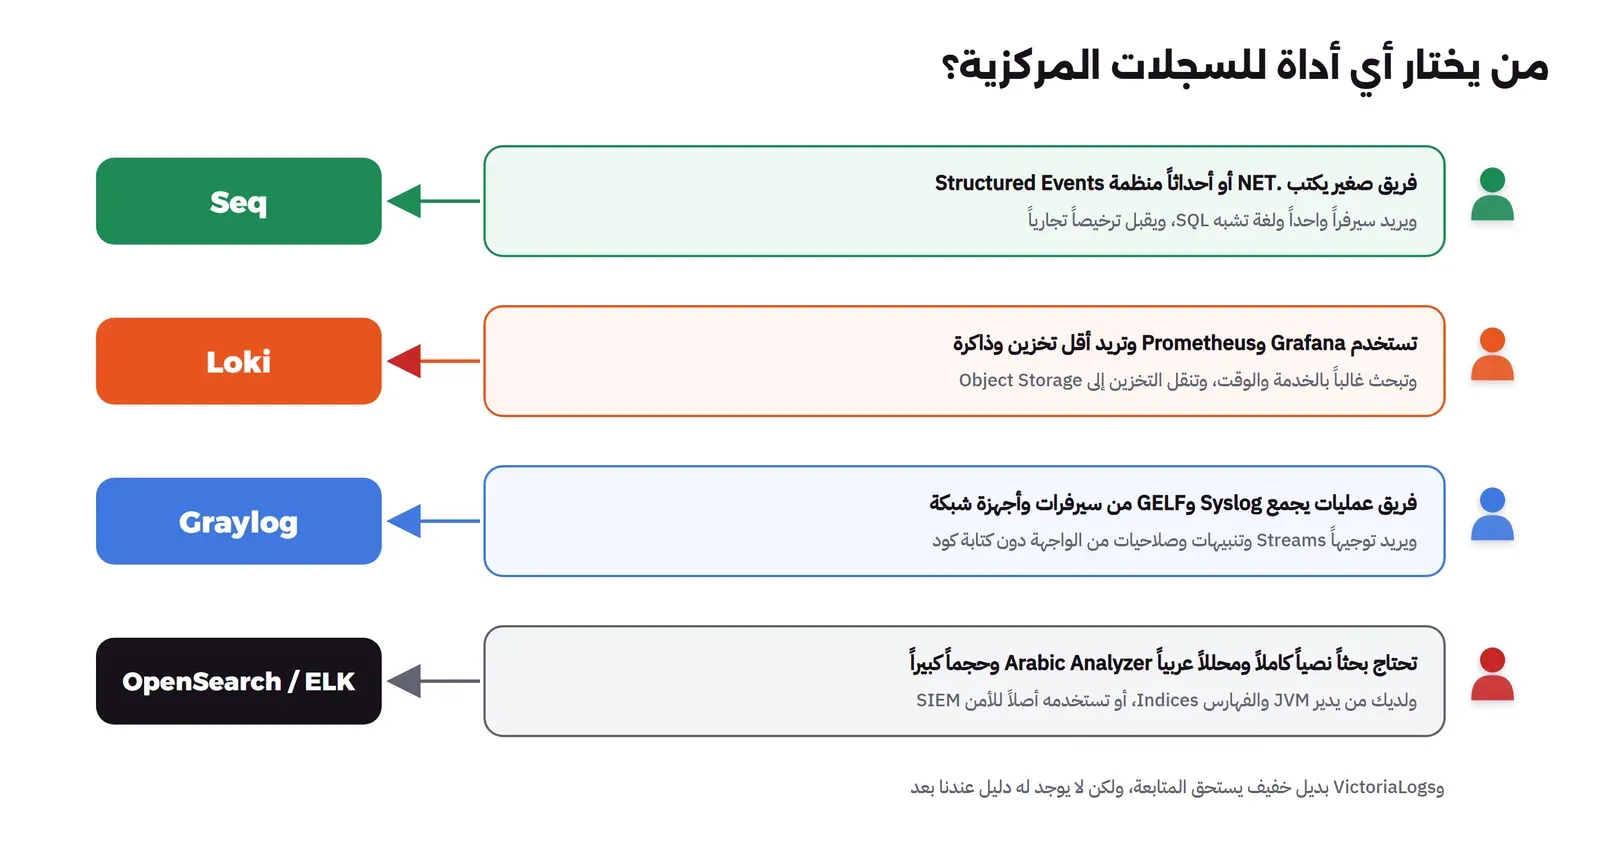
| إذا كان وضعك | فالأنسب | والسبب |
|---|---|---|
| سيرفرات قليلة، وGrafana موجودة، والميزانية للقرص محدودة | Loki | أقل ذاكرة وتخزين، وواجهة واحدة للمقاييس والسجلات |
| فريق .NET صغير يكتب سجلات منظمة | Seq | سيرفر واحد ولغة SQL وتكامل Serilog، مع ترخيص Team للفريق |
| فريق عمليات يجمع من أجهزة شبكة وسيرفرات متنوعة | Graylog | المدخلات والتوجيه والتنبيه والصلاحيات من الواجهة |
| بحث نصي عربي حقيقي، أو حجم كبير جداً، أو استخدام أمني SIEM | OpenSearch أو ELK | المحلل العربي والتوسع بالعقد، مع تكلفة أعلى في الموارد |
أخطاء شائعة عند الاختيار
- الاختيار من الشهرة: ELK مشهور، ولكن فريقاً من ثلاثة أشخاص بسيرفر واحد قد يدفع فيه ذاكرة وقرصاً ووقتاً أكثر بكثير مما يحتاج.
- الحكم على التخزين في أول ساعة: حجم Seq نزل إلى النصف بعد الفهرسة، وسجل الكتابة في Loki مؤقت، فقس بعد يوم من التشغيل.
- توقع بحث عربي كامل من كل أداة: أربع أدوات من خمس تطابق الحروف أو الكلمات كما هي، فاعتمد على الخصائص الثابتة.
- معرف الطلب تسمية في Loki: يوقف الإدخال عند حد السلاسل، وضعه في السطر أو في البيانات الوصفية المنظمة Structured Metadata.
- تجاهل الرخصة: Seq مجاني لشخص واحد فقط، وSSPL تهمك إذا قدمت الأداة خدمة لغيرك.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الفرق الحقيقي بين الأدوات هو ما تفهرسه وقت الإدخال: الفهرس الكامل في OpenSearch وGraylog يعطي أسرع بحث بأكبر تخزين وذاكرة، وفهرس التسميات في Loki يعطي أقل تكلفة ويؤجل العمل إلى وقت البحث.
- على 500 ألف حدث (152 MB) احتاج Loki قرابة 24 MB من الأجزاء المضغوطة و270 MiB ذاكرة، واحتاج OpenSearch قرابة 287 MB و1.7 GiB، واحتاج Graylog بمكوناته الثلاثة 555 MB و3.5 GiB.
- كل الأدوات أجابت الأسئلة بالأعداد الصحيحة في أقل من ثانية ونصف، فالسرعة على هذا الحجم ليست ما يفرق، وإنما الموارد ولغة الاستعلام وما يعرفه فريقك.
- OpenSearch وحده فيه محلل عربي حقيقي، وGraylog لم يجد العبارة العربية داخل حقل إضافي إلا بقيمته الكاملة.
- Seq الأسهل لفريق .NET ولكنه تجاري، وVictoriaLogs كان الأخف في مختبرنا ويستحق التجربة.
سجل التحديثات
- أكتوبر 2026: كتابة المقارنة وتنفيذ المختبر على Loki 3.7.9 وVictoriaLogs v1.53.0 وSeq 2026.1.17182 وOpenSearch 3.9.0 وGraylog 7.2.1 مع OpenSearch 3.7.0، بالبيانات نفسها وبأداة Vector 0.60.0، ومراجعة الرخص والأسعار من مصادرها.