

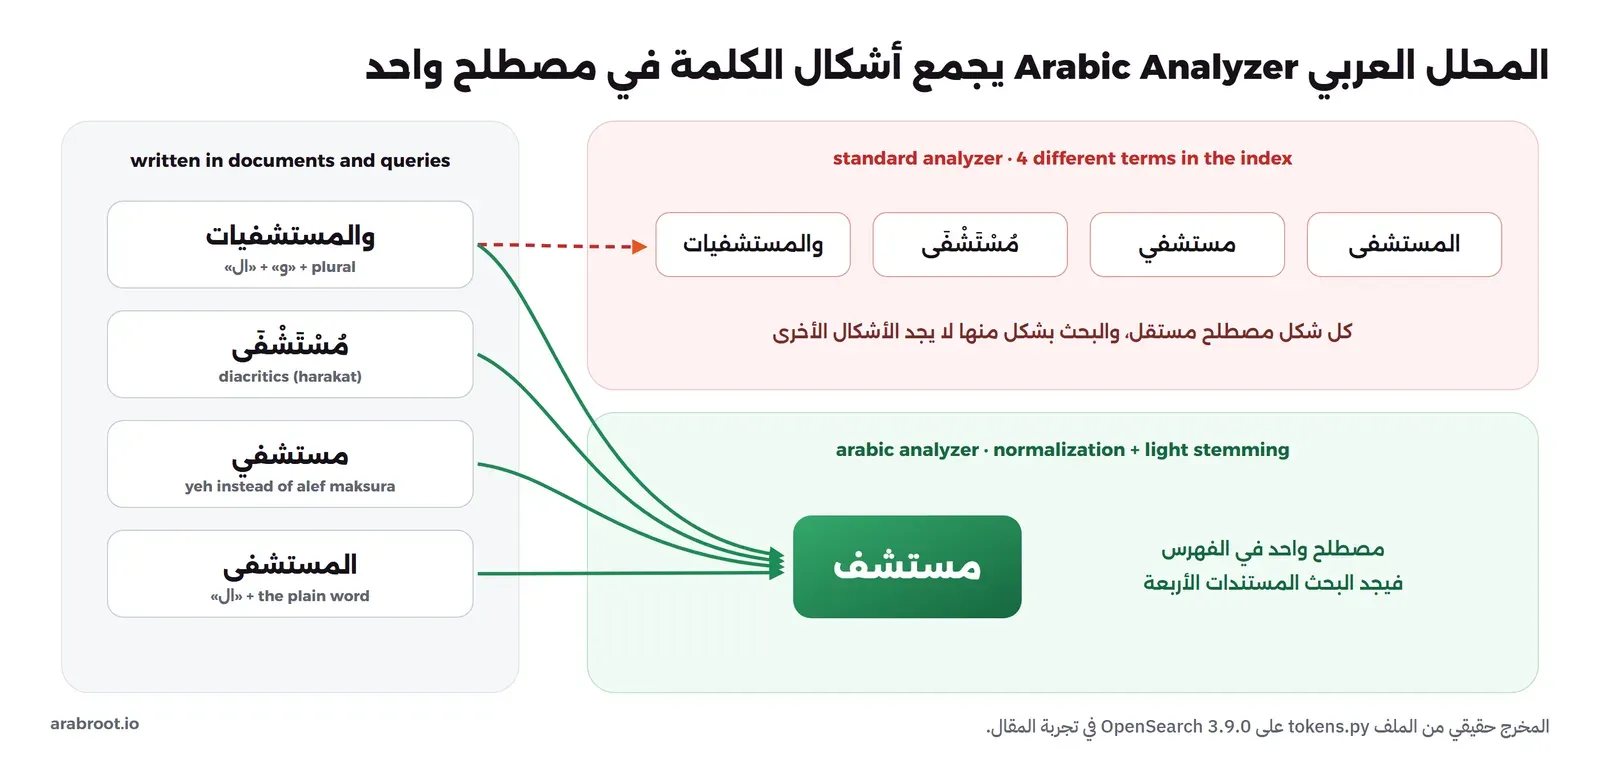
في مقال كيف يعمل البحث بنينا فهرساً معكوساً بأيدينا، ورأينا أن البحث عن «سيرفر» لم يجد إلا مستنداً واحداً من أربعة، والسبب أن المحلل الافتراضي حفظ «السيرفر» و«سيرفر» كلمتين مختلفتين. وهذه المشكلة ليست حالة نادرة في العربية، وإنما هي القاعدة: المستخدم يكتب «مستشفي» بالياء، والمستند فيه «المستشفى» بالألف المقصورة، وآخر فيه «والمستشفيات»، وثالث منسوخ من مصدر رسمي بالتشكيل، فإذا لم يعالج محرك البحث هذه الأشكال فسوف يرى المستخدم صفحة فارغة أمام سؤال له إجابة موجودة. وهذا المقال الثاني في مرحلة محركات البحث والفهرسة، وهو عملي بالكامل، وسوف نناقش فيه ما يلي:
- الأشكال التي تكتب بها الكلمة العربية، وما يجب أن يوحده محرك البحث منها.
- مجموعة صغيرة من المستندات وأسئلة نعرف إجاباتها مسبقاً، حتى نقيس كل تغيير بالأرقام وليس بالانطباع.
- المحلل العربي Arabic Analyzer في OpenSearch: التوحيد Normalization والجذع الخفيف Light Stemming، وما الذي لا يستطيع فعله.
- المرادفات Synonyms وتحمل الأخطاء الإملائية Fuzziness، ومتى يضر كل منهما.
- Meilisearch مع العربية: ما يفعله من نفسه، وما يحتاج منك إعداداً.
- جدول القياس لثمانية إعدادات، ثم نكسر البحث عمداً بمحلل مختلف، ثم أخطاء شائعة.
ولن نعيد هنا شرح لماذا تصعب العربية على البرامج، من الزوائد الملتصقة إلى الأصل والوزن، فقد شرحناه في مقال معالجة اللغة العربية، وإنما نركز على ما تكتبه في إعدادات محرك البحث.
كلمة واحدة بأشكال كثيرة
قبل أي إعداد يجب أن تعرف ما الذي تريد أن يتطابق، وفي العربية هناك نوعان من الاختلاف بين ما يكتبه المستخدم وما في المستند:
- اختلاف في الكتابة فقط Orthographic Variation: الهمزات «إجازة» و«اجازة»، والتاء المربوطة والهاء «رخصة» و«رخصه»، والألف المقصورة والياء «مستشفى» و«مستشفي»، والتشكيل
مُسْتَشْفَى، والتطويل «إجـــازة»، والأرقام العربية ١٥ والأرقام 15. وكلها الكلمة نفسها، ويحلها التوحيد Normalization، وقد شرحنا تفاصيلها في قسم توحيد الحروف. - اختلاف في بنية الكلمة Morphological Variation: الزوائد الملتصقة مثل «و» و«ال» و«ب» في «والمستشفيات» و«بالسيارة»، وعلامات الجمع مثل «ات»، وهذه يحلها الجذع Stemming الذي يقطع الزوائد الشائعة من أول الكلمة وآخرها. وأصعب من ذلك جمع التكسير Broken Plural مثل «فاتورة» و«فواتير» و«مدرسة» و«مدارس»، الذي يغير داخل الكلمة نفسها.
والصورة التالية تبين ما يحدث لأربعة أشكال من كلمة واحدة في محللين مختلفين، والكلمات من مخرج التجربة التي سوف نبنيها:
تجهيز التجربة
نكمل من مختبر المقال السابق، أي Container فيه OpenSearch 3.9.0 باسم lab-search-os وContainer فيه Python 3.13 باسم lab-search-py على الشبكة lab-search-net، فإذا حذفتهما فارجع إلى قسم التجربة في مقال كيف يعمل البحث وشغلهما بالأوامر نفسها. ونضيف إليهما Meilisearch 1.54.3 على الشبكة نفسها:
docker run -d --name lab-search-meili --network lab-search-net \
  -p 127.0.0.1:17700:7700 \
  -e MEILI_MASTER_KEY=lab-search-master-key-1234567890 \
  -e MEILI_NO_ANALYTICS=true \
  getmeili/meilisearch:v1.54.3

curl -s 127.0.0.1:17700/version -H "Authorization: Bearer lab-search-master-key-1234567890"
والمخرج سوف يكون كما يلي:
{"commitSha":"7ebd97e38c36882b0c78d79e433b9115b4f003b3","commitDate":"unknown","pkgVersion":"1.54.3"}ولاحظ أن مفتاح الإدارة MEILI_MASTER_KEY هنا للتجربة فقط، وفي الإنتاج اجعله سلسلة عشوائية طويلة، ولا تعطه لتطبيق الواجهة الأمامية، وإنما أنشئ له مفتاحاً للبحث فقط Search Key.
المستندات والأسئلة التي نعرف إجاباتها
لا تستطيع أن تحكم على إعدادات البحث بتجربة كلمتين، لذلك كتبنا ثلاثين مستنداً قصيراً تشبه صفحات مركز مساعدة في خدمة حكومية، وفيها عن قصد الأشكال التي يقابلها البحث العربي: تشكيل وتطويل وهمزات وجموع تكسير، ثم كتبنا ستة عشر سؤالاً بالطريقة التي يكتبها الناس فعلاً، أي دون همزات وبالهاء بدل التاء المربوطة وبخطأ إملائي أو كلمة عامية، وبجانب كل سؤال أرقام المستندات التي يتوقع أي شخص أن يراها. احفظ الملف التالي باسم corpus.py في مجلد lab-search:
# A small help-centre corpus written for this lab, and queries labelled by hand.
DOCS = [
    (1,  "تجديد رخصة القيادة إلكترونياً", "خطوات تجديد الرخصة عبر المنصة ودفع الرسوم"),
    (2,  "رسوم تجديد رخص القيادة", "جدول الرسوم بحسب مدة الرخصة ونوعها"),
    (3,  "استبدال رخصة قيادة أجنبية", "الشروط والمستندات المطلوبة للاستبدال"),
    (4,  "مواعيد عمل المستشفى في العيد", "ساعات الطوارئ والعيادات أيام العيد"),
    (5,  "حجز موعد في مستشفى الملك فهد", "طريقة الحجز من التطبيق وتأكيد الموعد"),
    (6,  "قائمة المستشفيات الحكومية في الرياض", "العناوين وأرقام التواصل لكل مستشفى"),
    (7,  "الإجازة المرضية للموظفين", "كيف تطلب الإجازة وما التقرير الطبي المطلوب"),
    (8,  "رصيد الإجازات السنوية", "حساب الأيام المتبقية وترحيلها للعام القادم"),
    (9,  "سداد فاتورة الكهرباء", "طرق الدفع عبر البنك والتطبيق"),
    (10, "الاعتراض على فواتير الماء المرتفعة", "متى يقبل الاعتراض وكم يستغرق"),
    (11, "تقسيط الفاتورة الشهرية", "شروط التقسيط وعدد الدفعات"),
    (12, "تغيير رقم الجوال المسجل في الحساب", "تحديث الرقم بعد التحقق من الهوية"),
    (13, "فقدان الهاتف المحمول وإيقاف الشريحة", "أوقف الشريحة ثم اطلب بديلة"),
    (14, "نقل ملكية السيارة بين الأفراد", "الخطوات والرسوم ومتى يكتمل النقل"),
    (15, "فحص المركبات الدوري", "مواعيد الفحص والمراكز المعتمدة"),
    (16, "مخالفات المرور وطرق السداد", "الاستعلام عن المخالفات وسدادها"),
    (17, "إصدار جواز السفر لأول مرة", "المستندات والرسوم ومدة الإصدار"),
    (18, "تجديد جوازات السفر للأطفال", "حضور ولي الأمر والصور المطلوبة"),
    (19, "تأشيرة الخروج والعودة", "إصدار التأشيرة ومدتها وإلغاؤها"),
    (20, "التسجيل في المدارس الابتدائية", "العمر المطلوب ومواعيد التسجيل"),
    (21, "نقل طالب من مدرسة إلى أخرى", "طلب النقل وموافقة المدرسة الجديدة"),
    (22, "استرجاع كلمة المرور للحساب", "رابط الاسترجاع يصل إلى بريدك"),
    (23, "تفعيل التحقق بخطوتين", "رمز يصل إلى جوالك عند كل دخول"),
    (24, "مُسْتَشْفَى الوِلادَة: مواعيد الزيارة", "ساعات الزيارة وعدد الزوار"),
    (25, "طلب إجـــازة اضطرارية", "متى تقبل وكم يوماً تمنح"),
    (26, "أسعار الكهرباء للشرائح السكنية", "سعر الكيلوواط لكل شريحة"),
    (27, "مؤسسة التأمينات: الاشتراك الإختياري", "من يحق له الاشتراك وكيف يحسب"),
    (28, "التامينات الاجتماعية للعاملين", "نسبة الاشتراك على العامل وصاحب العمل"),
    (29, "صيانة المكيفات قبل الصيف", "تنظيف الفلاتر وفحص الغاز"),
    (30, "شحن الطرود الدولية", "الأوزان المسموحة ومدة التوصيل"),
]

# query -> the documents a person would expect to see (labelled by us, illustrative)
QUERIES = [
    ("تجديد رخصه القياده", {1, 2}),
    ("مستشفي", {4, 5, 6, 24}),
    ("اجازه", {7, 8, 25}),
    ("فواتير", {9, 10, 11}),
    ("الجوال", {12, 13}),
    ("سياره", {14, 15}),
    ("جواز سفر", {17, 18}),
    ("مدرسه", {20, 21}),
    ("التأمينات", {27, 28}),
    ("الكهربا", {9, 26}),
    ("تاشيره", {19}),
    ("كلمة السر", {22}),
    ("مخالفات المرور", {16}),
    ("مكيف", {29}),
    ("الولاده", {24}),
    ("باسورد", {22}),
]

SYNONYMS = [
    ["جوال", "هاتف", "موبايل"],
    ["سيارة", "مركبة"],
    ["كلمة المرور", "كلمة السر", "باسورد"],
]
وهذه الأرقام وضعناها نحن بأيدينا، فهي للتوضيح على مجموعة صغيرة، وليست مقياساً عاماً لأي محرك، والطريقة نفسها هي ما تحتاجه على بياناتك: خذ أكثر الأسئلة تكراراً من سجل البحث في تطبيقك، واكتب بجانب كل سؤال ما يجب أن يظهر.
ثم الملف lab.py الذي فيه دوال الاتصال بالمحركين والبحث فيهما، وكل بحث يرجع أول خمس نتائج ويبحث في العنوان والنص معاً، مع وزن مضاعف للعنوان في OpenSearch:
import json, time, urllib.request

OS = "http://lab-search-os:9200"
MEILI = "http://lab-search-meili:7700"
KEY = "lab-search-master-key-1234567890"

def call(base, method, path, body=None, ndjson=False):
    headers = {"Content-Type": "application/x-ndjson" if ndjson else "application/json"}
    if base == MEILI:
        headers["Authorization"] = f"Bearer {KEY}"
    data = None if body is None else (body.encode() if ndjson else json.dumps(body).encode())
    req = urllib.request.Request(base + path, data=data, method=method, headers=headers)
    try:
        return json.load(urllib.request.urlopen(req))
    except urllib.error.HTTPError as e:
        return json.load(e)

def meili_wait(task, must_succeed=True):
    while True:
        t = call(MEILI, "GET", f"/tasks/{task['taskUid']}")
        if t["status"] in ("succeeded", "failed"):
            assert t["status"] == "succeeded" or not must_succeed, t
            return
        time.sleep(0.2)

def os_search(index, q, fuzzy=False):
    mm = {"query": q, "fields": ["title^2", "body"]}
    if fuzzy:
        mm["fuzziness"] = "AUTO"
    r = call(OS, "POST", f"/{index}/_search", {"size": 5, "query": {"multi_match": mm}})
    return [int(h["_id"]) for h in r["hits"]["hits"]]

def meili_search(index, q, strategy="last"):
    r = call(MEILI, "POST", f"/indexes/{index}/search",
             {"q": q, "limit": 5, "locales": ["ara"], "matchingStrategy": strategy})
    return [h["id"] for h in r["hits"]]

def os_fallback(q):
    # exact analysis first, fuzzy only when nothing was found
    return os_search("os_custom", q) or os_search("os_custom", q, fuzzy=True)
المحلل العربي في OpenSearch
يأتي OpenSearch بمحلل جاهز اسمه arabic، وهو من مكتبة Lucene، ويصفه توثيق ArabicAnalyzer بأنه يطبق الجذع الخفيف Light Stemming، ويتكون من ثلاثة أجزاء: التوحيد الإملائي، والجذع الخفيف، وقائمة بالكلمات الشائعة Stop Words. وبحسب الكود المصدري لمرحلة التوحيد فإنها تفعل خمسة أشياء: تحول الألف بهمزة إلى ألف بلا همزة، والتاء المربوطة إلى هاء، والألف المقصورة إلى ياء، وتحذف التشكيل، وتحذف التطويل. أما مرحلة الجذع فتحذف أداة التعريف وحروف العطف والجر الملتصقة بأول الكلمة، والنهايات الشائعة من آخرها.
الآن سوف نرى ما يخرج من المحللين standard وarabic لكلمات من المستندات والأسئلة، عبر واجهة Analyze API التي استخدمناها في المقال السابق. احفظ الملف التالي باسم setup.py، وهو ينشئ ثلاثة فهارس في OpenSearch بالمستندات نفسها: الأول بالمحلل standard، والثاني بالمحلل arabic، والثالث بمحلل نبنيه بأنفسنا سوف نشرحه بعد قليل، ثم فهرسين في Meilisearch:
import json
from lab import call, meili_wait, OS, MEILI
from corpus import DOCS, SYNONYMS

# ---------- OpenSearch: three indexes, same documents ----------
ARABIC_FILTERS = ["lowercase", "decimal_digit", "arabic_stop", "arabic_normalization", "arabic_stemmer"]
analysis = {
    "filter": {
        "arabic_stop": {"type": "stop", "stopwords": "_arabic_"},
        "arabic_stemmer": {"type": "stemmer", "language": "arabic"},
        "ar_synonyms": {"type": "synonym_graph",
                        "synonyms": [", ".join(group) for group in SYNONYMS]},
    },
    "analyzer": {
        "ar_index": {"type": "custom", "tokenizer": "standard", "filter": ARABIC_FILTERS},
        "ar_search": {"type": "custom", "tokenizer": "standard",
                      "filter": ARABIC_FILTERS + ["ar_synonyms"]},
    },
}
OS_INDEXES = {
    "os_standard": {"analyzer": "standard"},
    "os_arabic": {"analyzer": "arabic"},
    "os_custom": {"analyzer": "ar_index", "search_analyzer": "ar_search"},
}
bulk_lines = []
for name, field in OS_INDEXES.items():
    call(OS, "DELETE", f"/{name}")
    r = call(OS, "PUT", f"/{name}", {
        "settings": {"number_of_shards": 1, "number_of_replicas": 0, "analysis": analysis},
        "mappings": {"properties": {"title": {"type": "text", **field},
                                    "body": {"type": "text", **field}}}})
    assert r.get("acknowledged"), r
    for doc_id, title, body in DOCS:
        bulk_lines.append(json.dumps({"index": {"_index": name, "_id": doc_id}}))
        bulk_lines.append(json.dumps({"title": title, "body": body}))
call(OS, "POST", "/_bulk?refresh=true", "\n".join(bulk_lines) + "\n", ndjson=True)

# ---------- Meilisearch: default settings, then with synonyms ----------
docs = [{"id": d, "title": t, "body": b} for d, t, b in DOCS]
for name in ("meili_default", "meili_synonyms"):
    meili_wait(call(MEILI, "DELETE", f"/indexes/{name}"), must_succeed=False)
    meili_wait(call(MEILI, "POST", "/indexes", {"uid": name, "primaryKey": "id"}))
    meili_wait(call(MEILI, "PATCH", f"/indexes/{name}/settings", {
        "searchableAttributes": ["title", "body"],
        "localizedAttributes": [{"attributePatterns": ["*"], "locales": ["ara"]}]}))
    meili_wait(call(MEILI, "POST", f"/indexes/{name}/documents", docs))
syn = {}
for group in SYNONYMS:
    for word in group:
        syn[word] = [w for w in group if w != word]
meili_wait(call(MEILI, "PUT", "/indexes/meili_synonyms/settings/synonyms", syn))

print("indexes ready:", ", ".join(list(OS_INDEXES) + ["meili_default", "meili_synonyms"]))
ثم tokens.py:
from lab import call, OS

def analyze(analyzer, text):
    tokens = call(OS, "POST", "/os_custom/_analyze", {"analyzer": analyzer, "text": text})["tokens"]
    return " ".join(t["token"] for t in tokens) or "(removed)"

words = ["والمستشفيات", "مُسْتَشْفَى", "مستشفي", "الإجـــازة", "اجازه", "بالسيارة",
         "المكيفات", "فاتورة", "فواتير", "مدرسة", "المدارس", "في", "على"]
print(f"{'word':<14}{'standard':<14}{'arabic':<10}")
for w in words:
    print(f"{w:<14}{analyze('standard', w):<14}{analyze('arabic', w):<10}")
print()
print("ar_search: سياره ->", analyze("ar_search", "سياره"))
print("ar_search: كلمة السر ->", analyze("ar_search", "كلمة السر"))
انسخ المجلد إلى Container ال Python وشغل الملفين:
docker cp lab-search/. lab-search-py:/lab
docker exec -w /lab lab-search-py python setup.py
docker exec -w /lab lab-search-py python tokens.py
والمخرج سوف يكون كما يلي:
indexes ready: os_standard, os_arabic, os_custom, meili_default, meili_synonyms
word          standard      arabic
والمستشفيات   والمستشفيات   مستشف
مُسْتَشْفَى   مُسْتَشْفَى   مستشف
مستشفي        مستشفي        مستشف
الإجـــازة    الإجـــازة    اجاز
اجازه         اجازه         اجاز
بالسيارة      بالسيارة      سيار
المكيفات      المكيفات      مكيف
فاتورة        فاتورة        فاتور
فواتير        فواتير        فواتير
مدرسة         مدرسة         مدرس
المدارس       المدارس       مدارس
في            في            (removed)
على           على           (removed)

ar_search: سياره -> مركب سيار
ar_search: كلمة السر -> كلم باسورد كلم مرور سر
في المخرج أعلاه لاحظ التالي:
- المحلل
standardترك كل كلمة كما هي، فالأشكال الثلاثة لكلمة مستشفى ثلاث كلمات مختلفة في الفهرس، و«الإجـــازة» بالتطويل لا تطابق «اجازه». - المحلل
arabicحول «والمستشفيات» والكلمة المشكولة و«مستشفي» كلها إلىمستشف، و«الإجـــازة» و«اجازه» إلىاجاز، وحذف «ال» و«بال» من «بالسيارة» و«المكيفات»، وحذف «في» و«على» لأنهما في قائمة الكلمات الشائعة. - «فاتورة» أصبحت
فاتورلكن «فواتير» بقيتفواتير، و«مدرسة» أصبحتمدرسو«المدارس» أصبحتمدارس، أي أن جمع التكسير لم يتطابق مع المفرد، وهذا ما سوف نراه في القياس. - السطران الأخيران من المحلل الثالث
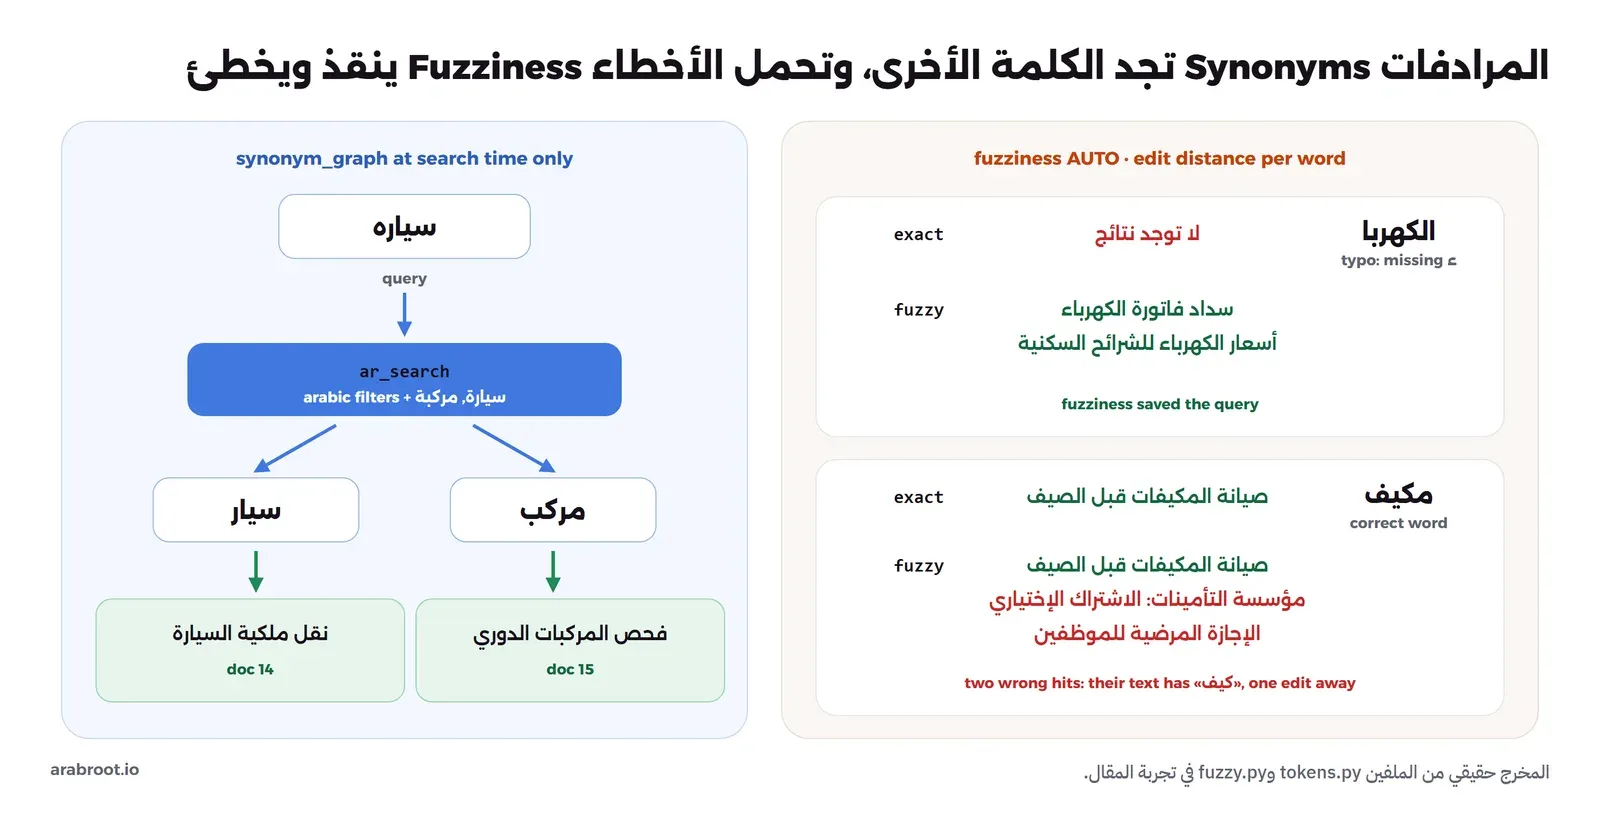
ar_searchالذي أضفنا إليه المرادفات، فالبحث عن «سياره» يبحث أيضاً عنمركب، والبحث عن «كلمة السر» يبحث عن «باسورد» و«كلمة المرور» أيضاً.
المحلل خطوة بخطوة
المحلل arabic الجاهز لا يسمح لك بإضافة مرحلة في وسطه، لذلك تبين صفحة المحلل العربي في توثيق OpenSearch كيف تبنيه بنفسك من مراحله لتعدل فيه، وهذا ما فعلناه في setup.py بالمحلل ar_index: المقطع standard، ثم lowercase للحروف اللاتينية، ثم decimal_digit لتحويل الأرقام العربية إلى 0 إلى 9، ثم حذف الكلمات الشائعة، ثم arabic_normalization، ثم arabic_stemmer. ولنرى أثر كل مرحلة، احفظ الملف التالي باسم chain.py، وهو يستخدم الخيار explain في Analyze API الذي يطبع المخرج بعد كل مرحلة:
from lab import call, OS

body = {"tokenizer": "standard",
        "filter": ["lowercase", "decimal_digit", {"type": "stop", "stopwords": "_arabic_"},
                   "arabic_normalization", {"type": "stemmer", "language": "arabic"}],
        "text": "وزرنا المستشفى في الرياض يوم ١٥ مارس",
        "explain": True}
detail = call(OS, "POST", "/_analyze", body)["detail"]
print(f"{'tokenizer':<22}", " ".join(t["token"] for t in detail["tokenizer"]["tokens"]))
for f in detail["tokenfilters"]:
    print(f"{f['name']:<22}", " ".join(t["token"] for t in f["tokens"]))
والمخرج سوف يكون كما يلي:
tokenizer              وزرنا المستشفى في الرياض يوم ١٥ مارس
lowercase              وزرنا المستشفى في الرياض يوم ١٥ مارس
decimal_digit          وزرنا المستشفى في الرياض يوم 15 مارس
__anonymous__stop      وزرنا المستشفى الرياض يوم 15 مارس
arabic_normalization   وزرنا المستشفي الرياض يوم 15 مارس
__anonymous__stemmer   زرنا مستشف رياض يوم 15 مارس
والصورة التالية تبين المراحل نفسها مع ما تغير في كل واحدة:
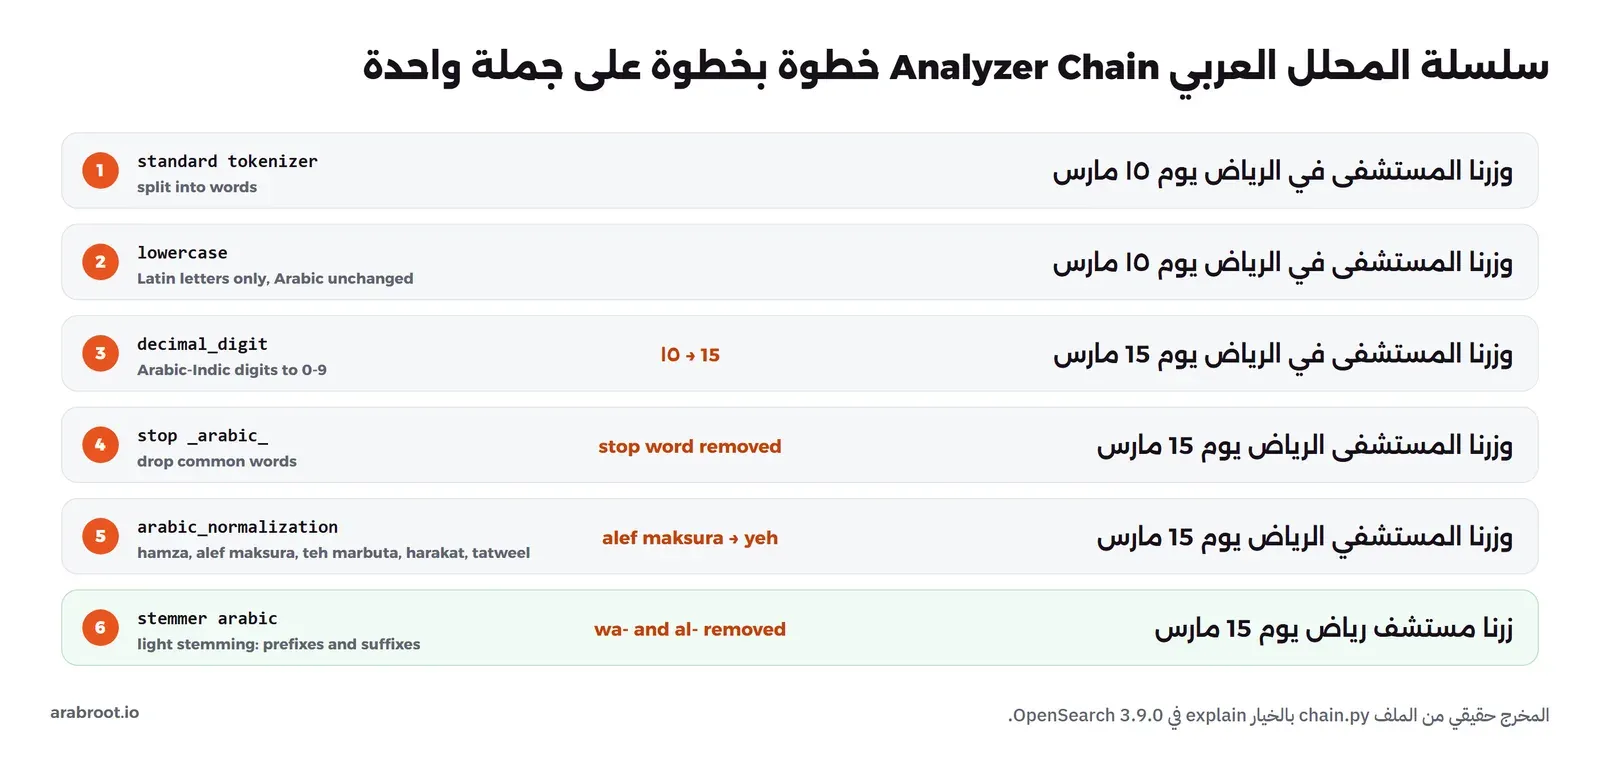
ولاحظ ترتيب المراحل كما في صفحة التوثيق، فالتوحيد يأتي قبل الجذع، فيعمل الجذع على كلمات موحدة لا يهمه فيها شكل الهمزة أو التاء المربوطة. ولاحظ أيضاً أن الجذع حول «وزرنا» إلى «زرنا»، فهو لا يعرف هل الواو حرف عطف أم من أصل الكلمة، وإنما يحذفها بقاعدة عامة، وعندما مررنا كلمة «وزارة» على المحلل نفسه عبر Analyze API خرجت زار، وهي نفس الكلمة التي يخرجها الفعل «زار»، وهذا ثمن القواعد البسيطة، وإذا وجدت كلمات مهمة يفسدها الجذع في بياناتك فاحمها من الجذع بالمرشح keyword_marker الذي تذكره صفحة المحلل العربي في القائمة arabic_keywords.
لماذا الجذع الخفيف وليس الأصل الاشتقاقي Root؟
وقد يتساءل البعض: إذا كانت المشكلة في جمع التكسير، فلماذا لا نرجع كل كلمة إلى أصلها الاشتقاقي Root، أي الحروف الثلاثة التي تشتق منها، فتصبح «فاتورة» و«فواتير» من الأصل نفسه؟ والإجابة أن الأصل الاشتقاقي يجمع أكثر مما تريد، فكلمات «مكتب» و«كتاب» و«كاتب» و«مكتبة» كلها من الأصل نفسه، والمستخدم الذي يبحث عن «مكتب» لا يريد صفحة عن الكتب، وقد شرحنا فكرة الأصل والوزن في مقال معالجة اللغة العربية. وقارنت ورقة Larkey وBallesteros وConnell في مؤتمر SIGIR 2002 بين الطريقتين على بيانات TREC-2001 العربية، فوجدت أن أفضل جذع خفيف كان أفضل في البحث بين اللغات من محلل صرفي يبحث عن الأصل الاشتقاقي، وأن الجذع رفع متوسط الدقة في البحث العربي إلى قرابة الضعف مقارنة بالبحث دون أي معالجة، وذكرت صراحة أن الجذع الخفيف لا يجمع جموع التكسير مع مفردها. والجذع الخفيف هو ما يطبقه Lucene، والحل العملي لجموع التكسير المهمة في بياناتك هو قائمة مرادفات صغيرة كما سيأتي، وليس جذعاً أقوى.
المرادفات Synonyms
المستخدم يكتب «جوال» والمستند فيه «الهاتف المحمول»، ويكتب «باسورد» والمستند فيه «كلمة المرور»، وهذا لا يحله التوحيد ولا الجذع، والحل قائمة مرادفات تكتبها بنفسك من سجل البحث في تطبيقك. وفي setup.py لاحظ ثلاثة أشياء في المحلل ar_search:
- استخدمنا المرشح
synonym_graph، وهو بحسب توثيقه النسخة المتقدمة من مرشح المرادفات التي تدعم المرادفات المكونة من أكثر من كلمة، مثل «كلمة المرور» مقابل «باسورد». - وضعنا المرادفات في محلل البحث فقط، وجعلناه
search_analyzerللحقل، أما محلل الفهرسةar_indexفبلا مرادفات، والسبب أنك تستطيع تعديل قائمة المرادفات لاحقاً دون إعادة فهرسة كل المستندات، لأنها تطبق على السؤال فقط. - المرادفات تمر على مراحل التوحيد والجذع نفسها قبلها، لذلك كتبناها بشكلها الطبيعي «سيارة» و«مركبة»، فأصبحت في المخرج
سيارومركب، وتطابق «السيارة» و«المركبات» في المستندات.
ولا تكتب قائمة مرادفات كبيرة من قاموس عام، فكل مرادف يوسع المطابقة وقد يدخل نتائج خاطئة، وابدأ بالكلمات التي تظهر في سجل البحث بنتيجة صفر.
تحمل الأخطاء الإملائية Fuzziness
السؤال «الكهربا» بدون همزة في آخره لا يطابق «الكهرباء» بعد التوحيد والجذع، والحل في OpenSearch هو الخيار fuzziness في الاستعلام، وبحسب توثيق استعلام match فالقيمة AUTO تعني أن الكلمة من حرفين أو أقل يجب أن تتطابق تماماً، ومن ثلاثة إلى خمسة أحرف يسمح فيها بتعديل واحد، وما زاد على خمسة يسمح فيه بتعديلين، والتعديل هو إضافة حرف أو حذفه أو تغييره أو تبديل حرفين متجاورين. احفظ الملف التالي باسم fuzzy.py:
from lab import os_search
from corpus import DOCS
TITLE = {d: t for d, t, b in DOCS}

for q in ["الكهربا", "جواز سفر", "مكيف"]:
    for fuzzy in [False, True]:
        ids = os_search("os_custom", q, fuzzy)
        print(f"{q:<10}{'fuzzy' if fuzzy else 'exact':<7}", " | ".join(f"{i} {TITLE[i]}" for i in ids) or "(no results)")
والمخرج سوف يكون كما يلي:
الكهربا   exact   (no results)
الكهربا   fuzzy   9 سداد فاتورة الكهرباء | 26 أسعار الكهرباء للشرائح السكنية
جواز سفر  exact   18 تجديد جوازات السفر للأطفال | 17 إصدار جواز السفر لأول مرة
جواز سفر  fuzzy   18 تجديد جوازات السفر للأطفال | 17 إصدار جواز السفر لأول مرة | 12 تغيير رقم الجوال المسجل في الحساب | 26 أسعار الكهرباء للشرائح السكنية
مكيف      exact   29 صيانة المكيفات قبل الصيف
مكيف      fuzzy   29 صيانة المكيفات قبل الصيف | 27 مؤسسة التأمينات: الاشتراك الإختياري | 7 الإجازة المرضية للموظفين
والصورة التالية تجمع أثر المرادفات وتحمل الأخطاء معاً:
في المخرج أعلاه لاحظ التالي:
- «الكهربا» لم يجد شيئاً دون تحمل الأخطاء، ومعه وجد المستندين الصحيحين، وهذا هو الهدف.
- «مكيف» كلمة صحيحة وجدت المستند الصحيح، لكن تحمل الأخطاء أضاف مستندين لا علاقة لهما، والسبب أن الكلمة من أربعة أحرف فيسمح فيها بتعديل واحد، ونص المستندين فيه «كيف» التي تبعد عن «مكيف» حذف حرف واحد. والكلمات العربية بعد الجذع قصيرة في الغالب، لذلك يضر تحمل الأخطاء في العربية أكثر منه في الإنجليزية.
- «جواز سفر» وجد المستندين الصحيحين في الحالتين، ومع تحمل الأخطاء أضاف «الجوال» و«الكهرباء».
والحل الذي استخدمناه في الدالة os_fallback داخل lab.py هو أن تبحث بالمطابقة الدقيقة أولاً، ولا تستخدم تحمل الأخطاء إلا إذا كانت النتيجة صفراً، فيحصل السؤال الصحيح على نتائج نظيفة، والسؤال الخاطئ على فرصة ثانية، وسوف نرى أثر ذلك بالأرقام في القياس.
Meilisearch مع العربية
يختلف Meilisearch عن OpenSearch في أنه لا يطلب منك بناء محلل، فهو يكتشف اللغة ويختار المقطع المناسب بمكتبة charabia، وبحسب جدول اللغات فيها فإنه للعربية يفصل «ال» عن الكلمة، ويحذف التشكيل، ويوحد التطويل والألف والياء والتاء المربوطة، ويحول الأرقام الفارسية إلى أرقام 0 إلى 9. ولاحظ أن الجدول لا يذكر جذعاً للعربية، وفي تجربتنا لم يطابق Meilisearch «جوازات» مع «جواز» ولا «المركبات» مع «مركبة». وما يفعله من نفسه أيضاً:
- تحمل الأخطاء الإملائية Typo Tolerance مفعل افتراضياً: بحسب توثيق الإعدادات القيم الافتراضية تسمح بخطأ واحد في الكلمة من خمسة أحرف فأكثر، وبخطأين من تسعة أحرف فأكثر، لذلك وجد «الكهربا» دون أي إعداد.
- تحديد اللغة: في
setup.pyاستخدمنا الإعدادlocalizedAttributesلنقول إن كل الحقول عربيةara، وفي البحث الخيارlocales، والسبب أن اكتشاف اللغة من نص قصير قد يخطئ، فتحديدها يضمن أن السؤال والمستندات يقطعان بالطريقة نفسها. - المرادفات: قائمة تضيفها بالإعداد
synonyms، وكل كلمة فيها تعرف مرادفاتها، كما في آخرsetup.py.
وهناك إعداد واحد غير نتائجنا كثيراً، وهو matchingStrategy في البحث. فبحسب توثيق البحث القيمة الافتراضية last تعني أنه إذا لم يجد عدداً كافياً من النتائج التي فيها كل كلمات السؤال، يحذف كلمات السؤال واحدة بعد الأخرى من آخره، أما frequency فتحذف أولاً الكلمة الأكثر تكراراً في البيانات، فتعطي وزناً أكبر للكلمات النادرة. احفظ الملف التالي باسم meili_strategy.py:
from lab import meili_search
from corpus import DOCS
TITLE = {d: t for d, t, b in DOCS}

for q in ["الجوال", "الولاده"]:
    for strategy in ["last", "frequency"]:
        ids = meili_search("meili_synonyms", q, strategy)
        print(f"{q:<9}{strategy:<10}", " | ".join(f"{i} {TITLE[i]}" for i in ids))
والمخرج سوف يكون كما يلي:
الجوال   last       13 فقدان الهاتف المحمول وإيقاف الشريحة | 12 تغيير رقم الجوال المسجل في الحساب | 23 تفعيل التحقق بخطوتين | 6 قائمة المستشفيات الحكومية في الرياض | 7 الإجازة المرضية للموظفين
الجوال   frequency  13 فقدان الهاتف المحمول وإيقاف الشريحة | 12 تغيير رقم الجوال المسجل في الحساب | 23 تفعيل التحقق بخطوتين
الولاده  last       24 مُسْتَشْفَى الوِلادَة: مواعيد الزيارة | 6 قائمة المستشفيات الحكومية في الرياض | 7 الإجازة المرضية للموظفين | 10 الاعتراض على فواتير الماء المرتفعة | 14 نقل ملكية السيارة بين الأفراد
الولاده  frequency  24 مُسْتَشْفَى الوِلادَة: مواعيد الزيارة
لاحظ أن السؤال «الولاده» كلمة واحدة، ومع ذلك رجعت last خمس نتائج أربع منها لا علاقة لها بالولادة، والسبب أن Meilisearch فصل «ال» فأصبح السؤال كلمتين، «ال» و«ولاده»، ولما وجد مستنداً واحداً فيه الكلمتان أكمل العدد بحذف آخر كلمة، فبقيت «ال» وحدها، وهي في كل مستند تقريباً. أما frequency فحذفت «ال» لأنها الأكثر تكراراً، فبقيت النتيجة الصحيحة وحدها. لذلك إذا استخدمت Meilisearch مع العربية فجرب frequency على أسئلتك قبل أن تقبل القيمة الافتراضية.
القياس: ثمانية إعدادات على ستة عشر سؤالاً
الآن نجمع كل ما سبق في جدول واحد. احفظ الملف التالي باسم evaluate.py، وهو يشغل الأسئلة الستة عشر على ثمانية إعدادات، ويحسب لكل إعداد متوسط الاستدعاء في أول خمس نتائج recall@5، ومتوسط الدقة في أول خمس نتائج precision@5 للأسئلة التي رجعت نتائج، وعدد الأسئلة التي لم ترجع أي نتيجة، وقد شرحنا المقياسين في قسم الدقة والاستدعاء في المقال السابق:
from lab import os_search, meili_search, os_fallback
from corpus import QUERIES

# ---------- measure ----------
CONFIGS = {
    "A OS standard":            lambda q: os_search("os_standard", q),
    "B OS arabic":              lambda q: os_search("os_arabic", q),
    "C B + synonyms":           lambda q: os_search("os_custom", q),
    "D C + fuzzy always":       lambda q: os_search("os_custom", q, fuzzy=True),
    "E C + fuzzy fallback":     os_fallback,
    "F Meili default":          lambda q: meili_search("meili_default", q),
    "G F + synonyms":           lambda q: meili_search("meili_synonyms", q),
    "H G + frequency":          lambda q: meili_search("meili_synonyms", q, "frequency"),
}
results = {c: {q: f(q) for q, _ in QUERIES} for c, f in CONFIGS.items()}

print(f"{'query':<20}" + "".join(f"{c[0]:>8}" for c in CONFIGS))
for q, relevant in QUERIES:
    row = f"{q:<20}"
    for c in CONFIGS:
        found = results[c][q]
        hit = len(set(found) & relevant)
        row += f"{f'{hit}/{len(relevant)}:{len(found)}':>8}"
    print(row)

print()
print(f"{'config':<24}{'recall@5':>10}{'precision@5':>13}{'zero results':>14}")
for c in CONFIGS:
    rec, prec, zero = [], [], 0
    for q, relevant in QUERIES:
        found = results[c][q]
        hit = len(set(found) & relevant)
        rec.append(hit / len(relevant))
        if found:
            prec.append(hit / len(found))
        else:
            zero += 1
    p = sum(prec) / len(prec) if prec else 0
    print(f"{c:<24}{sum(rec) / len(rec):>10.2f}{p:>13.2f}{zero:>14}")
docker exec -w /lab lab-search-py python evaluate.pyوالمخرج سوف يكون كما يلي، وفي الجدول الأول لكل سؤال وإعداد: عدد النتائج الصحيحة من المستندات المناسبة، ثم عدد النتائج التي رجعت:
query                      A       B       C       D       E       F       G       H
تجديد رخصه القياده     2/2:3   2/2:4   2/2:4   2/2:5   2/2:4   2/2:3   2/2:3   2/2:2
مستشفي                 0/4:0   4/4:4   4/4:4   4/4:4   4/4:4   4/4:4   4/4:4   4/4:4
اجازه                  0/3:0   3/3:3   3/3:3   3/3:3   3/3:3   3/3:3   3/3:3   3/3:3
فواتير                 1/3:1   1/3:1   1/3:1   3/3:4   1/3:1   1/3:1   1/3:1   1/3:1
الجوال                 1/2:1   1/2:1   2/2:2   2/2:2   2/2:2   1/2:5   2/2:5   2/2:3
سياره                  0/2:0   1/2:1   2/2:2   2/2:2   2/2:2   1/2:1   1/2:1   1/2:1
جواز سفر               1/2:1   2/2:2   2/2:2   2/2:4   2/2:2   1/2:1   1/2:1   1/2:1
مدرسه                  0/2:0   1/2:1   1/2:1   2/2:2   1/2:1   1/2:1   1/2:1   1/2:1
التأمينات              1/2:1   2/2:2   2/2:2   2/2:3   2/2:2   2/2:5   2/2:5   2/2:2
الكهربا                0/2:0   0/2:0   0/2:0   2/2:2   2/2:2   2/2:5   2/2:5   2/2:2
تاشيره                 0/1:0   1/1:1   1/1:1   1/1:1   1/1:1   1/1:1   1/1:1   1/1:1
كلمة السر              1/1:1   1/1:1   1/1:1   1/1:1   1/1:1   1/1:1   1/1:1   1/1:1
مخالفات المرور         1/1:2   1/1:2   1/1:2   1/1:2   1/1:2   1/1:1   1/1:1   1/1:1
مكيف                   0/1:0   1/1:1   1/1:1   1/1:3   1/1:1   1/1:1   1/1:1   1/1:1
الولاده                0/1:0   1/1:1   1/1:1   1/1:1   1/1:1   1/1:5   1/1:5   1/1:1
باسورد                 0/1:0   0/1:0   1/1:1   1/1:1   1/1:1   0/1:0   1/1:1   1/1:1

config                    recall@5  precision@5  zero results
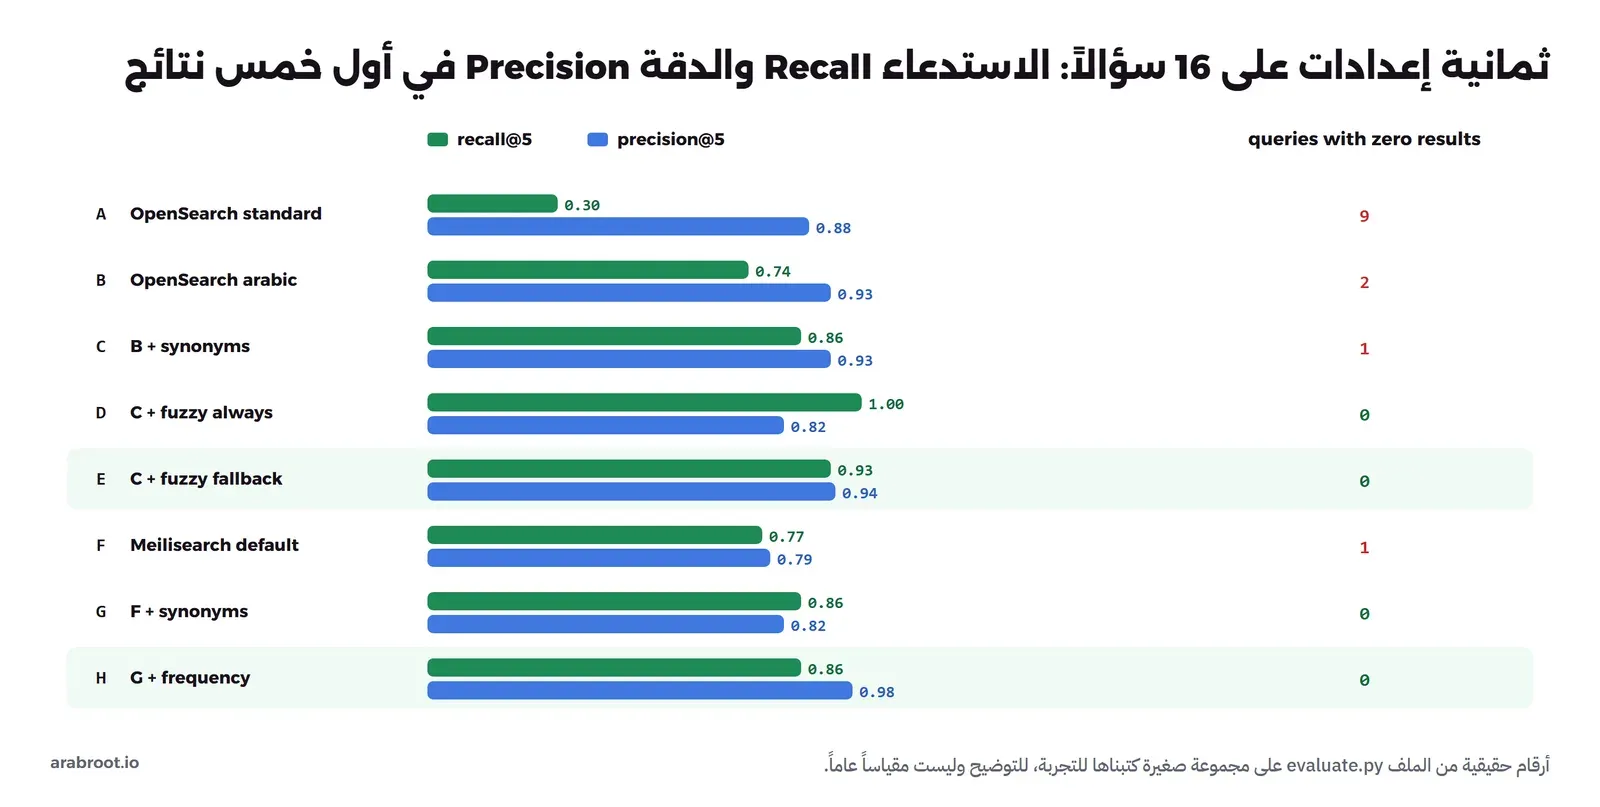
A OS standard                 0.30         0.88             9
B OS arabic                   0.74         0.93             2
C B + synonyms                0.86         0.93             1
D C + fuzzy always            1.00         0.82             0
E C + fuzzy fallback          0.93         0.94             0
F Meili default               0.77         0.79             1
G F + synonyms                0.86         0.82             0
H G + frequency               0.86         0.98             0
والصورة التالية تبين الجدول الثاني:
في المخرج أعلاه لاحظ التالي:
- المحلل الافتراضي غير مناسب إطلاقاً للعربية: الإعداد A وجد 30% فقط مما يجب أن يظهر، وتسعة أسئلة من ستة عشر رجعت صفحة فارغة، منها «مستشفي» و«اجازه» و«مدرسه» التي لها إجابات واضحة.
- التوحيد والجذع هما أكبر قفزة: الإعداد B رفع الاستدعاء من 0.30 إلى 0.74 بتغيير اسم المحلل فقط، وبقيت «فواتير» تجد مستنداً واحداً من ثلاثة، و«مدرسه» واحداً من اثنين، وهذه جموع التكسير التي توقعناها.
- المرادفات أصلحت ما لا يصلحه المحلل: الإعداد C أصلح «الجوال» و«سياره» و«باسورد» دون أن تنخفض الدقة.
- تحمل الأخطاء الدائم رفع الاستدعاء إلى 1.00 وخفض الدقة إلى 0.82: في الإعداد D وجد كل شيء، حتى «فواتير» لأن «فاتور» قريبة منها، لكنه أضاف نتائج خاطئة لأسئلة صحيحة مثل «مكيف» و«جواز سفر».
- تحمل الأخطاء عند الصفر فقط هو التوازن الأفضل في OpenSearch: الإعداد E أعطى استدعاء 0.93 ودقة 0.94 ولا يوجد سؤال بلا نتائج.
- Meilisearch جيد من البداية ويحتاج ضبطاً: الإعداد F دون أي ضبط أفضل من A بكثير، لأن التوحيد وتحمل الأخطاء مفعلان، لكن دقته 0.79 بسبب مشكلة «ال» التي رأيناها، ومع المرادفات و
frequencyفي الإعداد H وصل إلى استدعاء 0.86 ودقة 0.98، ولم يجد «فواتير» و«مدرسه» و«سياره» و«جواز سفر» كاملة لأنه لا يجذع الكلمات العربية.
ولا تأخذ هذه الأرقام على أنها حكم على المحركين، فالمستندات ثلاثون والأسئلة ستة عشر كتبناها نحن، والفرق بين 0.93 و0.86 هنا هو سؤالان أو ثلاثة، وإنما خذ الطريقة: اكتب أسئلتك الحقيقية ونتائجها المتوقعة، وقس قبل كل تغيير وبعده.
نكسر البحث: محلل مختلف في السؤال
ذكرنا في المقال السابق أن المحلل يجب أن يكون نفسه في الفهرسة وفي البحث، ولنرى ماذا يحدث إذا اختلفا، احفظ الملف التالي باسم mismatch.py، وهو يبحث عن «المستشفى» في الفهرس os_arabic مرة بمحلل الحقل نفسه، ومرة بإجبار المحلل standard على السؤال:
from lab import call, OS

def count(match):
    r = call(OS, "POST", "/os_arabic/_search", {"query": {"match": {"title": match}}})
    return r["hits"]["total"]["value"]

print("same analyzer    :", count({"query": "المستشفى"}))
print("standard at query:", count({"query": "المستشفى", "analyzer": "standard"}))
والمخرج سوف يكون كما يلي:
same analyzer    : 4
standard at query: 0
الفهرس فيه مستشف بعد الجذع، والمحلل standard أرسل «المستشفى» كما هي، فلم تطابق أي كلمة في الفهرس، والنتيجة صفر بدل أربعة، دون أي رسالة خطأ. وهذا يحدث في الواقع عندما تضع في الاستعلام محللاً صراحة، أو تنظف السؤال في تطبيقك بطريقة مختلفة عن المحلل، كأن تحذف الهمزات ولا تحذف التشكيل، أو عندما تغير محلل الحقل دون إعادة الفهرسة. والقاعدة أن تترك المحرك يطبق محلل الحقل على السؤال، وإذا احتجت محللاً مختلفاً للبحث، كما فعلنا بالمرادفات، فعرفه في ال Mapping بالخيار search_analyzer وليس في الاستعلام.
OpenSearch أم Meilisearch للبحث العربي؟
على أساس ما رأيناه، الاختيار يعتمد على حجم البيانات ومقدار التحكم الذي تحتاجه:
| السؤال | OpenSearch | Meilisearch |
|---|---|---|
| التوحيد Normalization | في المحلل arabic أو مرشح arabic_normalization | تلقائي بمكتبة charabia |
| الجذع Stemming | جذع خفيف في المحلل arabic | لا يوجد في تجربتنا، فالجموع لا تطابق المفرد |
| تحمل الأخطاء | تختاره في كل استعلام، والأفضل عند الصفر فقط | مفعل افتراضياً حسب طول الكلمة |
| المرادفات | مرشح synonym_graph في محلل البحث | الإعداد synonyms |
| الضبط المطلوب للعربية | بناء محلل وفهم مراحله | تحديد اللغة ara وتجربة frequency |
| الأنسب | بيانات كبيرة وسجلات وتحكم كامل في الترتيب | مربع بحث داخل تطبيق أو متجر ونتائج أثناء الكتابة |
وإذا كانت بياناتك في PostgreSQL وحجمها متوسط، فقد يكفيك البحث النصي فيها مع توحيد الحروف العربية كما شرحنا في قسم البحث العربي في مقال PostgreSQL لكل شيء، والأفكار في هذا المقال نفسها: وحد الحروف، واحذف الزوائد، وأضف المرادفات، وقس. وسوف نتناول تثبيت كل محرك للإنتاج في دليل مستقل ضمن المرحلة.
أخطاء شائعة
- ترك المحلل الافتراضي: الحقل النصي في OpenSearch يأخذ
standardإذا لم تحدد غيره، ورأينا أنه يجد ثلث ما يجب أن يظهر. حدد محلل كل حقل عربي في ال Mapping قبل أول فهرسة. - توحيد النص في التطبيق فقط: إذا حذفت التشكيل من المستندات قبل إرسالها ولم تحذفه من سؤال المستخدم، أو العكس، فقد صنعت المشكلة التي رأيناها في قسم الكسر. اجعل التوحيد في المحلل.
- تحمل الأخطاء الدائم: مع الكلمات العربية القصيرة بعد الجذع يدخل نتائج خاطئة لأسئلة صحيحة، فاستخدمه عند الصفر فقط أو لكلمات طويلة.
- قاموس مرادفات ضخم: يرفع الاستدعاء ويخفض الدقة، ويجعل الترتيب غريباً. ابدأ بالكلمات التي ترجع صفراً في سجل البحث.
- تعديل المحلل دون إعادة الفهرسة: المستندات القديمة تبقى بكلماتها القديمة، فيتطابق بعضها ولا يتطابق بعض.
- الحكم دون أسئلة مرجعية: ثلاث تجارب يدوية لا تكشف أن تغييراً أصلح سؤالاً وأفسد خمسة. احتفظ بملف الأسئلة وشغله بعد كل تعديل.
حذف المختبر
الأوامر التالية تحذف ال Containers الثلاثة والشبكة، ثم ال Images إذا لم تعد تحتاجها:
docker rm -f lab-search-os lab-search-meili lab-search-py
docker network rm lab-search-net
docker rmi opensearchproject/opensearch:3.9.0 getmeili/meilisearch:v1.54.3
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الكلمة العربية تختلف بين السؤال والمستند في الكتابة، مثل الهمزات والتاء المربوطة والألف المقصورة والتشكيل والتطويل، وفي البنية، مثل «و» و«ال» والجموع، والمحلل الافتراضي لا يعالج أياً منها.
- المحلل
arabicفي OpenSearch يوحد الحروف ويطبق الجذع الخفيف، ورفع الاستدعاء في تجربتنا من 0.30 إلى 0.74 بتغيير واحد، وبناؤه بنفسك من مراحله يسمح لك بالإضافة إليه. - الجذع الخفيف لا يجمع جموع التكسير مع مفردها، والأصل الاشتقاقي Root يجمع كلمات لا علاقة بينها في البحث، والحل العملي قائمة مرادفات صغيرة في محلل البحث فقط.
- تحمل الأخطاء الإملائية ينقذ السؤال الخاطئ ويضيف نتائج خاطئة للسؤال الصحيح، واستخدامه عند الصفر فقط أعطى أفضل توازن: استدعاء 0.93 ودقة 0.94.
- Meilisearch يوحد الحروف ويتحمل الأخطاء دون إعداد، لكنه لا يجذع العربية، ومع «ال» المفصولة يحتاج
matchingStrategy: frequency. - اكتب أسئلة حقيقية بنتائجها المتوقعة وقس الاستدعاء والدقة بعد كل تغيير، واجعل المحلل نفسه في الفهرسة والبحث.
 دليلكيف يعمل البحث؟ الفهرس المعكوس Inverted Index وترتيب النتائجلماذا لا يكفي LIKE للبحث في تطبيقك، وكيف يجد محرك البحث الكلمات في جزء من الثانية ويرتب أهم النتائج في الأعلى.
 دليلمعالجة اللغة الطبيعية NLP للعربية ولماذا تصعب على البرامجلماذا تصعب العربية على البرامج من الزوائد واللهجات إلى تكلفة التوكنز، وما الأدوات والنماذج المتاحة لمن يبني مساعداً عربياً.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ تجربة OpenSearch 3.9.0 (Lucene 10.5.1) وMeilisearch 1.54.3 مع Python 3.13 في Docker، وقياس ثمانية إعدادات على ثلاثين مستنداً وستة عشر سؤالاً.


