

يكتب الموظف في مساعد الشركة «شروط الاجازه المرضيه» بالهاء بدلاً من التاء المربوطة كما يكتب أغلبنا على الجوال، فيرد المساعد بأنه لم يجد شيئاً، مع أن سياسة الإجازة المرضية موجودة في المستندات منذ سنوات. ويكتب عميل في تطبيق المتجر «وين ألقى الطلب حقي» بلهجته، فلا يفهمه نظام التصنيف الذي تدرب على الفصحى، ثم يصلك أن تكلفة نموذج اللغة على النصوص العربية أعلى مما حسبته. وكل هذه المشكلات من نفس النوع: البرنامج لا يرى اللغة كما نراها نحن، وإنما يرى حروفاً وأرقاماً، والعربية لها خصائص تجعل هذه الحروف أصعب على البرامج من الإنجليزية.
وفي مقالات مرحلة الذكاء الاصطناعي شرحنا كيف تعمل نماذج اللغة الكبيرة وكيف تبني بحثاً في مستنداتك مع RAG، وفي هذا المقال نرجع خطوة إلى الأساس الذي يقوم عليه كل ذلك، وهو معالجة اللغة الطبيعية Natural Language Processing واختصاراً NLP، ونركز على العربية تحديداً: لماذا تصعب على البرامج، وما الأدوات والنماذج المتاحة لها، وكيف تبني بحثاً أو مساعداً يفهمها، مع تجربة حقيقية على Python ترى فيها كل مشكلة بعينك.
وسوف نناقش في هذا المقال ما يلي:
- ما هي معالجة اللغة الطبيعية NLP، وما مهامها الكلاسيكية من التقطيع Tokenization إلى الترجمة الآلية Machine Translation.
- كيف انتقل المجال من القواعد المكتوبة باليد إلى الإحصاء ثم المتجهات ثم نماذج Transformer، في صورة واحدة دون إعادة القصة كاملة.
- لماذا تصعب العربية على البرامج: الزوائد الملتصقة بالكلمة، والأصل والوزن، والحركات والالتباس، وأشكال الحروف، واللهجات وArabizi، والكتابة من اليمين لليسار في Unicode، وتكلفة التوكنز.
- تجربة عملية مع CAMeL Tools وPyArabic وtiktoken وال Tokenizers الخاصة بنماذج عربية.
- الأدوات المتاحة للعربية ورخصها، ومجموعات البيانات ومقاييس الأداء Benchmarks، والنماذج التي تدعم العربية وأين تجدها.
- نصائح عملية لمن يبني بحثاً عربياً أو مساعد محادثة Chatbot.
ما هي معالجة اللغة الطبيعية NLP؟
معالجة اللغة الطبيعية هي كل برنامج يأخذ نصاً أو كلاماً كتبه أو قاله إنسان، ويستخرج منه معنى يستطيع البرنامج أن يعمل به، أو ينتج نصاً جديداً يفهمه الإنسان. وكلمة «الطبيعية» هنا مقابل لغات البرمجة: لغة Python لها قواعد صارمة لا تقبل الخطأ، أما اللغة التي نتكلمها فمليئة بالاختصار والالتباس والأخطاء الإملائية، ونفهمها نحن دون أن ننتبه لصعوبتها. ولذلك قسم الباحثون العمل منذ البداية إلى مهام صغيرة، كل مهمة تجيب على سؤال واحد عن النص، ثم تبنى التطبيقات الكبيرة فوقها.
الصورة التالية تبين هذه المهام على جملة عربية واحدة، وكل المخرجات فيها حقيقية من التجربة التي سوف نشغلها بعد قليل:
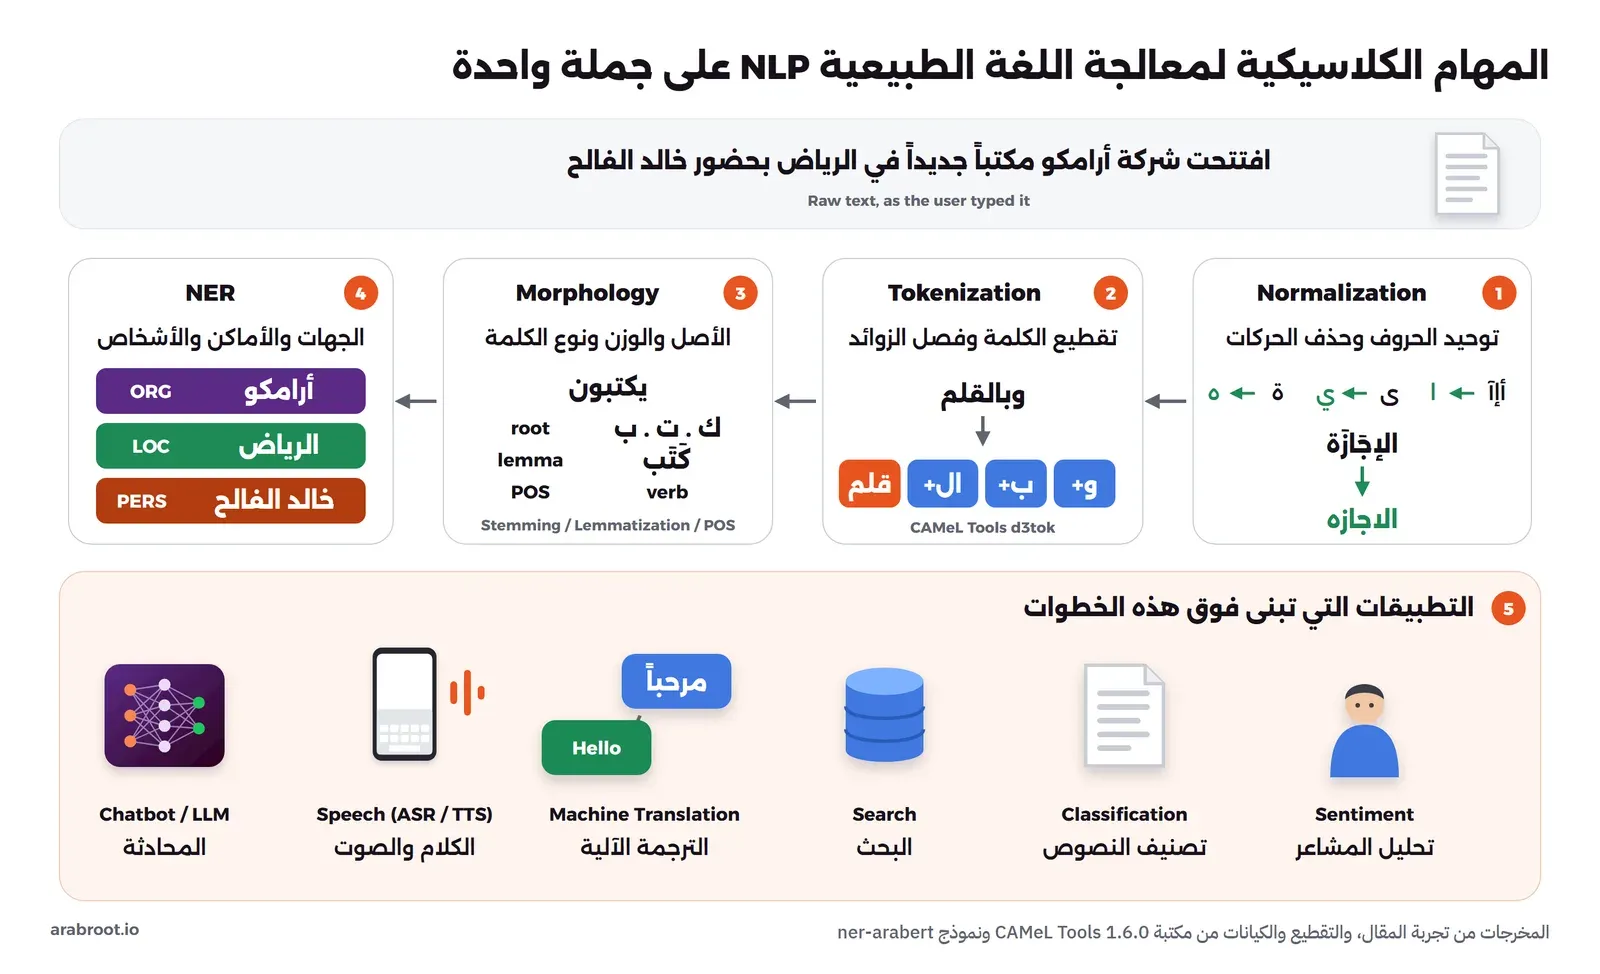
وفيما يلي المهام الكلاسيكية بالترتيب الذي تراه في الصورة تقريباً:
- التقطيع Tokenization: تقسيم النص إلى وحدات يتعامل معها البرنامج، كلمات أو أجزاء كلمات أو علامات ترقيم. وفي الإنجليزية تكفي المسافات في أغلب الحالات، أما في العربية فالكلمة الواحدة قد تحمل حرف العطف وحرف الجر وأداة التعريف والضمير معاً كما سوف ترى.
- توحيد الحروف Normalization: تحويل الأشكال المختلفة لنفس الكلمة إلى شكل واحد، مثل حذف الحركات وتوحيد الهمزات، حتى يقارن البرنامج الكلمة بالكلمة وليس الحرف بالحرف.
- استخراج الأصل Stemming والصيغة الأساسية Lemmatization: الأول يقطع الزوائد بقواعد بسيطة ليصل إلى جزء مشترك، والثاني يرجع الكلمة إلى صيغتها في القاموس، فكلمة «يكتبون» صيغتها الأساسية Lemma هي الفعل «كتب».
- تحديد نوع الكلمة Part-of-Speech Tagging واختصاراً POS: هل الكلمة اسم أو فعل أو حرف أو صفة، وهذه المهمة مهمة في العربية لأن نفس الحروف قد تكون اسماً أو فعلاً.
- استخراج الكيانات المسماة Named Entity Recognition واختصاراً NER: تحديد أسماء الأشخاص والجهات والأماكن في النص، وهي أساس استخراج البيانات من العقود والأخبار والبلاغات.
- تحليل المشاعر Sentiment Analysis: هل التعليق إيجابي أو سلبي أو محايد، وتستخدمه الشركات لقراءة آلاف التقييمات.
- تصنيف النصوص Text Classification: توجيه الرسالة إلى القسم الصحيح، أو تحديد نوع الطلب، أو كشف الرسائل المزعجة Spam، وقد شرحنا فكرته العامة في قسم التعلم الموجه في مقال التعلم الآلي.
- الترجمة الآلية Machine Translation واختصاراً MT: من لغة إلى أخرى، وهي من أقدم مهام المجال.
- الكلام Speech: تحويل الكلام إلى نص Automatic Speech Recognition واختصاراً ASR، وتحويل النص إلى كلام Text-to-Speech واختصاراً TTS، وكل لهجة عربية هنا تكاد تكون لغة مستقلة بالنسبة للنموذج.
وقد يتساءل البعض: لماذا أحتاج هذه المهام الصغيرة ما دام نموذج اللغة الكبير LLM يقوم بكل شيء؟ والإجابة أن هذه المهام ما زالت تعمل داخل الأنظمة الحديثة نفسها: البحث في مستنداتك يحتاج التقطيع وتوحيد الحروف قبل أن يصل أي شيء إلى النموذج، وال Tokenizer الذي يقطع النص للنموذج هو نسخة حديثة من مهمة التقطيع، وكثير من المهام مثل استخراج الكيانات من مليون مستند تكون أرخص وأسرع وأدق بأداة صغيرة متخصصة منها بنموذج كبير، وقد ناقشنا متى يكون النموذج الكبير الأداة الخطأ في مقال لماذا تفوقت نماذج اللغة.
من القواعد إلى نماذج اللغة في أربع مراحل
قصة الذكاء الاصطناعي كاملة موجودة في مقال قصة الذكاء الاصطناعي، ولن نعيدها هنا، وإنما نأخذ منها ما يخص اللغة، لأن كل أداة عربية ستقابلها في عملك تنتمي إلى واحدة من هذه المراحل الأربع، ومعرفة المرحلة تخبرك بنقاط قوتها ونقاط ضعفها قبل أن تجربها. الصورة التالية تبين المراحل ومحطات العربية في كل واحدة:
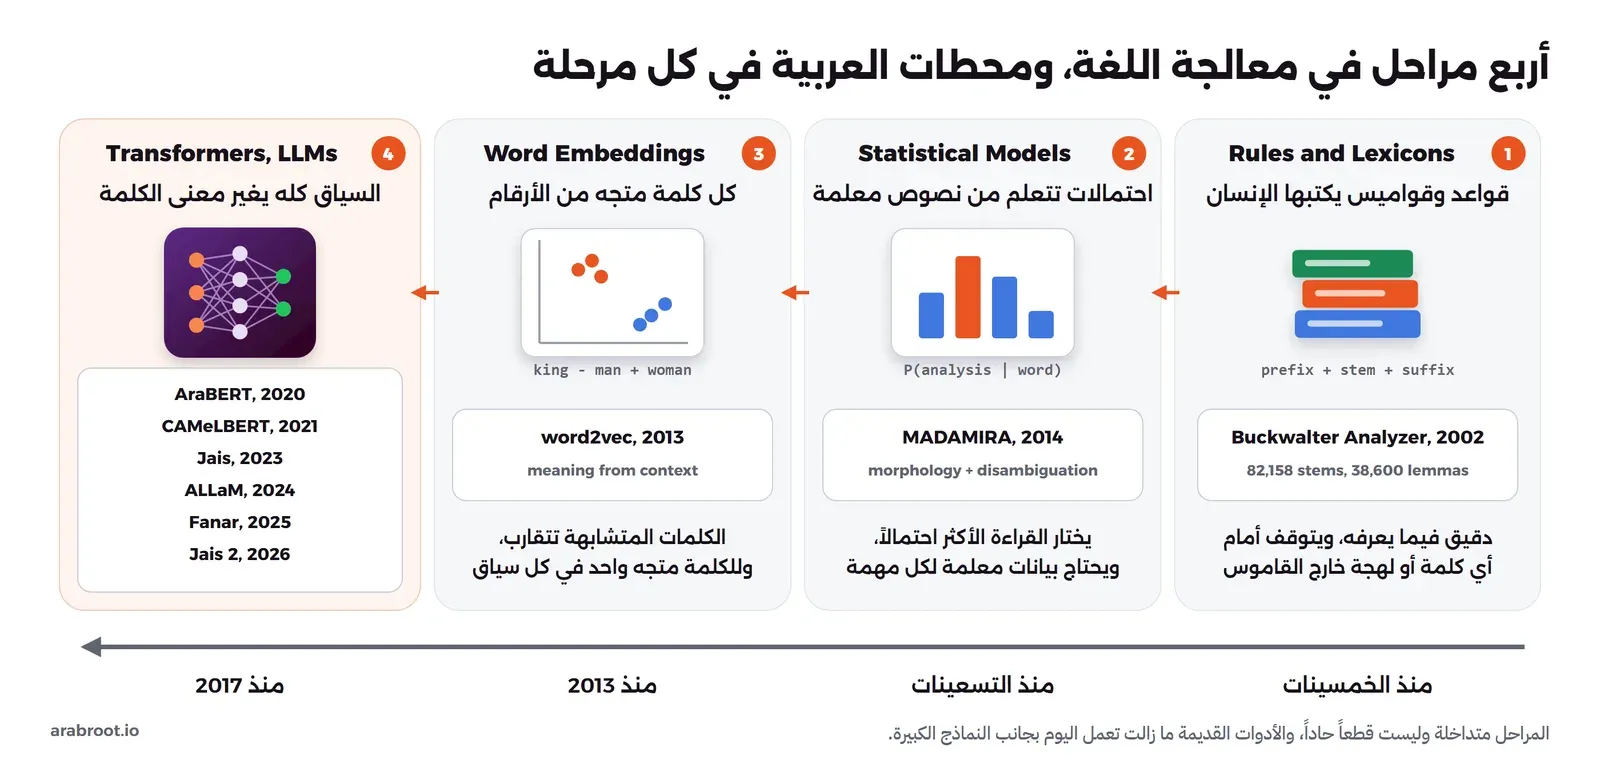
- القواعد والقواميس Rules and Lexicons: يكتب الخبير اللغوي القواعد بيده، ومن أشهر أمثلتها في العربية محلل Buckwalter الصرفي الذي نشره Tim Buckwalter سنة 2002، وفيه قوائم بالسوابق Prefixes واللواحق Suffixes والجذوع Stems مع جداول تحدد أيها يجتمع مع أيها، فيجد كل التحليلات الممكنة لأي كلمة يعرف جذعها. والمشكلة أنه يعطيك كل الاحتمالات دون أن يختار، ويتوقف أمام أي كلمة أو لهجة ليست في قاموسه.
- النماذج الإحصائية Statistical Models: بدلاً من القاعدة نتعلم الاحتمالات من نصوص صحح الإنسان تحليلها يدوياً، فيختار البرنامج التحليل الأكثر احتمالاً، ومثاله في العربية MADAMIRA سنة 2014 الذي جمع التحليل الصرفي واختيار التحليل المناسب Disambiguation في أداة واحدة، وفي نفس الفترة سيطرت الترجمة الإحصائية. والثمن أنك تحتاج بيانات معلمة Labeled Data لكل مهمة ولكل لهجة.
- متجهات الكلمات Word Embeddings: مع word2vec سنة 2013 أصبحت كل كلمة متجهاً من الأرقام تتقارب فيه الكلمات المتشابهة في المعنى، وقد شرحنا فكرة التضمين في مقال كيف تعمل نماذج اللغة. والمشكلة أن لكل كلمة متجهاً واحداً، فكلمة «علم» لها نفس المتجه سواء كانت علم البلد أو علم الفلك.
- نماذج Transformer ونماذج اللغة الكبيرة: الانتباه Attention يجعل معنى الكلمة يتغير بحسب الجملة كلها، ومن هنا جاءت النماذج العربية: AraBERT من الجامعة الأمريكية في بيروت سنة 2020، ثم CAMeLBERT سنة 2021 الذي وجد أن قرب نوع النص في التدريب المسبق (فصحى أو لهجات أو تراث) من نوع النص في المهمة أهم من حجم بيانات التدريب، ثم نماذج المحادثة الكبيرة مثل Jais وALLaM وFanar التي سوف نتحدث عنها لاحقاً. وقد شرحنا لماذا تفوقت هذه النماذج على ما قبلها في مقال لماذا تفوقت نماذج اللغة.
لاحظ أن المراحل متداخلة وليست قطعاً حاداً، فأدوات اليوم تخلط بينها: CAMeL Tools التي سوف نستخدمها تحتوي قاموساً صرفياً من المرحلة الأولى، ونموذجاً إحصائياً من المرحلة الثانية، ونماذج BERT من المرحلة الرابعة، وسوف ترى في التجربة أين يتفوق كل واحد على الآخر.
تجهيز بيئة التجربة
سوف نشغل كل الأمثلة داخل Container واحد من Python حتى لا نغير شيئاً في جهازك، ولا نحتاج أي منفذ Port مفتوح لأن التجربة كلها سطر أوامر. ونحفظ ال Volume المسمى lab-nlp-cache لملفات التحميل حتى لا تنزلها مرة ثانية إذا أعدت إنشاء ال Container. الأوامر التالية تنشئ ال Container وتثبت المكتبات بإصدارات محددة:
docker volume create lab-nlp-cache
docker run -d --name lab-nlp-py -v lab-nlp-cache:/root/.cache -e HF_HOME=/root/.cache/huggingface python:3.12-slim sleep infinity
docker exec lab-nlp-py pip install torch==2.14.1 --index-url https://download.pytorch.org/whl/cpu
docker exec lab-nlp-py pip install camel-tools==1.6.0 pyarabic==0.6.15 tiktoken==0.14.0 transformers==5.19.0 sentencepiece==0.2.2 protobuf==7.36.2 scikit-learn==1.9.0
في الإعداد أعلاه لاحظ التالي:
- نثبت نسخة المعالج CPU من PyTorch من رابطها الخاص، لأن CAMeL Tools تحتاجها لنماذج BERT، والنسخة الافتراضية تنزل مكتبات البطاقات الرسومية GPU بعدة جيجابايتات لا نحتاجها هنا.
- تشترط CAMeL Tools بحسب صفحتها Python من 3.11 إلى 3.14 بنظام 64 بت، ويذكر دليل التثبيت أن Linux وmacOS يحتاجان CMake وBoost، وذلك عندما لا تتوفر حزمة جاهزة Wheel لنظامك وتحتاج pip أن تبني مكتبة camel-kenlm من الكود.
- نحدد scikit-learn بالإصدار 1.9.0 لأن نموذج تمييز اللهجات الذي سوف نستخدمه محفوظ بهذا الإصدار، وأي إصدار آخر يطبع تحذير InconsistentVersionWarning عند تحميله.
بعد ذلك ننزل بيانات CAMeL Tools، فالمكتبة نفسها كود فقط، والقواميس والنماذج حزم بيانات منفصلة تنزلها بالأمر camel_data:
docker exec lab-nlp-py camel_data -i light
docker exec lab-nlp-py camel_data -i disambig-bert-unfactored-msa
docker exec lab-nlp-py camel_data -i ner-arabert
docker exec lab-nlp-py camel_data -i sentiment-analysis-arabert
docker exec lab-nlp-py du -sh /root/.camel_tools
والمخرج سوف يكون كما يلي:
2.0G /root/.camel_toolsالحزمة light وحدها كانت 536 MB وفيها القواميس الصرفية للفصحى واللهجات المصرية والخليجية والشامية، ونموذج اختيار التحليل الإحصائي، ونموذج تمييز اللهجات، أما الحزم الثلاث الأخرى فنماذج BERT لاختيار التحليل بحسب السياق ولاستخراج الكيانات وتحليل المشاعر، وكل واحدة منها قرابة نصف جيجابايت. ويجدر الإشارة هنا إلى أن البيانات داخل ال Container تحفظ في /root/.camel_tools خارج ال Volume، فإذا حذفت ال Container فسوف تحتاج تنزيلها مرة ثانية، وإذا أردت حفظها فاستخدم المتغير CAMELTOOLS_DATA الذي يذكره دليل التثبيت.
وأخيراً أنشئ مجلداً اسمه lab-nlp على جهازك تحفظ فيه ملفات Python التي سوف نكتبها في الأقسام التالية، وبعد كل ملف انسخ المجلد إلى ال Container بالأمر التالي:
docker cp lab-nlp/. lab-nlp-py:/labلماذا تصعب العربية على البرامج؟
العربية ليست أصعب على الإنسان من غيرها بالضرورة، ولكنها تخالف الافتراضات التي بنيت عليها أغلب أدوات NLP، لأن هذه الأدوات صممت أولاً للإنجليزية: كلمة واحدة بين مسافتين تعني معنى واحداً، والحروف تكتب بشكل واحد، والنص المكتوب هو نفسه النص المنطوق تقريباً. وفي العربية تسقط هذه الافتراضات الثلاثة، وفيما يلي كل مشكلة مع مثال حقيقي.
كلمة واحدة تحمل جملة: الزوائد الملتصقة Clitics
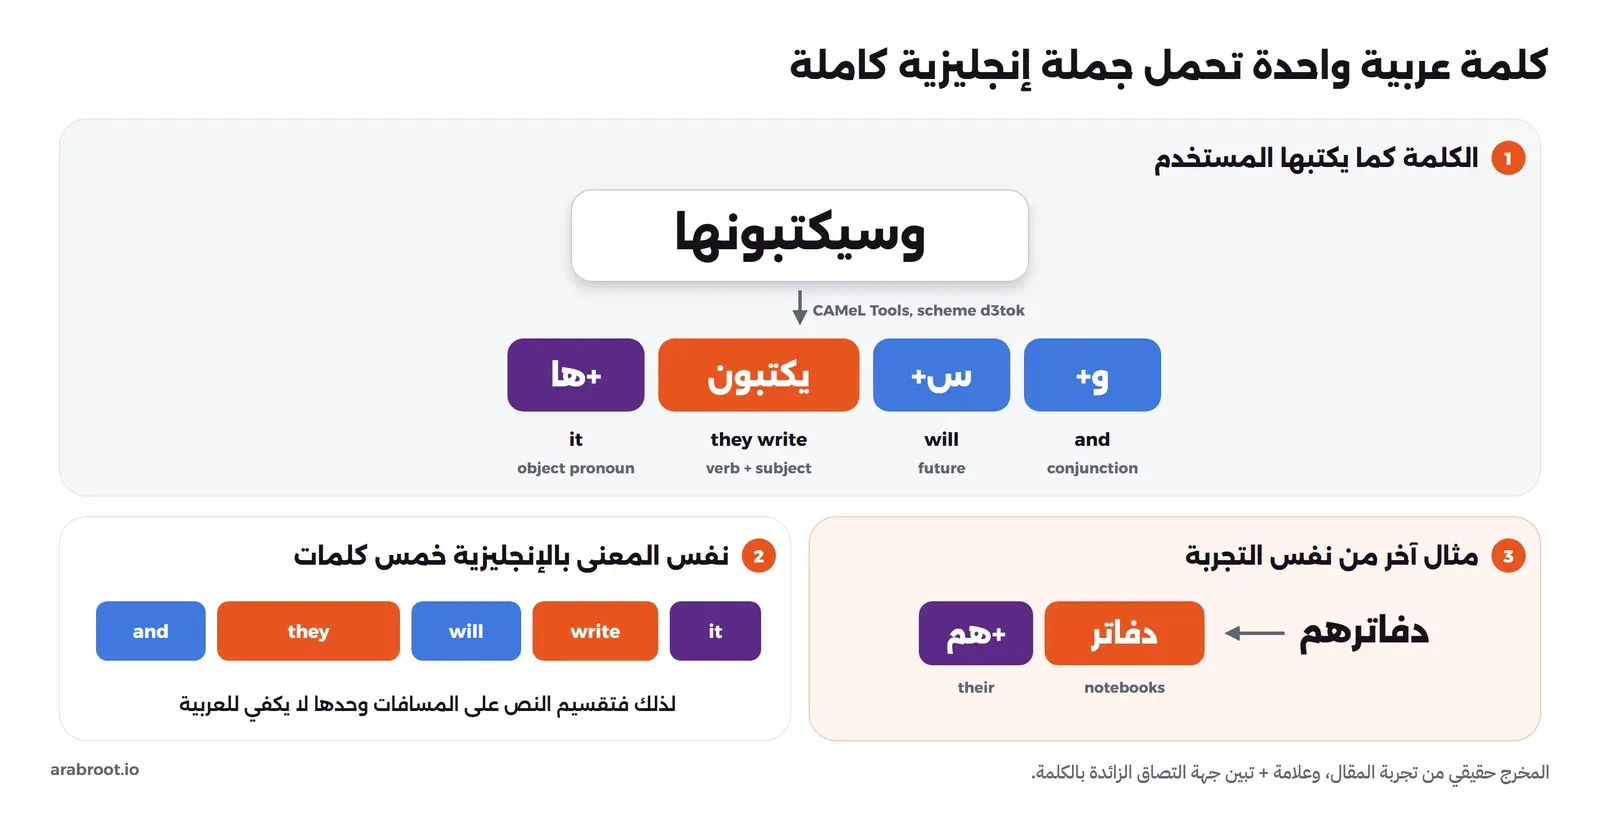
في العربية تلتصق بالكلمة حروف وضمائر هي في الإنجليزية كلمات مستقلة، مثل واو العطف وفاء العطف وحروف الجر والسين للمستقبل وأداة التعريف والضمائر المتصلة، وتسمى هذه الزوائد Clitics. فكلمة «وسيكتبونها» جملة إنجليزية كاملة من خمس كلمات، والمثال التالي يقارن بين ثلاث طرق لتقطيعها، احفظه في lab-nlp/tok.py:
from camel_tools.tokenizers.word import simple_word_tokenize
from camel_tools.disambig.mle import MLEDisambiguator
from camel_tools.tokenizers.morphological import MorphologicalTokenizer

s = "وسيكتبونها في دفاترهم، وبالقلم الأحمر!"
print("split()       :", s.split())
print("simple_word   :", simple_word_tokenize(s))
mle = MLEDisambiguator.pretrained()
tok = MorphologicalTokenizer(mle, scheme="d3tok", split=True)
print("d3tok clitics :", tok.tokenize(simple_word_tokenize(s)))
docker cp lab-nlp/. lab-nlp-py:/lab
docker exec -w /lab lab-nlp-py python tok.pyوالمخرج سوف يكون كما يلي:
split()       : ['وسيكتبونها', 'في', 'دفاترهم،', 'وبالقلم', 'الأحمر!']
simple_word   : ['وسيكتبونها', 'في', 'دفاترهم', '،', 'وبالقلم', 'الأحمر', '!']
d3tok clitics : ['و+', 'س+', 'يكتبون', '+ها', 'في', 'دفاتر', '+هم', '،', 'و+', 'ب+', 'ال+', 'قلم', 'ال+', 'أحمر', '!']
في المخرج أعلاه لاحظ التالي:
- التقسيم على المسافات بالدالة
split()ترك علامات الترقيم ملتصقة بالكلمات، فأصبحت «دفاترهم،» كلمة مختلفة عن «دفاترهم»، وهذا وحده يكفي ليفشل البحث. - الدالة
simple_word_tokenizeفصلت علامات الترقيم فقط، أما الكلمات فبقيت كما هي. - التقطيع الصرفي بطريقة
d3tokفصل الزوائد عن الكلمة، وعلامة + تبين جهة الالتصاق، فأصبحت «وبالقلم» أربع قطع «و+ ب+ ال+ قلم»، وهذا ما يجعل البحث عن «قلم» يجد «وبالقلم». ولاحظ أن هذا التقطيع احتاج نموذج اختيار التحليلMLEDisambiguator، لأن البرنامج لا يستطيع أن يفصل الزوائد قبل أن يقرر ما هي الكلمة أصلاً.
الصورة التالية تبين الكلمة نفسها ومقابلها الإنجليزي:
الأصل والوزن Root and Pattern
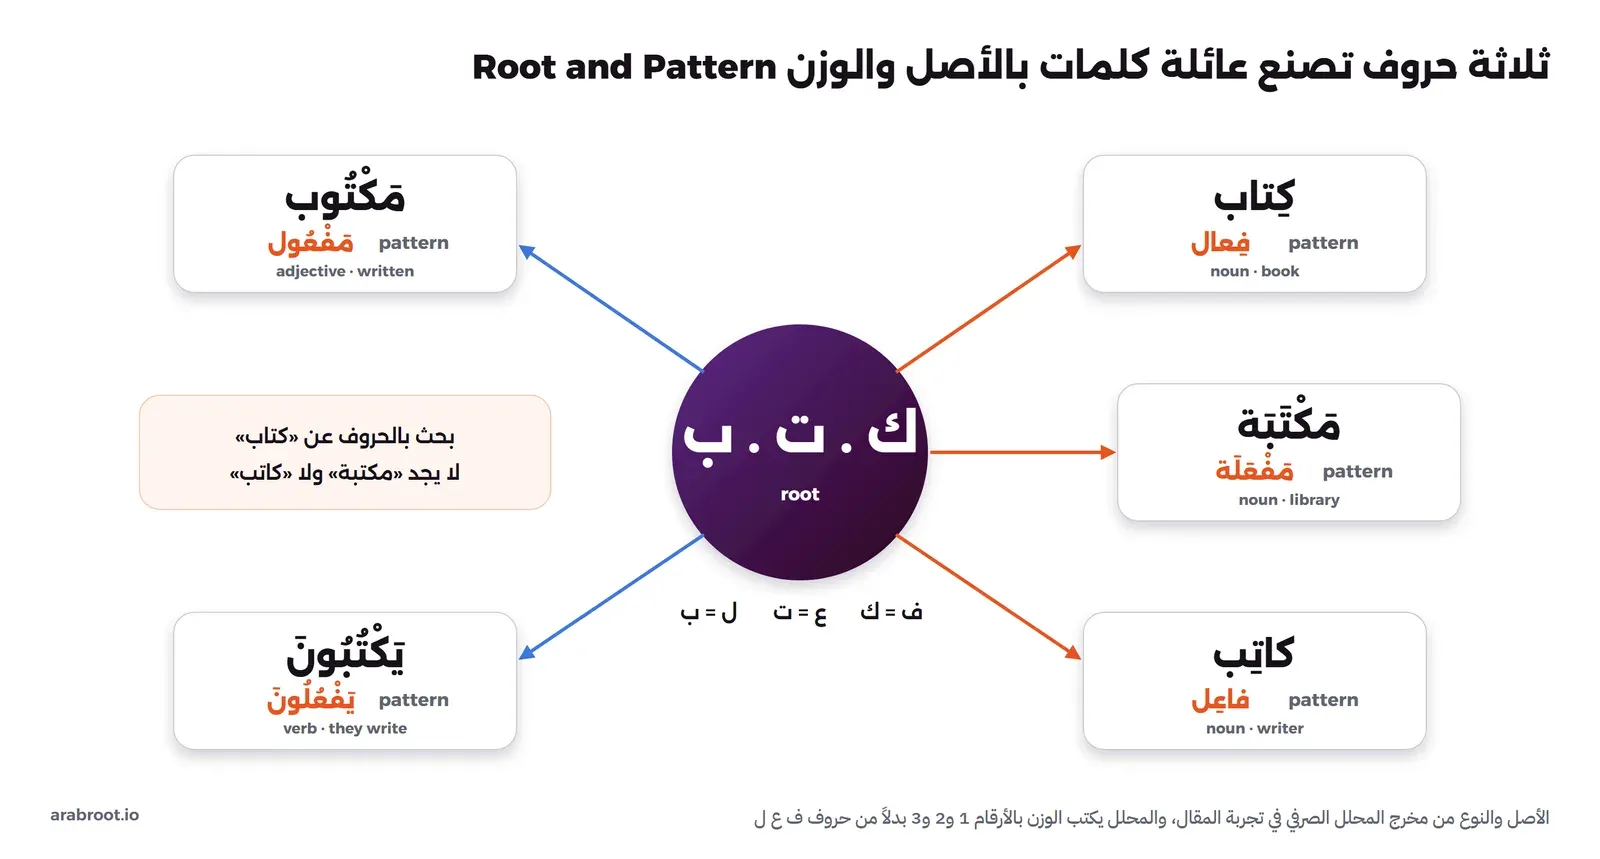
أغلب الكلمات العربية تبنى من أصل Root من ثلاثة حروف غالباً، يوضع في وزن Pattern مثل «فاعل» و«مفعول» و«مفعلة»، فيخرج منه معنى جديد. فمن الأصل «ك ت ب» تأتي «كتاب» و«مكتبة» و«كاتب» و«مكتوب» و«يكتبون»، وهي كلمات مختلفة في الحروف ومترابطة في المعنى. والمثال التالي يطلب من CAMeL Tools تحليل هذه الكلمات الخمس، ويحلل قبلها كلمة «علم» التي سوف نحتاجها في القسم التالي، احفظه في lab-nlp/morph.py:
from camel_tools.morphology.database import MorphologyDB
from camel_tools.morphology.analyzer import Analyzer
from camel_tools.disambig.mle import MLEDisambiguator

an = Analyzer(MorphologyDB.builtin_db())
analyses = an.analyze("علم")
readings = {}
for a in analyses:
    readings.setdefault((a["lex"], a["pos"]), a["gloss"])
print("علم:", len(analyses), "analyses,", len(readings), "different words (lemma + POS)")
for (lex, pos), gloss in readings.items():
    print(f"  lemma={lex:<8} pos={pos:<5} {gloss[:30]}")
print()
mle = MLEDisambiguator.pretrained()
for w in ["كتاب", "مكتبة", "كاتب", "مكتوب", "يكتبون"]:
    a = mle.disambiguate([w])[0].analyses[0].analysis
    print(f"{w:<7} root={a['root']:<6} pattern={a['pattern']:<11} pos={a['pos']:<5} lemma={a['lex']}")
docker cp lab-nlp/. lab-nlp-py:/lab
docker exec -w /lab lab-nlp-py python morph.pyوالمخرج سوف يكون كما يلي:
علم: 21 analyses, 4 different words (lemma + POS)
  lemma=عِلْم    pos=noun  science;study_of
  lemma=عَلِم    pos=verb  know;find_out+he;it_<verb>
  lemma=عَلَم    pos=noun  flag;banner;badge
  lemma=عَلَّم   pos=verb  teach;instruct+he;it_<verb>

كتاب    root=ك.ت.ب  pattern=1ِ2ا3ِ      pos=noun  lemma=كِتاب
مكتبة   root=ك.ت.ب  pattern=مَ1ْ2َ3َةِ  pos=noun  lemma=مَكْتَبَة
كاتب    root=ك.ت.ب  pattern=1ا2ِ3ٌ      pos=noun  lemma=كاتِب
مكتوب   root=ك.ت.ب  pattern=مَ1ْ2ُو3ٍ   pos=adj   lemma=مَكْتُوب
يكتبون  root=ك.ت.ب  pattern=يَ1ْ2ُ3ُونَ pos=verb  lemma=كَتَب
في المخرج أعلاه لاحظ التالي:
- الكلمات الخمس رجعت إلى نفس الأصل
ك.ت.ب، والوزن مكتوب بالأرقام 1 و2 و3 مكان حروف الأصل، فوزن «كاتب» هو1ا2ِ3أي «فاعل». - الصيغة الأساسية Lemma تختلف عن الأصل، فصيغة «يكتبون» هي الفعل
كَتَب، وصيغة «مكتبة» هيمَكْتَبَةنفسها لأنها اسم مستقل في القاموس، وهذا الفرق مهم عند اختيار طريقة البحث كما سوف نرى. - القاموس الصرفي يعيد كل كلمة بحركاتها كاملة، لأنه يعرف الكلمة ونطقها، أما النص الذي تكتبه أنت فعادة دون حركات.
الصورة التالية تبين الفكرة:
وقد يتساءل البعض: هل أبحث إذن بالأصل دائماً حتى أجد كل الكلمات المرتبطة؟ والإجابة لا، لأن الأصل الواحد يجمع معاني متباعدة، فالبحث بالأصل «ك ت ب» عن «كتاب» سوف يرجع لك «كتيبة» العسكرية أيضاً، لذلك تستخدم محركات البحث عادة استخراج جذع خفيف Light Stemming يحذف الزوائد الشائعة فقط مثل «ال» و«ات» و«ون»، وهو ما تفعله مرشحات العربية في Lucene وElasticsearch كما سوف نرى في قسم النصائح.
الحركات والالتباس Diacritics and Ambiguity
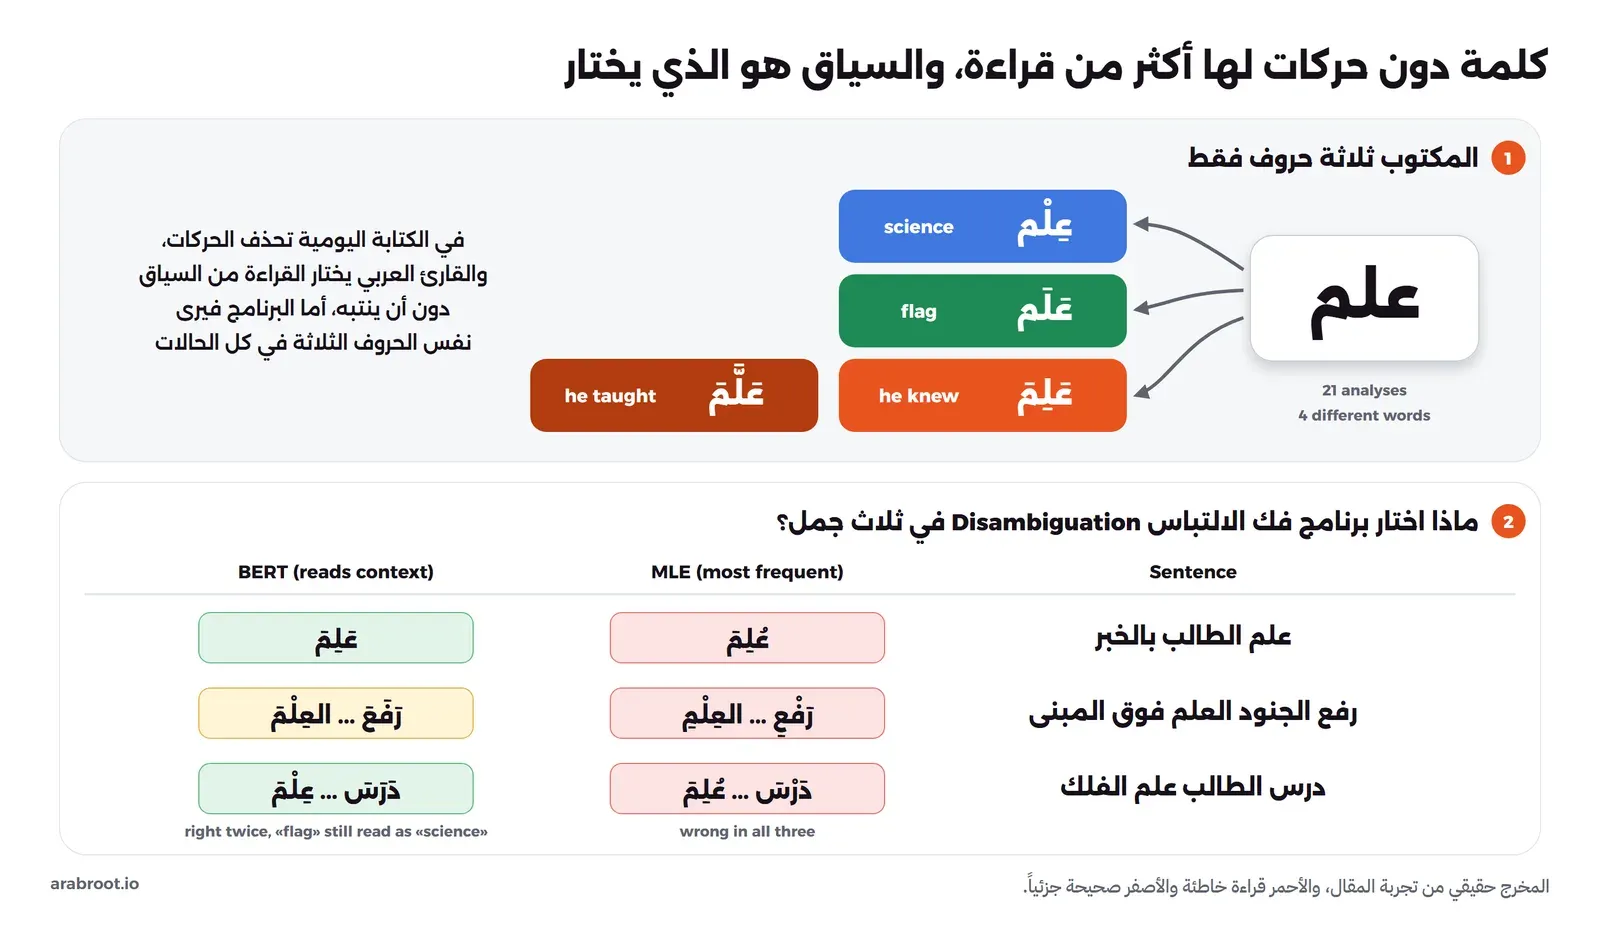
الحركات Diacritics في العربية اختيارية، فنحن نكتب «علم» ونفهم من السياق هل هي عِلْم أو عَلَم أو عَلِمَ، أما البرنامج فيرى ثلاثة حروف فقط. وقد رأيت في مخرج morph.py أعلاه أن القاموس وجد لكلمة «علم» وحدها 21 تحليلاً، منها أربع كلمات مختلفة تماماً في المعنى: العلم بمعنى المعرفة، والفعل علم بمعنى عرف، والعلم بمعنى الراية، والفعل علم بتشديد اللام بمعنى درس غيره، أما بقية التحليلات فهي حالات الإعراب المختلفة لنفس الكلمة.
ومهمة اختيار التحليل الصحيح من بين هذه الاحتمالات تسمى فك الالتباس Disambiguation، وفي CAMeL Tools طريقتان: نموذج إحصائي اسمه MLE يختار التحليل الأكثر تكراراً في بيانات التدريب لكل كلمة، ونموذج BERT يقرأ الجملة كاملة. المثال التالي يقارن بينهما على ثلاث جمل، احفظه في lab-nlp/context.py:
from camel_tools.disambig.mle import MLEDisambiguator
from camel_tools.disambig.bert import BERTUnfactoredDisambiguator
from camel_tools.tokenizers.word import simple_word_tokenize

mle = MLEDisambiguator.pretrained()
bert = BERTUnfactoredDisambiguator.pretrained("msa")
for sent in ["علم الطالب بالخبر", "رفع الجنود العلم فوق المبنى", "درس الطالب علم الفلك"]:
    words = simple_word_tokenize(sent)
    print(sent)
    for name, d in [("MLE ", mle), ("BERT", bert)]:
        out = d.disambiguate(words)
        print(f"  {name}:", "  ".join(f"{x.analyses[0].analysis['diac']}/{x.analyses[0].analysis['pos']}" for x in out))
docker cp lab-nlp/. lab-nlp-py:/lab
docker exec -w /lab lab-nlp-py python context.pyوالمخرج سوف يكون كما يلي، بعد حذف سطر تحميل الأوزان الذي يطبعه BERT:
علم الطالب بالخبر
  MLE : عُلِمَ/verb  الطالِبُ/noun  بِالخَبَر/noun
  BERT: عَلِمَ/verb  الطالِبُ/noun  بِالخَبَرِ/noun
رفع الجنود العلم فوق المبنى
  MLE : رَفْعِ/noun  الجُنُودِ/noun  العِلْمِ/noun  فَوْقَ/noun  المَبْنَى/noun
  BERT: رَفَعَ/verb  الجُنُودُ/noun  العِلْمَ/noun  فَوْقَ/noun  المَبْنَى/noun
درس الطالب علم الفلك
  MLE : دَرْسَ/noun  الطالِبُ/noun  عُلِمَ/verb  الفَلَك/noun
  BERT: دَرَسَ/verb  الطالِبُ/noun  عِلْمَ/noun  الفَلَكِ/noun
في المخرج أعلاه لاحظ التالي:
- نموذج MLE أخطأ في الجمل الثلاث، والسبب أنه ينظر إلى الكلمة وحدها دون سياقها، فقرأ «علم» في الجملة الأولى فعلاً مبنياً للمجهول، وقرأ «رفع» و«درس» اسمين لأن الاسم أكثر تكراراً في بيانات التدريب، مع أن كل جملة تبدأ بفعل واضح لأي قارئ.
- نموذج BERT صحح الأفعال الثلاثة لأنه يقرأ الجملة كلها، وقرأ «علم الفلك» قراءة صحيحة.
- ولكن BERT أيضاً قرأ «العلم» في «رفع الجنود العلم فوق المبنى» بمعنى المعرفة وليس الراية، وهذه نتيجة حقيقية وليست خطأ في التجربة، وتذكرك بقاعدة مهمة: لا توجد أداة لغوية دقيقة بنسبة 100%، فقس دقة أي أداة على نصوص من عملك قبل أن تعتمد عليها.
الصورة التالية تجمع التحليلات الأربعة ونتيجة المقارنة:
أشكال الحروف وتوحيدها Normalization
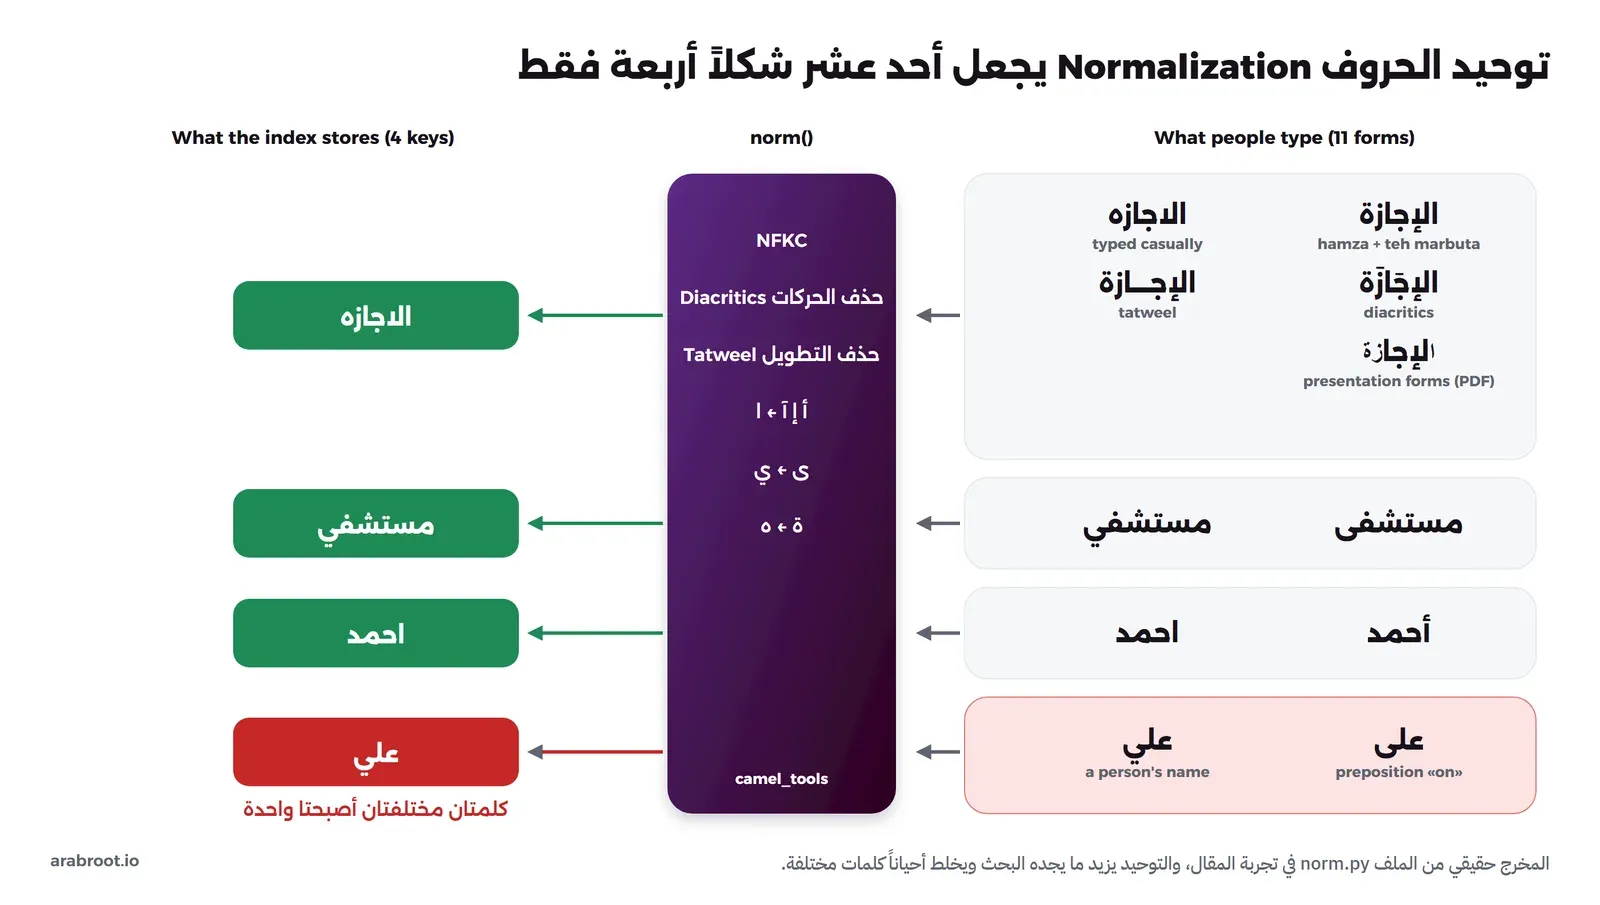
نفس الكلمة العربية تكتب بأشكال كثيرة: الهمزة على الألف أو بدونها «أحمد» و«احمد»، والتاء المربوطة أو الهاء «الإجازة» و«الاجازه»، والألف المقصورة أو الياء «مستشفى» و«مستشفي»، مع الحركات أو بدونها، أو بالتطويل Tatweel «الإجـــازة» الذي يستخدمه البعض للزينة. وكل شكل من هذه الأشكال سلسلة حروف مختلفة في الكمبيوتر، فالبحث عن واحد منها لا يجد الآخر. وقد رأينا أثر ذلك على البحث في قسم توحيد الحروف في مقال RAG، وهنا نرى الدالة نفسها من الداخل. احفظ الملف التالي في lab-nlp/norm.py:
from camel_tools.utils.normalize import (normalize_unicode, normalize_alef_ar,
    normalize_alef_maksura_ar, normalize_teh_marbuta_ar)
from camel_tools.utils.dediac import dediac_ar
import pyarabic.araby as araby

def norm(t):
    t = normalize_unicode(t)          # presentation forms → normal letters (NFKC)
    t = dediac_ar(t)                  # remove diacritics
    t = t.replace(chr(0x0640), "")    # remove tatweel (U+0640)
    t = normalize_alef_ar(t)          # أ إ آ ٱ → ا
    t = normalize_alef_maksura_ar(t)  # ى → ي
    t = normalize_teh_marbuta_ar(t)   # ة → ه
    return t

words = ["الإجازة", "الاجازه", "الإجَازَة", "الإجـــازة", "ﺍﻹﺟﺎﺯﺓ", "مستشفى", "مستشفي", "أحمد", "احمد", "على", "علي"]
for w in words:
    print(f"{w:<12} {len(w):>2} chars -> {norm(w)}")
print()
print("distinct before:", len(set(words)), " after:", len({norm(w) for w in words}))
print()
s = "الإجَازَةُ المَرَضِيَّةُ"
print("pyarabic strip_tashkeel:", araby.strip_tashkeel(s))
print("pyarabic strip_tatweel :", araby.strip_tatweel("الإجـــازة"))
print("pyarabic normalize_hamza:", araby.normalize_hamza("سأل مسؤول أُسرة"))
docker cp lab-nlp/. lab-nlp-py:/lab
docker exec -w /lab lab-nlp-py python norm.pyوالمخرج سوف يكون كما يلي:
الإجازة       7 chars -> الاجازه
الاجازه       7 chars -> الاجازه
الإجَازَة     9 chars -> الاجازه
الإجـــازة   10 chars -> الاجازه
ﺍﻹﺟﺎﺯﺓ        6 chars -> الاجازه
مستشفى        6 chars -> مستشفي
مستشفي        6 chars -> مستشفي
أحمد          4 chars -> احمد
احمد          4 chars -> احمد
على           3 chars -> علي
علي           3 chars -> علي

distinct before: 11  after: 4

pyarabic strip_tashkeel: الإجازة المرضية
pyarabic strip_tatweel : الإجازة
pyarabic normalize_hamza: سءل مسءول ءُسرة
في المخرج أعلاه لاحظ التالي:
- ترتيب الخطوات مهم: نبدأ بالدالة
normalize_unicodeالتي تحول أشكال العرض Presentation Forms المنسوخة من ملفات PDF القديمة إلى حروف عادية، ثم نحذف الحركات والتطويل، ثم نوحد الهمزات والألف المقصورة والتاء المربوطة. - الأشكال الإحدى عشرة أصبحت أربعة فقط، وهذا يعني أن البحث يجد الكلمة مهما كانت طريقة كتابتها.
- ولكن «على» حرف الجر و«علي» اسم الشخص أصبحتا كلمة واحدة، وهذا هو ثمن التوحيد: يزيد ما يجده البحث Recall ويقلل دقته Precision أحياناً، والحل أن تحتفظ بالنص الأصلي بجانب النص الموحد، فتبحث بالموحد وتعرض الأصلي وترتب النتائج التي تطابق الأصلي أعلى.
- الدالة
normalize_hamzaفي PyArabic لم توحد الهمزات إلى ألف كما قد تتوقع، وإنما حولت كل الهمزات إلى همزة منفصلة «ء» فأصبحت «سأل» «سءل»، والسبب أن كلمة «توحيد» تعني أشياء مختلفة في المكتبات المختلفة، لذلك لا تستخدم دالة توحيد من أي مكتبة قبل أن تطبعها على أمثلة من نصوصك.
الصورة التالية تلخص ما حدث:
الفصحى واللهجات وArabizi
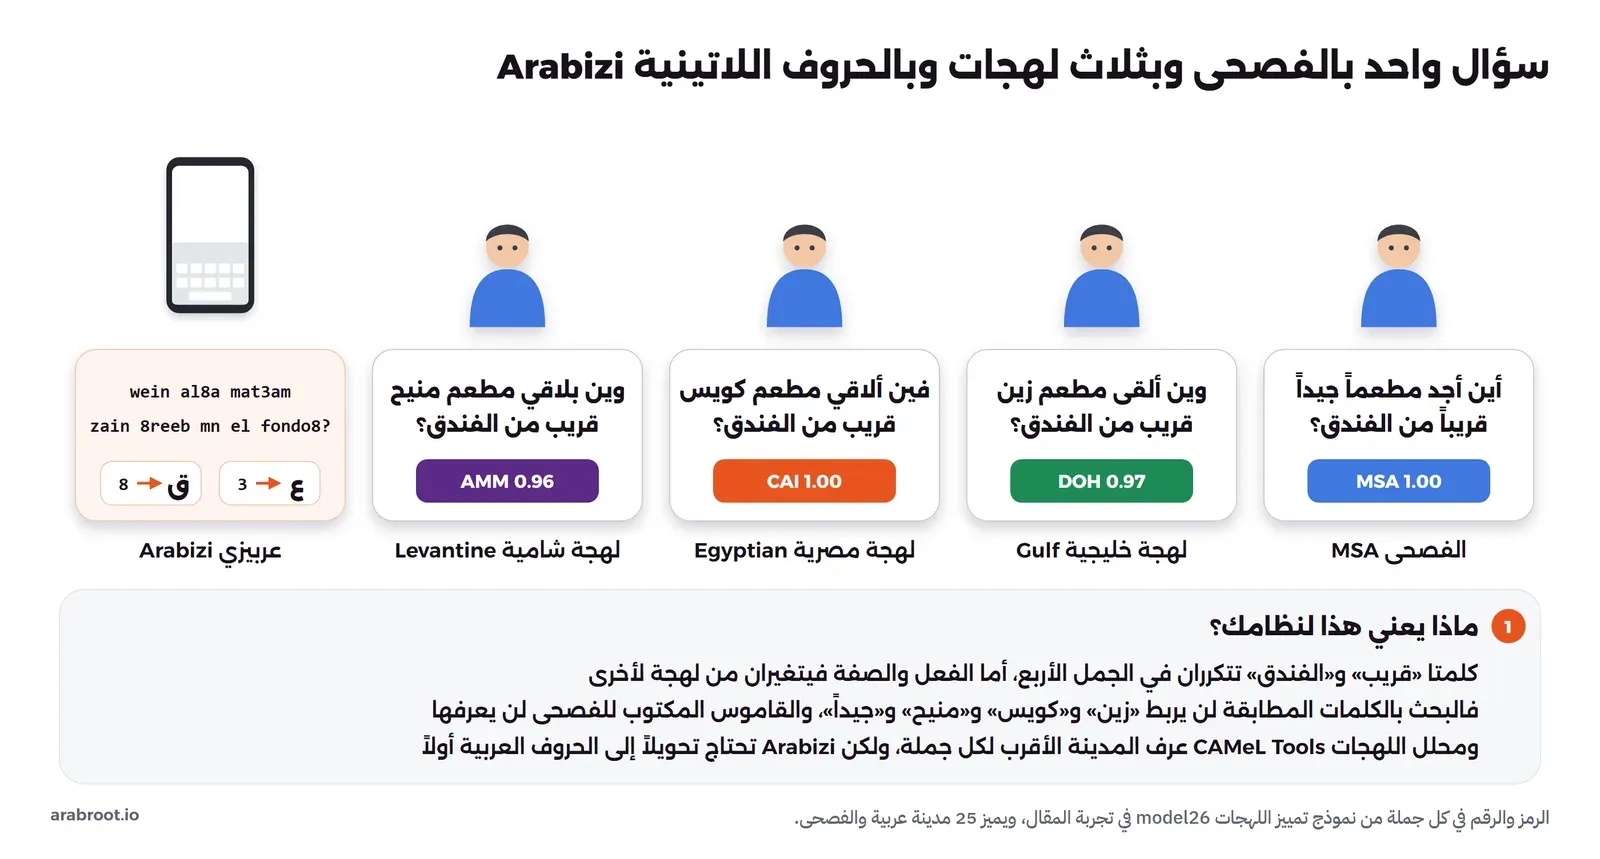
الفصحى Modern Standard Arabic واختصاراً MSA هي لغة الكتب والأخبار والعقود، ولكن الناس يكتبون في المحادثات والتعليقات وطلبات الدعم بلهجاتهم، واللهجات تختلف عن الفصحى وعن بعضها في المفردات والصرف وحتى ترتيب الكلمات. وفوق ذلك يكتب البعض العربية بحروف لاتينية وأرقام، وهذا ما يسمى Arabizi، فالرقم 3 مكان «ع» والرقم 7 مكان «ح» والرقم 8 مكان «ق» في بعض المناطق، ولا توجد طريقة واحدة متفق عليها للكتابة بها.
وفي CAMeL Tools نموذج لتمييز اللهجات Dialect Identification مبني بحسب توثيقه على نظام نشره Salameh وBouamor وHabash، وهم من فريق مدونة MADAR للهجات، ووصفه في قائمة حزم البيانات أنه يميز بين 25 مدينة عربية إضافة إلى الفصحى. المثال التالي يجربه مع استخراج الكيانات وتحليل المشاعر، احفظه في lab-nlp/apps.py:
from camel_tools.ner import NERecognizer
from camel_tools.sentiment import SentimentAnalyzer
from camel_tools.dialectid import DialectIdentifier
from camel_tools.tokenizers.word import simple_word_tokenize

ner = NERecognizer.pretrained()
s = "افتتحت شركة أرامكو مكتباً جديداً في الرياض بحضور خالد الفالح"
words = simple_word_tokenize(s)
print(list(zip(words, ner.predict_sentence(words))))
print()
sa = SentimentAnalyzer.pretrained()
reviews = ["الخدمة ممتازة والتوصيل سريع", "التطبيق يعلق كل شوي ومافي دعم", "استلمت الطلب يوم الأحد"]
for r, p in zip(reviews, sa.predict(reviews)):
    print(f"{p:<9} {r}")
print()
did = DialectIdentifier.pretrained()
sents = ["أين أجد مطعماً جيداً قريباً من الفندق؟", "وين ألقى مطعم زين قريب من الفندق؟",
         "فين ألاقي مطعم كويس قريب من الفندق؟", "وين بلاقي مطعم منيح قريب من الفندق؟"]
for s, p in zip(sents, did.predict(sents)):
    top = sorted(p.scores.items(), key=lambda kv: -kv[1])[:2]
    print(f"{p.top:<5} {top[0][1]:.2f}  next={top[1][0]} {top[1][1]:.2f}  {s}")
docker cp lab-nlp/. lab-nlp-py:/lab
docker exec -w /lab lab-nlp-py python apps.pyوالمخرج سوف يكون كما يلي، بعد حذف أسطر تحميل الأوزان:
[('افتتحت', 'O'), ('شركة', 'O'), ('أرامكو', 'B-ORG'), ('مكتباً', 'O'), ('جديداً', 'O'), ('في', 'O'), ('الرياض', 'B-LOC'), ('بحضور', 'O'), ('خالد', 'B-PERS'), ('الفالح', 'I-PERS')]

positive  الخدمة ممتازة والتوصيل سريع
negative  التطبيق يعلق كل شوي ومافي دعم
neutral   استلمت الطلب يوم الأحد

MSA   1.00  next=MUS 0.00  أين أجد مطعماً جيداً قريباً من الفندق؟
DOH   0.97  next=AMM 0.02  وين ألقى مطعم زين قريب من الفندق؟
CAI   1.00  next=ASW 0.00  فين ألاقي مطعم كويس قريب من الفندق؟
AMM   0.96  next=JER 0.02  وين بلاقي مطعم منيح قريب من الفندق؟
في المخرج أعلاه لاحظ التالي:
- نموذج الكيانات NER وجد أرامكو جهة
B-ORGوالرياض مكاناًB-LOCوخالد الفالح شخصاً، والحرف B يعني بداية الكيان والحرف I يعني استمراره، فالاسم الثنائي جاءB-PERSثمI-PERS. - نموذج المشاعر صنف التعليق الثاني سلبياً مع أنه مكتوب باللهجة «يعلق كل شوي ومافي دعم»، وصنف الثالث محايداً لأنه خبر دون رأي.
- نموذج اللهجات حدد الفصحى، ثم الدوحة DOH للجملة الخليجية، والقاهرة CAI للمصرية، وعمان AMM للشامية، والرقم بجانب كل واحدة احتمال اختياره، وبجانبه الاحتمال الثاني. ولاحظ أنه يعطيك مدينة وليس دولة، وأن قائمته فيها الرياض RIY وجدة JED أيضاً، ومع ذلك اختار الدوحة للجملة الخليجية، لأن عبارة قصيرة مثل «وين ألقى مطعم زين» مشتركة بين مدن الخليج، فلا تبن قراراً على المدينة من جملة واحدة.
الصورة التالية تبين نفس السؤال بالأشكال الخمسة:
وقد يتساءل البعض: هل أحتاج نموذجاً لكل لهجة؟ والإجابة تعتمد على عملك، فإذا كان أغلب ما يصلك من نصوص بالفصحى، مثل العقود والسياسات والمراسلات الرسمية، فأداة الفصحى تكفي، أما إذا كنت تحلل تعليقات العملاء أو محادثات الدعم فاجمع عينة حقيقية منها أولاً واعرف لهجاتها، ثم اختر نموذجاً تدرب على لهجات قريبة منها، وتذكر نتيجة CAMeLBERT التي ذكرناها: قرب نوع النص أهم من حجم البيانات.
من اليمين لليسار في Unicode
الحرف العربي في UTF-8 يكتب في بايتين، وقد شرحنا ذلك في قسم ASCII وUnicode وUTF-8 في مقال الترميز، ولكن للعربية في Unicode مشكلتان أخريان تظهران عند البحث والمقارنة. الأولى أن Unicode فيه للعربية كتلة الحروف العادية التي تبدأ من U+0600، وكتلة أخرى اسمها أشكال العرض Arabic Presentation Forms-B فيها شكل مستقل لكل حرف في أول الكلمة ووسطها وآخرها، وكانت تستخدم قديماً في الأنظمة التي لا تعرف ربط الحروف، وما زالت تخرج من بعض ملفات PDF. والثانية أن النص المختلط بين العربية والإنجليزية يحتاج خوارزمية الاتجاه الثنائي Unicode Bidirectional Algorithm لعرضه، وقد يحتوي حروفاً غير مرئية مثل علامة الاتجاه RIGHT-TO-LEFT MARK. المثال التالي يبين المشكلة الأولى، احفظه في lab-nlp/uni.py:
import unicodedata
a = "الإجازة"          # typed on a keyboard
b = "ﺍﻹﺟﺎﺯﺓ"           # copied from an old PDF
print("same on screen, equal?", a == b)
for w in (a, b):
    print(" ".join(f"U+{ord(c):04X}" for c in w))
print("after NFKC, equal?", unicodedata.normalize("NFKC", b) == a)
for cp in (0x0640, 0x200F, 0xFEF9):
    print(f"U+{cp:04X}", unicodedata.name(chr(cp)))
docker cp lab-nlp/. lab-nlp-py:/lab
docker exec -w /lab lab-nlp-py python uni.pyوالمخرج سوف يكون كما يلي:
same on screen, equal? False
U+0627 U+0644 U+0625 U+062C U+0627 U+0632 U+0629
U+FE8D U+FEF9 U+FE9F U+FE8E U+FEAF U+FE93
after NFKC, equal? True
U+0640 ARABIC TATWEEL
U+200F RIGHT-TO-LEFT MARK
U+FEF9 ARABIC LIGATURE LAM WITH ALEF WITH HAMZA BELOW ISOLATED FORM
الكلمتان تظهران على الشاشة متشابهتين، ولكن الكمبيوتر يراهما مختلفتين تماماً، لأن الثانية مكتوبة بحروف من كتلة أشكال العرض، ولاحظ أنها ستة رموز وليست سبعة، لأن «لإ» فيها رمز واحد هو U+FEF9. والتوحيد بطريقة NFKC التي يعرفها معيار Unicode Normalization Forms يعيدها إلى حروفها العادية، وهذا ما تفعله الدالة normalize_unicode في CAMeL Tools التي وضعناها في أول دالة التوحيد. أما الحروف غير المرئية مثل U+200F فاحذفها في نفس الخطوة إذا كانت تصل من نسخ ولصق المستخدمين، لأنها تجعل كلمتين متطابقتين في الشكل مختلفتين في المقارنة.
تكلفة التوكنز في نماذج اللغة
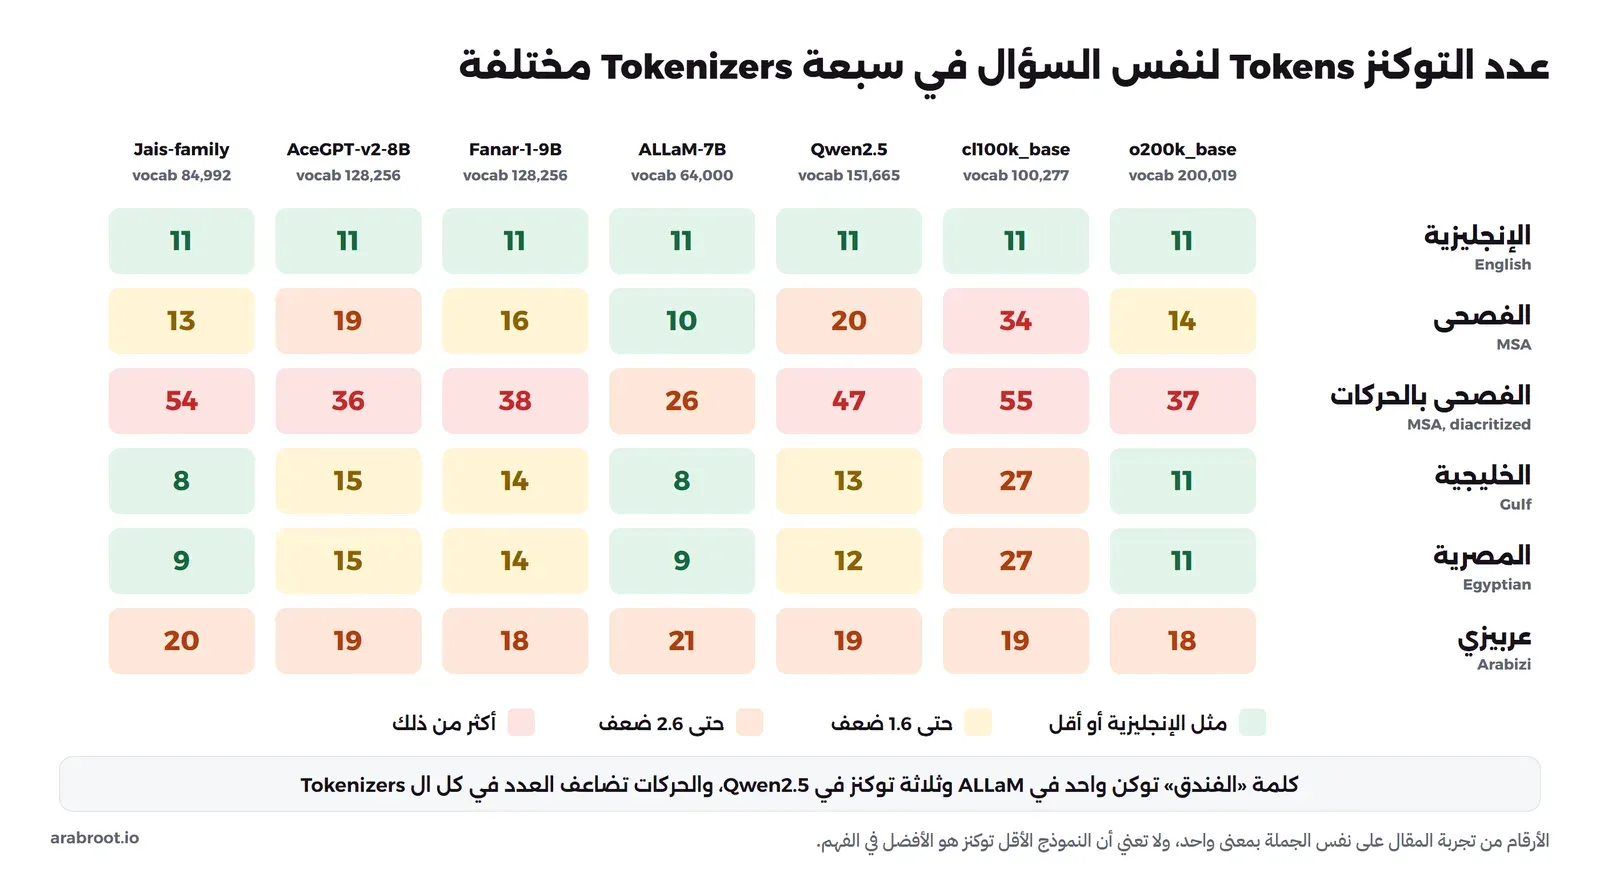
في مقال كيف تعمل نماذج اللغة قسنا جملة واحدة في أربعة Tokenizers، ورأينا أن الجملة العربية كانت قرابة خمسة أضعاف الإنجليزية في ال Tokenizer القديم ثم نزلت كثيراً في الحديث، وشرحنا لماذا يهمك عدد التوكنز في التكلفة ونافذة السياق والسرعة. وهنا نذهب خطوة أبعد ونسأل سؤالين لم نجب عليهما هناك: هل تختلف الفصحى عن اللهجات وعن النص بالحركات وعن Arabizi؟ وهل ال Tokenizers الخاصة بالنماذج العربية أوفر للعربية؟ احفظ الملف التالي في lab-nlp/count.py:
import tiktoken
from transformers import AutoTokenizer

texts = {
  "English":          "Where can I find a good restaurant near the hotel?",
  "MSA":              "أين أجد مطعماً جيداً قريباً من الفندق؟",
  "MSA diacritized":  "أَيْنَ أَجِدُ مَطْعَماً جَيِّداً قَرِيباً مِنَ الفُنْدُقِ؟",
  "Gulf dialect":     "وين ألقى مطعم زين قريب من الفندق؟",
  "Egyptian dialect": "فين ألاقي مطعم كويس قريب من الفندق؟",
  "Arabizi":          "wein al8a mat3am zain 8reeb mn el fondo8?",
}
toks = {"o200k_base": tiktoken.get_encoding("o200k_base"),
        "cl100k_base": tiktoken.get_encoding("cl100k_base")}
hf = {"Qwen2.5": "Qwen/Qwen2.5-0.5B",
      "ALLaM-7B": "humain-ai/ALLaM-7B-Instruct-preview",
      "Fanar-1-9B": "QCRI/Fanar-1-9B-Instruct",
      "AceGPT-v2-8B": "FreedomIntelligence/AceGPT-v2-8B-Chat",
      "Jais-family": "inception42/jais-family-590m-chat"}
for n, r in hf.items():
    toks[n] = AutoTokenizer.from_pretrained(r, trust_remote_code=False)

def count(t, s):
    return len(t.encode(s)) if hasattr(t, "n_vocab") else len(t.encode(s, add_special_tokens=False))

print(f"{'text':<17}" + "".join(f"{n:>13}" for n in toks))
for k, s in texts.items():
    print(f"{k:<17}" + "".join(f"{count(t, s):>13}" for t in toks.values()))
print()
print(f"{'vocab size':<17}" + "".join(f"{(t.n_vocab if hasattr(t,'n_vocab') else len(t)):>13}" for t in toks.values()))
a = toks["ALLaM-7B"]; q = toks["Qwen2.5"]
for w in ["الفندق", "وسيكتبونها"]:
    print(w, "ALLaM:", [a.decode([i]) for i in a.encode(w, add_special_tokens=False)],
          " Qwen2.5:", [q.decode([i]) for i in q.encode(w, add_special_tokens=False)])
docker cp lab-nlp/. lab-nlp-py:/lab
docker exec -w /lab lab-nlp-py python count.pyوالمخرج سوف يكون كما يلي:
text                o200k_base  cl100k_base      Qwen2.5     ALLaM-7B   Fanar-1-9B AceGPT-v2-8B  Jais-family
English                     11           11           11           11           11           11           11
MSA                         14           34           20           10           16           19           13
MSA diacritized             37           55           47           26           38           36           54
Gulf dialect                11           27           13            8           14           15            8
Egyptian dialect            11           27           12            9           14           15            9
Arabizi                     18           19           19           21           18           19           20

vocab size              200019       100277       151665        64000       128256       128256        84992
الفندق ALLaM: ['الفندق']  Qwen2.5: ['الف', 'ند', 'ق']
وسيكتبونها ALLaM: ['وسي', 'كتب', 'ونها']  Qwen2.5: ['و', 'سي', 'كتب', 'ون', 'ها']
في المخرج أعلاه لاحظ التالي:
- ال Tokenizers الخاصة بالنماذج التي بنيت للعربية من البداية كانت الأوفر: ALLaM احتاج 10 توكنز للسؤال بالفصحى، أي أقل من الإنجليزية نفسها، مع أن قائمة مفرداته Vocabulary هي الأصغر بين السبعة بحجم 64,000 قطعة، والسبب أن جزءاً كبيراً من قائمته قطع عربية، فكلمة «الفندق» عنده توكن واحد بينما قطعها Qwen2.5 إلى ثلاث قطع.
- النماذج المبنية فوق نماذج أخرى ورثت Tokenizer النموذج الأصلي، فAceGPT-v2 المبني على Llama 3 احتاج 19 توكناً، وFanar-1-9B احتاج 16.
- الحركات ضاعفت العدد في كل ال Tokenizers، وفي Jais-family وصلت إلى 54 توكناً مقابل 13 دون حركات، والسبب أن النصوص التي بنيت منها هذه القوائم أغلبها دون حركات، لذلك احذف الحركات قبل إرسال النص إلى النموذج إلا إذا كانت جزءاً من المعنى الذي تريده، كما في النصوص الدينية أو تعليم اللغة.
- اللهجات جاءت أقصر من الفصحى في أغلب ال Tokenizers، لأن الجملة بالعامية أقصر في الحروف «وين ألقى مطعم زين»، فلا تحكم على فهم النموذج للهجة من عدد توكنزها، لأن العدد مقياس للتكلفة وليس للفهم.
- Arabizi كلفت بين 18 و21 توكناً في كل ال Tokenizers، أي أغلى من الفصحى في ال Tokenizers العربية، لأنها لا تشبه العربية ولا الإنجليزية في النصوص التي تعلمت منها.
وعند تحميل Tokenizer نموذج Jais سوف تلاحظ أن المستودع يحتوي كوداً خاصاً بالنموذج، لذلك وضعنا trust_remote_code=False صراحة، فلا يشغل transformers أي كود من المستودع، وال Tokenizer يعمل دونه. لا تقم بتغيير هذا الخيار إلى True لمجرد أن رسالة طلبت ذلك، والسبب أنه يشغل كوداً من الإنترنت على جهازك بصلاحيات برنامجك، فاقرأ الكود أولاً وثبت إصداره Revision إذا احتجته فعلاً.
الصورة التالية تجمع الأرقام في جدول واحد:
الأدوات المتاحة للعربية ورخصها
قبل أن تختار أداة لاحظ أن الرخصة في أدوات اللغة العربية لها طبقتان: رخصة الكود ورخصة البيانات أو النموذج الذي يعمل معه، وقد تختلفان تماماً. وقد شرحنا أنواع الرخص وما تسمح به في مقال رخص البرمجيات مفتوحة المصدر، وفيما يلي الأدوات الأكثر استخداماً:
| الأداة | الجهة | ماذا تقدم | الرخصة |
|---|---|---|---|
| CAMeL Tools | مختبر CAMeL في جامعة نيويورك أبوظبي | التوحيد والتقطيع والتحليل الصرفي وفك الالتباس وتمييز اللهجات والكيانات والمشاعر، للفصحى ولهجات | الكود MIT، والبيانات بحسب الحزمة |
| Farasa | معهد قطر لبحوث الحوسبة QCRI | التقطيع والصيغة الأساسية وتحديد نوع الكلمة والتدقيق الإملائي والكيانات والتشكيل Diacritization والإعراب Parsing، كبرنامج أو واجهة API | مجاني للأغراض الأكاديمية والبحثية، وللاستخدام التجاري تواصل معهم |
| PyArabic | طه زروقي | دوال خفيفة لحذف الحركات والتطويل وتوحيد الهمزات والتقطيع البسيط | GPLv3 |
| Stanza | جامعة Stanford | تقطيع وتحديد نوع الكلمة وخصائص صرفية وصيغة أساسية وإعراب على شجرة UD Arabic-PADT، وكيانات بأربعة أنواع على بيانات AQMAR | Apache 2.0 |
| spaCy | Explosion | بيانات لغوية للعربية فقط مثل كلمات التوقف Stop Words، ولا يوجد نموذج مدرب للعربية في الجدول الرسمي حتى الآن | MIT |
وفيما يلي ملاحظات على كل أداة:
- CAMeL Tools هي الأكثر اكتمالاً للعربية بين الأدوات المفتوحة، وقد نشر فريقها وصفها في مؤتمر LREC سنة 2020، وهي التي استخدمناها في كل التجربة. ولكن انتبه لرخص حزم البيانات: الأمر
camel_data -lيطبع رخصة كل حزمة، فالقاموس الصرفي للفصحىmorphology-db-msa-r13ونموذج MLE برخصة GPL v2، والقاموسmorphology-db-msa-s31برخصة LDC، ونموذجا الكيانات والمشاعر برخصة AraBERT، وقاموسا الخليجية والشامية برخصة CC BY 4.0، ونماذج تمييز اللهجات وBERT لفك الالتباس برخصة MIT، وتجد القائمة في صفحة الحزم. - Farasa أداة قوية وسريعة، ولكن صفحتها تذكر أنها منشورة للأغراض البحثية فقط، وأنك تحتاج التسجيل قبل التنزيل أو استخدام الواجهة، لذلك لا تبن عليها منتجاً تجارياً قبل أن تحصل على رخصة مكتوبة.
- PyArabic مناسبة للمهام البسيطة، ولكن رخصة GPLv3 تفرض شروطاً على برنامجك إذا وزعته، فاقرأها قبل أن تضيفها لمنتج مغلق المصدر، ولاحظ ما رأيناه في دالة
normalize_hamza. - Stanza مناسبة إذا كنت تحتاج الإعراب Dependency Parsing، ويذكر جدول نماذج الكيانات أن النموذج العربي سجل 74.3 على بيانات AQMAR، وهو رقم من بياناتهم وليس من بياناتك.
- spaCy تعطيك تقطيعاً بسيطاً للعربية فقط بحسب ملفات اللغة العربية في المستودع، فلا تختارها لمشروع عربي ثم تكتشف أنك تحتاج تدريب كل شيء بنفسك.
camel_data، ولا تقبل ملفات نماذج يرسلها لك أحد مباشرة.البيانات ومقاييس الأداء Benchmarks
مقياس الأداء Benchmark مجموعة أسئلة أو مهام لها إجابات معروفة، نعطيها للنموذج ونحسب نسبة إجاباته الصحيحة، وهو الطريقة الوحيدة لمقارنة النماذج بأرقام بدلاً من الانطباع. وفيما يلي ثلاثة مقاييس عربية تستطيع التحقق منها بنفسك:
- Open Arabic LLM Leaderboard واختصاراً OALL: لوحة ترتيب مفتوحة تشغلها مبادرة 2A2I ومعهد الابتكار التقني TII وHugging Face، وأطلقت نسختها الثانية في 10 فبراير 2025 بحسب إعلانها. وتجمع مقاييس مثل AlGhafa وArabicMMLU بأربعين مهمة وMMLU المترجمة بشرياً وEXAMS وBelebele وMedinaQA وAraTrust وALRAGE لتقييم RAG بالعربية، وقد حذفت في النسخة الثانية المقاييس المترجمة آلياً بسبب جودتها، وذكرت أن بعض مقاييس النسخة الأولى أصبحت سهلة جداً بعد أن وصلت النماذج فيها إلى درجات شبه كاملة، وأنها وجدت خطأ في مهمة AlGhafa غير ترتيب بعض النماذج.
- ArabicMMLU: 14,575 سؤال اختيار من متعدد من اختبارات مدرسية في شمال أفريقيا والشام والخليج، بالفصحى، ونشر في Findings of ACL 2024، وانتبه أن البيانات نفسها برخصة CC BY-NC 4.0 أي لا تسمح بالاستخدام التجاري.
- بلسم BALSAM: منصة تقييم وصفها بحثها المنشور في يوليو 2025 بأنها 78 مهمة في 14 فئة، وأكثر من 52 ألف مثال منها 37 ألفاً للاختبار، وتقيم النماذج تقييماً أعمى Blind Evaluation لا ترى فيه الجهات المتنافسة بيانات الاختبار، حتى لا تتسرب الإجابات إلى تدريب النماذج، وتجد لوحة الترتيب على موقع بلسم التابع لمجمع الملك سلمان العالمي للغة العربية King Salman Global Academy for Arabic Language.
وأما البيانات التي تدرب عليها الأدوات فأشهرها مدونة MADAR للهجات التي ذكرناها، وشجرة PADT التي تدربت عليها Stanza، وقبل أن تستخدم أي مجموعة بيانات في منتج اقرأ رخصتها، فكثير من البيانات العربية الأكاديمية تسمح بالبحث فقط أو توزع عبر اتحاد LDC برسوم.
نماذج اللغة التي تدعم العربية
النماذج التي تدعم العربية نوعان: نماذج بنيت للعربية والإنجليزية تحديداً، ونماذج متعددة اللغات العربية واحدة من لغاتها. والجدول التالي يجمع المعلومات من بطاقات النماذج Model Cards الرسمية، وقد شرحنا ما تعنيه الأوزان المفتوحة Open Weights ولماذا تقرأ الرخصة في قسم النماذج المفتوحة ورخصها:
| النموذج | الجهة | ما تذكره البطاقة | الرخصة |
|---|---|---|---|
| ALLaM-7B-Instruct-preview | المركز الوطني للذكاء الاصطناعي في سدايا SDAIA، ومنشور اليوم في حساب شركة HUMAIN على Hugging Face | 7B، تدرب من الصفر على 4 تريليونات توكن إنجليزية ثم 1.2 تريليون عربية وإنجليزية، وسياق 4,096 توكناً | Apache 2.0 |
| Jais family وJais 2 | Inception وجامعة محمد بن زايد MBZUAI وCerebras | العائلة الأولى من 590M إلى 70B، وJais 2 بحجمي 8B و70B تدرب من الصفر بقائمة مفردات عربية من 150,272 قطعة وسياق 8,192 توكناً | Apache 2.0، وتنزيل Jais 2 يتطلب مشاركة بيانات التواصل |
| AceGPT-v2 | KAUST وجامعة هونغ كونغ الصينية في شنتشن ومعهد SRIBD | عائلة من 7B إلى 70B، والنسخة 8B مبنية على Meta-Llama-3-8B | البطاقة تذكر Apache 2.0، والنموذج الأصلي له رخصة Llama 3 |
| Fanar-1-9B وFanar-2-27B | معهد قطر لبحوث الحوسبة QCRI في جامعة حمد بن خليفة | الأول مبني على Gemma 2 9B مع تريليون توكن عربي وإنجليزي، والثاني على Gemma 3 27B، ويذكران الفصحى ولهجات الخليج والشام ومصر | البطاقة تذكر Apache 2.0، والنموذج الأصلي له شروط Gemma |
| Qwen3 | Alibaba | 119 لغة ولهجة، منها الفصحى واللهجات النجدية والشامية والمصرية والمغربية والتونسية | النماذج الكثيفة Dense برخصة Apache 2.0 |
| Llama 4 | Meta | العربية من 12 لغة مدعومة رسمياً، بينما Llama 3.1 لا يذكر العربية بين لغاته الثماني المدعومة | Llama 4 Community License، وتنزيله يتطلب الموافقة على الشروط |
| Gemma 4 | أكثر من 140 لغة | Apache 2.0 |
في الجدول أعلاه لاحظ التالي:
- كلمة «يدعم العربية» تعني أشياء مختلفة: ALLaM وJais 2 تدربا من الصفر مع Tokenizer مبني للعربية كما رأيت في عدد التوكنز، وAceGPT وFanar أخذا نموذجاً عاماً وأكملا تدريبه بالعربية، والنماذج المتعددة اللغات تتعلم العربية كواحدة من عشرات اللغات، وكل طريقة لها أثر على التكلفة وعلى فهم الثقافة المحلية.
- عندما يبنى نموذج فوق نموذج آخر فاقرأ رخصة الاثنين، لأن البطاقة قد تذكر رخصة مختلفة عن رخصة النموذج الأصلي، وهذه مسألة قانونية يقررها فريقك القانوني وليس المقال.
- الأحجام تحدد أين يعمل النموذج: نموذج 7B أو 8B يعمل على جهاز واحد بعد التكميم Quantization، أما 70B فيحتاج عتاداً أكبر بكثير، وقد شرحنا حساب الذاكرة في مقال تشغيل نماذج اللغة على جهازك.
وتذكر أن مشروع ALLaM نشر بحثه في يوليو 2024، وJais في أغسطس 2023 وJais 2 في 2026، وFanar في يناير 2025 ثم Fanar 2.0 في مارس 2026، فإذا قرأت هذا المقال بعد أشهر فراجع صفحات النماذج نفسها، لأن هذا المجال يصدر نموذجاً جديداً كل بضعة أشهر.
نصائح عملية لمن يبني بحثاً أو مساعداً عربياً
إذا كنت تبني بحثاً في مستندات عربية أو مساعد محادثة يجيب منها، فالصورة التالية تبين أين تقع كل خطوة مما سبق، وقد طبقنا هذا المسار بالكود الكامل في مقال البحث في مستنداتك مع RAG:
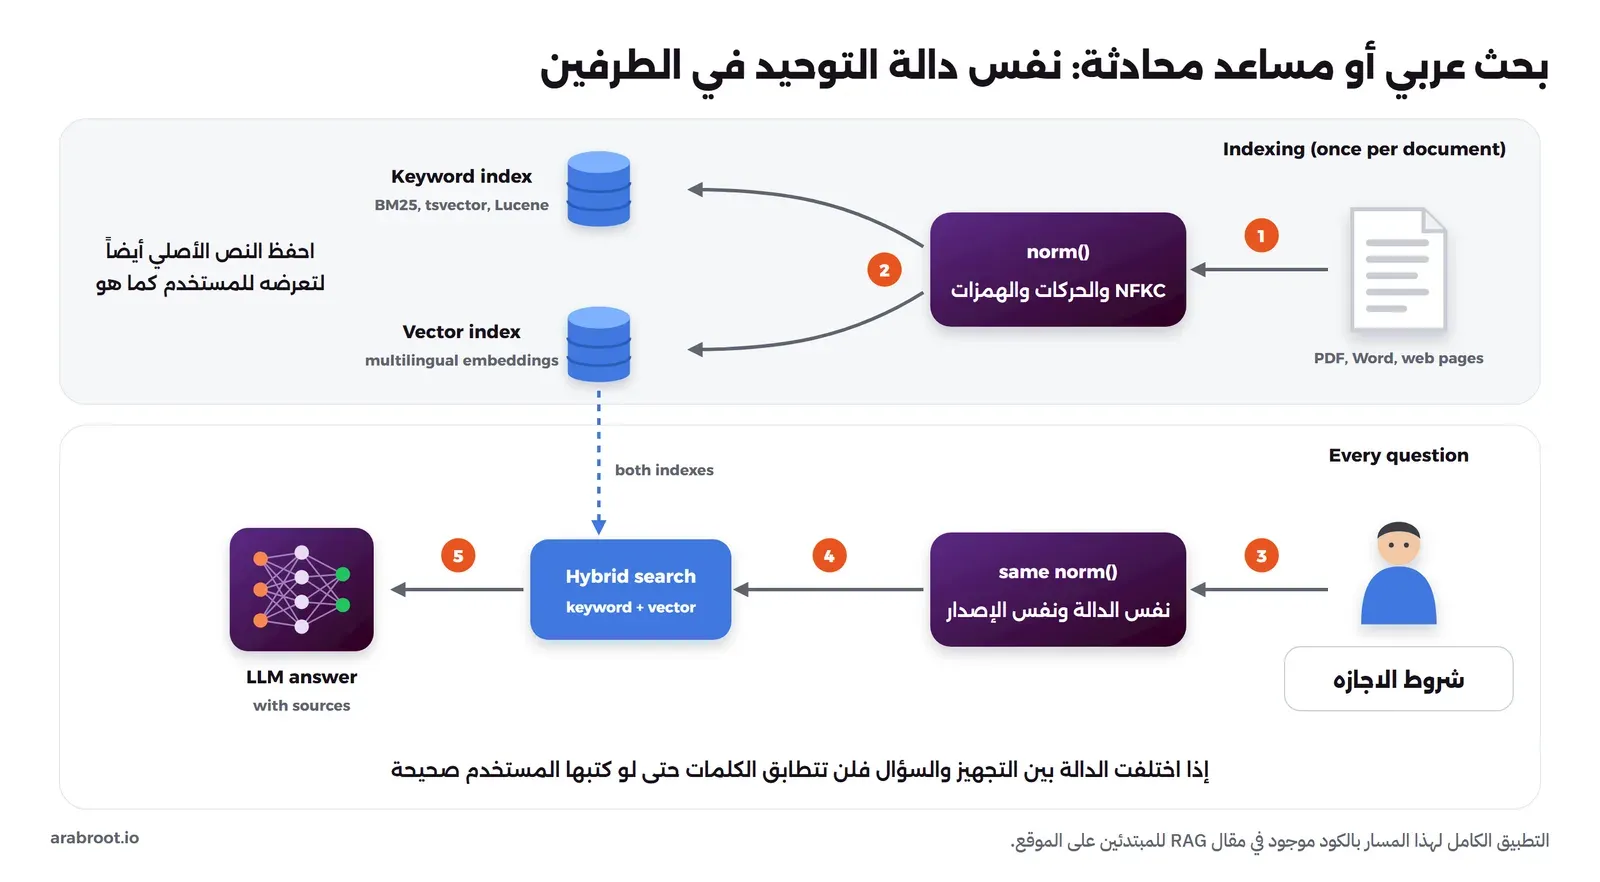
- وحد الحروف قبل الفهرسة Indexing وقبل البحث بنفس الدالة: الخطأ الأشهر أن تكتب دالة توحيد للمستندات ثم ينسى أحد تطبيقها على السؤال، أو يغير أحدهم الدالة دون أن يعيد فهرسة المستندات، والنتيجة أن الكلمات لا تتطابق حتى لو كتبها المستخدم صحيحة، لذلك ضع الدالة في مكان واحد في الكود واكتب لها اختباراً Unit Test بأمثلة مثل التي في
norm.py. - احفظ النص الأصلي بجانب النص الموحد: تبحث بالموحد وتعرض الأصلي للمستخدم، والسبب أن التوحيد يغير الكلمات «على» و«علي»، ولا تريد أن يرى المستخدم «الاجازه المرضيه» في نتيجة رسمية.
- استخدم محلل العربية في محرك البحث ولا تكتب واحداً من الصفر: محلل arabic في Elasticsearch يجمع حذف كلمات التوقف
arabic_stopوتوحيد الحروفarabic_normalizationواستخراج الجذع الخفيف بمرشحstemmerبلغةarabic، وفي PostgreSQL إعداد بحث نصي اسمهarabicضمن قواميس البحث النصي، ولكنه وحده لا يوحد التاء المربوطة كما رأينا في مقال RAG، فوحد الحروف قبله. - اجمع البحث بالكلمات مع البحث بالمعنى: البحث بالكلمات يجد الأسماء والأرقام والمصطلحات الدقيقة، والبحث بالمتجهات يجد «ضاع اللابتوب» عند السؤال عن «فقدان الجهاز» حتى بلهجة مختلفة، وقد بينا في قسم البحث الهجين كيف تدمج القائمتين، وفي قسم اختيار نموذج التضمين للعربية ماذا تقرأ في بطاقة النموذج.
- احذف الحركات قبل إرسال النص للنموذج إلا إذا كانت جزءاً من المعنى، لأنها ضاعفت التوكنز في كل ال Tokenizers التي قسناها، فتضاعف التكلفة وتقلل ما يدخل في نافذة السياق.
- اختبر على لهجات مستخدميك الحقيقية: اجمع مئة سؤال حقيقي من سجلات الدعم، وانظر كم منها بالفصحى وكم بالعامية وكم بالحروف اللاتينية، ثم قس عليها البحث والنموذج قبل الإطلاق وليس بعده.
- قس تكلفة ال Tokenizer قبل اختيار النموذج: شغل
count.pyعلى نصوصك، فالفرق بين 10 توكنز و34 للجملة نفسها يعني ثلاثة أضعاف في الفاتورة إذا كنت تستخدم خدمة سحابية تحاسب بالتوكن. - لا ترسل كل شيء لنموذج كبير: استخراج الكيانات من مليون مستند أو تصنيف التعليقات إلى ثلاثة أنواع قد يكفيه نموذج صغير متخصص مثل الذي استخدمناه في التجربة، فيعمل على المعالج CPU بتكلفة أقل بكثير، ويبقى النموذج الكبير للأسئلة المفتوحة.
تدريب عملي
- أضف إلى قائمة
wordsفيnorm.pyعشر كلمات من أسماء موظفين أو منتجات في شركتك، وابحث عن أزواج أصبحت متطابقة بعد التوحيد وهي مختلفة في المعنى مثل «على» و«علي». - غير الجمل في
context.pyإلى جمل من عملك فيها كلمات ملتبسة، وقارن بين MLE وBERT، واحسب كم مرة أخطأ كل واحد. - غير النصوص في
count.pyإلى رسالة حقيقية من الدعم الفني بالعامية، ثم إلى نفس المعنى بالفصحى، وقارن التكلفة في كل Tokenizer.
وعند الانتهاء احذف ما أنشأته في التجربة:
docker rm -f lab-nlp-py
docker volume rm lab-nlp-cache
وإذا كنت لا تستخدم ال Image في مشاريع أخرى فاحذفها أيضاً بالأمر docker image rm python:3.12-slim.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- معالجة اللغة الطبيعية NLP مجموعة مهام صغيرة: التقطيع والتوحيد والتحليل الصرفي وتحديد نوع الكلمة والكيانات والمشاعر والتصنيف والترجمة والكلام، وما زالت تعمل داخل أنظمة البحث ونماذج اللغة الحديثة.
- المجال انتقل من القواعد إلى الإحصاء ثم المتجهات ثم Transformer، والأدوات العربية اليوم تخلط بين هذه المراحل.
- العربية تصعب على البرامج لأن الكلمة تحمل زوائد ملتصقة، وتبنى من أصل ووزن، وتكتب دون حركات فتلتبس، ولها أشكال كتابة كثيرة ولهجات وArabizi وأشكال عرض قديمة في Unicode.
- التوحيد بنفس الدالة على المستندات وعلى السؤال هو أهم خطوة في أي بحث عربي، مع حفظ النص الأصلي لأن التوحيد يخلط بعض الكلمات.
- ال Tokenizer المبني للعربية مثل ALLaM يوفر التوكنز بوضوح، والحركات تضاعف التكلفة في كل ال Tokenizers.
- CAMeL Tools هي الأداة المفتوحة الأكثر اكتمالاً للعربية، وانتبه لرخص حزم بياناتها، ولرخصة Farasa البحثية، ولرخصة GPLv3 في PyArabic.
- أرقام المقاييس تختلف بحسب من قاسها، فاستخدم OALL وBALSAM وArabicMMLU لتصفية النماذج، ثم قس القائمة القصيرة على أسئلتك أنت.
وفي المقالات القادمة من مرحلة الذكاء الاصطناعي بإذن الله سوف نتحدث عن تشغيل نموذج عربي على سيرفرك وربطه بمستنداتك.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
 دليلRAG للمبتدئين: نموذج لغة يجيب من مستنداتك على سيرفرككيف تجعل نموذج اللغة يجيب من مستندات مؤسستك ويذكر مصدره، دون أن يخرج أي مستند من سيرفرك.
 دليللماذا تفوقت نماذج اللغة LLM على التعلم الآلي التقليدي؟ما الذي جعل نموذج لغة واحداً يحل مهاماً كانت تحتاج نموذجاً لكل منها، وأين ما زالت الخوارزميات التقليدية هي الخيار الأفضل.
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجارب على Docker Engine 29.8.0 مع Python 3.12.15 وCAMeL Tools 1.6.0 وPyArabic 0.6.15 وtiktoken 0.14.0 وtransformers 5.19.0 وtorch 2.14.1 وscikit-learn 1.9.0، وال Tokenizers الخاصة بالنماذج Qwen2.5-0.5B وALLaM-7B-Instruct-preview وFanar-1-9B-Instruct وAceGPT-v2-8B-Chat وjais-family-590m-chat.


