

عندما يكتب المستخدم كلمة في مربع البحث داخل تطبيقك فهو يتوقع ما تعود عليه في Google: نتيجة خلال جزء من الثانية، وأهم النتائج في الأعلى، ولا يهمه إن كتب الكلمة بحرف كبير أو صغير أو بصيغة الجمع أو المفرد. والحل البسيط الذي يكتبه أغلبنا في البداية هو استعلام LIKE '%كلمة%' على قاعدة البيانات، وهو يعمل جيداً مع ألف سطر، ثم يبطؤ مع كل سطر جديد، ولا يرتب النتائج، ولا يعرف أن «servers» و«server» كلمة واحدة. وفي هذا المقال نشرح الفكرة التي تقوم عليها كل محركات البحث، من OpenSearch وElasticsearch إلى Meilisearch والبحث النصي في PostgreSQL، حتى تفهم ما يحدث داخل المحرك قبل أن تختار واحداً منها، وهذا المقال هو المدخل إلى مرحلة محركات البحث والفهرسة في خريطة الطريق.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي
LIKEأوgrepللبحث في نصوص كثيرة. - الفهرس المعكوس Inverted Index: ما هو وكيف يبنى، ثم نبنيه بأيدينا في Python على ستة مستندات.
- التقطيع Tokenization والمحلل Analyzer: كيف يتحول النص إلى الكلمات التي تحفظ في الفهرس.
- الترتيب Ranking مع خوارزمية BM25، ونحسب الدرجات يدوياً ونقارنها بما يرجعه OpenSearch.
- كيف تقيس جودة البحث بالدقة Precision والاستدعاء Recall.
- أخطاء شائعة وتدريب عملي.
لماذا لا يكفي LIKE أو grep؟
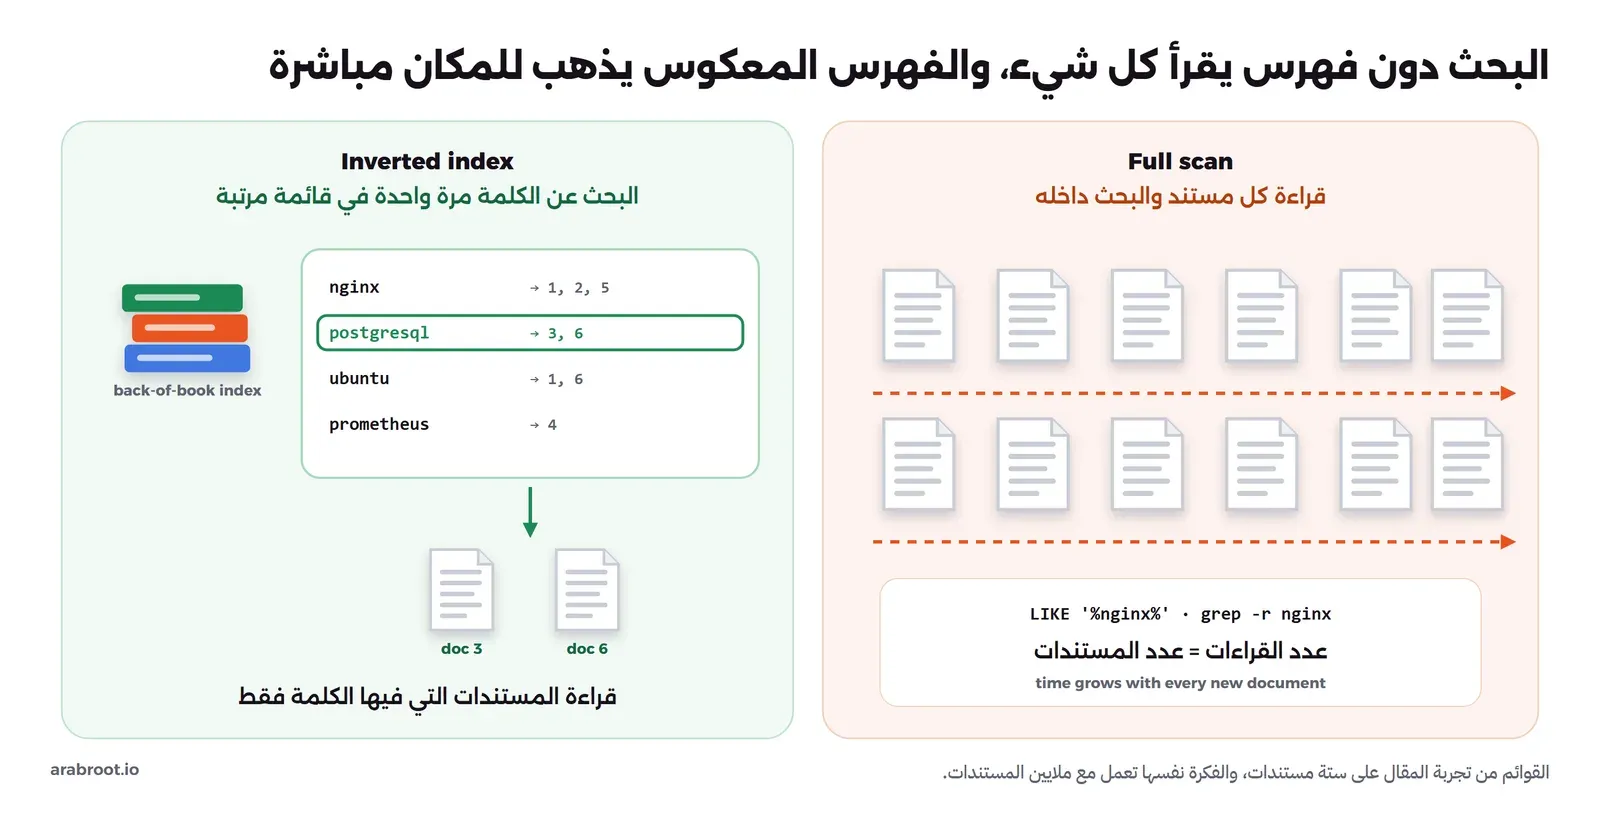
لنفرض أن لديك جدولاً فيه مئة ألف مقال، وتريد المقالات التي فيها كلمة nginx، فالاستعلام WHERE body LIKE '%nginx%' لا يستطيع استخدام الفهرس العادي B-tree الذي شرحناه في قسم الفهارس من دليل تصميم قواعد البيانات، والسبب أن هذا الفهرس مرتب من أول الكلمة، فيفيد في LIKE 'nginx%' ولا يفيد إذا بدأ النمط بعلامة % كما تقول وثائق PostgreSQL عن أنواع الفهارس، فتقرأ قاعدة البيانات كل سطر وتبحث داخله، وهذا ما يسمى المسح الكامل Full Scan، ومثله تماماً الأمر grep -r على مجلد من الملفات. وهناك ثلاث مشكلات في هذه الطريقة:
- الوقت يزيد مع البيانات: عدد القراءات يساوي عدد المستندات، فإذا تضاعفت المقالات تضاعف وقت كل بحث.
- لا يوجد ترتيب Ranking: النتيجة إما موجودة أو غير موجودة، والمقال الذي ذكر nginx مرة في الهامش يظهر بجانب المقال الذي عنوانه «تثبيت Nginx».
- المطابقة حرفية: البحث عن «server» لا يجد «Servers,» لأن الحروف مختلفة، والبحث عن «سيرفر» لا يجد «السيرفر».
وفكرة محركات البحث هي نفس فكرة الفهرس في آخر الكتاب: بدلاً من أن تقرأ الكتاب كله لتجد كلمة «التشفير»، تذهب إلى الفهرس المرتب أبجدياً فتجد الكلمة وبجانبها أرقام الصفحات، ثم تفتح تلك الصفحات فقط. والصورة التالية تبين الفرق بين الطريقتين:
الفهرس المعكوس Inverted Index
الفهرس المعكوس Inverted Index هو جدول مفتاحه الكلمة Term وقيمته قائمة المستندات التي تظهر فيها هذه الكلمة، وتسمى هذه القائمة Postings List، وغالباً يحفظ معها موضع الكلمة Position داخل كل مستند وعدد مرات ظهورها. وسمي معكوساً لأن الطريقة الطبيعية لحفظ البيانات هي من المستند إلى كلماته، أي المستند رقم 1 فيه الكلمات كذا وكذا، أما هنا فالاتجاه معكوس: من الكلمة إلى المستندات، كما يشرح كتاب Introduction to Information Retrieval من جامعة Stanford، وهو المرجع المعتاد في هذا المجال.
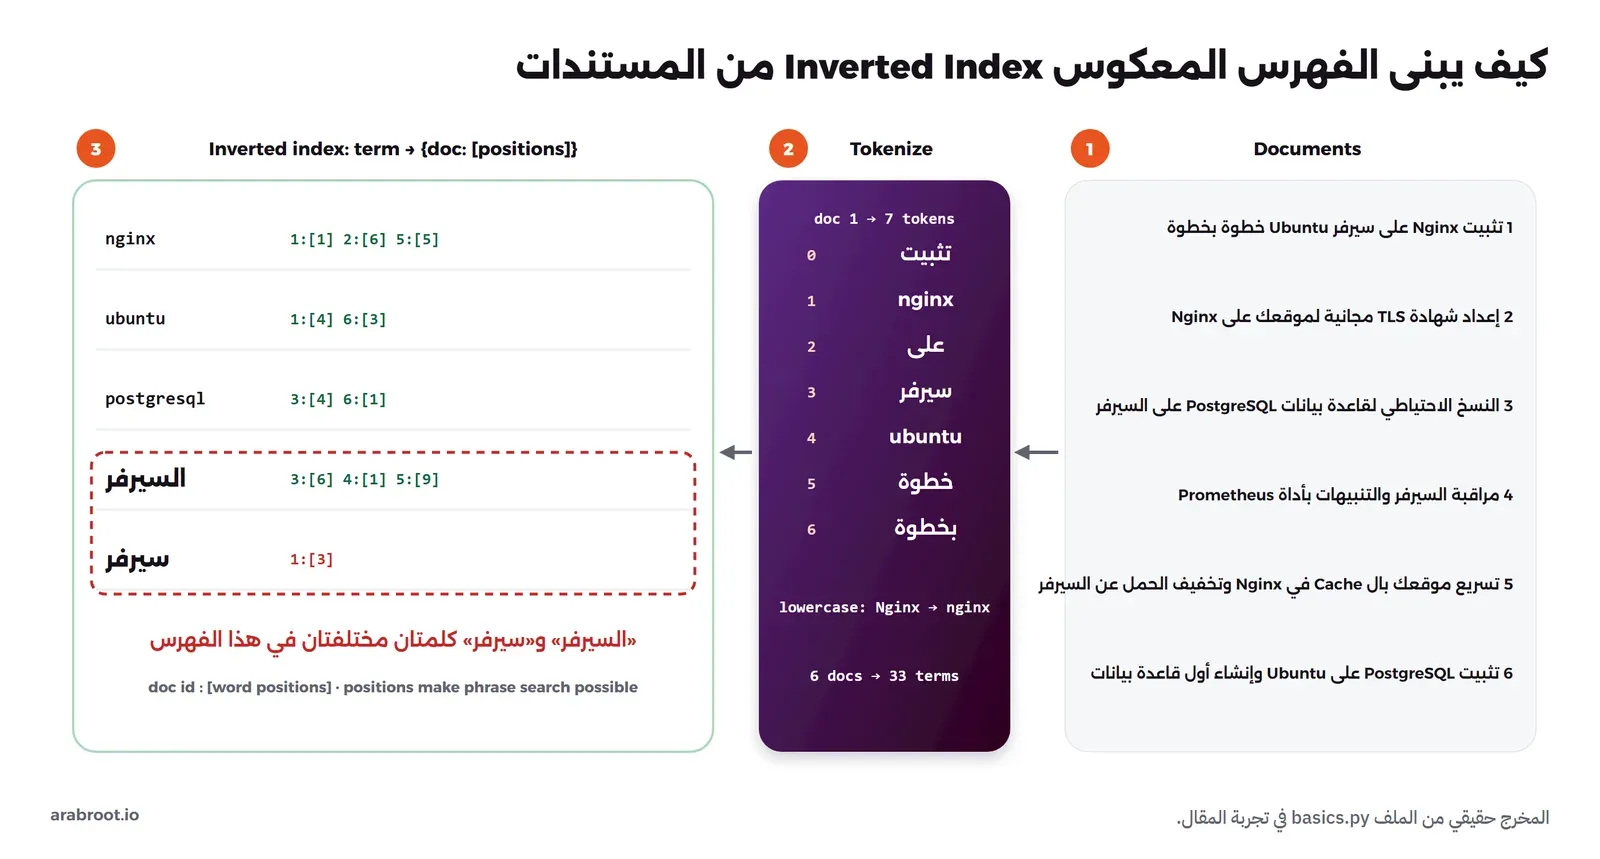
وبناء الفهرس يمر بثلاث خطوات: نأخذ المستند، ثم نقطعه إلى كلمات، ثم نضيف كل كلمة إلى قائمتها مع رقم المستند وموضعها فيه. وعند البحث عن كلمتين نجلب قائمة كل كلمة ثم نأخذ التقاطع إذا أردنا المستندات التي فيها الكلمتان معاً، أو الاتحاد إذا كفت إحداهما، والقوائم مرتبة بأرقام المستندات لذلك يكون التقاطع سريعاً جداً. أما المواضع فهي التي تجعل البحث عن عبارة Phrase Search ممكناً، فعند البحث عن "تثبيت nginx" بين علامتي تنصيص لا يكفي أن تكون الكلمتان في المستند، وإنما يجب أن يكون موضع nginx بعد موضع «تثبيت» مباشرة. والصورة التالية تبين الخطوات الثلاث على المستندات التي سوف نستخدمها في التجربة:
وقد يتساءل البعض: إذا كانت الفكرة بهذه البساطة فلماذا نحتاج محركاً كاملاً؟ والإجابة أن الفهرس الحقيقي يجب أن يحفظ على القرص بشكل مضغوط، ويتحدث عند إضافة مستندات جديدة دون إعادة بنائه من الصفر، ويتوزع على أكثر من سيرفر عندما يكبر، ويرتب ملايين النتائج في أجزاء من الثانية، وهذا ما تقدمه مكتبة Apache Lucene التي يقوم عليها OpenSearch وElasticsearch وSolr، أما Meilisearch فيبني فهرسه بطريقته الخاصة، وكلها تقوم على الفكرة نفسها.
تجربة: نبني الفهرس بأيدينا ثم نقارنه بـ OpenSearch
أفضل طريقة لفهم الفهرس هي أن تبنيه بنفسك، لذلك سوف نكتب فهرساً معكوساً في Python دون أي مكتبة، ونحسب ترتيب النتائج يدوياً، ثم نرسل نفس المستندات إلى OpenSearch ونقارن. نحتاج Container فيه OpenSearch وContainer فيه Python، على شبكة Docker واحدة حتى يصل أحدهما للآخر بالاسم، وإذا لم يكن Docker مثبتاً لديك فقد شرحنا ذلك في دليل تثبيت Docker على Ubuntu:
docker network create lab-search-net

docker run -d --name lab-search-os --network lab-search-net \
  -p 127.0.0.1:19200:9200 \
  -e discovery.type=single-node \
  -e DISABLE_SECURITY_PLUGIN=true -e DISABLE_INSTALL_DEMO_CONFIG=true \
  -e "OPENSEARCH_JAVA_OPTS=-Xms1g -Xmx1g" \
  opensearchproject/opensearch:3.9.0

docker run -d --name lab-search-py --network lab-search-net python:3.13-slim sleep infinity

# wait until OpenSearch answers
until curl -sf 127.0.0.1:19200 >/dev/null; do sleep 3; done
curl -s 127.0.0.1:19200
والمخرج سوف يكون كما يلي:
{
  "name" : "cd37cc615310",
  "cluster_name" : "docker-cluster",
  "cluster_uuid" : "gr3ztAejS7mw7L2VozCw3A",
  "version" : {
    "distribution" : "opensearch",
    "number" : "3.9.0",
    "build_type" : "tar",
    "build_hash" : "4ee42a94e87f66fbf1e62a9871b1b87f91e02472",
    "build_date" : "2026-09-23T01:01:31.883915140Z",
    "build_snapshot" : false,
    "lucene_version" : "10.5.1",
    "minimum_wire_compatibility_version" : "2.19.0",
    "minimum_index_compatibility_version" : "2.0.0"
  },
  "tagline" : "The OpenSearch Project: https://opensearch.org/"
}
في الإعداد أعلاه لاحظ التالي:
- المنفذ مربوط على
127.0.0.1فقط، فلا يصل إليه أحد من خارج جهازك، وقد شرحنا سبب ذلك في دليل شبكات Docker. - المتغير
discovery.type=single-nodeيشغل OpenSearch كسيرفر واحد دون البحث عن سيرفرات أخرى في عنقود Cluster. - السطر
lucene_versionفي المخرج يؤكد أن OpenSearch 3.9.0 يقوم على Lucene 10.5.1.
DISABLE_SECURITY_PLUGIN=true يلغي كلمة المرور والتشفير بالكامل، وهو مذكور في وثائق تشغيل OpenSearch في Docker للتجربة المحلية فقط، لذلك لا تستخدمه على سيرفر يصل إليه أحد غيرك، والسبب أن أي شخص يصل للمنفذ يستطيع قراءة كل الفهارس وحذفها.الآن احفظ الملف التالي في مجلد اسمه lab-search باسم basics.py. وهو يفعل ثلاثة أشياء: يبني الفهرس المعكوس من ستة عناوين، ثم يحسب درجة BM25 يدوياً للسؤال «تثبيت nginx»، ثم يرسل نفس المستندات والسؤال إلى OpenSearch ويطبع الدرجتين بجانب بعض:
import json, math, re, urllib.request

DOCS = {
    1: "تثبيت Nginx على سيرفر Ubuntu خطوة بخطوة",
    2: "إعداد شهادة TLS مجانية لموقعك على Nginx",
    3: "النسخ الاحتياطي لقاعدة بيانات PostgreSQL على السيرفر",
    4: "مراقبة السيرفر والتنبيهات بأداة Prometheus",
    5: "تسريع موقعك بال Cache في Nginx وتخفيف الحمل عن السيرفر",
    6: "تثبيت PostgreSQL على Ubuntu وإنشاء أول قاعدة بيانات",
}

def tokenize(text):
    return re.findall(r"\w+", text.lower())

# 1) the inverted index: term -> {doc_id: [positions]}
index = {}
lengths = {}
for doc_id, text in DOCS.items():
    tokens = tokenize(text)
    lengths[doc_id] = len(tokens)
    for pos, tok in enumerate(tokens):
        index.setdefault(tok, {}).setdefault(doc_id, []).append(pos)

print("terms in the index:", len(index))
for term in ["nginx", "ubuntu", "السيرفر", "سيرفر", "postgresql"]:
    print(f"{term:<11} -> {index.get(term, {})}")

# 2) BM25 by hand (the Lucene formula, k1=1.2, b=0.75)
N = len(DOCS)
avgdl = sum(lengths.values()) / N
def bm25(query, k1=1.2, b=0.75):
    scores = {}
    for term in tokenize(query):
        postings = index.get(term, {})
        n = len(postings)
        if not n:
            continue
        idf = math.log(1 + (N - n + 0.5) / (n + 0.5))
        for doc_id, positions in postings.items():
            tf = len(positions)
            norm = tf / (tf + k1 * (1 - b + b * lengths[doc_id] / avgdl))
            scores[doc_id] = scores.get(doc_id, 0) + idf * norm
    return sorted(scores.items(), key=lambda x: -x[1])

query = "تثبيت nginx"
print(f"\nN={N} avgdl={avgdl:.3f}  query: {query}")
hand = bm25(query)

# 3) the same documents and query in OpenSearch
OS = "http://lab-search-os:9200"
def call(method, path, body=None, ndjson=False):
    data = None
    if body is not None:
        data = body.encode() if ndjson else json.dumps(body).encode()
    req = urllib.request.Request(OS + path, data=data, method=method,
        headers={"Content-Type": "application/x-ndjson" if ndjson else "application/json"})
    try:
        return json.load(urllib.request.urlopen(req))
    except urllib.error.HTTPError as e:
        return json.load(e)

call("DELETE", "/basics")
call("PUT", "/basics", {"settings": {"number_of_shards": 1, "number_of_replicas": 0},
                        "mappings": {"properties": {"title": {"type": "text"}}}})
bulk = "".join(json.dumps({"index": {"_index": "basics", "_id": i}}) + "\n" +
               json.dumps({"title": t}) + "\n" for i, t in DOCS.items())
call("POST", "/_bulk?refresh=true", bulk, ndjson=True)
res = call("POST", "/basics/_search", {"query": {"match": {"title": query}}})
engine = {int(h["_id"]): h["_score"] for h in res["hits"]["hits"]}

print(f"{'doc':<4}{'by hand':>10}{'OpenSearch':>12}  title")
for doc_id, score in hand:
    print(f"{doc_id:<4}{score:>10.4f}{engine.get(doc_id, 0):>12.4f}  {DOCS[doc_id]}")
ثم انسخ المجلد إلى Container ال Python وشغل الملف:
docker cp lab-search/. lab-search-py:/lab
docker exec -w /lab lab-search-py python basics.py
والمخرج سوف يكون كما يلي:
terms in the index: 33
nginx       -> {1: [1], 2: [6], 5: [5]}
ubuntu      -> {1: [4], 6: [3]}
السيرفر     -> {3: [6], 4: [1], 5: [9]}
سيرفر       -> {1: [3]}
postgresql  -> {3: [4], 6: [1]}

N=6 avgdl=7.333  query: تثبيت nginx
doc    by hand  OpenSearch  title
1       0.7979      0.7979  تثبيت Nginx على سيرفر Ubuntu خطوة بخطوة
6       0.4512      0.4512  تثبيت PostgreSQL على Ubuntu وإنشاء أول قاعدة بيانات
2       0.3210      0.3210  إعداد شهادة TLS مجانية لموقعك على Nginx
5       0.2743      0.2743  تسريع موقعك بال Cache في Nginx وتخفيف الحمل عن السيرفر
في المخرج أعلاه لاحظ التالي:
- الدالة
tokenizeقسمت النص عند كل حرف ليس من حروف الكلمات وحولت الحروف اللاتينية إلى صغيرة، فأصبحت «Nginx» و«nginx» كلمة واحدة، وبلغ عدد الكلمات المختلفة في الفهرس 33 كلمة. - الكلمة
nginxتشير إلى المستندات 1 و2 و5 ومعها موضعها في كل مستند، فالبحث عنها لا يقرأ المستندات 3 و4 و6 إطلاقاً. - الكلمتان «السيرفر» و«سيرفر» لكل واحدة قائمة منفصلة، والسبب أن التقطيع وحده لا يعرف أن «ال» ليست جزءاً من الكلمة، وهذه هي المشكلة التي سوف نعود إليها بعد قليل.
- الدرجات التي حسبناها يدوياً طابقت درجات OpenSearch حتى أربع خانات بعد الفاصلة، أي أن ما سوف نشرحه في قسم الترتيب هو فعلاً ما يحدث داخل المحرك.
التقطيع Tokenization والمحلل Analyzer
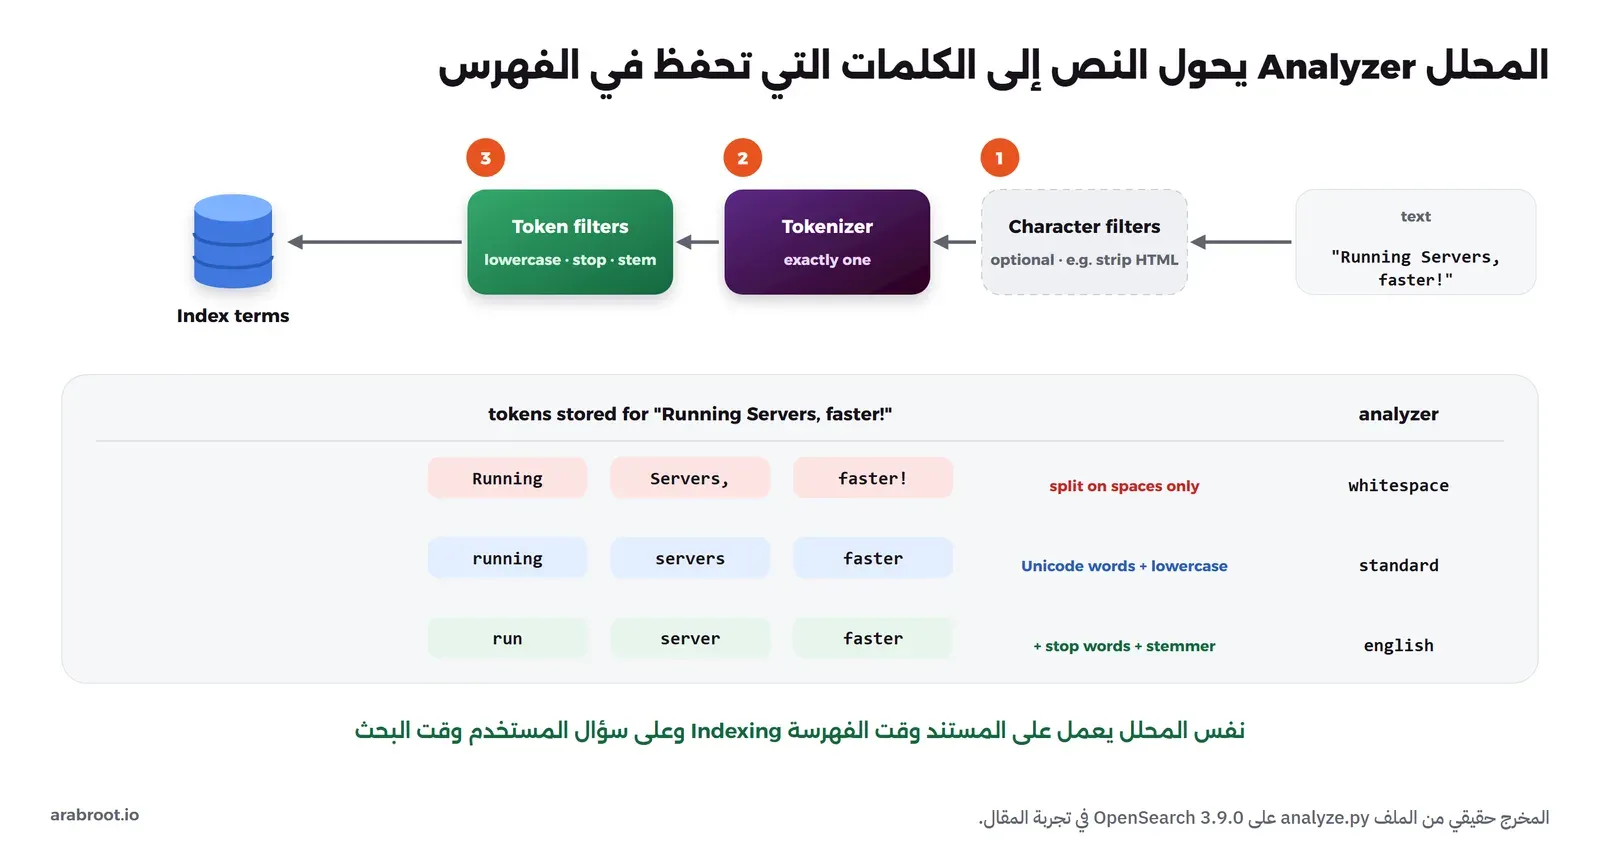
قبل أن تدخل أي كلمة إلى الفهرس تمر على المحلل Analyzer، وهو سلسلة من ثلاث مراحل كما تشرح وثائق OpenSearch عن المحللات: مرشحات الحروف Character Filters التي تعدل النص الخام قبل تقطيعه، مثل حذف وسوم HTML، ثم المقطع Tokenizer الذي يقسم النص إلى كلمات Tokens، ويوجد واحد فقط في كل محلل، ثم مرشحات الكلمات Token Filters التي تعدل كل كلمة، مثل تحويلها إلى حروف صغيرة Lowercase، أو حذف الكلمات الشائعة Stop Words مثل «the» و«في»، أو إرجاع الكلمة إلى جذعها Stemming حتى تصبح «running» و«runs» كلمة واحدة هي «run». والصورة التالية تبين المراحل الثلاث وما يخرج من ثلاثة محللات مختلفة لنفس الجملة:
ولنرى ذلك من OpenSearch نفسه عبر واجهة Analyze API التي تريك ما يخرج من أي محلل دون أن تفهرس شيئاً. احفظ الملف التالي باسم analyze.py في نفس المجلد، وهو يمرر جملة إنجليزية وجملة عربية على ثلاثة محللات، ثم يحسب الدقة والاستدعاء لسؤال واحد سوف نشرحهما في قسم القياس:
import json, urllib.request

OS = "http://lab-search-os:9200"
def call(path, body):
    req = urllib.request.Request(OS + path, data=json.dumps(body).encode(),
        method="POST", headers={"Content-Type": "application/json"})
    return json.load(urllib.request.urlopen(req))

# what each analyzer stores in the index for the same text
for text in ["Running Servers, faster!", "والسيرفرات، السيرفر"]:
    for analyzer in ["whitespace", "standard", "english"]:
        tokens = [t["token"] for t in call("/_analyze", {"analyzer": analyzer, "text": text})["tokens"]]
        print(f"{analyzer:<11} {tokens}")
    print()

# precision and recall for one query: the documents about a server are 1, 3, 4 and 5
relevant = {1, 3, 4, 5}
hits = call("/basics/_search", {"query": {"match": {"title": "سيرفر"}}})["hits"]["hits"]
found = {int(h["_id"]) for h in hits}
tp = len(found & relevant)
print("query: سيرفر   found:", sorted(found), "  relevant:", sorted(relevant))
print(f"precision = {tp}/{len(found)} = {tp / len(found):.2f}   recall = {tp}/{len(relevant)} = {tp / len(relevant):.2f}")
docker cp lab-search/. lab-search-py:/lab
docker exec -w /lab lab-search-py python analyze.pyوالمخرج سوف يكون كما يلي:
whitespace  ['Running', 'Servers,', 'faster!']
standard    ['running', 'servers', 'faster']
english     ['run', 'server', 'faster']

whitespace  ['والسيرفرات،', 'السيرفر']
standard    ['والسيرفرات', 'السيرفر']
english     ['والسيرفرات', 'السيرفر']

query: سيرفر   found: [1]   relevant: [1, 3, 4, 5]
precision = 1/1 = 1.00   recall = 1/4 = 0.25
في المخرج أعلاه لاحظ التالي:
- المحلل
whitespaceقسم عند المسافات فقط، فبقيت الفاصلة وعلامة التعجب جزءاً من الكلمة، والبحث عن «servers» لن يجد «Servers,» أبداً. - المحلل
standard، وهو الافتراضي في OpenSearch، يقسم بحسب قواعد الكلمات في Unicode ويحول الحروف إلى صغيرة، وهذا كاف في أغلب الحالات للإنجليزية. - المحلل
englishأضاف حذف الكلمات الشائعة والجذع، فأصبحت «Running» هي «run» و«Servers» هي «server»، والآن يجد البحث عن «server» الجملة. - الجملة العربية خرجت من المحللات الثلاثة كما هي تقريباً: «والسيرفرات» كلمة واحدة فيها حرف العطف و«ال» وعلامة الجمع، ولا يعرف المحلل الإنجليزي شيئاً عن ذلك. وقد شرحنا لماذا تحمل الكلمة العربية كل هذه الزوائد في قسم الزوائد الملتصقة Clitics من مقال معالجة اللغة العربية، أما كيف تبني محللاً عربياً صحيحاً في محرك البحث فهو موضوع المقال التالي في هذه المرحلة.
نفس المحلل في الفهرسة وفي البحث
المحلل لا يعمل على المستندات فقط، وإنما يعمل أيضاً على سؤال المستخدم قبل البحث في الفهرس، فإذا حفظت المستندات بالمحلل english فأصبحت «servers» في الفهرس «server»، ثم بحث المستخدم عن «servers» فإن نفس المحلل يحولها إلى «server» فتتطابق الكلمتان. والخطأ الشائع أن يختلف المحلل بين الطرفين، كأن تغير محلل الحقل في الإعدادات دون إعادة الفهرسة Reindex، أو تكتب دالة تنظيف للنص في تطبيقك ثم تنسى تطبيقها على سؤال المستخدم، فتصبح الكلمة في الفهرس بشكل وفي السؤال بشكل آخر، والنتيجة صفر نتائج دون أي رسالة خطأ. لذلك اجعل المحلل جزءاً من تعريف الحقل Mapping في المحرك نفسه، ولا تقم بتنظيف النص في أكثر من مكان.
الترتيب Ranking مع BM25
بعد أن يجد الفهرس المستندات التي فيها كلمات السؤال يبقى السؤال الأهم للمستخدم: أيها أولاً؟ والحل البسيط هو العد: المستند الذي تتكرر فيه الكلمة أكثر يأتي أولاً، وهذا يفشل لسببين، فالكلمة الشائعة مثل «على» تتكرر في كل مكان فتغطي على الكلمة المهمة، والمستند الطويل يفوز دائماً لأن فيه كلمات أكثر. لذلك ظهرت فكرة TF-IDF التي تضرب تكرار الكلمة في المستند Term Frequency في ندرتها بين المستندات Inverse Document Frequency، ثم جاءت خوارزمية BM25 التي قدمها فريق Okapi في مؤتمر TREC-3 عام 1994، وهي اليوم الترتيب الافتراضي في Lucene كما تذكر وثائق BM25Similarity، وفي OpenSearch كما تذكر وثائق التشابه Similarity. وتسأل BM25 ثلاثة أسئلة لكل كلمة من السؤال في كل مستند، والصورة التالية تبينها بأرقام تجربتنا:
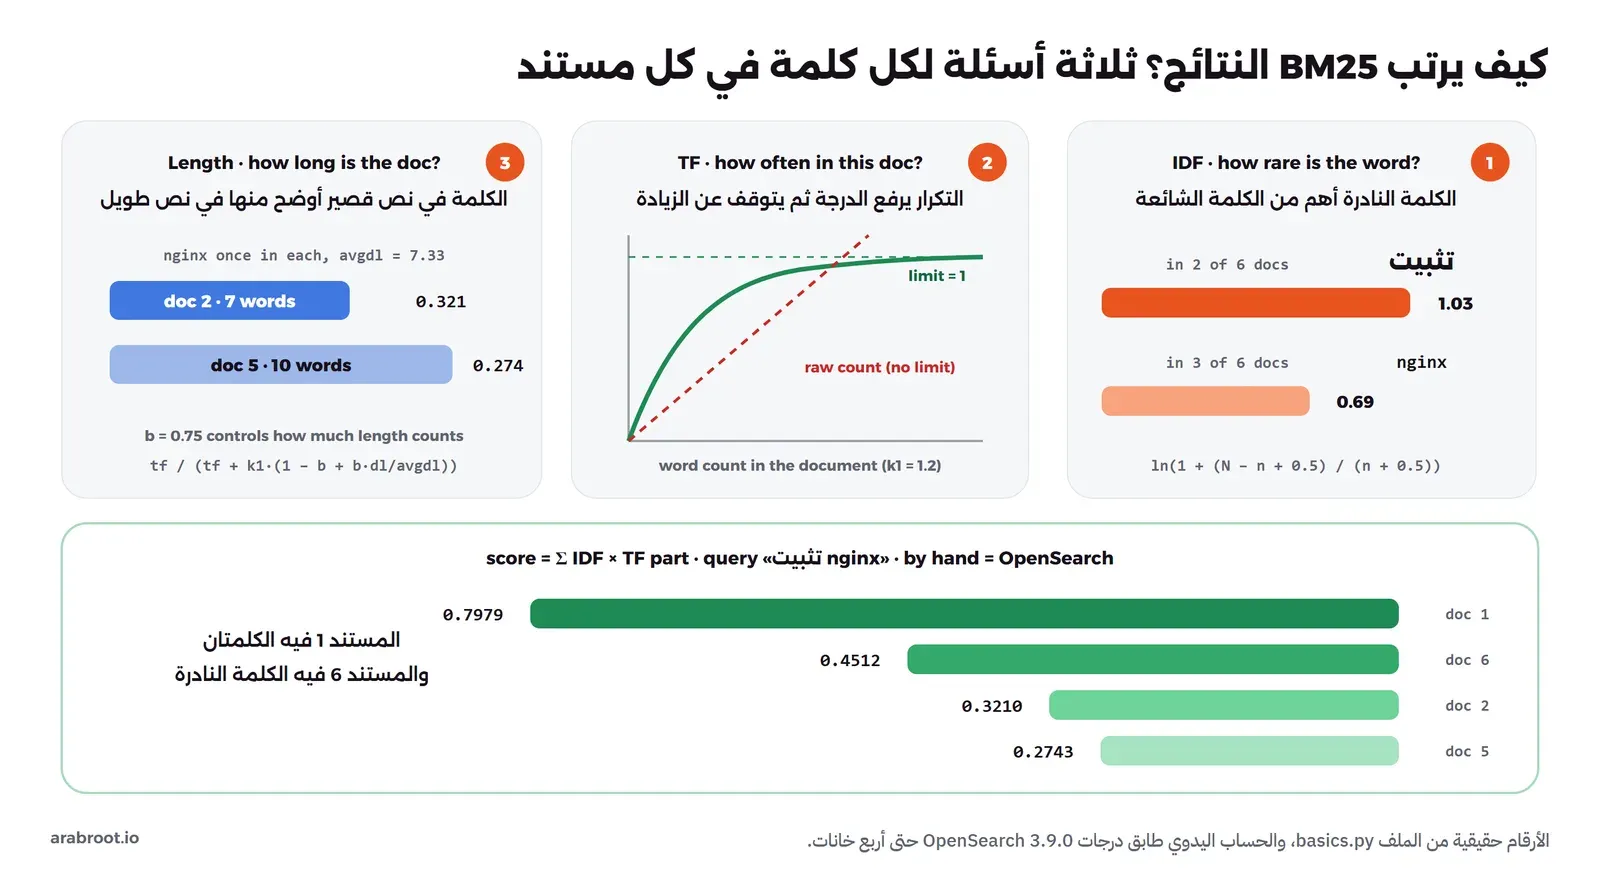
- ما مدى ندرة الكلمة؟ IDF: كلمة «تثبيت» في مستندين من ستة فوزنها 1.03، وكلمة nginx في ثلاثة من ستة فوزنها 0.69، والصيغة في Lucene هي
ln(1 + (N - n + 0.5) / (n + 0.5))حيث N عدد المستندات وn عدد المستندات التي فيها الكلمة. والسبب أن الكلمة التي تظهر في كل مكان لا تساعدك على التمييز بين المستندات. - كم مرة ظهرت في هذا المستند؟ TF: التكرار يرفع الدرجة، لكن BM25 تجعل الزيادة تتباطأ ثم تتوقف عند حد، والمعامل
k1وقيمته الافتراضية 1.2 يحدد سرعة الوصول للحد، والسبب أن المستند الذي ذكر الكلمة عشرين مرة ليس أهم بعشرين ضعفاً من مستند ذكرها مرة. - ما طول المستند؟ Length Normalization: الكلمة في عنوان من سبع كلمات أوضح منها في نص من عشر كلمات، لذلك أخذ المستند 2 درجة 0.321 والمستند 5 درجة 0.274 مع أن في كل منهما nginx مرة واحدة، والمعامل
bوقيمته الافتراضية 0.75 يحدد وزن الطول، فإذا جعلته صفراً لم يعد للطول أي أثر.
ثم تجمع درجات كلمات السؤال، فأخذ المستند 1 أعلى درجة لأن فيه الكلمتين، ثم المستند 6 لأن فيه الكلمة النادرة «تثبيت»، ثم المستندان 2 و5 لأن فيهما nginx فقط. ولاحظ أن ما سبق يفسر لماذا طابق حسابنا اليدوي درجات OpenSearch: لا يوجد سحر داخل المحرك، وإنما صيغة معروفة تستطيع أن تقرأها وتتوقعها. ويجدر الانتباه إلى أن الدالة ts_rank في PostgreSQL لا تستخدم BM25 وإنما ترتب بتكرار الكلمات دون معرفة ندرتها بين المستندات، كما ذكرنا في قسم البحث النصي من مقال PostgreSQL لكل شيء، وهذا أحد الأسباب التي تجعل محرك بحث مستقل يرتب النتائج أفضل عندما تكبر البيانات.
كيف تقيس جودة البحث؟ الدقة Precision والاستدعاء Recall
عندما تغير المحلل أو تضيف مرادفات أو تتحمل الأخطاء الإملائية فأنت تحتاج رقماً يقول هل أصبح البحث أفضل أم أسوأ، وليس انطباعاً من تجربة ثلاث كلمات. والمقياسان الأساسيان كما يعرفهما كتاب Stanford في فصل التقييم هما:
- الدقة Precision: من النتائج التي ظهرت، كم منها صحيح؟ أي عدد النتائج الصحيحة مقسوماً على عدد النتائج المعروضة.
- الاستدعاء Recall: من كل المستندات التي كان يجب أن تظهر، كم وجدنا؟ أي عدد النتائج الصحيحة مقسوماً على عدد المستندات المناسبة كلها.
وفي آخر مخرج analyze.py بحثنا عن «سيرفر» بالمحلل standard، والمستندات التي تتكلم عن سيرفر هي 1 و3 و4 و5، فوجد البحث المستند 1 فقط، والصورة التالية تبين النتيجة:
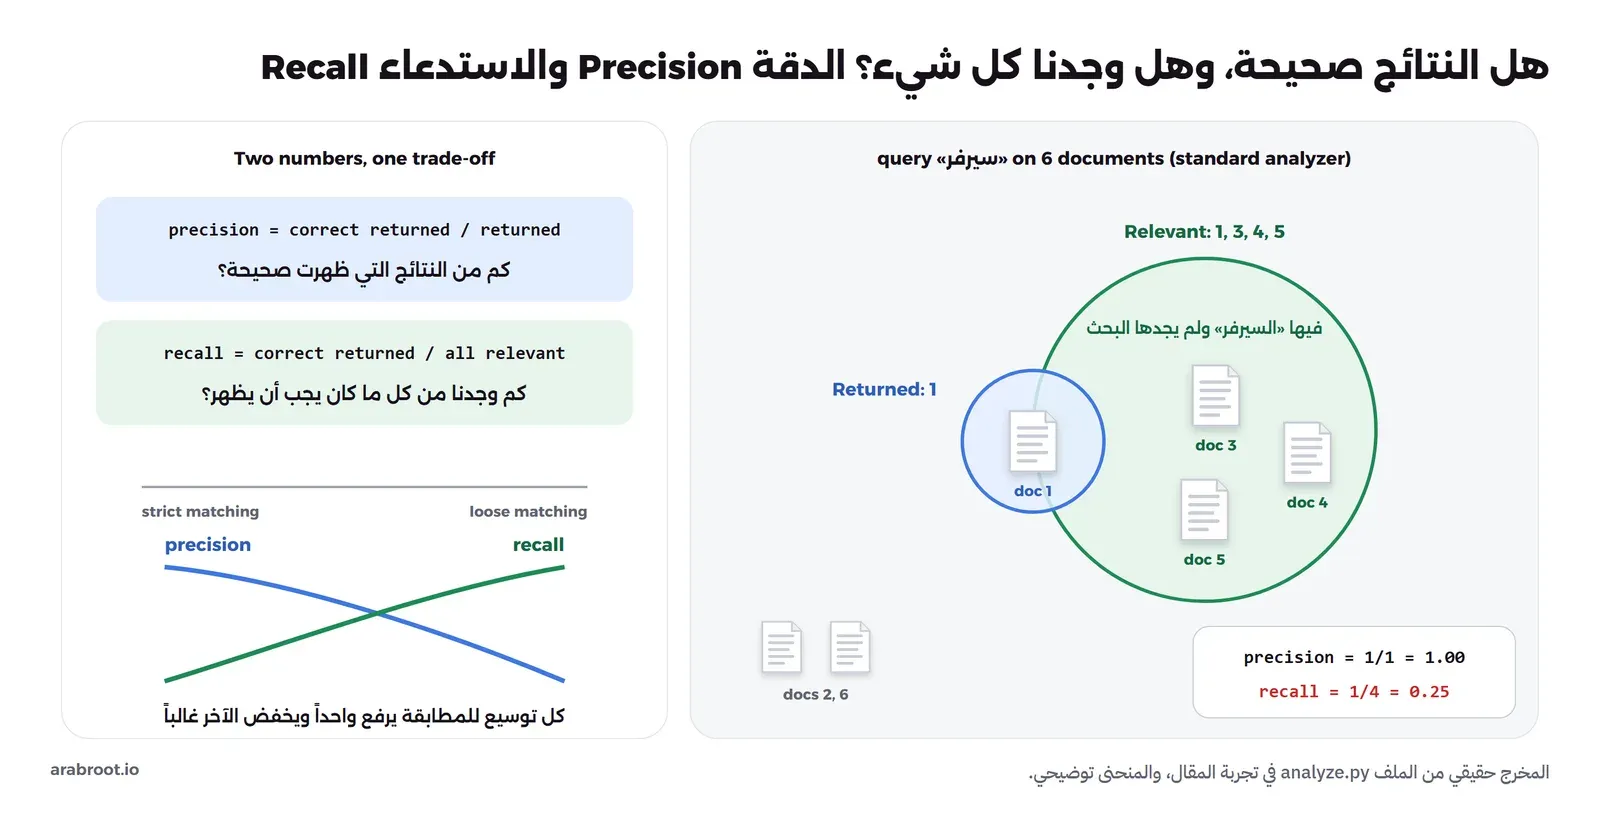
والدقة هنا 1.00 لأن النتيجة الوحيدة صحيحة، لكن الاستدعاء 0.25، أي أن المستخدم لم ير ثلاثة أرباع ما يبحث عنه، والسبب هو «ال» التي رأيناها في الفهرس. ولاحظ أن الرقمين يتحركان عادة في اتجاهين متعاكسين: كل ما يوسع المطابقة، مثل الجذع والمرادفات وتحمل الأخطاء الإملائية، يرفع الاستدعاء وقد يدخل نتائج خاطئة فيخفض الدقة، لذلك قس الاثنين معاً بعد كل تغيير. والطريقة العملية لذلك أن تكتب قائمة صغيرة من الأسئلة الحقيقية التي يكتبها مستخدموك، وبجانب كل سؤال أرقام المستندات التي يجب أن تظهر، ثم تشغلها بعد كل تعديل وتقارن الأرقام، وهذا ما فعلناه بالتفصيل على نصوص عربية في قسم القياس من مقال البحث في النصوص العربية.
أين تجد هذه الأفكار في الأدوات؟
كل ما سبق موجود في كل محرك بحث بأسماء مختلفة، والفرق بين المحركات هو في الحجم الذي يتحمله كل واحد، وسهولة التشغيل، والمحللات الجاهزة للغات، وطريقة الترتيب الافتراضية:
| الأداة | الفهرس والترتيب | متى تناسبك |
|---|---|---|
| البحث النصي في PostgreSQL | فهرس GIN على tsvector، وترتيب ts_rank | عندما تكون البيانات في PostgreSQL أصلاً والحجم متوسط، كما في مقال PostgreSQL لكل شيء |
| OpenSearch وElasticsearch وSolr | فهرس Lucene وترتيب BM25، ومحللات لعشرات اللغات منها العربية | بيانات كبيرة، وسجلات Logs، وتحكم كامل في المحلل والترتيب |
| Meilisearch وTypesense | فهرس خاص بكل منهما، وترتيب بقواعد Ranking Rules، وتحمل الأخطاء الإملائية Typo Tolerance مفعل افتراضياً كما في وثائق Meilisearch ووثائق Typesense | مربع بحث داخل تطبيق أو متجر، ونتائج أثناء الكتابة Search as you type |
وسوف نتناول كل أداة من هذه الأدوات في دليل مستقل ضمن مرحلة محركات البحث، من ELK وOpenSearch وقصة ترخيصها إلى Meilisearch وTypesense والمقارنة بينها، ثم البحث الدلالي بالمتجهات.
أخطاء شائعة
- البحث بـ LIKE في جدول يكبر: يعمل في بيئة التطوير مع مئة سطر ثم يصبح أبطأ استعلام في التطبيق، لذلك ابدأ على الأقل بالبحث النصي في قاعدة البيانات نفسها قبل أن تحتاج محركاً مستقلاً.
- محلل مختلف بين الفهرسة والبحث: النتيجة صفر نتائج دون رسالة خطأ، وقد شرحنا السبب في قسم نفس المحلل في الفهرسة وفي البحث.
- تغيير المحلل دون إعادة الفهرسة: المحلل يطبق عند إدخال المستند، فالمستندات القديمة تبقى بكلماتها القديمة حتى تعيد فهرستها كلها.
- اختيار المحلل الافتراضي لنصوص عربية: المحلل
standardلا يعرف «ال» ولا الهمزات ولا التاء المربوطة، ورأينا أن الاستدعاء نزل إلى الربع في مثال من ستة مستندات فقط. - الحكم على البحث بالانطباع: تجرب ثلاث كلمات فتبدو النتائج جيدة، ثم يشتكي المستخدمون، لذلك اكتب قائمة أسئلة بالنتائج المتوقعة وقس الدقة والاستدعاء بعد كل تغيير.
تدريب عملي
- أضف إلى
basics.pyدالة تبحث عن عبارة كاملة مثل «قاعدة بيانات» باستخدام المواضع: المستند يطابق إذا كان موضع الكلمة الثانية بعد موضع الأولى مباشرة، ثم قارن نتيجتها بنتيجةmatch_phraseفي OpenSearch. - غير المعامل
bفي الدالةbm25إلى صفر، وشاهد كيف تتساوى درجتا المستندين 2 و5، ثم فسر السبب.
حذف المختبر
إذا كنت سوف تكمل إلى مقال البحث في النصوص العربية فأبق الحاويتين كما هما لأنه يبدأ منهما، وإلا فاحذف ما أنشأناه بالاسم:
docker rm -f lab-search-os lab-search-py
docker network rm lab-search-net
# optional: remove the image if you do not need it any more
docker rmi opensearchproject/opensearch:3.9.0
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- البحث بـ
LIKE '%كلمة%'أوgrepيقرأ كل مستند، ولا يرتب النتائج، ويطابق الحروف حرفياً. - الفهرس المعكوس Inverted Index يربط كل كلمة بقائمة المستندات التي فيها ومواضعها، فيجد الكلمة مرة واحدة ثم يقرأ المستندات المطابقة فقط.
- المحلل Analyzer يقرر الكلمات التي تدخل الفهرس: مرشحات الحروف ثم المقطع ثم مرشحات الكلمات، ويجب أن يكون نفسه في الفهرسة وفي البحث.
- BM25 ترتب بثلاثة أشياء: ندرة الكلمة، وتكرارها مع حد أعلى، وطول المستند، وحسابنا اليدوي طابق OpenSearch تماماً.
- قس الدقة Precision والاستدعاء Recall على أسئلة حقيقية بعد كل تغيير، لأن ما يرفع واحداً منهما قد يخفض الآخر.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
 دليلمعالجة اللغة الطبيعية NLP للعربية ولماذا تصعب على البرامجلماذا تصعب العربية على البرامج من الزوائد واللهجات إلى تكلفة التوكنز، وما الأدوات والنماذج المتاحة لمن يبني مساعداً عربياً.
 دليلRAG للمبتدئين: نموذج لغة يجيب من مستنداتك على سيرفرككيف تجعل نموذج اللغة يجيب من مستندات مؤسستك ويذكر مصدره، دون أن يخرج أي مستند من سيرفرك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وبناء فهرس معكوس وحساب BM25 يدوياً في Python 3.13 ومقارنته بـ OpenSearch 3.9.0 (Lucene 10.5.1) في Docker.


