

في دليل السجلات Logging جمعنا سجلات التطبيق في مكان واحد مع Loki، وذكرنا أن هناك طريقة ثانية تفهرس كل كلمة في كل سطر فيصبح البحث النصي الحر سريعاً مهما كبرت السجلات، وهذه الطريقة هي ما تقوم عليه مجموعة ELK التي يجدها أغلبنا في أول وظيفة أو أول مشروع مراقبة: Elasticsearch للتخزين والبحث، وLogstash لتحليل الأسطر، وKibana للعرض. وقد يتساءل البعض: لماذا لا أشغلها بأمر واحد من أي دليل على الإنترنت؟ والإجابة أن أغلب تلك الأدلة تعطل الحماية وتترك الذاكرة بلا حد وتفتح المنفذ 9200 للجميع، ثم يكتشف صاحبها بعد شهر أن القرص امتلأ أو أن سجلاته صارت متاحة لمن يبحث عنها.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي يفعله كل جزء في المجموعة، وأين يقع Filebeat وElastic Agent منها، ومتى تكفيك غيرها.
- المفاهيم التي تحتاجها قبل أن تكتب أول إعداد: ال Index وال Mapping والمحلل Analyzer وال Shards وال Replicas.
- قصة الرخصة: من Apache 2.0 إلى SSPL وElastic License ثم إضافة AGPL، وماذا تعني لك اليوم.
- تجربة كاملة على سيرفر واحد: nginx يكتب سجلات حقيقية، وFilebeat يرسلها، وLogstash يحللها، وElasticsearch يخزنها مع حماية مفعلة، وKibana يعرضها، ثم نبحث في كلمات البحث العربية بالمحلل العربي.
- دورة حياة البيانات ILM، والنسخ الاحتياطي، والمراقبة، والأخطاء الشائعة.
ما هي مجموعة ELK؟
ELK اختصار لأسماء ثلاث أدوات من شركة Elastic تعمل معاً، والصورة التالية تبين المسار الذي سوف نبنيه في التجربة، من سطر يكتبه nginx في ملف إلى رسم في المتصفح:
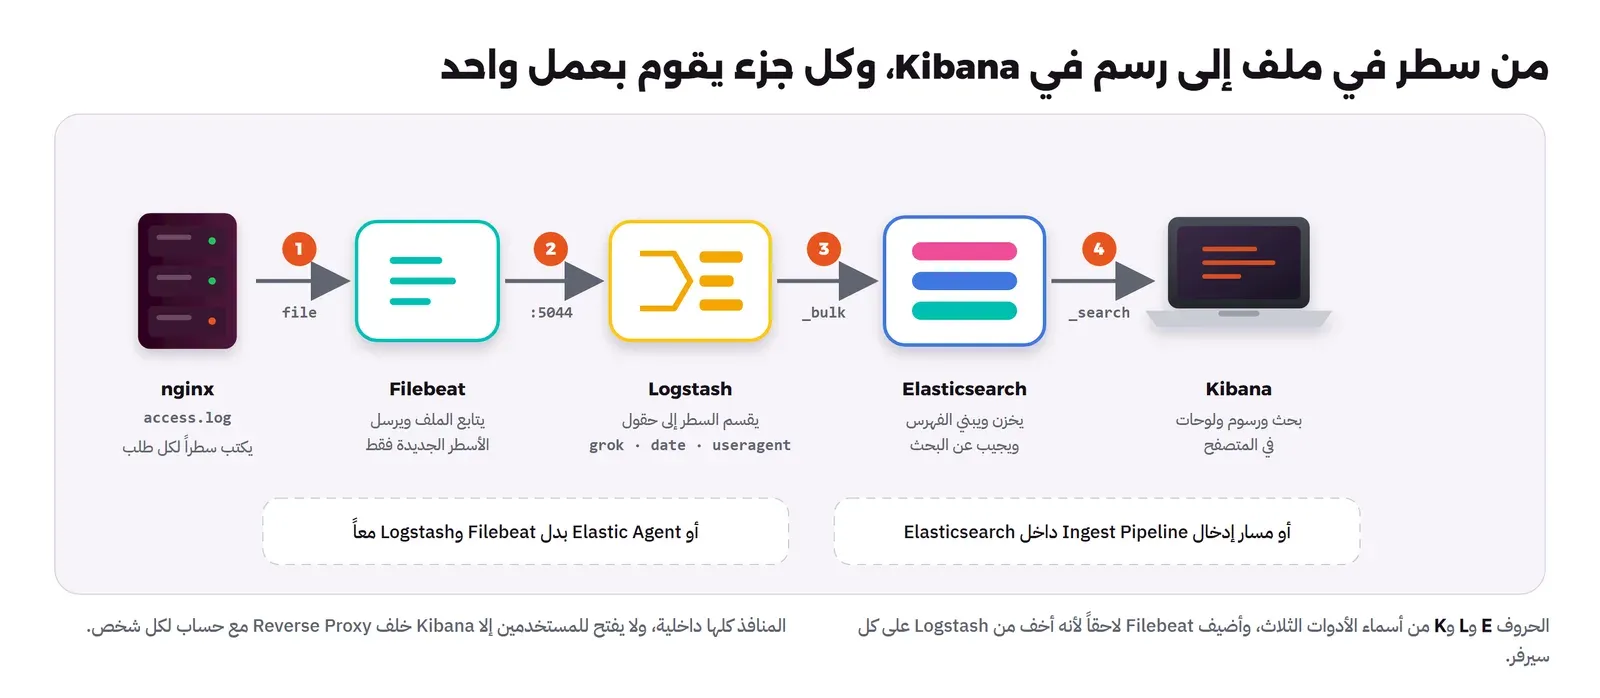
- Elasticsearch: محرك بحث وتخزين مبني على مكتبة Apache Lucene، يحفظ كل سجل كمستند JSON، ويبني له فهرساً معكوساً Inverted Index كالذي شرحناه في مقال كيف يعمل البحث، ويجيب عن البحث والتجميع Aggregations عبر HTTP على المنفذ 9200.
- Logstash: خط معالجة Pipeline من ثلاثة أقسام: مدخل Input يستقبل البيانات، ومرشحات Filters تحول السطر النصي إلى حقول، ومخرج Output يرسلها إلى Elasticsearch أو غيره، وهو برنامج Java يحتاج ذاكرة، لذلك لا يوضع عادة على كل سيرفر.
- Kibana: واجهة الويب، ومنها تبحث في السجلات في شاشة Discover وتبني الرسوم واللوحات Dashboards وتدير المستخدمين والصلاحيات، وهي لا تخزن شيئاً بنفسها، فكل ما تعرضه يأتي من Elasticsearch.
- Beats: برامج صغيرة مكتوبة بلغة Go توضع على كل سيرفر، وأشهرها Filebeat الذي يتابع ملفات السجلات ويحفظ آخر موضع قرأه، فإذا توقف ثم عاد أكمل من حيث توقف دون أن يكرر أو يفقد الأسطر، ولهذا أصبح اسم المجموعة عند Elastic «Elastic Stack» بدل ELK.
- Elastic Agent: وكيل واحد يحل محل عدة Beats، ويدار مركزياً من Kibana عبر Fleet، ومعه تكاملات Integrations جاهزة لعشرات الأنظمة مثل nginx وPostgreSQL، وهو الطريق الذي توصي به Elastic اليوم للأساطيل الكبيرة، أما في التجربة فاخترنا Filebeat مع Logstash لأنهما يظهران كل خطوة بوضوح.
متى تناسبك ELK ومتى لا تناسبك؟
تناسبك ELK عندما تحتاج بحثاً نصياً حراً وسريعاً في كمية كبيرة من السجلات أو المستندات، مثل البحث عن رقم طلب أو رسالة خطأ لا تعرف في أي خدمة ظهرت، أو عندما تحتاج تجميعات وتحليلات على حقول كثيرة، أو عندما يكون عندك فريق أمن يبني عليها قواعد كشف كما في مقال محرك SIEM. ولا تناسبك عندما يكون كل ما تحتاجه هو سجلات خدمات قليلة تبحث فيها بالخدمة والوقت، فهنا يكفيك Loki بتكلفة ذاكرة وقرص أقل بكثير، والسبب أن Elasticsearch يفهرس كل كلمة فيحتاج على الأقل عدة جيجابايت من الذاكرة لسيرفر واحد، ويحتاج متابعة للقرص وال Shards. وإذا كانت الرخصة مهمة لك وتريد Apache 2.0 فانظر إلى دليل OpenSearch، فهو تفرع من Elasticsearch كما سيأتي.
المفاهيم التي تحتاجها قبل أول إعداد
ال Index والمستند وال Mapping
ال Index في Elasticsearch يشبه الجدول في قاعدة البيانات، وكل سجل فيه مستند Document بصيغة JSON، أما ال Mapping فهو تعريف نوع كل حقل: نص يقطع إلى كلمات text، أو قيمة كاملة للتصفية والتجميع keyword، أو رقم أو تاريخ أو عنوان IP. والحل البسيط الذي يتركه الكثيرون هو الاعتماد على التخمين التلقائي Dynamic Mapping، فيرسلون JSON ويتركون Elasticsearch يقرر النوع، والمشكلة أن أول قيمة تصل تحدد النوع للأبد، فإذا وصل رقم الحالة "200" كنص مرة صار نصاً، وإذا كتب كل فريق حقولاً جديدة كما يشاء انفجر عدد الحقول وامتلأت ذاكرة الخريطة، لذلك عرف ال Mapping بنفسك في قالب Index Template، واجعل "dynamic": false حتى تبقى الحقول غير المعرفة في المستند ولكنها لا تفهرس، وسوف نرى أثر هذا الخيار بأعيننا في التجربة.
المحلل Analyzer للنص العربي
حقل text يمر عند الفهرسة وعند البحث على محلل Analyzer يقطع النص ويوحد الحروف ويحذف الزوائد، والمحلل الافتراضي standard لا يعرف «ال» التعريف ولا الهمزات ولا التاء المربوطة، أما المحلل arabic المدمج فيوحد الحروف ويحذف السوابق واللواحق الشائعة كما في توثيق محللات اللغات. وقد شرحنا سلسلة المحلل العربي ومشكلاتها بالتفصيل في مقال البحث في النصوص العربية، فلن نعيدها هنا، وإنما نستخدمها على حقل واحد في السجلات: الكلمات التي يكتبها الزوار في مربع البحث.
ال Shards وال Replicas
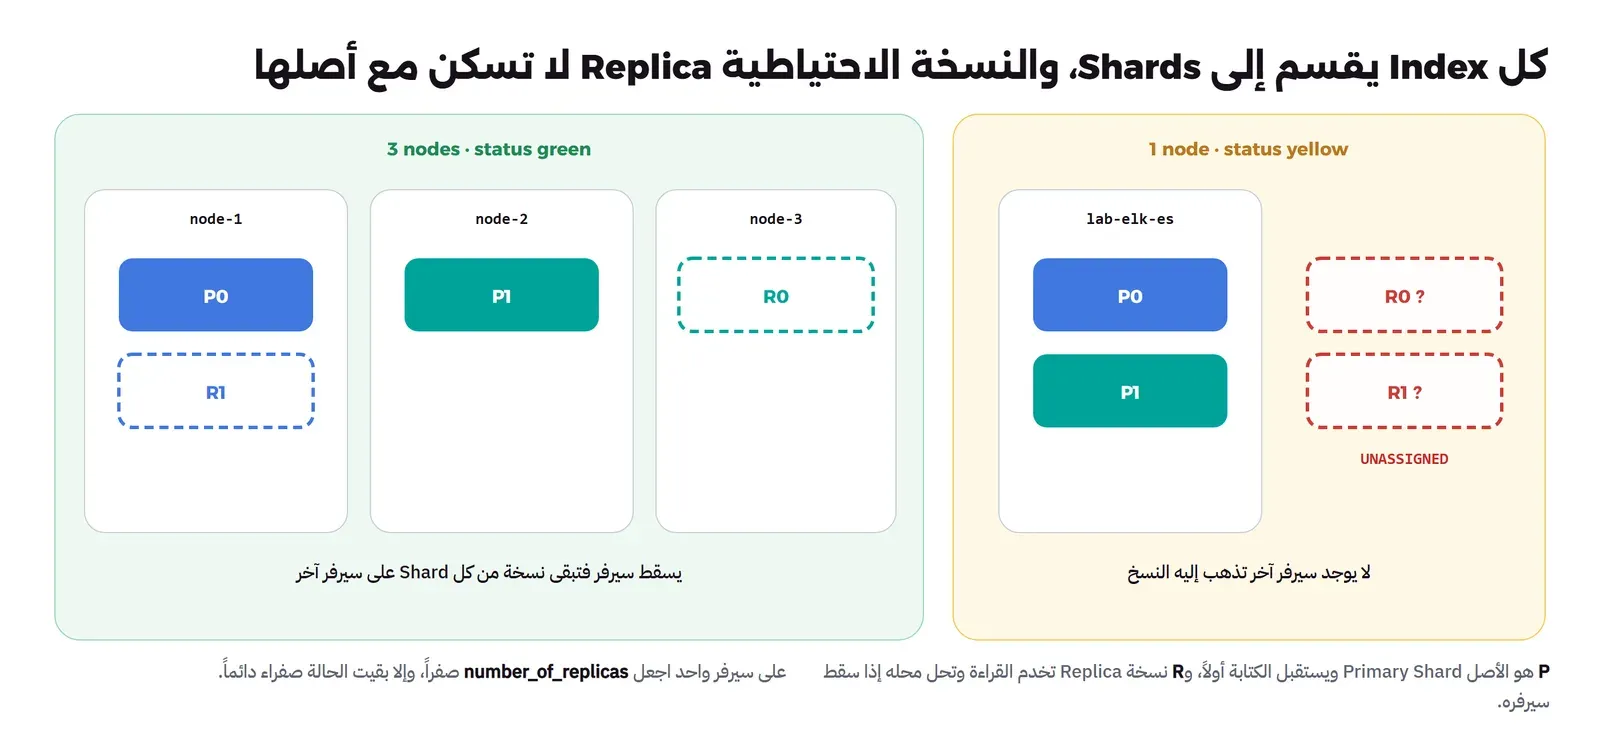
كل Index يقسم إلى أجزاء اسمها Shards، وكل Shard هو فهرس Lucene كامل يمكن أن يسكن على سيرفر مختلف، وهذا ما يجعل Elasticsearch يتوزع على عدة سيرفرات Nodes. ولكل Shard أصلي Primary نسخ اختيارية اسمها Replicas تخدم القراءة وتحل محله إذا سقط سيرفره، والشرط الذي ينساه الجميع أن النسخة لا توضع أبداً على نفس السيرفر الذي عليه أصلها، والسبب أن سقوط ذلك السيرفر سوف يأخذ النسختين معاً. والصورة التالية تبين ذلك:
والقاعدة العملية أن حجم ال Shard الواحد يبقى بين عشرة وخمسين جيجابايت بحسب توثيق Elastic عن حجم ال Shards، وأقل من 200 مليون مستند، وأن كثرة ال Shards الصغيرة أسوأ من قلتها، لأن كل Shard يأخذ ذاكرة وملفات مفتوحة حتى لو كان فارغاً.
ال Data Streams ودورة الحياة ILM
السجلات بيانات زمنية تضاف ولا تعدل، والحل البسيط أن تكتبها كلها في Index واحد ثم تحذف القديم باستعلام حذف، وهذه أسوأ طريقة على الإطلاق، لأن الحذف في Lucene يعلم المستندات كمحذوفة ثم يعيد كتابة الملفات لاحقاً، فتدفع ثمن الحذف مرتين. والطريقة الصحيحة هي ال Data Stream: اسم واحد تكتب إليه، وخلفه Indices مخفية تسمى Backing Indices، وسياسة دورة حياة Index Lifecycle Management واختصاراً ILM تنشئ Index جديداً كل يوم أو عند حجم معين، وهذا يسمى Rollover، ثم تحذف ال Index كاملاً بعد المدة التي تحددها، وحذف ملف كامل أرخص بكثير من حذف ملايين المستندات واحداً واحداً.
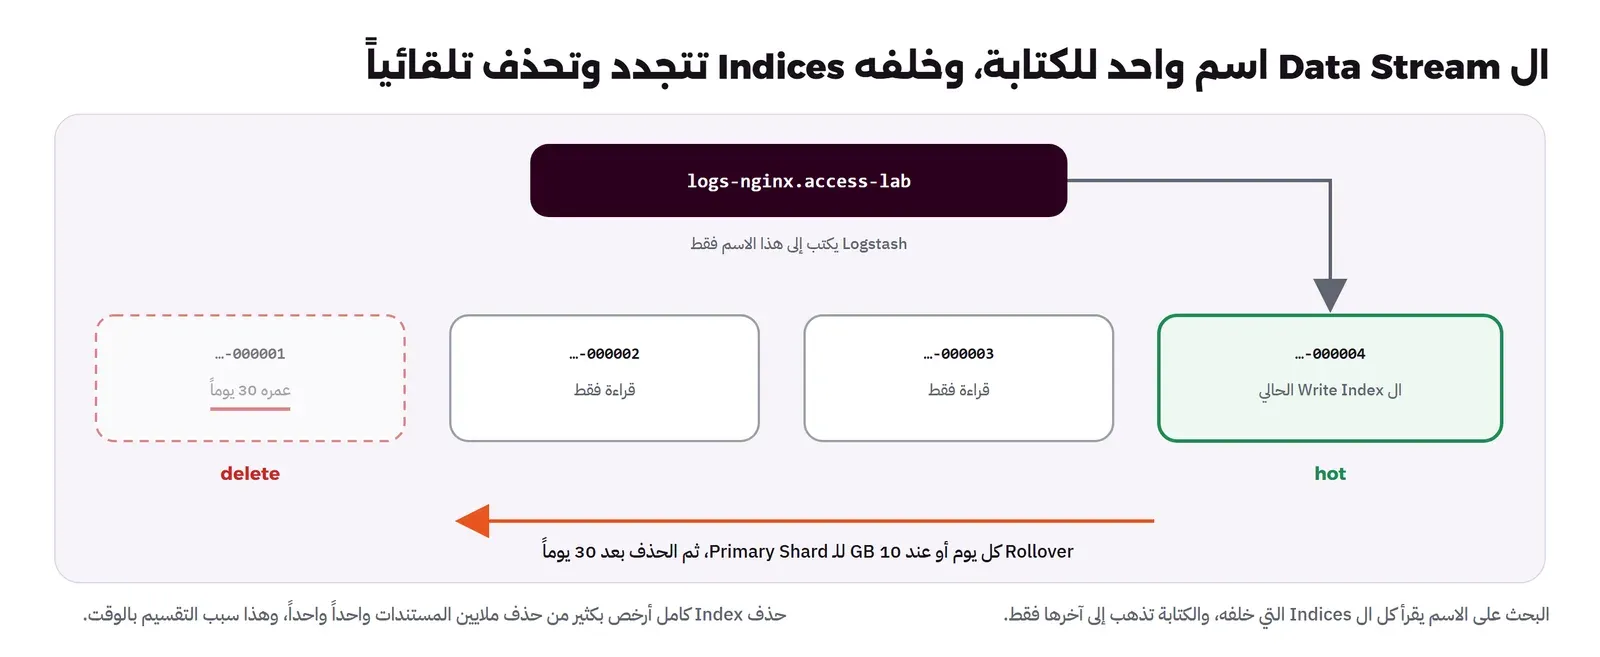
ومنذ Elasticsearch 9.0 تأخذ كل Data Stream اسمها بصيغة logs-*-* وضع التخزين logsdb تلقائياً، وهو بحسب توثيق Logs data streams يخفض مساحة السجلات حتى 60% مقابل بطء في الفهرسة بين 10 و20%، وسوف نراه مفعلاً في التجربة دون أن نطلبه.
قصة الرخصة: لماذا يهمك أي إصدار تشغله
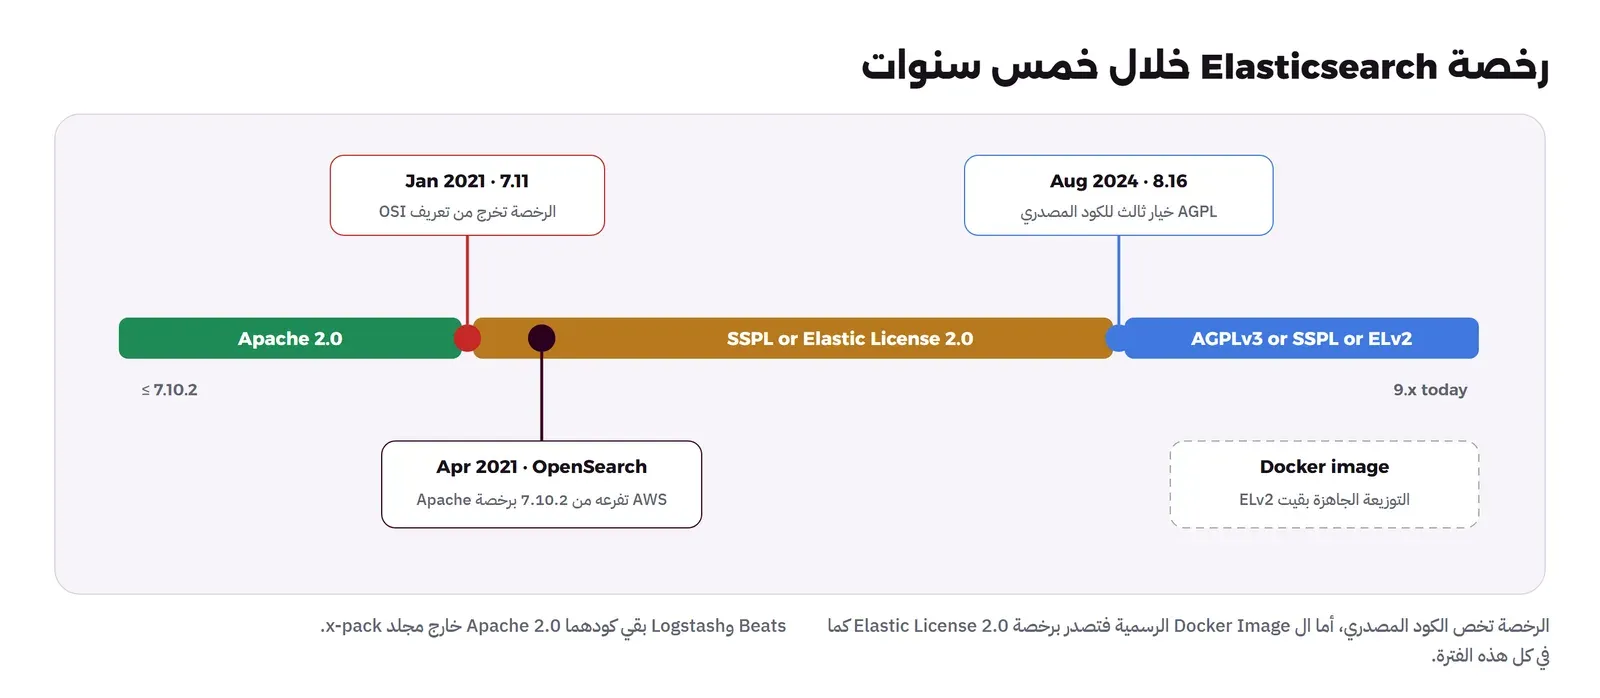
بدأ Elasticsearch وKibana برخصة Apache 2.0، ثم في 14 يناير 2021 أعلنت Elastic في مقال Doubling down on open, Part II أن الكود الذي كان برخصة Apache 2.0 سوف يصبح بدءاً من الإصدار 7.11 برخصتين يختار المستخدم إحداهما: Server Side Public License واختصاراً SSPL، أو Elastic License 2.0 واختصاراً ELv2، وكان السبب المعلن منع مزودي السحابة من تقديمه خدمة مدارة دون أن يساهموا. وكلا الرخصتين ليستا مفتوحتي المصدر بتعريف OSI، وقد شرحنا الفرق بين الأنواع في مقال الرخص. وبعد أسبوع واحد أعلنت AWS في 21 يناير 2021 أنها سوف تفرع آخر إصدار برخصة Apache وهو 7.10، وهكذا ولد OpenSearch الذي نشرحه في دليله المستقل.
ثم في 29 أغسطس 2024 كتب مؤسس الشركة Shay Banon مقال Elasticsearch Is Open Source. Again! وأعلن إضافة رخصة AGPLv3، وهي رخصة مفتوحة المصدر معتمدة من OSI، خياراً ثالثاً بجانب SSPL وELv2، وتقول صفحة الأسئلة الشائعة عن الترخيص إن التغيير طبق قبل صدور الإصدار 8.16. والصورة التالية تلخص الفترة كلها:
وفي الإعداد أعلاه لاحظ التالي:
- ملف LICENSE.txt في مستودع Elasticsearch اليوم يقول إن الكود بثلاث رخص AGPLv3 وSSPL وELv2، وإن ما في مجلد
x-packبرخصة ELv2 وحدها. - ال Docker Image الرسمية التي نشغلها في التجربة هي «التوزيعة الافتراضية» Default Distribution، وتقول صفحة الأسئلة الشائعة إنها ما زالت تصدر برخصة Elastic License 2.0، فإذا أردت AGPL فعليك أن تبني من الكود بنفسك.
- ELv2 تسمح لك بتشغيله داخل مؤسستك وبناء تطبيقك عليه مجاناً، وتمنع تقديمه خدمة مدارة لغيرك أو تعطيل مفاتيح الترخيص بحسب نص الرخصة، لذلك لا يتأثر أغلب من يستضيفه لنفسه.
- كود Logstash وBeats خارج مجلد
x-packبرخصة Apache 2.0 بحسب ملفي رخصة Logstash ورخصة Beats.
التجربة: سجلات nginx حقيقية من الطلب إلى Kibana
سوف نشغل كل شيء على جهاز واحد بـ Docker Compose، وكل المنافذ على 127.0.0.1 فقط، وأسماء ال Containers تبدأ بـ lab-elk-، والإصدارات مثبتة: Elasticsearch وKibana وLogstash وFilebeat بالإصدار 9.5.5، وnginx 1.31.6. وإذا لم يكن Docker مثبتاً عندك فابدأ من دليل تثبيت Docker.
ملف Docker Compose
المثال التالي هو الملف compose.yaml كاملاً:
# ELK lab: nginx writes real access logs, Filebeat ships them to Logstash,
# Logstash parses them and writes to Elasticsearch, Kibana shows them.
# Every port is bound to 127.0.0.1 only. Run: docker compose -p lab-elk up -d
name: lab-elk

services:
  es:
    image: docker.elastic.co/elasticsearch/elasticsearch:9.5.5
    container_name: lab-elk-es
    environment:
      - node.name=lab-elk-es
      - discovery.type=single-node
      - ES_JAVA_OPTS=-Xms1g -Xmx1g
      - ELASTIC_PASSWORD=${ELASTIC_PASSWORD}
      - xpack.security.enabled=true
      # lab only: plain HTTP on 127.0.0.1; production keeps TLS on the HTTP layer
      - xpack.security.http.ssl.enabled=false
      - xpack.license.self_generated.type=basic
    mem_limit: 2g
    ulimits:
      memlock: { soft: -1, hard: -1 }
    volumes:
      - es-data:/usr/share/elasticsearch/data
    ports:
      - "127.0.0.1:19200:9200"
    healthcheck:
      test: ["CMD-SHELL", "curl -s -u elastic:${ELASTIC_PASSWORD} http://localhost:9200/_cluster/health | grep -q '\"status\"'"]
      interval: 10s
      retries: 30

  kibana:
    image: docker.elastic.co/kibana/kibana:9.5.5
    container_name: lab-elk-kibana
    depends_on: { es: { condition: service_healthy } }
    environment:
      - ELASTICSEARCH_HOSTS=http://lab-elk-es:9200
      - ELASTICSEARCH_USERNAME=kibana_system
      - ELASTICSEARCH_PASSWORD=${KIBANA_PASSWORD}
      - SERVER_PUBLICBASEURL=http://127.0.0.1:15601
      - I18N_LOCALE=en
    mem_limit: 1536m
    ports:
      - "127.0.0.1:15601:5601"

  logstash:
    image: docker.elastic.co/logstash/logstash:9.5.5
    container_name: lab-elk-logstash
    depends_on: { es: { condition: service_healthy } }
    environment:
      - LS_JAVA_OPTS=-Xms512m -Xmx512m
      - LOGSTASH_WRITER_PASSWORD=${LOGSTASH_WRITER_PASSWORD}
      - xpack.monitoring.enabled=false
    mem_limit: 1g
    volumes:
      - ./logstash/nginx.conf:/usr/share/logstash/pipeline/logstash.conf:ro

  nginx:
    image: nginx:1.31.6-alpine
    container_name: lab-elk-nginx
    volumes:
      - ./nginx/default.conf:/etc/nginx/conf.d/default.conf:ro
      - nginx-logs:/var/log/lab

  filebeat:
    image: docker.elastic.co/beats/filebeat:9.5.5
    container_name: lab-elk-filebeat
    user: root
    depends_on: [logstash, nginx]
    command: ["filebeat", "-e", "--strict.perms=false"]
    volumes:
      - ./filebeat/filebeat.yml:/usr/share/filebeat/filebeat.yml:ro
      - nginx-logs:/var/log/lab:ro

volumes:
  es-data:
  nginx-logs:
في الإعداد أعلاه لاحظ التالي:
- الحماية مفعلة
xpack.security.enabled=trueومعها باسورد المستخدمelasticمن ملف.env، ولم نعطلها كما تفعل أدلة كثيرة، وإنما عطلنا TLS على طبقة HTTP فقط لأن المنفذ على127.0.0.1، أما في الإنتاج فأبق TLS مفعلاً كما يفعل Elasticsearch تلقائياً عند أول تشغيل. - الذاكرة:
-Xms1g -Xmx1gهو المثال الذي يستخدمه توثيق التثبيت بـ Docker للتجارب، ومعه حد للـ Container بـmem_limit: 2g، لأن Elasticsearch يستخدم ذاكرة خارج ال Heap لذاكرة الملفات المؤقتة Page Cache وغيرها، وفي الإنتاج اترك التحديد التلقائي يقرر بحسب ذاكرة ال Container كما ينصح التوثيق. discovery.type=single-nodeيجعل السيرفر يكون Cluster وحده دون البحث عن سيرفرات أخرى، ويتجاوز فحوص الإقلاع Bootstrap Checks، أما في الإنتاج فالتوثيق يشترط رفعvm.max_map_countإلى 1048576 على نظام السيرفر.- Logstash بذاكرة 512 ميجابايت، وKibana بحد 1.5 جيجابايت، وFilebeat يقرأ ملف السجل من Volume مشترك مع nginx للقراءة فقط.
وملف .env فيه ثلاث كلمات مرور، وأنشئها عشوائياً ولا تضعها في Git:
{ echo "ELASTIC_PASSWORD=$(openssl rand -hex 12)"
  echo "KIBANA_PASSWORD=$(openssl rand -hex 12)"
  echo "LOGSTASH_WRITER_PASSWORD=$(openssl rand -hex 12)"; } > .env
docker compose -p lab-elk up -d es
وعند أول طلب سوف تجد المخرج كما يلي:
source .env
curl -s -u elastic:$ELASTIC_PASSWORD http://127.0.0.1:19200/
{
"name" : "lab-elk-es",
"cluster_name" : "docker-cluster",
"version" : {
"number" : "9.5.5",
"build_flavor" : "default",
"build_type" : "docker",
"lucene_version" : "10.5.1",
"minimum_wire_compatibility_version" : "8.19.0",
"minimum_index_compatibility_version" : "8.0.0"
},
"tagline" : "You Know, for Search"
}الحسابات والصلاحيات والقالب قبل وصول أي سجل
قبل أن يكتب Logstash أي شيء نجهز ثلاثة أشياء: باسورد المستخدم kibana_system الذي تتصل به Kibana، ودوراً Role لا يملك إلا الكتابة في سجلات nginx ومستخدماً لـ Logstash بهذا الدور، ثم سياسة ILM وقالباً Index Template فيه ال Mapping. والسبب في دور خاص بـ Logstash أن الباسورد الموجود في ملف إعداده سوف يقرؤه كل من يصل إلى السيرفر، فإذا كان باسورد elastic فقد أعطيته كل شيء. والملف setup.sh كاملاً:
#!/usr/bin/env bash
# Prepares Elasticsearch before Logstash and Kibana use it:
# passwords, a writer role for Logstash, an ILM policy and an index template with an Arabic field.
set -euo pipefail
source .env
ES=http://127.0.0.1:19200
es() { curl -s -u "elastic:$ELASTIC_PASSWORD" -H 'Content-Type: application/json' "$@"; echo; }

# 1) the built-in user Kibana uses to talk to Elasticsearch
es -X POST "$ES/_security/user/kibana_system/_password" -d "{\"password\":\"$KIBANA_PASSWORD\"}"

# 2) a role that can only write to the logs-nginx.* data streams, and a user for Logstash
es -X PUT "$ES/_security/role/logstash_writer" -d '{
  "cluster": ["monitor"],
  "indices": [{ "names": ["logs-nginx.*"], "privileges": ["create_doc", "auto_configure", "view_index_metadata"] }]
}'
es -X PUT "$ES/_security/user/logstash_writer" -d "{\"password\":\"$LOGSTASH_WRITER_PASSWORD\",\"roles\":[\"logstash_writer\"]}"

# 3) lifecycle: a new backing index every day or 10 GB per primary shard, delete after 30 days
es -X PUT "$ES/_ilm/policy/nginx-logs" -d '{
  "policy": { "phases": {
    "hot":    { "actions": { "rollover": { "max_age": "1d", "max_primary_shard_size": "10gb" } } },
    "delete": { "min_age": "30d", "actions": { "delete": {} } }
  } }
}'

# 4) the template every logs-nginx.access-* data stream is created from
es -X PUT "$ES/_index_template/logs-nginx-access" -d '{
  "index_patterns": ["logs-nginx.access-*"],
  "data_stream": {},
  "priority": 200,
  "template": {
    "settings": {
      "number_of_shards": 1,
      "number_of_replicas": 0,
      "index.lifecycle.name": "nginx-logs"
    },
    "mappings": {
      "dynamic": false,
      "properties": {
        "@timestamp":   { "type": "date" },
        "message":      { "type": "match_only_text" },
        "tags":         { "type": "keyword" },
        "service":      { "properties": { "name": { "type": "keyword" } } },
        "source":       { "properties": { "address": { "type": "ip" } } },
        "http": { "properties": {
          "request":  { "properties": { "method": { "type": "keyword" }, "referrer": { "type": "keyword" } } },
          "response": { "properties": { "status_code": { "type": "short" },
                                        "body": { "properties": { "bytes": { "type": "long" } } } } } } },
        "url": { "properties": { "original": { "type": "wildcard" }, "path": { "type": "keyword" } } },
        "user_agent": { "properties": {
          "original": { "type": "keyword", "ignore_above": 512 },
          "name":     { "type": "keyword" },
          "os":       { "properties": { "name": { "type": "keyword" } } } } },
        "search_query": { "type": "text", "analyzer": "arabic",
                          "fields": { "raw": { "type": "keyword" } } }
      }
    }
  }
}'
والمخرج سوف يكون كما يلي، سطر لكل طلب:
{}
{"role":{"created":true}}
{"created":true}
{"acknowledged":true}
{"acknowledged":true}
في الإعداد أعلاه لاحظ التالي:
- الدور
logstash_writerيملكcreate_docفقط علىlogs-nginx.*، فلا يستطيع القراءة ولا الحذف، وسوف نتحقق من ذلك بعد قليل. - الحقل
search_queryنوعهtextبالمحللarabic، ومعه حقل فرعيrawمن نوعkeywordللتجميع والعد، لأن الحقل النصي لا يجمع عليه. - الحقل
url.originalمن نوعwildcard، وهو مصمم للبحث بنمط داخل نص طويل مثل*wp-admin*دون أن يقطع إلى كلمات. - الحقل
tagsأضفناه بعد خطوة «نكسر الإعداد» التالية، وسوف ترى لماذا.
Filebeat وLogstash: من سطر نصي إلى حقول
هذا إعداد Filebeat، وهو يتابع الملف ويرسل إلى Logstash:
filebeat.inputs:
  - type: filestream
    id: nginx-access
    paths:
      - /var/log/lab/access.log
    fields:
      service.name: shop
    fields_under_root: true

output.logstash:
  hosts: ["lab-elk-logstash:5044"]

logging.level: info
logging.metrics.enabled: false
وهذا خط Logstash الذي يحول السطر إلى حقول:
input {
  beats { port => 5044 }
}

filter {
  # 1) split the combined log line into ECS fields
  grok {
    match => { "message" => "%{COMBINEDAPACHELOG}" }
  }
  # 2) the time of the request, not the time Logstash read the line
  date {
    match => [ "timestamp", "dd/MMM/yyyy:HH:mm:ss Z" ]
    remove_field => [ "timestamp" ]
  }
  # 3) the search words a visitor typed: /search?q=...
  if [url][original] =~ /^\/search\?/ {
    grok { match => { "[url][original]" => "^%{URIPATH:[url][path]}\?%{GREEDYDATA:[url][query]}" } }
    kv { source => "[url][query]" field_split => "&" target => "[@metadata][params]" }
    if [@metadata][params][q] {
      urldecode { field => "[@metadata][params][q]" }
      mutate { gsub => [ "[@metadata][params][q]", "\+", " " ] }
      mutate { add_field => { "search_query" => "%{[@metadata][params][q]}" } }
    }
  }
  # 4) browser name and OS from the User-Agent header
  useragent {
    source => "[user_agent][original]"
    target => "user_agent"
  }
  mutate { remove_field => [ "event", "log", "input", "agent", "ecs", "host" ] }
}

output {
  elasticsearch {
    hosts => ["http://lab-elk-es:9200"]
    user => "logstash_writer"
    password => "${LOGSTASH_WRITER_PASSWORD}"
    data_stream => true
    data_stream_type => "logs"
    data_stream_dataset => "nginx.access"
    data_stream_namespace => "lab"
  }
}
في الإعداد أعلاه لاحظ التالي:
- النمط
%{COMBINEDAPACHELOG}يفهم صيغةcombinedالتي يكتبها nginx، ومنذ Logstash 8 يعمل كل Plugin بوضع ECS v8 افتراضياً، فيخرج أسماء حقول بمعيار Elastic Common Schema مثلsource.addressوhttp.response.status_code، وهذا ما يجعل لوحات Kibana الجاهزة تعمل مع سجلاتك. - المرشح
dateيجعل@timestampوقت الطلب نفسه وليس وقت قراءة Logstash للسطر، وبدونه تظهر السجلات المتأخرة في الوقت الخطأ. - كلمات البحث تصل مرمزة بصيغة URL مثل
%D8%B4...، لذلك نقطع ال Query String بالمرشحkvثم نفك الترميز بـurldecodeونحول علامة+إلى مسافة. - المخرج يكتب إلى Data Stream اسمها
logs-nginx.access-labبمستخدمlogstash_writerوليسelastic.
أما عنوان الزائر فقد ضبطناه في nginx بـ set_real_ip_from وreal_ip_header، لأن مولد الطلبات يرسل عناوين من نطاقات التوثيق RFC 5737 في الترويسة X-Forwarded-For، وهذه نفس مشكلة عنوان الزائر الحقيقي خلف ال Reverse Proxy. وفي أول تشغيل نسينا أن Docker أعطى الشبكة نطاقاً من 192.168.0.0/16 وليس 172.16.0.0/12، فظهر عنوان مولد الطلبات نفسه في كل سطر، وهذا خطأ شائع يجعل السجلات بلا فائدة في التحقيق.
تشغيل كل شيء وإرسال طلبات حقيقية
الآن نشغل باقي الخدمات، ثم نشغل مولد طلبات صغير بلغة Python يرسل طلبات HTTP حقيقية إلى nginx لمدة أربع دقائق: صفحات منتجات، وبحث بكلمات عربية، ومحاولات دخول فاشلة، وتعطلاً قصيراً في /api/orders يرجع 503 لمدة عشرين ثانية، وماسحاً يبحث عن /.env و/wp-admin في آخر ربع من المدة:
docker compose -p lab-elk up -d
docker run --rm --name lab-elk-traffic --network lab-elk_default \
  -v "$PWD/traffic:/app:ro" python:3.13.16-slim python /app/traffic.py 240
done: 1024 iterations in 240sوهذه ثلاثة أسطر حقيقية من access.log:
192.0.2.23 - - [11/Oct/2026:06:55:33 +0000] "GET /search?q=%D8%B4%D8%A7%D8%AD%D9%86+%D8%B3%D8%B1%D9%8A%D8%B9 HTTP/1.1" 200 8 "https://shop.example.com/" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/141.0.0.0 Safari/537.36"
192.0.2.13 - - [11/Oct/2026:06:55:46 +0000] "POST /login HTTP/1.1" 401 179 "https://shop.example.com/" "Mozilla/5.0 (X11; Linux x86_64; rv:144.0) Gecko/20100101 Firefox/144.0"
ثم نسأل Elasticsearch كم مستنداً وصل، وكيف تبدو الحالة:
curl -s -u elastic:$ELASTIC_PASSWORD "http://127.0.0.1:19200/_cat/count/logs-nginx.access-lab?v"
curl -s -u elastic:$ELASTIC_PASSWORD "http://127.0.0.1:19200/_data_stream/logs-nginx.access-lab?pretty"
epoch timestamp count
1791701987 06:59:47 1183 "indices" : [
{
"index_name" : ".ds-logs-nginx.access-lab-2026.10.11-000001",
"managed_by" : "Index Lifecycle Management",
"ilm_policy" : "nginx-logs",
"index_mode" : "logsdb"
}
],
"status" : "GREEN",
"template" : "logs-nginx-access",لاحظ أن عدد المستندات 1183 يساوي عدد الأسطر في الملف تماماً، وأن index_mode أصبح logsdb دون أن نكتبه في القالب، لأن اسم ال Data Stream يطابق logs-*-*. وهذا مستند واحد كما خزنه Elasticsearch:
{
  "url" : {
    "original" : "/search?q=%D9%83%D8%AA%D8%A8+%D8%A7%D9%84%D8%A3%D8%B7%D9%81%D8%A7%D9%84",
    "path" : "/search",
    "query" : "q=%D9%83%D8%AA%D8%A8+%D8%A7%D9%84%D8%A3%D8%B7%D9%81%D8%A7%D9%84"
  },
  "service" : { "name" : "shop" },
  "source" : { "address" : "198.51.100.5" },
  "@timestamp" : "2026-10-11T06:59:32.000Z",
  "user_agent" : {
    "os" : { "full" : "Android 16", "name" : "Android", "version" : "16" },
    "name" : "Chrome Mobile",
    "device" : { "name" : "Pixel 9" },
    "version" : "141.0.0.0"
  },
  "http" : {
    "response" : { "status_code" : 200, "body" : { "bytes" : 8 } },
    "request" : { "referrer" : "https://shop.example.com/", "method" : "GET" },
    "version" : "1.1"
  },
  "search_query" : "كتب الأطفال"
}
وعدد الطلبات بحسب رمز الحالة، بتجميع Terms Aggregation:
curl -s -u elastic:$ELASTIC_PASSWORD -H 'Content-Type: application/json' \
  "http://127.0.0.1:19200/logs-nginx.access-lab/_search?pretty&filter_path=aggregations" \
  -d '{"size":0,"aggs":{"status":{"terms":{"field":"http.response.status_code"}}}}'
"buckets" : [
{ "key" : 200, "doc_count" : 891 },
{ "key" : 503, "doc_count" : 164 },
{ "key" : 404, "doc_count" : 74 },
{ "key" : 401, "doc_count" : 54 }
]البحث في كلمات البحث العربية
الآن السؤال الذي يسأله مدير المتجر: كم مرة بحث الزوار عن مستشفى؟ والزوار كتبوا «المستشفى التخصصي» و«مستشفيات الرياض» ولم يكتب أحد «مستشفى» وحدها. نبحث مرة بالحقل النصي ذي المحلل العربي، ومرة بالحقل keyword الذي يطابق القيمة كاملة:
// match على search_query (المحلل arabic)
{ "size": 0, "query": { "match": { "search_query": "مستشفى" } },
  "aggs": { "q": { "terms": { "field": "search_query.raw" } } } }
{
"hits" : { "total" : { "value" : 57 } },
"aggregations" : { "q" : { "buckets" : [
{ "key" : "المستشفى التخصصي", "doc_count" : 30 },
{ "key" : "مستشفيات الرياض", "doc_count" : 27 }
] } }
}// term على search_query.raw
{"hits":{"total":{"value":0}}}المحلل وجد 57 طلباً بالشكلين، والحقل keyword لم يجد شيئاً لأنه يقارن النص كاملاً حرفاً بحرف. والسبب يظهر من الأمر _analyze على نفس الحقل:
{"field":"search_query","text":"المستشفيات مستشفى الشواحن شاحن"}{"tokens":[{"token":"مستشف"},{"token":"مستشف"},{"token":"شواحن"},{"token":"شاحن"}]}«المستشفيات» و«مستشفى» أصبحتا «مستشف»، أما «الشواحن» فبقيت «شواحن» ولم تلتق مع «شاحن»، لأن المحلل يحذف اللواحق ولا يعرف جموع التكسير، ولهذا رجع البحث عن «شاحن» 26 طلباً كلها «شاحن سريع» ولم يجد طلبات «الشواحن». والحل بالمرادفات Synonyms أو بالبحث الدلالي، وقد شرحنا الأول في قسم المرادفات.
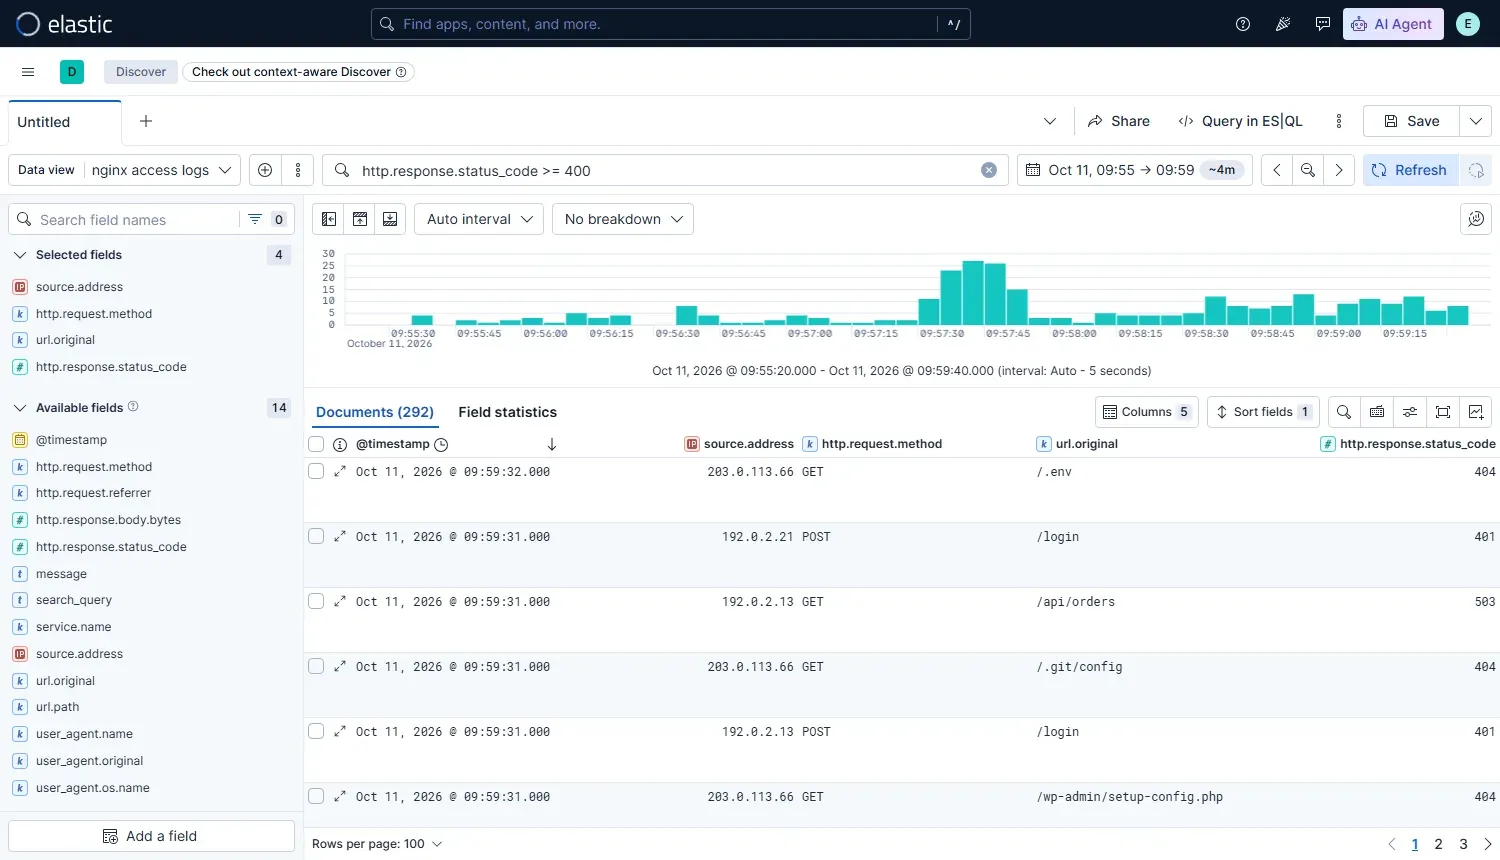
وفي Kibana أنشأنا Data View باسم logs-nginx.access-*، وهذه شاشة Discover بالاستعلام http.response.status_code >= 400، ويظهر فيها الارتفاع في منتصف المدة وقت تعطل /api/orders، والماسح 203.0.113.66 وهو يطلب /.env و/.git/config:
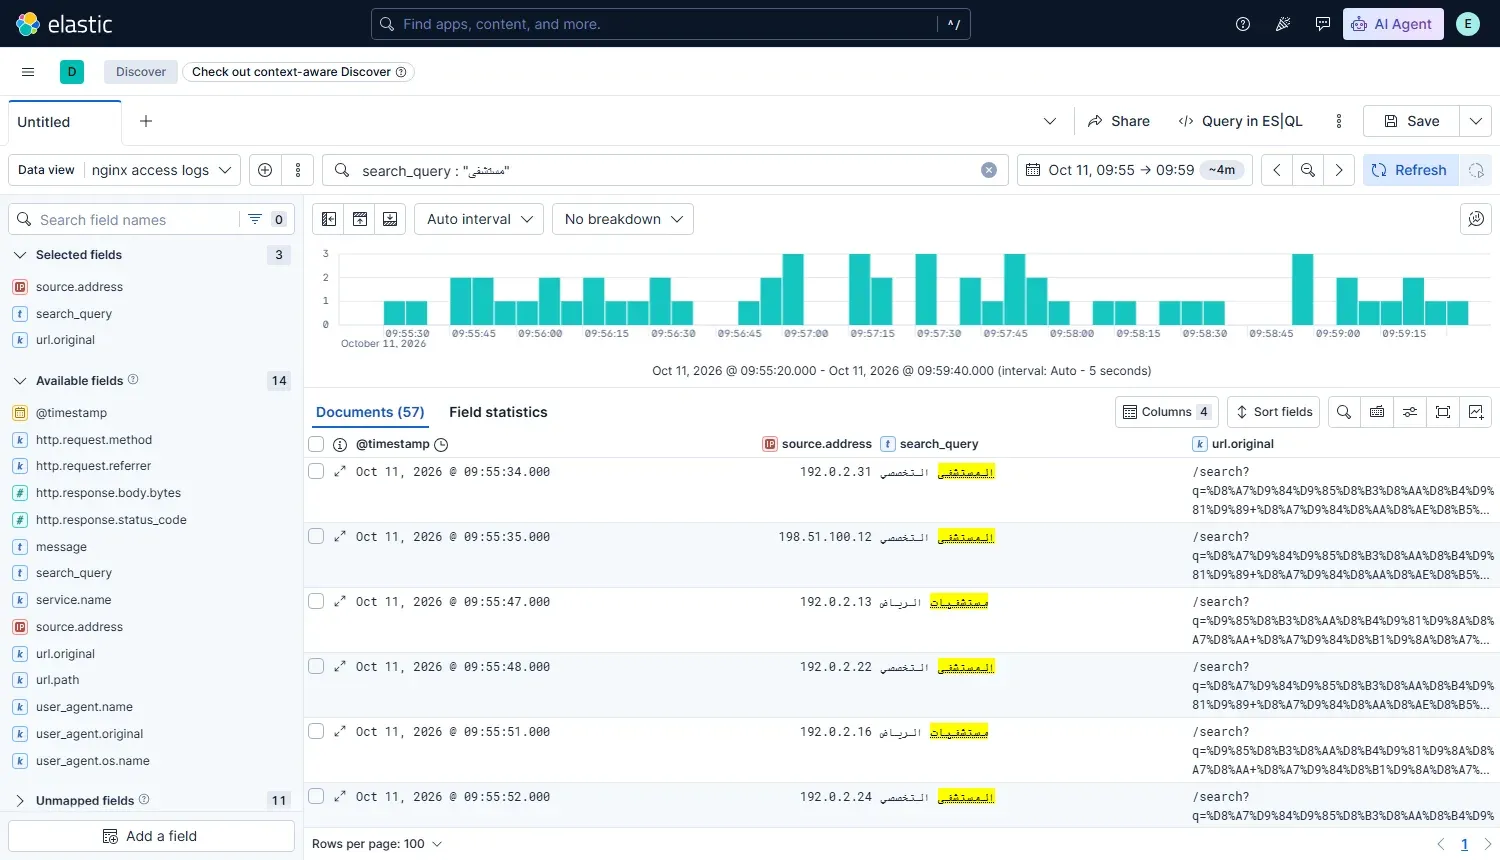
والاستعلام search_query : "مستشفى" في نفس الشاشة يرجع 57 مستنداً، أي أن Kibana تستخدم نفس المحلل العربي:
هل الصلاحيات تعمل فعلاً؟
الحساب الذي يملكه Logstash يجب ألا يقرأ ولا يحذف، والطلب بدون حساب يجب أن يرفض، وهذا ما نتحقق منه:
curl -s -u logstash_writer:$LOGSTASH_WRITER_PASSWORD "http://127.0.0.1:19200/logs-nginx.access-lab/_search?size=0"
curl -s -X DELETE -u logstash_writer:$LOGSTASH_WRITER_PASSWORD "http://127.0.0.1:19200/_data_stream/logs-nginx.access-lab"
curl -s "http://127.0.0.1:19200/_cat/indices"
action [indices:data/read/search] is unauthorized for user [logstash_writer] with effective roles [logstash_writer] on indices [logs-nginx.access-lab], this action is granted by the index privileges [read,all]
action [indices:admin/data_stream/delete] is unauthorized for user [logstash_writer] with effective roles [logstash_writer] on indices [logs-nginx.access-lab], this action is granted by the index privileges [delete_index,manage,all]
missing authentication credentials for REST request [/_cat/indices]وبهذا الشكل إذا تسرب ملف إعداد Logstash فأسوأ ما يحدث أن يكتب أحدهم سجلات مزورة، ولا يستطيع قراءة سجلاتك أو حذفها.
ILM وال Rollover
الأمر _ilm/explain يبين أين يقف كل Index في سياسته، ويمكن أن تطلب Rollover يدوياً لترى ما سوف يحدث كل يوم:
curl -s -u elastic:$ELASTIC_PASSWORD "http://127.0.0.1:19200/.ds-logs-nginx.access-lab-2026.10.11-000001/_ilm/explain?pretty"
curl -s -X POST -u elastic:$ELASTIC_PASSWORD "http://127.0.0.1:19200/logs-nginx.access-lab/_rollover?pretty"
curl -s -u elastic:$ELASTIC_PASSWORD "http://127.0.0.1:19200/_cat/indices/.ds-logs-nginx*?v&h=index,health,docs.count,store.size,pri,rep&s=index"
"policy" : "nginx-logs", "age" : "4.8m", "phase" : "hot", "action" : "rollover", "step" : "check-rollover-ready"
"old_index" : ".ds-logs-nginx.access-lab-2026.10.11-000001",
"new_index" : ".ds-logs-nginx.access-lab-2026.10.11-000002",
"rolled_over" : true,
index health docs.count store.size pri rep
.ds-logs-nginx.access-lab-2026.10.11-000001 green 1183 682.6kb 1 0
.ds-logs-nginx.access-lab-2026.10.11-000002 green 0 227b 1 0لاحظ أن 1183 سطراً أخذت 682 كيلوبايت، أي قرابة 580 بايت للسطر شاملة الفهرس، وهذا رقم من تجربة صغيرة ولا يقاس عليه، ولكن الطريقة صحيحة: شغل يوماً من سجلاتك الحقيقية، واقسم الحجم على عدد الأسطر، ثم اضربه في عدد الأسطر اليومية وأيام الاحتفاظ.
نكسر الإعداد لنفهمه
الحالة الصفراء: Replica بلا مكان
لنفرض أن أحد الفريق أنشأ Index بالإعدادات المعتادة في الإنتاج، أي اثنين من ال Shards ونسخة لكل منهما، على سيرفرنا الوحيد:
curl -s -X PUT -u elastic:$ELASTIC_PASSWORD -H 'Content-Type: application/json' \
  "http://127.0.0.1:19200/orders-test?timeout=60s" \
  -d '{"settings":{"number_of_shards":2,"number_of_replicas":1}}'
curl -s -u elastic:$ELASTIC_PASSWORD "http://127.0.0.1:19200/_cluster/health?filter_path=status,unassigned_shards"
curl -s -u elastic:$ELASTIC_PASSWORD "http://127.0.0.1:19200/_cat/shards/orders-test?v&h=index,shard,prirep,state,node"
{"status":"yellow","unassigned_shards":2}
index shard prirep state node
orders-test 0 p STARTED lab-elk-es
orders-test 0 r UNASSIGNED
orders-test 1 p STARTED lab-elk-es
orders-test 1 r UNASSIGNED الحالة صفراء، ولا تخمن السبب، وإنما اسأل Elasticsearch نفسه بالأمر _cluster/allocation/explain:
curl -s -u elastic:$ELASTIC_PASSWORD -H 'Content-Type: application/json' \
  "http://127.0.0.1:19200/_cluster/allocation/explain?pretty" \
  -d '{"index":"orders-test","shard":0,"primary":false}'
"current_state" : "unassigned",
"unassigned_info" : { "reason" : "INDEX_CREATED" },
"node_allocation_decisions" : [ { "deciders" : [ {
"decider" : "same_shard",
"decision" : "NO",
"explanation" : "a copy of this shard is already allocated to this node [[orders-test][0], node[rfYH8EPmQ7yJdiPlPTSJEA], [P], s[STARTED], a[id=YlgaZs48QByjM48HaeCtcQ], failed_attempts[0]]"
} ] } ]القاعدة same_shard رفضت لأن الأصل على نفس السيرفر، والحل على سيرفر واحد أن تجعل النسخ صفراً، ثم ترجع الحالة خضراء:
curl -s -X PUT -u elastic:$ELASTIC_PASSWORD -H 'Content-Type: application/json' \
  "http://127.0.0.1:19200/orders-test/_settings" -d '{"index":{"number_of_replicas":0}}'
{"acknowledged":true}
{"status":"green","unassigned_shards":0}وتذكر أن الحالة الخضراء على سيرفر واحد لا تعني أن بياناتك محمية، فلا توجد نسخة ثانية على الإطلاق، والحماية هنا من النسخ الاحتياطي Snapshots كما سيأتي.
سطر لا يفهمه grok
الآن نضيف إلى ملف السجل سطراً ليس بصيغة nginx، كما يحدث عندما يكتب برنامج آخر في نفس الملف أو تتغير صيغة السجل بعد تحديث:
docker exec lab-elk-nginx sh -c 'echo "upstream timed out (110: Connection timed out) while reading response header" >> /var/log/lab/access.log'لم يرفض Logstash السطر، وإنما وصل إلى Elasticsearch كما هو مع وسم _grokparsefailure:
"_source" : {
  "message" : "upstream timed out (110: Connection timed out) while reading response header",
  "service" : { "name" : "shop" },
  "@timestamp" : "2026-10-11T07:16:21.950Z",
  "tags" : [ "beats_input_codec_plain_applied", "_grokparsefailure" ]
}
والمفاجأة كانت في البحث عنه:
curl -s -u elastic:$ELASTIC_PASSWORD -H 'Content-Type: application/json' \
  "http://127.0.0.1:19200/logs-nginx.access-lab/_count" \
-d '{"query":{"term":{"tags":"_grokparsefailure"}}}'{"count":0,"_shards":{"total":2,"successful":2,"skipped":0,"failed":0}}الصفر هنا ليس لأن السطر غير موجود، وإنما لأننا كتبنا "dynamic": false ولم نعرف الحقل tags في القالب، فبقي داخل المستند ولكنه لم يفهرس، وأي بحث عليه يرجع صفراً دون أي خطأ. وهذا أخطر من رسالة خطأ، لأن لوحة «الأسطر التي فشل تحليلها» سوف تبقى فارغة وأنت تظن أن كل شيء سليم. لذلك أضفنا "tags": { "type": "keyword" } إلى القالب في setup.sh أعلاه، والقالب يطبق على ال Backing Index التالي بعد ال Rollover، أما الموجود فيحتاج إعادة فهرسة Reindex. وإحصاءات Logstash نفسها تؤكد أن كل الأسطر الأخرى حللت دون فشل:
docker exec lab-elk-logstash curl -s "localhost:9600/_node/stats/pipelines/main?pretty""events": { "in": 2350, "filtered": 2350, "out": 2350 }
grok events.out=2350 failures=0
urldecode events.out=711التشغيل اليومي: الذاكرة والنسخ الاحتياطي والمراقبة
- الذاكرة Memory: في التجربة استهلك Elasticsearch قرابة 1.7 جيجابايت من حد 2 جيجابايت، وKibana قرابة 1 جيجابايت، وLogstash قرابة 730 ميجابايت، وFilebeat 50 ميجابايت فقط، بحسب
docker stats، لذلك لا تبدأ ELK على سيرفر فيه أقل من 8 جيجابايت إذا كانت معها خدمات أخرى، واجعل ال Heap نصف ذاكرة ال Container أو أقل، والباقي يستخدمه نظام التشغيل لذاكرة الملفات المؤقتة. - النسخ الاحتياطي Snapshots: لا تنسخ مجلد البيانات وهو يعمل، وإنما سجل مستودع Snapshot Repository، مثل مجلد مشترك أو تخزين متوافق مع S3، ثم جدول اللقطات بسياسة SLM من Kibana، واختبر الاستعادة كما في قاعدة 3-2-1. وفي السجلات اسأل نفسك أولاً: هل تحتاج استعادتها فعلاً؟ فكثير من الفرق تكتفي بالمدة الموجودة في ILM.
- المراقبة Monitoring: راقب على الأقل حالة ال Cluster من
_cluster/health، ونسبة امتلاء القرص، لأن Elasticsearch لا يضع Shards جديدة على سيرفر امتلأ قرصه 85%، ويجعل ال Indices للقراءة فقط عند 95%، بحسب إعدادات Disk Watermark الافتراضية، وراقب أيضاً أعداد_grokparsefailureبعد أن تفهرس الحقل. - الأمان Security: لا تفتح المنفذ 9200 للإنترنت أبداً، واجعل Kibana خلف Reverse Proxy بـ HTTPS، وحساباً لكل شخص بدور مناسب، وإذا كان عندك دخول موحد فاربط Kibana به أو ضعه خلف Forward Auth، ولا تنس أن السجلات فيها عناوين IP ومعرفات مستخدمين، فمن يقرؤها يحتاج صلاحية مبررة.
أخطاء شائعة
- تعطيل الحماية «مؤقتاً»: الأدلة التي تضع
xpack.security.enabled=falseتختصر خمس دقائق، ثم يبقى الإعداد في الإنتاج، والإعداد الصحيح موجود في التجربة أعلاه ولا يأخذ أكثر من ملف واحد. - استخدام المستخدم
elasticفي Logstash وKibana: هو مستخدم المدير الكامل، وكل خدمة تحتاج مستخدماً بأقل صلاحية ممكنة. - الاعتماد على Dynamic Mapping: أول قيمة تحدد النوع للأبد، وعدد الحقول يكبر بلا حد، لذلك عرف قالباً بنفسك، وإذا استخدمت
"dynamic": falseفتذكر أن الحقل غير المعرف لا يبحث فيه. - Replicas على سيرفر واحد: تجعل الحالة صفراء دائماً، فيتعود الفريق على اللون الأصفر ولا يلاحظ عندما يصبح أحمر.
- Shards كثيرة صغيرة: Index يومي لكل خدمة بخمس Shards ينتج آلاف ال Shards خلال أشهر، واجعل الحجم هو الذي يقرر ال Rollover.
- حذف السجلات القديمة باستعلام
_delete_by_query: بطيء ومكلف، واحذف Index كاملاً بسياسة ILM. - تجاهل الرخصة: تشغيله داخلياً لا يتأثر بـ ELv2، ولكن إذا كنت تبني خدمة تبيعها للعملاء وفيها Elasticsearch مدار فاقرأ الرخصة أولاً، أو اختر OpenSearch.
تدريب عملي
- أضف إلى خط Logstash المرشح
geoipعلى الحقلsource.address، ثم لاحظ لماذا لا يجد موقعاً لعناوين نطاقات التوثيق. - احذف Logstash من المسار واجعل Filebeat يرسل مباشرة إلى Elasticsearch مع Ingest Pipeline فيها معالج
grok، ثم قارن ذاكرة الطريقتين فيdocker stats.
حذف المختبر
احذف ما أنشأناه بالاسم فقط، ومعه ال Volumes الخاصة بالتجربة:
docker compose -p lab-elk down -v
rm .env
# optional: remove the images if you do not need them any more
docker rmi docker.elastic.co/elasticsearch/elasticsearch:9.5.5 docker.elastic.co/kibana/kibana:9.5.5 \
  docker.elastic.co/logstash/logstash:9.5.5 docker.elastic.co/beats/filebeat:9.5.5
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Elasticsearch يخزن ويفهرس، وLogstash يحول الأسطر إلى حقول، وKibana يعرض، وFilebeat أو Elastic Agent يجمع من كل سيرفر.
- عرف ال Mapping بنفسك في قالب، واستخدم المحلل
arabicللنص العربي مع حقلkeywordللتجميع، وتذكر أن الحقل غير المعرف مع"dynamic": falseلا يبحث فيه. - السجلات تكتب إلى Data Stream، وILM ينشئ Index جديداً ويحذف القديم كاملاً، ومنذ 9.0 تأخذ
logs-*-*وضعlogsdbالذي يوفر المساحة. - الحماية تبقى مفعلة حتى في التجربة، ولكل خدمة مستخدم بأقل صلاحية، والمنفذ 9200 لا يفتح للإنترنت.
- الكود المصدري اليوم بثلاث رخص منها AGPLv3، والتوزيعة الجاهزة بـ ELv2، وهذا لا يمنعك من تشغيله لنفسك، فإذا احتجت Apache 2.0 فاقرأ دليل OpenSearch.
 دليلOpenSearch: البديل المفتوح لـ Elasticsearch وقصة الترخيصلماذا ولد OpenSearch من Elasticsearch، وكيف تشغله على سيرفرك بصلاحيات دقيقة وتنبيهات حقيقية على سجلاتك.
 دليلالسجلات Logging للمطورين: ماذا تسجل وماذا لا تسجلكيف تكتب سجلات Logs تساعدك على فهم ما حدث في الإنتاج، وما الذي لا يدخل السجل أبداً، وكيف تجمعها في مكان واحد.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلكيف يعمل محرك كشف SIEM من الداخل؟كيف يجمع SIEM ملايين السجلات ويوحدها ويطبق قواعد الكشف، مع خط أنابيب Vector وLoki وقاعدة Sigma تطلق فعلاً.
سجل التحديثات
- أكتوبر 2026: كتابة الدليل، وتجربة كاملة على Elasticsearch وKibana وLogstash وFilebeat بالإصدار 9.5.5 مع nginx 1.31.6 وسجلات حقيقية من مولد طلبات، والتحقق من تاريخ الرخصة من إعلانات Elastic وAWS وملفات الرخص في المستودعات.


