


لنفرض أنك في فريق صغير لشركة ناشئة تبيع خدمة اشتراكات عبر الإنترنت، ولديكم أربعة سيرفرات: سيرفر للتطبيق، وسيرفر لقاعدة البيانات، وسيرفر للملفات التي يرفعها العملاء، وسيرفر قديم عليه بعض المهام المجدولة. وفي صباح أحد الأيام وصلت ثلاث رسائل من العملاء تقول إن رفع المرفقات يفشل منذ الليل، فدخل أحد الزملاء إلى سيرفر الملفات وكتب df -h فوجد القرص ممتلئاً بنسبة 100%. والمحزن في القصة أن الامتلاء لم يحدث فجأة، فالقرص كان يمتلئ بمعدل ثابت تقريباً منذ أسابيع، وكان يمكن لأي رسم بياني بسيط أن يقول قبل أيام «سوف يمتلئ القرص يوم الخميس فجراً». ولكن لم يكن هناك رسم بياني، وإنما Grafana قديم ثبته زميل سابق ولا أحد يعرف كلمة مروره، وفحص Uptime Kuma يقول إن الموقع يعمل، وهو صادق، فالصفحة الرئيسية تفتح والرفع وحده هو الذي يفشل.
وهذا المقال هو بداية سلسلة نبني فيها مع هذا الفريق نظام مراقبة متكاملاً، من المقاييس Metrics إلى التنبيهات، ثم بوابة واحدة تجمع كل شيء. وقد شرحنا المفاهيم العامة، مثل الفرق بين المقاييس والسجلات والتتبع، وطريقتي RED وUSE، في مقال مفاهيم المراقبة Observability، فلن نكررها هنا، وإنما نبدأ من الأداة نفسها: Prometheus لجمع المقاييس وتخزينها، وGrafana لعرضها. والمواضيع في السلسلة:
- مقاييس السيرفرات مع Prometheus ولوحات Grafana (الموضوع الحالي).
- ماذا تقيس في خدمتك؟ الإشارات الذهبية Golden Signals.
- فحص التوفر Uptime Checks مع Blackbox Exporter أو Uptime Kuma.
- التنبيهات Alerting: ماذا تنبه عليه، وكيف تتجنب تعب التنبيهات Alert Fatigue.
- بوابة مراقبة واحدة Monitoring Portal تجمع Grafana مع Wazuh.
وسوف نناقش في هذا المقال ما يلي:
- لماذا ظهر Prometheus، ولماذا يسحب Pull الأرقام من السيرفرات بدل أن تدفعها إليه.
- نموذج البيانات: السلسلة الزمنية Time Series والتسميات Labels وأنواع المقاييس الأربعة.
- مختبر حقيقي فيه «سيرفران» وContainers، مع node_exporter وcAdvisor، ومشكلة واجهتنا في التشغيل.
- أساسيات لغة PromQL على المعالج والذاكرة والقرص والعقد Inodes، بمخرجات حقيقية نشرحها سطراً سطراً.
- إعادة تشغيل الـ Containers وقتلها بسبب نفاد الذاكرة OOM، ولماذا أعطتنا دالة
changesرقماً خاطئاً. - قواعد التسجيل Recording Rules، والتنبؤ بموعد امتلاء القرص بالدالة
predict_linear. - Grafana: مصدر البيانات ولوحة كاملة نحفظها ككود في Git.
- مدة الاحتفاظ Retention وحساب مساحة التخزين، ثم الأمان والأخطاء الشائعة وقائمة تحقق.
لماذا ظهر Prometheus؟ ولماذا السحب Pull؟
بدأ Prometheus في شركة SoundCloud عام 2012 كما يذكر توثيقه الرسمي، وكانت الشركة قد انتقلت إلى عدد كبير من الخدمات الصغيرة التي تعمل وتتوقف وتنتقل بين الأجهزة، والأدوات التقليدية في ذلك الوقت كانت مصممة لسيرفرات ثابتة تعرف أسماءها مسبقاً، وتحفظ لكل سيرفر رقماً واحداً لكل مقياس. ثم أصبح المشروع مستقلاً عن أي شركة، وانضم إلى مؤسسة Cloud Native Computing Foundation عام 2016 كثاني مشروع فيها بعد Kubernetes، وهذا يفسر لماذا تجده اليوم في كل مكان تقريباً: أغلب البرامج التي تشغلها، من قواعد البيانات إلى الـ Reverse Proxy، إما تعرض مقاييسها بصيغته مباشرة، أو لها برنامج صغير يترجمها إليها.
والفكرة الأساسية التي تميزه هي نموذج السحب Pull Model: كل برنامج تريد مراقبته يعرض صفحة HTTP بسيطة، عادة على المسار /metrics، فيها أرقامه الحالية كنص عادي، وPrometheus يزور هذه الصفحة كل فترة ثابتة، مثل كل 15 ثانية، ويحفظ ما يجده. وهذه العملية اسمها السحب Scrape، والبرنامج الذي يعرض الأرقام اسمه الهدف Target، وإذا كان البرنامج لا يعرض أرقامه بنفسه، مثل نظام التشغيل، فهناك برنامج وسيط اسمه المصدر Exporter يقرأ الأرقام ويعرضها بالصيغة المطلوبة. والصورة التالية تبين المسار كاملاً كما سوف نبنيه في المختبر:
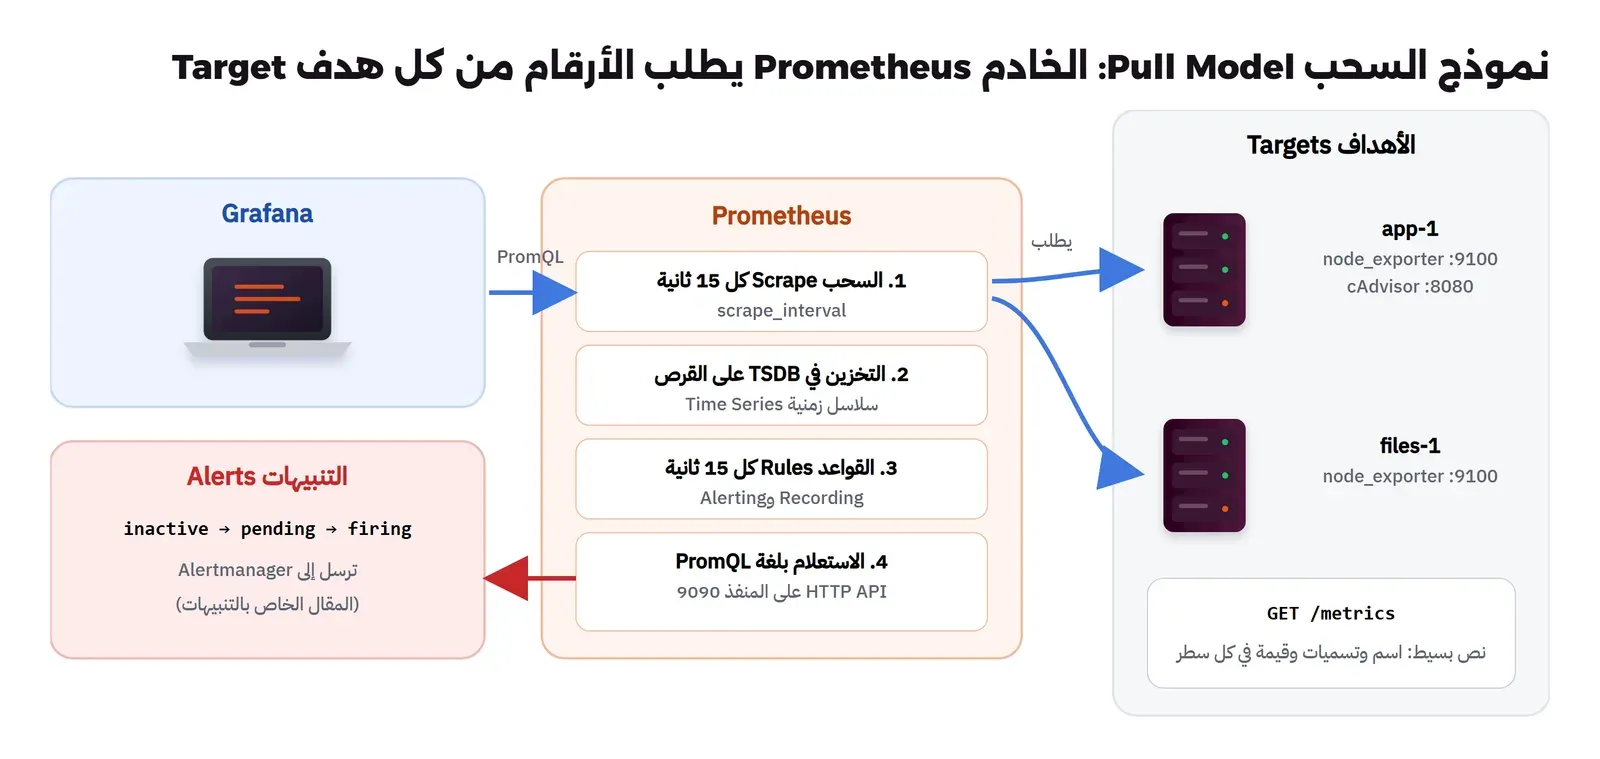
وقد يتساءل البعض: لماذا لا ترسل السيرفرات أرقامها بنفسها، كما تفعل أدوات كثيرة؟ والإجابة في الأسئلة الشائعة للمشروع، حيث يذكر ثلاث فوائد للسحب: تستطيع تشغيل نسخة إضافية من Prometheus على جهازك وقت التطوير فتسحب الأرقام نفسها دون أن تغير شيئاً في السيرفرات، وتعرف بسهولة وبشكل موثوق أن الهدف متوقف لأن السحب نفسه يفشل، وتستطيع فتح صفحة /metrics في المتصفح لترى بعينك ما يعرضه الهدف. والنقطة الثانية هي الأهم في حالتنا: في نموذج الدفع Push إذا توقف السيرفر عن الإرسال فلا تعرف هل توقف السيرفر أم الشبكة أم البرنامج المرسل، أما في السحب فكل محاولة سحب تنتج مقياساً اسمه up، قيمته 1 إذا نجح السحب و0 إذا فشل، فيصبح «السيرفر لا يرد» رقماً يمكن التنبيه عليه مثل أي رقم آخر.
ويعترف التوثيق نفسه بأن الفرق بين السحب والدفع ليس كبيراً، ويوفر للحالات التي تحتاج الدفع فعلاً، مثل مهمة قصيرة تعمل دقيقة ثم تنتهي قبل أن يزورها أحد، أداة اسمها Pushgateway، ولكن الحالة الطبيعية لسيرفرات وخدمات تعمل باستمرار هي السحب. ولاحظ أيضاً أن Prometheus يقول في الصفحة نفسها إنه ليس مكاناً للسجلات Logs، وينصح بأداة مثل Grafana Loki أو OpenSearch لها، فهو يحفظ أرقاماً عبر الزمن فقط، ولا يحفظ سطوراً نصية.
نموذج البيانات Data Model: السلسلة الزمنية Time Series والتسميات Labels
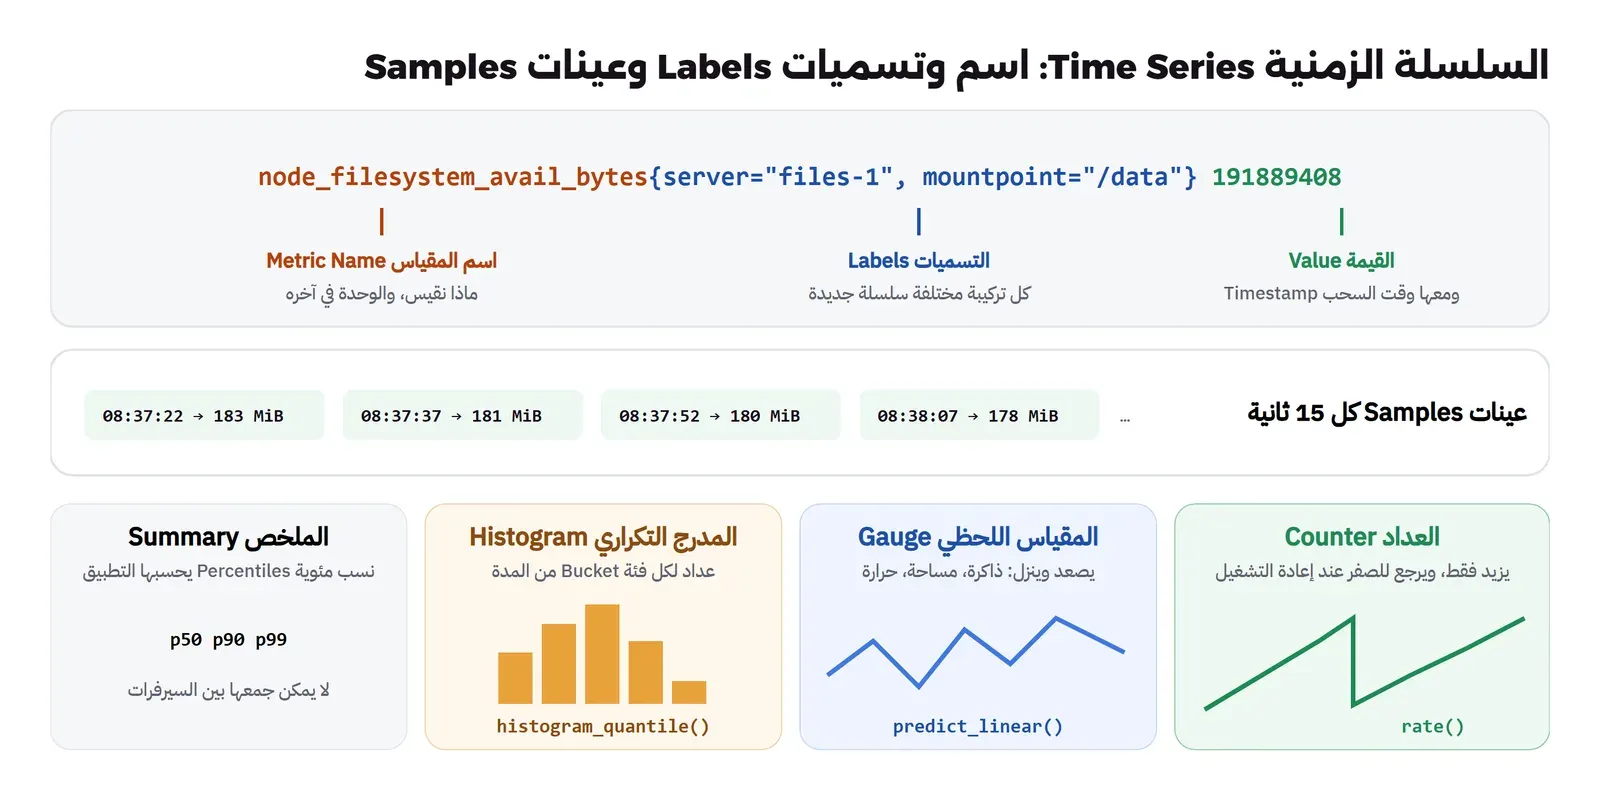
كل ما يحفظه Prometheus هو سلاسل زمنية Time Series، أي سلسلة من القيم الرقمية، ولكل قيمة وقتها، وتعرف كل سلسلة باسم المقياس Metric Name ومجموعة من التسميات Labels على شكل مفتاح وقيمة، كما يشرح توثيق نموذج البيانات. والقيمة الواحدة مع وقتها اسمها العينة Sample. والصورة التالية تبين سلسلة حقيقية من المختبر، وهي المساحة المتاحة على القرص /data في السيرفر files-1، مع أربع عينات متتالية كما سحبها Prometheus كل 15 ثانية تقريباً:
والتسميات هي مصدر قوة Prometheus، وهي أيضاً مصدر أكثر مشاكله. فهي قوية لأنك تستطيع أن تسأل عن أي تركيبة منها دون أن تحددها مسبقاً: المساحة في كل السيرفرات، أو في سيرفرات الإنتاج فقط، أو في القرص /data في كل مكان، وكل ذلك بالسلسلة نفسها. ولكن كل تركيبة مختلفة من التسميات هي سلسلة جديدة تحتاج ذاكرة وقرصاً، ولذلك يحذر دليل التسمية صراحة من وضع قيم كثيرة الاحتمالات في التسميات، مثل معرف المستخدم أو البريد الإلكتروني، لأن كل قيمة جديدة تضيف سلسلة جديدة، وهذا ما يسمى مشكلة كثرة القيم Cardinality. فإذا كان لديك عشرة آلاف مستخدم ووضعت معرفهم في تسمية على مقياس فيه عشرون سلسلة، فقد صنعت مئتي ألف سلسلة من مقياس واحد. والقاعدة العملية: التسمية لشيء عدد قيمه صغير ومعروف، مثل اسم السيرفر والبيئة ونوع الطلب ورمز الحالة، والتفاصيل التي لا حدود لها مكانها السجلات.
وأنواع المقاييس كما يشرحها توثيق أنواع المقاييس أربعة، وفهمها مهم لأن كل نوع له دوال تناسبه ودوال تعطي معه نتائج خاطئة:
- العداد Counter: رقم يزيد فقط، مثل عدد الطلبات أو عدد الثواني التي عمل فيها المعالج منذ الإقلاع، ويرجع إلى الصفر إذا أعيد تشغيل البرنامج. والرقم نفسه لا يعني شيئاً، فمعرفة أن السيرفر استقبل 8 ملايين طلب منذ تشغيله لا تفيد، والمهم هو سرعة زيادته، ولذلك تستخدم معه دائماً الدالة
rateأوincrease. ويتبع اسمه عادة اللاحقة_total. - المقياس اللحظي Gauge: رقم يصعد وينزل، مثل الذاكرة المتاحة والمساحة الحرة وعدد الاتصالات المفتوحة الآن، وتقرؤه كما هو، ولا تستخدم معه
rate. - المدرج التكراري Histogram: مجموعة عدادات، لكل فئة Bucket من القيم عداد، مثل عدد الطلبات التي انتهت في أقل من 100 ميلي ثانية، وفي أقل من 250، وهكذا، ومنها تحسب النسب المئوية Percentiles بالدالة
histogram_quantile، وسوف نستخدمه بالتفصيل في المقال القادم عن الإشارات الذهبية. - الملخص Summary: يحسب التطبيق نفسه النسب المئوية ويعرضها جاهزة، وهو أدق للسيرفر الواحد، ولكن لا يمكن جمع النسب المئوية لعدة سيرفرات رياضياً، فمتوسط p99 لسيرفرين ليس p99 للاثنين، ولذلك يفضل Histogram في أغلب الحالات.
المختبر Lab: سيرفران مع Containers على جهاز واحد
نبني الآن نسخة صغيرة من بيئة الفريق: Prometheus 3.15.1 وGrafana 13.3.0، ومصدرين node_exporter 1.12.1 يمثل كل منهما سيرفراً، وcAdvisor 0.60.6 لمقاييس الـ Containers، وكل ذلك على شبكة Docker واحدة اسمها mon-net، ولا يفتح على الجهاز إلا منفذا Prometheus وGrafana على العنوان 127.0.0.1. والسيرفر الأول app-1 هو الجهاز الذي يعمل عليه Docker نفسه، والثاني files-1 هو node_exporter داخل Container له قرص /data صغير حجمه 256 MiB، وسوف نملؤه ببطء لنرى كيف يتنبأ Prometheus بموعد امتلائه. ولأن الاثنين يعملان على الجهاز نفسه فسوف تجد أرقام المعالج والذاكرة متطابقة بينهما، والفرق الحقيقي بينهما هو القرص /data.
مصدر مقاييس السيرفر node_exporter
الأداة node_exporter هي المصدر الرسمي لمقاييس أنظمة Linux، وتقرأ الأرقام من الملفات التي تعرضها النواة في /proc و/sys، وفيها عشرات المجمعات Collectors، كل مجمع لجزء من النظام: المعالج والذاكرة وأنظمة الملفات والشبكة والأقراص وغيرها. والأفضل أن تثبتها مباشرة على السيرفر كخدمة systemd، لأن توثيقها يقول إنها مصممة لمراقبة السيرفر نفسه، وإن تشغيلها داخل Container يحتاج عناية خاصة حتى لا تراقب الـ Container بدل السيرفر. فإذا شغلتها في Docker، كما سوف نفعل، فعليك أن تربط نظام ملفات السيرفر كاملاً داخلها وتخبرها بمكانه بالخيار --path.rootfs، وأن تشاركها مساحة العمليات بالخيار --pid host.
والأمر الذي ينشره التوثيق كما يلي:
docker network create mon-net
docker run -d --name mon-node --network mon-net --pid host \
  -v /:/host:ro,rslave prom/node-exporter:v1.12.1 --path.rootfs=/host
وعند تشغيله على Docker Desktop سوف تجد أنه يفشل بهذه الرسالة:
docker: Error response from daemon: path / is mounted on / but it is not a shared or slave mountوهذه مشكلة واجهتنا فعلاً، وسببها الخيار rslave في نهاية الربط، وهو يطلب أن تنتقل إلى داخل الـ Container أي أقراص يركبها السيرفر بعد تشغيله، وهذا يحتاج أن يكون الجذر / في السيرفر مركباً بنوع مشاركة Shared أو Slave، وهو كذلك في أغلب توزيعات Linux التي تستخدم systemd، ولكنه ليس كذلك في الجهاز الافتراضي الذي يشغله Docker Desktop. والحل في المختبر أن نحذف rslave، ونقبل أن القرص الذي يركب بعد تشغيل node_exporter لن يظهر حتى نعيد تشغيله:
docker run -d --name mon-node --network mon-net --pid host \
  -v /:/host:ro prom/node-exporter:v1.12.1 --path.rootfs=/host
أما على سيرفر Linux حقيقي فاترك rslave كما هو، أو الأفضل أن تثبت node_exporter كخدمة مباشرة وتتجنب المسألة كلها. والسيرفر الثاني files-1 يأخذ قرصاً من نوع tmpfs في الذاكرة حجمه 256 MiB على المسار /data:
docker run -d --name mon-files --network mon-net --tmpfs /data:size=256m prom/node-exporter:v1.12.1 \
  --collector.filesystem.fs-types-exclude='^(autofs|binfmt_misc|bpf|cgroup2?|configfs|debugfs|devpts|devtmpfs|fusectl|hugetlbfs|iso9660|mqueue|nsfs|overlay|proc|procfs|pstore|rpc_pipefs|securityfs|selinuxfs|squashfs|sysfs|tracefs)$'
والخيار الطويل هنا له سبب: node_exporter يتجاهل بشكل افتراضي أنظمة الملفات المؤقتة مثل tmpfs، لأنها في السيرفر الحقيقي غالباً مساحات صغيرة في الذاكرة لا تهمك، فكتبنا القائمة الافتراضية نفسها بعد حذف tmpfs منها حتى يظهر القرص /data. وهذا درس عام أيضاً: إذا لم تجد قرصاً في المقاييس فابحث أولاً في الخيارين fs-types-exclude وmount-points-exclude، فقد يكون مستبعداً بالإعداد الافتراضي.
مقاييس الـ Containers مع cAdvisor
node_exporter يرى السيرفر كاملاً، ولكنه لا يعرف أي Container يستهلك الذاكرة، ولا كم مرة أعيد تشغيل Container معين. وهذه مهمة cAdvisor من Google، وهو يقرأ مجموعات التحكم cgroups لكل Container ويعرض استهلاكه من المعالج والذاكرة والشبكة، ووقت تشغيله، وعدد مرات قتله بسبب نفاد الذاكرة:
docker run -d --name mon-cadvisor --network mon-net --privileged --device /dev/kmsg \
  -v /:/rootfs:ro -v /var/run:/var/run:ro -v /sys:/sys:ro -v /var/lib/docker/:/var/lib/docker:ro \
  ghcr.io/google/cadvisor:v0.60.6 --docker_only=true --housekeeping_interval=10s --store_container_labels=false \
  --disable_metrics=advtcp,cpu_topology,disk,diskIO,hugetlb,memory_numa,percpu,referenced_memory,resctrl,sched,tcp,udp,process,cpuset
في الأمر أعلاه لاحظ التالي:
--device /dev/kmsgيسمح لـ cAdvisor بقراءة رسائل النواة، ومنها يعرف أن النواة قتلت عملية بسبب نفاد الذاكرة OOM Kill، فبدونه لن يزيد العدادcontainer_oom_events_totalأبداً.--store_container_labels=falseيمنع cAdvisor من تحويل كل تسمية Docker على كل Container إلى تسمية Prometheus، لأن بعض أدوات النشر تضع تسميات كثيرة متغيرة، وهذا باب سهل لمشكلة كثرة السلاسل التي ذكرناها.--disable_metricsيوقف مجموعات مقاييس لا نحتاجها، فالإعداد الافتراضي يعرض أرقاماً لكل نواة معالج ولكل قرص ولكل اتصال، وهي كثيرة على سيرفر صغير.--privilegedوربط/var/lib/dockerيحتاجهما cAdvisor ليقرأ معلومات الـ Containers، ولذلك لا تفتح منفذه للشبكة أبداً، فهو يرى كل ما يعمل على السيرفر.
إعداد Prometheus
الملف prometheus.yml يحدد ماذا يسحب Prometheus وكل كم ثانية:
# Prometheus for the lab: two "servers" (node_exporter), container metrics (cAdvisor) and Prometheus itself.
global:
  scrape_interval: 15s        # how often every target is pulled
  evaluation_interval: 15s    # how often rules are evaluated

rule_files:
  - /etc/prometheus/rules.yml

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]

  - job_name: node
    static_configs:
      - targets: ["mon-node:9100"]
        labels: { server: app-1, env: lab }
      - targets: ["mon-files:9100"]
        labels: { server: files-1, env: lab }

  - job_name: cadvisor
    scrape_interval: 30s
    static_configs:
      - targets: ["mon-cadvisor:8080"]
        labels: { server: app-1, env: lab }
    metric_relabel_configs:
      # keep only the lab's containers: this Docker host runs many other projects
      - source_labels: [name]
        regex: "mon-.*|"
        action: keep
في الإعداد أعلاه لاحظ التالي:
scrape_interval: 15sهو الوقت بين كل سحبين، وهو توازن بين الدقة والتكلفة: 15 ثانية تكفي لأغلب السيرفرات، وتقليلها إلى ثانية يضاعف حجم البيانات خمس عشرة مرة دون فائدة حقيقية في أغلب الحالات.- كل هدف يأخذ التسميتين
jobوinstanceتلقائياً، وأضفناserverوenvبأنفسنا، لأن اسم السيرفر الذي يفهمه الفريق أوضح في اللوحات منmon-files:9100، وهذه أول عادة جيدة: سم الأشياء بالأسماء التي يستخدمها الفريق في حديثه. metric_relabel_configsتعمل بعد السحب وقبل التخزين، وهنا تحتفظ فقط بسلاسل الـ Containers التي يبدأ اسمها بـmon-، لأن جهاز المختبر يشغل مشاريع أخرى كثيرة لا تهمنا. والقيمة الفارغة بعد الخط العمودي تحتفظ بالسلاسل التي لا تحمل تسميةnameأصلاً، مثل مقاييس cAdvisor عن نفسه.scrape_interval: 30sلـ cAdvisor أطول من البقية لأن مقاييسه كثيرة، وسوف نرى بعد قليل كيف أثر هذا الاختيار على عد إعادات التشغيل.
ثم نشغل Prometheus مع مدة احتفاظ قصيرة تناسب المختبر، وGrafana مع ملفات الإعداد التي سوف نشرحها لاحقاً:
docker volume create mon-prom-data
docker run -d --name mon-prom --network mon-net -p 127.0.0.1:19090:9090 \
  -v "$PWD/prometheus.yml:/etc/prometheus/prometheus.yml:ro" -v "$PWD/rules.yml:/etc/prometheus/rules.yml:ro" \
  -v mon-prom-data:/prometheus prom/prometheus:v3.15.1 \
  --config.file=/etc/prometheus/prometheus.yml --storage.tsdb.path=/prometheus \
  --storage.tsdb.retention.time=2d --storage.tsdb.retention.size=1GB --web.enable-lifecycle
docker run -d --name mon-grafana --network mon-net -p 127.0.0.1:13000:3000 \
  -e GF_SECURITY_ADMIN_PASSWORD=lab-only-9f3k -e GF_AUTH_ANONYMOUS_ENABLED=true -e GF_AUTH_ANONYMOUS_ORG_ROLE=Viewer \
  -v "$PWD/grafana/provisioning:/etc/grafana/provisioning:ro" -v "$PWD/grafana/dashboards:/var/lib/grafana/dashboards:ro" \
  grafana/grafana:13.3.0
وبعد ثوان نسأل Prometheus عن حالة الأهداف من الواجهة البرمجية API:
curl -s 127.0.0.1:19090/api/v1/targets | python3 -c "import sys,json;[print(t['labels']['job'],t['labels']['instance'],t['health'],t['lastError']) for t in json.load(sys.stdin)['data']['activeTargets']]"والمخرج سوف يكون كما يلي:
cadvisor mon-cadvisor:8080 up
node mon-node:9100 up
node mon-files:9100 up
prometheus localhost:9090 up
أربعة أهداف كلها up، والحقل الأخير فارغ لأنه لا يوجد خطأ في آخر سحب. وهذه الصفحة نفسها موجودة في الواجهة على المسار /targets، وهي أول مكان تذهب إليه عندما لا تظهر أرقام سيرفر في اللوحات، فإذا وجدت الهدف down فالسبب في الشبكة أو الجدار الناري Firewall أو في المصدر نفسه، وإذا لم تجده أصلاً فالسبب في ملف الإعداد.
أساسيات لغة PromQL
PromQL هي لغة الاستعلام في Prometheus، وكل لوحة في Grafana وكل تنبيه وكل قاعدة هي استعلام PromQL، ولذلك لا يمكنك أن تتجاوزها. والفكرة الأساسية التي يشرحها توثيق أساسيات الاستعلام أن هناك نوعين من النتائج: المتجه اللحظي Instant Vector وهو آخر قيمة لكل سلسلة في لحظة محددة، والمتجه المدى Range Vector وهو كل القيم في نافذة زمنية، مثل آخر خمس دقائق، ويكتب بأقواس مربعة بعد الاستعلام. والاستعلام الأبسط هو اسم المقياس وحده:
upup{instance="mon-files:9100",job="node",server="files-1"} 1
up{instance="mon-node:9100",job="node",server="app-1"} 1
up{instance="localhost:9090",job="prometheus"} 1
up{instance="mon-cadvisor:8080",job="cadvisor",server="app-1"} 1وهذا متجه لحظي فيه أربع سلاسل، واحدة لكل هدف. ولكي ترى ما يحفظه Prometheus فعلاً اطلب متجهاً مدى لدقيقة واحدة على مساحة القرص:
node_filesystem_avail_bytes{mountpoint="/data"}[1m]08:37:22 191889408
08:37:37 189792256
08:37:52 188743680
08:38:07 186646528أربع عينات بينها 15 ثانية بالضبط، وهي التي رأيتها في الصورة الثانية. ولاحظ الأقواس المعقوفة: {mountpoint="/data"} مرشح على التسميات، ويقبل المساواة = وعدمها != والتعبيرات النمطية Regular Expressions بالعلامتين =~ و!~.
المعالج CPU: من عداد الثواني إلى نسبة الانشغال
node_exporter لا يعرض نسبة استخدام المعالج، وإنما يعرض عداداً لكل نواة ولكل حالة، وهو عدد الثواني التي قضتها النواة في تلك الحالة منذ الإقلاع: user لكود التطبيقات، وsystem لكود النواة، وiowait لانتظار القرص، وidle للراحة، وغيرها. ولأنه عداد فنطبق عليه الدالة rate، وهي كما يشرح توثيق الدوال تحسب متوسط الزيادة في الثانية خلال النافذة، وتعالج تلقائياً رجوع العداد إلى الصفر عند إعادة التشغيل. ونطبقها على النواة الأولى في السيرفر app-1:
rate(node_cpu_seconds_total{server="app-1",cpu="0"}[5m]){cpu="0",mode="idle"} 0.442
{cpu="0",mode="iowait"} 0.025
{cpu="0",mode="irq"} 0
{cpu="0",mode="nice"} 0
{cpu="0",mode="softirq"} 0.078
{cpu="0",mode="steal"} 0
{cpu="0",mode="system"} 0.116
{cpu="0",mode="user"} 0.198وطريقة قراءة هذا المخرج أن كل رقم هو جزء من الثانية: في كل ثانية خلال آخر خمس دقائق قضت النواة 0.442 ثانية في الراحة، و0.198 في كود التطبيقات، و0.116 في كود النواة، وهكذا، ومجموعها ثانية واحدة تقريباً. لذلك فنسبة الانشغال هي واحد ناقص نسبة الراحة، ثم نأخذ المتوسط على كل الأنوية في كل سيرفر:
1 - avg by (server) (rate(node_cpu_seconds_total{mode="idle"}[5m])){server="files-1"} 0.8597
{server="app-1"} 0.8622والمعالج مشغول بنسبة 86% في الجهازين، والسبب أن جهاز المختبر كان يشغل في الوقت نفسه مهام تدريب لمشاريع أخرى، وهذا أيضاً درس مفيد: الرقم صحيح، ولكنه لا يقول من الذي يستهلك المعالج، وهذا سؤال تجيب عنه مقاييس الـ Containers أو أدوات مثل top كما شرحنا في تحليل أداء سيرفر Linux في 60 ثانية. ولاحظ أيضاً الحالة steal، وهي الوقت الذي أرادت فيه النواة أن تعمل ولكن مزود الاستضافة أعطى المعالج الحقيقي لجهاز افتراضي آخر، وهي صفر هنا، ولكنها في VPS رخيص قد تكون السبب الحقيقي لبطء لا تجد له تفسيراً.
والعبارة avg by (server) هي دالة تجميع Aggregation، وهي تجمع السلاسل التي لها القيمة نفسها في التسمية server وتحذف بقية التسميات، ومثلها sum وmax وmin وcount. وعكسها without، أي اجمع بكل التسميات ما عدا المذكورة. فإذا أردت عدد الأنوية في كل سيرفر:
count by (server) (node_cpu_seconds_total{mode="idle"}){server="files-1"} 8
{server="app-1"} 8الذاكرة Memory: المتاحة وليس الحرة
أكثر خطأ تراه في لوحات الذاكرة هو استخدام الذاكرة الحرة MemFree، وهذا يعطي صورة مخيفة دائماً، لأن Linux يستخدم الذاكرة غير المشغولة كذاكرة مؤقتة Cache للملفات، ويتخلى عنها فوراً إذا احتاجها برنامج. والرقم الصحيح هو الذاكرة المتاحة MemAvailable، وهو تقدير النواة لما يمكن أن يأخذه برنامج جديد دون أن يبدأ النظام في استخدام مساحة التبديل Swap. والفرق في المختبر كبير:
node_memory_MemTotal_bytes{server="app-1"}      33592188928
node_memory_MemFree_bytes{server="app-1"}       17844142080
node_memory_MemAvailable_bytes{server="app-1"}  29552893952
فالذاكرة الكلية 31.3 GiB، والحرة 16.6 GiB، أي أن من ينظر إلى الحرة يظن أن 47% مستخدمة، بينما المتاحة 27.5 GiB، أي أن ما يستخدمه البرنامج فعلاً 12% فقط، والباقي ذاكرة مؤقتة تتنازل عنها النواة عند الحاجة. لذلك استخدم دائماً هذه النسبة:
node_memory_MemAvailable_bytes / node_memory_MemTotal_bytesولاحظ هنا أن القسمة بين مقياسين تعمل لأن السلاسل في الطرفين لها التسميات نفسها، فيطابق Prometheus كل سلسلة مع نظيرتها، وهذا اسمه مطابقة المتجهات Vector Matching، وإذا اختلفت التسميات بين الطرفين فالنتيجة فارغة دون أي رسالة خطأ، وهذه من أكثر الأمور التي تحير المبتدئ في PromQL.
القرص Disk والعقد Inodes
للقرص مقياسان مهمان: المساحة المتاحة node_filesystem_avail_bytes، وهي المساحة التي يستطيع برنامج عادي أن يكتب فيها، وليست free_bytes التي تشمل الكتل المحجوزة للمستخدم root، وعدد العقد Inodes المتاحة node_filesystem_files_free. والعقدة Inode هي السجل الذي يحفظ فيه نظام الملفات معلومات كل ملف، وعددها في أغلب أنظمة الملفات ثابت يحدد عند التهيئة، فإذا انتهت لا تستطيع إنشاء ملف جديد حتى لو كانت المساحة متوفرة، وهذه حالة حقيقية تحدث مع التطبيقات التي تكتب ملايين الملفات الصغيرة، مثل ملفات الجلسات Sessions أو الذاكرة المؤقتة. وقد شرحنا الأقراص وأنظمة الملفات بالتفصيل في دليل الأقراص في Linux.
وفي المختبر جربنا الحالة: شغلنا node_exporter ثالثاً مع قرص tmpfs حجمه 64 MiB وحددنا عدد العقد فيه بألفين فقط، ثم أنشأنا ملفات فارغة حتى توقف النظام:
docker run -d --name mon-inodes --network mon-net --tmpfs /cache:size=64m,nr_inodes=2000 \
  prom/node-exporter:v1.12.1 --collector.filesystem.fs-types-exclude='^(proc|sysfs|overlay)$'
docker exec mon-inodes sh -c 'i=0; while touch /cache/s$i 2>/tmp/err; do i=$((i+1)); done; echo "files created: $i"; cat /tmp/err; df -h /cache; df -i /cache'
docker run --rm --network mon-net curlimages/curl:8.11.1 -s mon-inodes:9100/metrics | grep -E '^node_filesystem_(avail_bytes|files_free|files)\{.*/cache'
والمخرج سوف يكون كما يلي:
files created: 1999
touch: /cache/s1999: No space left on device
Filesystem                Size      Used Available Use% Mounted on
tmpfs                    64.0M         0     64.0M   0% /cache
Filesystem              Inodes      Used Available Use% Mounted on
tmpfs                     2000      2000         0 100% /cache
node_filesystem_avail_bytes{device="tmpfs",device_error="",fstype="tmpfs",mountpoint="/cache"} 6.7108864e+07
node_filesystem_files{device="tmpfs",device_error="",fstype="tmpfs",mountpoint="/cache"} 2000
node_filesystem_files_free{device="tmpfs",device_error="",fstype="tmpfs",mountpoint="/cache"} 0
وهذا المخرج يستحق أن تقرأه بتمهل: الأمر touch فشل برسالة No space left on device، وهي الرسالة نفسها التي تراها عندما يمتلئ القرص، بينما df -h يقول إن القرص مستخدم بنسبة 0% وفيه 64 MiB متاحة كاملة، لأن الملفات فارغة لا تأخذ أي مساحة. والذي امتلأ هو العقد، كما يبين df -i: ألفان من ألفين، والملف رقم 1999 فشل لأن المجلد الرئيسي للقرص نفسه يأخذ عقدة. فإذا كان المسؤول يعرف df -h فقط فسوف يبقى يبحث عن مساحة لا تنقص، وإذا كانت لوحتك فيها المساحة فقط فسوف تبقى خضراء والتطبيق متوقف. والمقياس node_filesystem_files_free يقول الحقيقة بوضوح: صفر، لذلك ضع بجانب كل لوح للمساحة لوحاً للعقد، ونبه على الاثنين.
الـ Containers: إعادة التشغيل Restarts والقتل بسبب نفاد الذاكرة OOM
بعد السيرفر تأتي المشكلة التي تحدث يومياً في أي فريق يستخدم Docker: Container يستهلك الذاكرة حتى يتجاوز حده، فتقتله النواة، ثم يعيد Docker تشغيله، ثم يتكرر ذلك. والموقع يعمل في أغلب الوقت، وفحص التوفر يقول إن كل شيء بخير، ولكن بعض الطلبات تفشل كل دقيقة. ولكي نرى ذلك شغلنا Container اسمه mon-oom بحد ذاكرة 64 MiB، يحجز 8 MiB كل نصف ثانية:
# Grows a list by 8 MB every half second until the container's memory limit kills it.
import time
blocks = []
while True:
    blocks.append(bytearray(8 * 1024 * 1024))
    print(f"holding {len(blocks) * 8} MB", flush=True)
    time.sleep(0.5)
docker run -d --name mon-oom --network mon-net --memory 64m --memory-swap 64m --restart on-failure:20 \
-v "$PWD/oom.py:/oom.py:ro" python:3.13-slim python /oom.pyوالخيار --memory-swap 64m يساوي حد الذاكرة، أي لا يوجد Swap إضافي، فيقتل الـ Container بمجرد أن يصل إلى الحد، و--restart on-failure:20 يعيد تشغيله عشرين مرة ثم يتركه متوقفاً. وبعد سبع دقائق كانت أرقام Docker نفسه كما يلي:
docker inspect mon-oom --format 'docker_restarts={{.RestartCount}} status={{.State.Status}} oom={{.State.OOMKilled}}'docker_restarts=20 status=exitedوسألنا Prometheus بطريقتين:
changes(container_start_time_seconds{name="mon-oom"}[15m])
increase(container_oom_events_total{name="mon-oom"}[15m])
container_oom_events_total{name="mon-oom"}
{name="mon-oom"} 8
{name="mon-oom"} 20.250000000000004
container_oom_events_total{name="mon-oom"} 20وهنا مشكلة حقيقية واجهتنا: الطريقة المنتشرة في كثير من الأمثلة لعد إعادات التشغيل هي changes(container_start_time_seconds[15m])، أي كم مرة تغير وقت بدء الـ Container خلال ربع ساعة، وقد أعطتنا 8 بينما العدد الحقيقي 20. والسبب أن container_start_time_seconds مقياس لحظي Gauge يحمل آخر وقت تشغيل فقط، وPrometheus يسحب cAdvisor كل 30 ثانية، وفي البداية كان Docker يعيد تشغيل الـ Container كل بضع ثوان، فإذا حدثت ثلاث إعادات بين سحبين فلن يرى Prometheus إلا الأخيرة. والصورة التالية تبين ذلك:
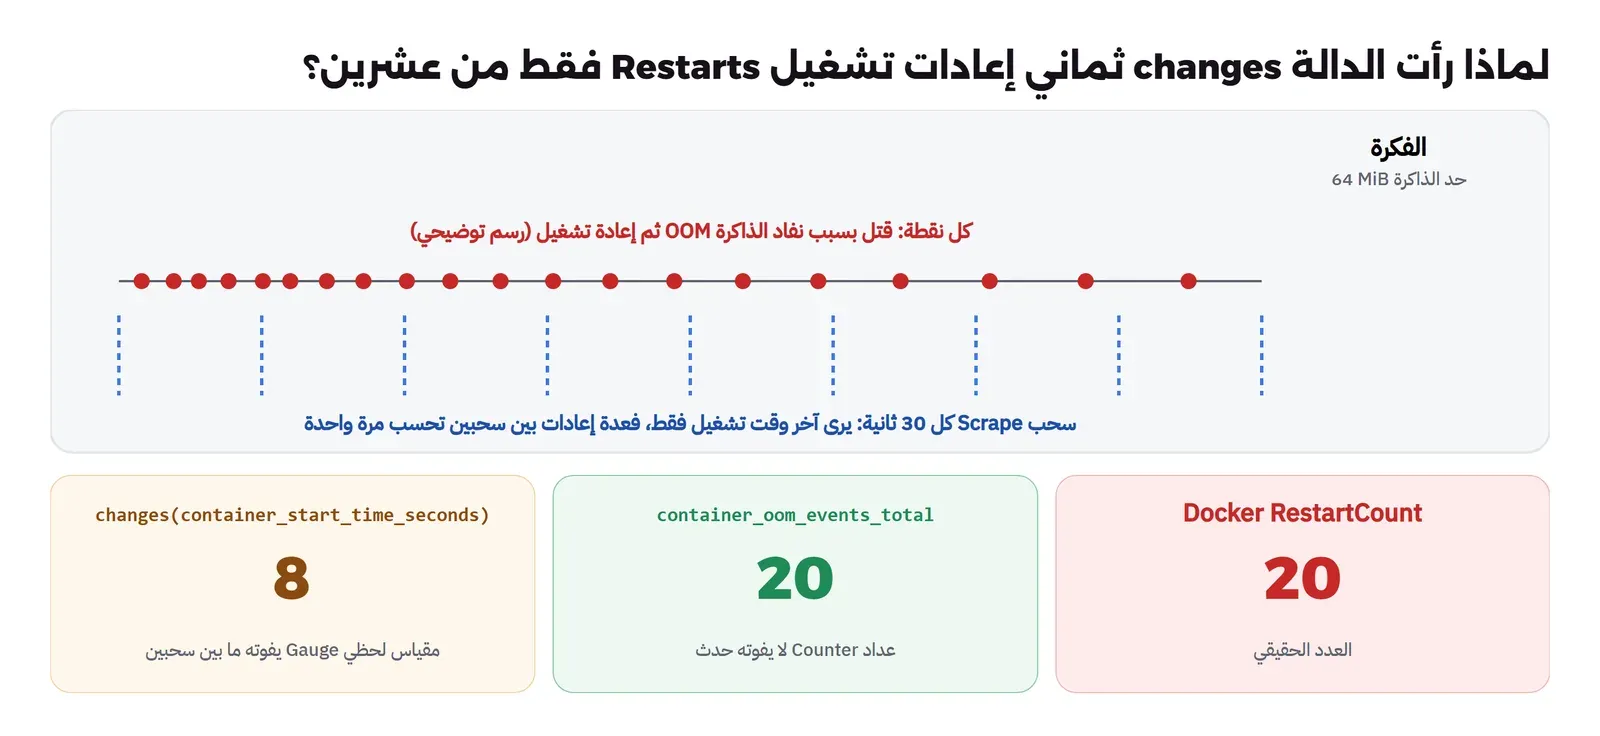
أما container_oom_events_total فهو عداد Counter، وcAdvisor يزيده مع كل حدث يقرؤه من رسائل النواة، فلا يهم كم حدثاً وقع بين سحبين، لأن الرقم التالي سوف يحملها كلها، ولذلك أعطى 20 بالضبط. والقاعدة التي تخرج بها من هذه التجربة: إذا أردت أن تعد أحداثاً فابحث عن عداد، ولا تحاول أن تستنتجها من تغير مقياس لحظي، لأن السحب الدوري يرى صوراً متفرقة وليس فيلماً كاملاً.
ولاحظ أيضاً أن increase أعطت 20.25 وليس 20، وهذا ليس خطأ، وإنما لأن الدالة كما يذكر توثيقها تمد الحساب إلى طرفي النافذة Extrapolation، فإذا كانت العينات لا تغطي النافذة كلها بالضبط تقدر ما حدث في الجزء الباقي. لذلك لا تكتب تنبيهاً من نوع increase(...) == 1، وإنما > 0، ولا تعرض نتيجتها في تقرير على أنها عدد دقيق.
وهناك ملاحظة أخيرة لا تظهر إلا بالتجربة: بعد أن توقف الـ Container نهائياً اختفت كل سلاسله من cAdvisor، لأنه لا يعرض إلا الـ Containers الموجودة، فإذا كان التنبيه يعتمد على increase خلال 15 دقيقة فسوف يختفي بعد أن يتوقف الـ Container، مع أن المشكلة أصبحت أسوأ، فالخدمة متوقفة تماماً. ولذلك تحتاج تنبيهاً آخر على غياب الخدمة نفسها، وهذا ما يفعله فحص التوفر الذي نشرحه في مقال قادم من السلسلة.
قواعد التسجيل Recording Rules
الاستعلام الذي يحسب نسبة انشغال المعالج يمر على كل سلاسل node_cpu_seconds_total، وهي في سيرفر بثماني أنوية 64 سلسلة، فإذا كان لديك خمسون سيرفراً ولوحة يفتحها عشرة أشخاص ويتحدث كل منهم كل 30 ثانية، فإن Prometheus يعيد الحساب نفسه مرات كثيرة. وقواعد التسجيل Recording Rules تحل ذلك: تحسب الاستعلام مرة واحدة في كل دورة تقييم، وتحفظ النتيجة كسلسلة جديدة باسم جديد، فتصبح اللوحات والتنبيهات تقرأ رقماً جاهزاً، كما يشرح توثيق القواعد. والملف rules.yml في المختبر:
groups:
  - name: node-recording
    interval: 30s
    rules:
      # CPU busy share per server, 0..1 (all modes except idle, averaged over cores)
      - record: server:cpu_busy:ratio_rate5m
        expr: 1 - avg by (server) (rate(node_cpu_seconds_total{mode="idle"}[5m]))
      - record: server:memory_available:ratio
        expr: node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes
      - record: server:fs_free:ratio
        expr: node_filesystem_avail_bytes{fstype!~"tmpfs|overlay",mountpoint!~"/boot.*"} / node_filesystem_size_bytes
          or node_filesystem_avail_bytes{mountpoint="/data"} / node_filesystem_size_bytes
      # seconds until the filesystem is full if the last 30 minutes continue (negative or absent = not filling)
      - record: server:fs_seconds_to_full:predict30m
        expr: |
          (node_filesystem_avail_bytes{mountpoint="/data"} > 0)
            / (-deriv(node_filesystem_avail_bytes{mountpoint="/data"}[30m]) > 0)

  - name: node-alerts
    rules:
      - alert: DiskWillFillIn4Hours
        expr: |
          predict_linear(node_filesystem_avail_bytes{mountpoint="/data"}[30m], 4 * 3600) < 0
          and node_filesystem_avail_bytes{mountpoint="/data"} / node_filesystem_size_bytes < 0.5
        for: 5m
        labels: { severity: warning }
        annotations:
          summary: "{{ $labels.server }}: {{ $labels.mountpoint }} will be full within 4 hours"
      - alert: ContainerRestarting
        expr: changes(container_start_time_seconds{name=~"mon-.+"}[15m]) > 2
        labels: { severity: warning }
        annotations:
          summary: "container {{ $labels.name }} restarted {{ $value }} times in 15 minutes"
      - alert: ContainerOOMKilled
        expr: increase(container_oom_events_total{name=~"mon-.+"}[15m]) > 0
        labels: { severity: warning }
        annotations:
          summary: "container {{ $labels.name }} was killed for running out of memory"
      - alert: TargetDown
        expr: up == 0
        for: 2m
        labels: { severity: critical }
        annotations:
          summary: "{{ $labels.job }} target {{ $labels.instance }} is not answering"
في الإعداد أعلاه لاحظ التالي:
- أسماء القواعد تتبع الصيغة
level:metric:operationsالتي يوصي بها دليل القواعد: المستوى الذي جمعت عليه النتيجة، وهو هناserver، ثم اسم المقياس، ثم العمليات التي طبقت عليه. فعندما ترىserver:cpu_busy:ratio_rate5mفي لوحة تعرف دون أن تفتح الملف أنها نسبة محسوبة منrateعلى خمس دقائق ومجمعة لكل سيرفر. - القاعدة الأخيرة تحسب كم ثانية بقيت حتى يمتلئ القرص: المساحة المتاحة مقسومة على سرعة نقصها. والدالة
derivتحسب ميل الخط Slope بالانحدار الخطي البسيط Linear Regression على آخر 30 دقيقة، والإشارة السالبة تجعل النقص رقماً موجباً، والشرط> 0يحذف الأقراص التي لا تمتلئ، فالقسمة على صفر أو على رقم سالب لا معنى لها هنا. - قواعد التنبيه Alerting Rules في الملف نفسه، وسوف نشرح بناءها بالتفصيل في مقال التنبيهات، ويكفي هنا أن تعرف أن
for: 5mتعني أن الشرط يجب أن يبقى صحيحاً خمس دقائق متتالية قبل أن يطلق التنبيه، وقبلها يكون التنبيه في حالة الانتظارpending. - القاعدة
ContainerRestartingفيها المشكلة التي رأيناها معchanges، وتركناها كما هي في المختبر لنقارن، وفي الإنتاج الأفضل أن تعتمد علىcontainer_oom_events_totalلأحداث الذاكرة، وعلى عداد إعادة التشغيل من Docker أو Kubernetes إذا كان متاحاً.
وبعد أن يعمل الملف تستطيع أن تسأل عن القاعدة باسمها كأي مقياس:
server:memory_available:ratioserver:memory_available:ratio{instance="mon-files:9100",job="node",server="files-1"} 0.8344
server:memory_available:ratio{instance="mon-node:9100",job="node",server="app-1"} 0.8392وقبل أن تحمل أي ملف قواعد في الإنتاج افحصه بالأداة promtool الموجودة في Image الرسمية، فخطأ واحد في الملف يجعل Prometheus يرفض تحميله:
docker run --rm -v "$PWD/rules.yml:/rules.yml:ro" --entrypoint promtool prom/prometheus:v3.15.1 check rules /rules.ymlChecking /rules.yml
SUCCESS: 8 rules foundمتى يمتلئ القرص؟ الدالة predict_linear
نعود إلى قصة الفريق: القرص امتلأ فجراً، ولو كان هناك تنبيه على «القرص فوق 90%» لما ساعد كثيراً، لأن القرص الذي يمتلئ بسرعة يصل من 90% إلى 100% في دقائق، والقرص الذي يمتلئ ببطء قد يبقى عند 91% أسابيع ويوقظ أحداً كل ليلة دون أي حاجة. والسؤال الصحيح ليس «كم امتلأ القرص؟» وإنما «متى سوف يمتلئ إذا استمر الوضع كما هو؟»، وهذا ما تجيب عنه الدالة predict_linear، وهي كما يشرح توثيقها ترسم خطاً مستقيماً بالانحدار الخطي البسيط على العينات في النافذة، ثم تمده إلى المستقبل وتعطيك القيمة المتوقعة بعد عدد الثواني الذي تحدده، ويذكر التوثيق أنها تستخدم مع المقاييس اللحظية Gauges فقط.
وفي المختبر بدأنا كتابة ملف حجمه 1 MiB كل عشر ثوان في القرص /data:
docker exec -d mon-files sh -c 'i=0; while true; do i=$((i+1)); dd if=/dev/zero of=/data/upload-$i.bin bs=1M count=1 2>/dev/null; sleep 10; done'أي أن القرص يمتلئ بسرعة ثابتة تقريباً، 6 MiB في الدقيقة، وهذا يشبه سيرفر الملفات في قصتنا ولكن بسرعة أكبر حتى نرى النتيجة في أقل من ساعة. ثم سألنا Prometheus كل خمس دقائق كم دقيقة بقيت حتى الامتلاء، من قاعدة التسجيل server:fs_seconds_to_full:predict30m مقسومة على 60:
08:30=41.0 08:35=33.8 08:40=28.7 08:45=23.6 08:50=18.5 08:55=13.4 09:00=8.4 09:05=3.3عند 08:30 قال التوقع إن القرص يمتلئ بعد 41 دقيقة، أي عند 09:11، وعند 08:50 قال 18.5 دقيقة، أي عند 09:08 ونصف، والقرص امتلأ فعلاً عند 09:08 كما تبين القيم الخام لمساحة القرص بوحدة MiB:
08:26=252.0 08:30=228.0 08:40=168.0 08:50=108.0 09:00=48.0 09:04=24.0 09:06=12.0 09:08=0.0 09:10=0.0والصورة التالية تبين المنحنى الحقيقي مع لحظتي التنبيه:
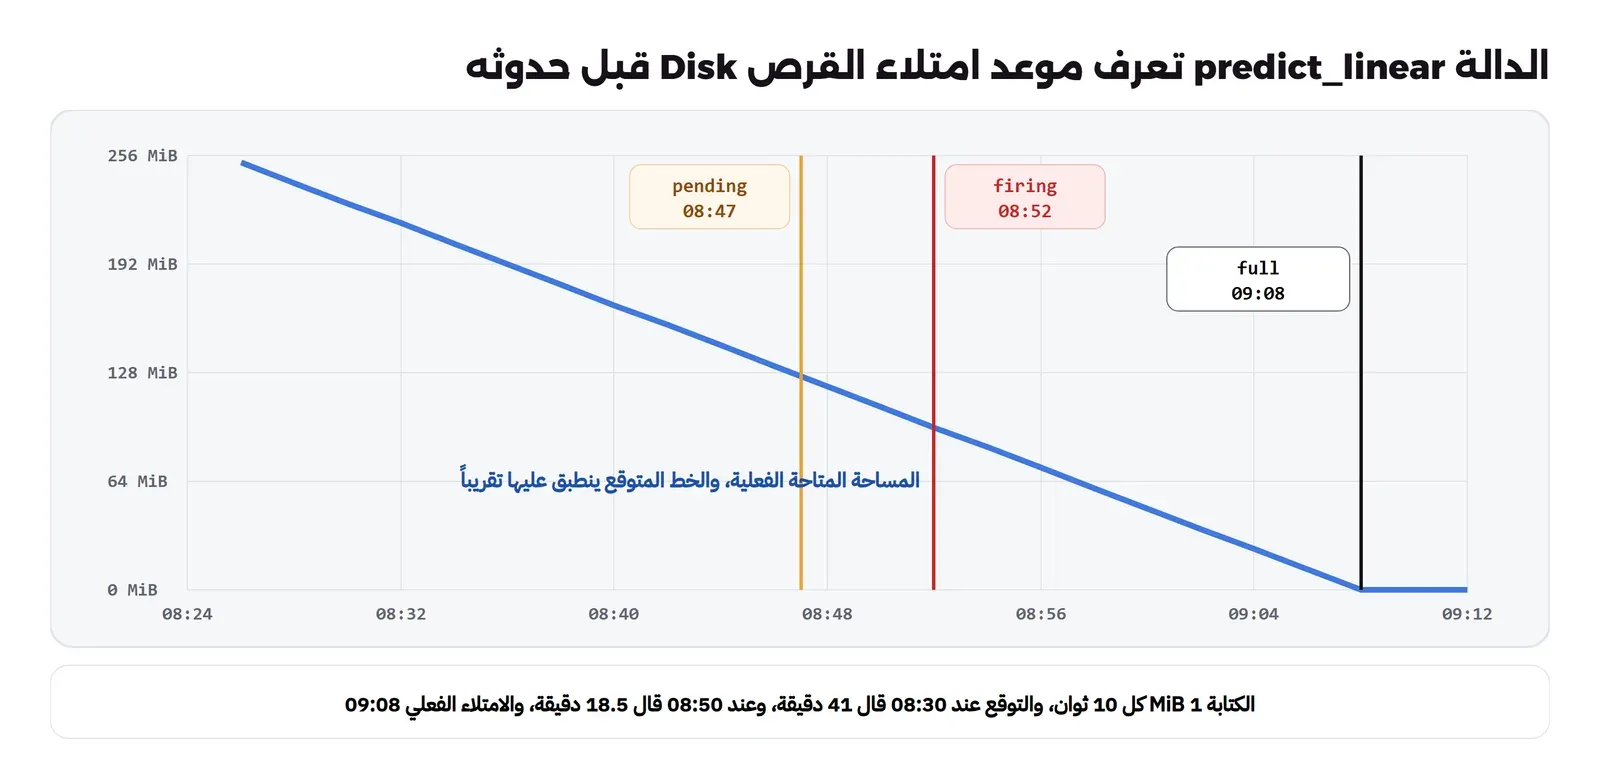
والتنبيه DiskWillFillIn4Hours دخل حالة الانتظار pending عند 08:47:02 وأطلق عند 08:52:02 بعد خمس دقائق بالضبط من for: 5m، أي قبل الامتلاء بست عشرة دقيقة. وقد يتساءل البعض: إذا كان التوقع سالباً منذ البداية، أي أن القرص سوف يمتلئ قبل مرور أربع ساعات، فلماذا لم يطلق التنبيه عند 08:30؟ والسبب هو الشرط الثاني في القاعدة: node_filesystem_avail_bytes / node_filesystem_size_bytes < 0.5، أي لا تنبه إلا إذا كانت المساحة المتاحة أقل من النصف، والمساحة وصلت إلى النصف تقريباً عند 08:46. وهذا الشرط مقصود، فالقرص الجديد الذي ينسخ إليه الفريق بيانات كثيرة في الساعة الأولى سوف يبدو وكأنه يمتلئ بسرعة، والتوقع يقول إنه سوف يمتلئ خلال ساعتين، بينما النسخ نفسه سوف ينتهي بعد عشر دقائق ويستقر القرص عند 30%، فإذا نبهت على التوقع وحده فسوف تطلق تنبيهات كثيرة لا تحتاج عملاً. والتوازن الذي يناسب أغلب الفرق: نافذة تقيس الاتجاه أطول من أي عملية مؤقتة، مثل ست ساعات، ومدة توقع تكفي لكي يتصرف أحد في وقت العمل، مثل 24 ساعة، وشرط على المساحة الحالية يمنع التنبيه على قرص شبه فارغ.
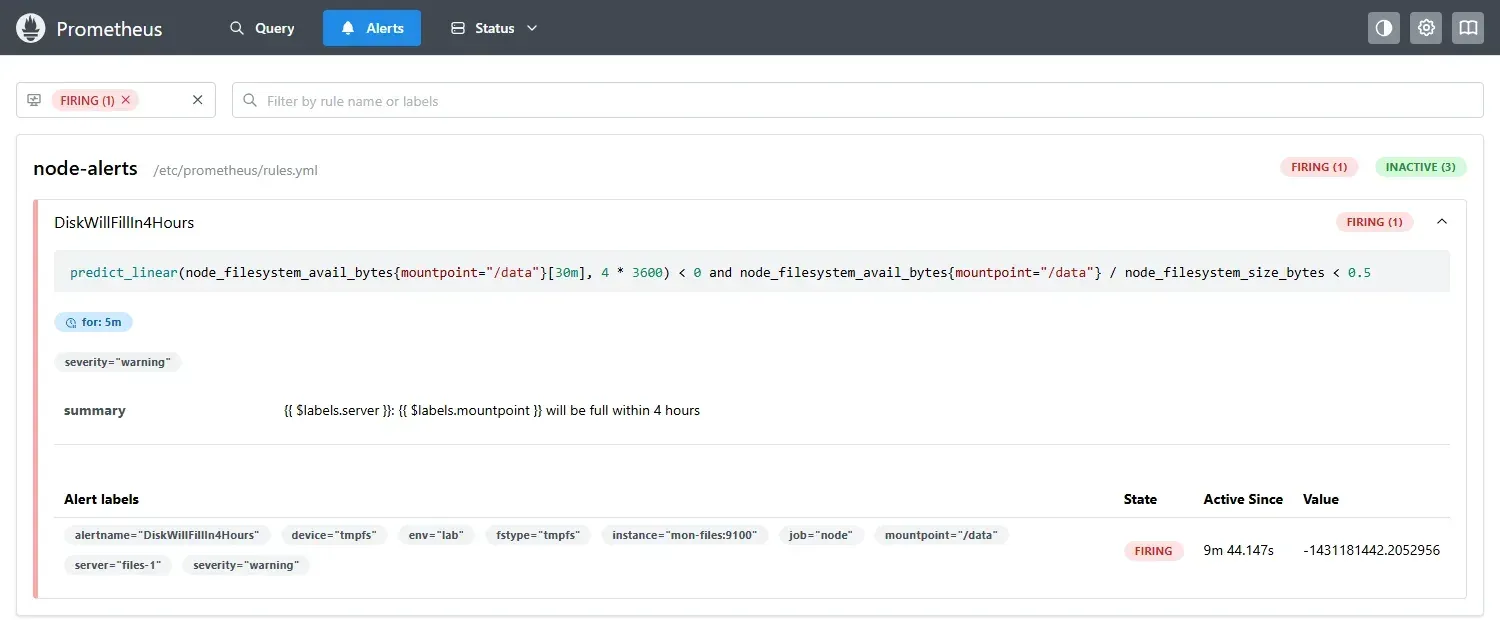
والصورة التالية من صفحة التنبيهات في Prometheus بعد أن أطلق التنبيه، ولاحظ أن العمود Value يحمل نتيجة predict_linear نفسها، أي القيمة المتوقعة بعد أربع ساعات، وهي سالبة لأن الخط المستقيم لا يعرف أن القرص لا ينزل تحت الصفر، لذلك اكتب في رسالة التنبيه الوقت المتبقي وليس هذا الرقم:
وهناك حدود يجب أن تعرفها عن هذه الدالة: هي ترسم خطاً مستقيماً، فإذا كان الامتلاء يتسارع، مثل سجلات تكبر مع زيادة العملاء، فسوف يتأخر التوقع، وإذا كان هناك تنظيف دوري كل ليلة يحذف الملفات القديمة فالخط يتأثر بالنافذة التي اخترتها، فنافذة ساعة واحدة قبل التنظيف تقول إن القرص يمتلئ، وبعده تقول إنه يفرغ. ولذلك اختر النافذة بعد أن ترى شكل منحنى القرص عندك أسبوعاً كاملاً، ولا تنسخ رقماً من مثال.
Grafana: مصدر البيانات Data Source ولوحة ككود Dashboard as Code
Prometheus فيه واجهة بسيطة للاستعلام، ولكنها للتجربة وليست لوحة يفتحها الفريق كل صباح. وGrafana هي الأداة التي تعرض الأرقام من Prometheus وغيره في لوحات Dashboards، وكل لوحة مجموعة من الألواح Panels، وكل لوح استعلام وطريقة عرض. والخطأ الذي وقع فيه فريقنا، أي Grafana ثبته شخص بالنقر في الواجهة ولا أحد يعرف كيف بناه، شائع جداً، والحل هو التهيئة المسبقة Provisioning: مصادر البيانات واللوحات ملفات في Git، وGrafana يقرؤها عند التشغيل، كما يشرح توثيق Provisioning. وبهذا الشكل إذا ضاع السيرفر أعدت بناءه بالملفات نفسها، وإذا عدل أحد لوحة رأيت التعديل في مراجعة الكود.
وأول ملف هو مصدر البيانات grafana/provisioning/datasources/prometheus.yml:
apiVersion: 1
datasources:
  - name: Prometheus
    uid: prom
    type: prometheus
    access: proxy
    url: http://mon-prom:9090
    isDefault: true
    jsonData:
      timeInterval: 15s   # same as scrape_interval, so $__rate_interval is never too short
في الإعداد أعلاه لاحظ التالي:
uid: promمعرف ثابت نختاره نحن، واللوحات تشير إليه، فلو تركناه لـ Grafana لاختار معرفاً عشوائياً مختلفاً في كل تثبيت، وتوقفت اللوحات المحفوظة في Git عن العمل في السيرفر الجديد.access: proxyيعني أن سيرفر Grafana هو الذي يتصل بـ Prometheus وليس متصفح المستخدم، ولذلك لا يحتاج Prometheus أن يكون مفتوحاً للمستخدمين، ويكفي أن يصل إليه Grafana داخل الشبكة.timeInterval: 15sيخبر Grafana بفترة السحب، فيحسب المتغير$__rate_intervalبحيث لا تكون نافذةrateأقصر من أربع فترات سحب، لأن النافذة التي فيها عينة واحدة لا تعطي أي نتيجة.
والملف الثاني grafana/provisioning/dashboards/files.yml يقول لـ Grafana أين يجد ملفات اللوحات:
apiVersion: 1
providers:
  - name: lab
    folder: Servers
    type: file
    allowUiUpdates: false
    options:
      path: /var/lib/grafana/dashboards
والخيار allowUiUpdates: false يمنع حفظ التعديلات من الواجهة على اللوحات التي جاءت من الملفات، وهذا مقصود: يذكر التوثيق أنك إذا سمحت بالتعديل من الواجهة ثم عدلت الملف لاحقاً فإن Grafana يكتب فوق تعديل الواجهة بمحتوى الملف، أي أن من عدل في الواجهة سوف يفقد عمله دون أن يعرف. فالأفضل أن تكون القاعدة واضحة للفريق: اللوحة المهمة تعدل في Git فقط، ومن يريد التجربة ينسخ اللوحة باسم جديد.
واللوحة نفسها ملف JSON، وكتابته باليد متعبة، لذلك كتبنا سكربت Python صغيراً يولده، والجزء المهم منه هو الاستعلامات:
panels = [
    stat(1, "Server up", 'max by (server) (up{job="node"})', "{{server}}", "none", 0, 0, w=6,
         thresholds=[{"color": RED, "value": None}, {"color": GREEN, "value": 1}],
         mappings=[{"type": "value", "options": {"0": {"text": "DOWN"}, "1": {"text": "UP"}}}]),
    stat(2, "CPU busy", "server:cpu_busy:ratio_rate5m", "{{server}}", "percentunit", 6, 0,
         thresholds=[{"color": GREEN, "value": None}, {"color": ORANGE, "value": 0.8}, {"color": RED, "value": 0.95}]),
    stat(3, "Free disk (/data)", 'server:fs_free:ratio{mountpoint="/data"}', "{{server}}", "percentunit", 12, 0,
         thresholds=[{"color": RED, "value": None}, {"color": ORANGE, "value": 0.15}, {"color": GREEN, "value": 0.3}]),
    stat(4, "Time to full (/data)", "server:fs_seconds_to_full:predict30m", "{{server}}", "s", 18, 0,
         thresholds=[{"color": RED, "value": None}, {"color": ORANGE, "value": 14400}, {"color": GREEN, "value": 86400}]),
    ts(5, "CPU busy per server", "server:cpu_busy:ratio_rate5m", "{{server}}", "percentunit", 0, 5, extra={"max": 1, "min": 0}),
    ts(6, "Memory available", "server:memory_available:ratio", "{{server}}", "percentunit", 12, 5, extra={"max": 1, "min": 0}),
    ts(7, "Free bytes on /data, and the 4h prediction", 'node_filesystem_avail_bytes{mountpoint="/data"}', "{{server}} now", "bytes", 0, 13),
    ts(8, "Inodes free", 'node_filesystem_files_free{mountpoint="/data"} / node_filesystem_files{mountpoint="/data"}', "{{server}}", "percentunit", 12, 13),
    ts(9, "Container restarts (15m)", 'changes(container_start_time_seconds{name=~"mon-.+"}[15m])', "{{name}}", "none", 0, 21),
    ts(10, "Container memory vs limit", 'container_memory_working_set_bytes{name=~"mon-.+"}', "{{name}}", "bytes", 12, 21),
]
والسكربت كاملاً في ملفات المختبر باسم make_dashboard.py، وهو يكتب الملف grafana/dashboards/servers.json. ولاحظ أن الصف الأول من اللوحة أرقام كبيرة Stat Panels تجيب عن أسئلة الصباح: هل السيرفرات تعمل؟ وهل المعالج مشغول؟ وكم بقي في القرص؟ ومتى يمتلئ؟ ثم تأتي تحتها الرسوم البيانية لمن يريد التفاصيل. وهذا الترتيب مقصود، فمن يفتح اللوحة يريد أن يعرف في ثانيتين هل هناك ما يستحق الانتباه، والألوان الثلاثة في الصف الأول هي حدود Thresholds بسيطة تجعل الإجابة لوناً قبل أن تكون رقماً. والصورة التالية هي اللوحة كما ظهرت في المختبر:
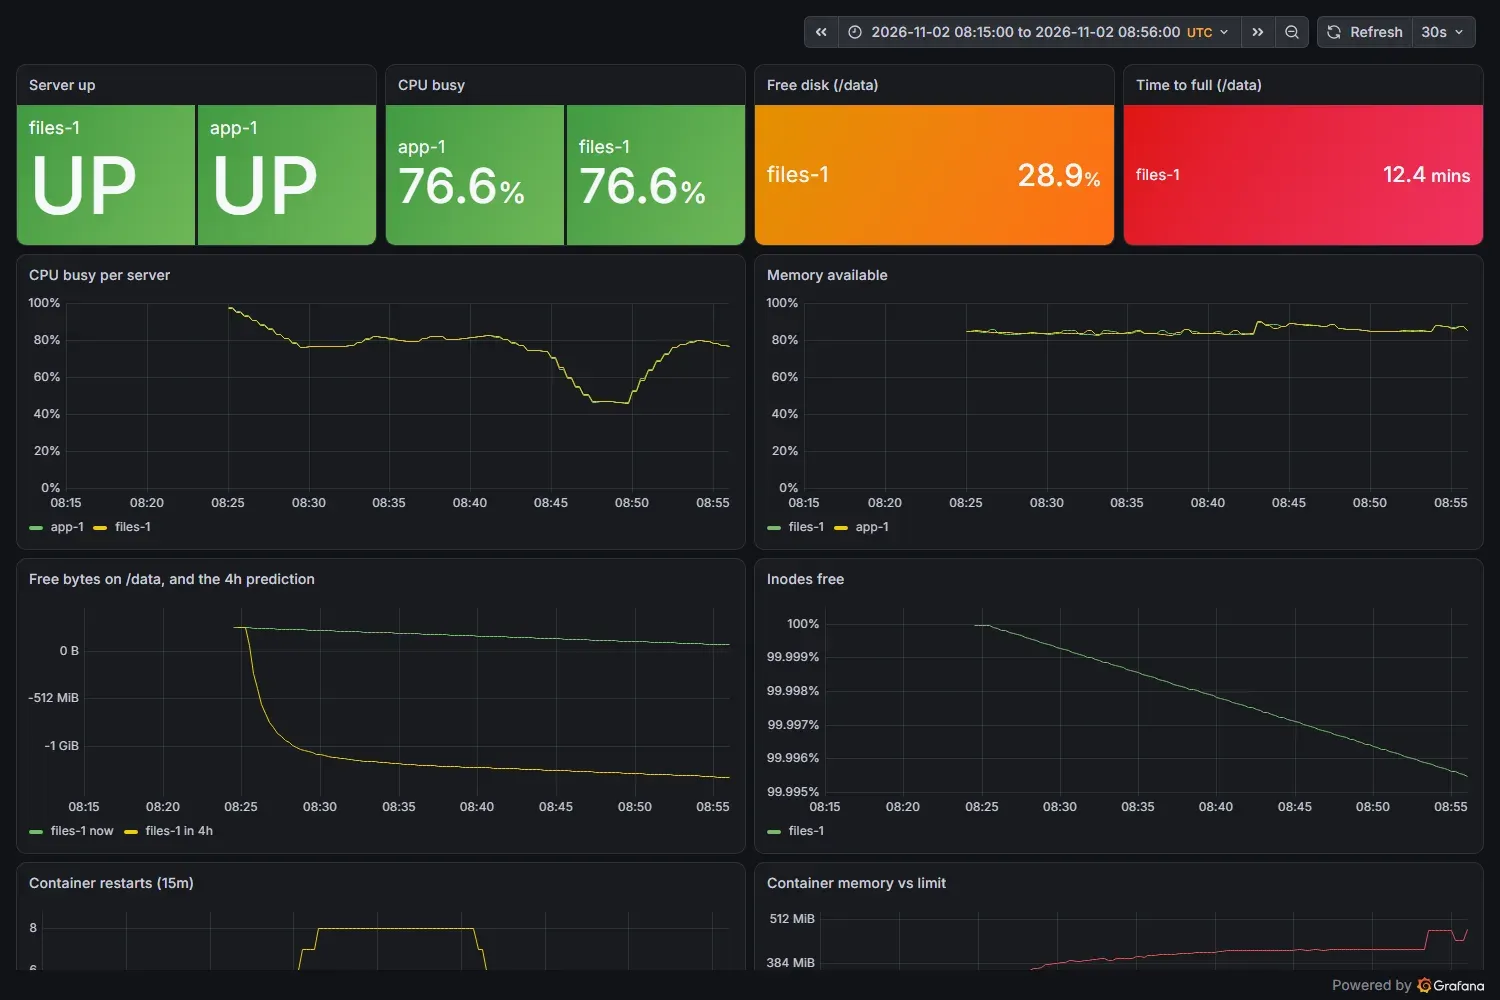
والصورة مأخوذة للفترة التي انتهت عند 08:56، والصف الأول يقول القصة كلها في ثانيتين: السيرفران يعملان، والمعالج مشغول بنسبة 76.6%، والمساحة الحرة في /data بقي منها 28.9% وهي باللون البرتقالي، والوقت المتبقي حتى الامتلاء 12.4 دقيقة باللون الأحمر. ولاحظ الفرق بين الرقمين الأخيرين: 28.9% وحده لا يخيف أحداً، فكثير من الأقراص تعمل شهوراً عند هذه النسبة، ولكن 12.4 دقيقة تقول إن هناك مشكلة الآن، ولهذا السبب وضعنا الوقت المتبقي في اللوحة بجانب النسبة. وهناك أيضاً درس في تصميم اللوحة من الرسم الثالث: وضعنا المساحة الحالية والتوقع بعد أربع ساعات في رسم واحد، فنزل التوقع تحت سالب 1 GiB، وضغط المقياس خط المساحة الحقيقية حتى أصبح شبه مستقيم قرب الصفر ولا يقرأ. والأفضل أن تعرض التوقع كوقت متبق في لوح Stat كما في الصف الأول، وأن يبقى الرسم البياني للقيمة الحقيقية وحدها.
وفي رسم العقد Inodes ترى نزولاً بطيئاً من 100% إلى 99.995%، لأن كل ملف كتبناه أخذ عقدة واحدة من أكثر من أربعة ملايين، وهذا هو السلوك الطبيعي لقرص فيه ملفات كبيرة قليلة، والمشكلة تظهر فقط مع ملايين الملفات الصغيرة كما رأينا في تجربة العقد.
مدة الاحتفاظ Retention وحجم التخزين Storage
Prometheus يحفظ البيانات في قاعدة بيانات زمنية خاصة به اسمها TSDB على قرص السيرفر نفسه، ويشرح توثيق التخزين طريقتها: العينات الجديدة تبقى في الذاكرة وفي سجل الكتابة المسبقة Write-Ahead Log على القرص حتى لا تضيع إذا توقف البرنامج، ثم تكتب كل ساعتين في كتلة Block على القرص، والكتل الصغيرة تدمج في الخلفية في كتل أكبر، وهذه العملية اسمها الضغط Compaction. والقرار الأهم هنا هو مدة الاحتفاظ، والقيمة الافتراضية كما يذكر التوثيق 15 يوماً إذا لم تحدد المدة ولا الحجم.
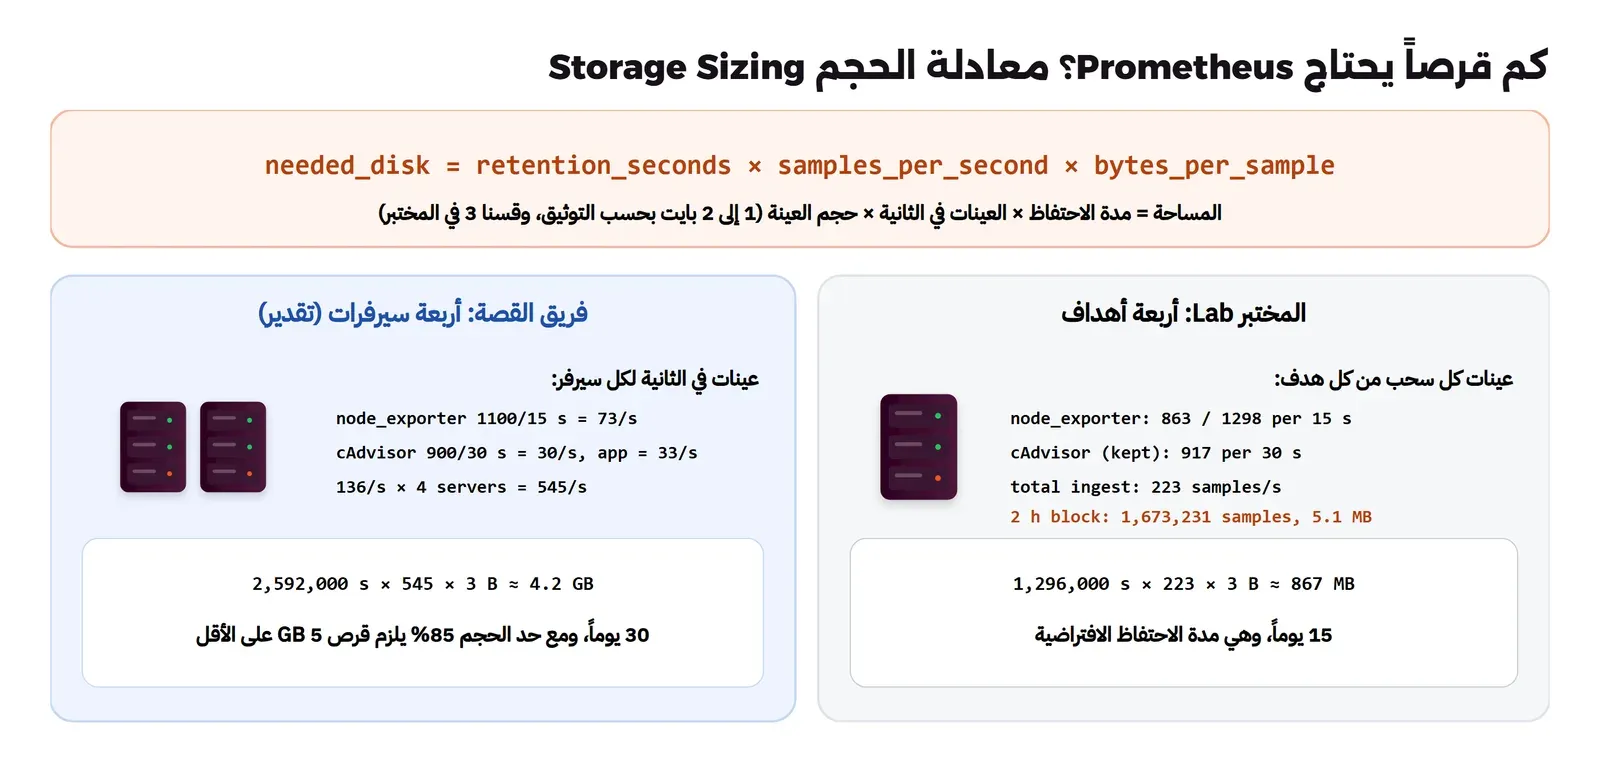
ولحساب المساحة يعطي التوثيق معادلة تقريبية: المساحة المطلوبة تساوي مدة الاحتفاظ بالثواني مضروبة في عدد العينات التي تدخل في الثانية مضروبة في حجم العينة، ويذكر أن Prometheus يحفظ العينة في 1 إلى 2 بايت في المتوسط. وعدد العينات في الثانية يأتي من Prometheus نفسه:
rate(prometheus_tsdb_head_samples_appended_total[5m])
prometheus_tsdb_head_series
scrape_samples_scraped
{type="float"} 223.10
{type="histogram"} 0
prometheus_tsdb_head_series 3702
scrape_samples_scraped{instance="mon-files:9100",job="node",server="files-1"} 863
scrape_samples_scraped{instance="mon-node:9100",job="node",server="app-1"} 1298
scrape_samples_scraped{instance="localhost:9090",job="prometheus"} 841
scrape_samples_scraped{instance="mon-cadvisor:8080",job="cadvisor",server="app-1"} 917والمخرج يقول إن مختبرنا الصغير يدخل 223 عينة في الثانية من 3702 سلسلة. ولاحظ أن node_exporter وحده يعرض 863 إلى 1298 عينة من كل سيرفر، أي أن عدد السيرفرات هو العامل الأكبر في الحجم. والآن نحسب بالمعادلة لمدة 15 يوماً، أي 1,296,000 ثانية، وبحجم 2 بايت للعينة حتى نكون في الجانب الآمن:
1,296,000 s × 223 samples/s × 2 bytes ≈ 578 MBوهذه المعادلة تعتمد على حجم العينة، والتوثيق يقول 1 إلى 2 بايت في المتوسط، فأردنا أن نقيس الرقم الحقيقي في مختبرنا. فبعد أن عمل المختبر أكثر من اثنتي عشرة ساعة كتب Prometheus ست كتل Blocks، كل كتلة تغطي ساعتين، وقرأنا الملف meta.json وحجم الملفات لإحداها، وقد اختصرنا المخرج إلى الحقول المهمة:
docker exec mon-prom sh -c 'du -sh /prometheus; cd /prometheus/01M6ECCMVX849AJA1Z9FF1VXFP; cat meta.json; ls -l index chunks/'31.6M /prometheus
"stats":{"numSamples":1673231,"numFloatSamples":1673231,"numSeries":3835,"numChunks":14043}
"compaction":{"level":1}
-rw-r--r-- 1 nobody nobody 472345 Nov 2 15:00 index
-rw-r--r-- 1 nobody nobody 4643225 Nov 2 15:00 000001والحساب هنا بسيط: 4,643,225 بايت للبيانات مقسومة على 1,673,231 عينة تساوي 2.8 بايت للعينة، ومع ملف الفهرس Index تصبح 3.1 بايت، أي أكثر من الرقم الذي يذكره التوثيق. والسبب أن هذه كتلة من المستوى الأول، أي لم تدمج بعد في كتلة أكبر، وأن كثيراً من سلاسل المختبر عدادات تتغير قيمها في كل سحب، وهذه تضغط أقل من القيم الثابتة. لذلك استخدم في التخطيط 3 بايت للعينة حتى تكون في الجانب الآمن، ثم قس الرقم الحقيقي عندك بعد أسبوع من التشغيل. فبهذا الرقم يحتاج مختبرنا 867 MB لخمسة عشر يوماً، وفريق القصة بأربعة سيرفرات يحتاج قرابة 4.2 GB لثلاثين يوماً، والصورة التالية تبين الحساب كاملاً، مع ملاحظة أن أرقام الفريق تقدير بنيناه من أرقام المختبر لكل هدف:
وهناك خياران يحددان متى يحذف Prometheus البيانات القديمة: --storage.tsdb.retention.time للمدة، و--storage.tsdb.retention.size للحجم، وإذا حددت الاثنين يطبق أيهما يأتي أولاً. ويوصي التوثيق إذا استخدمت الحجم أن تجعله 80% إلى 85% من المساحة المخصصة لـ Prometheus كحد أقصى، لأن عملية الضغط تحتاج مساحة مؤقتة تحتفظ فيها بالكتل القديمة والجديدة معاً قبل أن تحذف القديمة، فإذا كان القرص 50 GB فاجعل الحجم 40 GB. ولاحظ أيضاً أن حذف الكتل المنتهية قد يتأخر حتى ساعتين بحسب التوثيق، فلا تتوقع أن تنخفض المساحة فور تغيير الخيار.
وقد يتساءل البعض: وماذا إذا احتجت أرقام سنة كاملة للتخطيط؟ والإجابة أن Prometheus المحلي مصمم لسيرفر واحد، ولا يوفر تكراراً Replication ولا حماية من تلف القرص، ويقول التوثيق نفسه إن التخزين المحلي محدود بقدرة سيرفر واحد واعتماديته، ولذلك يوفر واجهة الكتابة البعيدة Remote Write لإرسال نسخة إلى نظام تخزين طويل المدى. فالترتيب المعتاد للفريق الصغير: احتفاظ محلي من 15 إلى 30 يوماً تكفي لأي تحقيق في حادثة، وإذا احتجت أكثر فقواعد تسجيل تحسب متوسطات ساعية تحفظها لمدة أطول، أو نظام تخزين خارجي عندما يكبر الفريق.
ماذا يحدث إذا توقف سيرفر؟ المقياس up والقيم القديمة Staleness
والآن التجربة التي يجب أن تعرف نتيجتها قبل أن تحتاجها: ماذا يرى Prometheus عندما يتوقف سيرفر كاملاً؟ أوقفنا الـ Container الذي يمثل السيرفر files-1 عند 22:12:16، ثم سألنا بعد عشرين ثانية:
docker stop mon-files
python q.py 'up{job="node"}'
python q.py 'node_memory_MemAvailable_bytes'
up{instance="mon-files:9100",job="node",server="files-1"} 0
up{instance="mon-node:9100",job="node",server="app-1"} 1
node_memory_MemAvailable_bytes{instance="mon-node:9100",job="node",server="app-1"} 31012507648والملف q.py سكربت صغير في ملفات المختبر يرسل الاستعلام إلى الواجهة البرمجية ويطبع النتيجة في سطر لكل سلسلة. ولاحظ هنا شيئين: المقياس up للسيرفر المتوقف أصبح 0 مباشرة، وهذا ما يجعل نموذج السحب مفيداً كما ذكرنا في البداية. والشيء الثاني أن ذاكرة files-1 اختفت من النتيجة، فلا تظهر بقيمتها الأخيرة ولا بصفر، وإنما تختفي. والسبب أن Prometheus عندما يفشل السحب يكتب علامة خاصة تعلن انتهاء السلسلة اسمها Staleness Marker لكل السلاسل التي كانت تأتي من هذا الهدف، فيعرف أنها انتهت، ولا يستمر في عرض آخر قيمة لمدة خمس دقائق، وهي مدة البحث للخلف Lookback التي يشرحها توثيق الاستعلام. وهذا يعني أن أي تنبيه مبني على قيمة السيرفر نفسه، مثل «الذاكرة أقل من 10%»، لن يطلق أبداً عندما يتوقف السيرفر كاملاً، لأن السلسلة غير موجودة أصلاً، والاستعلام يرجع نتيجة فارغة، والنتيجة الفارغة في Prometheus تعني «لا يوجد تنبيه».
ولهذا السبب تحتاج دائماً تنبيهاً على up نفسه، وهو القاعدة TargetDown في ملفنا. وفي صفحة الأهداف ظهر السبب بوضوح:
mon-files:9100 down Get "http://mon-files:9100/metrics": dial tcp: lookup mon-files on 127.0.0.11:53: no such hostوالرسالة هنا خاصة بـ Docker، لأن الـ Container المتوقف يختفي اسمه من خادم DNS الداخلي للشبكة، أما مع سيرفر حقيقي فسوف ترى غالباً connection refused إذا كان السيرفر يعمل وnode_exporter متوقف، أو context deadline exceeded إذا كان السيرفر كله لا يرد، والفرق بين الرسالتين يختصر عليك نصف التشخيص. ثم أصبح التنبيه في حالة pending بوقت بدء 22:12:32، وأطلق بعد دقيقتين كما في for: 2m، ورأيناه firing عند 22:14:51. ولاحظ أن الدقيقتين لها سبب: سحب واحد فاشل قد يكون مشكلة شبكة عابرة، وإعادة تشغيل السيرفر بعد التحديث تأخذ دقيقة غالباً، فالتنبيه الفوري على كل سحب فاشل يصنع ضجيجاً لا يحتاج عملاً.
الأمان Security: لا تفتح المنافذ للعالم
كل المكونات التي شغلناها تعرض بياناتها دون أي تسجيل دخول بشكل افتراضي: صفحة /metrics في node_exporter تكشف أسماء الأقراص وإصدار النواة وواجهات الشبكة، وcAdvisor يكشف أسماء كل الـ Containers وImages التي تشغلها، وواجهة Prometheus تسمح لأي شخص بالاستعلام عن كل شيء، والخيار --web.enable-lifecycle الذي استخدمناه في المختبر يسمح لأي شخص يصل إلى المنفذ بإيقاف Prometheus بطلب HTTP واحد. لذلك:
- اربط المنافذ بالعنوان الداخلي فقط، كما فعلنا بـ
127.0.0.1، أو بعنوان الشبكة الخاصة بين السيرفرات، واستخدم الجدار الناري ليسمح لسيرفر Prometheus وحده بالوصول إلى المنفذ 9100 في كل سيرفر. - إذا كانت السيرفرات في مواقع مختلفة وتمر المقاييس عبر الإنترنت فاستخدم TLS مع المصادقة الأساسية Basic Authentication التي يدعمها node_exporter وPrometheus عبر ملف إعداد الويب web-config، أو اربط السيرفرات بشبكة خاصة افتراضية VPN مثل WireGuard.
- لا تعرض Prometheus للمستخدمين، فهم يرون الأرقام من خلال Grafana، وGrafana نفسه خلف Reverse Proxy مع HTTPS، ومع تسجيل الدخول الموحد SSO إذا كان لديكم.
- غير كلمة مرور المدير في Grafana من أول تشغيل، فالقيمة الافتراضية معروفة للجميع، وفي المختبر أعطيناها قيمة بمتغير البيئة
GF_SECURITY_ADMIN_PASSWORD.
أخطاء شائعة Common Mistakes
- استخدام
rateعلى مقياس لحظي: مثلrate(node_memory_MemAvailable_bytes[5m])، والنتيجة رقم بلا معنى، لأنrateتفترض أن أي نقص هو رجوع العداد للصفر. وعكسه أيضاً خطأ: عرض عداد مثلnode_cpu_seconds_totalكما هو في لوحة، فتجد خطاً يصعد دائماً ولا يقول شيئاً. - نافذة
rateقصيرة جداً: مثل[15s]مع سحب كل 15 ثانية، فالنافذة فيها عينة واحدة أو لا شيء، والنتيجة فراغات في الرسم. اجعل النافذة أربع فترات سحب على الأقل، أو استخدم$__rate_intervalفي Grafana. - الذاكرة الحرة بدل المتاحة: كما رأينا، الفرق في المختبر كان 47% مقابل 12%، والتنبيه على الأولى يوقظ الفريق دون سبب.
- نسيان العقد Inodes: لوحة فيها المساحة فقط، ثم يتوقف التطبيق والقرص نصفه فارغ.
- تسميات بقيم لا حدود لها: معرف المستخدم أو رابط الطلب الكامل في تسمية، فيتضاعف عدد السلاسل حتى يستهلك Prometheus ذاكرة السيرفر كلها.
- عد الأحداث من مقياس لحظي: مثل
changes(container_start_time_seconds)التي أعطتنا 8 بدل 20، فابحث دائماً عن عداد للحدث نفسه. - لوحات تبنى بالنقر وتحفظ في قاعدة Grafana فقط: فإذا ضاع السيرفر ضاعت اللوحات، وإذا عدلها أحد لا تعرف من ولماذا.
- Prometheus على السيرفر نفسه الذي يراقبه وحده: إذا توقف السيرفر توقف معه من يفترض أن يخبرك بتوقفه، ولذلك سوف نخصص لهذا السؤال، أي من يراقب المراقب، جزءاً من مقال فحص التوفر.
- ترك مدة الاحتفاظ على الافتراضي دون حساب: 15 يوماً قد تكون أقل مما تحتاج للمقارنة بالشهر الماضي، وقد تكون أكثر مما يتسع له قرص صغير.
قائمة تحقق Checklist قبل أن تعتمد على Prometheus
| البند | كيف تتحقق منه |
|---|---|
كل السيرفرات أهداف up | صفحة /targets، والاستعلام up == 0 يرجع نتيجة فارغة |
node_exporter كخدمة على كل سيرفر، أو في Docker مع --path.rootfs | المساحة في اللوحة تطابق df -h على السيرفر |
| كل قرص مهم ظاهر في المقاييس | count by (server, mountpoint) (node_filesystem_avail_bytes) |
| العقد Inodes في اللوحة بجانب المساحة | لوح node_filesystem_files_free |
| مقاييس الـ Containers مع أحداث نفاد الذاكرة | container_oom_events_total موجود، وcAdvisor يعمل مع /dev/kmsg |
| تنبؤ بامتلاء القرص بدل نسبة ثابتة فقط | قاعدة predict_linear مع شرط على المساحة الحالية |
| ملفات القواعد مفحوصة | promtool check rules في مسار CI قبل النشر |
| مصدر البيانات واللوحات في Git | إعادة إنشاء Grafana من الصفر تعطي اللوحات نفسها |
| مدة الاحتفاظ والحجم محسوبان | المعادلة بأرقامك، وretention.size عند 80% إلى 85% من القرص |
| المنافذ مغلقة عن الإنترنت | فحص المنافذ 9090 و9100 و8080 من خارج الشبكة لا يصل |
تدريب عملي Practice
- أضف إلى اللوحة لوحاً لحجم الشبكة الداخل والخارج لكل سيرفر من العدادين
node_network_receive_bytes_totalوnode_network_transmit_bytes_total، واستبعد الواجهةlo. - غير نافذة
predict_linearمن 30 دقيقة إلى 6 ساعات على سيرفر حقيقي، وقارن كم مرة يطلق التنبيه بسبب ارتفاع مؤقت، مثل نسخة احتياطية تكتب ملفاً كبيراً ثم تحذفه.
حذف المختبر Cleanup
docker rm -f mon-node mon-files mon-cadvisor mon-prom mon-grafana mon-oom mon-inodes
docker volume rm mon-prom-data
docker network rm mon-net
ونترك Images الخاصة بـ Prometheus وGrafana لأننا سوف نستخدمها في بقية مقالات السلسلة، وإذا لم تكن تتابع السلسلة فاحذفها بالأمر docker rmi.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Prometheus يسحب الأرقام من كل هدف كل فترة ثابتة، فيصبح فشل السحب نفسه رقماً هو
up، وكل سلسلة اسم وتسميات، وكل تركيبة تسميات سلسلة جديدة لها ثمن في الذاكرة والقرص. - العداد Counter يستخدم مع
rateوincrease، والمقياس اللحظي Gauge يقرأ كما هو أو معpredict_linear، وإذا أردت عد أحداث فابحث عن عداد، فقد رأيناchangesتعد 8 من 20 إعادة تشغيل. - الذاكرة المتاحة وليس الحرة، والعقد Inodes بجانب المساحة، والتنبؤ بموعد امتلاء القرص أنفع من نسبة ثابتة.
- قواعد التسجيل تحسب الاستعلام الثقيل مرة واحدة، وGrafana يقرأ مصادر البيانات واللوحات من ملفات في Git.
- احسب المساحة بالمعادلة وأرقامك الحقيقية، واجعل حد الحجم 80% إلى 85% من القرص، ولا تفتح أي منفذ من منافذ المراقبة للإنترنت.
وفي المقال القادم من السلسلة بإذن الله ننتقل من السيرفر إلى الخدمة نفسها: ماذا تقيس في تطبيقك حتى تعرف أن المستخدم يعاني قبل أن يتصل بك، مع الإشارات الذهبية Golden Signals ومقاييس نضيفها إلى كود خدمة حقيقية.
 دليلمفاهيم المراقبة Observability: من الإشارة إلى التنبيهما الذي تجيب عنه المقاييس والسجلات والتتبع، وكيف تبني تنبيهاً على ما يشعر به المستخدم وعلى ميزانية الأخطاء بدل كل رقم.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلجمع السجلات Logs مركزياً مع Grafana Lokiكيف تشغل Grafana Loki مع Alloy وGrafana، وتختار التسميات Labels التي لا توقف الإدخال، ثم تبحث وتنبه وتحذف بلغة LogQL.
 دليلاستكشاف الأخطاء وتحليل الأداء للمبتدئين: من العرض إلى السببعندما يبطئ الموقع أو يعطي 502، هذه طريقة منظمة توصلك من العرض إلى السبب قبل أن تخمن أو تشتري سيرفراً أكبر.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Prometheus 3.15.1 وnode_exporter 1.12.1 وcAdvisor 0.60.6 وGrafana 13.3.0 على Docker Engine 29.8.0.