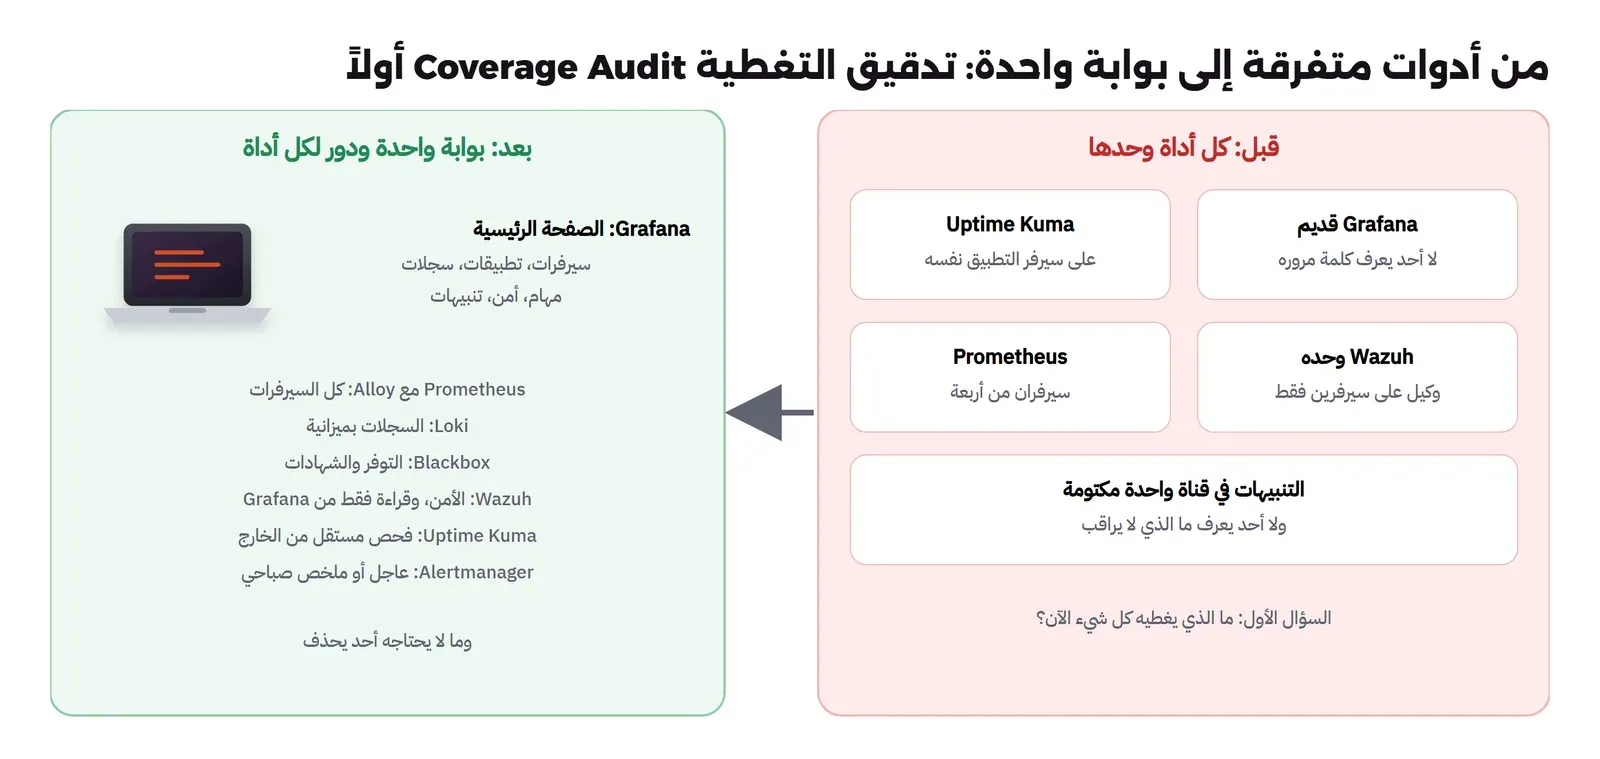
نصل في هذا المقال إلى آخر محطة مع الفريق الذي تابعناه طوال السلسلة. فقبل أن يبدأ كان لديه أربعة سيرفرات وأدوات متفرقة لا يعرف أحد صورتها الكاملة: Uptime Kuma ثبته أحدهم على سيرفر التطبيق نفسه، وGrafana قديم لا يعرف أحد كلمة مروره، وPrometheus يجمع من سيرفرين فقط من أربعة، وWazuh يعمل على سيرفر مستقل ووكيله مثبت على سيرفرين فقط، وتنبيهات كل هذه الأدوات تصل إلى قناة واحدة كتمها الجميع. وفي كل مقال أضفنا قطعة: مقاييس السيرفرات، ثم الإشارات الذهبية للخدمة، ثم الفحص من الخارج والمهام المجدولة، ثم التنبيهات العاجلة والملخص الصباحي. والآن جاء السؤال الذي يطرحه أي مدير على الفريق بعد هذا كله: أين أنظر كل صباح لأعرف أن كل شيء بخير؟ والإجابة التي نبنيها هنا بوابة واحدة: لوحة رئيسية في Grafana تجمع السيرفرات والتطبيقات والسجلات والتنبيهات والمهام والشهادات، ومعها ملخص الأمن والثغرات من Wazuh، دون أن ننقل Wazuh من مكانه ودون أن نخلط أقراص الاثنين.
والتصميم الذي نتبعه في هذا المقال وضعه صاحب الموقع لفريق حقيقي بهذا الحجم، وقد بنيناه كاملاً في مختبر وشغلناه وقسنا كل جزء منه، وسوف نذكر في كل مكان ما تحققنا منه بالضبط وما لم نتحقق منه. والمواضيع في السلسلة:
- مقاييس السيرفرات مع Prometheus ولوحات Grafana.
- ماذا تقيس في خدمتك؟ الإشارات الذهبية Golden Signals.
- فحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟
- التنبيهات Alerting: ماذا تنبه عليه ومتى توقظ أحداً؟
- بوابة مراقبة واحدة Monitoring Portal تجمع Grafana مع Wazuh (الموضوع الحالي).
وسوف نناقش في هذا المقال ما يلي:
- الخطوة الأولى قبل أي تثبيت: تدقيق التغطية Coverage Audit لما هو موجود، مع جدول تدقيق تستخدمه كما هو.
- التصميم: لماذا يبقى Wazuh على سيرفره، ولماذا تحتاج المراقبة سيرفراً مستقلاً، وكيف تتحقق من سعة سيرفر موجود قبل أن تشتري آخر.
- ميزانية التخزين من اليوم الأول بأرقام قسناها في المختبر.
- Grafana Alloy على كل سيرفر، وأربع مشاكل حقيقية واجهتنا فيه، منها تسميات كشفت مسارات الملفات على السيرفر وعداد لم يعد أي قتل بسبب نفاد الذاكرة.
- ملخص Wazuh في Grafana بمستخدم للقراءة فقط Read-only، وما الذي تحققنا منه في التوافق.
- الثغرات والتحديثات: فحص Trivy كل ليلة، وRenovate، وWazuh، والعاجل فوراً والروتيني في الملخص.
- اللوحة الرئيسية صفاً صفاً، ثم خطة التنفيذ للفريق، والأخطاء الشائعة، وقائمة تحقق.
الخطوة الأولى: تدقيق التغطية Coverage Audit
أول خطأ يقع فيه فريق يريد بوابة واحدة هو أن يبدأ بتثبيت شيء جديد. ففي حالتنا هناك أربع أدوات تعمل فعلاً، وكل منها يغطي جزءاً، وأحياناً يغطي جزءاً لا يعرف الفريق أنه مغطى، أو يظن أنه مغطى وهو غير ذلك. لذلك الخطوة الأولى تدقيق Audit: لكل أداة موجودة نسأل ماذا تراقب الآن فعلاً، وعلى أي سيرفرات، وإلى أين تصل تنبيهاتها، وكم تحتفظ بالبيانات، ومن يملكها، ثم نقرر لكل منها: تبقى، أو تدمج، أو تحذف. والصورة التالية تبين نقطة البداية ونقطة النهاية:
والجدول التالي هو جدول التدقيق الذي نقترحه، وكل سطر فيه سؤال، وطريقة تحصل بها على الإجابة الحقيقية من الأداة نفسها وليس من الذاكرة، والقرار الذي تبنيه على الإجابة:
| الأداة | السؤال | كيف تتحقق | ماذا تقرر |
|---|---|---|---|
| Prometheus | أي السيرفرات والخدمات تسحب منها فعلاً؟ | صفحة /targets، أو count by (job, instance) (up) | كل سيرفر غير موجود في القائمة يحتاج Alloy أو node_exporter |
| Prometheus | كم تحتفظ، وكم المساحة الآن؟ | /api/v1/status/flags للخيارين retention، و/api/v1/status/tsdb لعدد السلاسل | ميزانية تخزين مكتوبة |
| Prometheus | أي قواعد تنبيه موجودة، ومتى أطلقت آخر مرة؟ | /api/v1/rules، والسلسلة ALERTS لآخر 30 يوماً | القاعدة التي لم تطلق أبداً أو تطلق كل يوم تراجع بالأسئلة الأربعة |
| Grafana | من يملك كل لوحة، وهل يفتحها أحد؟ | قائمة اللوحات وتاريخ آخر تعديل، وسجل الاستخدام إن كان مفعلاً | اللوحات المهمة تصدر إلى Git، والباقي يحذف |
| Grafana | أي مصادر بيانات Data Sources موجودة، وبأي صلاحيات؟ | صفحة مصادر البيانات، وزر Test لكل مصدر | كل مصدر بمستخدم مدير يستبدل بمستخدم قراءة فقط |
| Uptime Kuma | ماذا يفحص، ومن أين؟ | قائمة الفحوص، ومكان تشغيله | الفحوص الداخلية تنتقل إلى Blackbox، وKuma ينتقل إلى سيرفر آخر للفحص المستقل |
| Wazuh | على أي سيرفرات يعمل الوكيل، ومتى اتصل آخر مرة؟ | قائمة الوكلاء Agents وحالتها في لوحة Wazuh | كل سيرفر بلا وكيل يضاف |
| Wazuh | كم مساحة يستخدم المفهرس Indexer، وكم يحتفظ؟ | _cat/indices/wazuh-* وسياسة إدارة الفهارس | سياسة احتفاظ مكتوبة، وقرص لا يشاركه أحد |
| كل الأدوات | إلى أين تصل التنبيهات، ومن يقرؤها؟ | إعداد المستقبلات في كل أداة، وآخر رسالة وصلت فعلاً | مسار واحد للعاجل، وملخص واحد للروتيني |
| كل الأدوات | ما الذي لا يراقبه أحد؟ | قائمة السيرفرات والخدمات والمهام المجدولة والشهادات، مقابل ما سبق | هذه القائمة هي خطة العمل |
والسطر الأخير هو أهم ما في الجدول، لأن الهدف من التدقيق ليس معرفة ما يعمل، وإنما معرفة الفراغات. ففي حالة الفريق خرج التدقيق بقائمة قصيرة واضحة: سيرفران بلا مقاييس، وسيرفران بلا وكيل Wazuh، وثلاث مهام مجدولة لا يعرف أحد هل تعمل، منها النسخ الاحتياطي، وشهادتان لا يراقبهما أحد، وفحص Kuma يعمل على السيرفر نفسه الذي يفحصه. وهذه القائمة هي ما يجب أن يغطيه التصميم، وليس قائمة أدوات جميلة.
التصميم Architecture: أين يعمل كل مكون؟
التصميم يقوم على ثلاثة أماكن، ولكل منها قرصه، كما في الصورة التالية:
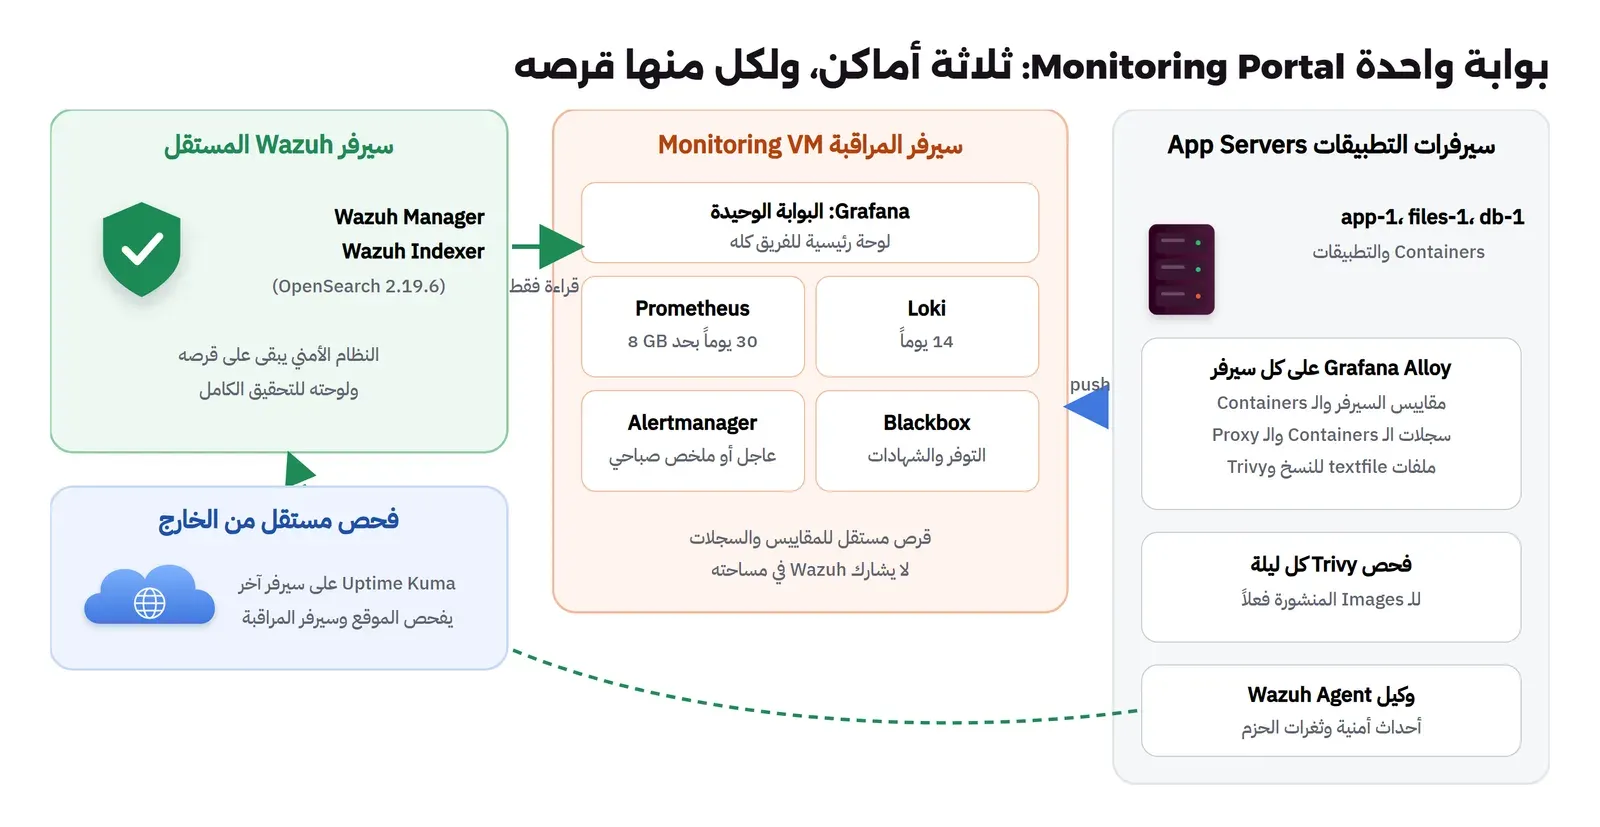
- سيرفرات التطبيقات: على كل سيرفر Grafana Alloy يجمع مقاييس السيرفر والـ Containers وسجلاتها، ويقرأ ملفات textfile للنسخ الاحتياطي وفحص Trivy، ويرسل كل ذلك إلى سيرفر المراقبة، ومعه وكيل Wazuh الذي يرسل الأحداث الأمنية إلى Wazuh.
- سيرفر المراقبة: جهاز افتراضي VM مستقل عليه Prometheus للمقاييس، وLoki للسجلات، وAlertmanager للتنبيهات، وBlackbox Exporter للفحص من الداخل، وGrafana هو البوابة الوحيدة التي يفتحها الفريق.
- سيرفر Wazuh: يبقى كما هو على سيرفره المستقل، وهو نظام الأمن ولوحة التحقيق الكاملة، وGrafana يقرأ منه ملخصات محددة فقط بمستخدم للقراءة.
- فحص مستقل: Uptime Kuma أو خدمة خارجية على سيرفر آخر، يفحص الموقع وسيرفر المراقبة نفسه، كما شرحنا في قسم من يراقب المراقب.
وقد يتساءل البعض: لماذا لا نضع Prometheus وLoki وGrafana على سيرفر Wazuh نفسه، وهو يعمل وفيه مساحة؟ والإجابة في القرص. فالسجلات المركزية تستهلك المساحة بسرعة لا يتوقعها أحد، وسجل تطبيق واحد يكتب سطراً لكل طلب قد يضاعف حجمه في يوم عرض تسويقي، وإذا كان هذا القرص هو قرص Wazuh نفسه فإن امتلاءه يوقف المفهرس، ويتوقف معه استقبال الأحداث الأمنية، أي أن ضجيج سجلات التطبيق يعطل نظام الأمن في الوقت الذي قد يحتاجه فيه الفريق أكثر من أي وقت. والفصل أيضاً يسهل الحساب: لكل نظام ميزانية مساحة معروفة، ولا يأكل أحدهما من الآخر. وقد شرحنا في دليل Wazuh ما يحتاجه Wazuh نفسه من موارد.
قبل أن تشتري سيرفراً: هل تتسع سعة Capacity سيرفر موجود؟
السيرفر المستقل للمراقبة لا يعني بالضرورة سيرفراً جديداً تدفع له، فقد يكون لدى الفريق جهاز افتراضي سليم يستخدم جزءاً صغيراً من موارده. والطريقة الصحيحة لمعرفة ذلك هي الطريقة نفسها التي بنيناها في المقال الأول: انظر إلى مقاييس السيرفر المرشح أسبوعين على الأقل، وخاصة نسبة انشغال المعالج في أسوأ ساعة، والذاكرة المتاحة في أسوأ ساعة، والمساحة الحرة واتجاهها بالدالة predict_linear، ثم قارنها بما تحتاجه المراقبة. وما تحتاجه المراقبة قسناه في المختبر، فهذه الذاكرة التي استخدمها كل مكون بعد أن استقر، بحسب docker stats:
mon-p-cadvisor 27.34MiB / 31.29GiB
mon-p-alloy 124.6MiB / 31.29GiB
mon-p-grafana 415.2MiB / 31.29GiB
mon-p-prom 84.09MiB / 31.29GiB
mon-p-am 15.96MiB / 31.29GiB
mon-p-bb 27.96MiB / 31.29GiB
mon-p-loki 131.5MiB / 31.29GiB
mon-p-os 1021MiB / 31.29GiB
ومكونات سيرفر المراقبة، أي Grafana وPrometheus وLoki وAlertmanager وBlackbox، استخدمت معاً قرابة 675 MiB لسيرفر واحد مراقب ومتجر صغير، أما OpenSearch فهو يمثل في المختبر مفهرس Wazuh ويعمل على سيرفر Wazuh وليس على سيرفر المراقبة. وهذه أرقام مختبر بسيرفر واحد، والذاكرة في Prometheus وLoki تكبر مع عدد السلاسل والسجلات، فاترك هامشاً لا يقل عن الضعف، وإذا كان لديك جهاز افتراضي فيه 4 GB متاحة في أسوأ ساعة وقرص مستقل يمكن إضافته، فهو كاف غالباً لفريق بهذا الحجم.
ميزانية التخزين Storage Budget من اليوم الأول
في المقالات السابقة كان الاحتفاظ خياراً نتركه على الافتراضي في المختبر، وهنا يصبح قراراً من اليوم الأول، لأن الامتلاء الذي يحدث بعد ثلاثة أشهر هو الذي يوقف كل شيء. والصورة التالية تبين الميزانية لكل نظام بأرقام قسناها:
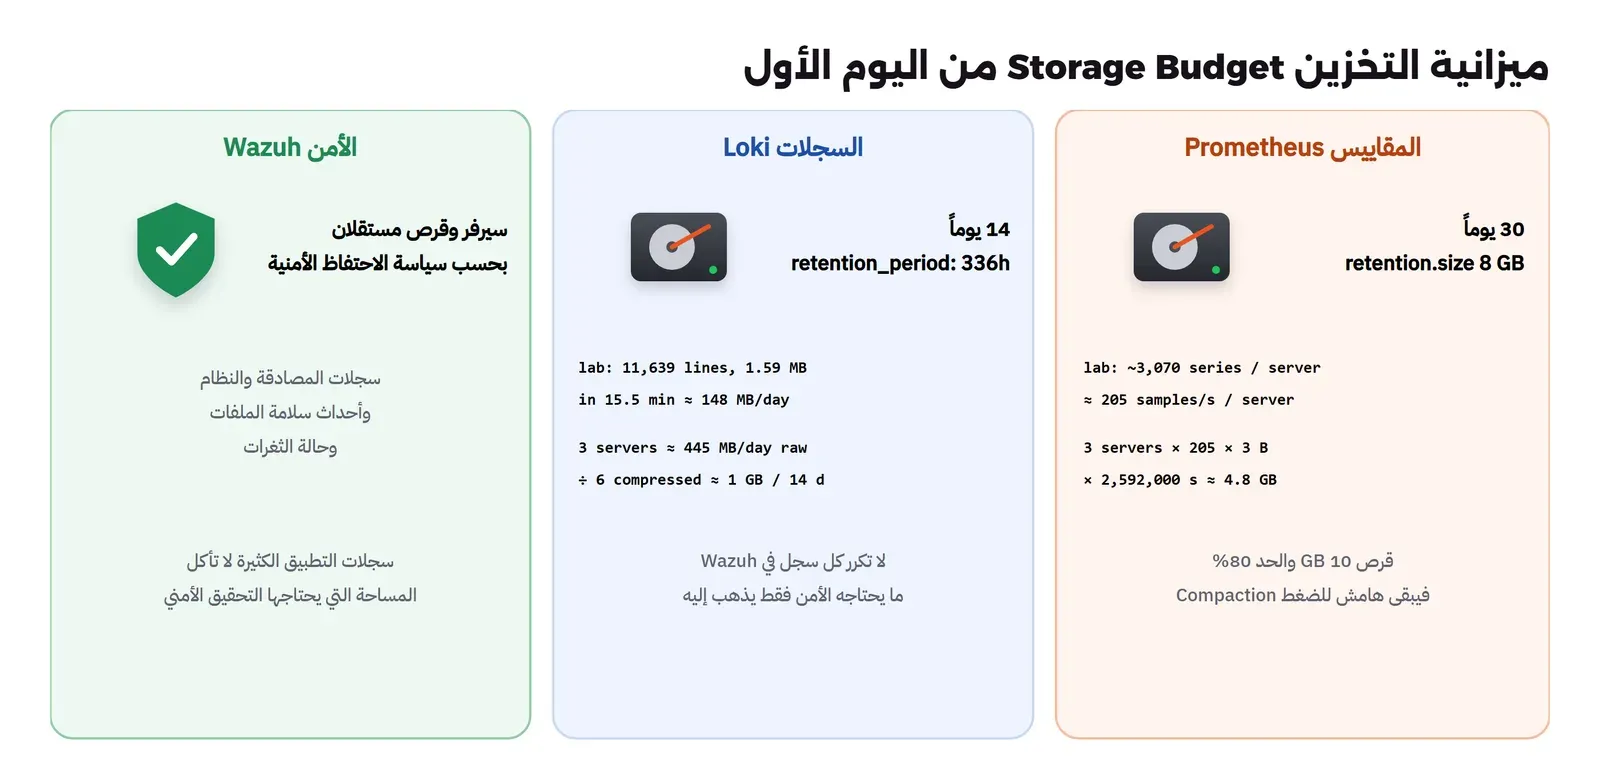
والحساب للمقاييس بالمعادلة التي شرحناها في قسم الاحتفاظ في المقال الأول: سألنا Prometheus في المختبر عن عدد السلاسل لكل مصدر بعد أن استقر:
count by (job) ({__name__=~".+"}){job="blackbox_http"} 51
{job="blackbox_tls"} 36
{} 8
{job="integrations/unix"} 1926
{job="prometheus.scrape.local"} 979أي قرابة 1,926 سلسلة لمقاييس السيرفر من Alloy، و979 لمقاييس الـ Containers، وما يقارب 87 للفحوص، فنحو 3,000 سلسلة لكل سيرفر، وبسحب كل 15 ثانية نحو 205 عينات في الثانية. ولثلاثة سيرفرات لمدة 30 يوماً و3 بايت للعينة كما قسنا في المقال الأول تكون المساحة قرابة 4.8 GB، لذلك جعلنا الحد --storage.tsdb.retention.size=8GB مع مدة 30 يوماً، وعلى قرص 10 GB يبقى هذا الحد عند 80% كما يوصي توثيق التخزين.
وللسجلات قرأنا عدادي Loki بعد 15.5 دقيقة من التشغيل:
loki_distributor_bytes_received_total{format="loki",is_internal_stream="false",policy="",retention_hours="336",tenant="fake"} 1.593013e+06
loki_distributor_lines_received_total{format="loki",is_internal_stream="false",policy="",tenant="fake"} 11639
أي 1.59 MB في 15.5 دقيقة من متجر صغير يستقبل قرابة ثلاثة طلبات ونصف في الثانية، وهذا 148 MB في اليوم قبل الضغط. وقد رأينا في دليل Loki أن ملفاً حجمه 61 MB أصبح أقل من 10 MB بعد الضغط، أي قرابة ستة أضعاف، فإذا كان لدى الفريق ثلاثة سيرفرات بحجم مشابه فالميزانية نحو 1 GB لأربعة عشر يوماً. ولاحظ الكلمة «بحجم مشابه»: هذه أرقام مختبر بحركة اصطناعية، والطريقة الصحيحة أن تشغل النظام أسبوعاً ثم تقرأ العدادين نفسيهما عندك وتعيد الحساب. والإعداد الذي يطبق الميزانية في loki.yaml:
limits_config:
  retention_period: 336h          # 14 days of logs: the storage budget decides this, not the default
  ingestion_rate_mb: 8
compactor:
  working_directory: /loki/compactor
  retention_enabled: true
  delete_request_store: filesystem
ويذكر توثيق الاحتفاظ في Loki أن الحذف الفعلي يقوم به ال Compactor، لذلك لا يكفي أن تحدد المدة، ويجب أن يكون retention_enabled: true، وإلا بقيت السجلات إلى الأبد مهما كتبت في المدة.
لا تكرر Duplicate كل سجل في نظامين
هناك قرار يحسم نصف الميزانية: أي سجل يذهب إلى أين؟ والإغراء الطبيعي أن ترسل كل شيء إلى Loki وإلى Wazuh معاً، حتى يكون كل شيء في كل مكان. ولكن هذا يضاعف المساحة، ويضاعف عمل المفهرس الأمني بسجلات لا يحتاجها، ويعيد مشكلة القرص المشترك من الباب الخلفي. والقاعدة التي اتبعناها:
- إلى Wazuh: ما له قيمة أمنية فقط، أي سجلات المصادقة والنظام، وسجل الوصول للـ Reverse Proxy إذا كانت قواعد Wazuh تحلله، وأحداث سلامة الملفات، وهذه يجمعها وكيل Wazuh كما هو مشروح في دليله.
- إلى Loki: سجلات التطبيقات والـ Containers للتشخيص اليومي، بمدة أقصر، لأن قيمتها تنخفض بسرعة بعد أيام.
- إلى الاثنين: لا شيء افتراضياً، وإذا احتاج سجل معين أن يكون في الاثنين، مثل سجل الوصول للـ Proxy، فليكن ذلك قراراً مكتوباً لسجل محدد، وليس الإعداد العام.
وقد ناقشنا اختيار أداة السجلات نفسها بالأرقام في مقارنة أدوات السجلات المركزية، ومسار السجل من التطبيق إلى البحث في مسار السجل Log Pipeline.
المختبر Lab: البوابة كاملة على جهاز واحد
بنينا التصميم كاملاً في Containers على شبكة واحدة، حيث يمثل app-1 سيرفر التطبيق، وعليه متجر على Nginx 1.31.6 يكتب سجل الوصول بصيغة JSON، ومولد حركة صغير، ومهمة نسخ احتياطي من مقال فحص التوفر، وAlloy 1.21.3، وcAdvisor 0.60.6. ويمثل باقي الـ Containers سيرفر المراقبة: Prometheus 3.15.1 وLoki 3.7.9 وAlertmanager 0.34.2 وBlackbox Exporter 0.29.1 وGrafana 13.3.0 مع إضافة OpenSearch 2.34.6. أما Wazuh فقد مثلناه بعقدة OpenSearch 2.19.6 مفردة فيها تنبيهات بصيغة Wazuh، وسوف نشرح لماذا هذا الإصدار بالذات ولماذا اخترنا هذه الطريقة في قسم Wazuh.
والمتجر يكتب كل طلب سطراً JSON واحداً، حتى يستطيع Loki أن يقرأ الحقول دون تعبيرات نمطية:
# The shop on app-1: JSON access log to stdout (collected by Alloy), a health page and an endpoint that fails.
log_format json escape=json '{"time":"$time_iso8601","status":$status,"method":"$request_method","path":"$uri","duration":$request_time,"bytes":$body_bytes_sent}';
server {
    listen 80;
    access_log /dev/stdout json;
    default_type application/json;
    location = /health    { return 200 '{"status": "ok"}'; }
    location = /api/pay   { return 500 '{"error": "payment provider timeout"}'; }
    location /            { return 200 '{"page": "home"}'; }
}
Grafana Alloy على كل سيرفر
Alloy هو البرنامج الوحيد الذي يثبت على سيرفرات التطبيقات للمراقبة، ويحل محل node_exporter وناقل السجلات معاً، ويدفع البيانات إلى سيرفر المراقبة بدل أن ينتظر من يسحبها، وهذا يناسب السيرفرات التي لا تريد أن تفتح فيها منفذاً للدخول. والملف config.alloy بصيغته النهائية بعد أن أصلحنا ما واجهناه:
// Grafana Alloy on app-1: host metrics, container metrics, the backup and Trivy textfiles, and container logs.
prometheus.exporter.unix "host" {
  rootfs_path = "/host/root"
  procfs_path = "/host/proc"
  sysfs_path  = "/host/sys"
  textfile {
    directory = "/textfile"
  }
}

// container metrics: a standalone cAdvisor next to Alloy (the embedded prometheus.exporter.cadvisor did not count OOM kills here)
discovery.relabel "cadvisor" {
  targets = [{"__address__" = "mon-p-cadvisor:8080"}]
}

// keep only this lab's containers: the Docker host runs other projects too
prometheus.relabel "only_lab" {
  rule {
    source_labels = ["name"]
    regex         = "mon-p-.*|"
    action        = "keep"
  }
  forward_to = [prometheus.remote_write.central.receiver]
}

prometheus.scrape "local" {
  targets         = array.concat(prometheus.exporter.unix.host.targets, discovery.relabel.cadvisor.output)
  scrape_interval = "15s"
  forward_to      = [prometheus.relabel.only_lab.receiver]
}

prometheus.remote_write "central" {
  external_labels = { server = "app-1", env = "lab" }
  endpoint {
    url = "http://mon-p-prom:9090/api/v1/write"
  }
}

discovery.docker "local" {
  host = "unix:///var/run/docker.sock"
  filter {
    name   = "name"
    values = ["mon-p-"]
  }
}

discovery.relabel "containers" {
  targets = discovery.docker.local.targets
  rule {
    source_labels = ["__meta_docker_container_name"]
    regex         = "/(.*)"
    target_label  = "container"
  }
}

loki.source.docker "containers" {
  host       = "unix:///var/run/docker.sock"
  targets    = discovery.relabel.containers.output
  labels     = { server = "app-1", env = "lab" }
  forward_to = [loki.write.central.receiver]
}

loki.write "central" {
  endpoint {
    url = "http://mon-p-loki:3100/loki/api/v1/push"
  }
}
في الإعداد أعلاه لاحظ التالي:
- الملف مكون من مكونات Components، كل مكون يخرج شيئاً يدخل في مكون آخر عبر
forward_toأوtargets، فتقرأ المسار من الأعلى إلى الأسفل: مصدر مقاييس السيرفر prometheus.exporter.unix وهو node_exporter نفسه مدمجاً، ثم السحب، ثم الترشيح، ثم الإرسال. textfileداخل مصدر السيرفر يقرأ ملفات*.promكما يفعل node_exporter، وفيه ملف النسخ الاحتياطي وملف Trivy.external_labelsفي prometheus.remote_write تضع اسم السيرفر على كل سلسلة يرسلها، وهذا ما يجعل كل اللوحات تعمل بالتسميةserverنفسها كما في المقالات السابقة.- الإرسال يذهب إلى
/api/v1/writeفي Prometheus، وهذا يحتاج تشغيل Prometheus بالخيار--web.enable-remote-write-receiverبحسب توثيق التخزين، وإلا رفض كل ما يصل. - loki.source.docker يقرأ سجلات الـ Containers من Docker مباشرة، ويضع اسم الـ Container في التسمية
container، وهي تسمية قيمها محدودة كما يجب أن تكون.
أربع مشاكل واجهتنا مع Alloy
الإعداد أعلاه هو النسخة الرابعة، وكل نسخة قبلها أصلحت مشكلة حقيقية، وكلها مشاكل سوف تقابلها في الإنتاج.
المشكلة الأولى: ملف Trivy لا يقرأ. بعد أن كتبنا ملف نتائج Trivy في المجلد ظهرت هذه الرسالة كل 15 ثانية في سجل Alloy:
level=error msg="failed to collect textfile data" component_id=prometheus.exporter.unix.host collector=textfile file=trivy.prom err="failed to parse textfile data from \"/textfile/trivy.prom\": text format parsing error in line 2: unknown metric type \"gauge\\r\""والسبب في آخر الرسالة: \r، أي أن الملف كتب بنهايات سطور Windows، لأننا شغلنا سكربت التحويل أول مرة على جهاز Windows، وصيغة Prometheus النصية لا تقبلها. وأصلحناه بتشغيل السكربت داخل Container من Linux، وفي الإنتاج سوف تعمل المهمة الليلية على السيرفر نفسه، ولكن تذكر هذا إذا ولدت ملفاً على جهازك ونقلته، أو إذا كتب أحد السكربت بمحرر يضيف هذه النهايات.
المشكلة الثانية: مقاييس الـ Containers لا ترى أي Container. في البداية استخدمنا المكون المدمج prometheus.exporter.cadvisor داخل Alloy، فظهرت سلسلة واحدة فقط للجذر id="/"، وفي سجل Alloy:
msg="Registration of the docker container factory failed: unable to create containerd client: containerd: cannot unix dial containerd api service: dial unix /run/containerd/containerd.sock: connect: no such file or directory"فالمكون يحتاج مقبس containerd إضافة إلى مقبس Docker، ويحتاج /sys في مكانه الأصلي، فلما ربطنا /var/run و/sys كاملين ظهرت كل الـ Containers.
المشكلة الثالثة: تسميات كشفت مسارات الملفات. عندما ظهرت الـ Containers ظهرت معها تسميات غريبة على كل سلسلة، مثل هذه لـ Container واحد:
container_oom_events_total{container_label_desktop_docker_io_binds_1_Source="D:/Active_Projects/Cloud-Event/ArabRoot/content/articles/monitoring-portal/lab/loki.yaml",container_label_desktop_docker_io_binds_1_Target="/etc/loki/config.yaml",...,name="mon-p-loki",server="app-1"} 0والسبب أن الخيار store_container_labels في المكون قيمته الافتراضية true بحسب توثيقه، أي أن كل تسمية Docker على كل Container تتحول إلى تسمية Prometheus. وهذا خطر مزدوج: كثرة سلاسل بلا فائدة، وكشف مسارات الملفات وأسماء المجلدات وأحياناً متغيرات البيئة لكل من يستطيع أن يقرأ Prometheus. بل إن إحدى التسميات كانت container_label_restartcount، أي عدد إعادات التشغيل، فكل إعادة تشغيل صنعت سلسلة جديدة. وقبل الإصلاح كان Alloy يستخدم 838 MiB من الذاكرة، فلما أوقفنا التسميات ثم نقلنا مقاييس الـ Containers إلى cAdvisor المستقل نزل إلى 125 MiB.
المشكلة الرابعة: عداد نفاد الذاكرة لا يعد. وهذه أهمها. شغلنا Container يستهلك الذاكرة حتى يقتل، كما في المقال الأول، فقتل خمس مرات بحسب Docker، والمكون المدمج قال صفراً:
container_oom_events_total{id="/docker/cd182f2aec9b...",image="python:3.13-slim",job="integrations/cadvisor",name="mon-p-worker",server="app-1"}  0
container_oom_events_total{id="/docker/0879df2e3e36...",image="python:3.13-slim",instance="mon-p-cadvisor:8080",job="prometheus.scrape.local",name="mon-p-worker",server="app-1"}  5
والسطر الثاني من cAdvisor 0.60.6 المستقل الذي شغلناه بجانب Alloy بالخيارات نفسها التي استخدمناها في المقال الأول، ومنها ربط /dev/kmsg، فعد الخمس كلها. لذلك بقي cAdvisor مستقلاً في التصميم النهائي، وAlloy يسحب منه ويرسل، وهذا ما تراه في الإعداد. والدرس العام: لا تفترض أن المكون المدمج يعطي ما يعطيه البرنامج الأصلي، وجرب الحدث الذي تريد التنبيه عليه بعينه، فلو لم نجرب لكان التنبيه ContainerOOMKilled موجوداً في الملف ولا يطلق أبداً.
مشكلة في اللوحة: خطأ JSONParserErr
عندما بنينا لوح عدد الطلبات بحسب الرمز من السجلات ظهر اللوح بعلامة خطأ حمراء، وعند تشغيل الاستعلام مباشرة على Loki جاءت هذه الرسالة:
pipeline error: 'JSONParserErr' for series: '{__error__="JSONParserErr", __error_details__="Value looks like object, but can't find closing '}' symbol", container="mon-p-shop", ...}'.
Use a label filter to intentionally skip this error. (e.g | __error__!="JSONParserErr").
والسبب أن الـ Container لا يكتب JSON فقط، فعند بدايته يكتب Nginx أسطراً عادية عن إعداده، ودالة json تفشل عليها، وLoki يرفض استعلام المقاييس إذا كان فيه خطأ في أي سطر. والحل الذي يقترحه Loki نفسه في الرسالة أن تضيف | __error__="" بعد json، فيتجاهل الأسطر التي لا تقرأ:
sum by (status) (count_over_time({container="mon-p-shop"} | json | __error__="" [1m])){"metric":{"status":"200"},"value":[1793668272.906,"910"]},{"metric":{"status":"500"},"value":[1793668272.906,"149"]}ملخص Wazuh في Grafana: مصدر قراءة فقط Read-only Data Source
الهدف هنا محدود ومقصود: أن يرى الفريق في الصفحة الرئيسية ملخصاً للأمن، مثل عدد التنبيهات عالية المستوى وأكثر القواعد إطلاقاً وحالة الثغرات، مع رابط يفتح Wazuh للتحقيق، وليس أن نبني نسخة من لوحة Wazuh داخل Grafana. ومفهرس Wazuh مبني على OpenSearch، فالطريقة الطبيعية هي إضافة مصدر بيانات OpenSearch الرسمية في Grafana، بمستخدم لا يستطيع إلا القراءة.
التوافق Compatibility: ما الذي تحققنا منه
قبل أي إعداد يجب أن تعرف إصدار OpenSearch الذي يقوم عليه مفهرس Wazuh عندك، لأن توثيق الإضافة يقول إن الإصدار المكتوب في إعداد المصدر يستخدم لبناء الاستعلامات، وإن عدم التطابق قد يسبب أخطاء، وينبه إلى تحديثه عند ترقية OpenSearch. وفي ملف الإصدارات في مستودع wazuh-indexer للإصدار 4.14.9 السطر opensearch = 2.19.6، أي أن مفهرس Wazuh 4.14.9 مبني على OpenSearch 2.19.6. لذلك اخترنا في المختبر Image الرسمية opensearchproject/opensearch:2.19.6 بالإصدار نفسه، بدل تشغيل Wazuh كاملاً الذي تحتاج Images الثلاث فيه قرابة 7.4 GB كما قسنا في دليل Wazuh، وملأناها بتنبيهات بصيغة Wazuh وبحالة ثغرات حقيقية من فحص Trivy لـ Image المتجر.
وصيغة البيانات أخذناها من مصدرين رسميين: قالب فهرس التنبيهات في مستودع Wazuh، وفيه أن نمط الفهارس wazuh-alerts-4.x-* وأن حقل الوقت timestamp، وأن الحقول الأساسية rule.level وrule.description وrule.id وagent.name، ومثال حالة الثغرات في توثيق كشف الثغرات، وفيه أن الفهرس wazuh-states-vulnerabilities-<اسم العنقود> والحقول package.name وvulnerability.id وvulnerability.severity. ورقم القواعد ومستوياتها من قواعد Wazuh التي جربناها في دليل Wazuh، مثل 5763 لتخمين كلمات مرور SSH بالمستوى 10.
والذي تحققنا منه بالضبط: الإضافة 2.34.6 على Grafana 13.3.0 تتصل بـ OpenSearch 2.19.6 مع إضافة الأمان، وتقرأ الفهارس بنمط Wazuh، وتجمع حسب الحقول، وتعمل بمستخدم للقراءة فقط. والذي لم نتحقق منه: مفهرس Wazuh الحقيقي بشهاداته الخاصة، وأدواره وتعدد المستأجرين Multi-tenancy فيه، والحجم الحقيقي لفهارس فريق يعمل منذ سنة. لذلك جرب الإعداد نفسه على نسخة اختبار من Wazuh قبل الإنتاج، وابدأ بمستخدم القراءة على فهرس واحد.
مستخدم القراءة فقط Read-only User
السكربت os-setup.py في ملفات المختبر ينشئ قوالب الفهارس ويحمل البيانات، والجزء الذي يهمك في الإنتاج هو الدور والمستخدم، عبر واجهة الأمان في OpenSearch:
# read-only access for Grafana: search and read the two index families, nothing else
print(call("PUT", "/_plugins/_security/api/roles/grafana_wazuh_read", {
    "cluster_permissions": ["cluster_composite_ops_ro"],
    "index_permissions": [{"index_patterns": ["wazuh-alerts-4.x-*", "wazuh-states-vulnerabilities-*"],
                           "allowed_actions": ["read", "indices:admin/mappings/get", "indices:monitor/settings/get"]}]}))
print(call("PUT", "/_plugins/_security/api/internalusers/grafana_ro", {"password": GRAFANA_PW, "backend_roles": []}))
print(call("PUT", "/_plugins/_security/api/rolesmapping/grafana_wazuh_read", {"users": ["grafana_ro"]}))
200
200
bulk 200 errors: False items: 214
(201, {'status': 'CREATED', 'message': "'grafana_wazuh_read' created."})
(201, {'status': 'CREATED', 'message': "'grafana_ro' created."})
(201, {'status': 'CREATED', 'message': "'grafana_wazuh_read' created."})والسطر الثالث يقول إن 214 وثيقة حملت دون أخطاء: 150 تنبيهاً و64 حالة ثغرة. ومجموعتا الإجراءات Action Groups read وcluster_composite_ops_ro من المجموعات الافتراضية في OpenSearch. ثم جربنا المستخدم بخمسة طلبات، اثنان يجب أن ينجحا وثلاثة يجب أن تفشل:
c(){ docker run --rm --network mon-net curlimages/curl:8.11.1 -sk -u 'grafana_ro:...' "$@"; }
c 'https://mon-p-os:9200/wazuh-alerts-4.x-*/_count'
c -H 'Content-Type: application/json' 'https://mon-p-os:9200/wazuh-alerts-4.x-*/_search?size=0' \
  -d '{"query":{"range":{"rule.level":{"gte":10}}},"aggs":{"r":{"terms":{"field":"rule.description"}}}}'
c -H 'Content-Type: application/json' -X POST 'https://mon-p-os:9200/wazuh-alerts-4.x-2026.11.03/_doc' -d '{"rule":{"level":1}}'
c 'https://mon-p-os:9200/.opendistro_security/_search'
c -X DELETE 'https://mon-p-os:9200/wazuh-alerts-4.x-2026.11.03'
{"count":150,"_shards":{"total":2,"successful":2,"skipped":0,"failed":0}}
{'value': 6, 'relation': 'eq'} [('sshd: brute force trying to get access to the system. Authentication failed.', 6)]
{"error":{... "reason":"no permissions for [indices:data/write/index] and User [name=grafana_ro, ...]"},"status":403}
{"error":{... "reason":"no permissions for [indices:data/read/search] and User [name=grafana_ro, ...]"},"status":403}
{"error":{... "reason":"no permissions for [indices:admin/delete] and User [name=grafana_ro, ...]"},"status":403}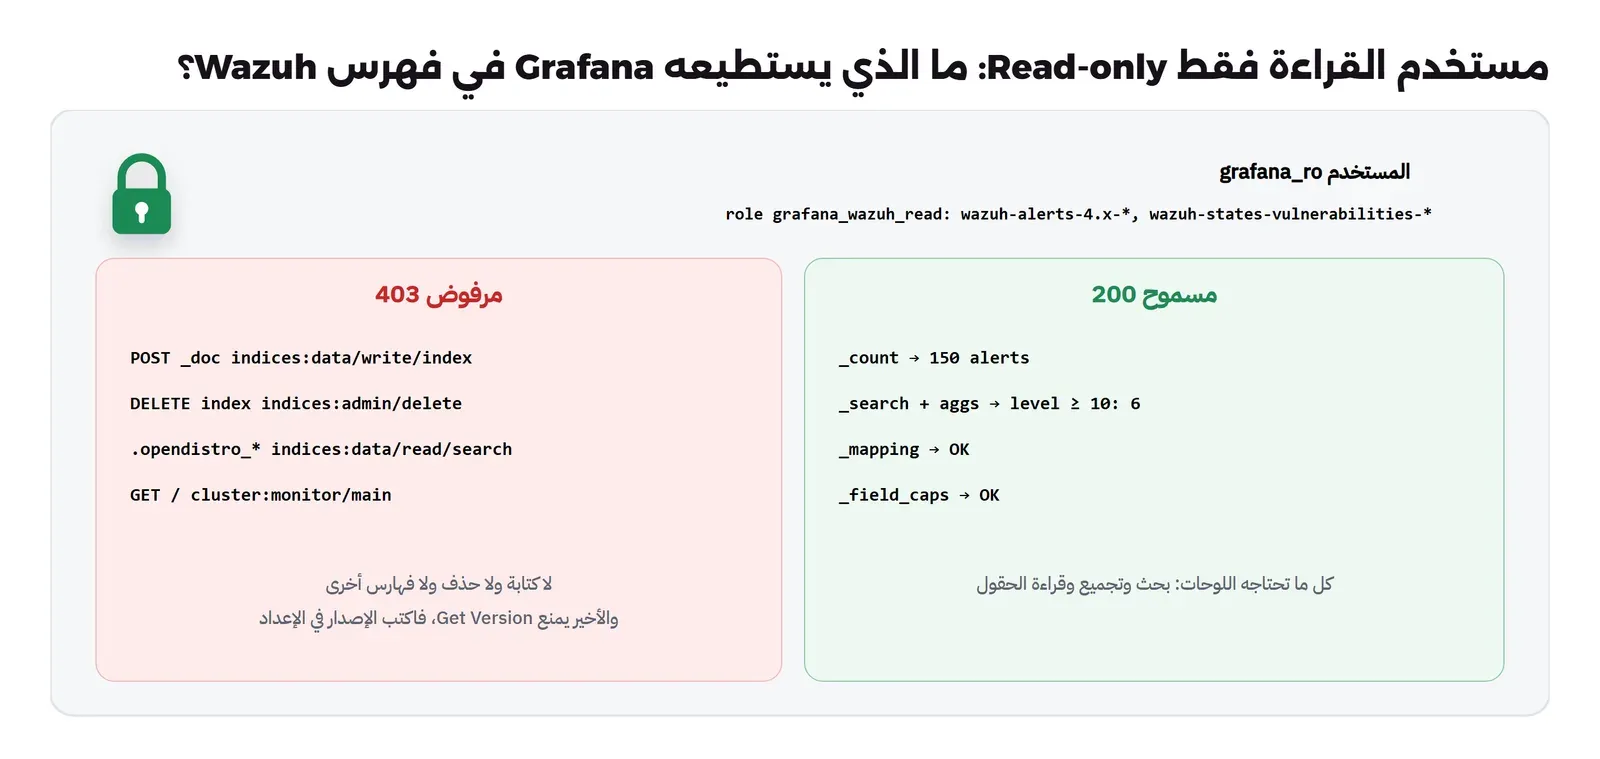
وهناك طلب سادس رفض ولم نكن نقصده: الصفحة الرئيسية GET / التي تعرض إصدار OpenSearch، ورفضت لأن الدور لا يملك cluster:monitor/main. وهذا يعني أن زر Get Version في إعداد المصدر في Grafana لن يعمل بهذا المستخدم، والحل الأبسط أن تكتب الإصدار في ملف الإعداد بنفسك كما فعلنا، أو أن تضيف هذا الإجراء وحده إلى الدور إذا أردت الاكتشاف التلقائي.
إعداد المصدر في Grafana، ومشكلة «Index not found»
نثبت الإضافة عند تشغيل Grafana بمتغير البيئة [email protected]، وهو كما يذكر مرجع إعدادات Grafana يثبت الإضافات قبل أن يبدأ Grafana، وهذا مهم عندما تأتي مصادر البيانات من ملفات Provisioning تحتاج الإضافة. وفي السجل:
logger=plugin.backgroundinstaller level=info msg="Plugin successfully installed" pluginId=grafana-opensearch-datasource version=2.34.6 duration=6.911489443sثم كتبنا المصدر في الملف أول مرة بنمط الفهارس wazuh-alerts-4.x-*، فقال زر الاختبار:
{"message":"Index not found: wazuh-alerts-4.x-*","status":"ERROR"}مع أن الفهارس موجودة والمستخدم يقرؤها، واللوحات نفسها كانت تعرض البيانات بشكل صحيح. فقرأنا كود الفحص في الإضافة فوجدنا السبب: الفحص يطلب <النمط>/_mapping/field/timestamp ثم يبحث في الرد عن مفتاح يساوي النمط نفسه حرفياً، بينما يرد OpenSearch بأسماء الفهارس الحقيقية مثل wazuh-alerts-4.x-2026.11.03، فلا يجد المفتاح. والحل أن تستخدم نمط الفهرس اليومي الذي تدعمه الإضافة، لأن Wazuh يكتب فهرساً لكل يوم أصلاً، فتولد الإضافة الأسماء الحقيقية لكل يوم في الفترة:
  - name: Wazuh alerts
    uid: wazuh-alerts
    type: grafana-opensearch-datasource
    access: proxy
    url: https://mon-p-os:9200
    basicAuth: true
    basicAuthUser: grafana_ro
    jsonData:
      flavor: opensearch
      version: "2.19.6"
      database: "[wazuh-alerts-4.x-]YYYY.MM.DD"   # Wazuh writes one index per day
      interval: Daily
      timeField: timestamp
      pplEnabled: false
      tlsSkipVerify: true          # lab only: demo certificates; in production add the indexer CA instead
      maxConcurrentShardRequests: 5
    secureJsonData: { basicAuthPassword: "$WAZUH_RO_PASSWORD" }
{"message":"Index OK. Time field name OK.","status":"OK"}وفي الإعداد أعلاه لاحظ أن كلمة المرور لا تكتب في الملف، وإنما تأتي من متغير البيئة $WAZUH_RO_PASSWORD، وأن tlsSkipVerify للمختبر فقط لأن الشهادات تجريبية، وفي الإنتاج أضف شهادة جهة الإصدار الخاصة بمفهرس Wazuh بدلاً منه. ولمصدر الثغرات كتبنا اسم الفهرس الكامل wazuh-states-vulnerabilities-lab، لأنه فهرس واحد لكل عنقود وليس لكل يوم، فقال الفحص Index OK. Note: vulnerability.detected_at is not a date field، مع أن الحقل من نوع تاريخ، والسبب الأرجح الطريقة نفسها في قراءة الرد مع الحقول المتداخلة، واللوحات عملت على أي حال.
الثغرات Vulnerabilities مع التحديثات Updates: Trivy مع Renovate مع Wazuh
في التصميم ثلاثة مصادر للثغرات، ولكل منها سؤال مختلف، والصورة التالية تبين مسار الأول منها في البوابة:
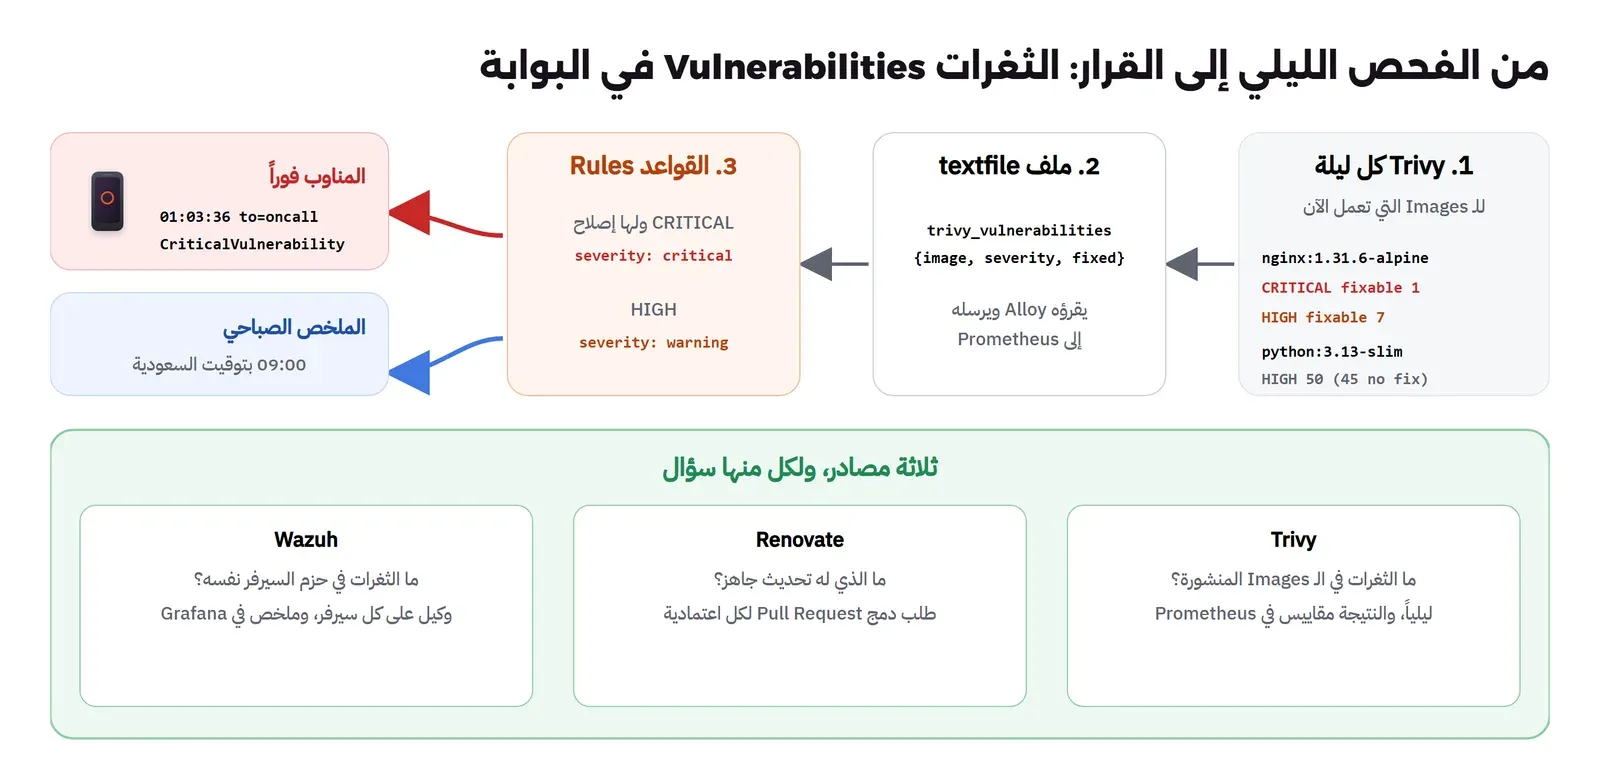
- Trivy: يفحص الـ Images التي تعمل الآن على السيرفر، وليس التي في المستودع، لأن ما يهم هو ما يستقبل الطلبات فعلاً. وقد شرحناه بالتفصيل في دليل فحص الحاويات مع Trivy.
- Renovate: يفتح طلب دمج Pull Request لكل اعتمادية لها إصدار أحدث في مستودع الكود، أي أنه يحول «هناك ثغرة» إلى «هذا هو الإصلاح جاهزاً للمراجعة»، وقد قارناه مع Dependabot في دليل فحص الاعتماديات، وهو يعمل في المستودع وليس على السيرفر، لذلك لا يظهر في البوابة إلا كعدد طلبات مفتوحة إن أردت.
- Wazuh: يكشف الثغرات في حزم نظام التشغيل على كل سيرفر عبر وكيله، ويحفظها في فهرس حالة الثغرات الذي تقرؤه البوابة.
وفي المختبر فحصنا الـ Image المنشورتين بالأمر نفسه الذي سوف يعمل كل ليلة:
for img in nginx:1.31.6-alpine python:3.13-slim; do
  n=$(echo $img | tr ':/' '__')
  docker run --rm -v /var/run/docker.sock:/var/run/docker.sock -v mon-p-trivy-cache:/root/.cache/trivy \
    -v "$PWD/reports:/reports" aquasec/trivy:0.76.1 image --quiet --scanners vuln --format json --output /reports/$n.json $img
done
docker run --rm -v "$PWD:/lab" -w /lab python:3.13-slim sh -c \
  'python trivy2prom.py reports/*.json > textfile/trivy.prom.tmp && mv textfile/trivy.prom.tmp textfile/trivy.prom'
والسكربت trivy2prom.py في ملفات المختبر يعد الثغرات لكل Image ومستوى، ويفرق بين التي لها إصلاح والتي ليس لها، ثم يكتب النتيجة بصيغة textfile، والقيم غير الصفرية منها كما يلي:
trivy_vulnerabilities{image="nginx:1.31.6-alpine",severity="CRITICAL",fixed="yes"} 1
trivy_vulnerabilities{image="nginx:1.31.6-alpine",severity="HIGH",fixed="yes"} 7
trivy_vulnerabilities{image="nginx:1.31.6-alpine",severity="LOW",fixed="yes"} 44
trivy_vulnerabilities{image="nginx:1.31.6-alpine",severity="MEDIUM",fixed="yes"} 10
trivy_vulnerabilities{image="nginx:1.31.6-alpine",severity="UNKNOWN",fixed="yes"} 2
trivy_vulnerabilities{image="python:3.13-slim",severity="HIGH",fixed="no"} 45
trivy_vulnerabilities{image="python:3.13-slim",severity="HIGH",fixed="yes"} 5
trivy_vulnerabilities{image="python:3.13-slim",severity="LOW",fixed="no"} 61
trivy_vulnerabilities{image="python:3.13-slim",severity="MEDIUM",fixed="no"} 71
trivy_last_scan_timestamp_seconds 1793667683
وهذه الأرقام تشرح لماذا فرقنا بالتسمية fixed: في Image المتجر المبنية على Alpine 3.24.2 كل الثغرات لها إصلاح، منها ثغرة حرجة واحدة في brotli-libs تحل بالترقية من 1.2.0 إلى 1.2.1، أما Image الـ Python المبنية على Debian 13.7 فإن 45 من 50 ثغرة عالية فيها ليس لها إصلاح بعد في التوزيعة، أغلبها في حزم util-linux. فإذا كان التنبيه على كل ثغرة عالية فسوف يطلق كل يوم على شيء لا يستطيع أحد أن يصلحه، وهذا تعب التنبيهات بعينه. لذلك القاعدة العاجلة على الحرج الذي له إصلاح فقط، والعالي يذهب إلى الملخص الصباحي، والذي ليس له إصلاح يبقى في اللوحة ويراجع أسبوعياً. ولاحظ أن قاعدة العالي في المختبر بالأسفل تعد كل الثغرات العالية دون شرط الإصلاح، فأرسلت Image الـ Python إلى الملخص بخمسين ثغرة، وفي الإنتاج أضف إليها fixed="yes" أيضاً حتى يبقى الملخص قائمة عمل وليس قائمة انتظار، كما شرحنا في ترتيب أولوية الثغرات:
      - alert: CriticalVulnerabilityDeployed
        expr: sum by (server, image) (trivy_vulnerabilities{severity="CRITICAL", fixed="yes"}) > 0
        labels: { severity: critical }
        annotations: { summary: "{{ $value }} fixable CRITICAL vulnerabilities in {{ $labels.image }} on {{ $labels.server }}" }
      - alert: HighVulnerabilitiesDeployed
        expr: sum by (server, image) (trivy_vulnerabilities{severity="HIGH"}) > 0
        labels: { severity: warning }
        annotations: { summary: "{{ $value }} HIGH vulnerabilities in {{ $labels.image }}" }
01:03:36 to=oncall status=firing group={'server': 'app-1'} n=1 :: CriticalVulnerabilityDeployed[app-1]=firingوصلت رسالة الحرج إلى المناوب بعد ثوان من وصول المقياس، أما تنبيهات العالي وتنبيه نفاد الذاكرة فبقيت في Alertmanager تنتظر نافذة الملخص الصباحي، وهذا هو جزء التوجيه من alertmanager.yml الذي بنيناه في مقال التنبيهات، مع المنطقة الزمنية هذه المرة:
    - matchers: [severity=~"warning|info"]
      receiver: digest
      group_by: [severity]
      group_interval: 15m
      repeat_interval: 24h
      active_time_intervals: [morning]
time_intervals:
  - name: morning
    time_intervals: [{ times: [{ start_time: "09:00", end_time: "09:15" }], location: "Asia/Riyadh" }]
ولاحظ أن تنبيه الثغرة الحرجة قد يبدو للوهلة الأولى من نوع «السبب» الذي قلنا إنه لا يوقظ أحداً، ولكنه يجتاز الأسئلة الأربعة: هناك عمل واضح، أي ترقية Image ونشرها، والتأخير له ثمن حقيقي إذا كانت الخدمة مكشوفة للإنترنت. ومع ذلك فالقرار يعود لكل فريق، فإذا كانت ترقيات الـ Images تتم دائماً في وقت العمل، فمكان هذا التنبيه أيضاً هو أول ما في الملخص الصباحي وليس الهاتف ليلاً.
وقد يتساءل البعض: لماذا لا ننبه على كل ثغرة حرجة حتى لو لم يكن لها إصلاح؟ والإجابة أن التنبيه الذي لا يستطيع أحد أن يعمل عليه يعلم الفريق أن يتجاهل هذا النوع من التنبيهات كله، ثم يأتي يوم يصدر فيه الإصلاح فلا ينتبه أحد. والأفضل أن تبقى الثغرات التي ليس لها إصلاح في اللوحة، مع مراجعة أسبوعية قصيرة تسأل سؤالين: هل صدر إصلاح لأي منها؟ وهل هناك تخفيف مؤقت، مثل إيقاف خاصية لا نستخدمها أو تقييد الوصول من الشبكة؟ وعندما يصدر الإصلاح تتحول التسمية fixed في الفحص التالي إلى yes، فتطلق القاعدة تلقائياً، دون أن يتذكر أحد شيئاً.
الصفحة الرئيسية Home Dashboard صفاً صفاً
جعلنا اللوحة الرئيسية الصفحة الافتراضية التي تفتح في Grafana لكل الفريق بالمتغير GF_DASHBOARDS_DEFAULT_HOME_DASHBOARD_PATH، وهي مولدة من السكربت make_home.py ومحفوظة في Git كما تعلمنا في المقال الأول. والصورة التالية هي اللوحة كما ظهرت في المختبر على آخر ست ساعات:
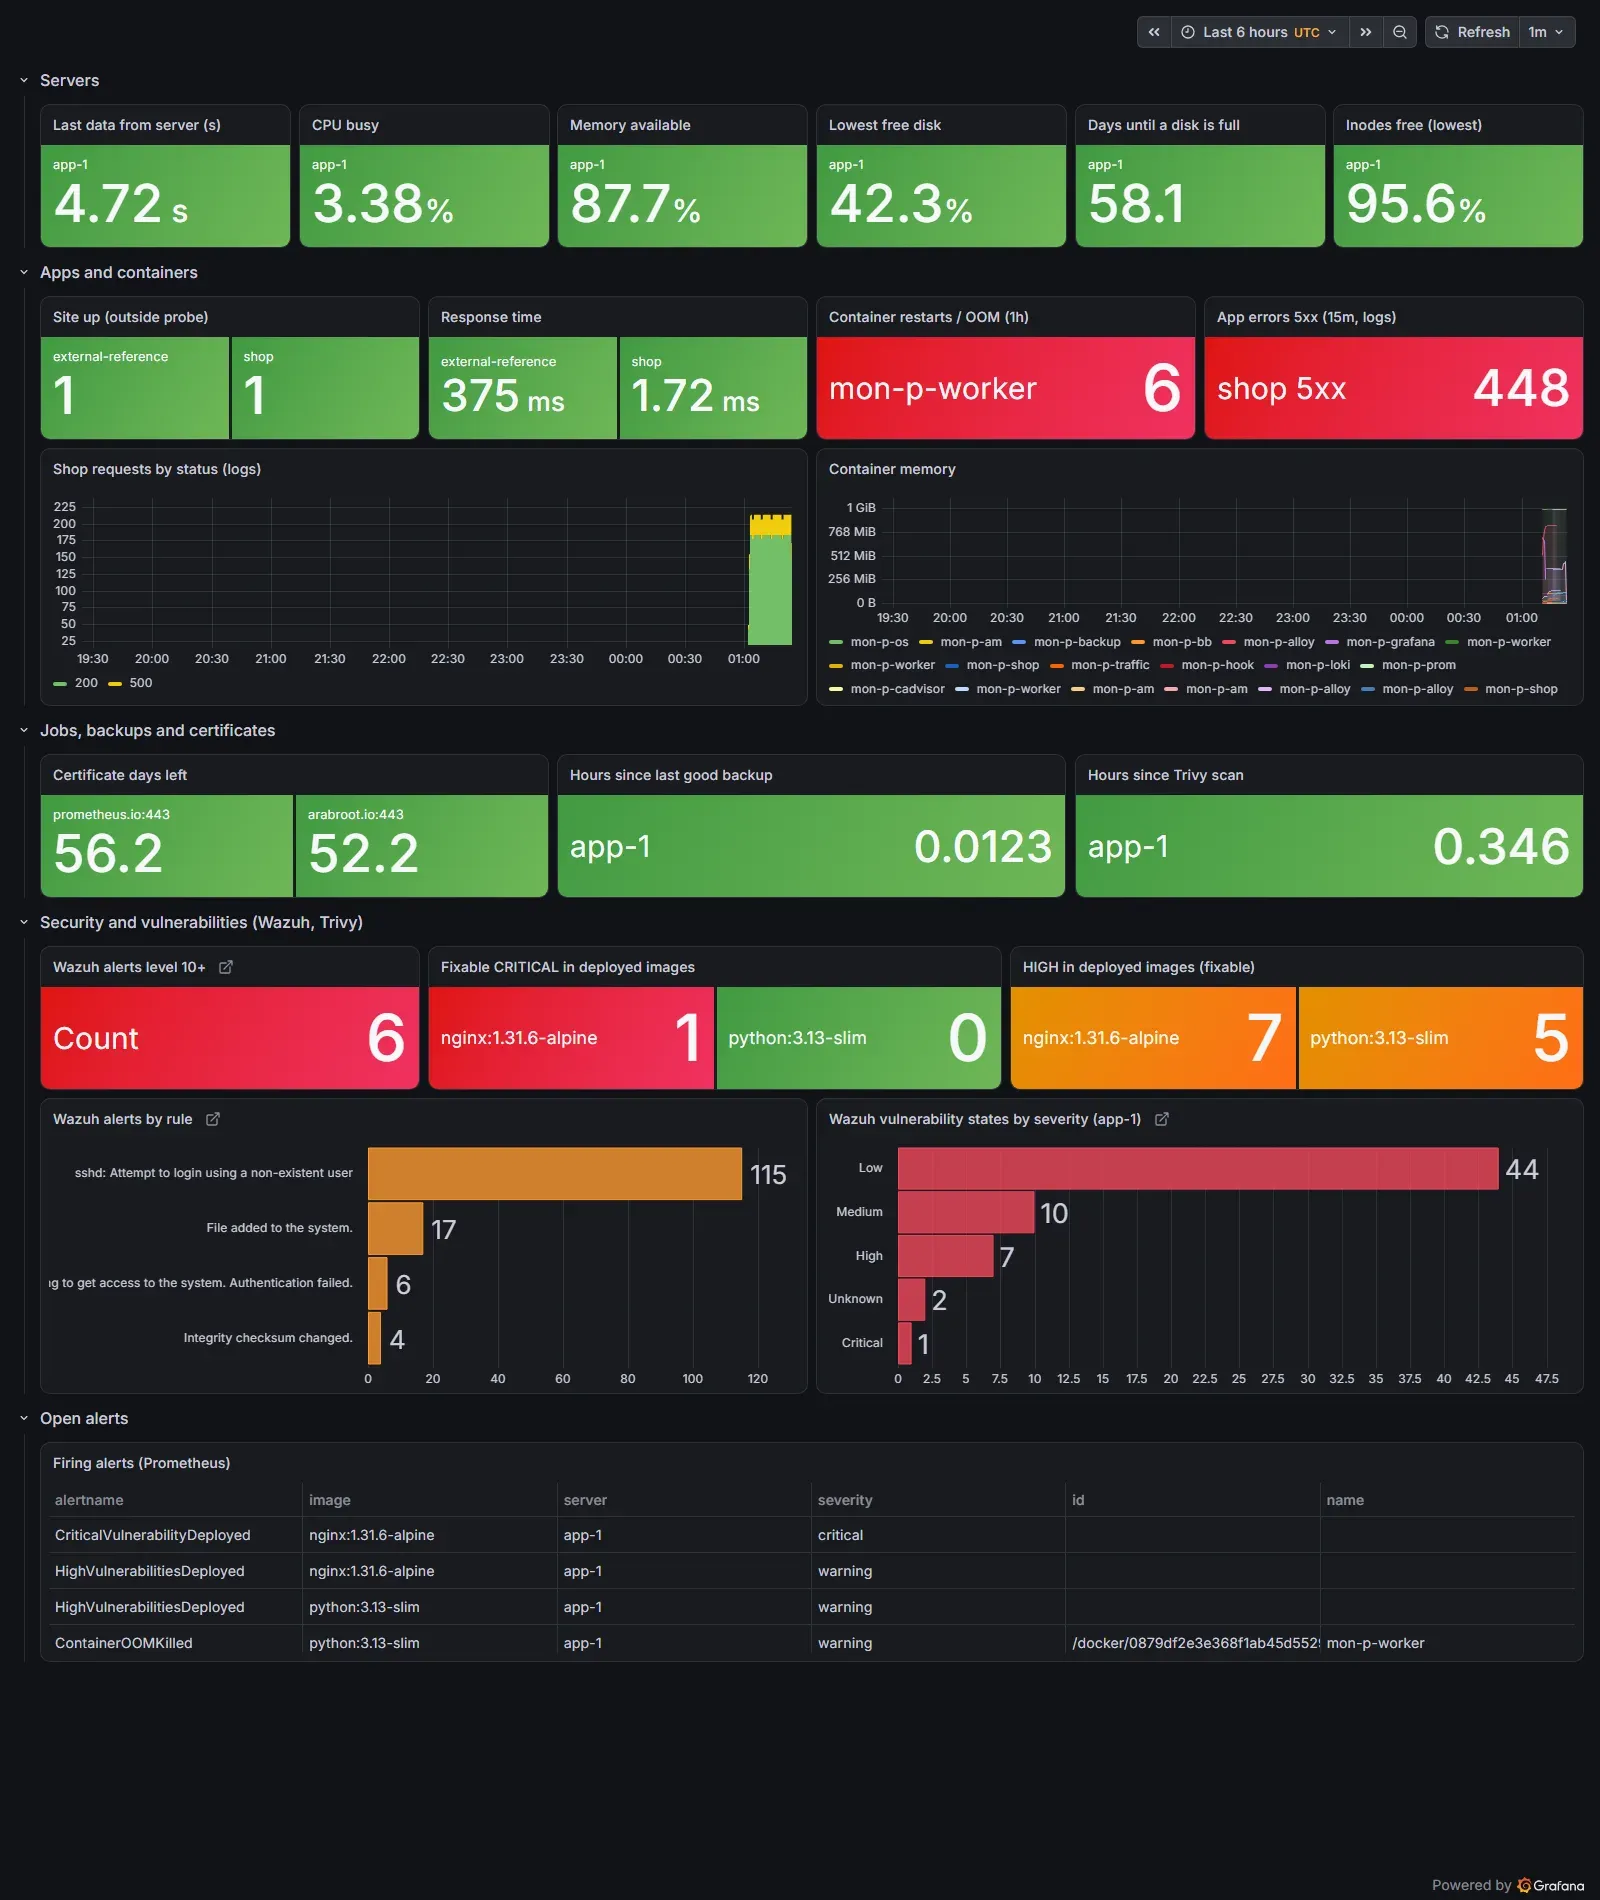
وكل صف يجيب عن سؤال واحد، والترتيب من الأعلى إلى الأسفل بحسب ما يسأل عنه الفريق أولاً:
- السيرفرات Servers: هل يصل كل سيرفر؟ وأول لوح فيه «منذ متى وصلت آخر بيانات»، وهو بديل
upفي نموذج الدفع، لأن Prometheus لا يسحب من السيرفرات، فإذا توقف Alloy أو السيرفر كله ارتفع هذا الرقم، ثم المعالج والذاكرة والمساحة والأيام المتبقية حتى امتلاء القرص والعقد Inodes، وكلها من المقال الأول. - التطبيقات والـ Containers: هل يصل المستخدم إلى المتجر من الخارج، وكم يأخذ، وكم مرة قتل Container بسبب نفاد الذاكرة خلال ساعة، والرقم 6 في الصورة للخمس مرات التي عدها cAdvisor مع امتداد الدالة
increaseإلى طرفي النافذة كما شرحنا في المقال الأول، وكم خطأ 5xx في السجلات، والرقم 448 في الصورة هو الطلبات التي أرسلها مولد الحركة إلى/api/payعمداً خلال ربع ساعة، ومعه رسم الطلبات بحسب الرمز من سجلات Loki مباشرة. - المهام والنسخ والشهادات: الأيام المتبقية لكل شهادة، والساعات منذ آخر نسخة احتياطية ناجحة، والساعات منذ آخر فحص Trivy، أي مفتاح الرجل الميت الذي شرحناه في مقال فحص التوفر، فإذا توقف الفحص الليلي نفسه عرفت من هنا، ولن تظن أن الثغرات صفر لأن أحداً لم يفحص.
- الأمن والثغرات: عدد تنبيهات Wazuh بالمستوى 10 فما فوق، وأكثر القواعد إطلاقاً، وحالة الثغرات على السيرفر من فهرس Wazuh، ونتائج Trivy للـ Images. ولكل لوح من Wazuh رابط Open in Wazuh يفتح لوحة Wazuh للتحقيق، لأن البوابة تقول إن هناك شيئاً يستحق النظر، وWazuh هو المكان الذي تنظر فيه.
- التنبيهات المطلقة: جدول من السلسلة
ALERTSفي Prometheus، حتى يرى من يفتح الصفحة ما ينتظر الملخص الصباحي، وما هو عاجل الآن.
ولاحظ ما ليس في اللوحة: لا يوجد رسم لكل نواة معالج، ولا قائمة بآلاف السطور، ولا تفاصيل كل تنبيه أمني. فالصفحة الرئيسية للإجابة في ثوان عن «هل كل شيء بخير؟»، وكل لوح فيها يجب أن يقود إلى مكان التفاصيل: لوحة السيرفر من المقال الأول، ولوحة الخدمة من مقال الإشارات الذهبية، وLoki للسجلات، وWazuh للأمن.
الفحص المستقل Independent Check خارج البوابة
كل ما في هذه البوابة يعتمد على سيرفر المراقبة، فإذا توقف توقفت البوابة كلها، ولن ترسل أي تنبيه، والصفحة الرئيسية لن تفتح أصلاً. لذلك يبقى في التصميم Uptime Kuma، ولكن في مكانه الصحيح هذه المرة: على سيرفر آخر، يفحص الموقع وصفحة الصحة في Prometheus وGrafana، ويستقبل نبض Watchdog من Alertmanager، ويرسل تنبيهه بطريق لا يمر بسيرفر المراقبة، كما بنينا ذلك وجربناه بإيقاف Prometheus في مقال فحص التوفر. ولا تنقل إليه الفحوص اليومية، فهي في Blackbox حتى تكون في البوابة مع بقية الأرقام، ويكفيه عدد قليل من الفحوص المهمة جداً.
حماية البوابة نفسها Portal Security
البوابة الواحدة تعني أيضاً هدفاً واحداً: من يدخل إلى Grafana يرى أسماء كل السيرفرات، وإصدارات البرامج، والثغرات غير المصلحة في كل Image، وأي عناوين تحاول تخمين كلمات المرور، وهذه بالضبط المعلومات التي يبحث عنها المخترق قبل أن يبدأ. لذلك تحتاج البوابة الحماية نفسها التي تعطيها لأي نظام حساس، وفي المختبر تركنا الدخول المجهول Anonymous بصلاحية القراءة حتى نأخذ الصور، وهذا لا يكون في الإنتاج أبداً. والقواعد التي تناسب فريقاً صغيراً:
- الدخول: Grafana خلف Reverse Proxy مع HTTPS، ومع الدخول الموحد SSO إذا كان لديكم، وكلمة مرور المدير تتغير من أول تشغيل، ولا يوجد دخول مجهول.
- الأدوار: أغلب الفريق بصلاحية المشاهدة Viewer، وقلة بصلاحية التعديل Editor، والمدير Admin لشخص أو شخصين. ولأن اللوحات في Git فالتعديل الحقيقي يمر بمراجعة الكود، وصلاحية التعديل في الواجهة للتجربة فقط.
- صلاحيات مصادر البيانات: مستخدم Wazuh الذي بنيناه يقرأ فقط، ومع ذلك فمن يستطيع أن يكتب استعلاماً في Grafana يستطيع أن يقرأ كل ما في الفهارس المسموحة، فإذا كان في التنبيهات الأمنية بيانات شخصية، مثل أسماء مستخدمين أو عناوين، فقيد مصدر البيانات بفريق محدد عبر صلاحيات Grafana نفسها.
- الشبكة: Alloy يدفع البيانات إلى سيرفر المراقبة، أي أن الاتصال يخرج من سيرفرات التطبيقات ولا يدخل إليها، وهذا أفضل من فتح منفذ node_exporter على كل سيرفر. ولكن نقطة الاستقبال
/api/v1/writeفي Prometheus تقبل أي بيانات من أي أحد يصل إليها، فلا تفتحها إلا للشبكة الخاصة بين السيرفرات، أو ضع أمامها Reverse Proxy مع مصادقة، وAlloy يدعم المصادقة الأساسية والـ TLS في كتلةendpointبحسب توثيقprometheus.remote_write. - الأسرار: كلمات مرور مصادر البيانات في متغيرات بيئة أو مدير أسرار، كما فعلنا بالمتغير
$WAZUH_RO_PASSWORD، وليس في الملفات التي تحفظ في Git.
ما الذي لا تفعله البوابة؟ Limits
من الإنصاف أن نختم بحدود هذا التصميم، حتى لا يحمله الفريق أكثر مما يحتمل. فالبوابة تجمع الإشارات في مكان واحد، ولكنها لا تحلل الحوادث بنفسها، ولا تربط تلقائياً بين ارتفاع الأخطاء في المتجر وتنبيه أمني على السيرفر نفسه في الدقيقة نفسها، فهذا ما يفعله إنسان يفتح الصفحة ويرى اللونين معاً. ولا تغني عن لوحة Wazuh في التحقيق الأمني، فالملخص يقول إن هناك ستة تنبيهات بمستوى عال، وتفاصيلها، أي الأوامر التي نفذت والملفات التي تغيرت، في Wazuh. ولا تغني عن التتبع الموزع Distributed Tracing عندما تكبر الخدمات وتصبح الطلبات تمر بخمس خدمات، وقد شرحناه في دليل التتبع الموزع، ويمكن إضافته إلى البوابة نفسها لاحقاً كمصدر بيانات آخر. وأخيراً، البوابة تعتمد على أن كل شيء يرسل إليها، فالسيرفر الجديد الذي أضافه أحدهم دون Alloy لن يظهر فيها أبداً، ولن ينبهك أحد أنه غير موجود، ولهذا السبب يبقى تدقيق التغطية عملاً دورياً كل بضعة أشهر، وليس خطوة تقوم بها مرة واحدة في البداية.
خطة التنفيذ Rollout Plan لفريق صغير
لا تحاول بناء كل ما في هذا المقال في أسبوع واحد، فالترتيب أهم من السرعة، وكل خطوة يجب أن تعمل وتجرب قبل التالية:
| الأسبوع | العمل | كيف تعرف أنه انتهى |
|---|---|---|
| 1 | تدقيق التغطية بالجدول، وقائمة الفراغات، وقرار لكل أداة | وثيقة واحدة يوافق عليها الفريق |
| 1 | التحقق من سعة سيرفر موجود، أو طلب جهاز افتراضي بقرص مستقل | أسبوعا مقاييس للسيرفر المرشح |
| 2 | Prometheus مع Alertmanager وGrafana على سيرفر المراقبة، ومصادر البيانات في Git | إعادة البناء من الصفر تعطي النتيجة نفسها |
| 2 | Alloy مع cAdvisor على كل سيرفر، وميزانية Prometheus مكتوبة | كل السيرفرات في لوح «آخر بيانات»، وتجربة OOM تعد |
| 3 | Loki بمدة احتفاظ مكتوبة، وسجلات الـ Containers والـ Proxy | قراءة عدادي Loki بعد أسبوع وإعادة حساب الميزانية |
| 3 | Blackbox للمواقع والشهادات، ومفاتيح الرجل الميت للمهام المجدولة | إيقاف مهمة تجريبية يطلق التنبيه |
| 4 | مستخدم القراءة في Wazuh ومصدر البيانات وألواح الأمن | اختبار الطلبات الخمسة، والاختبار في Grafana يقول OK |
| 4 | Trivy كل ليلة، وRenovate في المستودعات، وقواعد الثغرات | ثغرة حرجة تجريبية تصل إلى المناوب، والعالي إلى الملخص |
| 5 | نقل Kuma إلى سيرفر آخر، وWatchdog، وحذف الأدوات القديمة | إيقاف سيرفر المراقبة يصل تنبيهه من الخارج |
أخطاء شائعة Common Mistakes
- البدء بالتثبيت قبل التدقيق: أداة خامسة فوق أربع أدوات لا يعرف أحد ماذا تغطي.
- المراقبة على قرص Wazuh: سجلات التطبيق تملأ القرص ويتوقف استقبال الأحداث الأمنية.
- ميزانية تخزين بعد الامتلاء: الاحتفاظ الافتراضي في Prometheus 15 يوماً، وفي Loki لا يحذف شيء حتى تفعل ال Compactor.
- كل سجل في نظامين: ضعف المساحة وضعف العمل دون فائدة.
- مستخدم المدير في مصدر البيانات: أي شخص يعدل لوحة يستطيع أن يقرأ أو يحذف كل فهارس الأمن.
- الثقة في المكون المدمج دون تجربة: رأينا عداد نفاد الذاكرة يقول صفراً بعد خمس مرات قتل.
- تحويل كل تسمية Docker إلى تسمية: سلاسل كثيرة ومسارات ملفات مكشوفة، وذاكرة Alloy 838 MiB بدل 125.
- التنبيه على كل ثغرة عالية: 45 من 50 في Image الـ Python ليس لها إصلاح، فالتنبيه يطلق كل يوم بلا عمل.
- إصدار OpenSearch خاطئ في المصدر: الإضافة تبني الاستعلامات بحسبه، فحدثه مع كل ترقية لـ Wazuh.
- البوابة بلا فحص مستقل: إذا توقف سيرفر المراقبة توقفت البوابة وتنبيهاتها معاً.
- نقل لوحة Wazuh إلى Grafana: البوابة للملخص والرابط، والتحقيق في Wazuh نفسه.
قائمة تحقق Checklist للبوابة
| البند | كيف تتحقق منه |
|---|---|
| جدول التدقيق مكتمل، وقائمة الفراغات مغطاة | كل سطر في قائمة الفراغات له لوح أو تنبيه |
| سيرفر المراقبة بقرص لا يشاركه Wazuh | df على السيرفرين، وقرص منفصل لكل منهما |
| ميزانية تخزين مكتوبة لكل نظام | retention.time وretention.size في Prometheus، وretention_period مع ال Compactor في Loki |
| كل السيرفرات ترسل | لوح «آخر بيانات من السيرفر» أقل من دقيقتين لكل سيرفر |
| أحداث نفاد الذاكرة تعد | Container تجريبي بحد ذاكرة صغير، والعداد يطابق Docker |
| تسميات الـ Containers محدودة | لا توجد سلاسل تبدأ تسمياتها بـ container_label_ |
| مصدر Wazuh بمستخدم قراءة فقط | طلب كتابة وحذف يرجع 403، والاختبار في Grafana OK |
| إصدار OpenSearch في المصدر يطابق مفهرس Wazuh | الإصدار في ملف الإعداد مقابل ملف الإصدارات لإصدار Wazuh عندك |
| فحص Trivy الليلي يعمل | لوح «ساعات منذ فحص Trivy» أقل من 26 |
| الحرج القابل للإصلاح عاجل، والعالي في الملخص | رسالة إلى المناوب للأول، ولا شيء للثاني قبل التاسعة صباحاً |
| فحص مستقل خارج سيرفر المراقبة | إيقاف Prometheus يصل تنبيهه من الخارج |
تدريب عملي Practice
- طبق جدول التدقيق على بيئتك الحالية، حتى لو كانت أداة واحدة فقط، واكتب قائمة الفراغات قبل أن تثبت أي شيء.
- أضف إلى الدور
grafana_wazuh_readالإجراءcluster:monitor/mainوحده، وتأكد أن زر Get Version في Grafana يعمل، وأن طلب الكتابة ما زال يرجع 403.
حذف المختبر Cleanup
docker rm -f $(docker ps -aq --filter name=mon-p-)
docker volume rm mon-p-loki-data mon-p-prom-data mon-p-trivy-cache
docker network rm mon-net
docker rmi opensearchproject/opensearch:2.19.6 grafana/loki:3.7.9 grafana/alloy:v1.21.3 aquasec/trivy:0.76.1 \
  ghcr.io/google/cadvisor:v0.60.6 prom/alertmanager:v0.34.2 prom/blackbox-exporter:v0.29.1 \
  prom/node-exporter:v1.12.1 prom/prometheus:v3.15.1 grafana/grafana:13.3.0
الخلاصة Summary
وصلنا لنهاية الموضوع ونهاية السلسلة، وأهم ما فيه:
- ابدأ بتدقيق التغطية لما هو موجود، فالهدف معرفة الفراغات وليس تثبيت أداة جديدة.
- Grafana هو البوابة الوحيدة، والمراقبة على سيرفر مستقل بقرصه، وWazuh يبقى نظام الأمن على سيرفره، ويقرأ منه Grafana ملخصات بمستخدم لا يستطيع إلا القراءة.
- ميزانية التخزين من اليوم الأول: قرابة 3,000 سلسلة لكل سيرفر في مختبرنا، و148 MB من السجلات في اليوم لمتجر صغير، ثم أعد الحساب بأرقامك بعد أسبوع.
- جرب كل حدث تريد التنبيه عليه، فقد عد المكون المدمج صفراً من خمس مرات قتل، وكشف خيار افتراضي مسارات الملفات في التسميات.
- مفهرس Wazuh 4.14.9 مبني على OpenSearch 2.19.6، وعلى هذا الإصدار تحققنا من مصدر القراءة، ومن فحص الاتصال بنمط الفهرس اليومي.
- الثغرة الحرجة التي لها إصلاح عاجلة، والعالية في الملخص الصباحي، وما ليس له إصلاح في اللوحة، وفحص مستقل من الخارج يراقب البوابة نفسها.
 دليلمقاييس السيرفرات Metrics: Prometheus مع لوحات Grafanaنجمع مقاييس المعالج والذاكرة والقرص والـ Containers مع Prometheus، ونتنبأ بموعد امتلاء القرص قبل أن يحدث، ونبني لوحة Grafana محفوظة ككود في Git.
 دليلالإشارات الذهبية Golden Signals: ماذا تقيس في خدمتك؟نضيف القياس إلى خدمة دفع حقيقية ونضغط عليها حتى تنهار، فنرى لماذا انتظر المستخدم ست ثوان والمعالج عند 5% دون خطأ واحد.
 دليلفحص التوفر Uptime Checks: من يراقب سيرفر المراقبة؟نفحص الموقع والشهادة وRedis من الخارج مع Blackbox Exporter وUptime Kuma، ونكشف النسخ الاحتياطي الذي توقف بصمت، ونتأكد أن أحداً يراقب سيرفر المراقبة نفسه.
 دليلالتنبيهات Alerting: ماذا تنبه عليه ومتى توقظ أحداً؟نبني مع Alertmanager تنبيهات تصل فيها المشكلة الواحدة في رسالة واحدة، والعاجل فوراً والروتيني في ملخص صباحي، ونجرب كل قرار بالثواني.
 دليلمراقبة السيرفرات مع Wazuh: من السجل Log إلى حظر المهاجمشغلنا Wazuh مع وكيل على سيرفر تجريبي، فكشف تخمين كلمات مرور SSH وحظر المهاجم تلقائياً، ونبه على ملف PHP دخيل خلال ثانية.
 دليلجمع السجلات Logs مركزياً مع Grafana Lokiكيف تشغل Grafana Loki مع Alloy وGrafana، وتختار التسميات Labels التي لا توقف الإدخال، ثم تبحث وتنبه وتحذف بلغة LogQL.
 دليلفحص ال Docker Images وملفات البنية ككود IaCماذا يرى فاحص الثغرات داخل ال Docker Image وما الذي يفوته، وكيف تختار Base Image أصغر وتجعل الفحص بوابة في خط CI.
 دليلأي ثغرة تصلح أولاً؟ ترتيب الأولوية Prioritization بلغة بسيطةفحصنا ثلاث Containers فظهرت 5025 نتيجة، فرتبناها بالتقييم CVSS واحتمال الاستغلال EPSS وقائمة KEV لنعرف ما يصلح هذا الأسبوع.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر بإصدارات Grafana 13.3.0 مع إضافة OpenSearch 2.34.6، وPrometheus 3.15.1، وLoki 3.7.9، وGrafana Alloy 1.21.3، وcAdvisor 0.60.6، وAlertmanager 0.34.2، وBlackbox Exporter 0.29.1، وTrivy 0.76.1، وOpenSearch 2.19.6 بديلاً عن مفهرس Wazuh 4.14.9 المبني عليه، على Docker Engine 29.8.0.