


غالباً مر عليك هذا المشهد: تفتح ملف CSV صدره لك نظام ما، أو رسالة بريد قديمة، أو صفحة موقع بعد نقله إلى سيرفر جديد، فتجد بدل «السلام عليكم» سطراً مثل «Ø§Ù„سلام عليكم»، أو حروفاً عربية غريبة مثل «ط§ظ„ط³ظ„ط§ظ…»، أو علامات استفهام في كل مكان. وقد تقابل أخطاء أخفى من ذلك: اسم عميل لا يجده البحث رغم أنه مكتوب أمامك في القاعدة، وحقل في قاعدة البيانات يرفض اسماً فيه رمز تعبيري، وعمود في ملف لا يجده الكود رغم أن اسمه صحيح، ونص يقطع عند حد معين فيظهر في آخره مربع غريب. وكل هذه المشاكل لها سبب واحد: النص في الحاسب ليس حروفاً، وإنما أرقام وبايتات، وبين الحرف الذي تراه والبايت الذي يحفظ خطوات يمكن أن تخطئ فيها أي طبقة من طبقات النظام.
وفي مقال الترميز Base64 وBase32 وBase58 مررنا سريعاً على ASCII وUnicode وUTF-8 لأننا احتجناها لشرح Base64، وفي مقال التعريب i18n والنص ثنائي الاتجاه BiDi شرحنا كيف يعرض النص العربي على الشاشة، أما هنا فسوف نتابع نصاً عربياً واحداً، «السلام عليكم»، من لحظة كتابته إلى أن يحفظ في ملف ويرسل ويقرأ ويخزن في قاعدة بيانات ويقارن ويقطع، ونرى بايتاته الحقيقية في كل خطوة بتجربة في Python. وسوف نناقش في هذا المقال ما يلي:
- لماذا يحتاج النص إلى ترميز Character Encoding، والفرق بين مجموعة الحروف وطريقة تحويلها إلى بايتات.
- ASCII وصفحات الترميز Code Pages مثل Windows-1256 وISO-8859-6، ولماذا لم تكف.
- Unicode ونقاط الرمز Code Points، ثم UTF-8 وUTF-16 وUTF-32 بايتاً بايتاً، وعلامة ترتيب البايتات BOM.
- الحروف المشوهة Mojibake: كيف تحدث «Ø§Ù„» و«ط§ظ„»، وكيف تعرف السبب من شكل التشويه، ومتى يمكن الإصلاح ومتى لا يمكن.
- التطبيع Normalization: لماذا تكون كلمتان متطابقتان على الشاشة مختلفتين في المقارنة.
- كم طول النص؟ نقاط الرمز والبايتات ووحدات UTF-16، وماذا يحدث إذا قطعت النص عند عدد من البايتات.
- تجربة عملية كاملة بالبايتات الحقيقية، ثم الأخطاء الشائعة وقائمة تحقق للنص العربي من الإدخال إلى قاعدة البيانات.
لماذا يحتاج النص إلى ترميز Character Encoding؟
الذاكرة والقرص والشبكة لا تحفظ إلا البايتات، أي أرقاماً من 0 إلى 255، كما شرحنا في مقال الأنظمة العددية للمبرمجين، فلكي تحفظ حرفاً يجب أن يتفق الكاتب والقارئ على جدول يقول إن هذا الرقم يعني هذا الحرف. والمشكلة كلها في كلمة «يتفق»: الملف الذي تحفظه لا يحمل في داخله اسم الجدول الذي كتب به، فإذا قرأه برنامج بجدول آخر فلن يعطيك أي خطأ، وإنما يعطيك حروفاً أخرى بكل ثقة. والصورة التالية تبين الخطوات التي يمر بها النص، والمكان الذي يحدث فيه الخطأ:
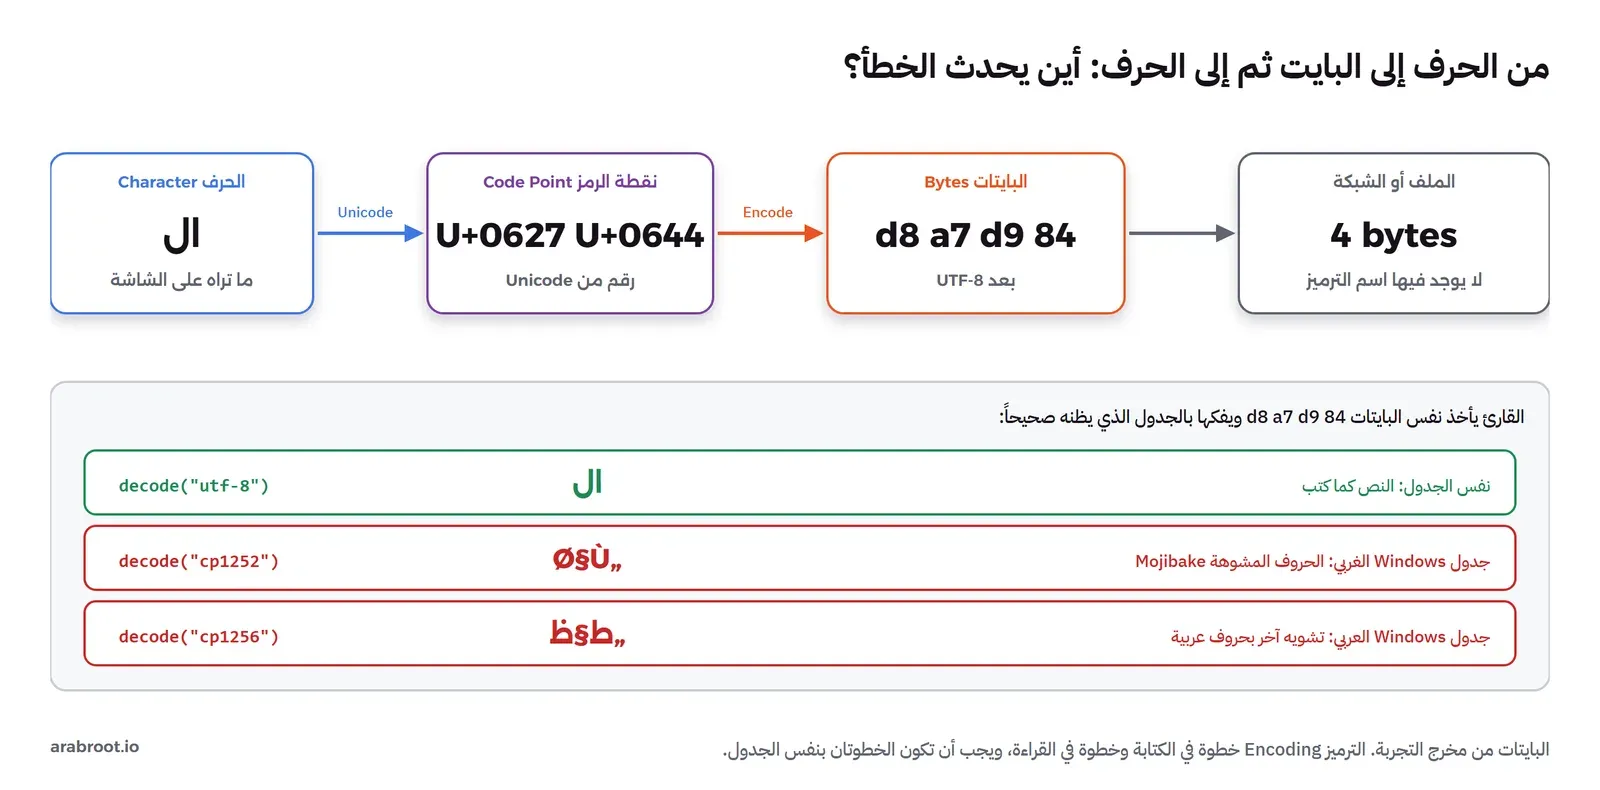
في الصورة أعلاه لاحظ التالي:
- الخطوة الأولى تعطي كل حرف رقماً، وهذا عمل مجموعة الحروف Character Set، واليوم هي Unicode في كل مكان تقريباً، فالألف U+0627 واللام U+0644.
- الخطوة الثانية تحول الرقم إلى بايت أو أكثر، وهذا هو الترميز Encoding بمعناه الدقيق، مثل UTF-8 الذي حول الحرفين إلى أربعة بايتات.
- الملف يحمل البايتات فقط، ولذلك يحتاج القارئ أن يعرف الترميز من مكان آخر: من رأس HTTP، أو من سطر
<meta charset>في الصفحة، أو من إعداد الاتصال بقاعدة البيانات، أو من افتراض البرنامج نفسه، وكل خطأ في هذه الأماكن يعطيك أحد السطرين الأحمرين.
ASCII: سبعة بتات تكفي الإنجليزية
أشهر جدول قديم هو ASCII، وقد صدر كمعيار أمريكي في الستينيات بسبعة بتات، أي 128 رقماً من 0 إلى 127، وعندما بدأت شبكة ARPANET تحتاج طريقة موحدة لتبادل النص بين الأجهزة اقترحت RFC 20 في 1969 استخدام ASCII بسبعة بتات داخل بايت من ثمانية بتات يكون البت الأعلى فيه صفراً دائماً. وفي هذه الأرقام ال 128 الحروف الإنجليزية الكبيرة والصغيرة والأرقام وعلامات الترقيم، وفي أولها 32 حرف تحكم لا تظهر على الشاشة، ومنها حرفان ما زالا يسببان مشاكل حتى اليوم: الرجوع إلى أول السطر CR ورقمه 13، والسطر الجديد LF ورقمه 10، فملفات Windows تنهي السطر بالاثنين، وملفات Linux بالثاني فقط، ولذلك يفشل سكربت Bash كتب على Windows برسالة غريبة عن حرف \r.
والمشكلة الواضحة أن ASCII لا يوجد فيه حرف عربي واحد، وإذا حاولت أن تحول كلمة عربية إليه في Python فسوف تحصل على الخطأ التالي من التجربة:
== ASCII has no Arabic
UnicodeEncodeError: 'ascii' codec can't encode characters in position 0-2: ordinal not in range(128)
والخطأ صريح: الحروف في المواقع من 0 إلى 2 أرقامها ليست أقل من 128، أي خارج الجدول، وهذا أفضل بكثير من البديل الذي سوف نراه بعد قليل، حيث لا يظهر أي خطأ.
صفحات الترميز Code Pages: لكل لغة جدولها
الحل البسيط الذي انتشر في الثمانينيات والتسعينيات كان استخدام البت الثامن الذي تركه ASCII فارغاً: الأرقام من 0 إلى 127 تبقى ASCII كما هي، والأرقام من 128 إلى 255 تضع فيها كل لغة حروفها، وكل جدول من هذه الجداول اسمه صفحة ترميز Code Page. فللعربية صفحة ISO-8859-6 من المعايير الدولية، وصفحة Windows-1256 من Microsoft، وللغات أوروبا الغربية Windows-1252، وغيرها كثير. والصورة التالية تبين ما يحدث لنفس البايت في ثلاث صفحات، والقيم من مخرج التجربة:
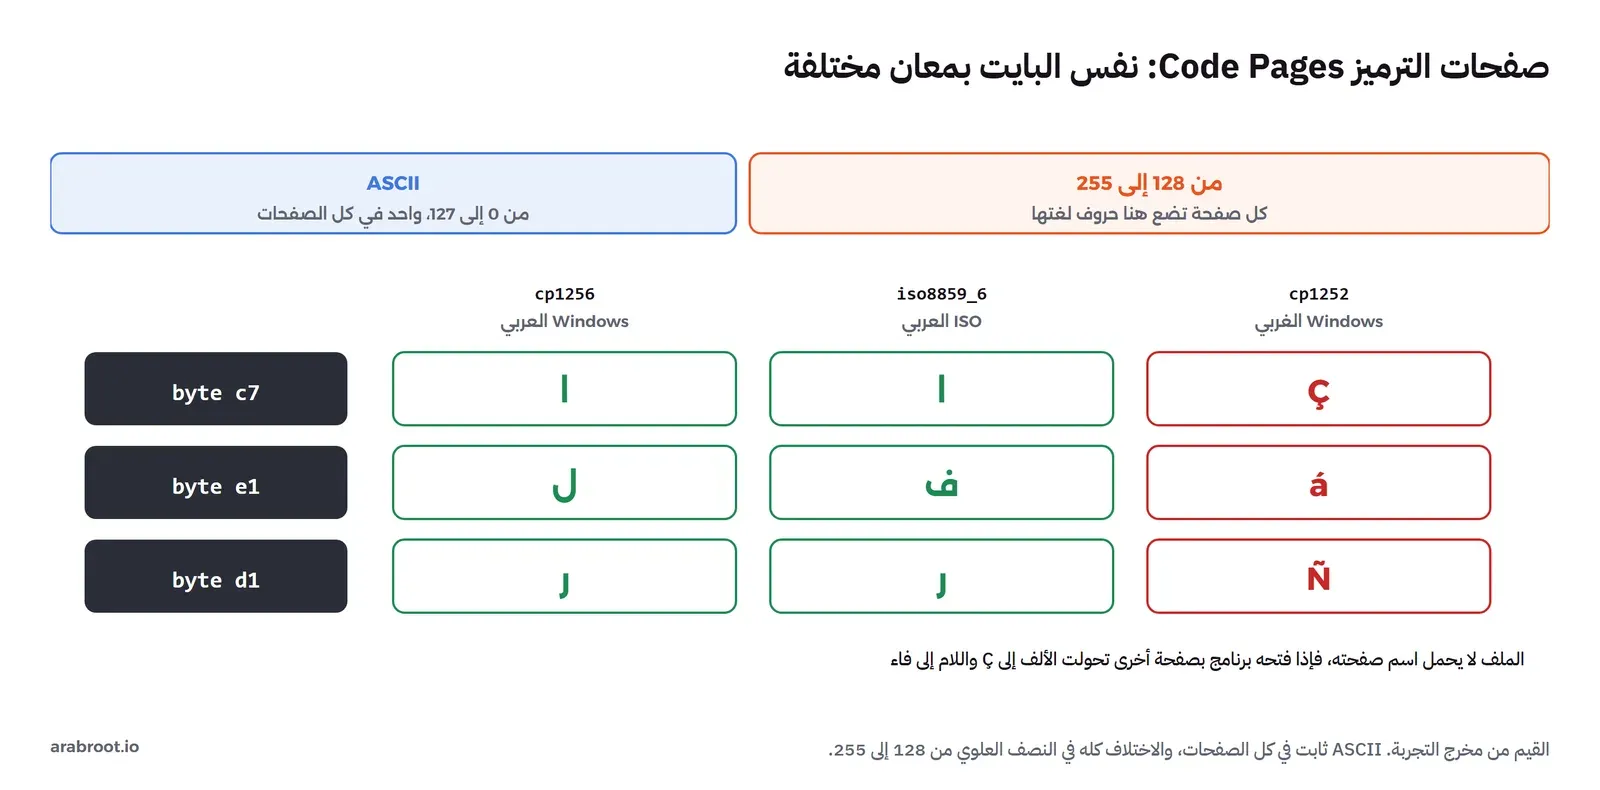
والمخرج الذي جاءت منه هذه القيم كما يلي:
== one byte, three code pages
byte c7: cp1256=ا (U+0627)   iso8859_6=ا (U+0627)   cp1252=Ç (U+00C7)
byte e1: cp1256=ل (U+0644)   iso8859_6=ف (U+0641)   cp1252=á (U+00E1)
byte d1: cp1256=ر (U+0631)   iso8859_6=ر (U+0631)   cp1252=Ñ (U+00D1)
سلام in cp1256: d3 e1 c7 e3 | in utf-8: d8 b3 d9 84 d8 a7 d9 85
في المخرج أعلاه لاحظ التالي:
- البايت
c7ألف في الصفحتين العربيتين، وÇفي الصفحة الغربية، فملف عربي يفتح بالصفحة الغربية يتحول إلى حروف فرنسية وإسبانية. - البايت
e1لام في Windows-1256 وفاء في ISO-8859-6، أي أن الصفحتين العربيتين نفسيهما غير متفقتين، فنقل ملف بينهما دون تحويل يغير الحروف العربية إلى حروف عربية أخرى، وهذا أصعب في الملاحظة من التشويه اللاتيني. - كلمة «سلام» أربعة بايتات في Windows-1256، بايت لكل حرف، وثمانية بايتات في UTF-8، وهذه كانت ميزة حقيقية للصفحات القديمة عندما كانت المساحة غالية.
ولكن الصفحات لها مشكلتان لا حل لهما من داخلها: الأولى أن المستند الواحد لا يستطيع أن يجمع لغتين من صفحتين، فلا يمكنك أن تكتب العربية والروسية في ملف واحد بصفحة واحدة، والثانية أن الملف لا يحمل اسم صفحته، فكل برنامج يخمن، وأغلب البرامج تخمن صفحة نظام التشغيل نفسه، فيفتح الملف صحيحاً على جهاز عربي ومشوهاً على جهاز إنجليزي، وهذه هي البيئة التي ولدت فيها أغلب الحروف المشوهة التي ما زالت تظهر في الأنظمة القديمة.
Unicode ونقاط الرمز Code Points: رقم واحد لكل حرف في العالم
الحل الذي جاء بعد ذلك هو Unicode: جدول واحد يعطي كل حرف في كل لغة رقماً فريداً اسمه نقطة الرمز Code Point، ويكتب عادة بالشكل U+0627، أي الرقم بالست عشري بعد U+. والجدول لا يتوقف عند 65,536 حرفاً كما ظن مصمموه في البداية، وإنما يمتد إلى الرقم U+10FFFF، وأضاف الإصدار 16.0 وحده 5,185 حرفاً ليصل المجموع إلى 154,998 حرفاً. والحروف العربية الأساسية في الكتلة من U+0600 إلى U+06FF بحسب جدول Unicode للعربية، والأرقام الأولى من U+0000 إلى U+007F هي ASCII نفسه بنفس الترتيب، وهذا قرار مقصود يجعل كل نص ASCII قديم نص Unicode صحيحاً.
وهناك فرق مهم يجب أن تفصله منذ البداية: نقطة الرمز تمثل الحرف وليس شكله على الشاشة، فحرف العين له نقطة رمز واحدة U+0639، رغم أنه يرسم بأربعة أشكال بحسب مكانه في الكلمة، والذي يختار الشكل هو محرك العرض في نظام التشغيل أو المتصفح وليس النص المحفوظ، وقد شرحنا ذلك في قسم العربية قبل الرسم في مقال الشاشة. ولكن Unicode يحتوي أيضاً على كتل قديمة اسمها أشكال العرض Presentation Forms، فيها كل شكل من أشكال الحروف العربية كحرف مستقل، مثل لام ألف U+FEFB، وقد أضيفت للتوافق مع الأنظمة القديمة التي كانت تحفظ الأشكال بدل الحروف، وسوف نرى في قسم التطبيع لماذا تسبب هذه الكتل مشاكل في البحث والمقارنة.
ولاحظ أن Unicode حتى الآن رقم فقط، ولم نتكلم بعد عن البايتات، فالرقم U+0639 يمكن أن يحفظ في بايتين أو أربعة أو بطرق أخرى، وهذا هو عمل الترميز الذي يأتي بعده.
UTF-8: الترميز الذي انتصر
أبسط طريقة لتحويل نقطة الرمز إلى بايتات هي أن تحفظ كل حرف في أربعة بايتات ثابتة، وهذا هو UTF-32، ولكنه يضاعف حجم النصوص الإنجليزية أربع مرات، ولا يعمل مع البرامج القديمة التي تعتبر البايت صفر نهاية النص. وفي سبتمبر 1992 تقريباً صمم Ken Thompson وRob Pike ترميزاً آخر على ورقة في مطعم في New Jersey كما يروي Pike في رسالته عن تاريخ UTF-8، وهو UTF-8 المعرف اليوم في RFC 3629، وفكرته أن يأخذ الحرف من بايت واحد إلى أربعة بحسب رقمه، كما في الصورة التالية:
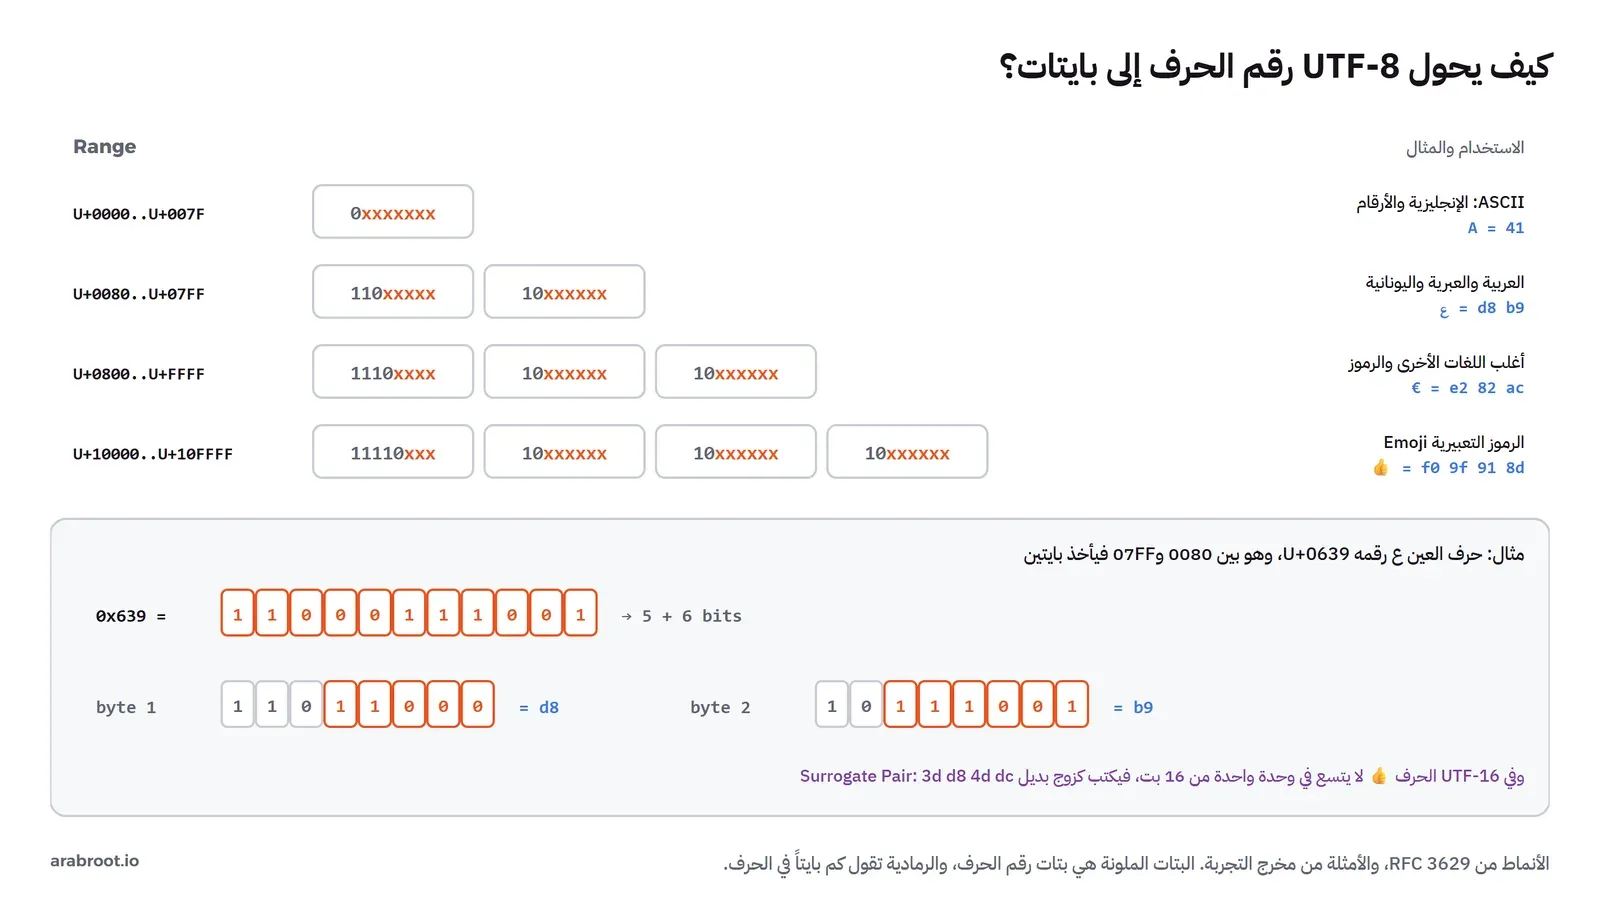
والمخرج التالي من التجربة يبين خمسة حروف بالترميزات الثلاثة:
== code points and bytes
'A'    U+0041 LATIN CAPITAL LETTER A       utf-8: 41           utf-16-le: 41 00        utf-32-le: 41 00 00 00
'ع'    U+0639 ARABIC LETTER AIN            utf-8: d8 b9        utf-16-le: 39 06        utf-32-le: 39 06 00 00
'ل'    U+0644 ARABIC LETTER LAM            utf-8: d9 84        utf-16-le: 44 06        utf-32-le: 44 06 00 00
'€'    U+20AC EURO SIGN                    utf-8: e2 82 ac     utf-16-le: ac 20        utf-32-le: ac 20 00 00
'👍'    U+1F44D THUMBS UP SIGN               utf-8: f0 9f 91 8d  utf-16-le: 3d d8 4d dc  utf-32-le: 4d f4 01 00
في المخرج أعلاه لاحظ التالي:
- الحرف
Aبايت واحد41في UTF-8، وهو نفس بايته في ASCII، أي أن كل ملف ASCII قديم ملف UTF-8 صحيح دون أي تحويل، وهذا أهم سبب لانتشار UTF-8. - العين واللام بايتان لكل منهما،
d8 b9وd9 84، وكل الحروف العربية الأساسية بايتان لأن أرقامها أقل من U+0800، والحساب في أسفل الصورة: رقم العين 0x639 أحد عشر بتاً، خمسة منها في البايت الأول بعد110وستة في الثاني بعد10. - رمز اليورو ثلاثة بايتات، والإبهام 👍 أربعة، لأن رقمه U+1F44D أكبر من 65,535.
- في UTF-16 العين بايتان
39 06، وهو الرقم 0x0639 نفسه بترتيب Little Endian الذي شرحناه في قسم ترتيب البايتات، والإبهام أربعة بايتات3d d8 4d dcلأنه لا يتسع في وحدة واحدة من 16 بت. - في UTF-32 كل حرف أربعة بايتات، فيضيع نصفها أو ثلاثة أرباعها أصفاراً في النصوص العادية.
وتصميم UTF-8 فيه خصائص أذكى مما تبدو أول مرة: لا يوجد أي بايت من حرف متعدد البايتات أقل من 128، فلا يمكن أن يظهر بايت يشبه / أو " في وسط حرف عربي فيخدع برنامجاً قديماً يبحث عنه، وكل بايت يخبرك بنفسه هل هو أول الحرف أم وسطه، فإذا بدأت القراءة من منتصف ملف تقدمت بايتات قليلة حتى تجد أول حرف كامل، وهذا اسمه التزامن الذاتي Self-Synchronization. ولذلك انتصر UTF-8 على الإنترنت بشكل شبه كامل، فبحسب إحصاء W3Techs يستخدمه 99.1% من المواقع التي يعرف ترميزها، و0.2% فقط تستخدم Windows-1252.
UTF-16 وUTF-32: أين ما زلت تقابلهما؟
قد يتساءل البعض: إذا كان UTF-8 قد انتصر فلماذا نتكلم عن UTF-16؟ والإجابة أنه ما زال داخل أدوات تستخدمها كل يوم: النصوص داخل JavaScript وJava و.NET ودوال Windows الداخلية كلها وحدات من 16 بت، لأن هذه الأنظمة صممت في التسعينيات عندما كان المتوقع أن 65,536 حرفاً تكفي العالم. وعندما تجاوز Unicode هذا الرقم أضيفت طريقة لتمثيل الحروف الكبيرة بوحدتين متتاليتين اسمها الزوج البديل Surrogate Pair بحسب RFC 2781، وهذا هو سبب أن "👍".length في JavaScript يعطي 2 وليس 1، وأن قطع النص في JavaScript عند موقع معين قد يقسم رمزاً تعبيرياً إلى نصفين لا معنى لهما. ولاحظ أن UTF-16 يحتاج أن تعرف ترتيب البايتين في كل وحدة، Big Endian أم Little Endian، وهذا يقودنا إلى علامة ترتيب البايتات.
علامة ترتيب البايتات BOM
علامة ترتيب البايتات Byte Order Mark هي الحرف U+FEFF يوضع في أول الملف، فإذا قرأه البرنامج ff fe عرف أن الملف UTF-16 بترتيب Little Endian، وإذا قرأه fe ff عرف أنه Big Endian. وفي UTF-8 لا يوجد ترتيب بايتات أصلاً، ولكن بعض البرامج، وأشهرها برامج Windows، تضع العلامة نفسها مرمزة بال UTF-8، أي البايتات ef bb bf، لتقول للقارئ «هذا الملف UTF-8»، وأسئلة Unicode الشائعة تذكر أنها مسموحة ولكنها غير مطلوبة ولا ينصح بها في كل الحالات. والمشكلة أن البرنامج الذي لا يتوقعها يعتبرها حرفاً عادياً في أول النص، وهذا ما رأيناه في التجربة على ملف CSV:
== BOM at the start of a CSV file
first bytes: ef bb bf 6e 61 6d 65 2c
keys with utf-8: ['\ufeffname', 'city']
KeyError: 'name'
keys with utf-8-sig: ['name', 'city'] -> سارة
في المخرج أعلاه لاحظ التالي:
- أول ثلاثة بايتات
ef bb bfهي العلامة، ثم يبدأ اسم العمودnameمن البايت الرابع. - عند القراءة بال
utf-8أصبح اسم العمود الأول'name'، أي أن الحرف الخفي التصق باسمه، ولا تراه إذا طبعت النص على الشاشة، ولذلك فشلrow["name"]بالخطأKeyErrorرغم أن الاسم يبدو صحيحاً تماماً. - عند القراءة بال
utf-8-sigحذف Python العلامة إذا وجدها، فرجع اسم العمود صحيحاً وخرج الاسم «سارة».
والقاعدة العملية: عند قراءة ملفات نصية قد تأتي من Windows أو Excel في Python استخدم encoding="utf-8-sig"، فهو يقرأ الملف بالعلامة وبدونها، وعند كتابة ملفات لأنظمة Linux والويب لا تقم بإضافة العلامة إلا إذا طلبها البرنامج الذي سيقرأ الملف.
الحروف المشوهة Mojibake: كيف تحدث وكيف تصلحها؟
الكلمة اليابانية Mojibake تعني «الحروف المتحولة»، وهي الاسم المعروف للنص الذي حفظ بترميز وقرئ بآخر. والصورة التالية تبين بالضبط كيف تصبح «ال» هي «Ø§Ù„»:
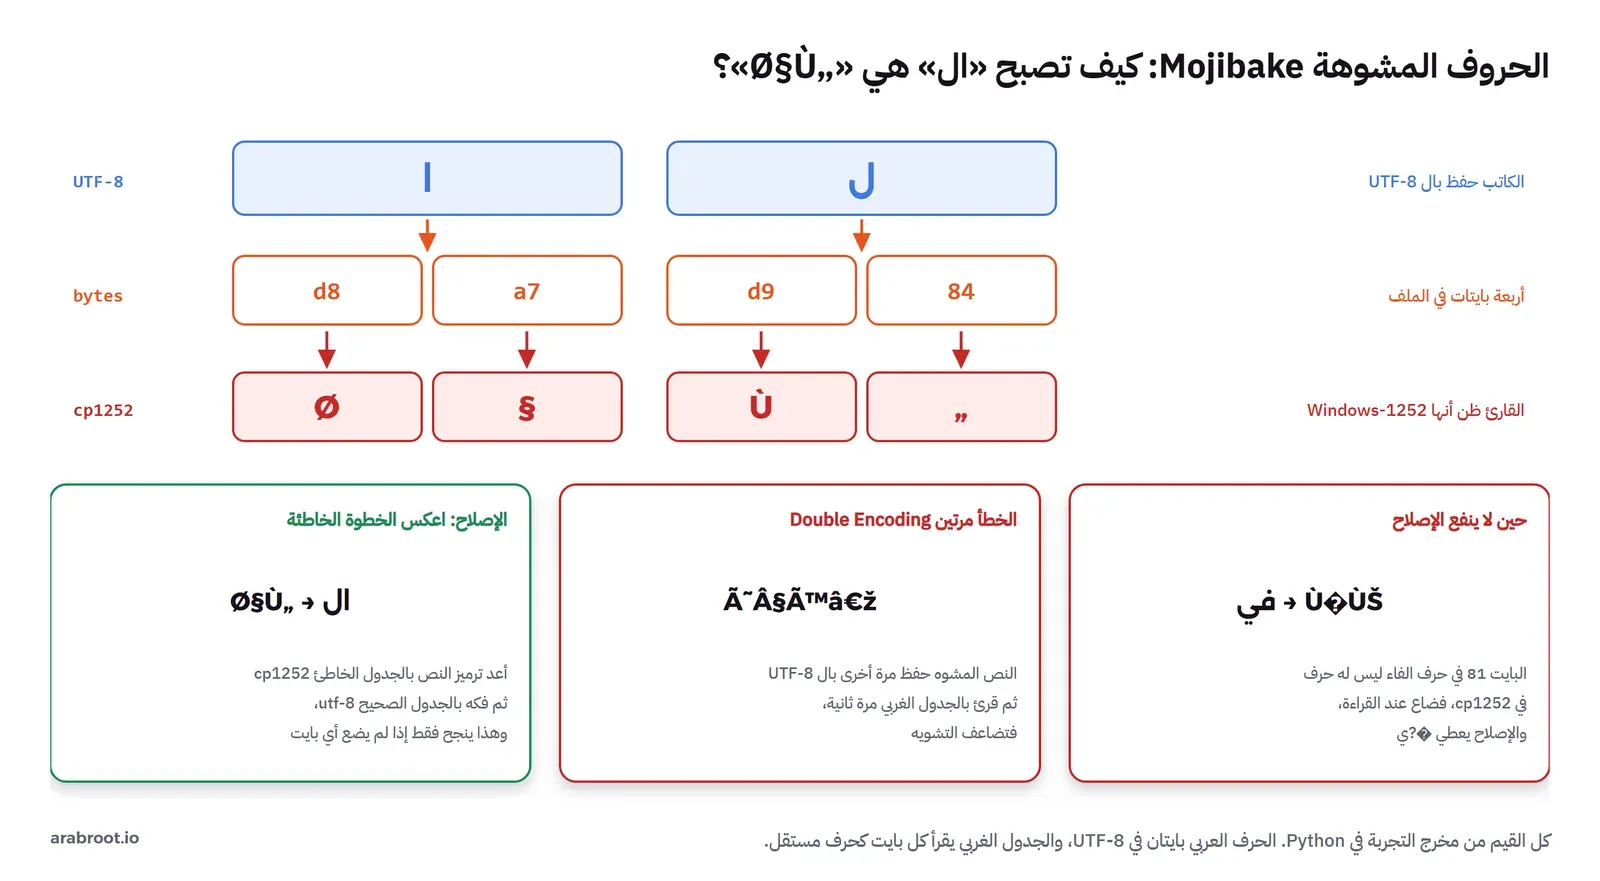
والمخرج الحقيقي من التجربة كما يلي:
== mojibake: UTF-8 bytes read as Windows-1252
ال: bytes d8 a7 d9 84 -> cp1252: ال
السلام عليكم: bytes d8 a7 d9 84 d8 b3 d9 84 d8 a7 d9 85 20 d8 b9 d9 84 d9 8a d9 83 d9 85 -> cp1252: السلام عليكم
في: bytes d9 81 d9 8a -> cp1252 failed: 'charmap' codec can't decode byte 0x81 in position 1: character maps to <undefined>
في: with errors='replace': 'Ù�ÙŠ' -> back: '�?ي'
repair: ال -> ال
decoded wrong twice: ال
utf-8 bytes read as cp1256: ط§ظ„
في المخرج أعلاه لاحظ التالي:
- «ال» أصبحت «Ø§Ù„»: البايت
d8في Windows-1252 هوØ، وa7هو§، وd9هوÙ، و84هو„، فكل حرف عربي أصبح حرفين، والحرف الأول منهما دائماًØأوÙلأن أغلب الحروف العربية في UTF-8 تبدأ بالبايتd8أوd9. - «السلام عليكم» كاملة أصبحت السطر الذي بدأنا به المقال، والمسافة بقيت مسافة لأنها
20في ASCII، ولذلك يبقى شكل الكلمات وطولها التقريبي ظاهراً في النص المشوه. - الإصلاح
repairيعكس الخطأ: نحول النص المشوه إلى بايتات بنفس الجدول الخاطئ cp1252 فنحصل على البايتات الأصلية، ثم نقرؤها بالجدول الصحيح، فرجعت «ال». - الخطأ مرتين: إذا حفظ النص المشوه مرة أخرى بال UTF-8 ثم قرئ بالجدول الغربي تضاعف التشويه إلى
ال، وهذا يحدث عندما يمر النص في نظامين خاطئين متتاليين، وعلامته الحرفÃالمتكرر. - القراءة بالجدول العربي cp1256 أعطت
ط§ظ„، أي حروفاً عربية مختلطة بالرموز، وهذا هو التشويه الذي تراه غالباً على المواقع العربية القديمة، لأن الجهاز العربي يقرأ بالصفحة العربية.
ومن هنا تستطيع أن تعرف السبب من شكل التشويه وحده: إذا رأيت Ø وÙ كثيرة فالنص UTF-8 قرئ بجدول غربي، وإذا رأيت ط وظ في أول كل حرف تقريباً فالنص UTF-8 قرئ بالصفحة العربية Windows-1256، وإذا رأيت Ã متكررة فالخطأ حدث مرتين، وإذا رأيت حروفاً عربية صحيحة ولكنها غير الحروف المقصودة فالملف نقل بين صفحتين عربيتين مختلفتين.
المشكلة التي ظهرت: كلمة «في» لا تصلح
عندما أضفنا كلمة «في» إلى التجربة فشلت القراءة بالجدول الغربي نفسها بالخطأ can't decode byte 0x81، والسبب أن حرف الفاء بال UTF-8 هو d9 81، والبايت 81 من خمسة بايتات لا يعرف لها Windows-1252 أي حرف. والمتصفحات لا تتوقف هنا، فهي تتبع مواصفة الترميز من WHATWG التي تعرف لكل بايت حرفاً ما، ولكن أدوات كثيرة تفعل ما فعلناه في السطر التالي: تضع علامة الاستبدال � مكان البايت المجهول، وعندها يضيع البايت الأصلي نهائياً، والإصلاح بعكس الخطوة أعطانا �?ي بدل «في». والدرس أن إصلاح النص المشوه بعد حفظه محاولة لا تنجح دائماً، فإذا حفظ النظام النص المشوه في قاعدة البيانات وضاعت منه بايتات فلا يوجد أي كود يعيده، والحل الحقيقي أن تصلح الطبقة التي قرأت بالجدول الخاطئ، ثم تعيد استيراد البيانات من المصدر الأصلي إن وجد.
أين تعلن الترميز Charset حتى لا يخمن أحد؟
بما أن الملف لا يحمل ترميزه، فيجب أن تعلنه في كل حدود يعبرها النص، والأماكن التي تتكرر في أي نظام هي:
- صفحات الويب: رأس HTTP
Content-Type: text/html; charset=utf-8، والسطر<meta charset="utf-8">في أول الصفحة، ومواصفة HTML تشترط أن يكون هذا السطر في أول 1024 بايتاً من الصفحة. - الملفات في الكود: مرر الترميز صراحة عند فتح أي ملف نصي، مثل
open(path, encoding="utf-8")في Python، ولا تعتمد على الافتراضي، لأن الافتراضي يختلف بين Windows وLinux بحسب توثيق الدالة open في Python. - قاعدة البيانات: ترميز القاعدة والجداول، وترميز الاتصال بين التطبيق والقاعدة، فإذا كانت القاعدة UTF-8 والاتصال بجدول آخر حفظت البايتات الخاطئة في قاعدة صحيحة.
- الملفات المتبادلة: CSV والتصدير والاستيراد، اكتب في التوثيق ترميز الملف، واقرأه بالترميز المكتوب وليس بالتخمين.
وفي MySQL بالذات مثال موثق على أن اسم الترميز وحده قد يخدعك: الترميز الذي اسمه utf8 كان لسنوات اسماً بديلاً لترميز اسمه utf8mb3، وهو يحفظ الحرف في ثلاثة بايتات كحد أقصى، أي أنه لا يستطيع أن يحفظ الحروف من U+10000 فما فوق ومنها الرموز التعبيرية، بحسب توثيق MySQL الذي يذكر أنه أصبح مهجوراً Deprecated، والترميز الكامل اسمه utf8mb4. فالنص العربي يعمل في الاثنين، لأن حروفه بايتان، ولذلك لا تلاحظ المشكلة حتى يكتب أحد العملاء رمزاً تعبيرياً في اسمه أو تعليقه، فيرفض الحقل الإدخال أو يقطعه، ولذلك لا تقم بإنشاء جداول جديدة بال utf8 في MySQL، واستخدم utf8mb4 صراحة.
التطبيع Normalization: نص متطابق على الشاشة ومختلف في الذاكرة
حتى لو كان الترميز صحيحاً في كل مكان، فهناك مشكلة أخرى: Unicode يسمح بكتابة بعض الحروف بأكثر من طريقة. فالألف التي عليها همزة «أ» لها نقطة رمز خاصة U+0623، ويمكن كتابتها أيضاً بحرفين: ألف U+0627 ثم همزة فوقها U+0654، والشكل على الشاشة واحد، ولكن المقارنة تقارن نقاط الرمز وليس الشكل. والحل هو التطبيع Normalization، أي تحويل النص إلى شكل موحد قبل المقارنة، وتعرفه الملحق UAX #15 بأربعة نماذج:
- NFC: يجمع الحرف وعلاماته في نقطة رمز واحدة إذا وجدت، وهو النموذج المناسب للحفظ والمقارنة في أغلب الحالات.
- NFD: يفصل الحرف عن علاماته، وهو مفيد إذا أردت أن تحذف العلامات أو تعالجها وحدها.
- NFKC وNFKD: مثل السابقين، ويضيفان تحويلات التوافق Compatibility، أي تحويل الأشكال القديمة والبديلة إلى الحروف الأساسية، مثل أشكال العرض العربية.
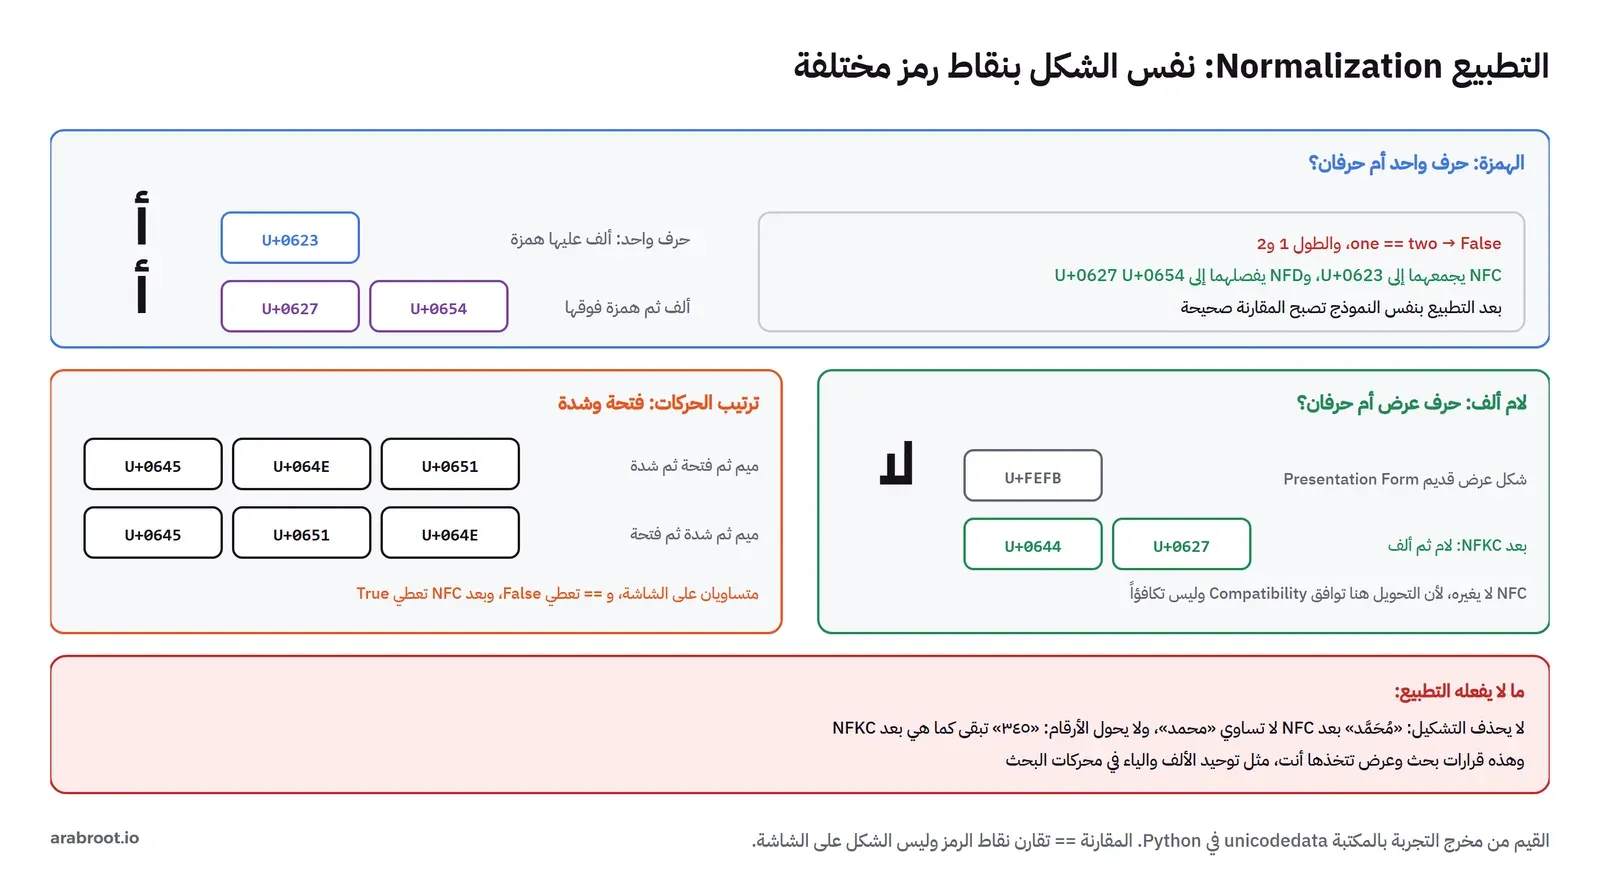
والمخرج من التجربة كما يلي:
== normalization
one == two: False | lengths: 1 2
NFC: one -> ['U+0623']  two -> ['U+0623']
NFD: one -> ['U+0627', 'U+0654']  two -> ['U+0627', 'U+0654']
fatha+shadda == shadda+fatha: False | after NFC: True | NFC order: ['U+0645', 'U+064E', 'U+0651']
U+FEFB NFC: ['U+FEFB'] NFKC: ['U+0644', 'U+0627']
Arabic yeh U+064A vs Farsi yeh U+06CC after NFKC: False | ARABIC LETTER FARSI YEH
tashkeel kept by NFC: False | digits: ٣٤٥ int: 345
في المخرج أعلاه لاحظ التالي:
- السطر الأول: «أ» بحرف واحد و«أ» بحرفين غير متساويين، وطولهما 1 و2، فإذا كان اسم العميل في القاعدة بالشكل الأول وكتبه في البحث بالشكل الثاني فلن يجده البحث.
- NFC حول الاثنين إلى U+0623، وNFD حول الاثنين إلى U+0627 U+0654، فبعد التطبيع بنفس النموذج يصبحان متساويين.
- الفتحة والشدة: يكتب البعض الشدة قبل الفتحة والبعض العكس، والشكل واحد، والمقارنة
False، وبعد NFC أصبحتTrue، لأن التطبيع يرتب العلامات بحسب رقم يسمى صنف الدمج Combining Class، فوضع الفتحة U+064E قبل الشدة U+0651. - لام ألف
U+FEFB: بقي كما هو بعد NFC، وأصبح لاماً ثم ألفاً بعد NFKC، فإذا كان النص منسوخاً من ملف PDF أو نظام قديم يحفظ أشكال العرض فلن تجده بالبحث عن «لا» إلا بعد NFKC. - الياء الفارسية: الياء العربية U+064A والياء الفارسية U+06CC حرفان مختلفان في Unicode، وشكلهما متشابه جداً في أغلب الخطوط، وNFKC نفسه لا يوحدهما كما يبين السطر قبل الأخير، فنص منسوخ من لوحة مفاتيح فارسية أو من موقع فارسي قد يحمل ياء لا يجدها البحث العربي، وهذا شيء تحتاج أن تعالجه بنفسك في البحث كما تعالج الألف والهمزات.
- ما لا يفعله التطبيع: «
مُحَمَّد» بالتشكيل لا تساوي «محمد» حتى بعد NFC، لأن التشكيل حروف حقيقية في النص وليس طريقة أخرى لكتابة نفس الحرف، والأرقام «٣٤٥» بقيت هندية بعد NFKC، ومع ذلك حولهاint()في Python إلى 345 لأنه يقبل الأرقام من كل اللغات.
وقد يتساءل البعض: لماذا لا نطبق NFKC على كل النصوص ونرتاح؟ والإجابة أن NFKC يغير المعنى أحياناً، فهو يحول الأرقام المرفوعة مثل ² إلى أرقام عادية، ويحول بعض الرموز إلى حروف، فاستخدمه في الأماكن التي تريد فيها التسامح مثل البحث وأسماء المستخدمين، واحفظ النص الأصلي بال NFC. أما حذف التشكيل وتوحيد الألف والهمزات والياء والألف المقصورة فهذه قرارات بحث خاصة بالعربية لا يفعلها Unicode، وقد شرحناها في مقال البحث في النصوص العربية.
كم طول النص؟ نقاط الرمز والبايتات ووحدات UTF-16
سؤال «كم طول هذا النص؟» له ثلاث إجابات صحيحة على الأقل، وكل لغة برمجة وقاعدة بيانات تختار واحدة منها، وهذا مصدر أخطاء كثيرة عند التحقق من الطول أو قطع النص. والصورة التالية تبين الإجابات الثلاث لخمسة نصوص:
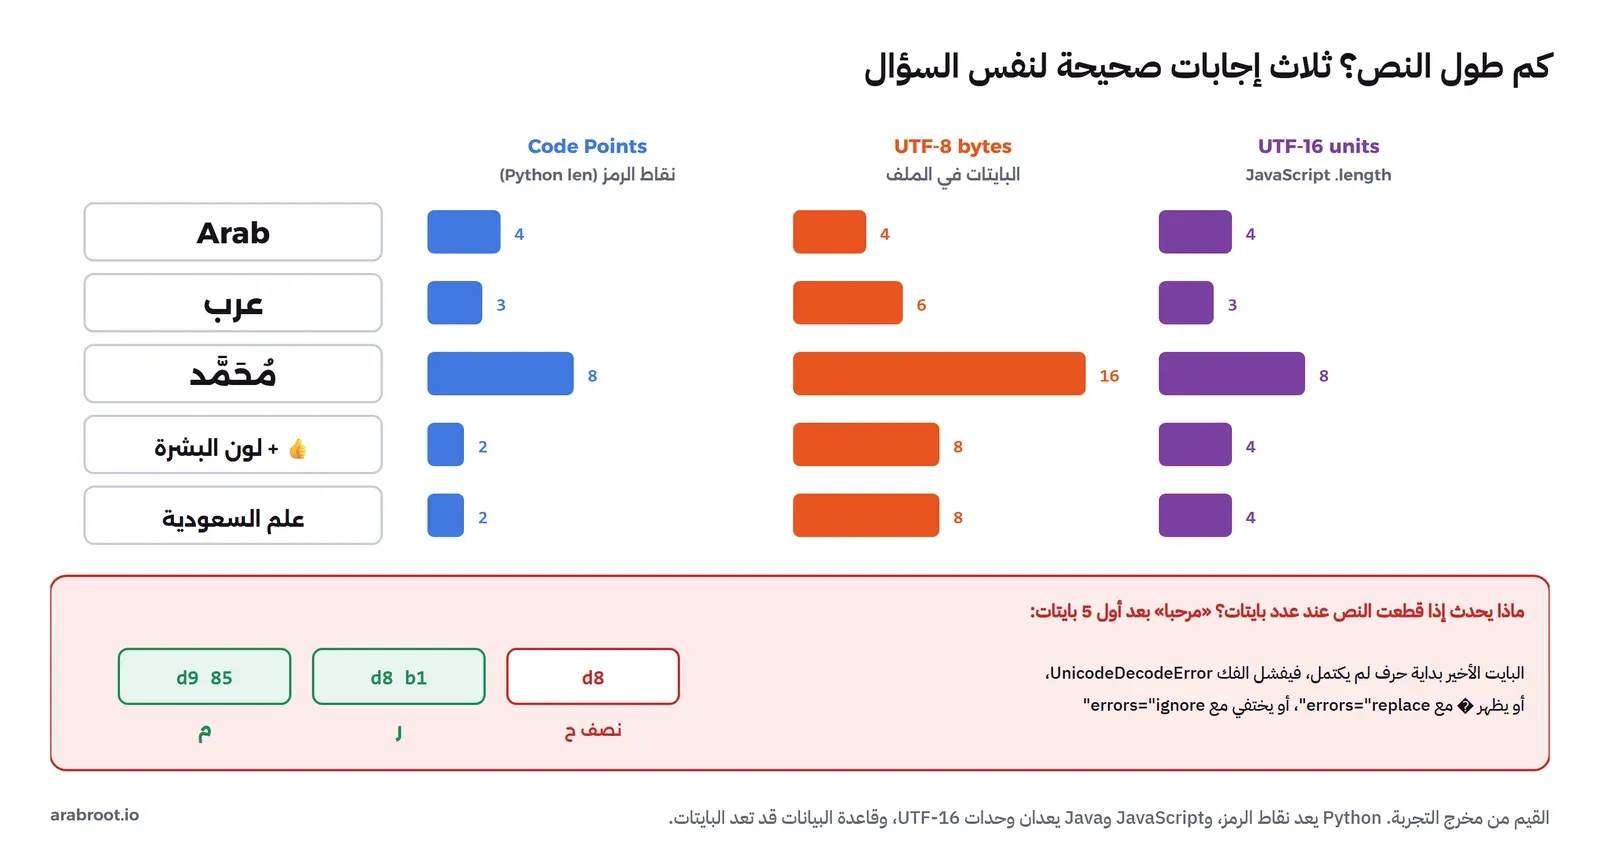
== how long is a string?
'Arab'       code points= 4  utf-8 bytes= 4  utf-16 units= 4
'عرب'        code points= 3  utf-8 bytes= 6  utf-16 units= 3
'مُحَمَّد'   code points= 8  utf-8 bytes=16  utf-16 units= 8
'👍🏽'         code points= 2  utf-8 bytes= 8  utf-16 units= 4
'🇸🇦'         code points= 2  utf-8 bytes= 8  utf-16 units= 4
في المخرج أعلاه لاحظ التالي:
- «عرب» ثلاث نقاط رمز وستة بايتات، فحقل في قاعدة بيانات يحسب الطول بالبايت يحمل نصف عدد الحروف العربية التي تتوقعها.
- «
مُحَمَّد» بالتشكيل ثماني نقاط رمز، أربعة حروف وأربع علامات، فالتشكيل يضاعف الطول، ومستخدم يكتب اسمه مشكولاً قد يتجاوز حداً يكفي نفس الاسم بدون تشكيل. - الإبهام مع لون البشرة نقطتا رمز يراهما المستخدم حرفاً واحداً، وأربع وحدات في UTF-16، أي أن
.lengthفي JavaScript يعطي 4 لما يراه المستخدم رمزاً واحداً. - علم السعودية نقطتا رمز من نوع خاص اسمه Regional Indicator، حرفا S وA، والنظام هو الذي يرسمهما علماً، وإذا لم يكن في الخط علم ظهر الحرفان كما هما.
وما يراه المستخدم حرفاً واحداً اسمه في Unicode العنقود المرئي Grapheme Cluster، وقواعد تحديده في الملحق UAX #29، والمكتبة القياسية في Python لا تعده، فإذا احتجت أن تعرض «بقي 20 حرفاً» للمستخدم بدقة فأنت تحتاج مكتبة تتبع هذا الملحق، أو الكلاس Intl.Segmenter في المتصفح.
ماذا يحدث إذا قطعت النص عند عدد من البايتات Bytes؟
هذه تجربة «ماذا يحدث إذا» في هذا المقال، وهي شيء يحدث فعلاً عندما تقطع رسالة أو اسماً لكي يتسع في حقل أو رسالة قصيرة أو سجل Log بطول محدد بالبايت. أخذنا «مرحبا»، عشرة بايتات، وقطعناها عند خمسة بايتات:
== cutting UTF-8 at a byte limit
first 5 bytes: d9 85 d8 b1 d8
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd8 in position 4: unexpected end of data
errors='replace': مر�
errors='ignore': مر
في المخرج أعلاه لاحظ التالي:
- البايتات الخمسة هي الميم
d9 85والراءd8 b1ثمd8وحده، وهو أول بايت من الحاء، فالقطع وقع في وسط حرف. - الفك العادي فشل بالخطأ
unexpected end of data، وهذا الخطأ هو الذي يوقف خدمة كاملة إذا لم تتوقعه، مثل برنامج يقرأ سجلات قطعها برنامج آخر. errors="replace"وضع علامة الاستبدال�مكان نصف الحرف، وهذا المربع الغريب الذي تراه في آخر بعض الرسائل المقطوعة.errors="ignore"حذف نصف الحرف، فبقي «مر» نظيفاً، وهذا مقبول في القطع، ولكنه خطير في بقية النص لأنه يخفي الأخطاء بصمت.
والحل الصحيح أن تقطع النص بعدد الحروف وليس البايتات، أو إذا كان الحد بالبايت فعلاً أن ترجع من نقطة القطع إلى أول بايت لا يبدأ بالبتين 10، وهذا ممكن بالضبط بسبب خاصية التزامن الذاتي في UTF-8 التي ذكرناها.
النص العربي في الروابط Percent-Encoding وأسماء النطاقات Punycode
هناك مكانان يمر فيهما النص العربي كل يوم ولا يقبلان إلا ASCII: الرابط URL واسم النطاق Domain Name، والسبب أن المواصفات الأصلية لهما كتبت قبل Unicode، وما زالت البرامج في الطريق، من الخوادم إلى أجهزة الشبكة، تفترض ذلك. ولذلك لا يرسل المتصفح الحرف العربي في الرابط كما هو، وإنما يحوله إلى بايتات UTF-8 أولاً، ثم يكتب كل بايت بالشكل % ثم رقمين بالست عشري، وهذا اسمه Percent-Encoding وتعرفه RFC 3986. أما اسم النطاق فيمر بتحويل آخر اسمه Punycode معرف في RFC 3492، يحول كل جزء من الاسم إلى حروف ASCII تبدأ بالبادئة xn--. والمخرج التالي من التجربة يبين الاثنين على رابط بنفس أسلوب روابط هذا الموقع، وعلى نطاق عربي تحت النطاق العلوي «السعودية»:
== Arabic in URLs and domain names
path: %D8%AA%D8%B1%D9%85%D9%8A%D8%B2-%D8%A7%D9%84%D9%86%D8%B5%D9%88%D8%B5
back: ترميز-النصوص
percent bytes == utf-8 bytes: True
domain: b'xn--mgbh0fb.xn--mgberp4a5d4ar'
في المخرج أعلاه لاحظ التالي:
- السطر
pathهو نفس بايتات UTF-8 التي رأيناها في أول المقال، فالتاء%D8%AAوالراء%D8%B1، والشرطة بقيت كما هي لأنها من ASCII المسموح في الروابط، وهذا هو الشكل الذي تراه عندما تنسخ رابطاً عربياً من المتصفح وتلصقه في برنامج آخر. - السطر الثالث يتحقق أن البايتات بعد فك ال Percent-Encoding هي بايتات UTF-8 نفسها، أي أن الرابط العربي ليس ترميزاً جديداً، وإنما UTF-8 مكتوب بحروف يقبلها الرابط.
- اسم النطاق «مثال.السعودية» أصبح
xn--mgbh0fb.xn--mgberp4a5d4ar، والجزء الثاني هو النطاق العلوي «السعودية» نفسه كما هو مسجل في قاعدة النطاقات العليا في IANA، فالخادم وسجلات DNS وشهادة TLS كلها ترى الشكل الثاني، والمتصفح وحده يعرض لك الشكل العربي.
وهذا يفسر مشكلتين تقابلهما في العمل: الأولى رابط عربي يعمل في المتصفح ويفشل في سكربت، لأن السكربت أرسل الحروف العربية كما هي أو رمزها بصفحة غير UTF-8، فاستخدم دائماً دالة الترميز في مكتبتك مثل urllib.parse.quote ولا تبن الرابط بيدك. والثانية سجلات الخادم Logs التي تحفظ الروابط بالشكل المرمز، فإذا بحثت فيها عن كلمة عربية فلن تجدها حتى تبحث بشكلها المرمز أو تفك الرابط أولاً. ولاحظ أن الدالة encode("idna") في مكتبة Python القياسية تطبق النسخة القديمة من قواعد النطاقات IDNA 2003، وهي كافية لهذا المثال، ولكن الأنظمة التي تسجل نطاقات أو تتحقق منها تستخدم مكتبات تطبق القواعد الأحدث.
كيف تعرف ترميز ملف لا تعرف مصدره؟ Encoding Detection
قد يتساءل البعض: إذا وصلني ملف قديم لا أعرف ترميزه، ألا يوجد أمر يخبرني به؟ والإجابة الصادقة أنه لا توجد طريقة مضمونة، لأن أي سلسلة بايتات هي نص صحيح في Windows-1252 مثلاً، كما رأينا عندما قرأ الجدول الغربي بايتات UTF-8 دون أي خطأ. والذي تملكه هو أدلة ترجح احتمالاً على آخر، وترتيبها من الأقوى إلى الأضعف كما يلي:
- علامة BOM: إذا بدأ الملف ب
ef bb bfفهو UTF-8 تقريباً بالتأكيد، وإذا بدأ بff feأوfe ffفهو UTF-16. - نجاح الفك بال UTF-8: قواعد UTF-8 صارمة، فالبايت الذي يبدأ بالبتين
10لا يأتي إلا بعد بايت أول صحيح، ولذلك فإن ملفاً طويلاً بصفحة قديمة فيه حروف عربية سوف يفشل غالباً في الفك بال UTF-8، كما فشلت البايتات الخمسة المقطوعة في التجربة، فإذا نجح الفك على ملف طويل فيه حروف غير ASCII فهو غالباً UTF-8 فعلاً. - شكل الحروف بعد الفك: إذا فككته بال Windows-1256 وظهرت كلمات عربية مفهومة فهذا دليل، وإذا ظهرت حروف عربية بلا معنى فجرب ISO-8859-6، لأننا رأينا أن الصفحتين تختلفان في بعض الحروف فقط.
- أدوات التخمين: الأمر
file -iفي Linux ومكتبات التخمين تحسب احتمالات من تكرار البايتات، وهي مفيدة كبداية، ولكنها تخطئ في الملفات القصيرة، فلا تبن عليها عملية آلية دون مراجعة نتيجتها.
والقاعدة العملية لمن يستورد بيانات قديمة إلى نظام جديد: حول كل شيء إلى UTF-8 مرة واحدة عند الحدود، بعد أن تتحقق من عينة يدوياً، ثم لا تسمح لأي ترميز آخر بالدخول بعد ذلك، لأن نظاماً يخلط ترميزين في نفس الجدول أصعب بكثير في الإصلاح من نظام كل بياناته بترميز قديم واحد.
التجربة العملية Lab: كل ما سبق بالبايتات الحقيقية
كل المخرجات في هذا المقال من سكربت واحد بمكتبة Python القياسية، مقسم إلى أجزاء بحسب الأقسام، ونشغله داخل Container من python:3.13.17-slim حتى تكون النتيجة واحدة على أي جهاز، لأن الترميز الافتراضي يختلف بين الأنظمة. والسكربت كاملاً كما يلي:
# How text becomes bytes, and how it breaks. Python 3.13 standard library only:
#   docker run --rm -v "$PWD":/lab python:3.13.17-slim python /lab/text_lab.py [part]
import csv, io, sys, unicodedata, urllib.parse

def hexs(b):
    return " ".join(f"{x:02x}" for x in b)

def part(name):
    return len(sys.argv) < 2 or sys.argv[1] == name

if part("points"):
    print("== code points and bytes")
    for ch in ["A", "ع", "ل", "€", "👍"]:
        print(f"{ch!r:6} U+{ord(ch):04X} {unicodedata.name(ch):28} utf-8: {hexs(ch.encode('utf-8')):12} "
              f"utf-16-le: {hexs(ch.encode('utf-16-le')):12} utf-32-le: {hexs(ch.encode('utf-32-le'))}")

if part("ascii"):
    print("== ASCII has no Arabic")
    try:
        "عرب".encode("ascii")
    except UnicodeEncodeError as e:
        print("UnicodeEncodeError:", e)

if part("codepages"):
    print("== one byte, three code pages")
    for b in [0xC7, 0xE1, 0xD1]:
        row = []
        for cp in ["cp1256", "iso8859_6", "cp1252"]:
            try:
                ch = bytes([b]).decode(cp); row.append(f"{cp}={ch} (U+{ord(ch):04X})")
            except UnicodeDecodeError:
                row.append(f"{cp}=undefined")
        print(f"byte {b:02x}: " + "   ".join(row))
    word = "سلام"
    print("سلام in cp1256:", hexs(word.encode("cp1256")), "| in utf-8:", hexs(word.encode("utf-8")))

if part("mojibake"):
    print("== mojibake: UTF-8 bytes read as Windows-1252")
    for text in ["ال", "السلام عليكم", "في"]:
        raw = text.encode("utf-8")
        try:
            print(f"{text}: bytes {hexs(raw)} -> cp1252: {raw.decode('cp1252')}")
        except UnicodeDecodeError as e:
            print(f"{text}: bytes {hexs(raw)} -> cp1252 failed: {e}")
            lossy = raw.decode("cp1252", errors="replace")
            print(f"{text}: with errors='replace': {lossy!r} -> back: {lossy.encode('cp1252', errors='replace').decode('utf-8', errors='replace')!r}")
    bad = "ال".encode("utf-8").decode("cp1252")
    print("repair:", bad, "->", bad.encode("cp1252").decode("utf-8"))
    twice = "ال".encode("utf-8").decode("cp1252").encode("utf-8").decode("cp1252")
    print("decoded wrong twice:", twice)
    print("utf-8 bytes read as cp1256:", "ال".encode("utf-8").decode("cp1256"))

if part("bom"):
    print("== BOM at the start of a CSV file")
    data = "name,city\nسارة,مكة\n".encode("utf-8-sig")
    print("first bytes:", hexs(data[:8]))
    reader = csv.DictReader(io.StringIO(data.decode("utf-8")))
    row = next(reader)
    print("keys with utf-8:", list(row.keys()))
    try:
        print(row["name"])
    except KeyError as e:
        print("KeyError:", e)
    row = next(csv.DictReader(io.StringIO(data.decode("utf-8-sig"))))
    print("keys with utf-8-sig:", list(row.keys()), "->", row["name"])

if part("normalize"):
    print("== normalization")
    one = "أ"              # أ as one code point
    two = "أ"        # ا + hamza above
    print("one == two:", one == two, "| lengths:", len(one), len(two))
    for form in ["NFC", "NFD"]:
        print(f"{form}: one -> {[f'U+{ord(c):04X}' for c in unicodedata.normalize(form, one)]}"
              f"  two -> {[f'U+{ord(c):04X}' for c in unicodedata.normalize(form, two)]}")
    a = "مَّ"    # meem + fatha + shadda
    b = "مَّ"    # meem + shadda + fatha
    print("fatha+shadda == shadda+fatha:", a == b, "| after NFC:", unicodedata.normalize("NFC", a) == unicodedata.normalize("NFC", b),
          "| NFC order:", [f"U+{ord(c):04X}" for c in unicodedata.normalize("NFC", a)])
    lig = "ﻻ"              # lam-alef ligature (presentation form)
    print("U+FEFB NFC:", [f"U+{ord(c):04X}" for c in unicodedata.normalize("NFC", lig)],
          "NFKC:", [f"U+{ord(c):04X}" for c in unicodedata.normalize("NFKC", lig)])
    print("Arabic yeh U+064A vs Farsi yeh U+06CC after NFKC:", unicodedata.normalize("NFKC", "ي") == unicodedata.normalize("NFKC", "ی"),
          "|", unicodedata.name("ی"))
    print("tashkeel kept by NFC:", unicodedata.normalize("NFC", "مُحَمَّد") == "محمد", "| digits:", unicodedata.normalize("NFKC", "٣٤٥"), "int:", int("٣٤٥"))

if part("lengths"):
    print("== how long is a string?")
    for s in ["Arab", "عرب", "مُحَمَّد", "👍🏽", "🇸🇦"]:
        print(f"{s!r:12} code points={len(s):2}  utf-8 bytes={len(s.encode('utf-8')):2}  utf-16 units={len(s.encode('utf-16-le')) // 2:2}")

if part("truncate"):
    print("== cutting UTF-8 at a byte limit")
    raw = "مرحبا".encode("utf-8")
    cut = raw[:5]
    print("first 5 bytes:", hexs(cut))
    try:
        cut.decode("utf-8")
    except UnicodeDecodeError as e:
        print("UnicodeDecodeError:", e)
    print("errors='replace':", cut.decode("utf-8", errors="replace"))
    print("errors='ignore':", cut.decode("utf-8", errors="ignore"))

if part("url"):
    print("== Arabic in URLs and domain names")
    slug = "ترميز-النصوص"
    q = urllib.parse.quote(slug)
    print("path:", q)
    print("back:", urllib.parse.unquote(q))
    print("percent bytes == utf-8 bytes:", urllib.parse.unquote_to_bytes(q) == slug.encode("utf-8"))
    print("domain:", "مثال.السعودية".encode("idna"))
في السكربت أعلاه لاحظ التالي:
- الدالة
hexsتطبع البايتات بالست عشري، فكل ما تراه في المخرج هو البايتات كما في الذاكرة، وليس تمثيلاً لها. - كل تحويل مكتوب بترميزه صراحة:
encode("utf-8")وdecode("cp1252")، ولا يوجد أي اعتماد على الترميز الافتراضي، وهذه هي القاعدة التي ننصح بها في الكود الحقيقي أيضاً. - الأخطاء تطبع ولا تخفى: كل جزء يتوقع خطأ يلتقطه ويطبع رسالته الحقيقية، لأن رسالة الخطأ نفسها جزء مما نريد أن نتعلمه.
- الجزء
normalizeيكتب النصوص بأرقام نقاط الرمزأبدل الحروف، لأن محرر النصوص نفسه قد يطبع الحروف عند الحفظ فتختفي التجربة. - يمكن تشغيل جزء واحد بتمرير اسمه، مثل
python /lab/text_lab.py mojibake.
ونشغله بالأمر التالي من مجلد lab:
docker run --rm -v "$PWD":/lab python:3.13.17-slim python /lab/text_lab.pyوالمخرج كاملاً سوف يكون كما يلي، وقد شرحنا كل جزء منه في القسم الخاص به:
== code points and bytes
'A'    U+0041 LATIN CAPITAL LETTER A       utf-8: 41           utf-16-le: 41 00        utf-32-le: 41 00 00 00
'ع'    U+0639 ARABIC LETTER AIN            utf-8: d8 b9        utf-16-le: 39 06        utf-32-le: 39 06 00 00
'ل'    U+0644 ARABIC LETTER LAM            utf-8: d9 84        utf-16-le: 44 06        utf-32-le: 44 06 00 00
'€'    U+20AC EURO SIGN                    utf-8: e2 82 ac     utf-16-le: ac 20        utf-32-le: ac 20 00 00
'👍'    U+1F44D THUMBS UP SIGN               utf-8: f0 9f 91 8d  utf-16-le: 3d d8 4d dc  utf-32-le: 4d f4 01 00
== ASCII has no Arabic
UnicodeEncodeError: 'ascii' codec can't encode characters in position 0-2: ordinal not in range(128)
== one byte, three code pages
byte c7: cp1256=ا (U+0627)   iso8859_6=ا (U+0627)   cp1252=Ç (U+00C7)
byte e1: cp1256=ل (U+0644)   iso8859_6=ف (U+0641)   cp1252=á (U+00E1)
byte d1: cp1256=ر (U+0631)   iso8859_6=ر (U+0631)   cp1252=Ñ (U+00D1)
سلام in cp1256: d3 e1 c7 e3 | in utf-8: d8 b3 d9 84 d8 a7 d9 85
== mojibake: UTF-8 bytes read as Windows-1252
ال: bytes d8 a7 d9 84 -> cp1252: ال
السلام عليكم: bytes d8 a7 d9 84 d8 b3 d9 84 d8 a7 d9 85 20 d8 b9 d9 84 d9 8a d9 83 d9 85 -> cp1252: السلام عليكم
في: bytes d9 81 d9 8a -> cp1252 failed: 'charmap' codec can't decode byte 0x81 in position 1: character maps to <undefined>
في: with errors='replace': 'Ù�ÙŠ' -> back: '�?ي'
repair: ال -> ال
decoded wrong twice: ال
utf-8 bytes read as cp1256: ط§ظ„
== BOM at the start of a CSV file
first bytes: ef bb bf 6e 61 6d 65 2c
keys with utf-8: ['\ufeffname', 'city']
KeyError: 'name'
keys with utf-8-sig: ['name', 'city'] -> سارة
== normalization
one == two: False | lengths: 1 2
NFC: one -> ['U+0623']  two -> ['U+0623']
NFD: one -> ['U+0627', 'U+0654']  two -> ['U+0627', 'U+0654']
fatha+shadda == shadda+fatha: False | after NFC: True | NFC order: ['U+0645', 'U+064E', 'U+0651']
U+FEFB NFC: ['U+FEFB'] NFKC: ['U+0644', 'U+0627']
Arabic yeh U+064A vs Farsi yeh U+06CC after NFKC: False | ARABIC LETTER FARSI YEH
tashkeel kept by NFC: False | digits: ٣٤٥ int: 345
== how long is a string?
'Arab'       code points= 4  utf-8 bytes= 4  utf-16 units= 4
'عرب'        code points= 3  utf-8 bytes= 6  utf-16 units= 3
'مُحَمَّد'   code points= 8  utf-8 bytes=16  utf-16 units= 8
'👍🏽'         code points= 2  utf-8 bytes= 8  utf-16 units= 4
'🇸🇦'         code points= 2  utf-8 bytes= 8  utf-16 units= 4
== cutting UTF-8 at a byte limit
first 5 bytes: d9 85 d8 b1 d8
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd8 in position 4: unexpected end of data
errors='replace': مر�
errors='ignore': مر
== Arabic in URLs and domain names
path: %D8%AA%D8%B1%D9%85%D9%8A%D8%B2-%D8%A7%D9%84%D9%86%D8%B5%D9%88%D8%B5
back: ترميز-النصوص
percent bytes == utf-8 bytes: True
domain: b'xn--mgbh0fb.xn--mgberp4a5d4ar'
ولاحظ في هذا المخرج الكامل شيئاً لم نذكره في الأقسام: أعمدة الجدول في جزء الأطوال تبدو غير مستقيمة عند الرموز التعبيرية والكلمات المشكولة، لأن الطرفية تعرض كل نقطة رمز في خانة، بينما يأخذ الرمز التعبيري خانتين ولا تأخذ الحركات أي خانة، وهذه نفس مشكلة الطول ولكن في العرض، فعرض النص على الشاشة مسألة رابعة غير عدد الحروف والبايتات والوحدات.
أخطاء شائعة Common Mistakes في ترميز النصوص
- فتح الملفات بدون ترميز صريح: الكود يعمل على جهازك ويفشل على السيرفر أو العكس، لأن الترميز الافتراضي مختلف.
- إصلاح الحروف المشوهة في العرض بدل المصدر: رأينا أن «في» لا يمكن إصلاحها بعد أن ضاع البايت
81، فأصلح الطبقة التي قرأت بالترميز الخاطئ. - استخدام
utf8في MySQL: هوutf8mb3ولا يحفظ الرموز التعبيرية، واستخدمutf8mb4. - مقارنة نصوص أو إنشاء مفتاح فريد Unique Key دون تطبيع: «أ» بحرف و«أ» بحرفين تمران كقيمتين مختلفتين، فيتكرر الاسم نفسه في القاعدة.
- اعتبار التطبيع حلاً للبحث العربي: NFC لا يحذف التشكيل ولا يوحد الألف والهمزات، وهذه معالجة خاصة بالبحث.
- التحقق من طول النص بالبايت وعرضه للمستخدم بالحروف: «عرب» ثلاثة حروف وستة بايتات، والاسم المشكول ضعف طوله.
- قطع النص عند عدد بايتات بدون مراعاة حدود الحروف: فيظهر
�أو يتوقف البرنامج بخطأUnicodeDecodeError. - تجاهل BOM في ملفات CSV: اسم العمود الأول يصبح
nameولا تراه بعينك، واقرأ بالutf-8-sig. - الاعتماد على
.lengthفي JavaScript لعدد الحروف: هو عدد وحدات UTF-16، والرمز التعبيري الواحد قد يكون 4.
قائمة تحقق Checklist: النص العربي من الإدخال إلى قاعدة البيانات
| المرحلة | ما يجب أن تتحقق منه | كيف تتحقق |
|---|---|---|
| الصفحة والنموذج | الصفحة معلنة UTF-8 في الرأس وفي أول الصفحة | رأس Content-Type و<meta charset="utf-8"> |
| الواجهة البرمجية API | الطلبات والردود UTF-8، وJSON بدون ترميز آخر | charset=utf-8 في الرأس، واختبار بنص عربي ورمز تعبيري |
| الكود | كل فتح ملف وكل تحويل بترميز صريح | ابحث في الكود عن open( بدون encoding |
| التطبيع | تطبيع NFC عند الإدخال قبل الحفظ والمقارنة والمفاتيح الفريدة | اختبار «أ» بحرف وبحرفين |
| قاعدة البيانات | القاعدة والجداول والاتصال كلها UTF-8 كامل | utf8mb4 في MySQL، واختبار حفظ رمز تعبيري |
| الطول | الحدود معرفة بوحدة واحدة واضحة، وتشمل التشكيل | اختبار اسم مشكول طويل |
| القطع | القطع عند حدود الحروف وليس في وسطها | اختبار قطع نص عربي عند عدد فردي من البايتات |
| الملفات المتبادلة | الترميز مكتوب في التوثيق، وBOM متوقع عند القراءة | القراءة بال utf-8-sig |
| البحث | معالجة عربية فوق التطبيع: التشكيل والألف والياء | البحث عن «احمد» يجد «أحمد» |
تدريب عملي
- شغل الجزء
mojibakeبعد إضافة كلمة «تحية»، وتوقع قبل التشغيل هل تنجح القراءة بال cp1252، والسبب أن حرف الحاء في UTF-8 هوd8 ad، والبايتadفي Windows-1252 حرف خفي اسمه الواصلة الناعمة Soft Hyphen. - اكتب دالة
cut_utf8(text, limit)تعيد أطول جزء من النص لا يتجاوزlimitبايتاً ولا يقطع حرفاً، وجربها على «مرحبا» من 1 إلى 10 بايتات. - افتح أداة المطور في المتصفح واكتب
"👍🏽".lengthثم[..."👍🏽"].length، وقارن النتيجتين بجزءlengthsفي المخرج.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- النص يمر بخطوتين: حرف إلى نقطة رمز في Unicode، ثم نقطة رمز إلى بايتات بترميز مثل UTF-8، والملف لا يحمل اسم ترميزه، فيجب أن يعلن في كل حد يعبره.
- ASCII لا يعرف العربية، وصفحات الترميز أعطت كل لغة النصف العلوي من البايت فاختلفت حتى الصفحتان العربيتان، وUnicode أنهى ذلك برقم واحد لكل حرف.
- UTF-8 يحفظ ASCII كما هو والعربية في بايتين والرموز التعبيرية في أربعة، ولا يظهر في حروفه بايت يشبه ASCII، ولذلك يستخدمه 99.1% من المواقع، وUTF-16 ما زال داخل JavaScript وJava وWindows بأزواجه البديلة.
- «Ø§Ù„» هي UTF-8 قرئ بجدول غربي، و«ط§ظ„» هي UTF-8 قرئ بالصفحة العربية، والإصلاح بعكس الخطوة ينجح فقط إذا لم يضع أي بايت، كما رأينا مع «في».
- التطبيع NFC يوحد الأشكال المختلفة لنفس الحرف وترتيب الحركات، وNFKC يحول أشكال العرض القديمة، ولا يحذف أي منهما التشكيل.
- الروابط العربية هي بايتات UTF-8 مكتوبة بالشكل
%D8%AA، وأسماء النطاقات العربية تتحول إلى Punycode يبدأ بxn--، ولا توجد طريقة مضمونة لمعرفة ترميز ملف مجهول، وإنما أدلة أقواها BOM ثم نجاح الفك بال UTF-8، فحول البيانات القديمة مرة واحدة عند الحدود وراجع عينة منها بيدك. - طول النص بنقاط الرمز غير طوله بالبايت غير طوله بوحدات UTF-16، والقطع بالبايت في وسط حرف يعطيك خطأ أو علامة
�.
وفي نفس المرحلة نكمل بإذن الله إلى بقية أنواع البيانات داخل الحاسب، ومنها الترميز من ثنائي إلى نص والتاريخ والوقت:
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
 دليلالأنظمة العددية للمبرمجين: من Binary إلى Floating Pointلماذا يظهر القرص 465 بدل 500، ويصبح العداد سالباً فجأة، ولا يساوي 0.1 + 0.2 القيمة 0.3؟ الإجابة في طريقة تخزين الأرقام.
 دليلFloating Point من الداخل: كيف يخزن الحاسب الكسوركيف يحفظ معيار IEEE 754 الكسور في البتات، ولماذا تكبر الفجوة بين الأرقام وتضيع خانات المعرفات، ومتى تحتاج النوع العشري.
 دليلالتاريخ والوقت للمطورين ومديري الأنظمةلماذا يتأخر التقرير ثلاث ساعات ولا تعمل المهمة المجدولة ليلة تغيير التوقيت، وكيف تضبط الوقت في السيرفر والكود.
 دليلالتعريب i18n للمطورين: لماذا ينقلب النص العربي في الواجهة؟لماذا ينقلب النص المختلط في الواجهة العربية وكيف تعزله، وكيف تنسق الأرقام والتواريخ وصيغ الجمع العربية بأدوات المتصفح نفسها.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة بسكربت Python 3.13 بالمكتبة القياسية فقط (Docker Image python:3.13.17-slim): نقاط الرمز وبايتات UTF-8 وUTF-16 وUTF-32، وصفحات الترميز cp1256 وiso8859_6 وcp1252، والحروف المشوهة وإصلاحها، وBOM في ملف CSV، والتطبيع NFC وNFD وNFKC، وأطوال النصوص، وقطع UTF-8 عند حد بالبايت، مع رسوم من عرب رووت.


