


كل مبرمج سمع هذه الجملة في اجتماع أو في مراجعة كود: «الاحتمال ضئيل جداً، لا تقلق». قد تكون عن معرف من 32 بت يولد عشوائياً لكل طلب، أو عن رابط قصير من ستة أحرف، أو عن أول سبع خانات من هاش ال Commit في Git، أو عن سيرفرين خلف موزع الطلبات Load Balancer «لن يتوقفا معاً أبداً». والمشكلة أن هذه الجملة تقال غالباً دون رقم، وعندما تحسب الرقم فعلاً تكتشف أن 32 بت تعطيك تكراراً واحداً على الأقل باحتمال 50% بعد 77 ألف معرف فقط، مع أن عدد القيم الممكنة أكثر من أربعة مليارات، وأن الخدمة التي تنتظر 100 خدمة أخرى سوف يتأخر 63% من طلباتها حتى لو كانت كل خدمة بطيئة في 1% من الوقت فقط. والفرق بين الجملة والرقم هو موضوع هذا المقال: الاحتمالات كما تظهر في عمل المبرمج اليومي، من جهة المشكلة التقنية، مع أرقام نحسبها ونقيسها في تجربة حقيقية.
وهذا المقال من مرحلة الرياضيات التي يحتاجها المبرمج فعلاً، ويأتي بعد مقال الإحصاء للتقنيين الذي يشرح المتوسط والمئين p99، ويسبق مقال الرياضيات خلف التشفير. وقد ذكرنا في مقال المعرفات الفريدة UUID وULID وSnowflake احتمال تكرار UUIDv4 باختصار، وشرحنا في مقال مفاهيم التوفر العالي قاعدتي السلسلة والتوازي، فلن نعيد هذا الكلام هنا، وإنما نبدأ من حيث توقفا. وسوف نناقش في هذا المقال ما يلي:
- لماذا يأتي التكرار Collision أبكر بكثير مما يتوقعه الحدس، وكيف نصل من عدد الأزواج إلى معادلة مسألة يوم الميلاد Birthday Problem وقاعدة نصف البتات.
- أرقام فعلية لأحجام شائعة: معرفات 32 و64 بت، والروابط القصيرة بستة وسبعة وثمانية أحرف، والهاش القصير في Git.
- تجربة عملية في Container نحسب فيها المعادلة الدقيقة والتقريبية، ثم نبحث عن تكرار حقيقي بالمحاكاة، ومشكلتان ظهرتا أثناء التجربة.
- لماذا لا تنطبق المعادلة على CRC32، وكيف استغل المخترقون تصادم الهاش لإيقاف السيرفرات، وما علاقة ذلك بهجوم Sweet32.
- التوفر بعد السلسلة والتوازي: النصاب Quorum بالتوزيع الثنائي Binomial، وافتراض الاستقلال Independence والأعطال المترابطة Correlated Failures.
- البطء في الطلبات الموزعة Fan-out، والإعادة Retry، والقيمة المتوقعة Expected Value، ومتى تثق بالمعادلة ومتى تحتاج المحاكاة Simulation.
لماذا يأتي التصادم Collision أبكر مما تتوقع؟
لنفرض أن لديك جدولاً في قاعدة البيانات مفتاحه الأساسي رقم عشوائي من 32 بت، والسبب أن هذا الحجم يناسب عمود integer ويظهر قصيراً في الرابط. عدد القيم الممكنة 232، أي 4,294,967,296 قيمة، والحدس يقول إن التكرار يبدأ عندما تقترب من هذا العدد، أو على الأقل من نصفه، وهذا خطأ كبير، والسبب أن الحدس يفكر في سؤال آخر: «ما احتمال أن يساوي المعرف الجديد معرفاً معيناً؟»، وهذا احتمال صغير فعلاً، واحد من أربعة مليارات. أما السؤال الحقيقي فهو: «ما احتمال أن يتساوى أي معرفين في الجدول كله؟»، وهنا تكون المقارنة بين كل زوج من المعرفات، وليس بين المعرف الجديد والباقي فقط.
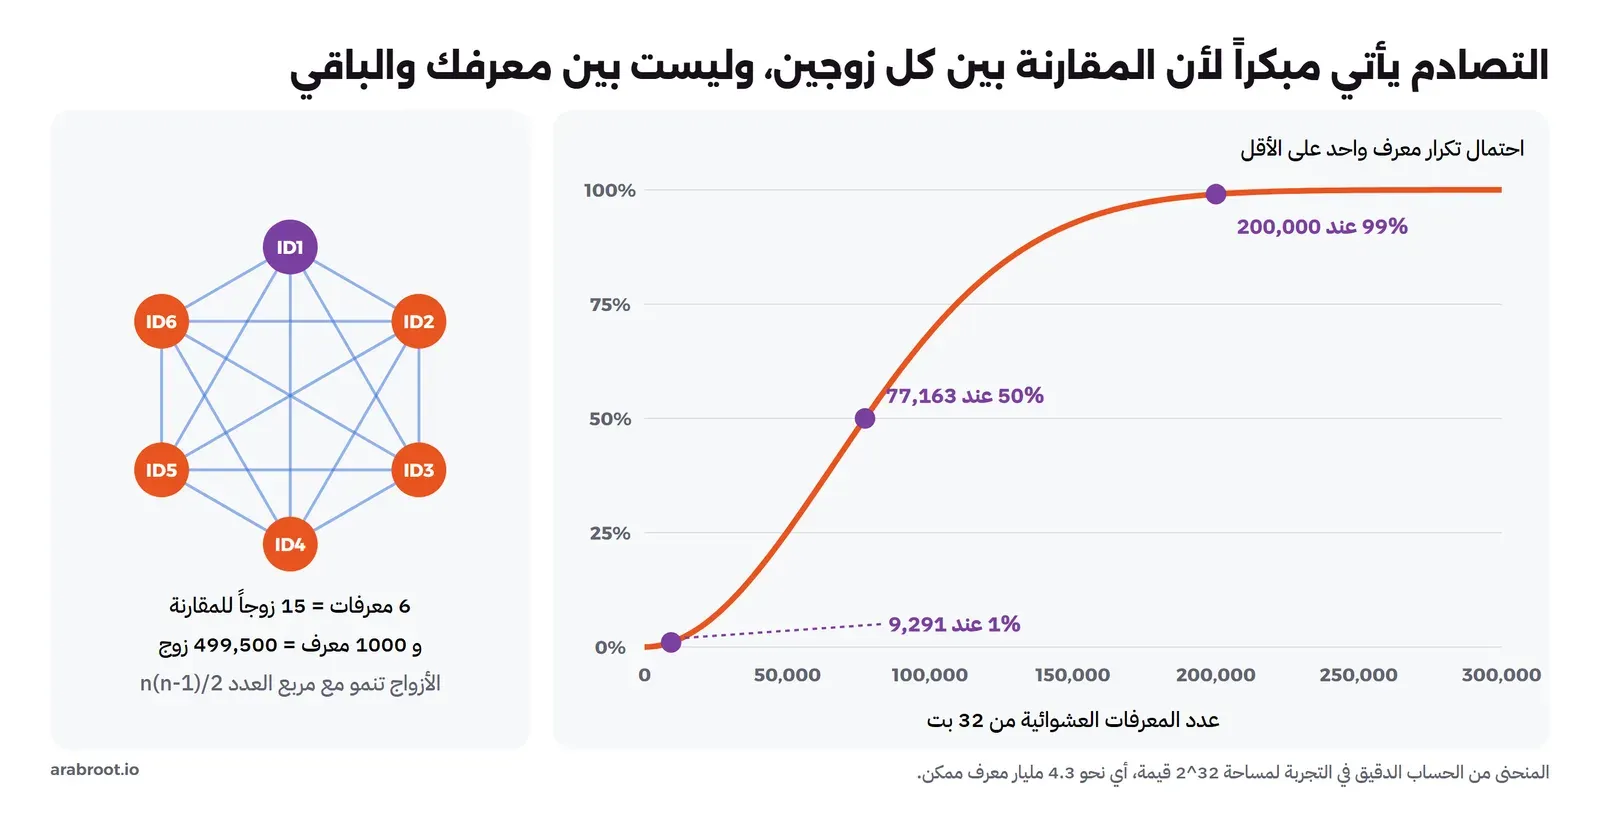
وعدد الأزواج ينمو بسرعة أكبر بكثير من عدد العناصر، فإذا كان لديك n عنصر فعدد الأزواج n(n-1)/2، أي أن ستة معرفات فيها 15 زوجاً، وألف معرف فيها 499,500 زوج، ومئة ألف معرف فيها نحو خمسة مليارات زوج، وهو أكثر من عدد القيم الممكنة نفسها. وكل زوج من هذه الأزواج فرصة صغيرة للتكرار، وعندما تجمع فرصاً صغيرة كثيرة بهذا الحجم فإن النتيجة لا تبقى صغيرة. وهذه هي مسألة يوم الميلاد Birthday Problem المشهورة، والتي تقول إن 23 شخصاً في غرفة يكفون ليكون احتمال اشتراك اثنين منهم في يوم الميلاد أكثر من النصف، وقد ذكرناها في مقال المعرفات الفريدة، والآن سوف نأخذها من جهة المبرمج: كم معرفاً أستطيع أن أنشئ قبل أن يصبح التكرار مشكلة حقيقية؟
والصورة التالية تبين الفكرة من جهتين: في اليسار ستة معرفات وكل الأزواج بينها، وفي اليمين احتمال التكرار في مساحة 32 بت كما حسبناه في التجربة، ولاحظ أن المنحنى يصل إلى 50% قبل أن تنشئ حتى واحداً من خمسين ألفاً من القيم الممكنة:
من الأزواج Pairs إلى المعادلة: مسألة يوم الميلاد Birthday Problem
الطريقة الأسهل لحساب احتمال التكرار هي أن تحسب عكسه، أي احتمال ألا يتكرر أي معرف، ثم تطرحه من الواحد. فالمعرف الأول لا يمكن أن يتكرر، والثاني يجب أن يختلف عن الأول فاحتمال ذلك (N-1)/N، والثالث يجب أن يختلف عن الاثنين السابقين فاحتماله (N-2)/N، وهكذا حتى المعرف رقم n، وبما أن كل معرف عشوائي ومستقل عن غيره فإننا نضرب هذه الاحتمالات ببعضها، فتكون المعادلة الدقيقة كما يلي:
P(no collision) = (1 - 1/N) × (1 - 2/N) × … × (1 - (n-1)/N)
P(collision)    = 1 - P(no collision)
وهذه المعادلة دقيقة ولكنها غير عملية عندما يكون n بالملايين، فهي حاصل ضرب ملايين الأرقام القريبة من الواحد، وكل عملية ضرب في الأرقام العشرية Floating Point تضيف خطأ تقريب صغيراً. لذلك يستخدم الجميع تقريباً بسيطاً يعتمد على أن 1 - x قريب جداً من e^(-x) عندما يكون x صغيراً، فيتحول حاصل الضرب إلى أس واحد مجموعه n(n-1)/2N، وهو عدد الأزواج مقسوماً على عدد القيم:
P(collision) ≈ 1 - e^(-n(n-1) / 2N)
n for probability p ≈ sqrt(2N × ln(1/(1-p)))
expected colliding pairs ≈ n(n-1) / 2N
وفي هذه المعادلات لاحظ التالي:
- السطر الأول يعطيك الاحتمال إذا عرفت عدد المعرفات، وهو ما تحتاجه عندما يسألك أحد: «ما خطر التكرار بعد سنة من التشغيل؟».
- السطر الثاني يعكس السؤال: كم معرفاً أستطيع أن أنشئ قبل أن يصل الاحتمال إلى حد معين؟ وعندما يكون p صغيراً، مثل واحد في المليون، يصبح
ln(1/(1-p))قريباً من p نفسه، فيكون العدد تقريباًsqrt(2Np). - السطر الثالث هو عدد التكرارات المتوقع، وهو مختلف عن الاحتمال: إذا كان العدد المتوقع 116 فهذا يعني أنك سوف ترى نحو 116 زوجاً متكرراً، وليس أن الاحتمال 11600%. والقيمة المتوقعة Expected Value مفهوم سوف نعود إليه في آخر المقال.
قاعدة نصف البتات: حد يوم الميلاد Birthday Bound
من السطر الثاني نستخرج القاعدة الأهم في هذا المقال، وهي أن عدد المعرفات الذي يوصلك إلى احتمال تكرار ملحوظ يتناسب مع الجذر التربيعي لعدد القيم، والجذر التربيعي لعدد 2b هو 2b/2، أي أن مساحة من b بت تبدأ في التكرار بعد نحو 2b/2 عنصر. فمعرف من 32 بت يتكرر بعد عشرات الآلاف وليس بعد المليارات، ومعرف من 64 بت يتكرر بعد مليارات وليس بعد 18 مليار مليار، وهاش من 128 بت يعطيك حماية من التكرار العشوائي بحجم 64 بت فقط. ولهذا السبب تسمع في التشفير عن «حد يوم الميلاد Birthday Bound»، فدالة الهاش التي تخرج 256 بت تقاوم البحث عن تصادم بقوة 128 بت، وقد ذكرنا في مقال التشفير للمطورين لماذا لا تستخدم MD5 وSHA-1، وجزء من السبب هو هذه القاعدة نفسها مع ضعف في بنية الدالة جعل البحث أسرع من حد يوم الميلاد.
وقد يتساءل البعض: لماذا الجذر التربيعي تحديداً؟ والإجابة أن الاحتمال يعتمد على عدد الأزواج مقسوماً على N، وعدد الأزواج يقارب n²/2، فإذا أردت أن يبقى n²/2N ثابتاً فإن n يجب أن ينمو مع جذر N. وهذا يعني عملياً أن إضافة بت واحد إلى المعرف لا تضاعف عدد المعرفات الآمنة، وإنما تضربه في جذر اثنين فقط، أي نحو 1.41، وأنك تحتاج إلى بتين إضافيين حتى تضاعف هذا العدد.
كم معرفاً ID يكفي قبل التصادم؟ أرقام لأحجام شائعة
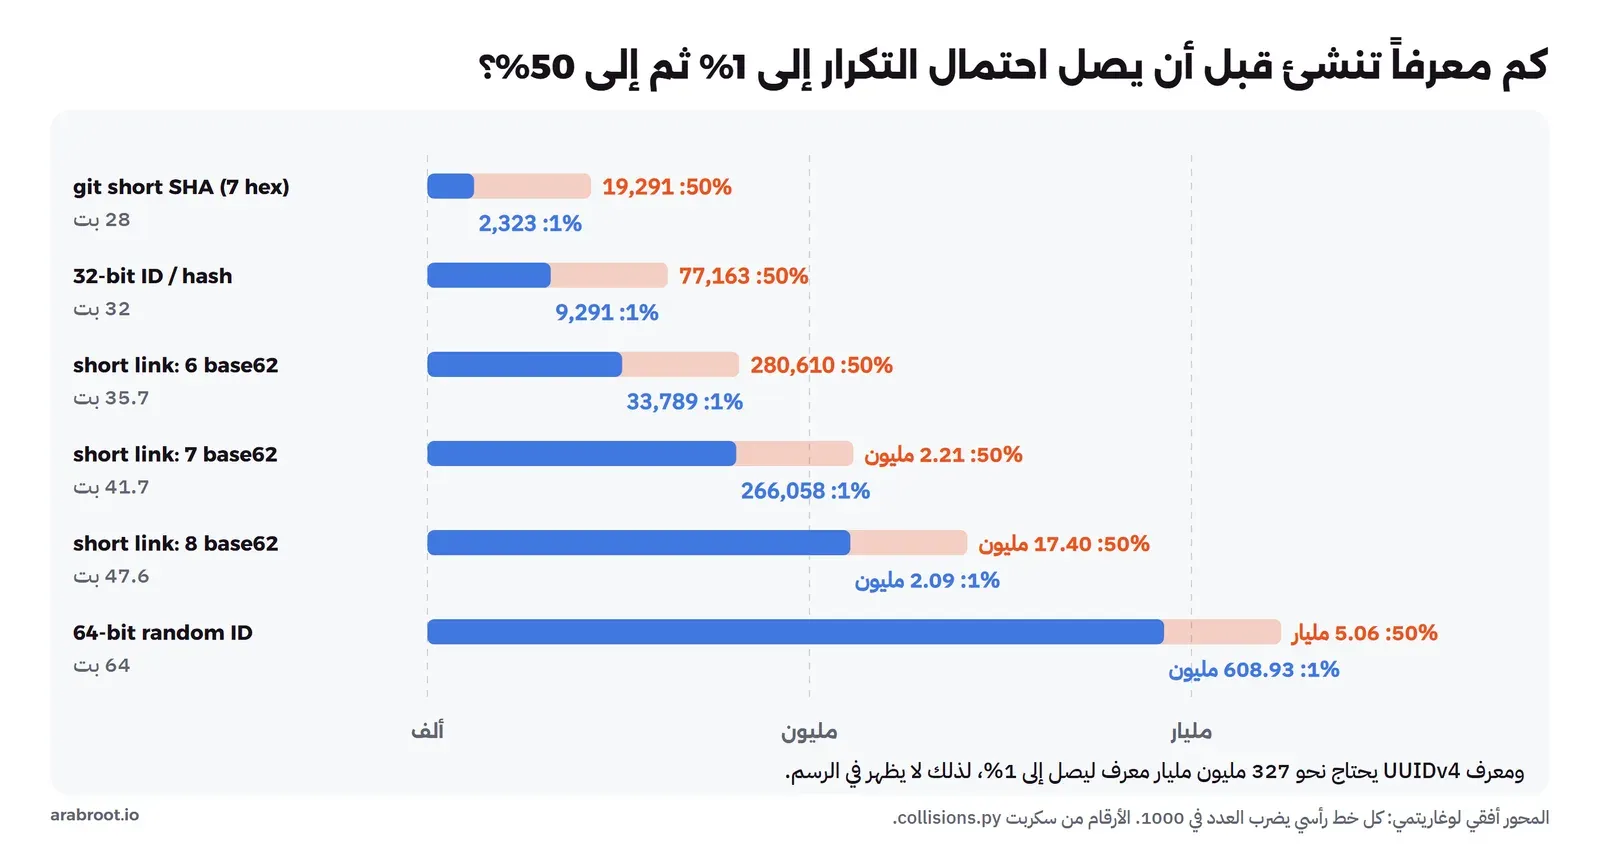
الآن نطبق المعادلات على الأحجام التي تقابلها في العمل، والأرقام التالية حسبها سكربت collisions.py في التجربة العملية، وسوف نشرح مخرجه سطراً سطراً هناك. والصورة التالية تبين لكل حجم عدد المعرفات التي يصل عندها احتمال التكرار إلى 1% ثم إلى 50%، والمحور لوغاريتمي لأن الفرق بين الأحجام يصل إلى ملايين المرات:
معرفات ID بطول 32 و64 بت
معرف عشوائي من 32 بت يصل إلى احتمال تكرار 1% عند 9,291 معرفاً، وإلى 50% عند 77,163، وإذا أنشأت مليون معرف فالعدد المتوقع للأزواج المتكررة 116 زوجاً، وبالتالي هذا الحجم لا يصلح معرفاً عشوائياً لأي جدول يتجاوز بضعة آلاف من السجلات، إلا إذا كان لديك قيد تفرد Unique Constraint يرفض التكرار وكود يعيد المحاولة عند الرفض، وحتى مع ذلك سوف تزداد المحاولات الفاشلة كلما امتلأ الجدول. أما معرف من 64 بت فيصل إلى واحد في المليون عند 6 ملايين معرف، وإلى 1% عند 609 ملايين، وإلى 50% عند 5 مليارات، وهذا كاف لمعظم الأنظمة إذا كانت البتات كلها عشوائية فعلاً، ولكن انتبه إلى أن كثيراً من معرفات 64 بت ليست عشوائية بالكامل، فمعرف Snowflake مثلاً يحجز جزءاً للوقت وجزءاً لرقم الجهاز وجزءاً للعداد، وهو لا يعتمد على الاحتمال أصلاً وإنما على أن كل جهاز يملك رقمه الخاص، كما شرحنا في مقال المعرفات الفريدة.
وهنا يجدر الإشارة إلى أن 64 بت عدد صحيح كبير لا تحفظه JavaScript بدقة في النوع Number، فإذا أرسلت معرفاً عشوائياً من 64 بت كرقم في JSON فقد تتغير آخر خاناته عند الكلاينت، وهذا موضوع شرحناه في مقال Floating Point، والحل أن ترسله كنص.
الروابط القصيرة Short Links
خدمة اختصار الروابط تولد غالباً رمزاً من أحرف base62، أي الأحرف الإنجليزية الصغيرة والكبيرة والأرقام، وكل حرف يحمل نحو 5.95 بت، وبالتالي ستة أحرف تعطي 626، أي نحو 56.8 مليار رمز ممكن، وهو رقم يبدو كبيراً جداً لخدمة صغيرة. ولكن الحساب يقول إن احتمال التكرار يصل إلى 1% عند 33,789 رابطاً، وإلى 50% عند 280,610 رابطاً، وإذا وصلت الخدمة إلى مليون رابط فالعدد المتوقع للتكرارات نحو 9. أما سبعة أحرف فتؤخر نقطة 50% إلى 2.2 مليون رابط، وثمانية أحرف إلى 17.4 مليون رابط.
وماذا يحدث عند التكرار في خدمة روابط؟ إذا كان الكود يكتب الرابط الجديد فوق القديم دون فحص، فإن من يضغط على رابط قديم منشور في رسالة أو في تقرير سوف يصل إلى موقع شخص آخر، وهذه مشكلة خصوصية وليست خطأ تقنياً فقط. لذلك القاعدة هنا ليست «اختر طولاً لا يتكرر»، فكل طول قصير يتكرر في النهاية، وإنما «اجعل قاعدة البيانات ترفض التكرار، وأعد التوليد عند الرفض، واختر الطول بحيث تبقى إعادة المحاولة نادرة». فإذا كانت الخدمة فيها مليون رابط وطول الرمز سبعة أحرف، فاحتمال أن يصطدم الرمز الجديد برمز موجود هو مليون على 3.5 تريليون، أي نحو ثلاثة في العشرة ملايين، وهذا رقم مختلف عن احتمال التكرار في الجدول كله، والسبب أن الرمز الجديد يقارن بالرموز الموجودة فقط، وهذا هو السؤال الذي يجيب عنه الحدس بشكل صحيح.
الهاش القصير في Git
عندما تكتب git log --oneline ترى أول سبع خانات من هاش ال Commit، وكل خانة Hex تحمل 4 بتات، فسبع خانات تعني 28 بتاً فقط، أي 268 مليون قيمة. والحساب يقول إن احتمال أن يشترك كائنان Objects في أول سبع خانات يصل إلى 1% عند 2,323 كائناً، وإلى 50% عند 19,291 كائناً، والكائنات في Git ليست ال Commits فقط وإنما كل ملف Blob وكل مجلد Tree أيضاً، فالمستودع المتوسط يتجاوز هذا العدد بسهولة. وقد عالج Git هذا الأمر بطريقتين: الأولى أنه عندما تعطيه هاشاً قصيراً يطابق أكثر من كائن يرفضه برسالة واضحة بأن الاختصار غامض ambiguous بدلاً من أن يختار أحدها، والثانية أن الإعداد core.abbrev قيمته الافتراضية auto، وبحسب التوثيق فإن Git يحسب الطول المناسب من عدد الكائنات التقريبي في المستودع حتى تبقى الاختصارات فريدة لفترة، ولهذا ترى في المستودعات الكبيرة اختصارات أطول من سبع خانات.
والدرس العملي هنا لمن يكتب أدوات أو سكربتات حول Git: لا تحفظ الهاش القصير في قاعدة بيانات أو في ملف إعداد على أنه معرف دائم، فاختصار فريد اليوم قد يصبح غامضاً بعد سنة من ال Commits، واحفظ الهاش الكامل دائماً، واستخدم القصير للعرض فقط.
وماذا عن UUIDv4؟
ذكرنا في مقال المعرفات الفريدة أن UUIDv4 فيه 122 بتاً عشوائية بحسب RFC 9562، وأن التكرار فيه لا يقلق أحداً، والتجربة تعطي الرقم بدقة: احتمال واحد في المليون يحتاج إلى 3.26 مليون مليار معرف، و50% يحتاج إلى 2.7 مليار مليار معرف. ولكن هذه الأرقام كلها تفترض شيئاً واحداً، وهو أن المولد عشوائي فعلاً، فإذا ولدت UUID من مولد أرقام عادي بذرته Seed هي الوقت، أو نسخت Container فيه حالة المولد نفسها إلى عدة نسخ، فإن الحساب كله لا ينطبق، ويصبح التكرار مسألة وقت. لذلك استخدم الدوال التي تأخذ العشوائية من نظام التشغيل، مثل uuid.uuid4() ووحدة secrets في Python وcrypto.randomUUID() في Node.js.
تجربة عملية Lab: نحسب ونبحث عن تصادم حقيقي
الآن سوف نقوم بالحساب والمحاكاة في Container واحد من Python 3.13 دون أي مكتبة خارجية، والسكربتات كلها في مجلد lab مع هذا المقال، وكل سكربت يجيب عن سؤال واحد: collisions.py يحسب المعادلات للأحجام الشائعة، وsimulate.py يبحث عن تكرارات حقيقية، وbuckets.py يوزع مفاتيح على خانات جدول هاش، وtimeid.py يجرب معرفاً نصفه وقت، وavailability.py للتوفر والإعادة. وتشغيل أي سكربت يكون من داخل مجلد lab بالأمر التالي:
docker run --rm --name scm-prob-lab -v "$PWD:/lab" -w /lab python:3.13.17-slim python collisions.pyوالخيار --rm يحذف ال Container بعد انتهاء السكربت، والخيار -v يربط المجلد الحالي بالمسار /lab داخله حتى يرى السكربتات، والوسم python:3.13.17-slim محدد بالإصدار حتى تحصل على النتيجة نفسها، والسكربتات التي تستخدم أرقاماً عشوائية تثبت البذرة Seed في أولها حتى تتكرر النتيجة إذا أعدت التشغيل.
المشكلة الأولى: المعادلة التي تعطي صفراً بسبب الأعداد العشرية Floating Point
عند كتابة المعادلة التقريبية لأول مرة كتبناها كما هي في الكتب، أي 1 - math.exp(-x)، وعند تشغيلها على UUIDv4 جاءت النتيجة صفراً، وهذا هو السكربت الصغير الذي يبين المشكلة والحل:
# naive.py: the birthday approximation written the obvious way, then with expm1
import math
N = 2**122          # random bits in a UUIDv4
for n in (10**6, 10**9, 10**12):
    x = n * (n - 1) / (2 * N)
    print(f"n={n:>16,}  1-exp(-x)={1 - math.exp(-x):.3e}  -expm1(-x)={-math.expm1(-x):.3e}")
والمخرج سوف يكون كما يلي:
n=       1,000,000  1-exp(-x)=0.000e+00  -expm1(-x)=9.404e-26
n=   1,000,000,000  1-exp(-x)=0.000e+00  -expm1(-x)=9.404e-20
n=1,000,000,000,000  1-exp(-x)=9.404e-14  -expm1(-x)=9.404e-14
لاحظ أن الطريقة البسيطة أعطت صفراً تماماً لمليون ولمليار معرف، مع أن الاحتمال الحقيقي 9.4 في عشرة أس 26، والسبب أن exp(-x) لقيمة x صغيرة جداً يعطي رقماً قريباً جداً من الواحد، وdouble لا يستطيع أن يحفظ الفرق بين الواحد والرقم الذي يليه إذا كان أصغر من نحو 2.2 في عشرة أس 16، فيقرب الناتج إلى الواحد بالضبط، ثم يطرحه من الواحد فيعطي صفراً. وهذه المشكلة خطيرة لأنها لا تظهر كخطأ، وإنما كرقم مطمئن جداً، فتقرير يقول «احتمال التكرار صفر» يبدو مقنعاً لمن لا يعرف السبب. والحل هو الدالة math.expm1 التي تحسب e^x - 1 مباشرة بدقة للقيم الصغيرة، وبحسب توثيق وحدة math فهي موجودة لهذا السبب تحديداً، ومعها أختها math.log1p التي تحسب ln(1 + x) بدقة، وسوف نستخدمها في المعادلة الدقيقة. أما عند تريليون معرف فقد كبر x بما يكفي فتساوت الطريقتان.
المعادلات لكل الأحجام
السكربت collisions.py يحتوي على ثلاث دوال: approx للمعادلة التقريبية مكتوبة بـ expm1، وexact لحاصل الضرب الدقيق محسوباً كمجموع لوغاريتمات بـ log1p حتى لا يضيع في الضرب، وn_for لعدد المعرفات عند احتمال معين:
# collisions.py: birthday-problem numbers for common ID and hash sizes
import math

SPACES = [
    ("32-bit id / hash",        2**32),
    ("git short SHA (7 hex)",   16**7),
    ("short link 6 x base62",   62**6),
    ("short link 7 x base62",   62**7),
    ("short link 8 x base62",   62**8),
    ("64-bit random id",        2**64),
    ("UUIDv4 (122 bits)",       2**122),
]

def approx(n, N):                 # 1 - e^(-n(n-1)/2N), written with expm1 so tiny values survive
    return -math.expm1(-n * (n - 1) / (2 * N))

def exact(n, N):                  # 1 - prod (1 - i/N), summed as logs
    s = 0.0
    for i in range(1, n):
        s += math.log1p(-i / N)
    return -math.expm1(s)

def n_for(p, N):                  # how many IDs until the collision probability reaches p
    return math.sqrt(2 * N * math.log(1 / (1 - p)))

print(f"{'space':<24}{'bits':>6}{'n for 1e-6':>24}{'n for 1%':>26}{'n for 50%':>28}{'E[pairs] at 1M':>16}")
for name, N in SPACES:
    print(f"{name:<24}{math.log2(N):>6.1f}{n_for(1e-6, N):>24,.0f}{n_for(0.01, N):>26,.0f}"
          f"{n_for(0.5, N):>28,.0f}{1e6 * (1e6 - 1) / (2 * N):>16.3g}")

print()
print("32-bit space: approximation vs exact product")
N = 2**32
for n in (1_000, 10_000, 50_000, 77_163, 100_000, 200_000, 500_000):
    a, e = approx(n, N), exact(n, N)
    print(f"n={n:>8,}  approx={a:.6f}  exact={e:.6f}  diff={abs(a - e):.1e}")
والمخرج سوف يكون كما يلي:
space                     bits              n for 1e-6                  n for 1%                   n for 50%  E[pairs] at 1M
32-bit id / hash          32.0                      93                     9,291                      77,163             116
git short SHA (7 hex)     28.0                      23                     2,323                      19,291        1.86e+03
short link 6 x base62     35.7                     337                    33,789                     280,610             8.8
short link 7 x base62     41.7                   2,654                   266,058                   2,209,524           0.142
short link 8 x base62     47.6                  20,897                 2,094,942                  17,397,806         0.00229
64-bit random id          64.0               6,074,003               608,926,881               5,056,937,541        2.71e-08
UUIDv4 (122 bits)        122.0   3,260,955,271,581,437   326,915,130,069,136,896   2,714,922,669,395,445,248         9.4e-26

32-bit space: approximation vs exact product
n=   1,000  approx=0.000116  exact=0.000116  diff=9.0e-12
n=  10,000  approx=0.011573  exact=0.011573  diff=8.9e-09
n=  50,000  approx=0.252509  exact=0.252509  diff=8.4e-07
n=  77,163  approx=0.499998  exact=0.500000  diff=2.1e-06
n= 100,000  approx=0.687809  exact=0.687812  diff=2.8e-06
n= 200,000  approx=0.990501  exact=0.990502  diff=6.9e-07
n= 500,000  approx=1.000000  exact=1.000000  diff=2.2e-16
في المخرج أعلاه لاحظ التالي:
- عمود
bitsهو اللوغاريتم بالأساس 2 لعدد القيم، فالرابط القصير بستة أحرف يساوي 35.7 بت، وهذا يسهل المقارنة بين أحجام من أنظمة مختلفة. - عمود
n for 1e-6هو العدد الذي يصل عنده الاحتمال إلى واحد في المليون، وهو الحد المناسب عندما يكون التكرار مكلفاً جداً، ولاحظ أن معرف 32 بت يصل إليه بعد 93 معرفاً فقط، والهاش القصير في Git بعد 23 كائناً. - عمود
E[pairs] at 1Mهو العدد المتوقع للأزواج المتكررة بعد مليون معرف، فهو 116 في 32 بت، و1,860 في الهاش القصير، و8.8 في رابط بستة أحرف، وأقل من واحد في الأحجام الأكبر، وعندما يكون أقل من واحد بكثير فهو قريب من الاحتمال نفسه. - الجزء الثاني يقارن التقريب بالحاصل الدقيق في 32 بت، وأكبر فرق بينهما 2.8 في المليون عند مئة ألف معرف، أي أن التقريب أكثر من كاف لأي قرار هندسي، ولهذا لا داعي لحساب حاصل الضرب إلا للتحقق كما فعلنا هنا.
- عند 77,163 معرفاً أعطى الحاصل الدقيق 0.500000، وهذا يؤكد أن معادلة
n_forحسبت الرقم الصحيح.
المحاكاة Simulation: هل يظهر التصادم فعلاً حيث تقول المعادلة؟
المعادلة شيء، ورؤية التكرار في بيانات حقيقية شيء آخر، لذلك كتبنا سكربتاً يولد أرقاماً ويبحث عن أول تكرار فعلاً. وسوف نشرح كل جزء فيه قبل المخرج:
# simulate.py: look for real collisions instead of trusting the formula
import math, random, zlib, hashlib, statistics, time

rng = random.Random(2026)          # fixed seed so the run can be repeated
N = 2**32

# 1) how many random 32-bit IDs until the first repeat? (300 trials)
firsts = []
t0 = time.perf_counter()
for _ in range(300):
    seen = set()
    while True:
        x = rng.getrandbits(32)
        if x in seen:
            break
        seen.add(x)
    firsts.append(len(seen) + 1)
print(f"first collision, 300 trials: mean={statistics.mean(firsts):,.0f}  median={statistics.median(firsts):,.0f}"
      f"  min={min(firsts):,}  max={max(firsts):,}  theory sqrt(pi*N/2)={math.sqrt(math.pi * N / 2):,.0f}"
      f"  ({time.perf_counter() - t0:.1f}s)")

# 2) one million random 32-bit IDs: how many collide?
ids = [rng.getrandbits(32) for _ in range(1_000_000)]
dupes = len(ids) - len(set(ids))
print(f"1,000,000 random 32-bit ids: duplicates={dupes}  expected n^2/2N={1e6 * (1e6 - 1) / (2 * N):.1f}")

# 3) a real checksum: CRC32 of "user-0", "user-1", ...
t0 = time.perf_counter()
seen = {}
i = 0
while True:
    key = f"user-{i}"
    h = zlib.crc32(key.encode())
    if h in seen:
        print(f"CRC32 collision after {i + 1:,} keys: {seen[h]!r} and {key!r} -> {h:#010x}  ({time.perf_counter() - t0:.0f}s)")
        break
    seen[h] = key
    i += 1

# 3b) CRC32 of random 16-byte keys
seen = set()
while True:
    h = zlib.crc32(rng.randbytes(16))
    if h in seen:
        print(f"CRC32 of random 16-byte keys: first collision after {len(seen) + 1:,} keys")
        break
    seen.add(h)

# 4) SHA-256 cut to its first 32 bits (what a short hash or a short link does)
seen = {}
i = 0
while True:
    key = f"https://example.com/p/{i}"
    h = hashlib.sha256(key.encode()).hexdigest()[:8]
    if h in seen:
        print(f"SHA-256[:8 hex] collision after {i + 1:,} urls: {seen[h]!r} and {key!r} -> {h}")
        break
    seen[h] = key
    i += 1
في الكود أعلاه لاحظ التالي:
- الجزء الأول يكرر التجربة 300 مرة، وفي كل مرة يولد أرقاماً من 32 بت ويحفظها في
setحتى يظهر أول رقم مكرر، ثم يقارن متوسط عدد الأرقام بالقيمة النظريةsqrt(πN/2)، وهي متوسط موضع أول تكرار، وتختلف قليلاً عن نقطة 50% لأن المتوسط يتأثر بالمحاولات الطويلة. - الجزء الثاني يولد مليون رقم ويعد المكرر منها بطرح حجم ال
setمن حجم القائمة، ويقارنه بالعدد المتوقع. - الجزء الثالث لا يستخدم أرقاماً عشوائية، وإنما يحسب
zlib.crc32لنصوص متتالية تشبه أسماء المستخدمين، وهذا ما يفعله من يستخدم CRC32 كهاش سريع لتوزيع المفاتيح أو لاختصار المعرفات. - الجزء الرابع يأخذ أول 8 خانات Hex من SHA-256، أي 32 بتاً، وهذا ما تفعله بعض أنظمة الروابط القصيرة والكاش عندما تقصر الهاش.
والمخرج سوف يكون كما يلي:
first collision, 300 trials: mean=80,404  median=78,124  min=1,640  max=255,058  theory sqrt(pi*N/2)=82,137  (17.7s)
1,000,000 random 32-bit ids: duplicates=120  expected n^2/2N=116.4
CRC32 collision after 27,860,003 keys: 'user-91499' and 'user-27860002' -> 0xf44fad42  (59s)
CRC32 of random 16-byte keys: first collision after 70,644 keys
SHA-256[:8 hex] collision after 50,419 urls: 'https://example.com/p/27449' and 'https://example.com/p/50418' -> 9a3a1b06
وهذه قراءة كل سطر:
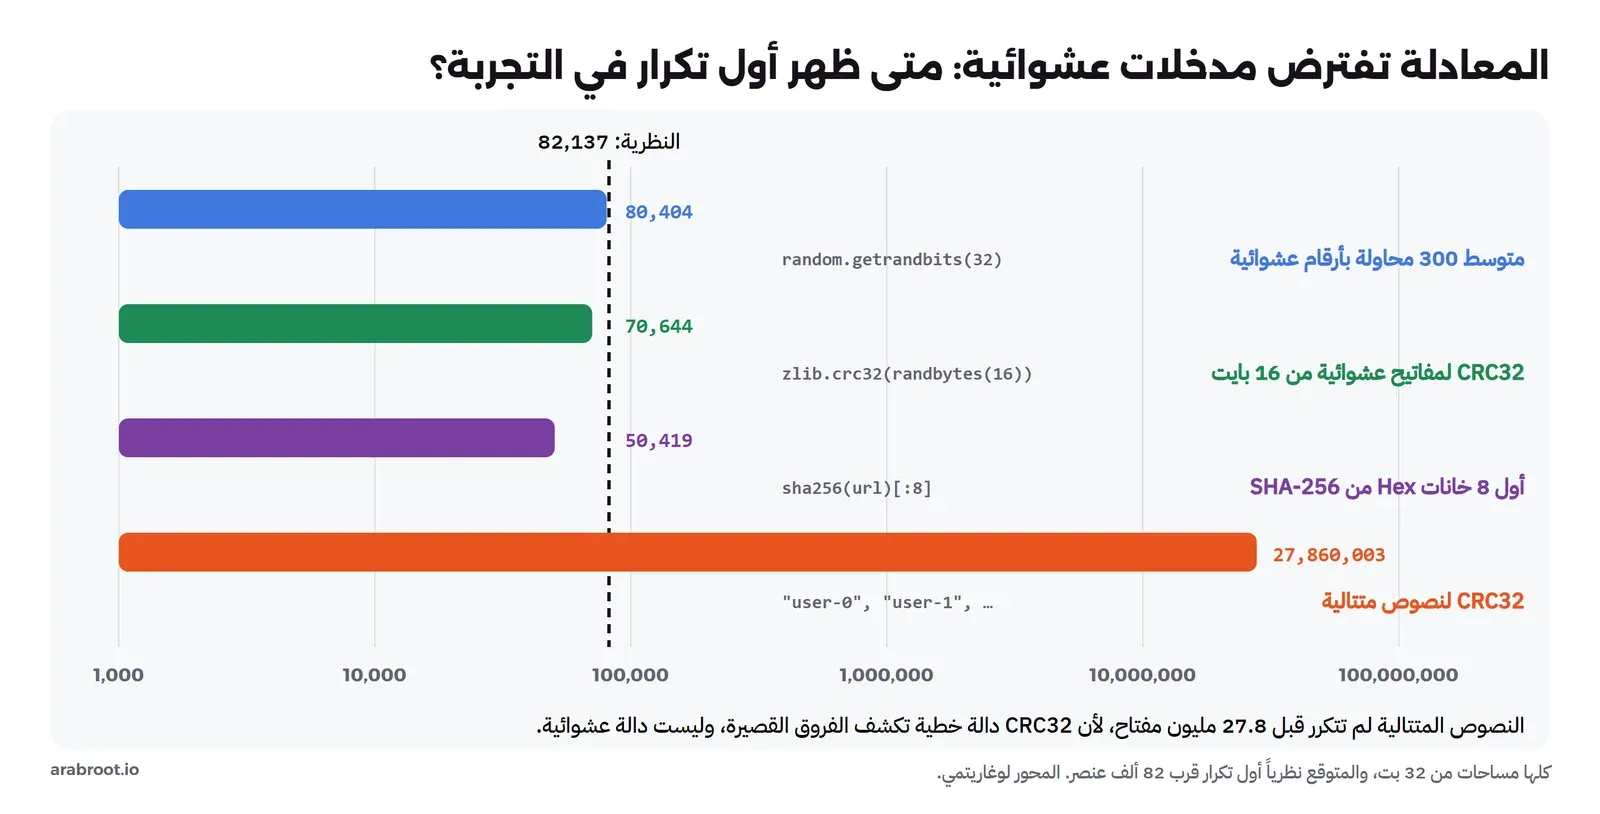
- السطر الأول: متوسط موضع أول تكرار في 300 محاولة كان 80,404، والقيمة النظرية 82,137، والوسيط Median كان 78,124 وهو قريب جداً من نقطة 50% التي حسبناها، أي 77,163. ولكن انظر إلى أقل قيمة وأكبر قيمة: في محاولة ظهر التكرار بعد 1,640 رقماً فقط، وفي أخرى بعد 255,058 رقماً، وهذا هو الفرق بين الاحتمال والضمان، فالمعادلة تخبرك عن المتوسط، أما نظامك فيعيش محاولة واحدة فقط، وقد تكون هي المحاولة المحظوظة أو غير المحظوظة. واستغرق هذا الجزء 17.7 ثانية في هذا التشغيل، و13.6 ثانية في تشغيل سابق على الجهاز نفسه.
- السطر الثاني: مليون رقم عشوائي من 32 بت فيها 120 تكراراً، والمتوقع 116.4، وهذا تطابق جيد، والفرق الصغير طبيعي في أي تجربة عشوائية.
- السطر الثالث: وهنا المفاجأة، فقد احتاج CRC32 للنصوص المتتالية إلى 27,860,003 مفتاح حتى يظهر أول تكرار، أي أكثر من 300 ضعف ما تتوقعه المعادلة، والزوج المتكرر هو
'user-91499'و'user-27860002'، واستغرق البحث 59 ثانية. - السطر الرابع: CRC32 نفسه، ولكن لمفاتيح عشوائية من 16 بايت، تكرر بعد 70,644 مفتاحاً، وهذا رقم طبيعي قريب من المتوقع.
- السطر الخامس: أول 32 بت من SHA-256 لروابط متتالية تكررت بعد 50,419 رابطاً، وهو أيضاً في المجال الطبيعي، فاحتمال التكرار عند 50 ألفاً كان 25% في الجدول السابق.
المشكلة الثانية: لماذا لم تنطبق المعادلة على CRC32؟
عندما كتبنا الجزء الثالث كنا نتوقع أن ينتهي خلال ثانية واحدة بعد نحو 80 ألف مفتاح، مثل الأجزاء الأخرى، ولكنه استمر قرابة دقيقة واستهلك ذاكرة كبيرة لأن القاموس seen وصل إلى قرابة 28 مليون عنصر. وقد يبدو هذا خبراً جيداً، فالتكرار تأخر، ولكنه في الحقيقة يكشف أن المعادلة لا تصف CRC32 أصلاً، والسبب أن معادلة يوم الميلاد تفترض أن الدالة تعطي قيماً عشوائية مستقلة لكل مدخل، وCRC32 ليس كذلك، فهو دالة خطية صممت لاكتشاف أخطاء النقل، ومن خصائص هذا النوع من الدوال أنه يكشف كل خطأ متصل Burst Error طوله لا يتجاوز عدد بتاته، وبالتالي نصان بالطول نفسه يختلفان في بضعة بايتات متجاورة فقط، مثل user-27860001 وuser-27860002، لا يعطيان غالباً نفس القيمة. ولاحظ أن الزوج الذي تكرر في النهاية مختلف في الطول، عشرة أحرف مقابل ثلاثة عشر حرفاً.
والدرس هنا أعمق من CRC32 نفسه: سلوك الدالة مع مدخلاتك أنت يمكن أن يختلف كثيراً عن المعادلة في الاتجاهين، فهنا تأخر التكرار، ولكن الخطية نفسها تعني أن من يعرف الدالة يستطيع أن يصنع مدخلين لهما نفس ال CRC32 متى شاء، وهذا ما يجعله غير صالح لأي شيء يحتاج حماية من التلاعب. والتوثيق الرسمي لدالة zlib.crc32 في Python يقول ذلك صراحة: الخوارزمية ليست قوية تشفيرياً ولا تستخدم للمصادقة أو التوقيع، ولأنها صممت كمجموع اختباري Checksum فهي غير مناسبة لاستخدامها كدالة هاش عامة. والصورة التالية تجمع نتائج الأجزاء الأربعة على محور واحد:
دالة الهاش Hash Function ليست رقماً عشوائياً: متى تنطبق المعادلة؟
المعادلة تنطبق على دالة الهاش بقدر ما تشبه الدالة مولد أرقام عشوائياً، ودوال الهاش التشفيرية مثل SHA-256 صممت لهذا تحديداً، فأي تغيير في المدخل يغير نصف البتات تقريباً بطريقة لا يمكن توقعها، ولهذا تكرر الهاش المقصوص في التجربة في المجال المتوقع. أما الدوال السريعة غير التشفيرية، مثل CRC32 وFNV والدوال التي تستخدمها اللغات داخل القواميس، فهي جيدة في توزيع المدخلات العادية ولكنها لا تقاوم من يختار المدخلات عمداً، وهنا يتحول الاحتمال من سؤال رياضي إلى سؤال أمني.
عندما يختار المخترق التصادم: هجوم Hash Flooding
في نهاية 2011 نشرت oCERT التحذير oCERT-2011-003 عن ثغرة في جداول الهاش في عدة لغات وخوادم، منها Java وPHP وPython وRuby وApache Tomcat، والفكرة أن هذه اللغات كانت تحسب هاش النصوص بدالة ثابتة معروفة، فيستطيع المخترق أن يحسب مسبقاً آلاف المفاتيح التي تعطي نفس الهاش، ثم يرسلها كمعاملات في طلب POST واحد، فيضعها السيرفر كلها في الخانة نفسها من جدول الهاش، وبدلاً من أن يكون إدخال كل مفتاح عملية سريعة يصبح مقارنة مع كل المفاتيح السابقة، فيستهلك طلب واحد المعالج لفترة طويلة. وهذا هو التصادم نفسه الذي نحسبه في هذا المقال، ولكن من شخص يختاره وليس من الصدفة. والحل الذي اعتمدته Python في PEP 456 هو استخدام SipHash، وهي دالة هاش سريعة بمفتاح سري عشوائي يتغير مع كل تشغيل للبرنامج، فلا يستطيع المخترق أن يحسب التصادم مسبقاً، وهذا هو سبب أن hash("abc") في Python يعطي قيمة مختلفة في كل تشغيل، إلا إذا ثبتها المتغير PYTHONHASHSEED. وبالتالي لا تقم بحفظ نتيجة hash() في قاعدة بيانات أو ملف، والسبب أنها لن تتطابق في التشغيل التالي.
حد يوم الميلاد في التشفير: هجوم Sweet32
قاعدة نصف البتات لها مثال موثق في التشفير أيضاً، ففي 2016 نشر باحثان من INRIA هجوم Sweet32 على خوارزميات التشفير التي حجم الكتلة Block فيها 64 بت، مثل Triple-DES وBlowfish. وفي هذه الخوارزميات يبدأ تكرار الكتل المشفرة في اتصال طويل بعد نحو 232 كتلة بحسب قاعدة يوم الميلاد، وعند التكرار يتسرب XOR كتلتين من النص الأصلي. وبحسب صفحة الهجوم فقد توقعوا أول تكرار بعد نحو 232.3 كتلة، أي 40 جيجابايت أو ساعة تقريباً من الاتصال، ورأوه فعلاً بعد 30 دقيقة، واستعادوا Cookie من اتصال HTTPS بعد التقاط نحو 785 جيجابايت خلال يومين. والدرس للمبرمج أن 64 بت في التشفير لم تعد كافية للكتلة، ليس لأن 264 رقم صغير، وإنما لأن 232 رقم صغير، وهذا سبب أن AES حجم كتلته 128 بت.
التصادم داخل جدول الهاش Hash Table
في جدول الهاش Hash Table التصادم ليس خطأ وإنما جزء طبيعي من التصميم، فالجدول فيه عدد محدود من الخانات Buckets، ويختار لكل مفتاح خانته من الهاش، وعندما يقع مفتاحان في الخانة نفسها يحفظهما الجدول معاً في سلسلة Chaining أو يبحث عن خانة أخرى. والسؤال هنا ليس «هل يحدث التصادم؟» فهو يحدث بالتأكيد، وإنما «كم خانة تبقى فارغة، وكم يطول أسوأ صف؟». والسكربت التالي يوزع مفاتيح عشوائية على ألف خانة:
# buckets.py: n keys into m hash-table buckets
import random, collections

rng = random.Random(11)
m = 1000
for n in (500, 750, 1000, 2000):
    counts = collections.Counter(rng.randrange(m) for _ in range(n))
    empty = m - len(counts)
    shared = sum(c for c in counts.values() if c > 1)
    print(f"n={n:>5} m={m} load={n / m:.2f}  empty={empty:>4} (expected {m * (1 - 1 / m) ** n:6.1f})"
          f"  keys sharing a bucket={shared:>5}  longest chain={max(counts.values())}")
والمخرج سوف يكون كما يلي:
n=  500 m=1000 load=0.50  empty= 607 (expected  606.4)  keys sharing a bucket=  199  longest chain=4
n=  750 m=1000 load=0.75  empty= 463 (expected  472.2)  keys sharing a bucket=  372  longest chain=4
n= 1000 m=1000 load=1.00  empty= 358 (expected  367.7)  keys sharing a bucket=  622  longest chain=7
n= 2000 m=1000 load=2.00  empty= 128 (expected  135.2)  keys sharing a bucket= 1730  longest chain=7
في المخرج أعلاه لاحظ التالي:
- عمود
loadهو معامل التحميل Load Factor، أي عدد المفاتيح مقسوماً على عدد الخانات، وعند 0.75، وهي القيمة الافتراضية في HashMap في Java، بقيت 463 خانة فارغة من ألف، وتشارك 372 مفتاحاً من 750 خانتها مع مفتاح آخر على الأقل، أي نصف المفاتيح تقريباً. - عند تحميل 1.00، أي عدد مفاتيح يساوي عدد الخانات، بقيت 358 خانة فارغة، والمتوقع من المعادلة
m(1-1/m)^nهو 367.7، وهي قريبة منm/e، أي أن أكثر من ثلث الجدول يبقى فارغاً حتى عندما يكون عدد المفاتيح مساوياً لعدد الخانات. - أطول سلسلة كانت 4 مفاتيح عند التحميل المنخفض و7 عند التحميل 1.00 و2.00، وهذا هو سبب أن البحث في جدول الهاش يبقى سريعاً في المتوسط، ولكن أسوأ حالة أبطأ من المتوسط بعدة مرات.
ولهذا تكبر جداول الهاش نفسها عندما يتجاوز التحميل حداً معيناً، فتضاعف عدد الخانات وتعيد توزيع المفاتيح، والقرار بين التحميل المنخفض والمرتفع هو قرار بين الذاكرة والسرعة، فالخانات الفارغة ذاكرة تدفعها مقابل سلاسل أقصر.
ماذا لو كان نصف المعرف وقتاً Timestamp؟
من التصاميم المنتشرة في الأنظمة القديمة معرف من 48 بت مثلاً، فيه 32 بت للوقت بالثواني و16 بت عشوائية، والفكرة أن الوقت يجعل المعرفات مرتبة ويمنع التكرار بين الثواني المختلفة، والعشوائية تفرق بين المعرفات داخل الثانية الواحدة. ويبدو هذا آمناً لأن العدد الكلي للقيم كبير، ولكن المعرفات التي تولد في الثانية نفسها تشترك في جزء الوقت، فالمنافسة بينها هي على 16 بت فقط، أي 65,536 قيمة، ومسألة يوم الميلاد تعمل داخل كل ثانية وحدها. والسكربت التالي يحاكي ذلك ويقارنه بالمعادلة:
# timeid.py: what if the "random" ID is a timestamp plus only 16 random bits?
import math, random

rng = random.Random(7)
for per_second in (10, 100, 300, 1000):
    trials, hit = 2000, 0
    for _ in range(trials):
        seen = set()
        for _ in range(per_second):
            r = rng.getrandbits(16)          # IDs made in the same second share the timestamp part
            if r in seen:
                hit += 1
                break
            seen.add(r)
    formula = -math.expm1(-per_second * (per_second - 1) / (2 * 2**16))
    print(f"{per_second:>5} ids in one second: simulated P(collision)={hit / trials:.3f}  formula={formula:.3f}")
والمخرج سوف يكون كما يلي:
   10 ids in one second: simulated P(collision)=0.001  formula=0.001
  100 ids in one second: simulated P(collision)=0.062  formula=0.073
  300 ids in one second: simulated P(collision)=0.497  formula=0.496
 1000 ids in one second: simulated P(collision)=1.000  formula=1.000
عند 100 معرف في الثانية يكون احتمال التكرار داخل الثانية الواحدة نحو 7%، والمحاكاة أعطت 6.2% لأن 2000 محاولة لا تكفي لدقة أعلى، وعند 300 معرف في الثانية يصبح الاحتمال 50%، وعند ألف معرف يصبح التكرار مؤكداً في كل ثانية تقريباً. والآن فكر في معنى ذلك على مدى يوم كامل: نظام يولد 100 معرف في الثانية فيه 86,400 ثانية في اليوم، وفي كل ثانية فرصة 7% للتكرار، فالعدد المتوقع للثواني التي فيها تكرار يقارب ستة آلاف ثانية في اليوم. أي أن التصميم الذي يبدو آمناً بـ 48 بت يتصرف عملياً كأنه 16 بت تحت الضغط. وهذا هو سبب أن المعيار الحديث UUIDv7 الذي يضع الوقت في أوله يترك بعده 74 بتاً عشوائية، وأن Snowflake يستخدم رقم الجهاز والعداد بدلاً من العشوائية داخل المللي ثانية.
التوفر Availability على التسلسل Series والتوازي Parallel
في مقال مفاهيم التوفر العالي حسبنا التوفر Availability في حالتين: السلسلة Series حيث يجب أن تعمل كل الأجزاء فنضرب نسب التوفر، والتوازي Parallel حيث تكفي نسخة واحدة فنضرب نسب التعطل. ولكن كثيراً من الأنظمة الحقيقية لا تقع في أي من الحالتين، فقاعدة بيانات مثل etcd أو عنقود Kafka أو PostgreSQL مع التكرار المتزامن تحتاج إلى أغلبية العقد وليس إلى كلها ولا إلى واحدة منها، وهذا هو النصاب Quorum. والسؤال هنا: إذا كان لدي n عقدة، وكل عقدة تعمل بنسبة p من الوقت، فما احتمال أن تعمل k عقدة على الأقل في اللحظة نفسها؟
النصاب بالتوزيع الثنائي Binomial
الإجابة هي التوزيع الثنائي Binomial Distribution، والفكرة بسيطة: احتمال أن تعمل i عقدة بالضبط من n هو عدد طرق اختيار هذه العقد، أي C(n, i)، مضروباً في احتمال أن تعمل هي p^i، وفي احتمال أن تتوقف الباقية (1-p)^(n-i)، ثم نجمع هذا الاحتمال لكل قيم i من k إلى n. ولاحظ أن السلسلة حالة خاصة منه، فهي n من n، والتوازي حالة خاصة أيضاً، فهو 1 من n. والجزء الأول من السكربت availability.py يحسب هذه المعادلة ثم يحاكيها بمليون لحظة عشوائية:
# availability.py: k-of-n, correlated failures, fan-out and retries; formula next to simulation
import math, random

rng = random.Random(42)
TRIALS = 1_000_000

def k_of_n(k, n, p):                          # P(at least k of n independent replicas are up)
    return sum(math.comb(n, i) * p**i * (1 - p)**(n - i) for i in range(k, n + 1))

def sim_k_of_n(k, n, p):
    ok = sum(1 for _ in range(TRIALS) if sum(rng.random() < p for _ in range(n)) >= k)
    return ok / TRIALS

print("k-of-n with p=0.99 per node (1,000,000 simulated moments)")
for k, n in ((1, 1), (2, 2), (1, 2), (2, 3), (3, 5)):
    f = k_of_n(k, n, 0.99)
    s = sim_k_of_n(k, n, 0.99)
    print(f"  {k}-of-{n}: formula={f:.6f} ({(1 - f) * 525600:7.1f} min/yr)  simulated={s:.6f}")
والمخرج سوف يكون كما يلي:
k-of-n with p=0.99 per node (1,000,000 simulated moments)
  1-of-1: formula=0.990000 ( 5256.0 min/yr)  simulated=0.990064
  2-of-2: formula=0.980100 (10459.4 min/yr)  simulated=0.980115
  1-of-2: formula=0.999900 (   52.6 min/yr)  simulated=0.999882
  2-of-3: formula=0.999702 (  156.6 min/yr)  simulated=0.999708
  3-of-5: formula=0.999990 (    5.2 min/yr)  simulated=0.999992
في المخرج أعلاه لاحظ التالي:
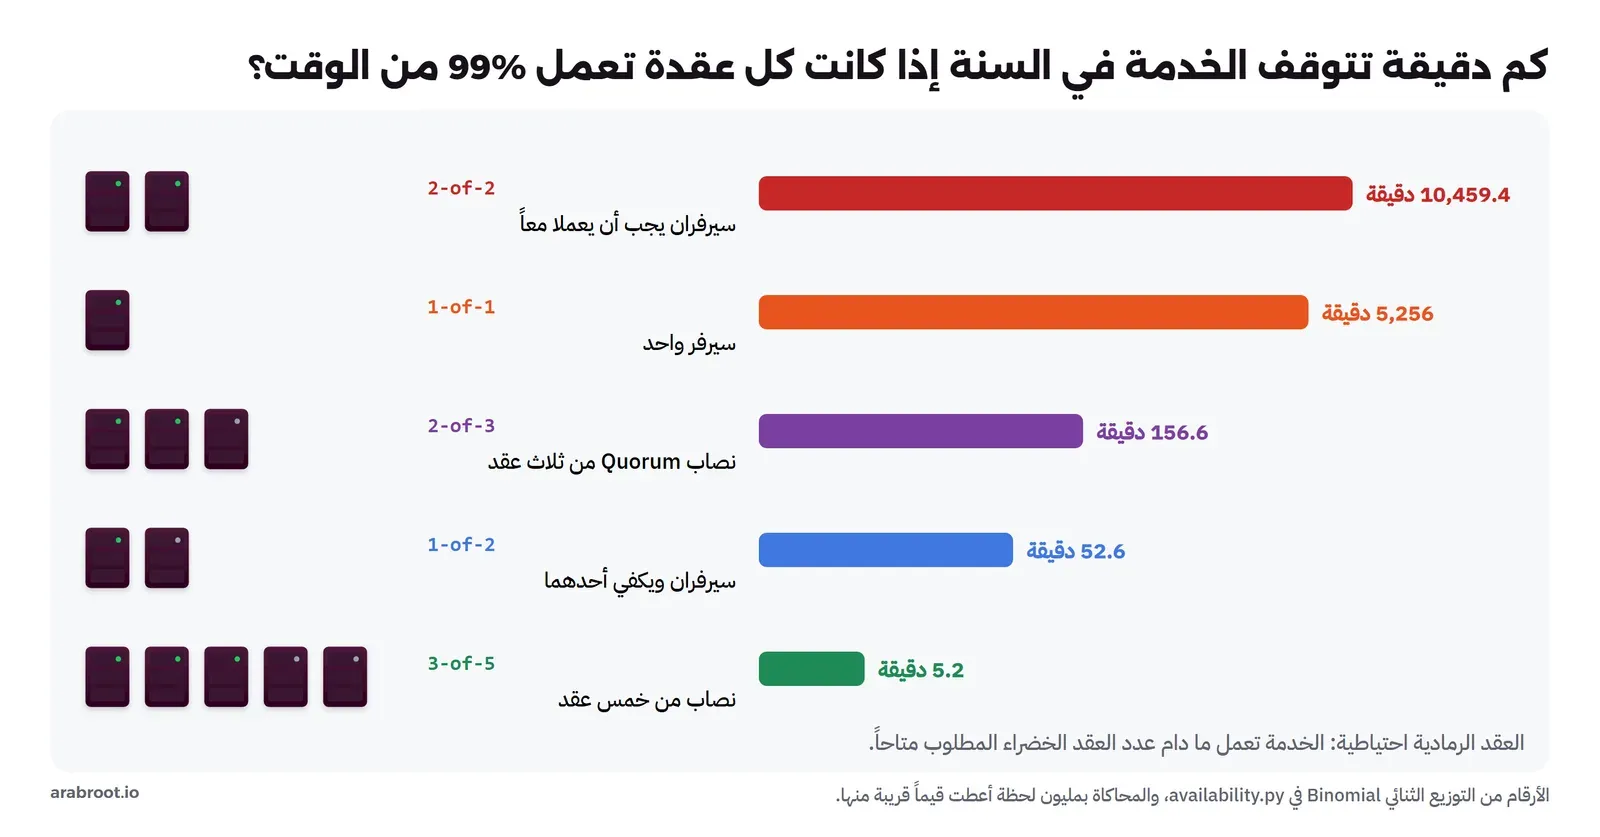
- العقدة الواحدة بنسبة 99% تتوقف 5,256 دقيقة في السنة، أي نحو 3.65 يوم، والرقم 525,600 في الكود هو عدد دقائق السنة.
- سيرفران يجب أن يعملا معاً، أي 2 من 2، أسوأ من سيرفر واحد، فهما يتوقفان 10,459 دقيقة في السنة، وهذا ما يحدث عندما تقسم البيانات على سيرفرين دون نسخ، فكل سيرفر تضيفه بهذه الطريقة يزيد التوقف.
- النصاب 2 من 3 يتوقف 156.6 دقيقة، وهو أكثر بثلاث مرات من سيرفرين يكفي أحدهما، أي 52.6 دقيقة، وهذا يفاجئ كثيرين، والسبب أن النصاب يحتاج إلى عقدتين سليمتين من ثلاث، فأي عطل في عقدتين من الأزواج الثلاثة يوقفه، بينما سيرفران بنسخ كاملة يتوقفان فقط إذا تعطل الاثنان. وثمن هذا التوقف الإضافي هو ما يشتريه النصاب: الاتساق Consistency ومنع انقسام الدماغ Split Brain الذي شرحناه في مقال التوفر العالي.
- النصاب 3 من 5 ينزل إلى 5.2 دقيقة في السنة، وهذا يتفق مع ما يقوله توثيق etcd من أن عنقوداً من خمس عقد يتحمل تعطل عقدتين، وأن هذا كاف في معظم الحالات، ولماذا ينصح بعدد فردي من العقد، فأربع عقد تحتاج أغلبية ثلاث وتتحمل تعطل عقدة واحدة فقط مثل ثلاث عقد.
- عمود
simulatedقريب من المعادلة في كل الحالات، والفرق في الخانة الخامسة أو السادسة، وسوف نرى الآن متى لا يكون هذا الفرق صغيراً.
والصورة التالية تبين دقائق التوقف السنوية لكل تصميم على محور لوغاريتمي، والعقد الرمادية هي العقد التي يستطيع النظام أن يعمل بدونها:
متى تثق بالمحاكاة Simulation ومتى لا تكفي؟
المحاكاة Simulation، وتسمى أيضاً طريقة Monte Carlo، أداة ممتازة عندما يكون النظام معقداً فلا توجد له معادلة بسيطة، فأنت تصف سلوك كل جزء وتترك الكمبيوتر يجرب ملايين الحالات ويعد النتائج. ولكن لها حداً مهماً يجب أن تعرفه قبل أن تثق برقمها، وهو الأحداث النادرة. والجزء التالي من السكربت يحاكي سيرفرين بنسبة 99.9% يكفي أحدهما، فالتوقف الحقيقي هو 0.001 × 0.001، أي واحد في المليون، ويكرر المحاكاة ثلاث مرات بمليون لحظة في كل مرة:
print("\nwhat the simulation sees for rare events (p=0.999, 1-of-2, exact unavailability 1e-6)")
for run in range(3):
    down = sum(1 for _ in range(TRIALS) if rng.random() >= 0.999 and rng.random() >= 0.999)
    print(f"  run {run + 1}: {down} down moments out of {TRIALS:,} -> {down / TRIALS:.1e}")
والمخرج سوف يكون كما يلي:
what the simulation sees for rare events (p=0.999, 1-of-2, exact unavailability 1e-6)
  run 1: 1 down moments out of 1,000,000 -> 1.0e-06
  run 2: 3 down moments out of 1,000,000 -> 3.0e-06
  run 3: 7 down moments out of 1,000,000 -> 7.0e-06
ثلاث محاولات بالكود نفسه أعطت ثلاث نتائج مختلفة، من واحد في المليون إلى سبعة في المليون، أي أن التقدير في المحاولة الثالثة أسوأ من الحقيقة سبع مرات. والسبب أن مليون لحظة فيها حدث نادر بنسبة واحد في المليون تعطيك حدثاً واحداً في المتوسط، والعدد الفعلي يتذبذب حول هذا المتوسط بنسبة كبيرة، فالقاعدة التقريبية أن الخطأ النسبي في عد الأحداث يقارب واحداً على جذر عددها، فإذا رأيت حدثاً واحداً فخطؤك قريب من 100%، وإذا رأيت مئة حدث فخطؤك قريب من 10%. لذلك إذا كان الحدث الذي يهمك نادراً جداً، مثل توقف نظام بتسع خانات أو تكرار معرف من 64 بت، فالمعادلة هي الأداة الصحيحة، أما المحاكاة فتحتاج إلى عدد محاولات أكبر بكثير من مقلوب الاحتمال، أو إلى طرق متخصصة خارج نطاق هذا المقال. والقاعدة العملية: استخدم المعادلة عندما تكون الافتراضات واضحة وبسيطة، واستخدم المحاكاة عندما تكون الافتراضات معقدة، ثم تحقق من المحاكاة بحالة صغيرة تعرف معادلتها، كما فعلنا في جدول k من n.
افتراض الاستقلال Independence: أخطر سطر في كل معادلة توفر
كل المعادلات السابقة، من التوازي إلى النصاب، تقوم على افتراض واحد لا يكتب غالباً، وهو أن العقد تتعطل بشكل مستقل Independent، أي أن تعطل السيرفر الأول لا يغير احتمال تعطل الثاني. وهذا الافتراض هو الذي سمح لنا بأن نضرب الاحتمالات، فإذا كان خاطئاً فالضرب كله خاطئ. وفي الواقع تشترك السيرفرات في أشياء كثيرة: مصدر الكهرباء، ومفتاح الشبكة Switch، ومنطقة التوفر Availability Zone عند مزود السحابة، ونسخة نظام التشغيل، وملف الإعداد الذي ينشر على الكل في الوقت نفسه، وشهادة TLS التي تنتهي في اليوم نفسه، وهذه كلها تجعل الأعطال مترابطة Correlated، وقد ذكرنا أمثلة لها في قسم الأعطال المترابطة من مقال التوفر العالي، والآن سوف نحسب أثرها بالأرقام. والجزء التالي من السكربت يأخذ سيرفرين بنسبة 99.9% لكل منهما، ولكنهما يشتركان في منطقة واحدة تتوقف 0.05% من الوقت، والأرقام هنا مثال للتوضيح وليست أرقام مزود معين:
print("\ntwo servers p=0.999 each, sharing one power feed / zone that is down 0.05% of the time")
p, q = 0.999, 0.0005
indep = 1 - (1 - p)**2
shared = (1 - q) * indep
up = 0
for _ in range(TRIALS):
    if rng.random() < q:
        continue
    if rng.random() < p or rng.random() < p:
        up += 1
print(f"  independent formula={indep:.6f}  with shared zone formula={shared:.6f}  simulated={up / TRIALS:.6f}")
والمخرج سوف يكون كما يلي:
two servers p=0.999 each, sharing one power feed / zone that is down 0.05% of the time
  independent formula=0.999999  with shared zone formula=0.999499  simulated=0.999435
المعادلة التي تفترض الاستقلال تعطي 99.9999%، أي نصف دقيقة توقف في السنة، أما مع المنطقة المشتركة فالتوفر 99.9499%، أي نحو 263 دقيقة في السنة، والمحاكاة أعطت رقماً قريباً منها. لاحظ أن المنطقة المشتركة أقل تعطلاً من كل سيرفر وحده، فهي تتوقف 0.05% من الوقت مقابل 0.1% للسيرفر، ومع ذلك أصبحت هي التي تحدد التوفر كله، والسبب أن التوازي يخفض احتمال تعطل السيرفرين معاً إلى واحد في المليون، فيبقى العطل المشترك وحده، وهو أكبر بخمسمئة مرة. وهذه قاعدة عامة: كلما أضفت تكراراً Redundancy، صارت الأعطال المشتركة هي الجزء الأكبر من التوقف، وأصبح عملك الحقيقي هو البحث عنها وإزالتها، وليس إضافة سيرفر ثالث.
لماذا يصبح البطء النادر قاعدة؟ حساب ال Fan-out
في مقال الإحصاء للتقنيين رأينا أن p99 هو الزمن الذي تنتهي قبله 99% من الطلبات، وأن 1% من الطلبات أبطأ منه. وقد يبدو 1% رقماً صغيراً يمكن تجاهله، ولكن ماذا يحدث عندما يحتاج طلب المستخدم إلى انتظار عدة خدمات معاً، مثل صفحة تجمع بيانات من عشر خدمات، أو بحث يرسل الاستعلام إلى مئة جزء Shard من الفهرس؟ الطلب ينتهي عندما ترد أبطأ خدمة، فيكفي أن تكون خدمة واحدة بطيئة حتى يكون الطلب كله بطيئاً. واحتمال ألا تكون أي خدمة بطيئة هو 0.99^N إذا كانت مستقلة، وبالتالي احتمال أن يتأخر الطلب هو 1 - 0.99^N. والجزء التالي من السكربت يحسبها ويحاكيها:
print("\nfan-out: one user request waits for N backends, each slow 1% of the time")
for n in (1, 5, 10, 50, 100):
    sims = 200_000
    slow = sum(1 for _ in range(sims) if any(rng.random() < 0.01 for _ in range(n)))
    print(f"  N={n:>3}: formula 1-0.99^N={1 - 0.99**n:.3f}  simulated={slow / sims:.3f}")
والمخرج سوف يكون كما يلي:
fan-out: one user request waits for N backends, each slow 1% of the time
  N=  1: formula 1-0.99^N=0.010  simulated=0.010
  N=  5: formula 1-0.99^N=0.049  simulated=0.048
  N= 10: formula 1-0.99^N=0.096  simulated=0.096
  N= 50: formula 1-0.99^N=0.395  simulated=0.395
  N=100: formula 1-0.99^N=0.634  simulated=0.633
مع عشر خدمات يتأخر نحو 10% من الطلبات، ومع خمسين خدمة 39.5%، ومع مئة خدمة 63.4%، أي أن ما كان «أسوأ 1%» لكل خدمة وحدها أصبح أغلب الطلبات من جهة المستخدم. وهذا الرقم بالضبط هو المثال الذي استخدمه Jeffrey Dean وLuiz André Barroso من Google في ورقة The Tail at Scale سنة 2013، حيث بينا أن الطلب الذي ينتظر مئة سيرفر، كل منها يتأخر ثانية في 1% من الطلبات، سوف يتأخر في 63% من الحالات. والصورة التالية توضح ذلك:
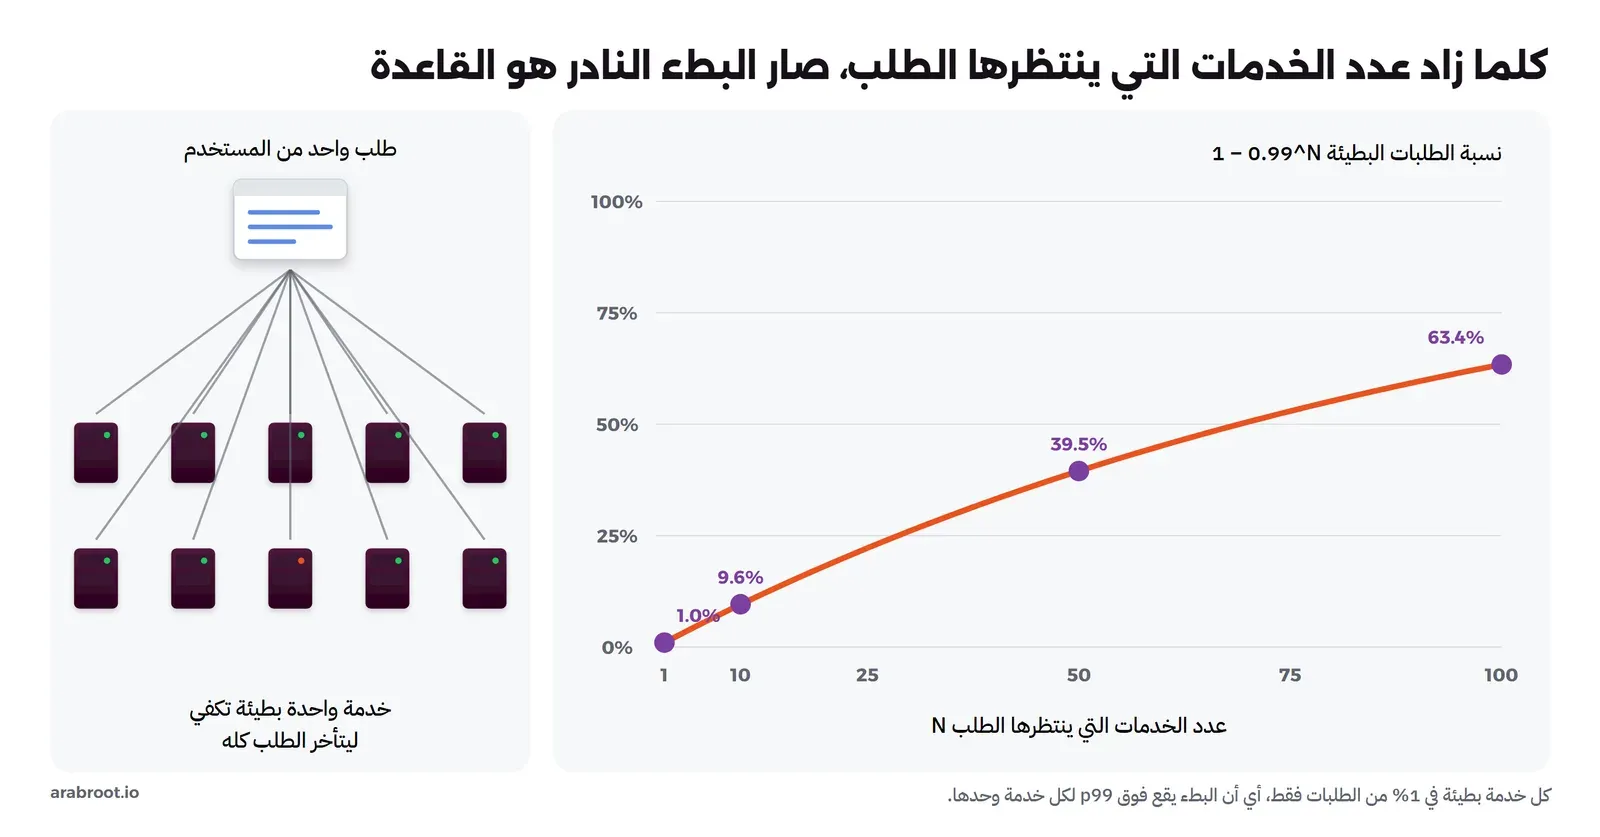
والنتيجة العملية من هذا الحساب أن الخدمة التي يعتمد عليها طلب موزع يجب أن تراقب بمئين أعلى من المئين الذي تهتم به للمستخدم، فإذا أردت أن يكون p99 للطلب الكامل جيداً وهو ينتظر عشر خدمات، فيجب أن يكون p99.9 لكل خدمة جيداً، والسبب أن 1 - 0.999^10 تقارب 1%. وهذا أيضاً سبب ظهور تقنيات مثل الطلب المكرر Hedged Request، حيث يرسل الكلاينت الطلب نفسه إلى نسخة ثانية إذا تأخرت الأولى أكثر من p95، فيقبل بزيادة صغيرة في الضغط Load مقابل قطع الذيل البطيء، وهي من الأفكار التي تشرحها الورقة نفسها.
الإعادة Retry: متى تساعد ومتى تخدعك؟
الحساب البسيط للإعادة يقول: إذا كانت نسبة فشل الطلب 1%، فمحاولتان تعطيان فشلاً بنسبة 0.01²، أي واحد في العشرة آلاف، وثلاث محاولات تعطيان واحداً في المليون. وهذا صحيح فقط إذا كانت المحاولات مستقلة، أي أن فشل المحاولة الأولى لا يخبرك شيئاً عن الثانية، وهذا الافتراض نادراً ما يكون صحيحاً بالكامل، فجزء من الأعطال مؤقت Transient، مثل انقطاع اتصال أو سيرفر أعيد تشغيله، وجزء آخر مستمر Persistent، مثل قاعدة بيانات متوقفة أو طلب فيه خطأ في البيانات، والإعادة لا تساعد في الثاني أبداً. والجزء الأخير من السكربت يفترض أن 1% من الطلبات تفشل، وأن تسعة أعشار هذا الفشل مؤقت، وعشره مستمر في كل المحاولات:
print("\nretries: 1% of calls fail; 90% of failures are transient, 10% last for all retries")
for tries in (1, 2, 3):
    sims, fail, calls = 1_000_000, 0, 0
    for _ in range(sims):
        persistent = rng.random() < 0.001
        for t in range(tries):
            calls += 1
            if not persistent and rng.random() >= 0.009 / 0.999:
                break
        else:
            fail += 1
    naive = 0.01**tries
    print(f"  tries={tries}: independent 0.01^k={naive:.1e}  simulated failure={fail / sims:.1e}  mean calls per request={calls / sims:.4f}")
في الكود أعلاه لاحظ أن المتغير persistent يقرر مرة واحدة لكل طلب، باحتمال واحد في الألف، أن الفشل مستمر، فإذا كان كذلك فإن كل المحاولات تفشل، وإلا فكل محاولة تفشل باحتمال 0.009/0.999، والقسمة على 0.999 تجعل نسبة الفشل الكلية في المحاولة الأولى 1% بالضبط. ونستخدم هنا for … else في Python، فجملة else تنفذ فقط إذا انتهت الحلقة دون break، أي إذا فشلت كل المحاولات. والمخرج سوف يكون كما يلي:
retries: 1% of calls fail; 90% of failures are transient, 10% last for all retries
  tries=1: independent 0.01^k=1.0e-02  simulated failure=1.0e-02  mean calls per request=1.0000
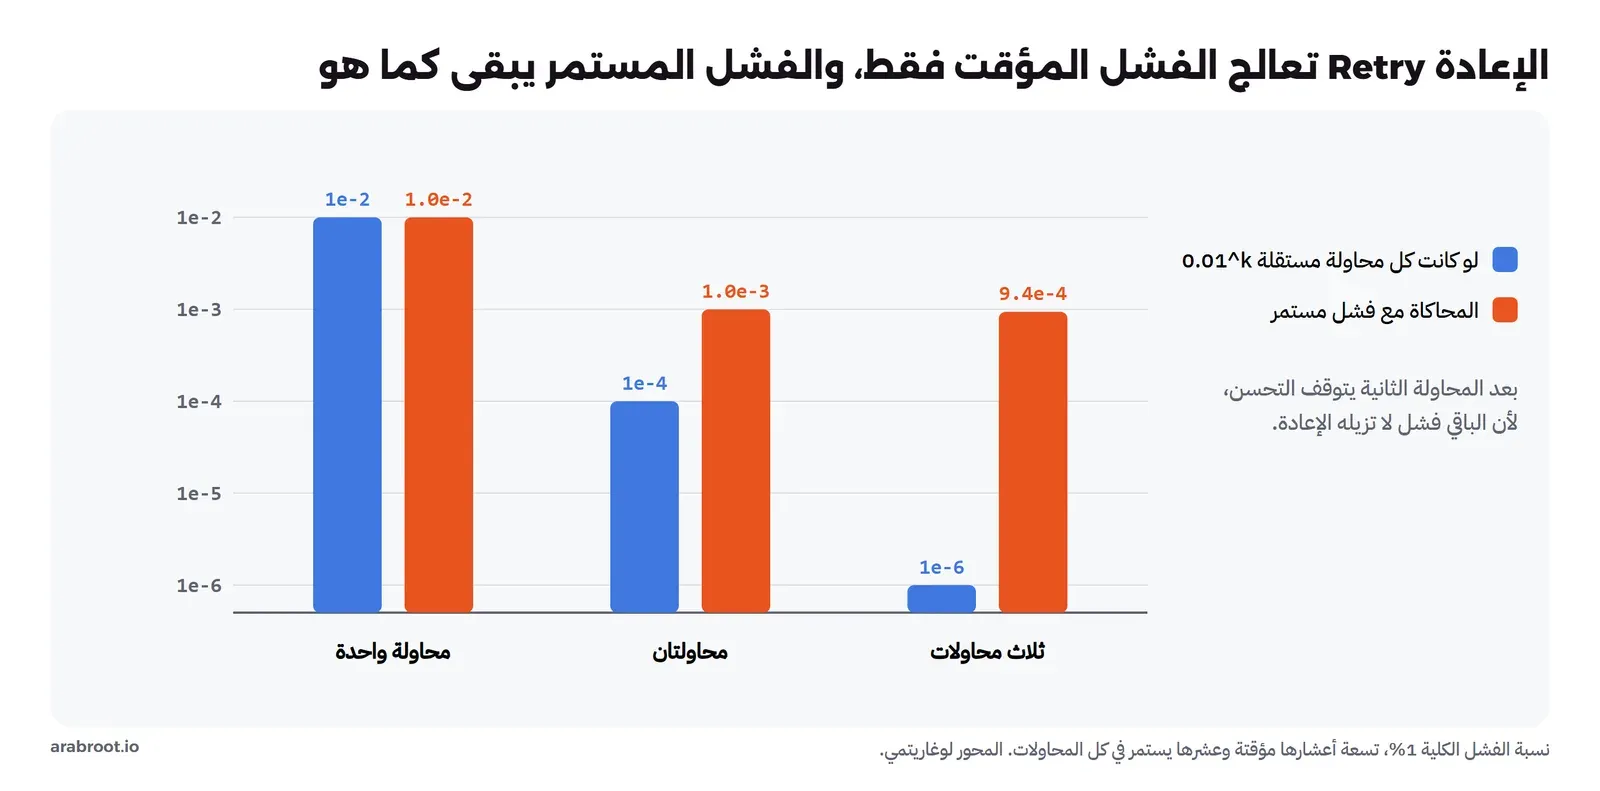
  tries=2: independent 0.01^k=1.0e-04  simulated failure=1.0e-03  mean calls per request=1.0101
  tries=3: independent 0.01^k=1.0e-06  simulated failure=9.4e-04  mean calls per request=1.0112
مع محاولتين يتوقع الحساب البسيط فشلاً بنسبة واحد في العشرة آلاف، والمحاكاة أعطت واحداً في الألف، أي عشرة أضعاف، ومع ثلاث محاولات يتوقع الحساب البسيط واحداً في المليون، والمحاكاة أعطت 9.4 في العشرة آلاف، أي نحو ألف ضعف. والسبب أن المحاولة الثانية أزالت كل الفشل المؤقت تقريباً، وبقي الفشل المستمر الذي نسبته واحد في الألف، والمحاولة الثالثة لا تغير فيه شيئاً، والفرق بين 1.0e-03 و9.4e-04 هو تذبذب المحاكاة الذي شرحناه قبل قليل. والصورة التالية تبين ذلك:
وفي المخرج رقم آخر مهم، وهو متوسط عدد الاستدعاءات لكل طلب: 1.0101 مع محاولتين و1.0112 مع ثلاث، أي أن الإعادة في الأوقات العادية تكلف نحو 1% من الضغط الإضافي فقط. ولكن هذا المتوسط يخفي الحالة الخطرة، فعندما تتوقف الخدمة التي تستدعيها ويصبح كل الفشل مستمراً، فإن كل طلب يستدعيها ثلاث مرات بدلاً من مرة، فيتضاعف الضغط عليها ثلاث مرات في اللحظة التي تكون فيها أضعف ما يكون، وإذا كان كل طبقة في النظام تعيد ثلاث مرات فإن خمس طبقات تضرب الضغط في 35، أي 243 ضعفاً. وهذا المثال نفسه، خمس طبقات وثلاث محاولات و243 ضعفاً، موجود في دليل Timeouts, retries, and backoff with jitter من Amazon، والذي ينصح بأن تكون الإعادة في نقطة واحدة من الطبقات، مع انتظار يزيد بعد كل محاولة Exponential Backoff، وعشوائية في مدة الانتظار Jitter حتى لا تعود كل الطلبات في اللحظة نفسها، ومع حد أعلى لعدد الإعادات.
القيمة المتوقعة Expected Value: من الاحتمال إلى القرار
الاحتمال وحده لا يكفي لاتخاذ قرار، فاحتمال 1% لتكرار رابط في خدمة تجريبية يختلف عن احتمال 1% لتكرار رقم فاتورة. والأداة التي تربط الاحتمال بالقرار هي القيمة المتوقعة Expected Value، وهي مجموع كل نتيجة ممكنة مضروبة في احتمالها، وقد استخدمناها في هذا المقال ثلاث مرات دون أن نسميها: العدد المتوقع للتكرارات n²/2N، ودقائق التوقف المتوقعة في السنة، ومتوسط عدد الاستدعاءات مع الإعادة. وعند اتخاذ القرار نضرب الاحتمال في التكلفة، فإذا كانت الخدمة فيها مليون رابط بسبعة أحرف، فالعدد المتوقع للتكرارات 0.142 كما في الجدول، وإذا كانت تكلفة كل تكرار ساعة عمل لمعالجة شكوى، فالتكلفة المتوقعة نحو ثمان دقائق في السنة، وهذا لا يبرر تعقيد التصميم، أما إذا كان التكرار يعني أن عميلاً يرى فاتورة عميل آخر، فالتكلفة قد تكون غرامة أو ثقة لا تعود، وحتى احتمال صغير جداً يستحق قيد تفرد وإعادة توليد.
ولكن انتبه إلى حدود القيمة المتوقعة: فهي متوسط، والمتوسط يخفي التوزيع كما ذكرنا في مقال الإحصاء، فمعرف 32 بت تكرر في التجربة مرة بعد 1,640 رقماً ومرة بعد 255 ألفاً، والنظام الواحد لا يعيش المتوسط وإنما يعيش حالة واحدة. لذلك عندما تكون التكلفة كبيرة جداً ولا يمكن إصلاحها، فاسأل عن الحالة السيئة وليس عن المتوسط فقط.
أخطاء شائعة
- حساب الاحتمال على عدد القيم وليس على جذره: «لدينا أربعة مليارات قيمة ولن نصل إليها أبداً» صحيح، ولكنك تصل إلى التكرار عند 77 ألفاً، فاستخدم قاعدة نصف البتات.
- الخلط بين احتمال التكرار في الجدول واحتمال اصطدام العنصر الجديد: الأول ينمو مع مربع العدد والثاني مع العدد نفسه، ولكل منهما قرار مختلف.
- حساب الاحتمال على طول المعرف كله: المعرف الذي فيه وقت أو رقم سيرفر أو بادئة ثابتة يتنافس على البتات العشوائية فقط، كما رأينا في تجربة الوقت مع 16 بت.
- افتراض أن أي دالة هاش عشوائية: CRC32 لم يتبع المعادلة في التجربة، ودوال القواميس كانت قابلة للتصادم المتعمد حتى 2011، فاستخدم SHA-256 أو دالة بمفتاح عندما يهمك التوزيع أو الأمان.
- حساب
1 - exp(-x)مباشرة: يعطي صفراً للاحتمالات الصغيرة جداً، فاستخدمexpm1وlog1p. - الاعتماد على الاحتمال بدلاً من قيد التفرد: حتى UUIDv4 يحتاج قيد تفرد في قاعدة البيانات، والسبب أن المولد السيئ أو النسخة المكررة من ال Container يكسران الافتراض، وقيد التفرد في PostgreSQL وغيرها لا يعتمد على أي افتراض.
- ضرب نسب التوفر دون التحقق من الاستقلال: المنطقة المشتركة رفعت التوقف في التجربة من نصف دقيقة إلى 263 دقيقة في السنة.
- الثقة بمحاكاة حدث نادر بعدد محاولات قليل: مليون محاولة لحدث بنسبة واحد في المليون أعطت تقديرات بين 1 و7 في المليون.
- حساب الإعادة كأن المحاولات مستقلة: الفشل المستمر يبقى بعد كل المحاولات، والإعادة في كل طبقة تضاعف الضغط وقت العطل.
- تجاهل ال Fan-out عند تحديد أهداف الخدمات الداخلية: p99 لكل خدمة لا يعطي p99 للطلب الذي ينتظر عشر خدمات.
جدول القرار Decision Table: أي حجم وأي أداة؟
الجدول التالي يجمع القرارات العملية من هذا المقال، والأرقام فيه من مخرج التجربة:
| الموقف | القرار | والسبب |
|---|---|---|
| معرف عشوائي لجدول قد يصل إلى ملايين السجلات | 64 بت على الأقل، والأفضل UUIDv4 أو UUIDv7، مع قيد تفرد | 32 بت يصل إلى 50% عند 77 ألفاً، و64 بت إلى 1% عند 609 ملايين |
| رابط قصير أو رمز دعوة يظهر للمستخدم | 7 أو 8 أحرف base62 مع قيد تفرد وإعادة توليد | 6 أحرف تصل إلى 50% عند 280 ألف رابط |
| مرجع إلى Commit في سكربت أو قاعدة بيانات | الهاش الكامل | الاختصار قد يصبح غامضاً مع نمو المستودع |
| هاش لتوزيع مفاتيح يتحكم فيها المستخدم | دالة بمفتاح سري مثل SipHash، أو SHA-256 | CRC32 والدوال الثابتة قابلة للتصادم المتعمد |
| كشف تلف البيانات أثناء النقل | CRC32 مناسب | صمم لكشف الأخطاء المتصلة وهو سريع جداً |
| تقدير احتمال حدث نادر جداً | المعادلة | المحاكاة تحتاج محاولات أكثر بكثير من مقلوب الاحتمال |
| نظام بافتراضات معقدة أو مترابطة | المحاكاة، مع التحقق بحالة لها معادلة | المعادلة البسيطة تفترض الاستقلال |
| عنقود يحتاج اتساقاً | 3 أو 5 عقد بنصاب | العدد الزوجي لا يزيد عدد الأعطال التي يتحملها النصاب |
| طلب ينتظر N خدمة | هدف لكل خدمة عند p99.9 أو أعلى | 1 - 0.99^N يرفع البطء بسرعة |
قائمة تحقق Checklist
- هل حسبت احتمال التكرار على البتات العشوائية فقط، وعلى عدد العناصر الذي يتنافس عليها فعلاً؟
- هل يوجد قيد تفرد في قاعدة البيانات، وكود يعيد التوليد عند الرفض ويسجل عدد المرات؟
- هل يأتي المعرف من مولد آمن يأخذ عشوائيته من نظام التشغيل، وليس من مولد بذرته الوقت؟
- هل الدالة التي تعتمد على توزيعها دالة هاش جيدة، أم Checksum مثل CRC32؟
- هل حسبت الاحتمال بدوال تحافظ على الدقة للقيم الصغيرة مثل
expm1؟ - هل كتبت افتراض الاستقلال صراحة بجانب كل حساب توفر، وبحثت عن الأجزاء المشتركة بين النسخ؟
- هل عدد عقد النصاب فردي، وهل تعرف كم دقيقة توقف يعطيك مقارنة بالتصاميم الأخرى؟
- هل الإعادة في طبقة واحدة، مع Backoff وJitter وحد أعلى للمحاولات؟
- هل أهداف الخدمات الداخلية محسوبة من عدد الخدمات التي ينتظرها الطلب؟
- إذا استخدمت المحاكاة، فهل عدد المحاولات أكبر بكثير من مقلوب الاحتمال الذي تقيسه؟
تدريب عملي
- احسب بالمعادلة عدد الروابط التي تستطيع خدمة بتسعة أحرف base62 أن تنشئها قبل أن يصل احتمال التكرار إلى واحد في المليون، ثم أضف السطر إلى قائمة
SPACESفيcollisions.pyوتحقق من رقمك. - عدل
simulate.pyحتى يحسب CRC32 لنصوص متتالية بالطول نفسه فقط، مثلuser-10000000إلىuser-99999999، وراقب متى يظهر أول تكرار، ثم فسر النتيجة بخاصية كشف الأخطاء المتصلة. - غير في
availability.pyاحتمال المنطقة المشتركةqإلى 0.0001 ثم إلى 0.001، واحسب دقائق التوقف في كل حالة، ثم حدد القيمة التي يصبح عندها السيرفر الثاني بلا فائدة تقريباً.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التكرار يأتي من عدد الأزواج
n(n-1)/2، والاحتمال يقارب1 - e^(-n²/2N)، وعدد المعرفات الآمن يتناسب مع جذر عدد القيم، فمساحة b بت تبدأ في التكرار قرب 2b/2. - 32 بت تصل إلى 50% عند 77,163 معرفاً، والرابط بستة أحرف base62 عند 280,610، والهاش القصير في Git بسبع خانات عند 19,291 كائناً، و64 بت عند 5 مليارات.
- المحاكاة أكدت المعادلة للأرقام العشوائية ولـ SHA-256 المقصوص، ولكن CRC32 للنصوص المتتالية لم يتبعها، لأن المعادلة تفترض دالة تشبه العشوائية.
- التصادم المتعمد في دوال القواميس أوقف سيرفرات في 2011، وحد يوم الميلاد في كتل 64 بت أنتج هجوم Sweet32 في 2016.
- النصاب يحسب بالتوزيع الثنائي، و2 من 3 يتوقف أكثر من 1 من 2 مقابل الاتساق، و3 من 5 ينزل إلى دقائق في السنة.
- كل معادلة توفر تفترض الاستقلال، والعطل المشترك يسيطر على التوقف كلما زاد التكرار.
- الطلب الذي ينتظر N خدمة يتأخر بنسبة
1 - 0.99^N، والإعادة تعالج الفشل المؤقت فقط، والقيمة المتوقعة تربط الاحتمال بالتكلفة ولكنها تخفي الحالة السيئة.
وفي المرحلة نفسها يأتي مقال الإحصاء للتقنيين قبل هذا المقال، ومقال الرياضيات خلف التشفير بعده، وهذه المقالات المنشورة التي يعتمد عليها هذا المقال أو يكملها:
 دليلالرقم المتسلسل أم UUID؟ كيف تختار المعرف الفريدلماذا يفشل الرقم المتسلسل في الروابط وعند تعدد السيرفرات، وكيف يؤثر نوع المعرف الذي تختاره على فهرس قاعدة البيانات.
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلالتشفير للمطورين: ماذا تستخدم ولماذا لا تخترع خوارزميتكأي هاش تستخدم لكلمات المرور، ومتى تحتاج التشفير المتماثل أو غير المتماثل، وأين تحفظ المفاتيح بأمان في تطبيقك.
 دليلFloating Point من الداخل: كيف يخزن الحاسب الكسوركيف يحفظ معيار IEEE 754 الكسور في البتات، ولماذا تكبر الفجوة بين الأرقام وتضيع خانات المعرفات، ومتى تحتاج النوع العشري.
 دليلالأنظمة العددية للمبرمجين: من Binary إلى Floating Pointلماذا يظهر القرص 465 بدل 500، ويصبح العداد سالباً فجأة، ولا يساوي 0.1 + 0.2 القيمة 0.3؟ الإجابة في طريقة تخزين الأرقام.
 دليلمفاهيم المراقبة Observability: من الإشارة إلى التنبيهما الذي تجيب عنه المقاييس والسجلات والتتبع، وكيف تبني تنبيهاً على ما يشعر به المستخدم وعلى ميزانية الأخطاء بدل كل رقم.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ السكربتات في Container من
python:3.13.17-slim(Python 3.13.17) على Docker Engine 29.8.0.