في المقال الأول من السلسلة عرفنا ماذا نقيس، وفي المقال الثاني بنينا دورة التقييم من اجتماع 1:1 إلى المعايرة، وبقي السؤال الذي يسأله كل مدير بعد ذلك: هل أحتاج إلى أداة؟ والإجابة أن الأداة تنظم الدورة وتجمع البيانات، ولكنها لا تقرر ماذا تعني الأرقام، وبعض الأدوات تعرض أرقاماً لكل شخص تدفعك إلى الخطأ الذي حذرنا منه. وفي هذا المقال سوف نقارن الأدوات بأسعارها كما في صفحاتها الرسمية، ثم نبني مختبراً يحسب مقاييس DORA من مستودع Gitea، ونكسره بطلبات دمج صغيرة كثيرة، ونحاكي اجتماع المعايرة Calibration بالأرقام.
المواضيع في السلسلة:
- كيف تقيم أداء المطورين دون أن تقيس الأشياء الخطأ؟
- دورة تقييم أداء الفريق التقني: متى وكيف تقيم؟
- أدوات تقييم الأداء ومقاييس فرق التطوير (الموضوع الحالي)
وسوف نناقش في هذا المقال ما يلي:
- ثلاثة أنواع من الأدوات، وما يناسب كل فريق.
- أدوات الأشخاص Lattice و15Five وCulture Amp وLeapsome بأسعارها.
- الخيارات المفتوحة Frappe HR وOdoo وOrangeHRM ورخصها.
- أدوات مقاييس الهندسة LinearB وSwarmia وJellyfish وDX وApache DevLake.
- مختبر: مقاييس DORA من Gitea بسكربت، ثم نكسرها بطلبات دمج صغيرة.
- محاكاة اجتماع المعايرة Calibration بثلاثة مديرين وعشرين مهندساً.
ثلاثة أنواع من الأدوات
الأدوات في هذا المجال تحل مشكلتين مختلفتين، وكثير من الشركات تشتري واحدة وهي تحتاج الأخرى، والصورة التالية تبين الأنواع الثلاثة:
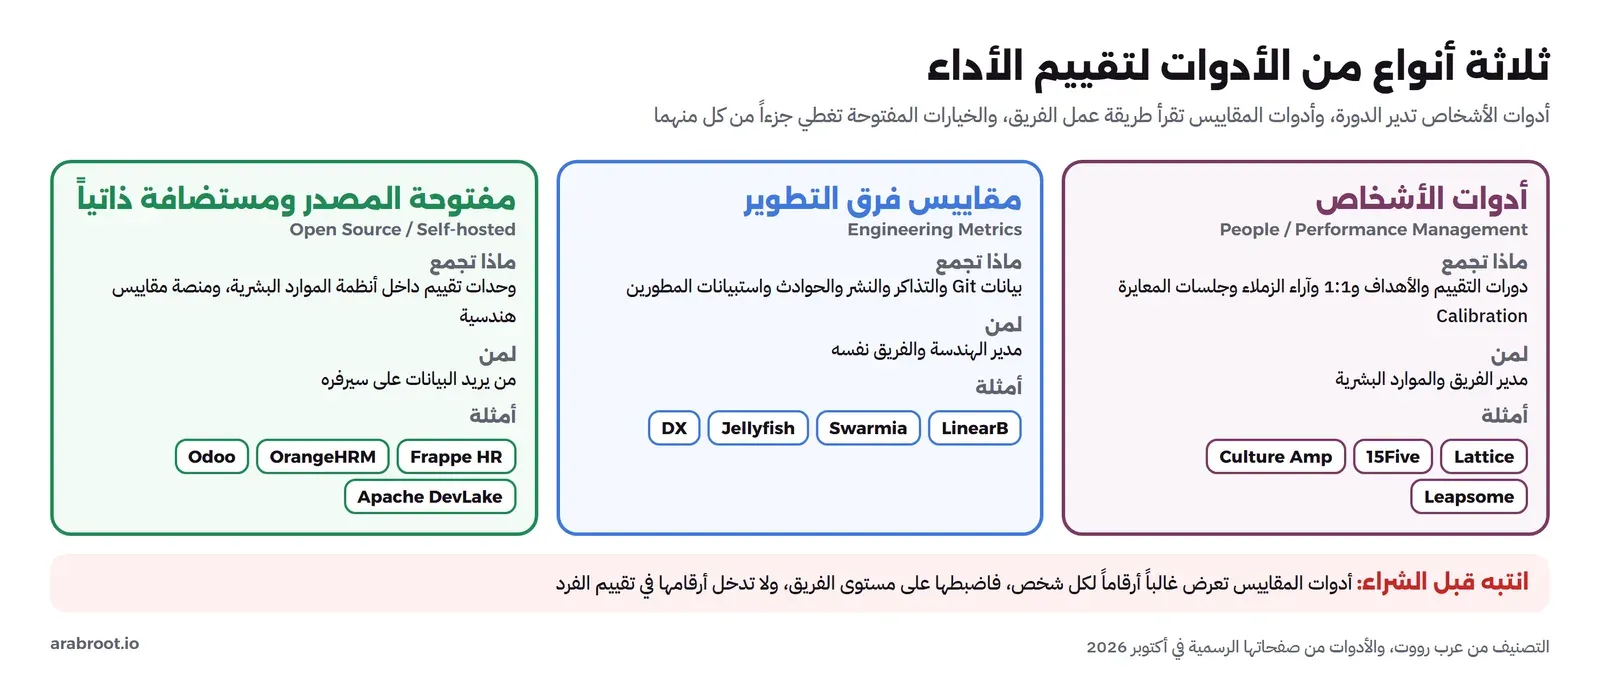
في الصورة أعلاه لاحظ التالي:
- أدوات الأشخاص لا تعرف شيئاً عن الكود، وهي تنفع أي قسم في الشركة، وقيمتها في تنظيم الدورة وحفظ الأدلة وتنظيم اجتماع المعايرة Calibration بين المديرين.
- أدوات المقاييس لا تقيم أحداً بنفسها، وقيمتها أن تظهر أين يتعطل العمل، مثل طلبات دمج تنتظر المراجعة أياماً.
- الفريق الصغير يستطيع أن يبدأ بلا أداة: ملف مشترك لكل موظف وقوالب المقال السابق وسكربت مثل الذي سوف نبنيه.
أدوات تقييم الأداء للأشخاص
هذه الأدوات تجمع في مكان واحد دورات التقييم والأهداف واجتماعات 1:1 وآراء الزملاء، وأغلبها تبيع وحدات منفصلة بسعر لكل موظف في الشهر. والجدول التالي ينقل الأسعار كما في صفحات الأسعار الرسمية يوم 15 أكتوبر 2026، وهي تتغير، فراجعها قبل الشراء:
| الأداة | وحدة تقييم الأداء | وحدات أخرى | الفوترة والحد الأدنى |
|---|---|---|---|
| Lattice | Performance بسعر 10 دولارات للمقعد شهرياً، وتذكر الصفحة فيها المراجعات والترقيات وخطط PIP وجلسات المعايرة Calibration بين المديرين | Goals and OKRs بسعر 8 دولارات، وEngagement بسعر 4، وCompensation بإضافة 6 | سنوية بالدولار، وأقل عقد 4,000 دولار في السنة |
| 15Five | Perform بسعر 11 دولاراً للمستخدم شهرياً | Engage بسعر 4 دولارات، وTotal Platform بسعر 16 | سنوية، والصفحة محدثة في فبراير 2026 |
| Culture Amp | Perform بعرض سعر Quote | Engage بعرض سعر | سنوية، والسعر حسب عدد الموظفين والمنتج ومستوى الخدمة |
| Leapsome | Performance Reviews بسعر 7 يورو للموظف شهرياً | Goals and OKRs بسعر 4 يورو، وEngagement Surveys بسعر 4، ويشترط معها أساس HRIS Foundation بسعر 7 يورو (مجاني حتى 31 ديسمبر مع أي وحدة) | لا تذكر الصفحة حداً أدنى، وتذكر تجربة مجانية 14 يوماً |
والذي يهم عند الاختيار أكثر من السعر ثلاثة أسئلة، فاسأل البائع عنها قبل أي عرض:
- هل تستطيع أن تكتب مصفوفة كفاءاتك بنفسك بمستوياتك وأوصافك السلوكية، أم تفرض الأداة نموذجها؟
- هل تدعم المعايرة Calibration كما شرحناها، أي كتابة الدرجات قبل رؤية درجات الآخرين، وتسجيل سبب كل تغيير؟
- أين تحفظ البيانات، وهل يتوافق ذلك مع سياسة شركتك ونظام حماية البيانات الشخصية، فتقييم الأداء من أكثر البيانات حساسية عندك.
خيارات مفتوحة المصدر ومستضافة ذاتياً
إذا كان عندك نظام موارد بشرية أو ERP مفتوح، فقد تجد فيه وحدة للتقييم تكفي فريقك، والجدول التالي يلخص ما راجعناه من المستودعات والتوثيق الرسمي:
| النظام | الرخصة | آخر إصدار عند الكتابة | التقييم فيه |
|---|---|---|---|
| Frappe HR | GPL-3.0 | v15.64.5 (15 أكتوبر 2026) | دورة تقييم Appraisal Cycle وقالب بمجالات النتائج الرئيسية KRAs وأوزانها، وأهداف وآراء وتقييم ذاتي، كما في توثيق Appraisal |
| Odoo | نسخة Community بـ LGPL-3 | الفرع 19.0 | تطبيق Appraisals فيه تقييم ذاتي ورأي المدير وتقييم نهائي وآراء من عدة جهات 360 ومهارات وأهداف، كما في توثيقه، ولكن وحدته hr_appraisal ليست في مستودع Community في الفرعين 18.0 و19.0، أي أنها تأتي مع الاشتراك المدفوع Enterprise |
| OrangeHRM | GPL-3.0 | v5.9 (28 يونيو 2026) | وحدة أداء Performance ضمن الكود المفتوح نفسه |
ولاحظ في توثيق Frappe HR أن الدرجة النهائية «is calculated as an average of your Goal Score, Avg Feedback Score, and Self Appraisal Score»، أي أن التقييم الذاتي ثلث الدرجة النهائية في الإعداد الذي يصفه التوثيق، وهذا قرار يجب أن تتخذه بوعي، فالتقييم الذاتي مفيد كمادة للنقاش، ولكن جعله جزءاً ثابتاً من الرقم يكافئ من يقيم نفسه بسخاء. وإذا كنت تستخدم Odoo Community فقد شرحنا تثبيته في دليل Odoo، ولكن لا تتوقع أن تجد فيه تطبيق التقييم.
أدوات مقاييس فرق التطوير
هذه الأدوات تتصل بمستودعات Git ونظام التذاكر وخط النشر، وتحسب منها مقاييس مثل DORA وزمن المراجعة، وبعضها يضيف استبيانات للمطورين. والجدول التالي من صفحاتها يوم 15 أكتوبر 2026:
| الأداة | السعر المعلن | ملاحظات |
|---|---|---|
| LinearB | Essentials بسعر 29 دولاراً، وEnterprise بسعر 59 دولاراً، للمساهم شهرياً | سنوية فقط، وأقل عدد 50 مساهماً في الأولى و100 في الثانية، وتجربة 45 يوماً |
| Swarmia | Standard بسعر 45 دولاراً، وEnterprise بسعر 55 دولاراً، للمطور شهرياً | مجانية للشركات التي فيها أقل من 10 مطورين، ومن الوحدات مقاييس DORA واستبيانات المطورين |
| Jellyfish | بعرض سعر | السعر حسب عدد المقاعد والوحدات |
| DX | لا تذكر الصفحة سعراً | أعلنت Atlassian في 18 سبتمبر 2025 اتفاقاً للاستحواذ عليها، واثنان من كتاب ورقة DevEx كانا من فريق DX عند نشرها |
| Apache DevLake | مجانية ومفتوحة بـ Apache-2.0 | آخر إصدار مستقر v1.0.2 (2 يوليو 2025)، وآخر إصدار تجريبي v1.0.3-beta18 (27 سبتمبر 2026) |
وApache DevLake هي الخيار المفتوح الأقرب إلى هذه الأدوات، فهي تجمع البيانات من مصادر كثيرة في قاعدة واحدة وتعرض منها لوحات فيها لوحة لمقاييس DORA، وقبل أن تختارها لاحظ التالي:
- أربع خدمات: ملف Docker Compose الرسمي للإصدار v1.0.2 فيه mysql:8 ولوحات Grafana والخادم devlake وواجهة الإعداد config-ui.
- المصادر المدعومة: في قائمة المصادر GitHub وGitLab وJira وJenkins وBitbucket وAzure DevOps وغيرها.
- لا يوجد Gitea: ليس في القائمة، وليس بين إضافات الكود في الإصدار v1.0.2.
- الطريق للمصادر الأخرى: إضافة Webhook التي ترسل إليها النشرات والحوادث بنفسك.
وقبل أن تشتري أي أداة من هذا النوع، اتبع القواعد التالية:
- اضبطها على الفريق: أغلبها يعرض لوحات لكل شخص، فأخفها أو لا تفتحها، والسبب ما شرحناه في المقال الأول.
- اكتب تعريفاتك قبل الأداة: ما النشر، وما الحادثة، ومتى يعتبر النشر فاشلاً، والسبب أن الأداة سوف تختار تعريفاً عنك إذا لم تكتبه.
- أضف رأي الناس: استبيان قصير كل ربع كما يطلب إطار SPACE، فالأداة لا ترى العمل غير المرئي Invisible Work مثل التوجيه والتوثيق.
- ابدأ بلا أداة: كما تقول صفحة DORA نفسها، بناء تكاملات معقدة قد لا يستحق الاستثمار في البداية، والسكربت التالي يكفي فريقاً صغيراً.
مختبر: مقاييس DORA من Gitea بسكربت
كان الهدف الأول أن نشغل Apache DevLake على مستودع Gitea محلي، ولكن كما ذكرنا لا تدعم DevLake مصدر Gitea، فإما أن ننقل المختبر إلى GitHub أو GitLab، أو نكتب الأحداث بأنفسنا عبر Webhook ونشغل أربع خدمات لنحصل على أرقام نستطيع حسابها مباشرة. لذلك كتبنا سكربتاً صغيراً بلغة Python يقرأ Gitea API فقط ويحسب المقاييس الخمسة، وهذا ما يحتاجه فريق صغير في الغالب. والصورة التالية تبين أجزاء المختبر:
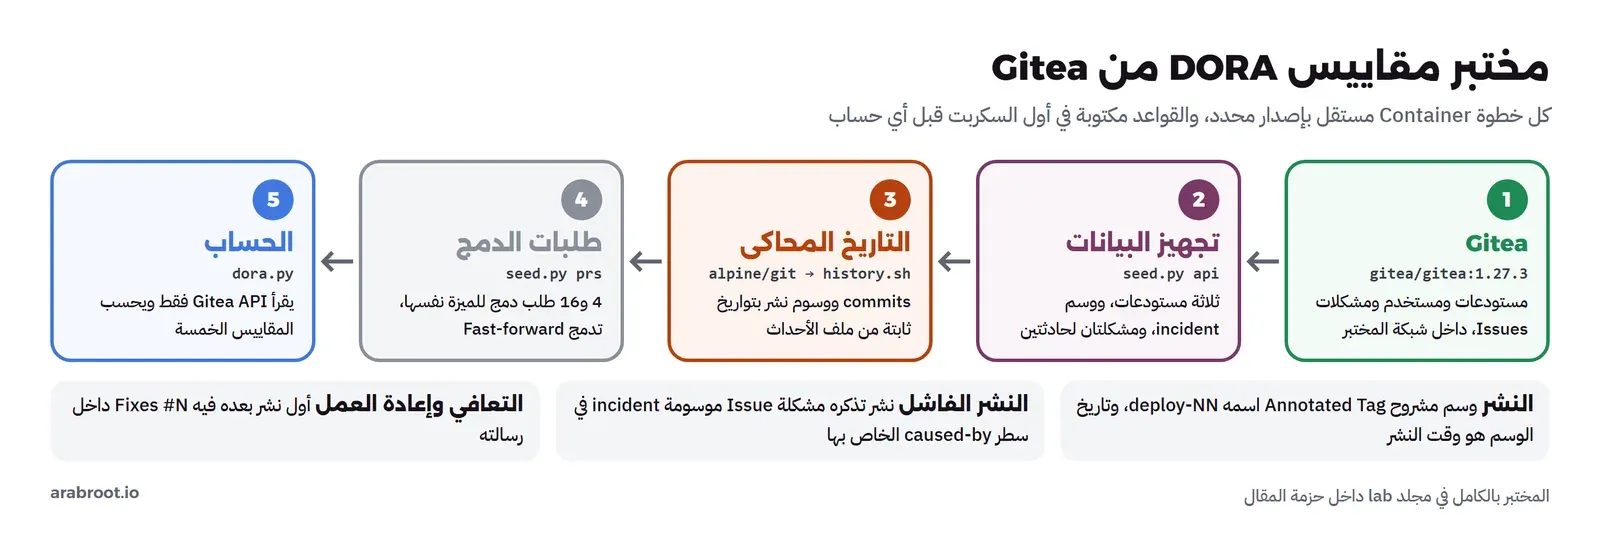
والبيانات كلها محاكاة كتبناها لهذا المختبر: مستودع اسمه shop لخدمة متجر، وثلاثة مطورين بأسماء dev1 وdev2 وdev3، وحادثتان. والأوامر هنا بصيغة Linux، وقد شغلناها على Docker Engine 29.8.0 في Docker Desktop على Windows عبر Git Bash، فاستبدلنا $PWD بـ $(pwd -W) وأضفنا MSYS_NO_PATHCONV=1.
تشغيل Gitea
نشغل Gitea بقاعدة SQLite وبدون معالج التثبيت، على شبكة خاصة بالمختبر، ثم ننشئ المستخدم المدير، وقد شرحنا التثبيت الكامل للإنتاج في دليل Gitea:
docker network create lab-perf-net
docker run -d --name lab-perf-gitea --network lab-perf-net -p 127.0.0.1:38300:3000 \
  -e GITEA__security__INSTALL_LOCK=true -e GITEA__database__DB_TYPE=sqlite3 \
  -e GITEA__server__ROOT_URL=http://lab-perf-gitea:3000/ -e GITEA__server__DOMAIN=lab-perf-gitea \
  -e GITEA__service__DISABLE_REGISTRATION=true gitea/gitea:1.27.3
docker exec -u git lab-perf-gitea gitea admin user create --username lead \
  --password lab-perf-Pass-2026 --email [email protected] --admin --must-change-password=false
والمخرج سوف يكون كما يلي:
New user 'lead' has been successfully created!ملف الأحداث
كل سطر في الملف التالي حدث في أربعة أسابيع من سبتمبر 2026: C لـ commit، وD لنشر، وI لحادثة مع النشر الذي سببها:
kind,when,ref,author,text
C,2026-09-01T09:20:00+03:00,orders,dev1,add order export endpoint
C,2026-09-01T11:05:00+03:00,orders,dev1,validate export date range
C,2026-09-01T15:40:00+03:00,ui,dev3,export button on orders page
D,2026-09-02T13:00:00+03:00,deploy-01,,release
C,2026-09-02T16:30:00+03:00,payments,dev2,retry card authorization once
C,2026-09-03T10:10:00+03:00,payments,dev2,log gateway error codes
D,2026-09-03T14:00:00+03:00,deploy-02,,release
C,2026-09-04T09:45:00+03:00,search,dev3,index product tags
C,2026-09-07T11:00:00+03:00,search,dev3,rank by stock level
C,2026-09-07T15:20:00+03:00,search,dev3,tests for ranking
D,2026-09-08T12:00:00+03:00,deploy-03,,release
C,2026-09-08T16:10:00+03:00,payments,dev2,switch gateway timeout to 3s
D,2026-09-09T10:00:00+03:00,deploy-04,,release
I,1,deploy-04,dev2,payments time out at checkout after deploy-04
C,2026-09-09T11:25:00+03:00,payments,dev2,restore gateway timeout to 10s
D,2026-09-09T12:05:00+03:00,deploy-05,,hotfix: Fixes #1
C,2026-09-10T09:30:00+03:00,orders,dev1,export as CSV stream
C,2026-09-10T14:50:00+03:00,orders,dev1,export streaming test
D,2026-09-14T10:40:00+03:00,deploy-06,,release
C,2026-09-14T15:00:00+03:00,ui,dev3,loading state on export
C,2026-09-15T09:30:00+03:00,ui,dev3,fix export button alignment
D,2026-09-16T13:00:00+03:00,deploy-07,,release
C,2026-09-17T10:20:00+03:00,accounts,dev1,migrate password hashes to argon2
C,2026-09-17T16:45:00+03:00,accounts,dev1,rehash on next login
D,2026-09-21T11:00:00+03:00,deploy-08,,release
I,2,deploy-08,dev1,old accounts cannot log in after deploy-08
C,2026-09-21T14:30:00+03:00,accounts,dev1,fall back to old hash check
D,2026-09-21T18:10:00+03:00,deploy-09,,hotfix: Fixes #2
C,2026-09-22T09:15:00+03:00,reports,dev2,weekly sales summary
C,2026-09-22T13:40:00+03:00,reports,dev2,cache summary for 10 minutes
D,2026-09-23T11:00:00+03:00,deploy-10,,release
C,2026-09-24T10:05:00+03:00,search,dev3,typo tolerance
C,2026-09-24T16:20:00+03:00,search,dev3,typo tolerance tests
D,2026-09-28T10:30:00+03:00,deploy-11,,release
C,2026-09-28T14:00:00+03:00,docs,dev1,export api usage
في الملف أعلاه لاحظ التالي:
- النشر deploy-04 غير مهلة بوابة الدفع إلى ثلاث ثوان فسبب الحادثة 1، والنشر deploy-05 بعد ساعتين أصلحها ورسالته
hotfix: Fixes #1. - النشر deploy-08 غير طريقة تخزين كلمات المرور فسبب الحادثة 2، وأصلحها deploy-09 في المساء.
- آخر commit في 28 سبتمبر بعد آخر نشر، فلن يدخل في الحساب لأنه لم يصل إلى الإنتاج.
سكربت التجهيز
السكربت التالي ينشئ المستودعات والمشكلات عبر Gitea API، ويكتب سكربت git بالتواريخ الثابتة، ويفتح طلبات الدمج ويدمجها بطريقة Fast-forward حتى تبقى تواريخ ال commits كما هي:
"""Seeds the lab Gitea with simulated history (standard library only).

  python seed.py api    create the repos, the incident label and the incident issues of "shop"
  python seed.py git    write history.sh for the alpine/git container (commits and deploy tags with fixed dates)
  python seed.py prs    open and fast-forward merge the pull requests of cart-3prs and cart-15prs

Everything here is invented: the repos, the commits, the authors dev1..dev3 and the incidents.
"""
import base64, csv, json, sys, time, urllib.error, urllib.request
from datetime import datetime, timedelta

API = "http://lab-perf-gitea:3000/api/v1"
USER, PASSWORD = "lead", "lab-perf-Pass-2026"
AUTH = "Basic " + base64.b64encode(f"{USER}:{PASSWORD}".encode()).decode()
REMOTE = f"http://{USER}:{PASSWORD}@lab-perf-gitea:3000/{USER}"
TZ = "+03:00"


def call(method, path, body=None):
    req = urllib.request.Request(API + path, method=method, headers={"Authorization": AUTH, "Content-Type": "application/json"},
                                 data=json.dumps(body).encode() if body is not None else None)
    with urllib.request.urlopen(req) as r:
        raw = r.read()
        return json.loads(raw) if raw else None


def shop_events():
    with open("events-shop.csv", newline="") as f:
        return list(csv.DictReader(f))


# The same feature («saved carts»): 15 commits by dev2 between 7 and 17 September, then a flag commit on 21 September.
CART_COMMITS = ["2026-09-07T10:00", "2026-09-07T14:00", "2026-09-08T10:00", "2026-09-08T15:00", "2026-09-09T11:00",
                "2026-09-10T10:00", "2026-09-10T16:00", "2026-09-13T10:00", "2026-09-14T11:00", "2026-09-14T15:00",
                "2026-09-15T10:00", "2026-09-16T11:00", "2026-09-16T15:00", "2026-09-17T10:00", "2026-09-17T14:00"]
FLAG_COMMIT, FLAG_DEPLOY = "2026-09-21T09:30", "2026-09-21T10:00"


def cart_plan(per_pr):
    """Groups the 15 commits into pull requests of `per_pr` commits; each PR is deployed after its last commit."""
    prs = []
    for i in range(0, len(CART_COMMITS), per_pr):
        group = CART_COMMITS[i:i + per_pr]
        last = datetime.fromisoformat(group[-1])
        # big PRs wait for review and go out at 17:00 or the next morning; one-commit PRs go out one hour later
        deploy = last + timedelta(hours=1) if per_pr == 1 else last.replace(hour=17, minute=0)
        prs.append({"commits": group, "deploy": deploy.isoformat(timespec="minutes")})
    prs.append({"commits": [FLAG_COMMIT], "deploy": FLAG_DEPLOY, "flag": True})
    return prs


def cmd_api():
    for name in ("shop", "cart-3prs", "cart-15prs"):
        call("POST", "/user/repos", {"name": name, "default_branch": "main", "auto_init": False, "private": False})
        call("PATCH", f"/repos/{USER}/{name}", {"allow_fast_forward_only_merge": True})
        print("repo", name)
    label = call("POST", f"/repos/{USER}/shop/labels", {"name": "incident", "color": "#e11d48"})
    for e in shop_events():
        if e["kind"] == "I":
            issue = call("POST", f"/repos/{USER}/shop/issues", {"title": f"incident: {e['text']}", "labels": [label["id"]],
                                                                "body": f"caused-by: {e['ref']}\nreported-by: {e['author']}"})
            assert issue["number"] == int(e["when"]), "incident numbers must match the CSV"
            print("issue", issue["number"], issue["title"])


def git_env(when):
    return f"GIT_AUTHOR_DATE='{when}' GIT_COMMITTER_DATE='{when}'"


def cmd_git():
    out = ["set -e", "git config --global init.defaultBranch main", "git config --global user.email [email protected]",
           "git config --global advice.detachedHead false"]

    def repo(name):
        out.extend([f"rm -rf /work/{name}", f"mkdir -p /work/{name}", f"cd /work/{name}", "git init -q",
                    f"git remote add origin {REMOTE}/{name}.git"])

    def commit(when, author, path, msg):
        out.append(f"echo '{msg}' >> {path}.txt && git add -A && {git_env(when)} git -c user.name={author} commit -q -m '{msg}'")

    def tag(when, name, msg):
        out.append(f"GIT_COMMITTER_DATE='{when}' git -c user.name=pipeline tag -a {name} -m '{msg}'")

    # shop: trunk-based, every commit on main, deploy tags from the CSV
    repo("shop")
    commit("2026-09-01T08:00:00" + TZ, "dev1", "README", "init: shop service")
    tag("2026-09-01T08:00:00" + TZ, "deploy-00", "baseline")
    for e in shop_events():
        if e["kind"] == "C":
            commit(e["when"], e["author"], e["ref"], f"{e['ref']}: {e['text']}")
        elif e["kind"] == "D":
            tag(e["when"], e["ref"], e["text"])
    out.append("git push -q origin main --tags")

    # cart-3prs and cart-15prs: the same commits, split into 4 or 16 pull requests (branch pr-N built on pr-N-1)
    for name, per_pr in (("cart-3prs", 5), ("cart-15prs", 1)):
        repo(name)
        commit("2026-09-01T08:00:00" + TZ, "dev2", "README", "init: cart service")
        tag("2026-09-01T08:00:00" + TZ, "deploy-00", "baseline")
        out.append("git push -q origin main --tags")
        n = 0
        for i, pr in enumerate(cart_plan(per_pr), 1):
            out.append(f"git checkout -q -b pr-{i}")
            for when in pr["commits"]:
                n += 1
                msg = "cart: enable saved-cart flag" if pr.get("flag") else f"cart: saved carts step {n}"
                commit(when + ":00" + TZ, "dev2", "cart", msg)
            tag(pr["deploy"] + ":00" + TZ, f"deploy-{i:02d}", "enable saved-cart" if pr.get("flag") else "release")
        out.append("git push -q origin --all && git push -q origin --tags")
    with open("history.sh", "w", newline="\n") as f:
        f.write("\n".join(out) + "\n")
    print("history.sh:", len(out), "lines")


def cmd_prs():
    for name, per_pr in (("cart-3prs", 5), ("cart-15prs", 1)):
        existing = {p["head"]["ref"]: p for p in call("GET", f"/repos/{USER}/{name}/pulls?state=all&limit=50")}
        for i, _ in enumerate(cart_plan(per_pr), 1):
            pr = existing.get(f"pr-{i}") or call("POST", f"/repos/{USER}/{name}/pulls",
                                                 {"head": f"pr-{i}", "base": "main", "title": f"saved carts part {i}"})
            for _attempt in range(30):          # Gitea checks mergeability in the background right after a PR is opened
                if pr.get("merged"):
                    break
                try:
                    call("POST", f"/repos/{USER}/{name}/pulls/{pr['number']}/merge", {"Do": "fast-forward-only"})
                    break
                except urllib.error.HTTPError:
                    time.sleep(1)
            else:
                raise SystemExit(f"{name}: PR {pr['number']} did not merge")
        print(name, "merged", i, "pull requests")


{"api": cmd_api, "git": cmd_git, "prs": cmd_prs}[sys.argv[1]]()
ونشغله في ثلاث خطوات، بينها Container من alpine/git ينفذ السكربت الذي كتبه:
docker run --rm --name lab-perf-seed --network lab-perf-net -v "$PWD:/lab" -w /lab \
  python:3.13.16-slim sh -c "python seed.py api && python seed.py git"
docker run --rm --name lab-perf-git --network lab-perf-net -v "$PWD:/lab:ro" \
  --entrypoint sh alpine/git:v2.52.0 /lab/history.sh
docker run --rm --name lab-perf-seed --network lab-perf-net -v "$PWD:/lab" -w /lab \
  python:3.13.16-slim python seed.py prs
والمخرج سوف يكون كما يلي، دون سطور git push التي تقترح فتح طلب دمج لكل فرع:
repo shop
repo cart-3prs
repo cart-15prs
issue 1 incident: payments time out at checkout after deploy-04
issue 2 incident: old accounts cannot log in after deploy-08
history.sh: 135 lines
cart-3prs merged 4 pull requests
cart-15prs merged 16 pull requests
وأول سطور سكربت git الذي كتبه seed.py تبين كيف تثبت التواريخ، فكل commit يأخذ تاريخ المؤلف والمنفذ من الملف، وكل نشر وسم مشروح Annotated Tag له تاريخ:
set -e
git config --global init.defaultBranch main
git config --global user.email [email protected]
git config --global advice.detachedHead false
rm -rf /work/shop
mkdir -p /work/shop
cd /work/shop
git init -q
git remote add origin http://lead:lab-perf-Pass-2026@lab-perf-gitea:3000/lead/shop.git
echo 'init: shop service' >> README.txt && git add -A && GIT_AUTHOR_DATE='2026-09-01T08:00:00+03:00' GIT_COMMITTER_DATE='2026-09-01T08:00:00+03:00' git -c user.name=dev1 commit -q -m 'init: shop service'
GIT_COMMITTER_DATE='2026-09-01T08:00:00+03:00' git -c user.name=pipeline tag -a deploy-00 -m 'baseline'
echo 'orders: add order export endpoint' >> orders.txt && git add -A && GIT_AUTHOR_DATE='2026-09-01T09:20:00+03:00' GIT_COMMITTER_DATE='2026-09-01T09:20:00+03:00' git -c user.name=dev1 commit -q -m 'orders: add order export endpoint'
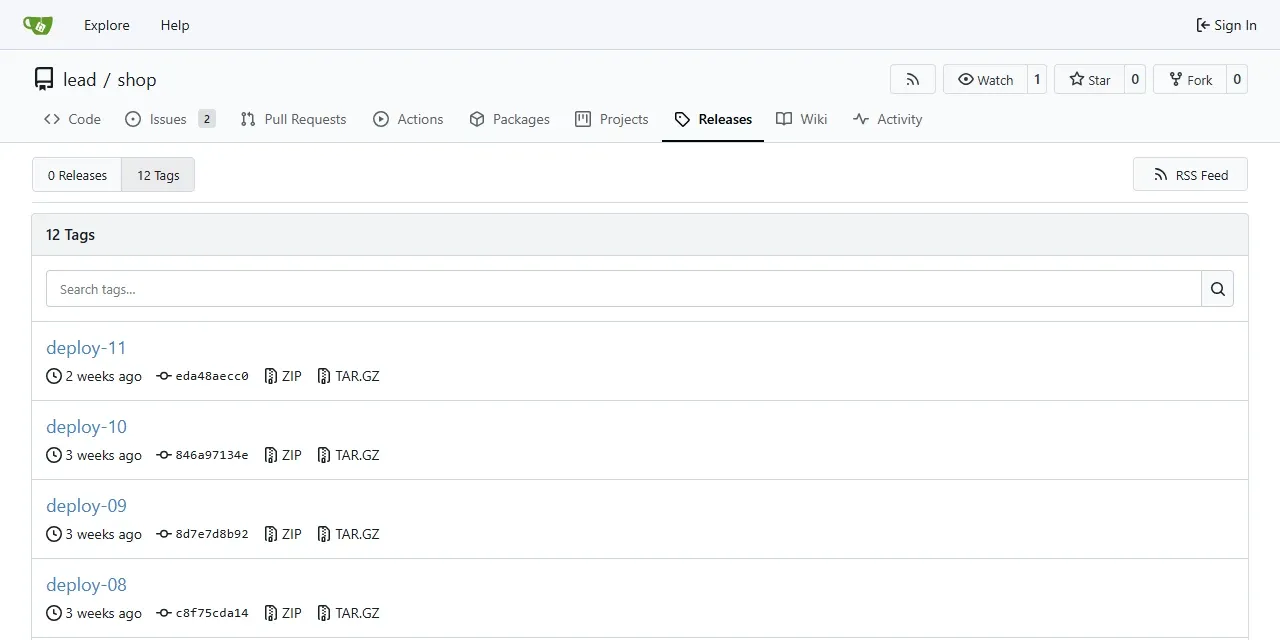
والصورة التالية من واجهة Gitea في المختبر وفيها وسوم النشر:
حساب المقاييس
السكربت التالي هو الحساب كله، ولاحظ أن التعريفات في أوله قبل أي سطر كود، والسبب أن الخلاف على المقاييس يكون غالباً خلافاً على التعريف لا على الحساب:
"""Computes DORA software delivery metrics for one repo from the Gitea API only (standard library).

  python dora.py <repo> <from-date> <to-date>      e.g. python dora.py shop 2026-09-01 2026-09-29
  python dora.py --value <repo>                    pull requests, deploys and lead time to value of a feature

Conventions of this lab (write yours down the same way before you measure anything):
  deployment       an annotated tag deploy-NN; the tag date is the deploy time; deploy-00 is the baseline
  failed deploy    a deploy named in "caused-by:" of an issue labelled incident
  recovery         the first later deploy whose tag message says "Fixes #N" for that incident
  rework deploy    an unplanned deploy, i.e. a tag message with "Fixes #"
"""
import base64, json, statistics, sys, urllib.request
from datetime import datetime, timedelta, timezone

API, OWNER = "http://lab-perf-gitea:3000/api/v1", "lead"
RIYADH = timezone(timedelta(hours=3))           # Gitea returns UTC; print local time
AUTH = "Basic " + base64.b64encode(b"lead:lab-perf-Pass-2026").decode()


def get(path):
    req = urllib.request.Request(API + path, headers={"Authorization": AUTH})
    with urllib.request.urlopen(req) as r:
        return json.loads(r.read())


def ts(s):
    return datetime.fromisoformat(s.replace("Z", "+00:00")).astimezone(RIYADH)


def hours(d):
    return d.total_seconds() / 3600


def deploys(repo):
    out = []
    for t in get(f"/repos/{OWNER}/{repo}/tags?limit=100"):
        if not t["name"].startswith("deploy-"):
            continue
        tag = get(f"/repos/{OWNER}/{repo}/git/tags/{t['id']}")          # annotated tag: tagger date and message
        out.append({"name": t["name"], "sha": t["commit"]["sha"], "at": ts(tag["tagger"]["date"]), "msg": tag["message"].strip()})
    return sorted(out, key=lambda d: d["at"])


def changes(repo, deps):
    """Every commit with the first deploy that shipped it (compare between consecutive deploy tags)."""
    rows = []
    for prev, cur in zip(deps, deps[1:]):
        for c in get(f"/repos/{OWNER}/{repo}/compare/{prev['name']}...{cur['name']}")["commits"]:
            rows.append({"sha": c["sha"][:7], "msg": c["commit"]["message"].strip(), "at": ts(c["commit"]["committer"]["date"]),
                         "deploy": cur["name"], "lead_h": hours(cur["at"] - ts(c["commit"]["committer"]["date"]))})
    return rows


def dora(repo, start, end):
    deps = deploys(repo)
    shipped = [d for d in deps[1:] if start <= d["at"].date().isoformat() < end]
    rows = [r for r in changes(repo, deps) if r["deploy"] in {d["name"] for d in shipped}]
    incidents = get(f"/repos/{OWNER}/{repo}/issues?state=all&type=issues&labels=incident&limit=50")
    weeks = (datetime.fromisoformat(end) - datetime.fromisoformat(start)).days / 7

    print(f"== {repo}: {start} to {end} ({weeks:.0f} weeks), {len(shipped)} deploys, {len(rows)} commits shipped")
    for d in shipped:
        n = sum(1 for r in rows if r["deploy"] == d["name"])
        print(f"  {d['name']}  {d['at']:%a %d %b %H:%M}  {n} commit(s)  {d['msg']}")

    failed, recover = set(), []
    for i in sorted(incidents, key=lambda i: i["number"]):
        cause = next(l.split(":", 1)[1].strip() for l in i["body"].splitlines() if l.startswith("caused-by:"))
        failed.add(cause)
        bad = next(d for d in deps if d["name"] == cause)
        fix = next(d for d in deps if d["at"] > bad["at"] and f"Fixes #{i['number']}" in d["msg"])
        recover.append(hours(fix["at"] - bad["at"]))
        print(f"  incident #{i['number']}: {cause} -> fixed by {fix['name']} after {recover[-1]:.1f} h")
    rework = [d for d in shipped if "Fixes #" in d["msg"]]
    leads = [r["lead_h"] for r in rows]

    print("\nDORA software delivery metrics")
    print(f"  deployment frequency            {len(shipped) / weeks:.2f} per week ({len({d['at'].date() for d in shipped})} deploy days)")
    print(f"  change lead time (median)       {statistics.median(leads):.1f} h   (p90 {statistics.quantiles(leads, n=10)[-1]:.1f} h)")
    print(f"  change fail rate                {len(failed)}/{len(shipped)} = {len(failed) / len(shipped):.0%}")
    print(f"  failed deployment recovery time median {statistics.median(recover):.1f} h  (each: {', '.join(f'{h:.1f}' for h in recover)})")
    print(f"  deployment rework rate          {len(rework)}/{len(shipped)} = {len(rework) / len(shipped):.0%}")
    by_author = {}
    for c in get(f"/repos/{OWNER}/{repo}/commits?limit=100&stat=false"):
        by_author[c["commit"]["author"]["name"]] = by_author.get(c["commit"]["author"]["name"], 0) + 1
    print("\ncommits per author (not a DORA metric; shown to be ignored):", dict(sorted(by_author.items())))


def value(repo):
    deps = deploys(repo)
    rows = changes(repo, deps)
    prs = [p for p in get(f"/repos/{OWNER}/{repo}/pulls?state=closed&limit=50") if p["merged"]]
    first = min(r["at"] for r in rows if r["msg"].startswith("cart: saved carts"))
    flag = next(d for d in deps if d["msg"] == "enable saved-cart")
    leads = [r["lead_h"] for r in rows if r["msg"].startswith("cart:")]
    print(f"== {repo}")
    print(f"  merged pull requests            {len(prs)}  (by {sorted({p['user']['login'] for p in prs})} as API user; commits by dev2)")
    print(f"  deploys                         {len(deps) - 1}")
    print(f"  change lead time (median)       {statistics.median(leads):.1f} h")
    print(f"  lead time to value              {hours(flag['at'] - first) / 24:.1f} days  (first commit {first:%d %b %H:%M} -> {flag['name']} {flag['at']:%d %b %H:%M})")


if sys.argv[1] == "--value":
    value(sys.argv[2])
else:
    dora(*sys.argv[1:4])
docker run --rm --name lab-perf-dora --network lab-perf-net -v "$PWD:/lab:ro" -w /lab \
python:3.13.16-slim python dora.py shop 2026-09-01 2026-09-29والمخرج سوف يكون كما يلي:
== shop: 2026-09-01 to 2026-09-29 (4 weeks), 11 deploys, 21 commits shipped
  deploy-01  Wed 02 Sep 13:00  3 commit(s)  release
  deploy-02  Thu 03 Sep 14:00  2 commit(s)  release
  deploy-03  Tue 08 Sep 12:00  3 commit(s)  release
  deploy-04  Wed 09 Sep 10:00  1 commit(s)  release
  deploy-05  Wed 09 Sep 12:05  1 commit(s)  hotfix: Fixes #1
  deploy-06  Mon 14 Sep 10:40  2 commit(s)  release
  deploy-07  Wed 16 Sep 13:00  2 commit(s)  release
  deploy-08  Mon 21 Sep 11:00  2 commit(s)  release
  deploy-09  Mon 21 Sep 18:10  1 commit(s)  hotfix: Fixes #2
  deploy-10  Wed 23 Sep 11:00  2 commit(s)  release
  deploy-11  Mon 28 Sep 10:30  2 commit(s)  release
  incident #1: deploy-04 -> fixed by deploy-05 after 2.1 h
  incident #2: deploy-08 -> fixed by deploy-09 after 7.2 h

DORA software delivery metrics
  deployment frequency            2.75 per week (9 deploy days)
  change lead time (median)       25.9 h   (p90 97.1 h)
  change fail rate                2/11 = 18%
  failed deployment recovery time median 4.6 h  (each: 2.1, 7.2)
  deployment rework rate          2/11 = 18%

commits per author (not a DORA metric; shown to be ignored): {'dev1': 9, 'dev2': 6, 'dev3': 8}
في المخرج أعلاه لاحظ التالي:
- زمن التغيير Change Lead Time هو الوسيط Median لكل commit من وقته إلى أول نشر يحمله، والوسيط 25.9 ساعة، ولكن 10% من التغييرات انتظرت أكثر من 97 ساعة، وهي commits كتبت يوم الخميس أو الجمعة ولم تنشر حتى الاثنين أو الثلاثاء، وهذا سؤال للفريق عن أيام النشر لا عن أحد.
- نسبة فشل التغيير ونسبة إعادة العمل كلتاهما 18% هنا، لأن كل حادثة أصلحت بنشر عاجل واحد، وفي الواقع قد تختلفان، فالحادثة قد تصلح بالتراجع دون نشر جديد.
- وقت التعافي ساعتان للحادثة الأولى وسبع ساعات للثانية، والوسيط من رقمين فقط لا معنى له، لذلك يطبع السكربت كل قيمة، ومع حادثتين في الشهر انظر إلى كل حادثة على حدة كما في تقرير ما بعد الحادثة.
- آخر سطر عدد ال commits لكل مطور، وقد طبعناه لنقول إنه لا يدخل في أي مقياس: dev1 أكثر عدداً، وهو نفسه صاحب التغيير الذي سبب الحادثة 2 وصاحب إصلاحها، والرقم لا يقول شيئاً عن أي من ذلك.
نكسرها: طلبات دمج صغيرة كثيرة
الآن نفترض أن الإدارة أعلنت أن «الإنتاجية» تقاس بعدد طلبات الدمج المدمجة لكل مطور. فالميزة نفسها، وهي حفظ سلة المشتريات، كتبها dev2 في 15 commit بين 7 و17 سبتمبر، ثم فعلها بمفتاح ميزة في 21 سبتمبر، وبنيناها في مستودعين: في cart-3prs ثلاثة طلبات دمج للعمل وطلب للتفعيل، وفي cart-15prs طلب لكل commit وطلب للتفعيل، وكل طلب ينشر بعد دمجه. والتواريخ في المستودعين واحدة:
for r in cart-3prs cart-15prs; do
  docker run --rm --name lab-perf-dora --network lab-perf-net -v "$PWD:/lab:ro" -w /lab \
    python:3.13.16-slim python dora.py --value $r
done
والمخرج سوف يكون كما يلي:
== cart-3prs
  merged pull requests            4  (by ['lead'] as API user; commits by dev2)
  deploys                         4
  change lead time (median)       28.0 h
  lead time to value              14.0 days  (first commit 07 Sep 10:00 -> deploy-04 21 Sep 10:00)
== cart-15prs
  merged pull requests            16  (by ['lead'] as API user; commits by dev2)
  deploys                         16
  change lead time (median)       1.0 h
  lead time to value              14.0 days  (first commit 07 Sep 10:00 -> deploy-16 21 Sep 10:00)
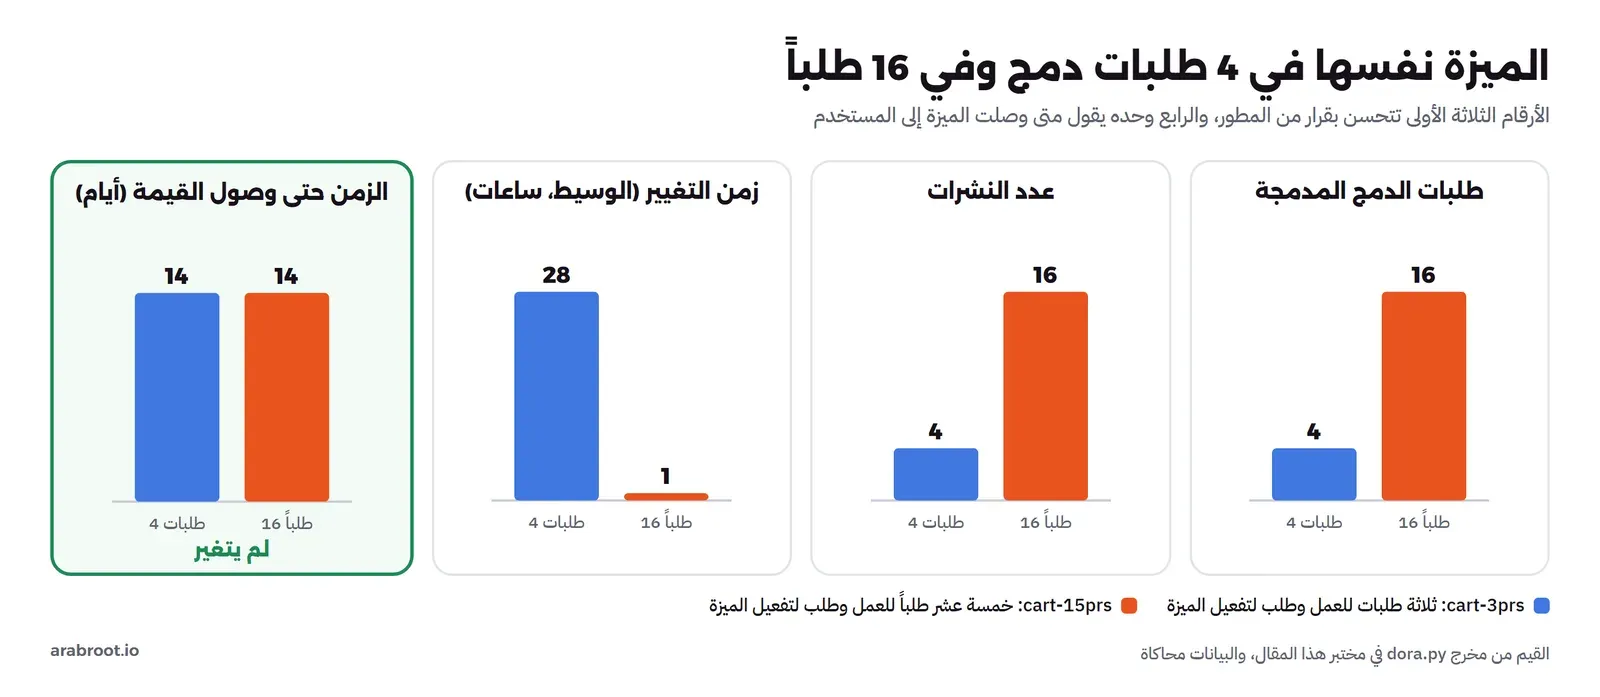
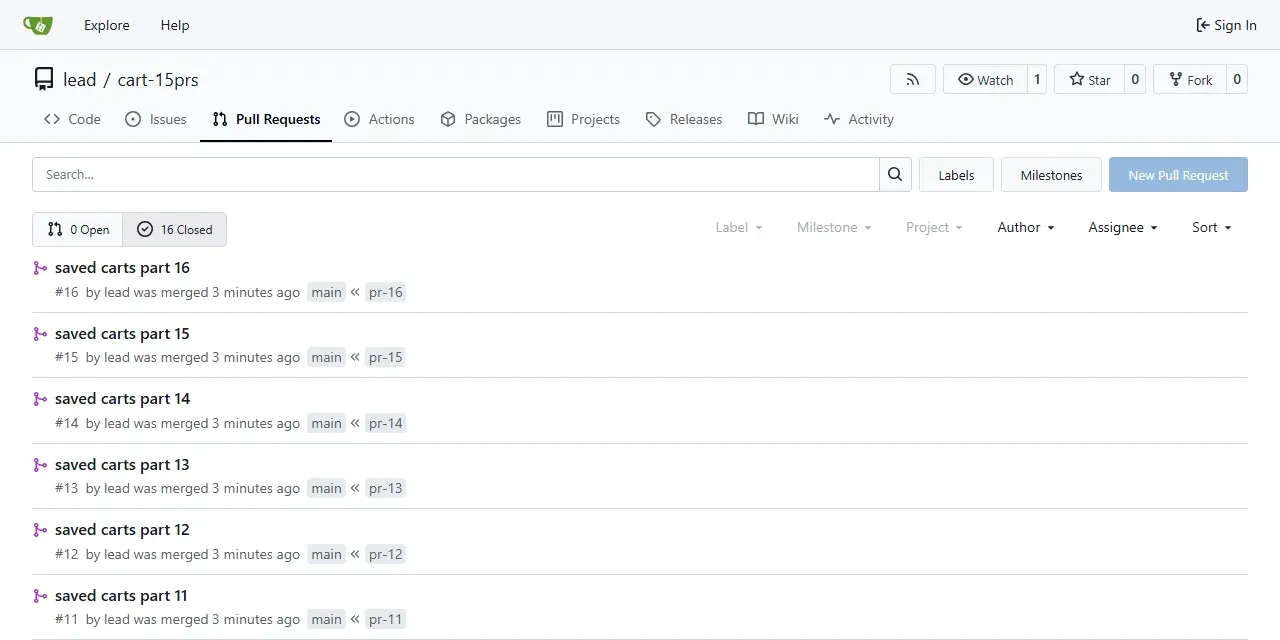
ولاحظ أن الطلبات في المخرج باسم المستخدم lead لأن السكربت هو من فتحها ودمجها، أما ال commits فكلها باسم dev2، وأن وقت الدمج في Gitea هو يوم تشغيل المختبر، أما تواريخ ال commits والنشر التي يحسب منها السكربت فثابتة من الخطة في seed.py. والصورة التالية تضع الأرقام الأربعة بجانب بعضها:
والصورة التالية من صفحة طلبات الدمج في المستودع الثاني:
وقد يتساءل البعض: أليست الطلبات الصغيرة أفضل؟ ألا تنصح DORA نفسها بالدفعات الصغيرة؟ والإجابة نعم، وهذا ما يجعل الكسر خطيراً، فالتقسيم نفسه قد يكون جيداً، ولكن عد الطلبات لكل شخص يكافئ التقسيم الشكلي، وحتى زمن التغيير Change Lead Time الذي انخفض من 28 ساعة إلى ساعة واحدة يقيس المسافة من commit إلى الإنتاج، لا من بداية العمل إلى استفادة المستخدم. والذي لم يتغير هو الزمن حتى وصول القيمة Lead Time to Value، أي 14 يوماً من أول commit إلى تفعيل الميزة، لذلك إذا أردت رقماً عن السرعة فقسه على مستوى الميزة، وارجع إليه مع الفريق في الاستعادة Retrospective لا في تقييم dev2.
محاكاة اجتماع المعايرة Calibration بثلاثة مديرين وعشرين مهندساً
شرحنا في مقال الدورة لماذا نحتاج إلى المعايرة، وهذه المحاكاة تبين الفكرة بالأرقام: ثلاثة مديرين يقيمون العشرين مهندساً أنفسهم، الأول متساهل والثاني متشدد والثالث يتأثر بآخر حدث في الشهر الأخير، مرة بالانطباع العام ومرة بمقياس مرتبط بالسلوك BARS مع الأدلة. وتذكر أن هذا نموذج: كل أرقامه افتراضات مكتوبة في أول السكربت، وليست قياساً لأشخاص حقيقيين، وفائدته أن يبين الآلية لا أن يثبت مقدار التحسن في شركتك.
"""Calibration simulation: three managers with different rater bias rate the same 20 engineers twice,
first from overall impression, then with a behaviour-anchored rubric (standard library only).

  python calibration.py [seed]

The model and every number in it are assumptions written for this article, not measurements of real people:
  true       each engineer's real performance on a 1..5 scale (unknown to the managers)
  M1         lenient: adds +0.7 to the impression
  M2         harsh:   adds -0.7
  M3         recency: one event from the last month (good, bad or none) moves the impression by +-0.9
  impression rating = round(true + bias + noise sd 0.6), clipped to 1..5
  rubric     four competencies, each scored 1..5 against written behaviour anchors with evidence:
             the score is the anchor the evidence matches (true competency + noise sd 0.3); a manager's bias can only
             move it one level, and only when the evidence sits within 0.25 of the boundary between two anchors;
             the final rating is the rounded mean of the four competencies
"""
import random, statistics, sys

SEED = int(sys.argv[1]) if len(sys.argv) > 1 else 2026
rnd = random.Random(SEED)
N, COMPETENCIES = 20, ("delivery", "quality", "collaboration", "ownership")
BIAS = {"M1": 0.7, "M2": -0.7}
clip = lambda x: max(1, min(5, x))

engineers = []
for i in range(1, N + 1):
    true = round(rnd.uniform(1.6, 4.6), 2)
    engineers.append({"id": f"E{i:02d}", "true": true, "recent": rnd.choice((-1, 0, 0, 1)),
                      "comp": [true + rnd.gauss(0, 0.35) for _ in COMPETENCIES]})


def bias_of(m, e):
    return BIAS.get(m, 0.9 * e["recent"])


def impression(m, e):
    return clip(round(e["true"] + bias_of(m, e) + rnd.gauss(0, 0.6)))


def rubric(m, e):
    scores = []
    for c in e["comp"]:
        seen = c + rnd.gauss(0, 0.3)                        # what the written evidence shows
        level = clip(round(seen))
        edge = seen - round(seen)                           # distance from the anchor (-0.5 .. 0.5)
        b = bias_of(m, e)
        if b > 0 and edge > 0.25:                           # benefit of the doubt only at an ambiguous boundary
            level = clip(level + 1)
        elif b < 0 and edge < -0.25:
            level = clip(level - 1)
        scores.append(level)
    return clip(round(statistics.mean(scores)))


def report(title, rate):
    print(f"== {title}")
    print("eng   true   M1 M2 M3   spread")
    spreads, rows = [], {}
    for e in engineers:
        r = {m: rate(m, e) for m in ("M1", "M2", "M3")}
        spread = max(r.values()) - min(r.values())
        spreads.append(spread)
        rows[e["id"]] = r
        flag = "  <- discuss" if spread >= 2 else ""
        print(f"{e['id']}  {e['true']:4.2f}    {r['M1']}  {r['M2']}  {r['M3']}     {spread}{flag}")
    exact = sum(1 for e in engineers if len(set(rows[e['id']].values())) == 1)
    top = sum(1 for e in engineers if len({v >= 4 for v in rows[e['id']].values()}) > 1)
    err = {m: statistics.mean(abs(rows[e["id"]][m] - e["true"]) for e in engineers) for m in ("M1", "M2", "M3")}
    means = {m: statistics.mean(rows[e["id"]][m] for e in engineers) for m in ("M1", "M2", "M3")}
    print(f"mean spread {statistics.mean(spreads):.2f} | spread >= 2: {sum(s >= 2 for s in spreads)}/{N}"
          f" | all three agree: {exact}/{N}")
    print(f"'4 or 5' (bonus line) depends on the manager for {top}/{N} engineers")
    print("manager mean rating:", "  ".join(f"{m} {v:.2f}" for m, v in means.items()))
    print("mean distance from true:", "  ".join(f"{m} {v:.2f}" for m, v in err.items()))
    print()
    return statistics.mean(spreads)


print(f"seed {SEED}, {N} engineers, 3 managers (model and numbers are assumptions, see the docstring)\n")
before = report("A. overall impression", impression)
after = report("B. behaviour-anchored rubric with evidence", rubric)
print(f"mean spread: {before:.2f} -> {after:.2f} ({(after - before) / before:+.0%})")
docker run --rm --name lab-perf-calib -v "$PWD:/lab:ro" -w /lab python:3.13.16-slim python calibration.pyوالمخرج سوف يكون كما يلي:
seed 2026, 20 engineers, 3 managers (model and numbers are assumptions, see the docstring)

== A. overall impression
eng   true   M1 M2 M3   spread
E01  1.96    2  1  1     1
E02  3.32    3  4  4     1
E03  1.93    1  1  2     1
E04  2.23    2  2  2     0
E05  3.84    4  3  2     2  <- discuss
E06  2.02    2  1  3     2  <- discuss
E07  2.80    4  2  4     2  <- discuss
E08  4.23    4  3  5     2  <- discuss
E09  3.04    4  3  1     3  <- discuss
E10  3.17    5  2  2     3  <- discuss
E11  4.15    5  3  5     2  <- discuss
E12  4.56    5  5  5     0
E13  3.11    4  2  5     3  <- discuss
E14  1.63    2  1  2     1
E15  3.07    4  3  3     1
E16  4.02    5  3  3     2  <- discuss
E17  3.67    4  2  5     3  <- discuss
E18  3.04    4  3  3     1
E19  4.17    5  3  5     2  <- discuss
E20  4.40    4  3  4     1
mean spread 1.65 | spread >= 2: 11/20 | all three agree: 2/20
'4 or 5' (bonus line) depends on the manager for 14/20 engineers
manager mean rating: M1 3.65  M2 2.50  M3 3.30
mean distance from true: M1 0.65  M2 0.83  M3 0.86

== B. behaviour-anchored rubric with evidence
eng   true   M1 M2 M3   spread
E01  1.96    2  1  2     1
E02  3.32    3  3  3     0
E03  1.93    2  1  2     1
E04  2.23    2  2  2     0
E05  3.84    4  4  4     0
E06  2.02    2  2  2     0
E07  2.80    2  2  3     1
E08  4.23    4  4  5     1
E09  3.04    3  2  2     1
E10  3.17    4  3  3     1
E11  4.15    4  4  4     0
E12  4.56    5  4  4     1
E13  3.11    4  3  4     1
E14  1.63    2  1  2     1
E15  3.07    3  3  3     0
E16  4.02    4  3  4     1
E17  3.67    4  4  4     0
E18  3.04    3  3  2     1
E19  4.17    4  4  4     0
E20  4.40    5  4  4     1
mean spread 0.60 | spread >= 2: 0/20 | all three agree: 8/20
'4 or 5' (bonus line) depends on the manager for 3/20 engineers
manager mean rating: M1 3.30  M2 2.85  M3 3.15
mean distance from true: M1 0.29  M2 0.42  M3 0.35

mean spread: 1.65 -> 0.60 (-64%)
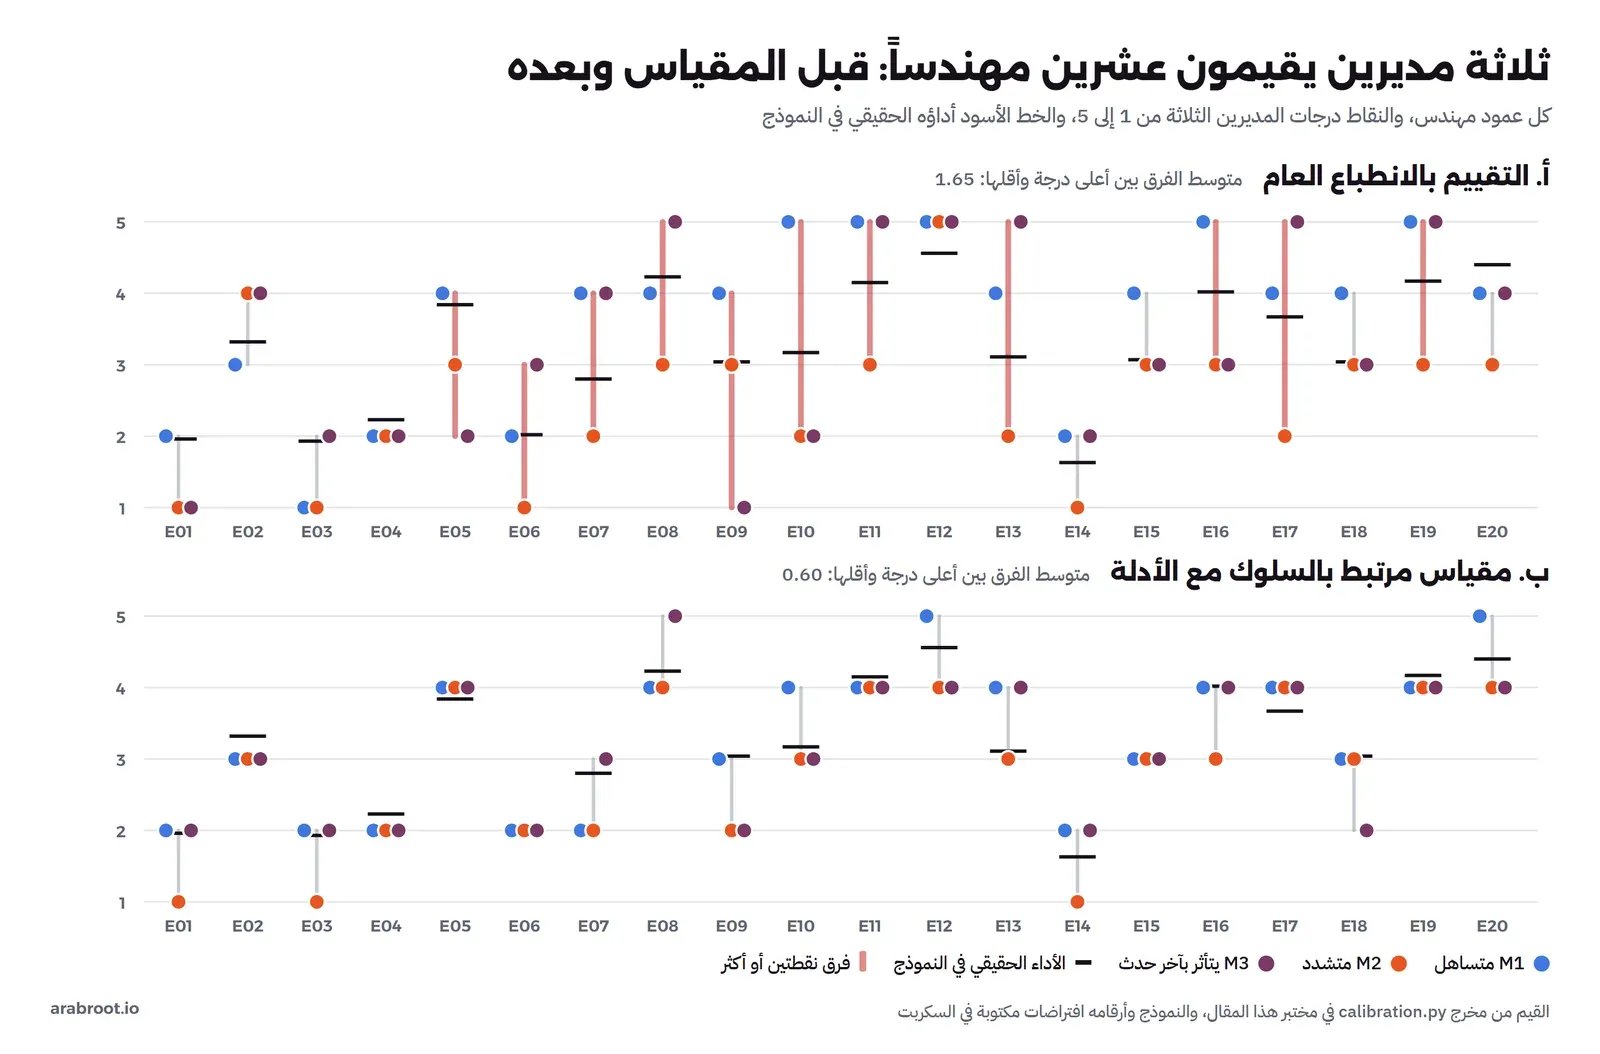
والصورة التالية ترسم الجدولين، فكل عمود مهندس، والخط الأحمر فرق نقطتين أو أكثر بين المديرين:
في المخرج أعلاه لاحظ التالي:
- بالانطباع العام اختلف المديرون بنقطتين أو أكثر على 11 مهندساً من 20، واتفق الثلاثة على اثنين فقط، وكان الوصول إلى درجة 4 أو 5 (خط المكافأة في هذا المثال) يعتمد على المدير الذي يقيمك عند 14 مهندساً.
- متوسط درجات المدير المتساهل 3.65 والمتشدد 2.50، وهذا الفرق وحده هو ما يكشفه فحص التوزيع في اجتماع المعايرة Calibration بين المديرين.
- بالمقياس المرتبط بالسلوك BARS انخفض متوسط الفرق من 1.65 إلى 0.60، وأصبحت درجة المكافأة تعتمد على المدير عند 3 مهندسين فقط، وهؤلاء هم من يناقش في الاجتماع.
- لم يختف التحيز، فالمتساهل ما زال أعلى من المتشدد، والسبب أن النموذج يسمح للتحيز بأن يحرك الدرجة عندما يكون الدليل على حدود مستويين، وهذا ما نتوقعه في الواقع أيضاً.
ولكي لا تعتمد النتيجة على بذرة عشوائية واحدة شغلنا النموذج بمئتي بذرة مختلفة:
# Runs the simulation with 200 different seeds and summarises the mean spread before and after the rubric
for s in $(seq 1 200); do python calibration.py $s | tail -1; done | awk '
  { b += $3; a += $5; n++
    if (bmin == "" || $3 < bmin) bmin = $3; if ($3 > bmax) bmax = $3
    if (amin == "" || $5 < amin) amin = $5; if ($5 > amax) amax = $5 }
  END { printf "%d seeds | impression: mean spread %.2f (%.2f to %.2f) | rubric: %.2f (%.2f to %.2f)\n", n, b/n, bmin, bmax, a/n, amin, amax }'
200 seeds | impression: mean spread 1.63 (1.20 to 2.10) | rubric: 0.54 (0.25 to 0.85)وفي كل البذور كان متوسط الفرق بالمقياس أقل من أقل قيمة بالانطباع، ولكن تذكر أن هذا ثبات النموذج مع افتراضاته، وليس دليلاً من بيانات حقيقية، والدليل الحقيقي على أن ميول المقيم تصنع جزءاً كبيراً من الدرجة هو دراسة Scullen وزملائه.
حذف المختبر
نحذف ما أنشأناه بالاسم فقط، ومعه ال Volume المجهول الذي ينشئه Docker Image الخاص بـ Gitea لمجلد البيانات، فلا تقم باستخدام أوامر prune على جهاز عليه مشاريع أخرى:
docker rm -f -v lab-perf-gitea
docker network rm lab-perf-net
docker rmi gitea/gitea:1.27.3 alpine/git:v2.52.0
أخطاء شائعة
- شراء أداة قبل كتابة الدورة: الأداة تنفذ طريقتك، فإذا لم تكن مكتوبة سوف تأخذ طريقة البائع.
- فتح لوحات الأفراد في أداة المقاييس: تتحول الأرقام إلى ترتيب للأشخاص حتى لو لم يقصد أحد ذلك.
- تعريفات غير مكتوبة: ما النشر وما الحادثة، فيختلف الفريق على الرقم بدل أن يحسنه.
- توقع تطبيق التقييم في Odoo Community: وحدته ليست في المستودع المفتوح.
- التقييم الذاتي جزء ثابت من الدرجة: كما في الإعداد الذي يصفه توثيق Frappe HR، فراجعه قبل أن تعتمده.
- مقارنة الأسعار دون الحد الأدنى: 10 دولارات للمقعد مع حد أدنى 4,000 دولار في السنة تعني أن فريقاً من عشرين يدفع أكثر من السعر الظاهر.
الخلاصة
وصلنا لنهاية الموضوع ونهاية السلسلة، وأهم ما فيه:
- أدوات الأشخاص تدير دورة التقييم، وأدوات المقاييس تقرأ طريقة عمل الفريق، ولا تحل إحداهما مكان الأخرى.
- سعر وحدة الأداء وحدها في أدوات الأشخاص من 7 يورو إلى 11 دولاراً للموظف شهرياً، مع فوترة سنوية وحدود دنيا، وبعضها بعرض سعر.
- Frappe HR وOrangeHRM فيهما تقييم مفتوح بـ GPL-3.0، أما تطبيق التقييم في Odoo فليس في نسخة Community.
- Apache DevLake مفتوحة بـ Apache-2.0 ولكنها لا تدعم Gitea، وسكربت صغير على Gitea API يحسب المقاييس الخمسة لفريق صغير.
- تقسيم الميزة إلى طلبات صغيرة رفع عدد الطلبات أربع مرات وخفض زمن التغيير Change Lead Time من 28 ساعة إلى ساعة، والزمن حتى وصول القيمة بقي 14 يوماً.
- في نموذج المعايرة Calibration خفض المقياس المرتبط بالسلوك BARS متوسط الفرق بين المديرين من 1.65 إلى 0.60، وبقيت حالات الحدود للنقاش.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، ومراجعة صفحات الأسعار في 15 أكتوبر 2026 لكل من Lattice و15Five وCulture Amp وLeapsome وLinearB وSwarmia وJellyfish وDX، ورخص Frappe HR وOdoo وOrangeHRM وApache DevLake من مستودعاتها، وتشغيل المختبر على Gitea 1.27.3 وalpine/git v2.52.0 وPython 3.13.16 وDocker Engine 29.8.0.