

في البداية تكون التقارير بسيطة: مبيعات اليوم، وعدد الطلبات هذا الأسبوع، وكلها تعمل من قاعدة بيانات التطبيق في PostgreSQL أو MySQL في أجزاء من الثانية. ثم يكبر جدول الطلبات إلى عشرات الملايين، ويطلب فريق المبيعات لوحة تعرض الإيرادات بالشهر وعدد العملاء المختلفين في كل شهر، فيأخذ الاستعلام دقيقة كاملة، ويبطئ التطبيق نفسه لأنه يقرأ كل الجدول من نفس السيرفر. وهذا هو الفرق بين عمليات التطبيق OLTP والتحليل OLAP الذي ذكرناه في مقال تصميم قواعد البيانات، وClickHouse من أشهر قواعد البيانات المفتوحة المصممة للتحليل.
وسوف نناقش في هذا المقال ما يلي:
- التخزين بالأعمدة Columnar Storage، ولماذا يقرأ أقل بكثير من التخزين بالصفوف.
- محرك MergeTree والأجزاء Parts والدمج في الخلفية، ومفتاح الترتيب ORDER BY والفهرس المتباعد Sparse Index.
- العروض المحفوظة Materialized Views التي تحدث مع كل INSERT، والفخ الذي يقع فيه الجميع معها.
- أين يكون ClickHouse سيئاً: تعديل صف واحد، والبحث بعمود خارج مفتاح الترتيب، وتاريخ الربط JOIN.
- تجربة عملية: نفس عشرة ملايين طلب في PostgreSQL 18.6 وClickHouse 26.8، بنفس الاستعلامات وأوقات حقيقية.
التخزين بالأعمدة: لماذا يقرأ أقل؟
PostgreSQL وMySQL يحفظان الصف كاملاً في مكان واحد على القرص: رقم الطلب والعميل والدولة والحالة والمبلغ والتاريخ متجاورة، وهذا ممتاز للتطبيق لأنه يقرأ ويكتب طلباً كاملاً في كل مرة، وشرحنا كيف يحدث ذلك في مقال تخزين قاعدة البيانات من الداخل. أما سؤال مثل «مجموع المبالغ لكل دولة» فلا يحتاج إلا عمودين من ستة، ومع ذلك يقرأ السيرفر الصفوف كاملة. وClickHouse يحفظ كل عمود في ملف مستقل كما يشرح توثيق ClickHouse، فيقرأ الأعمدة التي يحتاجها السؤال فقط، والصورة التالية تبين الفرق:
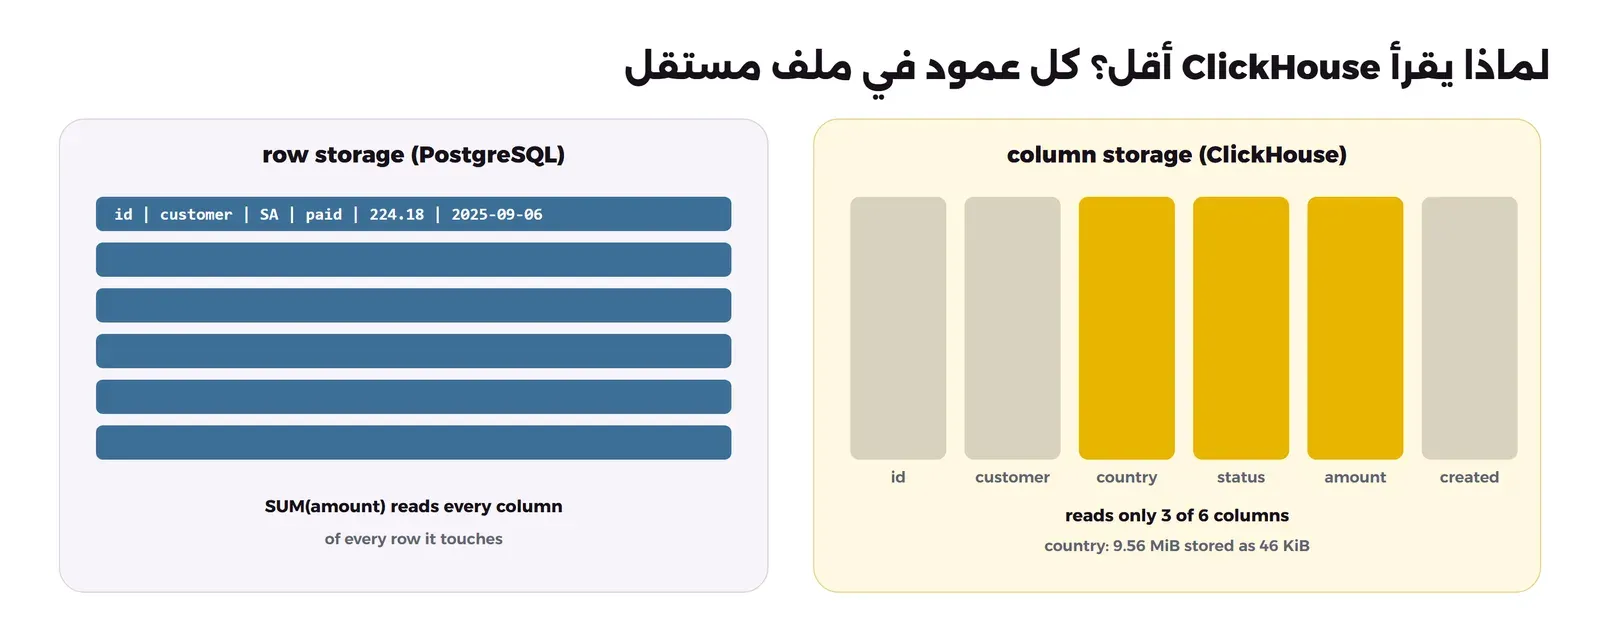
والفائدة الثانية الضغط: عمود الدولة فيه ثماني قيم فقط تتكرر، فإذا حفظ وحده يضغط ضغطاً هائلاً، وفي التجربة أصبح عمود country لعشرة ملايين صف 46 KiB من 9.56 MiB، أي 213 مرة أصغر. والفائدة الثالثة أن ClickHouse يعالج كل عمود دفعات Vectors بدل صف بعد صف، ويستخدم كل أنوية المعالج في الاستعلام الواحد.
MergeTree ومفتاح الترتيب ORDER BY
أغلب جداول ClickHouse تستخدم محرك MergeTree أو أحد أفراد عائلته. وكل INSERT يكتب جزءاً Part جديداً مرتباً بحسب ORDER BY الذي تحدده عند إنشاء الجدول، وفي الخلفية يدمج ClickHouse الأجزاء الصغيرة في أجزاء أكبر. ولذلك القاعدة الأولى في ClickHouse: اكتب دفعات كبيرة (آلاف الصفوف أو أكثر في كل INSERT) وليس صفاً صفاً، والسبب أن كل INSERT ينتج جزءاً، والأجزاء الكثيرة الصغيرة تتعب الدمج وتنتهي بالخطأ المشهور «too many parts».
ومفتاح الترتيب هو أهم قرار في تصميم الجدول، لأنه يحدد الفهرس الأساسي. والفهرس هنا ليس B-tree فيه مدخل لكل صف كما في مقال الفهارس، وإنما فهرس متباعد Sparse Index فيه علامة Mark واحدة لكل مجموعة من 8192 صفاً تسمى Granule بحسب دليل الفهرس الأساسي، وهو صغير جداً ويبقى في الذاكرة، ولا يشترط أن يكون فريداً. وعندما يسأل الاستعلام عن قيم في أول أعمدة المفتاح يقفز السيرفر مباشرة إلى المجموعات التي قد تحتويها ويتخطى الباقي. والصورة التالية تبين ذلك:
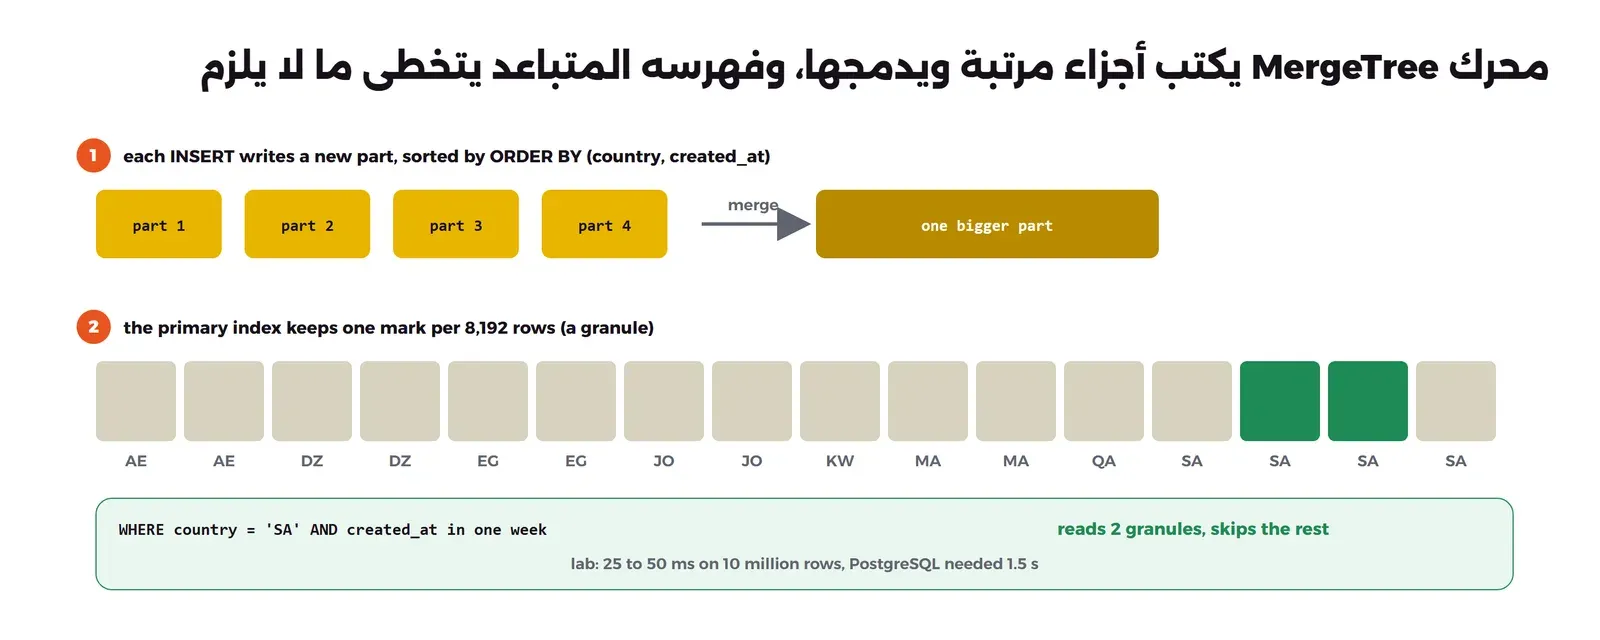
والدليل نفسه ينصح بأن ترتب أعمدة المفتاح من الأقل تنوعاً Cardinality إلى الأكثر، مثل الدولة ثم التاريخ، والسبب أن ذلك يحسن التخطي على العمود الثاني ويحسن الضغط معاً. وفي المقابل أي عمود خارج المفتاح، مثل رقم العميل في جدولنا، لا يستفيد من الفهرس، وسوف نرى ثمن ذلك في التجربة.
العروض المحفوظة Materialized Views
العرض المحفوظ في ClickHouse يختلف عن العرض المحفوظ في PostgreSQL: هو ليس نتيجة تحسب كلها ثم تحدث عند الطلب، وإنما Trigger على INSERT، فكل دفعة تدخل الجدول الأصلي تمر عبر استعلام العرض وتكتب نتيجتها في جدول آخر كما في توثيق العروض المحفوظة. وبهذا تستطيع أن تحفظ الإيرادات اليومية لكل دولة وهي تحدث مع كل طلب جديد دون أن تعيد حسابها. ولاحظ نقطتين: العرض يعالج الصفوف الجديدة فقط بعد إنشائه، أما البيانات القديمة فتملؤها بنفسك بـ INSERT … SELECT، والجدول الهدف عادة من نوع SummingMergeTree الذي يجمع الصفوف المتشابهة عند الدمج في الخلفية، وليس فوراً، وهذا هو الفخ الذي سوف نكسره في التجربة.
أين يكون ClickHouse سيئاً؟
ClickHouse ليس بديلاً لقاعدة بيانات التطبيق، وهذه هي الحالات التي يخسر فيها بوضوح:
- تعديل وحذف صف واحد: الأجزاء لا تعدل في مكانها، فالتعديل التقليدي
ALTER TABLE … UPDATEعملية خلفية تسمى Mutation تعيد كتابة الأعمدة المتأثرة في الأجزاء المعنية. والإصدارات الحديثة أضافت UPDATE الخفيف Lightweight الذي يكتب جزءاً صغيراً بالتعديلات Patch Part يطبق عند القراءة، ولكنه يحتاج إعدادين في الجدول، والتوثيق يقول إنه مصمم لتعديل كميات صغيرة حتى 10% من الجدول تقريباً، وكثرة التعديلات الصغيرة تعيدك إلى خطر الأجزاء الكثيرة. - البحث عن صف بعمود خارج مفتاح الترتيب: لا يوجد فهرس B-tree لكل صف، فيقرأ السيرفر العمود كله، بسرعة ولكن أبطأ من فهرس PostgreSQL.
- الربط JOIN تاريخياً: كان ClickHouse يبني الجدول الأيمن في الذاكرة ويطلب منك أن تضع الجدول الأصغر على اليمين بنفسك، ومنذ 24.12 يعيد المخطط ترتيب الربط بين جدولين تلقائياً، ومنذ 25.9 لثلاثة جداول أو أكثر بحسب صفحة الربط. فالربط مع جدول أبعاد Dimension Table صغير أصبح ممتازاً، ولكن ربط جدولين ضخمين ما زال يحتاج تخطيطاً، وأغلب تصاميم ClickHouse تقلل الربط بتكرار الأعمدة في جدول واحد عريض.
- المعاملات Transactions والقيود: لا توجد مفاتيح أجنبية ولا معاملات على عدة جداول كما في مقال SQL المتقدم، والمفتاح الأساسي لا يمنع التكرار.
ورخصة ClickHouse هي Apache 2.0 كما في ملف الرخصة، ولا توجد نسخة مجانية ناقصة كما في بعض القواعد الأخرى، والشركة تبيع خدمة ClickHouse Cloud.
تجربة عملية: عشرة ملايين طلب في PostgreSQL وClickHouse
سوف نضع نفس عشرة ملايين طلب في PostgreSQL 18.6 وClickHouse 26.8.23.6 (خط 26.8 هو إصدار LTS)، ونسأل الاثنين نفس الأسئلة. ولكي تكون البيانات متطابقة دون ملف ضخم، نولدها في كل قاعدة بنفس المعادلات من رقم الصف، ثم نتحقق أن المجاميع متساوية. والتجربة على Docker Engine 29.8.0 في Docker Desktop على جهاز بثمانية أنوية و32 GB، وعلى نفس الجهاز كانت تعمل Containers أخرى، ولذلك نأخذ أفضل وقت من ثلاث محاولات، والأرقام للتوضيح فقط.
ملف التشغيل
# PostgreSQL and ClickHouse side by side on the same orders (ArabRoot lab).
#   docker compose -p lab-ch up -d
name: lab-ch
services:
  postgres:
    image: postgres:18.6
    container_name: lab-ch-postgres
    environment:
      POSTGRES_PASSWORD: lab-pass
    command: ["postgres", "-c", "shared_buffers=1GB", "-c", "max_parallel_workers_per_gather=4"]
    shm_size: 1g
    ports: ["127.0.0.1:15434:5432"]
    volumes: ["./:/lab:ro", "pg-data:/var/lib/postgresql"]
  clickhouse:
    image: clickhouse/clickhouse-server:26.8.23.6
    container_name: lab-ch-clickhouse
    environment:
      CLICKHOUSE_USER: lab
      CLICKHOUSE_PASSWORD: lab-pass
    ulimits:
      nofile: { soft: 262144, hard: 262144 }
    ports: ["127.0.0.1:18123:8123"]
    volumes: ["./:/lab:ro", "ch-data:/var/lib/clickhouse"]
volumes:
  pg-data:
  ch-data:
ولاحظ أننا أعطينا PostgreSQL ذاكرة shared_buffers بحجم 1 GB وأربعة Workers للاستعلام المتوازي بدل الإعدادات الافتراضية الصغيرة، حتى لا تكون المقارنة ظالمة له، فشرحنا ضبط هذه القيم في مقال ضبط أداء PostgreSQL.
توليد البيانات
الملف pg.sql:
-- 10 million orders in PostgreSQL, generated by formula so ClickHouse gets exactly the same rows (ArabRoot lab)
CREATE TABLE orders (
  id          BIGINT PRIMARY KEY,
  customer_id INT NOT NULL,
  country     CHAR(2) NOT NULL,
  status      TEXT NOT NULL,
  amount      NUMERIC(10,2) NOT NULL,
  created_at  TIMESTAMP NOT NULL
);
\timing on
INSERT INTO orders
SELECT n,
       (n * 7919) % 100000 + 1,
       (ARRAY['SA','EG','AE','JO','MA','KW','QA','DZ'])[(n * 31) % 8 + 1],
       CASE WHEN (n * 17) % 10 < 7 THEN 'paid' WHEN (n * 17) % 10 = 7 THEN 'refunded' WHEN (n * 17) % 10 = 8 THEN 'cancelled' ELSE 'pending' END,
       5 + ((n * 48271) % 89500) / 100.0,
       TIMESTAMP '2025-01-01' + ((n * 2654435761) % 31536000) * INTERVAL '1 second'
FROM generate_series(1::bigint, 10000000) AS n;
CREATE INDEX ON orders (customer_id);
CREATE INDEX ON orders (created_at);
VACUUM ANALYZE orders;
\timing off
SELECT pg_size_pretty(pg_table_size('orders')) AS table_size, pg_size_pretty(pg_indexes_size('orders')) AS indexes;
والملف ch.sql بنفس المعادلات:
-- The same 10 million orders in ClickHouse (ArabRoot lab)
CREATE TABLE orders (
  id          UInt64,
  customer_id UInt32,
  country     LowCardinality(String),
  status      LowCardinality(String),
  amount      Decimal(10,2),
  created_at  DateTime
) ENGINE = MergeTree
ORDER BY (country, created_at);

INSERT INTO orders
SELECT number,
       (number * 7919) % 100000 + 1,
       ['SA','EG','AE','JO','MA','KW','QA','DZ'][(number * 31) % 8 + 1],
       multiIf((number * 17) % 10 < 7, 'paid', (number * 17) % 10 = 7, 'refunded', (number * 17) % 10 = 8, 'cancelled', 'pending'),
       toDecimal64(500 + (number * 48271) % 89500, 2) / 100,
       toDateTime('2025-01-01 00:00:00', 'UTC') + ((number * 2654435761) % 31536000)
FROM numbers(1, 10000000);

SELECT formatReadableSize(sum(data_compressed_bytes)) AS on_disk, formatReadableSize(sum(data_uncompressed_bytes)) AS uncompressed, count() AS parts
FROM system.parts WHERE table = 'orders' AND active;
والمخرج من PostgreSQL:
INSERT 0 10000000
Time: 216419.831 ms (03:36.420)
CREATE INDEX
Time: 65383.742 ms (01:05.384)
CREATE INDEX
Time: 34411.597 ms (00:34.412)
VACUUM
Time: 29818.850 ms (00:29.819)
 table_size | indexes
------------+---------
 651 MB     | 494 MB
ومن ClickHouse (الأرقام المنفردة هي الوقت بالثواني لكل أمر):
0.159
18.776
162.53 MiB	247.99 MiB	9
في المخرج أعلاه لاحظ التالي:
- ClickHouse حمل عشرة ملايين صف في 18.8 ثانية، وPostgreSQL في 3 دقائق و36 ثانية ثم دقيقة و40 ثانية للفهرسين.
- الحجم في PostgreSQL قرابة 1.1 GB مع الفهارس، وفي ClickHouse قرابة 163 MiB، وبعد الدمج النهائي
OPTIMIZE TABLE orders FINALأصبح 187 MiB في جزأين لأننا أضفنا أعمدة التعديل الخفيف كما سوف ترى. ولاحظ أن بياناتنا مولدة بمعادلات تشبه العشوائية فلا تضغط أعمدتها الرقمية كثيراً، والبيانات الحقيقية تضغط عادة أفضل. - أنواع
LowCardinality(String)للدولة والحالة تحفظ القيم كقاموس صغير وأرقام، وهي مناسبة لأي عمود نصي فيه قيم قليلة متكررة بحسب توثيق LowCardinality.
قبل أي قياس نتأكد أن البيانات متطابقة:
PostgreSQL:  10000000|4524948235.00|2025-01-01 00:00:01|2025-12-31 23:59:51|100000|7000000
ClickHouse:  10000000	4524948235	2025-01-01 00:00:01	2025-12-31 23:59:51	100000	7000000
نفس الأسئلة على الاثنين
الملف bench.sql فيه خمسة أسئلة تعمل كما هي على الاثنين دون تغيير:
-- The same questions for both databases; each is run three times (ArabRoot lab)
-- Q1 revenue by country (paid orders)
SELECT country, count(*) AS orders, sum(amount) AS revenue FROM orders WHERE status = 'paid' GROUP BY country ORDER BY revenue DESC;
-- Q2 revenue and distinct customers per month
SELECT date_trunc('month', created_at) AS month, sum(amount) AS revenue, count(DISTINCT customer_id) AS customers FROM orders GROUP BY month ORDER BY month;
-- Q3 top 10 customers by revenue
SELECT customer_id, sum(amount) AS revenue FROM orders GROUP BY customer_id ORDER BY revenue DESC LIMIT 10;
-- Q4 one customer's orders (an index in PostgreSQL, not in the ClickHouse sort key)
SELECT count(*), sum(amount) FROM orders WHERE customer_id = 4242;
-- Q5 one country, one week (matches the ClickHouse sort key)
SELECT count(*), sum(amount) FROM orders WHERE country = 'SA' AND created_at >= '2025-07-01' AND created_at < '2025-07-08';
grep -v '^--' bench.sql | while IFS= read -r q; do
for i in 1 2 3; do docker exec lab-ch-postgres psql -U postgres -c '\timing on' -c "$q" </dev/null | grep "^Time"; done
for i in 1 2 3; do docker exec lab-ch-clickhouse clickhouse-client --user lab --password lab-pass --time -q "$q" </dev/null 2>&1 >/dev/null; done
doneوالأوقات الثلاثة لكل سؤال كانت كما يلي:
| السؤال | PostgreSQL 18.6 | ClickHouse 26.8 |
|---|---|---|
| Q1 الإيرادات لكل دولة | 5.53 ثم 9.85 ثم 4.83 ثانية | 1.65 ثم 0.81 ثم 0.78 ثانية |
| Q2 الإيرادات والعملاء المختلفون بالشهر | 68.4 ثم 55.5 ثم 47.7 ثانية | 0.44 ثم 0.50 ثم 0.96 ثانية |
| Q3 أعلى عشرة عملاء | 12.7 ثم 18.5 ثم 15.6 ثانية | 1.31 ثم 1.17 ثم 1.72 ثانية |
| Q4 طلبات عميل واحد | 72 ثم 17 ثم 6 ملي ثانية | 59 ثم 75 ثم 136 ملي ثانية |
| Q5 دولة واحدة في أسبوع | 1.77 ثم 2.71 ثم 1.55 ثانية | 25 ثم 50 ثم 33 ملي ثانية |
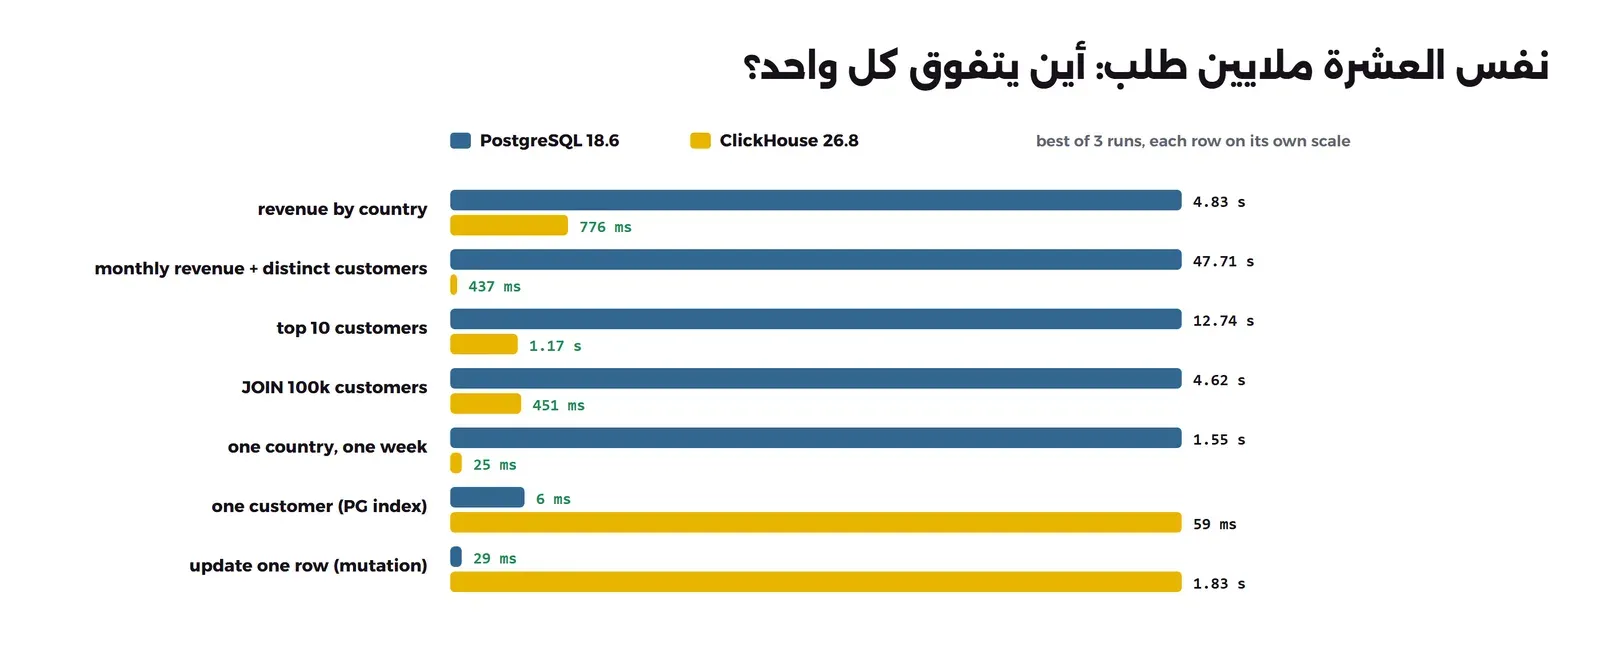
والصورة التالية تبين أفضل وقت لكل سؤال، مع نتائج الربط والتعديل من الأقسام التالية:
في النتائج أعلاه لاحظ التالي:
- السؤال الثاني هو الأكبر فرقاً، 47.7 ثانية مقابل 0.44، والسبب أن
count(DISTINCT …)في PostgreSQL ثقيل على عشرة ملايين صف، وClickHouse يقرأ ثلاثة أعمدة مضغوطة بكل الأنوية. - السؤال الخامس يطابق مفتاح الترتيب
(country, created_at)، فقرأ ClickHouse مجموعات قليلة وأجاب في 25 ملي ثانية. - السؤال الرابع بعمود خارج المفتاح، فقرأ ClickHouse عمود العملاء كله في 59 ملي ثانية أو أكثر، بينما أجاب فهرس PostgreSQL في 6 ملي ثانية. هذا هو نوع الأسئلة الذي يسأله التطبيق آلاف المرات في الدقيقة، ولذلك يبقى في PostgreSQL.
- تباين أوقات PostgreSQL بين المحاولات (مثل 9.85 ثانية في المحاولة الثانية) سببه أن الجهاز كان يشغل أشياء أخرى، وهذا سبب أخذ أفضل وقت.
الربط JOIN مع جدول عملاء
أنشأنا جدول عملاء من 100 ألف صف في الاثنين، وربطناه بالطلبات لنحسب الإيرادات لكل شريحة عملاء:
-- A dimension table of 100,000 customers, joined to the 10 million orders (ArabRoot lab)
-- PostgreSQL:  CREATE TABLE customers AS SELECT n AS id, (ARRAY['retail','wholesale','vip','staff','partner'])[n % 5 + 1] AS segment FROM generate_series(1, 100000) n;
-- ClickHouse:  CREATE TABLE customers ENGINE = MergeTree ORDER BY id AS SELECT number AS id, ['retail','wholesale','vip','staff','partner'][number % 5 + 1] AS segment FROM numbers(1, 100000);
SELECT c.segment, count(*) AS orders, sum(o.amount) AS revenue FROM orders o JOIN customers c ON c.id = o.customer_id GROUP BY c.segment ORDER BY revenue DESC;
PostgreSQL أخذ 6.76 ثم 6.87 ثم 4.62 ثانية، وClickHouse أخذ 0.99 ثم 0.47 ثم 0.45 ثانية، والنتيجة من ClickHouse:
vip	1999999	905029023.76
staff	2000000	905009695
partner	2000000	904988605
retail	2000000	904970200
wholesale	2000000	904949845
ولاحظ أن شريحة vip فيها صف أقل مما في PostgreSQL (2000000)، والسبب صف حذفناه في ClickHouse في الخطوة التالية قبل أن نشغل الربط. فالربط مع جدول أبعاد صغير لم يعد نقطة ضعف في الإصدارات الحديثة.
نكسرها: تعديل صف واحد
الآن نعدل حالة طلب واحد، وهو أبسط شيء في التطبيق:
docker exec lab-ch-postgres psql -U postgres -c '\timing on' -c "UPDATE orders SET status='refunded' WHERE id=4242"
docker exec lab-ch-clickhouse clickhouse-client --user lab --password lab-pass --time -q "ALTER TABLE orders UPDATE status='refunded' WHERE id=4242 SETTINGS mutations_sync=1"
docker exec lab-ch-clickhouse clickhouse-client --user lab --password lab-pass -q "UPDATE orders SET status='refunded' WHERE id=4243"
والمخرج:
UPDATE 1
Time: 28.844 ms

1.830

Code: 48. DB::Exception: … Lightweight updates are not supported. Lightweight updates are supported only for tables with materialized _block_number column. Run 'MODIFY SETTING enable_block_number_column = 1' command to enable it. (NOT_IMPLEMENTED)
PostgreSQL عدل الصف في 29 ملي ثانية، أما ClickHouse فالتعديل التقليدي Mutation أخذ 1.83 ثانية لصف واحد، لأنه أعاد كتابة عمود الحالة في الأجزاء المعنية، والتعديل الخفيف رفض لأن الجدول لم ينشأ بالإعدادين المطلوبين. فعلناهما ثم أعدنا المحاولة:
docker exec lab-ch-clickhouse clickhouse-client --user lab --password lab-pass --time -q "ALTER TABLE orders MODIFY SETTING enable_block_number_column = 1, enable_block_offset_column = 1"
docker exec lab-ch-clickhouse clickhouse-client --user lab --password lab-pass --time -q "UPDATE orders SET status='refunded' WHERE id=4243"
docker exec lab-ch-clickhouse clickhouse-client --user lab --password lab-pass --time -q "DELETE FROM orders WHERE id=4244"
0.087
0.212
0.434التعديل الخفيف أخذ 0.21 ثانية والحذف الخفيف 0.43 ثانية، وهو أفضل بكثير من 1.83، ولكنه ما زال أبطأ عشر مرات من PostgreSQL، ولا يناسب تطبيقاً يعدل الطلبات طوال اليوم. لذلك القاعدة: الطلبات تعيش وتعدل في PostgreSQL أو MySQL، وتنسخ إلى ClickHouse للتحليل، والتعديلات النادرة هناك مقبولة.
نكسرها: العرض المحفوظ الذي يعد مرتين
الملف mv.sql ينشئ جدولاً للإيرادات اليومية من نوع SummingMergeTree، وعرضاً محفوظاً يملؤه مع كل INSERT، ثم يضيف طلبين في دفعتين منفصلتين:
-- A materialized view that keeps daily revenue per country up to date on every INSERT (ArabRoot lab)
CREATE TABLE daily_revenue (day Date, country LowCardinality(String), orders UInt64, revenue Decimal(18,2))
ENGINE = SummingMergeTree ORDER BY (country, day);
CREATE MATERIALIZED VIEW daily_revenue_mv TO daily_revenue AS
SELECT toDate(created_at) AS day, country, count() AS orders, sum(amount) AS revenue FROM orders WHERE status = 'paid' GROUP BY day, country;
-- new orders arrive in two separate inserts
INSERT INTO orders VALUES (20000001, 7, 'SA', 'paid', 100.00, '2026-10-11 09:00:00');
INSERT INTO orders VALUES (20000002, 8, 'SA', 'paid', 50.00, '2026-10-11 10:00:00');
-- wrong: reading the rows as they are, before ClickHouse merges them in the background
SELECT day, country, orders, revenue FROM daily_revenue WHERE day = '2026-10-11';
-- right: always aggregate again when reading
SELECT day, country, sum(orders) AS orders, sum(revenue) AS revenue FROM daily_revenue WHERE day = '2026-10-11' GROUP BY day, country;
والمخرج:
2026-10-11	SA	1	50
2026-10-11	SA	1	100
2026-10-11	SA	2	150
القراءة المباشرة أعطت صفين لنفس اليوم ونفس الدولة، والسبب أن كل INSERT كتب جزءاً مستقلاً، وSummingMergeTree يجمعهما فقط عندما يدمج الأجزاء في الخلفية، ولا تعرف متى. فإذا عرضت لوحة التقارير الصفوف كما هي فسوف ترى أحياناً يوماً مكرراً، وإذا أخذت أول صف فسوف ترى نصف الإيرادات. والحل الصحيح هو الاستعلام الثاني: اجمع دائماً بـ sum() وGROUP BY عند القراءة، فيعطي 2 طلب و150 مهما كانت حالة الدمج. ولاحظ أيضاً أن العرض لم يحسب عشرة ملايين طلب القديمة، فهو يرى ما يدخل بعد إنشائه فقط.
حذف المختبر
docker compose -p lab-ch down -vالتشغيل: النسخ الاحتياطي والذاكرة والأمان
- النسخ الاحتياطي: الأمر
BACKUP TABLE … TO Disk(…)أو إلى S3 كما في توثيق النسخ الاحتياطي، ومع ذلك إذا كانت بيانات ClickHouse نسخة من قاعدة التطبيق فخطتك الأولى هي إعادة تحميلها من المصدر، وجرب ذلك مرة على الأقل. - الذاكرة: الاستعلامات الكبيرة تستهلك ذاكرة كثيرة، وفي التجربة وصل ClickHouse إلى 1.27 GiB بعد الأسئلة، فحدد
max_memory_usageللمستخدمين، ولا تضعه على نفس سيرفر قاعدة التطبيق إذا كانت الذاكرة قليلة. - الأمان: المنفذ 8123 واجهة HTTP تقبل SQL كاملاً، فلا تقم بنشره على الإنترنت، وأنشئ مستخدماً للقراءة فقط لأدوات التقارير مثل Apache Superset.
- إدخال البيانات: دفعات كبيرة دائماً، أو الإعداد
async_insertإذا كان لديك مصادر كثيرة ترسل صفوفاً قليلة.
متى تحتاج ClickHouse؟
نقاط القوة: أسرع بعشرة إلى مئة مرة في الأسئلة التحليلية على عشرة ملايين صف كما رأينا، وضغط قوي، وتحميل سريع جداً، وSQL مألوف، ورخصة Apache 2.0 دون نسخة ناقصة.
نقاط الضعف: التعديل والحذف ثقيلان حتى بالطريقة الخفيفة، والبحث بعمود خارج مفتاح الترتيب أبطأ من فهرس عادي، ولا توجد معاملات ولا مفاتيح أجنبية، والأخطاء في تصميم ORDER BY أو في قراءة SummingMergeTree لا تظهر إلا متأخراً.
- تحتاجه: تقارير ولوحات على عشرات الملايين من الأحداث أو الطلبات أو السجلات، وتحليلات استخدام المنتج كما في مقال مقاييس المنتج، وأي سؤال تحليلي يبطئ قاعدة التطبيق.
- لا تحتاجه: إذا كانت بياناتك بضعة ملايين صف وتقاريرك قليلة، فالعروض المحفوظة والتقسيم في PostgreSQL تكفيك كما في قسم التحليلات في مقال PostgreSQL لكل شيء.
- لا تستخدمه: قاعدة بيانات للتطبيق نفسه، أو لأي بيانات تعدل باستمرار.
- بيانات أجهزة ومقاييس زمنية فقط: قارن أولاً مع مقال قواعد السلاسل الزمنية.
أخطاء شائعة
- INSERT صفاً صفاً: كل INSERT جزء جديد، والنتيجة «too many parts».
- مفتاح ترتيب لا يطابق أسئلتك: ضع فيه الأعمدة التي تصفي بها دائماً، من الأقل تنوعاً إلى الأكثر.
- قراءة جدول SummingMergeTree دون
sum(): ترى صفوفاً مكررة أو أرقاماً ناقصة. - نسيان أن العرض المحفوظ لا يرى البيانات القديمة: املأها بنفسك بـ INSERT … SELECT.
- استخدامه قاعدة للتطبيق: التعديل أبطأ عشرات المرات والمعاملات غير موجودة.
- نشر المنفذ 8123 دون مصادقة: أي شخص يقرأ كل بياناتك.
الخلاصة
- ClickHouse يحفظ كل عمود في ملف مستقل مضغوط، فيقرأ الأعمدة التي يحتاجها السؤال فقط، وعمود الدولة أصبح 213 مرة أصغر.
- MergeTree يكتب أجزاء مرتبة بمفتاح ORDER BY ويدمجها في الخلفية، والفهرس المتباعد بعلامة لكل 8192 صفاً يتخطى ما لا يلزم.
- على عشرة ملايين طلب: الإيرادات بالشهر مع العملاء المختلفين 0.44 ثانية مقابل 47.7 في PostgreSQL، ودولة في أسبوع 25 ملي ثانية مقابل 1.55 ثانية، والربط مع 100 ألف عميل 0.45 مقابل 4.6 ثانية.
- PostgreSQL فاز في طلبات عميل واحد بالفهرس (6 مقابل 59 ملي ثانية) وفي تعديل صف (29 ملي ثانية مقابل 1.83 ثانية Mutation أو 0.21 ثانية تعديلاً خفيفاً).
- العرض المحفوظ مع SummingMergeTree يحتاج
sum()عند القراءة، والتطبيق يبقى في PostgreSQL أو MySQL، وClickHouse نسخة للتحليل بجانبه.
 دليلأنواع قواعد البيانات ومتى تختار كل نوعالفرق بين قواعد البيانات العلائقية والمستندات والمفتاح والقيمة وغيرها، وأي الأسئلة تجيب عنها كل عائلة بسهولة.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
 دليلTimescaleDB وInfluxDB لبيانات السلاسل الزمنية Time-Seriesكيف تحفظ قراءات الأجهزة والمقاييس سنوات دون أن يكبر القرص بلا حد، ومتى يناسبك TimescaleDB أو InfluxDB.
 دليلApache Superset: تحليلات ولوحات تقارير على سيرفرككيف تثبت Apache Superset على سيرفرك، وتبني منه مقاييس ورسوماً ولوحة تقارير من بيانات شركتك.
 دليلPostgreSQL أم MySQL أم MongoDB؟مقارنة عادلة بين أشهر ثلاث قواعد بيانات على نفس البيانات، وأسئلة بسيطة تساعدك على اختيار ما يناسب مشروعك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، والتجربة على ClickHouse 26.8.23.6 وPostgreSQL 18.6 في Docker Engine 29.8.0، والمعلومات من توثيق ClickHouse كما قرأناه في 11 أكتوبر 2026.


