

في الجزء الثاني جمعنا الصفوف من أكثر من جدول ولخصناها في أرقام، ورأينا كيف يتضاعف رقم في تقرير دون أي رسالة خطأ. ولكن الاستعلامات بدأت تطول، وفيها استعلام فرعي داخل استعلام فرعي يصعب قراءته، وبقيت أسئلة لا يجيب عليها GROUP BY بسهولة، مثل ترتيب الطالب داخل دورته والمجموع التراكمي للدفعات يوماً بعد يوم والهيكل الإداري بكل مستوياته. وكل ما فعلناه حتى الآن كان في جلسة واحدة، أما في الواقع فالسيرفر يخدم مئات الطلبات في نفس اللحظة، وهنا تظهر أخطاء لا تراها أبداً وأنت تجرب وحدك، مثل طالبين يحجزان آخر مقعد في نفس الثانية.
المواضيع في السلسلة:
- تعلم SQL (1): ما هو SQL وكيف تكتب أول استعلام: قواعد البيانات العلائقية وتاريخ اللغة، وأنواع الأوامر، وإنشاء الجداول والقيود، والإضافة والتعديل والحذف، والاستعلام SELECT والدوال والقيمة NULL.
- تعلم SQL (2): الربط JOIN والتجميع والاستعلامات الفرعية: أنواع الربط كلها، والتجميع GROUP BY وHAVING، والاستعلامات الفرعية Subqueries، وعمليات المجموعات UNION وINTERSECT وEXCEPT.
- تعلم SQL (3): CTE ودوال النوافذ والمعاملات (الموضوع الحالي): جمل WITH والاستعلام التكراري، ودوال النوافذ Window Functions، والعروض Views، والإضافة أو التحديث UPSERT، وJSON، والمعاملات ومستويات العزل، وحقن SQL.
وسوف نتناول في هذا الجزء ما يلي:
- جمل WITH التي تسمى Common Table Expression واختصاراً CTE، والاستعلام التكراري WITH RECURSIVE على الهيكل الإداري للمعهد.
- دوال النوافذ Window Functions بالتفصيل: ROW_NUMBER وRANK وLAG وLEAD والمجموع التراكمي والإطار Frame.
- العروض Views والعروض المادية Materialized Views، والإضافة أو التحديث UPSERT بالعبارة ON CONFLICT، وأساسيات JSON.
- المعاملات Transactions ووعود ACID، ومستويات العزل Isolation Levels بتجارب حقيقية على جلستين.
- الاستعلامات ذات المعاملات Parameterized Queries وحقن SQL، ثم إشارة إلى الفهارس وEXPLAIN، والأخطاء الشائعة وتمارين بحلولها.
قاعدة البيانات من الجزء الأول
نعمل على نفس قاعدة البيانات academy من الجزء الأول، فإذا لم يكن المختبر يعمل فأنشئه وحمل الملفين schema.sql وseed.sql من قسمي إنشاء الجداول والإضافة:
docker run -d --name lab-sql-pg -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=academy \
  -p 127.0.0.1:21471:5432 postgres:18.6
docker exec -i lab-sql-pg psql -U postgres -d academy < schema.sql
docker exec -i lab-sql-pg psql -U postgres -d academy < seed.sql
docker exec -it lab-sql-pg psql -U postgres -d academy
ثم نفذ \pset null NULL داخل psql كما في الجزأين السابقين.
جمل WITH أو CTE: أعط الاستعلام اسماً
عندما يكبر الاستعلام الفرعي ويصعب قراءته داخل جملة أخرى، أو تحتاج نتيجته مرتين، فالأفضل أن تعطيه اسماً في بداية الجملة بالكلمة WITH، ويسمى هذا الشكل Common Table Expression واختصاراً CTE، وهو مثل المتغير في لغات البرمجة: تحسب النتيجة مرة وتسميها، ثم تستخدم الاسم. والمثال التالي يحسب لكل طالب عدد دوراته ومجموع رسومها، ثم يستخدم النتيجة مرتين: مرة للعرض ومرة لحساب المتوسط:
WITH per_student AS (
    SELECT e.student_id, count(*) AS courses, sum(c.price) AS fees
    FROM enrollments e
    JOIN courses c ON c.id = e.course_id
    GROUP BY e.student_id
)
SELECT s.name, p.courses, p.fees
FROM per_student p
JOIN students s ON s.id = p.student_id
WHERE p.fees > (SELECT avg(fees) FROM per_student)
ORDER BY p.fees DESC;
والمخرج سوف يكون كما يلي:
 name | courses |  fees
------+---------+--------
 Huda |       2 | 850.00
 Lina |       2 | 800.00
 Sara |       2 | 750.00
 Omar |       2 | 700.00
(4 rows)
الطلاب الخمسة المسجلون رسومهم في المتوسط 690، وخالد وحده أقل منه (350) فلم يظهر. ولاحظ أن الجملة تقرأ من الأعلى إلى الأسفل كخطوات: احسب لكل طالب، ثم اختر من فوق المتوسط. ويمكنك أن تكتب أكثر من CTE بفاصلة، وكل واحد يستخدم ما قبله، فالمثال التالي يحسب ما على كل طالب من مبالغ متبقية في ثلاث خطوات، وهو نفس حل تضاعف الصفوف من الجزء الثاني ولكنه أسهل في القراءة:
WITH paid AS (
    SELECT enrollment_id, sum(amount) AS paid
    FROM payments
    GROUP BY enrollment_id
),
balances AS (
    SELECT e.id, e.student_id, c.price - COALESCE(p.paid, 0) AS balance
    FROM enrollments e
    JOIN courses c ON c.id = e.course_id
    LEFT JOIN paid p ON p.enrollment_id = e.id
)
SELECT s.name, sum(b.balance) AS owes
FROM balances b
JOIN students s ON s.id = b.student_id
GROUP BY s.id, s.name
HAVING sum(b.balance) > 0
ORDER BY owes DESC;
 name |  owes
------+--------
 Lina | 350.00
 Omar | 200.00
(2 rows)
وهذا هو سبب استخدام CTE في الاستعلامات الطويلة، فهي تقسم الاستعلام إلى أجزاء لها أسماء كما تقسم الكود إلى دوال، وتستطيع أن تختبر كل جزء وحده بأن تكتب بعده SELECT * FROM paid. والصيغة WITH تعمل في MySQL 8.4 وSQL Server 2022 وSQLite كما هي.
الاستعلام التكراري WITH RECURSIVE والهيكل الإداري
في الربط الذاتي عرضنا مدير كل مدرب، ولكن هذا مستوى واحد فقط، فإذا أردت الهيكل الإداري كاملاً، أو كل من تحت Majed مهما كان عمق الهيكل، فأنت لا تعرف مسبقاً كم مرة تربط الجدول بنفسه. والحل هو الاستعلام التكراري WITH RECURSIVE، وله جزءان بينهما UNION ALL: جزء البداية Anchor الذي يعطي الصفوف الأولى، والجزء التكراري الذي يربط الجدول بنتيجة الخطوة السابقة، وتكرر قاعدة البيانات الجزء الثاني حتى لا يضيف أي صف:
WITH RECURSIVE chain AS (
    SELECT id, name, manager_id, 1 AS level, name::text AS path
    FROM instructors
    WHERE manager_id IS NULL
  UNION ALL
    SELECT i.id, i.name, i.manager_id, c.level + 1, c.path || ' > ' || i.name
    FROM instructors i
    JOIN chain c ON i.manager_id = c.id
)
SELECT level, name, path
FROM chain
ORDER BY path;
 level |  name  |         path
-------+--------+-----------------------
     1 | Nora   | Nora
     2 | Majed  | Nora > Majed
     3 | Tariq  | Nora > Majed > Tariq
     3 | Yasser | Nora > Majed > Yasser
     2 | Rania  | Nora > Rania
     3 | Dana   | Nora > Rania > Dana
(6 rows)
في الاستعلام أعلاه لاحظ التالي:
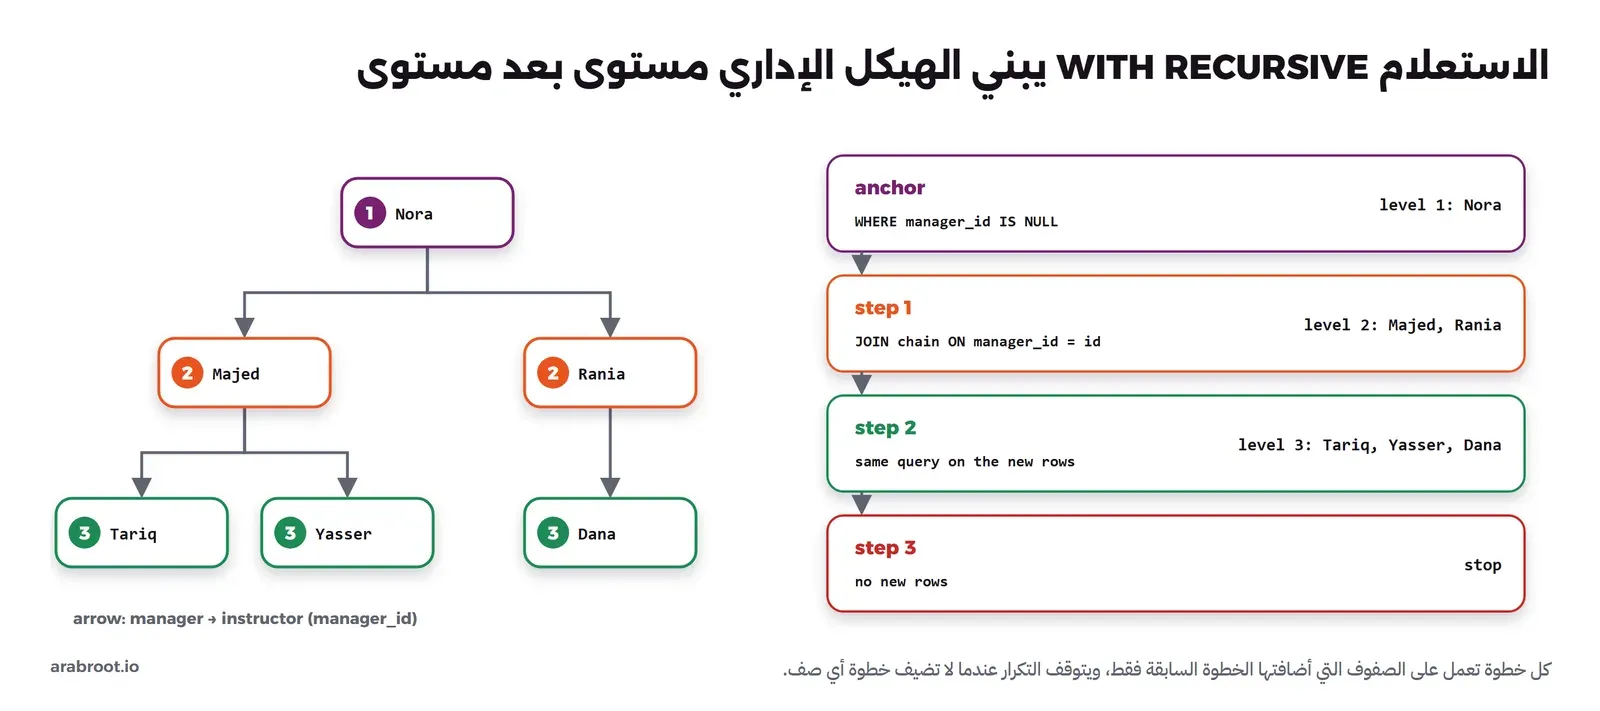
- جزء البداية يأخذ من ليس له مدير، وهي Nora، ويعطيها المستوى 1 ويبدأ المسار باسمها.
- الجزء التكراري يأخذ كل مدرب مديره موجود في نتيجة الخطوة السابقة، ويزيد المستوى واحداً ويضيف اسمه إلى المسار، فالخطوة الأولى تجد Majed وRania، والثانية تجد Tariq وYasser وDana، والثالثة لا تجد أحداً فيتوقف التكرار.
- الترتيب بالمسار
pathيضع كل مدرب تحت مديره مباشرة، فيظهر الهيكل كشجرة. - كتبنا
name::textفي جزء البداية حتى يكون نوع العمود نصاً بلا حد، لأن PostgreSQL يأخذ نوع العمود من جزء البداية، والمسار يطول في كل خطوة.
والصورة التالية تبين الشجرة والخطوات التي بنتها:
ويمكنك أن تمشي في الاتجاه المعاكس، من موظف إلى أعلى، فالمثال التالي يجد سلسلة المديرين فوق Tariq:
WITH RECURSIVE up AS (
    SELECT id, name, manager_id FROM instructors WHERE name = 'Tariq'
  UNION ALL
    SELECT i.id, i.name, i.manager_id
    FROM instructors i
    JOIN up ON i.id = up.manager_id
)
SELECT name FROM up;
 name
-------
 Tariq
 Majed
 Nora
(3 rows)
والاستخدام العملي الأشهر هو أن تستعمل نتيجة الشجرة في استعلام آخر، مثل كل الدورات التي يدرسها فريق Majed بكل مستوياته:
WITH RECURSIVE team AS (
    SELECT id FROM instructors WHERE name = 'Majed'
  UNION ALL
    SELECT i.id FROM instructors i JOIN team t ON i.manager_id = t.id
)
SELECT c.title, i.name AS instructor
FROM courses c
JOIN instructors i ON i.id = c.instructor_id
WHERE c.instructor_id IN (SELECT id FROM team)
ORDER BY c.title;
    title     | instructor
--------------+------------
 Docker       | Yasser
 Linux Basics | Tariq
(2 rows)
وانتبه أن الاستعلام التكراري لا يتوقف إذا كان في البيانات حلقة، مثل مدرب مديره نفسه أو مديرين يدير كل منهما الآخر، فتكرر قاعدة البيانات إلى ما لا نهاية، لذلك احم البيانات بقيد يمنع الحلقة، أو أضف في الجزء التكراري شرطاً على المستوى مثل WHERE c.level < 20، ويشرح توثيق WITH العبارة CYCLE التي تكتشف الحلقة تلقائياً. وأما في المحركات الأخرى فتعمل نفس الجملة في MySQL 8.4 وSQLite، أما SQL Server 2022 فرفض الكلمة RECURSIVE برسالة Incorrect syntax near 'n'، وعمل نفس الاستعلام بعد حذفها، لأن WITH فيه تكون تكرارية تلقائياً إذا أشارت إلى نفسها كما يذكر توثيق WITH في SQL Server.
دوال النوافذ Window Functions
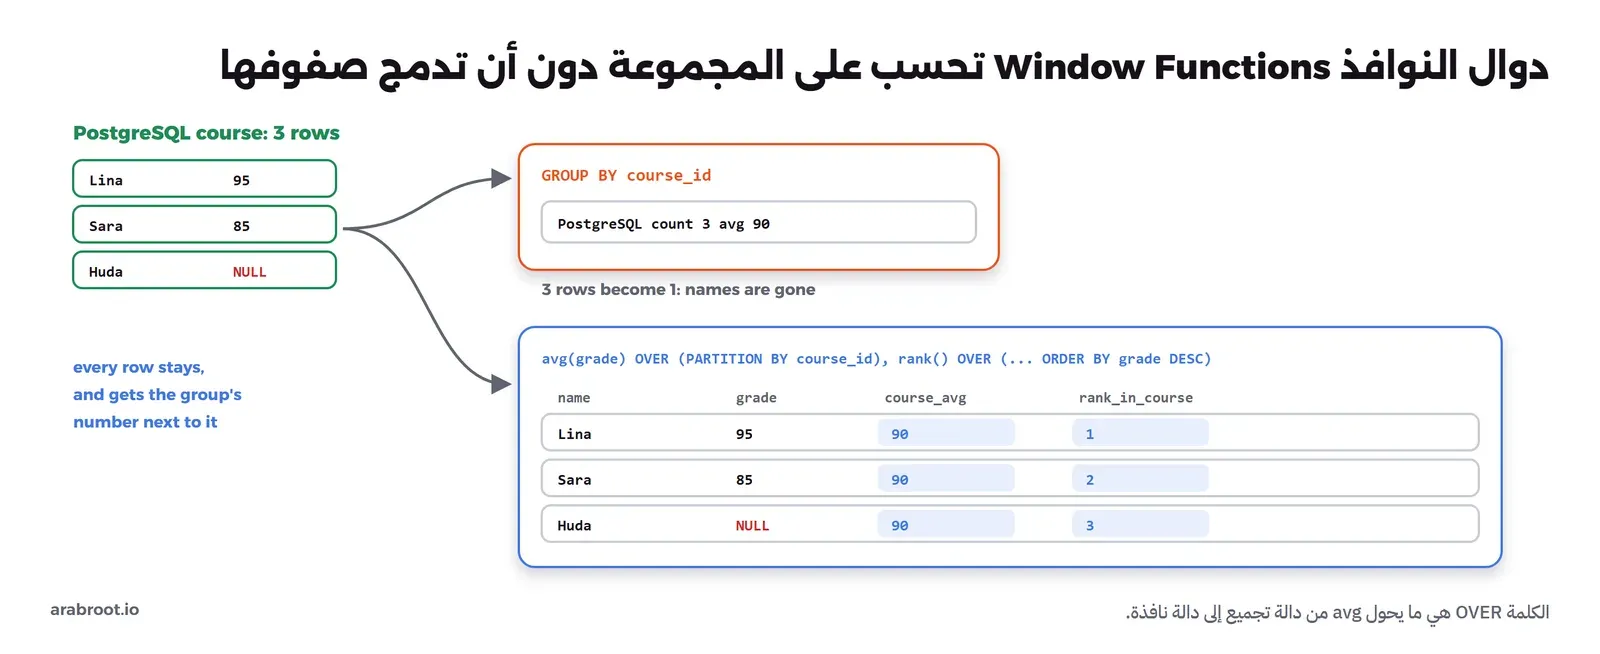
التجميع GROUP BY يدمج الصفوف، فإذا أردت متوسط الدورة بجانب درجة كل طالب، أو ترتيب الطالب داخل دورته، فقدت الأسماء عند التجميع. ودوال النوافذ تحل هذه المشكلة، فهي تحسب على مجموعة من الصفوف ولكنها تبقي كل صف كما هو وتضيف الرقم بجانبه، والكلمة التي تحول الدالة إلى دالة نافذة هي OVER، كما يشرح درس دوال النوافذ:
SELECT c.title, s.name, e.grade,
       rank() OVER (PARTITION BY e.course_id ORDER BY e.grade DESC NULLS LAST) AS rank_in_course,
       round(avg(e.grade) OVER (PARTITION BY e.course_id))                      AS course_avg
FROM enrollments e
JOIN students s ON s.id = e.student_id
JOIN courses  c ON c.id = e.course_id
ORDER BY c.title, rank_in_course;
    title     |  name  | grade | rank_in_course | course_avg
--------------+--------+-------+----------------+------------
 Docker       | Huda   |    88 |              1 |         88
 Docker       | Omar   |  NULL |              2 |         88
 Linux Basics | Sara   |    90 |              1 |         80
 Linux Basics | Omar   |    70 |              2 |         80
 PostgreSQL   | Lina   |    95 |              1 |         90
 PostgreSQL   | Sara   |    85 |              2 |         90
 PostgreSQL   | Huda   |  NULL |              3 |         90
 Python       | Khalid |    60 |              1 |         60
 Python       | Lina   |  NULL |              2 |         60
(9 rows)
في الاستعلام أعلاه لاحظ التالي:
- الجزء
PARTITION BY e.course_idيقسم الصفوف إلى نوافذ، نافذة لكل دورة، مثل GROUP BY ولكن دون دمج، فبقيت الصفوف التسعة كلها. - الدالة
avgنفسها التي استخدمناها في التجميع أصبحت دالة نافذة بإضافة OVER، فظهر متوسط الدورة بجانب كل طالب فيها. - كتبنا
NULLS LASTداخل ترتيب النافذة، لأن الترتيب التنازلي في PostgreSQL يضع NULL أولاً كما رأينا في الجزء الأول، ولولاها لأصبح الطالب الذي لم يختبر بعد الأول في دورته.
والصورة التالية تقارن بين الطريقتين على دورة PostgreSQL:
الترقيم والترتيب ROW_NUMBER وRANK وDENSE_RANK
هناك ثلاث دوال للترقيم من توثيق دوال النوافذ، والفرق بينها يظهر فقط عند التساوي، لذلك سوف نجربها على قائمة صغيرة فيها دورتان بنفس السعر، كتبناها مباشرة بالعبارة VALUES حتى لا نغير الجدول:
SELECT title, price,
       row_number() OVER (ORDER BY price DESC) AS row_number,
       rank()       OVER (ORDER BY price DESC) AS rank,
       dense_rank() OVER (ORDER BY price DESC) AS dense_rank
FROM (VALUES ('Kubernetes', 600), ('PostgreSQL', 450), ('Rust', 450), ('Docker', 400)) AS t(title, price);
   title    | price | row_number | rank | dense_rank
------------+-------+------------+------+------------
 Kubernetes |   600 |          1 |    1 |          1
 PostgreSQL |   450 |          2 |    2 |          2
 Rust       |   450 |          3 |    2 |          2
 Docker     |   400 |          4 |    4 |          3
(4 rows)
الدالة row_number تعطي رقماً مختلفاً لكل صف حتى لو تساويا، والترتيب بين المتساويين غير مضمون، وrank تعطي المتساويين نفس الرقم ثم تقفز، مثل ترتيب السباق الذي ليس فيه مركز ثالث إذا تعادل اثنان على الثاني، وdense_rank لا تقفز. وأشهر استخدام لها هو «الأول في كل مجموعة»، مثل أغلى دورة في كل مسار. والمحاولة الأولى التي يكتبها الجميع هي وضع الدالة في WHERE:
SELECT title, price, rank() OVER (ORDER BY price DESC) AS r
FROM courses
WHERE rank() OVER (ORDER BY price DESC) <= 2;
ERROR:  window functions are not allowed in WHERE
LINE 3: WHERE rank() OVER (ORDER BY price DESC) <= 2;
              ^
والسبب هو نفس ترتيب التنفيذ من الجزء الأول، فدوال النوافذ تحسب مع SELECT بعد WHERE وGROUP BY وHAVING، لذلك نحسبها في استعلام فرعي ثم نختار من نتيجته:
SELECT title, track, price
FROM (
    SELECT title, track, price,
           row_number() OVER (PARTITION BY track ORDER BY price DESC) AS rn
    FROM courses
) ranked
WHERE rn = 1
ORDER BY track;
   title    | track | price
------------+-------+--------
 PostgreSQL | data  | 450.00
 Python     | dev   | 350.00
 Kubernetes | ops   | 600.00
(3 rows)
واستخدمنا row_number لأننا نريد دورة واحدة لكل مسار حتى لو تساوت دورتان، ولو أردت كل المتساويين فاستخدم rank.
الصف السابق والتالي LAG وLEAD
الدالة lag تقرأ قيمة الصف السابق في النافذة، وlead تقرأ التالي، وهما مفيدتان في كل مقارنة مع ما قبله، مثل عدد الأيام بين كل تسجيلين لنفس الطالب. ولأننا نستخدم نفس النافذة ثلاث مرات، أعطيناها اسماً بالعبارة WINDOW في آخر الجملة:
SELECT s.name, e.enrolled_on,
       lag(e.enrolled_on)  OVER w AS previous,
       lead(e.enrolled_on) OVER w AS next,
       e.enrolled_on - lag(e.enrolled_on) OVER w AS days_since_previous
FROM enrollments e
JOIN students s ON s.id = e.student_id
WINDOW w AS (PARTITION BY e.student_id ORDER BY e.enrolled_on)
ORDER BY s.name, e.enrolled_on;
  name  | enrolled_on |  previous  |    next    | days_since_previous
--------+-------------+------------+------------+---------------------
 Huda   | 2026-09-08  | NULL       | 2026-09-12 |                NULL
 Huda   | 2026-09-12  | 2026-09-08 | NULL       |                   4
 Khalid | 2026-09-07  | NULL       | NULL       |                NULL
 Lina   | 2026-09-05  | NULL       | 2026-09-06 |                NULL
 Lina   | 2026-09-06  | 2026-09-05 | NULL       |                   1
 Omar   | 2026-09-02  | NULL       | 2026-09-10 |                NULL
 Omar   | 2026-09-10  | 2026-09-02 | NULL       |                   8
 Sara   | 2026-09-01  | NULL       | 2026-09-03 |                NULL
 Sara   | 2026-09-03  | 2026-09-01 | NULL       |                   2
(9 rows)
أول تسجيل لكل طالب ليس له سابق، وآخر تسجيل ليس له تال، لذلك ظهرت NULL، وخالد له تسجيل واحد فكلاهما NULL.
المجموع التراكمي والإطار Frame
إذا كتبت ORDER BY داخل OVER مع دالة تجميع مثل sum، أصبحت النتيجة مجموعاً تراكمياً Running Total، أي مجموع كل الصفوف من البداية حتى الصف الحالي، والمثال التالي يحسب الإيراد التراكمي للمعهد يوماً بعد يوم:
SELECT paid_on, amount,
       sum(amount) OVER (ORDER BY paid_on) AS running_total
FROM payments
ORDER BY paid_on;
  paid_on   | amount | running_total
------------+--------+---------------
 2026-09-01 | 300.00 |        300.00
 2026-09-02 | 300.00 |        600.00
 2026-09-03 | 225.00 |        825.00
 2026-09-05 | 450.00 |       1275.00
 2026-09-07 | 350.00 |       1625.00
 2026-09-08 | 450.00 |       2075.00
 2026-09-10 | 200.00 |       2275.00
 2026-09-12 | 200.00 |       2475.00
 2026-10-01 | 200.00 |       2675.00
 2026-10-03 | 225.00 |       2900.00
(10 rows)
والصفوف التي تدخل في حساب كل صف تسمى الإطار Frame، ويمكنك أن تحدده بنفسك، فالمثال التالي يحسب بجانب المجموع التراكمي متوسط آخر ثلاث دفعات، والمجموع الكلي، ونسبة كل دفعة منه:
SELECT paid_on, amount,
       sum(amount) OVER (ORDER BY paid_on, id) AS running_total,
       round(avg(amount) OVER (ORDER BY paid_on, id ROWS BETWEEN 2 PRECEDING AND CURRENT ROW), 2) AS avg_last_3,
       sum(amount) OVER () AS grand_total,
       round(100 * amount / sum(amount) OVER (), 1) AS pct
FROM payments
ORDER BY paid_on, id;
  paid_on   | amount | running_total | avg_last_3 | grand_total | pct
------------+--------+---------------+------------+-------------+------
 2026-09-01 | 300.00 |        300.00 |     300.00 |     2900.00 | 10.3
 2026-09-02 | 300.00 |        600.00 |     300.00 |     2900.00 | 10.3
 2026-09-03 | 225.00 |        825.00 |     275.00 |     2900.00 |  7.8
 2026-09-05 | 450.00 |       1275.00 |     325.00 |     2900.00 | 15.5
 2026-09-07 | 350.00 |       1625.00 |     341.67 |     2900.00 | 12.1
 2026-09-08 | 450.00 |       2075.00 |     416.67 |     2900.00 | 15.5
 2026-09-10 | 200.00 |       2275.00 |     333.33 |     2900.00 |  6.9
 2026-09-12 | 200.00 |       2475.00 |     283.33 |     2900.00 |  6.9
 2026-10-01 | 200.00 |       2675.00 |     200.00 |     2900.00 |  6.9
 2026-10-03 | 225.00 |       2900.00 |     208.33 |     2900.00 |  7.8
(10 rows)
والصورة التالية تبين الإطارات الثلاثة للصف الخامس:
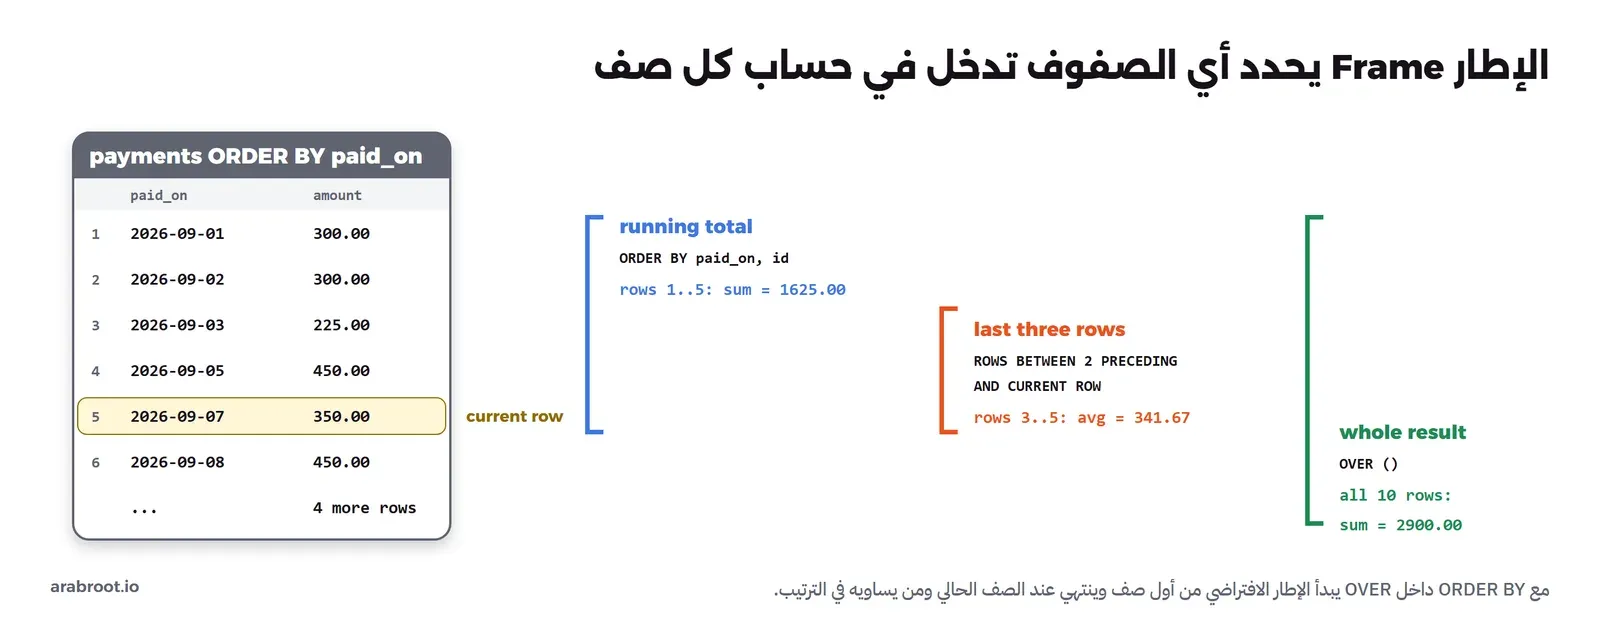
وقد يتساءل البعض: لماذا أضفنا id إلى الترتيب في المثال الثاني؟ والإجابة في الإطار الافتراضي، فعندما تكتب ORDER BY داخل OVER دون إطار، يكون الإطار كما يذكر توثيق صيغة دوال النوافذ من بداية النافذة حتى آخر صف «يساوي» الصف الحالي في الترتيب، وليس حتى الصف الحالي نفسه، والفرق يظهر عند التساوي:
SELECT d, v,
       sum(v) OVER (ORDER BY d) AS range_default,
       sum(v) OVER (ORDER BY d, v ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS rows_frame
FROM (VALUES (1, 10), (2, 20), (2, 30), (3, 40)) AS t(d, v)
ORDER BY d, v;
 d | v  | range_default | rows_frame
---+----+---------------+------------
 1 | 10 |            10 |         10
 2 | 20 |            60 |         30
 2 | 30 |            60 |         60
 3 | 40 |           100 |        100
(4 rows)
الصفان اللذان في اليوم 2 أخذا نفس المجموع 60 في الإطار الافتراضي، لأن قاعدة البيانات لا تعرف أيهما قبل الآخر، أما الإطار ROWS مع ترتيب كامل فيعطي كل صف مجموعه. لذلك في المجموع التراكمي أضف إلى الترتيب عموداً لا يتكرر مثل id. ودوال النوافذ أضيفت إلى المعيار في SQL:2003، وقد عملت نفس الأمثلة البسيطة على MySQL 8.4 وSQLite 3.49 دون تغيير.
العروض Views والعروض المادية
العرض View هو استعلام محفوظ له اسم، تستخدمه كأنه جدول، وكل مرة تقرؤه تنفذ قاعدة البيانات الاستعلام من جديد، لذلك هو لا يحفظ بيانات وإنما يحفظ الجملة، كما يشرح توثيق CREATE VIEW. والفائدة أن الربط المتكرر يكتب مرة واحدة، فالفريق كله يستخدم enrollment_details بدل أن يكتب كل شخص الربط بطريقته:
CREATE VIEW enrollment_details AS
SELECT e.id, s.name AS student, c.title AS course, c.price, e.grade, e.enrolled_on
FROM enrollments e
JOIN students s ON s.id = e.student_id
JOIN courses  c ON c.id = e.course_id;

SELECT student, course, grade
FROM enrollment_details
WHERE course = 'PostgreSQL'
ORDER BY student;
CREATE VIEW
 student |   course   | grade
---------+------------+-------
 Huda    | PostgreSQL |  NULL
 Lina    | PostgreSQL |    95
 Sara    | PostgreSQL |    85
(3 rows)
ولأن العرض يقرأ الجداول في كل مرة، فأي تغيير في الجدول يظهر فوراً:
UPDATE courses SET title = 'PostgreSQL 18' WHERE id = 2;
SELECT student, course FROM enrollment_details WHERE id = 2;
UPDATE courses SET title = 'PostgreSQL' WHERE id = 2;
UPDATE 1
 student |    course
---------+---------------
 Sara    | PostgreSQL 18
(1 row)

UPDATE 1
أما العرض المادي Materialized View فيحفظ النتيجة نفسها على القرص كأنها جدول، فتقرؤه بسرعة مهما كان الاستعلام ثقيلاً، والثمن أن النتيجة قديمة حتى تحدثها بنفسك بالأمر REFRESH، كما يشرح توثيق العروض المادية. والمثال التالي ينشئ تقرير الإيراد لكل دورة، ثم يضيف دفعة جديدة للينا:
CREATE MATERIALIZED VIEW course_revenue AS
SELECT c.title, count(DISTINCT e.id) AS students, COALESCE(sum(p.amount), 0) AS paid
FROM courses c
LEFT JOIN enrollments e ON e.course_id = c.id
LEFT JOIN payments p ON p.enrollment_id = e.id
GROUP BY c.id, c.title;

SELECT * FROM course_revenue ORDER BY paid DESC;
SELECT 5
    title     | students |  paid
--------------+----------+---------
 PostgreSQL   |        3 | 1350.00
 Linux Basics |        2 |  600.00
 Docker       |        2 |  600.00
 Python       |        2 |  350.00
 Kubernetes   |        0 |       0
(5 rows)
لاحظ أننا عددنا count(DISTINCT e.id) لأن الربط بالدفعات يكرر التسجيلات كما رأينا في تضاعف الصفوف، أما sum(p.amount) فصحيح لأن الدفعات هي الجدول الأخير. والآن نضيف الدفعة ونقرأ التقرير قبل التحديث وبعده:
INSERT INTO payments (enrollment_id, amount, paid_on) VALUES (6, 350, '2026-10-05');
SELECT * FROM course_revenue WHERE title = 'Python';
REFRESH MATERIALIZED VIEW course_revenue;
SELECT * FROM course_revenue WHERE title = 'Python';
INSERT 0 1
 title  | students |  paid
--------+----------+--------
 Python |        2 | 350.00
(1 row)

REFRESH MATERIALIZED VIEW
 title  | students |  paid
--------+----------+--------
 Python |        2 | 700.00
(1 row)
التقرير لم ير الدفعة حتى حدثناه، وهذا مقبول في لوحة تقارير تحدث كل ساعة، وغير مقبول في رصيد يراه الطالب قبل أن يدفع. ولكي نرجع البيانات كما كانت نحذف الدفعة ونحدث التقرير:
DELETE FROM payments WHERE enrollment_id = 6;
REFRESH MATERIALIZED VIEW course_revenue;
DELETE 1
REFRESH MATERIALIZED VIEW
وللعرض المحفوظ تفاصيل لا يتسع لها هذا الجزء، مثل التحديث REFRESH ... CONCURRENTLY الذي لا يوقف القراءة ويحتاج فهرساً فريداً، وجدولة التحديث داخل قاعدة البيانات، والتحديث التزايدي الذي يغير العرض مع كل كتابة، ومتى تختار بدلاً منه جدولاً ملخصاً أو كاشاً في التطبيق، وقد شرحناها بالتجربة في مقال العروض المحفوظة Materialized Views.
أضف أو حدث UPSERT بالعبارة ON CONFLICT
لنفرض أن نظام الاختبارات يرسل الدرجات إلى قاعدة البيانات، وقد يرسل نفس الدرجة مرتين، أو يرسل درجة لتسجيل موجود، فالسؤال: كيف تضيف الصف إذا لم يكن موجوداً وتحدثه إذا كان موجوداً؟ والحل البسيط أن تقرأ أولاً بـ SELECT ثم تقرر بين INSERT وUPDATE في الكود، ولكن بين القراءة والكتابة قد يضيف طلب آخر نفس الصف، فيفشل أحدهما بخطأ المفتاح المكرر:
INSERT INTO enrollments (student_id, course_id, grade) VALUES (1, 2, 92);
ERROR:  duplicate key value violates unique constraint "enrollments_student_id_course_id_key"
DETAIL:  Key (student_id, course_id)=(1, 2) already exists.
والطريقة الصحيحة في PostgreSQL هي INSERT ... ON CONFLICT، فقاعدة البيانات نفسها تقرر في عملية واحدة، ولها شكلان: أن تتجاهل الصف المكرر، أو أن تحدث الموجود:
INSERT INTO enrollments (student_id, course_id, grade) VALUES (1, 2, 92)
ON CONFLICT (student_id, course_id) DO NOTHING;

INSERT INTO enrollments (student_id, course_id, grade) VALUES (1, 2, 92)
ON CONFLICT (student_id, course_id)
DO UPDATE SET grade = EXCLUDED.grade
RETURNING id, student_id, course_id, grade;
INSERT 0 0
 id | student_id | course_id | grade
----+------------+-----------+-------
  2 |          1 |         2 |    92
(1 row)

INSERT 0 1
في المخرج أعلاه لاحظ التالي:
- الشكل الأول أعطى
INSERT 0 0أي لم يضف شيئاً ولم يعط خطأ. - الشكل الثاني حدث التسجيل الموجود رقم 2 ولم يضف صفاً جديداً، والكلمة
EXCLUDEDتعني الصف الذي حاولت إضافته، فأخذنا منه الدرجة الجديدة. - العبارة
ON CONFLICT (student_id, course_id)تحتاج قيداً UNIQUE أو مفتاحاً أساسياً على نفس الأعمدة، وهذا سبب آخر لكتابة القيود في الجدول.
وإذا لم يكن الصف موجوداً فالجملة نفسها تضيفه، ويمكنك أن تضيف شرطاً للتحديث، فلا تقبل إلا درجة أعلى من الموجودة:
INSERT INTO enrollments (student_id, course_id, enrolled_on) VALUES (6, 1, '2026-10-05')
ON CONFLICT (student_id, course_id)
DO UPDATE SET grade = EXCLUDED.grade
RETURNING id, student_id, course_id, grade;

INSERT INTO enrollments (student_id, course_id, grade) VALUES (1, 2, 70)
ON CONFLICT (student_id, course_id)
DO UPDATE SET grade = EXCLUDED.grade
WHERE enrollments.grade IS NULL OR EXCLUDED.grade > enrollments.grade
RETURNING id, grade;
 id | student_id | course_id | grade
----+------------+-----------+-------
 13 |          6 |         1 |  NULL
(1 row)

INSERT 0 1
 id | grade
----+-------
(0 rows)

INSERT 0 0
فيصل لم يكن مسجلاً في Linux Basics فأضيف تسجيله، والدرجة 70 لسارة رفضها الشرط لأن الموجودة 92، فلم يتغير شيء. ولاحظ أن تسجيل فيصل أخذ الرقم 13 وليس 10، لأن كل محاولة إضافة في هذا القسم أخذت رقماً من المولد حتى لو انتهت بتحديث أو بلا شيء، والرقم الذي تراه أنت قد يختلف بحسب ما نفذته قبله. والآن نرجع البيانات كما كانت:
UPDATE enrollments SET grade = 85 WHERE student_id = 1 AND course_id = 2;
DELETE FROM enrollments WHERE student_id = 6;
UPDATE 1
DELETE 1
وهذا الجزء من أكثر ما يختلف بين المحركات، فقد شغلنا نفس الفكرة على المحركات الثلاثة الأخرى:
- SQLite يقبل نفس الصيغة
ON CONFLICT (…) DO UPDATE SET grade = excluded.gradeكما يذكر توثيق UPSERT في SQLite. - MySQL يستخدم
INSERT … ON DUPLICATE KEY UPDATEكما في توثيقه، وقد أعطت الصيغة القديمةgrade = VALUES(grade)تحذيراً على MySQL 8.4 لأنها لم تعد مفضلة، أما الصيغةINSERT … VALUES (1, 2, 93) AS new ON DUPLICATE KEY UPDATE grade = new.gradeفعملت دون تحذير. - SQL Server لا يدعم ON CONFLICT، ويستخدم الجملة MERGE، وهي موجودة أيضاً في PostgreSQL منذ الإصدار 15.
أساسيات JSON داخل الجدول
أحياناً يكون للبيانات شكل يتغير من صف لآخر، مثل أحداث التطبيق: حدث الدخول فيه نوع الجهاز، وحدث مشاهدة الفيديو فيه الدورة وعدد الدقائق. وبدل أن تنشئ عموداً لكل احتمال، يمكنك أن تحفظ الحدث كمستند JSON في عمود واحد، وفي PostgreSQL النوع الأنسب هو jsonb كما يشرح توثيق أنواع JSON، لأنه يحفظ المستند بشكل ثنائي مفهوم يمكن البحث فيه وفهرسته. والمثال التالي ينشئ جدولاً للأحداث ويضيف أربعة:
CREATE TABLE events (
    id       int    GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    payload  jsonb  NOT NULL
);
INSERT INTO events (payload) VALUES
 ('{"type": "login",  "student_id": 1, "device": {"os": "ios"}}'),
 ('{"type": "video",  "student_id": 3, "course": "PostgreSQL", "minutes": 42}'),
 ('{"type": "login",  "student_id": 3, "device": {"os": "android"}}'),
 ('{"type": "video",  "student_id": 1, "course": "Linux Basics", "minutes": 15, "tags": ["cli", "intro"]}');
CREATE TABLE
INSERT 0 4
والقراءة بعاملين من توثيق دوال JSON: السهم -> يرجع القيمة كـ JSON، والسهم المزدوج ->> يرجعها كنص، ويمكنك أن تكرر السهم للدخول في مستند داخل مستند:
SELECT id,
       payload -> 'type'             AS type_json,
       payload ->> 'type'            AS type_text,
       payload -> 'device' ->> 'os'  AS os,
       (payload ->> 'minutes')::int  AS minutes
FROM events
ORDER BY id;
 id | type_json | type_text |   os    | minutes
----+-----------+-----------+---------+---------
  1 | "login"   | login     | ios     |    NULL
  2 | "video"   | video     | NULL    |      42
  3 | "login"   | login     | android |    NULL
  4 | "video"   | video     | NULL    |      15
(4 rows)
لاحظ علامتي التنصيص حول "login" في العمود الأول، فهي قيمة JSON وليست نصاً، لذلك إذا قارنتها بنص أو حولتها إلى رقم فاستخدم ->>، والمفتاح غير الموجود يعطي NULL. وللبحث داخل المستند العامل @> ومعناه «يحتوي»، و? ومعناه «فيه هذا المفتاح»، ويمكنك أن تجمع على قيمة داخل JSON كأي عمود:
SELECT id, payload ->> 'course' AS course
FROM events
WHERE payload @> '{"type": "video"}'
ORDER BY id;

SELECT id FROM events WHERE payload ? 'tags';

SELECT payload ->> 'type' AS type, count(*), sum((payload ->> 'minutes')::int) AS minutes
FROM events
GROUP BY payload ->> 'type'
ORDER BY type;
 id |    course
----+--------------
  2 | PostgreSQL
  4 | Linux Basics
(2 rows)

 id
----
  4
(1 row)

 type  | count | minutes
-------+-------+---------
 login |     2 |    NULL
 video |     2 |      57
(2 rows)
والاتجاه المعاكس مفيد أيضاً، أي بناء JSON من صفوف الجداول، وهو ما تحتاجه عندما يرجع الـ API مستنداً جاهزاً:
SELECT jsonb_build_object('name', name, 'city', city) AS doc FROM students WHERE id <= 2 ORDER BY id;
SELECT json_agg(title ORDER BY id) AS titles FROM courses WHERE track = 'ops';
                doc
------------------------------------
 {"city": "Riyadh", "name": "Sara"}
 {"city": "Jeddah", "name": "Omar"}
(2 rows)

                  titles
------------------------------------------
 ["Linux Basics", "Docker", "Kubernetes"]
(1 row)
لاحظ أن jsonb رتب المفاتيح بنفسه فجاءت city قبل name، لأنه لا يحفظ ترتيب المفاتيح ولا المسافات. وقاعدة البيانات ترفض المستند غير الصحيح عند الإضافة، مثل الفاصلة الزائدة:
SELECT '{"type": "login", }'::jsonb;
ERROR:  invalid input syntax for type json
LINE 1: SELECT '{"type": "login", }'::jsonb;
               ^
DETAIL:  Expected string, but found "}".
CONTEXT:  JSON data, line 1: {"type": "login", }
ولا تقم بوضع كل البيانات في JSON لأنه مرن، والسبب أن المفتاح الأجنبي والقيد CHECK والنوع لا تعمل داخل المستند، فالأعمدة الثابتة التي تعرفها مثل الطالب والمبلغ والتاريخ مكانها أعمدة عادية، وJSON للأجزاء التي يتغير شكلها فعلاً. وفي المحركات الأخرى، فقد عملت على MySQL 8.4 نفس الفكرة بمسار يبدأ بعلامة الدولار payload ->> '$.device.os'، ويقبل SQLite 3.49 نفس الصيغة، أما SQL Server فيستخدم الدالة JSON_VALUE. وفي النهاية نحذف الجدول:
DROP TABLE events;
DROP TABLE
المعاملات Transactions: كل الخطوات أو لا شيء
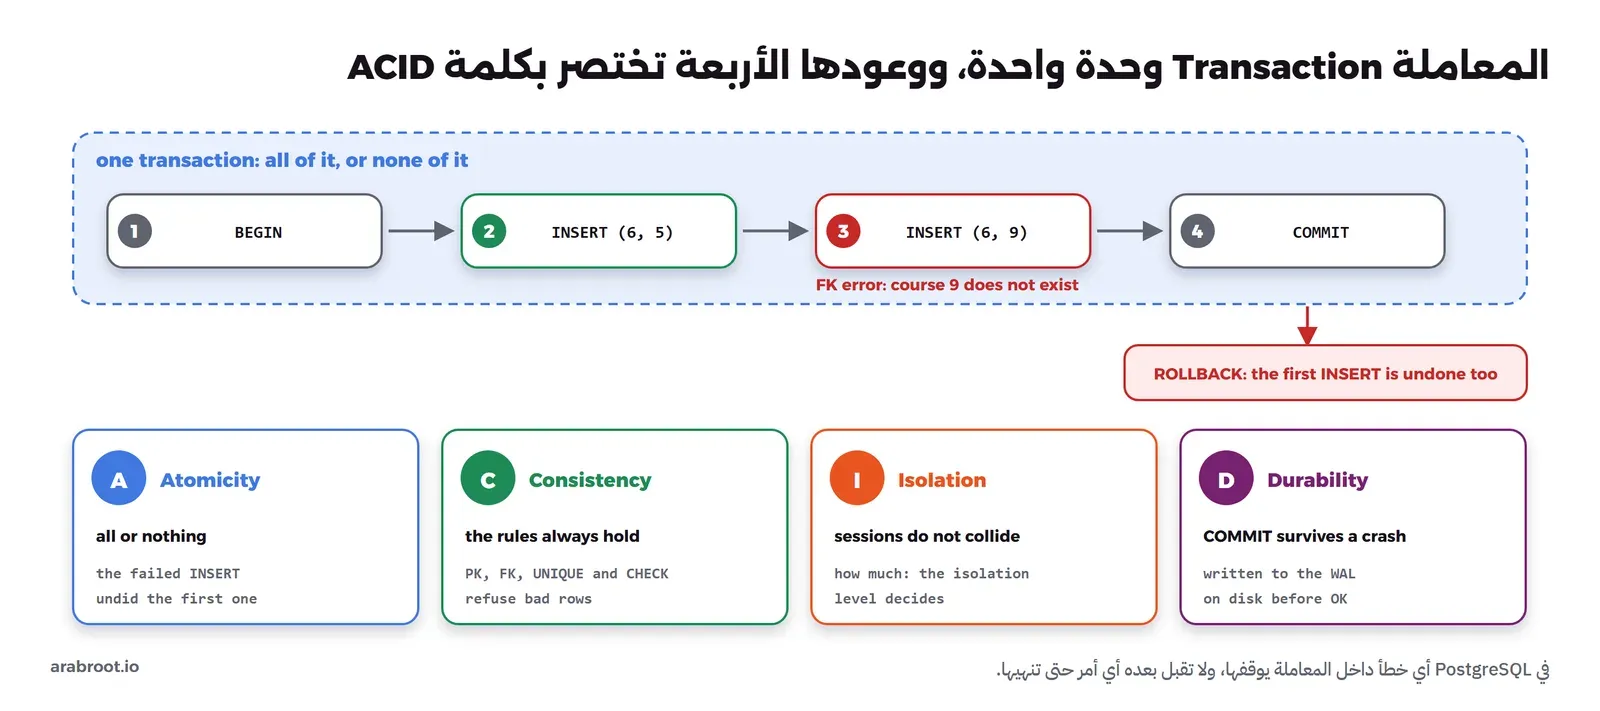
لنفرض أن تسجيل طالب في دورة يحتاج خطوتين: إضافة صف في enrollments، ثم إضافة صف في جدول الدفعات. فإذا نجحت الأولى وفشلت الثانية لأن السيرفر انقطع، أصبح لديك طالب مسجل بلا دفعة. والمعاملة Transaction هي الحل: مجموعة جمل تبدأ بـ BEGIN وتنتهي بـ COMMIT، وقاعدة البيانات تضمن أن تنفذ كلها أو لا ينفذ منها شيء. والمثال التالي يسجل فيصل في دورة Kubernetes، ثم يحاول تسجيله في دورة رقمها 9 وهي غير موجودة:
BEGIN;
INSERT INTO enrollments (student_id, course_id) VALUES (6, 5);
INSERT INTO enrollments (student_id, course_id) VALUES (6, 9);
SELECT count(*) FROM enrollments;
COMMIT;
SELECT count(*) FROM enrollments WHERE student_id = 6;
والمخرج سوف يكون كما يلي:
BEGIN
INSERT 0 1
ERROR:  insert or update on table "enrollments" violates foreign key constraint "enrollments_course_id_fkey"
DETAIL:  Key (course_id)=(9) is not present in table "courses".
ERROR:  current transaction is aborted, commands ignored until end of transaction block
ROLLBACK
 count
-------
     0
(1 row)
في المخرج أعلاه لاحظ التالي:
- الإضافة الأولى نجحت
INSERT 0 1، ثم رفض المفتاح الأجنبي الثانية. - بعد الخطأ رفض PostgreSQL أي جملة أخرى داخل المعاملة، حتى SELECT البسيطة، برسالة
current transaction is aborted، وهذا سلوك PostgreSQL تحديداً، فهو يعتبر المعاملة كلها فاشلة من أول خطأ. - كتبنا COMMIT فرد PostgreSQL بكلمة
ROLLBACK، أي أنه ألغى المعاملة كلها بما فيها الإضافة الأولى التي نجحت، والعد في النهاية صفر. وهذا ما نريده بالضبط: لم يبق تسجيل نصف منفذ.
وإذا أردت أن تتجاوز خطأ متوقعاً في خطوة واحدة دون أن تفقد المعاملة كلها، فهذا عمل نقطة الحفظ SAVEPOINT التي رأيناها في الجزء الأول، فهنا يبقى التسجيل بعد فشل الدفعة:
BEGIN;
INSERT INTO enrollments (student_id, course_id) VALUES (6, 5);
SAVEPOINT pay;
INSERT INTO payments (enrollment_id, amount, paid_on) VALUES (999, 600, '2026-10-05');
ROLLBACK TO SAVEPOINT pay;
SELECT count(*) FROM enrollments WHERE student_id = 6;
ROLLBACK;
BEGIN
INSERT 0 1
SAVEPOINT
ERROR:  insert or update on table "payments" violates foreign key constraint "payments_enrollment_id_fkey"
DETAIL:  Key (enrollment_id)=(999) is not present in table "enrollments".
ROLLBACK
 count
-------
     1
(1 row)

ROLLBACK
وفي كود التطبيق لا تكتب BEGIN وCOMMIT كنصوص غالباً، وإنما تفتح المعاملة من مكتبة الاتصال أو ال ORM وتغلقها في try/finally، والمهم أن تكون كل الخطوات التي يجب أن تنجح معاً داخل معاملة واحدة، وأن تبقى المعاملة قصيرة، فلا تنتظر داخلها رداً من خدمة خارجية أو من المستخدم، والسبب أن الأقفال التي تأخذها تبقى حتى تنتهي، وقد شرحنا الأقفال والجمود Deadlock بالتفصيل في الأقفال والجمود في قواعد البيانات.
ماذا تعني ACID؟
الحروف ACID تختصر الوعود الأربعة التي تقدمها قاعدة البيانات لكل معاملة:
- الذرية Atomicity: المعاملة وحدة لا تنقسم، تنفذ كلها أو لا شيء، كما رأيت في إلغاء الإضافة الأولى بعد فشل الثانية.
- الاتساق Consistency: المعاملة تنقل قاعدة البيانات من حالة صحيحة إلى حالة صحيحة، والقواعد هنا هي القيود التي كتبتها: المفتاح الأساسي والأجنبي وUNIQUE وCHECK، وقد رفض كل منها بيانات خاطئة في الجزء الأول. ولاحظ أن قاعدة البيانات لا تعرف من قواعد عملك إلا ما كتبته لها كقيد.
- العزل Isolation: المعاملات التي تعمل في نفس الوقت لا تفسد بعضها، ومقدار هذا العزل يحدده مستوى العزل، وهو موضوع القسم التالي كله.
- الديمومة Durability: إذا رجع COMMIT بنجاح فالبيانات باقية حتى لو انقطعت الكهرباء بعده بلحظة، والسبب أن PostgreSQL يكتب التغيير أولاً في سجل الكتابة المسبقة Write-Ahead Log واختصاراً WAL ويثبته على القرص قبل أن يرد عليك.
والصورة التالية تجمع المثال السابق والوعود الأربعة:
مستويات العزل Isolation Levels بتجارب على جلستين
كل ما سبق كان جلسة واحدة، أما في الواقع فالسيرفر يخدم مئات الطلبات في نفس الوقت، وكل طلب جلسة Session لها معاملتها. والسؤال: ماذا ترى معاملتي إذا غيرت معاملة أخرى نفس الصفوف وأنا أعمل؟ والإجابة يحددها مستوى العزل، ويعرف معيار SQL أربعة مستويات، ويقول توثيق العزل في PostgreSQL إنه يقبل الأربعة ولكنه ينفذ ثلاثة فقط، لأن Read Uncommitted فيه يعمل مثل Read Committed تماماً، فلا يمكنك في PostgreSQL أن تقرأ بيانات لم تؤكدها معاملة أخرى Dirty Read مهما طلبت.
ولكي نرى الفرق فعلاً نحتاج جلستين، والطريقة اليدوية أن تفتح نافذتي طرفية Terminal وفي كل منهما docker exec -it lab-sql-pg psql -U postgres -d academy وتنفذ الخطوات بالترتيب. وحتى تكون المخرجات أدناه حقيقية ومرتبة، كتبنا سكربتاً صغيراً يفتح جلستين psql داخل ال Container ويرسل لكل منهما خطوتها بالترتيب، وينتظر ثانية ونصفاً بعد كل خطوة ويطبع ما ردت به كل جلسة، احفظه باسم two.sh:
#!/bin/bash
# usage: two.sh steps-file ; lines "A: sql" or "B: sql"; prints each step and whatever output appeared after it
cd /tmp; rm -f fa fb oa ob; mkfifo fa fb; : > oa; : > ob
psql -U postgres -d academy -X -P null=NULL < fa > oa 2>&1 &
psql -U postgres -d academy -X -P null=NULL < fb > ob 2>&1 &
exec 3>fa 4>fb
la=0; lb=0
show() { na=$(wc -c < oa); nb=$(wc -c < ob)
  [ $na -gt $la ] && { tail -c +$((la+1)) oa | sed 's/^/   A| /'; la=$na; }
  [ $nb -gt $lb ] && { tail -c +$((lb+1)) ob | sed 's/^/   B| /'; lb=$nb; }; }
while IFS= read -r line; do
  [ -z "$line" ] && continue
  s=${line%%:*}; sql=${line#*: }
  echo "$s> $sql"
  if [ "$s" = A ]; then printf '%s\n' "$sql" >&3; else printf '%s\n' "$sql" >&4; fi
  sleep 1.5; show
done < "$1"
exec 3>&- 4>&-
sleep 1.5; show; wait
وكل تجربة ملف خطوات، كل سطر فيه اسم الجلسة ثم الجملة، وتشغله كما يلي:
docker cp two.sh lab-sql-pg:/tmp/two.sh
docker cp rc.txt lab-sql-pg:/tmp/rc.txt
docker exec lab-sql-pg bash /tmp/two.sh /tmp/rc.txt
وفي المخرج السطر الذي يبدأ بـ A> هو ما أرسلناه للجلسة A، والأسطر التي تبدأ بـ A| هي ردها، وإذا لم يظهر رد بعد خطوة فمعناه أن الجلسة ما زالت تنتظر.
القراءة المؤكدة Read Committed
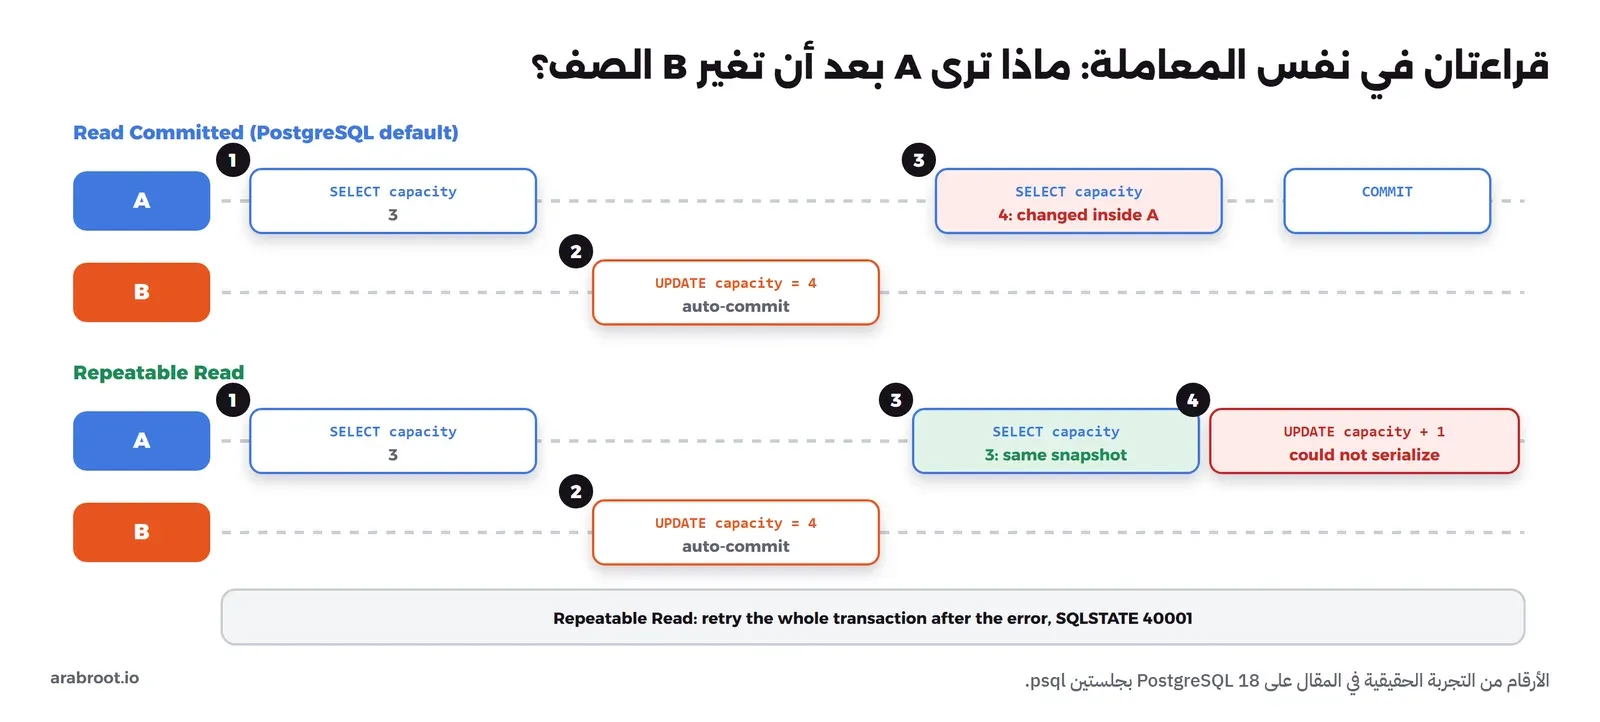
هذا هو المستوى الافتراضي في PostgreSQL، وتراه بالأمر SHOW default_transaction_isolation; الذي أعطانا read committed، وفيه ترى كل جملة البيانات المؤكدة لحظة بدء الجملة نفسها، وليس لحظة بدء المعاملة. ملف الخطوات rc.txt: الجلسة A تقرأ سعة دورة Docker مرتين داخل معاملة واحدة، وبين القراءتين تغيرها الجلسة B وتؤكد:
A: BEGIN;
A: SELECT title, capacity FROM courses WHERE id = 3;
B: UPDATE courses SET capacity = 4 WHERE id = 3;
A: SELECT title, capacity FROM courses WHERE id = 3;
A: COMMIT;
B: UPDATE courses SET capacity = 3 WHERE id = 3;
والمخرج سوف يكون كما يلي:
A> BEGIN;
   A| BEGIN
A> SELECT title, capacity FROM courses WHERE id = 3;
   A|  title  | capacity
   A| --------+----------
   A|  Docker |        3
   A| (1 row)
   A|
B> UPDATE courses SET capacity = 4 WHERE id = 3;
   B| UPDATE 1
A> SELECT title, capacity FROM courses WHERE id = 3;
   A|  title  | capacity
   A| --------+----------
   A|  Docker |        4
   A| (1 row)
   A|
A> COMMIT;
   A| COMMIT
B> UPDATE courses SET capacity = 3 WHERE id = 3;
   B| UPDATE 1
نفس الجملة في نفس المعاملة أعطت 3 ثم 4، وهذا يسمى القراءة غير المتكررة Nonrepeatable Read. وهل هذا خطأ؟ ليس دائماً، فأغلب صفحات التطبيق تقرأ مرة واحدة وتعرض، ولكنه يصبح خطأ عندما يتخذ الكود قراراً على القراءة الأولى ثم يعتمد على أن البيانات لم تتغير. والسطر الأخير في الملف يعيد السعة إلى 3 فقط حتى تبدأ التجربة التالية من نفس الحالة.
القراءة المتكررة Repeatable Read
في هذا المستوى ترى المعاملة لقطة ثابتة من البيانات أخذت عند أول جملة فيها، ولا ترى أي تأكيد يحدث بعدها. ملف الخطوات rr.txt هو نفس التجربة، ونضيف إليه محاولة من A لتعديل الصف الذي غيرته B:
A: BEGIN ISOLATION LEVEL REPEATABLE READ;
A: SELECT title, capacity FROM courses WHERE id = 3;
B: UPDATE courses SET capacity = 4 WHERE id = 3;
A: SELECT title, capacity FROM courses WHERE id = 3;
A: UPDATE courses SET capacity = capacity + 1 WHERE id = 3;
A: ROLLBACK;
B: UPDATE courses SET capacity = 3 WHERE id = 3;
A> BEGIN ISOLATION LEVEL REPEATABLE READ;
   A| BEGIN
A> SELECT title, capacity FROM courses WHERE id = 3;
   A|  title  | capacity
   A| --------+----------
   A|  Docker |        3
   A| (1 row)
   A|
B> UPDATE courses SET capacity = 4 WHERE id = 3;
   B| UPDATE 1
A> SELECT title, capacity FROM courses WHERE id = 3;
   A|  title  | capacity
   A| --------+----------
   A|  Docker |        3
   A| (1 row)
   A|
A> UPDATE courses SET capacity = capacity + 1 WHERE id = 3;
   A| ERROR:  could not serialize access due to concurrent update
A> ROLLBACK;
   A| ROLLBACK
B> UPDATE courses SET capacity = 3 WHERE id = 3;
   B| UPDATE 1
في المخرج أعلاه لاحظ التالي:
- القراءة الثانية أعطت 3 مع أن B أكدت 4، لأن A ما زالت ترى لقطتها.
- عندما حاولت A أن تعدل الصف رفض PostgreSQL، لأن تعديلها مبني على قيمة قديمة، ولو قبله لضاع تعديل B، وهذا هو التحديث المفقود Lost Update الذي يمنعه هذا المستوى. ويقول التوثيق إن التطبيق الذي يستقبل هذا الخطأ يجب أن يلغي المعاملة ويعيدها كلها من البداية، وكود الخطأ هو SQLSTATE 40001.
والصورة التالية تضع التجربتين بجانب بعض:
وهنا يختلف المحركان الآخران، ففي MySQL مع InnoDB المستوى الافتراضي هو Repeatable Read وليس Read Committed، وقد أعطانا @@transaction_isolation القيمة REPEATABLE-READ على MySQL 8.4، ويشرح توثيق InnoDB أن القراءة فيه من لقطة تؤخذ عند أول قراءة. أما SQL Server فالافتراضي فيه Read Committed، وقد تأكدنا منه على SQL Server 2022، ولكنه ينفذه افتراضياً بالأقفال وليس باللقطات، فالقراءة تنتظر الصف الذي تعدله معاملة أخرى حتى تنتهي، إلا إذا فعلت خيار READ_COMMITTED_SNAPSHOT لقاعدة البيانات، وهو مفعل افتراضياً في Azure SQL Database كما يذكر توثيق مستويات العزل في SQL Server. لذلك نفس الكود قد يتصرف بشكل مختلف إذا نقلته من محرك لآخر.
التسلسلي Serializable وانحراف الكتابة Write Skew
قد يتساءل البعض: إذا كان Repeatable Read يثبت القراءة ويمنع التحديث المفقود، فما الذي بقي؟ والإجابة حالة أذكى قليلاً، فلنفرض أن قاعدة العمل أن دورة Docker لا تقبل أكثر من ثلاثة طلاب، وفيها اثنان، وأن الكود يعد المسجلين، فإذا كانوا أقل من السعة أضاف التسجيل. وفي نفس اللحظة طلبت سارة ولينا آخر مقعد، فملف الخطوات skew-rr.txt هو:
A: BEGIN ISOLATION LEVEL REPEATABLE READ;
B: BEGIN ISOLATION LEVEL REPEATABLE READ;
A: SELECT count(*) FROM enrollments WHERE course_id = 3;
B: SELECT count(*) FROM enrollments WHERE course_id = 3;
A: INSERT INTO enrollments (student_id, course_id) VALUES (1, 3);
B: INSERT INTO enrollments (student_id, course_id) VALUES (3, 3);
A: COMMIT;
B: COMMIT;
A: SELECT count(*) FROM enrollments WHERE course_id = 3;
A> BEGIN ISOLATION LEVEL REPEATABLE READ;
   A| BEGIN
B> BEGIN ISOLATION LEVEL REPEATABLE READ;
   B| BEGIN
A> SELECT count(*) FROM enrollments WHERE course_id = 3;
   A|  count
   A| -------
   A|      2
   A| (1 row)
   A|
B> SELECT count(*) FROM enrollments WHERE course_id = 3;
   B|  count
   B| -------
   B|      2
   B| (1 row)
   B|
A> INSERT INTO enrollments (student_id, course_id) VALUES (1, 3);
   A| INSERT 0 1
B> INSERT INTO enrollments (student_id, course_id) VALUES (3, 3);
   B| INSERT 0 1
A> COMMIT;
   A| COMMIT
B> COMMIT;
   B| COMMIT
A> SELECT count(*) FROM enrollments WHERE course_id = 3;
   A|  count
   A| -------
   A|      4
   A| (1 row)
   A|
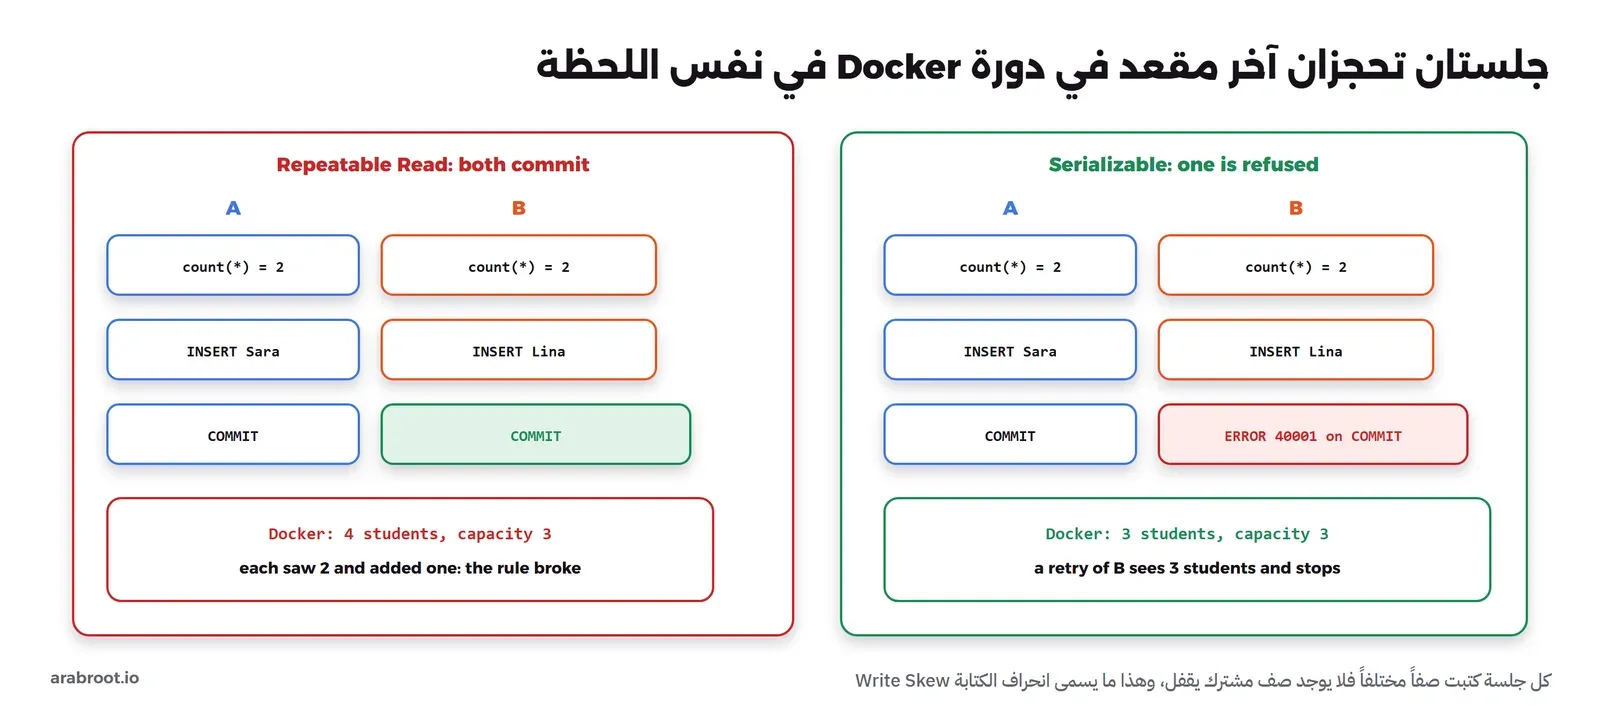
أصبح في الدورة أربعة طلاب وسعتها ثلاثة، ولم يعط PostgreSQL أي خطأ، والسبب أن كل جلسة كتبت صفاً جديداً مختلفاً عن الأخرى، فلا يوجد صف واحد تعدلانه معاً حتى يكتشف التعارض، وكل جلسة اتخذت قرارها على عدد صحيح في لقطتها. وهذا يسمى انحراف الكتابة Write Skew. والآن نحذف التسجيلين ونعيد نفس الخطوات بالمستوى SERIALIZABLE في ملف skew-ser.txt:
DELETE FROM enrollments WHERE course_id = 3 AND student_id IN (1, 3);
A> BEGIN ISOLATION LEVEL SERIALIZABLE;
   A| BEGIN
B> BEGIN ISOLATION LEVEL SERIALIZABLE;
   B| BEGIN
A> SELECT count(*) FROM enrollments WHERE course_id = 3;
   A|  count
   A| -------
   A|      2
   A| (1 row)
   A|
B> SELECT count(*) FROM enrollments WHERE course_id = 3;
   B|  count
   B| -------
   B|      2
   B| (1 row)
   B|
A> INSERT INTO enrollments (student_id, course_id) VALUES (1, 3);
   A| INSERT 0 1
B> INSERT INTO enrollments (student_id, course_id) VALUES (3, 3);
   B| INSERT 0 1
A> COMMIT;
   A| COMMIT
B> COMMIT;
   B| ERROR:  could not serialize access due to read/write dependencies among transactions
   B| DETAIL:  Reason code: Canceled on identification as a pivot, during commit attempt.
   B| HINT:  The transaction might succeed if retried.
A> SELECT count(*) FROM enrollments WHERE course_id = 3;
   A|  count
   A| -------
   A|      3
   A| (1 row)
   A|
في المستوى Serializable يضمن PostgreSQL أن النتيجة تساوي تنفيذ المعاملات واحدة بعد الأخرى بأي ترتيب، فاكتشف أن كلاً منهما قرأ ما كتبته الأخرى، ورفض تأكيد B. والرسالة نفسها تقول ما يجب فعله: أعد المعاملة، وعند إعادتها سوف تعد B ثلاثة طلاب فترفض المقعد. والصورة التالية تلخص التجربتين:
وهناك طريقة ثانية لنفس المشكلة دون Serializable، وهي أن تقفل صف الدورة نفسه قبل العد بالجملة SELECT ... FOR UPDATE، فتنتظر الجلسة الثانية حتى تنتهي الأولى. وبعد أن نحذف تسجيل سارة الذي أضافته التجربة السابقة بنفس جملة DELETE، يكون ملف الخطوات forupdate.txt بالمستوى الافتراضي Read Committed كما يلي:
A: BEGIN;
B: BEGIN;
A: SELECT capacity FROM courses WHERE id = 3 FOR UPDATE;
B: SELECT capacity FROM courses WHERE id = 3 FOR UPDATE;
A: SELECT count(*) FROM enrollments WHERE course_id = 3;
A: INSERT INTO enrollments (student_id, course_id) VALUES (1, 3);
A: COMMIT;
B: SELECT count(*) FROM enrollments WHERE course_id = 3;
B: ROLLBACK;
A> BEGIN;
   A| BEGIN
B> BEGIN;
   B| BEGIN
A> SELECT capacity FROM courses WHERE id = 3 FOR UPDATE;
   A|  capacity
   A| ----------
   A|         3
   A| (1 row)
   A|
B> SELECT capacity FROM courses WHERE id = 3 FOR UPDATE;
A> SELECT count(*) FROM enrollments WHERE course_id = 3;
   A|  count
   A| -------
   A|      2
   A| (1 row)
   A|
A> INSERT INTO enrollments (student_id, course_id) VALUES (1, 3);
   A| INSERT 0 1
A> COMMIT;
   A| COMMIT
   B|  capacity
   B| ----------
   B|         3
   B| (1 row)
   B|
B> SELECT count(*) FROM enrollments WHERE course_id = 3;
   B|  count
   B| -------
   B|      3
   B| (1 row)
   B|
B> ROLLBACK;
   B| ROLLBACK
لاحظ أن B لم ترد على FOR UPDATE حتى أكدت A، فظهر ردها بعد COMMIT مباشرة، ثم عدت ثلاثة طلاب فقررت ألا تسجل. والفرق بين الطريقتين أن FOR UPDATE تجعل الجلسات تنتظر بعضها في المكان الذي حددته أنت، أما Serializable فلا تنتظر وإنما ترفض بعد التعارض، فيجب أن يكون في الكود إعادة محاولة Retry عامة لكل معاملة. وعلى أي حال لا تختر مستوى العزل الأعلى لكل شيء، فالمعاملات الكثيرة التي تفشل وتعاد لها ثمن، والقاعدة العملية أن تبقى على Read Committed وترفع المستوى أو تقفل الصف في المعاملات التي تتخذ قراراً على بيانات قد تتغير. وفي النهاية احذف التسجيل الذي أضافته هذه التجربة بنفس جملة DELETE السابقة حتى ترجع البيانات كما كانت، وتجد التحديث المفقود وقراءة رسالة الجمود Deadlock كتمرينين في المستوى الثالث من تمارين SQL.
الاستعلامات ذات المعاملات وحقن SQL
كل الجمل في هذه السلسلة كتبناها بأيدينا، أما في التطبيق فجزء من الجملة يأتي من المستخدم، مثل البريد في صفحة الدخول، والخطأ القاتل أن تبني الجملة بدمج النصوص، فإذا كتب المهاجم في خانة البريد علامة تنصيص ثم شرطاً من عنده، أصبح يكتب الاستعلام بدلاً منك، وهذا هو حقن SQL Injection الذي يأتي ضمن فئة الحقن A05 في OWASP Top 10. والمثال التالي بلغة Python ومكتبة psycopg 3 يبين الطريقتين على نفس المدخل، واحفظه باسم login.py:
import psycopg

conn = psycopg.connect("host=127.0.0.1 port=21471 dbname=academy user=postgres password=lab")
email = "' OR '1'='1"          # what an attacker types into the email field

# Wrong: the input becomes part of the SQL text
sql = "SELECT id, name FROM students WHERE email = '" + email + "'"
print(sql)
print(conn.execute(sql).fetchall())

# Right: the SQL text and the value travel separately
rows = conn.execute("SELECT id, name FROM students WHERE email = %s", (email,)).fetchall()
print(rows)
ثم ثبت المكتبة وشغله:
pip install "psycopg[binary]"
python login.py
والمخرج سوف يكون كما يلي:
SELECT id, name FROM students WHERE email = '' OR '1'='1'
[(1, 'Sara'), (2, 'Omar'), (3, 'Lina'), (4, 'Khalid'), (5, 'Huda'), (6, 'Faisal')]
[]
في المخرج أعلاه لاحظ التالي:
- في الطريقة الأولى أغلقت علامة التنصيص الأولى في المدخل نص البريد، ثم أصبح
OR '1'='1'شرطاً حقيقياً صحيحاً دائماً، فرجع كل الطلاب، ولو كانت هذه صفحة دخول لدخل المهاجم بأول حساب. - في الطريقة الثانية رجعت قائمة فارغة، لأن قاعدة البيانات بحثت عن طالب بريده حرفياً
' OR '1'='1فلم تجده. - العلامة
%sفي psycopg ليست دمجاً للنص في Python، وإنما مكان للمعامل Parameter.
وقد يتساءل البعض: هل تهرب المكتبة علامات التنصيص فقط، أم أن القيمة لا تدخل في الجملة أصلاً؟ والإجابة أننا فعلنا تسجيل الجمل في PostgreSQL بالإعداد log_statement = 'all' أثناء التشغيل، فظهر في سجل السيرفر ما يلي:
LOG:  statement: SELECT id, name FROM students WHERE email = '' OR '1'='1'
LOG:  execute <unnamed>: SELECT id, name FROM students WHERE email = $1
DETAIL:  Parameters: $1 = ''' OR ''1''=''1'
الجملة الأولى وصلت السيرفر بالشرط المحقون كجزء من نصها، أما الثانية فوصلت بعلامة المكان $1 ووصلت القيمة منفصلة عنها، وهذا هو الاستعلام ذو المعاملات Parameterized Query، وتسميه psycopg 3 الربط على جهة السيرفر Server-side Binding كما في توثيقها. ونفس الفكرة موجودة داخل SQL نفسها بالأمر PREPARE:
PREPARE find_student (text) AS
    SELECT id, name, city FROM students WHERE email = $1;
EXECUTE find_student('[email protected]');
EXECUTE find_student(''' OR ''1''=''1');
DEALLOCATE find_student;
PREPARE
 id | name |  city
----+------+--------
  1 | Sara | Riyadh
(1 row)

 id | name | city
----+------+------
(0 rows)

DEALLOCATE
والقاعدة: كل قيمة تأتي من خارج الكود ترسل كمعامل، في كل لغة وكل مكتبة، ولا يوجد استثناء لأن «هذه القيمة رقم» أو «هذه من لوحة الإدارة». وأما الحالات التي لا تنفع فيها المعاملات، مثل اسم العمود في ORDER BY الذي يختاره المستخدم، وتفاصيل كل لغة وال ORM، فهي في مقال البرمجة الآمنة وورقة OWASP لمنع حقن SQL.
الخطوة التالية: الفهارس Indexes وEXPLAIN
كل الاستعلامات في هذه السلسلة سريعة لأن الجداول صغيرة، فقاعدة البيانات تقرأ الجدول كله في كل مرة ولا تشعر بذلك، ولكن عندما يصبح جدول التسجيلات عشرة ملايين صف فالبحث عن تسجيلات دورة واحدة يعني قراءة الملايين العشرة. وأول خطوة لفهم ما يحدث هي أن تسأل قاعدة البيانات كيف ستنفذ الجملة بالأمر EXPLAIN:
EXPLAIN SELECT * FROM enrollments WHERE course_id = 3;
EXPLAIN SELECT * FROM students WHERE email = '[email protected]';
                         QUERY PLAN
-------------------------------------------------------------
 Seq Scan on enrollments  (cost=0.00..31.25 rows=8 width=20)
   Filter: (course_id = 3)
(2 rows)

                                     QUERY PLAN
-------------------------------------------------------------------------------------
 Index Scan using students_email_key on students  (cost=0.15..8.17 rows=1 width=136)
   Index Cond: (email = '[email protected]'::text)
(2 rows)
البحث بالدورة قرأ الجدول كله Seq Scan لأن course_id بلا فهرس، والسبب أن PostgreSQL لا ينشئ فهرساً للمفتاح الأجنبي تلقائياً، أما البحث بالبريد فاستخدم الفهرس students_email_key الذي أنشأه PostgreSQL تلقائياً للقيد UNIQUE. والفهرس Index هيكل بيانات منفصل مرتب يصل إلى الصفوف بخطوات قليلة مثل فهرس الكتاب، وله ثمن في المساحة وفي سرعة كل INSERT وUPDATE. ومتى تضيف فهرساً، وأي نوع، وبأي ترتيب للأعمدة، وكيف تقرأ كل سطر في خطة EXPLAIN، فهو موضوع مقال الفهارس Indexes وقراءة EXPLAIN، وتجد التطبيق على جدول من 30 مليون صف في PostgreSQL للجداول الضخمة.
أخطاء شائعة في هذا الجزء
- وضع دالة نافذة في WHERE يعطي خطأ، فاحسبها في استعلام فرعي أو CTE ثم اختر من نتيجته.
- المجموع التراكمي بترتيب فيه تساو يعطي الصفوف المتساوية نفس الرقم، فأضف عموداً لا يتكرر إلى الترتيب أو اكتب الإطار ROWS.
- الاستعلام التكراري على بيانات فيها حلقة لا يتوقف، فاكتب شرطاً على العمق أو استخدم CYCLE.
- العرض المادي يعطي بيانات قديمة حتى تحدثه، فلا تستخدمه لما يجب أن يكون لحظياً.
- قراءة الصف ثم الإضافة أو التحديث في الكود تفشل عند التزامن، فاستخدم ON CONFLICT.
- كل البيانات في JSON يلغي حماية الأنواع والقيود، فاحفظ الأعمدة الثابتة كأعمدة.
- معاملة طويلة تنتظر خدمة خارجية تبقي الأقفال مفتوحة، فاجعل المعاملة قصيرة.
- قرار مبني على عد الصفوف في Read Committed أو Repeatable Read قد يكسر قاعدة العمل عند التزامن، فاقفل الصف بـ FOR UPDATE أو استخدم Serializable مع إعادة المحاولة.
- دمج مدخلات المستخدم في نص الجملة هو حقن SQL، فأرسل كل قيمة كمعامل.
تمارين
التمرين 1: اعرض الطالب صاحب أعلى درجة في كل دورة، دورة واحدة لكل سطر.
الحل Answer
SELECT title, name, grade
FROM (
    SELECT c.title, s.name, e.grade,
           row_number() OVER (PARTITION BY e.course_id ORDER BY e.grade DESC NULLS LAST) AS rn
    FROM enrollments e
    JOIN students s ON s.id = e.student_id
    JOIN courses  c ON c.id = e.course_id
) t
WHERE rn = 1
ORDER BY title;
    title     |  name  | grade
--------------+--------+-------
 Docker       | Huda   |    88
 Linux Basics | Sara   |    90
 PostgreSQL   | Lina   |    95
 Python       | Khalid |    60
(4 rows)
بدون NULLS LAST لأصبح عمر الأول في Docker ولينا الأولى في Python وهما بلا درجة.
التمرين 2: اعرض دفعات سارة وهدى مع المجموع التراكمي لكل طالبة على حدة.
الحل Answer
SELECT s.name, p.paid_on, p.amount,
       sum(p.amount) OVER (PARTITION BY s.id ORDER BY p.paid_on) AS student_total
FROM payments p
JOIN enrollments e ON e.id = p.enrollment_id
JOIN students s ON s.id = e.student_id
WHERE s.name IN ('Sara', 'Huda')
ORDER BY s.name, p.paid_on;
 name |  paid_on   | amount | student_total
------+------------+--------+---------------
 Huda | 2026-09-08 | 450.00 |        450.00
 Huda | 2026-09-12 | 200.00 |        650.00
 Huda | 2026-10-01 | 200.00 |        850.00
 Sara | 2026-09-01 | 300.00 |        300.00
 Sara | 2026-09-03 | 225.00 |        525.00
 Sara | 2026-10-03 | 225.00 |        750.00
(6 rows)
الجزء PARTITION BY s.id هو الذي جعل المجموع يبدأ من جديد لكل طالبة.
التمرين 3: احسب بالاستعلام التكراري عدد الأشخاص تحت Nora، وعدد المستويات تحتها.
الحل Answer
WITH RECURSIVE chain AS (
    SELECT id, name, 0 AS depth FROM instructors WHERE name = 'Nora'
  UNION ALL
    SELECT i.id, i.name, c.depth + 1
    FROM instructors i JOIN chain c ON i.manager_id = c.id
)
SELECT count(*) - 1 AS people_under_nora, max(depth) AS levels FROM chain;
 people_under_nora | levels
-------------------+--------
                 5 |      2
(1 row)
التمرين 4: اكتب جملة واحدة تضع درجة 80 لهدى في دورة PostgreSQL فقط إذا لم تكن لها درجة بعد، ثم شغلها مرة ثانية بدرجة 99 وتأكد أنها لم تغير شيئاً، داخل معاملة تلغيها في النهاية.
الحل Answer
BEGIN;
INSERT INTO enrollments (student_id, course_id, grade) VALUES (5, 2, 80)
ON CONFLICT (student_id, course_id)
DO UPDATE SET grade = EXCLUDED.grade
WHERE enrollments.grade IS NULL
RETURNING student_id, course_id, grade;
INSERT INTO enrollments (student_id, course_id, grade) VALUES (5, 2, 99)
ON CONFLICT (student_id, course_id)
DO UPDATE SET grade = EXCLUDED.grade
WHERE enrollments.grade IS NULL
RETURNING student_id, course_id, grade;
ROLLBACK;
BEGIN
 student_id | course_id | grade
------------+-----------+-------
          5 |         2 |    80
(1 row)

INSERT 0 1
 student_id | course_id | grade
------------+-----------+-------
(0 rows)

INSERT 0 0
ROLLBACK
التمرين 5: صفحة الدخول في تطبيقك تبحث عن الطالب بالبريد والمدينة، أعد كتابة السطر التالي بلغة Python حتى يكون آمناً من الحقن: conn.execute("SELECT id FROM students WHERE email = '" + email + "' AND city = '" + city + "'").
الحل Answer
conn.execute("SELECT id FROM students WHERE email = %s AND city = %s", (email, city))
علامتا المكان بلا علامات تنصيص حولهما، والقيمتان في tuple منفصلة، والمكتبة ترسلهما كمعاملين.
وعندما تنتهي من السلسلة احذف المختبر:
docker rm -f lab-sql-pg
الخلاصة
وصلنا لنهاية السلسلة، وأهم ما تخرج به من هذا الجزء:
- جمل WITH تقسم الاستعلام الطويل إلى خطوات لها أسماء، وWITH RECURSIVE تمشي في الشجرة مستوى بعد مستوى حتى لا تضيف صفاً.
- دوال النوافذ تحسب على مجموعة دون أن تدمجها، وPARTITION BY يقسم، وORDER BY يرتب ويصنع المجموع التراكمي، والإطار يحدد الصفوف الداخلة في الحساب.
- العرض يحفظ الجملة، والعرض المادي يحفظ النتيجة ويحتاج تحديثاً.
- ON CONFLICT يضيف أو يحدث في عملية واحدة آمنة عند التزامن، وJSON للأجزاء التي يتغير شكلها فقط.
- المعاملة تنفذ كلها أو لا شيء، والمستوى الافتراضي في PostgreSQL هو Read Committed، وRepeatable Read يثبت القراءة ويرفض التحديث المفقود، وSerializable وحده يمنع انحراف الكتابة، وكلاهما يحتاج إعادة محاولة في الكود.
- كل قيمة من المستخدم ترسل كمعامل منفصل عن الجملة، وهذا وحده يغلق باب حقن SQL.
والخطوة التالية بعد السلسلة أن تطبق ما تعلمته على بيانات أكبر في تمارين Kata في SQL، فالمستوى الثالث منها في المعاملات والأقفال وقراءة الخطط، ثم أن تتعلم كيف تسرع الاستعلام عندما يكبر الجدول:
 دليلتمارين Kata في SQL بثلاثة مستويات مع الحلولتمارين SQL تحلها بيدك دون ذكاء اصطناعي على متجر من مئتي ألف طلب، من فخاخ LEFT JOIN إلى اختيار الفهرس المناسب.
 دليلالفهارس Indexes: لماذا تسرع الاستعلام وكيف تقرأ EXPLAINكيف يبحث PostgreSQL داخل الفهرس، ومتى يتجاهله، وكم يكلفك كل فهرس عند الكتابة، وكيف تقرأ خطة EXPLAIN سطراً سطراً.
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
سجل التحديثات
- أكتوبر 2026: كتابة المقال كجزء ثالث من سلسلة «تعلم SQL»، ونقل دوال النوافذ والمعاملات ومستويات العزل وحقن SQL إليه من الجزء الأول بعد توسيعها، وإعادة تشغيل تجارب الجلستين على قاعدة البيانات الجديدة. نفذنا كل الأمثلة على PostgreSQL 18.6 (postgres:18.6، Debian 18.6-1.pgdg13+2) في Docker Engine 29.8.0 (Docker Desktop)، ومثال الحقن بلغة Python 3.13 ومكتبة psycopg 3.3.6، والمقارنات على MySQL 8.4.11 وSQL Server 2022 (16.0.4295.3، CU27) وSQLite 3.49.1.
- أكتوبر 2026: إضافة رابط من قسم العروض إلى مقال العروض المحفوظة Materialized Views.


