

لنفرض أن لديك موقع أسئلة وأجوبة لمجتمع من المطورين، وفي صفحته الرئيسية قائمة بأعلى عشرة أعضاء في السمعة Reputation، وعدد الأسئلة والأجوبة الكلي، وفي صفحة كل وسم Tag أفضل الأسئلة بحسب تقييم أجوبتها. في البداية كل هذه أرقام يحسبها استعلام بسيط عند كل زيارة، ثم يكبر الموقع حتى يصبح جدول التصويت Votes عشرين مليون صف، فيصبح فتح الصفحة الرئيسية ثواني، ويصبح كل زائر جديد استعلاماً ثقيلاً على قاعدة البيانات نفسها التي يكتب فيها المستخدمون أجوبتهم. والحل الذي يقترحه الجميع هو الكاش، ولكن قبل أن تضيف Redis وكوداً يحذف منه القيم القديمة Cache Invalidation، هناك أداة داخل قاعدة البيانات نفسها صممت لهذه المشكلة، وهي العرض المحفوظ Materialized View.
وقد عرفنا العرض View والعرض المحفوظ Materialized View بمثال صغير في الجزء الثالث من سلسلة SQL، وقسنا فرق السرعة على تقرير يومي في مقال تصميم قواعد البيانات، أما هذا المقال فيجيب عن السؤال الذي يأتي بعد ذلك في كل مشروع: أين يفيد العرض المحفوظ Materialized View فعلاً، وأين يضر، وكيف تحدثه دون أن توقف التطبيق. وسوف نناقش في هذا المقال ما يلي:
- ما هو العرض المحفوظ Materialized View، وما الفرق بينه وبين العرض العادي View والجدول الملخص Summary Table والكاش في التطبيق.
- الاستخدامات في تطبيق عادي: العدادات ولوحات الترتيب، وملخص الصفحة الرئيسية، وصفحات البحث والفلترة، والتقارير، ونسخة محلية من بيانات سيرفر آخر، ونماذج القراءة Read Models في CQRS، ومتى لا يناسبك.
- الفرق بين التحديث العادي
REFRESHوالتحديث المتزامنREFRESH ... CONCURRENTLY، والأقفال التي يأخذها كل منهما، وقدم البيانات Staleness، والجدولة بأداة pg_cron. - التحديث التزايدي Incremental Refresh بالإضافة pg_ivm، والعروض المحفوظة Materialized Views في ClickHouse، والملخصات المستمرة Continuous Aggregates في TimescaleDB.
- تجربة عملية بمقارنة أزمنة القراءة وكلفة التحديث على مليون وخمسة ملايين وعشرين مليون تصويت، ثم نكسرها بعدة طرق.
ما هو العرض المحفوظ Materialized View؟
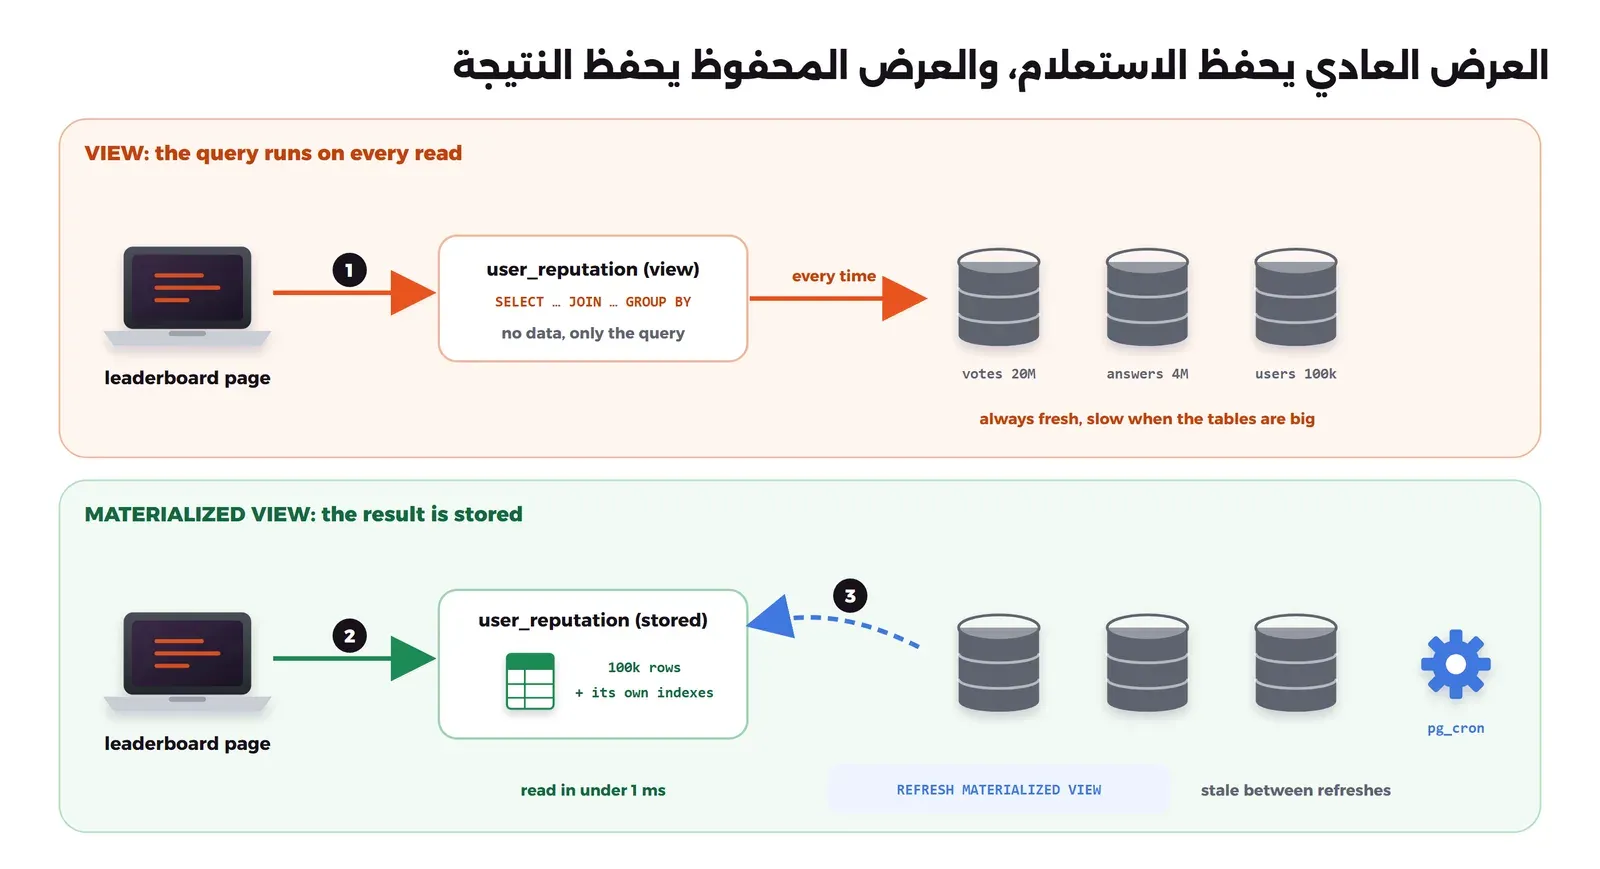
العرض المحفوظ Materialized View هو نتيجة استعلام تحفظها قاعدة البيانات في جدول حقيقي على القرص، باسم تستخدمه كأنه جدول، وتعيد حسابها عندما تطلب ذلك بالأمر REFRESH MATERIALIZED VIEW، كما يشرح توثيق PostgreSQL. والفرق أن العرض العادي View يحفظ جملة الاستعلام فقط، فكل قراءة منه تنفذ الاستعلام من جديد على الجداول الأصلية، أما العرض المحفوظ Materialized View فيحفظ النتيجة، فالقراءة منه قراءة من جدول صغير جاهز له فهارسه الخاصة.
والتشبيه الأقرب هو التقرير المطبوع: المحاسب لا يجمع دفاتر السنة كلها كلما سأله المدير عن المبيعات، وإنما يطبع التقرير صباحاً ويعطيه لكل من يسأل، والثمن أن التقرير لا يعرف ما بيع بعد الطباعة. والصورة التالية تبين الطريقين على لوحة السمعة في موقعنا:
وقد يتساءل البعض: إذا كان العرض المحفوظ Materialized View جدولاً، فما الفرق بينه وبين أن أنشئ جدولاً بنفسي وأملؤه بـ INSERT ... SELECT؟ والإجابة أن الفرق في من يحفظ التعريف، فالعرض المحفوظ Materialized View يحفظ الاستعلام مع النتيجة، فالتحديث أمر واحد لا يحتاج كوداً، والقراءة منه لا تتغير إذا غيرت طريقة حسابه، أما الجدول الذي تملؤه بنفسك فتعريفه في كود التطبيق أو في سكربت، وأنت المسؤول عن حذف القديم وإضافة الجديد في معاملة واحدة Transaction. وفي المقابل، الجدول الذي تملؤه بنفسك يسمح بشيء لا يسمح به العرض المحفوظ Materialized View في PostgreSQL، وهو أن تحدث جزءاً منه فقط، وهذا ما سوف نعود إليه في قسم التحديث التزايدي Incremental Refresh.
أين يفيد في تطبيق عادي؟
العرض المحفوظ Materialized View لا يخص التقارير ومستودعات البيانات، فأغلب التطبيقات فيها صفحات تعرض نتيجة واحدة لكل الزوار، وتحسبها من جداول كبيرة، ولا يضرها أن تتأخر دقيقة أو ساعة. وفيما يلي الاستخدامات الشائعة، ومع كل منها متى يناسب ومتى لا يناسب:
- العدادات ولوحات الترتيب Leaderboards: أعلى الأعضاء سمعة، وأكثر المنتجات مبيعاً، وأكثر المقالات قراءة هذا الأسبوع. وهذا أنسب استخدام، لأن النتيجة واحدة لكل الزوار، والتأخر دقيقة لا يلاحظه أحد. ولا يناسب إذا كان المستخدم يجب أن يرى نقطته فور التصويت، فهنا تحتاج عداداً يحدث في الكتابة نفسها، كما في استخدامات Redis أو التحديث التزايدي.
- ملخص الصفحة الرئيسية ولوحة الإدارة: عدد المستخدمين والطلبات اليوم ومجموع المبيعات، وغالباً صف واحد. ويناسبه عرض محفوظ Materialized View صغير يحدث كل دقيقة، ومعه عمود يقول متى حسب، حتى تكتب الصفحة «آخر تحديث قبل 40 ثانية» بدل أن يظن المدير أن الرقم لحظي.
- صفحات البحث والفلترة على جداول مربوطة: صفحة الأسئلة التي تفلتر بالوسم وترتب بالتقييم تحتاج ربط الأسئلة بالأجوبة والتصويت وأسماء الكتاب، والعرض المحفوظ Materialized View يجعلها صفاً واحداً لكل سؤال بفهارس على الوسم والتقييم، وهو نموذج قراءة Read Model غير مطبع Denormalized، أي أن البيانات المربوطة مجموعة فيه مسبقاً. ولا يناسب إذا كان صاحب السؤال يجب أن يرى عدد الأجوبة يتغير لحظة إضافة جواب.
- التقارير على ربط أو تجميع بطيء: وهو الاستخدام المعروف، وقسناه في مقال تصميم قواعد البيانات ومقال PostgreSQL لكل شيء، وعندما تكبر التقارير وتتعدد مصادرها تنتقل إلى مستودع بيانات.
- الصفحات الزمنية Feeds: صفحة «الأكثر تفاعلاً اليوم» واحدة لكل الزوار فيناسبها عرض محفوظ Materialized View، أما صفحة «ما يكتبه من تتابعهم» فمختلفة لكل مستخدم ويجب أن تظهر فيها المشاركة الجديدة فوراً، فلا يناسبها، لأن العرض المحفوظ Materialized View يحسب كل المستخدمين في كل تحديث. وهذه تبنى بجدول تكتب فيه المشاركات عند نشرها أو بكاش لكل مستخدم.
- نسخة محلية من بيانات سيرفر آخر: إذا كانت بيانات المدن والعملات والمناطق الزمنية في قاعدة يملكها فريق آخر وتقرؤها عبر postgres_fdw، فكل ربط معها يذهب عبر الشبكة، والعرض المحفوظ Materialized View يحفظ نسخة محلية تحدثها كل ساعة، وإذا توقف السيرفر الآخر تبقى النسخة الأخيرة تعمل، وهذا ما سوف نجربه.
- بيانات مرجعية وجغرافية Reference Data: جداول تتغير مرة في اليوم أو الشهر، مثل حدود المناطق أو قوائم الأسعار المحسوبة، فيحسب منها جدول جاهز للبحث مرة واحدة.
- تخفيف الحمل عن السيرفر الرئيسي: هنا انتبه، فالتحديث نفسه ينفذ على السيرفر الرئيسي Primary، لأن نسخ القراءة Read Replicas للقراءة فقط، ولكن العرض المحفوظ Materialized View ينسخ إليها مع بقية البيانات، فتحسبه مرة على الرئيسي ويقرؤه الجميع من النسخ، وتفاصيل النسخ في مقال العناقيد.
- نماذج القراءة في CQRS: أبسط صورة للفصل بين نموذج الكتابة ونموذج القراءة هي عرض محفوظ Materialized View فوق جداول التطبيق، كما رأينا في مقال Event Sourcing وCQRS، قبل أن تحتاج أحداثاً وProjectors.
وبالتالي فالقاعدة العامة أن العرض المحفوظ Materialized View يناسب النتيجة المشتركة بين كثير من القراء، التي يكلف حسابها كثيراً، ويقبل أصحابها أن تتأخر بمقدار معروف. ولا يناسب البيانات التي يجب أن تكون لحظية، ولا البيانات المختلفة لكل مستخدم، ولا الجداول التي تتغير بمعدل عال وتحتاج النتيجة بعد كل تغيير، لأن التحديث يعيد حساب كل شيء في كل مرة.
العرض المحفوظ Materialized View أم البدائل؟
الإجابة الجاهزة نفسها تستطيع أن تحفظها في أكثر من مكان، والفرق في من يحسبها ومتى. والصورة التالية تجمع الطرق التي سوف نقارنها:
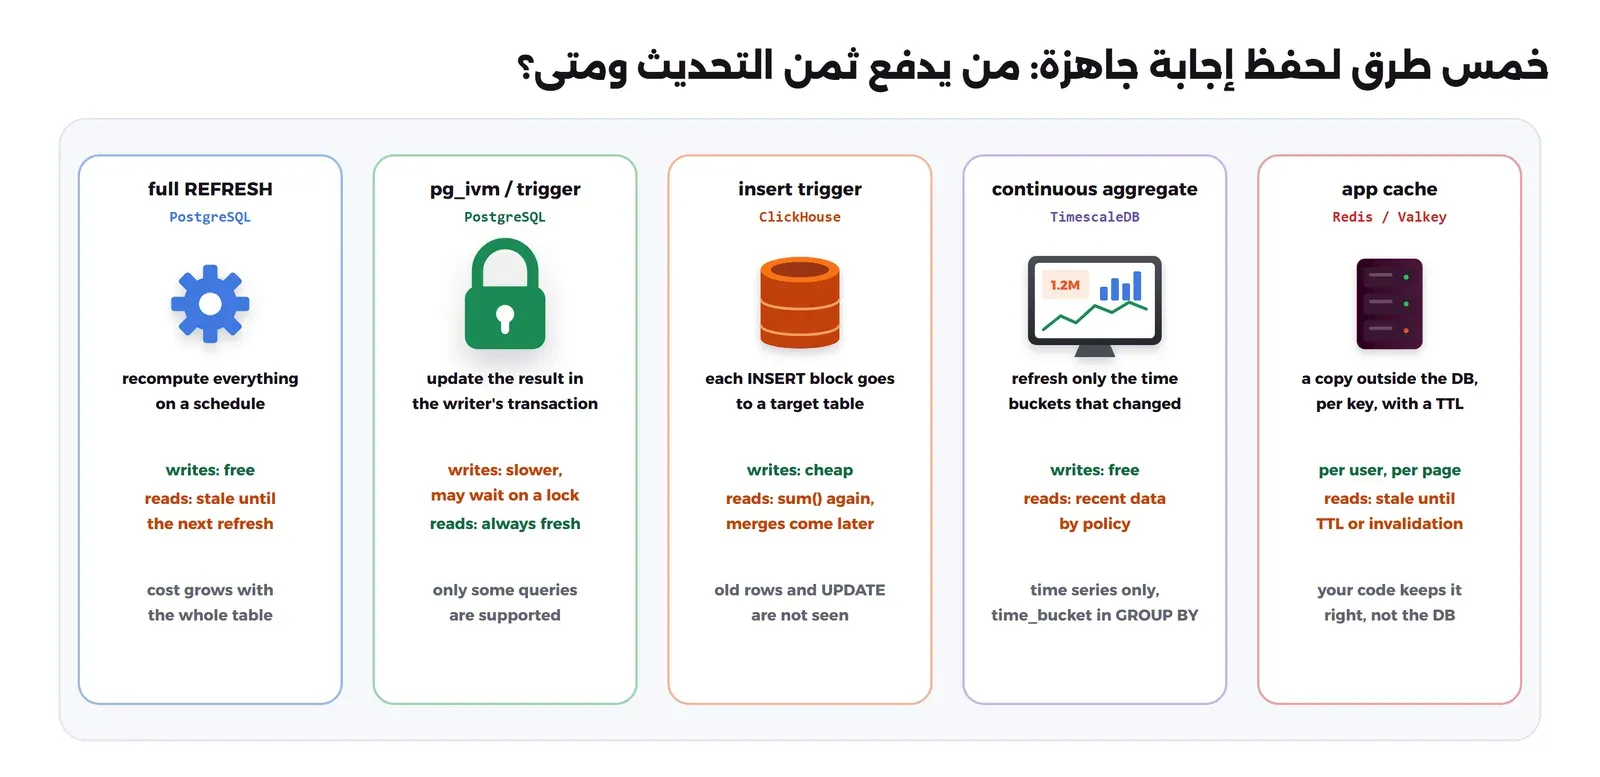
| الطريقة | حداثة البيانات | كلفة الكتابة | من يحافظ عليها | متى تختارها |
|---|---|---|---|---|
| العرض العادي View | لحظية | لا شيء | قاعدة البيانات | الاستعلام سريع أصلاً، وتريد اسماً واحداً لربط يتكرر |
| العرض المحفوظ Materialized View | حتى آخر تحديث | لا شيء، والتحديث يعيد حساب الكل | قاعدة البيانات، بأمر أو بجدول زمني | نتيجة مشتركة ثقيلة يقبل أصحابها تأخراً معروفاً |
| جدول ملخص Summary Table تحدثه Triggers أو الكود | لحظية | كل كتابة تحدث الملخص | أنت | عداد بسيط يجب أن يكون لحظياً، مثل عدد الأجوبة على سؤال |
| التحديث التزايدي pg_ivm | لحظية | كل كتابة تحدث العرض التزايدي IMMV وتأخذ قفلاً عليه | الإضافة | عرض View بتعريف تدعمه الإضافة، وكتابة ليست كثيفة |
| كاش التطبيق Redis أو Valkey | حتى انتهاء المدة TTL أو الإبطال Invalidation | الإبطال Invalidation من الكود | كود التطبيق | نتائج لكل مستخدم أو لكل صفحة، أو قراءات كثيرة جداً، أو نتيجة تأتي من خدمة خارجية |
والكاش في التطبيق موضوع مستقل له مشاكله، مثل تدفق الطلبات على قاعدة البيانات Cache Stampede عندما تنتهي صلاحية مفتاح عليه طلب كثير، وعودة البيانات القديمة Stale Data إلى الكاش بعد إبطالها Invalidation، وقد شرحناها بالتجربة في مقال التخزين المؤقت. أما العرض المحفوظ Materialized View فلا يعرف هذه المشاكل، لأن القراءة منه لا تنتهي صلاحيتها ولا تحتاج كوداً، وكل مشكلته في التحديث، وهو موضوع القسم التالي.
التحديث العادي REFRESH والتحديث المتزامن CONCURRENTLY
في PostgreSQL طريقتان لتحديث العرض المحفوظ Materialized View، وكلتاهما تعيد حساب الاستعلام كاملاً، والفرق في ما يحدث للقراءة أثناء الحساب، كما في الصورة التالية:
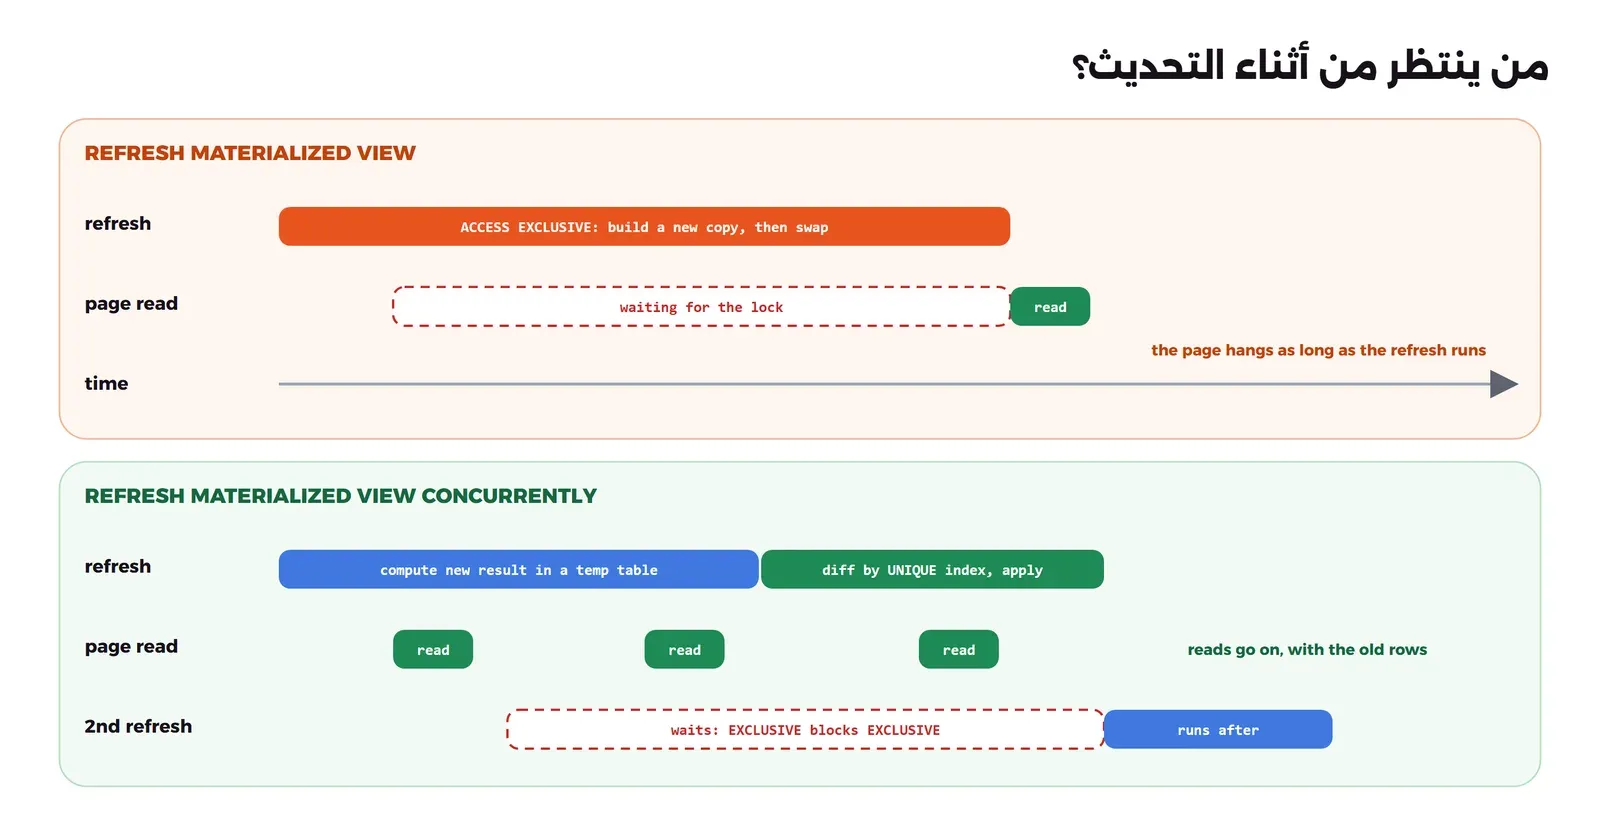
- التحديث العادي REFRESH: يأخذ قفل
ACCESS EXCLUSIVEعلى العرض المحفوظ Materialized View، وهو أعلى الأقفال، فيبني النتيجة في ملف جديد ويبدله بالقديم، وكلSELECTعليه ينتظر حتى ينتهي. وبحسب توثيق REFRESH هو الأسرع والأقل استهلاكاً عندما يتغير عدد كبير من الصفوف. - التحديث المتزامن CONCURRENTLY: يأخذ قفل
EXCLUSIVEالذي يسمح بالقراءة، ويحسب النتيجة الجديدة ثم يقارنها بالقديمة ويطبق الفروق فقط، ولذلك يشترط التوثيق فهرساً فريداًUNIQUEواحداً على الأقل، على أعمدة وليس على تعبير Expression، ودون شرطWHERE، ويشترط أن يكون العرض المحفوظ Materialized View قد ملئ من قبل. وقد يكون أسرع عندما يتغير عدد قليل من الصفوف، وحتى معه لا يعمل على العرض المحفوظ Materialized View الواحد إلا تحديث واحد في كل مرة.
وجدول الأقفال وما يتعارض مع ماذا شرحناه في مقال الأقفال. ولاحظ أن الطريقتين تعيدان حساب الاستعلام كاملاً، فكلفة التحديث تكبر مع حجم الجداول الأصلية وليس مع عدد الصفوف التي تغيرت، وهذا ما سوف نقيسه.
وهناك نقطتان في التوثيق نفسه يقع فيهما كثيرون: الأولى أن ORDER BY في تعريف العرض المحفوظ Materialized View لا يضمن ترتيب الصفوف بعد التحديث، فرتب دائماً في استعلام القراءة. والثانية أن العرض المحفوظ Materialized View الذي أنشئ بـ WITH NO DATA يبقى غير قابل للقراءة حتى أول تحديث، ولا يمكن تحديثه بـ CONCURRENTLY في المرة الأولى.
تجربة عملية: موقع أسئلة وأجوبة على ثلاثة أحجام
سوف نبني قاعدة موقع الأسئلة والأجوبة في PostgreSQL 18.6 مع إضافتي pg_cron وpg_ivm، وسيرفراً ثانياً يمثل خدمة بيانات مرجعية يملكها فريق آخر، ثم نقيس على ثلاثة أحجام: مليون تصويت، وخمسة ملايين، وعشرين مليوناً. والتجربة على Docker Engine 29.8.0 في جهاز بثمانية أنوية وذاكرة 32 جيجابايت، وكانت عليه Containers أخرى من تجارب ثانية تستهلك المعالج بشكل متغير، فالأزمنة التالية للتوضيح، والمهم فيها النسب والاتجاه، وليست مقياس أداء لـ PostgreSQL.
ملفات التجربة
صورة PostgreSQL الرسمية Docker Image لا تضم pg_cron ولا pg_ivm، ولكنها مبنية على مستودع حزم PostgreSQL الرسمي PGDG الذي فيه الإضافتان، فنضيفهما بإصدار مثبت:
# PostgreSQL 18.6 with pg_cron and pg_ivm from the PGDG packages that the official image already uses
FROM postgres:18.6
RUN apt-get update \
 && apt-get install -y --no-install-recommends postgresql-18-cron=1.6.8-1.pgdg13+2 postgresql-18-pg-ivm=1.15-2.pgdg13+1 \
 && rm -rf /var/lib/apt/lists/*
ولاحظ أن pg_ivm في PGDG هو 1.15، أما آخر إصدار في مستودع المشروع فهو 1.16 من 30 سبتمبر 2026، وهذا شائع في الحزم، فإذا احتجت ميزة من الإصدار الأحدث فابنه من المصدر. والملف compose.yaml:
# Materialized views lab: the app database, and a second server that plays the "remote" service (ArabRoot lab).
#   docker compose -p lab-mv up -d --build
name: lab-mv
services:
  app:
    build: .
    image: lab-mv-pg:18.6
    container_name: lab-mv-app
    environment:
      POSTGRES_PASSWORD: lab-pass
    command: ["postgres", "-c", "shared_preload_libraries=pg_cron,pg_ivm", "-c", "cron.database_name=postgres",
              "-c", "shared_buffers=1GB", "-c", "work_mem=64MB", "-c", "max_parallel_workers_per_gather=2",
              "-c", "timezone=Asia/Riyadh"]
    shm_size: 1g
    volumes: ["./:/lab:ro", "app-data:/var/lib/postgresql"]
  remote:
    image: postgres:18.6
    container_name: lab-mv-remote
    environment:
      POSTGRES_PASSWORD: lab-pass
    volumes: ["remote-data:/var/lib/postgresql"]
volumes:
  app-data:
    name: lab-mv-app-data
  remote-data:
    name: lab-mv-remote-data
networks:
  default:
    name: lab-mv-net
في الإعداد أعلاه لاحظ التالي:
- الإضافتان في
shared_preload_libraries، لأن pg_cron يشغل عملية خلفية Background Worker، وpg_ivm يحتاج التحميل المسبق بحسب توثيقه، وcron.database_nameيحدد القاعدة التي تحفظ فيها المهام. - لا يوجد منفذ منشور على الجهاز، فكل الأوامر بـ
docker exec، والسيرفرremoteعلى الشبكة الداخلية فقط.
docker compose -p lab-mv up -d --build
docker exec lab-mv-app psql -U postgres -c "CREATE EXTENSION pg_cron; CREATE EXTENSION pg_ivm; CREATE EXTENSION postgres_fdw;" \
  -c "SELECT extname, extversion FROM pg_extension ORDER BY 1;"
CREATE EXTENSION
CREATE EXTENSION
CREATE EXTENSION
extname | extversion
--------------+------------
pg_cron | 1.6
pg_ivm | 1.15
plpgsql | 1.0
postgres_fdw | 1.2
(4 rows)جداول التطبيق
الملف 01-app.sql ينشئ أربعة جداول مطبعة Normalized كما في أي تطبيق، ويملؤها بحسب المتغير scale، فالحجم 1 فيه 50 ألف سؤال و200 ألف جواب ومليون تصويت، ولاحظ أن قلة من الأعضاء يكتبون أغلب الأجوبة، كما في أي مجتمع حقيقي:
-- An ordinary Q&A community app: users, questions, answers and votes (ArabRoot lab).
-- psql -v scale=1 -f 01-app.sql      scale 1 = 50k questions, 200k answers, 1M votes
DROP SCHEMA IF EXISTS app CASCADE;
CREATE SCHEMA app;
SET search_path = app;
SELECT setseed(0.42);

CREATE TABLE users (
  id         int PRIMARY KEY,
  name       text NOT NULL,
  city       text NOT NULL,
  created_at timestamptz NOT NULL
);
CREATE TABLE questions (
  id         bigint PRIMARY KEY,
  user_id    int NOT NULL REFERENCES users,
  title      text NOT NULL,
  tags       text[] NOT NULL,
  created_at timestamptz NOT NULL
);
CREATE TABLE answers (
  id          bigint PRIMARY KEY,
  question_id bigint NOT NULL REFERENCES questions,
  user_id     int NOT NULL REFERENCES users,
  created_at  timestamptz NOT NULL
);
CREATE TABLE votes (
  id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  answer_id  bigint NOT NULL REFERENCES answers,
  user_id    int NOT NULL REFERENCES users,          -- who voted
  value      smallint NOT NULL CHECK (value IN (-1, 1)),
  created_at timestamptz NOT NULL
);

INSERT INTO users
SELECT g, 'user' || g, (ARRAY['Riyadh','Jeddah','Dammam','Cairo','Amman','Dubai','Rabat','Kuwait'])[1 + g % 8],
       timestamptz '2023-01-01' + random() * interval '1000 days'
FROM generate_series(1, 100000) g;

INSERT INTO questions
SELECT g, 1 + floor(random() * 100000)::int, 'Question ' || g,
       ARRAY[(ARRAY['postgresql','docker','linux','python','kubernetes','nginx','redis','git'])[1 + floor(random() * 8)::int],
             (ARRAY['performance','security','beginner','backup','networking'])[1 + floor(random() * 5)::int]],
       timestamptz '2024-01-01' + random() * interval '1000 days'
FROM generate_series(1, 50000 * :scale) g;

INSERT INTO answers
SELECT g, 1 + floor(random() * 50000 * :scale)::bigint,
       -- a few active users write most answers, as in any community
       1 + floor(100000 * power(random(), 3))::int,
       timestamptz '2024-01-01' + random() * interval '1000 days'
FROM generate_series(1, 200000 * :scale) g;

INSERT INTO votes (answer_id, user_id, value, created_at)
SELECT 1 + floor(random() * 200000 * :scale)::bigint, 1 + floor(random() * 100000)::int,
       CASE WHEN random() < 0.9 THEN 1 ELSE -1 END,
       timestamptz '2024-01-01' + random() * interval '1000 days'
FROM generate_series(1, 1000000 * :scale);

CREATE INDEX ON answers (question_id);
CREATE INDEX ON answers (user_id);
CREATE INDEX ON votes (answer_id);
CREATE INDEX ON questions USING gin (tags);
VACUUM ANALYZE;
SELECT (SELECT count(*) FROM questions) AS questions, (SELECT count(*) FROM answers) AS answers,
       (SELECT count(*) FROM votes) AS votes, pg_size_pretty(pg_database_size(current_database())) AS db_size;
ثلاثة عروض محفوظة Materialized Views
الملف 02-views.sql فيه العروض المحفوظة Materialized Views الثلاثة التي تحتاجها صفحات الموقع، ولكل منها فهرس فريد Unique Index حتى نستطيع تحديثه بـ CONCURRENTLY، وفهارس للقراءة كما في أي جدول:
-- Three materialized views an ordinary app needs (ArabRoot lab).
SET search_path = app;

-- 1) the leaderboard: reputation = 10 points for every up vote on your answers, minus 10 for a down vote
CREATE MATERIALIZED VIEW user_reputation AS
SELECT u.id AS user_id, u.name, u.city, 10 * sum(v.value)::int AS reputation
FROM votes v
JOIN answers a ON a.id = v.answer_id
JOIN users u   ON u.id = a.user_id
GROUP BY u.id, u.name, u.city;
CREATE UNIQUE INDEX ON user_reputation (user_id);          -- required by REFRESH ... CONCURRENTLY
CREATE INDEX ON user_reputation (reputation DESC);

-- 2) the read model behind the questions page: one row per question, joins and counts done in advance
CREATE MATERIALIZED VIEW question_list AS
SELECT q.id, q.title, q.tags, q.created_at, u.name AS author,
       coalesce(a.answers, 0) AS answers, coalesce(s.score, 0) AS score
FROM questions q
JOIN users u ON u.id = q.user_id
LEFT JOIN (SELECT question_id, count(*) AS answers FROM answers GROUP BY question_id) a ON a.question_id = q.id
LEFT JOIN (SELECT an.question_id, sum(v.value) AS score
           FROM votes v JOIN answers an ON an.id = v.answer_id GROUP BY an.question_id) s ON s.question_id = q.id;
CREATE UNIQUE INDEX ON question_list (id);
CREATE INDEX ON question_list USING gin (tags);
CREATE INDEX ON question_list (score DESC);

-- 3) the home page numbers: a single row
CREATE MATERIALIZED VIEW site_stats AS
SELECT 1 AS id, now() AS refreshed_at,               -- show the page how old the numbers are
       (SELECT count(*) FROM users) AS users, (SELECT count(*) FROM questions) AS questions,
       (SELECT count(*) FROM answers) AS answers, (SELECT count(*) FROM votes) AS votes;
CREATE UNIQUE INDEX ON site_stats (id);
ولاحظ في site_stats العمود refreshed_at، فالدالة now() تحسب وقت التحديث، وتقرؤه الصفحة لتكتب للمستخدم عمر الأرقام.
القراءة قبل وبعد، وكلفة التحديث
الملف 03-bench.sql يسأل الأسئلة الثلاثة مرة من الجداول ومرة من العروض المحفوظة Materialized Views، كل سؤال مرتين ونأخذ الزمن الثاني، ثم يضيف عشرة آلاف تصويت جديد، ويحدث كلاً منها بالطريقتين مرتين:
-- The same three questions with and without the materialized views, then the cost of refreshing them (ArabRoot lab).
-- Every query runs twice and the second (warm) time is the one we keep.
SET search_path = app;
\o /dev/null
\timing on
\echo leaderboard_base
SELECT u.id, u.name, u.city, 10 * sum(v.value)::int AS reputation FROM votes v JOIN answers a ON a.id = v.answer_id
JOIN users u ON u.id = a.user_id GROUP BY u.id, u.name, u.city ORDER BY reputation DESC LIMIT 10;
SELECT u.id, u.name, u.city, 10 * sum(v.value)::int AS reputation FROM votes v JOIN answers a ON a.id = v.answer_id
JOIN users u ON u.id = a.user_id GROUP BY u.id, u.name, u.city ORDER BY reputation DESC LIMIT 10;
\echo leaderboard_mv
SELECT user_id, name, reputation FROM user_reputation ORDER BY reputation DESC LIMIT 10;
SELECT user_id, name, reputation FROM user_reputation ORDER BY reputation DESC LIMIT 10;
\echo tagpage_base
SELECT q.id, q.title, sum(v.value) AS score FROM questions q JOIN answers a ON a.question_id = q.id
JOIN votes v ON v.answer_id = a.id WHERE q.tags @> '{postgresql}' GROUP BY q.id, q.title ORDER BY score DESC LIMIT 20;
SELECT q.id, q.title, sum(v.value) AS score FROM questions q JOIN answers a ON a.question_id = q.id
JOIN votes v ON v.answer_id = a.id WHERE q.tags @> '{postgresql}' GROUP BY q.id, q.title ORDER BY score DESC LIMIT 20;
\echo tagpage_mv
SELECT id, title, score FROM question_list WHERE tags @> '{postgresql}' ORDER BY score DESC LIMIT 20;
SELECT id, title, score FROM question_list WHERE tags @> '{postgresql}' ORDER BY score DESC LIMIT 20;
\echo stats_base
SELECT (SELECT count(*) FROM users), (SELECT count(*) FROM questions), (SELECT count(*) FROM answers), (SELECT count(*) FROM votes);
SELECT (SELECT count(*) FROM users), (SELECT count(*) FROM questions), (SELECT count(*) FROM answers), (SELECT count(*) FROM votes);
\echo stats_mv
SELECT * FROM site_stats;
SELECT * FROM site_stats;
-- 10,000 new votes arrive, then each view is refreshed both ways, twice
\echo insert_votes
INSERT INTO votes (answer_id, user_id, value, created_at)
SELECT 1 + floor(random() * (SELECT max(id) FROM answers))::bigint, 1 + floor(random() * 100000)::int, 1, now()
FROM generate_series(1, 10000);
ANALYZE votes;
\echo refresh_reputation
REFRESH MATERIALIZED VIEW user_reputation;
REFRESH MATERIALIZED VIEW user_reputation;
\echo refresh_reputation_concurrently
REFRESH MATERIALIZED VIEW CONCURRENTLY user_reputation;
REFRESH MATERIALIZED VIEW CONCURRENTLY user_reputation;
\echo refresh_questions
REFRESH MATERIALIZED VIEW question_list;
REFRESH MATERIALIZED VIEW question_list;
\echo refresh_questions_concurrently
REFRESH MATERIALIZED VIEW CONCURRENTLY question_list;
REFRESH MATERIALIZED VIEW CONCURRENTLY question_list;
\echo refresh_stats
REFRESH MATERIALIZED VIEW site_stats;
\timing off
\o
SELECT relname AS view, pg_size_pretty(pg_total_relation_size(oid)) AS size_with_indexes,
       (SELECT reltuples::bigint FROM pg_class c2 WHERE c2.oid = c.oid) AS rows
FROM pg_class c WHERE relkind = 'm' AND relnamespace = 'app'::regnamespace ORDER BY relname;
والسكربت bench.sh يشغل الملفات الثلاثة على كل حجم، ويطبع سطراً لكل قياس:
#!/bin/sh
# Runs the benchmark at growing sizes and prints one line per measurement (ArabRoot lab).
for s in 1 5 20; do
  echo "== scale $s"
  docker exec lab-mv-app psql -U postgres -q -v ON_ERROR_STOP=1 -v scale=$s -f /lab/01-app.sql | tail -3
  docker exec lab-mv-app psql -U postgres -q -v ON_ERROR_STOP=1 -c '\timing on' -f /lab/02-views.sql | grep Time | tr '\n' ' '; echo
  docker exec lab-mv-app psql -U postgres -q -v ON_ERROR_STOP=1 -f /lab/03-bench.sql | awk '/^[a-z_0-9]+$/ {k=$0; next} /^Time:/ {t[k]=$2} /\|/ || /rows/ {print} END {for (k in t) print k, t[k], "ms"}' | sort
done
sh bench.shوالمخرج للحجم الأول سوف يكون كما يلي:
== scale 1
     50000 |  200000 | 1000000 | 134 MB
(1 row)

Time: 0.578 ms Time: 2654.378 ms (00:02.654) Time: 49.819 ms Time: 56.162 ms Time: 1994.214 ms (00:01.994) Time: 36.452 ms Time: 99.730 ms Time: 73.970 ms Time: 104.934 ms Time: 3.757 ms
      view       | size_with_indexes | rows
 question_list   | 8864 kB           | 50000
 site_stats      | 32 kB             |     1
 user_reputation | 6136 kB           | 69110
(3 rows)
insert_votes 179.503 ms
leaderboard_base 4663.576 ms
leaderboard_mv 0.351 ms
refresh_questions 2686.176 ms
refresh_questions_concurrently 3169.920 ms
refresh_reputation 3346.542 ms
refresh_reputation_concurrently 5237.758 ms
refresh_stats 81.333 ms
stats_base 108.925 ms
stats_mv 0.312 ms
tagpage_base 272.492 ms
tagpage_mv 0.859 ms
وهذه نتائج الأحجام الثلاثة معاً بالمللي ثانية، عدا صفي الحجم:
| القياس | مليون تصويت | 5 ملايين | 20 مليوناً |
|---|---|---|---|
| حجم القاعدة بالميجابايت | 134 | 601 | 2347 |
| لوحة الترتيب من الجداول | 4,664 | 6,266 | 12,806 |
| لوحة الترتيب من العرض المحفوظ Materialized View | 0.35 | 0.13 | 0.31 |
| صفحة الوسم من الجداول | 272 | 1,342 | 3,624 |
| صفحة الوسم من العرض المحفوظ Materialized View | 0.86 | 0.87 | 0.48 |
| ملخص الصفحة الرئيسية من الجداول | 109 | 438 | 987 |
| ملخص الصفحة الرئيسية من العرض المحفوظ Materialized View | 0.31 | 0.15 | 0.16 |
| تحديث لوحة الترتيب بـ REFRESH | 3,347 | 8,492 | 12,847 |
| تحديث لوحة الترتيب بـ CONCURRENTLY | 5,238 | 12,516 | 15,061 |
| تحديث صفحة الأسئلة بـ REFRESH | 2,686 | 15,585 | 18,785 |
| تحديث صفحة الأسئلة بـ CONCURRENTLY | 3,170 | 8,818 | 23,834 |
| تحديث ملخص الصفحة الرئيسية بـ REFRESH | 81 | 216 | 1,238 |
| حجم question_list مع فهارسه بالميجابايت | 8.9 | 42 | 170 |
في النتائج أعلاه لاحظ التالي:
- القراءة من العروض المحفوظة Materialized Views الثلاثة أقل من مللي ثانية واحدة في كل الأحجام، لأنها قراءة بضعة صفوف من جدول جاهز بفهرس، أما القراءة من الجداول فتكبر مع البيانات: لوحة الترتيب من 4.7 ثانية إلى 12.8 ثانية، وصفحة الوسم من 0.27 إلى 3.6 ثانية. وهذا هو الفرق الذي يشعر به الزائر.
- كلفة التحديث تكبر مع حجم الجداول وليس مع ما تغير: في كل حجم أضفنا عشرة آلاف تصويت فقط، وهي 0.05% من عشرين مليوناً، ومع ذلك أخذ تحديث لوحة الترتيب 12.8 ثانية، لأن REFRESH يعيد حساب الاستعلام كاملاً. فإذا حدثت هذا العرض المحفوظ Materialized View كل 30 ثانية، فقاعدة البيانات تقضي قرابة نصف وقتها في حسابه.
- التحديث المتزامن CONCURRENTLY كان في أغلب القياسات أبطأ من التحديث العادي REFRESH، لأنه يحسب النتيجة كاملة ثم يقارنها بالقديمة صفاً صفاً، وكسب في قياس واحد. وهذا ما يقوله التوثيق: العادي أسرع غالباً، والمتزامن قد يكون أسرع عندما تتغير صفوف قليلة، وفائدته الحقيقية أنه لا يوقف القراءة كما سنرى في الخطوة التالية.
- العرض المحفوظ Materialized View الخاص بصفحة الأسئلة فيه صف لكل سؤال، فحجمه يكبر مع البيانات حتى 170 ميجابايت، أما لوحة الترتيب فصف لكل عضو له أجوبة، فبقيت قرابة 8.6 ميجابايت، والعرض المحفوظ Materialized View الصغير هو الأرخص في التحديث والأنسب للتحديث المتكرر.
- الأرقام متذبذبة بين الأحجام، مثل تحديث صفحة الأسئلة في الحجم 5، والسبب أن الجهاز كانت عليه تجارب أخرى تستهلك المعالج، فلا تقرأ الفروق الصغيرة، واقرأ الاتجاه.
من ينتظر من أثناء التحديث؟
السكربت 04-locks.sh يفتح ثلاث جلسات: الأولى تحدث لوحة الترتيب داخل معاملة وتبقيها مفتوحة ثلاث ثوان إضافية، والثانية تقرأ اللوحة كما تفعل الصفحة، والثالثة تعرض الأقفال على العرض المحفوظ Materialized View:
#!/bin/sh
# Who waits for whom while a materialized view refreshes? (ArabRoot lab)
#   sh 04-locks.sh ""              plain REFRESH
#   sh 04-locks.sh CONCURRENTLY    REFRESH ... CONCURRENTLY
P="docker exec lab-mv-app psql -U postgres -X -q"
MODE=$1
# session 1: the refresh, kept open 3 more seconds so we can look at the locks
$P -c "BEGIN; REFRESH MATERIALIZED VIEW $MODE app.user_reputation; SELECT pg_sleep(3); COMMIT;" &
sleep 1
# session 2: a page that reads the leaderboard
$P -c '\timing on' -c "SELECT count(*) AS leaderboard_rows FROM app.user_reputation;" &
sleep 1
# session 3: the locks held and awaited on the view
$P -c "SELECT a.pid, l.mode, l.granted, left(a.query, 60) AS query
       FROM pg_locks l JOIN pg_stat_activity a USING (pid)
       WHERE l.relation = 'app.user_reputation'::regclass ORDER BY l.granted DESC, a.pid;"
wait
sh 04-locks.sh "" pid | mode | granted | query
------+---------------------+---------+--------------------------------------------------------------
1526 | AccessExclusiveLock | t | BEGIN; REFRESH MATERIALIZED VIEW app.user_reputation; SELEC
1526 | ExclusiveLock | t | BEGIN; REFRESH MATERIALIZED VIEW app.user_reputation; SELEC
1535 | AccessShareLock | f | SELECT count(*) AS leaderboard_rows FROM app.user_reputation
(3 rows)
pg_sleep
----------
(1 row)
leaderboard_rows
------------------
99999
(1 row)
Time: 22582.028 ms (00:22.582)في المخرج أعلاه لاحظ التالي: جلسة التحديث تملك قفل AccessExclusiveLock على العرض المحفوظ Materialized View، وقراءة الصفحة تطلب AccessShareLock وقيمة granted لها f، أي أنها تنتظر. والقراءة التي تأخذ عادة أقل من مللي ثانية أخذت 22.6 ثانية، وهي مدة التحديث على عشرين مليون تصويت مع الثواني الثلاث الإضافية. وفي موقع حقيقي كل زائر يفتح الصفحة الرئيسية في هذه الثواني ينتظر، ثم تبدأ الاتصالات بالتراكم حتى تنفد، كما شرحنا في مقال تجميع الاتصالات. والآن الأمر نفسه مع CONCURRENTLY:
sh 04-locks.sh CONCURRENTLY leaderboard_rows
------------------
99999
(1 row)
Time: 22.530 ms
pid | mode | granted | query
------+---------------+---------+--------------------------------------------------------------
1550 | ExclusiveLock | t | BEGIN; REFRESH MATERIALIZED VIEW CONCURRENTLY app.user_reput
(1 row)
pg_sleep
----------
(1 row)هذه المرة رجعت القراءة في 22 مللي ثانية والتحديث ما زال يعمل، لأن جلسة التحديث تملك ExclusiveLock فقط، وهو يتعارض مع الكتابة ومع تحديث ثان، ولا يتعارض مع القراءة. والقارئ رأى الصفوف القديمة حتى انتهى التحديث، وهذا ما تريده الصفحة. والقاعدة أن كل عرض محفوظ Materialized View يقرؤه المستخدمون يحدث بـ CONCURRENTLY، ويبقى التحديث العادي REFRESH للعروض المحفوظة Materialized Views التي لا يقرؤها أحد أثناء التحديث، مثل تقرير ليلي، لأنه أسرع في أغلب قياساتنا ولا يترك صفوفاً ميتة Dead Tuples.
نكسرها: أربعة أخطاء شائعة
الملف 05-break.sql فيه أربع خطوات، كل منها خطأ يقع في الإنتاج:
-- Break it on purpose (ArabRoot lab).
SET search_path = app;
\set ON_ERROR_STOP off

-- 1) created WITH NO DATA (for example by a migration) and read before the first refresh
CREATE MATERIALIZED VIEW city_reputation AS
SELECT city, sum(reputation) AS reputation FROM user_reputation GROUP BY city WITH NO DATA;
SELECT * FROM city_reputation;

REFRESH MATERIALIZED VIEW CONCURRENTLY city_reputation;

-- 2) CONCURRENTLY without a unique index
REFRESH MATERIALIZED VIEW city_reputation;
REFRESH MATERIALIZED VIEW CONCURRENTLY city_reputation;
CREATE UNIQUE INDEX ON city_reputation (city);
REFRESH MATERIALIZED VIEW CONCURRENTLY city_reputation;

-- 3) a unique key that is unique by accident: user names are unique today, but the table does not promise it
CREATE MATERIALIZED VIEW user_cards AS SELECT name, city, reputation FROM user_reputation;
CREATE UNIQUE INDEX ON user_cards (name);
INSERT INTO users VALUES (100001, 'user7', 'Rabat', now());          -- a second user7 signs up
INSERT INTO answers VALUES (900000001, 1, 100001, now());
INSERT INTO votes (answer_id, user_id, value, created_at) VALUES (900000001, 2, 1, now());
REFRESH MATERIALIZED VIEW CONCURRENTLY user_reputation;
REFRESH MATERIALIZED VIEW CONCURRENTLY user_cards;
REFRESH MATERIALIZED VIEW user_cards;
SELECT count(*) AS user_cards_rows FROM user_cards;
DROP MATERIALIZED VIEW user_cards;

-- 4) stale on purpose: 50 up votes for one answer of user 1, before and after the refresh
SELECT reputation AS before FROM user_reputation WHERE user_id = 1;
INSERT INTO votes (answer_id, user_id, value, created_at)
SELECT (SELECT min(id) FROM answers WHERE user_id = 1), 1 + g, 1, now() FROM generate_series(1, 50) g;
SELECT reputation AS still_before FROM user_reputation WHERE user_id = 1;
REFRESH MATERIALIZED VIEW CONCURRENTLY user_reputation;
SELECT reputation AS after_refresh FROM user_reputation WHERE user_id = 1;
DROP MATERIALIZED VIEW city_reputation;
docker exec -i lab-mv-app psql -U postgres -X < 05-break.sqlSET
CREATE MATERIALIZED VIEW
ERROR: materialized view "city_reputation" has not been populated
HINT: Use the REFRESH MATERIALIZED VIEW command.
ERROR: CONCURRENTLY cannot be used when the materialized view is not populated
REFRESH MATERIALIZED VIEW
ERROR: cannot refresh materialized view "app.city_reputation" concurrently
HINT: Create a unique index with no WHERE clause on one or more columns of the materialized view.
CREATE INDEX
REFRESH MATERIALIZED VIEW
SELECT 99999
CREATE INDEX
INSERT 0 1
INSERT 0 1
INSERT 0 1
REFRESH MATERIALIZED VIEW
ERROR: duplicate key value violates unique constraint "user_cards_name_idx"
DETAIL: Key (name)=(user7) already exists.
CONTEXT: SQL statement "INSERT INTO app.user_cards SELECT (diff.newdata).* FROM pg_temp_60.pg_temp_18512_2 diff WHERE tid IS NULL"
ERROR: could not create unique index "user_cards_name_idx"
DETAIL: Key (name)=(user7) is duplicated.
user_cards_rows
-----------------
99999
(1 row)
DROP MATERIALIZED VIEW
before
---------
3446250
(1 row)
INSERT 0 50
still_before
--------------
3446250
(1 row)
REFRESH MATERIALIZED VIEW
after_refresh
---------------
3446750
(1 row)
DROP MATERIALIZED VIEWفي المخرج أعلاه لاحظ التالي:
- عرض محفوظ Materialized View غير مملوء: إذا أنشئ بـ
WITH NO DATA، كما يحدث في Migration تريد أن تكون سريعة، فهو يرفض القراءة برسالةhas not been populated، ويرفض أيضاً أول تحديث بـCONCURRENTLY، فأول تحديث يجب أن يكون عادياً. - دون فهرس فريد: بعد أن ملأناه رفض
CONCURRENTLYبرسالة واضحة تطلب فهرساً فريداً دونWHERE، وبعد إنشائه نجح. - مفتاح فريد بالصدفة: أسماء المستخدمين كانت فريدة يوم أنشأنا الفهرس، ثم سجل مستخدم ثان باسم
user7، فلم ينجح التحديث بأي طريقة:CONCURRENTLYفشل أثناء إضافة الفروق، والسطرCONTEXTيبين كيف يعمل من الداخل، فهو يكتب الصفوف الجديدة من جدول مؤقت فيه الفروق، والعادي فشل في بناء الفهرس. والأخطر أن العرض المحفوظ Materialized View بقي يعمل بنسخته القديمة 99,999 صفاً، فالصفحة لا تتعطل، وإنما تتوقف عن التحديث بصمت، ولا يعرف أحد إلا إذا كان هناك من يقرأ سجل الأخطاء. والإصلاح أن يكون المفتاح الفريد هو المفتاح الأساسي Primary Key وهوuser_id، وليس عموداً يبدو فريداً. - البيانات القديمة Stale Data: خمسون تصويتاً جديداً لم تغير سمعة العضو 1 في العرض المحفوظ Materialized View، وظهرت فقط بعد التحديث، فزادت 500 نقطة. وهذا ليس خطأ في PostgreSQL، وإنما هي طبيعة العرض المحفوظ Materialized View، فقرر مسبقاً لكل عرض محفوظ كم تأخراً يقبل.
الجدولة داخل قاعدة البيانات بأداة pg_cron
العرض المحفوظ Materialized View لا يحدث نفسه، فتحتاج من يشغل REFRESH كل فترة. والحل البسيط أن تضيف سطراً في Cron على السيرفر، ولكن هذا السطر يعيش خارج القاعدة: لا ينسخ معها، ولا يعرف إذا انتقلت القاعدة إلى سيرفر آخر بعد Failover. أما pg_cron فيحفظ المهام في جدول داخل القاعدة، ويحفظ سجل كل تشغيل، وقد ذكرناه باختصار في مقال PostgreSQL لكل شيء. والملف 06-cron.sql يجدول تحديث لوحة الترتيب كل 30 ثانية، وملخص الصفحة الرئيسية كل دقيقة:
-- Refresh on a schedule with pg_cron, inside the database (ArabRoot lab).
SELECT cron.schedule('refresh-reputation', '30 seconds',
                     'REFRESH MATERIALIZED VIEW CONCURRENTLY app.user_reputation');
SELECT cron.schedule('refresh-site-stats', '* * * * *',
                     'REFRESH MATERIALIZED VIEW CONCURRENTLY app.site_stats');
SELECT jobid, jobname, schedule, command FROM cron.job ORDER BY jobid;
schedule
----------
1
(1 row)
schedule
----------
2
(1 row)
jobid | jobname | schedule | command
-------+--------------------+------------+------------------------------------------------------------
1 | refresh-reputation | 30 seconds | REFRESH MATERIALIZED VIEW CONCURRENTLY app.user_reputation
2 | refresh-site-stats | * * * * * | REFRESH MATERIALIZED VIEW CONCURRENTLY app.site_stats
(2 rows)وبعد بضع دقائق نقرأ سجل التشغيل بالملف 06-cron-check.sql:
-- What did pg_cron do, and how long did each refresh take?
SELECT j.jobname, d.status, to_char(d.start_time, 'HH24:MI:SS') AS started,
       round(extract(epoch FROM d.end_time - d.start_time)::numeric, 2) AS seconds, d.return_message
FROM cron.job_run_details d JOIN cron.job j USING (jobid)
ORDER BY d.start_time DESC LIMIT 8;
jobname | status | started | seconds | return_message
--------------------+-----------+----------+---------+---------------------------
refresh-reputation | running | 08:12:20 | |
refresh-site-stats | succeeded | 08:12:00 | 4.07 | REFRESH MATERIALIZED VIEW
refresh-reputation | succeeded | 08:11:39 | 41.44 | REFRESH MATERIALIZED VIEW
refresh-reputation | succeeded | 08:11:01 | 37.86 | REFRESH MATERIALIZED VIEW
refresh-site-stats | succeeded | 08:11:00 | 6.04 | REFRESH MATERIALIZED VIEW
(5 rows)في المخرج أعلاه لاحظ التالي:
- ملخص الصفحة الرئيسية يحدث كل دقيقة في 4 إلى 6 ثوان، وهذا مقبول.
- أما لوحة الترتيب فطلبنا تحديثها كل 30 ثانية، وكل تحديث أخذ 38 إلى 41 ثانية لأن المهمتين كانتا تعملان معاً على جهاز مشغول، فبدأ كل تشغيل لحظة انتهاء السابق: 08:11:01 ثم 08:11:39 ثم 08:12:20. وهذا ما يقوله توثيق pg_cron: لا يشغل نسختين من المهمة نفسها، والتشغيل الذي يأتي وقته قبل انتهاء السابق ينتظر ثم يبدأ بعده. أي أن قاعدة البيانات أصبحت تحسب لوحة الترتيب بلا توقف.
- والقاعدة: اجعل الفترة أطول بكثير من زمن التحديث، وقس الزمن من هذا الجدول نفسه بعد كل زيادة في البيانات، ونبه على أي حالة
failed، لأن التحديث الذي يفشل يترك العرض المحفوظ Materialized View بنسخته القديمة دون أي رسالة في التطبيق.
وقبل أن نكمل نلغي المهمتين حتى لا تؤثرا على القياسات التالية، ولاحظ أن إلغاء المهمة يحذف سجل تشغيلها أيضاً:
docker exec lab-mv-app psql -U postgres -c "SELECT cron.unschedule(jobname) FROM cron.job;"التحديث التزايدي بالإضافة pg_ivm
كل ما سبق يعيد حساب العرض المحفوظ Materialized View كاملاً، والسؤال الطبيعي: لماذا لا تحدث قاعدة البيانات الصفوف التي تغيرت فقط؟ وهذا ما تفعله pg_ivm برخصة PostgreSQL License، فهي تنشئ عرضاً محفوظاً تزايدياً تسميه IMMV، أي Incrementally Maintainable Materialized View، وتضع Triggers على الجداول الأصلية تحدثه في نفس المعاملة Transaction التي تكتب فيها، فيكون حديثاً دائماً. والتوثيق صريح في حدودها: الدوال المدعومة count وsum وavg وmin وmax فقط، ولا تدعم دوال النوافذ Window Functions ولا HAVING ولا ORDER BY ولا LIMIT، وتقول إنها غير فعالة عندما تتغير الجداول الأصلية كثيراً. والملف 07-ivm.sql ينشئ سمعة الأعضاء نسخة تزايدية، ثم يضيف تصويتاً، ثم يجرب تعريفين غير مدعومين:
-- Incremental maintenance with pg_ivm: the view changes in the same transaction as the vote (ArabRoot lab).
SET search_path = app, pgivm;
\timing on
SELECT pgivm.create_immv('app.reputation_ivm',
  'SELECT a.user_id, sum(v.value) AS score, count(*) AS votes
   FROM app.votes v JOIN app.answers a ON a.id = v.answer_id GROUP BY a.user_id');
\timing off
SELECT score, votes FROM reputation_ivm WHERE user_id = 1;
INSERT INTO votes (answer_id, user_id, value, created_at)
VALUES ((SELECT min(id) FROM answers WHERE user_id = 1), 99, 1, now());
SELECT score, votes FROM reputation_ivm WHERE user_id = 1;

-- what it does not support
SELECT pgivm.create_immv('app.top_ivm',
  'SELECT a.user_id, sum(v.value) AS score FROM app.votes v JOIN app.answers a ON a.id = v.answer_id
   GROUP BY a.user_id ORDER BY score DESC LIMIT 10');
SELECT pgivm.create_immv('app.distinct_ivm',
  'SELECT a.user_id, count(DISTINCT v.user_id) AS voters FROM app.votes v JOIN app.answers a ON a.id = v.answer_id
   GROUP BY a.user_id');
SET
Timing is on.
NOTICE: created index "reputation_ivm_index" on immv "reputation_ivm"
create_immv
-------------
100000
(1 row)
Time: 23352.997 ms (00:23.353)
Timing is off.
score | votes
--------+--------
344675 | 430421
(1 row)
INSERT 0 1
score | votes
--------+--------
344676 | 430422
(1 row)
ERROR: ORDER BY clause is not supported on incrementally maintainable materialized view
ERROR: aggregate function with DISTINCT arguments is not supported on incrementally maintainable materialized viewفي المخرج أعلاه لاحظ التالي:
- إنشاء العرض التزايدي IMMV أخذ 23 ثانية، لأنه يحسب النتيجة كاملة أول مرة مثل أي عرض محفوظ Materialized View، ثم أنشأ وحده فهرساً فريداً على عمود
GROUP BY. - بعد تصويت واحد زاد
scoreمن 344,675 إلى 344,676، وvotesمن 430,421 إلى 430,422، في نفس المعاملة ودون أيREFRESH. ولاحظ أن ناتج344,675 × 10 = 3,446,750، وهو سمعة العضو 1 نفسها في العرض المحفوظ العادي Materialized View بعد تحديثه. - التعريفان الآخران رفضا: لوحة الترتيب بـ
ORDER BY ... LIMIT 10، وعدد المصوتين بـcount(DISTINCT ...)، فالعرض التزايدي IMMV يحفظ التجميع كاملاً، والترتيب والحد في استعلام القراءة.
والآن الثمن. السكربت 07-ivm-cost.sh يضيف ألفي تصويت، كل تصويت في معاملة مستقلة كما يفعل التطبيق، مرة والعرض التزايدي IMMV يعمل، ومرة بعد إيقاف تحديثه بالدالة refresh_immv(..., false):
#!/bin/sh
# The price of instant views: 2,000 single-vote transactions with and without the IMMV (ArabRoot lab).
P="docker exec -i lab-mv-app psql -U postgres -X -q"
run() {
  $P <<'SQL'
\timing on
DO $$ BEGIN
  FOR i IN 1..2000 LOOP
    INSERT INTO app.votes (answer_id, user_id, value, created_at)
    VALUES (1 + floor(random() * 1000000)::bigint, 1 + floor(random() * 100000)::int, 1, now());
    COMMIT;
  END LOOP;
END $$;
SQL
}
echo "with reputation_ivm:"; run
$P -c "SELECT pgivm.refresh_immv('app.reputation_ivm', false);" >/dev/null     # maintenance off
echo "without maintenance:"; run
$P -c "SELECT pgivm.refresh_immv('app.reputation_ivm', true);" >/dev/null
== run 1
with reputation_ivm:
Time: 8837.110 ms (00:08.837)
without maintenance:
Time: 8570.706 ms (00:08.571)
== run 2
with reputation_ivm:
Time: 14576.751 ms (00:14.577)
without maintenance:
Time: 6458.047 ms (00:06.458)شغلنا السكربت مرتين: في الأولى كان الفرق صغيراً، 8.8 ثانية مقابل 8.6، وفي الثانية كان 14.6 ثانية مقابل 6.5. والسبب في التذبذب أن أغلب زمن المعاملة الصغيرة على هذا الجهاز هو تأكيد الكتابة على القرص عند كل COMMIT، والجهاز كان مشغولاً بتجارب أخرى. فلا نستطيع أن نعطيك رقماً ثابتاً للكلفة، ولكن الاتجاه واضح: كل كتابة على votes أصبحت تقرأ وتعدل صفاً في العرض التزايدي IMMV، والتوثيق نفسه يقول إن التحديث الفوري لا يفيد عندما تتغير الجداول كثيراً، وإن الإدخال الكبير قد يكون أغلى من التحديث الكامل، ويقترح إيقاف التحديث قبل الإدخال الكبير وإعادته بعده كما فعلنا هنا.
والثمن الثاني أقل وضوحاً: بحسب قسم المعاملات المتزامنة في توثيق pg_ivm، تأخذ أي كتابة على جدول أصلي قفل ExclusiveLock على العرض التزايدي IMMV حتى نهاية معاملتها، حتى يحدثه بالترتيب الصحيح. والسكربت 07-ivm-locks.sh يصوت فيه مستخدمان في نفس اللحظة على جوابين مختلفين، والأول يبقي معاملته مفتوحة أربع ثوان:
#!/bin/sh
# Two users vote at the same time on different answers: with an IMMV the second one waits (ArabRoot lab).
P="docker exec lab-mv-app psql -U postgres -X -q"
$P -c "BEGIN; INSERT INTO app.votes (answer_id, user_id, value, created_at) VALUES (10, 5, 1, now()); SELECT pg_sleep(4); COMMIT;" &
sleep 1
$P -c '\timing on' -c "INSERT INTO app.votes (answer_id, user_id, value, created_at) VALUES (20, 6, 1, now());" &
sleep 1
$P -c "SELECT a.pid, l.mode, l.granted, left(a.query, 50) AS query FROM pg_locks l JOIN pg_stat_activity a USING (pid)
       WHERE l.relation = 'app.reputation_ivm'::regclass ORDER BY l.granted DESC;"
wait
pid | mode | granted | query
------+------------------+---------+----------------------------------------------------
1778 | ExclusiveLock | t | BEGIN; INSERT INTO app.votes (answer_id, user_id,
1778 | RowExclusiveLock | t | BEGIN; INSERT INTO app.votes (answer_id, user_id,
1785 | ExclusiveLock | f | INSERT INTO app.votes (answer_id, user_id, value,
(3 rows)
pg_sleep
----------
(1 row)
Time: 3129.782 ms (00:03.130)المصوت الثاني انتظر 3.1 ثانية مع أنه صوت على جواب آخر، والسطر الأخير في جدول الأقفال يبين السبب: طلبه ExclusiveLock على reputation_ivm لم يمنح حتى أنهى الأول معاملته. فإذا كان في تطبيقك معاملات طويلة تكتب في الجدول الأصلي، فكل كتابة أخرى على الجدول نفسه تنتظرها، والعرض التزايدي IMMV يحول جدولاً يكتب فيه الجميع بالتوازي إلى طابور Queue. ولهذا فهو مناسب لجدول يكتب فيه قليلاً ويقرأ منه كثيراً، وليس لجدول تصويت في موقع مزدحم.
نسخة محلية من بيانات سيرفر آخر
الآن الاستخدام الذي لا يذكر كثيراً: بيانات المدن، بالدولة والمنطقة الزمنية والعملة، في قاعدة يملكها فريق آخر، وفيها 200 ألف مكان آخر لا يستخدمها تطبيقنا. نجهزها على السيرفر lab-mv-remote بالملف 08-remote.sql، ثم نربطها من قاعدة التطبيق عبر postgres_fdw، ونحفظ منها نسخة في عرض محفوظ Materialized View بالملف 09-fdw.sql:
-- On lab-mv-remote: a reference service owned by another team (places with country, time zone and currency).
CREATE TABLE places (
  name     text PRIMARY KEY,
  country  text NOT NULL,
  timezone text NOT NULL,
  currency text NOT NULL
);
INSERT INTO places VALUES
  ('Riyadh','Saudi Arabia','Asia/Riyadh','SAR'), ('Jeddah','Saudi Arabia','Asia/Riyadh','SAR'),
  ('Dammam','Saudi Arabia','Asia/Riyadh','SAR'), ('Cairo','Egypt','Africa/Cairo','EGP'),
  ('Amman','Jordan','Asia/Amman','JOD'), ('Dubai','United Arab Emirates','Asia/Dubai','AED'),
  ('Rabat','Morocco','Africa/Casablanca','MAD'), ('Kuwait','Kuwait','Asia/Kuwait','KWD');
-- and many more places the app never uses
INSERT INTO places SELECT 'Place ' || g, 'Country ' || (g % 200), 'UTC', 'USD' FROM generate_series(1, 200000) g;
CREATE ROLE app_reader LOGIN PASSWORD 'reader-pass';
GRANT SELECT ON places TO app_reader;
ANALYZE places;
-- On lab-mv-app: read the remote table through postgres_fdw, then keep a local copy in a materialized view.
CREATE SERVER refdata FOREIGN DATA WRAPPER postgres_fdw OPTIONS (host 'lab-mv-remote', dbname 'postgres');
CREATE USER MAPPING FOR postgres SERVER refdata OPTIONS (user 'app_reader', password 'reader-pass');
CREATE SCHEMA ref;
IMPORT FOREIGN SCHEMA public LIMIT TO (places) FROM SERVER refdata INTO ref;
CREATE MATERIALIZED VIEW app.places_cache AS SELECT * FROM ref.places;
CREATE UNIQUE INDEX ON app.places_cache (name);
ANALYZE app.places_cache;ثم نقارن سؤالين: عدد المستخدمين في كل دولة، وصفحة ملف مستخدم واحد، مرة عبر الجدول البعيد ومرة من النسخة المحلية، بالملف 10-fdw-bench.sql:
-- Users per country: through the foreign table, then from the local copy (second run kept).
\o /dev/null
\timing on
\echo foreign
SELECT p.country, count(*) FROM app.users u JOIN ref.places p ON p.name = u.city GROUP BY p.country;
SELECT p.country, count(*) FROM app.users u JOIN ref.places p ON p.name = u.city GROUP BY p.country;
\echo local
SELECT p.country, count(*) FROM app.users u JOIN app.places_cache p ON p.name = u.city GROUP BY p.country;
SELECT p.country, count(*) FROM app.users u JOIN app.places_cache p ON p.name = u.city GROUP BY p.country;
\echo profile_page
SELECT u.name, p.country, p.timezone FROM app.users u JOIN ref.places p ON p.name = u.city WHERE u.id = 42;
SELECT u.name, p.country, p.timezone FROM app.users u JOIN ref.places p ON p.name = u.city WHERE u.id = 42;
\echo profile_page_local
SELECT u.name, p.country, p.timezone FROM app.users u JOIN app.places_cache p ON p.name = u.city WHERE u.id = 42;
SELECT u.name, p.country, p.timezone FROM app.users u JOIN app.places_cache p ON p.name = u.city WHERE u.id = 42;
\echo refresh_cache
REFRESH MATERIALIZED VIEW CONCURRENTLY app.places_cache;
Timing is on.
foreign
Time: 3892.460 ms (00:03.892)
Time: 3073.603 ms (00:03.074)
local
Time: 91.120 ms
Time: 120.082 ms
profile_page
Time: 1277.184 ms (00:01.277)
Time: 1431.537 ms (00:01.432)
profile_page_local
Time: 0.966 ms
Time: 1.251 ms
refresh_cache
Time: 12366.290 ms (00:12.366)في المخرج أعلاه لاحظ التالي:
- عدد المستخدمين في كل دولة أخذ 3.1 ثانية عبر الجدول البعيد، و0.09 ثانية من النسخة المحلية، لأن الربط عبر postgres_fdw ينقل صفوف الجدول البعيد عبر الشبكة في كل مرة.
- والأوضح صفحة ملف مستخدم واحد: 1.3 ثانية عبر الجدول البعيد مقابل مللي ثانية واحدة محلياً، فالربط بين جدول محلي وجدول بعيد كثيراً ما يجلب من السيرفر الآخر أكثر بكثير مما تحتاجه الصفحة.
- تحديث النسخة أخذ 12.4 ثانية لأنه ينقل 200 ألف صف ويقارنها، وتكفيك مرة في الساعة أو في اليوم لبيانات مرجعية.
ثم نكسرها: نوقف السيرفر الآخر كما يحدث عند صيانته، ونسأل من الطريقين، ونحاول التحديث:
docker stop lab-mv-remote
docker exec lab-mv-app psql -U postgres -X \
  -c "SELECT count(*) FROM ref.places;" \
  -c "SELECT count(*) FROM app.places_cache;" \
  -c "REFRESH MATERIALIZED VIEW CONCURRENTLY app.places_cache;" \
  -c "SELECT count(*) FROM app.places_cache;"
docker start lab-mv-remote
ERROR: could not connect to server "refdata"
DETAIL: could not translate host name "lab-mv-remote" to address: No address associated with hostname
count
--------
200008
(1 row)
ERROR: could not connect to server "refdata"
DETAIL: could not translate host name "lab-mv-remote" to address: Name or service not known
count
--------
200008
(1 row)عندما توقف السيرفر الآخر فشل كل استعلام على الجدول البعيد، وفشل التحديث، ولكن النسخة المحلية بقيت تعمل بكل صفوفها، فصفحات تطبيقك لم تتأثر بصيانة خدمة لا يملكها فريقك. وهذا نفس سلوك الخطوة الثالثة في الكسر، فالتحديث الفاشل لا يمسح العرض المحفوظ Materialized View، وهذا مفيد هنا، ولكن راقب فشل التحديث حتى لا تبقى النسخة قديمة أسابيع دون أن يعرف أحد.
حذف المختبر
docker exec lab-mv-app psql -U postgres -c "SELECT cron.unschedule(jobname) FROM cron.job;"
docker compose -p lab-mv down -v
docker image rm lab-mv-pg:18.6
والأمر الثاني يحذف Containers التجربة، ووحدات التخزين Volumes lab-mv-app-data وlab-mv-remote-data والشبكة lab-mv-net.
التحديث التزايدي Incremental Refresh في قواعد أخرى
مصطلح العرض المحفوظ Materialized View نفسه يعني أشياء مختلفة في كل قاعدة بيانات، وقد شرحنا اثنتين منها بالتجربة في مقالات سابقة، فنلخص هنا الفرق عن PostgreSQL فقط:
- ClickHouse: العرض المحفوظ Materialized View هناك يعمل مثل Trigger على INSERT، فكل دفعة تدخل الجدول الأصلي تمر عبر استعلامه وتكتب نتيجتها في جدول هدف، كما في توثيق ClickHouse. فالتحديث رخيص ولحظي، ولكنه لا يرى الصفوف التي كانت قبل إنشائه ولا يرى UPDATE وDELETE، والجمع النهائي يحدث عند الدمج في الخلفية Merge، فيجب أن تجمع مرة أخرى عند القراءة، وهذا الفخ كسرناه في مقال ClickHouse.
- TimescaleDB: الملخص المستمر Continuous Aggregate عرض محفوظ Materialized View يجمع بفترات زمنية، ويحدث فقط الفترات التي وصلت إليها بيانات جديدة بحسب سياسة تحديث، فلا يعيد حساب السنة كلها كل ساعة، وقسناه في مقال السلاسل الزمنية. وهو مناسب عندما يكون في تعريفك عمود زمني، أما لوحة السمعة في موقعنا فلا تجمع بالزمن، فلا يناسبها.
- PostgreSQL نفسه: لا يوجد فيه تحديث تزايدي مدمج حتى الإصدار 18، فالخيارات هي pg_ivm كما رأينا في المختبر، أو جدول ملخص تحدثه بنفسك، أو تقسيم المشكلة: عرض محفوظ Materialized View للأيام الماضية التي لا تتغير، واستعلام مباشر لليوم الحالي، وتجمعهما في استعلام القراءة.
أخطاء شائعة
- التحديث العادي REFRESH في صفحة يقرؤها الزوار: كل زائر ينتظر طوال التحديث، والصفحة التي كانت بطيئة تصبح متوقفة كل دقيقة.
- فهرس فريد على عمود فريد بالصدفة: مثل اسم المستخدم في عرض محفوظ Materialized View لا يضمن تعريفه تفرده، فيعمل شهوراً ثم يفشل كل تحديث عندما يتكرر الاسم، ويبقى على آخر نسخة ناجحة دون أن يلاحظ أحد. اجعل المفتاح الفريد هو المفتاح الأساسي للجدول الأصلي.
- لا أحد يراقب التحديث: اقرأ سجل
cron.job_run_detailsونبه على أي حالةfailed، واعرضrefreshed_atفي الصفحة، وإلا فالنسخة القديمة من العرض المحفوظ Materialized View تبدو صحيحة. - فترة تحديث أقصر من زمن التحديث: pg_cron لا يشغل نسخة ثانية من المهمة نفسها، بل يضعها في الانتظار حتى تنتهي الأولى بحسب توثيقه، فإذا كان التحديث 20 ثانية والفترة 10 ثوان فقاعدة البيانات تحدث العرض المحفوظ Materialized View بلا توقف.
- نسيان الصفوف الميتة:
CONCURRENTLYيحدث الصفوف بأوامر UPDATE وDELETE وINSERT، فيترك صفوفاً ميتة Dead Tuples ينظفها VACUUM مثل أي جدول، فراقب حجمه. - عرض محفوظ Materialized View لكل مستخدم أو لبيانات لحظية: هو يحسب كل المستخدمين في كل تحديث، فصفحة مختلفة لكل مستخدم مكانها كاش لكل مفتاح أو جدول تكتب فيه عند الحدث.
- الترتيب في تعريف العرض المحفوظ Materialized View:
ORDER BYفي التعريف لا يضمن الترتيب بعد التحديث، فرتب في استعلام القراءة واستخدم فهرساً.
الخلاصة
- العرض المحفوظ Materialized View نتيجة استعلام محفوظة في جدول، تقرأ في أقل من مللي ثانية، وتبقى كما هي حتى تحدثها، فهو يناسب النتيجة المشتركة الثقيلة التي يقبل أصحابها تأخراً معروفاً: لوحات الترتيب وملخص الصفحة الرئيسية وصفحات الفلترة والتقارير والنسخة المحلية من بيانات خدمة أخرى.
- لا يناسب البيانات اللحظية ولا المختلفة لكل مستخدم ولا الجداول التي تتغير كثيراً وتحتاج النتيجة بعد كل تغيير، وهنا الجدول الذي تحدثه في الكتابة أو الكاش لكل مفتاح.
- في التجربة بقيت القراءة من العروض المحفوظة Materialized Views أقل من مللي ثانية من مليون إلى عشرين مليون تصويت، بينما وصلت لوحة الترتيب من الجداول إلى 12.8 ثانية، وتحديثها إلى 13 ثانية مع أن ما تغير 0.05% فقط، لأن التحديث يعيد حساب الكل.
- التحديث العادي
REFRESHأوقف قراءة الصفحة 22.6 ثانية، والتحديث المتزامنCONCURRENTLYسمح بها في 22 مللي ثانية، بشرط فهرس فريد على مفتاح فريد فعلاً، وإلا يتوقف التحديث بصمت. - الأداة pg_cron تجعل الجدولة داخل القاعدة مع سجل لكل تشغيل، ولا تشغل نسختين من المهمة، فاجعل الفترة أطول من زمن التحديث.
- الإضافة pg_ivm تجعل العرض المحفوظ Materialized View لحظياً، ولكنها تدعم تعريفات محدودة، وتضيف عملاً إلى كل كتابة، وتجعل الكتابات المتزامنة تنتظر بعضها، وفي ClickHouse وTimescaleDB صور أخرى للتحديث التزايدي لكل منها حدودها.
 دليلتعلم SQL (3): CTE ودوال النوافذ والمعاملاتكيف تكتب استعلامات أوضح بجمل WITH ودوال النوافذ، وتحمي بياناتك بالمعاملات ومستويات العزل ومن حقن SQL.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلالتخزين المؤقت Caching بالتفصيل: الاستراتيجيات والإبطالكيف تختار نمط التخزين المؤقت المناسب، ومتى تبطل القيمة، وكيف تمنع انهيار قاعدة البيانات عندما ينتهي مفتاح مشهور.
 دليلEvent Sourcing وCQRS: متى تستحق التعقيد؟متى يستحق Event Sourcing وCQRS تعقيدهما، وكيف تبني مخزن أحداث صغيراً على PostgreSQL وتعيد بناء نماذج القراءة منه بأمان.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، والتجربة على PostgreSQL 18.6 مع pg_cron 1.6.8 وpg_ivm 1.15 وpostgres_fdw في Docker Engine 29.8.0، على مليون وخمسة ملايين وعشرين مليون تصويت.
- أكتوبر 2026: إصلاح التنسيق في النص المختلط، وإضافة المصطلح الإنجليزي بجانب العرض والعرض المحفوظ والمصطلحات غير الواضحة.


