

في البداية يطلب المدير تقريراً بسيطاً: مبيعات الإلكترونيات لكل منطقة في كل سنة، فيكتب أحد المطورين استعلاماً على قاعدة بيانات التطبيق يربط ستة جداول، ويضعه في أداة التقارير. ثم يطلب قسم المالية نفس الرقم، فيكتب محلل آخر استعلامه الخاص، ويصل الرقمان إلى الاجتماع مختلفين بفارق 95 مليوناً، وفي نفس الوقت يلاحظ فريق الدعم أن المتجر يبطؤ كل صباح عندما تفتح لوحات التقارير. وقد ذكرنا الفرق بين عمليات التطبيق OLTP والتحليل OLAP باختصار في مقال تصميم قواعد البيانات، وشرحنا التخزين بالأعمدة في مقال ClickHouse، وفي هذا المقال سوف نبني الطبقة التي تجمع بينهما: مستودع البيانات Data Warehouse وطريقة تصميم جداوله.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تبطئ التقارير قاعدة التطبيق، ولماذا يعطي كل تقرير رقماً مختلفاً.
- ما هو OLAP، والمكعب Cube وعملياته، والفرق بين MOLAP وROLAP وHOLAP والقواعد العمودية الحديثة.
- النمذجة البعدية Dimensional Modeling كما وصفها Ralph Kimball: الحقائق والأبعاد، والنجمة والندفة، ومستوى التفصيل Grain، والمفاتيح البديلة، والأبعاد بطيئة التغير SCD.
- الفرق بين ETL وELT، وبين المستودع وال Data Mart وبحيرة البيانات وال Lakehouse، والأدوات المفتوحة لكل منها.
- تجربة عملية: متجر في PostgreSQL فيه 1.5 مليون طلب، ننقله إلى مخطط نجمة في DuckDB، ونشغل عليه ROLLUP وCUBE وGROUPING SETS، ثم نكسر تقرير السنة الماضية بعميل ينتقل من مدينة إلى أخرى ونصلحه.
لماذا لا تكفي قاعدة التطبيق للتقارير؟
قاعدة التطبيق مصممة لعمل محدد: آلاف العمليات الصغيرة التي تقرأ وتكتب صفوفاً قليلة بالمفتاح، والتطبيع Normalization والفهارس فيها تخدم هذا العمل. أما التقرير فيقرأ ملايين الصفوف ويربط جداول كثيرة ويجمعها، وعندما يعمل على نفس السيرفر فهو يأخذ المعالج والذاكرة والقرص من طلبات العملاء. وهذه هي المشكلة الأولى، والحل المعروف لها أن تقرأ التقارير من نسخة للقراءة Read Replica كما شرحنا في مقال Metabase ومقال الجداول الضخمة.
ولكن النسخة تحل البطء فقط، وتبقى المشكلة الثانية وهي الأخطر: الجداول المطبعة لا تقول لك كيف تحسب الإيراد. فهل الإيراد هو سعر المنتج الحالي من جدول products أم السعر الذي دفعه العميل وقت الطلب؟ وهل تدخل الطلبات الملغاة؟ وهل يحسب يوم الطلب بتوقيت UTC أم بتوقيت الرياض؟ كل شخص يجيب على هذه الأسئلة في استعلامه بطريقته، فيخرج لكل تقرير رقم. والصورة التالية تبين المشكلتين كما ظهرتا في تجربتنا:
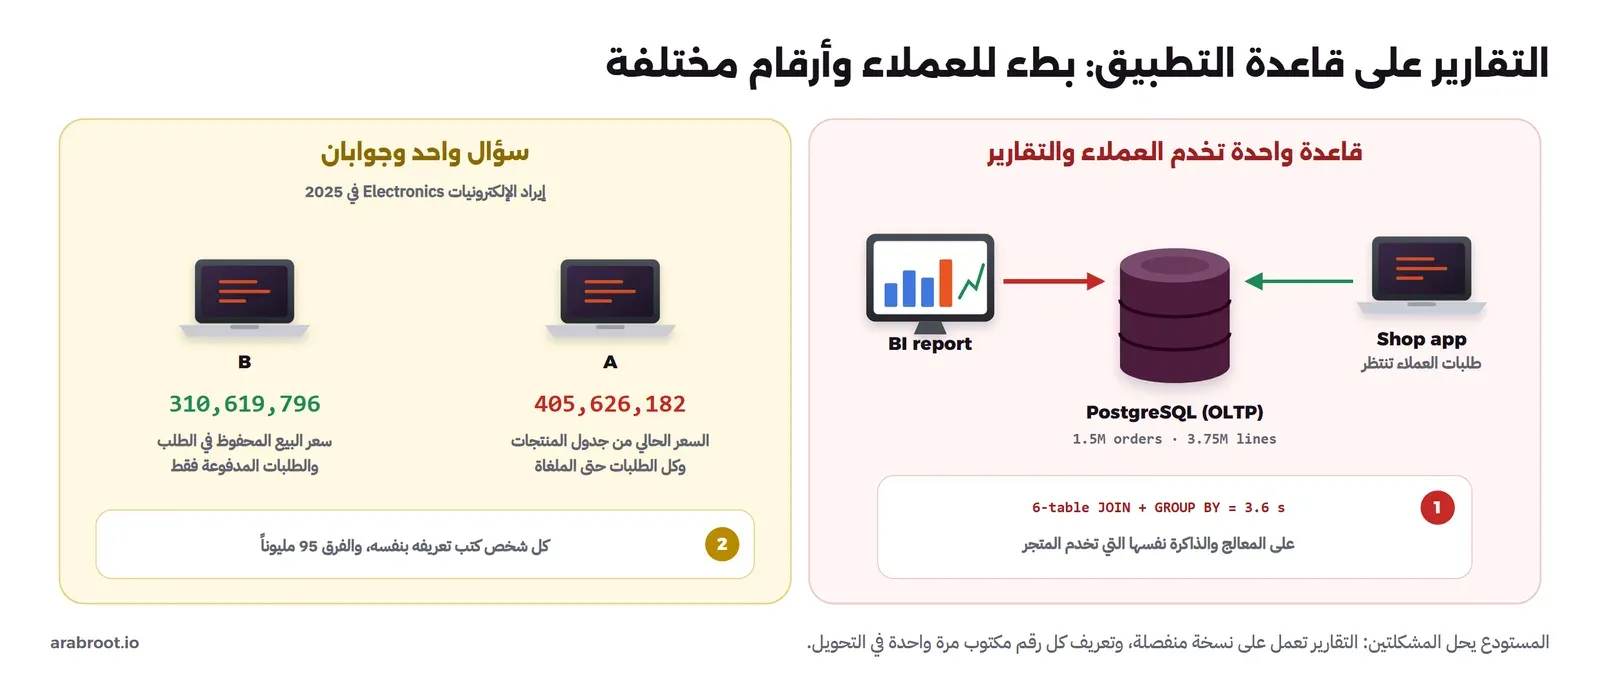
ومستودع البيانات Data Warehouse يحل المشكلتين معاً: هو قاعدة منفصلة مصممة للقراءة والتجميع، تنقل إليها البيانات من التطبيق ومن الأنظمة الأخرى، ويكتب تعريف كل رقم فيها مرة واحدة في خطوة التحويل، فيقرأ الجميع نفس الجدول ونفس الرقم.
ما هو OLAP؟ المكعب وعملياته
ال OLAP، واختصاراً Online Analytical Processing، هو طريقة النظر إلى البيانات كأرقام Measures تقاس على عدة محاور تسمى الأبعاد Dimensions: الإيراد مقاساً بالزمن والمنطقة والفئة. وإذا تخيلت كل بعد ضلعاً من أضلاع مكعب، فكل خانة في المكعب رقم واحد، مثل إيراد الإلكترونيات في المنطقة الوسطى في 2025، ومن هنا جاء اسم مكعب البيانات OLAP Cube، والصورة التالية تبين المكعب والعمليات عليه:
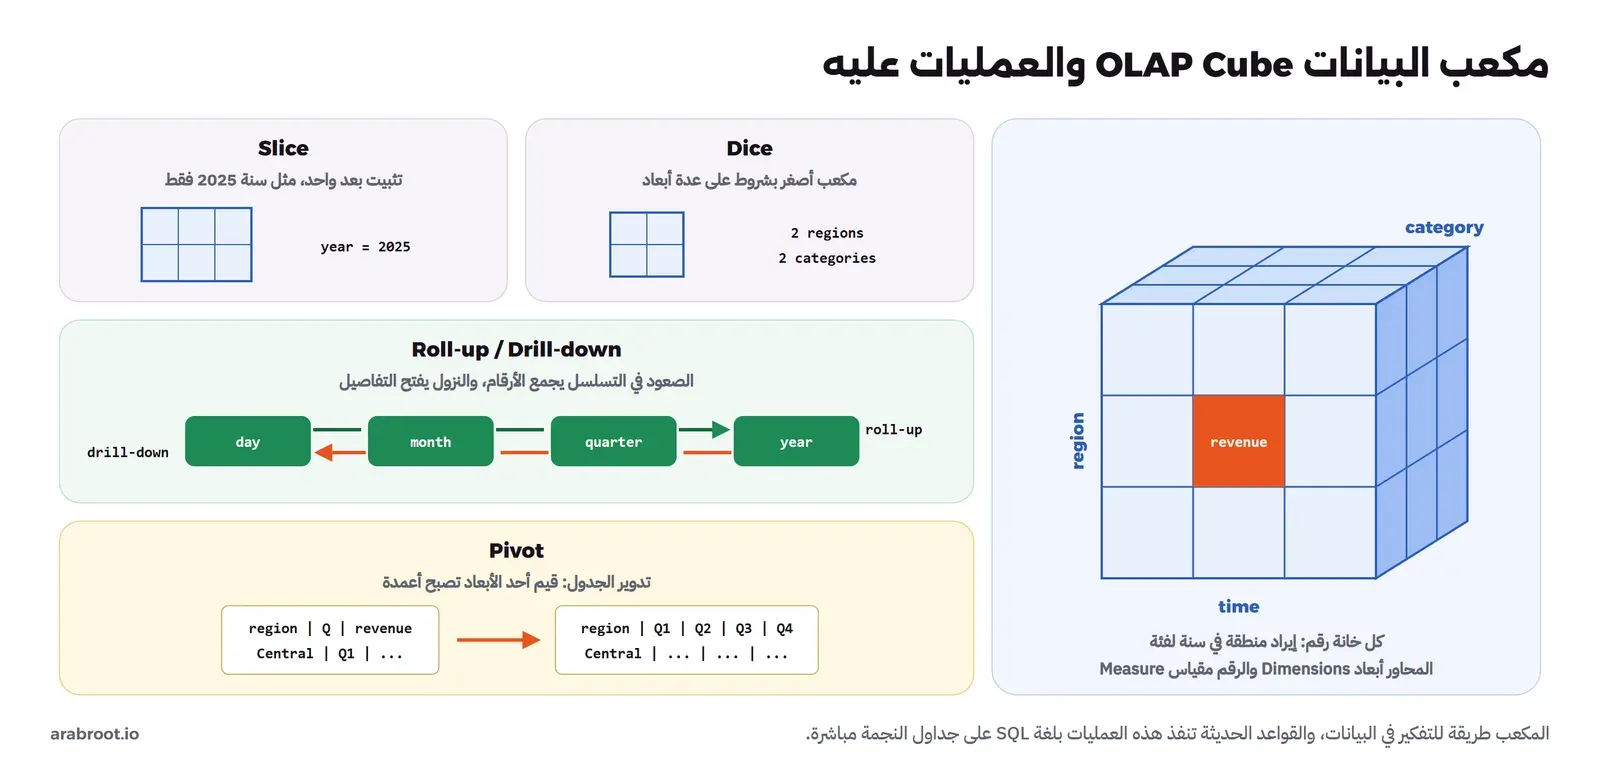
- التقطيع Slice: تثبيت بعد واحد على قيمة واحدة، مثل سنة 2025 فقط، وفي SQL هو شرط
WHERE year = 2025. - التقطيع بعدة شروط Dice: مكعب أصغر بشروط على أكثر من بعد، مثل منطقتين وفئتين وأيام نهاية الأسبوع.
- التجميع للأعلى Roll-up: الصعود في تسلسل البعد، من اليوم إلى الشهر إلى الربع إلى السنة، فتقل الصفوف ويكبر كل رقم.
- التفصيل للأسفل Drill-down: عكس السابق، يرى المدير رقم السنة فيفتح الأرباع ثم الشهور ليعرف أين حدث الانخفاض.
- التدوير Pivot: تحويل قيم أحد الأبعاد إلى أعمدة، مثل المناطق في الصفوف والأرباع في الأعمدة كما في جداول Excel.
MOLAP وROLAP وHOLAP والقواعد العمودية
في التسعينات وما بعدها كانت هذه العمليات تتطلب خادماً خاصاً بالمكعبات، وظهرت ثلاث طرق لتخزينها يشرحها توثيق SQL Server Analysis Services: في MOLAP تنسخ البيانات والمجاميع المحسوبة مسبقاً Aggregations إلى بنية متعددة الأبعاد خاصة بالخادم، فتكون القراءة سريعة جداً ولكن يجب إعادة معالجة المكعب Processing عند كل تحديث. وفي ROLAP تبقى البيانات في قاعدة علائقية وتحفظ المجاميع في جداول أو عروض فيها، فتكون البيانات أحدث والقراءة أبطأ. وفي HOLAP تحفظ المجاميع في المكعب وتبقى التفاصيل في القاعدة العلائقية. ويصف موقع Kimball Group المكعب بأنه في الغالب مشتق من مخطط نجمة علائقي، ويقرأ بلغات أغنى من SQL مثل XMLA.
وقد يتساءل البعض: هل ما زلت تحتاج خادم مكعبات اليوم؟ والإجابة في أغلب الحالات لا، والسبب أن القواعد العمودية Columnar مثل ClickHouse وDuckDB تقرأ الأعمدة التي يحتاجها السؤال فقط وتضغطها وتعالجها دفعات، كما شرحنا في قسم التخزين بالأعمدة، فتجمع ملايين الصفوف في أجزاء من الثانية دون أن تحسب المجاميع مسبقاً. ولذلك أصبح المكعب في الغالب فكرة في رأس من يصمم التقرير، وتنفذ عملياته بجمل SQL مباشرة على جداول النجمة، وسوف نرى ذلك في التجربة.
النمذجة البعدية Dimensional Modeling
النمذجة البعدية هي طريقة تصميم جداول المستودع التي ارتبطت باسم Ralph Kimball، ولاحظ أن موقع مجموعته نفسه يقول إنه لم يخترع الفكرة الأساسية للحقائق والأبعاد، وإنما بنى حولها مجموعة كبيرة من التقنيات والمصطلحات مثل الأبعاد المشتركة والأبعاد بطيئة التغير. والمرجع الذي نعتمد عليه في هذا القسم هو صفحات تقنيات النمذجة البعدية في موقع Kimball Group.
ويبدأ التصميم بحسب الخطوات الأربع بأربعة قرارات بالترتيب: اختيار العملية التجارية Business Process التي تقيسها (المبيعات في مثالنا)، ثم تحديد مستوى التفصيل Grain، ثم الأبعاد، ثم الحقائق.
الحقائق والأبعاد
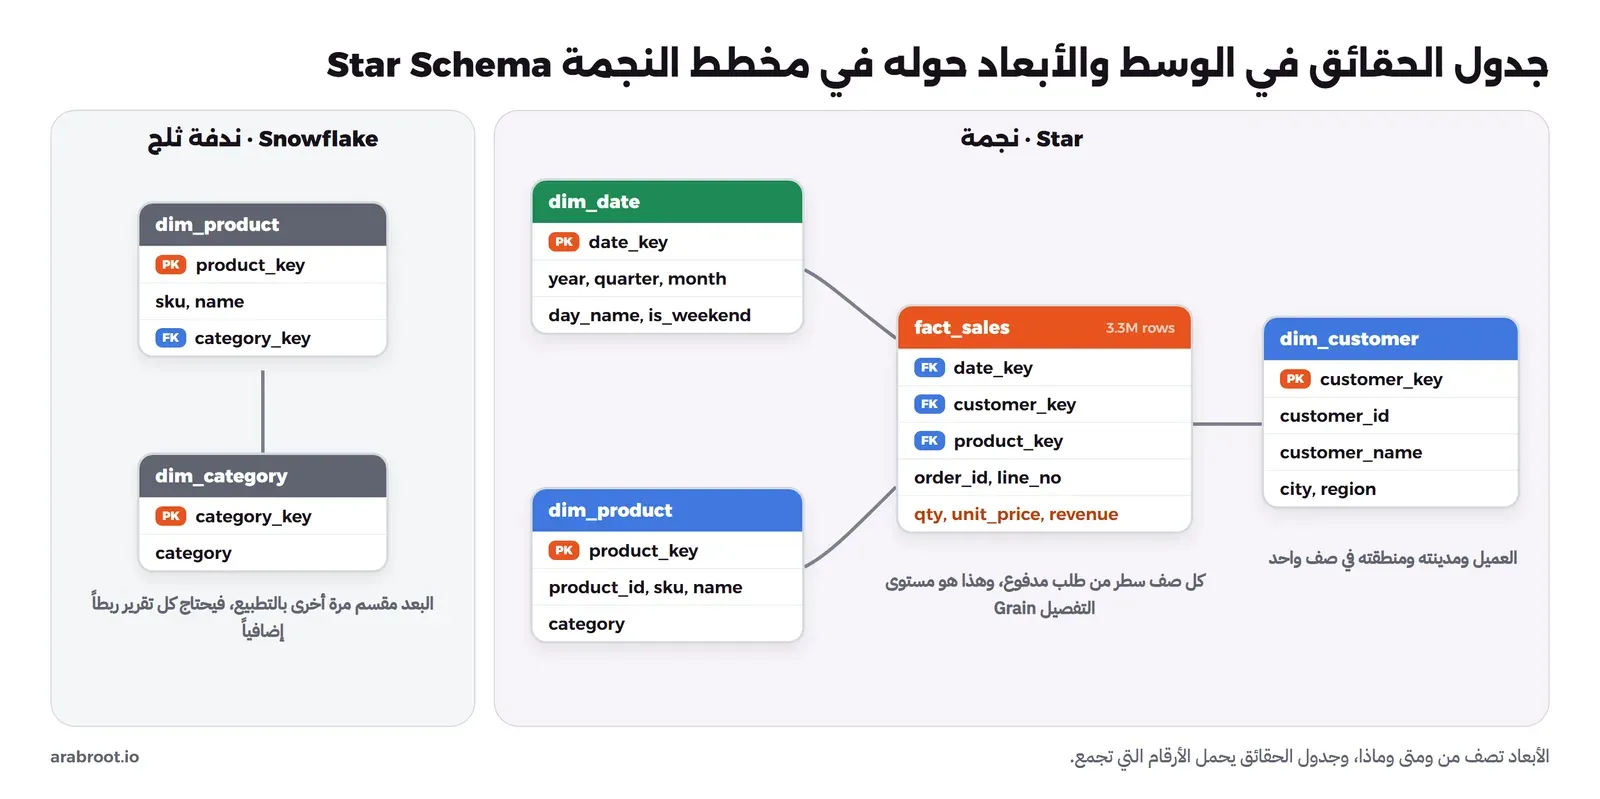
جدول الحقائق Fact Table يحفظ القياسات الرقمية لحدث في العملية التجارية، مثل الكمية والإيراد لكل سطر في طلب، ومعها مفاتيح تشير إلى الأبعاد. وجداول الأبعاد Dimension Tables تحفظ الوصف الذي تسأل به: من اشترى، ومتى، وماذا، وأين. والقاعدة السهلة للتفريق بينهما أن الحقيقة رقم تجمعه بـ sum، والبعد كلمة تضعها في GROUP BY أو WHERE. والصورة التالية تبين مخطط النجمة الذي سوف نبنيه في التجربة:
النجمة أم الندفة Snowflake؟
في مخطط النجمة Star Schema كل بعد جدول واحد غير مطبع: العميل ومدينته ومنطقته في صف واحد، والمنتج وفئته في صف واحد، فيحتاج كل تقرير ربطاً واحداً فقط من جدول الحقائق إلى كل بعد. أما في مخطط الندفة Snowflake Schema فتطبع الأبعاد نفسها، فيصبح للفئة جدول وللمدينة جدول وللمنطقة جدول. وقد يتساءل البعض: ألم نتعلم في مقال التصميم أن التكرار خطأ؟ والإجابة أن التطبيع يحمي قاعدة يكتب فيها التطبيق آلاف المرات في الثانية، أما المستودع فلا يكتب فيه إلا خطوة التحميل، ولذلك ينصح Kimball في صفحة الأبعاد المقسمة بتجنب الندفة، لأنها صعبة على مستخدمي الأعمال وقد تبطئ الاستعلام، والبعد المسطح يحمل نفس المعلومات تماماً.
مستوى التفصيل Grain: القرار الأهم
مستوى التفصيل يحدد بالضبط ماذا يمثل صف واحد في جدول الحقائق، وفي مثالنا: «سطر واحد من طلب مدفوع». ويصف Kimball في صفحة ال Grain هذا القرار بأنه عقد ملزم للتصميم يجب أن يسبق اختيار الأبعاد والحقائق، وينصح بالبدء بأدق مستوى تسجله العملية Atomic Grain، والسبب أن المستوى الدقيق يجيب عن أسئلة لم يتوقعها أحد، أما الجدول الملخص بالشهر مثلاً فيفترض مسبقاً أن أحداً لن يسأل عن يوم بعينه. ولا تقم بخلط مستويين في جدول واحد، مثل صفوف للطلبات وصفوف لسطور الطلبات، لأن أي sum سوف يحسب المبلغ مرتين.
ولاحظ أن رقم الطلب order_id في جدولنا ليس مفتاحاً لبعد، وإنما يبقى في جدول الحقائق كما هو، ويسمى البعد المنحل Degenerate Dimension، وينصح Kimball في صفحة رأس الطلب وسطوره بنقل أبعاد رأس الطلب، مثل العميل والتاريخ، إلى صف السطر نفسه.
المقاييس: ما الذي يجمع وما الذي لا يجمع؟
بحسب صفحة أنواع الحقائق هناك ثلاثة أنواع من الأرقام في جدول الحقائق، ومعرفة النوع تمنعك من تقرير خاطئ:
- قابلة للجمع Additive: تجمع على كل الأبعاد، مثل الكمية والإيراد، فمجموع إيراد المناطق يساوي إيراد الشركة.
- قابلة للجمع جزئياً Semi-additive: تجمع على بعض الأبعاد دون غيرها، ومثالها المعروف الرصيد Balance أو كمية المخزون، فرصيد الحسابات في يوم واحد يجمع على كل الحسابات، أما رصيد يناير مع رصيد فبراير فلا معنى له، وتأخذ فيه آخر قيمة أو المتوسط.
- غير قابلة للجمع Non-additive: مثل النسب ومتوسط السعر وهامش الربح، والحل الذي ينصح به Kimball أن تحفظ مكونات النسبة (الإيراد والتكلفة) وتجمعها أولاً ثم تقسم في النهاية، ولا تقم بجمع نسب جاهزة أو أخذ متوسط متوسطات.
المفاتيح البديلة Surrogate Keys في المستودع
شرحنا المفتاح البديل في مقال التصميم، ولكن سببه في المستودع مختلف: يقول Kimball في صفحة المفتاح البديل إن المفتاح الأساسي للبعد لا يصح أن يكون المفتاح الطبيعي Natural Key القادم من التطبيق، لأن العميل الواحد قد يصبح له أكثر من صف عندما تتبع تغييراته عبر الزمن، ولأن أنظمة مختلفة قد تعطي نفس العميل أرقاماً مختلفة. لذلك يأخذ المستودع ملكية مفاتيحه: رقم صحيح متسلسل لا معنى له لكل صف في البعد، ويبقى رقم العميل في التطبيق عموداً عادياً هو المفتاح الطبيعي، ويسميه Kimball المفتاح الدائم Durable Key في صفحة المفاتيح الطبيعية والدائمة. ويستثني Kimball بعد التاريخ، فمفتاحه يمكن أن يكون رقماً مقروءاً مثل 20250314 كما في صفحة بعد التاريخ، وهذا ما فعلناه في التجربة.
الأبعاد بطيئة التغير Slowly Changing Dimensions
العميل ينتقل من الرياض إلى جدة، والمنتج ينتقل من فئة إلى أخرى، والموظف يغير قسمه، وهذه تغييرات بطيئة في الأبعاد، والسؤال: ماذا يحدث لمبيعات الماضي عندما تتغير مدينة العميل؟ وهناك ثلاثة أنواع أساسية في صفحات Kimball:
- النوع الأول Type 1: تكتب القيمة الجديدة فوق القديمة، وهو سهل ولا يضيف صفوفاً، ولكن صفحة النوع الأول تقول صراحة إنه يدمر التاريخ Destroys History، فكل مبيعات العميل القديمة تنتقل معه إلى جدة. ويناسب تصحيح الأخطاء مثل اسم مكتوب خطأ.
- النوع الثاني Type 2: تضيف صفاً جديداً للعميل بمفتاح بديل جديد، والمبيعات القديمة تبقى مرتبطة بالصف القديم، والجديدة ترتبط بالصف الجديد. وتنص صفحة النوع الثاني على ثلاثة أعمدة على الأقل: تاريخ بداية صلاحية الصف، وتاريخ نهايتها، وعلامة الصف الحالي.
- النوع الثالث Type 3: تضيف عموداً للقيمة السابقة بجانب الحالية، مثل
previous_city، فتستطيع التجميع بالمدينة الحالية أو السابقة، ولكنه يحفظ تغييراً واحداً فقط، وتقول صفحة النوع الثالث إنه قليل الاستخدام.
والصورة التالية تبين الفرق بين النوع الأول والثاني على العميل الذي سوف ننقله في التجربة، بالأرقام الحقيقية:
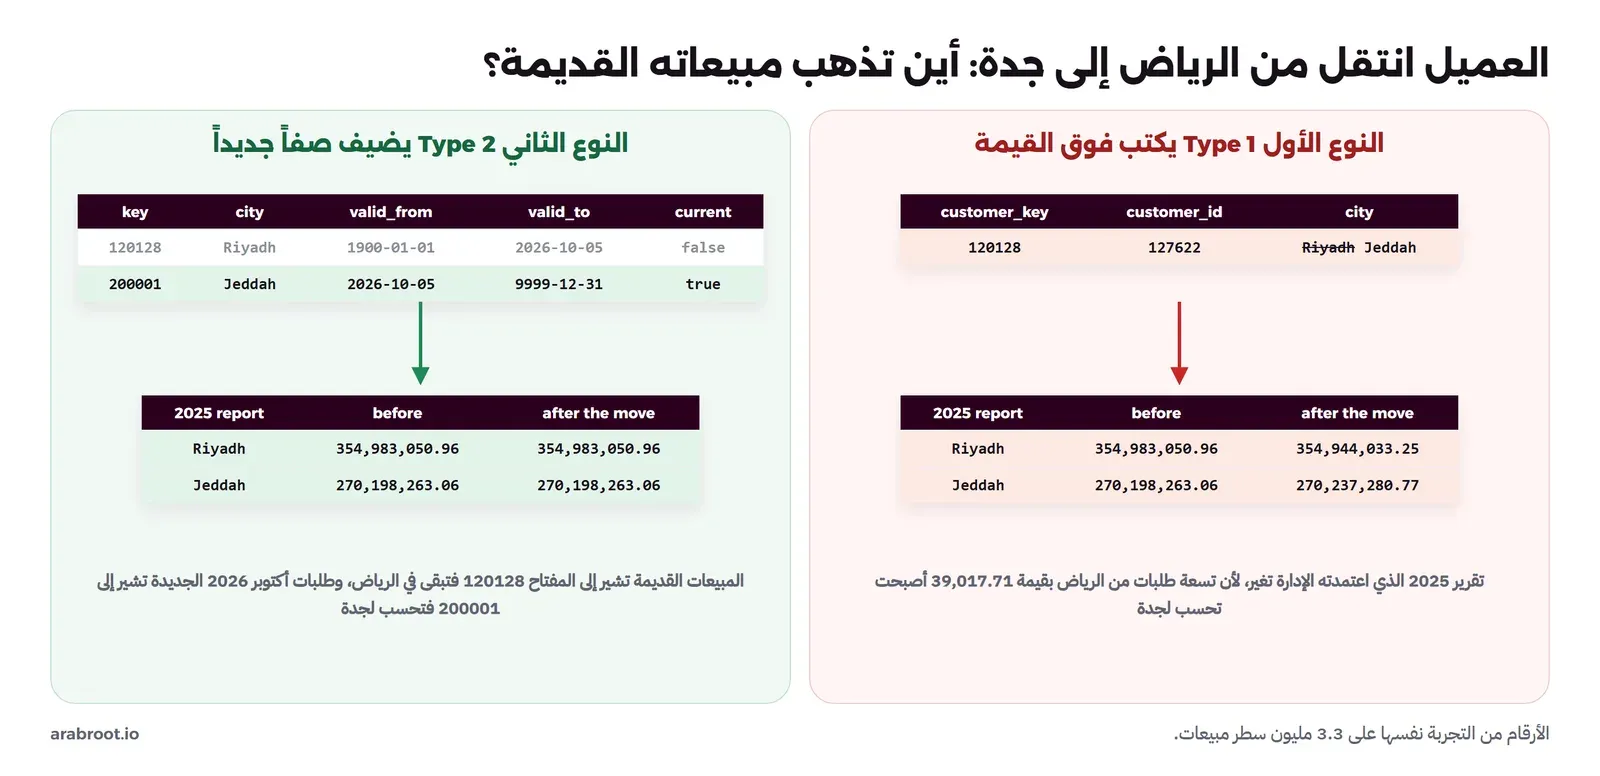
وفي الواقع تخلط الأنواع في البعد الواحد بحسب العمود: المدينة والمنطقة Type 2 لأن التقارير الجغرافية تحتاج تاريخها، والاسم Type 1 لأن تصحيح الاسم لا يحتاج تاريخاً، وهذا ما سوف نكتبه في التجربة.
الأبعاد المشتركة Conformed Dimensions
عندما يكون لديك جدول حقائق للمبيعات وجدول حقائق للمرتجعات وآخر لتذاكر الدعم، فكلها تحتاج بعد العميل وبعد التاريخ. والبعد المشترك هو بعد واحد بنفس الأعمدة ونفس القيم تستخدمه كل جداول الحقائق، فتستطيع أن تضع المبيعات والمرتجعات لكل مدينة في تقرير واحد وتتطابق الصفوف، ويسمي Kimball ذلك في صفحة الأبعاد المشتركة جوهر التكامل في المستودع. وإذا بنى كل فريق بعد العميل بنفسه، فسوف تعود مشكلة الأرقام المختلفة من باب آخر.
ETL أم ELT؟
نقل البيانات من التطبيق إلى المستودع له ثلاث خطوات: الاستخراج Extract من المصدر، والتحويل Transform إلى شكل النجمة، والتحميل Load في المستودع. وفي الطريقة التقليدية ETL يحدث التحويل على سيرفر أو أداة خارج المستودع، ثم تحمل الجداول النهائية فقط. وفي الطريقة الأحدث ELT تنسخ الجداول كما هي إلى المستودع أولاً، ثم يحدث التحويل داخله بلغة SQL، والصورة التالية تبين الفرق:
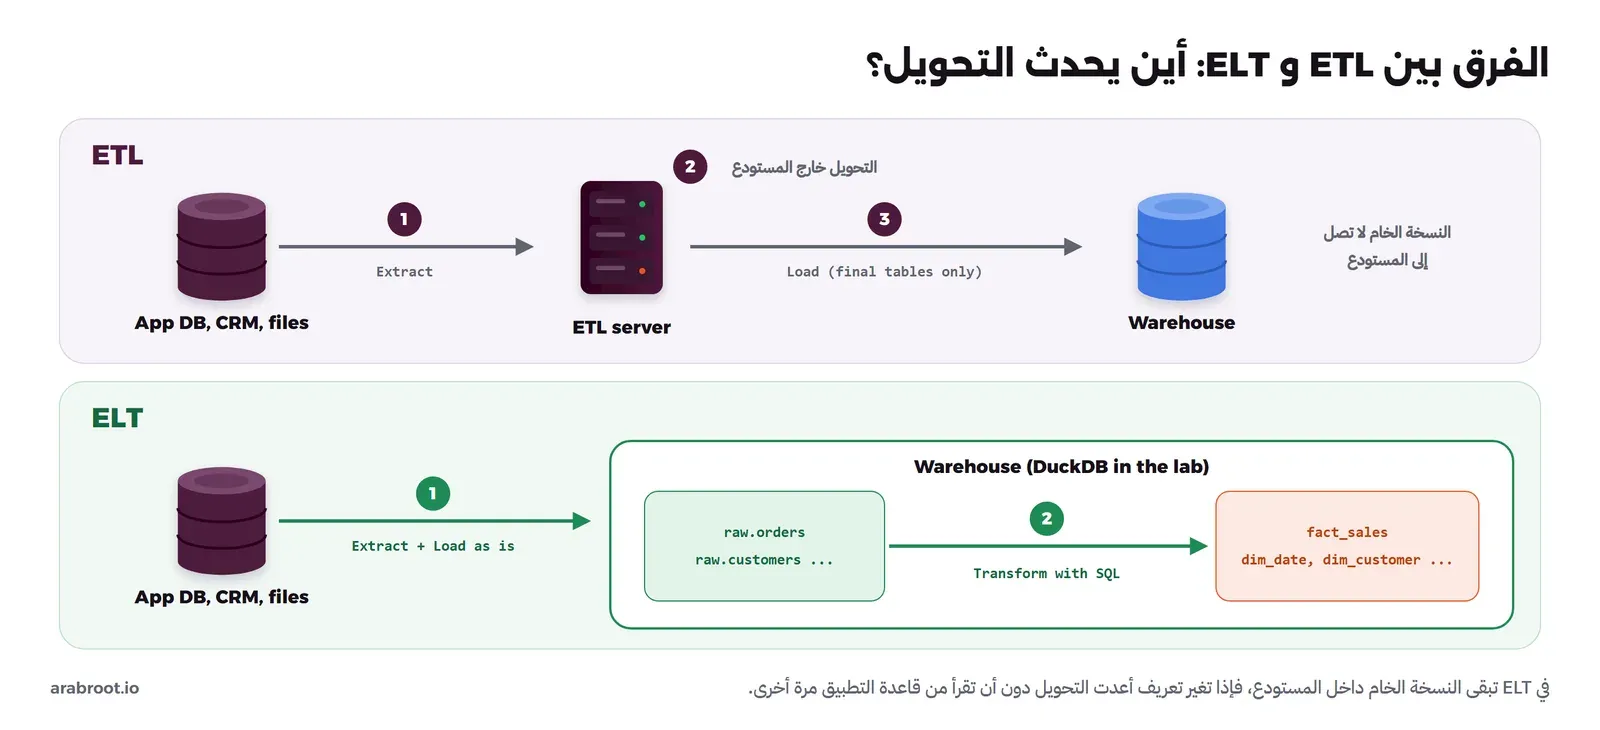
وانتشرت ELT لأن القواعد العمودية أصبحت سريعة بما يكفي لتحويل ملايين الصفوف بنفسها، ولأن النسخة الخام تعطيك ميزة مهمة: إذا اكتشفت خطأ في تعريف الإيراد فأنت تعدل جملة SQL وتعيد التحويل، دون أن تقرأ من قاعدة التطبيق مرة أخرى. أما ETL فما زالت مناسبة عندما يجب أن تحذف أو تخفي بيانات حساسة قبل أن تصل إلى المستودع أصلاً. وفي التجربة سوف نستخدم ELT بأبسط شكل، أما الأدوات التي تدير النقل والتحويل في الإنتاج، مثل Airbyte للنقل وdbt لتنظيم جمل التحويل واختبارها، فهي مواضيع مخطط لها في مرحلة البيانات في خريطة التعلم، وكذلك نقل التغييرات أولاً بأول CDC بدل النسخ الكامل.
المستودع وال Data Mart وبحيرة البيانات وال Lakehouse
هذه الأسماء تتكرر في كل نقاش عن البيانات، والفرق بينها في مكان الحفظ ومتى تنظم البيانات، والصورة التالية تضعها بجانب بعض:
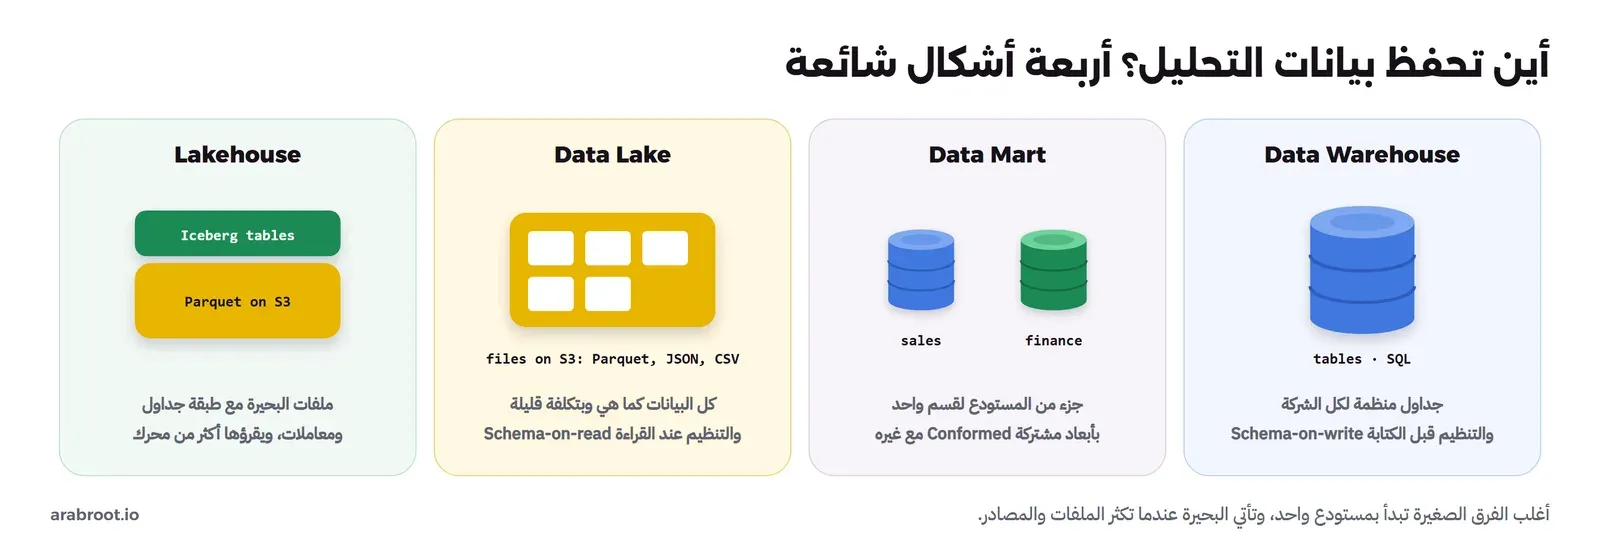
- مستودع البيانات Data Warehouse: قاعدة واحدة منظمة لتحليلات الشركة كلها، تكتب فيها الجداول بشكلها النهائي.
- ال Data Mart: جزء من المستودع لقسم واحد، مثل المبيعات أو المالية، وإذا استخدم الأبعاد المشتركة بقيت أرقامه متوافقة مع باقي الأقسام.
- بحيرة البيانات Data Lake: ملفات على تخزين كائنات مثل S3، بصيغ Parquet وJSON وCSV، تحفظ كما هي وبتكلفة قليلة، وتنظم عند القراءة، وبدون فهرس وإدارة تصبح كومة ملفات لا يعرف أحد ما فيها.
- ال Lakehouse: الفكرة التي عرضتها ورقة CIDR 2021: ملفات البحيرة نفسها بصيغة مفتوحة، وفوقها طبقة جداول مثل Apache Iceberg تضيف المعاملات وتغيير الأعمدة والرجوع إلى نسخة سابقة، فتعمل عليها محركات مختلفة كأنها مستودع، وقد ذكرنا Iceberg في خريطة مشاريع Apache، وبناء Lakehouse على S3 مستضاف ذاتياً موضوع مخطط له في مرحلة البيانات.
الأدوات المفتوحة للمستودع والتقارير
لا تحتاج خدمة سحابية لتبني مستودعاً، فهذه أشهر المحركات المفتوحة، والرخص كما قرأناها من مستودعاتها في أكتوبر 2026:
- DuckDB برخصة MIT: قاعدة تحليلية تعمل داخل برنامجك أو من سطر الأوامر في ملف واحد دون سيرفر، وتقرأ PostgreSQL وملفات Parquet مباشرة، وهي التي سوف نستخدمها في التجربة. وتناسب الفريق الصغير والمحلل الواحد والتحويل في خطوة ELT، ولا تناسب مستودعاً مشتركاً يكتب فيه ويقرأ منه عدة برامج في نفس الوقت، لأن ملف القاعدة يفتحه للكتابة برنامج واحد فقط بحسب صفحة التزامن Concurrency. وسوف نخصص لها مقالاً في مرحلة البيانات.
- ClickHouse برخصة Apache 2.0: سيرفر تحليلي عمودي لعشرات ومئات الملايين من الصفوف، وشرحناه بالتجربة في مقال ClickHouse. ويدعم
WITH ROLLUPوWITH CUBEوGROUPING SETS، ولكن لاحظ أن صفحة GROUP BY تقول إنه يضع في صفوف المجاميع الفرعية صفراً أو نصاً فارغاً بدل NULL، إلا إذا فعلت الإعدادgroup_by_use_nulls. - Apache Doris برخصة Apache 2.0: قاعدة تحليلية موزعة بمعمارية MPP من مؤسسة Apache، للتحليل اللحظي على عدة سيرفرات.
- StarRocks برخصة Apache 2.0: محرك تحليلي موزع يتصل به العملاء ببروتوكول MySQL ويقرأ جداول Iceberg مباشرة. ولاحظ تاريخ رخصته: نشر المستودع في سبتمبر 2021 برخصة Elastic License 2.0 كما في ملف الرخصة في أول نسخة، ثم انتقل إلى Apache 2.0 في ديسمبر 2022 بحسب طلب الدمج 14655.
- PostgreSQL نفسه: لمستودع صغير بالعروض المحفوظة أو بإضافة عمودية، والخيارات وحالتها في قسم التحليلات في مقال PostgreSQL لكل شيء. وإذا كانت بياناتك قراءات أجهزة ومقاييس زمنية فانظر أولاً في مقال قواعد السلاسل الزمنية.
وفوق المستودع تأتي أداة ذكاء الأعمال BI التي تعرض اللوحات للمدير، وقد شرحنا أداتين مفتوحتين بالتثبيت والتجربة:
 دليلMetabase: لوحات وتقارير من بياناتك دون كتابة كودكيف تثبت Metabase على سيرفرك، وتبني منه أسئلة ولوحة مبيعات من بيانات شركتك بالنقر أو بلغة SQL.
 دليلApache Superset: تحليلات ولوحات تقارير على سيرفرككيف تثبت Apache Superset على سيرفرك، وتبني منه مقاييس ورسوماً ولوحة تقارير من بيانات شركتك.
وقد أعدنا تجربة هذا المقال نفسها في دليل Superset: بنينا النجمة داخل PostgreSQL وربطنا بها Superset، ثم قيدنا الصفوف لفريق منطقة واحدة وقسنا الذاكرة المؤقتة، والأرقام في اللوحة هي أرقام هذا المقال حتى الهللة. وإذا كنت تختار بين Metabase وSuperset وPower BI لهذه الطبقة فقد قارناها بالرخص والأسعار والعربية وتقييد الصفوف في مقال المقارنة.
تجربة عملية: من قاعدة المتجر إلى مخطط نجمة
سوف نبني قاعدة متجر في PostgreSQL 18.6 مطبعة كما في مقال التصميم، فيها 200 ألف عميل و1.5 مليون طلب من يناير 2024 حتى سبتمبر 2026 و3.75 مليون سطر، ثم ننسخها إلى DuckDB 1.5.6 ونحولها إلى نجمة. والتجربة على Docker Engine 29.8.0 في Docker Desktop على جهاز بثمانية أنوية و32 GB، وعلى نفس الجهاز كانت تعمل Containers أخرى، لذلك نأخذ أفضل وقت من ثلاث محاولات، والأوقات قياس محلي للتوضيح فقط وليست مقارنة أداء عامة.
ملف التشغيل
نحتاج Container لقاعدة التطبيق وآخر فيه برنامج DuckDB من سطر الأوامر، ونبني الثاني من ملف الإصدار الرسمي في GitHub مع التحقق من الهاش Checksum، ومعه إضافة postgres التي تقرأ بها DuckDB من PostgreSQL. والملف Dockerfile كما يلي:
# DuckDB CLI 1.5.6 (official release binary, checksum from the GitHub release page)
FROM python:3.13.16-slim
ADD --checksum=sha256:cce2687a38681db644c248198b99ecd86170ff47e324c5f33e50c0042f142839 \
    https://github.com/duckdb/duckdb/releases/download/v1.5.6/duckdb_cli-linux-amd64.gz /tmp/duckdb.gz
RUN python -c "import gzip,shutil; shutil.copyfileobj(gzip.open('/tmp/duckdb.gz'), open('/usr/local/bin/duckdb','wb'))" \
 && chmod +x /usr/local/bin/duckdb && rm /tmp/duckdb.gz \
 && duckdb -c "INSTALL postgres;"
والملف compose.yaml:
# Online shop OLTP (PostgreSQL) + a DuckDB warehouse next to it (ArabRoot lab).
#   docker compose -p lab-olap up -d --build
name: lab-olap
services:
  postgres:
    image: postgres:18.6
    container_name: lab-olap-pg
    environment:
      POSTGRES_PASSWORD: lab-pass
    command: ["postgres", "-c", "shared_buffers=1GB", "-c", "max_parallel_workers_per_gather=4", "-c", "timezone=Asia/Riyadh"]
    shm_size: 1g
    ports: ["127.0.0.1:15440:5432"]
    volumes: ["./:/lab:ro", "pg-data:/var/lib/postgresql"]
  duckdb:
    build: .
    image: lab-olap-duckdb:1.5.6
    container_name: lab-olap-duckdb
    working_dir: /lab
    command: ["sleep", "infinity"]
    volumes: ["./:/lab:ro", "dw-data:/dw"]
volumes:
  pg-data:
  dw-data:
في الإعداد أعلاه لاحظ التالي:
- المنطقة الزمنية
Asia/Riyadhفي PostgreSQL، وسوف نضعها أيضاً في كل جلسة DuckDB، والسبب أن الطلب الساعة 11 ليلاً بتوقيت UTC هو طلب اليوم التالي في الرياض، وهذا وحده كاف ليعطي تقريرين أرقاماً مختلفة لنفس اليوم. - ملف المستودع يحفظ في Volume اسمه
dw-data، وDuckDB لا تحتاج سيرفراً، فال Container هنا مجرد مكان لتشغيل الأمر. - المنفذ مربوط على
127.0.0.1فقط.
قاعدة المتجر
الملف 01-oltp.sql ينشئ الجداول المطبعة ويولد البيانات، ولاحظ في آخره خطوتين مهمتين: رفع أسعار الإلكترونيات 15% بعد البيع، فتبقى أسعار السطور القديمة في unit_price كما دفعها العميل، وإنشاء مستخدم elt_reader للقراءة فقط يستخدمه المستودع بدل مستخدم المالك:
-- The application database of a small online shop (OLTP), normalised as in the db-design article.
-- docker exec -i lab-olap-pg psql -U postgres -v ON_ERROR_STOP=1 < 01-oltp.sql
CREATE SCHEMA shop;
CREATE TABLE shop.cities (
  id     int  PRIMARY KEY,
  name   text NOT NULL UNIQUE,
  region text NOT NULL
);
CREATE TABLE shop.categories (
  id   int  PRIMARY KEY,
  name text NOT NULL UNIQUE
);
CREATE TABLE shop.products (
  id          int GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  sku         text NOT NULL UNIQUE,
  name        text NOT NULL,
  category_id int  NOT NULL REFERENCES shop.categories,
  price       numeric(10,2) NOT NULL
);
CREATE TABLE shop.customers (
  id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email      text NOT NULL UNIQUE,
  name       text NOT NULL,
  city_id    int  NOT NULL REFERENCES shop.cities,
  created_at timestamptz NOT NULL,
  updated_at timestamptz NOT NULL
);
CREATE TABLE shop.orders (
  id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  customer_id bigint NOT NULL REFERENCES shop.customers,
  status      text NOT NULL CHECK (status IN ('paid', 'cancelled', 'pending')),
  created_at  timestamptz NOT NULL
);
CREATE TABLE shop.order_items (
  order_id   bigint   NOT NULL REFERENCES shop.orders,
  line_no    smallint NOT NULL,
  product_id int      NOT NULL REFERENCES shop.products,
  qty        int      NOT NULL CHECK (qty > 0),
  unit_price numeric(10,2) NOT NULL,      -- the price at the moment of sale
  PRIMARY KEY (order_id, line_no)
);
CREATE INDEX ON shop.orders (customer_id);
CREATE INDEX ON shop.orders (created_at);
CREATE INDEX ON shop.order_items (product_id);

INSERT INTO shop.cities VALUES
  (1, 'Riyadh', 'Central'), (2, 'Buraydah', 'Central'),
  (3, 'Jeddah', 'Western'), (4, 'Makkah', 'Western'), (5, 'Madinah', 'Western'),
  (6, 'Dammam', 'Eastern'), (7, 'Khobar', 'Eastern'), (8, 'Abha', 'Southern');
INSERT INTO shop.categories VALUES (1, 'Electronics'), (2, 'Books'), (3, 'Home'), (4, 'Fashion');

SELECT setseed(0.42);
INSERT INTO shop.products (sku, name, category_id, price)
SELECT 'SKU-' || lpad(g::text, 4, '0'), 'Product ' || g, 1 + g % 4,
       round((10 + random() * 990)::numeric, 2)
FROM generate_series(1, 300) g;

INSERT INTO shop.customers (email, name, city_id, created_at, updated_at)
SELECT 'c' || g || '@example.com', 'Customer ' || g,
       (ARRAY[1,1,1,1,2,3,3,3,4,5,6,6,7,8])[1 + floor(random() * 14)::int],
       ts, ts
FROM (SELECT g, timestamptz '2023-01-01' + random() * interval '364 days' AS ts
      FROM generate_series(1, 200000) g) s;

-- 1.5 million orders from January 2024 to the end of September 2026
INSERT INTO shop.orders (customer_id, status, created_at)
SELECT 1 + floor(random() * 200000)::bigint,
       CASE WHEN r < 0.88 THEN 'paid' WHEN r < 0.96 THEN 'cancelled' ELSE 'pending' END,
       timestamptz '2024-01-01 00:00+03' + random() * (timestamptz '2026-10-01 00:00+03' - timestamptz '2024-01-01 00:00+03')
FROM (SELECT random() AS r FROM generate_series(1, 1500000)) s;

-- 1 to 4 lines per order, unit_price copied from the product at the moment of sale
INSERT INTO shop.order_items (order_id, line_no, product_id, qty, unit_price)
SELECT l.order_id, l.line_no, l.product_id, l.qty, p.price
FROM (SELECT o.id AS order_id, n AS line_no,
             1 + floor(random() * 300)::int AS product_id,
             1 + floor(random() * 3)::int AS qty
      FROM shop.orders o
      CROSS JOIN LATERAL generate_series(1, 1 + ((o.id * 7919) % 4)::int) n) l
JOIN shop.products p ON p.id = l.product_id;

-- later, electronics became 15% more expensive: old order lines keep the old price
UPDATE shop.products SET price = round(price * 1.15, 2) WHERE category_id = 1;

-- a read-only role for the warehouse load, never the owner
CREATE ROLE elt_reader LOGIN PASSWORD 'elt-pass';
GRANT USAGE ON SCHEMA shop TO elt_reader;
GRANT SELECT ON ALL TABLES IN SCHEMA shop TO elt_reader;

VACUUM ANALYZE;
SELECT (SELECT count(*) FROM shop.customers) AS customers,
       (SELECT count(*) FROM shop.orders) AS orders,
       (SELECT count(*) FROM shop.order_items) AS order_items,
       pg_size_pretty(pg_database_size('postgres')) AS db_size;
نشغل الملفين بالأوامر التالية:
docker compose -p lab-olap up -d --build
docker exec -i lab-olap-pg psql -U postgres -v ON_ERROR_STOP=1 < 01-oltp.sql
والمخرج في آخره سوف يكون كما يلي، وأخذ التوليد نحو خمس دقائق:
UPDATE 75
CREATE ROLE
GRANT
GRANT
VACUUM
 customers | orders  | order_items | db_size
-----------+---------+-------------+---------
    200000 | 1500000 |     3750000 | 573 MB
(1 row)
التقرير على قاعدة التطبيق
السؤال: إيراد الإلكترونيات لكل منطقة في كل سنة، من الطلبات المدفوعة وبسعر البيع. وعلى القاعدة المطبعة يحتاج ستة جداول، وهذا هو الملف 05-report-oltp.sql، وفيه نفس الاستعلام ثلاث مرات مع \timing:
\timing on
SELECT extract(year FROM o.created_at)::int AS year, ci.region,
       sum(oi.qty * oi.unit_price) AS revenue
FROM shop.orders o
JOIN shop.order_items oi ON oi.order_id = o.id
JOIN shop.customers cu   ON cu.id = o.customer_id
JOIN shop.cities ci      ON ci.id = cu.city_id
JOIN shop.products p     ON p.id = oi.product_id
JOIN shop.categories cat ON cat.id = p.category_id
WHERE o.status = 'paid' AND cat.name = 'Electronics'
GROUP BY 1, 2 ORDER BY 1, 2;
-- the same query twice more with \o /dev/null, only the times are printed
docker exec -i lab-olap-pg psql -U postgres < 05-report-oltp.sqlوالمخرج سوف يكون كما يلي:
 year |  region  |   revenue
------+----------+--------------
 2024 | Central  | 111595090.23
 2024 | Eastern  |  66688370.84
 2024 | Southern |  21658650.35
 2024 | Western  | 111201281.80
 2025 | Central  | 110741177.29
 2025 | Eastern  |  66709525.70
 2025 | Southern |  21997743.95
 2025 | Western  | 111171348.67
 2026 | Central  |  82929638.63
 2026 | Eastern  |  49459894.18
 2026 | Southern |  16826037.76
 2026 | Western  |  82840453.99
(12 rows)

Time: 3749.566 ms (00:03.750)
Time: 3617.069 ms (00:03.617)
Time: 3721.413 ms (00:03.721)
نحو 3.6 ثانية في كل مرة، وخطة التنفيذ في EXPLAIN تبين أن PostgreSQL يشغل فيها ثلاثة Workers متوازية على نفس السيرفر الذي يخدم المتجر، وإذا فتح عشرون موظفاً اللوحة في نفس الدقيقة فأنت تعرف النتيجة.
نفس السؤال وجوابان
الآن نفرض أن شخصين كتبا استعلام «إيراد الإلكترونيات في 2025» كل بطريقته، والفرق بينهما في سطرين فقط، وهذا هو الملف 06-two-analysts.sql:
SELECT 'analyst A' AS who, sum(oi.qty * p.price) AS revenue_2025
FROM shop.orders o JOIN shop.order_items oi ON oi.order_id = o.id
JOIN shop.products p ON p.id = oi.product_id
WHERE p.category_id = 1 AND o.created_at >= '2025-01-01' AND o.created_at < '2026-01-01'
UNION ALL
SELECT 'analyst B', sum(oi.qty * oi.unit_price)
FROM shop.orders o JOIN shop.order_items oi ON oi.order_id = o.id
JOIN shop.products p ON p.id = oi.product_id
WHERE p.category_id = 1 AND o.status = 'paid'
  AND o.created_at >= '2025-01-01' AND o.created_at < '2026-01-01';
والمخرج:
    who    | revenue_2025
-----------+--------------
 analyst A | 405626182.48
 analyst B | 310619795.61
(2 rows)
الأول أخذ السعر الحالي من جدول المنتجات بعد رفعه 15%، وحسب الطلبات الملغاة والمعلقة، والثاني أخذ السعر المحفوظ في سطر الطلب والطلبات المدفوعة فقط، والفرق 95 مليوناً. ولا يوجد خطأ في SQL عند أي منهما، فالمشكلة أن تعريف «الإيراد» غير مكتوب في مكان واحد، وهذا ما سوف يصلحه المستودع.
ELT إلى DuckDB: النسخ ثم التحويل
الخطوة الأولى E وL: نتصل من DuckDB بقاعدة التطبيق بمستخدم القراءة وبوضع READ_ONLY كما في توثيق إضافة postgres، وننسخ الجداول كما هي إلى المخطط raw، وهذا هو الملف 02-extract.sql:
-- E + L of ELT: copy the source tables as they are into the raw schema of the warehouse.
-- The connection uses elt_reader, a role that can only SELECT.
SET TimeZone = 'Asia/Riyadh';
ATTACH 'host=lab-olap-pg port=5432 dbname=postgres user=elt_reader password=elt-pass'
  AS src (TYPE postgres, READ_ONLY);
CREATE SCHEMA IF NOT EXISTS raw;
CREATE OR REPLACE TABLE raw.cities      AS FROM src.shop.cities;
CREATE OR REPLACE TABLE raw.categories  AS FROM src.shop.categories;
CREATE OR REPLACE TABLE raw.products    AS FROM src.shop.products;
CREATE OR REPLACE TABLE raw.customers   AS FROM src.shop.customers;
CREATE OR REPLACE TABLE raw.orders      AS FROM src.shop.orders;
CREATE OR REPLACE TABLE raw.order_items AS FROM src.shop.order_items;
DETACH src;
والخطوة الثانية T: بعد التاريخ وبعد المنتج في الملف 03-dims.sql. لاحظ أن بعد التاريخ يولد من التقويم وليس من الطلبات، فيحمل معلومات لا توجد في قاعدة التطبيق أصلاً مثل الربع ونهاية الأسبوع (الجمعة والسبت)، ولاحظ أن الفئة تنسخ في صف المنتج، فهذه نجمة وليست ندفة:
-- T of ELT (part 1): the date and product dimensions, rebuilt on every run.
SET TimeZone = 'Asia/Riyadh';
CREATE OR REPLACE TABLE dim_date AS
SELECT CAST(strftime(d, '%Y%m%d') AS INTEGER) AS date_key,   -- 20250314: a readable key, as Kimball allows for dates
       CAST(d AS DATE)            AS full_date,
       year(d)                    AS year,
       quarter(d)                 AS quarter,
       month(d)                   AS month,
       strftime(d, '%Y-%m')       AS year_month,
       dayname(d)                 AS day_name,
       dayofweek(d) IN (5, 6)     AS is_weekend               -- Friday and Saturday
FROM range(TIMESTAMP '2024-01-01', TIMESTAMP '2027-01-01', INTERVAL 1 DAY) t(d);

-- star, not snowflake: the category name is copied into the product row
CREATE OR REPLACE TABLE dim_product AS
SELECT row_number() OVER (ORDER BY p.id) AS product_key,
       p.id AS product_id, p.sku, p.name AS product_name,
       c.name AS category, p.price AS list_price
FROM raw.products p JOIN raw.categories c ON c.id = p.category_id;
ثم بعد العميل وجدول الحقائق في الملف 04-star-type1.sql، وفي هذه المحاولة الأولى نبني بعد العميل بالطريقة البسيطة: نعيد إنشاءه من المصدر في كل تشغيل، أي Type 1:
-- T of ELT (part 2), first attempt: the customer dimension as type 1 (overwrite) and the fact table.
SET TimeZone = 'Asia/Riyadh';
CREATE OR REPLACE TABLE dim_customer AS
SELECT row_number() OVER (ORDER BY cu.id) AS customer_key,
       cu.id AS customer_id, cu.name AS customer_name,
       ci.name AS city, ci.region
FROM raw.customers cu JOIN raw.cities ci ON ci.id = cu.city_id;

-- grain: one row per line of a paid order
CREATE OR REPLACE TABLE fact_sales AS
SELECT CAST(strftime(CAST(o.created_at AS DATE), '%Y%m%d') AS INTEGER) AS date_key,
       dc.customer_key, dp.product_key,
       o.id AS order_id, oi.line_no,                 -- degenerate dimension
       oi.qty, oi.unit_price,
       oi.qty * oi.unit_price AS revenue             -- price at the moment of sale
FROM raw.orders o
JOIN raw.order_items oi ON oi.order_id = o.id
JOIN dim_customer dc    ON dc.customer_id = o.customer_id
JOIN dim_product dp     ON dp.product_id = oi.product_id
WHERE o.status = 'paid';

SELECT (SELECT count(*) FROM dim_date) AS dim_date, (SELECT count(*) FROM dim_product) AS dim_product,
       (SELECT count(*) FROM dim_customer) AS dim_customer, (SELECT count(*) FROM fact_sales) AS fact_sales;
هنا كتب تعريف الإيراد مرة واحدة: سعر البيع ضرب الكمية، والطلبات المدفوعة فقط، وتاريخ الطلب بتوقيت الرياض. وكل تقرير بعد ذلك يجمع العمود revenue ولا يعيد تعريفه. نشغل الملفات الثلاثة على ملف المستودع:
cat 02-extract.sql 03-dims.sql 04-star-type1.sql | docker exec -i lab-olap-duckdb duckdb /dw/shop.duckdbوالمخرج:
┌──────────┬─────────────┬──────────────┬────────────┐
│ dim_date │ dim_product │ dim_customer │ fact_sales │
│  int64   │    int64    │    int64     │   int64    │
├──────────┼─────────────┼──────────────┼────────────┤
│     1096 │         300 │       200000 │    3301384 │
└──────────┴─────────────┴──────────────┴────────────┘
أخذ النسخ من PostgreSQL نحو خمس ثوان، والتحويل نحو 3.6 ثانية، وأصبح جدول الحقائق 3,301,384 سطراً من الطلبات المدفوعة. وملف المستودع كله بالنسخة الخام والنجمة 184 MB، مقابل 573 MB لقاعدة التطبيق، والسبب أن DuckDB تحفظ بالأعمدة وتضغطها.
نفس التقرير على النجمة
الآن نفس السؤال على النجمة في الملف 08-report-star.sql، ومعه للمقارنة نفس الاستعلام بالجداول الستة على النسخة الخام داخل DuckDB، حتى نفصل أثر المحرك العمودي عن أثر التصميم:
SET TimeZone = 'Asia/Riyadh';
.timer on
SELECT d.year, c.region, sum(f.revenue) AS revenue
FROM fact_sales f
JOIN dim_date d     USING (date_key)
JOIN dim_customer c USING (customer_key)
JOIN dim_product p  USING (product_key)
WHERE p.category = 'Electronics'
GROUP BY ALL ORDER BY ALL;
-- then .mode trash, the star query twice more, and the six-table query on raw.* three times
docker exec -i lab-olap-duckdb duckdb /dw/shop.duckdb < 08-report-star.sqlوالمخرج:
┌───────┬──────────┬───────────────┐
│ year  │  region  │    revenue    │
│ int64 │ varchar  │ decimal(38,2) │
├───────┼──────────┼───────────────┤
│  2024 │ Central  │  111595090.23 │
│  2024 │ Eastern  │   66688370.84 │
│  2024 │ Southern │   21658650.35 │
│  2024 │ Western  │  111201281.80 │
│  2025 │ Central  │  110741177.29 │
│  2025 │ Eastern  │   66709525.70 │
│  2025 │ Southern │   21997743.95 │
│  2025 │ Western  │  111171348.67 │
│  2026 │ Central  │   82929638.63 │
│  2026 │ Eastern  │   49459894.18 │
│  2026 │ Southern │   16826037.76 │
│  2026 │ Western  │   82840453.99 │
└───────┴──────────┴───────────────┘
  12 rows                3 columns
Run Time (s): real 0.146 user 0.447706 sys 0.125784
Run Time (s): real 0.115 user 0.389000 sys 0.058939
Run Time (s): real 0.085 user 0.437381 sys 0.017121
Run Time (s): real 0.359 user 1.389258 sys 0.279546
Run Time (s): real 0.277 user 1.372760 sys 0.307145
Run Time (s): real 0.283 user 1.387157 sys 0.310625
في المخرج أعلاه لاحظ التالي:
- الأرقام مطابقة حتى الهللة لما أعطاه PostgreSQL، وهذا أول اختبار يجب أن تمر به أي خطوة تحويل: قارن مجموعاً معروفاً في المصدر مع المستودع.
- أفضل الأوقات على هذا الجهاز: 3.62 ثانية في PostgreSQL، و0.28 ثانية لنفس الاستعلام بستة جداول في DuckDB، و0.085 ثانية على النجمة. أي أن أغلب الفرق (نحو 13 مرة) جاء من المحرك العمودي، والنجمة أضافت نحو ثلاث مرات فوقه لأنها تربط ثلاثة أبعاد صغيرة بدل ستة جداول منها جدولان كبيران.
- والأهم من الوقت أن الاستعلام أقصر بكثير، ولا يحتاج كاتبه أن يعرف أي سعر يأخذ ولا أي حالة يستبعد، والتقرير كله يعمل على ملف منفصل لا يلمس قاعدة المتجر.
ROLLUP وCUBE وGROUPING SETS
هذه الثلاثة هي عمليات المكعب بلغة SQL، وهي جزء من SQL القياسي وتدعمها PostgreSQL كما في صفحة GROUPING SETS في توثيق PostgreSQL وDuckDB كما في توثيق DuckDB. والفكرة أن تحسب عدة مستويات من التجميع في استعلام واحد بدل أن تكتب عدة استعلامات وتجمعها بـ UNION ALL، وصفوف المجاميع تأخذ NULL في العمود الذي جمع عليه، والدالة grouping() تعيد 1 في هذه الصفوف حتى تميزها عن قيمة NULL حقيقية. وإذا كان التجميع العادي جديداً عليك فراجع مقال الربط والتجميع أولاً. وهذا هو الملف 09-olap.sql:
-- OLAP operations on the star schema: roll-up, cube, grouping sets, slice, dice and pivot.
SET TimeZone = 'Asia/Riyadh';

-- roll-up: quarters -> years -> grand total, for 2024 and 2025
SELECT CASE WHEN grouping(d.year) = 1 THEN 'ALL' ELSE d.year::VARCHAR END AS year,
       CASE WHEN grouping(d.quarter) = 1 THEN 'ALL' ELSE 'Q' || d.quarter END AS quarter,
       round(sum(f.revenue)) AS revenue
FROM fact_sales f JOIN dim_date d USING (date_key)
WHERE d.year IN (2024, 2025)
GROUP BY ROLLUP (d.year, d.quarter)
ORDER BY grouping(d.year), d.year, grouping(d.quarter), d.quarter;

-- cube: every combination of year and region, with all the subtotals
SELECT CASE WHEN grouping(d.year) = 1 THEN 'ALL' ELSE d.year::VARCHAR END AS year,
       CASE WHEN grouping(c.region) = 1 THEN 'ALL' ELSE c.region END AS region,
       round(sum(f.revenue)) AS revenue
FROM fact_sales f JOIN dim_date d USING (date_key) JOIN dim_customer c USING (customer_key)
WHERE d.year IN (2024, 2025)
GROUP BY CUBE (d.year, c.region)
ORDER BY grouping(d.year), d.year, grouping(c.region), c.region;

-- grouping sets: only the totals you ask for, by region, by category and the grand total, in one pass
SELECT CASE WHEN grouping(c.region) = 0 THEN 'region' WHEN grouping(p.category) = 0 THEN 'category' ELSE 'total' END AS level,
       coalesce(c.region, p.category, 'ALL') AS name,
       round(sum(f.revenue)) AS revenue
FROM fact_sales f JOIN dim_date d USING (date_key)
JOIN dim_customer c USING (customer_key) JOIN dim_product p USING (product_key)
WHERE d.year = 2025
GROUP BY GROUPING SETS ((c.region), (p.category), ())
ORDER BY level, revenue DESC;

-- slice (one year) and dice (two regions, two categories, weekends only)
SELECT c.region, p.category, round(sum(f.revenue)) AS weekend_revenue
FROM fact_sales f JOIN dim_date d USING (date_key)
JOIN dim_customer c USING (customer_key) JOIN dim_product p USING (product_key)
WHERE d.year = 2025 AND d.is_weekend
  AND c.region IN ('Central', 'Western') AND p.category IN ('Electronics', 'Books')
GROUP BY ALL ORDER BY ALL;

-- pivot: regions as rows, quarters of 2025 as columns
PIVOT (SELECT c.region, 'Q' || d.quarter AS quarter, f.revenue
       FROM fact_sales f JOIN dim_date d USING (date_key) JOIN dim_customer c USING (customer_key)
       WHERE d.year = 2025)
ON quarter USING round(sum(revenue)) GROUP BY region ORDER BY region;
docker exec -i lab-olap-duckdb duckdb /dw/shop.duckdb < 09-olap.sqlوالمخرج سوف يكون كما يلي، الجدول الأول من ROLLUP، والثاني من CUBE:
┌─────────┬─────────┬───────────────┐
│  year   │ quarter │    revenue    │
│ varchar │ varchar │ decimal(38,0) │
├─────────┼─────────┼───────────────┤
│ 2024    │ Q1      │     312455196 │
│ 2024    │ Q2      │     311997880 │
│ 2024    │ Q3      │     314210744 │
│ 2024    │ Q4      │     316938493 │
│ 2024    │ ALL     │    1255602312 │
│ 2025    │ Q1      │     308551196 │
│ 2025    │ Q2      │     311751769 │
│ 2025    │ Q3      │     315851293 │
│ 2025    │ Q4      │     313215994 │
│ 2025    │ ALL     │    1249370252 │
│ ALL     │ ALL     │    2504972564 │
└─────────┴─────────┴───────────────┘
┌─────────┬──────────┬───────────────┐
│  year   │  region  │    revenue    │
│ varchar │ varchar  │ decimal(38,0) │
├─────────┼──────────┼───────────────┤
│ 2024    │ Central  │     446951055 │
│ 2024    │ Eastern  │     269217721 │
│ 2024    │ Southern │      89286940 │
│ 2024    │ Western  │     450146596 │
│ 2024    │ ALL      │    1255602312 │
│ 2025    │ Central  │     444564933 │
│ 2025    │ Eastern  │     269352741 │
│ 2025    │ Southern │      89113934 │
│ 2025    │ Western  │     446338643 │
│ 2025    │ ALL      │    1249370252 │
│ ALL     │ Central  │     891515989 │
│ ALL     │ Eastern  │     538570462 │
│ ALL     │ Southern │     178400874 │
│ ALL     │ Western  │     896485239 │
│ ALL     │ ALL      │    2504972564 │
└─────────┴──────────┴───────────────┘
لاحظ الفرق بينهما: ROLLUP (year, quarter) يتبع التسلسل من اليمين إلى اليسار، فيعطي مجموع كل سنة ثم المجموع الكلي، ولا يعطي مجموع الربع الأول للسنتين معاً لأن الربع جزء من السنة. أما CUBE (year, region) فيعطي كل التوليفات، ومنها مجموع كل منطقة للسنتين (الصفوف التي سنتها ALL)، لأن المنطقة والسنة بعدان مستقلان. والقاعدة: ROLLUP لتسلسل داخل بعد واحد مثل السنة والربع والشهر، وCUBE لأبعاد مستقلة، وعدد مجموعات CUBE يتضاعف مع كل عمود تضيفه (2 أس عدد الأعمدة)، فلا تضع فيه عشرة أعمدة. وبقية المخرج:
┌──────────┬─────────────┬───────────────┐
│  level   │    name     │    revenue    │
│ varchar  │   varchar   │ decimal(38,0) │
├──────────┼─────────────┼───────────────┤
│ category │ Books       │     319614350 │
│ category │ Fashion     │     311231479 │
│ category │ Electronics │     310619796 │
│ category │ Home        │     307904627 │
│ region   │ Western     │     446338643 │
│ region   │ Central     │     444564933 │
│ region   │ Eastern     │     269352741 │
│ region   │ Southern    │      89113934 │
│ total    │ ALL         │    1249370252 │
└──────────┴─────────────┴───────────────┘
┌─────────┬─────────────┬─────────────────┐
│ region  │  category   │ weekend_revenue │
│ varchar │   varchar   │  decimal(38,0)  │
├─────────┼─────────────┼─────────────────┤
│ Central │ Books       │        32368840 │
│ Central │ Electronics │        31297979 │
│ Western │ Books       │        32678929 │
│ Western │ Electronics │        31824685 │
└─────────┴─────────────┴─────────────────┘
┌──────────┬───────────────┬───────────────┬───────────────┬───────────────┐
│  region  │      Q1       │      Q2       │      Q3       │      Q4       │
│ varchar  │ decimal(38,0) │ decimal(38,0) │ decimal(38,0) │ decimal(38,0) │
├──────────┼───────────────┼───────────────┼───────────────┼───────────────┤
│ Central  │     109645385 │     110764262 │     112550447 │     111604839 │
│ Eastern  │      66272783 │      67727202 │      67877409 │      67475348 │
│ Southern │      22090831 │      22342378 │      22280513 │      22400213 │
│ Western  │     110542197 │     110917926 │     113142924 │     111735595 │
└──────────┴───────────────┴───────────────┴───────────────┴───────────────┘
GROUPING SETS هو الشكل العام الذي يبنى عليه الاثنان: أنت تحدد المجموعات التي تريدها بالضبط، وهنا طلبنا مجموع كل منطقة ومجموع كل فئة والمجموع الكلي دون التوليفات بينها. ولاحظ أن مجموع المناطق يساوي مجموع الفئات ويساوي 1,249,370,252، لأن الإيراد مقياس قابل للجمع، ولو كان نسبة لما صح ذلك. أما Slice وDice فهما شروط WHERE عادية على أعمدة الأبعاد، والتدوير بجملة PIVOT في DuckDB، وفي PostgreSQL تكتبه بـ sum(...) FILTER (WHERE quarter = 1) لكل عمود.
نكسرها: عميل ينتقل من الرياض إلى جدة
قبل أن نكسر شيئاً، هذا هو تقرير مبيعات 2025 بالمدينة، ولنفرض أن الإدارة اعتمدته في يناير وأرسلته إلى مجلس الإدارة، وهذا هو الملف 10-city-2025.sql:
SELECT c.city, round(sum(f.revenue), 2) AS revenue_2025, count(DISTINCT f.order_id) AS orders
FROM fact_sales f JOIN dim_date d USING (date_key) JOIN dim_customer c USING (customer_key)
WHERE d.year = 2025
GROUP BY ALL ORDER BY revenue_2025 DESC;
┌──────────┬───────────────┬────────┐
│ city │ revenue_2025 │ orders │
│ varchar │ decimal(38,2) │ int64 │
├──────────┼───────────────┼────────┤
│ Riyadh │ 354983050.96 │ 136509 │
│ Jeddah │ 270198263.06 │ 103749 │
│ Dammam │ 178956222.18 │ 68337 │
│ Khobar │ 90396519.29 │ 34558 │
│ Buraydah │ 89581882.49 │ 34366 │
│ Abha │ 89113934.06 │ 34154 │
│ Makkah │ 88618103.32 │ 33958 │
│ Madinah │ 87522276.29 │ 33707 │
└──────────┴───────────────┴────────┘الآن العميل 127622، وهو أعلى عملاء الرياض شراء في 2025 بتسعة طلبات، ينتقل إلى جدة في 5 أكتوبر 2026، فيعدل التطبيق مدينته كما يفعل أي تطبيق، وهذا هو الملف 11-move.sql:
-- Customer 127622 moves from Riyadh to Jeddah on 5 October 2026: the application overwrites the city.
UPDATE shop.customers
SET city_id = (SELECT id FROM shop.cities WHERE name = 'Jeddah'),
updated_at = timestamptz '2026-10-05 10:00+03'
WHERE id = 127622;ثم نعيد تشغيل نفس خطوة ELT الليلية، ونعيد تقرير 2025:
docker exec -i lab-olap-pg psql -U postgres < 11-move.sql
cat 02-extract.sql 03-dims.sql 04-star-type1.sql | docker exec -i lab-olap-duckdb duckdb /dw/shop.duckdb
docker exec -i lab-olap-duckdb duckdb /dw/shop.duckdb < 10-city-2025.sqlوالمخرج:
┌──────────┬───────────────┬────────┐
│ city │ revenue_2025 │ orders │
│ varchar │ decimal(38,2) │ int64 │
├──────────┼───────────────┼────────┤
│ Riyadh │ 354944033.25 │ 136500 │
│ Jeddah │ 270237280.77 │ 103758 │
│ Dammam │ 178956222.18 │ 68337 │
│ Khobar │ 90396519.29 │ 34558 │
│ Buraydah │ 89581882.49 │ 34366 │
│ Abha │ 89113934.06 │ 34154 │
│ Makkah │ 88618103.32 │ 33958 │
│ Madinah │ 87522276.29 │ 33707 │
└──────────┴───────────────┴────────┘تقرير سنة انتهت قبل عشرة أشهر تغير: الرياض نقصت 39,017.71 وتسعة طلبات، وجدة زادت بنفس القيمة، مع أن هذه الطلبات شحنت فعلاً إلى الرياض في 2025. والسبب أن النوع الأول كتب المدينة الجديدة فوق القديمة، وكل مبيعات العميل تتبع صفه الوحيد. ومع عميل واحد يبدو الفرق صغيراً، ولكن في متجر حقيقي ينتقل مئات العملاء كل شهر، فيتغير تقرير السنة الماضية كل ليلة قليلاً، ولا يستطيع أحد أن يعيد الرقم الذي اعتمده المجلس، وتبدأ الأسئلة عن صحة المستودع كله.
الإصلاح: بعد العميل بالنوع الثاني SCD2
قبل الحل لاحظ نقطة مهمة: النوع الثاني لا يستطيع أن يستعيد تاريخاً لم يحفظه أحد، فقاعدة التطبيق كتبت فوق المدينة القديمة، والمستودع الذي يبني البعد من جديد كل ليلة فقدها أيضاً. لذلك يجب أن يكون البعد من النوع الثاني موجوداً قبل التغيير، ويحتفظ بصفوفه بين التشغيلات بدل أن يعاد إنشاؤه. وفي التجربة سوف نعيد العميل إلى الرياض كما كان قبل الانتقال، ونبدأ مستودعاً جديداً في ملف آخر /dw/history.duckdb، ثم ننقل العميل مرة أخرى. وهذا هو الملف 07-star-scd2.sql الذي يحل محل 04-star-type1.sql:
-- T of ELT (part 2), the fix: the customer dimension as SCD type 2, kept across runs (never rebuilt).
-- city and region are type 2 (keep history), customer_name is type 1 (overwrite).
SET TimeZone = 'Asia/Riyadh';
CREATE SEQUENCE IF NOT EXISTS customer_key_seq START 1;
CREATE TABLE IF NOT EXISTS dim_customer (
customer_key BIGINT DEFAULT nextval('customer_key_seq'), -- surrogate key, one per version
customer_id BIGINT NOT NULL, -- natural key from the application
customer_name VARCHAR,
city VARCHAR,
region VARCHAR,
valid_from TIMESTAMPTZ NOT NULL,
valid_to TIMESTAMPTZ NOT NULL,
is_current BOOLEAN NOT NULL
);
CREATE OR REPLACE TEMP TABLE src_customer AS
SELECT cu.id AS customer_id, cu.name AS customer_name, ci.name AS city, ci.region, cu.updated_at
FROM raw.customers cu JOIN raw.cities ci ON ci.id = cu.city_id;
-- 1) close the current version of every customer whose city or region changed
UPDATE dim_customer d
SET valid_to = s.updated_at, is_current = false
FROM src_customer s
WHERE d.customer_id = s.customer_id AND d.is_current
AND (d.city IS DISTINCT FROM s.city OR d.region IS DISTINCT FROM s.region);
-- 2) a new current version for new customers and for the ones just closed
INSERT INTO dim_customer (customer_id, customer_name, city, region, valid_from, valid_to, is_current)
SELECT s.customer_id, s.customer_name, s.city, s.region,
CASE WHEN EXISTS (SELECT 1 FROM dim_customer d WHERE d.customer_id = s.customer_id)
THEN s.updated_at ELSE TIMESTAMPTZ '1900-01-01 00:00:00+00' END,
TIMESTAMPTZ '9999-12-31 00:00:00+00', true
FROM src_customer s
WHERE NOT EXISTS (SELECT 1 FROM dim_customer d WHERE d.customer_id = s.customer_id AND d.is_current);
-- 3) customer_name is type 1: overwrite it in every version
UPDATE dim_customer d SET customer_name = s.customer_name
FROM src_customer s
WHERE d.customer_id = s.customer_id AND d.customer_name IS DISTINCT FROM s.customer_name;
-- each sale points to the version that was valid at the time of the order
CREATE OR REPLACE TABLE fact_sales AS
SELECT CAST(strftime(CAST(o.created_at AS DATE), '%Y%m%d') AS INTEGER) AS date_key,
dc.customer_key, dp.product_key,
o.id AS order_id, oi.line_no,
oi.qty, oi.unit_price,
oi.qty * oi.unit_price AS revenue
FROM raw.orders o
JOIN raw.order_items oi ON oi.order_id = o.id
JOIN dim_customer dc ON dc.customer_id = o.customer_id
AND o.created_at >= dc.valid_from AND o.created_at < dc.valid_to
JOIN dim_product dp ON dp.product_id = oi.product_id
WHERE o.status = 'paid';
SELECT (SELECT count(*) FROM dim_customer) AS dim_customer_rows,
(SELECT count(*) FROM dim_customer WHERE is_current) AS current_rows,
(SELECT count(*) FROM fact_sales) AS fact_sales;في الإعداد أعلاه لاحظ التالي:
- الجدول ينشأ بـ
CREATE TABLE IF NOT EXISTSوليسCREATE OR REPLACE، فصفوفه تبقى بين التشغيلات، وهذا هو الفرق الجوهري عن النوع الأول. - الأعمدة الثلاثة التي تطلبها صفحة Kimball:
valid_fromوvalid_toوis_current. والصف الأول لكل عميل يبدأ من 1900، والسبب أننا لا نعرف شيئاً عن تاريخه قبل أول تشغيل للمستودع، فنعتبر أول صورة له صالحة لكل ما قبلها. - نهاية الصلاحية القديمة تساوي بداية الجديدة، والشرط
>= valid_from AND < valid_toيضع كل طلب في صف واحد فقط، فلا يضيع طلب ولا يحسب مرتين. - في هذه التجربة نعيد بناء جدول الحقائق كاملاً ونربط كل طلب بالصف الذي كان صالحاً في تاريخه. أما في الإنتاج فتحمل الطلبات الجديدة فقط كل ليلة، وتأخذ مفتاح الصف الحالي للعميل، والنتيجة واحدة. وأداة dbt تبني هذا النمط بميزة جاهزة تسمى Snapshots يصفها توثيقها بأنها تطبيق للنوع الثاني من الأبعاد بطيئة التغير.
- هذه الطريقة تعتمد على أن التطبيق يحدث
updated_atعند كل تعديل، فإذا لم يفعل فأنت تحتاج نقل التغييرات CDC من سجل قاعدة البيانات.
والملف 12-rewind.sql يعيد العميل إلى الرياض، والملف 13-new-orders.sql يضيف له طلبين من جدة بعد الانتقال:
-- 12-rewind.sql (lab only): put customer 127622 back in Riyadh, as it was before the move.
UPDATE shop.customers
SET city_id = (SELECT id FROM shop.cities WHERE name = 'Riyadh'), updated_at = created_at
WHERE id = 127622;
-- 13-new-orders.sql: after the move, customer 127622 orders twice from Jeddah.
WITH o AS (
INSERT INTO shop.orders (customer_id, status, created_at)
VALUES (127622, 'paid', '2026-10-08 20:15+03'), (127622, 'paid', '2026-10-10 13:40+03')
RETURNING id
)
INSERT INTO shop.order_items (order_id, line_no, product_id, qty, unit_price)
SELECT o.id, 1, p.id, 2, p.price FROM o, shop.products p WHERE p.sku = 'SKU-0007';والتشغيل بالترتيب: نعيد العميل إلى الرياض، ثم التشغيل الأول، ثم الانتقال والتشغيل الثاني، ثم الطلبان الجديدان والتشغيل الثالث:
# lab only: back to Riyadh, as before the move
docker exec -i lab-olap-pg psql -U postgres < 12-rewind.sql
# run 1, before the move
cat 02-extract.sql 03-dims.sql 07-star-scd2.sql | docker exec -i lab-olap-duckdb duckdb /dw/history.duckdb
docker exec -i lab-olap-duckdb duckdb /dw/history.duckdb < 10-city-2025.sql
# the move, then run 2
docker exec -i lab-olap-pg psql -U postgres < 11-move.sql
cat 02-extract.sql 03-dims.sql 07-star-scd2.sql | docker exec -i lab-olap-duckdb duckdb /dw/history.duckdb
# two new orders from Jeddah, then run 3
docker exec -i lab-olap-pg psql -U postgres < 13-new-orders.sql
cat 02-extract.sql 03-dims.sql 07-star-scd2.sql | docker exec -i lab-olap-duckdb duckdb /dw/history.duckdb
docker exec -i lab-olap-duckdb duckdb /dw/history.duckdb < 10-city-2025.sqlوالمخرج من التشغيلات الثلاثة:
== run 1 (before the move)
┌───────────────────┬──────────────┬────────────┐
│ dim_customer_rows │ current_rows │ fact_sales │
│ int64 │ int64 │ int64 │
├───────────────────┼──────────────┼────────────┤
│ 200000 │ 200000 │ 3301384 │
└───────────────────┴──────────────┴────────────┘
== run 2 (after the move)
┌───────────────────┬──────────────┬────────────┐
│ dim_customer_rows │ current_rows │ fact_sales │
│ int64 │ int64 │ int64 │
├───────────────────┼──────────────┼────────────┤
│ 200001 │ 200000 │ 3301384 │
└───────────────────┴──────────────┴────────────┘
== run 3 (new orders)
┌───────────────────┬──────────────┬────────────┐
│ dim_customer_rows │ current_rows │ fact_sales │
│ int64 │ int64 │ int64 │
├───────────────────┼──────────────┼────────────┤
│ 200001 │ 200000 │ 3301386 │
└───────────────────┴──────────────┴────────────┘بعد الانتقال أصبح في البعد 200,001 صف و200,000 صف حالي، أي أن صفاً واحداً أضيف لعميل واحد. وتقرير 2025 بعد التشغيل الثالث:
┌──────────┬───────────────┬────────┐
│   city   │ revenue_2025  │ orders │
│ varchar  │ decimal(38,2) │ int64  │
├──────────┼───────────────┼────────┤
│ Riyadh   │  354983050.96 │ 136509 │
│ Jeddah   │  270198263.06 │ 103749 │
│ Dammam   │  178956222.18 │  68337 │
│ Khobar   │   90396519.29 │  34558 │
│ Buraydah │   89581882.49 │  34366 │
│ Abha     │   89113934.06 │  34154 │
│ Makkah   │   88618103.32 │  33958 │
│ Madinah  │   87522276.29 │  33707 │
└──────────┴───────────────┴────────┘نفس أرقام التقرير المعتمد حتى الهللة. ولنرى تاريخ العميل نفسه وأين ذهبت مبيعاته، وهذا هو الملف 14-customer-history.sql:
SELECT customer_key, customer_id, city, valid_from, valid_to, is_current
FROM dim_customer WHERE customer_id = 127622 ORDER BY valid_from;
SELECT c.city, d.year, count(DISTINCT f.order_id) AS orders, round(sum(f.revenue), 2) AS revenue
FROM fact_sales f JOIN dim_date d USING (date_key) JOIN dim_customer c USING (customer_key)
WHERE c.customer_id = 127622 GROUP BY ALL ORDER BY d.year, c.city;
┌──────────────┬─────────────┬─────────┬──────────────────────────┬──────────────────────────┬────────────┐
│ customer_key │ customer_id │ city │ valid_from │ valid_to │ is_current │
│ int64 │ int64 │ varchar │ timestamp with time zone │ timestamp with time zone │ boolean │
├──────────────┼─────────────┼─────────┼──────────────────────────┼──────────────────────────┼────────────┤
│ 120128 │ 127622 │ Riyadh │ 1900-01-01 00:00:00+00 │ 2026-10-05 07:00:00+00 │ false │
│ 200001 │ 127622 │ Jeddah │ 2026-10-05 07:00:00+00 │ 9999-12-31 00:00:00+00 │ true │
└──────────────┴─────────────┴─────────┴──────────────────────────┴──────────────────────────┴────────────┘
┌─────────┬───────┬────────┬───────────────┐
│ city │ year │ orders │ revenue │
│ varchar │ int64 │ int64 │ decimal(38,2) │
├─────────┼───────┼────────┼───────────────┤
│ Riyadh │ 2024 │ 2 │ 8633.30 │
│ Riyadh │ 2025 │ 9 │ 39017.71 │
│ Jeddah │ 2026 │ 2 │ 1983.88 │
│ Riyadh │ 2026 │ 2 │ 2500.48 │
└─────────┴───────┴────────┴───────────────┘للعميل صفان بمفتاحين بديلين ونفس المفتاح الطبيعي 127622، والوقت معروض بتوقيت UTC (الساعة 07:00 هي العاشرة صباحاً في الرياض). والطلبات التسعة في 2025 والطلبان في 2026 قبل الانتقال بقيت في الرياض، والطلبان الجديدان في أكتوبر 2026 حسبا لجدة، وهذا هو المطلوب بالضبط. وإذا أراد المدير مع ذلك أن يرى كل تاريخ العميل بمدينته الحالية، فهو يربط بالمفتاح الطبيعي على الصف الحالي is_current، فيحصل على الجوابين من نفس الجدول.
حذف المختبر
نحذف ما أنشأناه بالاسم فقط: ال Containers وال Volumes من مشروع Compose، ثم ال Image التي بنيناها:
docker compose -p lab-olap down -v
docker image rm lab-olap-duckdb:1.5.6
أخطاء شائعة
- لوحات التقارير على قاعدة الإنتاج بمستخدم المالك: بطء للعملاء وخطر تعديل البيانات، وابدأ على الأقل بنسخة للقراءة ومستخدم للقراءة فقط.
- تعريف الرقم في كل تقرير: عرف الإيراد والطلب المدفوع والمنطقة الزمنية مرة واحدة في التحويل، وإلا فسوف تعود مشكلة الرقمين في كل اجتماع.
- جدول حقائق بدون Grain واضح: صفوف للطلب وصفوف للسطر في نفس الجدول تعني أن
sumيحسب مرتين. - جمع أرقام غير قابلة للجمع: متوسط المتوسطات أو مجموع الأرصدة عبر الشهور أو مجموع النسب، واحفظ المكونات واقسم في النهاية.
- النوع الأول لكل الأعمدة: يدمر تاريخ التقارير بصمت، فحدد لكل عمود في الأبعاد هل يحتاج تاريخه أم لا قبل أن تبدأ، لأن النوع الثاني لا يستعيد تاريخاً لم يحفظ.
- المفتاح الطبيعي مفتاحاً للبعد: لا يتسع لأكثر من نسخة من العميل، ويتعارض عندما يأتي نفس العميل من نظامين.
- بعد مختلف لكل فريق: بعد عميل للمبيعات وآخر للدعم بأسماء مدن مختلفة، والحل بعد مشترك Conformed واحد.
- عدم مطابقة المستودع بالمصدر: بعد كل تحويل قارن مجموعاً معروفاً كما فعلنا مع تقرير الإلكترونيات، فخطأ صامت في ربط واحد يسقط صفوفاً دون أي رسالة.
متى تحتاج مستودع بيانات؟
- لا تحتاجه بعد: إذا كانت تقاريرك قليلة وبياناتك بضعة ملايين صف ومصدرها قاعدة واحدة، فنسخة للقراءة مع عروض محفوظة Materialized Views تكفيك كما في مقال PostgreSQL لكل شيء.
- تحتاجه: عندما تختلف الأرقام بين الأقسام، أو تحتاج تاريخاً لا تحفظه قاعدة التطبيق مثل مدينة العميل وقت الطلب، أو تجمع بيانات من عدة أنظمة مثل المتجر والمحاسبة والدعم، أو تبطئ التقارير حتى نسخة القراءة.
- ابدأ صغيراً: DuckDB في ملف واحد مع ELT ليلي يكفي لفريق صغير، وعندما يكبر عدد المستخدمين والبيانات انقل نفس النجمة إلى ClickHouse أو Doris أو StarRocks، فالتصميم البعدي لا يتغير بتغير المحرك.
الخلاصة
- التقارير على قاعدة التطبيق تبطئ العملاء، وفي التجربة أخذ تقرير بستة جداول 3.6 ثانية من سيرفر المتجر، والأخطر أن شخصين أجابا عن نفس السؤال برقمين بينهما 95 مليوناً.
- ال OLAP ينظر إلى البيانات كمكعب من الأبعاد والمقاييس، وعملياته Slice وDice وRoll-up وDrill-down وPivot تنفذ اليوم بلغة SQL على قواعد عمودية بدل خوادم MOLAP.
- النمذجة البعدية: حدد العملية ثم ال Grain ثم الأبعاد ثم الحقائق، وفضل النجمة على الندفة، ومفاتيح بديلة في الأبعاد، وأبعاد مشتركة بين جداول الحقائق.
- على نفس الجهاز أخذ التقرير 0.28 ثانية بالجداول الستة في DuckDB و0.085 ثانية على النجمة، فأغلب السرعة من المحرك العمودي، وفائدة النجمة الأكبر أن التعريف مكتوب مرة واحدة.
- ROLLUP للتسلسل داخل بعد واحد، وCUBE لكل توليفات أبعاد مستقلة، وGROUPING SETS لتحديد المجموعات بنفسك، و
grouping()يميز صفوف المجاميع. - عميل واحد انتقل إلى جدة غير تقرير 2025 المعتمد بالنوع الأول، والنوع الثاني أبقاه كما هو حتى الهللة، بشرط أن يكون موجوداً قبل التغيير.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلClickHouse للتحليلات على بيانات ضخمةلماذا يجيب ClickHouse عن أسئلة التقارير أسرع من PostgreSQL بعشرات المرات، وأين يخسر، ومتى تضيفه بجانب قاعدة تطبيقك.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.دليلMetabase: لوحات وتقارير من بياناتك دون كتابة كودكيف تثبت Metabase على سيرفرك، وتبني منه أسئلة ولوحة مبيعات من بيانات شركتك بالنقر أو بلغة SQL.دليلApache Superset: تحليلات ولوحات تقارير على سيرفرككيف تثبت Apache Superset على سيرفرك، وتبني منه مقاييس ورسوماً ولوحة تقارير من بيانات شركتك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، والتجربة على PostgreSQL 18.6 وDuckDB 1.5.6 في Docker Engine 29.8.0، ومصطلحات النمذجة البعدية من صفحات Kimball Group كما قرأناها في 11 أكتوبر 2026.
- أكتوبر 2026: إضافة فقرة في قسم الأدوات تربط المقال بتجربة Superset على النجمة نفسها وبمقال المقارنة بين Metabase وSuperset وPower BI.


