يصلك من فريق آخر مجلد فيه ستة ملفات بيانات Data Files حجمها معاً قرابة ثلاثمائة ميجابايت، وفيها أكثر من عشرين مليون سطر Row، ومعها سؤال بسيط من المدير Manager: كم رحلة في كل شهر، وما أكثر المناطق طلباً، وهل يتغير البقشيش Tip بحسب الساعة؟ فتفتح الملف في Excel فيتوقف عند مليون سطر تقريباً، وتجرب pandas فيأخذ من الذاكرة Memory في جهازك أربعة جيجابايت قبل أن يبدأ الحساب، وتفكر في تشغيل PostgreSQL ونقل البيانات إليه، فتجد أنك سوف تقضي ساعة في إنشاء الجداول Tables والتحميل قبل أن تكتب أول استعلام Query. وهذا موقف يتكرر كل يوم مع المحللين Analysts والمطورين Developers ومديري الأنظمة System Administrators: البيانات أكبر من أن تفتح في برنامج جداول Spreadsheet، وأصغر من أن تستحق مستودع بيانات Data Warehouse وسيرفراً وفريقاً يشغله.
وهنا يأتي دور DuckDB، وهي قاعدة بيانات تحليلية Analytical Database تعمل داخل برنامجك أو من سطر الأوامر Command Line كملف تنفيذي Executable واحد، دون سيرفر Server ودون تثبيت خدمة، وتقرأ ملفات CSV وParquet وJSON مباشرة كأنها جداول، فتكتب سؤالك بلغة SQL على الملف نفسه وتحصل على الإجابة في ثوان. وقد استخدمناها في مقال OLAP ومستودع البيانات كمستودع صغير بجانب قاعدة التطبيق، أما هنا فسوف نركز على الاستخدام الأكثر شيوعاً لها: تحليل ملفات كبيرة على جهازك.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي Excel ولا pandas ولا نقل البيانات إلى قاعدة بيانات عادية عندما يكبر الملف.
- كيف تعمل DuckDB من الداخل: داخل العملية In-process، والتنفيذ بالدفعات Vectorized Execution، وقراءة ما يحتاجه السؤال فقط من ملفات Parquet، والعمل بذاكرة أقل من حجم البيانات.
- تجربة حقيقية على بيانات رحلات التاكسي العامة في نيويورك: 20 مليون رحلة في ستة ملفات Parquet، وثلاثة أسئلة، ثم نفس الأسئلة على pandas وSQLite بالوقت والذاكرة.
- قراءة CSV وJSON، وقراءة ملف Parquet من الإنترنت دون تنزيله، وحفظ قاعدة دائمة في ملف واحد.
- النص العربي في DuckDB: الحروف Characters والبايتات Bytes، وتوحيد الهمزات، والترتيب الأبجدي، وملفات CSV بترميز Windows-1256.
- متى لا تستخدم DuckDB، وما البديل في كل حالة.
الحلول المعتادة ولماذا تتعب مع الملفات الكبيرة
قبل أن نتحدث عن DuckDB لنمر على الطرق التي يجربها أغلبنا أولاً، لأن كل طريقة منها صحيحة في حجم معين، والمشكلة أنها تستمر بعد أن يتجاوز الملف هذا الحجم.
الطريقة الأولى: برنامج الجداول Excel
Excel ممتاز لملف فيه عشرات الآلاف من السطور، ولكن له حد ثابت مكتوب في صفحة المواصفات والحدود من Microsoft: 1,048,576 سطراً في الورقة الواحدة، وكل ما بعده لا يظهر. والأخطر من الحد نفسه أن البرنامج قد يفتح جزءاً من الملف ويكمل كأن شيئاً لم يحدث، فيبني المحلل تقريره على جزء من البيانات دون أن ينتبه.
الطريقة الثانية: مكتبة pandas
pandas هي الأداة الأولى لمحلل البيانات في Python، وهي ممتازة طالما أن البيانات تدخل في الذاكرة بارتياح، والسبب في ذلك أنها تحمل الجدول كاملاً في الذاكرة Memory قبل أي حساب، وكثير من عملياتها تنشئ نسخاً جديدة من الأعمدة Columns أثناء الحساب. وقد كتب Wes McKinney الذي أنشأ المكتبة في مقاله عن حدود pandas أن قاعدته الشخصية هي ذاكرة من خمسة إلى عشرة أضعاف حجم البيانات، وسوف ترى في التجربة أن خمسة أعمدة فقط من ملفاتنا أخذت أكثر من أربعة جيجابايت. ومع ذلك فالمشكلة ليست في الذاكرة وحدها، فنفس المقال يذكر أن خوارزمياتها محدودة في استخدام عدة أنوية Cores، وسوف ترى في التجربة أن أغلب الوقت يذهب في نواة واحدة بينما جهازك فيه أربع أنوية أو ثمان تنتظر.
الطريقة الثالثة: نقل البيانات إلى قاعدة بيانات
الحل الثالث أن تنشئ قاعدة PostgreSQL أو SQLite، ثم تنقل إليها الملفات، ثم تسأل بلغة SQL، وهذا حل صحيح إذا كانت البيانات سوف تبقى وتتحدث ويستخدمها تطبيق، ولكنه ثقيل لسؤال واحد على ملف وصلك اليوم: يجب أن تكتب تعريف الجدول وأنواع Data Types الأعمدة بيدك، وأن تنتظر التحميل، وأن تحتفظ بنسختين من البيانات. وفوق ذلك فقواعد التطبيقات مثل PostgreSQL وSQLite تحفظ الصف Row كاملاً في مكان واحد، وهذا ممتاز لقراءة طلب واحد وتعديله، وأبطأ كثيراً عندما يقرأ السؤال عموداً واحداً من عشرين مليون صف، وقد شرحنا هذا الفرق بالتفصيل في مقال ClickHouse للتحليلات.
والآن لنر ما الذي تغيره DuckDB في الطرق الثلاث.
ما هي DuckDB؟
DuckDB قاعدة بيانات تحليلية OLAP مفتوحة المصدر برخصة MIT، بدأها Mark Raasveldt وHannes Mühleisen في معهد CWI للأبحاث في أمستردام، وتملك حقوقها اليوم مؤسسة DuckDB Foundation غير الربحية، وهذا يعني أن الكود لا يمكن أن يتحول فجأة إلى رخصة تجارية بقرار شركة واحدة. وأسهل طريقة لفهمها أن تقول إنها «SQLite للتحليلات»: مكتبة صغيرة تعمل داخل برنامجك، وتحفظ قاعدتها إن أردت في ملف واحد، ولكنها مصممة للأسئلة التي تقرأ ملايين الصفوف وتجمعها، وليس للعمليات الصغيرة الكثيرة التي يقوم بها التطبيق.
وفي 21 أكتوبر 2026 صدر الإصدار Release 2.0.0 كإصدار دعم طويل LTS مدعوم حتى أكتوبر 2027 على الأقل بحسب إعلان الإصدار، ومن أهم ما فيه القراءة غير المتزامنة Asynchronous I/O لملفات Parquet وCSV، وبروتوكول Quack الذي يسمح لعدة عمليات بالكتابة عبر سيرفر DuckDB، وإزالة مكتبة ICU واستبدالها بدعم مدمج للمناطق الزمنية والترتيب Collations. وانتبه هنا إلى نقطة تخص الترقية: ملف قاعدة البيانات الذي ينشئه الإصدار 2.0 لا تستطيع الإصدارات الأقدم قراءته، لذلك إذا كان عندك برنامج قديم يقرأ نفس الملف فلا تفتحه بالإصدار الجديد قبل أن تحدث الجميع.
وتستطيع أن تستخدمها بثلاث طرق، وكلها نفس المحرك:
- سطر الأوامر CLI: ملف تنفيذي واحد اسمه
duckdbتنزله من صفحة الإصدارات وتشغله مباشرة، وهي الطريقة التي سوف نبدأ بها. - مكتبة في لغة البرمجة:
pip install duckdbفي Python، ومكتبات رسمية لـ Java وNode.js وR وGo وRust وغيرها، فتصبح قاعدة البيانات جزءاً من برنامجك. - داخل أدوات أخرى: إضافة pg_duckdb تشغل محركها داخل PostgreSQL كما ذكرنا في مقال PostgreSQL لكل شيء، وأدوات التقارير مثل Superset وMetabase تتصل بها عبر برامج اتصال Drivers.
كيف تعمل DuckDB من الداخل؟
قد يتساءل البعض: كيف تجيب أداة بلا سيرفر عن سؤال على عشرين مليون صف في ثوان، بينما يأخذ نفس السؤال دقائق في أدوات أخرى على نفس الجهاز؟ والإجابة ليست في حيلة واحدة، وإنما في أربعة قرارات في تصميمها، وكل قرار منها يفسر جزءاً من الأرقام التي سوف تراها في التجربة.
داخل العملية In-process: لا يوجد سيرفر ولا شبكة
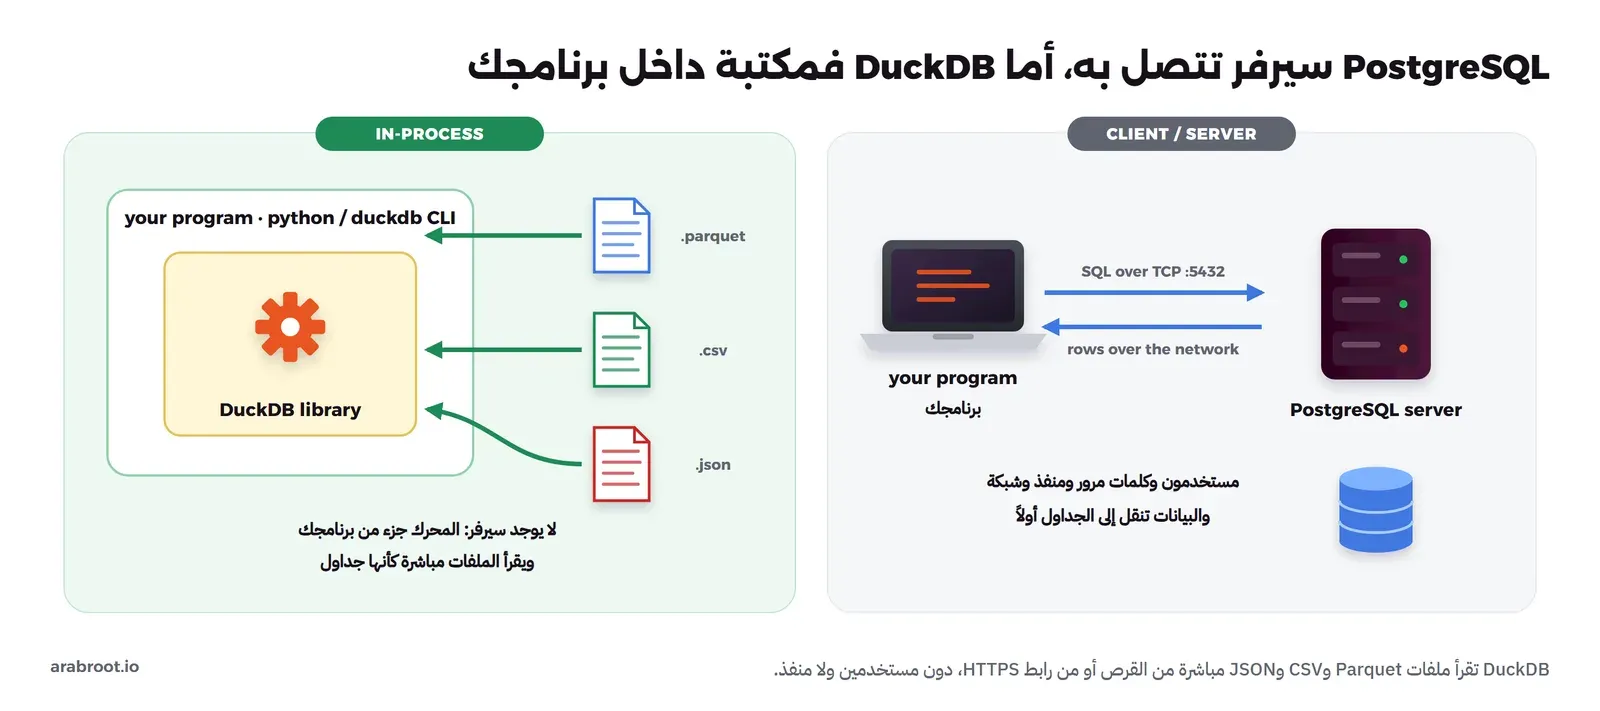
عندما يسأل تطبيقك PostgreSQL يرسل الاستعلام عبر الشبكة Network إلى عملية أخرى، ثم تعود النتيجة صفاً صفاً عبر نفس الشبكة بعد تحويلها إلى صيغة البروتوكول ثم إعادة تحويلها في برنامجك. أما DuckDB فتعمل داخل نفس العملية Process التي تشغل برنامجك، مثل SQLite تماماً، فلا يوجد اتصال ولا مستخدمون ولا كلمات مرور ولا منفذ Port، والنتيجة تصل إلى برنامجك كذاكرة مباشرة، بل إن مكتبة Python تستطيع أن تقرأ جدول pandas الموجود في الذاكرة دون نسخه، وأن تعيد النتيجة كجدول pandas أو Arrow.
وهذا القرار له ثمن واضح سوف نعود إليه في قسم متى لا تستخدم DuckDB: لا يوجد سيرفر يرتب طلبات عدة مستخدمين، وملف القاعدة يفتحه برنامج واحد للكتابة في نفس الوقت.
الأعمدة والتنفيذ بالدفعات Vectorized Execution
DuckDB قاعدة عمودية Columnar، أي أنها تحفظ وتعالج كل عمود منفصلاً، فإذا سألت عن متوسط الأجرة قرأت عمود الأجرة وحده من بين تسعة عشر عموداً، وقد شرحنا هذه الفكرة بالأرقام في مقال ClickHouse فلن نعيدها هنا. والجزء الذي يخص DuckDB هو طريقة التنفيذ: فهي لا تمرر صفاً صفاً بين مراحل الاستعلام كما تفعل قواعد التطبيقات، ولا تحمل العمود كاملاً في الذاكرة كما تفعل pandas، وإنما تمرر دفعات ثابتة الحجم تسمى المتجهات Vectors، وحجم الدفعة الافتراضي بحسب توثيق التنفيذ الداخلي هو 2048 قيمة.
ولماذا 2048 بالذات؟ لأنها صغيرة بما يكفي لتبقى الدفعة في ذاكرة المعالج CPU السريعة Cache بينما تمر على عمليات الفلترة Filtering والجمع، وكبيرة بما يكفي لتختفي تكلفة استدعاء الدالة لكل قيمة، فيكرر المعالج نفس التعليمة على ألفي رقم متجاورة، وهذا أسرع بكثير من ألفي استدعاء منفصل. وفوق ذلك تقسم DuckDB العمل إلى قطع صغيرة توزعها على كل أنوية المعالج، فعدد الخيوط Threads الافتراضي يساوي عدد الأنوية Cores في جهازك، ولذلك سوف ترى في التجربة أن DuckDB تستخدم المعالج كله بينما تعمل أغلب عمليات pandas على نواة واحدة.
ملف Parquet من الداخل: لماذا تقرأ جزءاً صغيراً منه فقط؟
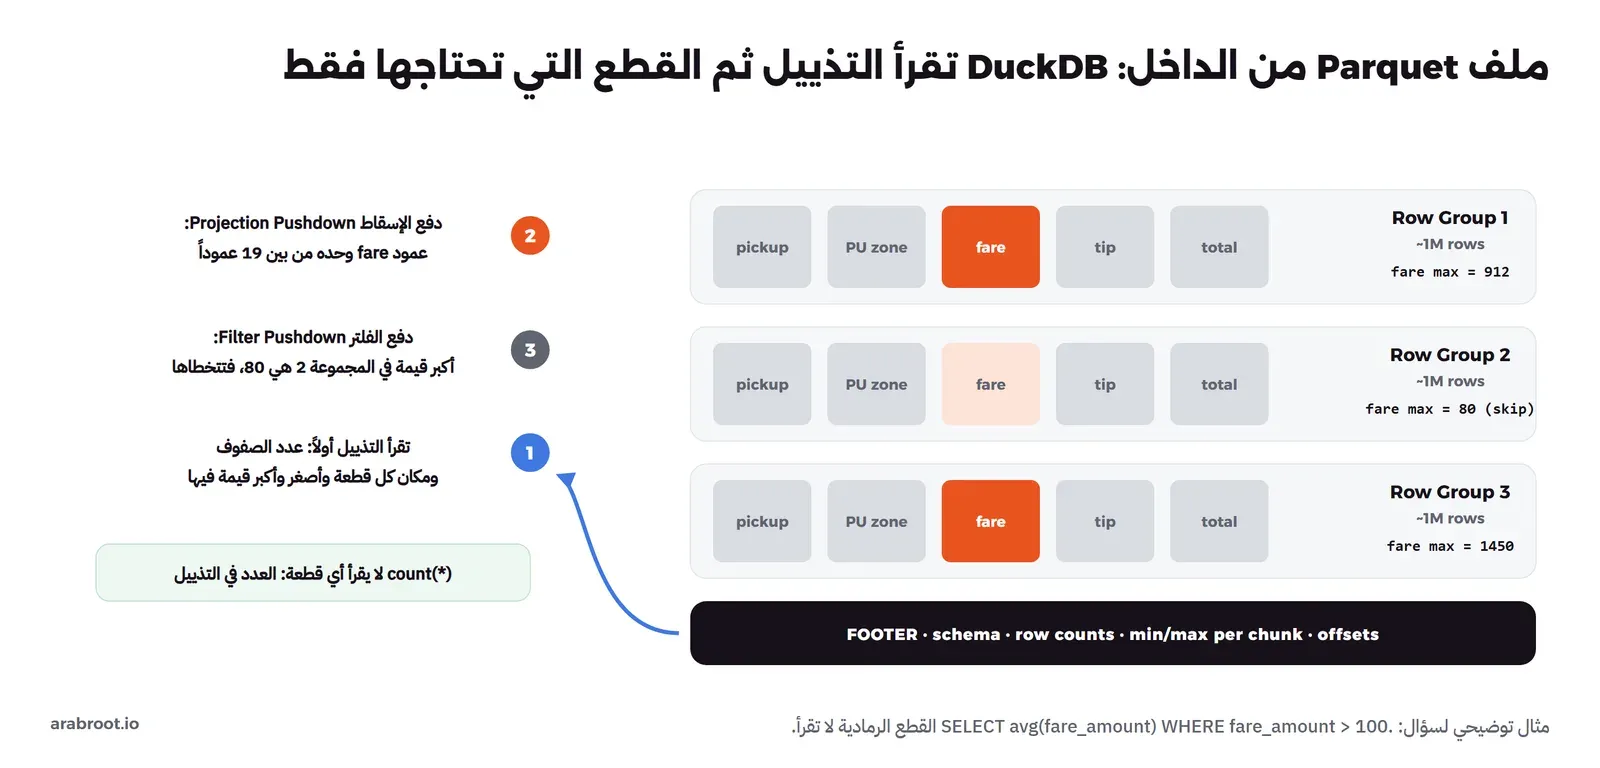
ملف CSV نص عادي، فلكي تعرف متوسط عمود واحد يجب أن تقرأ الملف كله من أوله إلى آخره، وأن تحول كل رقم من نص إلى رقم. أما ملف Parquet فهو صيغة عمودية ثنائية Binary مقسمة كما يلي:
- مجموعات الصفوف Row Groups: كل ملف مقسم إلى مجموعات، في كل منها عدد من الصفوف، مثلاً مليون صف.
- قطع الأعمدة Column Chunks: داخل كل مجموعة يحفظ كل عمود في قطعة منفصلة مضغوطة، فعمود الأجرة في مجموعة الصفوف الثالثة له مكان معروف في الملف.
- التذييل Footer: في آخر الملف بيانات وصفية Metadata تقول أين تبدأ كل قطعة، وما نوع كل عمود، وما أصغر قيمة وأكبر قيمة في كل قطعة Min/Max Statistics، وكم صفاً في الملف كله.
وبالتالي تقرأ DuckDB التذييل أولاً، ثم تقرر ماذا تحتاج: إذا كان السؤال عن عمودين فلا تقرأ إلا قطعهما، وهذا يسمى دفع الإسقاط Projection Pushdown، وإذا كان في السؤال شرط مثل fare_amount > 100 وكانت أكبر قيمة في إحدى المجموعات 80 فإنها تتخطى المجموعة كلها دون أن تقرأها، وهذا يسمى دفع الفلتر Filter Pushdown، وكلاهما مذكور في صفحة Parquet في توثيق DuckDB، ومعهما في الإصدار 2.0 قراءة فهرس الصفحات Page Index لتتخطى أجزاء أصغر من المجموعة. أما سؤال «كم صفاً في الملف؟» فإجابته مكتوبة في التذييل نفسه، لذلك سوف ترى في التجربة أن عد عشرين مليون صف يأخذ جزءاً من عشرة من الثانية.
بيانات أكبر من الذاكرة Larger-than-memory
القرار الرابع أن DuckDB لا تفترض أن البيانات تدخل في الذاكرة، فالقراءة من الملف تتم دفعة بعد دفعة، والعمليات التي تحتاج أن ترى كل البيانات قبل أن تخرج النتيجة، وهي التجميع GROUP BY والربط JOIN والترتيب ORDER BY ودوال النوافذ Window Functions، تستطيع أن تنقل جزءاً من عملها المؤقت إلى القرص Disk عندما تقترب من حد الذاكرة، وهذا يسمى Spilling. وبحسب دليل ضبط الأداء فالملفات المؤقتة تكتب افتراضياً في مجلد بجانب ملف القاعدة، أو في مجلد .tmp إذا كانت القاعدة في الذاكرة، وتستطيع تغييره بالإعداد temp_directory.
ولكن لاحظ أن هذا ليس سحراً، فنفس الدليل يذكر حدوده بصراحة: بعض دوال التجميع مثل string_agg لا تنقل حالتها إلى القرص، والدوال التي تحتاج كل القيم مثل الوسيط Median قد تسبب نفاد الذاكرة Out of Memory مع بيانات ضخمة جداً، والاستعلام الذي فيه عدة عمليات ثقيلة معاً قد يفشل أيضاً. وسوف نجرب ذلك عملياً بذاكرة 500 ميجابايت على بيانات أكبر منها بكثير.
تجربة حقيقية: 20 مليون رحلة تاكسي على جهاز واحد
البيانات في هذه التجربة من سجلات الرحلات التي تنشرها هيئة التاكسي والليموزين في مدينة نيويورك NYC Taxi and Limousine Commission للعموم، وهي من أشهر البيانات المفتوحة في تعليم التحليل لأنها حقيقية وكبيرة ومليئة بالأخطاء كما سوف ترى. أخذنا رحلات التاكسي الأصفر من يناير إلى يونيو 2024 في ستة ملفات Parquet، حجمها معاً 342 ميجابايت، ومعها ملف CSV صغير فيه أسماء المناطق، وشرح كل عمود موجود في قاموس البيانات الرسمي.
تجهيز بيئة التجربة
نحتاج Container واحداً فيه برنامج DuckDB من سطر الأوامر، ومعه Python ومكتبات DuckDB وpandas وpyarrow للمقارنة، وكلها بإصدارات مثبتة حتى تحصل على نفس النتائج. احفظ هذا في Dockerfile:
FROM python:3.13.18-slim
ADD https://github.com/duckdb/duckdb/releases/download/v2.0.0/duckdb-cli-linux-amd64.tar.gz /tmp/duckdb.tgz
RUN tar -xzf /tmp/duckdb.tgz -C /usr/local/bin && rm /tmp/duckdb.tgz && chmod +x /usr/local/bin/duckdb \
 && pip install --no-cache-dir duckdb==2.0.0 pandas==3.1.1 pyarrow==26.0.1
WORKDIR /lab
ثم ابن ال Image ونزل الملفات من موقع الهيئة:
docker build -t ad3-duck:1 .
mkdir -p data
for m in 01 02 03 04 05 06; do
  curl -s -o data/yellow_tripdata_2024-$m.parquet \
    https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2024-$m.parquet
done
curl -s -o data/taxi_zone_lookup.csv https://d37ci6vzurychx.cloudfront.net/misc/taxi_zone_lookup.csv
docker run --rm ad3-duck:1 sh -c "duckdb --version; python -c 'import duckdb, pandas, sqlite3; print(duckdb.__version__, pandas.__version__, sqlite3.sqlite_version)'"
والمخرج سوف يكون كما يلي:
v2.0.0 (Cyanoptera) d54cbbe3df
2.0.0 3.1.1 3.46.1
لاحظ أن DuckDB في سطر الأوامر ملف واحد نزلناه من صفحة الإصدار في GitHub، فلا يوجد سيرفر نشغله ولا منفذ نفتحه ولا مستخدم ننشئه، وال Container هنا مجرد مكان مرتب نشغل فيه الأوامر، وتستطيع أن تنزل نفس الملف على جهازك مباشرة. وكل ملفات SQL وPython التالية موجودة في مجلد lab مع المقال، ونشغلها كلها بنفس الشكل: مجلد العمل في /lab والبيانات في /lab/data للقراءة فقط.
النظرة الأولى: كم صفاً، وما الأعمدة؟
أول ما تفعله مع أي ملف يصلك أن تعرف حجمه وأعمدته قبل أي سؤال. احفظ هذا في 01-first-look.sql:
.timer on
-- كم رحلة في ستة ملفات Parquet؟ دون أي تحميل أو جدول
SELECT count(*) AS trips FROM 'data/yellow_tripdata_2024-*.parquet';
-- ما الأعمدة وأنواعها؟
SELECT column_name, column_type FROM (DESCRIBE SELECT * FROM 'data/yellow_tripdata_2024-01.parquet');
docker run --rm -v "$PWD/lab:/lab" -v "$PWD/data:/lab/data:ro" ad3-duck:1 sh -c "duckdb < 01-first-look.sql"والمخرج سوف يكون كما يلي، بعد حذف بعض الأعمدة من القائمة:
┌──────────┐
│  trips   │
│  int64   │
├──────────┤
│ 20332093 │
└──────────┘
Run Time (s): real 0.124 user 0.039212 sys 0.034581
┌───────────────────────┬─────────────┐
│      column_name      │ column_type │
├───────────────────────┼─────────────┤
│ VendorID              │ INTEGER     │
│ tpep_pickup_datetime  │ TIMESTAMP   │
│ tpep_dropoff_datetime │ TIMESTAMP   │
│ passenger_count       │ BIGINT      │
│ trip_distance         │ DOUBLE      │
│ PULocationID          │ INTEGER     │
│ DOLocationID          │ INTEGER     │
│ payment_type          │ BIGINT      │
│ fare_amount           │ DOUBLE      │
│ tip_amount            │ DOUBLE      │
│ total_amount          │ DOUBLE      │
│ ...                   │ ...         │
└───────────────────────┴─────────────┘
  19 rows                   2 columns
Run Time (s): real 0.005 user 0.002077 sys 0.001118
في المخرج أعلاه لاحظ التالي:
- كتبنا اسم الملف بين علامتي تنصيص في مكان اسم الجدول، ومعه النجمة
*التي تعني «كل الملفات التي يطابقها هذا النمط Glob»، فقرأت DuckDB الملفات الستة كجدول واحد دون أي أمر إنشاء أو تحميل. - عد 20,332,093 صفاً أخذ 0.124 ثانية، والسبب ما شرحناه في قسم Parquet: عدد الصفوف مكتوب في تذييل كل ملف، فلم تقرأ DuckDB أي صف.
- الأنواع جاءت من الملف نفسه:
TIMESTAMPللتاريخ وDOUBLEللمبالغ، ولم نكتب أي تعريف، وهذا من أهم فروق Parquet عن CSV، فالنوع محفوظ داخل الملف ولا يحتاج تخميناً.
أسئلة المدير الثلاثة
الآن نكتب الأسئلة الثلاثة التي بدأنا بها المقال. احفظ هذا في 02-questions.sql:
.timer on
-- السؤال 1: عدد الرحلات ومتوسط الأجرة في كل شهر
SELECT date_trunc('month', tpep_pickup_datetime) AS month,
       count(*) AS trips,
       round(avg(fare_amount), 2) AS avg_fare
FROM 'data/yellow_tripdata_2024-*.parquet'
WHERE tpep_pickup_datetime >= '2024-01-01' AND tpep_pickup_datetime < '2024-07-01'
GROUP BY month ORDER BY month;

-- السؤال 2: أكثر عشر مناطق انطلاق، بالربط مع ملف CSV فيه أسماء المناطق
SELECT z.Borough, z.Zone, count(*) AS trips
FROM 'data/yellow_tripdata_2024-*.parquet' t
JOIN 'data/taxi_zone_lookup.csv' z ON t.PULocationID = z.LocationID
GROUP BY ALL ORDER BY trips DESC LIMIT 10;

-- السؤال 3: نسبة البقشيش Tip في كل ساعة للدفع بالبطاقة، مع الوسيط Median
SELECT hour(tpep_pickup_datetime) AS hour,
       round(avg(tip_amount / fare_amount) * 100, 1) AS avg_tip_pct,
       round(median(tip_amount / fare_amount) * 100, 1) AS median_tip_pct
FROM 'data/yellow_tripdata_2024-*.parquet'
WHERE payment_type = 1 AND fare_amount > 0
GROUP BY hour ORDER BY hour;
والمخرج سوف يكون كما يلي، مع حذف بعض الساعات من السؤال الثالث:
┌─────────────────────┬─────────┬──────────┐
│        month        │  trips  │ avg_fare │
├─────────────────────┼─────────┼──────────┤
│ 2024-01-01 00:00:00 │ 2964617 │    18.18 │
│ 2024-02-01 00:00:00 │ 3007533 │    18.05 │
│ 2024-03-01 00:00:00 │ 3582611 │    18.68 │
│ 2024-04-01 00:00:00 │ 3514295 │    18.97 │
│ 2024-05-01 00:00:00 │ 3723843 │    19.74 │
│ 2024-06-01 00:00:00 │ 3539155 │    19.42 │
└─────────────────────┴─────────┴──────────┘
Run Time (s): real 3.889 user 2.783408 sys 0.962877
┌───────────┬──────────────────────────────┬────────┐
│  Borough  │             Zone             │ trips  │
├───────────┼──────────────────────────────┼────────┤
│ Manhattan │ Midtown Center               │ 954881 │
│ Manhattan │ Upper East Side South        │ 947084 │
│ Queens    │ JFK Airport                  │ 916784 │
│ Manhattan │ Upper East Side North        │ 879902 │
│ Manhattan │ Midtown East                 │ 701960 │
│ ...       │ ...                          │    ... │
│ Queens    │ LaGuardia Airport            │ 638770 │
│ Manhattan │ Midtown North                │ 584028 │
└───────────┴──────────────────────────────┴────────┘
Run Time (s): real 2.668 user 2.567623 sys 0.743755
┌───────┬─────────────┬────────────────┐
│ hour  │ avg_tip_pct │ median_tip_pct │
├───────┼─────────────┼────────────────┤
│     0 │        28.1 │           25.9 │
│     1 │        25.6 │           26.1 │
│     2 │        31.4 │           26.3 │
│     3 │        35.8 │           26.1 │
│     4 │        24.4 │           25.0 │
│     5 │        22.8 │           23.6 │
│   ... │         ... │            ... │
│    13 │        30.0 │           25.3 │
│    14 │        24.5 │           25.1 │
│   ... │         ... │            ... │
│    23 │        25.9 │           25.9 │
└───────┴─────────────┴────────────────┘
Run Time (s): real 6.822 user 3.849852 sys 1.159448
في المخرج أعلاه لاحظ التالي:
- كل سؤال أخذ بين ثانيتين وسبع ثوان على عشرين مليون صف، والسؤال الثاني ربط ملفات Parquet بملف CSV في نفس الاستعلام JOIN، دون أن ننقل أياً منهما إلى قاعدة بيانات.
- الشرط على التاريخ في السؤال الأول ليس زينة، فبدونه سوف تظهر في النتيجة شهور من 2002 و2008 و2009 وحتى من 2026 في ملفات النصف الأول من 2024، كما سوف ترى في فحص الجودة Data Quality بعد قليل. وهذه أول قاعدة مع أي بيانات حقيقية: لا تثق بالحدود التي يوحي بها اسم الملف.
- السؤال الثالث يبين لماذا نحسب الوسيط Median وليس المتوسط Average وحده: المتوسط يقفز إلى 35.8% في الساعة الثالثة فجراً و30% في الساعة الواحدة ظهراً، بينما الوسيط ثابت تقريباً بين 24% و27% طوال اليوم. والسبب رحلات قليلة أجرتها بضعة سنتات وبقشيشها عدة دولارات، فنسبتها آلاف في المائة، وهذه القلة تكفي لتحرك المتوسط. فإذا سأل المدير «متى يدفع الركاب بقشيشاً أكبر؟» فالإجابة الصحيحة من هذه البيانات أن الفرق صغير، وأما المتوسط فيوحي بقصة غير صحيحة.
فحص الجودة قبل أن تصدق الأرقام
البيانات العامة الحقيقية فيها أخطاء دائماً، وأسرع طريقة لتعرف حجمها أن تعدها قبل أن تبني عليها تقريراً. احفظ هذا في 04-quality.sql:
.timer on
-- كم رحلة تاريخها خارج النصف الأول من 2024؟ وما أغرب القيم؟
SELECT year(tpep_pickup_datetime) AS year, count(*) AS trips
FROM 'data/yellow_tripdata_2024-*.parquet'
WHERE tpep_pickup_datetime < '2024-01-01' OR tpep_pickup_datetime >= '2024-07-01'
GROUP BY year ORDER BY year;
SELECT count(*) FILTER (fare_amount < 0) AS negative_fare,
       count(*) FILTER (trip_distance = 0) AS zero_distance,
       count(*) FILTER (passenger_count IS NULL) AS null_passengers,
       max(trip_distance) AS max_distance_miles
FROM 'data/yellow_tripdata_2024-*.parquet';
-- إعدادات الجلسة الافتراضية على هذا الجهاز
SELECT current_setting('threads') AS threads, current_setting('memory_limit') AS memory_limit;
والمخرج سوف يكون كما يلي:
┌───────┬───────┐
│ year  │ trips │
├───────┼───────┤
│  2002 │    10 │
│  2008 │     5 │
│  2009 │     9 │
│  2023 │    10 │
│  2024 │     3 │
│  2026 │     2 │
└───────┴───────┘
┌───────────────┬───────────────┬─────────────────┬────────────────────┐
│ negative_fare │ zero_distance │ null_passengers │ max_distance_miles │
├───────────────┼───────────────┼─────────────────┼────────────────────┤
│        315747 │        364322 │         1975985 │           312722.3 │
└───────────────┴───────────────┴─────────────────┴────────────────────┘
┌─────────┬──────────────┐
│ threads │ memory_limit │
├─────────┼──────────────┤
│       8 │ 25.0 GiB     │
└─────────┴──────────────┘
في المخرج أعلاه لاحظ التالي:
- 39 رحلة فقط تاريخها خارج الفترة، منها رحلتان في 2026، أي في المستقبل بالنسبة لوقت تسجيلها، وهذا عدد صغير لا يغير المتوسطات، ولكنه يظهر كشهور غريبة في أي رسم بياني إذا لم تفلتره.
- 315,747 رحلة أجرتها سالبة، وهي في الغالب تصحيحات واسترجاعات، و364,322 رحلة مسافتها صفر، وقرابة مليوني رحلة دون عدد ركاب، وأطول رحلة 312,722 ميلاً، أي أكثر من مسافة الأرض إلى القمر. ولهذا كتبنا
fare_amount > 0في السؤال الثالث، والسبب أن القسمة على أجرة سالبة أو صفر تعطي نسبة لا معنى لها. - DuckDB اختارت 8 خيوط لأن المعالج فيه 8 خيوط، وحد ذاكرة 25 GiB، وهو 80% من ذاكرة الجهاز المتاحة لل Container، وهذا هو السلوك الافتراضي، فإذا كانت DuckDB تعمل بجانب خدمات أخرى على نفس السيرفر فحدد لها
memory_limitوthreadsبنفسك.
نفس البيانات بصيغة CSV: كم تخسر؟
أغلب الملفات التي تصلك من الأنظمة الأخرى ليست Parquet وإنما CSV، لذلك لنحول ثلاثة أشهر من البيانات إلى CSV بأمر COPY في DuckDB نفسها، ثم نسأل نفس السؤال على الصيغتين. احفظ هذا في 03-csv.sql:
.timer on
-- نحول ثلاثة أشهر إلى CSV لنرى الفرق بين الصيغتين على نفس البيانات
COPY (SELECT * FROM read_parquet(['data/yellow_tripdata_2024-01.parquet','data/yellow_tripdata_2024-02.parquet','data/yellow_tripdata_2024-03.parquet']))
  TO '/tmp/q1.csv' (HEADER);
-- ماذا استنتج DuckDB من الملف دون أن نخبره بشيء؟
SELECT Delimiter, HasHeader, Columns FROM sniff_csv('/tmp/q1.csv');
-- نفس السؤال على CSV ثم على Parquet
SELECT count(*), round(avg(fare_amount), 2) FROM '/tmp/q1.csv';
SELECT count(*), round(avg(fare_amount), 2) FROM read_parquet(['data/yellow_tripdata_2024-01.parquet','data/yellow_tripdata_2024-02.parquet','data/yellow_tripdata_2024-03.parquet']);
والمخرج سوف يكون كما يلي، بعد اختصار قائمة الأعمدة، ومعه حجم الملفين:
Run Time (s): real 80.261 user 61.126032 sys 51.632170
┌───────────┬───────────┬──────────────────────────────────────────────────────────────────────┐
│ Delimiter │ HasHeader │ Columns                                                              │
├───────────┼───────────┼──────────────────────────────────────────────────────────────────────┤
│ ,         │ true      │ [{'name': VendorID, 'type': BIGINT}, {'name': tpep_pickup_datetime,  │
│           │           │ 'type': TIMESTAMP}, ... {'name': PULocationID, 'type': BIGINT}, ...] │
└───────────┴───────────┴──────────────────────────────────────────────────────────────────────┘
┌──────────────┬────────────────────────────┐
│ count_star() │ round(avg(fare_amount), 2) │
├──────────────┼────────────────────────────┤
│      9554778 │                      18.33 │
└──────────────┴────────────────────────────┘
Run Time (s): real 15.154 user 16.604413 sys 7.254005
┌──────────────┬────────────────────────────┐
│ count_star() │ round(avg(fare_amount), 2) │
├──────────────┼────────────────────────────┤
│      9554778 │                      18.33 │
└──────────────┴────────────────────────────┘
Run Time (s): real 1.204 user 0.118932 sys 0.069130
-rw-r--r-- 1 root root 962170354 Nov 18 19:12 /tmp/q1.csv
153M	total
في المخرج أعلاه لاحظ التالي:
- الدالة
sniff_csvتبين ما يستنتجه قارئ CSV في DuckDB وحده من عينة الملف: الفاصل Delimiter، ووجود سطر العناوين Header، ونوع كل عمود، وقد عرف أن التاريخTIMESTAMPدون أن نخبره، وهذا ما يجعلSELECT * FROM 'file.csv'يعمل مباشرة. وتفاصيل هذا الاستنتاج في صفحة الاستنتاج التلقائي. - ولكن انظر إلى العمود
PULocationID: في Parquet نوعهINTEGER، وفي CSV أصبحBIGINT، لأن الملف النصي لا يحمل أي نوع، والقارئ يختار نوعاً آمناً بحسب ما يراه في العينة Sample. وهذا يعني أن ملف CSV واحداً قد يقرأ بأنواع مختلفة إذا تغيرت العينة، فإذا كان النوع مهماً لك فحدده بنفسك بالمعاملcolumnsأوtypes. - نفس البيانات أصبحت 962 MB في CSV مقابل 153 MB في Parquet، أي أكبر بأكثر من ست مرات، والسؤال على CSV أخذ 15.2 ثانية مقابل 1.2 ثانية على Parquet، لأن DuckDB يجب أن تقرأ كل بايت في النص وتحوله إلى رقم، بينما قرأت من Parquet عموداً واحداً مضغوطاً.
- التحويل نفسه أخذ 80 ثانية، وهذا هو الدرس العملي: إذا كنت سوف تسأل نفس ملف CSV الكبير أكثر من مرة، فحوله إلى Parquet مرة واحدة بأمر COPY، ثم اسأل Parquet.
-- تحويل CSV إلى Parquet مرة واحدة، ثم كل الأسئلة على Parquet
COPY (SELECT * FROM 'sales.csv') TO 'sales.parquet' (FORMAT parquet, COMPRESSION zstd);
نفس الأسئلة على pandas وSQLite: الوقت والذاكرة
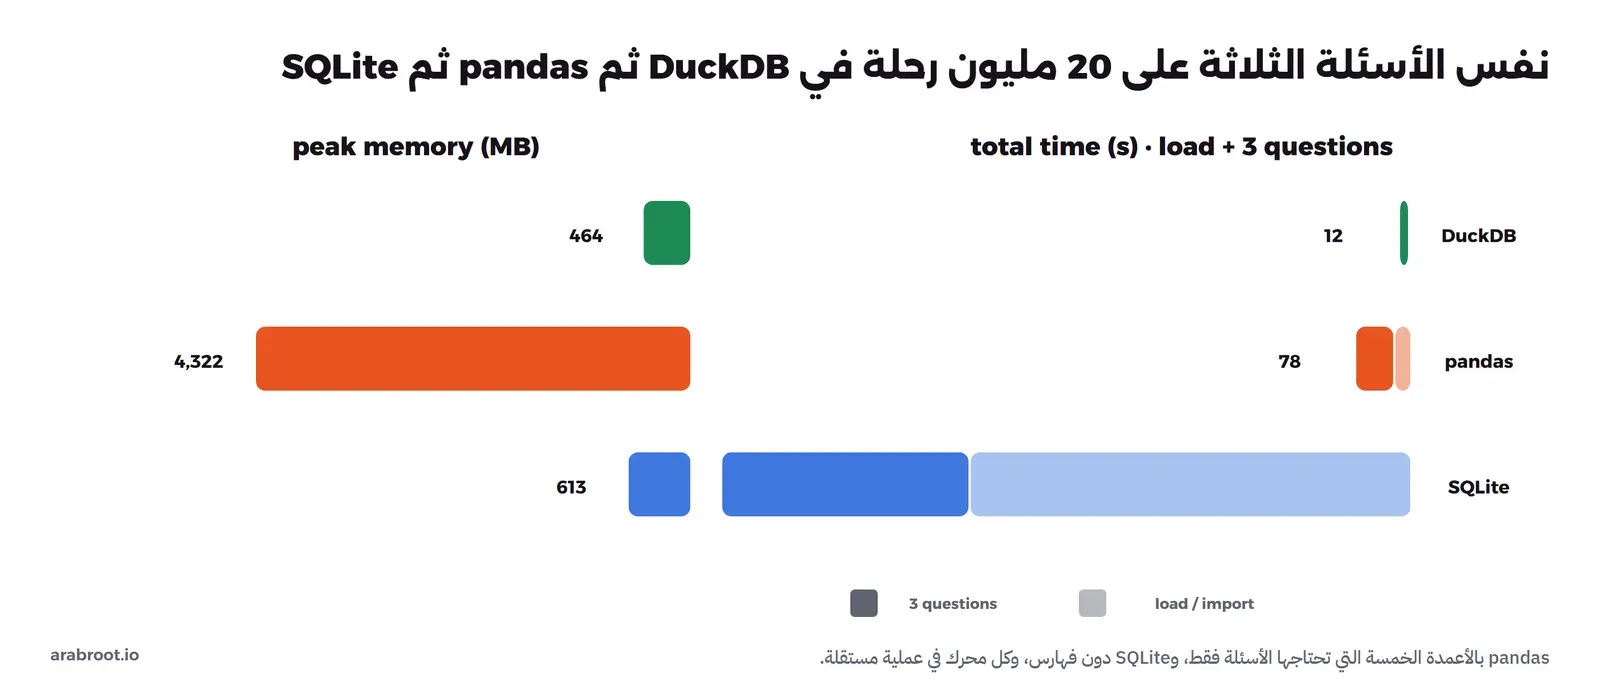
الأرقام وحدها لا تعني شيئاً دون مقارنة، فلنسأل نفس الأسئلة الثلاثة بالطريقتين الأخريين اللتين بدأنا بهما المقال. والبرنامج bench.py يشغل كل محرك في عملية Process مستقلة، حتى لا تؤثر ذاكرة أحدها في الآخر، ويطبع الوقت لكل خطوة، ثم أعلى ذاكرة استخدمتها العملية Peak RSS. ولكي تكون المقارنة عادلة مع pandas قرأنا الأعمدة الخمسة التي تحتاجها الأسئلة فقط، وليس الأعمدة التسعة عشر، ولم ننشئ في SQLite أي فهرس Index، لأن الأسئلة الثلاثة تمر على كل الصفوف على أي حال:
# نفس الأسئلة الثلاثة على DuckDB وpandas وSQLite، كل محرك في عملية Process مستقلة
# python bench.py duckdb|pandas|sqlite-load|sqlite
import glob, os, resource, sys, time
engine = sys.argv[1]
FILES = sorted(glob.glob("data/yellow_tripdata_2024-0*.parquet"))
COLS = ["tpep_pickup_datetime", "PULocationID", "payment_type", "fare_amount", "tip_amount"]
t0 = time.perf_counter()
def mark(label):
    global t0
    print(f"{engine:7} {label:28} {time.perf_counter() - t0:7.2f} s", flush=True)
    t0 = time.perf_counter()

if engine == "duckdb":
    import duckdb
    con = duckdb.connect()
    src = "'data/yellow_tripdata_2024-*.parquet'"
    con.sql(f"""SELECT date_trunc('month', tpep_pickup_datetime) m, count(*), avg(fare_amount) FROM {src}
        WHERE tpep_pickup_datetime >= '2024-01-01' AND tpep_pickup_datetime < '2024-07-01' GROUP BY m""").fetchall(); mark("Q1 trips per month")
    con.sql(f"""SELECT z.Zone, count(*) n FROM {src} t JOIN 'data/taxi_zone_lookup.csv' z ON t.PULocationID = z.LocationID
        GROUP BY z.Zone ORDER BY n DESC LIMIT 10""").fetchall(); mark("Q2 top zones (join)")
    con.sql(f"""SELECT hour(tpep_pickup_datetime) h, median(tip_amount / fare_amount) FROM {src}
        WHERE payment_type = 1 AND fare_amount > 0 GROUP BY h""").fetchall(); mark("Q3 median tip by hour")

elif engine == "pandas":
    import pandas as pd
    df = pd.concat([pd.read_parquet(f, columns=COLS) for f in FILES], ignore_index=True); mark(f"load {len(df):,} rows")
    zones = pd.read_csv("data/taxi_zone_lookup.csv")
    d = df[(df.tpep_pickup_datetime >= "2024-01-01") & (df.tpep_pickup_datetime < "2024-07-01")]
    d.groupby(d.tpep_pickup_datetime.dt.to_period("M")).fare_amount.agg(["count", "mean"]); mark("Q1 trips per month")
    df.merge(zones, left_on="PULocationID", right_on="LocationID").groupby("Zone").size().nlargest(10); mark("Q2 top zones (join)")
    c = df[(df.payment_type == 1) & (df.fare_amount > 0)]
    (c.tip_amount / c.fare_amount).groupby(c.tpep_pickup_datetime.dt.hour).median(); mark("Q3 median tip by hour")

elif engine == "sqlite-load":            # SQLite لا يقرأ Parquet، فننقل الأعمدة إليه أولاً
    import sqlite3, pyarrow.parquet as pq
    con = sqlite3.connect(os.environ.get("SQLITE_DB", "taxi.sqlite"))
    con.execute("DROP TABLE IF EXISTS trips")
    con.execute("CREATE TABLE trips (pickup TEXT, pu INTEGER, payment INTEGER, fare REAL, tip REAL)")
    n = 0
    for f in FILES:
        for b in pq.ParquetFile(f).iter_batches(batch_size=200_000, columns=COLS):
            rows = list(zip([str(x) for x in b.column(0).to_pylist()], *[b.column(i).to_pylist() for i in range(1, 5)]))
            con.executemany("INSERT INTO trips VALUES (?,?,?,?,?)", rows); n += len(rows)
    con.commit()
    con.execute("CREATE TABLE zones (id INTEGER PRIMARY KEY, borough TEXT, zone TEXT)")
    import csv
    con.executemany("INSERT INTO zones VALUES (?,?,?)", [(r[0], r[1], r[2]) for r in list(csv.reader(open("data/taxi_zone_lookup.csv")))[1:]])
    con.commit(); mark(f"load {n:,} rows")

elif engine == "sqlite":
    import sqlite3, statistics
    con = sqlite3.connect(os.environ.get("SQLITE_DB", "taxi.sqlite"))
    con.execute("""SELECT substr(pickup, 1, 7) m, count(*), avg(fare) FROM trips
        WHERE pickup >= '2024-01-01' AND pickup < '2024-07-01' GROUP BY m""").fetchall(); mark("Q1 trips per month")
    con.execute("""SELECT z.zone, count(*) n FROM trips t JOIN zones z ON t.pu = z.id
        GROUP BY z.zone ORDER BY n DESC LIMIT 10""").fetchall(); mark("Q2 top zones (join)")
    # SQLite لا يملك دالة median، فنرتب القيم في Python
    groups = {}
    for h, v in con.execute("SELECT CAST(substr(pickup, 12, 2) AS INTEGER), tip / fare FROM trips WHERE payment = 1 AND fare > 0"):
        groups.setdefault(h, []).append(v)
    {h: statistics.median(v) for h, v in groups.items()}; mark("Q3 median tip by hour")

print(f"{engine:7} peak memory (RSS)             {resource.getrusage(resource.RUSAGE_SELF).ru_maxrss / 1024:7.0f} MB")
والأوامر، مع ملاحظة أن SQLite تحتاج خطوة نقل قبل أي سؤال لأنها لا تقرأ Parquet:
docker run --rm -v "$PWD/lab:/lab" -v "$PWD/data:/lab/data:ro" ad3-duck:1 python bench.py duckdb
docker run --rm -v "$PWD/lab:/lab" -v "$PWD/data:/lab/data:ro" ad3-duck:1 python bench.py pandas
docker run --rm -e SQLITE_DB=/tmp/taxi.sqlite -v "$PWD/lab:/lab:ro" -v "$PWD/data:/lab/data:ro" ad3-duck:1 \
  sh -c "cd /tmp && cp /lab/bench.py . && ln -s /lab/data data && python bench.py sqlite-load && python bench.py sqlite && ls -la /tmp/taxi.sqlite"
والمخرج سوف يكون كما يلي:
duckdb  Q1 trips per month              4.88 s
duckdb  Q2 top zones (join)             2.60 s
duckdb  Q3 median tip by hour           4.47 s
duckdb  peak memory (RSS)                 464 MB
pandas  load 20,332,093 rows           22.36 s
pandas  Q1 trips per month             22.39 s
pandas  Q2 top zones (join)            22.57 s
pandas  Q3 median tip by hour          10.76 s
pandas  peak memory (RSS)                4322 MB
sqlite-load load 20,332,093 rows          662.32 s
sqlite-load peak memory (RSS)                 218 MB
sqlite  Q1 trips per month            181.73 s
sqlite  Q2 top zones (join)           116.13 s
sqlite  Q3 median tip by hour          73.16 s
sqlite  peak memory (RSS)                 613 MB
-rw-r--r-- 1 root root 936816640 Nov 18 20:34 /tmp/taxi.sqlite
والجدول التالي يجمع الأرقام:
| الخطوة | DuckDB | pandas | SQLite |
|---|---|---|---|
| التحميل أو النقل | لا يوجد، تقرأ الملفات مباشرة | 22.4 ثانية | 662 ثانية، وملف جديد 937 MB |
| السؤال 1: الرحلات في كل شهر | 4.9 ثانية | 22.4 ثانية | 181.7 ثانية |
| السؤال 2: أكثر المناطق مع الربط JOIN | 2.6 ثانية | 22.6 ثانية | 116.1 ثانية |
| السؤال 3: وسيط البقشيش في كل ساعة | 4.5 ثانية | 10.8 ثانية | 73.2 ثانية، والوسيط في Python |
| أعلى ذاكرة Peak RSS | 464 MB | 4,322 MB | 613 MB |
في المخرج أعلاه لاحظ التالي:
- DuckDB أجابت عن الأسئلة الثلاثة في 12 ثانية تقريباً دون أي تحميل، بينما احتاج pandas 22 ثانية للتحميل وحده، ثم 56 ثانية للأسئلة، أي قرابة ستة أضعاف الوقت الكلي، والسبب ما شرحناه: أغلب عمليات التجميع والربط في pandas تعمل على نواة واحدة، وكل عملية تنشئ نسخة جديدة من الأعمدة في الذاكرة.
- الذاكرة هي الفرق الأكبر: 4.3 GB لخمسة أعمدة في pandas مقابل 464 MB في DuckDB، أي أكثر من تسعة أضعاف، وهذا ما يحدد في الواقع هل يعمل التحليل على لابتوب الموظف أم لا. وسوف ترى بعد قليل ماذا يحدث عندما لا تكفي الذاكرة.
- SQLite ممتازة لما صممت له، أي قاعدة صغيرة داخل التطبيق، ولكنها هنا الأبطأ بفارق كبير: 11 دقيقة لنقل البيانات إليها، ثم دقائق لكل سؤال، والسبب أنها تحفظ الصفوف كاملة وتقرأ صفاً صفاً بنواة واحدة، ولا تملك دالة للوسيط، فحسبناه في Python بعد أن أخرجنا ملايين القيم منها.
ماذا لو كانت الذاكرة أقل من البيانات؟ What If
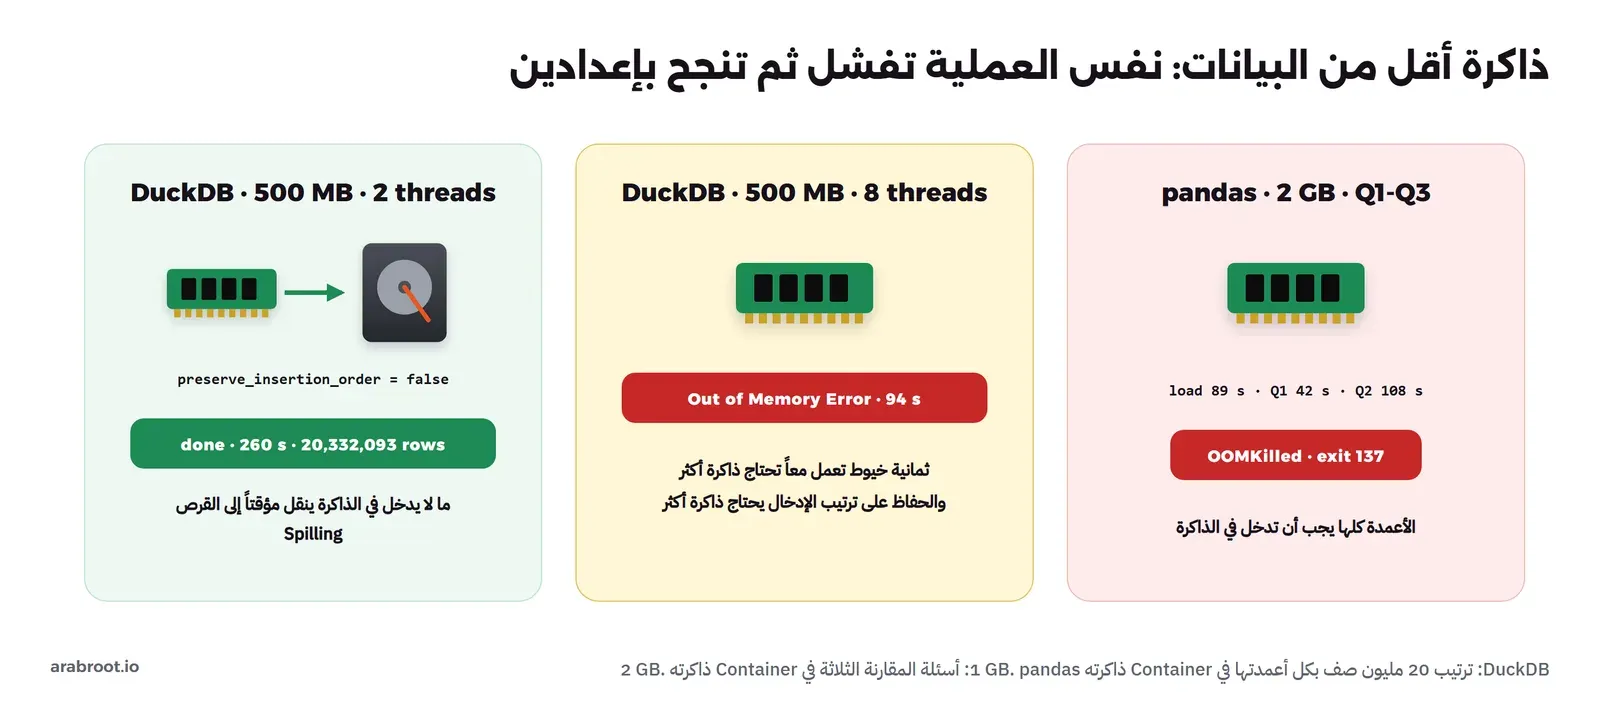
كل ما سبق عمل والذاكرة المتاحة كبيرة، فلنضيقها عمداً. نشغل DuckDB في Container ذاكرته 1 GB فقط بالخيار --memory=1g، ونحدد لها 500 MB، ونطلب منها أثقل عملية ممكنة على هذه البيانات: أن ترتب العشرين مليون رحلة بكل أعمدتها التسعة عشر بحسب المبلغ الكلي، وتكتب النتيجة في ملف جديد. وهذه العملية لا يمكن أن تتم دفعة بعد دفعة، لأن الصف الأول في النتيجة قد يكون في آخر ملف. احفظ هذا في 09-limit.sql:
.timer on
-- ذاكرة أقل من حجم البيانات: نرتب 20 مليون رحلة بكل أعمدتها ونكتبها في ملف جديد
SET memory_limit = '500MB';
SET temp_directory = '/tmp/spill';
COPY (SELECT * FROM 'data/yellow_tripdata_2024-*.parquet' ORDER BY total_amount DESC)
  TO '/tmp/sorted.parquet';
SELECT count(*) AS rows, max(total_amount) AS max_total FROM '/tmp/sorted.parquet';
docker run --rm --memory=1g -v "$PWD/lab:/lab:ro" -v "$PWD/data:/lab/data:ro" ad3-duck:1 sh -c "duckdb < 09-limit.sql"والمخرج سوف يكون كما يلي:
Out of Memory Error: could not allocate block of size 256.0 KiB (477.8 MiB/476.8 MiB used)

Possible solutions:
* Reducing the number of threads (SET threads=X)
* Disabling insertion-order preservation (SET preserve_insertion_order=false)
* Increasing the memory limit (SET memory_limit='...GB')

See also https://duckdb.org/docs/current/guides/performance/how_to_tune_workloads
Run Time (s): real 94.046 user 23.420813 sys 17.246534
IO Error: No files found that match the pattern "/tmp/sorted.parquet"
فشلت العملية بعد 94 ثانية، وهذا يذكرك بما قلناه في قسم البيانات الأكبر من الذاكرة: النقل إلى القرص Spilling ليس ضماناً. ولكن لاحظ أن رسالة الخطأ لا تقول «اشتر ذاكرة» فقط، وإنما تقترح أمرين قبل ذلك: خيوط أقل، لأن كل خيط من الخيوط الثمانية يعمل على جزء من الترتيب Sorting ويحتاج ذاكرة لعمله في نفس الوقت، وإلغاء الحفاظ على ترتيب الإدخال Insertion Order، لأن DuckDB بشكل افتراضي تحافظ على ترتيب الصفوف كما قرأتها في كل مرحلة، وهذا يحتاج ذاكرة إضافية لا نحتاجها هنا لأننا سوف نرتب على أي حال. فلنطبق النصيحتين في 09b-limit-fixed.sql:
.timer on
-- نفس العملية بعد نصيحة رسالة الخطأ: خيوط أقل، ودون الحفاظ على ترتيب الإدخال
SET memory_limit = '500MB';
SET temp_directory = '/tmp/spill';
SET threads = 2;
SET preserve_insertion_order = false;
COPY (SELECT * FROM 'data/yellow_tripdata_2024-*.parquet' ORDER BY total_amount DESC)
  TO '/tmp/sorted.parquet';
SELECT count(*) AS rows, max(total_amount) AS max_total FROM '/tmp/sorted.parquet';
والمخرج سوف يكون كما يلي، ومعه حجم الملف الناتج:
Run Time (s): real 260.099 user 82.426329 sys 104.459619
┌──────────┬───────────┐
│   rows   │ max_total │
├──────────┼───────────┤
│ 20332093 │  334145.3 │
└──────────┴───────────┘
-rw-r--r-- 1 root root 386020322 Nov 18 19:26 /tmp/sorted.parquet
نجحت نفس العملية في 260 ثانية بنفس الحد 500 MB، والوقت أطول لأن جزءاً كبيراً من العمل ذهب إلى الكتابة والقراءة من القرص، وهذا ما يقوله الرقم الكبير في sys. ولاحظ أيضاً أكبر مبلغ كلي في البيانات: 334,145 دولاراً لرحلة تاكسي واحدة، وهو مثال آخر على قيم يجب أن تفحصها قبل أي متوسط.
ولنعط pandas فرصة مشابهة: نفس برنامج المقارنة الذي رأيته في القسم السابق، بأعمدته الخمسة فقط وليس التسعة عشر، في Container ذاكرته 2 GB، أي ضعف ذاكرة DuckDB:
docker run --name ad3-pandas-m --memory=2g -v "$PWD/lab:/lab:ro" -v "$PWD/data:/lab/data:ro" ad3-duck:1 python bench.py pandas
docker inspect ad3-pandas-m --format 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}}'
pandas load 20,332,093 rows 89.28 s
pandas Q1 trips per month 42.32 s
pandas Q2 top zones (join) 107.60 s
OOMKilled=true ExitCode=137حمل pandas الأعمدة الخمسة وأجاب عن سؤالين ببطء شديد، ثم قتل نظام التشغيل العملية في السؤال الثالث بسبب نفاد الذاكرة OOMKilled، ورمز الخروج 137 يعني أن العملية أنهيت بالإشارة SIGKILL، فلم يطبع البرنامج أي رسالة خطأ، ولم يكتب أي نتيجة. وهذا الفرق الحقيقي بين الأداتين في الذاكرة الضيقة: DuckDB تعطيك رسالة خطأ تشرح ماذا تفعل، ثم تكمل بإعداد مختلف، وpandas تموت بصمت.
ملف Parquet على الإنترنت دون تنزيله
لنفرض أن البيانات ليست على جهازك أصلاً، وإنما على موقع أو في خزن كائنات Object Storage مثل S3 أو MinIO، وأنك تريد رقماً واحداً منها. والحل البسيط أن تنزل الملف كاملاً ثم تسأله، أما DuckDB فتقرأ من رابط HTTPS مباشرة عبر إضافة httpfs، وتطلب من السيرفر الأجزاء التي تحتاجها فقط بطلبات المدى HTTP Range Requests، كما يذكر توثيق httpfs. ولنتحقق من ذلك بالأرقام على ملف يوليو 2024، وهو ملف لم ننزله، وحجمه بحسب ترويسة Content-Length في رد السيرفر 52,299,432 بايت. احفظ هذا في 05-remote.sql:
.timer on
-- ملف Parquet على الإنترنت دون تنزيله: يوليو 2024 من موقع هيئة التاكسي في نيويورك
SET VARIABLE url = 'https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2024-07.parquet';
SELECT extension_name, installed, loaded FROM duckdb_extensions() WHERE extension_name = 'httpfs';
EXPLAIN ANALYZE SELECT count(*) FROM read_parquet(getvariable('url'));
EXPLAIN ANALYZE SELECT round(avg(fare_amount), 2) FROM read_parquet(getvariable('url'));
EXPLAIN ANALYZE SELECT round(avg(fare_amount), 2) FROM read_parquet(getvariable('url'));
SELECT round(avg(fare_amount), 2) AS avg_fare, count(*) AS trips FROM read_parquet(getvariable('url'));
SELECT extension_name, installed, loaded FROM duckdb_extensions() WHERE extension_name = 'httpfs';
الأمر EXPLAIN ANALYZE يشغل الاستعلام ويطبع خطته مع الوقت الحقيقي لكل مرحلة، ومع إحصاءات طلبات HTTP في أعلاها. والمخرج سوف يكون كما يلي، بعد اختصار الخطط إلى الأسطر المهمة:
│ extension_name │ installed │ loaded  │
│ httpfs         │ false     │ false   │

-- count(*)
││            in: 65.6 KiB           ││
││              #HEAD: 1             ││
││              #GET: 1              ││
Run Time (s): real 8.688 user 0.662149 sys 0.434790

-- avg(fare_amount), first time
││            in: 3.3 MiB            ││
││              #HEAD: 1             ││
││              #GET: 3              ││
│ Projections: fare_amount                                                        │
│ Row Groups Scanned: 3 / 3                                                       │
│ 3,076,903 rows                                                          220.0ms │
Run Time (s): real 1.676 user 0.105821 sys 0.164563

-- avg(fare_amount), second time
││            in: 0 bytes            ││
││              #HEAD: 1             ││
││              #GET: 0              ││
Run Time (s): real 0.397 user 0.052333 sys 0.041481

│ avg_fare │  trips  │
│    19.53 │ 3076903 │

│ extension_name │ installed │ loaded  │
│ httpfs         │ true      │ true    │
في المخرج أعلاه لاحظ التالي:
- إضافة httpfs لم تكن مثبتة في البداية، وعندما رأت DuckDB رابط https نزلتها وحملتها تلقائياً، وهذا سبب الثواني الثماني في الاستعلام الأول. وهذه الميزة مريحة على جهازك، ولكنها تعني أن DuckDB تنزل كوداً من موقع الإضافات أثناء العمل، فإذا كان سيرفرك لا يتصل بالإنترنت أو كانت سياسة الأمان تمنع ذلك فثبت الإضافات مسبقاً بالأمر
INSTALL httpfsفي مرحلة بناء ال Image. - عد ثلاثة ملايين صف كلف 65.6 KiB فقط من ملف حجمه قرابة 50 MiB، بطلب HEAD واحد لمعرفة حجم الملف وطلب GET واحد لقراءة التذييل الذي فيه عدد الصفوف.
- متوسط الأجرة كلف 3.3 MiB بثلاثة طلبات GET، أي طلب لكل مجموعة صفوف من المجموعات الثلاث في الملف، وكل طلب قرأ قطعة عمود الأجرة وحدها، وهذا دفع الإسقاط Projection Pushdown الذي شرحناه، ولكن هذه المرة عبر الشبكة.
- في المرة الثانية لم ينزل أي بايت، لأن DuckDB تحفظ الأجزاء التي قرأتها في ذاكرة مؤقتة Cache للملفات الخارجية أثناء الجلسة، فلا تكرر الطلب إذا لم يتغير الملف.
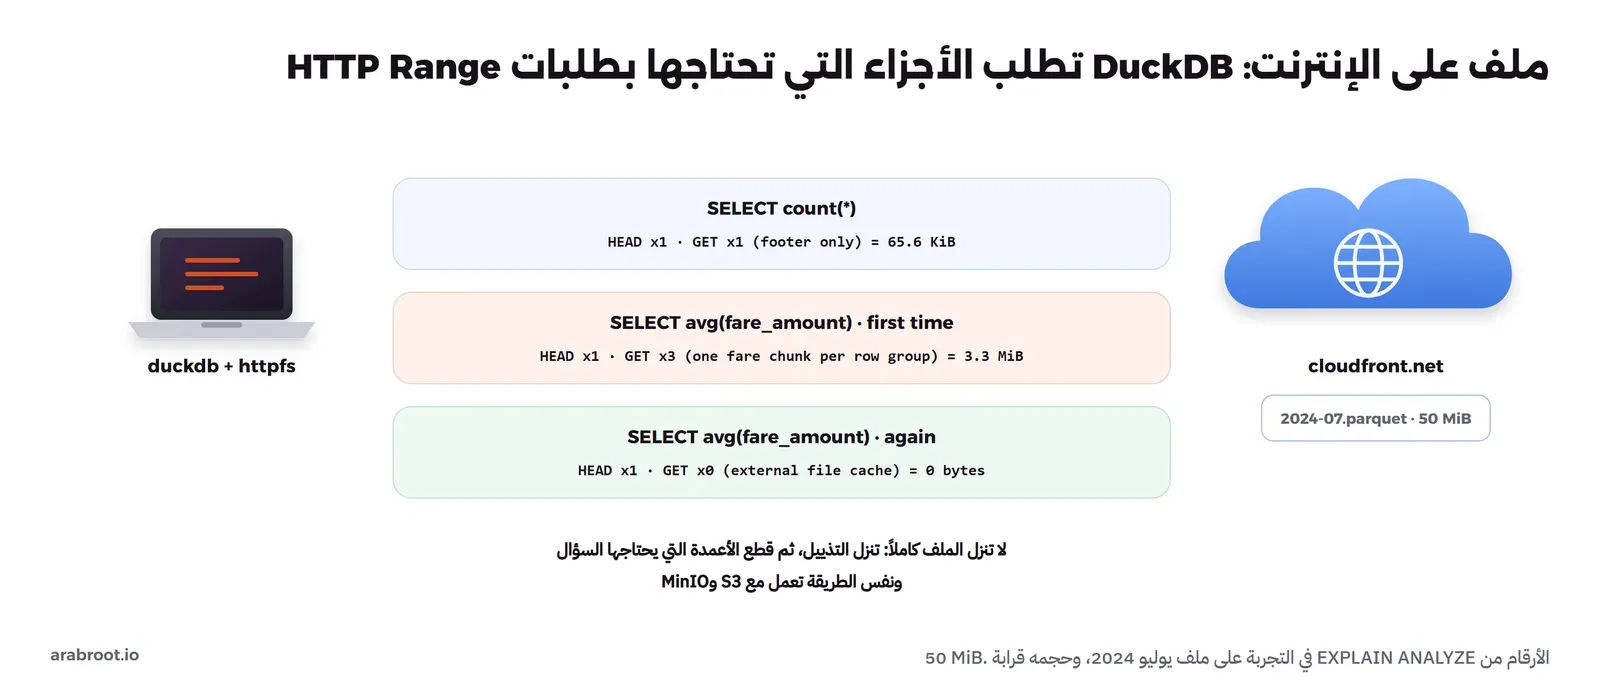
وهذه الطريقة نفسها تعمل مع S3 وMinIO بالمسار s3:// بعد إنشاء مفتاح الدخول بالأمر CREATE SECRET، وهي من أسباب انتشار DuckDB مع بحيرات البيانات Data Lakes التي شرحناها في مقال مصطلحات البيانات: تبقى الملفات في مكانها، ويقرأ كل محلل ما يحتاجه منها.
قراءة JSON متداخل من API
JSON هو الصيغة الثالثة التي تصلك كل يوم، غالباً من واجهات API أو من سجلات Logs التطبيقات، ومشكلته أنه متداخل: كائن داخله مصفوفة داخلها كائنات. والدالة read_json تحول الكائنات إلى نوع STRUCT والمصفوفات إلى قوائم LIST، ثم تفك القائمة إلى صفوف بالدالة unnest. ولنجرب على رد حقيقي من GitHub API فيه آخر خمسة إصدارات من DuckDB نفسها، وكل إصدار فيه مصفوفة ملفات بأحجامها. احفظ هذا في 08-json.sql:
.timer on
-- رد JSON حقيقي من GitHub API: إصدارات DuckDB نفسها، مع مصفوفة ملفات داخل كل إصدار
SELECT tag_name, published_at::DATE AS published, len(assets) AS files,
       round(sum(a.size) / 1e6) AS total_mb
FROM read_json('https://api.github.com/repos/duckdb/duckdb/releases?per_page=5'), unnest(assets) AS u(a)
GROUP BY ALL ORDER BY published DESC;
-- ما الأنواع التي استنتجها القارئ للحقول المتداخلة؟
SELECT column_name, column_type FROM (DESCRIBE SELECT author, assets FROM read_json('https://api.github.com/repos/duckdb/duckdb/releases?per_page=5'));
والمخرج سوف يكون كما يلي، بعد اختصار تعريف الأنواع الطويل:
┌──────────┬────────────┬───────┬──────────┐
│ tag_name │ published  │ files │ total_mb │
├──────────┼────────────┼───────┼──────────┤
│ v2.0.0   │ 2026-10-21 │    28 │    763.0 │
│ v1.5.6   │ 2026-09-28 │    29 │    709.0 │
│ v1.5.5   │ 2026-07-22 │    29 │    708.0 │
│ v1.5.4   │ 2026-06-17 │    29 │    701.0 │
│ v1.4.5   │ 2026-06-17 │    23 │    492.0 │
└──────────┴────────────┴───────┴──────────┘
Run Time (s): real 19.285 user 1.003807 sys 0.842560
┌─────────────┬────────────────────────────────────────────────────────────────────┐
│ column_name │ column_type                                                        │
├─────────────┼────────────────────────────────────────────────────────────────────┤
│ author      │ STRUCT(login VARCHAR, id BIGINT, node_id VARCHAR, avatar_url ...)  │
│ assets      │ STRUCT(url VARCHAR, id BIGINT, node_id VARCHAR, "name" VARCHAR,    │
│             │ "label" VARCHAR, uploader STRUCT(login VARCHAR, ...), ...)[]       │
└─────────────┴────────────────────────────────────────────────────────────────────┘
لاحظ أن القارئ استنتج البنية كاملة، بما فيها كائن داخل كائن مثل uploader داخل كل ملف، والقوسان [] في نهاية نوع assets يعنيان قائمة من هذه الكائنات، فوصلنا إلى حجم كل ملف بالكتابة a.size بعد unnest، دون أي كود Python لتحليل JSON. ولاحظ أيضاً أن الإصدار 1.4.5 صدر في نفس يوم 1.5.4، لأن المشروع يصدر تحديثات لسلسلة الدعم الطويل LTS السابقة بجانب السلسلة الحالية.
قاعدة دائمة في ملف واحد
كل ما سبق كان على الملفات مباشرة، دون أي قاعدة بيانات، وهذا يكفي في أغلب الأسئلة. ولكن إذا كنت سوف تسأل نفس البيانات كل يوم، أو تحتاج إلى تعديلها، فاحفظها في ملف قاعدة DuckDB. احفظ هذا في 06-persist.sql:
.timer on
-- قاعدة دائمة في ملف واحد: نحمل الأشهر الستة في جدول
CREATE OR REPLACE TABLE trips AS
  SELECT * FROM 'data/yellow_tripdata_2024-*.parquet'
  WHERE tpep_pickup_datetime >= '2024-01-01' AND tpep_pickup_datetime < '2024-07-01';
CREATE OR REPLACE TABLE zones AS SELECT * FROM 'data/taxi_zone_lookup.csv';
SELECT count(*) FROM trips;
CHECKPOINT;
SELECT database_size, block_size, total_blocks FROM pragma_database_size();
SELECT z.Zone, count(*) AS trips FROM trips t JOIN zones z ON t.PULocationID = z.LocationID
GROUP BY ALL ORDER BY trips DESC LIMIT 3;
docker run --rm -v "$PWD/lab:/lab:ro" -v "$PWD/data:/lab/data:ro" ad3-duck:1 \
sh -c "duckdb /tmp/taxi.duckdb < 06-persist.sql && ls -la /tmp/taxi.duckdb && du -sh data"والمخرج سوف يكون كما يلي:
Run Time (s): real 76.670 user 34.449196 sys 32.457335
Run Time (s): real 1.495 user 0.120753 sys 0.209646
┌──────────────┐
│ count_star() │
├──────────────┤
│     20332054 │
└──────────────┘
┌───────────────┬────────────┬──────────────┐
│ database_size │ block_size │ total_blocks │
├───────────────┼────────────┼──────────────┤
│ 536.2 MiB     │     262144 │         2145 │
└───────────────┴────────────┴──────────────┘
┌───────────────────────┬────────┐
│         Zone          │ trips  │
├───────────────────────┼────────┤
│ Midtown Center        │ 954879 │
│ Upper East Side South │ 947083 │
│ JFK Airport           │ 916779 │
└───────────────────────┴────────┘
Run Time (s): real 1.087 user 0.873707 sys 0.713741
-rw-r--r-- 1 root root 562311168 Nov 18 19:05 /tmp/taxi.duckdb
327M	data
في المخرج أعلاه لاحظ التالي:
- الجدول فيه 20,332,054 رحلة، أي 39 رحلة أقل من الملفات، وهي بالضبط الرحلات ذات التواريخ الخاطئة التي حذفها شرط التاريخ.
- سؤال المناطق على الجدول أخذ 1.1 ثانية مقابل 2.7 ثانية على ملفات Parquet، والسبب أن ملف القاعدة مصمم لقراءة DuckDB نفسها، وفيه إحصاءات لكل جزء من كل عمود.
- ولكن ملف القاعدة 536 MiB مقابل 327 MiB لملفات Parquet، أي أن الضغط Compression في Parquet هنا أقوى، لذلك لا تفترض أن «القاعدة» أصغر دائماً. والقاعدة العملية: Parquet لتبادل البيانات وأرشفتها وقراءتها من عدة أدوات، وملف DuckDB لبيانات تعمل عليها يومياً وتعدلها.
والآن السؤال الذي يقع فيه كثيرون: ماذا يحدث إذا فتح برنامجان نفس الملف؟ لنفرض أن لوحة تقارير تعمل في الخلفية وتفتح القاعدة، ثم جاء محلل يريد أن يسأل نفس الملف من سطر الأوامر. البرنامج hold.py يمثل اللوحة، فيفتح الملف ويبقيه مفتوحاً دقيقة:
# برنامج يفتح القاعدة للكتابة ويبقيها مفتوحة، مثل تطبيق أو لوحة تقارير تعمل في الخلفية
import duckdb, sys, time
con = duckdb.connect("/tmp/taxi.duckdb", read_only=(sys.argv[1] == "ro"))
print("holder opened the file, read_only =", sys.argv[1] == "ro", flush=True)
time.sleep(60)
والسكربت 06-lock.sh يشغله مرة للكتابة ومرة للقراءة فقط، ويحاول في كل مرة أن يسأل الملف من عملية ثانية، وقد أنشأنا له قاعدة صغيرة فيها شهر يناير فقط حتى لا ننتظر التحميل:
# عمليتان على نفس الملف: الأولى تبقيه مفتوحاً للكتابة، والثانية تحاول القراءة
python hold.py rw &
sleep 25
duckdb /tmp/taxi.duckdb -c "SELECT count(*) FROM trips;"
duckdb -readonly /tmp/taxi.duckdb -c "SELECT count(*) FROM trips;"
wait
# الآن الأولى تفتحه للقراءة فقط
python hold.py ro &
sleep 25
duckdb -readonly /tmp/taxi.duckdb -c "SELECT count(*) FROM trips;"
wait
والمخرج سوف يكون كما يلي:
holder opened the file, read_only = False
IO Error: Could not set lock on file "/tmp/taxi.duckdb": Conflicting lock is held in /usr/local/bin/python3.13 (PID 48). See also https://duckdb.org/docs/current/connect/concurrency
IO Error: Could not set lock on file "/tmp/taxi.duckdb": Conflicting lock is held in /usr/local/bin/python3.13 (PID 48). See also https://duckdb.org/docs/current/connect/concurrency
holder opened the file, read_only = True
┌──────────────┐
│ count_star() │
├──────────────┤
│      2964624 │
└──────────────┘
ورسالة الخطأ هنا واضحة وتذكر رقم العملية PID التي تمسك القفل Lock، ولاحظ أن العملية الثانية لم تستطع حتى القراءة فقط بالخيار -readonly طالما أن الأولى فاتحة للكتابة، وعندما فتحت الأولى الملف للقراءة فقط نجحت الثانية. وهذا هو نموذج التزامن Concurrency كما في توثيق DuckDB: عملية واحدة تقرأ وتكتب، داخلها خيوط كثيرة تكتب في نفس الوقت دون مشكلة، أو عدة عمليات تقرأ فقط ولا يكتب أحد. وأما الكتابة من عدة عمليات فتحتاج بروتوكول Quack الجديد في الإصدار 2.0 الذي يحول DuckDB إلى سيرفر، أو DuckLake مع فهرس مركزي في PostgreSQL.
النص العربي في DuckDB
أرقام التاكسي لا تختبر أي شيء يخص لغتنا، لذلك لننتقل إلى ملف آخر: الجزء الأول من سبعة أجزاء من مقالات ويكيبيديا العربية المنشورة على Hugging Face بنسخة 20231101.ar، وهو ملف Parquet واحد حجمه 408 MB فيه 174 ألف مقال بعناوينها ونصوصها الكاملة، برخصة CC BY-SA كما هي في ويكيبيديا. وقد استخدمنا نفس المجموعة في مقال البحث النصي داخل PostgreSQL، أما هنا فالسؤال مختلف: كيف تتعامل أداة التحليل مع الحروف العربية عندما تعد وتقارن وترتب؟
الحرف ليس بايتاً، والكلمة لها أكثر من شكل
احفظ هذا في 07-arabic.sql، وشغله بعد أن تربط مجلد الملف في /lab/wiki:
.timer on
-- 174 ألف مقال من ويكيبيديا العربية في ملف Parquet واحد (CC BY-SA)
CREATE VIEW wiki AS SELECT * FROM 'wiki/arwiki-0.parquet';
-- الحروف مقابل البايتات: الحرف العربي بايتان في UTF-8
SELECT count(*) AS articles,
       sum(length(text)) AS characters,
       sum(strlen(text)) AS bytes
FROM wiki;
-- نفس الكلمة بأشكال مختلفة في النص
SELECT count(*) FILTER (text LIKE '%الإسلام%') AS with_hamza,
       count(*) FILTER (text LIKE '%الاسلام%') AS without_hamza,
       count(*) FILTER (regexp_replace(text, '[أإآ]', 'ا', 'g') LIKE '%الاسلام%') AS normalized
FROM wiki;
والمخرج سوف يكون كما يلي:
┌──────────┬────────────┬───────────┐
│ articles │ characters │   bytes   │
├──────────┼────────────┼───────────┤
│   174172 │  478810616 │ 851425299 │
└──────────┴────────────┴───────────┘
Run Time (s): real 14.943 user 4.683861 sys 4.651602
┌────────────┬───────────────┬────────────┐
│ with_hamza │ without_hamza │ normalized │
├────────────┼───────────────┼────────────┤
│      15676 │           191 │      15740 │
└────────────┴───────────────┴────────────┘
Run Time (s): real 26.989 user 29.864229 sys 11.627795
في المخرج أعلاه لاحظ التالي:
- الدالة
lengthتعد الحروف، والدالةstrlenتعد البايتات، والفرق بينهما 1.78 ضعف، لأن كل حرف عربي في ترميز UTF-8 بايتان، بينما المسافات والأرقام والحروف اللاتينية بايت واحد. وهذا مهم عندما تحدد طول عمود في نظام آخر بالبايت، أو عندما تحسب حجم البيانات التي سوف ترسلها. - 191 مقالاً كتبت «الاسلام» دون همزة، ولو بحث المحلل بالشكل الصحيح وحده لما وجدها، ومع توحيد الألف بالدالة
regexp_replaceوصل العدد إلى 15,740، وهو أقل من مجموع العمودين لأن بعض المقالات فيها الشكلان معاً. - السؤال الثاني أخذ 27 ثانية مقابل 15 للأول، لأن
LIKEمع%في البداية يمر على كل النص، والتعبير المنتظم Regular Expression يعيد كتابة 478 مليون حرف قبل المقارنة. وDuckDB ليست محرك بحث نصي، فإذا كان سؤالك اليومي «ابحث عن كلمة في ملايين المستندات» فهذا عمل فهرس نصي كما في مقال البحث في النصوص العربية.
دالة توحيد عربية بالماكرو Macro، ورسالة خطأ تستحق القراءة
بدلاً من أن تكرر سلسلة regexp_replace في كل استعلام، تستطيع أن تعرفها مرة واحدة كماكرو Macro، أي دالة SQL قصيرة باسم تختاره. وأول محاولة كتبناها استخدمت ً لكتابة حروف التشكيل كما نكتبها في Python، فجاء الخطأ التالي:
Invalid Input Error: invalid escape sequence: \uوالسبب أن DuckDB تستخدم مكتبة RE2 للتعابير المنتظمة، كما يذكر توثيق دوال التعابير المنتظمة، وRE2 تكتب رقم الحرف بالشكل \x{064B} وليس ً. وبعد التصحيح أصبح الماكرو كما يلي، في 07b-macro.sql:
CREATE MACRO ar_norm(s) AS
  regexp_replace(regexp_replace(regexp_replace(regexp_replace(
    regexp_replace(s, '[\x{064B}-\x{0652}\x{0640}]', '', 'g'),
    '[أإآ]', 'ا', 'g'), 'ة', 'ه', 'g'), 'ى', 'ي', 'g'), '\s+', ' ', 'g');
SELECT ar_norm('الإِجَازَةُ المرضيـــة') AS a, ar_norm('الاجازه المرضيه') AS b, a = b AS same;
SELECT strip_accents('أحمد إبراهيم آمنة مؤسسة') AS stripped;
والمخرج سوف يكون كما يلي:
┌─────────────────┬─────────────────┬─────────┐
│        a        │        b        │  same   │
├─────────────────┼─────────────────┼─────────┤
│ الاجازه المرضيه │ الاجازه المرضيه │ true    │
└─────────────────┴─────────────────┴─────────┘
┌─────────────────────────┐
│        stripped         │
├─────────────────────────┤
│ احمد ابراهيم امنة موسسة │
└─────────────────────────┘
في المخرج أعلاه لاحظ التالي:
- الماكرو حذف التشكيل والتطويل Tatweel، ووحد الهمزات على الألف، والتاء المربوطة إلى هاء، والألف المقصورة إلى ياء، فأصبحت العبارة المشكولة والمطولة والعبارة المكتوبة «الاجازه المرضيه» نصاً واحداً. وهذه نفس قواعد التوحيد Normalization التي استخدمناها في مقال RAG، فإذا كان عندك نظام بحث فاستخدم نفس الدالة في الطرفين.
- الدالة الجاهزة
strip_accentsمغرية لأنها تحذف التشكيل، ولكن لاحظ ماذا فعلت: حذفت الهمزة من «مؤسسة» فأصبحت «موسسة»، وحذفت المدة من «آمنة»، لأنها تفكك كل حرف إلى أصله وعلاماته Unicode Decomposition ثم تحذف العلامات، والهمزة فوق الواو أو الألف علامة في هذا التفكيك. وهذا السلوك مقبول في توحيد البحث، وغير مقبول إذا كنت تنظف أسماء العملاء قبل حفظها، لذلك لا تستخدمها على عمود ستعرضه للمستخدم.
الترتيب الأبجدي Collation
عندما ترتب أسماء عربية بالأمر ORDER BY وحده، ترتبها DuckDB بحسب رقم كل حرف في Unicode، وهذا ترتيب لا يعرفه القارئ العربي، فالهمزات على الألف أرقامها قبل الألف نفسها. والإصدار 2.0 يحمل ترتيباً Collation مدمجاً لكل لغة بعد إزالة مكتبة ICU، والترتيب العربي اسمه ar، كما في صفحة الترتيب في التوثيق. ولنقارن:
SELECT x FROM (VALUES ('ياسر'),('أحمد'),('إبراهيم'),('بدر'),('آمنة'),('ابتسام')) t(x) ORDER BY x;
SELECT x FROM (VALUES ('ياسر'),('أحمد'),('إبراهيم'),('بدر'),('آمنة'),('ابتسام')) t(x) ORDER BY x COLLATE ar;
والمخرج سوف يكون كما يلي، الترتيب الأول ثم الثاني:
آمنة    أحمد    إبراهيم    ابتسام    بدر    ياسر
آمنة    ابتسام    إبراهيم    أحمد    بدر    ياسر
في الترتيب الأول جاءت «أحمد» و«إبراهيم» قبل «ابتسام» لأن رقم الألف بهمزة أصغر من رقم الألف وحدها، وفي الترتيب الثاني جاءت الأسماء كما في المعجم: الهمزة لا تغير مكان الكلمة، فتأتي «ابتسام» قبل «إبراهيم» لأن التاء قبل الراء. فإذا كان التقرير سوف يقرؤه إنسان فاكتب COLLATE ar في كل ترتيب لأسماء عربية.
ملف CSV بترميز Windows-1256
كثير من الأنظمة القديمة وبرامج المحاسبة تصدر ملفات CSV العربية بترميز Windows-1256 وليس UTF-8، وهذا أشهر سبب لظهور الحروف العربية رموزاً غريبة. ولنصنع ملفاً صغيراً بهذا الترميز Encoding بسكربت Python قصير، ونقرأه بطريقتين. هذا make_cp1256.py:
# ملف CSV عربي بترميز Windows-1256، كما تصدره أنظمة وبرامج قديمة كثيرة
rows = ["المنطقة,عدد_الطلبات,الإيراد", "الرياض,1250,48200.50", "مكة المكرمة,980,37150.00", "المنطقة الشرقية,1105,41800.75"]
open("sales_cp1256.csv", "w", encoding="cp1256", newline="\r\n").write("\n".join(rows) + "\n")
open("sales_utf8.csv", "w", encoding="utf-8").write("\n".join(rows) + "\n")
ثم الاستعلامات في 07c-encoding.sql:
-- ملف CSV عربي بترميز Windows-1256 كما تصدره أنظمة قديمة كثيرة
SELECT * FROM 'sales_cp1256.csv';
SELECT * FROM read_csv('sales_cp1256.csv', encoding = 'windows-1256');
SELECT extension_name, installed, loaded FROM duckdb_extensions() WHERE extension_name = 'encodings';
والمخرج سوف يكون كما يلي، بعد حذف إعدادات القارئ التي تطبعها رسالة الخطأ:
Invalid Input Error: CSV Error on Line: 1
Invalid unicode (byte sequence mismatch) detected. This file is not utf-8 encoded.

Possible Solution: Set the correct encoding, if available, to read this CSV File (e.g., encoding='UTF-16')
Possible Solution: Enable ignore errors (ignore_errors=true) to skip this row
┌─────────────────┬─────────────┬──────────┐
│     المنطقة     │ عدد_الطلبات │ الإيراد  │
│     varchar     │    int64    │  double  │
├─────────────────┼─────────────┼──────────┤
│ الرياض          │        1250 │  48200.5 │
│ مكة المكرمة     │         980 │  37150.0 │
│ المنطقة الشرقية │        1105 │ 41800.75 │
└─────────────────┴─────────────┴──────────┘
┌────────────────┬───────────┬─────────┐
│ extension_name │ installed │ loaded  │
├────────────────┼───────────┼─────────┤
│ encodings      │ true      │ true    │
└────────────────┴───────────┴─────────┘
رسالة الخطأ الأولى أفضل من أغلب الأدوات، لأن DuckDB رفضت الملف بدلاً من أن تقرأه رموزاً غريبة وتكمل، وأخبرتك أن الملف ليس UTF-8. ولا تقبل اقتراح ignore_errors=true هنا، فقد جربناه على نفس الملف فرجع الاستعلام 0 صفوف، لأن كل سطر فيه حرف عربي اعتبر خطأ. وبالمعامل encoding = 'windows-1256' قرئ الملف صحيحاً بأنواع الأعمدة الصحيحة، وقد حملت DuckDB إضافة encodings تلقائياً كما فعلت مع httpfs. وأفضل من ذلك أن تحول الملف إلى Parquet بأمر COPY الذي رأيناه، فيصبح الترميز مشكلة حللتها مرة واحدة وليس في كل استعلام.
متى لا تستخدم DuckDB؟
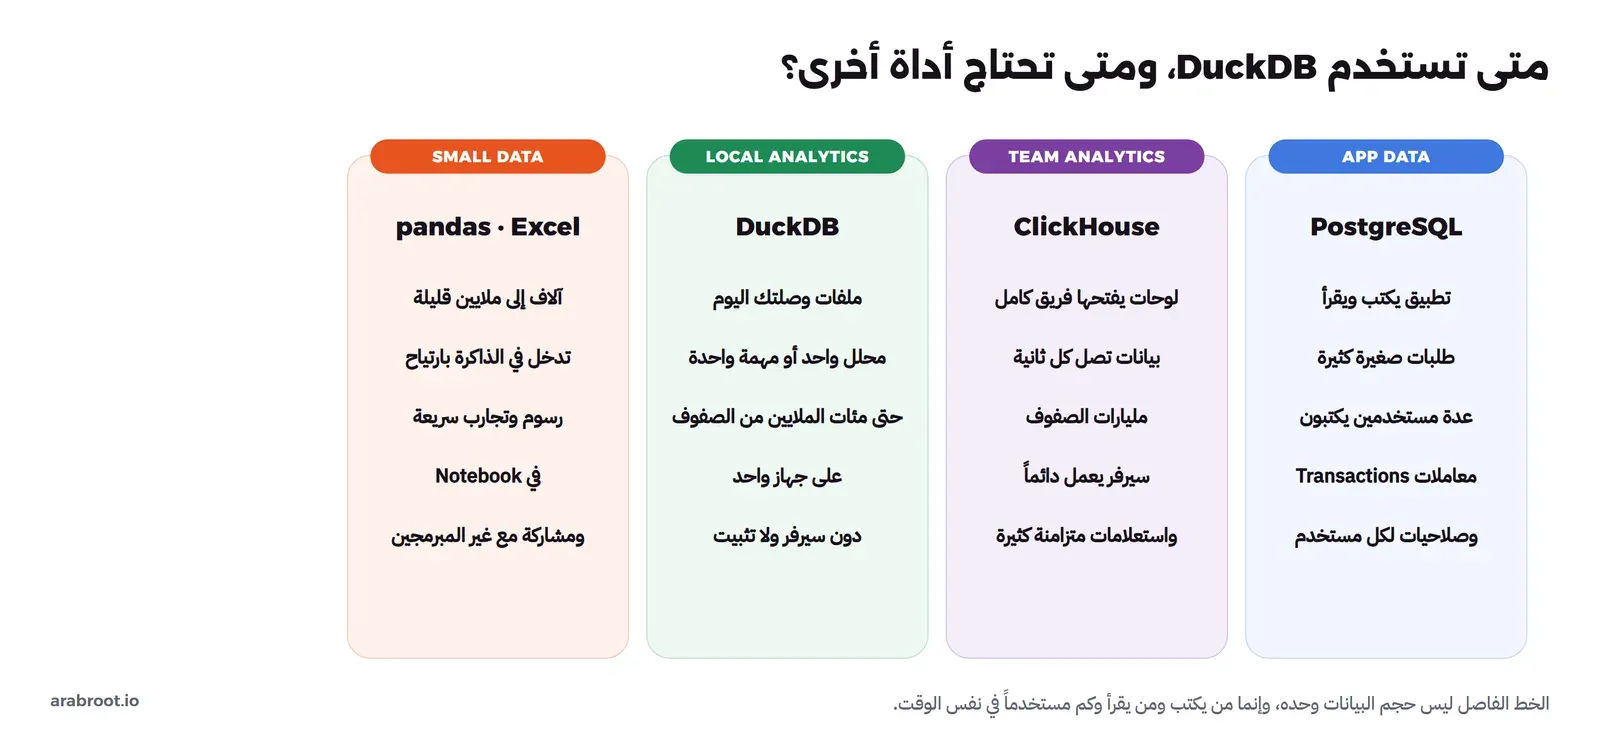
الأرقام في التجربة قد تجعلك تريد أن تستخدم DuckDB لكل شيء، ولكن تصميمها الذي جعلها سريعة هو نفسه الذي يحدد أين لا تصلح، وفيما يلي الحالات التي رأيت فيها أنها اختيار خاطئ، ومع كل حالة البديل:
- قاعدة التطبيق نفسها OLTP: إذا كان تطبيقك يكتب ويقرأ طلباً واحداً في كل مرة، آلاف المرات في الدقيقة، من عدة مستخدمين في نفس الوقت، فهذا عمل PostgreSQL أو MySQL، والسبب نموذج التزامن الذي رأيته في تجربة القفل: عملية واحدة فقط تكتب في الملف، والتخزين بالأعمدة يجعل تعديل صف واحد أغلى بكثير من قراءة عمود كامل.
- لوحات يفتحها فريق كامل طوال اليوم على بيانات تصل كل ثانية: هنا تحتاج سيرفراً تحليلياً يعمل دائماً ويخدم استعلامات متزامنة كثيرة ويستقبل الإدخال المستمر، مثل ClickHouse. وصحيح أن بروتوكول Quack في الإصدار 2.0 يحول DuckDB إلى سيرفر، ولكنه ميزة جديدة، فجربها طويلاً قبل أن تبني عليها نظاماً يعتمد عليه فريق.
- بيانات أكبر من قرص جهاز واحد، أو معالجة يجب أن تتوزع على عدة سيرفرات: DuckDB تعمل على جهاز واحد، وعندما تصل إلى عشرات التيرابايتات أو تحتاج إلى معالجة موزعة فهذا مجال أدوات مثل Spark أو محركات البحيرات Lakehouse، وهي موضوع مرحلة البيانات الضخمة.
- بحث نصي في ملايين المستندات: كما رأيت في القسم العربي،
LIKEيمر على كل النص في كل مرة، والبحث النصي الحقيقي يحتاج فهرساً مقلوباً Inverted Index كما في PostgreSQL أو OpenSearch. - بيانات صغيرة يحللها شخص بالرسوم والتجارب: إذا كان الملف عشرات الآلاف من السطور، فـ pandas أو Excel أسهل للمشاركة مع زملائك، ولا تكسب شيئاً من محرك جديد.
أخطاء شائعة
- تحليل ملف CSV كبير مرة بعد مرة: كل استعلام على CSV يقرأ الملف كله ويحول النصوص إلى أرقام من جديد، وقد رأيت الفرق 15.2 ثانية مقابل 1.2 ثانية. حوله إلى Parquet مرة واحدة، ثم اسأل Parquet.
- الثقة بالأنواع التي يستنتجها قارئ CSV: الاستنتاج مبني على عينة، وقد يختار
BIGINTبدلاً منINTEGERأوVARCHARبدلاً من تاريخ إذا كان في العينة سطر غريب. حدد الأنواع بنفسك للملفات التي تتكرر. - المتوسط وحده على بيانات حقيقية: رحلة أجرتها سنتات وبقشيشها دولارات تكفي لتحرك متوسط ساعة كاملة، فاحسب الوسيط Median ونسب الأخطاء قبل أن تكتب الاستنتاج.
- نسيان الشرط على التاريخ: ملفات «يناير» فيها رحلات من 2002 و2026، والرسم البياني سوف يظهرها إذا لم تفلترها.
- فتح ملف القاعدة من برنامجين للكتابة: سوف ترى رسالة
Could not set lock، وحلها أن يفتح القراء الملف للقراءة فقط، وأن تكتب المهمة الليلية ملفاً جديداً ثم تستبدله. - ترك الإعدادات الافتراضية على سيرفر مشترك: DuckDB تأخذ 80% من الذاكرة وكل الأنوية، فحدد
memory_limitوthreadsإذا كانت بجانب خدمات أخرى. - استخدام
strip_accentsلتنظيف أسماء عربية تحفظها: الدالة تحذف الهمزة من «مؤسسة» والمدة من «آمنة»، وهي مناسبة للمقارنة في البحث فقط. - كتابة
ًفي التعابير المنتظمة: DuckDB تستخدم RE2 التي تكتب الحرف بالشكل\x{064B}. - قبول
ignore_errors=trueمع ملف بترميز خاطئ: في ملف Windows-1256 جربنا هذا الخيار فرجع الاستعلام 0 صفوف، لأن كل سطر فيه حرف عربي اعتبر خطأ. الحل هو المعاملencodingالصحيح. - الاعتماد على التثبيت التلقائي للإضافات في سيرفر لا يتصل بالإنترنت: httpfs وencodings تنزل عند أول استخدام، فثبتها في مرحلة بناء ال Image.
قائمة التحقق Checklist قبل أن تحلل ملفاً كبيراً
- هل عرفت عدد الصفوف والأعمدة وأنواعها قبل أي سؤال؟
- هل الملف CSV سوف تسأله أكثر من مرة؟ حوله إلى Parquet أولاً.
- هل عددت القيم الخاطئة: تواريخ خارج الفترة، ومبالغ سالبة، وقيم فارغة، وقيم أكبر من المعقول؟
- هل حسبت الوسيط بجانب المتوسط في كل سؤال عن «القيمة المعتادة»؟
- هل حددت
memory_limitوthreadsوtemp_directoryعلى جهاز مشترك أو في Container محدود؟ - إذا كان في البيانات نص عربي: هل استخدمت
COLLATE arللترتيب، ودالة توحيد واحدة في كل استعلام بحث، والترميز الصحيح للملف؟ - إذا كانت البيانات على الإنترنت أو في S3: هل تحتاج الملف كاملاً، أم تكفيك الأعمدة التي تقرؤها DuckDB بطلبات المدى؟
- إذا كان أكثر من برنامج سوف يقرأ الملف: هل يفتحونه للقراءة فقط، ومن الذي يكتب ومتى؟
تدريب عملي
- نزل ملفات التاكسي الأخضر Green Taxi لنفس الأشهر من نفس الصفحة، واكتب استعلاماً واحداً يقارن متوسط ووسيط الأجرة بين الأصفر والأخضر في كل شهر، مع الدالة
read_parquetوالمعاملfilename = trueلتعرف من أي ملف جاء كل صف. - أعد تجربة الذاكرة الضيقة بحد 250 MB، وجرب
threads = 1، وقس هل تنجح العملية وكم تأخذ. - خذ ملف CSV عربياً من بوابة بيانات مفتوحة تعرفها، واقرأه بالترميز الصحيح، ثم رتب أسماء المناطق فيه مرة دون
COLLATE arومرة معه.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- DuckDB قاعدة تحليلية برخصة MIT تعمل داخل برنامجك أو كملف تنفيذي واحد، وتقرأ ملفات Parquet وCSV وJSON مباشرة كأنها جداول، دون سيرفر ولا تحميل.
- سرعتها من أربعة قرارات: داخل العملية، وأعمدة مضغوطة تعالج بدفعات من 2048 قيمة على كل الأنوية، وقراءة ما يحتاجه السؤال فقط من Parquet بالتذييل والإحصاءات، ونقل العمل المؤقت إلى القرص عندما تضيق الذاكرة.
- في التجربة أجابت عن ثلاثة أسئلة على 20 مليون رحلة في ثوان بذاكرة أقل من 500 MB، بينما احتاج pandas أكثر من أربعة جيجابايت، ومات في Container ذاكرته 2 GB.
- Parquet أصغر من CSV بست مرات وأسرع منه بعشر مرات تقريباً في نفس السؤال، وعد ملف على الإنترنت كلف 65.6 KiB من 50 MiB.
- العربية تحتاج ثلاثة أشياء: توحيداً بماكرو تكتبه بنفسك، و
COLLATE arللترتيب، والمعاملencodingلملفات Windows-1256. - عملية واحدة تكتب في ملف القاعدة، فإذا كان عندك تطبيق يكتب أو فريق يفتح اللوحات في نفس الوقت فأنت تحتاج PostgreSQL أو ClickHouse.
وفي المقالات القادمة من مرحلة البيانات الضخمة بإذن الله سوف نتحدث عن نقل البيانات بين الأنظمة وتنظيم خطوطها، ومتى تحتاج المعالجة الموزعة فعلاً.
 دليلOLAP ومستودع البيانات: تقارير لا تبطئ تطبيقككيف تنقل تقاريرك من قاعدة التطبيق إلى مستودع بيانات بمخطط النجمة، فتسرع التقارير وتبقى أرقام السنوات الماضية ثابتة.
 دليلClickHouse للتحليلات على بيانات ضخمةلماذا يجيب ClickHouse عن أسئلة التقارير أسرع من PostgreSQL بعشرات المرات، وأين يخسر، ومتى تضيفه بجانب قاعدة تطبيقك.
 دليلمصطلحات البيانات للمبتدئين: من ETL إلى BIشرح مصطلحات البيانات التي تسمعها في الاجتماعات بمثال متجر واحد، من قاعدة التطبيق إلى لوحة المدير.
 دليلMetabase: لوحات وتقارير من بياناتك دون كتابة كودكيف تثبت Metabase على سيرفرك، وتبني منه أسئلة ولوحة مبيعات من بيانات شركتك بالنقر أو بلغة SQL.
سجل التحديثات
- 18 نوفمبر 2026: كتابة المقال، واختبار التجربة على Docker Engine 29.8.0 مع DuckDB 2.0.0 (سطر الأوامر ومكتبة Python) وpandas 3.1.1 وpyarrow 26.0.1 وSQLite 3.46.1 وPython 3.13.18، على بيانات رحلات التاكسي الأصفر في نيويورك من يناير إلى يونيو 2024، وويكيبيديا العربية (20231101.ar).