إذا جربت البحث بالكلمات Keyword Search في PostgreSQL كما في مقال البحث النصي داخل PostgreSQL، أو في محرك بحث كما في مقال البحث في النصوص العربية، فقد وصلت غالباً إلى نفس الحد: المستخدم User يكتب «كيف أبحث في قائمة مرتبة بتقسيمها إلى نصفين؟» والمقال الذي يجيب عن سؤاله عنوانه «خوارزمية البحث الثنائي» ولا يحوي كلمة «نصفين» في أول سطوره، فلا يجده البحث بالكلمات مهما حسنت توحيد الحروف Normalization والجذوع Stemming. والحل الذي تقوم عليه كل أنظمة البحث بالمعنى Semantic Search وكل أنظمة RAG اليوم أن تحول كل نص إلى قائمة أرقام تسمى التضمين Embedding، بحيث تكون النصوص المتقاربة في المعنى متقاربة في الأرقام Numbers، ثم تبحث عن أقرب الأرقام إلى رقم السؤال.
وقد بنينا في مقال RAG للمبتدئين نظاماً كاملاً بهذه الفكرة على 16 مستنداً، ومررنا سريعاً على قاعدة البيانات الشعاعية Vector Database والفهرس HNSW. أما هذا المقال فيفتح الصندوقين اللذين مررنا عليهما: ما هو المتجه Vector الذي يخرج من نموذج التضمين Embedding Model بالضبط وكيف تقيس قربه، وكيف تجد قاعدة البيانات أقرب عشرة متجهات من بين آلاف أو ملايين دون أن تقارن السؤال بكل واحد منها، وما الذي تخسره مقابل هذه السرعة. وسوف نجيب بالأرقام على 10 آلاف مقطع حقيقي من ويكيبيديا العربية، في Qdrant وفي pgvector جنباً إلى جنب.
وسوف نناقش في هذا المقال ما يلي:
- ما هو التضمين Embedding، وكيف يخرج من النموذج، ومقاييس القرب: جيب التمام Cosine والضرب الداخلي Dot Product والمسافة الإقليدية Euclidean Distance.
- تجربة على نموذج multilingual-e5-small: جمل عربية وإنجليزية، والنفي، وأشكال كتابة الكلمة، والبادئة التي يشترطها النموذج.
- لماذا لا يكفي ملف أرقام مع بحث دقيق Exact Search، وكيف تعمل الفهارس التقريبية Approximate Nearest Neighbor: IVF وHNSW والتكميم Quantization.
- Qdrant وpgvector على نفس المتجهات: زمن البناء والحجم، ودقة البحث Recall@10 مقابل البحث الدقيق، والزمن Latency لكل إعداد من إعدادات HNSW.
- الفلاتر على البيانات الوصفية Metadata Filters، والمشكلة التي تجعل البحث يرجع نتائج أقل مما طلبت.
- تقليل الذاكرة Memory بالتكميم Quantization وhalfvec، وأثر الكتابة العربية دون همزات على جودة البحث.
- كيف تختار بين قاعدة شعاعية مستقلة وإضافة داخل قاعدتك الحالية.
ما هو التضمين Embedding؟
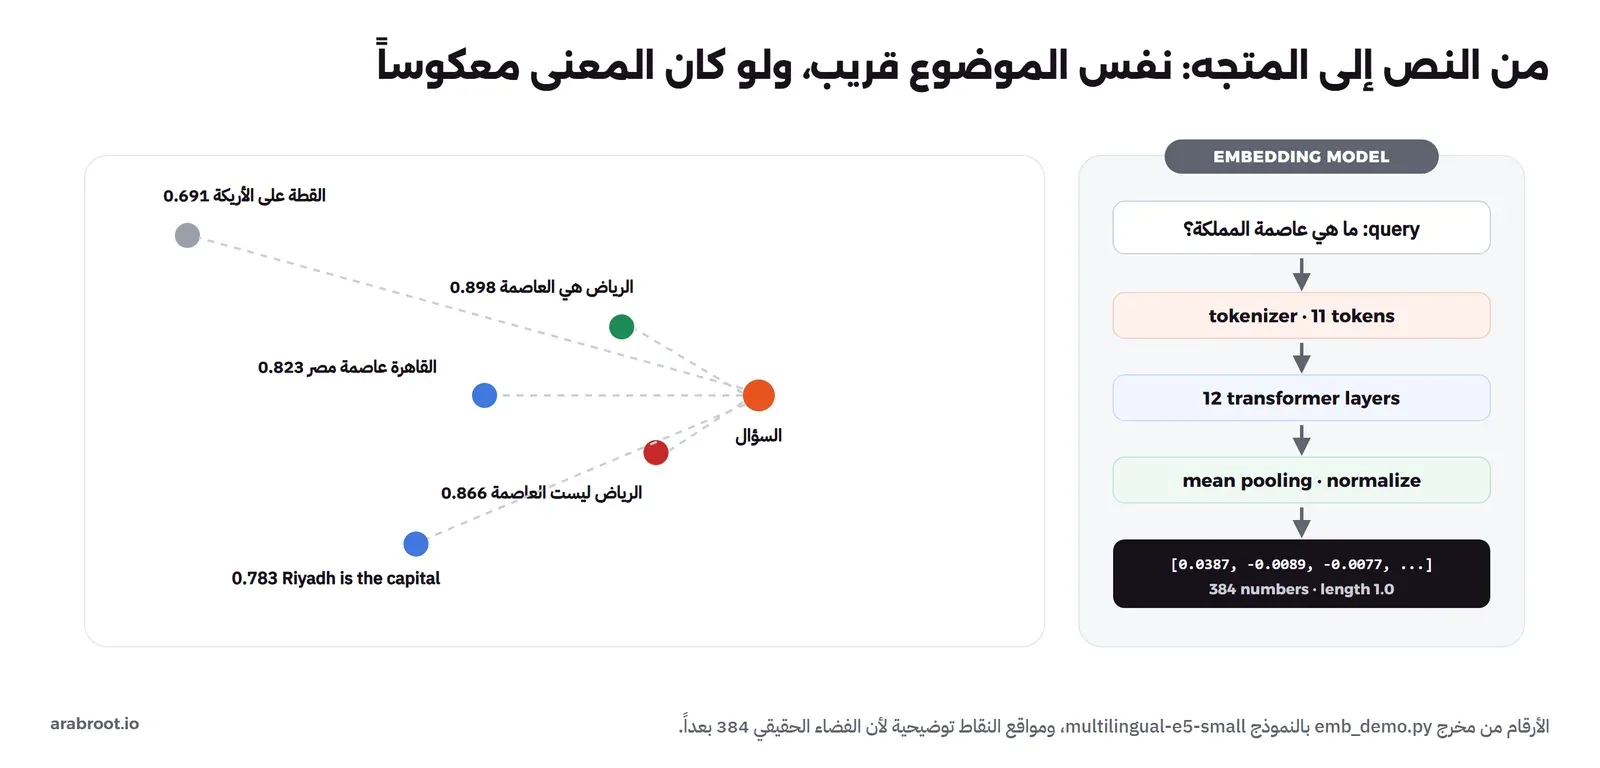
التضمين Embedding قائمة ثابتة الطول من الأعداد العشرية يخرجها نموذج مدرب لنص كامل، مثل جملة أو فقرة، بحيث يقترب متجها نصين كلما تقارب معناهما. وقد رأيت في مقال كيف تعمل نماذج اللغة الفكرة على مستوى الكلمة الواحدة داخل النموذج، أما نموذج التضمين فيذهب خطوة أبعد: يقرأ النص كله بطبقات Transformer، فيخرج متجهاً لكل توكن، ثم يجمعها في متجه واحد للنص كله، وأغلب النماذج تأخذ متوسطها Mean Pooling، ثم تقسمه على طوله حتى يصبح طوله 1، وهذا يسمى التطبيع Normalization. والتشبيه الأقرب أن تتخيل خريطة لها 384 اتجاهاً بدلاً من اتجاهين، وكل نص نقطة عليها، فالنصوص عن الزلازل في منطقة، والنصوص عن لغات البرمجة في منطقة أخرى، والسؤال نقطة تبحث عن أقرب جيرانها.
ونموذج التضمين نموذج صغير منفصل عن نموذج المحادثة، وفي هذا المقال نستخدم intfloat/multilingual-e5-small برخصة MIT، وبحسب بطاقته Model Card فيه 12 طبقة، ويخرج متجهاً بطول 384، ويقطع النص بعد 512 توكناً، ووصفه الكامل في التقرير التقني لنماذج Multilingual E5. واخترناه لأن حجمه قرابة 470 MB ويعمل على المعالج CPU وحده، ولأن العربية من لغات تدريبه وتقييمه. ولكن البطاقة تشترط شرطاً يقع فيه كثيرون: كل نص يجب أن يبدأ بكلمة query: إذا كان سؤالاً، أو passage: إذا كان مستنداً، حتى مع النصوص غير الإنجليزية، وسوف نرى ماذا يحدث إذا نسيتها.
كيف تقيس القرب؟ Cosine وDot Product وEuclidean
هناك ثلاثة مقاييس شائعة، وكلها في Qdrant وpgvector:
- تشابه جيب التمام Cosine Similarity: يقيس الزاوية بين المتجهين دون النظر إلى طولهما، فيكون 1 عندما يشيران إلى نفس الاتجاه. وفي pgvector العملية
<=>تعيد المسافة Cosine Distance، وهي 1 ناقص التشابه، لذلك ترتب تصاعدياً. - الضرب الداخلي Dot Product: مجموع حاصل ضرب الأرقام المتقابلة، وهو أسرع في الحساب، ويأخذ الطول في الاعتبار. وفي pgvector العملية
<#>تعيد سالب الضرب الداخلي حتى يبقى الترتيب تصاعدياً. - المسافة الإقليدية Euclidean Distance أو L2: طول الخط المستقيم بين النقطتين، والعملية
<->.
والقاعدة التي توفر عليك نقاشاً طويلاً: إذا كانت المتجهات مطبعة Normalized بطول 1، وهذا حال أغلب نماذج التضمين ومنها نموذجنا، فالمقاييس الثلاثة تعطي نفس الترتيب تماماً، والسبب أن التشابه يساوي الضرب الداخلي في هذه الحالة، والمسافة الإقليدية تساوي جذر 2 ناقص ضعف التشابه. لذلك اختر المقياس الذي توصي به بطاقة النموذج، وطبعه مرة واحدة عند الحفظ، ولا تخلط بين مقياس البناء ومقياس البحث، فالفهرس المبني على Cosine في pgvector لا يستخدمه استعلام يرتب بالمسافة الإقليدية.
تجهيز بيئة التجربة
نحتاج ثلاثة Containers: PostgreSQL مع إضافة pgvector، وQdrant، وContainer لبرامج Python فيه مكتبة sentence-transformers التي تشغل نموذج التضمين، ومعها مكتبتا الاتصال بالقاعدتين. هذا Dockerfile لبرامج Python، ونثبت فيه نسخة PyTorch التي تعمل على المعالج فقط لأنها أصغر بكثير من نسخة البطاقات الرسومية:
FROM python:3.13.18-slim
RUN pip install --no-cache-dir --index-url https://download.pytorch.org/whl/cpu torch==2.15.0 \
 && pip install --no-cache-dir sentence-transformers==6.3.0 "psycopg[binary]==3.3.9" qdrant-client==1.20.0 pyarrow==26.0.1 numpy==2.5.5
WORKDIR /lab
ثم نشغل القاعدتين على شبكة واحدة، دون أن ننشر منفذ PostgreSQL على الجهاز، وننشر منفذ Qdrant على 127.0.0.1 فقط لنفتح لوحته من المتصفح:
docker build -t ad3-vec:1 .
docker network create ad3-net
docker volume create ad3-pg
docker volume create ad3-qdrant
docker volume create ad3-hf
docker run -d --name ad3-pg --network ad3-net -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=vec \
  -v ad3-pg:/var/lib/postgresql --shm-size=1g pgvector/pgvector:0.8.7-pg18-trixie \
  -c shared_buffers=1GB -c maintenance_work_mem=1GB -c max_parallel_maintenance_workers=3
docker run -d --name ad3-qdrant --network ad3-net -p 127.0.0.1:9578:6333 \
  -v ad3-qdrant:/qdrant/storage qdrant/qdrant:v1.20.2
curl -s localhost:9578
docker exec ad3-pg psql -U postgres -d vec -c "CREATE EXTENSION vector; SELECT extversion FROM pg_extension WHERE extname='vector'; SELECT version();"
والمخرج سوف يكون كما يلي:
{"title":"qdrant - vector search engine","version":"1.20.2","commit":"23065a0bf6857c3e5da45f6c8939cc746cc0580e"}CREATE EXTENSION
 extversion
------------
 0.8.7
(1 row)

                                                      version
--------------------------------------------------------------------------------------------------------------------
 PostgreSQL 18.7 (Debian 18.7-1.pgdg13+2) on x86_64-pc-linux-gnu, compiled by gcc (Debian 14.2.0-19) 14.2.0, 64-bit
(1 row)
لاحظ أن Qdrant لا يطلب أي مفتاح افتراضياً، فكل من يصل إلى المنفذ 6333 يستطيع أن يقرأ المجموعات ويحذفها، ولهذا لم ننشره إلا على 127.0.0.1، وفي الإنتاج Production فعل المفتاح بالمتغير QDRANT__SERVICE__API_KEY كما في دليل الأمان في Qdrant. وال Volume الثالث ad3-hf يحفظ ملفات النموذج بعد أول تنزيل من Hugging Face، حتى لا ينزل في كل تشغيل.
التجربة الأولى: ماذا يرى النموذج في الجمل العربية؟
قبل أن نحفظ أي شيء في قاعدة بيانات، لنر المتجه نفسه ونقيس القرب بين جمل نعرف معناها. البرنامج emb_demo.py يطبع التوكنات Tokens التي يراها النموذج، ثم طول المتجه وأول أرقامه، ثم التشابه بين سؤال وخمس جمل، ثم بين أشكال مختلفة من نفس العبارة، ثم أثر حذف البادئة:
# ما هو المتجه Embedding؟ نموذج multilingual-e5-small على جمل عربية
import numpy as np
from sentence_transformers import SentenceTransformer

m = SentenceTransformer("intfloat/multilingual-e5-small", device="cpu")
tok = m.tokenizer
q = "ما هي عاصمة المملكة العربية السعودية؟"
print("tokens:", tok.tokenize("query: " + q))

def emb(texts):
    return m.encode(texts, normalize_embeddings=True, convert_to_numpy=True)

v = emb(["query: " + q])[0]
raw = m.encode(["query: " + q], normalize_embeddings=False, convert_to_numpy=True)[0]
print("dimensions:", v.shape[0], "| first 6:", np.round(v[:6], 4).tolist())
print(f"length before normalize: {np.linalg.norm(raw):.3f} | after: {np.linalg.norm(v):.3f}")

passages = [
    "الرياض هي عاصمة المملكة العربية السعودية وأكبر مدنها.",
    "Riyadh is the capital and largest city of Saudi Arabia.",
    "الرياض ليست عاصمة المملكة العربية السعودية.",
    "القاهرة هي عاصمة جمهورية مصر العربية.",
    "تنام القطة على الأريكة بعد الظهر.",
]
P = emb(["passage: " + p for p in passages])
print("\ncosine(query, passage):")
for p, s in sorted(zip(passages, P @ v), key=lambda x: -x[1]):
    print(f"  {s:.3f}  {p}")

print("\nspelling variants of one phrase (passage vs passage):")
forms = ["الإجازة المرضية", "الاجازه المرضيه", "الإِجَازَةُ المَرَضِيَّةُ", "الإجـــازة المرضية", "sick leave"]
F = emb(["passage: " + f for f in forms])
for f, s in zip(forms, F @ F[0]):
    print(f"  {s:.3f}  {f}")

print("\nsame query without the 'query: ' prefix:")
v2 = emb([q])[0]
for p, s in zip(passages[:2], P[:2] @ v2):
    print(f"  {s:.3f}  {p}")
docker run --rm -v ad3-hf:/root/.cache/huggingface -v "$PWD:/lab" ad3-vec:1 python emb_demo.pyوالمخرج سوف يكون كما يلي:
tokens: ['▁que', 'ry', ':', '▁ما', '▁هي', '▁', 'عاصمة', '▁المملكة', '▁العربية', '▁السعودية', '؟']
dimensions: 384 | first 6: [0.03869999945163727, -0.008899999782443047, -0.007699999958276749, -0.05469999834895134, 0.012799999676644802, 0.004399999976158142]
length before normalize: 1.000 | after: 1.000

cosine(query, passage):
  0.898  الرياض هي عاصمة المملكة العربية السعودية وأكبر مدنها.
  0.866  الرياض ليست عاصمة المملكة العربية السعودية.
  0.823  القاهرة هي عاصمة جمهورية مصر العربية.
  0.783  Riyadh is the capital and largest city of Saudi Arabia.
  0.691  تنام القطة على الأريكة بعد الظهر.

spelling variants of one phrase (passage vs passage):
  1.000  الإجازة المرضية
  0.977  الاجازه المرضيه
  0.931  الإِجَازَةُ المَرَضِيَّةُ
  0.963  الإجـــازة المرضية
  0.890  sick leave

same query without the 'query: ' prefix:
  0.913  الرياض هي عاصمة المملكة العربية السعودية وأكبر مدنها.
  0.811  Riyadh is the capital and largest city of Saudi Arabia.
في المخرج أعلاه لاحظ التالي:
- المقطع Tokenizer في هذا النموذج يحفظ كلمات عربية كاملة مثل «المملكة» و«السعودية» كتوكن واحد، والعلامة
▁تعني أن قبل التوكن مسافة. وكلمةquery:نفسها أصبحت ثلاثة توكنات، فهي جزء من النص الذي يقرؤه النموذج وليست إعداداً خارجياً. - المتجه 384 رقماً صغيراً، ولا يعني أي رقم منها شيئاً وحده، فلا يوجد رقم «للمدن» ورقم «للسعودية»، وإنما يظهر المعنى في المقارنة بين متجهين. والأرقام مطبوعة بكسور طويلة مثل 0.03869999945163727 لأنها محفوظة بدقة 32 بت Float32، والتقريب إلى أربعة أرقام لا يمثل بدقة في هذا النوع.
- الطول قبل التطبيع وبعده 1.000، والسبب أن النموذج نفسه ينتهي بطبقة تطبيع Normalize، فالمكتبة تعيد متجهاً مطبعاً حتى لو لم نطلب. وهذا يؤكد ما قلناه: Cosine والضرب الداخلي هنا نفس الشيء.
- أهم سطر في التجربة كلها هو الثاني: جملة «الرياض ليست عاصمة المملكة» حصلت على 0.866، أي قريبة جداً من الجملة الصحيحة 0.898، وأقرب من الجملة الإنجليزية الصحيحة 0.783. فالتضمين يقيس «عن ماذا يتحدث النص» وليس «هل النص صحيح»، والنفي كلمة واحدة لا تغير موضوع الجملة. ولهذا لا تستخدم درجة التشابه كدليل على صحة الإجابة، فهي دليل على قرب الموضوع فقط، والتحقق يأتي من النموذج الذي يقرأ المقطع أو من إنسان.
- الجملة الإنجليزية الصحيحة جاءت بعد جملة القاهرة، أي أن النموذج متعدد اللغات يقرب بين اللغتين ولكنه يعطي وزناً للغة نفسها، فإذا كانت مستنداتك مختلطة بين العربية والإنجليزية فاختبر البحث بأسئلة باللغتين.
- أشكال الكتابة: «الاجازه المرضيه» دون همزة وبالهاء 0.977، والتطويل 0.963، والتشكيل الكامل 0.931، وكلها قريبة جداً، فالنموذج تعلم أنها نفس العبارة، وهذا الفرق الكبير عن البحث بالكلمات الذي يفشل تماماً مع الهاء بدلاً من التاء المربوطة كما رأينا في مقال RAG. ومع ذلك فالتشكيل الكامل هو الأبعد، وسوف نقيس أثر الكتابة على البحث الحقيقي بعد قليل.
- دون البادئة
query:ارتفع تشابه الجملة العربية إلى 0.913، فقد يبدو أن حذفها أفضل، ولكن الدرجة المطلقة لا تهم في البحث، وإنما الترتيب بين آلاف المقاطع Passages، وهذا ما سوف نقيسه على ويكيبيديا، لأن جملتين لا تكفيان لحكم.
لماذا نحتاج قاعدة بيانات للمتجهات أصلاً؟
بعد أن أصبح لكل مقطع متجه، السؤال الوحيد الذي نريد أن نجيب عنه هو: ما أقرب k متجهات إلى متجه السؤال؟ ولنمر على الحلول بالترتيب الذي يجربه أغلبنا.
الحل البسيط الأول: ملف أرقام ومقارنة بكل المتجهات
تحفظ المتجهات في ملف NumPy، وعند كل سؤال تضرب متجه السؤال في المصفوفة كلها، ثم ترتب النتائج وتأخذ أعلى عشرة، وهذا يسمى البحث الدقيق Exact Search أو Brute Force، ونتيجته صحيحة بالتعريف، وسوف تراه في التجربة يجيب في جزء من المللي ثانية لعشرة آلاف مقطع. ولكن الزمن يكبر مع عدد المتجهات بشكل خطي، فمليون مقطع تعني مائة ضعف، وعشرة ملايين تعني ألف ضعف، والمصفوفة كلها يجب أن تكون في الذاكرة. والأهم من الزمن أن الملف ليس قاعدة بيانات: لا يوجد حذف ولا تعديل لمقطع واحد دون إعادة كتابة الملف، ولا توجد فلاتر على البيانات الوصفية، ولا نسخ احتياطي ولا صلاحيات، ولا يستطيع أكثر من برنامج أن يكتب فيه.
الحل البسيط الثاني: مكتبة فهرسة في الذاكرة
الخطوة التالية مكتبة مثل FAISS من Meta أو hnswlib، وهي تبني فهرساً تقريبياً سريعاً في ذاكرة برنامجك، وتحل مشكلة الزمن. ولكن مشكلات الملف ما زالت: الفهرس يعيش في عملية واحدة، وإذا أعيد تشغيل البرنامج يجب أن تحمله من القرص Disk أو تبنيه من جديد، والفلاتر والتحديثات والصلاحيات Permissions تكتبها أنت. وهذا مناسب لتجربة أو لنظام صغير للقراءة فقط، وغير مناسب لنظام تتغير مستنداته كل يوم.
الحل المستخدم: قاعدة بيانات تفهم المتجهات
القاعدة الشعاعية Vector Database تجمع الفهرس التقريبي مع ما تنتظره من أي قاعدة بيانات: إضافة وتعديل وحذف لكل سجل، وبيانات وصفية Metadata مع كل متجه تفلتر بها أثناء البحث، وحفظ على القرص، ونسخ احتياطي، وصلاحيات، وفي بعضها التوزيع على عدة سيرفرات. وأمامك طريقان:
- قاعدة متخصصة مستقلة مثل Qdrant، المكتوبة بلغة Rust برخصة Apache-2.0، أو Milvus أو Weaviate، وكل منها مصمم للمتجهات من البداية.
- إضافة داخل قاعدتك الحالية، وأشهرها pgvector لقاعدة PostgreSQL برخصة PostgreSQL، فتبقى المتجهات في جدول بجانب بقية بياناتك.
وقد ذكرنا نقاط القوة والضعف لكل منها باختصار مع غيرها من الأدوات في قسم قواعد البيانات الشعاعية في مقال RAG، أما هنا فسوف نقيس.
البحث التقريبي Approximate Nearest Neighbor من الداخل
كل فهرس سريع للمتجهات يقوم على نفس الصفقة: يقبل أن يفوته أحياناً أحد الجيران الحقيقيين، مقابل أن يقارن السؤال بجزء صغير من المتجهات بدلاً من كلها، وهذا يسمى البحث التقريبي عن أقرب الجيران Approximate Nearest Neighbor واختصاراً ANN. والمقياس الذي يخبرك كم خسرت اسمه الاستدعاء Recall@k: من بين أقرب k متجهات حقيقية، كم واحداً وجده الفهرس؟ فإذا كان Recall@10 يساوي 0.9 فقد وجد الفهرس تسعة من العشرة الحقيقيين في المتوسط. وهناك ثلاث عائلات من الفهارس يجب أن تعرفها:
التقسيم إلى مجموعات IVF
فهرس IVF واختصاره Inverted File يقسم المتجهات أولاً إلى مجموعات Clusters بخوارزمية مثل k-means، ولكل مجموعة مركز، وعند البحث يقارن السؤال بالمراكز أولاً، ثم يبحث داخل أقرب عدد من المجموعات فقط، وهذا العدد في pgvector هو الإعداد ivfflat.probes. وهو سريع البناء وصغير الحجم Size، ولكن له نقطة ضعف: المجموعات تحسب من البيانات الموجودة وقت البناء، فإذا أضفت آلاف المستندات من موضوع جديد بعد ذلك فلن يكون لها مركز مناسب وتضعف الدقة Recall، لذلك يحتاج إعادة بناء دورية.
الرسم البياني متعدد الطبقات HNSW
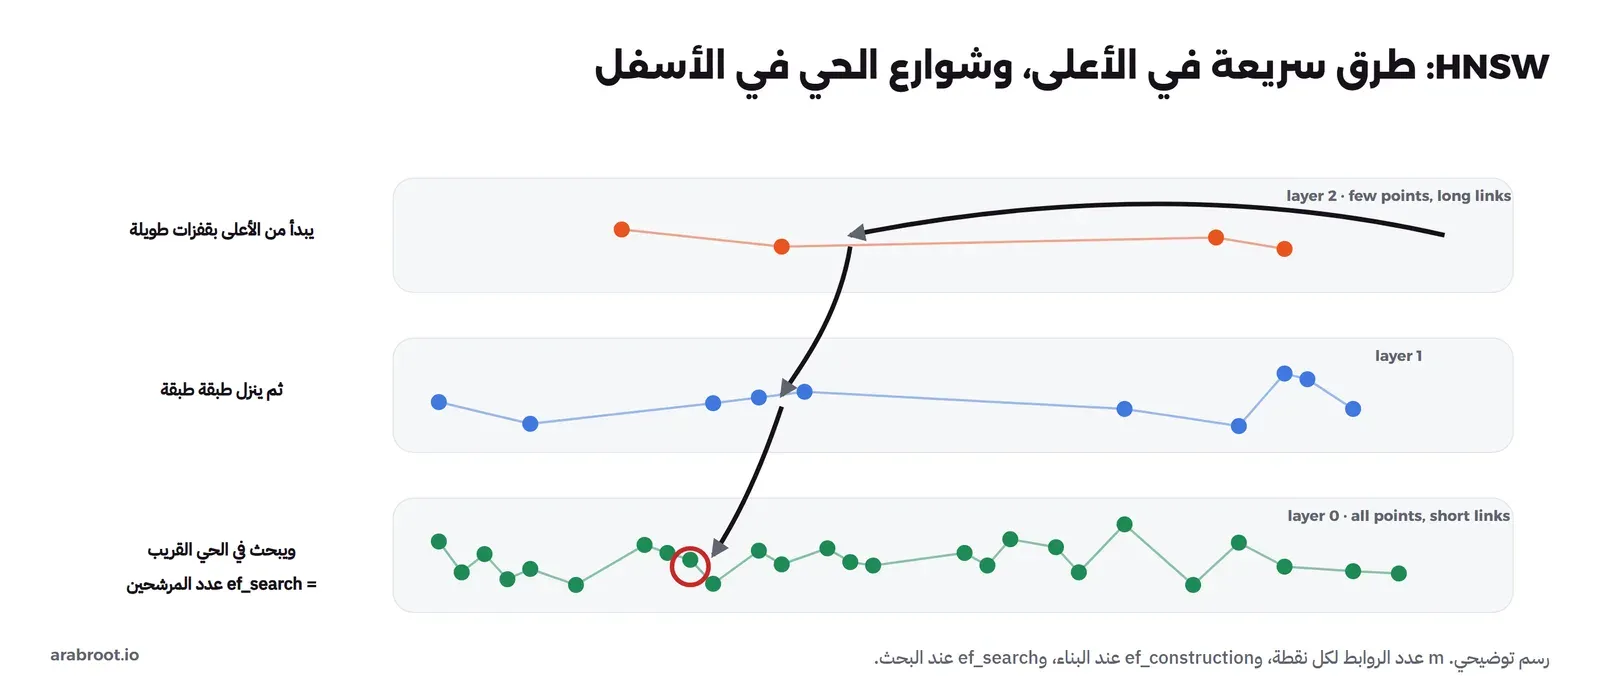
فهرس HNSW واختصاره Hierarchical Navigable Small World، الذي وصفه Malkov وYashunin في ورقتهما، هو الافتراضي اليوم في Qdrant وفي أغلب القواعد. وفكرته أن يبني رسماً بيانياً Graph يربط كل متجه بعدد من أقرب جيرانه، في عدة طبقات: الطبقة العليا فيها متجهات قليلة وروابط طويلة تشبه الطرق السريعة بين المدن، والطبقة السفلى فيها كل المتجهات وروابط قصيرة تشبه شوارع الحي. ويبدأ البحث من الطبقة العليا، فيقفز إلى أقرب نقطة للسؤال، ثم ينزل طبقة ويكمل من حيث وصل، حتى يصل إلى الطبقة السفلى فيبحث في الحي القريب. ويتحكم فيه ثلاثة إعدادات:
- عدد الروابط Links لكل نقطة
m: كلما زاد كانت الطرق أكثر فالدقة أعلى، والفهرس أكبر في الذاكرة، والافتراضي 16 في pgvector وفي Qdrant. - عدد المرشحين Candidates عند البناء
ef_constructionفي pgvector واسمهef_constructفي Qdrant: كلما زاد كان الرسم أجود والبناء أبطأ، والافتراضي 64 في pgvector و100 في Qdrant بحسب صفحة الفهرسة في توثيقه. - عدد المرشحين عند البحث
hnsw.ef_searchفي pgvector وhnsw_efفي Qdrant: وهو الإعداد الذي تغيره دون إعادة بناء، فكلما زاد احتفظ البحث بقائمة مرشحين أطول فوجد جيراناً أكثر صحة، والثمن وقت أكثر لكل سؤال. والافتراضي 40 في pgvector، ويساويef_constructفي Qdrant.
التكميم Quantization: نفس المتجه بذاكرة أقل
المتجه بطول 384 بدقة Float32 يأخذ 1,536 بايتاً، وعشرة ملايين متجه تعني قرابة 15 GB للمتجهات وحدها قبل الفهرس، والذاكرة هي أغلى ما في سيرفر المتجهات. والتكميم Quantization يحفظ كل رقم بعدد بتات أقل، وأشهر أنواعه:
- نصف الدقة Half Precision بـ 16 بت لكل رقم، وهو النوع
halfvecفي pgvector، فيصبح الحجم النصف، والخسارة في الترتيب صغيرة جداً عادة. - التكميم الرقمي Scalar Quantization إلى عدد صحيح بـ 8 بتات INT8، وهو في Qdrant، فيصبح الحجم الربع، مع إعادة ترتيب Rescoring اختيارية بالمتجهات الأصلية لأفضل المرشحين لتعويض الخسارة.
- التكميم الثنائي Binary Quantization ببت واحد لكل رقم، فيصبح الحجم 1/32، وهو مناسب لمتجهات طويلة جداً مع إعادة ترتيب، وتفاصيل الأنواع كلها في دليل التكميم في Qdrant.
وسوف نقيس النوعين الأولين على بياناتنا، لأن الخسارة تعتمد على النموذج والبيانات ولا يمكن أن تفترضها.
التجربة الثانية: 10 آلاف مقطع من ويكيبيديا العربية
البيانات من الجزء الأول من سبعة أجزاء من مقالات ويكيبيديا العربية على Hugging Face بنسخة 20231101.ar، برخصة CC BY-SA. والبرنامج prep.py يأخذ المقالات التي يزيد نصها على 1,500 حرف، حتى نترك المقالات القصيرة جداً التي أنشأتها برامج آلية، ويقص من كل مقال أول 400 حرف تقريباً عند نهاية جملة، ثم يختار 10 آلاف مقال عشوائياً، و500 مقال آخر لا تدخل الفهرس نستخدم عناوينها كأسئلة. ويضيف لكل مقطع حقلاً اسمه topic نستنتجه من كلمات في أول النص، مثل «مدينة» و«قرية» للأماكن و«ولد» و«لاعب» للأشخاص، حتى نجرب الفلاتر بعد قليل:
# Arabic Wikipedia (wikimedia/wikipedia 20231101.ar, shard 0 of 7, CC BY-SA 4.0) -> passages.parquet
# one passage per article: the opening text up to ~400 characters, cut at a sentence end
import re, sys, random
import pyarrow as pa, pyarrow.parquet as pq
from collections import Counter

src, n = sys.argv[1], int(sys.argv[2])
t = pq.read_table(src, columns=["id", "title", "text"]).to_pylist()

def topic(head):
    if re.search(r"\b(قرية|بلدة|بلدية|مدينة|عاصمة|دولة|ناحية|مقاطعة|محافظة|نهر|جزيرة|جبل)\b", head): return "place"
    if re.search(r"\b(ولد|ولدت|توفي|توفيت|لاعب|لاعبة|ممثل|ممثلة|مغني|مغنية|كاتب|شاعر|سياسي)\b", head): return "person"
    if re.search(r"\b(فيلم|مسلسل|ألبوم|رواية)\b", head): return "work"
    if re.search(r"\b(مرض|عنصر|مركب|خلية|نوع|جنس|فصيلة|نظرية|علم|لغة|برمجة|حاسوب)\b", head): return "science"
    return "other"

rows = []
for r in t:
    text = r["text"].split("\nمراجع")[0].strip()       # drop the references block
    if len(text) < 1500: continue                       # skip stubs: keep real articles
    cut = text[:400]
    m = max(cut.rfind("."), cut.rfind("؟"))
    if m > 150: cut = cut[:m + 1]
    rows.append({"id": int(r["id"]), "title": r["title"], "text": " ".join(cut.split()), "topic": topic(cut[:300])})
print("articles in shard:", len(t), "| long enough:", len(rows))
random.seed(42)
random.shuffle(rows)
# the articles that answer our 24 test questions must be in the index
from questions import QUESTIONS
targets = {t for _, t in QUESTIONS}
rows = [r for r in rows if r["title"] in targets] + [r for r in rows if r["title"] not in targets]
pq.write_table(pa.Table.from_pylist(rows[:n]), "passages.parquet")
pq.write_table(pa.Table.from_pylist(rows[n:n + 500]), "heldout.parquet")   # queries that are NOT in the index
print("kept:", n, Counter(r["topic"] for r in rows[:n]).most_common())
docker run --rm -v "$PWD:/lab" -v "$PWD/data:/data:ro" ad3-vec:1 python prep.py /data/arwiki-0.parquet 10000articles in shard: 174172 | long enough: 61265
kept: 10000 [('other', 4984), ('place', 2587), ('person', 1399), ('science', 720), ('work', 310)]ولاحظ أن البرنامج يضع أولاً المقالات التي تجيب عن 24 سؤالاً كتبناها بأيدينا في questions.py، حتى نقيس بها جودة البحث في قسم الكتابة العربية. ثم نحسب المتجهات بالبرنامج embed.py:
# حساب متجهات كل المقاطع بنموذج multilingual-e5-small وحفظها في ملف
import time, numpy as np, pyarrow.parquet as pq, torch
from sentence_transformers import SentenceTransformer

torch.set_num_threads(4)
model = SentenceTransformer("intfloat/multilingual-e5-small", device="cpu")
rows = pq.read_table("passages.parquet").to_pylist()
texts = ["passage: " + r["text"] for r in rows]          # بطاقة النموذج تشترط البادئة passage: للمستندات
t = time.perf_counter()
parts = []
for i in range(0, len(texts), 1000):
    parts.append(model.encode(texts[i:i + 1000], batch_size=32, normalize_embeddings=True, convert_to_numpy=True))
    print(f"{i + len(parts[-1])} passages, {time.perf_counter() - t:.0f} s", flush=True)
emb = np.vstack(parts)
secs = time.perf_counter() - t
np.save("passages.npy", emb.astype(np.float32))
print(f"{len(texts)} passages -> {emb.shape} float32 in {secs:.0f} s ({len(texts) / secs:.1f} passages/s), "
      f"{emb.nbytes / 1e6:.1f} MB")

held = pq.read_table("heldout.parquet").to_pylist()
q = model.encode(["query: " + r["title"] for r in held], batch_size=64, normalize_embeddings=True, convert_to_numpy=True)
np.save("queries.npy", q.astype(np.float32))
print("queries:", q.shape)
docker run -d --name ad3-embed -v ad3-hf:/root/.cache/huggingface -v "$PWD:/lab" ad3-vec:1 python -u embed.py
docker logs -f ad3-embedوالمخرج سوف يكون كما يلي، بعد حذف سطور التقدم من 2000 إلى 8000:
1000 passages, 469 s
9000 passages, 4053 s
10000 passages, 4288 s
10000 passages -> (10000, 384) float32 in 4288 s (2.3 passages/s), 15.4 MB
queries: (500, 384)
كل مقطع أصبح 384 رقماً بدقة Float32، أي 1,536 بايتاً، وعشرة آلاف مقطع 15.4 MB فقط. أما الوقت فهو أطول ما في التجربة كلها: أكثر من ساعة على المعالج لعشرة آلاف مقطع قصير، أي مقطعين في الثانية تقريباً. وهذا هو الدرس الأول الذي لا تراه في الأمثلة الصغيرة: حساب المتجهات Embedding أغلى بكثير من حفظها والبحث فيها، فإذا كان عندك مليون مستند فالسؤال الأول هو أين وكم وقتاً تحسب متجهاتها، وتغيير نموذج التضمين لاحقاً يعني أن تعيد الحساب كله، كما ذكرنا في مقال RAG. لذلك احفظ المتجهات في ملف بجانب المستندات بعد حسابها، كما فعلنا هنا بملف passages.npy، حتى تعيد تحميلها إلى أي قاعدة دون أن تحسبها من جديد.
التحميل Loading إلى pgvector
البرنامج load_pg.py ينشئ جدولاً فيه النص والعنوان والموضوع والمتجه في عمود من نوع vector(384)، ويحمل الصفوف بأمر COPY لأنه أسرع بكثير من INSERT لكل صف، ثم يبني فهرس HNSW بإعداداته الافتراضية:
# تحميل 30 ألف متجه إلى PostgreSQL مع pgvector ثم بناء فهرس HNSW
import time, numpy as np, pyarrow.parquet as pq, psycopg

rows = pq.read_table("passages.parquet").to_pylist()
emb = np.load("passages.npy")
conn = psycopg.connect("host=ad3-pg user=postgres password=lab dbname=vec", autocommit=True)
cur = conn.cursor()
cur.execute("DROP TABLE IF EXISTS docs")
cur.execute("""CREATE TABLE docs (
    id        bigint PRIMARY KEY,
    title     text NOT NULL,
    topic     text NOT NULL,
    body      text NOT NULL,
    embedding vector(384) NOT NULL)""")
t = time.perf_counter()
with cur.copy("COPY docs (id, title, topic, body, embedding) FROM STDIN") as cp:
    for r, e in zip(rows, emb):
        cp.write_row((r["id"], r["title"], r["topic"], r["text"], "[" + ",".join(f"{x:.7f}" for x in e) + "]"))
print(f"COPY {len(rows)} rows: {time.perf_counter() - t:.1f} s")
cur.execute("CREATE INDEX docs_topic ON docs (topic)")
cur.execute("ANALYZE docs")
t = time.perf_counter()
cur.execute("CREATE INDEX docs_hnsw ON docs USING hnsw (embedding vector_cosine_ops) WITH (m = 16, ef_construction = 64)")
print(f"CREATE INDEX hnsw (m=16, ef_construction=64): {time.perf_counter() - t:.1f} s")
cur.execute("""SELECT pg_size_pretty(pg_table_size('docs')), pg_size_pretty(pg_relation_size('docs_hnsw'))""")
print("table size, hnsw index size:", cur.fetchone())
docker run --rm --network ad3-net -v "$PWD:/lab" ad3-vec:1 python -u load_pg.pyCOPY 10000 rows: 13.2 s
CREATE INDEX hnsw (m=16, ef_construction=64): 11.3 s
table size, hnsw index size: ('22 MB', '20 MB')بناء الفهرس أخذ 11 ثانية، وحجمه 20 MB بجانب جدول حجمه 22 MB فيه النصوص والمتجهات، أي أن الفهرس وحده قريب من حجم البيانات، وهذا طبيعي في HNSW لأنه يحفظ نسخة من كل متجه ومعها روابطه. والعملية vector_cosine_ops في تعريف الفهرس هي التي تقول إنه مبني لمسافة Cosine، فلن يستخدمه إلا استعلام يرتب بالعملية <=>.
التحميل إلى Qdrant، والفهرس الذي لم يبن
والبرنامج load_qdrant.py ينشئ مجموعة Collection بنفس المقياس ونفس إعدادات HNSW، ويرفع النقاط Points على دفعات، ومع كل نقطة حمولة Payload فيها العنوان والموضوع:
# تحميل نفس المتجهات إلى Qdrant مع نفس إعدادات HNSW
import time, numpy as np, pyarrow.parquet as pq
from qdrant_client import QdrantClient, models

rows = pq.read_table("passages.parquet").to_pylist()
emb = np.load("passages.npy")
q = QdrantClient(url="http://ad3-qdrant:6333", timeout=120)
if q.collection_exists("wiki"):
    q.delete_collection("wiki")
q.create_collection("wiki",
    vectors_config=models.VectorParams(size=384, distance=models.Distance.COSINE),
    hnsw_config=models.HnswConfigDiff(m=16, ef_construct=64))
t = time.perf_counter()
for i in range(0, len(rows), 500):
    q.upsert("wiki", wait=True, points=[
        models.PointStruct(id=r["id"], vector=e.tolist(), payload={"title": r["title"], "topic": r["topic"]})
        for r, e in zip(rows[i:i + 500], emb[i:i + 500])])
print(f"upsert {len(rows)} points: {time.perf_counter() - t:.1f} s")
time.sleep(10)
info = q.get_collection("wiki")
print(f"after 10 s: status={info.status.value} points={info.points_count} "
      f"indexed_vectors={info.indexed_vectors_count} segments={info.segments_count}")

# كل Segment أصغر من الحدود الافتراضية (10000 KB)، فلا يبنى HNSW ويبحث Qdrant بالمرور على الكل
q.update_collection("wiki",
    optimizers_config=models.OptimizersConfigDiff(indexing_threshold=1000),
    hnsw_config=models.HnswConfigDiff(full_scan_threshold=1000))
t = time.perf_counter()
while True:
    info = q.get_collection("wiki")
    if info.status == models.CollectionStatus.GREEN and (info.indexed_vectors_count or 0) >= len(rows) * 0.99:
        break
    time.sleep(1)
print(f"indexed after {time.perf_counter() - t:.1f} s: status={info.status.value} "
      f"points={info.points_count} indexed_vectors={info.indexed_vectors_count} segments={info.segments_count}")
docker run --rm --network ad3-net -v "$PWD:/lab" ad3-vec:1 python -u load_qdrant.pyupsert 10000 points: 9.5 s
after 10 s: status=green points=10000 indexed_vectors=0 segments=4
indexed after 13.5 s: status=green points=10000 indexed_vectors=10000 segments=4في المخرج أعلاه لاحظ التالي:
- بعد الرفع كانت حالة المجموعة
green، أي جاهزة، ولكنindexed_vectors=0: لم يبن Qdrant أي فهرس HNSW لعشرة آلاف متجه. والسبب أن Qdrant يقسم المجموعة إلى أجزاء Segments، وهنا أربعة أجزاء في كل منها 2,500 متجه، أي قرابة 3.7 MB، والحد الافتراضي لبناء الفهرسindexing_thresholdهو 10,000 KB لكل جزء، وكذلك الحد الذي يفضل تحته البحث بالمرور على الكلfull_scan_threshold، كما في صفحة الفهرسة. وهذا قرار صحيح من Qdrant وليس خطأ: لهذا الحجم البحث الدقيق سريع بما يكفي. - ولكننا نريد أن نقارن الفهرسين، لذلك خفضنا الحدين إلى 1,000 KB بالأمر
update_collection، فبنى Qdrant الفهرس في الخلفية خلال 22 ثانية، وأصبحindexed_vectors=10000. ولا تفعل ذلك في نظامك الحقيقي دون سبب، فالإعداد الافتراضي مناسب، وإنما اعرف لماذا تقرأ صفراً في هذا الحقل Field. - Qdrant يعطي كل نقطة رقماً، واستخدمنا رقم المقال في ويكيبيديا نفسه، حتى نقارن نتائج القاعدتين بنفس الأرقام.
وبعد التحميل كانت الذاكرة التي يستخدمها كل Container كما يلي، بالأمر docker stats، ومعها حجم المجموعة على القرص في Qdrant:
ad3-pg 108.9MiB / 31.29GiB
ad3-qdrant 101.2MiB / 31.29GiB
36M	/qdrant/storage/collections/wiki
القاعدتان صغيرتان جداً لهذا الحجم، قرابة 100 MiB لكل منهما، وحجم مجموعة Qdrant على القرص 36 MB لأنه يحفظ المتجهات والفهرس والحمولة Payload وسجل الكتابة WAL.
الدقة والزمن: البحث الدقيق مقابل HNSW
الآن السؤال الأهم: كم يفوت الفهرس التقريبي من الجيران الحقيقيين؟ البرنامج bench.py يحسب أولاً الإجابة الصحيحة لكل سؤال من الأسئلة Queries الخمسمائة بالبحث الدقيق في NumPy، ثم يسأل كل قاعدة بكل إعداد، ويحسب Recall@10 والزمن الوسيط p50 وزمن النسبة 95 p95:
# الدقة Recall@10 والزمن Latency: البحث الدقيق مقابل HNSW في pgvector وQdrant، على 500 سؤال ليست في الفهرس
import time, numpy as np, pyarrow.parquet as pq, psycopg
from qdrant_client import QdrantClient, models

ids = np.array([r["id"] for r in pq.read_table("passages.parquet", columns=["id"]).to_pylist()])
emb, Q = np.load("passages.npy"), np.load("queries.npy")
K = 10

t = time.perf_counter()
truth = [set(ids[np.argsort(-(emb @ q))[:K]]) for q in Q]          # البحث الدقيق: مقارنة كل سؤال بكل المتجهات
print(f"exact search in numpy: {(time.perf_counter() - t) / len(Q) * 1000:.2f} ms per query")

def run(search):
    lat, rec = [], []
    for q, tr in zip(Q, truth):
        t = time.perf_counter()
        got = search(q)
        lat.append((time.perf_counter() - t) * 1000)
        rec.append(len(tr & set(got)) / K)
    return np.mean(rec), np.percentile(lat, 50), np.percentile(lat, 95)

def report(name, r):
    print(f"{name:34} recall@10={r[0]:.3f}  p50={r[1]:6.2f} ms  p95={r[2]:6.2f} ms")

# prepare_threshold=None: لا نترك psycopg يحفظ خطة عامة بعد خمسة استدعاءات، لأن الخطة المحفوظة تبقى بعد تغيير الإعدادات
pg = psycopg.connect("host=ad3-pg user=postgres password=lab dbname=vec", autocommit=True, prepare_threshold=None).cursor()
vec = lambda q: "[" + ",".join(f"{x:.7f}" for x in q) + "]"
def pg_search(q):
    pg.execute("SELECT id FROM docs ORDER BY embedding <=> %s::vector LIMIT 10", (vec(q),))
    return [r[0] for r in pg.fetchall()]

pg.execute("SET enable_indexscan = off")
report("pgvector exact (no index)", run(pg_search))
pg.execute("SET enable_indexscan = on")
pg.execute("SET hnsw.ef_search = 10")
pg.execute("EXPLAIN (ANALYZE, COSTS OFF) SELECT id FROM docs ORDER BY embedding <=> %s::vector LIMIT 10", (vec(Q[0]),))
print("\n".join("    " + r[0] for r in pg.fetchall() if "Scan" in r[0] or "Execution" in r[0]))
for ef in (10, 20, 40, 100, 200):
    pg.execute(f"SET hnsw.ef_search = {ef}")
    report(f"pgvector hnsw ef_search={ef}", run(pg_search))

qd = QdrantClient(url="http://ad3-qdrant:6333", prefer_grpc=False)
def qd_search(params):
    return lambda q: [p.id for p in qd.query_points("wiki", query=q.tolist(), limit=K, search_params=params).points]
report("qdrant exact=True", run(qd_search(models.SearchParams(exact=True))))
for ef in (10, 20, 40, 100, 200):
    report(f"qdrant hnsw_ef={ef}", run(qd_search(models.SearchParams(hnsw_ef=ef))))
docker run --rm --network ad3-net -e OPENBLAS_NUM_THREADS=1 -e OMP_NUM_THREADS=1 -v "$PWD:/lab" ad3-vec:1 python -u bench.pyexact search in numpy: 5.92 ms per query
pgvector exact (no index) recall@10=1.000 p50= 72.60 ms p95=115.90 ms
-> Index Scan using docs_hnsw on docs (actual time=21.539..21.611 rows=10.00 loops=1)
Execution Time: 21.653 ms
pgvector hnsw ef_search=10 recall@10=0.728 p50= 2.33 ms p95= 14.74 ms
pgvector hnsw ef_search=20 recall@10=0.843 p50= 2.46 ms p95= 14.40 ms
pgvector hnsw ef_search=40 recall@10=0.917 p50= 3.44 ms p95= 15.78 ms
pgvector hnsw ef_search=100 recall@10=0.975 p50= 6.22 ms p95= 16.09 ms
pgvector hnsw ef_search=200 recall@10=0.993 p50= 11.04 ms p95= 21.34 ms
qdrant exact=True recall@10=1.000 p50= 16.35 ms p95= 43.01 ms
qdrant hnsw_ef=10 recall@10=0.791 p50= 15.11 ms p95= 35.30 ms
qdrant hnsw_ef=20 recall@10=0.897 p50= 15.90 ms p95= 40.91 ms
qdrant hnsw_ef=40 recall@10=0.958 p50= 14.83 ms p95= 36.70 ms
qdrant hnsw_ef=100 recall@10=0.991 p50= 17.52 ms p95= 56.48 ms
qdrant hnsw_ef=200 recall@10=0.999 p50= 17.33 ms p95= 45.32 msفي المخرج أعلاه لاحظ التالي:
- السطران الأولان بعد البحث الدقيق في pgvector هما خطة EXPLAIN لاستعلام واحد، وتؤكد أن الاستعلام Query يستخدم الفهرس
docs_hnsw، ووقت تنفيذه في السيرفر نفسه 21.7 مللي ثانية، وهو استعلام واحد، أما وسيط الاستعلامات الخمسمائة التالية بنفس الإعداد فكان 2.3 مللي ثانية من البرنامج كله. - البحث الدقيق في pgvector دقته 1.000 بالتعريف، ووسيط زمنه 72.6 مللي ثانية، بينما HNSW بالإعداد الافتراضي ef_search = 40 دقته 0.917 بزمن 3.4 مللي ثانية، أي أسرع عشرين مرة تقريباً مقابل أن يفوته في المتوسط أقل من واحد من كل عشرة جيران حقيقيين.
- كلما زاد ef_search زادت الدقة وزاد الزمن: من 0.728 عند 10 إلى 0.993 عند 200، والزمن من 2.3 إلى 11 مللي ثانية، وهذه هي الصفقة كلها في رقمين، وأنت الذي تختار نقطتك عليها بحسب ما يكلفه جار ضائع في نظامك.
- Qdrant أعلى دقة من pgvector بنفس قيمة ef في كل الإعدادات، فعند 40 أعطى 0.958 مقابل 0.917، والسبب المرجح أن تقسيمه إلى أربعة أجزاء Segments يعني أربعة رسوم صغيرة يبحث فيها كلها ويجمع النتائج. أما زمنه فثابت تقريباً حول 15 إلى 17 مللي ثانية في كل الإعدادات، وأغلبه هنا تكلفة طلب HTTP وتحويل JSON في مكتبة Python، وليس البحث نفسه، ولذلك لا تقارن الزمن بين القاعدتين من هذه الأرقام، وإنما الدقة، وإذا كان الزمن مهماً فاستخدم gRPC مع Qdrant وقس من تطبيقك.
- البحث الدقيق في NumPy أخذ 5.9 مللي ثانية لكل سؤال على عشرة آلاف مقطع، أي أسرع من البحث الدقيق داخل PostgreSQL، لأن المصفوفة كلها في ذاكرة البرنامج نفسه. وهذا يؤكد ما قلناه في البداية: لعشرات الآلاف من المقاطع البحث الدقيق كاف تماماً، والفهرس التقريبي يبدأ في تبرير نفسه مع مئات الآلاف والملايين.
OPENBLAS_NUM_THREADS=1 وOMP_NUM_THREADS=1 عندما تقيس زمن عمليات صغيرة كثيرة، كما فعلنا في الأمر أعلاه.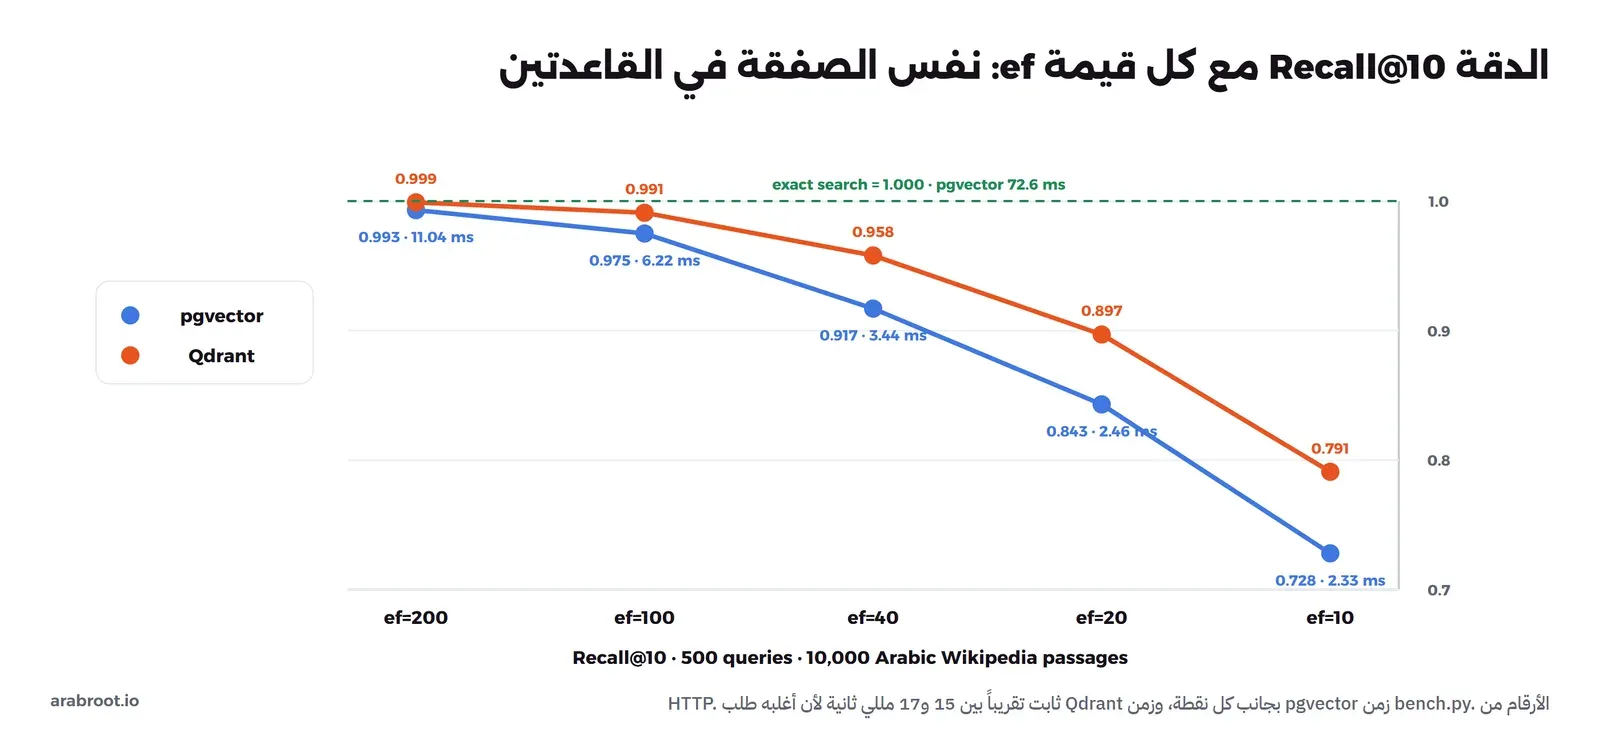
ماذا لو بنينا الرسم البياني فقيراً؟ What If
الأرقام أعلاه بالإعدادات الافتراضية تقريباً، فماذا يحدث إذا وفرنا في البناء؟ البرنامج whatif_m.py يحذف فهرس pgvector، ويبني بدلاً منه فهرساً بأربعة روابط لكل نقطة m = 4 وثمانية مرشحين عند البناء ef_construction = 8، ثم يقيس الدقة بثلاث قيم لـ ef_search، ثم يعيد الفهرس الأصلي:
# ماذا لو بنينا الفهرس برسم فقير؟ m=4 وef_construction=8 بدلاً من 16 و64
import time, numpy as np, pyarrow.parquet as pq, psycopg
ids = np.array([r["id"] for r in pq.read_table("passages.parquet", columns=["id"]).to_pylist()])
emb, Q = np.load("passages.npy"), np.load("queries.npy")
truth = [set(ids[np.argsort(-(emb @ q))[:10]]) for q in Q]
pg = psycopg.connect("host=ad3-pg user=postgres password=lab dbname=vec", autocommit=True).cursor()
vec = lambda q: "[" + ",".join(f"{x:.7f}" for x in q) + "]"
pg.execute("DROP INDEX IF EXISTS docs_hnsw")
t = time.perf_counter()
pg.execute("CREATE INDEX docs_hnsw_poor ON docs USING hnsw (embedding vector_cosine_ops) WITH (m = 4, ef_construction = 8)")
print(f"build m=4 ef_construction=8: {time.perf_counter() - t:.1f} s")
pg.execute("SELECT pg_size_pretty(pg_relation_size('docs_hnsw_poor'))"); print("index size:", pg.fetchone()[0])
for ef in (10, 40, 200):
    pg.execute(f"SET hnsw.ef_search = {ef}")
    rec = []
    for q, tr in zip(Q, truth):
        pg.execute("SELECT id FROM docs ORDER BY embedding <=> %s::vector LIMIT 10", (vec(q),))
        rec.append(len(tr & {r[0] for r in pg.fetchall()}) / 10)
    print(f"m=4 ef_search={ef:3}  recall@10={np.mean(rec):.3f}  worst query={min(rec):.1f}")
pg.execute("DROP INDEX docs_hnsw_poor")
pg.execute("CREATE INDEX docs_hnsw ON docs USING hnsw (embedding vector_cosine_ops) WITH (m = 16, ef_construction = 64)")
build m=4 ef_construction=8: 3.1 s
index size: 20 MB
m=4 ef_search= 10 recall@10=0.218 worst query=0.0
m=4 ef_search= 40 recall@10=0.430 worst query=0.0
m=4 ef_search=200 recall@10=0.681 worst query=0.1بناء الفهرس أصبح 3 ثوان بدلاً من 11، ولكن الدقة انهارت: 0.218 عند ef_search = 10، وحتى عند 200 لم تتجاوز 0.681، وفي كل الإعدادات هناك أسئلة لم يجد لها الفهرس أي واحد من الجيران العشرة الحقيقيين. والسبب أن الرسم الفقير فيه طرق قليلة بين مناطق الفضاء، فيعلق البحث في منطقة قريبة ولا يجد الطريق إلى المنطقة الصحيحة مهما وسعت قائمة المرشحين. ولاحظ أيضاً أن حجم الفهرس بقي 20 MB رغم الروابط الأقل، لأن أغلب الحجم هو المتجهات نفسها. والدرس: ef_search تصلح به الدقة عند البحث، ولكنها لا تعوض رسماً بني بإعدادات ضعيفة، والوفر في البناء يدفع ثمنه كل سؤال بعد ذلك.
الفلاتر على البيانات الوصفية Metadata Filters
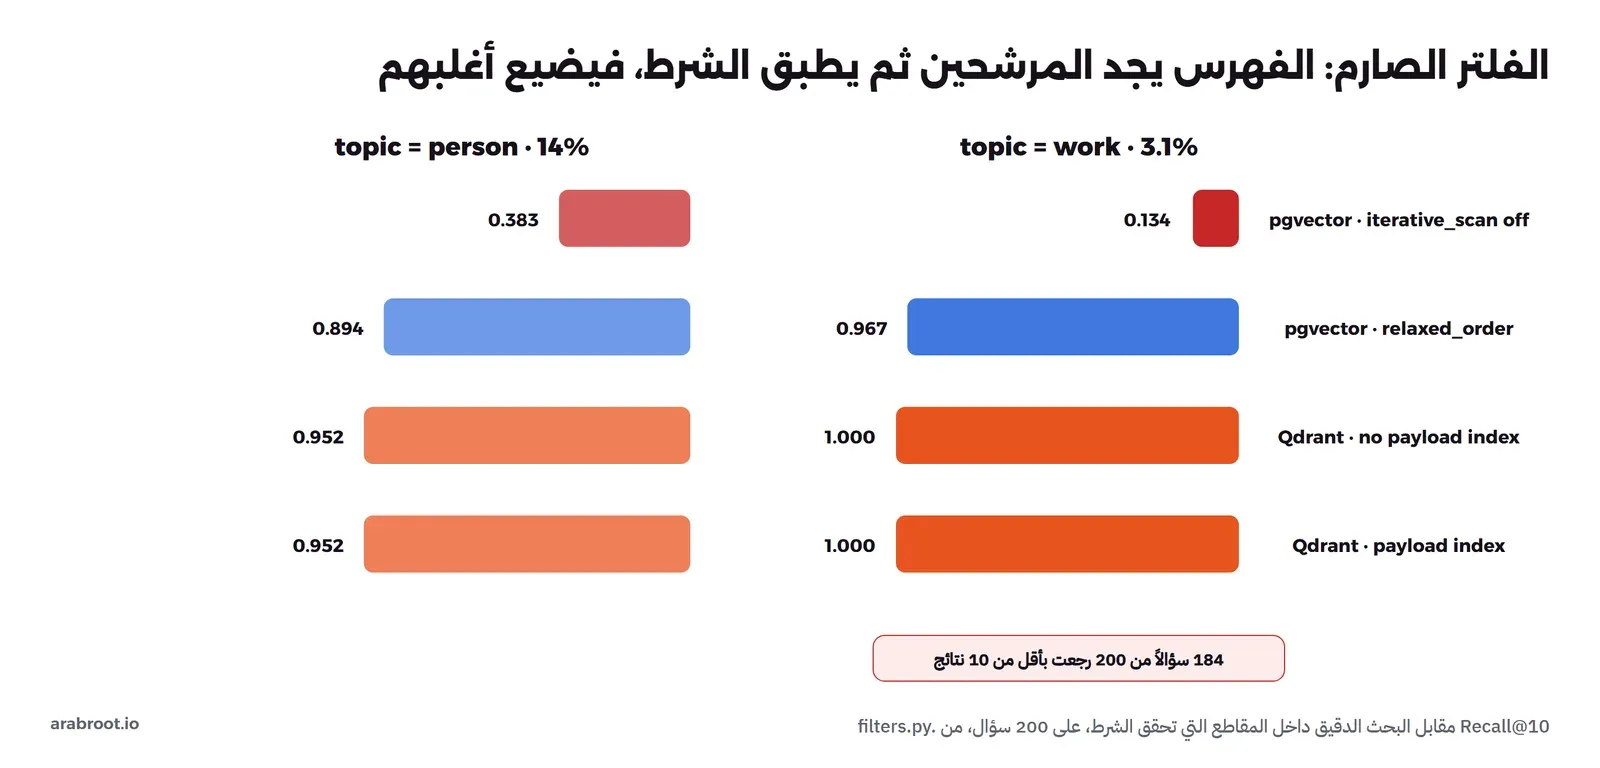
في الأنظمة الحقيقية لا تبحث في كل المقاطع، وإنما في مقاطع هذا القسم، أو هذا العميل، أو ما يحق لهذا الموظف أن يقرأه، كما شرحنا في قسم الصلاحيات في مقال RAG. وهنا تظهر أصعب مشكلة في الفهارس التقريبية: الفهرس يعرف القرب ولا يعرف الفلتر. والبرنامج filters.py يسأل 200 سؤال مع شرط على الحقل topic: مرة على «work» وهي 310 مقاطع فقط، أي 3.1%، ومرة على «person» وهي 1,399 مقطعاً، أي 14%، ويقارن بالإجابة الصحيحة من البحث الدقيق داخل المقاطع التي تحقق الشرط فقط، ويعد كم سؤالاً رجع بأقل من عشر نتائج:
# البحث مع فلتر على البيانات الوصفية: topic = 'work' (أقل من 3% من المقاطع) وtopic = 'person' (قرابة 15%)
import time, numpy as np, pyarrow.parquet as pq, psycopg
from qdrant_client import QdrantClient, models

rows = pq.read_table("passages.parquet", columns=["id", "topic"]).to_pylist()
ids = np.array([r["id"] for r in rows]); topics = np.array([r["topic"] for r in rows])
emb, Q = np.load("passages.npy"), np.load("queries.npy")[:200]
pg = psycopg.connect("host=ad3-pg user=postgres password=lab dbname=vec", autocommit=True).cursor()
qd = QdrantClient(url="http://ad3-qdrant:6333")
vec = lambda q: "[" + ",".join(f"{x:.7f}" for x in q) + "]"

def measure(name, topic, search):
    mask = topics == topic
    sub_ids, sub = ids[mask], emb[mask]
    rec, lat, short = [], [], 0
    for q in Q:
        truth = set(sub_ids[np.argsort(-(sub @ q))[:10]])
        t = time.perf_counter(); got = search(q, topic); lat.append((time.perf_counter() - t) * 1000)
        short += len(got) < 10
        rec.append(len(truth & set(got)) / 10)
    print(f"{name:44} topic={topic:6} recall@10={np.mean(rec):.3f} fewer_than_10={short:3}/200 p50={np.median(lat):6.2f} ms")

def pg_search(q, topic):
    pg.execute("SELECT id FROM docs WHERE topic = %s ORDER BY embedding <=> %s::vector LIMIT 10", (topic, vec(q)))
    return [r[0] for r in pg.fetchall()]

def qd_search(q, topic):
    f = models.Filter(must=[models.FieldCondition(key="topic", match=models.MatchValue(value=topic))])
    return [p.id for p in qd.query_points("wiki", query=q.tolist(), query_filter=f, limit=10).points]

pg.execute("EXPLAIN (COSTS OFF) SELECT id FROM docs WHERE topic = 'work' ORDER BY embedding <=> (SELECT embedding FROM docs LIMIT 1) LIMIT 10")
print("\n".join(r[0] for r in pg.fetchall()))
for topic in ("work", "person"):
    pg.execute("SET hnsw.iterative_scan = off")
    measure("pgvector hnsw, iterative_scan=off", topic, pg_search)
    pg.execute("SET hnsw.iterative_scan = relaxed_order")
    measure("pgvector hnsw, iterative_scan=relaxed_order", topic, pg_search)
    pg.execute("SET hnsw.iterative_scan = off")
    measure("qdrant, no payload index", topic, qd_search)
qd.create_payload_index("wiki", field_name="topic", field_schema=models.PayloadSchemaType.KEYWORD, wait=True)
for topic in ("work", "person"):
    measure("qdrant, keyword payload index on topic", topic, qd_search)
والمخرج سوف يكون كما يلي، بعد حذف خطة EXPLAIN التي يطبعها في البداية، وسوف نعود إليها:
pgvector hnsw, iterative_scan=off            topic=work   recall@10=0.134 fewer_than_10=184/200 p50= 12.95 ms
pgvector hnsw, iterative_scan=relaxed_order  topic=work   recall@10=0.967 fewer_than_10=  0/200 p50= 30.17 ms
qdrant, no payload index                     topic=work   recall@10=1.000 fewer_than_10=  0/200 p50= 31.82 ms
pgvector hnsw, iterative_scan=off            topic=person recall@10=0.383 fewer_than_10=145/200 p50=  6.82 ms
pgvector hnsw, iterative_scan=relaxed_order  topic=person recall@10=0.894 fewer_than_10=  0/200 p50= 16.19 ms
qdrant, no payload index                     topic=person recall@10=0.952 fewer_than_10=  0/200 p50= 33.01 ms
qdrant, keyword payload index on topic       topic=work   recall@10=1.000 fewer_than_10=  0/200 p50= 10.77 ms
qdrant, keyword payload index on topic       topic=person recall@10=0.952 fewer_than_10=  0/200 p50= 15.82 ms
في المخرج أعلاه لاحظ التالي:
- في pgvector دون المسح التكراري رجع 184 سؤالاً من 200 بأقل من عشر نتائج في فلتر «work»، والدقة 0.134 فقط، والسبب ما يذكره توثيق pgvector: الفهرس التقريبي يجد أولاً ef_search مرشحاً، أي 40 افتراضياً، ثم يطبق شرط WHERE عليهم، فإذا كان 3% فقط من المقاطع يحقق الشرط فسوف يبقى من الأربعين واحد أو اثنان في المتوسط. وأسوأ ما في هذه المشكلة أنها لا تظهر كخطأ: الاستعلام ناجح، ويرجع ثلاث نتائج بدلاً من عشر، والمستخدم يظن أن هذا كل ما في المستندات.
- مع
hnsw.iterative_scan = relaxed_order، وهو موجود منذ الإصدار 0.8.0، يكمل الفهرس المسح تلقائياً حتى يجد ما يكفي، حتى الحدhnsw.max_scan_tuplesوهو 20,000 افتراضياً، فارتفعت الدقة إلى 0.967 ولم يرجع أي سؤال بأقل من عشر نتائج، والثمن زمن أطول. - Qdrant أعطى 1.000 في فلتر «work» بلا فهرس للحقل ومعه، لأنه يطبق الشرط أثناء المرور على الرسم البياني وليس بعده، فلا يضيع المرشحون كما في pgvector، ومع فهرس الحقل يستطيع مخطط الاستعلام Query Planner أن يقدر عدد النقاط التي تحقق الشرط، فإذا كانت قليلة بحث فيها مباشرة بالمرور على الكل، ولاحظ أن الزمن انخفض مع فهرس الحقل من 32 إلى 11 مللي ثانية.
- في فلتر «person» الأوسع بقيت دقة Qdrant 0.952 حتى بعد إنشاء فهرس الحقل Payload Index، والسبب ما تذكره صفحة الفهرسة: الروابط الإضافية التي تجعل الرسم يفهم الفلتر تبنى فقط إذا كان فهرس الحقل موجوداً قبل بناء الرسم، ونحن أنشأناه بعد التحميل. لذلك أنشئ فهارس الحقول التي تفلتر بها قبل أن تحمل البيانات، أو أعد بناء الرسم بعد إنشائها.
الخطة Query Plan التي يراها تطبيقك غير الخطة التي تراها في psql
بقي سؤال: في بداية filters.py طبع البرنامج خطة EXPLAIN لاستعلام «work»، وكانت الخطة فهرس B-tree على الحقل topic ثم ترتيب دقيق Sort، أي بحثاً دقيقاً صحيحاً تماماً، فكيف جاءت الدقة 0.134؟ والإجابة في مكتبة psycopg نفسها: بعد أن ينفذ البرنامج نفس الاستعلام خمس مرات تحوله المكتبة إلى استعلام محضر Prepared Statement، وعندها قد يختار PostgreSQL خطة عامة Generic Plan لا تعرف قيمة الفلتر، فيختار فهرس HNSW ثم يفلتر. ولنر الخطتين بأعيننا بالأمر PREPARE في psql، مرة بخطة خاصة بالقيم Custom Plan ومرة بخطة عامة، والسكربت plans.sh:
# نفس الاستعلام بخطتين: خطة خاصة بالقيم Custom Plan، وخطة عامة Generic Plan كالتي يحفظها psycopg بعد خمسة استدعاءات
V=$(docker run --rm -v "$PWD:/lab" ad3-vec:1 python -c "import numpy as np; q=np.load('queries.npy')[0]; print('[' + ','.join(f'{x:.7f}' for x in q) + ']')")
docker exec -i ad3-pg psql -U postgres -d vec <<SQL
PREPARE f(text, vector) AS SELECT id FROM docs WHERE topic = \$1 ORDER BY embedding <=> \$2 LIMIT 10;
SET plan_cache_mode = force_custom_plan;
EXPLAIN (COSTS OFF) EXECUTE f('work', '$V');
SET plan_cache_mode = force_generic_plan;
EXPLAIN (COSTS OFF) EXECUTE f('work', '$V');
SQL
والمخرج سوف يكون كما يلي، بعد اختصار المتجه الطويل:
PREPARE
SET
 QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
 Limit
 -> Sort
 Sort Key: ((embedding <=> '[...]'::vector))
 -> Bitmap Heap Scan on docs
 Recheck Cond: (topic = 'work'::text)
 -> Bitmap Index Scan on docs_topic
 Index Cond: (topic = 'work'::text)
(7 rows)

SET
 QUERY PLAN
------------------------------------------
 Limit
 -> Index Scan using docs_hnsw on docs
 Order By: (embedding <=> $2)
 Filter: (topic = $1)
(4 rows)
الخطة الخاصة بالقيم تعرف أن «work» قليلة، فتختار فهرس الحقل ثم ترتب بدقة، والخطة العامة لا تعرف القيمة، فتختار HNSW ثم تطبق الفلتر في السطر Filter: (topic = $1)، وهذه هي الخطة التي نفذها البرنامج في أغلب الاستدعاءات بعد أن حضرت المكتبة الاستعلام. ونفس المشكلة أفسدت أول تشغيل لبرنامج bench.py: حفظت المكتبة خطة البحث الدقيق التي اخترناها بالأمر enable_indexscan = off، ثم بقيت تستخدمها بعد أن أعدنا الإعداد، فجاءت دقة الفهرس 1.000 وزمنه مثل البحث الدقيق، وهذه علامة مؤكدة على أن الفهرس لم يستخدم. لذلك اتصل برنامج المقارنة بالخيار prepare_threshold=None. والقاعدة: لا تحكم على فهرس بخطة EXPLAIN من psql وحدها، وإنما بخطة الاستعلام كما ينفذه تطبيقك، وقس الدقة دائماً، فالدقة 1.000 مع فهرس تقريبي إشارة تستحق التحقق وليست نتيجة تحتفل بها.
ذاكرة أقل: halfvec والتكميم Scalar Quantization
البرنامج quant.py يبني في pgvector فهرساً ثانياً على المتجه بعد تحويله إلى نصف الدقة halfvec، بفهرس تعبير Expression Index كما في توثيق pgvector، ويقيس دقته بنفس الإعداد ef_search = 40، ثم يفعل في Qdrant التكميم إلى INT8 مع حفظ النسخة المكممة في الذاكرة، ويقيس الدقة مرة دون إعادة ترتيب ومرة معها:
# تقليل الذاكرة: halfvec في pgvector، والتكميم الرقمي Scalar Quantization في Qdrant
import time, numpy as np, pyarrow.parquet as pq, psycopg
from qdrant_client import QdrantClient, models

ids = np.array([r["id"] for r in pq.read_table("passages.parquet", columns=["id"]).to_pylist()])
emb, Q = np.load("passages.npy"), np.load("queries.npy")
truth = [set(ids[np.argsort(-(emb @ q))[:10]]) for q in Q]
def run(search):
    rec, lat = [], []
    for q, tr in zip(Q, truth):
        t = time.perf_counter(); got = search(q); lat.append((time.perf_counter() - t) * 1000)
        rec.append(len(tr & set(got)) / 10)
    return f"recall@10={np.mean(rec):.3f} p50={np.median(lat):.2f} ms"

pg = psycopg.connect("host=ad3-pg user=postgres password=lab dbname=vec", autocommit=True).cursor()
vec = lambda q: "[" + ",".join(f"{x:.7f}" for x in q) + "]"
t = time.perf_counter()
pg.execute("CREATE INDEX docs_hnsw_half ON docs USING hnsw ((embedding::halfvec(384)) halfvec_cosine_ops)")
print(f"halfvec index build: {time.perf_counter() - t:.1f} s")
pg.execute("SELECT pg_size_pretty(pg_relation_size('docs_hnsw')), pg_size_pretty(pg_relation_size('docs_hnsw_half'))")
print("index size vector / halfvec:", pg.fetchone())
pg.execute("SET hnsw.ef_search = 40")
def pg_half(q):
    pg.execute("SELECT id FROM docs ORDER BY embedding::halfvec(384) <=> %s::halfvec(384) LIMIT 10", (vec(q),))
    return [r[0] for r in pg.fetchall()]
print("pgvector halfvec ef_search=40:", run(pg_half))
pg.execute("DROP INDEX docs_hnsw_half")

qd = QdrantClient(url="http://ad3-qdrant:6333", timeout=300)
qd.update_collection("wiki", quantization_config=models.ScalarQuantization(
    scalar=models.ScalarQuantizationConfig(type=models.ScalarType.INT8, quantile=0.99, always_ram=True)))
t = time.perf_counter()
while qd.get_collection("wiki").status != models.CollectionStatus.GREEN:
    time.sleep(1)
print(f"qdrant int8 quantization ready after {time.perf_counter() - t:.1f} s")
def qd_q(rescore):
    p = models.SearchParams(hnsw_ef=64, quantization=models.QuantizationSearchParams(rescore=rescore))
    return lambda q: [x.id for x in qd.query_points("wiki", query=q.tolist(), limit=10, search_params=p).points]
print("qdrant int8, rescore=False:", run(qd_q(False)))
print("qdrant int8, rescore=True: ", run(qd_q(True)))
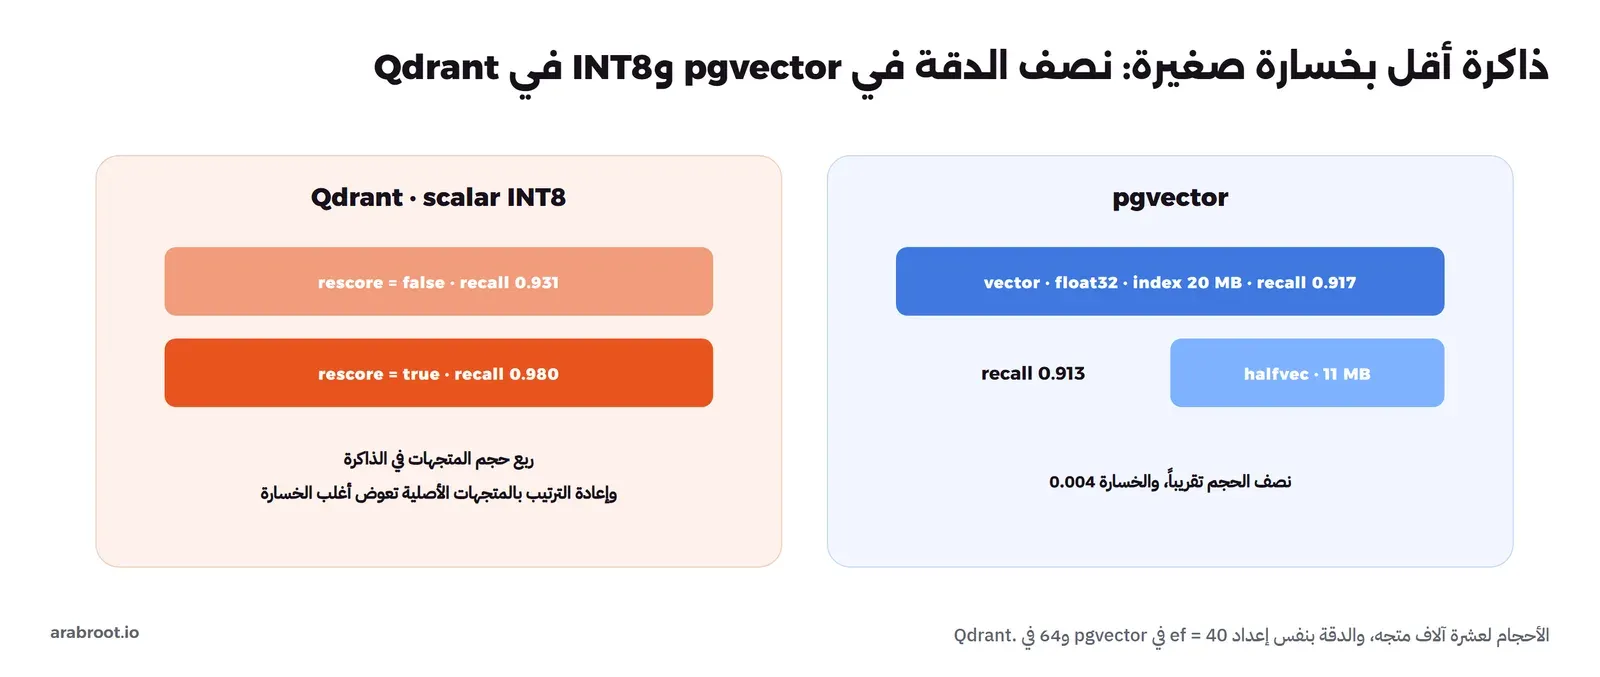
halfvec index build: 14.9 s
index size vector / halfvec: ('20 MB', '11 MB')
pgvector halfvec ef_search=40: recall@10=0.913 p50=2.75 ms
qdrant int8 quantization ready after 13.3 s
qdrant int8, rescore=False: recall@10=0.931 p50=21.05 ms
qdrant int8, rescore=True: recall@10=0.980 p50=19.15 msفي المخرج أعلاه لاحظ التالي:
- فهرس halfvec حجمه 11 MB مقابل 20 MB للفهرس الكامل، أي قرابة النصف، ودقته 0.913 مقابل 0.917 للفهرس الكامل بنفس الإعداد في جدول المقارنة، أي أن الخسارة من نصف الدقة شبه معدومة مع هذا النموذج. ولاحظ أن الاستعلام يجب أن يكتب نفس التحويل
embedding::halfvec(384)حرفياً حتى يستخدم الفهرس، وإلا عاد PostgreSQL إلى الفهرس الآخر أو إلى البحث الدقيق. - في Qdrant أعطى التكميم إلى INT8 دقة 0.931 دون إعادة ترتيب، و0.980 معها، والسبب أن إعادة الترتيب Rescoring تأخذ أفضل المرشحين من البحث بالنسخة المكممة، ثم ترتبهم من جديد بالمتجهات الأصلية الكاملة، فتعوض أغلب ما ضاع في التقريب. فاجعلها مفعلة إلا إذا قست أنك لا تحتاجها، وثمنها قراءة المتجهات الأصلية لعدد قليل من المرشحين.
- التكميم في هذه الأحجام لا يغير شيئاً تقريباً في الذاكرة، فعشرة آلاف متجه 15 MB، ولكن الحساب نفسه يتغير مع الحجم: عشرة ملايين متجه بطول 384 قرابة 15 GB بدقة Float32، و7.5 GB بنصف الدقة، و3.8 GB بـ INT8، وهذا هو الفرق بين سيرفر ب 32 GB وسيرفر ب 64 GB.
الكتابة العربية: الهمزات والتاء المربوطة والبادئة
رأينا في التجربة الأولى أن النموذج يقرب بين «الإجازة المرضية» و«الاجازه المرضيه» بدرجة 0.977، ولكن السؤال الحقيقي: هل يجد البحث المقال الصحيح من بين عشرة آلاف عندما يكتب المستخدم دون همزات؟ ملف questions.py فيه 24 سؤالاً كتبناها بأيدينا، ولكل سؤال المقال الذي يجيب عنه، مثل «كيف تبحث عن عنصر في قائمة مرتبة بتقسيمها إلى نصفين في كل خطوة؟» وإجابته مقال «خوارزمية البحث الثنائي». والبرنامج quality.py يحسب رتبة المقال الصحيح في البحث الدقيق لكل سؤال، بثلاث طرق: بالكتابة الصحيحة مع البادئة query:، وبالكتابة التي يكتب بها أغلب الناس في البحث، أي الألف دون همزة والهاء بدلاً من التاء المربوطة والياء بدلاً من الألف المقصورة، ثم بالكتابة الصحيحة دون البادئة:
# هل يجد البحث بالمعنى المقال الصحيح؟ وما أثر الكتابة دون همزات وبالهاء بدلاً من التاء المربوطة؟
import re, numpy as np, pyarrow.parquet as pq
from sentence_transformers import SentenceTransformer
from questions import QUESTIONS

def sloppy(s):                      # كما يكتب أغلب الناس في البحث: دون همزات على الألف، وة تصبح ه، وى تصبح ي
    s = re.sub("[أإآ]", "ا", s)
    s = re.sub(r"ة\b", "ه", s)
    return re.sub(r"ى\b", "ي", s)

rows = pq.read_table("passages.parquet", columns=["title"]).to_pylist()
titles = [r["title"] for r in rows]
emb = np.load("passages.npy")
m = SentenceTransformer("intfloat/multilingual-e5-small", device="cpu")

def evaluate(label, texts):
    Q = m.encode(texts, normalize_embeddings=True, convert_to_numpy=True)
    ranks = []
    for q, (_, target) in zip(Q, QUESTIONS):
        order = np.argsort(-(emb @ q))
        ranks.append(next(i for i, j in enumerate(order) if titles[j] == target) + 1)
    hit1 = sum(r == 1 for r in ranks); hit10 = sum(r <= 10 for r in ranks)
    print(f"{label:34} hit@1={hit1:2}/24  hit@10={hit10:2}/24  ranks={ranks}")
    return ranks

base = evaluate("query: + correct spelling", ["query: " + q for q, _ in QUESTIONS])
evaluate("query: + sloppy spelling", ["query: " + sloppy(q) for q, _ in QUESTIONS])
evaluate("no prefix + correct spelling", [q for q, _ in QUESTIONS])
query: + correct spelling hit@1=18/24 hit@10=23/24 ranks=[2, 1, 1, 1, 2, 1, 1, 2, 6, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 1, 1, 22, 1, 1]
query: + sloppy spelling hit@1=18/24 hit@10=22/24 ranks=[1, 11, 1, 1, 2, 1, 1, 2, 6, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 1, 1, 27, 1, 1]
no prefix + correct spelling hit@1=19/24 hit@10=23/24 ranks=[2, 2, 1, 1, 1, 1, 1, 1, 5, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 1, 1, 30, 1, 1]في المخرج أعلاه لاحظ التالي:
- بالكتابة الصحيحة وجد البحث المقال الصحيح في المرتبة الأولى في 18 سؤالاً من 24، وفي العشرة الأولى في 23، وهذا مستوى جيد لنموذج صغير بحجم 470 MB، ويكفي كمرحلة أولى قبل إعادة الترتيب Re-ranking التي شرحناها في مقال RAG.
- السؤال الذي فشل في الطرق الثلاث هو الثاني والعشرون «أطول نهار وأقصر نهار في السنة»، والمقال الصحيح «انقلاب شمسي» جاء في المرتبة 22 ثم 27 ثم 30، والسبب أن السؤال لا يشترك مع المقطع في أي كلمة تقريباً، والمقطع نفسه يشرح الانقلاب بارتفاع الشمس فوق الأفق وقت الظهر، ولا يذكر طول النهار، وهذا حد البحث بالمعنى مع المقاطع القصيرة: النموذج يقارن السؤال بأول 400 حرف فقط من المقال، وليس بالمقال كله.
- الكتابة دون همزات لم تغير hit@1، ولكنها أخرجت سؤالاً واحداً من العشرة الأولى: سؤال «لغة برمجة مفسرة مشهورة...» عن بايثون نزل من المرتبة 1 إلى 11، ولاحظ أن مقطع ويكيبيديا نفسه يكتب الكلمة مشكولة «مفسرة» بالشدة والضمة، فالسؤال المكتوب «مفسره» بالهاء أبعد عنها بخطوتين. أي أن النموذج قوي أمام أشكال الكتابة في أغلب الأسئلة، ولكنه ليس محصناً تماماً، فإذا كان مستخدموك يكتبون دون همزات فوحد الحروف في السؤال وفي المستندات معاً بنفس الدالة قبل حساب المتجه، أو اجمع البحث بالمعنى مع البحث بالكلمات بعد التوحيد كما في البحث الهجين.
- حذف البادئة
query:لم يضر في هذه الأسئلة، بل رفع hit@1 إلى 19، وغير ترتيب بعض الأسئلة صعوداً وبعضها نزولاً. وهذا لا يعني أن تحذفها، فبطاقة النموذج تشترطها، وأسئلة قليلة لا تكفي لحكم بعكسها، وإنما يعني ما قلناه منذ البداية: قس على أسئلتك، فالقاعدة العامة قد لا تظهر في بياناتك، والعكس صحيح.
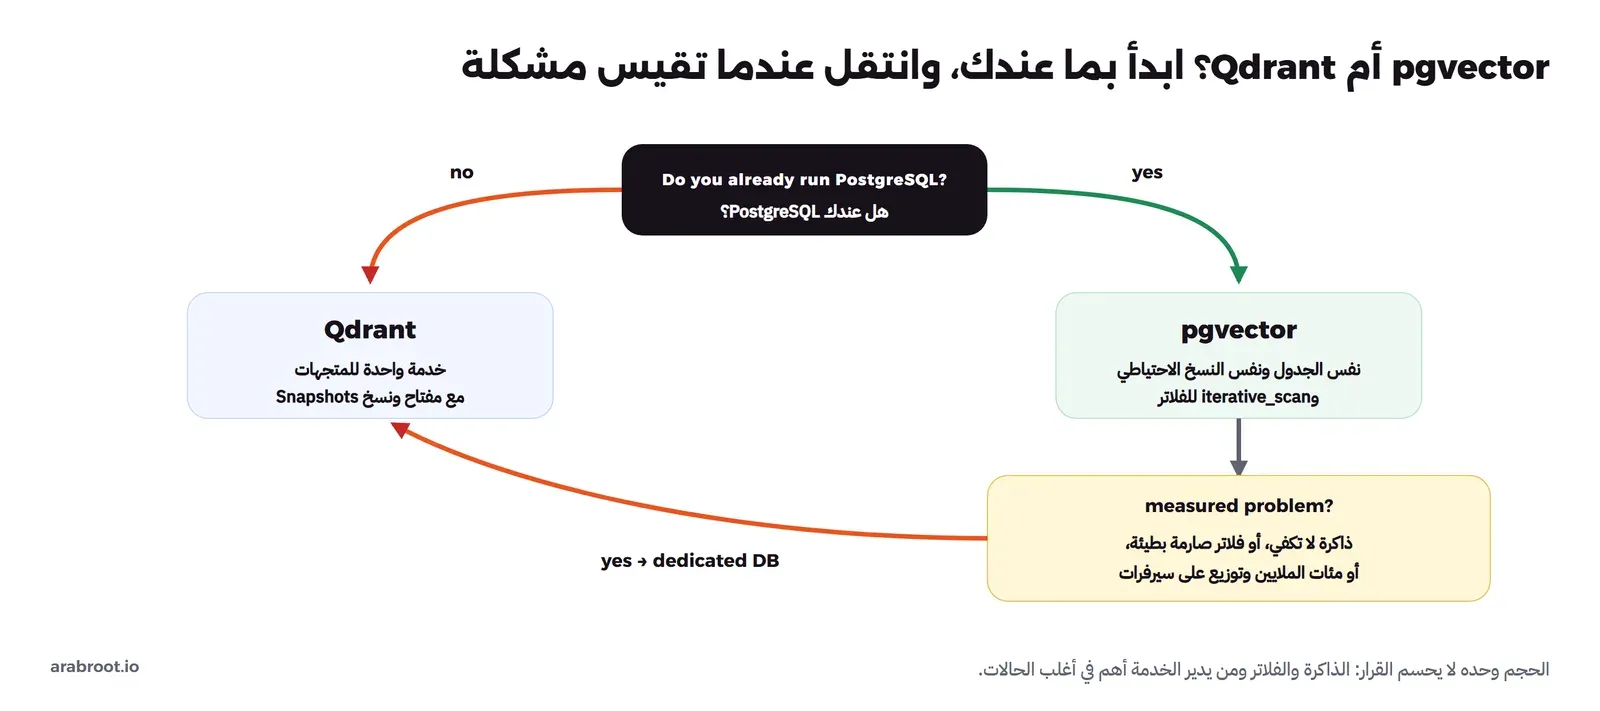
Qdrant أم pgvector؟
بعد الأرقام، القرار في أغلب الحالات لا يحسمه الأداء على بضعة آلاف أو مئات الآلاف من المقاطع، فالاثنان يجيبان في أجزاء من الثانية، وإنما تحسمه أسئلة التشغيل: أين بقية بياناتك، ومن يدير القاعدة، وكم ستكبر البيانات. وفيما يلي نقاط القوة ونقاط الضعف لكل منهما كما رأيناها في التجربة وفي التوثيق.
pgvector
نقاط القوة: المتجهات في نفس الجدول Table مع المستند وصلاحياته وتاريخ تحديثه، فتكتب الفلتر والربط JOIN والصلاحيات بلغة SQL التي يعرفها فريقك، ومع نفس النسخ الاحتياطي Backup ونفس المعاملات Transactions، فلا يوجد نظام ثان تزامن معه البيانات. وإذا كان عندك PostgreSQL أصلاً فالتكلفة الإضافية تقريباً صفر، ومعه البحث النصي في نفس القاعدة للبحث الهجين كما في مقال البحث النصي. نقاط الضعف: الفلتر يطبق بعد الفهرس، فيرجع نتائج أقل مما طلبت ما لم تفعل المسح التكراري كما رأيت، وبناء الفهرس على عشرات الملايين يحتاج ذاكرة maintenance_work_mem كبيرة ووقتاً، والفهرس يتنافس على ذاكرة نفس السيرفر مع بقية التطبيق، والتوزيع على عدة سيرفرات ليس جزءاً منه.
Qdrant
نقاط القوة: مصمم للمتجهات من البداية، فالفلتر جزء من البحث داخل الرسم البياني، وفيه التكميم بأنواعه مع إعادة الترتيب، والتقسيم Sharding والنسخ المتماثل Replication على عدة سيرفرات، وواجهة REST وgRPC بسيطة ولوحة إدارة. نقاط الضعف: خدمة إضافية تحتاج تشغيلاً ومراقبة ونسخاً احتياطياً بالـ Snapshots وصلاحيات خاصة بها، ولا تطلب مفتاحاً افتراضياً، والبيانات الوصفية والصلاحيات نسخة من قاعدتك الأصلية يجب أن تبقيها متزامنة، فإذا حذف مستند من قاعدة التطبيق ونسيت حذفه من Qdrant فسوف يجده البحث.
| السؤال | pgvector | Qdrant |
|---|---|---|
| عندك PostgreSQL وفريق يعرفه | الاختيار الطبيعي | خدمة إضافية |
| آلاف إلى بضعة ملايين من المقاطع | يكفي | يكفي |
| عشرات أو مئات الملايين، أو ذاكرة محدودة | ممكن مع halfvec وتخطيط | أسهل مع التكميم والتقسيم |
| فلاتر صارمة على البيانات الوصفية | فعل hnsw.iterative_scan | فهرس للحقل قبل التحميل |
| الصلاحيات على مستوى المستند | بلغة SQL مع بقية بياناتك | في الحمولة Payload مع مزامنة |
| النسخ الاحتياطي | نفس أدوات PostgreSQL | Snapshots خاصة به |
والقاعدة العملية: ابدأ بـ pgvector إذا كان عندك PostgreSQL، وانتقل إلى قاعدة متخصصة عندما تقيس مشكلة حقيقية في الحجم أو الذاكرة أو الفلاتر، وليس قبل ذلك، وهو نفس المنطق الذي شرحناه في مقال PostgreSQL لكل شيء. وأما Chroma وMilvus وWeaviate وOpenSearch فقد مررنا على نقاط قوتها وضعفها في مقال RAG، والطريقة التي قسنا بها هنا تنطبق عليها كما هي.
التشغيل: ما يتغير بعد أول يوم
- تغيير نموذج التضمين يعني إعادة حساب كل المتجهات، فاحفظ اسم النموذج وإصداره مع كل متجه، أو في اسم المجموعة أو الجدول، وابن الجديد بجانب القديم ثم بدل بينهما.
- كل مستند يتغير يحتاج متجهاً جديداً، فاربط التحديث بنفس العملية التي تحفظ المستند، أو بطابور Queue يعيد الحساب، وإلا أجاب البحث من نسخة قديمة.
- الحذف في HNSW لا يعيد بناء الرسم فوراً، والقاعدتان تنظفان لاحقاً، ففي pgvector يحتاج الجدول
VACUUM، وفي Qdrant يعمل المحسن Optimizer في الخلفية، فراقب حجم الفهرس بعد الحذف الكثير. - النسخ الاحتياطي: في pgvector هو نسخ PostgreSQL العادي، وفي Qdrant لقطات Snapshots للمجموعة، واحتفظ أيضاً بملف المتجهات نفسه، لأن إعادة الحساب أغلى من إعادة التحميل كما رأيت.
- القياس الدوري: احتفظ بمجموعة أسئلة ثابتة مع إجاباتها، مثل الأسئلة الأربعة والعشرين في التجربة، وأعد قياس Recall وhit@10 بعد كل تغيير في النموذج أو الإعدادات أو حجم البيانات.
أخطاء شائعة
- اعتبار درجة التشابه دليلاً على الصحة: «الرياض ليست عاصمة المملكة» حصلت على 0.866، فالتشابه يقيس الموضوع وليس الحقيقة.
- نسيان البادئة التي يشترطها النموذج، مثل
query:وpassage:في e5، أو استخدام بادئة السؤال للمستندات. - متجهات المستندات بنموذج ومتجه السؤال بنموذج آخر: الأرقام لا تقارن بين نموذجين، والنتيجة ترتيب عشوائي دون أي رسالة خطأ.
- مقياس البحث غير مقياس الفهرس: فهرس
vector_cosine_opsلا يستخدمه استعلام يرتب بالعملية<->، فيعود PostgreSQL إلى البحث الدقيق بصمت. - فلتر صارم دون المسح التكراري في pgvector: نتائج أقل من k دون أي تحذير، كما رأيت في 145 سؤالاً من 200.
- إنشاء فهرس الحقل في Qdrant بعد تحميل البيانات، ثم توقع أن يستفيد منه الرسم البياني مباشرة.
- افتراض أن Qdrant بنى الفهرس لأن الحالة green: انظر إلى
indexed_vectors_count، فقد يكون صفراً للمجموعات الصغيرة، وهذا مقصود. - الحكم على الفهرس بمتجهات عشوائية أو بأسئلة قليلة: قس Recall على بياناتك وأسئلتك الحقيقية.
- نشر منفذ Qdrant 6333 على الشبكة دون مفتاح: كل من يصل إليه يقرأ ويحذف.
قائمة التحقق Checklist
- هل قرأت بطاقة نموذج التضمين: اللغات، والطول الأقصى، وطول المتجه، والرخصة، والبادئات المطلوبة؟
- هل المتجهات مطبعة، والمقياس في الفهرس هو نفس المقياس في الاستعلام؟
- هل حفظت المتجهات في ملف بعد حسابها، ومعها اسم النموذج وإصداره؟
- هل قست Recall@10 مقابل البحث الدقيق على أسئلة من عملك، بالإعدادات التي ستستخدمها؟
- هل جربت كل فلتر تستخدمه، وعددت كم سؤالاً رجع بأقل من k نتيجة؟
- هل حسبت الذاكرة للحجم المتوقع بعد سنة، وجربت halfvec أو التكميم إذا لزم؟
- هل القاعدة الشعاعية خلف مصادقة، ونسخها الاحتياطي مجرب؟
- هل عندك مجموعة أسئلة ثابتة بإجاباتها تعيد تشغيلها بعد كل تغيير؟
حذف التجربة
docker rm -f ad3-pg ad3-qdrant
docker volume rm ad3-pg ad3-qdrant ad3-hf
docker network rm ad3-net
docker rmi ad3-vec:1
تدريب عملي
- غير نموذج التضمين إلى نموذج آخر متعدد اللغات من صفحة نماذج التضمين في Ollama أو Hugging Face، وأعد حساب المتجهات والأسئلة الأربعة والعشرين، وقارن hit@1 وhit@10.
- أضف إلى bench.py فهرس IVFFlat في pgvector بالإعداد
lists = 100، وقس Recall معivfflat.probesبقيم 1 و5 و20. - اكتب عشرة أسئلة بالعامية عن مقالات تعرف أنها في المقاطع، وقس هل يجدها البحث بالمعنى كما وجد الأسئلة الفصيحة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التضمين Embedding قائمة أرقام بطول ثابت لكل نص، والنصوص المتقاربة في الموضوع متقاربة في الأرقام، وليس بالضرورة في الحقيقة: «الرياض ليست العاصمة» حصلت على 0.866 مقابل 0.898 للجملة الصحيحة.
- مع المتجهات المطبعة يعطي Cosine والضرب الداخلي والمسافة الإقليدية نفس الترتيب، والمهم أن يكون مقياس الفهرس هو مقياس الاستعلام، وأن تستخدم نفس النموذج ونفس البادئات للمستندات والأسئلة.
- حساب المتجهات أغلى ما في النظام: ساعة على المعالج لعشرة آلاف مقطع، مقابل ثوان للتحميل والفهرسة، فاحفظ المتجهات بعد حسابها.
- HNSW صفقة بين الدقة والزمن: في pgvector من 0.728 عند ef_search = 10 إلى 0.993 عند 200، والافتراضي 40 أعطى 0.917 أسرع من البحث الدقيق عشرين مرة، ورسم مبني بإعدادات فقيرة لم يتجاوز 0.681 مهما رفعت ef_search.
- الفلتر الصارم أخطر ما في الفهارس التقريبية: pgvector رجع بأقل من عشر نتائج في 184 سؤالاً من 200 حتى فعلنا المسح التكراري، والخطة التي ينفذها تطبيقك قد تختلف عن خطة psql بسبب الاستعلامات المحضرة.
- Qdrant يطبق الفلتر أثناء البحث، ولا يبني HNSW للمجموعات الصغيرة افتراضياً، وفهارس الحقول تنشأ قبل التحميل.
- نصف الدقة halfvec قسم الفهرس على اثنين تقريباً دون خسارة تذكر، والتكميم INT8 مع إعادة الترتيب في Qdrant أعطى 0.980.
- النموذج الصغير وجد المقال الصحيح في العشرة الأولى في 23 سؤالاً من 24، والكتابة دون همزات أضرت بسؤال واحد فقط، فوحد الحروف في الطرفين إذا كان مستخدموك يكتبون هكذا.
- ابدأ بـ pgvector إذا كان عندك PostgreSQL، وانتقل إلى قاعدة متخصصة عندما تقيس مشكلة.
والخطوة التالية في نفس المرحلة أن تضع هذه القاعدة داخل نظام كامل يجيب من مستنداتك، وهو ما بنيناه في مقال RAG، أو أن تعطي النموذج أدوات يستخدمها بنفسه، وهو موضوع مقال الوكيل الذكي.
 دليلRAG للمبتدئين: نموذج لغة يجيب من مستنداتك على سيرفرككيف تجعل نموذج اللغة يجيب من مستندات مؤسستك ويذكر مصدره، دون أن يخرج أي مستند من سيرفرك.
 دليلالوكيل الذكي AI Agent: استدعاء الأدوات Tool Calling والحلقةكيف يعمل الوكيل الذكي من الداخل: حلقة صغيرة تكتبها بيدك بثلاث أدوات، والأعطال الحقيقية التي تقع فيها، والحراسات التي تمنع ضررها في الكود.
 دليلاستدعاء نموذج اللغة من الكود عبر API متوافقة مع OpenAIكيف تستدعي نموذجاً على سيرفرك من الكود بنفس واجهة OpenAI، وتتعامل مع البث والمخرج المنظم والأدوات والأخطاء وتحسب تكلفة كل طلب.
 دليلالبحث النصي Full-Text Search داخل PostgreSQL: متى يكفيك؟كيف يعمل البحث النصي في PostgreSQL مع النص العربي، وأين يخطئ الإعداد arabic، وكم يكلف الترتيب والتمييز، مقاساً على 348 ألف مقال من ويكيبيديا العربية.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
سجل التحديثات
- 19 نوفمبر 2026: كتابة المقال، واختبار التجربة على Docker Engine 29.8.0 (معالج فقط) مع PostgreSQL 18.7 وpgvector 0.8.7 (pgvector/pgvector:0.8.7-pg18-trixie) وQdrant 1.20.2، وPython 3.13.18 مع sentence-transformers 6.3.0 وtorch 2.15.0 (CPU) وqdrant-client 1.20.0 وpsycopg 3.3.9، والنموذج intfloat/multilingual-e5-small، على 10 آلاف مقطع من ويكيبيديا العربية (20231101.ar).