

في دليل Metabase شرحنا ما هي أداة ذكاء الأعمال BI، ولماذا تقرأ من قاعدة البيانات بمستخدم للقراءة فقط، وبنينا لوحة مبيعات لمتجر تجريبي دون كتابة كود. ولكن عندما يكبر فريق البيانات ويصبح فيه محللون يكتبون SQL كل يوم، ويحتاجون تعريفاً واحداً للمقاييس Metrics تستخدمه كل الرسوم، وأنواعاً كثيرة من الرسوم، وصلاحيات دقيقة وذاكرة مؤقتة Cache أمام قاعدة البيانات، فالأداة التي تذكر غالباً هي Apache Superset. وهذا المقال يكمل مرحلة البيانات وذكاء الأعمال على البيانات نفسها، فلا نعيد شرح المفاهيم، وسوف نناقش فيه ما يلي:
- مكونات Superset: التطبيق وقاعدة بياناته الوصفية وRedis والعمال Workers، ولماذا هو أثقل من Metabase.
- التثبيت بإصدار مثبت مع PostgreSQL وRedis، ومشكلة برنامج الاتصال Driver الذي لا يأتي مع ال Image، والمفتاح السري SECRET_KEY.
- ال Dataset والمقاييس، وهي الفكرة الأهم في Superset.
- محرر SQL Lab، وبناء الرسوم، ولوحة بفلاتر.
- العربية في Superset بصراحة، والنسخ الاحتياطي، ومتى تختار Superset بدلاً من Metabase.
- Superset على مستودع بيانات فيه 3.3 مليون سطر: تقييد الصفوف لدور واحد، والذاكرة المؤقتة بالأرقام، وخطوتان نكسر فيهما الاثنين.
مكونات Superset
Superset مشروع من مؤسسة Apache برخصة Apache-2.0 كما في ملف الرخصة، فلا توجد نسخة مفتوحة وأخرى تجارية للمشروع نفسه، وهو تطبيق Python مبني على Flask مع واجهة React. والصورة التالية تبين مكوناته في الإنتاج Production:
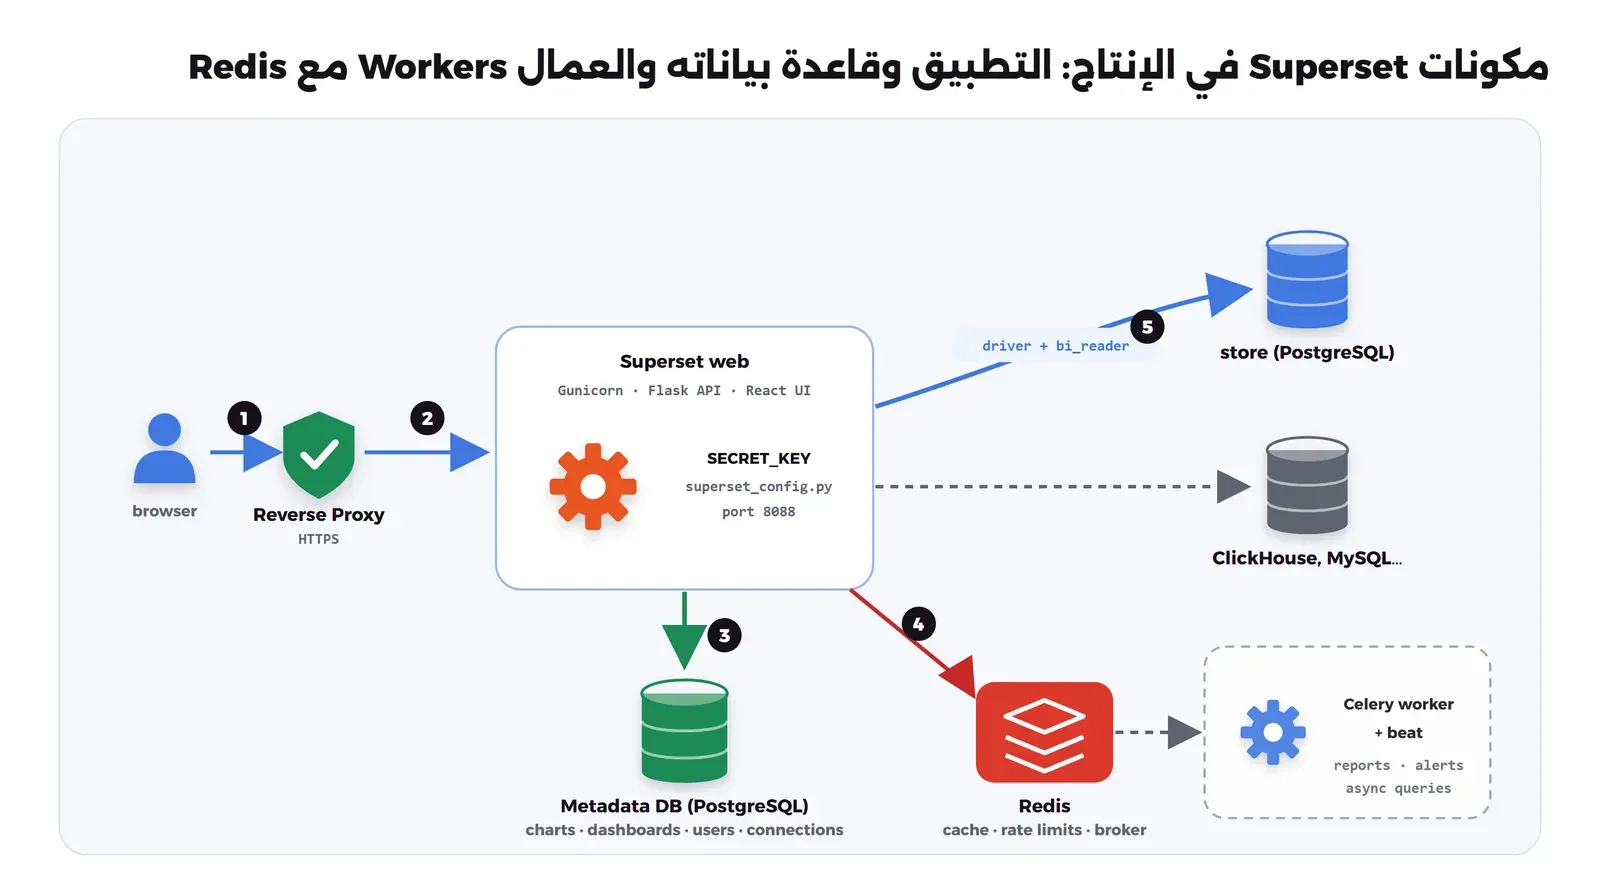
- تطبيق الويب: يعمل على المنفذ 8088، وكل إعداداته في ملف Python اسمه
superset_config.pyكما في توثيق الإعداد. - قاعدة البيانات الوصفية Metadata Database: فيها الرسوم واللوحات والمستخدمون والاتصالات، كقاعدة التطبيق في Metabase، وPostgreSQL هو الخيار المعتاد لها.
- Redis: يحفظ نتائج الاستعلامات حتى لا تسأل اللوحة قاعدة بياناتك في كل مرة يفتحها أحد، ويعد محاولات تسجيل الدخول، ويستخدم وسيطاً Broker للعمال.
- العمال Celery: اختيارية، وتحتاجها للتقارير المجدولة والتنبيهات Alerts والاستعلامات الطويلة غير المتزامنة، ولم نشغلها في التجربة.
وهذا يعني أن Superset في الإنتاج أربع خدمات على الأقل، مقابل خدمتين في Metabase، وأن الإعداد يكون بملف Python وليس بمتغيرات البيئة فقط. والتوثيق صريح في ذلك، فصفحة Docker Compose تقول إن ملفات Compose في المستودع للتجربة والتطوير وإنها ليست جاهزة للإنتاج كما هي، وتوصي صفحة Kubernetes بالمشغل Operator الرسمي للتركيبات الكبيرة. أما لسيرفر واحد لفريق صغير فملف Compose من كتابتك، كالذي نكتبه الآن، مع نسخ احتياطي لقاعدة البيانات الوصفية، طريقة معقولة.
تجربة عملية: Superset على بيانات المتجر نفسها
نستخدم قاعدة المتجر lab-bi-store ومستخدم القراءة bi_reader وشبكة lab-bi-net التي أنشأناها في تجربة Metabase، فإذا لم تكن قد أنشأتها فابدأ من هناك.
ال Image وبرنامج الاتصال بقاعدة البيانات
آخر إصدار عند كتابة المقال هو 6.1.0، والطريقة البسيطة أن تشغل apache/superset:6.1.0 مباشرة، ولكنها تفشل مع PostgreSQL، والسبب أن ال Image لا تحتوي مكتبة psycopg2 التي يتصل بها Python ب PostgreSQL، وهذا ما وجدناه عند فحصها:
docker run --rm --entrypoint sh apache/superset:6.1.0 \
  -c '. /app/.venv/bin/activate; python -c "import psycopg2"'
ModuleNotFoundError: No module named 'psycopg2'لاحظ أن صفحة بناء ال Images في التوثيق الحالي، وهو بعنوان النسخة القادمة Next، تقول إن ال Image الافتراضية تضم psycopg2، ولكن الإصدار 6.1.0 الذي استخدمناه لم يكن كذلك، فتأكد بنفسك من الإصدار الذي تستخدمه. والحل كما يقترح التوثيق نفسه أن تبني Image فوقها تضيف المكتبة، وهذا هو ملف Dockerfile:
FROM apache/superset:6.1.0
USER root
# The published image has no database drivers: psycopg2 for the PostgreSQL metadata DB and for our data
RUN . /app/.venv/bin/activate && uv pip install --no-cache psycopg2-binary==2.9.13
USER superset
والمكتبة نفسها تحتاجها مرتين: لقاعدة البيانات الوصفية، ولقاعدة المتجر التي نسألها، وإذا كانت بياناتك في MySQL أو ClickHouse فأضف برنامج الاتصال الخاص بها في السطر نفسه.
ملف الإعداد والمفتاح السري
نضع الإعداد في مجلد pythonpath يربط داخل ال Container، والأسرار نفسها تأتي من متغيرات البيئة:
import os

# Signs session cookies and encrypts saved database passwords; Superset refuses to start without it
SECRET_KEY = os.environ["SUPERSET_SECRET_KEY"]

# Charts, dashboards, users and connections live here (not in SQLite)
SQLALCHEMY_DATABASE_URI = (
    f"postgresql+psycopg2://superset:{os.environ['SUPERSET_DB_PASS']}@superset-db:5432/superset"
)

# Redis keeps query results so a dashboard opened twice does not hit your database twice
REDIS_URL = "redis://redis:6379"
CACHE_CONFIG = {"CACHE_TYPE": "RedisCache", "CACHE_DEFAULT_TIMEOUT": 300,
                "CACHE_KEY_PREFIX": "superset_", "CACHE_REDIS_URL": f"{REDIS_URL}/0"}
DATA_CACHE_CONFIG = {**CACHE_CONFIG, "CACHE_KEY_PREFIX": "superset_data_",
                     "CACHE_DEFAULT_TIMEOUT": 3600, "CACHE_REDIS_URL": f"{REDIS_URL}/1"}
# Login rate limits are counted in Redis too, so they survive restarts and work with several workers
RATELIMIT_STORAGE_URI = f"{REDIS_URL}/2"

# Native filters on dashboards are on by default; SQL Lab may only run SELECT unless allowed per database
FEATURE_FLAGS = {"DASHBOARD_RBAC": True}
وقد يتساءل البعض: ما أهمية SECRET_KEY؟ والإجابة أنه يوقع ملفات Cookie الجلسات ويشفر كلمات مرور قواعد البيانات المحفوظة، وبحسب توثيق الإعداد يرفض Superset أن يبدأ بالقيمة الافتراضية منذ الإصدار 2.1.0. وهذا ما يحدث فعلاً إذا شغلت ال Image دون إعداد:
docker run --rm --name lab-bi-nokey apache/superset:6.1.0--------------------------------------------------------------------------------
WARNING
--------------------------------------------------------------------------------
A Default SECRET_KEY was detected, please use superset_config.py to override it.
Use a strong complex alphanumeric string and use a tool to help you generate
a sufficiently random sequence, ex: openssl rand -base64 42
For more info, see: https://superset.apache.org/docs/configuration/configuring-superset#specifying-a-secret_key
--------------------------------------------------------------------------------
--------------------------------------------------------------------------------
Refusing to start due to insecure SECRET_KEY
[2026-10-08 07:39:04 +0000] [9] [INFO] Worker exiting (pid: 9)
[2026-10-08 07:39:05 +0000] [8] [ERROR] Worker (pid:9) exited with code 1ولا تغير هذا المفتاح بعد أن تحفظ اتصالات، لأن كلمات المرور المشفرة به لن تفتح، فاحفظه مع النسخ الاحتياطية كما ذكرنا في Metabase.
ملف Compose والتشغيل
mkdir -p ~/lab-bi/superset/pythonpath && cd ~/lab-bi/superset
# Dockerfile and pythonpath/superset_config.py from above
cat > .env <<EOF
SUPERSET_SECRET_KEY=$(openssl rand -base64 42)
SUPERSET_DB_PASS=$(openssl rand -hex 16)
ADMIN_PASSWORD=$(openssl rand -base64 18)
EOF
chmod 600 .env
docker build -t lab-bi-superset:6.1.0 .
name: lab-bi-superset
x-superset: &superset
image: lab-bi-superset:6.1.0
environment:
SUPERSET_SECRET_KEY: ${SUPERSET_SECRET_KEY}
SUPERSET_DB_PASS: ${SUPERSET_DB_PASS}
volumes:
- ./pythonpath:/app/pythonpath:ro
depends_on:
superset-db:
condition: service_healthy
redis:
condition: service_started
networks: [data]
services:
superset-db:
image: postgres:18.6
container_name: lab-bi-ssdb
restart: unless-stopped
environment:
POSTGRES_DB: superset
POSTGRES_USER: superset
POSTGRES_PASSWORD: ${SUPERSET_DB_PASS}
volumes:
- ssdb-data:/var/lib/postgresql
healthcheck:
test: ["CMD-SHELL", "pg_isready -U superset -d superset"]
interval: 5s
retries: 10
networks: [data]
redis:
image: redis:8.2.2-alpine
container_name: lab-bi-redis
restart: unless-stopped
networks: [data]
superset-init:
<<: *superset
container_name: lab-bi-superset-init
command: >
sh -c "superset db upgrade &&
superset fab create-admin --username admin --firstname Lab --lastname Admin --email [email protected] --password \"$${ADMIN_PASSWORD}\" &&
superset init"
environment:
SUPERSET_SECRET_KEY: ${SUPERSET_SECRET_KEY}
SUPERSET_DB_PASS: ${SUPERSET_DB_PASS}
ADMIN_PASSWORD: ${ADMIN_PASSWORD}
superset:
<<: *superset
container_name: lab-bi-superset
restart: unless-stopped
depends_on:
superset-init:
condition: service_completed_successfully
ports:
- "127.0.0.1:19310:8088"
healthcheck:
test: ["CMD-SHELL", "curl -fs http://localhost:8088/health"]
interval: 15s
start_period: 120s
networks:
data:
name: lab-bi-net
external: true
volumes:
ssdb-data:
name: lab-bi-ssdb-datadocker compose up -d
docker logs lab-bi-superset-initوالمخرج المهم من سجل التهيئة:
2026-10-07 18:05:47,153:INFO:superset.app:Syncing configuration to database...
Admin User admin created.
2026-10-07 18:07:46,751:INFO:superset.security.manager:Syncing role definition
2026-10-07 18:07:47,483:INFO:superset.security.manager:Syncing Admin perms
2026-10-07 18:07:47,531:INFO:superset.security.manager:Syncing Alpha perms
2026-10-07 18:07:49,616:INFO:superset.security.manager:Syncing Gamma perms
2026-10-07 18:07:51,195:INFO:superset.security.manager:Syncing sql_lab perms
2026-10-07 18:07:52,796:INFO:superset.security.manager:Cleaning faulty perms
في الإعداد أعلاه لاحظ التالي:
- الخدمة
superset-initتعمل مرة واحدة ثم تخرج: تنشئ جداول القاعدة الوصفية بالأمرsuperset db upgrade، ثم المدير، ثم الأدوار والصلاحيات بالأمرsuperset init، والخدمة الرئيسية لا تبدأ إلا بعد أن تنتهي بنجاح بفضلservice_completed_successfully. وعند كل تحديث للإصدار تعيد تشغيلها لتحدث الجداول. - ثبتنا كل Image على إصدار محدد، ونشرنا منفذ Superset على
127.0.0.1فقط، أما القاعدة الوصفية وRedis فليس لهما منفذ منشور. - الأدوار التي ظهرت في السجل، Admin وAlpha وGamma وsql_lab، هي الأدوار الجاهزة التي توزع عليها الفريق، وتفاصيلها في توثيق الأمان.
إضافة قاعدة المتجر
بعد تسجيل الدخول على http://127.0.0.1:19310 نفتح Settings ثم Database Connections ونضيف PostgreSQL بعنوان SQLAlchemy التالي، بالمستخدم نفسه الذي لا يملك إلا القراءة:
postgresql+psycopg2://bi_reader:change-me-reader@lab-bi-store:5432/storeوفي الخيارات المتقدمة للاتصال تأكد أن Allow DML معطل، وفعل Expose database in SQL Lab. والآن لدينا طبقتا حماية، فإذا كتب أحدهم في SQL Lab أمر حذف رفضه Superset قبل أن يصل إلى القاعدة، وهذا ما رأيناه عندما أرسلنا DELETE FROM orders WHERE id = 1 عبر واجهة SQL Lab البرمجية:
500 This database does not allow for DDL/DML, but the query mutates data. Please contact your administrator for more assistance.
200 [{"count":37860}]
والطبقة الثانية هي مستخدم القراءة نفسه، فلو فعل أحد المديرين Allow DML بالخطأ لرفض PostgreSQL الأمر كما رأينا في تجربة Metabase.
ال Dataset والمقاييس: تعريف واحد لكل الرسوم
هنا يختلف Superset عن Metabase في طريقة التفكير، فكل رسم في Superset يبنى على Dataset، وهو جدول أو View أو استعلام SQL محفوظ، ومعه تعريفات تعيد استخدامها: أسماء عرض للأعمدة، وأي عمود هو الزمن، ومقاييس Metrics مكتوبة بلغة SQL. والصورة التالية تبين هذا الطريق:
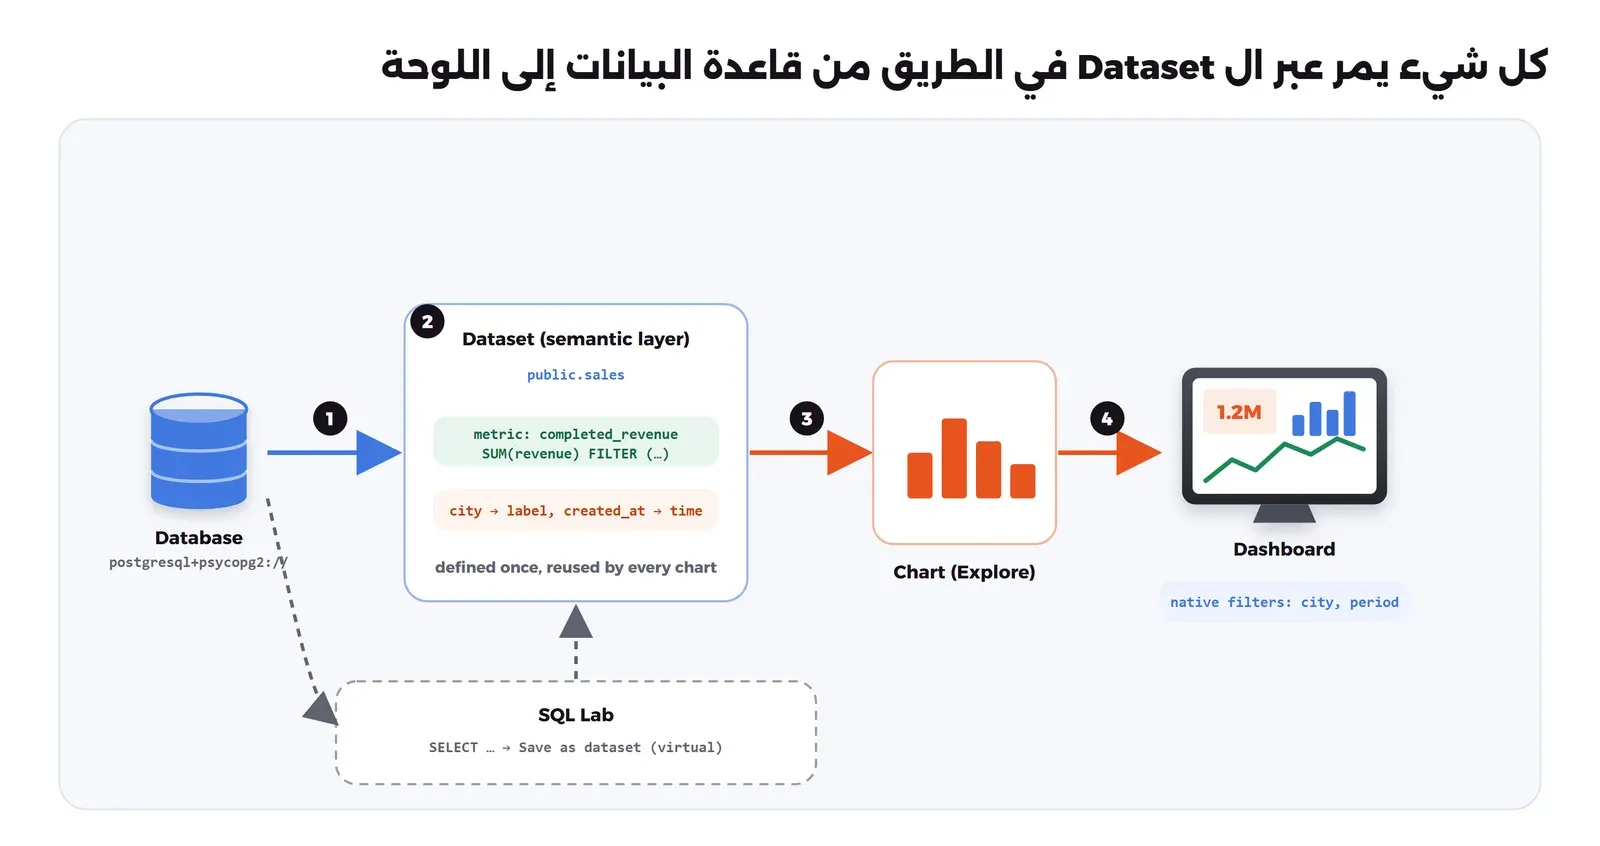
أنشأنا Dataset من ال View sales، وأضفنا مقياسين، وأعطينا الأعمدة أسماء عربية:
-- completed_revenue  (المبيعات المكتملة)
SUM(revenue) FILTER (WHERE status = 'مكتمل')

-- completed_orders   (الطلبات المكتملة)
COUNT(DISTINCT order_id) FILTER (WHERE status = 'مكتمل')
والفائدة أن «المبيعات» أصبح لها تعريف واحد، فإذا قرر الفريق المالي غداً أن الطلبات المسترجعة تخصم، تغير التعريف في مكان واحد فتتغير كل الرسوم واللوحات، أما في الطريقة البسيطة فكل رسم يحمل فلتره الخاص، ويختلف رقمان في لوحتين ولا يعرف أحد أيهما الصحيح.
SQL Lab: محرر للمحللين
SQL Lab محرر SQL كامل داخل المتصفح، فيه شجرة الجداول وسجل الاستعلامات وحفظها، وتحويل النتيجة إلى Dataset أو رسم مباشرة. والصورة التالية تبين استعلاماً عن مبيعات كل منطقة منذ بداية 2026:
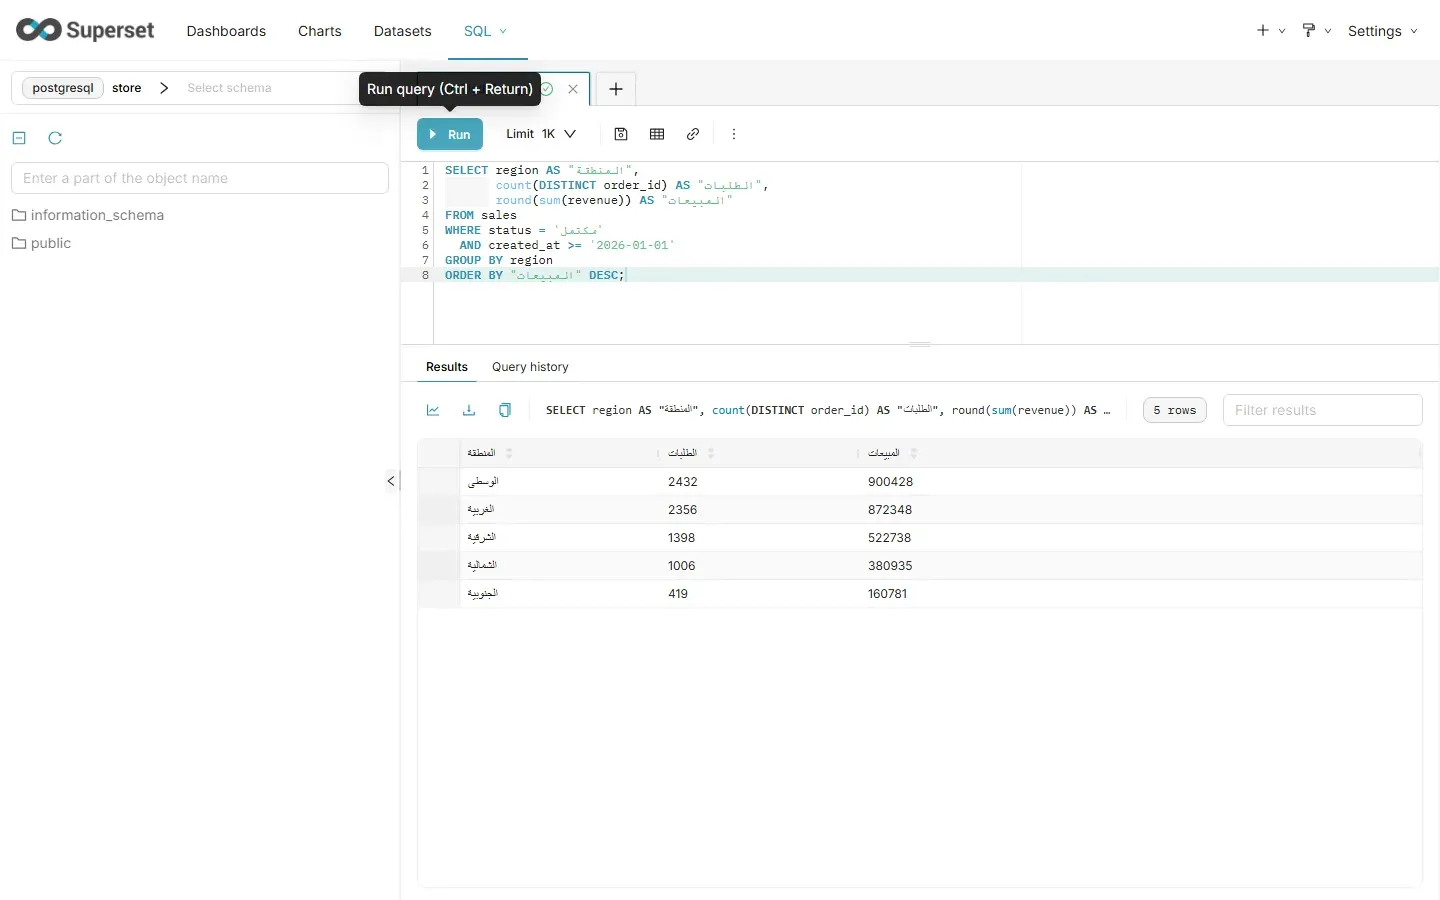
لاحظ أن الأسماء العربية في الاستعلام نفسه، مثل "المنطقة" و'مكتمل'، تظهر في المحرر بخط متصل من اليسار لليمين، فقراءتها داخل المحرر أصعب قليلاً من النتيجة، ولكنها تنفذ صحيحة.
بناء رسم في Explore
من ال Dataset نفتح محرر الرسوم Explore، فنختار نوع الرسم، ثم المحور والمقياس والفلاتر، والصورة التالية تبين رسم المبيعات حسب المدينة بالمقياس المبيعات المكتملة:
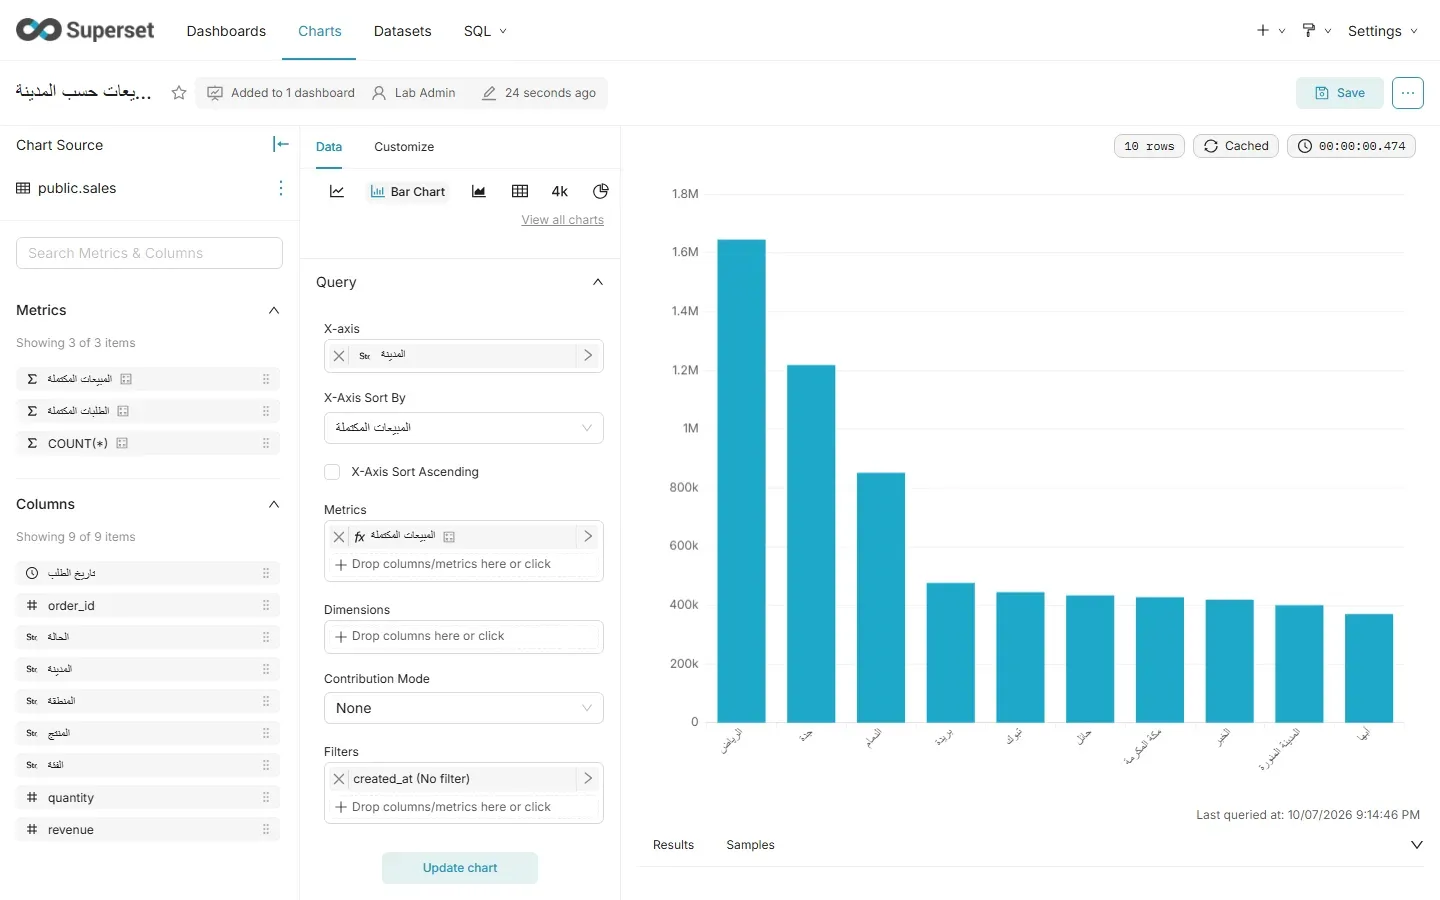
لاحظ الوسم Cached فوق الرسم: النتيجة جاءت من Redis وليس من قاعدة المتجر، وهذا ما أعددناه في DATA_CACHE_CONFIG لمدة ساعة، فإذا فتح عشرون شخصاً اللوحة نفسها في الصباح لا تصل إلى قاعدة بياناتك إلا مرة واحدة.
اللوحة والفلاتر
جمعنا ستة رسوم في لوحة: إجمالي المبيعات وعدد الطلبات رقمين كبيرين، والمبيعات الشهرية خطاً، والمبيعات حسب المدينة أعمدة، والمبيعات حسب المنطقة والفئة أعمدة مكدسة Stacked، وجدول المنتجات، ثم أضفنا فلترين أصليين Native Filters للمدينة والفترة. والصورة التالية تبين اللوحة:
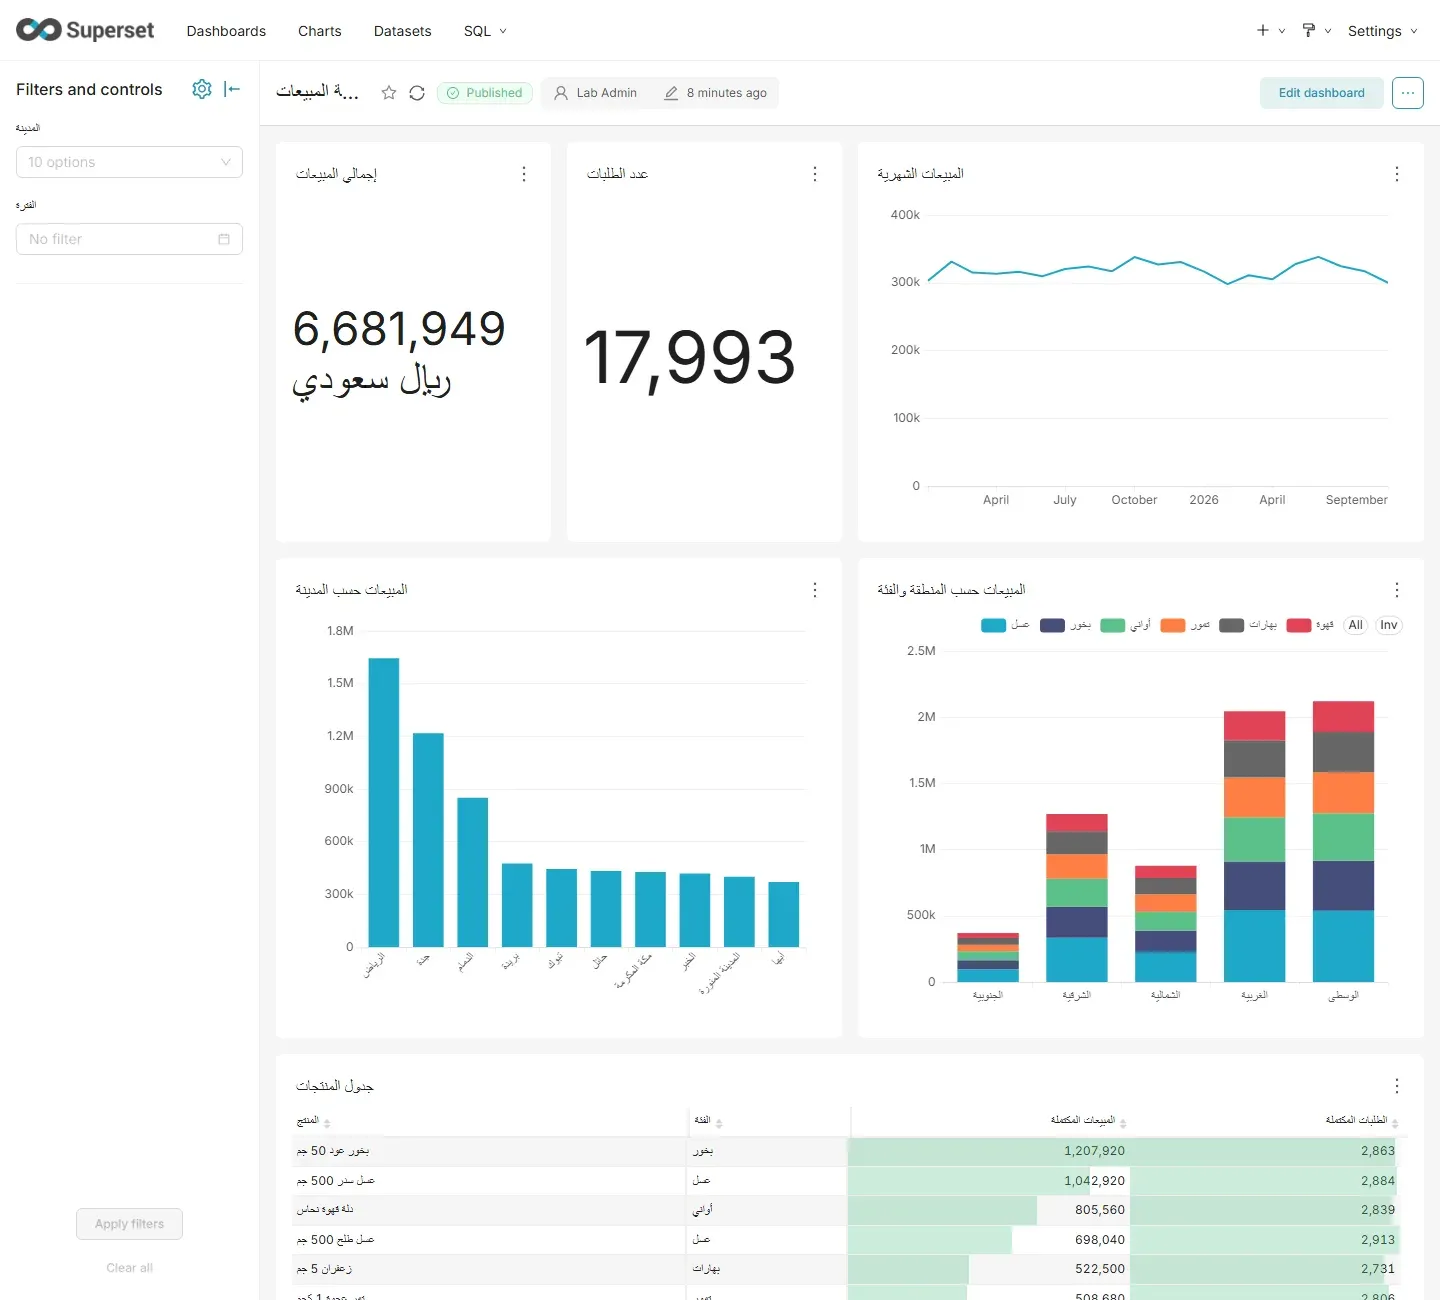
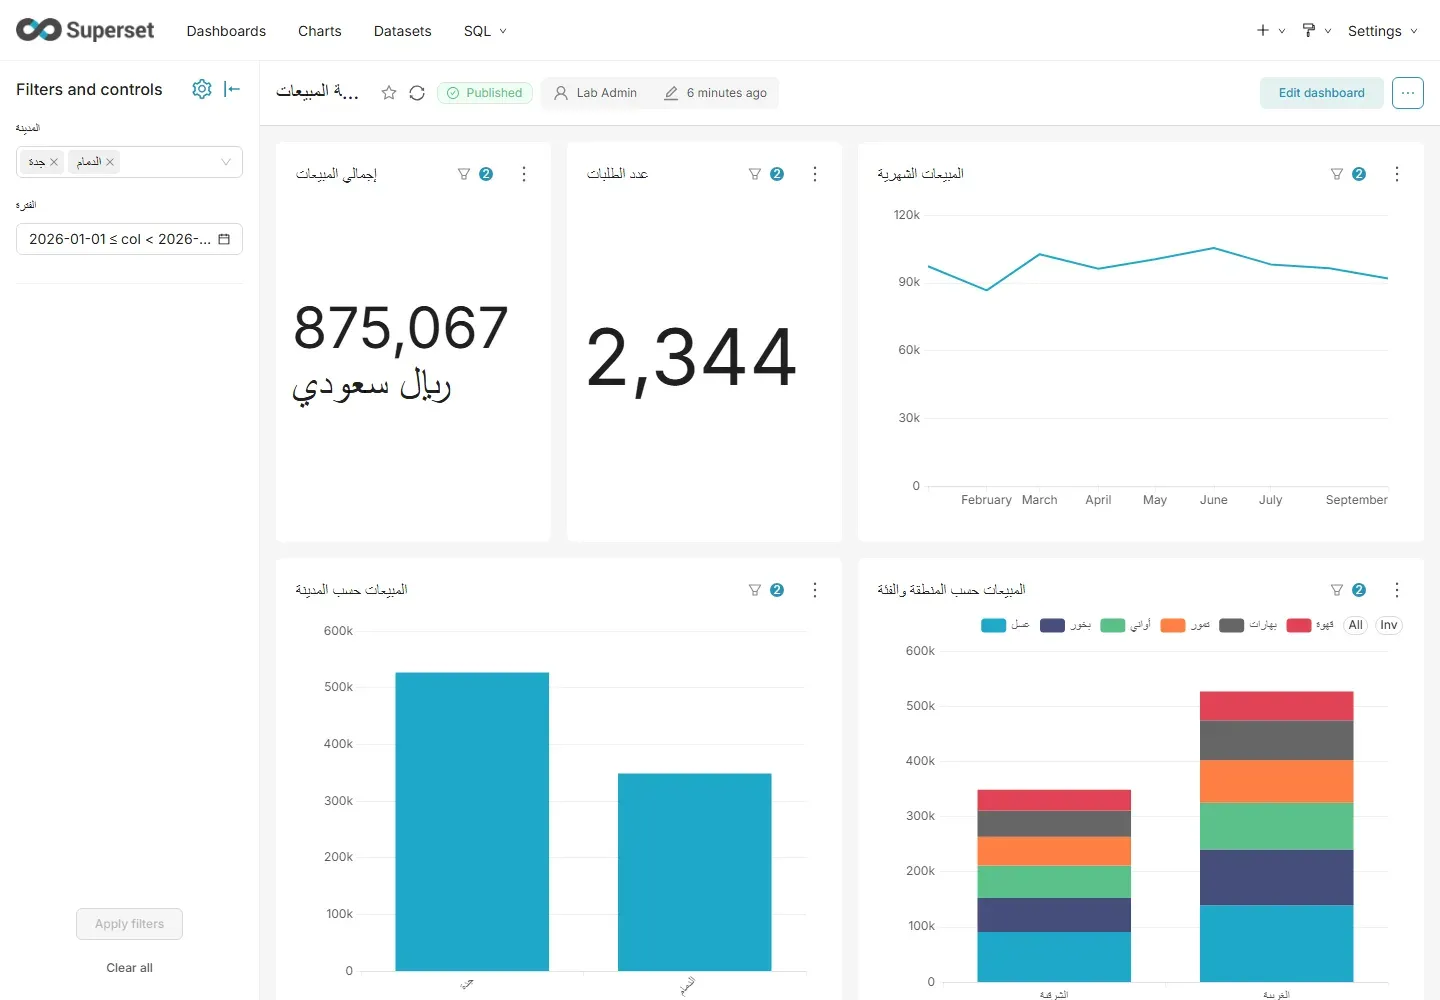
ولاحظ أن إجمالي المبيعات 6,681,949 هو الرقم نفسه الذي عرضته Metabase، وهذا متوقع لأنه السؤال نفسه على البيانات نفسها، وهو طريقة جيدة لتتأكد أن تعريف المقياس صحيح. وعند اختيار جدة والدمام وفترة من بداية 2026 تتغير الرسوم كلها، كما في الصورة التالية:
العربية في Superset بصراحة
- البيانات العربية تعمل: أسماء المدن والمناطق والفئات والمنتجات، وعناوين الرسوم واللوحة، والأسماء العربية للأعمدة والمقاييس، كلها ظهرت صحيحة كما في الصور أعلاه، مع ملاحظة أن أسماء المدن تحت الأعمدة تدار بزاوية حتى تتسع.
- قائمة اللغات معطلة افتراضياً: في ملف الإعداد الافتراضي للإصدار 6.1.0 قائمة لغات لا تذكر العربية، ثم يعاد تعريفها
LANGUAGES = {}مع تعليق يقول إن الترجمات في أغلب اللغات غير كاملة وغير مصانة جيداً. - والترجمات غير موجودة في ال Image أصلاً: أضفنا العربية إلى
LANGUAGESفي ملف الإعداد فظهرت قائمة اختيار اللغة، واخترنا العربية، فبقيت الواجهة كلها بالإنجليزية ما عدا الوقت النسبي مثل «قبل 13 ساعات»، والسبب كما تشرح صفحة بناء ال Images أن ال Images الرسمية تبنى دون ملفات الترجمة إلا إذا فعل الخيارBUILD_TRANSLATIONSوقت البناء، ولا يمكن إضافتها بملف Dockerfile فوق ال Image، وإنما تحتاج أن تبني من الكود المصدري كاملاً. - الاتجاه من اليسار لليمين: الصفحة لم تحمل أي اتجاه من اليمين لليسار، فالقائمة والفلاتر في اليسار مهما كانت اللغة.
أضفنا للتجربة هذا السطر إلى ملف الإعداد:
# Show the language menu with English and Arabic
LANGUAGES = {"en": {"flag": "us", "name": "English"}, "ar": {"flag": "sa", "name": "Arabic"}}
والصورة التالية تبين صفحة اللوحات بعد اختيار العربية:
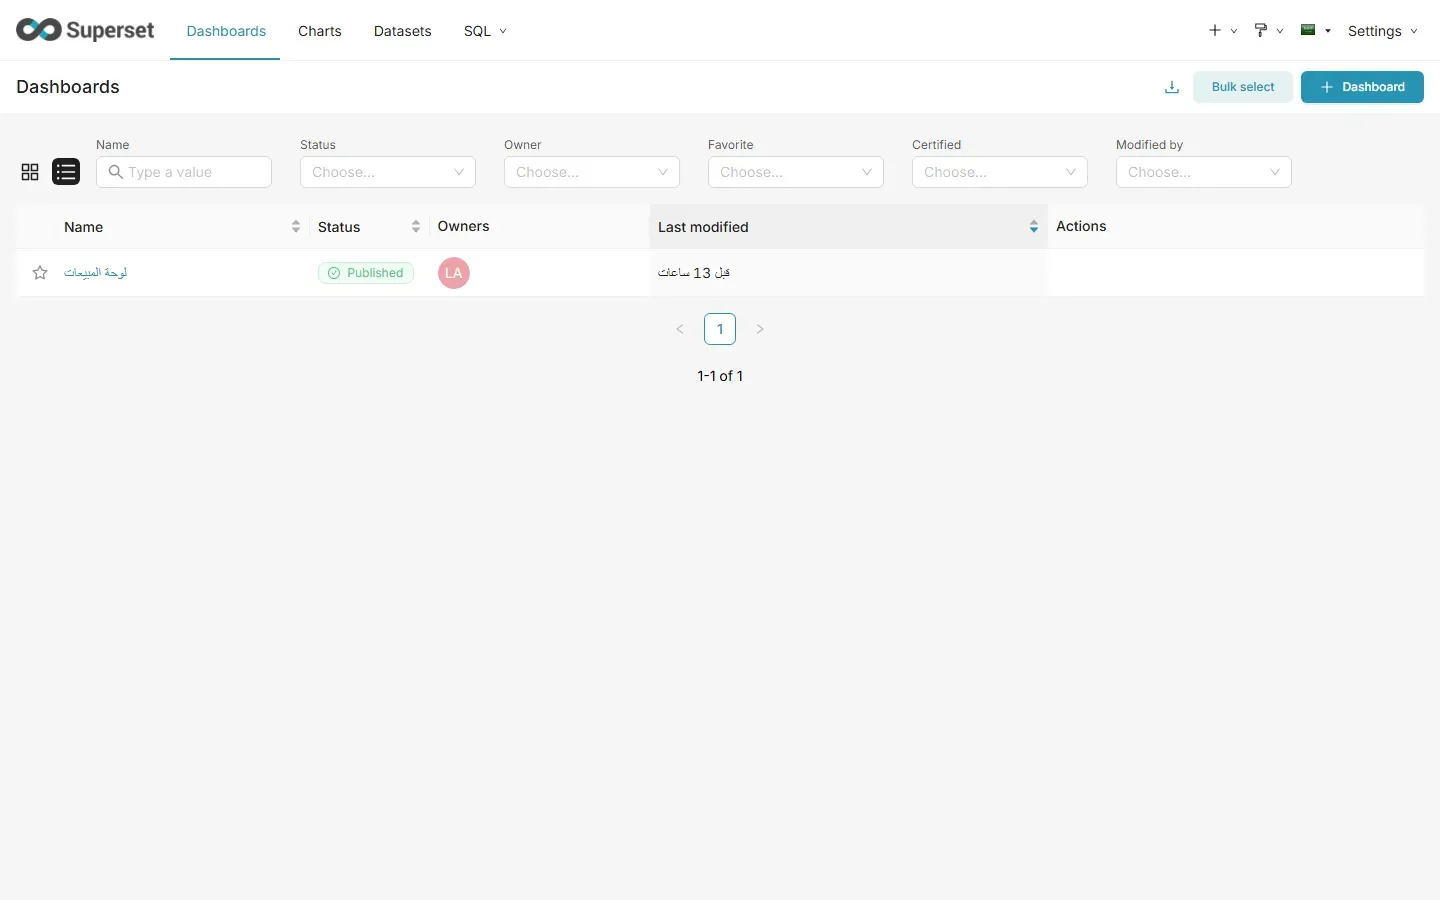
وبالتالي فإذا كان فريقك يحتاج واجهة عربية فMetabase أقرب، رغم أنها من اليسار لليمين، أما Superset فاعتبره أداة بواجهة إنجليزية تعرض بيانات عربية بشكل صحيح.
النسخ الاحتياطي
كل الرسوم واللوحات والاتصالات والمستخدمين في القاعدة الوصفية، وصفحة Docker Compose نفسها تنبه إلى أن هذه القاعدة يجب أن تنسخ في الإنتاج، لذلك نأخذ تفريغاً منها كما فعلنا مع Metabase:
docker exec lab-bi-ssdb pg_dump -U superset -d superset -Fc -f /tmp/superset-meta.dump
docker exec lab-bi-ssdb ls -la /tmp/superset-meta.dump
-rw-r--r-- 1 root root 230386 Oct 8 07:47 /tmp/superset-meta.dumpواحفظ معه ملف .env وفيه SUPERSET_SECRET_KEY، ومجلد pythonpath، وضع الثلاثة ضمن نظام النسخ في النسخ الاحتياطي بقاعدة 3-2-1. أما Redis فلا يحتاج نسخاً، لأنه ذاكرة مؤقتة يعاد بناؤها.
التنظيف
cd ~/lab-bi/superset && docker compose down -v
docker rmi lab-bi-superset:6.1.0
وإذا انتهيت من التجربتين فاحذف قاعدة المتجر والشبكة كما في تنظيف تجربة Metabase.
Superset على مستودع البيانات: الصلاحيات والذاكرة المؤقتة
التجربة السابقة كانت على قاعدة متجر صغيرة فيها 37 ألف سطر، وفيها يجيب PostgreSQL عن أي سؤال في أجزاء من الثانية، فلا تظهر فائدة الذاكرة المؤقتة ولا خطورة الصلاحيات. أما في الشركة فأداة التقارير تقرأ في الغالب من مستودع بيانات Data Warehouse فيه ملايين الصفوف، ويفتح لوحاتها أشخاص من أقسام ومناطق مختلفة لا يجب أن يرى كل منهم أرقام الآخر. لذلك سوف نعيد التجربة على مخطط النجمة Star Schema الذي بنيناه في مقال OLAP ومستودع البيانات، بنفس البيانات ونفس تعريف الإيراد، وسوف نناقش في هذا القسم ما يلي:
- بناء النجمة داخل PostgreSQL، وربط Superset بها بمستخدم لا يقرأ إلا مخطط المستودع.
- إنشاء الاتصال وال Dataset والرسوم واللوحة من الواجهة البرمجية REST API، حتى تتكرر التجربة كما هي.
- تقييد الصفوف Row Level Security لدور واحد، وكيف يدخل في مفتاح الذاكرة المؤقتة.
- الذاكرة المؤقتة بالأرقام، ثم نكسر الاثنين: SQL Lab يتجاوز تقييد الصفوف، وطلب متأخر لا يظهر في اللوحة.
والصورة التالية تبين ما سوف نبنيه: مستخدمان يفتحان الرسم نفسه، فيضيف Superset شرط المنطقة لأحدهما، وبالتالي يختلف الاستعلام ويختلف مفتاحه في Redis، وفي الأسفل الطريق الجانبي الذي سوف نكسره:
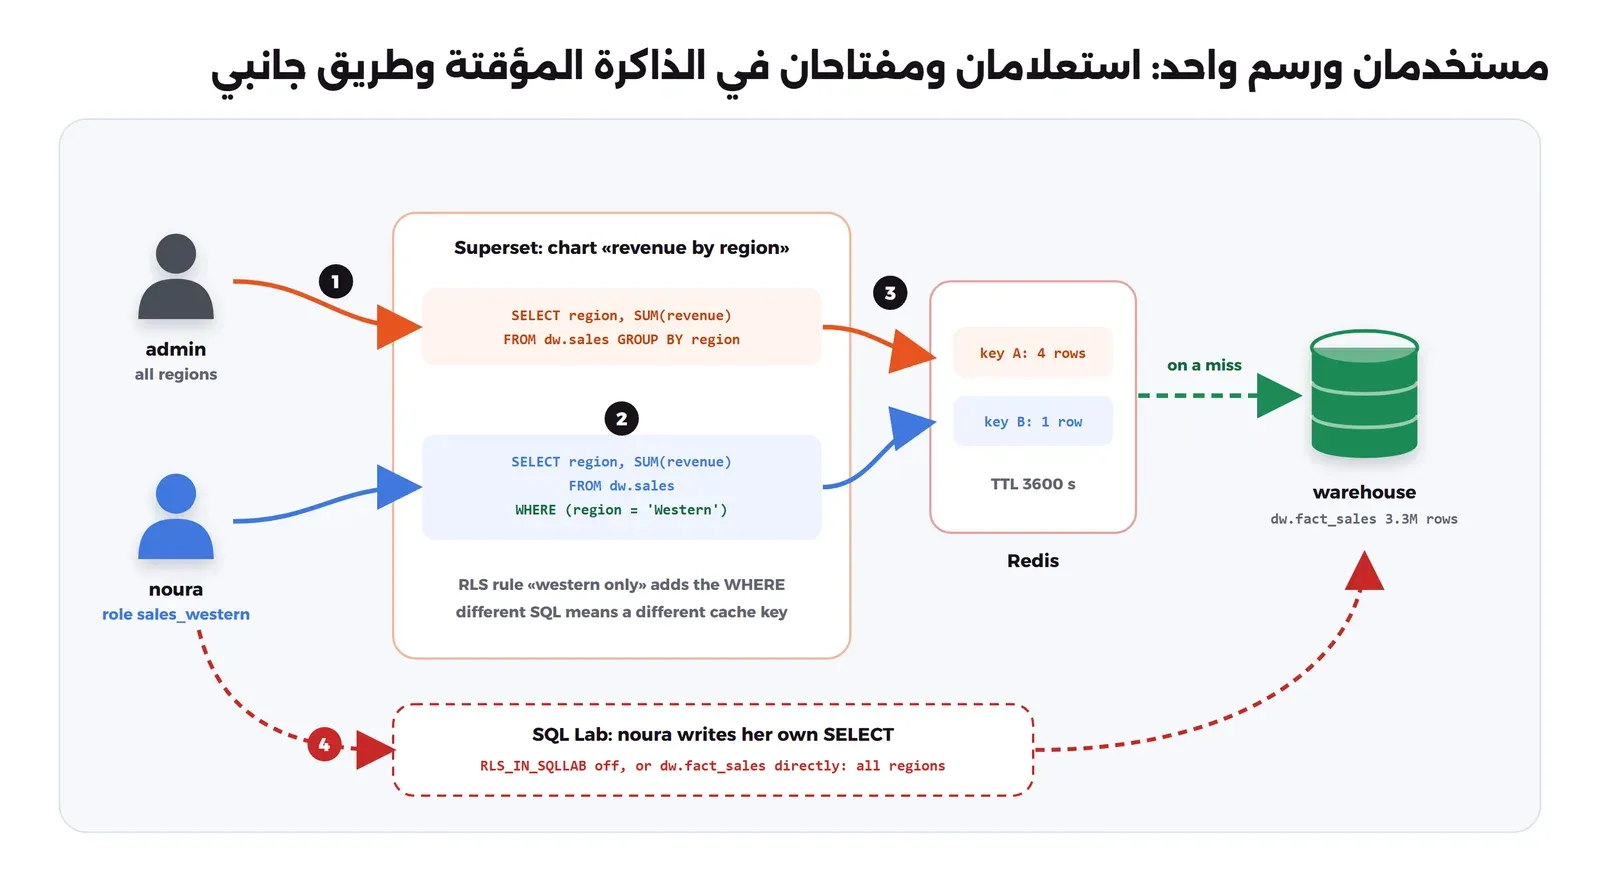
النجمة داخل PostgreSQL
في مقال OLAP بنينا النجمة في ملف DuckDB، وهذا مناسب لمحلل واحد، ولكن أداة BI يفتحها فريق كامل في نفس الوقت، وملف DuckDB يفتحه للكتابة برنامج واحد فقط، لذلك نبني النجمة نفسها في مخطط dw داخل PostgreSQL 18.6 بجانب قاعدة المتجر. ونستخدم ملف المتجر 01-oltp.sql من مقال OLAP كما هو، فيه 200 ألف عميل و1.5 مليون طلب، ثم الملف 02-star.sql الذي يبني الأبعاد وجدول الحقائق بنفس ال Grain، أي سطر لكل بند في طلب مدفوع بسعر البيع، ويضيف أسماء عربية للمدن والمناطق والفئات حتى نرى كيف تعرضها الأداة:
-- The star schema of the OLAP article, built inside PostgreSQL (schema dw) so Superset can read it as a server.
-- docker exec -i lab-bi-dw psql -U postgres -v ON_ERROR_STOP=1 < 02-star.sql
SET TimeZone = 'Asia/Riyadh';
CREATE SCHEMA dw;

CREATE TABLE dw.dim_date AS
SELECT to_char(d, 'YYYYMMDD')::int        AS date_key,
       d::date                            AS full_date,
       extract(year FROM d)::int          AS year,
       extract(quarter FROM d)::int       AS quarter,
       extract(month FROM d)::int         AS month,
       to_char(d, 'YYYY-MM')              AS year_month,
       extract(isodow FROM d) IN (5, 6)   AS is_weekend          -- Friday and Saturday
FROM generate_series(date '2024-01-01', date '2026-12-31', interval '1 day') d;
ALTER TABLE dw.dim_date ADD PRIMARY KEY (date_key);

-- Arabic labels next to the English ones, to see how each BI tool shows Arabic data
CREATE TABLE dw.dim_product AS
SELECT row_number() OVER (ORDER BY p.id)::int AS product_key,
       p.id AS product_id, p.sku, p.name AS product_name,
       c.name AS category,
       (ARRAY['إلكترونيات','كتب','المنزل','أزياء'])[c.id] AS category_ar,
       p.price AS list_price
FROM shop.products p JOIN shop.categories c ON c.id = p.category_id;
ALTER TABLE dw.dim_product ADD PRIMARY KEY (product_key);

CREATE TABLE dw.dim_customer AS
SELECT row_number() OVER (ORDER BY cu.id)::int AS customer_key,
       cu.id AS customer_id, cu.name AS customer_name,
       ci.name AS city, ci.region,
       (ARRAY['الرياض','بريدة','جدة','مكة المكرمة','المدينة المنورة','الدمام','الخبر','أبها'])[ci.id] AS city_ar,
       CASE ci.region WHEN 'Central' THEN 'الوسطى' WHEN 'Western' THEN 'الغربية'
                      WHEN 'Eastern' THEN 'الشرقية' ELSE 'الجنوبية' END AS region_ar
FROM shop.customers cu JOIN shop.cities ci ON ci.id = cu.city_id;
ALTER TABLE dw.dim_customer ADD PRIMARY KEY (customer_key);

-- grain: one row per line of a paid order, revenue at the price of the sale
CREATE TABLE dw.fact_sales AS
SELECT to_char(o.created_at, 'YYYYMMDD')::int AS date_key,
       dc.customer_key, dp.product_key,
       o.id AS order_id, oi.line_no,
       oi.qty, oi.unit_price,
       oi.qty * oi.unit_price AS revenue
FROM shop.orders o
JOIN shop.order_items oi ON oi.order_id = o.id
JOIN dw.dim_customer dc  ON dc.customer_id = o.customer_id
JOIN dw.dim_product dp   ON dp.product_id = oi.product_id
WHERE o.status = 'paid';
ALTER TABLE dw.fact_sales ADD PRIMARY KEY (order_id, line_no);
CREATE INDEX ON dw.fact_sales (date_key);
CREATE INDEX ON dw.fact_sales (customer_key);

-- one flat view for the BI tool: the joins are written once, here
CREATE VIEW dw.sales AS
SELECT d.full_date AS sale_date, d.year, d.quarter, d.year_month, d.is_weekend,
       c.city, c.city_ar, c.region, c.region_ar,
       p.category, p.category_ar, p.product_name,
       f.order_id, f.qty, f.revenue
FROM dw.fact_sales f
JOIN dw.dim_date d     USING (date_key)
JOIN dw.dim_customer c USING (customer_key)
JOIN dw.dim_product p  USING (product_key);

-- the BI tool reads the warehouse schema only, never shop.*
CREATE ROLE bi_reader LOGIN PASSWORD 'bi-pass';
GRANT USAGE ON SCHEMA dw TO bi_reader;
GRANT SELECT ON ALL TABLES IN SCHEMA dw TO bi_reader;

VACUUM ANALYZE;
SELECT (SELECT count(*) FROM dw.dim_customer) AS dim_customer,
       (SELECT count(*) FROM dw.dim_product)  AS dim_product,
       (SELECT count(*) FROM dw.fact_sales)   AS fact_sales,
       pg_size_pretty(pg_total_relation_size('dw.fact_sales')) AS fact_size;
في الإعداد أعلاه لاحظ التالي:
- العرض
dw.salesيكتب الربط بين الحقائق والأبعاد مرة واحدة، وهو الذي سوف نبني عليه ال Dataset، والعروض Views شرحناها في الجزء الثالث من سلسلة SQL. - المستخدم
bi_readerيملكUSAGEعلى المخططdwفقط، فلا يستطيع Superset أن يقرأ جداول المتجرshop.*ولو كتب أحدهم استعلاماً عليها. - المنطقة الزمنية
Asia/Riyadhفي أول الملف، لأن تاريخ الطلب يحسب منها كما شرحنا في مقال OLAP.
وملف compose.yaml هو نفسه ملف التجربة الأولى مع خدمة إضافية للمستودع، والفرق الوحيد في الإعداد أننا فعلنا واجهة الصلاحيات البرمجية FAB_ADD_SECURITY_API لأن سكربت التجربة ينشئ الأدوار والمستخدمين منها، وأضفنا الخيار RLS_IN_SQLLAB بقيمته الافتراضية حتى نرى أثره بعد قليل:
# Superset on the star schema of the OLAP article (ArabRoot lab).
#   docker build -t lab-bi-superset:6.1.0 .
#   docker compose -p lab-bi-dw up -d
name: lab-bi-dw

x-superset: &superset
  image: lab-bi-superset:6.1.0
  environment:
    SUPERSET_SECRET_KEY: ${SUPERSET_SECRET_KEY}
    SUPERSET_DB_PASS: ${SUPERSET_DB_PASS}
  volumes:
    - ./pythonpath:/app/pythonpath:ro
  depends_on:
    superset-db:
      condition: service_healthy
    redis:
      condition: service_started

services:
  dw:
    image: postgres:18.6
    container_name: lab-bi-dw
    environment:
      POSTGRES_PASSWORD: lab-pass
    command: ["postgres", "-c", "shared_buffers=1GB", "-c", "timezone=Asia/Riyadh",
              "-c", "log_min_duration_statement=0", "-c", "log_line_prefix=%m [%u] "]
    shm_size: 1g
    volumes: ["dw-data:/var/lib/postgresql"]

  superset-db:
    image: postgres:18.6
    container_name: lab-bi-ssdb
    environment:
      POSTGRES_DB: superset
      POSTGRES_USER: superset
      POSTGRES_PASSWORD: ${SUPERSET_DB_PASS}
    volumes: ["ssdb-data:/var/lib/postgresql"]
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U superset -d superset"]
      interval: 5s
      retries: 10

  redis:
    image: redis:8.2.2-alpine
    container_name: lab-bi-redis

  superset-init:
    <<: *superset
    container_name: lab-bi-superset-init
    command: >
      sh -c "superset db upgrade &&
      superset fab create-admin --username admin --firstname Lab --lastname Admin --email [email protected] --password \"$${ADMIN_PASSWORD}\" &&
      superset init"
    environment:
      SUPERSET_SECRET_KEY: ${SUPERSET_SECRET_KEY}
      SUPERSET_DB_PASS: ${SUPERSET_DB_PASS}
      ADMIN_PASSWORD: ${ADMIN_PASSWORD}

  superset:
    <<: *superset
    container_name: lab-bi-superset
    depends_on:
      superset-init:
        condition: service_completed_successfully
    ports: ["127.0.0.1:19310:8088"]
    healthcheck:
      test: ["CMD-SHELL", "curl -fs http://localhost:8088/health"]
      interval: 15s
      start_period: 120s

networks:
  default:
    name: lab-bi-net

volumes:
  dw-data:
    name: lab-bi-dw-data
  ssdb-data:
    name: lab-bi-ssdb-data
# Roles, users and permissions through the REST API (/api/v1/security/...), used by the lab scripts
FAB_ADD_SECURITY_API = True
FEATURE_FLAGS = {
"DASHBOARD_RBAC": True,
# Off by default in 6.1.0: row level security is NOT applied to SQL Lab queries
"RLS_IN_SQLLAB": False,
}ولاحظ في خدمة المستودع الخيار log_min_duration_statement=0 الذي يسجل كل استعلام يصل إليه، وقد استخدمناه لنعرف متى تصل الرسوم إلى المستودع ومتى تأخذ من Redis، فلا تتركه في الإنتاج لأنه يملأ السجل. والآن نشغل المستودع أولاً ونملؤه، ثم بقية الخدمات:
docker build -t lab-bi-superset:6.1.0 .
docker compose -p lab-bi-dw --env-file .env up -d dw
docker exec -i lab-bi-dw psql -U postgres -v ON_ERROR_STOP=1 -q < 01-oltp.sql
docker exec -i lab-bi-dw psql -U postgres -v ON_ERROR_STOP=1 < 02-star.sql
docker compose -p lab-bi-dw --env-file .env up -d
والمخرج في آخر الملف الثاني سوف يكون كما يلي، وأخذ التوليد والبناء معاً نحو ربع ساعة على جهازنا لأن تهيئة Superset كانت تعمل في الوقت نفسه:
 dim_customer | dim_product | fact_sales | fact_size
--------------+-------------+------------+-----------
       200000 |         300 |    3301384 | 389 MB
(1 row)
جدول الحقائق 3,301,384 سطراً، وهو العدد نفسه في مقال OLAP. وقبل أن نفتح أي أداة نطابق رقماً معروفاً، فإيراد الإلكترونيات لكل منطقة في 2025 يجب أن يساوي ما أعطته DuckDB هناك حتى الهللة:
docker exec lab-bi-dw psql -U postgres -c "\timing on" \
  -c "SELECT year, region, sum(revenue) FROM dw.sales WHERE category = 'Electronics' AND year = 2025 GROUP BY 1, 2 ORDER BY 1, 2;"
year | region | sum
------+----------+--------------
2025 | Central | 110741177.29
2025 | Eastern | 66709525.70
2025 | Southern | 21997743.95
2025 | Western | 111171348.67
(4 rows)
Time: 1195.461 ms (00:01.195)الأرقام الأربعة مطابقة، فالمستودع صحيح، وما سوف نراه بعد ذلك في Superset هو أثر الأداة وليس أثر البيانات.
الاتصال وال Dataset واللوحة من الواجهة البرمجية
في التجربة الأولى بنينا كل شيء بالنقر، وهذه المرة نبنيه بسكربت Python صغير يكلم الواجهة البرمجية REST API، والسبب أن ما تبنيه بالنقر لا يمكن مراجعته ولا إعادته على سيرفر آخر، أما السكربت فيوضع في Git ويتكرر كما هو. وهذا هو الملف المساعد ss.py الذي يسجل الدخول ويأخذ التوكن ورمز CSRF:
# Small helper for the Superset REST API (ArabRoot lab). Python 3 + requests.
import json, os, time, requests

BASE = os.environ.get("SS_URL", "http://127.0.0.1:19310")


class SS:
    def __init__(self, user, password):
        self.s = requests.Session()
        r = self.s.post(f"{BASE}/api/v1/security/login",
                        json={"username": user, "password": password, "provider": "db", "refresh": True})
        r.raise_for_status()
        self.s.headers["Authorization"] = "Bearer " + r.json()["access_token"]
        csrf = self.s.get(f"{BASE}/api/v1/security/csrf_token/").json()["result"]
        self.s.headers.update({"X-CSRFToken": csrf, "Referer": BASE})

    def req(self, method, path, **kw):
        r = self.s.request(method, f"{BASE}{path}", **kw)
        if r.status_code >= 400:
            raise RuntimeError(f"{method} {path} -> {r.status_code} {r.text[:400]}")
        return r.json() if r.text else {}

    def get(self, path, **kw): return self.req("GET", path, **kw)
    def post(self, path, body): return self.req("POST", path, json=body)
    def put(self, path, body): return self.req("PUT", path, json=body)

    def find(self, path, col, value):
        q = json.dumps({"filters": [{"col": col, "opr": "eq", "value": value}]})
        res = self.get(path, params={"q": q})["result"]
        return res[0] if res else None

    def sql(self, database_id, sql):
        t = time.perf_counter()
        r = self.s.post(f"{BASE}/api/v1/sqllab/execute/",
                        json={"database_id": database_id, "sql": sql, "runAsync": False, "schema": "dw"})
        return r.status_code, r.json(), time.perf_counter() - t

    def chart_data(self, query_context, force=False):
        qc = dict(query_context, force=force)
        t = time.perf_counter()
        r = self.req("POST", "/api/v1/chart/data", json=qc)
        return r["result"][0], time.perf_counter() - t
والملف 03-setup.py ينشئ الاتصال بالمستودع، ثم Dataset على العرض dw.sales بثلاثة مقاييس بأسماء عربية، ثم لوحة بأربعة رسوم:
# Creates the warehouse connection, the dataset with its metrics, four charts and a dashboard (ArabRoot lab).
#   ADMIN_PASSWORD=... python 03-setup.py
import json, os
from ss import SS

a = SS("admin", os.environ["ADMIN_PASSWORD"])

# 1) the warehouse, read through bi_reader; DML stays off
db = a.find("/api/v1/database/", "database_name", "warehouse")
if not db:
    db = a.post("/api/v1/database/", {
        "database_name": "warehouse",
        "sqlalchemy_uri": "postgresql+psycopg2://bi_reader:bi-pass@lab-bi-dw:5432/postgres",
        "expose_in_sqllab": True, "allow_dml": False, "allow_run_async": False,
    })
db_id = db["id"]

# 2) a physical dataset on the flat view dw.sales, with the metrics written once
ds = a.find("/api/v1/dataset/", "table_name", "sales")
if not ds:
    ds = a.post("/api/v1/dataset/", {"database": db_id, "schema": "dw", "table_name": "sales"})
ds_id = ds["id"]
a.put(f"/api/v1/dataset/{ds_id}", {
    "main_dttm_col": "sale_date",
    "metrics": [
        {"metric_name": "revenue", "verbose_name": "الإيراد", "expression": "SUM(revenue)", "d3format": ",.0f"},
        {"metric_name": "orders", "verbose_name": "عدد الطلبات", "expression": "COUNT(DISTINCT order_id)", "d3format": ",d"},
        {"metric_name": "avg_order", "verbose_name": "متوسط الطلب", "expression": "SUM(revenue) / COUNT(DISTINCT order_id)", "d3format": ",.2f"},
    ],
})

# 3) the dashboard first, so the charts can be attached to it
dash = a.find("/api/v1/dashboard/", "dashboard_title", "مبيعات المستودع")
if not dash:
    dash = a.post("/api/v1/dashboard/", {"dashboard_title": "مبيعات المستودع", "slug": "dw-sales", "published": True})
dash_id = dash["id"]

no_time = {"clause": "WHERE", "subject": "sale_date", "operator": "TEMPORAL_RANGE",
           "comparator": "No filter", "expressionType": "SIMPLE"}
charts = [
    ("إجمالي الإيراد", "big_number_total", {"metric": "revenue", "y_axis_format": "SMART_NUMBER"}),
    ("الإيراد حسب المنطقة", "echarts_timeseries_bar", {"x_axis": "region_ar", "metrics": ["revenue"], "groupby": [],
                                                 "row_limit": 100, "orientation": "vertical", "y_axis_format": "SMART_NUMBER"}),
    ("الإيراد الشهري", "echarts_timeseries_line", {"x_axis": "sale_date", "time_grain_sqla": "P1M", "metrics": ["revenue"],
                                             "groupby": [], "y_axis_format": "SMART_NUMBER"}),
    ("الفئات", "table", {"query_mode": "aggregate", "groupby": ["category_ar"], "metrics": ["revenue", "orders", "avg_order"],
                         "row_limit": 100, "order_desc": True}),
]
ids = []
for name, viz, extra in charts:
    c = a.find("/api/v1/chart/", "slice_name", name)
    params = {"datasource": f"{ds_id}__table", "viz_type": viz, "adhoc_filters": [no_time], **extra}
    body = {"slice_name": name, "viz_type": viz, "datasource_id": ds_id, "datasource_type": "table",
            "params": json.dumps(params, ensure_ascii=False), "dashboards": [dash_id]}
    c = a.put(f"/api/v1/chart/{c['id']}", body) if c else a.post("/api/v1/chart/", body)
    ids.append((c["id"], name))

# 4) the layout: two rows of two charts
pos = {"DASHBOARD_VERSION_KEY": "v2", "ROOT_ID": {"type": "ROOT", "id": "ROOT_ID", "children": ["GRID_ID"]},
       "GRID_ID": {"type": "GRID", "id": "GRID_ID", "children": ["ROW-1", "ROW-2"], "parents": ["ROOT_ID"]},
       "HEADER_ID": {"type": "HEADER", "id": "HEADER_ID", "meta": {"text": "مبيعات المستودع"}}}
for r, pair in (("ROW-1", ids[:2]), ("ROW-2", ids[2:])):
    pos[r] = {"type": "ROW", "id": r, "children": [], "parents": ["ROOT_ID", "GRID_ID"], "meta": {"background": "BACKGROUND_TRANSPARENT"}}
    for cid, name in pair:
        key = f"CHART-{cid}"
        pos[r]["children"].append(key)
        pos[key] = {"type": "CHART", "id": key, "children": [], "parents": ["ROOT_ID", "GRID_ID", r],
                    "meta": {"chartId": cid, "width": 6, "height": 50, "sliceName": name}}
a.put(f"/api/v1/dashboard/{dash_id}", {"position_json": json.dumps(pos, ensure_ascii=False)})
print(json.dumps({"database_id": db_id, "dataset_id": ds_id, "dashboard_id": dash_id, "charts": ids}, ensure_ascii=False))
set -a; . ./.env; set +a
python 03-setup.pyوالمخرج:
{"database_id": 1, "dataset_id": 1, "dashboard_id": 1, "charts": [[1, "إجمالي الإيراد"], [2, "الإيراد حسب المنطقة"], [3, "الإيراد الشهري"], [4, "الفئات"]]}والصورة التالية تبين اللوحة بعد أن أنهت رسومها:
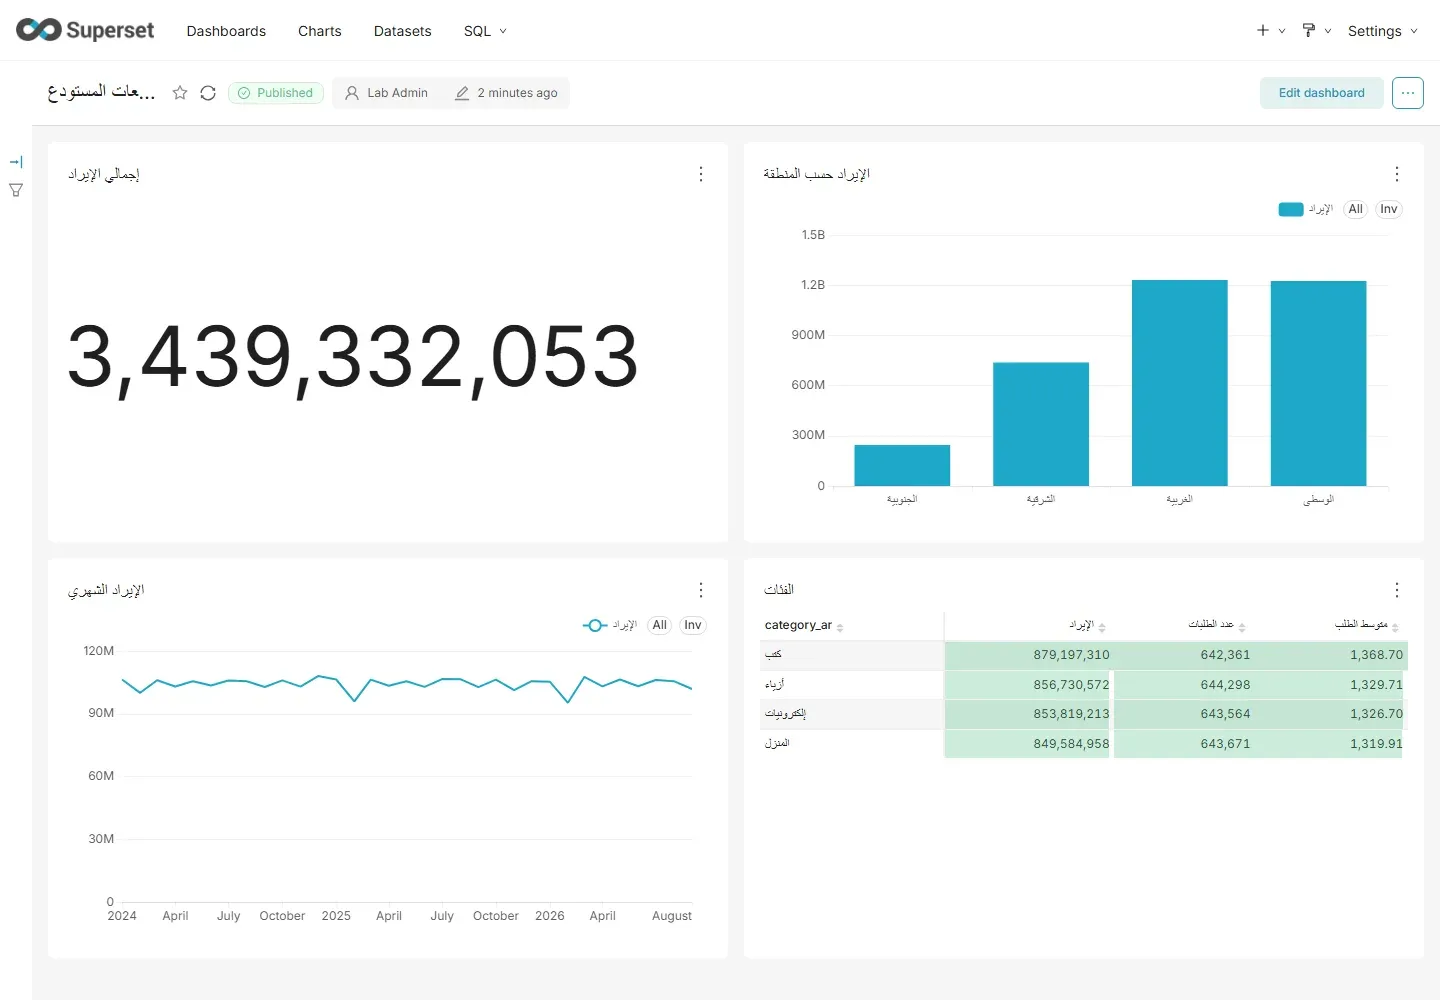
في الصورة أعلاه لاحظ التالي:
- إجمالي الإيراد 3,439,332,053 يساوي مجموع المناطق الأربع، والمقاييس العربية «الإيراد» و«عدد الطلبات» و«متوسط الطلب» ظهرت كما عرفناها في ال Dataset مرة واحدة.
- أول فتح للوحة عرض «Waiting on warehouse» في الرسوم الأربعة عدة ثوان، لأن كل رسم يرسل استعلاماً يمر على 3.3 مليون سطر، وهنا يبدأ دور الذاكرة المؤقتة.
- عنوان اللوحة العربي «مبيعات المستودع» قصته الواجهة من الجهة الخطأ وظهرت النقاط الثلاث في وسطه، وهذه من ملاحظات الاتجاه التي ذكرناها في قسم العربية، فاجعل عناوين اللوحات قصيرة.
ومن SQL Lab يستطيع المحلل أن يكتب على النجمة مباشرة، والصورة التالية تبين إيراد كل منطقة في 2025 بالأسماء العربية، وهي الأرقام نفسها في تقرير CUBE في مقال OLAP:
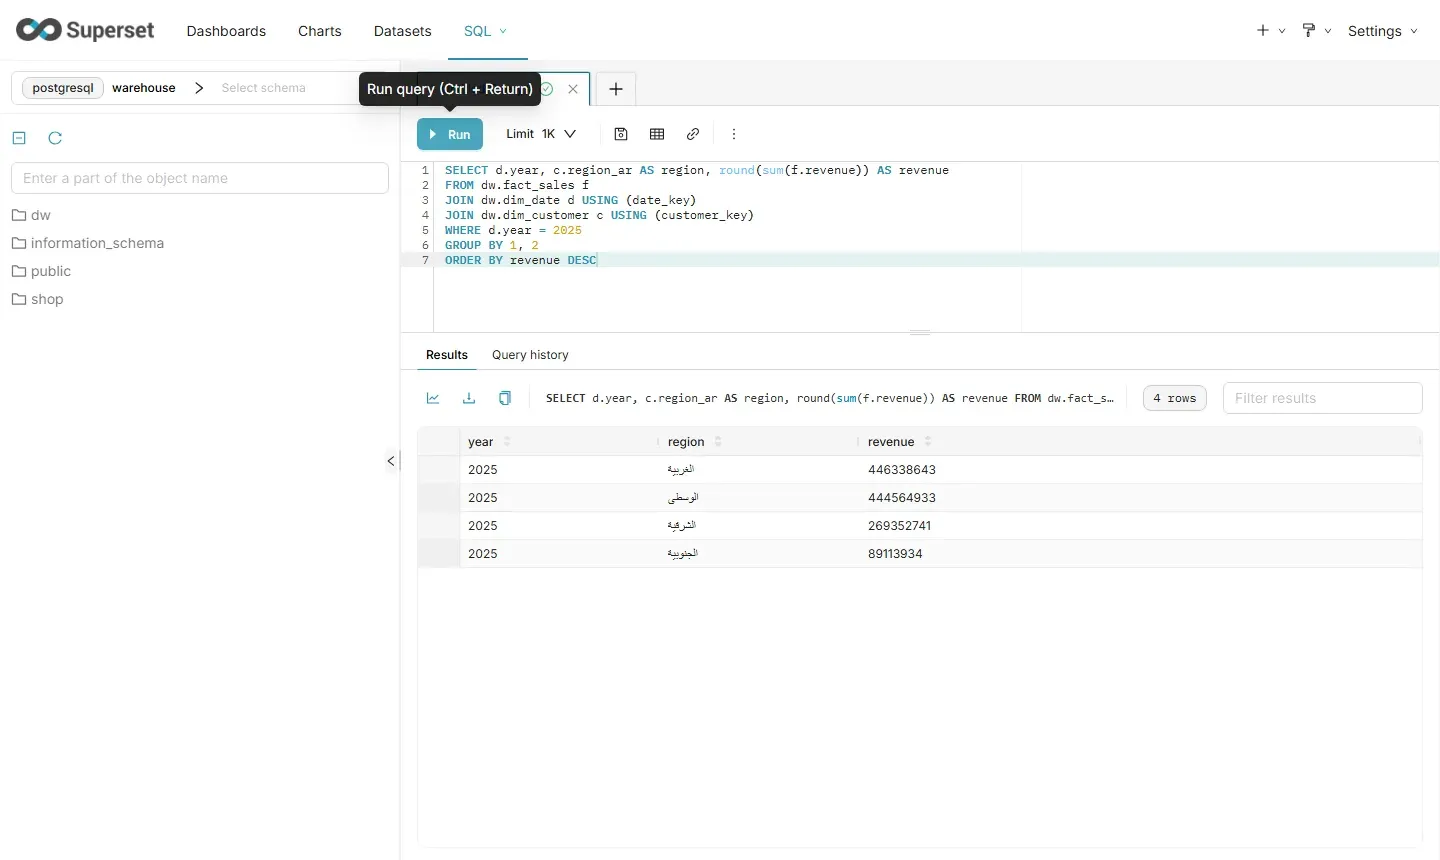
ولاحظ في الشجرة أن المخطط shop يظهر بالاسم، ولكن أي استعلام عليه يرفضه PostgreSQL لأن bi_reader لا يملك صلاحية عليه، فالحماية هنا من قاعدة البيانات وليست من الأداة.
تقييد الصفوف Row Level Security لدور واحد
لنفرض أن فريق مبيعات المنطقة الغربية يحتاج اللوحة نفسها، ولكن بأرقام منطقته فقط. والحل البسيط أن تنسخ اللوحة وتضع فلتراً ثابتاً في كل رسم، وهذا لا ينفع، والسبب أن الفلتر في الرسم يستطيع المستخدم أن يغيره من Explore، وأن كل تعديل على اللوحة الأصلية يجب أن يتكرر في النسخ. والطريقة الصحيحة في Superset هي قواعد تقييد الصفوف Row Level Security: قاعدة مرتبطة ب Dataset وبدور Role، فيها شرط SQL يضيفه Superset إلى كل استعلام يرسله لأعضاء هذا الدور. والقاعدة من نوعين بحسب التوثيق: Regular يطبق الشرط على الأدوار المذكورة، وBase يطبقه على الجميع ما عدا الأدوار المذكورة.
الملف 04-rls.py ينشئ الدور sales_western بصلاحية قراءة ال Dataset، ومستخدمة اسمها noura بالأدوار Gamma وsql_lab والدور الجديد، ثم القاعدة. ولاحظ أننا أعطينا الدور صلاحية الوصول إلى قاعدة المستودع كلها في SQL Lab عن قصد، لأن هذا ما يفعله أغلب المديرين عندما يطلب المحلل SQL Lab، وسوف نرى ثمنه في خطوة الكسر:
# A role for the Western region sales team, one user in it, and a row level security rule (ArabRoot lab).
#   ADMIN_PASSWORD=... python 04-rls.py
import json, os
from ss import SS

a = SS("admin", os.environ["ADMIN_PASSWORD"])
DS_ID, DB_ID, DASH_ID = 1, 1, 1


def perm_id(permission, view_menu):
    q = json.dumps({"filters": [{"col": "permission", "opr": "rel_o_m", "value": a.find("/api/v1/security/permissions/", "name", permission)["id"]},
                                {"col": "view_menu", "opr": "rel_o_m", "value": a.find("/api/v1/security/resources/", "name", view_menu)["id"]}]})
    return a.get("/api/v1/security/permissions-resources/", params={"q": q})["result"][0]["id"]


# 1) the role: read the sales dataset; SQL Lab on the warehouse is added on purpose (see the break-it step)
role = a.find("/api/v1/security/roles/", "name", "sales_western") or a.post("/api/v1/security/roles/", {"name": "sales_western"})
a.post(f"/api/v1/security/roles/{role['id']}/permissions", {"permission_view_menu_ids": [
    perm_id("datasource_access", f"[warehouse].[sales](id:{DS_ID})"),
    perm_id("database_access", f"[warehouse].(id:{DB_ID})"),
]})

# 2) a user with Gamma (read only), sql_lab, and the new role
roles = {r["name"]: r["id"] for r in a.get("/api/v1/security/roles/", params={"q": json.dumps({"page_size": 100})})["result"]}
if not a.find("/api/v1/security/users/", "username", "noura"):
    a.post("/api/v1/security/users/", {"username": "noura", "first_name": "Noura", "last_name": "West", "email": "[email protected]",
                                       "password": os.environ["NOURA_PASSWORD"], "active": True,
                                       "roles": [roles["Gamma"], roles["sql_lab"], roles["sales_western"]]})

# 3) the dashboard is visible to the role (DASHBOARD_RBAC)
a.put(f"/api/v1/dashboard/{DASH_ID}", {"roles": [roles["sales_western"]]})

# 4) the rule: members of sales_western see the Western region only
rule = a.find("/api/v1/rowlevelsecurity/", "name", "western only")
if not rule:
    rule = a.post("/api/v1/rowlevelsecurity/", {"name": "western only", "filter_type": "Regular", "tables": [DS_ID],
                                                 "roles": [roles["sales_western"]], "group_key": "region",
                                                 "clause": "region = 'Western'"})
print(json.dumps({"role": role["id"], "rule": rule["id"]}))
ثم نسأل السؤال نفسه، الإيراد حسب المنطقة، مرة باسم noura ومرة باسم المدير، بالملف 05-check.py الذي يرسل نفس ال Query Context الذي ترسله الرسوم إلى /api/v1/chart/data:
# What does each user see, and where does the answer come from? (ArabRoot lab)
#   python 05-check.py cache | rls | sqllab
import os, sys
from ss import SS

QC = {"datasource": {"id": 1, "type": "table"}, "result_format": "json", "result_type": "full",
      "queries": [{"columns": ["region"], "metrics": ["revenue"], "orderby": [["revenue", False]], "row_limit": 100}]}


def show(who, res, secs):
    rows = ", ".join(f"{r['region']}={r['revenue']:,.0f}" for r in res["data"])
    print(f"{who:<6} cached={str(res['is_cached']):<5} {secs:6.3f}s  {rows}")


step = sys.argv[1]
admin = SS("admin", os.environ["ADMIN_PASSWORD"])
noura = SS("noura", os.environ["NOURA_PASSWORD"])

if step == "cache":
    show("admin", *admin.chart_data(QC))               # first time: the warehouse answers
    show("admin", *admin.chart_data(QC))               # same question: from Redis
    show("admin", *admin.chart_data(QC, force=True))   # the refresh button: the warehouse again

if step == "rls":
    show("noura", *noura.chart_data(QC))
    show("noura", *noura.chart_data(QC))
    show("admin", *admin.chart_data(QC))
    res, _ = noura.chart_data(QC)
    print("SQL sent for noura:", " ".join(res["query"].split()))

if step == "sqllab":
    for sql in ["SELECT region, round(sum(revenue)) AS revenue FROM dw.sales GROUP BY region ORDER BY 2 DESC",
                "SELECT c.region, round(sum(f.revenue)) AS revenue FROM dw.fact_sales f "
                "JOIN dw.dim_customer c USING (customer_key) GROUP BY c.region ORDER BY 2 DESC"]:
        code, body, secs = noura.sql(1, sql)
        print(f"noura  SQL Lab {code}  " + (", ".join(f"{r['region']}={r['revenue']:,.0f}" for r in body.get("data", [])) or str(body)[:300]))
python 04-rls.py
python 05-check.py rlsوالمخرج سوف يكون كما يلي:
noura  cached=None   3.987s  Western=1,230,976,060
noura  cached=True   0.398s  Western=1,230,976,060
admin  cached=True   0.907s  Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970
SQL sent for noura: SELECT region AS region, SUM(revenue) AS revenue FROM dw.sales WHERE (region = 'Western') GROUP BY region ORDER BY revenue DESC LIMIT 100;
في المخرج أعلاه لاحظ التالي:
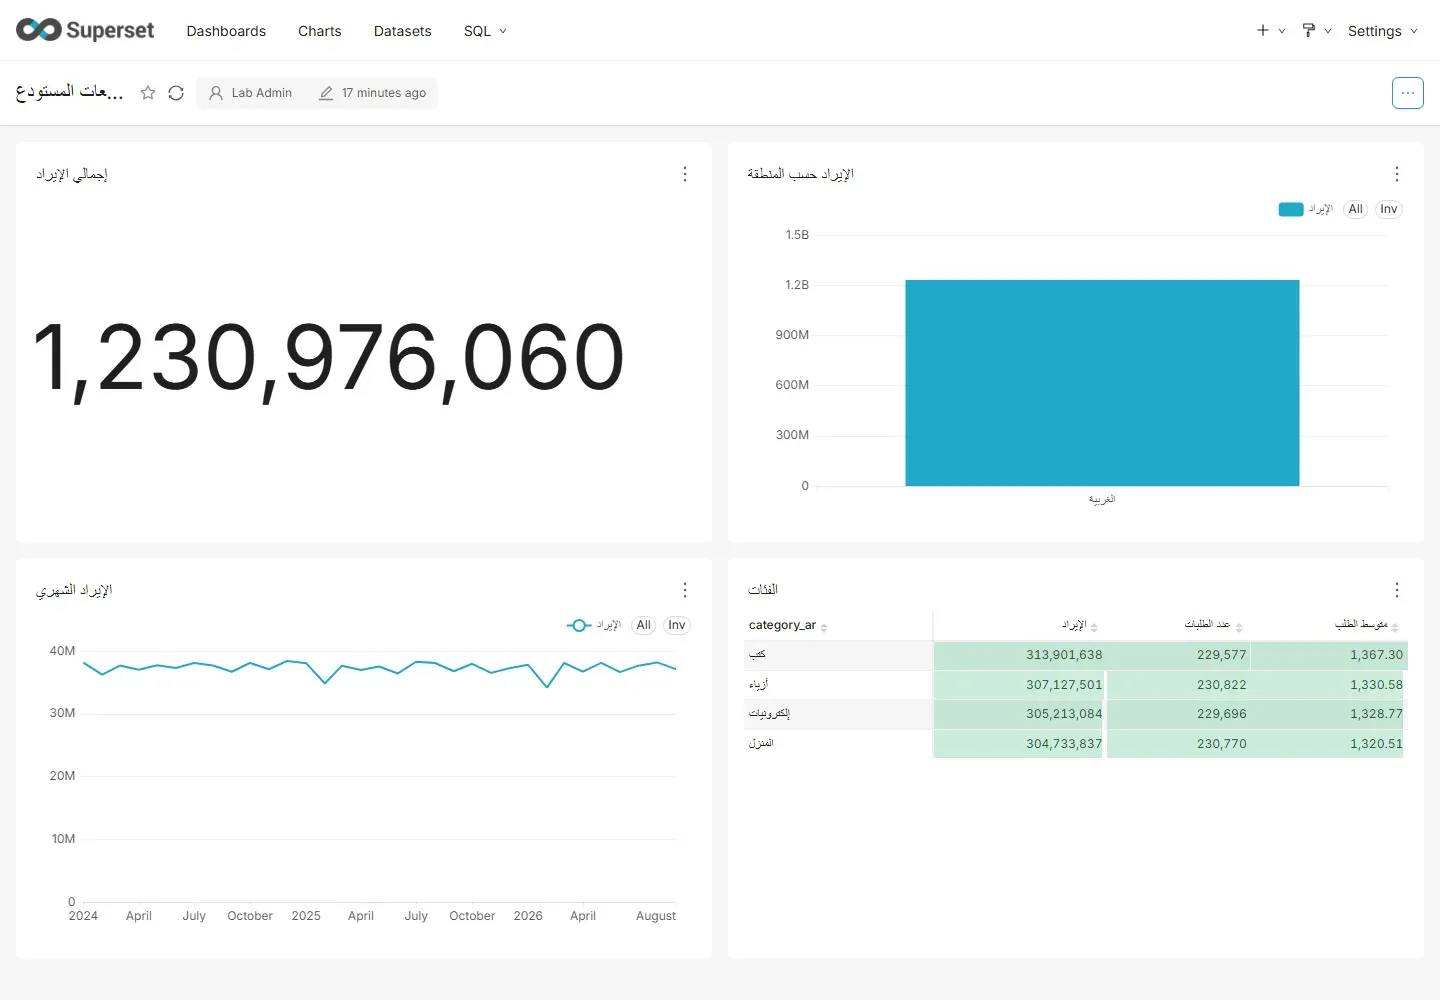
- noura رأت المنطقة الغربية وحدها، والسطر الأخير يبين السبب: الاستعلام الذي أرسله Superset إلى المستودع فيه
WHERE (region = 'Western')، أي أن الشرط ينفذ في قاعدة البيانات وليس في المتصفح. - المدير طلب السؤال نفسه بعدها فجاءه من الذاكرة المؤقتة
cached=Trueبالمناطق الأربع، وnoura جاءها في المرة الأولى من المستودعcached=None. والسبب أن مفتاح الذاكرة المؤقتة يحسب من الاستعلام النهائي بعد إضافة الشرط، فلكل دور مفتاحه، ولا يرى أحد نتيجة محفوظة لغيره.
والصورة التالية تبين اللوحة نفسها عندما تفتحها noura، ولم نغير فيها أي رسم:
الذاكرة المؤقتة بالأرقام
في إعداد التجربة جعلنا نتائج الاستعلامات في Redis لمدة ساعة عبر DATA_CACHE_CONFIG، ولاحظ أن القيمة الافتراضية في ملف الإعداد للإصدار 6.1.0 هي NullCache، أي لا توجد ذاكرة مؤقتة للنتائج أصلاً إذا لم تضبطها، فكل فتح للوحة يصل إلى قاعدة البيانات. والآن نفرغ قاعدة Redis الخاصة بالنتائج، ونسأل السؤال ثلاث مرات: الأولى، ثم مرة ثانية، ثم كأننا ضغطنا زر التحديث Force Refresh:
docker exec lab-bi-redis redis-cli -n 1 FLUSHDB
python 05-check.py cache
admin cached=None 4.893s Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970
admin cached=True 0.740s Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970
admin cached=None 3.066s Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970المرة الأولى 4.9 ثانية لأن المستودع جمع 3.3 مليون سطر، والثانية 0.74 ثانية من Redis، والثالثة رجعت إلى المستودع لأن force يتجاوز الذاكرة المؤقتة ويكتب النتيجة الجديدة فوق القديمة. وفي سجل المستودع، الذي يسجل كل استعلام بسبب log_min_duration_statement=0 في ملف Compose، ظهر استعلامان فقط لكل تشغيل من الثلاثة، فالمرة الثانية لم تصل إلى PostgreSQL أصلاً. وفي تشغيل ثان كانت الأرقام 4.86 و0.52 و5.34 ثانية، وهذه أزمنة من جهاز واحد عليه Containers أخرى، فهي للتوضيح وليست مقياس أداء. ولاحظ أن الزمن من Redis ليس صفراً، لأن Superset يبني الاستعلام ويتحقق من الصلاحيات ويحسب المفتاح في كل طلب.
وتستطيع أن تحدد مدة مختلفة لكل Dataset أو لكل رسم أو لكل قاعدة بيانات في خانة Cache Timeout، فتجعل لوحة المبيعات اليومية ساعة، ولوحة السنة الماضية يوماً كاملاً. ولكن قبل أن تطيل المدة تذكر أن الذاكرة المؤقتة لا تعرف شيئاً عن تغير البيانات، وهذا ما سوف نكسره الآن.
نكسرها: SQL Lab يتجاوز تقييد الصفوف
noura عندها الدور sql_lab، فلنرى ماذا يحدث إذا كتبت الاستعلام بنفسها في SQL Lab بدل أن تفتح اللوحة. والخطوة sqllab في الملف 05-check.py ترسل استعلامين باسمها: الأول على العرض dw.sales نفسه الذي عليه القاعدة، والثاني على الجداول الأصلية dw.fact_sales وdw.dim_customer:
python 05-check.py sqllabnoura SQL Lab 200 Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970
noura SQL Lab 200 Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970المناطق الأربع في الاستعلامين، أي أن القاعدة التي حمت اللوحة لم تحم SQL Lab. والسبب مكتوب في توثيق الأمان: تقييد الصفوف لا يطبق في SQL Lab إلا إذا فعلت الخيار RLS_IN_SQLLAB، وهو معطل افتراضياً، وفي ملف الإعداد للإصدار 6.1.0 تحذير صريح بجانبه أنه قد يكسر بعض الاستعلامات أو يسمح بتجاوز التقييد. فلنفعله ونعيد التشغيل:
sed -i 's/"RLS_IN_SQLLAB": False,/"RLS_IN_SQLLAB": True,/' pythonpath/superset_config.py
docker restart lab-bi-superset
python 05-check.py sqllab
noura SQL Lab 200 Western=1,230,976,060
noura SQL Lab 200 Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970الاستعلام على dw.sales أصبح يعطي المنطقة الغربية فقط، لأن Superset أضاف الشرط إلى الجدول الذي عليه قاعدة، ولكن الاستعلام على الجداول الأصلية ما زال يعطي كل شيء، والسبب أن القاعدة مرتبطة ب Dataset اسمه sales، أما fact_sales وdim_customer فلا توجد عليهما قاعدة، والصلاحية database_access تسمح لها بقراءة أي جدول في القاعدة.
والإصلاح أن يبقى للدور ال Dataset وحده، فنحذف منه الوصول إلى القاعدة كلها بالملف 06-fix.py:
# The fix for the SQL Lab bypass: the restricted role keeps the dataset and loses direct database access.
import json, os
from ss import SS
a = SS("admin", os.environ["ADMIN_PASSWORD"])
role = a.find("/api/v1/security/roles/", "name", "sales_western")
cur = a.get(f"/api/v1/security/roles/{role['id']}/permissions/")["result"]
keep = [p["id"] for p in cur if p["permission_name"] != "database_access"]
a.post(f"/api/v1/security/roles/{role['id']}/permissions", {"permission_view_menu_ids": keep})
print([f"{p['permission_name']} on {p['view_menu_name']}" for p in a.get(f"/api/v1/security/roles/{role['id']}/permissions/")["result"]])
python 06-fix.py
python 05-check.py sqllab['datasource_access on [warehouse].[sales](id:1)']
noura SQL Lab 200 Western=1,230,976,060
noura SQL Lab 500 {'errors': [{'error_type': 'TABLE_SECURITY_ACCESS_ERROR', 'extra': {'link': '', 'tables': ['postgres.dw.fact_sales', 'postgres.dw.dim_customer']}, 'message': 'You need access to the following tables: `postgres.dw.fact_sales`, `postgres.dw.dim_customer`,\n `all_database_access` or `all_datالآن الاستعلام على العرض مقيد بالمنطقة الغربية، والاستعلام على الجداول الأصلية مرفوض بخطأ TABLE_SECURITY_ACCESS_ERROR. ولكن انتبه إلى أن الإصلاح يحتاج الأمرين معاً، فقد أعدنا RLS_IN_SQLLAB إلى False مع بقاء الصلاحيات الجديدة، فكانت النتيجة كما يلي:
noura  SQL Lab 200  Western=1,230,976,060, Central=1,225,387,428, Eastern=737,459,595, Southern=245,508,970
noura  SQL Lab 500  {'errors': [{'error_type': 'TABLE_SECURITY_ACCESS_ERROR', 'extra': {'link': '', 'tables': ['postgres.dw.fact_sales', 'postgres.dw.dim_customer']}, 'message': 'You need access to the following tables: `postgres.dw.fact_sales`, `postgres.dw.dim_customer`,\n            `all_database_access` or `all_dat
صلاحية قراءة ال Dataset وحدها كافية لتقرأ noura العرض dw.sales كاملاً من SQL Lab، مع أن واجهة SQL Lab لم تعرض لها قاعدة المستودع في قائمة القواعد، أي أن إخفاء القاعدة من الواجهة ليس حماية، فالواجهة البرمجية نفذت الاستعلام. وبالتالي فالقاعدة العملية كما يلي:
- إذا كان الدور مقيداً بصفوف فلا تعطه SQL Lab إلا إذا كان ضرورياً، فاللوحات وExplore تطبق القاعدة دائماً.
- إذا أعطيته SQL Lab ففعل
RLS_IN_SQLLAB، وأعطه ال Datasets المقيدة فقط دونdatabase_access، ثم جرب بنفسك استعلاماً على الجداول الأصلية باسم المستخدم كما فعلنا. - وإذا كانت البيانات حساسة فعلاً فاجعل الحماية في قاعدة البيانات نفسها: مستخدم PostgreSQL منفصل لكل فريق لا يرى إلا عروضاً مقيدة، أو سياسات Row Level Security في PostgreSQL، واتصال منفصل في Superset بهذا المستخدم، لأن قاعدة البيانات لا تهتم بالطريق الذي جاء منه الاستعلام.
نكسرها: طلب متأخر لا يظهر في اللوحة
لنفرض أن خطوة ELT الليلية أضافت طلباً متأخراً من المنطقة الغربية بنصف مليون بعد أن فتح المدير اللوحة، وهذا هو الملف 07-late-order.sql:
-- A late order arrives in the warehouse after the dashboard was cached (lab only).
INSERT INTO dw.fact_sales (date_key, customer_key, product_key, order_id, line_no, qty, unit_price, revenue)
SELECT 20260930, c.customer_key, 1, 9000001, 1, 1, 500000, 500000
FROM dw.dim_customer c WHERE c.region = 'Western' ORDER BY c.customer_key LIMIT 1;
ثم نسأل باسم المدير من الذاكرة المؤقتة، ثم بزر التحديث، ثم من الذاكرة المؤقتة مرة أخرى، بالملف 08-stale.py، وبعدها نسأل باسم noura:
# After the late order: the cached answer, then the refresh button, then the cache again (ArabRoot lab).
import os
from ss import SS
a = SS("admin", os.environ["ADMIN_PASSWORD"])
QC = {"datasource": {"id": 1, "type": "table"}, "result_format": "json", "result_type": "full",
      "queries": [{"columns": ["region"], "metrics": ["revenue"], "orderby": [["revenue", False]], "row_limit": 100}]}
for label, force in (("cached", False), ("forced", True), ("cached", False)):
    res, secs = a.chart_data(QC, force=force)
    west = next(r["revenue"] for r in res["data"] if r["region"] == "Western")
    print(f"{label:<7} is_cached={str(res['is_cached']):<5} cached_dttm={res.get('cached_dttm')}  Western={west:,.0f}")
docker exec -i lab-bi-dw psql -U postgres < 07-late-order.sql
python 08-stale.py
python 05-check.py rls | head -1INSERT 0 1
cached is_cached=True cached_dttm=2026-10-11T22:08:43 Western=1,230,976,060
forced is_cached=None cached_dttm=None Western=1,231,476,060
cached is_cached=True cached_dttm=2026-10-11T22:08:58 Western=1,231,476,060
noura cached=True 0.321s Western=1,230,976,060الذاكرة المؤقتة أعطت الرقم القديم 1,230,976,060 مع أن الطلب أصبح في المستودع، والتحديث الإجباري جاء بالرقم الجديد 1,231,476,060 وكتبه في المفتاح، ولكن لاحظ السطر الأخير: noura ما زالت ترى الرقم القديم، لأن مفتاحها مختلف كما رأينا، وتحديث المدير لم يلمسه. فإذا كانت لديك عشرة أدوار بقواعد مختلفة، فهناك عشر نسخ من كل رسم في Redis، وكل نسخة تنتهي في وقتها. والقاعدة: اجعل مدة الذاكرة المؤقتة أقصر من المدة بين تحميلين للمستودع، أو أقل من ذلك بكثير للوحات التي تتابع اليوم الحالي، وإذا كان التحميل في وقت معروف كل ليلة فمدة تنتهي قبله تكفي. وفي الإنتاج يمكن تسخين الذاكرة المؤقتة Cache Warm-up بعد التحميل بعمال Celery كما يشرح توثيق الذاكرة المؤقتة. وأخيراً نحذف الطلب التجريبي:
docker exec lab-bi-dw psql -U postgres -c "DELETE FROM dw.fact_sales WHERE order_id = 9000001;"حذف تجربة المستودع
docker compose -p lab-bi-dw down -v
docker image rm lab-bi-superset:6.1.0
والأمر الأول يحذف ال Containers الخمسة وال Volumes lab-bi-dw-data وlab-bi-ssdb-data والشبكة lab-bi-net التي أنشأها المشروع.
Superset أم Metabase؟
المقارنة الكاملة بين Metabase وSuperset وPower BI، بالرخص والأسعار والعربية وتقييد الصفوف، في مقال المقارنة ضمن مرحلة البيانات، ولكن بعد التجربتين على البيانات نفسها يمكن أن نلخص الفرق في نقاط:
- من سيستخدمها؟ إذا كان أغلب المستخدمين لا يكتبون SQL فMetabase أسهل، فالأسئلة بالنقر هي محورها، أما إذا كان لديك محللون يكتبون SQL كل يوم فSQL Lab والمقاييس في Superset أقوى.
- من سيشغلها؟ Metabase خدمتان ومتغيرات بيئة، وSuperset أربع خدمات وملف Python وبناء Image لبرامج الاتصال، فهو يحتاج من يفهم Python وDocker.
- الرخصة: Superset برخصة Apache-2.0 دون نسخة تجارية، وMetabase برخصة AGPL مع ميزات مثل تقييد الصفوف في الخطط المدفوعة.
- العربية: البيانات العربية تعمل في الاثنين، والواجهة العربية موجودة في Metabase فقط، والاتجاه من اليسار لليمين في الاثنين.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Superset تطبيق ويب مع قاعدة بيانات وصفية وRedis وعمال اختياريين، وملفات Compose في مستودعه ليست للإنتاج كما هي، فاكتب ملفك وثبت الإصدارات وانسخ القاعدة الوصفية.
- ال Image الرسمية 6.1.0 لا تحتوي psycopg2، فابن Image فوقها تضيف برنامج الاتصال، ولا يبدأ Superset دون
SECRET_KEYقوي. - ال Dataset والمقاييس تعطيك تعريفاً واحداً لكل رقم، وهذه أهم فكرة في Superset.
- عطل Allow DML واستخدم مستخدم القراءة، فتحصل على طبقتين تمنعان الحذف.
- البيانات العربية تعرض صحيحة، أما الواجهة فبالإنجليزية لأن ال Images الرسمية تبنى دون ترجمات.
- تقييد الصفوف يحمي اللوحات وExplore دائماً، أما SQL Lab فيحتاج
RLS_IN_SQLLABودوراً بلا وصول مباشر إلى القاعدة، والذاكرة المؤقتة لكل دور مفتاحها ولا تعرف أن البيانات تغيرت.
 دليلMetabase: لوحات وتقارير من بياناتك دون كتابة كودكيف تثبت Metabase على سيرفرك، وتبني منه أسئلة ولوحة مبيعات من بيانات شركتك بالنقر أو بلغة SQL.
 دليلMetabase أم Superset أم Power BI؟ أداة التقارير لفريقككيف تختار أداة التقارير لفريقك بحسب الرخصة والتكلفة ومكان بياناتك ودعم العربية وتقييد الصفوف.
 دليلOLAP ومستودع البيانات: تقارير لا تبطئ تطبيقككيف تنقل تقاريرك من قاعدة التطبيق إلى مستودع بيانات بمخطط النجمة، فتسرع التقارير وتبقى أرقام السنوات الماضية ثابتة.
 دليلمتى تستخدم العروض المحفوظة Materialized Views في تطبيقك؟ما هو العرض المحفوظ في قاعدة البيانات، ومتى يسرع صفحات تطبيقك، ومتى تختار الكاش أو جدولاً تحدثه بنفسك بدلاً منه.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتثبيت Apache Superset 6.1.0 مع PostgreSQL 18.6 وRedis 8.2.2 في Docker، وبناء Dataset بمقاييس ولوحة بفلاتر على متجر تجريبي ببيانات عربية، واختبار اللغة العربية.
- أكتوبر 2026: إضافة قسم Superset على مستودع البيانات بنفس الإصدار 6.1.0: النجمة من مقال OLAP في PostgreSQL 18.6 بثلاثة ملايين سطر، والإعداد من الواجهة البرمجية، وتقييد الصفوف لدور واحد، والذاكرة المؤقتة بالأرقام، وكسر SQL Lab والذاكرة المؤقتة، ورابط مقال المقارنة.


