

لنفرض أن عميلاً اتصل بالدعم الفني يسأل لماذا دفع 215.50 ريالاً في طلبه، وهو متأكد أنه أضاف كوباً للقهوة ثم حذفه، ويريد أن يعرف متى حذفه وهل كان الكوب في السلة عند الدفع، فيفتح المطور جدول الطلبات فيجد سطراً واحداً فيه الحالة «مدفوع» والمبلغ 215.50، وكل ما حدث قبل ذلك لم يعد موجوداً، والسبب أن جملة UPDATE تكتب القيمة الجديدة فوق القديمة. وهذه هي الفكرة التي يبدأ منها Event Sourcing: بدل أن تحفظ آخر حالة للبيانات، تحفظ كل ما حدث لها بالترتيب، ثم تحسب الحالة من الأحداث عند الحاجة.
وفي مقال أنماط المعمارية ذكرنا أن كلمة Event-Driven تطلق على أربعة أشياء مختلفة، وشرحنا هناك الإشعار بالحدث ونقل الحالة مع الحدث، ووعدنا بمقال عن الاثنين الباقيين: تخزين الأحداث Event Sourcing، وفصل القراءة عن الكتابة CQRS. وهذا هو المقال، وسوف نعتمد فيه على ما شرحناه عن ال Aggregate والأحداث في التصميم الموجه بالمجال DDD دون أن نكرره، وعلى دفتر القيود في المحفظة الرقمية لأنه أقرب شيء تعرفه إلى Event Sourcing.
 دليلأنماط المعمارية Architecture Styles ومتى تختار كلاً منهاكيف تختار بين التطبيق الواحد والخدمات التي تتبادل الأحداث، وما الذي يناسب نظامك من أشهر أنماط المعمارية.
 دليلالتصميم الموجه بالمجال Domain-Driven Design ببساطةلماذا تعني كلمة «الطلب» ثلاثة أشياء في نفس الشركة، وكيف يقسم DDD النظام إلى سياقات لكل منها لغته ونموذجه.
 دليلالمحفظة الرقمية من الداخل: دفتر القيد المزدوج Ledgerكيف تبني محفظة رقمية لا يضيع فيها ريال ولا يخصم مرتين، بالقيد المزدوج والمعاملات والمطابقة مع مزود الدفع.
وسوف نناقش في هذا المقال ما يلي:
- ما هو Event Sourcing، وما الفرق بينه وبين سجل التدقيق وبين بث الأحداث في Kafka.
- ما هو CQRS، ولماذا يأتي غالباً مع Event Sourcing، ومتى تستخدمه وحده دون أحداث.
- جانب الكتابة: الأمر Command والقواعد والإصدار المتوقع Expected Version الذي يمنع الكتابة المتزامنة.
- ال Projections ونماذج القراءة Read Models، ولماذا يجب أن تكون آمنة عند التكرار، وأين تحفظ نقطة التقدم Checkpoint، والخطأ الصامت في الترتيب بالرقم التسلسلي.
- ال Snapshots، وتغيير شكل الأحداث مع الوقت Schema Evolution، والبيانات الشخصية وحق الحذف.
- الثمن الحقيقي، ومتى لا تستخدمه، وجدول قرار سريع.
- تجربة عملية: مخزن أحداث صغير في PostgreSQL، نبني منه نماذج قراءة ونهدمها ونعيد بناءها، ثم نكسر ال Projector عمداً مرتين.
ما هو Event Sourcing؟
يعرف Martin Fowler في مقاله Event Sourcing المنشور في ديسمبر 2005 الفكرة بأنها التأكد من أن كل تغيير في حالة التطبيق يحفظ في كائن حدث Event، وأن هذه الأحداث تحفظ بالترتيب الذي طبقت به، ولنفس عمر بيانات التطبيق. أي أن الأحداث هنا ليست سجلاً جانبياً بجوار البيانات، وإنما هي البيانات نفسها، ومصدر الحقيقة Source of Truth الوحيد، وكل ما عداها يحسب منها.
والحدث شيء حدث فعلاً في الماضي، لذلك يسمى بصيغة الماضي: OrderPlaced وItemAdded وOrderPaid، وهو لا يقبل الرفض لأنه وقع، بخلاف الأمر Command مثل AddItem الذي قد يرفض إذا خالف قاعدة. وتجمع أحداث الكيان الواحد في مجرى Stream، فالطلب رقم 1001 له مجرى اسمه order-1001، وكل حدث فيه يحمل رقم إصدار Version يبدأ من 1 ويزيد بواحد، والكيان الذي يملك المجرى هو غالباً ال Aggregate الذي شرحناه في مقال DDD، أي حدود القواعد التي يجب أن تتحقق معاً.
ولكي تعرف الحالة الحالية للطلب، تقرأ أحداث المجرى بالترتيب وتطبقها واحداً بعد الآخر على حالة تبدأ فارغة، وتسمى هذه العملية الطي Fold، أو إعادة التشغيل Replay، أو إعادة بناء الكيان Rehydration، والصورة التالية تبين الفرق بين الطريقتين بالطلب نفسه الذي سوف نبنيه في التجربة العملية:
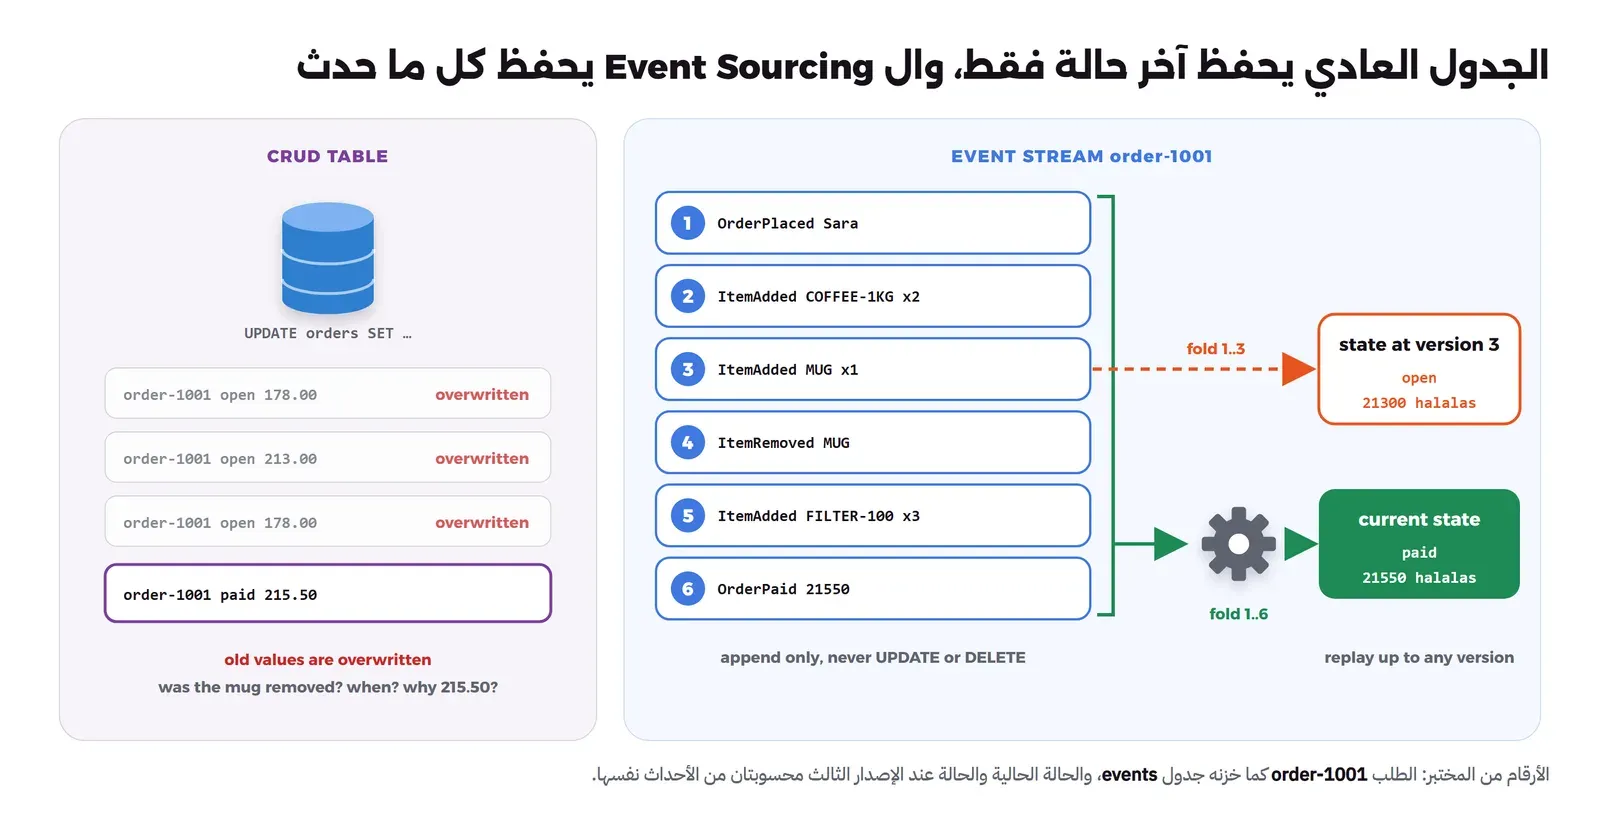
وفي الصورة أعلاه لاحظ أن الحالة عند الإصدار الثالث لم تحفظ في أي مكان، وإنما حسبت بتطبيق الأحداث الثلاثة الأولى فقط، وهذا ما يسميه Fowler الاستعلام الزمني Temporal Query. ويذكر في المقال نفسه قدرتين أخريين: إعادة البناء الكاملة Complete Rebuild، أي أن تحذف كل الحالة المحسوبة وتعيد بناءها من الأحداث، وإعادة التشغيل مع التصحيح Event Replay عندما تكتشف أن حدثاً قديماً كان خاطئاً. والقدرة الأولى هي التي سوف تستخدمها كل يوم، لأنها تعني أن أي جدول للقراءة يمكن حذفه وبناؤه من جديد بشكل مختلف.
ما الفرق بينه وبين سجل التدقيق وبث الأحداث؟
وقد يتساءل البعض: لدي جدول للطلبات وجدول آخر أسجل فيه كل تغيير، فهل هذا Event Sourcing؟ والإجابة لا، والسبب أن الجدول الثاني في هذه الحالة نسخة جانبية، والحقيقة ما زالت في جدول الطلبات، فإذا اختلفا صدقت جدول الطلبات، وإذا نسي مطور أن يكتب في السجل لم يتوقف شيء. أما في Event Sourcing فلا يوجد جدول للطلبات أصلاً بالمعنى المعتاد، والحدث الذي لم يكتب لم يحدث. وسجل التدقيق Audit Trail الذي شرحناه في مقال سجل التدقيق يجيب عن «من فعل ماذا ومتى» حتى في نظام CRUD عادي، وهو كاف في أغلب الأنظمة التي تحتاج التاريخ للمراجعة فقط.
والفرق الثاني مع بث الأحداث Event Streaming في Kafka وأمثاله، فالسجل فيه يحفظ الرسائل ويسمح بإعادة قراءتها كما شرحنا في الطابور أم بث الأحداث، ولكن رسائل التكامل Integration Events التي تنشرها خدمة للخدمات الأخرى هي عقد عام يجب أن يبقى ثابتاً، أما أحداث Event Sourcing فهي تفاصيل داخلية للخدمة تتغير مع نموذجها. لذلك لا تنشر أحداثك الداخلية كما هي للخدمات الأخرى، وإنما تترجمها إلى أحداث تكامل أبسط وأثبت، وتنشرها بنمط Outbox الذي شرحناه في مقال Saga وOutbox.
دفتر القيود: Event Sourcing الذي تعرفه
إذا قرأت مقال المحفظة الرقمية فأنت تعرف الفكرة من قبل، فالدفتر يقبل الإضافة فقط، والخطأ لا يمحى وإنما يصحح بقيد عكسي، والرصيد مجموع السطور. والفرق أن سطر الدفتر حركة مالية بشكل ثابت (حساب ومبلغ واتجاه)، أما الأحداث فلكل نوع منها شكل وقواعد، وجدول الرصيد المحفوظ الذي نتحقق منه كل ليلة هناك هو بالضبط ما يسمى هنا نموذج قراءة Read Model، أي نسخة محسوبة من الحقيقة وليست الحقيقة. لذلك إذا كان مجالك مالياً فابدأ بالدفتر المزدوج، وهو غالباً كل ما تحتاجه من Event Sourcing.
CQRS: نموذج للكتابة ونموذج للقراءة
يقول Martin Fowler في مقاله عن CQRS المنشور في يوليو 2011 إن الاسم اختصار Command Query Responsibility Segregation، وإنه سمع به أول مرة من Greg Young، وفكرته أن تستخدم نموذجاً لتحديث البيانات مختلفاً عن النموذج الذي تقرأ به البيانات. وفي التطبيق المعتاد يوجد كلاس واحد للطلب يحفظ ويقرأ ويعرض، أما في CQRS فجانب الكتابة يهتم بالقواعد فقط (هل يمكن إضافة صنف لطلب مدفوع؟)، وجانب القراءة يقدم البيانات بالشكل الذي تحتاجه كل شاشة، حتى لو كان ذلك جدولاً مسطحاً فيه بيانات مكررة.
ومع Event Sourcing تصبح الأحداث هي الجسر بين الجانبين، والصورة التالية تبين المسار كاملاً:
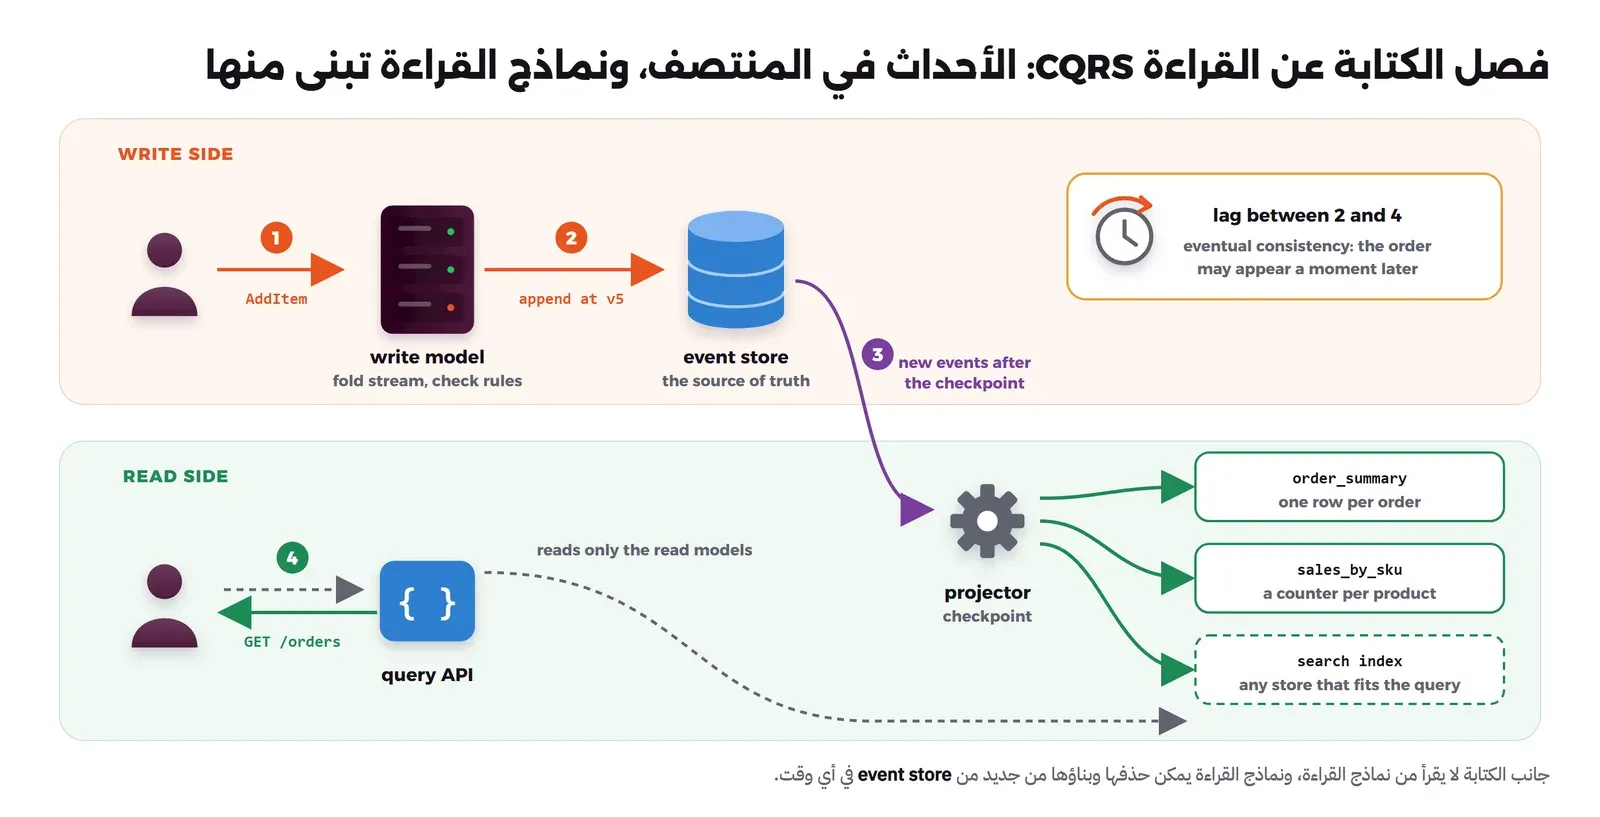
في الصورة أعلاه لاحظ التالي:
- الخطوة 2 هي الكتابة الوحيدة في النظام: سطور جديدة في جدول الأحداث، ولا شيء غيرها.
- ال Projector في الخطوة 3 برنامج يعمل في الخلفية، يقرأ الأحداث الجديدة ويحدث بها جداول القراءة، ويحفظ أين وصل في نقطة تقدم Checkpoint.
- بين الخطوة 2 والخطوة 4 فترة قصيرة لا تظهر فيها الكتابة الجديدة في القراءة، وهذا هو الاتساق النهائي Eventual Consistency، وعلى الواجهة أن تتعامل معه، فبعد الضغط على «أضف إلى السلة» تعرض الواجهة الصنف مما تعرفه، ولا تعيد تحميل السلة من جدول القراءة فوراً وتتوقع أن تجده.
- جداول القراءة يمكن أن تكون في قاعدة بيانات أخرى أو محرك بحث، ويمكن أن تضيف جدولاً جديداً بعد سنة فيبنى من كل الأحداث القديمة كأنه كان موجوداً من البداية.
CQRS دون Event Sourcing
لا يحتاج CQRS إلى أحداث، فالفكرة فصل النموذجين فقط. ويكتب Fowler في المقال نفسه بوضوح أن CQRS في أغلب الأنظمة يضيف تعقيداً خطراً، وأنه يجب أن يستخدم في أجزاء محددة من النظام، أي في سياق محدد Bounded Context بلغة DDD، وليس في النظام كله، ويقترح لمن يعاني من استعلامات تقارير ثقيلة أن يبدأ بقاعدة بيانات للتقارير Reporting Database بدل CQRS كامل. وأبسط صورة لذلك في PostgreSQL هي العرض المادي Materialized View، وهو جدول قراءة يحسب من جدول عادي ويحدث عند الطلب، وسوف تراه في التجربة العملية، وصورة أخرى هي نسخة القراءة Read Replica التي توجه إليها التقارير. وكلا الحلين فيه نموذج قراءة متأخر قليلاً عن الكتابة، أي أنهما CQRS بسيط دون أن يسميه أحد بهذا الاسم.
أما العكس، أي Event Sourcing دون CQRS، فهو صعب في الواقع، والسبب أن جدول الأحداث ممتاز لسؤال واحد هو «أعطني أحداث المجرى order-1001»، وسيء لكل سؤال آخر مثل «كل الطلبات المدفوعة لهذا العميل التي تزيد عن 500 ريال»، لأن الإجابة تحتاج طي آلاف المجاري. لذلك كل نظام Event Sourcing تقريباً يحتاج نماذج قراءة، أي يحتاج CQRS.
جانب الكتابة: الأمر والقواعد والإصدار المتوقع
كل أمر في جانب الكتابة يمر بنفس الخطوات الأربع: تقرأ أحداث المجرى وتطويها لتعرف الحالة، ثم تتحقق من القواعد على هذه الحالة، ثم تقرر الأحداث الجديدة، ثم تكتبها. والخطر هنا في الكتابة المتزامنة، فإذا فتح العميل الطلب في نافذتين وأضاف من كل نافذة صنفاً في اللحظة نفسها، فكلاهما قرأ المجرى عند الإصدار 1، وكلاهما سوف يكتب الإصدار 2، وإذا قبلت قاعدة البيانات الكتابتين فقد بنيت كل نافذة قرارها على حالة لم تعد صحيحة، وهذه هي مشكلة التحديث المفقود Lost Update التي رأيناها في المحفظة الرقمية.
والحل المعروف هو التزامن المتفائل Optimistic Concurrency: تكتب الأحداث مع الإصدار الذي تتوقعه، أي «أضف الإصدار 2 بشرط ألا يكون موجوداً»، وفي PostgreSQL يكفي لذلك قيد فريد على (stream_id, version)، فالكتابة الثانية تفشل، والكود يعيد قراءة المجرى ويتحقق من القواعد من جديد، ثم يكتب الإصدار 3 أو يرفض الأمر. وهذا القيد يحمي المجرى الواحد فقط، أما القواعد التي تمتد على أكثر من مجرى (مثل «لا يتكرر اسم المستخدم في النظام كله») فلا يحميها، وتحتاج جدولاً عادياً بقيد فريد بجانب الأحداث، وهذا من أول ما يفاجئ الفرق التي تبدأ بهذا النمط.
ويجدر الإشارة هنا إلى أن الحدث يكتب بعد التحقق، وليس قبله، فلا تحفظ حدثاً اسمه AddItemRequested ثم تتحقق منه لاحقاً، لأن الأحداث حقائق، والحدث المرفوض لا مكان له في المجرى.
ال Projections ونماذج القراءة
ال Projection دالة تأخذ حدثاً وتحدث به نموذج قراءة، و ال Projector هو البرنامج الذي يمر على الأحداث ويستدعيها. وأهم ما في نموذج القراءة أنه قابل للرمي Disposable: إذا ظهر فيه خطأ أو احتجت شكلاً جديداً تحذفه وتعيد بناءه من الحدث الأول، لذلك لا تكتب فيه أي شيء لا يأتي من الأحداث، ولا تجعل جانب الكتابة يقرأ منه ليتخذ قراراً، والسبب أنه متأخر بطبيعته.
وال Projector يرى الحدث الواحد أكثر من مرة في حالات كثيرة: عند إعادة البناء، وعند توقفه بعد أن طبق الحدث وقبل أن يحفظ نقطة التقدم، وعندما تصله الأحداث عبر طابور يضمن التسليم مرة على الأقل At-Least-Once كما شرحنا في الأنظمة الموزعة، ويؤكد دليل Microsoft لنمط Event Sourcing أن معالجات الأحداث يجب أن تكون آمنة عند التكرار Idempotent لهذا السبب. وهناك طريقتان لذلك، وسوف تراهما في المختبر:
- اجعل التحديث نفسه آمناً عند تكراره: جدول
order_summaryفي المختبر يحفظ رقم آخر إصدار طبقه لكل طلب، ولا يطبق حدثاً إصداره أقل من أو يساوي المحفوظ، فإذا وصله الحدث مرتين تجاهل الثانية. وقد شرحنا هذه الفكرة بالتفصيل في مقال Idempotency. - احفظ نقطة التقدم في نفس المعاملة Transaction التي تحدث جدول القراءة: فإما أن يحفظ الاثنان معاً أو لا يحفظ أي منهما، وهذا هو الحل الوحيد للعدادات مثل
sales_by_skuالتي تزيد بكل حدث ولا تعرف هل رأته من قبل.
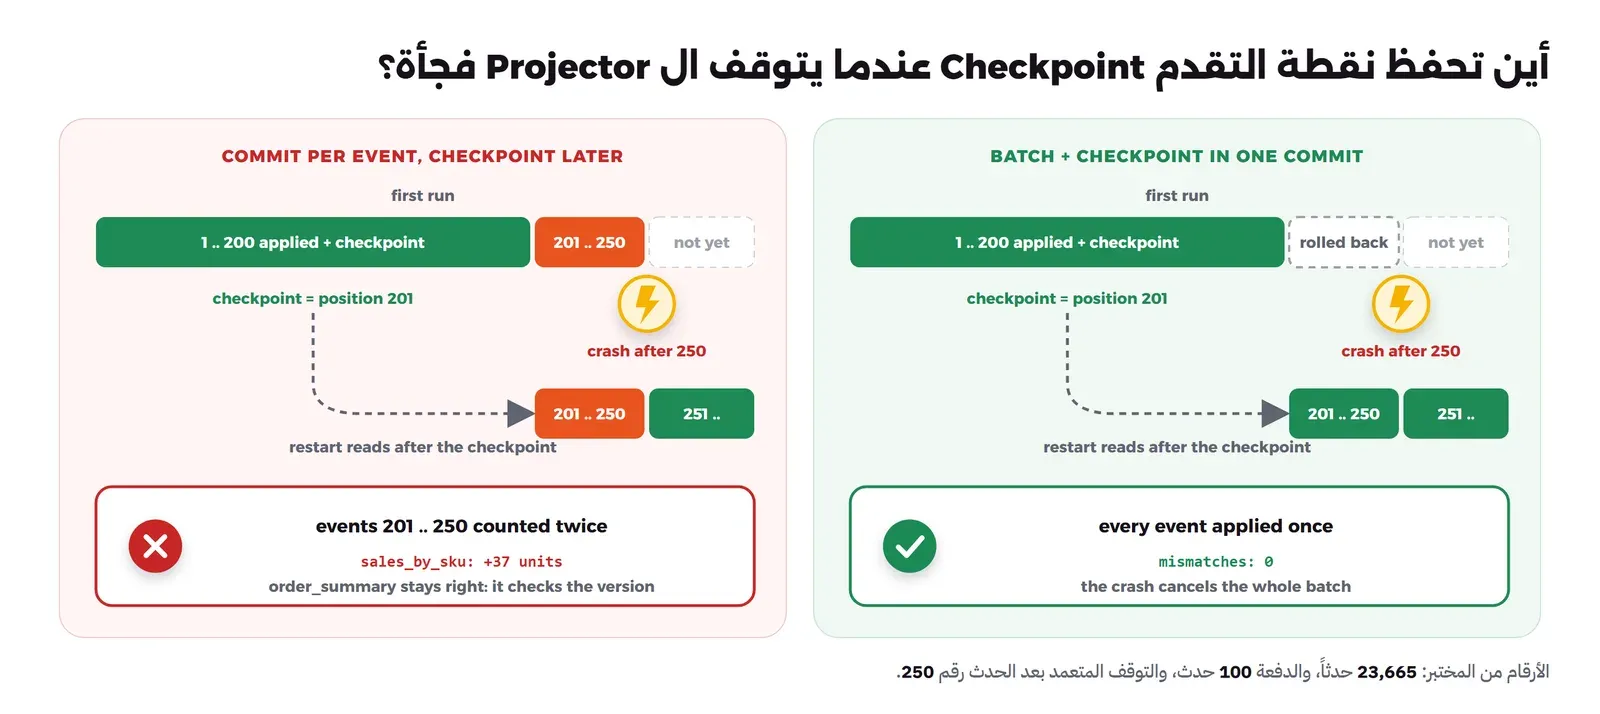
والصورة التالية تبين ما حدث في المختبر عندما أوقفنا ال Projector عمداً بعد الحدث 250 بالطريقتين:
لا ترسل بريداً من ال Projector
ويحذر Fowler في مقاله من حالة تقع فيها أغلب الفرق مرة واحدة على الأقل: الأحداث التي تؤثر على أنظمة خارجية External Updates، فإذا كان ال Projector يرسل بريد «تم شحن طلبك» عند الحدث OrderShipped، فإن إعادة البناء من الصفر سوف ترسل البريد لكل من شحن طلبه منذ أول يوم. والحل الذي يقترحه أن تمر الاتصالات الخارجية عبر بوابة Gateway تعرف هل هي في إعادة تشغيل فلا ترسل شيئاً، والحل العملي الذي نقترحه أبسط: افصل المعالجات التي تبني جداول القراءة عن المعالجات التي تنفذ أفعالاً خارجية، واجعل الثانية تعمل على الأحداث الجديدة فقط بنقطة تقدم لا تعود إلى الصفر أبداً، ومع مفتاح Idempotency Key عند المزود الخارجي.
الرقم التسلسلي لا يعني ترتيب الالتزام
هذه أخطر مشكلة في هذا المقال لأنها لا تظهر في الاختبار ولا تعطي أي خطأ. الطريقة البسيطة لقراءة الأحداث الجديدة هي «أعطني الأحداث التي رقمها أكبر من آخر رقم قرأته»، والرقم يأتي من Sequence أو عمود IDENTITY في PostgreSQL، وهنا المشكلة: توثيق PostgreSQL يوضح أن الرقم يأخذه من يطلبه أولاً، ولا يعود إذا ألغيت المعاملة، فالأرقام فيها فجوات Gaps، والأهم أن المعاملة التي أخذت الرقم 23667 قد تلتزم Commit بعد المعاملة التي أخذت 23668. فإذا قرأ ال Projector في تلك اللحظة فسوف يرى 23668 فقط، ويحفظ نقطة تقدمه عنده، ثم يلتزم 23667 بعد ذلك فلا يقرؤه أبداً، لأنه أصغر من نقطة التقدم. وفي المختبر حدث هذا بالأرقام التي في الصورة التالية:
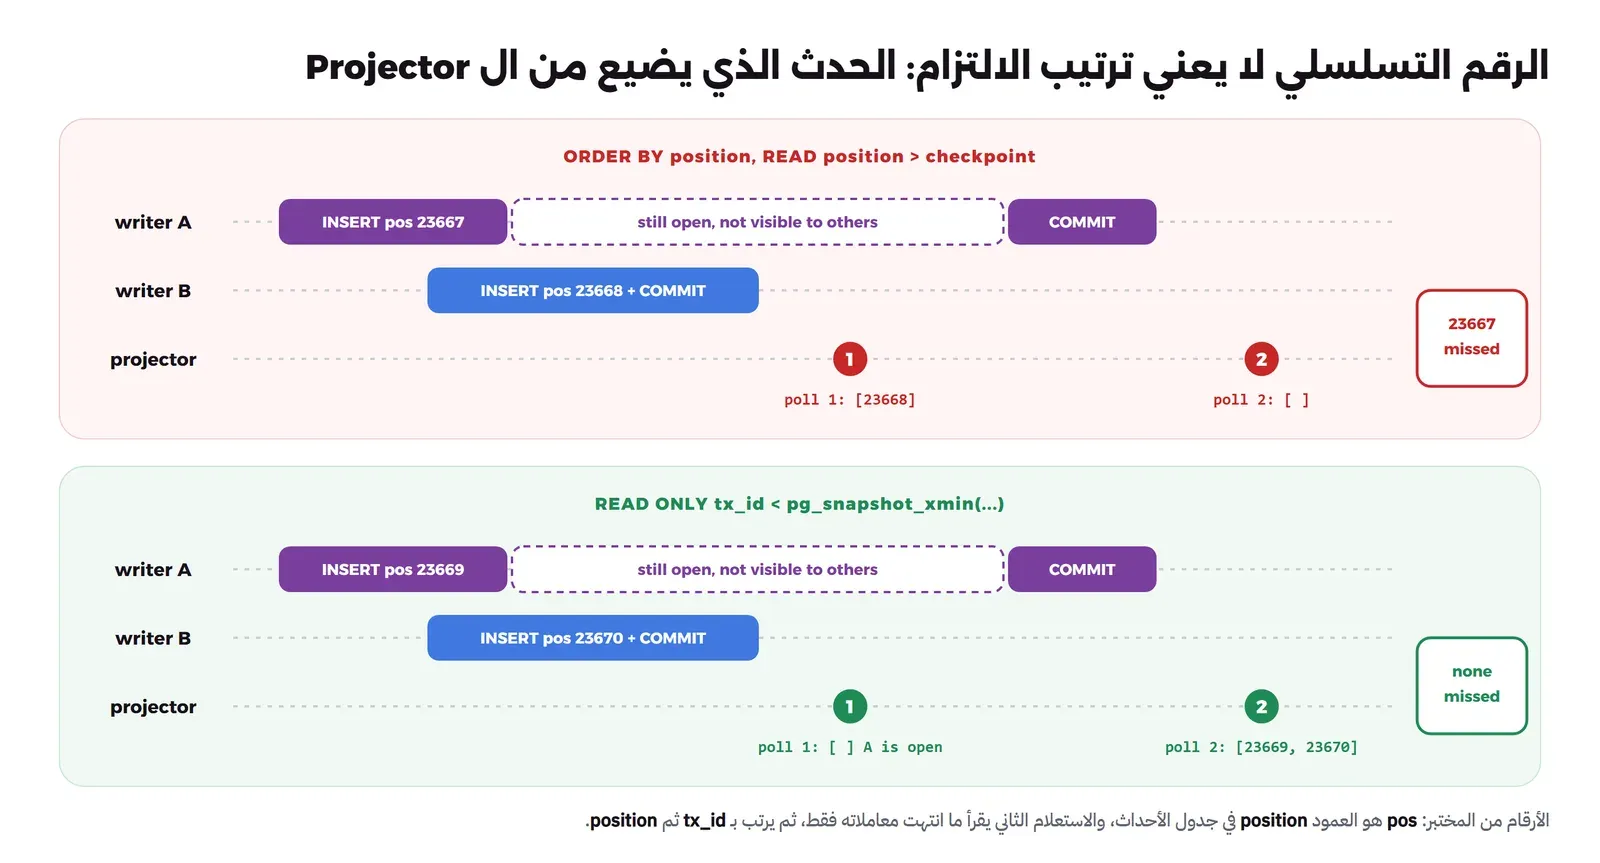
والحل الذي استخدمناه في المختبر يعتمد على دالتين في PostgreSQL موثقتين في دوال معلومات النظام: الدالة pg_current_xact_id() التي تعطي معرف المعاملة الحالية بنوع xid8 الذي لا يلتف، ونحفظها مع كل حدث، والدالة pg_snapshot_xmin(pg_current_snapshot()) التي تعطي أصغر معرف معاملة ما زالت نشطة، ويقول التوثيق إن كل معاملة معرفها أقل منه إما التزمت وظهرت أو ألغيت. لذلك يقرأ ال Projector الأحداث التي معرف معاملتها أقل من هذا الحد فقط، ويرتبها بمعرف المعاملة ثم بالرقم، فلا يتجاوز معاملة لم تنته بعد. والثمن أن معاملة طويلة واحدة مفتوحة توقف تقدم كل ال Projectors حتى تنتهي، لذلك أبق معاملات الكتابة قصيرة. وإذا استخدمت مكتبة جاهزة فوق PostgreSQL فابحث في توثيقها عن طريقتها في حل هذه المشكلة قبل أن تعتمد عليها.
ال Snapshots: عندما يطول المجرى
طي المجرى سريع إذا كان فيه عشرات الأحداث، وهو الوضع الطبيعي لطلب أو حجز، ولكن بعض المجاري تطول بلا نهاية، مثل مخزون صنف في مستودع يتغير مع كل عملية بيع، وفي المختبر كتبنا 200,000 حدث لمخزون صنف واحد فاستغرق طيها أكثر من ثانيتين في كل مرة نحتاج فيها الحالة. والحل هو ال Snapshot، أي أن تحفظ الحالة عند إصدار معين، ثم تقرأ عند التحميل ال Snapshot مع الأحداث التي بعده فقط، ويؤكد دليل Microsoft أن ال Snapshot تحسين للأداء وليس بديلاً عن المجرى، وأن المجرى يبقى مصدر الحقيقة ويمكن توليد ال Snapshot منه في أي وقت.
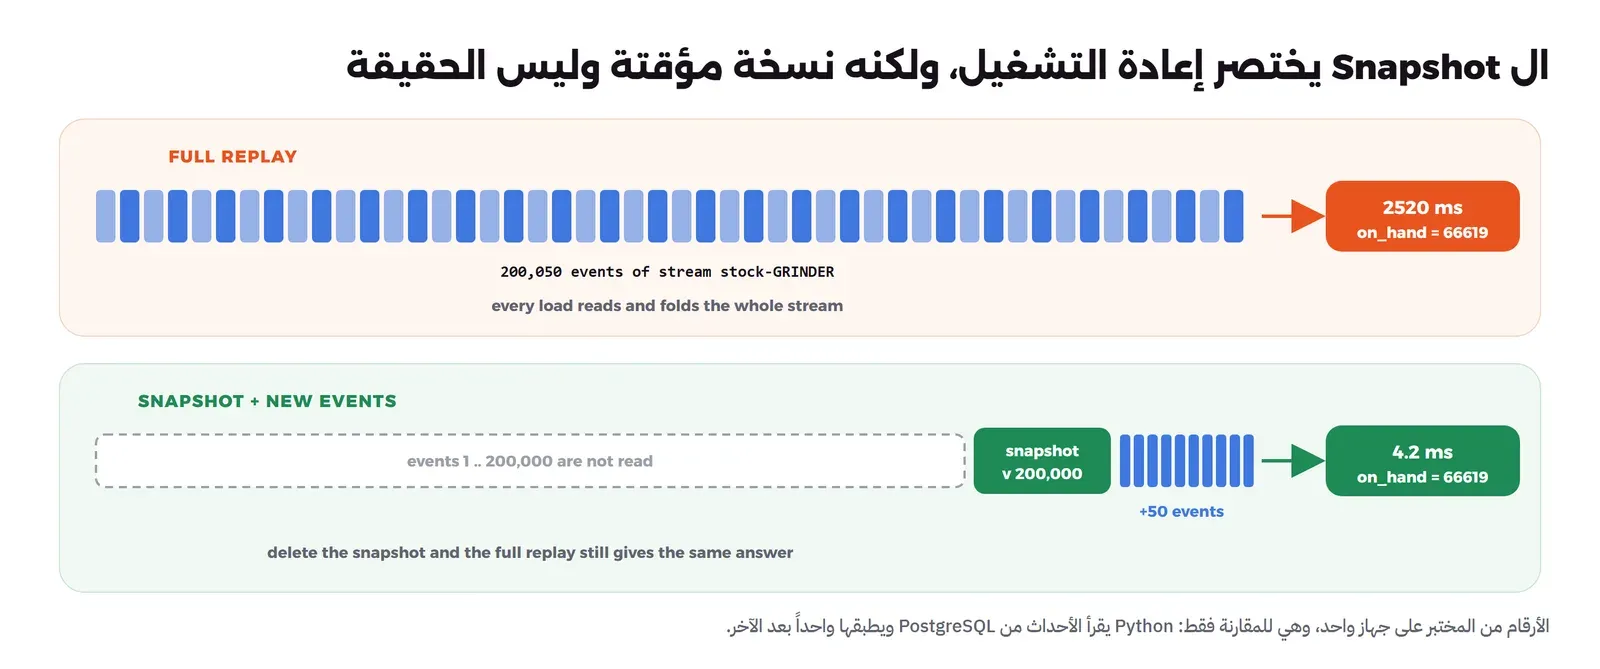
وقبل أن تضيف Snapshots اسأل لماذا طال المجرى، والسبب في أغلب الحالات أن حدود المجرى خاطئة، فمخزون الصنف قد يقسم إلى مجرى لكل يوم يبدأ برصيد إغلاق اليوم السابق، مثل المحاسب الذي يقفل الدفاتر في نهاية الشهر. وإذا أضفت Snapshots فاحفظ معها رقم إصدار شكلها، لأنك عندما تغير شكل الحالة في الكود يجب أن تحذف ال Snapshots القديمة وتعيد بناءها، وهذا سهل لأنها مجرد نسخة.
تغيير شكل الأحداث مع الوقت
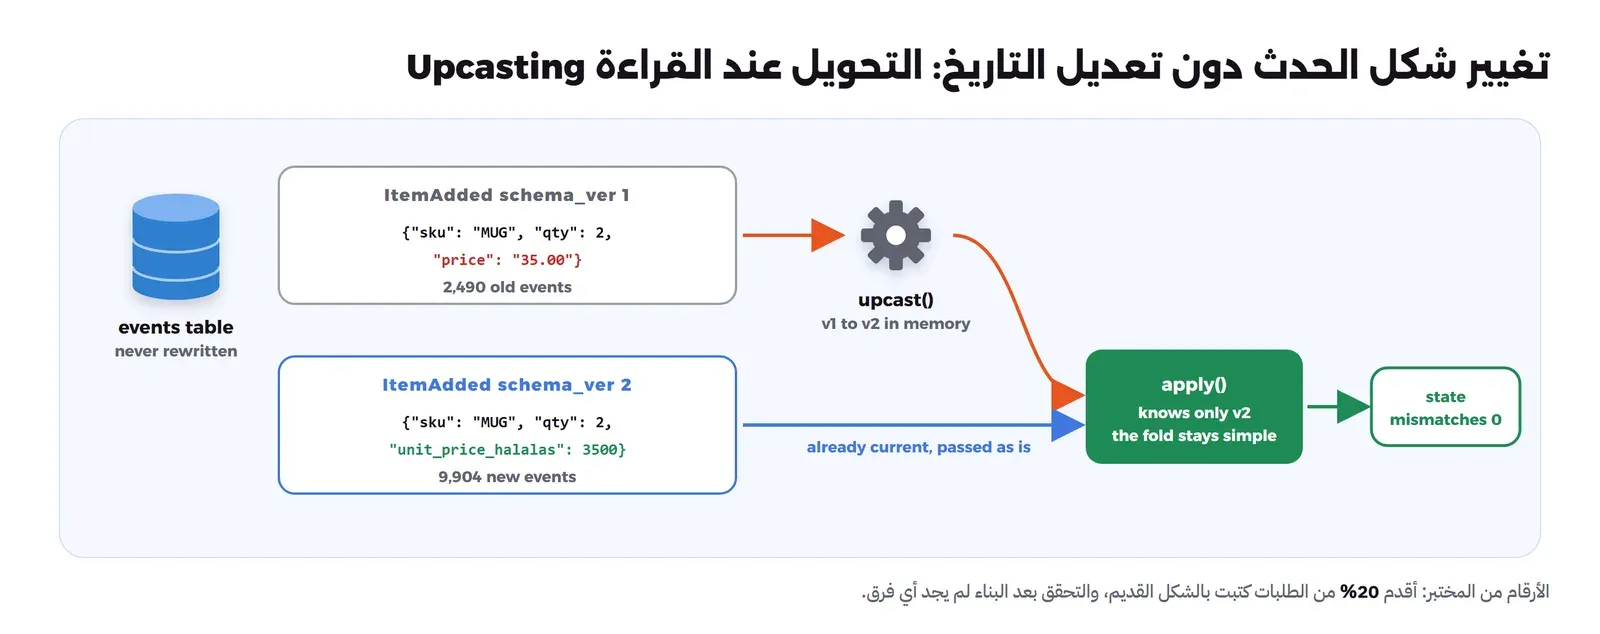
الأحداث تبقى للأبد، ولكن الكود لا يبقى، فبعد سنة سوف تكتشف أن الحدث ItemAdded كان يحفظ السعر بالريال كنص مثل "35.00"، وأنك تريده بالهللة كرقم صحيح كما شرحنا في المحفظة الرقمية. والحل البسيط أن تكتب سكربت يحدث الأحداث القديمة، وهو أسوأ الحلول على الإطلاق في هذا النمط، والسبب أن الأحداث هي التاريخ، ومن يعدل التاريخ يفقد الثقة في كل ما يبنى عليه، لذلك جدول الأحداث في المختبر يرفض أي UPDATE أو DELETE بـ Trigger.
ويشرح Greg Young في كتابه Versioning in an Event Sourced System عدة طرق، أشهرها:
- إصدار في نوع الحدث Type-Based Versioning: حدث جديد باسم أو رقم إصدار جديد، والكود يعرف النوعين.
- المخطط المرن Weak Schema: تضيف حقولاً اختيارية فقط ولا تحذف ولا تغير معنى حقل، فيقرأ الكود القديم والجديد كلا الشكلين، وهذا يكفي لأغلب التغييرات.
- النسخ والتحويل Copy-Transform: في التغيير الكبير تنسخ المجاري إلى مخزن جديد بالشكل الجديد، وهي عملية كبيرة تحتاج تخطيطاً، ولا تلجأ إليها إلا عندما تفشل الطرق الأخرى.
والطريقة التي استخدمناها في المختبر هي التحويل عند القراءة Upcasting، ويصفها دليل Microsoft بأنها دوال تحول الشكل القديم إلى الشكل الحالي عند قراءة الحدث، ويمكن ربطها بالتسلسل حتى لا يعرف كود التطبيق إلا آخر شكل، بينما تبقى الأحداث المحفوظة كما هي:
أما الحدث الخاطئ في معناه، كمبلغ دفع حسب خطأ بسبب Bug، فلا يحله أي تحويل، والحل هو حدث تعويض Compensating Event جديد يصحح الأثر، كما يفعل المحاسب الذي يكتب قيداً عكسياً بدل أن يمسح السطر، وفي كتاب Greg Young فصل عن هذا عنوانه «المحاسبون يكتبون بالقلم» Accountants Use Pens.
البيانات الشخصية وحق الحذف
جدول لا يقبل الحذف يتعارض مباشرة مع حق الشخص في حذف بياناته، ويذكر دليل Microsoft هذا التعارض صراحة، وينبه إلى أن حذف الأحداث يكسر سلامة المجرى، لذلك يجب أن يصمم الحل من البداية وليس بعد أول طلب حذف. والطريقة الأبسط أن تبقى البيانات الشخصية خارج الأحداث: الحدث يحمل معرف العميل فقط، والاسم ورقم الجوال والعنوان في جدول عادي يمكن حذفه أو إخفاؤه، وهذا ما فعلناه في المختبر حيث يحمل الحدث customer-7 وليس اسم العميل. والطريقة الثانية أن تشفر الحقول الشخصية في الحدث بمفتاح خاص بكل شخص، فإذا طلب الحذف حذفت المفتاح فتصبح الحقول غير مقروءة، وهي أعقد في التشغيل لأن ضياع المفتاح بالخطأ له نفس الأثر. وقد ناقشنا ما يتعلق بالخصوصية في السجلات التي لا تقبل التعديل في مقال سجل التدقيق.
الثمن الحقيقي
قد تبدو الفكرة من الوهلة الأولى بسيطة، جدول واحد للإضافة فقط، لكن في الواقع فهي تغير طريقة عمل الفريق كله، وهذه قائمة بما ستدفعه:
- الاتساق النهائي في كل شاشة: كل واجهة تقرأ من نموذج قراءة متأخر، ويجب أن تصمم لذلك، وهذا يصل إلى فريق الواجهات وفريق الدعم الفني.
- تشغيل ال Projectors: برامج تعمل في الخلفية، تحتاج مراقبة لتأخرها Lag، وخطة لإعادة البناء، وإعادة البناء نفسها تأخذ وقتاً يزيد مع الأحداث، ففي المختبر أخذت 23,665 حدثاً بين 12 و70 ثانية بحسب الطريقة، والنظام الحقيقي فيه ملايين.
- الإصدارات للأبد: كل شكل لحدث كتب مرة يجب أن يبقى الكود قادراً على قراءته طوال عمر النظام.
- القواعد بين المجاري: القيد الفريد الذي كان سطراً في SQL يصبح جدولاً جانبياً أو عملية من خطوتين.
- التحقيق في الأخطاء: لا يوجد سطر واحد تنظر إليه، وإنما مجرى تطويه، وأدوات قواعد البيانات المعتادة لا تساعدك كثيراً.
- التخزين: الأحداث لا تحذف، وفي المختبر وصل جدول الأحداث إلى 47 MB مع 223,719 حدثاً صغيراً، وهذا قليل، ولكنه ينمو دائماً ولا ينقص.
- التعلم: يذكر دليل Microsoft أن الفرق التي لا تملك خبرة في الأنظمة المبنية على الأحداث تقع في أنماط خاطئة يصعب الرجوع عنها، ويقترح أسلوب اختبار خاصاً: أحداث سابقة، ثم أمر، ثم تتحقق من الأحداث الناتجة Given-When-Then.
وفي المقابل تحصل على تاريخ كامل لا يمكن إخفاؤه، وعلى استعلامات زمنية، وعلى نماذج قراءة جديدة تبنى من الماضي كله، وعلى أحداث جاهزة للتكامل مع بقية النظام. والسؤال هو هل تحتاج هذه الأشياء في هذا الجزء من النظام بالذات.
متى لا تستخدمه؟
يذكر دليل Microsoft أن النمط قد لا يناسب الأنظمة التي عملياتها CRUD مباشرة ولا تحتاج تدقيقاً أو إعادة تشغيل أو حالة تاريخية، ولا النماذج الأولية والمنتجات في مرحلة MVP، ولا الأنظمة التي تحتاج أن ترى القراءة كل كتابة فوراً، ولا البيانات الثابتة مثل جداول المراجع والكتالوجات، ولا الفرق التي لا تملك خبرة في الأنظمة المبنية على الأحداث، وينصح بأن يطبق على الأجزاء التي تستفيد منه فقط، مثل دفتر المدفوعات أو مسار معالجة الطلبات، ويبقى الباقي CRUD عادياً. ويقول الشيء نفسه دليل CQRS عن الأنظمة التي قواعدها بسيطة وتكفيها واجهة CRUD.
والجدول التالي يبدأ من الحاجة الحقيقية التي تدفع الناس إلى هذا النمط، ويقترح الحل الأبسط لها أولاً:
| الحاجة | الحل الأبسط أولاً | متى يستحق Event Sourcing |
|---|---|---|
| من غير ماذا ومتى | سجل تدقيق بجانب الجداول | عندما يكون التاريخ نفسه هو المنتج، لا مجرد مراجعة |
| تقارير ثقيلة تبطئ قاعدة البيانات | Materialized View أو نسخة قراءة Read Replica | نادراً، فهذه مشكلة قراءة وليست مشكلة تاريخ |
| إخبار خدمات أخرى بما حدث | نمط Outbox | عندما تكون الأحداث هي البيانات أصلاً، فالنشر يصبح Projection آخر |
| أموال وأرصدة | دفتر قيد مزدوج | الدفتر هو Event Sourcing لمجال المال، وغالباً يكفي |
| «ماذا كانت الحالة يوم 3 مارس؟» | جدول تاريخ History Table يكتبه Trigger، أو سجل تدقيق | إذا كان السؤال يومياً ولكيانات معقدة القواعد |
| مجال معقد كثير القواعد وشاشات قراءة متعددة الأشكال | Modular Monolith مع نموذج واحد جيد | هنا يبدأ النمط في دفع ثمنه، في سياق محدد واحد |
والقاعدة التي نقترحها: لا تقم بتطبيق Event Sourcing على النظام كله، ولا تبدأ به في منتج لم يثبت بعد، والسبب أن ثمنه يدفع من اليوم الأول وفائدته تظهر بعد سنوات. وإذا وجدت جزءاً يحتاجه فعلاً، فطبقه على هذا الجزء وحده، واتركه بجانب جداول CRUD عادية في نفس قاعدة البيانات، وهذا ما يجعل PostgreSQL مناسباً للبداية كما شرحنا في PostgreSQL لكل شيء.
الأدوات
- جدول في PostgreSQL: كما في المختبر، وهو كاف للبداية ولأحمال كبيرة، بشرط أن تحل مشكلة ترتيب الالتزام ونقطة التقدم كما شرحنا.
- Marten: مكتبة .NET تستخدم PostgreSQL كقاعدة مستندات ومخزن أحداث، وتدعم Projections يعرفها المستخدم على مجاري الأحداث، ورخصتها MIT.
- Axon Framework: إطار Java لبناء أنظمة CQRS وEvent Sourcing، ورخصته Apache 2.0.
- eventsourcing: مكتبة Python تحفظ الأحداث في PostgreSQL وغيرها، ورخصتها BSD 3-Clause.
- KurrentDB: قاعدة بيانات متخصصة في الأحداث كان اسمها EventStoreDB قبل أن تغير الشركة اسمها إلى Kurrent، وانتبه إلى رخصتها: الملف LICENSE.md في المستودع اليوم هو Kurrent License v1، وهي رخصة تتيح المصدر Source-Available وليست رخصة مفتوحة المصدر، وتمنع تقديم البرنامج كخدمة مستضافة Hosted Service للآخرين.
التجربة العملية: مخزن أحداث في PostgreSQL
سوف نبني مخزن أحداث لمتجر صغير يبيع مستلزمات القهوة، في جدول واحد على PostgreSQL، مع برنامج Python واحد يقوم بجانب الكتابة وال Projector والأوامر التي نجرب بها، ثم نبني نماذج القراءة ونحذفها ونعيد بناءها، ونكسر ال Projector مرتين، ونرى مشكلة ترتيب الالتزام بأرقام حقيقية. والأرقام الزمنية في هذا القسم من جهاز واحد وهي للمقارنة فقط.
ملفات التجربة
أنشئ مجلداً فارغاً وضع فيه أربعة ملفات، أولها compose.yaml، وفيه قاعدة البيانات على منفذ محلي فقط، والتطبيق في ملف تعريف Profile اسمه run حتى لا يعمل إلا عندما نستدعيه:
name: lab-es
services:
  db:
    image: postgres:18.6
    container_name: lab-es-db
    environment:
      POSTGRES_PASSWORD: lab-only-password
      POSTGRES_DB: shop
    ports: ["127.0.0.1:25432:5432"]
    volumes:
      - ./schema.sql:/docker-entrypoint-initdb.d/01-schema.sql:ro
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U postgres -d shop"]
      interval: 2s
      retries: 30
  app:
    build: .
    image: lab-es-app:1
    environment:
      DATABASE_URL: postgresql://postgres:lab-only-password@db:5432/shop
    depends_on:
      db:
        condition: service_healthy
    profiles: ["run"]
ثم Dockerfile للتطبيق:
FROM python:3.13.16-slim
RUN pip install --no-cache-dir "psycopg[binary]==3.3.6"
WORKDIR /app
COPY es.py .
ENTRYPOINT ["python", "-u", "es.py"]
ثم schema.sql، وهو مخزن الأحداث كله مع نماذج القراءة:
-- Event store: one append-only table for every stream
CREATE TABLE events (
  position    bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,  -- global order (may have gaps)
  stream_id   text        NOT NULL,                             -- e.g. order-1001
  version     int         NOT NULL,                             -- 1, 2, 3 … inside the stream
  type        text        NOT NULL,                             -- OrderPlaced, ItemAdded …
  schema_ver  int         NOT NULL DEFAULT 1,                   -- version of the event's shape
  data        jsonb       NOT NULL,
  metadata    jsonb       NOT NULL DEFAULT '{}',
  tx_id       xid8        NOT NULL DEFAULT pg_current_xact_id(),
  recorded_at timestamptz NOT NULL DEFAULT now(),
  UNIQUE (stream_id, version)                                   -- optimistic concurrency
);
CREATE INDEX events_tx_pos ON events (tx_id, position);

-- Nobody edits history: corrections are new events
CREATE FUNCTION events_append_only() RETURNS trigger LANGUAGE plpgsql AS $$
BEGIN
  RAISE EXCEPTION 'events are append-only: % on event %', TG_OP, OLD.position;
END $$;
CREATE TRIGGER events_append_only BEFORE UPDATE OR DELETE ON events
  FOR EACH ROW EXECUTE FUNCTION events_append_only();

-- Read models (projections): disposable, rebuilt from the events
CREATE TABLE order_summary (
  order_id      text PRIMARY KEY,
  customer      text NOT NULL,
  status        text NOT NULL,
  items         int  NOT NULL,
  total_halalas bigint NOT NULL,
  last_version  int  NOT NULL
);
CREATE TABLE sales_by_sku (
  sku text PRIMARY KEY,
  qty bigint NOT NULL
);
CREATE TABLE checkpoints (
  projection    text PRIMARY KEY,
  last_tx       xid8   NOT NULL DEFAULT '0',
  last_position bigint NOT NULL DEFAULT 0
);

-- Snapshots: a cache of a stream's state at a version, never the truth
CREATE TABLE snapshots (
  stream_id text PRIMARY KEY,
  version   int   NOT NULL,
  state     jsonb NOT NULL
);
في الإعداد أعلاه لاحظ التالي:
- القيد
UNIQUE (stream_id, version)هو التزامن المتفائل كله، فلا يوجد قفل ولا جدول إصدارات منفصل. - العمود
positionيرتب الأحداث في كل المجاري، ولكنه لا يكفي وحده لقراءة الأحداث الجديدة كما سوف نرى، لذلك نحفظ بجانبهtx_idبقيمةpg_current_xact_id(). - العمود
schema_verيحفظ إصدار شكل الحدث، وهو ما يعتمد عليه التحويل عند القراءة. - ال Trigger يرفض أي
UPDATEأوDELETE، أما جداول القراءة فلا حماية عليها لأننا سوف نحذفها ونعيد بناءها. - جدول
checkpointsيحفظ أين وصل كل Projector، وجدولsnapshotsنسخة مؤقتة من الحالة.
وأخيراً es.py، وهو البرنامج كله، وكل أمر في آخره خطوة من خطوات التجربة:
# A small event store on PostgreSQL: write side, projections, snapshots, upcasting.
#   python es.py <command> [args]      (see the commands at the bottom)
import json, os, random, sys, threading, time
import psycopg
from psycopg.types.json import Jsonb

DSN = os.environ["DATABASE_URL"]


def connect(autocommit=False):
    return psycopg.connect(DSN, autocommit=autocommit)


# ---------- reading events: upcasting old shapes to the current one ----------
def upcast(etype, schema_ver, data):
    # ItemAdded v1 stored the price in riyals as text: {"sku": "A1", "qty": 2, "price": "12.50"}
    # ItemAdded v2 stores halalas as an integer:      {"sku": "A1", "qty": 2, "unit_price_halalas": 1250}
    if etype == "ItemAdded" and schema_ver == 1:
        riyals, _, frac = data["price"].partition(".")
        return {"sku": data["sku"], "qty": data["qty"],
                "unit_price_halalas": int(riyals) * 100 + int((frac + "00")[:2])}
    return data


# ---------- the fold: state + event -> new state ----------
def apply(state, etype, data):
    if etype == "OrderPlaced":
        return {"customer": data["customer"], "status": "open", "lines": {}, "paid": 0}
    if etype == "ItemAdded":
        line = state["lines"].setdefault(data["sku"], {"qty": 0, "unit_price_halalas": data["unit_price_halalas"]})
        line["qty"] += data["qty"]
    elif etype == "ItemRemoved":
        state["lines"].pop(data["sku"], None)
    elif etype == "OrderPaid":
        state["status"], state["paid"] = "paid", data["amount_halalas"]
    elif etype == "OrderShipped":
        state["status"] = "shipped"
    elif etype == "StockReceived":
        state = state or {"on_hand": 0}
        state["on_hand"] += data["qty"]
    elif etype == "StockReserved":
        state["on_hand"] -= data["qty"]
    return state


def total(state):
    return sum(l["qty"] * l["unit_price_halalas"] for l in state["lines"].values())


def load(cur, stream_id, use_snapshot=False, at_version=None):
    state, version = None, 0
    if use_snapshot:
        cur.execute("SELECT version, state FROM snapshots WHERE stream_id = %s", (stream_id,))
        row = cur.fetchone()
        if row:
            version, state = row
    cur.execute("""SELECT version, type, schema_ver, data FROM events
                   WHERE stream_id = %s AND version > %s AND version <= %s ORDER BY version""",
                (stream_id, version, at_version or 2**31 - 1))
    for v, etype, sv, data in cur:
        state, version = apply(state, etype, upcast(etype, sv, data)), v
    return state, version


# ---------- writing events: expected version = optimistic concurrency ----------
class Conflict(Exception):
    pass


def append(cur, stream_id, expected_version, events):
    try:
        for i, (etype, data) in enumerate(events, 1):
            cur.execute("""INSERT INTO events (stream_id, version, type, schema_ver, data)
                           VALUES (%s, %s, %s, %s, %s)""",
                        (stream_id, expected_version + i, etype, 2 if etype == "ItemAdded" else 1, Jsonb(data)))
    except psycopg.errors.UniqueViolation:
        raise Conflict(f"{stream_id} moved past version {expected_version}")


def handle(stream_id, decide, pause=None):
    """Load the stream, let decide(state) return new events, append them at the version we read."""
    with connect() as c, c.cursor() as cur:
        state, version = load(cur, stream_id)
        events = decide(state)
        if pause:
            pause()
        append(cur, stream_id, version, events)
        return version + len(events)


# business rules live in the decide functions
def place(customer):
    return lambda s: [("OrderPlaced", {"customer": customer})]


def add_item(sku, qty, price):
    def decide(s):
        if s["status"] != "open":
            raise ValueError(f"cannot add items to a {s['status']} order")
        return [("ItemAdded", {"sku": sku, "qty": qty, "unit_price_halalas": price})]
    return decide


def remove_item(sku):
    def decide(s):
        line = s["lines"][sku]
        return [("ItemRemoved", {"sku": sku, "qty": line["qty"], "unit_price_halalas": line["unit_price_halalas"]})]
    return decide


def pay(s):
    if s["status"] != "open" or not s["lines"]:
        raise ValueError("nothing to pay")
    return [("OrderPaid", {"amount_halalas": total(s)})]


def ship(s):
    if s["status"] != "paid":
        raise ValueError("ship only paid orders")
    return [("OrderShipped", {})]


# ---------- projections ----------
def project_event(cur, stream_id, version, etype, data):
    if not stream_id.startswith("order-"):
        return
    if etype in ("ItemAdded", "ItemRemoved"):
        sign = 1 if etype == "ItemAdded" else -1
        # a counter: correct once, wrong when the same event is applied twice
        cur.execute("""INSERT INTO sales_by_sku (sku, qty) VALUES (%s, %s)
                       ON CONFLICT (sku) DO UPDATE SET qty = sales_by_sku.qty + EXCLUDED.qty""",
                    (data["sku"], sign * data["qty"]))
    # the summary carries the stream version, so a repeated event changes nothing
    if etype == "OrderPlaced":
        cur.execute("""INSERT INTO order_summary VALUES (%s, %s, 'open', 0, 0, %s)
                       ON CONFLICT (order_id) DO NOTHING""", (stream_id, data["customer"], version))
        return
    sets = {"ItemAdded": "items = items + %(q)s::int, total_halalas = total_halalas + %(q)s::bigint * %(p)s::bigint",
            "ItemRemoved": "items = items - %(q)s::int, total_halalas = total_halalas - %(q)s::bigint * %(p)s::bigint",
            "OrderPaid": "status = 'paid'", "OrderShipped": "status = 'shipped'"}[etype]
    cur.execute(f"""UPDATE order_summary SET {sets}, last_version = %(v)s
                    WHERE order_id = %(id)s AND last_version < %(v)s""",
                {"q": data.get("qty"), "p": data.get("unit_price_halalas"), "v": version, "id": stream_id})


def run_projector(mode, crash_after=None, batch=100):
    """naive: read everything from the start, no checkpoint.
       separate: read after the checkpoint, commit each event, save the checkpoint every batch.
       safe: read only finished transactions, commit the batch and the checkpoint together."""
    done = 0
    with connect() as c:
        while True:
            with c.cursor() as cur:
                if mode == "naive":
                    cur.execute("SELECT position, tx_id, stream_id, version, type, schema_ver, data FROM events ORDER BY position")
                elif mode == "separate":
                    cur.execute("SELECT last_position FROM checkpoints WHERE projection = 'sales'")
                    last = (cur.fetchone() or [0])[0]
                    cur.execute("""SELECT position, tx_id, stream_id, version, type, schema_ver, data FROM events
                                   WHERE position > %s ORDER BY position LIMIT %s""", (last, batch))
                else:
                    cur.execute("SELECT last_tx, last_position FROM checkpoints WHERE projection = 'sales'")
                    last_tx, last_pos = cur.fetchone() or ("0", 0)
                    cur.execute("""SELECT position, tx_id, stream_id, version, type, schema_ver, data FROM events
                                   WHERE (tx_id, position) > (%s::xid8, %s)
                                     AND tx_id < pg_snapshot_xmin(pg_current_snapshot())
                                   ORDER BY tx_id, position LIMIT %s""", (last_tx, last_pos, batch))
                rows = cur.fetchall()
                if not rows:
                    c.commit()
                    return done
                for pos, tx, sid, ver, etype, sv, data in rows:
                    project_event(cur, sid, ver, etype, upcast(etype, sv, data))
                    done += 1
                    if mode == "separate":
                        c.commit()                      # read model saved, checkpoint not yet
                    if crash_after and done == crash_after:
                        print(f"projector crashed after {done} events")
                        os._exit(1)
                cur.execute("""INSERT INTO checkpoints VALUES ('sales', %s, %s)
                               ON CONFLICT (projection) DO UPDATE SET last_tx = EXCLUDED.last_tx,
                                                                      last_position = EXCLUDED.last_position""",
                            (str(rows[-1][1]), rows[-1][0]))
                c.commit()                              # safe: batch + checkpoint in one commit
                if mode == "naive":
                    return done


# ---------- commands ----------
def cmd_demo():
    sid = "order-1001"
    for decide in (place("Sara"), add_item("COFFEE-1KG", 2, 8900), add_item("MUG", 1, 3500),
                   remove_item("MUG"), add_item("FILTER-100", 3, 1250), pay):
        handle(sid, decide)
    with connect() as c, c.cursor() as cur:
        cur.execute("SELECT position, version, type, data FROM events WHERE stream_id = %s ORDER BY version", (sid,))
        for row in cur:
            print(*row, sep=" | ")
        state, v = load(cur, sid)
        print(f"current state (version {v}): status={state['status']} total={total(state)} lines={json.dumps(state['lines'])}")
        old, _ = load(cur, sid, at_version=3)
        print(f"state at version 3: status={old['status']} total={total(old)} lines={json.dumps(old['lines'])}")
    try:
        handle(sid, add_item("MUG", 1, 3500))
    except ValueError as e:
        print("rejected:", e)


def cmd_conflict():
    sid = "order-2001"
    handle(sid, place("Omar"))
    barrier = threading.Barrier(2)

    def worker(name, sku):
        try:
            v = handle(sid, add_item(sku, 1, 1000), pause=barrier.wait)
            print(f"{name}: appended, stream now at version {v}")
        except Conflict as e:
            print(f"{name}: conflict ({e}), reloading and trying again")
            v = handle(sid, add_item(sku, 1, 1000))
            print(f"{name}: appended on retry, stream now at version {v}")
    ts = [threading.Thread(target=worker, args=(n, s)) for n, s in (("tab-1", "PEN"), ("tab-2", "BOOK"))]
    [t.start() for t in ts]
    [t.join() for t in ts]


def cmd_seed(n):
    random.seed(7)
    skus = [("COFFEE-1KG", 8900), ("MUG", 3500), ("FILTER-100", 1250), ("KETTLE", 15900), ("GRINDER", 24900)]
    rows = []
    for i in range(n):
        sid, v = f"order-{10000 + i}", 0
        def ev(etype, data, sv=1):
            nonlocal v
            v += 1
            rows.append((sid, v, etype, sv, Jsonb(data)))
        ev("OrderPlaced", {"customer": f"customer-{i % 500}"})
        legacy = i < n // 5                              # the oldest 20% were written before the price change
        lines = {}
        for _ in range(random.randint(1, 4)):
            sku, price = random.choice(skus)
            qty = random.randint(1, 3)
            if legacy:
                ev("ItemAdded", {"sku": sku, "qty": qty, "price": f"{price // 100}.{price % 100:02d}"}, 1)
            else:
                ev("ItemAdded", {"sku": sku, "qty": qty, "unit_price_halalas": price}, 2)
            lines[sku] = (lines.get(sku, (0, price))[0] + qty, price)
        if random.random() < 0.2:
            sku = random.choice(list(lines))
            ev("ItemRemoved", {"sku": sku, "qty": lines[sku][0], "unit_price_halalas": lines[sku][1]})
            del lines[sku]
        if lines and random.random() < 0.7:
            ev("OrderPaid", {"amount_halalas": sum(q * p for q, p in lines.values())})
            if random.random() < 0.6:
                ev("OrderShipped", {})
    with connect() as c, c.cursor() as cur:
        cur.executemany("INSERT INTO events (stream_id, version, type, schema_ver, data) VALUES (%s, %s, %s, %s, %s)", rows)
    print(f"seeded {n} orders, {len(rows)} events")


def cmd_verify():
    """Fold every order stream directly from the events and compare with the read models."""
    with connect() as c, c.cursor() as cur:
        cur.execute("SELECT DISTINCT stream_id FROM events WHERE stream_id LIKE 'order-%'")
        ids = [r[0] for r in cur.fetchall()]
        expected_sku, bad = {}, 0
        for sid in ids:
            s, v = load(cur, sid)
            for sku, l in s["lines"].items():
                expected_sku[sku] = expected_sku.get(sku, 0) + l["qty"]
            cur.execute("SELECT status, total_halalas, last_version FROM order_summary WHERE order_id = %s", (sid,))
            if cur.fetchone() != (s["status"], total(s), v):
                bad += 1
        cur.execute("SELECT sku, qty FROM sales_by_sku")
        got = dict(cur.fetchall())
        print(f"orders checked: {len(ids)}, order_summary mismatches: {bad}")
        for sku in sorted(expected_sku):
            mark = "ok" if got.get(sku) == expected_sku[sku] else "WRONG"
            print(f"  {sku:<11} expected {expected_sku[sku]:>5}  read model {got.get(sku, 0):>5}  {mark}")


def cmd_reset():
    with connect() as c:
        c.execute("TRUNCATE order_summary, sales_by_sku, checkpoints")
    print("read models and checkpoint dropped")


def cmd_project(mode, crash_after=None):
    t = time.perf_counter()
    n = run_projector(mode, int(crash_after) if crash_after else None)
    print(f"projected {n} events in {time.perf_counter() - t:.2f}s ({mode})")


def cmd_gap(mode):
    """Two writers: A takes a position first but commits last. Does the projector see A's event?"""
    seen = []
    with connect() as c:
        c.execute("TRUNCATE checkpoints")
        c.commit()
    a, b = connect(), connect()
    pa = a.execute("INSERT INTO events (stream_id, version, type, data) VALUES (%s, 1, 'Ping', '{}') RETURNING position",
                   (f"gap-{mode}-a",)).fetchone()[0]
    pb = b.execute("INSERT INTO events (stream_id, version, type, data) VALUES (%s, 1, 'Ping', '{}') RETURNING position",
                   (f"gap-{mode}-b",)).fetchone()[0]
    b.commit()
    print(f"writer A holds position {pa} (not committed), writer B committed position {pb}")

    def poll(label):
        with connect() as c, c.cursor() as cur:
            cur.execute("SELECT last_tx, last_position FROM checkpoints WHERE projection = 'gap'")
            last_tx, last_pos = cur.fetchone() or ("0", 0)
            if mode == "position":
                cur.execute("SELECT position, tx_id FROM events WHERE stream_id LIKE %s AND position > %s ORDER BY position", (f"gap-{mode}-%", last_pos))
            else:
                cur.execute("""SELECT position, tx_id FROM events WHERE stream_id LIKE %s
                               AND (tx_id, position) > (%s::xid8, %s) AND tx_id < pg_snapshot_xmin(pg_current_snapshot())
                               ORDER BY tx_id, position""", (f"gap-{mode}-%", last_tx, last_pos))
            rows = cur.fetchall()
            seen.extend(r[0] for r in rows)
            if rows:
                cur.execute("""INSERT INTO checkpoints VALUES ('gap', %s, %s) ON CONFLICT (projection)
                               DO UPDATE SET last_tx = EXCLUDED.last_tx, last_position = EXCLUDED.last_position""",
                            (str(rows[-1][1]), rows[-1][0]))
            print(f"{label}: read {[r[0] for r in rows]}")
    poll("poll 1")
    a.commit()
    print(f"writer A committed position {pa}")
    poll("poll 2")
    print(f"projector saw {sorted(seen)}, missed {sorted({pa, pb} - set(seen))}")
    a.close(); b.close()


def cmd_snapshot_bench(n):
    sid = "stock-GRINDER"
    with connect() as c:
        c.execute("""INSERT INTO events (stream_id, version, type, data)
                     SELECT %s, g, CASE WHEN g %% 3 = 1 THEN 'StockReceived' ELSE 'StockReserved' END,
                            jsonb_build_object('qty', CASE WHEN g %% 3 = 1 THEN 5 ELSE 2 END)
                     FROM generate_series(1, %s) g""", (sid, n))
    with connect() as c, c.cursor() as cur:
        t = time.perf_counter(); s, v = load(cur, sid); full = time.perf_counter() - t
        print(f"full replay:   {v} events -> on_hand={s['on_hand']} in {full * 1000:.0f} ms")
        cur.execute("INSERT INTO snapshots VALUES (%s, %s, %s) ON CONFLICT (stream_id) DO UPDATE SET version = EXCLUDED.version, state = EXCLUDED.state", (sid, v, Jsonb(s)))
        for i in range(1, 51):
            append(cur, sid, v + i - 1, [("StockReserved", {"qty": 1})])
        c.commit()
        t = time.perf_counter(); s2, v2 = load(cur, sid, use_snapshot=True); snap = time.perf_counter() - t
        print(f"with snapshot: snapshot at {v} + {v2 - v} events -> on_hand={s2['on_hand']} in {snap * 1000:.1f} ms")
        t = time.perf_counter(); s3, v3 = load(cur, sid); full2 = time.perf_counter() - t
        print(f"full replay again: {v3} events -> on_hand={s3['on_hand']} in {full2 * 1000:.0f} ms")


if __name__ == "__main__":
    cmd, *args = sys.argv[1:]
    {"demo": cmd_demo, "conflict": cmd_conflict, "seed": lambda n: cmd_seed(int(n)), "verify": cmd_verify,
     "reset": cmd_reset, "project": cmd_project, "gap": cmd_gap,
     "snapshot-bench": lambda n: cmd_snapshot_bench(int(n))}[cmd](*args)
في الكود أعلاه لاحظ التالي:
- الدالة
handleهي جانب الكتابة كله: تقرأ وتطوي، ثم تستدعي دالة القرار التي تتحقق من القواعد، ثم تكتب عند الإصدار الذي قرأته، وكل قواعد العمل موجودة في دوال القرار مثلadd_itemوpay. - الدالة
applyلا تتحقق من أي قاعدة، لأنها تطبق أحداثاً وقعت، ولو رفضت حدثاً قديماً لما استطعت تحميل المجرى. - الدالة
project_eventفيها نموذجان عن قصد:order_summaryيتحقق من الإصدار فهو آمن عند التكرار، وsales_by_skuعداد يزيد بكل حدث فهو غير آمن. - الدالة
run_projectorفيها ثلاث طرق:naiveيقرأ كل شيء من البداية دون نقطة تقدم، وseparateيحفظ كل حدث في معاملة ونقطة التقدم كل مئة حدث، وsafeيقرأ ما انتهت معاملاته فقط ويحفظ الدفعة ونقطة التقدم في معاملة واحدة.
التشغيل وأول طلب
شغل قاعدة البيانات وابن ال Docker Image للتطبيق، ثم نفذ الأمر demo الذي يمر بالطلب order-1001 من الإنشاء إلى الدفع، ثم يحاول إضافة صنف بعد الدفع:
docker compose up -d --wait db
docker compose build app
docker compose run --rm app demo
والمخرج سوف يكون كما يلي:
1 | 1 | OrderPlaced | {'customer': 'Sara'}
2 | 2 | ItemAdded | {'qty': 2, 'sku': 'COFFEE-1KG', 'unit_price_halalas': 8900}
3 | 3 | ItemAdded | {'qty': 1, 'sku': 'MUG', 'unit_price_halalas': 3500}
4 | 4 | ItemRemoved | {'qty': 1, 'sku': 'MUG', 'unit_price_halalas': 3500}
5 | 5 | ItemAdded | {'qty': 3, 'sku': 'FILTER-100', 'unit_price_halalas': 1250}
6 | 6 | OrderPaid | {'amount_halalas': 21550}
current state (version 6): status=paid total=21550 lines={"COFFEE-1KG": {"qty": 2, "unit_price_halalas": 8900}, "FILTER-100": {"qty": 3, "unit_price_halalas": 1250}}
state at version 3: status=open total=21300 lines={"COFFEE-1KG": {"qty": 2, "unit_price_halalas": 8900}, "MUG": {"qty": 1, "unit_price_halalas": 3500}}
rejected: cannot add items to a paid order
في المخرج أعلاه لاحظ التالي:
- الطلب ستة أحداث، وسؤال الدعم الفني في أول المقال أصبح له إجابة: الكوب أضيف في الإصدار 3 وحذف في الإصدار 4 قبل الدفع.
- السطر
state at version 3هو الاستعلام الزمني، فقد حسبنا الحالة كما كانت بعد إضافة الكوب، ولم نحفظها في أي مكان. - الأمر الأخير رفض لأن دالة القرار رأت الحالة
paid، ولم يكتب أي حدث.
والآن نحاول تعديل التاريخ من قاعدة البيانات مباشرة، كما يفعل مطور مستعجل يريد إصلاح مبلغ:
docker exec lab-es-db psql -U postgres -d shop -c "UPDATE events SET data = '{\"amount_halalas\": 100}' WHERE position = 6;"
docker exec lab-es-db psql -U postgres -d shop -c "DELETE FROM events WHERE stream_id = 'order-1001';"
والمخرج سوف يكون كما يلي:
ERROR:  events are append-only: UPDATE on event 6
CONTEXT:  PL/pgSQL function events_append_only() line 3 at RAISE
ERROR:  events are append-only: DELETE on event 1
CONTEXT:  PL/pgSQL function events_append_only() line 3 at RAISE
وهذا ال Trigger يحمي من الخطأ وليس من مدير قاعدة البيانات، فمن يملك صلاحية المدير يستطيع إيقافه، وإذا أردت كشف ذلك أيضاً فسلسلة الهاش في مقال سجل التدقيق تنطبق هنا كما هي.
نافذتان تكتبان في نفس الطلب
الأمر conflict ينشئ الطلب order-2001، ثم يشغل خيطين Threads يقرأ كل منهما المجرى عند الإصدار 1، وينتظران بعضهما عند Barrier حتى يكتبا في اللحظة نفسها:
docker compose run --rm app conflict
docker exec lab-es-db psql -U postgres -d shop -c "SELECT position, version, type, data FROM events WHERE stream_id='order-2001' ORDER BY version;"
والمخرج سوف يكون كما يلي:
tab-1: appended, stream now at version 2
tab-2: conflict (order-2001 moved past version 1), reloading and trying again
tab-2: appended on retry, stream now at version 3
 position | version |    type     |                         data
----------+---------+-------------+-------------------------------------------------------
        7 |       1 | OrderPlaced | {"customer": "Omar"}
        8 |       2 | ItemAdded   | {"qty": 1, "sku": "PEN", "unit_price_halalas": 1000}
       10 |       3 | ItemAdded   | {"qty": 1, "sku": "BOOK", "unit_price_halalas": 1000}
(3 rows)
في المخرج أعلاه لاحظ التالي:
- النافذة الثانية لم تكتب الإصدار 2 فوق الأولى، وإنما رفضها القيد الفريد، فأعادت القراءة والتحقق ثم كتبت الإصدار 3، ولو كانت القاعدة تمنع ذلك (مثلاً لو كان الطلب قد دفع في النافذة الأولى) لرفض الأمر.
- الرقم 9 غير موجود في العمود
position، والسبب أن المحاولة الفاشلة أخذت الرقم 9 من ال Sequence ثم ألغيت معاملتها، ولم يعد الرقم، وهذه هي الفجوات التي تحدث عنها توثيق PostgreSQL، وسوف نعود إليها.
خمسة آلاف طلب ونماذج القراءة
الأمر seed يكتب 5,000 طلب بأحداث عشوائية ثابتة البذرة، وأقدم 20% منها يكتب فيها ItemAdded بالشكل القديم الذي يحفظ السعر بالريال كنص، كأنها كتبت قبل أن نغير الشكل، ثم نشغل ال Projector بالطريقة الآمنة، ثم نتحقق من النتيجة بالأمر verify الذي يطوي كل مجرى من الأحداث مباشرة ويقارنه بجداول القراءة:
docker compose run --rm app seed 5000
docker exec lab-es-db psql -U postgres -d shop -c "SELECT type, schema_ver, count(*) FROM events GROUP BY 1,2 ORDER BY 1,2;"
docker compose run --rm app project safe
docker compose run --rm app verify
والمخرج سوف يكون كما يلي:
seeded 5000 orders, 23656 events
     type     | schema_ver | count
--------------+------------+-------
 ItemAdded    |          1 |  2490
 ItemAdded    |          2 |  9904
 ItemRemoved  |          1 |  1008
 OrderPaid    |          1 |  3256
 OrderPlaced  |          1 |  5002
 OrderShipped |          1 |  2005
(6 rows)

projected 23665 events in 34.84s (safe)
orders checked: 5002, order_summary mismatches: 0
  BOOK        expected     1  read model     1  ok
  COFFEE-1KG  expected  4422  read model  4422  ok
  FILTER-100  expected  4497  read model  4497  ok
  GRINDER     expected  4458  read model  4458  ok
  KETTLE      expected  4498  read model  4498  ok
  MUG         expected  4532  read model  4532  ok
  PEN         expected     1  read model     1  ok
وهذه النتيجة تثبت أن التحويل عند القراءة يعمل، فالأحداث القديمة وعددها 2,490 دخلت في الحساب بأسعار صحيحة دون أن يعدل منها حرف. ويمكنك أن ترى التحويل وحده بهذا الأمر:
docker compose run --rm --entrypoint python app -c "
from es import upcast
print(upcast('ItemAdded', 1, {'sku': 'MUG', 'qty': 2, 'price': '35.00'}))
print(upcast('ItemAdded', 1, {'sku': 'FILTER-100', 'qty': 1, 'price': '12.5'}))
print(upcast('ItemAdded', 2, {'sku': 'MUG', 'qty': 2, 'unit_price_halalas': 3500}))"
{'sku': 'MUG', 'qty': 2, 'unit_price_halalas': 3500}
{'sku': 'FILTER-100', 'qty': 1, 'unit_price_halalas': 1250}
{'sku': 'MUG', 'qty': 2, 'unit_price_halalas': 3500}لاحظ السطر الثاني: السعر القديم "12.5" بخانة عشرية واحدة تحول إلى 1250 وليس 125، وهذه بالضبط الحالات الصغيرة التي يجب أن يغطيها اختبار لكل دالة تحويل، لأن الخطأ فيها يصل إلى كل حساب مبني على الأحداث القديمة.
نكسر ال Projector: إعادة التشغيل مرتين
الآن نحذف جداول القراءة ونشغل ال Projector بالطريقة البسيطة التي لا تحفظ نقطة تقدم، ثم نشغله مرة ثانية، كما يحدث عندما يعيد Kubernetes تشغيل Container أو يشغل مطور السكربت مرتين:
docker compose run --rm app reset
docker compose run --rm app project naive
docker compose run --rm app project naive
docker compose run --rm app verify
والمخرج سوف يكون كما يلي:
read models and checkpoint dropped
projected 23665 events in 20.97s (naive)
projected 23665 events in 13.13s (naive)
orders checked: 5002, order_summary mismatches: 0
  BOOK        expected     1  read model     2  WRONG
  COFFEE-1KG  expected  4422  read model  8844  WRONG
  FILTER-100  expected  4497  read model  8994  WRONG
  GRINDER     expected  4458  read model  8916  WRONG
  KETTLE      expected  4498  read model  8996  WRONG
  MUG         expected  4532  read model  9064  WRONG
  PEN         expected     1  read model     2  WRONG
في المخرج أعلاه لاحظ التالي:
- كل عداد في
sales_by_skuتضاعف بالضبط، لأن كل حدث طبق مرتين، ولا يوجد أي خطأ في السجلات يخبرك بذلك، فالأرقام فقط خاطئة. - جدول
order_summaryبقي صحيحاً تماماً رغم أنه رأى نفس الأحداث مرتين، والسبب الشرطlast_version < %(v)sالذي يتجاهل الحدث الذي طبق من قبل.
ولكن نقطة التقدم وحدها لا تكفي إذا حفظت في معاملة منفصلة، والأمر التالي يحفظ كل حدث في معاملته، ونقطة التقدم كل مئة حدث، ويتوقف فجأة بعد الحدث 250 كأن السيرفر انطفأ:
docker compose run --rm app reset
docker compose run --rm app project separate 250
docker exec lab-es-db psql -U postgres -d shop -Atc "SELECT projection, last_position FROM checkpoints"
docker compose run --rm app project separate
docker compose run --rm app verify
والمخرج سوف يكون كما يلي:
read models and checkpoint dropped
projector crashed after 250 events
sales|201
projected 23465 events in 69.52s (separate)
orders checked: 5002, order_summary mismatches: 0
  BOOK        expected     1  read model     1  ok
  COFFEE-1KG  expected  4422  read model  4428  WRONG
  FILTER-100  expected  4497  read model  4500  WRONG
  GRINDER     expected  4458  read model  4469  WRONG
  KETTLE      expected  4498  read model  4510  WRONG
  MUG         expected  4532  read model  4537  WRONG
  PEN         expected     1  read model     1  ok
نقطة التقدم كانت عند الموضع 201، وهو آخر حدث في الدفعة الثانية (الموضع 9 فجوة كما رأينا)، والأحداث الخمسون بعده كانت قد حفظت في جدول القراءة قبل التوقف، فطبقت مرة ثانية بعد إعادة التشغيل، والفرق في العدادات مجموعه 37 وحدة، وهو خطأ صغير يصعب أن يلاحظه أحد في تقرير مبيعات، وهذا ما يجعله خطيراً. ولاحظ أن هذه الطريقة كانت الأبطأ أيضاً، لأنها تلتزم بعد كل حدث. والآن نعيد التجربة نفسها بالطريقة الآمنة:
docker compose run --rm app reset
docker compose run --rm app project safe 250
docker exec lab-es-db psql -U postgres -d shop -Atc "SELECT projection, last_tx, last_position FROM checkpoints"
docker compose run --rm app project safe
docker compose run --rm app verify
والمخرج سوف يكون كما يلي:
read models and checkpoint dropped
projector crashed after 250 events
sales|784|201
projected 23465 events in 12.24s (safe)
orders checked: 5002, order_summary mismatches: 0
  BOOK        expected     1  read model     1  ok
  COFFEE-1KG  expected  4422  read model  4422  ok
  FILTER-100  expected  4497  read model  4497  ok
  GRINDER     expected  4458  read model  4458  ok
  KETTLE      expected  4498  read model  4498  ok
  MUG         expected  4532  read model  4532  ok
  PEN         expected     1  read model     1  ok
التوقف نفسه في المكان نفسه، ولكن الأحداث من 201 إلى 250 كانت في معاملة الدفعة الثالثة التي لم تلتزم، فألغتها قاعدة البيانات مع نقطة التقدم، وبدأ التشغيل الثاني من حيث يجب أن يبدأ. وهذا هو الفرق الذي في الصورة التي رأيتها في قسم ال Projections.
الحدث الذي لا يراه ال Projector
الأمر gap يفتح اتصالين: الكاتب A يكتب حدثاً ولا يلتزم، ثم الكاتب B يكتب حدثاً ويلتزم، ثم يقرأ ال Projector، ثم يلتزم A، ثم يقرأ ال Projector مرة ثانية. نشغله مرة بالقراءة حسب الرقم ومرة بالقراءة حسب معرف المعاملة:
docker compose run --rm app gap position
docker compose run --rm app gap tx
والمخرج سوف يكون كما يلي:
writer A holds position 23667 (not committed), writer B committed position 23668
poll 1: read [23668]
writer A committed position 23667
poll 2: read []
projector saw [23668], missed [23667]
writer A holds position 23669 (not committed), writer B committed position 23670
poll 1: read []
writer A committed position 23669
poll 2: read [23669, 23670]
projector saw [23669, 23670], missed []
في المرة الأولى ضاع الحدث 23667 للأبد من هذا ال Projector، ولن يظهر في جدول القراءة حتى تعيد البناء من الصفر، ولو كان هذا الحدث دفعة عميل لظهر الطلب في التقارير غير مدفوع. وفي المرة الثانية لم يقرأ ال Projector شيئاً في القراءة الأولى، رغم أن B كان قد التزم، والسبب أن A ما زال مفتوحاً ومعرف معاملته أصغر، فانتظر ثم قرأ الاثنين بالترتيب. وهذا الخطأ لا يظهر في بيئة التطوير لأن الكتابة فيها لا تتزامن، ويظهر في الإنتاج تحت الضغط مرة كل بضعة آلاف حدث.
مجرى من مئتي ألف حدث
الأمر snapshot-bench يكتب 200,000 حدث لمخزون الصنف GRINDER في مجرى واحد، ثم يقيس الطي الكامل، ثم يحفظ Snapshot ويضيف 50 حدثاً بعده، ثم يقيس التحميل من ال Snapshot، ثم الطي الكامل مرة ثانية للمقارنة:
docker compose run --rm app snapshot-bench 200000والمخرج سوف يكون كما يلي:
full replay:   200000 events -> on_hand=66669 in 2390 ms
with snapshot: snapshot at 200000 + 50 events -> on_hand=66619 in 4.2 ms
full replay again: 200050 events -> on_hand=66619 in 2520 ms
الطي الكامل والتحميل من ال Snapshot أعطيا نفس الرصيد 66619، والفرق في الوقت أكثر من 500 ضعف، لأن التحميل الثاني قرأ سطراً واحداً و50 حدثاً بدل 200,050 حدث. وتذكر أن هذا المجرى مصطنع عن قصد، والحل الأول لمجرى بهذا الطول هو أن تراجع حدوده كما ذكرنا.
CQRS دون أحداث: Materialized View
وللمقارنة، هذا أبسط فصل بين الكتابة والقراءة في نفس قاعدة البيانات، دون أي حدث: جدول طلبات عادي يكتب فيه التطبيق، وعرض مادي للتقارير يحسب منه مبيعات كل عميل:
CREATE TABLE orders_crud (id int PRIMARY KEY, customer text NOT NULL, status text NOT NULL, total_halalas bigint NOT NULL);
INSERT INTO orders_crud SELECT g, 'customer-' || (g % 500), (ARRAY['open','paid','shipped'])[1 + g % 3], 1000 + (g * 37) % 50000 FROM generate_series(1, 5000) g;
CREATE MATERIALIZED VIEW sales_per_customer AS
  SELECT customer, count(*) AS orders, sum(total_halalas) AS spent_halalas
  FROM orders_crud WHERE status <> 'open' GROUP BY customer;
CREATE UNIQUE INDEX ON sales_per_customer (customer);
SELECT * FROM sales_per_customer WHERE customer = 'customer-3';
UPDATE orders_crud SET status = 'paid' WHERE id = 3;
SELECT * FROM sales_per_customer WHERE customer = 'customer-3';
REFRESH MATERIALIZED VIEW CONCURRENTLY sales_per_customer;
SELECT * FROM sales_per_customer WHERE customer = 'customer-3';
والمخرج سوف يكون كما يلي:
  customer  | orders | spent_halalas
------------+--------+---------------
 customer-3 |      6 |        206166
(1 row)

UPDATE 1
  customer  | orders | spent_halalas
------------+--------+---------------
 customer-3 |      6 |        206166
(1 row)

REFRESH MATERIALIZED VIEW
  customer  | orders | spent_halalas
------------+--------+---------------
 customer-3 |      7 |        207277
(1 row)
بعد دفع الطلب رقم 3 بقي التقرير على القيمة القديمة حتى التحديث، وهذا نفس الاتساق النهائي الذي في CQRS، بثمن أقل بكثير. والخيار CONCURRENTLY يسمح بالقراءة من العرض أثناء التحديث، ويشترط توثيق PostgreSQL لذلك فهرساً فريداً على العرض، لذلك أنشأناه. وإذا كانت مشكلتك تقارير بطيئة فقط، فقد يكون هذا كل ما تحتاجه.
حذف التجربة
docker compose --profile run down -v
docker image rm lab-es-app:1
أخطاء شائعة
- تطبيق Event Sourcing على النظام كله، بما فيه إعدادات المستخدم وجداول المراجع التي لا يهم تاريخها أحداً.
- تعديل الأحداث القديمة بسكربت عند تغيير شكلها، بدل التحويل عند القراءة أو حدث التعويض.
- Projector يحفظ جدول القراءة ونقطة التقدم في معاملتين، أو عدادات تزيد بكل حدث دون أي حماية من التكرار.
- قراءة الأحداث الجديدة بشرط «الرقم أكبر من آخر رقم» على Sequence عادي، فتضيع أحداث تحت الضغط دون أي خطأ.
- جانب الكتابة يقرأ من جدول القراءة ليتحقق من قاعدة، فيتخذ قراراً على بيانات متأخرة.
- إرسال بريد أو استدعاء بوابة دفع من Projector يعاد تشغيله من الصفر.
- نشر الأحداث الداخلية كما هي للخدمات الأخرى، فيصبح كل تغيير في نموذجك تغييراً في عقد عام.
- وضع الاسم ورقم الجوال داخل الأحداث، ثم اكتشاف أنه لا توجد طريقة لحذفها.
- مجاري بلا نهاية تعالج بال Snapshots بدل مراجعة حدودها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- Event Sourcing يجعل الأحداث هي البيانات ومصدر الحقيقة، والحالة تحسب منها بالطي، فتحصل على التاريخ والاستعلام الزمني وإعادة البناء.
- CQRS يفصل نموذج الكتابة عن نموذج القراءة، ويأتي غالباً مع Event Sourcing، ويمكن أن يكون وحده في صورة بسيطة مثل Materialized View أو قاعدة تقارير.
- التزامن المتفائل في المجرى الواحد يكفيه قيد فريد على المجرى والإصدار.
- نماذج القراءة قابلة للرمي، ويجب أن تكون آمنة عند التكرار، ونقطة التقدم تحفظ في نفس معاملة التحديث، والمختبر أظهر الفرق: العدادات تضاعفت أو زادت 37 وحدة بالطرق الخاطئة، وصفر أخطاء بالطريقة الآمنة.
- الرقم التسلسلي لا يعني ترتيب الالتزام، والقراءة بمعرف المعاملة مع
pg_snapshot_xminمنعت ضياع الحدث. - ال Snapshot نسخة مؤقتة، والتحويل عند القراءة يغير شكل الأحداث دون تعديل التاريخ، والبيانات الشخصية تبقى خارج الأحداث.
- الثمن يدفع من اليوم الأول، لذلك طبقه على سياق محدد يحتاجه فعلاً، وابدأ دائماً بالحل الأبسط في جدول القرار.
وفي مقالات هذا القسم نكمل ما تحتاجه الأنظمة التي تعتمد على الأحداث والخدمات المتعددة:
 دليلالمعاملات الموزعة: Saga ونمط Outbox بدل 2PCكيف تنفذ عملية تمتد على عدة خدمات دون 2PC، بخطوات محلية وتعويضات وجدول Outbox لا يضيع فيه أي حدث.
 دليلIdempotency: كيف تجعل العملية آمنة عند تكرارهالماذا تصل الرسالة نفسها أكثر من مرة، وكيف تكتب مستهلكاً يطبقها مرة واحدة فقط مهما تكررت.
 دليلالطابور Queue أم بث الأحداث Event Streaming؟ما يحدث للرسالة بعد قراءتها هو الفرق بين طابور مثل RabbitMQ وسجل أحداث مثل Kafka، ومنه تعرف أيهما يناسب مشروعك.
 دليلAudit Trail: كيف تبني سجل تدقيق لا يقبل العبثكيف تصمم سجلاً يجيب عن سؤال من غير هذه الصلاحية ومتى، وتحميه من الحذف والتعديل بعد كتابته.
 دليلMonolith أم Microservices؟ قرار صادق للفرق الصغيرة والكبيرةمتى يكفيك برنامج واحد مقسم إلى وحدات، ومتى تستحق الخدمات المصغرة ثمنها، مع حالات موثقة وتجربة تقيس الفرق.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة العملية على Docker Engine 29.8.0 وDocker Compose 5.5.1 مع PostgreSQL 18.6 وPython 3.13.16 وpsycopg 3.3.6.