

يكتب المطور استعلاماً يعمل في أجزاء من الثانية على جهازه، ثم يصل إلى الإنتاج فيأخذ ثوان، فيضيف فهرساً Index ويعود الاستعلام سريعاً، ثم يضيف فهرساً آخر لاستعلام آخر، وبعد سنة يجد أن الجدول عليه تسعة فهارس، وأن الإدخال أصبح بطيئاً، وأن بعض الاستعلامات ما زالت تقرأ الجدول كله مع أن الفهرس موجود. والسبب في أغلب هذه الحالات أن الفهرس يعامل كصندوق أسود: نضيفه ونأمل أن يستخدم، بدل أن نفهم كيف يبحث فيه PostgreSQL، ومتى يقرر المخطط Planner أن قراءة الجدول كله أرخص منه، وما الذي يدفعه كل INSERT وUPDATE مقابل كل فهرس.
وقد ذكرنا فكرة الفهرس في الجزء الثالث من سلسلة تعلم SQL، وفي تصميم قواعد البيانات، وطبقنا الفهرس المركب والجزئي والمغطي وBRIN على جدول طلبات من 30 مليون صف في PostgreSQL للجداول الضخمة، أما هذا المقال فيفتح الفهرس من الداخل، ويعلمك أن تقرأ خطة EXPLAIN سطراً سطراً حتى تعرف السبب بنفسك في المرة القادمة.
 دليلتعلم SQL (3): CTE ودوال النوافذ والمعاملاتكيف تكتب استعلامات أوضح بجمل WITH ودوال النوافذ، وتحمي بياناتك بالمعاملات ومستويات العزل ومن حقن SQL.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
وسوف نناقش في هذا المقال ما يلي:
- كيف تقرأ خطة التنفيذ EXPLAIN (ANALYZE, BUFFERS) سطراً سطراً، وما معنى كل رقم فيها.
- شجرة B-tree من الداخل بالإضافة pageinspect: كم صفحة تقرأ قاعدة البيانات لتجد صفاً واحداً من خمسة ملايين.
- متى يكون الفهرس أبطأ من قراءة الجدول كله، ودور الانتقائية Selectivity والترابط Correlation.
- ترتيب الأعمدة في الفهرس المركب، والبحث بالتخطي Skip Scan الجديد في PostgreSQL 18.
- الاستعلامات التي لا تستخدم الفهرس رغم وجوده، وفهارس التعبيرات Expression Indexes وفهارس الأنماط.
- فهارس GIN للنص وJSONB، والبحث داخل الفهرس دون قراءة الجدول Index Only Scan.
- ثمن الفهرس عند الكتابة بالأرقام، والتحديث السريع HOT.
- قراءة خطة فيها ربط Join، وما يحدث عندما يخطئ المخطط في تقدير عدد الصفوف.
تجهيز المختبر: خمسة ملايين مستخدم وعشرة ملايين طلب
سوف نعمل على سيرفر PostgreSQL 18.6 واحد في Docker، والمنفذ مربوط على 127.0.0.1 فقط، وملف ال Compose كما يلي:
name: lab-idx
services:
  pg:
    image: postgres:18.6
    container_name: lab-idx-pg
    environment:
      POSTGRES_PASSWORD: lab-only-password
      POSTGRES_DB: shop
    command: >
      postgres -c shared_buffers=512MB -c work_mem=32MB -c maintenance_work_mem=512MB
               -c max_wal_size=4GB -c track_io_timing=on
    ports:
      - "127.0.0.1:15441:5432"
    volumes:
      - lab-idx-data:/var/lib/postgresql
    shm_size: 1g
volumes:
  lab-idx-data:
في الإعداد أعلاه لاحظ التالي:
- الإعداد
track_io_timing=onيجعل EXPLAIN يعرض الوقت الذي ذهب في انتظار القرص في سطرI/O Timings، وهو مغلق افتراضياً. - ذاكرة
shared_buffersهنا 512 ميجابايت، والجدولان معاً قرابة 1.4 جيجابايت، فلا يتسع كل شيء في الذاكرة، وهذا مقصود حتى ترى الفرق بين القراءة من الذاكرة والقراءة من القرص.
بعد ذلك ننشئ جدول مستخدمين فيه خمسة ملايين صف وجدول طلبات فيه عشرة ملايين، والبيانات كلها تولد داخل PostgreSQL بالدالة generate_series، ولاحظ أن نسبة الباقات مقصودة: 90% مجانية و9% Pro و1% Enterprise، وأن كل مدينة تنتمي دائماً إلى المنطقة نفسها، وسوف نحتاج هاتين الملاحظتين لاحقاً:
CREATE EXTENSION IF NOT EXISTS pageinspect;
CREATE EXTENSION IF NOT EXISTS pg_trgm;

CREATE TABLE users (
    id         bigint PRIMARY KEY,
    email      text        NOT NULL,
    city       text        NOT NULL,
    region     text        NOT NULL,
    plan       text        NOT NULL,
    signup_at  timestamptz NOT NULL,
    last_login timestamptz,
    meta       jsonb       NOT NULL
);

CREATE TABLE orders (
    id         bigint PRIMARY KEY,
    user_id    bigint        NOT NULL,
    total      numeric(10,2) NOT NULL,
    status     text          NOT NULL,
    created_at timestamptz   NOT NULL
);

-- 20 cities, each always in the same region (city and region are correlated on purpose)
CREATE TABLE cities (n int PRIMARY KEY, city text, region text);
INSERT INTO cities VALUES
 (0,'Riyadh','Riyadh'),(1,'Jeddah','Makkah'),(2,'Makkah','Makkah'),(3,'Madinah','Madinah'),(4,'Dammam','Eastern'),
 (5,'Khobar','Eastern'),(6,'Abha','Asir'),(7,'Taif','Makkah'),(8,'Tabuk','Tabuk'),(9,'Buraidah','Qassim'),
 (10,'Hail','Hail'),(11,'Jazan','Jazan'),(12,'Najran','Najran'),(13,'Yanbu','Madinah'),(14,'Jubail','Eastern'),
 (15,'Hofuf','Eastern'),(16,'Khamis Mushait','Asir'),(17,'Arar','Northern Borders'),(18,'Sakaka','Jouf'),(19,'Baha','Baha');

INSERT INTO users
SELECT g,
       'user' || g || '@' || (ARRAY['gmail.com','outlook.com','yahoo.com','company.sa'])[1 + g % 4],
       c.city, c.region,
       CASE WHEN abs(hashint8(g)) % 100 < 90 THEN 'free' WHEN abs(hashint8(g)) % 100 < 99 THEN 'pro' ELSE 'enterprise' END,
       timestamptz '2021-01-01' + (g * interval '30 seconds'),
       CASE WHEN g % 5 = 0 THEN NULL ELSE now() - random() * interval '365 days' END,
       jsonb_build_object('lang', CASE WHEN g % 3 = 0 THEN 'en' ELSE 'ar' END,
                          'newsletter', g % 7 = 0,
                          'device', (ARRAY['ios','android','web'])[1 + g % 3])
FROM generate_series(1::bigint, 5000000) AS g
JOIN cities c ON c.n = (CASE WHEN g % 10 < 4 THEN 0 ELSE (g * 7919) % 20 END);

INSERT INTO orders
SELECT g, 1 + (g * 7919) % 5000000, round((10 + random() * 990)::numeric, 2),
       (ARRAY['delivered','delivered','delivered','shipped','pending','cancelled'])[1 + g % 6],
       timestamptz '2021-01-01' + (g * interval '15 seconds')
FROM generate_series(1::bigint, 10000000) AS g;

VACUUM ANALYZE users;
VACUUM ANALYZE orders;
استغرق التوليد قرابة دقيقتين ونصف على جهاز المختبر، والملفات كاملة مع كل خطوات المقال بالترتيب في مجلد lab مع المقال. وهذا حجم الجدولين:
 relname | n_live_tup | table_size
---------+------------+------------
 users   |    4999942 | 748 MB
 orders  |   10000002 | 704 MB
(2 rows)قبل الفهرس: كيف تقرأ خطة EXPLAIN؟
قبل أن نضيف أي فهرس، نسأل PostgreSQL كيف ينفذ استعلاماً يبحث عن مستخدم واحد بالبريد، وهو استعلام صفحة تسجيل الدخول في أي تطبيق:
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, city, plan FROM users WHERE email = '[email protected]';
والمخرج سوف يكون كما يلي:
                                                           QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------
 Gather  (cost=1000.00..122829.46 rows=1 width=19) (actual time=15.724..626.251 rows=1.00 loops=1)
   Workers Planned: 2
   Workers Launched: 2
   Buffers: shared hit=513 read=95275
   I/O Timings: shared read=389.838
   ->  Parallel Seq Scan on users  (cost=0.00..121829.36 rows=1 width=19) (actual time=380.644..582.101 rows=0.33 loops=3)
         Filter: (email = '[email protected]'::text)
         Rows Removed by Filter: 1666666
         Buffers: shared hit=513 read=95275
         I/O Timings: shared read=389.838
 Planning:
   Buffers: shared hit=11 read=1
   I/O Timings: shared read=0.036
 Planning Time: 0.201 ms
 JIT:
   Functions: 12
   Options: Inlining false, Optimization false, Expressions true, Deforming true
   Timing: Generation 1.458 ms (Deform 0.530 ms), Inlining 0.000 ms, Optimization 1.280 ms, Emission 27.908 ms, Total 30.646 ms
 Execution Time: 688.262 ms
الأمر EXPLAIN وحده يعرض الخطة Plan التي اختارها المخطط مع تقديراته دون أن ينفذ شيئاً، ومع ANALYZE ينفذ الاستعلام فعلاً ويضيف بجانب كل تقدير ما حدث في الواقع، ومع BUFFERS يعرض عدد الصفحات التي لمسها، وقد أصبح PostgreSQL 18 يعرض BUFFERS تلقائياً مع ANALYZE كما في ملاحظات الإصدار 18، ولكننا نكتبها صراحة حتى يعمل الأمر نفسه على الإصدارات الأقدم. والخطة شجرة من العقد Nodes، وكل سطر يبدأ بالسهم -> عقدة تعطي صفوفها للعقدة التي فوقها، لذلك اقرأها من الأكثر إزاحة إلى اليمين، أي من الداخل إلى الخارج، والصورة التالية تفكك سطراً واحداً منها:
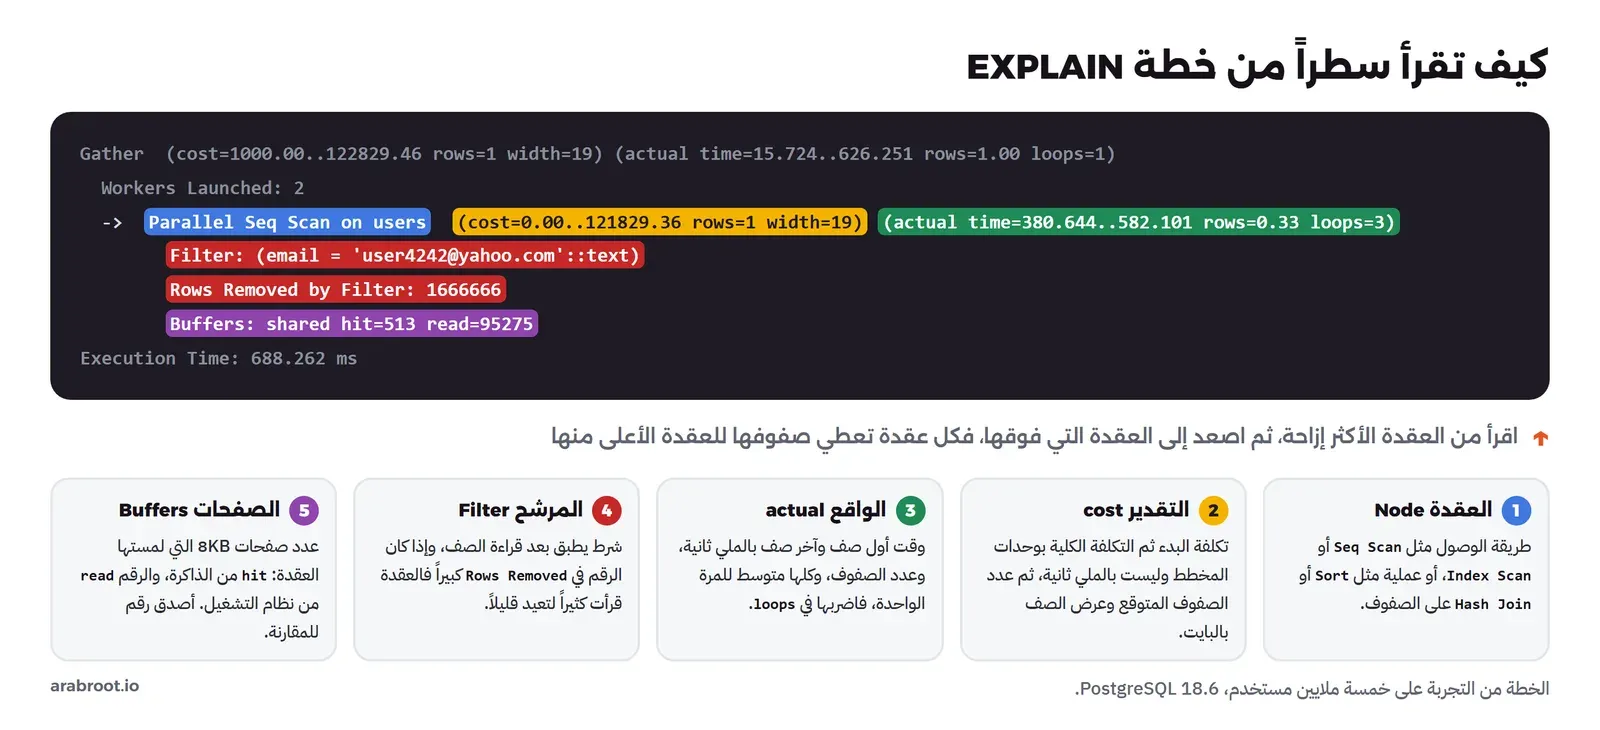
وفي المخرج أعلاه لاحظ التالي، من الداخل إلى الخارج:
Parallel Seq Scan on users: القراءة المتسلسلة Sequential Scan تعني أن PostgreSQL قرأ كل صفحات الجدول من أولها إلى آخرها، وكلمة Parallel تعني أن أكثر من عملية تقاسمت الصفحات.cost=0.00..121829.36: هذه وحدات تكلفة تقديرية وليست ملي ثانية، والرقم الأول تكلفة البدء Startup Cost قبل أن تخرج أول نتيجة، والثاني التكلفة الكلية، ويحسبها المخطط من عدد الصفحات والصفوف بأوزان مثلseq_page_costوقيمتها 1 وrandom_page_costوقيمتها 4 كما في إعدادات المخطط. وهذه الأرقام تفيدك عندما تقارن خطتين للاستعلام نفسه، ولا معنى لها بين استعلامين مختلفين.rows=1 width=19: المخطط قدر أن صفاً واحداً سوف يخرج بعرض 19 بايت تقريباً، وrows=0.33 loops=3في الجزء الحقيقي تعني أن العقدة نفذت ثلاث مرات، مرة في كل عملية، ومتوسط ما أخرجته في المرة الواحدة ثلث صف، أي صف واحد في المجموع. وتذكر هذه القاعدة لأنها أكثر ما يخدع في قراءة الخطط: الأرقام الحقيقية في كل عقدة متوسط للمرة الواحدة، فاضربها في loops.actual time=380.644..582.101: الرقم الأول متى خرج أول صف، والثاني متى انتهت العقدة، بالملي ثانية ولكل loop.Rows Removed by Filter: 1666666: كل عملية قرأت قرابة مليون وستمئة ألف صف ورمتها لأنها لا تطابق الشرط، أي أن PostgreSQL قرأ خمسة ملايين صف ليعيد صفاً واحداً، وهذا السطر هو أوضح علامة على فهرس ناقص.Buffers: shared hit=513 read=95275: الصفحة Page في PostgreSQL حجمها 8 كيلوبايت، وقد لمس الاستعلام 95,788 صفحة، أي الجدول كله تقريباً، منها 513 كانت في الذاكرة المشتركة shared buffers والباقي قرئ من نظام التشغيل، وسطرI/O Timingsيقول إن قرابة 390 ملي ثانية ذهبت في انتظار القراءة.GatherوWorkers Launched: 2: العقدة العليا جمعت نتائج العاملين Workers مع العملية الرئيسية.JIT: لأن المخطط قدر أن الاستعلام مكلف فقد ترجم جزءاً منه إلى كود الآلة، وهذا أخذ 30 ملي ثانية، وسوف نوقفه بالأمرSET jit = offفي بقية التجارب حتى تكون الخطط أقصر وأوضح.Execution Time: 688.262 ms: الوقت الكلي للتنفيذ داخل السيرفر، ولا يشمل إرسال النتائج عبر الشبكة.
شجرة B-tree من الداخل
الفهرس الافتراضي في PostgreSQL هو B-tree، وهو ملف منفصل عن الجدول، فيه نسخة مرتبة من قيم العمود، وبجانب كل قيمة عنوان الصف في الجدول، والعنوان اسمه ctid ويتكون من رقم الصفحة ورقم الصف داخلها. والآن ننشئ فهرساً على البريد ونقيس:
\timing on
CREATE INDEX users_email_idx ON users (email);
\timing off
SELECT pg_size_pretty(pg_relation_size('users_email_idx')) AS index_size;
Timing is on.
CREATE INDEX
Time: 25368.168 ms (00:25.368)
Timing is off.
index_size
------------
194 MB
(1 row)بناء الفهرس على خمسة ملايين صف أخذ 25 ثانية، وحجمه 194 ميجابايت، أي قرابة ربع حجم الجدول، ولاحظ أن CREATE INDEX العادي يمنع الكتابة على الجدول حتى ينتهي، لذلك في الإنتاج استخدم CREATE INDEX CONCURRENTLY كما شرحنا في مقال الجداول الضخمة، وسوف نعود إلى الأقفال في مقال الأقفال.
والإضافة pageinspect تسمح لنا بأن نفتح صفحات الفهرس وننظر داخلها، ونبدأ بالصفحة الوصفية Metapage التي تقول أين تبدأ الشجرة وكم طابقاً فيها:
SELECT magic, version, root, level, fastroot, fastlevel FROM bt_metap('users_email_idx');
SELECT blkno, type, live_items, avg_item_size, free_size
FROM bt_page_stats('users_email_idx', (SELECT root FROM bt_metap('users_email_idx')));
magic | version | root | level | fastroot | fastlevel
--------+---------+------+-------+----------+-----------
340322 | 4 | 164 | 2 | 164 | 2
(1 row)
blkno | type | live_items | avg_item_size | free_size
-------+------+------------+---------------+-----------
164 | r | 156 | 31 | 2556
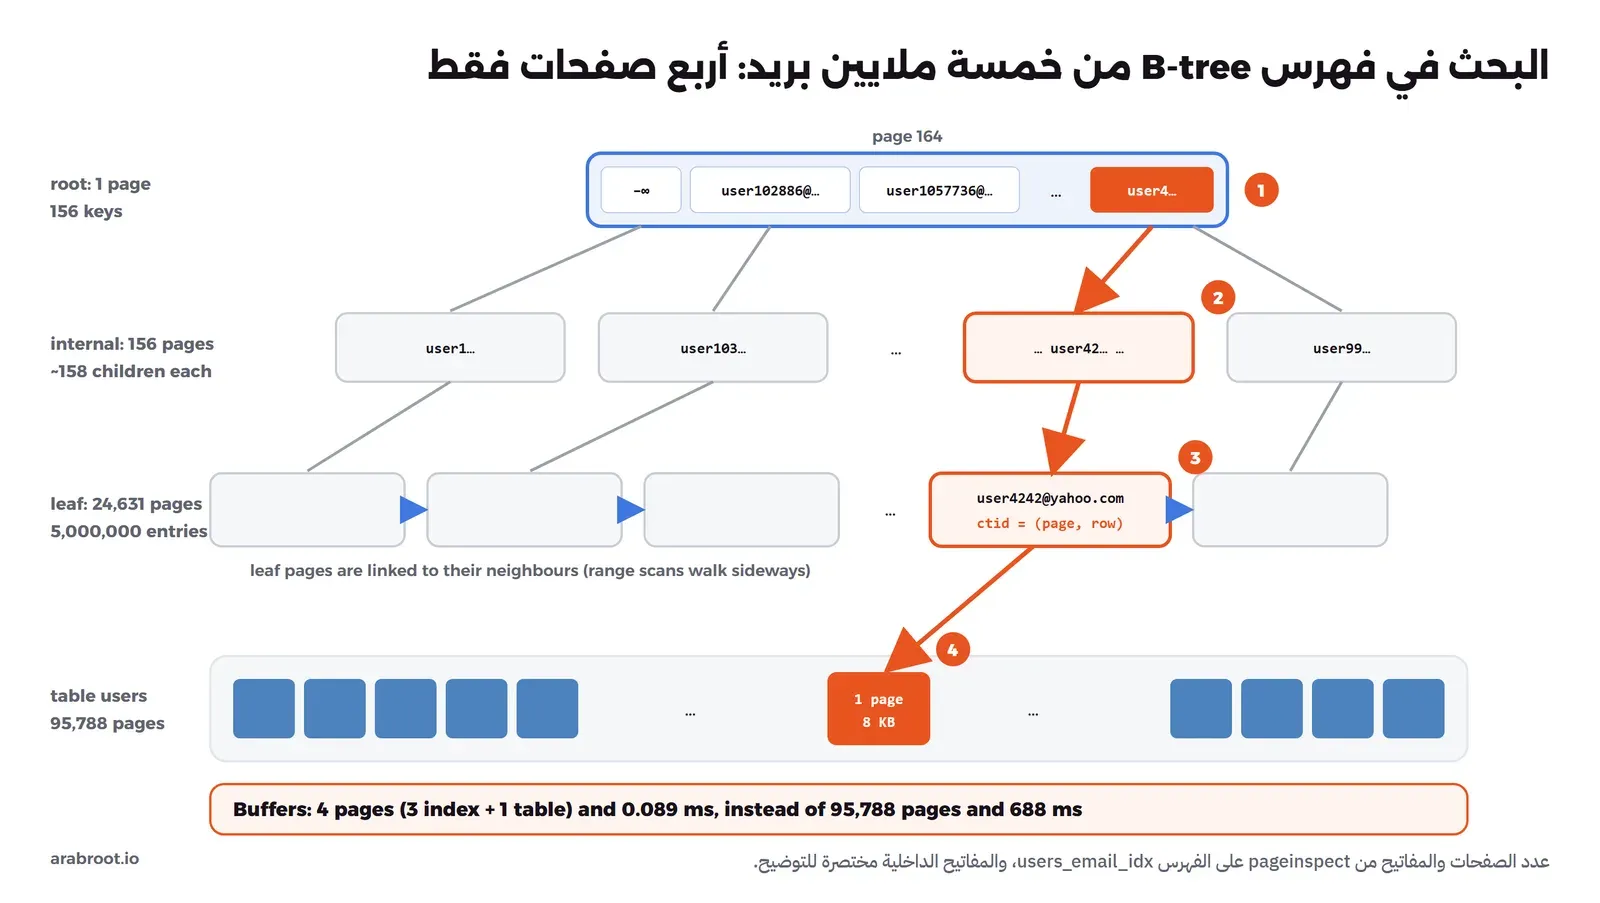
(1 row)الصفحة العليا Root Page هي رقم 164، وlevel = 2 يعني أن تحتها طابقين، فالشجرة ثلاثة طوابق: الصفحة العليا، ثم الصفحات الداخلية Internal Pages، ثم صفحات الأوراق Leaf Pages التي فيها القيم الفعلية. والصفحة العليا فيها 156 مدخلاً فقط، وكل مدخل يشير إلى صفحة داخلية. ولنعد صفحات كل نوع في الفهرس كله:
SELECT type, count(*) AS pages, sum(live_items) AS items
FROM bt_multi_page_stats('users_email_idx', 1, -1) GROUP BY type ORDER BY type DESC;
type | pages | items
------+-------+---------
r | 1 | 156
l | 24631 | 5024630
i | 156 | 24786
(3 rows)في المخرج أعلاه لاحظ التالي:
- صفحة واحدة عليا
r، و156 صفحة داخليةi، و24,631 صفحة أوراقl. - عدد المداخل في الأوراق 5,024,630 وليس خمسة ملايين بالضبط، والفرق 24,630 هو مفتاح أعلى High Key في كل صفحة أوراق ما عدا آخرها، وهو أكبر قيمة يسمح بها في الصفحة، ويستخدمه PostgreSQL ليعرف أن البحث يجب أن ينتقل إلى الصفحة المجاورة إذا انقسمت الصفحة أثناء البحث، وهذه فكرة خوارزمية Lehman وYao التي يطبقها PostgreSQL كما في ملف README لكود ال B-tree.
- كل صفحة داخلية تشير إلى قرابة 158 صفحة تحتها، وهذا ما يسمى درجة التفرع Fanout، ومنه تأتي قوة ال B-tree: طابق إضافي واحد يضرب السعة في قرابة 160، فثلاثة طوابق تكفي لخمسة ملايين بريد، وأربعة تكفي لمئات الملايين.
وماذا يوجد داخل الصفحة العليا؟ كل مدخل فيها مفتاح فاصل Separator Key وعنوان الصفحة التي تحته، وقد حولنا البايتات إلى نص حتى تقرأها:
SELECT itemoffset, ctid,
       convert_from(rtrim(substring(decode(replace(data, ' ', ''), 'hex') from 2), '\x00'::bytea), 'UTF8') AS separator_key
FROM bt_page_items('users_email_idx', (SELECT root FROM bt_metap('users_email_idx')))
WHERE itemoffset <= 4;
itemoffset | ctid | separator_key
------------+---------+-----------------------
1 | (3,0) |
2 | (163,1) | [email protected]
3 | (323,1) | [email protected]
4 | (482,1) | [email protected]
(4 rows)المدخل الأول بلا مفتاح ويعني «كل ما هو أصغر من المفتاح التالي»، والمدخل الثاني يقول إن كل بريد من [email protected] وحتى المفتاح التالي موجود تحت الصفحة 163، وهكذا. ولاحظ أن user102886 يأتي قبل user1057736 لأن النص يرتب حرفاً حرفاً حسب ترتيب اللغة Collation وليس كرقم، وهذا ما يجعل البحث بالمساواة وبالبداية ممكناً، كما سوف نرى. والآن نعيد استعلام تسجيل الدخول:
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, city, plan FROM users WHERE email = '[email protected]';
QUERY PLAN
---------------------------------------------------------------------------------------------------------------------------
Index Scan using users_email_idx on users (cost=0.43..8.45 rows=1 width=19) (actual time=0.072..0.073 rows=1.00 loops=1)
Index Cond: (email = '[email protected]'::text)
Index Searches: 1
Buffers: shared hit=2 read=2
I/O Timings: shared read=0.032
Planning:
Buffers: shared hit=49
Planning Time: 0.369 ms
Execution Time: 0.089 msنزل الوقت من 688 ملي ثانية إلى 0.089 ملي ثانية، والأهم أن عدد الصفحات نزل من قرابة 96 ألفاً إلى أربع صفحات بالضبط: الصفحة العليا، ثم صفحة داخلية، ثم صفحة أوراق، ثم صفحة الجدول التي فيها الصف، والصورة التالية تبين هذا الطريق:
وقد يتساءل البعض: إذا كان الفهرس بهذه السرعة، فلماذا لا نضع فهرساً على كل عمود؟ والإجابة في القسمين التاليين: الفهرس لا يفيد كل استعلام، وكل فهرس له ثمن يدفع مع كل كتابة.
متى يكون الفهرس أبطأ من قراءة الجدول كله؟
الفهرس يعطيك عناوين الصفوف، ولكن كل عنوان يعني قفزة إلى صفحة في الجدول، وإذا كانت الصفوف المطلوبة كثيرة ومتفرقة فإن هذه القفزات العشوائية تصبح أغلى من أن تقرأ الجدول كله بالترتيب. وهذا ما يزنه المخطط بالانتقائية Selectivity، أي نسبة الصفوف التي يتوقع أن تطابق الشرط. لنضع فهرساً على عمود الباقة، ونسأل عن الباقة النادرة ثم عن الباقة الشائعة:
SET jit = off;
CREATE INDEX users_plan_idx ON users (plan);
SELECT plan, count(*), round(100.0 * count(*) / sum(count(*)) OVER (), 2) AS pct FROM users GROUP BY plan ORDER BY 2 DESC;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*), max(last_login) FROM users WHERE plan = 'enterprise';
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*), max(last_login) FROM users WHERE plan = 'free';
plan | count | pct
------------+---------+-------
free | 4499618 | 89.99
pro | 450106 | 9.00
enterprise | 50276 | 1.01
(3 rows)
QUERY PLAN
---------------------------------------------------------------------------------------------------
Aggregate (actual time=597.098..597.099 rows=1.00 loops=1)
Buffers: shared hit=36 read=39256 written=225
I/O Timings: shared read=432.145 write=1.719
-> Index Scan using users_plan_idx on users (actual time=0.042..575.685 rows=50276.00 loops=1)
Index Cond: (plan = 'enterprise'::text)
Index Searches: 1
Buffers: shared hit=36 read=39256 written=225
I/O Timings: shared read=432.145 write=1.719
Planning:
Buffers: shared hit=6
Planning Time: 0.155 ms
Execution Time: 597.135 ms
(12 rows)
QUERY PLAN
----------------------------------------------------------------------------------------------------
Finalize Aggregate (actual time=1652.088..1671.969 rows=1.00 loops=1)
Buffers: shared hit=33439 read=62349
I/O Timings: shared read=216.859
-> Gather (actual time=1648.340..1671.955 rows=3.00 loops=1)
Workers Planned: 2
Workers Launched: 2
Buffers: shared hit=33439 read=62349
I/O Timings: shared read=216.859
-> Partial Aggregate (actual time=1645.635..1645.636 rows=1.00 loops=3)
Buffers: shared hit=33439 read=62349
I/O Timings: shared read=216.859
-> Parallel Seq Scan on users (actual time=0.144..1313.026 rows=1499872.67 loops=3)
Filter: (plan = 'free'::text)
Rows Removed by Filter: 166794
Buffers: shared hit=33439 read=62349
I/O Timings: shared read=216.859
Planning Time: 0.089 ms
Execution Time: 1672.018 ms
(18 rows)للباقة Enterprise، وهي 1% من المستخدمين، اختار المخطط الفهرس، وللباقة المجانية، وهي 90%، تجاهله وقرأ الجدول كله مع أن الفهرس موجود، وهذا قرار صحيح. ولنتأكد نجبره على عدم القراءة المتسلسلة بالإعداد enable_seqscan، وهو إعداد للتجارب فقط ولا تضعه في الإنتاج:
SET enable_seqscan = off;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*), max(last_login) FROM users WHERE plan = 'free';
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------
Finalize Aggregate (actual time=1761.151..1772.391 rows=1.00 loops=1)
Buffers: shared hit=12764 read=86854 written=18240
I/O Timings: shared read=221.408 write=338.514
-> Gather (actual time=1759.213..1772.376 rows=3.00 loops=1)
Workers Planned: 2
Workers Launched: 2
Buffers: shared hit=12764 read=86854 written=18240
I/O Timings: shared read=221.408 write=338.514
-> Partial Aggregate (actual time=1752.888..1752.890 rows=1.00 loops=3)
Buffers: shared hit=12764 read=86854 written=18240
I/O Timings: shared read=221.408 write=338.514
-> Parallel Bitmap Heap Scan on users (actual time=321.105..1381.029 rows=1499872.67 loops=3)
Recheck Cond: (plan = 'free'::text)
Heap Blocks: exact=31343
Buffers: shared hit=12764 read=86854 written=18240
I/O Timings: shared read=221.408 write=338.514
Worker 0: Heap Blocks: exact=30503
Worker 1: Heap Blocks: exact=33942
-> Bitmap Index Scan on users_plan_idx (actual time=275.805..275.806 rows=4499618.00 loops=1)
Index Cond: (plan = 'free'::text)
Index Searches: 1
Buffers: shared hit=2 read=3788
I/O Timings: shared read=47.297
Planning Time: 0.167 ms
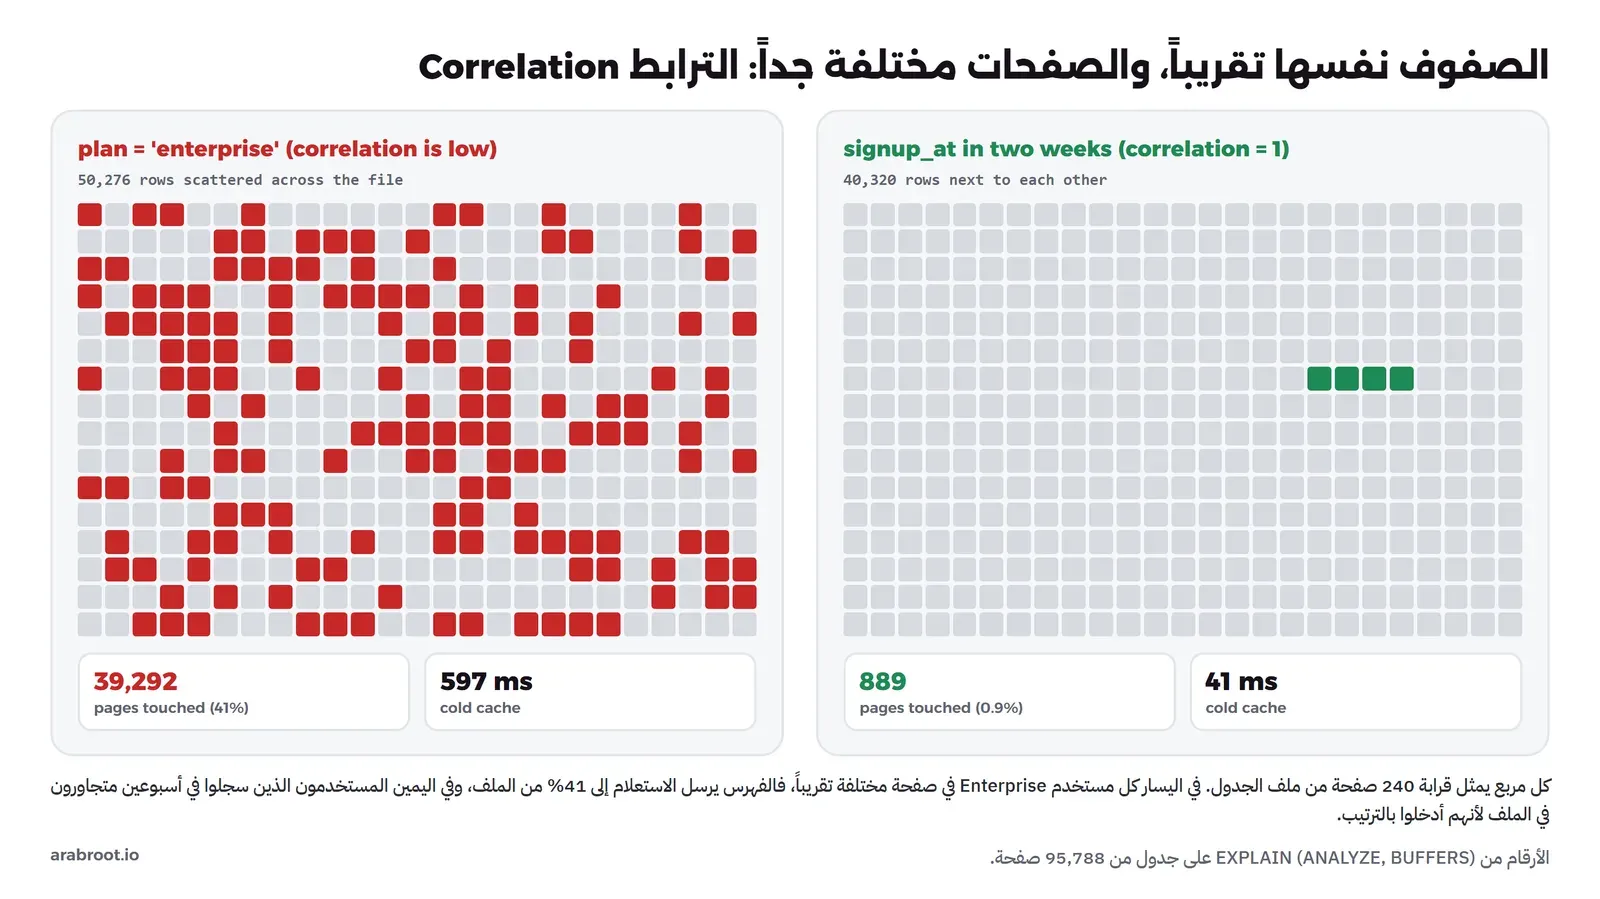
Execution Time: 1772.494 msهنا استخدم الفهرس بطريقة المسح بالخريطة Bitmap Scan: عقدة Bitmap Index Scan تقرأ الفهرس وتبني خريطة بكل الصفحات التي فيها صفوف مطلوبة، ثم Bitmap Heap Scan تقرأ هذه الصفحات بترتيبها في الملف، وهي طريقة وسطى بين البحث في الفهرس والقراءة المتسلسلة كما يشرح التوثيق. والنتيجة 1772 ملي ثانية مقابل 1672 بالقراءة المتسلسلة، أي أن الفهرس لم يوفر شيئاً، والسبب أن 4.5 مليون صف من الخمسة موزعة على كل صفحات الجدول، فالفهرس أضاف عمل قراءة 3,790 صفحة من الفهرس نفسه دون أن يستبعد صفحة واحدة من الجدول.
ولكن انظر مرة أخرى إلى الباقة Enterprise: 50,276 صفاً فقط، ومع ذلك لمس الاستعلام 39,292 صفحة، أي قرابة 40% من الجدول. لماذا؟ لأن هؤلاء المستخدمين متفرقون في الملف، فكل مستخدم تقريباً في صفحة مختلفة. وقارن ذلك باستعلام يطلب عدداً مقارباً من الصفوف بمدى من تاريخ التسجيل، بعد أن نضع فهرساً على هذا العمود:
SET max_parallel_workers_per_gather = 0;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*), max(last_login) FROM users WHERE signup_at >= '2022-01-01' AND signup_at < '2022-01-15';
CREATE INDEX users_signup_idx ON users (signup_at);
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*), max(last_login) FROM users WHERE signup_at >= '2022-01-01' AND signup_at < '2022-01-15';
QUERY PLAN
----------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=1675.102..1675.104 rows=1.00 loops=1)
Buffers: shared hit=65046 read=30742
I/O Timings: shared read=120.062
-> Seq Scan on users (actual time=410.550..1670.351 rows=40320.00 loops=1)
Filter: ((signup_at >= '2022-01-01 00:00:00+00'::timestamp with time zone) AND (signup_at < '2022-01-15 00:00:00+00'::timestamp with time zone))
Rows Removed by Filter: 4959680
Buffers: shared hit=65046 read=30742
I/O Timings: shared read=120.062
Planning:
Buffers: shared hit=8 read=3
I/O Timings: shared read=0.028
Planning Time: 0.252 ms
Execution Time: 1675.147 ms
(13 rows)
CREATE INDEX
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=40.927..40.929 rows=1.00 loops=1)
Buffers: shared hit=314 read=575
I/O Timings: shared read=5.673
-> Index Scan using users_signup_idx on users (actual time=0.086..34.655 rows=40320.00 loops=1)
Index Cond: ((signup_at >= '2022-01-01 00:00:00+00'::timestamp with time zone) AND (signup_at < '2022-01-15 00:00:00+00'::timestamp with time zone))
Index Searches: 1
Buffers: shared hit=314 read=575
I/O Timings: shared read=5.673
Planning:
Buffers: shared hit=18 read=1
I/O Timings: shared read=0.025
Planning Time: 0.365 ms
Execution Time: 40.959 ms
(13 rows)40,320 صفاً في 889 صفحة فقط، والاستعلام نزل من 1675 إلى 41 ملي ثانية. والفرق بين الحالتين اسمه الترابط Correlation، أي هل ترتيب القيم في العمود قريب من ترتيب الصفوف في الملف؟ المستخدمون سجلوا بالترتيب، فالصفوف المتجاورة في التاريخ متجاورة في الملف، أما الباقة فلا علاقة لها بمكان الصف. ويحفظ PostgreSQL هذا الرقم لكل عمود في العرض pg_stats، ويستخدمه في تقدير تكلفة البحث بالفهرس:
SELECT attname, n_distinct, round(correlation::numeric, 3) AS correlation
FROM pg_stats WHERE tablename = 'users' AND attname IN ('id','plan','signup_at','email','city');
attname | n_distinct | correlation
-----------+------------+-------------
id | -1 | 1.000
email | -1 | 0.334
city | 13 | 0.190
plan | 3 | 0.816
signup_at | -1 | 1.000
(5 rows)العمودان id وsignup_at ترابطهما 1، أي مرتبان تماماً مع الملف، والبريد 0.334، ولاحظ أن الرقم للباقة 0.816 يبدو عالياً، والسبب أن 90% من القيم هي free فالعمود يبدو مرتباً في أغلبه، ولكن الصفوف القليلة من Enterprise متفرقة رغم ذلك، وهذا مثال على أن الإحصاءات تقريب وليست حقيقة كاملة. والصورة التالية تبين الحالتين:
وهل الفهرس على الباقة بلا فائدة إذن؟ لا، فقد شغلنا استعلام Enterprise مرتين بالفهرس ثم مرتين بالقراءة المتسلسلة دون توازي Parallelism، فكان الوقت 668 ثم 110 ملي ثانية بالفهرس، و3251 ثم 3164 ملي ثانية دونه، فالفهرس ما زال أسرع بكثير لنسبة 1%، ولكنه يخسر عندما تقترب النسبة من أغلب الجدول. والقاعدة العملية: الفهرس على عمود قيمه قليلة ومتكررة لا يفيد إلا للقيم النادرة فيه، وفي هذه الحالة فكر في الفهرس الجزئي Partial Index على القيمة النادرة وحدها، فهو أصغر بكثير ويقوم بالعمل نفسه.
الفهرس المركب وترتيب الأعمدة
الفهرس المركب Composite Index على عدة أعمدة مرتب بالعمود الأول، ثم بالثاني داخل كل قيمة من الأول، كدليل الهاتف المرتب بالمدينة ثم بالتاريخ، وقد شرحنا قاعدة الترتيب في مقال الجداول الضخمة: عمود المساواة أولاً ثم عمود المدى. ننشئ فهرساً على المدينة ثم تاريخ التسجيل، ونسأل عن مستخدمي أبها في شهر واحد:
CREATE INDEX users_city_signup_idx ON users (city, signup_at);
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT count(*) FROM users WHERE city = 'Abha' AND signup_at >= '2024-01-01' AND signup_at < '2024-02-01';
QUERY PLAN
----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=1.328..1.329 rows=1.00 loops=1)
Buffers: shared hit=1 read=20
I/O Timings: shared read=0.205
-> Index Only Scan using users_city_signup_idx on users (actual time=0.091..0.987 rows=4464.00 loops=1)
Index Cond: ((city = 'Abha'::text) AND (signup_at >= '2024-01-01 00:00:00+00'::timestamp with time zone) AND (signup_at < '2024-02-01 00:00:00+00'::timestamp with time zone))
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=1 read=20
I/O Timings: shared read=0.205
Planning:
Buffers: shared hit=92 read=15
I/O Timings: shared read=0.209
Planning Time: 0.880 ms
Execution Time: 1.410 msبحث واحد في الفهرس Index Searches: 1 نزل مباشرة إلى بداية «أبها، يناير 2024» وقرأ 21 صفحة. ولاحظ أن العقدة هنا Index Only Scan، أي أن PostgreSQL أجاب من الفهرس وحده دون أن يلمس الجدول، لأن كل ما يحتاجه الاستعلام موجود في الفهرس، وسوف نعود إليها في قسم Index Only Scan.
والسؤال المهم: ماذا يحدث إذا سألنا بالتاريخ وحده دون المدينة؟ في الإصدارات قبل 18 كان الجواب في الغالب أن هذا الفهرس لا يفيد إلا بقراءته كاملاً، أما PostgreSQL 18 فقد أضاف البحث بالتخطي Skip Scan كما في توثيق الفهارس المركبة. سوف نحذف الفهرس على التاريخ داخل معاملة ثم نلغي الحذف، حتى لا يبقى أمام المخطط إلا الفهرس المركب:
BEGIN;
DROP INDEX users_signup_idx;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT count(*) FROM users WHERE signup_at >= '2024-01-01' AND signup_at < '2024-02-01';
ROLLBACK;
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=34.879..34.883 rows=1.00 loops=1)
Buffers: shared hit=52 read=394
I/O Timings: shared read=9.196
-> Index Only Scan using users_city_signup_idx on users (actual time=0.118..27.753 rows=89280.00 loops=1)
Index Cond: ((signup_at >= '2024-01-01 00:00:00+00'::timestamp with time zone) AND (signup_at < '2024-02-01 00:00:00+00'::timestamp with time zone))
Heap Fetches: 0
Index Searches: 27
Buffers: shared hit=52 read=394
I/O Timings: shared read=9.196
Planning:
Buffers: shared hit=4
Planning Time: 0.116 ms
Execution Time: 34.939 ms
(13 rows)السطر المهم هو Index Searches: 27، فبدل أن يقرأ الفهرس كله، قفز PostgreSQL إلى كل مدينة على حدة وبحث داخلها عن يناير 2024، وعندنا 20 مدينة، والبحثات الإضافية هي محاولات يقوم بها ليكتشف أين تبدأ المدينة التالية. والنتيجة 446 صفحة و35 ملي ثانية، والصورة التالية تبين الفرق بين البحثين:
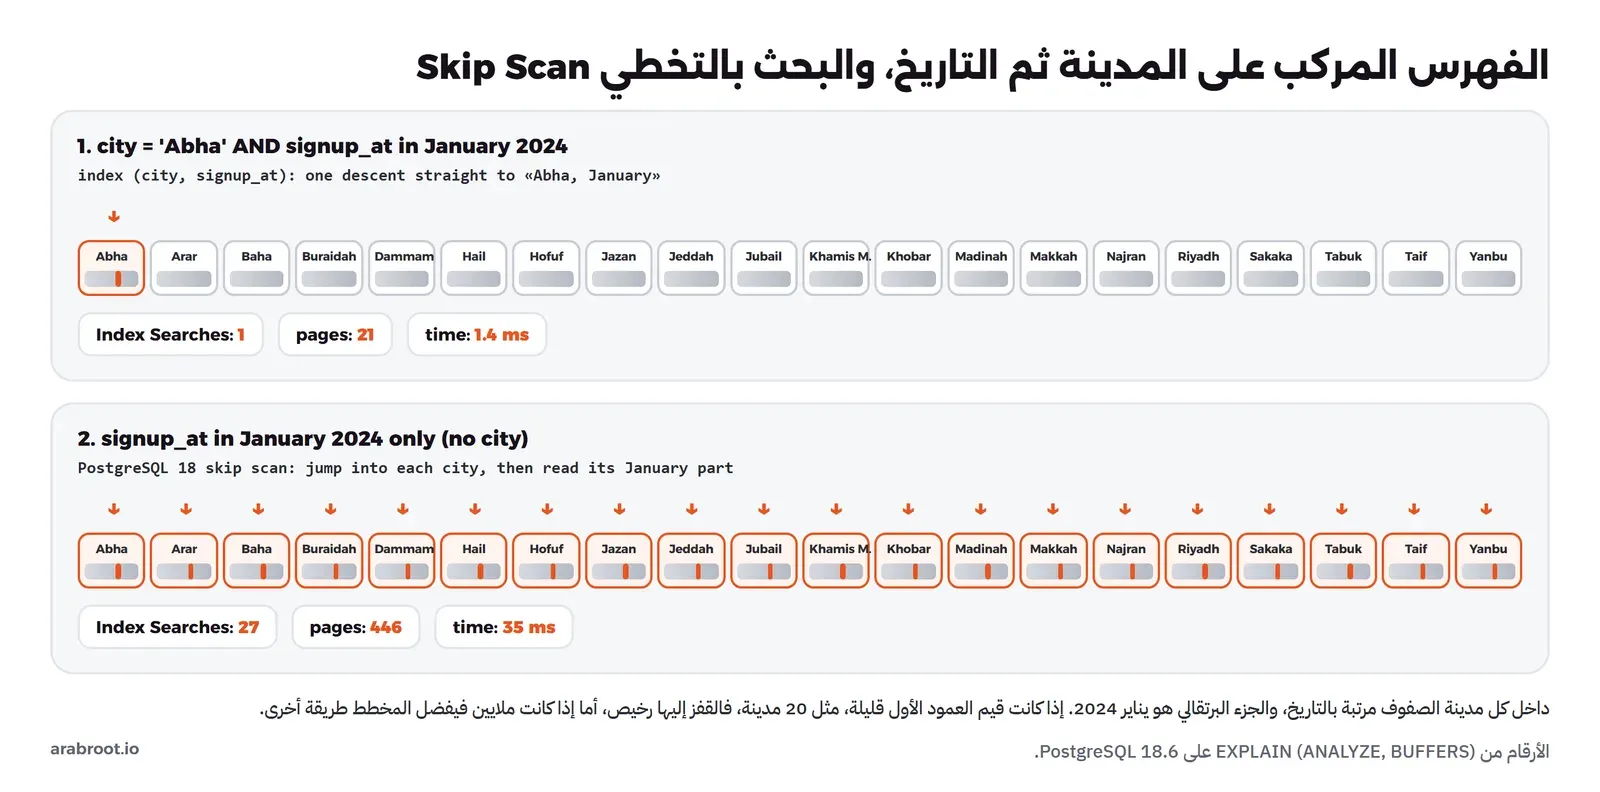
وهذا لا يغير القاعدة، فالتخطي نجح هنا لأن العمود الأول فيه 20 قيمة فقط، ولو كان العمود الأول هو البريد بخمسة ملايين قيمة لكان على PostgreSQL أن يقفز خمسة ملايين مرة، وعندها يفضل المخطط قراءة الجدول. لذلك رتب أعمدة الفهرس المركب حسب استعلاماتك الأكثر تكراراً، واعتبر التخطي ميزة تنقذ استعلاماً نادراً وليس سبباً لتجاهل الترتيب.
لماذا لا يستخدم PostgreSQL الفهرس الذي أنشأته؟
هذا أكثر سؤال يصلنا في هذا الموضوع، والإجابة في أغلب الحالات أن الاستعلام نفسه يمنع الفهرس، لأن الفهرس مرتب بقيم العمود كما هي، وأي شرط لا يمكن ترجمته إلى «من هذه القيمة إلى تلك» في هذا الترتيب لا يستطيع أن يستخدمه. وفيما يلي ثلاث حالات حقيقية على الجدول نفسه، والفهارس على email وsignup_at موجودة:
SET jit = off; SET max_parallel_workers_per_gather = 0;
-- 1) a function around the column
EXPLAIN (ANALYZE, COSTS OFF) SELECT id FROM users WHERE lower(email) = '[email protected]';
-- 2) the date of a timestamp
EXPLAIN (ANALYZE, COSTS OFF) SELECT count(*) FROM users WHERE signup_at::date = '2024-01-10';
EXPLAIN (ANALYZE, COSTS OFF) SELECT count(*) FROM users WHERE signup_at >= '2024-01-10' AND signup_at < '2024-01-11';
-- 3) prefix search with LIKE
SELECT datcollate FROM pg_database WHERE datname = current_database();
EXPLAIN (ANALYZE, COSTS OFF) SELECT id FROM users WHERE email LIKE 'user4242@%';
QUERY PLAN
--------------------------------------------------------------------
Seq Scan on users (actual time=5.620..11051.185 rows=1.00 loops=1)
Filter: (lower(email) = '[email protected]'::text)
Rows Removed by Filter: 4999999
Buffers: shared hit=64467 read=31321
I/O Timings: shared read=33.820
Planning:
Buffers: shared hit=122
Planning Time: 0.691 ms
Execution Time: 11051.257 ms
(9 rows)
QUERY PLAN
-------------------------------------------------------------------------------------------------------------
Aggregate (actual time=1877.548..1877.549 rows=1.00 loops=1)
Buffers: shared hit=3 read=13664 written=1
I/O Timings: shared read=407.475 write=0.045
-> Index Only Scan using users_signup_idx on users (actual time=1340.320..1877.247 rows=2880.00 loops=1)
Filter: ((signup_at)::date = '2024-01-10'::date)
Rows Removed by Filter: 4997120
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=3 read=13664 written=1
I/O Timings: shared read=407.475 write=0.045
Planning:
Buffers: shared hit=22
Planning Time: 0.258 ms
Execution Time: 1877.588 ms
(14 rows)
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=0.687..0.689 rows=1.00 loops=1)
Buffers: shared hit=11 read=1
I/O Timings: shared read=0.013
-> Index Only Scan using users_signup_idx on users (actual time=0.050..0.457 rows=2880.00 loops=1)
Index Cond: ((signup_at >= '2024-01-10 00:00:00+00'::timestamp with time zone) AND (signup_at < '2024-01-11 00:00:00+00'::timestamp with time zone))
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=11 read=1
I/O Timings: shared read=0.013
Planning:
Buffers: shared hit=8
Planning Time: 0.158 ms
Execution Time: 0.726 ms
(13 rows)
datcollate
------------
en_US.utf8
(1 row)
QUERY PLAN
-------------------------------------------------------------------
Seq Scan on users (actual time=2.978..1857.592 rows=1.00 loops=1)
Filter: (email ~~ 'user4242@%'::text)
Rows Removed by Filter: 4999999
Buffers: shared hit=50933 read=44855
I/O Timings: shared read=123.903
Planning:
Buffers: shared hit=5 read=4
I/O Timings: shared read=6.048
Planning Time: 6.252 ms
Execution Time: 1857.632 ms
(10 rows)في المخرج أعلاه لاحظ التالي:
- الدالة
lower(email)جعلت الاستعلام يقرأ الجدول كله وينفذ الدالة على خمسة ملايين بريد، فأخذ 11 ثانية، والسبب أن الفهرس فيه البريد كما كتب، وليس فيه نتيجةlower، وهذا يحدث كثيراً عندما يضيف المطورlowerليجعل تسجيل الدخول لا يفرق بين الأحرف الكبيرة والصغيرة. - التحويل
signup_at::dateله الأثر نفسه، فقد استخدم PostgreSQL الفهرس هنا ولكن بقراءته كاملاً كقائمة، وحسب التاريخ لكل مدخل، فقرأ 13,667 صفحة في 1.9 ثانية، أما الشرط نفسه مكتوباً كمدى على العمود كما هو فقد أخذ 0.7 ملي ثانية. وانتبه هنا إلى أن حدود اليوم بتوقيت UTC، وقد شرحنا ذلك في مقال التاريخ والوقت. - البحث بالبداية
LIKE 'user4242@%'يبدو مناسباً لل B-tree، ومع ذلك قرأ الجدول كله، والسبب أن ترتيب قاعدة البيانات هوen_US.utf8، وفي هذا الترتيب لا تضمن مقارنة الأحرف أن كل ما يبدأ بنص معين يقع في مدى متصل من الفهرس، لذلك لا يستخدم PostgreSQL الفهرس العادي ل LIKE إلا مع الترتيبC، كما في توثيق فئات المعاملات Operator Classes.
والحل لكل حالة أن تجعل الفهرس يطابق ما يكتبه الاستعلام، فإما أن تغير الاستعلام كما فعلنا مع التاريخ، أو تنشئ الفهرس المناسب للاستعلام كما هو. فهرس التعبير Expression Index يحفظ نتيجة الدالة بدل العمود، وفئة المعاملات text_pattern_ops تقارن حرفاً حرفاً فتسمح بالبحث بالبداية:
\timing on
CREATE INDEX users_email_lower_idx ON users (lower(email));
CREATE INDEX users_email_pattern_idx ON users (email text_pattern_ops);
\timing off
EXPLAIN (ANALYZE, COSTS OFF) SELECT id FROM users WHERE lower(email) = '[email protected]';
EXPLAIN (ANALYZE, COSTS OFF) SELECT id FROM users WHERE email LIKE 'user4242@%';
EXPLAIN (ANALYZE, COSTS OFF) SELECT id FROM users WHERE email LIKE '%4242@yahoo%';
Timing is on.
CREATE INDEX
Time: 37942.331 ms (00:37.942)
CREATE INDEX
Time: 5188.747 ms (00:05.189)
Timing is off.
QUERY PLAN
-----------------------------------------------------------------------------------------------
Bitmap Heap Scan on users (actual time=0.053..0.054 rows=1.00 loops=1)
Recheck Cond: (lower(email) = '[email protected]'::text)
Heap Blocks: exact=1
Buffers: shared hit=1 read=3
I/O Timings: shared read=0.023
-> Bitmap Index Scan on users_email_lower_idx (actual time=0.043..0.043 rows=1.00 loops=1)
Index Cond: (lower(email) = '[email protected]'::text)
Index Searches: 1
Buffers: shared read=3
I/O Timings: shared read=0.023
Planning:
Buffers: shared hit=107 read=11
I/O Timings: shared read=0.198
Planning Time: 0.905 ms
Execution Time: 0.098 ms
(15 rows)
QUERY PLAN
------------------------------------------------------------------------------------------------
Index Scan using users_email_pattern_idx on users (actual time=0.055..0.056 rows=1.00 loops=1)
Index Cond: ((email ~>=~ 'user4242@'::text) AND (email ~<~ 'user4242A'::text))
Filter: (email ~~ 'user4242@%'::text)
Index Searches: 1
Buffers: shared hit=1 read=3
I/O Timings: shared read=0.028
Planning:
Buffers: shared hit=53 read=4 dirtied=2
I/O Timings: shared read=0.058
Planning Time: 0.355 ms
Execution Time: 0.069 ms
(11 rows)
QUERY PLAN
---------------------------------------------------------------------
Seq Scan on users (actual time=1.893..1781.650 rows=500.00 loops=1)
Filter: (email ~~ '%4242@yahoo%'::text)
Rows Removed by Filter: 4999500
Buffers: shared hit=52470 read=43318
I/O Timings: shared read=27.750
Planning Time: 0.097 ms
Execution Time: 1782.472 ms
(7 rows)الاستعلامان الأولان نزلا إلى أقل من عشر ملي ثانية، ولاحظ في الثاني كيف حول PostgreSQL الشرط LIKE 'user4242@%' إلى مدى ~>=~ 'user4242@' و~<~ 'user4242A'، أي «من هذه القيمة إلى ما قبل الحرف التالي»، وهذا بالضبط ما يحتاجه ال B-tree. أما البحث عن نص في وسط القيمة '%4242@yahoo%' فلا يمكن أن يتحول إلى مدى في أي ترتيب، وما زال يقرأ الجدول كله، وحله في نوع آخر من الفهارس.
ولكن انتبه إلى الثمن قبل أن تضيف فهارس التعبيرات: عندنا الآن ثلاثة فهارس على البريد، كل واحد 194 ميجابايت، وفي تطبيق حقيقي اختر واحداً، فإذا كان كل الكود يبحث ب lower(email) فاحفظ البريد بأحرف صغيرة عند التسجيل، أو استخدم النوع citext، ويكفيك فهرس واحد.
فهارس GIN للبحث داخل النص وJSONB
ال B-tree يحفظ القيمة كاملة في مكان واحد، أما الفهرس المعكوس GIN، أي Generalized Inverted Index، فيقسم كل قيمة إلى أجزاء ويحفظ لكل جزء قائمة الصفوف التي تحتويه، وهي نفس فكرة الفهرس المعكوس في محركات البحث التي شرحناها في كيف يعمل البحث. ومع الإضافة pg_trgm يقسم النص إلى مقاطع من ثلاثة أحرف Trigrams، فيصبح البحث عن نص في وسط القيمة ممكناً، ومع JSONB يقسم المستند إلى مفاتيح وقيم:
\timing on
CREATE INDEX users_email_trgm_idx ON users USING gin (email gin_trgm_ops);
CREATE INDEX users_meta_idx ON users USING gin (meta jsonb_path_ops);
\timing off
EXPLAIN (ANALYZE, COSTS OFF) SELECT id FROM users WHERE email LIKE '%4242@yahoo%';
Timing is on.
CREATE INDEX
Time: 49526.640 ms (00:49.527)
CREATE INDEX
Time: 8448.081 ms (00:08.448)
Timing is off.
QUERY PLAN
--------------------------------------------------------------------------------------------------
Bitmap Heap Scan on users (actual time=94.907..110.483 rows=500.00 loops=1)
Recheck Cond: (email ~~ '%4242@yahoo%'::text)
Rows Removed by Index Recheck: 31
Heap Blocks: exact=531
Buffers: shared hit=2050 read=282
I/O Timings: shared read=10.599
-> Bitmap Index Scan on users_email_trgm_idx (actual time=94.396..94.397 rows=531.00 loops=1)
Index Cond: (email ~~ '%4242@yahoo%'::text)
Index Searches: 1
Buffers: shared hit=1801
Planning:
Buffers: shared hit=148 read=10
I/O Timings: shared read=0.240
Planning Time: 1.191 ms
Execution Time: 111.364 ms
(15 rows)نزل البحث في وسط النص من 1782 إلى 111 ملي ثانية، ولاحظ السطر Rows Removed by Index Recheck: 31: الفهرس أعطى 531 صفاً مرشحاً تحتوي على كل المقاطع الثلاثية المطلوبة، ثم تحقق PostgreSQL من الشرط الحقيقي على كل صف فرفض 31 منها، لأن وجود المقاطع لا يعني أنها متتالية بالترتيب نفسه. وهذا طبيعي في GIN، فهو يعطي مرشحين ثم يتحقق.
وللمستندات JSONB نضيف علامة لألف مستخدم في برنامج تجريبي، ونبحث عنهم بالمعامل @> الذي يعني «يحتوي على»، مرة بالفهرس ومرة بعد حذفه داخل معاملة:
UPDATE users SET meta = meta || '{"beta": true}' WHERE id % 5000 = 0;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*) FROM users WHERE meta @> '{"beta": true}';
BEGIN; DROP INDEX users_meta_idx;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT count(*) FROM users WHERE meta @> '{"beta": true}';
ROLLBACK;
UPDATE 1000
QUERY PLAN
-------------------------------------------------------------------------------------------------
Aggregate (actual time=0.948..0.950 rows=1.00 loops=1)
Buffers: shared hit=35
-> Bitmap Heap Scan on users (actual time=0.350..0.869 rows=1000.00 loops=1)
Recheck Cond: (meta @> '{"beta": true}'::jsonb)
Heap Blocks: exact=23
Buffers: shared hit=35
-> Bitmap Index Scan on users_meta_idx (actual time=0.275..0.276 rows=1000.00 loops=1)
Index Cond: (meta @> '{"beta": true}'::jsonb)
Index Searches: 1
Buffers: shared hit=12
Planning:
Buffers: shared hit=10
Planning Time: 0.412 ms
Execution Time: 1.000 ms
(14 rows)
BEGIN
DROP INDEX
QUERY PLAN
-----------------------------------------------------------------------------
Aggregate (actual time=3195.698..3195.700 rows=1.00 loops=1)
Buffers: shared hit=39094 read=56714 dirtied=3
I/O Timings: shared read=162.525
-> Seq Scan on users (actual time=34.714..3195.601 rows=1000.00 loops=1)
Filter: (meta @> '{"beta": true}'::jsonb)
Rows Removed by Filter: 4999000
Buffers: shared hit=39094 read=56714 dirtied=3
I/O Timings: shared read=162.525
Planning:
Buffers: shared hit=5
Planning Time: 0.154 ms
Execution Time: 3195.758 ms
(12 rows)
ROLLBACKملي ثانية واحدة و35 صفحة مقابل 3.2 ثانية و95,808 صفحات، والفئة jsonb_path_ops التي اخترناها أصغر وأسرع من الفئة الافتراضية لكنها تدعم معاملات الاحتواء فقط، ولا تدعم السؤال عن وجود مفتاح بالمعامل ?، كما يشرح توثيق JSONB، والفهرس كله 16 ميجابايت. وقد شرحنا متى تكفيك JSONB بدل قاعدة مستندات في PostgreSQL لكل شيء، وفي مقال أنواع قواعد البيانات.
وبقية أنواع الفهارس باختصار، والتفصيل في صفحة أنواع الفهارس:
- BRIN: يحفظ أقل قيمة وأكبر قيمة لكل مجموعة من الصفحات، فهو صغير جداً ويناسب عموداً مرتباً مع الملف مثل تاريخ الإدخال، وقد قسناه على 30 مليون طلب في مقال الجداول الضخمة، وترابط 1 الذي رأيته في signup_at هو بالضبط الشرط الذي يحتاجه.
- GiST وSP-GiST: للبيانات التي لا ترتب في خط واحد، مثل الإحداثيات الجغرافية في PostGIS والمديات الزمنية التي تتداخل.
- Hash: يدعم المساواة فقط، ونادراً ما يكون أفضل من B-tree في الواقع.
البحث في الفهرس وحده Index Only Scan وخريطة الرؤية
رأينا Index Only Scan مع Heap Fetches: 0 في الفهرس المركب، ومعناه أن PostgreSQL أجاب من الفهرس دون أن يقرأ صفحات الجدول. ولكن هناك شرط لا يظهر في تعريف الفهرس: الفهرس لا يعرف هل الصف الذي يشير إليه ما زال مرئياً لمعاملتك أم أنه نسخة قديمة، لأن معلومات الرؤية موجودة في الجدول فقط، كما سوف نشرح في مقال التخزين من الداخل. والحل خريطة الرؤية Visibility Map، وهي بت لكل صفحة يقول «كل الصفوف هنا مرئية للجميع»، وإذا كان البت مرفوعاً تجاوز PostgreSQL الجدول، وإلا ذهب إليه ليتأكد، وهذا ما يحسبه السطر Heap Fetches. والتجربة التالية تبين ذلك:
VACUUM users;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT count(*) FROM users WHERE signup_at >= '2023-01-01' AND signup_at < '2023-02-01';
UPDATE users SET last_login = now() WHERE signup_at >= '2023-01-01' AND signup_at < '2023-02-01' AND id % 10 = 0;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT count(*) FROM users WHERE signup_at >= '2023-01-01' AND signup_at < '2023-02-01';
VACUUM users;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT count(*) FROM users WHERE signup_at >= '2023-01-01' AND signup_at < '2023-02-01';
VACUUM
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=30.980..30.982 rows=1.00 loops=1)
Buffers: shared hit=38 read=246
I/O Timings: shared read=6.197
-> Index Only Scan using users_signup_idx on users (actual time=0.107..23.110 rows=89280.00 loops=1)
Index Cond: ((signup_at >= '2023-01-01 00:00:00+00'::timestamp with time zone) AND (signup_at < '2023-02-01 00:00:00+00'::timestamp with time zone))
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=38 read=246
I/O Timings: shared read=6.197
Planning:
Buffers: shared hit=59
Planning Time: 0.504 ms
Execution Time: 31.052 ms
(13 rows)
UPDATE 8928
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=65.059..65.060 rows=1.00 loops=1)
Buffers: shared hit=2359
-> Index Only Scan using users_signup_idx on users (actual time=0.097..48.721 rows=89280.00 loops=1)
Index Cond: ((signup_at >= '2023-01-01 00:00:00+00'::timestamp with time zone) AND (signup_at < '2023-02-01 00:00:00+00'::timestamp with time zone))
Heap Fetches: 89291
Index Searches: 1
Buffers: shared hit=2359
Planning Time: 0.178 ms
Execution Time: 65.102 ms
(9 rows)
VACUUM
QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------------------------------------
Aggregate (actual time=28.202..28.203 rows=1.00 loops=1)
Buffers: shared hit=285
-> Index Only Scan using users_signup_idx on users (actual time=0.120..18.588 rows=89280.00 loops=1)
Index Cond: ((signup_at >= '2023-01-01 00:00:00+00'::timestamp with time zone) AND (signup_at < '2023-02-01 00:00:00+00'::timestamp with time zone))
Heap Fetches: 7
Index Searches: 1
Buffers: shared hit=285
Planning:
Buffers: shared hit=5
Planning Time: 0.324 ms
Execution Time: 28.253 msفي المخرج أعلاه لاحظ التالي:
- بعد VACUUM كان البحث يقرأ 284 صفحة من الفهرس فقط، و
Heap Fetches: 0. - عدلنا 10% فقط من صفوف الشهر، ولكن كل صفحة فيها صف معدل فقدت علامة «مرئية للجميع»، فذهب PostgreSQL إلى الجدول 89,291 مرة، وارتفعت الصفحات إلى 2,359 والوقت إلى الضعف.
- بعد VACUUM عادت العلامات وعادت الأرقام كما كانت تقريباً.
لذلك فالفهرس المغطي Covering Index الذي تضيف إليه أعمدة بالكلمة INCLUDE حتى يجيب الاستعلام منه وحده، كما في مقال الجداول الضخمة، يعمل بكامل سرعته على الجداول التي يمر عليها autovacuum بانتظام، أما على جدول يعدل طوال الوقت فقد يعود إلى قراءة الجدول في أغلب الصفوف، كما يشرح توثيق Index Only Scan.
ثمن الفهرس عند الكتابة
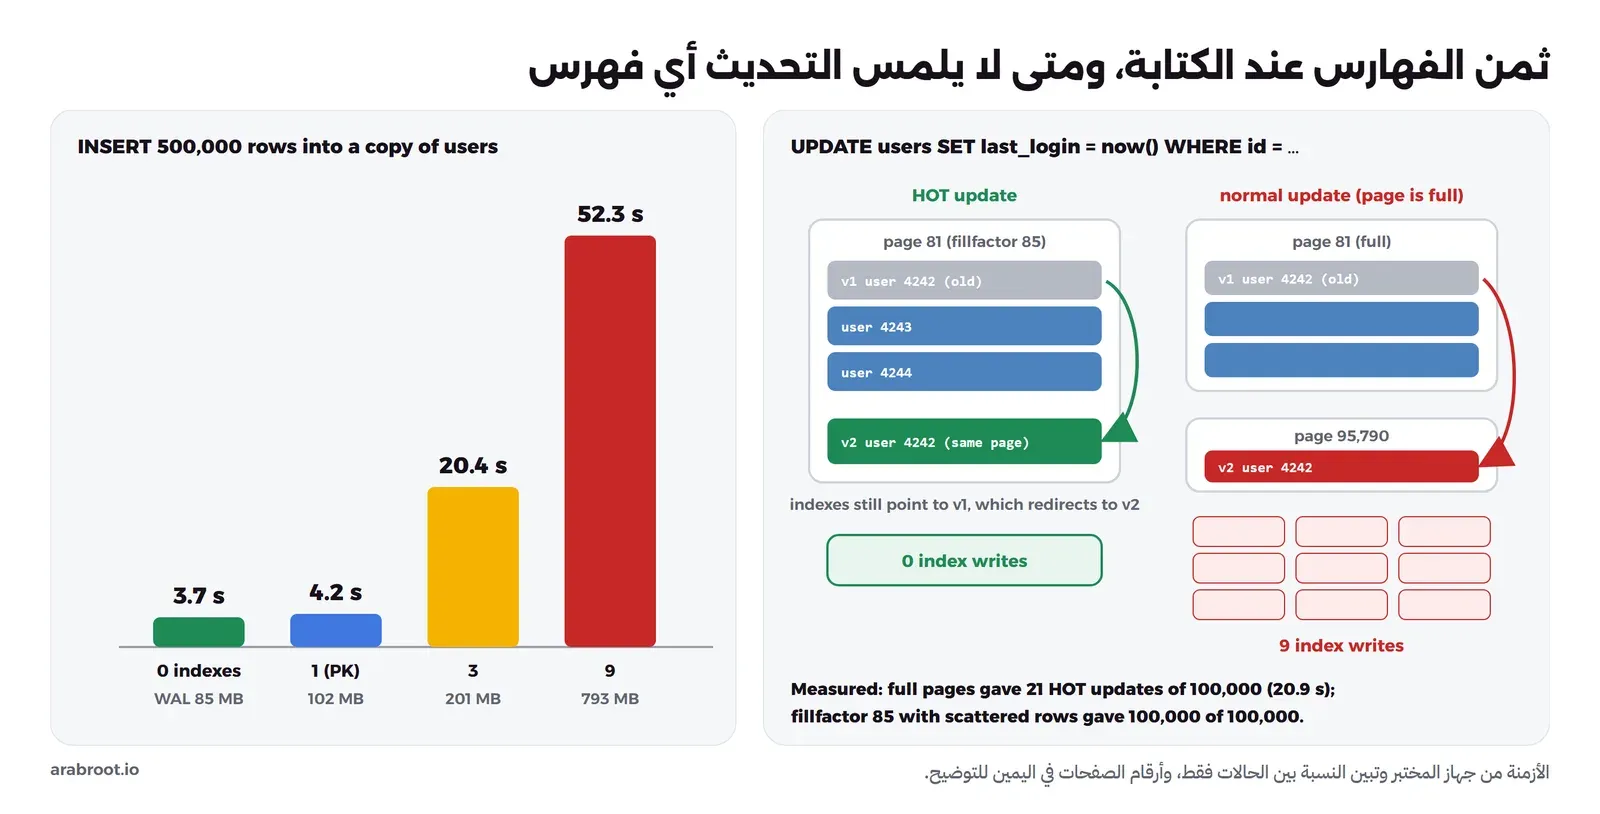
كل فهرس نسخة مرتبة إضافية من جزء من الجدول، وكل INSERT يجب أن يضيف مدخلاً في كل فهرس، في المكان الصحيح من الترتيب، وأن يكتب ذلك في سجل WAL. والآن على الجدول تسعة فهارس، وهذا حجمها مقارنة بالجدول:
          index          |  size
-------------------------+--------
 users_email_lower_idx   | 194 MB
 users_email_idx         | 194 MB
 users_email_pattern_idx | 194 MB
 users_city_signup_idx   | 153 MB
 users_email_trgm_idx    | 146 MB
 users_signup_idx        | 107 MB
 users_pkey              | 107 MB
 users_plan_idx          | 33 MB
 users_meta_idx          | 16 MB
(9 rows)

 table_size | all_indexes
------------+-------------
 748 MB     | 1143 MB
(1 row)
الفهارس معاً 1143 ميجابايت، أي أكبر من الجدول نفسه، وهذا شائع في تطبيقات عمرها سنوات. ولكي نقيس ثمن الكتابة، كتبنا إجراءً ينسخ 500 ألف مستخدم إلى جدول جديد فيه صفر، ثم واحد، ثم ثلاثة، ثم تسعة فهارس، ويقيس الوقت وحجم ال WAL الذي كتبه:
CREATE TEMP TABLE results (indexes int, ms numeric, wal text);
CREATE OR REPLACE PROCEDURE bench(n_idx int) LANGUAGE plpgsql AS $$
DECLARE t0 timestamptz; l0 pg_lsn;
BEGIN
  DROP TABLE IF EXISTS users_copy;
  CREATE TABLE users_copy (LIKE users);
  IF n_idx >= 1 THEN ALTER TABLE users_copy ADD PRIMARY KEY (id); END IF;
  IF n_idx >= 3 THEN CREATE INDEX ON users_copy (email); CREATE INDEX ON users_copy (signup_at); END IF;
  IF n_idx >= 9 THEN
    CREATE INDEX ON users_copy (plan); CREATE INDEX ON users_copy (city, signup_at);
    CREATE INDEX ON users_copy (lower(email)); CREATE INDEX ON users_copy (email text_pattern_ops);
    CREATE INDEX ON users_copy USING gin (email gin_trgm_ops); CREATE INDEX ON users_copy USING gin (meta jsonb_path_ops);
  END IF;
  CHECKPOINT;
  t0 := clock_timestamp(); l0 := pg_current_wal_lsn();
  INSERT INTO users_copy SELECT * FROM users WHERE id <= 500000;
  INSERT INTO results VALUES (n_idx, round(extract(epoch FROM clock_timestamp() - t0)::numeric * 1000),
                              pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), l0)));
END $$;
CALL bench(0);
CALL bench(1);
CALL bench(3);
CALL bench(9);
SELECT * FROM results;
والمخرج سوف يكون كما يلي:
 indexes |  ms   |  wal
---------+-------+--------
       0 |  3730 | 85 MB
       1 |  4206 | 102 MB
       3 | 20412 | 201 MB
       9 | 52286 | 793 MB
(4 rows)
الإدخال نفسه أخذ 3.7 ثانية دون فهارس، و52 ثانية مع تسعة فهارس، أي أبطأ بقرابة 14 مرة، وال WAL الذي يجب أن يكتب على القرص وينتقل إلى نسخ القراءة والنسخ الاحتياطي زاد من 85 إلى 793 ميجابايت. ولاحظ أن القفزة الكبيرة جاءت مع فهارس النص، فالبريد قيمة عشوائية الترتيب، وكل إدخال يذهب إلى صفحة مختلفة من الفهرس، أما فهرس GIN بالمقاطع الثلاثية فيضيف عشرات المداخل لكل بريد. والفكرة نفسها تشرح لماذا يتعب UUIDv4 الفهرس، كما قسناه في مقال المعرفات الفريدة.
التحديث السريع HOT: متى لا يلمس التحديث الفهارس؟
التحديث في PostgreSQL يكتب نسخة جديدة من الصف، والنسخة الجديدة لها عنوان جديد، فهل يجب تحديث كل الفهارس التسعة مع كل UPDATE؟ ليس دائماً، فهناك تحسين اسمه HOT، أي Heap-Only Tuple، وفيه تكتب النسخة الجديدة في الصفحة نفسها، وتبقى الفهارس تشير إلى العنوان القديم الذي يحول القارئ إلى الجديد، بشرطين كما في توثيق HOT: ألا يغير التحديث عموداً عليه فهرس، وأن توجد مساحة فارغة في الصفحة نفسها. والعمود last_login لا يوجد عليه فهرس، فلنحدثه لمئة ألف مستخدم متتالين:
VACUUM users;
SELECT pg_stat_reset_single_table_counters('users'::regclass);
\timing on
UPDATE users SET last_login = now() WHERE id BETWEEN 1000001 AND 1100000;
\timing off
SELECT pg_sleep(1.5);
SELECT n_tup_upd, n_tup_hot_upd FROM pg_stat_user_tables WHERE relname = 'users';
Timing is on.
UPDATE 100000
Time: 20906.824 ms (00:20.907)
Timing is off.
pg_sleep
----------
(1 row)
n_tup_upd | n_tup_hot_upd
-----------+---------------
100000 | 21
(1 row)21 تحديثاً فقط من مئة ألف كان HOT، والتحديث أخذ 21 ثانية، والسبب الشرط الثاني: الجدول أنشئ بإدخال متواصل فصفحاته ممتلئة تماماً، فذهبت كل نسخة جديدة إلى صفحة أخرى واحتاجت مدخلاً جديداً في الفهارس التسعة. والإعداد fillfactor يترك مساحة فارغة في كل صفحة، وهو لا يطبق إلا على الصفحات التي تكتب بعده، لذلك أعدنا كتابة الجدول بالأمر VACUUM FULL، وهو أمر يقفل الجدول كاملاً ويصلح للمختبر فقط، ثم كررنا التحديث على مئة ألف مستخدم آخرين:
ALTER TABLE users SET (fillfactor = 85);
VACUUM FULL users;
ANALYZE users;
SELECT pg_stat_reset_single_table_counters('users'::regclass);
UPDATE users SET last_login = now() WHERE id BETWEEN 3000001 AND 3100000;
Timing is on.
VACUUM
Time: 215785.689 ms (03:35.786)
Timing is off.
ANALYZE
table_size
------------
884 MB
(1 row)
pg_stat_reset_single_table_counters
-------------------------------------
(1 row)
Timing is on.
UPDATE 100000
Time: 5935.432 ms (00:05.935)
Timing is off.
pg_sleep
----------
(1 row)
n_tup_upd | n_tup_hot_upd
-----------+---------------
100000 | 18185
(1 row)الجدول كبر من 748 إلى 884 ميجابايت بسبب المساحة الفارغة، والتحديث نزل من 21 ثانية إلى ست ثوان، ولكن HOT كان 18% فقط، والسبب أننا حدثنا مستخدمين متتالين، أي كل الصفوف في كل صفحة، والمساحة الفارغة 15% تكفي لنسخ جديدة لبعضها فقط. وفي الواقع لا تحدث التطبيقات صفحة كاملة في وقت واحد، وإنما صفوفاً متفرقة، فكررنا التحديث على مئة ألف مستخدم متفرقين في كل الجدول:
SELECT pg_stat_reset_single_table_counters('users'::regclass);
UPDATE users SET last_login = now() WHERE id % 50 = 7;
Timing is on.
UPDATE 100000
Time: 50852.812 ms (00:50.853)
Timing is off.
pg_sleep
----------
(1 row)
n_tup_upd | n_tup_hot_upd
-----------+---------------
100000 | 100000
(1 row)كل التحديثات المئة ألف كانت HOT ولم تلمس أي فهرس، وأما الوقت في هذه التجربة فلا يقارن بما قبله، لأن الشرط id % 50 = 7 لا يستخدم فهرساً فقرأ الاستعلام الجدول كله. والدرس هنا مزدوج: كل فهرس على عمود يتغير كثيراً يمنع HOT لكل تحديث على هذا العمود، والصفحات الممتلئة تمنعه حتى للأعمدة التي لا فهرس عليها. ولذلك قبل أن تضيف فهرساً اسأل: كم مرة يقرأ هذا الاستعلام، وكم مرة يكتب الجدول؟ وراقب النسبة بين n_tup_hot_upd وn_tup_upd، واحذف الفهارس التي لا يستخدمها أحد. والصورة التالية تلخص الحالتين:
قراءة خطة فيها ربط Join
الخطط الحقيقية فيها عدة جداول، والقراءة بالطريقة نفسها: من الداخل إلى الخارج، مع الانتباه إلى loops. لنسأل عن مجموع مشتريات كل مستخدم Enterprise في أبها، وقد أضفنا فهرساً على orders.user_id، وهو فهرس ينساه كثيرون لأن PostgreSQL لا ينشئه تلقائياً للمفتاح الأجنبي كما يذكر توثيق القيود:
CREATE INDEX orders_user_idx ON orders (user_id);
VACUUM ANALYZE users;
EXPLAIN (ANALYZE, BUFFERS)
SELECT u.id, u.email, sum(o.total) AS spent
FROM users u JOIN orders o ON o.user_id = u.id
WHERE u.city = 'Abha' AND u.region = 'Asir' AND u.plan = 'enterprise'
GROUP BY u.id, u.email;
QUERY PLAN
------------------------------------------------------------------------------------------------------------------------------------------------------------------------
GroupAggregate (cost=17926.82..17933.36 rows=242 width=62) (actual time=81.117..85.330 rows=2535.00 loops=1)
Group Key: u.id
Buffers: shared hit=16252 read=3
I/O Timings: shared read=0.261
-> Sort (cost=17926.82..17927.99 rows=468 width=36) (actual time=81.082..81.876 rows=5070.00 loops=1)
Sort Key: u.id
Sort Method: quicksort Memory: 470kB
Buffers: shared hit=16252 read=3
I/O Timings: shared read=0.261
-> Nested Loop (cost=6403.92..17906.06 rows=468 width=36) (actual time=59.595..79.846 rows=5070.00 loops=1)
Buffers: shared hit=16252 read=3
I/O Timings: shared read=0.261
-> Bitmap Heap Scan on users u (cost=6403.48..14891.52 rows=242 width=30) (actual time=59.527..63.936 rows=2535.00 loops=1)
Recheck Cond: ((plan = 'enterprise'::text) AND (city = 'Abha'::text))
Filter: (region = 'Asir'::text)
Heap Blocks: exact=2554
Buffers: shared hit=3577 read=3
I/O Timings: shared read=0.261
-> BitmapAnd (cost=6403.48..6403.48 rows=2390 width=0) (actual time=57.979..57.981 rows=0.00 loops=1)
Buffers: shared hit=1026
-> Bitmap Index Scan on users_plan_idx (cost=0.00..526.05 rows=47683 width=0) (actual time=7.428..7.428 rows=51111.00 loops=1)
Index Cond: (plan = 'enterprise'::text)
Index Searches: 1
Buffers: shared hit=46
-> Bitmap Index Scan on users_city_signup_idx (cost=0.00..5877.06 rows=250750 width=0) (actual time=46.374..46.374 rows=254018.00 loops=1)
Index Cond: (city = 'Abha'::text)
Index Searches: 1
Buffers: shared hit=980
-> Index Scan using orders_user_idx on orders o (cost=0.43..12.44 rows=2 width=14) (actual time=0.004..0.006 rows=2.00 loops=2535)
Index Cond: (user_id = u.id)
Index Searches: 2535
Buffers: shared hit=12675
Planning:
Buffers: shared hit=194
Planning Time: 1.904 ms
Execution Time: 85.838 msاقرأها من الداخل إلى الخارج كما يلي:
- عقدتا
Bitmap Index Scan: الأولى تجمع من فهرس الباقة عناوين Enterprise، والثانية من الفهرس المركب عناوين أبها، ولاحظ أن PostgreSQL استخدم الفهرس المركب للعمود الأول وحده، وهذا مسموح دائماً. BitmapAnd: تقاطع الخريطتين، أي الصفحات التي فيها صفوف تحقق الشرطين، وهكذا يجمع PostgreSQL فهرسين منفصلين في استعلام واحد.Bitmap Heap Scan on users: يقرأ 2,554 صفحة من الجدول، ويطبق الشرط الثالثregion = 'Asir'كمرشح Filter لأنه لا يوجد فهرس عليه، ويخرج 2,535 مستخدماً.Nested Loop: لكل مستخدم من الخطوة السابقة يبحث في الطلبات، ولذلك ترى في العقدة الداخليةloops=2535وIndex Searches: 2535، وrows=2.00هنا متوسط للمرة الواحدة، أي 5,070 طلباً في المجموع، وهو الرقم الذي تراه في العقدة فوقها.SortثمGroupAggregate: ترتيب الطلبات برقم المستخدم ثم جمعها، وSort Method: quicksort Memory: 470kBيعني أن الترتيب تم في الذاكرة دون أن يكتب ملفات مؤقتة على القرص، وإذا رأيتexternal merge Diskفهذا علامة على أنwork_memلا يكفي.
والآن قارن التقدير بالواقع في عقدة المستخدمين: قدر المخطط 242 صفاً، والحقيقة 2,535، أي أخطأ عشر مرات. لماذا؟ لأن المخطط يفترض افتراضياً أن الأعمدة مستقلة، فيضرب نسبة «أبها» في نسبة «عسير» في نسبة Enterprise، ولكن كل من في أبها هو في عسير أصلاً، فالشرط الثاني لا يستبعد أحداً. والخطأ هنا لم يغير الخطة لأن الأرقام صغيرة، ولكن في استعلامات أكبر يجعل المخطط يختار Nested Loop على مئات الآلاف من الصفوف بدل Hash Join، وهذه من أشهر أسباب الاستعلام الذي يبطئ فجأة. والحل أن تخبر PostgreSQL أن العمودين مرتبطان بالإحصاءات الموسعة CREATE STATISTICS:
CREATE STATISTICS users_city_region (dependencies) ON city, region FROM users;
ANALYZE users;
وبعد إعادة الاستعلام نفسه أصبحت عقدة المستخدمين كما يلي:
-> Bitmap Heap Scan on users u (cost=6691.79..16212.26 rows=2705 width=30) (actual time=46.138..50.589 rows=2535.00 loops=1)التقدير أصبح 2,705 والواقع 2,535، وهذا قريب جداً، وتشرح صفحة إحصاءات المخطط الأنواع الثلاثة من الإحصاءات الموسعة. وتذكر قاعدة عامة عند قراءة أي خطة: ابحث عن أول عقدة من الداخل يختلف فيها التقدير عن الواقع بعشرة أضعاف أو أكثر، فهناك في الغالب سبب المشكلة، وكل ما فوقها بني على رقم خاطئ.
ويجدر الإشارة هنا إلى أن عقدة فهرس الباقة أعطت rows=51111 مع أن عدد مستخدمي Enterprise 50,276، والسبب أن Bitmap Index Scan يعد مداخل الفهرس، وقد يبقى في الفهرس مداخل لنسخ قديمة من صفوف عدلناها، ثم يستبعدها Bitmap Heap Scan عند قراءة الجدول، فلا تعتمد على هذا الرقم كعدد للصفوف.
أخطاء شائعة
- إضافة فهرس على كل عمود في جملة WHERE دون قياس، فيصبح حجم الفهارس أكبر من الجدول ويبطئ كل إدخال.
- فهرس على عمود قيمه قليلة مثل الحالة أو الجنس أو الباقة، وهو لا يفيد إلا للقيم النادرة، والأنسب له فهرس جزئي.
- كتابة دالة أو تحويل حول العمود في الشرط، مثل
lower(email)أوcreated_at::date، ثم الاستغراب من أن الفهرس لا يستخدم. - توقع أن يعمل
LIKE 'abc%'مع الفهرس العادي في قاعدة ترتيبها ليسC، أو أن يعملLIKE '%abc%'مع أي B-tree. - نسيان الفهرس على المفتاح الأجنبي في الجدول الابن، فيبطئ الربط ويبطئ حذف الصف الأب.
- قراءة
rowsوactual timeفي العقدة الداخلية دون ضربها فيloops. - تشغيل
EXPLAIN ANALYZEعلى UPDATE أو DELETE خارج معاملة يتم إلغاؤها. - الحكم على الفهرس من تشغيلة واحدة، فالمرة الأولى تقرأ من القرص والثانية من الذاكرة، وقد رأيت 668 ثم 110 ملي ثانية للاستعلام نفسه، لذلك قارن عدد الصفحات في Buffers.
حذف المختبر
الأمر التالي يحذف ال Container وال Volume والشبكة التي أنشأها ملف ال Compose فقط:
docker compose -p lab-idx down -vالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- اقرأ خطة EXPLAIN من الداخل إلى الخارج، واضرب أرقام كل عقدة في loops، وقارن التقدير بالواقع، واعتمد على عدد الصفحات في Buffers أكثر من الوقت.
- ال B-tree شجرة قليلة الطوابق بدرجة تفرع كبيرة، فوجدنا صفاً من خمسة ملايين بقراءة أربع صفحات بدل 95 ألفاً.
- الفهرس يفيد عندما يطلب الاستعلام نسبة صغيرة من الصفوف، أو صفوفاً متجاورة في الملف، ويخسر أمام القراءة المتسلسلة عندما تكون الصفوف كثيرة ومتفرقة.
- رتب الفهرس المركب حسب استعلاماتك، والبحث بالتخطي في PostgreSQL 18 ينقذ الاستعلام بالعمود الثاني فقط عندما تكون قيم العمود الأول قليلة.
- الدالة حول العمود والتحويل وLIKE في قاعدة غير C تمنع الفهرس، والحل فهرس يطابق الاستعلام أو استعلام يطابق الفهرس.
- فهارس GIN تبحث داخل النص وJSONB، وتعطي مرشحين يتحقق منهم PostgreSQL.
- كل فهرس ثمنه مساحة ووقت وWAL مع كل كتابة، وقد أبطأت تسعة فهارس الإدخال 14 مرة، والتحديث HOT يحتاج عموداً بلا فهرس ومساحة فارغة في الصفحة.
- عندما يخطئ المخطط في التقدير بسبب أعمدة مترابطة، فالإحصاءات الموسعة تصحح الرقم.
وفي المقالات التالية من هذه المرحلة نكمل من حيث توقفنا: كيف يكتب PostgreSQL الصفحات وسجل WAL والنسخ المتعددة من الصفوف، ثم الأقفال التي تجعل أمراً بسيطاً مثل إنشاء فهرس يوقف التطبيق:
 دليلكيف تخزن قاعدة البيانات بياناتك من الداخلماذا يحدث على القرص عند INSERT وUPDATE وCOMMIT، ولماذا تنجو قاعدة البيانات من الانهيار، وكيف تختلف LSM عن B-tree.
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.
 دليلتقسيم الجداول Partitioning وتوزيعها على السيرفرات Shardingمتى تقسم الجدول داخل سيرفر واحد، ومتى توزع البيانات على عدة سيرفرات، وكيف تضيف سيرفراً وتتعامل مع العميل الضخم.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ كل التجارب على Docker Engine 29.8.0 مع PostgreSQL 18.6.