

عندما ينفذ تطبيقك COMMIT ويعود إليه الرد بنجاح، فهو يفترض أن البيانات أصبحت محفوظة حتى لو انقطعت الكهرباء عن السيرفر بعد جزء من الثانية، وعندما يحدث صفاً يفترض أن الصف القديم اختفى، وعندما يحذف مليون صف يفترض أن القرص سوف يفرغ. والحقيقة أن الافتراضات الثلاثة غير دقيقة، فقاعدة البيانات لا تكتب في ملف الجدول عند COMMIT أصلاً، والتحديث لا يمسح الصف القديم، والحذف لا يعيد المساحة إلى القرص، وكل واحدة من هذه القرارات لها سبب، وفهمها هو ما يجعلك تعرف لماذا كبر الجدول، ولماذا أبطأ القرص البطيء كل عملية كتابة، ولماذا عادت قاعدة البيانات بعد انقطاع الكهرباء دون أن تفقد شيئاً.
وقد استخدمنا في مقال الفهارس كلمات مثل الصفحة Page وخريطة الرؤية والتحديث HOT دون أن نفتح ملف الجدول نفسه، وفي مقال الجداول الضخمة ضبطنا autovacuum على جدول من 30 مليون صف، أما هذا المقال فينزل طبقة أعمق: كيف يكتب PostgreSQL البيانات على القرص فعلاً، ثم نقارنه بطريقة مختلفة تماماً تستخدمها قواعد بيانات أخرى، وهي شجرة LSM في RocksDB.
 دليلالفهارس Indexes: لماذا تسرع الاستعلام وكيف تقرأ EXPLAINكيف يبحث PostgreSQL داخل الفهرس، ومتى يتجاهله، وكم يكلفك كل فهرس عند الكتابة، وكيف تقرأ خطة EXPLAIN سطراً سطراً.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
وسوف نناقش في هذا المقال ما يلي:
- ملف الجدول والصفحة Page من الداخل: أين يوضع كل صف، وما هي الحقول المخفية فيه.
- التحكم في التزامن بتعدد النسخ MVCC: ماذا يحدث فعلاً عند UPDATE وDELETE، وكيف ترى معاملتان بيانات مختلفة في اللحظة نفسها.
- عمل VACUUM على مستوى الصفحة، ولماذا تمنع معاملة مفتوحة على جدول آخر تنظيف جدولك.
- سجل الكتابة المسبقة WAL: لماذا يكتب PostgreSQL كل تغيير مرتين، وماذا يكلف COMMIT على قرص بطيء، وماذا تخسر مع
synchronous_commit = off. - نقاط الحفظ Checkpoints والصفحات الكاملة Full Page Images.
- تجربة انهيار حقيقية بالإشارة KILL، والاستعادة Crash Recovery من سجل WAL.
- شجرة B-tree مقابل شجرة LSM في RocksDB، وتضخيم الكتابة Write Amplification وتضخيم القراءة Read Amplification بالأرقام.
تجهيز المختبر
سوف نستخدم Container ل PostgreSQL 18.6 وContainer آخر فيه Python مع المكتبة rocksdict التي تحمل RocksDB داخلها، والمنفذ مربوط على 127.0.0.1 فقط:
name: lab-store
services:
  pg:
    image: postgres:18.6
    container_name: lab-store-pg
    environment:
      POSTGRES_PASSWORD: lab-only-password
      POSTGRES_DB: bank
    command: >
      postgres -c shared_buffers=256MB -c max_wal_size=1GB -c checkpoint_timeout=5min
               -c log_checkpoints=on -c track_wal_io_timing=on
    ports:
      - "127.0.0.1:15451:5432"
    volumes:
      - lab-store-data:/var/lib/postgresql
  lsm:
    image: python:3.13.16-slim
    container_name: lab-store-lsm
    command: sh -c "pip install --root-user-action=ignore -q rocksdict==0.3.29 && sleep infinity"
    volumes:
      - ./lsm.py:/lab/lsm.py:ro
volumes:
  lab-store-data:
ثم نفعل ثلاث إضافات تأتي مع PostgreSQL وتسمح لنا بالنظر داخل الملفات: pageinspect لقراءة الصفحات، وpgstattuple لعد الصفوف الحية والميتة، وpg_walinspect لقراءة سجل WAL:
docker compose -p lab-store up -d
docker exec lab-store-pg psql -U postgres -d bank \
  -c "CREATE EXTENSION pageinspect; CREATE EXTENSION pgstattuple; CREATE EXTENSION pg_walinspect; CREATE EXTENSION pgcrypto;"
وكل الأوامر وملفات الخطوات في مجلد lab مع المقال.
الجدول ملف، والملف صفحات
كل جدول في PostgreSQL ملف عادي على القرص، أو عدة ملفات كل منها جيجابايت إذا كبر، داخل مجلد البيانات، وكل ملف مقسم إلى صفحات Pages حجم كل منها 8 كيلوبايت، والصفحة هي أصغر وحدة يقرؤها PostgreSQL من القرص أو يكتبها، فإذا أردت صفاً من 40 بايت قرأ الصفحة كلها. لنبدأ بجدول حسابات صغير فيه ثلاثة صفوف، ونسأل أين ملفه:
CREATE TABLE accounts (id int PRIMARY KEY, owner text NOT NULL, balance bigint NOT NULL);
INSERT INTO accounts VALUES (1, 'Sara', 5000), (2, 'Khalid', 1200), (3, 'Noura', 800);
SELECT pg_relation_filepath('accounts') AS file, pg_relation_size('accounts') AS bytes;
SELECT lsn, lower, upper, special, pagesize FROM page_header(get_raw_page('accounts', 0));
SELECT lp, lp_off, lp_len, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('accounts', 0));
file | bytes
------------------+-------
base/16384/16448 | 8192
(1 row)
lsn | lower | upper | special | pagesize
-----------+-------+-------+---------+----------
0/1C50468 | 36 | 8048 | 8192 | 8192
(1 row)
lp | lp_off | lp_len | t_xmin | t_xmax | t_ctid
----+--------+--------+--------+--------+--------
1 | 8144 | 48 | 756 | 0 | (0,1)
2 | 8096 | 48 | 756 | 0 | (0,2)
3 | 8048 | 48 | 756 | 0 | (0,3)
(3 rows)والملف موجود فعلاً على القرص بحجم صفحة واحدة:
docker exec lab-store-pg ls -l /var/lib/postgresql/18/docker/base/16384/16448-rw------- 1 postgres postgres 8192 Oct 10 05:34 /var/lib/postgresql/18/docker/base/16384/16448في المخرج أعلاه لاحظ التالي:
- المسار
base/16384/16448يعني قاعدة البيانات رقم 16384 والملف رقم 16448، وتشرح صفحة تخطيط الملفات بقية المجلدات. - الصفحة تبدأ بترويسة Page Header حجمها 24 بايت، ثم مصفوفة مؤشرات Line Pointers كل واحد منها 4 بايت يشير إلى مكان صف داخل الصفحة، وهذا ما يقوله
lower = 36: 24 للترويسة و12 لثلاثة مؤشرات، كما في توثيق تخطيط الصفحة. - الصفوف نفسها تكتب من آخر الصفحة إلى أولها: الأول عند البايت 8144، والثاني عند 8096، والثالث عند 8048، وهو
upper. والمساحة بين lower وupper هي المساحة الفارغة، فالمؤشرات تكبر من الأعلى والصفوف تكبر من الأسفل حتى يلتقيا. - كل صف طوله 48 بايت مع أن البيانات قليلة، والسبب أن لكل صف ترويسة Tuple Header فيها 23 بايت على الأقل، وأهم ما فيها الحقلان
t_xminوt_xmax. t_xmin = 756رقم المعاملة Transaction ID التي أنشأت الصف، وt_xmax = 0يعني أن لا أحد حذفه أو عدله بعد، وt_ctidعنوان الصف نفسه: الصفحة 0 والمؤشر 1.lsnفي ترويسة الصفحة هو موقع آخر سجل WAL غير هذه الصفحة، وسوف نرى لماذا يحتاجه PostgreSQL في قسم الاستعادة.
والصورة التالية تبين شكل الصفحة:
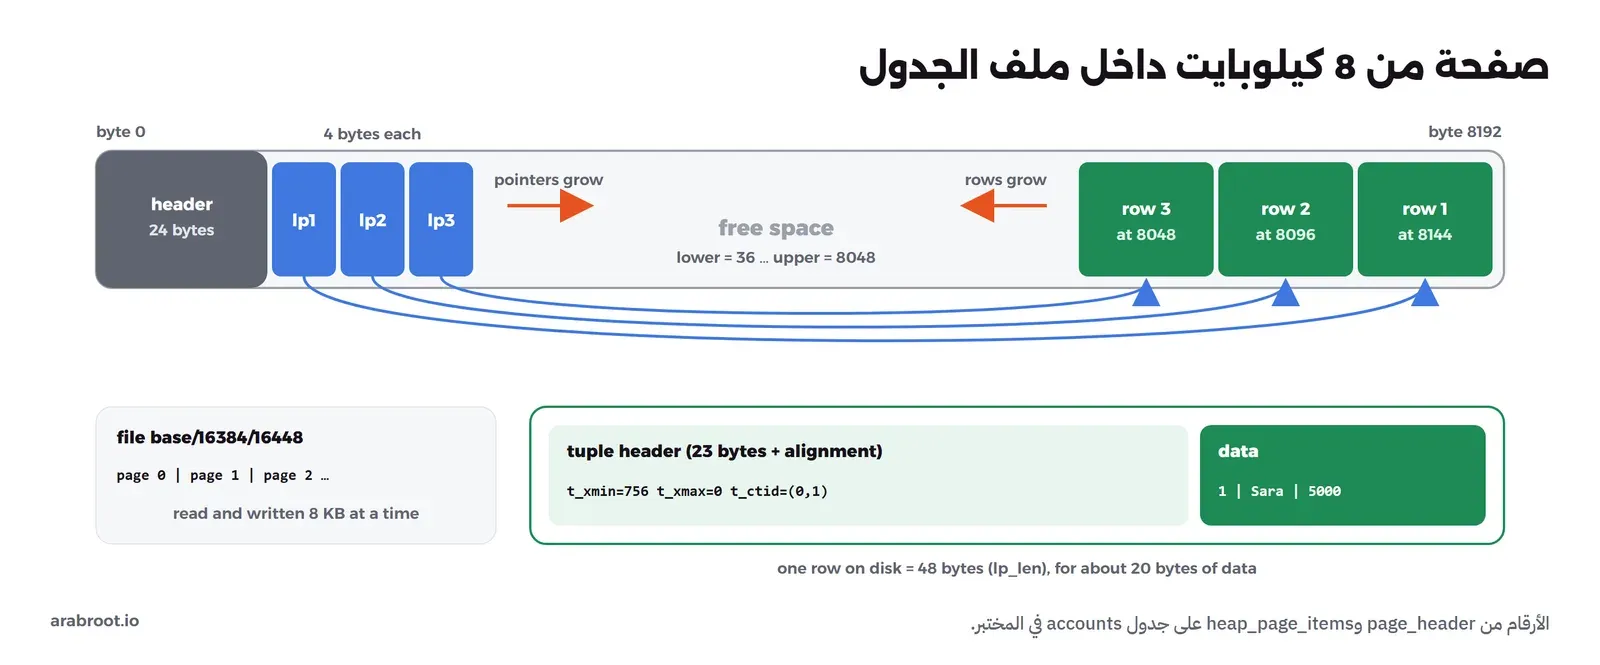
وقد يتساءل البعض: لماذا هذا الترتيب غير المباشر، مؤشر ثم صف؟ والإجابة أن الفهارس تشير إلى رقم المؤشر وليس إلى مكان الصف بالبايت، فيستطيع PostgreSQL أن يرتب الصفوف داخل الصفحة ويضغطها دون أن يغير أي فهرس، وسوف تراه يفعل ذلك بعد قليل.
ماذا يحدث فعلاً عند UPDATE وDELETE؟
الطريقة البسيطة لقاعدة بيانات أن تكتب القيمة الجديدة فوق القديمة، وهي طريقة تعمل حتى تأتي معاملة تقرأ الصف في اللحظة نفسها، فإما أن تنتظر حتى تنتهي الكتابة، أي أن القارئ ينتظر الكاتب، أو أن ترى نصف تعديل. وPostgreSQL يحل ذلك بالتحكم في التزامن بتعدد النسخ MVCC، أي Multiversion Concurrency Control: التحديث لا يغير الصف وإنما يكتب نسخة جديدة منه، ويضع في النسخة القديمة رقم المعاملة التي أنهتها في الحقل xmax، والحذف يضع xmax فقط، وكل معاملة ترى النسخة المناسبة للحظة التي أخذت فيها لقطتها Snapshot، كما في مقدمة MVCC في التوثيق.
ولكي نرى ذلك نحتاج جلستين في الوقت نفسه، وقد كتبنا سكربتاً صغيراً sessions.sh يفتح جلستين psql باسم A وB، ويرسل لكل منهما سطرها من ملف خطوات بالترتيب، ويطبع ما ترد به، والسطر الذي يبدأ ب A> هو ما أرسلناه، والأسطر التي تبدأ ب A| هي الرد:
#!/bin/bash
# Runs a steps file against two psql sessions A and B inside the container, in order, and prints what each answered.
#   docker exec lab-store-pg bash /lab/sessions.sh /lab/steps.txt
# Step lines look like "A: SELECT ..." or "B: UPDATE ...". A session that waits on a lock simply prints nothing yet.
set -u
dir=$(mktemp -d); cd "$dir"; mkfifo in_a in_b; : > out_a; : > out_b
psql -U postgres -d "${DB:-bank}" -X -q < in_a > out_a 2>&1 &
psql -U postgres -d "${DB:-bank}" -X -q < in_b > out_b 2>&1 &
exec 3>in_a 4>in_b
seen_a=0; seen_b=0
flush() {
  local n
  n=$(wc -c < out_a); if [ "$n" -gt "$seen_a" ]; then tail -c +$((seen_a + 1)) out_a | sed 's/^/   A| /'; seen_a=$n; fi
  n=$(wc -c < out_b); if [ "$n" -gt "$seen_b" ]; then tail -c +$((seen_b + 1)) out_b | sed 's/^/   B| /'; seen_b=$n; fi
}
while IFS= read -r line || [ -n "$line" ]; do
  [ -z "$line" ] && continue
  who=${line%%:*}; sql=${line#*: }
  echo "$who> $sql"
  if [ "$who" = A ]; then printf '%s\n' "$sql" >&3; else printf '%s\n' "$sql" >&4; fi
  sleep "${PAUSE:-1.2}"; flush
done < "$1"
exec 3>&- 4>&-
sleep 1.5; flush; wait
rm -rf "$dir"
وملف الخطوات mvcc.txt: الجلسة A تفتح معاملة بالمستوى Repeatable Read وتقرأ الحسابات، ثم الجلسة B تزيد رصيد خالد وتحذف حساب نورة، ثم تقرأ الجلستان، ثم تنظر B داخل الصفحة:
A: BEGIN ISOLATION LEVEL REPEATABLE READ;
A: SELECT id, owner, balance FROM accounts ORDER BY id;
B: UPDATE accounts SET balance = balance + 300 WHERE id = 2;
B: DELETE FROM accounts WHERE id = 3;
B: SELECT id, owner, balance FROM accounts ORDER BY id;
A: SELECT id, owner, balance FROM accounts ORDER BY id;
B: SELECT lp, lp_off, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('accounts', 0));
A: COMMIT;
docker cp sessions.sh lab-store-pg:/tmp/sessions.sh
docker cp mvcc.txt lab-store-pg:/tmp/mvcc.txt
docker exec lab-store-pg bash /tmp/sessions.sh /tmp/mvcc.txtوالمخرج سوف يكون كما يلي:
A> BEGIN ISOLATION LEVEL REPEATABLE READ;
A> SELECT id, owner, balance FROM accounts ORDER BY id;
   A|  id | owner  | balance
   A| ----+--------+---------
   A|   1 | Sara   |    5000
   A|   2 | Khalid |    1200
   A|   3 | Noura  |     800
   A| (3 rows)
   A|
B> UPDATE accounts SET balance = balance + 300 WHERE id = 2;
B> DELETE FROM accounts WHERE id = 3;
B> SELECT id, owner, balance FROM accounts ORDER BY id;
   B|  id | owner  | balance
   B| ----+--------+---------
   B|   1 | Sara   |    5000
   B|   2 | Khalid |    1500
   B| (2 rows)
   B|
A> SELECT id, owner, balance FROM accounts ORDER BY id;
   A|  id | owner  | balance
   A| ----+--------+---------
   A|   1 | Sara   |    5000
   A|   2 | Khalid |    1200
   A|   3 | Noura  |     800
   A| (3 rows)
   A|
B> SELECT lp, lp_off, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('accounts', 0));
   B|  lp | lp_off | t_xmin | t_xmax | t_ctid
   B| ----+--------+--------+--------+--------
   B|   1 |   8144 |    756 |      0 | (0,1)
   B|   2 |   8096 |    756 |    768 | (0,4)
   B|   3 |   8048 |    756 |    769 | (0,3)
   B|   4 |   8000 |    768 |      0 | (0,4)
   B| (4 rows)
   B|
A> COMMIT;
في المخرج أعلاه لاحظ التالي:
- في اللحظة نفسها ترى B حسابين، وترى A ثلاثة حسابات ورصيد خالد القديم، ولم تنتظر أي منهما الأخرى.
- الصفحة فيها الآن أربع نسخ لثلاثة صفوف: النسخة القديمة لخالد في المؤشر 2 أصبح لها
t_xmax = 768، أي المعاملة التي عدلتها، وt_ctid = (0,4)يشير إلى النسخة الجديدة في المؤشر 4، والتي أنشأتها المعاملة 768 نفسها. - صف نورة ما زال في الصفحة كما هو، والفرق الوحيد أن
t_xmax = 769، أي أن الحذف لم يحذف شيئاً من القرص، وإنما كتب رقم المعاملة التي حذفت. - والقاعدة التي تقرر بها كل معاملة ما تراه: النسخة مرئية إذا كانت المعاملة التي أنشأتها xmin قد انتهت بنجاح قبل لقطتي، ولم تكن المعاملة التي أنهتها xmax قد انتهت قبل لقطتي. لذلك ترى A النسخة القديمة لأن 768 بدأت بعد لقطتها.
والصورة التالية تبين النسخ ومن يرى كل نسخة:
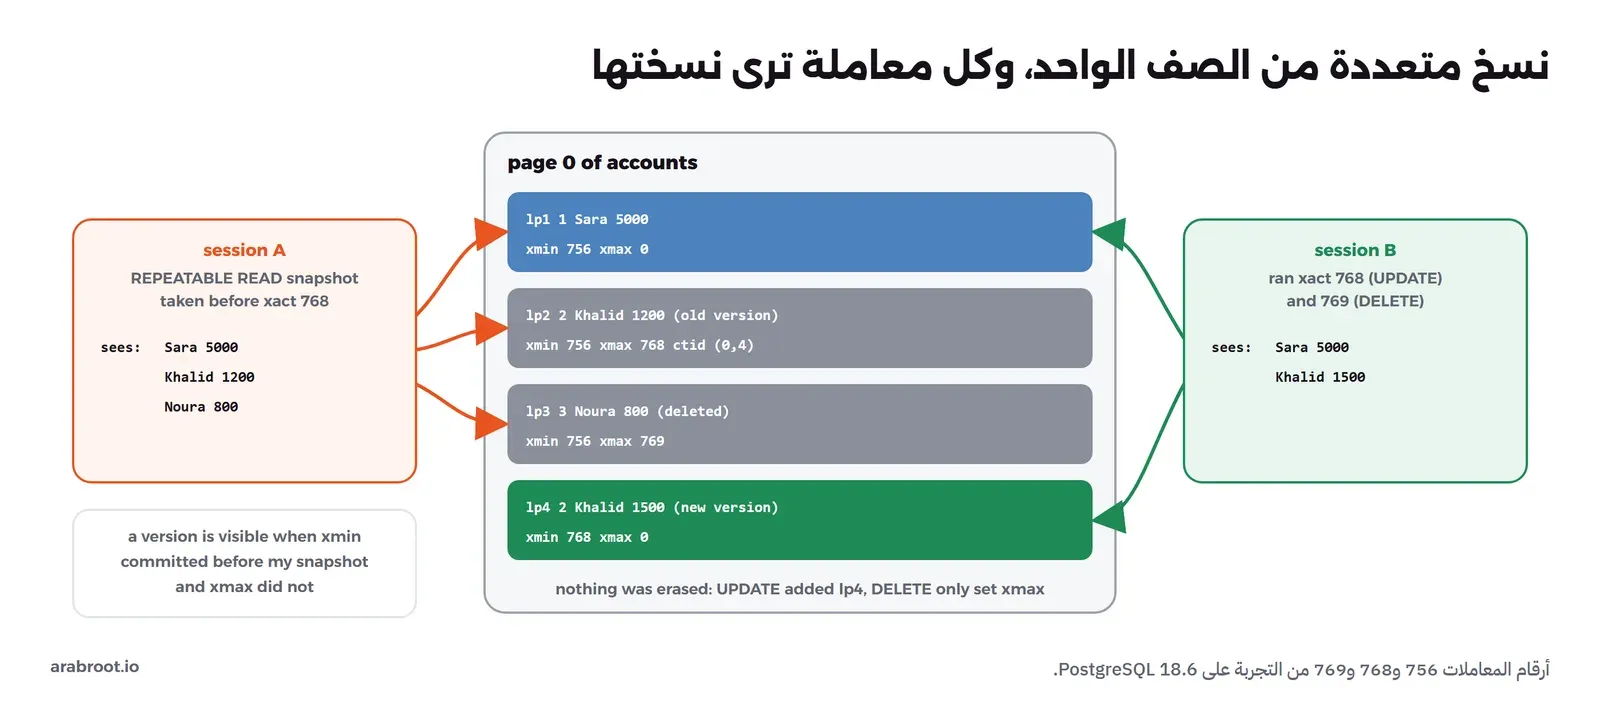
وهذا هو ثمن MVCC: كل تحديث يترك نسخة ميتة Dead Tuple، وكل حذف يترك الصف كما هو، وشخص ما يجب أن ينظف هذه النسخ عندما لا يحتاجها أحد، وهذا عمل VACUUM.
ال VACUUM على مستوى الصفحة
بعد أن أنهت A معاملتها لم تعد أي معاملة تحتاج النسخة القديمة لخالد ولا صف نورة، فنشغل VACUUM وننظر إلى الصفحة مرة أخرى، وهذه المرة نعرض أيضاً حالة كل مؤشر lp_flags:
VACUUM (VERBOSE) accounts;
SELECT lp, lp_flags, lp_off, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('accounts', 0));
والمخرج سوف يكون كما يلي، وقد حذفنا منه جزء الجدول المساعد TOAST لأنه فارغ:
INFO:  vacuuming "bank.public.accounts"
INFO:  finished vacuuming "bank.public.accounts": index scans: 1
pages: 0 removed, 1 remain, 1 scanned (100.00% of total), 0 eagerly scanned
tuples: 2 removed, 2 remain, 0 are dead but not yet removable
removable cutoff: 770, which was 0 XIDs old when operation ended
new relfrozenxid: 756, which is 1 XIDs ahead of previous value
frozen: 0 pages from table (0.00% of total) had 0 tuples frozen
visibility map: 1 pages set all-visible, 0 pages set all-frozen (0 were all-visible)
index scan needed: 1 pages from table (100.00% of total) had 1 dead item identifiers removed
index "accounts_pkey": pages: 2 in total, 0 newly deleted, 0 currently deleted, 0 reusable
avg read rate: 0.000 MB/s, avg write rate: 36.939 MB/s
buffer usage: 63 hits, 0 reads, 4 dirtied
WAL usage: 9 records, 4 full page images, 33661 bytes, 0 buffers full
system usage: CPU: user: 0.00 s, system: 0.00 s, elapsed: 0.00 s
VACUUM
 lp | lp_flags | lp_off | t_xmin | t_xmax | t_ctid
----+----------+--------+--------+--------+--------
  1 |        1 |   8144 |    756 |      0 | (0,1)
  2 |        2 |      4 |        |        |
  3 |        0 |      0 |        |        |
  4 |        1 |   8096 |    768 |      0 | (0,4)
(4 rows)
في المخرج أعلاه لاحظ التالي:
tuples: 2 removed: أزال VACUUM نسختين، القديمة لخالد وصف نورة المحذوف.- المؤشر 3 أصبحت حالته 0، أي غير مستخدم Unused، ويمكن أن يأخذه صف جديد، وقبل ذلك حذف VACUUM مدخل نورة من الفهرس
accounts_pkey، وهذا ما يقوله السطرindex scan needed. - المؤشر 2 حالته 2، أي تحويل Redirect إلى المؤشر 4، والسبب أن تحديث خالد كان تحديثاً سريعاً HOT، فالفهرس ما زال يشير إلى المؤشر 2، والمؤشر 2 يحول القارئ إلى النسخة الحية في 4، كما شرحنا في قسم HOT في مقال الفهارس.
- النسخة الحية في المؤشر 4 انتقلت من البايت 8000 إلى 8096، أي أن VACUUM أعاد ترتيب الصفوف داخل الصفحة وجمع المساحة الفارغة في مكان واحد، دون أن يتغير رقم أي مؤشر.
- ملف الجدول لم يصغر، وما زال صفحة واحدة، فال VACUUM العادي يجعل المساحة قابلة لإعادة الاستخدام داخل الملف ولا يعيدها إلى نظام التشغيل إلا إذا كانت الصفحات الفارغة في آخر الملف، وقد شرحنا البدائل VACUUM FULL وpg_repack في مقال الجداول الضخمة.
معاملة مفتوحة تمنع التنظيف
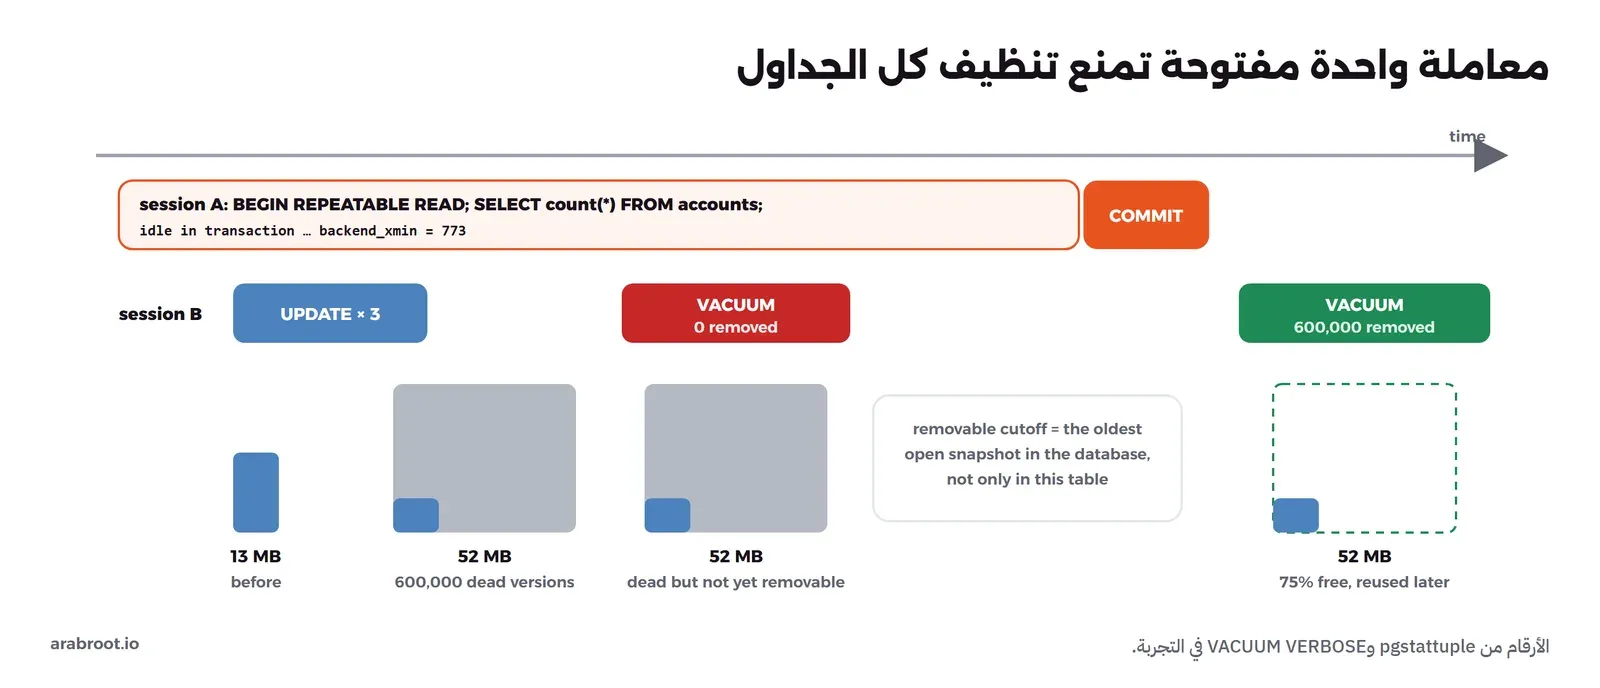
متى يقرر VACUUM أن نسخة ميتة لم يعد يحتاجها أحد؟ عندما تكون المعاملة التي أنهتها أقدم من أقدم لقطة ما زالت مفتوحة في كل قاعدة البيانات، وهذا الحد يسمى أفق الإزالة Removable Cutoff. والنتيجة التي يغفل عنها كثيرون أن معاملة واحدة مفتوحة منذ ساعة، حتى لو كانت تقرأ جدولاً آخر لا علاقة له، تمنع تنظيف كل الجداول. لنجهز جدول تحويلات فيه 200 ألف صف:
CREATE TABLE transfers (id bigint PRIMARY KEY, amount bigint NOT NULL, note text NOT NULL);
INSERT INTO transfers SELECT g, g % 1000, 'transfer number ' || g FROM generate_series(1, 200000) g;
VACUUM ANALYZE transfers;
SELECT pg_size_pretty(pg_relation_size('transfers')) AS size, tuple_count, dead_tuple_count, round(free_percent) AS free_pct FROM pgstattuple('transfers');
size | tuple_count | dead_tuple_count | free_pct
-------+-------------+------------------+----------
13 MB | 200000 | 0 | 0
(1 row)ثم ملف الخطوات horizon.txt: الجلسة A تفتح معاملة Repeatable Read وتقرأ جدول الحسابات فقط ثم تبقى صامتة، كأنها تقرير يعمل ببطء أو كود نسي أن يغلق المعاملة، والجلسة B تحدث كل التحويلات ثلاث مرات ثم تشغل VACUUM:
A: BEGIN ISOLATION LEVEL REPEATABLE READ;
A: SELECT count(*) FROM accounts;
B: UPDATE transfers SET amount = amount + 1;
B: UPDATE transfers SET amount = amount + 1;
B: UPDATE transfers SET amount = amount + 1;
B: SELECT pg_size_pretty(pg_relation_size('transfers')) AS size, tuple_count, dead_tuple_count FROM pgstattuple('transfers');
B: VACUUM (VERBOSE) transfers;
B: SELECT pid, state, now() - xact_start AS xact_age, backend_xmin FROM pg_stat_activity WHERE backend_xmin IS NOT NULL AND pid <> pg_backend_pid();
A: COMMIT;
B: VACUUM (VERBOSE) transfers;
B: SELECT pg_size_pretty(pg_relation_size('transfers')) AS size, tuple_count, dead_tuple_count, round(free_percent) AS free_pct FROM pgstattuple('transfers');
والمخرج سوف يكون كما يلي، وقد حذفنا منه أجزاء الجدول المساعد TOAST:
A> BEGIN ISOLATION LEVEL REPEATABLE READ;
A> SELECT count(*) FROM accounts;
   A|  count
   A| -------
   A|      2
   A| (1 row)
   A|
B> UPDATE transfers SET amount = amount + 1;
B> UPDATE transfers SET amount = amount + 1;
B> UPDATE transfers SET amount = amount + 1;
B> SELECT pg_size_pretty(pg_relation_size('transfers')) AS size, tuple_count, dead_tuple_count FROM pgstattuple('transfers');
B> VACUUM (VERBOSE) transfers;
   B|  size  | tuple_count | dead_tuple_count
   B| -------+-------------+------------------
   B|  52 MB |      200000 |           600000
   B| (1 row)
   B|
   B| INFO:  vacuuming "bank.public.transfers"
   B| INFO:  finished vacuuming "bank.public.transfers": index scans: 0
   B| pages: 0 removed, 6667 remain, 6667 scanned (100.00% of total), 0 eagerly scanned
   B| tuples: 0 removed, 800000 remain, 600000 are dead but not yet removable
   B| removable cutoff: 773, which was 3 XIDs old when operation ended
   B| frozen: 0 pages from table (0.00% of total) had 0 tuples frozen
   B| visibility map: 0 pages set all-visible, 0 pages set all-frozen (0 were all-visible)
   B| index scan not needed: 0 pages from table (0.00% of total) had 0 dead item identifiers removed
   B| avg read rate: 0.000 MB/s, avg write rate: 0.044 MB/s
   B| buffer usage: 13358 hits, 0 reads, 1 dirtied
   B| WAL usage: 2 records, 1 full page images, 8499 bytes, 0 buffers full
   B| system usage: CPU: user: 0.15 s, system: 0.01 s, elapsed: 0.17 s
B> SELECT pid, state, now() - xact_start AS xact_age, backend_xmin FROM pg_stat_activity WHERE backend_xmin IS NOT NULL AND pid <> pg_backend_pid();
   B|  pid |        state        |    xact_age     | backend_xmin
   B| -----+---------------------+-----------------+--------------
   B|  213 | idle in transaction | 00:00:21.012926 |          773
   B| (1 row)
   B|
A> COMMIT;
B> VACUUM (VERBOSE) transfers;
   B| INFO:  vacuuming "bank.public.transfers"
   B| INFO:  finished vacuuming "bank.public.transfers": index scans: 1
   B| pages: 0 removed, 6667 remain, 6667 scanned (100.00% of total), 0 eagerly scanned
   B| tuples: 600000 removed, 200000 remain, 0 are dead but not yet removable
   B| removable cutoff: 776, which was 0 XIDs old when operation ended
   B| new relfrozenxid: 775, which is 4 XIDs ahead of previous value
   B| frozen: 0 pages from table (0.00% of total) had 0 tuples frozen
   B| visibility map: 6667 pages set all-visible, 5000 pages set all-frozen (0 were all-visible)
   B| index scan needed: 5000 pages from table (75.00% of total) had 600000 dead item identifiers removed
   B| index "transfers_pkey": pages: 1647 in total, 0 newly deleted, 0 currently deleted, 0 reusable
   B| avg read rate: 0.000 MB/s, avg write rate: 0.000 MB/s
   B| buffer usage: 20010 hits, 0 reads, 0 dirtied
   B| WAL usage: 18308 records, 0 full page images, 4906371 bytes, 0 buffers full
   B| system usage: CPU: user: 0.42 s, system: 0.00 s, elapsed: 0.42 s
B> SELECT pg_size_pretty(pg_relation_size('transfers')) AS size, tuple_count, dead_tuple_count, round(free_percent) AS free_pct FROM pgstattuple('transfers');
   B|  size  | tuple_count | dead_tuple_count | free_pct
   B| -------+-------------+------------------+----------
   B|  52 MB |      200000 |                0 |       75
   B| (1 row)
   B|
في المخرج أعلاه لاحظ التالي:
- ثلاثة تحديثات على 200 ألف صف تركت 600 ألف نسخة ميتة، وكبر الجدول من 13 إلى 52 ميجابايت، أي أربعة أضعاف، دون أن يزيد صف واحد.
- أول VACUUM لم يزل شيئاً:
600000 are dead but not yet removable، والسبب في السطرremovable cutoff: 773، فلا يستطيع أن يزيل نسخة أنهتها معاملة بعد 773. - العرض
pg_stat_activityيكشف السبب: الجلسة 213 في حالةidle in transactionمنذ 21 ثانية، وbackend_xmin = 773، وهي جلسة لم تلمس جدول التحويلات إطلاقاً. - بعد COMMIT في الجلسة A أزال VACUUM النسخ الستمئة ألف كلها، ولكن الملف بقي 52 ميجابايت، منها 75% مساحة فارغة سوف تستخدمها التحديثات القادمة.
والصورة التالية تلخص ما حدث:
لذلك راقب أقدم معاملة مفتوحة في كل قاعدة بيانات، وضع حداً للمعاملات الصامتة بالإعداد idle_in_transaction_session_timeout كما في تمرين Kata رقم 15، وتذكر أن نسخ القراءة مع hot_standby_feedback وال Replication Slots المهجورة تمسك الأفق نفسه، وتشرح صفحة الصيانة الدورية التفاصيل. وسوف نعود إلى المعاملات المفتوحة من زاوية الأقفال في مقال الأقفال.
سجل الكتابة المسبقة WAL: لماذا يكتب PostgreSQL كل تغيير مرتين؟
الطريقة البسيطة لحفظ البيانات أن تكتب الصفحة المعدلة في ملف الجدول عند كل COMMIT وتنتظر القرص، وهي طريقة بطيئة جداً، لأن معاملة واحدة قد تعدل صفوفاً في عشرين صفحة متفرقة في خمسة ملفات، والكتابة العشوائية والمزامنة fsync لكل ملف هي أغلى ما في القرص. وهي أيضاً غير آمنة، فإذا انقطعت الكهرباء بعد كتابة عشر صفحات من العشرين فإن الجدول يبقى في حالة لا تطابق أي معاملة.
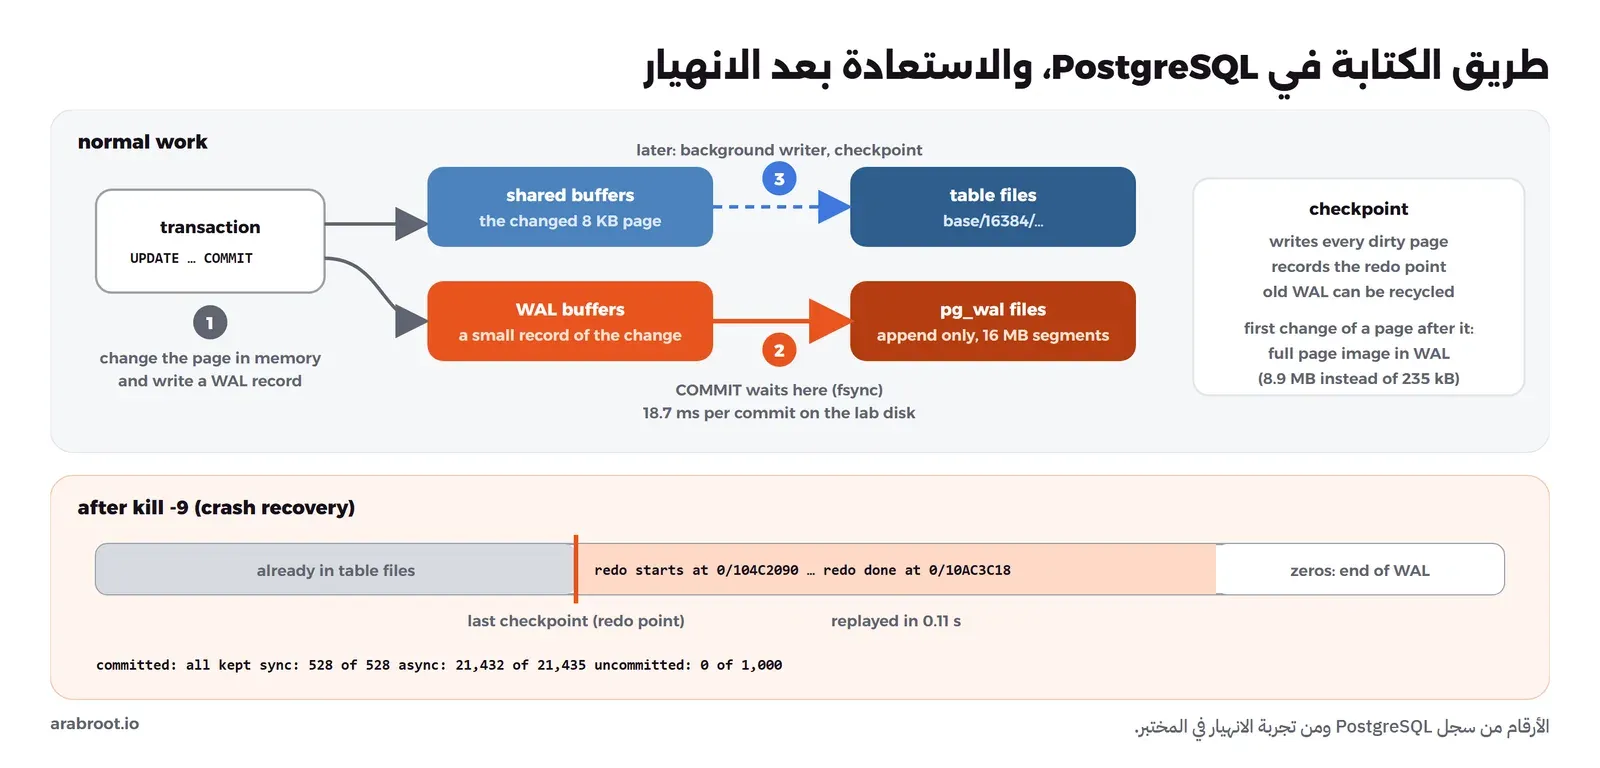
والحل الذي تستخدمه كل قواعد البيانات الجادة هو سجل الكتابة المسبقة WAL، أي Write-Ahead Log: قبل أن تتغير أي صفحة على القرص، يكتب وصف التغيير في سجل يكتب في آخره فقط Append-Only، وعند COMMIT تكفي مزامنة هذا السجل وحده، أما الصفحات المعدلة فتبقى في الذاكرة وتكتب إلى ملفاتها لاحقاً على مهل، وإذا انهار السيرفر فإنه يعيد تنفيذ السجل عند التشغيل، كما يشرح توثيق WAL. لنقس ما يكتبه إدخال 100 ألف صف:
CREATE TABLE ledger (id bigint PRIMARY KEY, account int NOT NULL, amount bigint NOT NULL, note text NOT NULL);
SELECT pg_current_wal_lsn() AS before \gset
INSERT INTO ledger SELECT g, g % 5000, g % 997, 'entry ' || g FROM generate_series(1, 100000) g;
SELECT pg_current_wal_lsn() AS after \gset
SELECT :'before' AS before, :'after' AS after,
       pg_size_pretty(pg_wal_lsn_diff(:'after', :'before')) AS wal_written,
       pg_size_pretty(pg_relation_size('ledger')) AS table_size, pg_size_pretty(pg_relation_size('ledger_pkey')) AS index_size;
SELECT "resource_manager/record_type" AS rmgr, count, pg_size_pretty(combined_size) AS size, pg_size_pretty(fpi_size) AS fpi
FROM pg_get_wal_stats(:'before', :'after') WHERE count > 0 ORDER BY combined_size DESC;
SELECT start_lsn, resource_manager, record_type, record_length, block_ref
FROM pg_get_wal_records_info(:'before', :'after') LIMIT 3;
INSERT 0 100000
before | after | wal_written | table_size | index_size
-----------+-----------+-------------+------------+------------
0/DDC2B18 | 0/ED43180 | 16 MB | 6672 kB | 2208 kB
(1 row)
rmgr | count | size | fpi
-------------+--------+----------+---------
Heap | 100000 | 8876 kB | 0 bytes
Btree | 100274 | 6453 kB | 0 bytes
Heap2 | 1 | 54 bytes | 0 bytes
Transaction | 1 | 34 bytes | 0 bytes
(4 rows)
start_lsn | resource_manager | record_type | record_length | block_ref
-----------+------------------+-----------------+---------------+-------------------------------------------------------------------------------------------------
0/DDC2B18 | Heap2 | PRUNE_ON_ACCESS | 54 | blkref #0: rel 1663/16384/1259 fork main blk 5
0/DDC2B50 | Heap | INSERT+INIT | 87 | blkref #0: rel 1663/16384/16472 fork main blk 0
0/DDC2BA8 | Btree | NEWROOT | 90 | blkref #0: rel 1663/16384/16481 fork main blk 1 blkref #2: rel 1663/16384/16481 fork main blk 0
(3 rows)في المخرج أعلاه لاحظ التالي:
- الموقع في السجل اسمه LSN، أي Log Sequence Number، وهو عدد البايتات منذ بداية السجل، والفرق بين الرقمين هو حجم ما كتب: قرابة 16 ميجابايت، مقابل 6.5 ميجابايت للجدول و2.2 للفهرس.
- كل صف أنتج سجلين: سجل Heap للصف وسجل Btree لمدخل الفهرس، ولو كان على الجدول تسعة فهارس لكانت عشرة سجلات، وهذا ما قسناه في ثمن الفهرس عند الكتابة.
- كل سجل يذكر الملف والصفحة التي يغيرها
blkref، وهذا ما يحتاجه PostgreSQL ليعيد التغيير على الصفحة الصحيحة عند الاستعادة، وما تحتاجه نسخ القراءة Replicas التي تستقبل السجل نفسه وتطبقه، كما شرحنا في مقال عناقيد قواعد البيانات.
والسجل نفسه ملفات بحجم 16 ميجابايت في المجلد pg_wal، ويعيد PostgreSQL استخدام الملفات القديمة أو يحذفها بعد كل نقطة حفظ كما سوف نرى:
total 213000
-rw------- 1 postgres postgres 16777216 Oct 10 05:36 000000010000000000000001
-rw------- 1 postgres postgres 16777216 Oct 10 05:36 000000010000000000000002
-rw------- 1 postgres postgres 16777216 Oct 10 05:36 000000010000000000000003
-rw------- 1 postgres postgres 16777216 Oct 10 05:36 000000010000000000000004
ماذا يكلف COMMIT؟ و synchronous_commit
عند COMMIT ينتظر PostgreSQL حتى يؤكد نظام التشغيل أن سجل WAL وصل إلى القرص فعلاً، وهذا ما يجعل المعاملة دائمة Durable، ومعناه أن زمن COMMIT لا يمكن أن يقل عن زمن مزامنة واحدة fsync للقرص. والأداة pg_test_fsync التي تأتي مع PostgreSQL تقيس ذلك:
docker exec -u postgres lab-store-pg bash -c "cd /var/lib/postgresql/18/docker && pg_test_fsync -s 2 -f /var/lib/postgresql/18/docker/fsync_test.out"2 seconds per test
O_DIRECT supported on this platform for open_datasync and open_sync.
Compare file sync methods using one 8kB write:
(in "wal_sync_method" preference order, except fdatasync is Linux's default)
open_datasync 199.097 ops/sec 5023 usecs/op
fdatasync 284.090 ops/sec 3520 usecs/op
fsync 33.963 ops/sec 29444 usecs/op
fsync_writethrough n/a
open_sync 57.969 ops/sec 17251 usecs/opالطريقة الافتراضية على Linux هي fdatasync، وعلى قرص المختبر تأخذ قرابة 3.5 ملي ثانية للمرة الواحدة، وقرص NVMe في سيرفر حقيقي أسرع من ذلك بكثير، وأقراص الشركات التي فيها مكثف يحمي الذاكرة المؤقتة Power Loss Protection أسرع أيضاً. والآن نقيس عميلاً واحداً يدخل صفاً واحداً في كل معاملة لمدة 15 ثانية، مرة بالإعداد الافتراضي، ومرة مع synchronous_commit = off الذي يجعل COMMIT يعود قبل أن يصل السجل إلى القرص:
\set acc random(1, 5000)
INSERT INTO payments (account, amount) VALUES (:acc, 100);
docker exec lab-store-pg psql -U postgres -d bank -c "CREATE TABLE payments (id bigserial PRIMARY KEY, account int NOT NULL, amount bigint NOT NULL, created_at timestamptz NOT NULL DEFAULT now())"
docker exec lab-store-pg pgbench -U postgres -n -c 1 -T 15 -f /tmp/insert-one.sql bank
docker exec -e PGOPTIONS="-c synchronous_commit=off" lab-store-pg pgbench -U postgres -n -c 1 -T 15 -f /tmp/insert-one.sql bank## synchronous_commit = on
number of transactions actually processed: 804
latency average = 18.669 ms
tps = 53.565864 (without initial connection time)
## synchronous_commit = off
number of transactions actually processed: 43850
latency average = 0.342 ms
tps = 2923.070062 (without initial connection time)الفرق هنا 55 ضعفاً: 53 معاملة في الثانية مقابل 2923، لأن كل معاملة في الحالة الأولى تنتظر القرص، وفي الثانية لا تنتظره. وقد يتساءل البعض: إذا كان الفرق بهذا الحجم فلماذا لا نوقفه دائماً؟ والإجابة أن الإيقاف يعني أن التطبيق قد يخبر المستخدم أن عمليته تمت ثم تضيع إذا انهار السيرفر خلال جزء من الثانية، ويحدد توثيق الالتزام غير المتزامن هذه النافذة بثلاثة أضعاف wal_writer_delay، أي 600 ملي ثانية بالقيمة الافتراضية، وسوف نرى ذلك يحدث فعلاً في تجربة الانهيار. ولاحظ أن قاعدة البيانات نفسها لا تتلف في هذه الحالة، وإنما تخسر آخر المعاملات فقط، بخلاف fsync = off الذي قد يترك ملفات تالفة ولا يصلح إلا لبيانات يمكنك إعادة إنشائها.
والإعداد يمكن تغييره لكل معاملة، فالحل الأنسب أن يبقى مفعلاً لكل ما يتعلق بالمال والطلبات، وأن توقفه لمعاملة بعينها تكتب بيانات يمكن خسارة آخر جزء من الثانية منها، مثل سجل الزيارات أو آخر ظهور للمستخدم: SET LOCAL synchronous_commit = off داخل المعاملة.
نقاط الحفظ Checkpoints والصفحات الكاملة
إذا كانت الصفحات المعدلة تبقى في الذاكرة، فمتى تكتب في ملفاتها؟ يكتبها كاتب الخلفية Background Writer تدريجياً، ثم تأتي نقطة الحفظ Checkpoint فتكتب كل صفحة معدلة لم تكتب بعد، وتزامن الملفات، وتسجل في السجل أن كل ما قبل هذا الموقع موجود في ملفات الجداول. ومن هنا تأتي فائدتها عند الاستعادة: يبدأ PostgreSQL إعادة التنفيذ من آخر نقطة حفظ وليس من بداية الزمن، ويستطيع أن يحذف ملفات WAL الأقدم منها أو يعيد استخدامها. وتبدأ نقطة الحفظ كل checkpoint_timeout أو عندما يقترب حجم WAL من max_wal_size، كما في توثيق إعدادات WAL:
SELECT name, setting, unit FROM pg_settings
WHERE name IN ('checkpoint_timeout','max_wal_size','checkpoint_completion_target','wal_writer_delay','full_page_writes','synchronous_commit') ORDER BY name;
name | setting | unit
------------------------------+---------+------
checkpoint_completion_target | 0.9 |
checkpoint_timeout | 300 | s
full_page_writes | on |
max_wal_size | 1024 | MB
synchronous_commit | on |
wal_writer_delay | 200 | ms
(6 rows)والقيمة checkpoint_completion_target = 0.9 تعني أن PostgreSQL يوزع كتابة الصفحات على 90% من الوقت حتى الموعد التالي بدل أن يكتبها دفعة واحدة. والقرار هنا موازنة: نقاط حفظ متقاربة تعني استعادة أسرع بعد الانهيار، ولكنها تعني كتابة أكثر، لسبب لا يظهر في أي إعداد، وهو الصفحات الكاملة Full Page Images.
المشكلة أن صفحة PostgreSQL 8 كيلوبايت، والقرص ونظام التشغيل يكتبان بوحدات أصغر، فإذا انقطعت الكهرباء أثناء كتابة صفحة فقد يكتب نصفها الجديد ويبقى نصفها القديم، وهذا يسمى الصفحة الممزقة Torn Page، ولا يمكن إصلاحها بسجل يقول «غير الصف 3». لذلك عند أول تعديل لأي صفحة بعد نقطة الحفظ، يكتب PostgreSQL في السجل نسخة كاملة من الصفحة، وهذا ما يفعله الإعداد full_page_writes كما في توثيق إعدادات WAL. لنقس ذلك بتحديث صف واحد في كل صفحة من جدول ledger، مرتين متتاليتين بعد نقطة حفظ:
CHECKPOINT;
SELECT pg_current_wal_lsn() AS l0 \gset
UPDATE ledger SET amount = amount + 1 WHERE id % 120 = 0;
SELECT pg_current_wal_lsn() AS l1 \gset
UPDATE ledger SET amount = amount + 1 WHERE id % 120 = 0;
SELECT pg_current_wal_lsn() AS l2 \gset
SELECT 'first update after CHECKPOINT' AS run, pg_size_pretty(pg_wal_lsn_diff(:'l1', :'l0')) AS wal,
       (SELECT sum(fpi_size) FROM pg_get_wal_stats(:'l0', :'l1')) AS fpi_bytes
UNION ALL
SELECT 'same update again', pg_size_pretty(pg_wal_lsn_diff(:'l2', :'l1')),
       (SELECT sum(fpi_size) FROM pg_get_wal_stats(:'l1', :'l2'));
CHECKPOINT
UPDATE 833
UPDATE 833
run | wal | fpi_bytes
-------------------------------+---------+-----------
first update after CHECKPOINT | 8893 kB | 8841912
same update again | 235 kB | 0
(2 rows)التحديث نفسه على 833 صفاً كتب 8.9 ميجابايت في المرة الأولى و235 كيلوبايت في الثانية، أي 38 ضعفاً، و8.8 ميجابايت من الأولى كانت صفحات كاملة. ولهذا فإن تقريب نقاط الحفظ كثيراً لتسريع الاستعادة يضاعف حجم WAL، وهذا ينعكس على القرص وعلى نسخ القراءة وعلى النسخ الاحتياطي، والقيمة الافتراضية خمس دقائق مناسبة لأغلب الحالات، والعلامة على أن max_wal_size صغير أن ترى في السجل تحذيراً بأن نقاط الحفظ تحدث بشكل متقارب جداً، أو أن ترى العمود num_requested في العرض pg_stat_checkpointer أكبر من num_timed.
تجربة انهيار: الإشارة KILL والاستعادة من WAL
الآن نختبر كل ما سبق بانهيار حقيقي، وليس بإيقاف مرتب للسيرفر. سوف نجهز جدولاً فيه 1000 صف مؤكد، ثم نشغل ثلاثة أشياء في الوقت نفسه: معاملة تدخل 1000 صف ولا تنهي أبداً، وعميلاً من Container آخر يدخل صفاً في كل معاملة بالإعداد الافتراضي، وعميلاً ثالثاً يفعل الشيء نفسه مع synchronous_commit = off. وبعد 12 ثانية نرسل الإشارة KILL إلى العملية الرئيسية ل PostgreSQL، وهي العملية رقم 1 داخل ال Container، فيتوقف كل شيء دون أن يكتب أي شيء إضافي، تماماً كما في انقطاع الكهرباء عن العملية:
docker exec -i lab-store-pg psql -U postgres -d bank <<'SQL'
CREATE TABLE crash_test (id bigserial PRIMARY KEY, kind text NOT NULL, created_at timestamptz NOT NULL DEFAULT now());
INSERT INTO crash_test (kind) SELECT 'committed' FROM generate_series(1, 1000);
SQL

# 1) a transaction that never commits
docker exec lab-store-pg psql -U postgres -d bank -c "BEGIN; INSERT INTO crash_test (kind) SELECT 'uncommitted' FROM generate_series(1, 1000); SELECT pg_sleep(120); COMMIT;" &

# 2) and 3) two clients from another container: one INSERT per transaction, synchronous_commit on and off
docker run --rm --name lab-store-client-sync --network lab-store_default -e PGPASSWORD=lab-only-password \
  -v "$PWD:/lab:ro" postgres:18.6 pgbench -h pg -U postgres -n -c 1 -T 60 -f /lab/insert-sync.sql bank &
docker run --rm --name lab-store-client-async --network lab-store_default -e PGPASSWORD=lab-only-password \
  -e PGOPTIONS="-c synchronous_commit=off" \
  -v "$PWD:/lab:ro" postgres:18.6 pgbench -h pg -U postgres -n -c 1 -T 60 -f /lab/insert-async.sql bank &

sleep 12
docker kill -s KILL lab-store-pg
الملفان insert-sync.sql وinsert-async.sql فيهما سطر واحد يدخل صفاً بالنوع sync أو async. ووضعنا العميلين في Container منفصل عن قاعدة البيانات حتى يبقيا حيين بعد الانهيار ويخبرانا كم معاملة أكد لهما السيرفر قبل أن يتوقف، وهذا ما طبعه كل منهما:
--- sync client
pgbench: error: client 0 script 0 aborted in command 0 query 0: FATAL:  terminating connection due to unexpected postmaster exit
number of transactions actually processed: 528
latency average = 20.643 ms
--- async client
number of transactions actually processed: 21435
latency average = 0.481 ms
pgbench: error: client 0 aborted in command 0 (SQL) of script 0; perhaps the backend died while processing
اختصرنا المخرج إلى الأسطر المهمة. والآن نعيد تشغيل ال Container ونقرأ السجل:
docker start lab-store-pg
docker logs lab-store-pg
2026-10-10 05:44:57.027 UTC [33] LOG: database system was interrupted; last known up at 2026-10-10 05:43:43 UTC
2026-10-10 05:45:01.035 UTC [33] LOG: database system was not properly shut down; automatic recovery in progress
2026-10-10 05:45:01.041 UTC [33] LOG: redo starts at 0/104C2090
2026-10-10 05:45:01.155 UTC [33] LOG: invalid record length at 0/10AC3C40: expected at least 24, got 0
2026-10-10 05:45:01.155 UTC [33] LOG: redo done at 0/10AC3C18 system usage: CPU: user: 0.09 s, system: 0.01 s, elapsed: 0.11 s
2026-10-10 05:45:01.169 UTC [31] LOG: checkpoint starting: end-of-recovery immediate wait
2026-10-10 05:45:01.236 UTC [31] LOG: checkpoint complete: wrote 247 buffers (0.8%), wrote 3 SLRU buffers; 0 WAL file(s) added, 0 removed, 0 recycled; write=0.027 s, sync=0.018 s, total=0.074 s; sync files=18, longest=0.007 s, average=0.001 s; distance=6151 kB, estimate=6151 kB; lsn=0/10AC3C40, redo lsn=0/10AC3C40
2026-10-10 05:45:01.244 UTC [1] LOG: database system is ready to accept connectionsاقرأ السجل بالترتيب:
database system was interruptedوnot properly shut down; automatic recovery in progress: وجد PostgreSQL في ملف التحكم أنه لم يتوقف بشكل مرتب، فبدأ الاستعادة تلقائياً دون أي تدخل منك.redo starts at 0/104C2090: بدأ من موقع آخر نقطة حفظ، وليس من بداية السجل.invalid record length ... got 0: هذه ليست مشكلة، وإنما الطريقة التي يعرف بها نهاية السجل، فبعد آخر سجل كامل كتب على القرص لا يوجد إلا أصفار.redo done at 0/10AC3C18: أعاد تنفيذ قرابة 6 ميجابايت من السجل في 0.11 ثانية، ثم كتب نقطة حفظ فوراًend-of-recoveryوأصبح جاهزاً.
وقبل ذلك في السجل نفسه أسطر syncing data directory (fsync) استغرقت قرابة نصف دقيقة في الانهيار الأول الذي نفذناه على هذا القرص، فمزامنة كل ملفات مجلد البيانات قبل الاستعادة هي الخطوة الأبطأ هنا وليس إعادة السجل. والآن السؤال المهم، ماذا بقي في الجدول؟
SELECT kind, count(*) FROM crash_test GROUP BY kind ORDER BY 1; kind | count
-----------+-------
async | 21432
committed | 1000
sync | 528
(3 rows)في المخرج أعلاه لاحظ التالي:
- الصفوف المؤكدة قبل التجربة بقيت كلها 1000.
- الصفوف الألف للمعاملة التي لم تنته غير موجودة، مع أن جزءاً منها ربما كتب في سجل WAL أو حتى في ملف الجدول، والسبب أن سجل المعاملة لا يحتوي على COMMIT، فنسخها تبقى غير مرئية لأي أحد إلى الأبد، ويزيلها VACUUM لاحقاً كأي نسخ ميتة. وهذا ما يسمى الذرية Atomicity: كل المعاملة أو لا شيء منها.
- العميل المتزامن أكد له السيرفر 528 معاملة، وفي الجدول 528 صفاً بالضبط، فكل COMMIT عاد بنجاح بقي بعد الانهيار، وهذه هي الديمومة Durability.
- العميل غير المتزامن أكد له السيرفر 21,435 معاملة، وفي الجدول 21,432، أي أن ثلاث معاملات قيل للتطبيق إنها تمت ثم اختفت، وهذه هي النافذة التي يحذر منها التوثيق، وهي حقيقية.
والصورة التالية تجمع طريق الكتابة والاستعادة:
وتذكر حدود هذه الحماية: WAL يحميك من انهيار العملية أو انقطاع الكهرباء بشرط أن يقول القرص الحقيقة عندما يؤكد المزامنة، كما تشرح صفحة الموثوقية، ولا يحميك من قرص يتلف أو من أمر DELETE خاطئ، وهذا عمل النسخ الاحتياطي الذي شرحناه في قاعدة 3-2-1.
طريقة أخرى للتخزين: شجرة LSM
كل ما سبق يقوم على فكرة واحدة: للبيانات مكان ثابت في صفحة، والتعديل يذهب إلى تلك الصفحة، أو إلى صفحة قريبة منها، وهذا ما يفعله PostgreSQL وMySQL InnoDB وأغلب قواعد البيانات العلائقية، ويسمى أحياناً التحديث في المكان Update in Place، والفهرس B-tree مبني على الفكرة نفسها. وهناك عائلة أخرى من محركات التخزين لا تعدل أي ملف بعد كتابته، وهي شجرة LSM، أي Log-Structured Merge Tree، وتستخدمها RocksDB، وApache Cassandra، وخادم البريد Stalwart الذي يحفظ بياناته في RocksDB كما شرحنا في دليل Stalwart.
والفكرة كما في نظرة RocksDB العامة: كل كتابة تذهب إلى سجل WAL وإلى جدول في الذاكرة مرتب اسمه Memtable، وعندما يمتلئ يكتب كاملاً إلى ملف مرتب لا يتغير اسمه SST في المستوى L0، ومع تراكم الملفات تقوم عملية الدمج Compaction في الخلفية بقراءة ملفات وكتابة ملفات أكبر مرتبة في المستوى التالي، وتحذف أثناء ذلك القيم القديمة للمفتاح نفسه والمفاتيح المحذوفة، كما في توثيق الدمج بالمستويات. والقراءة تبحث في ال Memtable أولاً ثم في الملفات من الأحدث إلى الأقدم حتى تجد المفتاح، ومرشحات Bloom Filters تجعلها تتجاوز أغلب الملفات التي لا تحتوي عليه.
ولأن RocksDB مكتبة وليست سيرفراً، فقد كتبنا سكربت Python يكتب فيها 2.5 مليون مفتاح على 500 ألف مفتاح مختلف، أي أن كل مفتاح يكتب خمس مرات تقريباً، بقيم عشوائية من 100 بايت، ثم يطبع إحصاءات RocksDB نفسها:
# Writes the same workload into RocksDB (an LSM-tree) and prints what RocksDB wrote to disk for it.
# 500,000 distinct keys, 2,500,000 puts in random order (every key is overwritten about five times), 100-byte values.
import os, random, shutil, time
from rocksdict import Rdict, Options

path = '/tmp/lsm-lab'
shutil.rmtree(path, ignore_errors=True)
opt = Options()
opt.create_if_missing(True)
opt.set_write_buffer_size(4 * 1024 * 1024)        # small memtable (4 MB) so flushes and compactions happen in a small lab
opt.set_max_bytes_for_level_base(16 * 1024 * 1024)
opt.set_target_file_size_base(4 * 1024 * 1024)
db = Rdict(path, opt)

random.seed(42)
KEYS, PUTS = 500_000, 2_500_000
t0 = time.time()
for i in range(PUTS):
    k = random.randrange(KEYS)
    db[b'acct:%010d' % k] = random.randbytes(100)      # random bytes do not compress, like real data
db.flush()
time.sleep(5)                                        # let background compactions finish
elapsed = time.time() - t0

user_bytes = PUTS * (14 + 100)                      # key (14 bytes) + value
live_bytes = KEYS * (14 + 100)
sst = int(db.property_value('rocksdb.total-sst-files-size'))
print(f'puts: {PUTS:,}  distinct keys: {KEYS:,}  time: {elapsed:.1f} s')
print(f'user data written: {user_bytes / 2**20:.0f} MB, live data: {live_bytes / 2**20:.0f} MB, SST files now: {sst / 2**20:.0f} MB')
for lvl in range(7):
    n = int(db.property_value(f'rocksdb.num-files-at-level{lvl}'))
    if n: print(f'  level {lvl}: {n} files')
stats = db.property_value('rocksdb.stats')
for line in stats.splitlines():
    if line.lstrip().startswith(('Level', 'L', 'Sum', 'Cumulative writes', 'Cumulative compaction', 'Flush(GB)')):
        print(line)
db.close()
with open(os.path.join(path, 'LOG')) as f:
    print([l.strip() for l in f if 'RocksDB version' in l][0])
docker exec lab-store-lsm python /lab/lsm.pyputs: 2,500,000 distinct keys: 500,000 time: 101.3 s
user data written: 272 MB, live data: 54 MB, SST files now: 91 MB
level 5: 11 files
level 6: 19 files
Level Files Size Score Read(GB) Rn(GB) Rnp1(GB) Write(GB) Wnew(GB) Moved(GB) W-Amp Rd(MB/s) Wr(MB/s) Comp(sec) CompMergeCPU(sec) Comp(cnt) Avg(sec) KeyIn KeyDrop Rblob(GB) Wblob(GB)
L0 0/0 0.00 KB 0.0 0.0 0.0 0.0 0.3 0.3 0.0 1.0 0.0 7.4 36.27 6.55 90 0.403 0 0 0.0 0.0
L5 11/1 37.86 MB 20.1 0.5 0.2 0.3 0.4 0.2 0.0 1.9 13.1 11.0 41.42 13.38 19 2.180 4927K 793K 0.0 0.0
L6 19/2 53.56 MB 0.0 0.3 0.1 0.2 0.2 0.1 0.0 1.5 19.4 13.7 15.58 6.86 32 0.487 2750K 807K 0.0 0.0
Sum 30/3 91.42 MB 0.0 0.8 0.4 0.4 0.9 0.5 0.0 3.5 9.1 10.1 93.28 26.79 141 0.662 7677K 1600K 0.0 0.0
Low 0/0 0.00 KB 0.0 0.8 0.4 0.4 0.7 0.2 0.0 0.0 14.9 11.7 57.01 20.24 51 1.118 7677K 1600K 0.0 0.0
Flush(GB): cumulative 0.263, interval 0.263
Cumulative compaction: 0.92 GB write, 9.25 MB/s write, 0.83 GB read, 8.35 MB/s read, 93.3 seconds
Cumulative writes: 2500K writes, 2500K keys, 2500K commit groups, 1.0 writes per commit group, ingest: 0.31 GB, 3.10 MB/s
2026/10/10-05:48:26.425898 140657061761920 RocksDB version: 9.8.4في المخرج أعلاه لاحظ التالي:
- دخل إلى RocksDB قرابة 0.31 جيجابايت، والبيانات الحية في النهاية 54 ميجابايت، وملفات SST الآن 91 ميجابايت، أي أن الدمج لم يزل كل القيم القديمة بعد، وهذا ما يسمى تضخيم المساحة Space Amplification.
- السطر
Flush(GB): cumulative 0.263هو ما كتبته ال Memtables إلى L0، وCumulative compaction: 0.92 GB writeهو كل ما كتبه الدمج، والعمود W-Amp في سطر Sum قيمته 3.5، أي أن كل بايت دخل إلى المستويات كتب قرابة ثلاث مرات ونصف على القرص، وهذا هو تضخيم الكتابة Write Amplification، يضاف إليه سجل WAL نفسه. - الملفات في المستويين L5 وL6 وليس L1 وL2، والسبب أن RocksDB في الإصدارات الحديثة يبدأ من المستوى الأخير ويحدد أحجام المستويات حسب حجم البيانات، وهو الإعداد
level_compaction_dynamic_level_bytesالذي أصبح مفعلاً افتراضياً كما في سجل تغييرات RocksDB. - القراءة لمفتاح واحد قد تحتاج أن تفحص ال Memtable وكل ملفات L0 وملفاً واحداً في كل مستوى، وهذا هو تضخيم القراءة Read Amplification، وكلما تأخر الدمج زادت الملفات التي تفحصها القراءة.
ولكي تكون المقارنة عادلة، شغلنا عملاً مشابهاً على PostgreSQL: 500 ألف مفتاح بقيمة عشوائية من 100 بايت، ثم تحديث كل المفاتيح خمس مرات، أي 2.5 مليون تحديث، وقسنا ما كتب في WAL وما كتب في ملفات الجداول بالعرض pg_stat_io:
CREATE TABLE kv (k text PRIMARY KEY, v bytea NOT NULL);
INSERT INTO kv SELECT 'acct:' || lpad(g::text, 10, '0'), gen_random_bytes(100) FROM generate_series(0, 499999) g;
VACUUM ANALYZE kv;
CHECKPOINT;
SELECT pg_stat_reset_shared('io');
SELECT pg_current_wal_lsn() AS l0 \gset
UPDATE kv SET v = gen_random_bytes(100);
UPDATE kv SET v = gen_random_bytes(100);
UPDATE kv SET v = gen_random_bytes(100);
UPDATE kv SET v = gen_random_bytes(100);
UPDATE kv SET v = gen_random_bytes(100);
CHECKPOINT;
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), :'l0')) AS wal_written,
       (SELECT pg_size_pretty(sum(write_bytes)) FROM pg_stat_io WHERE object = 'relation') AS data_files_written,
       pg_size_pretty(pg_total_relation_size('kv')) AS table_and_index_now;
wal_written | data_files_written | table_and_index_now
-------------+--------------------+---------------------
972 MB | 564 MB | 456 MB
(1 row)بيانات المستخدم 272 ميجابايت، وكتب PostgreSQL قرابة 972 ميجابايت في WAL و564 في ملفات الجدول والفهرس، أي قرابة 5.6 أضعاف، وأصبح الجدول وفهرسه 456 ميجابايت لبيانات حية حجمها 54 ميجابايت، لأن كل تحديث ترك نسخة ميتة في صفحات ممتلئة. ولا تأخذ هذه الأرقام كحكم على المحركين، فالحملان ليسا متطابقين تماماً، والإعدادات صغيرة لتناسب المختبر، ولكنها تبين أن كلاً منهما يدفع ثمناً، والفرق في نوع الثمن:
| السؤال | B-tree والصفحات (PostgreSQL) | LSM (RocksDB) |
|---|---|---|
| أين تذهب الكتابة؟ | إلى الصفحة الخاصة بالصف، مع WAL وصفحات كاملة بعد كل نقطة حفظ | إلى ال Memtable ثم ملفات جديدة متتالية، ولا يعدل ملف بعد كتابته |
| تضخيم الكتابة Write Amplification | كتابة صفحة 8 كيلوبايت لتغيير صف صغير، ونسخ ميتة يكتبها VACUUM لاحقاً | الدمج يعيد كتابة البيانات عدة مرات بين المستويات |
| تضخيم القراءة Read Amplification | قليل ومتوقع: طوابق الشجرة ثم صفحة الجدول | قد يفحص عدة ملفات، وتخففه مرشحات Bloom |
| تضخيم المساحة Space Amplification | نسخ ميتة وانتفاخ Bloat حتى يعمل VACUUM | قيم قديمة حتى يصل إليها الدمج |
| العمل في الخلفية | VACUUM ونقاط الحفظ | الدمج Compaction |
| يناسب أكثر | قراءة كثيرة واستعلامات مرنة ومعاملات | كتابة كثيرة جداً بمفاتيح، مثل السجلات والأحداث والقياسات |
والصورة التالية تضع الطريقتين بجانب بعض:
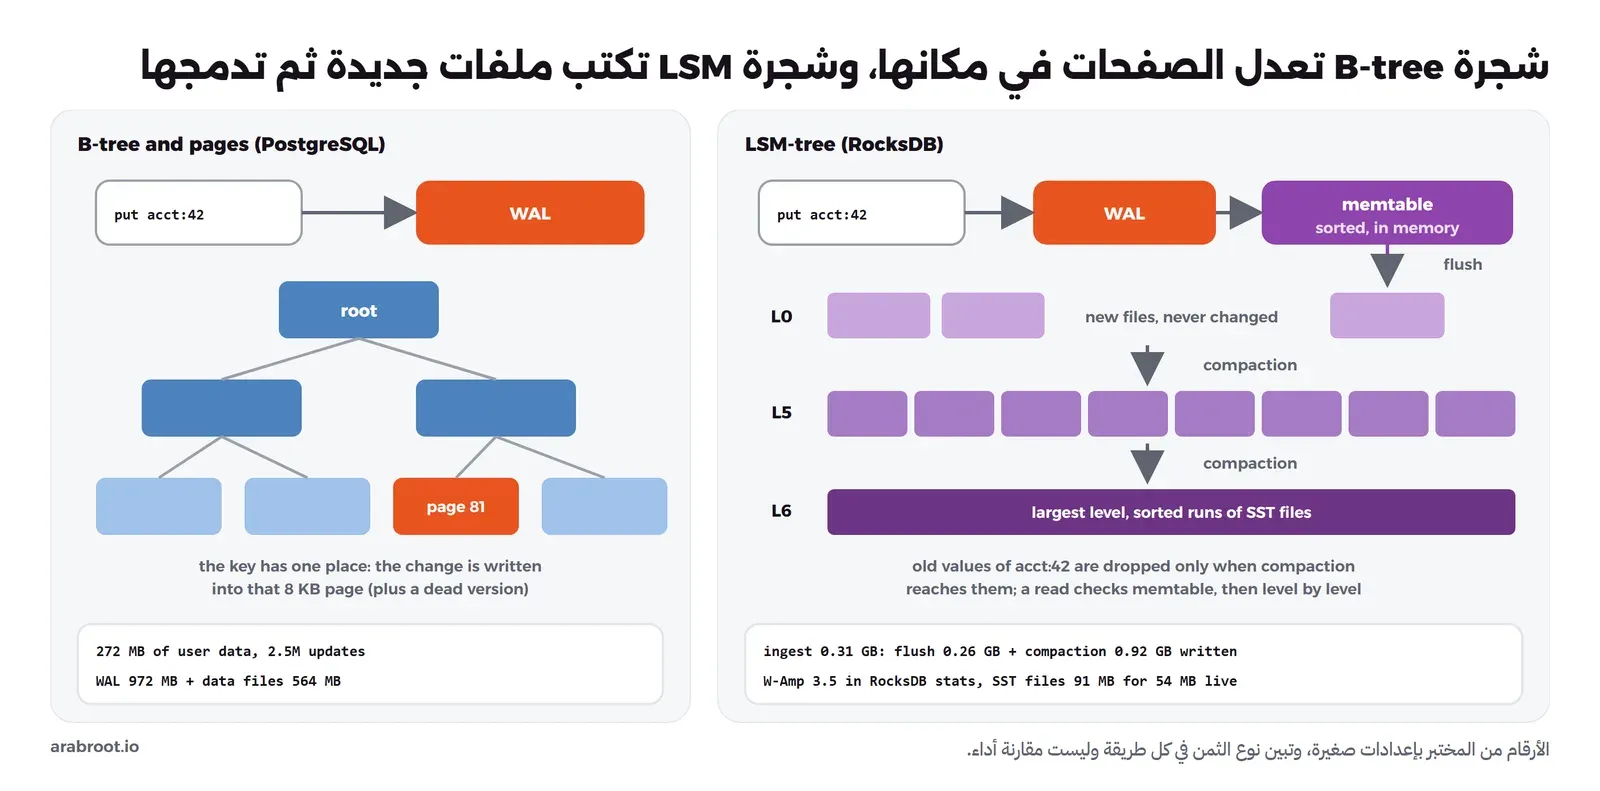
وRocksDB مرخصة برخصتين يختار المستخدم بينهما: GPLv2 وApache 2.0، كما في مستودعها، وهي محرك تخزين داخل برامج أخرى أكثر منها قاعدة بيانات تستخدمها مباشرة، وقد شرحنا متى تختار كل عائلة من قواعد البيانات في مقال أنواع قواعد البيانات.
أخطاء شائعة
- ترك معاملة مفتوحة أو جلسة في حالة
idle in transactionلساعات، فيتوقف التنظيف في كل الجداول وتنتفخ. - توقع أن يصغر الملف بعد DELETE أو VACUUM العادي.
- إيقاف
fsyncلتسريع قاعدة إنتاج، وهو قد يترك ملفات تالفة بعد انهيار، والأنسب إن احتجت السرعةsynchronous_commit = offلمعاملات محددة تقبل خسارة آخر جزء من الثانية. - تقريب نقاط الحفظ كثيراً، فيتضاعف حجم WAL بسبب الصفحات الكاملة.
- تشغيل قاعدة بيانات على قرص أو طبقة تخزين تكذب في المزامنة، مثل ذاكرة مؤقتة للكتابة بلا حماية من انقطاع الكهرباء.
- الاعتماد على الإحصاءات مباشرة بعد انهيار، وهي تبدأ من الصفر.
حذف المختبر
docker compose -p lab-store down -vالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الجدول ملف من صفحات 8 كيلوبايت، والمؤشرات في أول الصفحة والصفوف في آخرها، والفهارس تشير إلى المؤشر وليس إلى البايت.
- التحديث يكتب نسخة جديدة والحذف يضع رقم المعاملة في xmax، وكل معاملة ترى النسخ المناسبة للقطتها، فلا ينتظر القارئ الكاتب.
- ال VACUUM يزيل النسخ التي لا يحتاجها أحد ويعيد ترتيب الصفحة، ولكن أقدم معاملة مفتوحة في كل قاعدة البيانات تمنعه، وقد رأينا 600 ألف نسخة ميتة لا تزال بسبب جلسة لم تلمس الجدول.
- سجل WAL يجعل COMMIT مزامنة واحدة لسجل متتالي، وزمن هذه المزامنة هو حد سرعة المعاملات الصغيرة، وقد كان الفرق 55 ضعفاً مع
synchronous_commit = offمع خسارة ثلاث معاملات مؤكدة عند الانهيار. - نقاط الحفظ تحدد من أين تبدأ الاستعادة، وأول تعديل لكل صفحة بعدها يكتب الصفحة كاملة، فكان التحديث نفسه أكبر 38 مرة.
- بعد الإشارة KILL عاد PostgreSQL وحده: المعاملات المؤكدة بقيت كلها، والمعاملة غير المنتهية اختفت كلها.
- شجرة LSM لا تعدل الملفات وإنما تدمجها، فتدفع ثمن الكتابة في الدمج، بينما يدفعه B-tree في الصفحات وWAL والنسخ الميتة.
وفي المقال التالي من هذه المرحلة ننتقل من النسخ المتعددة إلى ما لا تحله النسخ: الأقفال، ولماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه:
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.دليلالفهارس Indexes: لماذا تسرع الاستعلام وكيف تقرأ EXPLAINكيف يبحث PostgreSQL داخل الفهرس، ومتى يتجاهله، وكم يكلفك كل فهرس عند الكتابة، وكيف تقرأ خطة EXPLAIN سطراً سطراً.
 دليلتقسيم الجداول Partitioning وتوزيعها على السيرفرات Shardingمتى تقسم الجدول داخل سيرفر واحد، ومتى توزع البيانات على عدة سيرفرات، وكيف تضيف سيرفراً وتتعامل مع العميل الضخم.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب على Docker Engine 29.8.0 مع PostgreSQL 18.6 وPython 3.13.16 والمكتبة rocksdict 0.3.29 التي تحمل RocksDB 9.8.4.


