

في مقال لماذا تتمرن دون ذكاء اصطناعي؟ شرحنا لماذا تضعف المهارة التي لا تستخدمها وكيف تتمرن بطريقة Kata، وهذا المقال يطبق الطريقة على SQL وقواعد البيانات. والسبب أن الاستعلام الخاطئ في SQL نادراً ما يعطيك رسالة خطأ، وإنما يعطيك رقماً يبدو معقولاً: إيراد مضاعف، أو عملاء اختفوا من التقرير، أو قائمة فارغة لأن في الجدول قيمة NULL واحدة، ومثل هذه الأخطاء لا تكتشفها إلا إذا كنت تعرف ما يجب أن يخرج قبل أن تشغل الاستعلام، وهذه بالضبط المهارة التي تضعف عندما يكتب غيرك الاستعلامات نيابة عنك.
وطريقة الاستخدام قصيرة: أغلق أي مساعد ذكاء اصطناعي، واقرأ التمرين، واضبط مؤقتاً على الوقت المقترح، ثم اكتب الاستعلام كاملاً واكتب بجانبه ما تتوقع أن يخرج، عدد الصفوف أو الرقم أو شكل الخطة، قبل أن تشغله. المسموح لك هو توثيق PostgreSQL والأمر \d داخل psql، وإذا علقت فافتح التلميح Hint ثم حاول مرة أخرى، وبعدها فقط افتح الحل Answer، وفي النهاية سجل الوقت في جدول المتابعة.
وسوف نناقش في هذا المقال ما يلي:
- تجهيز قاعدة بيانات متجر صغير في PostgreSQL 18 فيها أربعة جداول ومئتا ألف طلب، تنشأ بنفس الأرقام عند كل من يشغل السكربت.
- المستوى الأول: SELECT وWHERE وORDER BY، والدوال التجميعية وGROUP BY وHAVING، وأنواع الربط JOIN، وNULL، والبحث عن التكرار.
- المستوى الثاني: فخ LEFT JOIN مع WHERE، وNOT IN مع NULL، ودوال النوافذ Window Functions، والإيراد المضاعف بسبب الربط، وUPDATE مع الربط داخل معاملة Transaction.
- المستوى الثالث: اختيار الفهرس Index وقراءة EXPLAIN ANALYZE، ومشكلة N+1، ومن يقفل من، والجمود Deadlock، والتحديث المفقود Lost Update ومستويات العزل Isolation Levels.
- جدول متابعة تنسخه لتسجل تقدمك، وروابط المقالات التي تشرح كل موضوع بالتفصيل.
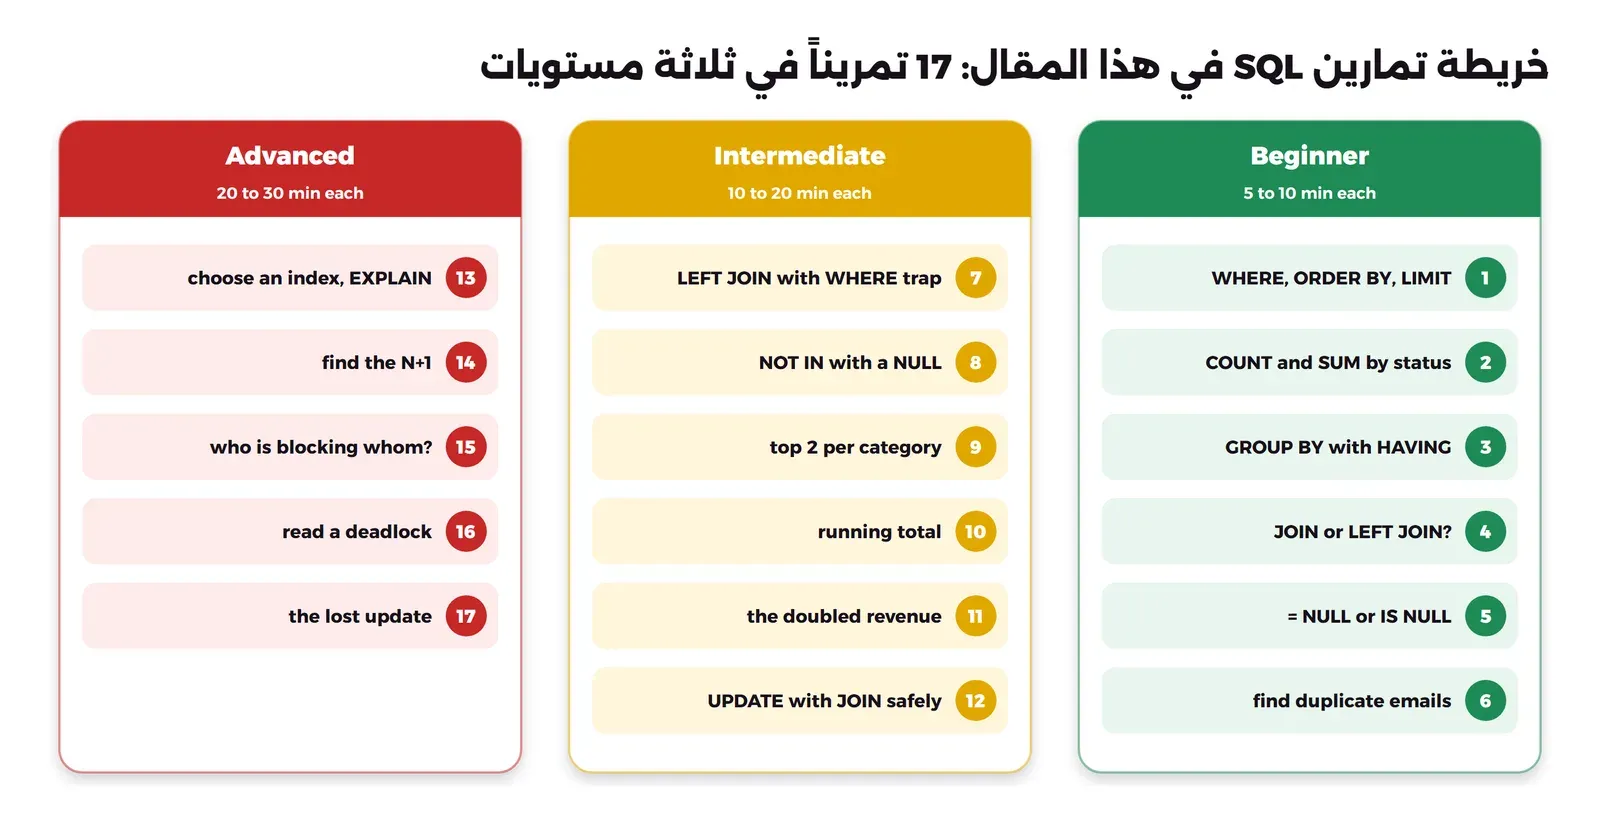
والصورة التالية تبين التمارين السبعة عشر موزعة على المستويات الثلاثة:
تجهيز المختبر Lab وقاعدة البيانات
كل التمارين تعمل على قاعدة بيانات واحدة لمتجر إلكتروني صغير: عملاء ومنتجات وطلبات وأسطر الطلبات، والصورة التالية تبين الجداول ومفاتيحها والفخاخ التي وضعناها في البيانات عن قصد، لأن البيانات الحقيقية لا تكون نظيفة أبداً:
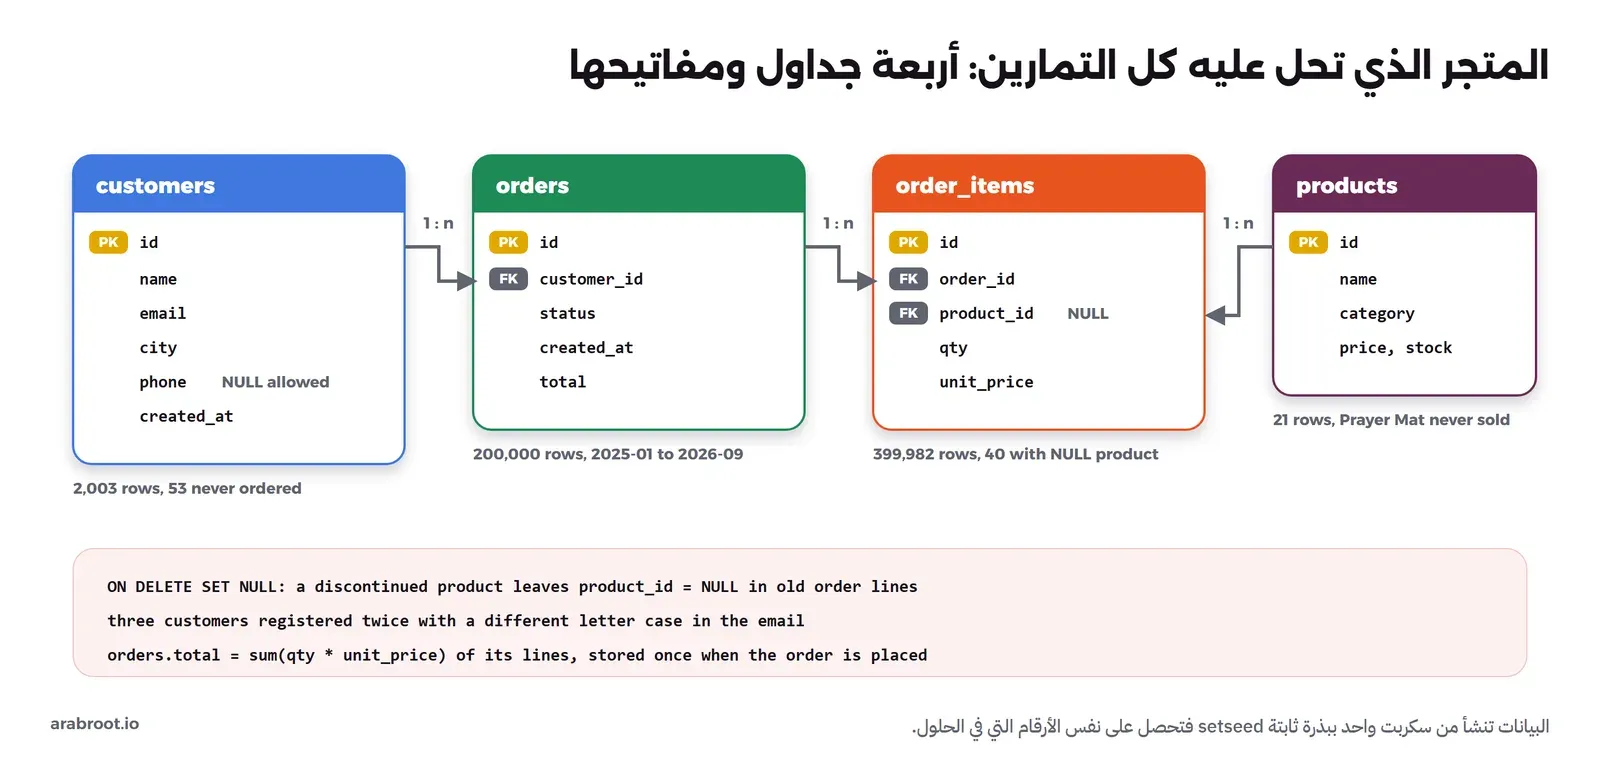
ابدأ بتشغيل PostgreSQL 18، ولاحظ الإعدادات الثلاثة في آخر الأمر: pg_stat_statements نحتاجه في التمرين 14، وlog_lock_waits مع deadlock_timeout يجعلان السجل يكتب كل انتظار لقفل يزيد على ثانية، ونحتاجهما في التمرينين 15 و16:
docker run -d --name kata-pg -e POSTGRES_PASSWORD=kata -e POSTGRES_DB=shop -p 127.0.0.1:21395:5432 postgres:18 \
  -c shared_preload_libraries=pg_stat_statements -c log_lock_waits=on -c deadlock_timeout=1s
ثم احفظ الجداول في ملف schema.sql:
CREATE TABLE customers (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name        text        NOT NULL,
    email       text        NOT NULL,
    city        text        NOT NULL,
    phone       text,
    created_at  timestamptz NOT NULL
);

CREATE TABLE products (
    id        bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name      text          NOT NULL,
    category  text          NOT NULL,
    price     numeric(10,2) NOT NULL CHECK (price >= 0),
    stock     int           NOT NULL DEFAULT 0
);

CREATE TABLE orders (
    id           bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id  bigint        NOT NULL REFERENCES customers(id),
    status       text          NOT NULL CHECK (status IN ('pending','paid','shipped','cancelled')),
    created_at   timestamptz   NOT NULL,
    total        numeric(12,2) NOT NULL DEFAULT 0
);

CREATE TABLE order_items (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    order_id    bigint        NOT NULL REFERENCES orders(id),
    product_id  bigint        REFERENCES products(id) ON DELETE SET NULL,
    qty         int           NOT NULL CHECK (qty > 0),
    unit_price  numeric(10,2) NOT NULL
);
CREATE INDEX ON order_items (order_id);
ثم البيانات في ملف seed.sql، والدالة setseed في أوله تجعل random() يعطي نفس السلسلة في كل مرة، فتحصل على نفس الأرقام التي في الحلول:
SELECT setseed(0.42);

INSERT INTO products (name, category, price, stock) VALUES
 ('USB-C Charger 65W','Electronics',149.00,120), ('Wireless Mouse','Electronics',89.00,300),
 ('Mechanical Keyboard','Electronics',349.00,80), ('27" Monitor','Electronics',1199.00,25),
 ('Noise-Cancelling Headphones','Electronics',899.00,40), ('HDMI Cable 2m','Electronics',39.00,500),
 ('Clean Code','Books',129.00,60), ('Designing Data-Intensive Applications','Books',189.00,45),
 ('The Pragmatic Programmer','Books',159.00,50), ('Arabic Calligraphy Basics','Books',75.00,30),
 ('Site Reliability Engineering','Books',199.00,20), ('Coffee Maker','Home',399.00,35),
 ('Desk Lamp','Home',119.00,90), ('Office Chair','Home',1450.00,12), ('Standing Desk','Home',2100.00,8),
 ('Water Bottle','Home',45.00,400), ('Arabic Coffee 500g','Grocery',65.00,220), ('Dates Box 1kg','Grocery',89.00,180),
 ('Green Tea 100 bags','Grocery',35.00,260), ('Honey 500g','Grocery',120.00,70);

INSERT INTO customers (name, email, city, phone, created_at)
SELECT f || ' ' || l,
       lower(f) || '.' || lower(l) || g || '@example.com',
       (ARRAY['Riyadh','Jeddah','Dammam','Makkah','Madinah','Abha'])[1 + floor(random()*6)::int],
       CASE WHEN random() < 0.15 THEN NULL ELSE '05' || lpad((floor(random()*100000000))::int::text, 8, '0') END,
       timestamptz '2024-01-01 00:00+03' + random() * interval '600 days'
FROM generate_series(1, 2000) g,
     LATERAL (SELECT (ARRAY['Ahmed','Sara','Omar','Noura','Khalid','Lama','Faisal','Reem','Yousef','Huda','Majed','Amal'])[1 + floor(random()*12 + g*0)::int] AS f,
                     (ARRAY['Alharbi','Alqahtani','Alotaibi','Alghamdi','Alzahrani','Alshehri','Aldosari','Almutairi'])[1 + floor(random()*8 + g*0)::int] AS l) n;

-- three customers registered twice with a different letter case in the email
INSERT INTO customers (name, email, city, phone, created_at)
SELECT name, upper(left(email,1)) || substr(email,2), city, phone, created_at + interval '40 days'
FROM customers WHERE id IN (17, 230, 1404);

-- orders: customers 1..1950 only, so the last 50 customers never ordered
INSERT INTO orders (customer_id, status, created_at)
SELECT 1 + floor(random()*1950)::int,
       (ARRAY['paid','paid','paid','shipped','shipped','pending','cancelled'])[1 + floor(random()*7)::int],
       timestamptz '2025-01-01 00:00+03' + random() * interval '638 days'
FROM generate_series(1, 200000);

INSERT INTO order_items (order_id, product_id, qty, unit_price)
SELECT o.id, p.id, 1 + floor(random()*3)::int, p.price
FROM orders o
CROSS JOIN LATERAL generate_series(1, 1 + floor(random()*3)::int + (o.id*0)::int) k
JOIN LATERAL (SELECT id, price FROM products ORDER BY random() + k*0 + o.id*0 LIMIT 1) p ON true;

-- a discontinued product: deleting it leaves NULL in old order lines
INSERT INTO products (name, category, price, stock) VALUES ('Old Webcam 720p','Electronics',99.00,0);
INSERT INTO order_items (order_id, product_id, qty, unit_price)
SELECT id, currval(pg_get_serial_sequence('products','id')), 1, 99.00 FROM orders WHERE id % 5000 = 0;
DELETE FROM products WHERE name = 'Old Webcam 720p';

UPDATE orders o SET total = s.t
FROM (SELECT order_id, sum(qty*unit_price) t FROM order_items GROUP BY order_id) s
WHERE s.order_id = o.id;

-- a new product nobody has ordered yet
INSERT INTO products (name, category, price, stock) VALUES ('Prayer Mat','Home',85.00,150);

ANALYZE;
ولاحظ أن g*0 وk*0 وo.id*0 لا تغير القيم، وإنما تجبر PostgreSQL أن يحسب random() لكل صف بدل أن يحسبه مرة واحدة ويكرر النتيجة. الآن انسخ الملفين وحملهما، والتحميل أخذ قرابة دقيقة ونصف على جهازنا:
docker cp schema.sql kata-pg:/tmp/ && docker cp seed.sql kata-pg:/tmp/
docker exec kata-pg psql -U postgres -d shop -v ON_ERROR_STOP=1 -q -f /tmp/schema.sql -f /tmp/seed.sql
docker exec kata-pg psql -U postgres -d shop -c "SELECT (SELECT count(*) FROM customers) c, (SELECT count(*) FROM orders) o, (SELECT count(*) FROM order_items) i, (SELECT count(*) FROM order_items WHERE product_id IS NULL) nulls"
والمخرج سوف يكون كما يلي:
  c   |   o    |   i    | nulls
------+--------+--------+-------
 2003 | 200000 | 399982 |    40
(1 row)
وكل التمارين تكتب داخل psql، فادخل إليه ب docker exec -it kata-pg psql -U postgres -d shop. ولاحظ أن تمارين المستوى الأول والثاني تقرأ فقط أو تنتهي ب ROLLBACK، أما المستوى الثالث فينشئ فهرساً ويغير المخزون في بعض المنتجات، فحلها بالترتيب، وإذا أردت أن تبدأ من جديد فاحذف القاعدة وأنشئها وحمل الملفين مرة أخرى.
المستوى الأول: مبتدئ Beginner
في هذا المستوى اكتب الاستعلام، ثم اكتب بجانبه عدد الصفوف الذي تتوقعه قبل أن تشغله، والهدف أن تقرأ الجدول بعين من يعرف ما فيه.
التمرين 1: أحدث خمسة عملاء من أبها
اكتب استعلاماً يعرض رقم العميل واسمه ومدينته وتاريخ تسجيله كتاريخ فقط دون وقت، للعملاء من مدينة Abha الذين سجلوا من أول يونيو 2025، الأحدث أولاً، وخمسة فقط.
الوقت المقترح: 5 دقائق.
تلميح Hint
شرطان في WHERE مع AND، ثم ORDER BY على العمود الأصلي وليس على التاريخ المختصر، ثم LIMIT. والتحويل إلى تاريخ ب ::date.
الحل Answer
SELECT id, name, city, created_at::date AS joined
FROM customers
WHERE city = 'Abha' AND created_at >= '2025-06-01'
ORDER BY created_at DESC
LIMIT 5;
والمخرج سوف يكون كما يلي:
  id  |       name       | city |   joined
------+------------------+------+------------
  300 | Yousef Alghamdi  | Abha | 2025-08-20
 1511 | Ahmed Alshehri   | Abha | 2025-08-19
   50 | Omar Almutairi   | Abha | 2025-08-18
 1663 | Sara Alqahtani   | Abha | 2025-08-17
 1406 | Yousef Alqahtani | Abha | 2025-08-17
(5 rows)
في الاستعلام أعلاه لاحظ التالي:
- رتبنا ب
created_atالكامل وليس بjoined، والسبب أن العميلين 1663 و1406 في نفس اليوم، والترتيب بالتاريخ وحده يجعل ترتيبهما عشوائياً بين مرة وأخرى. - النص
'2025-06-01'يتحول إلى بداية اليوم في المنطقة الزمنية للجلسة، وهي UTC في هذا ال Container، فإذا كان سيرفرك بتوقيت آخر فقد يختلف أول يوم بثلاث ساعات. - بدون LIMIT سوف يعيد الاستعلام كل العملاء المطابقين، وفي التطبيق الحقيقي ترسل الصفحة التالية بشرط على آخر قيمة رأيتها وليس ب OFFSET.
للتفصيل: الترقيم بالمفتاح بدل OFFSET في دليل الجداول الضخمة، والتاريخ والوقت والمناطق الزمنية.
التمرين 2: كم طلباً وكم إيراداً في كل حالة؟
اكتب استعلاماً واحداً يعرض لكل حالة طلب status عدد الطلبات ومجموع total، الأكثر طلبات أولاً. واكتب قبل التشغيل كم صفاً تتوقع.
الوقت المقترح: 5 دقائق.
تلميح Hint
كل عمود في SELECT إما داخل دالة تجميع مثل count وsum، وإما مذكور في GROUP BY. وعدد الصفوف هو عدد القيم المختلفة في العمود الذي تجمع به، وهي في القيد CHECK.
الحل Answer
SELECT status, count(*) AS orders, sum(total) AS revenue
FROM orders
GROUP BY status
ORDER BY orders DESC;
والمخرج سوف يكون كما يلي:
  status   | orders |   revenue
-----------+--------+--------------
 paid      |  85723 | 135674081.00
 shipped   |  57062 |  90196414.00
 cancelled |  28681 |  45562331.00
 pending   |  28534 |  44754043.00
(4 rows)
أربعة صفوف لأن القيد CHECK يسمح بأربع قيم فقط، ومجموع العمود الأول 200000 وهو عدد كل الطلبات. ولاحظ أن الإيراد هنا يشمل الطلبات الملغاة والمعلقة، فإذا سألك المدير عن «الإيراد» فاسأله أولاً أي الحالات يقصد، وهذا سؤال أهم من الاستعلام نفسه. ويمكن أن تكتب ORDER BY 2 DESC برقم العمود، ولكن الاسم أوضح لمن يقرأ بعدك.
للتفصيل: الدوال التجميعية في توثيق PostgreSQL، والقيود Constraints في دليل تصميم قواعد البيانات.
التمرين 3: العملاء الذين أنفقوا أكثر من 95 ألفاً هذا العام
اعرض رقم العميل وعدد طلباته ومجموع إنفاقه، للطلبات المدفوعة أو المشحونة فقط من أول يناير 2026 حتى نهاية سبتمبر 2026، للعملاء الذين يزيد مجموعهم على 95000، الأعلى أولاً.
الوقت المقترح: 8 دقائق.
تلميح Hint
شرط الحالة والتاريخ يطبق على كل صف قبل التجميع فمكانه WHERE، وشرط المجموع يطبق على المجموعة بعد التجميع فمكانه HAVING. وللتاريخ استخدم >= للبداية و< لأول يوم بعد النهاية.
الحل Answer
SELECT customer_id, count(*) AS orders, sum(total) AS spent
FROM orders
WHERE status IN ('paid','shipped')
  AND created_at >= '2026-01-01' AND created_at < '2026-10-01'
GROUP BY customer_id
HAVING sum(total) > 95000
ORDER BY spent DESC;
والمخرج سوف يكون كما يلي:
 customer_id | orders |   spent
-------------+--------+-----------
        1226 |     43 | 105910.00
         557 |     50 | 100597.00
        1742 |     40 |  99206.00
         871 |     40 |  95063.00
(4 rows)
وقد يتساءل البعض: لماذا لا نكتب WHERE sum(total) > 95000؟ والإجابة أن WHERE تنفذ على كل صف قبل أن توجد المجموعات، فلا يوجد مجموع لتقارن به، وسوف يرفض PostgreSQL الاستعلام بالخطأ aggregate functions are not allowed in WHERE. ولاحظ أننا كتبنا نهاية الفترة < '2026-10-01' وليس <= '2026-09-30'، والسبب أن الثانية تعني منتصف ليل 30 سبتمبر فتسقط كل طلبات ذلك اليوم.
للتفصيل: GROUP BY وHAVING في توثيق PostgreSQL.
التمرين 4: فاتورة الطلب 5000 لا تساوي مجموعها
كتب زميلك هذا الاستعلام لعرض فاتورة الطلب 5000:
SELECT o.id AS order_id, c.name AS customer, p.name AS product, i.qty, i.unit_price, i.qty * i.unit_price AS line_total
FROM orders o
JOIN customers   c ON c.id = o.customer_id
JOIN order_items i ON i.order_id = o.id
JOIN products    p ON p.id = i.product_id
WHERE o.id = 5000;
فظهر سطر واحد مجموعه 135، بينما orders.total لهذا الطلب 234. أين ذهب الفرق؟ وكيف تصلح الاستعلام بحيث تظهر كل أسطر الفاتورة؟
الوقت المقترح: 10 دقائق.
تلميح Hint
انظر إلى أسطر الطلب نفسها دون أي ربط: SELECT * FROM order_items WHERE order_id = 5000. ثم تذكر ماذا يفعل JOIN العادي بالصف الذي لا يجد شريكاً في الجدول الآخر.
الحل Answer
SELECT * FROM order_items WHERE order_id = 5000;
   id   | order_id | product_id | qty | unit_price
--------+----------+------------+-----+------------
  10068 |     5000 |         16 |   3 |      45.00
 399943 |     5000 |            |   1 |      99.00
(2 rows)
للطلب سطران، والثاني منتجه NULL لأن المنتج حذف من الكتالوج والمفتاح الأجنبي معرف ب ON DELETE SET NULL. والربط العادي INNER JOIN مع products يبقي فقط الصفوف التي تجد منتجاً مطابقاً، فاختفى السطر الثاني بقيمة 99، و135 + 99 = 234. والإصلاح أن تربط المنتجات ب LEFT JOIN، فيبقى السطر وتأتي أعمدة المنتج NULL:
SELECT o.id AS order_id, p.name AS product, i.qty, i.unit_price, i.qty * i.unit_price AS line_total
FROM orders o
JOIN order_items i ON i.order_id = o.id
LEFT JOIN products p ON p.id = i.product_id
WHERE o.id = 5000;
والمخرج سوف يكون كما يلي:
 order_id |   product    | qty | unit_price | line_total
----------+--------------+-----+------------+------------
     5000 | Water Bottle |   3 |      45.00 |     135.00
     5000 |              |   1 |      99.00 |      99.00
(2 rows)
وفي الفاتورة الحقيقية تكتب coalesce(p.name, '(discontinued product)') حتى لا يظهر للعميل سطر بلا اسم، والأفضل من ذلك أن تحفظ اسم المنتج في سطر الطلب وقت البيع كما حفظنا السعر، لأن الفاتورة وثيقة تاريخية لا يجب أن تتغير إذا تغير الكتالوج.
للتفصيل: المفتاح الأجنبي Foreign Key ومتى تكسر التطبيع عن قصد في دليل تصميم قواعد البيانات.
التمرين 5: كم عميلاً بلا رقم جوال؟
توقع قبل التشغيل نتيجة كل استعلام من الثلاثة التالية، ثم فسر الفرق:
SELECT count(*) FROM customers WHERE phone = NULL;
SELECT count(*) FROM customers WHERE phone IS NULL;
SELECT count(*) AS all_rows, count(phone) AS with_phone FROM customers;
الوقت المقترح: 7 دقائق.
تلميح Hint
NULL تعني «قيمة غير معروفة»، فما نتيجة مقارنة شيء غير معروف بشيء آخر غير معروف؟ ليست صحيحة ولا خاطئة. وcount(column) يتجاهل NULL بينما count(*) يعد الصفوف.
الحل Answer
والمخرج سوف يكون كما يلي:
 count
-------
     0
(1 row)

 count
-------
   303
(1 row)

 all_rows | with_phone
----------+------------
     2003 |       1700
(1 row)
المقارنة phone = NULL نتيجتها NULL لكل صف، حتى للصفوف التي فيها NULL، وWHERE تقبل فقط ما نتيجته true، فخرج صفر صف دون أي رسالة خطأ. والطريقة الصحيحة هي IS NULL كما في توثيق المقارنة، فخرج 303. والاستعلام الثالث يؤكد الرقم بطريقة أخرى: 2003 صفاً منها 1700 فيها جوال، والفرق 303. وهذه الطريقة الثالثة مفيدة في التقارير لأنها تعطيك العددين في سطر واحد.
للتفصيل: القيود NOT NULL ومتى تسمح بالقيمة الفارغة في دليل تصميم قواعد البيانات.
التمرين 6: عملاء مسجلون مرتين
فريق الدعم يقول إن بعض العملاء يصلهم البريد التسويقي مرتين. اكتب استعلاماً يجد البريد الذي يتكرر، مع عدد النسخ وأرقام العملاء، ثم اقترح القيد الذي يمنع تكرار المشكلة.
الوقت المقترح: 10 دقائق.
تلميح Hint
جرب أولاً GROUP BY email HAVING count(*) > 1 وانظر هل يجد شيئاً. البريد لا يفرق بين الأحرف الكبيرة والصغيرة عند المستخدم، ولكن النص في قاعدة البيانات يفرق.
الحل Answer
التجميع بالعمود كما هو لا يجد شيئاً، لأن النسخة الثانية تبدأ بحرف كبير، فالحل أن تجمع بالقيمة بعد توحيد حالة الأحرف:
SELECT lower(email) AS email, count(*) AS copies, array_agg(id ORDER BY id) AS ids
FROM customers
GROUP BY lower(email)
HAVING count(*) > 1;
والمخرج سوف يكون كما يلي:
              email               | copies |     ids
----------------------------------+--------+-------------
 [email protected] |      2 | {1404,2003}
 [email protected]   |      2 | {230,2002}
 [email protected]      |      2 | {17,2001}
(3 rows)
وarray_agg يجمع أرقام العملاء في قائمة واحدة لتعرف أي الحسابين تدمج. والقيد الذي يمنع التكرار هو فهرس فريد على القيمة الموحدة CREATE UNIQUE INDEX ON customers (lower(email));، ولكنه سوف يفشل اليوم لأن التكرار موجود:
ERROR:  could not create unique index "customers_lower_idx"
DETAIL:  Key (lower(email))=([email protected]) is duplicated.
فعليك أن تدمج الحسابات الثلاثة أولاً ثم تنشئ الفهرس. ولا تقم بالاعتماد على فحص التكرار في كود التطبيق وحده، والسبب أن طلبين في نفس اللحظة يمران من الفحص معاً.
للتفصيل: القيود Constraints في دليل تصميم قواعد البيانات، وما المشكلة التي يحلها المعرف الفريد في مقال المعرفات.
المستوى الثاني: متوسط Intermediate
أخطاء هذا المستوى أخطر من الأول، لأن الاستعلام يعمل ويعطي رقماً قريباً من المعقول، فلا ينتبه أحد حتى يقارن التقرير بمصدر آخر.
التمرين 7: أين ذهب العملاء الذين لم يطلبوا؟
المطلوب تقرير لكل عملاء أبها مع عدد طلباتهم في سبتمبر 2026، ومن لم يطلب يظهر بصفر. كتب زميلك:
SELECT c.id, c.name, count(o.id) AS sept_orders
FROM customers c
LEFT JOIN orders o ON o.customer_id = c.id
WHERE c.city = 'Abha'
  AND o.created_at >= '2026-09-01' AND o.created_at < '2026-10-01'
GROUP BY c.id, c.name
ORDER BY sept_orders, c.id
LIMIT 5;
في أبها 344 عميلاً، فكم صفاً يعيد الاستعلام بدون LIMIT؟ ولماذا لا يظهر أي عميل بصفر رغم أنه LEFT JOIN؟ أصلحه.
الوقت المقترح: 12 دقيقة.
تلميح Hint
ما قيمة o.created_at للعميل الذي ليس له طلب في سبتمبر بعد LEFT JOIN؟ وما نتيجة NULL >= '2026-09-01' في WHERE؟
الحل Answer
العميل الذي ليس له طلبات يخرج من LEFT JOIN بصف واحد أعمدة o فيه كلها NULL، ثم يأتي شرط WHERE على o.created_at فتكون نتيجته NULL فيحذف الصف، فتحول LEFT JOIN عملياً إلى JOIN عادي. والمخرج:
 id  |       name       | sept_orders
-----+------------------+-------------
   5 | Lama Alghamdi    |           1
 189 | Yousef Almutairi |           1
 201 | Yousef Aldosari  |           1
 379 | Sara Alqahtani   |           1
 435 | Khalid Alshehri  |           1
(5 rows)

 rows_returned
---------------
           334
(1 row)
فاختفى عشرة عملاء دون أي تحذير. والإصلاح أن ينتقل شرط الجدول الأيمن إلى ON، فيصبح جزءاً من قرار الربط وليس فلتراً بعده، ويبقى شرط الجدول الأيسر في WHERE:
SELECT c.id, c.name, count(o.id) AS sept_orders
FROM customers c
LEFT JOIN orders o ON o.customer_id = c.id
                  AND o.created_at >= '2026-09-01' AND o.created_at < '2026-10-01'
WHERE c.city = 'Abha'
GROUP BY c.id, c.name
ORDER BY sept_orders, c.id
LIMIT 5;
والمخرج سوف يكون كما يلي:
  id  |       name       | sept_orders
------+------------------+-------------
  461 | Yousef Almutairi |           0
  716 | Sara Alqahtani   |           0
 1959 | Majed Alghamdi   |           0
 1966 | Sara Alshehri    |           0
 1971 | Faisal Almutairi |           0
(5 rows)

 rows_returned
---------------
           344
(1 row)
ولاحظ أننا عددنا count(o.id) وليس count(*)، والسبب أن count(*) يعد الصف الذي أضافه LEFT JOIN بأعمدة NULL فيعطي العميل الذي لم يطلب الرقم 1 بدل 0. والسطر rows_returned من نفس الاستعلام داخل SELECT count(*) FROM (...) x دون LIMIT.
للتفصيل: أنواع الربط وشرط ON في توثيق PostgreSQL.
التمرين 8: المنتجات التي لم تبع أبداً
مدير المخزون يريد قائمة المنتجات التي لم تطلب أبداً. كتبت:
SELECT name FROM products WHERE id NOT IN (SELECT product_id FROM order_items);
فخرجت القائمة فارغة، بينما المدير متأكد أن «Prayer Mat» أضيف هذا الأسبوع ولم يبع. لماذا؟ واكتب استعلاماً صحيحاً.
الوقت المقترح: 12 دقيقة.
تلميح Hint
تذكر الأسطر الأربعين في التمرين 4. والتعبير x NOT IN (1, 2, NULL) يعني x <> 1 AND x <> 2 AND x <> NULL، فما نتيجة الجزء الأخير؟
الحل Answer
الاستعلام الفرعي يعيد كل قيم product_id ومنها NULL من أسطر المنتج المحذوف، والمقارنة 22 <> NULL نتيجتها NULL، فيصبح الشرط كله NULL لكل منتج ولا يمر أحد، وهذا موثق في توثيق NOT IN: إذا لم توجد قيمة مساوية وكانت قيمة واحدة على الأقل NULL فالنتيجة NULL وليست true. والحل الأفضل هو NOT EXISTS لأنه لا يتأثر ب NULL، أو أن تستبعد NULL صراحة:
SELECT name FROM products WHERE id NOT IN (SELECT product_id FROM order_items);
SELECT name FROM products p WHERE NOT EXISTS (SELECT 1 FROM order_items i WHERE i.product_id = p.id);
SELECT name FROM products WHERE id NOT IN (SELECT product_id FROM order_items WHERE product_id IS NOT NULL);
والمخرج سوف يكون كما يلي:
 name
------
(0 rows)

    name
------------
 Prayer Mat
(1 row)

    name
------------
 Prayer Mat
(1 row)
واجعل NOT EXISTS عادتك، والسبب أن العمود الذي لا يحمل NULL اليوم قد يحمله غداً بعد تغيير بسيط في التصميم مثل الذي حدث هنا، فينكسر التقرير بصمت.
للتفصيل: الحذف المنطقي أم الحذف الفعلي في دليل تصميم قواعد البيانات.
التمرين 9: أعلى منتجين في كل فئة
اعرض لكل فئة category أعلى منتجين في الإيراد qty * unit_price، للطلبات المدفوعة أو المشحونة من أول يناير 2026 حتى نهاية سبتمبر 2026، مرتبة بالفئة ثم بالترتيب داخلها.
الوقت المقترح: 15 دقيقة.
تلميح Hint
احسب الإيراد لكل منتج أولاً في CTE، ثم أعط كل منتج رقماً داخل فئته ب row_number() OVER (PARTITION BY ... ORDER BY ...)، ثم صف بالرقم. ولا تستطيع أن تكتب دالة النافذة في WHERE مباشرة.
الحل Answer
WITH revenue AS (
    SELECT p.category, p.name, sum(i.qty * i.unit_price) AS revenue
    FROM order_items i
    JOIN orders   o ON o.id = i.order_id
    JOIN products p ON p.id = i.product_id
    WHERE o.status IN ('paid','shipped')
      AND o.created_at >= '2026-01-01' AND o.created_at < '2026-10-01'
    GROUP BY p.category, p.name
), ranked AS (
    SELECT *, row_number() OVER (PARTITION BY category ORDER BY revenue DESC) AS rn
    FROM revenue
)
SELECT category, rn, name, revenue
FROM ranked
WHERE rn <= 2
ORDER BY category, rn;
والمخرج سوف يكون كما يلي:
  category   | rn |                 name                  |   revenue
-------------+----+---------------------------------------+-------------
 Books       |  1 | Site Reliability Engineering          |  2505808.00
 Books       |  2 | Designing Data-Intensive Applications |  2343600.00
 Electronics |  1 | 27" Monitor                           | 15006684.00
 Electronics |  2 | Noise-Cancelling Headphones           | 11092761.00
 Grocery     |  1 | Honey 500g                            |  1476000.00
 Grocery     |  2 | Dates Box 1kg                         |  1095768.00
 Home        |  1 | Standing Desk                         | 25265100.00
 Home        |  2 | Office Chair                          | 17955350.00
(8 rows)
في الاستعلام أعلاه لاحظ التالي:
- دوال النوافذ تحسب بعد WHERE وGROUP BY، لذلك احتجنا طبقة ثانية
rankedلنصفي بالرقمrn. row_numberيعطي رقماً مختلفاً لكل صف حتى عند التعادل، فإذا كان لمنتجين نفس الإيراد فسوف يختار واحداً، وإذا أردت أن يظهر الاثنان فاستخدمrank()أوdense_rank().- الربط مع
productsهنا JOIN عادي عن قصد، لأن أسطر المنتج المحذوف لا فئة لها ولا تدخل في الترتيب.
للتفصيل: دوال النوافذ وقائمتها في توثيق PostgreSQL، وعمليات التطبيق أم التحليل في دليل تصميم قواعد البيانات.
التمرين 10: المجموع التراكمي لإيراد الأسبوع
اعرض لكل يوم من 1 إلى 7 سبتمبر 2026 إيراد ذلك اليوم من الطلبات المدفوعة أو المشحونة، وبجانبه المجموع التراكمي من أول الأسبوع حتى ذلك اليوم.
الوقت المقترح: 12 دقيقة.
تلميح Hint
جمع باليوم أولاً، ثم sum(...) OVER (ORDER BY day). ويمكن أن تضع دالة النافذة حول دالة التجميع مباشرة في نفس SELECT.
الحل Answer
SELECT created_at::date AS day,
       sum(total) AS day_revenue,
       sum(sum(total)) OVER (ORDER BY created_at::date) AS running_total
FROM orders
WHERE status IN ('paid','shipped')
  AND created_at >= '2026-09-01' AND created_at < '2026-09-08'
GROUP BY created_at::date
ORDER BY day;
والمخرج سوف يكون كما يلي:
    day     | day_revenue | running_total
------------+-------------+---------------
 2026-09-01 |   370340.00 |     370340.00
 2026-09-02 |   383439.00 |     753779.00
 2026-09-03 |   363911.00 |    1117690.00
 2026-09-04 |   334793.00 |    1452483.00
 2026-09-05 |   360094.00 |    1812577.00
 2026-09-06 |   363040.00 |    2175617.00
 2026-09-07 |   384768.00 |    2560385.00
(7 rows)
والتعبير sum(sum(total)) OVER (...) يبدو غريباً أول مرة: الداخلية دالة تجميع تعطي إيراد اليوم بعد GROUP BY، والخارجية دالة نافذة تجمع هذه القيم من أول صف حتى الصف الحالي بترتيب اليوم. وتحقق بيدك: 370340 + 383439 = 753779. ولاحظ أن اليوم يحسب بتوقيت الجلسة UTC، فالطلب الذي جاء الساعة الواحدة فجراً بتوقيت الرياض يحسب في اليوم السابق، وهذا يهم في تقرير يقرؤه فريق في السعودية.
للتفصيل: دوال النوافذ في توثيق PostgreSQL، والتاريخ والوقت والمناطق الزمنية.
التمرين 11: الإيراد تضاعف في التقرير
المطلوب لشهر سبتمبر 2026: عدد الطلبات المدفوعة أو المشحونة، وإيرادها، وعدد القطع المباعة. كتب زميلك:
SELECT count(*) AS orders, sum(o.total) AS revenue, sum(i.qty) AS units
FROM orders o
JOIN order_items i ON i.order_id = o.id
WHERE o.status IN ('paid','shipped')
  AND o.created_at >= '2026-09-01' AND o.created_at < '2026-10-01';
فخرج 13599 طلباً وإيراد 25402471.00 و27348 قطعة، والمحاسبة تقول إن الإيراد أقل من نصف ذلك. أي الأرقام الثلاثة صحيح وأيها خاطئ ولماذا؟ أصلح الاستعلام.
الوقت المقترح: 15 دقيقة.
تلميح Hint
كم صفاً يخرج من الربط لطلب فيه ثلاثة أسطر؟ وكم مرة تتكرر قيمة o.total لهذا الطلب في تلك الصفوف؟
الحل Answer
الربط يعطي صفاً لكل سطر طلب، فالطلب الذي فيه ثلاثة أسطر يظهر ثلاث مرات، ويتكرر معه total ثلاث مرات، فالعدد يعد الأسطر وليس الطلبات، والإيراد مضروب في عدد الأسطر، بينما القطع وحدها صحيحة لأن qty من الجدول الأيمن نفسه. وهذه المشكلة تسمى انتشار الصفوف Fan-out. والإصلاح أن تجمع الأسطر إلى مستوى الطلب قبل الربط:
SELECT count(*) AS orders, sum(o.total) AS revenue, sum(u.units) AS units
FROM orders o
JOIN (SELECT order_id, sum(qty) AS units FROM order_items GROUP BY order_id) u ON u.order_id = o.id
WHERE o.status IN ('paid','shipped')
  AND o.created_at >= '2026-09-01' AND o.created_at < '2026-10-01';
والمخرج قبل الإصلاح وبعده:
 orders |   revenue   | units
--------+-------------+-------
  13599 | 25402471.00 | 27348
(1 row)

 orders |   revenue   | units
--------+-------------+-------
   6817 | 10936061.00 | 27348
(1 row)
وتحققنا بطريقة ثالثة دون ربط أصلاً، بحساب القطع في استعلام فرعي مستقل، فأعطت نفس الأرقام 6817 و10936061.00 و27348. وقد يتساءل البعض: هل نستخدم count(DISTINCT o.id) ونكتفي؟ والإجابة أنها تصلح العدد فقط، أما sum(DISTINCT o.total) فخطأ أسوأ، لأن طلبين بنفس المبلغ يحسبان مرة واحدة.
للتفصيل: الاستعلامات الفرعية وWITH في توثيق PostgreSQL، والعلاقات بين الجداول في دليل تصميم قواعد البيانات.
التمرين 12: إلغاء الطلبات المعلقة لعملاء أبها بأمان
أغلق مستودع أبها، والمطلوب تحويل كل الطلبات المعلقة pending لعملاء أبها التي أنشئت قبل أول سبتمبر 2026 إلى cancelled. كتب زميلك هذا الأمر وكان على وشك أن يشغله على الإنتاج:
UPDATE orders o
SET status = 'cancelled'
FROM customers c
WHERE c.city = 'Abha'
  AND o.status = 'pending'
  AND o.created_at < '2026-09-01';
ما الخطأ؟ وكم صفاً تتوقع أن يغير؟ ثم اكتب الطريقة الآمنة خطوة بخطوة.
الوقت المقترح: 15 دقيقة.
تلميح Hint
في UPDATE ... FROM شرط الربط بين الجدولين ليس تلقائياً، فإذا نسيته فكل طلب يرتبط بكل عميل من أبها. والطريقة الآمنة: عد أولاً، ثم نفذ داخل BEGIN، ثم قارن العدد قبل COMMIT.
الحل Answer
الأمر لا يربط c.id = o.customer_id، فشرط c.city = 'Abha' يصبح «يوجد عميل واحد على الأقل من أبها»، وهذا صحيح دائماً، فيلغي كل الطلبات المعلقة لكل المدن. وشغلناه داخل معاملة ثم تراجعنا:
BEGIN;
UPDATE orders o
SET status = 'cancelled'
FROM customers c
WHERE c.city = 'Abha'
  AND o.status = 'pending'
  AND o.created_at < '2026-09-01';
ROLLBACK;
BEGIN
UPDATE 27182
ROLLBACK
والطريقة الآمنة أن تعد الصفوف بنفس الشروط أولاً، ثم تنفذ داخل معاملة، ثم تقارن الرقم الذي يطبعه UPDATE بالعدد:
BEGIN;
SELECT count(*) AS will_change
FROM orders o
JOIN customers c ON c.id = o.customer_id
WHERE c.city = 'Abha' AND o.status = 'pending' AND o.created_at < '2026-09-01';

UPDATE orders o
SET status = 'cancelled'
FROM customers c
WHERE c.id = o.customer_id
  AND c.city = 'Abha'
  AND o.status = 'pending'
  AND o.created_at < '2026-09-01';
-- the two numbers match: COMMIT; otherwise: ROLLBACK;
ROLLBACK;
والمخرج سوف يكون كما يلي:
BEGIN
 will_change
-------------
        4678
(1 row)

UPDATE 4678
ROLLBACK
الرقمان متطابقان، ففي الإنتاج تكتب COMMIT، وفي المختبر كتبنا ROLLBACK حتى تبقى البيانات كما هي لبقية التمارين. وقارن 4678 بالرقم 27182 الذي كاد يغير ستة أضعاف الطلبات المقصودة. ولاحظ أن المعاملة المفتوحة تقفل الصفوف التي غيرتها، فلا تتركها مفتوحة وأنت تفكر، وهذا موضوع التمرين 15. وتوثيق UPDATE يحذر من نفس الأمر: الصف المستهدف يجب أن يرتبط بصف واحد على الأكثر من الجدول الآخر.
للتفصيل: الشرط الذي تنساه في استعلام واحد في دليل تعدد المستأجرين، والتحديث والحذف على دفعات في دليل الجداول الضخمة.
المستوى الثالث: متقدم Advanced
في هذا المستوى السؤال ليس «ما الاستعلام الصحيح؟» وإنما «لماذا السيرفر بطيء أو معلق؟»، فتقرأ خطة التنفيذ ونشاط الجلسات والسجل، وتربط بينها.
التمرين 13: اختر الفهرس الصحيح لصفحة «طلباتي»
صفحة «طلباتي» في التطبيق تنفذ هذا الاستعلام مع كل زيارة، ولا يوجد على orders أي فهرس غير المفتاح الأساسي:
SELECT id, status, total, created_at
FROM orders
WHERE customer_id = 1226
ORDER BY created_at DESC
LIMIT 10;
توقع شكل الخطة قبل أي فهرس، ثم قارن بين فهرسين: (customer_id) وحده، و(customer_id, created_at DESC). أيهما تختار ولماذا؟ واستخدم EXPLAIN (ANALYZE, BUFFERS) لتثبت إجابتك.
الوقت المقترح: 25 دقيقة.
تلميح Hint
الاستعلام يحتاج شيئين: أن يجد طلبات عميل واحد بسرعة، وأن يأخذها مرتبة بالتاريخ دون أن يقرأها كلها ثم يرتبها. ابحث في الخطة عن عقدة Sort وعن الرقم rows الفعلي الذي يمر من كل عقدة، وعن Buffers.
الحل Answer
بدون فهرس، يقرأ PostgreSQL الجدول كله بثلاث عمليات متوازية، ويرمي كل الصفوف إلا طلبات العميل، ثم يرتبها:
 Limit  (cost=5441.60..5442.76 rows=10 width=28) (actual time=33.407..38.604 rows=10.00 loops=1)
   Buffers: shared hit=3475
   ->  Gather Merge  (cost=5441.60..5453.36 rows=101 width=28) (actual time=33.404..38.598 rows=10.00 loops=1)
         Workers Planned: 2
         Workers Launched: 2
         Buffers: shared hit=3475
         ->  Sort  (cost=4441.57..4441.68 rows=42 width=28) (actual time=28.166..28.169 rows=7.67 loops=3)
               Sort Key: created_at DESC
               Sort Method: top-N heapsort  Memory: 26kB
               Buffers: shared hit=3475
               Worker 0:  Sort Method: top-N heapsort  Memory: 26kB
               Worker 1:  Sort Method: top-N heapsort  Memory: 26kB
               ->  Parallel Seq Scan on orders  (cost=0.00..4440.67 rows=42 width=28) (actual time=11.577..27.996 rows=39.67 loops=3)
                     Filter: (customer_id = 1226)
                     Rows Removed by Filter: 66627
                     Buffers: shared hit=3399
 Planning Time: 0.603 ms
 Execution Time: 38.728 ms
والسطر Rows Removed by Filter: 66627 مع loops=3 يعني أنه قرأ قرابة 200 ألف صف ليجد 119، و3475 صفحة Buffers. ثم جربنا الفهرس على العمود وحده:
CREATE INDEX orders_customer_idx ON orders (customer_id);
EXPLAIN (ANALYZE, BUFFERS) SELECT id, status, total, created_at FROM orders WHERE customer_id = 1226 ORDER BY created_at DESC LIMIT 10;
 Limit  (cost=360.33..360.36 rows=10 width=28) (actual time=0.314..0.317 rows=10.00 loops=1)
   Buffers: shared hit=120 read=2
   ->  Sort  (cost=360.33..360.59 rows=102 width=28) (actual time=0.312..0.313 rows=10.00 loops=1)
         Sort Key: created_at DESC
         Sort Method: top-N heapsort  Memory: 26kB
         Buffers: shared hit=120 read=2
         ->  Bitmap Heap Scan on orders  (cost=5.09..358.13 rows=102 width=28) (actual time=0.067..0.274 rows=119.00 loops=1)
               Recheck Cond: (customer_id = 1226)
               Heap Blocks: exact=117
               Buffers: shared hit=120 read=2
               ->  Bitmap Index Scan on orders_customer_idx  (cost=0.00..5.06 rows=102 width=0) (actual time=0.047..0.047 rows=119.00 loops=1)
                     Index Cond: (customer_id = 1226)
                     Index Searches: 1
                     Buffers: shared hit=3 read=2
 Planning Time: 0.307 ms
 Execution Time: 0.339 ms
أسرع بمئة مرة، ولكنه ما زال يقرأ كل طلبات العميل الـ 119 من 117 صفحة مختلفة ثم يرتبها ليأخذ عشرة. ثم الفهرس المركب Composite Index:
DROP INDEX orders_customer_idx;
CREATE INDEX orders_customer_created_idx ON orders (customer_id, created_at DESC);
EXPLAIN (ANALYZE, BUFFERS) SELECT id, status, total, created_at FROM orders WHERE customer_id = 1226 ORDER BY created_at DESC LIMIT 10;
 Limit  (cost=0.42..40.59 rows=10 width=28) (actual time=0.059..0.078 rows=10.00 loops=1)
   Buffers: shared hit=10 read=3
   ->  Index Scan using orders_customer_created_idx on orders  (cost=0.42..410.20 rows=102 width=28) (actual time=0.058..0.075 rows=10.00 loops=1)
         Index Cond: (customer_id = 1226)
         Index Searches: 1
         Buffers: shared hit=10 read=3
 Planning Time: 0.275 ms
 Execution Time: 0.097 ms
في الخطط أعلاه لاحظ التالي:
- اختفت عقدة Sort تماماً، لأن الفهرس يخزن طلبات كل عميل مرتبة بالتاريخ، فيقرأ أول عشرة ويتوقف، و
rows=10.00في Index Scan تؤكد أنه لم يقرأ أكثر مما يحتاج. - الصفحات نزلت من 3475 إلى 122 إلى 13، والوقت من 38.7 إلى 0.34 إلى 0.097 ملي ثانية. والأرقام هنا للمقارنة على نفس الجهاز ونفس البيانات، وتختلف عندك في القيمة وليس في الاتجاه.
- ترتيب الأعمدة مهم: عمود المساواة أولاً ثم عمود الترتيب، ولو كان الفهرس
(created_at, customer_id)لما استفاد منه هذا الاستعلام بنفس الطريقة. - الفهرس المركب يخدم أيضاً أي استعلام بشرط على
customer_idوحده، لذلك لا تحتاج الفهرس الأول بجانبه، وحجمه في المختبر 6184 kB لجدول حجمه 27 MB.
للتفصيل: ال EXPLAIN (ANALYZE, BUFFERS) وفهرس B-tree مركب: ترتيب الأعمدة مهم في دليل الجداول الضخمة، والفهارس وORDER BY في توثيق PostgreSQL.
التمرين 14: الصفحة سريعة في الاستعلام وبطيئة في الواقع
صفحة «آخر الطلبات المدفوعة» في لوحة الإدارة بطيئة، ولكن كل استعلام في سجل البطء سريع. فعلت pg_stat_statements وصفرت الإحصاءات، ثم فتحت الصفحة مرة واحدة، ثم قرأت:
 calls | rows | total_ms |                                 query
-------+------+----------+------------------------------------------------------------------------
    50 |   50 |     0.57 | SELECT name, city FROM customers WHERE id = $1
     1 |   50 |    70.01 | SELECT id, customer_id, total FROM orders WHERE status = $1 ORDER BY c
(2 rows)
ما المشكلة؟ ولماذا لا تظهر في أي سجل بطء؟ وكيف يجب أن تبدو هذه القائمة بعد الإصلاح؟
الوقت المقترح: 20 دقيقة.
تلميح Hint
قارن calls للاستعلام الثاني بعدد الصفوف rows للأول. والتطبيق يرسل كل استعلام عبر الشبكة وينتظر الرد قبل أن يرسل التالي.
الحل Answer
هذه مشكلة N+1: استعلام واحد يجلب 50 طلباً، ثم حلقة في الكود تجلب العميل لكل طلب باستعلام منفصل، فيصبح المجموع 51 ذهاباً وعودة Round Trip إلى قاعدة البيانات. وكل استعلام عميل يأخذ قرابة 0.01 ملي ثانية داخل PostgreSQL فلا يظهر في أي سجل بطء، ولكن كل ذهاب وعودة يدفع زمن الشبكة وزمن المكتبة في التطبيق، فإذا كان الذهاب والعودة يأخذ ملي ثانية واحدة بين سيرفر التطبيق وسيرفر القاعدة فقد أضفت 50 ملي ثانية إلى الصفحة، ومع 200 طلب في الصفحة تصبح الثواني. وأنتجنا القائمة في المختبر بمحاكاة الحلقة داخل psql:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
SELECT pg_stat_statements_reset() IS NOT NULL AS reset;
\o /dev/null
SELECT id, customer_id, total FROM orders WHERE status = 'paid' ORDER BY created_at DESC LIMIT 50;
SELECT format('SELECT name, city FROM customers WHERE id = %s', customer_id)
FROM (SELECT customer_id FROM orders WHERE status = 'paid' ORDER BY created_at DESC LIMIT 50) x \gexec
\o
SELECT calls, rows, round(total_exec_time::numeric, 2) AS total_ms, left(query, 70) AS query
FROM pg_stat_statements
WHERE query NOT ILIKE '%pg_stat_statements%' AND query NOT ILIKE 'SELECT format%'
ORDER BY calls DESC
LIMIT 5;
والأمر \gexec ينفذ كل صف من النتيجة كاستعلام مستقل، تماماً كما تفعل الحلقة في الكود. ولاحظ أن pg_stat_statements وحد الخمسين استعلاماً في سطر واحد بالرمز $1، لذلك تبحث عن العمود calls الكبير وليس عن total_ms. والإصلاح استعلام واحد بالربط:
SELECT pg_stat_statements_reset() IS NOT NULL AS reset;
\o /dev/null
SELECT o.id, o.total, c.name, c.city
FROM orders o
JOIN customers c ON c.id = o.customer_id
WHERE o.status = 'paid'
ORDER BY o.created_at DESC
LIMIT 50;
\o
SELECT calls, rows, round(total_exec_time::numeric, 2) AS total_ms, left(query, 70) AS query
FROM pg_stat_statements WHERE query NOT ILIKE '%pg_stat_statements%' ORDER BY calls DESC;
والمخرج سوف يكون كما يلي:
 calls | rows | total_ms |                query
-------+------+----------+--------------------------------------
     1 |   50 |    94.31 | SELECT o.id, o.total, c.name, c.city+
       |      |          | FROM orders o                       +
       |      |          | JOIN customers c ON
(1 row)
ذهاب وعودة مرة واحدة بدل 51. ولاحظ أن الاستعلام نفسه يأخذ 70 إلى 94 ملي ثانية لأنه يقرأ كل الطلبات المدفوعة ليرتبها، وهذه مشكلة ثانية منفصلة حلها فهرس على (status, created_at) كما في التمرين 13، فلا تخلط بين المشكلتين، فالأولى عدد مرات الذهاب والعودة والثانية كلفة الاستعلام الواحد. وفي ORM تحل الأولى بالتحميل المسبق Eager Loading مثل Include في Entity Framework أو select_related في Django.
للتفصيل: صفحة N+1 مقابل JOIN في دليل الطلب البطيء، ومشكلة N+1 في دليل التصميم، وال pg_stat_statements في دليل الجداول الضخمة.
التمرين 15: تعديل السعر معلق منذ دقائق
مسؤول الكتالوج غير سعر «Mechanical Keyboard» من لوحة الإدارة فبقيت الصفحة تدور. نفذت هذا الاستعلام في جلسة ثالثة:
SELECT pid, application_name AS app, state, wait_event_type AS wait_type, wait_event,
       pg_blocking_pids(pid) AS blocked_by,
       now() - xact_start AS xact_age,
       left(query, 45) AS query
FROM pg_stat_activity
WHERE datname = 'shop' AND pid <> pg_backend_pid()
ORDER BY xact_start;
 pid |       app       |        state        | wait_type |  wait_event   | blocked_by |    xact_age     |                     query
-----+-----------------+---------------------+-----------+---------------+------------+-----------------+-----------------------------------------------
 351 | checkout-worker | idle in transaction | Client    | ClientRead    | {}         | 00:00:07.776617 | UPDATE products SET stock = stock - 1 WHERE i
 358 | admin-panel     | active              | Lock      | transactionid | {351}      | 00:00:04.260521 | UPDATE products SET price = 359.00 WHERE id =
(2 rows)
من يقفل من؟ ولماذا الجلسة 351 لا تفعل شيئاً ومع ذلك تمنع غيرها؟ ماذا تفعل الآن لتفك الانتظار، وماذا يحدث لعمل الجلسة 351؟ وما الإعداد الذي يمنع تكرار ذلك؟
الوقت المقترح: 25 دقيقة.
تلميح Hint
العمود blocked_by يجيب عن السؤال الأول. والحالة idle in transaction تعني أن المعاملة بدأت ونفذت أمراً ولم تنته ب COMMIT أو ROLLBACK، والعمود query يعرض آخر أمر نفذته وليس ما تفعله الآن.
الحل Answer
الجلسة 358 من لوحة الإدارة تنتظر قفلاً من نوع transactionid، وpg_blocking_pids يقول إن من يمنعها هو 351. والجلسة 351 عامل الدفع checkout-worker نفذ UPDATE على نفس المنتج داخل معاملة، ثم توقف عن إرسال أي شيء، فحالتها idle in transaction وهي تنتظر الكلاينت ClientRead، والقفل على الصف يبقى حتى تنتهي المعاملة، والسبب الأرجح كود يفتح معاملة ثم يستدعي خدمة خارجية بطيئة أو ينتظر شيئاً قبل COMMIT. والسجل كتب نفس القصة لأننا فعلنا log_lock_waits:
LOG:  process 358 still waiting for ShareLock on transaction 891 after 1000.207 ms
DETAIL:  Process holding the lock: 351. Wait queue: 358.
CONTEXT:  while updating tuple (0,3) in relation "products"
STATEMENT:  UPDATE products SET price = 359.00 WHERE id = 3
وأنتجنا الحالة بجلستين، الأولى تفتح المعاملة وتبقى صامتة، والثانية تحاول التعديل:
(echo "BEGIN; UPDATE products SET stock = stock - 1 WHERE id = 3;"; sleep 40) | docker exec -i -e PGAPPNAME=checkout-worker kata-pg psql -U postgres -d shop &
docker exec -e PGAPPNAME=admin-panel kata-pg psql -U postgres -d shop -c "UPDATE products SET price = 359.00 WHERE id = 3" &
والحل الفوري إنهاء الجلسة التي تقفل، وليس التي تنتظر:
SELECT pg_terminate_backend(351);
SELECT id, name, price, stock FROM products WHERE id = 3;
 pg_terminate_backend
----------------------
 t
(1 row)

UPDATE 1
 id |        name         | price  | stock
----+---------------------+--------+-------
  3 | Mechanical Keyboard | 359.00 |     80
(1 row)
فاكتمل تعديل السعر فوراً، والسطر UPDATE 1 هنا من جلسة لوحة الإدارة، والمخزون بقي 80 لأن إنهاء الجلسة 351 تراجع عن معاملتها كلها، فإذا كان الطلب قد دفع فعلاً فعلى فريق الدفع أن يعرف ذلك. والإعداد الذي يمنع التكرار هو idle_in_transaction_session_timeout، وجربناه:
SET idle_in_transaction_session_timeout = '3s';
BEGIN;
UPDATE products SET stock = stock - 1 WHERE id = 3;
\! sleep 5
SELECT stock FROM products WHERE id = 3;
SET
BEGIN
UPDATE 1
FATAL:  terminating connection due to idle-in-transaction timeout
server closed the connection unexpectedly
	This probably means the server terminated abnormally
	before or while processing the request.
connection to server was lost
ولكن الإصلاح الحقيقي في الكود: لا تقم باستدعاء خدمة خارجية أو انتظار المستخدم داخل معاملة مفتوحة، والسبب أن كل ثانية فيها قفل على صفوف واتصال محجوز من المجمع Pool لا يستطيع أحد غيرك استخدامه.
للتفصيل: طلب ينتظر قفلاً في دليل الطلب البطيء، وما الذي ينكسر في وضع transaction في مقال تجميع الاتصالات، وpg_stat_activity وpg_blocking_pids في التوثيق.
التمرين 16: اقرأ رسالة الجمود Deadlock
عامل الدفع checkout ينقص المخزون للمنتج 1 ثم للمنتج 2 في نفس الطلب، وعامل التوريد restock يزيد المخزون للمنتج 2 ثم للمنتج 1 في نفس الدفعة. ظهر في سجل PostgreSQL:
ERROR:  deadlock detected
DETAIL:  Process 430 waits for ShareLock on transaction 898; blocked by process 437.
	Process 437 waits for ShareLock on transaction 897; blocked by process 430.
	Process 430: UPDATE products SET stock = stock - 1 WHERE id = 2;
	Process 437: UPDATE products SET stock = stock + 10 WHERE id = 1;
HINT:  See server log for query details.
CONTEXT:  while updating tuple (0,29) in relation "products"
STATEMENT:  UPDATE products SET stock = stock - 1 WHERE id = 2;
ارسم ما حدث خطوة بخطوة، وحدد أي المعاملتين نجحت وأيها ألغيت، واكتب إصلاحاً يمنع الجمود دون أن تبطئ النظام.
الوقت المقترح: 25 دقيقة.
تلميح Hint
كل UPDATE يقفل الصف الذي يغيره حتى نهاية المعاملة. فماذا يملك كل عامل بعد خطوته الأولى، وماذا يطلب في خطوته الثانية؟ والإصلاح المعروف لا يغير المنطق وإنما يغير الترتيب.
الحل Answer
الصورة التالية تبين ما حدث:
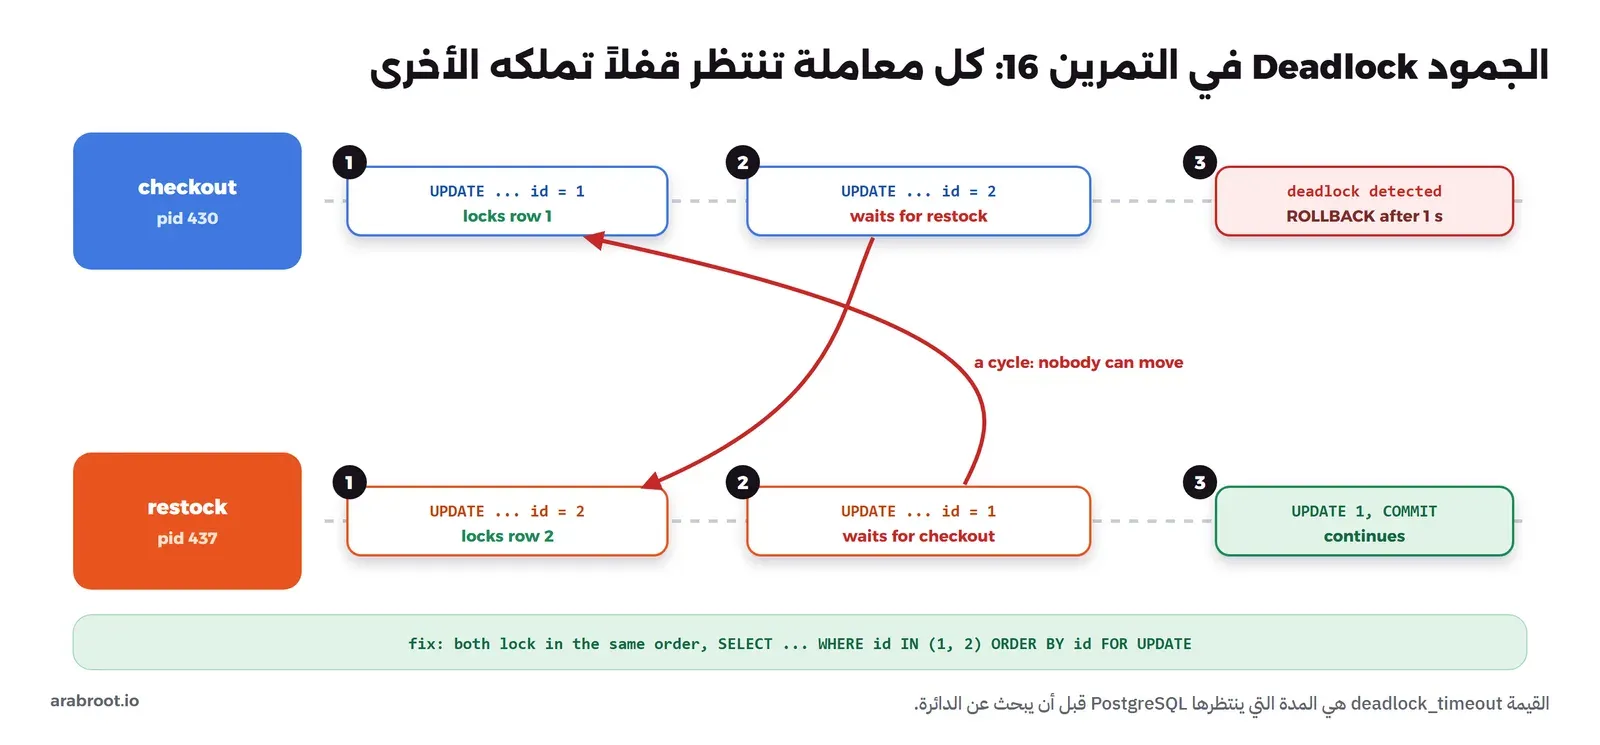
الخطوة الأولى: checkout (430) قفل المنتج 1، وrestock (437) قفل المنتج 2. الخطوة الثانية: checkout طلب المنتج 2 فانتظر 437، وrestock طلب المنتج 1 فانتظر 430. وبعد deadlock_timeout وهي ثانية في المختبر بحث PostgreSQL عن دائرة انتظار فوجدها، فألغى معاملة واحدة هي 430 checkout بالكامل، وأكملت 437. وأنتجنا الحالة بجلستين متزامنتين، كل منها تنام 3 ثوان بين التحديثين:
== A (checkout)
BEGIN
UPDATE 1
 pg_sleep
----------

(1 row)

ERROR:  deadlock detected
DETAIL:  Process 430 waits for ShareLock on transaction 898; blocked by process 437.
Process 437 waits for ShareLock on transaction 897; blocked by process 430.
HINT:  See server log for query details.
CONTEXT:  while updating tuple (0,29) in relation "products"
ROLLBACK
== B (restock)
BEGIN
UPDATE 1
 pg_sleep
----------

(1 row)

UPDATE 1
COMMIT
ولاحظ أن ROLLBACK في الجلسة A هو أمر COMMIT الذي أرسلته، فالمعاملة الملغاة لا يمكن أن تنجح، وpsql يطبع ROLLBACK بدل COMMIT. والإصلاح أن يقفل الجميع الصفوف بنفس الترتيب، وأسهل طريقة أن تبدأ المعاملة بقفل كل الصفوف التي سوف تحتاجها مرتبة بالمفتاح:
BEGIN;
SELECT id FROM products WHERE id IN (1, 2) ORDER BY id FOR UPDATE;
UPDATE products SET stock = stock + 10 WHERE id = 2;
UPDATE products SET stock = stock + 10 WHERE id = 1;
COMMIT;
وأعدنا نفس التجربة والجلستان تبدآن بهذا السطر، فانتظرت الثانية حتى انتهت الأولى ثم أكملت، ولم يظهر أي خطأ:
== A
UPDATE 1
UPDATE 1
COMMIT
== B
UPDATE 1
UPDATE 1
COMMIT
وفي الكود الحقيقي رتب قائمة المنتجات في الطلب بالرقم قبل أن تحدثها، وأضف إعادة المحاولة Retry عند الخطأ 40P01، لأن الجمود قد يحدث من مسار لم تفكر فيه، والمعاملة الملغاة آمنة للإعادة.
للتفصيل: الأقفال والجمود وdeadlock_timeout في توثيق PostgreSQL، وطلب ينتظر قفلاً في دليل الطلب البطيء.
التمرين 17: بعنا علبتين والمخزون نقص واحدة
كود الدفع يقرأ المخزون، ويحسب القيمة الجديدة في التطبيق، ثم يكتبها:
BEGIN;
SELECT stock FROM products WHERE id = 20;          -- the app reads 70
UPDATE products SET stock = 69 WHERE id = 20;      -- the app writes 70 - 1
COMMIT;
طلبان لنفس المنتج «Honey 500g» وصلا في نفس الثانية، والمخزون كان 70. ماذا تتوقع أن يكون المخزون بعدهما في مستوى العزل الافتراضي READ COMMITTED؟ وماذا يحدث في REPEATABLE READ؟ وما أبسط إصلاح؟
الوقت المقترح: 30 دقيقة.
تلميح Hint
في READ COMMITTED كل أمر يرى آخر ما تم حفظه لحظة بدايته، وUPDATE ينتظر الآخر ثم يكتب القيمة التي أعطيتها له كما هي. وفي REPEATABLE READ المعاملة ترى صورة ثابتة من بدايتها، فماذا يفعل PostgreSQL إذا حاولت تعديل صف تغير بعد تلك الصورة؟
الحل Answer
شغلنا جلستين بفارق ثانية، كل واحدة تقرأ المخزون وتحفظ stock - 1 في متغير ب \gset كما يفعل التطبيق، ثم تنام 5 ثوان، ثم تكتب القيمة:
BEGIN ISOLATION LEVEL READ COMMITTED;
SELECT stock, to_char(clock_timestamp(), 'HH24:MI:SS') AS at FROM products WHERE id = 20;
SELECT stock - 1 AS new_stock FROM products WHERE id = 20 \gset
SELECT pg_sleep(5);
UPDATE products SET stock = :new_stock WHERE id = 20;
COMMIT;
والمخرج سوف يكون كما يلي، مع حذف أسطر pg_sleep الفارغة وأسطر عدد الصفوف:
== session A
BEGIN
 stock |    at
-------+----------
    70 | 08:28:36
UPDATE 1
COMMIT
== session B
BEGIN
 stock |    at
-------+----------
    70 | 08:28:39
UPDATE 1
COMMIT
 id |    name    | stock
----+------------+-------
 20 | Honey 500g |    69
(1 row)
الجلستان قرأتا 70 قبل أن تحفظ الأولى، وكلتاهما كتبت 69، فضاع نقص واحد دون أي خطأ، وهذا هو التحديث المفقود Lost Update. ثم نفس التجربة في REPEATABLE READ:
== session A
BEGIN
 stock |    at
-------+----------
    70 | 08:27:48
ERROR:  could not serialize access due to concurrent update
ROLLBACK
== session B
BEGIN
 stock |    at
-------+----------
    70 | 08:27:47
UPDATE 1
COMMIT
 id |    name    | stock
----+------------+-------
 20 | Honey 500g |    69
(1 row)
هنا بدأت B قبل A بثانية فحفظت أولاً، وعندما حاولت A أن تعدل صفاً تغير بعد بداية معاملتها رفض PostgreSQL ذلك بالخطأ could not serialize access، فالمخزون 69 صحيح لأن البيع الثاني لم يتم، وعلى التطبيق أن يعيد المعاملة من البداية فيقرأ 69 ويكتب 68. وهذا السلوك موثق في مستويات العزل.
وأبسط إصلاح ألا يحسب التطبيق القيمة أصلاً، وأن يطلب من قاعدة البيانات أن تنقص، لأن UPDATE في READ COMMITTED يعيد قراءة الصف بعد انتظار القفل:
BEGIN;
UPDATE products SET stock = stock - 1 WHERE id = 20 RETURNING stock;
COMMIT;
 stock
-------
    69
(1 row)
 stock
-------
    68
(1 row)
وإذا كان المنطق أعقد من عملية حسابية، كأن تتحقق من شروط قبل البيع، فاقرأ الصف ب SELECT ... FOR UPDATE حتى ينتظر الطلب الثاني، أو استخدم REPEATABLE READ مع إعادة المحاولة. وأضف القيد CHECK (stock >= 0) حتى لا يبيع النظام ما ليس عنده مهما حدث في الكود.
للتفصيل: القيود Constraints في دليل تصميم قواعد البيانات، والمعاملة وSET LOCAL في دليل تعدد المستأجرين، والأقفال على مستوى الصف في التوثيق.
جدول المتابعة
انسخ الجدول التالي إلى ملف عندك، واكتب في كل مرة تحل فيها تمريناً التاريخ والوقت الذي أخذه وهل احتجت التلميح، وارجع إلى كل تمرين احتجت فيه التلميح أو تجاوزت الوقت بعد أسبوع، وإلى التمارين التي حللتها بسرعة بعد شهر:
| #  | المستوى  | التمرين                                  | التاريخ | الوقت | تلميح؟ | المراجعة القادمة |
|----|----------|------------------------------------------|---------|-------|--------|------------------|
| 1  | مبتدئ    | WHERE وORDER BY وLIMIT                   |         |       |        |                  |
| 2  | مبتدئ    | التجميع حسب الحالة                       |         |       |        |                  |
| 3  | مبتدئ    | GROUP BY مع HAVING                       |         |       |        |                  |
| 4  | مبتدئ    | الفاتورة وLEFT JOIN                      |         |       |        |                  |
| 5  | مبتدئ    | = NULL أم IS NULL                        |         |       |        |                  |
| 6  | مبتدئ    | البريد المكرر                            |         |       |        |                  |
| 7  | متوسط    | فخ LEFT JOIN مع WHERE                    |         |       |        |                  |
| 8  | متوسط    | NOT IN مع NULL                           |         |       |        |                  |
| 9  | متوسط    | أعلى منتجين في كل فئة                    |         |       |        |                  |
| 10 | متوسط    | المجموع التراكمي                         |         |       |        |                  |
| 11 | متوسط    | الإيراد المضاعف                          |         |       |        |                  |
| 12 | متوسط    | UPDATE مع الربط في معاملة                |         |       |        |                  |
| 13 | متقدم    | الفهرس وEXPLAIN ANALYZE                  |         |       |        |                  |
| 14 | متقدم    | مشكلة N+1                                |         |       |        |                  |
| 15 | متقدم    | من يقفل من                               |         |       |        |                  |
| 16 | متقدم    | الجمود Deadlock                          |         |       |        |                  |
| 17 | متقدم    | التحديث المفقود                          |         |       |        |                  |
وعندما تنتهي احذف المختبر:
docker rm -f kata-pg
الخلاصة
وصلنا لنهاية تمارين SQL، وأهم ما تخرج به منها:
- اكتب الرقم الذي تتوقعه قبل أن تشغل الاستعلام، فأخطاء SQL الخطيرة لا تعطي رسالة خطأ وإنما رقماً معقولاً: 334 عميلاً بدل 344، وإيراد مضاعف، وقائمة فارغة.
- NULL ليست قيمة وإنما «غير معروف»، فلا تقارنها ب = واستخدم IS NULL، واستخدم NOT EXISTS بدل NOT IN، وانتبه أن شرط WHERE على الجدول الأيمن يلغي LEFT JOIN.
- الربط يكرر صفوف الجدول الأيسر بعدد الأسطر المطابقة، فجمع إلى المستوى الصحيح قبل الربط، ونفذ كل UPDATE مع الربط داخل معاملة بعد أن تعد الصفوف.
- الفهرس الصحيح يتبع الاستعلام: عمود المساواة ثم عمود الترتيب، وEXPLAIN (ANALYZE, BUFFERS) هو الدليل وليس الإحساس، وN+1 يظهر في عدد الاستدعاءات calls وليس في زمن الاستعلام.
- المعاملة المفتوحة تقفل، فلا تنتظر شيئاً داخلها، واقفل الصفوف بنفس الترتيب، وأعط قاعدة البيانات عملية الحساب
stock = stock - 1بدل أن تحسبها في التطبيق.
وهذه المقالات التي تشرح كل موضوع في التمارين بالتفصيل:
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلالرقم المتسلسل أم UUID؟ كيف تختار المعرف الفريدلماذا يفشل الرقم المتسلسل في الروابط وعند تعدد السيرفرات، وكيف يؤثر نوع المعرف الذي تختاره على فهرس قاعدة البيانات.
 دليلتطبيق SaaS متعدد المستأجرين عملياً مع Row-Level Securityنبني على PostgreSQL تطبيق SaaS يعزل كل مستأجر Tenant عن غيره بسياسات Row-Level Security، ونرى أين تتسرب البيانات رغم ذلك.
وفي بقية سلسلة تمارين Kata سوف نطبق نفس الطريقة بإذن الله على البرمجة والأمن وDevOps وتشخيص الأعطال.
سجل التحديثات
- أكتوبر 2026: كتابة التمارين السبعة عشر، وتنفيذ كل الحلول على PostgreSQL 18.6 (postgres:18، Debian 18.6-1.pgdg13+2) مع pg_stat_statements وlog_lock_waits وdeadlock_timeout بثانية، على قاعدة متجر تجريبية من 2003 عملاء و200 ألف طلب وقرابة 400 ألف سطر، في Docker Engine 29.8.0 (Docker Desktop). أرقام EXPLAIN ANALYZE للمقارنة على نفس الجهاز فقط.


