

كلمة التقسيم تستخدم لشيئين مختلفين تماماً، وخلطهما من أكثر ما يربك في نقاشات قواعد البيانات: الأول تقسيم الجدول Partitioning، أي أن يبقى الجدول على سيرفر واحد ولكنه يحفظ في عدة جداول صغيرة يراها التطبيق جدولاً واحداً، والثاني التوزيع Sharding، أي أن توزع البيانات على عدة سيرفرات، وكل سيرفر لا يعرف شيئاً عن الآخرين، والتطبيق أو طبقة فوقها هي التي تعرف أين يعيش كل صف. والأول قرار في قاعدة البيانات تستطيع أن تجربه وتتراجع عنه، أما الثاني فقرار في معمارية النظام كلها يصعب الرجوع عنه.
وقد طبقنا التقسيم حسب الشهر على جدول طلبات من 30 مليون صف في PostgreSQL للجداول الضخمة، بما في ذلك استبعاد الأقسام Partition Pruning في EXPLAIN، وحذف الشهور القديمة بالأمر DROP بدل DELETE، ومشكلات القسم الافتراضي، وأتمتة الأقسام مع pg_partman، وشرحنا اختيار مفتاح التوزيع Shard Key في عناقيد قواعد البيانات، والهاش المتسق Consistent Hashing في الأنظمة الموزعة، وأين تضع بيانات كل مستأجر Tenant في تعدد المستأجرين. فلن نكرر شيئاً من ذلك، وإنما نكمل ما لم نشرحه بتجارب حقيقية.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلتعدد المستأجرين Multi-Tenancy في SaaS للمبتدئينكيف يخدم تطبيق SaaS واحد مئات العملاء دون أن يرى أحدهم بيانات غيره، وأي نموذج عزل يناسب تطبيقك.
وسوف نناقش في هذا المقال ما يلي:
- الفرق بين التقسيم والتوزيع، ومتى تحتاج كل واحد منهما، ومتى لا تحتاج أياً منهما.
- التقسيم بالهاش HASH وبالقائمة LIST، وما يستبعده كل منهما وما لا يستبعده.
- الاستبعاد أثناء التنفيذ Runtime Pruning مع الاستعلامات المجهزة والربط.
- انتقال الصف بين الأقسام عند UPDATE.
- إضافة قسم جاهز ATTACH PARTITION دون فحص طويل تحت القفل.
- التوزيع على ثلاثة سيرفرات بتجربة حقيقية: الأجزاء المنطقية Logical Shards وجدول التوجيه Directory.
- كم بيانات تنتقل عند إضافة سيرفر: باقي القسمة مقابل الأجزاء المنطقية.
- الجزء الساخن Hot Shard والمستأجر الضخم، والاستعلام الذي يسأل كل السيرفرات Scatter-Gather.
التقسيم أم التوزيع؟ وهل تحتاج أياً منهما؟
الصورة التالية تبين الفرق، وأنواع التقسيم الثلاثة داخل السيرفر الواحد:
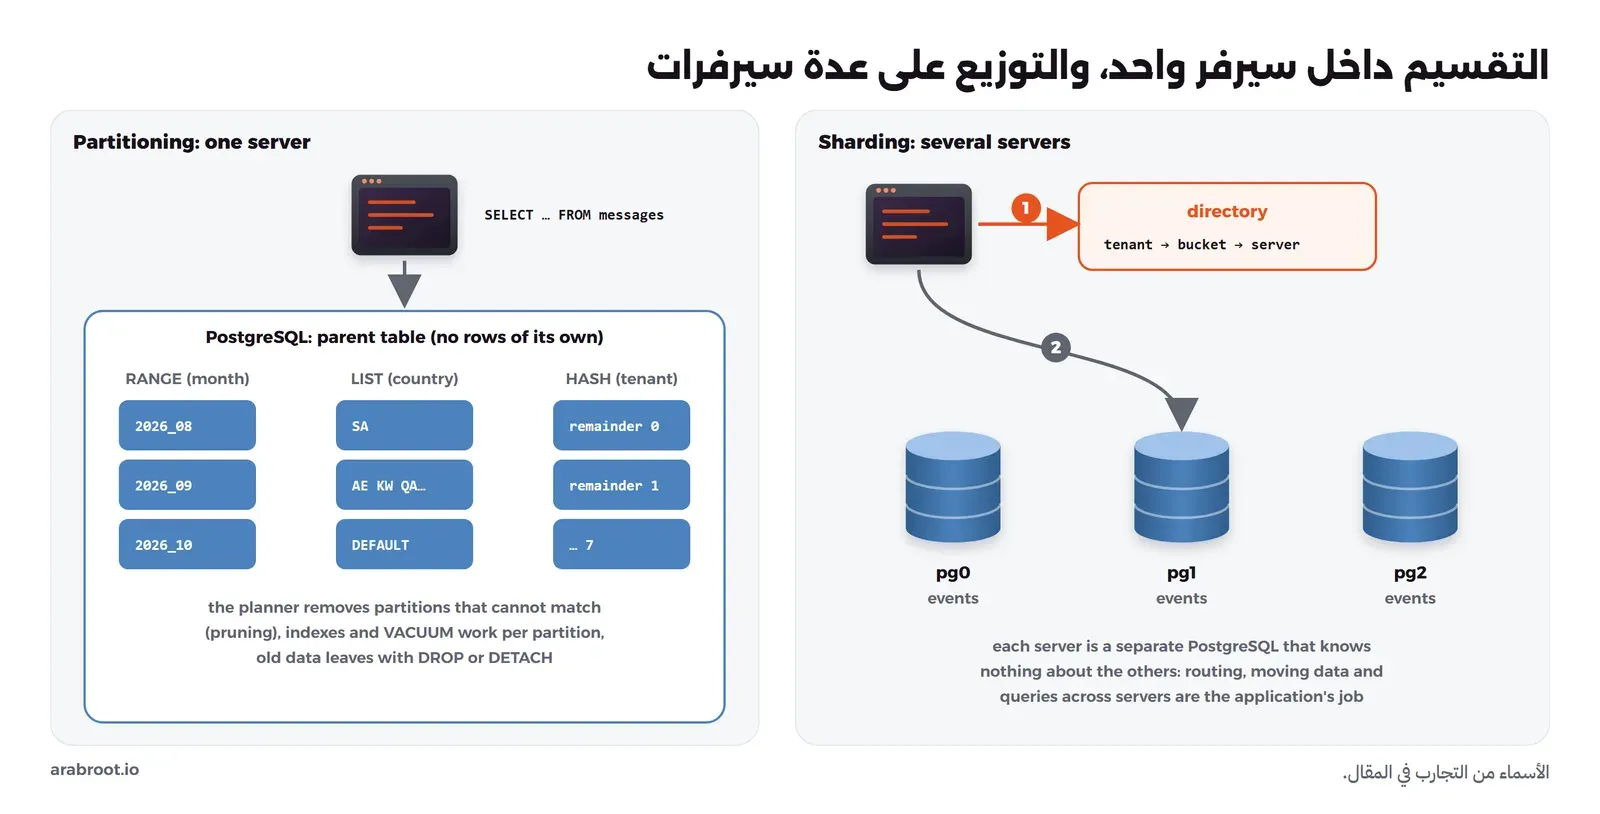
ولاحظ أن التقسيم لا يجعل الاستعلام العادي أسرع في الغالب، فالفهرس الجيد على جدول من 50 مليون صف يجد صفاً في أربع صفحات كما رأينا في مقال الفهارس، والجدول المقسم قد يجعله أبطأ إذا لم يحمل الاستعلام عمود التقسيم. وفائدة التقسيم الحقيقية في ثلاثة أشياء: حذف بيانات قديمة كاملة بحذف قسم، وجعل الصيانة مثل VACUUM وإعادة بناء الفهارس تعمل على جداول صغيرة، والاستعلامات التي تقرأ جزءاً كبيراً من قسم واحد. أما التوزيع فسببه الوحيد تقريباً أن سيرفراً واحداً، بعد كل ما في سلم التوسع، لم يعد يتحمل الكتابة أو حجم البيانات. والقاعدة: لا تقسم جدولاً حجمه أقل من ذاكرة السيرفر إلا لسبب في الحذف أو الصيانة، ولا توزع على عدة سيرفرات قبل أن تستنفد السيرفر الواحد.
تجهيز المختبر
ثلاثة سيرفرات PostgreSQL 18.6 سوف نستخدمها كأجزاء Shards، والأول نستخدمه أيضاً لتجارب التقسيم، وContainer فيه Python مع المكتبة psycopg يقوم بدور التطبيق الذي يوجه الصفوف، وكل المنافذ على 127.0.0.1:
name: lab-shard
x-pg: &pg
  image: postgres:18.6
  environment:
    POSTGRES_PASSWORD: lab-only-password
    POSTGRES_DB: app
  command: postgres -c shared_buffers=256MB -c max_wal_size=2GB
services:
  pg0:
    <<: *pg
    container_name: lab-shard-pg0
    ports: ["127.0.0.1:15470:5432"]
    volumes: [lab-shard-pg0:/var/lib/postgresql]
  pg1:
    <<: *pg
    container_name: lab-shard-pg1
    ports: ["127.0.0.1:15471:5432"]
    volumes: [lab-shard-pg1:/var/lib/postgresql]
  pg2:
    <<: *pg
    container_name: lab-shard-pg2
    ports: ["127.0.0.1:15472:5432"]
    volumes: [lab-shard-pg2:/var/lib/postgresql]
  app:
    image: python:3.13.16-slim
    container_name: lab-shard-app
    command: sh -c "pip install --root-user-action=ignore -q 'psycopg[binary]==3.3.6' && sleep infinity"
    volumes: ["./:/lab"]
    working_dir: /lab
volumes:
  lab-shard-pg0:
  lab-shard-pg1:
  lab-shard-pg2:
docker compose -p lab-shard up -d
docker exec -i lab-shard-pg0 psql -U postgres -d app < p1-hash.sqlالتقسيم بالهاش HASH وبالقائمة LIST
التقسيم بالمدى RANGE يناسب الوقت، وقد طبقناه في مقال الجداول الضخمة. أما عندما يكون المفتاح الطبيعي رقم مستأجر Tenant أو عميل، فلا يوجد «مدى» له معنى، وهنا يأتي التقسيم بالهاش: يحسب PostgreSQL هاش القيمة ويضع الصف في القسم الذي يساوي باقي قسمة الهاش على عدد الأقسام، كما في توثيق التقسيم. لنقسم جدول رسائل لنظام SaaS فيه 1000 مستأجر إلى ثمانية أقسام، وندخل مليوني رسالة:
CREATE TABLE messages (
    tenant_id  int         NOT NULL,
    id         bigint      NOT NULL,
    created_at timestamptz NOT NULL,
    body       text        NOT NULL,
    PRIMARY KEY (tenant_id, id)
) PARTITION BY HASH (tenant_id);
DO $$ BEGIN
  FOR i IN 0..7 LOOP
    EXECUTE format('CREATE TABLE messages_p%s PARTITION OF messages FOR VALUES WITH (MODULUS 8, REMAINDER %s)', i, i);
  END LOOP;
END $$;
INSERT INTO messages
SELECT 1 + g % 1000, g, timestamptz '2026-01-01' + g * interval '7 seconds', 'message ' || g
FROM generate_series(1, 2000000) g;
ANALYZE messages;
SELECT tableoid::regclass AS partition, count(*) AS rows, count(DISTINCT tenant_id) AS tenants
FROM messages GROUP BY 1 ORDER BY 1;
EXPLAIN (COSTS OFF) SELECT count(*) FROM messages WHERE tenant_id = 42;
EXPLAIN (COSTS OFF) SELECT count(*) FROM messages WHERE tenant_id BETWEEN 40 AND 45;
partition | rows | tenants
-------------+--------+---------
messages_p0 | 248000 | 124
messages_p1 | 248000 | 124
messages_p2 | 280000 | 140
messages_p3 | 216000 | 108
messages_p4 | 270000 | 135
messages_p5 | 220000 | 110
messages_p6 | 272000 | 136
messages_p7 | 246000 | 123
(8 rows)
QUERY PLAN
---------------------------------------------------
Aggregate
-> Bitmap Heap Scan on messages_p2 messages
Recheck Cond: (tenant_id = 42)
-> Bitmap Index Scan on messages_p2_pkey
Index Cond: (tenant_id = 42)
(5 rows)والخطة الثانية للمدى BETWEEN 40 AND 45 تبدأ كما يلي، ثم يتكرر الشيء نفسه للأقسام الثمانية كلها حتى messages_p7:
                                QUERY PLAN
---------------------------------------------------------------------------
 Aggregate
   ->  Append
         ->  Bitmap Heap Scan on messages_p0 messages_1
               Recheck Cond: ((tenant_id >= 40) AND (tenant_id <= 45))
               ->  Bitmap Index Scan on messages_p0_pkey
                     Index Cond: ((tenant_id >= 40) AND (tenant_id <= 45))
في المخرج أعلاه لاحظ التالي:
- كل مستأجر في قسم واحد بالضبط، ولكن التوزيع ليس متساوياً: من 108 مستأجرين في القسم p3 إلى 140 في p2، أي فرق قرابة 30% بين أصغر قسم وأكبرها، والسبب أن ألف قيمة فقط موزعة عشوائياً على ثمانية أقسام. ومع ملايين القيم يتقارب التوزيع، ومع مستأجرين قليلين يكون واضحاً، وإذا كان بعضهم أكبر من غيره فالفرق أكبر.
- البحث بالمساواة
tenant_id = 42استبعد سبعة أقسام وبحث في p2 فقط. - البحث بمدى من ستة مستأجرين متتالين بحث في الأقسام الثمانية كلها، لأن الهاش يفرق القيم المتجاورة عمداً، وهذا هو ثمن التوزيع المتساوي.
والتقسيم بالقائمة LIST يضع قيماً محددة في كل قسم، ويناسب عموداً قيمه معروفة وقليلة، مثل الدولة أو المنطقة أو باقة العميل، ومعه قسم افتراضي DEFAULT لما لا يوجد في القوائم. ولنر معه حالة يغفل عنها كثيرون: ماذا يحدث إذا عدلت قيمة عمود التقسيم نفسه؟
CREATE TABLE customers (
    id      int  NOT NULL,
    country text NOT NULL,
    name    text NOT NULL,
    PRIMARY KEY (country, id)
) PARTITION BY LIST (country);
CREATE TABLE customers_sa PARTITION OF customers FOR VALUES IN ('SA');
CREATE TABLE customers_gulf PARTITION OF customers FOR VALUES IN ('AE', 'KW', 'QA', 'BH', 'OM');
CREATE TABLE customers_other PARTITION OF customers DEFAULT;
INSERT INTO customers VALUES (1, 'SA', 'Sara'), (2, 'AE', 'Omar'), (3, 'EG', 'Mona');
SELECT tableoid::regclass AS partition, id, country, name FROM customers ORDER BY id;
UPDATE customers SET country = 'SA' WHERE id = 3;
SELECT tableoid::regclass AS partition, id, country, name FROM customers ORDER BY id;
partition | id | country | name
-----------------+----+---------+------
customers_sa | 1 | SA | Sara
customers_gulf | 2 | AE | Omar
customers_other | 3 | EG | Mona
(3 rows)
UPDATE 1
partition | id | country | name
----------------+----+---------+------
customers_sa | 1 | SA | Sara
customers_gulf | 2 | AE | Omar
customers_sa | 3 | SA | Mona
(3 rows)
انتقلت منى من القسم الافتراضي إلى قسم السعودية تلقائياً، وكما يذكر توثيق UPDATE فهذا الانتقال في الحقيقة حذف من قسم وإدخال في آخر، لذلك هو أغلى من تحديث عادي، ولا يمكن أن يكون تحديثاً سريعاً HOT، وقد يفشل إذا عدلت معاملة أخرى الصف نفسه في اللحظة نفسها. والقاعدة: اختر عمود تقسيم لا يتغير، أو يتغير نادراً.
الاستبعاد أثناء التنفيذ Runtime Pruning
في كل ما سبق كانت القيمة مكتوبة في الاستعلام، فاستبعد المخطط الأقسام قبل التنفيذ. ولكن التطبيقات الحقيقية لا تكتب القيم داخل SQL، وإنما ترسل استعلاماً مجهزاً Prepared Statement بمعامل، وأحياناً تأتي القيمة من جدول آخر في ربط Join. وهنا يستبعد PostgreSQL الأقسام أثناء التنفيذ، ولكن الخطة تبدو مختلفة، وإذا لم تعرف شكلها ظننت أن الاستبعاد لا يعمل. نجبر الاستعلام المجهز على الخطة العامة Generic Plan التي لا تعرف القيمة مسبقاً، وهي ما يستخدمه PostgreSQL بعد عدة تنفيذات لاستعلام مجهز:
PREPARE tenant_count(int) AS SELECT count(*) FROM messages WHERE tenant_id = $1;
SET plan_cache_mode = force_generic_plan;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF) EXECUTE tenant_count(42);
QUERY PLAN
---------------------------------------------------------------------------------------
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=2017
-> Append (actual rows=2000.00 loops=1)
Buffers: shared hit=2017
Subplans Removed: 7
-> Bitmap Heap Scan on messages_p2 messages_1 (actual rows=2000.00 loops=1)
Recheck Cond: (tenant_id = $1)
Heap Blocks: exact=2000
Buffers: shared hit=2017
-> Bitmap Index Scan on messages_p2_pkey (actual rows=2000.00 loops=1)
Index Cond: (tenant_id = $1)
Index Searches: 1
Buffers: shared hit=17
Planning:
Buffers: shared hit=312
(15 rows)السطر المهم Subplans Removed: 7، فالخطة كانت لثمانية أقسام، واستبعد PostgreSQL سبعة منها عند بدء التنفيذ بعد أن عرف قيمة المعامل، فلم تظهر في المخرج أصلاً. والحالة الثانية الربط، حيث لا تعرف القيمة إلا بعد قراءة الجدول الآخر:
CREATE TABLE tenants (id int PRIMARY KEY, name text NOT NULL);
INSERT INTO tenants SELECT g, 'tenant-' || g FROM generate_series(1, 1000) g;
ANALYZE tenants;
RESET plan_cache_mode;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT count(*) FROM tenants t JOIN messages m ON m.tenant_id = t.id WHERE t.name = 'tenant-42';
والمخرج طويل، وهذه بدايته، ثم قسم استبعد وقسم نفذ، وقد اختصرنا الباقي لأنه يتكرر:
                                         QUERY PLAN
---------------------------------------------------------------------------------------------
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=2023
   ->  Nested Loop (actual rows=2000.00 loops=1)
         Buffers: shared hit=2023
         ->  Seq Scan on tenants t (actual rows=1.00 loops=1)
               Filter: (name = 'tenant-42'::text)
               Rows Removed by Filter: 999
               Buffers: shared hit=6
         ->  Append (actual rows=2000.00 loops=1)
               Buffers: shared hit=2017
               ->  Bitmap Heap Scan on messages_p0 m_1 (never executed)
                     Recheck Cond: (tenant_id = t.id)
                     ->  Bitmap Index Scan on messages_p0_pkey (never executed)
                           Index Cond: (tenant_id = t.id)
                           Index Searches: 0
               ->  Bitmap Heap Scan on messages_p1 m_2 (never executed)
                     Recheck Cond: (tenant_id = t.id)
                     ->  Bitmap Index Scan on messages_p1_pkey (never executed)
                           Index Cond: (tenant_id = t.id)
                           Index Searches: 0
               ->  Bitmap Heap Scan on messages_p2 m_3 (actual rows=2000.00 loops=1)
                     Recheck Cond: (tenant_id = t.id)
                     Heap Blocks: exact=2000
                     Buffers: shared hit=2017
                     ->  Bitmap Index Scan on messages_p2_pkey (actual rows=2000.00 loops=1)
                           Index Cond: (tenant_id = t.id)
                           Index Searches: 1
                           Buffers: shared hit=17
الأقسام هنا موجودة في الخطة، ولكن بجانب سبعة منها (never executed)، أي أن PostgreSQL قرأ رقم المستأجر من جدول tenants، ثم لم يدخل إلا القسم الذي يحتوي عليه. وكلا الشكلين يعني أن الاستبعاد يعمل، كما يشرح قسم الاستبعاد في التوثيق. ويجدر الإشارة هنا إلى أن الأقسام المستبعدة عند بدء التنفيذ تقفل رغم ذلك، فإذا كان عندك آلاف الأقسام فهذا عمل إضافي مع كل استعلام، وهو من أسباب القاعدة في كم قسماً أكثر من اللازم.
إضافة قسم جاهز دون فحص تحت القفل
الطريقة الشائعة لتحميل بيانات شهر كامل أو أرشيف أن تجهزها في جدول عادي منفصل، وتبني فهارسه، ثم تجعله قسماً بالأمر ATTACH PARTITION، فلا يتأثر الجدول الأصلي بالتحميل. والمشكلة أن PostgreSQL يجب أن يتأكد أن كل صف في الجدول الجديد يقع في حدود القسم، فيقرأ الجدول كاملاً وهو يمسك قفلاً من نوع ACCESS EXCLUSIVE على الجدول المضاف، كما يذكر التوثيق. والحل أن تضيف قبل ذلك قيداً CHECK يطابق حدود القسم، فيعرف PostgreSQL أن الشرط مضمون ولا يفحص:
CREATE TABLE readings (sensor_id int NOT NULL, at timestamptz NOT NULL, value real NOT NULL) PARTITION BY RANGE (at);
CREATE TABLE readings_2026_08 PARTITION OF readings FOR VALUES FROM ('2026-08-01') TO ('2026-09-01');
CREATE TABLE readings_2026_09 (LIKE readings);
INSERT INTO readings_2026_09
SELECT g % 500, timestamptz '2026-09-01' + (g % 2592000) * interval '1 second', random()
FROM generate_series(1, 5000000) g;
\timing on
ALTER TABLE readings ATTACH PARTITION readings_2026_09 FOR VALUES FROM ('2026-09-01') TO ('2026-10-01');
ALTER TABLE readings DETACH PARTITION readings_2026_09;
ALTER TABLE readings_2026_09 ADD CONSTRAINT in_september
  CHECK (at >= '2026-09-01' AND at < '2026-10-01') NOT VALID;
ALTER TABLE readings_2026_09 VALIDATE CONSTRAINT in_september;
ALTER TABLE readings ATTACH PARTITION readings_2026_09 FOR VALUES FROM ('2026-09-01') TO ('2026-10-01');
\timing off
ALTER TABLE readings_2026_09 DROP CONSTRAINT in_september;
Timing is on.
ALTER TABLE
Time: 1122.296 ms (00:01.122)
ALTER TABLE
Time: 1.679 ms
ALTER TABLE
Time: 1.718 ms
ALTER TABLE
Time: 540.428 ms
ALTER TABLE
Time: 2.133 ms
Timing is off.في المخرج أعلاه لاحظ التالي:
- الإضافة الأولى دون قيد أخذت 1.1 ثانية لخمسة ملايين صف، وكلها تحت قفل ACCESS EXCLUSIVE، وعلى جدول من مئات الملايين تصبح دقائق.
- القيد أضيف بالخيار
NOT VALIDفي ملي ثانيتين لأنه لا يفحص الصفوف الموجودة، ثمVALIDATE CONSTRAINTفحصها في نصف ثانية، ولكن بقفل أضعف هو SHARE UPDATE EXCLUSIVE الذي لا يمنع القراءة ولا الكتابة، كما في توثيق ALTER TABLE. - الإضافة الثانية أخذت ملي ثانيتين لأن PostgreSQL وجد القيد المطابق، ثم حذفنا القيد لأنه لم يعد له فائدة، فالقسم نفسه يضمن الشرط الآن.
وهذه الطريقة، أي القيد بالخيار NOT VALID ثم التحقق منه بقفل ضعيف، تفيدك أيضاً عند إضافة أي قيد إلى جدول كبير يعمل في الإنتاج، وقد شرحنا لماذا يهم نوع القفل في مقال الأقفال.
التوزيع على عدة سيرفرات: الأجزاء المنطقية وجدول التوجيه
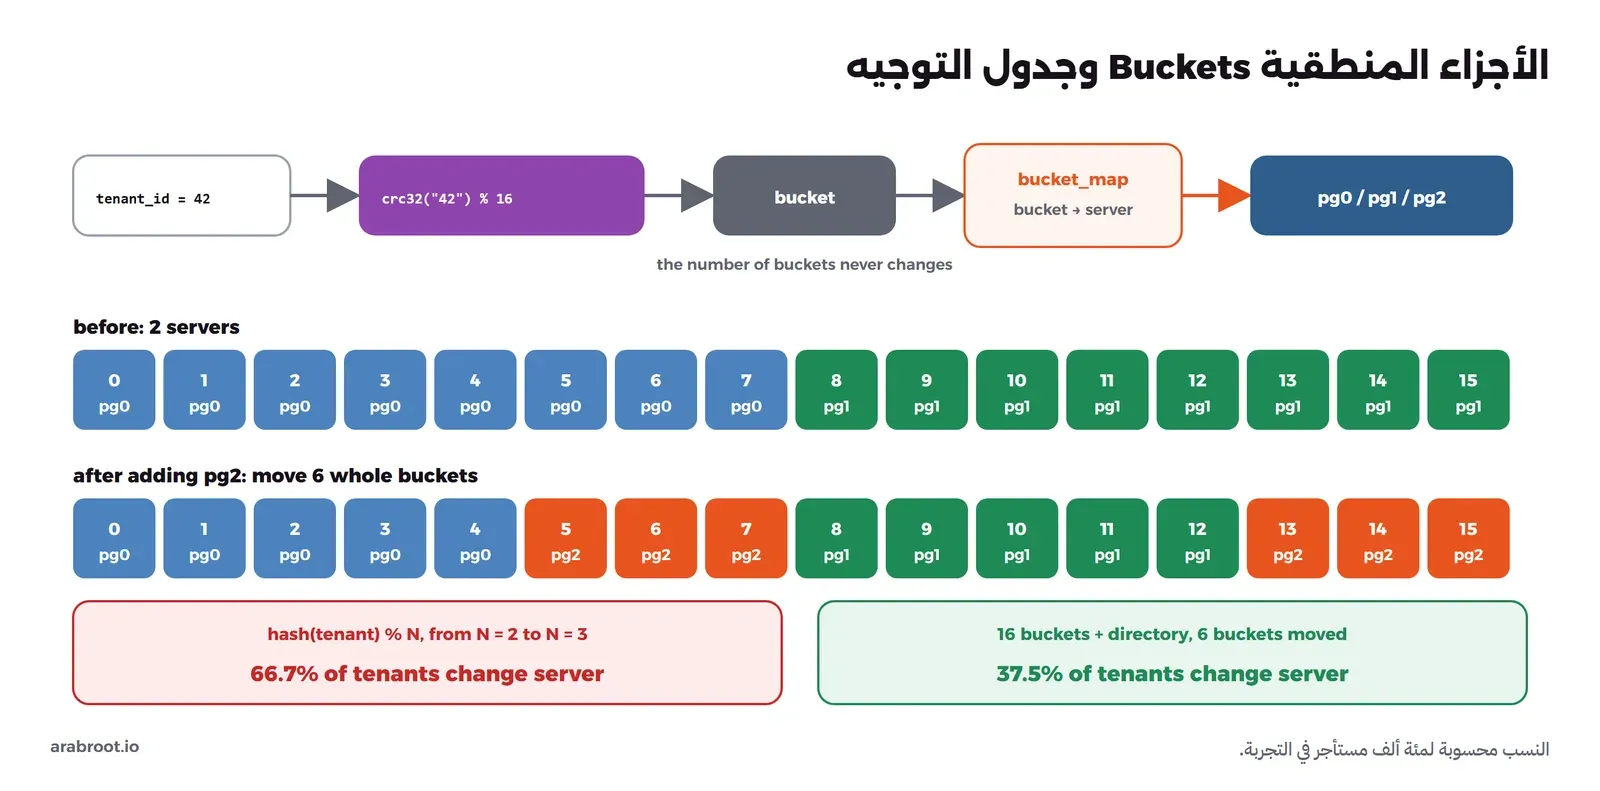
الآن ننتقل إلى السيرفرات الثلاثة. السؤال الأول في أي توزيع: كيف يعرف التطبيق أين يعيش المستأجر رقم 42؟ والحل البسيط هو باقي القسمة hash(tenant) % N حيث N عدد السيرفرات، وهو لا يحتاج أي جدول، ولكنه ينهار في اللحظة التي تضيف فيها سيرفراً، لأن N تتغير فيتغير مكان أغلب المستأجرين. والحل الذي تستخدمه أغلب الأنظمة الكبيرة طبقتان: يقسم المفتاح إلى عدد ثابت من الأجزاء المنطقية Logical Shards أو Buckets أكبر بكثير من عدد السيرفرات، مثل 16 أو 1024، ولا يتغير هذا العدد أبداً، ثم جدول توجيه Directory صغير يقول أي جزء منطقي على أي سيرفر. وعند إضافة سيرفر تنقل أجزاء منطقية كاملة إليه وتغير سطورها في جدول التوجيه، والصورة التالية تبين الفكرة:
وقد كتبنا التطبيق كاملاً في ملف Python واحد shard.py، وأهم ما فيه الدوال التالية:
BUCKETS = 16

def bucket_of(tenant_id: int) -> int:
    # a stable hash: the same tenant always gets the same bucket, in every process and language
    return zlib.crc32(str(tenant_id).encode()) % BUCKETS

def shard_of(tenant_id, buckets, overrides):
    return overrides.get(tenant_id) or buckets[bucket_of(tenant_id)]
في الكود أعلاه لاحظ التالي:
- استخدمنا
crc32وليس الدالةhash()المدمجة في Python، والسبب أنhash()للنصوص تتغير بين تشغيل وآخر لأسباب أمنية كما في توثيق Python، فلو استخدمتها لذهب المستأجر إلى سيرفر مختلف بعد إعادة تشغيل التطبيق. ودالة الهاش في التوزيع يجب أن تكون ثابتة ومتطابقة في كل لغة وكل خدمة تقرأ البيانات. - جدول التوجيه
bucket_mapوجدول الاستثناءاتtenant_overrideمحفوظان في pg0، وفي نظام حقيقي يحفظان في مكان موثوق وتقرؤهما كل نسخة من التطبيق وتحفظهما في ذاكرتها مع تحديث دوري. - كل صف يحفظ معه رقم جزئه المنطقي
bucketمع فهرس عليه، حتى يمكن نقل جزء كامل بأمر واحد.
والآن ننشئ الجداول على السيرفرات الثلاثة، ونضع الأجزاء 0 إلى 7 على pg0 و8 إلى 15 على pg1، ثم ندخل 300 ألف حدث من 500 مستأجر، منهم مستأجر ضخم رقم 7 يكتب 40% من كل الأحداث، كما يحدث في أي SaaS فيه عميل كبير:
docker exec lab-shard-app python shard.py setup
docker exec lab-shard-app python shard.py load
docker exec lab-shard-app python shard.py stats
### python shard.py setup
16 buckets: 0-7 on pg0, 8-15 on pg1
### python shard.py load
pg0: 216,364 events in 10.0 s
pg1: 83,636 events in 3.5 s
### python shard.py stats
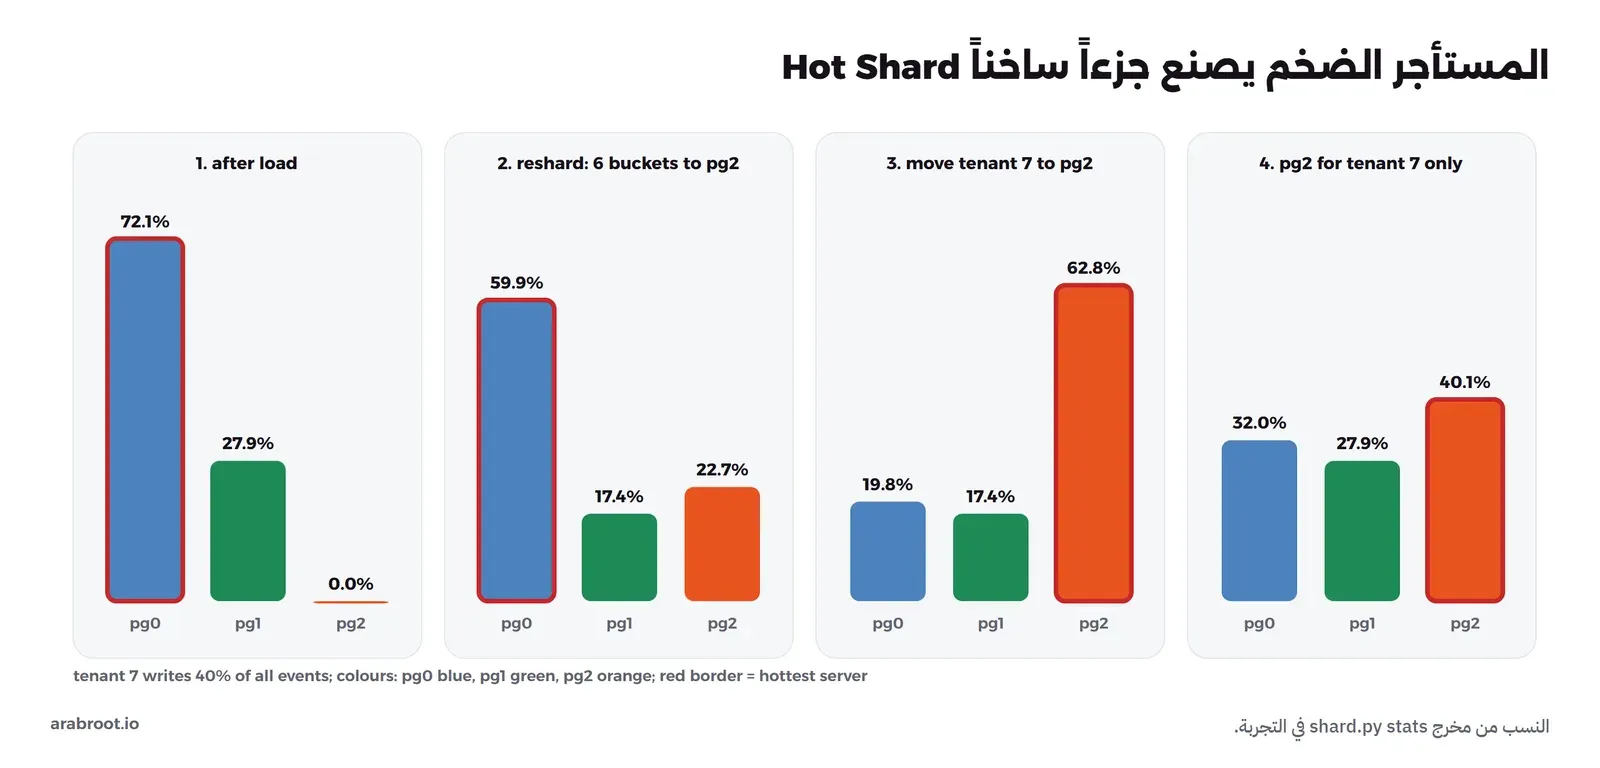
pg0: 216,364 events (72.1%), 268 tenants, buckets [0, 1, 2, 3, 4, 5, 6, 7]
pg1: 83,636 events (27.9%), 232 tenants, buckets [8, 9, 10, 11, 12, 13, 14, 15]
pg2: 0 events ( 0.0%), 0 tenants, buckets []
tenant overrides: none
read requests per shard: {'pg0': 14571, 'pg1': 5429, 'pg2': 0}pg0 عليه 72% من الأحداث و73% من طلبات القراءة، مع أن الأجزاء موزعة بالتساوي ثمانية وثمانية، والسبب أن المستأجر 7 في الجزء 2 على pg0. وهذا هو الجزء الساخن Hot Shard، وسوف نعود إليه بعد أن نضيف السيرفر الثالث.
كم بيانات تنتقل عند إضافة سيرفر؟
قبل أن ننقل شيئاً، نحسب لمئة ألف مستأجر كم منهم سوف يغير سيرفره عند الانتقال من سيرفرين إلى ثلاثة بالطريقتين:
docker exec lab-shard-app python shard.py moves### python shard.py moves
hash % N, 2 -> 3 servers : 66,679 of 100,000 tenants move (66.7%)
16 buckets, move 6 to pg2: 37,500 of 100,000 tenants move (37.5%)مع باقي القسمة ينتقل ثلثا المستأجرين، أي أغلب البيانات تتحرك بين السيرفرات في الوقت الذي أضفت فيه السيرفر لأن الحمل زاد أصلاً. ومع الأجزاء المنطقية ينتقل 37.5%، وهو تقريباً الحد الأدنى الممكن، فالسيرفر الجديد يجب أن يأخذ ثلث البيانات حتى يتساوى الحمل، والفرق الصغير عن الثلث لأن 16 لا تقسم على 3، وكلما زاد عدد الأجزاء المنطقية اقتربت من الثلث. والهاش المتسق الذي شرحناه في مقال الأنظمة الموزعة يصل إلى النتيجة نفسها بطريقة أخرى، والأجزاء المنطقية مع جدول التوجيه أبسط في التشغيل لأنك ترى بعينك أي جزء على أي سيرفر وتنقله متى شئت.
إعادة التوزيع Resharding: نقل الأجزاء إلى السيرفر الجديد
نقل جزء منطقي في التجربة ثلاث خطوات: نسخ صفوفه من السيرفر القديم إلى الجديد بالأمر COPY، ثم تغيير سطره في جدول التوجيه، ثم حذف النسخة القديمة:
def move_bucket(b, src, dst):
    t0 = time.time()
    with conn(src) as s, conn(dst) as d, s.cursor() as sc, d.cursor() as dc:
        with sc.copy('COPY (SELECT tenant_id, bucket, id, created_at, kind, payload FROM events WHERE bucket = %s) TO STDOUT', (b,)) as out, \
             dc.copy('COPY events (tenant_id, bucket, id, created_at, kind, payload) FROM STDIN') as inp:
            for chunk in out:
                inp.write(chunk)
        with conn('pg0') as c:
            c.execute('UPDATE bucket_map SET shard = %s WHERE bucket = %s', (dst, b))   # switch the route
        n = s.execute('DELETE FROM events WHERE bucket = %s', (b,)).rowcount           # then clean the old copy
    print(f'bucket {b:>2}: {src} -> {dst}, {n:,} events, {time.time() - t0:.1f} s')
docker exec lab-shard-app python shard.py reshard
docker exec lab-shard-app python shard.py stats### python shard.py reshard
bucket 5: pg0 -> pg2, 11,933 events, 0.8 s
bucket 6: pg0 -> pg2, 12,071 events, 0.7 s
bucket 7: pg0 -> pg2, 12,529 events, 0.7 s
bucket 13: pg1 -> pg2, 10,694 events, 0.6 s
bucket 14: pg1 -> pg2, 10,854 events, 0.5 s
bucket 15: pg1 -> pg2, 10,021 events, 0.5 s
### python shard.py stats
pg0: 179,831 events (59.9%), 166 tenants, buckets [0, 1, 2, 3, 4]
pg1: 52,067 events (17.4%), 144 tenants, buckets [8, 9, 10, 11, 12]
pg2: 68,102 events (22.7%), 190 tenants, buckets [5, 6, 7, 13, 14, 15]
tenant overrides: none
read requests per shard: {'pg0': 12036, 'pg1': 3372, 'pg2': 4592}نقلنا ستة أجزاء في قرابة أربع ثوان، وأصبح لكل سيرفر جزء من البيانات، ولكن انتبه إلى أمرين قبل أن تطبق هذا في الإنتاج:
- الطريقة في التجربة تصلح فقط إذا أوقفت الكتابة على الجزء أثناء النقل، فأي حدث يكتب بين COPY وتغيير التوجيه يذهب إلى السيرفر القديم ثم يحذف معه. والنقل دون توقف يحتاج نسخاً مستمراً للتغييرات أثناء النقل، مثل النسخ المنطقي Logical Replication لصفوف الجزء، ثم توقفاً قصيراً جداً لتبديل التوجيه، وهذا ما تفعله Citus عند نقل الأجزاء دون إيقاف الكتابة كما في توثيق دوالها.
- المعرفات Primary Keys يجب ألا تتكرر بين السيرفرات، لأن الصف ينتقل بمعرفه، والرقم التسلسلي من كل سيرفر لا يكفي، وقد شرحنا الخيارات في مقال المعرفات الفريدة.
الجزء الساخن والمستأجر الضخم
بعد إعادة التوزيع ما زال pg0 عليه 60% من الأحداث، والسبب لم يتغير: المستأجر 7 وحده 40% من كل شيء، ولا يمكن لأي توزيع على رقم المستأجر أن يقسم مستأجراً واحداً على سيرفرين. والحل الأول الذي يخطر بالبال أن ننقل المستأجر الضخم إلى سيرفر آخر بسطر في جدول الاستثناءات:
docker exec lab-shard-app python shard.py hot
docker exec lab-shard-app python shard.py stats
### python shard.py hot
tenant 7 is in bucket 2 on pg0
moved tenant 7: 120,370 events pg0 -> pg2 in 4.9 s
### python shard.py stats
pg0: 59,461 events (19.8%), 165 tenants, buckets [0, 1, 2, 3, 4]
pg1: 52,067 events (17.4%), 144 tenants, buckets [8, 9, 10, 11, 12]
pg2: 188,472 events (62.8%), 191 tenants, buckets [5, 6, 7, 13, 14, 15]
tenant overrides: {7: 'pg2'}
read requests per shard: {'pg0': 3925, 'pg1': 3372, 'pg2': 12703}والنتيجة أن المشكلة انتقلت ولم تحل: pg2 أصبح الساخن بنسبة 63%، لأنه يحمل المستأجر الضخم وستة أجزاء أخرى. والحل الصحيح أن يكون للمستأجر الضخم سيرفر لا يشاركه فيه أحد، فنعيد الأجزاء الستة من pg2 إلى السيرفرين الآخرين:
docker exec lab-shard-app python shard.py dedicate
docker exec lab-shard-app python shard.py stats
### python shard.py dedicate
bucket 5: pg2 -> pg0, 11,933 events, 0.6 s
bucket 6: pg2 -> pg0, 12,071 events, 0.5 s
bucket 7: pg2 -> pg0, 12,529 events, 0.6 s
bucket 13: pg2 -> pg1, 10,694 events, 0.5 s
bucket 14: pg2 -> pg1, 10,854 events, 0.5 s
bucket 15: pg2 -> pg1, 10,021 events, 0.5 s
### python shard.py stats
pg0: 95,994 events (32.0%), 267 tenants, buckets [0, 1, 2, 3, 4, 5, 6, 7]
pg1: 83,636 events (27.9%), 232 tenants, buckets [8, 9, 10, 11, 12, 13, 14, 15]
pg2: 120,370 events (40.1%), 1 tenants, buckets []
tenant overrides: {7: 'pg2'}
read requests per shard: {'pg0': 6460, 'pg1': 5429, 'pg2': 8111}الآن pg2 عليه مستأجر واحد فقط بنسبة 40%، وpg0 وpg1 يتقاسمان الباقي. وما زال pg2 أكبر سيرفر، وهذا طبيعي، فلا يوجد توزيع يجعل مستأجراً واحداً أصغر من نفسه، ولكن الآن تستطيع أن تعطيه سيرفراً أكبر، أو أن تقسم بياناته داخله حسب الوقت، دون أن يتأثر بقية العملاء به، وهذا ما يسمى أحياناً العزل للعملاء الكبار في نموذج Bridge الذي شرحناه في تعدد المستأجرين. وإذا كان المستأجر الضخم نفسه أكبر من أي سيرفر، فلا مفر من أن توزع بياناته هو بمفتاح آخر داخله، مثل رقم المشروع أو المستخدم، مع كل ما يعنيه ذلك من استعلامات على أكثر من سيرفر. والصورة التالية تجمع المراحل الأربع:
الاستعلام الذي يسأل كل السيرفرات
التوزيع حسب المستأجر يجعل كل استعلامات المستأجر الواحد على سيرفر واحد، وهذا هو سبب اختياره، ولكن أي تقرير عن كل المستأجرين يجب أن يسأل كل السيرفرات ثم يجمع النتائج في التطبيق، وهذا ما يسمى Scatter-Gather:
def scatter():
    buckets, overrides = directory()
    t0 = time.time()
    with conn(shard_of(42, buckets, overrides)) as c:
        one = c.execute('SELECT kind, count(*) FROM events WHERE tenant_id = 42 GROUP BY kind ORDER BY kind').fetchall()
    t1 = time.time()
    merged = {}
    for name in DSN:                                   # scatter: ask every shard
        with conn(name) as c:
            for kind, n in c.execute('SELECT kind, count(*) FROM events GROUP BY kind').fetchall():
                merged[kind] = merged.get(kind, 0) + n   # gather: merge in the application
    t2 = time.time()
    print(f'one tenant (1 shard): {dict(one)} in {1000 * (t1 - t0):.0f} ms')
    print(f'all tenants (3 shards): {dict(sorted(merged.items()))} in {1000 * (t2 - t1):.0f} ms')
### python shard.py scatter
one tenant (1 shard): {'login': 98, 'order': 87, 'payment': 84, 'search': 95} in 13 ms
all tenants (3 shards): {'login': 75542, 'order': 74902, 'payment': 74521, 'search': 75035} in 100 msاستعلام المستأجر الواحد 13 ملي ثانية من سيرفر واحد، والتقرير الشامل 100 ملي ثانية من ثلاثة سيرفرات بالتتابع، ولاحظ أن العد سهل الجمع، أما المتوسط فلا تجمعه كمتوسط للمتوسطات وإنما تجمع المجموع والعدد من كل سيرفر، والترتيب مع LIMIT يحتاج أن تطلب من كل سيرفر أفضل N نتيجة ثم ترتبها كلها، والربط بين جدولين على سيرفرين مختلفين لا تفعله قاعدة البيانات لك. لذلك فالتقارير الشاملة في الأنظمة الموزعة تذهب غالباً إلى مخزن تحليلي منفصل تنقل إليه البيانات من كل الأجزاء، كما ذكرنا في مقال الجداول الضخمة.
هل تكتب التوزيع بنفسك؟
ما كتبناه في التجربة هو التوزيع في التطبيق Application-Level Sharding، وهو مفيد لتفهم ما يحدث، ويعمل في الواقع عندما يكون عدد السيرفرات قليلاً وعمليات النقل نادرة. وقبل أن تكتب نسختك، فكر في البدائل التي تقوم بالتوجيه والنقل والاستعلام على كل الأجزاء نيابة عنك:
- الإضافة Citus تجعل PostgreSQL نفسه يوزع الجداول على سيرفرات عاملة حسب عمود تختاره، وتنفذ الاستعلام الشامل على كل الأجزاء وتنقل الأجزاء بين السيرفرات، وقد ذكرنا رخصتها وحدودها في مقال الجداول الضخمة.
- القسم الذي يعيش على سيرفر آخر: يمكن أن يكون قسم الجدول المقسم جدولاً خارجياً Foreign Table عبر postgres_fdw، فيوجه PostgreSQL الاستعلام إلى السيرفر الصحيح بالاستبعاد نفسه الذي رأيناه، ولكن المعاملات والأداء بين السيرفرات لها حدود يجب أن تختبرها قبل أن تعتمد عليها.
- قواعد SQL الموزعة Distributed SQL التي تقوم بالتقسيم والنقل تلقائياً، وقد ذكرناها في عناقيد قواعد البيانات.
أخطاء شائعة
- تقسيم جدول صغير على أمل أن يصبح أسرع، والفهرس الصحيح كان يكفي.
- عمود تقسيم لا يظهر في أغلب الاستعلامات، فكل استعلام يمر على كل الأقسام.
- عمود تقسيم يتغير كثيراً، فكل تغيير يصبح حذفاً وإدخالاً بين قسمين.
- التقسيم بالهاش ثم الاستغراب من أن استعلامات المدى تقرأ كل الأقسام.
- إضافة قسم كبير بالأمر ATTACH دون قيد CHECK مطابق، فيفحص الجدول كله تحت قفل قوي.
- التوزيع بباقي القسمة على عدد السيرفرات، ثم اكتشاف أن إضافة سيرفر واحد تنقل ثلثي البيانات.
- استخدام دالة هاش تختلف بين اللغات أو بين تشغيل وآخر.
- تجاهل المستأجر الضخم حتى يصبح سيرفره هو حد النظام كله.
- التوزيع قبل استنفاد السيرفر الواحد، فتدفع ثمن التعقيد سنوات قبل أن تحتاجه.
حذف المختبر
docker compose -p lab-shard down -vالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التقسيم يبقى على سيرفر واحد ويفيد الحذف والصيانة أكثر من السرعة، والتوزيع على عدة سيرفرات قرار معماري لا تتخذه قبل أن تستنفد السيرفر الواحد.
- التقسيم بالهاش يوزع القيم بالتساوي تقريباً ويستبعد الأقسام في البحث بالمساواة فقط، والتقسيم بالقائمة يناسب قيماً معروفة وقليلة، وتغيير عمود التقسيم ينقل الصف بين الأقسام.
- الاستبعاد يعمل أيضاً مع الاستعلامات المجهزة والربط، وتراه في EXPLAIN كسطر Subplans Removed أو كأقسام never executed.
- قيد CHECK مطابق قبل ATTACH PARTITION حول فحص 1.1 ثانية تحت قفل قوي إلى ملي ثانيتين.
- الأجزاء المنطقية مع جدول التوجيه نقلت 37.5% من المستأجرين عند إضافة سيرفر، مقابل 66.7% مع باقي القسمة.
- المستأجر الضخم يصنع جزءاً ساخناً لا يحله أي توزيع على رقم المستأجر، والحل سيرفر خاص به أو مفتاح توزيع آخر داخله.
- الاستعلام على كل المستأجرين يسأل كل السيرفرات ويجمع في التطبيق، وهذا ثمن دائم للتوزيع.
 دليلأنواع قواعد البيانات ومتى تختار كل نوعالفرق بين قواعد البيانات العلائقية والمستندات والمفتاح والقيمة وغيرها، وأي الأسئلة تجيب عنها كل عائلة بسهولة.
 دليلالفهارس Indexes: لماذا تسرع الاستعلام وكيف تقرأ EXPLAINكيف يبحث PostgreSQL داخل الفهرس، ومتى يتجاهله، وكم يكلفك كل فهرس عند الكتابة، وكيف تقرأ خطة EXPLAIN سطراً سطراً.
 دليلكيف تخزن قاعدة البيانات بياناتك من الداخلماذا يحدث على القرص عند INSERT وUPDATE وCOMMIT، ولماذا تنجو قاعدة البيانات من الانهيار، وكيف تختلف LSM عن B-tree.
 دليلالأقفال Locks والجمود Deadlock في قواعد البياناتلماذا يوقف أمر ALTER TABLE صغير كل الاستعلامات خلفه، وكيف تقرأ pg_locks وتتجنب الجمود وظواهر العزل في PostgreSQL.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب على Docker Engine 29.8.0 مع PostgreSQL 18.6 وPython 3.13.16 وpsycopg 3.3.6.


