

عندما يبطئ التطبيق، أول ما يفعله كثير من الفرق هو البحث عن «أفضل إعدادات PostgreSQL للأداء»، ثم نسخ ملف من مدونة أو من أداة مثل PGTune، وإعادة تشغيل القاعدة، والأمل في أن تختفي المشكلة. وأحياناً تتحسن الأمور فعلاً، وأحياناً لا يتغير شيء، وأحياناً تتوقف القاعدة في منتصف الليل لأن نظام التشغيل قتلها بعد أن نفدت الذاكرة. والسبب أن الإعدادات ليست وصفة واحدة، وإنما أرقام تعتمد على ذاكرة السيرفر، وعدد الاتصالات، ونوع العمل، والقرص. وفي مقال PostgreSQL للجداول الضخمة ذكرنا قيم البداية باختصار، وفي هذا المقال سوف نقيسها: نفس الحمل قبل الضبط وبعده بأرقام حقيقية، ثم نكسر كل إعداد عمداً لنرى أثره.
وسوف نناقش في هذا المقال ما يلي:
- من أين تبدأ: هل المشكلة في الإعدادات أصلاً؟
- الذاكرة:
shared_buffersوeffective_cache_sizeوwork_memوmaintenance_work_mem، ولماذا يتضاعف بعضها مع الاتصالات. - WAL ونقاط التفتيش Checkpoints و
wal_compression. - ال autovacuum: متى يعمل، ولماذا ينتظر طويلاً في الجداول الكبيرة، وكيف تضبطه لكل جدول.
random_page_costعلى أقراص SSD، والتجربة التي جعلت الاستعلام أبطأ بثلاث مرات.- مختبر pgbench قبل الضبط وبعده، ومثال حقيقي لاستعلام يكتب على القرص لأن
work_memصغير. - أدوات الحساب مثل PGTune وحدودها، والأخطاء الشائعة، وقائمة تحقق.
أما الاتصالات و PgBouncer وأوضاعه فقد شرحناها كاملة في مقال تجميع الاتصالات Connection Pooling، ولن نكررها هنا إلا حيث تؤثر في حساب الذاكرة.
من أين تبدأ؟
قبل أي إعداد اسأل: ما الذي يأخذ الوقت فعلاً؟ والإجابة تأتي من الإضافة pg_stat_statements التي تجمع لكل استعلام عدد مرات تنفيذه، ومتوسط وقته، وكم صفحة قرأ من الذاكرة ومن القرص، وكم كتب في ملفات مؤقتة. وقد شرحنا تفعيلها وقراءتها في مقال الجداول الضخمة، وقراءة خطة التنفيذ بالأمر EXPLAIN في مقال الفهارس وقراءة EXPLAIN. وهذا ما ظهر في المختبر بعد دقيقتين من الحمل بالإعدادات الافتراضية:
                            query                             |  calls  | mean_ms | shared_blks_hit | shared_blks_read | temp_blks_written
--------------------------------------------------------------+---------+---------+-----------------+------------------+-------------------
 SELECT abalance FROM pgbench_accounts WHERE aid = $1         | 1186454 |    0.20 |         2917385 |          1880857 |                 0
 UPDATE pgbench_branches SET bbalance = bbalance + $1 WHERE b |   64222 |    1.94 |          289045 |                1 |                 0
 UPDATE pgbench_accounts SET abalance = abalance + $1 WHERE a |   64222 |    0.28 |          485578 |           106610 |                 0
 UPDATE pgbench_tellers SET tbalance = tbalance + $1 WHERE ti |   64222 |    0.26 |          324562 |               26 |                 0
 INSERT INTO pgbench_history (tid, bid, aid, delta, mtime) VA |   64222 |    0.02 |           65370 |                5 |                 0
وهنا معلومتان مختلفتان تماماً: الاستعلام الأول قرأ 1.88 مليون صفحة من خارج shared_buffers، وهذه مشكلة ذاكرة يحلها الضبط، أما تحديث pgbench_branches فمتوسطه 1.94 مللي ثانية مقابل 0.28 لتحديث الحسابات رغم أنه يقرأ من الذاكرة كلياً، والسبب أن الجدول فيه 100 صف فقط يتنافس عليها 16 اتصالاً، فالوقت انتظار للأقفال Locks، ولا يوجد إعداد ذاكرة يحل ذلك، وإنما تصميم الكتابة كما في مقال الأقفال والجمود. وتذكر القاعدة: الضبط يحسن ما يحدث داخل السيرفر الواحد، ولكنه لن يعوض فهرساً ناقصاً أو استعلاماً يقرأ الجدول كله، وهذه عادة تعطي أضعاف ما يعطيه أي إعداد، وإذا كان نفس الاستعلام يتكرر آلاف المرات بنفس النتيجة فالحل قد يكون ألا يصل إلى القاعدة أصلاً، كما في مقال التخزين المؤقت Caching.
المختبر: نفس الحمل قبل الضبط وبعده
شغلنا PostgreSQL 18.6 في Container محدود بأربع أنوية و4 جيجابايت ذاكرة، كأنه سيرفر صغير مخصص للقاعدة، مع قاعدة pgbench بمعامل 100 حجمها 1.5 جيجابايت، أي أكبر من الإعداد الافتراضي shared_buffers = 128MB بكثير وأصغر من الذاكرة الكلية. والإعدادات في ملفات منفصلة في مجلد conf.d يقرؤها PostgreSQL بعد ملفه الرئيسي، فتراجعها في Git بدل أن تضيع في ALTER SYSTEM:
# One PostgreSQL limited to 4 CPUs and 4 GB, first with the defaults, then with conf/10-tuned.conf included.
name: lab-tuning
services:
  db:
    image: postgres:18.6
    container_name: lab-tuning-db
    environment:
      POSTGRES_PASSWORD: lab-only-password
    volumes:
      - lab-tuning-data:/var/lib/postgresql
      - ./conf.d:/etc/postgresql/conf.d:ro
      - ./initdb:/docker-entrypoint-initdb.d:ro
    shm_size: 1g
    stop_grace_period: 2m   # a checkpoint at shutdown with a large shared_buffers can take more than the 10s default
    cpus: 4
    mem_limit: 4g
    ports:
      - "127.0.0.1:55433:5432"
volumes:
  lab-tuning-data:
    name: lab-tuning-data
والسكربت يشغل نفس الحمل من Container منفصل: تسخين 30 ثانية، ثم دقيقتان من القراءة والكتابة على طريقة TPC-B، ثم دقيقتان من القراءة فقط، مع 16 اتصالاً، ويجمع بعد كل مرحلة عدد نقاط التفتيش وحجم WAL ونسبة القراءة من الذاكرة:
#!/bin/sh
# Same load before and after tuning: 16 clients, read-write (TPC-B like) then read-only, from a separate container.
# usage: sh bench.sh <label>
set -eu
NET=lab-tuning_default
q() { docker exec -u postgres lab-tuning-db psql -XAt -c "$1"; }
run() { docker run --rm --network $NET --cpus 2 -e PGPASSWORD=lab-only-password postgres:18.6 \
          pgbench -h db -U postgres -c 16 -j 4 -T 120 -n "$@" postgres 2>&1 | grep -E "^(tps|latency average)"; }
# warm-up so both runs start with the same cache state
docker run --rm --network $NET --cpus 2 -e PGPASSWORD=lab-only-password postgres:18.6 pgbench -h db -U postgres -c 16 -j 4 -T 30 -n -S postgres >/dev/null 2>&1
q "SELECT pg_stat_reset_shared('checkpointer'); SELECT pg_stat_reset_shared('wal'); SELECT pg_stat_reset(); SELECT pg_stat_statements_reset();" >/dev/null
echo "== $1 read-write"; run
q "SELECT 'checkpoints timed=' || num_timed || ' requested=' || num_requested || ' buffers_written=' || buffers_written FROM pg_stat_checkpointer"
q "SELECT 'wal=' || pg_size_pretty(wal_bytes) || ' full_page_images=' || wal_fpi FROM pg_stat_wal"
q "SELECT 'cache_hit=' || round(100.0*blks_hit/(blks_hit+blks_read),2) || '% blks_read=' || blks_read FROM pg_stat_database WHERE datname='postgres'"
q "SELECT pg_stat_reset();" >/dev/null
echo "== $1 read-only"; run -S
q "SELECT 'cache_hit=' || round(100.0*blks_hit/(blks_hit+blks_read),2) || '% blks_read=' || blks_read FROM pg_stat_database WHERE datname='postgres'"
وملف الضبط الذي أضفناه في المرحلة الثانية:
# starting values for a dedicated 4 vCPU / 4 GB database server with SSD, about 100 connections through a pool
shared_buffers = 1GB                    # ~25% of RAM
effective_cache_size = 3GB              # ~75% of RAM: a hint for the planner, allocates nothing
work_mem = 16MB                         # per sort/hash node, per connection
maintenance_work_mem = 256MB            # VACUUM, CREATE INDEX
max_wal_size = 4GB                      # fewer forced checkpoints under heavy writes
checkpoint_timeout = 15min
checkpoint_completion_target = 0.9     # the default since PostgreSQL 14
wal_compression = zstd
random_page_cost = 1.1                  # SSD: random reads cost about the same as sequential
effective_io_concurrency = 200
autovacuum_vacuum_scale_factor = 0.05   # vacuum after 5% dead rows instead of 20%
autovacuum_analyze_scale_factor = 0.02
والنتائج كما يلي، وكل رقم من تشغيل حقيقي:
| التشغيل | قراءة وكتابة tps | زمن الاستجابة | قراءة فقط tps | نقاط تفتيش بسبب WAL | حجم WAL | القراءة من الذاكرة (كتابة / قراءة) |
|---|---|---|---|---|---|---|
| الافتراضي، المرة الأولى | 535 | 29.9 ms | 9364 | 1 | 618 MB | 93.1% / 58.3% |
| الافتراضي، المرة الثانية | 486 | 32.9 ms | 5016 | 1 | 421 MB | 91.6% / 58.3% |
| بعد الضبط، المرة الأولى | 892 | 17.9 ms | 10296 | 0 | 121 MB | 98.3% / 90.5% |
| بعد الضبط، المرة الثانية | 1031 | 15.5 ms | 11028 | 0 | 121 MB | 97.6% / 90.5% |
بعد الضبط دون wal_compression | 1389 | 11.5 ms | 12460 | 0 | 550 MB | 98.0% / 90.5% |
في النتائج أعلاه لاحظ التالي:
- أكبر فرق جاء من
shared_buffers: نسبة القراءة من الذاكرة في القراءة فقط ارتفعت من 58% إلى 90%، لأن الجدول 1.5 جيجابايت لا يدخل في 128 ميجابايت، فكانت كل قراءة تقريباً تمر بذاكرة نظام التشغيل أو القرص. - عدد نقاط التفتيش التي طلبها امتلاء WAL انخفض من واحدة في كل دقيقتين إلى صفر، وفي السجل كانت النقطة بالإعداد الافتراضي تبدأ بالسبب
walوليسtime. - الإعداد
wal_compression = zstdخفض حجم WAL من 550 إلى 121 ميجابايت لنفس الحمل، ولكن التشغيل دونه كان أسرع على جهازنا، والسبب المرجح أن المعالج كان مشغولاً والضغط يأخذ من وقته، لذلك هو مفيد عندما يكون القرص أو الشبكة إلى النسخ المتماثلة Replicas أو الأرشيف هو الحد، وليس المعالج، وقرر بعد أن تقيس على سيرفرك.
والآن سوف نأخذ كل إعداد على حدة، ما الذي يفعله، وكيف تختار قيمته، وما الذي ينكسر إذا أخطأت.
الذاكرة: ما المشترك وما الذي يتضاعف
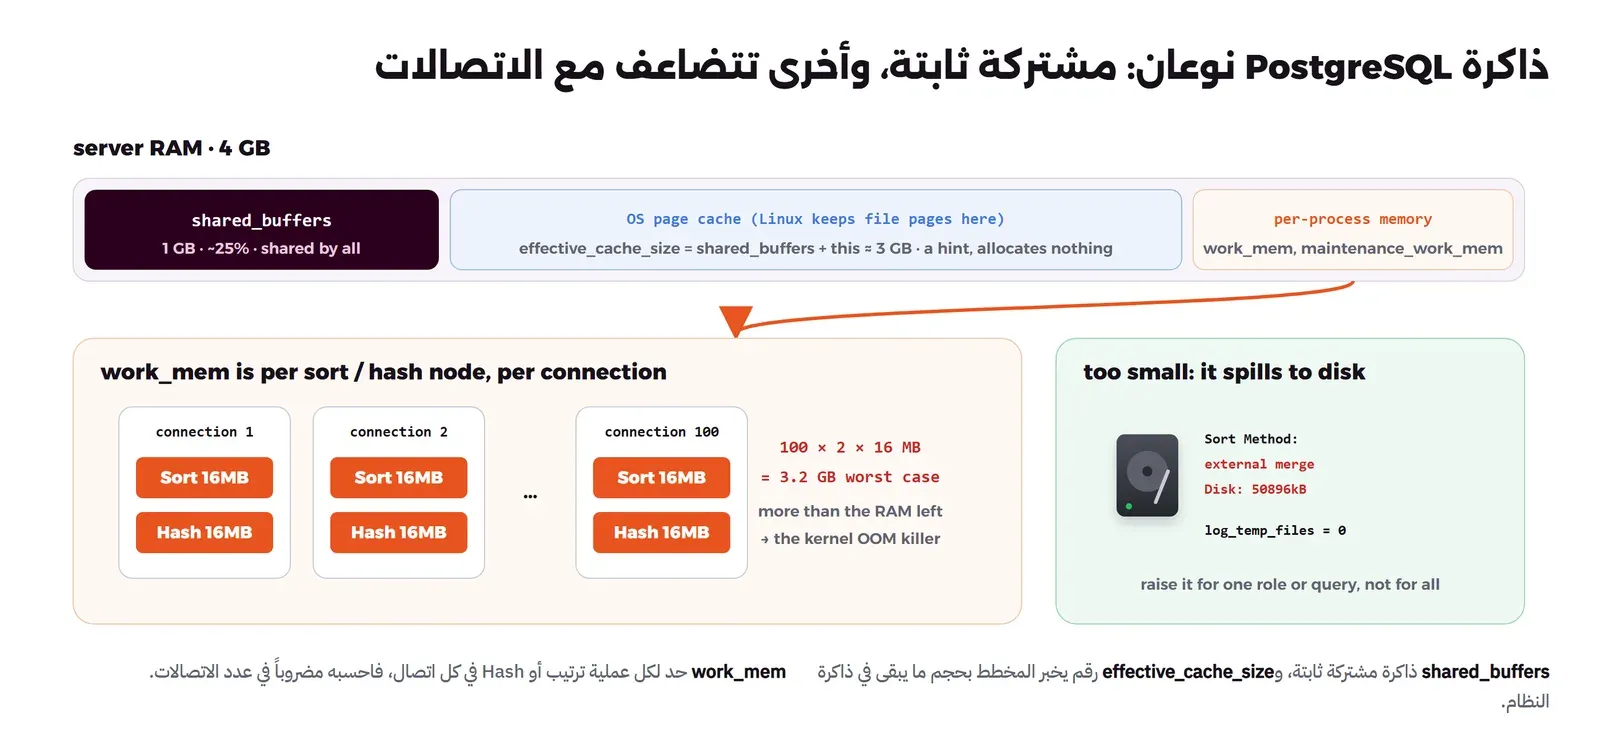
الصورة التالية تبين أين تذهب ذاكرة سيرفر قاعدة البيانات:
shared_buffers
هو الذاكرة التي يحفظ فيها PostgreSQL صفحات الجداول والفهارس، وتقول الوثائق الرسمية إن نقطة البداية المعقولة لسيرفر مخصص بذاكرة 1 جيجابايت أو أكثر هي 25% من الذاكرة، وإنه من غير المرجح أن يكون أكثر من 40% أفضل، والسبب أن PostgreSQL يقرأ الملفات عبر نظام التشغيل الذي يحتفظ بنسخة منها في ذاكرته Page Cache، فإذا أعطيت PostgreSQL أكثر من اللازم بقيت نفس الصفحة في مكانين وضاقت ذاكرة نظام التشغيل. وتغييره يحتاج إعادة تشغيل القاعدة.
وهنا درس من المختبر: بعد رفعه إلى 1 جيجابايت أعدنا تشغيل ال Container بالأمر docker restart، فبدأت القاعدة برسالة database system was not properly shut down; automatic recovery in progress، والسبب أن Docker ينتظر عشر ثوان افتراضياً ثم يقتل العملية، والإغلاق السليم يكتب كل الصفحات المعدلة في نقطة تفتيش أخيرة، وهذا مع ذاكرة كبيرة وقرص بطيء قد يأخذ أكثر من عشر ثوان. لذلك أضفنا stop_grace_period: 2m في ملف Compose، فالاستعادة بعد التوقف المفاجئ آمنة ولكنها تؤخر بدء القاعدة دون داع.
effective_cache_size
هذا الإعداد لا يحجز أي ذاكرة، وإنما يخبر المخطط Query Planner بتقديرك لحجم الذاكرة المتاحة للتخزين المؤقت في PostgreSQL ونظام التشغيل معاً، فيقرر على أساسه هل قراءة الفهرس ستجد الصفحات في الذاكرة غالباً، كما في وثائق إعدادات المخطط. والقيمة المعتادة 50% إلى 75% من ذاكرة السيرفر المخصص، وخطؤه لا يسبب نفاد ذاكرة، وإنما خططاً أسوأ.
work_mem: الإعداد الذي يتضاعف
هو حد الذاكرة لكل عملية ترتيب Sort أو جدول Hash داخل الاستعلام قبل أن يكتب إلى ملفات مؤقتة على القرص، والقيمة الافتراضية 4 ميجابايت. والنقطة التي يخطئ فيها الكثيرون أنه ليس حداً للاتصال، فالاستعلام الواحد قد يحتوي عدة عمليات ترتيب وHash، وكل منها يأخذ حتى هذا الحد، وعمليات Hash يمكن أن تأخذ أضعافه بحسب hash_mem_multiplier الذي قيمته الافتراضية 2، وكل اتصال يشغل استعلامه الخاص. فإذا جعلته 64 ميجابايت مع 100 اتصال، فالأسوأ ليس 6.4 جيجابايت، وإنما أكثر من ذلك، وهذا ما يجعل نظام التشغيل يقتل PostgreSQL بأداة OOM Killer في ساعة الذروة وليس في الاختبار.
ولنرى ما يحدث عندما يكون صغيراً، أنشأنا جدولاً من مليوني صف ورتبناه، مرة بالقيمة الافتراضية ومرة بقيمة أكبر لهذه الجلسة فقط:
SET max_parallel_workers_per_gather = 0;
CREATE TABLE sales AS
  SELECT g AS id, (random()*1e9)::bigint AS k, (random()*500)::int AS customer_id,
         round((random()*100)::numeric, 2) AS amount
  FROM generate_series(1, 2000000) g;
VACUUM ANALYZE sales;

SET work_mem = '4MB';
EXPLAIN (ANALYZE, COSTS OFF) SELECT id, k FROM sales ORDER BY k;
SET work_mem = '128MB';
EXPLAIN (ANALYZE, COSTS OFF) SELECT id, k FROM sales ORDER BY k;
والمخرج سوف يكون كما يلي (أفضل وقت من ثلاث مرات لكل حالة):
work_mem = 4MB
   Sort Method: external merge  Disk: 50896kB
 Execution Time: 5237.745 ms

work_mem = 128MB
   Sort Method: quicksort  Memory: 111653kB
 Execution Time: 4592.029 ms
وفي سجل PostgreSQL ظهر السطر التالي بسبب الإعداد log_temp_files = 0:
LOG: temporary file: path "base/pgsql_tmp/pgsql_tmp186.0", size 52117504في المخرج أعلاه لاحظ التالي:
external merge Disk: 50896kBيعني أن الترتيب قسم البيانات إلى أجزاء وكتبها على القرص ثم دمجها، وquicksort Memoryيعني أنه رتبها كلها في الذاكرة، وهذا السطر فيEXPLAIN ANALYZEهو الطريقة الأوضح لتعرف أنwork_memصغير لاستعلام معين.- الترتيب في الذاكرة احتاج 109 ميجابايت تقريباً، بينما الملفات على القرص 50 ميجابايت، والسبب أن الترتيب في الذاكرة يحفظ معلومات إضافية لكل صف، فلا تجعل
work_memبحجم ملف القرص الذي تراه وتتوقع أن يكفي. - الفرق في الوقت هنا 12% فقط، والسبب أن الملف المؤقت بقي في ذاكرة نظام التشغيل ولم يصل فعلاً إلى القرص البطيء، وعلى سيرفر مشغول بذاكرة ممتلئة يكون الفرق أكبر بكثير، والمهم أن ترى الملفات المؤقتة في السجل وفي
temp_blks_writtenقبل أن تشعر بالبطء.
والقرار الصحيح: أبق القيمة العامة متواضعة، واحسبها تقريباً هكذا: الذاكرة المتبقية بعد shared_buffers مقسومة على عدد الاتصالات الحقيقية مضروبة في عدد عمليات الترتيب المتوقعة، ثم ارفعها لدور التقارير فقط ALTER ROLE reports SET work_mem = '256MB' أو للاستعلام الثقيل داخل معاملته بالأمر SET LOCAL work_mem. ولاحظ أن مجمع الاتصالات يجعل هذا الحساب ممكناً، لأن عدد الاتصالات الحقيقية بالقاعدة يصبح رقماً صغيراً تعرفه.
maintenance_work_mem
هو الذاكرة لعمليات الصيانة: VACUUM وCREATE INDEX وALTER TABLE ADD FOREIGN KEY، والقيمة الافتراضية 64 ميجابايت. وبما أن هذه العمليات قليلة في نفس الوقت، فرفعه آمن نسبياً، وفي المختبر عندما أنشأنا فهرساً على عمود k في جدول المليوني صف، كتب PostgreSQL بالقيمة الافتراضية ملفين مؤقتين بحجم 28 و40 ميجابايت، وبقيمة 512 ميجابايت لم يكتب أي ملف. أما الأزمنة فلم نعتمدها، لأن نفس الأمر بنفس القيمة أخذ مرة 5 ثوان ومرة 38 ثانية بسبب انشغال الجهاز، وهذا بالضبط سبب تكرار القياس قبل أي استنتاج. وتذكر أن ال autovacuum يستخدم نفس القيمة لكل Worker إذا لم تحدد autovacuum_work_mem، فمع ثلاثة Workers وقيمة 1 جيجابايت قد تذهب 3 جيجابايت للتنظيف.
WAL ونقاط التفتيش Checkpoints
كل تغيير يكتب أولاً في WAL، ثم تكتب الصفحات المعدلة إلى ملفات الجداول على مراحل، وكل فترة يضمن PostgreSQL أن كل الصفحات المعدلة حتى لحظة معينة وصلت إلى القرص، وهذه هي نقطة التفتيش Checkpoint، وبعدها يستطيع إعادة استخدام ملفات WAL القديمة، والتفاصيل في وثائق إعدادات WAL وفي مقال كيف تخزن قاعدة البيانات بياناتك من الداخل. ونقطة التفتيش تبدأ لأحد سببين: مرور checkpoint_timeout وقيمته الافتراضية 5 دقائق، أو وصول حجم WAL منذ آخر نقطة إلى max_wal_size وقيمته الافتراضية 1 جيجابايت.
الصورة التالية تبين لماذا يهم ذلك:
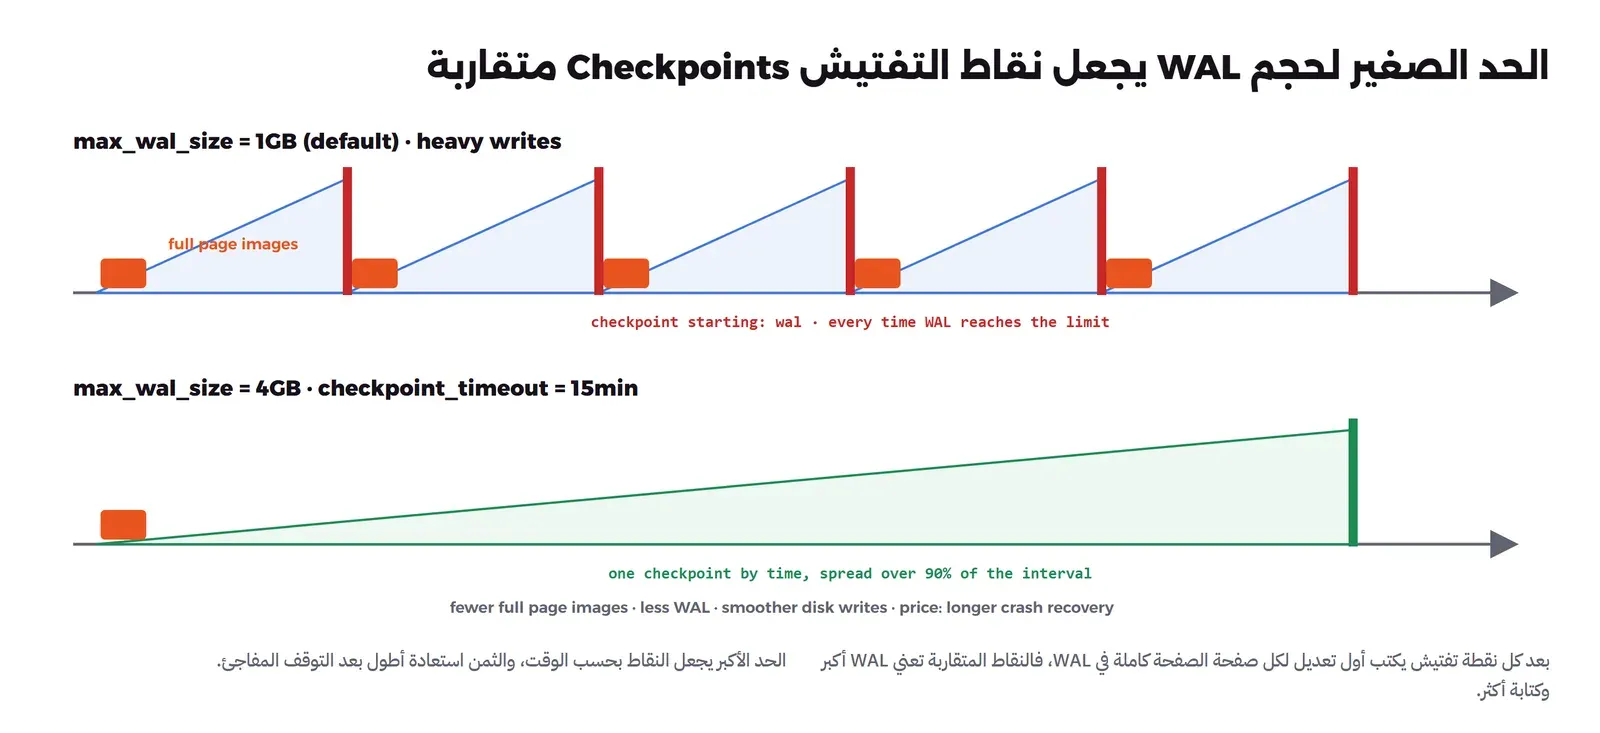
والسبب في أن النقاط المتقاربة تكلف أكثر مما تتوقع هو الصفحات الكاملة Full Page Images: أول تعديل على أي صفحة بعد نقطة التفتيش يكتب الصفحة كاملة (8 كيلوبايت) في WAL وليس التغيير الصغير فقط، حتى يستطيع PostgreSQL إصلاح الصفحة إذا انقطعت الكهرباء في منتصف كتابتها، فكلما تقاربت النقاط تكررت كتابة الصفحات الكاملة. وفي المختبر بالإعداد الافتراضي ظهر في السجل:
LOG:  checkpoint starting: wal
LOG:  checkpoint complete: wrote 1295 buffers (7.9%), wrote 31 SLRU buffers; 0 WAL file(s) added, 0 removed, 33 recycled; write=94.474 s, sync=0.160 s, total=95.882 s; ... distance=540425 kB, estimate=540425 kB
كلمة wal بعد checkpoint starting تعني أن النقطة بدأت لأن WAL امتلأ وليس لأن الوقت حان، وإذا رأيتها كثيراً في السجل، أو رأيت التحذير checkpoints are occurring too frequently، أو رأيت العداد num_requested في الجدول pg_stat_checkpointer يزيد أسرع من num_timed، فارفع max_wal_size. والثمن الوحيد هو مساحة القرص لملفات WAL، ووقت أطول لاستعادة القاعدة بعد توقف مفاجئ لأنها تعيد تنفيذ WAL منذ آخر نقطة تفتيش. أما checkpoint_completion_target = 0.9 فهو القيمة الافتراضية منذ PostgreSQL 14، ويوزع كتابة النقطة على 90% من الفترة بدل دفعة واحدة تخنق القرص.
وwal_compression يضغط الصفحات الكاملة في WAL، ويقبل منذ PostgreSQL 15 الخوارزميات pglz وlz4 وzstd، وقد رأيت في المختبر أنه خفض WAL إلى الخمس تقريباً، وأن ثمنه وقت المعالج.
ال autovacuum: لماذا ينتظر طويلاً في الجداول الكبيرة؟
في PostgreSQL التحديث UPDATE لا يغير الصف في مكانه، وإنما يكتب نسخة جديدة ويترك القديمة ميتة Dead Tuple حتى لا يراها أحد، ثم يأتي VACUUM لينظفها ويجعل مكانها قابلاً لإعادة الاستخدام، كما شرحنا في مقال الجداول الضخمة. وال autovacuum يقرر متى ينظف الجدول بهذه المعادلة من وثائق التنظيف الدوري:
vacuum threshold = min(autovacuum_vacuum_max_threshold,
                       autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor * reltuples)
                 = min(100,000,000, 50 + 0.2 * rows)
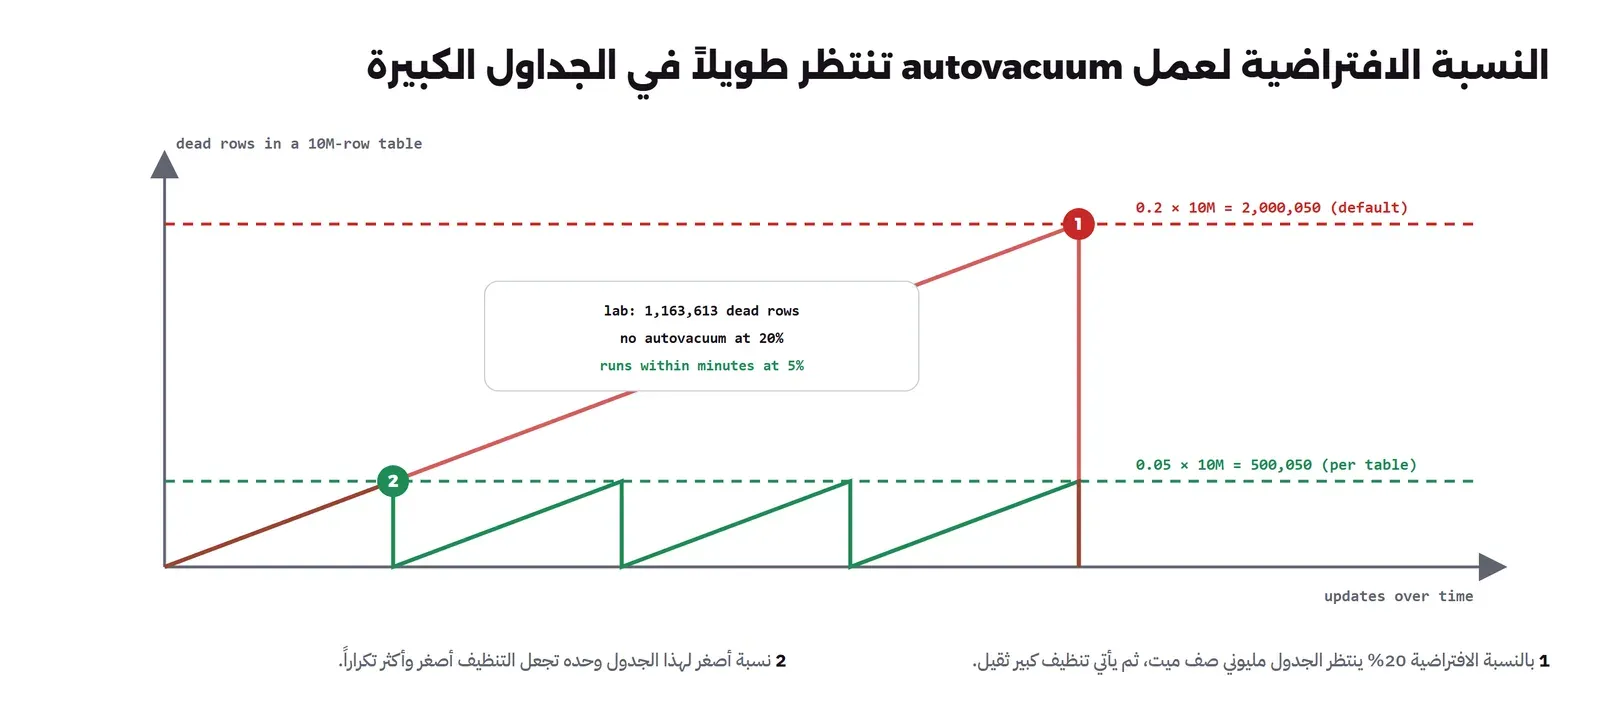
أي أن الجدول بعشرة ملايين صف ينتظر مليوني صف ميت قبل التنظيف، والجدول بمليار صف كان ينتظر مئتي مليون قبل أن يضيف PostgreSQL 18 الحد الأعلى autovacuum_vacuum_max_threshold بقيمة مئة مليون. وفي المختبر حدثنا مليون صف من عشرة ملايين، وانتظرنا دقيقة ونصفاً:
     relname      | n_live_tup | n_dead_tup | vacuum_after | last_autovacuum
------------------+------------+------------+--------------+-----------------
 pgbench_accounts |    9999844 |    1163613 |      2000019 |
مليون ومئة ألف صف ميت ولم يبدأ التنظيف، لأن الحد مليونان. والحل الذي شرحناه في مقال الجداول الضخمة هو نسبة أصغر لهذا الجدول وحده:
ALTER TABLE pgbench_accounts SET (autovacuum_vacuum_scale_factor = 0.05, autovacuum_analyze_scale_factor = 0.02);فبدأ التنظيف في الدورة التالية، والجديد هنا ليس النسبة، وإنما ما يقوله السجل عن سرعة التنظيف وثمنه، وقد ظهر بسبب log_autovacuum_min_duration = 0:
LOG:  automatic vacuum of table "postgres.public.pgbench_accounts": index scans: 1
	pages: 0 removed, 180369 remain, 180369 scanned (100.00% of total), 0 eagerly scanned
	tuples: 1000048 removed, 10000000 remain, 0 are dead but not yet removable
	frozen: 176000 pages from table (97.58% of total) had 1518327 tuples frozen
	I/O timings: read: 4764.687 ms, write: 22783.781 ms
	avg read rate: 7.729 MB/s, avg write rate: 8.207 MB/s
	WAL usage: 734979 records, 374270 full page images, 2928154436 bytes, 1858 buffers full
	system usage: CPU: user: 13.10 s, system: 16.86 s, elapsed: 356.28 s
الصورة التالية تبين الفرق بين النسبتين:
في السجل أعلاه لاحظ التالي:
- التنظيف أخذ ست دقائق تقريباً بسرعة 8 ميجابايت في الثانية، وهذا ليس بطء القرص، وإنما حد مقصود: ال autovacuum يتوقف لحظة كلما أنفق قدراً معيناً من العمل، بحسب
autovacuum_vacuum_cost_limitالذي يأخذ القيمة 200 منvacuum_cost_limitوautovacuum_vacuum_cost_delay = 2ms، حتى لا يزاحم الاستعلامات، كما في وثائق إعدادات التنظيف. وعلى سيرفر بقرص SSD سريع يرفع كثيرون الحد إلى 1000 أو أكثر حتى لا يتأخر التنظيف عن الكتابة. - التنظيف جمد Froze 97% من صفحات الجدول، وكتب 2.9 جيجابايت من WAL، وهذا جزء طبيعي من عمله يحمي من نفاد أرقام المعاملات Transaction ID Wraparound، ولكنه يعني أن أول تنظيف لجدول كبير لم ينظف من قبل قد يكون ثقيلاً على القرص وعلى النسخ المتماثلة.
- غيرنا النسبة للجدول الكبير وحده وليس للسيرفر كله، والسبب أن الجداول الصغيرة لا تحتاج ذلك، وتغييرها يعني تنظيفاً أكثر دون فائدة.
ومتى تعرف أن ال autovacuum متأخر؟ عندما يزيد n_dead_tup في pg_stat_user_tables أياماً، أو يكبر حجم الجدول وعدد صفوفه ثابت، أو ترى أن last_autovacuum قديم لجدول يتغير كل دقيقة. ولا تقم بإيقاف ال autovacuum لأنه «يبطئ القاعدة»، والسبب أن الجدول عندها يكبر بالصفوف الميتة حتى تصبح كل قراءة أبطأ، ثم يجبرك PostgreSQL على تنظيف طارئ عندما تقترب أرقام المعاملات من نهايتها.
random_page_cost على SSD: التجربة التي جعلت الاستعلام أبطأ
المخطط يقدر تكلفة كل خطة بأرقام نسبية، وrandom_page_cost هو تكلفة قراءة صفحة من مكان عشوائي مقارنة بالقراءة المتتابعة seq_page_cost = 1، وقيمته الافتراضية 4.0 من زمن الأقراص الدوارة. والنصيحة المنتشرة أن تجعله 1.1 مع SSD، ووثائق PostgreSQL نفسها تذكر أن القيمة الأقل مناسبة للأقراص التي يكون فيها الوصول العشوائي قريباً من المتتابع. ولكن لنرى ماذا حدث لاستعلام على جدول المبيعات بعد إضافة فهرس على عمود customer_id الذي قيمه موزعة عشوائياً على الصفحات:
CREATE INDEX sales_customer_idx ON sales (customer_id);
ANALYZE sales;
SET random_page_cost = 4;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT sum(amount) FROM sales WHERE customer_id BETWEEN 1 AND 200;
SET random_page_cost = 1.1;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) SELECT sum(amount) FROM sales WHERE customer_id BETWEEN 1 AND 200;
والمخرج سوف يكون كما يلي:
== random_page_cost=4
Aggregate (actual time=923.145..923.147 rows=1.00 loops=1)
  Buffers: shared hit=15392
  ->  Bitmap Heap Scan on sales (actual time=206.140..581.158 rows=798931.00 loops=1)
        Recheck Cond: ((customer_id >= 1) AND (customer_id <= 200))
        Heap Blocks: exact=14706
        ->  Bitmap Index Scan on sales_customer_idx (actual time=192.194..192.195 rows=798931.00 loops=1)
Execution Time: 923.189 ms

== random_page_cost=1.1
Aggregate (actual time=2707.941..2707.943 rows=1.00 loops=1)
  Buffers: shared hit=701003
  ->  Index Scan using sales_customer_idx on sales (actual time=0.017..2380.489 rows=798931.00 loops=1)
Execution Time: 2707.973 ms
الاستعلام يطلب 40% من الجدول، وبالقيمة 4 اختار المخطط Bitmap Heap Scan الذي يجمع الصفحات المطلوبة ثم يقرأ كل صفحة مرة واحدة، 15 ألف صفحة. وبالقيمة 1.1 أصبحت القراءة العشوائية رخيصة في حسابه فاختار Index Scan الذي يزور الصفحة مع كل صف، فقرأ 701 ألف صفحة وكان أبطأ بثلاث مرات تقريباً، رغم أن كل الصفحات كانت في الذاكرة. والدرس ليس أن 1.1 خطأ، فمع استعلامات تطلب صفوفاً قليلة يجعل المخطط يستخدم الفهارس بدل قراءة الجدول كله وهذا غالباً ما تريده على SSD، وإنما أن كل إعداد للمخطط يغير خططاً لم تكن تفكر فيها، لذلك قارن أبطأ الاستعلامات في pg_stat_statements قبل التغيير وبعده، أو جرب القيمة لجلسة واحدة بالأمر SET قبل أن تكتبها في الملف.
أدوات الحساب مثل PGTune: نقطة بداية وليست إجابة
أداة PGTune تسألك عن الذاكرة والمعالج ونوع العمل وعدد الاتصالات ونوع القرص، ثم تحسب القيم بمعادلات ثابتة قريبة مما في ملف الضبط أعلاه: ربع الذاكرة ل shared_buffers، وثلاثة أرباعها ل effective_cache_size، وwork_mem بقسمة الباقي على الاتصالات. وهي مفيدة كبداية لأنها تمنعك من الأرقام المجنونة، ولكن حدودها واضحة:
- لا تعرف أن نصف ذاكرة السيرفر يأخذها تطبيق آخر يعمل بجانب القاعدة، أو أن ال Container محدود بذاكرة أقل من ذاكرة السيرفر.
- تحسب
work_memمنmax_connectionsوليس من الاتصالات الحقيقية خلف المجمع، ولا تعرف أن عندك تقارير تحتاج قيمة أكبر لدور واحد. - لا تعرف شيئاً عن جداولك: أيها كبير ويحتاج autovacuum خاصاً، وأيها عليه أقفال.
- القيم المرتفعة فيها قد تكون صحيحة لسيرفر مخصص، وخطيرة لسيرفر مشترك.
فاستخدمها لتعرف من أين تبدأ، ثم غير قيمة واحدة في كل مرة، وقس نفس الحمل قبل وبعد، واحتفظ بالقيمة التي أثبتت فائدتها فقط.
أخطاء شائعة
- رفع
max_connectionsإلى آلاف بدل مجمع اتصالات: كل اتصال عملية بذاكرتها، وwork_memيتضاعف معها. work_memكبير للسيرفر كله: يعمل في الاختبار ويقتل القاعدة في الذروة، فارفعه لدور أو استعلام.shared_buffersبأكثر من نصف الذاكرة: يضيق ذاكرة نظام التشغيل التي يعتمد عليها PostgreSQL أيضاً.- إيقاف ال autovacuum أو تركه بإعداداته على جداول بمئات الملايين: انتفاخ Bloat ثم تنظيف طارئ.
- نسخ ملف إعدادات دون قياس: لا تعرف أي سطر أفاد وأيها أضر.
- قياس مرة واحدة: في مختبرنا اختلف نفس التشغيل عن تكراره بأكثر من 40% في القراءة فقط.
- تغيير إعدادات المخطط للسيرفر كله لإصلاح استعلام واحد: يغير خطط استعلامات أخرى كانت جيدة.
قائمة تحقق
- هل عرفت أبطأ الاستعلامات من
pg_stat_statements، وهل السبب ذاكرة أم فهرس أم أقفال؟ - هل
shared_buffersقريب من ربع الذاكرة المتاحة للقاعدة فعلاً، وهل تراقب نسبة القراءة من الذاكرة؟ - هل حسبت
work_memمع عدد الاتصالات الحقيقية خلف المجمع، وهلlog_temp_filesمفعل؟ - هل نقاط التفتيش تبدأ بالوقت غالباً وليس بامتلاء WAL؟
- هل للجداول الكبيرة نسب autovacuum خاصة، وهل حد التكلفة مناسب لقرصك؟
- هل غيرت إعدادات المخطط بعد قياس الاستعلامات المهمة قبل وبعد؟
- هل الإعدادات في ملفات تراجع في Git، مع
stop_grace_periodكاف في Compose؟
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- ابدأ من
pg_stat_statementsلتعرف هل المشكلة ذاكرة أم استعلام أم أقفال، فالضبط لا يصلح الأخيرين. - في المختبر ضاعف الضبط تقريباً عدد معاملات الكتابة على نفس الجهاز، وأغلب الفرق جاء من
shared_buffersالذي رفع القراءة من الذاكرة من 58% إلى 90%، ومنmax_wal_sizeالذي أوقف نقاط التفتيش المتقاربة. work_memحد لكل عملية ترتيب أو Hash في كل اتصال، فأبقه متواضعاً وارفعه لدور أو استعلام، والسطرexternal merge Diskيخبرك متى يكون صغيراً.- النسبة الافتراضية لل autovacuum تنتظر مليوني صف ميت في جدول بعشرة ملايين، فاضبط النسبة للجداول الكبيرة وحدها، وراجع حد التكلفة.
random_page_cost = 1.1جعل أحد استعلاماتنا أبطأ بثلاث مرات، فكل إعداد للمخطط يحتاج قياساً قبل وبعد.- PGTune وأمثالها نقطة بداية، والقياس المتكرر هو الذي يقرر.
 دليلConnection Pooling: لماذا الاتصال بقاعدة البيانات مكلفلماذا تظهر رسالة too many clients عندما تزيد نسخ تطبيقك، وكيف يحل مجمع الاتصالات وPgBouncer هذه المشكلة.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
 دليلالفهارس Indexes: لماذا تسرع الاستعلام وكيف تقرأ EXPLAINكيف يبحث PostgreSQL داخل الفهرس، ومتى يتجاهله، وكم يكلفك كل فهرس عند الكتابة، وكيف تقرأ خطة EXPLAIN سطراً سطراً.
 دليلPostgreSQL للفرق: تثبيت آمن وصلاحيات واضحةكيف تثبت PostgreSQL لفريقك بأدوار لا تسمح للتطبيق بحذف الجداول، واتصال مشفر، ونسخة احتياطية تختبر استعادتها كل ليلة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختباره على PostgreSQL 18.6 (الصورة postgres:18.6) في Container محدود بأربع أنوية و4 جيجابايت، مع pgbench 18.6 وDocker Engine 29.8.0.