

تكتب دالة تحذف التكرار من قائمة البريد قبل إرسال النشرة، وتجربها على مئة عنوان فتنتهي قبل أن ترفع إصبعك عن الزر، ثم تشغلها في الإنتاج Production على مئة ألف عنوان فتنتظر دقائق، ثم تضيف سيرفراً أقوى فلا يتغير شيء تقريباً. والسبب في أغلب هذه الحالات ليس السيرفر ولا اللغة، وإنما أن الكود يعمل بطريقة يتضاعف فيها العمل أربع مرات كلما تضاعفت البيانات، وهذا لا يظهر مع بيانات التجربة الصغيرة أبداً، ويظهر فجأة عندما يكبر النظام.
وفي مقال هياكل البيانات شرحنا كيف ترتب البيانات في الذاكرة، وفي هذا المقال نكمل من مرحلة أساسيات علوم الحاسب Computer Science Fundamentals بالسؤال الثاني: ما الذي نفعله بهذه البيانات، وكم يكبر الزمن عندما تكبر. وسوف نجيب بلغة يستخدمها كل المطورين اسمها Big-O، ثم نقيس كل فكرة بتجربة حقيقية.
وسوف نناقش في هذا المقال ما يلي:
- ما هي الخوارزمية Algorithm، وما هو ترميز Big-O، والفئات المشهورة من O(1) إلى O(2ⁿ) مع رسم يقارن منحنياتها.
- أفضل حالة ومتوسطها وأسوأها، وتعقيد الذاكرة Space Complexity.
- تجربة حقيقية في Node.js تقيس البحث والترتيب وحذف التكرار والاستدعاء الذاتي على بيانات تكبر، مع رسم لنتائجها.
- البحث الخطي Linear Search والبحث الثنائي Binary Search، وخطأ بقي سنوات في مكتبة Java.
- خوارزميات الترتيب Sorting من Bubble Sort إلى Merge Sort وQuick Sort، وما تستخدمه C# وJava وPython وJavaScript فعلاً.
- الاستدعاء الذاتي Recursion والحفظ Memoization.
- اختيار الهيكل الصحيح: البحث في قائمة داخل حلقة مقابل المجموعة Set، في ثلاث لغات.
- مشكلة N+1 في قواعد البيانات كمشكلة O(n) من الرحلات على الشبكة، ثم كيف تكتشف الكود البطيء قبل الإنتاج.
ما هي الخوارزمية Algorithm؟
الخوارزمية Algorithm هي خطوات محددة وواضحة تحل مشكلة وتنتهي، مثل وصفة الطبخ التي تحدد المقادير والخطوات بالترتيب حتى يخرج الطبق. والنقطة المهمة أن المشكلة الواحدة لها خوارزميات كثيرة كلها تعطي نفس النتيجة الصحيحة، فالبحث عن اسم في دليل هاتف يمكن أن يكون بقراءة الأسماء من الصفحة الأولى واحداً واحداً، ويمكن أن يكون بفتح الدليل من المنتصف ثم النصف الذي يحتوي الاسم وهكذا، والطريقتان صحيحتان، ولكن الأولى قد تحتاج آلاف الخطوات والثانية بضع عشرات، والفرق يكبر كلما كبر الدليل.
وقد يتساءل البعض: لماذا لا نقارن الخوارزميات بالثواني مباشرة؟ والإجابة أن الثواني تعتمد على المعالج واللغة والبيانات وما يعمل على السيرفر في نفس اللحظة، فالكود الذي يأخذ ثانية على جهازك قد يأخذ نصف ثانية على السيرفر، ولكن الشيء الذي لا يتغير هو العلاقة بين حجم البيانات وعدد الخطوات: هل يتضاعف العمل عندما تتضاعف البيانات، أم يزيد خطوة واحدة، أم يتضاعف أربع مرات؟ وهذه العلاقة هي ما يصفه ترميز Big-O.
ترميز Big-O: كيف يكبر العمل مع البيانات
ترميز Big-O يصف كيف يزيد الوقت أو الذاكرة التي تحتاجها الخوارزمية مع حجم المشكلة n، وهو عادة عدد العناصر، كما يعرفه قاموس NIST للخوارزميات وهياكل البيانات، والمعنى غير الرسمي للعبارة f(n) = O(g(n)) أن العمل لا يتجاوز مضاعفاً ثابتاً من g(n) عندما تكبر n. وبلغة أبسط: نعد الخطوات بدلالة n، ثم نحتفظ بالجزء الذي يكبر أسرع ونحذف الثوابت، فالدالة التي تمر على القائمة مرتين O(n) وليست O(2n)، والدالة التي تأخذ n² + 3n + 10 خطوة هي O(n²)، والسبب أن الثوابت والأجزاء الصغيرة لا تغير شكل المنحنى عندما تصبح n مليوناً.
الصورة التالية تبين منحنيات الفئات المشهورة لأعداد صغيرة، ثم عدد الخطوات لكل فئة عندما تصبح البيانات مليون عنصر:
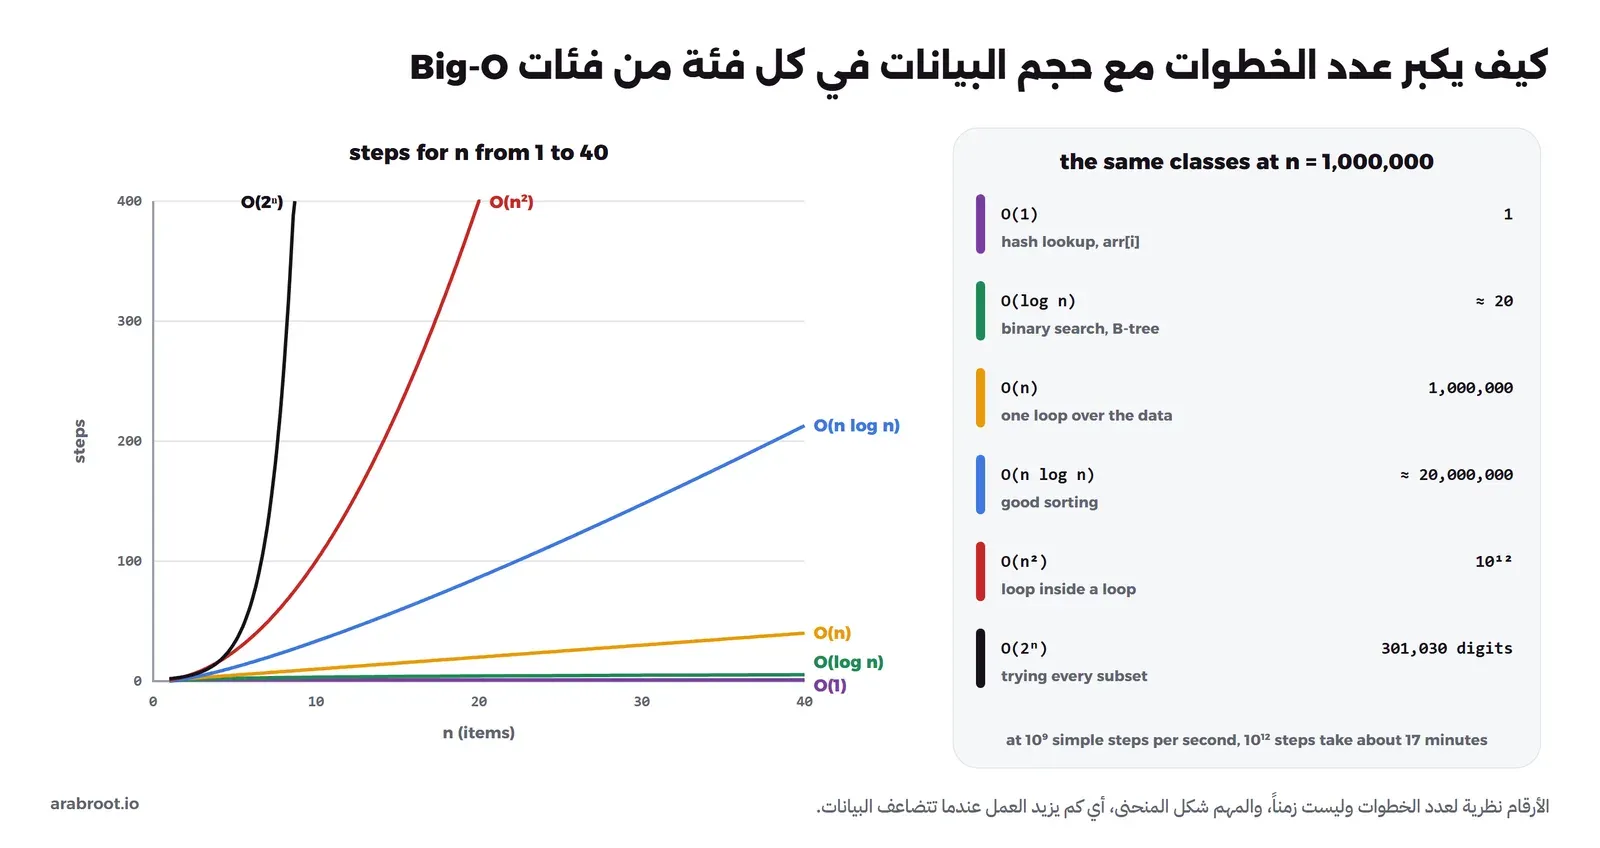
والفئات التي سوف تقابلها في عملك أغلب الوقت هي التالية:
| الفئة | الاسم | عندما تتضاعف البيانات | أمثلة |
|---|---|---|---|
| O(1) | ثابت Constant | لا يتغير العمل | قراءة arr[i]، والبحث في جدول هاش أو مجموعة |
| O(log n) | لوغاريتمي Logarithmic | يزيد خطوة واحدة | البحث الثنائي، والبحث في فهرس B-tree |
| O(n) | خطي Linear | يتضاعف | المرور على كل العناصر مرة، والبحث في قائمة غير مرتبة |
| O(n log n) | خطي لوغاريتمي Linearithmic | يزيد قليلاً عن الضعف | خوارزميات الترتيب الجيدة |
| O(n²) | تربيعي Quadratic | يتضاعف أربع مرات | حلقة داخل حلقة على نفس البيانات، وBubble Sort |
| O(2ⁿ) | أسي Exponential | عنصر واحد إضافي يضاعف العمل | تجربة كل المجموعات الجزئية، وFibonacci بالاستدعاء الذاتي البسيط |
ولاحظ أن log n هنا هو لوغاريتم الأساس 2، أي عدد المرات التي تقسم فيها n على 2 حتى تصل إلى 1، فاللوغاريتم لمليون نحو 20 وللمليار نحو 30، وهو قريب من عدد البتات التي تحتاجها لكتابة الرقم بالنظام الثنائي كما في مقال الأنظمة العددية. ولهذا السبب فالخوارزمية O(log n) تبقى سريعة مهما كبرت البيانات تقريباً.
أفضل حالة Best Case ومتوسطها Average Case وأسوأها Worst Case
نفس الخوارزمية قد يختلف عملها بحسب البيانات نفسها وليس حجمها فقط، فالبحث الخطي عن قيمة قد يجدها في أول خانة وهي أفضل حالة Best Case، وقد يمر على كل العناصر لأنها في الأخير أو غير موجودة وهي أسوأ حالة Worst Case، وفي المتوسط Average Case يمر على النصف تقريباً، وكلها O(n) ما عدا أفضل حالة. وعندما يقال إن خوارزمية O(n) دون تحديد فالمقصود غالباً أسوأ حالة، لأنها الضمان الذي تبني عليه، وأحياناً المتوسط عندما يكون الأسوأ نادراً جداً، مثل جدول الهاش الذي متوسطه O(1) وأسوأ حالته O(n) عندما تقع كل المفاتيح في خانة واحدة، وقد رأينا هذا الأسوأ بالأرقام ورأينا مهاجمين استغلوه فعلاً في قسم التصادم في مقال هياكل البيانات. لذلك عندما تكون البيانات من مستخدم لا تثق به فاحسب حسابك على أسوأ حالة وليس المتوسط.
تعقيد الذاكرة Space Complexity
نفس الترميز يصف الذاكرة الإضافية التي تحتاجها الخوارزمية، فالبحث الخطي يحتاج متغيراً واحداً مهما كبرت البيانات وهو O(1) في الذاكرة، وحذف التكرار بمجموعة Set يحتاج مجموعة قد تصل إلى n عنصر وهو O(n) في الذاكرة. وكثير من التحسينات في هذا المقال هي مقايضة Trade-off بين الاثنين: ندفع ذاكرة إضافية لنوفر وقتاً، كما سترى في حفظ نتائج Fibonacci وفي المجموعة. وهذه المقايضة مقبولة غالباً على السيرفر، ولكن تذكر أنها ليست مجانية عندما يعمل الكود على ملايين الصفوف في طلب واحد، فهذه الذاكرة تخرج من نفس السيرفر الذي يخدم بقية الطلبات.
تجربة عملية Lab: نقيس كيف يكبر الزمن مع البيانات
الكلام عن المنحنيات مفيد، ولكن الأفضل أن نراها بالأرقام، لذلك كتبنا ملفاً واحداً بلغة JavaScript يقيس أربع تجارب على بيانات تكبر بالمضاعفة، وشغلناه على جهاز يعمل بنظام Windows 11 بمعالج Intel Core i7-7700K مع Node.js 22.14.0. والأرقام توضيحية من هذا الجهاز وحده، وكل رقم هو الأفضل من ثلاث مرات تشغيل حتى نقلل أثر ما يعمل في الخلفية، والدالة performance.now تعطي الوقت بدقة أجزاء من المللي ثانية. والمهم ليس الأرقام نفسها، وإنما كيف تتغير عندما تتضاعف n.
احفظ الملف التالي باسم bigo.js، وبجانبه ملف package.json فيه {"type":"module"} لأن الملف يستخدم import:
// bigo.js: how does the time grow when the data grows? (Node.js, illustrative numbers on one machine)
//   node bigo.js            prints the tables
//   node bigo.js --json     also writes results.json for the chart
import { writeFileSync } from 'node:fs';

// time a function: best of `runs` runs, in milliseconds
const time = (fn, runs = 3) => {
  let best = Infinity;
  for (let r = 0; r < runs; r++) { const t = performance.now(); fn(); best = Math.min(best, performance.now() - t); }
  return best;
};
// the same random numbers on every run (a small linear congruential generator)
let seed = 42;
const rand = (max) => { seed = (seed * 1103515245 + 12345) % 2147483648; return seed % max; };
const randomArray = (n) => Array.from({ length: n }, () => rand(n * 10));
const ms = (x) => x.toFixed(x < 10 ? 2 : 1).padStart(9);
const out = {};

// 1) Searching: 1,000 lookups in a sorted array of n numbers
function linearSearch(arr, x) { for (let i = 0; i < arr.length; i++) if (arr[i] === x) return i; return -1; }
function binarySearch(arr, x) {
  let lo = 0, hi = arr.length - 1;
  while (lo <= hi) {
    const mid = (lo + hi) >>> 1;
    if (arr[mid] === x) return mid;
    if (arr[mid] < x) lo = mid + 1; else hi = mid - 1;
  }
  return -1;
}
console.log('1) 1,000 lookups          linear O(n)   binary O(log n)   Set.has O(1)');
out.search = [];
for (const n of [1_000, 10_000, 100_000, 1_000_000]) {
  const arr = Array.from({ length: n }, (_, i) => i * 2);          // sorted, even numbers
  const set = new Set(arr);
  const targets = Array.from({ length: 1000 }, () => rand(n * 2));  // half of them are missing
  const tl = time(() => targets.forEach(x => linearSearch(arr, x)));
  const tb = time(() => targets.forEach(x => binarySearch(arr, x)));
  const ts = time(() => targets.forEach(x => set.has(x)));
  out.search.push({ n, linear: tl, binary: tb, set: ts });
  console.log(`   n=${n.toLocaleString('en').padStart(9)}   ${ms(tl)} ms   ${ms(tb)} ms    ${ms(ts)} ms`);
}

// 2) Removing duplicates: «includes» on an array inside a loop, against a Set
const dedupArray = (items) => { const seen = []; for (const x of items) if (!seen.includes(x)) seen.push(x); return seen; };
const dedupSet = (items) => { const seen = new Set(); for (const x of items) seen.add(x); return [...seen]; };
// 3) Sorting: bubble sort O(n²), our merge sort O(n log n), and the built-in sort
function bubbleSort(a) {
  for (let i = 0; i < a.length - 1; i++)
    for (let j = 0; j < a.length - 1 - i; j++)
      if (a[j] > a[j + 1]) { const t = a[j]; a[j] = a[j + 1]; a[j + 1] = t; }
  return a;
}
function mergeSort(a) {
  if (a.length <= 1) return a;
  const mid = a.length >> 1, left = mergeSort(a.slice(0, mid)), right = mergeSort(a.slice(mid));
  const res = []; let i = 0, j = 0;
  while (i < left.length && j < right.length) res.push(left[i] <= right[j] ? left[i++] : right[j++]);
  while (i < left.length) res.push(left[i++]);
  while (j < right.length) res.push(right[j++]);
  return res;
}
console.log('\n2+3) n items        dedup includes   dedup Set    bubble sort   merge sort   built-in sort');
out.growth = [];
for (const n of [2_000, 4_000, 8_000, 16_000, 32_000, 64_000]) {
  const items = randomArray(n);
  const r = {
    n,
    dedupArray: time(() => dedupArray(items)),
    dedupSet: time(() => dedupSet(items)),
    bubble: time(() => bubbleSort([...items])),
    merge: time(() => mergeSort([...items])),
    builtin: time(() => [...items].sort((a, b) => a - b)),
  };
  out.growth.push(r);
  console.log(`   n=${n.toLocaleString('en').padStart(7)}   ${ms(r.dedupArray)} ms   ${ms(r.dedupSet)} ms   ${ms(r.bubble)} ms   ${ms(r.merge)} ms   ${ms(r.builtin)} ms`);
}
console.log('\n   n=1,000,000   merge sort', ms(time(() => mergeSort(randomArray(1_000_000)), 1)), 'ms   built-in sort',
  ms(time(() => randomArray(1_000_000).sort((a, b) => a - b), 1)), 'ms   (including building the array)');

// 4) Recursion: Fibonacci, naive O(2ⁿ) against remembering the answers O(n)
let calls = 0;
const fib = (n) => { calls++; return n < 2 ? n : fib(n - 1) + fib(n - 2); };
const fibMemo = (n, memo = new Map()) => {
  calls++;
  if (n < 2) return n;
  if (!memo.has(n)) memo.set(n, fibMemo(n - 1, memo) + fibMemo(n - 2, memo));
  return memo.get(n);
};
console.log('\n4) Fibonacci     naive calls        naive time    memo calls   memo time');
out.fib = [];
for (const n of [20, 25, 30, 35, 40]) {
  calls = 0; let t = performance.now(); const a = fib(n); const tn = performance.now() - t; const cn = calls;
  calls = 0; t = performance.now(); const b = fibMemo(n); const tm = performance.now() - t; const cm = calls;
  if (a !== b) throw new Error('mismatch');
  out.fib.push({ n, naiveCalls: cn, naiveMs: tn, memoCalls: cm });
  console.log(`   fib(${n})   ${cn.toLocaleString('en').padStart(13)}   ${ms(tn)} ms   ${String(cm).padStart(8)}   ${ms(tm)} ms`);
}
if (process.argv.includes('--json')) writeFileSync('results.json', JSON.stringify(out, null, 1));
node bigo.js --jsonوالمخرج سوف يكون كما يلي، والتشغيل كله أخذ نحو دقيقة ونصف أغلبها في Bubble Sort:
1) 1,000 lookups          linear O(n)   binary O(log n)   Set.has O(1)
   n=    1,000        0.81 ms        0.60 ms         0.14 ms
   n=   10,000        9.74 ms        0.13 ms         0.11 ms
   n=  100,000       102.3 ms        0.21 ms         0.10 ms
   n=1,000,000      1372.4 ms        0.44 ms         0.60 ms

2+3) n items        dedup includes   dedup Set    bubble sort   merge sort   built-in sort
   n=  2,000        0.97 ms        0.16 ms        8.03 ms        2.09 ms        0.87 ms
   n=  4,000        2.03 ms        0.46 ms        28.7 ms        2.89 ms        1.18 ms
   n=  8,000        4.82 ms        0.24 ms       130.7 ms        6.44 ms        2.43 ms
   n= 16,000        19.8 ms        0.46 ms       593.6 ms        9.85 ms        12.4 ms
   n= 32,000        48.4 ms        0.82 ms      3673.8 ms        32.3 ms        35.3 ms
   n= 64,000       216.1 ms        1.71 ms     11150.0 ms        65.8 ms        25.9 ms

   n=1,000,000   merge sort    2358.7 ms   built-in sort     971.8 ms   (including building the array)

4) Fibonacci     naive calls        naive time    memo calls   memo time
   fib(20)          21,891        1.57 ms         39        0.13 ms
   fib(25)         242,785        2.23 ms         49        0.05 ms
   fib(30)       2,692,537        31.5 ms         59        0.03 ms
   fib(35)      29,860,703       298.6 ms         69        0.03 ms
   fib(40)     331,160,281      4133.5 ms         79        0.03 ms
وسوف نقرأ كل جدول من هذا المخرج في القسم الذي يخصه، ولكن لاحظ من الآن أن الأرقام الصغيرة جداً، مثل 0.24 ms و0.46 ms، تتأثر بالضجيج أكثر من غيرها، فلا تحكم على خوارزمية من فرق بين رقمين صغيرين، وإنما من اتجاه الأرقام عندما تكبر n.
البحث الخطي Linear Search والبحث الثنائي Binary Search
البحث الخطي Linear Search هو أبسط حل: تمر على العناصر من الأول حتى تجد ما تبحث عنه أو تنتهي القائمة، وهو O(n) ويعمل على أي قائمة مرتبة أو غير مرتبة. أما إذا كانت البيانات مرتبة فهناك طريقة أفضل بكثير هي البحث الثنائي Binary Search: تقارن بالعنصر الأوسط، فإذا كان أصغر مما تبحث عنه فالنتيجة في النصف الأيمن، وإذا كان أكبر ففي النصف الأيسر، وتستبعد النصف الآخر كله في خطوة واحدة، ثم تكرر على النصف الباقي. والصورة التالية تبين البحث عن 63 في 16 رقماً مرتباً:
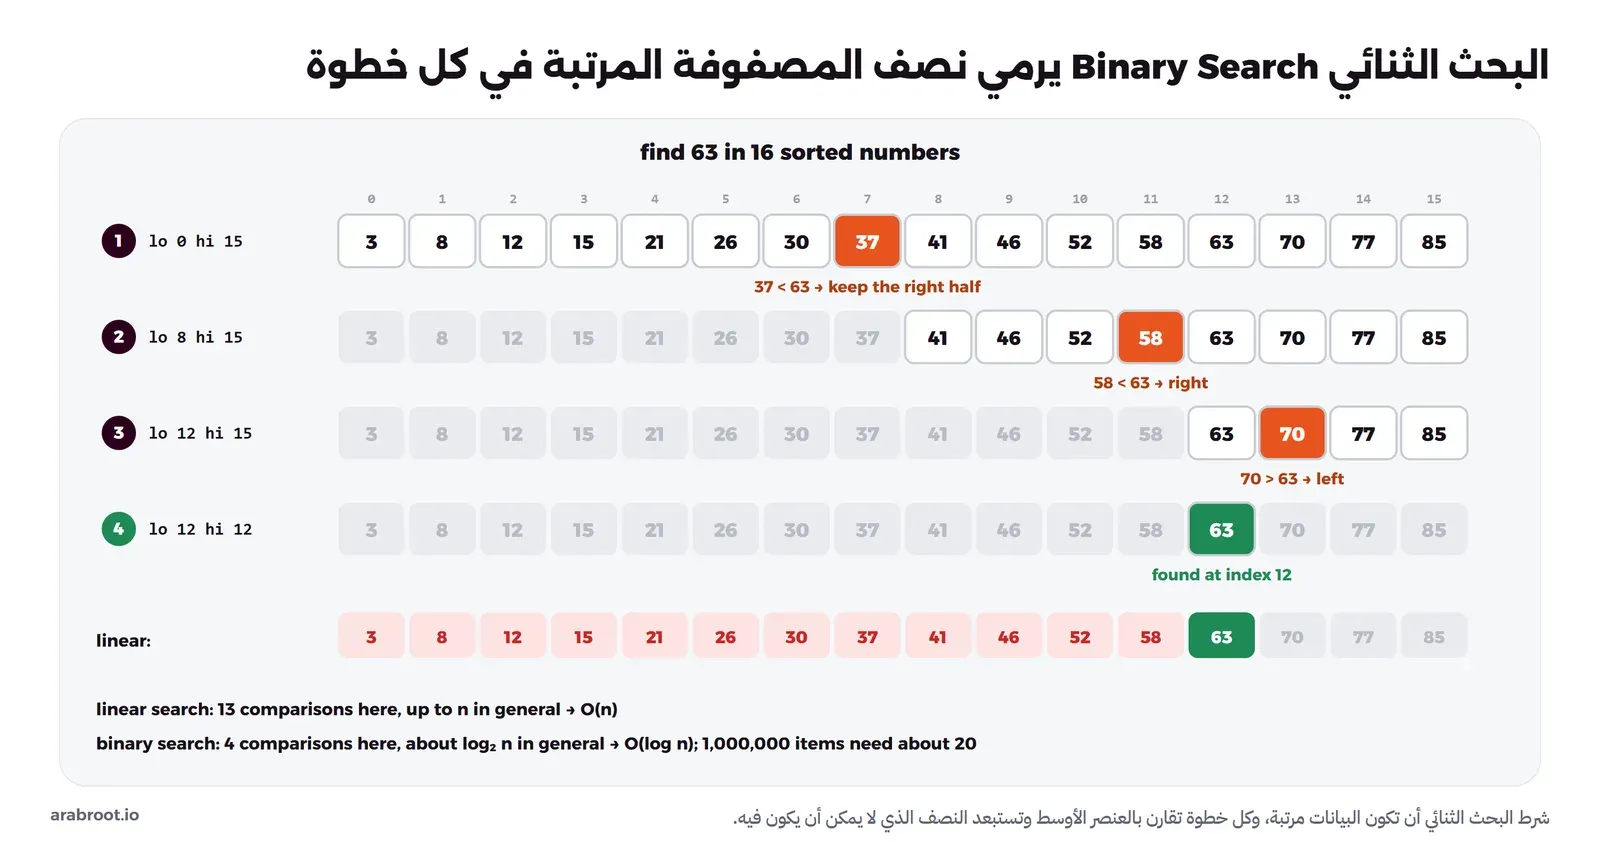
والجدول الأول من مخرج التجربة يبين الفرق بالأرقام: ألف عملية بحث في مصفوفة من مليون رقم أخذت 1372.4 ms بالبحث الخطي و0.44 ms بالبحث الثنائي، أي أسرع بأكثر من ثلاثة آلاف مرة. ولاحظ شكل الأرقام: البحث الخطي تضاعف تقريباً عشر مرات كلما تضاعفت n عشر مرات، من 9.74 إلى 102.3 ثم إلى 1372.4، وهذا هو O(n)، أما البحث الثنائي فبقي أقل من نصف مللي ثانية في كل الأحجام، لأن الانتقال من ألف عنصر إلى مليون أضاف نحو عشر مقارنات فقط لكل بحث.
وقد يتساءل البعض: إذا كان البحث الثنائي بهذه السرعة فلماذا لا نستخدمه دائماً؟ والإجابة أن شرطه أن تكون البيانات مرتبة، والترتيب نفسه يكلف O(n log n)، والإضافة إلى مصفوفة مرتبة مع بقائها مرتبة تكلف O(n) لأنك تحرك العناصر لتفسح مكاناً، لذلك فهو مناسب للبيانات التي تقرأ كثيراً وتتغير قليلاً. وعندما تتغير البيانات كثيراً تحتاج هيكلاً يبقى مرتباً وحده، وهذا ما تفعله الشجرة المتوازنة وفهرس B-tree في قاعدة البيانات، فهو نفس فكرة البحث الثنائي ولكن في صفحات، كما شرحنا في مقال هياكل البيانات. ولاحظ أيضاً أن المجموعة Set كانت بنفس سرعة البحث الثنائي تقريباً هنا، فإذا كان سؤالك «هل هذا موجود؟» فقط فالمجموعة أبسط، أما البحث الثنائي فيجيب أيضاً عن «ما أقرب قيمة؟» و«ما القيم بين كذا وكذا؟».
وتقابل فكرة البحث الثنائي في أماكن لا تتوقعها، فالأمر git bisect يجد الالتزام Commit الذي أدخل خطأً بين مئات الالتزامات بنفس الطريقة، كما ذكرنا في مقال Git، وفي Python توجد الوحدة bisect للبحث والإضافة في قائمة مرتبة.
java.util.Arrays بقي فيها خطأ نحو تسع سنوات حتى كسرت برنامج أحد المستخدمين. والخطأ في سطر يبدو بريئاً: int mid = (low + high) / 2، فعندما يتجاوز مجموع low وhigh أكبر عدد موجب في int وهو 2³¹ − 1 يصبح الناتج سالباً، فترمي Java الاستثناء ArrayIndexOutOfBoundsException، وهذا يحدث فقط مع مصفوفات طولها 2³⁰ عنصر أو أكثر، أي نحو مليار، وهو حجم لم يكن متخيلاً عندما كتبت الكتب التي نقلت هذا السطر. والإصلاح الذي اقترحه هو int mid = (low + high) >>> 1، وهو نفس السطر الذي استخدمناه في bigo.js. والدرس أن الخوارزمية الصحيحة على الورق قد تنكسر بسبب حدود الأنواع عندما تكبر البيانات، لذلك اختبر الحالات الحدية وليس المتوسط فقط.خوارزميات الترتيب Sorting
الترتيب من أكثر العمليات تكراراً في البرامج، فنتائج البحث والجداول والتقارير والفهارس كلها مرتبة، وهو أيضاً أفضل مثال على الفرق بين O(n²) وO(n log n)، لأن الخوارزميتين تعطيان نفس النتيجة تماماً بأزمنة مختلفة جداً.
الطريقة البسيطة: Bubble Sort
أبسط فكرة للترتيب هي ترتيب الفقاعات Bubble Sort: تمر على المصفوفة وتقارن كل عنصرين متجاورين، فإذا كانا بالترتيب الخطأ تبدلهما، وبعد المرور الأول يكون أكبر عنصر قد «طفا» إلى الآخر، ثم تكرر المرور على الباقي. وهي سهلة الفهم والكتابة كما ترى في الدالة bubbleSort، ولكنها حلقة داخل حلقة، وكل مرور يقارن قرابة n عنصر، وعدد المرورات قرابة n، فالمجموع O(n²). والجدول الثاني من مخرج التجربة يبين ذلك: من 16 ألفاً إلى 32 ألف عنصر قفز الزمن من 593.6 ms إلى 3673.8 ms، ومن 32 ألفاً إلى 64 ألفاً إلى 11150.0 ms، أي أن ترتيب 64 ألف رقم فقط أخذ أكثر من 11 ثانية، وهذا حجم صغير لجدول في أي نظام حقيقي.
الترتيب بالدمج Merge Sort
الترتيب بالدمج Merge Sort يقوم على فكرة «فرق تسد» Divide and Conquer: قسم المصفوفة إلى نصفين، ورتب كل نصف بنفس الطريقة، ثم ادمج النصفين المرتبين. والتقسيم يستمر حتى يبقى عنصر واحد في كل جزء، والعنصر الواحد مرتب بطبيعته، والدمج سهل لأنك تقارن أول عنصر في كل نصف وتأخذ الأصغر وتكرر. والصورة التالية تبين ذلك على ثمانية أرقام:
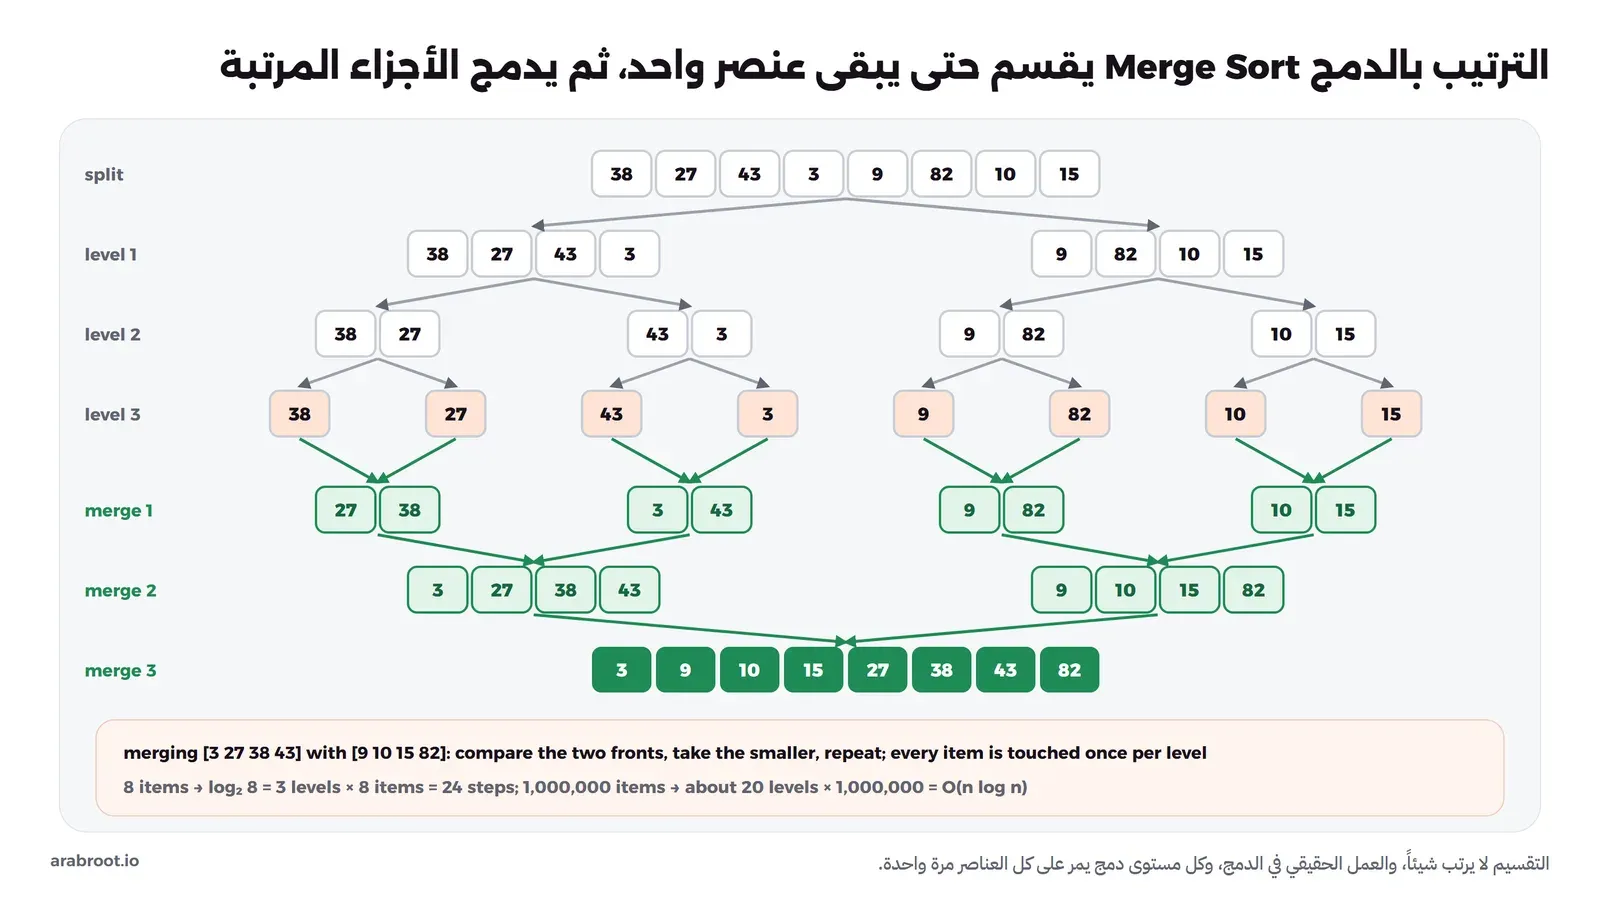
وعدد المستويات هو عدد المرات التي تقسم فيها n على 2، أي log n، وكل مستوى دمج يمر على كل العناصر مرة، فالمجموع n × log n، أي O(n log n) في كل الحالات. وفي التجربة رتبت mergeSort 64 ألف رقم في 65.8 ms مقابل 11150.0 ms ل Bubble Sort، ومليون رقم في نحو ثانيتين، وهو حجم لن تفكر حتى في تجربته مع Bubble Sort. وثمنها في الذاكرة O(n) لأنها تنشئ مصفوفات جديدة عند الدمج، وهذا مثال على مقايضة الذاكرة بالوقت التي ذكرناها.
الترتيب السريع Quick Sort
الترتيب السريع Quick Sort يستخدم «فرق تسد» أيضاً ولكن بالعكس: يختار عنصراً يسمى المحور Pivot، ثم يرتب المصفوفة بحيث يكون كل ما هو أصغر منه قبله وكل ما هو أكبر بعده، ثم يكرر على كل جهة. ولا يحتاج مصفوفات جديدة لأنه يبدل العناصر في مكانها، وهو في المتوسط O(n log n) وسريع جداً في الواقع، ولكن أسوأ حالته O(n²) عندما يكون المحور في كل مرة أصغر عنصر أو أكبره، مثل اختيار أول عنصر كمحور في مصفوفة مرتبة أصلاً. ولذلك لا تستخدم المكتبات الحديثة الترتيب السريع البسيط، وإنما نسخاً تحمي نفسها من هذه الحالة كما سنرى الآن.
الترتيب الجاهز Built-in Sort في اللغات: ماذا تستخدم فعلاً؟
لاحظ في التجربة أن الترتيب الجاهز في JavaScript كان أسرع من mergeSort التي كتبناها، فقد رتب مليون رقم في 971.8 ms مقابل 2358.7 ms، رغم أن الاثنين O(n log n). والسبب أن المكتبات القياسية لا تستخدم خوارزمية واحدة من الكتب، وإنما خوارزميات هجينة مضبوطة لسنوات على بيانات حقيقية، وكل لغة لها اختيارها:
| اللغة | الخوارزمية | مستقر Stable؟ | المصدر |
|---|---|---|---|
Python list.sort وsorted | Timsort: دمج يستفيد من الأجزاء المرتبة أصلاً في البيانات، ويستخدم اليوم في ترتيب الدمج استراتيجية powersort كما يذكر الملف نفسه | نعم | listsort.txt في CPython |
Java Arrays.sort للأنواع الأولية مثل int[] | Dual-Pivot Quicksort: ترتيب سريع بمحورين، O(n log n) على كل البيانات بحسب التوثيق | لا يحتاج، فالأرقام المتساوية لا تتميز | توثيق Arrays |
Java Arrays.sort للكائنات | ترتيب بالدمج مأخوذ من Timsort في Python | نعم | توثيق Arrays |
C# Array.Sort وList<T>.Sort | Introsort: ترتيب بالإدراج Insertion Sort للأجزاء حتى 16 عنصراً، وHeapsort إذا زاد عمق التقسيم عن 2 × log n، وQuicksort في الباقي | لا | توثيق Array.Sort |
| JavaScript في V8 (Node.js وChrome) | Timsort منذ V8 7.0 وChrome 70 | نعم، والمواصفة تشترط ذلك منذ ECMAScript 2019 | مدونة V8 وMDN |
في الجدول أعلاه لاحظ التالي:
- الترتيب المستقر Stable Sort يحافظ على ترتيب العناصر المتساوية كما كان، فإذا رتبت الطلبات حسب الحالة وكانت مرتبة قبل ذلك حسب التاريخ بقيت الطلبات ذات الحالة الواحدة مرتبة بالتاريخ، وهذا مهم عندما ترتب بأكثر من عمود على مراحل. و
Array.Sortفي .NET غير مستقر كما يقول توثيقه، فإذا احتجت الاستقرار فاستخدم OrderBy من LINQ الذي يقول توثيقه إنه ترتيب مستقر. - الحماية من أسوأ حالة الترتيب السريع موجودة في Introsort نفسه: عندما يلاحظ أن التقسيم أصبح عميقاً أكثر من اللازم ينتقل إلى Heapsort الذي يضمن O(n log n)، وهو نفس الكومة Heap التي شرحناها في مقال هياكل البيانات.
- لا تكتب خوارزمية ترتيب بنفسك في كود الإنتاج، فالمكتبة أسرع وأكثر اختباراً، كما رأيت في التجربة، وكتابتها مفيدة للتعلم فقط.
وهناك فخ في JavaScript يقع فيه كثيرون: الدالة sort دون دالة مقارنة تحول العناصر إلى نصوص وترتبها كنصوص، كما يذكر توثيق MDN، والمثال التالي يبين ذلك:
node -e "console.log([10, 9, 1, 100, 25].sort()); console.log([10, 9, 1, 100, 25].sort((a, b) => a - b))"والمخرج سوف يكون كما يلي:
[ 1, 10, 100, 25, 9 ]
[ 1, 9, 10, 25, 100 ]
لذلك عند ترتيب الأرقام في JavaScript مرر دائماً دالة المقارنة (a, b) => a - b كما فعلنا في التجربة.
الاستدعاء الذاتي Recursion والحفظ Memoization
الاستدعاء الذاتي Recursion أن تستدعي الدالة نفسها على جزء أصغر من المشكلة حتى تصل إلى حالة بسيطة تعرف إجابتها مباشرة وتسمى حالة التوقف Base Case، وقد رأيته في mergeSort التي ترتب كل نصف باستدعاء نفسها. وهو طريقة طبيعية لكتابة الحلول على الأشجار والبيانات المتداخلة، ولكن له فخان: الأول أن كل استدعاء يأخذ إطاراً في مكدس الاستدعاءات Call Stack، فإذا كان العمق كبيراً امتلأ المكدس، وقد قسنا ذلك في قسم المكدس في مقال هياكل البيانات، والثاني أن الاستدعاء الذاتي قد يعيد نفس الحساب مرات كثيرة دون أن تنتبه.
والمثال المشهور على الفخ الثاني متتالية Fibonacci، حيث كل رقم مجموع الرقمين قبله، والكتابة المباشرة لها fib(n) = fib(n-1) + fib(n-2) صحيحة ولكنها تستدعي نفسها مرتين في كل خطوة. والصورة التالية تبين ما يحدث مع fib(5):
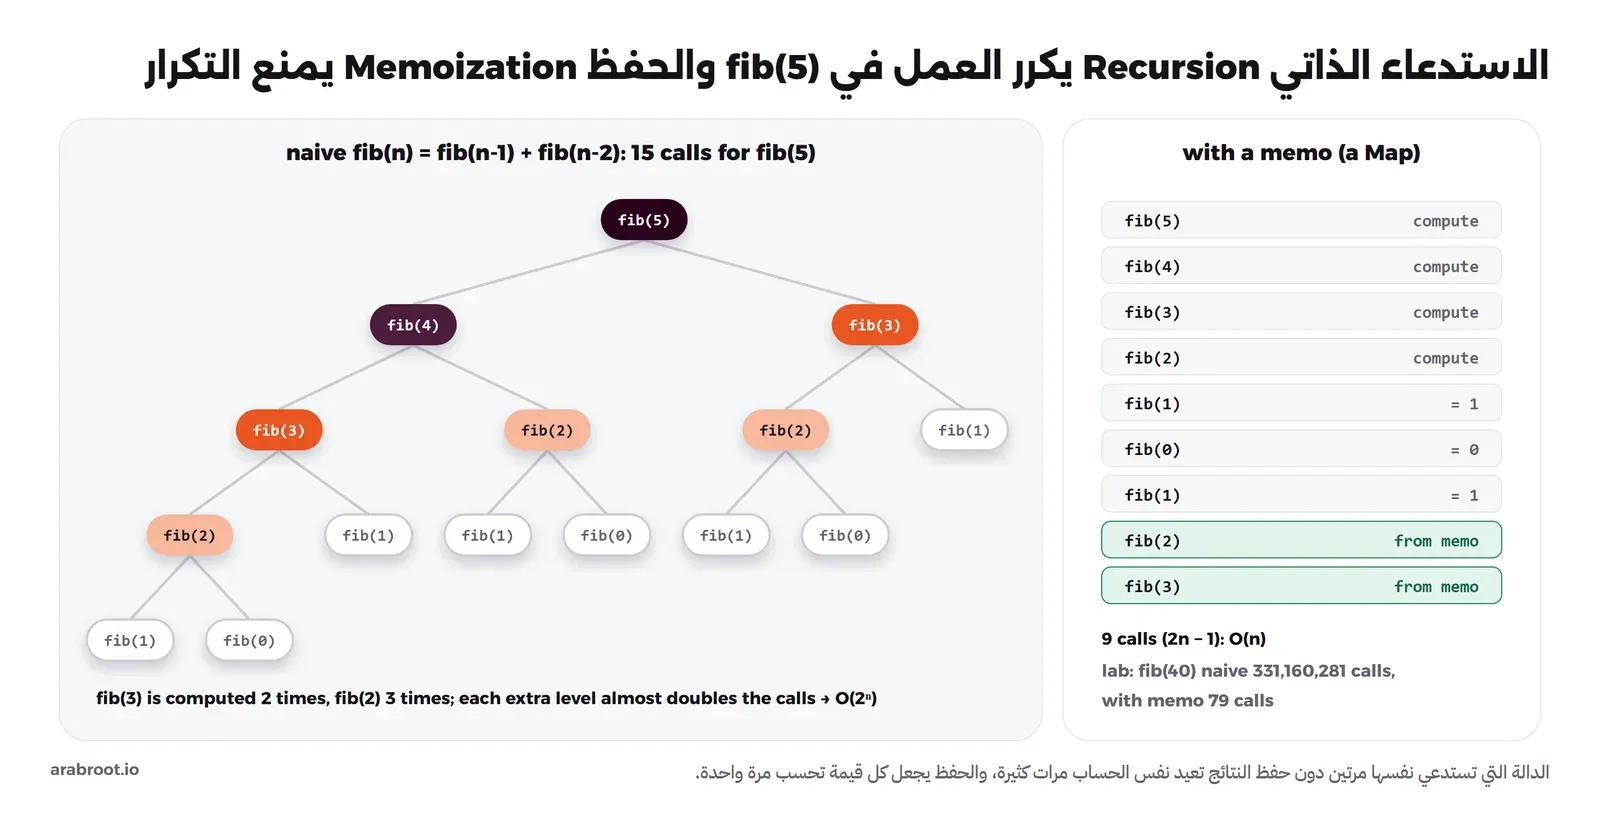
والجدول الرابع من مخرج التجربة يبين حجم المشكلة: fib(30) احتاجت 2,692,537 استدعاء، وfib(40) احتاجت 331,160,281 استدعاء وأكثر من أربع ثوان، فكل زيادة بخمسة في n ضربت عدد الاستدعاءات في أكثر من عشرة، وهذا نمو أسي. والحل هو الحفظ Memoization: نحفظ نتيجة كل fib(k) في جدول هاش Map عند أول حساب، وفي المرة التالية نأخذها من الجدول، فيصبح عدد الاستدعاءات 2n − 1، أي 79 استدعاء لfib(40) في 0.03 ms بدل أربع ثوان، وتحولت الخوارزمية من O(2ⁿ) إلى O(n) مقابل ذاكرة O(n) للجدول. وهذه هي نفس فكرة التخزين المؤقت Cache في السيرفرات: إذا كانت نفس الإجابة تحسب مرات كثيرة فاحفظها، كما شرحنا في مدخل تصميم الأنظمة.
اختيار هيكل البيانات Data Structure الصحيح: البحث في قائمة List داخل حلقة Loop
أكثر خطأ أداء نراه في الكود الحقيقي ليس خوارزمية معقدة، وإنما سطر بسيط: البحث في قائمة داخل حلقة. فالدالة dedupArray في التجربة تبدو بريئة، تمر على العناصر وتضيف كل عنصر غير موجود في القائمة seen، ولكن includes نفسها تمر على seen كلها، فهي حلقة داخل حلقة، أي O(n²). والحل تغيير هيكل البيانات فقط: نفس المنطق مع مجموعة Set التي تجيب عن «هل هذا موجود؟» في O(1)، فتصبح الدالة كلها O(n).
والصورة التالية تجمع أرقام التجربة الحقيقية للترتيب وحذف التكرار، ومعها منحنى n² النظري مرسوماً من آخر نقطة مقاسة:
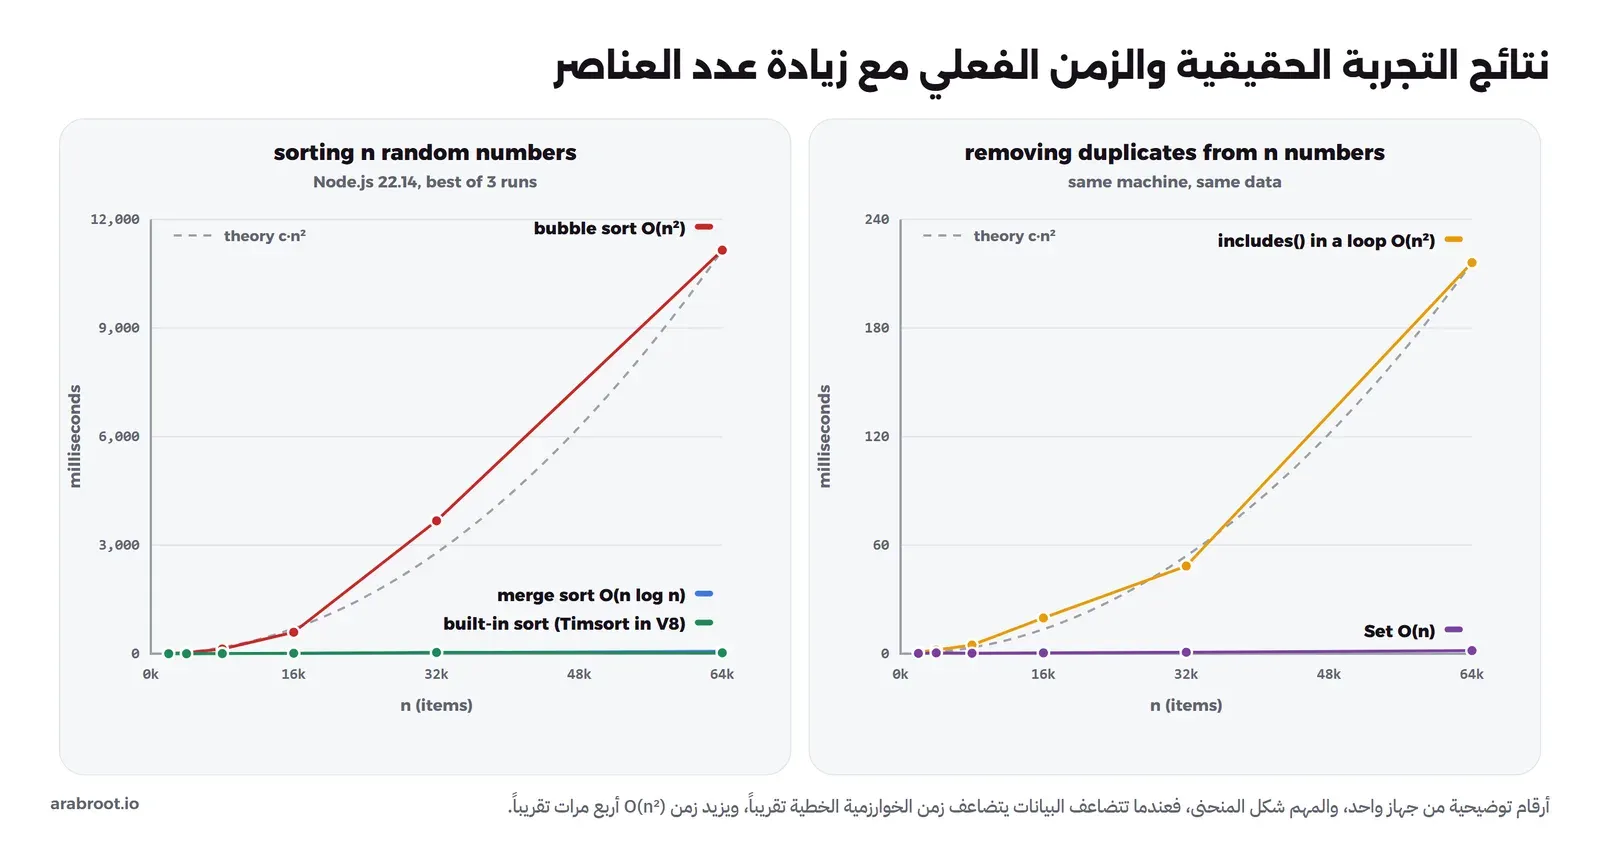
ولكي نتأكد أن المشكلة في الفكرة وليست في JavaScript، كتبنا نفس المقارنة في C# وPython على نفس الجهاز. ملف C# اسمه dedup.cs ويعمل مع .NET SDK 10.0.400 كتطبيق من ملف واحد:
// dedup.cs: List.Contains inside a loop against HashSet (dotnet run -c Release dedup.cs)
using System.Diagnostics;

var rnd = new Random(42);
foreach (int n in new[] { 1_000, 10_000, 20_000, 40_000, 80_000 })
{
    int[] items = Enumerable.Range(0, n).Select(_ => rnd.Next(n * 10)).ToArray();
    double tList = Best(() => { var seen = new List<int>(); foreach (var x in items) if (!seen.Contains(x)) seen.Add(x); return seen.Count; });
    double tSet = Best(() => { var seen = new HashSet<int>(); foreach (var x in items) seen.Add(x); return seen.Count; });
    if (n == 1_000) continue;   // warm-up round for the JIT
    Console.WriteLine($"n={n,7:N0}   List.Contains {tList,8:F1} ms   HashSet {tSet,5:F2} ms");
}

static double Best(Func<int> f)
{
    double best = double.MaxValue;
    for (int r = 0; r < 3; r++) { var sw = Stopwatch.StartNew(); f(); best = Math.Min(best, sw.Elapsed.TotalMilliseconds); }
    return best;
}
dotnet run -c Release dedup.csوالمخرج سوف يكون كما يلي:
n= 10,000   List.Contains     21.3 ms   HashSet  0.45 ms
n= 20,000   List.Contains     30.5 ms   HashSet  1.06 ms
n= 40,000   List.Contains     98.7 ms   HashSet  1.51 ms
n= 80,000   List.Contains    407.0 ms   HashSet  5.06 ms
وملف Python اسمه dedup.py، وشغلناه على Python 3.13.3:
# dedup.py: "x in list" inside a loop against a set
import random, time

def best(fn, runs=3):
    t = []
    for _ in range(runs):
        s = time.perf_counter(); fn(); t.append((time.perf_counter() - s) * 1000)
    return min(t)

def dedup_list(items):
    seen = []
    for x in items:
        if x not in seen:
            seen.append(x)
    return seen

def dedup_set(items):
    seen = set()
    for x in items:
        seen.add(x)
    return seen

random.seed(42)
for n in (10_000, 20_000, 40_000, 80_000):
    items = [random.randrange(n * 10) for _ in range(n)]
    print(f"n={n:7,}   x in list {best(lambda: dedup_list(items)):9.1f} ms   set {best(lambda: dedup_set(items)):5.2f} ms")
python dedup.pyوالمخرج سوف يكون كما يلي:
n= 10,000   x in list     505.7 ms   set  1.60 ms
n= 20,000   x in list    2811.5 ms   set  4.02 ms
n= 40,000   x in list   13018.5 ms   set  6.09 ms
n= 80,000   x in list   42989.4 ms   set 18.59 ms
في المخرجات أعلاه لاحظ التالي:
- في اللغات الثلاث تقريباً كلما تضاعف عدد العناصر تضاعف زمن القائمة أربع مرات أو أكثر، فمن 40 ألفاً إلى 80 ألفاً انتقل C# من 98.7 إلى 407.0 ms، وانتقلت JavaScript من 48.4 إلى 216.1 ms بين 32 و64 ألفاً، وهذا هو O(n²)، أما المجموعة فبقيت بضعة مللي ثوان.
- Python مع القائمة احتاجت 43 ثانية لثمانين ألف عنصر، أي أن قائمة بريد متوسطة الحجم تكفي لتعطيل مهمة كاملة، ومع المجموعة 18.59 ms، والفرق أكثر من ألفي مرة بتغيير سطر واحد.
- الفرق بين اللغات كبير في الأرقام المطلقة، وPython هنا أبطأ من C# بمئة مرة تقريباً في القائمة، ولكن الدرس واحد في الثلاث: الخوارزمية الصحيحة في Python أسرع بكثير من الخوارزمية الخطأ في C#، فقد حذفت Python التكرار من 80 ألف عنصر بالمجموعة في 18.59 ms، وحذفته C# بالقائمة في 407.0 ms.
وصفحة TimeComplexity في ويكي Python تلخص ذلك: x in s على القائمة O(n)، وعلى المجموعة O(1) في المتوسط. لذلك كلما رأيت contains أو includes أو in أو indexOf على قائمة داخل حلقة فتوقف واسأل: هل تكفي مجموعة أو جدول هاش هنا؟ والإجابة في أغلب الحالات نعم.
مشكلة N+1: حلقة O(n) من الرحلات على الشبكة Network Round Trips
نفس فكرة «الحلقة التي تخفي عملاً مكلفاً» تظهر بشكل أخطر عندما يكون العمل داخل الحلقة استعلاماً لقاعدة البيانات. فالصفحة التي تعرض آخر مئة طلب مع اسم كل عميل قد تكتب هكذا: استعلام واحد يجلب الطلبات، ثم لكل طلب استعلام يجلب اسم العميل، فيصبح المجموع 1 + N استعلاماً، ولهذا تسمى مشكلة N+1، وتحدث كثيراً مع أدوات ORM التي تجلب البيانات المرتبطة عند أول استخدام دون أن تنتبه. والصورة التالية تبين الفرق:
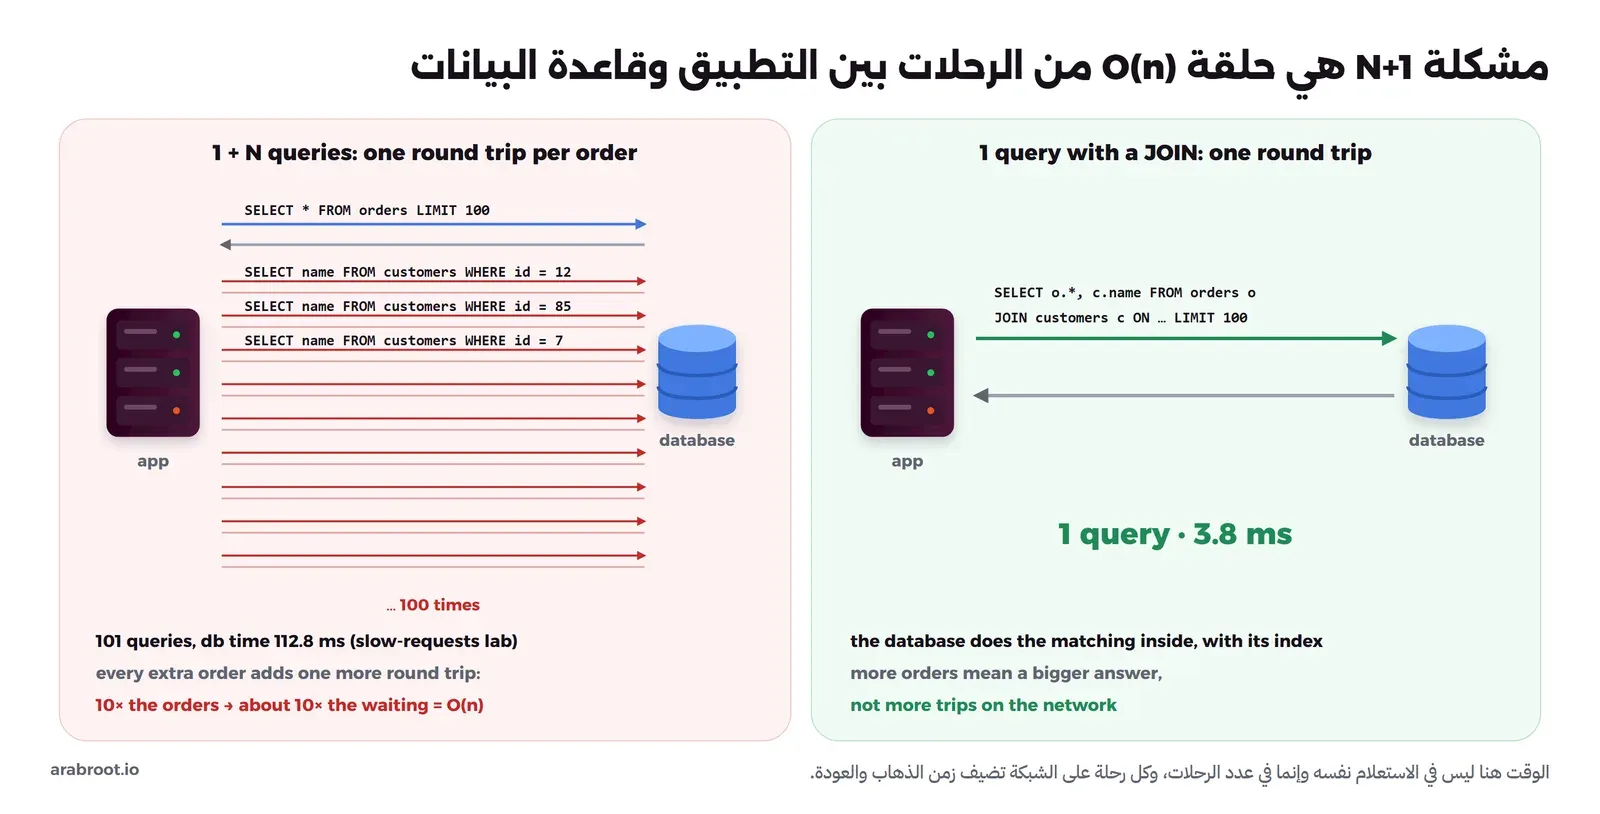
ومن جهة Big-O فكل استعلام قد يكون سريعاً جداً بفضل الفهرس، ولكن عدد الاستعلامات O(n)، وكل استعلام يدفع زمن الذهاب والعودة Round Trip على الشبكة وزمن تحليل الاستعلام وتجهيزه، وهذا الزمن ثابت لا يقل مهما كان الاستعلام صغيراً. وفي تجربة تتبع الطلب البطيء قسنا ذلك فعلاً: الصفحة بطريقة N+1 نفذت 101 استعلام أخذت 112.8 ms، ونفس الصفحة باستعلام واحد فيه JOIN أخذت 3.8 ms، وكانت قاعدة البيانات على نفس الجهاز، فإذا كانت على سيرفر آخر أضيف زمن الشبكة إلى كل استعلام من المئة. والحل أن تجعل قاعدة البيانات تقوم بالربط في استعلام واحد بالأمر JOIN، أو أن تجمع المعرفات وتجلبها مرة واحدة بالشرط WHERE id IN (...)، وكلاهما يحول عدد الرحلات من O(n) إلى O(1)، وقد شرحنا الحلول من جهة قاعدة البيانات في مقال تصميم قواعد البيانات.
كيف تكتشف الخوارزمية Algorithm البطيئة في كودك؟
لن تحسب Big-O لكل دالة تكتبها، ولكن هناك أنماط إذا رأيتها في مراجعة الكود Code Review فتوقف عندها:
- حلقة داخل حلقة على نفس البيانات: مقارنة كل عنصر بكل عنصر O(n²)، وكثيراً ما يحل جدول هاش المشكلة بمرور واحد.
- بحث في قائمة داخل حلقة:
containsوincludesوinوindexOfوfind، كما رأيت بالأرقام. - ترتيب داخل حلقة: ترتيب نفس البيانات في كل دورة يحول O(n log n) إلى O(n² log n)، فرتب مرة واحدة قبل الحلقة.
- استعلام أو طلب HTTP داخل حلقة: هذه N+1 حتى لو لم تكن مع قاعدة بيانات، فاجمع الطلبات في طلب واحد.
- استدعاء ذاتي يعيد نفس الحساب: احفظ النتائج، أو حوله إلى حلقة.
ولكن تذكر أن Big-O يصف الشكل عندما تكبر البيانات، ولا يقول شيئاً عن الثوابت، ففي التجربة كان البحث الخطي في ألف عنصر قريباً من البحث الثنائي، لأن الثابت الصغير للحلقة البسيطة يعوض الفرق عندما تكون n صغيرة، ولهذا السبب تستخدم Introsort في .NET الترتيب بالإدراج O(n²) للأجزاء الصغيرة حتى 16 عنصراً. لذلك لا تقم بتعقيد كود يعمل على عشرة عناصر دائماً، وإنما ركز على الكود الذي يكبر مع المستخدمين والبيانات، وعندما تشك في مكان البطء فلا تخمن، وإنما قس بأداة Profiling كما في مقال تتبع الطلب البطيء، واختبر على حجم بيانات قريب من الإنتاج، لأن مشكلات O(n²) لا تظهر في بيانات التجربة الصغيرة أبداً.
أخطاء شائعة
- الحكم على الأداء من بيانات التطوير الصغيرة: مئة صف لا تكشف O(n²)، فاختبر بحجم الإنتاج أو بعشرة أضعافه.
- كتابة خوارزمية ترتيب أو بحث بنفسك: المكتبة القياسية أسرع وأكثر اختباراً، وخطأ Joshua Bloch في سطر واحد بقي سنوات.
- نسيان دالة المقارنة في
sortفي JavaScript: ترتيب الأرقام كنصوص يعطي[1, 10, 100, 25, 9]. - الاعتماد على ترتيب مستقر من دالة غير مستقرة:
Array.Sortفي .NET لا يضمن ترتيب العناصر المتساوية. - الثقة بمتوسط O(1) مع بيانات يتحكم فيها مهاجم: احسب أسوأ حالة لكل ما يأتي من الخارج.
- إصلاح البطء بسيرفر أكبر: سيرفر أسرع مرتين لا ينفع كثيراً مع خوارزمية يتضاعف عملها أربع مرات مع كل مضاعفة للبيانات، فأصلح الخوارزمية أولاً.
تدريب عملي Practice
- غير في
bigo.jsقائمة الأحجام لتصل إلى 128 ألف عنصر لحذف التكرار فقط، وتوقع زمنdedupArrayقبل التشغيل من الأرقام السابقة، ثم قارن توقعك بالنتيجة. - اكتب دالة تجد العناصر المشتركة بين قائمتين بحلقتين متداخلتين، ثم بمجموعة، وقس الفرق على قائمتين من خمسين ألف عنصر.
- ابحث في مشروع تعمل عليه عن
includesأوcontainsأوinداخل حلقة، وقرر هل تحتاج مجموعة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الخوارزمية خطوات تحل مشكلة، والمشكلة الواحدة لها خوارزميات كثيرة، وBig-O يصف كيف يكبر عملها مع البيانات بغض النظر عن الجهاز واللغة.
- O(1) وO(log n) تبقى سريعة مهما كبرت البيانات تقريباً، وO(n) تتضاعف معها، وO(n²) تتضاعف أربع مرات، وO(2ⁿ) لا تصلح إلا لأعداد صغيرة جداً.
- في التجربة أخذ البحث الخطي في مليون عنصر 1372.4 ms لألف بحث مقابل 0.44 ms بالبحث الثنائي، وأخذ Bubble Sort أكثر من 11 ثانية ل 64 ألف رقم مقابل 25.9 ms للترتيب الجاهز.
- المكتبات القياسية تستخدم خوارزميات هجينة مثل Timsort وIntrosort وDual-Pivot Quicksort، فاستخدمها ولا تكتب الترتيب بنفسك، وانتبه للاستقرار ولدالة المقارنة في JavaScript.
- الحفظ Memoization حول Fibonacci من 331 مليون استدعاء إلى 79، وهو نفس فكرة التخزين المؤقت في السيرفرات.
- أكثر مشكلات الأداء الحقيقية حلقة تخفي عملاً مكلفاً: بحث في قائمة يحل بمجموعة، واستعلام لكل عنصر يحل ب JOIN.
وبقية مواضيع المرحلة، ومنها الذاكرة والمعالج والأنظمة العددية، تجدها في صفحة الخارطة.
 دليلهياكل البيانات Data Structures للمبتدئينلماذا تكون نفس العملية سريعة في هيكل بيانات وبطيئة في آخر، وأين تقابل كل هيكل في السيرفرات وقواعد البيانات.
 دليلتتبع الطلب البطيء من المتصفح إلى قاعدة البياناتكيف تأخذ طلباً واحداً بطيئاً أو فاشلاً وتعرف في أي طبقة ضاع وقته، بقياسات حقيقية في كل طبقة بدل التخمين.
 دليلتصميم قواعد البيانات: التطبيع Normalization ومتى تكسرهلماذا يفشل الجدول الواحد الكبير، وكيف تقسمه إلى جداول لا تناقض نفسها، وما الذي يتغير عندما تكبر البيانات.
 دليلمدخل إلى تصميم الأنظمة: من سيرفر واحد إلى ملايين المستخدمينكيف يكبر متجر إلكتروني من سيرفر واحد إلى نظام يخدم ملايين المستخدمين، وما الثمن الذي تدفعه في كل خطوة.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، واختبار التجارب على Windows 11 بمعالج Intel Core i7-7700K باستخدام Node.js 22.14.0 و.NET SDK 10.0.400 (Runtime 10.0.11) وPython 3.13.3.