إذا قمت بتثبيت Docker Desktop أو WSL2 أو برنامج أجهزة افتراضية على جهازك فغالباً مررت بهذه الخطوة: رسالة تطلب منك تفعيل خيار اسمه «Intel Virtualization Technology» أو «SVM Mode» من إعدادات BIOS، ثم إعادة التشغيل، ثم تفتح مدير المهام فتجد في صفحة المعالج سطراً يقول «Virtualization: Enabled». وبعدها يعمل كل شيء، ويعمل Linux كامل داخل Windows بسرعة قريبة من سرعة الجهاز نفسه. ولكن ما الذي فعله هذا الخيار فعلاً؟ هل هو مجرد إذن من الشركة المصنعة، أم أن داخل المعالج دوائر كاملة كانت نائمة ثم استيقظت؟ ولماذا يقول Windows في نفس الجهاز إن «دعم المحاكاة الافتراضية في البرنامج الثابت» غير مفعل مع أن الأجهزة الافتراضية تعمل أمامك؟
في مقال المحاكاة الافتراضية من Hypervisor إلى KVM شرحنا الفكرة العامة: المشرف Hypervisor، وطريقة الاعتراض والمحاكاة Trap and Emulate، والفرق بين النوع الأول والثاني، وقسنا نفس الجهاز الافتراضي مع KVM ودونه فكان الفرق عشرات الأضعاف. أما هنا فسوف ننزل طبقة أعمق إلى المعالج نفسه: ما الذي أضافته Intel وAMD إلى العتاد، وكيف يدخل المعالج إلى الضيف ويخرج منه، وكم يكلف هذا الخروج بالنانوثانية، وسوف نقيس ذلك بمشرف صغير نكتبه بأنفسنا في نحو مئة سطر من لغة C فوق واجهة KVM. وسوف نناقش في هذا المقال ما يلي:
- لماذا كانت معمارية x86 صعبة على المحاكاة الافتراضية، وكيف تحايلت عليها VMware وXen قبل أن يساعدهما العتاد.
- ما الذي أضافته تقنيتا VT-x من Intel وAMD-V من AMD: عالمان داخل المعالج اسمهما VMX root وVMX non-root، وبنية التحكم VMCS، والدخول VM Entry والخروج VM Exit.
- مختبر حقيقي: نقرأ أعلام المعالج ونسأل التعليمة
cpuidعن المشرف الذي نعمل تحته، ثم نبني مشرفاً صغيراً على KVM يشغل ضيفاً من 63 بايت، ونعد مرات الخروج وأسبابها ونقيس زمنها. - ترجمة الذاكرة على مرحلتين EPT وNPT، وكيف رأينا في المختبر 255 خروجاً في المرة الأولى ثم لا شيء في المرة الثانية.
- الأجهزة الطرفية: لماذا يحتاج الضيف virtio، ومتى يحتاج IOMMU مثل VT-d.
- WSL2 وHyper-V مثالاً حقيقياً: لماذا يعمل Windows نفسه ضيفاً على جهازك، وما معنى المحاكاة المتداخلة Nested Virtualization وكم تكلف.
- حوادث أمنية حقيقية في هذه الطبقة، وأخطاء شائعة، وجدول قرار، وقائمة تحقق قبل أن تعتمد على الأجهزة الافتراضية في عملك.
وهذا المقال ضمن مقالات المعالجات، ويفترض أنك تعرف ما هي مجموعة التعليمات ISA وما الفرق بين فضاء النواة وفضاء المستخدم، فإن لم تكن قرأت عنهما فهذه المقالات تكمل الصورة:
 دليلمعمارية المعالج ISA: لماذا لا يعمل برنامج x86 على ARM؟نترجم نفس برنامج C لثلاث معماريات ونقرأ تعليماته سطراً سطراً، لنفهم ما الذي يجعل الملف التنفيذي يعمل على معالج ويرفضه معالج آخر.
 دليلقصة x86: من Intel 8086 إلى x86-64 الذي صممته AMDكيف وصلت معمارية معالج 16 بت من 1978 إلى أغلب سيرفرات اليوم، ولماذا ما زال معالجك يقلع كأنه 8086، مع قطاع إقلاع يصعد الأوضاع الثلاثة أمامك.
 دليلالمحاكاة Emulation والترجمة الثنائية: QEMU وRosetta 2نفتح محاكي QEMU ونرى كيف تتحول تعليمات ARM إلى تعليمات x86 ونقيس كلفة كل خطوة، ثم نقارن ذلك بما تفعله Rosetta 2 وWindows Prism.
لماذا كانت x86 صعبة على المحاكاة الافتراضية؟
الفكرة التي يقوم عليها أي مشرف بسيطة: شغل كود الضيف مباشرة على المعالج الحقيقي، فهو أسرع بكثير من ترجمته أو محاكاته، ولكن اجعل الضيف يعمل بصلاحيات أقل من صلاحيات المشرف، بحيث إذا حاول تنفيذ تعليمة خطيرة، مثل تغيير جدول الصفحات أو إيقاف المقاطعات Interrupts أو الكتابة إلى منفذ جهاز، يرفضها المعالج ويرسل خطأ Trap إلى المشرف، فيقوم المشرف بتنفيذ ما أراده الضيف على نسخته الافتراضية من الجهاز ثم يعيده. وقد شرحنا هذه الطريقة في مقال المحاكاة الافتراضية، والمهم هنا شرط واحد فيها: يجب أن يكون كل شيء حساس في المعالج مسبباً لهذا الخطأ عندما ينفذ بصلاحيات منخفضة.
وهذا الشرط له اسم في علوم الحاسب: في عام 1974 نشر Gerald Popek وRobert Goldberg ورقة تقول إن المعمارية تكون قابلة للمحاكاة الافتراضية بهذه الطريقة إذا كانت كل تعليمة حساسة Sensitive Instruction، أي تعليمة تقرأ حالة الجهاز أو تغيرها، هي أيضاً تعليمة مميزة Privileged Instruction، أي تسبب Trap إذا نفذت خارج أعلى مستوى صلاحيات. ومعالجات x86 لم تحقق هذا الشرط، وفي عام 2000 أحصت ورقة Robin وIrvine في مؤتمر USENIX Security سبع عشرة تعليمة في معالج Pentium حساسة ولكنها لا تسبب أي خطأ عندما ينفذها برنامج عادي.
لنأخذ مثالاً واحداً حتى تتضح المشكلة: التعليمة POPF تقرأ من الـ Stack قيمة وتضعها في مسجل الأعلام، ومن هذه الأعلام علم المقاطعات IF. فإذا نفذتها نواة نظام تشغيل في Ring 0 تغير العلم فعلاً، أما إذا نفذتها في مستوى أقل فإن المعالج يتجاهل تغيير IF بصمت دون أي خطأ. والآن تخيل نواة ضيف أنزلها المشرف إلى Ring 1 حتى يحمي نفسه منها، وتريد أن توقف المقاطعات قبل أن تعدل جدولاً مهماً: سوف تنفذ POPF، ولن يحدث شيء، ولن يعرف المشرف بذلك، وسوف تكمل النواة عملها وهي تظن أن المقاطعات متوقفة. وتعليمات مثل SGDT وSMSW تكشف للضيف قيماً حقيقية من المعالج يفترض أن يراها مختلفة، فيعرف أنه ليس في Ring 0 الذي يظنه.
الحل الأول: ترجمة الكود أثناء التشغيل Binary Translation
في أواخر التسعينيات قدمت VMware حلاً عملياً: يعمل كود المستخدم في الضيف مباشرة على المعالج لأنه لا يحتوي تعليمات حساسة تهم المشرف، أما كود نواة الضيف فيمر قبل تشغيله على مترجم يقرؤه على شكل كتل صغيرة، ويستبدل كل تعليمة حساسة باستدعاء إلى المشرف، ويحفظ الكتلة المترجمة في ذاكرة مؤقتة حتى لا يترجمها مرة أخرى. وهذه هي نفس فكرة الترجمة الثنائية التي يستعملها QEMU في وضع TCG، ولكن على نطاق أضيق لأن المعمارية هي نفسها. والحل نجح وبنيت عليه صناعة كاملة، ولكنه معقد جداً، فالمترجم يجب أن يفهم كل حالة غريبة في x86، ويجب أن يتعامل مع كود يعدل نفسه، ومع قفزات إلى منتصف كتلة مترجمة.
الحل الثاني: تعديل الضيف نفسه Paravirtualization
وفي عام 2003 نشر فريق من جامعة Cambridge ورقة Xen and the Art of Virtualization بفكرة أخرى: لماذا نخدع الضيف أصلاً؟ لنعدل نواة الضيف بحيث تعرف أنها تعمل فوق مشرف، فبدلاً من تنفيذ التعليمة الحساسة تستدعي المشرف مباشرة باستدعاء خاص اسمه Hypercall، يشبه استدعاء النظام System Call الذي يستعمله البرنامج ليطلب شيئاً من النواة. وكانت النتيجة أداء ممتازاً، ولكن بشرط أن تملك كود نواة الضيف وتستطيع تعديله، وهذا ممكن مع Linux وغير ممكن مع Windows في ذلك الوقت. ولاحظ أن هذه الفكرة لم تمت مع وصول الدعم العتادي، وإنما انتقلت إلى الأجهزة الطرفية، فأجهزة virtio التي سوف نصل إليها بعد قليل هي Paravirtualization للأقراص والشبكة.
ما الذي أضافته VT-x وAMD-V إلى المعالج؟
في عامي 2005 و2006 وصلت إلى المعالجات تقنية Intel VT-x ثم تقنية AMD-V، والفكرة في الاثنتين واحدة: بدلاً من أن نطرد الضيف من Ring 0 ونحاول اكتشاف تعليماته الحساسة بأنفسنا، نضيف إلى المعالج بعداً جديداً كاملاً للصلاحيات. فيصبح في المعالج عالمان، يسمى الأول في كتيبات Intel وضع VMX root وفيه يعمل المشرف، ويسمى الثاني VMX non-root وفيه يعمل الضيف، ولكل عالم مستوياته الأربعة Ring 0 حتى Ring 3. وبالتالي تعمل نواة الضيف في Ring 0 كما صممت دون أي تعديل، وبرامجه في Ring 3، ولكن كل ذلك داخل العالم الثاني. والصورة التالية تبين الفرق:
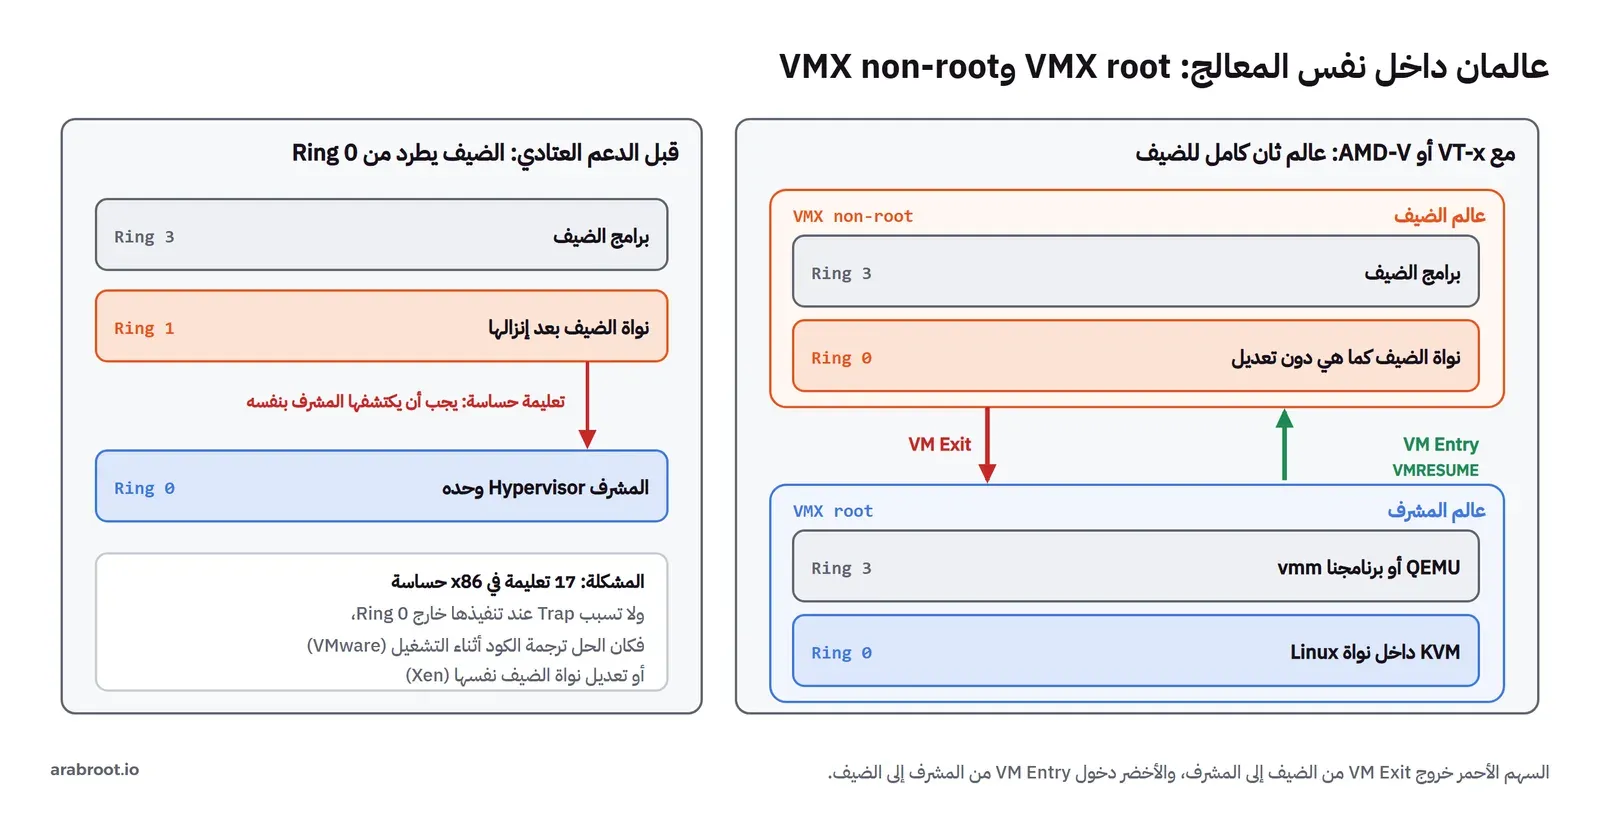
وفي الصورة أعلاه لاحظ التالي:
- في العالم الثاني يرى الضيف كل شيء كما لو كان على جهاز حقيقي، ولكن المعالج نفسه يعرف أنه في وضع non-root، ولذلك يستطيع أن يقرر عند تعليمات وأحداث معينة أن يتوقف ويعود إلى المشرف.
- الانتقال من الضيف إلى المشرف اسمه الخروج VM Exit، والعودة اسمها الدخول VM Entry، وكلاهما يقوم به المعالج بنفسه بحفظ حالة كاملة واستعادة أخرى، وليس بتعليمة قفز عادية في الكود.
- المشكلة التي ناقشناها مع
POPFاختفت، فنواة الضيف في Ring 0 حقيقي داخل عالمها، وتغيير علم المقاطعات يعمل كما تتوقع، والمشرف يختار عن طريق إعدادات معينة هل يريد أن يعرف بذلك أم لا.
وقد يتساءل البعض: إذا كانت الفكرة واحدة فلماذا اسمان؟ والإجابة أن كل شركة صممت تعليماتها وأسماءها بنفسها، فالمشرف المكتوب لإحداهما لا يعمل على الأخرى دون طبقة خاصة بها، ولذلك تجد في KVM وحدتين منفصلتين هما kvm_intel وkvm_amd. والجدول التالي يضع الأسماء جنباً إلى جنب:
| المفهوم | Intel VT-x | AMD-V (SVM) |
|---|---|---|
علم الدعم في /proc/cpuinfo | vmx | svm |
| تشغيل الوضع | VMXON | علم EFER.SVME |
| بنية التحكم بالضيف | VMCS | VMCB |
| الدخول إلى الضيف | VMLAUNCH ثم VMRESUME | VMRUN |
| الخروج إلى المشرف | VM Exit | #VMEXIT |
| ترجمة الذاكرة على مرحلتين | EPT | NPT (تسميه AMD أيضاً RVI) |
| عزل الأجهزة الطرفية IOMMU | VT-d | AMD-Vi |
وبقية المقال تستعمل أسماء Intel لأن جهاز المختبر من Intel، والفكرة نفسها تنطبق على AMD.
بنية VMCS والخروج VM Exit: كيف يقرر المعالج متى يتوقف؟
لكل معالج افتراضي vCPU في الضيف منطقة في الذاكرة اسمها VMCS، اختصاراً لـ Virtual Machine Control Structure، وهي التي تجعل الدخول والخروج ممكناً. وحسب كتيبات Intel للمطورين تنقسم هذه البنية إلى أجزاء واضحة: جزء لحالة الضيف Guest State فيه مسجلاته ومسجلات التحكم مثل CR3 وعنوان التعليمة التالية RIP، وجزء لحالة المضيف Host State يقول للمعالج أين يذهب وبأي حالة عندما يخرج، وجزء لإعدادات التحكم Controls يحدد فيه المشرف ما الذي يسبب خروجاً، وجزء أخير لمعلومات الخروج Exit Information يكتب فيه المعالج سبب آخر خروج وتفاصيله.
وإعدادات التحكم هي أهم ما في الأمر، لأنها تجعل الاعتراض اختيارياً ودقيقاً: يستطيع المشرف مثلاً أن يقول «أخرجني عند كل وصول لمنفذ إدخال وإخراج» أو «فقط عند هذه المنافذ»، و«أخرجني عند تعليمة HLT» أو «اتركها للضيف». وهناك تعليمات تسبب خروجاً دائماً مهما كانت الإعدادات، ومنها CPUID، والسبب أن المشرف يجب أن يتحكم فيما يراه الضيف عن المعالج، فهو قد يخفي عنه بعض الميزات حتى يستطيع نقله إلى سيرفر آخر بمعالج أقدم مثلاً. ولذلك اخترنا CPUID في المختبر: نعرف مسبقاً أنها سوف تخرج في كل مرة.
والصورة التالية تبين الحلقة التي يدور فيها كل مشرف مبني على KVM، سواءً كان QEMU أو البرنامج الصغير الذي سوف نكتبه:
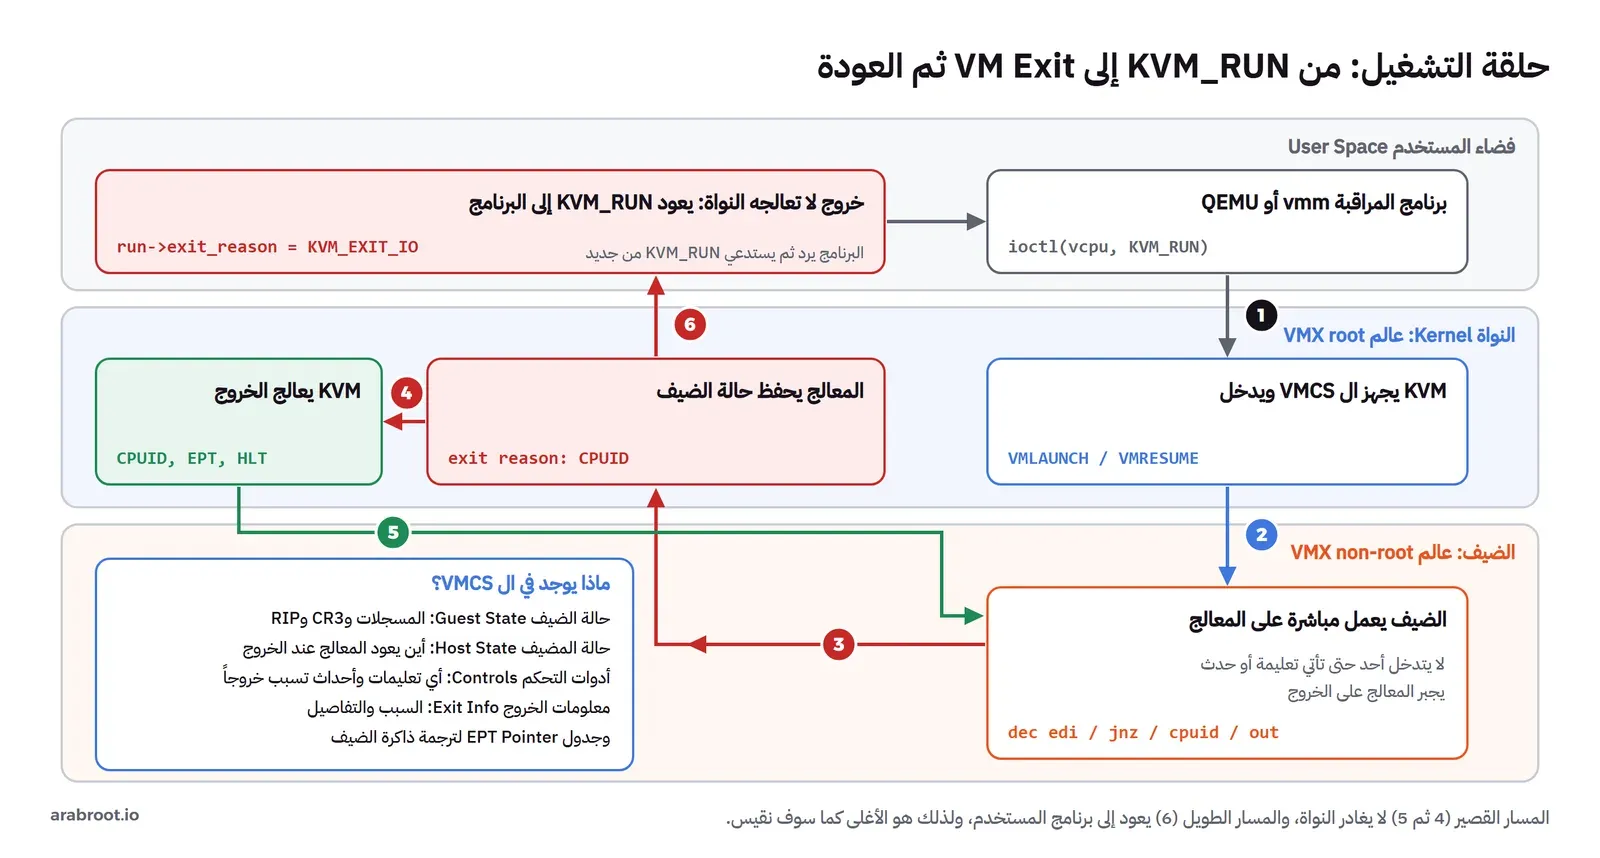
وفي الصورة أعلاه لاحظ أن هناك نوعين من الخروج: نوع يعالجه KVM داخل النواة ثم يدخل الضيف مباشرة، مثل CPUID وخطأ ترجمة الذاكرة، ونوع لا يعرف KVM ماذا يفعل به لأنه يخص جهازاً يقلده برنامج المستخدم، مثل الكتابة إلى منفذ لبطاقة شبكة يحاكيها QEMU، فيعود الاستدعاء KVM_RUN إلى البرنامج ومعه السبب في بنية مشتركة اسمها kvm_run، فيعالجه البرنامج ثم يستدعي KVM_RUN مرة أخرى. وهذا التقسيم هو سبب وجود KVM في النواة وQEMU في فضاء المستخدم معاً، وسوف نرى بعد قليل أن الفرق بينهما في الزمن كبير.
المختبر Lab: نكتب مشرفاً صغيراً على KVM
الآن سوف نقوم بالتجربة بأنفسنا. والفكرة أن KVM ليس برنامجاً تشغله وإنما واجهة في نواة Linux، يفتحها أي برنامج عن طريق الملف /dev/kvm ويطلب منها بأوامر ioctl أن تنشئ جهازاً افتراضياً وذاكرة ومعالجاً افتراضياً ثم تشغله، وهذا بالضبط ما يفعله QEMU، وتوثيق واجهة KVM في النواة يشرح كل أمر منها، وقد كتب LWN مقالاً معروفاً عن استعمالها بأقل كود ممكن. وسوف نشغل كل شيء داخل Container من debian:trixie-slim على Docker Desktop، والملفات كلها موجودة في مجلد lab مع المقال.
ماذا يقول المعالج عن نفسه؟ cpuinfo وcpuid
قبل أن نكتب أي كود نتأكد أن المعالج يدعم VT-x وأن KVM موجود. وهذا ملف Docker الذي نبني منه بيئة المختبر، وفيه المترجم gcc وأداة cpuid التي تقرأ معلومات المعالج وتشرحها:
# cs3-vt: gcc for the tiny VMM, cpuid to read the CPU feature bits
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends gcc libc6-dev binutils make cpuid \
 && rm -rf /var/lib/apt/lists/*
WORKDIR /lab
ثم السكربت الذي يقرأ الأعلام والإعدادات:
#!/bin/sh
# cpu-flags.sh: what this (virtual) CPU says about virtualization
echo "== kernel and CPU"; uname -r; grep -m1 'model name' /proc/cpuinfo
echo "== flags related to virtualization"
grep -m1 '^flags' /proc/cpuinfo | tr ' ' '\n' | grep -xE 'vmx|svm|hypervisor|ept|vpid|ept_ad|tpr_shadow|vnmi|flexpriority|unrestricted_guest' | tr '\n' ' '; echo
grep -m1 '^vmx flags' /proc/cpuinfo
echo "== KVM device and module parameters"
ls -l /dev/kvm
for p in nested ept unrestricted_guest enable_shadow_vmcs; do printf '%s=%s\n' $p "$(cat /sys/module/kvm_intel/parameters/$p 2>/dev/null)"; done
echo "== IOMMU"; ls /sys/class/iommu/ 2>/dev/null | head; [ -z "$(ls /sys/class/iommu/ 2>/dev/null)" ] && echo "no IOMMU visible in this VM"
echo "== cpuid leaf 1: VMX and hypervisor bits"
cpuid -1 -l 1 | grep -iE 'VMX: virtual machine extensions|hypervisor guest status'
echo "== cpuid leaf 0x40000000: who is the hypervisor?"
cpuid -1 -r -l 0x40000000
cpuid -1 -l 0x40000000 | grep -i 'hypervisor_id'
ونبني ال Image ونشغل السكربت في Container له صلاحيات كاملة، لأن قراءة بعض الملفات تحتاجها كما سوف نرى:
docker build -t cs3-vt:1 .
docker run --rm --privileged -v "$PWD:/lab" cs3-vt:1 sh cpu-flags.sh
والمخرج سوف يكون كما يلي:
== kernel and CPU
5.15.167.4-microsoft-standard-WSL2
model name	: Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
== flags related to virtualization
vmx hypervisor tpr_shadow vnmi ept vpid ept_ad
vmx flags	: vnmi invvpid ept_x_only ept_ad ept_1gb tsc_offset vtpr ept vpid unrestricted_guest ept_mode_based_exec
== KVM device and module parameters
crw------- 1 root root 10, 232 Nov 16 19:29 /dev/kvm
nested=Y
ept=Y
unrestricted_guest=Y
enable_shadow_vmcs=N
== IOMMU
no IOMMU visible in this VM
== cpuid leaf 1: VMX and hypervisor bits
      VMX: virtual machine extensions         = true
      hypervisor guest status                 = true
== cpuid leaf 0x40000000: who is the hypervisor?
CPU:
   0x40000000 0x00: eax=0x4000000b ebx=0x7263694d ecx=0x666f736f edx=0x76482074
   hypervisor_id (0x40000000) = "Microsoft Hv"
وفي المخرج أعلاه لاحظ التالي:
- النواة
microsoft-standard-WSL2: نحن لسنا على جهاز حقيقي، وإنما داخل VM يشغلها Docker Desktop عن طريق WSL2، وهذا مهم لكل ما بعده. - العلم
vmx: المعالج الذي يراه Linux يدعم VT-x، ولو كان المعالج من AMD لرأيتsvmمكانه. وإذا لم تجد أياً منهما على سيرفر حقيقي فغالباً الخيار مغلق في BIOS. - العلم
hypervisor: هذا العلم يقول إن نظام التشغيل نفسه يعمل تحت مشرف، فالمعالج الذي نراه افتراضي، وهو مع ذلك يعرض علمvmx، أي أن المشرف الأعلى يسمح لنا بتشغيل أجهزة افتراضية داخل جهازنا الافتراضي. - سطر
vmx flags: قائمة الميزات الثانوية التي يدعمها VT-x هنا، ومنهاeptلترجمة الذاكرة على مرحلتين، وvpidلوسم سجلات ال TLB حتى لا تمسح عند كل دخول وخروج، وept_1gbللصفحات الكبيرة، وunrestricted_guestالذي يسمح للضيف أن يعمل في الوضع الحقيقي 16 بت مباشرة، وسوف نحتاجه لأن ضيفنا يبدأ في هذا الوضع، وept_mode_based_execالذي سوف نعود إليه عند الحديث عن Windows. - الملف
/dev/kvm: موجود، ومالكه root، وهو كل ما يحتاجه أي برنامج ليستعمل KVM. nested=Y: المحاكاة المتداخلة مفعلة في وحدةkvm_intel، أي أن KVM نفسه يستطيع أن يسمح لضيوفه بتشغيل ضيوف.- لا يوجد IOMMU: لا يرى هذا ال VM أي وحدة IOMMU، وهذا متوقع داخل VM، وسوف نرى أن الجهاز الحقيقي نفسه لا يستعملها.
- التعليمة
cpuidمع الورقة 0x40000000: عندما يكون علمhypervisorمرفوعاً يحجز المعالج أرقام هذه الورقة وما بعدها للمشرف، والمسجلاتebxوecxوedxفيها نص من 12 حرفاً، وإذا قرأت القيم السداسية عشرية حرفاً حرفاً بترتيب البايتات الصحيح سوف تجد «Microsoft Hv». فالمشرف الحقيقي الذي يحمل كل هذا هو Hyper-V، كما يوثق ذلك توثيق Hyper-V للمطورين.
ماذا يقول Windows على نفس الجهاز؟
والآن نسأل Windows نفسه بسكربت PowerShell صغير:
# windows-check.ps1: what Windows reports about virtualization on this machine
(systeminfo | Select-String 'Hyper-V Requirements').Line
Get-CimInstance Win32_ComputerSystem | Select-Object HypervisorPresent | Format-List
Get-CimInstance Win32_Processor | Select-Object Name, VirtualizationFirmwareEnabled, VMMonitorModeExtensions, SecondLevelAddressTranslationExtensions | Format-List
Get-CimInstance -ClassName Win32_DeviceGuard -Namespace root\Microsoft\Windows\DeviceGuard |
    Select-Object AvailableSecurityProperties, VirtualizationBasedSecurityStatus, SecurityServicesRunning | Format-List
والمخرج سوف يكون كما يلي:
Hyper-V Requirements:          A hypervisor has been detected. Features required for Hyper-V will not be displayed.
HypervisorPresent : True
Name                                    : Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
VirtualizationFirmwareEnabled           : False
VMMonitorModeExtensions                 : False
SecondLevelAddressTranslationExtensions : False
AvailableSecurityProperties       : {1, 2, 7}
VirtualizationBasedSecurityStatus : 2
SecurityServicesRunning           : {2}
وهنا المفاجأة التي ذكرناها في بداية المقال: المعالج يقول إن VirtualizationFirmwareEnabled وVMMonitorModeExtensions وSecondLevelAddressTranslationExtensions كلها False، مع أن VT-x وEPT يعملان أمامنا داخل Docker. والسبب في السطر الأول: «A hypervisor has been detected»، فعندما يعمل Hyper-V يصبح Windows نفسه ضيفاً مميزاً فوقه يسمى قسم الجذر Root Partition، ويرى معالجاً تقدمه له Hyper-V، ولذلك لا تعكس هذه الخصائص حقيقة العتاد، وsysteminfo نفسه يقول إنه لن يعرض متطلبات Hyper-V لهذا السبب. أما السطر HypervisorPresent : True فهو الجواب الصحيح.
والقسم الأخير من صنف Win32_DeviceGuard، وقيمه مشروحة في صفحة Microsoft عن سلامة الذاكرة: القيمة 1 تعني أن دعم المشرف متاح، و2 أن Secure Boot متاح، و7 أن MBEC متاح، والقيمة 2 في VirtualizationBasedSecurityStatus تعني أن الأمان المبني على المحاكاة VBS مفعل ويعمل، والقيمة 2 في SecurityServicesRunning تعني أن سلامة الذاكرة HVCI تعمل. ولاحظ القيمة الغائبة: لا توجد القيمة 3، أي أن حماية DMA غير متاحة، لأن IOMMU غير مستعمل في هذه اللوحة الأم، وسوف نعود إلى هذه النقطة عند الحديث عن الأجهزة.
كود الضيف: 63 بايت في الوضع الحقيقي
نريد ضيفاً بسيطاً جداً لا يحتاج نظام تشغيل ولا BIOS، فكل معالج x86 يبدأ بعد التشغيل في الوضع الحقيقي Real Mode بعناوين 16 بت، وفيه نستطيع أن نكتب بضعة أسطر Assembly تعمل مباشرة. والكود التالي فيه أربعة اختبارات، يختار المشرف أحدها بوضع رقمه في المسجل AX، وعدد التكرار في المسجل EDI:
# Guest code for vmm.c: 16-bit real mode, loaded at guest physical address 0x1000.
# The VMM puts the test number in AX and the repeat count in EDI before it starts the vCPU.
        .code16
        .globl _start
_start:
        cmp     $1, %ax
        je      alu
        cmp     $2, %ax
        je      do_cpuid
        cmp     $3, %ax
        je      do_io
        cmp     $4, %ax
        je      do_mem
        hlt

alu:                            # 1: plain arithmetic, nothing the CPU must stop for
        dec     %edi
        jnz     alu
        hlt

do_cpuid:                       # 2: CPUID always causes a VM exit under VT-x
        xor     %eax, %eax
        cpuid
        dec     %edi
        jnz     do_cpuid
        hlt

do_io:                          # 3: OUT to port 0x10, handled by our program in user space
        mov     $0x10, %dx
1:      out     %al, %dx
        dec     %edi
        jnz     1b
        hlt

do_mem:                         # 4: write one byte in every 4 KiB page from 0x2000 up to 1 MiB
        mov     $0x0200, %bx
2:      mov     %bx, %es
        movb    $1, %es:0
        add     $0x0100, %bx
        jnz     2b
        hlt
وفي الكود أعلاه لاحظ التالي:
- الاختبار الأول
alu: حلقة تنقص عداداً وتقفز، ولا يوجد فيها أي شيء يجبر المعالج على الخروج، فهي مقياس لسرعة الضيف عندما يعمل وحده. - الاختبار الثاني
cpuid: نفس الحلقة ومعهاCPUID، أي خروج مضمون في كل دورة يعالجه KVM داخل النواة. - الاختبار الثالث
io: كتابة بايت إلى المنفذ 0x10، وهو منفذ لا يعرفه KVM، فيعود في كل مرة إلى برنامجنا في فضاء المستخدم، وهذا يشبه ما يحدث عندما يكلم الضيف جهازاً يحاكيه QEMU. - الاختبار الرابع
mem: يكتب بايتاً في بداية كل صفحة من 4 KiB من العنوان 0x2000 حتى نهاية أول 1 MiB، أي 254 صفحة، عن طريق تغيير المسجل ES الذي يضرب في 16، فزيادته بمقدار 0x100 تعني التقدم 4096 بايت.
وبعد التجميع بالأمر as --32 ثم استخراج الكود بالأمر objcopy يصبح الضيف كله 63 بايت، وهذا هو بعد فكه:
    1000:	83 f8 01             	cmp    $0x1,%ax
    1003:	74 10                	je     0x1015
    1005:	83 f8 02             	cmp    $0x2,%ax
    1008:	74 10                	je     0x101a
    100a:	83 f8 03             	cmp    $0x3,%ax
    100d:	74 15                	je     0x1024
    100f:	83 f8 04             	cmp    $0x4,%ax
    1012:	74 19                	je     0x102d
    1014:	f4                   	hlt
    1015:	66 4f                	dec    %edi
    1017:	75 fc                	jne    0x1015
    1019:	f4                   	hlt
    101a:	66 31 c0             	xor    %eax,%eax
    101d:	0f a2                	cpuid
    101f:	66 4f                	dec    %edi
    1021:	75 f7                	jne    0x101a
    1023:	f4                   	hlt
    1024:	ba 10 00             	mov    $0x10,%dx
    1027:	ee                   	out    %al,(%dx)
    1028:	66 4f                	dec    %edi
    102a:	75 fb                	jne    0x1027
    102c:	f4                   	hlt
    102d:	bb 00 02             	mov    $0x200,%bx
    1030:	8e c3                	mov    %bx,%es
    1032:	26 c6 06 00 00 01    	movb   $0x1,%es:0x0
    1038:	81 c3 00 01          	add    $0x100,%bx
    103c:	75 f2                	jne    0x1030
    103e:	f4                   	hlt
لاحظ البادئة 66 قبل dec %edi: في الوضع 16 بت تحتاج كل عملية على مسجل 32 بت هذه البادئة، وقد شرحنا تفاصيل ترميز تعليمات x86 في مقالات المعماريات.
المشرف: برنامج vmm.c
وهذا هو المشرف كاملاً، وهو برنامج عادي يعمل في فضاء المستخدم:
// vmm.c: the smallest useful virtual machine monitor on the Linux KVM API.
// One vCPU in 16-bit real mode, 1 MiB of guest RAM, the guest code from guest.bin at 0x1000.
// ./vmm <test> <count> test: 1=alu 2=cpuid 3=io 4=mem (mem runs twice and ignores count)
#include <dirent.h>
#include <fcntl.h>
#include <linux/kvm.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/ioctl.h>
#include <sys/mman.h>
#include <time.h>
#include <unistd.h>
#define MEM_SIZE (1 << 20)
static int vmfd;
static char statdir[300];
// The per-VM folder is named <pid>-<fd> with the pid as the kernel sees it, which differs from getpid() inside a
// container, so we remember the folders that exist before KVM_CREATE_VM and pick the new one after it.
static char seen[64][256]; static int nseen;
static void scan(int remember) {
DIR *d = opendir("/sys/kernel/debug/kvm"); struct dirent *e;
if (!d) return;
while ((e = readdir(d))) {
if (!strchr(e->d_name, '-')) continue;
int old = 0; for (int i = 0; i < nseen; i++) if (!strcmp(seen[i], e->d_name)) old = 1;
if (remember && nseen < 64) snprintf(seen[nseen++], 256, "%s", e->d_name);
else if (!remember && !old) snprintf(statdir, sizeof statdir, "/sys/kernel/debug/kvm/%s", e->d_name);
}
closedir(d);
}
static void die(const char *m) { perror(m); exit(1); }
static double now(void) { struct timespec t; clock_gettime(CLOCK_MONOTONIC, &t); return t.tv_sec + t.tv_nsec / 1e9; }
// Per-VM counters that KVM keeps in debugfs: /sys/kernel/debug/kvm/<pid>-<vmfd>/<name>
static long kvm_stat(const char *name) {
char p[400]; snprintf(p, sizeof p, "%s/%s", statdir, name);
FILE *f = fopen(p, "r"); long v = -1;
if (f) { if (fscanf(f, "%ld", &v) != 1) v = -1; fclose(f); }
return v;
}
int main(int argc, char **argv) {
if (argc < 3) { fprintf(stderr, "usage: %s <1-4> <count>\n", argv[0]); return 2; }
int test = atoi(argv[1]); long count = atol(argv[2]);
int kvm = open("/dev/kvm", O_RDWR | O_CLOEXEC);
if (kvm < 0) die("open /dev/kvm");
printf("KVM API version: %d\n", ioctl(kvm, KVM_GET_API_VERSION, 0));
scan(1);
vmfd = ioctl(kvm, KVM_CREATE_VM, 0);
if (vmfd < 0) die("KVM_CREATE_VM");
scan(0);
printf("KVM counters for this VM: %s\n", statdir);
// Guest RAM is ordinary memory of this process; KVM maps it into the guest at physical address 0
uint8_t *mem = mmap(NULL, MEM_SIZE, PROT_READ | PROT_WRITE, MAP_SHARED | MAP_ANONYMOUS, -1, 0);
if (mem == MAP_FAILED) die("mmap");
struct kvm_userspace_memory_region region = { .slot = 0, .guest_phys_addr = 0, .memory_size = MEM_SIZE, .userspace_addr = (uint64_t)mem };
if (ioctl(vmfd, KVM_SET_USER_MEMORY_REGION, ®ion) < 0) die("KVM_SET_USER_MEMORY_REGION");
FILE *g = fopen("guest.bin", "rb"); if (!g) die("guest.bin");
size_t n = fread(mem + 0x1000, 1, 4096, g); fclose(g);
printf("guest code: %zu bytes at 0x1000\n", n);
int vcpu = ioctl(vmfd, KVM_CREATE_VCPU, 0);
if (vcpu < 0) die("KVM_CREATE_VCPU");
int runsz = ioctl(kvm, KVM_GET_VCPU_MMAP_SIZE, 0);
struct kvm_run *run = mmap(NULL, runsz, PROT_READ | PROT_WRITE, MAP_SHARED, vcpu, 0);
if (run == MAP_FAILED) die("mmap kvm_run");
int passes = (test == 4) ? 2 : 1;
for (int pass = 1; pass <= passes; pass++) {
struct kvm_sregs sregs; ioctl(vcpu, KVM_GET_SREGS, &sregs);
sregs.cs.base = 0; sregs.cs.selector = 0;
if (ioctl(vcpu, KVM_SET_SREGS, &sregs) < 0) die("KVM_SET_SREGS");
struct kvm_regs regs = { .rip = 0x1000, .rax = test, .rdi = count, .rflags = 0x2 };
if (ioctl(vcpu, KVM_SET_REGS, ®s) < 0) die("KVM_SET_REGS");
long e0 = kvm_stat("exits"), io0 = kvm_stat("io_exits"), h0 = kvm_stat("halt_exits"), pf0 = kvm_stat("pf_fixed");
long user_io = 0, user_exits = 0;
double t0 = now();
for (;;) {
if (ioctl(vcpu, KVM_RUN, 0) < 0) die("KVM_RUN");
user_exits++;
if (run->exit_reason == KVM_EXIT_IO) { user_io++; continue; }
if (run->exit_reason == KVM_EXIT_HLT) break;
fprintf(stderr, "unexpected exit_reason %d\n", run->exit_reason); return 1;
}
double t = now() - t0;
long e = kvm_stat("exits") - e0, io = kvm_stat("io_exits") - io0, h = kvm_stat("halt_exits") - h0, pf = kvm_stat("pf_fixed") - pf0;
static const char *names[] = { "", "alu", "cpuid", "io", "mem" };
printf("test=%s pass=%d count=%ld time=%.3f s", names[test], pass, test == 4 ? 254 : count, t);
if (test != 4) printf(" per_iteration=%.1f ns", t * 1e9 / count);
printf("\n returned to user space: %ld (KVM_EXIT_IO %ld)\n", user_exits, user_io);
printf(" KVM counters: exits=%ld io_exits=%ld halt_exits=%ld pf_fixed=%ld\n", e, io, h, pf);
}
return 0;
}وفي الكود أعلاه لاحظ التالي:
- ثلاثة مستويات من الملفات: نفتح
/dev/kvmفنحصل على ملف لـ KVM نفسه، ومنه نطلبKVM_CREATE_VMفنحصل على ملف للجهاز الافتراضي، ومنه نطلبKVM_CREATE_VCPUفنحصل على ملف للمعالج الافتراضي، وكل أمر بعد ذلك يذهب إلى الملف المناسب. - ذاكرة الضيف ذاكرة عادية: نحجز 1 MiB بالدالة
mmapكما يفعل أي برنامج، ثم نقول لـ KVM بالأمرKVM_SET_USER_MEMORY_REGIONإن هذه الذاكرة تظهر للضيف على أنها ذاكرة فعلية تبدأ من العنوان 0، ولذلك نستطيع نسخ كود الضيف إليها بسطرfreadعادي. - البنية
kvm_run: نربطها بالدالةmmapعلى ملف المعالج الافتراضي، فهي مشتركة بين النواة وبرنامجنا، وفيها يكتب KVM سبب كل عودة إلينا. - المسجلات: نجعل
RIPيشير إلى 0x1000 حيث وضعنا الكود، ونضع رقم الاختبار فيRAXوالعدد فيRDI، وهذا كل ما يحتاجه الضيف ليبدأ. - الحلقة: نستدعي
KVM_RUN، فإذا عاد بسببKVM_EXIT_IOنتجاهل الكتابة ونعيد التشغيل، وإذا عاد بسببKVM_EXIT_HLTفالضيف انتهى. ولاحظ أن البرنامج لا يرى أبداً خروجCPUIDلأن KVM يعالجه داخل النواة. - العدادات: يحتفظ KVM لكل جهاز افتراضي بعدادات في نظام الملفات debugfs، مثل عدد مرات الخروج
exitsوالخروج بسبب المنافذio_exitsوعدد أخطاء الصفحات التي أصلحهاpf_fixed، فنقرؤها قبل التشغيل وبعده ونطبع الفرق.
وبقية الملفات هي Makefile لبناء الضيف والمشرف، والبرنامج cpuid-cost.c الذي يقيس زمن CPUID داخل ال Container نفسه دون ضيف، والسكربت run.sh الذي يشغل كل الاختبارات بالترتيب:
#!/bin/sh
# run.sh: everything the article shows, in order. Needs a privileged container with /dev/kvm.
set -e
make -s
echo "load average: $(cat /proc/loadavg)"
mount -t debugfs none /sys/kernel/debug 2>/dev/null || true
echo "== 1. alu";   ./vmm 1 10000000
echo "== 2. cpuid"; ./vmm 2 1000000
echo "== 3. io";    ./vmm 3 1000000
echo "== 4. mem";   ./vmm 4 0
echo "== cpuid in this container (no nested guest)"; ./cpuid-cost 1000000
echo "== exit reasons"
sh exit-reasons.sh 2 20000
sh exit-reasons.sh 3 20000
sh exit-reasons.sh 4 0
docker run --rm --privileged -v "$PWD:/lab" cs3-vt:1 sh run.shالنتائج سطراً سطراً Results
والمخرج سوف يكون كما يلي، وهذا الجزء الأول منه:
load average: 3.87 4.93 5.51 3/587 13
== 1. alu
KVM API version: 12
KVM counters for this VM: /sys/kernel/debug/kvm/1041897-4
guest code: 63 bytes at 0x1000
test=alu pass=1 count=10000000 time=0.010 s per_iteration=1.0 ns
  returned to user space: 1 (KVM_EXIT_IO 0)
  KVM counters: exits=3 io_exits=0 halt_exits=1 pf_fixed=1
== 2. cpuid
KVM API version: 12
KVM counters for this VM: /sys/kernel/debug/kvm/1041899-4
guest code: 63 bytes at 0x1000
test=cpuid pass=1 count=1000000 time=9.192 s per_iteration=9191.6 ns
  returned to user space: 1 (KVM_EXIT_IO 0)
  KVM counters: exits=1000454 io_exits=0 halt_exits=1 pf_fixed=1
== 3. io
KVM API version: 12
KVM counters for this VM: /sys/kernel/debug/kvm/1042040-4
guest code: 63 bytes at 0x1000
test=io pass=1 count=1000000 time=11.617 s per_iteration=11617.0 ns
  returned to user space: 1000001 (KVM_EXIT_IO 1000000)
  KVM counters: exits=1000444 io_exits=1000000 halt_exits=1 pf_fixed=1
== 4. mem
KVM API version: 12
KVM counters for this VM: /sys/kernel/debug/kvm/1042143-4
guest code: 63 bytes at 0x1000
test=mem pass=1 count=254 time=0.003 s
  returned to user space: 1 (KVM_EXIT_IO 0)
  KVM counters: exits=256 io_exits=0 halt_exits=1 pf_fixed=255
test=mem pass=2 count=254 time=0.000 s
  returned to user space: 1 (KVM_EXIT_IO 0)
  KVM counters: exits=1 io_exits=0 halt_exits=1 pf_fixed=0
== cpuid in this container (no nested guest)
cpuid: 731.8 ns each, add: 0.43 ns each (n=1000000, sink=23000000)
وفي المخرج أعلاه لاحظ التالي:
KVM API version: 12: رقم ثابت منذ سنوات، والتوثيق يطلب من أي برنامج أن يتأكد منه قبل أن يكمل.- اختبار
alu: عشرة ملايين دورة في 0.010 ثانية، أي نحو 1 نانوثانية للدورة، ومعها ثلاث مرات خروج فقط في كل التشغيل، منها خروجHLTفي النهاية. فالضيف عندما لا يطلب شيئاً حساساً يعمل بسرعة المعالج الحقيقي تقريباً، وهذا بالضبط ما وعدت به VT-x. - اختبار
cpuid: مليون دورة أخذت 9.2 ثانية، أي 9.2 ميكروثانية للدورة الواحدة، وعداد KVM يقول 1000454 خروجاً، أي مليون خروج لـCPUIDونحو 450 خروجاً آخر سببها مقاطعات خارجية من المؤقت ومن الأجهزة. ولاحظ أن برنامجنا لم يستقبل منها إلا عودة واحدة في النهاية، فكلها عولجت داخل النواة. - اختبار
io: هنا عادKVM_RUNإلى برنامجنا 1000001 مرة، مليون مرة بسبب المنفذ ومرة للنهاية، والعدادio_exitsيساوي مليوناً تماماً، والزمن 11.6 ميكروثانية للدورة، أي أغلى منCPUIDلأن كل خروج يضيف انتقالاً من النواة إلى فضاء المستخدم ثم العودة. - اختبار
mem: في المرة الأولى 256 خروجاً منها 255 خطأ صفحة أصلحه KVM، 254 صفحة كتبنا فيها وصفحة الكود نفسها، وفي المرة الثانية لم يحدث أي خطأ صفحة وخروج واحد فقط هوHLT. وسوف نشرح السبب في جزء EPT. - السطر الأخير:
CPUIDداخل ال Container نفسه، دون ضيفنا، أخذ 732 نانوثانية، مقابل أقل من نصف نانوثانية لتعليمة جمع. وهذا رقم مهم سوف نعود إليه، فالتعليمة هنا أيضاً تخرج، لأن ال Container نفسه داخل VM.
والجزء الثاني من المخرج يجيب عن سؤال مهم: كيف نعرف أن الخروج سببه CPUID فعلاً وليس شيئاً آخر؟ نواة Linux فيها نقطة تتبع Tracepoint اسمها kvm:kvm_exit تكتب سطراً عند كل خروج مع سببه، والسكربت exit-reasons.sh يشغلها حول تشغيل قصير من 20000 دورة ثم يعد الأسباب:
#!/bin/sh
# exit-reasons.sh <test> <count>: run vmm with the kvm:kvm_exit tracepoint on, then count the exit reasons
T=/sys/kernel/debug/tracing
echo 0 > $T/tracing_on; echo > $T/trace; echo 8192 > $T/buffer_size_kb
echo 1 > $T/events/kvm/kvm_exit/enable
echo 1 > $T/tracing_on
./vmm "$1" "$2" > /dev/null
echo 0 > $T/tracing_on
echo 0 > $T/events/kvm/kvm_exit/enable
echo "sample line:"; grep ' vmm-' $T/trace | grep -m1 kvm_exit | sed 's/^ *//'
echo "exit reasons for test $1 ($2):"
grep ' vmm-' $T/trace | grep -o 'reason [A-Z_]*' | sort | uniq -c | sort -rn
echo > $T/trace
== exit reasons
sample line:
vmm-1042166 [000] d.... 165573.709362: kvm_exit: vcpu 0 reason EPT_VIOLATION rip 0x1000 info1 0x0000000000000784 info2 0x0000000000000000 intr_info 0x00000000 error_code 0x00000000
exit reasons for test 2 (20000):
20000 reason CPUID
5 reason EXTERNAL_INTERRUPT
1 reason HLT
1 reason EPT_VIOLATION
sample line:
vmm-1042177 [000] d.... 165574.402327: kvm_exit: vcpu 0 reason EPT_VIOLATION rip 0x1000 info1 0x0000000000000784 info2 0x0000000000000000 intr_info 0x00000000 error_code 0x00000000
exit reasons for test 3 (20000):
20000 reason IO_INSTRUCTION
9 reason EXTERNAL_INTERRUPT
1 reason HLT
1 reason EPT_VIOLATION
sample line:
vmm-1042188 [005] d.... 165575.309604: kvm_exit: vcpu 0 reason EPT_VIOLATION rip 0x1000 info1 0x0000000000000784 info2 0x0000000000000000 intr_info 0x00000000 error_code 0x00000000
exit reasons for test 4 (0):
255 reason EPT_VIOLATION
2 reason HLTوفي المخرج أعلاه لاحظ التالي:
- سطر العينة فيه اسم البرنامج
vmmورقم المعالج الافتراضي وسبب الخروجEPT_VIOLATIONوعنوان التعليمةrip 0x1000، أي أن أول ما فعله الضيف عند أول تعليمة هو خطأ في ترجمة صفحة الكود نفسها، لأن KVM لم يربطها بعد بذاكرة حقيقية. - في الاختبار الثاني 20000 خروج بسبب
CPUIDبالضبط، وفي الثالث 20000 بسببIO_INSTRUCTION، وهذه الأسماء هي أسماء أسباب الخروج في كتيبات Intel. EXTERNAL_INTERRUPTخروج لم يطلبه الضيف: جاءت مقاطعة للمعالج الحقيقي من المؤقت أو من جهاز، والمقاطعات ملك للمضيف، فيخرج الضيف حتى يعالجها المضيف.- في الاختبار الرابع 255 خروجاً بسبب
EPT_VIOLATION، وهو نفس الرقم الذي قرأناه من العدادpf_fixed، أي أن الطريقتين متفقتان.
مشكلة حقيقية: العدادات كلها صفر
في أول تشغيل للبرنامج كانت كل العدادات صفراً مع أن الأزمنة تقول بوضوح إن مليون خروج قد حدث. والسبب أن KVM ينشئ لكل جهاز افتراضي مجلداً في /sys/kernel/debug/kvm اسمه رقم العملية Process ID ثم رقم الملف، مثل 1041897-4، وكانت النسخة الأولى من البرنامج تبني اسم المجلد من getpid(). ولكن داخل ال Container يرى البرنامج رقم عملية مختلفاً عن الرقم الذي تراه النواة، لأن ال Container له فضاء أسماء خاص بالعمليات PID Namespace، وحتى مع الخيار --pid=host بقي الرقم مختلفاً، لأن Docker Desktop نفسه يشغل المحرك داخل فضاء أسماء خاص به داخل ال VM. والدالة التي تقرأ ملفاً غير موجود كانت تعيد -1 قبل التشغيل وبعده، فيكون الفرق صفراً دون أي رسالة خطأ.
والحل الذي تراه في الكود هو الدالة scan: تقرأ أسماء المجلدات قبل إنشاء الجهاز الافتراضي، ثم بعده، والمجلد الجديد هو مجلدنا. والدرس العام هنا أن الأرقام التي تأتي من داخل Container عن العمليات لا تطابق بالضرورة الأرقام التي تراها النواة، وأن أداة القياس التي تفشل بصمت أخطر من أداة تتوقف برسالة خطأ، فاطبع دائماً المسار الذي تقرأ منه كما يفعل البرنامج الآن في سطر KVM counters for this VM.
ماذا يحدث إذا لم يصل /dev/kvm؟ What If
نشغل نفس البرنامج دون --privileged ودون أي خيار آخر:
docker run --rm -v "$PWD:/lab" cs3-vt:1 ./vmm 2 1000open /dev/kvm: No such file or directoryالملف غير موجود داخل ال Container أصلاً، لأن Docker لا يمرر أجهزة المضيف إلا إذا طلبت ذلك. وهذا نفس الخطأ الذي سوف تراه في QEMU أو أي أداة أخرى بصيغة مختلفة، وهو أول ما تتأكد منه إذا كان جهازك الافتراضي بطيئاً بشكل غريب، فبعض الأدوات تتراجع بصمت إلى المحاكاة البرمجية الكاملة كما رأينا في مقال المحاكاة الافتراضية. والآن نمرر الجهاز وحده دون صلاحيات كاملة:
docker run --rm --device /dev/kvm -v "$PWD:/lab" cs3-vt:1 ./vmm 2 100000KVM API version: 12
KVM counters for this VM:
guest code: 63 bytes at 0x1000
test=cpuid pass=1 count=100000 time=1.202 s per_iteration=12016.4 ns
returned to user space: 1 (KVM_EXIT_IO 0)
KVM counters: exits=0 io_exits=0 halt_exits=0 pf_fixed=0والنتيجة مهمة: الجهاز الافتراضي عمل بشكل كامل، فتشغيل KVM لا يحتاج إلا الوصول إلى /dev/kvm، أما العدادات فكلها صفر ومسارها فارغ، لأن ربط debugfs يحتاج صلاحيات كاملة. ولذلك لا تقم بتشغيل Containers الأجهزة الافتراضية بالخيار --privileged في الإنتاج، والسبب أن هذا الخيار يعطي ال Container تقريباً كل صلاحيات المضيف، ويكفي --device /dev/kvm، واترك --privileged لتجربة قياس مثل هذه على جهاز تجارب.
كم يكلف الخروج VM Exit؟
الصورة التالية تضع الأرقام الأربعة على مقياس لوغاريتمي، لأن الفرق بين أصغرها وأكبرها أكثر من عشرة آلاف ضعف:
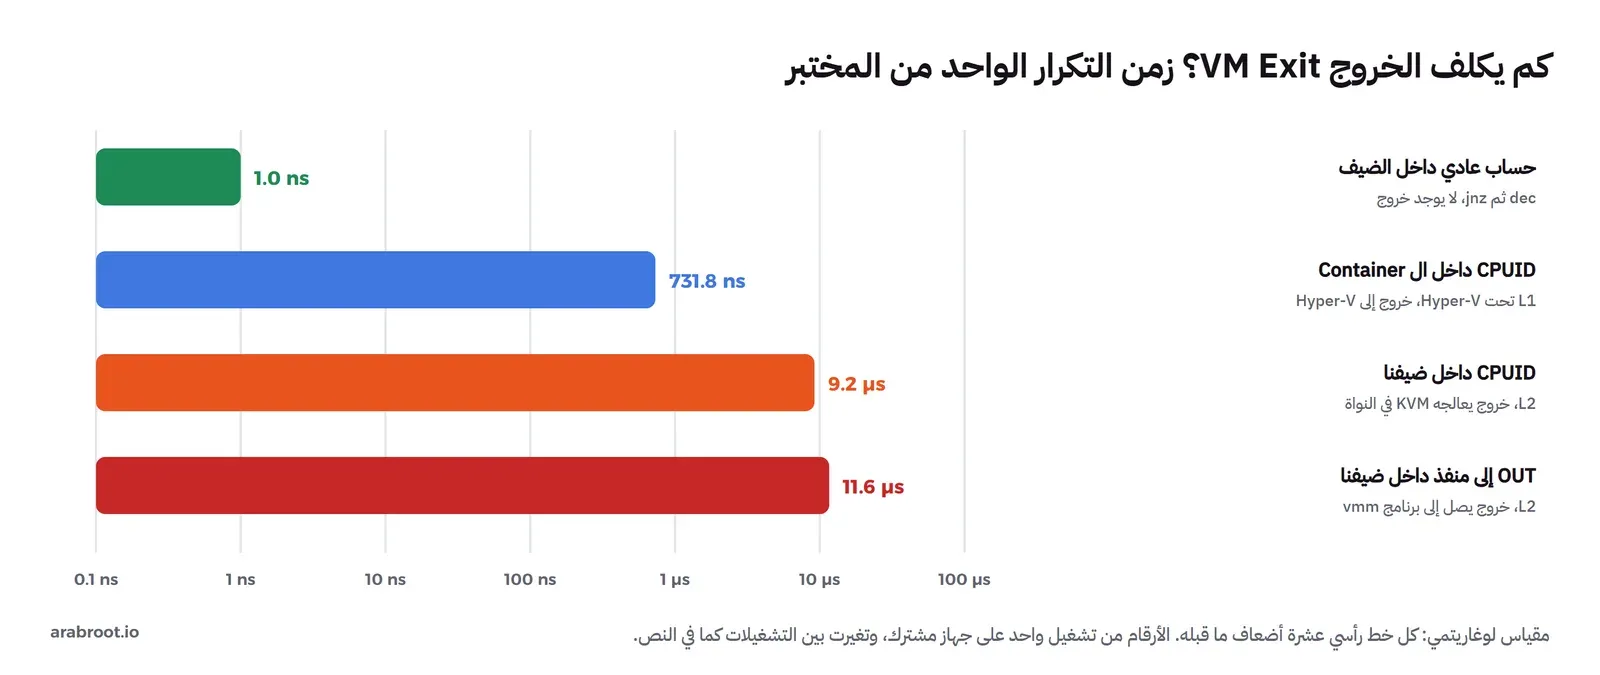
وقبل أن نفسر الأرقام يجب أن نكون صادقين بشأن دقتها: جهاز المختبر مشترك، وكانت عليه أعمال أخرى في نفس الوقت، ومتوسط الضغط Load Average في بداية التشغيل كان قريباً من 4 على 8 خيوط. وفي تشغيلات أخرى على نفس الجهاز تراوح زمن CPUID داخل ضيفنا بين 4.2 و9.9 ميكروثانية، وزمن المنفذ بين 8.7 و22.7 ميكروثانية، وزمن CPUID داخل ال Container بين 540 و1228 نانوثانية. فالترتيب ثابت في كل التشغيلات، والأرقام نفسها تتغير بضعفين أو أكثر حسب ما يحدث على الجهاز، وهذا بحد ذاته درس: لا تقس أداء الأجهزة الافتراضية مرة واحدة على جهاز مشغول ثم تبني عليها قراراً.
والآن ماذا تقول الأرقام؟ أولاً، الضيف يعمل بسرعة المعالج الحقيقي ما دام لا يخرج، فدورة الحساب أخذت نحو نانوثانية. ثانياً، الخروج نفسه هو الكلفة، فكل CPUID في ضيفنا كلف آلاف النانوثانيات، أي عشرات الآلاف من دورات الساعة، وهذا يعني أن مشرفاً يخرج مئة ألف مرة في الثانية يضيع جزءاً ملحوظاً من وقت المعالج في الدخول والخروج وحدهما. ثالثاً، الخروج الذي يصل إلى فضاء المستخدم أغلى من الذي يعالج في النواة، ولذلك نقلت أنظمة الإنتاج الأجهزة الأكثر استعمالاً من QEMU إلى داخل النواة، مثل وحدات vhost-net للشبكة.
ولكن هل 9 ميكروثانية رقم طبيعي لخروج واحد؟ لا، وهو أكبر بكثير مما تراه على سيرفر حقيقي يعمل عليه KVM مباشرة، والسبب في الرقم الأزرق: حتى CPUID داخل ال Container، دون أي ضيف، أخذ 732 نانوثانية، لأن ال Container نفسه داخل VM تحت Hyper-V، فكل CPUID فيه خروج إلى Hyper-V. وضيفنا ليس ضيفاً واحداً، وإنما ضيف داخل ضيف، وهذا موضوع الجزء التالي.
المحاكاة المتداخلة Nested Virtualization: ضيف داخل ضيف
الصورة التالية تبين ما يحدث فعلاً على جهاز المختبر:
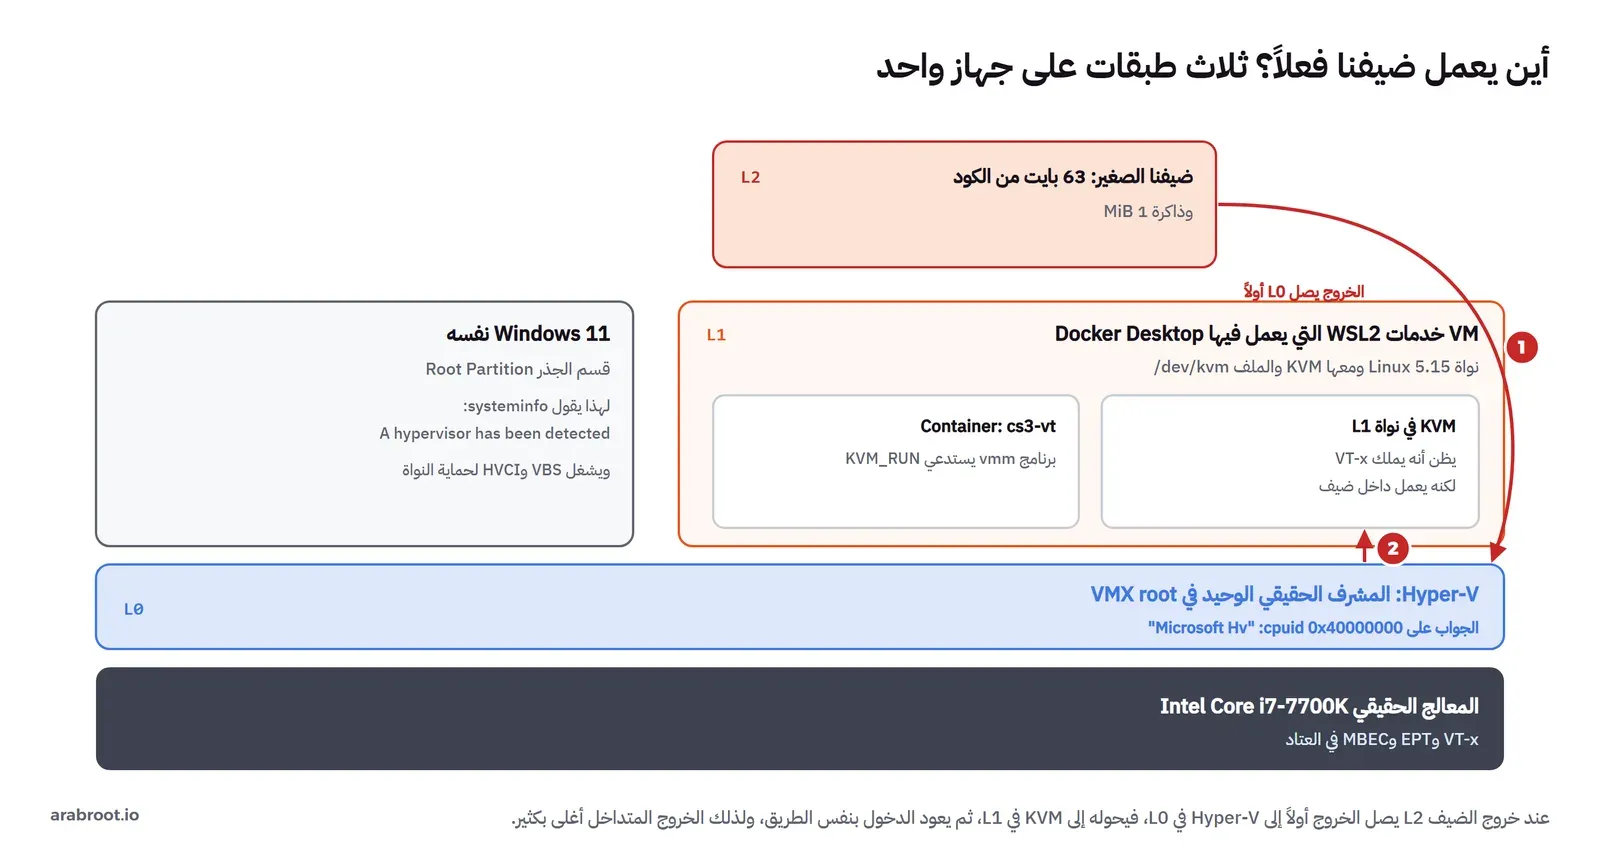
عندما تفعل WSL2 أو Docker Desktop أو Windows Sandbox أو ميزة سلامة الذاكرة على Windows يعمل Hyper-V تحت كل شيء، ويصبح Windows الذي تراه أمامك ضيفاً مميزاً يملك الوصول إلى الأجهزة، وتعمل نواة Linux الخاصة بـ WSL2 في VM خفيفة كما تشرح صفحة المقارنة بين WSL1 وWSL2. والمعالج الحقيقي لا يملك إلا عالماً واحداً للمشرف، يجلس فيه Hyper-V وحده، ولذلك عندما يعمل KVM داخل ال VM ويظن أنه ينفذ VMLAUNCH فهو في الحقيقة ينفذ تعليمة تسبب خروجاً إلى Hyper-V، فيقوم Hyper-V بتشغيل ضيفنا نيابة عنه، ببناء VMCS حقيقية من ال VMCS التي جهزها KVM، كما تشرح صفحة Microsoft عن المحاكاة المتداخلة وتوثيق KVM لنفس الفكرة.
وبالتالي كل خروج من ضيفنا في L2 يمر بهذا الطريق: يخرج المعالج إلى Hyper-V في L0، فيعرف Hyper-V أن الخروج يخص ضيفاً يديره KVM، فيدخل KVM في L1 ويقدم له الخروج كأنه جاء من عتاد حقيقي، فيعالجه KVM، ثم يحاول الدخول إلى الضيف بتعليمة تخرج بدورها إلى Hyper-V، فيدخل Hyper-V الضيف من جديد. فالخروج الواحد في L2 أصبح عدة دخول وخروج حقيقية، وهذا ما رأيناه في الأرقام. ولاحظ السطر enable_shadow_vmcs=N في مخرج المختبر: ميزة Shadow VMCS تسمح لمشرف في L1 بقراءة وكتابة ال VMCS دون خروج في كل مرة، وهي غير متاحة هنا، فكل قراءة يقوم بها KVM لحقل في ال VMCS هي خروج آخر إلى Hyper-V.
هل يعني هذا أن المحاكاة المتداخلة غير مفيدة؟ لا، فهي مناسبة جداً لما صممت له: تجربة Proxmox أو KVM داخل VM، ومختبرات التعليم، وبيئات CI التي تبني Images لأجهزة افتراضية، وأدوات مثل Docker Desktop التي تحتاج KVM أحياناً داخل VM. ولكنها غير مناسبة إطلاقاً لتشغيل أجهزة إنتاج كثيرة الخروج، مثل سيرفر قاعدة بيانات بقرص محاكى، داخل VM على سحابة، وإذا احتجت ذلك فاطلب من مزود السحابة سيرفراً فعلياً Bare Metal.
لماذا يهم Windows نفسه أن يكون فوق مشرف؟ VBS وMBEC
قد يتساءل البعض: لماذا يشغل Windows نفسه فوق Hyper-V حتى لو لم تطلب جهازاً افتراضياً؟ والإجابة هي الأمان المبني على المحاكاة VBS: يستعمل Windows المشرف ليصنع منطقة ذاكرة معزولة لا تستطيع النواة نفسها الوصول إليها، ويضع فيها فحص توقيع الكود الذي يعمل في النواة، فإذا اخترق أحد نواة Windows لا يستطيع أن يجعل صفحة ذاكرة قابلة للتنفيذ دون موافقة هذه المنطقة، لأن صلاحيات التنفيذ تحددها جداول EPT التي يملكها Hyper-V وليس جداول النواة. وصفحة Microsoft التي ذكرناها تقول إن هذه الميزة تعمل أفضل على معالجات Intel من جيل Kaby Lake وما بعده لوجود ميزة MBEC، وهي اختصار Mode-Based Execution Control، التي تسمح بأن تختلف صلاحية التنفيذ في EPT بين كود النواة وكود المستخدم. ومعالج المختبر من جيل Kaby Lake، ولذلك ظهرت القيمة 7 في مخرج Windows، وظهر العلم ept_mode_based_exec في مخرج Linux، وهما نفس الميزة يراها نظامان مختلفان.
الذاكرة: EPT وNPT من الداخل
في مقال الذاكرة الافتراضية وجداول الصفحات شرحنا كيف يترجم المعالج كل عنوان يستعمله البرنامج إلى عنوان فعلي في RAM عن طريق جداول الصفحات Page Tables التي تديرها النواة. والمشكلة في الأجهزة الافتراضية أن نواة الضيف تدير جداولها أيضاً وتظن أن العناوين الفعلية التي تكتبها فيها عناوين حقيقية، وهي ليست كذلك، فالذاكرة التي يظنها الضيف ذاكرته الفعلية هي في الحقيقة ذاكرة عادية حجزها برنامج المراقبة بالدالة mmap كما رأينا في الكود. والصورة التالية تبين الحل:
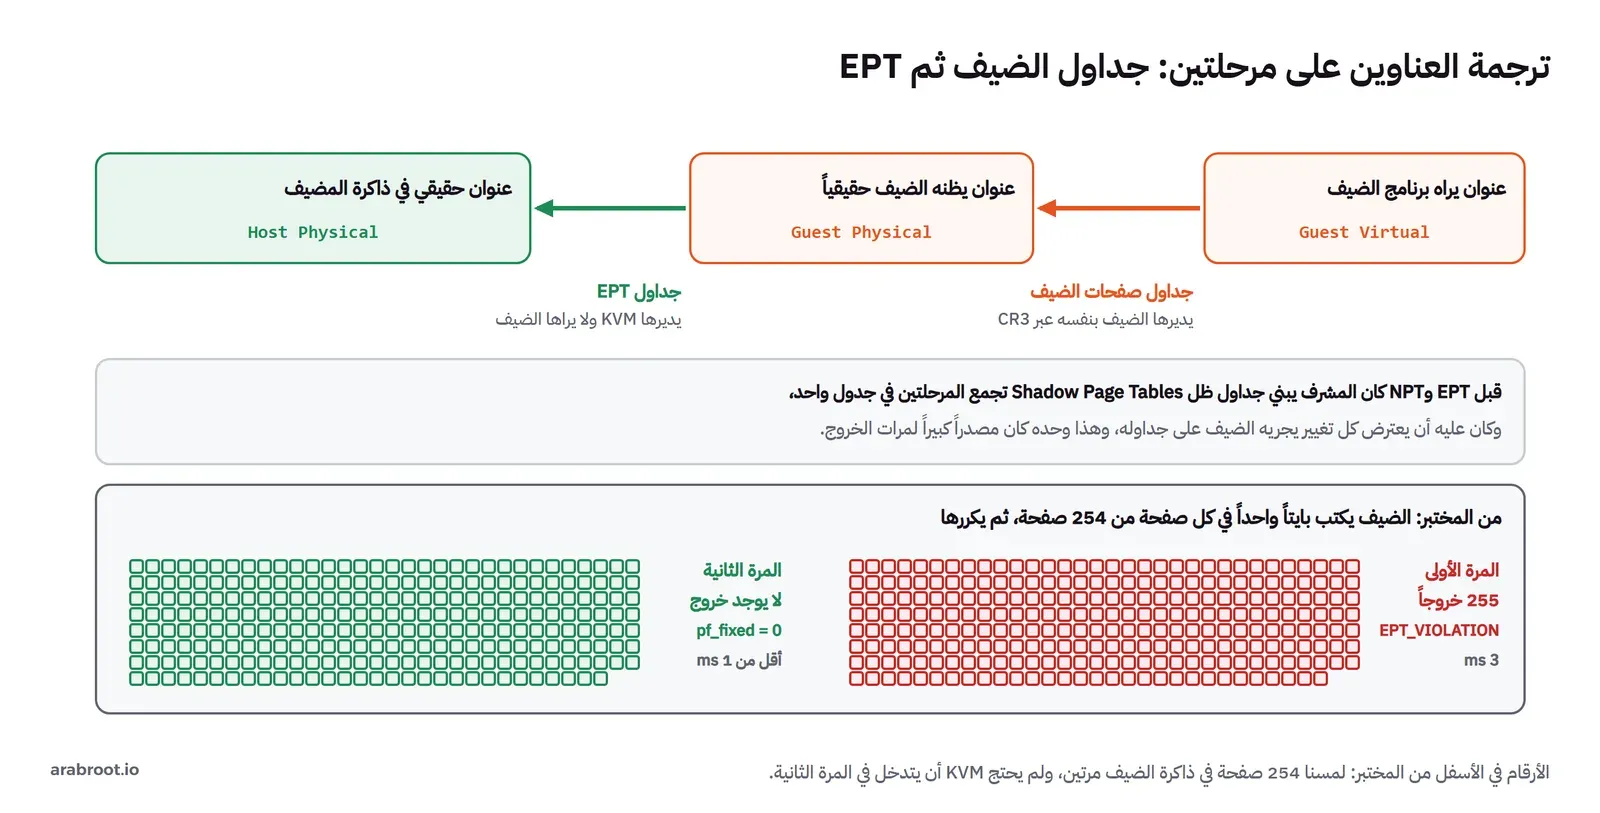
قبل EPT كان على المشرف أن يبني جداول ظل Shadow Page Tables تترجم عنوان الضيف الافتراضي إلى العنوان الحقيقي مباشرة، ويعطيها للمعالج بدلاً من جداول الضيف، ولكي تبقى صحيحة يجب أن يعترض كل تعديل يقوم به الضيف على جداوله، وكل تبديل لـ CR3 عند تبديل العمليات، وهذا مصدر خروج لا يتوقف في أي نظام فيه عمليات كثيرة، وتوثيق وحدة MMU في KVM ما زال يشرح هذا الأسلوب لأنه يستعمل عندما لا يتوفر EPT. ومع EPT عند Intel، وNPT عند AMD، يمشي المعالج نفسه على جدولين: جداول الضيف يديرها الضيف كما يريد دون أي خروج، وجداول EPT يديرها KVM، ويشير إليها حقل في ال VMCS، ولا يراها الضيف أبداً.
وهذا ما رأيناه في الاختبار الرابع: عندما بدأ الضيف كانت جداول EPT فارغة، فعند أول كتابة في كل صفحة لم يجد المعالج ترجمة لها في EPT، فخرج بسبب EPT_VIOLATION ومعه العنوان المطلوب، فوجد KVM أن هذا العنوان يقع في منطقة الذاكرة التي سجلناها، فأضاف الترجمة وأعاد الضيف، ولذلك العداد اسمه pf_fixed. وفي المرة الثانية كانت الترجمات موجودة، فمر الضيف على 254 صفحة دون أي خروج. وهذه الطريقة الكسولة هي التي تجعل جهازاً افتراضياً بذاكرة 64 GB يبدأ خلال ثوان قليلة: لا يحجز KVM ذاكرة حقيقية لصفحة لم يلمسها الضيف بعد.
وللمرحلتين ثمن: عندما لا يجد المعالج الترجمة في ال TLB يجب أن يمشي على جداول الضيف، وكل عنوان في جداول الضيف هو عنوان ضيف فعلي يحتاج بدوره ترجمة عبر EPT، فمع أربعة مستويات في كل جدول يصل عدد قراءات الذاكرة في أسوأ حالة إلى 24 قراءة بدلاً من 4. ولذلك تهم أشياء صغيرة في الإعدادات: الصفحات الكبيرة Huge Pages التي تقلل عدد المستويات، والعلم ept_1gb الذي رأيناه، والعلم vpid الذي يوسم سجلات ال TLB برقم الضيف حتى لا يمسحها المعالج عند كل دخول وخروج.
الأجهزة: virtio وIOMMU مثل VT-d
الاختبار الثالث في المختبر يشبه ما يحدث مع جهاز محاكى بالكامل: كل كتابة إلى مسجل في الجهاز خروج يصل إلى فضاء المستخدم. وبطاقة شبكة حقيقية مثل Intel e1000 يحتاج تعريفها إلى عدة قراءات وكتابات لكل حزمة، فإذا حاكاها QEMU مسجلاً بمسجل فكل حزمة تكلف عدة خروج، ومع عشرات الآلاف من الحزم في الثانية يصبح الخروج هو كل العمل. والصورة التالية تبين الطرق الثلاث المستعملة اليوم:
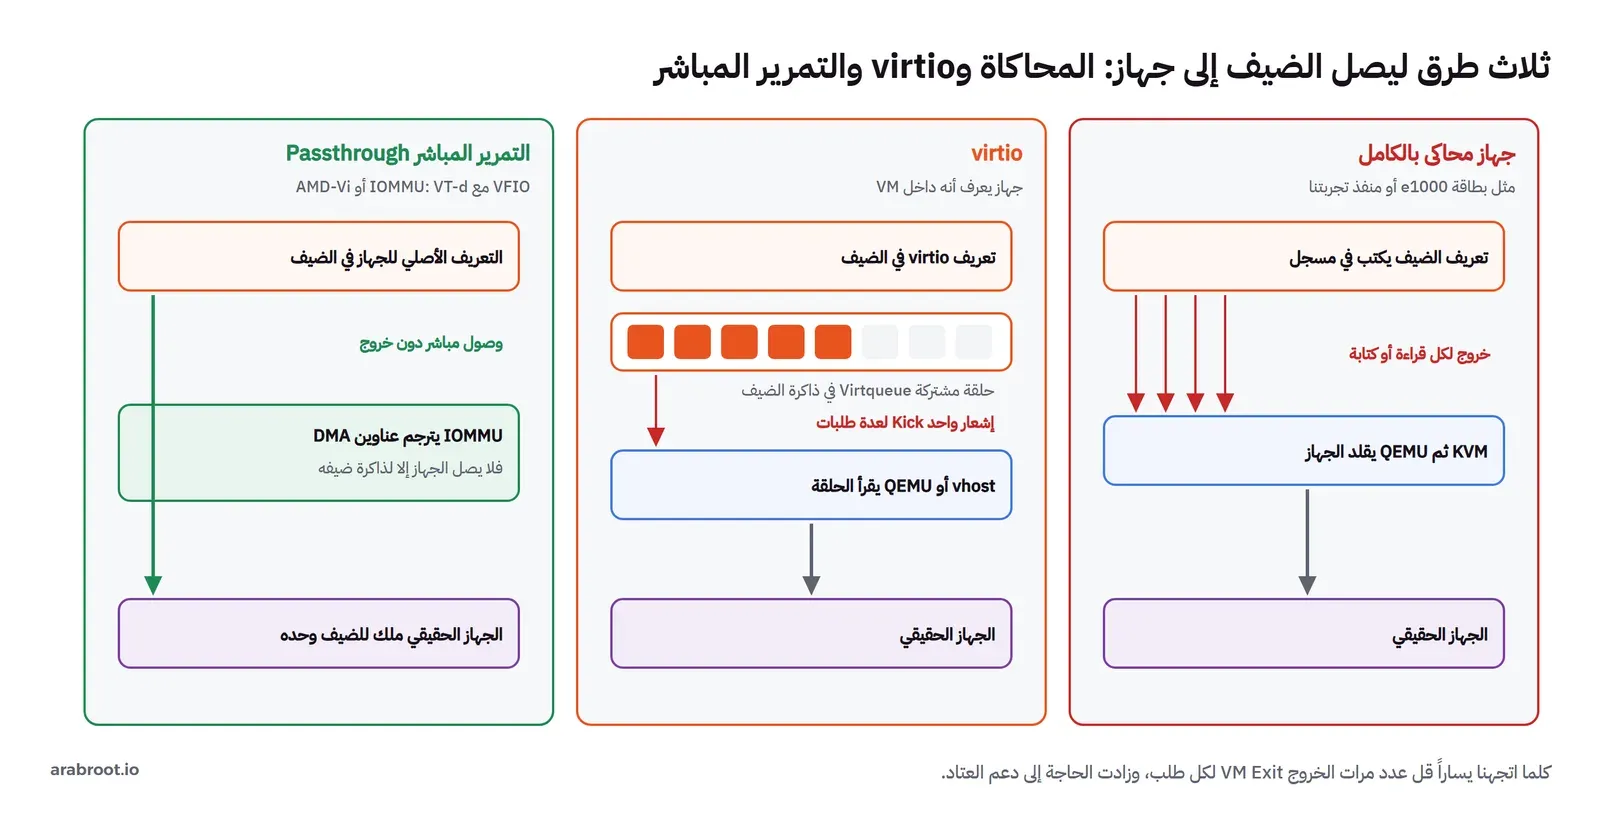
والحل الأول هو virtio، وقد شرحناه باختصار في مقال المحاكاة الافتراضية: جهاز لا يقلد أي بطاقة حقيقية، وإنما صمم ليعرف أنه داخل VM، فيضع الضيف طلباته في حلقة مشتركة في الذاكرة اسمها Virtqueue، ثم يرسل إشعاراً واحداً يسمى Kick لعدة طلبات معاً، والمواصفة منشورة كاملة في موقع OASIS. فالفكرة هي نفسها فكرة Xen في 2003، ولكنها طبقت على الأجهزة فقط.
والحل الثاني هو التمرير المباشر Passthrough: تعطي الضيف بطاقة حقيقية، بطاقة شبكة أو GPU، فيكلمها بتعريفها الأصلي دون أي مشرف في الطريق. ولكن هنا مشكلة أمنية كبيرة: الأجهزة تكتب في الذاكرة مباشرة عن طريق DMA، والضيف هو الذي يعطي البطاقة العناوين، وهو يعطيها عناوين يظنها فعلية، فإذا لم يترجمها أحد فسوف تكتب البطاقة في ذاكرة المضيف أو ضيف آخر. وهذا عمل وحدة IOMMU، واسمها عند Intel تقنية VT-d وعند AMD تقنية AMD-Vi، فهي تفعل للأجهزة ما تفعله EPT للمعالج: تترجم كل عنوان DMA وتمنع الجهاز من الوصول إلى أي ذاكرة خارج ضيفه، وعلى Linux تستعمل هذه الميزة عن طريق VFIO. ولذلك إذا أردت تمرير GPU إلى VM على Proxmox فأول شرط أن يكون VT-d مفعلاً في BIOS وأن تراه النواة.
وتذكر أن IOMMU يحمي المضيف أيضاً دون أي أجهزة افتراضية، فـ Windows يستعمله لحماية DMA من أجهزة Thunderbolt التي توصل من الخارج كما تشرح صفحة Microsoft عن حماية DMA. وفي جهاز المختبر لم تظهر القيمة 3 في AvailableSecurityProperties، أي أن هذه الحماية غير متاحة، فإذا كانت عندك أجهزة تعمل بـ Thunderbolt أو تريد تمرير أجهزة فهذا أول ما تفحصه.
عندما تفشل هذه الطبقة: حوادث حقيقية
كل ما سبق يقوم على وعد واحد: الضيف لا يرى إلا ما يعطيه المشرف. وعندما يفشل هذا الوعد تكون النتيجة خطيرة، لأن السيرفر الواحد في السحابة يحمل ضيوفاً لعملاء مختلفين.
l1d_flush الذي رأيناه في مجلد KVM في المختبر هو عداد هذا الحل نفسه، فهو ما زال يعمل على كل جهاز تأثر بالثغرة.ولهذا السبب بنت السحابات الكبيرة مشرفات أصغر ونقلت الأجهزة خارج المعالج، مثل نظام AWS Nitro الذي يضع الشبكة والتخزين في بطاقات خاصة ويترك على السيرفر مشرفاً خفيفاً، فكلما قل الكود الذي يتلقى مدخلات من الضيف قلت فرص الخروج منه.
أخطاء شائعة Common Mistakes
- الحكم على دعم VT-x من شاشة Windows: إذا كان Hyper-V يعمل فإن
VirtualizationFirmwareEnabledسوف يظهر False حتى لو كان الدعم يعمل، فاقرأHypervisorPresentومدير المهام، أو اقرأ العلمvmxأوsvmمن Linux. - تشغيل VM دون KVM دون أن تعرف: بعض الأدوات تتراجع إلى المحاكاة البرمجية الكاملة عندما لا تجد
/dev/kvm، والنتيجة جهاز يعمل ولكن أبطأ بعشرات الأضعاف، فتأكد من الملف ومن صلاحياته قبل أن تبحث عن السبب في مكان آخر. - استعمال
--privilegedلتشغيل QEMU داخل Container: يكفي--device /dev/kvmكما رأينا، والصلاحيات الكاملة تفتح لل Container كل أجهزة المضيف. - اختيار أجهزة محاكاة قديمة مثل IDE وe1000 لسيرفر Linux: كل وصول لمسجل فيها خروج، والأفضل دائماً virtio للقرص والشبكة ما دام الضيف يدعمه، وكل توزيعات Linux الحديثة تدعمه.
- بناء بيئة إنتاج على المحاكاة المتداخلة: رأينا أن الخروج في L2 أغلى بكثير، فهي مناسبة للتجربة والتعليم وCI، وليست لسيرفرات قواعد البيانات.
- قياس الأداء مرة واحدة على جهاز مشترك: أرقامنا نفسها تغيرت بضعفين بين تشغيل وآخر، فكرر القياس واكتب متوسط الضغط معه.
- تمرير GPU أو بطاقة شبكة دون IOMMU: غالباً لن يعمل، وإذا عمل بطريقة ما فقد فتحت للضيف الطريق إلى ذاكرة المضيف كلها.
- ترك أجهزة لا يحتاجها الضيف: القرص المرن ومنافذ تسلسلية وبطاقات صوت في سيرفر لا صوت فيه، وكل واحد منها كود إضافي يمكن أن تكون فيه ثغرة كما حدث في VENOM.
قبل أن تعتمد على الأجهزة الافتراضية: قائمة تحقق Checklist
| ما تفحصه | كيف | لماذا |
|---|---|---|
| دعم VT-x أو AMD-V | grep -E -c 'vmx|svm' /proc/cpuinfo | دونه لا يوجد KVM، ويصبح كل شيء محاكاة برمجية |
| EPT أو NPT | سطر vmx flags أو lscpu | دونه يعود المشرف إلى جداول الظل وخروج كثير |
| وصول KVM | ls -l /dev/kvm ثم virt-host-validate | أول سبب لبطء غير مفهوم |
| هل أنت داخل VM أصلاً؟ | العلم hypervisor وورقة cpuid 0x40000000 | المحاكاة المتداخلة أبطأ، فاعرف أين تعمل |
| IOMMU قبل التمرير | ls /sys/class/iommu أو رسائل DMAR في سجل النواة | شرط للتمرير الآمن لأي جهاز |
| نوع الأجهزة في الضيف | إعدادات الجهاز الافتراضي | virtio للقرص والشبكة، وإزالة ما لا يلزم |
| تحديثات الثغرات | grep . /sys/devices/system/cpu/vulnerabilities/* | ثغرات مثل L1TF تعالج في النواة وفي البرنامج الثابت للمعالج |
وإذا كنت ستبني هذه الطبقة على سيرفر Linux فقد شرحنا التثبيت والإدارة خطوة خطوة في دليل KVM مع libvirt، وفي دليل أول VM في Proxmox إذا أردت واجهة جاهزة.
تدريب عملي
- شغل
cpu-flags.shعلى سيرفرك أو على جهازك، وقارن سطرvmx flagsبما رأيته هنا، وابحث هل يظهر العلمhypervisor، فإذا ظهر فاقرأ ورقةcpuid0x40000000 لتعرف من هو المشرف الذي يعمل تحتك، وقد تجد «KVMKVMKVM» على سحابة أو «VMwareVMware» في شركتك. - في
vmm.cاجعل الذاكرة تحجز بالعلمMAP_POPULATE، وأعد الاختبار الرابع، وتوقع قبل التشغيل: هل سوف يختفي خروجEPT_VIOLATIONفي المرة الأولى أم يبقى؟ ولماذا؟ - أضف إلى
guest.Sاختباراً خامساً يقرأ من المنفذ بالتعليمةinبدلاً من الكتابة، واجعلvmm.cيعيد للضيف قيمة ثابتة فيrun->io، ثم قس الزمن.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- معمارية x86 لم تكن قابلة للمحاكاة الافتراضية بطريقة الاعتراض البسيطة، لأن فيها تعليمات حساسة لا تسبب خطأ، فتحايلت VMware بترجمة الكود، وXen بتعديل الضيف.
- VT-x وAMD-V أضافتا عالماً ثانياً كاملاً داخل المعالج، فتعمل نواة الضيف في Ring 0 دون تعديل، ويخرج المعالج إلى المشرف عند ما يحدده المشرف في ال VMCS أو ال VMCB.
- الضيف يعمل بسرعة المعالج الحقيقي ما دام لا يخرج، والخروج هو الكلفة: قسنا نحو نانوثانية لدورة حساب مقابل آلاف النانوثانيات لكل خروج، والخروج إلى فضاء المستخدم أغلى من الخروج الذي يعالج في النواة.
- EPT وNPT تتركان جداول الضيف للضيف، ويملأ KVM جداوله عند أول لمس لكل صفحة، فرأينا 255 خروجاً في المرة الأولى ولا شيء في الثانية.
- virtio يقلل الخروج للأجهزة بجمع الطلبات، والتمرير المباشر يلغيه، ولكنه يحتاج IOMMU مثل VT-d حتى لا يصل الجهاز إلى ذاكرة غير ذاكرة ضيفه.
- على Windows مع WSL2 أو Docker Desktop يعمل Hyper-V تحت كل شيء، ويصبح Windows ضيفاً مميزاً، وأي KVM داخل WSL2 هو محاكاة متداخلة أغلى بكثير في الخروج.
وفي مقالات المعالجات القادمة بإذن الله نخرج من المعالج إلى وحدات أخرى في نفس الجهاز، فنرى لماذا لا يكفي CPU للذكاء الاصطناعي، ثم كيف تصنع الشريحة نفسها:
 دليلGPU وNPU وTPU: لماذا لا يكفي CPU للذكاء الاصطناعي؟نضرب نفس المصفوفات على المعالج وعلى المعالج الرسومي المدمج ونقيس الحساب وسرعة الذاكرة، لنفهم ما الذي يجعل GPU وNPU وTPU أسرع ومتى لا تفيد.
 دليلكيف تصنع الرقاقة؟ من الرمل إلى المعالج والنانومترنتتبع الشريحة من الرمل إلى الغلاف مروراً بأجهزة EUV، ونحسب بسكربت صغير كم شريحة تخرج من الرقاقة وكم منها يعمل ولماذا تغلو الشرائح الكبيرة.دليلالمحاكاة Emulation والترجمة الثنائية: QEMU وRosetta 2نفتح محاكي QEMU ونرى كيف تتحول تعليمات ARM إلى تعليمات x86 ونقيس كلفة كل خطوة، ثم نقارن ذلك بما تفعله Rosetta 2 وWindows Prism.
 دليلCISC أم RISC: ما الفرق الحقيقي بين x86 وARM وRISC-V؟نقيس حجم الكود وعدد التعليمات المنفذة لنفس البرامج على x86-64 وARM64 وRISC-V، ونرى ما بقي من نقاش CISC وRISC وما لم يعد صحيحاً.دليلمعمارية المعالج ISA: لماذا لا يعمل برنامج x86 على ARM؟نترجم نفس برنامج C لثلاث معماريات ونقرأ تعليماته سطراً سطراً، لنفهم ما الذي يجعل الملف التنفيذي يعمل على معالج ويرفضه معالج آخر.
سجل التحديثات Changelog
- 16 نوفمبر 2026: كتابة المقال وتنفيذ المختبر على Windows 11 مع معالج Intel Core i7-7700K وDocker Desktop (نواة WSL2 5.15، Hyper-V، KVM متداخل): قراءة الأعلام بالأداة cpuid 20250316، وبناء مشرف صغير بلغة C على واجهة KVM بـ gcc 14.2 وbinutils 2.44 في Container من debian:trixie-slim، وعد مرات الخروج من debugfs ومن نقطة التتبع kvm:kvm_exit.