إذا شغلت يوماً Container لمعمارية arm64 على حاسبك العادي فقد لاحظت أنه يعمل، ولكن ببطء غريب: أمر يأخذ ثانية على السيرفر يأخذ نصف دقيقة هنا، وتثبيت حزم Python يتحول من دقائق إلى ساعة. وإذا كان عندك جهاز Mac بمعالج Apple فأنت تشغل كل يوم تقريباً برامج مبنية لمعالجات Intel دون أن تلاحظ أي فرق تقريباً، وإذا اشتريت حاسباً بنظام Windows على ARM فسوف تجد برامجك القديمة تعمل عليه أيضاً. والسؤال الذي يجمع هذه الحالات: كيف يشغل معالج برنامجاً مكتوباً بلغة معالج آخر؟ ولماذا تكون الكلفة أحياناً ضعفين وأحياناً عشرين ضعفاً؟
وقد رأينا في مقال Hello World من الداخل أن ملف ARM يعمل على جهاز x86 عندما يكون محاكي QEMU مسجلاً في النواة، وشرحنا في مقال المحاكاة الافتراضية من Hypervisor إلى KVM الفرق بين تشغيل جهاز افتراضي بمساعدة المعالج ودونها، وفي مقال المترجم والمفسر وJIT رأينا كيف تترجم لغات البرمجة الكود أثناء التشغيل. وفي نفس مرحلة المعالجات قسنا كلفة المحاكاة على Docker في مقال ARM، وأقلعنا Debian كاملاً على RISC-V داخل QEMU:
 دليلمعمارية المعالج ISA: لماذا لا يعمل برنامج x86 على ARM؟نترجم نفس برنامج C لثلاث معماريات ونقرأ تعليماته سطراً سطراً، لنفهم ما الذي يجعل الملف التنفيذي يعمل على معالج ويرفضه معالج آخر.
 دليلARM من الجوال إلى السيرفر: Apple Silicon وGravitonكيف تربح Arm من شرائح لا تصنعها، ولماذا صار في كل سحابة معالج ARM، مع مختبر يبني Image لـ arm64 ويقيس كلفة تشغيلها تحت المحاكاة.
 دليلRISC-V: المعمارية المفتوحة وهل تغير سوق المعالجات؟ما الذي يعنيه أن تكون معمارية المعالج مفتوحة، وكيف تقرأ امتدادات RISC-V وملفاتها التعريفية، مع مختبر يقلع Debian كاملاً على RISC-V داخل QEMU.
أما هنا فسوف نفتح المحاكي نفسه ونرى ما يفعله بكل تعليمة، وسوف نناقش في هذا المقال ما يلي:
- الفرق بين المحاكاة Emulation والافتراضية Virtualization في جملة واحدة.
- ثلاث طرق لتشغيل كود معالج آخر: التفسير Interpretation، والترجمة الثنائية أثناء التشغيل Dynamic Binary Translation، والترجمة المسبقة Ahead-of-Time.
- كيف يعمل QEMU TCG من الداخل: كتل الترجمة Translation Blocks واللغة الوسيطة وذاكرة الكود المترجم وربط الكتل.
- مختبر حقيقي: نرى كيف تحولت ست تعليمات ARM إلى 243 بايتاً من تعليمات x86، ونعد الكتل المترجمة والمنفذة، ونطفئ تحسينات QEMU واحداً واحداً ونقيس أثرها.
- لماذا تكون كلفة المحاكاة ضعفين في برنامج وعشرين ضعفاً في آخر، ولماذا يعاني البرنامج الذي فيه JIT أكثر من غيره.
- وضع المستخدم ووضع النظام في QEMU.
- الخيوط وترتيب الذاكرة، ولماذا محاكاة x86 على ARM أصعب من العكس.
- Rosetta 2 وWindows Prism وbox64 وFEX: ما الذي يختلف في كل منها عن QEMU.
المحاكاة Emulation أم الافتراضية Virtualization؟
الكلمتان تستخدمان أحياناً بنفس المعنى، ولكن الفرق بينهما هو كل موضوع هذا المقال. الافتراضية Virtualization تعني تشغيل نظام ضيف على نفس معمارية المضيف، فتعليمات الضيف تعمل مباشرة على المعالج الحقيقي بسرعته الكاملة تقريباً، والمعالج نفسه يساعد بامتدادات مثل VT-x وAMD-V ليعزل الضيف ويوقفه عند التعليمات الحساسة فقط، وهذا ما يفعله KVM. أما المحاكاة Emulation فتعني تشغيل كود مكتوب لمعالج آخر، فلا يستطيع المعالج الحقيقي أن ينفذ تعليمة واحدة منه كما هي، وبالتالي يجب أن يقرأ برنامج آخر كل تعليمة ويحولها إلى ما يقابلها. ولذلك لا يوجد KVM بين x86 وARM، ولا يمكن لأي امتداد في المعالج أن يجعل تعليمة RISC-V تعمل على معالج Intel، فكل السرعة في المحاكاة تأتي من ذكاء البرنامج الذي يترجم.
وQEMU يجمع الاثنين: مع KVM يكون مشغلاً لأجهزة افتراضية بسرعة عالية، ومن دونه، أو عندما تختلف المعمارية، يعمل بمحركه الخاص للترجمة واسمه TCG، اختصاراً لـ Tiny Code Generator. وقد قسنا في مقال المحاكاة الافتراضية نفس الجهاز مع KVM ومع TCG على نفس المعمارية، أما في هذا المقال فنتحدث عن TCG فقط، وعن أمثاله في Mac وWindows.
ثلاث طرق لتشغيل كود معالج آخر
لنفرض أن أمامك ملفاً تنفيذياً لمعالج ARM، وتريد أن تشغله على حاسب x86، فأمامك ثلاث طرق كما في الصورة التالية:
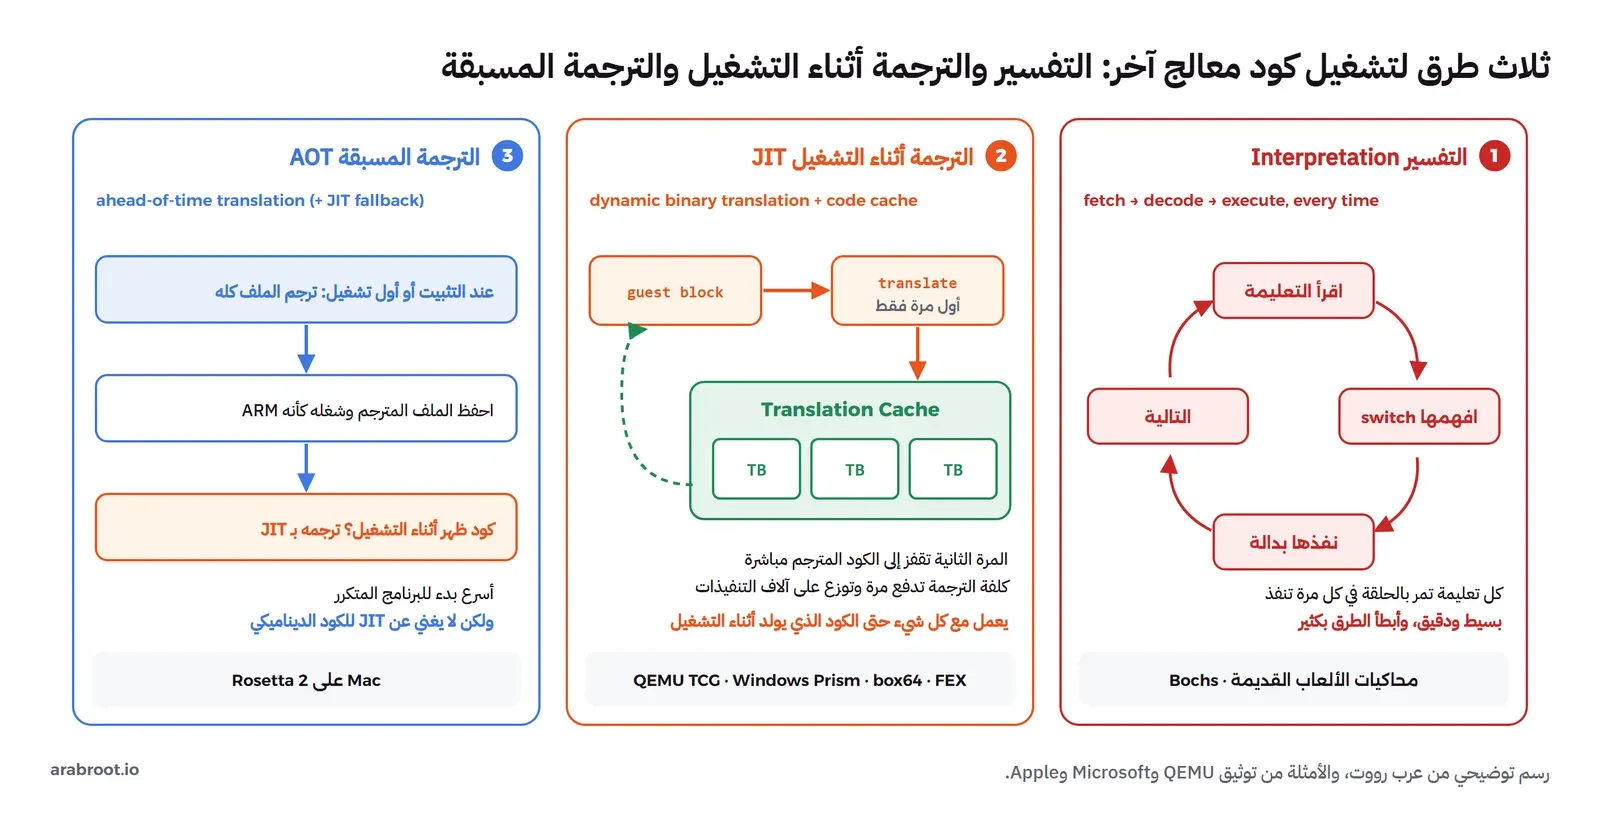
- التفسير Interpretation: تكتب برنامجاً فيه حلقة: اقرأ تعليمة ARM التالية من الذاكرة، وافهم ما هي بأمر
switchكبير، ثم نفذ دالة تقوم بعملها على مسجلات وهمية في الذاكرة، ثم انتقل إلى التالية. وهذا هو نفس ما بنيناه بأيدينا في مقال من شجرة AST إلى Bytecode وآلة افتراضية، ولكن على تعليمات معالج حقيقي بدلاً من Bytecode اخترعناه. والطريقة بسيطة ودقيقة جداً، ولكن كل تعليمة تمر بالحلقة كاملة في كل مرة تنفذ فيها، فالحلقة التي تدور مليون مرة يفك المفسر تعليماتها مليون مرة، ولذلك يكون المفسر أبطأ من المعالج الحقيقي بعشرات أو مئات المرات. - الترجمة الثنائية أثناء التشغيل Dynamic Binary Translation: بدل أن تفسر كل تعليمة في كل مرة، تأخذ مجموعة متتالية من تعليمات الضيف، وتترجمها مرة واحدة إلى تعليمات المعالج الحقيقي، وتحفظ النتيجة في ذاكرة خاصة للكود المترجم، وفي المرة التالية التي يصل فيها البرنامج إلى نفس العنوان تقفز إلى الكود المترجم مباشرة. وهذه هي فكرة JIT التي تعرفها من Java وJavaScript، ولكن المصدر هنا كود آلة وليس Bytecode، وهذه طريقة QEMU وPrism وbox64 وFEX.
- الترجمة المسبقة Ahead-of-Time: تترجم الملف التنفيذي كله قبل أن يعمل، وتحفظ النسخة المترجمة على القرص، فلا يدفع البرنامج كلفة الترجمة أثناء تشغيله. ولكن هذه الطريقة وحدها لا تكفي، لأن بعض الكود لا يوجد في الملف أصلاً وإنما يولد أثناء التشغيل، مثل الكود الذي ينتجه JIT داخل متصفح أو تطبيق Java، ولذلك يحتاج المترجم المسبق دائماً ترجمة أثناء التشغيل احتياطاً، وهذه طريقة Rosetta 2.
وقد يتساءل البعض: ولماذا لا نترجم كل الملفات مسبقاً ونرتاح؟ والإجابة أن ترجمة كود الآلة إلى كود آلة أصعب بكثير من ترجمة لغة برمجة، لأن الملف التنفيذي لا يخبرك أين تبدأ كل دالة وأين ينتهي الكود وتبدأ البيانات، وفيه قفزات غير مباشرة لا تعرف هدفها إلا أثناء التشغيل، مثل الاستدعاء عبر مؤشر دالة الذي رأيناه في qsort. أما المترجم أثناء التشغيل فلا يحتاج أن يعرف شيئاً مسبقاً، لأنه يترجم فقط الكود الذي وصل إليه البرنامج فعلاً، من العنوان الذي وصل إليه فعلاً.
كيف يعمل QEMU TCG من الداخل؟
كتب Fabrice Bellard المحاكي QEMU ونشر طريقته في ورقة في مؤتمر USENIX سنة 2005 بعنوان «QEMU, a Fast and Portable Dynamic Translator»، والكلمتان في العنوان هما سر التصميم: سريع لأنه يترجم ولا يفسر، ومحمول لأنه لا يترجم من كل معمارية إلى كل معمارية مباشرة، وإنما يمر بلغة وسيطة في المنتصف. ولو ترجم مباشرة لاحتاج مترجماً لكل زوج من المعماريات، أما مع اللغة الوسيطة فيكفي لكل معمارية جزءان: واجهة أمامية Front End تقرأ تعليماتها وتكتبها باللغة الوسيطة، وواجهة خلفية Back End تكتب اللغة الوسيطة بتعليماتها. وهذا نفس السبب الذي جعل LLVM يعتمد على لغة وسيطة كما شرحنا في مقال LLVM من الداخل.
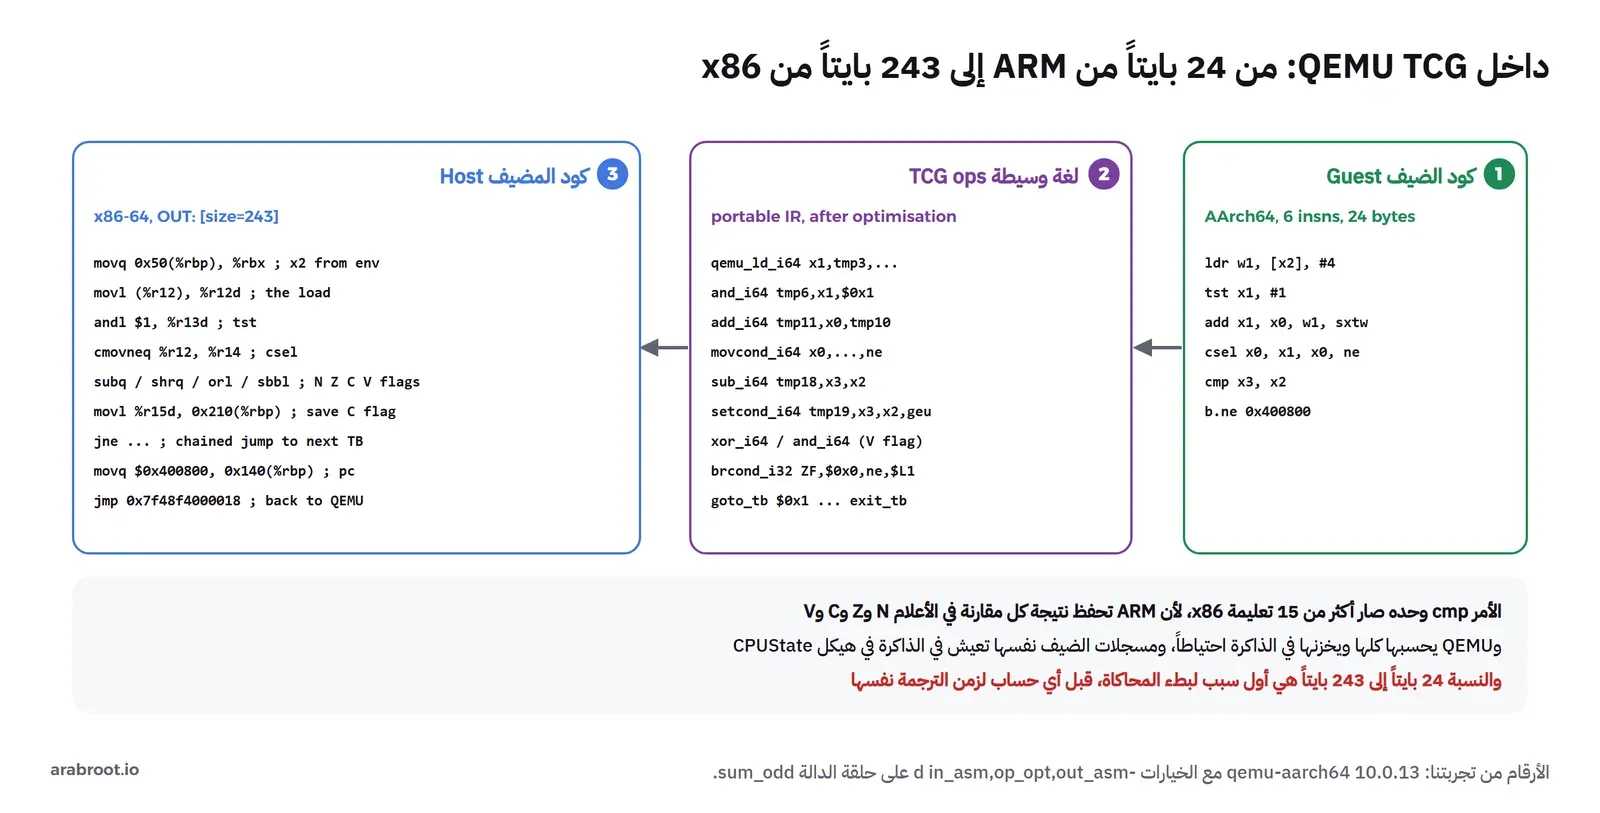
ووحدة العمل في TCG هي كتلة الترجمة Translation Block، واختصاراً TB: سلسلة تعليمات متتالية من الضيف تنتهي عند أول تعليمة قفز Jump أو تفرع، لأن ما بعد التفرع لا يعرف المحاكي أين سيكون حتى يصل إليه. وكما يشرح توثيق TCG، يبحث QEMU قبل تنفيذ أي كتلة عن نسخة مترجمة منها في الذاكرة، فإذا لم يجدها ترجمها وحفظها، ثم ينفذها. والصورة التالية تبين مراحل ترجمة كتلة واحدة، بالأرقام الحقيقية التي سوف نراها في المختبر بعد قليل:
تجهيز المختبر Lab Setup
سوف نعمل داخل Container من debian:trixie-slim فيه المترجمات المتقاطعة لـ aarch64 وriscv64 والمحاكي QEMU في وضع المستخدم، على جهاز بمعالج Intel Core i7-7700K:
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends \
      gcc libc6-dev gcc-aarch64-linux-gnu libc6-dev-arm64-cross gcc-riscv64-linux-gnu libc6-dev-riscv64-cross \
      binutils qemu-user file zstd xz-utils openssl time \
    && rm -rf /var/lib/apt/lists/*
WORKDIR /lab
docker build -t cs2-lab:1 .
docker run --rm -it --name cs2-emu -v "$PWD":/lab cs2-lab:1 bashونستخدم ملفين بلغة C: الأول bench.c الذي استخدمناه في مقال ARM، وفيه عملان: hash يحسب دالة الهاش FNV-1a على عدد من الميغابايتات، وsort يرتب ملايين الأرقام بالدالة qsort، والثاني tb.c الذي استخدمناه في مقال RISC-V، وفيه دالة صغيرة sum_odd تجمع الأرقام الفردية في مصفوفة، وكلاهما في ملفات المختبر. ونترجم الأول ثلاث مرات، مرة لكل معمارية، والثاني لـ aarch64، كلها ملفات ثابتة Static لا تحتاج مكتبات:
gcc -O2 -static -o bench-x86_64 bench.c
aarch64-linux-gnu-gcc -O2 -static -o bench-aarch64 bench.c
riscv64-linux-gnu-gcc -O2 -static -o bench-riscv64 bench.c
aarch64-linux-gnu-gcc -O2 -static -o tb-aarch64 tb.c
file bench-* | cut -c1-120
qemu-aarch64 --version | head -1
والمخرج سوف يكون كما يلي:
bench-aarch64: ELF 64-bit LSB executable, ARM aarch64, version 1 (GNU/Linux), statically linked, BuildID[sha1]=425bd8b66
bench-riscv64: ELF 64-bit LSB executable, UCB RISC-V, RVC, double-float ABI, version 1 (GNU/Linux), statically linked, B
bench-x86_64:  ELF 64-bit LSB executable, x86-64, version 1 (GNU/Linux), statically linked, BuildID[sha1]=3dab8047677a96
qemu-aarch64 version 10.0.13 (Debian 1:10.0.13+ds-0+deb13u1)
ثلاثة ملفات من نفس الكود، كل منها بلغة معالج مختلف، والمحاكي QEMU بالإصدار 10.0.13.
نرى الترجمة بأعيننا: كتلة واحدة من البداية إلى النهاية
أولاً لنقرأ الدالة sum_odd كما كتبها المترجم لـ ARM:
aarch64-linux-gnu-objdump -d --no-show-raw-insn tb-aarch64 | sed -n "/<sum_odd>:/,/^$/p"والمخرج سوف يكون كما يلي، وحذفنا منه أسطر nop في آخره:
00000000004007e0 <sum_odd>:
  4007e0:	cmp	x1, #0x0
  4007e4:	b.le	40081c <sum_odd+0x3c>
  4007e8:	mov	x2, x0
  4007ec:	mov	x0, #0x0                   	// #0
  4007f0:	add	x3, x2, x1, lsl #2
  4007f4:	nop
  4007f8:	nop
  4007fc:	nop
  400800:	ldr	w1, [x2], #4
  400804:	tst	x1, #0x1
  400808:	add	x1, x0, w1, sxtw
  40080c:	csel	x0, x1, x0, ne	// ne = any
  400810:	cmp	x3, x2
  400814:	b.ne	400800 <sum_odd+0x20>  // b.any
  400818:	ret
  40081c:	mov	x0, #0x0                   	// #0
  400820:	ret
جسم الحلقة هو التعليمات الست من 0x400800 إلى 0x400814: تحميل رقم من المصفوفة مع زيادة المؤشر بأربعة، واختبار البت الأخير، وجمع مؤقت، واختيار الجمع إذا كان الرقم فردياً بالتعليمة csel دون تفرع، ثم مقارنة المؤشر بنهاية المصفوفة، والقفز إلى البداية إذا لم تنته. وهذه الست هي بالضبط كتلة ترجمة واحدة، لأنها تنتهي بالتفرع b.ne.
والآن نطلب من QEMU أن يكتب في ملف ما يفعله بهذه الكتلة، والخيار -d يحدد ما يسجله، و-dfilter يحصر التسجيل في عناوين بعينها حتى لا يغرقنا بآلاف الكتل الأخرى من مكتبة C:
qemu-aarch64 -d help 2>&1 | head -5
qemu-aarch64 -d in_asm,out_asm,op_opt -dfilter 0x400800+0x18 -D /tmp/q.log ./tb-aarch64 1000
cat /tmp/q.log
والأسطر الأولى من قائمة الخيارات تشرح ما طلبناه:
Log items (comma separated):
out_asm         show generated host assembly code for each compiled TB
in_asm          show target assembly code for each compiled TB
op              show micro ops for each compiled TB
op_opt          show micro ops after optimization
أما الملف نفسه فيبدأ بكتلة الضيف كما قرأها المحاكي:
IN: sum_odd
0x00400800:  b8404441  ldr      w1, [x2], #4
0x00400804:  f240003f  tst      x1, #1
0x00400808:  8b21c001  add      x1, x0, w1, sxtw
0x0040080c:  9a801020  csel     x0, x1, x0, ne
0x00400810:  eb02007f  cmp      x3, x2
0x00400814:  54ffff61  b.ne     #0x400800
وهي نفس التعليمات التي رأيناها في objdump مع البايتات الأربعة لكل منها، فهذه هي المدخلات. ثم تأتي اللغة الوسيطة بعد التحسين، ونأخذ منها الأجزاء المهمة:
OP after optimization and liveness analysis:
 ld_i32 tmp0,env,$0xfffffffffffffff0      pref=0xffff
 brcond_i32 tmp0,$0x0,lt,$L0              dead: 0
 st8_i32 $0x0,env,$0xfffffffffffffff4

 ---- 0000000000400800 0000000000000000 0000000000000000
 shl_i64 tmp3,x2,$0x8                     pref=0xffff
 sar_i64 tmp3,tmp3,$0x8                   dead: 1 2  pref=0xffff
 and_i64 tmp3,tmp3,x2                     dead: 1  pref=0xffff
 qemu_ld_i64 x1,tmp3,noat+un+leul,0       dead: 1  pref=0xffff
 add_i64 tmp2,x2,$0x4                     dead: 1 2  pref=0xffff
 mov_i64 x2,tmp2                          sync: 0  dead: 1  pref=0xffff

 ---- 0000000000400804 0000000000000000 0000000000000000
 and_i64 tmp6,x1,$0x1                     dead: 2  pref=0xffff
 extrl_i64_i32 ZF,tmp6                    dead: 1  pref=0xffff

 ---- 0000000000400810 0000000000000000 0000000000000000
 sub_i64 tmp18,x3,x2                      pref=0xffff
 extrl_i64_i32 ZF,tmp18                   pref=0xffff
 extrh_i64_i32 NF,tmp18                   sync: 0  pref=0xffff
 or_i32 ZF,ZF,NF                          sync: 0  dead: 1 2  pref=0xffff
 setcond_i64 tmp19,x3,x2,geu              pref=0xffff
 extrl_i64_i32 CF,tmp19                   sync: 0  dead: 0 1  pref=0xffff
 xor_i64 tmp19,tmp18,x3                   dead: 1  pref=0xffff
 xor_i64 tmp20,x3,x2                      dead: 1 2  pref=0xffff
 and_i64 tmp19,tmp19,tmp20                dead: 1 2  pref=0xffff
 extrh_i64_i32 VF,tmp19                   sync: 0  dead: 0 1  pref=0xffff
 st8_i32 $0x1,env,$0xfffffffffffffff4     dead: 0 1

 ---- 0000000000400814 0000000000000000 0000000000000000
 brcond_i32 ZF,$0x0,ne,$L1                dead: 0 1
 goto_tb $0x0
 mov_i64 pc,$0x400818                     sync: 0  dead: 0 1  pref=0xffff
 exit_tb $0x7f48f4058640
 set_label $L1
 goto_tb $0x1
 mov_i64 pc,$0x400800                     sync: 0  dead: 0 1  pref=0xffff
 exit_tb $0x7f48f4058641
 set_label $L0
 exit_tb $0x7f48f4058643
في المخرج أعلاه لاحظ التالي:
ld_i32 tmp0,env,...وbrcond_i32 tmp0,$0x0,lt,$L0في البداية: قبل أي تعليمة من الضيف، تتحقق الكتلة من علامة في هيكل الحالةenv، فإذا طلب أحد إيقاف المعالج المحاكى، مثلاً لإشارة وصلت أو لخيط آخر يريد أن يتوقف، خرجت الكتلة فوراً عبر$L0. وهذا الثمن يدفع في بداية كل كتلة.shl_i64ثمsar_i64ثمand_i64قبل التحميل: ثلاث عمليات على العنوان قبل قراءة الذاكرة، والسبب أن AArch64 تسمح للبرامج بأن تضع وسماً في البايت الأعلى من المؤشر، وهي ميزة اسمها Top Byte Ignore، فينظف المحاكي العنوان قبل أن يستخدمه، وهو عمل لا يحتاجه المعالج الحقيقي لأنه يتجاهل هذا البايت في العتاد.qemu_ld_i64 x1,...: التحميل نفسه، ولاحظ أنx1وx2أسماء مسجلات ARM ما زالت موجودة في اللغة الوسيطة، فهي بالنسبة لـ TCG متغيرات تعيش في الذاكرة.- الكتلة
0x400810، وهي تعليمةcmp x3, x2وحدها: طرح، ثم استخراجZFوNFمن النتيجة، ثمsetcondلحسابCF، ثم عمليتاxorوعمليةandلحسابVF، أي علم الفيض Overflow. والسبب أن ARM تحفظ نتيجة كل مقارنة في أربعة أعلام N وZ وC وV، وأي تعليمة لاحقة قد تقرأ أياً منها، فيحسبها المحاكي كلها احتياطاً، مع أن التفرع التاليb.neلا يحتاج إلا Z. goto_tbثمexit_tb: نهاية الكتلة لها مخرجان، واحد إذا انتهت الحلقة إلى0x400818وواحد إذا عادت إلى0x400800، وgoto_tbمكان محجوز لانتقال مباشر إلى الكتلة التالية سوف نعود إليه في قسم ربط الكتل.
وأخيراً كود x86 الذي كتبه QEMU، ونعرض منه الجزأين الأول والأخير:
OUT: [size=243]
  -- guest addr 0x0000000000400800 + tb prologue
0x7f48f4058700:  8b 5d f0                 movl     -0x10(%rbp), %ebx
0x7f48f4058703:  85 db                    testl    %ebx, %ebx
0x7f48f4058705:  0f 8c dc 00 00 00        jl       0x7f48f40587e7
0x7f48f405870b:  c6 45 f4 00              movb     $0, -0xc(%rbp)
0x7f48f405870f:  48 8b 5d 50              movq     0x50(%rbp), %rbx
0x7f48f4058713:  4c 8b e3                 movq     %rbx, %r12
0x7f48f4058716:  49 c1 e4 08              shlq     $8, %r12
0x7f48f405871a:  49 c1 fc 08              sarq     $8, %r12
0x7f48f405871e:  4c 23 e3                 andq     %rbx, %r12
0x7f48f4058721:  45 8b 24 24              movl     (%r12), %r12d
0x7f48f4058725:  48 83 c3 04              addq     $4, %rbx
0x7f48f4058729:  48 89 5d 50              movq     %rbx, 0x50(%rbp)
  -- guest addr 0x0000000000400804
0x7f48f405872d:  4d 8b ec                 movq     %r12, %r13
0x7f48f4058730:  41 83 e5 01              andl     $1, %r13d
0x7f48f4058734:  45 8b ed                 movl     %r13d, %r13d
  -- guest addr 0x0000000000400808
0x7f48f4058737:  4d 63 e4                 movslq   %r12d, %r12
0x7f48f405873a:  4c 8b 75 40              movq     0x40(%rbp), %r14
0x7f48f405873e:  4d 03 e6                 addq     %r14, %r12
0x7f48f4058741:  4c 89 65 48              movq     %r12, 0x48(%rbp)
  -- guest addr 0x000000000040080c
0x7f48f4058745:  4d 63 ed                 movslq   %r13d, %r13
0x7f48f4058748:  4d 85 ed                 testq    %r13, %r13
0x7f48f405874b:  4d 0f 45 f4              cmovneq  %r12, %r14
0x7f48f405874f:  4c 89 75 40              movq     %r14, 0x40(%rbp)
-- guest addr 0x0000000000400814
0x7f48f40587a3: 45 85 f6 testl %r14d, %r14d
0x7f48f40587a6: 0f 85 1f 00 00 00 jne 0x7f48f40587cb
0x7f48f40587ac: 66 66 90 nop
0x7f48f40587af: e9 00 00 00 00 jmp 0x7f48f40587b4
0x7f48f40587b4: 48 c7 85 40 01 00 00 18 movq $0x400818, 0x140(%rbp)
0x7f48f40587bc: 08 40 00
0x7f48f40587bf: 48 8d 05 7a fe ff ff leaq -0x186(%rip), %rax
0x7f48f40587c6: e9 4d 78 fa ff jmp 0x7f48f4000018
0x7f48f40587cb: e9 00 00 00 00 jmp 0x7f48f40587d0
0x7f48f40587d0: 48 c7 85 40 01 00 00 00 movq $0x400800, 0x140(%rbp)
0x7f48f40587d8: 08 40 00
0x7f48f40587db: 48 8d 05 5f fe ff ff leaq -0x1a1(%rip), %rax
0x7f48f40587e2: e9 31 78 fa ff jmp 0x7f48f4000018في المخرج أعلاه لاحظ التالي:
OUT: [size=243]: ست تعليمات ARM حجمها 24 بايتاً صارت 243 بايتاً من x86، أي نحو عشرة أضعاف الحجم، وعدد التعليمات تقريباً ستون تعليمة مقابل ست.%rbpفي كل مكان: المسجلrbpفي كود QEMU يشير دائماً إلى هيكل الحالةenv، و0x50(%rbp)هو مكان المسجلx2لمعالج ARM في الذاكرة، و0x40(%rbp)مكانx0. ولاحظ أن الكتلة تقرأ المسجل من الذاكرة في أولها، ثم تكتبه إليها مرة أخرى بالتعليمةmovq %rbx, 0x50(%rbp)، لأن ما بعد الكتلة قد يحتاج أن يقرأه.cmovneq %r12, %r14: التعليمةcselفي ARM وجدت مقابلاً مباشراً في x86، فصارت تعليمة واحدة تقريباً، وهذا أحسن حالات الترجمة.movl %r15d, 0x210(%rbp)وأخواتها في الجزء المحذوف: تخزين الأعلام C وV وN فيenvبعد حسابها، وهي أكثر جزء مكلف في الكتلة كلها.jmp 0x7f48f40587b4وjmp 0x7f48f40587d0بالبايتاتe9 00 00 00 00: تعليمتا قفز إلى السطر التالي مباشرة، أي لا تفعلان شيئاً الآن. وهذه هيgoto_tbبعد الترجمة: مكان محجوز سوف يكتب فيه QEMU لاحقاً عنوان الكتلة التالية.jmp 0x7f48f4000018: الخروج إلى QEMU، والعنوان هو نهاية المقدمة Prologue التي يبدأ منها كل تنفيذ للكود المترجم ويعود إليها.
وهنا نصل إلى أول سبب حقيقي لبطء المحاكاة: ليس زمن الترجمة، فهذه الكتلة ترجمت مرة واحدة فقط، وإنما أن الكود المترجم نفسه أكبر وأبطأ من الأصلي، لأن مسجلات الضيف تعيش في الذاكرة، ولأن أعلام ARM تحسب كلها، ولأن العنوان ينظف قبل كل وصول للذاكرة.
ذاكرة الكود المترجم: كم مرة نترجم وكم مرة ننفذ؟
إذا كانت الترجمة مكلفة فهي تستحق فقط إذا نفذ الكود المترجم مرات كثيرة، فلنعد الكتل التي ترجمها QEMU والكتل التي نفذها، على عمل الهاش لميغابايت واحد. والخيار in_asm يسجل كل كتلة مرة واحدة عند ترجمتها، والخيار exec يسجل سطراً عند كل تنفيذ لكتلة، ولكنه لا يرى التنفيذات التي تقفز فيها كتلة إلى أخرى مباشرة، ولذلك نضيف معه nochain كما يقول نص المساعدة نفسه:
qemu-aarch64 -d in_asm -D /tmp/in.log ./bench-aarch64 hash 1
echo "translated blocks: $(grep -c '^IN:' /tmp/in.log)"
qemu-aarch64 -d exec,nochain -D /tmp/exec.log ./bench-aarch64 hash 1
echo "executed blocks:   $(grep -c 'Trace' /tmp/exec.log)"
والمخرج سوف يكون كما يلي:
hash mb=1 h=3e5c3685cb07de3d time=0.034s
translated blocks: 1383
hash mb=1 h=3e5c3685cb07de3d time=10.657s
executed blocks:   2129979
في المخرج أعلاه لاحظ التالي:
- 1383 كتلة ترجمت، وأغلبها من بدء البرنامج ومكتبة C: قراءة المتغيرات وتهيئة الذاكرة و
printf. - أكثر من مليوني تنفيذ لكتلة، لأن البرنامج فيه حلقتان على مليون بايت: حلقة تملأ البيانات، وحلقة الهاش، وكل دورة منهما تنفيذ لكتلة. أي أن كل كتلة نفذت في المتوسط أكثر من ألف وخمسمئة مرة، وهذا سبب نجاح الفكرة كلها: الترجمة مرة، والتنفيذ آلاف المرات.
- الزمن 0.034 ثانية في التشغيل الأول، و10.657 ثانية في الثاني، والفرق كله كلفة كتابة مليوني سطر في السجل مع إطفاء الربط، فلا تقم بقياس الأداء والتسجيل مفعل، والسبب أنك سوف تقيس التسجيل وحده.
والجانب الآخر لهذه المعادلة هو البرنامج الذي يعمل قليلاً ثم ينتهي، فهنا لا توجد آلاف التنفيذات لتوزيع كلفة الترجمة عليها. ولذلك نقيس تشغيلاً شبه فارغ، أي ترتيب رقم واحد، ثلاث مرات على المعالج الحقيقي ثم تحت المحاكي:
for i in 1 2 3; do /usr/bin/time -f "native        %e s  %M KB" ./bench-x86_64 sort 1 >/dev/null; done
for i in 1 2 3; do /usr/bin/time -f "qemu-aarch64  %e s  %M KB" qemu-aarch64 ./bench-aarch64 sort 1 >/dev/null; done
والمخرج سوف يكون كما يلي:
native        0.04 s  812 KB
native        0.03 s  804 KB
native        0.05 s  804 KB
qemu-aarch64  0.12 s  12080 KB
qemu-aarch64  0.11 s  12032 KB
qemu-aarch64  0.08 s  14076 KB
البرنامج نفسه لا يفعل شيئاً تقريباً، ومع ذلك يأخذ تحت المحاكي ضعفين إلى ثلاثة أضعاف الزمن، ويستهلك نحو 12 MB من الذاكرة مقابل أقل من 1 MB، وهذا الفرق هو كلفة تشغيل المحاكي نفسه وترجمة كود البدء وحجز ذاكرة الكود المترجم. وهذا يفسر لماذا يبدو Container لـ arm64 بطيئاً جداً في سكربت يشغل مئات الأوامر الصغيرة، حتى لو كان كل أمر بسيطاً: كل أمر يبدأ بمحاكي جديد وذاكرة ترجمة فارغة.
ربط الكتل Block Chaining: ماذا لو أطفأناه؟
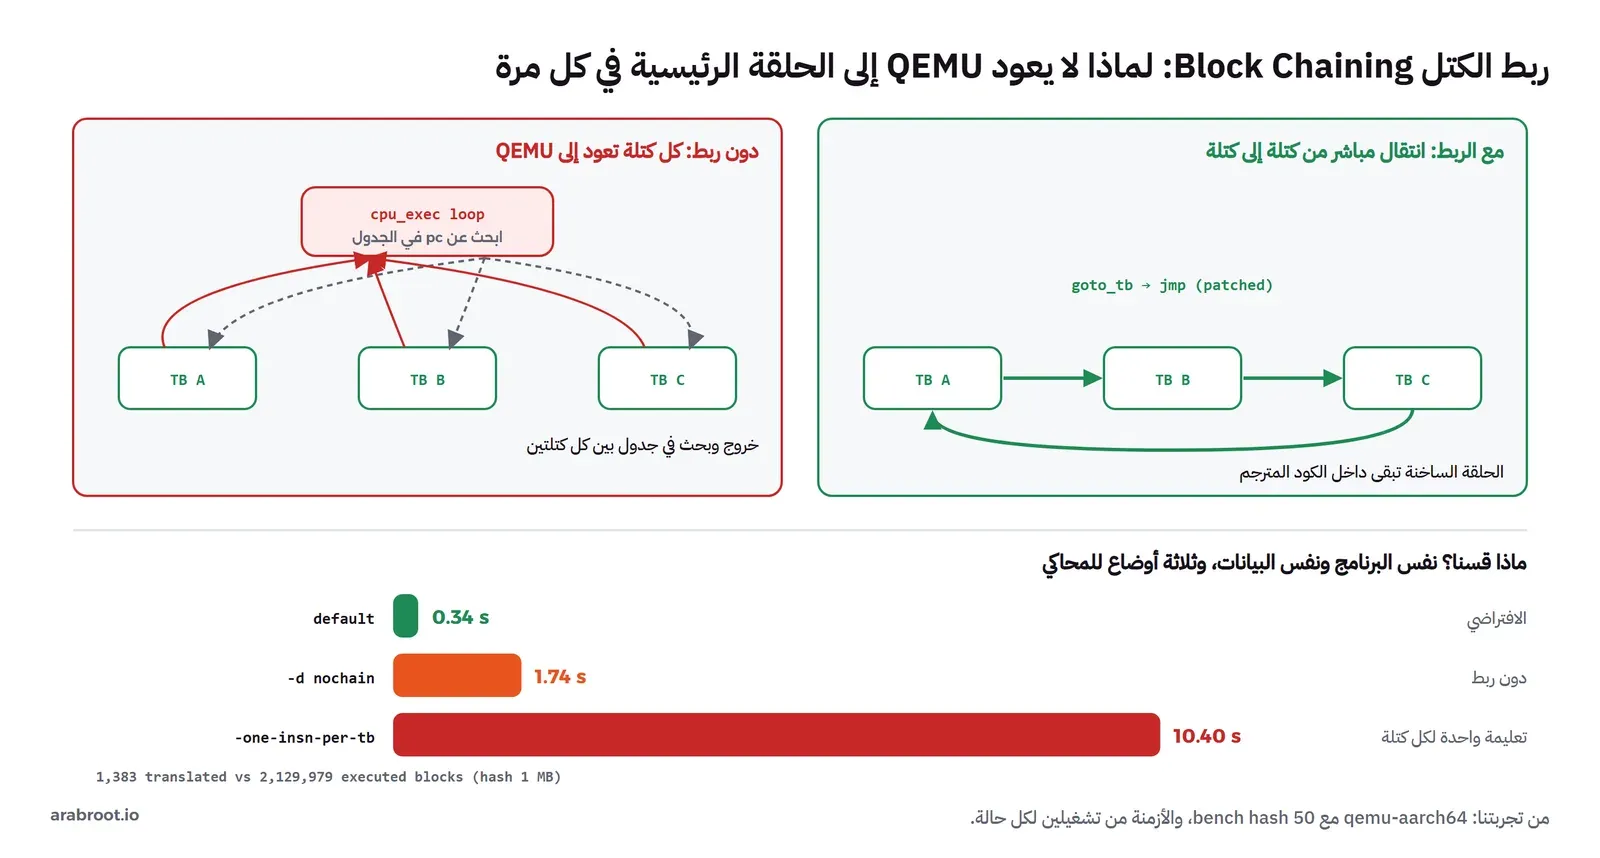
رأينا في الكود المترجم مكانين محجوزين بعد كل كتلة، فما فائدتهما؟ دون ربط، تنتهي كل كتلة بالعودة إلى الحلقة الرئيسية في QEMU، التي تقرأ عنوان التعليمة التالية للضيف، وتبحث عن الكتلة المترجمة التي تبدأ عنده في جدول، ثم تقفز إليها. ومع الربط، بعد أول مرة ينتقل فيها البرنامج من كتلة إلى كتلة يكتب QEMU في المكان المحجوز في الكتلة الأولى تعليمة قفز مباشر إلى الثانية، فالحلقة الساخنة تقفز من كتلة إلى كتلة دون أن تخرج من الكود المترجم أبداً. ويقول توثيق TCG إن الربط يحدث فقط عندما يكون الهدف ثابتاً، أي ليس قفزاً غير مباشر، وعندما لا يعبر الانتقال حدود صفحة الذاكرة. ولنقس أثره بالخيار nochain، ثم بالخيار -one-insn-per-tb الذي يجعل كل كتلة تعليمة واحدة فقط:
for i in 1 2; do printf 'default          '; qemu-aarch64 ./bench-aarch64 hash 50; done
for i in 1 2; do printf 'nochain          '; qemu-aarch64 -d nochain -D /dev/null ./bench-aarch64 hash 50; done
for i in 1 2; do printf 'one-insn-per-tb  '; qemu-aarch64 -one-insn-per-tb ./bench-aarch64 hash 50; done
والمخرج سوف يكون كما يلي:
default          hash mb=50 h=f61b4eb1eaaf6d2b time=0.380s
default          hash mb=50 h=f61b4eb1eaaf6d2b time=0.304s
nochain          hash mb=50 h=f61b4eb1eaaf6d2b time=1.686s
nochain          hash mb=50 h=f61b4eb1eaaf6d2b time=1.798s
one-insn-per-tb  hash mb=50 h=f61b4eb1eaaf6d2b time=10.970s
one-insn-per-tb  hash mb=50 h=f61b4eb1eaaf6d2b time=9.836s
في المخرج أعلاه لاحظ التالي:
- إطفاء الربط وحده جعل البرنامج أبطأ بنحو خمسة أضعاف، مع أن الترجمة نفسها لم تتغير، فكل الفرق هو العودة إلى الحلقة الرئيسية والبحث في الجدول بعد كل كتلة.
- كتلة لكل تعليمة جعلت البرنامج أبطأ بنحو ثلاثين ضعفاً، لأن كل تعليمة صارت تدفع كلفة الدخول والخروج والفحص في أول الكتلة، ولأن المحاكي لم يعد يرى عدة تعليمات معاً فيحسن بينها، مثل إسقاط علم لا يقرأه أحد. وهذا الخيار موجود للتشخيص وليس للاستخدام، وهو يقربنا من سلوك المفسر.
- والقيمة
h=f61b4eb1eaaf6d2bواحدة في كل الحالات، فالتحسينات تغير السرعة فقط وليس النتيجة.
والصورة التالية تجمع الفكرة والأرقام:
نفس البرنامج على المعالج الحقيقي وتحت ثلاثة محاكيات
الآن نقيس الصورة الكاملة: نفس bench.c على المعالج الحقيقي، ثم تحت qemu-x86_64، أي x86-64 على x86-64 دون أي اختلاف في المعمارية، ثم تحت qemu-aarch64 وqemu-riscv64، ثلاث مرات لكل حالة، بالسكربت emu.sh من ملفات المختبر:
sh /lab/emu.shوالمخرج سوف يكون كما يلي:
== hash 200 MB
native x86-64              hash mb=200 h=46ddfd31d041d963 time=0.276s
native x86-64              hash mb=200 h=46ddfd31d041d963 time=0.238s
native x86-64              hash mb=200 h=46ddfd31d041d963 time=0.241s
qemu-x86_64 (same)         hash mb=200 h=46ddfd31d041d963 time=0.555s
qemu-x86_64 (same)         hash mb=200 h=46ddfd31d041d963 time=0.547s
qemu-x86_64 (same)         hash mb=200 h=46ddfd31d041d963 time=0.524s
qemu-aarch64               hash mb=200 h=46ddfd31d041d963 time=0.761s
qemu-aarch64               hash mb=200 h=46ddfd31d041d963 time=0.778s
qemu-aarch64               hash mb=200 h=46ddfd31d041d963 time=0.934s
qemu-riscv64               hash mb=200 h=46ddfd31d041d963 time=0.506s
qemu-riscv64               hash mb=200 h=46ddfd31d041d963 time=0.470s
qemu-riscv64               hash mb=200 h=46ddfd31d041d963 time=0.663s
== sort 5M ints
native x86-64              sort n=5000000 first=24 last=2147483240 time=1.366s
native x86-64              sort n=5000000 first=24 last=2147483240 time=0.695s
native x86-64              sort n=5000000 first=24 last=2147483240 time=0.935s
qemu-x86_64 (same)         sort n=5000000 first=24 last=2147483240 time=5.214s
qemu-x86_64 (same)         sort n=5000000 first=24 last=2147483240 time=4.652s
qemu-x86_64 (same)         sort n=5000000 first=24 last=2147483240 time=4.895s
qemu-aarch64               sort n=5000000 first=24 last=2147483240 time=9.228s
qemu-aarch64               sort n=5000000 first=24 last=2147483240 time=10.109s
qemu-aarch64               sort n=5000000 first=24 last=2147483240 time=20.494s
qemu-riscv64               sort n=5000000 first=24 last=2147483240 time=19.251s
qemu-riscv64               sort n=5000000 first=24 last=2147483240 time=20.223s
qemu-riscv64               sort n=5000000 first=24 last=2147483240 time=13.951s
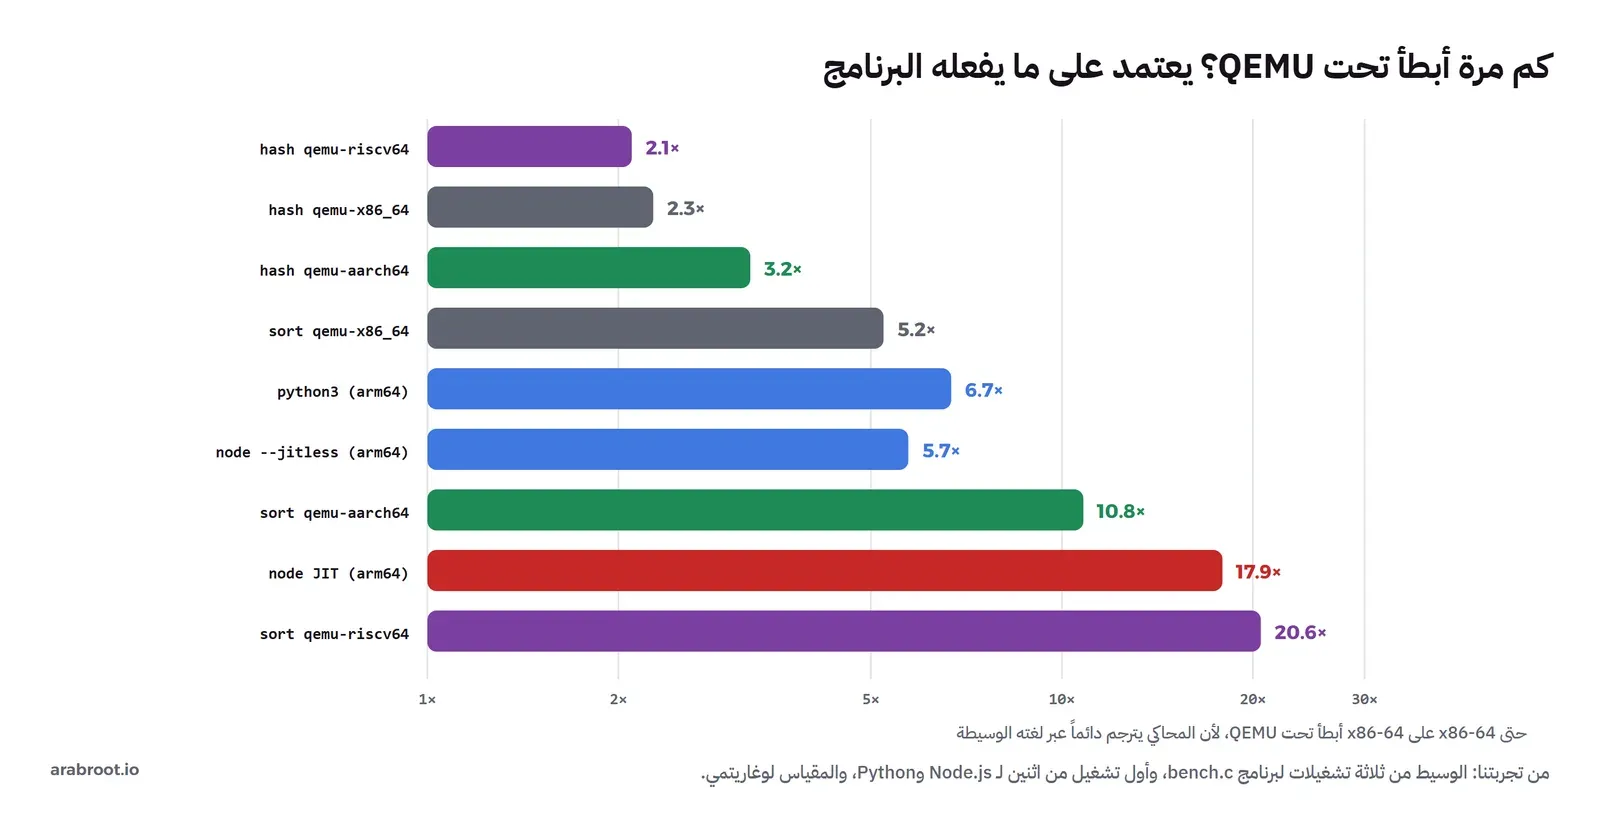
في المخرج أعلاه لاحظ التالي:
qemu-x86_64 (same): حتى عندما تكون معمارية الضيف هي نفس معمارية المضيف، يبقى البرنامج أبطأ بضعفين في الهاش وخمسة أضعاف في الترتيب، لأن QEMU لا يعرف أن التعليمات «نفسها»، فهو يمر بنفس المراحل: واجهة أمامية ثم لغة وسيطة ثم واجهة خلفية، ومسجلات الضيف في الذاكرة، والقفزات غير المباشرة تبحث في الجدول. ولهذا السبب بالذات يحتاج تشغيل جهاز x86 على x86 بسرعة إلى KVM وليس إلى ترجمة أفضل.qemu-riscv64في الهاش: أسرع من ARM وقريب من x86 على x86، وأحد الأسباب أن RISC-V لا تملك أعلاماً للمقارنة أصلاً، فالتفرع فيها يقارن مسجلين مباشرة، ولا يحتاج المحاكي أن يحسب أربعة أعلام بعد كل عملية كما رأينا في ARM.- الترتيب أبطأ بكثير من الهاش في كل المحاكيات، لأن
qsortتستدعي دالة المقارنة عبر مؤشر ملايين المرات، والقفز عبر مؤشر قفز غير مباشر لا يمكن ربطها مسبقاً، فيبحث المحاكي عن هدفها في كل مرة. - التشغيلات تختلف كثيراً، فـ
qemu-aarch64أخذ مرة 9.2 ثانية ومرة 20.5 ثانية، لأن الجهاز كان مشغولاً بأعمال أخرى في نفس الوقت، والمحاكي يتأثر بذلك أكثر من البرنامج الأصلي. ولذلك نأخذ الوسيط، ولا تقارن بين محاكيين من تشغيل واحد، فقد قسنا نفس الترتيب تحتqemu-riscv64في تشغيل سابق بين 8.5 و11.6 ثانية.
ماذا لو كان البرنامج الضيف نفسه JIT؟
بقي سؤال مهم: البرامج الحديثة نفسها تولد كوداً أثناء التشغيل، مثل محرك V8 في Node.js الذي يترجم JavaScript إلى كود آلة كما شرحنا في مقال المترجم والمفسر وJIT، فماذا يحدث عندما يعمل JIT داخل محاك يعمل هو أيضاً بطريقة JIT؟ لنجرب حلقة بسيطة في Node.js:
// jit.js: a hot loop that V8 compiles to machine code after a few iterations.
let s = 0;
for (let i = 0; i < 3e7; i++) s = (s + i * i) % 1000003;
console.log('s=' + s);
ونشغلها في Container من Alpine لـ amd64 ثم لـ arm64، مرة عادية ومرة بالخيار --jitless الذي يمنع V8 من توليد كود آلة ويجعله يفسر Bytecode فقط، ومعها نفس الحلقة في Python:
for p in amd64 arm64; do
  echo "### linux/$p"
  docker run --rm --platform linux/$p -v "$PWD":/lab:ro alpine:3.22 sh -c 'apk add -q --no-cache nodejs python3 >/dev/null
    node --version; python3 --version
    for i in 1 2; do
      /usr/bin/time -f "node jit      %e s" node /lab/jit.js
      /usr/bin/time -f "node jitless  %e s" node --jitless /lab/jit.js
      /usr/bin/time -f "python3       %e s" python3 -c "s=0
for i in range(3*10**6): s=(s+i*i)%1000003
print(\"s=%d\"%s)"
    done'
done
ومن المخرج نأخذ أسطر الأزمنة، مع حذف رسائل التحذير التي يطبعها Node.js عند --jitless ونتائج الحساب المتطابقة:
### linux/amd64
v22.23.5
Python 3.12.16
node jit      0.92 s
node jitless  12.20 s
python3       3.35 s
node jit      0.86 s
node jitless  5.39 s
python3       2.40 s
### linux/arm64
v22.23.5
Python 3.12.16
node jit      16.48 s
node jitless  69.89 s
python3       22.42 s
node jit      21.22 s
node jitless  53.00 s
python3       18.49 s
في المخرج أعلاه لاحظ التالي:
- Python أبطأ تحت المحاكاة بنحو سبعة أضعاف، وNode دون JIT بنحو خمسة إلى عشرة أضعاف، وكلاهما مفسر يدور في حلقة واحدة كبيرة يترجمها QEMU مرة ثم يعيد تنفيذها، فهو يشبه الهاش في سلوكه.
- Node مع JIT أبطأ تحت المحاكاة بنحو عشرين ضعفاً، أي أن البرنامج الأسرع على المعالج الحقيقي هو الذي خسر أكثر من غيره تحت المحاكاة. والسبب أن V8 يكتب كوداً جديداً في الذاكرة أثناء التشغيل، وكل كود جديد يجب أن يترجمه QEMU من البداية، والأسوأ من ذلك أن V8 يعدل كوده أحياناً بعد كتابته. ويشرح توثيق TCG أن QEMU في وضع المستخدم يحمي صفحات الذاكرة التي ترجم منها كوداً من الكتابة، فإذا كتب البرنامج فيها التقط المحاكي الخطأ وألغى كل الكتل المترجمة من تلك الصفحة، فيضطر لترجمتها من جديد.
- ورغم ذلك بقي Node مع JIT أسرع من Node دونه تحت المحاكاة، فلا تقم بإطفاء JIT في Container محاكى ظناً أنه يساعد، والسبب أن الكود المترجم مرتين ما زال أسرع من المفسر المترجم مرة.
والصورة التالية تجمع كل النسب التي قسناها في هذا المقال، من الأقل كلفة إلى الأكثر:
الخيوط وترتيب الذاكرة: لماذا محاكاة x86 على ARM أصعب من العكس؟
كل تجاربنا السابقة كانت بخيط واحد، ولكن أغلب البرامج الحقيقية متعددة الخيوط، وهنا تظهر مشكلة لا تراها في برنامج بخيط واحد إطلاقاً. فكما شرحنا في مقال المعالج والخيوط والتزامن، عندما يكتب خيط في الذاكرة ويقرأ خيط آخر على نواة أخرى، فالسؤال هو: بأي ترتيب يرى الخيط الثاني ما كتبه الأول؟ وكل معمارية تجيب بطريقتها، وهذه الإجابة جزء من ال ISA اسمه نموذج الذاكرة Memory Model. وx86 تعطي ضمانات قوية، فالكتابات تظهر للأنوية الأخرى بنفس ترتيبها تقريباً، أما ARM وRISC-V فتعطيان ضمانات أضعف، وتسمحان للمعالج بأن يعيد ترتيب القراءة والكتابة ما دام البرنامج لم يطلب غير ذلك بتعليمة حاجز Barrier صريحة.
والآن فكر في الاتجاهين. إذا حاكيت ARM على x86، كما فعلنا في هذا المقال، فالمضيف أقوى من الضيف، وكل ترتيب يتوقعه برنامج ARM تضمنه x86 تلقائياً، فلا يحتاج المحاكي أن يضيف شيئاً تقريباً. أما إذا حاكيت x86 على ARM، كما تفعل Rosetta وPrism وbox64، فبرنامج x86 متعدد الخيوط يعتمد على ضمانات لم يكتبها صراحة لأن معالجه كان يعطيها مجاناً، والمعالج المضيف لا يعطيها، فعلى المترجم أن يضيف حواجز حول عمليات الذاكرة حتى لا يرى خيط ما لم يكن ليراه على x86. ويقول توثيق QEMU عن TCG متعدد الخيوط إن QEMU يشغل كل معالج محاكى في خيط مستقل على المضيف فقط عندما يكون نموذج ذاكرة المضيف قادراً على استيعاب نموذج الضيف، وإن محاكاة ضيف بترتيب قوي على مضيف بترتيب ضعيف قد تكلف كثيراً في الأداء، وإن QEMU يدمج الحواجز المتتالية في حاجز واحد ليقلل هذه الكلفة.
وهذا يفسر لماذا اهتمت Apple بإضافة وضع TSO في عتاد معالجاتها كما سوف نرى في قسم Rosetta بعد قليل: بدلاً من أن يضيف المترجم حاجزاً قبل كل قراءة وكتابة، يطلب من النواة أن تتصرف مثل x86 في الترتيب أثناء تشغيل الكود المترجم فقط. وهو أيضاً سبب في أن بعض البرامج متعددة الخيوط تعمل تحت محاكي ضعيف التنفيذ لفترة ثم تعطي نتيجة خاطئة نادراً، وهذا أصعب نوع من الأخطاء، لأنه لا يظهر في كل تشغيل ولا يظهر أبداً على المعالج الأصلي. والقاعدة العملية لك: إذا رأيت برنامجاً متعدد الخيوط يتصرف بغرابة تحت المحاكاة فقط، فلا تفترض أن الخطأ في برنامجك قبل أن تجربه على عتاد حقيقي بنفس معماريته.
وفي وضع المستخدم يتبع QEMU نفس بنية الخيوط في البرنامج المترجم كما يذكر نفس التوثيق، فكل خيط في برنامج الضيف خيط حقيقي على المضيف، وهذا ما جعل Node.js يعمل في تجربتنا بخيوطه الداخلية دون أي إعداد خاص. ولكن ترجمة الكود نفسها تتم تحت قفل واحد، فإذا كانت كل الخيوط تترجم كوداً جديداً في نفس الوقت، كما يحدث في بداية برنامج كبير، فهي تنتظر بعضها، وهذا سبب آخر لبطء البدء تحت المحاكاة.
وضع المستخدم ووضع النظام: ماذا يترجم QEMU بالضبط؟
كل ما فعلناه حتى الآن كان في وضع المستخدم User Mode، كما في توثيق QEMU لهذا الوضع: المحاكي يترجم تعليمات البرنامج وحده، وعندما يطلب البرنامج شيئاً من النواة، مثل فتح ملف، يحول QEMU الطلب من صيغة معمارية الضيف إلى صيغة النواة الحقيقية ويمرره إليها، فالنواة تعمل بسرعتها الكاملة، وعناوين الذاكرة في البرنامج هي عناوين حقيقية داخل عملية QEMU. أما وضع النظام System Mode فيحاكي جهازاً كاملاً: المعالج والذاكرة ووحدة إدارة الذاكرة MMU والأقراص والشبكة، ونواة الضيف نفسها تترجم تعليمة تعليمة، وكل وصول إلى الذاكرة يمر بترجمة العنوان الافتراضي إلى الحقيقي في برنامج يسمى softmmu بدلاً من العتاد. والصورة التالية تقارن بين الوضعين بأرقام من مقال RISC-V:
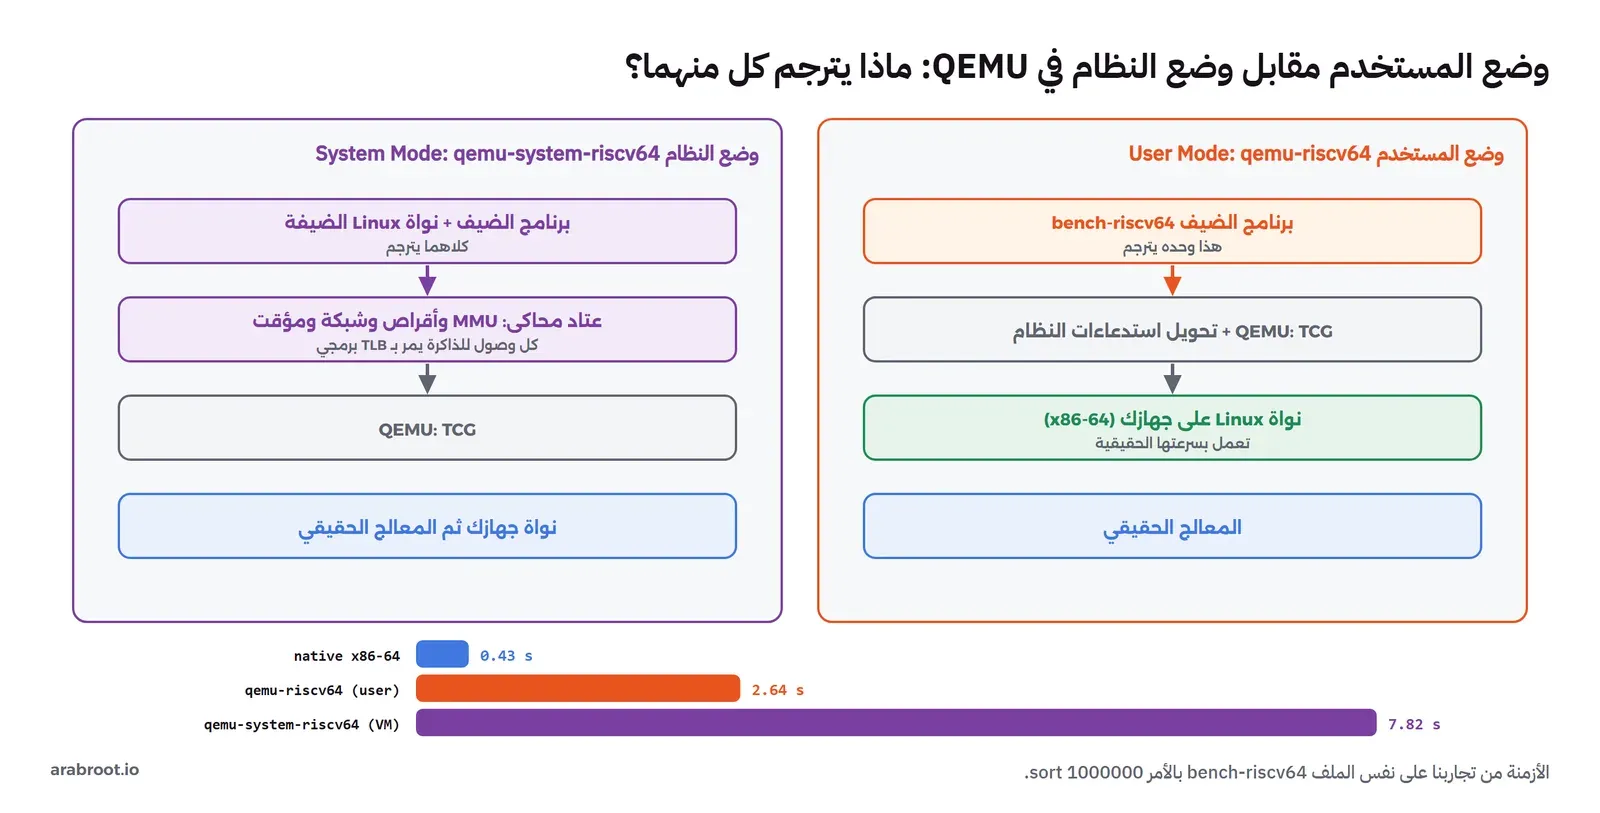
ونفس الملف bench-riscv64 رتب مليون رقم في 2.64 ثانية في وضع المستخدم، وفي 7.82 ثانية داخل جهاز Debian الافتراضي، وفي 0.43 ثانية لنسخة x86-64 على المعالج الحقيقي. والفرق بين الوضعين في الترتيب كبير لأن الترتيب يقرأ ويكتب في الذاكرة ملايين المرات، وكل قراءة في وضع النظام تمر بالبحث في TLB برمجي، فإذا لم تجد العنوان فيه مرت بجداول الصفحات المحاكاة. ولذلك القاعدة العملية: إذا كنت تحتاج تشغيل برنامج واحد من معمارية أخرى فاستخدم وضع المستخدم، ولا تقلع جهازاً كاملاً إلا إذا كنت تحتاج النواة نفسها، مثل اختبار الإقلاع أو تعريف أو امتدادات النظام.
Rosetta 2: كيف يشغل Mac برامج Intel بهذه السرعة؟
إذا كانت المحاكاة بهذه الكلفة، فكيف عملت برامج Intel على أجهزة Mac بمعالجات Apple بسرعة جعلت أغلب المستخدمين لا يلاحظون الفرق؟ الإجابة في ثلاثة قرارات مختلفة عن QEMU، وكلها ممكنة لأن Apple تتحكم في المعالج ونظام التشغيل معاً.
القرار الأول هو الترجمة المسبقة، فيقول توثيق Apple لـ Rosetta إن macOS عندما يجد ملفاً فيه تعليمات Intel فقط يشغل Rosetta ويبدأ الترجمة، وعندما تنتهي يشغل الملف المترجم بدلاً من الأصلي، وإن الترجمة تأخذ وقتاً فقد يلاحظ المستخدم بطئاً عند فتح البرنامج أحياناً. أي أن كلفة الترجمة تدفع مرة عند أول تشغيل وتحفظ، وليس في كل تشغيل كما رأينا في QEMU. ويقول نفس التوثيق إن Rosetta تترجم أيضاً البرامج التي فيها JIT، أي أن عندها ترجمة أثناء التشغيل للكود الذي لا يوجد في الملف، تماماً كما رأينا مع Node.js.
والقرار الثاني يخص ترتيب الذاكرة Memory Ordering، وهو الفرق الذي لم نره في تجاربنا لأنها كلها بخيط واحد. ففي x86 تضمن المعالجات أن عمليات الكتابة تظهر للأنوية الأخرى بنفس ترتيبها تقريباً، وهو نموذج اسمه TSO، اختصاراً لـ Total Store Order، أما ARM فتسمح للمعالج بإعادة ترتيب أكثر، والبرامج المكتوبة لـ x86 متعددة الخيوط تعتمد على ضمانات x86 دون أن تكتبها صراحة. فإذا أراد المترجم أن يكون صحيحاً على ARM فعليه أن يضيف حواجز Barriers كثيرة، وهي مكلفة. ومعالجات Apple فيها وضع في العتاد يجعل النواة تتصرف بترتيب TSO أثناء تشغيل الكود المترجم، وهذا ما تستخدمه أيضاً مشاريع Linux على أجهزة Apple، كما في سلسلة تعديلات النواة من Asahi Linux في أبريل 2024، التي تقول إن استخدام TSO في محاكاة x86 يعطي فرقاً كبيراً في الأداء.
والقرار الثالث هو الحدود الواضحة، فيذكر التوثيق أن Rosetta لا تترجم امتدادات النواة Kernel Extensions، ولا برامج الأجهزة الافتراضية التي تحاكي حاسب x86-64 كاملاً، ولا تدعم تعليمات AVX-512، وأن العملية الواحدة لا يمكن أن تخلط كود arm64 بكود x86_64، فالترجمة تشمل العملية كلها مع كل المكتبات التي تحملها. وأهم من ذلك أن Rosetta كانت أداة انتقال من البداية، فيقول نفس التوثيق إنها متاحة كأداة عامة حتى macOS 27، وبعد ذلك تبقي Apple جزءاً منها فقط لتشغيل الألعاب القديمة التي لم تعد تحدث. فإذا كنت تطور برنامجاً لـ Mac ولم تبنه لـ arm64 حتى الآن فهذا هو الوقت.
Windows Prism وARM64EC
في Windows القصة مختلفة لأن Microsoft لا تصنع المعالج، وكما ذكرنا في مقال ARM يقول توثيق Microsoft إن Prism هو المحاكي الذي جاء مع Windows 11 24H2، وإنه يترجم كتل تعليمات x86 إلى Arm64 أثناء التشغيل، أي نفس طريقة TCG، مع خدمة تحفظ الكتل المترجمة لكل ملف حتى يستفيد منها البرنامج عند التشغيل التالي وتستفيد منها البرامج الأخرى التي تحمل نفس المكتبة، وهي خطوة نحو ما تفعله Rosetta دون ترجمة الملف كله مسبقاً. ويذكر التوثيق أن بعض ميزات الأداء في Prism تحتاج ميزات في عتاد Snapdragon X، وأن المحاكاة لكود المستخدم فقط، فأي تعريف Driver يجب أن يكون Arm64. والفرق المهم عن Rosetta هو ARM64EC، وهي واجهة ثنائية تسمح بأن يعمل كود Arm64 الأصلي وكود x64 المحاكى في نفس العملية، فيستطيع المطور أن ينقل برنامجه الكبير إلى ARM جزءاً بعد جزء، بينما يبقى الجزء الذي يحمل إضافات قديمة محاكى.
وعلى Linux: box64 وFEX
وفي Linux على ARM لا يوجد مترجم من الشركة المصنعة، وإنما مشروعان مفتوحان يتخصصان في تشغيل برامج x86-64 على ARM64. الأول box64، ويصف نفسه بأنه يشغل برامج Linux لـ x86_64، ومنها الألعاب، على أنظمة Linux بمعماريات أخرى، ويستخدم مترجماً ديناميكياً Dynarec يقول المشروع إنه أسرع من مفسره بخمسة إلى عشرة أضعاف، وفكرته الأذكى أنه لا يحاكي المكتبات المعروفة مثل libc وOpenGL وSDL، وإنما يستبدلها بنسخها الأصلية لـ ARM، فالجزء الثقيل من الرسومات يعمل بسرعة المعالج الحقيقي. والثاني FEX، ويشغل برامج x86 على أجهزة Linux بـ ARM64، ويستخدم مع Wine وProton لتشغيل ألعاب Windows، ويستفيد من وضع TSO في معالجات Apple عند توفره كما في سلسلة التعديلات التي ذكرناها. والصورة التالية تقارن هذه المترجمات مع QEMU:
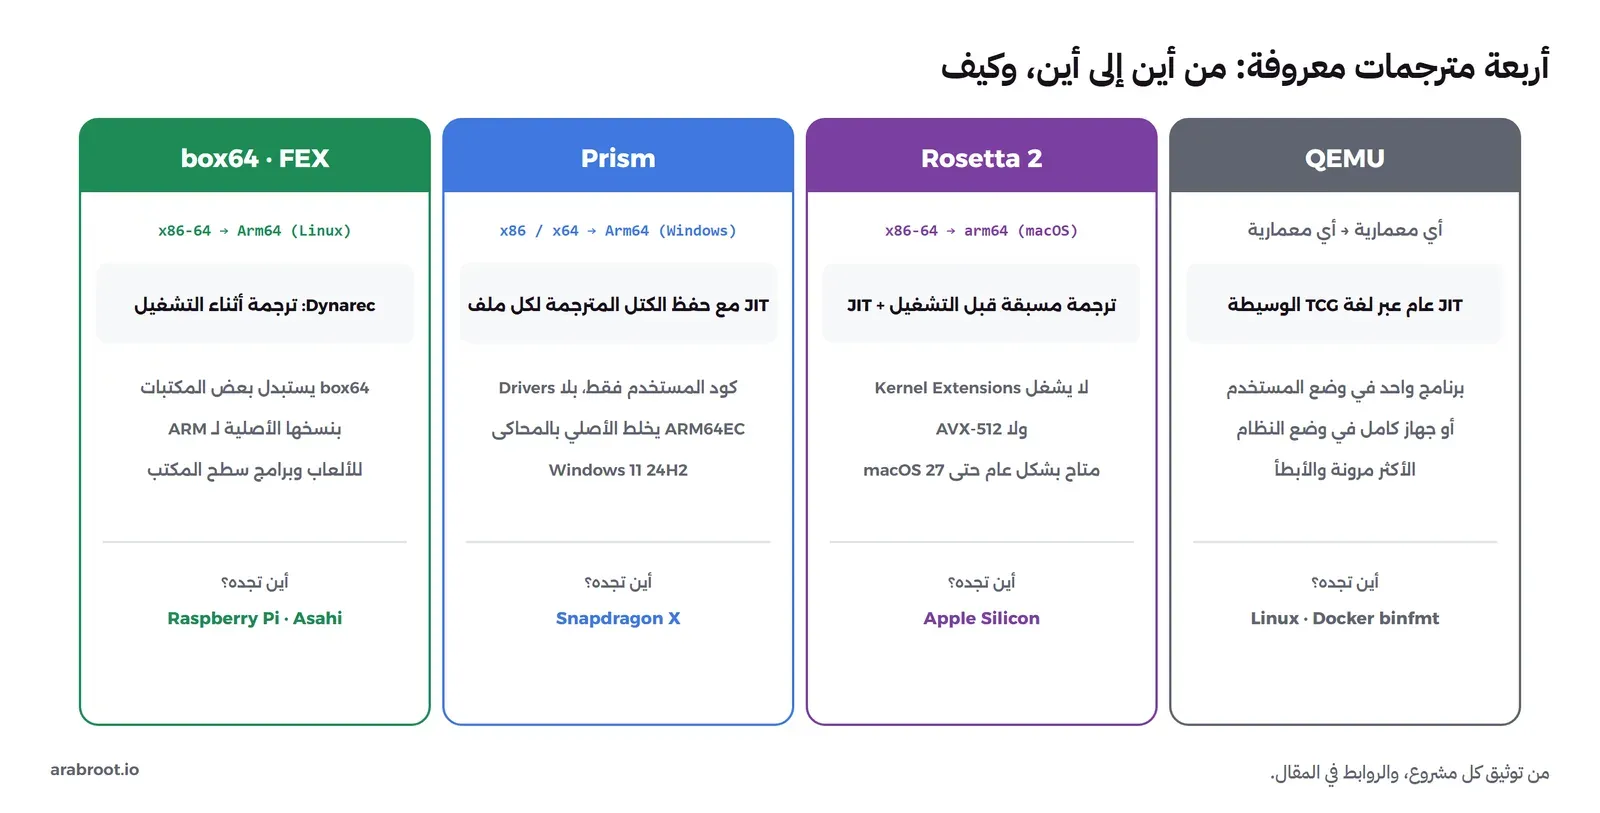
لاحظ الفكرة المشتركة بين المترجمات الأسرع: كلها تتخصص في زوج واحد من المعماريات، x86-64 إلى ARM64، فتستطيع أن تترجم كل تعليمة إلى أفضل ما يقابلها مباشرة دون لغة وسيطة عامة، وأن تستخدم ميزات معالج بعينه مثل TSO، وأن تتجنب محاكاة ما يمكن تشغيله أصلياً مثل المكتبات. أما QEMU فيدفع ثمن عموميته، لأنه يترجم من عشرات المعماريات إلى عشرات المعماريات عبر طريق واحد.
أخطاء شائعة وأفكار غير صحيحة
- «المحاكاة والافتراضية شيء واحد»: الافتراضية تشغل تعليمات الضيف مباشرة على المعالج، والمحاكاة تترجمها، والفرق في السرعة بين عشرات المرات وقريب من الأصل.
- «إذا كانت المعمارية واحدة فـ QEMU سريع دون KVM»: رأينا x86-64 على x86-64 أبطأ بضعفين إلى خمسة أضعاف تحت TCG، فالسرعة تأتي من KVM وليس من تطابق المعمارية.
- قياس الأداء مع خيارات التسجيل
-d: نفس البرنامج أخذ 0.034 ثانية ثم 10.6 ثانية مع التسجيل، فأطفئ كل التسجيل قبل أي قياس. - الحكم على سرعة معالج من محاكاته: المتجهات والتشفير والقفزات غير المباشرة تتغير كلفتها تحت المحاكاة بطريقة لا علاقة لها بالعتاد الحقيقي.
- تشغيل سكربت فيه مئات الأوامر القصيرة في Container محاكى: كل أمر يبدأ محاكياً جديداً بذاكرة ترجمة فارغة، فاجمع العمل في عملية واحدة أو شغله على معمارية الجهاز.
- إطفاء JIT داخل Container محاكى ظناً أنه أسرع: رأينا Node مع JIT أسرع من دونه حتى تحت المحاكاة.
- الاعتماد على Rosetta في منتج جديد لـ Mac: Apple أعلنت أنها أداة عامة حتى macOS 27 فقط، فابن لـ arm64 أو Universal.
- شراء جهاز Windows على ARM لبرنامج يحتاج تعريفاً: Prism يحاكي كود المستخدم فقط.
أي طريقة تختار؟ جدول قرار Decision Table
| حالتك | الأداة | والسبب |
|---|---|---|
| تشغيل برنامج Linux واحد لمعمارية أخرى للاختبار | QEMU في وضع المستخدم، أو Docker مع binfmt | أخف طريقة، والنواة تعمل بسرعتها |
| اختبار الإقلاع أو النواة أو تعريف لمعمارية أخرى | QEMU في وضع النظام | الوحيد الذي يحاكي الجهاز كله، ولكنه أبطأ بثلاثة أضعاف في تجربتنا |
| جهاز افتراضي بنفس معمارية المضيف | QEMU مع KVM | TCG دون KVM أبطأ بكثير حتى على نفس المعمارية |
| برنامج Intel قديم على Mac بمعالج Apple | Rosetta 2 | ترجمة مسبقة مع دعم العتاد، ولكن حتى macOS 27 كأداة عامة |
| برنامج x64 على حاسب Windows بـ Snapdragon X | Prism تلقائياً | يعمل لكود المستخدم، وتأكد من التعريفات |
| لعبة أو برنامج x86-64 على Linux بـ ARM64 | box64 أو FEX | متخصصان في هذا الزوج ويستبدلان المكتبات بنسخها الأصلية |
| تحتاج الأداء الكامل | ابن البرنامج لمعمارية الجهاز | أفضل محاكاة ما زالت أبطأ من الكود الأصلي |
قائمة تحقق Checklist قبل أن تعتمد على المحاكاة
- تعرف هل تحتاج وضع المستخدم أم وضع النظام، واخترت الأخف.
- أطفأت كل خيارات التسجيل
-dقبل القياس، وقست ثلاث مرات على الأقل وأخذت الوسيط. - لا تقارن بين معالجين حقيقيين بأرقام المحاكاة.
- جمعت الأوامر القصيرة في عملية واحدة إذا كانت تعمل تحت المحاكاة.
- بنيت برامجك الدائمة لمعمارية الجهاز الذي تعمل عليه، وتركت المحاكاة للاختبار والانتقال.
- إذا كنت على Mac أو Windows على ARM، تأكدت من وجود نسخة أصلية لكل برنامج يعمل في النواة.
حذف المختبر Cleanup
docker rm -f cs2-emu 2>/dev/null
docker image rm cs2-lab:1
rm -f bench-x86_64 bench-aarch64 bench-riscv64 tb-aarch64
تدريب عملي
- شغل
qemu-riscv64 -d in_asm,out_asmعلى نسخة RISC-V منtb.cمع-dfilterعلى عنوان الحلقة، وقارن حجم الكود المترجم بحجم كود ARM، وابحث عن حساب الأعلام. - كرر قياس
nochainعلى عملsortبدلhash، وتوقع قبل التشغيل هل يكون الفرق أكبر أم أصغر، والسبب. - غير عدد دورات الحلقة في
jit.jsمن3e7إلى3e5، وراقب كيف تتغير النسبة بين amd64 وarm64 عندما يقصر زمن البرنامج ويصبح أغلبه بدء Node.js نفسه.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المحاكاة تترجم تعليمات معالج آخر، والافتراضية تشغل تعليمات نفس المعالج مباشرة، ولا يوجد KVM بين معماريتين.
- التفسير يفك كل تعليمة في كل مرة، والترجمة أثناء التشغيل تترجم كتلة مرة وتنفذها آلاف المرات، والترجمة المسبقة تترجم الملف قبل تشغيله وتحتاج JIT احتياطاً.
- QEMU TCG يمر بلغة وسيطة، وكتلة من ست تعليمات ARM صارت 243 بايتاً من x86، وأغلب الكلفة في المسجلات التي تعيش في الذاكرة وفي أعلام المقارنة.
- ترجم QEMU 1383 كتلة ونفذ أكثر من مليوني كتلة، وإطفاء ربط الكتل جعل البرنامج أبطأ خمس مرات، وكتلة لكل تعليمة جعلته أبطأ ثلاثين مرة.
- الكلفة الكلية بين ضعفين وعشرين ضعفاً حسب البرنامج، والقفزات غير المباشرة والكود المولد أثناء التشغيل هي الأغلى.
- وضع النظام يحاكي الجهاز كله ويدفع كلفة إضافية في كل وصول للذاكرة.
- Rosetta 2 وPrism وbox64 وFEX أسرع لأنها تتخصص في زوج واحد من المعماريات وتستخدم الترجمة المسبقة أو الحفظ أو ميزات العتاد أو المكتبات الأصلية.
وفي نفس مرحلة المعالجات نكمل بإذن الله إلى الطرف الآخر من هذا الموضوع: كيف يساعد المعالج نفسه على تشغيل الأجهزة الافتراضية بسرعة شبه كاملة، ثم إلى المعالج الرسومي GPU:
 دليلدعم المعالج للأجهزة الافتراضية: VT-x وAMD-V من الداخلنكتب مشرفاً صغيراً على KVM يشغل ضيفاً من 63 بايت، ونعد مرات الخروج VM Exit ونقيس كلفتها لنفهم ما يفعله VT-x وEPT داخل المعالج.
 دليلGPU وNPU وTPU: لماذا لا يكفي CPU للذكاء الاصطناعي؟نضرب نفس المصفوفات على المعالج وعلى المعالج الرسومي المدمج ونقيس الحساب وسرعة الذاكرة، لنفهم ما الذي يجعل GPU وNPU وTPU أسرع ومتى لا تفيد.دليلARM من الجوال إلى السيرفر: Apple Silicon وGravitonكيف تربح Arm من شرائح لا تصنعها، ولماذا صار في كل سحابة معالج ARM، مع مختبر يبني Image لـ arm64 ويقيس كلفة تشغيلها تحت المحاكاة.دليلRISC-V: المعمارية المفتوحة وهل تغير سوق المعالجات؟ما الذي يعنيه أن تكون معمارية المعالج مفتوحة، وكيف تقرأ امتدادات RISC-V وملفاتها التعريفية، مع مختبر يقلع Debian كاملاً على RISC-V داخل QEMU.
 دليلالمحاكاة الافتراضية Virtualization: من Hypervisor إلى KVMماذا يحدث داخل المعالج عندما يعمل نظام كامل فوق نظام آخر، ومتى تختار جهازاً افتراضياً ومتى يكفيك Container، مع قياس حقيقي لنفس الجهاز مع KVM أو دونه.
 دليلالمترجم Compiler والمفسر Interpreter و JIT و WebAssemblyنشغل دالة واحدة بلغة C وPython وJavaScript وWebAssembly على نفس الجهاز، ونفتح ما كتبه كل مترجم لنعرف لماذا اختلف الوقت من ثلث ثانية إلى دقيقة.
سجل التحديثات
- 16 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب على Windows 11 مع معالج Intel Core i7-7700K وDocker Engine 29.8.0: ترجمة bench.c وtb.c بـ GCC 14.2 لثلاث معماريات وتشغيلها بـ QEMU 10.0.13 في وضع المستخدم مع خيارات التسجيل -d in_asm,op_opt,out_asm,exec,nochain و-one-insn-per-tb، وتشغيل Node.js 22.23.5 وPython 3.12.16 من Alpine 3.22 لـ amd64 وarm64 عبر binfmt، مع أرقام من جهاز Debian 13 لـ riscv64 من مقال RISC-V ورسوم من عرب رووت.