


كل مبرمج سمع هذه الجمل في نفس الأسبوع: «Python بطيئة، اكتبها بلغة C»، و«JavaScript صارت سريعة بسبب ال JIT»، و«انقل الكود إلى WebAssembly وسوف يعمل بسرعة الكود الأصلي داخل المتصفح». ثم تكتب دالة تحسب شيئاً بسيطاً في تقرير، فتأخذ دقيقة كاملة في Python، ويعيد زميلك كتابتها بلغة JavaScript فتنتهي في ثلاث ثوان، ويكتبها ثالث بلغة C فتنتهي في نصف ثانية، فتسأل نفسك: ما الذي تغير فعلاً؟ الدالة هي نفسها، والمعالج هو نفسه، والجهاز لم يتغير، فأين ذهب الفرق بين دقيقة ونصف ثانية؟
والإجابة أن الفرق ليس في الدالة، وإنما في الطريق الذي تسلكه حتى تصل إلى المعالج: هل تتحول إلى تعليمات آلة Machine Code قبل التشغيل على جهاز المطور، أم يقرؤها برنامج آخر سطراً سطراً وهي تعمل، أم تبدأ مقروءة ثم تتحول إلى تعليمات آلة أثناء التشغيل عندما تتكرر بما يكفي، أم تتحول إلى صيغة وسيطة محمولة يترجمها المتصفح على جهاز المستخدم. وفي مقال ماذا يحدث عندما تشغل برنامج Hello World؟ رأينا هذه الطرق باختصار على برنامج يطبع جملة واحدة، وفي مقال أنماط البرمجة وأنظمة الأنواع رأينا أن طريقة التنفيذ صفة للتطبيق Implementation وليست للغة. وهنا سوف نأخذ دالة واحدة تقوم بعمل حقيقي، ونشغلها بالطرق الأربع على نفس الجهاز، ونقيس الوقت، ونفتح ما ينتجه كل مترجم لنرى السبب بأعيننا.
وسوف نناقش في هذا المقال ما يلي:
- الطرق الأربع: الترجمة المسبقة Ahead-of-Time، والمفسر Interpreter، والترجمة أثناء التشغيل JIT، وWebAssembly، ومتى ظهرت كل واحدة ولماذا.
- الدالة التي سوف نقيسها، وتجهيز المختبر في Container واحد فيه gcc وclang وPython وNode.js وأدوات WebAssembly.
- الترجمة المسبقة في C: ما الذي كتبه المترجم فعلاً بلغة التجميع، ولماذا اختلف gcc عن clang في نفس الكود.
- المفسر في CPython: تعليمات ال Bytecode، ولماذا كل خطوة تكلف مئات النانو ثانية.
- ال JIT في محرك V8: الطبقات، والإحماء Warm-up، وإيقاف الطبقات واحدة واحدة، والتخمين Speculation وإلغاء التحسين Deoptimization.
- WebAssembly: البناء بلغة C، والملف الناتج، ولماذا كانت أول نتيجة أبطأ مما توقعنا.
- زمن البدء Startup Time والذاكرة، ثم النتائج في جدول واحد، وجدول قرار، وأخطاء شائعة في قياس الأداء.
أربع طرق لتشغيل نفس الكود: AOT والمفسر Interpreter وJIT وWebAssembly
المعالج لا يفهم إلا تعليمات آلة لمعماريته، مثل x86-64 في أغلب السيرفرات وARM في الهواتف وأجهزة Mac الحديثة، ولذلك لا بد لأي كود تكتبه من أن يتحول في النهاية إلى هذه التعليمات، أو أن يقرأه برنامج مكتوب بها. والسؤال الذي يفرق بين الطرق هو متى يحدث هذا التحويل، ومن يقوم به، وعلى أي جهاز. والصورة التالية تضع الطرق الأربع جنباً إلى جنب بنفس الأمثلة التي سوف نشغلها في المختبر:
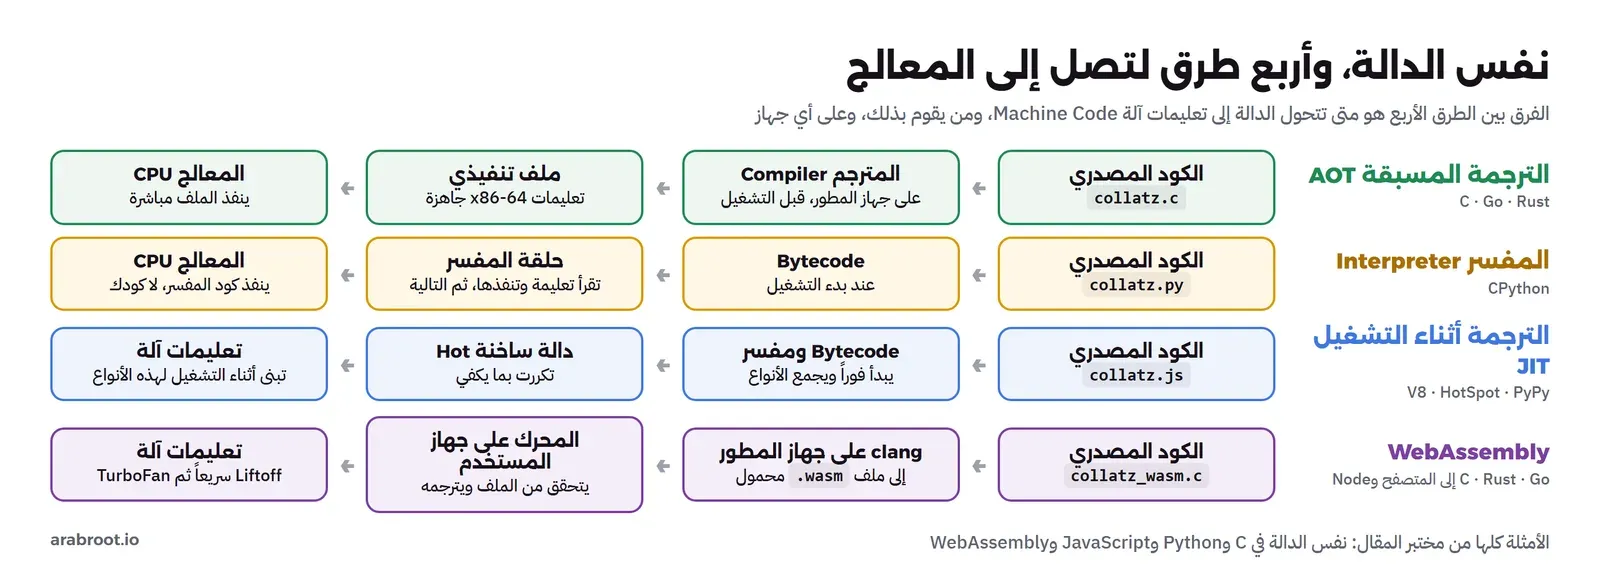
- الترجمة المسبقة Ahead-of-Time، واختصاراً AOT: المترجم Compiler يقرأ الكود كله على جهاز المطور، ويحوله إلى ملف تنفيذي فيه تعليمات آلة جاهزة، ثم ينفذ المعالج هذا الملف مباشرة. هكذا تعمل C وC++ وGo وRust، وهي أقدم الطرق، وفكرتها منذ مترجمات الخمسينات مثل FORTRAN أن يكتب المبرمج معادلات ويترك للمترجم كتابة تعليمات الآلة.
- المفسر Interpreter: برنامج يقرأ كودك وينفذه وهو يعمل، دون أن يحوله إلى تعليمات آلة. وفي CPython يتحول الكود أولاً إلى تعليمات وسيطة اسمها Bytecode، ثم تقرأ حلقة داخل البرنامج
python3هذه التعليمات واحدة واحدة وتنفذ لكل منها كوداً مكتوباً بلغة C. والمعالج هنا ينفذ المفسر، والمفسر هو الذي ينفذ كودك. - الترجمة أثناء التشغيل Just-In-Time، واختصاراً JIT: يبدأ البرنامج في مفسر، ويراقب المحرك الدوال التي تتكرر كثيراً، فيترجمها وحدها إلى تعليمات آلة أثناء التشغيل، ويستخدم في ذلك ما رآه من أنواع القيم الحقيقية. هكذا يعمل V8 في Chrome وNode.js، وHotSpot في Java، وPyPy كتطبيق آخر للغة Python.
- WebAssembly، واختصاراً Wasm: صيغة تعليمات لآلة افتراضية صغيرة، يبنيها مترجم مثل clang من C أو Rust على جهاز المطور، ثم يحملها المتصفح أو Node.js، ويتحقق من سلامتها، ويترجمها إلى تعليمات آلة على جهاز المستخدم. وقد أصبحت توصية رسمية من W3C في ديسمبر 2019، وهي اليوم اللغة الرابعة التي تفهمها المتصفحات بعد HTML وCSS وJavaScript.
وقد يتساءل البعض: إذا كانت الترجمة المسبقة أسرع، فلماذا وجدت الطرق الأخرى؟ والإجابة أن لكل طريقة ثمناً تدفعه في مكان آخر: الملف المترجم مسبقاً مربوط بمعالج ونظام تشغيل محددين، ويحتاج إعادة بناء مع كل تعديل، ولا يعرف شيئاً عن البيانات الحقيقية التي سوف يعمل عليها. والمفسر يبدأ فوراً ويعمل على أي جهاز فيه المفسر، ولكنه يدفع ثمن القراءة والتفسير مع كل تعليمة. وال JIT يحاول أن يأخذ الميزتين، فيبدأ بسرعة المفسر وينتهي بسرعة قريبة من الكود المترجم، ولكنه يدفع ثمن الإحماء والذاكرة وتعقيد المحرك. وسوف نقيس كل هذه الأثمان بالأرقام في الأقسام التالية.
الدالة التي سوف نقيسها: أطول سلسلة Collatz
اخترنا دالة صغيرة تقوم بعمل حسابي حقيقي ولا تعتمد على أي مكتبة، حتى يكون الفرق في طريقة التنفيذ وحدها، لا في جودة مكتبة أو سرعة قرص. والقاعدة بسيطة: خذ أي عدد موجب، فإن كان زوجياً فاقسمه على 2، وإن كان فردياً فاضربه في 3 وأضف 1، وكرر حتى تصل إلى 1. هذه السلسلة معروفة باسم متتالية Collatz، وعدد الخطوات حتى تصل إلى 1 يختلف كثيراً من عدد إلى آخر. والدالة تبحث عن أطول سلسلة لكل الأعداد من 1 حتى أقل من مليون، وهذا يعني 131,434,272 خطوة في المجموع حسبناها في المختبر، وكل خطوة فيها قسمة أو ضرب ومقارنة وتفرع، وهذه هي العمليات التي يتكرر مثلها في أي كود حسابي تكتبه.
وهذه نسخة C، والنسخ الأخرى بلغة Python وJavaScript مكتوبة سطراً بسطر بنفس الشكل، وكلها في مجلد المختبر:
// The same function in every language: the longest Collatz chain below n.
#include <stdio.h>
#include <stdlib.h>
#include <time.h>

int longest_chain(int n) {
    int best = 0;
    for (int start = 1; start < n; start++) {
        long long x = start;
        int steps = 0;
        while (x != 1) {
            x = (x % 2 == 0) ? x / 2 : 3 * x + 1;
            steps++;
        }
        if (steps > best) best = steps;
    }
    return best;
}

int main(int argc, char **argv) {
    int n = argc > 1 ? atoi(argv[1]) : 1000000;
    struct timespec a, b;
    clock_gettime(CLOCK_MONOTONIC, &a);
    int r = longest_chain(n);
    clock_gettime(CLOCK_MONOTONIC, &b);
    double ms = (b.tv_sec - a.tv_sec) * 1e3 + (b.tv_nsec - a.tv_nsec) / 1e6;
    printf("C        n=%d  result=%d  %.1f ms\n", n, r, ms);
    return 0;
}
في الكود أعلاه لاحظ التالي:
- المتغير
xمن النوعlong longأي 64 بت، لأن السلاسل تصعد إلى قيم أكبر بكثير من بدايتها، وأكبر قيمة وصلت إليها السلاسل تحت المليون هي 56,991,483,520، وهذه لا تتسع في عدد صحيح من 32 بت. وهذه التفصيلة الصغيرة سوف تظهر لنا مرة أخرى في JavaScript وتشرح نتيجة غريبة هناك. - القياس داخل البرنامج نفسه بالساعة
CLOCK_MONOTONIC، حول استدعاء الدالة فقط، حتى لا يدخل في الرقم وقت تحميل البرنامج أو بدء المفسر. ووقت البدء سوف نقيسه وحده في قسم مستقل لأنه قصة أخرى. - البرنامج يطبع النتيجة 524، وهي نفس النتيجة في كل اللغات، وهذا أول فحص تقوم به قبل أن تقارن أي أرقام: إذا اختلفت النتيجة فأنت تقارن برنامجين مختلفين.
تجهيز المختبر Lab Setup: أربعة مسارات في Container واحد
كل التجارب تعمل في Container واحد مبني على Debian 13، فيه مترجما C وهما gcc وclang، ومعهما الأداة wasm-ld التي تربط ملفات WebAssembly، والحزمة wabt التي تحول ملف .wasm إلى نص مقروء، وPython من Debian، وNode.js 22 من الـ Image الرسمية:
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends gcc libc6-dev clang lld wabt python3 time binutils libstdc++6 && rm -rf /var/lib/apt/lists/*
# Node.js 22 from the official image (Debian trixie ships Node 20)
COPY --from=node:22-slim /usr/local/bin/node /usr/local/bin/node
WORKDIR /lab
docker build -t scp5-cj:2 .
docker run --rm scp5-cj:2 sh -c 'cat /etc/debian_version; gcc --version|head -1; clang --version|head -1; wasm-ld --version; wasm2wat --version; python3 --version; node --version; node -p process.versions.v8'13.7
gcc (Debian 14.2.0-19) 14.2.0
Debian clang version 19.1.7 (3+b1)
Debian LLD 19.1.7
1.0.36
Python 3.13.5
v22.23.4
12.4.254.21-node.57وقد يتساءل البعض: لماذا لم نبدأ من الـ Image الرسمية node:22-slim مباشرة ونثبت فوقها الباقي؟ وهذا ما فعلناه في المحاولة الأولى، ثم وجدنا أن Python فيها 3.11 والمترجم gcc 12، لأن تلك الـ Image مبنية على Debian 12. والمقارنة بإصدارات قديمة تعطي أرقاماً لا تمثل ما سوف تستخدمه اليوم، فبنينا على Debian 13 ونسخنا ملف node وحده من الـ Image الرسمية، وهو ملف واحد لا يحتاج إلا مكتبة C ومكتبة C++ القياسية. والدرس العام هنا أن تطبع إصدار كل أداة في بداية أي قياس، لأن الـ Image التي تظن أنك تعرف محتواها قد تحمل إصداراً لا تتوقعه.
والجهاز معالج Intel Core i7-7700K بثماني أنوية منطقية، ونواة Linux 5.15 داخل WSL2 تحت Docker Desktop. وكل ملفات المختبر في المجلد lab/، وكل سكربت يعمل بالأمر docker run --rm -v "$PWD":/lab scp5-cj:2 sh /lab/run-final.sh وما يشبهه.
الترجمة المسبقة Ahead-of-Time في C
نبني نفس الملف ثلاث مرات: مع gcc دون تحسين بالخيار -O0، ومع gcc بالتحسين المعتاد -O2، ومع clang بنفس الخيار. والخيار -O يحدد كم من الجهد يبذل المترجم في تحسين الكود، كما في صفحة خيارات التحسين في توثيق GCC، و-O0 هو الافتراضي حين لا تكتب شيئاً، وهو مناسب لتتبع الأخطاء Debugging لأن كل سطر في الكود يقابله تعليمات واضحة، وكل متغير يبقى في الذاكرة حيث تتوقعه.
gcc -O0 -o collatz_O0 collatz.c
gcc -O2 -o collatz_O2 collatz.c
clang -O2 -o collatz_clang collatz.c
والوقت في الجولة الأولى من القياس النهائي كان كما يلي:
gcc -O0             C        n=1000000  result=524  1300.8 ms
gcc -O2             C        n=1000000  result=524  375.0 ms
clang -O2           C        n=1000000  result=524  250.0 ms
نفس الكود ونفس اللغة، ومع ذلك الفرق بين أبطأ بناء وأسرعه أكثر من خمس مرات. والسطر الأول يذكرك بخطأ يقع فيه كثيرون: أن يقيس أداء برنامج C مبني دون تحسين، أو أن ينشر في الإنتاج ملفاً بني بإعدادات التطوير، ثم يحكم على اللغة كلها. والسؤال الأهم هنا: ماذا فعل المترجم بالضبط حتى صار الكود أسرع؟ والطريقة الوحيدة لمعرفة ذلك أن تطلب منه لغة التجميع Assembly التي كتبها.
ماذا كتب gcc بلغة التجميع Assembly؟
الخيار -S يوقف المترجم بعد مرحلة الترجمة ويعطيك ملف لغة التجميع بدلاً من الملف التنفيذي، والخيار -o - يطبعه على الشاشة، ثم نقطع منه الدالة وحدها:
gcc -O2 -S -fno-asynchronous-unwind-tables -o - collatz.c | sed -n '/^longest_chain:/,/\.size\s*longest_chain/p'longest_chain:
cmpl $1, %edi
jle .L8
movl %edi, %r8d
movl $1, %esi
xorl %edi, %edi
.p2align 4
.p2align 3
.L7:
movq %rsi, %rax
xorl %ecx, %ecx
cmpq $1, %rsi
jne .L5
jmp .L3
.p2align 5
.p2align 4,,10
.p2align 3
.L4:
leaq 1(%rax,%rax,2), %rdx
addl $2, %ecx
movq %rdx, %rax
shrq $63, %rax
addq %rdx, %rax
sarq %rax
.L5:
testb $1, %al
jne .L4
movq %rax, %rdx
addl $1, %ecx
shrq $63, %rdx
addq %rdx, %rax
sarq %rax
cmpq $1, %rax
jne .L5
.L3:
cmpl %ecx, %edi
cmovl %ecx, %edi
addq $1, %rsi
cmpq %r8, %rsi
jne .L7
movl %edi, %eax
ret
.L8:
xorl %edi, %edi
movl %edi, %eax
ret
.size longest_chain, .-longest_chainلا تحتاج أن تقرأ لغة التجميع بطلاقة حتى تفهم ما حدث هنا، ويكفي أن تلاحظ التالي:
- لا يوجد في الكود أي تعليمة قسمة
idivولا ضربimul، مع أن الكود الأصلي فيهx / 2و3 * x. فالضرب في 3 مع إضافة 1 تحول إلى تعليمة واحدةleaq 1(%rax,%rax,2)، وهي تعليمة حساب عناوين تحسبx + 2x + 1في دورة واحدة تقريباً. والقسمة على 2 تحولت إلى إزاحةsarq، ومعها التعليمتانshrq $63وaddqاللتان تصححان النتيجة للأعداد السالبة، لأن قسمة C تقرب نحو الصفر بينما الإزاحة تقرب نحو الأسفل. والمترجم لا يعرف أنxلن تكون سالبة أبداً، فيضيف التصحيح احتياطاً. - السطر
testb $1, %alهو فحص الزوجية: ينظر إلى أصغر بت في العدد بدل أن يحسب باقي القسمةx % 2. - وأجمل ما في الكود الكتلة
.L4: عندما يكون العدد فردياً يحسب3x + 1ثم يقسم على 2 مباشرة ويضيف خطوتين إلى العداد بالسطرaddl $2, %ecx. فالمترجم استنتج وحده أن3x + 1لعدد فردي هو دائماً عدد زوجي، فدمج الخطوتين في دورة واحدة من الحلقة دون أن يفحص الزوجية مرة ثانية. ولم يكتب أحد هذا في الكود، وإنما وجده المحسن Optimizer من تحليل الحلقة. - والسطر
cmovlفي نهاية الحلقة الخارجية هوif (steps > best) best = stepsدون تفرع، وسوف نعود إلى هذه التعليمة بعد قليل لأنها تشرح الفرق بين gcc وclang.
نفس الكود ومترجمان: لماذا كان clang أسرع؟
في الجولات الثلاث كان البناء بالمترجم clang أسرع من gcc في كل مرة: 250 و319 و356 ms، مقابل 375 و528 و562 ms. والفرق لا يأتي من أن أحدهما مترجم أفضل بشكل عام، وإنما من قرار واحد في هذه الحلقة بالذات، وهذا ما كتبه clang:
.LBB0_4:                                #   Parent Loop BB0_2 Depth=1
	leaq	(%r8,%r8,2), %r9
	incq	%r9
	sarq	%rdi
	testb	$1, %r8b
	cmovneq	%r9, %rdi
	incl	%esi
	movq	%rdi, %r8
	cmpq	$1, %rdi
	jne	.LBB0_4
المترجم clang يحسب النتيجتين في كل خطوة، 3x + 1 وx / 2، ثم يختار إحداهما بالتعليمة cmovneq حسب زوجية العدد، أي أنه لا يوجد تفرع Branch داخل الحلقة إلا شرط نهايتها. أما gcc فاختار التفرع بالتعليمة jne .L4، والمعالج الحديث لا ينتظر نتيجة الشرط، وإنما يخمن الاتجاه ويكمل التنفيذ، فإذا أخطأ التخمين رمى ما نفذه وبدأ من جديد وخسر عدة دورات. وفي متتالية Collatz لا يوجد نمط واضح بين الأعداد الزوجية والفردية، فيخطئ متنبئ التفرعات Branch Predictor كثيراً، والتفسير الأرجح للفرق أن clang تجنب هذه الأخطاء كلها بثمن حساب إضافي صغير في كل خطوة. ولم نقس عدد أخطاء التنبؤ بأداة مثل perf لأن عدادات المعالج غير متاحة داخل WSL2، لذلك خذ هذا التفسير كاستنتاج من الكود والأرقام، وإذا أردت التأكد على سيرفر Linux عادي فالأمر perf stat -e branch-misses ./collatz_O2 يعطيك العدد مباشرة.
والدرس هنا أكبر من gcc وclang: الترجمة المسبقة تأخذ قرارات ثابتة قبل أن ترى البيانات، فإذا كان القرار مناسباً لبياناتك كان الكود سريعاً، وإذا لم يكن كذلك لن يتغير القرار مهما عمل البرنامج. وهذه بالضبط النقطة التي يحاول ال JIT أن يستغلها، فهو يرى البيانات الحقيقية قبل أن يقرر، كما سوف ترى. ولمن يريد أن يساعد المترجم المسبق بنفس الفكرة، يوجد ما يسمى التحسين الموجه بالقياس Profile-Guided Optimization، حيث تشغل البرنامج مرة على بيانات حقيقية ليسجل أين تذهب التفرعات، ثم تعيد البناء بهذه المعلومات، والخيارات في GCC هي -fprofile-generate ثم -fprofile-use في نفس صفحة التوثيق.
المفسر Interpreter في CPython: كل خطوة تمر بحلقة
الآن نشغل النسخة المكتوبة بلغة Python، وهي نفس الدالة سطراً بسطر. والوقت في الجولات الثلاث كان 60.7 و72.4 و61.8 ثانية، أي أكثر من دقيقة في بعض الجولات، لنفس العمل الذي أنهاه clang في ثلث ثانية. ولكي تفهم السبب، اطلب من Python أن يريك ما يحدث فعلاً داخله بالوحدة dis:
python3 -c 'import dis, collatz; dis.dis(collatz.longest_chain)'وهذا الجزء الخاص بالحلقة الداخلية من المخرج:
 10   L2:     LOAD_FAST                3 (x)
              LOAD_CONST               3 (2)
              BINARY_OP                6 (%)
              LOAD_CONST               1 (0)
              COMPARE_OP              88 (bool(==))
              POP_JUMP_IF_FALSE        5 (to L3)
              LOAD_FAST                3 (x)
              LOAD_CONST               3 (2)
              BINARY_OP                2 (//)
              JUMP_FORWARD             7 (to L4)
      L3:     LOAD_CONST               4 (3)
              LOAD_FAST                3 (x)
              BINARY_OP                5 (*)
              LOAD_CONST               2 (1)
              BINARY_OP                0 (+)
      L4:     STORE_FAST               3 (x)

 11           LOAD_FAST                4 (steps)
              LOAD_CONST               2 (1)
              BINARY_OP               13 (+=)
              STORE_FAST               4 (steps)

  9           LOAD_FAST                3 (x)
              LOAD_CONST               2 (1)
              COMPARE_OP             119 (bool(!=))
              POP_JUMP_IF_FALSE        2 (to L5)
              JUMP_BACKWARD           35 (to L2)
في المخرج أعلاه لاحظ التالي:
- الرقم في أقصى اليسار هو رقم السطر في الملف المصدري، فالسطر 10 هو
x = x // 2 if x % 2 == 0 else 3 * x + 1، والسطر 11 هوsteps += 1، والسطر 9 هو شرط الحلقة. - الخطوة الواحدة من متتالية Collatz تمر بنحو عشرين تعليمة Bytecode، بينما هي في كود clang تسع تعليمات آلة بسيطة. وكل تعليمة Bytecode ليست تعليمة واحدة للمعالج، وإنما دخول إلى حلقة المفسر، وقراءة رمز التعليمة، والقفز إلى الكود الذي ينفذها، ثم العودة لقراءة التالية.
- التعليمة
BINARY_OP 6 (%)لا تعرف أنxعدد صحيح، فهي تسأل الكائن عن نوعه في كل مرة، ثم تستدعي دالة الباقي الخاصة بنوعint. والأعداد الصحيحة في Python كائنات في الذاكرة بحجم غير محدود، فلا يوجد Overflow أبداً، وهذه ميزة حقيقية، ولكن ثمنها أن كل عملية حسابية تنشئ كائناً جديداً للنتيجة إذا كانت خارج الأعداد الصغيرة التي يحتفظ بها المفسر جاهزة. - كل قيمة تمر عبر مكدس Stack المفسر، فالتعليمة
LOAD_FASTتضع المتغير على المكدس، وBINARY_OPتأخذ قيمتين وتضع النتيجة، وSTORE_FASTتعيدها إلى المتغير. وهذه حركة ذاكرة لا وجود لها في كود clang حيث بقيت كل القيم في مسجلات المعالج Registers.
وإذا قسمت 61.8 ثانية على عدد الخطوات تجد أن الخطوة الواحدة تكلف نحو 470 نانو ثانية، مقابل 2.4 نانو ثانية في كود clang، أي نحو مئتي ضعف. وهذا لا يعني أن مطوري CPython لم يحسنوه، فمنذ الإصدار 3.11 يعمل فيه ما يسمى المفسر المتخصص التكيفي Specializing Adaptive Interpreter الموصوف في PEP 659، حيث تستبدل التعليمة العامة بنسخة متخصصة للنوع الذي رآه المفسر، مثل نسخة للجمع خاصة بالأعداد الصحيحة. وهذا التحسين من أهم أسباب أن Python 3.11 جاء أسرع من 3.10 كما في صفحة ما الجديد في Python 3.11، ولكنه يبقى داخل حلقة المفسر، فلا يلغي ثمن القراءة والقفز في كل تعليمة.
وقد يتساءل البعض: أليس في Python 3.13 مترجم JIT؟ والإجابة أن PEP 744 أضاف مترجم JIT تجريبياً في الإصدار 3.13، ولكنه لا يدخل في البناء إلا إذا بني CPython بالخيار --enable-experimental-jit، وهذا ما فحصناه في نسخة Debian:
python3 -c 'import sysconfig; print("experimental-jit" in (sysconfig.get_config_var("CONFIG_ARGS") or ""))'Falseأي أن Python الذي تثبته من توزيعة Linux اليوم مفسر خالص، وكل الأرقام في هذا المقال تخصه. وإذا كان عندك كود Python حسابي ثقيل فالحلول المعتادة ليست انتظار ال JIT، وإنما نقل الحلقة الثقيلة إلى مكتبة مكتوبة بلغة C مثل NumPy، أو تشغيل البرنامج على PyPy وهو تطبيق آخر للغة فيه JIT، أو كتابة الجزء الساخن وحده بلغة مترجمة.
الترجمة أثناء التشغيل JIT في محرك V8
النسخة المكتوبة بلغة JavaScript أخذت 3.2 و3.8 و3.6 ثانية في الجولات الثلاث، أي أسرع من Python بنحو 17 مرة، مع أن JavaScript لغة ديناميكية مثلها تماماً، والمتغير فيها لا يحمل نوعاً ثابتاً. والسبب أن V8 لا يبقى في المفسر، وإنما يصعد بالدالة عبر عدة طبقات Tiers كما في الصورة التالية:
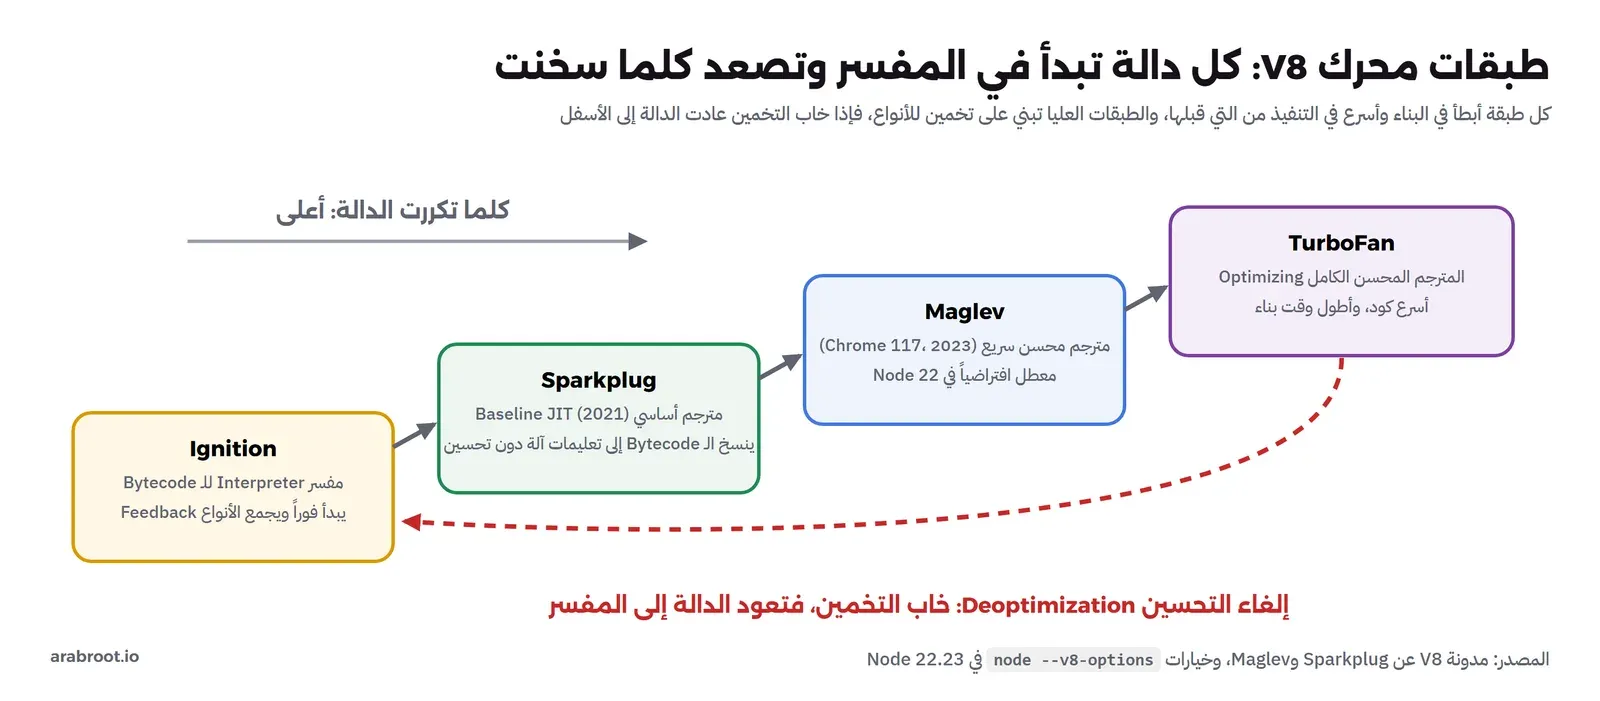
- Ignition: مفسر لل Bytecode، كما في مدونة V8 عند إطلاقه. كل كود JavaScript يبدأ هنا، والمفسر لا ينفذ فقط، وإنما يسجل في كل عملية أنواع القيم التي مرت بها، وهذا السجل اسمه التغذية الراجعة Feedback، وهو الوقود الذي تحتاجه الطبقات العليا.
- Sparkplug: مترجم أساسي Baseline JIT أضيف في 2021 كما في مدونة V8 عنه، يحول ال Bytecode إلى تعليمات آلة بسرعة كبيرة دون أي تحسين، فيزيل ثمن حلقة المفسر فقط.
- Maglev: مترجم محسن سريع أضيف في Chrome 117 في ديسمبر 2023 كما في مدونة V8 عنه، ويقول فريق V8 إنه أبطأ في البناء من Sparkplug بعشر مرات تقريباً وأسرع من TurboFan بعشر مرات، والكود الذي يكتبه في المنتصف بينهما.
- TurboFan: المترجم المحسن الكامل، يأخذ ال Bytecode والتغذية الراجعة ويكتب كوداً متخصصاً للأنواع التي رآها، وهو أبطأ الطبقات في البناء وأسرعها في التنفيذ.
ولنرى ال Bytecode الذي يبدأ به V8، نطلب منه أن يطبعه للدالة longestChain وحدها بالخيار --print-bytecode، والخيارات كلها موثقة في صفحة خيارات سطر الأوامر في Node.js التي تمرر خيارات V8 إلى المحرك:
node --print-bytecode --print-bytecode-filter=longestChain collatz.js 10وهذا الجزء الخاص بخطوة Collatz:
  228 S> 0x2e70efcc1fb8 @   24 : 0b f7             Ldar r2
  235 E> 0x2e70efcc1fba @   26 : 4b 02 02          ModSmi [2], [2]
         0x2e70efcc1fbd @   29 : c5                Star4
         0x2e70efcc1fbe @   30 : 0c                LdaZero
  239 E> 0x2e70efcc1fbf @   31 : 70 f5 03          TestEqualStrict r4, [3]
         0x2e70efcc1fc2 @   34 : 9e 09             JumpIfFalse [9] (0x2e70efcc1fcb @ 43)
         0x2e70efcc1fc4 @   36 : 0b f7             Ldar r2
  250 E> 0x2e70efcc1fc6 @   38 : 4a 02 04          DivSmi [2], [4]
         0x2e70efcc1fc9 @   41 : 8f 0a             Jump [10] (0x2e70efcc1fd3 @ 51)
         0x2e70efcc1fcb @   43 : 0b f7             Ldar r2
  258 E> 0x2e70efcc1fcd @   45 : 49 03 06          MulSmi [3], [6]
  262 E> 0x2e70efcc1fd0 @   48 : 47 01 05          AddSmi [1], [5]
         0x2e70efcc1fd3 @   51 : c7                Star2
في المخرج أعلاه لاحظ التالي:
- الشكل قريب جداً من Bytecode في CPython: تحميل قيمة، عملية، تخزين. والفرق أن Ignition آلة مسجلات Register Machine، فالتعليمة
Ldar r2تحمل المتغيرxمن المسجل الافتراضيr2إلى مسجل واحد اسمه المجمع Accumulator، بينما CPython آلة مكدس Stack Machine. - الرقم بين القوسين في نهاية كثير من التعليمات، مثل
[2]فيModSmi [2], [2]، هو رقم الخانة في متجه التغذية الراجعة Feedback Vector حيث يسجل المفسر الأنواع التي رآها في هذه العملية بالذات. فكل عملية في الكود لها ذاكرتها الخاصة عن الأنواع. - اسم Smi في
ModSmiوMulSmiيعني Small Integer، وهو الشكل الذي يخزن به V8 الأعداد الصحيحة الصغيرة داخل المؤشر نفسه دون كائن في الذاكرة. والمعامل الثاني ثابت صغير مكتوب في التعليمة، مثل 2 في القسمة و3 في الضرب. وتذكر هذا الاسم، فهو مفتاح النتيجة الغريبة التي سوف نصل إليها.
الإحماء Warm-up: الدالة تصبح أسرع وهي تعمل
لكي نرى ال JIT يعمل، نحتاج دالة صغيرة تستدعى مرات كثيرة، ونقيس الوقت على دفعات. الدالة steps تحسب طول سلسلة عدد واحد، والبرنامج يستدعيها 2000 مرة في كل دفعة ويطبع وقت الدفعة:
// A small function called many times: time every batch of 2,000 calls.
// The first batches run in the interpreter; V8 then moves the function up its tiers.
function steps(x) {
  let s = 0;
  while (x !== 1) {
    x = (x % 2 === 0) ? x / 2 : 3 * x + 1;
    s++;
  }
  return s;
}

let start = 1;
for (let batch = 1; batch <= 12; batch++) {
  const t = process.hrtime.bigint();
  let best = 0;
  for (let i = 0; i < 2000; i++, start++) best = Math.max(best, steps(start));
  const us = Number(process.hrtime.bigint() - t) / 1e3;
  console.log(`batch ${String(batch).padStart(2)}  starts ${String(start - 2000).padStart(5)}..${String(start - 1).padEnd(5)}  ${us.toFixed(0).padStart(6)} us`);
}
ونشغله مع الخيار --trace-opt الذي يطبع كل قرار تحسين يتخذه المحرك:
node --trace-opt --trace-deopt --trace-gc --trace-osr warmup2.js[marking <JSFunction steps (sfi = 0xb1399d9b8f9)> for optimization to TURBOFAN, ConcurrencyMode::kConcurrent, reason: hot and stable]
[compiling method <JSFunction steps (sfi = 0xb1399d9b8f9)> (target TURBOFAN), mode: ConcurrencyMode::kConcurrent]
[completed compiling <JSFunction steps (sfi = 0xb1399d9b8f9)> (target TURBOFAN) - took 0.033, 1.752, 0.020 ms]
[completed optimizing <JSFunction steps (sfi = 0xb1399d9b8f9)> (target TURBOFAN)]
batch 1 starts 1..2000 3116 us
batch 2 starts 2001..4000 3946 us
batch 3 starts 4001..6000 4277 us
batch 4 starts 6001..8000 654 us
batch 5 starts 8001..10000 755 us
batch 6 starts 10001..12000 701 us
batch 7 starts 12001..14000 702 us
batch 8 starts 14001..16000 783 us
batch 9 starts 16001..18000 877 us
batch 10 starts 18001..20000 872 us
batch 11 starts 20001..22000 753 us
[marking <JSFunction (sfi = 0xb1399d9b891)> for optimization to TURBOFAN, ConcurrencyMode::kConcurrent, reason: hot and stable]
batch 12 starts 22001..24000 1019 usفي المخرج أعلاه لاحظ التالي:
- السطر الأول يقول إن المحرك قرر تحسين الدالة
stepsبالمترجم TurboFan، والسببhot and stable، أي أنها ساخنة لأنها تكررت كثيراً، ومستقرة لأن الأنواع التي رآها فيها لم تتغير. ConcurrencyMode::kConcurrentيعني أن الترجمة تحدث في خيط Thread آخر في الخلفية، بينما يكمل البرنامج تنفيذه في الطبقة الأدنى، فلا يتوقف البرنامج لينتظر المترجم.- السطر
took 0.033, 1.752, 0.020 msهو وقت الترجمة في ثلاث مراحل، أطولها 1.75 ms، أي أن بناء كود TurboFan لهذه الدالة الصغيرة كلف أقل من 2 ms. - ترتيب الأسطر في المخرج لا يطابق ترتيب حدوثها بالضبط، لأن رسائل المحرك ورسائل
console.logتكتب عبر مسارين مختلفين، فلا تعتمد على موقع سطرmarkingلتعرف في أي دفعة حدث التحسين، واعتمد على الأرقام: الدفعات الثلاث الأولى أخذت بين 3.1 و4.3 ms، ثم نزل الوقت فجأة إلى أقل من 1 ms وبقي هناك، مع أن الأعداد تكبر والسلاسل تطول. - والسطر الأخير يقول إن المحرك قرر تحسين دالة بلا اسم، وهي الكود الرئيسي للملف نفسه الذي يحتوي الحلقة الخارجية، لأنه أيضاً صار ساخناً بعد 11 دفعة.
ولكي نتأكد أن هذا الفرق من ال JIT وليس من شيء آخر، نشغل نفس البرنامج مع الخيار --jitless الذي يمنع V8 من كتابة أي تعليمات آلة أثناء التشغيل، كما في مدونة V8 عن وضع jitless، ويبقي المفسر وحده. والصورة التالية تجمع التشغيلين:
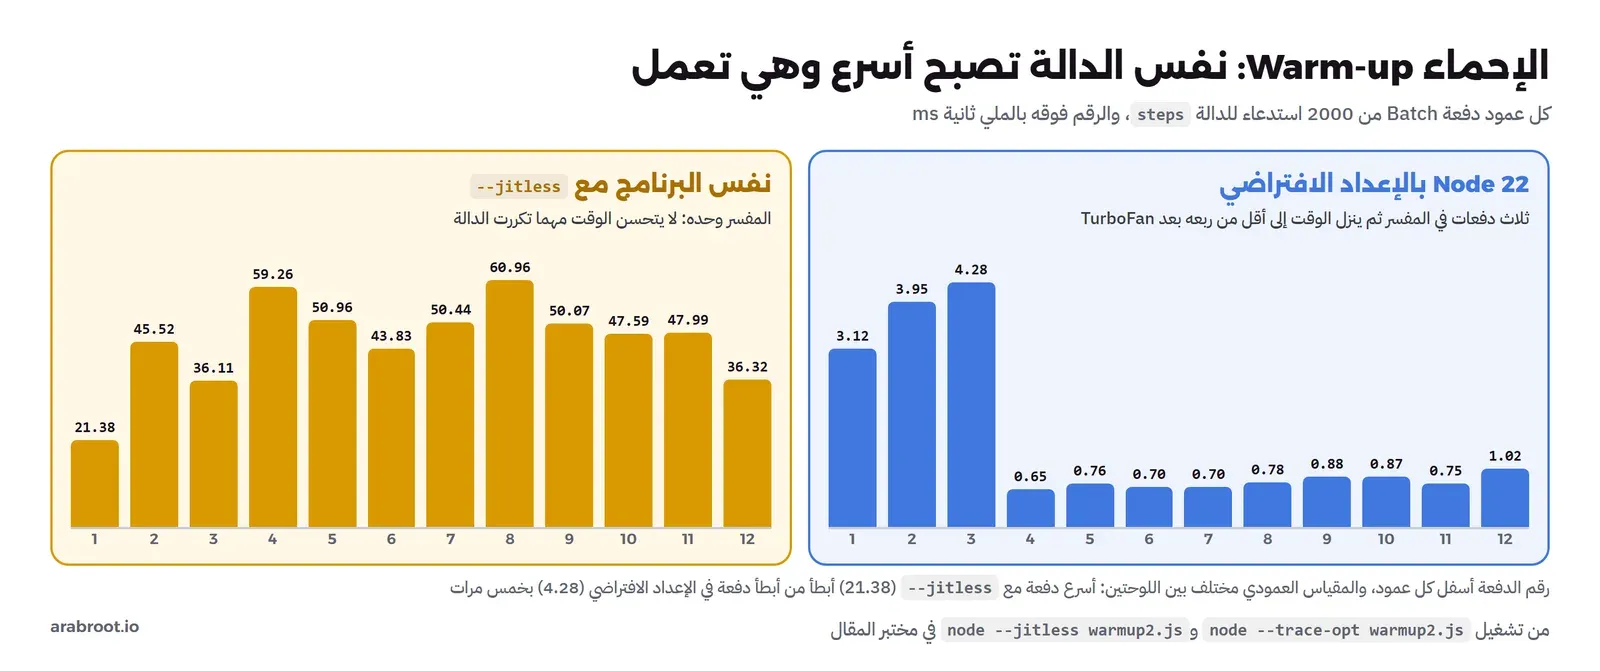
--jitless لم يتحسن مهما تكررت الدالةمع --jitless أخذت الدفعات بين 21 و61 ms ولم تنزل أبداً، أي أن أسرع دفعة في المفسر أبطأ بخمس مرات من أبطأ دفعة في الإعداد الافتراضي، وأبطأ من الدفعات بعد التحسين بأكثر من خمسين مرة. وهذا هو معنى الإحماء Warm-up: برنامج JavaScript أو Java يبدأ بطيئاً ثم يتسارع، وأول الطلبات بعد تشغيل الخدمة أبطأ من التي بعدها، وهذا سبب أن قياس أداء خدمة Node.js أو Java في أول ثوان بعد تشغيلها لا يمثل أداءها الحقيقي. ولاحظ أيضاً أن أوقات الدفعات تتأرجح في التشغيلات المختلفة، فقد ظهرت في تشغيل آخر دون خيارات التتبع دفعة واحدة أخذت 9.3 ms بين دفعات أخذت 0.7 ms، وهذه الضوضاء Noise من جهاز تعمل عليه برامج أخرى، ولذلك لا تحكم على الأداء من تشغيل واحد.
نطفئ الطبقات Tiers واحدة واحدة
V8 يسمح بإيقاف كل طبقة بخيار، وهذا يعطينا قياساً مباشراً لما تضيفه كل واحدة. شغلنا الدالة الكاملة على المليون مع كل مجموعة خيارات:
for f in "" "--no-turbofan" "--maglev --no-turbofan" "--no-turbofan --no-sparkplug"; do echo "flags: $f"; node $f collatz.js; doneflags:
Node n=1000000 result=524 3172.6 ms
flags: --no-turbofan
Node n=1000000 result=524 8588.7 ms
flags: --maglev --no-turbofan
Node n=1000000 result=524 6724.6 ms
flags: --no-turbofan --no-sparkplug
Node n=1000000 result=524 26262.9 msوهنا وقعنا في مشكلة حقيقية أثناء التجربة. ففي المحاولة الأولى شغلنا --no-turbofan ثم --no-turbofan --no-maglev، وتوقعنا أن الأول يعمل بالمترجم Maglev والثاني بالمترجم Sparkplug، فيظهر الفرق بينهما، ولكن الرقمين جاءا متقاربين جداً: 8.7 و7.8 ثانية. فسألنا المحرك نفسه عن القيم الافتراضية لخياراته:
node --v8-options | grep -E "^\s+--(sparkplug|turbofan|maglev|liftoff|wasm-tier-up|jitless) " -A1 --maglev (enable the maglev optimizing compiler)
type: bool default: --no-maglev
--
--jitless (Disable runtime allocation of executable memory.)
type: bool default: --no-jitless
--
--sparkplug (enable Sparkplug baseline compiler)
type: bool default: --sparkplug
--
--turbofan (use the Turbofan optimizing compiler)
type: bool default: --turbofanأي أن Maglev معطل افتراضياً في Node 22، مع أنه مفعل في Chrome منذ الإصدار 117، فالرقمان كانا لنفس الطبقة Sparkplug. وهذا درس مهم: المحرك الذي في المتصفح والمحرك الذي في Node.js قد يحملان نفس الاسم ونفس الكود، ولكن الخيارات الافتراضية تختلف، فلا تنقل نتائج قياس من Chrome إلى سيرفر Node.js ولا العكس، واسأل المحرك عن إعداداته بالأمر node --v8-options قبل أن تفسر أي رقم. وبعد أن فعلنا Maglev بنفسنا بالخيار --maglev صارت الصورة واضحة:
| الطبقات التي تعمل | الخيارات | الوقت | مقارنة بالمفسر وحده |
|---|---|---|---|
| Ignition وحده | --no-turbofan --no-sparkplug | 26.3 ثانية | 1x |
| Ignition وSparkplug | --no-turbofan | 8.6 ثانية | أسرع 3 مرات |
| Ignition وSparkplug وMaglev | --maglev --no-turbofan | 6.7 ثانية | أسرع 4 مرات |
| Ignition وSparkplug وTurboFan | الإعداد الافتراضي | 3.2 ثانية | أسرع 8 مرات |
والملاحظ أن Sparkplug وحده، وهو مترجم لا يحسن شيئاً وينسخ ال Bytecode كما هو إلى تعليمات آلة، جعل الكود أسرع بثلاث مرات. وهذا يقيس لك ثمن حلقة المفسر نفسها، أي القراءة والقفز مع كل تعليمة، بعيداً عن أي تحسين حقيقي. أما الخيار --jitless فأعطى في القياس النهائي 34.5 و30.7 و27.7 ثانية، قريباً من Ignition وحده، لأنه يلغي حتى الكود المساعد الذي يكتبه المحرك أثناء التشغيل، وهو الوضع الذي تستخدمه بعض المنصات التي تمنع البرامج من إنشاء ذاكرة قابلة للتنفيذ لأسباب أمنية.
التخمين Speculation وإلغاء التحسين Deoptimization
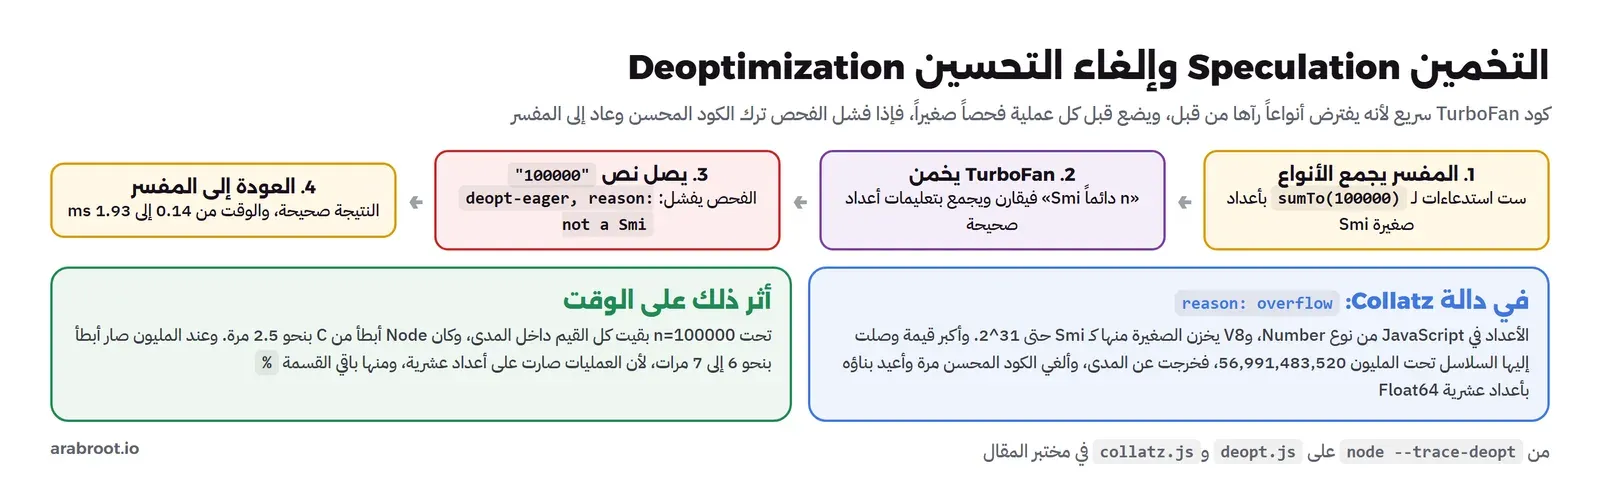
كيف يكتب TurboFan كوداً سريعاً للغة لا تعرف نوع المتغير قبل التشغيل؟ والإجابة أنه يخمن. فإذا رأى في التغذية الراجعة أن n كان دائماً عدداً صحيحاً صغيراً، كتب كوداً يقارن ويجمع بتعليمات الأعداد الصحيحة مباشرة، ووضع قبله فحصاً صغيراً يتأكد أن القيمة ما زالت من هذا النوع. فإذا جاءت يوماً قيمة من نوع آخر، فشل الفحص، وترك المحرك الكود المحسن، وأعاد بناء حالة المفسر من حالة الكود المحسن، وأكمل التنفيذ في Ignition، وهذا اسمه إلغاء التحسين Deoptimization. ولنرى ذلك بعيننا، نكتب برنامجاً يحمي الدالة بأعداد ثم يمرر لها نصاً:
// What happens if the types change after the JIT has specialised the code?
// sumTo() is warmed up with small integers, then called once with a string.
function sumTo(n) {
  let total = 0;
  for (let i = 0; i < n; i++) total += i;
  return total;
}

function timeIt(label, arg) {
  const t = process.hrtime.bigint();
  const r = sumTo(arg);
  const us = Number(process.hrtime.bigint() - t) / 1e3;
  console.log(`${label.padEnd(26)} result=${String(r).padEnd(12)} ${us.toFixed(0).padStart(6)} us`);
}

for (let i = 1; i <= 6; i++) timeIt(`warm-up ${i} (n=100000)`, 100000);
timeIt('string "100000"', "100000");
timeIt('back to n=100000', 100000);
timeIt('again n=100000', 100000);
node deopt.js
node --trace-deopt deopt.js 2>&1 | grep -E "bailout|deoptimiz|sumTo" | cut -c1-220 | head -20warm-up 1 (n=100000) result=4999950000 40171 us
warm-up 2 (n=100000) result=4999950000 136 us
warm-up 3 (n=100000) result=4999950000 137 us
warm-up 4 (n=100000) result=4999950000 146 us
warm-up 5 (n=100000) result=4999950000 173 us
warm-up 6 (n=100000) result=4999950000 146 us
string "100000" result=4999950000 1929 us
back to n=100000 result=4999950000 544 us
again n=100000 result=4999950000 465 us
[bailout (kind: deopt-eager, reason: not a Smi): begin. deoptimizing 0x1f2248c63c39 <JSFunction sumTo (sfi = 0x3565b341b989)>, 0x0ea083c42331 <Code TURBOFAN>, opt id 0, bytecode offset 6, deopt exit 2, FP to SP delta 96,
[bailout (kind: deopt-eager, reason: not a Smi): begin. deoptimizing 0x1f2248c63c39 <JSFunction sumTo (sfi = 0x3565b341b989)>, 0x0ea083c44b21 <Code TURBOFAN>, opt id 1, bytecode offset 6, deopt exit 1, FP to SP delta 96,في المخرج أعلاه لاحظ التالي:
- الاستدعاء الأول أخذ 40 ms، والاستدعاءات التالية نحو 0.14 ms، أي أسرع بنحو ثلاثمئة مرة. والسبب أن الاستدعاء الأول بدأ في المفسر، وأثناءه ترجمت الحلقة وهي تعمل بتقنية تسمى الاستبدال على المكدس On-Stack Replacement، واختصاراً OSR، حيث ينتقل التنفيذ إلى الكود المحسن في منتصف الحلقة دون انتظار الاستدعاء التالي.
- الاستدعاء بالنص
"100000"أعطى نفس النتيجة الصحيحة، لأن JavaScript تحول النص إلى عدد في المقارنةi < n، ولكنه أخذ 1.93 ms، أي أبطأ بأكثر من ثلاث عشرة مرة. - سطرا
bailoutيقولان كل شيء: النوعdeopt-eagerيعني أن الفحص فشل في مكانه فوراً، والسببnot a Smiيعني أن الكود كان يفترض عدداً صحيحاً صغيراً فجاءه نص، وbytecode offset 6هو مكان العودة في ال Bytecode. وظهر السطر مرتين لأن الدالة كان لها نسختان محسنتان،opt id 0وopt id 1، إحداهما نسخة OSR والأخرى النسخة العادية، وكلتاهما ألغيت. - بعد العودة إلى الأعداد لم يرجع الوقت فوراً إلى 0.14 ms، وإنما بقي بين 0.47 و0.54 ms، لأن المحرك يحتاج أن يجمع تغذية راجعة جديدة ويعيد الترجمة، وتلك الخانة في التغذية الراجعة صارت تعرف أن النوع قد يكون نصاً.
وهذا يشرح لماذا تسمع نصيحة «اجعل أنواع القيم ثابتة في الكود الساخن» في كل حديث عن أداء JavaScript: الدالة التي تستقبل أحياناً عدداً وأحياناً نصاً، أو كائنات بأشكال مختلفة، تحرم ال JIT من التخمين الذي يجعله سريعاً، أو تدفعه إلى دورات من التحسين والإلغاء.
لماذا كان Node أبطأ من C بست مرات؟ تجاوز مدى Smi Overflow
هنا نعود إلى المتغير long long في نسخة C. فنتيجة Node في دالة Collatz كانت أبطأ من gcc بنحو ست إلى سبع مرات، وهذا أكثر مما يتوقعه من يقرأ أن ال JIT يقترب من سرعة C. فشغلنا نفس البرنامجين على مدى أصغر، ثم سألنا المحرك عن أسباب إلغاء التحسين على المدى الكامل:
for n in 100000 1000000; do for r in 1 2 3; do ./collatz_O2 $n; node collatz.js $n; done; done
node --trace-deopt collatz.js 1000000 2>&1 | grep -oE "reason: [^)]*\)" | sort | uniq -c
C n=100000 result=350 36.0 ms
Node n=100000 result=350 76.1 ms
C n=100000 result=350 26.8 ms
Node n=100000 result=350 77.1 ms
C n=100000 result=350 36.3 ms
Node n=100000 result=350 87.4 ms
C n=1000000 result=524 541.0 ms
Node n=1000000 result=524 3149.1 ms
C n=1000000 result=524 519.6 ms
Node n=1000000 result=524 3451.6 ms
C n=1000000 result=524 393.7 ms
Node n=1000000 result=524 3033.5 ms
1 reason: overflow)تحت مئة ألف كان Node أبطأ من C بنحو مرتين ونصف فقط، وعند المليون صار أبطأ بست إلى سبع مرات، وظهر إلغاء تحسين واحد بسبب overflow. والتفسير أن كل الأعداد في JavaScript من النوع Number، وهو في المواصفة عدد عشري من 64 بت، ولكن V8 يخزن الأعداد الصحيحة الصغيرة كـ Smi ليحسب بها بتعليمات الأعداد الصحيحة السريعة، كما تشرح مدونة V8 في قسم اختيار التمثيل Representation Selection. والمدونة تذكر أن ال Smi من 31 بت، وهذا في Chrome الذي يفعل ضغط المؤشرات Pointer Compression، أما Node.js على 64 بت فلا يفعله، والأمر node -p "process.config.variables.v8_enable_pointer_compression" طبع 0 في المختبر، فيصل مدى ال Smi إلى 2^31. وتشغيل --trace-deopt على مئة ألف لم يطبع أي إلغاء للتحسين. وأكبر قيمة وصلت إليها السلاسل تحت مئة ألف هي 1,570,824,736، وهي أقل من 2^31 أي 2,147,483,648، فبقي كل شيء داخل مدى Smi. أما تحت المليون فوصلت القيمة إلى 56,991,483,520، فخرج الحساب عن المدى، وألغي الكود المحسن، وأعيد بناؤه بأعداد عشرية Float64، وصار باقي القسمة % عملية على أعداد عشرية بدل فحص بت واحد. والصورة التالية تجمع قصتي التخمين:
والدرس العملي أن «سرعة JavaScript» ليست رقماً واحداً، وإنما تعتمد على أن يبقى الكود في المنطقة التي يحسنها المحرك: أعداد صحيحة صغيرة، وأنواع ثابتة، وكائنات بنفس الشكل. وإذا كان عندك حساب يحتاج أعداداً صحيحة كبيرة بدقة كاملة فالنوع BigInt يعطيك الدقة ولكنه أبطأ بكثير، وفي هذه الحالة بالذات يكون WebAssembly أو كود مترجم مسبقاً هو الأنسب، لأن فيهما عدداً صحيحاً من 64 بت حقيقياً.
وماذا عن Java وPython وPHP؟
نفس الأفكار تجدها في كل JIT تقريباً بأسماء أخرى. فآلة Java الافتراضية HotSpot تبدأ بمفسر، ثم مترجم سريع اسمه C1، ثم مترجم محسن اسمه C2، وهذا ما يسمى الترجمة المتدرجة Tiered Compilation في توثيق Oracle لتحسينات HotSpot، وفيها أيضاً إلغاء التحسين عندما تتغير الفرضيات، مثل تحميل كلاس جديد يغير شكل الوراثة. ولأن الإحماء في Java مكلف للخدمات التي تبدأ وتنتهي كثيراً، ظهرت الترجمة المسبقة للغة Java نفسها، مثل GraalVM Native Image الذي يحول البرنامج إلى ملف تنفيذي يبدأ في أجزاء من الثانية، وثمنه أن البناء أبطأ، وأن بعض المزايا الديناميكية مثل Reflection تحتاج إعداداً مسبقاً، وأن الكود لا يستفيد من التخمين أثناء التشغيل. وفي Python يقدم PyPy JIT كاملاً منذ سنوات، وفي PHP أضاف الإصدار 8.0 مترجم JIT. أي أن الحدود بين الطرق الأربع لم تعد حادة، فكل لغة اليوم تقريباً لها أكثر من تطبيق بأكثر من طريقة، كما شرحنا في مقال اللغة شيء والمترجم شيء آخر.
WebAssembly: كود C يعمل داخل Node.js والمتصفح
WebAssembly يحل مشكلة مختلفة عن ال JIT: كيف تشغل كوداً مكتوباً بلغة C أو Rust أو Go داخل المتصفح، بسرعة قريبة من الكود الأصلي، ودون أن تثق بهذا الكود ثقة كاملة. والفكرة أن المترجم على جهاز المطور يحول الكود إلى تعليمات لآلة افتراضية بسيطة ذات مكدس، بأنواع ثابتة هي أعداد صحيحة وعشرية من 32 و64 بت، وذاكرة خطية Linear Memory معزولة لا يستطيع الكود أن يخرج منها. ثم يتحقق المحرك على جهاز المستخدم من أن الملف سليم، ويترجمه إلى تعليمات آلة، كما في مواصفة WebAssembly الرسمية وتوثيق MDN. ولأن الأنواع ثابتة من البداية، لا يحتاج المحرك إلى تخمين ولا إلى إلغاء تحسين، وهذا هو الفرق الجوهري بينه وبين JavaScript.
ونسخة C التي نبنيها لا تحتوي main ولا تستخدم مكتبة C، وإنما دالة واحدة نعلن أنها مصدرة Export بالخاصية export_name الموثقة في مرجع خصائص clang:
// The same C function, built for WebAssembly: no main, no libc, one exported function.
__attribute__((export_name("longest_chain")))
int longest_chain(int n) {
    int best = 0;
    for (int start = 1; start < n; start++) {
        long long x = start;
        int steps = 0;
        while (x != 1) {
            x = (x % 2 == 0) ? x / 2 : 3 * x + 1;
            steps++;
        }
        if (steps > best) best = steps;
    }
    return best;
}
clang --target=wasm32 -O2 -nostdlib -Wl,--no-entry -o collatz.wasm collatz_wasm.c
ls -l collatz.wasm | awk '{print $5, $9}'384 collatz.wasmفي الأوامر أعلاه لاحظ التالي:
--target=wasm32يطلب من clang أن يكتب لمعمارية WebAssembly بدل x86-64، وهذا ممكن لأن clang مبني على LLVM الذي يفصل بين فهم اللغة وكتابة التعليمات، فنفس المترجم يكتب لعشرات المعماريات.-nostdlibلأن مكتبة C العادية تفترض نظام تشغيل فيه ملفات واستدعاءات نظام، وهذه غير موجودة داخل WebAssembly الخام. وإذا احتجت مكتبة C كاملة فهناك WASI وأدوات مثل Emscripten التي توفر بديلاً لها.-Wl,--no-entryيمرر إلى الرابطwasm-ldأنه لا توجد دالة بداية، فالملف مكتبة تستدعي منها لا برنامج يعمل وحده، كما في توثيق wasm-ld.- الملف كله 384 بايت، مقابل 16,104 بايت للملف التنفيذي من gcc، لأن ملف ELF يحمل جداول ورؤوساً للربط مع مكتبة C والتحميل في نظام التشغيل، وملف WebAssembly لا يحمل إلا الدالة وما تحتاجه.
والآن نحول الملف إلى صيغته النصية بالأداة wasm2wat من مجموعة أدوات wabt، لنرى ما كتبه clang، وهذا الجزء الخاص بالحلقة الداخلية:
          loop  ;; label = @4
            local.get 0
            i32.const 1
            i32.add
            local.set 0
            local.get 4
            i64.const 1
            i64.shr_s
            local.get 4
            i64.const 3
            i64.mul
            i64.const 1
            i64.add
            local.get 4
            i64.const 1
            i64.and
            i64.eqz
            select
            local.tee 4
            i64.const 1
            i64.ne
            br_if 0 (;@4;)
          end
في المخرج أعلاه لاحظ التالي:
- كل تعليمة تحمل نوعها في اسمها:
i64.mulضرب أعداد صحيحة من 64 بت، وi32.addجمع من 32 بت. فالمحرك لا يحتاج أن يخمن أي شيء، والنوع مكتوب في الملف. - القسمة على 2 صارت إزاحة
i64.shr_sدون تصحيح للسالب، لأن clang لاحظ أن العدد هنا زوجي دائماً فلا يوجد كسر يقرب، والضرب في 3 بقي ضرباً لأن WebAssembly لا تحتوي تعليمة مثلlea، وهذا قرار يتركه clang لمترجم المحرك على جهاز المستخدم. - التعليمة
selectتختار بين النتيجتين حسب الزوجية، وهذا نفس اختيار clang في الكود الأصلي الذي رأيناه معcmovneq، دون تفرع داخل الحلقة.
لماذا كانت أول نتيجة أبطأ من C بثلاث مرات؟ Liftoff وTurboFan
البرنامج run-wasm.js يقرأ الملف، ويبني الـ Module، ويستدعي الدالة ويقيس الوقت:
// Loads collatz.wasm in Node (V8 compiles the module), calls the exported function and times it.
const fs = require('node:fs');
const n = Number(process.argv[2] || 1000000);
const bytes = fs.readFileSync(__dirname + '/collatz.wasm');
let t = process.hrtime.bigint();
const instance = new WebAssembly.Instance(new WebAssembly.Module(bytes));
const compileMs = Number(process.hrtime.bigint() - t) / 1e6;
t = process.hrtime.bigint();
const r = instance.exports.longest_chain(n);
const ms = Number(process.hrtime.bigint() - t) / 1e6;
console.log(`Wasm     n=${n}  result=${r}  ${ms.toFixed(1)} ms  (module ${bytes.length} bytes, compile ${compileMs.toFixed(2)} ms)`);
Wasm n=1000000 result=524 1048.2 ms (module 384 bytes, compile 0.42 ms)النتيجة صحيحة، وبناء الـ Module أخذ أقل من نصف ملي ثانية، ولكن الوقت أكثر من ثانية، أي أبطأ من نفس الكود المبني بالمترجم clang لنفس الجهاز بنحو ثلاث مرات، مع أن التعليمات تقريباً هي نفسها. وكانت هذه المشكلة الثانية التي واجهتنا في المختبر، والسبب في طريقة V8 مع WebAssembly: فالمحرك يبني كل Module أولاً بمترجم أساسي سريع اسمه Liftoff، كما في مدونة V8 عن Liftoff، حتى تبدأ الصفحة في العمل فوراً، ثم يبني في الخلفية نسخة محسنة بالمترجم TurboFan للدوال الساخنة. والقياس يكشف ما يحدث عندما نجبر المحرك على طبقة واحدة:
node run-wasm.js; node --liftoff-only run-wasm.js; node --no-liftoff run-wasm.jsWasm n=1000000 result=524 926.3 ms (module 384 bytes, compile 0.45 ms)
Wasm n=1000000 result=524 980.9 ms (module 384 bytes, compile 0.41 ms)
Wasm n=1000000 result=524 276.1 ms (module 384 bytes, compile 0.37 ms)الإعداد الافتراضي يساوي Liftoff وحده تقريباً، ومع --no-liftoff يبنى كود TurboFan قبل الاستدعاء الأول فينزل الوقت إلى 276 ms، أي مثل C المبني بالمترجم clang. فلماذا لم يصعد الإعداد الافتراضي إلى TurboFan؟ لأن دالتنا استدعيت مرة واحدة فقط، وهذا الاستدعاء الواحد استمر ثانية كاملة في كود Liftoff، والكود المحسن الجاهز في الخلفية لا يستخدم إلا في الاستدعاء التالي. ولنتأكد من ذلك، نستدعي الدالة خمس مرات على مدى أصغر:
// Calls the WebAssembly function five times: V8 starts with Liftoff code and swaps in TurboFan code for later calls.
const fs = require('node:fs');
const bytes = fs.readFileSync(__dirname + '/collatz.wasm');
const { longest_chain } = new WebAssembly.Instance(new WebAssembly.Module(bytes)).exports;
for (let i = 1; i <= 5; i++) {
  const t = process.hrtime.bigint();
  const r = longest_chain(300000);
  const ms = Number(process.hrtime.bigint() - t) / 1e6;
  console.log(`call ${i}  result=${r}  ${ms.toFixed(1)} ms`);
}
== five calls, default
call 1 result=442 276.5 ms
call 2 result=442 64.2 ms
call 3 result=442 62.7 ms
call 4 result=442 86.6 ms
call 5 result=442 63.8 ms
== five calls, --liftoff-only
call 1 result=442 193.9 ms
call 2 result=442 218.6 ms
call 3 result=442 224.7 ms
call 4 result=442 228.4 ms
call 5 result=442 232.3 ms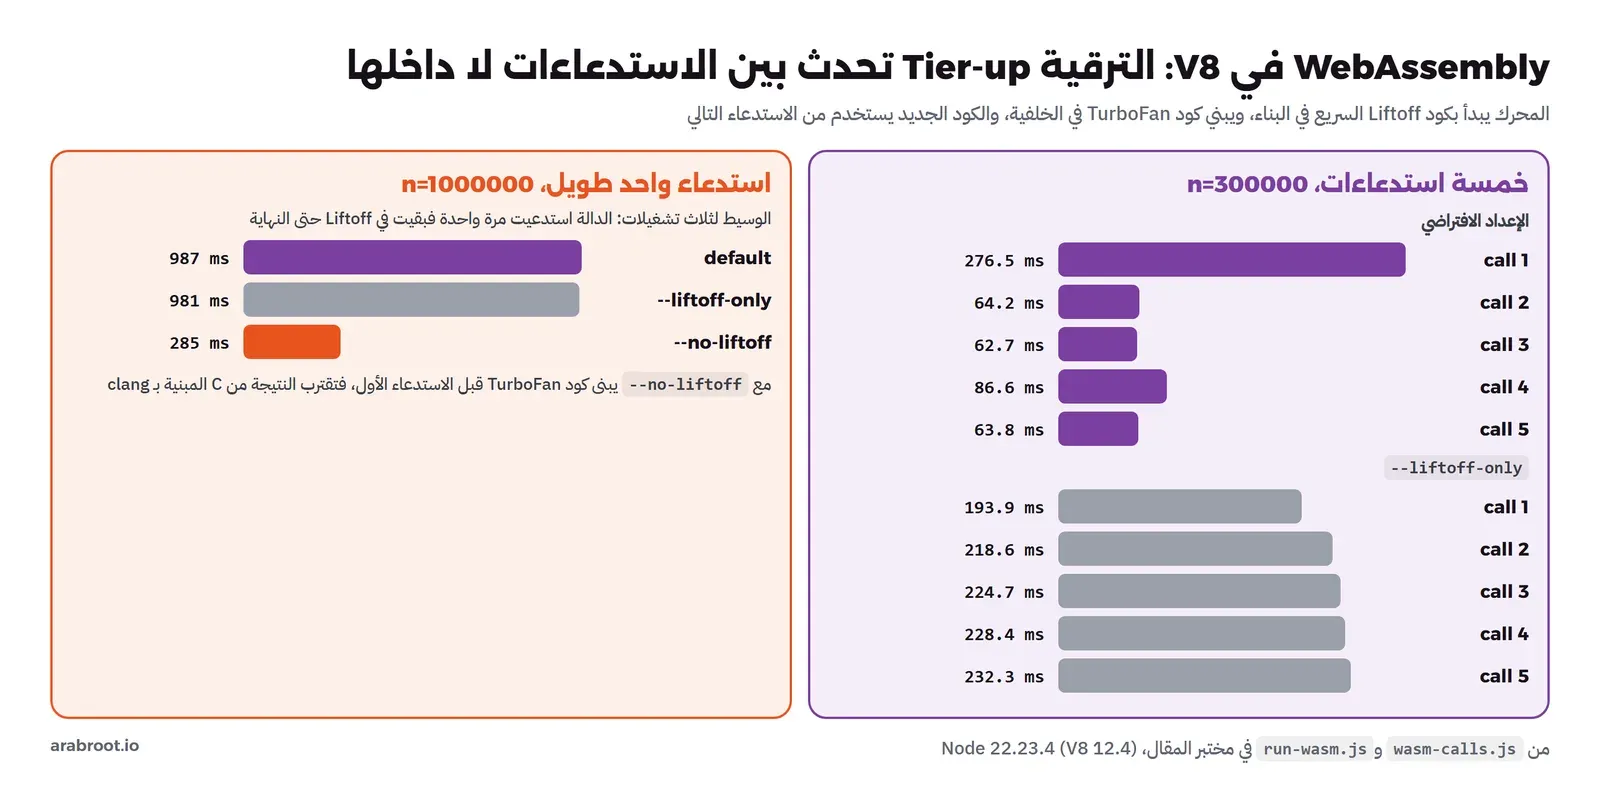
الاستدعاء الأول بقي في Liftoff، ومن الثاني نزل الوقت إلى نحو 64 ms، أي أسرع بأكثر من ثلاث مرات، بينما بقي --liftoff-only فوق 190 ms في كل الاستدعاءات. وهذا يختلف عن JavaScript، حيث رأينا أن الحلقة الطويلة تنتقل إلى الكود المحسن وهي تعمل بتقنية OSR، فإصدار V8 الذي في Node 22 لا يفعل ذلك مع WebAssembly. والنتيجة العملية: إذا كانت مكتبة WebAssembly عندك تستدعى مرة واحدة لعمل طويل، مثل ضغط ملف كبير أو معالجة صورة، فقسم العمل إلى استدعاءات أصغر، أو تأكد أن الدالة استدعيت مرة على بيانات صغيرة قبل العمل الكبير.
وقد يتساءل البعض: إذا كان WebAssembly بسرعة C، فلماذا لا نكتب كل شيء به؟ والإجابة أن WebAssembly لا يصل إلى DOM في المتصفح مباشرة، وكل تعامل مع الصفحة يمر عبر JavaScript، وكل عبور بين العالمين له ثمن، والسلاسل النصية والكائنات تحتاج نسخاً بين ذاكرة WebAssembly وذاكرة JavaScript. لذلك المكان الطبيعي له هو الحساب الثقيل المعزول، مثل معالجة الصور والفيديو، والضغط، والتشفير، وتشغيل مكتبات C وRust موجودة في المتصفح، وتشغيل إضافات Plugins معزولة داخل برنامج آخر، لا كتابة واجهة المستخدم.
زمن البدء Startup Time والذاكرة Memory: ما لا يظهر في القياس الأول
كل الأرقام السابقة تقيس الدالة وحدها، ولكن البرنامج الحقيقي يدفع أيضاً ثمن البدء: تحميل الملف، وبدء المفسر أو المحرك، وقراءة المكتبات. وهذا الثمن هو الذي تراه في أداة سطر أوامر تعمل مئات المرات في سكربت، أو في دالة Serverless تبدأ مع كل طلب. فشغلنا كل نسخة على n=2، أي دون عمل تقريباً، وقسنا الوقت الكلي وذروة الذاكرة بالأداة /usr/bin/time:
/usr/bin/time -f "%e s  %M KB  C" ./collatz_O2 2 >/dev/null
/usr/bin/time -f "%e s  %M KB  Python" python3 collatz.py 2 >/dev/null
/usr/bin/time -f "%e s  %M KB  Node" node collatz.js 2 >/dev/null
/usr/bin/time -f "%e s  %M KB  Wasm in Node" node run-wasm.js 2 >/dev/null
0.00 s 1648 KB C
0.10 s 9156 KB Python
0.09 s 46332 KB Node
0.09 s 47604 KB Wasm in Node
0.02 s 1572 KB C
0.14 s 9232 KB Python
0.11 s 46140 KB Node
0.15 s 47684 KB Wasm in Node
0.00 s 1708 KB C
0.08 s 9124 KB Python
0.12 s 46288 KB Node
0.15 s 47752 KB Wasm in Nodeفي المخرج أعلاه لاحظ التالي:
- برنامج C يبدأ وينتهي في أقل من 20 ms بذاكرة نحو 1.6 MB، لأنه لا يوجد شيء يبدأ قبل الدالة إلا تحميل الملف ومكتبة C.
- Python يحتاج نحو 0.1 ثانية ونحو 9 MB قبل أن ينفذ أول سطر من كودك، وهذا وقت بدء المفسر وتحميل وحداته الأساسية.
- Node.js يحتاج وقتاً قريباً من Python ولكن بذاكرة أكبر بخمس مرات، نحو 46 MB، لأن المحرك يحمل معه بيئة JavaScript كاملة ومساحة لل Heap وللكود المترجم.
- WebAssembly داخل Node.js يدفع ثمن Node.js كله، فملف 384 بايت لا يغير شيئاً في البدء، والذاكرة زادت نحو 1.3 MB فقط فوق Node.
والأرقام هنا تقلب المقارنة في بعض الحالات: أداة صغيرة تعمل مئة مرة في سكربت تدفع ثانية كاملة من البدء وحده في Python أو Node.js، وقد يكون هذا أكثر من وقت العمل نفسه. وهذا سبب أن أدوات سطر الأوامر التي تعمل كثيراً تكتب غالباً بلغات تترجم مسبقاً مثل Go وRust، وأن الخدمات الطويلة التي تعمل أياماً لا يهمها وقت البدء ولكن يهمها الأداء بعد الإحماء.
النتائج Results في جدول واحد
شغلنا كل النسخ ثلاث جولات بالسكربت run-final.sh، وهذه الأرقام كلها كما خرجت:
== round 1
gcc -O0             C        n=1000000  result=524  1300.8 ms
gcc -O2             C        n=1000000  result=524  375.0 ms
clang -O2           C        n=1000000  result=524  250.0 ms
python3             Python   n=1000000  result=524  60741.8 ms
node                Node     n=1000000  result=524  3185.0 ms
node --jitless      Node     n=1000000  result=524  34514.2 ms
wasm (default)      Wasm     n=1000000  result=524  1097.3 ms  (module 384 bytes, compile 0.49 ms)
wasm --no-liftoff   Wasm     n=1000000  result=524  336.8 ms  (module 384 bytes, compile 0.37 ms)
== round 2
gcc -O0             C        n=1000000  result=524  1274.5 ms
gcc -O2             C        n=1000000  result=524  528.1 ms
clang -O2           C        n=1000000  result=524  319.2 ms
python3             Python   n=1000000  result=524  72426.8 ms
node                Node     n=1000000  result=524  3803.4 ms
node --jitless      Node     n=1000000  result=524  30670.2 ms
wasm (default)      Wasm     n=1000000  result=524  959.2 ms  (module 384 bytes, compile 0.39 ms)
wasm --no-liftoff   Wasm     n=1000000  result=524  358.1 ms  (module 384 bytes, compile 0.36 ms)
== round 3
gcc -O0             C        n=1000000  result=524  1252.8 ms
gcc -O2             C        n=1000000  result=524  562.0 ms
clang -O2           C        n=1000000  result=524  356.3 ms
python3             Python   n=1000000  result=524  61830.9 ms
node                Node     n=1000000  result=524  3613.2 ms
node --jitless      Node     n=1000000  result=524  27730.8 ms
wasm (default)      Wasm     n=1000000  result=524  863.1 ms  (module 384 bytes, compile 0.48 ms)
wasm --no-liftoff   Wasm     n=1000000  result=524  258.4 ms  (module 384 bytes, compile 0.38 ms)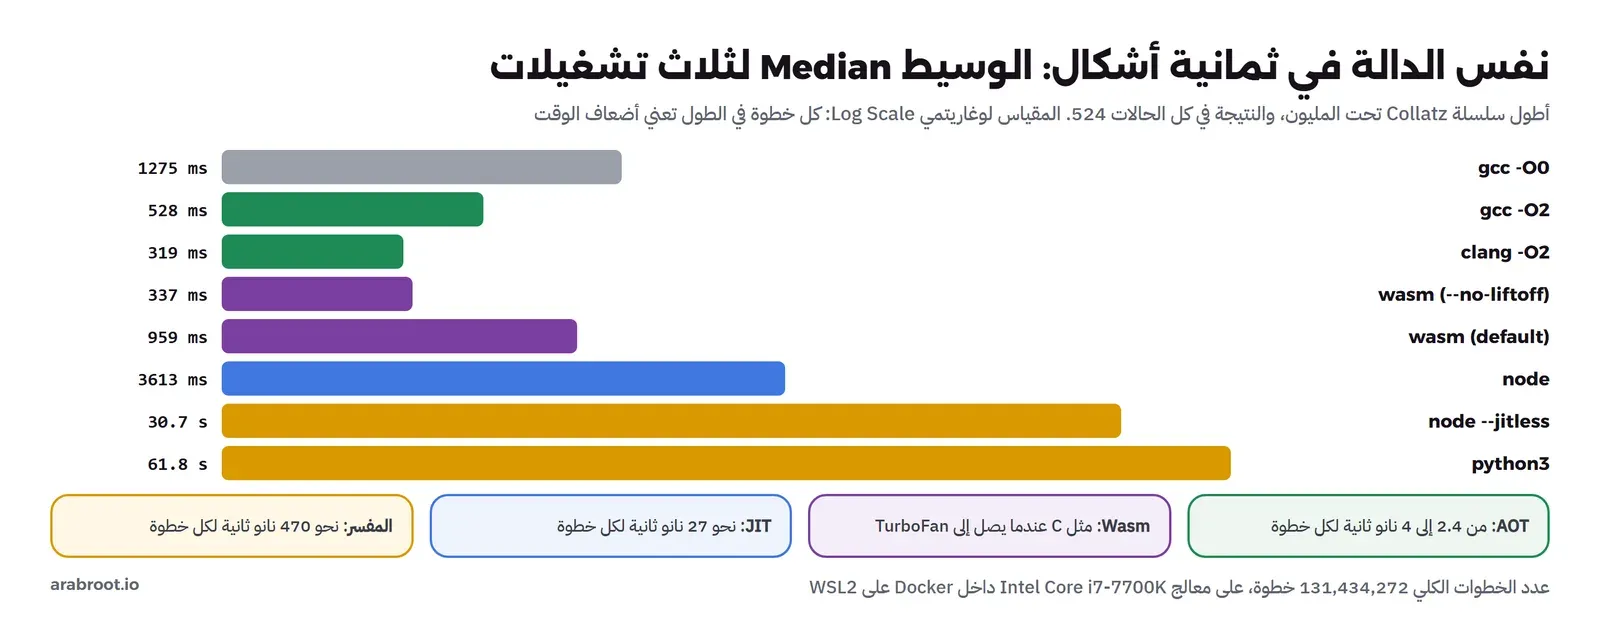
| الطريقة | الوسيط | لكل خطوة | مقارنة بأسرع نتيجة |
|---|---|---|---|
AOT: clang -O2 | 319 ms | 2.4 ns | 1x |
| WebAssembly مع TurboFan | 337 ms | 2.6 ns | 1.1x |
AOT: gcc -O2 | 528 ms | 4.0 ns | 1.7x |
| WebAssembly بالإعداد الافتراضي (Liftoff) | 959 ms | 7.3 ns | 3x |
AOT: gcc -O0 | 1,275 ms | 9.7 ns | 4x |
| JIT: Node.js 22 | 3,613 ms | 27 ns | 11x |
مفسر: Node.js مع --jitless | 30.7 s | 233 ns | 96x |
| مفسر: CPython 3.13 | 61.8 s | 470 ns | 194x |
ولاحظ في الأرقام أن الفرق بين جولة وأخرى لنفس البناء وصل إلى 50% أحياناً، فالبناء gcc -O2 أخذ 375 ms مرة و562 ms مرة أخرى، والسبب أن الجهاز تعمل عليه برامج أخرى، والمعالج يغير سرعته حسب الحرارة والضغط Load عليه. ولذلك أخذنا الوسيط Median لا المتوسط، فالوسيط لا يتأثر بجولة واحدة شاذة، ولذلك أيضاً لا يصح أن تستنتج من فرق 10% أو 20% في تشغيل واحد أن طريقة أسرع من أخرى. أما الفروق الكبيرة، مثل أن المفسر أبطأ من الكود المترجم بنحو مئتي مرة، فهي ثابتة في كل الجولات.
كيف تختار؟ جدول قرار Decision Table
لا توجد طريقة أفضل في المطلق، وإنما طريقة أنسب لنوع العمل. والجدول التالي يجمع ما قسناه في صورة قرارات:
| الحالة | الأنسب | والسبب من المختبر |
|---|---|---|
| أداة سطر أوامر تعمل مرات كثيرة لوقت قصير | ترجمة مسبقة AOT | برنامج C بدأ في أقل من 20 ms بذاكرة 1.6 MB، وNode وPython احتاجا نحو 0.1 ثانية قبل أول سطر |
| خدمة ويب تعمل أياماً | JIT أو AOT | الإحماء يكلف ثوان في البداية فقط، وبعدها نزل وقت الدفعة إلى أقل من ربعه |
| حلقة حسابية ثقيلة داخل برنامج Python | مكتبة مترجمة مثل NumPy، أو PyPy، أو كتابة الجزء الساخن بلغة مترجمة | المفسر كلف 470 نانو ثانية لكل خطوة مقابل 2.4 في C |
| حساب ثقيل داخل المتصفح | WebAssembly | نفس كود C وصل إلى 337 ms مع TurboFan، وأعداد 64 بت حقيقية دون Overflow إلى أعداد عشرية |
| كود JavaScript يتعامل مع أعداد كبيرة | انتبه للتمثيل، أو انقل الحساب إلى WebAssembly | الخروج عن مدى Smi ضاعف الفرق مع C من 2.5 إلى 6 مرات |
| تطوير سريع وتعديل مستمر ونصوص إدارية | مفسر | لا يوجد بناء، والكود نفسه يعمل على أي معمارية فيها المفسر |
| بيئة تمنع الذاكرة القابلة للتنفيذ لأسباب أمنية | مفسر أو AOT | --jitless يعمل ولكنه كان أبطأ من الإعداد الافتراضي بنحو تسع مرات |
أخطاء شائعة Common Mistakes في قياس الأداء Benchmarking
- قياس كود C مبني دون تحسين:
-O0هو الافتراضي في gcc، وكان أبطأ من-O2بأكثر من مرتين ومن clang بأربع مرات. - الحكم على لغة من مترجم واحد: نفس كود C أعطى 319 ms مع clang و528 ms مع gcc، لأن كل مترجم اتخذ قراراً مختلفاً في التفرع.
- قياس كود JIT مرة واحدة من البداية: الدفعات الثلاث الأولى كانت أبطأ بأربع مرات من التالية، وأول استدعاء في
deopt.jsأبطأ بثلاثمئة مرة. - تمرير أنواع مختلفة لنفس الدالة الساخنة في JavaScript: نص واحد ألغى التحسين وجعل الاستدعاء أبطأ بأكثر من ثلاث عشرة مرة، ولم يرجع الوقت إلى أصله في الاستدعاءين التاليين.
- نسيان أن أعداد JavaScript عشرية: أعداد Collatz تحت المليون تجاوزت 2^31، فألغي التحسين بسبب
overflowوتضاعف الفرق مع C. - افتراض أن خيارات المحرك في Node.js مثل Chrome: Maglev معطل افتراضياً في Node 22، فخيار
--no-turbofanلم يعمل بالطبقة التي توقعناها. - استدعاء دالة WebAssembly مرة واحدة لعمل طويل ثم الحكم على سرعتها: بقيت في Liftoff وأخذت ثلاثة أضعاف وقت TurboFan.
- تجاهل وقت البدء والذاكرة: Node.js احتاج نحو 46 MB قبل أن ينفذ سطراً، وهذا يهمك في Containers صغيرة وفي دوال Serverless.
- الحكم من تشغيل واحد أو بالمتوسط: نفس البناء تغير بين 375 و562 ms، والوسيط لثلاث جولات أو أكثر أصدق.
- مقارنة برامج لا تعطي نفس النتيجة: اطبع النتيجة دائماً، فإذا اختلفت فأنت تقيس عملين مختلفين.
قائمة تحقق Checklist قبل أن تقارن أداء لغتين
- نفس الخوارزمية سطراً بسطر، ونفس النتيجة مطبوعة في كل نسخة.
- إصدار كل مترجم ومحرك مطبوع في بداية القياس، والخيارات الافتراضية للمحرك معروفة من
node --v8-optionsأو ما يقابلها. - الكود المترجم مسبقاً مبني بإعدادات الإنتاج،
-O2أو ما يستخدمه مشروعك فعلاً. - القياس داخل البرنامج حول العمل نفسه، ووقت البدء يقاس وحده.
- كود JIT يحمى قبل القياس، أو يقاس على دفعات لترى الإحماء بدل أن يختلط بالنتيجة.
- ثلاث جولات على الأقل، والوسيط لا المتوسط، ولا يحكم على فرق صغير.
- عند نتيجة غريبة: افتح ما كتبه المترجم، لغة التجميع بالخيار
-S، وال Bytecode بالوحدةdisأو الخيار--print-bytecode، وقرارات ال JIT بالخيارين--trace-optو--trace-deopt.
حذف المختبر Cleanup
docker rmi scp5-cj:2
rm -f lab/collatz_O0 lab/collatz_O2 lab/collatz_clang lab/collatz.wasm
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الفرق بين الطرق الأربع هو متى تتحول الدالة إلى تعليمات آلة وعلى أي جهاز: قبل التشغيل في AOT، وأبداً في المفسر، وأثناء التشغيل للدوال الساخنة في JIT، وعلى جهاز المستخدم من ملف محمول في WebAssembly.
- نفس الدالة أخذت من 319 ms إلى 61.8 ثانية على نفس الجهاز، أي نحو مئتي ضعف بين أسرع طريقة وأبطئها.
- المترجم المسبق يكتب كوداً ذكياً، فقد حول gcc الضرب والقسمة إلى
leaوإزاحة ودمج خطوتين في واحدة، ولكنه يقرر قبل أن يرى البيانات، وقرار clang بتجنب التفرع جعله أسرع في هذه الحلقة. - مفسر CPython يمر بنحو عشرين تعليمة Bytecode في كل خطوة، وكل تعليمة دخول إلى حلقة المفسر وفحص للنوع، فكلفت الخطوة نحو 470 نانو ثانية، والمترجم JIT التجريبي غير موجود في نسخة Debian.
- محرك V8 يصعد بالدالة من Ignition إلى Sparkplug إلى TurboFan، وكل طبقة أضافت سرعة: من 26.3 ثانية في المفسر إلى 3.2 ثانية، وMaglev معطل افتراضياً في Node 22.
- ال JIT يخمن الأنواع ويضع لكل تخمين فحصاً، ونص واحد أو عدد تجاوز مدى Smi كاف لإلغاء التحسين، وهذا ما جعل Node أبطأ من C بست مرات في هذه الدالة.
- WebAssembly وصل إلى سرعة C عندما بني بالمترجم TurboFan، ولكن الاستدعاء الطويل الواحد بقي في Liftoff، والترقية ظهرت من الاستدعاء الثاني.
- وقت البدء والذاكرة جزء من الصورة: C بدأ في أقل من 20 ms بذاكرة 1.6 MB، وNode.js احتاج نحو 0.1 ثانية و46 MB.
- القياس الصحيح يحتاج نفس النتيجة، وإعدادات الإنتاج، وإحماء، وأكثر من جولة، وفتح ما كتبه المترجم عند أي نتيجة غريبة.
 دليلماذا يحدث عندما تشغل برنامج Hello World؟نتتبع برنامج C صغيراً من المحرر إلى الشاشة، فترى كل طبقة يمر بها في الجهاز حتى تظهر الجملة أمامك.
 دليلأنماط البرمجة وأنظمة الأنواع: لماذا تختلف اللغات؟نحل مسألة واحدة بعدة أساليب برمجة، ونرى هل تكتشف اللغة أخطاءك قبل التشغيل أم بعده، وماذا يعني ذلك عند اختيار لغة لمشروعك.
 دليلاللغة شيء والمترجم شيء آخر: من يقرر مستقبل لغات البرمجة؟لماذا لا تصح جمل مثل «Python بطيئة»، وما الفرق بين مواصفة اللغة والبرامج التي تطبقها، ومن يقرر مستقبلها.
 دليلإدارة الذاكرة: يدوياً أم Garbage Collector أم Ownership؟نقيس بأيدينا في C وGo وPython وRust من يحرر الذاكرة ومتى، وكم يكلف ذلك من الذاكرة والوقت، وما الأخطاء التي تبقى ممكنة في كل طريقة.
 دليلأدوات البناء Build Tools وماذا يحدث عندما تبني مشروعكما الذي يحدث بين ضغطة البناء والملف الناتج، ولماذا ينجح البناء على جهازك ويفشل على سيرفر CI، ومتى يعطيك نفس النتيجة مرتين.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب داخل Container من Debian 13.7 (trixie) مع gcc 14.2.0 وclang وwasm-ld 19.1.7 وwabt 1.0.36 وPython 3.13.5 وNode.js 22.23.4 (V8 12.4)، على معالج Intel Core i7-7700K بثماني أنوية منطقية ونواة Linux 5.15 (WSL2)، على Docker Engine 29.8.0.


