


في مقال ابن مفسراً صغيراً Interpreter بيدك بنينا لغة الصيغ التي طلبها فريق المبيعات في نظام الفواتير، وانتهينا بمفسر يحلل الصيغة إلى شجرة AST ثم يمشي على الشجرة لكل فاتورة. ونجحت اللغة، وصار الفريق يكتب قواعد الخصم والضريبة بنفسه، ثم جاء الطلب التالي كما يأتي دائماً: تقرير نهاية الشهر يحسب الصيغة لكل سطر في كل فاتورة، والمحاسب يريد صيغة لسعر الوحدة تقسم الإجمالي على الكمية دون أن يسقط التقرير كله عند سطر كميته صفر، والإدارة تريد أن تحفظ الصيغ في قاعدة البيانات جاهزة للتنفيذ بدل أن تحللها كل مرة. وثلاثة الطلبات تقودنا إلى نفس الخطوة التي اتخذتها Python وJava وLua قبلنا: أن نحول الشجرة إلى تعليمات مسطحة اسمها Bytecode، وأن نكتب آلة افتراضية Virtual Machine صغيرة تنفذها.
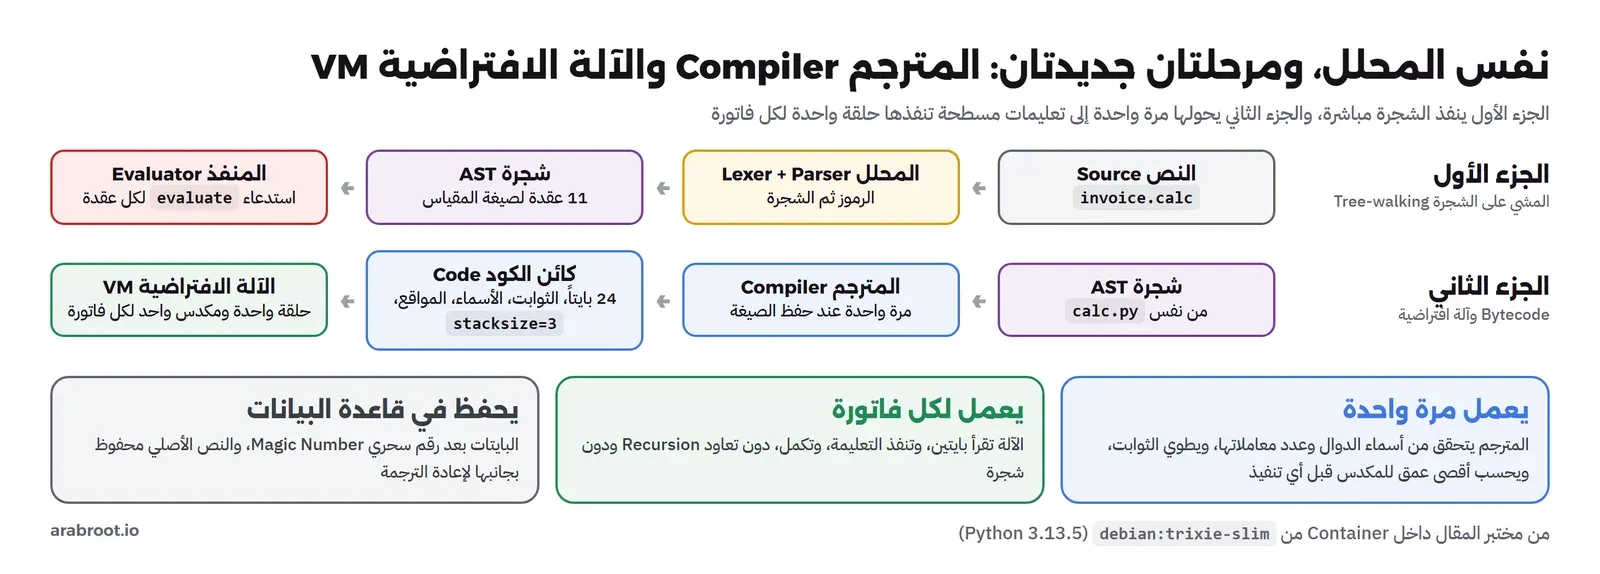
وهذا هو الجزء الثاني من المفسر، فسوف نأخذ نفس الملف calc.py من الجزء الأول دون أي تعديل، ونضيف بجانبه ملفاً واحداً vm.py فيه مترجم Compiler يحول الشجرة إلى Bytecode، ومفكك Disassembler يعرضه لنا كما يعرض dis كود Python، وآلة افتراضية تنفذه بحلقة واحدة ومكدس واحد. ثم نقيس بصدق: هل صار التنفيذ أسرع فعلاً؟ والإجابة سوف تفاجئك، وهي أهم ما في المقال، لأنها تشرح من أين تأتي سرعة CPython وJVM حقاً.
وسوف نناقش في هذا المقال ما يلي:
- لماذا تنتقل اللغات من المشي على الشجرة إلى Bytecode، وما الفرق بين آلة المكدس Stack Machine وآلة المسجلات Register Machine.
- تصميم مجموعة تعليمات Instruction Set صغيرة، ومترجم يمر على الشجرة مرة واحدة ويحسب عمق المكدس مسبقاً ويطوي الثوابت.
- قراءة المخرج بمفككنا ومقارنته بمخرج
disفي CPython تعليمة بتعليمة. - الآلة الافتراضية وجدول المواقع Line Table الذي يجعل الخطأ يعرف سطره وعموده بعد أن اختفت الشجرة.
- تعليمات القفز Jump، ولماذا لا تستطيع
if()أن تكون دالة عادية. - القياس: المفسر الشجري أمام الآلة الافتراضية أمام CPython، ثم نفس الحلقة بلغة C، وكيف يعيد CPython كتابة تعليماته وهو يعمل.
- خطأ حقيقي وجده الاختبار التفاضلي Differential Testing في جدول الثوابت، وحدود البايت الواحد، وحفظ الصيغ المترجمة بالرقم السحري Magic Number.
لماذا لا يكفي المشي على الشجرة Tree-walking؟
في الجزء الأول قسنا ثلاث طرق لتنفيذ نفس الصيغة، ووجدنا أن تحليل الصيغة مع كل تنفيذ هو الأغلى، فقررنا أن نحلل مرة ونحتفظ بالشجرة. وبعد هذا القرار بقي المشي على الشجرة نفسه، وكان أبطأ من Bytecode الخاص بلغة Python بنحو سبع مرات. وقد يتساءل البعض: إذا كانت الشجرة محفوظة في الذاكرة، فما الذي يكلف في المشي عليها؟ والإجابة أن كل عقدة في الشجرة تعني استدعاء الدالة evaluate من جديد، ومع كل استدعاء ينشئ Python إطاراً Frame جديداً، ثم تجرب جملة match الأنماط واحداً بعد الآخر، فتسأل هل العقدة Num؟ هل هي Var؟ هل هي Unary؟ حتى تصل إلى النوع الصحيح، ثم تقرأ الخصائص من الكائن، ثم تعود بالنتيجة إلى الإطار السابق. والصيغة round((price * qty - discount) * (1 + tax), 2) فيها 11 عقدة، فكل تقييم لها يمر بإحدى عشرة دورة من هذا العمل.
وهناك أيضاً مشكلة أخرى غير السرعة: الشجرة كائنات Python مترابطة بالمؤشرات، ولا توجد طريقة طبيعية لحفظها في عمود في قاعدة البيانات أو إرسالها إلى خدمة أخرى إلا بأن تعيد تحليل النص الأصلي. والطلب الثالث للإدارة، أي أن تحفظ الصيغة جاهزة للتنفيذ، يحتاج شكلاً مسطحاً من البايتات يمكن كتابته وقراءته. وهذا بالضبط ما يقدمه Bytecode: قائمة تعليمات صغيرة متتالية في الذاكرة، تقرأها حلقة واحدة من أولها إلى آخرها دون تعاود Recursion، ويمكن حفظها كما هي في ملف، كما يفعل CPython عندما يكتب ملفات .pyc في المجلد __pycache__.
والطلب الثاني، أي سعر الوحدة الذي لا يسقط عند الكمية صفر، يحتاج شيئاً لم يكن في لغتنا أصلاً: أن ينفذ جزء من الصيغة ويترك جزء آخر حسب قيمة. وفي الشجرة يمكن فعل ذلك بشرط داخل المنفذ، ولكن في Bytecode سوف نراه بشكله الحقيقي الذي تراه في كل معالج: تعليمة قفز Jump تغير مكان التعليمة التالية.
ما هو Bytecode؟ تعليمات مسطحة لآلة افتراضية Virtual Machine
الـ Bytecode هو لغة آلة لمعالج غير موجود، أي أنك تصمم معالجاً على الورق بتعليمات بسيطة تناسب لغتك، ثم تكتب برنامجاً يتصرف كأنه ذلك المعالج، وهذا البرنامج هو الآلة الافتراضية Virtual Machine. والتشبيه الأقرب من الحياة هو وصفة الطبخ المكتوبة كخطوات مرقمة مقابل صورة الطبق النهائي: الشجرة تشبه الصورة، تعرف منها بنية الطبق ولكنك تحتاج أن تفكر في كل مرة من أين تبدأ، أما الخطوات المرقمة فتنفذها واحدة بعد الأخرى دون تفكير، وهذا ما تريده من حلقة تنفذ ملايين المرات.
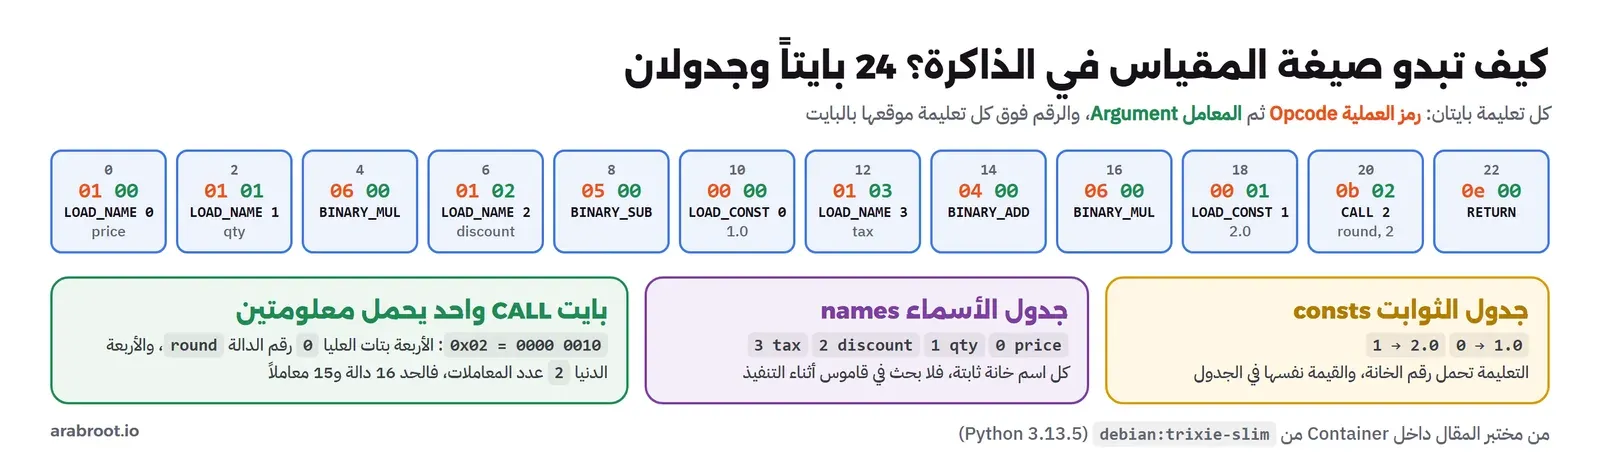
والكلمة نفسها تأتي من أن كل تعليمة في التصميمات الأولى كانت بايتاً واحداً Byte يحمل رقم العملية، واسمه رمز العملية Opcode، ويتبعه أحياناً بايت أو أكثر للمعامل Argument. وفي CPython منذ الإصدار 3.6 صارت كل تعليمة بايتين بالضبط، بايت لرمز العملية وبايت للمعامل، كما يذكر توثيق الوحدة dis، وسوف نتبع نفس التصميم لأنه يجعل الحلقة بسيطة: التعليمة التالية دائماً بعد بايتين.
ولاحظ أن Bytecode لا يعني ترجمة إلى كود الآلة الحقيقي، فالمعالج لا يفهم تعليماتنا، وإنما تقرؤها حلقة مكتوبة بلغة أخرى. والترجمة إلى كود الآلة الحقيقي هي عمل المترجم الكامل كما في GCC وClang، أو عمل ال JIT أثناء التشغيل، وشرحنا الفرق بين هذه الطرق في مقال المترجم Compiler والمفسر Interpreter و JIT و WebAssembly. وهنا نبقى في المنطقة الوسطى التي تقف فيها أغلب اللغات الديناميكية: ترجمة إلى تعليمات افتراضية، ثم تفسير هذه التعليمات.
آلة المكدس Stack Machine أم آلة المسجلات Register Machine؟
أول قرار في تصميم أي آلة افتراضية هو أين تضع القيم المؤقتة أثناء الحساب. ففي آلة المكدس Stack Machine تأخذ كل عملية معاملاتها من أعلى مكدس Stack وتضع نتيجتها عليه، فلحساب price * qty تكتب ثلاث تعليمات: ضع price، ضع qty، اضرب، والتعليمة BINARY_MUL لا تحتاج أن تعرف أين القيمتان لأنهما دائماً في أعلى المكدس. وفي آلة المسجلات Register Machine يوجد عدد من الخانات المرقمة كمسجلات المعالج، وكل تعليمة تذكر صراحة من أين تأخذ وأين تضع، فتصبح نفس العملية تعليمة واحدة مثل MUL r2, r0, r1.
وآلة المكدس أسهل كثيراً في كتابة مترجمها، لأن المترجم يمر على الشجرة ويكتب الأبناء ثم الأب دون أن يفكر في توزيع المسجلات، وتعليماتها أقصر لأنها لا تحمل أرقام مسجلات. ولكنها تنفذ تعليمات أكثر، وكل تعليمة في المفسر لها ثمن ثابت في القراءة والتوزيع، لذلك آلة المسجلات تنفذ عملاً أقل في المجمل. وعلى هذا الأساس اختارت المشاريع الكبيرة طرقاً مختلفة:
- CPython وآلة Java الافتراضية JVM وWebAssembly آلات مكدس، فتعريف تعليمات JVM في الفصل السادس من مواصفة JVM يصف كل تعليمة بما تأخذه من مكدس المعاملات Operand Stack وما تضعه عليه، ومواصفة WebAssembly تصف التنفيذ بنفس الطريقة.
- Lua انتقلت في الإصدار 5.0 من آلة مكدس إلى آلة مسجلات، وشرح مصمموها الأسباب والقياسات في ورقة The Implementation of Lua 5.0.
- آلة Dalvik في Android آلة مسجلات، وتوثيق صيغة Dalvik Bytecode يذكر أن كل دالة تحدد عدد المسجلات التي تحتاجها.
ولغتنا صغيرة، وأولويتنا أن يكون المترجم قصيراً وواضحاً، لذلك سوف نبني آلة مكدس مثل CPython، وسوف ترى في القياس لاحقاً أن عدد التعليمات هو بالضبط ما يحدد الوقت في آلة مكتوبة بلغة Python.
تصميم مجموعة التعليمات Instruction Set
مجموعة التعليمات هي العقد بين المترجم والآلة الافتراضية: المترجم لا يكتب إلا هذه التعليمات، والآلة لا تفهم إلا هي. ولغتنا فيها أرقام وأسماء متغيرات وست عمليات حسابية وسالب ودوال وجملة let، لذلك يكفينا 16 تعليمة، وهذا أول جزء في الملف vm.py:
# ---------- 1. the instruction set: one byte for the opcode, one byte for the argument ----------
OPS = ["LOAD_CONST", "LOAD_NAME", "STORE_NAME", "POP_TOP",
       "BINARY_ADD", "BINARY_SUB", "BINARY_MUL", "BINARY_DIV", "BINARY_MOD", "BINARY_POW", "UNARY_NEG",
       "CALL", "JUMP", "JUMP_IF_ZERO", "RETURN", "EXTENDED_ARG"]
for number, name in enumerate(OPS):
    globals()[name] = number
HAS_ARG = {LOAD_CONST, LOAD_NAME, STORE_NAME, CALL, JUMP, JUMP_IF_ZERO, EXTENDED_ARG}
BINARY = {"+": BINARY_ADD, "-": BINARY_SUB, "*": BINARY_MUL, "/": BINARY_DIV, "%": BINARY_MOD, "^": BINARY_POW}
# how each instruction changes the stack depth (CALL: pops argc, pushes one)
EFFECT = {LOAD_CONST: 1, LOAD_NAME: 1, STORE_NAME: -1, POP_TOP: -1, UNARY_NEG: 0, JUMP: 0, JUMP_IF_ZERO: -1,
          RETURN: -1, EXTENDED_ARG: 0, **{op: -1 for op in BINARY.values()}}

FUNCTIONS = ["round", "min", "max", "sqrt", "abs"]
ARITY = {"round": (1, 2), "min": (2, 2), "max": (2, 2), "sqrt": (1, 1), "abs": (1, 1), "if": (3, 3)}
MAGIC = b"CALC\x00\x02"          # file header: change the second byte whenever the instruction set changes


class Code:
    """What the compiler produces: like a Python code object (co_code, co_consts, co_names, co_stacksize)."""
    def __init__(self, code, consts, names, positions, stacksize):
        self.code, self.consts, self.names = bytes(code), consts, names
        self.positions, self.stacksize = positions, stacksize
في الكود أعلاه لاحظ التالي:
- رقم كل تعليمة هو ترتيبها في القائمة
OPS، فالتعليمةLOAD_CONSTرقمها 0 وBINARY_MULرقمها 6، والسطر الذي يستخدمglobals()يعرف لكل اسم ثابتاً برقمه حتى نكتبBINARY_MULفي الكود بدل الرقم 6. - القاموس
EFFECTيقول كم تغير كل تعليمة عمق المكدس:LOAD_CONSTتضيف قيمة فأثرها 1، والعمليات الثنائية تأخذ قيمتين وتضع واحدة فأثرها سالب 1، وCALLتأخذ عدد المعاملات وتضع النتيجة. وسوف يستخدم المترجم هذا الجدول ليعرف أقصى عمق يحتاجه المكدس قبل التشغيل. - التعليمة
CALLتحمل في بايت واحد معلومتين: رقم الدالة في الأربعة بتات العليا، وعدد المعاملات في الأربعة الدنيا، وهذا يكفي 16 دالة بحد أقصى 15 معاملاً. وهذا النوع من الضغط شائع في مجموعات التعليمات الحقيقية، وثمنه حدود صريحة يجب أن تعرفها. - الكلاس
Codeهو ما يخرجه المترجم، ويقابل كائن الكود Code Object في CPython بحقولهco_codeوco_constsوco_namesوco_stacksize، ووثيقة Code Objects في مستودع CPython تشرح هذه الحقول وما يضاف إليها. - الثابت
MAGICهو أول بايتات أي صيغة نحفظها، وسوف نعود إليه عند الحفظ في قاعدة البيانات.
ولاحظ أن الثوابت والأسماء لا توضع داخل التعليمات نفسها، وإنما في جدولين بجانبها، والتعليمة تحمل رقم الخانة فقط. فالتعليمة LOAD_CONST 0 تعني «ضع الثابت رقم صفر من جدول الثوابت»، وهذا يجعل كل التعليمات بحجم ثابت مهما كان الرقم طويلاً أو الاسم طويلاً، ويجعل الثابت الذي يتكرر في الصيغة يحفظ مرة واحدة.
المترجم Compiler: من الشجرة إلى التعليمات
المترجم في حالتنا يمر على الشجرة مرة واحدة كما كان المنفذ يفعل في الجزء الأول، ولكن بدل أن يحسب القيمة يكتب التعليمات التي سوف تحسبها لاحقاً. والقاعدة الأساسية لآلة المكدس بسيطة جداً: لكي تترجم عملية ثنائية، ترجم الطرف الأيسر، ثم الأيمن، ثم اكتب تعليمة العملية. فعندما تنتهي تعليمات الطرفين تكون قيمتاهما في أعلى المكدس بالترتيب الصحيح، وتأتي تعليمة العملية فتأخذهما. وهذا الترتيب، الأبناء ثم الأب، يسمى المرور اللاحق Post-order، وهو نفس الترتيب الذي تكتب به الحاسبات القديمة العمليات بالترميز البولندي العكسي Reverse Polish Notation. وهذا قلب المترجم:
# ---------- 2. the compiler: walk the tree once, emit flat instructions ----------
class Compiler:
    def __init__(self, fold=True):
        self.code = bytearray()
        self.consts, self.names, self.positions = [], [], []
        self.const_index = {}
        self.depth = self.max_depth = 0
        self.fold = fold

    def emit(self, op, arg=0, node=None):
        if arg > 255:                              # the argument does not fit in one byte
            self.emit(EXTENDED_ARG, arg >> 8, node)
            arg &= 0xFF
        self.code.extend((op, arg))
        self.positions.append((node.line, node.col) if node else (0, 0))
        effect = -argc_of(arg) + 1 if op == CALL else EFFECT[op]
        self.depth += effect
        self.max_depth = max(self.max_depth, self.depth)
        return len(self.code) - 2                  # offset of this instruction, used to patch jumps

    def const(self, value):
        key = (type(value), repr(value))           # 0.0 == -0.0 in Python, so compare the text, not the value
        if key not in self.const_index:
            self.const_index[key] = len(self.consts)
            self.consts.append(value)
        return self.const_index[key]

    def name(self, name):
        if name not in self.names:
            self.names.append(name)
        return self.names.index(name)

    def program(self, statements):
        for i, st in enumerate(statements):
            self.statement(st, last=(i == len(statements) - 1))
        if not statements:
            self.emit(LOAD_CONST, self.const(None))
        self.emit(RETURN)
        return Code(self.code, self.consts, self.names, self.positions, self.max_depth)

    def statement(self, node, last):
        if isinstance(node, Let):
            self.expr(node.value)
            self.emit(STORE_NAME, self.name(node.name), node)
            if last:
                self.emit(LOAD_NAME, self.name(node.name), node)
        else:
            self.expr(node)
            if not last:
                self.emit(POP_TOP)

    def expr(self, node):
        if self.fold and (value := constant(node)) is not None:      # constant folding: 1 + 0.15 -> 1.15
            self.emit(LOAD_CONST, self.const(value), node)
            return
        match node:
            case Num(value=v):
                self.emit(LOAD_CONST, self.const(v), node)
            case Var(name=n):
                self.emit(LOAD_NAME, self.name(n), node)
            case Unary(operand=o):
                self.expr(o)
                self.emit(UNARY_NEG, 0, node)
            case Binary(op=op, left=l, right=r):
                self.expr(l)
                self.expr(r)
                self.emit(BINARY[op], 0, node)
            case Call(name="if", args=args) if len(args) == 3:       # if(c, a, b): only one branch runs
                cond, then, other = args
                self.expr(cond)
                jump_else = self.emit(JUMP_IF_ZERO, 0, node)
                self.expr(then)
                self.depth -= 1                                      # the two branches share one stack slot
                jump_end = self.emit(JUMP, 0, node)
                self.patch(jump_else)
                self.expr(other)
                self.patch(jump_end)
            case Call(name=n, args=args):
                if n not in FUNCTIONS:
                    raise CalcError("NameError", f"unknown function '{n}'", node.line, node.col)
                lo, hi = ARITY[n]
                if not lo <= len(args) <= hi:
                    want = lo if lo == hi else f"{lo} to {hi}"
                    raise CalcError("TypeError", f"{n}() takes {want} arguments, got {len(args)}", node.line, node.col)
                for a in args:
                    self.expr(a)
                self.emit(CALL, FUNCTIONS.index(n) << 4 | len(args), node)

    def patch(self, at):
        target = len(self.code)
        if target > 255:
            raise CalcError("SyntaxError", "formula too long for a jump", 0, 0)
        self.code[at + 1] = target
في الكود أعلاه لاحظ التالي:
- الدالة
emitهي المكان الوحيد الذي يكتب فيه المترجم، وتفعل في كل مرة أربعة أشياء: تكتب البايتين، وتسجل فيpositionsسطر العقدة وعمودها، وتحدث العمق الحالي للمكدس، وتحتفظ بأقصى عمق وصل إليه. والقائمةpositionsفيها عنصر لكل تعليمة، وهي ما يسمح للآلة لاحقاً أن تقول أين وقع الخطأ في النص الأصلي. - الدالة
nameتعطي كل اسم رقم خانة ثابتاً عند الترجمة، فالآلة لا تبحث عنpriceفي قاموس أثناء التنفيذ، وإنما تقرأ الخانة رقم صفر من قائمة. وهذه نفس الفكرة التي تجعل المتغيرات المحلية في دوال Python أسرع من المتغيرات العامة، فالأولىLOAD_FASTبرقم خانة، والثانية بحث في قاموس. - جملة
letتترجم إلى قيمة ثمSTORE_NAME، وإذا كانت آخر جملة نضيفLOAD_NAMEلأن نتيجة البرنامج هي قيمة آخر جملة. وأي تعبير ليس الأخير تتبعهPOP_TOPحتى لا تتراكم على المكدس قيم لا يستخدمها أحد. - المترجم يتحقق من أسماء الدوال وعدد معاملاتها عند الترجمة، بينما كان المفسر الشجري يتحقق منها عند التنفيذ. والفرق عملي جداً: صيغة فيها
roudبدلroundترفض لحظة حفظها في لوحة الإدارة، لا عند أول فاتورة في تقرير نهاية الشهر. - الحالة الخاصة
ifتأتي قبل حالة الدوال العادية، وتترجم إلى تعليمات قفز لا إلىCALL، وسوف نشرحها في قسم كامل.
حساب عمق المكدس Stack Depth مسبقاً
قد يبدو حساب أقصى عمق للمكدس تفصيلاً غير مهم، ولكنه في الآلات الحقيقية شرط للأمان والسرعة معاً. فالآلة المكتوبة بلغة C تحجز المكدس كمصفوفة بحجم ثابت قبل أن تبدأ، وإذا لم تعرف الحجم مسبقاً فإما أن تفحص قبل كل push هل امتلأت المصفوفة، وهذا فحص إضافي في كل تعليمة، وإما أن تكتب خارج حدودها، وهذا خطأ أمني خطير. لذلك يحسب مترجم CPython الحقل co_stacksize لكل دالة، والآلة تحجز هذا الحجم وتثق به.
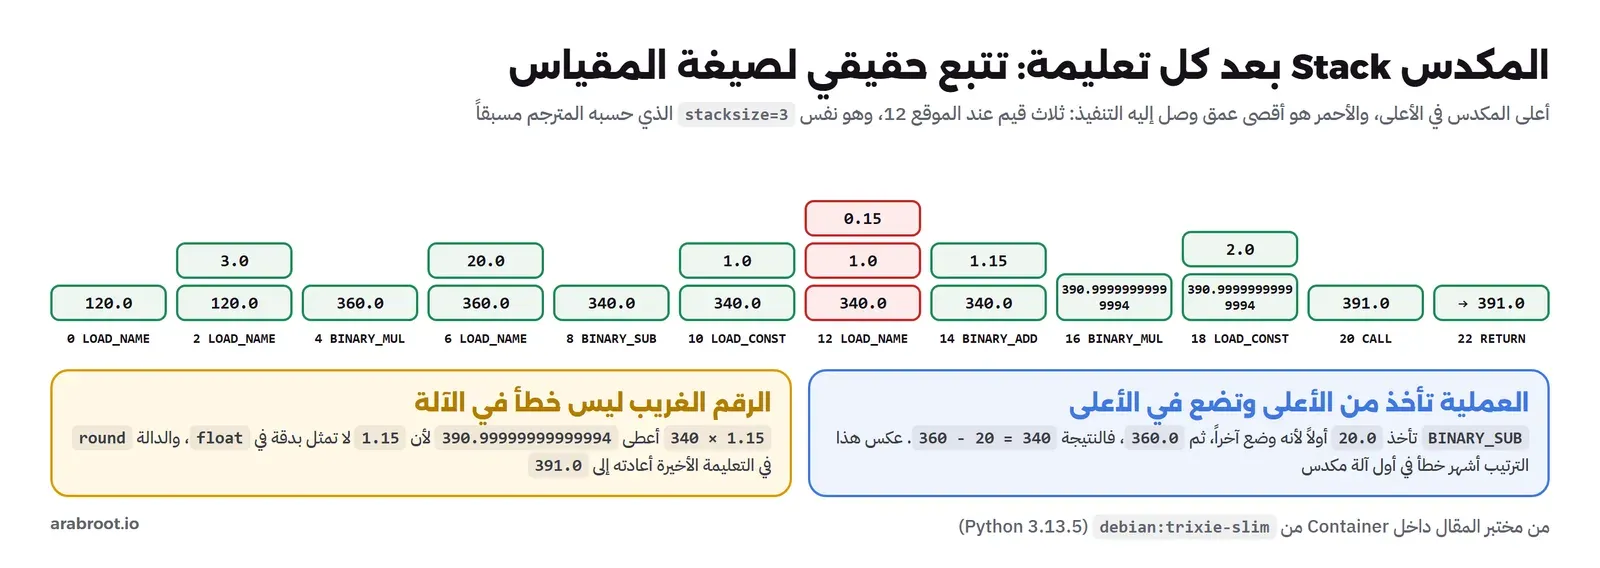
وفي المترجم نحسب العمق بمحاكاة بسيطة: كل تعليمة تضيف أثرها من الجدول EFFECT إلى العمق الحالي، ونحتفظ بأكبر قيمة. ولصيغة الفاتورة كان أقصى عمق 3، أي أن الآلة لا تحتاج في أي لحظة أكثر من ثلاث قيم مؤقتة، وسوف تراها بعينك بعد قليل في تتبع التنفيذ. والنقطة الدقيقة الوحيدة هي if، لأن فرعيها لا ينفذان معاً، فإذا جمعنا أثرهما كما هو سوف نحسب قيمة زائدة على المكدس، لذلك يطرح المترجم واحداً قبل الفرع الثاني، وهذا هو السطر self.depth -= 1 مع تعليقه.
طي الثوابت Constant Folding
لأن المترجم يرى الصيغة كاملة قبل أي تنفيذ، فهو يستطيع أن يحسب مسبقاً كل جزء لا يعتمد على متغير. فإذا كتب أحدهم price * (1 + 0.15) فلا معنى لأن تجمع الآلة 1 و0.15 لكل فاتورة، والمترجم يستبدلهما بالثابت 1.15 مرة واحدة. والدالة constant تفعل ذلك:
def constant(node):
    """The value of a sub-tree that has no names in it, or None."""
    match node:
        case Num(value=v):
            return v
        case Unary(operand=o):
            v = constant(o)
            return None if v is None else -v
        case Binary(op=op, left=l, right=r) if op in "+-*":
            a, b = constant(l), constant(r)
            if a is None or b is None:
                return None
            return a + b if op == "+" else a - b if op == "-" else a * b
    return None                                    # / % ^ are left to run time: they can raise errors
ولاحظ أنها تطوي الجمع والطرح والضرب فقط، وتترك القسمة والباقي والأس للتنفيذ. والسبب أن هذه العمليات قد ترفع أخطاء، والمترجم إذا حسب 1 / 0 وقت الترجمة إما أن يرفض صيغة لن ينفذ هذا الجزء منها أبداً، كما في فرع if لا يصل إليه التنفيذ، وإما أن يحتاج منطقاً إضافياً ليؤجل الخطأ. وهذا مثال صغير على قاعدة عامة في كل المترجمات: التحسين Optimization يجب ألا يغير ما يراه المستخدم، لا النتيجة ولا الأخطاء. وسوف نرى في مقال المترجم الحقيقي كيف يطبق GCC وClang نفس الفكرة على نطاق أوسع بكثير، وكيف تجعل هذه القاعدة السلوك غير المعرف Undefined Behaviour خطيراً.
المفكك Disassembler: كيف تقرأ Bytecode
البايتات وحدها لا تقرأ، لذلك كل لغة تستخدم Bytecode تأتي بمفكك يعيدها إلى نص: dis في Python، وjavap -c في Java، وluac -l في Lua. ومفككنا في الملف نفسه، يمر على الكود بايتين بايتين ويطبع لكل تعليمة اسمها ومعاملها وما يعنيه المعامل:
# ---------- 3. the disassembler: bytes back to readable text ----------
def disassemble(co, out=sys.stdout):
    print(f"stacksize={co.stacksize}  consts={co.consts}  names={co.names}", file=out)
    last_line, ext = None, 0
    for i in range(0, len(co.code), 2):
        op, arg = co.code[i], co.code[i + 1] | ext
        ext = arg << 8 if op == EXTENDED_ARG else 0
        line = co.positions[i // 2][0]
        shown = f"{line:>3}" if line != last_line and line else "   "
        last_line = line or last_line
        rep = ""
        if op == LOAD_CONST:
            rep = f"({co.consts[arg]!r})"
        elif op in (LOAD_NAME, STORE_NAME):
            rep = f"({co.names[arg]})"
        elif op == CALL:
            rep = f"({FUNCTIONS[arg >> 4]}, {argc_of(arg)} args)"
        elif op in (JUMP, JUMP_IF_ZERO):
            rep = f"(to {arg})"
        argtext = str(arg) if op in HAS_ARG else ""
        print(f"{shown}  {i:>4} {OPS[op]:<14}{argtext:>4} {rep}", file=out)
والآن نترجم ملف الفاتورة من الجزء الأول ونعرضه. وكل التجارب في هذا المقال تعمل داخل Container صغير من الـ Image الرسمية debian:trixie-slim مع حزمتي python3 وgcc من Debian، وملف Dockerfile في مجلد المختبر:
docker build -t scc1-vm lab/
docker run --rm -v "$PWD/lab":/lab -w /lab scc1-vm python3 vm.py --dis invoice.calc
والمخرج سوف يكون كما يلي:
stacksize=3  consts=[0.15, 1.0, 2.0]  names=['tax', 'price', 'qty', 'discount', 'subtotal', 'total']
  2     0 LOAD_CONST       0 (0.15)
        2 STORE_NAME       0 (tax)
  3     4 LOAD_NAME        1 (price)
        6 LOAD_NAME        2 (qty)
        8 BINARY_MUL
       10 LOAD_NAME        3 (discount)
       12 BINARY_SUB
       14 STORE_NAME       4 (subtotal)
  4    16 LOAD_NAME        4 (subtotal)
       18 LOAD_CONST       1 (1.0)
       20 LOAD_NAME        0 (tax)
       22 BINARY_ADD
       24 BINARY_MUL
       26 STORE_NAME       5 (total)
  5    28 LOAD_NAME        5 (total)
       30 LOAD_CONST       2 (2.0)
       32 CALL             2 (round, 2 args)
       34 RETURN
في المخرج أعلاه لاحظ التالي:
- السطر الأول يلخص كائن الكود: المكدس يحتاج ثلاث خانات، وفي جدول الثوابت ثلاث قيم، وفي جدول الأسماء ستة أسماء بالترتيب الذي ظهرت به في الصيغة، فخانة
taxرقمها 0 لأنها أول اسم. - العمود الأول رقم السطر في ملف الصيغة، ويظهر عند أول تعليمة من كل سطر فقط. والسطر الأول في الملف تعليق، لذلك تبدأ التعليمات من السطر 2.
- العمود الثاني موقع التعليمة بالبايت، ويزيد 2 في كل مرة لأن كل تعليمة بايتان، وهذا الرقم هو ما سوف تستخدمه تعليمات القفز.
- السطر 3 من الصيغة،
price * qty - discount، صار ست تعليمات بالترتيب البولندي العكسي: ضع السعر، ضع الكمية، اضرب، ضع الخصم، اطرح، احفظ فيsubtotal. وهذا هو المرور اللاحق على الشجرة بالضبط. - الثابت
1.0في السطر 4 لم يطو معtax، لأنtaxمتغير في نظر المترجم حتى لو أعطيناه قيمة ثابتة في السطر 2. فالمترجم البسيط لا يتتبع قيم المتغيرات بين الجمل، وهذا التتبع اسمه نشر الثوابت Constant Propagation، وهو من أول ما تفعله المترجمات الحقيقية. - التعليمة
CALL 2معاملها 2، أي الدالة رقم 0 (round) في البتات العليا وعدد المعاملات 2 في الدنيا، والمفكك يفك هذا الضغط ويكتب(round, 2 args).
مقارنة مع dis في CPython
لكي تعرف أن ما بنيناه ليس لعبة بعيدة عن الواقع، لنكتب نفس الصيغة بلغة Python ونطلب من CPython أن يعرض Bytecode الخاص به، وهذا الملف python_side.py:
"""The same invoice formula written as Python, and the bytecode CPython makes for it."""
import dis, sys
src = """tax = 0.15
subtotal = price * qty - discount
total = subtotal * (1 + tax)
round(total, 2)
"""
print(sys.version.split()[0])
dis.dis(compile(src, "invoice", "exec"))
co = compile("subtotal * (1 + 0.15)", "f", "eval")
print("folded:", co.co_consts)
والمخرج سوف يكون كما يلي:
3.13.5
  0           RESUME                   0

  1           LOAD_CONST               0 (0.15)
              STORE_NAME               0 (tax)

  2           LOAD_NAME                1 (price)
              LOAD_NAME                2 (qty)
              BINARY_OP                5 (*)
              LOAD_NAME                3 (discount)
              BINARY_OP               10 (-)
              STORE_NAME               4 (subtotal)

  3           LOAD_NAME                4 (subtotal)
              LOAD_CONST               1 (1)
              LOAD_NAME                0 (tax)
              BINARY_OP                0 (+)
              BINARY_OP                5 (*)
              STORE_NAME               5 (total)

  4           LOAD_NAME                6 (round)
              PUSH_NULL
              LOAD_NAME                5 (total)
              LOAD_CONST               2 (2)
              CALL                     2
              POP_TOP
              RETURN_CONST             3 (None)
folded: (1.15,)
ضع المخرجين بجانب بعضهما وسوف تجد أن أغلب السطور متطابقة تقريباً: LOAD_CONST ثم STORE_NAME للضريبة، ثم LOAD_NAME مرتين وBINARY_OP (*) ثم LOAD_NAME وBINARY_OP (-)، بنفس الترتيب وبنفس أسماء التعليمات تقريباً. وهذا ليس صدفة، فكل مترجم لآلة مكدس ينتج نفس الترتيب من نفس الشجرة. والفروق تعلمك ما يحتاجه مفسر لغة كاملة:
- CPython يجمع كل العمليات الثنائية في تعليمة واحدة
BINARY_OPويحدد نوع العملية في المعامل، فالرقم 5 للضرب و10 للطرح و0 للجمع، بينما خصصنا نحن تعليمة لكل عملية. - الدالة
roundعنده اسم عادي يبحث عنه بالتعليمةLOAD_NAMEويوضع على المكدس قبل المعاملات، ومعهPUSH_NULLالتي تحجز مكاناً يستخدمه استدعاء الدوال، لأن الدوال في Python قيم يمكن تغييرها، أما في لغتنا فالدوال ثابتة في قائمة، لذلك يكفي رقمها داخلCALL. - التعليمة
RESUMEفي البداية لا تحسب شيئاً، وإنما نقطة يفحص عندها المفسر أشياء مثل الإشارات والتتبع، وRETURN_CONSTتعيدNoneلأن الكود كتلةexecوليس تعبيراً. - السطر الأخير يبين أن CPython يطوي الثوابت أيضاً، فقد صار
1 + 0.15ثابتاً واحداً1.15في جدول الثوابت.
الآلة الافتراضية VM: حلقة واحدة ومكدس واحد
الآن نصل إلى الجزء الذي ينفذ لكل فاتورة. والآلة الافتراضية كلها حلقة while تقرأ بايتين، وتنظر في رمز العملية، وتنفذ ما يقابله، ثم تكمل. وفي أدبيات المفسرات يسمى هذا التصميم حلقة الجلب والتوزيع Fetch-Decode-Dispatch، وهو نفس ما يفعله المعالج الحقيقي في كل دورة، وشرحناه في مقال كيف يعمل المعالج CPU من الداخل:
# ---------- 4. the virtual machine: one loop, one stack ----------
IMPL = [lambda x, d=0: round(x, int(d)), min, max, math.sqrt, abs]
UNSET = object()


def execute(co, env):
    code, consts, names = co.code, co.consts, co.names
    slots = [env.get(n, UNSET) for n in names]     # names resolved to slot numbers at compile time
    stack = []
    push, pop = stack.append, stack.pop
    pc = ext = 0
    while True:
        op, arg = code[pc], code[pc + 1] | ext
        pc += 2
        ext = 0
        if op == LOAD_CONST:
            push(consts[arg])
        elif op == LOAD_NAME:
            v = slots[arg]
            if v is UNSET:
                raise error(co, pc, "NameError", f"'{names[arg]}' is not defined")
            push(v)
        elif op == BINARY_MUL:
            b = pop(); push(pop() * b)
        elif op == BINARY_ADD:
            b = pop(); push(pop() + b)
        elif op == BINARY_SUB:
            b = pop(); push(pop() - b)
        elif op == STORE_NAME:
            slots[arg] = pop()
        elif op == BINARY_DIV or op == BINARY_MOD:
            b = pop(); a = pop()
            if b == 0:
                raise error(co, pc, "ZeroDivisionError", "division by zero")
            push(a / b if op == BINARY_DIV else a % b)
        elif op == BINARY_POW:
            b = pop(); a = pop()
            try:
                r = a ** b
            except OverflowError:
                raise error(co, pc, "OverflowError", "result is too large")
            if isinstance(r, complex):
                raise error(co, pc, "ValueError", "negative number to a fractional power")
            push(r)
        elif op == UNARY_NEG:
            push(-pop())
        elif op == CALL:
            n = argc_of(arg)
            args = stack[-n:]
            del stack[-n:]
            try:
                push(IMPL[arg >> 4](*args))
            except ValueError as e:
                raise error(co, pc, "ValueError", f"{FUNCTIONS[arg >> 4]}(): {e}")
        elif op == JUMP_IF_ZERO:
            if pop() == 0:
                pc = arg
        elif op == JUMP:
            pc = arg
        elif op == POP_TOP:
            pop()
        elif op == EXTENDED_ARG:
            ext = arg << 8
        elif op == RETURN:
            return pop()


def error(co, pc, kind, message):
    line, col = co.positions[pc // 2 - 1]           # the instruction that just ran
    return CalcError(kind, message, line, col)
في الكود أعلاه لاحظ التالي:
- المتغير
pcهو عداد البرنامج Program Counter، أي موقع التعليمة التالية، ويزيد 2 بعد كل قراءة، وتعليمات القفز تغيره مباشرة. - القائمة
slotsتبنى مرة واحدة في بداية التنفيذ من القاموسenv، والقيمةUNSETكائن خاص يعني أن الاسم لم يعط قيمة بعد، ولم نستخدمNoneلأنNoneقد تكون قيمة حقيقية في لغة أكبر. - ترتيب الفحوص في سلسلة
ifليس ترتيب القائمةOPS، وإنما وضعنا التعليمات الأكثر تكراراً أولاً، أي التحميل ثم الضرب والجمع والطرح، لأن كل فحص فاشل قبل الوصول إلى التعليمة الصحيحة له ثمن، وسوف نقيس هذا الثمن. - في العمليات الثنائية نأخذ
bأولاً ثمa، لأن الطرف الأيمن وضع على المكدس آخراً فهو في أعلاه. وعكس هذا الترتيب أشهر خطأ في أول آلة مكدس يكتبها أي مبرمج، ولا يظهر في الجمع والضرب لأنهما لا يتأثران بالترتيب، ويظهر في أول عملية طرح أو قسمة. - كل أخطاء التنفيذ من نوع
CalcErrorكما في الجزء الأول، والدالةerrorتجد موقع الخطأ منpositionsبرقم التعليمة التي نفذت للتو.
ولكي ترى المكدس وهو يعمل، شغلنا نسخة من نفس الحلقة تطبع المكدس بعد كل تعليمة، وهي الملف trace.py، على صيغة المقياس من الجزء الأول:
  0 LOAD_NAME   [120.0]
  2 LOAD_NAME   [120.0, 3.0]
  4 BINARY_MUL  [360.0]
  6 LOAD_NAME   [360.0, 20.0]
  8 BINARY_SUB  [340.0]
 10 LOAD_CONST  [340.0, 1.0]
 12 LOAD_NAME   [340.0, 1.0, 0.15]
 14 BINARY_ADD  [340.0, 1.15]
 16 BINARY_MUL  [390.99999999999994]
 18 LOAD_CONST  [390.99999999999994, 2.0]
 20 CALL        [391.0]
 22 RETURN      -> 391.0
اقرأ العمود الأيمن من الأعلى إلى الأسفل وسوف ترى الحساب يحدث: السعر ثم الكمية، ثم يحل محلهما حاصل ضربهما 360، ثم يأتي الخصم ويحل الفرق 340 محلهما. وعند الموقع 12 يصل المكدس إلى أقصى عمق، ثلاث قيم، وهو بالضبط الرقم 3 الذي حسبه المترجم مسبقاً. ولاحظ القيمة 390.99999999999994 في الموقع 16، فهي ليست خطأ في الآلة، وإنما لأن 1.15 لا تمثل بدقة في النوع float، وشرحنا السبب في مقال الأرقام العشرية Floating Point من الداخل، والدالة round في التعليمة الأخيرة هي التي أعادتها إلى 391.
جدول المواقع Line Table: كيف يعرف الخطأ مكانه؟
في المفسر الشجري كان موقع الخطأ سهلاً، لأن كل عقدة تحمل سطرها وعمودها، والمنفذ يرفع الخطأ وهو واقف على العقدة. ولكن بعد الترجمة اختفت الشجرة، والآلة لا ترى إلا بايتات، فكيف تعرف أن القسمة على صفر وقعت في العمود 7 من السطر 3؟ والحل هو القائمة positions التي ملأها المترجم: عنصر لكل تعليمة فيه سطر وعمود العقدة التي أنتجتها. وعندما يقع خطأ تحسب الآلة رقم التعليمة من pc وتقرأ موقعها. وCPython يفعل نفس الشيء بجدول مضغوط في الحقل co_linetable، ويمكنك أن تقرأه بالدالة co_positions() الموصوفة في توثيق dis، ومنه تأتي العلامات ^^^^ تحت الجزء الخاطئ في رسائل الخطأ منذ Python 3.11.
ولنجرب ذلك على صيغة سعر الوحدة التي طلبها المحاسب، وهي الملف unit.calc:
# unit price for the report: total divided by quantity
let total = price * qty - discount
total / qty
والجزء الأول من الملف experiments.py ينفذها بكمية صفر:
== 1. a runtime error still knows its line and column
  ZeroDivisionError at line 3, column 7: division by zero
      total / qty
            ^
الرسالة بنفس الشكل الذي تعود عليه فريق المبيعات في الجزء الأول، بالسطر والعمود والعلامة تحت علامة القسمة، مع أن الآلة لم تر أي شجرة. وهذا شرط لا تتنازل عنه عندما تنقل لغة من المشي على الشجرة إلى Bytecode: المستخدم لا يجب أن يلاحظ أي فرق إلا السرعة. ولكن الرسالة نفسها تقول إن الصيغة لا تصلح لتقرير نهاية الشهر، لأن سطراً واحداً بكمية صفر سوف يوقف التقرير كله، وهذا ما ينقلنا إلى القسم التالي.
تعليمات القفز Jump: دالة if() التي لا تستطيع أن تكون دالة
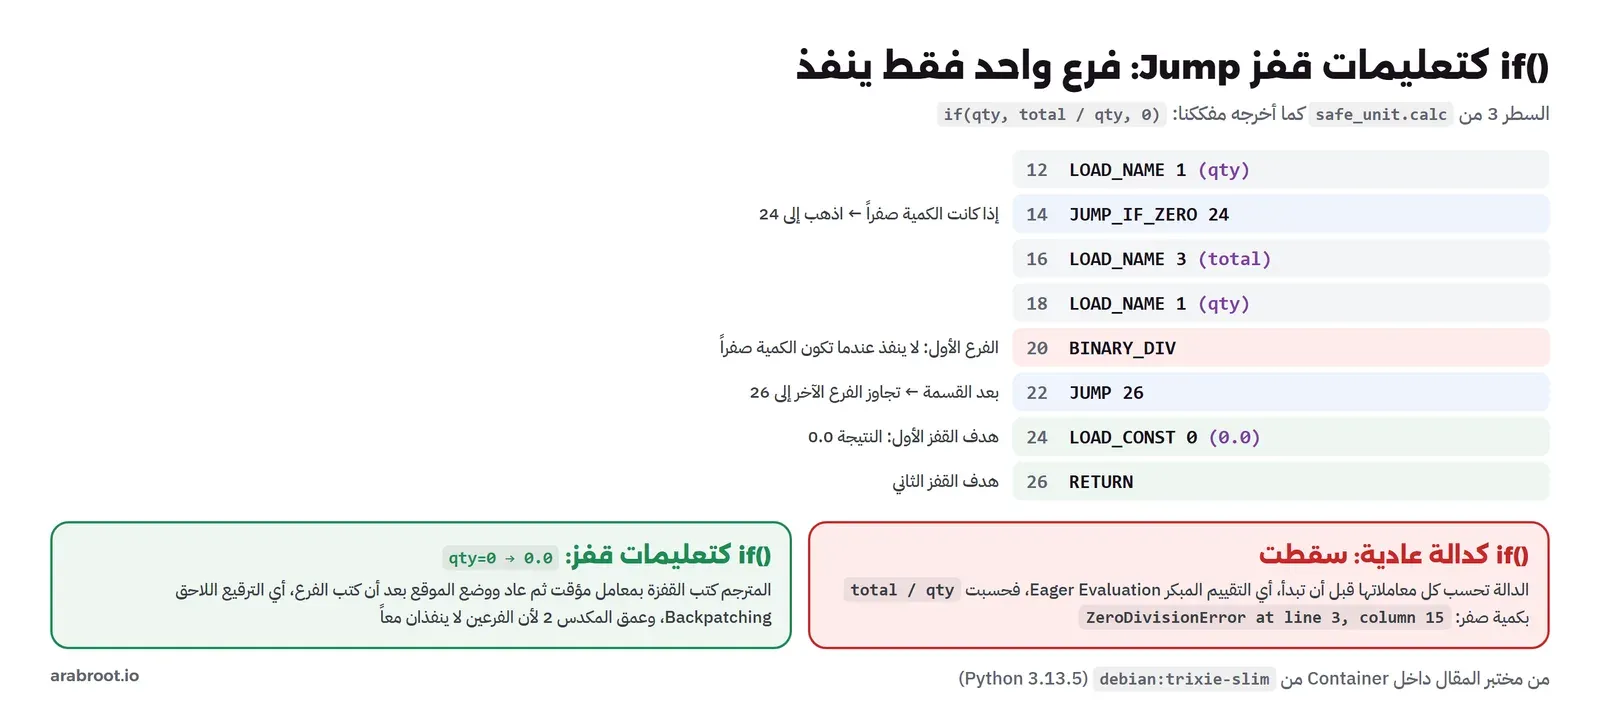
المحاسب يريد أن يكتب: إذا كانت الكمية غير صفر فاقسم، وإلا فالنتيجة صفر. والطريقة الأولى التي تخطر في البال أن نضيف دالة if(condition, a, b) إلى قائمة الدوال كما أضفنا min وmax، فهي دالة بثلاثة معاملات تعيد الثاني أو الثالث. وهذه الصيغة الجديدة safe_unit.calc:
# the same, but a line with qty = 0 shows 0 instead of failing
let total = price * qty - discount
if(qty, total / qty, 0)
والجزء الثاني من التجارب ينفذها ثلاث مرات: مرة بالمفسر الشجري كما هو، ومرة بعد أن نضيف إليه if كدالة عادية، ومرة بالآلة الافتراضية:
== 2. if(): the tree walker, an eager if(), and the VM
  NameError at line 3, column 1: unknown function 'if'
      if(qty, total / qty, 0)
      ^
  ZeroDivisionError at line 3, column 15: division by zero
      if(qty, total / qty, 0)
                    ^
stacksize=2  consts=[0.0]  names=['price', 'qty', 'discount', 'total']
  2     0 LOAD_NAME        0 (price)
        2 LOAD_NAME        1 (qty)
        4 BINARY_MUL
        6 LOAD_NAME        2 (discount)
        8 BINARY_SUB
       10 STORE_NAME       3 (total)
  3    12 LOAD_NAME        1 (qty)
       14 JUMP_IF_ZERO    24 (to 24)
       16 LOAD_NAME        3 (total)
       18 LOAD_NAME        1 (qty)
       20 BINARY_DIV
       22 JUMP            26 (to 26)
       24 LOAD_CONST       0 (0.0)
       26 RETURN
  qty=0.0: 0.0
  qty=3.0: 113.33333333333333
في المخرج أعلاه لاحظ التالي:
- المحاولة الأولى رفضت الصيغة لأن المفسر الشجري لا يعرف دالة اسمها
if، وهذا متوقع. - المحاولة الثانية هي الأهم: أضفنا
ifكدالة عادية، فسقطت الصيغة بنفس خطأ القسمة على صفر الذي أردنا أن نتجنبه. والسبب أن أي دالة عادية تحسب كل معاملاتها قبل أن تبدأ، وهذا ما يسمى التقييم المبكر Eager Evaluation، فحسب المفسرtotal / qtyقبل أن تنظر الدالة في الشرط أصلاً. لذلك لا يمكن أن تكونifدالة في أي لغة تقيم المعاملات مبكراً، ولهذا السبب نفسهandوorفي Python ليستا دالتين. - في الآلة الافتراضية ترجم المترجم
ifإلى تعليمتي قفز:JUMP_IF_ZERO 24عند الموقع 14 تأخذ الكمية من المكدس، فإذا كانت صفراً تقفز إلى الموقع 24 حيث الثابت0.0، وإلا تكمل إلى القسمة. وبعد القسمة تقفزJUMP 26فوق الفرع الآخر إلىRETURN. - بكمية صفر كانت النتيجة 0.0 دون أي خطأ، لأن تعليمة القسمة لم تنفذ أبداً، وبكمية 3 كانت 113.33.
- عمق المكدس المحسوب 2 وليس 3، لأن المترجم يعرف أن الفرعين لا ينفذان معاً، وهذا هو السطر
self.depth -= 1.
وفي المترجم، المشكلة أن موقع الفرع الثاني غير معروف عند كتابة تعليمة القفز الأولى، لأن تعليمات الفرع الأول لم تكتب بعد. لذلك يكتب المترجم التعليمة بمعامل صفر مؤقتاً ويحتفظ بموقعها، ثم بعد أن يكتب الفرع الأول يعود ويضع الموقع الصحيح، والدالة patch تفعل ذلك. وهذه التقنية اسمها الترقيع اللاحق Backpatching، وتستخدمها كل المترجمات التي تكتب في مرور واحد، ومنها المجمعات Assemblers التي تقابل اسم علامة Label قبل أن تعرف موقعها.
if() كتعليمات قفز لا تصل إلى القسمة عندما تكون الكمية صفراً، أما كدالة عادية فتحسب كل معاملاتها أولاًالأداء Performance: هل صار أسرع فعلاً؟
هذا هو السؤال الذي بدأ به كل شيء، فتقرير نهاية الشهر بطيء ونريد أن يصبح أسرع. والملف bench.py ينفذ صيغة المقياس من الجزء الأول 100,000 مرة بثلاث طرق: المفسر الشجري بشجرة محفوظة، وآلتنا الافتراضية بكود مترجم مرة واحدة، وBytecode الخاص بلغة CPython. وتعلمنا من الجزء الأول أن الأرقام تتأرجح بين التشغيلات، لذلك غيرنا طريقة القياس: كل طريقة تأخذ دورها داخل كل جولة، وهناك سبع جولات، ونقيس وقت المعالج بالدالة time.process_time لا وقت الساعة، ونأخذ أفضل جولة والوسيط، والـ Container محدود بمعالج واحد بالخيار --cpus=1:
"""Tree walking (part one) vs our bytecode VM vs CPython: the same formula, 100,000 evaluations per round.
The three take turns inside every round, so a busy moment on the machine hits all of them alike."""
import statistics
import time
from calc import parse, evaluate
from vm import compile_source, execute

src = "round((price * qty - discount) * (1 + tax), 2)"
env = {"price": 120.0, "qty": 3.0, "discount": 20.0, "tax": 0.15}
N, ROUNDS = 100_000, 7

tree = parse(src)[0]
co = compile_source(src)
py = compile(src, "<formula>", "eval")
runs = {"tree walking (parse once)": lambda: evaluate(tree, env),
        "our VM (compile once)": lambda: execute(co, env),
        "CPython bytecode (compile once)": lambda: eval(py, {"round": round}, env)}
times = {k: [] for k in runs}
for _ in range(ROUNDS):
    for label, fn in runs.items():
        t = time.process_time()
        for _ in range(N):
            r = fn()
        times[label].append((time.process_time() - t) * 1e6 / N)
for label, ts in times.items():
    print(f"{label:<34} best {min(ts):5.2f}  median {statistics.median(ts):5.2f} us/call  result={r}")
وهذه ثلاث تشغيلات كما خرجت:
tree walking (parse once)          best  6.76  median  7.94 us/call  result=391.0
our VM (compile once)              best  6.03  median  7.17 us/call  result=391.0
CPython bytecode (compile once)    best  0.92  median  1.04 us/call  result=391.0
tree walking (parse once)          best  7.71  median  8.74 us/call  result=391.0
our VM (compile once)              best  6.80  median  9.26 us/call  result=391.0
CPython bytecode (compile once)    best  1.14  median  1.40 us/call  result=391.0
tree walking (parse once)          best  7.33  median  7.86 us/call  result=391.0
our VM (compile once)              best  6.63  median  7.31 us/call  result=391.0
CPython bytecode (compile once)    best  0.96  median  1.10 us/call  result=391.0
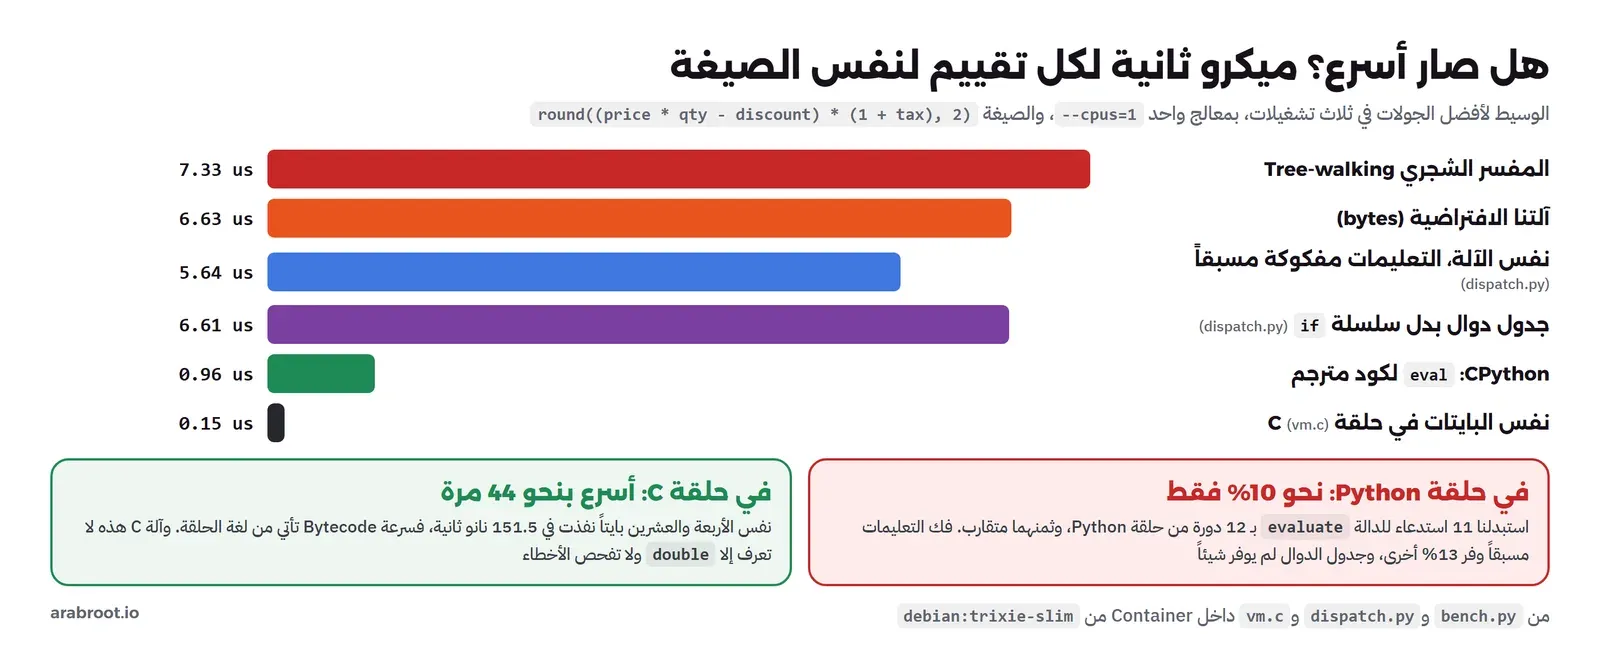
والنتيجة ليست ما توقعه فريق التقرير. فإذا أخذت الوسيط لأفضل الجولات في التشغيلات الثلاث، فالمفسر الشجري 7.33 ميكرو ثانية لكل تقييم، وآلتنا الافتراضية 6.63، أي أن كل هذا العمل جعل التنفيذ أسرع بنحو 10% فقط، بينما CPython ينفذ نفس الصيغة في 0.96 ميكرو ثانية، أي أسرع من آلتنا بنحو سبع مرات. ولاحظ أن أرقام المفسر الشجري هنا أقل من أرقام الجزء الأول، لأن الجهاز وطريقة القياس تغيرا، لذلك لا تقارن إلا الأرقام التي خرجت من نفس التشغيل.
فلماذا لم يأت Bytecode بالسرعة التي يأتي بها في CPython؟ لأن آلتنا مكتوبة بلغة Python، فكل تعليمة من تعليماتها الاثنتي عشرة تكلف عدة تعليمات Bytecode في CPython نفسه: قراءة بايتين من code، وعملية | مع ext، وزيادة pc، وسلسلة مقارنات حتى نصل إلى الفرع الصحيح، ثم استدعاء push وpop وهما استدعاءا دوال. أي أننا استبدلنا 11 استدعاء للدالة evaluate بـ 12 دورة من حلقة Python، وكلاهما ثمنه متقارب. والمكسب الحقيقي من Bytecode يأتي عندما تكون الحلقة نفسها مكتوبة بلغة تترجم إلى كود الآلة، وهذا ما سوف نختبره بعد قليل.
طريقة التوزيع Dispatch: سلسلة if أم جدول دوال؟
قبل أن نستسلم، لنسأل أين يذهب الوقت داخل آلتنا. والملف dispatch.py يقارن ثلاث نسخ من الحلقة على نفس Bytecode: (a) الآلة كما هي في vm.py، و(b) نفس الحلقة بكل تعليماتها وفحوصها، ولكن بعد أن نفك البايتات مرة واحدة إلى قائمتين، قائمة لرموز العمليات وقائمة للمعاملات، فلا يبقى في الحلقة فحص EXTENDED_ARG ولا قراءة بايتين، و(c) حلقة تستدعي لكل تعليمة دالة من قاموس بدل سلسلة if، وهي فكرة شائعة في كتب التصميم. وهذا الجزء الذي يختلف بين (a) و(b):
# (b) decode once: no EXTENDED_ARG check and no byte pairs in the hot loop
def predecode(co):
    ops, args, ext = [], [], 0
    for i in range(0, len(co.code), 2):
        op, arg = co.code[i], co.code[i + 1] | ext
        ext = arg << 8 if op == vm.EXTENDED_ARG else 0
        ops.append(op); args.append(arg)
    return ops, args
والنتائج من ثلاث تشغيلات:
(a) if chain, bytes, EXTENDED_ARG    best  6.48  median  7.02 us/call  result=391.0
(b) if chain, decoded once           best  5.73  median  6.51 us/call  result=391.0
(c) table of handler functions       best  6.61  median  7.46 us/call  result=391.0
(a) if chain, bytes, EXTENDED_ARG    best  6.24  median  6.62 us/call  result=391.0
(b) if chain, decoded once           best  5.64  median  6.11 us/call  result=391.0
(c) table of handler functions       best  6.33  median  6.95 us/call  result=391.0
(a) if chain, bytes, EXTENDED_ARG    best  6.68  median 14.79 us/call  result=391.0
(b) if chain, decoded once           best  5.58  median 11.94 us/call  result=391.0
(c) table of handler functions       best  6.71  median 15.00 us/call  result=391.0
في المخرج أعلاه لاحظ التالي:
- فك التعليمات مرة واحدة في (b) وفر نحو 13%، من 6.48 إلى 5.64 ميكرو ثانية، والسبب أن كل تعليمة كانت تدفع ثمن قراءتين من
bytesوعملية|وتصفيرext، وكلها عمل لا علاقة له بالحساب. وهذه نفس الفكرة التي يستخدمها كثير من الآلات الحقيقية: صيغة مضغوطة للحفظ، وصيغة مفكوكة للتنفيذ. - جدول الدوال في (c) لم يكن أسرع من سلسلة
if، مع أن نسخته لا تحتوي إلا تعليمات هذه الصيغة ولا تفحص الأسماء المفقودة. والسبب أن استدعاء دالة في Python أغلى من بضع مقارنات أعداد صحيحة، فوفرنا المقارنات ودفعنا ثمن الاستدعاء. - الجولة الأخيرة في التشغيل الثالث وسيطها أعلى بكثير من أفضلها، 14.79 مقابل 6.68، لأن الجهاز كان مشغولاً بعمل آخر في تلك اللحظة، وهذا سبب أننا ننظر إلى أفضل جولة وإلى الوسيط معاً، وسبب أن الطرق الثلاث تأخذ دورها داخل نفس الجولة.
وفي المفسرات المكتوبة بلغة C يختلف الحساب تماماً، فسلسلة if تصبح جملة switch يترجمها المترجم إلى جدول قفز Jump Table بتعليمة واحدة، وتوجد طريقة أسرع منها اسمها الانتقال المحسوب Computed Goto، حيث تنتهي كل تعليمة بتعليمة قفز مباشرة إلى كود التعليمة التالية، فيستطيع متنبئ التفرعات Branch Predictor في المعالج أن يتعلم أنماط كل تعليمة على حدة. ووثيقة المفسر في مستودع CPython تذكر أن CPython يبنى بأحد ثلاثة أشكال: switch تقليدي، أو Computed Goto وهو الافتراضي حيث يدعمه المترجم، أو شكل أحدث يعتمد على استدعاءات الذيل Tail Calls في Clang.
ماذا يحدث إذا كتبنا نفس الحلقة بلغة C؟
لكي نتأكد أن المشكلة في لغة الحلقة لا في فكرة Bytecode، كتبنا الملف vm.c: نفس رموز العمليات بنفس الأرقام، ونفس المكدس، ونفس سلسلة القرارات ولكن بجملة switch، ويأخذ نفس البايتات الأربعة والعشرين التي أنتجها مترجمنا كنص Hex، ثم ينفذها عشرة ملايين مرة. وهذا قلب الحلقة:
static double run(const unsigned char *code, const double *consts, double *slots) {
    double stack[64];
    int sp = 0, pc = 0;
    for (;;) {
        unsigned char op = code[pc], arg = code[pc + 1];
        pc += 2;
        switch (op) {
        case LOAD_CONST: stack[sp++] = consts[arg]; break;
        case LOAD_NAME:  stack[sp++] = slots[arg]; break;
        case STORE_NAME: slots[arg] = stack[--sp]; break;
        case BINARY_ADD: sp--; stack[sp - 1] += stack[sp]; break;
        case BINARY_SUB: sp--; stack[sp - 1] -= stack[sp]; break;
        case BINARY_MUL: sp--; stack[sp - 1] *= stack[sp]; break;
        case BINARY_DIV: sp--; stack[sp - 1] /= stack[sp]; break;
        case CALL: {                                   /* only round(x, d) is needed here */
            double d = stack[--sp], x = stack[sp - 1], m = pow(10, d);
            stack[sp - 1] = round(x * m) / m; break; }
        case RETURN: return stack[--sp];
        default: fprintf(stderr, "opcode %d not in this demo\n", op); exit(1);
        }
    }
}
والملف export_c.py يطبع Bytecode الصيغة وثوابتها، ثم نبني vm.c بالمترجم gcc من Debian داخل نفس النوع من الـ Container، والمخرج من ثلاث تشغيلات:
24 bytes of bytecode, result=391, 145.7 ns per evaluation (10000000 runs)
24 bytes of bytecode, result=391, 159.9 ns per evaluation (10000000 runs)
24 bytes of bytecode, result=391, 151.5 ns per evaluation (10000000 runs)
نفس البايتات، ونفس النتيجة 391، والوسيط 151.5 نانو ثانية، أي 0.15 ميكرو ثانية، وهذا أسرع من آلتنا المكتوبة بلغة Python بنحو 44 مرة، وأسرع من eval في CPython بنحو ست مرات. ولكن لا تقارن الرقم الأخير ببساطة، لأن آلة C هذه لا تعرف إلا الأعداد من نوع double، ولا تفحص الأسماء المفقودة ولا القسمة على صفر، ولا تنشئ كائنات، بينما CPython يتعامل في كل تعليمة مع كائنات بأنواع قد تتغير، ويدخل ويخرج من الدالة eval مع قاموسين في كل مرة. والدرس واضح: Bytecode يزيل ثمن المشي على الشجرة والتعاود، ولكن هذا المكسب لا يظهر إلا إذا كانت الحلقة التي تنفذه سريعة، وفي لغة مستضيفة مثل Python تأكل الحلقة نفسها المكسب كله تقريباً.
compile، فتحصل على حلقة CPython المكتوبة بلغة C. وBytecode الخاص بك يستحق البناء عندما تحتاج الحفظ أو النقل أو التحكم الكامل في التنفيذ، أو عندما تكتب الآلة بلغة سريعة.كيف يسرع CPython نفسه؟ التعليمات المتخصصة Specializing Interpreter
رأينا أن كل تعليمة في آلة عامة تدفع ثمن السؤال عن نوع قيمها. وCPython منذ الإصدار 3.11 يقلل هذا الثمن بطريقة ذكية وصفها PEP 659: المفسر يراقب كل تعليمة وهي تعمل، فإذا وجد أن BINARY_OP (*) في مكان معين تضرب دائماً عددين من نوع float، يستبدلها في Bytecode نفسه بتعليمة متخصصة لا تسأل عن النوع إلا فحصاً سريعاً، وإذا تغير النوع يوماً تعود إلى الشكل العام. والملف adaptive.py يعرض دالة الصيغة قبل التشغيل وبعد ألف استدعاء، بالخيار adaptive=True في dis:
before:
  4           RESUME                   0

  5           LOAD_GLOBAL              1 (round + NULL)
              LOAD_FAST_LOAD_FAST      1 (price, qty)
              BINARY_OP                5 (*)
              LOAD_FAST                2 (discount)
              BINARY_OP               10 (-)
              LOAD_CONST               1 (1)
              LOAD_FAST                3 (tax)
              BINARY_OP                0 (+)
              BINARY_OP                5 (*)
              LOAD_CONST               2 (2)
              CALL                     2
              RETURN_VALUE
after 1000 calls:
  4           RESUME_CHECK             0

  5           LOAD_GLOBAL_BUILTIN      1 (round + NULL)
              LOAD_FAST_LOAD_FAST      1 (price, qty)
              BINARY_OP_MULTIPLY_FLOAT 5 (*)
              LOAD_FAST                2 (discount)
              BINARY_OP_SUBTRACT_FLOAT 10 (-)
              LOAD_CONST               1 (1)
              LOAD_FAST                3 (tax)
              BINARY_OP                0 (+)
              BINARY_OP_MULTIPLY_FLOAT 5 (*)
              LOAD_CONST               2 (2)
              CALL_BUILTIN_FAST_WITH_KEYWORDS 2
              RETURN_VALUE
في المخرج أعلاه لاحظ التالي:
- الضرب والطرح صارا
BINARY_OP_MULTIPLY_FLOATوBINARY_OP_SUBTRACT_FLOAT، واستدعاءroundصارCALL_BUILTIN_FAST_WITH_KEYWORDS، والبحث عنroundصارLOAD_GLOBAL_BUILTINالذي يتذكر مكانها بدل أن يبحث في قاموسين. - الجمع
1 + taxبقيBINARY_OPعاماً، لأن الثابت1عدد صحيح وtaxعدد عشري، ولا توجد في هذا الإصدار تعليمة متخصصة لهذا الخليط. ولو كتبت1.0 + taxلاختلف الأمر، وهذا مثال على أن تفاصيل صغيرة في الكود تغير ما يفعله المفسر. - التعليمة
LOAD_FAST_LOAD_FASTتحمل متغيرين في تعليمة واحدة، وهذا ما يسمى التعليمة المدمجة Superinstruction، وهي حل مباشر لما رأيناه في القياس: كل تعليمة لها ثمن ثابت، فدمج تعليمتين متكررتين يوفر ثمن واحدة.
وصفحة ما الجديد في Python 3.11 تذكر أن الإصدار كان أسرع من 3.10 بنحو 1.25 مرة في المتوسط على مجموعة القياس القياسية، وأن التخصص أحد أهم أسباب ذلك. وهذا كله داخل المفسر نفسه، قبل أي JIT.
مشكلة حقيقية: صفران مختلفان Negative Zero في جدول الثوابت
عندما يكون لديك تطبيقان لنفس اللغة، المفسر الشجري والآلة الافتراضية، فلديك أداة اختبار قوية مجاناً: أعط الاثنين نفس المدخلات وقارن المخرجات، وأي فرق يعني خطأ في أحدهما. وهذا اسمه الاختبار التفاضلي Differential Testing، وهو من أهم الطرق التي تختبر بها المترجمات الحقيقية، فأداة Csmith مثلاً تولد برامج C عشوائية وتقارن مخرجات المترجمات عليها، وورقة فريقها في مؤتمر PLDI 2011 تذكر أنهم أبلغوا خلال ثلاث سنوات عن أكثر من 325 خطأ لم يكن معروفاً في مترجمات C، منها GCC وLLVM. وفي مقال أنواع الاختبارات شرحنا الاختبارات العادية، وهذا نوع لا يحتاج أن تعرف النتيجة الصحيحة مسبقاً.
والملف fuzz.py يولد صيغاً عشوائية من الأرقام والأسماء وكل العمليات والدوال، ومعها الاسم missing الذي لا قيمة له حتى نختبر الأخطاء أيضاً، ثم ينفذ كل صيغة بالطريقتين ويقارن القيمة أو نوع الخطأ وموقعه:
"""Differential testing: random formulas through the tree walker (calc.py) and the VM (vm.py); every difference is printed."""
import random
import sys
from calc import run, CalcError
from vm import compile_source, execute

NAMES = ["price", "qty", "discount", "tax", "missing"]
ENV = {"price": 120.0, "qty": 3.0, "discount": 20.0, "tax": 0.15}

def gen(rng, depth=0):
    r = rng.random()
    if depth > 4 or r < 0.3:
        return rng.choice(["0", "1", "2", "0.5", "3", "10"]) if rng.random() < 0.6 else rng.choice(NAMES)
    if r < 0.75:
        return f"({gen(rng, depth + 1)} {rng.choice('+-*/%^')} {gen(rng, depth + 1)})"
    if r < 0.85:
        return f"-{gen(rng, depth + 1)}"
    fn = rng.choice(["round", "min", "max", "abs", "sqrt"])
    n = {"round": 2, "min": 2, "max": 2, "abs": 1, "sqrt": 1}[fn]
    return f"{fn}({', '.join(gen(rng, depth + 1) for _ in range(n))})"

def outcome(fn):
    try:
        return ("value", repr(fn()))
    except CalcError as e:
        return ("error", e.kind, e.line, e.col)
    except Exception as e:                       # anything that is not a CalcError is a bug in itself
        return ("CRASH", type(e).__name__, str(e))

seed, count = int(sys.argv[1]), int(sys.argv[2])
rng = random.Random(seed)
diffs = 0
for i in range(count):
    src = gen(rng)
    a = outcome(lambda: run(src, dict(ENV)))
    b = outcome(lambda: execute(compile_source(src), dict(ENV)))
    if a != b:
        diffs += 1
        if diffs <= 6:
            print(f"#{i}: {src}\n    tree: {a}\n    vm:   {b}")
print(f"{count} formulas, {diffs} differences")
وفي أول تشغيل على 20,000 صيغة كان المخرج كما يلي:
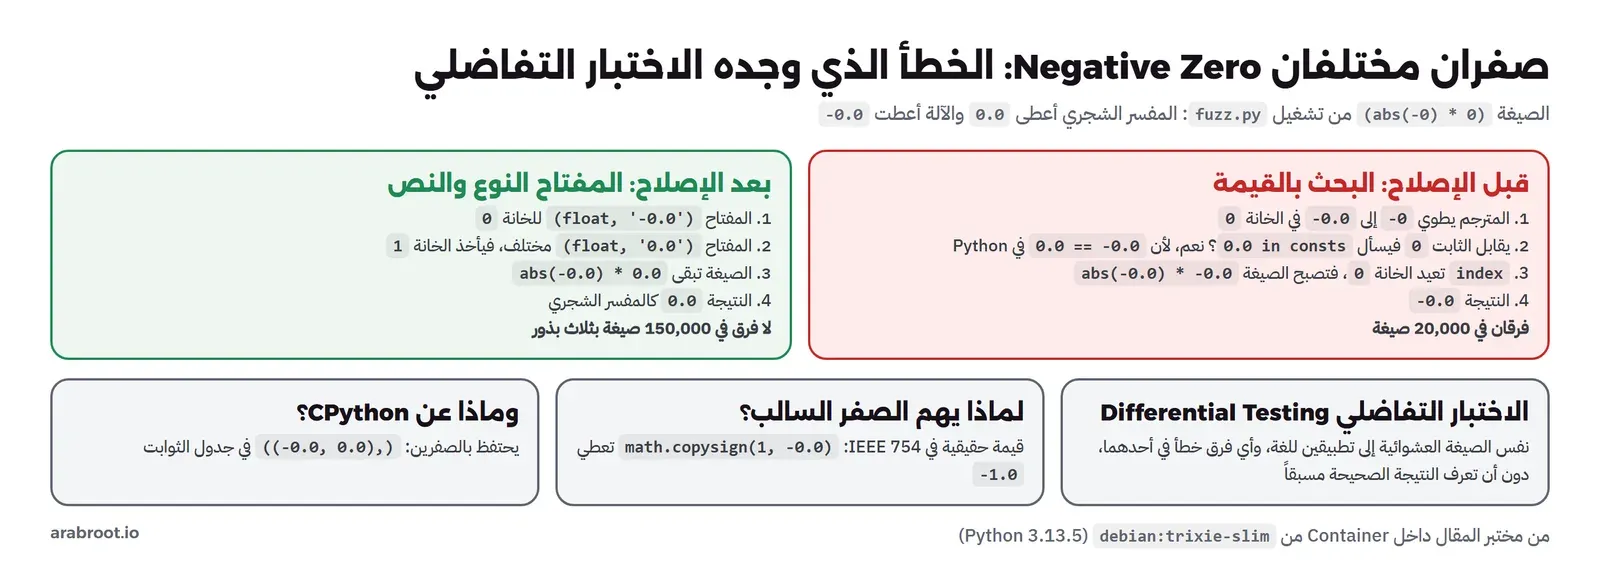
#7516: (((((10 ^ 0) ^ (10 * tax)) - 2) ^ --(10 % price)) * -0)
    tree: ('value', '-0.0')
    vm:   ('value', '0.0')
#19178: ((0 % (((2 % tax) + 3) / max((qty - 3), (qty + 0)))) * sqrt((1 * (-0 * 1))))
    tree: ('value', '-0.0')
    vm:   ('value', '0.0')
20000 formulas, 2 differences
فرقان في عشرين ألف صيغة، وكلاهما في إشارة الصفر: المفسر الشجري أعطى -0.0 والآلة أعطت 0.0. وقد تقول إن الفرق لا يهم لأن الصفر صفر، ولكن الصفر السالب قيمة حقيقية في معيار الأعداد العشرية IEEE 754، فإذا قسمت عليه عدداً موجباً في لغة تسمح بذلك تحصل على سالب ما لا نهاية بدل موجب ما لا نهاية، والدالة math.copysign تعطي -1.0 له. والأهم أن الآلة يجب أن تعطي نفس النتيجة بالضبط، وإلا فأنت لا تعرف أي فروق أخرى قد تخفيها.
ولكي نجد السبب، نبحث عن أصغر صيغة تظهر الفرق، وفي تشغيل آخر ظهرت صيغة قصيرة جداً: (abs(-0) * 0). والمترجم يطوي -0 إلى الثابت -0.0 ويضعه في جدول الثوابت، ثم يقابل الثابت 0 فيسأل هل هو موجود في الجدول؟ والدالة const كانت تستخدم value not in self.consts ثم self.consts.index(value)، وفي Python المقارنة 0.0 == -0.0 صحيحة، فأعادت خانة -0.0 للثابت 0، وصارت الصيغة abs(-0.0) * -0.0 فكانت النتيجة -0.0 بدل 0.0. وهذا تحقق سريع من Python نفسه داخل نفس الـ Container:
True 0 -0.0
-1.0
أي أن 0.0 == -0.0 صحيحة، و[0.0, -0.0].index(-0.0) تعطي 0، أي خانة الصفر الموجب. والإصلاح أن نقارن الثوابت بنوعها ونصها لا بقيمتها، وأن نستخدم قاموساً للبحث بدل index التي تمر على القائمة كلها:
    def const(self, value):
        key = (type(value), repr(value))           # 0.0 == -0.0 in Python, so compare the text, not the value
        if key not in self.const_index:
            self.const_index[key] = len(self.consts)
            self.consts.append(value)
        return self.const_index[key]
وبعد الإصلاح شغلنا الاختبار على ثلاث بذور Seeds مختلفة، كل واحدة 50,000 صيغة:
50000 formulas, 0 differences
50000 formulas, 0 differences
50000 formulas, 0 differences
ومئة وخمسون ألف صيغة دون أي فرق. وCPython يعرف هذه المشكلة منذ زمن، فمترجمه يحفظ الثوابت بمفتاح يميز النوع وإشارة الصفر، والسطر الأخير في الجزء الرابع من التجارب يبين أنه يحتفظ بالصفرين في جدول الثوابت: ((-0.0, 0.0),). والدرس هنا أكبر من الصفر: كل تحسين في المترجم، حتى إزالة ثابت مكرر، قد يغير النتيجة في حالة لم تفكر فيها، والاختبار التفاضلي يجد هذه الحالات لأنه يجرب ما لم يخطر لك.
حدود البايت الواحد Byte Limit: EXTENDED_ARG وتعليمات القفز البعيدة
المعامل بايت واحد، أي أن أكبر رقم يحمله 255، فماذا يحدث لصيغة فيها أكثر من 256 ثابتاً مختلفاً؟ قد تقول إن أحداً لن يكتب صيغة بهذا الطول، ولكن الصيغ ليست دائماً من كتابة إنسان، فقد يولدها نظام آخر من جدول أسعار فيه مئات السطور. وCPython يحل هذه المشكلة بالتعليمة EXTENDED_ARG: تعليمة لا تفعل شيئاً إلا أن تحمل البايت الأعلى للمعامل، فتضمه التعليمة التالية إلى معاملها، وتوثيق EXTENDED_ARG يشرح ذلك. ونحن نفعل نفس الشيء في emit وفي الآلة. والجزء الثالث من التجارب يبني صيغة من 300 حد مختلف:
== 3. more than 256 constants
  300 constants, 2488 bytes, result 45000.0
  tree walker: 45000.0
       2042 BINARY_MUL
       2044 BINARY_ADD
       2046 EXTENDED_ARG     1
       2048 LOAD_CONST     256 (256.5)
       2050 LOAD_NAME        0 (price)
  long if(): SyntaxError formula too long for a jump
في المخرج أعلاه لاحظ التالي:
- الصيغة ترجمت إلى 2488 بايتاً و300 ثابت، والنتيجة 45000 مطابقة للمفسر الشجري.
- عند الثابت رقم 256 كتب المترجم
EXTENDED_ARG 1ثمLOAD_CONST 256، والبايت الثاني لهذه التعليمة في الذاكرة صفر، والرقم 256 يأتي من ضم الواحد الذي حملتهEXTENDED_ARGكبايت أعلى. وهذا هو سبب الفحصextالذي رأينا ثمنه في قياس التوزيع. - السطر الأخير يبين الحد الذي لم نحله: صيغة
if()طويلة رفضت بالرسالة «formula too long for a jump»، لأن الدالةpatchتكتب موقع القفز في بايت واحد ولا تضيفEXTENDED_ARG. وحل هذا أصعب مما يبدو، لأن إضافةEXTENDED_ARGقبل تعليمة قفز تزيد طول الكود بايتين، فتتغير مواقع ما بعدها، وقد تحتاج تعليمة قفز أخرى بسببها إلىEXTENDED_ARGأيضاً. والمترجمات الحقيقية تعيد حساب المواقع حتى تستقر، وتركنا هذا الحد صريحاً برسالة واضحة بدل أن ننتج كوداً خاطئاً دون أن يشعر أحد.
حفظ الصيغ المترجمة Serialization والرقم السحري Magic Number
بقي طلب الإدارة: أن تحفظ الصيغة جاهزة للتنفيذ. والدالتان dump وload في vm.py تحفظان كائن الكود كاملاً، البايتات والثوابت والأسماء والمواقع وعمق المكدس، بعد ستة بايتات ثابتة في البداية هي الرقم السحري Magic Number:
# ---------- 5. saving compiled formulas: a header, then the parts of the code object ----------
def dump(co):
    import json
    body = json.dumps({"code": co.code.hex(), "consts": co.consts, "names": co.names,
                       "positions": co.positions, "stacksize": co.stacksize})
    return MAGIC + body.encode()


def load(blob):
    import json
    if blob[:len(MAGIC)] != MAGIC:
        raise ValueError(f"bad magic number {blob[:len(MAGIC)]!r}, expected {MAGIC!r}: recompile from the source")
    d = json.loads(blob[len(MAGIC):])
    return Code(bytes.fromhex(d["code"]), d["consts"], d["names"], [tuple(p) for p in d["positions"]], d["stacksize"])
والجزء الرابع من التجارب يحفظ صيغة الفاتورة ويعيد تحميلها، ثم يحاول تحميل صيغة حفظتها نسخة أقدم من الآلة، ثم صيغة عدلها أحدهم يدوياً:
== 4. saving compiled formulas
  header: b'CALC\x00\x02{"code' (372 bytes)
  loaded and run: 391.0
  old blob: bad magic number b'CALC\x00\x01', expected b'CALC\x00\x02': recompile from the source
  CPython .pyc magic: b'\xf3\r\r\n'
  CPython keeps both zeros: ((-0.0, 0.0),)
  tampered blob: IndexError list index out of range
في المخرج أعلاه لاحظ التالي:
- الصيغة المحفوظة 372 بايتاً، تبدأ بالبايتات
CALC\x00\x02، وأعيد تحميلها ونفذت بنفس النتيجة 391. - الصيغة التي حفظتها النسخة السابقة تبدأ بالرقم
\x01، فرفضتها الآلة برسالة تقول ماذا تفعل: أعد الترجمة من النص. والسبب أن أرقام التعليمات قد تتغير بين نسخة وأخرى، فلو أضفنا تعليمة في وسط القائمةOPSلتغيرت أرقام كل ما بعدها، وصارتBINARY_MULالقديمة تعني شيئاً آخر تماماً. لذلك يجب أن تغير الرقم السحري مع كل تغيير في مجموعة التعليمات، وأن تحفظ النص الأصلي للصيغة دائماً بجانب Bytecode حتى تستطيع إعادة ترجمته. - CPython يفعل نفس الشيء، فكل ملف
.pycيبدأ برقم سحري يتغير مع كل إصدار يغير Bytecode، وقيمته في Python 3.13 هيb'\xf3\r\r\n'كما تعطيهاimportlib.util.MAGIC_NUMBERفي توثيق importlib، ولهذا يعيد Python ترجمة ملفاتك عندما ترقي الإصدار. - الصيغة المعدلة يدوياً تحمل التعليمة
LOAD_CONST 200مع ثابت واحد فقط، فسقطت الآلة بخطأIndexErrorمن Python لا بخطأ من لغتنا. والسبب أن الآلة تثق بأن Bytecode جاء من مترجمها، فلا تفحص حدود الجداول ولا عمق المكدس في كل تعليمة، وهذا الفحص هو بالضبط ما وفرناه بحساب العمق مسبقاً.
.pyc أو بيانات marshal، والسبب أن الآلة الافتراضية تفترض أن التعليمات صحيحة، ففي آلة مكتوبة بلغة C تصبح التعليمة LOAD_CONST 200 قراءة خارج حدود الذاكرة. وتوثيق marshal يقول صراحة إنه غير مصمم للأمان أمام بيانات خاطئة أو خبيثة. والحل الأنسب أن يبقى النص الأصلي هو المصدر الموثوق، وأن تعيد الترجمة عند الشك، أو أن تتحقق من Bytecode قبل تنفيذه كما يفعل محقق JVM Bytecode Verifier قبل تحميل أي كلاس.أين تجد هذه الأفكار في الآلات الحقيقية Real VMs؟
كل ما بنيناه في نحو 280 سطراً موجود بشكل أكبر في الآلات التي تستخدمها كل يوم، وبعد هذا المقال تستطيع أن تقرأ مخرجاتها:
- CPython: Bytecode بتعليمات من بايتين، وكائن كود فيه الثوابت والأسماء والمواقع وعمق المكدس، ورقم سحري في ملفات
.pyc، وتخصص أثناء التشغيل، ومفككdisفي المكتبة القياسية، وهذا ما رأيناه كله في المخرجات أعلاه. - JVM: آلة مكدس بمكدس معاملات لكل إطار، والمترجم
javacيحسبmax_stackلكل دالة كما حسبناstacksize، والأداةjavap -cتفكك ملفات.class، ومحقق Bytecode يرفض الكود الذي لا يحترم القواعد قبل التشغيل، ثم يأتي ال JIT فيترجم الدوال الساخنة. - Lua: آلة مسجلات منذ 5.0، وتعليمات بحجم 32 بت تحمل أرقام المسجلات داخلها، والأداة
luac -lتعرضها. - WebAssembly: آلة مكدس أيضاً، ولكنها صممت لتترجم إلى كود الآلة لا لتفسر، لذلك قواعدها تجعل عمق المكدس ونوع كل قيمة معروفين عند التحقق، كما رأينا في مقال المترجم والمفسر و JIT.
- كتاب Crafting Interpreters لمؤلفه Robert Nystrom يبني في جزئه الثاني آلة مكدس كاملة بلغة C للغة صغيرة، وهو الخطوة الطبيعية إذا أردت أن تذهب أبعد من هذا المقال.
متى تحتاج Bytecode؟ جدول قرار Decision Table
| الحالة | الأنسب | والسبب |
|---|---|---|
| لغة صغيرة داخل Python، والمطلوب السرعة فقط | توليد نص Python آمن من الشجرة ثم compile | آلتنا بلغة Python كانت أسرع من الشجرة بنحو 10% فقط، وCPython أسرع منها بسبع مرات |
| تحتاج حفظ الصيغ المترجمة أو نقلها بين خدمات | Bytecode مع رقم سحري ونص أصلي محفوظ بجانبه | بايتات مسطحة تحفظ في عمود، وتعاد ترجمتها عند تغير الإصدار |
| تحتاج تحكماً في التنفيذ: حد للخطوات أو إيقاف أو تتبع | آلة افتراضية بحلقة واحدة | عداد في الحلقة يوقف أي صيغة تتجاوز حداً، وهذا صعب في المشي التعاودي |
| تكتب المفسر بلغة تترجم إلى كود الآلة (C أو Rust أو Go) | Bytecode وآلة مكدس | نفس البايتات نفذت في 0.15 ميكرو ثانية بحلقة C، أي أسرع بنحو 44 مرة |
| صيغ قليلة تنفذ مرات قليلة | المفسر الشجري من الجزء الأول | أبسط في الكود والاختبار، والفرق في الوقت لا يظهر |
أخطاء شائعة Common Mistakes عند بناء آلة افتراضية VM
- عكس ترتيب المعاملات عند أخذها من المكدس: الطرف الأيمن في الأعلى، فخذ
bقبلa، وإلا فسدت كل عمليات الطرح والقسمة والأس. - مقارنة الثوابت بالقيمة عند إزالة التكرار:
0.0 == -0.0في Python، فدمج المترجم صفرين مختلفين وغير النتيجة في صيغتين من عشرين ألفاً. - افتراض أن Bytecode أسرع دائماً: في حلقة مكتوبة بلغة Python كان المكسب نحو 10% فقط، فقس قبل أن تبني.
- تنفيذ
ifكدالة عادية: المعاملات تحسب كلها قبل الدالة، فسقطت القسمة على صفر التي أردنا تجنبها. - إهمال جدول المواقع: بعد الترجمة لا توجد شجرة، وبدون
positionsتصبح رسائل الخطأ بلا سطر ولا عمود. - تغيير أرقام التعليمات دون تغيير الرقم السحري: Bytecode المحفوظ يتغير معناه بصمت.
- تحميل Bytecode من مصدر غير موثوق: تعليمة واحدة معدلة أسقطت الآلة بخطأ من اللغة المستضيفة.
- نسيان حدود المعامل: بعد 256 ثابتاً يحتاج المترجم
EXTENDED_ARG، وتعليمات القفز البعيدة تحتاج إعادة حساب المواقع. - طي العمليات التي قد ترفع أخطاء وقت الترجمة:
1 / 0في فرع لا ينفذ أبداً يجب ألا يرفض الصيغة.
قائمة تحقق Checklist قبل أن تنقل لغتك إلى Bytecode
- القياس قبل وبعد، على نفس الجهاز وفي نفس التشغيل، بأفضل جولة ووسيط.
- عمق المكدس محسوب عند الترجمة ومحفوظ مع الكود.
- جدول المواقع يغطي كل تعليمة، ورسائل الخطأ مطابقة لرسائل المفسر الشجري.
- اختبار تفاضلي بين المفسر الشجري والآلة على عشرات الآلاف من الصيغ العشوائية، بأكثر من بذرة.
- الثوابت تقارن بنوعها ونصها، والطي لا يشمل العمليات التي ترفع أخطاء.
EXTENDED_ARGللمعاملات الكبيرة، وحد واضح برسالة واضحة لما لا تدعمه بعد.- رقم سحري يتغير مع كل تغيير في التعليمات، والنص الأصلي محفوظ بجانب Bytecode.
- Bytecode لا يحمل إلا من مترجمك، أو يمر بمحقق قبل التنفيذ.
تدريب عملي Practice
- أضف إلى الآلة عداداً للتعليمات المنفذة، وارفع
CalcErrorإذا تجاوز حداً تختاره، ثم فكر لماذا لا تحتاجه لغتنا الحالية التي لا توجد فيها حلقات، ومتى سوف تحتاجه. - أصلح حد تعليمات القفز البعيدة: اجعل
patchتكتبEXTENDED_ARGعند الحاجة، وأعد الحساب حتى تستقر المواقع، وتأكد بالاختبار التفاضلي أن النتائج لم تتغير. - أضف تعليمة مدمجة
LOAD_NAME_LOAD_NAMEمثلLOAD_FAST_LOAD_FASTفي CPython، وقس الفرق فيdispatch.py.
حذف المختبر Cleanup
كل التشغيلات استخدمت --rm، فلا يبقى أي Container بعدها، وبقي فقط الـ Image التي بنيتها:
docker rmi scc1-vm
rm -rf lab/__pycache__
الخلاصة
وصلنا لنهاية الجزء الثاني، وأهم ما فيه:
- Bytecode لغة آلة لمعالج افتراضي، والمترجم يكتبه بمرور لاحق على الشجرة، والآلة الافتراضية حلقة واحدة تقرأ بايتين وتنفذ.
- آلة المكدس أبسط في المترجم وأطول في التعليمات، وآلة المسجلات عكسها، وCPython وJVM وWebAssembly اختارت المكدس، وLua وDalvik اختارتا المسجلات.
- كائن الكود يحمل أكثر من التعليمات: جدول الثوابت، وجدول الأسماء، وجدول المواقع الذي يحفظ رسائل الخطأ، وعمق المكدس المحسوب مسبقاً.
if()لا تكون دالة في لغة تقيم معاملاتها مبكراً، وتعليمات القفز مع الترقيع اللاحق تجعل فرعاً واحداً فقط ينفذ.- آلتنا المكتوبة بلغة Python كانت أسرع من المفسر الشجري بنحو 10% فقط، ونفس البايتات في حلقة C كانت أسرع منها بنحو 44 مرة، فسرعة Bytecode تأتي من لغة الحلقة، ثم من التخصص والتعليمات المدمجة كما في CPython 3.11.
- الاختبار التفاضلي وجد خطأً لم يكن ليظهر في اختبار عادي: الصفر السالب في جدول الثوابت.
- Bytecode المحفوظ يحتاج رقماً سحرياً ونصاً أصلياً بجانبه، ولا يحمل من مصدر غير موثوق.
وفي المقال التالي من هذه المرحلة بإذن الله ننتقل من مترجمنا الصغير إلى مترجم حقيقي، ونفتح GCC وClang لنرى بأعيننا التمثيل الوسيط IR والتحسينات التي رأينا منها هنا طي الثوابت فقط.
 دليلابن مفسراً صغيراً Interpreter بيدك: من النص إلى ASTنبني بلغة Python لغة صيغ صغيرة لحقل في نظام فواتير، من المحلل اللغوي إلى شجرة AST والتنفيذ ورسائل الخطأ، ونرى لماذا لا تصلح eval لهذا العمل.
 دليلالمترجم Compiler والمفسر Interpreter و JIT و WebAssemblyنشغل دالة واحدة بلغة C وPython وJavaScript وWebAssembly على نفس الجهاز، ونفتح ما كتبه كل مترجم لنعرف لماذا اختلف الوقت من ثلث ثانية إلى دقيقة.
 دليلكيف يعمل المعالج CPU من الداخل ولماذا يهمك ذلكنتابع تعليمة واحدة داخل نواة المعالج، ونرى لماذا يصبح نفس الكود أبطأ بعشر مرات عندما تغير ترتيب المرور على البيانات.
 دليلFloating Point من الداخل: كيف يخزن الحاسب الكسوركيف يحفظ معيار IEEE 754 الكسور في البتات، ولماذا تكبر الفجوة بين الأرقام وتضيع خانات المعرفات، ومتى تحتاج النوع العشري.
 دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
 دليلاللغة شيء والمترجم شيء آخر: من يقرر مستقبل لغات البرمجة؟لماذا لا تصح جمل مثل «Python بطيئة»، وما الفرق بين مواصفة اللغة والبرامج التي تطبقها، ومن يقرر مستقبلها.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ كل التجارب داخل Container من الـ Image الرسمية
debian:trixie-slim(Debian 13.7) مع Python 3.13.5 وGCC 14.2.0 من حزم Debian، على Docker Engine 29.8.0، والملفcalc.pyمنسوخ من الجزء الأول دون تعديل.