


لنفرض أنك تعمل على نظام فواتير، وجاءك طلب من فريق المبيعات: «نريد أن نكتب قواعد الخصم والضريبة بأنفسنا، دون أن ننتظر المبرمجين ونشر إصدار جديد كل مرة». فاليوم الخصم 20 ريالاً على كل فاتورة، وغداً 5% على الكميات فوق عشرة، وبعد شهر الأكبر بين الاثنين، ويريدون حقلاً في لوحة الإدارة يكتبون فيه شيئاً مثل price * qty - discount ويحفظونه، ويحسب النظام النتيجة لكل فاتورة. والطلب يبدو صغيراً، ولكنك حين تفكر فيه تكتشف أنك مطالب ببناء لغة برمجة صغيرة: نص يكتبه إنسان، يجب أن يفهمه البرنامج، ويرفض الخطأ فيه برسالة واضحة، وينفذه بأمان على بيانات حقيقية.
وهذا بالضبط ما يقوم به كل مفسر Interpreter تستخدمه كل يوم، من Python إلى محرك JavaScript في المتصفح إلى صيغ Excel، والفرق في الحجم لا في الفكرة. وفي مقال ماذا يحدث عندما تشغل برنامج Hello World؟ رأينا أن CPython يحول الكود إلى Bytecode ثم ينفذه، وفي مقال أنماط البرمجة وأنظمة الأنواع رأينا أن اللغة تكتشف بعض الأخطاء قبل التشغيل وبعضها أثناءه. وهنا سوف نبني بأيدينا لغة الصيغ التي طلبها فريق المبيعات، في ملف Python واحد دون أي مكتبة خارجية، ونمر بكل مرحلة يمر بها أي مفسر حقيقي، ونشغل كل سطر ونقرأ مخرجه.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا نستخدم
eval، ولماذا لا يكفي التقسيم Split أو التعبيرات النمطية Regex، مع تجربة تشغل أوامر نظام من حقل صيغة. - مراحل أي مفسر: المحلل اللغوي Lexer، والمحلل النحوي Parser، وشجرة AST، والمنفذ Evaluator، ومقارنتها بما يفعله CPython نفسه.
- المحلل اللغوي كآلة حالات State Machine تقرأ حرفاً حرفاً.
- القواعد Grammar والأولويات Precedence والربط Associativity، والمحلل النحوي بالنزول التعاودي Recursive Descent.
- المنفذ الذي يمشي على الشجرة Tree-walking، ورسائل الخطأ بالسطر والعمود.
- ثلاث مشكلات حقيقية ظهرت في التجربة: الأقواس العميقة، والأس الكبير، والأس الكسري لعدد سالب، وكيف أصلحناها.
- كم يكلف المفسر الشجري مقارنة بالمفسر الحقيقي، ومتى تبني لغتك ومتى تستخدم لغة جاهزة.
لماذا تحتاج لغة صغيرة؟ حقل الصيغ Formula Field
قبل أن نبني أي شيء، لنمر على الحلول التي سوف تخطر في بالك أولاً، لأن كل واحد منها يفشل بطريقة تعلمك شيئاً عما يحتاجه الحل الصحيح.
الحل البسيط: الدالة eval
في Python ستجد الدالة eval التي تأخذ نصاً وتنفذه كتعبير Python، وأول ما يخطر في البال أن تكتب eval(formula, {"price": 120}) وينتهي الأمر. والمشكلة أن eval لا تنفذ الصيغ فقط، وإنما تنفذ أي كود Python، وهذا ما جربناه بالملف eval_danger.py:
"""Why not eval(): the formula field gets a 'formula' that is really Python code."""
formula = "__import__('os').popen('id; cat /etc/hostname').read()"
print("eval :", eval(formula, {"price": 120}))
print("eval with empty __builtins__ :", end=" ")
try:
    print(eval(formula, {"__builtins__": {}, "price": 120}))
except Exception as e:
    print(type(e).__name__, e)
escape = "[c for c in ().__class__.__base__.__subclasses__() if c.__name__ == 'catch_warnings'][0]()._module.__builtins__['__import__']('os').popen('id').read()"
print("escape with empty __builtins__ :", eval(escape, {"__builtins__": {}}))

from calc import run, CalcError
try:
    run(formula, {"price": 120})
except CalcError as e:
    print("calc :", e.show(formula))
وكل التجارب في هذا المقال تعمل داخل Container من الـ Image الرسمية python:3.13-slim بالأمر docker run --rm -v "$PWD":/lab -w /lab python:3.13.17-slim python3 eval_danger.py، والمخرج سوف يكون كما يلي:
eval : uid=0(root) gid=0(root) groups=0(root)
60d5308004a5

eval with empty __builtins__ : NameError name '__import__' is not defined
escape with empty __builtins__ : uid=0(root) gid=0(root) groups=0(root)

calc : SyntaxError at line 1, column 12: unexpected character "'"
    __import__('os').popen('id; cat /etc/hostname').read()
               ^
في المخرج أعلاه لاحظ التالي:
- السطر الأول: «الصيغة» شغلت الأمر
idوقرأت اسم الجهاز، والمستخدمrootداخل الـ Container. ولو كان هذا سيرفر الفواتير، فأي شخص له صلاحية تعديل الصيغ صار يملك السيرفر كله، يقرأ ملف.envوأسرار قاعدة البيانات ويشغل ما يريد. وهذا من نوع الحقن Injection في قائمة OWASP Top 10، وشرحنا القائمة في مقال OWASP Top 10 للمبتدئين. - الحل الذي يقترحه كثيرون هو تفريغ
__builtins__حتى لا تجد الصيغة دالة__import__، وقد نجح فعلاً في رفض الصيغة الأولى. - ولكن السطر الثالث يبين أن صيغة أطول وصلت إلى
osمن جديد، فقد صعدت من كائن فارغ()إلى الكلاس الأساسيobject، ثم بحثت بين كل الكلاسات المحملة في الذاكرة عن كلاس يحمل مرجعاً إلى الوحدةbuiltins، ومنها وصلت إلى__import__. وهذا هو السبب أن توثيق Python نفسه يحذر من تمرير نص غير موثوق إلىeval، فلا توجد طريقة موثوقة لعزله من داخل اللغة. - والسطر الأخير هو اللغة التي سوف نبنيها: رفضت نفس النص عند أول علامة اقتباس، لأن قواعدها لا تعرف شيئاً اسمه نص، فضلاً عن الاستيراد والوصول إلى خصائص الكائنات.
الحل الثاني: التقسيم Split والتعبيرات النمطية Regex
بعد أن تستبعد eval، قد تفكر في أن تقسم الصيغة على المسافات وتحسب من اليسار إلى اليمين، أو أن تكتب تعبيراً نمطياً يلتقط الأرقام والعمليات كما شرحنا في مقال التعبيرات النمطية Regex للمبتدئين. والتعبير النمطي أداة ممتازة لتقطيع النص إلى رموز، وسوف نستخدم الفكرة نفسها في المحلل اللغوي، ولكنه لا يستطيع وحده أن يفهم بنية متداخلة مثل الأقواس داخل الأقواس، ولا أن يعرف أن الضرب يحسب قبل الجمع. والملف naive.py يحسب من اليسار إلى اليمين دون أي أولويات:
"""What happens if the parser ignores precedence: read left to right, one operator after another."""
from calc import tokenize, run

def left_to_right(source):
    tokens = [t for t in tokenize(source) if t.kind != "EOF"]
    value = float(tokens[0].text)
    for op, num in zip(tokens[1::2], tokens[2::2]):
        b = float(num.text)
        value = {"+": value + b, "-": value - b, "*": value * b, "/": value / b}[op.text]
    return value

for f in ["1 + 2 * 3", "10 - 4 - 3", "100 - 20 * 1.15"]:
    print(f"{f:<16} left-to-right = {left_to_right(f):<8g} calc = {run(f):g}")
1 + 2 * 3 left-to-right = 9 calc = 7
10 - 4 - 3 left-to-right = 3 calc = 3
100 - 20 * 1.15 left-to-right = 92 calc = 77السطر الثاني صحيح بالصدفة، لأن الطرح يربط من اليسار فعلاً، أما الأول والثالث فخاطئان. والسطر الثالث هو ما يهم فريق المبيعات: فاتورة بمئة ريال وخصم 20 مع الضريبة، والحساب البسيط أعطى 92 بدل 77، أي أن العميل دفع 15 ريالاً زيادة دون أن يظهر أي خطأ. والأخطاء الصامتة في الحسابات المالية أسوأ بكثير من الأخطاء التي توقف البرنامج، لأنها تكتشف بعد أشهر في مراجعة الحسابات. لذلك الحل الصحيح هو أن نبني ما يفهم بنية الصيغة فعلاً، وهذا هو المفسر.
مراحل المفسر Interpreter Pipeline: أربع محطات
كل مفسر، صغيراً كان أو كبيراً، يمر بنفس المراحل الأربع، والصورة التالية تتبع الصيغة price * (1 + tax) - 5 من النص إلى الرقم:
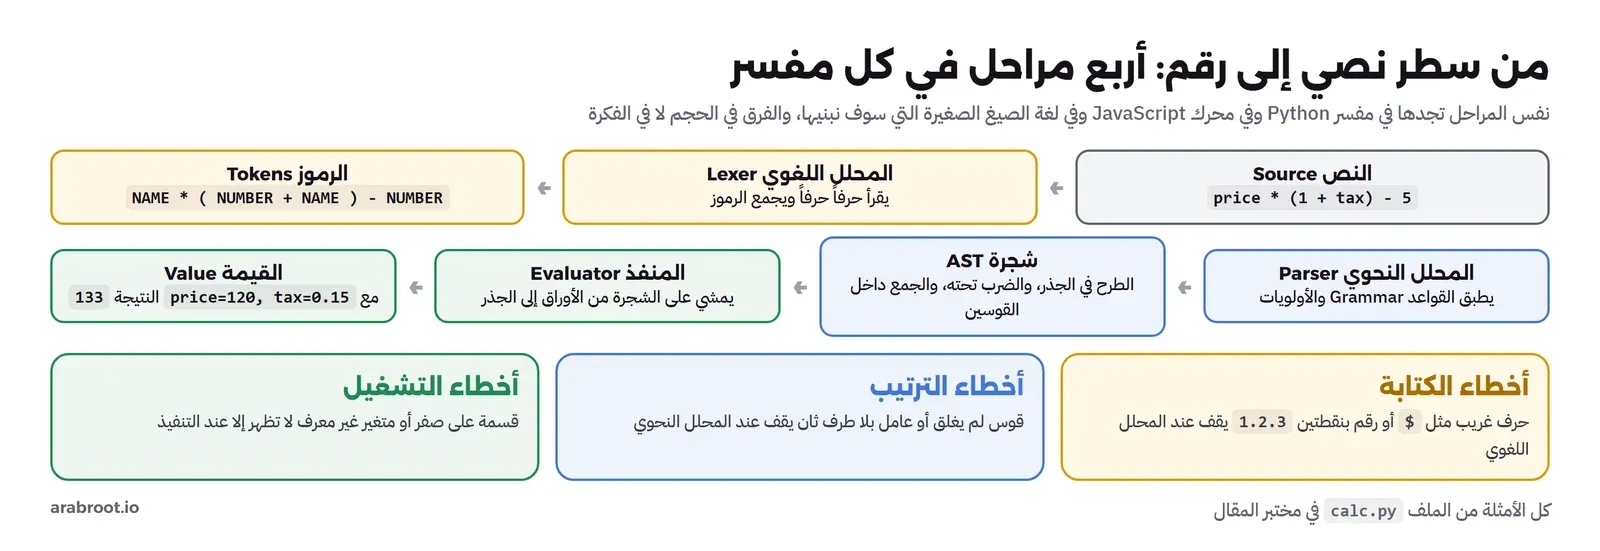
- المحلل اللغوي Lexer، ويسمى أيضاً Tokenizer أو Scanner: يقرأ الحروف ويجمعها في رموز Tokens لها معنى، فالحروف
p r i c eتصبح رمزاً واحداً نوعه اسم، والحرفان1 2رمزاً نوعه رقم، ويتجاهل المسافات والتعليقات. - المحلل النحوي Parser: يأخذ سلسلة الرموز ويتأكد أنها مرتبة حسب قواعد اللغة Grammar، ويبني منها شجرة.
- شجرة البناء المجرد Abstract Syntax Tree، واختصاراً AST: تمثيل للصيغة يحفظ معناها لا شكلها، فالأقواس والمسافات تختفي، والترتيب الصحيح للعمليات يصبح شكل الشجرة نفسه.
- المنفذ Evaluator: يمشي على الشجرة ويحسب كل عقدة من أبنائها حتى يصل إلى الجذر.
وقد يتساءل البعض: هل يفعل CPython نفس الشيء فعلاً؟ والإجابة نعم، ويمكنك أن ترى كل مرحلة فيه بوحدات من مكتبته القياسية: tokenize للمحلل اللغوي، وast للشجرة، وdis لل Bytecode. والملف python_side.py يمرر نفس الصيغة على الثلاثة:
"""How CPython itself handles the same formula: tokens, AST, bytecode."""
import ast, dis, io, tokenize
src = "price * (1 + tax) - 5"
print("tokens:")
for t in tokenize.generate_tokens(io.StringIO(src).readline):
    if t.type not in (tokenize.NEWLINE, tokenize.ENDMARKER):
        print(f"  {tokenize.tok_name[t.type]:<6} {t.string!r}")
print("ast:")
print(ast.dump(ast.parse(src, mode="eval").body, indent=2))
print("bytecode:")
dis.dis(compile(src, "<formula>", "eval"))
tokens:
NAME 'price'
OP '*'
OP '('
NUMBER '1'
OP '+'
NAME 'tax'
OP ')'
OP '-'
NUMBER '5'
ast:
BinOp(
left=BinOp(
left=Name(id='price', ctx=Load()),
op=Mult(),
right=BinOp(
left=Constant(value=1),
op=Add(),
right=Name(id='tax', ctx=Load()))),
op=Sub(),
right=Constant(value=5))
bytecode:
0 RESUME 0
1 LOAD_NAME 0 (price)
LOAD_CONST 0 (1)
LOAD_NAME 1 (tax)
BINARY_OP 0 (+)
BINARY_OP 5 (*)
LOAD_CONST 1 (5)
BINARY_OP 10 (-)
RETURN_VALUEاحتفظ بهذا المخرج أمامك، لأن اللغة التي سوف نبنيها سوف تخرج رموزاً وشجرة بنفس الشكل تقريباً. والفرق الوحيد أن CPython يضيف مرحلة خامسة: يحول الشجرة إلى تعليمات Bytecode مسطحة، ولاحظ ترتيبها: تحميل price ثم 1 ثم tax، ثم الجمع، ثم الضرب، ثم الطرح، أي نفس ترتيب المشي على الشجرة من الأوراق إلى الجذر، مكتوباً مرة واحدة كقائمة. أما نحن فسوف ننفذ الشجرة مباشرة، وهذا ما يسمى المفسر الشجري Tree-walking Interpreter، وهو أبسط أنواع المفسرات وأوضحها للتعلم، وسوف نقيس في النهاية كم يكلفنا هذا الاختيار.
والملف كله اسمه calc.py، ونبدأ بالجزء الذي يحمل الأخطاء، لأن كل مرحلة تحتاجه:
"""calc: a tiny formula language in one file (lexer, parser, AST, tree-walking evaluator).

    let tax = 0.15
    let total = price * (1 + tax) - discount
    round(total, 2)
"""
import math
import sys
from dataclasses import dataclass


# ---------- errors with a position ----------
class CalcError(Exception):
    def __init__(self, kind, message, line, col):
        super().__init__(message)
        self.kind, self.message, self.line, self.col = kind, message, line, col

    def show(self, source):
        lines = source.splitlines()
        text = lines[self.line - 1] if self.line <= len(lines) else ""
        return (f"{self.kind} at line {self.line}, column {self.col}: {self.message}\n"
                f"    {text}\n    {' ' * (self.col - 1)}^")
كل خطأ في اللغة يحمل نوعه ورسالته ورقم السطر والعمود، والدالة show تطبع السطر الذي فيه الخطأ وتضع تحته سهماً عند العمود بالضبط، وسوف ترى هذا الشكل في كل رسائل الخطأ بعد قليل.
المحلل اللغوي Lexer: من الحروف إلى الرموز Tokens
المحلل اللغوي يقرأ النص حرفاً حرفاً من اليسار إلى اليمين، ويقرر عند كل حرف: هل يبدأ رمزاً جديداً، أم يكمل الرمز الحالي، أم ينهيه. وأوضح طريقة لكتابة هذا القرار هي آلة الحالات State Machine، أو آلة الحالات المنتهية Finite State Machine: في كل لحظة يكون المحلل في حالة واحدة من عدد محدود من الحالات، والحرف التالي وحده يحدد الحالة التي بعدها. والصورة التالية ترسم الحالات الست في محللنا:
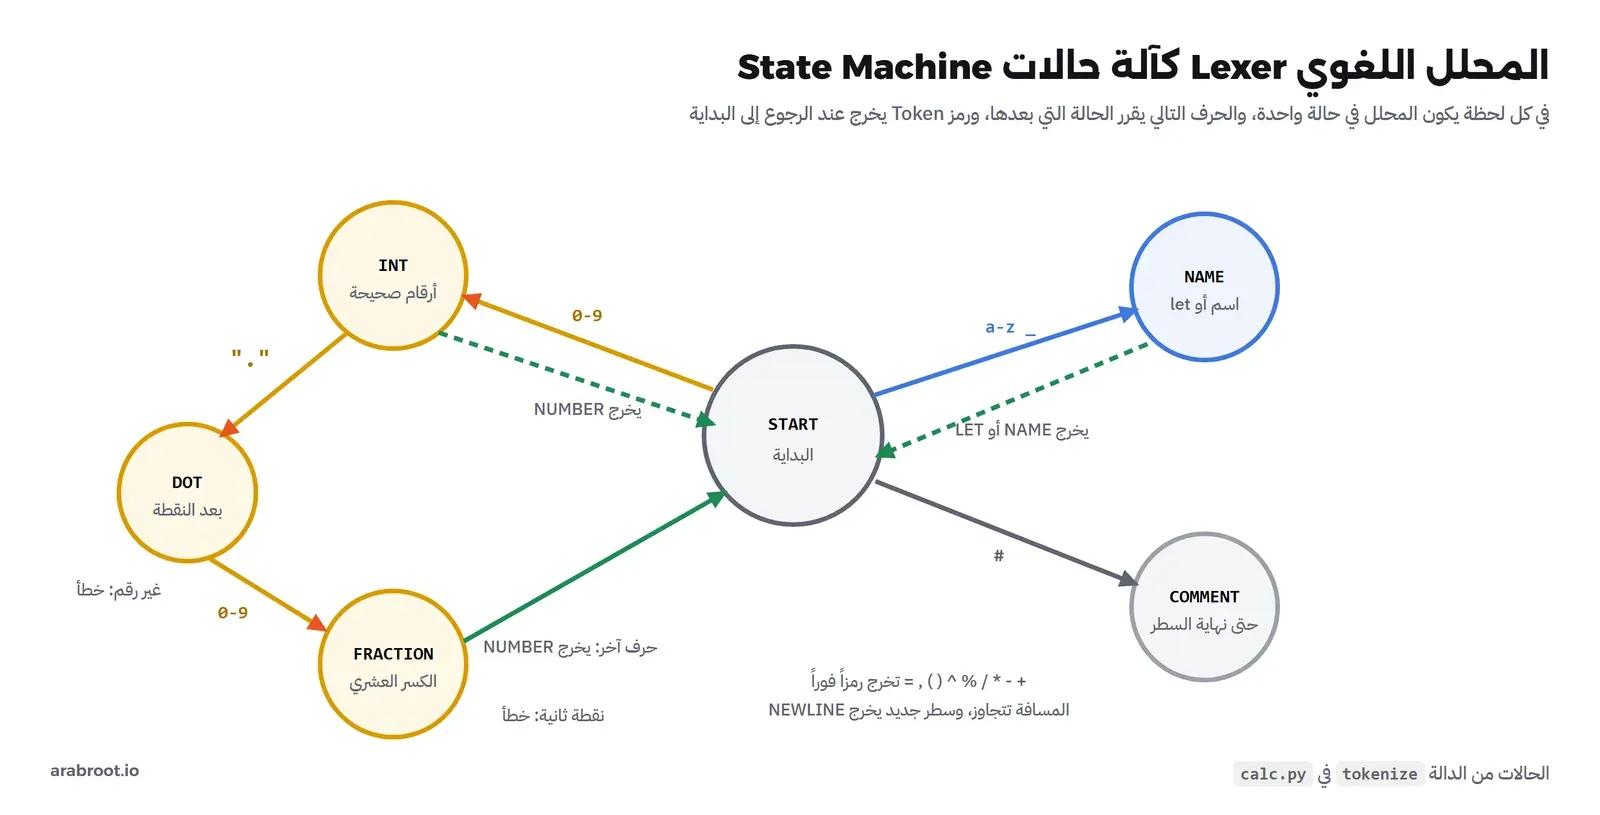
وهذا هو الكود، والحالات فيه هي نفس الحالات في الصورة:
# ---------- 1. lexer: characters -> tokens (a small state machine) ----------
@dataclass
class Token:
    kind: str      # NUMBER, NAME, OP, LET, NEWLINE, EOF
    text: str
    line: int
    col: int


OPERATORS = set("+-*/%^(),=")
KEYWORDS = {"let": "LET"}


def tokenize(source):
    tokens = []
    state = "START"
    i, line, col = 0, 1, 1
    start = start_col = 0
    while True:
        ch = source[i] if i < len(source) else ""        # "" marks the end of input
        if state == "START":
            start, start_col = i, col
            if ch == "":
                tokens.append(Token("EOF", "", line, col))
                return tokens
            if ch == "\n":
                tokens.append(Token("NEWLINE", "\\n", line, col))
                i, line, col = i + 1, line + 1, 1
                continue
            if ch in " \t\r":
                i, col = i + 1, col + 1
                continue
            if ch == "#":                                   # comment to the end of the line
                state = "COMMENT"
            elif ch.isdigit():
                state = "INT"
            elif ch == ".":
                state = "DOT"
            elif ch.isalpha() or ch == "_":
                state = "NAME"
            elif ch in OPERATORS:
                tokens.append(Token("OP", ch, line, col))
            else:
                raise CalcError("SyntaxError", f"unexpected character {ch!r}", line, col)
            i, col = i + 1, col + 1
        elif state == "COMMENT":
            if ch in ("\n", ""):
                state = "START"                             # do not consume the newline
            else:
                i, col = i + 1, col + 1
        elif state == "INT":                                # digits before the point
            if ch.isdigit():
                i, col = i + 1, col + 1
            elif ch == ".":
                state = "DOT"
                i, col = i + 1, col + 1
            else:
                tokens.append(Token("NUMBER", source[start:i], line, start_col))
                state = "START"
        elif state == "DOT":                                # just read the point: a digit must follow
            if ch.isdigit():
                state = "FRACTION"
                i, col = i + 1, col + 1
            else:
                raise CalcError("SyntaxError", "a digit must follow the decimal point", line, col)
        elif state == "FRACTION":
            if ch.isdigit():
                i, col = i + 1, col + 1
            elif ch == ".":
                raise CalcError("SyntaxError", "a number has two decimal points", line, col)
            else:
                tokens.append(Token("NUMBER", source[start:i], line, start_col))
                state = "START"
        elif state == "NAME":
            if ch.isalnum() or ch == "_":
                i, col = i + 1, col + 1
            else:
                word = source[start:i]
                tokens.append(Token(KEYWORDS.get(word, "NAME"), word, line, start_col))
                state = "START"
في الكود أعلاه لاحظ التالي:
- المتغير
stateهو الحالة الحالية، والحلقة كلهاifكبيرة على الحالة، ثم على الحرف داخلها. وهذا الشكل يجعل القاعدة الواحدة سهلة القراءة والتعديل: إذا أردت أن تسمح بالأرقام بصيغة1e5فإنك تضيف حالة جديدة وسهماً أو سهمين، دون أن تمس باقي الكود. - نهاية النص لها حرف خاص هو النص الفارغ
""، وهذا يريحنا من فحص منفصل في كل حالة، فالرقم في آخر الصيغة ينتهي بنفس الطريقة التي ينتهي بها رقم بعده مسافة. - عندما يكتمل رقم أو اسم، لا يتقدم المؤشر
i، وإنما تعود الحالة إلىSTARTويقرأ نفس الحرف مرة أخرى. فالحرف*الذي أنهى الاسمpriceهو نفسه بداية الرمز التالي، وهذا خطأ شائع عند كتابة أول محلل: أن تستهلك الحرف الذي أنهى الرمز فيضيع. - الحالة
DOTموجودة لسبب واحد: أن تكون الرسالة دقيقة. فالنص3.دون رقم بعد النقطة يعطي «a digit must follow the decimal point»، والنص1.2.3يعطي «a number has two decimal points» عند النقطة الثانية بالضبط. - الكلمة
letتمر بنفس حالة الأسماء، ثم يفحص القاموسKEYWORDSهل هي كلمة محجوزة، وهكذا تفعل أغلب اللغات، لأن الكلمات المحجوزة في شكلها أسماء عادية. - كل رمز يحمل السطر والعمود الذي بدأ فيه، وهذه المعلومة الصغيرة هي التي تجعل رسالة الخطأ تشير إلى المكان الصحيح بعد مرحلتين.
وقد يتساءل البعض: لماذا لم نكتب المحلل كله بتعبير نمطي واحد؟ وهذا ممكن، وكثير من المحللات الصغيرة تفعل ذلك بنمط فيه بديل لكل نوع من الرموز، ووحدة tokenize في Python نفسها كانت مبنية على تعابير نمطية لسنوات. ولكن آلة الحالات تعطيك تحكماً كاملاً في رسائل الخطأ وفي الحالات الخاصة، وتعلمك ما يفعله محرك التعبيرات النمطية من الداخل، فالتعبير النمطي نفسه يتحول داخل المحرك إلى آلة حالات من هذا النوع. والأداة show.py تطبع الرموز والشجرة لأي صيغة:
python3 show.py "price * (1 + tax) - 5"tokens:
NAME 'price' col 1
OP '*' col 7
OP '(' col 9
NUMBER '1' col 10
OP '+' col 12
NAME 'tax' col 14
OP ')' col 17
OP '-' col 19
NUMBER '5' col 21
EOF '' col 22
ast:
Binary -
Binary *
Var price
Binary +
Num 1
Var tax
Num 5قارن الرموز بمخرج tokenize في CPython قبل قليل، وستجد نفس الأنواع بنفس الترتيب: NAME وOP وNUMBER. والفرق أن محللنا يضيف رمز النهاية EOF ويحمل عمود كل رمز، والعمود هو موقع الحرف الأول، فالرمز tax يبدأ في العمود 14.
القواعد Grammar والأولويات Precedence
الرموز وحدها لا تقول شيئاً عن البنية، فالسلسلة 1 + 2 * 3 يمكن أن تقرأ (1 + 2) * 3 أو 1 + (2 * 3)، ونحن نعرف أن الثانية هي الصحيحة لأننا تعلمنا في المدرسة أن الضرب قبل الجمع. والمحلل النحوي يحتاج أن يعرف هذا بشكل صريح، والطريقة المعتادة لكتابته هي القواعد Grammar بصيغة قريبة من صيغة BNF، وهي نفس الصيغة التي تجدها في قواعد Python الكاملة في توثيقها. وهذه قواعد لغتنا، مكتوبة كتعليق في رأس المحلل:
#   program    := statement (NEWLINE statement)* EOF
#   statement  := "let" NAME "=" expression | expression
#   expression := term (("+" | "-") term)*
#   term       := unary (("*" | "/" | "%") unary)*
#   unary      := "-" unary | power
#   power      := primary ("^" unary)?          (right associative: 2^3^2 = 2^9)
#   primary    := NUMBER | NAME | NAME "(" args ")" | "(" expression ")"
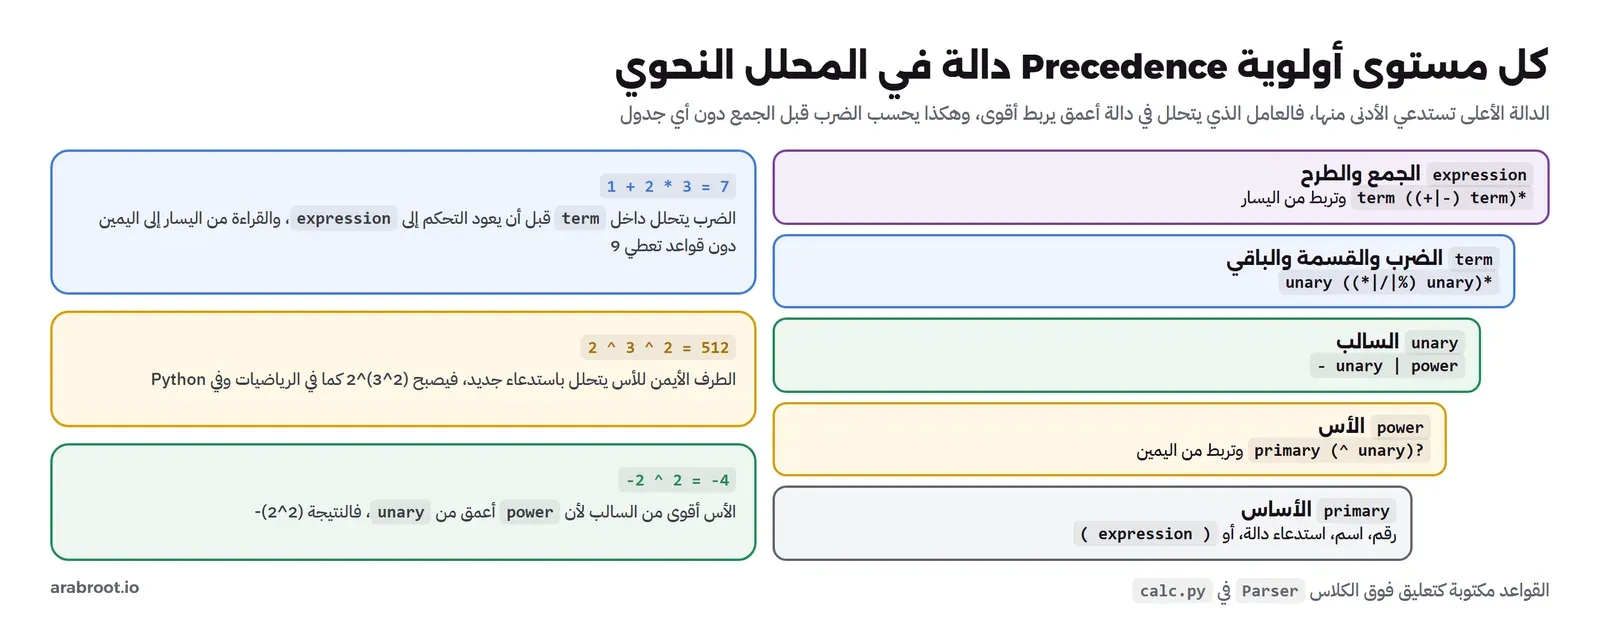
اقرأ كل سطر كتعريف: التعبير expression هو حد term يتبعه صفر أو أكثر من «زائد أو ناقص ثم حد»، والحد هو عامل أحادي unary يتبعه صفر أو أكثر من «ضرب أو قسمة أو باقي ثم عامل»، وهكذا حتى نصل إلى الأساس primary وهو رقم أو اسم أو استدعاء دالة أو تعبير كامل بين قوسين. والنجمة * تعني التكرار صفراً أو أكثر، وعلامة السؤال ? تعني مرة أو لا شيء.
والسر كله في الترتيب: كل مستوى يعرف بالمستوى الذي تحته، فالعمليات في المستوى الأعمق تربط أقوى. ولذلك يكفي أن تضع الضرب في مستوى أعمق من الجمع لكي يحسب قبله، دون أي جدول أولويات منفصل. والصورة التالية ترتب المستويات من الأضعف إلى الأقوى، ومعها ثلاثة أمثلة سوف نشغلها:
المحلل النحوي Parser بالنزول التعاودي Recursive Descent
أجمل ما في القواعد المكتوبة بهذا الشكل أنها تتحول إلى كود سطراً بسطر: كل قاعدة تصبح دالة، وكل إشارة إلى قاعدة أخرى تصبح استدعاء لدالتها، والتكرار * يصبح حلقة while. وهذه الطريقة اسمها النزول التعاودي Recursive Descent، لأن الدوال تستدعي بعضها نازلة من القاعدة العامة إلى الأساس، وتعود إلى نفسها عند الأقواس. وهي الطريقة التي يستخدمها أغلب المترجمات المكتوبة يدوياً، ومنها GCC وclang للغة C وC++، وقد انتقل CPython نفسه في الإصدار 3.9 إلى محلل من عائلة قريبة اسمه PEG كما في PEP 617. وهذه شجرة الأنواع التي يبنيها المحلل:
# ---------- 2. AST: the shape of the program ----------
@dataclass
class Num:
    value: float
    line: int
    col: int

@dataclass
class Var:
    name: str
    line: int
    col: int

@dataclass
class Unary:
    op: str
    operand: object
    line: int
    col: int

@dataclass
class Binary:
    op: str
    left: object
    right: object
    line: int
    col: int

@dataclass
class Call:
    name: str
    args: list
    line: int
    col: int

@dataclass
class Let:
    name: str
    value: object
    line: int
    col: int
كل نوع عقدة كلاس بيانات dataclass صغير يحمل ما يحتاجه المنفذ فقط، ومعه السطر والعمود لرسائل الخطأ في مرحلة التنفيذ. والآن المحلل نفسه:
# ---------- 3. parser: tokens -> AST (recursive descent) ----------
#   program    := statement (NEWLINE statement)* EOF
#   statement  := "let" NAME "=" expression | expression
#   expression := term (("+" | "-") term)*
#   term       := unary (("*" | "/" | "%") unary)*
#   unary      := "-" unary | power
#   power      := primary ("^" unary)?          (right associative: 2^3^2 = 2^9)
#   primary    := NUMBER | NAME | NAME "(" args ")" | "(" expression ")"
def describe(tok):
    return "end of input" if tok.kind == "EOF" else "end of line" if tok.kind == "NEWLINE" else repr(tok.text)


MAX_DEPTH = 100          # each "(" costs about six Python frames; stay far below sys.getrecursionlimit()


class Parser:
    def __init__(self, tokens):
        self.tokens, self.pos, self.depth = tokens, 0, 0

    def peek(self):
        return self.tokens[self.pos]

    def advance(self):
        tok = self.tokens[self.pos]
        self.pos += 1
        return tok

    def accept(self, kind, text=None):
        tok = self.peek()
        if tok.kind == kind and (text is None or tok.text == text):
            return self.advance()
        return None

    def expect(self, kind, text, what):
        tok = self.accept(kind, text)
        if tok is None:
            got = self.peek()
            raise CalcError("SyntaxError", f"expected {what}, found {describe(got)}", got.line, got.col)
        return tok

    def program(self):
        statements = []
        while self.peek().kind != "EOF":
            if self.accept("NEWLINE"):
                continue
            statements.append(self.statement())
            if self.peek().kind != "EOF":
                self.expect("NEWLINE", None, "end of line")
        return statements

    def statement(self):
        let = self.accept("LET")
        if let:
            name = self.expect("NAME", None, "a variable name after 'let'")
            self.expect("OP", "=", "'='")
            return Let(name.text, self.expression(), let.line, let.col)
        return self.expression()

    def expression(self):
        node = self.term()
        while (tok := self.accept("OP", "+") or self.accept("OP", "-")):
            node = Binary(tok.text, node, self.term(), tok.line, tok.col)
        return node

    def term(self):
        node = self.unary()
        while (tok := self.accept("OP", "*") or self.accept("OP", "/") or self.accept("OP", "%")):
            node = Binary(tok.text, node, self.unary(), tok.line, tok.col)
        return node

    def unary(self):
        tok = self.accept("OP", "-")
        if tok:
            return Unary("-", self.unary(), tok.line, tok.col)
        return self.power()

    def power(self):
        node = self.primary()
        tok = self.accept("OP", "^")
        if tok:
            node = Binary("^", node, self.unary(), tok.line, tok.col)
        return node

    def primary(self):
        tok = self.peek()
        if self.accept("NUMBER"):
            return Num(float(tok.text), tok.line, tok.col)
        if self.accept("NAME"):
            if self.accept("OP", "("):
                args = []
                if not self.accept("OP", ")"):
                    args.append(self.expression())
                    while self.accept("OP", ","):
                        args.append(self.expression())
                    self.expect("OP", ")", "',' or ')'")
                return Call(tok.text, args, tok.line, tok.col)
            return Var(tok.text, tok.line, tok.col)
        if (paren := self.accept("OP", "(")):
            self.depth += 1
            if self.depth > MAX_DEPTH:
                raise CalcError("SyntaxError", f"more than {MAX_DEPTH} nested parentheses", paren.line, paren.col)
            node = self.expression()
            self.expect("OP", ")", "')'")
            self.depth -= 1
            return node
        raise CalcError("SyntaxError", f"expected a number, a name or '(', found {describe(tok)}", tok.line, tok.col)


def parse(source):
    return Parser(tokenize(source)).program()
في الكود أعلاه لاحظ التالي:
- الدوال الأربع
peekوadvanceوacceptوexpectهي كل ما يحتاجه المحلل من أدوات:peekتنظر إلى الرمز الحالي دون أن تتقدم، وacceptتتقدم فقط إذا كان الرمز هو المطلوب وإلا أعادتNone، وexpectمثلها ولكنها ترفع خطأ بوصف ما كانت تنتظره. - الدالة
expressionهي القاعدةterm (("+" | "-") term)*حرفياً: حد، ثم حلقة طالما وجدنا زائداً أو ناقصاً. وفي كل دورة تصبح الشجرة السابقة الطرف الأيسر لعقدة جديدة، وهذا هو الربط من اليسار Left Associativity، فالصيغة10 - 4 - 3تصبح(10 - 4) - 3وتعطي 3، لا10 - (4 - 3)التي تعطي 9. - الدالة
powerمختلفة: الطرف الأيمن للأس يتحلل باستدعاءunaryالذي يصل إلىpowerمن جديد، أي أن الأس الثاني يصبح داخل الطرف الأيمن للأول، وهذا هو الربط من اليمين Right Associativity كما في الرياضيات. - الأقواس لا تنتج عقدة في الشجرة، فالدالة
primaryتقرأ القوس، وتستدعيexpressionمن البداية، وتتأكد من القوس المغلق، ثم تعيد الشجرة كما هي. فالأقواس وظيفتها أن تعيد القراءة إلى المستوى الأضعف داخل المستوى الأقوى، وبعد ذلك لا حاجة لها. - المتغير
depthوالثابتMAX_DEPTHلم يكونا في النسخة الأولى، وسوف ترى في قسم لاحق المشكلة الحقيقية التي جعلتنا نضيفهما.
الربط Associativity: لماذا 2 ^ 3 ^ 2 تساوي 512؟
لنرى كيف يبني المحلل الشجرة في حالتي الأس، نطبعها بالأداة show.py:
python3 show.py "2 ^ 3 ^ 2"
python3 show.py "-2 ^ 2"
tokens:
NUMBER '2' col 1
OP '^' col 3
NUMBER '3' col 5
OP '^' col 7
NUMBER '2' col 9
EOF '' col 10
ast:
Binary ^
Num 2
Binary ^
Num 3
Num 2
tokens:
OP '-' col 1
NUMBER '2' col 2
OP '^' col 4
NUMBER '2' col 6
EOF '' col 7
ast:
Unary -
Binary ^
Num 2
Num 2في الشجرة الأولى، الأس الثاني 3 ^ 2 صار ابناً أيمن للأول، فيحسب أولاً ويعطي 9، ثم 2 ^ 9 يعطي 512، وهذا ما تفعله Python بالعامل ** والرياضيات بالأسس المكتوبة فوق بعضها. ولو جعلنا الأس يربط من اليسار لكانت النتيجة (2 ^ 3) ^ 2 أي 64، وهذا فرق يفاجئ من ينقل صيغة من برنامج إلى آخر يتبع قاعدة مختلفة. وفي الشجرة الثانية، السالب في الأعلى والأس تحته، أي -(2 ^ 2) وتعطي -4، لأن power أعمق من unary في القواعد. وهذه قرارات تصميم لا يوجد فيها صواب مطلق، وإنما يجب أن تتخذها بوعي وتكتبها في توثيق لغتك، لأن من يكتب الصيغ سوف يفترض قاعدة البرنامج الذي اعتاد عليه.
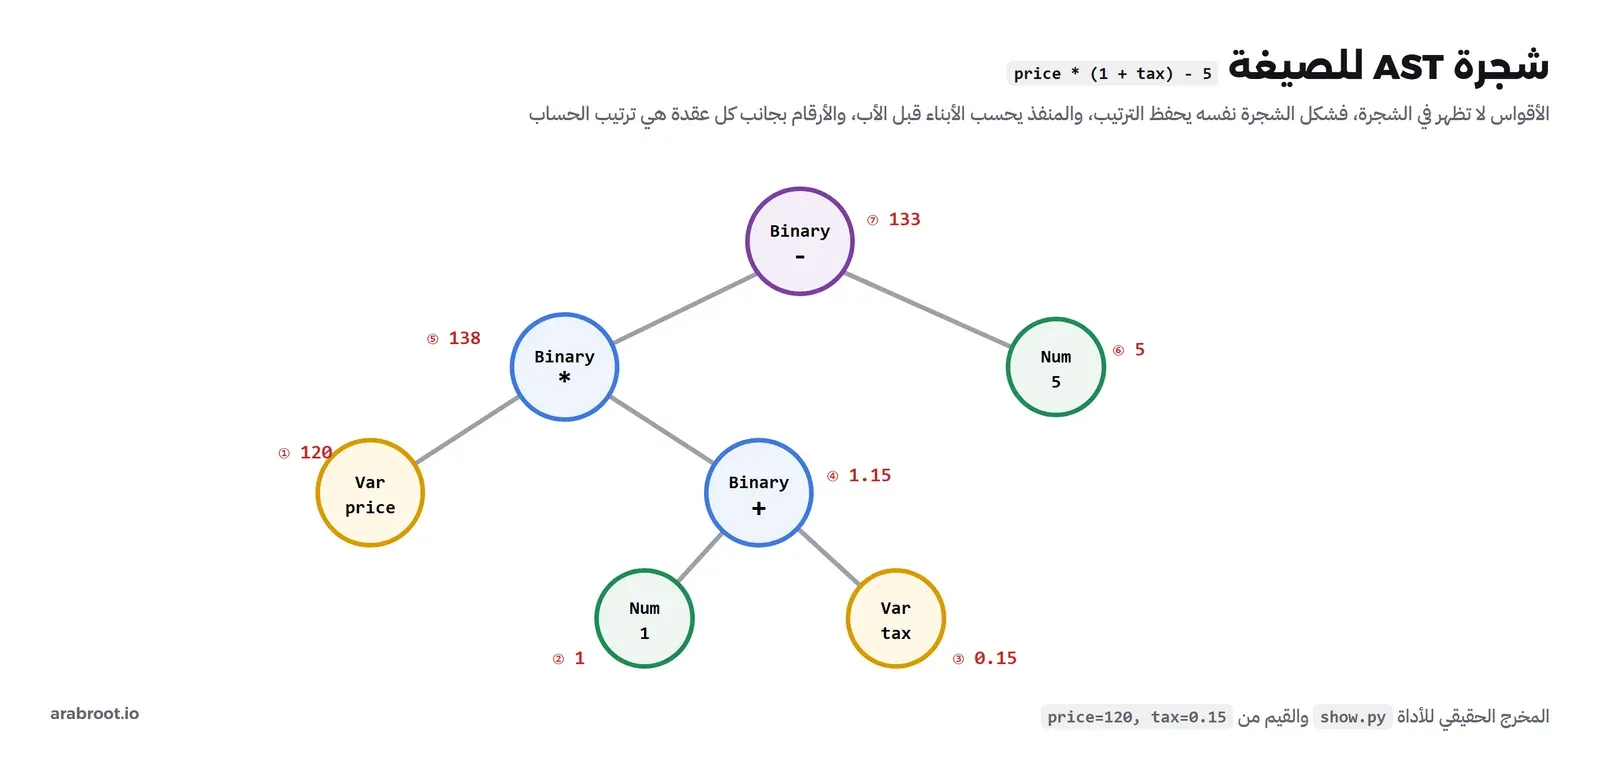
والصورة التالية ترسم شجرة الصيغة الأصلية، والأرقام بجانب كل عقدة هي ترتيب حسابها:
المنفذ Evaluator: المشي على الشجرة Tree-walking
بعد أن صارت الصيغة شجرة، يصبح التنفيذ أسهل جزء في المفسر كله: دالة واحدة تنظر إلى نوع العقدة، فإذا كانت رقماً أعادته، وإذا كانت متغيراً بحثت عنه في البيئة Environment، وإذا كانت عملية حسبت طرفيها بنفسها ثم طبقت العملية. والدالة تستدعي نفسها على الأبناء، فتنزل إلى الأوراق ثم تصعد بالنتائج إلى الجذر، وهذا هو ترتيب الأرقام في الصورة السابقة:
# ---------- 4. evaluator: walk the tree ----------
FUNCTIONS = {
    "round": (lambda x, d=0: round(x, int(d)), (1, 2)),
    "min": (min, (2, 2)),
    "max": (max, (2, 2)),
    "sqrt": (math.sqrt, (1, 1)),
    "abs": (abs, (1, 1)),
}


def evaluate(node, env):
    match node:
        case Num(value=v):
            return v
        case Var(name=name):
            if name not in env:
                raise CalcError("NameError", f"'{name}' is not defined", node.line, node.col)
            return env[name]
        case Unary(operand=operand):
            return -evaluate(operand, env)
        case Binary(op=op, left=left, right=right):
            a, b = evaluate(left, env), evaluate(right, env)
            if op == "+": return a + b
            if op == "-": return a - b
            if op == "*": return a * b
            if op in "/%" and b == 0:
                raise CalcError("ZeroDivisionError", "division by zero", node.line, node.col)
            if op == "/": return a / b
            if op == "%": return a % b
            if op == "^":
                try:
                    result = a ** b
                except OverflowError:
                    raise CalcError("OverflowError", "result is too large", node.line, node.col)
                if isinstance(result, complex):
                    raise CalcError("ValueError", "negative number to a fractional power", node.line, node.col)
                return result
        case Call(name=name, args=args):
            if name not in FUNCTIONS:
                raise CalcError("NameError", f"unknown function '{name}'", node.line, node.col)
            fn, (lo, hi) = FUNCTIONS[name]
            if not lo <= len(args) <= hi:
                want = lo if lo == hi else f"{lo} to {hi}"
                raise CalcError("TypeError", f"{name}() takes {want} arguments, got {len(args)}", node.line, node.col)
            try:
                return fn(*[evaluate(a, env) for a in args])
            except ValueError as e:
                raise CalcError("ValueError", f"{name}(): {e}", node.line, node.col)
        case Let(name=name, value=value):
            env[name] = evaluate(value, env)
            return env[name]
    raise TypeError(f"unknown node {node!r}")
في الكود أعلاه لاحظ التالي:
- الجملة
matchمع الأنماطcase Num(value=v)هي مطابقة الأنماط Pattern Matching التي أضيفت في Python 3.10، وهي مناسبة جداً للمفسرات لأنها تفحص نوع العقدة وتستخرج حقولها في سطر واحد. - البيئة
envقاموس عادي من الاسم إلى القيمة، والجملةletتكتب فيه، والمتغير يقرأ منه. والقيم التي تأتي من الفاتورة، مثلpriceوqty، توضع في نفس القاموس قبل التنفيذ، فلا فرق في نظر اللغة بين متغير عرفه المستخدم ومتغير جاء من النظام. - الدوال المسموحة خمس فقط في القاموس
FUNCTIONS، ولكل منها عدد المعاملات المسموح. وهذه القائمة البيضاء Allowlist هي حدود الأمان في اللغة: لا يوجد طريق من الصيغة إلى أي دالة لم تضعها أنت هنا، وهذا عكسevalتماماً حيث كل شيء مسموح إلا ما حاولت منعه. - القسمة على صفر تفحص قبل أن تحدث، فترفع خطأ اللغة بموقع العامل نفسه، بدل أن يرتفع
ZeroDivisionErrorالخاص بلغة Python ويطبع للمستخدم Traceback لا يفهمه. - الكتلة الخاصة بالأس فيها فحصان لم يكونا في النسخة الأولى، وسوف نشرح سببهما في قسم المشكلات.
والدالة run تربط المراحل معاً، وmain تشغل ملف صيغة أو حلقة تفاعلية:
def run(source, env=None):
    env = {} if env is None else env
    result = None
    for statement in parse(source):
        result = evaluate(statement, env)
    return result


def main():
    if len(sys.argv) > 1:                       # calc.py file.calc [name=value ...]
        source = open(sys.argv[1], encoding="utf-8").read()
        env = {k: float(v) for k, v in (a.split("=", 1) for a in sys.argv[2:])}
        try:
            print(run(source, env))
        except CalcError as e:
            print(e.show(source))
            sys.exit(1)
        return
    env = {}
    while True:                                  # REPL: read, evaluate, print, loop
        try:
            line = input("calc> ")
            if not sys.stdin.isatty():           # piped input: echo it so the transcript reads like a session
                print(line)
        except EOFError:
            print()
            break
        try:
            result = run(line, env)
            if result is not None:
                print(result)
        except CalcError as e:
            print(e.show(line))


if __name__ == "__main__":
    main()
الحلقة التفاعلية Read-Eval-Print Loop، واختصاراً REPL، هي نفس ما تراه حين تكتب python3 دون ملف: تقرأ سطراً، وتنفذه، وتطبع النتيجة، وتعود. ولاحظ أن البيئة env واحدة لكل الجلسة، فالمتغير الذي تعرفه في سطر يبقى للأسطر التالية.
تشغيل اللغة Running: الفاتورة والجلسة التفاعلية REPL
هذا ملف الصيغة الذي يكتبه فريق المبيعات، بتعليق ومتغيرين وسطر نتيجة:
# price, qty and discount come from the invoice line
let tax = 0.15
let subtotal = price * qty - discount
let total = subtotal * (1 + tax)
round(total, 2)
python3 calc.py invoice.calc price=120 qty=3 discount=20391.0ثلاث قطع بسعر 120 ريالاً تساوي 360، ناقص خصم 20 يساوي 340، ومع ضريبة 15% يصبح 391. والآن الجلسة التفاعلية مع مجموعة من الأسطر الصحيحة والخاطئة من الملف repl-input.txt، ممررة إلى الحلقة بالأمر python3 calc.py < repl-input.txt:
calc> 1 + 2 * 3
7.0
calc> 2 ^ 3 ^ 2
512.0
calc> -2 ^ 2
-4.0
calc> (1 + 2) * 3
9.0
calc> let x = 10
10.0
calc> x / (x - 10)
ZeroDivisionError at line 1, column 3: division by zero
    x / (x - 10)
      ^
calc> round(2 / 3, 2
SyntaxError at line 1, column 15: expected ',' or ')', found end of input
    round(2 / 3, 2
                  ^
calc> 3 $ 4
SyntaxError at line 1, column 3: unexpected character '$'
    3 $ 4
      ^
calc> 1.2.3
SyntaxError at line 1, column 4: a number has two decimal points
    1.2.3
       ^
calc> foo + 1
NameError at line 1, column 1: 'foo' is not defined
    foo + 1
    ^
calc> max(1)
TypeError at line 1, column 1: max() takes 2 arguments, got 1
    max(1)
    ^
calc> sqrt(-1)
ValueError at line 1, column 1: sqrt(): math domain error
    sqrt(-1)
    ^
calc> 0.1 + 0.2
0.30000000000000004
calc>
في المخرج أعلاه لاحظ التالي:
- الأسطر الأربعة الأولى تؤكد الأولويات والربط: 7 لا 9، و512 لا 64، و
-4لا 4، والأقواس تغير الترتيب فتعطي 9. - كل رسالة خطأ تشير إلى المكان الدقيق: القسمة على صفر تشير إلى العامل
/في العمود 3 لا إلى بداية السطر، والقوس الناقص يشير إلى نهاية السطر حيث كان المحلل ينتظره، والحرف الغريب يشير إلى نفسه. وهذا ما يجعل اللغة قابلة للاستخدام من شخص غير مبرمج: الرسالة تقول ماذا كان متوقعاً وماذا وجد وأين. - الأخطاء من ثلاث مراحل مختلفة كما في أول صورة:
$و1.2.3من المحلل اللغوي، والقوس الناقص من المحلل النحوي، والقسمة على صفر والمتغير غير المعرف وعدد المعاملات الخاطئ من المنفذ. والأخطاء الأولى يمكن كشفها لحظة حفظ الصيغة في لوحة الإدارة، بتحليلها دون تنفيذ، وهذا تحقق Validation مجاني تحصل عليه من بناء المفسر على مراحل. - السطر الأخير
0.30000000000000004ليس خطأ في اللغة، وإنما هو طريقة تمثيل الأعداد العشرية في الحاسب، وشرحناها في مقال الأرقام العشرية Floating Point من الداخل. وفي نظام فواتير حقيقي الأنسب أن يعمل المنفذ بالنوعDecimalمن مكتبة Python بدلfloat، والتغيير في مكان واحد: الدالةprimaryالتي تنشئNum.
ربط اللغة بنظام الفواتير Integration
بقي أن نضع اللغة في مكانها من النظام. والفكرة أن مراحل المفسر المنفصلة تعطيك نقطتين للاستخدام لا نقطة واحدة: لحظة الحفظ، حيث يكفي المحلل اللغوي والنحوي للتأكد أن الصيغة مكتوبة صحيحاً دون أي بيانات فاتورة، ولحظة الحساب، حيث ينفذ المنفذ الشجرة المحفوظة على بيانات كل سطر. والملف integrate.py يمثل هذا الربط بأبسط شكل:
"""How the invoice system uses calc: validate when the admin saves, parse once, evaluate per invoice line."""
from calc import parse, evaluate, CalcError

saved = {}                                       # formula id -> parsed statements (the AST, kept in memory)

def save_formula(fid, source):
    try:
        saved[fid] = parse(source)               # lexer + parser only: no invoice data needed yet
        return "saved"
    except CalcError as e:
        return "rejected\n" + e.show(source)

def apply(fid, line):
    env = dict(line)                             # a fresh environment per invoice line
    result = None
    for statement in saved[fid]:
        result = evaluate(statement, env)
    return result

print(save_formula("bulk", "let d = max(discount, price * qty * 0.05)\nround((price * qty - d) * 1.15, 2)"))
print(save_formula("typo", "round((price * qty - discount) * 1.15, 2"))
for line in [{"price": 120, "qty": 3, "discount": 20}, {"price": 40, "qty": 25, "discount": 20}]:
    print(line, "->", apply("bulk", line))
try:
    apply("bulk", {"price": 120, "qty": 3})
except CalcError as e:
    print("missing field ->", e.kind, e.message)
saved
rejected
SyntaxError at line 1, column 41: expected ',' or ')', found end of input
round((price * qty - discount) * 1.15, 2
^
{'price': 120, 'qty': 3, 'discount': 20} -> 391.0
{'price': 40, 'qty': 25, 'discount': 20} -> 1092.5
missing field -> NameError 'discount' is not definedفي المخرج أعلاه لاحظ التالي:
- الصيغة الأولى حفظت لأنها سليمة، والصيغة الثانية رفضت لحظة الحفظ بقوس ناقص، أي أن مدير المبيعات يرى الخطأ وهو يكتب في لوحة الإدارة، لا عميل يرى فاتورة خاطئة بعد أسبوع.
- الخصم في الصيغة الأولى هو الأكبر بين الخصم الثابت و5% من القيمة، فالسطر الأول بقيمة 360 أخذ الخصم الثابت 20 وأعطى 391، والسطر الثاني بقيمة 1000 أخذ 50 وأعطى 1092.5. وهذه بالضبط القاعدة التي وصفها فريق المبيعات في أول المقال، كتبت دون أي تعديل في كود النظام.
- كل سطر فاتورة له بيئة جديدة
dict(line)، حتى لا يتسرب متغير عرفتهletفي فاتورة إلى الفاتورة التالية، وهذا خطأ يصعب اكتشافه إذا شاركت البيئة بين التنفيذات. - السطر الأخير يبين خطأ لا يمكن كشفه عند الحفظ: الصيغة سليمة، ولكن بيانات الفاتورة لا تحتوي الحقل
discount. ويمكنك أن تكشفه مبكراً أيضاً بالمشي على الشجرة بعد التحليل وجمع كل أسماء المتغيرات التي لم تعرفهاlet، ثم مقارنتها بقائمة حقول الفاتورة، وهذا مثال على أن الشجرة لا تنفع للتنفيذ فقط، وإنما لأي تحليل تريده على الصيغة قبل تشغيلها.
ثلاث مشكلات حقيقية Edge Cases ظهرت في التجربة
اللغة نجحت في كل الأمثلة السابقة، ولكن الاختبار الحقيقي لأي مفسر هو المدخلات التي لم يفكر فيها من كتبه. وجربنا ثلاث حالات حدية، وكل واحدة منها أوقفت النسخة الأولى من اللغة.
ماذا يحدث إذا تعمقت الأقواس؟ حد التعاود Recursion Limit
المحلل بالنزول التعاودي يستخدم مكدس استدعاءات Python نفسه، فكل قوس يمر بالدوال expression ثم term ثم unary ثم power ثم primary، أي نحو خمسة إلى ستة استدعاءات لكل مستوى. وPython يحدد عمق المكدس بالقيمة sys.getrecursionlimit وهي 1000 افتراضياً. فجربنا صيغاً فيها ((((1)))) بأعماق مختلفة على النسخة الأولى:
recursion limit: 1000
100 -> 1.0
200 -> RecursionError: maximum recursion depth exceeded
300 -> RecursionError: maximum recursion depth exceeded
1000 -> RecursionError: maximum recursion depth exceeded
مئتا قوس كانت كافية لإسقاط المحلل، والخطأ هنا ليس من نوع CalcError، أي أن البرنامج المستضيف للغة لا يتوقعه، وقد يوقف معالجة الفاتورة كلها أو يطبع للمستخدم Traceback كاملاً. والمشكلة أخطر في الخدمات التي تستقبل الصيغ من الخارج، فهذا نوع معروف من هجمات حجب الخدمة Denial of Service، حيث يرسل المهاجم مدخلاً متداخلاً جداً يستنفد المكدس أو الذاكرة.
والحل الأنسب ليس رفع sys.setrecursionlimit، لأن هذا يؤجل المشكلة ويخاطر بإسقاط عملية Python نفسها إذا امتلأ مكدس نظام التشغيل، وإنما أن تضع حداً واضحاً في اللغة نفسها برسالة مفهومة. ولذلك أضفنا العداد depth في الدالة primary بحد 100 قوس، وهو أكثر بكثير مما يكتبه أي إنسان، وأقل بكثير من حد Python. وبعد الإصلاح أعدنا التجربة، وأضفنا في نهاية الملف deep.py بحثاً ثنائياً يعطل الحد مؤقتاً ليجد أعمق صيغة تتحملها Python فعلاً:
recursion limit: 1000
100 -> 1.0
101 -> SyntaxError: more than 100 nested parentheses at column 101
160 -> SyntaxError: more than 100 nested parentheses at column 101
170 -> SyntaxError: more than 100 nested parentheses at column 101
1000 -> SyntaxError: more than 100 nested parentheses at column 101
without the guard, the deepest formula that works: 197 levels
الآن كل صيغة أعمق من 100 ترفض برسالة تشير إلى القوس رقم 101، ودون الحد كانت أعمق صيغة ممكنة 197 مستوى، أي أن كل قوس كلف نحو خمسة استدعاءات من الألف المسموحة. والقيمة 197 ليست ثابتة، فهي تعتمد على عمق المكدس لحظة استدعاء المحلل، فإذا استدعيت اللغة من داخل إطار ويب عميق الاستدعاءات قلت المساحة المتاحة، وهذا سبب آخر لأن يكون الحد في اللغة أقل بكثير من حد Python.
الأس الكبير وتجاوز المدى Overflow
الحالة الثانية جاءت من سؤال بسيط: ماذا لو كتب أحدهم 9 ^ 9 ^ 9؟ وهذه نتيجة النسخة الأولى:
calc> 9 ^ 9 ^ 9
Traceback (most recent call last):
  File "/lab/calc.py", line 345, in <module>
    main()
    ~~~~^^
  File "/lab/calc.py", line 337, in main
    result = run(line, env)
  File "/lab/calc.py", line 313, in run
    result = evaluate(statement, env)
  File "/lab/calc.py", line 291, in evaluate
    if op == "^": return a ** b
                         ~~^^~~
OverflowError: (34, 'Numerical result out of range')
الحلقة التفاعلية سقطت كلها، لأن العامل ** على أعداد عشرية في Python يرفع OverflowError عندما تتجاوز النتيجة أكبر عدد عشري ممكن، و9 ^ 9 وحدها تساوي 387,420,489، فرفع 9 إلى هذه القوة خارج أي مدى. والدرس أن أي عملية في المنفذ تستدعي عملية من اللغة المستضيفة قد ترفع أخطاء هذه اللغة، وكل خطأ من هذا النوع يجب أن يترجم إلى خطأ في لغتك بموقعه.
الأس الكسري لعدد سالب والعدد المركب Complex Number
والحالة الثالثة أغرب: (-8) ^ (1 / 3). فالجذر التكعيبي لسالب ثمانية في الرياضيات المدرسية هو سالب اثنين، ولكن Python ترفع عدداً سالباً إلى قوة كسرية فتعطي عدداً مركباً Complex Number، ولا ترفع أي خطأ. أي أن النسخة الأولى كانت سوف تعيد عدداً مركباً إلى نظام الفواتير، وأول عملية بعده، مثل round، تفشل بخطأ لا علاقة له بالصيغة. ولذلك أضفنا في كتلة الأس الفحصين اللذين رأيتهما في الكود، ثم أعدنا التشغيل:
calc> 9 ^ 9 ^ 9
OverflowError at line 1, column 3: result is too large
    9 ^ 9 ^ 9
      ^
calc> 10 ^ 400
OverflowError at line 1, column 4: result is too large
    10 ^ 400
       ^
calc> 2 ^ 0.5
1.4142135623730951
calc> (-8) ^ (1 / 3)
ValueError at line 1, column 6: negative number to a fractional power
    (-8) ^ (1 / 3)
         ^
ولاحظ في السطر الأول أن السهم يشير إلى العمود 3، أي إلى الأس الأول لا الثاني، لأن الأس الثاني 9 ^ 9 نجح وأعطى 387,420,489، والذي فشل هو رفع 9 إلى هذه القوة. وهذه دقة لا تحصل عليها إلا لأن كل عقدة في الشجرة تحمل موقعها.
ويبقى حد لم نعالجه ونتركه لك: الضرب لا يرفع خطأ عند تجاوز المدى، وإنما يعطي ما لا نهاية بصمت، وهذا ما حدث فعلاً:
calc> 10 ^ 300 * 10 ^ 300
inf
calc>
والإصلاح سطر واحد في الدالة run يفحص أن النتيجة النهائية عدد محدود بالدالة math.isfinite، وهو التدريب الأول في نهاية المقال.
الأمان Security: لماذا نجحت اللغة حيث فشلت eval؟
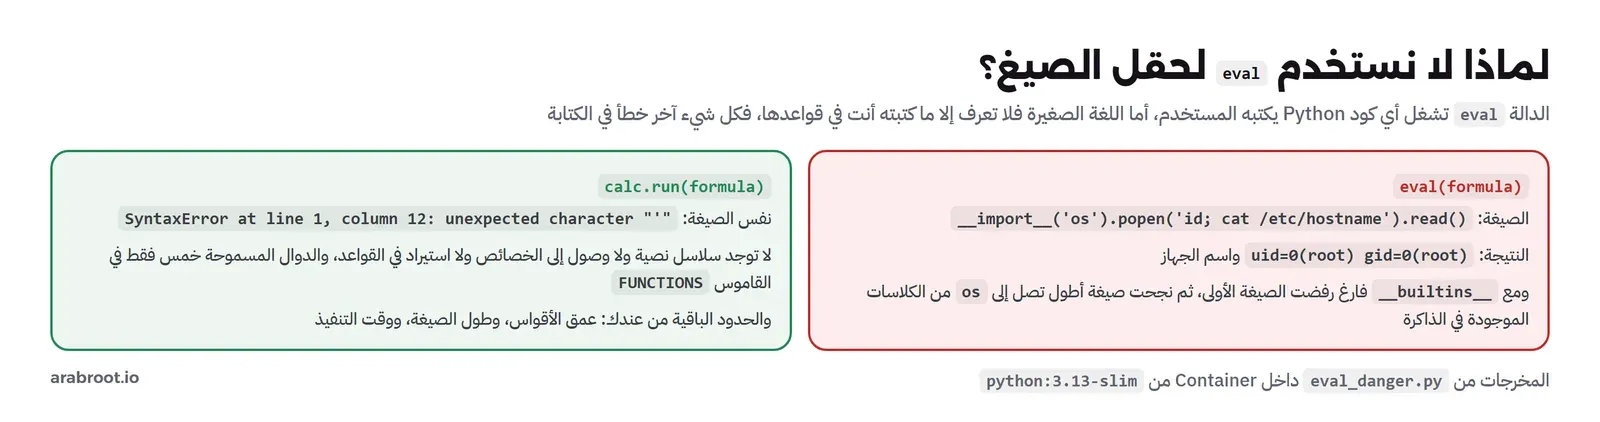
eval تسمح بكل شيء إلا ما منعته، واللغة الصغيرة لا تسمح إلا بما كتبته في قواعدهاالفرق بين الحلين فرق في الاتجاه: مع eval تبدأ من لغة كاملة قادرة على كل شيء وتحاول أن تغلق الأبواب واحداً واحداً، ورأينا أن باباً واحداً منسياً يكفي. ومع اللغة الصغيرة تبدأ من لا شيء، وكل قدرة في اللغة سطر كتبته بيدك في القواعد أو في قاموس الدوال، فلا توجد قدرة لم تقررها. ومع ذلك فالأمان ليس كاملاً بمجرد بناء اللغة، وتبقى عليك ثلاثة حدود لا تأتي من القواعد:
- العمق: رأيناه، وحله العداد
MAX_DEPTH. - الحجم: صيغة بطول مليون حرف سوف تحلل وتنفذ ببطء، فضع حداً لطول الصيغة لحظة حفظها في لوحة الإدارة.
- الوقت: لغتنا لا تحتوي حلقات، فكل صيغة تنتهي في وقت يتناسب مع طولها. وإذا أضفت يوماً حلقات أو دوال يعرفها المستخدم فقد صارت اللغة قادرة على حلقة لا تنتهي، وتحتاج حداً لعدد الخطوات في المنفذ، وهذا ما تفعله اللغات المدمجة الجادة.
وقد يتساءل البعض: أليست هناك طريقة لاستخدام محلل Python نفسه بأمان؟ والإجابة أن الدالة ast.literal_eval آمنة ولكنها لا تقبل إلا القيم الثابتة مثل الأرقام والقوائم، ولا تقبل المتغيرات ولا الدوال، فلا تكفي للصيغ. وهناك من يحلل الصيغة بالوحدة ast ثم يمشي على شجرة Python ويرفض كل نوع عقدة غير مسموح، وهذا نفس ما فعلناه تماماً، ولكن على لغة أكبر بكثير ذات عشرات الأنواع من العقد، فاحتمال أن تنسى نوعاً أكبر. ولذلك إذا احتجت لغة قواعد Rules أو سياسات Policies أكبر من حاسبة، فالأنسب لغة تعبيرات مصممة لهذا الغرض من البداية مثل CEL (Common Expression Language) من Google، والمستخدمة في Kubernetes وغيره، ومواصفتها في مستودع cel-spec.
الأداء Performance: كم يكلف المفسر الشجري؟
نظام الفواتير قد يحسب نفس الصيغة لعشرات الآلاف من الفواتير في تقرير شهري، فكم يكلفنا تنفيذ الشجرة بدوال Python؟ الملف bench.py ينفذ نفس الصيغة 100,000 مرة بثلاث طرق:
"""Tree walking vs CPython's own compiler: the same formula evaluated 100,000 times."""
import time
from calc import parse, evaluate

src = "round((price * qty - discount) * (1 + tax), 2)"
env = {"price": 120.0, "qty": 3.0, "discount": 20.0, "tax": 0.15}
N = 100_000

def timed(label, fn):
    t = time.perf_counter()
    for _ in range(N):
        r = fn()
    ms = (time.perf_counter() - t) * 1000
    print(f"{label:<34} {ms:8.1f} ms  {ms * 1000 / N:6.2f} us/call  result={r}")
    return ms

timed("calc: parse + walk every time", lambda: evaluate(parse(src)[0], env))
tree = parse(src)[0]
timed("calc: parse once, walk every time", lambda: evaluate(tree, env))
code = compile(src.replace("^", "**"), "<formula>", "eval")
timed("Python: compile once, eval (bytecode)", lambda: eval(code, {"round": round}, env))
وهذه التشغيلات الثلاثة كما خرجت:
calc: parse + walk every time       12251.3 ms  122.51 us/call  result=391.0
calc: parse once, walk every time    2776.5 ms   27.77 us/call  result=391.0
Python: compile once, eval (bytecode)    506.3 ms    5.06 us/call  result=391.0
calc: parse + walk every time       11902.0 ms  119.02 us/call  result=391.0
calc: parse once, walk every time    1786.7 ms   17.87 us/call  result=391.0
Python: compile once, eval (bytecode)    262.3 ms    2.62 us/call  result=391.0
calc: parse + walk every time       14009.2 ms  140.09 us/call  result=391.0
calc: parse once, walk every time    1530.4 ms   15.30 us/call  result=391.0
Python: compile once, eval (bytecode)    250.3 ms    2.50 us/call  result=391.0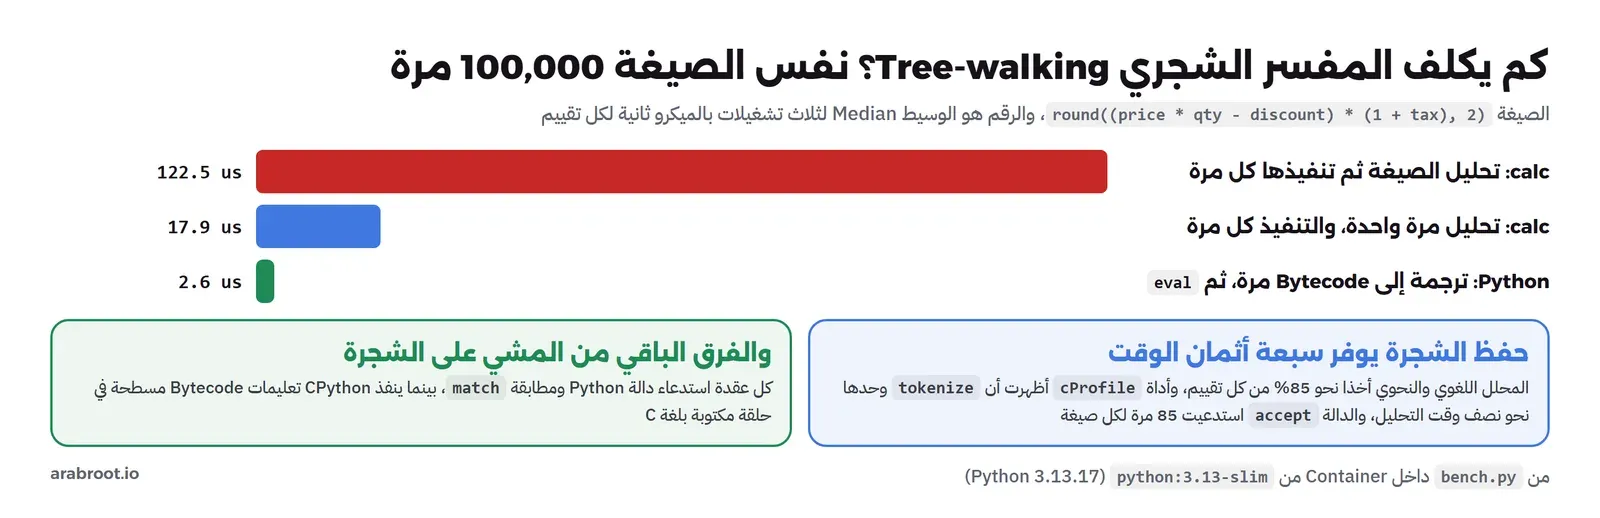
في المخرج أعلاه لاحظ التالي:
- الأرقام تتأرجح بين التشغيلات، فقد أخذ السطر الأوسط مرة 27.8 ومرة 15.3 ميكرو ثانية على نفس الجهاز، لذلك نأخذ الوسيط: 122.5 و17.9 و2.6 ميكرو ثانية.
- التحليل في كل مرة كلف نحو 85% من الوقت، وحفظ الشجرة وإعادة تنفيذها جعل التقييم أسرع بنحو سبع مرات. وهذا أول قرار عملي: حلل الصيغة مرة واحدة لحظة حفظها في قاعدة البيانات أو أول تحميل لها، واحتفظ بالشجرة في الذاكرة، ونفذها لكل فاتورة.
- وحتى بعد ذلك، المشي على الشجرة أبطأ بنحو سبع مرات من Bytecode الخاص بلغة Python لنفس الصيغة، لأن كل عقدة عندنا استدعاء دالة Python ومطابقة أنماط، بينما ينفذ CPython تعليمات مسطحة في حلقة مكتوبة بلغة C.
ولكي نعرف أين يذهب وقت التحليل بالضبط، شغلنا التحليل وحده 20,000 مرة تحت أداة القياس cProfile من مكتبة Python القياسية:
         7840003 function calls (7160003 primitive calls) in 11.020 seconds
   Ordered by: internal time
   List reduced from 24 to 6 due to restriction <6>
   ncalls  tottime  percall  cumtime  percall filename:lineno(function)
    20000    3.189    0.000    4.960    0.000 /lab/calc.py:38(tokenize)
  1700000    1.877    0.000    2.701    0.000 /lab/calc.py:177(accept)
180000/20000    1.114    0.000    5.363    0.000 /lab/calc.py:233(primary)
  1940000    0.682    0.000    0.682    0.000 /lab/calc.py:169(peek)
140000/20000    0.643    0.000    5.619    0.000 /lab/calc.py:214(term)
  1080000    0.445    0.000    0.445    0.000 {built-in method builtins.len}
المحلل اللغوي أخذ نحو 5 ثوان من 11، أي قرابة النصف، لأنه حلقة Python تمر على كل حرف وتفحص الحالة. والدالة accept استدعيت 1,700,000 مرة، أي 85 مرة لكل صيغة، لأن كل مستوى في القواعد يسأل «هل الرمز التالي زائد؟ هل هو ناقص؟» حتى لو كان الرمز رقماً. والأرقام 180000/20000 في سطر primary تعني 180 ألف استدعاء منها 20 ألفاً فقط من خارجها، والباقي تعاود داخلي عبر الأقواس. وهذه بالضبط الأماكن التي يحسنها من يبني مفسراً جاداً: محلل لغوي بتعبير نمطي واحد مترجم مسبقاً أو مكتوب بلغة C، وجدول يحدد مستوى كل عامل بدل سلسلة الأسئلة، وهذا ما يسمى تحليل الأولويات Precedence Climbing أو محلل Pratt.
من المفسر الشجري Tree-walking إلى Bytecode و JIT
إذا احتجت سرعة أكبر بعد حفظ الشجرة، فالخطوة التالية التي اتخذتها كل لغة كبيرة هي أن تحول الشجرة إلى قائمة تعليمات مسطحة، أي Bytecode خاص بلغتك، وتكتب حلقة صغيرة تنفذها بمكدس، تماماً كما رأينا في مخرج dis. وبعدها تأتي الخطوة الأكبر: أن تحول الصيغة الساخنة إلى تعليمات آلة أثناء التشغيل، وهذا هو ال JIT الذي تستخدمه محركات JavaScript وJava. وفي حالتنا هناك طريق مختصر يستحق أن تعرفه: بعد أن يتحقق محللك من الصيغة بالقواعد الآمنة، يمكنك أن تولد منها نص Python مكافئاً وتترجمه بالدالة compile، فتحصل على سرعة Bytecode مع أمان القواعد، لأن النص المولد لا يحتوي إلا ما بناه المحلل. ولكن هذا الطريق يضيف مكاناً جديداً للأخطاء، فلا تتخذه إلا إذا أثبت القياس أنك تحتاجه.
متى تبني لغتك؟ جدول قرار Decision Table
| الحالة | الأنسب | والسبب |
|---|---|---|
| صيغ حسابية بسيطة يكتبها مستخدمون داخل نظامك | لغة صغيرة مثل calc.py | أقل من 400 سطر، والقواعد والأخطاء والدوال كلها تحت سيطرتك |
| شروط وسياسات معقدة على كائنات وقوائم ونصوص | لغة تعبيرات جاهزة مثل CEL | مواصفة منشورة، وتطبيقات مختبرة في أكثر من لغة، وحدود للتكلفة |
| قيم ثابتة فقط في ملف إعداد | ast.literal_eval أو JSON | لا تحتاج متغيرات ولا دوال، فلا تحتاج مفسراً |
| كود من مبرمجين موثوقين في نفس الفريق | كود عادي مع مراجعة ونشر | بناء لغة هنا يضيف تعقيداً بلا فائدة |
| نص من مستخدم غير موثوق في أي حالة | أي شيء إلا eval وexec | صيغة واحدة شغلت id كـ root حتى مع __builtins__ فارغ |
أخطاء شائعة Common Mistakes عند بناء مفسر Interpreter
- استخدام
evalمع «تنظيف» المدخلات أو تفريغ__builtins__: صيغة أطول وصلت إلىosمن الكلاسات المحملة في الذاكرة. - الحساب من اليسار إلى اليمين دون قواعد: فاتورة بمئة ريال أعطت 92 بدل 77 دون أي خطأ.
- استهلاك الحرف الذي أنهى الرمز في المحلل اللغوي، فيضيع العامل الذي بعد الاسم.
- وضع الأس في نفس مستوى الضرب أو جعله يربط من اليسار دون قرار واع:
2 ^ 3 ^ 2تصبح 64 بدل 512. - رسائل خطأ دون موقع، أو تسريب أخطاء Python إلى المستخدم كـ Traceback: كل خطأ يجب أن يكون من نوع لغتك وبسطره وعموده.
- الاعتماد على حد التعاود في Python: مئتا قوس أسقطت المحلل، والحل حد صريح في اللغة لا رفع الحد.
- نسيان أن عمليات اللغة المستضيفة ترفع أخطاءها الخاصة:
9 ^ 9 ^ 9أسقط الحلقة كلها بخطأOverflowError. - نسيان القيم الغريبة التي لا ترفع أخطاء: عدد مركب من
(-8) ^ (1 / 3)وinfمن ضرب كبير. - تحليل الصيغة مع كل تنفيذ: التحليل كان 85% من الوقت.
- استخدام
floatفي المبالغ المالية:0.1 + 0.2لا تساوي 0.3، والأنسبDecimal.
قائمة تحقق Checklist قبل أن تنشر لغة صيغ
- القواعد مكتوبة كتعليق أو في التوثيق، ومعها قرارات الأولويات والربط.
- كل خطأ من نوع لغتك، بسطره وعموده ورسالة تقول ماذا كان متوقعاً.
- الصيغة تحلل لحظة حفظها في لوحة الإدارة، فترفض أخطاء الكتابة قبل أن تصل إلى أي فاتورة.
- الدوال المسموحة في قائمة بيضاء، بعدد معاملاتها.
- حدود للعمق والطول، وحد للخطوات إذا كانت في اللغة حلقات.
- كل خطأ من اللغة المستضيفة يترجم إلى خطأ في لغتك، والنتيجة النهائية تفحص أنها عدد محدود.
- النوع العددي مناسب للمجال:
Decimalللمال. - الشجرة تحفظ وتعاد، ولا تحلل الصيغة مع كل تنفيذ.
- اختبارات للحالات الحدية: أقواس عميقة، وأسس كبيرة، وأسس كسرية لأعداد سالبة، وقسمة على صفر، ونص فارغ.
تدريب عملي Practice
- أضف إلى الدالة
runفحصاً بالدالةmath.isfiniteيرفعCalcErrorعندما تكون النتيجةinf، وجربه على10 ^ 300 * 10 ^ 300. - أضف إلى اللغة عوامل المقارنة
<و>ودالةif(condition, a, b)، وقرر أين تضع المقارنة في القواعد بالنسبة للجمع. - غير المنفذ ليعمل بالنوع
Decimalوتأكد أن0.1 + 0.2صارت 0.3.
حذف المختبر Cleanup
كل التجارب استخدمت الـ Image الرسمية python:3.13-slim مع --rm، فلا يبقى أي Container بعد التشغيل، وإذا لم تكن تحتاج الـ Image بعد ذلك فاحذفها:
docker rmi python:3.13.17-slim
rm -rf lab/__pycache__
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- حقل صيغ يكتبه المستخدم هو لغة برمجة صغيرة، و
evalليس حلاً لها، فقد شغلت صيغة أمر نظام كـrootحتى بعد تفريغ__builtins__. - كل مفسر يمر بأربع مراحل: المحلل اللغوي يحول الحروف إلى رموز، والمحلل النحوي يبني شجرة AST، والمنفذ يمشي على الشجرة، وCPython يفعل نفس الشيء ويضيف مرحلة Bytecode.
- آلة الحالات تجعل المحلل اللغوي واضحاً وقابلاً للتعديل، وتعطي رسائل دقيقة مثل «a number has two decimal points» في المكان الصحيح.
- الأولويات تأتي من ترتيب مستويات القواعد، فكل مستوى أعمق يربط أقوى، والنزول التعاودي يحول كل قاعدة إلى دالة، والربط من اليمين في الأس قرار يجب أن تتخذه وتوثقه.
- المنفذ الشجري دالة واحدة مع
match، والأمان يأتي من أن كل قدرة في اللغة سطر كتبته أنت، والدوال في قائمة بيضاء. - ثلاث حالات حدية أسقطت النسخة الأولى: 200 قوس، و
9 ^ 9 ^ 9، والأس الكسري لعدد سالب، والإصلاح في كل مرة خطأ واضح من اللغة نفسها بموقعه. - التحليل كلف نحو 85% من وقت كل تقييم، وحفظ الشجرة جعل التنفيذ أسرع بسبع مرات، والمشي على الشجرة يبقى أبطأ من Bytecode الخاص بلغة Python بنحو سبع مرات.
- للقواعد والسياسات الأكبر من حاسبة، لغة مصممة لذلك مثل CEL أنسب من بناء لغة من الصفر.
 دليلالمترجم Compiler والمفسر Interpreter و JIT و WebAssemblyنشغل دالة واحدة بلغة C وPython وJavaScript وWebAssembly على نفس الجهاز، ونفتح ما كتبه كل مترجم لنعرف لماذا اختلف الوقت من ثلث ثانية إلى دقيقة.
 دليلالتعبيرات النمطية Regex للمبتدئين، مع النص العربيكيف تقرأ وتكتب تعبيراً نمطياً جزءاً بجزء، ولماذا يختلف سلوكه مع النص العربي بين اللغات، وكيف يوقف نمط واحد سيرفرك.
 دليلFloating Point من الداخل: كيف يخزن الحاسب الكسوركيف يحفظ معيار IEEE 754 الكسور في البتات، ولماذا تكبر الفجوة بين الأرقام وتضيع خانات المعرفات، ومتى تحتاج النوع العشري.
 دليلالاستدعاء الذاتي Recursion: كيف تفكر فيه ومتى تتجنبهكيف تكتب دالة تستدعي نفسها لشجرة تعليقات أو مجلدات، وما الذي يحدث في ال Stack، وإلى أي عمق تصل Python وNode.js بالقياس، ومتى تكون الحلقة هي الحل الأنسب.
 دليلOWASP Top 10 للمبتدئين: أخطر عشر مشكلات في تطبيقات الويبأخطر عشر مشكلات أمنية في تطبيقات الويب، كل واحدة بمثال ضعيف ثم مصلح، وكيف تمنعها في الكود وأين تكتشفها.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ كل الكود داخل Container من الـ Image الرسمية
python:3.13.17-slim(Python 3.13.17 على Debian 13.7)، على Docker Engine 29.8.0.


