

تفتح ملف السجل Log على السيرفر وتريد كل الأسطر التي فيها ERROR مع رقم الطلب والمدة، أو يطلب منك مدير المنتج أن يقبل حقل الجوال أرقاماً سعودية فقط، أو تريد أن تغير كل التواريخ في ملف من الشكل 2026-10-07 إلى 07/10/2026، أو يشتكي المستخدمون أن البحث عن «احمد» لا يجد «أحمد». وفي كل هذه الحالات سوف يقول لك أحد الزملاء: «استخدم Regex»، فتنسخ نمطاً من إجابة قديمة في الإنترنت، ويعمل في الاختبار، ثم يقبل في الإنتاج Production قيمة لم تتوقعها أو يجعل المعالج عند 100% بسبب نص واحد طويل.
والتعبيرات النمطية Regular Expressions، واختصاراً Regex، أداة قديمة وقوية جداً، ولكنها لغة صغيرة لها قواعدها، وكل محرك Engine يفهمها بطريقة مختلفة قليلاً، والعربية فيها تفاصيل لا تظهر في الأمثلة الإنجليزية، ولذلك فإن فهم ما يحدث داخل المحرك أهم من حفظ الرموز. وهذا المقال جزء من مرحلة أساسيات علوم الحاسب Computer Science Fundamentals في خارطة عرب رووت، وكل الأمثلة فيه شغلناها على Node.js و.NET وPython على نفس الجهاز، والمخرجات المنشورة هي المخرجات الحقيقية.
وسوف نناقش في هذا المقال ما يلي:
- ما هو التعبير النمطي، ولماذا لا يكفي البحث العادي
includesأوsplit. - مكونات النمط خطوة بخطوة: الحروف العادية Literals، وفئات الحروف Character Classes، والمكررات Quantifiers بنوعيها الجشع Greedy والكسول Lazy، والمرتكزات Anchors، والمجموعات Groups والالتقاط Capturing، والبدائل Alternation، والنظر للأمام والخلف Lookaround، والخيارات Flags.
- لهجات المحركات Dialects: PCRE وJavaScript و.NET وJava وPython وPOSIX وgrep، وأين تختلف فعلاً.
- النص العربي: نطاقات Unicode، والخاصية
\p{Arabic}في كل محرك، والأرقام العربية٠-٩وسلوك\d، وحدود الكلمة، وتوحيد الألف والتاء المربوطة وحذف الحركات والتطويل، ومشكلات اتجاه النص RTL. - التحقق Validation مقابل التحليل Parsing: لماذا لا تحلل HTML أو البريد الإلكتروني بتعبير نمطي.
- التراجع الكارثي Catastrophic Backtracking وهجوم ReDoS، مع تجربة تقيس نمو الوقت، ومهلة .NET وهي تعمل، والمحركات الخطية Linear-time Engines، وكيف تعيد كتابة النمط بأمان.
ما هو التعبير النمطي Regular Expression؟
التعبير النمطي هو وصف لشكل النص الذي تبحث عنه بدلاً من النص نفسه، فبدلاً من أن تقول للبرنامج «ابحث عن 2026» تقول له «ابحث عن أربعة أرقام بعدها شرطة ثم رقمين»، وهذا الوصف يكتب بلغة صغيرة من الرموز، ثم يأخذه محرك Regex Engine داخل لغة البرمجة أو الأداة ويمشي به على النص. والتشبيه الأقرب هو أن تبحث عن شخص في قاعة كبيرة، فإذا كنت تعرف اسمه فأنت تنادي الاسم، وهذا هو البحث العادي، أما إذا كنت تعرف فقط أنه «طويل ويلبس نظارة ويحمل حقيبة حمراء» فأنت تعطي وصفاً، والوصف يطابق كل من تنطبق عليه الصفات، وهذا هو التعبير النمطي.
وسوف تقابل التعبيرات النمطية في كل مكان تقريباً: في البحث داخل المحرر، وفي الأمر grep الذي شرحناه في دليل سطر الأوامر في Linux، وفي التحقق من مدخلات النماذج Forms، وفي قراءة السجلات، وفي قواعد جدار حماية التطبيقات WAF، وفي أدوات اكتشاف الأسرار التي تحمل مئات القواعد Rules وكل قاعدة تعبير نمطي كما شرحنا في دليل اكتشاف الأسرار المسربة، وفي القواعد المخصصة Custom Rules لأدوات الفحص الثابت كما في دليل SAST.
لماذا لا يكفي البحث العادي؟
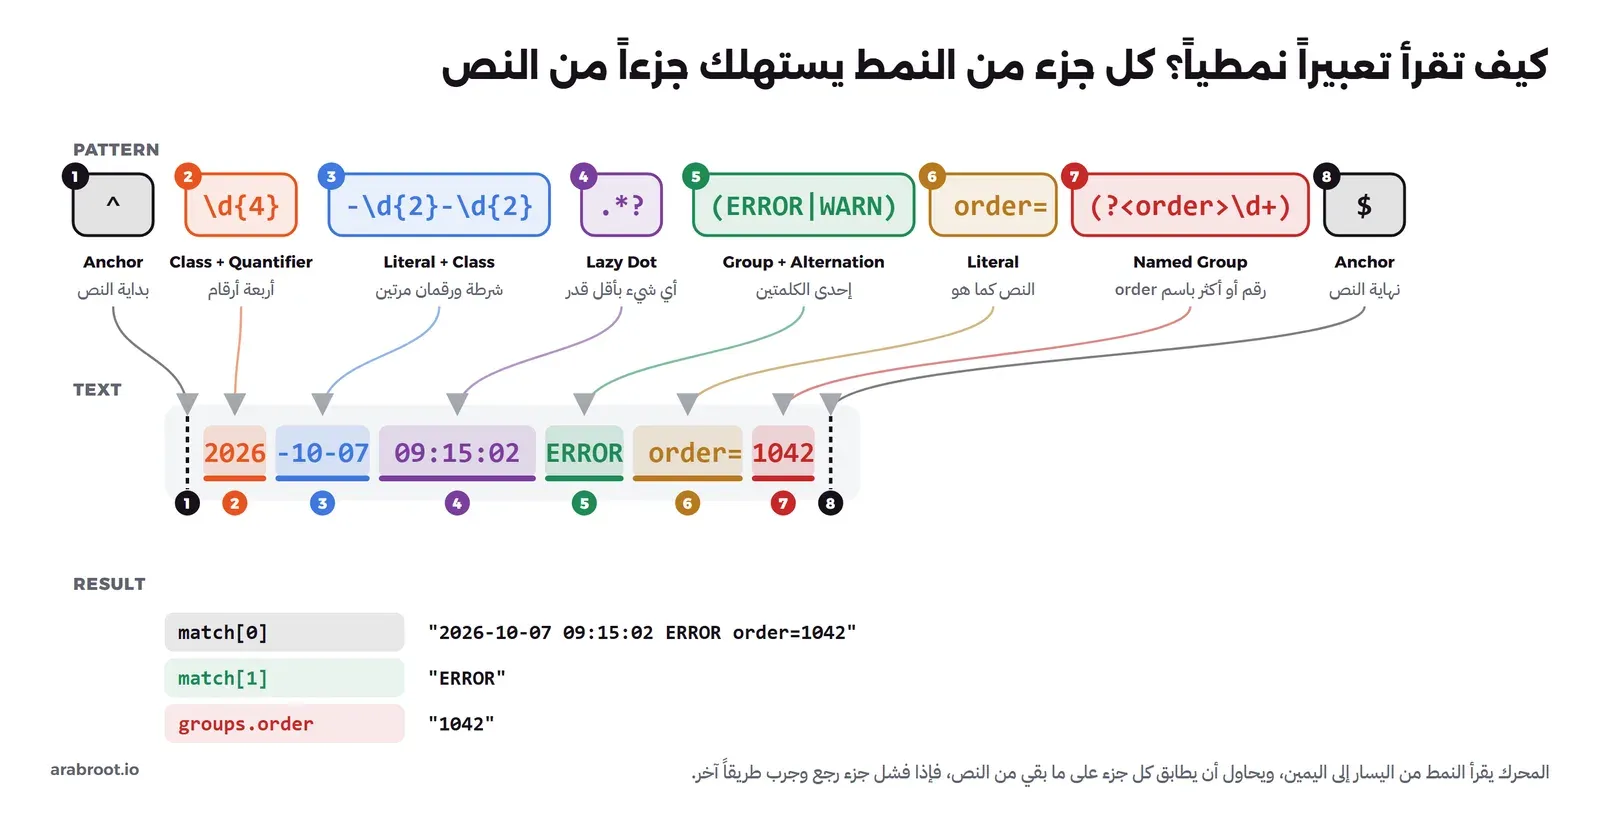
لنفرض أن لديك سطر السجل التالي، وتريد منه مستوى الخطأ ورقم الطلب:
2026-10-07 09:15:02 ERROR order=1042 [email protected] took=842msالحل البسيط الأول هو line.includes("ERROR")، وهو يخبرك أن الكلمة موجودة ولكنه لا يعطيك رقم الطلب، ويطابق أيضاً سطراً فيه user=ERRORS_BOT. والحل البسيط الثاني هو تقسيم السطر بالمسافات split(" ") وأخذ العنصر الثالث والرابع، وهذا يعمل حتى يضيف زميلك حقلاً جديداً في وسط السطر أو تأتي رسالة فيها مسافة، فتصبح الأرقام في غير مكانها دون أي خطأ ظاهر. أما التعبير النمطي فيصف الشكل كله: تاريخ في بداية السطر، ثم أي شيء، ثم كلمة المستوى، ثم order= وبعدها أرقام، ويعيد لك كل جزء باسمه. ولاحظ أن الحل الأفضل على الإطلاق للسجلات هو ألا تحتاج لهذا كله، أي أن تكتب السجل منظماً بصيغة JSON من البداية كما شرحنا في دليل السجلات Logging، ولكنك سوف تقرأ دائماً سجلات أدوات لم تكتبها أنت.
والصورة التالية تبين نمطاً واحداً مقسماً إلى أجزائه، وما الذي استهلكه كل جزء من سطر السجل:
مكونات النمط خطوة بخطوة
الحروف العادية Literals والحروف الخاصة Metacharacters
أبسط تعبير نمطي هو كلمة عادية، فالنمط ERROR يطابق الحروف الخمسة بنفس الترتيب في أي مكان من النص. ولكن هناك حروف لها معنى خاص في لغة الأنماط، وهي . ^ $ * + ? ( ) [ ] { } | \، فإذا أردت الحرف نفسه وجب أن تضع قبله الشرطة المائلة العكسية Backslash، أي \. للنقطة و\( للقوس. وهذا هو أول خطأ يقع فيه كل مبتدئ، فالنمط 10.0.0.1 يبدو صحيحاً، ولكن النقطة فيه تعني «أي حرف»، فيطابق 10x0y0z1 كما سوف ترى في التجربة بعد قليل.
فئات الحروف Character Classes
الأقواس المربعة تعني «حرفاً واحداً من هذه المجموعة»، فالنمط [aeiou] يطابق حرف علة واحداً، و[0-9] رقماً واحداً، و[A-Za-z] حرفاً إنجليزياً، وإذا بدأت الفئة بالعلامة ^ انعكس معناها، فالنمط [^0-9] يعني أي حرف ليس رقماً. وهناك اختصارات شائعة: \d للرقم Digit، و\w لحرف الكلمة Word Character، و\s للمسافة البيضاء Whitespace، وعكسها بالحرف الكبير \D و\W و\S، والنقطة . تعني أي حرف ما عدا نهاية السطر. ولاحظ من الآن أن معنى \d و\w يختلف من محرك لآخر مع العربية، وهذا موضوع قسم النص العربي بالتفصيل.
المكررات Quantifiers، والجشع Greedy مقابل الكسول Lazy
المكرر يأتي بعد حرف أو فئة أو مجموعة ويحدد عدد مرات تكراره:
| المكرر | المعنى | مثال |
|---|---|---|
* | صفر مرة أو أكثر | \d* يطابق النص الفارغ أيضاً |
+ | مرة أو أكثر | \d+ رقم واحد على الأقل |
? | صفر أو مرة، أي اختياري | https? يطابق http وhttps |
{n} و{n,m} و{n,} | عدد محدد، أو بين حدين، أو n فأكثر | \d{4} أربعة أرقام بالضبط |
والمكررات في الأصل جشعة Greedy، أي أنها تأخذ أكبر قدر ممكن من النص ثم تتراجع إذا احتاج باقي النمط ذلك، فإذا كتبت ".*" لتأخذ النص بين علامتي تنصيص في السطر قال "عرب" ثم قال "رووت" فسوف يأخذ من أول علامة إلى آخر علامة في السطر كله. والحل أن تضيف علامة الاستفهام بعد المكرر فيصبح كسولاً Lazy، أي ".*?"، فيأخذ أقل قدر ممكن ويتوقف عند أول علامة إغلاق. والأفضل من الكسول في أغلب الحالات أن تصف ما بين العلامتين بدقة، أي "[^"]*"، والسبب أن هذا النمط لا يحتاج للتراجع أصلاً، وهذا سوف يهمنا كثيراً في قسم ReDoS.
المرتكزات Anchors وحدود الكلمة Word Boundary
المرتكز لا يطابق حرفاً وإنما موضعاً، فالعلامة ^ تعني بداية النص، و$ تعني نهايته، و\b تعني الحد بين حرف كلمة وحرف ليس من الكلمة. وأهم قاعدة في التحقق من المدخلات أن تضع المرتكزين دائماً، والسبب أن النمط \d{4} وحده يبحث عن أربعة أرقام في أي مكان، فيقبل 12345678 وabc1234xyz كرمز تحقق من أربعة أرقام، أما ^\d{4}$ فيشترط أن يكون النص كله أربعة أرقام فقط.
وهنا أول اختلاف حقيقي بين المحركات: في JavaScript تعني $ نهاية النص فعلاً، أما في Python و.NET وPCRE فهي تطابق أيضاً قبل سطر جديد \n في آخر النص، فيقبل النمط ^\d{4}$ القيمة "1234\n"، وهذا ما سوف تراه في مخرجات .NET وPython لاحقاً. والحل في هذه المحركات أن تستخدم \z في .NET و\Z في Python، أو الدالة re.fullmatch في Python التي تشترط مطابقة النص كله.
المجموعات Groups والالتقاط Capturing
الأقواس العادية ( ) تفعل شيئين: تجمع جزءاً من النمط ليطبق عليه مكرر أو بديل، وتلتقط Capture النص الذي طابقه هذا الجزء ليعود لبرنامجك برقم المجموعة، فالمجموعة الأولى $1 أو match[1]، والثانية $2، وهكذا. وإذا أردت التجميع دون التقاط فاكتب (?:...)، وهذا أسرع قليلاً ويبقي أرقام المجموعات مرتبة. وإذا كثرت المجموعات فأعطها أسماء بالشكل (?<order>\d+)، فتقرأ القيمة باسمها groups.order بدلاً من رقم يتغير كلما أضفت قوساً. وفي الاستبدال Replace تستخدم أرقام المجموعات لإعادة ترتيب النص، مثل تحويل التاريخ 2026-10-07 إلى 07/10/2026 بالنمط (\d{4})-(\d{2})-(\d{2}) والاستبدال $3/$2/$1. وهناك أيضاً المرجع الخلفي Backreference مثل \1 الذي يعني «نفس النص الذي التقطته المجموعة الأولى»، وهو مفيد في حالات قليلة مثل البحث عن كلمة مكررة، ولكن لاحظ أنه الميزة التي ترفضها المحركات الخطية كما سوف ترى.
البدائل Alternation
العلامة | تعني «هذا أو ذاك»، فالنمط ERROR|WARN يطابق إحدى الكلمتين. والخطأ الشائع هنا هو الأولوية Precedence، فالعلامة | هي الأضعف في اللغة كلها، وبالتالي فإن ^cat|dogs$ لا يعني «cat أو dog في كل النص» وإنما يعني «cat في البداية» أو «dogs في النهاية»، فيقبل كلمة catalog. والحل أن تضع البدائل داخل مجموعة: ^(cat|dog)s?$.
النظر للأمام Lookahead والنظر للخلف Lookbehind
أحياناً تريد شرطاً على ما حول النص دون أن يدخل في النتيجة، فالنظر للأمام (?=...) يشترط أن يأتي بعد الموضع نص معين، فالنمط \d+(?= SAR) يأخذ الأرقام التي بعدها كلمة SAR فقط ولا يأخذ SAR نفسها، وعكسه (?!...) يشترط ألا يأتي. والنظر للخلف (?<=...) يشترط ما قبل الموضع، فالنمط (?<=#)\d+ يأخذ الأرقام التي قبلها علامة #، وعكسه (?<!...). ولاحظ أن دعم النظر للخلف يختلف كثيراً: Python تشترط أن يكون طول ما داخله ثابتاً، وRE2 وGo وRust لا تدعم النظر للأمام ولا للخلف أصلاً.
الخيارات Flags
الخيارات تغير سلوك النمط كله، وتكتب في JavaScript بعد الشرطة الأخيرة مثل /error/gi، وفي .NET كقيمة من RegexOptions، وفي Python كقيمة من re مثل re.IGNORECASE، وفي PCRE وJava و.NET وPython أيضاً داخل النمط نفسه بالشكل (?i):
| الخيار | JavaScript | .NET | Python | المعنى |
|---|---|---|---|---|
| تجاهل حالة الحروف Case-insensitive | i | IgnoreCase | re.I | error وError وERROR سواء |
| كل النتائج Global | g | Regex.Matches | re.findall | لا يتوقف عند أول نتيجة |
| متعدد الأسطر Multiline | m | Multiline | re.M | ^ و$ لبداية ونهاية كل سطر |
| النقطة تطابق نهاية السطر DotAll | s | Singleline | re.S | . تطابق \n أيضاً |
| Unicode | u أو v | دائماً | دائماً للنصوص str | يفعل \p{...} ويعامل الحرف خارج BMP كحرف واحد |
| شرح داخل النمط Verbose | غير موجود | IgnorePatternWhitespace | re.X | مسافات وتعليقات داخل النمط |
التجربة الأولى: كل المكونات في ملف واحد
الآن سوف نجرب كل ما سبق في Node.js، والملف التالي فيه مثال لكل مكون، وكل سطر يطبع نتيجة واحدة:
// basics.mjs
const log = "2026-10-07 09:15:02 ERROR order=1042 [email protected] took=842ms";
console.log(/ERROR/.test(log));
const m = log.match(/^(\d{4})-(\d{2})-(\d{2}) (\d{2}:\d{2}:\d{2}) (?<level>[A-Z]+) order=(?<order>\d+)/);
console.log(m[1], m[2], m[3], m[4], m.groups.level, m.groups.order);
console.log(log.match(/took=(\d+)ms/)[1]);
const text = 'قال "عرب" ثم قال "رووت"';
console.log(text.match(/".*"/)[0]);
console.log(text.match(/".*?"/g));
console.log("price: 100 SAR, 250 SAR, 75 USD".match(/\d+(?= SAR)/g));
console.log("ID-77 #12 #345".match(/(?<=#)\d+/g));
console.log("Error error ERROR".match(/error/gi).length);
console.log("2026-10-07".replace(/(\d{4})-(\d{2})-(\d{2})/, "$3/$2/$1"));
console.log(/^(cat|dog)s?$/.test("dogs"), /^cat|dogs$/.test("catalog"));
console.log(/^10.0.0.1$/.test("10x0y0z1"), /^10\.0\.0\.1$/.test("10x0y0z1"));
node --version
node basics.mjsوالمخرج سوف يكون كما يلي:
v22.14.0
true
2026 10 07 09:15:02 ERROR 1042
842
"عرب" ثم قال "رووت"
[ '"عرب"', '"رووت"' ]
[ '100', '250' ]
[ '12', '345' ]
3
07/10/2026
true true
true false
في الإعداد أعلاه لاحظ التالي:
- الدالة
testتعيدtrueأوfalseفقط، وهي المناسبة للتحقق، أماmatchفتعيد النص والمجموعات، والمجموعات المسماةlevelوorderتقرأ منm.groups. - النمط الجشع
".*"أخذ"عرب" ثم قال "رووت"كاملاً، والكسول".*?"مع الخيارgأعاد الكلمتين منفصلتين. - النظر للأمام أعاد
100و250فقط ولم يأخذ75لأن بعدها USD، والنظر للخلف أعاد12و345ولم يأخذ77. - السطر قبل الأخير يبين خطأ الأولوية:
^cat|dogs$قبل كلمةcatalog، وفي السطر الأخير طابقت النقاط غير المحمية10x0y0z1كعنوان IP، وبعد إضافة\.رفضه النمط.
والآن لنتأكد من موضوع المرتكزات، والملف التالي يقارن النمط بدون مرتكزات ومعها، ثم الخيارين m وs:
// anchors.mjs
const pin = /\d{4}/;
console.log(pin.test("1234"), pin.test("12345678"), pin.test("abc1234xyz"));
const strict = /^\d{4}$/;
console.log(strict.test("1234"), strict.test("12345678"), strict.test("1234\n"));
const lines = "ERROR a\nINFO b\nERROR c";
console.log(lines.match(/^ERROR.*$/g), lines.match(/^ERROR.*$/gm));
console.log(/a.b/.test("a\nb"), /a.b/s.test("a\nb"));
true true true
true false false
null [ 'ERROR a', 'ERROR c' ]
false trueالنمط بدون مرتكزات قبل الثلاثة، ومع المرتكزين قبل 1234 فقط، ولاحظ أن JavaScript رفضت "1234\n"، وهذا السلوك سوف يختلف في .NET وPython. ودون الخيار m لم يجد النمط ^ERROR.*$ شيئاً لأن النص كله لا ينتهي بعد السطر الأول، ومعه وجد السطرين.
لهجات المحركات Dialects: نفس النمط ونتائج مختلفة
قد يتساءل البعض: إذا كانت التعبيرات النمطية لغة واحدة، فلماذا يعمل النمط في regex101 ثم يفشل في الكود؟ والإجابة أنها ليست لغة واحدة، وإنما عائلة لهجات Dialects أو Flavors: معيار POSIX القديم الذي تتبعه أدوات Unix مثل grep وsed، ثم لهجة Perl التي أضافت \d والمكررات الكسولة والنظر للأمام، وأخذت عنها مكتبة PCRE ومعظم اللغات الحديثة، ولكن كل لغة اختارت تفاصيلها الخاصة، خصوصاً في Unicode. والجدول التالي يجمع الفروقات التي تهمك عملياً، وكل خلية فيه من التوثيق الرسمي للمحرك، والخلايا الخاصة بالعربية جربناها كما سوف ترى في القسم التالي:
| المحرك | \d مع ١٤٣٢ | خاصية الكتابة العربية | النظر للخلف Lookbehind | المجموعات الذرية Atomic | الحماية من التراجع |
|---|---|---|---|---|---|
POSIX ERE وgrep -E | \d غير معرف في المعيار، استخدم [[:digit:]] أو [0-9] | غير موجودة | غير موجود | غير موجودة | غير مطبق |
PCRE2 وgrep -P وPHP | ASCII فقط إلا مع الخيار PCRE2_UCP أو (*UCP) | \p{Arabic} | نعم | نعم، ومعها المكررات المستحوذة Possessive | حدود pcre2_set_match_limit |
| JavaScript | ASCII فقط [0-9] | \p{Script=Arabic} مع u أو v | نعم | غير موجودة | لا توجد مهلة، ومحرك خطي تجريبي في V8 بالخيار l |
| .NET | كل أرقام Unicode \p{Nd}، وASCII مع RegexOptions.ECMAScript | \p{IsArabic} وهي كتلة Block وليست كتابة Script | نعم | نعم (?>...) | المهلة matchTimeout، وRegexOptions.NonBacktracking |
| Java | ASCII إلا مع UNICODE_CHARACTER_CLASS | \p{IsArabic} أو \p{script=Arabic} | نعم | نعم، ومعها المستحوذة | لا توجد مهلة في الواجهة |
| Python re | كل أرقام Unicode للنصوص str، وASCII مع re.ASCII | غير مدعومة \p | بطول ثابت فقط | نعم منذ 3.11، ومعها المستحوذة | لا توجد مهلة |
| RE2 وGo | ASCII فقط | \p{Arabic} | غير موجود | غير موجودة | وقت خطي مضمون |
| Rust regex | كل أرقام Unicode \p{Nd} | \p{Arabic} | غير موجود | غير موجودة | وقت خطي مضمون |
ويجدر بك أن تعرف أمراً عن grep بالذات، لأنه الأداة التي تستخدمها كل يوم على السيرفر: يقول دليل GNU grep إن \d مع الخيار -P تطابق الأرقام العشرة ASCII فقط مهما كانت اللغة Locale، بينما تطابق [[:digit:]] مع -P كل أرقام Unicode ومنها ٣، وإن الشرطة المائلة العكسية قبل حرف عادي في الأنماط غير -P سلوكها غير محدد، لذلك لا تكتب grep -E '\d' وتتوقع أنه يعني رقماً، واكتب grep -E '[0-9]'.
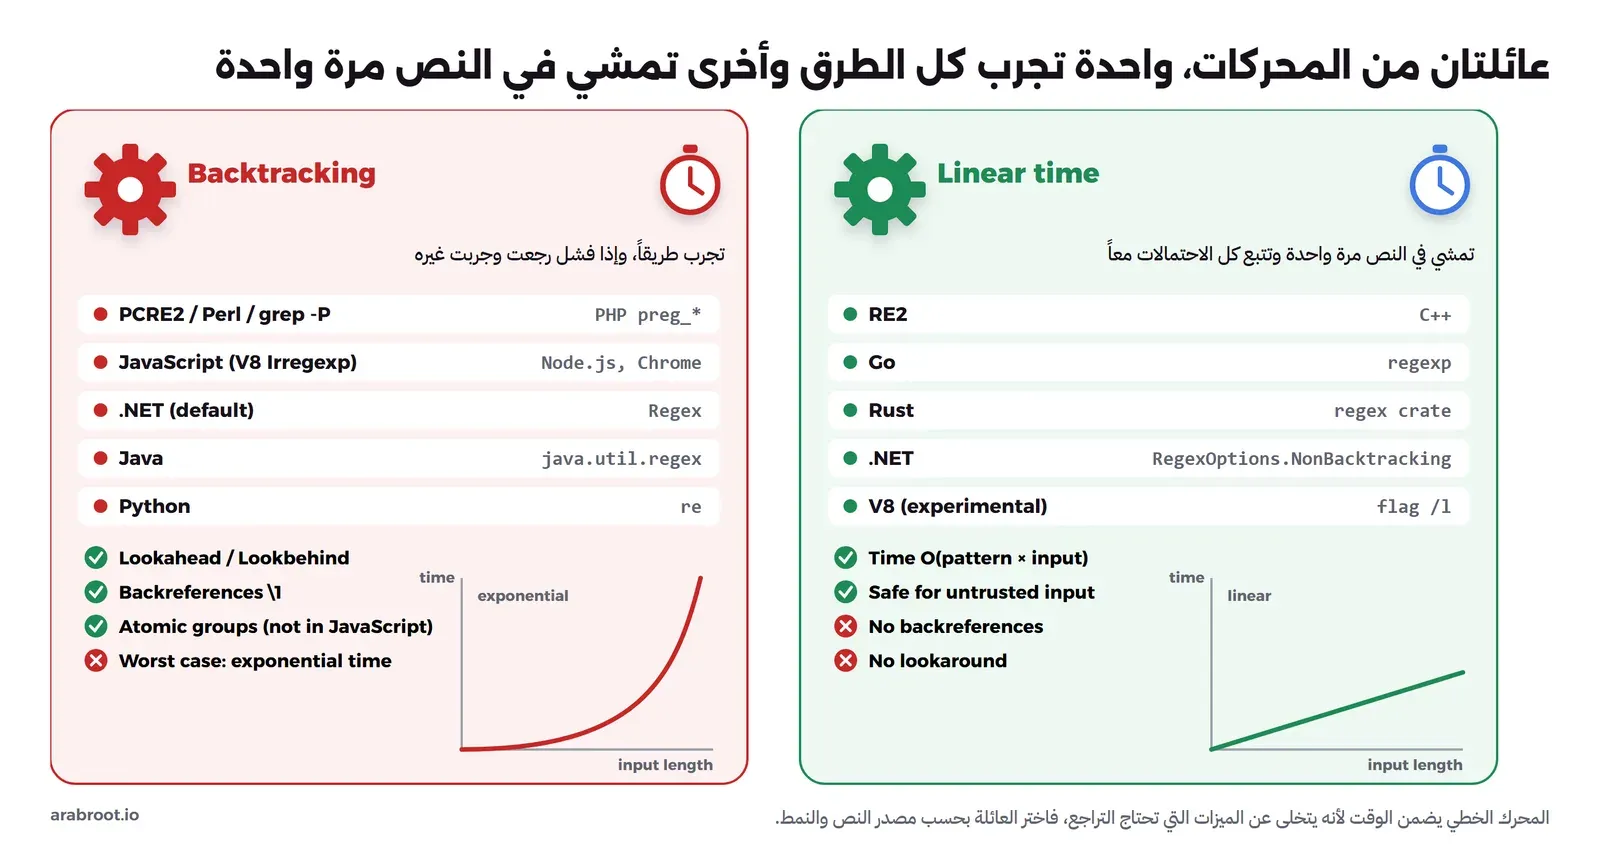
والصورة التالية تبين الفرق الأهم بين هذه المحركات، وهو طريقة البحث نفسها، وسوف نعود لها بالتفصيل في قسم المحركات الخطية:
النص العربي Arabic Text في التعبيرات النمطية
كل الأمثلة السابقة كانت بحروف إنجليزية، والعربية تضيف طبقة كاملة من التفاصيل، والسبب أن الحرف العربي في Unicode له أكثر من شكل، وأن الحركات Diacritics حروف مستقلة، وأن هناك أرقاماً عربية وفارسية بجانب الأرقام الإنجليزية، وأن النص يكتب من اليمين إلى اليسار. وإذا كنت لا تعرف الفرق بين نقطة الترميز Code Point والبايت في UTF-8 فابدأ بقسم مجموعة الحروف والترميز في دليل الترميز Encoding، لأن المحرك يطابق نقاط ترميز وليس ما تراه بعينك على الشاشة.
نطاقات Unicode للعربية Unicode Ranges
الحروف العربية الأساسية والحركات والأرقام العربية وعلامات الترقيم العربية كلها في كتلة Arabic من U+0600 إلى U+06FF، ولذلك فإن النمط الذي تراه في كثير من الإجابات هو [\u0600-\u06FF]. ولكن هناك كتل أخرى للحروف العربية: Arabic Supplement من U+0750 إلى U+077F، وArabic Extended-A من U+08A0 إلى U+08FF، ثم أشكال العرض Presentation Forms في FB50 إلى FDFF وFE70 إلى FEFF، وهي الأشكال التي تظهر أحياناً عند نسخ نص من ملف PDF، مثل حرف لام ألف ﻻ الذي هو حرف واحد U+FEFB وليس حرفين. لذلك فإن النطاق اليدوي يعمل في أغلب النصوص، ولكنه يفوت هذه الكتل، والأدق منه هو خاصية الكتابة Script Property التي يعرفها المحرك من بيانات Unicode نفسها.
الخاصية \p{Arabic} في كل محرك
المعيار Unicode Regular Expressions UTS #18 يعرف خصائص يمكن استخدامها داخل النمط بالشكل \p{...}، ومنها خاصية الكتابة Script. ولكن لاحظ تفصيلاً مهماً من UAX #24: الحركات مثل الفتحة والشدة ليست من كتابة Arabic في جدول Scripts.txt وإنما من كتابة Inherited لأنها تستخدم مع أكثر من كتابة، وحرف التطويل ـ وعلامة الفاصلة العربية ، من كتابة Common، أما خاصية Script_Extensions فتضمها إلى العربية. والملف التالي يبين ماذا يعني ذلك في JavaScript:
// arabic.mjs
const s = "طلب رقم ١٤٣٢ بتاريخ 2026";
console.log("1:", s.match(/\d+/g));
console.log("2:", s.match(/[0-9\u0660-\u0669]+/g));
console.log("3:", s.match(/\p{Nd}+/gu));

const w = "مُحَمَّد الإجـــازة";
console.log("4:", w.match(/\p{Script=Arabic}+/gu));
console.log("5:", w.match(/\p{Script_Extensions=Arabic}+/gu));
console.log("6:", w.match(/[\u0600-\u06FF]+/g));

console.log("7:", /\w/.test("م"), /\p{L}/u.test("م"));
console.log("8:", /\bمحمد\b/u.test("قال محمد"), /(?<!\p{L})محمد(?!\p{L})/u.test("قال محمد"));
try { new RegExp(String.raw`\p{Arabic}`, "u"); } catch (e) { console.log("9:", e.message); }
node arabic.mjsوالمخرج سوف يكون كما يلي:
1: [ '2026' ]
2: [ '١٤٣٢', '2026' ]
3: [ '١٤٣٢', '2026' ]
4: [ 'م', 'ح', 'م', 'د', 'الإج', 'ازة' ]
5: [ 'مُحَمَّد', 'الإجـــازة' ]
6: [ 'مُحَمَّد', 'الإجـــازة' ]
7: false true
8: false true
9: Invalid regular expression: /\p{Arabic}/u: Invalid property name
في الإعداد أعلاه لاحظ التالي:
- السطر 4 هو المفاجأة:
\p{Script=Arabic}قطع كلمةمُحَمَّدإلى أربعة حروف منفصلة عند كل حركة، وقطعالإجـــازةعند التطويل، والسبب ما ذكرناه من أن الحركات Inherited والتطويل Common. ومع\p{Script_Extensions=Arabic}في السطر 5 بقيت الكلمتان كاملتين، لذلك استخدمScript_Extensionsواختصارهاscxعندما تريد «كلمة عربية». - السطر 9 يبين أن JavaScript لا تقبل الاسم المختصر
\p{Arabic}الذي تقبله PCRE2 وRE2 وRust، وتشترطScript=أوScript_Extensions=مع الخيارuكما في توثيق MDN. ويقول توثيق PCRE2 إن الاسم بدون نوع الخاصية يعامل كأنهscx، أي أنه يضم الحركات. - السطر 7 يبين أن
\wفي JavaScript لا تطابق الحرف العربي، لأنها تعني[A-Za-z0-9_]فقط، ولذلك فشل\bفي السطر 8 في إيجاد كلمةمحمد، فالمحرك لا يرى حداً بين مسافة وحرف لا يعتبره من حروف الكلمة أصلاً. والحل هو النظر للخلف والأمام مع\p{L}كما في الجزء الثاني من نفس السطر.
والآن نفس الأسئلة في .NET، ولاحظ أننا نستخدم ميزة تشغيل ملف C# واحد مباشرة dotnet run arabic.cs الموجودة في .NET 10، فلا نحتاج لمشروع كامل:
// arabic.cs
using System.Text.RegularExpressions;

var s = "طلب رقم ١٤٣٢ بتاريخ 2026";
Console.WriteLine("1: " + string.Join(" | ", Regex.Matches(s, @"\d+").Select(m => m.Value)));
Console.WriteLine("2: " + string.Join(" | ", Regex.Matches(s, @"\d+", RegexOptions.ECMAScript).Select(m => m.Value)));
Console.WriteLine("3: " + string.Join(" | ", Regex.Matches(s, @"[0-9]+").Select(m => m.Value)));
Console.WriteLine("4: " + int.TryParse("١٤٣٢", out _));
Console.WriteLine("5: " + string.Join(" | ", Regex.Matches("مُحَمَّد الإجـــازة", @"\p{IsArabic}+").Select(m => m.Value)));
try { new Regex(@"\p{Arabic}"); } catch (ArgumentException e) { Console.WriteLine("6: " + e.Message); }
Console.WriteLine("7: " + Regex.IsMatch("1234\n", @"^\d{4}$") + " " + Regex.IsMatch("1234\n", @"^\d{4}\z"));
dotnet --version
dotnet run arabic.cs10.0.400
1: ١٤٣٢ | 2026
2: 2026
3: 2026
4: False
5: مُحَمَّد | الإجـــازة
6: Invalid pattern '\p{Arabic}' at offset 10. Unknown property 'Arabic'.
7: True Falseفي الإعداد أعلاه لاحظ التالي:
- في .NET تطابق
\dالرقم١٤٣٢لأنها تعني\p{Nd}كما في توثيق Microsoft، ومعRegexOptions.ECMAScriptتصبح[0-9]مثل JavaScript. - السطر 4 هو الخطر الحقيقي: النمط
^\d+$في .NET سوف يقبل١٤٣٢كرقم صحيح، ثم يفشلint.TryParseفي تحويله، فإذا كان كودك يتحقق بالنمط ثم يستخدمint.Parseمباشرة فسوف يرمي استثناء Exception في الإنتاج على قيمة «صحيحة» حسب التحقق. - .NET لا تعرف
\p{Arabic}، وإنما تعرف الكتل بأسمائها مثل\p{IsArabic}وهي النطاق U+0600 إلى U+06FF فقط، وبما أن الحركات والتطويل داخل هذا النطاق فقد بقيت الكلمتان كاملتين. - السطر 7 يؤكد ما ذكرناه عن المرتكزات:
$في .NET قبلت"1234\n"، و\zرفضته.
الأرقام العربية ٠-٩ وسلوك \d
هناك مجموعتان من الأرقام في كتلة Arabic: الأرقام العربية الهندية Arabic-Indic Digits ٠١٢٣٤٥٦٧٨٩ من U+0660 إلى U+0669، والأرقام الممتدة Extended Arabic-Indic ۰۱۲۳۴۵۶۷۸۹ من U+06F0 إلى U+06F9 التي تستخدم في الفارسية والأردية، ولوحات المفاتيح العربية في الجوالات تكتب المجموعة الأولى في كثير من الإعدادات. ومن التجربتين السابقتين ومن تجربة Python في قسم ReDoS فإن \d تطابق هذه الأرقام في .NET وPython وRust، ولا تطابقها في JavaScript وJava وRE2 وGo وفي grep -P. والقاعدة العملية هي أن تقرر ماذا تريد ثم تكتبه صراحة، والسبب أن نفس النمط ينتقل بين الواجهة Frontend والخادم Backend:
- إذا كان النظام يخزن أرقاماً إنجليزية فقط، مثل رقم الجوال أو رقم الهوية، فاكتب
[0-9]وليس\d، وقبل التحقق حول الأرقام العربية إلى إنجليزية بالدالةtoAsciiDigitsفي القسم التالي، فيكتب المستخدم بأي لوحة مفاتيح ويخزن النظام شكلاً واحداً. - إذا كنت تريد قبول الشكلين فاكتب
[0-9\u0660-\u0669]صراحة، أو\p{Nd}إذا كنت تقبل كل أرقام العالم، ولكن حول القيمة قبل أن تمررها لدالة تحويل الأرقام، لأنNumber("١٤٣٢")في JavaScript تعيدNaNوint.TryParseفي .NET تعيدFalseكما رأيت، بينماint("١٤٣٢")في Python تعيد 1432.
توحيد الحروف Normalization: الألف والتاء المربوطة والحركات والتطويل
شرحنا في دليل RAG لماذا يفشل البحث بالكلمات عندما يكتب المستند «الإجازة» ويكتب المستخدم «الاجازه»، وكيف تحل المشكلة بتوحيد Normalization الشكلين قبل المقارنة، وهنا سوف نرى الأنماط نفسها خطوة بخطوة. وهناك طريقتان: الأولى أن تجعل النمط يقبل كل الأشكال، مثل [اأإآ]حمد لأشكال الألف ومدرس[ةه] للتاء المربوطة، وهذه مناسبة لبحث واحد سريع:
// alef.mjs
const names = ["أحمد", "احمد", "إحمد", "محمد", "آحمد"];
const re = /^[اأإآ]حمد$/;
console.log(names.filter((n) => re.test(n)));
const taa = /^مدرس[ةه]$/;
console.log(["مدرسة", "مدرسه", "مدرس"].map((w) => taa.test(w)));
[ 'أحمد', 'احمد', 'إحمد', 'آحمد' ]
[ true, true, false ]ولكن هذه الطريقة لا تتوسع، فكل كلمة تحتاج نمطاً خاصاً، ولا تحل الحركات والتطويل، لذلك فالطريقة الثانية والأنسب هي أن توحد النص نفسه بدالة واحدة تطبقها على المستند وعلى كلمات البحث، والصورة التالية تبين خطواتها وترتيبها:
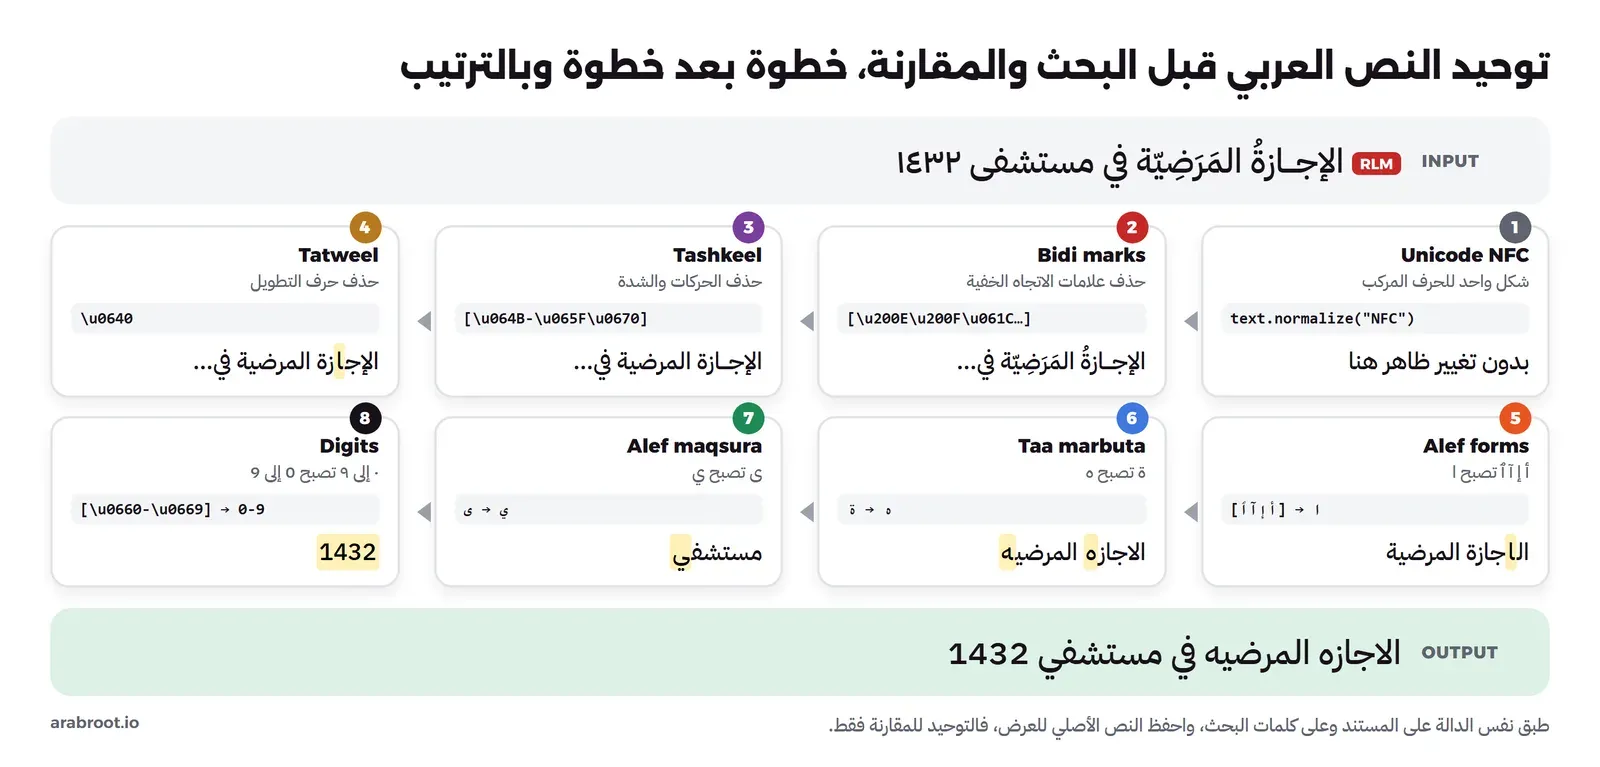
// normalize.mjs
const BIDI = /[\u200E\u200F\u061C\u202A-\u202E\u2066-\u2069]/g;  // LRM, RLM, ALM, embeddings, isolates
const TASHKEEL = /[\u064B-\u065F\u0670]/g;                       // harakat, shadda, sukun, superscript alef
const TATWEEL = /\u0640/g;

function normalizeArabic(text) {
  return text
    .normalize("NFC")
    .replace(BIDI, "")
    .replace(TASHKEEL, "")
    .replace(TATWEEL, "")
    .replace(/[أإآٱ]/g, "ا")
    .replace(/ة/g, "ه")
    .replace(/ى/g, "ي");
}

function toAsciiDigits(text) {
  return text
    .replace(/[\u0660-\u0669]/g, (d) => String(d.charCodeAt(0) - 0x0660))   // ٠-٩ Arabic-Indic
    .replace(/[\u06F0-\u06F9]/g, (d) => String(d.charCodeAt(0) - 0x06F0));  // ۰-۹ Extended (Persian, Urdu)
}

for (const w of ["الإجـــازة", "الاجازه", "مُحَمَّد", "مستشفى", "آمنة", "محمد\u200F"])
  console.log(JSON.stringify(w), "->", JSON.stringify(normalizeArabic(w)));
console.log("محمد\u200F" === "محمد", normalizeArabic("محمد\u200F") === "محمد");
console.log(toAsciiDigits("١٤٣٢ و ۱۴۳۲"), Number("١٤٣٢"), Number(toAsciiDigits("١٤٣٢")));
const doc = "سياسة الإجـازة المَرَضية", query = "الاجازه المرضيه";
console.log(doc.includes(query), normalizeArabic(doc).includes(normalizeArabic(query)));
node normalize.mjs"الإجـــازة" -> "الاجازه"
"الاجازه" -> "الاجازه"
"مُحَمَّد" -> "محمد"
"مستشفى" -> "مستشفي"
"آمنة" -> "امنه"
"محمد" -> "محمد"
false true
1432 و 1432 NaN 1432
false trueفي الإعداد أعلاه لاحظ التالي:
- الخطوة الأولى
normalize("NFC")من معيار Unicode Normalization UAX #15 تجعل الحرف المركب بشكل واحد، والسبب أنإيمكن أن يكتب كحرف واحد U+0625، أو كألف U+0627 وبعدها همزة تحت U+0655، والشكلان متطابقان على الشاشة ومختلفان للمحرك، وبعد NFC يصبحان الحرف الواحد الذي يطابقه النمط[أإآٱ]. - نطاق الحركات
\u064B-\u065Fمع\u0670للألف الخنجرية يشمل الفتحة والضمة والكسرة والتنوين والشدة والسكون وعلامات أخرى من نفس النوع حسب جدول كتلة Arabic. - السطر السادس من المخرج يبدو كأن الكلمتين متطابقتان، ولكن السطر بعده يقول
falseللمقارنة المباشرة، والسبب علامة RLM الخفية U+200F في آخر الكلمة، وهذا ما نشرحه في القسم التالي. - التوحيد يفقد معلومات، فكلمة «مدرسه» قد تكون «مدرسة» أو «مدرسه» بمعنى «مدرس + ضمير»، لذلك استخدمه للمقارنة والبحث فقط، واحفظ النص الأصلي كما هو واعرضه للمستخدم.
اتجاه النص RTL عند كتابة النمط وقراءته
عندما تكتب نمطاً فيه حروف عربية داخل محرر الكود، فإن خوارزمية الاتجاه الثنائي Unicode Bidirectional Algorithm UAX #9 تعيد ترتيب ما تراه على الشاشة، فالنمط ة → ه أو ^[أإآ]ل قد يظهر مقلوباً أو تظهر الأقواس في غير مكانها، رغم أن المحرك يقرأ الحروف بترتيبها المخزن في الملف وليس بترتيب العرض، وقد رأينا ذلك بأنفسنا أثناء رسم صور هذا المقال. ولذلك لدينا ثلاث قواعد عملية:
- اكتب الحروف العربية الخاصة بنقاط الترميز مثل
\u0640و\u0660-\u0669بدلاً من الحرف نفسه، خصوصاً في الحركات والتطويل التي لا تظهر وحدها أصلاً، وضع تعليقاً بجانبها يقول ما هي، كما فيnormalize.mjs. - احذف علامات الاتجاه الخفية Bidi Control Characters قبل المقارنة، مثل LRM وRLM وArabic Letter Mark U+061C، لأنها تأتي مع النص المنسوخ من المتصفح أو من برامج المحادثة وتكسر المطابقة دون أن تراها.
- لا تحكم على نتيجة النمط من شكلها على الشاشة، واطبعها بـ
JSON.stringifyأو اطبع نقاط الترميز، كما فعلنا في التجربة السابقة.
التحقق Validation مقابل التحليل Parsing: متى لا تستخدم Regex
التعبير النمطي ممتاز للتحقق من أن النص له شكل بسيط ومحدد، مثل رمز من ستة أرقام أو رقم جوال أو تاريخ بصيغة ثابتة، ولكنه غير مناسب لتحليل لغة لها بنية متداخلة، مثل HTML أو JSON أو XML، والسبب أن هذه اللغات فيها عناصر داخل عناصر بعمق غير محدود، والتعبير النمطي بمعناه الأصلي لا يستطيع أن يعد الأقواس المفتوحة والمغلقة. فإذا أردت روابط صفحة HTML فاستخدم محلل HTML Parser مثل DOMParser في المتصفح أو مكتبة تحليل في لغتك، وإذا أردت قيمة من JSON فاستخدم JSON.parse، وإذا أردت تاريخاً حقيقياً فاستخدم مكتبة التاريخ في لغتك كما شرحنا في دليل التاريخ والوقت، لأن النمط \d{4}-\d{2}-\d{2} يقبل 2026-02-31.
البريد الإلكتروني: المعيار يقول شيئاً، والواقع شيئاً آخر
البريد الإلكتروني هو أشهر مثال على الإفراط في استخدام Regex، فهناك أنماط منشورة بطول صفحة كاملة تحاول أن تطبق RFC 5322، والمعيار نفسه يسمح بأشياء لا يتوقعها أحد، مثل التعليقات والمسافات داخل علامات التنصيص. لذلك اختار معيار HTML لحقل <input type="email"> تعريفاً أبسط، ويقول معيار HTML صراحة إن هذا التعريف «مخالفة متعمدة Willful Violation» ل RFC 5322 لأن الأخير شديد التقييد قبل علامة @، وغامض بعدها، ومتساهل أكثر من اللازم، ويعطي المعيار نمطاً جاهزاً يطبق تعريفه، وهو ما جربناه:
// email.mjs: the pattern from the HTML Standard for <input type="email">
const html = /^[a-zA-Z0-9.!#$%&'*+\/=?^_`{|}~-]+@[a-zA-Z0-9](?:[a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?(?:\.[a-zA-Z0-9](?:[a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?)*$/;
for (const e of ["[email protected]", "[email protected]", "sara@localhost", "[email protected]", "\"sara x\"@example.com", "سارة@مثال.السعودية", "[email protected]"])
  console.log(html.test(e) ? "valid  " : "invalid", e);
valid [email protected]
valid [email protected]
valid sara@localhost
valid [email protected]
invalid "sara x"@example.com
invalid سارة@مثال.السعودية
valid [email protected]لاحظ أن النمط قبل sara@localhost دون نطاق علوي، وقبل نقطتين متتاليتين، ورفض العنوان العربي بالكامل رغم أن البريد الدولي له معيار هو RFC 6531، وقبل نفس النطاق العربي بعد تحويله إلى Punycode. والدرس أن أي نمط للبريد هو تقريب، وأن الطريقة الصحيحة الوحيدة لمعرفة أن العنوان صحيح هي أن ترسل إليه رسالة تأكيد فيها رابط، لذلك اكتف بفحص بسيط يمنع الأخطاء الواضحة، مثل وجود علامة @ واحدة وشيء قبلها وبعدها، ثم أرسل رسالة التأكيد، وقد شرحنا ما يحدث بعد ذلك في دليل البريد الإلكتروني للتطبيقات.
فخ الأداء: التراجع الكارثي Catastrophic Backtracking وهجوم ReDoS
أغلب المحركات التي تستخدمها كل يوم، أي JavaScript وJava و.NET وPython وPCRE، تعمل بطريقة التراجع Backtracking: يجرب المحرك طريقاً لمطابقة النمط، وإذا فشل في نقطة رجع إلى آخر اختيار وجرب البديل. وهذه الطريقة سريعة جداً في الحالة العادية، ولكن بعض الأنماط تعطي المحرك عدداً هائلاً من الطرق لتقسيم نفس النص، فإذا كان النص لا يطابق في النهاية جرب المحرك كل هذه الطرق واحدة واحدة قبل أن يقول «لا يطابق». وعندما يرسل مستخدم خبيث نصاً مصمماً لهذا الغرض فإن عملية واحدة تحجز المعالج ثواني أو دقائق، وهذا هو هجوم حجب الخدمة بالتعبيرات النمطية Regular expression Denial of Service، واختصاراً ReDoS، وهو مصنف في CWE-1333 وله صفحة في OWASP.
وهذا ليس خطراً نظرياً، فقد أوقف تعبير نمطي واحد يحذف المسافات الصفحة الرئيسية لموقع Stack Overflow في 2016 كما ذكرنا في قصة بنية Stack Overflow، وأوقفت قاعدة WAF فيها تعبير نمطي سيرفرات Cloudflare في العالم في 2019 كما شرحنا في دليل استكشاف الأخطاء.
لماذا تنفجر المكررات المتداخلة Nested Quantifiers؟
لنأخذ نمطاً يبدو بريئاً تماماً للتحقق من أن النص كلمات بينها مسافات: ^(\w+\s?)*$. المشكلة أن المسافة اختيارية \s?، فإذا جاءت كلمة طويلة بدون مسافات فيمكن أن تقسم بين المكرر الداخلي \w+ والمكرر الخارجي * بطرق كثيرة جداً: كلمة aaaa يمكن أن تكون قطعة واحدة aaaa، أو aaa ثم a، أو aa ثم aa، وهكذا، وعدد الطرق لكلمة من n حروف هو 2 أس n ناقص 1. وإذا انتهت الكلمة بحرف مثل ! يجعل $ تفشل، فإن المحرك يجرب كل التقسيمات قبل أن يستسلم، والصورة التالية تبين الشجرة لأربعة حروف، والأرقام الحقيقية من تجربتنا:
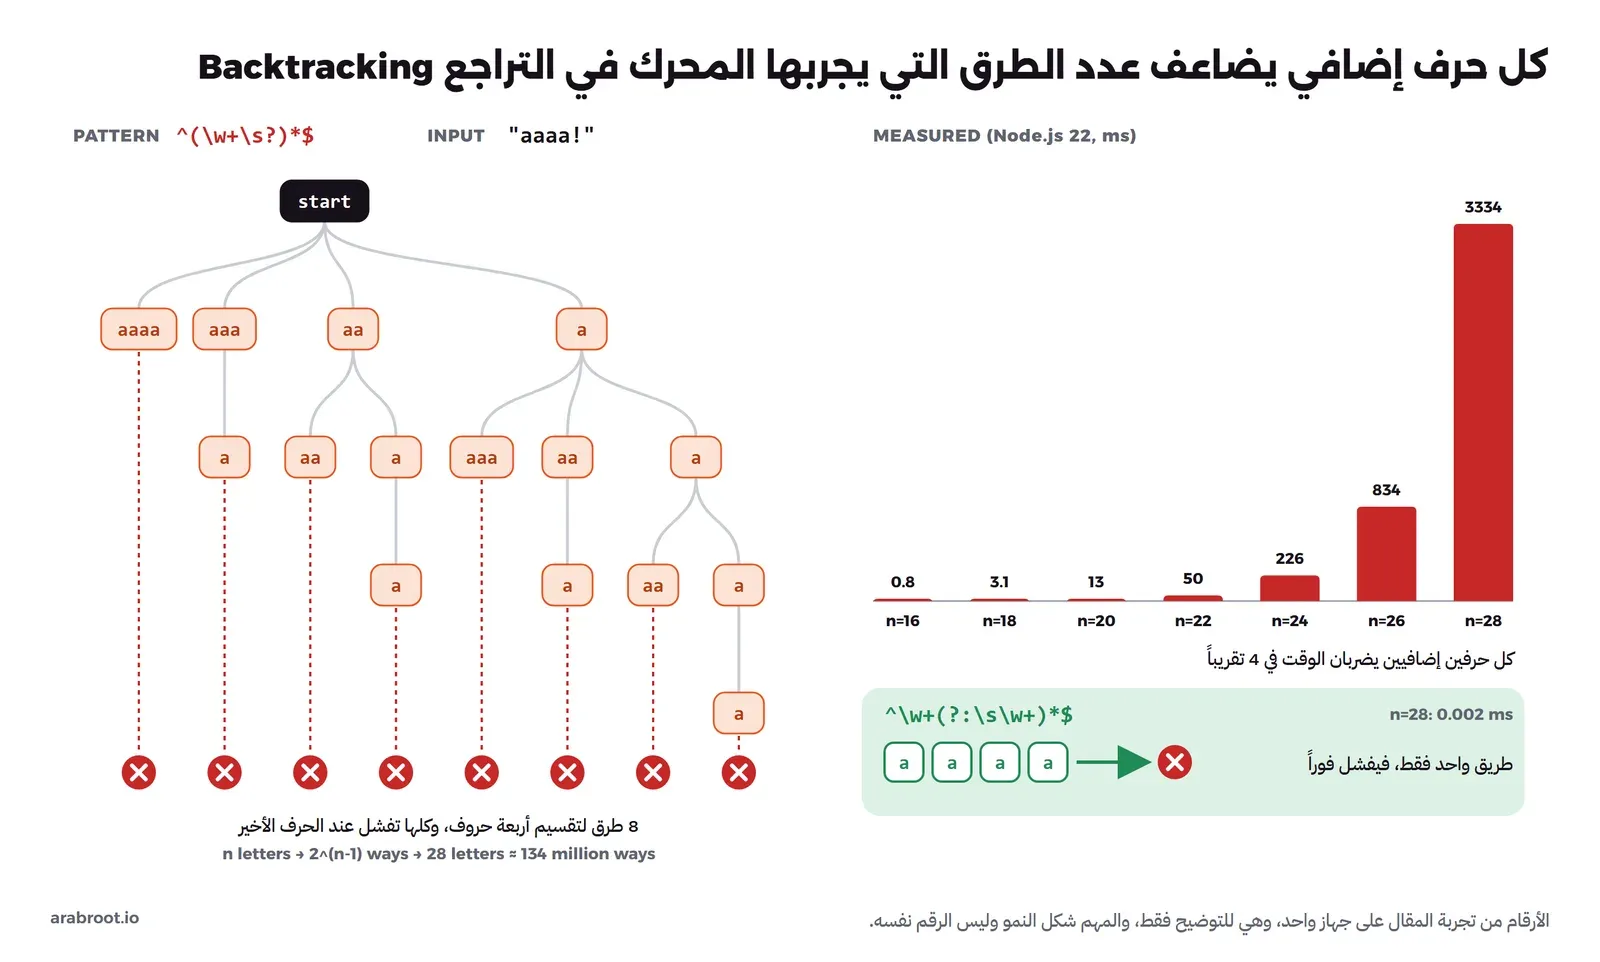
والقاعدة العامة: احذر من أي مكرر داخل مكرر آخر (x+)+ أو (x*)* عندما يستطيع الجزء الداخلي أن يطابق نفس الحروف بأكثر من طريقة، وكذلك البدائل التي تتداخل مثل (a|a)* أو (\w|\d)+، لأن \d جزء من \w فيعطي المحرك خيارين لكل رقم. والفكرة في كتب الخوارزميات هي أن وقت التراجع في أسوأ حالاته أسي Exponential بالنسبة لطول النص، ومعنى هذه الكلمة ومعنى O الكبيرة هو موضوع دليل الخوارزميات والتعقيد Big-O في نفس المرحلة.
التجربة: الوقت يتضاعف مع طول النص
الملف التالي يقيس النمط السابق والنمط المصحح على نص من حروف a بعدها !، ويبدأ بتشغيل قصير لتسخين المحرك Warm-up حتى لا يدخل وقت الترجمة JIT في القياس. والأطوال صغيرة عمداً، فلا تجرب 40 حرفاً على جهازك لأن الانتظار سوف يطول جداً:
// redos.mjs
const bad = /^(\w+\s?)*$/;
const good = /^\w+(?:\s\w+)*$/;
const time = (re, input) => { const t = process.hrtime.bigint(); re.test(input); return Number(process.hrtime.bigint() - t) / 1e6; };
for (let i = 0; i < 50; i++) { time(bad, "a".repeat(10) + "!"); time(good, "a".repeat(10) + "!"); }
console.log("n     bad (ms)   good (ms)");
for (const n of [16, 18, 20, 22, 24, 26, 28]) {
  const input = "a".repeat(n) + "!";
  console.log(String(n).padEnd(5), time(bad, input).toFixed(1).padStart(9), time(good, input).toFixed(3).padStart(10));
}
console.log(good.test("hello arab root"), good.test("hello  arab"), good.test("hello!"));
node redos.mjsn bad (ms) good (ms)
16 0.8 0.001
18 3.1 0.002
20 13.0 0.002
22 49.6 0.002
24 225.5 0.005
26 833.8 0.002
28 3333.7 0.002
true false falseفي الإعداد أعلاه لاحظ التالي:
- كل حرفين إضافيين ضربا الوقت في 4 تقريباً، أي أن كل حرف يضاعفه، ومن 29 حرفاً فقط وصلنا إلى أكثر من ثلاث ثوان من المعالج لطلب واحد. والأرقام من جهاز واحد بمعالج Intel Core i7-7700K وهي للتوضيح، والمهم شكل النمو وليس الرقم.
- النمط المصحح
^\w+(?:\s\w+)*$يصف نفس الشيء، أي كلمات بينها مسافة واحدة، ولكن كل تكرار من المكرر الخارجي يجب أن يبدأ بمسافة إجبارية\s، فلا توجد إلا طريقة واحدة لتقسيم النص، ووقته ثابت تقريباً. - السطر الأخير يبين أن النمط الجديد ليس مطابقاً للقديم حرفاً بحرف: فهو يرفض مسافتين متتاليتين، وهذا غالباً ما تريده أصلاً، ولكن عندما تعيد كتابة نمط في الإنتاج فاكتب اختبارات للحالات المقبولة والمرفوضة قبل التغيير وبعده.
مهلة .NET: matchTimeout وهي تعمل
في .NET يمكنك أن تعطي كل تعبير نمطي مهلة Timeout، فإذا تجاوزها المحرك رمى الاستثناء RegexMatchTimeoutException، والقيمة الافتراضية هي Regex.InfiniteMatchTimeout أي بدون مهلة، إلا إذا وضعت قيمة عامة للتطبيق كله بالإعداد REGEX_DEFAULT_MATCH_TIMEOUT كما في أفضل الممارسات من Microsoft. والملف التالي يشغل نفس النمط بمهلة 100 ملي ثانية، ثم بالخيار RegexOptions.NonBacktracking الذي أضيف في .NET 7، ثم النمط المصحح:
// redos.cs
using System.Diagnostics;
using System.Text.RegularExpressions;

const string pattern = @"^(\w+\s?)*$";
var input = new string('a', 28) + "!";

var guarded = new Regex(pattern, RegexOptions.None, TimeSpan.FromMilliseconds(100));
var sw = Stopwatch.StartNew();
try { guarded.IsMatch(input); }
catch (RegexMatchTimeoutException e) { Console.WriteLine($"timeout after {sw.ElapsedMilliseconds} ms: {e.Message}"); }

var linear = new Regex(pattern, RegexOptions.NonBacktracking);
foreach (var n in new[] { 28, 1000, 100000 })
{
    var s = new string('a', n) + "!";
    sw.Restart();
    var r = linear.IsMatch(s);
    Console.WriteLine($"NonBacktracking n={n}: {r} in {sw.Elapsed.TotalMilliseconds:F2} ms");
}

var fixedRe = new Regex(@"^\w+(?:\s\w+)*$", RegexOptions.None, TimeSpan.FromMilliseconds(100));
sw.Restart();
Console.WriteLine($"fixed pattern: {fixedRe.IsMatch(input)} in {sw.Elapsed.TotalMilliseconds:F2} ms");

try { new Regex(@"^(\w+)\1$", RegexOptions.NonBacktracking); }
catch (NotSupportedException e) { Console.WriteLine(e.Message); }
dotnet run redos.cstimeout after 117 ms: The Regex engine has timed out while trying to match a pattern to an input string. This can occur for many reasons, including very large inputs or excessive backtracking caused by nested quantifiers, back-references and other factors.
NonBacktracking n=28: False in 17.30 ms
NonBacktracking n=1000: False in 0.11 ms
NonBacktracking n=100000: False in 3.77 ms
fixed pattern: False in 0.02 ms
RegexOptions.NonBacktracking is not supported in conjunction with expressions containing: 'backreference (\ number)'.في الإعداد أعلاه لاحظ التالي:
- المهلة أوقفت المطابقة بعد 117 ملي ثانية بدلاً من ثوان، ولاحظ أنها ليست دقيقة، فالمحرك يفحص الوقت في نقاط معينة فقط، وفي تشغيل آخر على نفس الجهاز ظهرت 228 ملي ثانية، وتقول Microsoft إن الوقت الفعلي قد يتجاوز المهلة. لذلك عامل المهلة كحد أمان وليس كرقم دقيق، والتقط الاستثناء وأعد للمستخدم خطأ واضحاً مثل 400.
- مع
NonBacktrackingانتهى نص من 100 ألف حرف في أقل من 4 ملي ثانية بنفس النمط السيئ، والقياس الأول 17 ملي ثانية لأن المحرك يبني الآلة Automaton الخاصة بالنمط تدريجياً عند أول استخدام. - السطر الأخير يبين الثمن: المحرك الخطي يرفض المرجع الخلفي
\1عند إنشاء النمط، ويذكر توثيق الخيارات أنه يرفض أيضاً المجموعات الذرية والشروط Conditionals والنظر للأمام والخلف.
Python: المجموعات الذرية Atomic Groups منذ 3.11
Python لا تملك مهلة في الوحدة re، ولكن منذ الإصدار 3.11 أضافت المجموعات الذرية (?>...) والمكررات المستحوذة Possessive مثل ++ و*+ كما في توثيق re. والمجموعة الذرية تعني «إذا طابقت هذه المجموعة شيئاً فلا ترجع لتجرب تقسيماً آخر داخلها»، وهذا يقطع شجرة الاحتمالات من أساسها. والملف التالي يبين ذلك، ويبين في أوله سلوك \d و$ الذي وعدنا به:
# python-re.py
import re, time

s = "طلب رقم ١٤٣٢ بتاريخ 2026"
print(re.findall(r"\d+", s), re.findall(r"\d+", s, re.ASCII))
print(bool(re.match(r"^\d{4}$", "1234\n")), bool(re.fullmatch(r"\d{4}", "1234\n")))
try:
    re.compile(r"\p{Arabic}")
except re.error as e:
    print("error:", e)

inp = "a" * 22 + "!"
for name, rx in [("nested", r"^(\w+\s?)*$"), ("atomic", r"^(?>\w+\s?)*$"), ("fixed", r"^\w+(?:\s\w+)*$")]:
    t = time.perf_counter()
    r = re.match(rx, inp)
    print(f"{name:7} {r} {(time.perf_counter() - t) * 1000:.2f} ms")
python --version
python python-re.pyPython 3.13.3
['١٤٣٢', '2026'] ['2026']
True False
error: bad escape \p at position 0
nested None 1004.83 ms
atomic None 0.17 ms
fixed None 0.10 msلاحظ أن \d في Python طابقت ١٤٣٢ مثل .NET، ومع re.ASCII أصبحت [0-9]، وأن $ قبلت "1234\n" وfullmatch رفضته، وأن \p غير مدعومة. أما في الأداء فقد استغرق النمط المتداخل ثانية كاملة مع 23 حرفاً فقط، لأن Python أبطأ من V8 في هذا النوع من العمل، والمجموعة الذرية أنهت نفس المطابقة في أقل من ملي ثانية.
المحركات الخطية Linear-time Engines: RE2 وGo وRust
هناك طريقة أخرى للبحث لا تحتاج التراجع أصلاً، وهي أن يحول المحرك النمط إلى آلة حالات Automaton ثم يمشي في النص مرة واحدة ويتتبع كل الحالات الممكنة معاً، وقد شرحها Russ Cox في مقاله المعروف عن مطابقة التعبيرات النمطية، وعليها بنيت مكتبة RE2 من Google. ويقول توثيق Go إن الحزمة regexp مضمونة أن تعمل في وقت خطي بالنسبة لطول المدخل، ويقول توثيق مكتبة regex في Rust إن أسوأ وقت هو O(m × n) حيث m حجم النمط وn طول النص، مقابل التخلي عن النظر للأمام والخلف والمراجع الخلفية. وفي Java لا توجد مهلة في java.util.regex، والبديل هو مكتبة RE2/J التي تنقل نفس الفكرة إلى Java.
وحتى V8 محرك JavaScript في Node.js وChrome فيه محرك خطي تجريبي منذ الإصدار 8.8 كما في مدونة V8، ويعمل بالخيار --enable-experimental-regexp-engine والعلامة l على النمط:
// linear.mjs
const linear = /^(\w+\s?)*$/l;
for (const n of [28, 1000, 100000]) {
  const input = "a".repeat(n) + "!";
  const t = process.hrtime.bigint(); const r = linear.test(input);
  console.log(n, r, (Number(process.hrtime.bigint() - t) / 1e6).toFixed(2) + " ms");
}
try { new RegExp(String.raw`^(\w+)\1$`, "l"); } catch (e) { console.log(e.message); }
node --enable-experimental-regexp-engine linear.mjs28 false 0.03 ms
1000 false 1.51 ms
100000 false 233.25 ms
Invalid regular expression: /^(\w+)\1$/l: Cannot be executed in linear timeنفس النمط الذي أخذ 3.3 ثانية مع 28 حرفاً أصبح 0.03 ملي ثانية، ومع 100 ألف حرف أخذ 233 ملي ثانية، أي أن الوقت يزيد بزيادة النص وليس بمضاعفته. ولكن لاحظ أن الفريق نفسه يقول إن المحرك تجريبي وأبطأ بكثير من المحرك العادي في أغلب الأنماط، لذلك لا تعتمد عليه في الإنتاج، والفائدة هنا أن ترى الفكرة بنفسك.
NonBacktracking في .NET، والسبب أن المستخدم يستطيع أن يكتب نمطاً كارثياً على أي نص، فلا تنفعك مراجعة الأنماط. وتذكر أن Microsoft نفسها تقول إن المهلة وNonBacktracking تحمي من أخطاء المطورين ولا تعتبر حدوداً أمنية Security Boundary أمام أنماط خبيثة، لذلك ضع حداً لطول النمط وطول النص أيضاً.كيف تعيد كتابة النمط بأمان؟
عندما تجد نمطاً مشكوكاً فيه في الكود، فهذه هي الخطوات بالترتيب:
- ابحث عن المكررات المتداخلة والبدائل المتداخلة:
(x+)+و(x*)*و(x+)*و(a|ab)*، وأي مكرر بعده مكرر آخر يطابق نفس الحروف مثل\s*\s*أو.*.*. - اجعل كل تكرار يبدأ بشيء إجباري لا يطابقه ما قبله: كما حولنا
(\w+\s?)*إلى\w+(?:\s\w+)*، أو حدد الفئة بدلاً من النقطة، مثل"[^"]*"بدلاً من".*?". - استخدم المجموعات الذرية أو المكررات المستحوذة إذا كان محركك يدعمها، وهي موجودة في PCRE2 وJava و.NET وPython 3.11، وغير موجودة في JavaScript.
- حدد طول المدخل قبل المطابقة: إذا كان حقل الاسم لا يتجاوز 100 حرف فارفض ما هو أطول قبل أن يصل للنمط، وهذا وحده يجعل أسوأ حالة محدودة، وهو أرخص حماية على الإطلاق.
- ضع مهلة حيث يدعمها المحرك، مثل
matchTimeoutفي .NET. - استخدم محركاً خطياً للنصوص أو الأنماط غير الموثوقة.
- اختبر بنص قريب من المطابق وينتهي بحرف يفشل، مثل الذي استخدمناه في التجربة، وقس الوقت مع زيادة الطول، فإذا تضاعف مع كل حرف فالنمط معرض للمشكلة.
أدوات تساعدك في كتابة الأنماط واختبارها
موقع regex101 يشرح كل جزء من النمط ويعرض المجموعات، ويدعم عدة لهجات منها PCRE2 وJavaScript وPython و.NET وJava وGo، فاختر نفس لهجة لغتك دائماً قبل أن تحكم على النتيجة، ولا تلصق فيه بيانات حقيقية مثل السجلات التي فيها بيانات المستخدمين أو المفاتيح. وفي سطر الأوامر فإن grep -E وgrep -P وsed -E هي أدواتك اليومية كما في دليل سطر الأوامر. وإذا كانت لديك قواعد أمان في أداة فحص مثل Semgrep أو Gitleaks فهي تعبيرات نمطية أيضاً، وتنطبق عليها كل قواعد هذا المقال، ومنها الأداء.
أخطاء شائعة Common Mistakes
- التحقق بدون مرتكزات:
\d{4}بدلاً من^\d{4}$يقبل أي نص فيه أربعة أرقام. - الاعتماد على
$في Python و.NET: تقبل سطراً جديداً في آخر النص، فاستخدم\zأوfullmatch. - نسيان حماية النقطة:
example.comفي نمط يطابقexampleXcom. - البدائل بدون مجموعة:
^a|b$ليس^(a|b)$. \dو\wبدون معرفة المحرك: في .NET وPython تقبل\dالأرقام العربية ثم يفشل التحويل، وفي JavaScript لا تطابق\wالحرف العربي فيفشل\b.\p{Script=Arabic}للكلمات العربية: تقطع الكلمة عند الحركات والتطويل، فاستخدمScript_Extensions.- مقارنة نص عربي دون توحيد: الألف والتاء المربوطة والحركات والتطويل وعلامات الاتجاه الخفية تجعل الكلمة الواحدة نصوصاً مختلفة.
- تحليل HTML أو JSON بالتعبيرات النمطية: استخدم المحلل Parser المناسب.
- نمط بريد إلكتروني بطول صفحة: افحص بشكل بسيط وأرسل رسالة تأكيد.
- مكررات متداخلة على مدخلات المستخدم:
(x+)+مع نص غير محدود الطول هو باب لهجوم ReDoS. - إنشاء النمط داخل حلقة Loop: أنشئه مرة واحدة خارج الحلقة أو كمتغير ثابت، لأن تحويل النمط إلى آلة له تكلفة، وهذا واضح في قياس .NET الأول.
تدريب عملي
- اكتب نمطاً لرقم جوال سعودي بالشكل
05XXXXXXXX، ثم اجعل الكود يقبل نفس الرقم إذا كتب بالأرقام العربية٠٥، مع تخزينه دائماً بالأرقام الإنجليزية، واختبره في JavaScript و.NET. - خذ ملف
redos.mjsوجرب النمط^(a|aa)+$بنفس الطريقة، وقس الوقت مع زيادة الطول، ثم أعد كتابته بحيث يبقى الوقت ثابتاً. - ابحث في كود مشروعك عن
new RegExpأوRegex(أوre.compileوراجع كل نمط فيه مكرر داخل مكرر.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التعبير النمطي وصف لشكل النص، ويتكون من حروف عادية وفئات ومكررات ومرتكزات ومجموعات وبدائل ونظر للأمام والخلف وخيارات، والمرتكزان
^و$شرط في كل تحقق، مع\zأوfullmatchفي .NET وPython. - كل محرك لهجة مختلفة، فاختبر النمط في نفس اللغة التي سوف يعمل فيها، وأهم الفروقات في
\dو\wوخصائص Unicode والنظر للخلف. - مع العربية: استخدم
Script_Extensions=Arabicفي JavaScript أو\p{IsArabic}في .NET، واكتب[0-9]صراحة إذا كنت تريد الأرقام الإنجليزية، وحول الأرقام العربية قبل التحقق والتخزين، ووحد الألف والتاء المربوطة والحركات والتطويل وعلامات الاتجاه قبل المقارنة. - التعبير النمطي للتحقق من الأشكال البسيطة، وليس لتحليل HTML وJSON والتواريخ، ونمط البريد الإلكتروني تقريب ورسالة التأكيد هي التحقق الحقيقي.
- المكررات المتداخلة مع محرك تراجع تجعل الوقت يتضاعف مع كل حرف، والحماية بإعادة كتابة النمط وتحديد طول المدخل والمهلة في .NET والمجموعات الذرية، والمحرك الخطي للأنماط والنصوص غير الموثوقة.
 دليلالترميز Encoding للمطورين: Base64 وأخواتهلماذا نحول البايتات إلى حروف حتى تمر في البريد والروابط، وكيف تفك أي سلسلة منها، ولماذا لا يحمي Base64 أي سر.
 دليلRAG للمبتدئين: نموذج لغة يجيب من مستنداتك على سيرفرككيف تجعل نموذج اللغة يجيب من مستندات مؤسستك ويذكر مصدره، دون أن يخرج أي مستند من سيرفرك.
 دليلالسجلات Logging للمطورين: ماذا تسجل وماذا لا تسجلكيف تكتب سجلات Logs تساعدك على فهم ما حدث في الإنتاج، وما الذي لا يدخل السجل أبداً، وكيف تجمعها في مكان واحد.
 دليلSecrets Scanning: كيف تكتشف الأسرار المسربة في الكودكيف يخرج المفتاح من جهازك إلى تاريخ Git وخط CI، وكيف تكتشفه قبل غيرك، وماذا تفعل في الساعة الأولى بعد تسربه.
 دليلSAST: كيف يجد تحليل الكود الثابت الثغرات قبل التشغيلكيف تقرأ أداة SAST الكود بحثاً عن الثغرات، وما الذي لا تراه أبداً، وكيف تمنع الإنذارات الخاطئة من أن تفقد الفريق ثقته بها.
 دليلالتاريخ والوقت للمطورين ومديري الأنظمةلماذا يتأخر التقرير ثلاث ساعات ولا تعمل المهمة المجدولة ليلة تغيير التوقيت، وكيف تضبط الوقت في السيرفر والكود.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل التجارب على Windows 11 بمعالج Intel Core i7-7700K مع Node.js 22.14.0 (V8 مع محرك Irregexp والمحرك الخطي التجريبي)، و.NET SDK 10.0.400، وPython 3.13.3.


