إذا فتحت صفحة الإصدارات لأي أداة مشهورة على GitHub، مثل محرك قاعدة بيانات أو أداة سطر أوامر، فسوف تجد نفس الأداة بنفس رقم الإصدار في عدة ملفات: واحد ينتهي بـ linux-amd64 وآخر بـ linux-arm64 وربما ثالث بـ riscv64، وقد تسأل نفسك: لماذا لا يكفي ملف واحد؟ الكود نفسه واحد، والنظام نفسه Linux، فما الذي يجعل ملفاً يعمل على السيرفر وآخر يرفض العمل عليه برسالة غريبة مثل exec format error؟ ونفس السؤال يظهر عندما تبني Docker Image على جهاز Mac حديث ثم ترفعها إلى VPS فلا تعمل، أو عندما تشتري Raspberry Pi وتكتشف أن البرنامج الذي تعرفه على حاسبك لا يوجد له ملف جاهز لهذه اللوحة.
والإجابة المختصرة أن الملف التنفيذي ليس «برنامجاً» بالمعنى المجرد، وإنما بايتات مكتوبة بلغة معالج محدد، وهذه اللغة اسمها معمارية مجموعة التعليمات Instruction Set Architecture، واختصاراً ISA. وقد ذكرنا هذا باختصار في مقال كيف يعمل المعالج من الداخل عندما قارنا دالة واحدة مترجمة لـ x86-64 وARM64، وفي مقال ماذا يحدث عندما تشغل Hello World عندما رأينا الخطأ لأول مرة، أما هنا فسوف نفتح الموضوع كاملاً، وهذا أول مقال في مرحلة المعالجات من مسار أساسيات الحاسب. وسوف نناقش في هذا المقال ما يلي:
- ما هي ال ISA بالضبط، ولماذا نسميها عقداً بين البرنامج والشريحة، وما الفرق بينها وبين المعمارية الدقيقة Microarchitecture.
- الأشياء الستة التي تحددها ال ISA: التعليمات والمسجلات والعنونة والترميز ونموذج الذاكرة والصلاحيات.
- الواجهة الثنائية ABI واتفاقية الاستدعاء Calling Convention، ولماذا لا تكفي ال ISA وحدها لتشغيل برنامج.
- مختبر حقيقي: نفس برنامج C مترجم لثلاث معماريات هي x86-64 وARM64 وRISC-V، نقرأ تعليماته سطراً سطراً، ونرى الخطأ
exec format errorكما يحدث فعلاً، ثم نشغل الملفات عبر المحاكي QEMU. - برنامج بلغة التجميع Assembly دون مكتبة C لكل معمارية، يطلب من النواة مباشرة، لنرى أين يختلف كل شيء.
- لماذا لا يعمل برنامج x86 على ARM، وما الطبقات التي يتوقف عندها.
- ماذا يحدث داخل نفس المعمارية عندما يبني المترجم لمستوى أعلى من معالجك، مع خطأ
Illegal instructionحقيقي. - ما يعنيه كل هذا لك عملياً: أسماء المعماريات في Docker وفي ملفات الإصدارات، والأخطاء الشائعة، وجدول قرار.
ما هي معمارية مجموعة التعليمات ISA؟
معمارية مجموعة التعليمات هي الوصف الكامل لما يستطيع المعالج أن يفهمه وينفذه، كما يراه البرنامج: ما التعليمات الموجودة، وما المسجلات التي تعمل عليها، وكيف تكتب كل تعليمة بالبايتات، وماذا يحدث عند الخطأ أو المقاطعة. والكلمة المهمة هنا «كما يراه البرنامج»، لأن ال ISA لا تقول شيئاً عن كيفية تنفيذ المعالج للتعليمة من الداخل، وإنما تقول فقط: إذا وضعت هذه البايتات في الذاكرة وأشرت إليها، فسوف تحصل على هذه النتيجة.
ولتقريب الفكرة تخيل ال ISA كعقد بين طرفين لا يعرف أحدهما الآخر: الطرف الأول هو من يكتب المترجم Compiler ونظام التشغيل والبرامج، والطرف الثاني هو الشركة التي تصمم الشريحة. فالمترجم ينتج بايتات مطابقة للعقد، والشريحة تنفذ أي بايتات مطابقة للعقد، وبالتالي يستطيع برنامج ترجم في 2010 أن يعمل على معالج صنع في 2026، ويستطيع معالج من AMD أن يشغل برنامجاً ترجم على جهاز فيه معالج Intel، لأن الطرفين التزما بنفس العقد وهو x86-64. والصورة التالية تبين هذه الفكرة: ثلاثة ملفات لنفس البرنامج من مختبر هذا المقال، وتحت كل ملف العقد الذي كتب به، وتحت كل عقد عدة شرائح مختلفة تماماً من الداخل:
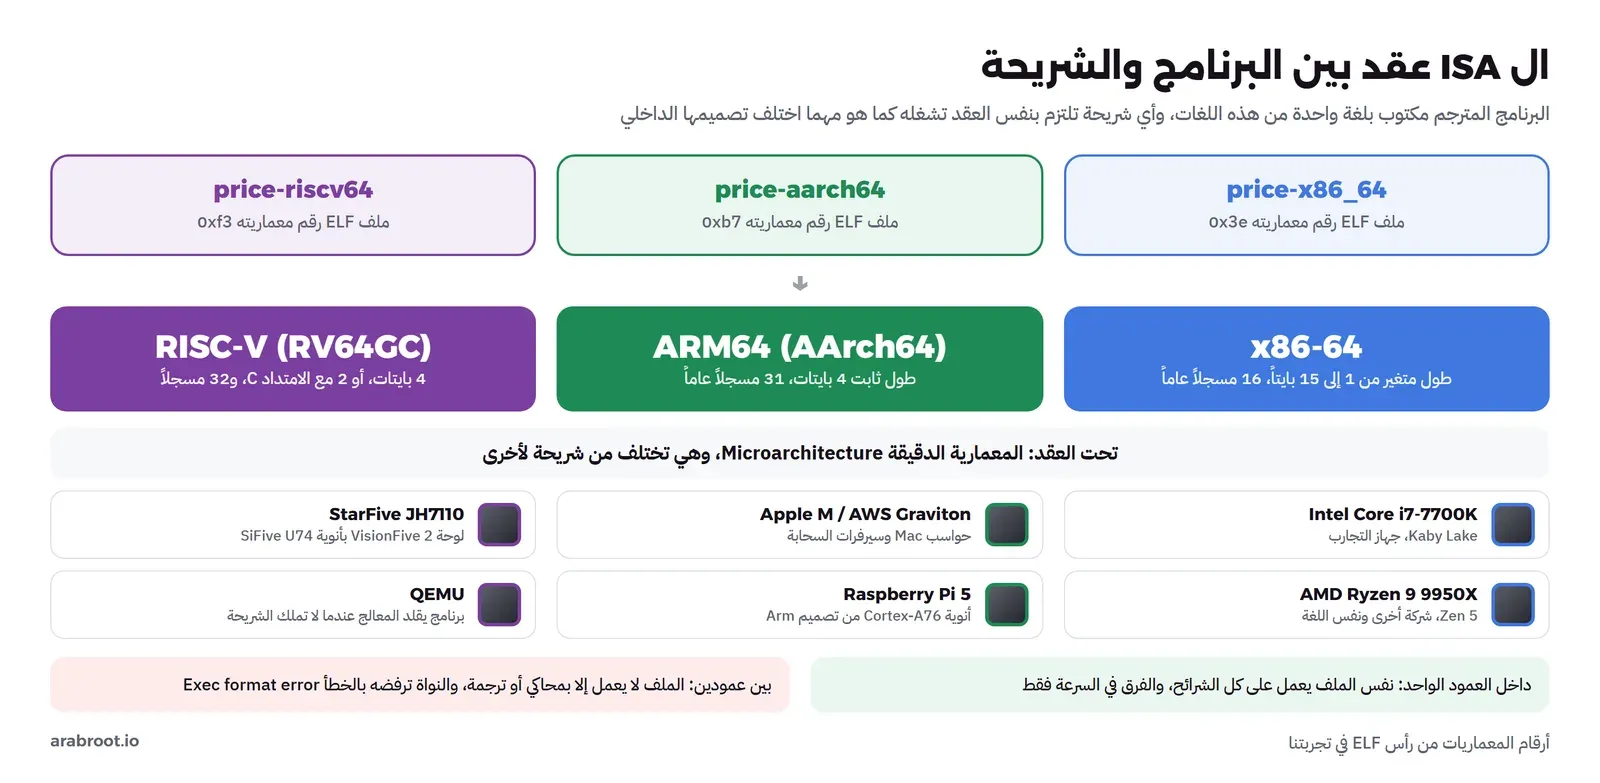
ولاحظ في الصورة أن الحد الحقيقي ليس بين الشركات وإنما بين العقود، فمعالج Intel ومعالج AMD في نفس العمود لأنهما يتكلمان x86-64، بينما معالج Apple ومعالج Raspberry Pi وسيرفرات AWS Graviton في عمود آخر لأنها تتكلم ARM64، مع أن الشركات الثلاث مختلفة. وهذا ما يجعل جملة «برنامج x86 لا يعمل على ARM» دقيقة، وجملة «برنامج Intel لا يعمل على AMD» غير صحيحة.
المعمارية الدقيقة Microarchitecture: نفس العقد وشرائح مختلفة
إذا كانت ال ISA هي العقد، فالمعمارية الدقيقة Microarchitecture هي الطريقة التي ينفذ بها مصمم الشريحة هذا العقد: كم مرحلة في خط التنفيذ Pipeline، وكم تعليمة يفك في النبضة الواحدة، وحجم ال Cache، ودقة متوقع التفرعات، وهل ينفذ التعليمات خارج الترتيب. وهذه الأشياء التي شرحناها في مقال المعالج من الداخل كلها من المعمارية الدقيقة، ولا يراها البرنامج إلا كفرق في السرعة. فمعالج جهاز التجارب في هذا المقال، وهو Intel Core i7-7700K، معماريته الدقيقة اسمها Kaby Lake، ومعالج AMD Ryzen 9 9950X معماريته الدقيقة Zen 5 كما تذكر صفحته عند AMD، وهما مختلفان تماماً من الداخل، ولكن نفس الملف التنفيذي يعمل على الاثنين دون تغيير.
والعكس صحيح أيضاً: يمكن أن تكون المعمارية الدقيقة متشابهة جداً بين شريحتين بعقدين مختلفين، فأفكار مثل التنفيذ خارج الترتيب Out-of-Order Execution وتوقع التفرعات موجودة اليوم في معالجات x86-64 وARM64 وRISC-V الكبيرة كلها. وبالتالي عندما تقرأ مقارنة بين «Intel وApple» فاسأل نفسك أولاً: هل المقارنة بين عقدين، أم بين تصميمين داخليين، أم بين مصنعين؟ لأن هذه ثلاثة أسئلة مختلفة، وسوف نعود إليها في مقال CISC أم RISC من نفس المرحلة.
والصورة التالية فيها ثلاث صور حقيقية لثلاث شرائح من ثلاثة عقود: معالج Intel Core i7-12700KF يتكلم x86-64، ولوحة Raspberry Pi 5 التي يتكلم معالجها ARM64، ولوحة StarFive VisionFive 2 التي يتكلم معالجها RISC-V:
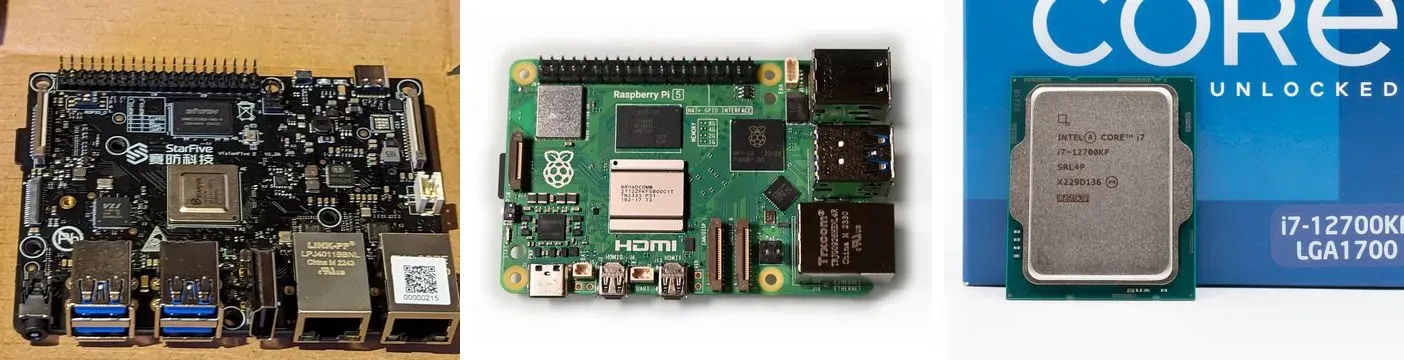
ومن الخارج لا يوجد ما يدلك على العقد، فكلها شرائح مربعة على لوحات، ولذلك لا تعتمد على الشكل أو اسم الجهاز لتعرف المعمارية، وإنما على أمر واحد مثل uname -m كما سوف نرى في الجزء العملي.
ماذا تحدد ال ISA بالضبط؟
قد يبدو تعريف «لغة المعالج» غامضاً، ولكنه في الحقيقة مكتوب في مستندات طويلة جداً تنشرها الشركات: دليل Intel للمطورين لـ x86-64، ودليل معمارية Arm لـ ARM64، ودليل RISC-V المفتوح على GitHub. وإذا جمعت ما في هذه المستندات فسوف تجد ستة أشياء أساسية، تبينها الصورة التالية مع مثال حقيقي لكل منها من مخرج المختبر:
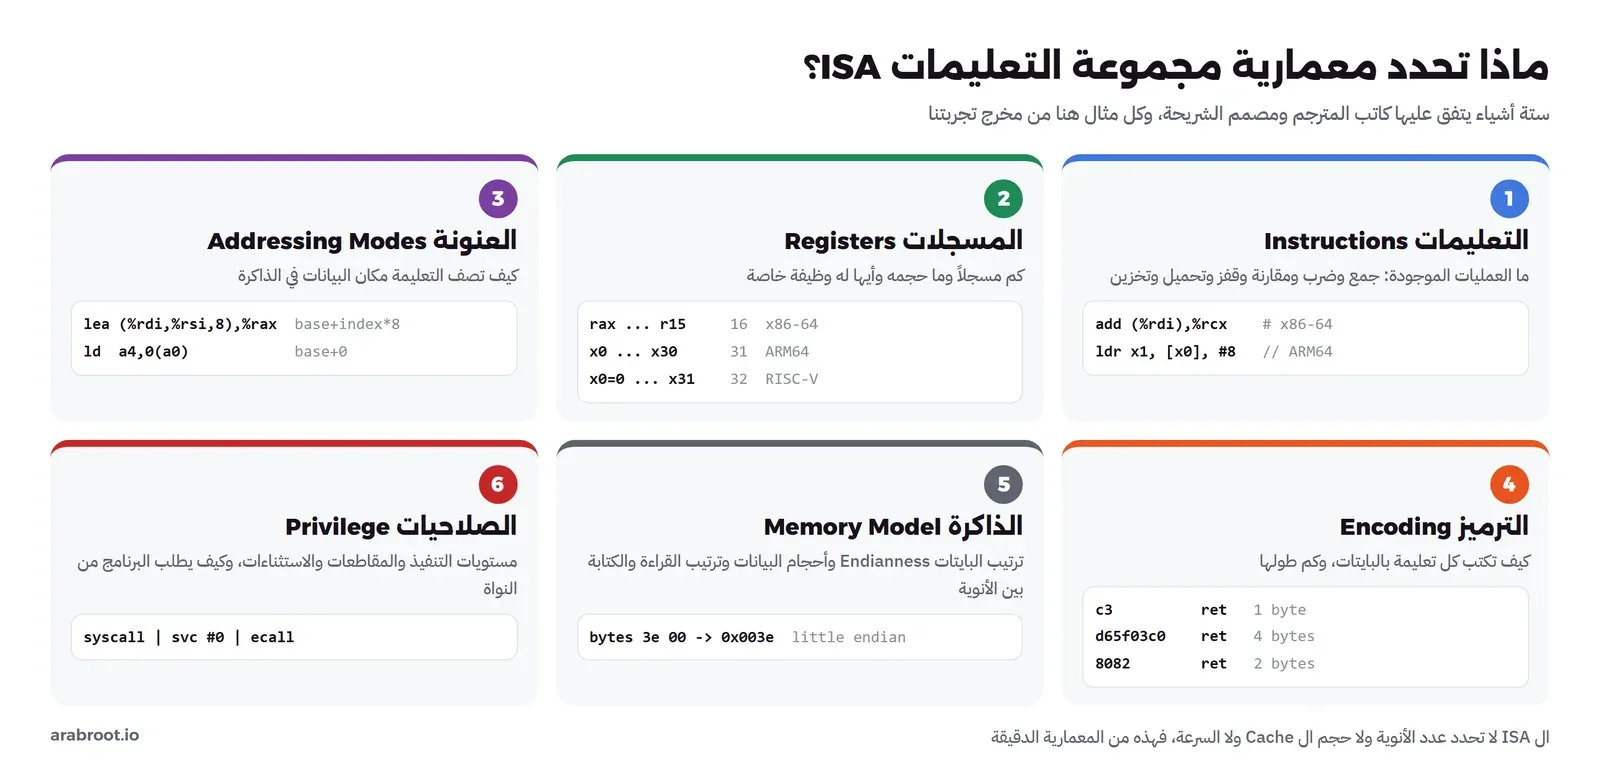
وفيما يلي كل واحد منها باختصار، لأننا سوف نراها كلها في المختبر:
- التعليمات Instructions: قائمة العمليات المتاحة، مثل الجمع والضرب والمقارنة والقفز وتحميل قيمة من الذاكرة وتخزينها. وبعض ال ISAs فيها تعليمات تفعل أشياء كثيرة في خطوة واحدة، مثل تعليمة x86-64 التي تقرأ من الذاكرة وتجمع في نفس الوقت، وبعضها يفصل القراءة عن الحساب، وهذا الفرق هو أصل نقاش CISC وRISC.
- المسجلات Registers: الخانات الصغيرة داخل المعالج التي تجري عليها الحسابات، وعددها وحجمها جزء من العقد: في x86-64 ستة عشر مسجلاً عاماً بحجم 64 بت من
raxإلىr15، وفي ARM64 واحد وثلاثون منx0إلىx30، وفي RISC-V اثنان وثلاثون منx0إلىx31، والأول منهاx0قيمته صفر دائماً. - العنونة Addressing Modes: الطرق التي تصف بها التعليمة مكان البيانات في الذاكرة، مثل «العنوان في هذا المسجل» أو «العنوان في هذا المسجل زائد ثمانية أضعاف ذاك».
- الترميز Encoding: كيف تكتب كل تعليمة بالبايتات، وهذا هو الجزء الذي يجعل الملف غير مفهوم لمعالج آخر، فالتعليمة
retمثلاً هي البايتc3في x86-64، والبايتاتd65f03c0في ARM64، والبايتان8082في RISC-V. - نموذج الذاكرة Memory Model: ترتيب البايتات Endianness، وأحجام البيانات، والقواعد التي تحدد متى ترى نواة ما كتبته نواة أخرى، وهذه القواعد الأخيرة هي سبب كثير من مشاكل التزامن التي ذكرناها في مقال الخيوط والأقفال.
- الصلاحيات والاستثناءات Privilege and Exceptions: مستويات التنفيذ مثل وضع النواة ووضع المستخدم، وماذا يحدث عند المقاطعة أو الخطأ، وكيف يطلب البرنامج خدمة من النواة، وهذا ما شرحناه بالتفصيل في مقال استدعاءات النظام على x86-64.
ولاحظ ما لا يوجد في القائمة: عدد الأنوية، وحجم ال Cache، والسرعة بالجيجاهرتز، وعدد مراحل خط التنفيذ. هذه كلها من المعمارية الدقيقة، ولذلك يمكن أن يتكلم معالج بنواتين ومعالج بمئة وثمانية وعشرين نواة نفس العقد تماماً.
الواجهة الثنائية ABI: لماذا لا تكفي ال ISA وحدها؟
قد يتساءل البعض: إذا كان معالجا جهازين يتكلمان x86-64، فهل يعمل أي ملف من الأول على الثاني؟ والإجابة: ليس بالضرورة، لأن البرنامج لا يتكلم مع المعالج وحده، وإنما مع نظام التشغيل والمكتبات أيضاً، وهنا يأتي عقد ثان فوق ال ISA اسمه الواجهة الثنائية للتطبيقات Application Binary Interface، واختصاراً ABI. وال ABI تجيب عن أسئلة لا تجيب عنها ال ISA: في أي مسجل تضع المعامل الأول للدالة؟ وأين تجد القيمة الراجعة؟ وأي المسجلات يجب أن تحافظ عليها الدالة لمن استدعاها؟ وكيف تحاذى ال Stack؟ وما رقم كل طلب من النواة؟ وما شكل الملف التنفيذي نفسه؟
ولنأخذ مثالاً يبين أن ال ABI شيء منفصل عن ال ISA: على Linux تتبع برامج x86-64 الوثيقة System V x86-64 psABI، وفيها يأتي المعامل الأول في rdi والثاني في rsi، بينما على Windows تتبع نفس المعالجات اتفاقية Microsoft لـ x64، وفيها يأتي المعامل الأول في rcx والثاني في rdx. فنفس العقد x86-64 ونفس المعالج، ولكن دالة مترجمة لأحد النظامين تقرأ معاملاتها من المسجلات الخطأ إذا استدعيتها من الآخر. وهذا أحد أسباب أن ملف .exe لا يعمل على Linux مباشرة، مع أن التعليمات نفسها مفهومة للمعالج.
وأهم جزء في ال ABI للمطور هو اتفاقية الاستدعاء Calling Convention، والصورة التالية تلخصها للمعماريات الثلاث على Linux بحسب psABI لـ x86-64 وAAPCS64 لـ ARM64 وpsABI لـ RISC-V، مع طريقة الطلب من النواة كما تصفها صفحة syscall(2):
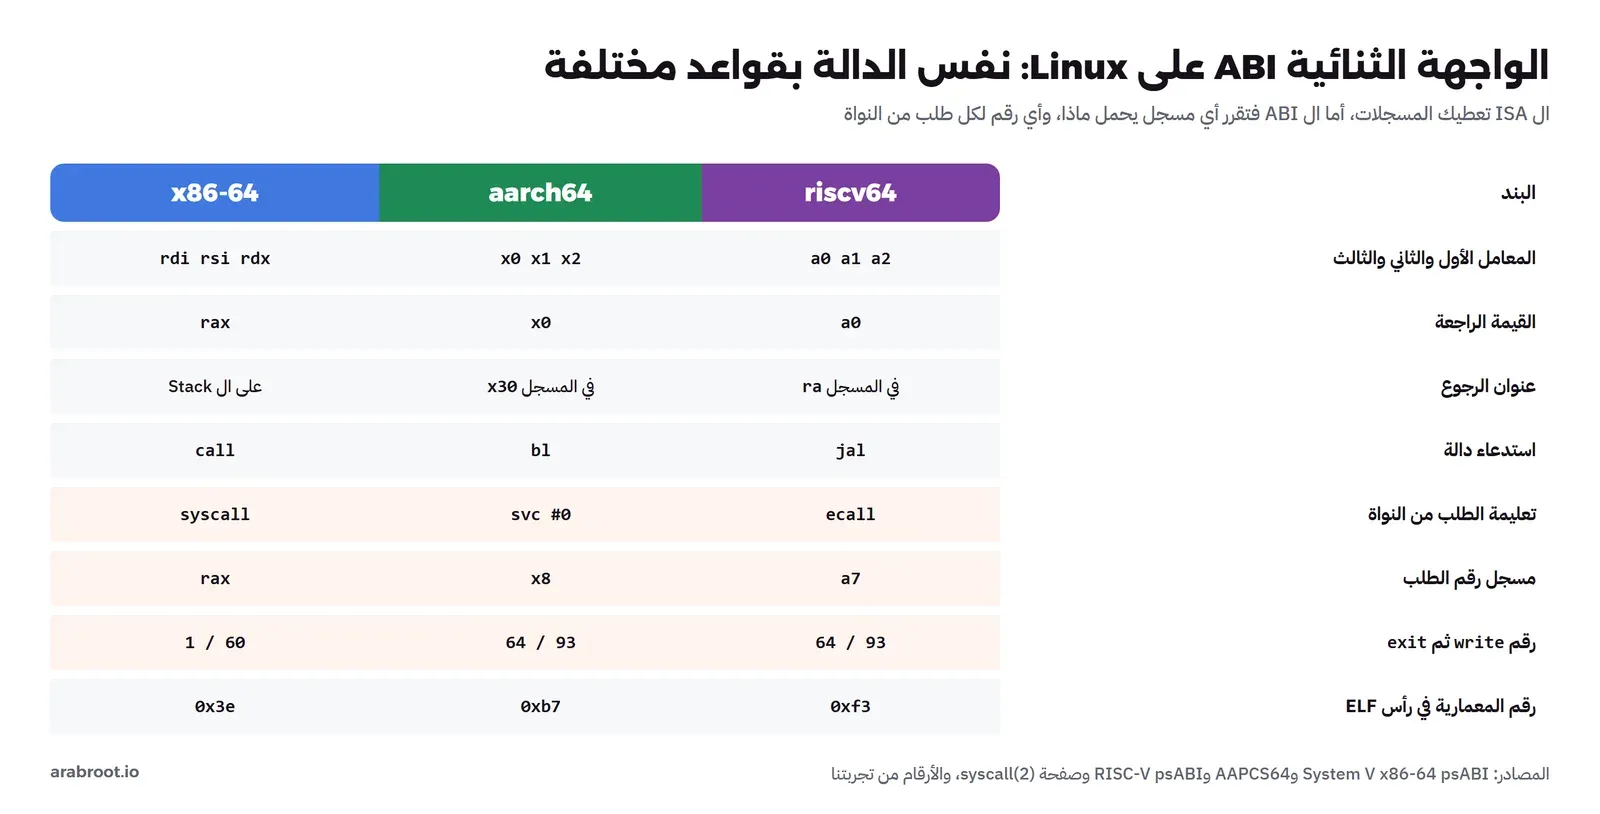
في الجدول أعلاه لاحظ التالي:
- عنوان الرجوع في x86-64 يوضع على ال Stack بالتعليمة
callنفسها، بينما في ARM64 وRISC-V يوضع في مسجل خاص هوx30أوra، وهذا فرق في ال ISA نفسها وليس في ال ABI فقط، وسوف نرى أثره في كود الدالةmain. - أرقام طلبات النواة ليست واحدة: الطلب
writeرقمه 1 على x86-64 و64 على ARM64 وRISC-V، والسبب أن Linux على x86-64 احتفظ بترتيب قديم في جدوله الخاص، بينما المعماريات الأحدث تستخدم الجدول المشترك الذي وضع لها. - رقم المعمارية في رأس ملف ELF هو أول ما تنظر إليه النواة قبل التشغيل، وقيمه موثقة في صفحة elf(5)، وسوف نقرؤه بالبايت في المختبر.
وتغير ال ABI بين إصدارين من نفس المكتبة مشكلة أخرى شرحناها في مقال الرابط والمحمل، أما هنا فيهمنا ال ABI بين المعمارية والنظام.
تجهيز المختبر Lab Setup
سوف نترجم نفس البرنامج لثلاث معماريات على جهاز واحد، وهذا ممكن لأن المترجم لا يحتاج أن يعمل على المعالج الذي يترجم له، وهذا ما يسمى الترجمة المتقاطعة Cross Compilation. ونحتاج لذلك ثلاثة مترجمات GCC ومكتبة C لكل معمارية، وأدوات objdump لكل معمارية لقراءة التعليمات، والمحاكي QEMU في وضع المستخدم User Mode لتشغيل الملفات الغريبة عن جهازنا، وكلها في Debian 13. والملف التالي هو Dockerfile المختبر:
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends \
      gcc libc6-dev gcc-aarch64-linux-gnu libc6-dev-arm64-cross gcc-riscv64-linux-gnu libc6-dev-riscv64-cross \
      binutils qemu-user file cpuid nasm qemu-system-x86 qemu-system-gui- \
    && rm -rf /var/lib/apt/lists/*
WORKDIR /lab
نبني ال Image ونفتح Container يرى مجلد المختبر:
mkdir isa-lab && cd isa-lab      # put the Dockerfile and the lab files here
docker build -t cs1-isa:1 .
docker run --rm -it --name cs1-isa -v "$PWD:/lab" cs1-isa:1 bash
وحجم ال Image النهائي قرابة 400 MB، والحزمتان nasm وqemu-system-x86 لن نحتاجهما هنا، ولكننا نستخدم نفس ال Image في مقال قصة x86 لنقلع قطاع إقلاع حقيقياً، فثبتناهما مرة واحدة. والأمر uname -m داخل ال Container يطبع x86_64، أي أن كل ما سوف نشغله دون محاكي يعمل على معالج Intel Core i7-7700K مباشرة.
نفس البرنامج لثلاث معماريات
البرنامج الذي سوف نتابعه صغير عن قصد، فهو دالة تجمع أسعار سلة مشتريات ثم تضيف عليها نسبة الضريبة، ودالة main تستدعيها وتطبع النتيجة:
// price.c: the same small C program, compiled for three instruction sets
#include <stdio.h>

__attribute__((noinline))
long total(const long *prices, long n, long tax_percent)
{
    long sum = 0;
    for (long i = 0; i < n; i++)
        sum += prices[i];
    return sum + sum * tax_percent / 100;
}

int main(void)
{
    long prices[4] = {120, 80, 45, 255};
    printf("total = %ld\n", total(prices, 4, 15));
    return 0;
}
والخاصية noinline تمنع المترجم من دمج الدالة داخل main، لأنه بدونها سوف يحسب النتيجة كلها وقت الترجمة ويطبع الرقم مباشرة، كما رأينا في مقال داخل المترجم، ونحن نريد أن نرى كيف تمر المعاملات بين دالتين. الآن نترجم البرنامج ثلاث مرات، مرة بكل مترجم، ونطلب ملفات ثابتة Static لا تحتاج مكتبات من النظام، ثم نسأل الأداة file عن كل ملف:
gcc -O2 -static price.c -o price-x86_64
aarch64-linux-gnu-gcc -O2 -static price.c -o price-aarch64
riscv64-linux-gnu-gcc -O2 -static price.c -o price-riscv64
file price-x86_64 price-aarch64 price-riscv64
والمخرج سوف يكون كما يلي:
price-x86_64:  ELF 64-bit LSB executable, x86-64, version 1 (GNU/Linux), statically linked, BuildID[sha1]=a0e45fc3e51fa4851fcefc7d79ce9fa77e2519a7, for GNU/Linux 3.2.0, not stripped
price-aarch64: ELF 64-bit LSB executable, ARM aarch64, version 1 (GNU/Linux), statically linked, BuildID[sha1]=2a8e3fee933cec660b69729321b8cf83d6b0da41, for GNU/Linux 3.7.0, not stripped
price-riscv64: ELF 64-bit LSB executable, UCB RISC-V, RVC, double-float ABI, version 1 (GNU/Linux), statically linked, BuildID[sha1]=edadcd32dd0a67ab6721d690a9ad5123e4f7a5db, for GNU/Linux 4.15.0, not stripped
في المخرج أعلاه لاحظ التالي:
- الملفات الثلاثة من نوع ELF بحجم كلمة 64 بت، وكلها
LSB، أي أن البايت الأقل وزناً يأتي أولاً Little Endian، فالمعماريات الثلاث تتفق هنا. - الكلمة التي تختلف هي المعمارية:
x86-64ثمARM aarch64ثمUCB RISC-V، والحرفان UCB إشارة إلى جامعة كاليفورنيا في بيركلي حيث بدأ مشروع RISC-V. - ملف RISC-V يذكر شيئين إضافيين:
RVC، أي أنه يستخدم الامتداد C للتعليمات المضغوطة بطول بايتين، وdouble-float ABI، أي أن ال ABI تمرر الأرقام العشرية في مسجلات الفاصلة العائمة. وهذا مثال واضح على أن ال ABI جزء من هوية الملف، فملف بنفس المعمارية وبال ABI الأخرى لا يربط مع مكتبات هذا النظام. - الرقم بعد
for GNU/Linuxهو أقدم نواة يدعمها الملف، وهو أحدث في RISC-V لأن دعمه في Linux أحدث.
والأداة file تعرف المعمارية من رأس الملف، فلنقرأ نفس المعلومة بأنفسنا: الأداة readelf تعرض الحقل بالاسم، والأمر od يعرض البايتين في الموضع 18 من بداية الملف، وهو مكان الحقل e_machine في رأس ELF:
for f in price-x86_64 price-aarch64 price-riscv64; do
  readelf -h $f | grep Machine
  od -A d -t x1 -j 18 -N 2 $f | head -1
done
والمخرج سوف يكون كما يلي:
  Machine:                           Advanced Micro Devices X86-64
0000018 3e 00
  Machine:                           AArch64
0000018 b7 00
  Machine:                           RISC-V
0000018 f3 00
لاحظ أولاً أن اسم المعمارية x86-64 في رأس ELF هو «Advanced Micro Devices X86-64»، أي AMD، وليس Intel، والسبب أن AMD هي التي صممت هذا الامتداد ذا 64 بت للمعمارية x86 في بداية الألفية، وهي قصة نرويها في مقال قصة x86. ولاحظ ثانياً أن البايتين 3e 00 يقرآن من اليمين لأن الترتيب Little Endian، فالقيمة هي 0x003e أي 62، وهذا ما سوف تقارنه النواة برقم معماريتها بعد قليل. وقد شرحنا قراءة الأرقام الست عشرية وترتيب البايتات في مقال الأنظمة العددية.
الخطأ exec format error كما يحدث فعلاً
الآن نشغل الملفات الثلاثة مباشرة على جهازنا:
./price-x86_64
./price-aarch64
./price-riscv64
والمخرج سوف يكون كما يلي، والأوامر هنا داخل سكربت المختبر run.sh، ولذلك تبدأ رسائل الخطأ باسمه ورقم السطر:
total = 575
run.sh: line 10: ./price-aarch64: cannot execute binary file: Exec format error
run.sh: line 11: ./price-riscv64: cannot execute binary file: Exec format error
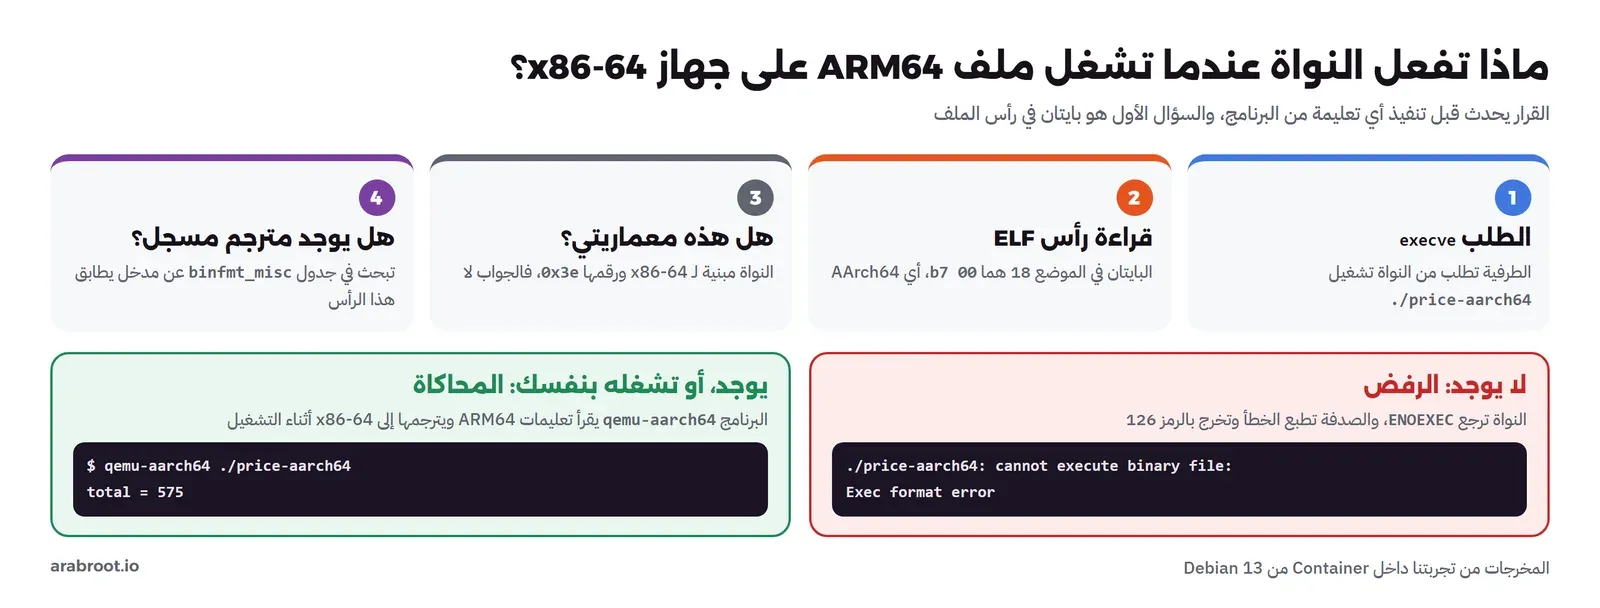
الملف الأول عمل وطبع 575، وهو مجموع الأسعار 500 مضافاً إليه 15% أي 75. أما الآخران فرفضتهما النواة قبل أن ينفذ منهما أي بايت. والذي حدث أن الصدفة bash طلبت من النواة تشغيل الملف بالطلب execve، والنواة قرأت رأس الملف ووجدت رقم معمارية لا يطابق رقمها، فبحثت هل سجل أحد برنامجاً يتعامل مع هذا النوع من الملفات عبر الميزة binfmt_misc، ولم تجد، فرجعت بالخطأ ENOEXEC الذي تصفه صفحة execve(2) بأنه ملف بصيغة غير معروفة أو لمعمارية أخرى، والصدفة حولته إلى الرسالة التي تراها، وخرجت بالرمز 126 الذي تستخدمه bash لملف موجود لا يمكن تنفيذه. والصورة التالية ترسم هذا المسار:
مشكلة واجهناها: نفس الأمر نجح بعد ساعات
بعد ساعات من التجربة السابقة أعدنا تشغيل نفس الأوامر الثلاثة على نفس الجهاز لنتأكد من المخرج، فكانت النتيجة مختلفة تماماً:
### run directly
total = 575
total = 575
exit=0
total = 575
exit=0
الملفات الثلاثة عملت دون أي محاك ظاهر، مع أننا لم نغير شيئاً في ال Image ولا في الملفات. والسبب في جدول binfmt_misc نفسه، فهذا الجدول على Docker Desktop مشترك بين كل ال Containers لأنها تعمل على نواة واحدة داخل جهاز WSL2، ويستطيع أي Container بصلاحيات كاملة أن يسجل فيه محاكياً. وهذا ما رأيناه عندما قرأنا الجدول قبل التجربة الأولى وبعد الثانية بالأمر ls /proc/sys/fs/binfmt_misc/ من Container بالخيار --privileged:
### earlier (before the price run): ls /proc/sys/fs/binfmt_misc/
python3.11
register
status
### later: ls /proc/sys/fs/binfmt_misc/ ; head -3 qemu-aarch64
python3.11
qemu-aarch64
qemu-riscv64
register
status
enabled
interpreter /usr/bin/qemu-aarch64
flags: POCF
في المخرج أعلاه لاحظ أن الجدول في المرة الأولى لم يكن فيه إلا مدخل لا علاقة له بـ ARM، ثم ظهر فيه مدخلان qemu-aarch64 وqemu-riscv64، وكل منهما يقول للنواة: «أي ملف ELF بهذا الرأس سلمه إلى البرنامج /usr/bin/qemu-aarch64». والحرف F في flags يعني أن النواة فتحت ملف المحاكي وقت التسجيل وتحتفظ به، ولذلك يعمل حتى داخل Container لا يوجد فيه هذا الملف أصلاً. وهذا هو نفس ما حدث في مقال Hello World عندما عمل ملف ARM الثابت على جهاز x86-64. والدرس العملي هنا أنك إذا رأيت ملف ARM «يعمل» على جهاز x86-64 فلا تفترض أن المعالج فهمه، وإنما اقرأ جدول binfmt_misc على المضيف، لأن نفس الملف سوف يرفض على أي سيرفر لم يسجل فيه أحد محاكياً.
التشغيل عبر المحاكي QEMU
المحاكي QEMU في وضع المستخدم، كما يصفه توثيق QEMU، يشغل برنامج Linux مترجماً لمعمارية أخرى: يقرأ تعليماته ويترجمها إلى تعليمات المعالج الحقيقي أثناء التشغيل، ويحول طلبات النواة من أرقام المعمارية الغريبة إلى أرقام النواة الحقيقية. نشغله يدوياً هذه المرة:
qemu-aarch64 ./price-aarch64
qemu-riscv64 ./price-riscv64
والمخرج سوف يكون كما يلي:
total = 575
total = 575
نفس النتيجة من ثلاثة ملفات لا يشترك منها اثنان في بايت واحد من التعليمات، وهذا هو المعنى العملي للعقد: البرنامج واحد على مستوى C، وثلاثة ملفات مختلفة على مستوى الآلة. والمحاكاة لها كلفة كبيرة في السرعة، لأن كل تعليمة غريبة تتحول إلى عدة تعليمات حقيقية، وهذا موضوع مقال المحاكاة والترجمة الثنائية في نفس المرحلة، والمهم هنا أن المحاكي يعطينا طريقة لتشغيل ما نترجمه دون أن نشتري ثلاث لوحات.
نقرأ نفس الدالة بثلاث لغات
الآن نفتح الملفات ونقرأ تعليمات الدالة total في كل منها بالأداة objdump، ولكل معمارية نسختها من الأداة:
objdump -d --disassemble=total price-x86_64
aarch64-linux-gnu-objdump -d --disassemble=total price-aarch64
riscv64-linux-gnu-objdump -d --disassemble=total price-riscv64
على x86-64
والمخرج الأول سوف يكون كما يلي، بعد حذف أسطر العناوين:
0000000000401730 <total>:
  401730:	48 85 f6             	test   %rsi,%rsi
  401733:	7e 43                	jle    401778 <total+0x48>
  401735:	48 8d 04 f7          	lea    (%rdi,%rsi,8),%rax
  401739:	31 c9                	xor    %ecx,%ecx
  40173b:	0f 1f 44 00 00       	nopl   0x0(%rax,%rax,1)
  401740:	48 03 0f             	add    (%rdi),%rcx
  401743:	48 83 c7 08          	add    $0x8,%rdi
  401747:	48 39 f8             	cmp    %rdi,%rax
  40174a:	75 f4                	jne    401740 <total+0x10>
  40174c:	48 b8 0b d7 a3 70 3d 	movabs $0xa3d70a3d70a3d70b,%rax
  401753:	0a d7 a3
  401756:	48 0f af d1          	imul   %rcx,%rdx
  40175a:	48 89 d6             	mov    %rdx,%rsi
  40175d:	48 f7 ea             	imul   %rdx
  401760:	48 8d 04 32          	lea    (%rdx,%rsi,1),%rax
  401764:	48 c1 fe 3f          	sar    $0x3f,%rsi
  401768:	48 c1 f8 06          	sar    $0x6,%rax
  40176c:	48 29 f0             	sub    %rsi,%rax
  40176f:	48 01 c8             	add    %rcx,%rax
  401772:	c3                   	ret
  401773:	0f 1f 44 00 00       	nopl   0x0(%rax,%rax,1)
  401778:	31 c0                	xor    %eax,%eax
  40177a:	c3                   	ret
كل سطر فيه ثلاثة أعمدة: عنوان التعليمة في الذاكرة، ثم بايتاتها كما هي في الملف، ثم ترجمتها إلى لغة التجميع Assembly. وفي المخرج أعلاه لاحظ التالي:
- المعاملات في مسجلات ال ABI: مؤشر الأسعار في
rdi، والعددnفيrsi، ونسبة الضريبة فيrdx، كما في الجدول السابق تماماً. والسطر الأولtest %rsi,%rsiيفحص هلnصفر أو سالب، فيقفز إلى آخر الدالة ويرجع صفراً. - العنونة المركبة: التعليمة
lea (%rdi,%rsi,8),%raxتحسب عنوان نهاية المصفوفة في خطوة واحدة: بداية المصفوفة زائد العدد مضروباً في 8، لأن كلlongثمانية بايتات. وهذه إحدى طرق العنونة التي تقدمها x86-64. - الحلقة أربع تعليمات: من العنوان
401740إلى40174a، وأولهاadd (%rdi),%rcxتقرأ السعر من الذاكرة وتجمعه على المجموع في تعليمة واحدة، وهذه صفة مهمة في x86-64: كثير من التعليمات الحسابية تستطيع أن تأخذ أحد معاملاتها من الذاكرة مباشرة. - أطوال مختلفة:
c3بايت واحد، وadd (%rdi),%rcxثلاثة بايتات، وmovabsعشرة بايتات تحمل رقماً كاملاً بحجم 64 بت داخل التعليمة نفسها، حتى أنobjdumpقسمها على سطرين. - القسمة على 100 اختفت: المترجم لم يستخدم تعليمة قسمة، لأنها بطيئة، وإنما ضرب في الرقم السحري
0xa3d70a3d70a3d70bوأخذ الجزء الأعلى من الناتج بالتعليمةimul %rdxثم أزاح بست خانات، وهي حيلة معروفة تعطي نفس نتيجة القسمة على ثابت. - تعليمات
nopl: لا تفعل شيئاً، ووظيفتها أن تجعل بداية الحلقة على عنوان مضاعف لـ 16، لأن الجلب أسرع من عنوان محاذى على هذا المعالج.
على ARM64
والمخرج الثاني سوف يكون كما يلي:
00000000004007a0 <total>:
  4007a0:	f100003f 	cmp	x1, #0x0
  4007a4:	5400024d 	b.le	4007ec <total+0x4c>
  4007a8:	8b010c04 	add	x4, x0, x1, lsl #3
  4007ac:	d2800003 	mov	x3, #0x0                   	// #0
  4007b0:	f8408401 	ldr	x1, [x0], #8
  4007b4:	8b010063 	add	x3, x3, x1
  4007b8:	eb00009f 	cmp	x4, x0
  4007bc:	54ffffa1 	b.ne	4007b0 <total+0x10>  // b.any
  4007c0:	d29ae161 	mov	x1, #0xd70b                	// #55051
  4007c4:	9b037c40 	mul	x0, x2, x3
  4007c8:	f2ae1461 	movk	x1, #0x70a3, lsl #16
  4007cc:	f2c147a1 	movk	x1, #0xa3d, lsl #32
  4007d0:	f2f47ae1 	movk	x1, #0xa3d7, lsl #48
  4007d4:	9b417c01 	smulh	x1, x0, x1
  4007d8:	8b000021 	add	x1, x1, x0
  4007dc:	9346fc21 	asr	x1, x1, #6
  4007e0:	cb80fc20 	sub	x0, x1, x0, asr #63
  4007e4:	8b030000 	add	x0, x0, x3
  4007e8:	d65f03c0 	ret
  4007ec:	d2800000 	mov	x0, #0x0                   	// #0
  4007f0:	d65f03c0 	ret
في المخرج أعلاه لاحظ التالي:
- كل تعليمة أربعة بايتات بالضبط: العمود الثاني دائماً ثمانية أرقام ست عشرية، والعناوين تزيد بأربعة في كل سطر، وهذا ما يقصد بالطول الثابت.
- المعاملات في
x0وx1وx2: نفس الدالة، ونفس ترتيب المعاملات، ولكن بأسماء مسجلات أخرى بحسب AAPCS64. - القراءة منفصلة عن الجمع: الحلقة أربع تعليمات أيضاً، ولكن السعر يقرأ بالتعليمة
ldr x1, [x0], #8ثم يجمع بالتعليمةadd x3, x3, x1، لأن ARM64 معمارية Load-Store: التعليمات الحسابية لا تلمس الذاكرة أبداً، والتحميل والتخزين لهما تعليمات خاصة. ولاحظ أنldrنفسها تزيد المؤشر بثمانية بعد القراءة، وهذه طريقة عنونة اسمها Post-Index. - الرقم السحري على أربع مراحل: لأن التعليمة طولها 32 بت فقط، فلا يمكن أن تحمل رقماً بحجم 64 بت كاملاً، لذلك بناه المترجم بأربع تعليمات:
movتضع أول 16 بت، ثم ثلاثmovkتضع كل منها 16 بت في مكانها. وهذا ثمن الطول الثابت: أربع تعليمات و16 بايتاً مقابل تعليمة واحدة و10 بايتات في x86-64. - ثلاثة معاملات في التعليمة:
add x4, x0, x1, lsl #3تجمعx0معx1مزاحاً بثلاث خانات وتضع الناتج في مسجل ثالث، دون أن تغير أياً من المصدرين، بينما في x86-64 أغلب التعليمات تكتب الناتج فوق أحد المصدرين.
على RISC-V
والمخرج الثالث سوف يكون كما يلي:
00000000000104b6 <total>:
   104b6:	04b05063          	blez	a1,104f6 <total+0x40>
   104ba:	058e                	slli	a1,a1,0x3
   104bc:	00b506b3          	add	a3,a0,a1
   104c0:	4781                	li	a5,0
   104c2:	6118                	ld	a4,0(a0)
   104c4:	0521                	addi	a0,a0,8
   104c6:	97ba                	add	a5,a5,a4
   104c8:	fea69de3          	bne	a3,a0,104c2 <total+0xc>
   104cc:	02f60633          	mul	a2,a2,a5
   104d0:	a3d71537          	lui	a0,0xa3d71
   104d4:	a3d50513          	addi	a0,a0,-1475 # ffffffffa3d70a3d <__BSS_END__+0xffffffffa3cebd45>
   104d8:	70a3d737          	lui	a4,0x70a3d
   104dc:	70b70713          	addi	a4,a4,1803 # 70a3d70b <__BSS_END__+0x709b8a13>
   104e0:	1502                	slli	a0,a0,0x20
   104e2:	953a                	add	a0,a0,a4
   104e4:	02a61533          	mulh	a0,a2,a0
   104e8:	43f65713          	srai	a4,a2,0x3f
   104ec:	9532                	add	a0,a0,a2
   104ee:	8519                	srai	a0,a0,0x6
   104f0:	8d19                	sub	a0,a0,a4
   104f2:	953e                	add	a0,a0,a5
   104f4:	8082                	ret
   104f6:	4501                	li	a0,0
   104f8:	8082                	ret
في المخرج أعلاه لاحظ التالي:
- طولان فقط: بعض التعليمات ثمانية أرقام ست عشرية، أي أربعة بايتات، وبعضها أربعة أرقام، أي بايتان، وهذه الأخيرة من الامتداد C الذي ذكرته
fileباسم RVC. فالتعليمةadd a5,a5,a4بايتان فقط لأنها شائعة جداً ولها صيغة مختصرة، بينماmulأربعة بايتات. - أسماء المسجلات حسب وظيفتها: المعاملات في
a0وa1وa2، وهي أسماء ال ABI للمسجلاتx10إلىx12، والحرف a من كلمة Argument. - المقارنة والقفز في تعليمة واحدة:
blez a1تقفز إذا كانa1أصغر من أو يساوي صفراً، وbne a3,a0تقارن مسجلين وتقفز إذا اختلفا، ولا توجد أعلام Flags كما فيcmpثمjneفي x86-64 أوcmpثمb.neفي ARM64. وهذا قرار تصميم في RISC-V يبسط المعالج لأنه لا يحتاج سجلاً خاصاً للأعلام تكتب فيه كل تعليمة. - الحلقة أربع تعليمات مرة ثالثة:
ldثمaddiثمaddثمbne، وهي Load-Store مثل ARM64، ولكن المؤشر يزاد بتعليمة منفصلة لأن RISC-V لا تملك عنونة Post-Index. - الرقم السحري بست تعليمات:
luiوaddiتبنيان النصف الأعلى، ومثلهما للنصف الأدنى، ثم إزاحة وجمع، لأن الرقم الفوري Immediate في تعليمات RISC-V قصير.
وإذا جمعت الملاحظات الثلاث فسوف تجد أن الحلقة نفسها أربع تعليمات في المعماريات الثلاث، وأن الفرق الحقيقي في التفاصيل: هل تقرأ التعليمة الحسابية من الذاكرة، وهل يوجد سجل أعلام، وكيف يبنى رقم كبير، وكم بايتاً تأخذ كل تعليمة. وهذه التفاصيل هي موضوع مقال CISC أم RISC الذي يأتي بعد هذا المقال، حيث نقيس حجم الكود وعدد التعليمات المنفذة على برنامج أكبر.
اتفاقية الاستدعاء بعينك: الدالة main
الآن ننظر إلى الطرف الآخر، أي من يستدعي total، لنرى ال ABI وهي تعمل:
objdump -d --disassemble=main price-x86_64
aarch64-linux-gnu-objdump -d --disassemble=main price-aarch64
riscv64-linux-gnu-objdump -d --disassemble=main price-riscv64
والمخرج سوف يكون كما يلي، الأول x86-64 ثم ARM64 ثم RISC-V:
0000000000401570 <main>:
  401570:	48 83 ec 28          	sub    $0x28,%rsp
  401574:	ba 0f 00 00 00       	mov    $0xf,%edx
  401579:	be 04 00 00 00       	mov    $0x4,%esi
  40157e:	66 0f 6f 05 aa 6b 07 	movdqa 0x76baa(%rip),%xmm0        # 478130 <slashdot.0+0x67a>
  401585:	00
  401586:	48 89 e7             	mov    %rsp,%rdi
  401589:	0f 29 04 24          	movaps %xmm0,(%rsp)
  40158d:	66 0f 6f 05 ab 6b 07 	movdqa 0x76bab(%rip),%xmm0        # 478140 <slashdot.0+0x68a>
  401594:	00
  401595:	0f 29 44 24 10       	movaps %xmm0,0x10(%rsp)
  40159a:	e8 91 01 00 00       	call   401730 <total>
  40159f:	48 8d 3d 6a 4a 07 00 	lea    0x74a6a(%rip),%rdi        # 476010 <__rseq_flags+0xc>
  4015a6:	48 89 c6             	mov    %rax,%rsi
  4015a9:	31 c0                	xor    %eax,%eax
  4015ab:	e8 30 32 00 00       	call   4047e0 <_IO_printf>
  4015b0:	31 c0                	xor    %eax,%eax
  4015b2:	48 83 c4 28          	add    $0x28,%rsp
  4015b6:	c3                   	ret

0000000000400500 <main>:
  400500:	d00002e3 	adrp	x3, 45e000 <__PRETTY_FUNCTION__.0+0x68>
  400504:	91040063 	add	x3, x3, #0x100
  400508:	a9bd7bfd 	stp	x29, x30, [sp, #-48]!
  40050c:	d28001e2 	mov	x2, #0xf                   	// #15
  400510:	d2800081 	mov	x1, #0x4                   	// #4
  400514:	910003fd 	mov	x29, sp
  400518:	910043e0 	add	x0, sp, #0x10
  40051c:	4c40a07e 	ld1	{v30.16b-v31.16b}, [x3]
  400520:	4c00a01e 	st1	{v30.16b-v31.16b}, [x0]
  400524:	9400009f 	bl	4007a0 <total>
  400528:	aa0003e1 	mov	x1, x0
  40052c:	f00002a0 	adrp	x0, 457000 <__pthread_mutex_cond_lock_full+0x640>
  400530:	91242000 	add	x0, x0, #0x908
  400534:	94000493 	bl	401780 <_IO_printf>
  400538:	52800000 	mov	w0, #0x0                   	// #0
  40053c:	a8c37bfd 	ldp	x29, x30, [sp], #48
  400540:	d65f03c0 	ret

000000000001037e <main>:
   1037e:	7179                	addi	sp,sp,-48
   10380:	07800813          	li	a6,120
   10384:	05000693          	li	a3,80
   10388:	02d00713          	li	a4,45
   1038c:	0ff00793          	li	a5,255
   10390:	463d                	li	a2,15
   10392:	4591                	li	a1,4
   10394:	850a                	mv	a0,sp
   10396:	f406                	sd	ra,40(sp)
   10398:	e042                	sd	a6,0(sp)
   1039a:	e436                	sd	a3,8(sp)
   1039c:	e83a                	sd	a4,16(sp)
   1039e:	ec3e                	sd	a5,24(sp)
   103a0:	116000ef          	jal	104b6 <total>
   103a4:	85aa                	mv	a1,a0
   103a6:	00040517          	auipc	a0,0x40
   103aa:	68250513          	addi	a0,a0,1666 # 50a28 <__rseq_flags+0x4>
   103ae:	17f000ef          	jal	10d2c <_IO_printf>
   103b2:	70a2                	ld	ra,40(sp)
   103b4:	4501                	li	a0,0
   103b6:	6145                	addi	sp,sp,48
   103b8:	8082                	ret
في المخرج أعلاه لاحظ التالي:
- نفس القيم في مسجلات مختلفة: قبل كل استدعاء توضع نسبة الضريبة 15، وهي
0xf، في المعامل الثالث (edxثمx2ثمa2)، والعدد 4 في المعامل الثاني (esiثمx1ثمa1)، وعنوان المصفوفة على ال Stack في المعامل الأول (rdiثمx0ثمa0). - ثلاث طرق لنسخ الأسعار: x86-64 نسخت الأسعار الأربعة من نسخة جاهزة في الملف بتعليمات SIMD بعرض 128 بت (
movdqaوmovaps)، وARM64 فعلت نفس الشيء بتعليمةld1وst1على مسجلين بعرض 128 بت، أما RISC-V فوضعت كل سعر برقمه في مسجل ثم خزنته، لأن مترجمها لم يستخدم امتداد المتجهات Vector هنا، فالقيم 120 و80 و45 و255 ظاهرة في الكود. - أين يذهب عنوان الرجوع: في x86-64 لا ترى أي حفظ له، لأن
callتضعه على ال Stack تلقائياً وretتأخذه من هناك. أما في ARM64 فالتعليمةblتضعه فيx30، ولأنmainنفسها سوف تستدعي دوال أخرى تغيرx30، فقد حفظته في أول سطر بالتعليمةstp x29, x30واسترجعته قبل الرجوع بالتعليمةldp. ونفس الشيء في RISC-V معsd ra,40(sp)وld ra,40(sp). - النتيجة تنتقل إلى المعامل الثاني لـ printf: القيمة الراجعة من
totalفيraxأوx0أوa0، ثم تنسخ إلى المعامل الثاني لـprintf، لأن المعامل الأول هو نص التنسيق"total = %ld\n". - السطر
xor %eax,%eaxقبلprintf: قاعدة خاصة في ABI لـ x86-64 للدوال ذات المعاملات المتغيرة: يجب أن يحملalعدد معاملات الفاصلة العائمة في مسجلات SIMD، وهنا لا يوجد أي معامل عشري فهو صفر. ولا توجد هذه القاعدة في المعماريتين الأخريين، وهذا مثال صغير على أن ال ABI تختلف في تفاصيل لا تخطر على بالك.
دون مكتبة C: الطلب من النواة بثلاث لغات
في كل ما سبق كانت مكتبة C تخفي عنا الجزء الأخير، وهو كيف تصل printf إلى النواة. لنكتب الآن نفس البرنامج الصغير بلغة التجميع لكل معمارية، دون أي مكتبة: يطلب من النواة أن تكتب سطراً على المخرج القياسي، ثم يطلب الخروج. والملفات الثلاثة كما يلي:
# hello-x86_64.S: write(1, msg, 13) then exit(0), no C library
        .global _start
        .text
_start: mov  $1, %rax          # syscall number: write = 1 on x86-64
        mov  $1, %rdi          # arg 1: fd 1 (stdout)
        lea  msg(%rip), %rsi   # arg 2: address of the text
        mov  $13, %rdx         # arg 3: length
        syscall
        mov  $60, %rax         # exit = 60
        xor  %rdi, %rdi        # status 0
        syscall
        .data
msg:    .ascii "Hello x86-64\n"
// hello-aarch64.S: write(1, msg, 13) then exit(0), no C library
.global _start
.text
_start: mov x8, #64 // syscall number: write = 64 on arm64
mov x0, #1 // arg 1: fd 1 (stdout)
adr x1, msg // arg 2: address of the text
mov x2, #13 // arg 3: length
svc #0
mov x8, #93 // exit = 93
mov x0, #0 // status 0
svc #0
msg: .ascii "Hello ARM64!\n"# hello-riscv64.S: write(1, msg, 13) then exit(0), no C library
.global _start
.text
_start: li a7, 64 # syscall number: write = 64 on riscv64
li a0, 1 # arg 1: fd 1 (stdout)
lla a1, msg # arg 2: address of the text
li a2, 13 # arg 3: length
ecall
li a7, 93 # exit = 93
li a0, 0 # status 0
ecall
.data
msg: .ascii "Hello RISC-V\n"نترجمها دون مكتبة C بالخيار -nostdlib، ونشغلها:
gcc -nostdlib -static hello-x86_64.S -o hello-x86_64
aarch64-linux-gnu-gcc -nostdlib -static hello-aarch64.S -o hello-aarch64
riscv64-linux-gnu-gcc -nostdlib -static hello-riscv64.S -o hello-riscv64
./hello-x86_64
qemu-aarch64 ./hello-aarch64
qemu-riscv64 ./hello-riscv64
والمخرج سوف يكون كما يلي:
Hello x86-64
Hello ARM64!
Hello RISC-V
وإذا فتحنا الملفات بـ objdump فسوف نرى الترجمة الحقيقية لكل سطر، وهذا مخرج الملفات الثلاثة:
0000000000401000 <_start>:
  401000:	48 c7 c0 01 00 00 00 	mov    $0x1,%rax
  401007:	48 c7 c7 01 00 00 00 	mov    $0x1,%rdi
  40100e:	48 8d 35 eb 0f 00 00 	lea    0xfeb(%rip),%rsi        # 402000 <msg>
  401015:	48 c7 c2 0d 00 00 00 	mov    $0xd,%rdx
  40101c:	0f 05                	syscall
  40101e:	48 c7 c0 3c 00 00 00 	mov    $0x3c,%rax
  401025:	48 31 ff             	xor    %rdi,%rdi
  401028:	0f 05                	syscall

00000000004000d4 <_start>:
  4000d4:	d2800808 	mov	x8, #0x40                  	// #64
  4000d8:	d2800020 	mov	x0, #0x1                   	// #1
  4000dc:	100000c1 	adr	x1, 4000f4 <msg>
  4000e0:	d28001a2 	mov	x2, #0xd                   	// #13
  4000e4:	d4000001 	svc	#0x0
  4000e8:	d2800ba8 	mov	x8, #0x5d                  	// #93
  4000ec:	d2800000 	mov	x0, #0x0                   	// #0
  4000f0:	d4000001 	svc	#0x0

0000000000010144 <_start>:
   10144:	04000893          	li	a7,64
   10148:	4505                	li	a0,1
   1014a:	00001597          	auipc	a1,0x1
   1014e:	01858593          	addi	a1,a1,24 # 11162 <__DATA_BEGIN__>
   10152:	4635                	li	a2,13
   10154:	00000073          	ecall
   10158:	05d00893          	li	a7,93
   1015c:	4501                	li	a0,0
   1015e:	00000073          	ecall
في الملفات والمخرج أعلاه لاحظ التالي:
- ثلاث تعليمات للعبور إلى النواة:
syscallبالبايتين0f 05، وsvc #0بالبايتاتd4000001، وecallبالبايتات00000073. وكلها تفعل نفس الشيء من حيث المبدأ: تنقل المعالج من وضع المستخدم إلى وضع النواة وتقفز إلى عنوان سجلته النواة، كما شرحنا بالتفصيل في مقال استدعاءات النظام. - أرقام الطلبات مختلفة:
writeهو 1 على x86-64 و64 على الأخريين، وexitهو 60 أو 93، فلو نسخت كود x86-64 حرفياً إلى ARM64 بعد تغيير أسماء المسجلات فقط، لطلبت من النواة الطلب رقم 1 وهو على ARM64 طلب مختلف تماماً اسمهio_destroy. - المسجل الذي يحمل رقم الطلب مختلف:
raxثمx8ثمa7، والمعاملات فيrdi rsi rdxأوx0 x1 x2أوa0 a1 a2، كما في جدول صفحة syscall(2). - التحميل الفوري لرقم صغير: في x86-64 كتب المجمع
mov $1,%raxبسبعة بايتات لأننا طلبنا مسجلاً كاملاً بحجم 64 بت، وفي RISC-V صارتli a0,1بايتين فقط بفضل الامتداد C. وفي الكود الذي ينتجه المترجم عادة سوف ترىmov $1,%eaxبخمسة بايتات، لأن الكتابة في النصف الأدنى تصفر النصف الأعلى تلقائياً. - التحميل النسبي: عنوان النص يحسب بالنسبة لمكان التعليمة نفسها في المعماريات الثلاث (
lea msg(%rip)وadrوauipcمعaddi)، حتى يعمل الكود في أي مكان يحمل فيه.
la a1, msg بدلاً من lla، فعمل البرنامج، ولكن objdump أظهر أن العنوان صار يقرأ من جدول GOT بتعليمة ld إضافية، لأن المترجم في Debian يبني كوداً مستقلاً عن الموضع PIC افتراضياً، وla في هذا الوضع تمر عبر الجدول. واستخدم lla عندما يكون الرمز داخل نفس الملف، فهي تحسب العنوان نسبياً بتعليمتين دون قراءة من الذاكرة.لماذا لا يعمل برنامج x86 على ARM؟
الآن نستطيع أن نجيب عن سؤال العنوان بدقة، والإجابة أن الملف يتوقف عند أول طبقة لا تطابق، والطبقات أربع من الأعلى إلى الأسفل:
- رأس الملف: النواة تقرأ رقم المعمارية في رأس ELF، وإذا لم يطابق رقمها ولم يسجل محاكي لهذا النوع، ترفض الملف بالخطأ
Exec format errorقبل أي شيء آخر. وهذه هي الطبقة التي رأيناها في المختبر. - بايتات التعليمات: لو تجاوزنا الفحص الأول بطريقة ما، فإن البايتات نفسها لا معنى لها للمعالج الآخر، فالبايتات
48 85 f6التي تعنيtest %rsi,%rsiعلى x86-64 لا تكون حتى تعليمة كاملة على ARM64 الذي يقرأ أربعة بايتات في كل مرة، وسوف يفسرها كتعليمة أخرى أو يرفع استثناء تعليمة غير معروفة. - ال ABI وطلبات النواة: لو ترجمنا التعليمات واحدة بواحدة، فإن أرقام الطلبات والمسجلات التي تحمل المعاملات مختلفة، وبعض الطلبات القديمة في x86-64 مثل
openلا توجد أصلاً في الجدول المشترك لـ ARM64، الذي يحتوي فقط علىopenat. - المكتبات والمحمل: الملف الديناميكي يطلب محملاً بمسار معين، مثل
/lib64/ld-linux-x86-64.so.2على x86-64 و/lib/ld-linux-aarch64.so.1على ARM64، ومكتبات مترجمة لنفس معماريته، وكل هذا غير موجود على النظام الآخر، وقد رأينا هذا الخطأ مع المحاكي في مقال Hello World.
وبالتالي لا يوجد «تحويل» بسيط لملف من معمارية إلى أخرى، والحلول الحقيقية ثلاثة: أن تترجم الكود المصدري من جديد للمعمارية الأخرى كما فعلنا هنا، وهذا الأفضل دائماً، أو أن تشغل الملف داخل محاك مثل QEMU يترجم كل تعليمة أثناء التشغيل ويقبل البطء، أو أن تستخدم ترجمة ثنائية Binary Translation مثل Rosetta 2 من Apple التي تترجم أغلب الملف مسبقاً.
ماذا يحدث إذا بنيت لنفس المعمارية ولمستوى أعلى من معالجك؟
قد تظن أن المشكلة تنتهي إذا كانت المعمارية واحدة، ولكن ال ISA نفسها تكبر مع الزمن: كل جيل من المعالجات يضيف امتدادات Extensions، أي تعليمات جديدة، مثل SSE4.2 وAVX2 وAVX-512 في x86-64، أو امتدادات المتجهات في ARM64 وRISC-V. والبرنامج الذي يستخدم امتداداً لا يملكه معالجك يتجاوز فحص رأس الملف بنجاح، لأن رقم المعمارية واحد، ثم يتوقف عند أول تعليمة جديدة. ولكي لا تبقى قائمة الامتدادات بلا ترتيب، جمعت وثيقة psABI لـ x86-64 الامتدادات في أربعة مستويات تبينها الصورة التالية، ويمكنك أن تطلب أياً منها من GCC بالخيار -march كما في توثيق خيارات x86 في GCC:
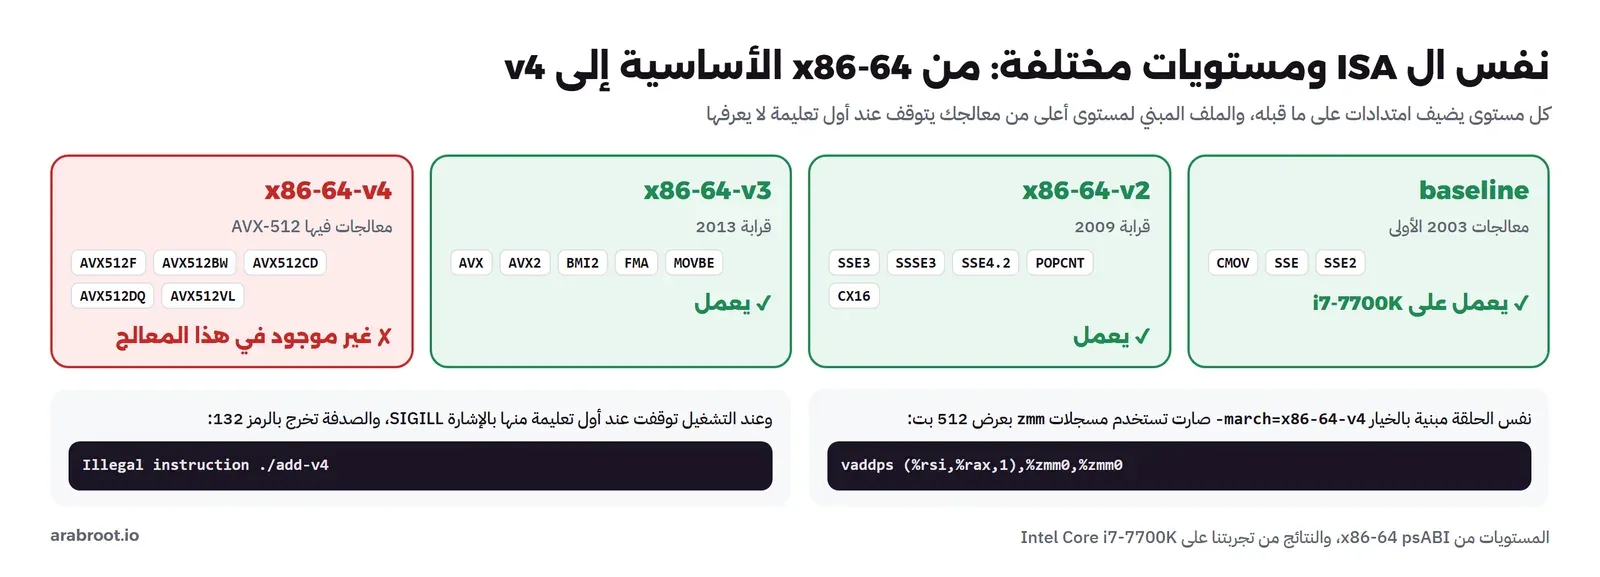
ولنجرب ذلك على الدالة التالية، وهي حلقة تجمع مصفوفتين من الأرقام العشرية، ونبنيها ثلاث مرات: للمستوى الأساسي، وللمستوى v3، وللمستوى v4:
// add.c: the same loop, built for a CPU level we choose with -march
#include <stdio.h>
#include <stdlib.h>

__attribute__((noinline))
void add(float *c, const float *a, const float *b, int n)
{
    for (int i = 0; i < n; i++)
        c[i] = a[i] + b[i];
}

int main(int argc, char **argv)
{
    int n = argc > 1 ? atoi(argv[1]) : 1024;
    float *a = malloc(n * sizeof *a), *b = malloc(n * sizeof *b), *c = malloc(n * sizeof *c);
    for (int i = 0; i < n; i++) { a[i] = i; b[i] = 2 * i; }
    add(c, a, b, n);
    printf("c[%d] = %.0f\n", n - 1, c[n - 1]);
    return 0;
}
gcc -O3 add.c -o add-base
gcc -O3 -march=x86-64-v3 add.c -o add-v3
gcc -O3 -march=x86-64-v4 add.c -o add-v4
./add-base; ./add-v3; ./add-v4; echo "exit=$?"
grep -o -w -E 'avx512[a-z]*|avx2' /proc/cpuinfo | sort -uوالمخرج سوف يكون كما يلي:
c[1023] = 3069
c[1023] = 3069
bash: line 12:    44 Illegal instruction     ./add-v4
exit=132
avx2
الملفان الأول والثاني عملا، والثالث توقف بالإشارة SIGILL، أي تعليمة غير قانونية Illegal Instruction، ورمز الخروج 132 هو 128 زائد رقم الإشارة 4. والسطر الأخير يوضح السبب: المعالج يعلن عن avx2 ولا يعلن عن أي امتداد يبدأ بـ avx512. ولنرى التعليمات التي اختارها المترجم في النسختين:
objdump -d --disassemble=add add-v4 | grep -m3 zmm
objdump -d --disassemble=add add-base | grep -m3 xmm
والمخرج سوف يكون كما يلي:
    14c0:	62 f1 7c 48 10 04 02 	vmovups (%rdx,%rax,1),%zmm0
    14c7:	62 f1 7c 48 58 04 06 	vaddps (%rsi,%rax,1),%zmm0,%zmm0
    14ce:	62 f1 7c 48 11 04 07 	vmovups %zmm0,(%rdi,%rax,1)
    1380:	0f 10 04 06          	movups (%rsi,%rax,1),%xmm0
    1384:	0f 10 14 02          	movups (%rdx,%rax,1),%xmm2
    1388:	0f 58 c2             	addps  %xmm2,%xmm0
في المخرج أعلاه لاحظ التالي:
- النسخة v4 تجمع 16 رقماً عشرياً في تعليمة واحدة على مسجلات
zmmبعرض 512 بت، والنسخة الأساسية تجمع 4 أرقام على مسجلاتxmmبعرض 128 بت، وقد شرحنا فكرة SIMD في مقال المعالج من الداخل. - تعليمات AVX-512 تبدأ بالبايت
62، وهو بادئة اسمها EVEX، بينما التعليمات القديمة تبدأ بـ0f. وهذا مثال على كيف كبرت x86-64 عبر السنين: كل امتداد جديد أضاف بادئة جديدة فوق الترميز القديم، ولذلك صار الطول المتغير أطول. - المعالج لم يفشل عند التحميل، وإنما عند أول تعليمة
zmm، أي بعد أن بدأ البرنامج يعمل، وفي برنامج حقيقي قد يحدث هذا بعد ساعات إذا كانت الدالة لا تستدعى إلا في حالة نادرة.
وكنا نتوقع أن ينقذنا المحاكي هنا، فشغلنا نفس الملف عبر محاكي x86-64 بأكبر مجموعة امتدادات يعرفها:
qemu-x86_64 -cpu max ./add-v4; echo "exit=$?"فكانت النتيجة نفس الإشارة:
qemu: uncaught target signal 4 (Illegal instruction) - core dumped
bash: line 15:    47 Illegal instruction     qemu-x86_64 -cpu max ./add-v4
exit=132
والسبب أن QEMU 10.0 لا يحاكي AVX-512 في وضع الترجمة البرمجية TCG، فهذا الملف لا يعمل على هذا الجهاز بأي طريقة، والحل الوحيد أن تعيد بناءه لمستوى أدنى أو أن تشغله على معالج فيه AVX-512. وهناك مشكلة أخرى واجهناها في نفس التجربة تستحق الذكر: في النسخة الأولى من الملف كانت المصفوفات ثابتة الحجم والقيم داخل main، فحسب المترجم النتيجة كلها وقت الترجمة، ولم تظهر أي تعليمة zmm وعملت النسخة v4 بلا مشكلة. لذلك إذا أردت أن تختبر أثر خيار -march، فاجعل الحجم يأتي من وقت التشغيل وضع الحلقة في دالة منفصلة، وإلا فأنت تختبر المترجم وليس المعالج.
وكيف تتعامل التوزيعات مع هذا؟ مكتبة glibc تبحث عن نسخ من المكتبات مبنية لكل مستوى، وتختار أعلى مستوى يدعمه معالجك، كما يصف دليل المحمل ld.so، وتستطيع أن تسأل المحمل عن المستويات التي يدعمها جهازك:
/lib64/ld-linux-x86-64.so.2 --help | grep -A4 Subdirectoriesوالمخرج سوف يكون كما يلي:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
والكلمتان supported, searched تظهران بجانب v3 وv2 فقط، أي أن هذا المعالج يقف عند المستوى v3، وهو ما رأيناه بالتجربة. وهذا الأمر أسرع طريقة لتعرف المستوى الذي يدعمه سيرفر قبل أن تشغل عليه ملفاً مبنياً لمستوى معين.
ماذا يعني هذا لك عملياً؟
أول شيء أن تعرف أن لكل معمارية عدة أسماء بحسب من يتكلم، وهذا وحده سبب نصف الأخطاء في اختيار الملف الصحيح. والجدول التالي يجمع الأسماء التي سوف تراها:
| المعمارية | الأمر uname -m | Debian وUbuntu | منصة Docker | أسماء أخرى في ملفات الإصدارات |
|---|---|---|---|---|
| x86-64 | x86_64 | amd64 | linux/amd64 | x64، x86_64، intel |
| ARM64 | aarch64 | arm64 | linux/arm64 | aarch64، armv8 |
| RISC-V 64 | riscv64 | riscv64 | linux/riscv64 | rv64، rv64gc |
| ARM 32 بت | armv7l | armhf | linux/arm/v7 | armv7 |
والمهم في الجدول أن amd64 لا تعني «لمعالجات AMD فقط»، وإنما هي اسم المعمارية x86-64 كلها، فالملف المسمى amd64 هو ما تحتاجه على سيرفر فيه معالج Intel. وتجد قائمة المعماريات التي يدعمها Debian في صفحة المنافذ Ports.
وثاني شيء هو Docker، لأن أغلب الناس يصطدمون بهذا الموضوع فيه: ال Docker Image مبنية لمعمارية واحدة أو لعدة معماريات في قائمة واحدة Manifest List، وعندما تسحب Image فإن Docker يختار النسخة المناسبة لجهازك تلقائياً، أما عندما تبني على جهاز Mac بمعالج Apple فإن النتيجة الافتراضية linux/arm64، فإذا رفعتها إلى VPS بمعالج x86-64 ظهر الخطأ الذي رأيناه. والحل كما يشرح توثيق البناء لعدة منصات في Docker أن تحدد المنصة عند البناء:
docker buildx build --platform linux/amd64,linux/arm64 -t registry.example.com/app:1.0 --push .
docker image inspect --format '{{.Os}}/{{.Architecture}}' registry.example.com/app:1.0
والأمر الثاني يخبرك بمعمارية Image موجودة عندك، كما في توثيق docker image inspect، فاجعله أول أمر عند أي خطأ exec format error داخل Container.
وثالث شيء هو اختيار السيرفر: سيرفرات ARM في السحابة أرخص غالباً لنفس الأداء في أعمال كثيرة، ولكن انتقالك إليها يعني أن كل ملف تنفيذي وكل Docker Image وكل مكتبة فيها كود مترجم يجب أن يكون لها نسخة ARM64. فلغات مثل Python وJava وNode.js تنتقل بسهولة لأن المفسر نفسه متوفر للمعماريتين، كما شرحنا في مقال المترجم والمفسر و JIT، أما الحزم التي فيها كود C أو برامج تجارية مغلقة لا توجد إلا لـ x86-64 فهي التي توقف الانتقال. وقبل أن تقرر افحص كل اعتماد في مشروعك، وسوف نناقش هذا القرار بالتفصيل في مقال ARM من الجوال إلى السيرفر.
أخطاء شائعة
- الظن أن
amd64لمعالجات AMD وx86_64لمعالجات Intel: الاسمان لنفس المعمارية، وكلاهما يعمل على معالجات الشركتين. - الظن أن ARM شركة تصنع المعالجات: Arm تصمم المعمارية وتبيع رخصتها وتصاميم أنوية جاهزة، والشرائح تصنعها Apple وQualcomm وAmazon وغيرها، ولكل منها معماريتها الدقيقة.
- تشخيص
exec format errorعلى أنه مشكلة صلاحيات أو ملف تالف: أول أمر هوfileعلى الملف وuname -mعلى الجهاز، فإذا اختلفت المعمارية فقد عرفت السبب. وانتبه أن نفس الرسالة تظهر أيضاً لسكربت يبدأ بسطر#!خاطئ أو بلا هذا السطر، فلا تفترض المعمارية قبل أن تنظر. - الاعتماد على أن ملف ARM «عمل» على جهازك x86-64: قد يكون محاكي QEMU مسجلاً في binfmt_misc، والبرنامج يعمل أبطأ بكثير، وسوف يفشل على سيرفر لا يوجد فيه محاك.
- بناء ملف بالخيار
-march=nativeعلى جهاز التطوير ثم نشره على سيرفرات مختلفة: المترجم يستخدم كل امتدادات معالجك، والسيرفر الأقدم يتوقف بالإشارةSIGILL. وابن للمستوى الذي تضمنه في كل سيرفراتك، مثلx86-64-v2أوx86-64-v3. - نسخ كود Assembly أو أرقام طلبات النواة من معمارية إلى أخرى: الأرقام والمسجلات تختلف كما رأينا، وطلبات مثل
openغير موجودة على ARM64. - الخلط بين ال ISA والأداء: معالجان بنفس ال ISA قد يختلفان في السرعة عدة أضعاف، والمقارنة الصحيحة بين شرائح محددة في عمل محدد، وليس بين معماريات.
جدول قرار Decision Table: ما تراه وماذا تفعل
| ما تراه | الأمر الأول | ما تبحث عنه | الحل الغالب |
|---|---|---|---|
exec format error عند تشغيل ملف | file ./app وuname -m | معمارية الملف مقابل معمارية الجهاز | نزل أو ابن الملف للمعمارية الصحيحة |
| نفس الخطأ داخل Container | docker image inspect | قيمة Architecture | ابن بالخيار --platform أو لعدة منصات |
| ملف لمعمارية أخرى يعمل ولكنه بطيء جداً | ls /proc/sys/fs/binfmt_misc/ | مدخل qemu-* مسجل | استخدم نسخة أصلية للمعمارية، فالمحاكاة للتجربة فقط |
Illegal instruction على نفس المعمارية | grep flags /proc/cpuinfo | امتداد يستخدمه الملف ولا يملكه المعالج | ابن لمستوى أدنى من -march |
| تحتاج مستوى المعالج قبل النشر | ld.so --help | المستويات المكتوب بجانبها supported | اختر أعلى مستوى مشترك بين سيرفراتك |
| تختار بين سيرفر x86-64 وARM64 | قائمة الاعتمادات وال Images | حزم أو برامج لا توجد إلا لمعمارية واحدة | اختبر الخدمة كاملة على ARM64 قبل الانتقال |
قائمة تحقق Checklist قبل نشر ملف تنفيذي
- عرفت معمارية كل سيرفر بالأمر
uname -m، ومستواه بالأمرld.so --helpإذا كان x86-64. - كل ملف تنزله من صفحة إصدارات يطابق المعمارية بأي من أسمائها في الجدول السابق.
- ال Docker Images مبنية لكل منصة تعمل عليها خدماتك، ومعرفة بالأمر
docker image inspect. - لا يوجد
-march=nativeفي سكربت البناء الذي ينتج ملفات النشر. - إذا كان في مشروعك كود Assembly أو أرقام طلبات نواة مكتوبة يدوياً، فلكل معمارية ملفها المختبر.
- لا تعتمد على محاكي QEMU في الإنتاج إلا وأنت تعرف كلفته، فهو مناسب للبناء والتجربة.
تدريب عملي
- أضف إلى
price.cدالة تأخذ ثمانية معاملات، وترجمها للمعماريات الثلاث، ثم ابحث فيobjdumpعن المعامل السابع: هل جاء في مسجل أم على ال Stack في كل معمارية؟ وقارن بما تقوله وثائق ال ABI الثلاث. - غير رقم الطلب في
hello-aarch64.Sمن 64 إلى 1، كما في x86-64، وشغل الملف عبرqemu-aarch64 -strace، واقرأ اسم الطلب الذي وصل إلى النواة فعلاً. - على سيرفر Linux عندك نفذ
uname -mوld.so --help، واكتب المستوى الذي يدعمه، ثم قارنه بمستوى البناء في ال Docker Images التي تستخدمها.
حذف المختبر Cleanup
كل ال Containers عملت بالخيار --rm، والملفات التنفيذية حذفها آخر سطر في سكربت المختبر، فيبقى فقط حذف ال Image:
docker rmi cs1-isa:1الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- ال ISA عقد بين البرنامج والشريحة: التعليمات والمسجلات والعنونة والترميز ونموذج الذاكرة والصلاحيات، والمعمارية الدقيقة هي طريقة تنفيذ العقد داخل كل شريحة ولا يراها البرنامج إلا كسرعة.
- الحد الحقيقي بين العقود وليس بين الشركات: Intel وAMD في x86-64، وApple وQualcomm وAmazon وRaspberry Pi في ARM64.
- ال ABI عقد ثان فوق ال ISA: أي مسجل لكل معامل، وأين عنوان الرجوع، وأرقام طلبات النواة، وشكل الملف، ولذلك لا يعمل ملف Windows على Linux ولو كان المعالج واحداً.
- نفس البرنامج أنتج ثلاثة ملفات لا يتشابه فيها بايت واحد من التعليمات، والحلقة نفسها كانت أربع تعليمات في الثلاث، والفرق في التفاصيل: القراءة من الذاكرة، والأعلام، وبناء الأرقام الكبيرة، وطول التعليمة.
- النواة ترفض الملف من رأسه بالخطأ
Exec format errorإذا لم يطابق رقم المعمارية ولم يسجل محاك، والمحاكي QEMU يشغله أبطأ، والحل الدائم إعادة الترجمة. - داخل نفس المعمارية تختلف المستويات، وملف مبني لـ
x86-64-v4توقف بالإشارةSIGILLعلى معالج يقف عند v3، ولم ينقذه المحاكي. - عملياً: اعرف أسماء المعماريات (
amd64هي x86-64 كلها)، وابن ال Docker Images بالخيار--platform، ولا تنشر ملفات مبنية بـ-march=native.
وفي المقالات التالية من هذه المرحلة سوف نقارن فلسفة CISC وRISC بالأرقام، ونروي قصة x86 من 8086 إلى AMD64، ونقرأ أسماء معالجات Intel وAMD:
 دليلCISC أم RISC: ما الفرق الحقيقي بين x86 وARM وRISC-V؟نقيس حجم الكود وعدد التعليمات المنفذة لنفس البرامج على x86-64 وARM64 وRISC-V، ونرى ما بقي من نقاش CISC وRISC وما لم يعد صحيحاً.
 دليلقصة x86: من Intel 8086 إلى x86-64 الذي صممته AMDكيف وصلت معمارية معالج 16 بت من 1978 إلى أغلب سيرفرات اليوم، ولماذا ما زال معالجك يقلع كأنه 8086، مع قطاع إقلاع يصعد الأوضاع الثلاثة أمامك.
 دليلعائلات Intel وAMD: كيف تقرأ اسم المعالج وجيله؟نفك أسماء معالجات Intel وAMD من المصادر الرسمية، ثم نقرأ معالجاً حقيقياً بأدوات Windows وLinux ونفك هويته الرقمية التي لا تتغير مع الاسم.
 دليلARM من الجوال إلى السيرفر: Apple Silicon وGravitonكيف تربح Arm من شرائح لا تصنعها، ولماذا صار في كل سحابة معالج ARM، مع مختبر يبني Image لـ arm64 ويقيس كلفة تشغيلها تحت المحاكاة.
 دليلRISC-V: المعمارية المفتوحة وهل تغير سوق المعالجات؟ما الذي يعنيه أن تكون معمارية المعالج مفتوحة، وكيف تقرأ امتدادات RISC-V وملفاتها التعريفية، مع مختبر يقلع Debian كاملاً على RISC-V داخل QEMU.
 دليلالمحاكاة Emulation والترجمة الثنائية: QEMU وRosetta 2نفتح محاكي QEMU ونرى كيف تتحول تعليمات ARM إلى تعليمات x86 ونقيس كلفة كل خطوة، ثم نقارن ذلك بما تفعله Rosetta 2 وWindows Prism.
 دليلكيف يعمل المعالج CPU من الداخل ولماذا يهمك ذلكنتابع تعليمة واحدة داخل نواة المعالج، ونرى لماذا يصبح نفس الكود أبطأ بعشر مرات عندما تغير ترتيب المرور على البيانات.
سجل التحديثات
- 16 نوفمبر 2026: كتابة المقال، وتنفيذ التجارب داخل Container من Debian 13 (trixie) مع GCC 14.2 والمترجمين المتقاطعين لـ aarch64 وriscv64 وQEMU 10.0.13 في وضع المستخدم، على نواة Linux 5.15 (WSL2) ومعالج Intel Core i7-7700K، على Docker Engine 29.8.0.