


لنفرض أن فريق الفواتير نقل حساب الإجماليات من الخدمة المكتوبة بلغة Python إلى مكتبة صغيرة بلغة C حتى يصبح تقرير نهاية الشهر أسرع، وأضاف أحد المطورين حماية لرقم الفاتورة: قبل أن يزيد الرقم بواحد يتأكد أن الزيادة لن تتجاوز أكبر عدد يحمله النوع int. وجرب الحماية على جهازه فعملت، ثم جاء البناء الرسمي على سيرفر البناء بالخيار -O2، وفي يوم وصل الرقم إلى الحد فلم تعمل الحماية، وصار رقم الفاتورة التالية سالباً. ولم يتغير سطر واحد في الكود، والذي تغير هو المترجم وخيار التحسين. فما الذي حدث بين النص الذي كتبه المطور والبرنامج الذي عمل على السيرفر؟
في الجزأين السابقين بنينا مفسراً صغيراً بأيدينا، ثم حولناه إلى Bytecode وآلة افتراضية VM، ورأينا هناك أول تحسين بسيط هو طي الثوابت. وفي مقال المترجم Compiler والمفسر Interpreter و JIT و WebAssembly قرأنا لغة التجميع التي يكتبها GCC وClang لدالة واحدة وقسنا الفرق بينهما. وهنا نفتح المترجم نفسه، ونطلب من GCC وClang أن يطبعا كل مرحلة يمر بها الكود: الشجرة، والتمثيل الوسيط IR، وصيغة SSA، وما فعلته كل مرحلة تحسين، ثم كود الآلة بكل مستوى تحسين، ونقيس الأثر بأيدينا، وننتهي بقصة الحماية التي اختفت.
وسوف نناقش في هذا المقال ما يلي:
- الأجزاء الثلاثة لأي مترجم حديث: الواجهة الأمامية Front End، والوسط Middle End، والواجهة الخلفية Back End، ولماذا قسمت بهذا الشكل.
- الشجرة من Clang، والتمثيل الوسيط GIMPLE من GCC، وصيغة SSA ودوال PHI، كما تخرج من المترجم حرفياً.
- التحسينات Optimizations على كود حقيقي: طي الثوابت ونشرها، والدمج Inlining، وحذف الكود الميت Dead Code Elimination، واستبدال القسمة بالضرب، والتوجيه Vectorization.
- كود الآلة من
-O0إلى-O3، وقياس الأثر، ومقياس Benchmark حذفه المترجم كله دون أن نشعر. - ماذا يحدث إذا كانت الدالة في ملف آخر، والتحسين وقت الربط LTO.
- السلوك غير المعرف Undefined Behaviour: كيف اختفت حماية رقم الفاتورة، وثغرة Linux في 2009، وأدوات كشفه.
ثلاثة أجزاء في كل مترجم Compiler: Front End و Middle End و Back End
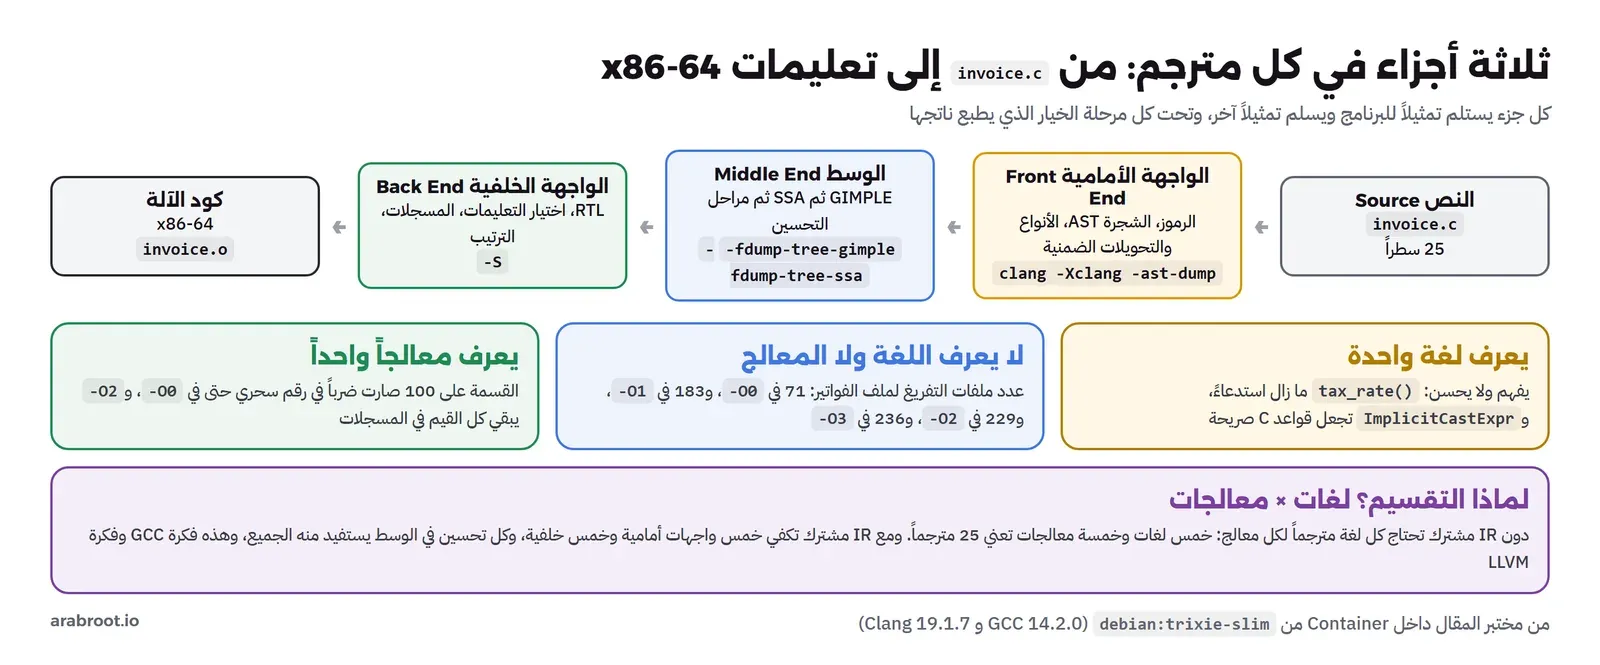
المترجم الحديث ليس برنامجاً واحداً يقرأ C ويكتب تعليمات x86، وإنما سلسلة مراحل تمرر بينها تمثيلاً للبرنامج يتغير شكله مع كل مرحلة. والتقسيم المعتاد ثلاثة أجزاء:
- الواجهة الأمامية Front End: تعرف لغة واحدة، فتقرأ النص وتحوله إلى رموز Tokens ثم إلى شجرة، وهذا ما بنيناه بأيدينا في الجزء الأول، ثم تضيف التحليل الدلالي Semantic Analysis: ما نوع كل تعبير، وأي متغير يقصده كل اسم، وهل الاستدعاء بعدد المعاملات الصحيح. وهنا تظهر أخطاء الكتابة والأنواع.
- الوسط Middle End: لا يعرف لغة المصدر ولا المعالج، وإنما يعمل على تمثيل وسيط Intermediate Representation، واختصاراً IR، ويطبق عليه عشرات مراحل التحسين Passes، كل مرحلة تأخذ IR وتعيد IR أفضل.
- الواجهة الخلفية Back End: تعرف معالجاً واحداً، فتختار تعليمات الآلة لكل عملية Instruction Selection، وتوزع القيم على المسجلات Register Allocation، وترتب التعليمات Scheduling بما يناسب المعالج، ثم تكتب لغة التجميع أو الملف الكائن Object File مباشرة.
وقد يتساءل البعض: لماذا هذا التقسيم؟ والإجابة أن المترجم الذي يدعم عدة لغات وعدة معالجات يحتاج بدونه كوداً لكل زوج من لغة ومعالج، فخمس لغات وخمسة معالجات تعني خمسة وعشرين مترجماً. ومع IR مشترك تكفي خمس واجهات أمامية وخمس خلفية، وكل تحسين في الوسط يستفيد منه الجميع. وهذا ما جعل GCC، الذي يعني اليوم GNU Compiler Collection، يترجم C وC++ وFortran وAda وGo وغيرها بنفس المحسن، وهو نفس الفكرة التي قام عليها LLVM، وسوف نخصص له المقال التالي بإذن الله.
المختبر Lab: ملف الفواتير وخيارات التفريغ Dump
كل التجارب تعمل داخل Container صغير من debian:trixie-slim ثبتنا فيه من حزم Debian المترجم GCC 14.2 وClang 19.1 وأدوات binutils، والملف Dockerfile في مجلد المختبر:
docker build -t scc1-cc lab/
docker run --rm -v "$PWD/lab":/lab -w /lab scc1-cc sh pipeline.sh
والملف الذي سوف نتتبعه هو invoice.c، وكتبناه عن قصد بالطريقة التي يكتب بها الناس كوداً واضحاً لا كوداً سريعاً: دالة صغيرة تعيد نسبة الضريبة، ودالة لإجمالي السطر، وعلامة DEBUG للطباعة أثناء التطوير، وخصم يمرر صفراً:
/* invoice.c: the total of an invoice, written the way people write it at -O0 (helpers, a debug flag, a constant rate) */
#include <stdio.h>
#include <stdlib.h>

#define DEBUG 0

static int tax_rate(void) { return 15; }                  /* percent */

static long line_total(long price, long qty, long discount)
{
    long subtotal = price * qty - discount;
    return subtotal * (100 + tax_rate()) / 100;
}

long invoice_total(const long *price, const long *qty, long n)
{
    long sum = 0;
    for (long i = 0; i < n; i++) {
        long t = line_total(price[i], qty[i], 0);
        if (DEBUG)
            printf("line %ld: %ld\n", i, t);
        sum += t;
    }
    return sum;
}
ولاحظ أن كل شيء في هذا الملف يبدو مكلفاً لو نفذ حرفياً: استدعاء دالتين لكل سطر، وجمع 100 + tax_rate() لكل سطر، وفحص DEBUG لكل سطر، وطرح خصم قيمته صفر. وسوف نرى كيف يختفي كل هذا مرحلة بعد مرحلة، ولماذا يحق للمترجم أن يحذفه.
الواجهة الأمامية Front End: الشجرة AST والتحليل الدلالي
أول ما نطلبه هو الشجرة التي بناها Clang للدالة line_total. والخيار -fsyntax-only يوقف المترجم بعد الواجهة الأمامية، و-ast-dump-filter يقصر المخرج على دالة واحدة، وحذفنا من المخرج عناوين الذاكرة الطويلة التي تسبق كل عقدة حتى يقرأ:
Dumping line_total:
FunctionDecl </lab/invoice.c:9:1, line:13:1> line:9:13 used line_total 'long (long, long, long)' static
|-ParmVarDecl <col:24, col:29> col:29 used price 'long'
|-ParmVarDecl <col:36, col:41> col:41 used qty 'long'
|-ParmVarDecl <col:46, col:51> col:51 used discount 'long'
`-CompoundStmt <line:10:1, line:13:1>
  |-DeclStmt <line:11:5, col:43>
  | `-VarDecl <col:5, col:35> col:10 used subtotal 'long' cinit
  |   `-BinaryOperator <col:21, col:35> 'long' '-'
  |     |-BinaryOperator <col:21, col:29> 'long' '*'
  |     | |-ImplicitCastExpr <col:21> 'long' <LValueToRValue>
  |     | | `-DeclRefExpr <col:21> 'long' lvalue ParmVar 0x55df30a26fa0 'price' 'long'
  |     | `-ImplicitCastExpr <col:29> 'long' <LValueToRValue>
  |     |   `-DeclRefExpr <col:29> 'long' lvalue ParmVar 0x55df30a27020 'qty' 'long'
  |     `-ImplicitCastExpr <col:35> 'long' <LValueToRValue>
  |       `-DeclRefExpr <col:35> 'long' lvalue ParmVar 0x55df30a270a0 'discount' 'long'
  `-ReturnStmt <line:12:5, col:44>
    `-BinaryOperator <col:12, col:44> 'long' '/'
      |-BinaryOperator <col:12, col:40> 'long' '*'
      | |-ImplicitCastExpr <col:12> 'long' <LValueToRValue>
      | | `-DeclRefExpr <col:12> 'long' lvalue Var 0x55df30a27270 'subtotal' 'long'
      | `-ImplicitCastExpr <col:23, col:40> 'long' <IntegralCast>
      |   `-ParenExpr <col:23, col:40> 'int'
      |     `-BinaryOperator <col:24, col:39> 'int' '+'
      |       |-IntegerLiteral <col:24> 'int' 100
      |       `-CallExpr <col:30, col:39> 'int'
      |         `-ImplicitCastExpr <col:30> 'int (*)(void)' <FunctionToPointerDecay>
      |           `-DeclRefExpr <col:30> 'int (void)' Function 0x55df30a26e98 'tax_rate' 'int (void)'
      `-ImplicitCastExpr <col:44> 'long' <IntegralCast>
        `-IntegerLiteral <col:44> 'int' 100
في المخرج أعلاه لاحظ التالي:
- هذه نفس الشجرة التي بنيناها في الجزء الأول، ولكن بلغة كاملة:
BinaryOperator '-'طرفها الأيسرBinaryOperator '*'، أي أن الضرب أعمق في الشجرة لأنه يحسب أولاً. ولكل عقدة موقعها بالسطر والعمود، ومنه تأتي رسائل الخطأ والتحذير. - كل عقدة تحمل نوعها، مثل
'long'و'int'، وهذا عمل التحليل الدلالي، فالمحلل النحوي وحده لا يعرف الأنواع. - العقد
ImplicitCastExprلم يكتبها أحد في الكود، وإنما أضافها Clang:LValueToRValueتعني «اقرأ قيمة المتغير»، وIntegralCastتحول ناتج100 + tax_rate()منintإلىlongقبل الضرب فيsubtotal. وهذه التحويلات الضمنية هي قواعد اللغة كما يحددها المعيار، والمترجم يجعلها صريحة في الشجرة حتى لا تحتاج المراحل التالية أن تعرف C. - الاستدعاء
tax_rate()ما زال استدعاء دالة، فالواجهة الأمامية لا تحسن، وإنما تفهم.
وGCC يمر بنفس الخطوات ولكنه يحفظ الشجرة في صيغة داخلية اسمها GENERIC، ويمكنك أن ترى شكلها بالخيار -fdump-tree-original. ولاحظ أن «لا تحسن» ليست دقيقة تماماً في GCC، فهو يطبق بعض التبسيط على التعابير وهو يبني الشجرة نفسها، وسوف نرى في قسم السلوك غير المعرف أن هذا التبسيط المبكر وحده كان كافياً لحذف حماية رقم الفاتورة حتى مع -O0.
التمثيل الوسيط IR: صيغة GIMPLE ذات العناوين الثلاثة
الشجرة مناسبة لفهم اللغة، ولكنها غير مناسبة للتحسين، لأن التعبير الواحد قد يكون عميقاً جداً، والتحسين يحتاج أن يسأل أسئلة بسيطة: ما القيمة التي تدخل هذه العملية؟ ومن يستخدم نتيجتها؟ لذلك تحول المترجمات الشجرة إلى صيغة مسطحة، كل سطر فيها عملية واحدة على قيمتين على الأكثر، وتسمى صيغة العناوين الثلاثة Three-Address Code، لأن كل سطر يذكر ثلاثة أشياء: معاملين ونتيجة. وفي GCC اسم هذه الصيغة GIMPLE، وتوثيق GIMPLE في دليل GCC الداخلي يصفها. والخيار -fdump-tree-gimple يطبعها:
int tax_rate ()
{
  int D.3755;

  D.3755 = 15;
  return D.3755;
}


long int line_total (long int price, long int qty, long int discount)
{
  long int D.3757;
  long int subtotal;

  _1 = price * qty;
  subtotal = _1 - discount;
  _2 = tax_rate ();
  _3 = _2 + 100;
  _4 = (long int) _3;
  _5 = subtotal * _4;
  D.3757 = _5 / 100;
  return D.3757;
}


long int invoice_total (const long int * price, const long int * qty, long int n)
{
  long int D.3761;
  long int sum;

  sum = 0;
  {
    long int i;

    i = 0;
    goto <D.3753>;
    <D.3752>:
    {
      long int t;

      i.0_1 = (long unsigned int) i;
      _2 = i.0_1 * 8;
      _3 = qty + _2;
      _4 = *_3;
      i.1_5 = (long unsigned int) i;
      _6 = i.1_5 * 8;
      _7 = price + _6;
      _8 = *_7;
      t = line_total (_8, _4, 0);
      if (0 != 0) goto <D.3759>; else goto <D.3760>;
      <D.3759>:
      printf ("line %ld: %ld\n", i, t);
      <D.3760>:
      sum = sum + t;
    }
    i = i + 1;
    <D.3753>:
    if (i < n) goto <D.3752>; else goto <D.3750>;
    <D.3750>:
  }
  D.3761 = sum;
  return D.3761;
}
في المخرج أعلاه لاحظ التالي:
- السطر
return subtotal * (100 + tax_rate()) / 100;صار سبعة أسطر، وكل نتيجة وسيطة لها اسم مؤقت مثل_1و_2. وهذا يشبه ما فعله مترجمنا في الجزء الثاني عندما حول الشجرة إلى تعليمات مكدس، والفرق أن القيم هنا لها أسماء بدل أن تكون مواقع في مكدس، وهذا ما يجعل تتبعها ممكناً. - التحويل الضمني من الشجرة صار سطراً صريحاً
_4 = (long int) _3;. - الحلقة
forاختفت، وحلت محلها علامات وgoto، فالمترجم لا يحتاج أنواع الحلقات المختلفة، وإنما كتل كود Basic Blocks وقفزات بينها، وهذا ما يسمى مخطط سير التحكم Control Flow Graph. - الوصول إلى
price[i]صار حساب عنوان صريح: تحويلiإلى عدد بلا إشارة، وضربه في 8 لأن حجمlongثمانية بايتات، وإضافته إلى عنوان المصفوفة، ثم القراءة*_7. - السطر
if (0 != 0)هو علامةDEBUGبعد أن استبدلها المعالج المسبق Preprocessor بالصفر، ومعه استدعاءprintf. ما زال كل شيء هنا، فلم يبدأ أي تحسين بعد.
صيغة SSA: كل متغير يكتب مرة واحدة
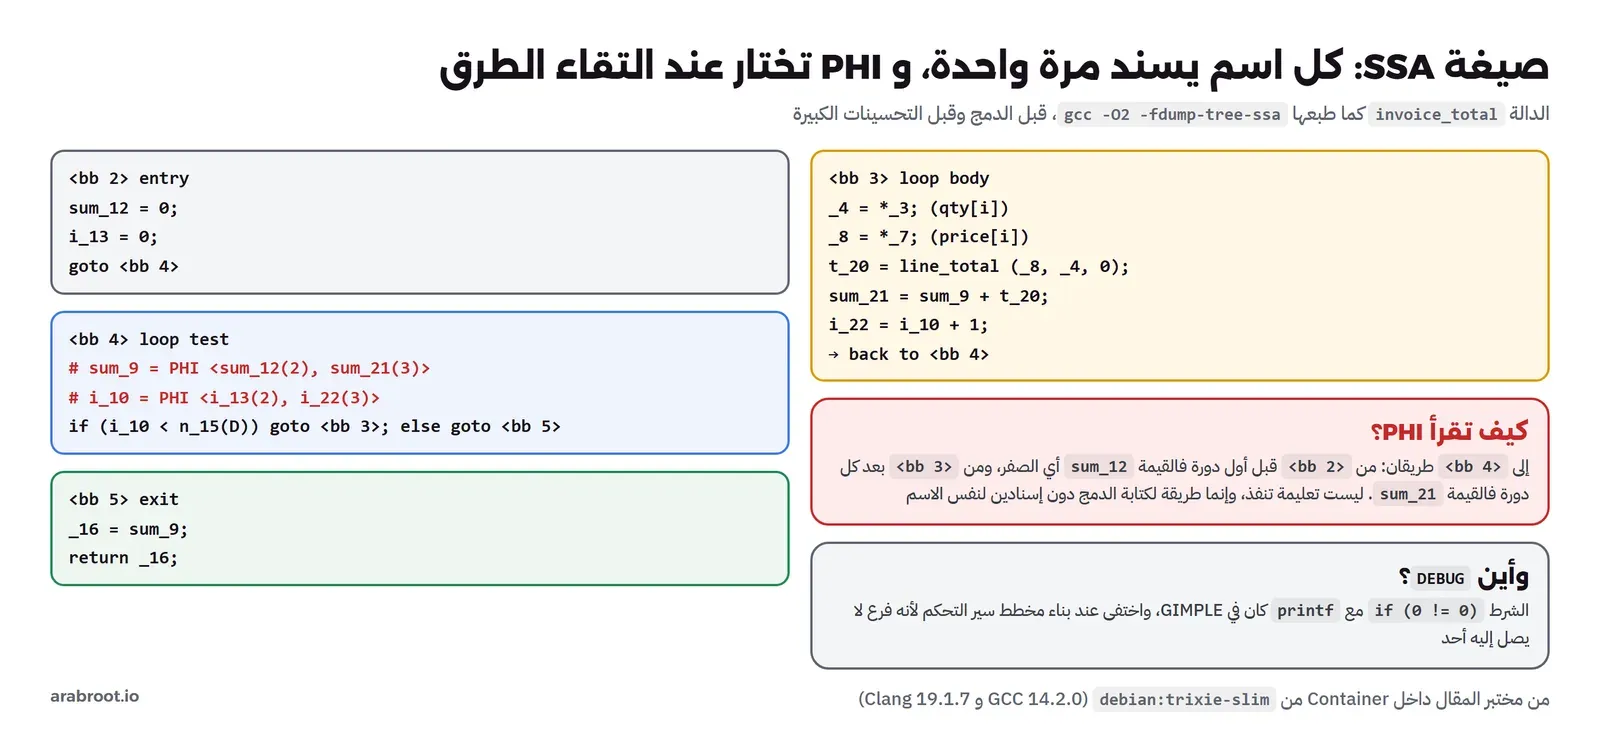
الخطوة التالية في كل المترجمات الحديثة هي صيغة الإسناد الواحد الثابت Static Single Assignment، واختصاراً SSA، وقاعدتها بسيطة: كل اسم يسند إليه مرة واحدة فقط في كل الدالة. فإذا كتب الكود sum = sum + t داخل حلقة، فالمترجم ينشئ نسخة جديدة من الاسم لكل إسناد: sum_12 للقيمة الأولى، وsum_21 للقيمة بعد الجمع. والفائدة أن سؤال «من أين جاءت هذه القيمة؟» تصبح إجابته سطراً واحداً دائماً، فلا تحتاج أن تتتبع كل الإسنادات الممكنة، وأغلب التحسينات التي سوف نراها تعتمد على ذلك. وصفحة SSA في دليل GCC الداخلي تشرح كيف يبني GCC هذه الصيغة. والخيار -fdump-tree-ssa يطبع الدالة بعد التحويل مباشرة، وهذا الجزء الخاص بالدالة invoice_total:
;; Function invoice_total (invoice_total, funcdef_no=24, decl_uid=3805, cgraph_uid=25, symbol_order=24)

long int invoice_total (const long int * price, const long int * qty, long int n)
{
  long int t;
  long int i;
  long int sum;
  long unsigned int i.0_1;
  long unsigned int _2;
  const long int * _3;
  long int _4;
  long unsigned int i.1_5;
  long unsigned int _6;
  const long int * _7;
  long int _8;
  long int _16;

  <bb 2> :
  sum_12 = 0;
  i_13 = 0;
  goto <bb 4>; [INV]

  <bb 3> :
  i.0_1 = (long unsigned int) i_10;
  _2 = i.0_1 * 8;
  _3 = qty_17(D) + _2;
  _4 = *_3;
  i.1_5 = (long unsigned int) i_10;
  _6 = i.1_5 * 8;
  _7 = price_18(D) + _6;
  _8 = *_7;
  t_20 = line_total (_8, _4, 0);
  sum_21 = sum_9 + t_20;
  i_22 = i_10 + 1;

  <bb 4> :
  # sum_9 = PHI <sum_12(2), sum_21(3)>
  # i_10 = PHI <i_13(2), i_22(3)>
  if (i_10 < n_15(D))
    goto <bb 3>; [INV]
  else
    goto <bb 5>; [INV]

  <bb 5> :
  _16 = sum_9;
  return _16;

}
في المخرج أعلاه لاحظ التالي:
- المعاملات مثل
qty_17(D)تحمل الحرفDأي Default، ومعناه القيمة التي دخلت بها الدالة. - الكتلة
<bb 4>هي شرط الحلقة، ويصل إليها التنفيذ من مكانين: من<bb 2>قبل أول دورة، ومن<bb 3>بعد كل دورة. فما قيمةsumعند الشرط؟ تعتمد على الطريق الذي جاء منه التنفيذ، وهذا هو دور السطر# sum_9 = PHI <sum_12(2), sum_21(3)>، ومعناه: إذا جئت من الكتلة 2 فالقيمةsum_12أي الصفر، وإذا جئت من الكتلة 3 فالقيمةsum_21أي المجموع الجديد. ودالة PHI ليست تعليمة تنفذ، وإنما طريقة لكتابة الدمج في صيغة لا تسمح بإسنادين لنفس الاسم. - السطر
if (0 != 0)معprintfاختفى تماماً، مع أننا لم نطلب أي تحسين خاص. والسبب أن GCC ينظف مخطط سير التحكم عند بنائه، والشرط الثابت يعني فرعاً لا يصل إليه أحد، فلا يبنى أصلاً. - ما زال
line_totalاستدعاء، وما زالت الدالةline_totalفي المخرج تستدعيtax_rate، فالتحسينات الكبيرة لم تأت بعد.
مراحل التحسين Optimization Passes: كم مرحلة يمر بها ملف صغير؟
الخيارات -fdump-tree-all و-fdump-ipa-all و-fdump-rtl-all تطلب من GCC أن يكتب ملفاً بعد كل مرحلة تعمل على الملف، في وسط المترجم وفي التحليل بين الدوال IPA وفي الواجهة الخلفية RTL، فإذا عددنا الملفات عرفنا تقريباً كم مرحلة مر بها ملف الفواتير بكل مستوى، وصفحة خيارات المطورين في توثيق GCC تشرح هذه الخيارات:
-O0: 71 dump files
-O1: 183 dump files
-O2: 229 dump files
-O3: 236 dump files
ملف من 25 سطراً مر بـ 71 مرحلة دون تحسين، وهي المراحل الإلزامية مثل بناء SSA وتوزيع المسجلات وكتابة لغة التجميع، ثم ارتفع العدد إلى 229 مع -O2. وكل مرحلة صغيرة ولها عمل واحد، وكثير منها يعمل أكثر من مرة لأن تحسيناً يفتح الباب لآخر، فالدمج مثلاً يكشف ثوابت جديدة، وطيها يكشف كوداً ميتاً جديداً. وقائمة مراحل Tree SSA في دليل GCC الداخلي تصف أهمها. والخيار -fopt-info يقول لك بلغة مقروءة ما الذي فعله المحسن وما الذي لم يستطع أن يفعله، وClang له الخيار المقابل -Rpass:
== gcc -O2 -fopt-info-inline-optimized -fopt-info-vec-missed (invoice.c)
/lab/invoice.c:12:30: optimized:  Inlining tax_rate/22 into line_total/23.
/lab/invoice.c:19:18: optimized:  Inlining line_total/23 into invoice_total/24.
/lab/invoice.c:18:24: missed: couldn't vectorize loop
/lab/invoice.c:19:18: missed: not vectorized: no vectype for stmt: _4 = *_3;
== gcc -O2 / -O3 -fopt-info-vec (sum.c)
/lab/sum.c:9:24: missed: couldn't vectorize loop
/lab/sum.c:22:24: missed: couldn't vectorize loop
/lab/sum.c:18:24: missed: couldn't vectorize loop
/lab/sum.c:9:24: optimized: loop vectorized using 16 byte vectors
== clang -O2 -Rpass='inline|loop-unroll' (invoice.c), -Rpass=loop-vectorize (sum.c)
/lab/invoice.c:12:30: remark: 'tax_rate' inlined into 'line_total' with (cost=-15030, threshold=337) at callsite line_total:3:30; [-Rpass=inline]
/lab/invoice.c:19:18: remark: 'line_total' inlined into 'invoice_total' with (cost=-15030, threshold=337) at callsite invoice_total:4:18; [-Rpass=inline]
/lab/invoice.c:18:5: remark: unrolled loop by a factor of 2 with run-time trip count [-Rpass=loop-unroll]
/lab/sum.c:9:5: remark: vectorized loop (vectorization width: 2, interleaved count: 2) [-Rpass=loop-vectorize]
/lab/sum.c:18:5: remark: vectorized loop (vectorization width: 4, interleaved count: 2) [-Rpass=loop-vectorize]
وسوف نعود إلى هذه السطور واحداً واحداً في الأقسام التالية. والآن لننظر إلى النتيجة النهائية للوسط، أي آخر صيغة GIMPLE قبل أن تنتقل إلى الواجهة الخلفية، بالخيار -fdump-tree-optimized مع -O2:
;; Function invoice_total (invoice_total, funcdef_no=24, decl_uid=3805, cgraph_uid=25, symbol_order=24)

Removing basic block 5
Removing basic block 6
Removing basic block 7
Removing basic block 8
long int invoice_total (const long int * price, const long int * qty, long int n)
{
  long int i;
  long int sum;
  long int _4;
  long int _6;
  long int _13;
  long int _16;
  long int _17;
  sizetype _31;

  <bb 2> [local count: 118111600]:
  if (n_10(D) > 0)
    goto <bb 3>; [89.00%]
  else
    goto <bb 4>; [11.00%]

  <bb 3> [local count: 955630224]:
  # sum_20 = PHI <sum_14(3), 0(2)>
  # i_22 = PHI <i_15(3), 0(2)>
  _31 = (sizetype) i_22;
  _4 = MEM[(const long int *)qty_11(D) + _31 * 8];
  _6 = MEM[(const long int *)price_12(D) + _31 * 8];
  _13 = _4 * _6;
  _16 = _13 * 115;
  _17 = _16 / 100;
  sum_14 = _17 + sum_20;
  i_15 = i_22 + 1;
  if (n_10(D) != i_15)
    goto <bb 3>; [89.00%]
  else
    goto <bb 4>; [11.00%]

  <bb 4> [local count: 118111600]:
  # sum_21 = PHI <sum_14(3), 0(2)>
  return sum_21;

}
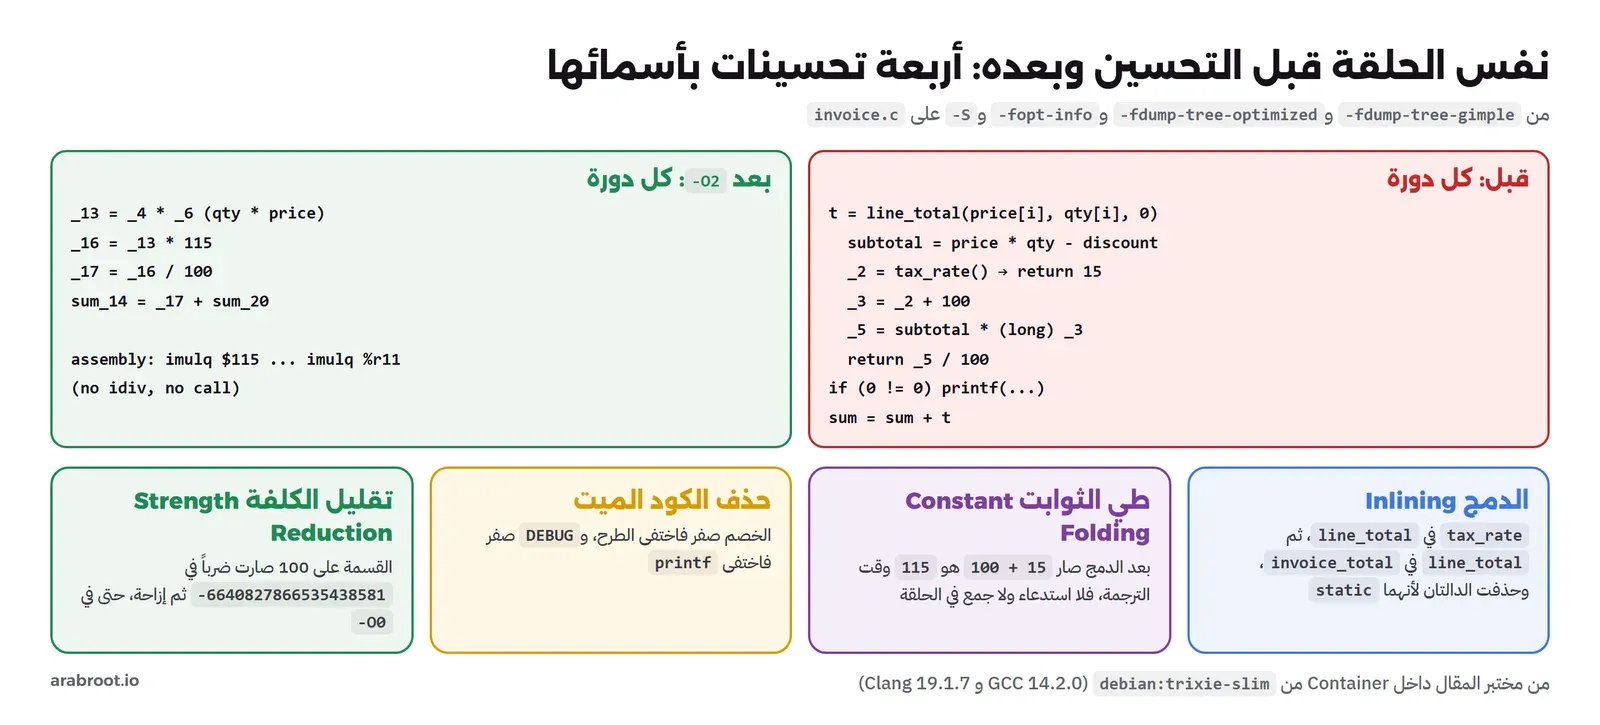
قارن هذا بالمخرج الأول للدالة وسوف تجد أن أربعة أشياء اختفت، وكل واحد منها تحسين له اسم.
الدمج Inlining: الدالتان اختفتا
أول ما تلاحظه أن المخرج فيه دالة واحدة فقط هي invoice_total، والدالتان tax_rate وline_total لم تعودا موجودتين أصلاً. والسطران الأولان في مخرج -fopt-info يقولان ما حدث: Inlining tax_rate/22 into line_total/23 ثم Inlining line_total/23 into invoice_total/24، أي أن المترجم نسخ جسم كل دالة في مكان استدعائها. ولأن الدالتين static فلا يمكن أن يستدعيهما ملف آخر، فبعد الدمج لم يبق لهما مستخدم، فحذفهما.
والدمج هو أهم تحسين في المترجمات على الإطلاق، لا لأن الاستدعاء نفسه مكلف، فهو بضع تعليمات، وإنما لأنه يفتح الباب لكل التحسينات الأخرى: بعد الدمج صار المحسن يرى أن الخصم يساوي صفراً وأن النسبة 15 داخل نفس الدالة، وقبل الدمج كان كل منهما خلف حدود دالة. ولكن الدمج له ثمن أيضاً، فكل نسخة تكبر الكود، والكود الكبير يملأ ذاكرة التعليمات المؤقتة Instruction Cache في المعالج. لذلك يحسب المترجم تكلفة كل دمج ويقارنها بحد، وهذا ما تراه في سطر Clang: (cost=-15030, threshold=337)، أي أن تكلفة الدمج سالبة جداً، والسبب مكافأة كبيرة يضيفها Clang عندما يكون الاستدعاء هو الوحيد لدالة static، لأن الدمج هنا يحذف الدالة الأصلية فلا يكبر الكود أبداً.
طي الثوابت Constant Folding ونشرها Propagation: من tax_rate() إلى 115
بعد الدمج صار tax_rate() هو الثابت 15، فطوى المترجم 100 + 15 إلى 115، وهذا هو السطر _16 = _13 * 115;. وهذا نفس طي الثوابت الذي كتبناه في الجزء الثاني، ولكن الفرق المهم أن مترجمنا الصغير لم يستطع أن يطوي 1 + tax لأن tax متغير، أما GCC فيتتبع القيم عبر الإسنادات والاستدعاءات، وهذا هو نشر الثوابت Constant Propagation. والنتيجة أن الحلقة لم تعد تستدعي أي دالة لحساب النسبة، ولا تجمع 100 في كل دورة.
حذف الكود الميت Dead Code Elimination: الخصم الصفري وعلامة DEBUG
الخصم كان يمرر صفراً، وsubtotal = price * qty - 0 هو نفسه price * qty، لذلك لا تجد أي طرح في المخرج: _13 = _4 * _6; ثم الضرب في 115 مباشرة. وفرع DEBUG مع printf حذف قبل ذلك كما رأينا في SSA. وهذا ما يجعل العلامات مثل DEBUG في C مجانية تماماً في البناء الرسمي، بشرط أن تكون قيمتها معروفة وقت الترجمة. والأسطر Removing basic block في أول المخرج هي آثار هذا الحذف، كتل كود لم يعد يصل إليها أي طريق.
تدوير الحلقة Loop Rotation: فحص واحد قبلها
لاحظ أن الشرط n_10(D) > 0 صار في الكتلة 2 قبل الحلقة، والشرط داخل الحلقة صار n_10(D) != i_15 في نهايتها. والمترجم حول الحلقة من «افحص ثم نفذ» إلى «افحص مرة، ثم نفذ وافحص في النهاية»، وهذا التحويل اسمه Loop Rotation، ويوفر تعليمة قفز في كل دورة. والنسب [89.00%] بجانب كل فرع هي تقدير المترجم لاحتمال كل طريق، ويستخدمها ليقرر ترتيب الكتل في الذاكرة.
الواجهة الخلفية Back End: من IR إلى تعليمات x86-64
بعد الوسط ينتقل الكود في GCC إلى تمثيل أقرب إلى الآلة اسمه RTL، وهناك تختار الواجهة الخلفية تعليمات المعالج لكل عملية، وتوزع القيم على المسجلات، وترتب التعليمات. ولكي ترى ما يعنيه كل هذا، قارن الدالة line_total كما كتبها GCC دون تحسين بالخيار -O0:
line_total:
	pushq	%rbp
	movq	%rsp, %rbp
	subq	$40, %rsp
	movq	%rdi, -24(%rbp)
	movq	%rsi, -32(%rbp)
	movq	%rdx, -40(%rbp)
	movq	-24(%rbp), %rax
	imulq	-32(%rbp), %rax
	subq	-40(%rbp), %rax
	movq	%rax, -8(%rbp)
	call	tax_rate
	addl	$100, %eax
	cltq
	imulq	-8(%rbp), %rax
	movq	%rax, %rcx
	movabsq	$-6640827866535438581, %rdx
	movq	%rcx, %rax
	imulq	%rdx
	leaq	(%rdx,%rcx), %rax
	sarq	$6, %rax
	movq	%rax, %rdx
	movq	%rcx, %rax
	sarq	$63, %rax
	subq	%rax, %rdx
	movq	%rdx, %rax
	leave
	ret
	.size	line_total, .-line_total
بالدالة invoice_total كلها مع -O2، وفيها line_total مدمجة:
invoice_total:
	movq	%rdi, %r9
	movq	%rsi, %r10
	movq	%rdx, %r8
	testq	%rdx, %rdx
	jle	.L4
	movabsq	$-6640827866535438581, %r11
	xorl	%esi, %esi
	xorl	%edi, %edi
	.p2align 6
	.p2align 4
	.p2align 3
.L3:
	movq	(%r10,%rsi,8), %rcx
	imulq	(%r9,%rsi,8), %rcx
	addq	$1, %rsi
	imulq	$115, %rcx, %rcx
	movq	%rcx, %rax
	imulq	%r11
	addq	%rcx, %rdx
	sarq	$63, %rcx
	sarq	$6, %rdx
	subq	%rcx, %rdx
	addq	%rdx, %rdi
	cmpq	%rsi, %r8
	jne	.L3
	movq	%rdi, %rax
	ret
	.p2align 4,,10
	.p2align 3
.L4:
	xorl	%edi, %edi
	movq	%rdi, %rax
	ret
	.size	invoice_total, .-invoice_total
في المخرجين أعلاه لاحظ التالي:
- في
-O0يمر كل متغير بالذاكرة:movq %rdi, -24(%rbp)يحفظ السعر في المكدس، ثمmovq -24(%rbp), %raxيقرؤه من جديد في السطر التالي. وهذا ليس غباءً من المترجم، وإنما وعد للمطور: كل متغير له مكان ثابت في الذاكرة طوال حياته، فيستطيع المنقح Debugger أن يعرضه ويغيره عند أي سطر. وفي-O2لا يوجد أيrbpولا أي قراءة من المكدس، فكل القيم في المسجلات. - في
-O0ما زال هناكcall tax_rate، وفي-O2صار الثابت مباشرة في التعليمةimulq $115, %rcx, %rcx. - القسمة على 100 لم تكتب كتعليمة قسمة
idivفي المستويين، وإنما ضرب في الرقم-6640827866535438581ثم إزاحةsarq $6وتصحيح للإشارة. فتعليمة القسمة على معالجات x86 أبطأ بكثير من الضرب، والمترجم يعرف أن القسمة على ثابت تساوي الضرب في مقلوبه مضروباً في قوة كبيرة للعدد 2، فيحسب هذا المقلوب وقت الترجمة. والملفت أن GCC يفعل هذا حتى مع-O0، لأن اختيار التعليمة جزء من الواجهة الخلفية لا من التحسين، وهذا التحويل اسمه تقليل الكلفة Strength Reduction. - السطر
.p2alignقبل الحلقة يجعل بدايتها على حد مناسب في الذاكرة حتى يجلبها المعالج بكفاءة أكبر، وهذا من عمل الواجهة الخلفية أيضاً.
وعدد التعليمات بكل مستوى يعطيك صورة سريعة، ولكنها مضللة إذا لم تقرأ ما وراءها:
-O0  invoice_total: 33 instructions   sum: 21 instructions
-O1  invoice_total: 25 instructions   sum: 14 instructions
-O2  invoice_total: 26 instructions   sum: 12 instructions
-O3  invoice_total: 26 instructions   sum: 52 instructions
الدالة invoice_total صغرت من 33 تعليمة إلى 25، ولكن الرقم في -O0 لا يحسب تعليمات line_total وtax_rate التي تستدعيها، فالفرق الحقيقي في العمل أكبر. والدالة sum صغرت من 21 إلى 12 ثم كبرت فجأة إلى 52 مع -O3. والسبب أن -O3 وجهها Vectorization، أي جعلها تجمع عدة أعداد في تعليمة واحدة، وهذا يحتاج كوداً لتجهيز الحلقة وكوداً لما يتبقى من عناصر في النهاية. فالكود الأكبر هنا أسرع، والكود الأصغر ليس دائماً الأفضل.
قياس أثر -O0 حتى -O3: المقياس الذي حذفه المترجم
الآن نقيس، والملف الأول الذي كتبناه للقياس هو sum_first.c: دالة تجمع مليون عدد صحيح، تستدعى 400 مرة بين قراءتين للساعة، ووضعنا عليها noinline حتى لا يدمجها المترجم في main ويغير ما نقيسه. وهذه أول ستة أسطر من مخرج bench.sh على هذا الملف:
gcc    -O0                    total=209456640000  2105.6 ms  5.02 ns/element
gcc    -O0                    total=209456640000  2675.8 ms  6.38 ns/element
gcc    -O0                    total=209456640000  2515.9 ms  6.00 ns/element
gcc    -O1                    total=209456640000  0.7 ms  0.00 ns/element
gcc    -O1                    total=209456640000  0.8 ms  0.00 ns/element
gcc    -O1                    total=209456640000  0.8 ms  0.00 ns/element
من نحو ثانيتين إلى أقل من ميلي ثانية واحدة، أي أسرع بأكثر من ألفي مرة. ولا يوجد تحسين في العالم يجعل جمع 400 مليون عدد يتم في 0.7 ميلي ثانية، والسطر 0.00 ns/element يقول ذلك بوضوح. والمشكلة إذاً في المقياس لا في المترجم، فلننظر ماذا كتب GCC بين قراءتي الساعة في main، ومعها ما قالته مرحلة pure-const عن الدالة sum:
	call	clock_gettime@PLT
	movq	%rbx, %rdi
	movl	$1048576, %esi
	call	sum
	leaq	16(%rsp), %rsi
	movl	$1, %edi
	movq	%rax, %rbp
	call	clock_gettime@PLT
Function is locally const.
Function is locally pure.
بين clock_gettime والأخرى استدعاء واحد فقط للدالة sum، لا 400. والسبب أن noinline تمنع الدمج فقط، ولكنها لا تمنع المترجم من تحليل الدالة. ومرحلة التحليل بين الدوال اكتشفت أن sum دالة نقية Pure، أي أنها لا تكتب في الذاكرة ونتيجتها تعتمد فقط على معاملاتها وعلى ما تقرؤه، ولأن المعاملات نفسها والذاكرة لم تتغير بين الدورات، فالنتيجة نفسها في كل دورة، فحسبها مرة واحدة وضربها في 400. وهذا تحسين صحيح تماماً، ونفس الشيء فعله Clang، والخطأ خطأ المقياس. وهذه أشهر طريقة يخدع بها المطور نفسه عند قياس الأداء، وذكرنا أخطاء القياس الأخرى في مقال المترجم والمفسر و JIT.
والإصلاح في sum.c أن نقول للمترجم في كل دورة إن الذاكرة ربما تغيرت، بسطر لغة تجميع فارغ يعلن أنه يقرأ المصفوفة ويغير الذاكرة، فلا يستطيع أن يفترض أن نتيجة الدورة السابقة ما زالت صالحة. وصغرنا المصفوفة إلى 65,536 عدداً، أي 256 كيلوبايت تبقى في ذاكرة المعالج المؤقتة، وزدنا الدورات إلى 6,400 حتى يبقى العدد الكلي نفسه تقريباً، لأننا نريد أن نقيس الحلقة لا سرعة الذاكرة:
__attribute__((noinline)) long sum(const int *a, long n)
{
    long s = 0;
    for (long i = 0; i < n; i++)
        s += a[i];
    return s;
}

int main(void)
{
    const long n = 1 << 16, rounds = 6400;      /* 256 KB of ints: stays in the cache, so we time the loop, not the memory */
    int *a = malloc(n * sizeof *a);
    for (long i = 0; i < n; i++) a[i] = (int)(i % 1000);
    struct timespec t0, t1;
    long total = 0;
    clock_gettime(CLOCK_MONOTONIC, &t0);
    for (long r = 0; r < rounds; r++) {
        __asm__ volatile("" : : "r"(a) : "memory");   /* "memory may have changed": sum() must really run every round */
        total += sum(a, n);
    }
    clock_gettime(CLOCK_MONOTONIC, &t1);
    double ms = (t1.tv_sec - t0.tv_sec) * 1e3 + (t1.tv_nsec - t0.tv_nsec) / 1e6;
    printf("total=%ld  %.1f ms  %.2f ns/element\n", total, ms, ms * 1e6 / (n * rounds));
    free(a);
    return 0;
}
وشغلنا كل بناء خمس مرات بمعالج واحد، والوقت بالنانو ثانية لكل عنصر:
gcc    -O0                    total=208709632000  2798.4 ms  6.67 ns/element
gcc    -O0                    total=208709632000  1965.0 ms  4.68 ns/element
gcc    -O0                    total=208709632000  3763.0 ms  8.97 ns/element
gcc    -O0                    total=208709632000  2762.4 ms  6.59 ns/element
gcc    -O0                    total=208709632000  2874.1 ms  6.85 ns/element
gcc    -O1                    total=208709632000  470.4 ms  1.12 ns/element
gcc    -O1                    total=208709632000  606.0 ms  1.44 ns/element
gcc    -O1                    total=208709632000  483.9 ms  1.15 ns/element
gcc    -O1                    total=208709632000  410.6 ms  0.98 ns/element
gcc    -O1                    total=208709632000  681.4 ms  1.62 ns/element
gcc    -O2                    total=208709632000  400.4 ms  0.95 ns/element
gcc    -O2                    total=208709632000  375.1 ms  0.89 ns/element
gcc    -O2                    total=208709632000  651.4 ms  1.55 ns/element
gcc    -O2                    total=208709632000  697.4 ms  1.66 ns/element
gcc    -O2                    total=208709632000  666.5 ms  1.59 ns/element
gcc    -O3                    total=208709632000  368.6 ms  0.88 ns/element
gcc    -O3                    total=208709632000  351.6 ms  0.84 ns/element
gcc    -O3                    total=208709632000  245.9 ms  0.59 ns/element
gcc    -O3                    total=208709632000  305.1 ms  0.73 ns/element
gcc    -O3                    total=208709632000  622.0 ms  1.48 ns/element
gcc    -O3 -march=x86-64-v3   total=208709632000  233.0 ms  0.56 ns/element
gcc    -O3 -march=x86-64-v3   total=208709632000  295.0 ms  0.70 ns/element
gcc    -O3 -march=x86-64-v3   total=208709632000  237.3 ms  0.57 ns/element
gcc    -O3 -march=x86-64-v3   total=208709632000  207.2 ms  0.49 ns/element
gcc    -O3 -march=x86-64-v3   total=208709632000  187.3 ms  0.45 ns/element
clang  -O0                    total=208709632000  1996.6 ms  4.76 ns/element
clang  -O0                    total=208709632000  2425.0 ms  5.78 ns/element
clang  -O0                    total=208709632000  2552.8 ms  6.09 ns/element
clang  -O0                    total=208709632000  2112.7 ms  5.04 ns/element
clang  -O0                    total=208709632000  2138.9 ms  5.10 ns/element
clang  -O1                    total=208709632000  828.2 ms  1.97 ns/element
clang  -O1                    total=208709632000  820.8 ms  1.96 ns/element
clang  -O1                    total=208709632000  775.9 ms  1.85 ns/element
clang  -O1                    total=208709632000  821.6 ms  1.96 ns/element
clang  -O1                    total=208709632000  611.2 ms  1.46 ns/element
clang  -O2                    total=208709632000  298.7 ms  0.71 ns/element
clang  -O2                    total=208709632000  447.5 ms  1.07 ns/element
clang  -O2                    total=208709632000  684.5 ms  1.63 ns/element
clang  -O2                    total=208709632000  376.3 ms  0.90 ns/element
clang  -O2                    total=208709632000  408.6 ms  0.97 ns/element
clang  -O3                    total=208709632000  350.9 ms  0.84 ns/element
clang  -O3                    total=208709632000  333.6 ms  0.80 ns/element
clang  -O3                    total=208709632000  557.5 ms  1.33 ns/element
clang  -O3                    total=208709632000  259.1 ms  0.62 ns/element
clang  -O3                    total=208709632000  284.1 ms  0.68 ns/element
clang  -O3 -march=x86-64-v3   total=208709632000  182.0 ms  0.43 ns/element
clang  -O3 -march=x86-64-v3   total=208709632000  235.4 ms  0.56 ns/element
clang  -O3 -march=x86-64-v3   total=208709632000  226.9 ms  0.54 ns/element
clang  -O3 -march=x86-64-v3   total=208709632000  234.1 ms  0.56 ns/element
clang  -O3 -march=x86-64-v3   total=208709632000  237.9 ms  0.57 ns/element
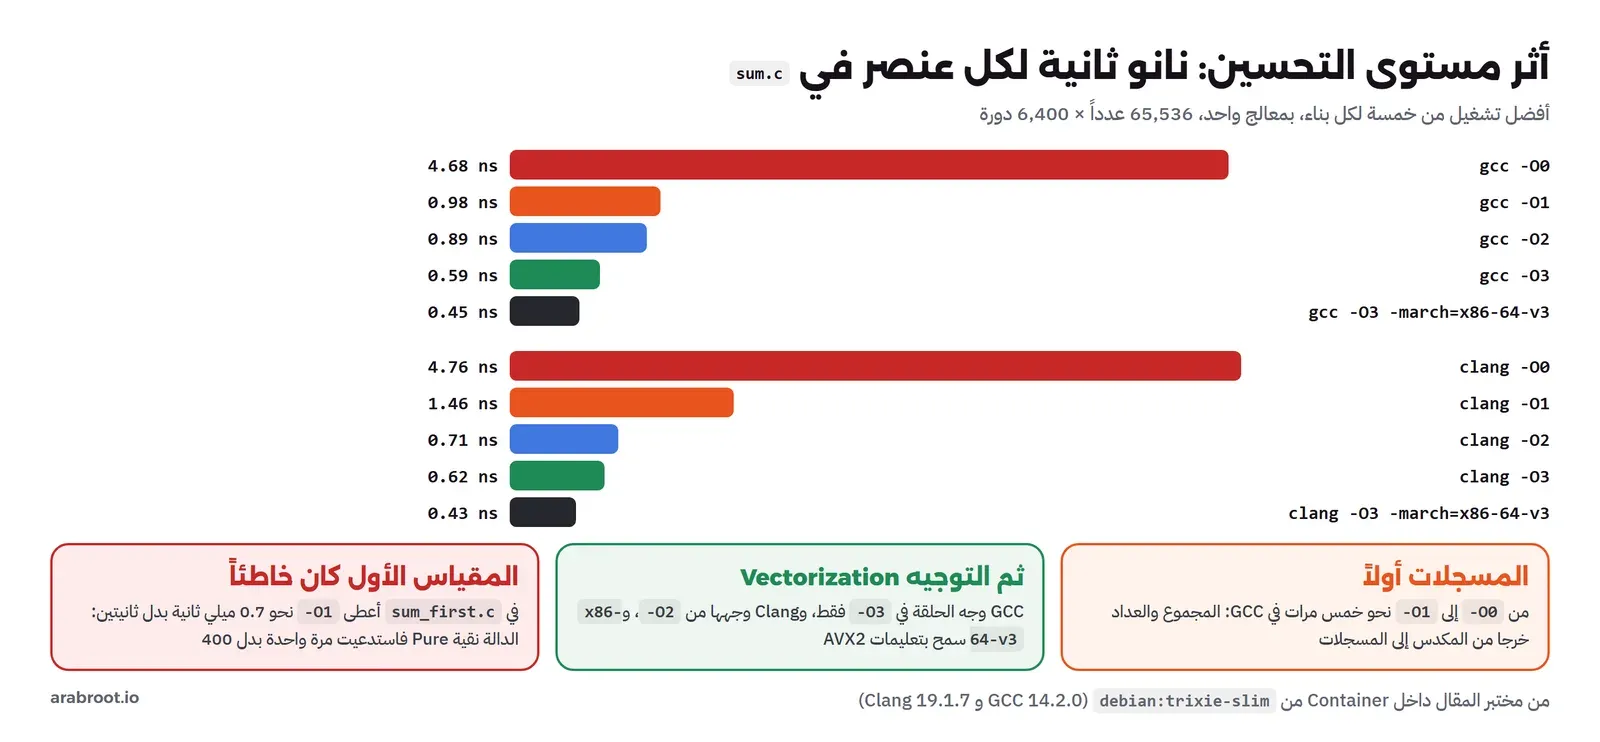
الجهاز كان مشغولاً بأعمال أخرى، والأرقام تتأرجح كثيراً، فبناء gcc -O0 أخذ مرة 4.68 ومرة 8.97 نانو ثانية، لذلك نقرأ أفضل تشغيل من الخمسة لكل بناء، فهو الأقرب إلى ما يستطيعه الكود دون إزعاج:
| البناء | gcc (أفضل تشغيل) | clang (أفضل تشغيل) |
|---|---|---|
-O0 | 4.68 ns | 4.76 ns |
-O1 | 0.98 ns | 1.46 ns |
-O2 | 0.89 ns | 0.71 ns |
-O3 | 0.59 ns | 0.62 ns |
-O3 -march=x86-64-v3 | 0.45 ns | 0.43 ns |
في الجدول أعلاه لاحظ التالي:
- الفرق الكبير من
-O0إلى-O1، نحو خمس مرات في GCC وثلاث في Clang، يأتي من نقل المجموع والعداد من المكدس إلى المسجلات، فدورة الحلقة في-O0تقرأ وتكتب الذاكرة عدة مرات. - بين
-O2و-O3في GCC يأتي الفرق من التوجيه. والسطران في مخرج-fopt-infoيقولان ذلك: مع-O2«couldn't vectorize loop»، ومع-O3«loop vectorized using 16 byte vectors»، أي أربعة أعداد من 32 بت في تعليمة واحدة. ومنذ GCC 12 يعمل التوجيه مع-O2أيضاً ولكن بنموذج تكلفة حذر جداً اسمه very-cheap، كما في ملاحظات إصدار GCC 12، وهذا النموذج يرفض الحلقات التي لا يعرف عدد دوراتها مسبقاً لأنها تحتاج كوداً إضافياً للعناصر المتبقية. - Clang في
-O2كان أسرع من GCC في-O2، والسبب في سطر-Rpass: «vectorized loop (vectorization width: 2, interleaved count: 2)»، فClang يوجه هذه الحلقة من-O2. وهذا مثال على أن-O2ليس معنى واحداً، وإنما قائمة مراحل تختلف بين المترجمين. - الخيار
-march=x86-64-v3يسمح للمترجم باستخدام تعليمات AVX2 بمسجلات 256 بت، فيجمع ثمانية أعداد في التعليمة بدل أربعة. وثمن ذلك أن البرنامج لن يعمل على معالج لا يدعم AVX2، لذلك لا تستخدمه في برنامج توزعه على أجهزة لا تعرفها، والتوزيعات مثل Debian تبني حزمها لمستوى أقدم لهذا السبب.
وهذه الحلقة الموجهة كما كتبها GCC مع -O3:
.L8:
	movdqu	(%rax), %xmm0
	movdqa	%xmm4, %xmm2
	addq	$16, %rax
	pcmpgtd	%xmm0, %xmm2
	movdqa	%xmm0, %xmm3
	punpckldq	%xmm2, %xmm3
	punpckhdq	%xmm2, %xmm0
	paddq	%xmm3, %xmm1
	paddq	%xmm0, %xmm1
	cmpq	%rdx, %rax
	jne	.L8
التعليمة movdqu تقرأ 16 بايتاً أي أربعة أعداد مرة واحدة، وaddq $16, %rax تقدم المؤشر أربعة عناصر. والتعليمات pcmpgtd وpunpckldq وpunpckhdq تحول كل عدد من 32 بت إلى 64 بت مع إشارته، لأن المجموع في الكود من نوع long، ثم paddq تجمع. ولو كان المجموع int لكانت الحلقة أقصر، ولكن المترجم لا يغير معنى الكود ليصبح أسرع.
ماذا يحدث إذا كانت الدالة في ملف آخر؟ التحسين وقت الربط LTO
كل ما رأيناه من دمج وطي حدث لأن tax_rate كانت في نفس الملف. ولكن في مشروع حقيقي تعيش النسبة غالباً في ملف إعدادات أو وحدة أخرى، والمترجم يترجم كل ملف C وحده كوحدة ترجمة Translation Unit، فلا يرى ما في الملفات الأخرى. والملف invoice_ext.c هو نفس الملف بعد أن نقلنا tax_rate إلى rate.c وتركنا التصريح فقط، والملف lto.sh يبنيه مرتين مع main صغيرة لفاتورة من سطرين:
== gcc -O2, separate files: the loop of invoice_total
529
    11c4:	imul   (%r12,%r14,8),%rdx
    11d0:	call   1220 <tax_rate>
    11e5:	imul   %r13,%rcx
    11e9:	imul   %rcx
== gcc -O2 -flto: main
529
0000000000001050 <main>:
    1050:	sub    $0x8,%rsp
    1054:	mov    $0x211,%esi
    1059:	lea    0xfa4(%rip),%rdi        # 2004 <_IO_stdin_used+0x4>
    1060:	xor    %eax,%eax
    1062:	call   1030 <printf@plt>
    1067:	xor    %eax,%eax
    1069:	add    $0x8,%rsp
    106d:	ret
    106e:	xchg   %ax,%ax

invoice_total symbols left in the LTO binary: 0
في المخرج أعلاه لاحظ التالي:
- في البناء العادي عادت
call tax_rateإلى داخل الحلقة، ومعها ضرب عامimul %r13,%rcxبدل الضرب في 115، لأن المترجم وهو يترجمinvoice_ext.cلا يعرف ماذا تعيد الدالة، ولا يعرف حتى أنها لا تغير الذاكرة، فيستدعيها في كل دورة. - مع
-fltoيحفظ GCC في كل ملف كائن صيغته الوسيطة بدل كود الآلة فقط، ثم عند الربط يجمع الملفات كلها ويكمل التحسين كأنها ملف واحد. والنتيجة هنا أبعد مما توقعنا: الدالةmainكلها صارتmov $0x211,%esiثمprintf، والرقم0x211هو 529 بالنظام العشري، أي إجمالي الفاتورة محسوباً وقت البناء. فقد دمج المترجمinvoice_totalفيmain، ورأى أن المصفوفتين ثابتتان، فحسب كل شيء، ولم يبق في البرنامج أي رمز اسمهinvoice_total.
والتحسين وقت الربط Link-Time Optimization له ثمن واضح: الربط يصبح أبطأ ويحتاج ذاكرة أكبر، لأن المحسن يعمل على البرنامج كله مرة واحدة، والأخطاء في البناء تصبح أصعب في التتبع. لذلك تستخدمه أغلب المشاريع في البناء الرسمي فقط. وسوف نعود إلى مرحلة الربط نفسها في مقال الربط والتحميل من هذه المرحلة بإذن الله، وشرحنا ما يحدث في البناء بشكل عام في مقال أدوات البناء Build Tools.
السلوك غير المعرف Undefined Behaviour: الحماية التي اختفت
الآن نعود إلى قصة رقم الفاتورة. والملف ub.c فيه ثلاث دوال: الحماية كما كتبها المطور، أي أن x + 1 > x تعني أن الزيادة لم تتجاوز الحد، ودالة الرقم التالي next_id، ودالة ثالثة سوف نصل إليها بعد قليل:
/* ub.c: two checks that the optimiser is allowed to delete */
#include <limits.h>
#include <stdio.h>
#include <stdlib.h>

struct line { long price; long qty; };

/* "does adding one overflow?" written with the overflow itself */
__attribute__((noinline)) int fits_after_increment(int x)
{
    return x + 1 > x;
}

/* the pointer is used first and checked afterwards (the shape of the 2009 Linux tun bug) */
__attribute__((noinline)) long qty_or_minus_one(struct line *l)
{
    long q = l->qty;
    if (l == NULL)
        return -1;
    return q;
}

/* the next invoice number: a plain increment that overflows at INT_MAX */
__attribute__((noinline)) int next_id(int last)
{
    return last + 1;
}

int main(int argc, char **argv)
{
    int x = argc > 1 ? atoi(argv[1]) : INT_MAX;
    printf("x = %d, fits_after_increment(x) = %d\n", x, fits_after_increment(x));
    printf("next_id(x) = %d\n", next_id(x));
    return 0;
}
والملف ub.sh يبنيه بالمترجمين ومستويين، ثم بخيارات مختلفة، ويشغله بالقيمة INT_MAX:
== gcc -O0
x = 2147483647, fits_after_increment(x) = 1
next_id(x) = -2147483648
== gcc -O2
x = 2147483647, fits_after_increment(x) = 1
next_id(x) = -2147483648
== clang -O0
x = 2147483647, fits_after_increment(x) = 0
next_id(x) = -2147483648
== clang -O2
x = 2147483647, fits_after_increment(x) = 1
next_id(x) = -2147483648
== gcc -O2 -fwrapv
x = 2147483647, fits_after_increment(x) = 0
next_id(x) = -2147483648
== gcc -O0 -fsanitize=undefined
/lab/ub.c:26:17: runtime error: signed integer overflow: 2147483647 + 1 cannot be represented in type 'int'
x = 2147483647, fits_after_increment(x) = 1
next_id(x) = -2147483648
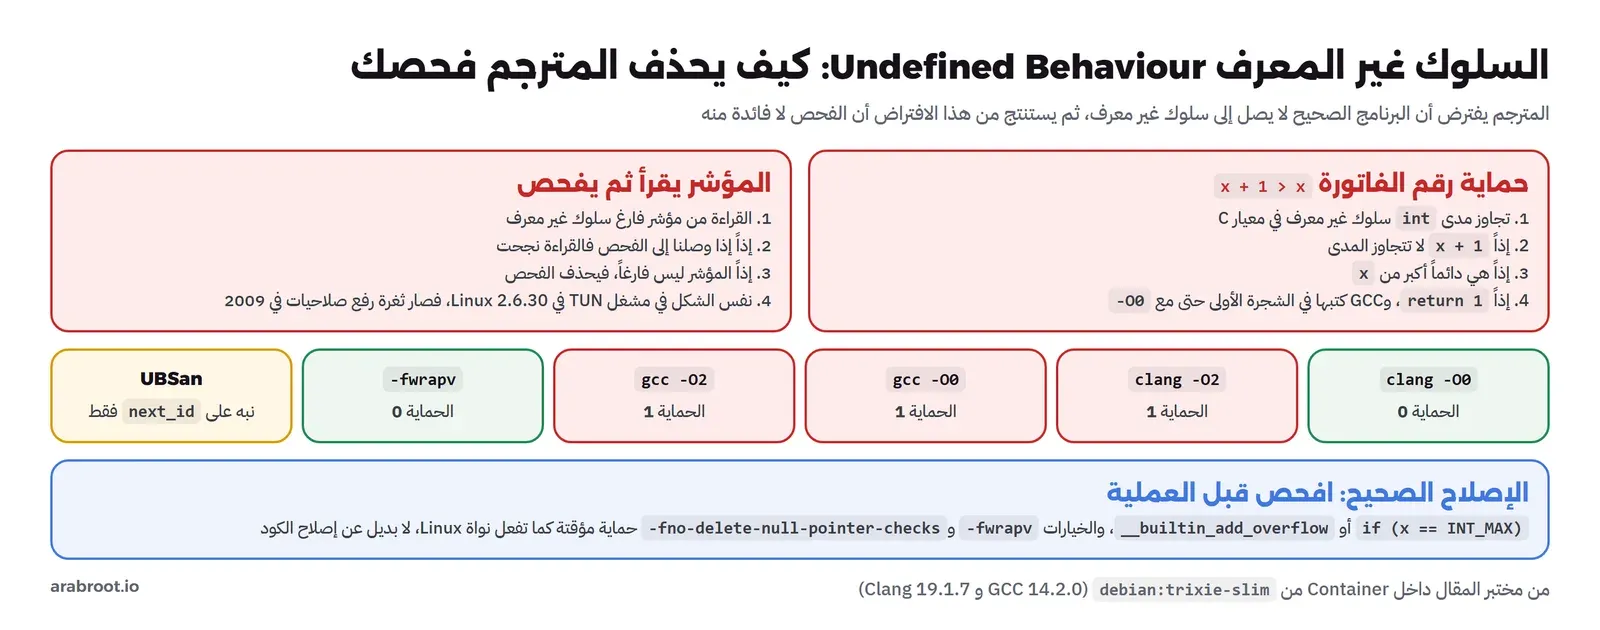
هذه هي القصة كلها في سطور: مع clang -O0 أعادت الحماية 0، أي «الزيادة سوف تتجاوز الحد»، وهذا ما رآه المطور على جهازه. ومع gcc -O2 على سيرفر البناء أعادت 1، أي «لا مشكلة»، ثم صار الرقم التالي -2147483648. والأغرب أن gcc -O0 أيضاً أعاد 1، أي أن GCC حذف الحماية حتى دون تحسين. فمن المخطئ؟
المخطئ هو الكود، لا المترجم. فمعيار C ينص على أن تجاوز مدى الأعداد الصحيحة ذات الإشارة Signed Integer Overflow سلوك غير معرف، أي أن المعيار لا يفرض على المترجم أي نتيجة إذا حدث. ومسودة معيار C23 المنشورة من لجنة WG14 تقول في الفصل 6.5 الخاص بالتعابير Expressions إن الحالة الاستثنائية أثناء حساب تعبير، كأن تكون النتيجة خارج مدى نوعها، سلوك غير معرف. والمترجم يقرأ هذا بطريقة واحدة: البرنامج الصحيح لا يتجاوز المدى أبداً، فيحق لي أن أفترض أن x + 1 لا تتجاوزه، وإذا لم تتجاوزه فهي دائماً أكبر من x، فالتعبير كله يساوي 1. وهذا ما تراه في مخرج GCC:
== gcc -O0 -fdump-tree-original: fits_after_increment
;; Function fits_after_increment (null)
;; enabled by -tree-original


{
  return 1;
}
== gcc -O2 -S: fits_after_increment and qty_or_minus_one
fits_after_increment:
	movl	$1, %eax
	ret
	.size	fits_after_increment, .-fits_after_increment
الشجرة الأولى من GCC، قبل أي مرحلة تحسين، فيها return 1;، أي أن التبسيط الذي يطبقه GCC على التعابير وهو يبني الشجرة كان كافياً لحذف الحماية، ولهذا لم يغير -O0 شيئاً. ولغة التجميع مع -O2 هي movl $1, %eax ثم ret دون أي حساب. أما clang -O0 فحسب الجمع فعلاً على المعالج، والمعالج يلف القيمة إلى أصغر عدد سالب، فكانت المقارنة خاطئة وأعادت 0، ولكن هذا ليس وعداً من Clang، وإنما ما حدث أن فعله كوده غير المحسن، ومع clang -O2 صارت النتيجة 1 مثل GCC. والدرس هنا أن الكود الذي فيه سلوك غير معرف لا يملك نتيجة صحيحة، وإنما نتائج تتغير مع المترجم والإصدار والخيارات.
وقد يتساءل البعض: لماذا يحتاج المترجم هذا الافتراض أصلاً؟ والإجابة أنه يجعل كثيراً من الكود الصحيح أسرع، فحلقة مثل for (int i = 0; i <= n; i++) تنتهي دائماً إذا افترضنا أن i لا تلف، فيعرف المترجم عدد دوراتها ويوجهها ويغير نوع العداد إلى 64 بت. ومقالة Chris Lattner مؤسس LLVM في مدونة المشروع تشرح هذه الأمثلة وتشرح لماذا لا يحذرك المترجم في كل مرة يستخدم فيها هذا الافتراض.
فحص المؤشر الفارغ Null Check الذي حذفه المترجم: ثغرة Linux في 2009
الدالة الثالثة qty_or_minus_one تقرأ l->qty أولاً، ثم تفحص هل l مؤشر فارغ. والقراءة من مؤشر فارغ سلوك غير معرف أيضاً، فيستنتج المترجم: إذا وصل التنفيذ إلى الفحص فالقراءة نجحت، فالمؤشر ليس فارغاً، فالفحص لا فائدة منه. وهذا ما فعله GCC مع -O2، والخيار -fno-delete-null-pointer-checks يعيد الفحص:
qty_or_minus_one:
	movq	8(%rdi), %rax
	ret
	.size	qty_or_minus_one, .-qty_or_minus_one
== gcc -O2 -fno-delete-null-pointer-checks -S: qty_or_minus_one
qty_or_minus_one:
	movq	8(%rdi), %rax
	testq	%rdi, %rdi
	je	.L6
	ret
.L6:
	movq	$-1, %rax
	ret
	.size	qty_or_minus_one, .-qty_or_minus_one
في البناء العادي بقيت تعليمة واحدة تقرأ qty من الإزاحة 8، ولا يوجد أي فحص. ومع الخيار ظهر testq %rdi, %rdi والفرع الذي يعيد -1. وهذا الشكل بالضبط كان سبب ثغرة حقيقية في نواة Linux 2.6.30: أضاف تعديل على مشغل الشبكة الافتراضية TUN سطراً يقرأ tun->sk قبل فحص if (!tun)، فحذف GCC الفحص، وفي النواة كان يمكن لبرنامج أن يجعل العنوان صفر صالحاً للقراءة، فصار الخطأ ثغرة رفع صلاحيات نشر Brad Spengler استغلالها في يوليو 2009، كما يشرح مقال LWN عن الثغرة بالتفصيل. ومنذ ذلك الحين تبني النواة كودها بالخيار -fno-delete-null-pointer-checks، ومعه -fno-strict-overflow لنفس فئة المشكلات، وتجد الخيارين في ملف Makefile الرئيسي في مستودع Linux. وصفحة خيارات التحسين في توثيق GCC تذكر أن -fdelete-null-pointer-checks يعمل افتراضياً في أغلب المعالجات.
x + 1 > x لكشف التجاوز أو فحص المؤشر بعد استخدامه، والسبب أن المترجم يحق له أن يفترض أن السلوك غير المعرف لا يحدث أبداً، فيحذف الفحص دون أي تحذير. افحص قبل العملية: if (x == INT_MAX)، أو استخدم الدوال المدمجة مثل __builtin_add_overflow الموصوفة في توثيق GCC ويدعمها Clang أيضاً، فهي تعيد هل حدث التجاوز دون أن يحدث سلوك غير معرف.أدوات كشف السلوك غير المعرف: UBSan و -fwrapv
عد إلى سطور ub.out الأولى وسوف تجد خيارين غيرا النتيجة. الأول -fwrapv، الذي يعرف تجاوز المدى بأنه لف بنظام المتمم الثنائي Two's Complement، فيصبح الكود معرفاً وتعمل الحماية كما أرادها المطور فتعيد 0. والثمن أنك تلغي بعض التحسينات التي يحتاجها الكود الصحيح، وأن الكود يصبح صحيحاً فقط مع هذا الخيار، فإذا نسخه أحد إلى مشروع آخر عاد الخطأ. والثاني -fsanitize=undefined، أي UBSan، الذي يضيف فحصاً لكل عملية قد تكون سلوكاً غير معرف، ويطبع رسالة عند حدوثها:
/lab/ub.c:26:17: runtime error: signed integer overflow: 2147483647 + 1 cannot be represented in type 'int'الرسالة تشير إلى السطر 26 في next_id، بالعمود والقيمتين ونوع الخطأ. ولكن لاحظ أنها لم تشر إلى الحماية fits_after_increment التي هي أصل المشكلة، وأعادت الحماية 1 حتى مع UBSan. والسبب ما رأيناه في الشجرة: GCC حذف الجمع قبل أن تصل إليه مرحلة إضافة الفحوص، فلا توجد عملية لتفحص. وهذا حد مهم يجب أن تعرفه: UBSan يكشف السلوك غير المعرف الذي يحدث فعلاً عند التشغيل، ولا يكشف الكود الذي حذفه المترجم بسببه. لذلك شغل الاختبارات بالأداة، وشغلها بأكثر من مترجم، وفي مشاريع C الحساسة استخدم أيضاً أدوات التحليل الساكن. وصفحة خيارات Instrumentation في GCC وتوثيق UBSan في Clang تشرحان الفحوص المتاحة. وفي Debian يحتاج Clang حزمة مكتبات التشغيل الخاصة بالأداة، فعندما جربنا clang -fsanitize=undefined فشل الربط برسالة «cannot find libclang_rt.ubsan_standalone.a»، لأن الحزمة clang وحدها لا تثبتها، فإذا رأيت هذه الرسالة فثبت حزمة libclang-rt الموافقة لإصدار Clang.
وفي مقال أمان الذاكرة Memory Safety رأينا لماذا تتجه الجهات نحو لغات مثل Rust، والسلوك غير المعرف من أهم الأسباب: في Rust الجمع الذي يتجاوز المدى يوقف البرنامج في بناء التطوير، ويلف بشكل معرف في البناء الرسمي، ولا يحق للمترجم أن يفترض أنه لا يحدث.
أي مستوى تحسين تستخدم؟ جدول قرار Decision Table
| الحالة | الخيار الأنسب | والسبب |
|---|---|---|
| التطوير وتتبع الأخطاء في المنقح | -O0 -g أو -Og -g | كل متغير في مكانه في الذاكرة، والمنقح يعرض ما كتبته، و-Og يحسن دون أن يفسد التتبع |
| البناء الرسمي لأغلب البرامج | -O2 | المسجلات والدمج والطي وحذف الكود الميت، وهي أغلب الفرق، دون تضخم كبير في الكود |
| حلقات حسابية ثقيلة قست أنها عنق الزجاجة | -O3 بعد القياس | التوجيه أعطى نحو 1.5 مرة في sum.c مع GCC، ولكن الكود أكبر وقد يكون أبطأ في برامج أخرى |
| برنامج يعمل على أجهزة تعرفها فقط | -march لمستوى معالجاتك | AVX2 أعطى خطوة إضافية، ولكن البرنامج لن يعمل على معالج أقدم |
| مشروع من عدة ملفات وفيه دوال صغيرة تعبر الملفات | -O2 -flto في البناء الرسمي | الدوال في ملفات أخرى عادت استدعاءات، ومع LTO حسبت الفاتورة كلها وقت البناء |
| كود قديم تشك أن فيه سلوكاً غير معرف | اختبارات مع -fsanitize=undefined، ومؤقتاً -fwrapv و-fno-delete-null-pointer-checks | تكشف الأخطاء وتحمي البناء حتى تصلح الكود، كما تفعل نواة Linux |
أخطاء شائعة Common Mistakes مع المترجم والتحسين
- قياس الأداء ببناء
-O0، ثم الحكم على اللغة أو الخوارزمية: الفرق بين-O0و-O2كان أكثر من خمس مرات في حلقة بسيطة. - مقياس يحذفه المترجم:
noinlineلا تمنع التحليل، والدالة النقية استدعيت مرة واحدة بدل 400، والنتيجة0.00 ns/element. إذا كانت النتيجة أسرع من المعقول فاقرأ لغة التجميع قبل أن تحتفل. - فحص يعتمد على السلوك غير المعرف:
x + 1 > xصارتreturn 1في GCC حتى مع-O0. - استخدام المؤشر قبل فحصه: المترجم حذف الفحص، وهذا ما حول خطأ برمجياً في Linux إلى ثغرة.
- افتراض أن نجاح الكود في بناء التطوير يعني صحته: Clang مع
-O0أعطى النتيجة المتوقعة، ونفس الكود مع-O2أعطى العكس. - الاعتماد على
-fwrapvبدل إصلاح الكود: الكود يبقى خاطئاً خارج إعدادات مشروعك. - افتراض أن
-O2يعني نفس الشيء في كل المترجمات: Clang وجه الحلقة في-O2وGCC لم يوجهها. - بناء برنامج للتوزيع بالخيار
-march=nativeأو مستوى معالج عال: يعمل على جهاز البناء ويتوقف على أجهزة العملاء. - الحكم على التحسين بحجم الكود:
sumكبرت من 12 تعليمة إلى 52 وصارت أسرع.
قائمة تحقق Checklist قبل أن تثق بالبناء الرسمي
- البناء الرسمي ببناء التطوير نفسه في الاختبارات، أو على الأقل الاختبارات تعمل على بناء
-O2. - الاختبارات تعمل مرة مع
-fsanitize=undefinedومرة مع-fsanitize=address، وبمترجمين إن أمكن. - التحذيرات مفعلة
-Wall -Wextra، ولا تتجاهل تحذيراً عن مقارنة دائماً صحيحة أو مؤشر يستخدم قبل فحصه. - كل فحص للتجاوز يتم قبل العملية، أو بالدوال المدمجة
__builtin_*_overflow. - القياس على البناء الرسمي، مع قراءة لغة التجميع للحلقة المقاسة، والتأكد أن المترجم لم يحذف العمل.
-fopt-infoأو-Rpassعلى الملفات الحساسة للأداء، لتعرف هل حدث الدمج والتوجيه فعلاً.- مستوى المعالج
-marchمكتوب صراحة في إعدادات البناء ومناسب لأجهزة التشغيل.
تدريب عملي Practice
- غير نوع المجموع في
sum.cمنlongإلىint، واقرأ حلقة-O3الجديدة، وعد التعليمات التي اختفت، ثم فكر في الثمن: متى يتجاوز المجموع المدى، وماذا يقول المعيار عندها؟ - أصلح
fits_after_incrementبالدالة__builtin_add_overflow، وتأكد أنها تعيد 0 لقيمةINT_MAXمعgcc -O2وclang -O2. - أضف
-fdump-tree-allواقرأ الملف الذي اختفت فيهtax_rateلأول مرة، واعرف اسم المرحلة التي فعلت ذلك.
حذف المختبر Cleanup
كل التشغيلات استخدمت --rm، وملفات التفريغ كتبت في /tmp داخل الـ Container فاختفت معه، وبقيت الـ Image فقط:
docker rmi scc1-ccالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المترجم ثلاثة أجزاء: الواجهة الأمامية تفهم اللغة وتبني الشجرة بالأنواع، والوسط يحسن تمثيلاً وسيطاً لا يعرف اللغة ولا المعالج، والواجهة الخلفية تكتب تعليمات المعالج.
- GIMPLE صيغة عناوين ثلاثة بكتل وقفزات، وSSA تجعل كل اسم يسند مرة واحدة، ودوال PHI تدمج القيم عند التقاء الطرق.
- ملف من 25 سطراً مر بـ 71 مرحلة في
-O0و229 في-O2، والدمج هو المفتاح الذي فتح طي النسبة إلى 115 وحذف الخصم الصفري وعلامةDEBUG. - القسمة على 100 صارت ضرباً في رقم سحري حتى في
-O0، و-O0يحفظ كل متغير في الذاكرة من أجل المنقح. - من
-O0إلى-O2أسرع بنحو خمس مرات في GCC، والتوجيه في-O3خطوة إضافية، وClang يوجه من-O2، والقياس الأول كان خاطئاً لأن المترجم حسب الدالة النقية مرة واحدة. - الدالة في ملف آخر تعود استدعاءً عادياً، ومع LTO حسب المترجم الفاتورة كلها وقت البناء.
- السلوك غير المعرف يسمح للمترجم أن يحذف فحوصك: حماية التجاوز صارت
return 1، وفحص المؤشر بعد استخدامه حذف كما في ثغرة Linux في 2009. افحص قبل العملية، وشغل اختباراتك مع UBSan.
وفي المقال التالي بإذن الله نفتح LLVM، البنية التي يقف عليها Clang وRust وSwift، ونكتب تمثيلها الوسيط بأيدينا.
 دليلمن شجرة AST إلى Bytecode وآلة افتراضية VM بيدكنحول لغة الصيغ من الجزء الأول إلى Bytecode تنفذه آلة مكدس صغيرة، ونقرأ مخرجها بجانب dis في CPython، ونقيس بصدق من أين تأتي السرعة.
 دليلالمترجم Compiler والمفسر Interpreter و JIT و WebAssemblyنشغل دالة واحدة بلغة C وPython وJavaScript وWebAssembly على نفس الجهاز، ونفتح ما كتبه كل مترجم لنعرف لماذا اختلف الوقت من ثلث ثانية إلى دقيقة.
 دليلاللغة شيء والمترجم شيء آخر: من يقرر مستقبل لغات البرمجة؟لماذا لا تصح جمل مثل «Python بطيئة»، وما الفرق بين مواصفة اللغة والبرامج التي تطبقها، ومن يقرر مستقبلها.
 دليلأدوات البناء Build Tools وماذا يحدث عندما تبني مشروعكما الذي يحدث بين ضغطة البناء والملف الناتج، ولماذا ينجح البناء على جهازك ويفشل على سيرفر CI، ومتى يعطيك نفس النتيجة مرتين.
 دليلأمان الذاكرة Memory Safety: لماذا تدفع الحكومات نحو Rust؟ماذا طلبت الحكومات فعلاً بشأن C وC++، ولماذا تسبب أخطاء الذاكرة أغلب الثغرات الخطيرة، ومتى يكون Rust هو الاختيار الصحيح.
 دليلكيف يعمل المعالج CPU من الداخل ولماذا يهمك ذلكنتابع تعليمة واحدة داخل نواة المعالج، ونرى لماذا يصبح نفس الكود أبطأ بعشر مرات عندما تغير ترتيب المرور على البيانات.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ كل التجارب داخل Container من الـ Image الرسمية
debian:trixie-slim(Debian 13.7) مع GCC 14.2.0 وClang 19.1.7 وbinutils من حزم Debian، على Docker Engine 29.8.0، والقياسات بمعالج واحد.


