


لنفرض أن لديك سكربت أو خدمة تصدر ملفاً كبيراً، أو تقرأ ملفاً وتعالجه، وعلى جهازك تعمل في ثوان، ثم على السيرفر تأخذ دقائق. وعندما تفتح top تجد أن المعالج مشغول فعلاً، ولكن النسبة الكبيرة ليست في العمود us الذي يمثل كودك، وإنما في العمود sy، أي أن المعالج يقضي وقته داخل النواة نفسها وليس في برنامجك. والسؤال الطبيعي هنا: ماذا يفعل برنامجي في النواة أصلاً؟ وأنا لم أكتب سطراً واحداً يطلب منها شيئاً، فقط أقرأ وأكتب.
والإجابة أن كل قراءة وكل كتابة وكل اتصال بالشبكة وكل فتح لملف هو طلب من برنامجك إلى النواة اسمه استدعاء النظام System Call، وكل طلب منها ذهاب وعودة بين عالمين يفصل بينهما المعالج نفسه: فضاء المستخدم User Space الذي يعمل فيه كودك، وفضاء النواة Kernel Space الذي تعمل فيه نواة نظام التشغيل. وقد رأينا في مقال ماذا يحدث عندما تشغل Hello World أن هذا الحد موجود، وأن الأداة strace تريك الطلبات التي تعبره، أما هنا فسوف نعبر الحد بأنفسنا دون أي مكتبة، ونرى ماذا يحدث داخل المعالج عند العبور، ونقيس كم يكلف، ولماذا صار أغلى بعد ثغرة Meltdown، وكيف تختصر عدد مرات العبور، وكيف يمنع Docker برامجك من بعض هذه الطلبات أصلاً.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يصل البرنامج إلى الأجهزة مباشرة، وما هي حلقات الحماية Protection Rings.
- ما هو استدعاء النظام بالضبط: رقم ومعاملات في مسجلات، ونجربه دون مكتبة C ونقرأ تعليماته بالأداة
objdump. - ماذا يحدث داخل المعالج والنواة من التعليمة
syscallحتى الرجوع، وكيف ترجع الأخطاء إلى المتغيرerrno. - كم يكلف الدخول إلى النواة بالأرقام، ولماذا رفعت حماية Meltdown هذه الكلفة، وكيف يتجنبها ال vDSO.
- تجربة القصة: النسخ بايتاً بايتاً مقابل الكتل، ووقت المستخدم مقابل وقت النواة.
- الأداة
straceبعمق وكلفتها، وكيف تعرف ماذا ينتظر برنامج معلق الآن. - تقييد الاستدعاءات بالآلية seccomp في Docker، ولماذا يمنع io_uring افتراضياً.
- طرق تقليل عدد مرات العبور، والأخطاء الشائعة، وجدول قرار.
تجهيز المختبر
نستخدم نفس ال Image التي بنيناها في مقال العمليات وجدولة المعالج، وفيها gcc وstrace وperf والأداة /usr/bin/time، فإذا لم تبنها بعد فهذا ملفها:
mkdir sys-lab && cd sys-lab
cat > Dockerfile <<'EOF'
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends procps strace time util-linux e2fsprogs gcc libc6-dev python3-minimal linux-perf psmisc && rm -rf /var/lib/apt/lists/*
WORKDIR /lab
EOF
docker build -t sos-tools:1 .
والجهاز معالج Intel Core i7-7700K بنواة Linux 5.15 داخل WSL2 تحت Docker Desktop، وهذه التفاصيل تهم هنا أكثر من أي مقال آخر في المرحلة، لأن كلفة استدعاء النظام تعتمد كثيراً على المعالج وعلى الحمايات المفعلة في النواة، كما سوف ترى.
لماذا لا يصل البرنامج إلى الأجهزة مباشرة؟
الحل البسيط أن يصل كل برنامج إلى القرص والشبكة والذاكرة بنفسه، وهذا ما كانت تفعله أنظمة مثل MS-DOS، حيث يستطيع أي برنامج أن يكتب في أي مكان في الذاكرة وأن يتحدث مع متحكم القرص مباشرة. والمشكلة أن خطأ واحداً في أي برنامج يوقف الجهاز كله، وأن أي برنامج يستطيع أن يقرأ ملفات غيره ويغير جدول الصفحات الذي شرحناه في مقال الذاكرة الافتراضية فيرى ذاكرة البرامج الأخرى، وأنه لا يمكن لنظام كهذا أن يكون متعدد المستخدمين، لأن الحماية بين المستخدمين اتفاق لا يفرضه أحد.
والحل الذي بقي هو أن يفرض المعالج نفسه الحد، فمعالجات x86 تعمل بمستويات صلاحية تسمى حلقات الحماية Protection Rings، من الحلقة 0 الأعلى صلاحية إلى الحلقة 3 الأقل، وLinux يستخدم اثنتين فقط: الحلقة 0 للنواة، وهو وضع النواة Kernel Mode، والحلقة 3 للبرامج، وهو وضع المستخدم User Mode. وفي الحلقة 3 يرفض المعالج تنفيذ التعليمات الحساسة، مثل تغيير السجل الذي يشير إلى جدول الصفحات أو إيقاف المقاطعات أو التحدث مع الأجهزة، ويرفض الوصول إلى صفحات الذاكرة المعلمة بأنها للنواة، فإذا حاول البرنامج ذلك رفع المعالج استثناء وأرسلت النواة إلى البرنامج إشارة تنهيه. وبالتالي فالبرنامج لا يستطيع أن يفعل شيئاً ذا قيمة خارج حساباته الخاصة إلا إذا طلب من النواة أن تفعله بالنيابة عنه، والطلب له باب واحد مضبوط: استدعاء النظام.
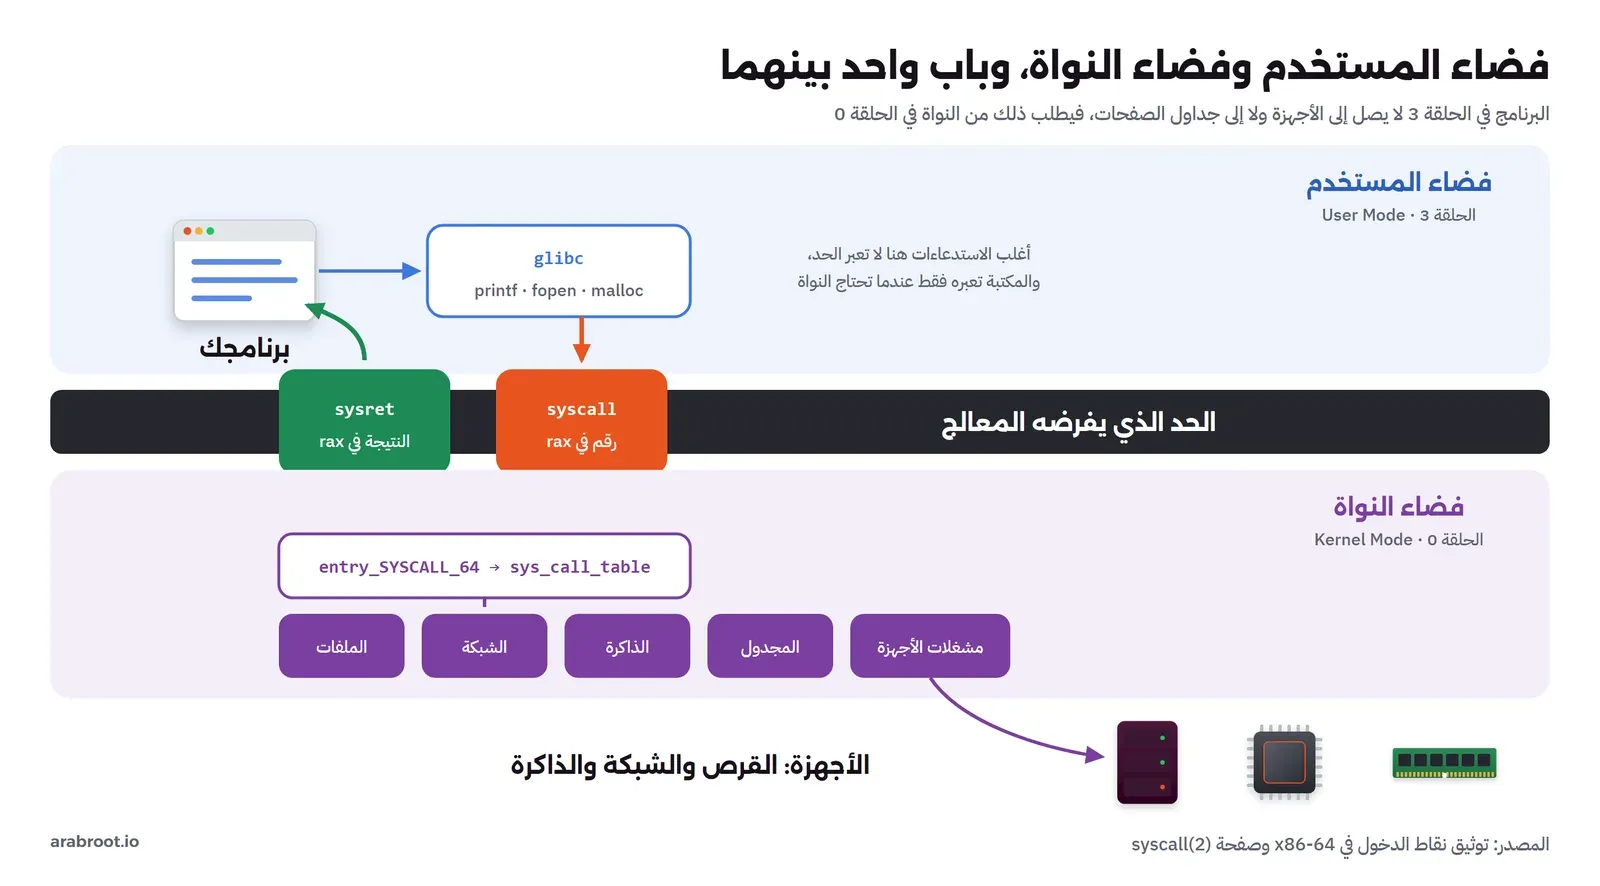
ولاحظ أن الحد ليس بين برنامجك ومكتبة C، فمكتبة C مثل glibc كود عادي يعمل في فضاء المستخدم داخل عمليتك، والدالة printf أو fopen أو malloc لا تعبر الحد في كل مرة، وإنما تعبره عندما تحتاج النواة فقط، كما رأينا في قسم لماذا لا تطلب printf من النواة عند كل حرف. وهذا التمييز هو نصف الحل في قصتنا كما سيأتي.
ما هو استدعاء النظام System Call بالضبط؟
استدعاء النظام ليس دالة بالمعنى الذي تعرفه، وإنما رقم ومعاملات: كل طلب في Linux له رقم ثابت، والبرنامج يضع الرقم في مسجل معين والمعاملات في مسجلات أخرى، ثم ينفذ تعليمة خاصة تنقل المعالج إلى النواة. والأرقام في معالجات x86-64 مكتوبة في ملف من ملفات النواة يأتي مع حزمة تطوير مكتبة C، ونقرأ منه بعض الأرقام التي سوف نقابلها:
grep -E "define __NR_(read|write|openat|close|mmap|getppid|clock_gettime|exit|fsync|io_uring_setup) " /usr/include/x86_64-linux-gnu/asm/unistd_64.hوالمخرج سوف يكون كما يلي:
#define __NR_read 0
#define __NR_write 1
#define __NR_close 3
#define __NR_mmap 9
#define __NR_exit 60
#define __NR_fsync 74
#define __NR_getppid 110
#define __NR_clock_gettime 228
#define __NR_openat 257
#define __NR_io_uring_setup 425
فالقراءة رقمها 0 والكتابة 1، والأرقام تتجاوز 400 لأن النواة تضيف طلبات جديدة مع الوقت ولا تغير أرقام القديمة أبداً، والسبب أن البرامج المبنية قبل عشرين سنة ما زالت تستخدم نفس الأرقام، وتغيير رقم واحد يكسر كل برنامج يستخدمه. وهذا الوعد بعدم تغيير ما يراه البرنامج من النواة من أشد قواعد تطوير Linux، ودليل إضافة استدعاء نظام جديد يشرح لماذا يأخذ المطورون وقتاً طويلاً قبل أن يقبلوا طلباً جديداً: لأنه سيبقى إلى الأبد. وقائمة الطلبات كلها مع الإصدار الذي ظهر فيه كل منها في صفحة syscalls.
أما أين يوضع الرقم والمعاملات فهذا ما يسمى واجهة النظام الثنائية ABI، وتلخصها صفحة syscall في جدول لكل معمارية. وفي x86-64: الرقم في المسجل rax، والمعاملات الست بالترتيب في rdi وrsi وrdx وr10 وr8 وr9، والتعليمة هي syscall، والنتيجة ترجع في rax، والمعالج يستخدم المسجلين rcx وr11 ليحفظ فيهما عنوان الرجوع وحالة المعالج، فيضيع ما كان فيهما.
استدعاء النظام System Call بلا مكتبة C
لكي نرى ذلك دون أي طبقة بيننا وبين النواة كتبنا برنامجاً لا يستخدم مكتبة C إطلاقاً: لا توجد فيه الدالة main، وإنما نقطة البداية _start مباشرة، وينفذ التعليمة syscall بنفسه ثلاث مرات: كتابة جملة إلى المخرج القياسي، ثم كتابة إلى رقم ملف غير مفتوح عمداً، ثم الخروج برقم الخطأ الذي رجع من الكتابة الثانية:
/* raw.c: talk to the kernel with no C library at all. Build: gcc -O2 -nostdlib -static -o raw raw.c */
static long sys3(long nr, long a, long b, long c)
{
    long ret;
    __asm__ volatile ("syscall"                       /* the instruction that enters the kernel */
                      : "=a"(ret)                    /* the result comes back in rax */
                      : "a"(nr), "D"(a), "S"(b), "d"(c) /* number in rax, arguments in rdi, rsi, rdx */
                      : "rcx", "r11", "memory");      /* the CPU uses rcx and r11 for the return trip */
    return ret;
}

void _start(void)
{
    static const char msg[] = "hello from a raw syscall\n";
    long n = sys3(1, 1, (long)msg, sizeof msg - 1);   /* 1 = write, fd 1 = stdout */
    long bad = sys3(1, 42, (long)msg, 5);             /* fd 42 is not open */
    sys3(60, bad < 0 ? -bad : (int)n, 0, 0);          /* 60 = exit; exit code = errno of the bad call */
}
ونبنيه ونشغله، ثم نشغله تحت strace:
docker run --rm --name sos-sys -v "$PWD:/lab" sos-tools:1 sh -c 'gcc -O2 -nostdlib -static -o raw raw.c && ./raw; echo "exit=$?"; strace ./raw'والمخرج سوف يكون كما يلي:
hello from a raw syscall
exit=9
execve("./raw", ["./raw"], 0x7ffd5e5c8dd0 /* 4 vars */) = 0
write(1, "hello from a raw syscall\n", 25) = 25
hello from a raw syscall
write(42, "hello", 5)                   = -1 EBADF (Bad file descriptor)
exit(9)                                 = ?
+++ exited with 9 +++
في المخرج أعلاه لاحظ التالي:
- البرنامج كله أربعة طلبات فقط:
execveالذي شغلته به الصدفة، ثم طلباتنا الثلاثة، بينما رأينا في مقال Hello World أن برنامجاً عادياً مع مكتبة C يرسل 36 طلباً قبل أن يطبع أي شيء، لأن المكتبة تحمل نفسها وتجهز الذاكرة والمحلية Locale. - الطلب الأول رجع بالقيمة 25، وهي عدد البايتات التي كتبت، وظهرت الجملة بين أسطر
straceلأن الاثنين يكتبان إلى نفس الطرفية. - الطلب الثاني رجع بالقيمة -1 ومعه
EBADF. وهنا نقطة مهمة: النواة لم ترجع -1، وإنما رجعت -9 في المسجلrax، أي سالب رقم الخطأ، وstraceهو الذي يعرضها بالشكل الذي تعرفه من مكتبة C. ومكتبة C عادة هي التي تحول -9 إلى القيمة -1 وتضع 9 في المتغيرerrnoكما في صفحتي intro وerrno، أما برنامجنا فلا مكتبة فيه، لذلك قلبنا الإشارة بأنفسنا وخرجنا بالقيمة 9، وظهرت فيexit=9، وهي فعلاً رقمEBADF.
والآن ننظر إلى التعليمات التي أنتجها المترجم للدالة _start:
objdump -d --no-show-raw-insn raw | sed -n "/<_start>:/,\$p"0000000000401000 <_start>:
401000: mov $0x1,%r8d
401006: lea 0xff3(%rip),%rsi # 402000 <msg.0>
40100d: mov $0x19,%edx
401012: mov %r8,%rax
401015: mov %r8,%rdi
401018: syscall
40101a: mov $0x2a,%edi
40101f: mov %rax,%r9
401022: mov $0x5,%edx
401027: mov %r8,%rax
40102a: syscall
40102c: mov %rax,%rdx
40102f: movslq %r9d,%rdi
401032: neg %rdx
401035: test %rax,%rax
401038: mov $0x3c,%eax
40103d: cmovs %rdx,%rdi
401041: xor %esi,%esi
401043: mov %rsi,%rdx
401046: syscall
401048: retوفيه كل ما قلناه حرفياً: قبل أول syscall يضع المترجم الرقم 1 في rax لأنه رقم write، والرقم 1 في rdi لأنه المخرج القياسي، وعنوان الجملة في rsi، وطولها 0x19، أي 25، في rdx. وقبل الثانية يضع 0x2a، أي 42، في rdi. وقبل الثالثة يضع 0x3c، أي 60 رقم exit، في eax، ثم يقلب إشارة النتيجة بالتعليمة neg ويختارها إذا كانت سالبة بالتعليمة cmovs. وبهذا الشكل يكون كل ما تفعله مكتبة C في أي طلب، مهما بدا معقداً، هو وضع أرقام في مسجلات ثم هذه التعليمة الواحدة.
ماذا يحدث بين syscall والرجوع؟
عندما ينفذ المعالج التعليمة syscall فإنه يفعل عدة أشياء دفعة واحدة دون أن يسأل البرنامج: يحفظ عنوان التعليمة التالية في rcx وحالة المعالج في r11، وينتقل إلى الحلقة 0، ويقفز إلى عنوان ثابت كتبته النواة عند بدء التشغيل في سجل خاص في المعالج، فالبرنامج لا يختار أين يقفز، وهذا هو جوهر الحماية. وهذا العنوان في Linux هو بداية كود اسمه entry_SYSCALL_64، وتوثيق نقاط الدخول في x86-64 يشرح أن النواة تدخل من عدة أبواب: هذا الباب للطلبات، وأبواب أخرى للمقاطعات Interrupts والاستثناءات مثل خطأ الصفحة. ومن هناك يمر الطلب بالخطوات التالية:
- تبدل النواة مؤشر ال Stack إلى Stack خاص بالنواة لهذا الخيط، فلا تثق في Stack البرنامج.
- إذا كانت حماية PTI مفعلة، وهي مفعلة على جهازنا، تبدل جدول الصفحات من نسخة المستخدم إلى نسخة النواة الكاملة، وسوف نرجع إليها بعد قليل.
- تحفظ كل مسجلات البرنامج في هيكل اسمه
pt_regsعلى Stack النواة، حتى ترجعها كما هي عند الخروج. - تتأكد أن الرقم في
raxداخل حدود الجدول، ثم تنفذ الدالة التي في الجدولsys_call_tableعند هذا الرقم، مثلksys_writeللرقم 1، وإذا كانت هناك مرشحات seccomp أو أداة تتبع فإنها تعمل قبل ذلك. - الدالة نفسها تتحقق من كل ما أرسله البرنامج قبل أن تستخدمه، فرقم الملف 42 في تجربتنا لم يكن في جدول ملفات العملية فرجعت
-EBADF، والعنوان الذي يشير إليه البرنامج تقرأ منه النواة بدوال خاصة تتأكد أنه في فضاء المستخدم، حتى لا يطلب برنامج من النواة أن تكتب في ذاكرتها هي. - قبل الرجوع تنظر النواة هل هناك عمل معلق لهذا الخيط: إشارة وصلت أثناء الطلب، أو أن المجدول يريد أن يعطي المعالج لغيره، كما شرحنا في مقال العمليات والجدولة.
- ترجع المسجلات وجدول الصفحات، وتضع النتيجة في
rax، وتنفذ التعليمةsysretفيرجع المعالج إلى الحلقة 3 عند العنوان الذي فيrcx.
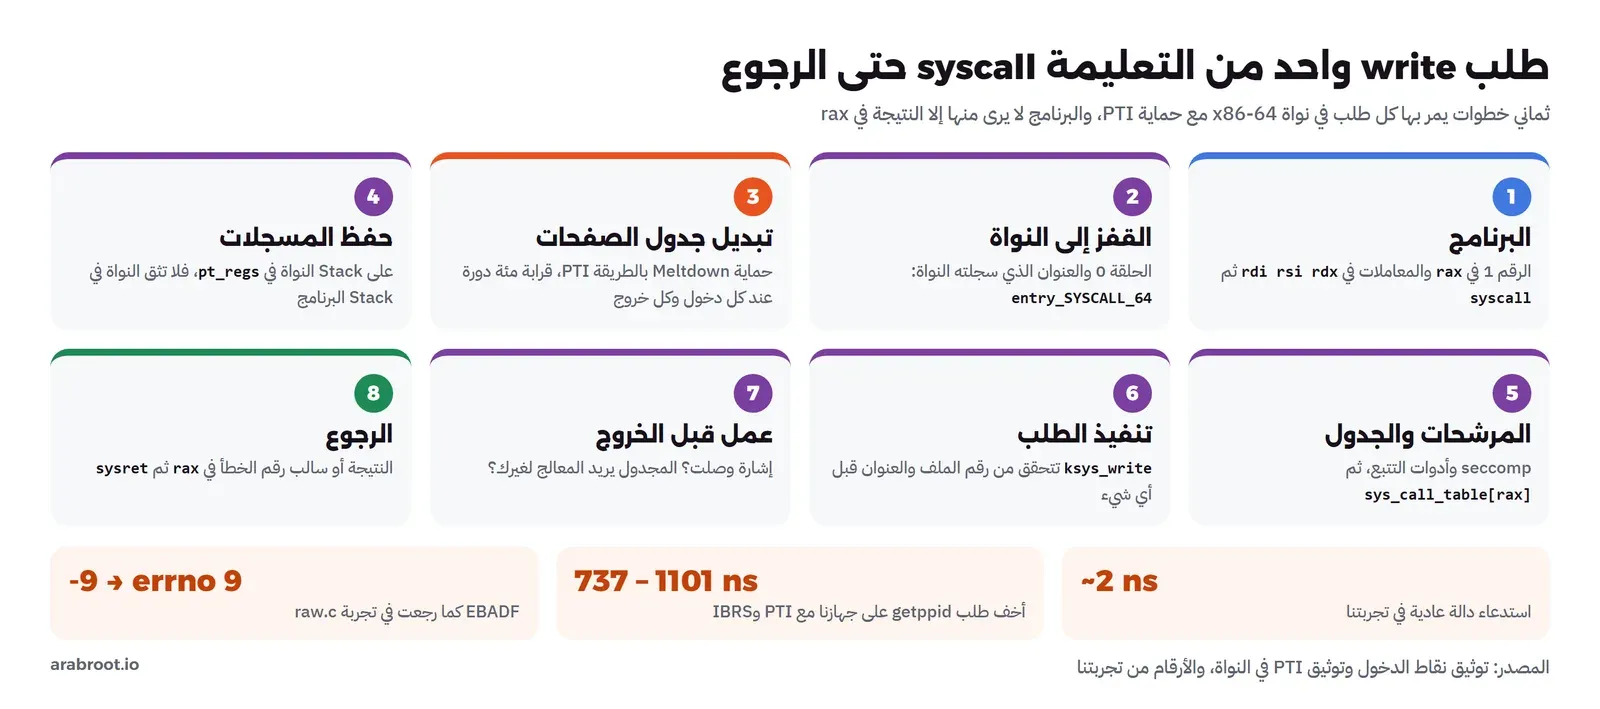
وهذه الخطوات تفسر شيئين تقابلهما في عملك: لماذا يكون كل طلب أبطأ بكثير من استدعاء دالة عادية، لأن فيه حفظاً وتبديلاً وتحققاً، ولماذا يكون البرنامج المعلق في طلب طويل مثل القراءة من الشبكة قابلاً للمقاطعة بإشارة، لأن النواة تنظر في الإشارات عند هذه النقاط بالذات.
كم يكلف الدخول إلى النواة؟
لكي نقيس الكلفة كتبنا برنامجاً يكرر أربعة أشياء خمسة ملايين مرة ويقسم الوقت على العدد: استدعاء دالة عادية لا تفعل شيئاً، وقراءة الساعة بالدالة clock_gettime كما تستدعيها أي لغة، ونفس القراءة بالطلب المباشر عبر syscall()، والطلب getppid الذي يرجع رقم العملية الأم، وهو من أخف الطلبات لأن النواة ترجع رقماً محفوظاً فقط:
/* cost.c: what does one trip to the kernel cost? Each test runs N times and prints ns per call. */
#define _GNU_SOURCE
#include <stdio.h>
#include <stdlib.h>
#include <time.h>
#include <unistd.h>
#include <sys/syscall.h>

static double now(void) { struct timespec t; clock_gettime(CLOCK_MONOTONIC, &t); return t.tv_sec * 1e9 + t.tv_nsec; }
__attribute__((noinline)) static long plain(long x) { __asm__ volatile(""); return x + 1; }

int main(int argc, char **argv)
{
    long n = argc > 1 ? atol(argv[1]) : 5000000;
    volatile long sink = 0; struct timespec ts; double t;

    t = now(); for (long i = 0; i < n; i++) sink += plain(i);
    printf("function call               %7.1f ns\n", (now() - t) / n);

    t = now(); for (long i = 0; i < n; i++) { clock_gettime(CLOCK_MONOTONIC, &ts); sink += ts.tv_nsec; }
    printf("clock_gettime via vDSO      %7.1f ns\n", (now() - t) / n);

    t = now(); for (long i = 0; i < n; i++) { syscall(SYS_clock_gettime, CLOCK_MONOTONIC, &ts); sink += ts.tv_nsec; }
    printf("clock_gettime as a syscall  %7.1f ns\n", (now() - t) / n);

    t = now(); for (long i = 0; i < n; i++) sink += syscall(SYS_getppid);
    printf("getppid syscall             %7.1f ns\n", (now() - t) / n);
    return 0;
}
docker run --rm --name sos-sys -v "$PWD:/lab" sos-tools:1 sh -c 'gcc -O2 -o cost cost.c && ./cost && ./cost; cat /sys/devices/system/cpu/vulnerabilities/meltdown /sys/devices/system/cpu/vulnerabilities/spectre_v2'والمخرج سوف يكون كما يلي:
function call                   1.9 ns
clock_gettime via vDSO         34.8 ns
clock_gettime as a syscall    810.1 ns
getppid syscall              1100.9 ns
function call                   2.5 ns
clock_gettime via vDSO         54.3 ns
clock_gettime as a syscall   1518.1 ns
getppid syscall               736.9 ns
Mitigation: PTI
Mitigation: IBRS; IBPB: conditional; STIBP: conditional; RSB filling; PBRSB-eIBRS: Not affected; BHI: SW loop, KVM: SW loop
في المخرج أعلاه لاحظ التالي:
- استدعاء الدالة العادية نانو ثانيتان تقريباً، أما أخف طلب إلى النواة
getppidفبين 737 و1101 نانو ثانية، أي قرابة ميكروثانية كاملة، وهذا أغلى من الدالة بأكثر من ثلاثمئة مرة. والأرقام تتغير بين التشغيلين لأن الجهاز مشترك مع برامج أخرى، ولكن الترتيب ثابت. - آخر سطرين يفسران لماذا الرقم كبير على هذا الجهاز تحديداً: النواة تحمي من ثغرة Meltdown بالطريقة PTI، ومن ثغرة Spectre بالطريقة IBRS، وكلتاهما تضيف عملاً عند كل دخول وخروج من النواة، وفوق ذلك فالجهاز افتراضي. وعلى معالجات أحدث لا تحتاج هذه الحمايات يكون الطلب أرخص بكثير، لذلك لا تنقل هذا الرقم إلى سيرفرك، وإنما شغل نفس البرنامج عليه.
- قراءة الساعة كلفت 35 إلى 54 نانو ثانية بالطريقة العادية، و810 إلى 1518 بالطلب المباشر، أي أن الطريقة العادية لم تدخل النواة أصلاً، وهذا هو ال vDSO الذي نشرحه بعد قليل.
لماذا صار الطلب أغلى بعد عام 2018؟
وهذا مثال واضح على أن كلفة استدعاء النظام ليست رقماً ثابتاً في الكتب، وإنما قرار أمني: النواة اختارت أن تدفع كلفة عند كل طلب مقابل ألا يقرأ أي برنامج ذاكرتها، والمعالجات التي صممت بعد ذلك أصلحت المشكلة في العتاد، فلا تحتاج PTI، وتعرض فيها النواة في نفس الملف Not affected.
ال vDSO: طلبات لا تدخل النواة
بعض الطلبات تسأل النواة عن معلومة لا تحتاج أي صلاحية، وأشهرها الوقت الحالي، والبرامج تسأل عنه كثيراً جداً، مع كل سطر في السجلات وكل قياس زمن استجابة. فلماذا تدفع ميكروثانية في كل مرة؟ الحل الذي يشرحه توثيق vdso أن تضع النواة في كل عملية مكتبة صغيرة اسمها virtual Dynamic Shared Object، وتضع معها صفحة بيانات للقراءة فقط تحدثها النواة باستمرار بالوقت ومعاملات الساعة، فتقرأ مكتبة C الوقت من هذه الصفحة دون أن تعبر الحد. وقد رأيت هذه المكتبة في خريطة الذاكرة في مقال Hello World باسم [vdso]، ورأيت أثرها في القياس السابق. ولكي ترى أن الطلب لا يصل إلى النواة إطلاقاً شغلنا برنامج Python يقرأ الوقت مئة ألف مرة تحت strace -c الذي يعد كل الطلبات:
strace -f -c -o /tmp/s python3 -c "import time
for _ in range(100000): time.time()"; echo "total lines: $(wc -l < /tmp/s)"; head -3 /tmp/s; grep -E "clock|time|total" /tmp/s
total lines: 37
% time seconds usecs/call calls errors syscall
------ ----------- ----------- --------- --------- ----------------
31.75 0.001438 21 66 rt_sigaction
100.00 0.004529 13 341 42 totalالبرنامج كله أرسل 341 طلباً فقط، أغلبها لتحميل المفسر نفسه، ولا يوجد بينها clock_gettime واحد مع أننا قرأنا الوقت مئة ألف مرة. ولاحظ أن هذا يعني أيضاً أن strace لا يرى هذه الطلبات، فإذا كنت تبحث عن سبب بطء متعلق بالوقت فلن تجده في مخرجه.
تجربة القصة: بايت واحد في كل طلب
الآن نرجع إلى القصة التي بدأنا بها، وأوضح طريقة لإعادتها هي الأمر dd، لأنه يقرأ ويكتب بالحجم الذي تعطيه بالخيار bs كما في صفحته، فكل كتلة طلب read وطلب write. ونقرأ من /dev/zero ونكتب إلى /dev/null حتى لا يكون هناك قرص ولا شبكة، وإنما الطلبات وحدها:
docker run --rm --name sos-sys sos-tools:1 sh -c 'dd if=/dev/zero of=/dev/null bs=1 count=10M 2>&1 | tail -1; dd if=/dev/zero of=/dev/null bs=64K count=160 2>&1 | tail -1'والمخرج سوف يكون كما يلي:
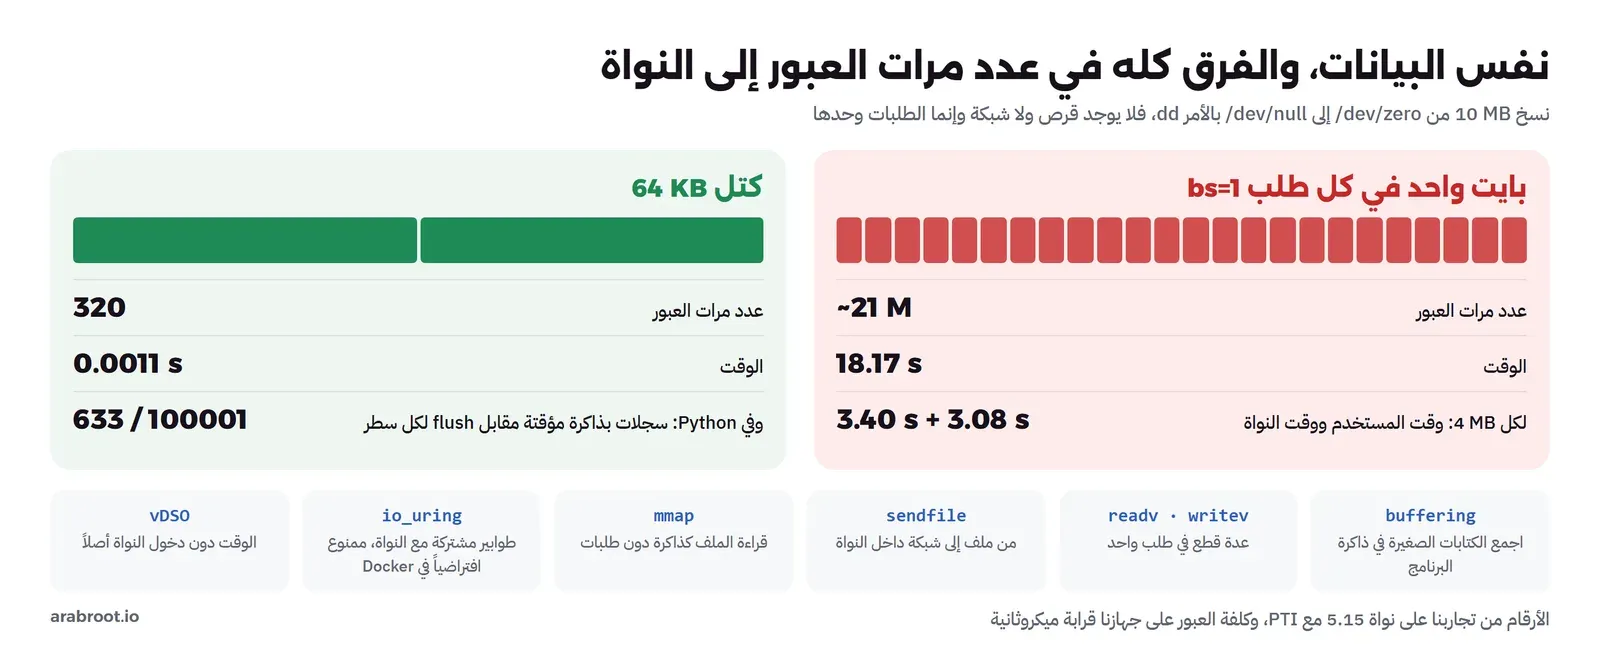
10485760 bytes (10 MB, 10 MiB) copied, 18.1729 s, 577 kB/s
10485760 bytes (10 MB, 10 MiB) copied, 0.00107867 s, 9.7 GB/s
نفس 10 MB أخذت 18 ثانية ببايت واحد في كل طلب، وأقل من ملي ثانية بكتل من 64 KB. والحساب يفسر ذلك: بايت واحد في كل طلب يعني 10485760 قراءة و10485760 كتابة، أي قرابة 21 مليون عبور إلى النواة، و18 ثانية مقسومة عليها تعطي قرابة 870 نانو ثانية للعبور الواحد، وهو نفس الرقم الذي قسناه في البرنامج السابق. أما بكتل 64 KB فهي 160 قراءة و160 كتابة فقط. وبالتالي فالمشكلة لم تكن في سرعة القراءة أو الكتابة، وإنما في عدد مرات العبور.
ثم نسأل السؤال الذي بدأنا به القصة: أين يذهب الوقت، في كودي أم في النواة؟ والأداة /usr/bin/time تقسم الوقت بين وقت المستخدم User Time ووقت النواة System Time، ونشغل بها نفس النسخ لحجم 4 MB بثلاثة أحجام للكتلة:
for bs in 1 4096 65536; do /usr/bin/time -f "bs=$bs: %e s elapsed, %U s user, %S s sys" dd if=/dev/zero of=/dev/null bs=$bs count=$((4194304/bs)) status=none; donebs=1: 6.48 s elapsed, 3.40 s user, 3.08 s sys
bs=4096: 0.00 s elapsed, 0.00 s user, 0.00 s sys
bs=65536: 0.00 s elapsed, 0.00 s user, 0.00 s sysببايت واحد ذهب نصف الوقت تقريباً إلى النواة، 3.08 ثانية، وهذا هو العمود sy المرتفع في top. والنصف الآخر في وقت المستخدم، وهذا قد يبدو غريباً لأن dd لا يحسب شيئاً، ولكن كل طلب له جزء في فضاء المستخدم أيضاً: الدالة في مكتبة C التي تجهز المسجلات، والحلقة في dd نفسها التي تتحقق من كل نتيجة، وعندما تتكرر هذه الأشياء الصغيرة ملايين المرات يصبح مجموعها ثواني. ومن 4 KB فما فوق اختفى الوقت كله تحت دقة الأداة.
وفي البرامج الحقيقية لا يكتب أحد bs=1 عمداً، ولكن نفس النمط يظهر بطرق غير مباشرة: قراءة ملف حرفاً حرفاً بدالة لا تستخدم ذاكرة مؤقتة، أو كتابة كل سطر سجل بطلب write مستقل مع flush بعد كل سطر، أو إرسال كل حقل في بروتوكول شبكة بطلب send مستقل، أو طلب stat على كل ملف في مجلد فيه مئات الآلاف من الملفات. والطريقة لتعرف ذلك في أي برنامج هي أن تعد طلباته، وهنا تأتي strace.
نفس المشكلة في لغة عالية: السجلات Logs والتفريغ Flush بعد كل سطر
قد يبدو المثال السابق بعيداً عن الكود الذي تكتبه كل يوم، فلنأخذ أكثر شيء تكتبه البرامج: السجلات Logs. البرنامج التالي بلغة Python يكتب مئة ألف سطر سجل إلى ملف، مرة بالذاكرة المؤقتة الافتراضية للغة، ومرة مع تفريغ flush بعد كل سطر، وهو ما تفعله بعض إعدادات مكتبات السجلات حتى لا يضيع سطر إذا توقف البرنامج فجأة:
# logs.py: write 100000 log lines to a file, with Python's default buffering or with flush after each line.
import sys, time
mode = sys.argv[1]
t = time.perf_counter()
with open("/tmp/app.log", "w") as f:
    for i in range(100000):
        f.write(f"2026-10-30T10:00:00 INFO request {i} done in 3 ms
")
        if mode == "flush":
            f.flush()
print(f"{mode}: {time.perf_counter() - t:.2f} s")
ونشغله مرتين للوقت، ثم مرتين تحت strace -c لنعد طلبات write فقط:
for m in buffered flush; do python3 /lab/logs.py $m; done
for m in buffered flush; do strace -c -e trace=write -o /tmp/s python3 /lab/logs.py $m >/dev/null; echo "$m:"; grep -E "write|total" /tmp/s; done
والمخرج سوف يكون كما يلي:
buffered: 0.05 s
flush: 0.31 s
buffered:
100.00    0.006890          10       633           write
100.00    0.006890          10       633           total
flush:
100.00    2.178803          21    100001           write
100.00    2.178803          21    100001           total
في المخرج أعلاه لاحظ التالي:
- بالذاكرة المؤقتة كتبت Python مئة ألف سطر بـ 633 طلب
writeفقط، أي أنها جمعت قرابة 158 سطراً في كل طلب، وأخذ البرنامج 0.05 ثانية. - مع التفريغ بعد كل سطر صار هناك طلب لكل سطر، 100001 طلب، والوقت ارتفع ستة أضعاف إلى 0.31 ثانية، وهذا لبرنامج لا يفعل شيئاً إلا الكتابة. وفي خدمة حقيقية تكتب سطراً لكل طلب HTTP يصبح هذا جزءاً ثابتاً من وقت كل طلب ومن العمود
sy. - والتفريغ لا يعني أن السطر وصل إلى القرص، وإنما وصل إلى النواة فقط، فإذا انقطعت الكهرباء قد يضيع رغم التفريغ، وهذا موضوع المقال التالي عن نظام الملفات والطلب
fsync. أي أن التفريغ بعد كل سطر يحميك من شيء واحد فقط: أن يتوقف البرنامج نفسه فجأة قبل أن يرسل ما في ذاكرته المؤقتة.
والحل الوسط الذي تأخذ به أغلب مكتبات السجلات أن يكون التفريغ كل فترة قصيرة أو عند امتلاء الذاكرة المؤقتة، وأن تفرغ فوراً عند الأخطاء المهمة وعند إيقاف البرنامج بإشارة، فتحصل على أغلب السرعة دون أن تخسر السطور التي تحتاجها عند التحقيق في عطل.
الأداة strace بعمق، وكم تكلف
الأداة strace تعرض كل طلب يرسله برنامج مع معاملاته ونتيجته، والخيارات التي تحتاجها أغلب الوقت كما في صفحتها:
-c: لا يعرض الطلبات وإنما يعدها ويجمع وقتها في جدول في النهاية، وهو أول ما تشغله عندما تشك في عدد الطلبات.-f: يتبع الخيوط والعمليات الفرعية، وبدونه ترى الخيط الأول فقط، وهذا خطأ شائع مع البرامج التي تعمل بخيوط كثيرة.-T: يضيف في آخر كل سطر الوقت الذي قضاه الطلب في النواة، فترى أي طلب ينتظر.-e trace=: يختار طلبات معينة، مثل-e trace=openat,stat، أو مجموعات مثل%fileو%network.-p PID: يتصل ببرنامج يعمل الآن دون إعادة تشغيله.-y: يعرض بجوار كل رقم ملف المسار أو الاتصال الذي يشير إليه.
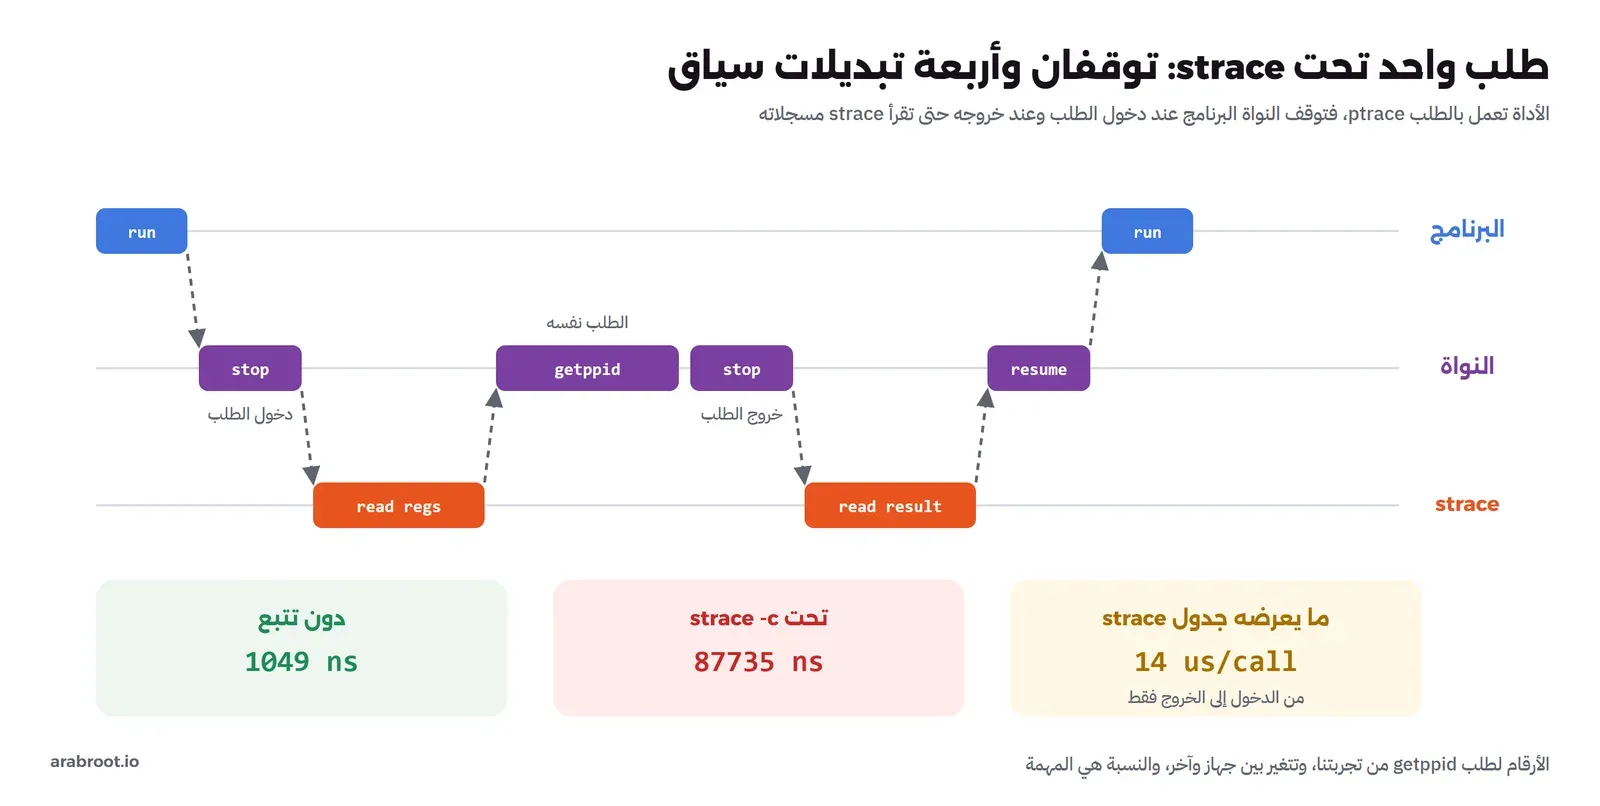
ولكن قبل أن تشغلها على سيرفر الإنتاج يجب أن تعرف كلفتها. فالأداة تعمل بالطلب ptrace كما في صفحته، وفيه توقف النواة البرنامج عند دخول كل طلب وعند خروجه، وتوقظ strace لتقرأ مسجلاته، ثم تكمل البرنامج، أي أن كل طلب واحد يصبح عدة تبديلات سياق بين عمليتين. ونقيس ذلك بنفس برنامج الكلفة بعدد أقل:
docker run --rm --name sos-sys -v "$PWD:/lab" sos-tools:1 sh -c 'gcc -O2 -o /tmp/cost cost.c; echo "-- without strace"; /tmp/cost 200000; echo "-- under strace -c"; strace -c -o /tmp/s /tmp/cost 200000; head -6 /tmp/s'-- without strace
function call 5.1 ns
clock_gettime via vDSO 53.3 ns
clock_gettime as a syscall 890.7 ns
getppid syscall 1049.0 ns
-- under strace -c
function call 2.2 ns
clock_gettime via vDSO 40.5 ns
clock_gettime as a syscall 83620.2 ns
getppid syscall 87735.2 ns
% time seconds usecs/call calls errors syscall
------ ----------- ----------- --------- --------- ----------------
51.71 2.971680 14 200000 getppid
48.26 2.773469 13 200000 clock_gettime
0.00 0.000254 31 8 mmap
0.00 0.000240 240 1 execveوالصورة التالية تبين لماذا يحدث ذلك: كل طلب واحد من البرنامج تحت التتبع يصبح سلسلة من التوقفات والإيقاظات بين عمليتين، كل منها يمر بالمجدول ويبدل السياق، بينما الطلب نفسه في النواة جزء صغير من الوقت:
في المخرج أعلاه لاحظ التالي:
- الطلب الواحد تحت
straceصار 84 إلى 88 ميكروثانية بدلاً من ميكروثانية واحدة، أي أبطأ بقرابة ثمانين مرة، والسطور التي لا تدخل النواة، أي الدالة العادية والوقت عبر ال vDSO، لم تتأثر إطلاقاً. - جدول
strace -cيقول إن الطلب أخذ 13 و14 ميكروثانية، بينما البرنامج رأى 84 و88. والفرق أنstraceيقيس الوقت بين دخول الطلب وخروجه فقط، أما وقت إيقاف البرنامج وإيقاظstraceوتبديل السياق فلا يظهر في الجدول، ولكنه يظهر في وقت البرنامج. لذلك استخدم الجدول لمعرفة العدد والنسب، ولا تستخدمه لمعرفة الزمن الحقيقي.
وفي تجربة أخرى شغلنا dd ببايت واحد لنسخ 1 MB فقط تحت strace -c:
strace -c -o /tmp/s1 dd if=/dev/zero of=/dev/null bs=1 count=1M 2>&1 | tail -1; head -8 /tmp/s11048576 bytes (1.0 MB, 1.0 MiB) copied, 327.254 s, 3.2 kB/s
% time seconds usecs/call calls errors syscall
------ ----------- ----------- --------- --------- ----------------
50.20 31.655854 30 1048577 read
49.80 31.401616 29 1048579 write
0.00 0.000061 8 7 close
0.00 0.000000 0 2 fstat
0.00 0.000000 0 1 lseek
0.00 0.000000 0 8 mmapالجدول نفسه يعطيك التشخيص في سطرين: مليون read ومليون write لنسخ 1 MB، أي طلبان لكل بايت. ولكن انظر إلى السطر الأول: 1 MB أخذ 327 ثانية، أي أكثر من خمس دقائق، بينما تتوقع من التجربة السابقة دون strace قرابة ثانيتين. وهذا هو الدرس العملي: strace على برنامج يرسل طلبات كثيرة قد يبطئه مئة مرة، فإذا وصلته بخدمة إنتاج مشغولة بالخيار -p فقد توقفها عملياً عن الخدمة. اتصل لثوان قليلة مع -c فقط، أو استخدم أدوات تعد الطلبات داخل النواة دون إيقاف البرنامج، مثل perf trace أو أدوات eBPF.
ماذا ينتظر البرنامج الآن؟
أحياناً لا يكون البرنامج بطيئاً وإنما معلقاً، وتريد أن تعرف في أي طلب هو الآن دون أن توقفه. والنواة تعرض ذلك في ملفين: /proc/<pid>/syscall الذي فيه رقم الطلب الحالي ومعاملاته كما في صفحته، و/proc/<pid>/wchan الذي فيه اسم الدالة في النواة التي ينتظر فيها كما في صفحته. والسكربت التالي ينشئ برنامجين معلقين، الأول يقرأ من أنبوب مسمى FIFO لا يكتب فيه أحد، والثاني ينام:
#!/bin/sh
# What is a sleeping process doing in the kernel right now?
mkfifo /tmp/req
cat /tmp/req > /dev/null &         # blocks: opening a FIFO waits for a writer
sleep 100 &                        # blocks in clock_nanosleep()
sleep 0.5
for p in $(pgrep -x cat) $(pgrep -x sleep | head -1); do
  echo "pid $p ($(cat /proc/$p/comm)): state=$(awk '{print $3}' /proc/$p/stat) wchan=$(cat /proc/$p/wchan) syscall=$(cat /proc/$p/syscall)"
done
echo "--- strace attaches to the running cat, then we write one line"
(sleep 1; echo hello > /tmp/req) &
timeout 3 strace -p $(pgrep -x cat) -T 2>&1 | head -5
kill $(jobs -p) 2>/dev/null; true
والمخرج سوف يكون كما يلي:
pid 8 (cat): state=S wchan=wait_for_partner syscall=257 0xffffffffffffff9c 0x7ffec2a84f76 0x0 0x0 0x0 0x0 0x7ffec2a842f0 0x7f38e6c453a7
pid 9 (sleep): state=S wchan=hrtimer_nanosleep syscall=230 0x0 0x0 0x7ffd216fe8f0 0x7ffd216fe930 0x0 0x0 0x7ffd216fe8b0 0x7fceff7273a7
--- strace attaches to the running cat, then we write one line
strace: Process 8 attached
openat(AT_FDCWD, "/tmp/req", O_RDONLY)  = 3 <0.995112>
fstat(3, {st_mode=S_IFIFO|0644, st_size=0, ...}) = 0 <0.000096>
fadvise64(3, 0, 0, POSIX_FADV_SEQUENTIAL) = -1 ESPIPE (Illegal seek) <0.000063>
mmap(NULL, 270336, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f38e6b71000 <0.000089>
وعندما كتبنا السكربت كان التعليق بجوار cat يقول إنه سينتظر في الطلب read، لأن هذا ما نتوقعه من برنامج يقرأ من أنبوب فارغ، ولكن المخرج قال شيئاً آخر:
- الرقم في
syscallللبرنامجcatهو 257، ورأينا في جدول الأرقام أنهopenatوليسread، والدالة التي ينتظر فيهاwait_for_partner. أي أنcatلم يصل إلى القراءة أصلاً، وإنما ما زال يفتح الملف، لأن فتح أنبوب مسمى للقراءة ينتظر حتى يفتحه طرف آخر للكتابة، كما تشرح صفحة fifo. وأول معامل0xffffffffffffff9cهو -100، أيAT_FDCWD، وهو نفس ما يظهر في سطرstraceبعده. - عندما اتصلت
straceكان الطلبopenatما زال جارياً، فلما كتبنا السطر بعد ثانية رجع بالرقم 3، والخيار-Tيقول إنه قضى 0.995 ثانية في النواة، أي كل الوقت منذ بدأت المراقبة حتى وصل الكاتب. - البرنامج
sleepفي الطلب 230، وهوclock_nanosleep، وينتظر فيhrtimer_nanosleep، وهي نفس الدالة التي رأيناها في عمود WCHAN في مقال الجدولة.
وهذا النوع من المفاجآت سبب جيد لتقرأ ما تقوله النواة قبل أن تفترض، فخدمة معلقة عند البدء لأنها تفتح أنبوباً أو جهازاً أو ملفاً على نظام ملفات شبكي لا يرد ستظهر بنفس الشكل، والملفان أعلاه يقولان لك ذلك في ثانية دون أي أداة إضافية.
الطلبات الطويلة والإشارات Signals والخطأ EINTR
بعض الطلبات ترجع فوراً مثل getppid، وبعضها ينتظر حدثاً قد يأخذ وقتاً طويلاً، مثل read من اتصال شبكة أو accept لاتصال جديد أو openat لأنبوب كما رأينا، وهذه تسمى الطلبات الحاجبة Blocking. فماذا يحدث إذا وصلت إشارة إلى البرنامج وهو داخل طلب منها، مثل SIGTERM عندما يطلب Docker إيقاف ال Container؟ صفحة signal تشرح الحالتين: إذا كان للبرنامج دالة تتعامل مع الإشارة تخرج النواة من الطلب وتنفذ الدالة، ثم إما أن تعيد الطلب تلقائياً إذا سجلت الدالة بالخيار SA_RESTART، وإما أن يرجع الطلب بالخطأ EINTR، ومعناه أن الطلب قوطع قبل أن يكمل وليس أنه فشل.
وفي كود C والكود القريب منه، مثل Go وRust عند التعامل مع الطلبات مباشرة، الخطأ الشائع أن يعامل EINTR كخطأ حقيقي فيغلق الاتصال أو يوقف البرنامج، والصحيح أن تعيد الطلب. أما في اللغات الأعلى مثل Python فالمفسر يعيد الطلب نيابة عنك في أغلب الحالات، ولكن معرفة هذا السلوك تفسر لماذا تظهر EINTR أحياناً في مخرج strace لبرنامج سليم.
تقييد الاستدعاءات: seccomp في Docker
إذا كان كل ما يفعله البرنامج خارج حساباته يمر عبر طلبات مرقمة، فمنع طلب معين يمنع قدرة كاملة، وهذه فكرة الآلية seccomp التي تشرحها صفحة seccomp وتوثيق مرشحات seccomp في النواة: تسجل العملية مرشحاً صغيراً يعمل في النواة عند كل طلب قبل تنفيذه، فيسمح به أو يرفضه برقم خطأ أو يقتل العملية، ويرث كل أبناء العملية المرشح ولا يستطيعون إلغاءه. وDocker يضع لكل Container مرشحاً افتراضياً يمنع قرابة 44 طلباً من أكثر من 300 كما يذكر توثيق seccomp في Docker، مثل تحميل وحدات النواة وتغيير ساعة النظام. وكتبنا برنامجاً صغيراً يسأل هل الطلب io_uring_setup مسموح، بأن يرسله بمؤشر غير صالح عمداً: إذا رجع EFAULT فالنواة وصلت إلى الطلب ورفضت المؤشر، وإذا رجع EPERM فالمرشح رفضه قبل أن يصل:
/* uring.c: does this container allow io_uring? Calls io_uring_setup with a bad pointer on purpose:
   EFAULT means the kernel looked at the call, EPERM means a filter refused it first. */
#define _GNU_SOURCE
#include <stdio.h>
#include <string.h>
#include <errno.h>
#include <unistd.h>
#include <sys/syscall.h>
int main(void)
{
    long r = syscall(__NR_io_uring_setup, 1, (void *)1);
    printf("io_uring_setup = %ld (%s)\n", r, r < 0 ? strerror(errno) : "ok");
    return 0;
}
ونشغله مرة بالمرشح الافتراضي ومرة دون مرشح بالخيار seccomp=unconfined:
docker run --rm --name sos-sys -v "$PWD:/lab" sos-tools:1 sh -c 'grep Seccomp /proc/self/status; gcc -o /tmp/uring uring.c && /tmp/uring'
docker run --rm --name sos-sys --security-opt seccomp=unconfined -v "$PWD:/lab" sos-tools:1 sh -c 'grep Seccomp /proc/self/status; gcc -o /tmp/uring uring.c && /tmp/uring'
والمخرج سوف يكون كما يلي:
Seccomp:	2
Seccomp_filters:	2
io_uring_setup = -1 (Operation not permitted)
Seccomp:	2
Seccomp_filters:	1
io_uring_setup = -1 (Bad address)
في المخرج أعلاه لاحظ التالي:
- القيمة
Seccomp: 2تعني أن العملية تعمل بمرشح، وفي ال Container العادي مرشحان، أما معunconfinedفبقي مرشح واحد لم يضعه Docker لهذا ال Container، وإنما جاء من البيئة التي يعمل فيها Docker Desktop نفسه، لذلك فقراءة هذا السطر على سيرفرك تخبرك بما هو مفروض فعلاً وليس بما تظنه. - مع المرشح الافتراضي رجع الطلب
EPERM، أي أن io_uring ممنوع، ودون المرشح رجعEFAULT، أي أن النواة وصلت إليه. وقد أضاف Docker هذا المنع في التعديل رقم 46762، والسبب المكتوب في توثيقه أن ثغرات في io_uring استخدمت للخروج من ال Containers، وهذا يعني أن برنامجاً يعتمد على io_uring لن يعمل داخل Docker إلا بملف مرشح مخصص.
ويمكنك أن تكتب ملف مرشح خاصاً بك، وهذا الملف يسمح بكل شيء إلا إنشاء المجلدات، والرقم errnoRet: 1 هو EPERM:
{
  "defaultAction": "SCMP_ACT_ALLOW",
  "syscalls": [
    { "names": ["mkdir", "mkdirat"], "action": "SCMP_ACT_ERRNO", "errnoRet": 1 }
  ]
}
docker run --rm --name sos-sys --security-opt seccomp=deny-mkdir.json sos-tools:1 sh -c 'mkdir /tmp/x; echo "exit=$?"; strace -e trace=mkdir,mkdirat mkdir /tmp/y'mkdir: cannot create directory '/tmp/x': Operation not permitted
exit=1
mkdir("/tmp/y", 0777) = -1 EPERM (Operation not permitted)
mkdir: cannot create directory '/tmp/y': Operation not permitted
+++ exited with 1 +++والصورة التالية تبين أين يقف المرشح في الطريق الذي رسمناه في قسم ما يحدث بين syscall والرجوع: بعد حفظ المسجلات وقبل البحث في جدول الطلبات، فالطلب المرفوض لا يصل إلى كود النواة الذي ينفذه إطلاقاً، ولهذا يعد المرشح حماية قوية حتى من ثغرات في هذا الكود نفسه:
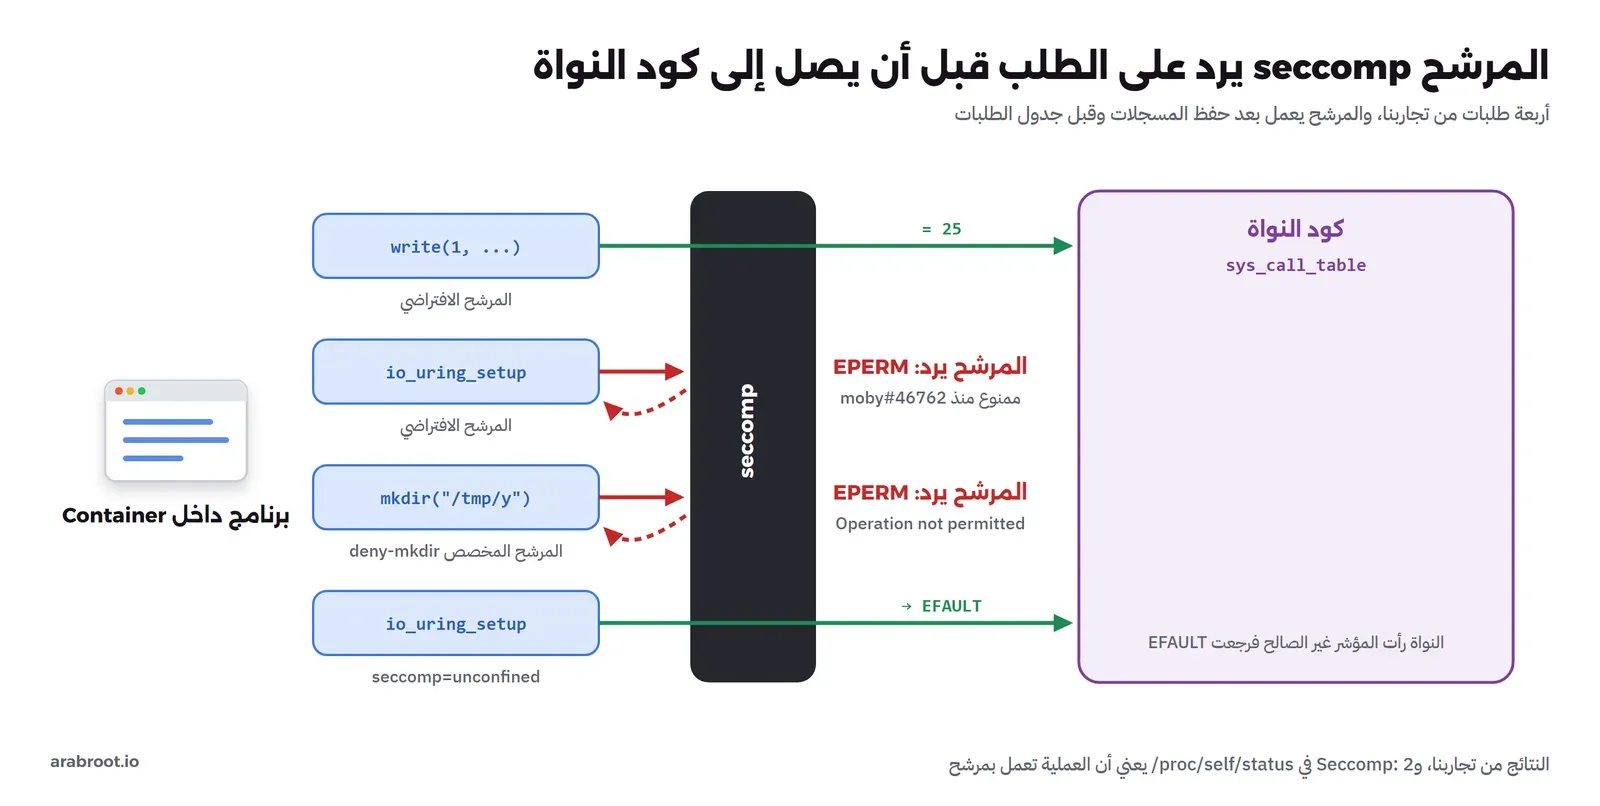
البرنامج mkdir لا يعرف أن هناك مرشحاً، فهو يرى خطأ صلاحيات عادياً، وstrace يريك الطلب نفسه والرقم الذي رجع. وهذا ما يجعل أخطاء seccomp محيرة: الرسالة نفسها التي تراها عندما يكون المجلد ملكاً لمستخدم آخر، لذلك عندما يفشل برنامج داخل Container بالرسالة Operation not permitted في عملية بسيطة فاسأل هل المنع من الصلاحيات أم من المرشح، وشغل strace لترى أي طلب رفض بالضبط. ولا تقم بحل المشكلة بالخيار seccomp=unconfined في الإنتاج، والسبب أنه يرفع حماية كاملة لكي تسمح بطلب واحد، والصحيح ملف مرشح يضيف هذا الطلب فقط إلى المرشح الافتراضي. ولاحظ الفرق بين هذا وبين الصلاحيات Capabilities التي رأيناها في المقالين السابقين، مثل CAP_PERFMON وCAP_SYS_ADMIN: الصلاحية تقول هل يحق لهذه العملية أن تفعل شيئاً، والمرشح يقول هل يمر هذا الطلب أصلاً، ويعملان معاً.
كيف تقلل عدد مرات العبور؟
بعد أن عرفت أن كل عبور له كلفة ثابتة، فكل طرق تسريع الإدخال والإخراج في البرامج تقريباً ترجع إلى فكرة واحدة: افعل أكثر في كل عبور، أو لا تعبر أصلاً. والطرق المعروفة بالترتيب من الأبسط:
- الذاكرة المؤقتة في فضاء المستخدم Buffering: اجمع الكتابات الصغيرة واكتبها دفعة واحدة، وهذا ما تفعله مكتبة C ومكتبات القراءة في كل لغة، والخطأ الشائع أن تعطلها بالتفريغ
flushبعد كل سطر دون حاجة. وفي تجربتنا كانت كتلة 4 KB كافية لإخفاء الكلفة كلها. - القراءة والكتابة المجمعة: الطلبان
readvوwritevيرسلان عدة قطع منفصلة في الذاكرة في طلب واحد كما في صفحتهما، مثل رأس رسالة ومحتواها، دون أن تنسخهما إلى مكان واحد أولاً. - النقل داخل النواة: الطلب
sendfileينقل البيانات من ملف إلى اتصال شبكة داخل النواة كما في صفحته، فلا تمر البيانات بفضاء المستخدم أصلاً، وهذا ما تستخدمه خوادم الويب لإرسال الملفات الثابتة. - ربط الملف بالذاكرة بالطلب
mmap: بعد الربط تصبح القراءة وصولاً عادياً للذاكرة دون طلبات، مع كلفة خطأ الصفحة عند أول لمس كما شرحنا في مقال الذاكرة الافتراضية. - الطوابير المشتركة مع النواة io_uring: يضع البرنامج طلباته في طابور في ذاكرة مشتركة مع النواة وتضع النواة النتائج في طابور آخر كما في صفحته، فيمكن أن تنفذ مئات العمليات بطلب واحد أو دون طلبات، ولكن رأينا أن Docker يمنعه افتراضياً.
- ال vDSO: للطلبات التي تقرأ معلومات فقط مثل الوقت، وهو يعمل تلقائياً دون أي تعديل منك.
أخطاء شائعة
- البحث عن البطء في الكود عندما يكون العمود
syمرتفعاً: الوقت في النواة، والسؤال الأول كم طلباً يرسل البرنامج، وجوابه فيstrace -cلثوان قليلة. - تشغيل
straceطويلاً على خدمة إنتاج: رأينا أنه يبطئ الطلب ثمانين مرة، وجعل نسخ 1 MB يأخذ خمس دقائق. - الثقة في أزمنة جدول
strace -c: تقيس ما داخل الطلب فقط، ولا تشمل كلفة التتبع نفسها. - نسيان
-fمع برنامج متعدد الخيوط: ترى خيطاً واحداً وتظن أن البرنامج لا يفعل شيئاً. - البحث عن طلبات الوقت في مخرج
strace: تمر غالباً عبر ال vDSO ولا تظهر. - التعامل مع
EINTRكفشل: الطلب قوطع بإشارة، والصحيح إعادته. - نقل أرقام كلفة الطلبات من مقال أو جهاز آخر: الكلفة تعتمد على المعالج والحمايات المفعلة والجهاز الافتراضي، وعلى جهازنا كانت قرابة ميكروثانية، فقسها على سيرفرك.
- حل خطأ
Operation not permittedداخل Container بالخيارseccomp=unconfinedأو--privileged: اعرف الطلب المرفوض أولاً، ثم اسمح به وحده. - تعطيل الذاكرة المؤقتة في السجلات بالتفريغ بعد كل سطر في كل البيئات: في التطوير يفيد أن ترى كل سطر فوراً، أما في الإنتاج فاجعل التفريغ بالوقت أو بالحجم.
جدول القرار Decision Table: ما تراه وماذا تفعل
| ما تراه | الأمر الأول | ما تبحث عنه | الحل الغالب |
|---|---|---|---|
العمود sy مرتفع | strace -c -f -p PID لثوان | طلب واحد بعدد ضخم | Buffering أو كتل أكبر أو writev |
| برنامج معلق | cat /proc/PID/syscall وwchan | رقم الطلب والدالة التي ينتظر فيها | الطرف الآخر: أنبوب أو شبكة أو قرص أو قفل |
| طلب بطيء أحياناً | strace -T -e trace=... | الطلب الذي يأخذ الوقت | بحسب الطلب: قرص أو DNS أو قفل |
Operation not permitted داخل Container | strace مع grep Seccomp /proc/self/status | الطلب الذي رجع EPERM | صلاحية واحدة أو مرشح مخصص للطلب وحده |
| برنامج يحتاج io_uring في Docker | التجربة السابقة uring.c | EPERM أو EFAULT | مرشح مخصص بعد تقييم الخطر، أو طريقة إدخال وإخراج أخرى |
| إرسال ملفات كبيرة من خادم | strace -c | read وwrite متكررة | sendfile |
| أداء متغير بين سيرفرين متشابهين | cat /sys/devices/system/cpu/vulnerabilities/* | حمايات مختلفة في النواة | اعرف الكلفة، ولا تعطل الحماية دون تقييم أمني |
حذف المختبر
كل ال Containers عملت بالخيار --rm، والملفات التي بنيناها داخلها اختفت معها، وتبقى ال Image وملف المرشح في مجلدك:
docker rmi sos-tools:1
rm deny-mkdir.json
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المعالج يفصل بين الحلقة 3 للبرامج والحلقة 0 للنواة، والبرنامج لا يصل إلى الأجهزة إلا بطلب، والطلب رقم في
raxومعاملات في المسجلات ثم التعليمةsyscall. - أرقام الطلبات لا تتغير أبداً، لأن تغييرها يكسر البرامج القديمة، والنواة ترجع الخطأ سالباً ومكتبة C تحوله إلى -1 والمتغير
errno. - الدخول يمر بتبديل ال Stack وجدول الصفحات وحفظ المسجلات والتحقق من كل معامل، لذلك أخف طلب على جهازنا كلف قرابة ميكروثانية، أي أكثر من ثلاثمئة ضعف استدعاء دالة.
- حماية Meltdown بالطريقة PTI جعلت كل دخول وخروج يبدل جدول الصفحات، والمعالجات الأحدث لا تحتاجها.
- ال vDSO يجيب عن طلبات الوقت دون دخول النواة، ومئة ألف قراءة للوقت في Python لم ترسل طلباً واحداً.
- نسخ 10 MB ببايت في كل طلب أخذ 18 ثانية، وبكتل 64 KB أقل من ملي ثانية، والفرق كله عدد مرات العبور.
- الأداة
straceتكشف عدد الطلبات ونوعها، ولكنها تبطئ البرنامج قرابة ثمانين مرة، فاستخدمها قصيراً، واقرأ/proc/PID/syscallوwchanلمعرفة ما ينتظره البرنامج دون إيقافه. - الآلية seccomp تمنع طلبات كاملة قبل تنفيذها، وDocker يمنع افتراضياً عشرات الطلبات ومنها io_uring، والخطأ يظهر للبرنامج كأنه خطأ صلاحيات عادي.
 دليلالعمليات Processes وجدولة المعالج CPU Scheduling في Linuxنرى من داخل النواة كيف يختار المجدول من يعمل الآن، ولماذا يبطئ سكربت ليلي واجهتك البرمجية، وكيف يعيدها سطر واحد إلى سرعتها.
 دليلالذاكرة الافتراضية Virtual Memory: جداول الصفحات وخطأ الصفحةنتابع العنوان من برنامجك إلى شريحة الذاكرة، ونفهم بأرقام حقيقية لماذا تخدعك أعمدة VIRT وRES، ومتى تسرع الصفحات الكبيرة برنامجك.
 دليلنظام الملفات File System: Inodes والسجل Journal وfsyncنتابع الكتابة من برنامجك حتى القرص داخل ext4، ونقطع الكهرباء عن نظام ملفات يعمل لنرى ماذا يبقى فعلاً، ومتى تحتاج fsync وكم يكلف.
 دليلماذا يحدث عندما تشغل برنامج Hello World؟نتتبع برنامج C صغيراً من المحرر إلى الشاشة، فترى كل طبقة يمر بها في الجهاز حتى تظهر الجملة أمامك.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب داخل Container من Debian 13 (trixie) مع gcc 14.2 وstrace 6.13 وGNU time وPython 3.13.5، على نواة Linux 5.15 (WSL2) مع حمايتي PTI وIBRS ومعالج Intel Core i7-7700K، على Docker Engine 29.8.0.