


إذا مر عليك يوم انقطعت فيه الكهرباء عن سيرفر، أو أعاد مزود الخدمة تشغيل الجهاز الافتراضي فجأة، فربما رأيت بعدها شيئاً لا يفسره منطق البرنامج: ملف إعدادات موجود وحجمه صفر، أو طلب أكدت الواجهة للعميل أنه حفظ ولم تجده في الملف، أو سجلات توقفت قبل الانقطاع بنصف دقيقة كاملة. والبرنامج في كل هذه الحالات استدعى write ورجع الطلب بنجاح، وأنت تفترض أن النجاح معناه أن البيانات على القرص، وهذا الافتراض هو أصل المشكلة.
والسبب أن بين الطلب write والقرص طبقات كثيرة: نظام الملفات الافتراضي، وذاكرة الصفحات المؤقتة، ونظام الملفات نفسه بسجله Journal وطريقة حجزه للمساحة، ثم طبقة الأجهزة، ثم ذاكرة القرص المؤقتة. وكل طبقة منها وجدت لتجعل الكتابة أسرع، وكل واحدة تؤخر وصول البيانات بطريقتها. وقد رأينا في مقال فضاء النواة واستدعاءات النظام كيف يصل الطلب إلى النواة، وفي هذا المقال نتابعه حتى القرص: كيف ينظم نظام الملفات ext4 الأسماء والبيانات من الداخل، ولماذا يحتاج سجلاً، وماذا يبقى فعلاً بعد انقطاع الكهرباء، وكم يكلف أن تتأكد بالطلب fsync. وكل ذلك بتجارب حقيقية، منها تجربة نقطع فيها الكهرباء عن نظام ملفات وهو يعمل.
وسوف نناقش في هذا المقال ما يلي:
- الطبقات بين
writeوالقرص، ونظام الملفات الافتراضي VFS. - الاسم شيء والملف شيء آخر: ال Inode والروابط الصلبة والرمزية، وماذا يفعل
mvوrmفعلاً. - نظام الملفات ext4 من الداخل دون تركيبه: الكتلة الرئيسية Superblock وجدول ال Inodes والامتدادات Extents، بالأداتين
dumpe2fsوdebugfs. - لماذا لا تعني الكتابة أن البيانات على القرص: الصفحات المتسخة Dirty Pages ومتى تكتب.
- السجل Journaling: المشكلة التي يحلها، وأوضاعه الثلاثة، وتجربة انقطاع كهرباء بثلاث نقاط زمنية.
- الاستبدال الآمن للملفات، ومشكلة الملفات الفارغة في ext4، والخيار
auto_da_alloc. - كم يكلف
fsyncوأخواته، وما حدث لقاعدة PostgreSQL مع أخطائه عام 2018. - الأخطاء الشائعة، وجدول قرار للكتابة الآمنة.
تجهيز المختبر
نستخدم نفس ال Image التي بنيناها في مقال العمليات وجدولة المعالج، وفيها أدوات ext4 من الحزمة e2fsprogs، وPython لتجربة الأزمنة. ونضع الملفات في Docker Volume اسمه sos-fs-data، لأن ال Volume على جهازنا نظام ملفات ext4 حقيقي، أما ملفات ال Container نفسه فتمر عبر نظام الملفات المتراكب overlayfs:
docker volume create sos-fs-data
docker run --rm --name sos-fs -v sos-fs-data:/data -v "$PWD:/lab" sos-tools:1 sh /lab/inodes.sh
وأغلب التجارب تعمل في Container عادي دون أي صلاحيات، حتى قراءة نظام ملفات كامل من الداخل، لأن الأدوات mkfs.ext4 وdumpe2fs وdebugfs تعمل على ملف عادي كما تعمل على قرص. والاستثناء الوحيد تجربتا انقطاع الكهرباء، لأنهما تحتاجان أن تركب النواة نظام الملفات فعلاً عبر جهاز Loop، وهذا يحتاج الصلاحية CAP_SYS_ADMIN والوصول إلى أجهزة /dev/loop*، لذلك شغلناهما وحدهما بالخيار --privileged. ولا تستخدم هذا الخيار خارج مختبر كهذا، والسبب أنه يعطي ال Container صلاحيات المضيف تقريباً. والجهاز Docker Desktop بنواة Linux 5.15 داخل WSL2، والقرص قرص افتراضي على SSD في جهاز المضيف.
ماذا يوجد بين write والقرص؟
عندما يكتب برنامجك إلى ملف فإن الطلب يمر بالطبقات التالية بالترتيب، والصورة بعدها تجمعها:
- نظام الملفات الافتراضي Virtual File System واختصاراً VFS: طبقة في النواة تجعل كل أنظمة الملفات تبدو للبرامج بنفس الشكل، فنفس
openوreadوwriteتعمل على ext4 وXFS وNFS وحتى على/proc. ويعرف توثيق VFS في النواة أربعة كائنات أساسية: الكتلة الرئيسية Superblock لكل نظام ملفات مركب، وال Inode لكل ملف، وال Dentry لكل اسم في مسار، وال File لكل ملف مفتوح في عملية. - ذاكرة الصفحات المؤقتة Page Cache: البيانات تنسخ إلى صفحات في الذاكرة وتعلم بأنها متسخة Dirty، ويرجع الطلب
writeبنجاح هنا، قبل أن يقترب أي شيء من القرص. وهي نفس الذاكرة التي شرحنا في تحليل أداء السيرفر أنها ليست ذاكرة مستهلكة. - نظام الملفات، وهنا ext4: يقرر أين توضع البيانات على القرص، ويحدث ال Inode والمجلدات وخرائط المساحة الفارغة، ويكتب هذه التغييرات في السجل.
- طبقة الأجهزة Block Layer: تجمع طلبات الكتابة وترتبها وترسلها إلى المشغل.
- القرص نفسه: وفيه ذاكرة مؤقتة خاصة به في أغلب الأقراص، وقد يرجع للنواة أن الكتابة تمت وهي ما زالت في هذه الذاكرة.
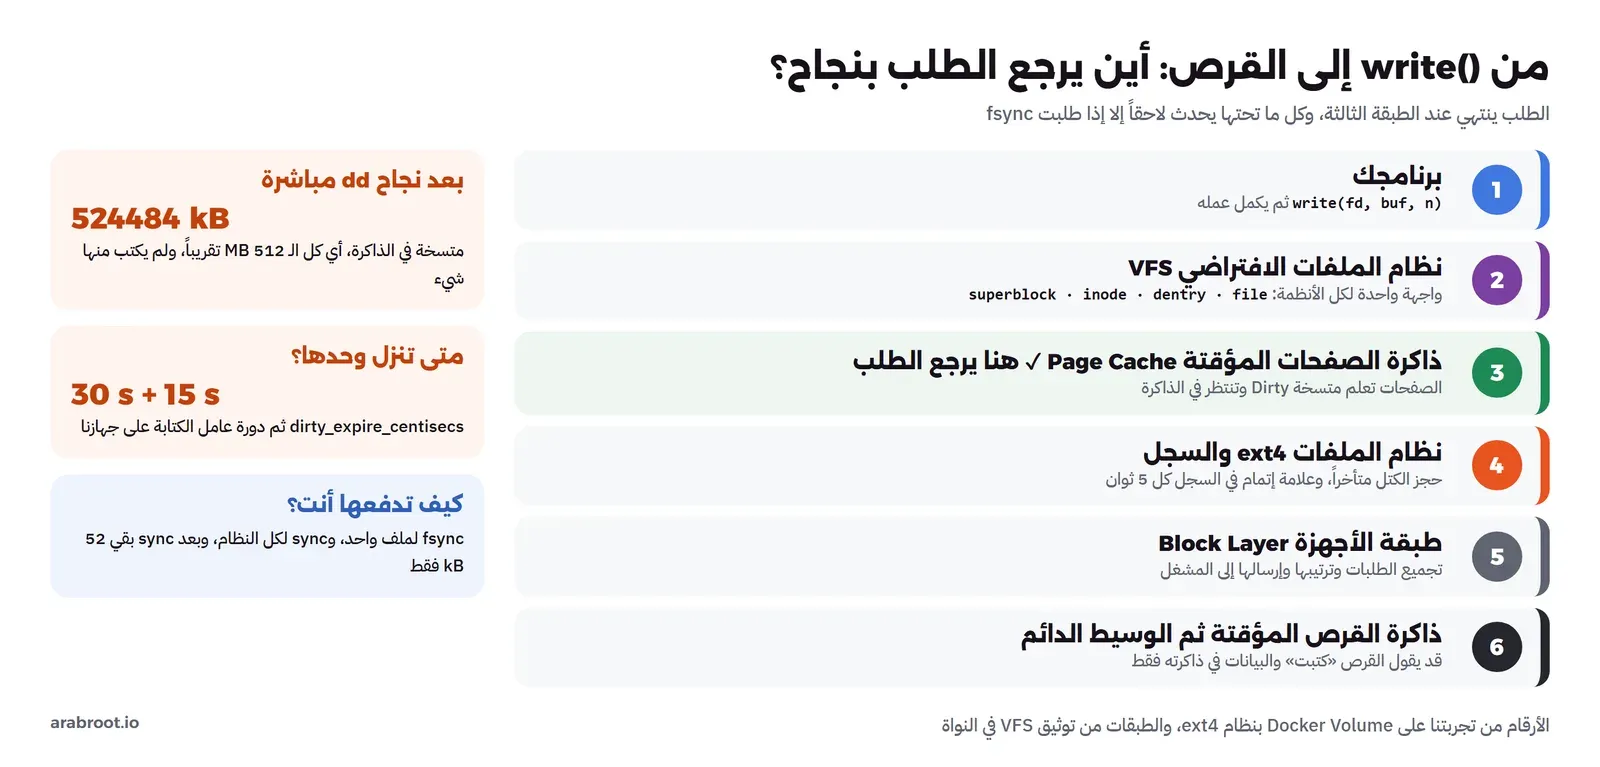
وكل طبقة من هذه الطبقات وجدت لسبب وجيه، فلو انتظر كل write حتى يصل إلى القرص لصارت كل كتابة صغيرة بطيئة بقدر القرص، كما سترى في قسم كلفة fsync. ولكن الثمن أن «نجح الطلب» لا تعني «البيانات آمنة»، وهذا ما يحتاج كل مطور أن يعرفه قبل أن يكتب أي كود يحفظ شيئاً مهماً.
الاسم شيء والملف شيء آخر: ال Inode
أول ما يحتاج أن تفهمه في أنظمة ملفات Unix أن الملف ليس اسمه. فالملف نفسه سجل اسمه Inode فيه كل ما يعرفه النظام عنه، أي الحجم والمالك والصلاحيات والأوقات وعدد الروابط وأماكن البيانات على القرص، إلا شيئاً واحداً: الاسم. أما الاسم فمكانه المجلد، والمجلد نفسه ملف خاص محتواه جدول من سطور، كل سطر اسم ورقم Inode، كما تشرح صفحة inode. والسكربت التالي يريك ذلك على نظام ملفات ext4 حقيقي:
#!/bin/sh
# Names, inodes and links on a real ext4 filesystem (a Docker volume).
cd /data && rm -rf demo && mkdir demo && cd demo
echo "price=10" > config.txt
ln config.txt hard.txt                 # a second name for the same inode
ln -s config.txt soft.txt              # a new inode that stores a path
cp config.txt copy.txt                 # a new inode with the same bytes
ls -lai
echo "--- stat config.txt"
stat config.txt
echo "--- rename keeps the inode, rm removes one name"
mv config.txt settings.txt; rm hard.txt
ls -li settings.txt soft.txt; cat soft.txt 2>&1
echo "--- directories"
mkdir -p sub/a sub/b; stat -c '%n inode=%i links=%h' . sub sub/a
والمخرج سوف يكون كما يلي:
total 20
37170 drwxr-xr-x 2 root root 4096 Oct 30 13:44 .
36596 drwxr-xr-x 3 root root 4096 Oct 30 13:44 ..
37205 -rw-r--r-- 2 root root    9 Oct 30 13:44 config.txt
37206 -rw-r--r-- 1 root root    9 Oct 30 13:44 copy.txt
37205 -rw-r--r-- 2 root root    9 Oct 30 13:44 hard.txt
37135 lrwxrwxrwx 1 root root   10 Oct 30 13:44 soft.txt -> config.txt
--- stat config.txt
  File: config.txt
  Size: 9         	Blocks: 8          IO Block: 4096   regular file
Device: 8,32	Inode: 37205       Links: 2
Access: (0644/-rw-r--r--)  Uid: (    0/    root)   Gid: (    0/    root)
Access: 2026-10-30 13:44:56.614064997 +0000
Modify: 2026-10-30 13:44:56.614064997 +0000
Change: 2026-10-30 13:44:56.614064997 +0000
 Birth: 2026-10-30 13:44:56.614064997 +0000
--- rename keeps the inode, rm removes one name
37205 -rw-r--r-- 1 root root  9 Oct 30 13:44 settings.txt
37135 lrwxrwxrwx 1 root root 10 Oct 30 13:44 soft.txt -> config.txt
cat: soft.txt: No such file or directory
--- directories
. inode=37170 links=3
sub inode=37207 links=4
sub/a inode=37208 links=2
في المخرج أعلاه لاحظ التالي:
- العمود الأول في
ls -iرقم ال Inode. والاسمانconfig.txtوhard.txtلهما نفس الرقم 37205، والعمود الثالث، وهو عدد الروابط Links، صار 2. أي أن الرابط الصلب Hard Link الذي أنشأهlnليس نسخة ولا اختصاراً، وإنما اسم ثان لنفس الملف بالضبط، ولا يوجد اسم «أصلي» واسم «فرعي»، فكلاهما متساويان كما تشرح صفحة link. - النسخة
copy.txtلها Inode جديد 37206 بنفس البايتات، فتغيير أحدهما لا يغير الآخر. - الرابط الرمزي
soft.txtله Inode خاص 37135 وحجمه 10 بايت، وهي بالضبط طول النصconfig.txt، أي أنه ملف صغير محتواه مسار كما تشرح صفحة symlink. - السطر
Blocks: 8فيstatبوحدات 512 بايت، أي أن ملفاً من 9 بايت يأخذ كتلة كاملة من 4 KB على القرص. والأوقات الأربعة: Access للقراءة، وModify لتغيير المحتوى، وChange لتغيير ال Inode نفسه مثل الصلاحيات أو عدد الروابط، وBirth لوقت الإنشاء. - بعد
mvبقي الرقم 37205 كما هو، فإعادة التسمية داخل نفس نظام الملفات لا تلمس البيانات أبداً، وإنما تحذف سطراً من جدول المجلد وتضيف سطراً، كما في صفحة rename، وهذا سبب أنها سريعة لملف من 100 GB كما هي لملف من 9 بايت. أما بين نظامي ملفات فالأمرmvينسخ ثم يحذف. - بعد
rm hard.txtرجع عدد الروابط إلى 1 وبقي الملف، لأنrmيحذف اسماً فقط، والطلب الذي يستخدمه اسمهunlink، والملف نفسه لا يحذف إلا عندما يصبح عدد روابطه صفراً ولا تفتحه أي عملية. وهذا هو تفسير الحالة التي شرحناها في قسم ملف محذوف ما زال يحجز المساحة. - الرابط الرمزي صار مكسور الهدف بعد إعادة التسمية، ورسالة
No such file or directoryهنا عن الهدف وليس عن الرابط، لأن الرابط الرمزي يحفظ الاسم وليس الملف. - عدد روابط المجلد
subصار 4: اسمه في المجلد الأب، والاسم.داخله، والاسم..في كل من المجلدينaوb. لذلك فعدد روابط أي مجلد يساوي 2 مع عدد مجلداته الفرعية.
نظام الملفات ext4 من الداخل دون تركيبه
نظام الملفات في النهاية بايتات على القرص مرتبة بطريقة متفق عليها، ويمكنك أن تقرأه كله كملف عادي. والسكربت التالي ينشئ نظام ext4 داخل ملف عادي حجمه 64 MB، ويضع فيه ملفين بالخيار -d من الأداة mkfs.ext4 الذي ينسخ محتوى مجلد إلى نظام الملفات الجديد دون تركيبه كما في صفحة mke2fs، ثم يقرأ هيكله بالأداتين dumpe2fs وdebugfs، وكل ذلك دون أي صلاحيات:
#!/bin/sh
# An ext4 filesystem inside an ordinary 64 MB file, built and read with no mount and no privileges.
cd /data && rm -rf src disk.img && mkdir src
echo "price=10" > src/config.txt
head -c 300000 /dev/urandom > src/photo.bin
mkfs.ext4 -q -F -b 4096 -d src -L lab disk.img 64M
echo "--- superblock"
dumpe2fs -h disk.img 2>/dev/null | grep -E "^(Filesystem features|Inode count|Block count|Free inodes|Block size|Inode size|Journal inode|Total journal size|Default mount options)"
echo "--- the root directory is inode 2"
debugfs -R "ls -l /" disk.img 2>/dev/null
echo "--- inode of photo.bin"
debugfs -R "stat /photo.bin" disk.img 2>/dev/null | grep -v -E "^ *$|crtime|atime|ctime|mtime|Inode checksum|Size of extra"
echo "--- which name owns block X? (ncheck / icheck)"
blk=$(debugfs -R "bmap /config.txt 0" disk.img 2>/dev/null)
echo "config.txt block 0 is at $blk"
debugfs -R "icheck $blk" disk.img 2>/dev/null
debugfs -R "ncheck 13" disk.img 2>/dev/null
echo "--- the bytes in that block"
dd if=disk.img bs=4096 skip=$blk count=1 status=none | head -c 9; echo
والمخرج سوف يكون كما يلي:
--- superblock
Filesystem features:      has_journal ext_attr resize_inode dir_index orphan_file filetype extent 64bit flex_bg metadata_csum_seed sparse_super large_file huge_file dir_nlink extra_isize metadata_csum
Default mount options:    user_xattr acl
Inode count:              16384
Block count:              16384
Free inodes:              16370
Block size:               4096
Inode size:               256
Journal inode:            8
Total journal size:       4096k
--- the root directory is inode 2
      2   40755 (2)      0      0    4096 30-Oct-2026 13:48 .
      2   40755 (2)      0      0    4096 30-Oct-2026 13:48 ..
     11   40700 (2)      0      0   16384 30-Oct-2026 13:48 lost+found
     13  100644 (1)      0      0       9 30-Oct-2026 13:48 config.txt
     14  100644 (1)      0      0   300000 30-Oct-2026 13:48 photo.bin

--- inode of photo.bin
Inode: 14   Type: regular    Mode:  0644   Flags: 0x80000
Generation: 0    Version: 0x00000000:00000000
User:     0   Group:     0   Project:     0   Size: 300000
File ACL: 0
Links: 1   Blockcount: 592
Fragment:  Address: 0    Number: 0    Size: 0
EXTENTS:
(0-73):2098-2171
--- which name owns block X? (ncheck / icheck)
config.txt block 0 is at 2097
Block	Inode number
2097	13
Inode	Pathname
13	//config.txt
--- the bytes in that block
price=10
وهذا المخرج خريطة كاملة لنظام الملفات، فلنقرأه جزءاً جزءاً:
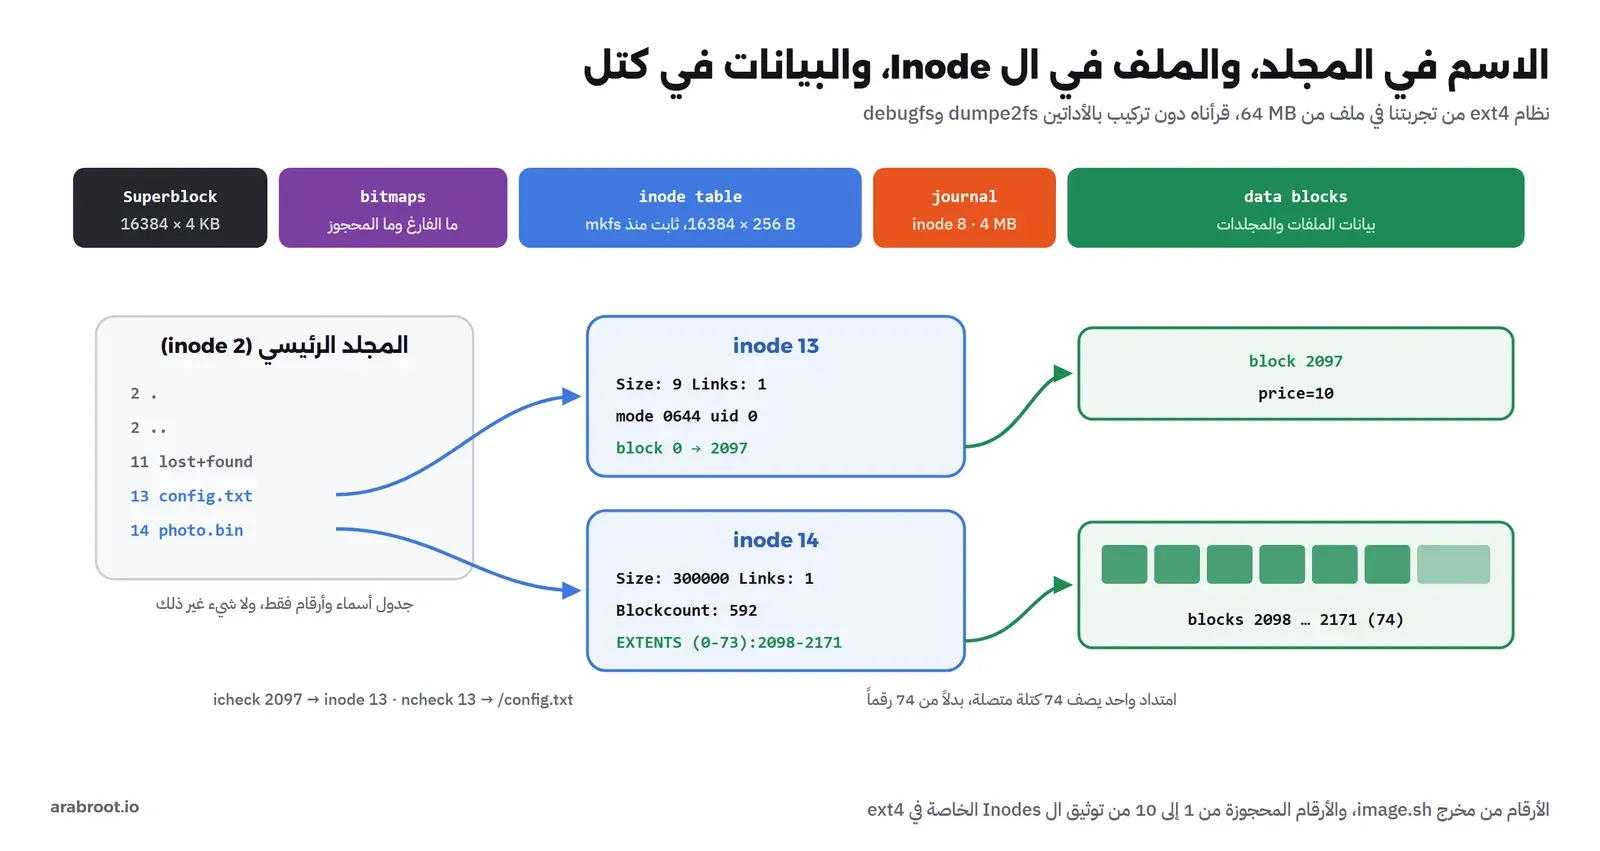
- الكتلة الرئيسية Superblock: نظام الملفات فيه 16384 كتلة من 4096 بايت، أي 64 MB، و16384 Inode بحجم 256 بايت لكل واحد. وعدد ال Inodes يحدد مرة واحدة عند
mkfsولا يتغير بعد ذلك، لذلك يمكن أن يمتلئ نظام الملفات بالملفات الصغيرة والمساحة فارغة، وهي المشكلة التي شرحناها في قسم ال inodes ممتلئة والمساحة فارغة. - الخاصية
has_journalفي قائمة الخصائص، ومعها السطرانJournal inode: 8وTotal journal size: 4096k: السجل نفسه ملف مخفي في ال Inode رقم 8 حجمه 4 MB في نظامنا الصغير. وخاصيةextentتعني أن أماكن البيانات تحفظ كامتدادات، وmetadata_csumتعني أن كل هيكل في نظام الملفات معه مجموع تحقق Checksum يكشف التلف. - المجلد الرئيسي Root Directory هو دائماً ال Inode رقم 2، و
lost+foundرقمه 11، وهو المجلد الذي يضع فيه برنامج الفحصe2fsckالملفات التي وجد لها Inode ولم يجد لها اسماً. والأرقام من 1 إلى 10 محجوزة لاستخدامات خاصة، منها السجل في الرقم 8، كما في جدول ال Inodes الخاصة في ext4. ولاحظ أن عمود العدد بين القوسين بعد الصلاحيات هو عدد الروابط. - ال Inode رقم 14 للملف
photo.binفيه كل ما رأيته فيstat، وفي آخره سطرEXTENTS:(0-73):2098-2171، أي أن كتل الملف المنطقية من 0 إلى 73 موجودة متصلة في الكتل الحقيقية من 2098 إلى 2171. وهذا هو الامتداد Extent كما يشرحه توثيق خريطة الكتل في ext4: بدلاً من أن يحفظ النظام رقم كل كتلة على حدة، كما كانت تفعل أنظمة ext2 وext3، يحفظ بداية ونهاية لكل قطعة متصلة، فملف من 74 كتلة يوصف بسطر واحد. وBlockcount: 592بوحدات 512 بايت، أي 74 كتلة. - ثم سألنا السؤال بالعكس: الكتلة رقم 2097 لمن؟ فأجاب
icheckأنها لل Inode رقم 13، وأجابncheckأن اسمهconfig.txt. وهذه هي نفس الطريقة التي تستخدمها أدوات الاستعادة عندما يفسد جزء من القرص ويريدون أن يعرفوا أي الملفات تأثرت. - وأخيراً قرأنا الكتلة 2097 مباشرة من ملف الصورة بالأمر
dd، فظهر النصprice=10، أي أن البيانات هي بالضبط ما كتبناه في ذلك المكان، ولا يوجد شيء سحري بين الاسم والبايتات إلا هذه الجداول.
الكتابة لا تعني أن البيانات على القرص
الآن نرجع إلى السؤال الأهم: متى تصل البيانات التي كتبتها إلى القرص فعلاً؟ عندما يرجع write تكون البيانات في ذاكرة الصفحات المؤقتة كصفحات متسخة، وتكتبها النواة لاحقاً في الخلفية بحسب إعدادات يشرحها توثيق إعدادات الذاكرة vm. والسكربت التالي يعرض هذه الإعدادات، ثم يكتب 512 MB ويقرأ مقدار الصفحات المتسخة في /proc/meminfo قبل الأمر sync وبعده:
#!/bin/sh
# Dirty pages: data written but not yet on the disk, and the knobs that decide when it goes.
for k in dirty_expire_centisecs dirty_writeback_centisecs dirty_background_ratio dirty_ratio; do echo "vm.$k = $(cat /proc/sys/vm/$k)"; done
grep -E "^(Dirty|Writeback):" /proc/meminfo
dd if=/dev/zero of=/data/dirty.bin bs=1M count=512 status=none
echo "--- right after writing 512 MB"; grep -E "^(Dirty|Writeback):" /proc/meminfo
sync
echo "--- after sync"; grep -E "^(Dirty|Writeback):" /proc/meminfo
rm /data/dirty.bin
والمخرج سوف يكون كما يلي:
vm.dirty_expire_centisecs = 3000
vm.dirty_writeback_centisecs = 1500
vm.dirty_background_ratio = 10
vm.dirty_ratio = 20
Dirty:               344 kB
Writeback:            96 kB
--- right after writing 512 MB
Dirty:            524484 kB
Writeback:            60 kB
--- after sync
Dirty:                52 kB
Writeback:           460 kB
في المخرج أعلاه لاحظ التالي:
- بعد أن انتهى
ddبنجاح كانت كل الـ 512 MB تقريباً متسخة في الذاكرة، 524484 KB، ولم يكتب منها شيء على القرص بعد. ولو انقطعت الكهرباء في تلك اللحظة لضاعت كلها، مع أن البرنامج انتهى وقال إنه نجح. - الإعداد
dirty_expire_centisecs = 3000بالأجزاء من مئة من الثانية، أي أن الصفحة المتسخة تعتبر قديمة بعد 30 ثانية فتكتب في الدورة التالية لعامل الكتابة في الخلفية، وdirty_writeback_centisecs = 1500هو الفاصل بين دورات هذا العامل، أي 15 ثانية على جهازنا. فالبيانات قد تبقى في الذاكرة قرابة 45 ثانية في أسوأ حالة. - الإعدادان
dirty_background_ratioوdirty_ratioنسبتان من الذاكرة المتاحة: عند الأولى تبدأ الكتابة في الخلفية دون انتظار المدة، وعند الثانية يجبر البرنامج الذي يكتب أن ينتظر حتى تنزل الصفحات المتسخة، وهذا ما تراه أحياناً كبرنامج يكتب بسرعة ثم يتوقف فجأة. - بعد
syncنزلت الصفحات المتسخة إلى 52 KB، فهذا الطلب يدفع كل البيانات المتسخة في النظام إلى الأجهزة وينتظرها كما في صفحة sync.
وهذه الأرقام تكفي لتفسير السجلات التي توقفت قبل الانقطاع بنصف دقيقة في أول المقال: هي لم تتوقف، وإنما كانت في الذاكرة ولم يحن وقت كتابتها.
لماذا يحتاج نظام الملفات سجلاً Journal؟
لنأخذ عملية تبدو بسيطة: إنشاء ملف جديد فيه بيانات. داخل نظام الملفات هذه عدة كتابات في أماكن مختلفة من القرص: حجز Inode في خريطة ال Inodes، وكتابة ال Inode نفسه، وإضافة سطر في جدول المجلد، وحجز كتل في خريطة المساحة الفارغة، وكتابة البيانات في تلك الكتل، وتحديث العدادات في الكتلة الرئيسية. والقرص لا يكتب هذه الأماكن كلها في لحظة واحدة، فإذا انقطعت الكهرباء في منتصفها بقي نظام الملفات في حالة غير متسقة: اسم يشير إلى Inode غير مستخدم، أو كتل محجوزة لا يملكها أحد، أو أسوأ من ذلك كتل يملكها ملفان.
والحل البسيط الذي استخدمته أنظمة مثل ext2 هو أن يفحص النظام القرص كله بعد كل انقطاع بالبرنامج fsck، فيمر على كل Inode وكل مجلد وكل كتلة ويصلح التناقضات. والمشكلة أن هذا الفحص يكبر مع حجم القرص، فقد يأخذ دقائق أو ساعات على أقراص كبيرة، والسيرفر لا يعمل طوال هذا الوقت.
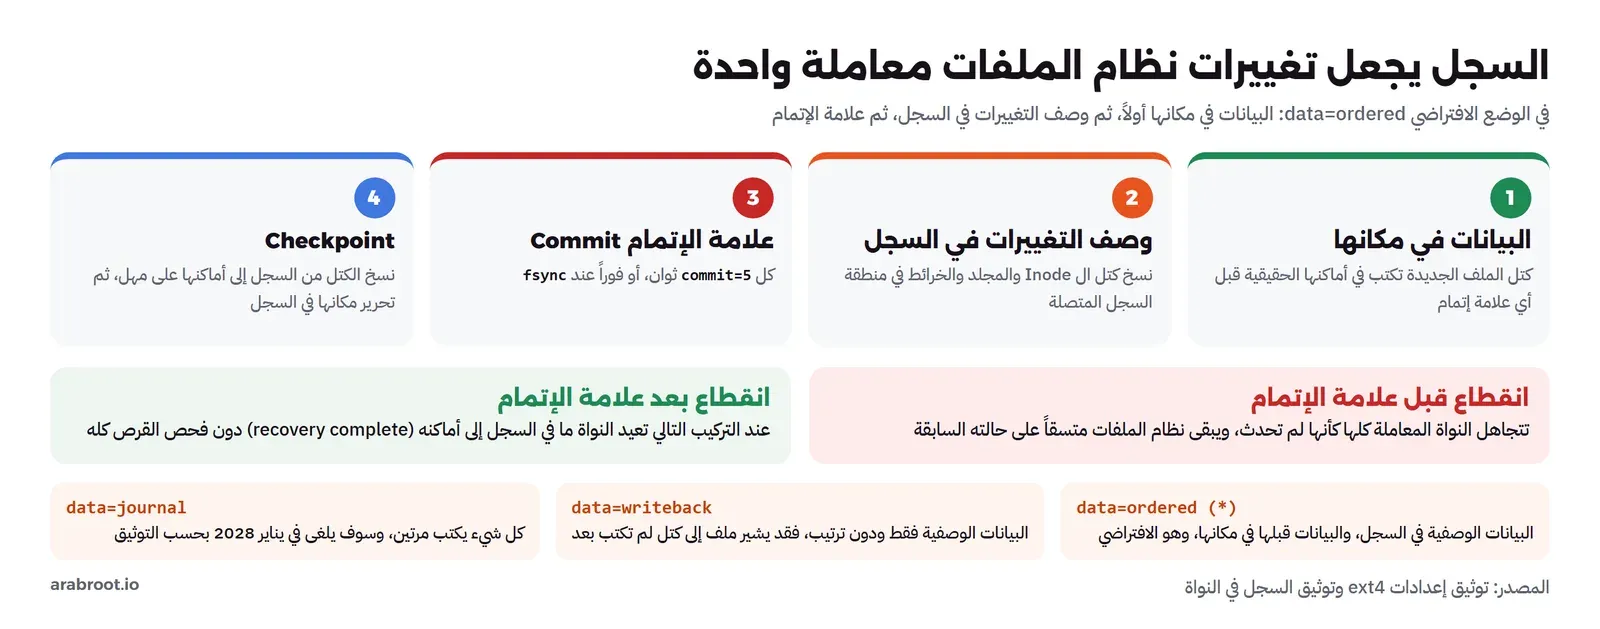
والحل الذي يستخدمه ext4 وأغلب أنظمة الملفات الحديثة هو السجل Journal، وفكرته مأخوذة من قواعد البيانات: قبل أن يغير النظام الأماكن الحقيقية يكتب في منطقة متصلة خاصة، هي السجل، وصفاً كاملاً لكل التغييرات في هذه العملية كأنها معاملة واحدة Transaction، ثم يكتب علامة الإتمام Commit. وبعد ذلك فقط يكتب التغييرات في أماكنها الحقيقية على مهل، وهذه المرحلة تسمى Checkpoint. فإذا انقطعت الكهرباء قبل علامة الإتمام تجاهل النظام المعاملة كأنها لم تحدث، وإذا انقطعت بعدها أعاد كتابة ما في السجل في أماكنه عند التركيب التالي، وهذا ما يسمى إعادة التشغيل Replay. والفحص هنا لا يحتاج المرور على القرص كله، وإنما على السجل فقط، وهو صغير، كما يشرح توثيق السجل في ext4.
ولكن أي شيء يكتب في السجل بالضبط؟ هنا يأتي الخيار data= عند التركيب، وقيمه كما في توثيق إعدادات ext4:
- الوضع
data=ordered، وهو الافتراضي: السجل فيه البيانات الوصفية Metadata فقط، أي ال Inodes والمجلدات والخرائط، ولكن النظام يكتب البيانات نفسها في أماكنها قبل أن يكتب علامة الإتمام للبيانات الوصفية التي تشير إليها. وبالتالي لا يمكن أن يشير Inode بعد الانقطاع إلى كتل فيها بيانات قديمة لملف آخر. - الوضع
data=writeback: البيانات الوصفية في السجل دون أي ترتيب مع البيانات، فقد يشير ملف بعد الانقطاع إلى كتل لم تكتب بياناتها الجديدة بعد. أسرع قليلاً وأقل أماناً. - الوضع
data=journal: البيانات نفسها تكتب في السجل أولاً ثم في مكانها، أي تكتب مرتين. وهو الأبطأ في أغلب الحالات، والتوثيق الحالي يقول إنه سيلغى في يناير 2028.
والإعداد الثاني المهم هو commit=، وقيمته الافتراضية 5 ثوان، أي أن ext4 يكتب علامة الإتمام للمعاملة الجارية كل 5 ثوان على الأكثر. والتوثيق نفسه يقول إنك عند انقطاع الكهرباء قد تفقد آخر 5 ثوان من تغييرات البيانات الوصفية، وإن نظام الملفات لن يتلف بفضل السجل، ثم يضيف جملة مهمة جداً: بسبب الحجز المتأخر قد تفقد بيانات أقدم من ذلك، لأن كتابتها تبدأ فقط بعد المدة في dirty_expire_centisecs. وهذا بالضبط ما سوف نراه الآن.
تجربة: نقطع الكهرباء عن نظام ملفات يعمل
لا نستطيع أن نقطع الكهرباء عن الجهاز، ولكن نستطيع أن نصنع نفس الأثر: نركب نظام ext4 موجوداً في ملف عبر جهاز Loop كما في صفحة losetup، ونكتب فيه، ثم ننسخ ملف القرص نفسه وهو ما زال مركباً. والنسخة تحتوي ما وصل إلى «القرص» فعلاً في تلك اللحظة، لا أكثر، تماماً كما يبقى على قرص حقيقي عند انقطاع مفاجئ. ثم نركب كل نسخة وحدها ونرى ماذا بقي. ونكتب ثلاثة ملفات: config.txt كتبناه ثم sync، وnosync.txt كتبناه دون أي شيء بعده، وfsync.txt كتبناه ثم استدعينا fsync عليه، ثم ننسخ القرص ثلاث مرات: فوراً، وبعد 7 ثوان، وبعد 50 ثانية:
#!/bin/sh
# Lab only, privileged container: mount an ext4 image through a loop device, write files,
# and copy the image while it is still mounted. The copy is the disk as a sudden power cut would leave it.
set -e
cd /data && rm -f disk.img cut-*.img
truncate -s 256M disk.img && mkfs.ext4 -q -F disk.img
mkdir -p /mnt/lab /mnt/check
mount -o loop disk.img /mnt/lab
findmnt -n -o TARGET,FSTYPE,OPTIONS /mnt/lab
echo "price=10" > /mnt/lab/config.txt && sync                 # the old version, safely on disk

echo "order 1001" > /mnt/lab/nosync.txt                         # 1) written, no fsync
python3 -c 'import os
fd = os.open("/mnt/lab/fsync.txt", os.O_WRONLY | os.O_CREAT, 0o644)
os.write(fd, b"order 1002\n"); os.fsync(fd)'                     # 2) written, then fsync
cp disk.img cut-now.img                                          # power cut right away
sleep 7
cp disk.img cut-7s.img                                           # power cut after 7 seconds
sleep 43
cp disk.img cut-50s.img                                          # power cut after 50 seconds
umount /mnt/lab

for img in cut-now cut-7s cut-50s; do
  echo "=== $img: $(dumpe2fs -h $img.img 2>/dev/null | grep -o needs_recovery || echo clean)"
  mount -o loop $img.img /mnt/check                     # mounting replays the journal
  for f in config.txt nosync.txt fsync.txt; do
    if [ -e /mnt/check/$f ]; then printf "%-11s %3s bytes  %s\n" $f $(stat -c %s /mnt/check/$f) "$(cat /mnt/check/$f)"; else printf "%-11s missing\n" $f; fi
  done
  umount /mnt/check
done
dmesg 2>/dev/null | grep -E "EXT4-fs \(loop" | tail -4 || true
rm -f disk.img cut-*.img
docker run --rm --name sos-fs --privileged -v sos-fs-data:/data -v "$PWD:/lab" sos-tools:1 sh /lab/crash.shوالمخرج سوف يكون كما يلي:
/mnt/lab ext4 rw,relatime
=== cut-now: needs_recovery
config.txt    9 bytes  price=10
nosync.txt    0 bytes
fsync.txt    11 bytes  order 1002
=== cut-7s: needs_recovery
config.txt    9 bytes  price=10
nosync.txt    0 bytes
fsync.txt    11 bytes  order 1002
=== cut-50s: needs_recovery
config.txt    9 bytes  price=10
nosync.txt   11 bytes  order 1001
fsync.txt    11 bytes  order 1002
[131388.450031] EXT4-fs (loop2): recovery complete
[131388.453195] EXT4-fs (loop2): mounted filesystem with ordered data mode. Opts: (null). Quota mode: none.
[131388.547559] EXT4-fs (loop2): recovery complete
[131388.549996] EXT4-fs (loop2): mounted filesystem with ordered data mode. Opts: (null). Quota mode: none.
وهذا المخرج أهم ما في المقال، فلنقرأه بهدوء:
- كل النسخ الثلاث فيها
needs_recovery، أي أن نظام الملفات كان مركباً وفي السجل معاملات لم تنقل إلى أماكنها، وعند التركيب أعادتها النواة، وهذا معنى السطرrecovery completeفي رسائل النواة، والوضعorderedهو الافتراضي كما قلنا. ولم يحتج أي نسخة فحصاً كاملاً، وكلها ركبت في جزء من الثانية. - الملف
fsync.txtسليم في كل النسخ، حتى النسخة التي أخذت في نفس اللحظة. فالطلبfsyncلا يرجع إلا بعد أن تصل بيانات الملف إلى القرص وتكتب علامة الإتمام لبياناته الوصفية، كما تقول صفحة fsync. - الملف
nosync.txtموجود في النسختين الأوليين ولكن حجمه صفر، وهنا المفاجأة. لم يضع الملف، وإنما ضاع محتواه. والسبب أنfsyncعلى الملف الآخر كتب علامة إتمام للمعاملة الجارية كلها، وفيها إنشاءnosync.txtواسمه في المجلد، لأن تغييرات البيانات الوصفية لكل الملفات تجتمع في نفس المعاملة، أما بياناتnosync.txtنفسها فكانت ما زالت في الذاكرة لم يحجز لها مكان بعد، بسبب الحجز المتأخر Delayed Allocation. - وبعد 7 ثوان، أي بعد مرور مدة
commit=5، بقي الملف فارغاً أيضاً، وهذا ما يقوله التوثيق: علامة الإتمام كل 5 ثوان تحمي البيانات الوصفية، أما البيانات فتنتظر 30 ثانية حتى تعتبر قديمة. - بعد 50 ثانية ظهرت البيانات
order 1001، لأن عامل الكتابة في الخلفية مر عليها بعد أن صار عمرها أكثر من 30 ثانية. أي أن الإجابة على «هل حفظ الطلب؟» دونfsyncهي: يعتمد على متى انقطعت الكهرباء.
وفي أول تشغيل لهذا السكربت كنا نركب النسخ للقراءة فقط بالخيار loop,ro حتى لا نغيرها، ففشل التركيب برسالة cannot mount /dev/loop2 read-only. والسبب أن نظام الملفات يحتاج أن يكتب ليعيد تشغيل السجل، والتركيب للقراءة فقط مع جهاز للقراءة فقط يمنعه من ذلك. وهذه رسالة قد تراها عند محاولة استعادة قرص بعد عطل وتركيبه للقراءة فقط للحذر، والحل أن تعمل على نسخة من القرص وتركبها عادياً، أو أن تضيف الخيار noload الذي يتجاهل السجل كما في إعدادات ext4، مع العلم أنك ترى عندها نظام ملفات قد يكون غير متسق.
ماذا يوجد داخل السجل Journal فعلاً؟
قلنا إن السجل في الوضع الافتراضي فيه البيانات الوصفية فقط، فلنره بأعيننا. السكربت التالي يكرر الخطوة الأولى من التجربة السابقة، أي كتابة nosync.txt ثم fsync.txt مع fsync، ثم ينسخ القرص فوراً، ولكنه هذه المرة لا يركب النسخة، وإنما يقرؤها بالأداة debugfs كما هي قبل أي إعادة للسجل، ويعرض محتوى السجل بالأمر logdump، ثم يركبها ليعرف ما هي الكتل التي كانت في السجل:
#!/bin/sh
# Lab only, privileged container: what is inside the journal right after a fsync? Read it with debugfs logdump.
cd /data && truncate -s 256M disk.img && mkfs.ext4 -q -F disk.img
mkdir -p /mnt/lab && mount -o loop disk.img /mnt/lab
echo "order 1001" > /mnt/lab/nosync.txt
python3 -c 'import os
fd = os.open("/mnt/lab/fsync.txt", os.O_WRONLY | os.O_CREAT, 0o644)
os.write(fd, b"order 1002\n"); os.fsync(fd)'
cp disk.img cut.img
umount /mnt/lab
echo "--- the root directory in place, before any recovery"
debugfs -R "ls -l /" cut.img 2>/dev/null
echo "--- journal"
debugfs -R "logdump -a" cut.img 2>/dev/null | grep -E "transaction|descriptor|commit|FS block|end of journal"
echo "--- after recovery: what are those blocks?"
mkdir -p /mnt/check && mount -o loop cut.img /mnt/check && umount /mnt/check
debugfs -R "ls -l /" cut.img 2>/dev/null | grep txt
for x in "blocks /" "imap <12>" "imap <13>"; do echo "$x: $(debugfs -R "$x" cut.img 2>/dev/null | tr "
" " ")"; done
dumpe2fs cut.img 2>/dev/null | grep -E "^Group [0-2]:|Primary superblock|Block bitmap at|Inode bitmap at|Inode table at" | head -12
debugfs -R "blocks /fsync.txt" cut.img 2>/dev/null
rm -f disk.img cut.img
والمخرج سوف يكون كما يلي:
--- the root directory in place, before any recovery
      2   40755 (2)      0      0    1024 30-Oct-2026 14:40 .
      2   40755 (2)      0      0    1024 30-Oct-2026 14:40 ..
     11   40700 (2)      0      0   12288 30-Oct-2026 14:40 lost+found

--- journal
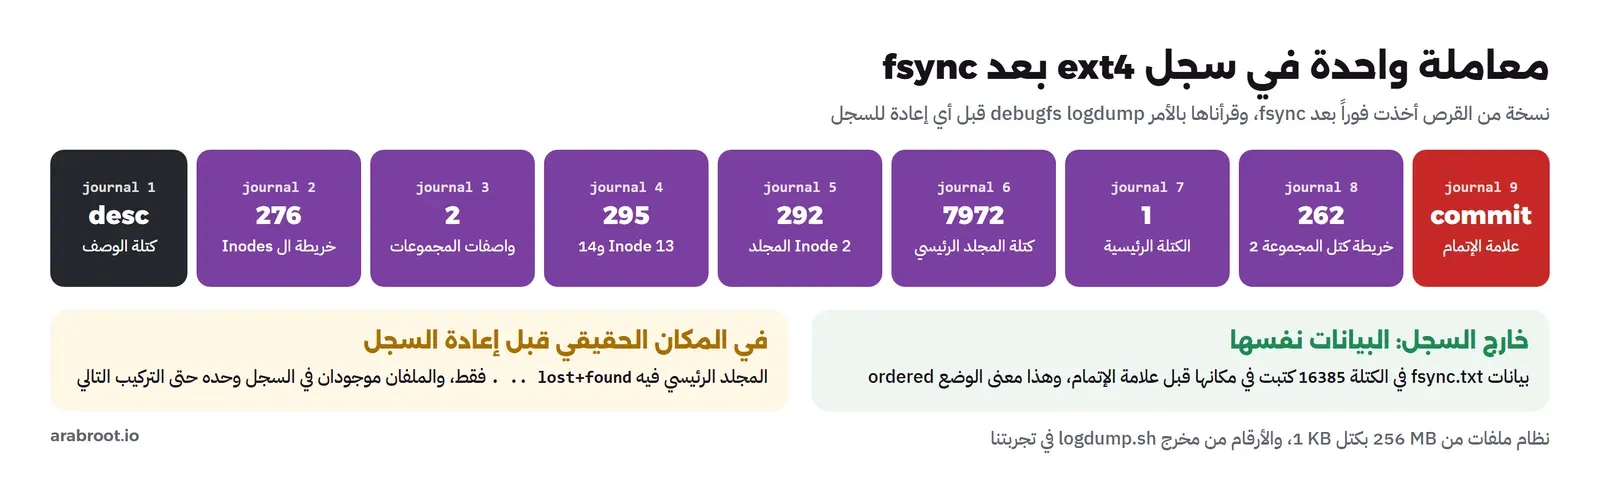
Journal starts at block 1, transaction 2
Found expected sequence 2, type 1 (descriptor block) at block 1
Dumping descriptor block, sequence 2, at block 1:
  FS block 276 logged at journal block 2 (flags 0x0)
  FS block 2 logged at journal block 3 (flags 0x2)
  FS block 295 logged at journal block 4 (flags 0x2)
  FS block 292 logged at journal block 5 (flags 0x2)
  FS block 7972 logged at journal block 6 (flags 0x2)
  FS block 1 logged at journal block 7 (flags 0x2)
  FS block 262 logged at journal block 8 (flags 0xa)
Found expected sequence 2, type 2 (commit block) at block 9
No magic number at block 10: end of journal.
--- after recovery: what are those blocks?
     13  100644 (1)      0      0       0 30-Oct-2026 14:40 nosync.txt
     14  100644 (1)      0      0      11 30-Oct-2026 14:40 fsync.txt
blocks /: 7972
imap <12>: Inode 12 is part of block group 0 	located at block 294, offset 0x0300
imap <13>: Inode 13 is part of block group 0 	located at block 295, offset 0x0000
Group 0: (Blocks 1-8192) csum 0xa9a8 [ITABLE_ZEROED]
  Primary superblock at 1, Group descriptors at 2-3
  Block bitmap at 260 (+259), csum 0x74902dd9
  Inode bitmap at 276 (+275), csum 0x3b11096b
  Inode table at 292-803 (+291)
Group 1: (Blocks 8193-16384) csum 0x47ee [INODE_UNINIT, ITABLE_ZEROED]
  Block bitmap at 261 (bg #0 + 260), csum 0x7a1fb5d8
  Inode bitmap at 277 (bg #0 + 276), csum 0x00000000
  Inode table at 804-1315 (bg #0 + 803)
Group 2: (Blocks 16385-24576) csum 0x2517 [INODE_UNINIT, ITABLE_ZEROED]
  Block bitmap at 262 (bg #0 + 261), csum 0x29a47fd4
  Inode bitmap at 278 (bg #0 + 277), csum 0x00000000
16385
في المخرج أعلاه لاحظ التالي:
- قبل إعادة السجل لا يوجد في المجلد الرئيسي إلا
.و..وlost+found، أي أن الملفين غير موجودين في مكانهما الحقيقي على القرص إطلاقاً، مع أنfsyncرجع بنجاح. ووجودهما الوحيد في هذه اللحظة هو في السجل، وهذا يكفي، لأن السجل هو ما وعد به النظام. - في السجل معاملة واحدة رقمها 2: كتلة وصف Descriptor في الكتلة 1 من السجل تقول أي كتل نظام الملفات تحتويها المعاملة، ثم سبع نسخ لكتل نظام الملفات، ثم كتلة الإتمام Commit في الكتلة 9، ثم نهاية السجل. ولو انقطعت الكهرباء قبل أن تكتب كتلة الإتمام لتجاهلت النواة الكتل السبع كلها.
- بعد التركيب، أي بعد إعادة السجل، ظهر الملفان، والسطور التالية تعرف الكتل السبع: الكتلة 1 هي الكتلة الرئيسية، والكتلة 2 من واصفات المجموعات Group Descriptors، والكتلة 276 خريطة ال Inodes للمجموعة 0، والكتلة 292 بداية جدول ال Inodes حيث يوجد Inode المجلد الرئيسي رقم 2، والكتلة 295 حيث يوجد ال Inode رقم 13 كما قال الأمر
imapومعه 14، والكتلة 7972 هي كتلة بيانات المجلد الرئيسي نفسه كما قال الأمرblocks /، والكتلة 262 خريطة الكتل للمجموعة 2. - والكتلة الوحيدة الغائبة عن السجل هي بيانات الملف نفسها، فالسطر الأخير يقول إن بيانات
fsync.txtفي الكتلة 16385، أي في المجموعة 2، ولذلك تغيرت خريطة كتل المجموعة 2. وهذه البيانات كتبت في مكانها مباشرة قبل علامة الإتمام، وهذا هو معنى الوضعorderedحرفياً.
ولاحظ أن حجم الكتلة في هذا النظام 1024 بايت وليس 4096، لأن mkfs.ext4 يختار كتلاً صغيرة لأنظمة الملفات الصغيرة مثل 256 MB، كما تشرح صفحة mke2fs في أنواع الاستخدام. وكل ما سبق يعني أن كتابة ملف واحد صغير مع fsync كلفت النظام كتابة تسع كتل في السجل وكتلة بيانات، ثم نسخ الكتل السبع إلى أماكنها لاحقاً، وهذا جزء من سبب أن fsync أغلى بكثير من حجم البيانات نفسها.
الاستبدال الآمن للملفات ومشكلة الملفات الفارغة Zero-Length Files
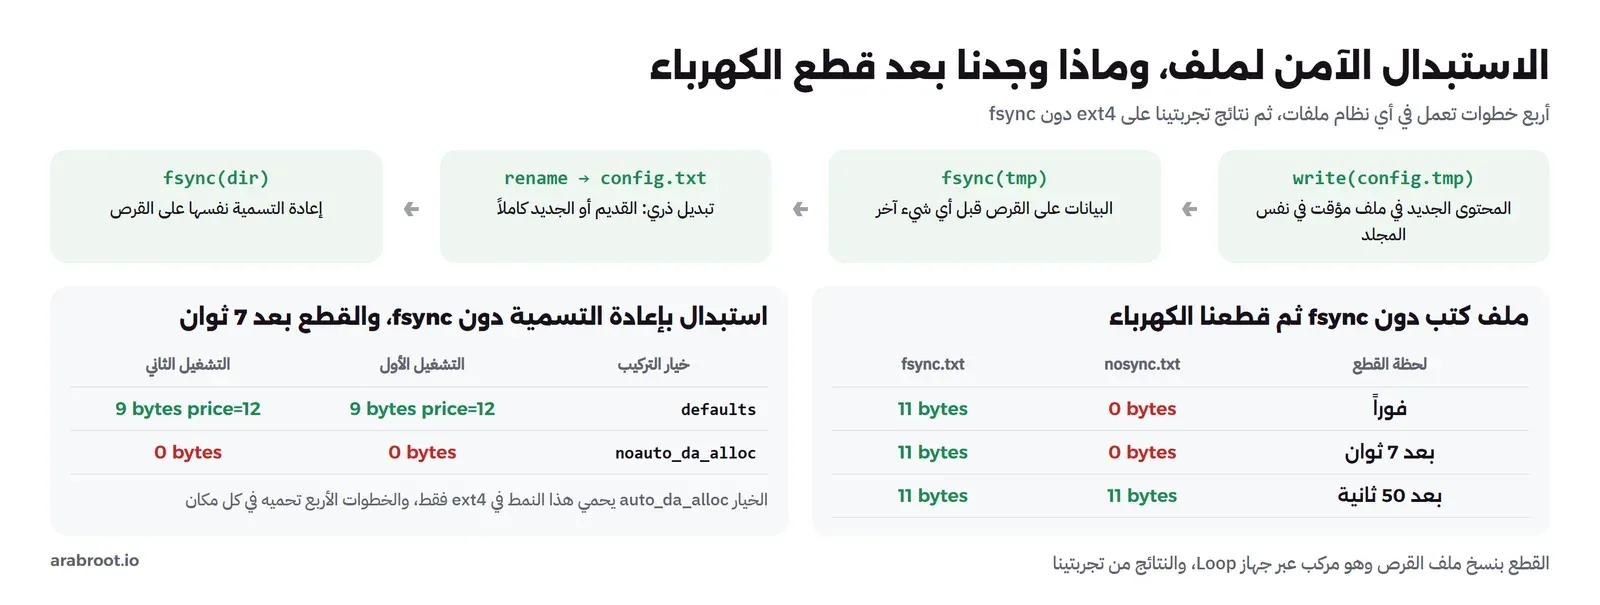
أشهر طريقة لتحديث ملف إعدادات أو حالة دون أن يرى أحد نصف ملف هي: اكتب المحتوى الجديد في ملف مؤقت، ثم أعد تسميته فوق الملف القديم، لأن إعادة التسمية ذرية Atomic، فمن يقرأ الملف يرى إما القديم كاملاً أو الجديد كاملاً. ولكن ماذا بعد انقطاع الكهرباء؟ رأينا في التجربة السابقة أن البيانات الوصفية تصل قبل البيانات، وإعادة التسمية بيانات وصفية، فقد تصل إعادة التسمية والملف الجديد ما زال فارغاً، فيصبح الملف القديم قد اختفى والجديد بحجم صفر. وهذه بالضبط مشكلة الملفات الفارغة Zero-Length Files التي ظهرت عند المستخدمين بعد أن صار ext4 نظام الملفات الافتراضي في التوزيعات، ويذكرها توثيق إعدادات ext4 بالاسم في شرح الخيار auto_da_alloc: الخيار مفعل افتراضياً، ويجعل ext4 يكتشف نمطي الاستبدال بإعادة التسمية والاستبدال بقص الملف، فيجبر كتابة بيانات الملف الجديد قبل أن تكتب علامة الإتمام لإعادة التسمية.
ولكي نرى ذلك جربنا الاستبدال دون fsync مرتين: مرة بالإعدادات الافتراضية ومرة مع إيقاف هذا الخيار بالقيمة noauto_da_alloc، ثم قطعنا الكهرباء بعد 7 ثوان، أي بعد علامة إتمام واحدة:
#!/bin/sh
# Lab only, privileged container: replace config.txt the "safe" way (write a temp file, rename it over
# the old one) without fsync, with and without the ext4 option auto_da_alloc, then cut the power.
cd /data && rm -f disk.img cut.img
mkdir -p /mnt/lab /mnt/check
for opts in defaults noauto_da_alloc; do
  truncate -s 256M disk.img && mkfs.ext4 -q -F disk.img
  mount -o loop,$opts disk.img /mnt/lab
  echo "price=10" > /mnt/lab/config.txt && sync                # version 1, safely on disk
  echo "price=12" > /mnt/lab/config.tmp                         # version 2, no fsync
  mv /mnt/lab/config.tmp /mnt/lab/config.txt
  sleep 7                                                       # one journal commit (5 s) has passed
  cp disk.img cut.img                                           # power cut
  umount /mnt/lab
  mount -o loop cut.img /mnt/check
  printf "%-16s config.txt after the cut: %s bytes [%s]\n" $opts "$(stat -c %s /mnt/check/config.txt)" "$(cat /mnt/check/config.txt)"
  umount /mnt/check
done
rm -f disk.img cut.img
شغلناه مرتين متتاليتين، والمخرج سوف يكون كما يلي:
defaults         config.txt after the cut: 9 bytes [price=12]
noauto_da_alloc  config.txt after the cut: 0 bytes []
defaults         config.txt after the cut: 9 bytes [price=12]
noauto_da_alloc  config.txt after the cut: 0 bytes []
مع الإعداد الافتراضي وجدنا الملف الجديد كاملاً، ومع إيقاف الخيار وجدنا الملف بحجم صفر، لا القديم ولا الجديد، في التشغيلين. وهذا يعني شيئين: أن الخيار يحميك فعلاً من هذا النمط على ext4، وأن هذه الحماية خاصة بنظام ملفات واحد وبنمط محدد، فلا يجوز أن يعتمد عليها كود يعمل على أنظمة ملفات أخرى أو يكتب بطرق أخرى. والطريقة الصحيحة في أي نظام ملفات هي:
- اكتب المحتوى الجديد في ملف مؤقت في نفس المجلد، حتى تكون إعادة التسمية داخل نفس نظام الملفات.
- استدع
fsyncعلى الملف المؤقت، فتصل بياناته إلى القرص قبل أي شيء آخر. - أعد تسميته فوق الملف القديم بالطلب
rename. - افتح المجلد نفسه واستدع
fsyncعليه، حتى يصل التغيير في جدول المجلد، أي إعادة التسمية، إلى القرص، وصفحة fsync تذكر صراحة أن مزامنة الملف لا تضمن مزامنة السطر الذي يشير إليه في المجلد.
وهذه الخطوات الأربع في Python، والدالة os.replace تستدعي الطلب rename وتعمل فوق ملف موجود في كل الأنظمة:
# safe_write.py: replace a file so that after a crash you find either the old or the new version, never an empty one.
import os, sys

def safe_write(path, data: bytes):
    folder = os.path.dirname(os.path.abspath(path))
    tmp = path + ".tmp"
    fd = os.open(tmp, os.O_WRONLY | os.O_CREAT | os.O_TRUNC, 0o644)
    try:
        os.write(fd, data)
        os.fsync(fd)                      # 1) the new bytes are on the disk
    finally:
        os.close(fd)
    os.replace(tmp, path)                 # 2) atomic rename over the old file
    dfd = os.open(folder, os.O_RDONLY)
    try:
        os.fsync(dfd)                     # 3) the rename itself is on the disk
    finally:
        os.close(dfd)

safe_write(sys.argv[1], sys.argv[2].encode() + b"\n")
print(open(sys.argv[1]).read(), end="")
ولكي نتأكد أن الكود يرسل الطلبات بالترتيب الذي نريده شغلناه تحت strace مع إخفاء الملفات التي يفتحها المفسر عند بدايته:
cd /data && echo "price=10" > config.txt && strace -f -e trace=openat,write,fsync,rename python3 /lab/safe_write.py config.txt price=12 2>&1 | grep -v -E "openat.*(usr|lib|etc|proc|dev|pycache|lab/)"; ls config.txt*openat(AT_FDCWD, "config.txt.tmp", O_WRONLY|O_CREAT|O_TRUNC|O_CLOEXEC, 0644) = 3
write(3, "price=12\n", 9) = 9
fsync(3) = 0
rename("config.txt.tmp", "config.txt") = 0
openat(AT_FDCWD, "/data", O_RDONLY|O_CLOEXEC) = 3
fsync(3) = 0
openat(AT_FDCWD, "config.txt", O_RDONLY|O_CLOEXEC) = 3
write(1, "price=12\n", 9price=12
) = 9
+++ exited with 0 +++
config.txtالترتيب كما أردنا تماماً: write ثم fsync على الملف المؤقت، ثم rename، ثم فتح المجلد /data نفسه وfsync عليه، ولم يبق بعدها ملف مؤقت. والسطر الذي تختلط فيه price=12 بمخرج strace هو طباعة البرنامج للمحتوى الجديد إلى نفس الطرفية. وهذا النمط تجده في مكتبات كثيرة باسم الكتابة الذرية Atomic Write، فإذا استخدمت واحدة منها فاقرأ كودها وتأكد أنها تفعل الخطوة الرابعة، لأن بعضها يكتفي بالثلاث الأولى.
كم يكلف fsync؟
إذا كان fsync هو الضمان الوحيد، فلماذا لا تستدعيه بعد كل كتابة؟ لأن كلفته كلفة القرص نفسه. والبرنامج التالي يضيف 500 سجل من 100 بايت إلى ملف بخمس طرق: كتابة فقط، وكتابة مع fsync بعد كل سجل، ومع fdatasync الذي يتجاهل البيانات الوصفية غير الضرورية مثل وقت التعديل، وفتح الملف بالخيار O_DSYNC الذي يجعل كل write ينتظر كأنه معه fdatasync كما في صفحة open، وأخيراً fsync واحد بعد كل 50 سجلاً:
# fsync_cost.py: append 500 records of 100 bytes to a log file, five ways, and time each way.
import os, sys, time

path = sys.argv[1] if len(sys.argv) > 1 else "/data/log.bin"
rec = b"x" * 99 + b"\n"
N = 500

def run(name, flags=0, sync=None, every=1):
    if os.path.exists(path):
        os.remove(path)
    fd = os.open(path, os.O_WRONLY | os.O_CREAT | os.O_APPEND | flags, 0o644)
    t = time.perf_counter()
    for i in range(1, N + 1):
        os.write(fd, rec)
        if sync and i % every == 0:
            sync(fd)
    total = (time.perf_counter() - t) * 1000
    os.close(fd)
    print(f"{name:<26} {total:9.1f} ms  {total * 1000 / N:8.1f} us per record")

run("write only")
run("write + fsync each", sync=os.fsync)
run("write + fdatasync each", sync=os.fdatasync)
run("O_DSYNC", flags=os.O_DSYNC)
run("write + fsync every 50", sync=os.fsync, every=50)
os.remove(path)
docker run --rm --name sos-fs -v sos-fs-data:/data -v "$PWD:/lab" sos-tools:1 sh -c 'python3 /lab/fsync_cost.py; echo; python3 /lab/fsync_cost.py'والمخرج سوف يكون كما يلي:
write only                       1.1 ms       2.2 us per record
write + fsync each            1255.3 ms    2510.6 us per record
write + fdatasync each        1245.9 ms    2491.8 us per record
O_DSYNC                       1246.6 ms    2493.3 us per record
write + fsync every 50          31.8 ms      63.6 us per record

write only                       1.6 ms       3.2 us per record
write + fsync each            1673.2 ms    3346.3 us per record
write + fdatasync each        1366.1 ms    2732.3 us per record
O_DSYNC                        952.4 ms    1904.7 us per record
write + fsync every 50          18.8 ms      37.6 us per record
في المخرج أعلاه لاحظ التالي:
- الكتابة وحدها 2 إلى 3 ميكروثانية للسجل، لأنها تنتهي عند ذاكرة الصفحات المؤقتة، ومع
fsyncبعد كل سجل صارت 2.5 إلى 3.3 ملي ثانية، أي أبطأ بقرابة ألف مرة. وهذا يعني أن البرنامج الذي يستدعيfsyncبعد كل كتابة لا يستطيع أن يحفظ أكثر من بضع مئات من السجلات في الثانية على هذا القرص، مهما كان المعالج سريعاً. - الطرق الثلاث
fsyncوfdatasyncوO_DSYNCمتقاربة هنا، والفرق بينها في التشغيل الثاني ضجيج قرص مشترك. والسبب أن كل سجل يزيد حجم الملف، وتغيير الحجم بيانات وصفية ضرورية لقراءة البيانات، فيحتاجfdatasyncأن يكتبها أيضاً. ويظهر الفرق لصالحfdatasyncعندما تكتب فوق مكان موجود دون تغيير الحجم، وهذا سبب أن قواعد البيانات تحجز ملفات السجل مسبقاً بحجمها الكامل. - سطر
fsyncكل 50 سجلاً هو الحل الذي تستخدمه قواعد البيانات: 38 إلى 64 ميكروثانية للسجل، أي أسرع بأربعين إلى تسعين مرة منfsyncلكل سجل، مع نفس الضمان لكل دفعة. وهذا ما يسمى الحفظ الجماعي Group Commit: يجمع النظام كتابات عدة طلبات أو عدة مستخدمين وينهيها بانتظار واحد للقرص، والثمن أن يتأخر الرد على كل منهم حتى ينتهي الانتظار المشترك.
وكلفة fsync هنا لقرص افتراضي فوق SSD في جهاز مكتبي، والرقم على سيرفرك يعتمد على القرص وعلى ذاكرته المؤقتة. وتوثيق موثوقية السجل في PostgreSQL يحذر من أن كثيراً من الأقراص، ومنها أقراص SSD، فيها ذاكرة كتابة مؤقتة لا تبقى عند انقطاع الكهرباء، فإذا كذب القرص على النواة وقال إنه كتب البيانات وهي في ذاكرته لم يحمك fsync نفسه. لذلك فرقم fsync الأسرع من المتوقع بكثير على قرص عادي علامة تستحق السؤال عن ذاكرة القرص، لا علامة على قرص ممتاز.
عندما يفشل fsync نفسه: ما حدث لـ PostgreSQL
fsync في Linux: إذا فشل الطلب بسبب خطأ في الكتابة إلى القرص، كانت القاعدة تكتب الخطأ في السجلات ثم تعيد المحاولة لاحقاً، فتنجح المحاولة الثانية، وتظن القاعدة أن البيانات وصلت. والحقيقة أن النواة بعد الخطأ الأول كانت قد أسقطت الصفحات التي فشلت كتابتها أو علمتها بأنها نظيفة، فالنجاح الثاني لم يكتب شيئاً، والبيانات ضاعت دون أن يعرف أحد. وتوثق صفحة أخطاء fsync في ويكي PostgreSQL القصة وسلوك كل نظام تشغيل، والإصلاح الذي اعتمدته القاعدة: أن تتوقف فوراً بخطأ PANIC عند أي فشل في fsync وتستعيد من سجلها عند التشغيل التالي، بدلاً من إعادة المحاولة، وقد نقل الإصلاح إلى الإصدارات من 9.4 حتى 11. كما حسن Linux 4.13 طريقة تتبع أخطاء الكتابة وإبلاغها لكل من فتح الملف، وأجرت مشاريع أخرى مثل InnoDB في MySQL وWiredTiger في MongoDB تغييرات مشابهة.والدرس العملي لكودك: إذا رجع fsync بخطأ فلا تعده خطأ عابراً تعيد المحاولة بعده، فالبيانات التي كتبتها قبله قد لا تكون على القرص، والتصرف الآمن أن تعتبر الكتابة كلها فاشلة وتعيدها من مصدرها، أو توقف البرنامج إذا لم يكن ذلك ممكناً.
الخيارات O_DIRECT وO_SYNC: متى تحتاجها؟
توجد طريقتان أخريان تراهما في إعدادات قواعد البيانات، وتشرحهما صفحة open:
- الخيار
O_SYNCوأخوهO_DSYNCالذي جربناه: كلwriteينتظر حتى تصل البيانات كأن بعدهfsyncأوfdatasync، وهو مفيد عندما تكون كل كتابة سجلاً كاملاً يجب أن يحفظ، ولكنه يمنعك من الحفظ الجماعي. - الخيار
O_DIRECT: يتجاوز ذاكرة الصفحات المؤقتة، فتذهب البيانات من ذاكرة البرنامج إلى القرص مباشرة، ويحتاج أن تكون العناوين والأحجام مضاعفات لحجم الكتلة. وتستخدمه قواعد البيانات التي تدير ذاكرتها المؤقتة بنفسها حتى لا تحفظ النواة نسخة ثانية من نفس البيانات. ولاحظ أنه لا يغني عنfsync، لأنه يتجاوز ذاكرة النواة ولكن ليس ذاكرة القرص ولا تحديث البيانات الوصفية.
وفي برامجك العادية لا تحتاج أياً منهما، والنمط الذي يكفي أغلب الحالات هو الكتابة العادية مع fsync في اللحظات التي تعد فيها شيئاً بأنه حفظ: بعد حفظ ملف مهم، وقبل أن ترد على المستخدم بأن طلبه سجل، وفي نهاية كل دفعة.
أخطاء شائعة
- اعتبار نجاح
writeأوcloseدليلاً على الحفظ: رأينا 512 MB في الذاكرة بعد نجاحdd، وملفاً بحجم صفر بعد الانقطاع. - الرد على المستخدم بأن الطلب حفظ قبل
fsyncأو قبل أن ترد قاعدة البيانات بإتمام المعاملة: الرد وعد، والوعد يحتاج الضمان. - الاستبدال بإعادة التسمية دون
fsyncعلى الملف ثم على المجلد: يعمل على ext4 بفضلauto_da_allocفي هذا النمط، ولا يعمل كذلك مع الخيار معطلاً كما رأينا، ولا تضمنه أنظمة الملفات الأخرى. - استدعاء
fsyncبعد كل سجل صغير في برنامج يكتب كثيراً: أبطأ بألف مرة، والحفظ الجماعي يعطي نفس الضمان لكل دفعة بجزء من الكلفة. - إعادة المحاولة بعد فشل
fsync: درس PostgreSQL أن النجاح الثاني قد يكون كاذباً. - تغيير
commit=أوdata=writebackأو تعطيل ال Barriers لتسريع القرص دون فهم الثمن: التوثيق يقول صراحة إنك تقايض الأمان بالسرعة. - الخلط بين الرابط الصلب والنسخة: تعديل الملف عبر أي من اسميه يغيره للاسمين، لأنهما ملف واحد.
- الحكم على امتلاء القرص من
df -hوحده: ال Inodes قد تمتلئ قبل المساحة، والأمرdf -iيكشف ذلك. - تركيب قرص بعد عطل للقراءة فقط وهو يحتاج إعادة السجل: يفشل التركيب، فاعمل على نسخة.
جدول القرار Decision Table: كيف تحفظ البيانات بحسب أهميتها
| ما تكتبه | الطريقة | ماذا تخسر عند انقطاع الكهرباء |
|---|---|---|
| سجلات تطبيق عادية | كتابة عادية بذاكرة مؤقتة | آخر ثوان، وقد تصل إلى قرابة 45 ثانية بإعدادات جهازنا |
| ملف إعدادات أو حالة يستبدل كاملاً | ملف مؤقت ثم fsync ثم rename ثم fsync للمجلد | لا شيء، إما القديم أو الجديد كاملاً |
| طلبات مستخدمين أو مدفوعات | قاعدة بيانات بإعدادات الحفظ الافتراضية، والرد بعد إتمام المعاملة | لا شيء مما رد عليه بالنجاح |
| سجل خاص بك يضاف إليه باستمرار | fdatasync بعد كل دفعة، وملف محجوز مسبقاً إن أمكن | الدفعة الجارية فقط |
| بيانات مؤقتة يمكن إعادة توليدها | كتابة عادية دون أي مزامنة | ما لم يكتب، وتعيد توليده |
| نسخة احتياطية Backup | sync في نهاية الكتابة، ثم التحقق بقراءتها | لا شيء بعد انتهاء sync |
حذف المختبر
كل ال Containers عملت بالخيار --rm، والسكربتات تحذف ملفات الصور التي أنشأتها، وبقي ال Volume وال Image:
docker volume rm sos-fs-data
docker rmi sos-tools:1
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- بين
writeوالقرص خمس طبقات، والطلب يرجع بنجاح عند ذاكرة الصفحات المؤقتة، وما تحتها يحدث لاحقاً. - الملف هو ال Inode، والاسم سطر في جدول المجلد، فالرابط الصلب اسم ثان لنفس الملف، و
mvيغير سطراً فقط، وrmيحذف اسماً لا ملفاً. - نظام ext4 بايتات على القرص يمكنك قراءتها دون تركيب، والامتداد يصف قطعة متصلة كاملة من الكتل في سطر واحد.
- الصفحات المتسخة تبقى في الذاكرة حتى يصبح عمرها 30 ثانية ويمر عليها عامل الكتابة، و
syncوfsyncيدفعانها فوراً. - السجل يجعل تغييرات نظام الملفات معاملة واحدة، فلا يحتاج فحصاً كاملاً بعد الانقطاع، والوضع الافتراضي
orderedيحمي البيانات الوصفية كل 5 ثوان. - في تجربتنا بقي الملف المكتوب دون
fsyncبحجم صفر بعد 7 ثوان من الانقطاع، وظهرت بياناته بعد 50 ثانية، والملف الذي استدعينا عليهfsyncكان سليماً في كل الحالات. - الاستبدال الآمن هو ملف مؤقت ثم
fsyncثمrenameثمfsyncللمجلد، والخيارauto_da_allocفي ext4 يحمي من نمط محدد فقط. - الطلب
fsyncأغلى من الكتابة بقرابة ألف مرة على جهازنا، والحفظ الجماعي يعطي نفس الضمان بجزء من الكلفة، وفشلfsyncلا يعالج بإعادة المحاولة.
 دليلالعمليات Processes وجدولة المعالج CPU Scheduling في Linuxنرى من داخل النواة كيف يختار المجدول من يعمل الآن، ولماذا يبطئ سكربت ليلي واجهتك البرمجية، وكيف يعيدها سطر واحد إلى سرعتها.
 دليلالذاكرة الافتراضية Virtual Memory: جداول الصفحات وخطأ الصفحةنتابع العنوان من برنامجك إلى شريحة الذاكرة، ونفهم بأرقام حقيقية لماذا تخدعك أعمدة VIRT وRES، ومتى تسرع الصفحات الكبيرة برنامجك.
 دليلفضاء النواة والمستخدم: كم يكلف استدعاء النظام System Call؟نعبر الحد بين برنامجك والنواة بأيدينا دون أي مكتبة، ونقيس كلفة كل عبور، ونرى لماذا يأخذ نسخ ملف ببايت واحد في كل طلب عشرات الثواني بدلاً من أقل من ملي ثانية.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
 دليلاستعادة PostgreSQL إلى أي لحظة مع pgBackRestكيف تأخذ نسخاً احتياطية من PostgreSQL مع أرشيف WAL، وتستعيد القاعدة إلى الثانية التي سبقت حذفاً خاطئاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب داخل Container من Debian 13 (trixie) مع e2fsprogs وPython 3.13.5، على نظام ملفات ext4 في Docker Volume وأنظمة ext4 في ملفات مركبة عبر Loop، على نواة Linux 5.15 (WSL2) وDocker Engine 29.8.0.