


لنفرض أن لديك سيرفراً صغيراً بنواة معالج واحدة أو اثنتين، وعليه واجهة برمجية API يستخدمها تطبيقك طوال اليوم، وبجوارها سكربت تقرير يعمل كل ليلة فيقرأ بيانات اليوم ويحسب الإجماليات ويكتب ملفاً. في النهار كل شيء جيد، وزمن الاستجابة Latency للطلب الواحد حول الملي ثانية، ولكن عندما يبدأ التقرير ترى في لوحة المراقبة أن المتوسط يتضاعف وأن أبطأ الطلبات تصل إلى عشرات الملي ثانية، مع أن ال API نفسها لم تتغير ولم يزد عدد المستخدمين. وإذا فتحت top في تلك اللحظة فسوف ترى مئات العمليات في القائمة، أغلبها نائم، وبعضها يأخذ المعالج بالكامل، والسؤال الذي يحير الكثير هنا: من الذي يقرر أي برنامج يعمل الآن على المعالج، ولماذا أخذ التقرير وقت ال API، وما الذي تستطيع فعله دون أن تشتري سيرفراً أكبر؟
والإجابة عند جزء صغير من نواة نظام التشغيل اسمه المجدول Scheduler، وهو الذي يوزع وقت المعالج على العمليات والخيوط آلاف المرات في الثانية. وقد ذكرنا في مقال المعالج والخيوط والتزامن أن المجدول موجود وأن تبديل السياق له كلفة، أما هنا فسوف ندخل إلى داخله: كيف يرى العملية، وكيف يحسب العدل، ولماذا يعطي الرقم nice نتيجة أقوى مما يتوقعه أغلب الناس، ومتى تصبح أولوية الوقت الحقيقي Real-Time خطراً على السيرفر كله. وكل رقم في هذا المقال خرج من تجربة نفذناها داخل Container على نواة Linux، ونفس الأوامر تعمل على سيرفرك.
وسوف نناقش في هذا المقال ما يلي:
- ما هي العملية Process في نظر النواة، ولماذا الخيط Thread عندها مهمة Task مثل العملية تماماً.
- حالات العملية R وS وD وT وZ، والعملية الميتة Zombie ولماذا لا تختفي وحدها.
- لماذا نحتاج مجدولاً أصلاً، وكيف تطور المجدول في Linux من O(n) إلى CFS ثم EEVDF.
- كيف يعمل المجدول العادل CFS من الداخل: الوقت الافتراضي vruntime والشجرة المرتبة والأوزان، ولماذا أعطت تجربتنا 75% لا 55%.
- تبديل السياق الطوعي والقسري، وكم يطول الدور الواحد فعلاً على سيرفر حقيقي.
- تجربة القصة كاملة: ال API والتقرير على معالج واحد بخمس طرق، ومشكلة واجهتنا في الأرقام.
- فئات الجدولة: العادي وBatch وIdle والوقت الحقيقي وDeadline، وتجربة تريك ماذا يفعل خيط واحد بأولوية FIFO.
- أكثر من نواة: طابور لكل معالج وموازنة المهام وربط العملية بمعالج Affinity، ثم ال Containers.
- كيف تقرأ كل هذا على سيرفرك، والأخطاء الشائعة، وجدول قرار لكل هدف.
تجهيز المختبر
كل التجارب تعمل داخل Container صغير من Debian 13 (trixie)، ونثبت فيه أدوات العمليات procps وأداة الجدولة chrt التي تأتي مع util-linux، والمترجم gcc لبرنامجين صغيرين بلغة C، والأداة perf لعد الأحداث داخل النواة. والسبب في أننا نكتب البرامج بلغة C وليس Python أن نريد أن نقيس المجدول وليس المفسر، فالبرنامج الصغير بلغة C لا يضيف شيئاً بين الكود والمعالج:
mkdir sched-lab && cd sched-lab
cat > Dockerfile <<'EOF'
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends procps strace time util-linux e2fsprogs gcc libc6-dev python3-minimal linux-perf psmisc && rm -rf /var/lib/apt/lists/*
WORKDIR /lab
EOF
docker build -t sos-tools:1 .
وهذه ال Image نفسها نستخدمها في المقالات الثلاثة الأخرى من هذه المرحلة، لذلك فيها أدوات لا نحتاجها هنا مثل e2fsprogs. والبرنامج الأول spin.c يمثل سكربت التقرير، وهو حلقة حسابية لا تنام أبداً لعدد من الثواني:
/* spin.c: a CPU-bound task that never sleeps (the nightly report job in the story) */
#include <stdio.h>
#include <stdlib.h>
#include <time.h>

int main(int argc, char **argv)
{
    double seconds = argc > 1 ? atof(argv[1]) : 10;
    struct timespec start, now;
    volatile unsigned long x = 0;
    clock_gettime(CLOCK_MONOTONIC, &start);
    do {
        for (int i = 0; i < 1000000; i++) x += i;
        clock_gettime(CLOCK_MONOTONIC, &now);
    } while ((now.tv_sec - start.tv_sec) + (now.tv_nsec - start.tv_nsec) / 1e9 < seconds);
    return 0;
}
والبرنامج الثاني lat.c يمثل ال API، فهو ينام 2 ملي ثانية كأنه ينتظر طلباً من الشبكة، ثم يؤدي كمية ثابتة من العمل الحسابي تأخذ قرابة ملي ثانية على معالج فارغ، ويسجل زمن الاستجابة لكل طلب، أي الوقت من لحظة انتهاء نومه حتى انتهاء عمله. وفي النهاية يطبع ما سجلته النواة عنه من الملف /proc/self/schedstat ومن عدادات تبديل السياق في /proc/self/status:
/* lat.c: an API-like task. Each "request": sleep 2 ms (waiting for the network), then a fixed
   amount of CPU work (about 1 ms on an idle core). It reports the response time of each request,
   from the moment it should have woken up until its work was done, and what the kernel recorded. */
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <time.h>

static double now_us(void)
{
    struct timespec t;
    clock_gettime(CLOCK_MONOTONIC, &t);
    return t.tv_sec * 1e6 + t.tv_nsec / 1e3;
}

static int cmp(const void *a, const void *b)
{
    double x = *(const double *)a, y = *(const double *)b;
    return (x > y) - (x < y);
}

int main(int argc, char **argv)
{
    int n = argc > 1 ? atoi(argv[1]) : 1000;
    long work = argc > 2 ? atol(argv[2]) : 1000000;      /* loop iterations per request */
    double *resp = malloc(n * sizeof *resp);
    struct timespec nap = { 0, 2000000 };                 /* 2 ms */
    volatile unsigned long x = 0;
    double start = now_us();
    for (int i = 0; i < n; i++) {
        double t0 = now_us();
        nanosleep(&nap, NULL);
        for (long k = 0; k < work; k++) x += k;          /* the same work every time */
        resp[i] = (now_us() - t0 - 2000) / 1000;          /* response time in ms, without the sleep */
    }
    double total = (now_us() - start) / 1e6;
    double sum = 0;
    for (int i = 0; i < n; i++) sum += resp[i];
    qsort(resp, n, sizeof *resp, cmp);
    printf("requests=%d in %.1f s  response ms: avg=%.2f p50=%.2f p99=%.2f max=%.2f\n",
           n, total, sum / n, resp[n / 2], resp[n * 99 / 100], resp[n - 1]);
    FILE *f = fopen("/proc/self/schedstat", "r");
    unsigned long long run, wait, slices;
    if (f && fscanf(f, "%llu %llu %llu", &run, &wait, &slices) == 3)
        printf("schedstat: on_cpu=%.0f ms  run_queue_wait=%.0f ms  timeslices=%llu\n", run / 1e6, wait / 1e6, slices);
    char line[256];
    f = fopen("/proc/self/status", "r");
    while (f && fgets(line, sizeof line, f))
        if (strstr(line, "ctxt_switches")) fputs(line, stdout);
    return 0;
}
لاحظ أن العمل داخل الطلب عدد ثابت من الدورات وليس مدة زمنية، والسبب أننا لو قلنا للبرنامج «اعمل لمدة ملي ثانية» لانتهى بعد ملي ثانية من الساعة حتى لو أخذ المجدول منه المعالج نصف هذا الوقت، فلا نرى أثر المجدول أبداً. أما مع عدد ثابت من الدورات فكل لحظة ينتظر فيها البرنامج دوره تظهر في زمن الاستجابة. ونبني البرنامجين داخل ال Container بالأوامر التالية:
gcc -O2 -o /usr/local/bin/spin spin.c
gcc -O2 -o /usr/local/bin/lat lat.c
والجهاز الذي نفذنا عليه التجارب معالج Intel Core i7-7700K بأربع أنوية وثمانية خيوط عتادية، عليه Docker Desktop بنواة Linux 5.15 داخل WSL2، وهذه النقطة سوف تهمنا لاحقاً لأن نواة 5.15 ما زالت تستخدم المجدول CFS، بينما توزيعة Debian 13 نفسها تأتي بنواة 6.12 التي انتقلت إلى EEVDF.
ما هي العملية Process في نظر النواة؟
من جهة المبرمج، العملية Process هي برنامج يعمل وله ذاكرة خاصة به، وقد شرحنا في مقال ماذا يحدث عندما تشغل برنامج Hello World كيف تنشئها الصدفة بالطلبين fork وexecve. أما من جهة النواة فالعملية سجل كبير في الذاكرة اسمه في كود Linux task_struct، فيه رقم المهمة، ومن أنشأها، وحالتها الآن، وأولويتها وسياسة جدولتها، وكم استهلكت من المعالج، والمعالج الذي عملت عليه آخر مرة، ومؤشر إلى جدول صفحات الذاكرة، وجدول الملفات المفتوحة، وغير ذلك. والمجدول لا يتعامل مع البرامج وإنما مع هذه السجلات، فهو يأخذ سجلاً من طابور الجاهزين ويحمل حالته على المعالج، ثم بعد فترة يحفظ حالته ويأخذ سجلاً آخر.
وكل ما تراه في ps وtop مقروء من هذه السجلات عبر الملفات في /proc/<pid>/، فالملف stat سطر واحد من الحقول التي يصفها توثيق proc_pid_stat، والملف status نفس المعلومات تقريباً بشكل يقرؤه الإنسان كما في proc_pid_status، والملف schedstat ثلاثة أرقام يحسبها المجدول نفسه: الوقت الذي قضته المهمة على المعالج، والوقت الذي قضته تنتظر في الطابور وهي جاهزة، وعدد الأدوار التي أخذتها، كما في توثيق إحصاءات المجدول في النواة. وهذا الرقم الثاني، أي وقت الانتظار في الطابور، هو أهم رقم في هذا المقال، لأنه يقيس مباشرة كم تأخر برنامجك بسبب أن غيره يستخدم المعالج.
الخيط Thread عند النواة مهمة Task مثل العملية
قد يتساءل البعض: إذا كانت العملية سجلاً، فأين الخيوط Threads؟ والإجابة أن Linux لا يفرق بينهما كثيراً، فكل خيط له سجل task_struct خاص به، والفرق أن خيوط العملية الواحدة تشترك في جدول الصفحات وجدول الملفات، ولكل منها رقم مهمة خاص يسمى في ps العمود LWP، بينما رقم العملية الذي تعرفه هو في الحقيقة رقم مجموعة الخيوط Thread Group ID. وبالتالي فالمجدول يجدول الخيوط وليس العمليات، والعملية التي فيها ثمانية خيوط مشغولة تنافس على المعالج كثماني مهام. والتجربة التالية تشغل برنامج Python فيه ثلاثة خيوط إضافية، ثم تعرض مهامها، ثم تغير الرقم nice لخيط واحد منها فقط:
python3 -c 'import threading,time,os
for i in range(3): threading.Thread(target=time.sleep,args=(30,),daemon=True).start()
time.sleep(30)' & p=$!; sleep 1
ls /proc/$p/task; ps -L -o pid,lwp,ni,stat,comm -p $p
t=$(ls /proc/$p/task | tail -1); renice -n 10 -p $t >/dev/null; ps -L -o pid,lwp,ni,comm -p $p
والمخرج سوف يكون كما يلي:
22
24
25
26
  PID   LWP  NI STAT COMMAND
   22    22   0 Sl   python3
   22    24   0 Sl   python3
   22    25   0 Sl   python3
   22    26   0 Sl   python3
  PID   LWP  NI COMMAND
   22    22   0 python3
   22    24   0 python3
   22    25   0 python3
   22    26  10 python3
في المخرج أعلاه لاحظ التالي:
- المجلد
/proc/22/taskفيه أربعة مجلدات، أي أربع مهام: الخيط الرئيسي ورقمه نفس رقم العملية 22، ثم الخيوط 24 و25 و26. - الحرف
lفي العمود STAT معناه أن العملية فيها أكثر من خيط، وSمعناها أنها نائمة، وهذا صحيح لأن كل الخيوط فيtime.sleep. - الأمر
reniceعلى الرقم 26 غير الخيط 26 وحده، وبقيت الخيوط الأخرى على 0. وهذا ليس خطأ في الأداة، فصفحة sched تقول صراحة إن المعيار POSIX يجعلniceصفة للعملية كلها، بينما هو في Linux صفة لكل خيط على حدة، وسوف نرجع لهذه النقطة في الأخطاء الشائعة.
حالات العملية Process States: R وS وD وT وZ
في أي لحظة تكون كل مهمة في حالة واحدة، والحرف الأول من العمود STAT في ps هو هذه الحالة. والصورة التالية تبين الحالات المهمة والطرق بينها:
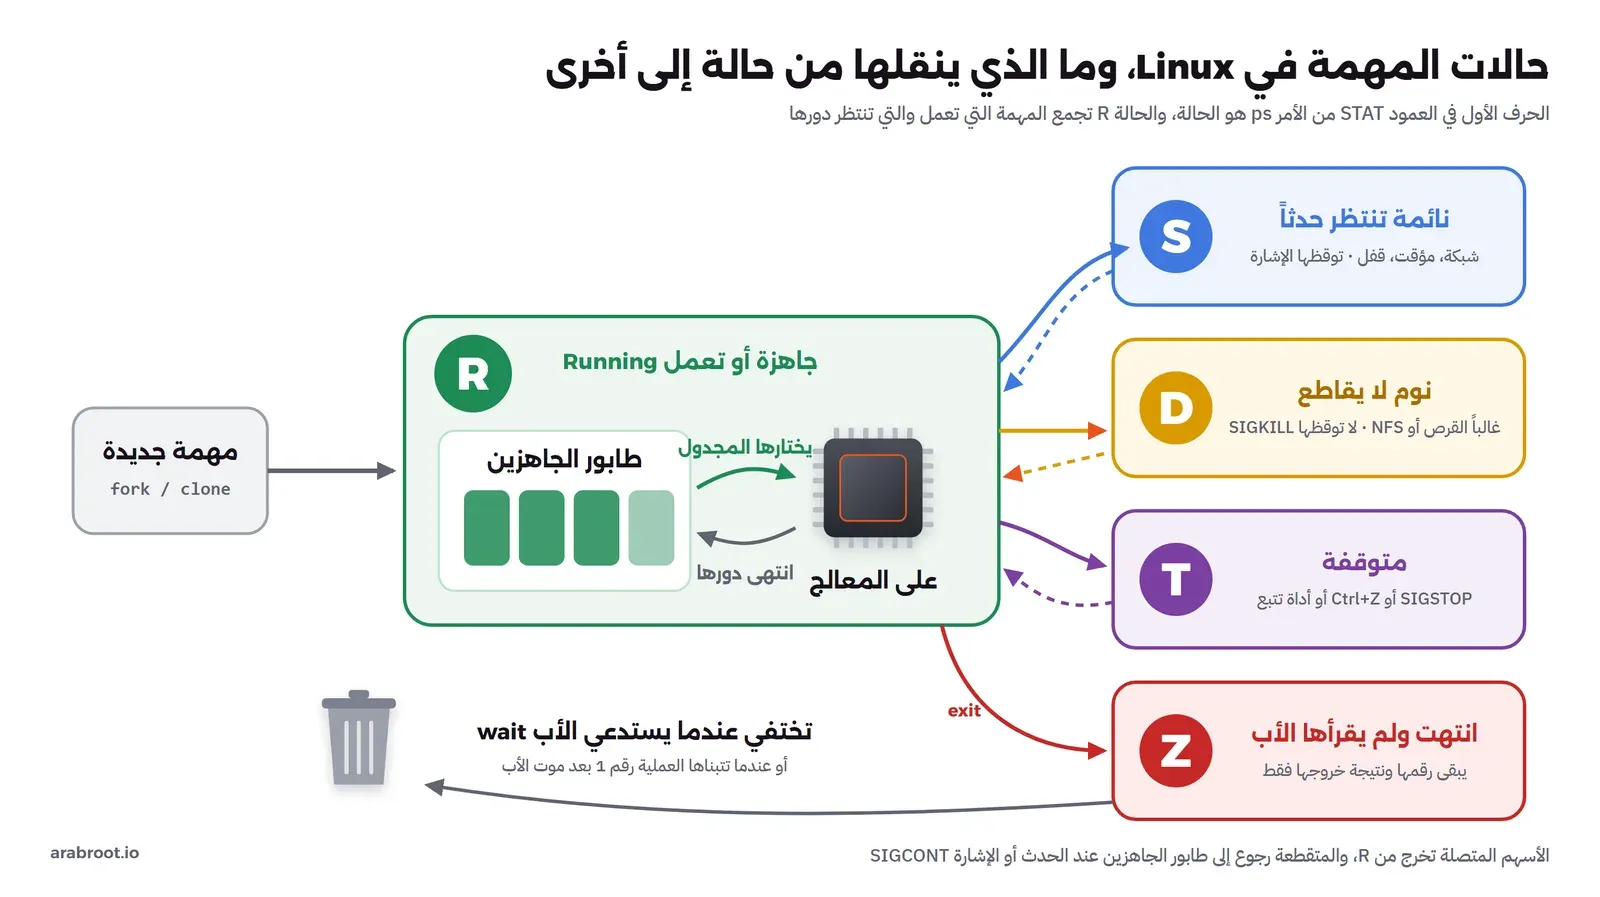
- الحالة R (Running أو Runnable): المهمة تعمل الآن على معالج، أو جاهزة تنتظر دورها في الطابور، والنواة لا تفرق بينهما في هذا الحرف، وهذا سبب أن متوسط الضغط Load Average يعد الاثنين معاً.
- الحالة S (Sleeping): نوم يمكن مقاطعته Interruptible، أي أن المهمة تنتظر حدثاً مثل وصول بيانات من الشبكة أو انتهاء مؤقت، وإذا وصلتها إشارة Signal استيقظت لتتعامل معها. وأغلب العمليات على أي سيرفر في هذه الحالة أغلب الوقت.
- الحالة D (Uninterruptible Sleep): نوم لا يمكن مقاطعته، وغالباً يكون انتظاراً لعملية إدخال وإخراج على القرص أو على نظام ملفات عبر الشبكة مثل NFS، ولا تستيقظ المهمة منه حتى بالإشارة
SIGKILL، والسبب أن النواة في منتصف عملية لا تستطيع تركها نصف منتهية. وقد شرحنا في مقال تحليل أداء سيرفر Linux كيف ترفع هذه الحالة متوسط الضغط والمعالج فارغ. - الحالة T (Stopped): أوقفتها إشارة مثل
SIGSTOPأو ضغطة Ctrl+Z في الطرفية، أو أداة تتبع مثل الأداةstrace، ولا يجدولها المجدول حتى تصلهاSIGCONT. - الحالة Z (Zombie): انتهت المهمة ولم يقرأ أبوها نتيجة خروجها بعد، فبقي منها سجل صغير فقط.
- وفي سجلات بعض خيوط النواة ترى الحالة I (Idle)، وهي خيوط نائمة لا تحسب في متوسط الضغط.
والسكربت التالي ينشئ مهمة في كل حالة، ثم يعرضها كلها في جدول واحد مع العمود WCHAN، وهو اسم الدالة في النواة التي تنتظر فيها المهمة إن كانت نائمة:
#!/bin/sh
# One process in each common state, then ps and /proc/<pid>/status for each.
sleep 300 &                                    # S: sleeping, waiting for a timer
spin 300 &                                     # R: running or ready to run
sleep 300 & stopped=$!; sleep 0.2; kill -STOP $stopped   # T: stopped by a signal
python3 -c 'import os,time
pid=os.fork()
if pid==0: os._exit(0)                          # the child exits at once
time.sleep(300)                                 # the parent never calls wait()' &
sleep 1
ps -o pid,ppid,stat,ni,cls,pri,psr,wchan:14,comm --ppid $$ --ppid $(pgrep -f "import os") 2>/dev/null
echo "--- /proc/<pid>/status of the zombie"
z=$(ps -eo pid,stat | awk '$2 ~ /^Z/ {print $1}')
grep -E "^(Name|State|Tgid|Pid|PPid|Threads|VmRSS)" /proc/$z/status
echo "--- kill the parent, then look again"
kill $(pgrep -f "import os"); sleep 1
ps -eo pid,ppid,stat,comm | awk 'NR==1 || $3 ~ /^Z/'
kill -CONT $stopped; kill $(jobs -p) 2>/dev/null; pkill spin; true
والمخرج سوف يكون كما يلي:
  PID  PPID STAT  NI CLS PRI PSR WCHAN          COMMAND
   31    30 S      0  TS  19   0 hrtimer_nanosl sleep
   32    30 R      0  TS  19   4 -              spin
   33    30 T      0  TS  19   7 do_signal_stop sleep
   35    30 S      0  TS  19   1 hrtimer_nanosl python3
   37    35 Z      0  TS  19   6 -              python3
   39    30 R      0  TS  19   1 -              ps
--- /proc/<pid>/status of the zombie
Name:	python3
State:	Z (zombie)
Tgid:	37
Pid:	37
PPid:	35
Threads:	1
--- kill the parent, then look again
  PID  PPID STAT COMMAND
في المخرج أعلاه لاحظ التالي:
- الأمر
sleepفي الحالة S، والعمود WCHAN يقول إنه ينتظر في الدالةhrtimer_nanosleep، أي مؤقت النواة عالي الدقة. وهذا العمود مفيد جداً عندما تجد عملية معلقة ولا تعرف ماذا تنتظر. - البرنامج
spinفي الحالة R وكذلكpsنفسه، لأنه كان يعمل لحظة قراءة القائمة. - العمود CLS هو فئة الجدولة، و
TSمعناها Time Sharing أي الفئة العادية SCHED_OTHER، والعمود PRI أولوية بصيغةpsالخاصة، والعمود PSR رقم المعالج الذي عملت عليه المهمة آخر مرة. - المهمة 37 ابن للعملية 35، وهي في الحالة Z ولا تملك ذاكرة، فالسطر VmRSS غير موجود أصلاً في ملفها، والذي بقي منها هو رقمها ونتيجة خروجها فقط.
وفي أول تشغيل لهذا السكربت ظهر لنا في سطر الحالة T الاسم sh بدلاً من sleep، والسبب أننا أرسلنا SIGSTOP مباشرة بعد إنشاء المهمة، فأوقفناها في اللحظة القصيرة بين fork وexecve وهي ما زالت نسخة من الصدفة، لذلك أضفنا sleep 0.2 قبل الإيقاف. وهذه نفس الفترة التي شرحنا في مقال Hello World أن الصدفة تستغلها لتوجيه المخرج قبل أن يبدأ البرنامج.
العملية الميتة Zombie ولماذا لا تختفي وحدها
عندما تنتهي عملية لا تحذفها النواة فوراً، لأن أباها قد يريد أن يعرف كيف انتهت: هل خرجت بالقيمة 0 أم بخطأ، أم قتلتها إشارة؟ لذلك تبقي النواة سجلاً صغيراً فيه رقم العملية ونتيجة خروجها حتى يطلبها الأب بالطلب wait أو waitpid كما في صفحة wait، وعندها فقط يختفي السجل. والعملية في هذه الفترة هي ال Zombie، فهي لا تعمل ولا تأخذ ذاكرة ولا معالجاً، ولا يمكن قتلها لأنها ميتة أصلاً، وإرسال kill -9 إليها لا يفعل شيئاً.
ولاحظ في آخر المخرج أن ال Zombie اختفى بعد أن قتلنا الأب، والسبب أن النواة تنقل أبناء العملية التي تموت إلى العملية رقم 1، وهذه العملية وظيفتها أن تقرأ نتيجة كل ابن يموت. وفي ال Container هنا العملية رقم 1 هي الصدفة sh التي شغلنا بها السكربت، فقرأت النتيجة واختفى السجل. وهذه بالضبط مشكلة يقابلها من يشغل برنامجه كعملية رقم 1 داخل Container، فإذا كان البرنامج ينشئ عمليات فرعية ولا ينتظرها، ولم يكتب أحد كود القراءة فيه، تتراكم ال Zombies حتى يمتلئ جدول أرقام العمليات، ولهذا يأتي Docker بالخيار --init الذي يضع برنامجاً صغيراً كعملية رقم 1 يقوم بهذا العمل.
لماذا نحتاج مجدولاً Scheduler أصلاً؟
لنبدأ من المشكلة: لدينا معالج واحد ومئات المهام، وبعضها يحسب وبعضها ينتظر الشبكة وبعضها يتفاعل مع مستخدم. والحل البسيط هو أن تعمل كل مهمة حتى تنتهي ثم تأتي التي بعدها، وهذا ما كانت تفعله أنظمة المعالجة بالدفعات Batch Processing في الحواسيب الأولى. والمشكلة واضحة: مهمة واحدة طويلة تجعل كل من خلفها ينتظر، ولو كانت ال API خلف التقرير في هذا الطابور لانتظر كل طلب حتى ينتهي التقرير بعد ساعة.
والحل الثاني هو التناوب Round Robin: كل مهمة تأخذ شريحة زمنية Time Slice ثابتة، مثلاً 10 ملي ثانية، ثم تذهب إلى آخر الطابور. وهذا الحل يمنع الاحتكار، ولكنه يضعنا أمام مفاضلة صعبة في طول الشريحة: إذا كانت قصيرة جداً صرف المعالج جزءاً كبيراً من وقته في التبديل بين المهام بدلاً من العمل، وفقدت كل مهمة بياناتها من ال Cache عند كل تبديل، وإذا كانت طويلة انتظر البرنامج التفاعلي طويلاً حتى يأتي دوره. وفوق ذلك فالتناوب البسيط لا يعرف أن ال API تنام أغلب وقتها وتحتاج المعالج لحظات قصيرة، بينما التقرير لا ينام أبداً، فيعاملهما كأنهما متساويان.
ولذلك مرت مجدولات Linux بعدة أجيال، كل جيل يحاول حل مشكلة الجيل الذي قبله:
- المجدول في سلسلة 2.4 كان يمر على كل المهام الجاهزة عند كل قرار ليحسب أفضلها، أي أن كلفة القرار تكبر مع عدد المهام، وهذا ما يسمى O(n)، وهو مقبول مع عشرات المهام وسيء مع الآلاف.
- المجدول O(1) في سلسلة 2.6 جعل كلفة القرار ثابتة مهما زاد عدد المهام، باستخدام مصفوفات من الطوابير لكل مستوى أولوية، ولكنه اعتمد على قواعد تخمين Heuristics معقدة ليعرف أي مهمة تفاعلية فيعطيها أولوية، وكانت هذه القواعد تخطئ وتنخدع ببرامج مكتوبة لاستغلالها.
- المجدول العادل CFS (Completely Fair Scheduler) دخل في الإصدار 2.6.23 عام 2007 كما في ملاحظات ذلك الإصدار، وكتبه Ingo Molnar، وألغى قواعد التخمين واستبدلها بفكرة رياضية واحدة سوف نشرحها الآن.
- ثم بدأ في الإصدار 6.6 الانتقال إلى المجدول EEVDF كما في ملاحظات الإصدار 6.6، وهو يحتفظ بفكرة العدل من CFS ويضيف فكرة الموعد النهائي الافتراضي.
كيف يعمل المجدول العادل CFS من الداخل؟
يلخص توثيق CFS في النواة فكرته في جملة واحدة: أن يحاكي على المعالج الحقيقي «معالجاً مثالياً يعمل بمهام متعددة في نفس اللحظة»، فإذا كانت هناك مهمتان جاهزتان فكل واحدة تأخذ نصف قوة المعالج في نفس الوقت. وهذا المعالج غير موجود طبعاً، فالمعالج الحقيقي ينفذ مهمة واحدة في كل لحظة، لذلك يحتفظ CFS لكل مهمة برقم اسمه الوقت الافتراضي vruntime، وهو الوقت الذي قضته المهمة على المعالج بالنانو ثانية، معدلاً بحسب وزنها كما سيأتي. ثم القاعدة بسيطة جداً: شغل دائماً المهمة صاحبة أصغر vruntime، أي المهمة التي أخذت أقل من حقها حتى الآن.
ولكي يجد المهمة صاحبة أصغر vruntime بسرعة يرتب CFS المهام الجاهزة في شجرة حمراء سوداء Red-Black Tree مرتبة بهذا الرقم، فالمهمة في أقصى يسار الشجرة هي التالية دائماً. وعندما تعمل المهمة يزيد vruntime الخاص بها، فتتحرك في الشجرة نحو اليمين، وعندما يزيد رقمها بما يكفي عن المهمة التي أصبحت في أقصى اليسار يأخذ المجدول منها المعالج ويعطيه للأخرى. والصورة التالية تبين ذلك:
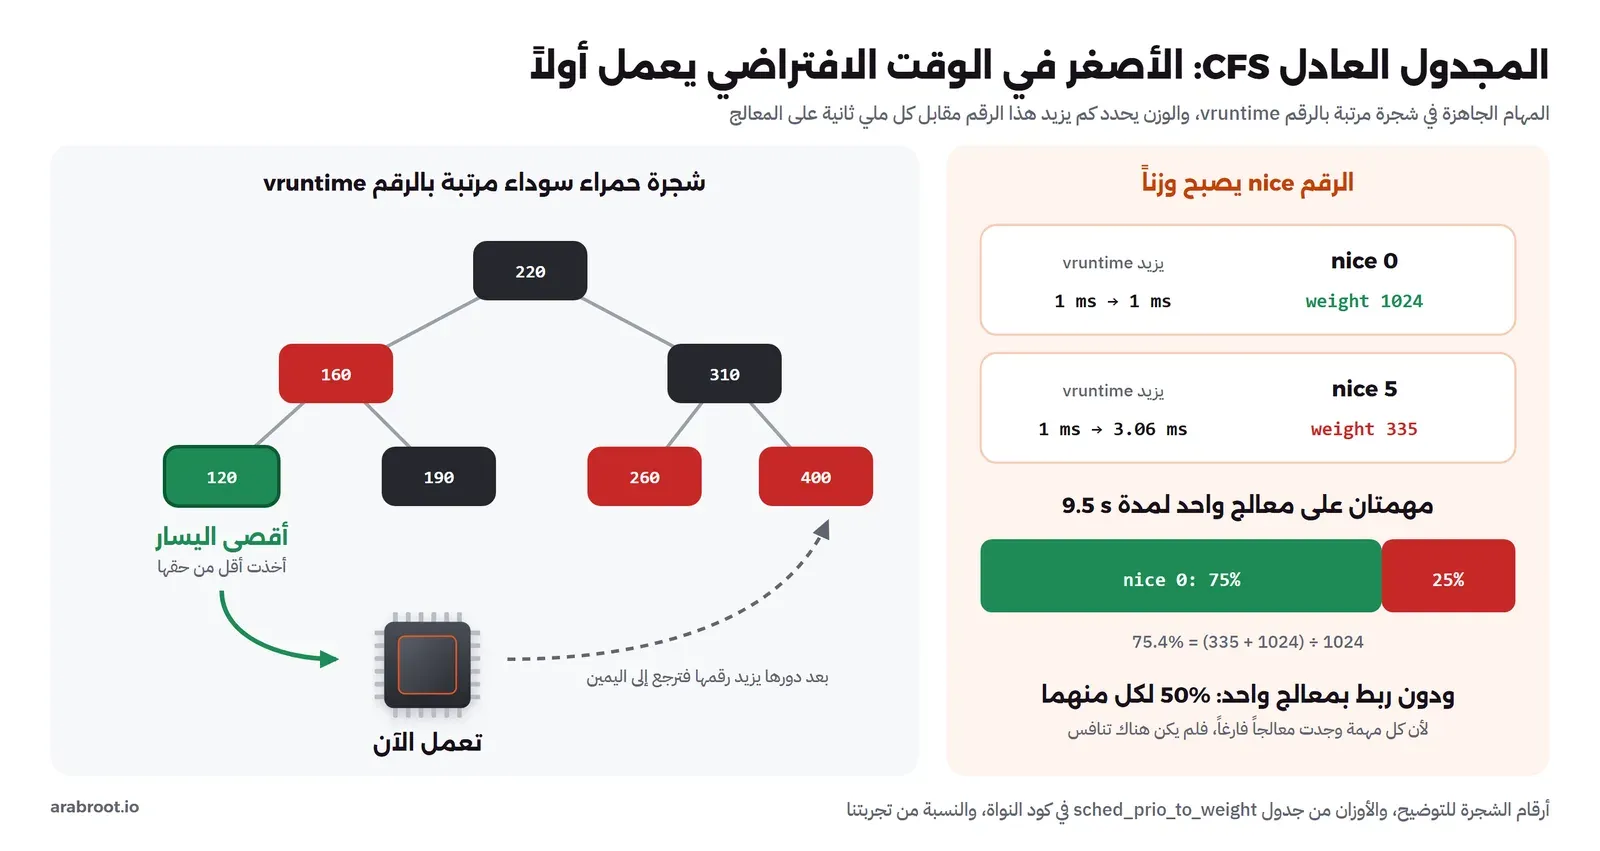
وهنا تظهر فائدة الفكرة للقصة التي بدأنا بها: ال API تنام أغلب الوقت، فلا يزيد الوقت الافتراضي الخاص بها وهي نائمة، بينما التقرير يعمل باستمرار فيزيد رقمه دائماً، وبالتالي عندما تستيقظ ال API تجد نفسها غالباً في أقصى يسار الشجرة فتأخذ المعالج بسرعة. ولكن هذا لا يجعل النائم يجمع رصيداً بلا حد، فلو نامت مهمة ساعة كاملة ثم استيقظت برقمها القديم لاحتكرت المعالج دقائق حتى تلحق بالآخرين، لذلك يحتفظ CFS بأصغر vruntime موجود في الطابور في متغير اسمه min_vruntime، ويضع المهمة التي تستيقظ قريباً منه وليس عند رقمها القديم، فتأخذ أفضلية قصيرة فقط.
وتلاحظ أن الفكرة لا تحتوي على شريحة زمنية ثابتة، فالتوثيق نفسه يقول إن CFS ليس فيه مفهوم الشرائح الزمنية بالشكل القديم، وإنما فيه فترة مستهدفة يحاول أن تأخذ فيها كل مهمة جاهزة دوراً واحداً، تقسم على عدد المهام، بحد أدنى للدور الواحد حتى لا يكثر التبديل. وفي نواتنا قرأنا هذه القيم من ملفات المجدول في debugfs داخل Container بصلاحيات كاملة، لأن هذا المجلد غير متاح في Container عادي:
mount -t debugfs none /sys/kernel/debug
for f in latency_ns min_granularity_ns wakeup_granularity_ns; do echo "$f $(cat /sys/kernel/debug/sched/$f)"; done
والمخرج سوف يكون كما يلي:
latency_ns 24000000
min_granularity_ns 3000000
wakeup_granularity_ns 4000000
أي أن الفترة المستهدفة 24 ملي ثانية، وأقل دور 3 ملي ثانية، والمهمة التي تستيقظ لا تأخذ المعالج من المهمة الحالية إلا إذا كان الفرق في vruntime بينهما أكبر من 4 ملي ثانية. وهذه الأرقام ليست الإعدادات الافتراضية المكتوبة في الكود كما هي، وإنما مضروبة في عامل يكبر مع عدد المعالجات، فالقيمة الأساسية 6 ملي ثانية للفترة و0.75 للدور الأدنى، وعلى ثمانية معالجات يصبح العامل 4. ولاحظ أن هذه الملفات تغيرت في النوى الأحدث، فمع EEVDF بقي فيها ملف واحد أساسي هو base_slice_ns كما يذكر توثيق CFS الحالي.
الرقم nice والأوزان Weights: لماذا 75% وليس 55%؟
الرقم nice يأخذ قيمة من -20 (أعلى أولوية) إلى 19 (أقل أولوية)، والقيمة الافتراضية 0، واسمه جاء من فكرة أن البرنامج الذي يرفع رقمه «لطيف» مع غيره. وأغلب الناس يظنون أن الفرق بين nice 0 وnice 5 صغير، فهي خمس درجات من أربعين، ولكن صفحة sched تقول إن كل درجة واحدة من الفرق تجعل المجدول يفضل المهمة الأعلى بمعامل 1.25. والطريقة التي ينفذ بها CFS ذلك هي الأوزان Weights، فكل قيمة nice لها وزن في جدول ثابت في كود النواة اسمه sched_prio_to_weight، والوزن للقيمة 0 هو 1024، وللقيمة 5 هو 335، وللقيمة 10 هو 110، وللقيمة 19 هو 15 فقط، ثم يزيد vruntime لكل مهمة بسرعة تتناسب عكسياً مع وزنها، فالمهمة الثقيلة يزيد رقمها ببطء فتبقى في يسار الشجرة أطول.
وحتى نرى ذلك نشغل مهمتين حسابيتين لمدة عشر ثوان، الأولى بالقيمة 0 والثانية بالقيمة 5، ونقرأ من الملف /proc/<pid>/stat مجموع الحقلين 14 و15، وهما وقت المستخدم ووقت النواة بوحدة النبضة Clock Tick. ونفعل ذلك مرتين: مرة والمهمتان مربوطتان بمعالج واحد بالأمر taskset -c 7، ومرة دون ربط:
#!/bin/sh
# Two CPU-bound jobs for 10 s. utime+stime from /proc/<pid>/stat (fields 14, 15) in clock ticks.
ticks=$(getconf CLK_TCK)
pair() {
  label="$1"; aff="$2"
  $aff spin 10 & a=$!
  $aff nice -n 5 spin 10 & b=$!
  sleep 9.5
  ta=$(awk '{print $14+$15}' /proc/$a/stat); tb=$(awk '{print $14+$15}' /proc/$b/stat)
  echo "== $label"
  echo "nice 0: $ta ticks   nice 5: $tb ticks   share of nice 0: $(( 100 * ta / (ta + tb) ))%"
  wait
}
echo "CLK_TCK=$ticks"
pair "same CPU (taskset -c 7)" "taskset -c 7"
pair "free to move (no taskset)" ""
والمخرج سوف يكون كما يلي:
CLK_TCK=100
== same CPU (taskset -c 7)
nice 0: 715 ticks   nice 5: 233 ticks   share of nice 0: 75%
== free to move (no taskset)
nice 0: 949 ticks   nice 5: 948 ticks   share of nice 0: 50%
في المخرج أعلاه لاحظ التالي:
- القيمة
CLK_TCK=100معناها أن النبضة الواحدة في هذه الملفات تساوي 10 ملي ثانية، فالمهمتان على المعالج الواحد أخذتا معاً 948 نبضة، أي 9.48 ثانية من 9.5 ثانية، وهذا يعني أن المعالج كان مشغولاً بهما طوال الوقت تقريباً. - المهمة بالقيمة 0 أخذت 75% والمهمة بالقيمة 5 أخذت 25%، وهذا يطابق الحساب من الأوزان: 1024 تقسيم مجموع 1024 و335 يساوي 75.4%. ولو كان التأثير خطياً كما يظن الكثير لكان الفرق بضع نقاط فقط.
- عندما تركنا المهمتين بلا ربط أخذت كل واحدة 949 نبضة، أي 50% لكل منهما ومعالج كامل لكل واحدة، فالرقم
niceلم يفعل شيئاً هنا إطلاقاً، والسبب أن الجهاز فيه ثمانية معالجات منطقية والمهمتان لم تتنافسا على معالج واحد.
وهذه النتيجة الأخيرة هي أهم ما في هذه التجربة: الرقم nice لا يبطئ البرنامج ولا يحدد له نسبة ثابتة، وإنما يقرر من يفوز عندما يتنافس أكثر من برنامج على نفس المعالج، فإذا كان المعالج فارغاً أخذ البرنامج الذي قيمته 19 المعالج كاملاً. وهذا بالضبط ما نريده في قصة التقرير الليلي، فنحن لا نريد أن يبطئ التقرير عندما لا يوجد أحد غيره، وإنما نريد أن يتنحى عندما تحتاج ال API المعالج.
ماذا تغير مع EEVDF في Linux 6.6؟
المجدول CFS عادل في الحصة الكلية، ولكنه لا يملك طريقة واضحة لتقول له إن مهمة معينة تحتاج أن تبدأ بسرعة عندما تستيقظ، وإن كانت لا تحتاج حصة أكبر. ولذلك اعتمد على قيم مثل wakeup_granularity_ns وعلى تعديلات متراكمة لمعاملة المهام النائمة. والمجدول EEVDF (Earliest Eligible Virtual Deadline First)، وهو خوارزمية نشرت في بحث علمي عام 1995، يحل ذلك بطريقة أخرى كما يشرح توثيق EEVDF: يحسب لكل مهمة قيمة اسمها التأخر Lag، وهي الفرق بين ما كان يجب أن تأخذه وما أخذته فعلاً، فالمهمة صاحبة التأخر الموجب لها حق عند المعالج، والمهمة صاحبة التأخر السالب أخذت أكثر من حقها. ثم يختار من بين المهام المؤهلة Eligible، أي صاحبة التأخر الموجب أو الصفر، المهمة صاحبة أقرب موعد نهائي افتراضي Virtual Deadline، وهذا الموعد يعتمد على طول الدور الذي تطلبه المهمة، فالمهمة التي تطلب أدواراً قصيرة يكون موعدها أقرب فتبدأ أسرع.
وبالتالي فالفرق العملي لك أن EEVDF يفصل بين شيئين كانا مختلطين في CFS: الحصة من المعالج يحددها الوزن كما كان، أي الرقم nice، وسرعة الاستجابة يمكن أن يحددها طول الدور الذي تطلبه المهمة عبر الطلب sched_setattr. ولاحظ أن الفكرة الأساسية لم تتغير، فالتجربة السابقة على EEVDF سوف تعطي نفس النسبة 75% لأن الأوزان هي نفسها، وأن التوثيق نفسه يقول إن معالجة التأخر للمهام النائمة ما زالت محل نقاش. ونواة سيرفرك تحدد أي المجدولين لديك، فإذا كانت 6.6 أو أحدث فهو EEVDF، مثل Debian 13 بنواة 6.12، وإذا كانت أقدم فهو CFS، مثل نواتنا 5.15 في هذه التجارب.
تبديل السياق Context Switch: الطوعي والقسري
كل مرة يأخذ المجدول المعالج من مهمة ويعطيه لأخرى يحدث تبديل سياق Context Switch، وتعد النواة هذه المرات لكل مهمة في عدادين في /proc/<pid>/status: العداد voluntary_ctxt_switches للتبديل الطوعي، أي أن المهمة هي التي تركت المعالج لأنها ستنتظر شيئاً، مثل قراءة من الشبكة أو نوم، والعداد nonvoluntary_ctxt_switches للتبديل القسري، أي أن المجدول أخذ المعالج منها وهي ما زالت تريد العمل لأن دورها انتهى أو لأن مهمة أهم استيقظت. والفرق بينهما يخبرك بنوع برنامجك: البرنامج الذي ينتظر الشبكة والقرص أغلب تبديلاته طوعية، والبرنامج الذي يحسب ويتزاحم مع غيره على المعالج تظهر عنده التبديلات القسرية.
ولكي نعرف كم يطول الدور الواحد فعلاً شغلنا ثلاث مهام حسابية على معالج واحد، وعددنا تبديلات واحدة منها بالأداة perf stat. وهذه الأداة تحتاج داخل Container صلاحية القياس CAP_PERFMON، لأن ملف الحماية الافتراضي في Docker يمنع الطلب perf_event_open الذي تستخدمه، كما في جدول الطلبات الممنوعة في Docker، والسبب أن هذه الأحداث قد تكشف معلومات عن المضيف:
docker run --rm --name sos-sched --cap-add PERFMON -v "$PWD:/lab" sos-tools:1 sh -c 'sh build.sh && sh slices.sh'والسكربت slices.sh كما يلي:
#!/bin/sh
# How long is a time slice? Three CPU-bound jobs on one CPU, perf counts the switches of one of them.
taskset -c 7 spin 6 & taskset -c 7 spin 6 &
perf stat -e task-clock,context-switches,cpu-migrations taskset -c 7 spin 5 2>&1 | grep -E "task-clock|context|migrations|elapsed"
wait
والمخرج سوف يكون كما يلي:
           1665.68 msec task-clock                       #    0.331 CPUs utilized
               107      context-switches                 #   64.238 /sec
                 1      cpu-migrations                   #    0.600 /sec
       5.036883969 seconds time elapsed
في المخرج أعلاه لاحظ التالي:
- المهمة عملت 1665 ملي ثانية من أصل 5 ثوان، أي ثلث الوقت تقريباً، وهذا هو العدل بين ثلاث مهام متساوية.
- أخذت هذه المدة في 107 أدوار، أي أن الدور الواحد كان قرابة 15.6 ملي ثانية في المتوسط، وهذا أطول من الثمانية ملي ثانية التي تتوقعها من قسمة 24 على ثلاث مهام.
- والسبب في الفرق إعداد في النواة نفسها، فقد قرأنا إعدادات بناء نواتنا من الملف
/proc/config.gzفوجدناCONFIG_HZ=100وCONFIG_PREEMPT_NONE=y، أي أن نبضة المؤقت التي يراجع عندها المجدول المهمة الحالية تأتي كل 10 ملي ثانية، فالمهمة الحسابية لا تترك المعالج إلا عند نبضة، فتأخذ دوراً من نبضة أو نبضتين. والنوى التي تبنى لأجهزة سطح المكتب تستخدم غالباً تردداً أعلى مثل 250 أو 1000 حتى تكون الاستجابة أسرع.
وهذه النقطة تعلمنا شيئاً مهماً عن الأرقام في الكتب والمقالات: إعدادات المجدول في التوثيق هي ما يحاول المجدول الوصول إليه، أما ما يحدث فعلاً فيعتمد على تردد المؤقت ونوع المقاطعة Preemption في نواتك، وهذه تختلف بين توزيعة وأخرى وبين سيرفر وجهاز افتراضي.
تجربة القصة: تقرير ليلي يبطئ ال API
الآن نعيد بناء القصة في المختبر: معالج واحد، وعليه البرنامج lat الذي يمثل ال API، يخدم 1000 طلب، كل طلب 2 ملي ثانية انتظار ثم قرابة ملي ثانية عمل، أي أنه يحتاج قرابة ثلث المعالج. ومعه ثلاث نسخ من spin تمثل التقرير الذي يقسم عمله على ثلاث عمليات. ونجرب ست حالات: ال API وحدها، ثم مع التقرير بالقيمة الافتراضية، ثم بالقيمة nice 10، ثم nice 19، ثم بسياسة SCHED_BATCH، ثم بسياسة SCHED_IDLE. والسكربت كما يلي:
#!/bin/sh
# One CPU (cpu 7), one API-like probe and three CPU-bound report jobs, five ways.
CPU=7
run() {
  label="$1"; shift
  for i in 1 2 3; do taskset -c $CPU "$@" spin 20 & done
  sleep 1
  echo "== $label"
  ps -o pid,ni,cls,pri,psr,stat,comm -C spin
  taskset -c $CPU lat 1000 800000
  pkill spin; wait
}
echo "== alone"; taskset -c $CPU lat 1000 800000
run "3 jobs, nice 0"
run "3 jobs, nice 10" nice -n 10
run "3 jobs, nice 19" nice -n 19
run "3 jobs, SCHED_BATCH" chrt -b 0
run "3 jobs, SCHED_IDLE" chrt -i 0
ونشغله في Container عادي دون أي صلاحيات إضافية، لأن رفع الرقم nice وتغيير السياسة إلى Batch أو Idle مسموح لأي مستخدم، فهو تنازل عن أولوية وليس طلباً لها:
docker run --rm --name sos-sched -v "$PWD:/lab" sos-tools:1 sh -c 'sh build.sh && sh contention.sh'والمخرج سوف يكون كما يلي:
== alone
requests=1000 in 3.1 s  response ms: avg=1.08 p50=1.06 p99=1.26 max=8.15
schedstat: on_cpu=985 ms  run_queue_wait=0 ms  timeslices=1002
voluntary_ctxt_switches:	1000
nonvoluntary_ctxt_switches:	1
== 3 jobs, nice 0
  PID  NI CLS PRI PSR STAT COMMAND
   20   0  TS  19   7 R    spin
   21   0  TS  19   7 R    spin
   22   0  TS  19   7 R    spin
requests=1000 in 4.9 s  response ms: avg=2.87 p50=1.09 p99=16.31 max=50.56
schedstat: on_cpu=1206 ms  run_queue_wait=1344 ms  timeslices=1009
voluntary_ctxt_switches:	1001
nonvoluntary_ctxt_switches:	7
== 3 jobs, nice 10
  PID  NI CLS PRI PSR STAT COMMAND
   27  10  TS   9   7 RN   spin
   28  10  TS   9   7 RN   spin
   29  10  TS   9   7 RN   spin
requests=1000 in 6.5 s  response ms: avg=4.53 p50=1.09 p99=11.38 max=27.32
schedstat: on_cpu=2711 ms  run_queue_wait=60 ms  timeslices=1005
voluntary_ctxt_switches:	1000
nonvoluntary_ctxt_switches:	4
== 3 jobs, nice 19
  PID  NI CLS PRI PSR STAT COMMAND
   34  19  TS   0   7 RN   spin
   35  19  TS   0   7 RN   spin
   36  19  TS   0   7 RN   spin
requests=1000 in 3.2 s  response ms: avg=1.19 p50=1.07 p99=3.66 max=10.89
schedstat: on_cpu=1091 ms  run_queue_wait=5 ms  timeslices=1003
voluntary_ctxt_switches:	1001
nonvoluntary_ctxt_switches:	1
== 3 jobs, SCHED_BATCH
  PID  NI CLS PRI PSR STAT COMMAND
   41   0   B  19   7 R    spin
   42   0   B  19   7 R    spin
   43   0   B  19   7 R    spin
requests=1000 in 4.3 s  response ms: avg=2.29 p50=1.09 p99=12.41 max=49.12
schedstat: on_cpu=1071 ms  run_queue_wait=1150 ms  timeslices=1006
voluntary_ctxt_switches:	1001
nonvoluntary_ctxt_switches:	4
== 3 jobs, SCHED_IDLE
  PID  NI CLS PRI PSR STAT COMMAND
   48   - IDL  19   7 R    spin
   49   - IDL  19   7 R    spin
   50   - IDL  19   7 R    spin
requests=1000 in 3.4 s  response ms: avg=1.42 p50=1.07 p99=10.47 max=11.37
schedstat: on_cpu=1159 ms  run_queue_wait=6 ms  timeslices=1003
voluntary_ctxt_switches:	1001
nonvoluntary_ctxt_switches:	1
ماذا تقول الأرقام؟
لنمش مع المخرج سطراً سطراً، ولنبدأ من السطر الذي يهمنا أكثر من غيره في كل حالة، وهو run_queue_wait، أي مجموع الوقت الذي قضته ال API جاهزة للعمل وتنتظر المعالج، وهذا الرقم تحسبه النواة نفسها فلا يتأثر بطريقة قياسنا:
- ال API وحدها: 1000 طلب في 3.1 ثانية، والوسيط p50 للاستجابة 1.06 ملي ثانية، و
run_queue_wait=0، أي أنها لم تنتظر المعالج إطلاقاً. وكل التبديلات طوعية تقريباً (1000 من 1001)، لأن البرنامج يترك المعالج بنفسه عند كل نوم. - مع التقرير بالقيمة الافتراضية: قضت ال API 1344 ملي ثانية في الانتظار، والمتوسط تضاعف تقريباً ثلاث مرات من 1.08 إلى 2.87، وأبطأ 1% من الطلبات p99 وصلت 16.31 ملي ثانية. وهذا هو ما تراه في لوحة المراقبة في القصة، والسبب حسابي: ثلاث مهام ثقيلة ومهمة رابعة بنفس الوزن، فحصة ال API العادلة 25% من المعالج، بينما هي تحتاج قرابة الثلث، فتتأخر.
- لاحظ مع ذلك أن الوسيط p50 بقي 1.09، أي أن أغلب الطلبات لم تتأثر، لأن ال API تستيقظ برقم vruntime صغير فتسبق غالباً، والتأخير يتراكم على جزء من الطلبات فقط. وهذا سبب أن مراقبة المتوسط وحده أو الوسيط وحده تخفي المشكلة، ولا بد من النظر إلى p99.
- العمود NI في
psصار 10 ثم 19، والحالةRNمعناها أن المهمة جاهزة وأولويتها مخفضة. ومعnice 10هبط الانتظار من 1344 إلى 60 ملي ثانية، ومعnice 19إلى 5 ملي ثانية، والحساب يفسر ذلك: وزن ثلاث مهام بالقيمة 10 مجموعه 330، فحصة ال API إذا تنافس الجميع 1024 من 1354، أي قرابة 76%، وهي أكثر بكثير من الثلث الذي تحتاجه. - السياسة SCHED_BATCH لم تساعد تقريباً، فالانتظار 1150 ملي ثانية، قريب من حالة القيمة الافتراضية. وهذا متوقع من التوثيق، فهذه السياسة تعني أن المهمة لا تقاطع غيرها كثيراً عند استيقاظها، وأن المجدول يفترض أنها حسابية، ولكنها تبقى بنفس الوزن بحسب الرقم
nice، فحصتها لا تتغير. وفي ذلك خطأ شائع، فكثير من الناس يظنون أن Batch معناها «أولوية منخفضة». - السياسة SCHED_IDLE أعطت انتظاراً 6 ملي ثانية فقط، وفي
psظهر العمود CLS بالقيمةIDLوالعمود NI بالعلامة-، لأن الرقمniceلا معنى له في هذه السياسة، فصفحة sched تصفها بأنها أقل حتى من القيمة 19.
والصورة التالية تجمع وقت الانتظار في الحالات الست في مكان واحد:
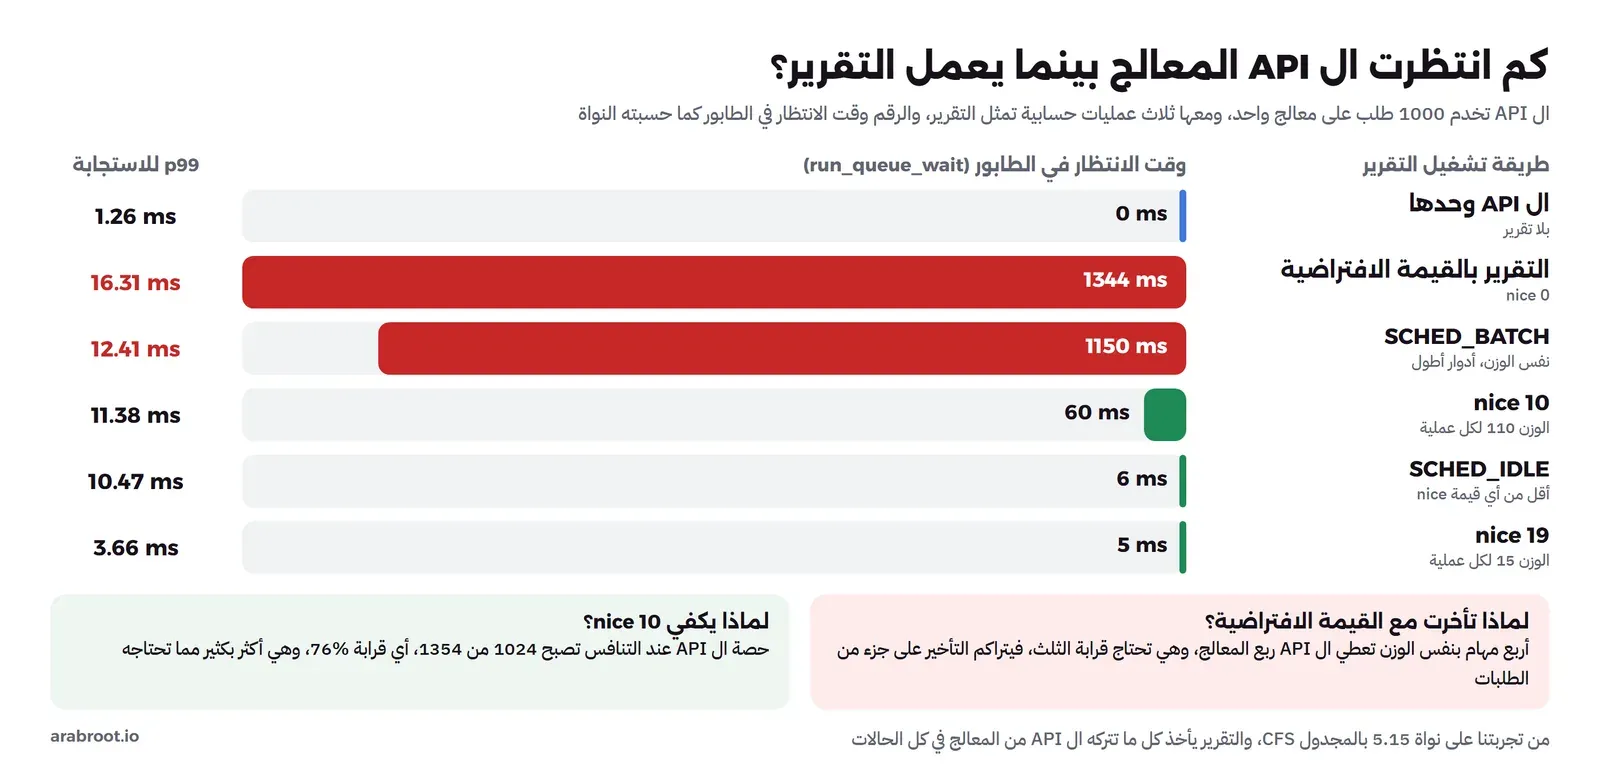
ولاحظ أن التقرير في كل هذه الحالات لم يتوقف، فقد أخذ كل ما تركته ال API من المعالج، وهذا هو المطلوب: التقرير ينتهي في نفس الليلة، وال API لا تشعر به.
مشكلة واجهتنا: أرقام تتغير بين تشغيل وآخر
عندما شغلنا التجربة أول مرة على المعالج 0 انتظرت ال API في الطابور 157 ملي ثانية وهي وحدها عليه، أي أن مهاماً أخرى كانت تعمل على نفس المعالج، فقد كانت على نفس الجهاز Containers أخرى تعمل في نفس الوقت. لذلك قرأنا من الملف /proc/stat نسبة انشغال كل معالج خلال خمس ثوان، فوجدنا المعالجات كلها بين 24% و38%، والمعالج 7 أقلها انشغالاً، فانتقلنا إليه. وحتى عليه ظهر في أحد التشغيلات p99 قدره 11.30 ملي ثانية وانتظار 120 ملي ثانية وال API وحدها، لذلك شغلنا التجربة كاملة مرتين أخريين وقارنا بينهما، والمخرج أعلاه هو الثاني منهما.
وحتى بعد ذلك بقي شيء غريب تراه في المخرج أعلاه نفسه: في حالة nice 10 كان الانتظار 60 ملي ثانية فقط، ومع ذلك صار المتوسط 4.53 وطال التشغيل إلى 6.5 ثانية. والسطر الذي يفسر ذلك هو on_cpu=2711 ms، فنفس العمل الذي أخذ 985 ملي ثانية والبرنامج وحده أخذ هنا قرابة ثلاثة أضعاف. أي أن البرنامج لم يكن ينتظر المجدول، وإنما كان يعمل على المعالج ببطء. وفي التشغيل الأول حدث نفس الشيء في حالة nice 19 وليس nice 10، فالمشكلة لا علاقة لها بالقيمة. وعندما قرأنا الملف /sys/devices/system/cpu/cpu7/topology/thread_siblings_list وجدنا فيه 6-7، أي أن المعالجين 6 و7 خيطان عتاديان على نفس النواة الفيزيائية، فإذا شغلت مهمة أخرى في الجهاز المعالج 6 في نفس اللحظة تقاسمت مع برنامجنا وحدات التنفيذ وال Cache، وفوق ذلك فالمعالج 7 في الجهاز الافتراضي هو نفسه خيط يجدوله نظام المضيف Windows مع برامجه.
والدرس من ذلك عملي جداً: عندما يبطئ برنامجك فهناك سؤالان مختلفان، الأول هل ينتظر المعالج، والجواب في وقت الانتظار في schedstat أو في عمود الطابور r في vmstat، والثاني هل يعمل على المعالج ببطء، والجواب في وقت التشغيل نفسه مقارنة بالحالة الطبيعية، أو في الوقت المسروق Steal في الأجهزة الافتراضية. والحل في الحالة الأولى عند المجدول، أي عند الأدوات التي في هذا المقال، أما في الحالة الثانية فالمجدول بريء، والحل في جيران النواة الفيزيائية أو في مزود الخدمة. ولهذا السبب أيضاً نقارن في التجربة وقت الانتظار والوسيط وليس الحد الأقصى، فالحد الأقصى 8.15 ملي ثانية ظهر في حالة ال API وحدها مع انتظار صفر، أي أنه جاء من خارج طابور نواتنا.
فئات الجدولة Scheduling Classes: من يسبق من؟
المجدول في Linux ليس خوارزمية واحدة، وإنما مجموعة من فئات الجدولة Scheduling Classes مرتبة بالأولوية، كما يشرح توثيق CFS في قسم الفئات. وعند كل قرار يسأل المجدول الفئات بالترتيب: هل عندك مهمة جاهزة؟ فإذا كان عند الفئة الأعلى مهمة جاهزة أخذت المعالج، ولا تصل الفئة الأدنى إلى المعالج إلا إذا لم يكن عند الأعلى منها شيء. والصورة التالية تبين هذا الترتيب:
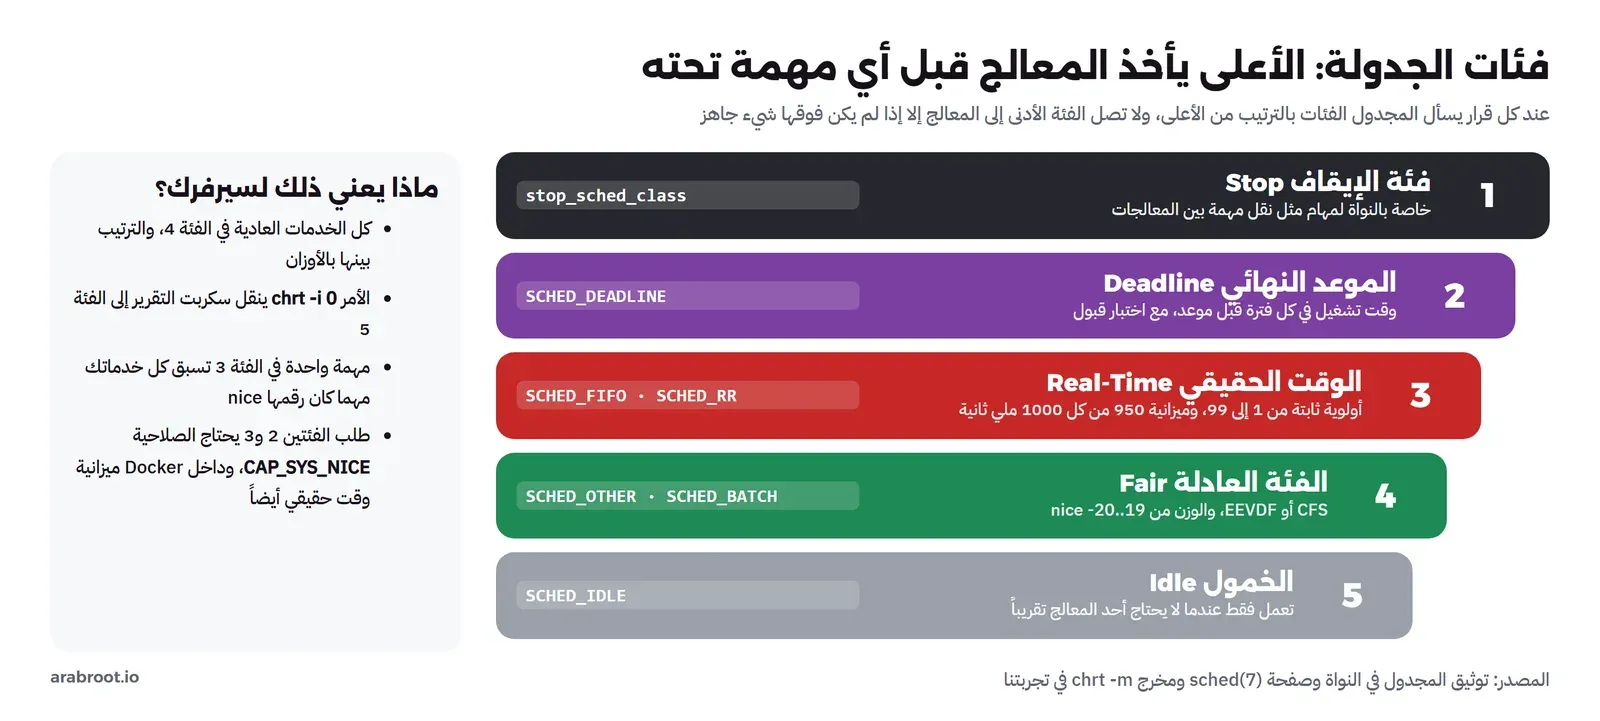
والأمر chrt -m يعرض السياسات المتاحة ومدى الأولوية في كل واحدة:
SCHED_OTHER min/max priority	: 0/0
SCHED_FIFO min/max priority	: 1/99
SCHED_RR min/max priority	: 1/99
SCHED_BATCH min/max priority	: 0/0
SCHED_IDLE min/max priority	: 0/0
SCHED_DEADLINE min/max priority	: 0/0
والسياسات الثلاث التي أولويتها 0/0 تعيش كلها في الفئة العادلة، والترتيب بينها بالأوزان كما رأينا، أما FIFO وRR فأولويتها رقم من 1 إلى 99، وأي مهمة فيها تسبق كل المهام العادية مهما كان رقمها nice.
الوقت الحقيقي Real-Time: سياستا SCHED_FIFO و SCHED_RR
في سياسة SCHED_FIFO تعمل المهمة حتى تنام أو تنتهي أو تأتي مهمة بأولوية أعلى، ولا يوجد دور ينتهي، أما SCHED_RR فهي نفس الشيء مع دور ثابت بين المهام المتساوية في الأولوية. والغرض منهما البرامج التي يجب أن تستجيب خلال زمن محدد مهما حدث، مثل معالجة الصوت أو التحكم في الأجهزة الصناعية. وقد يظن البعض أن الحل لمشكلة ال API أن نعطيها أولوية وقت حقيقي فتسبق التقرير دائماً، فلنجرب ذلك. في Container عادي كانت النتيجة:
chrt: failed to set pid 0's policy: Operation not permitted
exit=1
وهذا متوقع، فطلب أولوية الوقت الحقيقي يحتاج الصلاحية CAP_SYS_NICE كما في صفحة capabilities، وDocker لا يعطيها لل Container افتراضياً. فأضفناها بالخيار --cap-add SYS_NICE، وكانت المفاجأة أن الخطأ نفسه بقي. والسبب هنا ليس في الصلاحية وإنما في النواة: نواتنا مبنية بالخيار CONFIG_RT_GROUP_SCHED=y، أي أن لكل مجموعة cgroup ميزانية خاصة من وقت الوقت الحقيقي في الملف cpu.rt_runtime_us، وعندما قرأنا هذا الملف داخل ال Container وجدنا القيمة 0، أي أن ال Container لا يملك أي وقت لمهام الوقت الحقيقي، فترفض النواة الطلب. وتوثيق قيود الموارد في Docker يشرح الحل الرسمي: الخيار --cpu-rt-runtime لل Container، بشرط أن يكون خادم Docker نفسه قد بدأ بميزانية لمجموعته الأم، وعندما جربنا الخيار دون ذلك رفضه Docker برسالة invalid argument.
ولأن الغرض هنا أن نرى ماذا يفعل خيط واحد بأولوية FIFO، شغلنا في المختبر وحده Container بالخيار --privileged، وفيه ربطنا شجرة مجموعات المعالج وانقلنا بالصدفة إلى المجموعة الرئيسية التي تملك الميزانية الافتراضية، ثم شغلنا مهمة حسابية بأولوية FIFO 50 على المعالج 7 وال API على نفس المعالج. ولا تقم بذلك على سيرفر حقيقي، فالخيار --privileged يعطي ال Container صلاحيات المضيف تقريباً، وقد استخدمناه هنا لأنه الطريق الوحيد لتجاوز ميزانية Docker دون تغيير إعدادات خادمه:
#!/bin/sh
# Lab only (privileged container): Docker gives each container an RT budget of 0 (cpu.rt_runtime_us),
# so we mount the cpu cgroup hierarchy and move this shell to its root, which has the default budget.
mkdir -p /mnt/cg && mount -t cgroup -o cpu cgroup /mnt/cg
cat /mnt/cg/cpu.rt_period_us /mnt/cg/cpu.rt_runtime_us
echo $$ > /mnt/cg/cgroup.procs
taskset -c 7 chrt -f 50 spin 6 &
sleep 0.5
chrt -p $!
taskset -c 7 lat 200 800000
wait
والمخرج سوف يكون كما يلي:
1000000
950000
pid 22's current scheduling policy: SCHED_FIFO
pid 22's current scheduling priority: 50
requests=200 in 5.4 s  response ms: avg=24.90 p50=1.07 p99=954.16 max=955.35
schedstat: on_cpu=215 ms  run_queue_wait=5200 ms  timeslices=203
voluntary_ctxt_switches:	201
nonvoluntary_ctxt_switches:	1
في المخرج أعلاه لاحظ التالي:
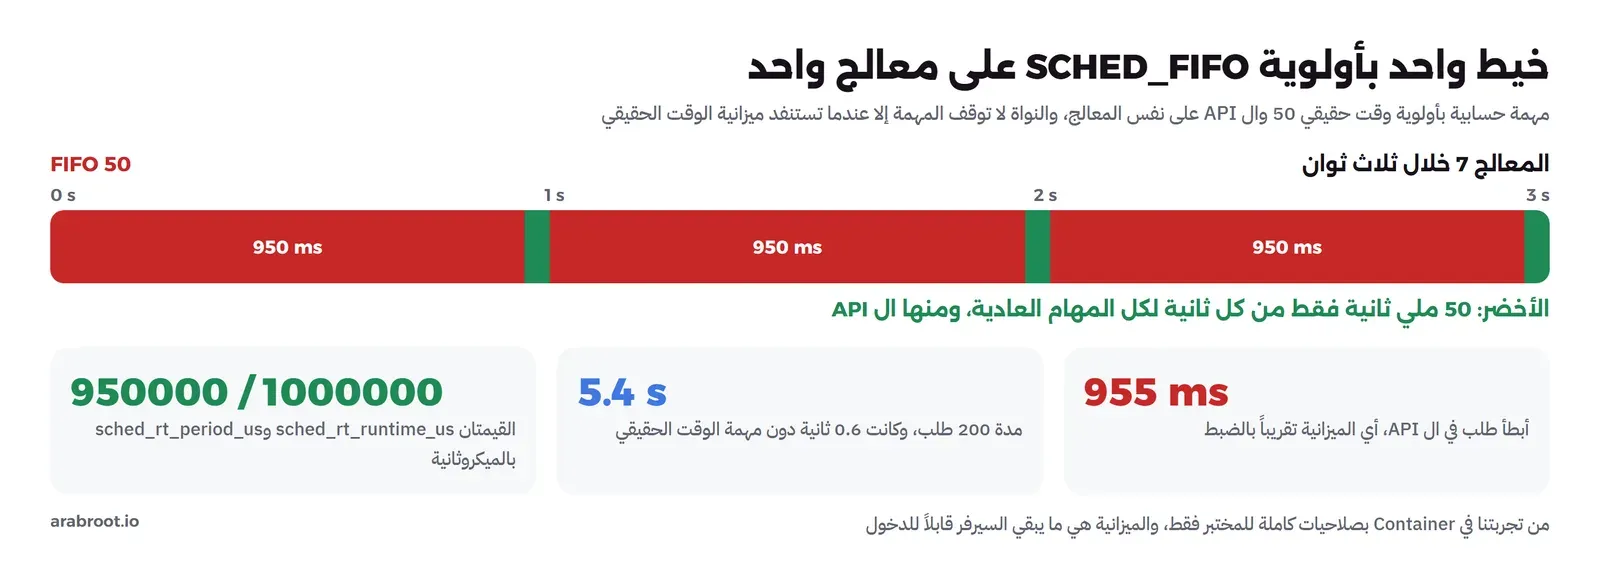
- السطران الأولان هما ميزانية الوقت الحقيقي للنظام كله: من كل فترة طولها 1000000 ميكروثانية، أي ثانية، يسمح لمهام الوقت الحقيقي بـ 950000 فقط، وتبقى 50 ملي ثانية للمهام العادية. وهذه القيم الافتراضية في الملفين
sched_rt_period_usوsched_rt_runtime_usاللذين تشرحهما صفحة sched وتوثيق جدولة مجموعات الوقت الحقيقي. - مئتا طلب أخذت 5.4 ثانية بدلاً من 0.6 ثانية، والانتظار في الطابور 5200 ملي ثانية، أي أن ال API لم تأخذ المعالج إلا في الفتات.
- الحد الأقصى 955 ملي ثانية، وهو تقريباً 950 ملي ثانية الميزانية بالضبط: المهمة FIFO احتكرت المعالج حتى استنفدت ميزانيتها في هذه الثانية، فأوقفتها النواة 50 ملي ثانية، وفيها فقط عملت ال API. وبدون هذه الميزانية لكانت ال API توقفت كلياً طوال الثواني الست.
والصورة التالية تبين ما حدث على المعالج خلال ثلاث ثوان من التجربة:
وهذا يجيب عن السؤال: أعطينا أولوية الوقت الحقيقي للمهمة الخطأ هنا عمداً، ولكن الخطأ نفسه يحدث فعلاً عندما يعطي أحدهم برنامجاً أولوية وقت حقيقي «حتى يكون أسرع» ثم يدخل هذا البرنامج في حلقة لا تنتهي بسبب خطأ في الكود، فيتجمد السيرفر إلا من نافذة 5% في كل ثانية، وهي النافذة التي وضعت النواة الميزانية من أجلها حتى يستطيع المدير الدخول وقتل البرنامج. ولذلك فالوقت الحقيقي ليس طريقة لتسريع ال API، وإنما وعد بأن الكود الذي يعمل به قصير ومحدود ولا يحتكر المعالج.
السياسة SCHED_DEADLINE باختصار
فوق الوقت الحقيقي توجد السياسة SCHED_DEADLINE، وفيها لا تعطي المهمة رقماً للأولوية، وإنما ثلاثة أرقام: كم تحتاج من وقت التشغيل Runtime في كل فترة Period، وما الموعد النهائي Deadline الذي يجب أن تنتهي قبله، كما في توثيق SCHED_DEADLINE. ثم تختبر النواة عند الطلب هل تستطيع الوفاء بكل المهام المسجلة معاً، وترفض المهمة الجديدة إذا لم تستطع، وهذا ما يسمى اختبار القبول Admission Control. وهذه السياسة تفيد في أنظمة الوسائط والتحكم، ونادراً ما تحتاجها في تطبيقات الويب، ولكن معرفتها تكمل الصورة: كلما صعدت في سلم الفئات زاد الضمان وزادت المسؤولية على من يطلبه.
انقلاب الأولوية Priority Inversion: ما حدث لمركبة Mars Pathfinder
الأولويات الثابتة لها مشكلة معروفة اسمها انقلاب الأولوية Priority Inversion: مهمة منخفضة الأولوية تمسك قفلاً Lock، ثم تحتاج مهمة عالية الأولوية نفس القفل فتنتظر، وفي هذه الأثناء تأتي مهمة متوسطة الأولوية لا تحتاج القفل فتأخذ المعالج من المنخفضة، فلا تستطيع المنخفضة أن تكمل وتحرر القفل، وتبقى العالية تنتظر خلف المتوسطة.
وفي Linux توجد نفس الفكرة في الأقفال من نوع PTHREAD_PRIO_INHERIT، ولكن الدرس الأهم لك أن خلط الأولويات الثابتة مع أقفال مشتركة يحتاج تصميماً حذراً، وهذا سبب آخر لعدم استخدام الوقت الحقيقي في تطبيقات عادية.
أكثر من نواة: طابور Run Queue لكل معالج وموازنة المهام Load Balancing
كل ما سبق كان على معالج واحد، أما سيرفرك ففيه غالباً عدة معالجات منطقية، والحل البسيط هنا أن يكون هناك طابور واحد يأخذ منه كل المعالجات، ولكن هذا الطابور يحتاج قفلاً يتزاحم عليه كل المعالجات عند كل قرار، ويجعل المهمة تنتقل بين المعالجات باستمرار فتفقد بياناتها من ال Cache الخاص بكل نواة. لذلك يحتفظ Linux بطابور تشغيل Run Queue مستقل لكل معالج منطقي، والمهمة تبقى غالباً على نفس المعالج، ثم يعمل جزء من المجدول اسمه موازنة المهام Load Balancing على فترات، وعندما يصبح أحد المعالجات فارغاً، فينقل مهاماً من الطوابير المزدحمة إلى الفارغة. وهذه الموازنة تحترم شكل الجهاز، فنقل مهمة بين خيطين عتاديين على نفس النواة الفيزيائية أرخص من نقلها إلى نواة أخرى، ونقلها بين معالجين على نفس الشريحة أرخص من نقلها إلى مقبس Socket آخر، وتسمى هذه المستويات نطاقات الجدولة Scheduling Domains كما في توثيقها في النواة.
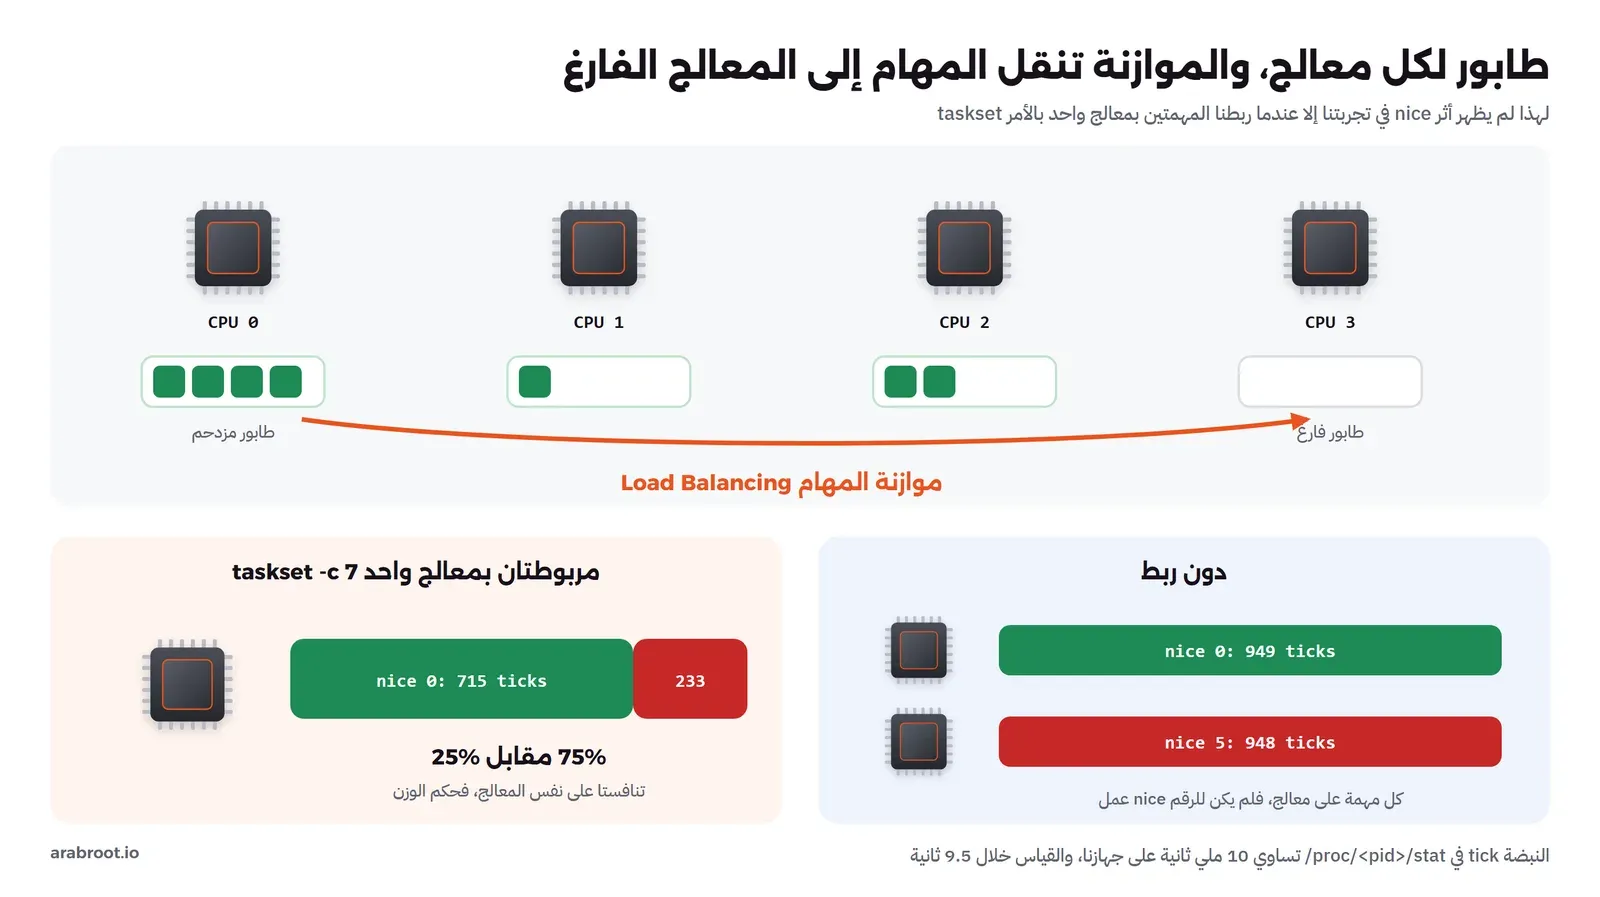
وهذا يفسر ما رأيناه في تجربة الأوزان: دون taskset وضعت الموازنة كل مهمة على معالج مختلف، فلم تتنافسا ولم يظهر أثر الرقم nice. وفي مخرج perf رأيت العداد cpu-migrations، وهو عدد المرات التي نقل فيها المجدول المهمة بين معالجين، وكان 1 فقط لأن taskset منع النقل. والأمر taskset يضبط ما يسمى انتماء المعالج CPU Affinity كما في صفحة taskset، أي قائمة المعالجات المسموح للمهمة أن تعمل عليها، وهو مفيد في التجارب وفي حالات خاصة مثل عزل برنامج حساس عن الباقي، ولكن الربط الثابت في الإنتاج يحرم الموازنة من حريتها، فإذا ربطت برنامجين بنفس المعالج تنافسا عليه والمعالجات الأخرى فارغة.
وماذا يحدث إذا لم نربط التقرير والـ API بمعالج واحد في القصة؟ على سيرفر فيه معالجان والتقرير ثلاث عمليات، تبقى المنافسة موجودة لأن عدد المهام الحسابية أكبر من المعالجات، وتتوزع ال API على المعالج الأقل ازدحاماً عند استيقاظها، فتقل المشكلة ولا تختفي. أما إذا كان التقرير عملية واحدة والسيرفر فيه أربعة معالجات فغالباً لن تشعر ال API به أصلاً، وهذا ما يجعل نفس السكربت يسبب مشكلة على سيرفر صغير ولا يسببها على سيرفر أكبر.
ال Containers والمجموعات cgroups
على سيرفر يشغل عدة Containers يظهر سؤال آخر: هل يعدل المجدول بين المهام أم بين ال Containers؟ فإذا كان في Container واحد عشرون خيطاً مشغولاً وفي آخر خيط واحد، هل يأخذ الأول عشرين ضعف الثاني؟ والجواب أن المجدول العادل يعمل على شكل شجرة، فكل مجموعة cgroup تعامل كمهمة واحدة لها وزن في مستوى أعلى، ثم يقسم وقت المجموعة بين مهامها في الداخل. وفي cgroup v2 الوزن هو الملف cpu.weight وقيمته الافتراضية 100، كما في توثيق cgroup v2، وفي cgroup v1 التي يعمل بها جهازنا هو cpu.shares بقيمة افتراضية 1024، والخيار --cpu-shares في Docker يضبطه. وبالتالي فالطريقة الصحيحة لحل قصة التقرير على سيرفر يشغلهما في Containers منفصلة هي أن تعطي Container التقرير وزناً أقل، وهذا هو نفس مبدأ nice على مستوى المجموعة.
ويختلف الوزن عن الحد الأقصى Quota الذي يضبطه الخيار --cpus، فالوزن لا يمنع ال Container من استخدام المعالج الفارغ، أما الحد فيوقفه عند نسبة ثابتة حتى لو كان السيرفر فارغاً، وقد شرحنا ما يسببه هذا الحد من خنق Throttling في قسم الخيار --cpus والخيار --cpuset-cpus. وفي قصة التقرير الوزن أنسب، لأنك تريد أن ينتهي التقرير بأسرع ما يمكن عندما لا يحتاج أحد المعالج.
كيف تقرأ المجدول على سيرفرك؟
عندما تشك أن برنامجاً يتأخر بسبب المنافسة على المعالج فهذه الأدوات بالترتيب، من الأسهل إلى الأعمق:
- العمود
rفيvmstat 1: عدد المهام الجاهزة، فإذا كان أكبر من عدد المعالجات باستمرار فهناك منافسة، وقد شرحناه في تحليل الأداء في 60 ثانية. والعمودcsفي نفس الأمر عدد تبديلات السياق في الثانية للنظام كله. - الأمر
ps -eo pid,ni,cls,pri,psr,stat,comm: يعرض لكل عملية الرقمniceوالفئة والمعالج والحالة، وهو أسرع طريقة لتعرف هل سكربت التقرير يعمل فعلاً بالأولوية التي تظن. - الملف
/proc/<pid>/schedstat: الرقم الثاني فيه هو وقت الانتظار في الطابور بالنانو ثانية منذ بدأت العملية، فاقرأه مرتين بينهما ثوان قليلة، والفرق مقسوماً على المدة هو نسبة الوقت الذي قضاه البرنامج ينتظر المعالج. وفي الخيوط المتعددة اقرأه لكل خيط من/proc/<pid>/task/<tid>/schedstat. - العدادان
voluntary_ctxt_switchesوnonvoluntary_ctxt_switchesفيstatus: إذا زاد القسري بسرعة في برنامج يفترض أنه ينتظر الشبكة فهناك من ينافسه. - الأداة
perf stat -e context-switches,cpu-migrations -p <pid>: نفس الأرقام لفترة محددة، مع عدد مرات النقل بين المعالجات كما في صفحة perf-stat. - الأمر
chrt -p <pid>: يعرض سياسة الجدولة الحالية للعملية وأولويتها.
أخطاء شائعة
- الاعتماد على
reniceلعملية فيها خيوط تعمل: الأمر يستدعي الطلبsetpriority، وصفحة setpriority تذكر في قسم الأخطاء أن الرقم في Linux صفة لكل خيط، وقد رأينا أن تغيير رقم خيط واحد غيره وحده. لذلك تأكد بالأمرps -Lأن كل الخيوط تغيرت، أو ابدأ البرنامج من البداية بالأمرniceفيرث كل خيط ينشئه نفس القيمة. - استخدام SCHED_BATCH على أنها أولوية منخفضة: رأينا أنها لم تخفض انتظار ال API تقريباً، والصحيح هو
nice -n 19أوchrt -i 0. - إعطاء برنامج عادي أولوية وقت حقيقي ليكون أسرع: رأينا أن مهمة FIFO واحدة على معالج واحد تركت لغيرها 50 ملي ثانية من كل ثانية، وأي خطأ في هذا البرنامج يجمد السيرفر.
- تخفيض أولوية برنامج يحتاج القرص بالرقم
niceوحده: هذا الرقم يخص المعالج فقط، فإذا كان التقرير يضغط القرص فالأداة المناسبةioniceكما في صفحتها، وقد يحتاج سكربت التقرير الأمرين معاً. - قراءة الحالة D على أنها برنامج معلق في الكود: هذه الحالة انتظار داخل النواة غالباً للقرص أو للشبكة في نظام ملفات بعيد، والبحث يكون في القرص وليس في البرنامج.
- محاولة قتل Zombie: ال Zombie ميت أصلاً، والذي يحتاج الإصلاح هو أبوه.
- الحكم على المجدول من أبطأ طلب: الحد الأقصى في الأجهزة الافتراضية يأتي كثيراً من خارج النواة كما رأينا، فاحكم من وقت الانتظار الذي تحسبه النواة ومن p99 عبر عدة تشغيلات.
- ربط البرامج بالمعالجات بالأمر
tasksetفي الإنتاج دون سبب: الربط يحرم موازنة المهام من حريتها، وقد يجعل برنامجين يتنافسان على معالج واحد والباقي فارغ.
جدول القرار Decision Table: أي أداة لأي هدف؟
| الهدف | الأداة | لماذا |
|---|---|---|
| مهمة خلفية حسابية لا تزعج الخدمات | nice -n 19 أو chrt -i 0 | تأخذ كل المعالج الفارغ وتتنحى عند المنافسة، وفي تجربتنا هبط الانتظار من 1344 إلى 5 و6 ملي ثانية |
| مهمة حسابية طويلة تريد ألا تقاطع كثيراً | chrt -b 0 | أدوار أطول وفائدة أكبر من ال Cache، ولكن بنفس الحصة، فلا تستخدمها لتخفيض الأولوية |
| مهمة تضغط القرص | ionice -c 3 مع nice | الرقم nice لا يخص القرص |
| Container أقل أهمية من غيره | --cpu-shares أو cpu.weight | وزن للمجموعة كلها لا يمنعها من المعالج الفارغ |
| حد صارم لاستهلاك Container | --cpus | حد ثابت حتى لو كان السيرفر فارغاً، مع خطر الخنق |
| استجابة مضمونة في نظام صوت أو تحكم | SCHED_FIFO أو SCHED_DEADLINE | فقط للكود القصير المحدود، ومع ميزانية الوقت الحقيقي |
| عزل برنامج حساس على معالجات خاصة | taskset أو --cpuset-cpus | يمنع التنقل ويضمن ال Cache، ولكنه يلغي موازنة المهام لهذا البرنامج |
| معرفة هل البرنامج ينتظر المعالج | /proc/<pid>/schedstat وvmstat 1 | وقت الانتظار تحسبه النواة نفسها |
وفي قصتنا الحل أبسط مما يظن الكثير: سطر واحد في ملف المهمة المجدولة يبدأ التقرير بالأمر nice -n 19 أو chrt -i 0، وإذا كان يعمل كخدمة في systemd فالإعدادان Nice=19 وCPUSchedulingPolicy=idle في ملف الخدمة يفعلان نفس الشيء.
حذف المختبر
كل ال Containers في التجارب عملت بالخيار --rm فحذفت نفسها عند انتهائها، وبقيت ال Image التي بنيناها، فإذا لم تكن ستكمل مع المقالات الأخرى في هذه المرحلة فاحذفها:
docker rmi sos-tools:1الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- النواة ترى كل عملية وكل خيط كمهمة لها سجل، والمجدول يجدول الخيوط، والرقم
niceفي Linux صفة لكل خيط. - حالات المهمة R وS وD وT وZ تخبرك أين هي الآن، والعمود WCHAN يخبرك ماذا تنتظر، وال Zombie ينتظر أباه ولا يقتل.
- المجدول CFS يشغل دائماً المهمة صاحبة أصغر وقت افتراضي، والوزن يحدد سرعة زيادة هذا الوقت، وكل درجة
niceفرق بمعامل 1.25، لذلك أعطى الفرق خمس درجات 75% مقابل 25%. - المجدول EEVDF منذ الإصدار 6.6 يحتفظ بنفس الأوزان ويضيف التأخر والموعد النهائي الافتراضي ليفصل الحصة عن سرعة الاستجابة.
- الرقم
niceلا يعمل إلا عند المنافسة على نفس المعالج، وهذا ما يجعله مناسباً للمهام الخلفية. - في قصة التقرير الليلي خفض
nice 19أو SCHED_IDLE انتظار ال API من 1344 إلى 5 و6 ملي ثانية، بينما لم تفعل SCHED_BATCH شيئاً يذكر. - الوقت الحقيقي يسبق كل المهام العادية، وخيط FIFO واحد حسابي ترك لغيره 50 ملي ثانية من كل ثانية في تجربتنا، فلا تستخدمه لتسريع تطبيق عادي.
- عند البطء افصل بين سؤالين: هل البرنامج ينتظر المعالج، والجواب في
schedstat، أم يعمل ببطء على المعالج، والجواب في وقت التشغيل والوقت المسروق.
وفي المقالات التالية من هذه المرحلة ننتقل من المعالج إلى الذاكرة، ثم إلى الحد بين النواة والبرامج، ثم إلى نظام الملفات:
 دليلالذاكرة الافتراضية Virtual Memory: جداول الصفحات وخطأ الصفحةنتابع العنوان من برنامجك إلى شريحة الذاكرة، ونفهم بأرقام حقيقية لماذا تخدعك أعمدة VIRT وRES، ومتى تسرع الصفحات الكبيرة برنامجك.
 دليلفضاء النواة والمستخدم: كم يكلف استدعاء النظام System Call؟نعبر الحد بين برنامجك والنواة بأيدينا دون أي مكتبة، ونقيس كلفة كل عبور، ونرى لماذا يأخذ نسخ ملف ببايت واحد في كل طلب عشرات الثواني بدلاً من أقل من ملي ثانية.
 دليلنظام الملفات File System: Inodes والسجل Journal وfsyncنتابع الكتابة من برنامجك حتى القرص داخل ext4، ونقطع الكهرباء عن نظام ملفات يعمل لنرى ماذا يبقى فعلاً، ومتى تحتاج fsync وكم يكلف.
 دليلالتزامن Concurrency والخيوط: ماذا يعني لسيرفرك وتطبيقاتكلماذا يكون المعالج عند 100% والتطبيق بطيئاً، ولا تسرع الخيوط كود Python، وكيف تضبط عدد العمال وحدود ال Containers.
 دليلتحليل أداء سيرفر Linux في 60 ثانية: ماذا تكتب أولاً؟ماذا تكتب أول ما تدخل إلى سيرفر بطيء، وكيف تعرف خلال دقيقة هل المشكلة في المعالج أم الذاكرة أم القرص أم الشبكة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجارب داخل Container من Debian 13 (trixie) مع util-linux 2.41.5 وperf 6.12 وgcc 14.2، على نواة Linux 5.15 (WSL2) ومعالج Intel Core i7-7700K، على Docker Engine 29.8.0.


