

في مقال PostgreSQL للفرق ذكرنا أن النسخة المنطقية بالأداة pg_dump تمثل لحظة واحدة فقط، فإذا نسخت القاعدة في الثانية فجراً ثم نفذ أحد أعضاء الفريق في الرابعة عصراً الأمر DELETE FROM orders ونسي الشرط WHERE، فأفضل ما تستطيعه هو العودة إلى الثانية فجراً وخسارة أربع عشرة ساعة من الطلبات. فماذا لو كنت تستطيع العودة إلى الثانية التي سبقت الأمر الخاطئ بالضبط؟ هذا ما يسمى الاستعادة إلى نقطة زمنية Point-in-Time Recovery واختصاراً PITR، وهو ما سوف نبنيه في هذا المقال بالأداة pgBackRest، ثم نحذف جدول الطلبات عمداً ونستعيده إلى ما قبل الحذف بأجزاء من الثانية.
وسوف نناقش في هذا المقال ما يلي:
- كيف تعمل الاستعادة إلى نقطة زمنية: النسخة الفيزيائية Physical Backup مع أرشيف WAL.
- لماذا pgBackRest وليس
pg_basebackupوحده، والبديل Barman، وتراخيص الأدوات. - النسخ الكاملة Full والفرقية Differential والتزايدية Incremental، وماذا تحتاج الاستعادة منها.
- مستودعان Repositories: قرص محلي، وتخزين متوافق مع S3 مشفر، وسياسة الاحتفاظ Retention لكل منهما.
- مختبر حقيقي: حذف كل الطلبات ثم الاستعادة إلى ما قبل الحذف، وطريقة أكثر أماناً تحفظ ما كتب بعد الخطأ.
- الأخطاء الشائعة وقائمة تحقق.
والقواعد العامة للنسخ الاحتياطي مثل قاعدة 3-2-1 وحساب RPO وRTO والنسخ التي لا يستطيع المخترق حذفها شرحناها في مقال النسخ الاحتياطي بقاعدة 3-2-1، وهذا المقال يطبقها على PostgreSQL.
كيف تعمل الاستعادة إلى نقطة زمنية؟
كل تغيير في PostgreSQL يكتب أولاً في سجل الكتابة المسبقة Write-Ahead Log واختصاراً WAL قبل أن يصل إلى ملفات الجداول، وهذا السجل مقسم إلى ملفات Segments حجم كل منها 16 ميجابايت افتراضياً، وطريقة عمله من الداخل شرحناها في مقال كيف تخزن قاعدة البيانات بياناتك من الداخل. والفكرة كلها أن نسخة من ملفات القاعدة في لحظة ما، ومعها كل ملفات WAL بعد تلك اللحظة، تكفي لإعادة بناء القاعدة في أي لحظة لاحقة، لأن PostgreSQL يعيد تنفيذ السجل كما كتبه أول مرة، ويستطيع أن يتوقف عند وقت تحدده، كما تشرح وثائق الأرشفة المستمرة.
ولذلك يحتاج PITR إلى شيئين معاً:
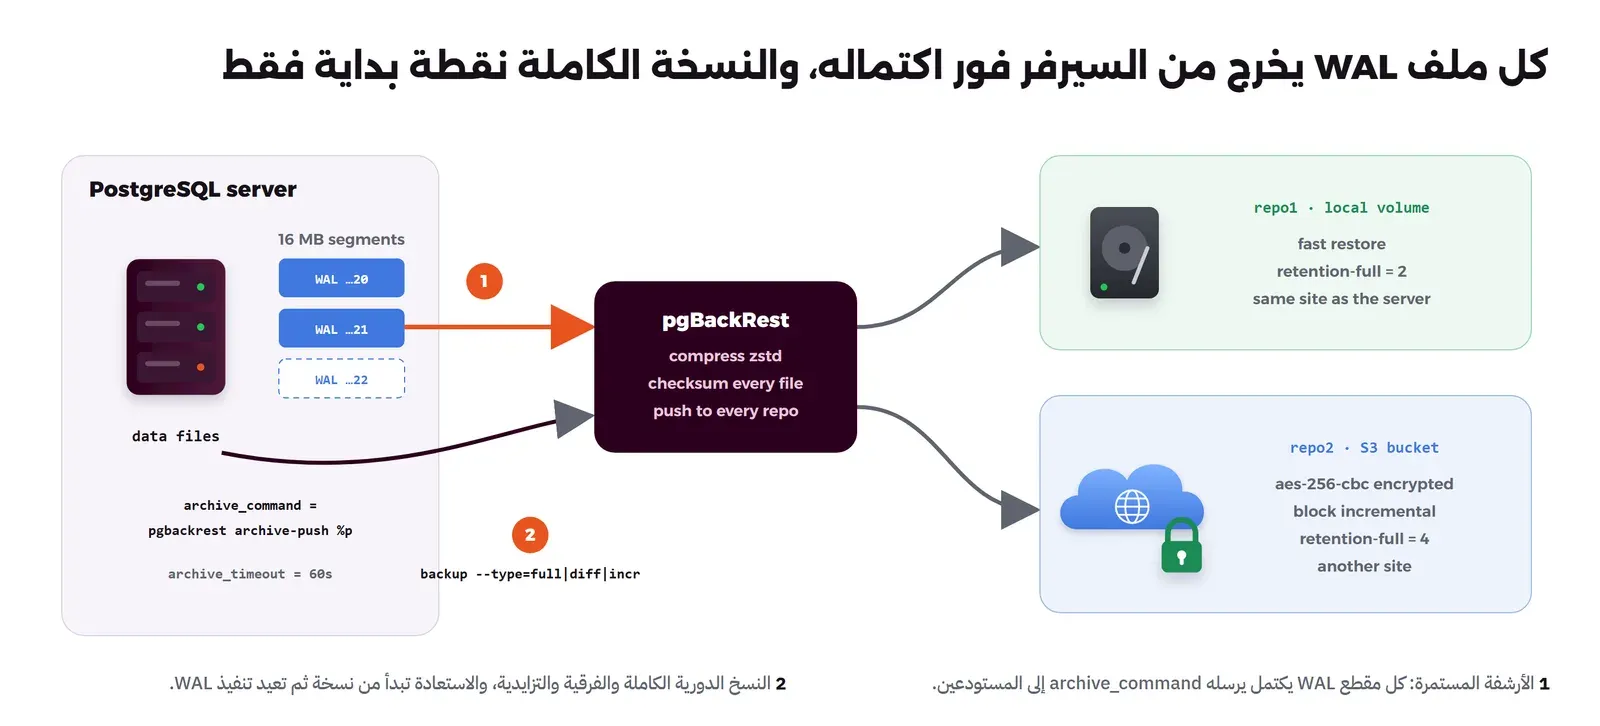
- الأرشفة المستمرة Continuous Archiving: كل ملف WAL يكتمل ينسخ فوراً خارج السيرفر عبر الإعداد
archive_command. - نسخة أساسية Base Backup دورية: نسخة فيزيائية من ملفات القاعدة تبدأ منها الاستعادة، فكلما كانت أحدث كان ما تعيد تنفيذه من WAL أقل والاستعادة أسرع.
الصورة التالية تبين الإعداد الذي سوف نبنيه:
لماذا pgBackRest؟
الطريقة البسيطة هي أدوات PostgreSQL نفسها: archive_command = 'cp %p /mnt/archive/%f' لنسخ WAL، وpg_basebackup للنسخة الأساسية، ومنذ PostgreSQL 17 أصبح pg_basebackup --incremental مع الأداة pg_combinebackup يدعم النسخ التزايدية أيضاً. وهذا يعمل، ولكنك سوف تكتب بنفسك كل ما حوله: سكربت يتحقق من أن cp لم يفشل في منتصف الملف، وحذف النسخ القديمة وملفات WAL التي لم تعد تحتاجها دون حذف ما تحتاجه نسخة أخرى، والضغط والتشفير، والرفع إلى S3، والتحقق من سلامة النسخ، وكل خطأ في هذا السكربت لا يظهر إلا يوم تحتاج الاستعادة.
والحل الأنسب أداة متخصصة، والأشهر اثنتان:
- pgBackRest: بترخيص MIT، وآخر إصدار 2.59.3، ويعمل على نفس سيرفر القاعدة أو من سيرفر نسخ مركزي، ويدعم النسخ والاستعادة المتوازية، والضغط، والتشفير، وعدة مستودعات في وقت واحد، والتخزين على قرص أو S3 أو Azure أو GCS، والتحقق من كل ملف بال Checksum.
- Barman: من شركة EDB بترخيص GPL-3.0، ويدير النسخ من سيرفر مركزي لعدة قواعد بيانات، ويناسب من يفضل هذا الشكل.
واخترنا pgBackRest لأن ملف إعداده الواحد يغطي الأرشفة والنسخ والاحتفاظ والاستعادة، ولأنه الأداة التي تستخدمها أشهر مشغلات PostgreSQL على Kubernetes مثل Crunchy PGO. وتذكر أن الأداة يجب أن تكون من نفس مستودع PGDG الذي ثبتت منه PostgreSQL، وهذا ما في ملف ال Dockerfile:
# PostgreSQL 18.6 with pgBackRest 2.59.3 from the same PGDG repository as the server
FROM postgres:18.6
RUN apt-get update \
 && apt-get install -y --no-install-recommends pgbackrest=2.59.3-1.pgdg13+1 ca-certificates \
 && rm -rf /var/lib/apt/lists/* \
 && install -d -o postgres -g postgres -m 750 /var/lib/pgbackrest /var/log/pgbackrest /var/spool/pgbackrest
النسخة الكاملة والفرقية والتزايدية
pgBackRest يأخذ ثلاثة أنواع من النسخ كما في مرجع الأوامر:
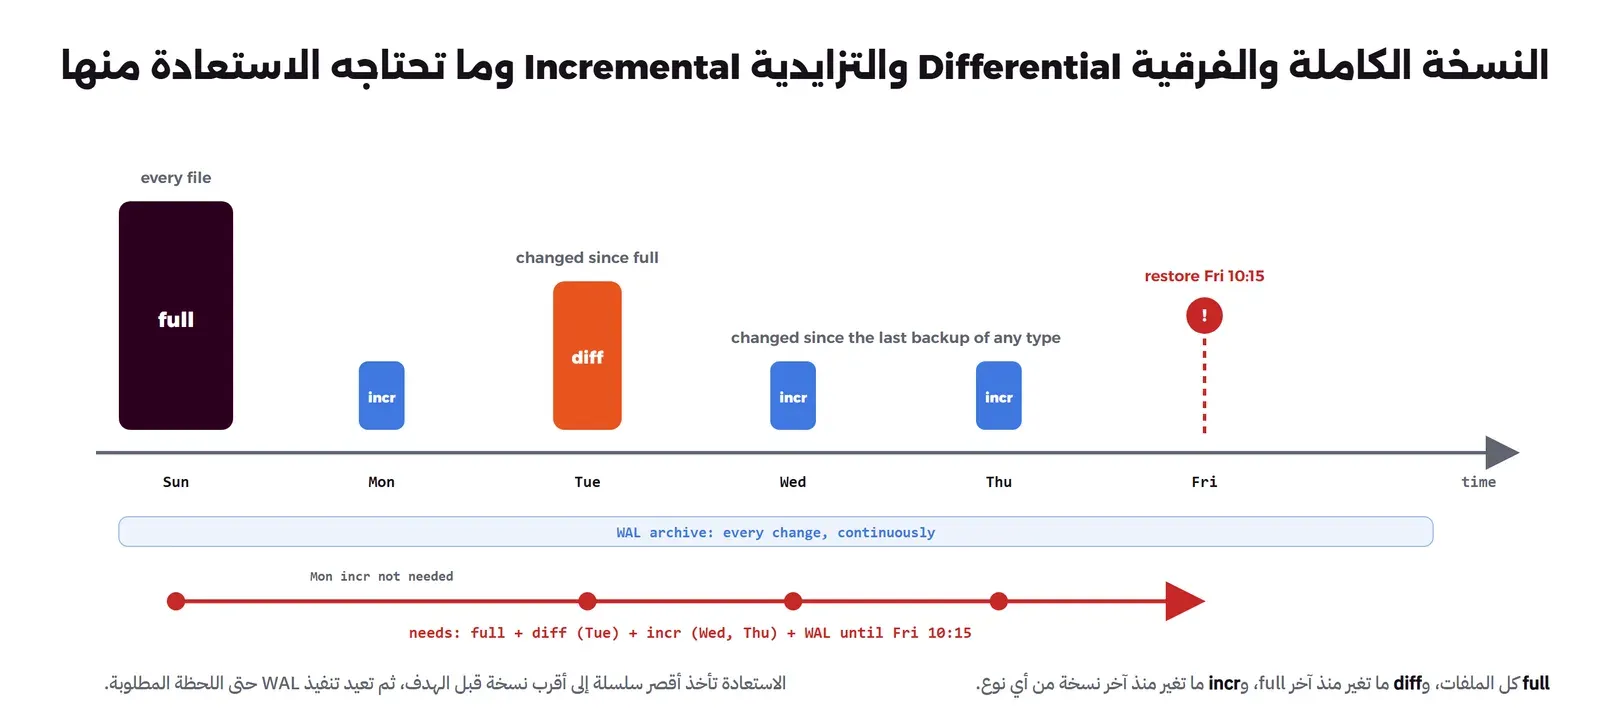
- الكاملة Full: كل ملفات القاعدة، وهي لا تعتمد على أي نسخة أخرى.
- الفرقية Differential: كل ما تغير منذ آخر نسخة كاملة، فتحتاج عند الاستعادة النسخة الكاملة وهذه فقط.
- التزايدية Incremental: ما تغير منذ آخر نسخة من أي نوع، فهي الأصغر، ولكن الاستعادة تحتاج السلسلة كلها حتى أول نسخة كاملة.
الصورة التالية تبين أسبوعاً من النسخ، وما تحتاجه الاستعادة يوم الجمعة:
وقد يتساءل البعض: لماذا لا آخذ نسخة كاملة كل يوم وأرتاح؟ والإجابة أن هذا ممكن لقاعدة صغيرة، ولكن القاعدة بمئات الجيجابايتات تأخذ ساعات في كل نسخة كاملة، وتضغط القرص والشبكة، لذلك يكون الجدول المعتاد نسخة كاملة أسبوعياً، وفرقية يومياً، وتزايدية كل بضع ساعات إذا أردت استعادة أسرع. ولاحظ أن النوع يحدد سرعة الاستعادة وليس دقتها، فالدقة إلى الثانية تأتي من WAL في كل الحالات.
وهناك تفصيل مهم: النسخ الفرقية والتزايدية في pgBackRest تنسخ الملف كاملاً إذا تغير أي جزء منه، وPostgreSQL يقسم الجدول إلى ملفات حجم كل منها 1 جيجابايت، فإذا كانت التحديثات موزعة على كل الجدول فالنسخة التزايدية تقارب الكاملة في الحجم. والخيار repo-block الذي فعلناه في المستودع الثاني يقسم الملفات إلى كتل Blocks وينسخ الكتل المتغيرة فقط، وهو يحتاج repo-bundle الذي يجمع الملفات الصغيرة معاً، وهذا مفيد خصوصاً مع S3 حيث كل ملف طلب منفصل، كما في مرجع الإعدادات.
تجهيز المختبر: قاعدة ومستودعان
المختبر يتكون من Container لقاعدة PostgreSQL 18.6 مع pgBackRest، وContainer لتخزين كائنات متوافق مع S3 هو SeaweedFS بترخيص Apache 2.0 ليمثل التخزين في موقع آخر. واخترناه بدل MinIO لأن مستودع MinIO المفتوح أصبح يذكر في أوله أنه لم يعد يصان، وتوجه الشركة المستخدمين إلى إصداراتها التجارية، وفي الإنتاج تستطيع استخدام أي خدمة S3 حقيقية بنفس الإعداد. والملف الكامل:
# PostgreSQL with continuous WAL archiving to two pgBackRest repositories:
# repo1 = a local volume (fast restores), repo2 = S3-compatible object storage (SeaweedFS here), encrypted.
name: lab-pitr
services:
  db:
    build: .
    image: lab-pitr-postgres:18.6-pgbackrest2.59.3
    container_name: lab-pitr-db
    environment:
      POSTGRES_PASSWORD_FILE: /run/secrets/pg_superuser
    secrets: [pg_superuser]
    env_file: ./secrets/pgbackrest.env
    command: ["postgres", "-c", "config_file=/etc/postgresql/postgresql.conf"]
    volumes:
      - lab-pitr-data:/var/lib/postgresql
      - lab-pitr-repo1:/var/lib/pgbackrest
      - ./conf/postgresql.conf:/etc/postgresql/postgresql.conf:ro
      - ./conf/pgbackrest.conf:/etc/pgbackrest/pgbackrest.conf:ro
      - ./certs/ca.crt:/etc/pgbackrest/s3-ca.crt:ro
    depends_on: [s3]
    healthcheck:
      test: ["CMD", "runuser", "-u", "postgres", "--", "pg_isready"]
      interval: 5s
      retries: 20

  s3:
    image: chrislusf/seaweedfs:4.48
    container_name: lab-pitr-s3
    command: >
      server -dir=/data -s3 -s3.port=8333 -s3.port.https=8443
      -s3.cert.file=/certs/s3.crt -s3.key.file=/certs/s3.key -s3.config=/etc/seaweedfs/s3.json
    volumes:
      - lab-pitr-s3:/data
      - ./certs:/certs:ro
      - ./secrets/s3.json:/etc/seaweedfs/s3.json:ro
    ports:
      - "127.0.0.1:58443:8443"
    networks:
      default:
        aliases: [s3.lab.internal]

secrets:
  pg_superuser:
    file: ./secrets/pg_superuser.txt
volumes:
  lab-pitr-data: { name: lab-pitr-data }
  lab-pitr-repo1: { name: lab-pitr-repo1 }
  lab-pitr-s3: { name: lab-pitr-s3 }
وفي إعداد PostgreSQL ثلاثة أسطر هي كل ما تحتاجه الأرشفة:
listen_addresses = '*'
shared_buffers = 256MB
# continuous archiving: every finished WAL segment goes to pgBackRest
wal_level = replica
archive_mode = on
archive_command = 'pgbackrest --stanza=main archive-push %p'
archive_timeout = 60s
max_wal_senders = 3
log_line_prefix = '%m [%p] '
لاحظ أن archive_timeout = 60s يجبر PostgreSQL على إغلاق ملف WAL الحالي وأرشفته كل دقيقة حتى لو لم يمتلئ، والسبب أن ملف WAL لا يؤرشف إلا عندما يكتمل، وفي قاعدة هادئة قد يأخذ ملف 16 ميجابايت ساعات حتى يمتلئ، فإذا ضاع السيرفر قبل ذلك ضاعت معه التغييرات التي لم تؤرشف. وهذا الرقم هو تقريباً أقصى ما تخسره إذا احترق السيرفر كاملاً، أي ال RPO، وإذا أردت أقل من ذلك فتحتاج نسخة متماثلة Replica تستقبل WAL لحظة بلحظة كما شرحنا في مقال عناقيد قواعد البيانات.
أما إعداد pgBackRest نفسه فهو ملف واحد:
[global]
# repo1: local volume, quick restores, short history
repo1-path=/var/lib/pgbackrest
repo1-retention-full=2

# repo2: S3-compatible object storage on another machine, encrypted, longer history
repo2-type=s3
repo2-s3-endpoint=s3.lab.internal
repo2-storage-port=8443
repo2-storage-ca-file=/etc/pgbackrest/s3-ca.crt
repo2-s3-bucket=pgbackrest
repo2-s3-region=us-east-1
repo2-s3-uri-style=path
repo2-path=/main-db
repo2-retention-full=4
repo2-cipher-type=aes-256-cbc
repo2-bundle=y
repo2-block=y
# repo2-s3-key, repo2-s3-key-secret and repo2-cipher-pass come from the environment (PGBACKREST_REPO2_*)

compress-type=zst
process-max=2
start-fast=y
log-level-console=info
log-level-file=detail

[main]
pg1-path=/var/lib/postgresql/18/docker
في الإعداد أعلاه لاحظ التالي:
- المستودع الأول على Volume محلي، وهو للاستعادة السريعة من الأخطاء اليومية، ويحتفظ بنسختين كاملتين فقط، وهو لا يحميك إذا ضاع السيرفر.
- المستودع الثاني على S3 في موقع آخر، ويحتفظ بأربع نسخ كاملة، وهو المشفر بالخوارزمية
aes-256-cbcلأنه يخرج إلى طرف آخر، وكلمة التشفير ومفاتيح S3 تأتي من متغيرات البيئةPGBACKREST_REPO2_*في ملف خارج Git، فلا تظهر في ملف الإعداد. - pgBackRest يتصل بخدمات S3 عبر TLS، لذلك أعطينا SeaweedFS شهادة من جهة إصدار صغيرة للمختبر، وأخبرنا pgBackRest بها في
repo2-storage-ca-file. start-fast=yيطلب نقطة تفتيش Checkpoint فورية حتى تبدأ النسخة مباشرة، ودونه قد تنتظر النسخة حتى نقطة التفتيش التالية.
repo2-cipher-pass فالمستودع الثاني كله لا يمكن قراءته، ولا توجد طريقة لاستعادته، لذلك احفظها في مدير الأسرار بعيداً عن السيرفر نفسه، فالسيرفر الذي احترق لن يعطيك كلمة المرور التي كانت عليه.إنشاء ال Stanza والتحقق من الأرشفة
بعد تشغيل ال Containers ظهر في سجل PostgreSQL مباشرة:
LOG:  archive command failed with exit code 103
DETAIL:  The failed archive command was: pgbackrest --stanza=main archive-push pg_wal/000000010000000000000001
WARNING:  archiving write-ahead log file "000000010000000000000001" failed too many times, will try again later
وهذا متوقع، فالأرشفة بدأت قبل أن ننشئ المستودع، والرسالة الكاملة عند تشغيل الأمر يدوياً تشرح السبب:
ERROR: [103]: unable to find a valid repository:
       repo1: [FileMissingError] unable to load info file '/var/lib/pgbackrest/archive/main/archive.info' ...
       HINT: has a stanza-create been performed?
ولاحظ أن PostgreSQL لا يحذف ملف WAL الذي فشلت أرشفته، وإنما يحتفظ به ويعيد المحاولة، وهذا يحمي الأرشيف من الفجوات، ولكنه يعني أيضاً أن الأرشفة المتعطلة أياماً سوف تملأ القرص بملفات WAL حتى تتوقف القاعدة، لذلك راقبها كما سيأتي. وال Stanza في pgBackRest هي إعداد Cluster واحد من PostgreSQL، وننشئها مرة واحدة ثم نتحقق:
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main stanza-create
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main check
والمخرج سوف يكون كما يلي:
INFO: stanza-create for stanza 'main' on repo1
INFO: stanza-create for stanza 'main' on repo2
INFO: stanza-create command end: completed successfully (317ms)
INFO: check repo2 configuration (primary)
INFO: check repo1 archive for WAL (primary)
INFO: WAL segment 000000010000000000000002 successfully archived to '/var/lib/pgbackrest/archive/main/18-1/0000000100000000/000000010000000000000002-d49a2901bb1d71177630bfbb577abcbb9e5b823e.zst' on repo1
INFO: check repo2 archive for WAL (primary)
INFO: WAL segment 000000010000000000000002 successfully archived to '/main-db/archive/main/18-1/0000000100000000/000000010000000000000002-d49a2901bb1d71177630bfbb577abcbb9e5b823e.zst' on repo2
INFO: check command end: completed successfully (1411ms)
الأمر check يطلب من PostgreSQL إغلاق ملف WAL الحالي ثم ينتظر حتى يجده في المستودعين، فهو اختبار حقيقي لكامل الطريق وليس لملف الإعداد فقط، وشغله بعد كل تعديل.
أخذ النسخ
جهزنا قاعدة shop بحجم 308 ميجابايت من بيانات pgbench مع جدول orders فيه عشرون ألف طلب، ثم أخذنا نسخة كاملة لكل مستودع، ثم شغلنا حملاً على القاعدة وأخذنا نسخة فرقية وتزايدية:
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main --repo=1 --type=full backup
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main --repo=2 --type=full backup
docker exec -u postgres lab-pitr-db pgbench -c 4 -T 20 -n shop
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main --repo=1 --type=diff backup
docker exec -u postgres lab-pitr-db pgbench -c 4 -T 10 -n shop
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main --repo=1 --type=incr backup
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main --repo=2 --type=incr backup
docker exec -u postgres lab-pitr-db pgbackrest --stanza=main info
والمخرج للأمر info سوف يكون كما يلي:
stanza: main
    status: ok
    cipher: mixed
        repo1: none
        repo2: aes-256-cbc

    db (current)
        wal archive min/max (18): 000000010000000000000001/000000010000000000000020

        full backup: 20261011-052938F
            timestamp start/stop: 2026-10-11 05:29:38+00 / 2026-10-11 05:29:45+00
            wal start/stop: 000000010000000000000013 / 000000010000000000000013
            database size: 331MB, database backup size: 331MB
            repo1: backup set size: 17.4MB, backup size: 17.4MB

        full backup: 20261011-052946F
            timestamp start/stop: 2026-10-11 05:29:46+00 / 2026-10-11 05:29:49+00
            wal start/stop: 000000010000000000000014 / 000000010000000000000015
            database size: 331MB, database backup size: 331MB
            repo2: backup size: 17MB

        diff backup: 20261011-052938F_20261011-053027D
            timestamp start/stop: 2026-10-11 05:30:27+00 / 2026-10-11 05:30:31+00
            wal start/stop: 00000001000000000000001B / 00000001000000000000001B
            database size: 331.9MB, database backup size: 302.1MB
            repo1: backup set size: 18.1MB, backup size: 14.6MB
            backup reference total: 1 full

        incr backup: 20261011-052938F_20261011-053045I
            timestamp start/stop: 2026-10-11 05:30:45+00 / 2026-10-11 05:30:50+00
            wal start/stop: 00000001000000000000001E / 00000001000000000000001E
            database size: 332.3MB, database backup size: 300.5MB
            repo1: backup set size: 18.2MB, backup size: 14.4MB
            backup reference total: 1 full, 1 diff

        incr backup: 20261011-052946F_20261011-053052I
            timestamp start/stop: 2026-10-11 05:30:52+00 / 2026-10-11 05:30:58+00
            wal start/stop: 00000001000000000000001F / 000000010000000000000020
            database size: 332.3MB, database backup size: 302.5MB
            repo2: backup size: 12.7MB
            backup reference total: 1 full
في المخرج أعلاه لاحظ التالي:
- القاعدة 331 ميجابايت والنسخة الكاملة 17 ميجابايت فقط بعد الضغط، والسبب أن بيانات
pgbenchفيها أعمدة كثيرة من المسافات الفارغة التي تضغط جداً، فلا تتوقع هذه النسبة مع بياناتك. - النسخة الفرقية والتزايدية نسختا 300 ميجابايت تقريباً من 331 قبل الضغط في المستودع الأول، لأن
pgbenchيحدث صفوفاً عشوائية في كل الجدول فتغير كل الملفات تقريباً، وهذا مثال واضح على أن حجم النسخة التزايدية يعتمد على توزيع التغييرات وليس على عددها. - كل نسخة تذكر مدى ملفات WAL الذي تحتاجه لتكون متسقة
wal start/stop، والسطرbackup reference totalيذكر النسخ التي تعتمد عليها. - السطر
cipher: mixedيبين أن المستودع الأول غير مشفر والثاني مشفر، وهذا مقصود.
وفي الإنتاج لا تأخذ النسخ يدوياً، وإنما بجدول cron أو systemd timer على السيرفر، مثلاً نسخة كاملة كل أحد إلى المستودعين، وفرقية كل ليلة، وكل أمر يرسل تنبيهاً إذا فشل.
المختبر: حذف كل الطلبات ثم الاستعادة إلى ما قبله
الآن نمثل يوماً عادياً: برنامج صغير يضيف طلباً جديداً كل جزء من الثانية، وفي منتصف ذلك ينفذ شخص هذا الأمر:
SELECT count(*) AS orders, max(created_at) AS last_order FROM orders;
SELECT clock_timestamp() AS before_delete;
DELETE FROM orders;
والمخرج سوف يكون كما يلي:
 orders |          last_order
--------+-------------------------------
  20017 | 2026-10-11 05:31:55.808592+00
(1 row)

         before_delete
-------------------------------
 2026-10-11 05:31:57.666522+00
(1 row)

DELETE 20017
واستمر البرنامج في إضافة الطلبات بعد الحذف، فبعد خمسين ثانية أصبح في الجدول 112 طلباً جديداً فقط. وفي الواقع لن تعرف وقت الحذف من سطر clock_timestamp()، وإنما من سجل القاعدة إذا كنت تسجل أوامر التعديل بالإعداد log_statement = 'mod'، أو من وقت أول خطأ في سجلات التطبيق، أو من سؤال الشخص نفسه، والمهم أن تختار وقتاً قبل الخطأ بقليل.
الطريقة الأولى: الاستعادة في نفس المكان
pgBackRest لا يستعيد والقاعدة تعمل، وإذا حاولت فسوف ترى:
ERROR: [038]: unable to restore while PostgreSQL is running
       HINT: presence of 'postmaster.pid' in '/var/lib/postgresql/18/docker' indicates PostgreSQL is running.
       HINT: remove 'postmaster.pid' only if PostgreSQL is not running.
لذلك نوقف ال Container، ونشغل الاستعادة في Container مؤقت يستخدم نفس ال Volumes، ثم نشغل القاعدة من جديد:
docker compose stop db
docker compose run --rm --no-deps --user postgres db \
  pgbackrest --stanza=main --repo=1 --delta --type=time \
  "--target=2026-10-11 05:31:57.666522+00" --target-action=promote restore
docker compose start db
والمخرج سوف يكون كما يلي:
INFO: repo1: restore backup set 20261011-052938F_20261011-053045I, recovery will start at 2026-10-11 05:30:45
INFO: remove invalid files/links/paths from '/var/lib/postgresql/18/docker'
INFO: write updated /var/lib/postgresql/18/docker/postgresql.auto.conf
INFO: restore global/pg_control (performed last to ensure aborted restores cannot be started)
INFO: restore size = 332.3MB, file total = 1289
INFO: restore command end: completed successfully (1422ms)

real	0m4.063s
في الأمر أعلاه لاحظ التالي:
- pgBackRest اختار بنفسه أقرب نسخة قبل الوقت المطلوب، وهي التزايدية من 05:30:45، والخيار
--deltaيستبدل الملفات المختلفة فقط بدل حذف المجلد كله، لذلك أخذت الاستعادة ثانية ونصفاً. - كتب pgBackRest في
postgresql.auto.confالإعداداتrestore_commandوrecovery_target_time، فعند بدء القاعدة سوف تجلب ملفات WAL من المستودع وتعيد تنفيذها. --target-action=promoteيجعل القاعدة تقبل الكتابة بعد الوصول إلى الهدف، والقيمة الافتراضيةpauseتتركها للقراءة فقط حتى تتأكد من البيانات، وهي الأسلم إذا لم تكن متأكداً من الوقت.
وفي سجل PostgreSQL عند البدء:
LOG:  starting point-in-time recovery to 2026-10-11 05:31:57.666522+00
LOG:  redo starts at 0/1E000028
LOG:  restored log file "00000001000000000000001F" from archive
LOG:  restored log file "000000010000000000000020" from archive
LOG:  restored log file "000000010000000000000021" from archive
LOG:  restored log file "000000010000000000000022" from archive
LOG:  recovery stopping before commit of transaction 8052, time 2026-10-11 05:31:57.682248+00
LOG:  selected new timeline ID: 2
LOG:  archive recovery complete
LOG:  database system is ready to accept connections
والسطر المهم هو recovery stopping before commit of transaction 8052, time 05:31:57.682248، فالمعاملة 8052 هي الحذف نفسه، وانتهت بعد الوقت الذي حددناه بستة عشر جزءاً من الألف من الثانية، فتوقفت الاستعادة قبلها مباشرة. والنتيجة:
 orders |          last_order
--------+-------------------------------
  20018 | 2026-10-11 05:31:56.871616+00
(1 row)

 timeline_id
-------------
           2
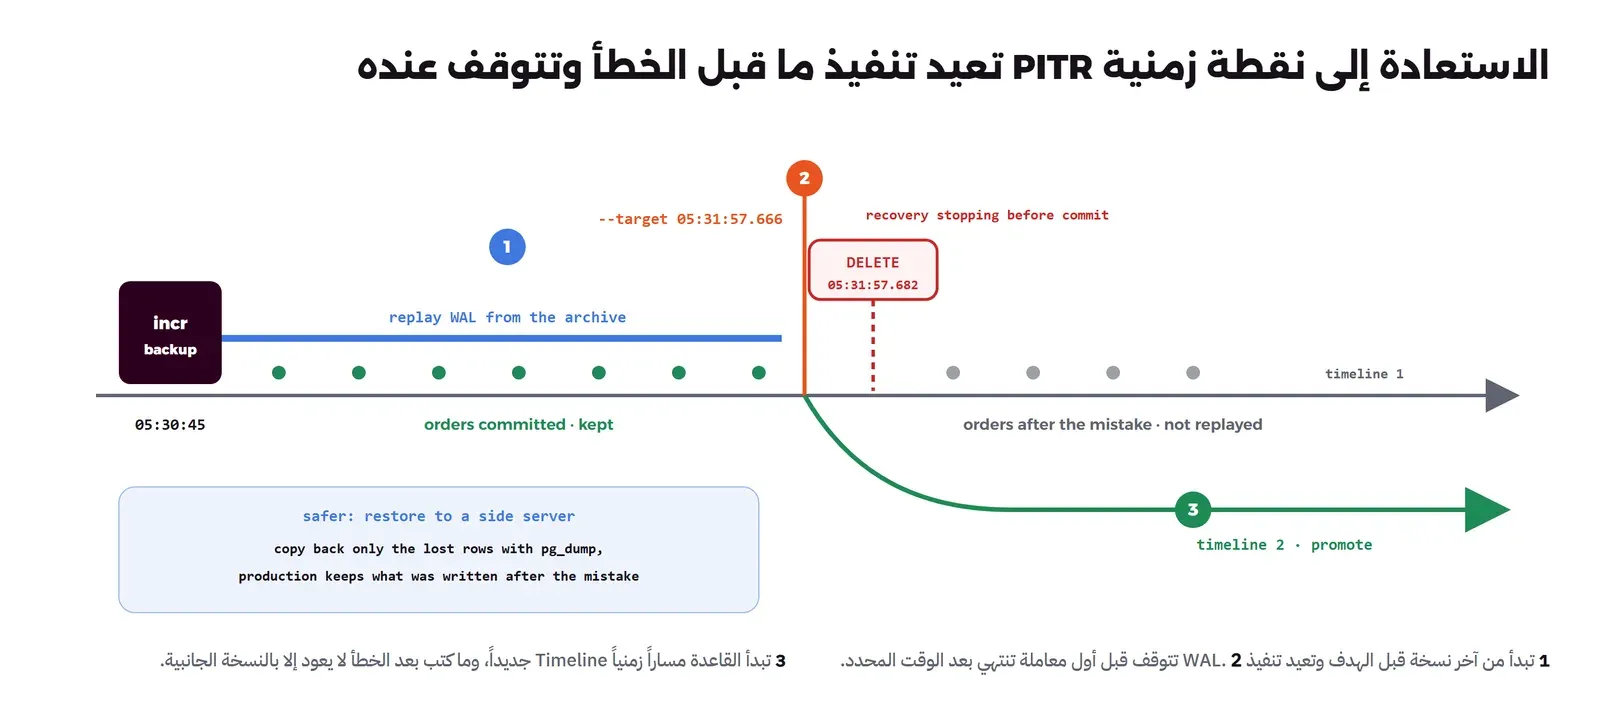
عادت الطلبات كلها، بل وجدنا 20018 وليس 20017 كما في عدنا قبل الحذف، والسبب درس صغير: الطلب الذي وقته 05:31:56.87 أضيف قبل العد، ولكن معاملته انتهت Commit بعد أن أخذ أمر العد لقطته من البيانات، فلم يظهر فيه، والاستعادة تعتمد على وقت انتهاء المعاملة وليس على قيمة العمود created_at، كما تشرح وثائق أهداف الاستعادة.
وما الثمن؟ الطلبات الـ 111 التي أضيفت بعد الحذف ضاعت، لأن القاعدة عادت إلى ما قبل الحذف وبدأت مساراً زمنياً Timeline جديداً رقمه 2، وكل ما في المسار القديم بعد الهدف لم يعد جزءاً منها. الصورة التالية تبين ما حدث:
الطريقة الثانية: نسخة جانبية ونقل الصفوف المفقودة
في الإنتاج غالباً لا تقبل خسارة ما كتب بعد الخطأ، فالعملاء استمروا في الشراء، لذلك الطريقة الأكثر أماناً أن تترك قاعدة الإنتاج تعمل، وتستعيد نسخة جانبية إلى ما قبل الخطأ، ثم تنقل منها الصفوف المفقودة فقط. ولتجربتها حذفنا الطلبات مرة أخرى من القاعدة بعد الاستعادة، وأضفنا خمسة طلبات جديدة تمثل ما كتب بعد الخطأ:
DELETE FROM orders;
DELETE 20018
INSERT INTO orders (customer, total) SELECT 'after-mistake', 7 FROM generate_series(1, 5);
INSERT 0 5
ثم استعدنا من المستودع الثاني المشفر على S3، في Volume جديد لا علاقة له بالإنتاج، إلى نفس الوقت على المسار الزمني الأول:
docker volume create lab-pitr-side
docker run --rm --network lab-pitr_default --env-file secrets/pgbackrest.env --user postgres \
  -v lab-pitr-side:/var/lib/postgresql \
  -v "$PWD/conf/pgbackrest.conf:/etc/pgbackrest/pgbackrest.conf:ro" \
  -v "$PWD/certs/ca.crt:/etc/pgbackrest/s3-ca.crt:ro" \
  lab-pitr-postgres:18.6-pgbackrest2.59.3 \
  pgbackrest --stanza=main --repo=2 --type=time "--target=2026-10-11 05:31:57.666522+00" \
  --target-timeline=1 --target-action=promote restore
# start it with archiving OFF so it never writes into the production stanza
docker run -d --name lab-pitr-side --network lab-pitr_default --env-file secrets/pgbackrest.env \
  -v lab-pitr-side:/var/lib/postgresql \
  -v "$PWD/conf/pgbackrest.conf:/etc/pgbackrest/pgbackrest.conf:ro" \
  -v "$PWD/certs/ca.crt:/etc/pgbackrest/s3-ca.crt:ro" \
  lab-pitr-postgres:18.6-pgbackrest2.59.3 postgres -c archive_mode=off
والمخرج:
INFO: repo2: restore backup set 20261011-052946F_20261011-053052I, recovery will start at 2026-10-11 05:30:52
INFO: restore size = 332.3MB, file total = 1289
INFO: restore command end: completed successfully (12091ms)

LOG:  recovery stopping before commit of transaction 8052, time 2026-10-11 05:31:57.682248+00
LOG:  selected new timeline ID: 3

 count |              max
-------+-------------------------------
 20018 | 2026-10-11 05:31:56.871616+00
في المخرج أعلاه لاحظ التالي:
- الاستعادة من S3 المشفر أخذت 12 ثانية مقابل ثانية ونصف من القرص المحلي، ومع قاعدة حقيقية بمئات الجيجابايتات يصبح الفرق ساعات، وهذا سبب وجود المستودع المحلي.
- حددنا
--target-timeline=1لأن الحذف حدث على المسار الزمني الأول، والقيمة الافتراضيةlatestكانت ستتبع المسار 2 الذي أنشأته الاستعادة السابقة، وهي نقطة يقع فيها من يستعيد أكثر من مرة في نفس اليوم. - شغلنا النسخة الجانبية بالإعداد
archive_mode=off، والسبب أنها تحمل نفس إعداد pgBackRest، ولو بقيت الأرشفة مفعلة لأرسلت ملفات WAL الخاصة بها إلى مستودع الإنتاج.
بعد ذلك نصدر الجدول من النسخة الجانبية ونستورد بياناته في الإنتاج:
docker exec -u postgres lab-pitr-side pg_dump -d shop --data-only --table=orders -Fc -f /tmp/orders.dump
docker cp lab-pitr-side:/tmp/orders.dump - | docker cp - lab-pitr-db:/tmp/
docker exec -u postgres lab-pitr-db pg_restore -d shop --data-only --table=orders /tmp/orders.dump
docker exec -u postgres lab-pitr-db psql -X -d shop -c "SELECT customer = 'after-mistake' AS after_mistake, count(*), min(id), max(id) FROM orders GROUP BY 1 ORDER BY 1"
والمخرج سوف يكون كما يلي:
 after_mistake | count |  min  |  max
---------------+-------+-------+-------
 f             | 20018 |     1 | 20018
 t             |     5 | 20034 | 20038
عادت الطلبات القديمة كلها، وبقيت الطلبات الخمسة التي كتبت بعد الخطأ، والإنتاج لم يتوقف لحظة. وهذا نجح مباشرة لأن أرقام الطلبات الجديدة id أكبر من القديمة فلا يوجد تعارض، أما إذا كان الخطأ UPDATE غير قيم الصفوف بدل حذفها، فاستورد الصفوف إلى جدول مؤقت ثم أصلح الجدول الأصلي باستعلام UPDATE … FROM بعد مراجعته.
الاحتفاظ Retention والتحقق
بعد أي استعادة خذ نسخة كاملة جديدة، والسبب أن القاعدة على مسار زمني جديد، ثم راقب كيف يحذف pgBackRest القديم. أخذنا نسختين كاملتين في المستودع الأول الذي يحتفظ بنسختين:
INFO: new backup label = 20261011-053504F
INFO: repo1: expire full backup set 20261011-052938F, 20261011-052938F_20261011-053027D, 20261011-052938F_20261011-053045I
INFO: repo1: remove expired backup 20261011-052938F_20261011-053045I
INFO: repo1: remove expired backup 20261011-052938F_20261011-053027D
INFO: repo1: remove expired backup 20261011-052938F
INFO: repo1: 18-1 remove archive, start = 0000000100000000, stop = 000000020000000000000021
لاحظ أن الأمر حذف النسخة الكاملة القديمة مع الفرقية والتزايدية التي تعتمد عليها، ثم حذف ملفات WAL التي لم تعد تحتاجها أي نسخة باقية، وهذا هو الجزء الذي يخطئ فيه السكربت المكتوب يدوياً. وتذكر أن مدى الاستعادة إلى نقطة زمنية يبدأ من أقدم نسخة كاملة باقية، فمع نسختين أسبوعيتين تستطيع العودة أسبوعين تقريباً، ومع أربع في المستودع الثاني شهراً تقريباً. ويمكن أيضاً أن تحدد الاحتفاظ بالأيام بدل العدد بالإعداد repo-retention-full-type=time.
وأخيراً الأمر verify يقرأ كل ملف في المستودع ويتحقق من ال Checksum الخاص به، دون أن يستعيد شيئاً:
$ pgbackrest --stanza=main --repo=2 verify
INFO: verify command end: completed successfully (3206ms)
وهو مفيد كل أسبوع، ولكنه لا يغني عن استعادة حقيقية على سيرفر منفصل كل فترة، والسبب أن verify يثبت أن الملفات سليمة، أما الاستعادة فتثبت أن الخطوات وكلمات المرور والصلاحيات كلها تعمل، وأن الوقت الذي تأخذه مقبول.
ماذا تراقب؟
- الأرشفة: الجدول
pg_stat_archiverفيهfailed_countوlast_failed_timeوlast_archived_time، وأي فشل متكرر أو آخر أرشفة أقدم من بضع دقائق يحتاج تنبيهاً، لأن ملفات WAL تتراكم على القرص. - عمر آخر نسخة: الأمر
pgbackrest info --output=jsonيعطي وقت كل نسخة بصيغة تقرأها أداة المراقبة. - مساحة المستودع: خصوصاً المحلي، فامتلاؤه يوقف الأرشفة ثم يوقف القاعدة.
- وقت الاستعادة: سجله في كل تجربة، فهو ال RTO الحقيقي.
أخطاء شائعة
- النسخة الأساسية دون أرشيف WAL: تستطيع العودة إلى وقت النسخة فقط، وليس إلى أي لحظة.
- المستودع الوحيد على نفس السيرفر: يحميك من الحذف الخاطئ ولا يحميك من ضياع السيرفر أو من مخترق يملك صلاحية عليه.
- كلمة التشفير على السيرفر نفسه فقط: تضيع معه.
- الاستعادة في نفس المكان عندما يمكن تجنبها: تخسر كل ما كتب بعد الخطأ، والنسخة الجانبية أبطأ قليلاً وأكثر أماناً.
- نسيان المسار الزمني: بعد استعادة أولى، الاستعادة الثانية إلى وقت قديم تحتاج
--target-timelineالصحيح. - نسخة جانبية بأرشفة مفعلة: تكتب في مستودع الإنتاج.
- عدم أخذ نسخة كاملة بعد الاستعادة: تعتمد على سلسلة من مسار زمني انتهى.
قائمة تحقق
- هل
archive_modeمفعل، وarchive_timeoutمضبوط بحسب ما تقبل خسارته؟ - هل يمر الأمر
pgbackrest checkبعد كل تعديل؟ - هل يوجد مستودعان، أحدهما خارج الموقع ومشفر، وكلمة التشفير محفوظة بعيداً عن السيرفر؟
- هل جدول النسخ الكاملة والفرقية مكتوب في cron أو systemd timer، مع تنبيه عند الفشل؟
- هل سياسة الاحتفاظ تغطي المدة التي قد تكتشف فيها خطأ بشرياً؟
- هل تراقب
pg_stat_archiverوعمر آخر نسخة ومساحة المستودع؟ - هل جربت الاستعادة إلى وقت محدد على سيرفر جانبي، وكتبت الخطوات ووقتها؟
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الاستعادة إلى نقطة زمنية تحتاج نسخة فيزيائية دورية وأرشيف WAL مستمراً، وPostgreSQL يعيد تنفيذ السجل ويتوقف قبل أول معاملة تنتهي بعد الوقت المحدد.
- pgBackRest يجمع الأرشفة والنسخ الكاملة والفرقية والتزايدية والضغط والتشفير والاحتفاظ والتحقق في ملف إعداد واحد، ويكتب إلى عدة مستودعات معاً.
- في المختبر حذفنا 20017 طلباً واستعدناها إلى ما قبل الحذف، وتوقفت الاستعادة قبل معاملة الحذف التي انتهت بعد الهدف بستة عشر جزءاً من الألف من الثانية.
- الاستعادة في نفس المكان تخسر ما كتب بعد الخطأ، والنسخة الجانبية مع نقل الصفوف المفقودة تحفظ الاثنين ولا توقف الإنتاج.
- المستودع المحلي للسرعة، والبعيد المشفر للكوارث، وجرب الاستعادة كل فترة لأنها الدليل الوحيد على أن النسخة تعمل.
 دليلPostgreSQL للفرق: تثبيت آمن وصلاحيات واضحةكيف تثبت PostgreSQL لفريقك بأدوار لا تسمح للتطبيق بحذف الجداول، واتصال مشفر، ونسخة احتياطية تختبر استعادتها كل ليلة.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلPostgreSQL للجداول الضخمة: عشرات الملايين من الصفوفماذا تفعل عندما يصل جدول الطلبات إلى عشرات الملايين من الصفوف وتبطئ لوحة التحكم ويمتلئ القرص، وكيف تقيس قبل أن تصلح.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختباره على PostgreSQL 18.6 وpgBackRest 2.59.3 من مستودع PGDG، مع SeaweedFS 4.48 كتخزين متوافق مع S3، وDocker Engine 29.8.0.