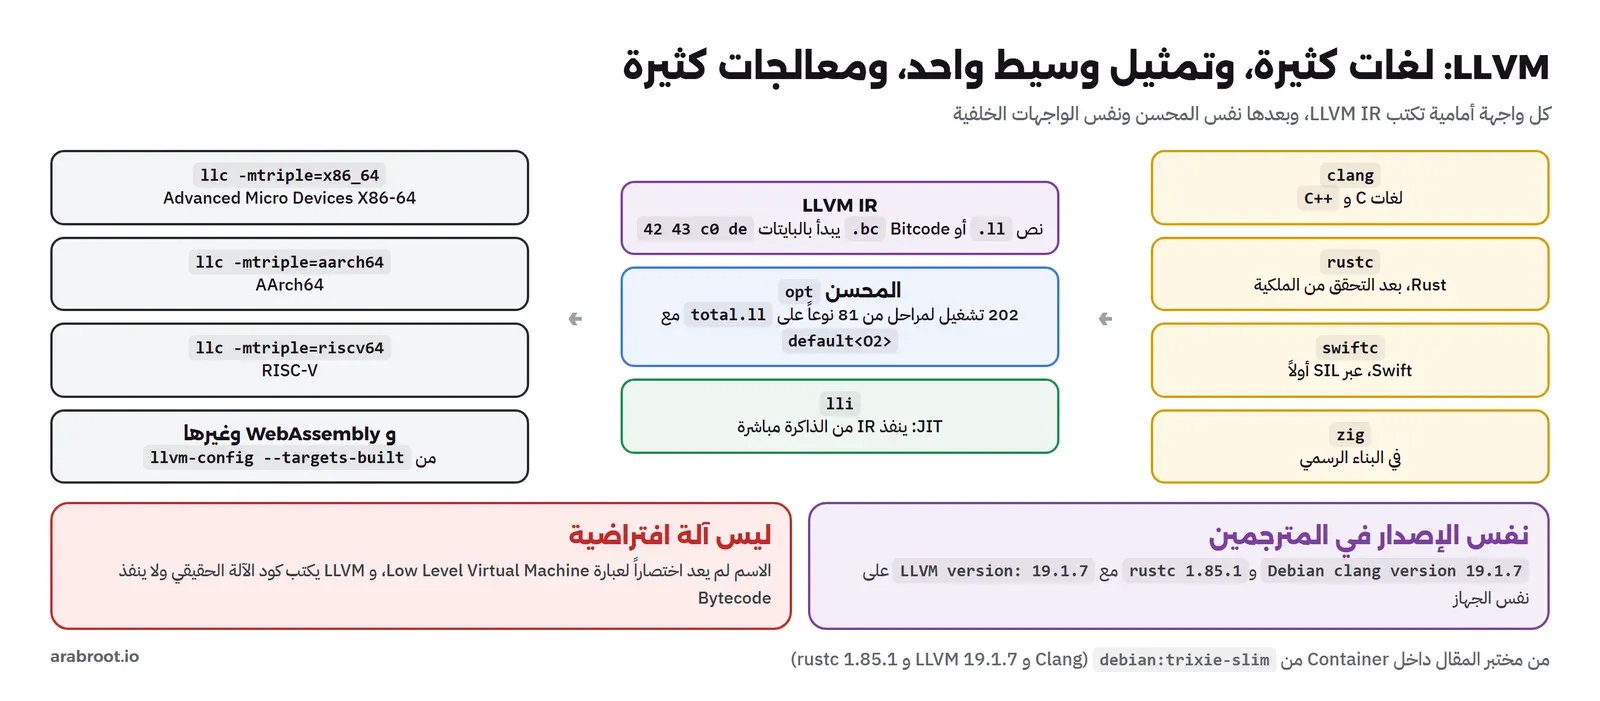
بعد قصة حماية رقم الفاتورة التي حذفها المترجم في المقال السابق، اقترح أحد أعضاء فريق الفواتير أن تعاد كتابة المكتبة بلغة Rust، وجاء السؤال المتوقع من مدير الفريق: هل سوف نخسر السرعة التي انتقلنا إلى C من أجلها؟ وإذا شغلت rustc --version --verbose على أي جهاز فسوف ترى في آخر سطر شيئاً مثل LLVM version: 19.1.7، وهو نفس الرقم الذي يطبعه clang --version على نفس الجهاز. أي أن المترجمين، مع أن اللغتين مختلفتان تماماً، يسلمان الكود في النهاية لنفس البنية، وهذه البنية هي LLVM، وهي التي تقف خلف Clang وRust وSwift وكثير غيرها.
وفي هذا المقال سوف نفتح LLVM من الداخل بنفس طريقة المقال السابق: نقرأ ما يخرج منه حرفياً. سوف نكتب التمثيل الوسيط LLVM IR لإجمالي الفاتورة بأيدينا، ونشغله، ونخطئ فيه عن قصد لنرى من يمسك الخطأ، ثم نرى ما يكتبه Clang وما يكتبه rustc لنفس الدالة، ونمرر الكود على المحسن opt، ثم نترجم نفس الملف بالأداة llc إلى ثلاثة معالجات مختلفة. وفي الطريق سوف نجيب عن سؤال مدير الفريق، ونرى لماذا لم تحذف Rust حماية رقم الفاتورة مع أنها تستخدم نفس المحسن الذي حذفها في C.
وسوف نناقش في هذا المقال ما يلي:
- ما هو LLVM ومن أين جاء، ومكوناته: التمثيل الوسيط IR، والمحسن
opt، والمولدllc، والمنفذlli. - قراءة LLVM IR وكتابته بأيدينا: الأنواع، والكتل، ودوال
phi، وكيف يرفض المحقق Verifier الكود الخاطئ. - ما يكتبه Clang دون تحسين، ولماذا يملأ الكود بالتعليمة
alloca، والمرحلةmem2regالتي تحوله إلى SSA. - المحسن
optومراحله، وما لم نكتبه في IR بأيدينا: وصف البيانات Data Layout. - العلامة
nsw: كيف تحمل IR وعود اللغة، ولماذا اختلفت C عن Rust في نفس الحماية. - ملف IR واحد إلى x86-64 وAArch64 وRISC-V، ولماذا استدعى كود RISC-V دالة لعملية ضرب.
- لماذا تبني Rust وSwift وZig على LLVM، وما الثمن، ولماذا تحاول Zig الابتعاد عنه.
ما هو LLVM؟ مكتبة مترجمات Compiler Infrastructure لا آلة افتراضية
بدأ LLVM كمشروع بحثي في جامعة Illinois، وكان هدفه كما يذكر موقع المشروع تقديم طريقة ترجمة حديثة مبنية على صيغة SSA تدعم الترجمة الثابتة والديناميكية لأي لغة. ونشر Chris Lattner التصميم الأول في رسالة الماجستير عام 2002. وكان الاسم في البداية اختصاراً لعبارة Low Level Virtual Machine، ولكن المشروع نما ولم يعد للاسم علاقة بالآلات الافتراضية، والموقع نفسه يقول اليوم إن LLVM ليس اختصاراً لشيء، وإنما اسم المشروع كاملاً. لذلك إذا سمعت «آلة LLVM الافتراضية» فاعرف أنها تسمية قديمة: LLVM لا ينفذ Bytecode كما فعلت آلتنا في الجزء الثاني من المفسر، وإنما يترجم إلى كود الآلة الحقيقي.
والفكرة التي جعلت LLVM مختلفاً عن المترجمات التي سبقته هي أنه مجموعة مكتبات لا برنامج واحد. ففي المقال السابق رأينا أن GCC مقسم إلى واجهة أمامية ووسط وواجهة خلفية، ولكن هذه الأجزاء مرتبطة داخل برنامج واحد، ولا يسهل أن تأخذ الوسط وحده وتبني عليه لغتك. أما في LLVM فكل جزء مكتبة لها واجهة واضحة، والتمثيل الوسيط نفسه لغة كاملة موثقة في مرجع لغة LLVM IR، يمكن أن تكتبها في ملف نصي، وتقرأها، وتمررها بين أدوات منفصلة. وشرح Lattner هذا القرار في فصل LLVM من كتاب The Architecture of Open Source Applications. والأدوات التي سوف نستخدمها كلها تأتي مع حزمة llvm في Debian:
clang: الواجهة الأمامية للغات C وC++ وObjective-C، وتكتب LLVM IR بالخيار-emit-llvm.opt: المحسن، يأخذ IR ويطبق عليه المراحل Passes ويعيد IR.llc: الواجهة الخلفية، تأخذ IR وتكتب لغة التجميع أو ملفاً كائناً لمعالج تختاره.lli: ينفذ IR مباشرة بالترجمة أثناء التشغيل JIT، دون أن تبني ملفاً تنفيذياً.llvm-linkوllvm-asوllvm-dis: لدمج ملفات IR والتحويل بين الصيغة النصية.llوالصيغة الثنائية.bcالمسماة Bitcode.
ورخصة LLVM هي Apache 2.0 مع استثناءات خاصة بالمشروع، كما في سياسة المطورين في LLVM، وهي رخصة تسمح للشركات بأن تبني عليه مترجمات مغلقة المصدر. وهذا، مع تصميم المكتبات، من أسباب انتشاره في الشركات وفي اللغات الجديدة، بينما GCC برخصة GPLv3، وتحدثنا عن أثر الرخص في مقال من يقرر مستقبل لغات البرمجة.
التمثيل الوسيط LLVM IR: لغة تجميع بأنواع
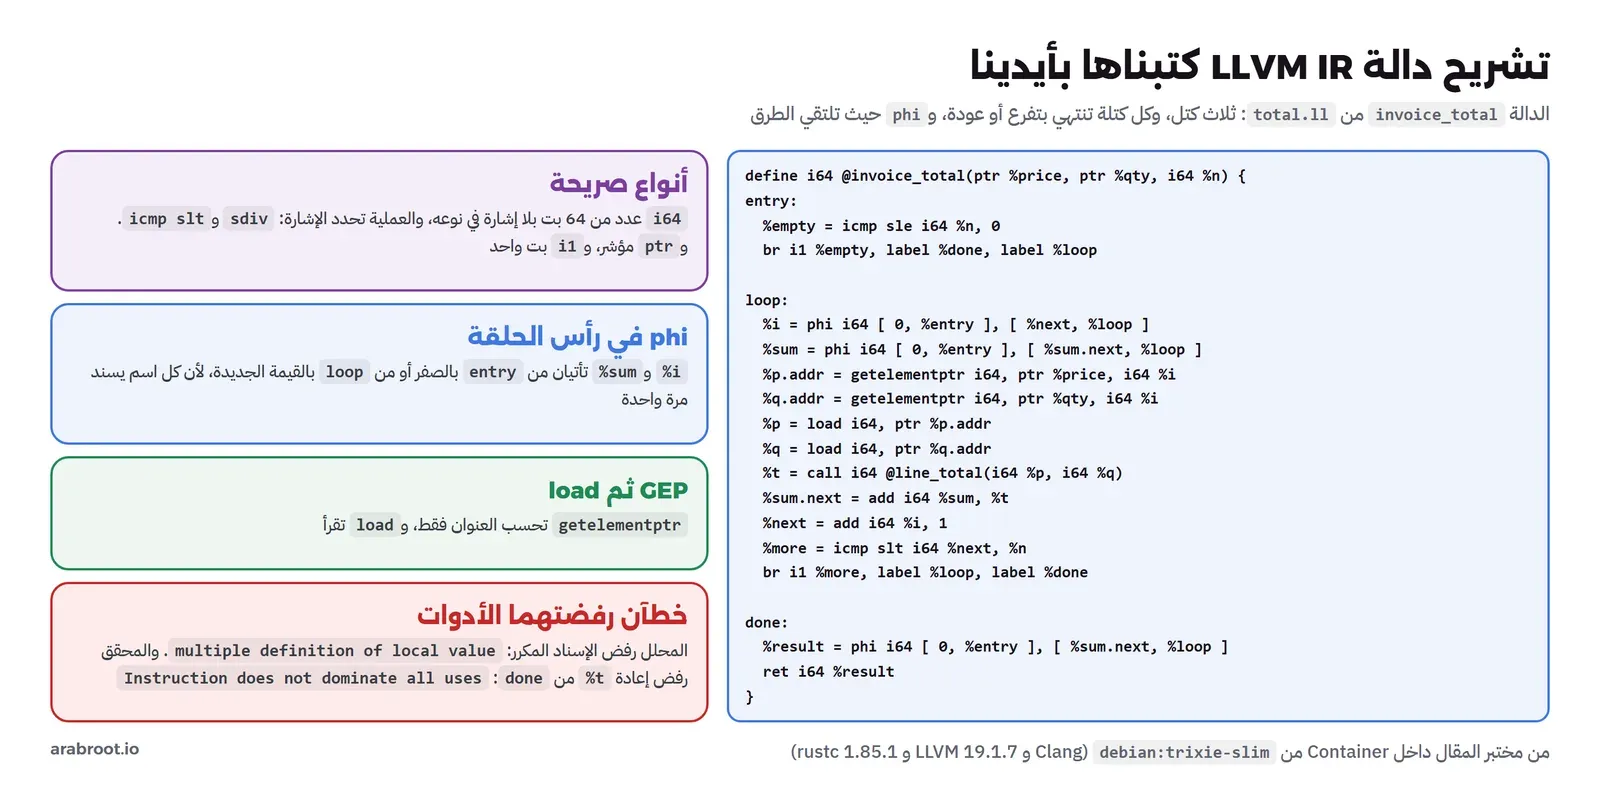
أقرب وصف لصيغة LLVM IR أنها لغة تجميع لمعالج خيالي، ولكن بثلاثة فروق كبيرة عن لغة التجميع الحقيقية. الأول أن كل قيمة لها نوع صريح: i64 عدد صحيح من 64 بت، وi1 قيمة منطقية من بت واحد، وptr مؤشر. ولاحظ أن الأعداد الصحيحة لا تحمل إشارة في نوعها، فالعدد i64 ليس موجباً ولا سالباً، وإنما العملية هي التي تحدد: sdiv قسمة بإشارة Signed، وudiv قسمة بلا إشارة Unsigned، وicmp slt مقارنة «أصغر من» بإشارة. والثاني أن عدد المسجلات غير محدود، فكل قيمة تأخذ اسماً جديداً يبدأ بالعلامة %. والثالث أن IR في صيغة SSA التي شرحناها في المقال السابق: كل اسم يسند مرة واحدة، والدمج عند التقاء الطرق بالتعليمة phi.
نكتب IR بأيدينا Hand-written IR
أفضل طريقة لفهم IR أن تكتبه، فهذا الملف total.ll هو حساب إجمالي الفاتورة من المقال السابق، مكتوباً مباشرة بلغة LLVM IR دون أي لغة مصدر:
; total.ll: an invoice total written by hand in LLVM IR
;   line_total(price, qty) = price * qty * 115 / 100
;   invoice_total(price[], qty[], n) = sum of line_total over n lines

define i64 @line_total(i64 %price, i64 %qty) {
entry:
  %sub = mul i64 %price, %qty
  %taxed = mul i64 %sub, 115
  %total = sdiv i64 %taxed, 100
  ret i64 %total
}

define i64 @invoice_total(ptr %price, ptr %qty, i64 %n) {
entry:
  %empty = icmp sle i64 %n, 0
  br i1 %empty, label %done, label %loop

loop:
  %i = phi i64 [ 0, %entry ], [ %next, %loop ]
  %sum = phi i64 [ 0, %entry ], [ %sum.next, %loop ]
  %p.addr = getelementptr i64, ptr %price, i64 %i
  %q.addr = getelementptr i64, ptr %qty, i64 %i
  %p = load i64, ptr %p.addr
  %q = load i64, ptr %q.addr
  %t = call i64 @line_total(i64 %p, i64 %q)
  %sum.next = add i64 %sum, %t
  %next = add i64 %i, 1
  %more = icmp slt i64 %next, %n
  br i1 %more, label %loop, label %done

done:
  %result = phi i64 [ 0, %entry ], [ %sum.next, %loop ]
  ret i64 %result
}
في الملف أعلاه لاحظ التالي:
- السطور التي تبدأ بالفاصلة المنقوطة تعليقات، و
define i64 @line_totalتعرف دالة تعيدi64، والأسماء العامة مثل الدوال تبدأ بالعلامة@والمحلية بالعلامة%. - كل دالة مقسمة إلى كتل Basic Blocks لكل منها اسم مثل
entryوloopوdone، وكل كتلة تنتهي بتعليمة تنهيها Terminator، مثلbrالتي تتفرع أوretالتي تعيد. ولا يوجد «سقوط» من كتلة إلى التي بعدها كما في لغة التجميع، فكل انتقال مكتوب صراحة. - العداد
%iوالمجموع%sumلا يمكن أن يتغيرا داخل الحلقة لأن كل اسم يسند مرة واحدة، لذلك تأتي قيمتهما منphi:[ 0, %entry ]عند الدخول، و[ %next, %loop ]بعد كل دورة. وهذا نفس ما رأيناه في مخرج-fdump-tree-ssaمن GCC، ولكن هنا نكتبه نحن. - التعليمة
getelementptr، واختصارها الشائع GEP، تحسب عنوان العنصر رقم%iفي مصفوفة منi64دون أن تقرأ الذاكرة، ثم تأتيloadلتقرأ. وفصل الحساب عن القراءة يجعل تحليل الذاكرة أسهل للمحسن. - الكتلة
doneيصل إليها التنفيذ من طريقين، منentryإذا كانت الفاتورة فارغة ومنloopبعد آخر سطر، لذلك نحتاجphiثالثة تختار بين الصفر والمجموع.
نشغل IR: مع برنامج C ومع JIT في lli
ملف IR ليس برنامجاً كاملاً، فليس فيه main، لذلك كتبنا main.c صغيراً يستدعي invoice_total لفاتورة من ثلاثة أسطر. وكل التجارب تعمل داخل Container من debian:trixie-slim فيه حزم clang وllvm وrustc من Debian، والملف llvm.sh في مجلد المختبر ينفذها كلها:
docker build -t scc1-cc lab/
docker run --rm -v "$PWD/lab":/lab -w /lab scc1-cc sh llvm.sh
والجزء الأول من السكربت يتحقق من الملف، ثم يبنيه مع main.c بالمترجم Clang، ثم يترجم main.c نفسه إلى IR، ويدمج الملفين بالأداة llvm-link، وينفذ الناتج بالأداة lli:
total.ll: verified
invoice_total = 632
lli (JIT) runs the linked IR:
invoice_total = 632
النتيجة 632 في الطريقتين، وهي 120 × 3 × 1.15 = 414 و50 × 2 × 1.15 = 115 و9 × 10 × 1.15 = 103.5 التي صارت 103 لأن القسمة صحيحة. ولاحظ أن Clang قبل ملف .ll كما يقبل ملف .c، لأنه يدخل IR مباشرة إلى المحسن ويتجاوز الواجهة الأمامية. والسطر الثاني نفذه lli دون أن يبني أي ملف تنفيذي، فقد ترجم IR إلى كود الآلة في الذاكرة ثم قفز إليه، وهذا نفس ما يفعله أي JIT، وتوثيق lli يشرح خياراته. ومكتبات JIT في LLVM هي ما تستخدمه مشاريع مثل محركات قواعد البيانات التي تترجم الاستعلامات أثناء التشغيل.
ثلاث صيغ لنفس IR: النص والـ Bitcode والذاكرة
الملف total.ll هو الصيغة النصية التي يقرؤها الإنسان، ولكن LLVM نفسه يتعامل مع IR بثلاث صيغ متكافئة تماماً: النص بالامتداد .ll، والصيغة الثنائية المضغوطة Bitcode بالامتداد .bc، والكائنات داخل الذاكرة التي تعمل عليها المكتبات. والأداة llvm-as تحول النص إلى Bitcode، وllvm-dis تعيده نصاً. والجزء السابع من السكربت يفعل ذلك، ثم يقارن أول أربعة بايتات من ملف كائن عادي بملف كائن بناه Clang بالخيار -flto:
total.ll: 999 bytes of text, total.bc: 1648 bytes of bitcode
first 4 bytes of total.bc:  42 43 c0 de
define i64 @line_total(i64 %price, i64 %qty) {
entry:
  %sub = mul i64 %price, %qty
  %taxed = mul i64 %sub, 115
  %total = sdiv i64 %taxed, 100
  ret i64 %total
}
clang -O2 -c      : first 4 bytes  7f 45 4c 46
clang -O2 -flto -c: first 4 bytes  42 43 c0 de
في المخرج أعلاه لاحظ التالي:
- ملف Bitcode أكبر من النص في هذه الحالة، 1648 بايتاً مقابل 999، لأن الملف صغير جداً، والصيغة الثنائية تحمل رأساً وجداول ثابتة الحجم تقريباً. وفي الملفات الكبيرة ينقلب الأمر، ولكن الهدف الأساسي من Bitcode ليس الحجم، وإنما أن القراءة والكتابة أسرع بكثير من تحليل النص.
- الملف يبدأ بالبايتات
42 43 c0 de، أي الحرفينBCثم0xC0DE، وهذا رقمه السحري، بنفس الفكرة التي وضعنا بهاCALCفي أول Bytecode لغتنا في الجزء الثاني، وCPython في أول ملفات.pyc. - الملف الكائن العادي يبدأ بالبايتات
7f 45 4c 46، أيELF، فهو كود آلة في صيغة ELF. أما مع-fltoفالملف الذي سماه Clang.oهو في الحقيقة Bitcode، وهذا ما رأيناه في المقال السابق مع GCC: التحسين وقت الربط يعني أن الملفات تحمل التمثيل الوسيط بدل كود الآلة، ويكمل المحسن عمله على البرنامج كله عند الربط. - والنص الذي أعادته
llvm-disهو نفس الدالة التي كتبناها، بلا تعليقاتنا، لأن التعليقات لا تدخل في Bitcode.
ماذا يحدث إذا خالفنا قواعد SSA؟ المحقق Verifier
لكي نعرف ما يحمينا عندما نكتب IR بأيدينا أو نولده من لغتنا، كتبنا نسختين خاطئتين عن قصد. الأولى broken-ssa.ll تسند %sum.next مرتين، والثانية broken-dom.ll تعيد %t من الكتلة done بدل %result:
opt: /lab/broken-ssa.ll:27:3: error: multiple definition of local value named 'sum.next'
  %sum.next = add i64 %sum.next, 1
  ^
Instruction does not dominate all uses!
  %t = call i64 @line_total(i64 %p, i64 %q)
  ret i64 %t
opt: /lab/broken-dom.ll: error: input module is broken!
في المخرج أعلاه لاحظ التالي:
- الخطأ الأول أمسكه المحلل نفسه قبل أي تحقق، برقم السطر والعمود: «multiple definition of local value»، لأن قاعدة الإسناد الواحد جزء من قواعد اللغة.
- الخطأ الثاني أصعب وأخطر، فالنص صحيح نحوياً، والقيمة
%tموجودة فعلاً في الدالة، ولكنها تعرف في الكتلةloop، والتنفيذ قد يصل إلىdoneمنentryمباشرة عندما تكون الفاتورة فارغة، فلا تكون%tقد حسبت أصلاً. وقاعدة SSA تقول إن تعريف كل قيمة يجب أن يسيطر Dominate على كل استخدام لها، أي أن كل طريق من بداية الدالة إلى الاستخدام يجب أن يمر بالتعريف، والمحقق Verifier فحص هذا ورفض الملف: «Instruction does not dominate all uses».
وهذه قيمة مهمة لمن يبني لغة على LLVM: المحقق يمسك أخطاء المولد الذي كتبته قبل أن تصبح كوداً خاطئاً يعمل بصمت. والخيار -passes=verify يشغله وحده، ومن يولد IR من برنامجه يستدعي نفس الدالة من المكتبة بعد كل دالة يولدها.
ماذا يكتب Clang؟ alloca ثم مرحلة mem2reg
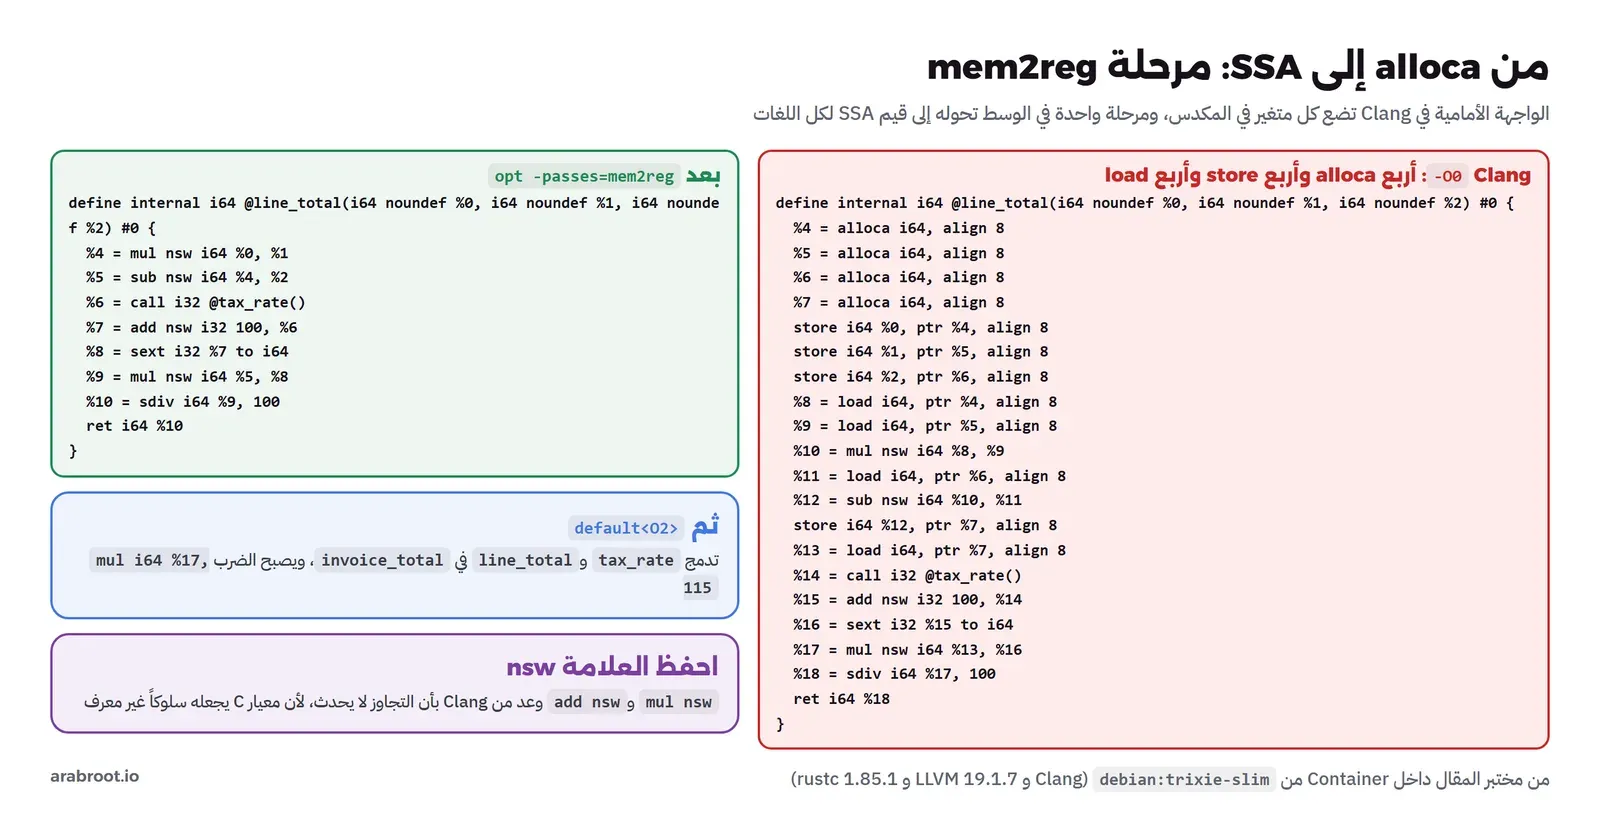
كتابة IR بأيدينا جعلتنا نفكر في phi لكل متغير يتغير في حلقة، وهذا عمل مرهق لأي واجهة أمامية، فكيف يفعله Clang؟ الإجابة أنه لا يفعله. فالواجهة الأمامية في Clang تضع كل متغير محلي في خانة في المكدس بالتعليمة alloca، وتكتب فيه بالتعليمة store وتقرأ منه بالتعليمة load، فلا تحتاج أن تفكر في SSA أبداً، لأن الذاكرة يمكن الكتابة فيها أكثر من مرة. وهذا ما كتبه Clang دون تحسين للدالة line_total من ملف invoice.c في المقال السابق:
define internal i64 @line_total(i64 noundef %0, i64 noundef %1, i64 noundef %2) #0 {
  %4 = alloca i64, align 8
  %5 = alloca i64, align 8
  %6 = alloca i64, align 8
  %7 = alloca i64, align 8
  store i64 %0, ptr %4, align 8
  store i64 %1, ptr %5, align 8
  store i64 %2, ptr %6, align 8
  %8 = load i64, ptr %4, align 8
  %9 = load i64, ptr %5, align 8
  %10 = mul nsw i64 %8, %9
  %11 = load i64, ptr %6, align 8
  %12 = sub nsw i64 %10, %11
  store i64 %12, ptr %7, align 8
  %13 = load i64, ptr %7, align 8
  %14 = call i32 @tax_rate()
  %15 = add nsw i32 100, %14
  %16 = sext i32 %15 to i64
  %17 = mul nsw i64 %13, %16
  %18 = sdiv i64 %17, 100
  ret i64 %18
}
وهذا يشبه تماماً ما رأيناه في لغة التجميع مع -O0 في المقال السابق: كل معامل يحفظ في المكدس ثم يقرأ منه في السطر التالي. والخيار -disable-O0-optnone يمنع Clang من وضع علامة optnone على الدوال في -O0، حتى نستطيع أن نمررها على المحسن بأيدينا. ثم يأتي دور مرحلة mem2reg، التي تبحث عن كل alloca لا يأخذ أحد عنوانها، وتحولها إلى قيم SSA، وتضع phi حيث تلزم:
define internal i64 @line_total(i64 noundef %0, i64 noundef %1, i64 noundef %2) #0 {
  %4 = mul nsw i64 %0, %1
  %5 = sub nsw i64 %4, %2
  %6 = call i32 @tax_rate()
  %7 = add nsw i32 100, %6
  %8 = sext i32 %7 to i64
  %9 = mul nsw i64 %5, %8
  %10 = sdiv i64 %9, 100
  ret i64 %10
}
اختفت الخانات الأربع وكل عمليات القراءة والكتابة، وبقي الحساب وحده. وهذا التقسيم من أذكى قرارات LLVM: كل لغة تكتب واجهة أمامية بسيطة تستخدم الذاكرة، ومرحلة واحدة في الوسط تحول الجميع إلى SSA، وهي المرحلة التي تظهر باسم PromotePass في قائمة المراحل التي سوف نراها بعد قليل. وهي أيضاً ما يجعل rustc وغيره يكتبون IR بنفس الطريقة.
ولاحظ في المخرجين العلامة nsw بعد كل mul وadd وsub، وهي اختصار No Signed Wrap، ولم نكتبها في ملفنا. وهذه العلامة سوف تكون مفتاح قصة الحماية، فاحفظها.
المحسن opt ومراحله Passes
الآن نمرر ملفنا total.ll على المحسن بنفس مستوى -O2، والخيار -passes='default<O2>' يطلب نفس قائمة المراحل التي يستخدمها Clang. وهذا الناتج كاملاً:
; ModuleID = '/lab/total.ll'
source_filename = "/lab/total.ll"

; Function Attrs: mustprogress nofree norecurse nosync nounwind willreturn memory(none)
define range(i64 -92233720368547758, 92233720368547759) i64 @line_total(i64 %price, i64 %qty) local_unnamed_addr #0 {
entry:
  %sub = mul i64 %price, 115
  %taxed = mul i64 %sub, %qty
  %total = sdiv i64 %taxed, 100
  ret i64 %total
}

; Function Attrs: nofree norecurse nosync nounwind memory(argmem: read)
define i64 @invoice_total(ptr nocapture readonly %price, ptr nocapture readonly %qty, i64 %n) local_unnamed_addr #1 {
entry:
  %empty = icmp slt i64 %n, 1
  br i1 %empty, label %done, label %loop

loop:                                             ; preds = %entry, %loop
  %i = phi i64 [ %next, %loop ], [ 0, %entry ]
  %sum = phi i64 [ %sum.next, %loop ], [ 0, %entry ]
  %p.addr = getelementptr i64, ptr %price, i64 %i
  %q.addr = getelementptr i64, ptr %qty, i64 %i
  %p = load i64, ptr %p.addr, align 4
  %q = load i64, ptr %q.addr, align 4
  %sub.i = mul i64 %p, 115
  %taxed.i = mul i64 %sub.i, %q
  %total.i = sdiv i64 %taxed.i, 100
  %sum.next = add i64 %total.i, %sum
  %next = add nuw nsw i64 %i, 1
  %more = icmp slt i64 %next, %n
  br i1 %more, label %loop, label %done

done:                                             ; preds = %loop, %entry
  %result = phi i64 [ 0, %entry ], [ %sum.next, %loop ]
  ret i64 %result
}

attributes #0 = { mustprogress nofree norecurse nosync nounwind willreturn memory(none) }
attributes #1 = { nofree norecurse nosync nounwind memory(argmem: read) }
في المخرج أعلاه لاحظ التالي:
- الدالة
line_totalما زالت موجودة لأننا لم نقل إنها خاصة بالملف، ولكن داخل الحلقة لم يعد هناكcall، فقد دمجها المحسن وأضاف إلى أسمائها اللاحقة.iأي Inlined. - غير المحسن ترتيب الضرب: كتبنا
price * qtyثم الضرب في 115، فصار الضرب في الثابت أولاً، وهذا عمل مرحلةReassociatePassالتي تعيد ترتيب العمليات التي يجوز إعادة ترتيبها حتى تجمع الثوابت معاً. - أضاف المحسن معلومات لم نكتبها:
memory(none)علىline_totalأي أنها لا تلمس الذاكرة، وnocapture readonlyعلى المؤشرين فيinvoice_totalأي أنها تقرأ منهما فقط ولا تحتفظ بهما، وrange(...)على نتيجةline_totalلأن القسمة على 100 تحصر النتيجة في جزء من مئة من مدىi64. وهذا نفس نوع الاستنتاج الذي جعل GCC يحسب الدالة النقية مرة واحدة في المقال السابق، وفائدته أن المستدعين يستطيعون أن يحسنوا أكثر. - العداد صار
add nuw nsw i64 %i, 1، أي أن المحسن أثبت أن%iتبدأ من صفر وتتوقف قبل%n، فلا يمكن أن تتجاوز المدى، فأضاف العلامتين بنفسه. - القراءتان صارتا
align 4، وهذه مشكلة سوف نعود إليها في القسم التالي.
وكم مرحلة مرت على ملف من نحو 35 سطراً؟ الخيار -debug-pass-manager يطبع كل مرحلة وهي تعمل، والجزء الثاني من السكربت يعدها ويطبع أول أربعين مرحلة عملت على invoice_total:
passes run by default<O2>: 202
distinct pass names: 81
EntryExitInstrumenterPass LowerExpectIntrinsicPass SimplifyCFGPass SROAPass EarlyCSEPass PromotePass InstCombinePass SimplifyCFGPass InvalidateAnalysisPass<llvm::AAManager> SROAPass EarlyCSEPass SpeculativeExecutionPass JumpThreadingPass CorrelatedValuePropagationPass SimplifyCFGPass InstCombinePass AggressiveInstCombinePass LibCallsShrinkWrapPass TailCallElimPass SimplifyCFGPass ReassociatePass ConstraintEliminationPass LoopSimplifyPass LCSSAPass LoopInstSimplifyPass LoopSimplifyCFGPass LICMPass LoopRotatePass LICMPass SimpleLoopUnswitchPass SimplifyCFGPass InstCombinePass LoopSimplifyPass LCSSAPass LoopIdiomRecognizePass IndVarSimplifyPass LoopDeletionPass LoopFullUnrollPass SROAPass VectorCombinePass
202 تشغيل لمراحل من 81 نوعاً مختلفاً، وأسماؤها تحكي ما يحدث: SimplifyCFGPass تنظف مخطط سير التحكم وتعمل مرات كثيرة، وSROAPass وPromotePass تحولان الذاكرة إلى قيم، وInstCombinePass تجمع التعليمات البسيطة في تعليمات أبسط، وLICMPass تخرج من الحلقة كل حساب لا يتغير داخلها، وLoopRotatePass تفعل نفس التدوير الذي رأيناه في GCC. وصفحة المراحل في توثيق LLVM تصف كل واحدة، وصفحة مدير المراحل الجديد تشرح كيف ترتب في خطوط مثل default<O2>. والفائدة العملية أنك تستطيع أن تشغل مرحلة واحدة على ملفك، كما فعلنا مع mem2reg، لترى أثرها وحدها، وهذا ما لا يسمح به GCC بسهولة.
المراحل Passes والتحليلات Analyses: ماذا يحدث داخل كل مرحلة؟
إذا نظرت إلى السجل الكامل الذي يطبعه -debug-pass-manager، وليس إلى أسماء المراحل فقط، فسوف تجد نوعين من السطور، وهذه أول عشرة سطور خاصة بالدالة invoice_total:
Running pass: EntryExitInstrumenterPass on invoice_total (15 instructions)
Running pass: LowerExpectIntrinsicPass on invoice_total (15 instructions)
Running pass: SimplifyCFGPass on invoice_total (15 instructions)
Running analysis: TargetIRAnalysis on invoice_total
Running analysis: AssumptionAnalysis on invoice_total
Running pass: SROAPass on invoice_total (15 instructions)
Running analysis: DominatorTreeAnalysis on invoice_total
Running pass: EarlyCSEPass on invoice_total (15 instructions)
Running analysis: TargetLibraryAnalysis on invoice_total
Invalidating analysis: DominatorTreeAnalysis on invoice_total
السطور التي تبدأ بعبارة Running pass مراحل تغير الكود، والسطور التي تبدأ بعبارة Running analysis تحليلات تحسب معلومات عن الكود دون أن تغيره، مثل DominatorTreeAnalysis التي تحسب شجرة السيطرة، أي أي كتلة يمر بها كل طريق إلى كتلة أخرى، وهي نفس المعلومة التي استخدمها المحقق ليرفض broken-dom.ll. والمرحلة التي تحتاج تحليلاً تطلبه من المدير، والمدير يحسبه مرة ويحفظه حتى تأتي مرحلة تغير الكود بطريقة تجعله قديماً، فيظهر السطر Invalidating analysis ويحذفه، ويحسب من جديد عندما تطلبه مرحلة أخرى. وهذا التصميم يحل مشكلة حقيقية في أي محسن: التحليلات مكلفة، والمراحل كثيرة، وحساب كل تحليل قبل كل مرحلة يجعل المترجم بطيئاً جداً، وحفظه دون إبطال يجعل المراحل تعمل على معلومات خاطئة. والرقم بين القوسين، مثل (15 instructions)، عدد تعليمات الدالة لحظة المرحلة، ويمكنك أن تراه ينقص أو يزيد مع تقدم التحسين، فالدمج يزيده، وحذف الكود الميت ينقصه.
مشكلة حقيقية: ما لم نكتبه في IR، وصف البيانات Data Layout
القراءة load i64 ... align 4 تعني أن المحسن افترض أن عنوان كل عدد من 64 بت مضاعف للرقم 4 فقط، مع أن المترجم على x86-64 يضع كل long على حد 8 بايتات. ولم يحدث هذا بسبب خطأ في المحسن، وإنما لأن ملفنا لم يقل أي شيء عن المعالج. فكل ملف يكتبه Clang يبدأ بسطرين نسيناهما، وهذا ما كتبه Clang وما كتبه rustc على نفس الجهاز:
target datalayout = "e-m:e-p270:32:32-p271:32:32-p272:64:64-i64:64-i128:128-f80:128-n8:16:32:64-S128"
target triple = "x86_64-pc-linux-gnu"
target datalayout = "e-m:e-p270:32:32-p271:32:32-p272:64:64-i64:64-i128:128-f80:128-n8:16:32:64-S128"
target triple = "x86_64-unknown-linux-gnu"
السطر target triple يحدد المعالج ونظام التشغيل، والسطر target datalayout نص مضغوط يصف حجم كل نوع ومحاذاته في الذاكرة، فالجزء i64:64 يعني أن العدد من 64 بت يحاذى على 64 بت أي 8 بايتات، وe في البداية تعني Little Endian. وعندما يغيب هذا الوصف يستخدم LLVM قيماً افتراضية من المرجع، وفيها محاذاة أصغر للنوع i64. والجزء الأخير من السكربت يضيف السطرين إلى ملفنا ويعيد التحسين:
== total.ll (no target lines) after opt -O2:
  %p = load i64, ptr %p.addr, align 4
  %q = load i64, ptr %q.addr, align 4
== the same IR with clang's target datalayout and triple, after opt -O2:
  %p = load i64, ptr %p.addr, align 8
  %q = load i64, ptr %q.addr, align 8
مع الوصف صارت المحاذاة 8 كما يجب. والمحاذاة الأصغر من الحقيقة لا تجعل الكود خاطئاً، ولكنها تمنع المحسن من استخدام تعليمات تفترض المحاذاة الكاملة. والدرس الأكبر هنا أن LLVM IR ليس مستقلاً عن المعالج تماماً كما يبدو: فالواجهة الأمامية تكتب حجم long وترتيب المعاملات في الاستدعاء ABI ووصف البيانات لمعالج محدد قبل أن يصل IR إلى المحسن، لذلك لا تأخذ ملف .ll كتبه Clang لمعالج x86-64 وتترجمه إلى معالج آخر، وإنما اطلب من Clang أن يكتبه للمعالج الهدف من البداية بالخيار --target. ونحن نستطيع أن نترجم ملفنا إلى أي معالج في قسم llc لأنه لا يعتمد على أي شيء خاص بالمعالج، فلا يوجد فيه long ولا هياكل ولا استدعاء لمكتبة النظام.
العلامة nsw: كيف تحمل IR وعود اللغة
الآن نعود إلى سؤال مدير الفريق، ونبدأ بالحماية التي اختفت. والملف ub.c هنا فيه الدالة fits_after_increment وحدها، وهذا ما كتبه Clang لها دون تحسين:
define dso_local i32 @fits_after_increment(i32 noundef %0) #0 {
  %2 = alloca i32, align 4
  store i32 %0, ptr %2, align 4
  %3 = load i32, ptr %2, align 4
  %4 = add nsw i32 %3, 1
  %5 = load i32, ptr %2, align 4
  %6 = icmp sgt i32 %4, %5
  %7 = zext i1 %6 to i32
  ret i32 %7
}
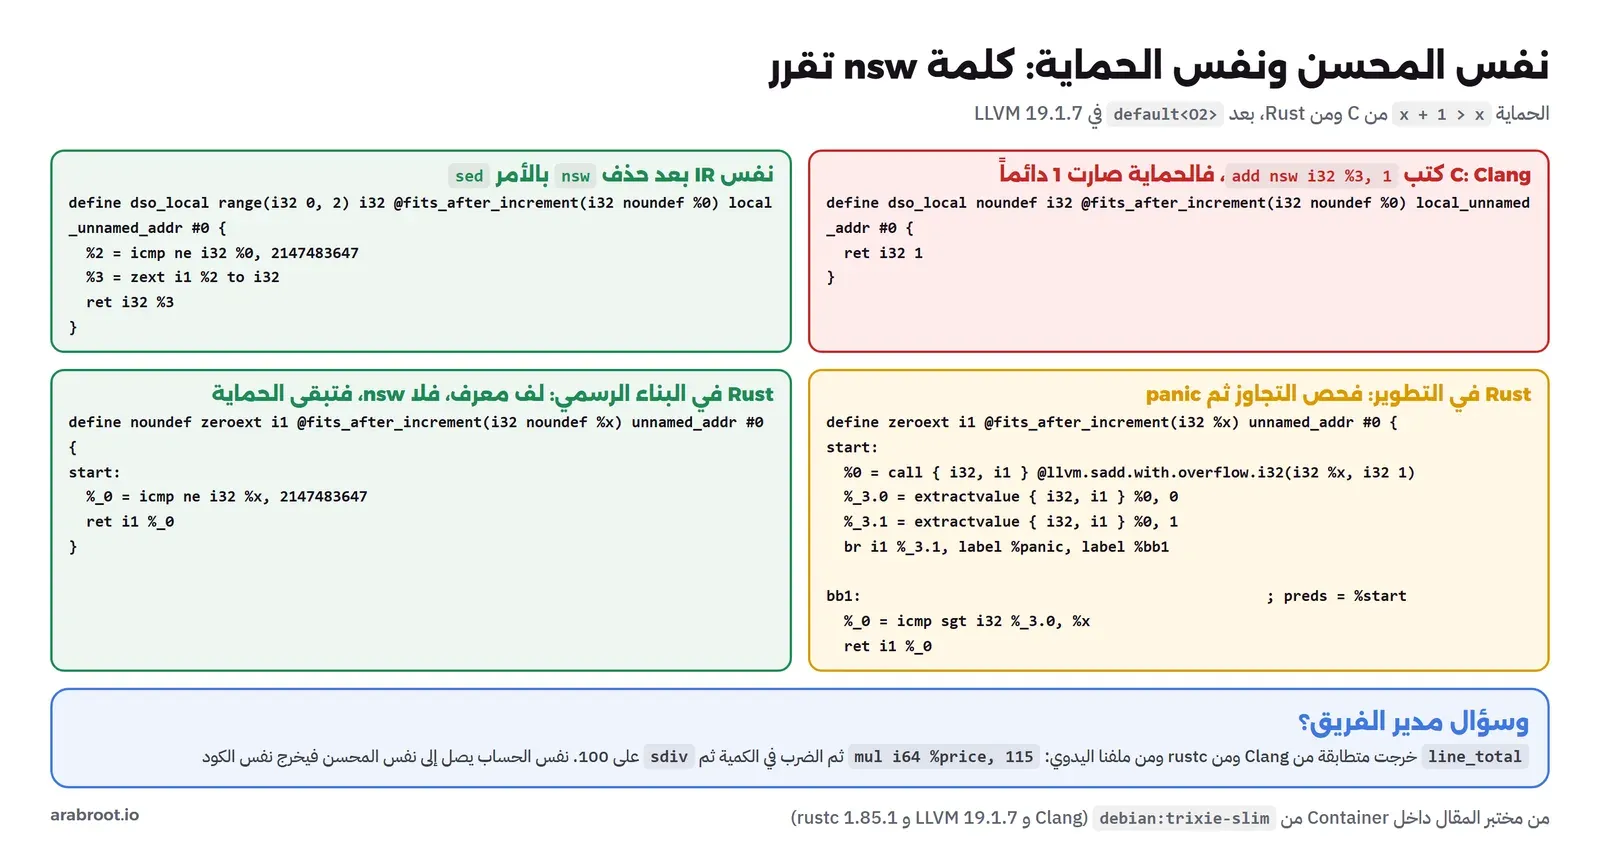
السطر المهم هو %4 = add nsw i32 %3, 1. والعلامة nsw هي الطريقة التي تقول بها الواجهة الأمامية للغة C لكل المراحل بعدها: «هذا الجمع لا يتجاوز المدى بإشارة، وإذا تجاوزه فالنتيجة قيمة سامة Poison». وتعريف التعليمة add في المرجع يقول ذلك صراحة، وقسم القيم السامة يشرح أن أي استخدام لها في قرار يجعل السلوك غير معرف. أي أن LLVM لا يعرف شيئاً عن معيار C، والذي يعرفه هو العلامة التي وضعها Clang لأن معيار C يقول إن التجاوز سلوك غير معرف. وهذا ما فعله المحسن بها:
define dso_local noundef i32 @fits_after_increment(i32 noundef %0) local_unnamed_addr #0 {
  ret i32 1
}
نفس return 1 التي رأيناها في GCC. والآن التجربة التي تبين أن السبب العلامة وحدها: أخذنا نفس IR وحذفنا كلمة nsw فقط بالأمر sed، ومررناه على نفس المحسن بنفس المستوى:
define dso_local range(i32 0, 2) i32 @fits_after_increment(i32 noundef %0) local_unnamed_addr #0 {
  %2 = icmp ne i32 %0, 2147483647
  %3 = zext i1 %2 to i32
  ret i32 %3
}
دون العلامة لم يستطع المحسن أن يفترض شيئاً، فالجمع يلف عند الحد، فحول الحماية إلى المقارنة الصحيحة الوحيدة: icmp ne i32 %0, 2147483647، أي «النتيجة 1 إلا إذا كانت x هي أكبر قيمة». ولاحظ أن المحسن لم يحسب الجمع أصلاً، وإنما فهم معنى الحماية وكتبها بأقصر شكل.
نفس الدالة في Rust: إيقاف البرنامج Panic أو اللف Wrapping
والآن كتبنا نفس الدالتين بلغة Rust في الملف invoice.rs:
// invoice.rs: the same invoice total and the same guard, written in Rust
#[no_mangle]
pub fn line_total(price: i64, qty: i64) -> i64 {
    price * qty * 115 / 100
}

#[no_mangle]
pub fn invoice_total(price: &[i64], qty: &[i64]) -> i64 {
    price.iter().zip(qty).map(|(p, q)| line_total(*p, *q)).sum()
}

#[no_mangle]
pub fn fits_after_increment(x: i32) -> bool {
    x + 1 > x
}
وهذا ما كتبه rustc للحماية دون تحسين، أي -C opt-level=0:
define zeroext i1 @fits_after_increment(i32 %x) unnamed_addr #0 {
start:
  %0 = call { i32, i1 } @llvm.sadd.with.overflow.i32(i32 %x, i32 1)
  %_3.0 = extractvalue { i32, i1 } %0, 0
  %_3.1 = extractvalue { i32, i1 } %0, 1
  br i1 %_3.1, label %panic, label %bb1

bb1:                                              ; preds = %start
  %_0 = icmp sgt i32 %_3.0, %x
  ret i1 %_0

panic:                                            ; preds = %start
; call core::panicking::panic_const::panic_const_add_overflow
  call void @_ZN4core9panicking11panic_const24panic_const_add_overflow17h44eace8930cb0ff0E(ptr align 8 @alloc_4aaa80a4ab7e0dd4918dffc0d31cd6ce) #10
  unreachable
}
لا يوجد هنا add nsw أبداً، وإنما الدالة llvm.sadd.with.overflow.i32 التي تعيد النتيجة ومعها بت يقول هل حدث تجاوز، فإذا حدث ذهب التنفيذ إلى الكتلة panic التي توقف البرنامج برسالة. وهذا لأن Rust تفعل فحص التجاوز Overflow Checks في بناء التطوير، كما في توثيق خيارات rustc. والدالة line_total في نفس الملف فيها ثلاثة فحوص: لكل ضرب، وللقسمة لأن قسمة أصغر عدد على سالب واحد تتجاوز المدى. ثم البناء الرسمي -C opt-level=2، حيث تطفأ هذه الفحوص افتراضياً:
define noundef range(i64 -92233720368547758, 92233720368547759) i64 @line_total(i64 noundef %price, i64 noundef %qty) unnamed_addr #0 {
start:
  %_4 = mul i64 %price, 115
  %_3 = mul i64 %_4, %qty
  %_0 = sdiv i64 %_3, 100
  ret i64 %_0
}
define noundef zeroext i1 @fits_after_increment(i32 noundef %x) unnamed_addr #0 {
start:
  %_0 = icmp ne i32 %x, 2147483647
  ret i1 %_0
}
في المخرج أعلاه لاحظ التالي:
- الدالة
line_totalهي حرفياً نفس ما كتبه المحسن من ملفنا اليدوي ومن Clang:mul i64 %price, 115ثم الضرب في الكمية ثمsdivعلى 100، ومع نفسrange. وهذه إجابة سؤال مدير الفريق: الحساب نفسه يصل إلى نفس المحسن ونفس الواجهة الخلفية، فيخرج نفس الكود. والفروق في الأداء بين C وRust تأتي من أماكن أخرى، مثل فحوص حدود المصفوفات، وطريقة استخدام الذاكرة، والمكتبات، لا من المترجم الخلفي. - الحماية في Rust صارت
icmp ne i32 %x, 2147483647، أي نفس ما خرج من IR بعد أن حذفناnsw. والسبب أن Rust تعرف تجاوز المدى في البناء الرسمي بأنه لف معرف، فلا تضعnswعلى الجمع، فلا يستطيع المحسن أن يفترض أنه لا يحدث، فتبقى الحماية.
أي أن نفس المحسن، بنفس المراحل، حذف الحماية في C وأبقاها في Rust، والفرق كله في كلمة واحدة كتبتها الواجهة الأمامية حسب وعود لغتها. وهذا يعطيك طريقة عملية لفهم أي لغة مبنية على LLVM: انظر ماذا تكتب واجهتها الأمامية من علامات مثل nsw وnuw وnoalias وinbounds، فكل علامة وعد، وكل وعد فرصة تحسين وخطر في نفس الوقت. وفي مقال أمان الذاكرة رأينا الجانب الآخر من هذه الوعود في الذاكرة.
من IR واحد إلى ثلاثة معالجات: llc
الوعد الثاني لأي تمثيل وسيط هو أن الواجهة الخلفية لكل معالج تستقبل نفس الملف. والأداة llc تأخذ الخيار -mtriple لتحدد المعالج الهدف، وحزمة llvm في Debian مبنية بكل المعالجات المدعومة، والأمر llvm-config --targets-built طبع لنا قائمة فيها X86 وAArch64 وRISCV وWebAssembly وغيرها. والجزء الخامس من السكربت يترجم الدالة line_total من الملف المحسن إلى ثلاثة معالجات، وتوثيق llc يشرح الخيارات:
== llc -O2 -mtriple=x86_64-pc-linux-gnu
line_total:                             # @line_total
	imulq	%rsi, %rdi
	imulq	$115, %rdi, %rcx
	movabsq	$-6640827866535438581, %rdx     # imm = 0xA3D70A3D70A3D70B
	movq	%rcx, %rax
	imulq	%rdx
	addq	%rdx, %rcx
	movq	%rcx, %rax
	shrq	$63, %rax
	sarq	$6, %rcx
	addq	%rax, %rcx
	movq	%rcx, %rax
	retq
== llc -O2 -mtriple=aarch64-linux-gnu
line_total:                             // @line_total
	mul	x8, x0, x1
	mov	w9, #115                        // =0x73
	mul	x8, x8, x9
	mov	x9, #55051                      // =0xd70b
	movk	x9, #28835, lsl #16
	movk	x9, #2621, lsl #32
	movk	x9, #41943, lsl #48
	smulh	x9, x8, x9
	add	x8, x9, x8
	asr	x9, x8, #6
	add	x0, x9, x8, lsr #63
	ret
== llc -O2 -mtriple=riscv64-linux-gnu
line_total:                             # @line_total
	addi	sp, sp, -16
	sd	ra, 8(sp)                       # 8-byte Folded Spill
	call	__muldi3
	li	a1, 115
	call	__muldi3
	li	a1, 100
	ld	ra, 8(sp)                       # 8-byte Folded Reload
	addi	sp, sp, 16
	tail	__divdi3
== llc -O2 -mtriple=riscv64-linux-gnu -mattr=+m
line_total:                             # @line_total
	lui	a2, %hi(.LCPI0_0)
	ld	a2, %lo(.LCPI0_0)(a2)
	mul	a0, a0, a1
	li	a1, 115
	mul	a0, a0, a1
	mulh	a1, a0, a2
	add	a0, a1, a0
	srli	a1, a0, 63
	srai	a0, a0, 6
	add	a0, a0, a1
	ret
في المخرج أعلاه لاحظ التالي:
- في x86-64 ستجد نفس الحيلة التي رأيناها في GCC: القسمة على 100 صارت ضرباً في
0xA3D70A3D70A3D70Bثم إزاحة وتصحيح للإشارة، والمعاملان يأتيان في المسجلين%rdiو%rsiحسب طريقة الاستدعاء في Linux. - في AArch64 نفس الرقم السحري، ولكن المعالج لا يستطيع أن يضع ثابتاً من 64 بت في تعليمة واحدة، فبناه على أربع مراحل:
movثم ثلاثmovkكل منها تضع 16 بت في مكانها. والتعليمةsmulhتعطي النصف الأعلى من حاصل الضرب، والمعاملان فيx0وx1. نفس الخوارزمية، بلغة معالج آخر. - في RISC-V حدث شيء لم نتوقعه: لا يوجد أي ضرب ولا قسمة، وإنما ثلاثة استدعاءات
call __muldi3مرتين وtail __divdi3. والسبب أن المعالجriscv64في أبسط أشكاله لا يحتوي تعليمات ضرب وقسمة، فهي في إضافة اسمها M Extension، وعندما لا نخبرllcأن المعالج يدعمها يستدعي دوال مكتبة تنفذها بالجمع والإزاحة. وصفحة استخدام RISC-V في توثيق LLVM تشرح هذه الإضافات. - مع
-mattr=+mعادت تعليماتmulوmulh، والرقم السحري يقرأ من الذاكرة بالتعليمتينluiوldبدل أن يبنى في المسجل. وفي الواقع كل توزيعات Linux على RISC-V تستخدم مجموعة إضافات أوسع تشمل M، لذلك يكتب Clang ذلك تلقائياً عندما تعطيه الهدف الكامل، ولكنllcمع ملف لا يذكر شيئاً يعطيك أبسط معالج.
وهذا نفس درس -march في المقال السابق من زاوية أخرى: المعالج ليس اسماً فقط، وإنما اسم ومجموعة إضافات، وكود الآلة يتغير كثيراً بحسبها. ولكي نتأكد أن الملفات الكائنية حقيقية لكل معالج، بنينا كلاً منها بالخيار -filetype=obj وقرأنا نوع المعالج من رأس ملف ELF بالأداة readelf:
x86_64-pc-linux-gnu    Advanced Micro Devices X86-64
aarch64-linux-gnu      AArch64
riscv64-linux-gnu      RISC-V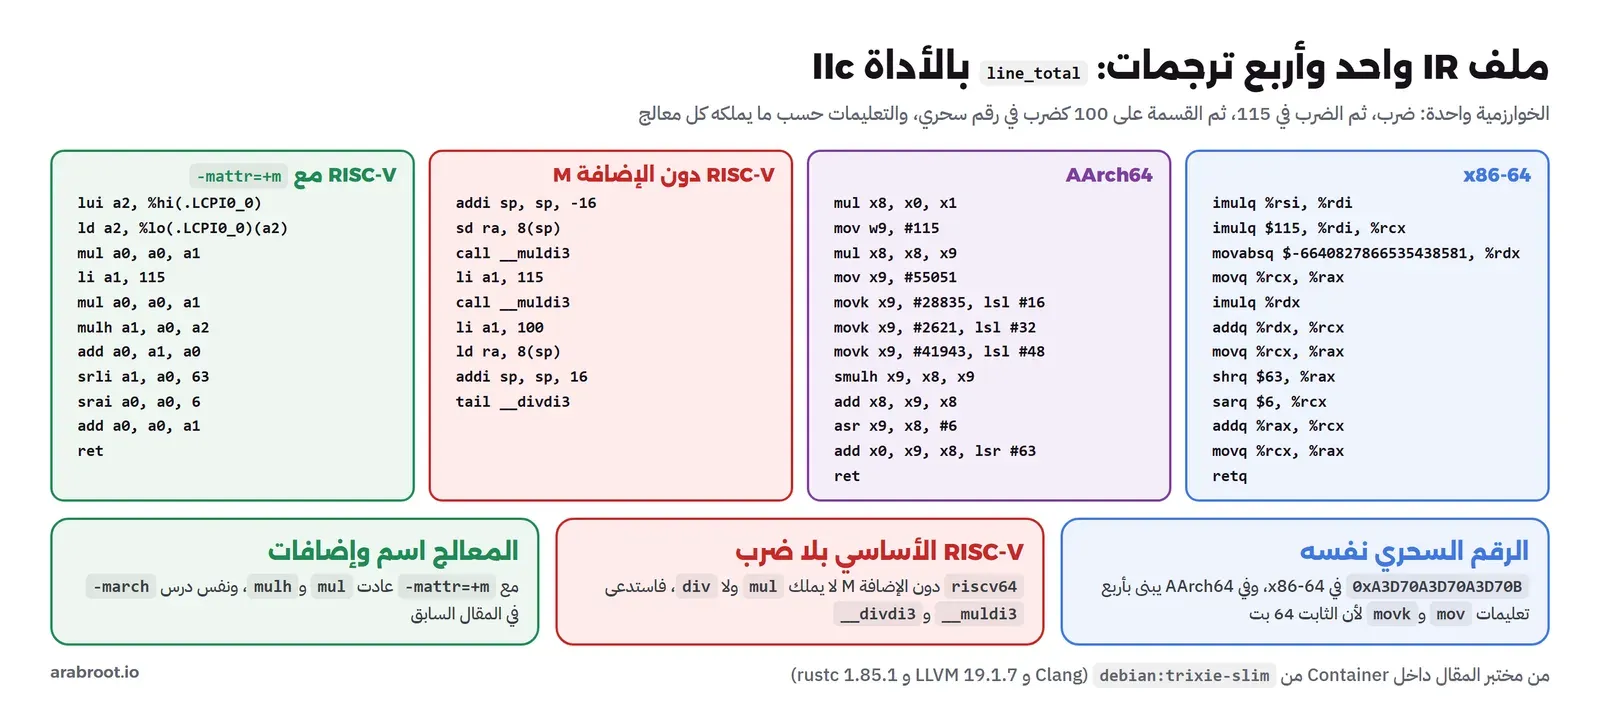
صيغة الفواتير كتمثيل LLVM IR: الأعداد العشرية Floating Point والخيار fast
بدأت هذه المرحلة بصيغة واحدة نفذناها بمفسر شجري ثم بآلة افتراضية: round((price * qty - discount) * (1 + tax), 2). فكيف تبدو لو ولدها مترجم لغتنا كتمثيل LLVM IR؟ كتبناها بأيدينا في الملف formula.ll بالنوع double، ومعها main تطبع النتيجة بالدالة printf من مكتبة C، فتعلمنا في الطريق كيف يصرح IR عن دالة خارجية بالكلمة declare، وكيف يعرف نصاً ثابتاً كمصفوفة بايتات:
; formula.ll: the benchmark formula of the interpreter series, round((price * qty - discount) * (1 + tax), 2), as LLVM IR
@fmt = private constant [16 x i8] c"formula = %.2f\0A\00"

declare i32 @printf(ptr, ...)
declare double @llvm.round.f64(double)

define double @formula(double %price, double %qty, double %discount, double %tax) {
entry:
  %gross = fmul double %price, %qty
  %net = fsub double %gross, %discount
  %rate = fadd double 1.0, %tax
  %total = fmul double %net, %rate
  %scaled = fmul double %total, 100.0
  %rounded = call double @llvm.round.f64(double %scaled)
  %result = fdiv double %rounded, 100.0
  ret double %result
}

define i32 @main() {
entry:
  %v = call double @formula(double 120.0, double 3.0, double 20.0, double 0.15)
  call i32 (ptr, ...) @printf(ptr @fmt, double %v)
  ret i32 0
}
وفي المحاولة الأولى كتبنا طول النص [17 x i8] بعد أن عددنا الحروف بأعيننا، فرفض المحلل الملف:
lli: lli: f17.ll:2:35: error: constant expression type mismatch: got type '[16 x i8]' but expected '[17 x i8]'
@fmt = private constant [17 x i8] c"formula = %.2f\0A\00"
                                  ^
النص formula = %.2f مع سطر جديد وصفر النهاية 16 بايتاً لا 17، وIR لا يحسب الطول عنك لأن كل نوع فيه صريح، وهذا ثمن الدقة التي تجعله سهلاً على الأدوات. وكل مولد IR حقيقي يحسب هذه الأطوال في الكود، ولا يكتبها إنسان. وبعد التصحيح شغلنا الملف بالأداة lli، ثم مررناه على المحسن، ثم أضفنا العلامة fast إلى كل عملية عشرية ومررناه مرة ثانية:
== lli formula.ll
formula = 391.00
== opt -O2: formula
define double @formula(double %price, double %qty, double %discount, double %tax) local_unnamed_addr #2 {
entry:
  %gross = fmul double %price, %qty
  %net = fsub double %gross, %discount
  %rate = fadd double %tax, 1.000000e+00
  %total = fmul double %net, %rate
  %scaled = fmul double %total, 1.000000e+02
  %rounded = tail call double @llvm.round.f64(double %scaled)
  %result = fdiv double %rounded, 1.000000e+02
  ret double %result
}
== opt -O2 with fast-math flags on every operation: formula
define double @formula(double %price, double %qty, double %discount, double %tax) local_unnamed_addr #2 {
entry:
  %gross = fmul fast double %qty, %price
  %net = fsub fast double %gross, %discount
  %rate = fadd fast double %tax, 1.000000e+00
  %total = fmul fast double %net, 1.000000e+02
  %scaled = fmul fast double %total, %rate
  %rounded = tail call double @llvm.round.f64(double %scaled)
  %result = fmul fast double %rounded, 1.000000e-02
  ret double %result
}
== lli on the fast-math version
formula = 391.00
في المخرج أعلاه لاحظ التالي:
- النتيجة 391.00، نفس ما أعطاه المفسر الشجري والآلة الافتراضية في الجزأين الأولين، ولكن هذه المرة من كود آلة حقيقي كتبه JIT في
lli. - المحسن مع
-O2لم يغير أي عملية حسابية تقريباً، فقط بدل ترتيب معاملي الجمع. والسبب أن الجمع والضرب في الأعداد العشرية ليسا تجميعيين، فالترتيب يغير النتيجة في البت الأخير أحياناً، كما شرحنا في مقال الأرقام العشرية Floating Point من الداخل، لذلك لا يحق للمحسن أن يعيد الترتيب كما فعل مع الأعداد الصحيحة فيline_total. - مع العلامة
fastصار المحسن حراً: ضرب في 100 قبل الضرب في النسبة بدل بعده، وحول القسمة على 100 إلى ضرب في1.000000e-02. والعدد 0.01 لا يمثل بدقة فيdouble، فهذه النتيجة قد تختلف عن القسمة في حالات حدية، مع أنها أعطت 391.00 هنا. والعلامةfastهي ما يضعه Clang عندما تبني بالخيار-ffast-math، وقسم Fast-Math Flags في المرجع يشرح كل وعد فيها، ومنها أن القيم ليستNaNولا لا نهائية.
وهذا يعيدنا إلى درس nsw من زاوية الأعداد العشرية: كل علامة تكتبها الواجهة الأمامية وعد يسمح للمحسن بتحسينات، ولا تكتب في كود مالي وعداً لا تريده، لذلك لا يستخدم -ffast-math في حساب الفواتير.
لماذا تبني Rust و Swift و Zig على LLVM؟
بعد كل ما رأيناه تصبح الإجابة واضحة: من يصمم لغة جديدة يريد أن يركز على اللغة نفسها، أي القواعد والأنواع ونظام الذاكرة ورسائل الخطأ، ولا يريد أن يكتب من الصفر مئات المراحل التي رأيناها، وواجهة خلفية لكل معالج، وتوزيع مسجلات، وكشفاً لتعليمات التوجيه. وLLVM يعطيه كل هذا مقابل شيء واحد: أن يكتب IR صحيحاً. وكل لغة كبيرة اليوم استخدمته بطريقتها:
- Rust: الواجهة الأمامية في
rustcتحلل الكود وتتحقق من الملكية والاستعارة على تمثيلات خاصة بها، ثم تكتب LLVM IR وتسلمه للمحسن والواجهة الخلفية، كما يشرح دليل مطوري rustc. ورأينا بأعيننا أنrustcفي Debian يستخدم LLVM 19.1.7 نفسه. - Swift: يمر الكود بتمثيل وسيط خاص باللغة اسمه SIL، تطبق عليه تحسينات تحتاج معرفة Swift نفسها، ثم يحول إلى LLVM IR، كما في وصف بنية مترجم Swift. وهذا نمط شائع في اللغات الحديثة: تمثيل وسيط أعلى يفهم اللغة، ثم LLVM IR للتحسينات العامة وكود الآلة.
- Zig: بنت على LLVM منذ البداية، ولكنها اليوم تحاول الابتعاد عنه، والسبب ثمن LLVM.
وثمن LLVM حقيقي، ويجب أن تعرفه قبل أن تبني عليه:
- زمن الترجمة: مئتا تشغيل لمراحل على ملف من نحو 35 سطراً عمل كثير، وفي المشاريع الكبيرة يأخذ LLVM جزءاً كبيراً من زمن الترجمة، وخاصة في البناء المحسن. لذلك يوجد لمترجم Rust واجهة خلفية بديلة مبنية على Cranelift للبناء السريع أثناء التطوير، في مستودع rustc_codegen_cranelift، وواجهة أخرى مبنية على GCC لدعم معالجات لا يدعمها LLVM، في مستودع rustc_codegen_gcc.
- الارتباط بإصدار: كل إصدار من LLVM يغير بعض واجهاته البرمجية، فاللغة المبنية عليه تتبعه في كل ترقية، وأخطاؤه تصبح أخطاءها.
- الحجم: مكتبات LLVM كبيرة، وبناؤها من المصدر يأخذ وقتاً طويلاً، وهذا يثقل على من يريد مترجماً صغيراً سهل البناء.
- الوعود المشتركة: دلالات LLVM نفسها، مثل القيم السامة، صممت في الأصل حول احتياجات C وC++، واللغات الأخرى تحتاج أن تكتب IR بحذر حتى لا ترث وعوداً لا تريدها، كما رأينا مع
nsw.
ولهذه الأسباب فتح فريق Zig في 2023 القضية رقم 16270 بعنوان جعل برنامج Zig الرئيسي لا يعتمد على مكتبات LLVM وLLD وClang، وفي الإصدار 0.15 صارت الواجهة الخلفية الخاصة بها لمعالجات x86-64 هي الافتراضية في وضع Debug، وملاحظات إصدار Zig 0.15.1 تذكر أن الترجمة في وضع Debug صارت أسرع بخمس مرات بها. ولاحظ أن الهدف ليس رمي LLVM، فهو باق كخيار للبناء الرسمي حيث يهم التحسين، وإنما أن لا تدفع ثمنه في كل مرة تحفظ فيها ملفاً أثناء التطوير. وهذا نفس الميزان الذي رأيناه في سلسلة المفسر: كل مرحلة إضافية تعطي سرعة في التنفيذ، وتأخذ سرعة من البناء.
هل تبني لغتك على LLVM؟ جدول قرار Decision Table
| الحالة | الأنسب | والسبب |
|---|---|---|
| لغة صيغ صغيرة داخل نظام، مثل لغة الفواتير | مفسر شجري أو Bytecode كما في الجزأين الأولين | لا تحتاج كود آلة، والبساطة والأمان أهم من السرعة |
| لغة عامة تريد أداء C على معالجات كثيرة | توليد LLVM IR | مئات المراحل وواجهات خلفية لكل معالج مجاناً، كما فعلت Rust وSwift |
| لغة تريد ترجمة سريعة جداً أثناء التطوير | واجهة خلفية خفيفة مثل Cranelift، وLLVM للبناء الرسمي | المحسن ثقيل على زمن البناء، وهذا ما دفع Zig وrustc_codegen_cranelift إلى واجهات أخف |
| تحتاج JIT داخل برنامجك لاستعلامات أو صيغ ثقيلة | مكتبات JIT في LLVM | lli شغل IR من الذاكرة مباشرة، والمكتبات نفسها متاحة لبرنامجك |
| تريد أبسط طريق لكود آلة دون تعلم IR | توليد C ثم ترجمته | أبسط في البداية، ولكنك ترث السلوك غير المعرف في C |
| تحليل كود موجود أو كتابة أداة فحص | مرحلة opt خاصة بك على IR | كل اللغات المبنية على LLVM تصل إليك بنفس الصيغة |
أخطاء شائعة Common Mistakes مع LLVM IR
- كتابة IR أو توليده دون
target datalayoutوtarget triple: القراءات صارتalign 4بدل 8 لأن المحسن استخدم القيم الافتراضية. - افتراض أن IR الذي كتبه Clang مستقل عن المعالج: حجم
longوطريقة الاستدعاء ووصف البيانات مكتوبة فيه لمعالج محدد. - بناء كود مالي بالخيار
-ffast-math: المحسن حول القسمة على 100 إلى ضرب في 0.01 الذي لا يمثل بدقة. - نسيان أن العلامات وعود: وضع
nswعلى جمع قد يتجاوز المدى جعل المحسن يحذف الحماية، وعدم وضعها حيث يجوز يضيع تحسينات. - استخدام قيمة في كتلة لا يسيطر عليها تعريفها:
%tمن الحلقة فيdone، والمحقق وحده أمسك الخطأ، فشغله دائماً على ما تولده. - محاولة كتابة
phiلكل متغير في الواجهة الأمامية: اكتبallocaوloadوstoreواتركmem2regتحول الكود كما يفعل Clang. - ترجمة لمعالج باسمه فقط:
riscv64دون الإضافة M استدعى__muldi3لكل عملية ضرب. - تسمية LLVM «آلة افتراضية»: هو مترجم يكتب كود الآلة، والاسم لم يعد اختصاراً.
- افتراض أن LLVM مجاني في زمن البناء: 202 تشغيل لمراحل على ملف من نحو 35 سطراً، لذلك تبحث اللغات عن واجهات أسرع للتطوير.
قائمة تحقق Checklist قبل أن تولد LLVM IR من لغتك
- كل ملف يبدأ بالسطرين
target datalayoutوtarget tripleللمعالج الهدف. - المحقق يعمل على كل دالة تولدها، في الاختبارات على الأقل.
- المتغيرات المحلية في
allocaفي كتلة البداية، وmem2regأوdefault<O2>تحولها. - كل علامة تضعها مثل
nswوnuwوnoaliasمكتوب سببها في قواعد لغتك، وما لا تعد به لغتك لا تكتبه. - فحوص التجاوز إن أردتها بالدوال
llvm.*.with.overflowكما يفعلrustc. - تجربة الترجمة إلى أكثر من معالج بالأداة
llc، مع الإضافات الصحيحة لكل معالج. - قياس زمن البناء مع زمن التنفيذ، وخطة لبناء سريع أثناء التطوير.
تدريب عملي Practice
- ترجم
total-O2.llبالأمرllc -mtriple=wasm32-unknown-unknownواقرأ الناتج، ولاحظ كيف يبدو كود آلة مكدس بعد أن رأينا آلة المكدس في الجزء الثاني من المفسر. - أضف
nswإلى الجمع%sum.nextفيtotal.llومرره علىopt، ثم فكر: هل هذا الوعد صحيح لفاتورة حقيقية؟ - غير الحماية في
invoice.rsإلىx.checked_add(1).is_some()واقرأ IR في المستويين.
حذف المختبر Cleanup
كل التشغيلات استخدمت --rm، والملفات الوسيطة كتبت في /tmp داخل الـ Container، وبقيت الـ Image فقط:
docker rmi scc1-ccالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- LLVM مجموعة مكتبات مترجمات، لا آلة افتراضية، وقلبها تمثيل وسيط نصي موثق تكتبه أي لغة وتقرؤه كل الأدوات:
optوllcوlli. - LLVM IR لغة تجميع بأنواع ومسجلات غير محدودة في صيغة SSA، والمحلل والمحقق يرفضان الإسناد المكرر والقيمة التي لا يسيطر تعريفها على استخدامها.
- Clang يكتب
allocaلكل متغير، وmem2regتحول الكود إلى SSA لكل اللغات، والمحسن طبق 202 تشغيل لمراحل من 81 نوعاً على ملف من نحو 35 سطراً. - غياب
target datalayoutجعل المحاذاة 4 بدل 8، وIR الذي يكتبه Clang مرتبط بمعالج محدد. - العلامة
nswوعد من اللغة: Clang يكتبها فيحذف المحسن الحماية، وrustc لا يكتبها فتبقى الحماية، والحساب نفسه خرج متطابقاً من C وRust والملف اليدوي. - نفس IR صار x86-64 وAArch64 وRISC-V، وRISC-V دون الإضافة M استدعى دوال مكتبة للضرب والقسمة.
- Rust وSwift تبنيان على LLVM لتركزا على اللغة، والثمن زمن البناء والارتباط بالإصدارات، ولذلك صارت Zig 0.15 تستخدم واجهتها الخاصة في وضع Debug.
وفي المقال التالي من هذه المرحلة بإذن الله نكمل الطريق بعد المترجم: ماذا يحدث بين الملف الكائن والبرنامج الذي يعمل، أي الربط والتحميل.
 دليلداخل المترجم Compiler: من الكود إلى IR وكود الآلةنفتح GCC وClang على ملف C صغير ونقرأ كل مرحلة يمر بها، من الشجرة إلى SSA والتحسينات وكود الآلة، ونرى كيف حذف المترجم فحصاً بسبب سلوك غير معرف.
 دليلمن شجرة AST إلى Bytecode وآلة افتراضية VM بيدكنحول لغة الصيغ من الجزء الأول إلى Bytecode تنفذه آلة مكدس صغيرة، ونقرأ مخرجها بجانب dis في CPython، ونقيس بصدق من أين تأتي السرعة.
 دليلالمترجم Compiler والمفسر Interpreter و JIT و WebAssemblyنشغل دالة واحدة بلغة C وPython وJavaScript وWebAssembly على نفس الجهاز، ونفتح ما كتبه كل مترجم لنعرف لماذا اختلف الوقت من ثلث ثانية إلى دقيقة.
 دليلاللغة شيء والمترجم شيء آخر: من يقرر مستقبل لغات البرمجة؟لماذا لا تصح جمل مثل «Python بطيئة»، وما الفرق بين مواصفة اللغة والبرامج التي تطبقها، ومن يقرر مستقبلها.
 دليلأمان الذاكرة Memory Safety: لماذا تدفع الحكومات نحو Rust؟ماذا طلبت الحكومات فعلاً بشأن C وC++، ولماذا تسبب أخطاء الذاكرة أغلب الثغرات الخطيرة، ومتى يكون Rust هو الاختيار الصحيح.
 دليلمديرو الحزم Package Managers: npm و pip و Maven و Cargoنجرب npm وpip وMaven وCargo على مشروع واحد بأربع لغات، فنقيس كم حزمة تأتي مع كل سطر، ونرى كيف يجعل ملف القفل التثبيت متطابقاً، وكيف خدع حرف واحد في اسم مكتبة مطوري Rust.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ كل التجارب داخل Container من الـ Image الرسمية
debian:trixie-slim(Debian 13.7) مع Clang وLLVM 19.1.7 وrustc 1.85.1 المبني على LLVM 19.1.7 من حزم Debian، على Docker Engine 29.8.0.