كل معالج قرأنا عنه في مقالات هذه السلسلة، من نواة x86 إلى وحدات Tensor Cores، بدأ حياته رملاً. وإذا قرأت صفحة معالج حاسبك فسوف تجد سطراً مثل «Lithography: 14 nm»، وإذا تابعت أخبار التقنية فسوف تقرأ عن TSMC التي تصنع شرائح 3 نانومتر ثم 2 نانومتر، وعن شركة هولندية واحدة اسمها ASML تصنع الأجهزة التي لا يمكن صنع هذه الشرائح دونها، وعن مصانع تكلف عشرات المليارات. ومع ذلك قليل من المبرمجين يعرف الإجابة عن أسئلة بسيطة: كيف يرسم أحد مليارات الترانزستورات على قطعة بحجم ظفر الإصبع؟ وما الذي يقاس بالنانومتر فعلاً؟ ولماذا تكون الشريحة الكبيرة أغلى بكثير من ضعف ثمن الشريحة الصغيرة؟ ولماذا يباع نفس التصميم بعدة أسماء وأسعار؟
وهذه الأسئلة ليست فضولاً فقط، فهي تفسر أشياء تراها كل يوم: لماذا تتأخر معالجات جديدة أو يقل المعروض منها، ولماذا انتقلت AMD ثم Intel إلى تقسيم المعالج إلى قطع صغيرة Chiplets، ولماذا أصبحت بطاقات الذكاء الاصطناعي بهذا السعر. وفي هذا المقال سوف نتتبع الشريحة من الرمل إلى الغلاف، ثم نحسب بأنفسنا كم شريحة تخرج من الرقاقة الواحدة وكم منها يعمل، بسكربت صغير يستعمل المعادلات المنشورة في كتب معمارية الحاسب. وسوف نناقش في هذا المقال ما يلي:
- من الرمل إلى الرقاقة Wafer: تنقية السيليكون وسحب السبيكة البلورية وتقطيعها، بصور حقيقية.
- الحلقة التي تتكرر لكل طبقة: الترسيب والطبقة الحساسة للضوء والطباعة الضوئية Lithography والحفر، ولماذا تحتاج كلها غرفة نظيفة.
- أجهزة EUV من الداخل: ضوء من قطرات القصدير ومرايا بدلاً من العدسات، بأرقام من صفحات ASML.
- ما معنى «3 نانومتر» فعلاً، ولماذا لم يعد الرقم مقياساً لشيء في الترانزستور، وكيف تغير شكل الترانزستور من المسطح إلى FinFET ثم GAA.
- مختبر: نقرأ ما يقوله معالجنا عن نفسه، ثم نحسب عدد الشرائح في الرقاقة ونسبة السليمة منها Yield، ونحاكي العيوب على رقاقة كاملة.
- الفحص والتقطيع والتغليف، وتصنيف الشرائح Binning، وChiplets، ومن يصنع الشرائح اليوم.
وقد شرحنا في مقال المعالج CPU من الداخل ما تحتويه الشريحة الجاهزة، وفي مقال البوابات المنطقية كيف تصبح الترانزستورات بوابات ثم وحدات حساب. أما هنا فنسأل سؤالاً آخر: كيف يصنع هذا الشيء أصلاً؟
لماذا السيليكون بالذات؟ أشباه الموصلات Semiconductors
قبل أن نبدأ بالمصنع يجب أن نجيب عن سؤال قد يبدو بديهياً: لماذا السيليكون وليس النحاس أو الحديد؟ والسبب أن الترانزستور يحتاج مادة نستطيع أن نجعلها موصلة للكهرباء في لحظة وعازلة في اللحظة التالية، والمعادن موصلة دائماً، والزجاج والبلاستيك عازلان دائماً. أما أشباه الموصلات Semiconductors، والسيليكون أشهرها، فتقع في المنتصف: في حالتها النقية توصل الكهرباء بشكل ضعيف، وإذا أضفنا إليها كمية صغيرة جداً ومحسوبة من عنصر آخر، وهي العملية التي تسمى التطعيم Doping، تغيرت قدرتها على التوصيل بشكل كبير، فيمكن أن نصنع مناطق فيها إلكترونات زائدة ومناطق ينقصها إلكترونات بجانب بعضها في نفس القطعة. ومن ترتيب هذه المناطق يصنع الترانزستور، وجهد صغير على البوابة يفتح بينها طريقاً للتيار أو يغلقه.
وللسيليكون ميزات عملية أخرى جعلته يتفوق على غيره من أشباه الموصلات: موجود بكميات هائلة، ويمكن تنقيته إلى درجة عالية جداً، والأهم أن أكسيده، أي ثاني أكسيد السيليكون، عازل ممتاز ينمو على سطحه بسهولة عند تسخينه، وهذه الطبقة العازلة كانت لعقود جزءاً أساسياً من كل ترانزستور. ولذلك عندما تقرأ عن مواد أخرى مثل نيتريد الغاليوم أو كربيد السيليكون فهي تستعمل في مجالات خاصة مثل شواحن الطاقة العالية والاتصالات، ويبقى السيليكون أساس المعالجات والذاكرة.
من الرمل إلى الرقاقة Wafer
السيليكون ثاني أكثر عنصر موجود في القشرة الأرضية، ولكنه لا يوجد وحده، وإنما مرتبطاً بالأكسجين على شكل ثاني أكسيد السيليكون، وهو المادة التي يتكون منها الكوارتز والرمل. والخطوة الأولى في الصناعة هي فصل السيليكون عن الأكسجين ثم تنقيته عدة مرات حتى يصبح نقياً بدرجة لا تحتاجها أي صناعة أخرى تقريباً، لأن ذرة غريبة في المكان الخطأ تغير خصائص الترانزستور الكهربائية. والنتيجة سيليكون متعدد البلورات Polysilicon، أي قطع صغيرة نقية ولكن ذراتها ليست مرتبة في بلورة واحدة.
والخطوة الثانية تحويل هذه القطع إلى بلورة واحدة كاملة: يصهر السيليكون في وعاء، وتغمس فيه بذرة صغيرة من بلورة سيليكون، ثم تسحب ببطء شديد إلى الأعلى وهي تدور، فيتجمد السيليكون عليها بنفس ترتيب ذراتها، حتى تخرج سبيكة Ingot أسطوانية كاملة كلها بلورة واحدة، وتسمى هذه الطريقة طريقة Czochralski نسبة إلى العالم البولندي الذي اكتشفها. والصورة التالية فيها سبيكة حقيقية في متحف، وبجانبها بلورة كوارتز، أي المادة التي بدأنا منها، وفيها أيضاً رقاقة جاهزة بعد التصنيع:
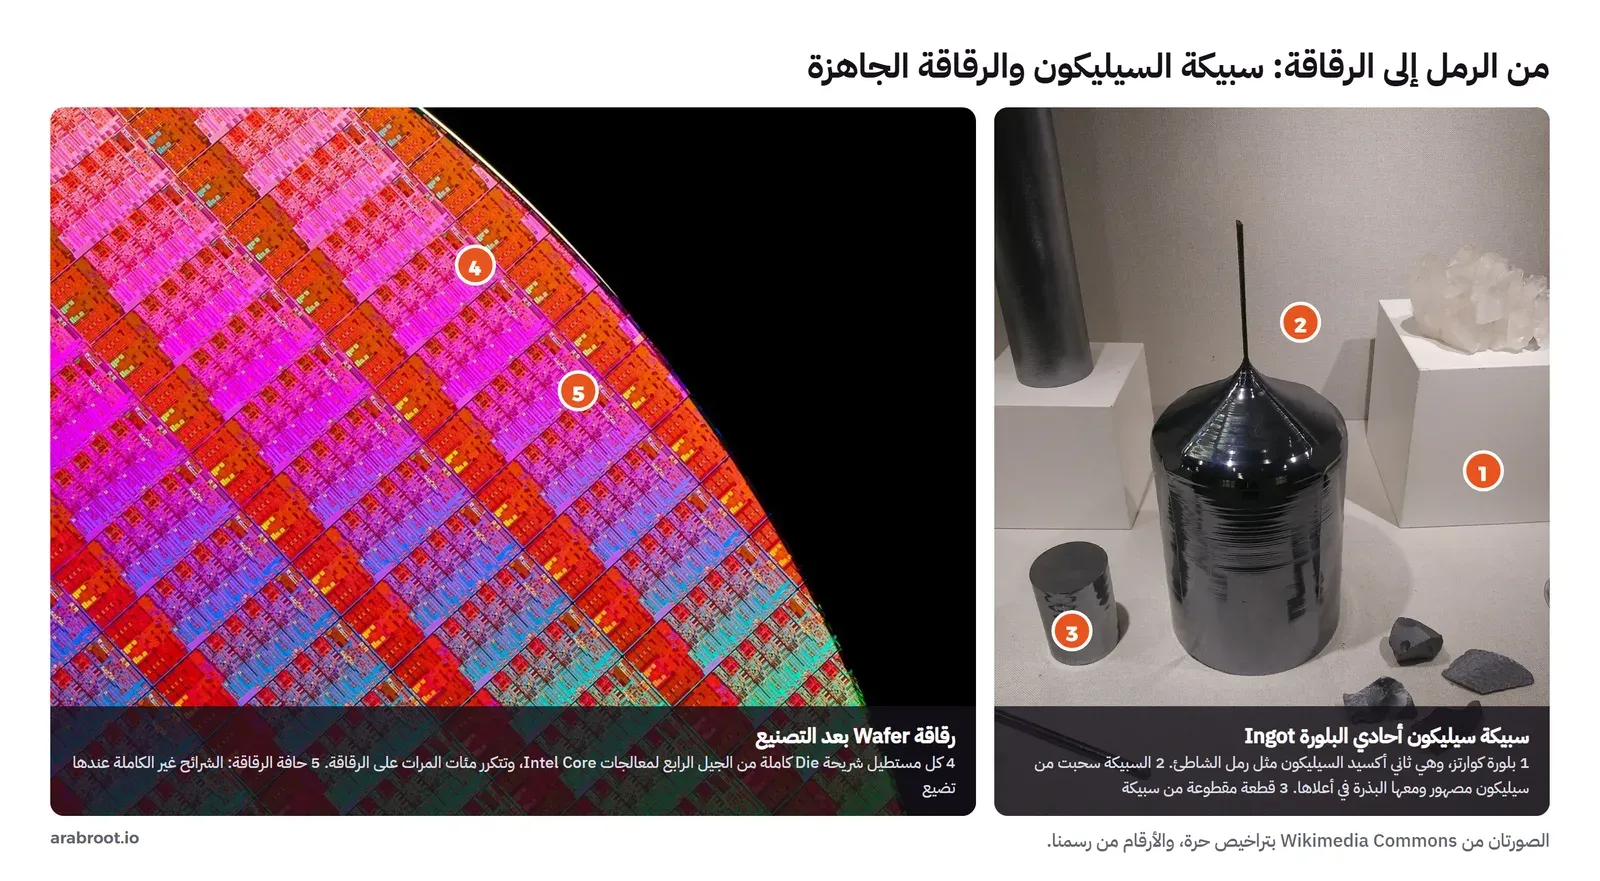
وفي الصورة أعلاه لاحظ التالي:
- بلورة الكوارتز: ثاني أكسيد السيليكون، وهو نفس مادة رمل الشاطئ ولكن على شكل بلورة كبيرة، ومنه يبدأ كل شيء.
- السبيكة: لاحظ العود الرفيع في أعلاها، وهو البذرة التي سحبت منها، والكتف المخروطي تحته حيث بدأ قطر البلورة يكبر حتى وصل إلى قطره النهائي.
- القطعة المقطوعة: السبيكة تقطع بمناشير دقيقة إلى أقراص رقيقة، ثم يصقل كل قرص حتى يصبح سطحه أملس كالمرآة، وهذا القرص هو الرقاقة Wafer.
- الشريحة Die: بعد التصنيع يصبح سطح الرقاقة مئات المستطيلات المتطابقة، كل واحد منها معالج كامل، وهذه هنا شرائح الجيل الرابع من معالجات Intel Core، والألوان التي تراها هي انعكاس الضوء على الطبقات الدقيقة وليست ألواناً حقيقية.
- الحافة: الرقاقة دائرية والشرائح مستطيلة، فعند الحافة تبقى أجزاء لا تتسع لشريحة كاملة وتضيع، وسوف نحسب كم يضيع منها في المختبر.
والرقائق في المصانع الحديثة قطرها 300 mm، وهذا ما تسميه TSMC في صفحة مصانعها الكبيرة GIGAFAB رقائق 12 بوصة، وتقول الصفحة إن المصنع من هذه الفئة ينتج أكثر من 100 ألف رقاقة في الشهر، وإن طاقة هذه المصانع مجتمعة تجاوزت 13 مليون رقاقة مكافئة في 2025.
الحلقة التي تتكرر لكل طبقة: كيف يرسم الترانزستور؟
الرقاقة الآن قرص أملس من السيليكون، والمطلوب أن نصنع عليه مليارات الترانزستورات ثم نوصلها ببعضها بأسلاك نحاسية في عشرات الطبقات فوقها. ولا توجد أداة تستطيع أن ترسم كل ترانزستور وحده، فهذا سوف يستغرق سنوات لرقاقة واحدة، ولذلك تعتمد الصناعة كلها على فكرة تشبه التصوير الفوتوغرافي القديم: نغطي الرقاقة بمادة حساسة للضوء، ونسلط عليها ضوءاً يمر عبر قالب فيه الرسم، فيتغير الجزء الذي وصله الضوء فقط، ثم نزيله ونعالج ما تحته. والصورة التالية تبين ترتيب الخطوات:
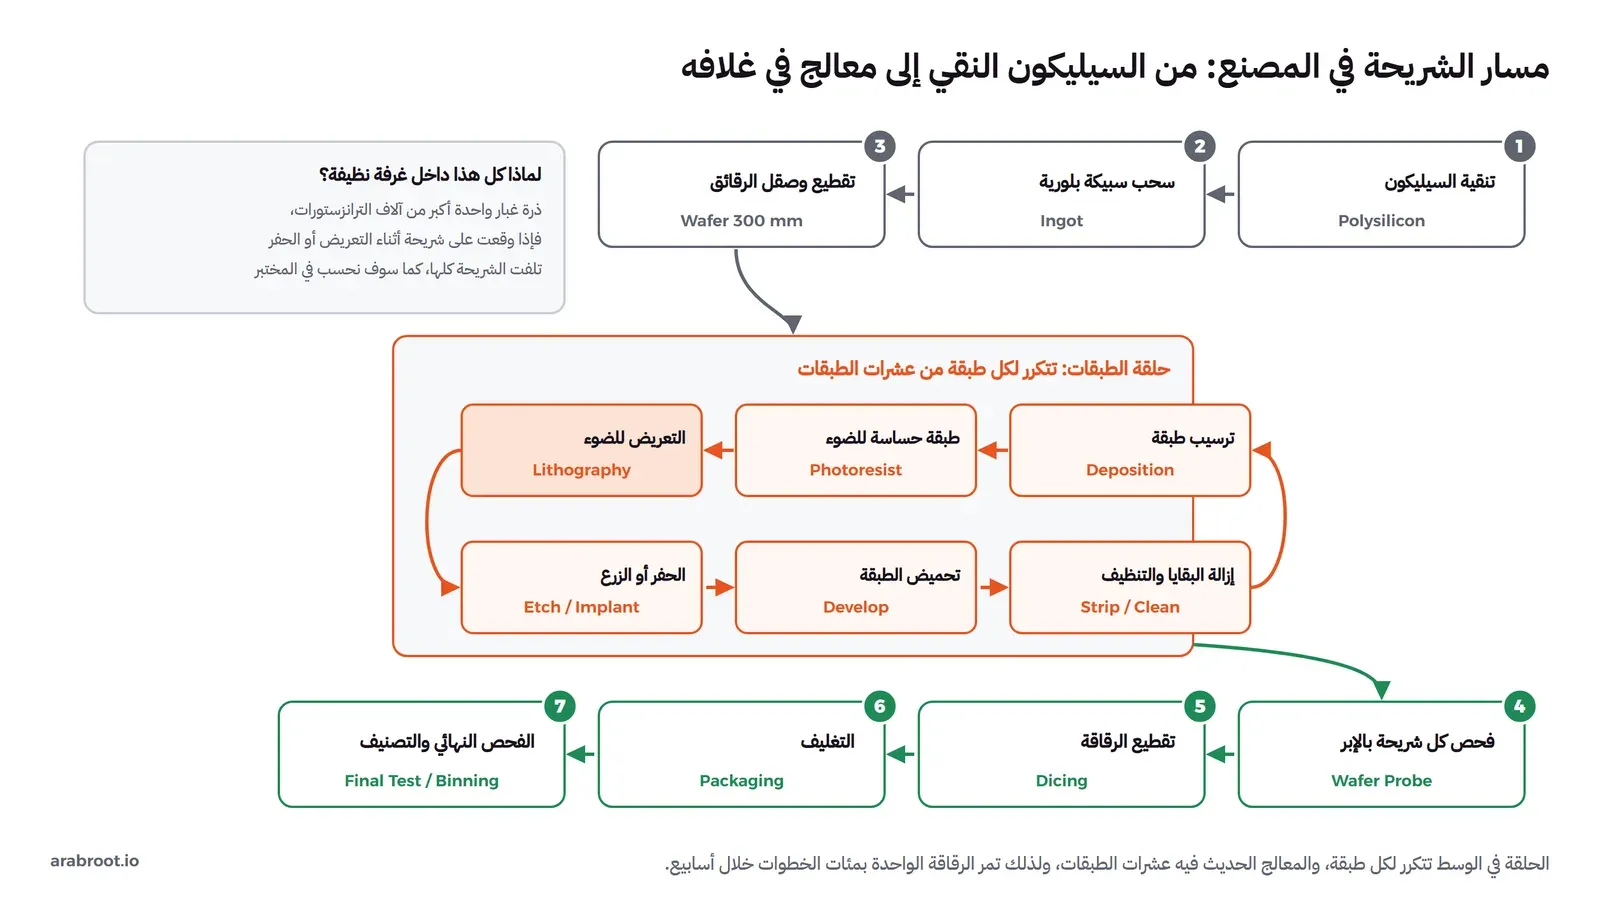
والحلقة في الوسط هي قلب الصناعة، وفيها:
- الترسيب Deposition: نضيف طبقة رقيقة جداً من مادة، عازل أو موصل أو سيليكون، قد يكون سمكها عدة ذرات فقط.
- الطبقة الحساسة للضوء Photoresist: سائل يفرد على الرقاقة وهي تدور بسرعة حتى يغطيها بسمك متساو، ثم يجفف.
- التعريض للضوء Lithography: جهاز الطباعة يسلط الضوء عبر القناع Mask، أو كما تسميه ASML الـ Reticle، وهو لوح فيه رسم طبقة واحدة من الشريحة، فيصغر الرسم وينطبع على الرقاقة. وكما تشرح صفحة ASML عن أساسيات الطباعة الضوئية فالجهاز في أساسه نظام عرض يصغر الصورة ويركزها على رقاقة حساسة للضوء.
- التحميض Develop: سائل يزيل الأجزاء التي تغيرت بالضوء، أو التي لم تتغير حسب نوع المادة، فيبقى على الرقاقة رسم من المادة الحساسة.
- الحفر أو الزرع Etch / Implant: نحفر الطبقة التي تحت الرسم في الأماكن المكشوفة فقط، أو نطلق عليها ذرات من عنصر آخر تغير خصائص السيليكون الكهربائية، وهذا ما يصنع مناطق الترانزستور.
- الإزالة والتنظيف Strip / Clean: نزيل ما بقي من المادة الحساسة، وننظف الرقاقة، ونبدأ الطبقة التالية.
وكل طبقة يجب أن تنطبق على التي تحتها بدقة نانومترات قليلة، وإلا لن يتصل السلك بالترانزستور الذي تحته، ولذلك تمر الرقاقة الواحدة بمئات الخطوات خلال أسابيع. وكل خطوة منها فرصة لعيب، وأي ذرة غبار تقع على الرقاقة في أثناء الطباعة أو الحفر أكبر من آلاف الترانزستورات، ولذلك يحدث كل هذا في غرف نظيفة Clean Rooms يتحكم فيها في الهواء والحرارة والرطوبة، ويلبس العاملون فيها ملابس تغطي كل شيء:
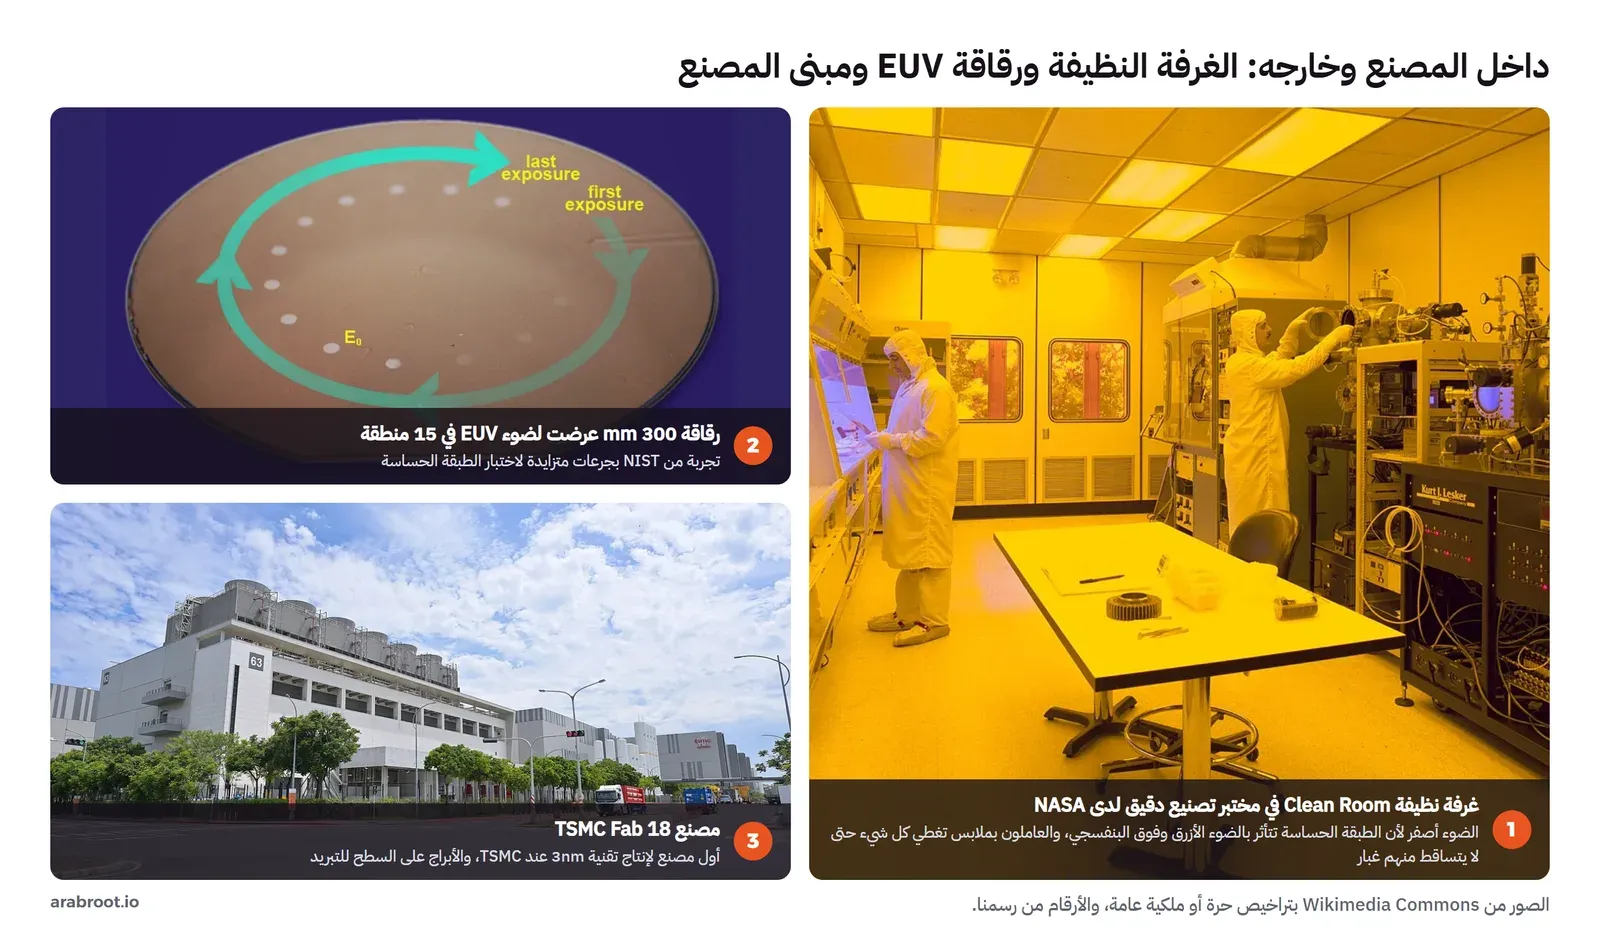
وفي الصورة أعلاه لاحظ لون الضوء في الغرفة النظيفة: أصفر، لأن المادة الحساسة تتأثر بالضوء الأزرق وفوق البنفسجي، فإضاءة الغرفة نفسها يجب ألا تعرض الرقائق قبل الأوان. ولاحظ الرقاقة في الوسط: تجربة من المعهد الأمريكي للمعايير NIST عرضت فيها 15 منطقة لضوء EUV بجرعات متزايدة لمعرفة الجرعة التي تكفي لتغيير المادة الحساسة، وهذا النوع من الاختبار يجرى مع كل مادة جديدة. أما المبنى فهو مصنع Fab 18، وتقول صفحة TSMC عن تقنية 3nm إنه أول مصنع لديها لإنتاج هذه التقنية، والأبراج على سطحه للتبريد، فالمصنع يستهلك كميات كبيرة من الكهرباء والماء.
الأسلاك فوق الترانزستورات: طبقات التوصيل Interconnect
الترانزستورات وحدها لا تصنع معالجاً، فيجب أن يتصل كل منها بغيره بالطريقة التي يحددها التصميم، ولذلك بعد أن تكتمل طبقات الترانزستورات في أسفل الشريحة تبدأ مرحلة ثانية طويلة تبني فوقها طبقات من الأسلاك المعدنية بينها طبقات عازلة. والطبقات السفلى أسلاكها رفيعة جداً وقريبة من بعضها لتوصل الترانزستورات المتجاورة، وكلما صعدنا أصبحت الأسلاك أعرض وأبعد عن بعضها لتنقل الإشارات لمسافات أطول داخل الشريحة ولتوزع الكهرباء، حتى نصل إلى أعلى طبقة فيها نقاط الاتصال التي توصل الشريحة بالغلاف. وتمر كل طبقة من هذه الأسلاك بنفس الحلقة في الرسم: ترسيب، ثم طبقة حساسة، ثم طباعة، ثم حفر، ثم ملء المجاري المحفورة بالمعدن، ثم صقل السطح حتى يصبح مستوياً للطبقة التالية. ولذلك فإن جزءاً كبيراً من الخطوات في المصنع، ومن العيوب المحتملة، ليس في الترانزستورات نفسها وإنما في الأسلاك التي فوقها.
الطباعة الضوئية EUV: لماذا تحتاج الصناعة كلها شركة واحدة؟
أصغر شيء تستطيع أن ترسمه بالضوء محدود بطول موجته، تماماً كما لا تستطيع أن ترسم خطاً رفيعاً بفرشاة عريضة. ولسنوات طويلة استعملت الصناعة ضوء الأشعة فوق البنفسجية العميقة DUV من ليزر فلوريد الأرجون ArF، وطول موجته 193 nm، ومع حيل كثيرة، منها وضع طبقة ماء بين العدسة والرقاقة كما تظهر في صفحة أجهزة DUV عند ASML، ومنها طباعة الطبقة الواحدة على عدة مراحل، وصلت إلى رسم خطوط أصغر بكثير من طول الموجة نفسها. ولكن كل مرحلة إضافية تعني وقتاً وكلفة وفرصة جديدة للخطأ، فكان لا بد من ضوء بموجة أقصر.
والحل كان الأشعة فوق البنفسجية القصوى EUV بطول موجة 13.5 nm، وهو كما تقول صفحة أجهزة EUV عند ASML قريب من الأشعة السينية. ولكن هذا الضوء له مشكلة كبيرة: يمتصه كل شيء تقريباً، حتى الهواء والزجاج، ولذلك تغير تصميم الجهاز كله، كما تبين الصورة التالية:
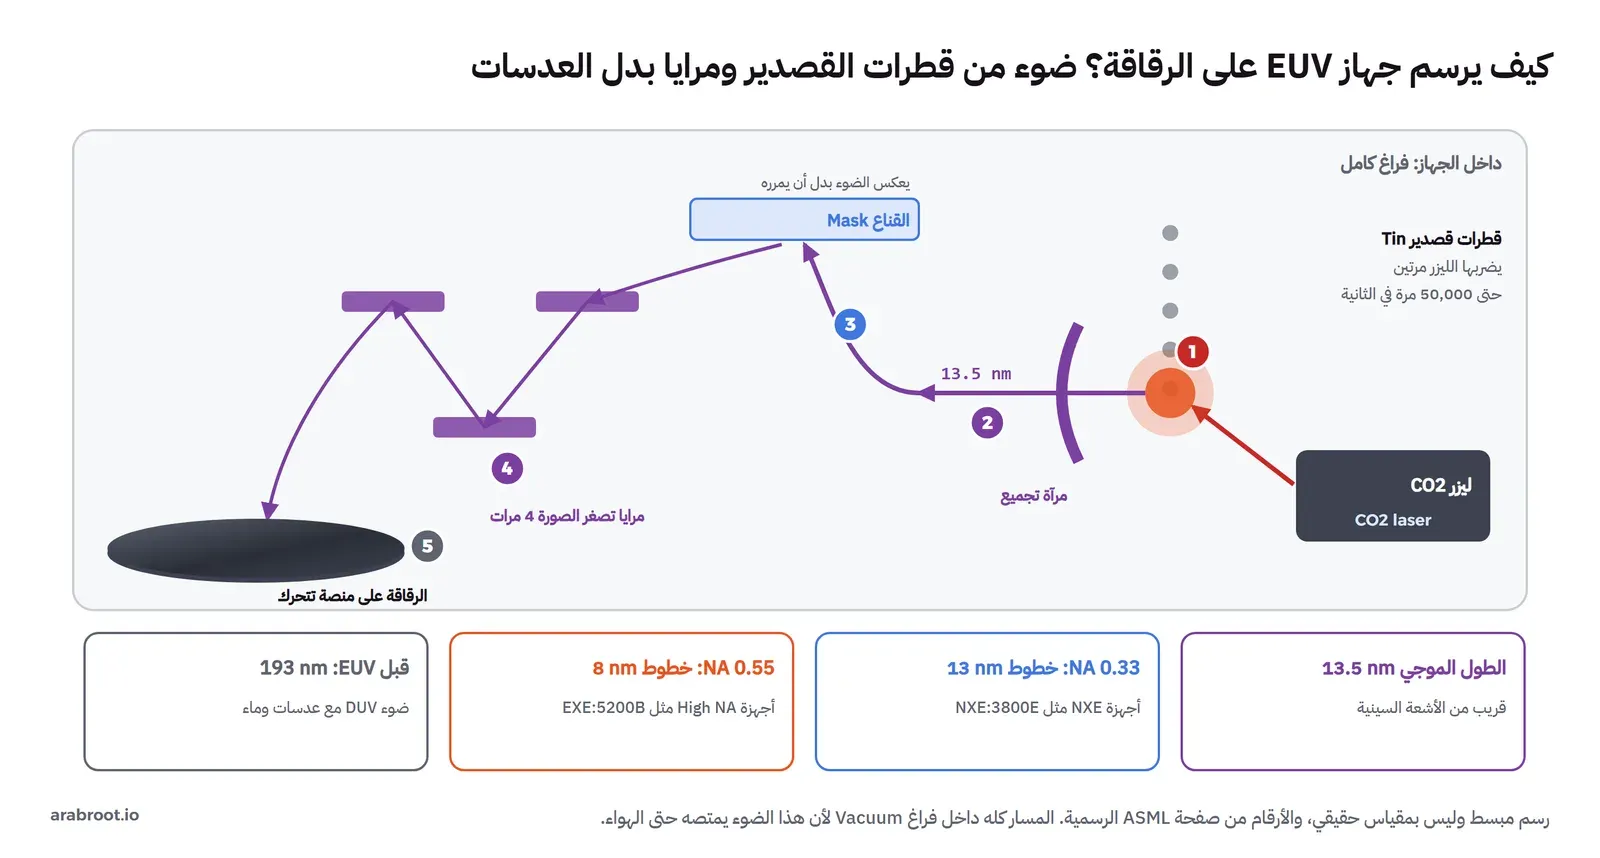
وفي الصورة أعلاه لاحظ التالي، وكل الأرقام من صفحة ASML:
- مصدر الضوء: لا يوجد مصباح يصدر هذا الضوء، فيضرب ليزر CO2 قطرة صغيرة من القصدير المصهور مرتين، المرة الأولى ليفردها والثانية ليحولها إلى بلازما ساخنة جداً تصدر ضوء EUV، ويتكرر هذا حتى 50,000 مرة في الثانية.
- المرايا بدلاً من العدسات: لأن الزجاج يمتص هذا الضوء، يحمل الضوء كله مرايا متعددة الطبقات، وكل مرآة تعكس جزءاً فقط مما يصلها، ولذلك يصل إلى الرقاقة جزء صغير من الضوء الذي خرج من البلازما.
- القناع العاكس: حتى القناع نفسه لا يمرر الضوء كما في DUV، وإنما يعكسه من الأجزاء التي فيها الرسم.
- التصغير: تصغر المرايا صورة القناع أربع مرات قبل أن تصل إلى الرقاقة.
- الفراغ: المسار كله داخل فراغ شديد Vacuum، لأن الهواء نفسه يمتص الضوء.
وهناك رقم آخر يحدد دقة الجهاز اسمه الفتحة العددية NA، وهو مقياس لاتساع زاوية الضوء الذي تجمعه المرايا: أجهزة NXE مثل NXE:3800E لها NA تساوي 0.33 وتطبع خطوطاً بعرض 13 nm، وأجهزة EXE التي تسميها ASML أجهزة High NA لها NA تساوي 0.55 وتطبع خطوطاً بعرض 8 nm. وشركة ASML الهولندية هي المورد الوحيد لهذه الأجهزة اليوم، ولذلك تجد اسمها في كل خبر عن تصنيع الشرائح المتقدمة، فكل مصنع يريد أصغر التقنيات يجب أن يشتري منها.
ما معنى «3 نانومتر» فعلاً؟
قد يتساءل البعض: إذا كانت تقنية TSMC اسمها 3nm فهل الترانزستور طوله 3 نانومتر؟ والإجابة لا، وهذه ليست مبالغة من شركة واحدة، وإنما شيء تقوله الشركات نفسها. ففي صفحة دعم Intel عن تسمية تقنياتها تقول Intel إن اسم التقنية كان لعقود يطابق طولاً حقيقياً في الترانزستور، وإن الصناعة تركت هذه الممارسة منذ سنوات طويلة، ولكنها استمرت في تسمية كل جيل برقم أصغر يوحي بوحدة قياس مثل النانومتر. ولذلك غيرت Intel أسماء تقنياتها في 2021 إلى أسماء مثل Intel 7 وIntel 4 دون كلمة نانومتر.
فالرقم اليوم اسم تسويقي لجيل، وهو يعني بشكل تقريبي أن الجيل الجديد أكثف وأكفأ من السابق، ولكنه لا يصلح لمقارنة شركتين ببعضهما، فتقنيتان بنفس الرقم عند شركتين مختلفتين قد تختلفان في الكثافة والأداء. والمقاييس التي يستعملها المهندسون هي المسافات الحقيقية بين البوابات وبين الأسلاك، وعدد الترانزستورات في كل ملليمتر مربع، وهذه المقاييس هي ما تتابعه الخارطة الدولية لأجهزة وأنظمة أشباه الموصلات IRDS التي تنشرها IEEE، وهي الوريث لخارطة ITRS التي كانت توجه الصناعة لسنوات.
وكل هذا بدأ من ملاحظة واحدة: في أبريل 1965 نشر Gordon Moore مقالاً في مجلة Electronics لاحظ فيه أن عدد المكونات في الدائرة المتكاملة يتضاعف كل سنة، وتوقع أن يصل إلى 65,000 مكون في 1975، ثم عدل التوقع في 1975 إلى تضاعف كل سنتين، كما يروي متحف تاريخ الحاسب. وهذه الملاحظة، التي أصبحت تسمى قانون Moore، تحولت إلى هدف تخطط له الصناعة كلها، وكل جيل جديد هو محاولة للاستمرار عليه.
شكل الترانزستور تغير: Planar ثم FinFET ثم GAA
عندما يصغر الترانزستور تصبح البوابة Gate، وهي الجزء الذي يفتح القناة ويغلقها كما شرحنا في مقال البوابات المنطقية، أقل قدرة على التحكم في القناة التي يمر فيها التيار، فيتسرب تيار حتى والترانزستور مغلق، وهذا يعني حرارة وطاقة ضائعة. والحل كان أن تحيط البوابة بالقناة من جهات أكثر، والصورة التالية تبين الأشكال الثلاثة:
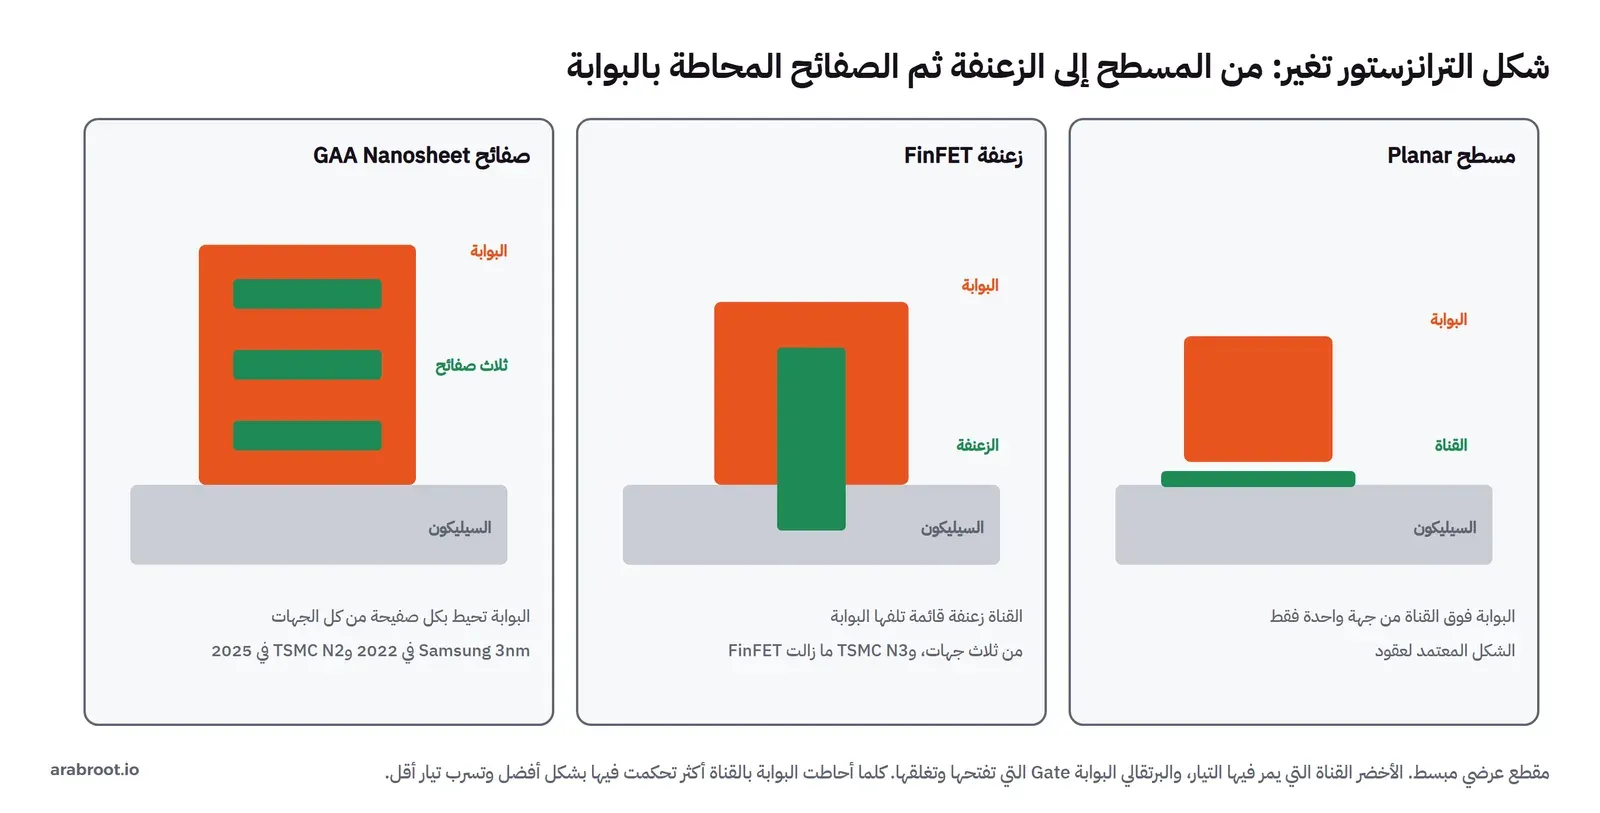
- المسطح Planar: البوابة فوق القناة من جهة واحدة، وهو الشكل الذي عملت به الصناعة لعقود.
- الزعنفة FinFET: القناة أصبحت زعنفة رفيعة قائمة، والبوابة تلفها من ثلاث جهات، وصفحة TSMC تقول إن تقنية N3 التي دخلت الإنتاج الكبير في 2022 ما زالت FinFET وتصفها بأنها أكثر تقنيات FinFET تقدماً.
- الصفائح GAA: اختصاراً لـ Gate-All-Around، فالقناة عدة صفائح أفقية فوق بعضها، والبوابة تحيط بكل صفيحة من كل الجهات. وقد أعلنت Samsung في يونيو 2022 بدء إنتاج تقنية 3nm بهذا الشكل، وتقول TSMC إن تقنية N2 التي بدأ إنتاجها الكبير في الربع الأخير من 2025 أول تقنياتها بترانزستورات الصفائح Nanosheet.
المختبر Lab: ماذا يقول معالجنا عن نفسه؟
لا نستطيع بالطبع أن نصنع شريحة في المختبر، ولكن نستطيع أمرين: أن نقرأ ما تقوله الشريحة التي أمامنا عن نفسها، وأن نحسب بأنفسنا اقتصاد الرقاقة الذي يحدد سعر كل معالج. والجزء الأول سكربت يقرأ معلومات المعالج من Linux ومن التعليمة cpuid:
#!/bin/sh
# cpu-info.sh: what the chip says about itself (run inside a Debian container with the cpuid package)
echo "== lscpu"; lscpu | grep -E 'Model name|Thread|Core|Socket|L1d|L1i|L2|L3|Flags' | sed 's/Flags:.*/Flags: (cut)/'
echo "== caches from /sys"
for d in /sys/devices/system/cpu/cpu0/cache/index*; do
  echo "L$(cat $d/level) $(cat $d/type) $(cat $d/size), $(cat $d/ways_of_associativity)-way, line $(cat $d/coherency_line_size) B, shared by CPUs $(cat $d/shared_cpu_list)"
done
echo "== cpuid: family, model, stepping and what the tool knows about it"
cpuid -1 -l 1 | grep -E '\((family|model) synth\)|stepping id'
cpuid -1 | grep -E '\(uarch synth\)|\(synth\) =' | head -3
echo "== microcode as this VM sees it"; grep -m1 microcode /proc/cpuinfo
ونشغله في Container من debian:trixie-slim بعد تثبيت أداة cpuid:
docker run --rm -v "$PWD:/lab" -w /lab debian:trixie-slim \
  sh -c "apt-get update -qq && apt-get install -y -qq cpuid >/dev/null 2>&1 && sh cpu-info.sh"
والمخرج سوف يكون كما يلي:
== lscpu
Model name:                           Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
Thread(s) per core:                   2
Core(s) per socket:                   4
Socket(s):                            1
Flags: (cut)
L1d cache:                            128 KiB (4 instances)
L1i cache:                            128 KiB (4 instances)
L2 cache:                             1 MiB (4 instances)
L3 cache:                             8 MiB (1 instance)
== caches from /sys
L1 Data 32K, 8-way, line 64 B, shared by CPUs 0-1
L1 Instruction 32K, 8-way, line 64 B, shared by CPUs 0-1
L2 Unified 256K, 4-way, line 64 B, shared by CPUs 0-1
L3 Unified 8192K, 16-way, line 64 B, shared by CPUs 0-7
== cpuid: family, model, stepping and what the tool knows about it
      stepping id     = 0x9 (9)
      (family synth)  = 0x6 (6)
      (model synth)   = 0x9e (158)
   (uarch synth) = Intel Kaby Lake {optim of Skylake}, 14nm+
   (synth) = Intel Core i*-7700 (Kaby Lake-H B0) [Kaby Lake] {optim of Skylake}, 14nm+
== microcode as this VM sees it
microcode	: 0xffffffff
وفي المخرج أعلاه لاحظ التالي:
- اسم الطراز: Intel Core i7-7700K، وصفحته عند Intel تقول إنه من عائلة Kaby Lake وصدر في الربع الأول من 2017 ومصنوع بتقنية 14 nm.
- ال Cache: كل نواة لها 32K للبيانات و32K للتعليمات و256K من L2، والسطر
shared by CPUs 0-1يعني أن الخيطين على نفس النواة يتشاركانها، أما L3 بحجم 8 MB فمشتركة بين كل المعالجات المنطقية0-7. وهذه المساحات كلها مرسومة على نفس الشريحة، وقد رأينا في مقال المعالج من الداخل كم تأخذ من مساحتها. - العائلة والطراز والإصدار: family 6 وmodel 158 أي 0x9E، وstepping 9. ورقم الإصدار Stepping هو رقم مراجعة القناع: كلما أصلحت الشركة خطأ في التصميم أو حسنت الإنتاج صنعت أقنعة جديدة لبعض الطبقات، وأصبحت الشرائح الجديدة بإصدار مختلف، ولذلك قد يختلف سلوك معالجين بنفس الاسم إذا كانا من إصدارين مختلفين.
- سطر
(uarch synth): أداة cpuid تعرف من الأرقام السابقة أن هذا المعالج من معمارية Kaby Lake بتقنية «14nm+»، أي نسخة محسنة من تقنية 14nm، ولاحظ أن الأداة تستنتج ذلك من جدول داخلها، فالمعالج نفسه لا يخبر بتقنية تصنيعه. - الـ microcode: القيمة
0xffffffffليست رقماً حقيقياً، لأننا داخل VM تحت Hyper-V، والمشرف يخفي رقم البرنامج الثابت للمعالج، وقد شرحنا هذه الطبقة في مقال دعم المعالج للأجهزة الافتراضية.
ونفس المعلومات تقريباً يقولها Windows:
Get-CimInstance Win32_Processor | Select-Object Name, Manufacturer, Caption, L2CacheSize, L3CacheSize,
    NumberOfCores, NumberOfLogicalProcessors, MaxClockSpeed, SocketDesignation | Format-List
Name : Intel(R) Core(TM) i7-7700K CPU @ 4.20GHz
Manufacturer : GenuineIntel
Caption : Intel64 Family 6 Model 158 Stepping 9
L2CacheSize : 1024
L3CacheSize : 8192
NumberOfCores : 4
NumberOfLogicalProcessors : 8
MaxClockSpeed : 4201
SocketDesignation : LGA1151ولاحظ SocketDesignation : LGA1151، أي أن هذه الشريحة بعد تقطيعها وضعت في غلاف بنحو 1151 نقطة تلامس، وهذا آخر ما يحدث في المصنع كما سوف نرى.
كم شريحة تخرج من الرقاقة؟ Dies per Wafer
والجزء الثاني هو الأهم: لماذا تكون الشريحة الكبيرة أغلى بكثير من ضعف ثمن الصغيرة؟ والسبب له شقان، عدد الشرائح في الرقاقة، ونسبة السليمة منها، وكلاهما نستطيع حسابه. والبرنامج التالي يحسب العدد بطريقتين: المعادلة التقريبية المعروفة في كتب معمارية الحاسب مثل كتاب Hennessy وPatterson، وهي مساحة الرقاقة مقسومة على مساحة الشريحة ناقص الشرائح الضائعة على المحيط، ثم العد الحقيقي بوضع شبكة من الشرائح على الدائرة وإبقاء الكاملة منها فقط. ثم يحسب نسبة السليمة بنموذجين معروفين، Poisson وMurphy، ثم يتحقق من النموذج بمحاكاة عيوب عشوائية على 300 رقاقة:
# wafer.py: how many dies fit on a 300 mm wafer, and how many of them work?
#   python wafer.py            prints the tables; also writes wafer-map.json for the article figure
# Assumptions are written next to each number. The yield models are the textbook ones (Poisson and Murphy);
# real fabs do not publish their defect density, so D0 is a scenario here, not a fact about any company.
import json, math, random

WAFER = 300.0       # mm, the standard wafer diameter of modern fabs
EDGE = 3.0          # mm lost at the rim (edge exclusion), an assumption
SCRIBE = 0.1        # mm of saw street between dies, an assumption
R = WAFER / 2 - EDGE

def formula(area):
    """Classic estimate: wafer area / die area, minus the partial dies on the rim."""
    d = WAFER
    return math.pi * (d / 2) ** 2 / area - math.pi * d / math.sqrt(2 * area)

def grid(w, h):
    """Real count: put a grid of w x h dies on the wafer and keep only dies fully inside the usable circle.
    Try many grid offsets and keep the best, as a mask designer would."""
    pw, ph = w + SCRIBE, h + SCRIBE
    best = []
    for i in range(20):
        for j in range(20):
            ox, oy = i / 20 * pw, j / 20 * ph
            dies = []
            nx, ny = int(WAFER / pw) + 2, int(WAFER / ph) + 2
            for a in range(-nx, nx):
                for b in range(-ny, ny):
                    x0, y0 = a * pw + ox, b * ph + oy
                    corners = [(x0, y0), (x0 + w, y0), (x0, y0 + h), (x0 + w, y0 + h)]
                    if all(x * x + y * y <= R * R for x, y in corners):
                        dies.append((x0, y0))
            if len(dies) > len(best):
                best = dies
    return best

def poisson(d0, area):   # d0 in defects per cm2, area in mm2
    return math.exp(-d0 * area / 100)

def murphy(d0, area):
    x = d0 * area / 100
    return ((1 - math.exp(-x)) / x) ** 2

def monte_carlo(dies, w, h, d0, wafers=300, seed=7):
    """Throw random point defects on the usable wafer area; a die with one defect or more is dead."""
    rnd = random.Random(seed)
    lam = d0 / 100 * math.pi * R * R          # expected defects on the wafer
    good_total, maps = 0, None
    for k in range(wafers):
        # Poisson count of defects, then uniform positions in the circle
        n, p, L = 0, rnd.random(), math.exp(-lam)
        while p > L:
            n += 1; p *= rnd.random()
        pts = []
        while len(pts) < n:
            x, y = rnd.uniform(-R, R), rnd.uniform(-R, R)
            if x * x + y * y <= R * R: pts.append((x, y))
        dead = set()
        for x, y in pts:
            for idx, (x0, y0) in enumerate(dies):
                if x0 <= x <= x0 + w and y0 <= y <= y0 + h: dead.add(idx)
        good_total += len(dies) - len(dead)
        if k == 0: maps = {"defects": pts, "dead": sorted(dead)}
    return good_total / wafers, maps

print(f"wafer {WAFER:.0f} mm, edge exclusion {EDGE} mm, scribe {SCRIBE} mm, usable radius {R} mm")
print()
print("die (mm)      area mm2  formula  grid  difference")
SIZES = [(5, 5), (10, 10), (14, 14), (20, 20), (28.5, 28.5)]
grids = {}
for w, h in SIZES:
    a = w * h; g = grid(w, h); grids[(w, h)] = g
    print(f"{w:>5} x {h:<5}  {a:8.1f}  {formula(a):7.0f}  {len(g):4d}  {len(g) - formula(a):+6.0f}")
print()
print("yield (share of good dies) by defect density D0, Poisson / Murphy")
print("area mm2  " + "  ".join(f"D0={d:<4} /cm2  " for d in (0.05, 0.1, 0.2, 0.5)))
for w, h in SIZES:
    a = w * h
    print(f"{a:8.1f}  " + "  ".join(f"{poisson(d, a)*100:5.1f}% {murphy(d, a)*100:5.1f}%" for d in (0.05, 0.1, 0.2, 0.5)))
print()
print("good dies per wafer at D0 = 0.1 /cm2: grid count x Poisson yield, then a Monte Carlo check (300 random wafers)")
out = {}
for w, h in SIZES:
    a = w * h; g = grids[(w, h)]
    mc, maps = monte_carlo(g, w, h, 0.1)
    print(f"{a:8.1f} mm2: {len(g):4d} dies, expected good {len(g)*poisson(0.1, a):7.1f}, simulated good {mc:7.1f}")
    if (w, h) in [(10, 10), (28.5, 28.5)]:
        out[f"{w}x{h}"] = {"w": w, "h": h, "R": R, "dies": g, **maps}
print()
small, big = SIZES[1], SIZES[-1]
gs = len(grids[small]) * poisson(0.1, small[0] * small[1]); gb = len(grids[big]) * poisson(0.1, big[0] * big[1])
print(f"silicon area per good die at D0 = 0.1: 100 mm2 die -> {math.pi*R*R/gs:6.1f} mm2 of wafer, "
      f"812 mm2 die -> {math.pi*R*R/gb:7.1f} mm2 of wafer ({(math.pi*R*R/gb)/(math.pi*R*R/gs):.1f}x for {big[0]*big[1]/(small[0]*small[1]):.1f}x the area)")
json.dump(out, open("wafer-map.json", "w"))
وفي الكود أعلاه لاحظ أن كل افتراض مكتوب بجانب رقمه: قطر الرقاقة 300 mm وهو المعيار الحالي، و3 mm من الحافة لا تستعمل، و0.1 mm بين الشرائح لمسار المنشار، وهذان الرقمان افتراضان للحساب. أما كثافة العيوب D0، أي عدد العيوب القاتلة في كل سنتيمتر مربع، فالمصانع لا تنشرها لخطوط إنتاجها، ولذلك جربنا أربع قيم كسيناريوهات وليس كأرقام لشركة بعينها. ونشغل البرنامج في Container من python:3.13-slim دون أي مكتبة إضافية:
docker run --rm -v "$PWD:/lab" -w /lab python:3.13-slim sh -c "python --version && python wafer.py"والمخرج سوف يكون كما يلي:
Python 3.13.18
wafer 300 mm, edge exclusion 3.0 mm, scribe 0.1 mm, usable radius 147.0 mm

die (mm)      area mm2  formula  grid  difference
    5 x 5          25.0     2694  2505    -189
   10 x 10        100.0      640   612     -28
   14 x 14        196.0      313   304      -9
   20 x 20        400.0      143   148      +5
 28.5 x 28.5      812.2       64    68      +4

yield (share of good dies) by defect density D0, Poisson / Murphy
area mm2  D0=0.05 /cm2    D0=0.1  /cm2    D0=0.2  /cm2    D0=0.5  /cm2
    25.0   98.8%  98.8%   97.5%  97.5%   95.1%  95.1%   88.2%  88.4%
   100.0   95.1%  95.1%   90.5%  90.6%   81.9%  82.1%   60.7%  61.9%
   196.0   90.7%  90.7%   82.2%  82.5%   67.6%  68.4%   37.5%  40.6%
   400.0   81.9%  82.1%   67.0%  67.9%   44.9%  47.4%   13.5%  18.7%
   812.2   66.6%  67.5%   44.4%  46.9%   19.7%  24.4%    1.7%   5.9%

good dies per wafer at D0 = 0.1 /cm2: grid count x Poisson yield, then a Monte Carlo check (300 random wafers)
    25.0 mm2: 2505 dies, expected good  2443.2, simulated good  2443.3
   100.0 mm2:  612 dies, expected good   553.8, simulated good   554.0
   196.0 mm2:  304 dies, expected good   249.9, simulated good   249.8
   400.0 mm2:  148 dies, expected good    99.2, simulated good    99.2
   812.2 mm2:   68 dies, expected good    30.2, simulated good    30.3

silicon area per good die at D0 = 0.1: 100 mm2 die ->  122.6 mm2 of wafer, 812 mm2 die ->  2249.2 mm2 of wafer (18.3x for 8.1x the area)
وفي المخرج أعلاه لاحظ التالي:
- المعادلة والعد: للشرائح الصغيرة تعطي المعادلة رقماً أكبر من العد الحقيقي، 2694 مقابل 2505 لشريحة 5 × 5 mm، لأنها لا تعرف شيئاً عن الحافة الضائعة ولا عن مسارات المنشار، وكل شريحة صغيرة تخسر نسبة أكبر من مساحتها في هذه المسارات. وللشرائح الكبيرة يعطي العد رقماً أكبر قليلاً، لأننا جربنا 400 موضع للشبكة واخترنا أفضلها كما يفعل مصمم القناع. فالمعادلة تقدير جيد، والعد هو ما يحدث فعلاً.
- الحافة وحدها: شريحة بمساحة 812 mm²، أي 28.5 × 28.5 mm، يدخل منها 68 فقط في رقاقة مساحتها أكثر من 70,000 mm²، فأكثر من خمس مساحة الرقاقة يضيع على الحواف لأن المربعات الكبيرة لا تملأ الدائرة. ونختار هذا الحجم لأنه قريب من شرائح حقيقية كبيرة جداً، فمثلاً تقول NVIDIA في مقالتها عن معمارية Hopper إن شريحة GH100 مساحتها 814 mm² وفيها 80 مليار ترانزستور بتقنية TSMC 4N، ونحن لا نعرف أبعادها الدقيقة ولا كثافة العيوب في مصنعها، فالأرقام هنا للمقارنة وليست حساباً لتلك الشريحة.
- نسبة السليمة: عند D0 = 0.1 تنجو 90.5% من شرائح 100 mm² و44.4% فقط من شرائح 812 mm²، لأن احتمال أن يقع عيب واحد على الأقل في الشريحة يكبر مع مساحتها بشكل أسي. وعند D0 = 0.5 لا ينجو من الشرائح الكبيرة إلا 1.7%.
- المحاكاة: متوسط الشرائح السليمة في 300 رقاقة عشوائية يطابق نموذج Poisson تقريباً في كل الأحجام، مثلاً 30.3 مقابل 30.2، وهذا ليس مفاجأة، لأن المحاكاة تفترض عيوباً مستقلة موزعة بالتساوي، وهو نفس افتراض النموذج. أما في المصانع الحقيقية فالعيوب تتجمع في مناطق، ولذلك وجد نموذج Murphy الذي يعطي أرقاماً أعلى قليلاً للشرائح الكبيرة.
- السطر الأخير: الشريحة الكبيرة أكبر بـ 8.1 مرة في المساحة، ولكنها تستهلك من الرقاقة 18.3 ضعف ما تستهلكه الصغيرة لكل شريحة سليمة، أي أنها تخسر مرتين: مرة لأن عددها أقل، ومرة لأن نسبة السليمة منها أقل.
وقد يتساءل البعض: من أين جاءت معادلة Poisson، وما معنى الرقم e-D0×A؟ والإجابة بسيطة إذا تخيلت العيوب كحبات غبار تسقط عشوائياً على الرقاقة: إذا كان متوسط العيوب في كل سنتيمتر مربع D0، فإن متوسط العيوب التي تقع على شريحة مساحتها A هو D0 × A، وإذا كانت العيوب مستقلة عن بعضها فإن احتمال ألا يقع على الشريحة أي عيب هو e-D0×A، وهذا هو احتمال أن تنجو. ولاحظ أن الأس يحتوي المساحة، ولذلك يكون العائد أسياً في المساحة وليس خطياً: مضاعفة مساحة الشريحة لا تنقص نسبة السليمة إلى النصف، وإنما ترفعها إلى القوة الثانية، فإذا كانت النسبة 67% أصبحت نحو 45%، وهذا ما تراه بالضبط في الجدول بين 400 mm² و812 mm². أما نموذج Murphy فيفترض أن كثافة العيوب نفسها تختلف من منطقة إلى أخرى في الرقاقة، فتتجمع العيوب، ويقع أكثر من عيب على نفس الشريحة أحياناً، فتكون الخسارة أقل قليلاً مما يقوله Poisson.
والصورة التالية ترسم الرقاقة الأولى من المحاكاة لحجمين، بنفس العيوب الـ 58 في نفس الأماكن:
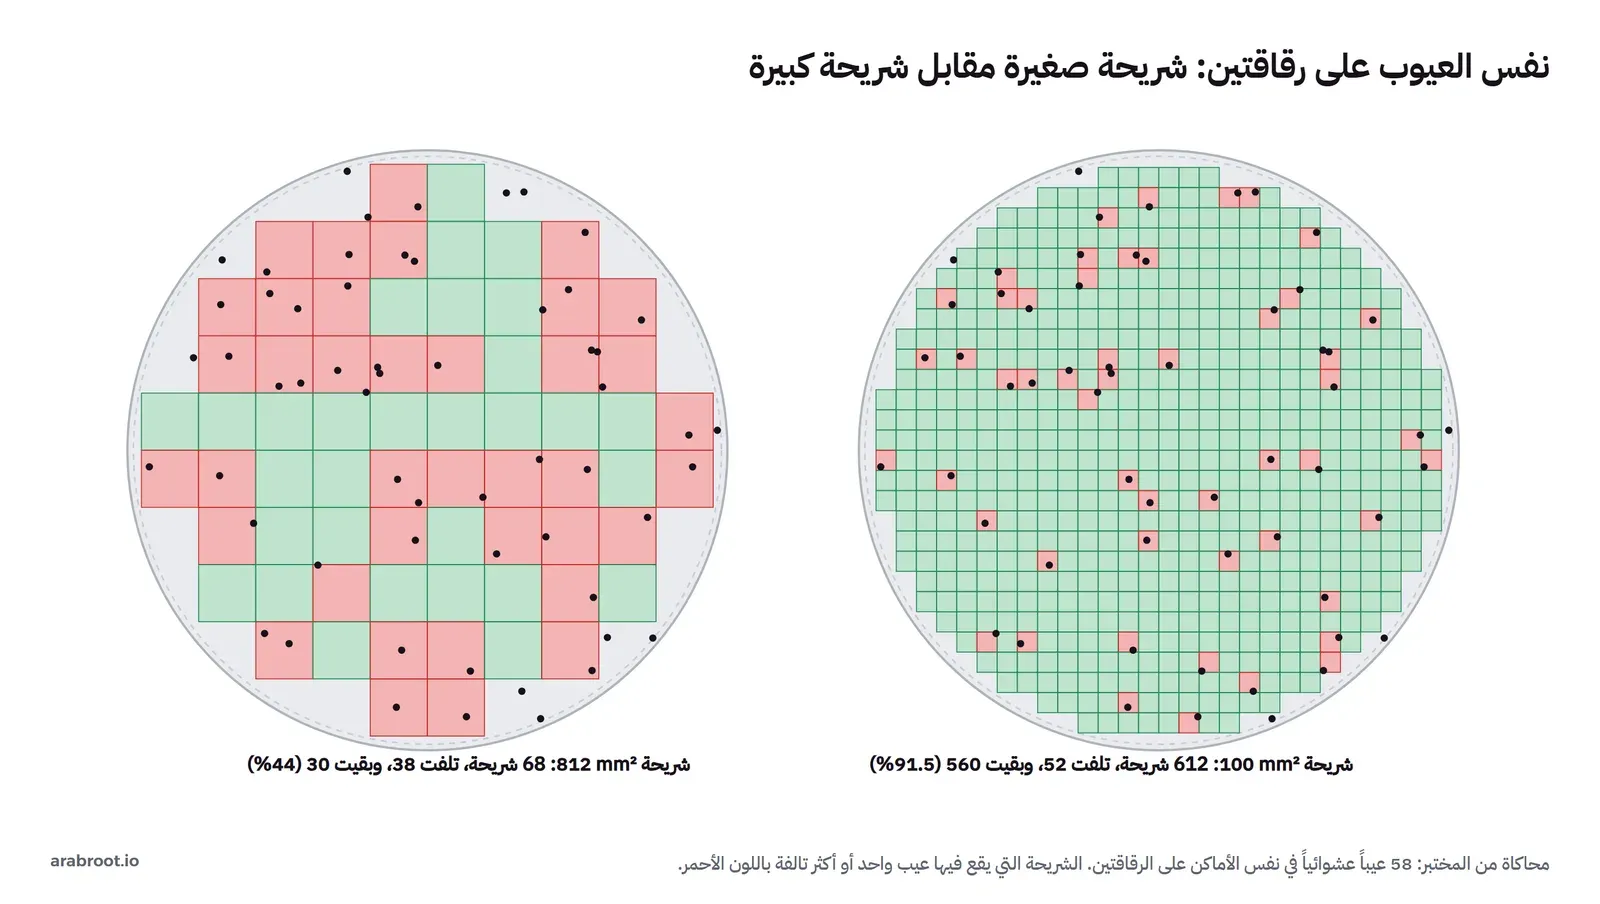
وفي الصورة أعلاه لاحظ أن العيب الواحد يقتل شريحة كاملة مهما كان حجمها: في الرقاقة اليمنى يقتل العيب مربعاً صغيراً واحداً، وفي اليسرى يقتل مربعاً كبيراً يساوي ثماني شرائح صغيرة. والصورة التالية تعمم ذلك على كل المساحات وكل قيم D0:
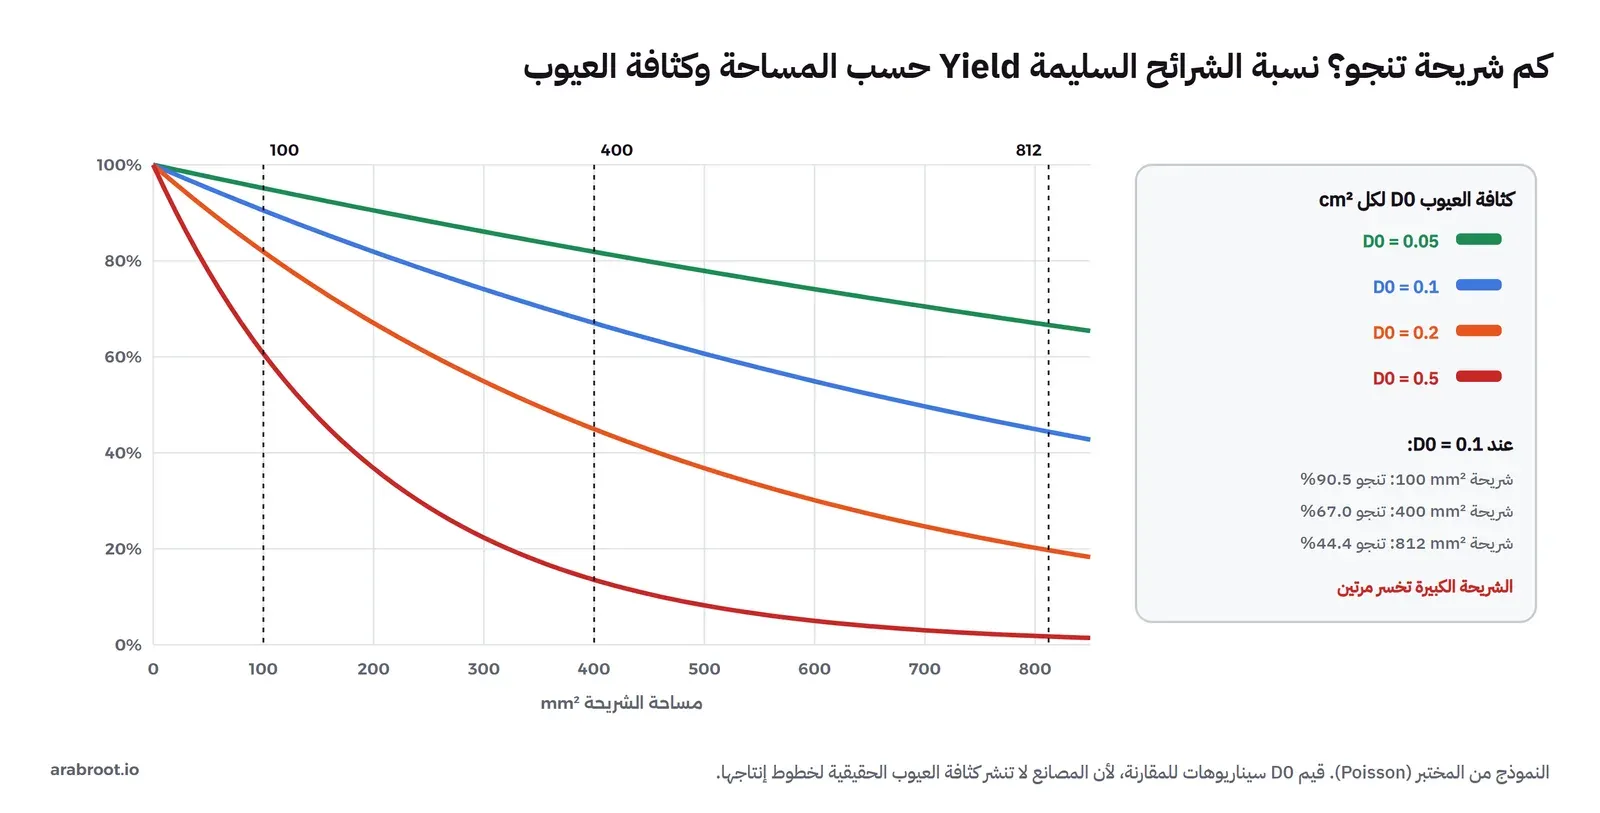
ومن هذا الرسم تفهم قرارات كثيرة في الصناعة. فالشركات تبدأ أي تقنية جديدة بشرائح صغيرة، مثل معالجات الجوال، لأن نسبة السليمة منها مقبولة حتى عندما تكون كثافة العيوب عالية، ثم تنتقل إلى الشرائح الكبيرة بعد أن تتحسن التقنية. وهذا الرسم أيضاً هو السبب الرئيسي لفكرة Chiplets التي نعود إليها بعد قليل.
ماذا لو تحسن المصنع؟ What If
جرب أن تقرأ الجدول بالعكس: شريحة 400 mm² في مصنع كثافة عيوبه 0.5 تنجو منها 13.5%، فإذا حسن المصنع عملياته حتى أصبحت الكثافة 0.1 ارتفعت النسبة إلى 67%، أي خمسة أضعاف الشرائح السليمة من نفس الرقاقة ونفس الآلات ونفس الكهرباء. ولهذا السبب تقضي المصانع الأشهر الأولى من كل تقنية في ما يسمى رفع العائد Yield Ramp، أي البحث عن مصادر العيوب وإزالتها واحداً بعد الآخر، ولهذا السبب أيضاً تتحسن أسعار المعالجات وتوفرها بعد أشهر من إطلاقها. ويمكنك أن تجرب ذلك بنفسك بتغيير قيمة 0.1 في آخر البرنامج.
بعد الرقاقة: الفحص والتقطيع والتغليف والتصنيف
عندما تنتهي الطبقات كلها لا تعرف الشركة بعد أي الشرائح تعمل، ولذلك تمر الرقاقة على جهاز فحص فيه إبر دقيقة جداً تلمس نقاط الاتصال على كل شريحة وتشغل عليها اختبارات كهربائية، وتعلم الشرائح التالفة. ثم تقطع الرقاقة بمنشار دقيق أو بالليزر على المسارات بين الشرائح، وتوضع كل شريحة سليمة في غلاف Package يوصلها بالعالم الخارجي، وهو ما رأيناه مفككاً طبقة طبقة في مقال المعالج من الداخل، ثم تفحص مرة أخيرة بعد التغليف.
وفي الفحص الأخير يحدث شيء مهم للمشتري: ليست كل الشرائح السليمة متساوية، فبعضها يعمل بتردد أعلى من غيره بنفس الجهد، وبعضها فيه نواة تالفة ولكن باقيه يعمل. فتصنف الشركة الشرائح Binning، وتبيع الأفضل منها بأعلى سعر، وتعطل النواة التالفة في بعضها وتبيعها بعدد أنوية أقل باسم آخر. ولذلك تجد عائلة كاملة من المعالجات بأسماء وأسعار مختلفة خرجت كلها من نفس التصميم ومن نفس الرقائق، وهذا يقلل الشرائح التي ترمى، فيحسن العائد الحقيقي للرقاقة أكثر مما يقوله النموذج البسيط في المختبر.
قطع صغيرة بدل شريحة كبيرة: Chiplets
رأينا في المختبر أن الشريحة الكبيرة تخسر مرتين، فما الحل إذا احتجت معالجاً بعشرات الأنوية؟ الحل الذي اعتمدته الصناعة في السنوات الأخيرة هو تقسيم المعالج إلى عدة شرائح صغيرة Chiplets، تصنع كل منها وحدها وتفحص وحدها، ثم تجمع في غلاف واحد وتتصل ببعضها بوصلات سريعة. وبهذه الطريقة تحصل على نسبة الشرائح السليمة العالية للشرائح الصغيرة، وتستطيع أن تصنع كل قطعة بالتقنية المناسبة لها: الأنوية بأحدث تقنية وأغلاها، وأجزاء الإدخال والإخراج بتقنية أقدم وأرخص. والثمن أن الاتصال بين القطع أبطأ وأكثر استهلاكاً للطاقة من الاتصال داخل شريحة واحدة، وأن التغليف نفسه أصبح صناعة متقدمة لها مصانعها وتقنياتها.
وفكرة الجمع داخل الغلاف لا تقتصر على المعالجات، فقد رأينا في مقال المعالج الرسومي GPU أن بطاقات مراكز البيانات وشرائح TPU تضع وحدات ذاكرة HBM داخل نفس الغلاف بجانب شريحة الحساب، فيصبح الغلاف الواحد عدة شرائح من مصانع مختلفة وتقنيات مختلفة، تتصل بآلاف الأسلاك القصيرة عبر طبقة وسيطة. ولذلك أصبحت قدرة المصنع على التغليف المتقدم Advanced Packaging جزءاً من قدرته على إنتاج هذه الشرائح، وليست خطوة أخيرة بسيطة كما كانت في الماضي، وأصبح نقص هذه القدرة سبباً لتأخر بعض المنتجات حتى عندما تكون الشرائح نفسها جاهزة.
من يصنع الشرائح اليوم؟
كانت الشركات في الماضي تصمم شرائحها وتصنعها في مصانعها، وما زالت Intel وSamsung تفعلان ذلك. ولكن كلفة المصنع الحديث وأجهزته جعلت أغلب الشركات تفصل بين الأمرين: شركات تصمم فقط ولا تملك مصانع، مثل NVIDIA وAMD وApple وQualcomm، وشركات تصنع لغيرها ولا تبيع شرائح باسمها، تسمى المسابك Foundries، وأكبرها TSMC. ولذلك عندما تقرأ أن معالجاً من AMD أو شريحة من Apple «بتقنية 3nm» فالمقصود غالباً تقنية من TSMC.
وفي هذه السلسلة كلها جهات قليلة جداً لا يمكن الاستغناء عنها: ASML وحدها تصنع أجهزة EUV، وعدد قليل من الشركات يستطيع تشغيل أحدث التقنيات بكميات كبيرة، ولذلك أصبح تصنيع الشرائح موضوعاً تتابعه الحكومات، وليس الشركات فقط. وبالنسبة لك كمبرمج أو مدير أنظمة فالنتيجة العملية أن توفر العتاد وسعره قد يتغيران لأسباب لا علاقة لها بالتقنية، فخطط لمشترياتك مبكراً، ولا تبن نظاماً لا يعمل إلا على نوع واحد من العتاد إذا كان لديك خيار.
ماذا يعني هذا لك كمبرمج أو مدير أنظمة؟
قد يبدو كل ما سبق بعيداً عن عملك اليومي، ولكنه يظهر في قرارات عملية كثيرة. أولها أن الجيل الجديد من التصنيع يعطي غالباً أداءً أكثر لكل واط من الكهرباء، وهذا هو الرقم الذي يهم في السيرفرات أكثر من أي رقم آخر، لأن الكهرباء والتبريد جزء كبير من كلفة تشغيل أي سيرفر لسنوات. ومثال معروف على ذلك أن Apple عندما أعلنت في نوفمبر 2020 عن شريحة M1 قالت إنها أول شريحة لحاسب شخصي بتقنية 5 نانومتر وفيها 16 مليار ترانزستور، وجزء من الفرق الذي لاحظه المستخدمون في البطارية والحرارة جاء من التصميم، وجزء جاء من تقنية التصنيع نفسها.
وثانيها أن المعالجات بنفس الاسم ليست دائماً متطابقة: رأينا رقم الإصدار Stepping في المختبر، وكل إصدار قد يصلح أخطاء أو يغير سلوكاً، والشركات تنشر قوائم الأخطاء المعروفة Errata لكل إصدار، وتصلح بعضها بتحديثات البرنامج الثابت Microcode التي تصل عن طريق BIOS أو نظام التشغيل. ولذلك عندما تشتري عدة سيرفرات لنظام واحد، مثل عنقود قاعدة بيانات أو مجموعة أجهزة افتراضية تنتقل بينها الأجهزة، فالأفضل أن تكون من نفس الطراز والإصدار، وأن تبقي البرنامج الثابت محدثاً على كل منها.
وثالثها أن أسعار العتاد وتوفره يتأثران بكل ما حسبناه: عندما يكون الطلب على الشرائح الكبيرة عالياً، كما حدث مع بطاقات الذكاء الاصطناعي، فإن العائد المنخفض للشرائح الكبيرة يجعل زيادة الإنتاج بطيئة ومكلفة، فلا تبن خططك على افتراض أن العتاد سوف يكون متاحاً وقتما تريده بالسعر الذي تتوقعه.
أفكار شائعة غير صحيحة Common Mistakes
- «3nm يعني أن الترانزستور طوله 3 نانومتر»: لا، فالرقم اسم جيل كما تقول Intel نفسها، والمقاييس الحقيقية هي المسافات بين البوابات والأسلاك وكثافة الترانزستورات.
- مقارنة تقنيتين من شركتين بالرقم فقط: تقنية بنفس الرقم عند شركتين قد تختلف في الكثافة والأداء والطاقة، فقارن المعالجات بقياس أدائها في عملك.
- «الشريحة ضعف الحجم تكلف ضعف الثمن»: رأينا في المختبر أنها تستهلك 18 ضعف المساحة لكل شريحة سليمة عندما كانت أكبر بـ 8 مرات، فالكلفة تزيد أسرع بكثير من المساحة.
- «المعالج الأرخص في العائلة تصميم أضعف»: غالباً هو نفس الشريحة بعد التصنيف، ببعض الأنوية معطلة أو بتردد أقل، وهذا يفسر لماذا يتشابه سلوكها مع الأغلى في أشياء كثيرة.
- الاعتماد على معادلة عدد الشرائح وحدها: المعادلة لا تعرف الحافة الضائعة ولا مسارات المنشار، وفي المختبر أعطت للشرائح الصغيرة رقماً أكبر من الحقيقي بنحو 7.5%.
- الثقة بأرقام كثافة العيوب المتداولة: المصانع لا تنشر أرقامها الحقيقية، فأي رقم تقرؤه دون مصدر رسمي هو تقدير، وهذا سبب أننا استعملنا سيناريوهات في المختبر.
ما الذي تقرؤه في مواصفات أي معالج؟ Checklist
| السطر في المواصفات | ماذا يعني | ما الذي لا يعنيه |
|---|---|---|
| Lithography أو اسم التقنية | جيل التصنيع عند المصنع | طولاً حقيقياً في الترانزستور، ولا مقارنة عادلة بين شركتين |
| Stepping | إصدار الأقنعة، وقد يصلح أخطاء | معالجاً مختلفاً في المعمارية |
| عدد الأنوية في عائلة واحدة | غالباً نتيجة التصنيف Binning | تصميماً مختلفاً بالضرورة |
| عدد الشرائح في الغلاف | تصميم Chiplets أو شريحة واحدة | أداءً أسوأ أو أفضل في كل الأحوال |
| المسبك Foundry | من صنع الشريحة فعلاً | من صممها |
تدريب عملي
- شغل
cpu-info.shعلى جهازك وسيرفرك، واكتب لكل معالج عائلته وطرازه وإصداره، ثم ابحث في صفحته الرسمية عن تقنية تصنيعه وتاريخ صدوره. - في
wafer.pyأضف حجم شريحة 8 × 8 mm، وهو قريب من حجم Chiplet صغير، واحسب كم شريحة منها تلزم لتساوي مساحة شريحة 28.5 × 28.5، وقارن الشرائح السليمة في الحالتين عند D0 = 0.2. - غير قطر الرقاقة في البرنامج إلى 200 mm، وهو المعيار القديم، ولاحظ نسبة المساحة الضائعة على الحافة للشرائح الكبيرة، وفكر لماذا انتقلت المصانع إلى 300 mm.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الشريحة تبدأ من ثاني أكسيد السيليكون، ينقى ثم يسحب سبيكة بلورية واحدة، ثم يقطع إلى رقائق 300 mm مصقولة كالمرآة.
- الترانزستورات والأسلاك ترسم طبقة طبقة بحلقة تتكرر: ترسيب ثم طبقة حساسة للضوء ثم طباعة ضوئية ثم تحميض ثم حفر أو زرع ثم تنظيف، في غرف نظيفة، ولمئات الخطوات.
- أجهزة EUV من ASML تولد ضوء 13.5 nm من قطرات القصدير، وتحمله على مرايا في فراغ، وتطبع خطوطاً بعرض 13 nm أو 8 nm في أجهزة High NA.
- أرقام مثل 3nm و2nm أسماء أجيال وليست أطوالاً حقيقية، والترانزستور نفسه تغير من المسطح إلى FinFET ثم إلى صفائح GAA.
- حسبنا في المختبر أن الشريحة الأكبر بثماني مرات تستهلك 18 ضعف مساحة الرقاقة لكل شريحة سليمة عند كثافة عيوب 0.1، وهذا ما يفسر سعر الشرائح الكبيرة وانتشار Chiplets والتصنيف Binning.
وبهذا المقال تكتمل مقالات المعالجات من المعمارية إلى السيليكون، ويمكنك أن تعود إلى أي مقال منها:
 دليلمعمارية المعالج ISA: لماذا لا يعمل برنامج x86 على ARM؟نترجم نفس برنامج C لثلاث معماريات ونقرأ تعليماته سطراً سطراً، لنفهم ما الذي يجعل الملف التنفيذي يعمل على معالج ويرفضه معالج آخر.
 دليلCISC أم RISC: ما الفرق الحقيقي بين x86 وARM وRISC-V؟نقيس حجم الكود وعدد التعليمات المنفذة لنفس البرامج على x86-64 وARM64 وRISC-V، ونرى ما بقي من نقاش CISC وRISC وما لم يعد صحيحاً.
 دليلقصة x86: من Intel 8086 إلى x86-64 الذي صممته AMDكيف وصلت معمارية معالج 16 بت من 1978 إلى أغلب سيرفرات اليوم، ولماذا ما زال معالجك يقلع كأنه 8086، مع قطاع إقلاع يصعد الأوضاع الثلاثة أمامك.
 دليلعائلات Intel وAMD: كيف تقرأ اسم المعالج وجيله؟نفك أسماء معالجات Intel وAMD من المصادر الرسمية، ثم نقرأ معالجاً حقيقياً بأدوات Windows وLinux ونفك هويته الرقمية التي لا تتغير مع الاسم.
 دليلARM من الجوال إلى السيرفر: Apple Silicon وGravitonكيف تربح Arm من شرائح لا تصنعها، ولماذا صار في كل سحابة معالج ARM، مع مختبر يبني Image لـ arm64 ويقيس كلفة تشغيلها تحت المحاكاة.
 دليلRISC-V: المعمارية المفتوحة وهل تغير سوق المعالجات؟ما الذي يعنيه أن تكون معمارية المعالج مفتوحة، وكيف تقرأ امتدادات RISC-V وملفاتها التعريفية، مع مختبر يقلع Debian كاملاً على RISC-V داخل QEMU.
 دليلالمحاكاة Emulation والترجمة الثنائية: QEMU وRosetta 2نفتح محاكي QEMU ونرى كيف تتحول تعليمات ARM إلى تعليمات x86 ونقيس كلفة كل خطوة، ثم نقارن ذلك بما تفعله Rosetta 2 وWindows Prism.
 دليلدعم المعالج للأجهزة الافتراضية: VT-x وAMD-V من الداخلنكتب مشرفاً صغيراً على KVM يشغل ضيفاً من 63 بايت، ونعد مرات الخروج VM Exit ونقيس كلفتها لنفهم ما يفعله VT-x وEPT داخل المعالج.
 دليلGPU وNPU وTPU: لماذا لا يكفي CPU للذكاء الاصطناعي؟نضرب نفس المصفوفات على المعالج وعلى المعالج الرسومي المدمج ونقيس الحساب وسرعة الذاكرة، لنفهم ما الذي يجعل GPU وNPU وTPU أسرع ومتى لا تفيد.
سجل التحديثات Changelog
- 17 نوفمبر 2026: كتابة المقال وتنفيذ المختبر على معالج Intel Core i7-7700K: قراءة معلومات المعالج بالأمر lscpu وملفات /sys والأداة cpuid 20250316 في Container من debian:trixie-slim وبأمر PowerShell على Windows 11، وحساب عدد الشرائح ونسبة السليمة منها ومحاكاة العيوب ببرنامج Python 3.13 في python:3.13-slim، مع صور حقيقية من Wikimedia Commons ورسوم من عرب رووت.