

في المقال الأول من هذه السلسلة وزعنا فاتورة شهر كامل على الفرق باستعلامات SQL، ووجدنا ما لا صاحب له واكتشفنا شذوذاً في حساب الاختبار. ولكن هذا التحليل يأتي بعد أن يصرف المال، ويبقى سؤالان لا تجيب عنهما الفاتورة: كم سوف يكلف هذا التغيير قبل أن ندمجه؟ وكيف نوزع تكلفة سيرفر Kubernetes واحد تعمل عليه خمسة فرق؟ فالفاتورة ترى السيرفر، ولا ترى ال Pods التي تعمل عليه.
المواضيع في السلسلة:
- FinOps: كيف تجعل فريقك مسؤولاً عن تكلفة السحابة
- أدوات FinOps: التكلفة قبل الدمج وبعد النشر (الموضوع الحالي)
- تكلفة الذكاء الاصطناعي بالتوكنات: كيف تقيسها وتخفضها (قريباً)
وسوف نناقش في هذا المقال ما يلي:
- أين تعمل كل أداة: قبل الدمج، وأثناء التشغيل، وبعد الفاتورة.
- أدوات المزودين نفسها: AWS وAzure وGoogle Cloud وOracle Cloud، باختصار.
- Infracost لتقدير التكلفة في طلب الدمج Pull Request، ورخصته وأسعاره، ولماذا يحتاج مفتاح API.
- تجربة على مشروع OpenTofu صغير، وسكربت يحسب فرق التكلفة من الأسعار العامة دون حساب سحابي.
- OpenCost لتوزيع تكلفة Kubernetes على ال Namespaces، مع تجربة كاملة على عنقود K3s داخل Docker بأسعار نكتبها بأنفسنا.
- Kubecost بعد استحواذ IBM عليه، وما المجاني فيه وما المدفوع.
- أدوات مفتوحة أخرى ما زالت تصان، وجدول للقرار.
أين تعمل كل أداة؟
لا توجد أداة واحدة تغطي كل شيء، والسبب أن التكلفة تظهر في ثلاث لحظات مختلفة من عمر التغيير، ولكل لحظة مصدر بيانات مختلف، والصورة التالية تبين ذلك:
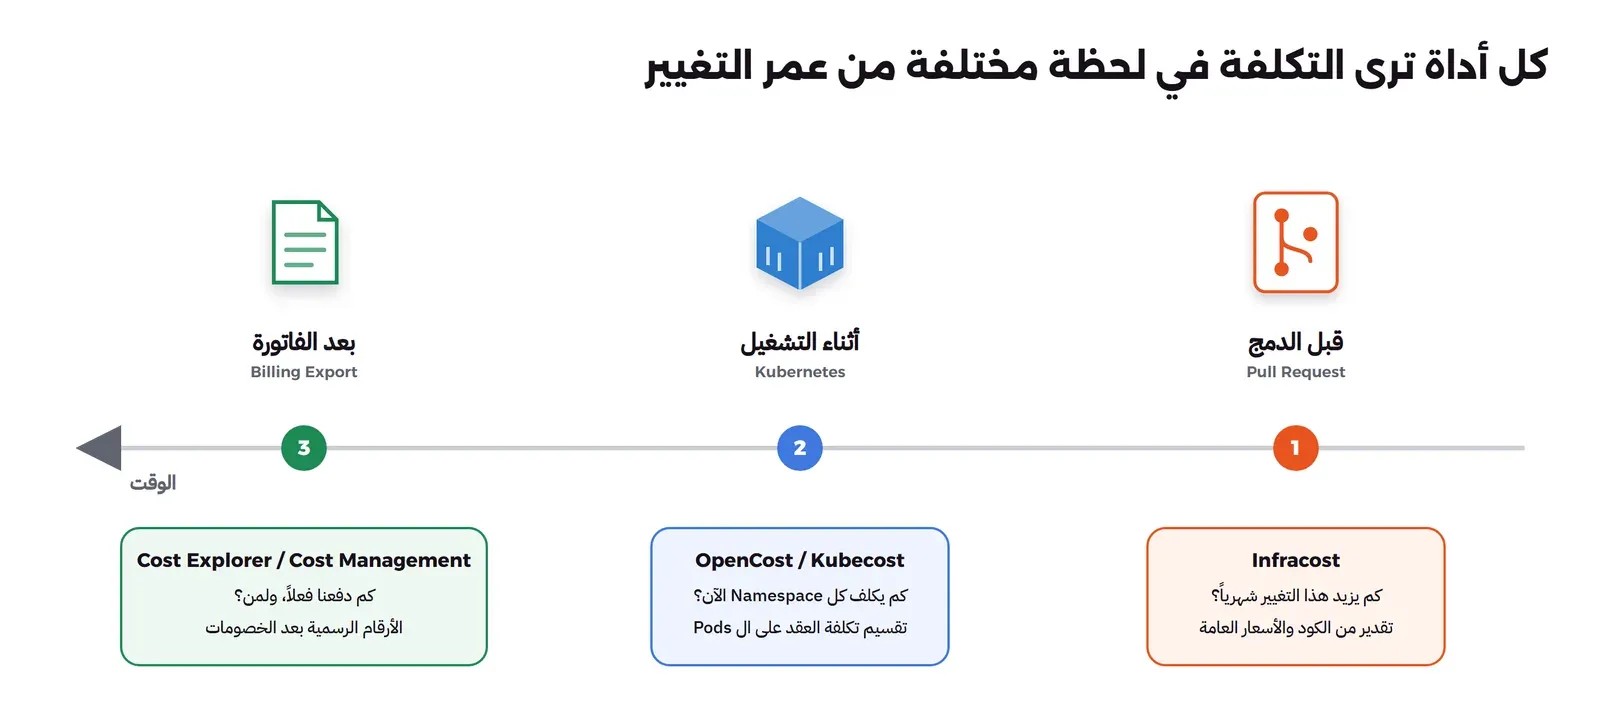
- قبل الدمج: لا يوجد استخدام بعد، فالأداة تقرأ كود البنية وتضربه في الأسعار العامة، والنتيجة تقدير وليس فاتورة.
- أثناء التشغيل: الأداة ترى ما يحدث داخل العنقود، مثل الطلبات Requests والاستخدام الفعلي لكل Pod، وتقسم سعر العقدة عليها.
- بعد الفاتورة: أدوات المزود ترى الخصومات والالتزامات والضرائب، وهي المرجع الرسمي الذي تطابق عليه كل ما سبق.
أدوات المزودين نفسها
قبل أن تثبت أي أداة، ابدأ بما يعطيك إياه المزود، فأغلبه مجاني أو رخيص، ويرى الخصومات والالتزامات التي لا تراها الأدوات الخارجية. والجدول التالي ملخص لأشهرها كما في صفحاتها الرسمية بتاريخ 13 أكتوبر 2026:
| المزود | الأدوات | ما يهمك منها |
|---|---|---|
| AWS | أدوات Cost Explorer وAWS Budgets وCost Anomaly Detection وData Exports | طلبات API الخاصة ب Cost Explorer بسنت واحد للطلب، ومراقبة الميزانيات مجانية، وتصدير البيانات متاح بصيغة FOCUS 1.2 مع أعمدة إضافية من AWS |
| Microsoft Azure | أداة Cost Management | تحليل التكلفة والميزانيات وتنبيهات الشذوذ وقواعد لتقسيم التكلفة المشتركة، وتصدير بصيغة FOCUS |
| Google Cloud | تقارير Cloud Billing وBudgets وتصدير BigQuery | تصدير بيانات الفوترة إلى BigQuery، وتصدير FOCUS ما زال في مرحلة Preview، ولا تدفع تخزينه وإنما تدفع الاستعلامات عليه |
| Oracle Cloud | أداة Cost Analysis وتقارير التكلفة | تحليل التكلفة، وتقارير CSV بصيغة FOCUS بجانب الصيغة الخاصة بها |
ونقاط القوة في هذه الأدوات أنها ترى الأرقام الرسمية بعد الخصومات، ولا تحتاج تثبيتاً، وتعمل من اليوم الأول. ونقاط الضعف أن كل مزود يرى نفسه فقط، وأنها لا ترى ما داخل Kubernetes، وأن بياناتها تتأخر ساعات، وأنها لا تعمل قبل الدمج. ولهذا تحتاج غالباً أداة لما قبل الدمج وأداة لما داخل العنقود، وهما موضوع بقية المقال.
التكلفة في طلب الدمج مع Infracost
Infracost أداة سطر أوامر CLI تقرأ كود البنية وتحسب التكلفة الشهرية المتوقعة، ثم تكتب الفرق كتعليق في طلب الدمج Pull Request، فيرى المراجع أن هذا التغيير يضيف 300 دولار في الشهر قبل أن يضغط زر الموافقة. وهذا تطبيق مباشر لمبدأ أن تصل البيانات إلى من يقرر في وقتها، فالمهندس الذي غير نوع السيرفر هو أفضل من يسأل: هل نحتاج هذا فعلاً؟
والأداة برخصة Apache 2.0 كما في المستودع، وآخر إصدار منها عند الكتابة هو v0.10.46 الصادر في 25 سبتمبر 2026. ولكن انتبه لنقطة مهمة: الأداة نفسها مفتوحة المصدر، والأسعار ليست فيها، وإنما تأتي من خدمة Cloud Pricing API التي تشغلها الشركة، ولذلك تحتاج مفتاح API حتى لو استخدمت الخطة المجانية. وتقول صفحة الأسئلة الشائعة إن الأداة تقرأ الكود أو ملف الخطة Plan محلياً، ولا ترسل ملف الخطة ولا أي مفاتيح أو أسرار، وإنما ترسل المعاملات التي تحدد السعر مثل نوع السيرفر، مع عدد أنواع الموارد ومعلومات مثل نظام التشغيل وإصدار الأداة. وقد كانت الشركة تنشر نسخة من خدمة الأسعار يمكنك تشغيلها على سيرفرك، ولكننا لم نجد مستودعها على GitHub عند الكتابة.
وخطط الاشتراك حسب صفحة الأسعار في 13 أكتوبر 2026 كما يلي:
- CI/CD: مجانية، وفيها 1000 تشغيل في الشهر.
- Starter: 250 دولاراً شهرياً، وفيها 10000 تشغيل.
- Cloud: 1000 دولار شهرياً، للفرق التي تحتاج سياسات ولوحات لممارسي FinOps.
- Enterprise: بالتواصل مع الشركة.
نقاط القوة: تعمل قبل الدمج، وتغطي أكثر من 1100 مورد Terraform لدى AWS وAzure وGoogle Cloud، وتعطي فرقاً واضحاً بين الفرع والفرع الرئيسي، والخطة المجانية تكفي فريقاً صغيراً.
نقاط الضعف: تحتاج حساباً ومفتاح API واتصالاً بخدمة الشركة، والتقدير لا يعرف استخدامك الفعلي لما يدفع بالاستخدام، مثل نقل البيانات وطلبات Lambda، إلا إذا كتبته في ملف استخدام، ولا تعرف خصوماتك الخاصة في الخطة المجانية.
تجربة على مشروع OpenTofu
لنفرض أن لدينا مشروعاً صغيراً بلغة HCL فيه سيرفرا API وسيرفر Worker، وقد شرحنا OpenTofu وقصة رخصته في Terraform أم OpenTofu؟. ولأننا لن ننشئ حساباً سحابياً، وضعنا في إعداد المزود مفاتيح وهمية وطلبنا منه ألا يتحقق منها، فيعمل الأمر plan دون أي اتصال بحساب:
terraform {
  required_providers {
    aws = { source = "hashicorp/aws", version = "6.66.0" }
  }
}

# Lab only: fake keys and no account calls, so "plan" runs without any cloud account
provider "aws" {
  region                      = "eu-central-1"
  access_key                  = "lab-not-a-real-key"
  secret_key                  = "lab-not-a-real-secret"
  skip_credentials_validation = true
  skip_requesting_account_id  = true
  skip_metadata_api_check     = true
}

variable "api_type"  { default = "m7g.large" }
variable "api_count" { default = 2 }

resource "aws_instance" "api" {
  count         = var.api_count
  ami           = "ami-0123456789abcdef0"
  instance_type = var.api_type
  root_block_device {
    volume_size = 30
    volume_type = "gp3"
  }
  tags = { team = "checkout", env = "prod" }
}

resource "aws_instance" "worker" {
  ami           = "ami-0123456789abcdef0"
  instance_type = "t4g.medium"
  tags          = { team = "checkout", env = "prod" }
}
نشغل OpenTofu 1.13.1 داخل Container، وننسخ الملف إلى داخله بدلاً من ربط مجلد ويندوز، والسبب أن أول تجربة لنا بربط المجلد فشلت بخطأ timeout while waiting for plugin to start، لأن ملف المزود الكبير يعمل ببطء من مجلد مشترك مع ويندوز:
docker run -d --name lab-fin-tofu --entrypoint sh ghcr.io/opentofu/opentofu:1.13.1 -c "mkdir -p /work && sleep infinity"
docker cp main.tf lab-fin-tofu:/work/main.tf
docker exec -w /work lab-fin-tofu tofu init
docker exec -w /work lab-fin-tofu tofu plan -out base.plan
والآن نشغل Infracost على المجلد نفسه، كما يفعل خط CI/CD:
docker run --rm --name lab-fin-infracost -v "$PWD:/w" -w /w infracost/infracost:0.10.46 breakdown --path . --no-colorوالمخرج سوف يكون كما يلي:
Error: INFRACOST_API_KEY is not set but is required, check your environment variable is named correctly or add your API key to your /root/.config/infracost/credentials.yml credentials file.
If you recently regenerated your API key, you can retrieve it from https://dashboard.infracost.io.
See https://infracost.io/support if you continue having issues.
وهذا هو الحد الذي توقفنا عنده، فالخطوة التالية أن تسجل في موقع Infracost وتحصل على مفتاح بالأمر infracost auth login، ونحن لا ننشئ حسابات في خدمات خارجية لمقالات الموقع. وإذا سجلت فإن الطريقة الموثقة للمقارنة في خط CI/CD أن تحسب التكلفة على الفرع الرئيسي وتحفظها في ملف JSON بالأمر infracost breakdown --path . --format json --out-file infracost-base.json، ثم تحسب الفرق على فرع التغيير بالأمر infracost diff --path . --compare-to infracost-base.json، ثم تنشر النتيجة كتعليق في طلب الدمج بالأمر infracost comment github أو infracost comment gitlab. وهذه الأوامر والخيارات نقلناها من المساعدة المدمجة في الإصدار 0.10.46 نفسه، أي من مخرج infracost diff --help وinfracost breakdown --help وinfracost comment --help، لأن صفحة الأوامر في موقع الشركة تصف اليوم أوامر أحدث مثل infracost scan.
الفكرة نفسها بسكربت صغير
حتى نرى الفكرة تعمل دون حساب، كتبنا سكربتاً صغيراً يفعل جزءاً صغيراً مما يفعله Infracost: يقرأ خطة OpenTofu بصيغة JSON، ويأخذ نوع كل سيرفر، ويضربه في السعر بالساعة من قائمة أسعار EC2 العامة لمنطقة فرانكفورت، وهي ملف JSON تنشره AWS ولا يحتاج حساباً، ثم يقارن خطتين:
"""Monthly EC2 cost of two OpenTofu plans and the difference between them.
Prices: AWS public on-demand price list for EU (Frankfurt), Linux, downloaded without an account.
Only instance hours are priced (730 h/month); disks, traffic and other resources are left out on purpose.
usage: python cost_diff.py ec2-frankfurt.json base.json pr.json
"""
import json, sys

prices_file, base_file, pr_file = sys.argv[1:4]
region = json.load(open(prices_file, encoding="utf-8"))["regions"]["EU (Frankfurt)"]
hourly = {v["Instance Type"]: float(v["price"]) for v in region.values()}
HOURS = 730

def monthly(plan_file):
    plan = json.load(open(plan_file))
    out = {}
    for rc in plan["resource_changes"]:
        if rc["type"] != "aws_instance" or "create" not in rc["change"]["actions"]:
            continue
        itype = rc["change"]["after"]["instance_type"]
        out[rc["address"]] = (itype, hourly[itype] * HOURS)
    return out

base, pr = monthly(base_file), monthly(pr_file)
print(f"{'resource':<20} {'before':>22} {'after':>22} {'diff':>9}")
for addr in sorted(set(base) | set(pr)):
    b, a = base.get(addr), pr.get(addr)
    bs = f"{b[0]} ${b[1]:.2f}" if b else "-"
    as_ = f"{a[0]} ${a[1]:.2f}" if a else "-"
    diff = (a[1] if a else 0) - (b[1] if b else 0)
    print(f"{addr:<20} {bs:>22} {as_:>22} {diff:>+9.2f}")
tb, ta = sum(v[1] for v in base.values()), sum(v[1] for v in pr.values())
print(f"{'monthly total':<20} {tb:>22.2f} {ta:>22.2f} {ta - tb:>+9.2f}  ({100 * (ta - tb) / tb:+.0f}%)")
والتغيير الذي نراجعه في طلب الدمج يكبر سيرفرات API من m7g.large إلى m7g.xlarge ويزيد عددها من اثنين إلى ثلاثة. نصنع خطة لكل حالة ونحولها إلى JSON:
docker exec -w /work lab-fin-tofu sh -c 'tofu show -json base.plan > base.json'
docker exec -w /work lab-fin-tofu sh -c 'tofu plan -var api_type=m7g.xlarge -var api_count=3 -out pr.plan | grep -E "^Plan|instance_type"'
docker exec -w /work lab-fin-tofu sh -c 'tofu show -json pr.plan > pr.json'
والمخرج سوف يكون كما يلي (السطور التي اخترناها بالأمر grep فقط):
      + instance_type                        = "m7g.xlarge"
      + instance_type                        = "m7g.xlarge"
      + instance_type                        = "m7g.xlarge"
      + instance_type                        = "t4g.medium"
Plan: 4 to add, 0 to change, 0 to destroy.
ثم نشغل السكربت على الخطتين:
docker cp lab-fin-tofu:/work/base.json . && docker cp lab-fin-tofu:/work/pr.json .
docker run --rm --name lab-fin-py -v "$PWD:/lab:ro" -w /lab python:3.13.16-slim python cost_diff.py ec2-frankfurt.json base.json pr.json
والمخرج سوف يكون كما يلي:
resource                             before                  after      diff
aws_instance.api[0]        m7g.large $71.39     m7g.xlarge $142.72    +71.32
aws_instance.api[1]        m7g.large $71.39     m7g.xlarge $142.72    +71.32
aws_instance.api[2]                       -     m7g.xlarge $142.72   +142.72
aws_instance.worker       t4g.medium $28.03      t4g.medium $28.03     +0.00
monthly total                        170.82                 456.18   +285.36  (+167%)
في المخرج أعلاه لاحظ التالي:
- التغيير الذي يبدو في الكود سطرين فقط يرفع تكلفة السيرفرات من 170.82 إلى 456.18 دولار شهرياً، أي بزيادة 167 بالمئة، وهذا هو الرقم الذي يجب أن يراه المراجع.
- السيرفر
aws_instance.workerلم يتغير، والفرق صفر، وهذا ما يجعل المراجع يركز على ما تغير فقط. - السكربت يحسب ساعات السيرفرات فقط، أما Infracost فيحسب الأقراص وموزعات الحمل وقواعد البيانات ومئات الموارد الأخرى، فلا تستخدم سكربتاً كهذا بدلاً منه، وإنما لتفهم ما يحدث داخله.
نكسر التجربة: نوع سيرفر غير موجود
نكتب الآن نوع السيرفر بخطأ إملائي، m7g.lage بدلاً من m7g.large، ونصنع الخطة ونشغل السكربت عليها:
docker exec -w /work lab-fin-tofu sh -c 'tofu plan -var api_type=m7g.lage -out typo.plan | grep -E "^Plan|Error"; tofu show -json typo.plan > typo.json'والمخرج سوف يكون كما يلي (آخر سطور الخطأ من السكربت):
Plan: 3 to add, 0 to change, 0 to destroy.
  File "/lab/cost_diff.py", line 20, in monthly
    out[rc["address"]] = (itype, hourly[itype] * HOURS)
                                 ~~~~~~^^^^^^^
KeyError: 'm7g.lage'
لاحظ أن OpenTofu قبل الخطة دون أي خطأ، لأن المزود لا يتحقق من نوع السيرفر إلا عند التنفيذ الفعلي في الحساب، بينما فشل السكربت لأن النوع غير موجود في قائمة الأسعار. وهذه فائدة جانبية لفحص التكلفة في خط CI/CD: يكتشف أخطاء من هذا النوع قبل أن تصل إلى apply.
وفي الأخير نحذف ال Container:
docker rm -f lab-fin-tofuتكلفة كل Namespace في Kubernetes مع OpenCost
عندما تعمل عشرة تطبيقات لخمسة فرق على ثلاث عقد Nodes، فإن الفاتورة ترى ثلاثة سيرفرات فقط. وOpenCost يقسم تكلفة هذه العقد على ال Pods التي تعمل عليها، ثم يجمعها حسب ال Namespace أو ال Label أو ال Deployment. وقد بدأ المشروع بجهد قادته شركة Kubecost مع خبراء من شركات أخرى، ثم قبلته CNCF في 17 يونيو 2022، وانتقل إلى مرحلة الحضانة Incubating في 25 أكتوبر 2024، ورخصته Apache 2.0، وآخر إصدار منه عند الكتابة هو 1.121.3 الصادر في 16 سبتمبر 2026.
والصورة التالية تبين كيف يحسب التكلفة:
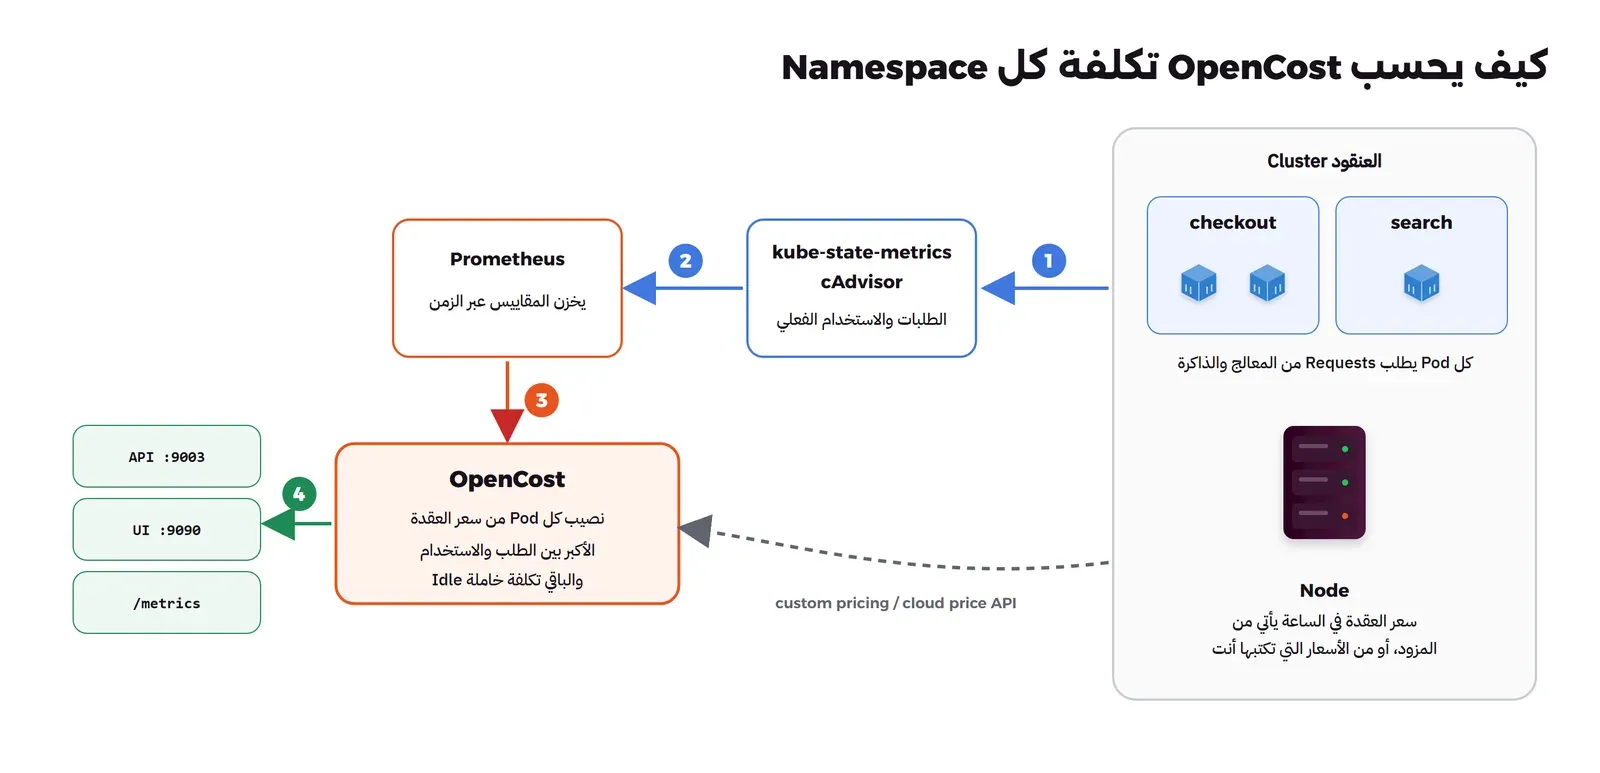
وأهم قاعدتين في مواصفة OpenCost: الأولى أن تكلفة ال Workload هي الأكبر بين الطلب Request والاستخدام Usage، والسبب أن ال Pod الذي يطلب نواة كاملة يحجزها من العقدة حتى لو لم يستخدمها، فلا يستطيع غيره أن يجدول عليها. والثانية أن ما لا يحجزه أحد من العقدة هو تكلفة خاملة Idle، وأن مجموع تكلفة ال Workloads والتكلفة الخاملة يساوي تكلفة العقد.
نقاط القوة: مفتوح المصدر بالكامل ومحايد تحت CNCF، ويعمل على أي Kubernetes حتى على سيرفراتك مع أسعار تكتبها بنفسك، ويعطي API واضحاً يمكن ربطه بأي تقرير.
نقاط الضعف: يحتاج Prometheus، ولا يعرف خصوماتك والتزاماتك من الفاتورة إلا إذا ربطته ببيانات الفوترة من المزود، ولا يعطيك توصيات الحجم الصحيح بالقدر الذي تعطيه المنتجات التجارية.
تجربة: عنقود K3s داخل Docker بأسعار نكتبها بأنفسنا
لا نحتاج حساباً سحابياً لهذه التجربة، فسوف نشغل K3s 1.36.5 داخل Container واحد، ونعطي OpenCost أسعاراً نكتبها بأنفسنا كما لو كان العنقود على سيرفراتنا: 0.02 دولار لكل نواة في الساعة، و0.003 دولار لكل GiB من الذاكرة في الساعة. وهذه الأسعار من اختيارنا للتجربة وليست سعراً لأي مزود.
docker run -d --privileged --name lab-fin-k3s --hostname lab-fin-k3s -p 127.0.0.1:19090:19090 --memory 6g \
  rancher/k3s:v1.36.5-k3s1 server --disable=traefik --disable=metrics-server
وعند تشغيل الأمر توقف ال Container بعد ثوان، وفي سجلاته وجدنا السطر التالي:
Error: failed to validate kubelet configuration, error: kubelet is configured to not run on a host using cgroup v1. cgroup v1 support is unsupported and will be removed in a future release, path: &TypeMeta{Kind:,APIVersion:,}والسبب أن بيئة Docker على جهاز التجربة تعمل بنظام cgroup v1، والإصدارات الحديثة من kubelet ترفض العمل عليه افتراضياً. وفي تجربة محلية يمكنك أن تسمح به بالخيار --kubelet-arg=fail-cgroupv1=false، أما في الإنتاج فالحل أن تستخدم نظاماً يعمل ب cgroup v2، لأن الدعم القديم سوف يزال كما تقول الرسالة نفسها:
docker run -d --privileged --name lab-fin-k3s --hostname lab-fin-k3s -p 127.0.0.1:19090:19090 --memory 6g \
  rancher/k3s:v1.36.5-k3s1 server --disable=traefik --disable=metrics-server --kubelet-arg=fail-cgroupv1=false
و K3s فيه متحكم Helm مدمج، فإذا وضعت ملف HelmChart في مجلد /var/lib/rancher/k3s/server/manifests ثبت المخطط Chart بنفسه دون أن تحتاج برنامج helm. والملف التالي يثبت Prometheus بإصدار المخطط 29.35.0، ثم OpenCost بإصدار المخطط 2.5.32، مع إعداد الأسعار المخصصة Custom Pricing وإعداد الجمع Scrape الذي يطلبه توثيق OpenCost:
# K3s installs these two charts by itself (its built-in Helm controller), so no helm binary is needed
apiVersion: helm.cattle.io/v1
kind: HelmChart
metadata: { name: prometheus, namespace: kube-system }
spec:
  repo: https://prometheus-community.github.io/helm-charts
  chart: prometheus
  version: 29.35.0
  targetNamespace: prometheus-system
  createNamespace: true
  valuesContent: |-
    alertmanager: { enabled: false }
    prometheus-pushgateway: { enabled: false }
    prometheus-node-exporter: { enabled: false }   # needs host mounts that a k3s-in-Docker node lacks
    server: { persistentVolume: { enabled: false } }
    extraScrapeConfigs: |
      - job_name: opencost
        honor_labels: true
        scrape_interval: 1m
        scrape_timeout: 10s
        metrics_path: /metrics
        scheme: http
        dns_sd_configs:
        - names: [opencost.opencost]
          type: A
          port: 9003
---
apiVersion: helm.cattle.io/v1
kind: HelmChart
metadata: { name: opencost, namespace: kube-system }
spec:
  repo: https://opencost.github.io/opencost-helm-chart
  chart: opencost
  version: 2.5.32
  targetNamespace: opencost
  createNamespace: true
  valuesContent: |-
    opencost:
      prometheus:
        internal:
          namespaceName: prometheus-system
          serviceName: prometheus-server
          port: 80
      exporter:
        defaultClusterId: lab-fin
      customPricing:
        enabled: true
        provider: custom
        costModel:
          description: Our own server, prices per hour chosen for the lab
          CPU: 0.02
          RAM: 0.003
          storage: 0.0001
      ui:
        enabled: true
في الإعداد أعلاه لاحظ التالي:
- أوقفنا node-exporter، لأنه فشل عندنا بخطأ
CreateContainerErrorفي أول تشغيل، والسبب أنه يحتاج ربط مجلدات من نظام المضيف لا يوفرها K3s داخل Docker، وOpenCost لا يحتاجه في حساب التوزيع. - ألغينا التخزين الدائم لـ Prometheus لأنها تجربة لساعة، أما في الإنتاج فتحتاجه حتى لا تفقد البيانات عند إعادة التشغيل.
- الأسعار في
costModelبالساعة:CPUلكل نواة، وRAMلكل GiB، وstorageلكل GiB من الأقراص الدائمة.
ثم ننشئ أربعة Namespaces فيها تطبيقات لا تفعل شيئاً (Image باسم pause)، ولكل منها طلبات Requests مختلفة، وأحدها old-demo نسيه أحدهم بلا وسم فريق:
# Three team namespaces with different resource requests, plus a namespace someone forgot
apiVersion: v1
kind: Namespace
metadata: { name: checkout, labels: { team: checkout } }
---
apiVersion: v1
kind: Namespace
metadata: { name: catalog, labels: { team: catalog } }
---
apiVersion: v1
kind: Namespace
metadata: { name: search, labels: { team: search } }
---
apiVersion: v1
kind: Namespace
metadata: { name: old-demo }
---
apiVersion: apps/v1
kind: Deployment
metadata: { name: api, namespace: checkout }
spec:
  replicas: 3
  selector: { matchLabels: { app: api } }
  template:
    metadata: { labels: { app: api, team: checkout } }
    spec:
      containers:
      - name: api
        image: registry.k8s.io/pause:3.10
        resources: { requests: { cpu: 500m, memory: 512Mi } }
---
apiVersion: apps/v1
kind: Deployment
metadata: { name: web, namespace: catalog }
spec:
  replicas: 2
  selector: { matchLabels: { app: web } }
  template:
    metadata: { labels: { app: web, team: catalog } }
    spec:
      containers:
      - name: web
        image: registry.k8s.io/pause:3.10
        resources: { requests: { cpu: 250m, memory: 1Gi } }
---
apiVersion: apps/v1
kind: Deployment
metadata: { name: indexer, namespace: search }
spec:
  replicas: 1
  selector: { matchLabels: { app: indexer } }
  template:
    metadata: { labels: { app: indexer, team: search } }
    spec:
      containers:
      - name: indexer
        image: registry.k8s.io/pause:3.10
        resources: { requests: { cpu: "1", memory: 2Gi } }
---
apiVersion: apps/v1
kind: Deployment
metadata: { name: demo, namespace: old-demo }
spec:
  replicas: 2
  selector: { matchLabels: { app: demo } }
  template:
    metadata: { labels: { app: demo } }
    spec:
      containers:
      - name: demo
        image: registry.k8s.io/pause:3.10
        resources: { requests: { cpu: 500m, memory: 1Gi } }
docker cp charts.yaml lab-fin-k3s:/var/lib/rancher/k3s/server/manifests/lab-charts.yaml
docker cp teams.yaml lab-fin-k3s:/tmp/teams.yaml
docker exec lab-fin-k3s kubectl apply -f /tmp/teams.yamlتركنا العنقود يعمل أكثر من ساعة، ثم سألنا API الخاص ب OpenCost عن التكلفة لساعة كاملة من 07:20 إلى 08:20 بتوقيت UTC، مجمعة حسب ال Namespace ومعها التكلفة الخاملة. ولا نحتاج أن نفتح منفذاً لهذا، فالأمر kubectl get --raw يمر عبر ال Proxy الخاص بال API Server:
docker exec lab-fin-k3s kubectl get --raw "/api/v1/namespaces/opencost/services/opencost:9003/proxy/allocation/compute?window=2026-10-13T07:20:00Z,2026-10-13T08:20:00Z&aggregate=namespace&accumulate=true&includeIdle=true" > alloc-ns.jsonوالرد JSON طويل، فاخترنا منه بعض الحقول وعرضناها في جدول بسكربت Python صغير، والأرقام كما جاءت في الرد:
name               cpu_req ram_GiB   cpu_$   ram_$  total_$
__idle__              0.00    0.00  0.0771  0.0699   0.1470
checkout              1.50    1.50  0.0300  0.0045   0.0345
old-demo              1.00    2.00  0.0200  0.0060   0.0260
search                1.00    2.00  0.0200  0.0060   0.0260
catalog               0.50    2.00  0.0100  0.0060   0.0160
kube-system           0.10    0.07  0.0020  0.0003   0.0022
prometheus-system     0.00    0.00  0.0005  0.0009   0.0014
opencost              0.02    0.11  0.0004  0.0003   0.0008
في المخرج أعلاه لاحظ التالي:
- فريق checkout طلب 1.5 نواة لساعة، فتكلفته 1.5 × 0.02 = 0.03 دولار، وطلب 1.5 GiB من الذاكرة، فتكلفتها 1.5 × 0.003 = 0.0045 دولار، أي أن الحساب هو الطلب في السعر، لأن التطبيق لا يستخدم شيئاً تقريباً، والأكبر بين الطلب والاستخدام هو الطلب.
- أكبر سطر هو
__idle__، لأن العقدة الوحيدة فيها ثماني أنوية ونحو 31 GiB من الذاكرة، وال Pods كلها تطلب نحو أربع أنوية، فالباقي تدفعه ولا يستخدمه أحد. وهذا هو الهدر الذي لا تراه في الفاتورة أبداً، لأن الفاتورة ترى سيرفراً واحداً مستخدماً. old-demoيكلف مثلsearchتماماً، وهو تطبيق لا يحتاجه أحد.
والآن نجمع حسب الوسم team على ال Pods بدلاً من ال Namespace، بتغيير المعامل إلى aggregate=label:team:
name               cpu_req ram_GiB   cpu_$   ram_$  total_$
checkout              1.50    1.50  0.0300  0.0045   0.0345
__unallocated__       1.12    2.18  0.0229  0.0075   0.0304
search                1.00    2.00  0.0200  0.0060   0.0260
catalog               0.50    2.00  0.0100  0.0060   0.0160
ظهر سطر جديد باسم __unallocated__ بتكلفة 0.0304 دولار، وهو كل Pod لا يحمل الوسم team: تطبيق old-demo، ومعه Pods النظام نفسه مثل CoreDNS وPrometheus وOpenCost. وهذا هو نفس «ما لا صاحب له» الذي رأيناه في الفاتورة في المقال الأول، ولكن داخل العنقود.
وللواجهة الرسومية نفتح المنفذ 9090 من داخل العنقود إلى الجهاز:
docker exec -d lab-fin-k3s sh -c 'while true; do kubectl port-forward --address 0.0.0.0 -n opencost svc/opencost 19090:9090; sleep 1; done'ثم نفتح http://127.0.0.1:19090 في المتصفح، والصورة التالية من تثبيتنا:
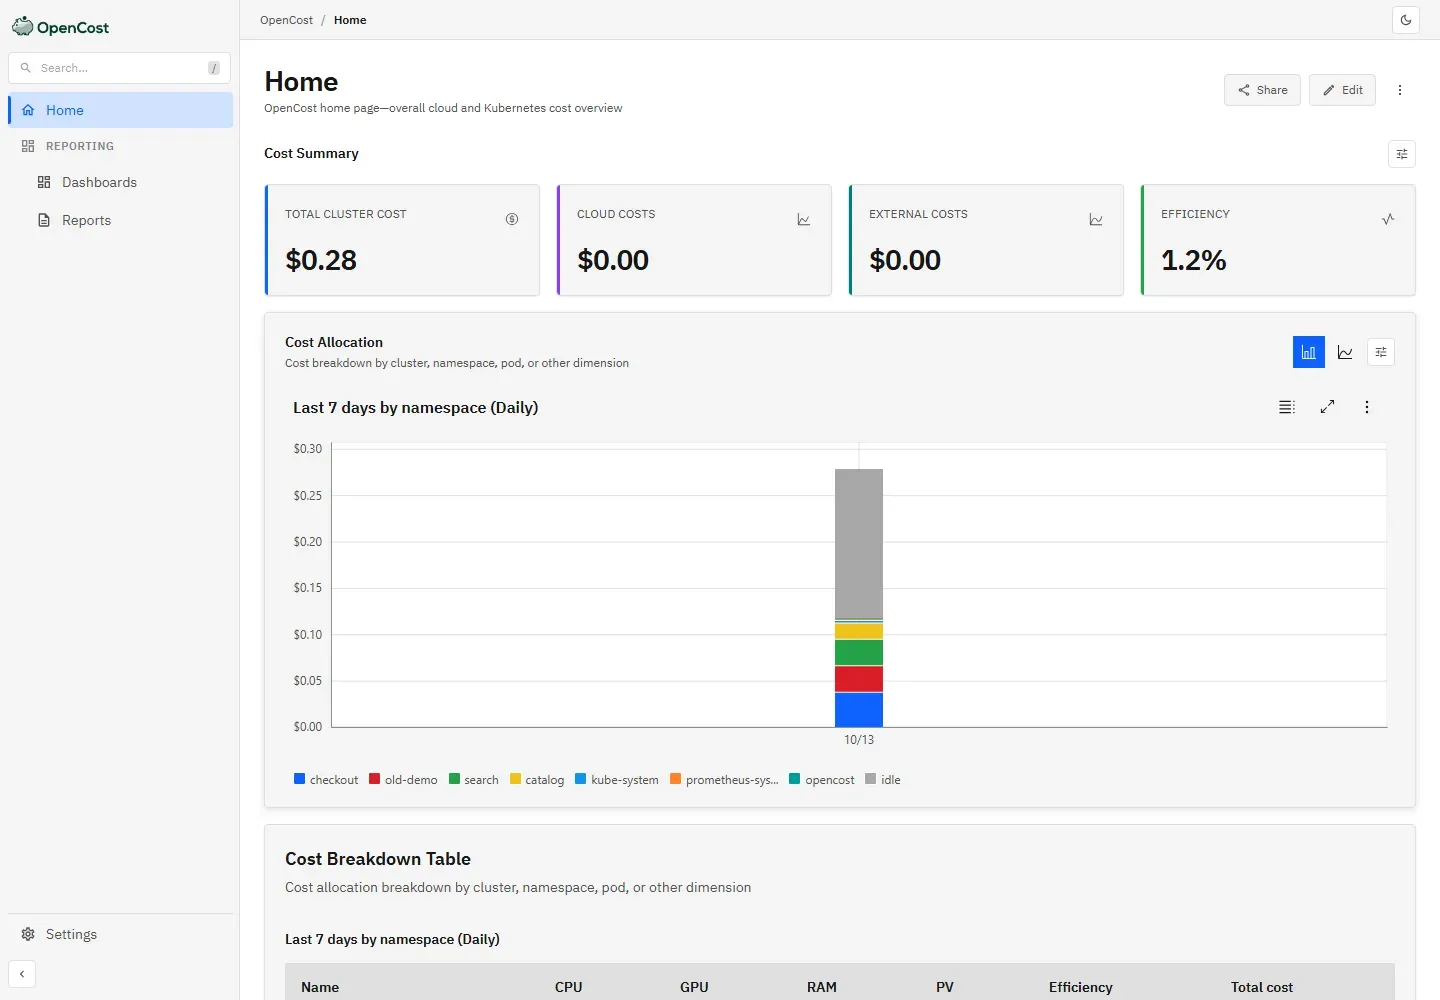
لاحظ أن الكفاءة Efficiency في الواجهة 1.2 بالمئة فقط، والسبب أن تطبيقات pause تطلب أنوية وذاكرة ولا تستخدم منها شيئاً تقريباً. وفي عنقود حقيقي تكشف هذه النسبة الطلبات المبالغ فيها، وهي أول مكان تبحث فيه عن الحجم الصحيح Rightsizing داخل Kubernetes.
وفي الأخير نحذف العنقود. ولاحظ أن Image الخاصة ب K3s تعرف أربعة Volumes لمجلداتها، فينشئها Docker تلقائياً بأسماء عشوائية ولا يحذفها مع ال Container، لذلك نطبع أسماءها قبل الحذف ثم نحذفها بأسمائها:
docker inspect -f '{{range .Mounts}}{{.Name}} {{end}}' lab-fin-k3s
docker rm -f lab-fin-k3s
docker volume rm VOLUME_1 VOLUME_2 VOLUME_3 VOLUME_4   # the four names printed by the first command
ماذا تغير في Kubecost بعد IBM؟
Kubecost هي الشركة التي بدأت مشروع OpenCost، ومنتجها التجاري يضيف فوقه ميزات مثل مطابقة التكلفة مع فاتورة المزود والتوصيات ورؤية عدة عناقيد. وقد أعلنت IBM استحواذها على Kubecost في 17 سبتمبر 2024، وأصبحت صفحة أسعاره اليوم جزءاً من موقع Apptio، وهي شركة تابعة ل IBM.
وحسب صفحة الأسعار في 13 أكتوبر 2026 هناك ثلاث خطط:
- Foundations: مجانية دائماً وتثبتها على عنقودك، وفيها عدد غير محدود من العناقيد حتى 250 نواة، واحتفاظ بالمقاييس 15 يوماً، ودعم من المجتمع فقط.
- Enterprise Self-hosted: تضيف عدداً غير محدود من الأنوية ومدة الاحتفاظ، والأسعار المخصصة، والصلاحيات RBAC.
- Enterprise Cloud: نسخة تديرها الشركة نفسها.
ولا تذكر الصفحة سعراً للخطتين المدفوعتين، وإنما تحيلك إلى متجر IBM أو إلى التواصل معهم.
والفرق المهم في الرخصة: OpenCost مفتوح المصدر برخصة Apache 2.0، أما Kubecost فمنتج تجاري مجاني في حدود الخطة الأولى، ولا تذكر صفحة أسعاره رخصة مفتوحة له. وهذا يعني أن قرارك اليوم مع Kubecost مرتبط بقرارات IBM في التسعير والحدود غداً، بينما يبقى OpenCost تحت حوكمة CNCF.
نقاط القوة: ميزات جاهزة فوق OpenCost، ومطابقة مع الفاتورة، وخطة مجانية تكفي عنقوداً صغيراً.
نقاط الضعف: حد 250 نواة و15 يوماً من البيانات في الخطة المجانية، وأسعار المؤسسات غير منشورة، والارتباط بمورد واحد Vendor Lock-in في الميزات التي ليست في OpenCost.
أدوات مفتوحة أخرى ما زالت تصان
اخترنا من الأدوات المفتوحة ما زال يصدر إصدارات في 2026، وتركنا ما توقف تطويره:
- Cloud Custodian: محرك قواعد Rules Engine تكتب فيه سياسات بصيغة YAML، مثل «أوقف كل سيرفر في حساب الاختبار لا يحمل وسم team بعد يومين»، ويعمل مع AWS وAzure وGoogle Cloud. رخصته Apache 2.0، وهو مشروع في مرحلة Incubating في CNCF منذ 14 سبتمبر 2022، وآخر إصدار منه 0.9.53.0 في 1 أكتوبر 2026. وهو الأداة المناسبة لتحويل قائمة «ما لا صاحب له» إلى إجراء تلقائي.
- Goldilocks: أداة من Fairwinds تنشئ Vertical Pod Autoscaler في وضع التوصية لكل Workload، وتعرض في لوحة الطلبات والحدود التي يقترحها. رخصتها Apache 2.0، وآخر إصدار منها v4.16.2 في 15 سبتمبر 2026. وهي مكملة ل OpenCost: الأول يقول لك كم تدفع، والثانية تقول لك كم يجب أن تطلب.
جدول القرار
| حالتك | ابدأ ب | والسبب |
|---|---|---|
| حساب سحابي واحد، دون Kubernetes | أدوات المزود مع الميزانيات وتنبيهات الشذوذ | مجانية تقريباً وترى الخصومات، ولا تحتاج تثبيتاً |
| عدة مزودين أو حسابات كثيرة | تصدير FOCUS من كل مزود إلى قاعدة تحليلية | أعمدة واحدة لكل المزودين، والاستعلامات نفسها التي رأيناها في المقال الأول |
| البنية مكتوبة بالكود وتغييرات كثيرة | أداة Infracost في خط CI/CD | يرى المراجع التكلفة قبل الدمج، والخطة المجانية تكفي فريقاً صغيراً |
| لا تريد إرسال أي بيانات إلى خدمة خارجية | فحص داخلي مثل سكربت المختبر على أسعار المزود العامة | لأن Infracost يحتاج خدمة الأسعار الخاصة به |
| عنقود Kubernetes على سيرفراتك أو بسعر ثابت | أداة OpenCost بأسعار مخصصة | مفتوح المصدر بالكامل، ويكشف التكلفة الخاملة والطلبات المبالغ فيها |
| عنقود Kubernetes سحابي كبير وتحتاج مطابقة مع الفاتورة | أداة OpenCost مع بيانات الفوترة، أو Kubecost إذا قبلت حدوده وسعره | المنتج التجاري يوفر وقت التكامل مقابل الارتباط بمورد |
| موارد بلا وسوم تتكرر كل أسبوع | أداة Cloud Custodian | يحول السياسة إلى إجراء تلقائي بدلاً من رسالة في قناة الفريق |
أخطاء شائعة
- اعتبار تقدير Infracost فاتورة: هو تقدير بأسعار القائمة، ولا يعرف استخدامك الفعلي لما يدفع بالاستخدام.
- تثبيت OpenCost دون أسعار صحيحة: الأسعار الافتراضية مأخوذة من مزود آخر، فإذا كانت سيرفراتك بسعر ثابت فاكتب سعرك الحقيقي، وإلا فالأرقام بلا معنى.
- تجاهل التكلفة الخاملة Idle: هي غالباً أكبر سطر في العناقيد الصغيرة، ومكانها الحجم الصحيح للعقد وليس التطبيقات.
- الطلبات Requests العشوائية: التطبيق الذي يطلب نواتين ويستخدم عشر نواة يكلف نواتين، فلا تقم بنسخ الطلبات من مثال على الإنترنت.
- الاعتماد على الخطة المجانية لمنتج تجاري دون خطة خروج: اسأل قبل أن تبني تقاريرك عليه: ماذا لو تغيرت الحدود؟
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التكلفة تظهر في ثلاث لحظات: قبل الدمج كتقدير، وأثناء التشغيل كتوزيع، وبعد الفاتورة كرقم رسمي، ولكل لحظة أداتها.
- ابدأ بأدوات المزود وتصدير FOCUS قبل أي أداة خارجية.
- Infracost مفتوح المصدر برخصة Apache 2.0، ولكن الأسعار من خدمة الشركة وتحتاج مفتاح API، وخطته المجانية فيها 1000 تشغيل في الشهر.
- OpenCost مشروع في مرحلة Incubating في CNCF، يحسب تكلفة كل Pod بالأكبر بين الطلب والاستخدام، ويظهر التكلفة الخاملة التي لا تراها في الفاتورة.
- Kubecost منتج تجاري فوق OpenCost تملكه IBM، وخطته المجانية حتى 250 نواة و15 يوماً من البيانات.
- Cloud Custodian وGoldilocks يكملان الصورة: الأول يحول السياسات إلى إجراءات، والثاني يقترح الطلبات الصحيحة.
وفي المقال القادم بإذن الله سوف نتحدث عن بند أصبح يظهر في كل فاتورة: تكلفة الذكاء الاصطناعي بالتوكنات، وكيف تقيسها لكل ميزة وتخفضها.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتشغيل OpenTofu 1.13.1 وInfracost 0.10.46 (حتى خطوة مفتاح API) وK3s 1.36.5 مع OpenCost 1.121.3 وPrometheus 3.15.0، ونقل الأسعار والحدود من صفحات Infracost وApptio وAWS بتاريخ 13 أكتوبر 2026.


