

تضيف ميزة تلخيص التذاكر بنموذج لغة، فتعمل في أسبوع الإطلاق بتكلفة لا يلاحظها أحد، ثم يستخدمها كل فريق الدعم، ثم يضيف أحدهم إليها المستندات الداخلية حتى تكون الإجابة أدق، وبعد شهرين تصبح فاتورة التوكنات أكبر من فاتورة السيرفرات. وهذا البند يختلف عن بقية الفاتورة في أمرين: تكلفته لا ترتبط بعدد السيرفرات وإنما بطول النصوص التي ترسلها وتستقبلها، وقرار التكلفة فيه يتخذه من يكتب التعليمات Prompt، وليس من يختار السيرفر.
وفي المقال الأول من سلسلة FinOps شرحنا التوزيع Allocation وتكلفة الوحدة Unit Cost والميزانيات، وكل ذلك ينطبق هنا، ولكن وحدة الحساب أصبحت التوكن Token بدلاً من الساعة. وإذا لم تكن تعرف ما هو التوكن ونافذة السياق Context Window فابدأ بمقال مصطلحات الذكاء الاصطناعي ونماذج اللغة.
المواضيع في السلسلة:
- FinOps: كيف تجعل فريقك مسؤولاً عن تكلفة السحابة
- أدوات FinOps: التكلفة قبل الدمج وبعد النشر
- تكلفة الذكاء الاصطناعي بالتوكنات: كيف تقيسها وتخفضها (الموضوع الحالي)
وسوف نناقش في هذا المقال ما يلي:
- كيف تسعر التوكنات: المدخلات والمخرجات والمقروء من الذاكرة المؤقتة، بأسعار ثلاثة مزودين من صفحاتهم الرسمية.
- كيف تقيس التكلفة لكل ميزة ولكل مستخدم.
- طرق التخفيض: الذاكرة المؤقتة للتعليمات Prompt Caching، والتوجيه بين النماذج Model Routing، والمعالجة المجمعة Batch، وحدود طول المخرجات، وحجم سياق RAG.
- مختبر محلي مع Ollama: نموذجان بحجمين مختلفين، وموجه بسيط يرسل الطلبات السهلة إلى الصغير، ونقيس الجودة والتكلفة على 60 رسالة معروفة الإجابة.
- النماذج المفتوحة على سيرفرك مقابل API، ومتى يكون التشغيل الذاتي أرخص.
- الميزانيات وحدود الطلبات لكل فريق.
كيف تسعر التوكنات Tokens؟
كل مزود يحسب ثمن الطلب من عدد التوكنات، ويضرب كل نوع منها في سعر مختلف لكل مليون توكن، واختصاراً MTok. والأنواع التي تراها في كل صفحات الأسعار تقريباً هي:
- المدخلات Input: كل ما ترسله: التعليمات الثابتة System Prompt، وتاريخ المحادثة، والمستندات التي يضيفها RAG، وتعريف الأدوات Tools، والسؤال نفسه.
- المخرجات Output: ما يكتبه النموذج، ومنها توكنات التفكير Thinking في النماذج التي تفكر قبل الإجابة، وسعرها عادة خمسة أضعاف المدخلات أو أكثر.
- المقروء من الذاكرة المؤقتة Cache Read: الجزء الثابت من المدخلات الذي أرسلته من قبل وحفظه المزود، ويحسب بجزء صغير من سعر المدخلات.
- الكتابة في الذاكرة المؤقتة Cache Write: عند بعض المزودين تكون أول مرة تحفظ فيها هذا الجزء أغلى قليلاً من المدخلات العادية.
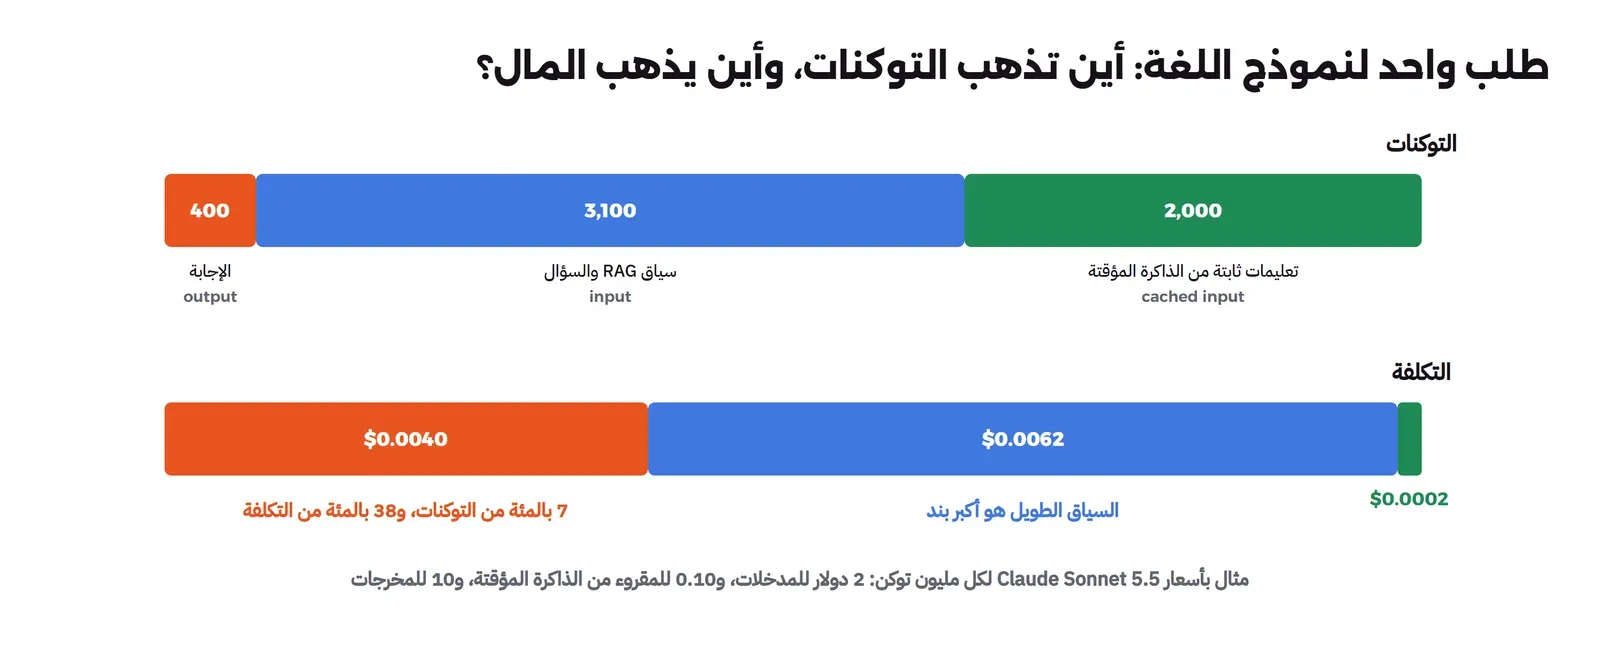
والصورة التالية تبين طلباً واحداً فيه تعليمات ثابتة وسياق من RAG وإجابة قصيرة:
والجدول التالي فيه أمثلة من صفحات الأسعار الرسمية لثلاثة مزودين، بالدولار لكل مليون توكن، كما ظهرت في 22 أكتوبر 2026، وهي أسعار الطلبات القصيرة والاستخدام الفوري، وأمثلة وليست كل النماذج:
| النموذج | المدخلات | المقروء من الذاكرة المؤقتة | المخرجات |
|---|---|---|---|
| Claude Haiku 5.5 | 0.10 | 0.01 | 0.50 |
| Claude Sonnet 5.5 | 2 | 0.10 | 10 |
| Claude Opus 5.5 | 4 | 0.20 | 20 |
| gpt-6-luna | 0.10 | 0.01 | 0.50 |
| gpt-6.1-sol | 2 | 0.10 | 10 |
| gpt-6-astra | 10 | 1 | 50 |
| Gemini 3.5 Flash-Lite | 0.30 | 0.03 | 2.50 |
| Gemini 3.8 Flash | 0.75 | 0.075 | 3.75 |
| Gemini 4 Argon | 2 | 0.10 | 10 |
والمصادر هي صفحة أسعار Claude، وصفحة أسعار OpenAI، وصفحة أسعار Gemini API. وعند قراءة الجدول لاحظ التالي:
- الطول يغير السعر: Claude Haiku 5.5 يصبح 0.50 دولار للمدخلات و2.50 للمخرجات إذا زاد الطلب عن 100 ألف توكن، وGemini 3.1 Pro Preview يرتفع من 2 إلى 4 دولارات للمدخلات فوق 200 ألف توكن، وOpenAI يضاعف سعر المدخلات لما فوق 272 ألف توكن. أما بقية نماذج Claude الحالية فسعرها واحد حتى مليون توكن.
- بعض الأسعار مؤقتة: سعر Gemini 4 Argon في الجدول حتى 30 نوفمبر 2026 ثم يتضاعف إلى 4 و20 دولاراً، وسعر Gemini 3.8 Flash حتى 31 ديسمبر 2026 ثم يتضاعف إلى 1.50 و7.50 دولار، حسب الصفحة نفسها، لذلك اكتب في حساباتك تاريخ السعر.
- التوكن ليس وحدة واحدة بين المزودين: كل مزود يقطع النص بطريقته، وتقول صفحة Claude نفسها إن المقطع Tokenizer في Claude 4.7 وما بعده ينتج نحو 30 بالمئة توكنات أكثر للنص نفسه مقارنة بالنماذج الأقدم. لذلك لا تقارن الأسعار لكل مليون توكن مباشرة، وإنما قس تكلفة الطلب نفسه على كل نموذج.
- الذاكرة المؤقتة لها شروط: في Claude الكتابة في الذاكرة لخمس دقائق ب 1.25 ضعف سعر المدخلات ولساعة بضعفين، والقراءة منها بعشر سعر المدخلات في أغلب النماذج وبنصف العشر في Sonnet 5.5 وOpus 5.5. وفي OpenAI عمود مستقل لكتابة الذاكرة: 1.25 ضعف لثلاثين دقيقة و2.5 ضعف لاثنتي عشرة ساعة. وفي Gemini تدفع أيضاً سعر تخزين بالساعة لما تحفظه، مثل 0.50 دولار لكل مليون توكن في الساعة في Gemini 3.8 Flash.
- المعالجة المجمعة Batch: المزودون الثلاثة يعطون خصماً 50 بالمئة لمن يقبل أن تصله النتيجة لاحقاً وليس فوراً.
قس التكلفة لكل ميزة Feature ولكل مستخدم
فاتورة المزود تقول لك كم صرفت على كل نموذج، ولا تقول لك أي ميزة صرفت. والطريقة البسيطة أن تنشئ مفتاح API لكل ميزة وتقرأ استخدامه من لوحة المزود، وهي تعمل حتى تصبح المفاتيح عشرين ولا يعرف أحد أيها لمن، ولا تعطيك تكلفة المستخدم الواحد. والطريقة الأصح أن تسجل مع كل طلب ما يرجعه المزود في الرد نفسه، فكل API يعيد عدد توكنات المدخلات والمخرجات والمقروء من الذاكرة المؤقتة، وكذلك Ollama يعيد prompt_eval_count وeval_count كما في توثيقه.
وسجل كل طلب بالحقول التالية على الأقل، كسطر في السجلات المنظمة Structured Logs كما شرحنا في السجلات Logging للمطورين، أو كحقول إضافية في الحدث الواسع Wide Event الذي شرحناه في سجلات تساعدك فعلاً:
{
  "ts": "2026-10-22T09:14:02Z",
  "feature": "ticket-summary",
  "team": "support",
  "tenant": "acme",
  "user_id": "u-1042",
  "model": "claude-haiku-5-5",
  "input_tokens": 3100,
  "cache_read_tokens": 2000,
  "output_tokens": 400,
  "cost_usd": 0.00053,
  "latency_ms": 1840,
  "routed_from": null
}
ثم احسب التكلفة بجدول أسعار ثابت في الكود تحدثه يدوياً عندما تتغير صفحة الأسعار، ولا تقم بحسابها من الفاتورة الشهرية لأنك تحتاجها يومياً. ومن هذا السجل تخرج كل أرقام FinOps التي عرفناها: التكلفة لكل ميزة، ولكل فريق، ولكل عميل Tenant، وتكلفة الوحدة مثل تكلفة التذكرة الملخصة، وتنبيه الشذوذ Anomaly Alert عندما تقفز ميزة واحدة. ولاحظ أن الحقل cost_usd في المثال محسوب بأسعار Claude Haiku 5.5: 3100 توكن مدخلات بسعر 0.10، و2000 من الذاكرة المؤقتة بسعر 0.01، و400 مخرجات بسعر 0.50 لكل مليون.
وقد يتساءل البعض: هل التوكنات هي كل تكلفة الميزة؟ والإجابة لا، ولذلك يجب أن تقيس الميزة كاملة. ففي مختبر الوكيل الصوتي على Asterisk كلفت المكالمة السحابية نحو 0.0065 دولار للدقيقة، ولكن النموذج اللغوي كان أقل من 0.0003 دولار للمكالمة كلها، والصوت المولد Text to Speech كان أكثر من 80 بالمئة من التكلفة. فلو خفضنا توكنات النموذج إلى النصف لما تغيرت الفاتورة تقريباً، والتوفير الحقيقي كان في تقصير ردود الوكيل وحفظ الجمل الثابتة مسبقاً.
كيف تخفض التكلفة؟
طرق التخفيض كثيرة، ورتبناها هنا من الأسهل إلى الأصعب، مع ما تحتاج أن تقيسه قبل أن تقرر.
الذاكرة المؤقتة للتعليمات Prompt Caching
إذا كانت كل الطلبات تبدأ بالتعليمات نفسها، أو بالمستند نفسه، أو بتعريف الأدوات نفسه، فاجعل هذا الجزء الثابت في أول الطلب وفعل الذاكرة المؤقتة، فيقرأ المزود الجزء المحفوظ بسعر أقل بكثير، كما في عمود «المقروء من الذاكرة المؤقتة» أعلاه. والشرط أن يكون الجزء الثابت في البداية تماماً وبالترتيب نفسه، لأن المزود يطابق البداية Prefix حرفاً بحرف، فإذا وضعت تاريخ اليوم أو اسم المستخدم في أول التعليمات تغير كل طلب ولم يعد يحفظ شيء، وسوف نرى أثر ذلك بالأرقام في المختبر. وفي Claude هناك فائدة إضافية تذكرها صفحة حدود الطلبات: التوكنات المقروءة من الذاكرة المؤقتة لا تحسب في حد توكنات المدخلات في الدقيقة ITPM لأغلب النماذج.
ولاحظ أن الكتابة في الذاكرة تكلف أكثر من المدخلات العادية، فالذاكرة لخمس دقائق في Claude تربح من أول قراءة، والذاكرة لساعة تربح من القراءة الثانية، وإذا كانت الميزة تستقبل طلباً كل ربع ساعة فالذاكرة لخمس دقائق تنتهي قبل الطلب التالي ولا تربح شيئاً، لذلك قس معدل القراءة من الذاكرة Cache Hit Rate في سجلك قبل أن تحسب التوفير.
التوجيه بين النماذج Model Routing
أغلب الطلبات في أي منتج سهلة: تصنيف رسالة، أو استخراج تاريخ، أو إعادة صياغة جملة، ولا تحتاج أكبر نموذج. والتوجيه أن ترسل الطلب أولاً إلى نموذج صغير رخيص، ولا ترسله إلى النموذج الكبير إلا عندما يتردد الصغير، والصورة التالية تبين الفكرة:
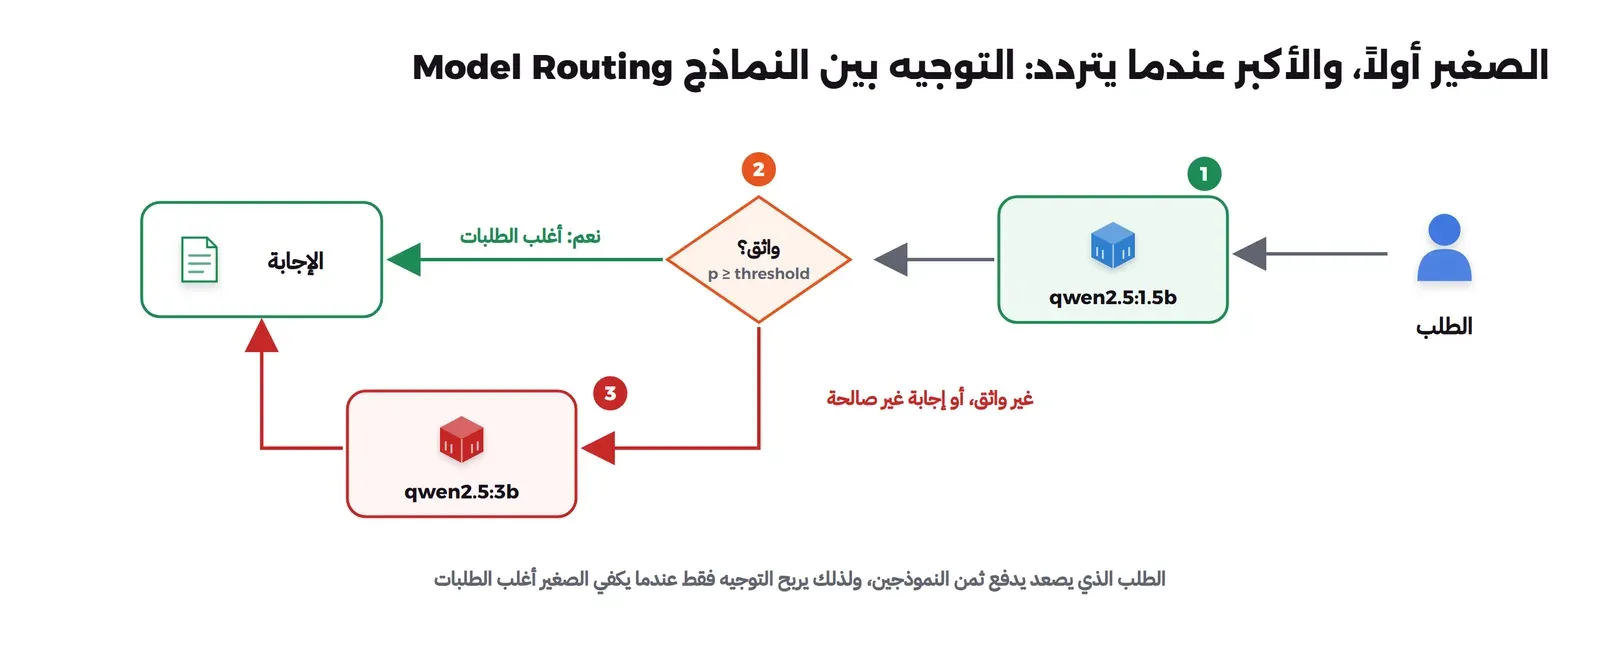
وكيف يعرف الموجه Router أن الصغير متردد؟ هناك عدة طرق:
- احتمال التوكن الأول Logprobs: في مهام التصنيف تطلب من ال API احتمالات التوكنات، فإذا كان احتمال الإجابة منخفضاً فالنموذج غير متأكد، وهذه الطريقة التي نستخدمها في المختبر. وقد شرحنا من أين تأتي هذه الاحتمالات في كيف تعمل نماذج اللغة الكبيرة من الداخل.
- التحقق من صيغة الإجابة Validation: إذا طلبت JSON أو قيمة من قائمة محددة ورجعت إجابة خارجها، فهذا سبب كاف للتصعيد.
- قواعد على الطلب نفسه: طول الرسالة، أو وجود مرفق، أو نوع العميل.
وتذكر أن الاحتمال العالي لا يعني أن الإجابة صحيحة، فالنموذج قد يكون واثقاً ومخطئاً كما رأينا في متى يكون الذكاء الاصطناعي واثقاً ومخطئاً؟، لذلك لا تختار حد الثقة Threshold بالتخمين، وإنما على مجموعة رسائل معروفة الإجابة كما سنفعل في المختبر.
وهذه الفكرة ليست نظرية، ففي تقرير The state of the tech industry in 2026 المنشور في 6 أكتوبر 2026 في نشرة The Pragmatic Engineer، يذكر Gergely Orosz أن الشركات التقنية تنتقل إلى النماذج المفتوحة لتوفر 50 بالمئة أو أكثر من تكلفة التوكنات، ويذكر مثال Uber: استخدامها للتوكنات يزيد، ولكن تكلفتها بقيت ثابتة منذ مايو لأنها تشغل نماذج مفتوحة وتوجه الطلبات بين النماذج، وانخفضت تكلفة التوكن الواحد عندها أكثر من 50 بالمئة.
المعالجة المجمعة Batch
ما لا يحتاجه المستخدم فوراً لا يجب أن تدفع ثمن السرعة فيه: تلخيص تذاكر الأمس، وتصنيف أرشيف المستندات، وتوليد الأوصاف لآلاف المنتجات، وتقييم النماذج على مجموعة اختبار. وكل المزودين في الجدول يعطون 50 بالمئة خصماً على Batch، وفي Claude يمكن جمعه مع خصم الذاكرة المؤقتة. ولاحظ أن الطلبات المجمعة لها حدود خاصة بها، ففي Claude مثلاً لا تزيد الدفعة الواحدة عن 100 ألف طلب، ولكل مستوى حساب حد لعدد الطلبات المنتظرة، فاقرأ هذه الحدود قبل أن ترسل مليون طلب.
حدود طول المخرجات Output
المخرجات أغلى توكن في الطلب، وهي أيضاً الجزء الذي يتحكم فيه النموذج وليس أنت. لذلك حدد أقصى عدد للتوكنات في كل طلب بما يناسب الميزة، واطلب صيغة قصيرة محددة، مثل كلمة واحدة من قائمة أو JSON بحقول معروفة، بدلاً من «اشرح». وفي مختبرنا حددنا المخرجات بأربعة توكنات لأن المطلوب كلمة واحدة. وانتبه في النماذج التي تفكر Reasoning إلى أن توكنات التفكير تحسب مخرجات حتى لو لم تظهر لك، فاضبط مستوى الجهد Effort أو التفكير في الميزات البسيطة.
حجم سياق RAG
في RAG للمبتدئين رأينا أن النظام يضيف إلى السؤال مقاطع من المستندات، وكل مقطع يضاف هو توكنات مدخلات تدفعها في كل سؤال. والطريقة البسيطة أن تضيف عشرين مقطعاً «احتياطاً»، وهي تضاعف التكلفة ولا تحسن الإجابة غالباً، بل قد تضيع فيها المعلومة المهمة. والأصح أن تقيس جودة الإجابة مع 3 و5 و10 مقاطع على أسئلة معروفة الإجابة، وتختار أصغر عدد لا تنخفض معه الجودة، وأن تستخدم إعادة الترتيب Re-ranking والبحث الهجين Hybrid Search حتى تكون المقاطع القليلة هي الأفضل، كما شرحنا في البحث الدلالي Semantic Search.
مختبر: نموذجان محليان وموجه Router بسيط
الآن سوف نقيس كل ما سبق على جهازنا دون أي مفتاح API مدفوع. المهمة: تصنيف رسائل عملاء متجر إلكتروني إلى خمسة فرق هي الدفع payment، والشحن shipping، والإرجاع returns، والحساب account، والمشاكل التقنية technical. والنموذجان هما qwen2.5:1.5b كنموذج صغير وqwen2.5:3b كنموذج أكبر، بتكميم Q4_K_M على Ollama 0.40.8 وعلى المعالج فقط دون بطاقة رسومية، كما في مقال تشغيل النماذج على جهازك. واخترنا نموذجين صغيرين حتى تعمل التجربة على أي جهاز، والفكرة نفسها تنطبق على Claude Haiku 5.5 مقابل Claude Sonnet 5.5، أو gpt-6-luna مقابل gpt-6.1-sol.
ولاحظ أن رخصة qwen2.5:1.5b هي Apache 2.0، أما qwen2.5:3b فرخصته Qwen Research License، وهي للبحث والتجربة، لذلك راجع الرخصة قبل أن تستخدمه في منتج تجاري.
التجهيز
نعمل في Git Bash على Windows، لذلك نضع MSYS_NO_PATHCONV=1 ونأخذ المسار بالأمر cygpath -w، وعلى Linux احذف هذا السطر واستخدم $PWD مباشرة. ولا نحتاج أي منفذ مفتوح على الجهاز، فالسكربت يصل إلى Ollama داخل شبكة Docker:
mkdir -p token-lab/out && cd token-lab
docker network create ai7-net
docker volume create ai7-models
docker run -d --name ai7-ollama --network ai7-net -v ai7-models:/root/.ollama ollama/ollama:0.40.8
docker exec ai7-ollama ollama pull qwen2.5:1.5b
docker exec ai7-ollama ollama pull qwen2.5:3b
ثم ملف الرسائل messages.jsonl، وفيه 60 رسالة كتبناها بالعربية، 12 رسالة لكل فريق، ومع كل رسالة الفريق الصحيح label. ووضعنا فيها رسائل سهلة ورسائل تحتاج تمييزاً، مثل الطرد الذي وصل تالفاً (شحن) مقابل المنتج المعيب الذي يريد العميل إرجاعه (إرجاع). وهذه أول ثلاثة أسطر منه:
{"id": 1, "label": "payment", "text": "تم خصم المبلغ من بطاقتي مرتين للطلب نفسه، أرجو إرجاع الخصم المكرر"}
{"id": 17, "label": "shipping", "text": "الطرد وصل وعليه آثار ماء والكرتون ممزق، استلمته من المندوب قبل قليل"}
{"id": 52, "label": "technical", "text": "البحث في الموقع لا يرجع أي نتائج حتى لأسماء منتجات موجودة"}
كود الموجه Router
السكربت route.py يستخدم مكتبة Python القياسية فقط، وفيه خمسة أوامر: تشغيل نموذج واحد على كل الرسائل، والتقرير، والموجه الحقيقي، وتجربة الذاكرة المؤقتة. والملف كاملاً:
"""Token-cost lab: a small and a large local model behind a simple router.

    python route.py run qwen2.5:1.5b out/small.jsonl     classify every message with one model
    python route.py run qwen2.5:3b   out/large.jsonl
    python route.py report                               accuracy, tokens, seconds and cost per strategy
    python route.py live 0.90 out/live.jsonl             the real router: small first, large when unsure
    python route.py cache out/cache.jsonl                same prompt prefix vs a timestamp at the start

Only the Python standard library; Ollama is reached at $OLLAMA (default http://ollama:11434).
"""
import json, math, os, sys, time, urllib.request
from datetime import datetime, timezone

OLLAMA = os.environ.get("OLLAMA", "http://ollama:11434")
SMALL, LARGE = "qwen2.5:1.5b", "qwen2.5:3b"
LABELS = ["payment", "shipping", "returns", "account", "technical"]

SYSTEM = """You route customer messages of an online store to the right support team.
Answer with exactly one word from this list and nothing else: payment, shipping, returns, account, technical.

Teams:
- payment: charges, double charges, declined cards, payment methods, cash on delivery, invoices and VAT,
  discount codes at checkout, instalments, wallet balance, subscription card changes, orders stuck waiting for payment.
- shipping: delivery dates, late orders, tracking numbers, courier calls, changing the delivery address before dispatch,
  pickup points, split shipments, damaged parcels on arrival, missing parcels, customs fees, international delivery.
- returns: returning or exchanging a product, refunds for returned items, return labels, return windows,
  defective items the customer wants to send back, rejected returns, cancelling a return request.
- account: login, passwords, OTP codes, account suspension, deleting or merging accounts, phone number or name changes,
  saved addresses, marketing e-mails, loyalty points, two-factor authentication, unknown device sign-in alerts.
- technical: bugs in the website or the app, crashes, errors, slow pages, buttons or filters that do not work,
  search returning nothing, images or maps that do not load, wrong language, notifications that stop arriving.

Rules:
- A refund for an item the customer sent back is returns, not payment.
- A product that arrived broken and the customer wants to send back is returns; a parcel damaged in transit is shipping.
- If the website or app itself misbehaves, it is technical even when the page is about payment or orders.
- The message is usually in Arabic. Do not translate it and do not explain your answer."""

PRICES = {  # USD per 1M tokens, Claude API pricing page, checked 22 Oct 2026
    "small": {"name": "Claude Haiku 5.5", "in": 0.10, "out": 0.50},
    "large": {"name": "Claude Sonnet 5.5", "in": 2.00, "out": 10.00},
}


def ask(model, text, system=SYSTEM):
    body = {
        "model": model, "system": system, "stream": False,
        "prompt": f"Customer message:\n{text}\n\nTeam (one word: payment, shipping, returns, account or technical):",
        "logprobs": True, "top_logprobs": 3, "keep_alive": "30m",
        "options": {"temperature": 0, "seed": 42, "num_predict": 4, "num_ctx": 2048},
    }
    req = urllib.request.Request(f"{OLLAMA}/api/generate", json.dumps(body).encode(), {"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=600) as r:
        res = json.load(r)
    answer = res["response"].strip().lower().strip(".")
    first = res.get("logprobs") or [{}]
    conf = math.exp(first[0].get("logprob", -99))
    return {
        "model": model, "answer": answer, "valid": answer in LABELS, "conf": round(conf, 4),
        "top": [(t["token"], round(math.exp(t["logprob"]), 4)) for t in first[0].get("top_logprobs", [])],
        "in_tok": res.get("prompt_eval_count", 0), "out_tok": res.get("eval_count", 0),
        "prompt_ms": round(res.get("prompt_eval_duration", 0) / 1e6),
        "busy_ms": round((res["total_duration"] - res.get("load_duration", 0)) / 1e6),
    }


def messages():
    with open("messages.jsonl", encoding="utf-8") as f:
        return [json.loads(line) for line in f if line.strip()]


def warm(model):
    ask(model, "warm-up")  # loads the model and caches the system prompt, not counted


def run(model, out):
    warm(model)
    with open(out, "w", encoding="utf-8") as f:
        for m in messages():
            r = ask(model, m["text"]) | {"id": m["id"], "label": m["label"]}
            f.write(json.dumps(r, ensure_ascii=False) + "\n")
            print(f'{m["id"]:>2} {m["label"]:<9} -> {r["answer"]:<10} conf={r["conf"]:.2f} in={r["in_tok"]} out={r["out_tok"]} {r["busy_ms"]} ms', flush=True)


def load(path):
    with open(path, encoding="utf-8") as f:
        return {r["id"]: r for r in map(json.loads, f)}


def cost(r, size):
    p = PRICES[size]
    return (r["in_tok"] * p["in"] + r["out_tok"] * p["out"]) / 1e6


def report():
    small, large = load("out/small.jsonl"), load("out/large.jsonl")
    n = len(small)
    rows = []

    def add(name, picks):  # picks: id -> list of (size, result) that were paid for; the last one answers
        ok = sum(1 for i, p in picks.items() if p[-1][1]["answer"] == small[i]["label"])
        sec = sum(r["busy_ms"] for p in picks.values() for _, r in p) / 1000
        usd = sum(cost(r, s) for p in picks.values() for s, r in p)
        tin = sum(r["in_tok"] for p in picks.values() for _, r in p)
        tout = sum(r["out_tok"] for p in picks.values() for _, r in p)
        up = sum(1 for p in picks.values() if len(p) > 1)
        rows.append((name, ok, up, tin, tout, sec, usd))

    add("small only", {i: [("small", small[i])] for i in small})
    add("large only", {i: [("large", large[i])] for i in small})
    for t in (0.50, 0.70, 0.80, 0.90, 0.95, 0.99):
        picks = {}
        for i in small:
            s = small[i]
            picks[i] = [("small", s)] if s["valid"] and s["conf"] >= t else [("small", s), ("large", large[i])]
        add(f"router t={t:.2f}", picks)

    print(f"messages: {n}   prices: small = {PRICES['small']['name']}, large = {PRICES['large']['name']}")
    print(f"{'strategy':<16}{'correct':>9}{'escalated':>11}{'in_tok':>9}{'out_tok':>9}{'cpu_s':>8}{'usd_per_1M_msgs':>17}")
    for name, ok, up, tin, tout, sec, usd in rows:
        print(f"{name:<16}{ok:>5}/{n:<3}{up:>11}{tin:>9}{tout:>9}{sec:>8.1f}{usd / n * 1e6:>17.0f}")

    print("\nsmall model mistakes (answer, confidence):")
    for i, s in small.items():
        if s["answer"] != s["label"]:
            print(f'  {i:>2} {s["label"]:<9} -> {s["answer"]:<10} conf={s["conf"]:.2f}  large says {large[i]["answer"]}')
    print("\nlarge model mistakes:")
    for i, r in large.items():
        if r["answer"] != r["label"]:
            print(f'  {i:>2} {r["label"]:<9} -> {r["answer"]:<10} conf={r["conf"]:.2f}')


def live(t, out):
    t = float(t)
    warm(SMALL); warm(LARGE)
    ok = up = 0
    start = time.time()
    with open(out, "w", encoding="utf-8") as f:
        for m in messages():
            s = ask(SMALL, m["text"])
            final, routed = s, None
            if not (s["valid"] and s["conf"] >= t):
                final, routed = ask(LARGE, m["text"]), SMALL
                up += 1
            ok += final["answer"] == m["label"]
            rec = {"id": m["id"], "feature": "ticket-routing", "model": final["model"], "routed_from": routed,
                   "answer": final["answer"], "label": m["label"], "small_conf": s["conf"],
                   "input_tokens": s["in_tok"] + (final["in_tok"] if routed else 0),
                   "output_tokens": s["out_tok"] + (final["out_tok"] if routed else 0),
                   "busy_ms": s["busy_ms"] + (final["busy_ms"] if routed else 0)}
            f.write(json.dumps(rec, ensure_ascii=False) + "\n")
    print(f"threshold {t}: correct {ok}/60, escalated {up}, wall time {time.time() - start:.0f} s")


def cache(out):
    """The same 10 messages twice on the small model: once with the fixed system prompt first,
    once with the current time written at the start of the system prompt (a common mistake)."""
    warm(SMALL)
    msgs = messages()[:60:6]
    with open(out, "w", encoding="utf-8") as f:
        for variant in ("fixed-prefix", "timestamp-first"):
            rows = []
            for m in msgs:
                system = SYSTEM if variant == "fixed-prefix" else f"Current time: {datetime.now(timezone.utc).isoformat()}\n" + SYSTEM
                r = ask(SMALL, m["text"], system)
                rows.append(r)
                f.write(json.dumps({"variant": variant, "id": m["id"], **r}, ensure_ascii=False) + "\n")
            avg = lambda k: sum(r[k] for r in rows) / len(rows)
            print(f"{variant:<16} prompt tokens evaluated {avg('in_tok'):6.0f}   prompt eval {avg('prompt_ms'):6.0f} ms   busy {avg('busy_ms'):6.0f} ms")


if __name__ == "__main__":
    cmd, *args = sys.argv[1:]
    {"run": run, "report": report, "live": live, "cache": cache}[cmd](*args)
في الكود أعلاه لاحظ التالي:
- التعليمات الثابتة
SYSTEMنحو 350 توكناً، وهي في أول الطلب ولا تتغير بين الرسائل، أما الرسالة نفسها فتأتي بعدها فيprompt، وهذا الترتيب هو شرط الذاكرة المؤقتة الذي ذكرناه. num_predict: 4يحدد المخرجات بأربعة توكنات، وtemperature: 0معseedثابت حتى تتكرر النتيجة نفسها في كل تشغيل.logprobsيعيد احتمال كل توكن في الإجابة، ونأخذ احتمال التوكن الأول كدرجة ثقة الصغير، والإجابة التي ليست من الكلمات الخمس تعتبر غير صالحة وتصعد مباشرة.- الدالة
reportلا تستدعي النموذج، وإنما تجمع نتائج تشغيل النموذجين وتحسب ماذا كان سيحدث مع كل حد ثقة، وهذا ممكن لأن الإجابات ثابتة بدرجة حرارة 0، ثم نتحقق من الحد الذي نختاره بتشغيل حقيقي. - التكلفة بالدولار محسوبة بعدد التوكنات التي أرجعها Ollama مضروباً في سعر Claude Haiku 5.5 للصغير وClaude Sonnet 5.5 للأكبر، وهذا تقريب لأن مقطع Qwen يختلف عن مقطع Claude، ولكن النسبة بين الطرق هي المهمة هنا وليس الرقم نفسه.
تشغيل النموذجين
نشغل السكربت في Container من python:3.13.16-slim على الشبكة نفسها، وأولاً النموذج الصغير على الرسائل الستين:
export MSYS_NO_PATHCONV=1
W=$(cygpath -w "$PWD")
py() { docker run --rm --network ai7-net -e OLLAMA=http://ai7-ollama:11434 -v "$W:/lab" -w /lab python:3.13.16-slim python "$@"; }
py route.py run qwen2.5:1.5b out/small.jsonl
والمخرج سوف يكون كما يلي، وهذه أول عشرة أسطر:
 1 payment   -> returns    conf=0.98 in=399 out=2 11714 ms
 2 payment   -> payment    conf=0.99 in=393 out=2 8938 ms
 3 payment   -> cash on delivery conf=0.58 in=385 out=4 10526 ms
 4 payment   -> invoices and vat conf=0.87 in=391 out=4 13293 ms
 5 payment   -> payment    conf=0.59 in=396 out=2 8906 ms
 6 payment   -> payment    conf=0.74 in=393 out=2 11317 ms
 7 payment   -> payment    conf=0.99 in=394 out=2 7674 ms
 8 payment   -> payment    conf=0.85 in=385 out=2 10435 ms
 9 payment   -> payment    conf=0.95 in=392 out=2 6895 ms
10 payment   -> subscription card changes conf=0.98 in=392 out=4 4747 ms
ولاحظ أن الصغير في الرسالتين 3 و4 لم يلتزم بالكلمات الخمس، وإنما نسخ عبارة من وصف الفريق في التعليمات، وهذا ما يكشفه التحقق من الصيغة. أما الرسالة الأولى فهي أخطر، لأنه أجاب returns باحتمال 0.98 والصحيح payment، فكلمة «إرجاع الخصم» جذبته إلى فريق الإرجاع، وهذا خطأ لن يكشفه أي حد ثقة. ثم نشغل الأكبر بالأمر نفسه:
py route.py run qwen2.5:3b out/large.jsonlالنتائج: الجودة مقابل التكلفة
بعد تشغيل النموذجين نطلب التقرير:
py route.py reportوالمخرج سوف يكون كما يلي:
messages: 60   prices: small = Claude Haiku 5.5, large = Claude Sonnet 5.5
strategy          correct  escalated   in_tok  out_tok   cpu_s  usd_per_1M_msgs
small only         48/60           0    23351      127   534.1               40
large only         58/60           0    23351      120   380.0              798
router t=0.50      51/60           4    24910      135   565.4               93
router t=0.70      51/60           7    26078      141   596.2              133
router t=0.80      52/60           9    26860      145   608.5              160
router t=0.90      56/60          15    29178      157   640.4              239
router t=0.95      56/60          16    29571      159   654.8              253
router t=0.99      57/60          39    38541      205   774.2              559

small model mistakes (answer, confidence):
   1 payment   -> returns    conf=0.98  large says payment
   3 payment   -> cash on delivery conf=0.58  large says payment
   4 payment   -> invoices and vat conf=0.87  large says payment
  10 payment   -> subscription card changes conf=0.98  large says account
  17 shipping  -> returns    conf=0.99  large says shipping
  18 shipping  -> returns    conf=0.82  large says shipping
  20 shipping  -> returns    conf=0.99  large says shipping
  24 shipping  -> returns    conf=0.89  large says shipping
  56 technical -> returns    conf=0.70  large says technical
  58 technical -> language selection conf=0.58  large says technical
  59 technical -> returns    conf=0.89  large says technical
  60 technical -> shipping   conf=0.84  large says technical

large model mistakes:
  10 payment   -> account    conf=1.00
  52 technical -> account    conf=0.86
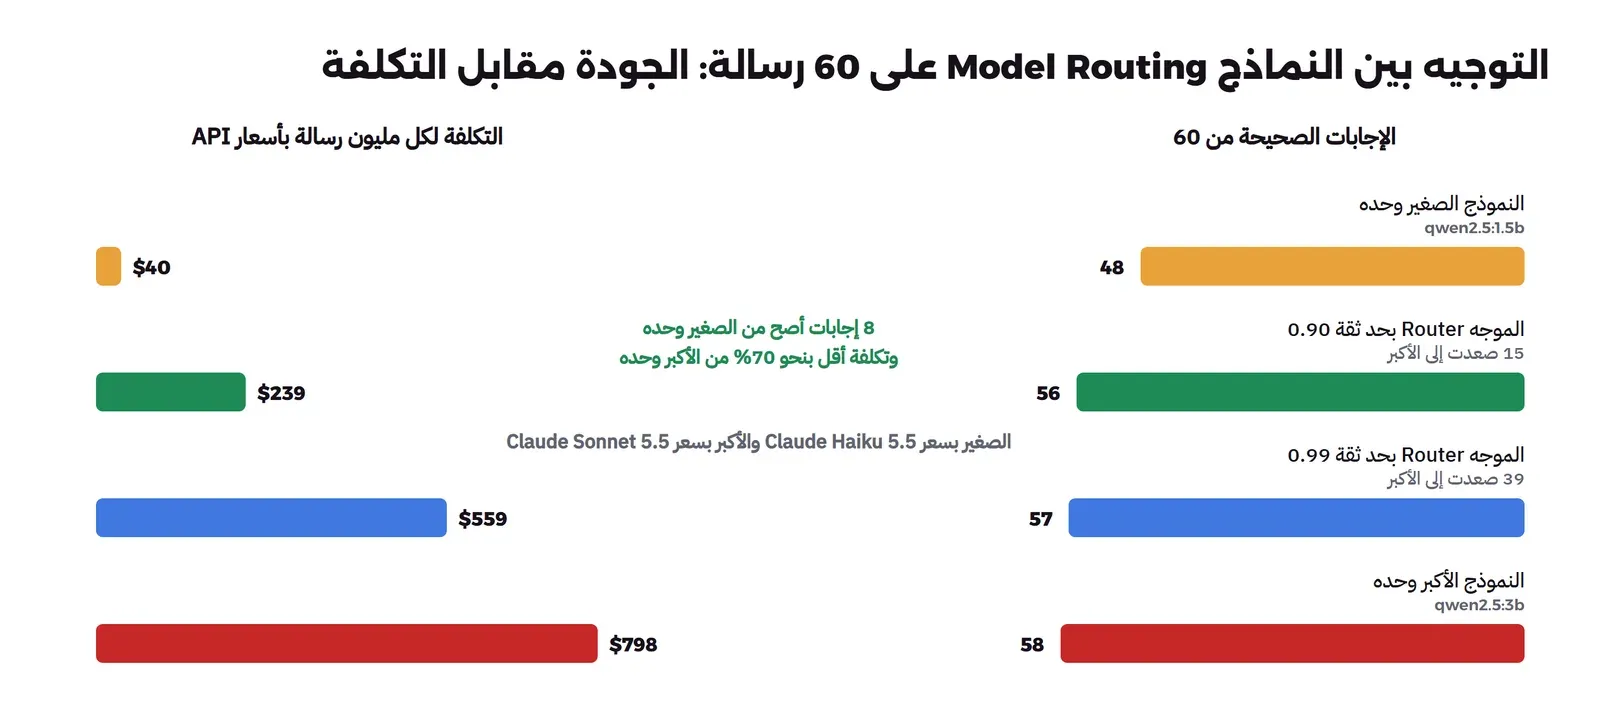
والصورة التالية تبين أهم أربعة أسطر من التقرير:
وفي النتائج أعلاه لاحظ التالي:
- الصغير وحده أرخص بعشرين مرة من الأكبر وحده (40 مقابل 798 دولاراً لكل مليون رسالة)، ولكنه أخطأ في 12 رسالة من 60، أي أن خمس العملاء يذهبون إلى الفريق الخطأ.
- الموجه بحد ثقة 0.90 صعد 15 رسالة فقط، وأعطى 56 إجابة صحيحة بتكلفة 239 دولاراً، أي بفارق إجابتين عن الأكبر وحده وبتكلفة أقل بنحو 70 بالمئة.
- رفع الحد إلى 0.99 صعد 39 رسالة وكسب إجابة واحدة فقط، وضاعف التكلفة تقريباً، فبعد نقطة معينة يصبح كل تصعيد إضافي ثمناً بلا فائدة.
- الأخطاء الأربعة الباقية مع حد 0.90 هي الرسائل 1 و10 و17 و20، وكلها أجاب فيها الصغير باحتمال 0.98 أو أكثر، وهذا هو الخطأ الواثق الذي لا يراه الموجه، فإذا كانت الأخطاء في ميزتك مكلفة فأضف قواعد على الطلب، أو راجع عينة من الإجابات الواثقة بشكل دوري.
- الموجه أصاب في الرسالة 52 مع أن الأكبر أخطأ فيها، لأن الصغير كان واثقاً ومصيباً فلم يصعد، أي أن النموذج الأكبر ليس أصح دائماً في كل رسالة.
- التصعيد زاد توكنات المدخلات من 23,351 إلى 29,178، لأن كل رسالة تصعد تقرأ التعليمات مرتين، مرة في كل نموذج، وهذا ما تبينه الصورة الثانية.
- عمود
cpu_sيقول إن الأكبر أسرع من الصغير، وهذا غير صحيح، والسبب أن الجهاز كان مشتركاً مع تجارب أخرى، فتراوح زمن الرسالة الواحدة بين 1.6 و35 ثانية حسب ما يعمل بجانبها. لذلك لا تقم بقياس زمن النموذج على جهاز مشغول إذا كنت ستبني عليه قرار شراء سيرفر.
بعد ذلك نشغل الموجه الحقيقي بحد 0.90، وهو يرسل كل رسالة إلى الصغير ثم إلى الأكبر فقط عندما يتردد، ويكتب لكل رسالة سطراً بحقول سجل التكلفة التي ذكرناها:
py route.py live 0.90 out/live.jsonlوالمخرج سوف يكون كما يلي:
threshold 0.9: correct 56/60, escalated 15, wall time 398 sأي أن التشغيل الحقيقي أعطى النتيجة نفسها التي حسبها التقرير، وهذا أول سطرين من سجله:
{"id": 1, "feature": "ticket-routing", "model": "qwen2.5:1.5b", "routed_from": null, "answer": "returns", "label": "payment", "small_conf": 0.9817, "input_tokens": 399, "output_tokens": 2, "busy_ms": 9511}
{"id": 2, "feature": "ticket-routing", "model": "qwen2.5:1.5b", "routed_from": null, "answer": "payment", "label": "payment", "small_conf": 0.9868, "input_tokens": 393, "output_tokens": 2, "busy_ms": 5761}
ماذا يحدث إذا وضعت الوقت في أول التعليمات Prompt؟
Ollama يحتفظ ببداية آخر طلب في الذاكرة، فإذا بدأ الطلب التالي بالنص نفسه لم يحسبه مرة أخرى، وهذه نفس فكرة الذاكرة المؤقتة عند المزودين، ولكن الفرق أنها هنا توفر وقت المعالج وليس الدولار. والأمر cache يرسل عشر رسائل مرتين: مرة بالتعليمات الثابتة، ومرة بعد أن نضيف سطر Current time في أولها، وهو خطأ شائع عندما يريد المطور أن يعرف النموذج تاريخ اليوم:
py route.py cache out/cache.jsonlوالمخرج سوف يكون كما يلي:
fixed-prefix     prompt tokens evaluated    390   prompt eval   4394 ms   busy   5495 ms
timestamp-first  prompt tokens evaluated    427   prompt eval  18466 ms   busy  19781 ms
والسبب واضح في سجل Ollama نفسه، فهذا سطر من كل حالة:
slot   operator(): id  0 | task 383 | cached n_tokens = 351, memory_seq_rm [351, end)
slot print_timing: id  0 | task 383 | prompt eval time =    4668.07 ms /    48 tokens (   97.25 ms per token,    10.28 tokens per second)
slot   operator(): id  0 | task 413 | cached n_tokens = 3, memory_seq_rm [3, end)
slot print_timing: id  0 | task 413 | prompt eval time =   19133.86 ms /   433 tokens (   44.19 ms per token,    22.63 tokens per second)
ولاحظ التالي:
- مع التعليمات الثابتة كان 351 توكناً محفوظة، ولم يحسب النموذج إلا 48 توكناً جديدة هي الرسالة نفسها وسطر السؤال بعدها، أما مع الوقت في أول التعليمات فكانت 3 توكنات فقط محفوظة، لأن الوقت يتغير في كل طلب، فحسب النموذج 433 توكناً من البداية.
- زمن قراءة الطلب ارتفع من نحو 4.4 ثانية إلى 18.5 ثانية، أي أكثر من أربعة أضعاف، بسبب سطر واحد. وعند المزود السحابي يظهر الأثر نفسه في الفاتورة، فبدلاً من أن تدفع 0.01 دولار لكل مليون توكن مقروءة من الذاكرة في Claude Haiku 5.5 تدفع 0.10 كاملة.
- عمود
prompt tokens evaluatedفي Ollama هو طول الطلب كاملاً حتى عندما يقرأ أغلبه من الذاكرة، لذلك قرأنا عدد التوكنات المحفوظة من سجل الخادم. أما API المزودين فيعيد هذا الرقم في حقل مستقل، مثلcache_read_input_tokensفي Claude. - الحل أن تضع الوقت أو اسم المستخدم بعد الجزء الثابت، في رسالة المستخدم نفسها مثلاً، وليس في أول التعليمات.
إزالة التجربة
docker rm -f ai7-ollama
docker volume rm ai7-models
docker network rm ai7-net
النماذج المفتوحة Open Models على سيرفرك أم API؟
في تشغيل نماذج اللغة على جهازك شرحنا الذاكرة التي يحتاجها كل نموذج والعتاد المناسب له، وهنا نسأل سؤال التكلفة فقط. فثمن ال API يدفع لكل توكن، وثمن السيرفر يدفع لكل ساعة سواء استخدمته أم لا، ولذلك يكون التشغيل الذاتي أرخص في حالة واحدة: أن يكون السيرفر مشغولاً أغلب الوقت بعدد كبير من الطلبات. وتكلفة الطلب على سيرفرك تحسب كما يلي:
cost per request = (server price per hour / 3600) x (busy seconds per request) / utilisationوالقسمة على نسبة الاستغلال Utilisation هي ما ينساه أغلب من يقارن، فالسيرفر الذي يعمل 10 بالمئة من الوقت يجعل كل طلب أغلى عشر مرات. ولنطبق ذلك على مختبرنا بأسعار EC2 حسب الطلب On-Demand في منطقة US East (N. Virginia) لنظام Linux، كما ظهرت في قائمة أسعار AWS المنشورة في 15 أكتوبر 2026:
- على المعالج CPU: السيرفر c7i.2xlarge فيه 8 vCPU مثل Docker في مختبرنا، وسعره 0.357 دولار في الساعة. وأسرع رسالة عندنا على النموذج الصغير أخذت 2.7 ثانية، فحتى بهذا الزمن وباستغلال 100 بالمئة تكون تكلفة الرسالة 0.357 ÷ 3600 × 2.7 = 0.00027 دولار، أي نحو 265 دولاراً لكل مليون رسالة، مقابل 40 دولاراً بسعر Claude Haiku 5.5. أي أن ال API الصغير أرخص بست مرات على الأقل في هذه المهمة.
- على بطاقة رسومية GPU: السيرفر g6.xlarge فيه بطاقة NVIDIA L4 بذاكرة 24 GB، وسعره 0.8048 دولار في الساعة. ولم نقس سرعته في مختبرنا، ولكن يمكننا أن نحسب كم رسالة يجب أن يعالج حتى يتعادل مع ال API: ليتعادل مع سعر Claude Haiku 5.5 (0.00004 دولار للرسالة) يجب أن يعالج 0.8048 ÷ 0.00004 = 20,120 رسالة في الساعة، أي 5.6 رسالة في الثانية طوال الساعة. وليتعادل مع سعر Claude Sonnet 5.5 (0.0008 دولار للرسالة) يكفي نحو 1,000 رسالة في الساعة.
أي أن السؤال الصحيح ليس «هل النموذج المفتوح مجاني؟» وإنما «كم طلباً سوف يعالج السيرفر في الساعة، وما هو النموذج في ال API الذي سوف يستبدله؟». فاستبدال نموذج كبير بنموذج مفتوح على سيرفر مشغول طوال اليوم قد يوفر كثيراً، كما في مثال Uber أعلاه، أما استبدال أرخص نموذج في ال API بسيرفر يعمل ساعتين في اليوم فهو خسارة. وإلى جانب الرقم هناك أسباب أخرى للتشغيل الذاتي لا علاقة لها بالتكلفة:
- أن تبقى البيانات داخل شبكتك لأسباب تنظيمية أو تعاقدية.
- أن تحتاج نموذجاً معدلاً Fine-tuned على بياناتك.
- أن تريد سعراً ثابتاً لا يتغير بقرار المزود.
وفي المقابل يكلفك التشغيل الذاتي وقت فريقك في التحديث والمراقبة، وهذا ما حسبناه في تشتري أم تبني؟.
الميزانيات Budgets وحدود الطلبات Rate Limits لكل فريق
الميزانية هنا لها نفس فكرة المقال الأول، ولكن الخطر أسرع، فحلقة تكرار Loop في وكيل AI Agent أو سكربت اختبار نسي أحدهم إيقافه يصرف في ساعة ما تصرفه ميزة في شهر، ولذلك جعلته قائمة OWASP خطراً مستقلاً باسم الاستهلاك غير المحدود Unbounded Consumption كما في OWASP Top 10 لتطبيقات LLM. لذلك تحتاج حدين لكل فريق أو ميزة: حداً للصرف في الشهر، وحداً للطلبات أو التوكنات في الدقيقة. وهناك مكانان لوضع هذه الحدود:
- عند المزود: في Claude مثلاً يمكنك حسب صفحة حدود الطلبات أن تضع لكل Workspace حداً للصرف وحدوداً لعدد الطلبات وللتوكنات في الدقيقة أقل من حد المؤسسة، فتعطي كل فريق Workspace ومفاتيحه. وعندما يصل الفريق إلى حد الصرف الذي وضعته ترجع الطلبات خطأ
400برسالة تبدأ بYou have reached your specified workspace API usage limitsبدلاً من أن تستمر الفاتورة. ولاحظ أن ال Workspace الافتراضي لا يقبل حداً للصرف، فلا تترك الميزات الحقيقية عليه. - في بوابة داخلية Gateway: تمر عبرها كل الطلبات إلى كل المزودين، مثل LiteLLM الذي أغلب كوده برخصة MIT إلا مجلد
enterprise، ويسمح بميزانية لكل فريق أو مفتاح أو مستخدم مع مدة لإعادة ضبطهاbudget_duration، وحدود للطلبات والتوكنات في الدقيقة. وانتبه لما يقوله توثيقه: الميزانيات تحسب من الصرف المخزن في قاعدة البيانات، فإذا شغلته دون قاعدة بيانات فلن توقف الميزانية شيئاً.
والبوابة الداخلية لها فائدة أكبر من الحدود، فهي المكان الطبيعي لسجل التكلفة الذي ذكرناه، وللتوجيه بين النماذج، ولتبديل المزود دون تغيير كود الميزات.
أخطاء شائعة
- مقارنة الأسعار لكل مليون توكن بين مزودين: المقطع يختلف بين المزودين، فقس تكلفة الطلب نفسه على كل نموذج.
- وضع الوقت أو اسم المستخدم في أول التعليمات: يلغي الذاكرة المؤقتة في كل طلب، كما رأينا في المختبر.
- اختيار حد الثقة بالتخمين: اختره على رسائل معروفة الإجابة، وراقب الأخطاء الواثقة التي لا يراها أي حد.
- حساب التشغيل الذاتي باستغلال 100 بالمئة: اقسم على نسبة الاستغلال الحقيقية، وقس الزمن على جهاز لا يعمل عليه شيء آخر.
- نسيان الأسعار المؤقتة: اكتب تاريخ كل سعر في جدولك، وراجع صفحات الأسعار قبل كل ميزانية.
- تجاهل بقية تكلفة الميزة: في الوكيل الصوتي كان الصوت المولد أكبر من التوكنات بكثير، فقس الميزة كاملة.
تدريب عملي
- أضف إلى
messages.jsonlعشر رسائل من نوع الرسالة الأولى (كلمة توحي بفريق والصحيح فريق آخر)، ثم أعد التقرير ولاحظ كم منها يتجاوز حد الثقة وهو خاطئ. - غير
num_predictإلى 50 واطلب من النموذج أن يشرح سبب اختياره، ثم قارن عمودout_tokوتكلفة المليون رسالة مع النتيجة أعلاه. - احسب لميزة عندك في العمل عدد الطلبات في الساعة في وقت الذروة وفي الليل، ثم طبق معادلة التشغيل الذاتي بنسبة الاستغلال الحقيقية.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التوكنات تسعر بأنواعها: المدخلات، والمخرجات وهي الأغلى، والمقروء من الذاكرة المؤقتة وهو الأرخص، والأسعار تتغير بطول الطلب وبالتاريخ، فاكتب تاريخ كل سعر.
- سجل مع كل طلب الميزة والفريق والمستخدم وعدد التوكنات من رد المزود، واحسب التكلفة يومياً، وقس الميزة كاملة وليس التوكنات فقط.
- ابدأ التخفيض بالأسهل: التعليمات الثابتة في أول الطلب، وBatch لما لا يحتاج إجابة فورية، وحدود المخرجات، وعدد أقل من مقاطع RAG.
- في مختبرنا أعطى الموجه بحد ثقة 0.90 56 إجابة صحيحة من 60، مقابل 48 للصغير وحده و58 للأكبر وحده، بتكلفة أقل بنحو 70 بالمئة من الأكبر وحده، وبقيت الأخطاء الواثقة التي لا يراها الموجه.
- سطر الوقت في أول التعليمات جعل قراءة الطلب أبطأ بأكثر من أربعة أضعاف، لأنه ألغى الذاكرة المؤقتة.
- التشغيل الذاتي يربح فقط مع استغلال عال، وعند استبدال نموذج غال، وعلى المعالج فقط كان أغلى من أرخص API بست مرات على الأقل.
- ضع حداً للصرف وحداً للتوكنات في الدقيقة لكل فريق، عند المزود أو في بوابة داخلية مثل LiteLLM مع قاعدة بيانات.
وبهذا تكتمل سلسلة FinOps، وفي مقالات قادمة بإذن الله سوف نعود إلى تكلفة الذكاء الاصطناعي من جهة أخرى: كيف تقيس جودة الإجابات Evaluation قبل أن تغير النموذج أو التعليمات.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ المختبر على Docker Engine 29.8.0 مع Ollama 0.40.8 والنموذجين qwen2.5:1.5b وqwen2.5:3b (تكميم Q4_K_M) على المعالج فقط، وPython 3.13.16 (python:3.13.16-slim)، ونقل أسعار Claude وOpenAI وGemini من صفحاتها الرسمية بتاريخ 22 أكتوبر 2026، وأسعار EC2 من قائمة أسعار AWS المنشورة في 15 أكتوبر 2026.